

1. قبل البدء
بما أنّ وكلاء الذكاء الاصطناعي يتعاملون مع تفاعلات محادثة مترابطة طويلة تمتد لعدة أيام وينفّذون مهام متعددة الخطوات طويلة الأمد، تظل النماذج اللغوية الكبيرة بطبيعتها غير مرتبطة بأي حالة عبر الجلسات. عندما يعود المستخدم إلى أحد وكلاء الدعم غدًا، سيبدأ النموذج من البداية ما لم يتمكّن التطبيق من إعادة إنشاء السياق اللازم.
يتمثل الأسلوب البسيط لحلّ هذه المشكلة في حشو الرموز المميزة، أي إلحاق سجلّات المحادثات الكاملة وسجلّات تنفيذ الأدوات وقواعد الرموز البرمجية مباشرةً بكل طلب نشط. على الرغم من أنّ قدرات الاستيعاب الكبيرة التي تبلغ مليون رمز مميّز تجعل ذلك ممكنًا من الناحية الفنية، إلا أنّ حشو السياق يؤدي إلى تباطؤ كبير في العمليات: تتضاعف تكاليف الرموز المميزة بشكل تربيعي في كل دورة، وتزداد مدة استجابة النماذج إلى عشرات الثواني، وتتأثر النماذج بتدهور السياق بسبب "فقدان المعلومات في المنتصف".
لبناء وكلاء ذكاء اصطناعي موثوق بهم، تحتاج إلى بنية ذاكرة من مستويين:
- مخزن مؤقت للجلسة القصيرة الأمد: يخزّن مؤقتًا أدوار المحادثة الأخيرة في الذاكرة النشطة باستخدام نافذة منزلقة محدودة الرموز المميزة. تتطلّب هذه الفئة عمليات بحث في الذاكرة ذات معدل نقل بيانات مرتفع وأقل من جزء من الألف من الثانية في كل دور، ما يجعل Memorystore for Valkey الخيار المثالي.
- الذاكرة الدائمة طويلة الأمد: تخزِّن الكيانات المنظَّمة وإعدادات المستخدم المفضّلة والحقائق العرضية على مستوى الجلسات. يتطلّب هذا المستوى سلامة المعاملات وأمانًا متعدد المستأجرين واسترجاعًا مختلطًا عبر البيانات الارتباطية والمتجهات، ما يجعل AlloyDB for PostgreSQL الخيار المناسب.
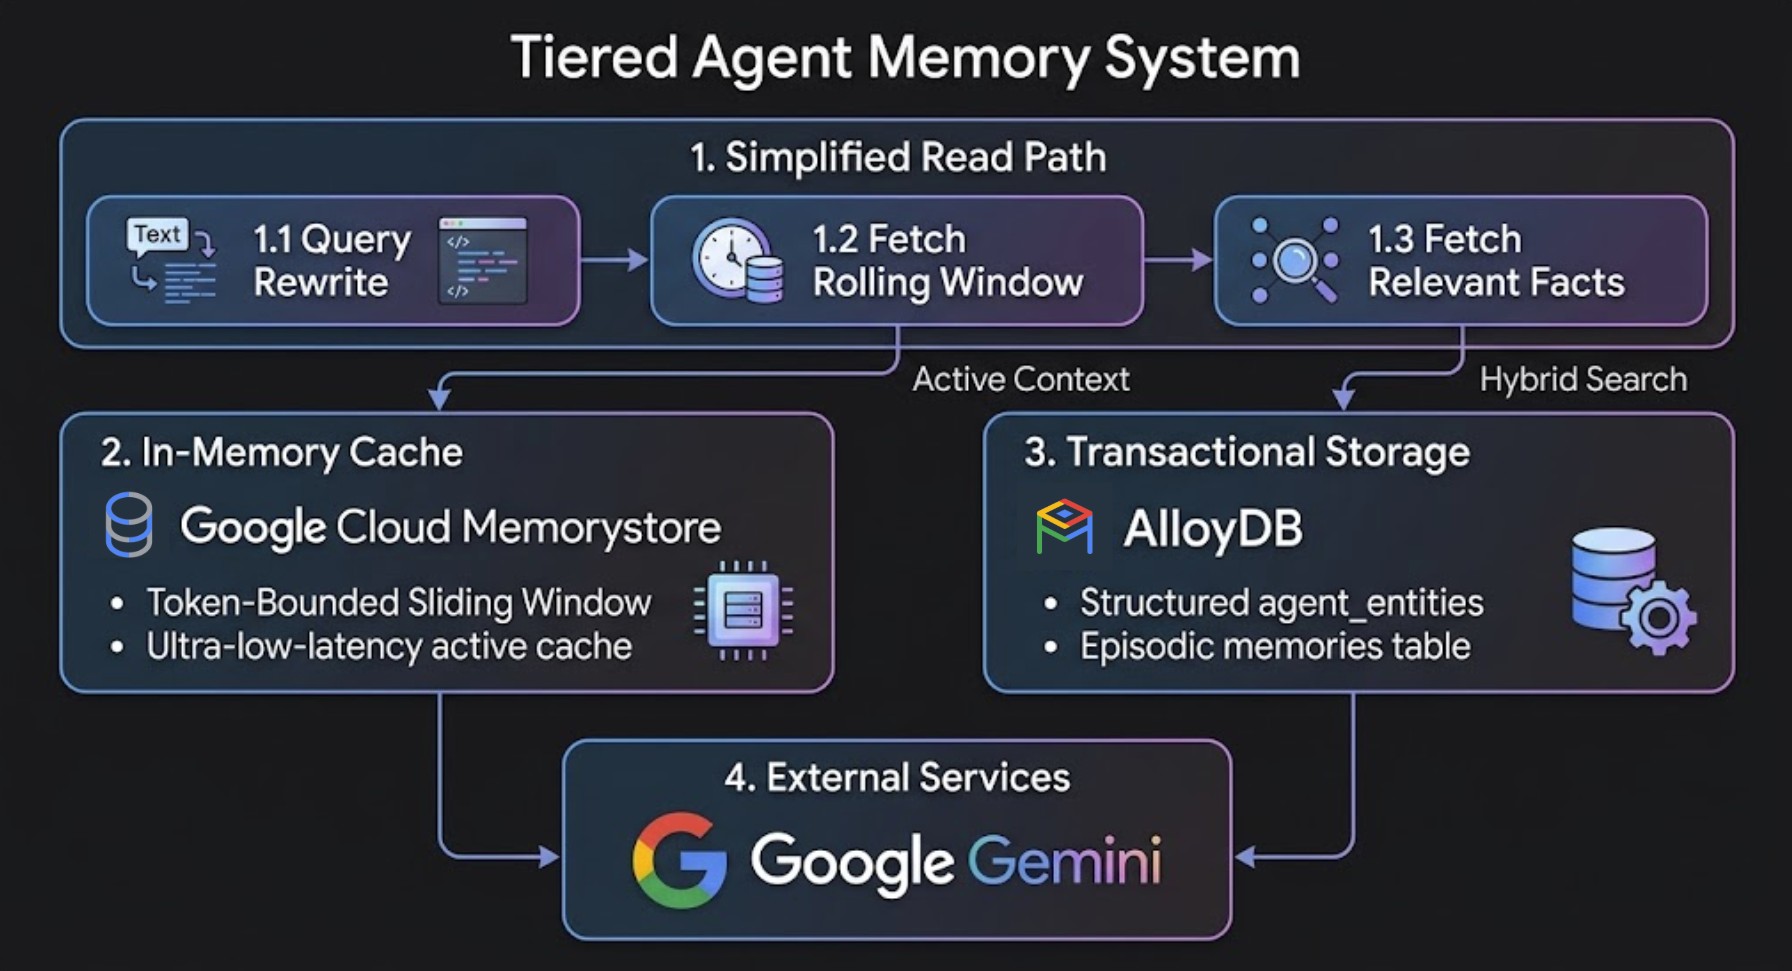
التعرّف على أنواع الذاكرة الأربعة
تعتمد بنية الذاكرة القوية على أربعة أنواع متكاملة من الذاكرة خلال رحلة المستخدم:
نوع الذاكرة | البيانات التي يتم تخزينها | طبقة التخزين | دورة الحياة |
التخزين المؤقت (قصير الأمد) | أحدث المحادثات غير المعالَجة | Memorystore for Valkey | الجلسة النشطة |
الذاكرة الموجزة | سجلّ مضغوط للردود الأقدم | Memorystore for Valkey | نافذة المحادثة المترابطة |
الذاكرة العرضية | الإجراءات والأحداث ونتائج الأدوات السابقة | AlloyDB for PostgreSQL (متّجه) | نهائية |
ذاكرة الكيانات والقواعد | الإعدادات المفضّلة للمستخدم والقيود والاعتراضات | AlloyDB for PostgreSQL (لغة SQL منظَّمة + متّجه) | نهائية |
التأثير الذي تم قياسه للذاكرة المتدرّجة
تُظهر اختبارات قياس الأداء الداخلية في محادثات التطوير المتعددة الأدوار (أكثر من 45 دورة مع سجلّات نواتج الأدوات الكثيفة) توفيرًا كبيرًا مقارنةً بحشو السياق البسيط:
المقياس / السمة | إدراج المحتوى غير ذي الصلة بشكل ساذج | الذاكرة المتدرّجة (AlloyDB + Memorystore) | صافي التأثير في الاختبار |
حجم الطلب النشط (الدوران 45) | 747,033 رمزًا مميّزًا | 83,262 رمزًا مميزًا | طلب أصغر بنسبة% 88.9 |
وقت استجابة 45 | 33.5 ثانية | 6.7 ثانية | استجابة أسرع بنسبة% 80.0 |
رموز الجلسات المميزة التراكمية | 17.9 مليون رمز مميّز | 4.09 مليون رمز مميّز | توفير إجمالي بنسبة% 72.0 في الرموز المميزة والتكلفة |
استرجاع القواعد والقيود | تتدهور على مدار الأدوار | تمنع فقدان المعلومات المهمة في الملخّص | المحافظة على البيانات من خلال البحث المختلط |
الإجراءات التي ستنفذّها
- توفير AlloyDB for PostgreSQL وMemorystore for Valkey
- فعِّل
google_ml_integrationواضبط عمليات التضمين التلقائي للمعاملات من جهة قاعدة البيانات (ai.initialize_embeddings). - تنفيذ مخزن مؤقت لجلسة Valkey قصيرة الأجل باستخدام نمط مسار "التلخيص قبل الاقتطاع"
- استخراج الكيانات الطويلة الأمد بشكلٍ أصلي باستخدام "دوال الذكاء الاصطناعي" الأصلية في AlloyDB (أي
ai.generate) - يمكنك طلب البحث عن حقائق طويلة الأمد بدقة وملاءمة عاليتَين باستخدام وظيفة "البحث المختلط" الأصلية في AlloyDB (
ai.hybrid_search) وإعادة الترتيب باستخدام طريقة "دمج الترتيب المتبادل" (RRF). - إنشاء أداة تقييم أذونات المؤسسة ذات 3 مستويات ومحرّك لضغط الذاكرة في الخلفية
- يمكنك دمج بنية الذاكرة ذات المستويَين مباشرةً في وكيل مستقل باستخدام Google Agent Development Kit (ADK).
المتطلبات
- مشروع Google Cloud تم تفعيل الفوترة فيه
- متصفّح ويب، مثل Chrome
- معرفة أساسية بلغتَي Python وSQL، بما في ذلك الخبرة في تنفيذ استعلامات SQL على AlloyDB، سواء من Studio أو واجهة سطر الأوامر أو غير ذلك
الجمهور والتكلفة
- الجمهور: مطوّرو الذكاء الاصطناعي ومهندسو الواجهة الخلفية ومهندسو قواعد البيانات
- التكلفة المقدّرة: ستكلّف موارد Google Cloud التي تم إنشاؤها في هذا الدرس التطبيقي حول الترميز حوالي 1.50 دولار أمريكي.
2. الإعداد والمتطلبات
بدء Cloud Shell
في هذا الدرس التطبيقي حول الترميز، ستنفّذ أوامر في Google Cloud Shell، وهو عبارة عن وحدة طرفية مستضافة على السحابة الإلكترونية تم ضبطها مسبقًا باستخدام gcloud وpsql وpython3.
- افتح Google Cloud Console.
- انقر على تفعيل Cloud Shell في أعلى يسار Cloud Console.
- إثبات صحة المصادقة:
gcloud auth list
export PROJECT_ID=<YOUR_PROJECT_ID>
gcloud config set project $PROJECT_ID

export REGION=us-east1
export GENAI_LOCATION=us
export ZONE=us-east1-b
export ADBCLUSTER=agent-memory-cluster
export ADBINSTANCE=agent-memory-instance
export VALKEYINSTANCE=agent-memory-cache
export VM_NAME=agent-dev-vm
تفعيل واجهات برمجة التطبيقات في Google Cloud وإنشاء جهاز افتراضي للتطوير
نفِّذ الأمر التالي في Cloud Shell لتفعيل واجهات برمجة التطبيقات المطلوبة:
gcloud services enable \
  alloydb.googleapis.com \
  memorystore.googleapis.com \
  aiplatform.googleapis.com \
  compute.googleapis.com \
  servicenetworking.googleapis.com \
  networkconnectivity.googleapis.com
أنشئ مثيل جهاز Compute Engine الظاهري في شبكة default VPC لاستضافة بيئة تطوير Python إلى جانب AlloyDB وMemorystore for Valkey:
gcloud compute instances create $VM_NAME \
    --zone=$ZONE \
    --machine-type=e2-standard-2 \
    --scopes=cloud-platform \
    --network=default \
    --shielded-secure-boot
3- توفير AlloyDB وMemorystore for Valkey
في هذه الخطوة، ستوفّر مجموعة AlloyDB for PostgreSQL ومثيلها الأساسي، وتنشئ شبكة خدمة خاصة، وتنشئ مثيل Memorystore for Valkey.
إنشاء نطاق عناوين IP لخدمة Private Service Access
تتطلّب AlloyDB نطاق عناوين IP خاصة في شبكة السحابة الإلكترونية الخاصة الافتراضية (VPC). بافتراض أنّك تستخدم شبكة default VPC:
- إنشاء عملية تخصيص لنطاق عناوين IP الخاصة:
gcloud compute addresses create psa-range \
    --global \
    --purpose=VPC_PEERING \
    --prefix-length=24 \
    --description="VPC private service access" \
    --network=default
- إنشاء اتصال تبادل معلومات بين شبكتَي VPC الخاصتَين:
gcloud services vpc-peerings connect \
    --service=servicenetworking.googleapis.com \
    --ranges=psa-range \
    --network=default
إنشاء مجموعة AlloyDB ومثيل أساسي
- أنشئ كلمة مرور مبدئية للمجموعة من أجل تهيئة النظام:
export PGPASSWORD=`openssl rand -hex 12`
- إنشاء مجموعة تجريبية مجانية:
gcloud alloydb clusters create $ADBCLUSTER \
    --password=$PGPASSWORD \
    --network=default \
    --region=$REGION \
    --subscription-type=TRIAL
- إنشاء المثيل الأساسي:
gcloud alloydb instances create $ADBINSTANCE \
    --instance-type=PRIMARY \
    --cpu-count=2 \
    --region=$REGION \
    --cluster=$ADBCLUSTER
توفير مثيل Memorystore for Valkey
يتطلّب استخدام Memorystore for Valkey توفُّر "سياسة اتصال الخدمة" (gcp-memorystore) في شبكتك ومنطقتك قبل إنشاء الجهاز الظاهري.
- أنشئ سياسة ربط الخدمة لـ Memorystore:
gcloud network-connectivity service-connection-policies create memorystore-policy \
    --network=default \
    --region=$REGION \
    --service-class=gcp-memorystore \
    --subnets=projects/$PROJECT_ID/regions/$REGION/subnetworks/default
- أنشئ مثيل Memorystore for Valkey:
gcloud memorystore instances create $VALKEYINSTANCE \
    --location=$REGION \
    --shard-count=1 \
    --replica-count=0 \
    --node-type=SHARED_CORE_NANO \
    --psc-auto-connections="network=projects/$PROJECT_ID/global/networks/default,projectId=$PROJECT_ID"
منح أذونات "إدارة الهوية وإمكانية الوصول" في Vertex AI
امنح حساب خدمة AlloyDB أذونات "إدارة الهوية وإمكانية الوصول" اللازمة لاستدعاء نماذج التضمين في "منصة الوكيل":
PROJECT_ID=$(gcloud config get-value project)

gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:service-$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")@gcp-sa-alloydb.iam.gserviceaccount.com" \
  --role="roles/aiplatform.user"
4. تهيئة البيئة ونقاط نهاية الوصول
إعداد مصادقة AlloyDB IAM وعلامات قاعدة البيانات
فعِّل ميزة "مصادقة قاعدة البيانات باستخدام إدارة الهوية وإمكانية الوصول" (alloydb.iam_authentication=on) ومحرّك طلبات البحث المستند إلى الذكاء الاصطناعي (google_ml_integration.enable_ai_query_engine=on) على مثيل AlloyDB:
gcloud beta alloydb instances update $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --update-mode=FORCE_APPLY \
  --database-flags=alloydb.iam_authentication=on,google_ml_integration.enable_ai_query_engine=on
بعد ذلك، أضِف حسابك على Google Cloud كمستخدم قاعدة بيانات مستند إلى "إدارة الهوية وإمكانية الوصول" (IAM) مع أذونات المستخدم المتميّز:
export USER_ACCOUNT=$(gcloud config get-value account)

gcloud alloydb users create $USER_ACCOUNT \
    --cluster=$ADBCLUSTER \
    --region=$REGION \
    --type=IAM_BASED \
    --db-roles=alloydbsuperuser
استرداد نقاط نهاية شبكة VPC الداخلية في Cloud Shell
قبل استخدام SSH للوصول إلى الجهاز الافتراضي الخاص بالتطوير، استردِد عناوين IP الداخلية لشبكة VPC لكل من AlloyDB وMemorystore for Valkey في Cloud Shell:
# Export GCP Project ID, Region, and IAM User
export PROJECT_ID=$(gcloud config get-value project)
export REGION=us-east1
export DB_USER=$(gcloud config get-value account)

# Retrieve Internal VPC IP Addresses for AlloyDB & Memorystore for Valkey
export DB_HOST=$(gcloud alloydb instances describe $ADBINSTANCE --cluster=$ADBCLUSTER --region=$REGION --format="value(ipAddress)")
export DB_PORT=5432
export DB_NAME=postgres

export VALKEY_HOST=$(gcloud memorystore instances describe $VALKEYINSTANCE --location=$REGION --format="value(discoveryEndpoints[0].address)")
export VALKEY_PORT=6379

# Verify exported endpoints
echo "Project ID:        $PROJECT_ID"
echo "Region:            $REGION"
echo "AlloyDB Private IP: $DB_HOST"
echo "IAM DB User:       $DB_USER"
echo "Valkey Private IP:  $VALKEY_HOST"
الاتصال بالجهاز الافتراضي الخاص بالتطوير من خلال بروتوكول النقل الآمن (SSH) وتصدير متغيرات الاتصال
استخدِم بروتوكول SSH من Cloud Shell للوصول إلى الجهاز الافتراضي (agent-dev-vm) المخصّص للتطوير في Compute Engine والموجود في شبكة VPC نفسها:
gcloud compute ssh $VM_NAME --zone=$ZONE
بعد تسجيل الدخول إلى الجهاز الافتراضي الخاص بالتطوير، يمكنك تصدير إعدادات المشروع ونقاط نهاية الاتصال الموضّحة أعلاه (مع استبدال
export PROJECT_ID=<YOUR_PROJECT_ID>
export REGION=us-east1
export GENAI_LOCATION=us
export DB_HOST=<YOUR_ALLOYDB_PRIVATE_IP>
export DB_PORT=5432
export DB_NAME=postgres
export DB_USER=<YOUR_IAM_DB_USER>
export VALKEY_HOST=<YOUR_VALKEY_PRIVATE_IP>
export VALKEY_PORT=6379
تهيئة بيئة Python الافتراضية
داخل الجهاز الافتراضي للتطوير، لننشئ أولاً دليل العمل المحلي:
mkdir -p ~/alloydb_agent_memory && cd ~/alloydb_agent_memory
الآن، لنثبّت حِزم بيئة Python الافتراضية للنظام، ونصدّق على بيانات الاعتماد التلقائية للتطبيق (ADC)، ونضبط مساحة العمل:
sudo apt-get update && sudo apt-get install -y python3-venv python3-pip

python3 -m venv venv
source venv/bin/activate
أخيرًا، في البيئة الافتراضية الجديدة، سنثبّت التبعيات:
gcloud auth application-default login
pip install psycopg2-binary valkey redis google-genai
5- بنية النظام والتدرّج الهرمي لوحدات الرموز البرمجية
نظرة عامة على ما تنشئه
قبل تنفيذ نصوص Python البرمجية الفردية، راجِع بنية النظام أدناه. تم تصميم هذا التطبيق النموذجي في 7 نصوص برمجية معيارية بلغة Python تعمل على مسارَي تنفيذ أساسيَّين يتفاعلان مع مثيل قاعدة بيانات AlloyDB for PostgreSQL نفسه:
- مسار القراءة (
hybrid_retriever.py): يحلّل الأسئلة المركّبة المتعددة الأجزاء إلى طلبات بحث فرعية ذات جانب واحد مباشرةً داخل PostgreSQL باستخدامai.generate()في AlloyDB AI، ويبحث في الذاكرة الطويلة الأمد باستخدام البحث المختلط الأصلي في AlloyDB (ai.hybrid_search). - مسار الكتابة (
async_worker.py): المنفِّذ غير المتزامن لقائمة انتظار في الخلفية يستخرج بشكل غير متزامن حقائق الكيانات المنظَّمة من تبادلات الحوار باستخدام Gemini Flash ويُدرجها أو يُعدّلها فيagent_entities.
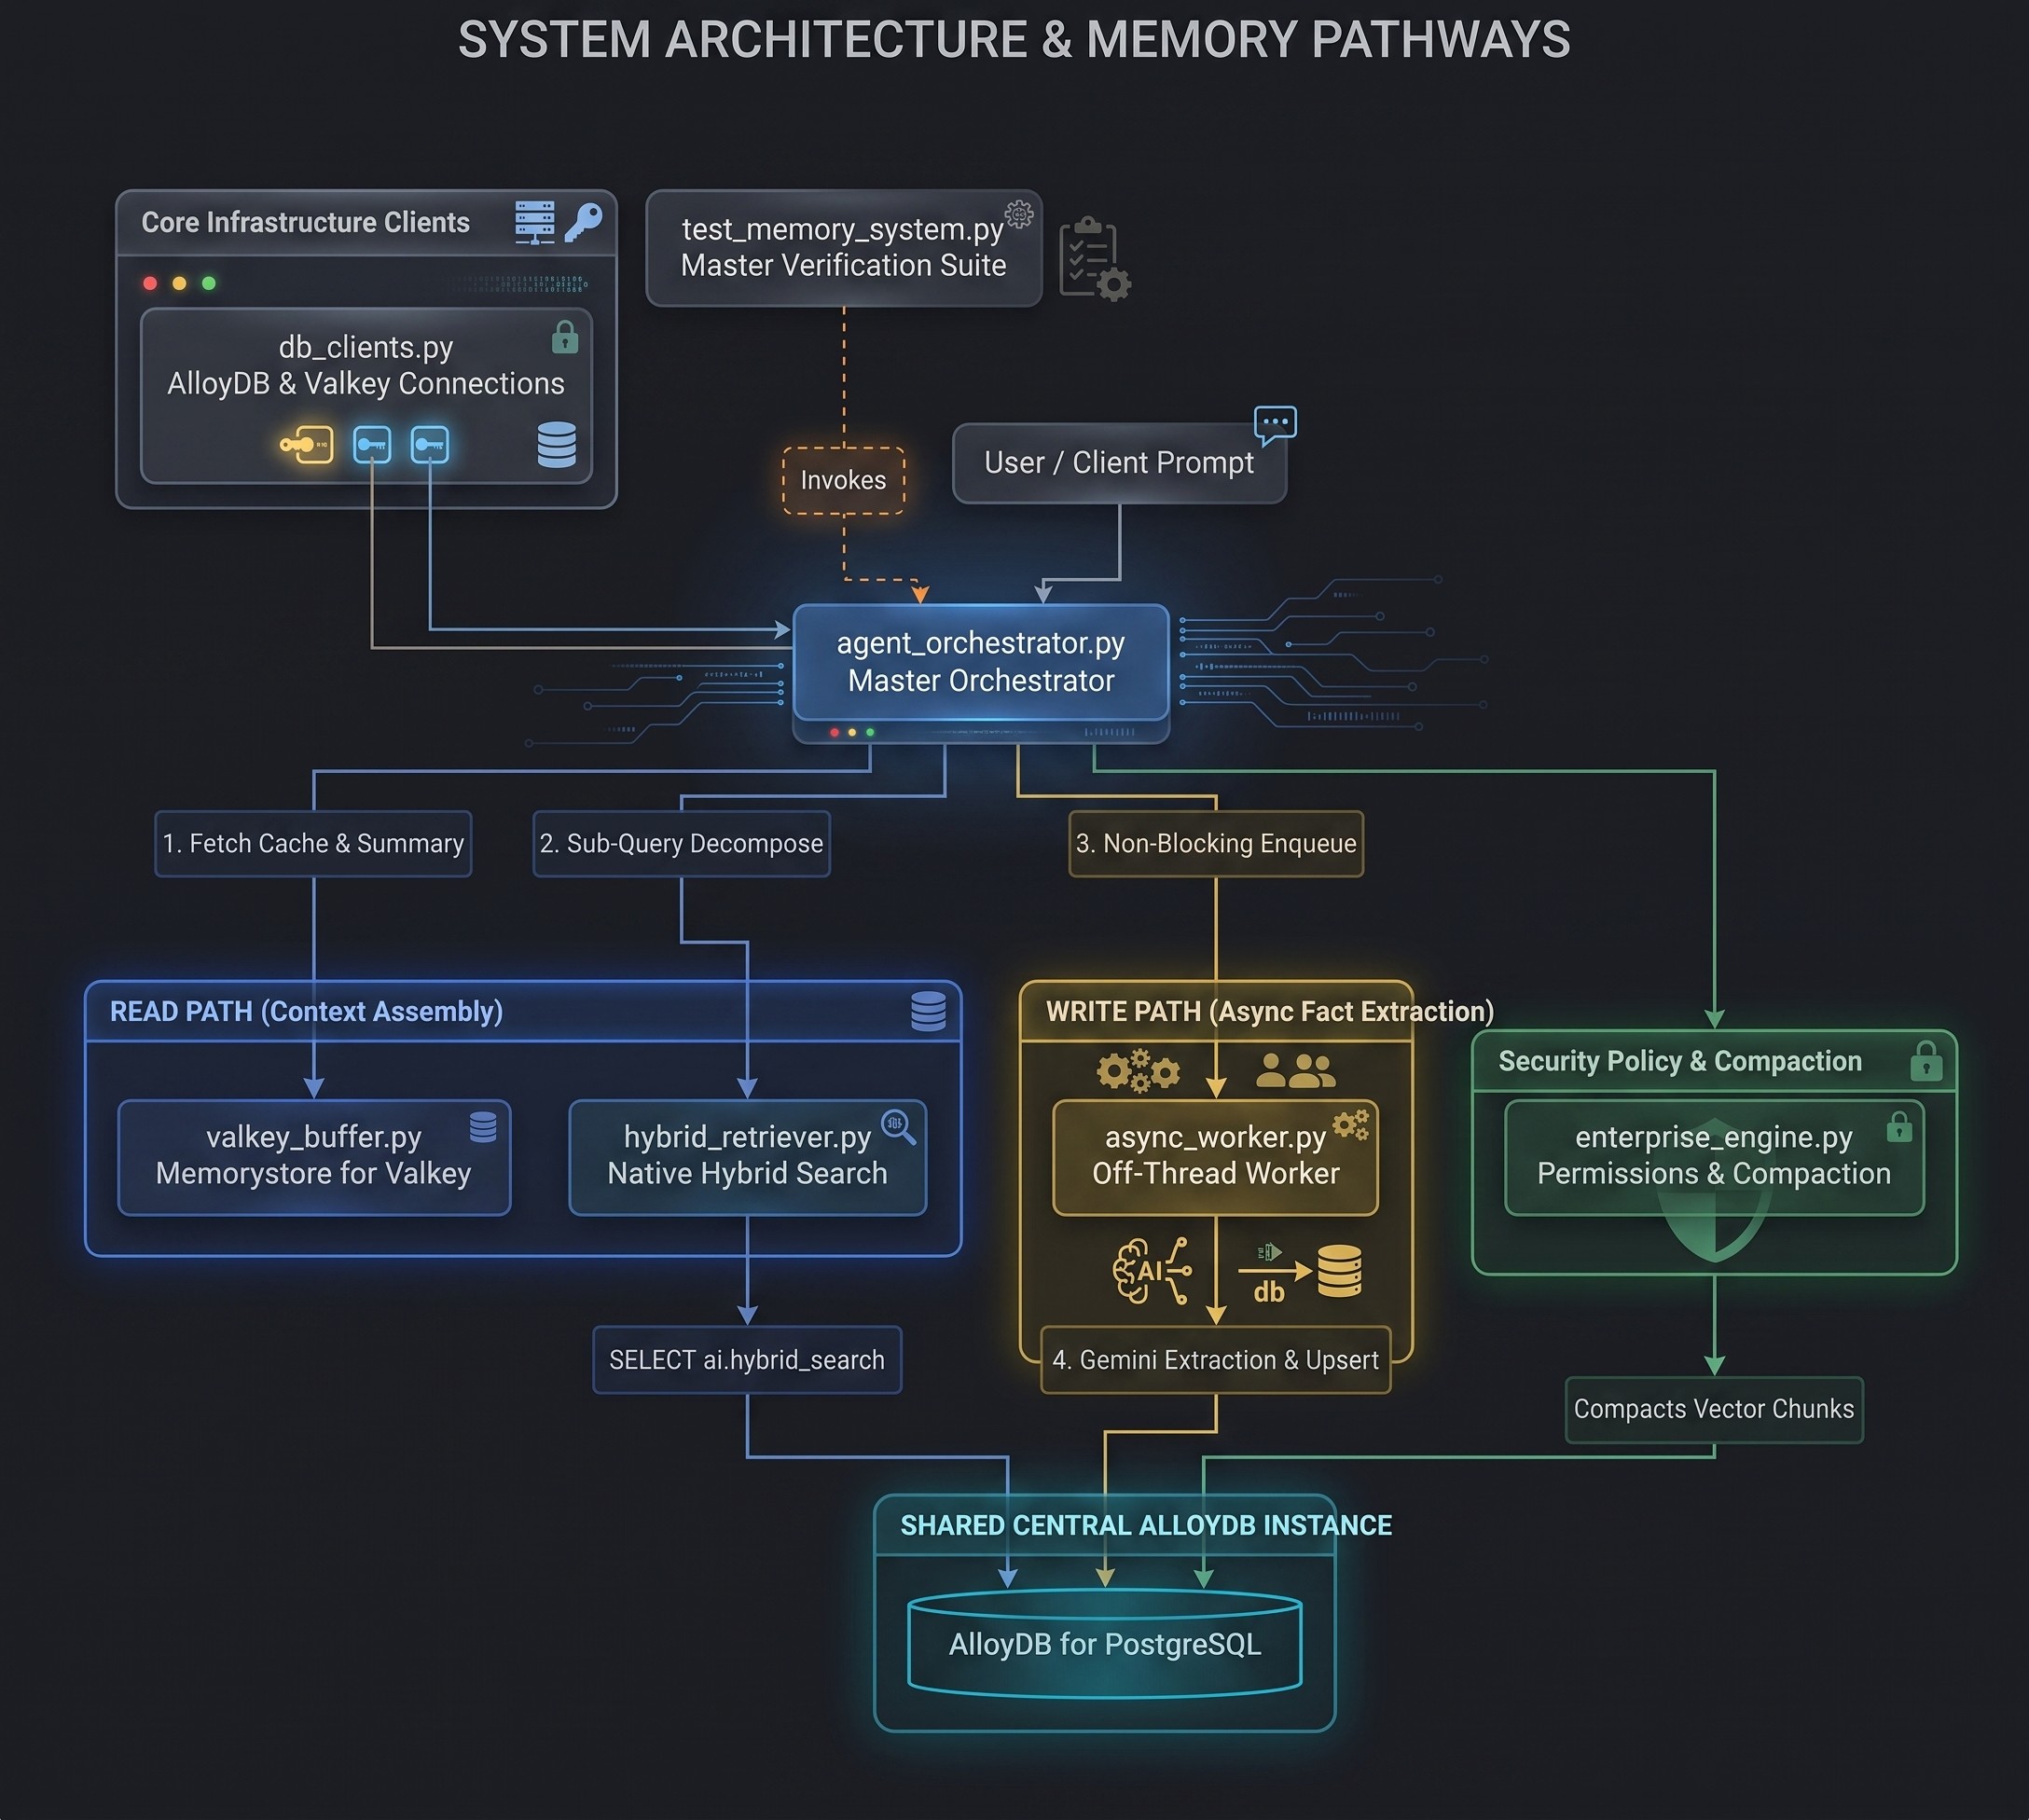
التسلسل الهرمي للوحدات وأدوار النظام
ملف الوحدة | طبقة النظام | المسؤولية الأساسية |
| طبقة الاتصال | تتيح إنشاء مصادقة IAM مشفّرة باستخدام طبقة المقابس الآمنة (SSL) في AlloyDB، واتصالات مرنة مع المقابس في Memorystore for Valkey. |
| الذاكرة قصيرة المدى | تدير هذه السمة سجلّ الجلسات الذي تقل مدته عن جزء من الألف من الثانية في Valkey، وتنفّذ ملخّصات متجدّدة باستخدام Summarize-Before-Trim. |
| Write Path Worker | يشغّل عامل قائمة انتظار خلفية لبرنامج خفي خارج سلسلة التعليمات يستخرج حقائق الكيانات باستخدام Gemini Flash ويُدرجها أو يُعدّلها في AlloyDB. |
| Read Path Retriever | تقسيم الأسئلة المركّبة إلى طلبات بحث فرعية ذات جانب واحد باستخدام |
| حلقة الوكيل الرئيسية | تنسيق حلقة تنفيذ المحادثة الكاملة: جلب البيانات على المدى القصير، والبحث على المدى الطويل، وتجميع الطلبات، وتنفيذ النموذج اللغوي الكبير، وإضافة البيانات إلى قائمة الانتظار بشكل غير متزامن |
| الإدارة والحوكمة | تفرض هذه السياسة سياسات أمان بثلاثة مستويات لتنفيذ الأدوات وتجمع الذاكرة السابقة. |
| الاختبار والتقييم | مجموعة التحقّق الرئيسية التي تنفّذ سيناريوهات متعددة الجولات والجلسات، وتقيس النسبة المئوية لتوفير الرموز المميزة، وتتحقّق من دقة الذاكرة |
6. إعداد المخطط والتضمينات التلقائية للمعاملات في AlloyDB AI
نظرة عامة على الهدف والبنية
في هذه الوحدة، ستحدّد مخطط قاعدة بيانات AlloyDB للذاكرة العرضية والطويلة الأمد، واستراتيجيات الفهرسة، والتضمين التلقائي من جهة قاعدة البيانات.
- مخزن المتجهات العرضي (
episodic_memory_embeddings): يتم فهرسة أجزاء من نصوص المحادثات غير المنظَّمة باستخدام فهارس المتجهات HNSW (vector_cosine_ops). - مستودع الكيانات الطويل الأمد (
agent_entities): الحقائق المنظَّمة وخيارات المستخدم وقواعد المشاريع المخزَّنة مع بيانات وصفية للنطاق (globalوprojectوsession)، ويتضمّن عمود بحث عن النص الكامل في PostgreSQL تم إنشاؤه تلقائيًا (summary_tsv) وفهرسته من خلال RUM. - عمليات التضمين التلقائي من جهة قاعدة البيانات (
ai.initialize_embeddings): يتم تلقائيًا تضمين الصفوف الجديدة أو المعدَّلة من النص العادي فيsummary_embeddingمن خلال "منصة الوكيل"text-embedding-005في الخلفية.
الربط بـ AlloyDB Studio
- انتقِل إلى صفحة AlloyDB for Postgres في Google Cloud Console.
- انقر على مثيلك الأساسي.
- في شريط التنقّل الأيمن، انقر على AlloyDB Studio.
- اختَر قاعدة بيانات
postgres - المصادقة باستخدام
IAM database authentication
التنفيذ ورمز المصدر
بعد الاتصال بقاعدة بيانات AlloyDB PostgreSQL، نفِّذ طلبات DDL أدناه:
-- 1. Enable google_ml_integration extension
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;
CREATE EXTENSION IF NOT EXISTS vector CASCADE;
CREATE EXTENSION IF NOT EXISTS rum CASCADE;
SET google_ml_integration.enable_preview_ai_functions = true;

-- 2. Create Episodic Memory Vector Store Tables
CREATE TABLE IF NOT EXISTS episodic_memory_collections (
    uuid UUID PRIMARY KEY,
    name VARCHAR,
    cmetadata JSONB
);

CREATE TABLE IF NOT EXISTS episodic_memory_embeddings (
    uuid UUID PRIMARY KEY,
    collection_id UUID REFERENCES episodic_memory_collections(uuid) ON DELETE CASCADE,
    embedding VECTOR(768),
    document VARCHAR,
    cmetadata JSONB,
    custom_id VARCHAR,
    created_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS episodic_memory_embedding_idx
ON episodic_memory_embeddings
USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);

-- 3. Create Entity & Preference Table with Metadata Scope & Auto-Generated TSVector Column
CREATE TABLE IF NOT EXISTS agent_entities (
    entity_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    entity_name TEXT NOT NULL,
    project_id TEXT DEFAULT 'global',
    session_id TEXT,
    scope TEXT NOT NULL DEFAULT 'project', -- 'global', 'project', 'session'
    summary TEXT NOT NULL,
    summary_embedding VECTOR(768),
    summary_tsv TSVECTOR GENERATED ALWAYS AS (
        to_tsvector('english', entity_name || ' ' || summary)
    ) STORED,
    updated_at TIMESTAMPTZ DEFAULT NOW(),
    UNIQUE (user_id, entity_name)
);

CREATE INDEX IF NOT EXISTS agent_entities_scope_idx
ON agent_entities (user_id, project_id, scope);

CREATE INDEX IF NOT EXISTS agent_entities_embedding_idx
ON agent_entities USING hnsw (summary_embedding vector_cosine_ops);

CREATE INDEX IF NOT EXISTS agent_entities_tsv_idx
ON agent_entities USING rum (summary_tsv rum_tsvector_ops);

-- 4. Create User Permissions Table for Tool Execution Controls
CREATE TABLE IF NOT EXISTS user_permissions (
    permission_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    project_id TEXT NOT NULL DEFAULT 'global',
    tool_name TEXT NOT NULL,
    command_pattern TEXT NOT NULL,
    action TEXT NOT NULL CHECK (action IN ('ALLOW', 'BLOCK')),
    created_at TIMESTAMPTZ DEFAULT NOW(),
    updated_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS idx_user_permissions_lookup
ON user_permissions (user_id, project_id, tool_name);
-- 5. Register Gemini 3.5 Flash Model Endpoint in AlloyDB
-- Replace PROJECT_ID with your Google Cloud project ID
CALL google_ml.create_model(
    model_id => 'gemini-3.5-flash',
    model_request_url => 'https://aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/global/publishers/google/models/gemini-3.5-flash:generateContent',
    model_qualified_name => 'gemini-3.5-flash',
    model_provider => 'google',
    model_type => 'llm',
    model_auth_type => 'alloydb_service_agent_iam'
);
تهيئة ميزة "التضمينات التلقائية للمعاملات" وتسجيل نموذج Gemini
بعد ذلك، نفِّذ عبارات CALL في مجموعات تنفيذ طلبات بحث منفصلة لتسجيل عملية التضمين التلقائي في الخلفية ونقطة نهاية نموذج Gemini 3.5 Flash:
-- 6. Register Database-Side Transactional Auto-Embedding
CALL ai.initialize_embeddings(
    model_id => 'text-embedding-005',
    table_name => 'agent_entities',
    content_column => 'summary',
    embedding_column => 'summary_embedding',
    incremental_refresh_mode => 'transactional',
    batch_size => 10
);
7. إعداد عملاء الاتصال في AlloyDB وValkey
نظرة عامة على الهدف والبنية
في هذه الوحدة، ستنشئ اتصالات شبكة آمنة بكل من AlloyDB for PostgreSQL (الذاكرة الطويلة الأمد) وMemorystore for Valkey (ذاكرة التخزين المؤقت القصيرة الأمد).
- مصادقة AlloyDB IAM: تستخدم
gcloud auth application-default print-access-tokenلاسترداد رمز OAuth2 مميّز قصير الأمد لاتصالات قاعدة البيانات غير المحمية بكلمة مرور والمشفّرة باستخدام طبقة المقابس الآمنة (sslmode="require"). - مرونة شبكة Valkey: يتم ضبط
redis.Redisبمهلة مقبس تبلغ 5 ثوانٍ (socket_timeout=5.0) للتعامل مع عمليات شبكة VPC بأمان على مستوى مثيلات Valkey أحادية العُقدة أو المجمّعة.
التنفيذ ورمز المصدر
أنشئ النص البرمجي db_clients.py في دليل العمل:
import os
import subprocess
import psycopg2
import redis

# Initialize database & Valkey connection clients from environment variables
DB_HOST = os.getenv("DB_HOST", "127.0.0.1")
DB_PORT = os.getenv("DB_PORT", "5432")
DB_NAME = os.getenv("DB_NAME", "postgres")
DB_USER = os.getenv("DB_USER")

VALKEY_HOST = os.getenv("VALKEY_HOST", "127.0.0.1")
VALKEY_PORT = int(os.getenv("VALKEY_PORT", "6379"))

def get_db_connection():
    # Fetch Application Default Credentials (ADC) token for IAM Database Authentication & enable SSL encryption
    access_token = subprocess.check_output(
        ["gcloud", "auth", "application-default", "print-access-token"], text=True
    ).strip()
    return psycopg2.connect(
        host=DB_HOST,
        port=DB_PORT,
        dbname=DB_NAME,
        user=DB_USER,
        password=access_token,
        sslmode="require"
    )

def get_valkey_client():
    return redis.Redis(
        host=VALKEY_HOST,
        port=VALKEY_PORT,
        db=0,
        socket_timeout=5.0,
        socket_connect_timeout=5.0
    )

if __name__ == "__main__":
    print(f"Connecting to AlloyDB via IAM Auth ({DB_USER}) at {DB_HOST}:{DB_PORT} and Valkey at {VALKEY_HOST}:{VALKEY_PORT}...")
    print("Database and Valkey connection client modules loaded successfully.")
8. تخزين حالة الجلسة القصيرة الأمد مؤقتًا في Memorystore for Valkey
نظرة عامة على الهدف والبنية
في هذه الوحدة، ستنشئ ذاكرة تخزين مؤقت للسياق القصير الأجل بأقل من جزء من الثانية في Memorystore for Valkey، مع تنفيذ نمط التلخيص قبل الاقتطاع التلقائي.
- نافذة Valkey المنزلقة: يتم تخزين أدوار المحادثة النشطة كسلاسل JSON في المفتاح
session:{session_id}:turns. - علامات التجزئة في Redis (
{session_id}): يستخدم تنسيق المفتاحsession:{session_id}:turnsوsession:{session_id}:summaryعلامات التجزئة في مجموعة Redis ({...})، ما يفرض على كلا المفتاحين استخدام خانة التجزئة نفسها لضمان التنفيذ الذري على أي عملية نشر فردية أو مجمّعة في Valkey. - تلخيص قبل الاقتطاع: عندما يتجاوز عدد الأدوار
trigger_limit، يقدّم Gemini Flash ملخّصًا نصيًا متجدّدًا (session:{session_id}:summary) للأدوار القديمة التي سيتم اقتطاعها، وذلك قبل اقتطاع السجلّ الأولي إلىwindow_size.
التنفيذ ورمز المصدر
أنشئ النص البرمجي valkey_buffer.py في دليل العمل:
import json
import logging
import time
from typing import Any, Dict, List
import redis

logger = logging.getLogger(__name__)

IN_MEMORY_VALKEY_FALLBACK: Dict[str, Any] = {}
VALKEY_COMPACTION_TOKENS = 0

def get_valkey_compaction_tokens() -> int:
    return VALKEY_COMPACTION_TOKENS

def append_session_turn_with_rolling_summary(
    valkey_client: redis.Redis,
    llm_client: Any,
    session_id: str,
    user_msg: str,
    ai_msg: str,
    trigger_limit: int = 10,
    window_size: int = 4
) -> None:
    """Appends turn to Valkey. Before trimming old turns, summarizes them into a rolling summary."""
    global VALKEY_COMPACTION_TOKENS
    # Use Redis Hash Tags {session_id} so both keys hash to the same cluster slot
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        # 1. Append new turn messages
        valkey_client.rpush(turns_key, json.dumps({"role": "user", "content": user_msg}))
        valkey_client.rpush(turns_key, json.dumps({"role": "assistant", "content": ai_msg}))

        raw_turns = valkey_client.lrange(turns_key, 0, -1)

        # 2. Check if total turns exceed summary trigger threshold
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2

        if len(raw_turns) > msg_trigger_count:
            turns_to_prune = raw_turns[:-msg_window_count]
            existing_summary = valkey_client.get(summary_key)
            existing_summary_text = (
                existing_summary.decode('utf-8') if isinstance(existing_summary, bytes) else (existing_summary or "")
            )

            pruned_text = "\n".join([
                f"{json.loads(t)['role']}: {json.loads(t)['content']}" for t in turns_to_prune
            ])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            updated_summary_text = llm_client.models.generate_content(
                model="gemini-3.5-flash", contents=prompt
            ).text.strip()
            # Execute commands directly to support all Redis/Valkey cluster topologies
            valkey_client.set(summary_key, updated_summary_text)
            valkey_client.ltrim(turns_key, -msg_window_count, -1)
            logger.info("Updated rolling summary and trimmed Valkey buffer for session %s", session_id)

    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey operation warning (%s). Falling back to in-memory short-term buffer.", e)
        if turns_key not in IN_MEMORY_VALKEY_FALLBACK:
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = []
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "user", "content": user_msg})
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "assistant", "content": ai_msg})

        # In-memory summarize-before-trim fallback logic
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2
        raw_fallback_turns = IN_MEMORY_VALKEY_FALLBACK[turns_key]

        if len(raw_fallback_turns) > msg_trigger_count:
            turns_to_prune = raw_fallback_turns[:-msg_window_count]
            existing_summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
            pruned_text = "\n".join([f"{t['role']}: {t['content']}" for t in turns_to_prune])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            for attempt in range(4):
                try:
                    updated_summary_text = llm_client.models.generate_content(
                        model="gemini-3.5-flash", contents=prompt
                    ).text.strip()
                    break
                except Exception as e:
                    if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                        time.sleep(3 * (2 ** attempt))
                    else:
                        raise

            IN_MEMORY_VALKEY_FALLBACK[summary_key] = updated_summary_text
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = raw_fallback_turns[-msg_window_count:]

def get_session_context_buffer(
    valkey_client: redis.Redis,
    session_id: str
) -> Dict[str, Any]:
    """Retrieves rolling summary + sliding window history from Valkey to build prompt context."""
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        summary = valkey_client.get(summary_key)
        summary_text = summary.decode('utf-8') if isinstance(summary, bytes) else (summary or "")

        raw_turns = valkey_client.lrange(turns_key, 0, -1)
        recent_turns = [json.loads(t) for t in raw_turns]

        return {
            "rolling_summary": summary_text,
            "recent_turns": recent_turns
        }
    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey read error (%s). Using in-memory short-term fallback buffer.", e)
        summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
        recent_turns = IN_MEMORY_VALKEY_FALLBACK.get(turns_key, [])
        return {"rolling_summary": summary_text, "recent_turns": recent_turns}
9. استخراج الكيانات خارج سلسلة التعليمات (المنفِّذ في الخلفية للذاكرة)
نظرة عامة على الهدف والبنية
في هذه الوحدة، ستنشئ عامل استخراج في الخلفية لمسار الكتابة خارج سلسلة التعليمات (AsyncMemoryWorker) يستخرج حقائق الكيانات الطويلة الأمد بدون إبطاء ردود الذكاء الاصطناعي التفاعلية.
- Non-Blocking Queue Worker: يتم تشغيل سلسلة تعليمات خلفية (
queue.Queue) لكي يتم عرض نتائج محادثة المطوّر على الفور بدون انتظار استخراج البيانات من النموذج اللغوي الكبير أو كتابتها في قاعدة البيانات. - استخراج الحقائق عن الكيانات خارج سلسلة المحادثات: يتم استدعاء Gemini Flash (
model="gemini-3.5-flash"وresponse_mime_type="application/json") في الخلفية لتحليل الكيانات المنظَّمة بدون حظر أدوار الحوار التي تظهر للمستخدم. - حلّ الإحالة إلى المرجع الزمني (
build_temporal_rules_prompt): يفرض قواعد تحوّل التعبيرات الزمنية النسبية (مثل "حاليًا" و"الجلسة الأخيرة") إلى أرقام تعريف جلسات صريحة (مثلsession_id). - عمليات إدراج/تعديل المخطط: تطلب من Gemini Flash عرض مصفوفة JSON للعناصر (
entity_nameوproject_idوscopeوsummary) وكتابة نص عادي فيagent_entitiesمن خلال عبارات PostgreSQLON CONFLICT DO UPDATEذات المَعلمات.
التنفيذ ورمز المصدر
أنشئ النص البرمجي async_worker.py في دليل العمل:
import json
import logging
import queue
import threading
import time
from typing import Dict, Any, Optional
import psycopg2

logger = logging.getLogger(__name__)

def build_temporal_rules_prompt(active_session_id: str, prev_session_id: Optional[str] = None) -> str:
    """REUSABLE PROMPT HELPER: Defines temporal coreference rules for both Read and Write paths."""
    return f"""TEMPORAL COREFERENCE RULES:
1. Do not use relative temporal words like 'currently', 'now', 'this session', 'previous session', or 'last session'.
2. Replace any relative temporal reference with explicit session identifiers:
   - Active Session: '{active_session_id}'
   - Previous Session: '{prev_session_id if prev_session_id else active_session_id}'
   (e.g., write 'User prefers Python in session {active_session_id}' instead of 'User currently prefers Python')."""

class AsyncMemoryWorker:
    """Off-thread daemon queue worker performing background entity extraction and upserts into AlloyDB."""
    def __init__(self, conn_factory, llm_client):
        self.conn_factory = conn_factory
        self.llm_client = llm_client
        self.work_queue = queue.Queue()
        self.total_extraction_tokens = 0
        self.worker_thread = threading.Thread(target=self._run_worker, daemon=True)
        self.worker_thread.start()

    def enqueue_extraction(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        self.work_queue.put((user_id, session_id, user_msg, ai_msg, prev_session_id))

    def _run_worker(self):
        while True:
            item = self.work_queue.get()
            if item is None:
                break
            user_id, session_id, user_msg, ai_msg, prev_session_id = item
            try:
                self._extract_and_upsert(user_id, session_id, user_msg, ai_msg, prev_session_id)
            except Exception as e:
                logger.error("Background extraction failed: %s", e)
            finally:
                self.work_queue.task_done()

    def _extract_and_upsert(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        temporal_rules = build_temporal_rules_prompt(session_id, prev_session_id)
        json_fmt = '[{"entity_name": "...", "project_id": "...", "scope": "global|project|session", "summary": "..."}]'

        prompt = f"""Extract key preferences and named entities from this exchange.
Format output strictly as a JSON array of objects with structure: {json_fmt}.

{temporal_rules}

Rules for Scope:
- 'global': Universal developer preferences.
- 'project': Architecture, database choices, timeouts, and rules for a specific project.
- 'session': Ephemeral task state tied strictly to a single session.

User: {user_msg}
AI: {ai_msg}

Output (JSON array only):"""

        self.total_extraction_tokens += max(1, len(prompt) // 4)

        for attempt in range(4):
            try:
                response = self.llm_client.models.generate_content(
                    model="gemini-3.5-flash",
                    contents=prompt,
                    config={"response_mime_type": "application/json"}
                )
                break
            except Exception as e:
                if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                    time.sleep(3 * (2 ** attempt))
                else:
                    raise
        content = str(response.text).strip()
        if not content:
            return

        extracted_list = json.loads(content)
        if not isinstance(extracted_list, list):
            return

        upsert_sql = """
            INSERT INTO agent_entities (user_id, entity_name, project_id, session_id, scope, summary, updated_at)
            VALUES (%s, %s, %s, %s, %s, %s, NOW())
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET
                project_id = EXCLUDED.project_id,
                session_id = EXCLUDED.session_id,
                scope = EXCLUDED.scope,
                summary = EXCLUDED.summary,
                updated_at = NOW();
        """

        conn = self.conn_factory()
        try:
            with conn:
                with conn.cursor() as cur:
                    for item in extracted_list:
                        e_name = item.get("entity_name", "General_Fact")
                        p_id = item.get("project_id", "global")
                        s_scope = item.get("scope", "project")
                        summary = item.get("summary", "")
                        if e_name and summary:
                            cur.execute(upsert_sql, (user_id, e_name, p_id, session_id, s_scope, summary))
            logger.info("Saved %d entities for user %s", len(extracted_list), user_id)
        finally:
            conn.close()
10. الاستعلام من الذاكرة الطويلة الأمد باستخدام ميزة "البحث المختلط الأصلي"
نظرة عامة على الهدف والبنية
في هذه الوحدة، ستنفّذ عملية تقسيم الاستعلام الفرعي لمسار القراءة، وإعادة كتابة الاستعلام المؤقت، وعزل نطاق البيانات الوصفية، واستخدام البحث المختلط الأصلي في AlloyDB (ai.hybrid_search).
- تقسيم الاستعلام الفرعي داخل قاعدة البيانات (
rewrite_and_decompose_query): تستخدم هذه الميزة الدالة المضمّنةai.generate()في AlloyDB AI مباشرةً داخل PostgreSQL لتقسيم الأسئلة المركّبة إلى استعلامات فرعية ذات جانب واحد مع معرّفات جلسات موحّدة، ما يمنع الاستعلامات المتعددة المواضيع من تقليل دقة البحث عن المتّجهات. - فلترة على مستوى الفهرس: تنشئ فلاتر SQL من جهة قاعدة البيانات (
filter_condition => "user_id = '%s' AND (project_id = '%s' OR scope = 'global')") لعزل الذكريات لكل مستخدم ومشروع مع تضمين الإعدادات المفضّلة العامة للمطوّرين. - البحث المختلط الأصلي في AlloyDB (
ai.hybrid_search): يجمع بين التشابه الجيب التمامي للمتجهات (public.<=>) والبحث عن النص الكامل (rum) داخل AlloyDB باستخدام طريقة "دمج الترتيب المتبادل" (RRF) لتقديم أفضل دقة واسترجاع وملاءمة.
التنفيذ ورمز المصدر
أنشئ النص البرمجي hybrid_retriever.py في دليل العمل:
import os
import json
import logging
from typing import Any, Dict, List, Optional
import psycopg2
from psycopg2.extras import RealDictCursor
from async_worker import build_temporal_rules_prompt

logger = logging.getLogger(__name__)

def rewrite_and_decompose_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> List[str]:
    """Read-Path LLM Query Normalizer & Sub-Query Decomposer using AlloyDB AI ai.generate() directly in PostgreSQL."""
    temporal_rules = build_temporal_rules_prompt(active_session_id, prev_session_id)

    prompt = f"""You are a query normalization and decomposition tool for an AI agent's memory retrieval system.

Tasks:
1. Normalize any relative temporal phrases in the user query into explicit session identifiers.
{temporal_rules}

2. Decompose compound user queries asking about multiple distinct topics into up to 4 concise, single-topic search queries. Ensure all distinct questions (both general developer preferences and project-specific architecture/rules) are preserved as separate sub-queries.
3. Return ONLY a valid JSON array of strings containing the sub-queries.

Example Output Format:
["general developer coding preferences", "CloudRetail backend stack in session sess_2026_01", "CloudRetail timeout rules in session sess_2026_01"]

Text to Process: {text}
JSON Output:"""

    try:
        with conn.cursor() as cur:
            cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
            cur.execute("SELECT ai.generate(prompt => %s::text, model_id => 'gemini-3.5-flash'::varchar(100));", (prompt,))
            row = cur.fetchone()
            if row and row[0]:
                res_text = str(row[0]).strip()
                clean_text = res_text
                if clean_text.startswith("```"):
                    clean_text = clean_text.removeprefix("```json").removeprefix("```").removesuffix("```").strip()
                parsed = json.loads(clean_text)
                if isinstance(parsed, list) and len(parsed) > 0:
                    return [str(q).strip() for q in parsed]
        return [text]
    except Exception as e:
        logger.error("Error in in-database ai.generate sub-query decomposition: %s", e)
        return [text]

def rewrite_temporal_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> str:
    """Backward-compatible wrapper returning first decomposed query string."""
    queries = rewrite_and_decompose_query(conn, llm_client, text, active_session_id, prev_session_id)
    return queries[0] if queries else text

def retrieve_hybrid_entities(
    conn,
    llm_client: Any,
    user_id: str,
    active_session_id: str,
    query_text: str,
    query_embedding: Optional[List[float]] = None,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    k: int = 20
) -> Dict[str, Any]:
    """Queries long-term entities using Sub-Query Decomposition, metadata scope filtering, and parameterized AlloyDB hybrid search."""
    sub_queries = rewrite_and_decompose_query(
        conn=conn, llm_client=llm_client, text=query_text, active_session_id=active_session_id, prev_session_id=prev_session_id
    )
    all_search_queries = list(dict.fromkeys(sub_queries + [query_text]))

    retrieved_entities: Dict[str, Any] = {}

    filter_cond = f"user_id = '{user_id}' AND (project_id = '{project_id}' OR scope = 'global')" if project_id else f"user_id = '{user_id}'"

    query_sql = """
        SELECT e.entity_name, e.summary, e.project_id, e.scope, e.updated_at
        FROM ai.hybrid_search(
          search_inputs => %s::JSONB[],
          include_json_output => false
        ) h
        JOIN agent_entities e ON e.entity_name = h.id
        WHERE e.user_id = %s
        LIMIT %s;
    """

    from google import genai
    embed_client = genai.Client(
        vertexai=True,
        project=os.getenv("PROJECT_ID"),
        location=os.getenv("REGION", "us-east1")
    )

    for sq in all_search_queries:
        try:
            emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=sq)
            sq_embedding = emb_resp.embeddings[0].values
            vector_literal = f"'{sq_embedding}'::vector"
        except Exception as e:
            logger.error(f"Failed to generate embedding for sub-query: {sq}. Error: {e}")
            # Fallback to zero vector to prevent Postgres from crashing
            sq_embedding = [0.0] * 768
            vector_literal = f"'{sq_embedding}'::vector"

        search_inputs = [
            json.dumps({
                "data_type": "vector",
                "weight": 0.4,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "vec_column": "summary_embedding",
                "distance_operator": "public.<=>",
                "limit": 20,
                "query_vector": vector_literal,
                "filter_condition": filter_cond
            }),
            json.dumps({
                "data_type": "text",
                "weight": 0.6,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "text_column": "summary_tsv",
                "limit": 20,
                "ranking_function": "ts_rank",
                "query_text_input": sq,
                "filter_condition": filter_cond
            })
        ]

        with conn.cursor(cursor_factory=RealDictCursor) as cur:
            try:
                cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                cur.execute(query_sql, (search_inputs, user_id, k))
                rows = cur.fetchall()

                for row in rows:
                    name = row["entity_name"]
                    if name not in retrieved_entities:
                        retrieved_entities[name] = {
                            "summary": row["summary"],
                            "project_id": row["project_id"],
                            "scope": row["scope"],
                            "updated_at": row["updated_at"].isoformat() if row["updated_at"] else None
                        }
            except Exception as e:
                logger.error("Error executing hybrid search for sub-query '%s': %s", sq, e)

    return retrieved_entities
11. إنشاء حلقة ذاكرة الوكيل المتكاملة وتشغيلها
نظرة عامة على الهدف والبنية
في هذه الوحدة، ستنشئ وظيفة تنسيق الوكيل الرئيسية (run_agent_turn) التي تجمع بين استرجاع ذاكرة التخزين المؤقت القصيرة المدى والبحث في الذاكرة الطويلة المدى وتجميع الطلبات والتوليد باستخدام النموذج اللغوي الكبير واستخراج الذاكرة في الخلفية.
- السياق القصير الأمد: يستردّ هذا السياق نوبات الحوار النشطة في Valkey والملخّص المتجدّد (
get_session_context_buffer). - Long-Term Search: يرسل طلبات بحث إلى AlloyDB من خلال
retrieve_hybrid_entitiesباستخدام طلبات بحث فرعية مقسّمة يتم فلترتها حسب رقم تعريف المشروع النشط والنطاق العام. - تنسيق طلب النظام: يجمع
build_agent_promptالذي يحتوي على كيانات طويلة الأمد وملخّص قصير الأمد والحوار الأخير وطلب المستخدم في طلب نظام فعّال من حيث الرموز المميزة. - Async Queue Enqueue: تخزّن هذه السمة مؤقتًا عملية التسليم في Valkey وتضيف عملية الاستخراج في الخلفية إلى
AsyncMemoryWorkerبدون حظر حمولة الإرجاع.
التنفيذ ورمز المصدر
أنشئ النص البرمجي agent_orchestrator.py في دليل العمل:
import logging
import time
from typing import Any, Dict, Optional, Tuple
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import rewrite_temporal_query, retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

logger = logging.getLogger(__name__)

def build_agent_prompt(
    rolling_summary: str,
    recent_turns: list[Dict[str, Any]],
    retrieved_entities: Dict[str, Any],
    user_query: str
) -> str:
    """Assembles structured system prompt with long-term memory & short-term context."""
    entity_lines = [
        f"- {name}: {info['summary']}" for name, info in retrieved_entities.items()
    ]
    entity_context = "\n".join(entity_lines) if entity_lines else "No relevant entity facts."
    history_lines = [f"{t['role']}: {t['content']}" for t in recent_turns]
    history_str = "\n".join(history_lines)

    return f"""You are an intelligent, context-aware AI assistant.

[LONG-TERM PREFERENCES & ENTITIES]
{entity_context}

[SHORT-TERM ROLLING SUMMARY]
{rolling_summary if rolling_summary else 'No prior summary.'}

[RECENT DIALOGUE]
{history_str}

User: {user_query}
AI:"""

def run_agent_turn(
    db_conn,
    valkey_client: redis.Redis,
    async_worker: AsyncMemoryWorker,
    genai_client: Any,
    user_id: str,
    session_id: str,
    user_query: str,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    trigger_limit: int = 10,
    window_size: int = 4
) -> Tuple[str, str, float]:
    """Executes a complete 2-tier agent memory turn loop, returning (response_text, system_prompt, latency_seconds)."""
    import time
    start_time = time.time()

    # 1. Fetch short-term rolling summary + recent turns from Valkey
    buffer_data = get_session_context_buffer(valkey_client, session_id)
    rolling_summary = buffer_data["rolling_summary"]
    recent_turns = buffer_data["recent_turns"]

    # 2. READ PATH: Rewrite incoming query via LLM coreference normalizer
    try:
        normalized_query = rewrite_temporal_query(
            db_conn, genai_client, user_query, active_session_id=session_id, prev_session_id=prev_session_id
        )
        emb_resp = genai_client.models.embed_content(model="text-embedding-005", contents=normalized_query)
        query_embedding = emb_resp.embeddings[0].values
    except Exception:
        query_embedding = None

    # Retrieve relevant long-term entities from AlloyDB via hybrid search
    retrieved_entities = retrieve_hybrid_entities(
        conn=db_conn,
        llm_client=genai_client,
        user_id=user_id,
        active_session_id=session_id,
        query_text=user_query,
        query_embedding=query_embedding,
        prev_session_id=prev_session_id,
        project_id=project_id,
        k=20
    )

    # 3. Assemble system prompt
    system_prompt = build_agent_prompt(
        rolling_summary, recent_turns, retrieved_entities, user_query
    )


    # 4. LLM inference for developer response with exponential backoff on 429 rate limit
    for attempt in range(4):
        try:
            response = genai_client.models.generate_content(
                model="gemini-3.5-flash", contents=system_prompt
            )
            break
        except Exception as e:
            if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                time.sleep(3 * (2 ** attempt))
            else:
                raise
    ai_response = str(response.text)

    # 5. Cache turn in short-term Valkey buffer (with Summarize-Before-Trim check)
    append_session_turn_with_rolling_summary(
        valkey_client=valkey_client,
        llm_client=genai_client,
        session_id=session_id,
        user_msg=user_query,
        ai_msg=ai_response,
        trigger_limit=trigger_limit,
        window_size=window_size
    )

    # 6. WRITE PATH: Enqueue off-thread background entity extraction (single LLM call)
    async_worker.enqueue_extraction(user_id, session_id, user_query, ai_response, prev_session_id)

    latency = time.time() - start_time
    return ai_response, system_prompt, latency
12. تنفيذ عناصر التحكّم في أذونات المؤسسة وضغط الذاكرة
نظرة عامة على الهدف والبنية
في هذه الوحدة، ستنشئ عناصر تحكّم في أمان المؤسسة لتنفيذ الأدوات وضغط ذاكرة قاعدة البيانات (AgentMemoryEngine).
- تقييم الأذونات على 3 مستويات (
evaluate_tool_permission):- المستوى 1 (منح مفتاح Valkey للاستخدام الفردي): يتحقّق من مفاتيح المنح للاستخدام الفردي (
one_time_perm:{session_id}:{cmd_hash}) مع مدة بقاء تبلغ 300 ثانية. في حال توفّر هذه السمة، يتم حذف المفتاح على الفور ويتم عرضALLOW. - المستوى 2 و3 (قواعد سياسة PostgreSQL): يتم أولاً تنفيذ طلبات البحث
user_permissionsالتي تتطابق مع القواعد على مستوى المشروع (project_id)، ثم القواعد العامة ('global'). - القيمة الاحتياطية: تعرض
PROMPT_USERإذا لم تتوفر أي سياسة مطابقة.
- المستوى 1 (منح مفتاح Valkey للاستخدام الفردي): يتحقّق من مفاتيح المنح للاستخدام الفردي (
- ضغط الذاكرة (
compact_old_memories): يجمع أحداث المتجهات الأولية السابقة فيepisodic_memory_embeddingsالأقدم منretention_daysفي ملخّص موحّد واحد فيagent_entitiesباستخدام طلب بحث SQL CTE محدود بـ 50 صفًا.
التنفيذ ورمز المصدر
أنشئ النص البرمجي enterprise_engine.py في دليل العمل:
import hashlib
import logging
import re
from typing import Any, Dict, Tuple
import psycopg2
import redis

logger = logging.getLogger(__name__)

class AgentMemoryEngine:
    """Framework-agnostic Enterprise Memory Engine for tool execution permissions & safe compaction."""

    def __init__(self, valkey_client: redis.Redis, db_conn: Any):
        self.valkey_client = valkey_client
        self.db_conn = db_conn

    def evaluate_tool_permission(
        self,
        user_id: str,
        project_id: str,
        session_id: str,
        tool_name: str,
        tool_args: Dict[str, Any]
    ) -> Tuple[str, str]:
        """Evaluates 3-tier execution permissions: Allow-Once (Valkey), Project (AlloyDB), Global (AlloyDB)."""
        command_str = str(tool_args.get("CommandLine", "") or tool_args)

        # Tier 1: Allow-Once (Single-Use Valkey Check with 300s TTL)
        cmd_hash = hashlib.sha256(command_str.encode("utf-8")).hexdigest()[:16]
        valkey_key = f"one_time_perm:{session_id}:{cmd_hash}"

        if self.valkey_client.get(valkey_key):
            self.valkey_client.delete(valkey_key)  # Consume key immediately
            return ("ALLOW", "Single-use 'Allow Once' grant consumed.")

        # Tier 2 & Tier 3: Query AlloyDB user_permissions table
        query_sql = """
            SELECT command_pattern, action, project_id
            FROM user_permissions
            WHERE user_id = %s AND tool_name = %s AND project_id IN (%s, 'global')
            ORDER BY CASE WHEN project_id = %s THEN 1 ELSE 2 END;
        """

        with self.db_conn.cursor() as cur:
            cur.execute(query_sql, (user_id, tool_name, project_id, project_id))
            rules = cur.fetchall()
            for pattern, action, scope in rules:
                if re.search(pattern, command_str, flags=re.IGNORECASE):
                    return (action, f"Matched {scope}-scoped rule: {pattern}")

        # Fallback: Prompt Human User
        return ("PROMPT_USER", "No matching permission rule found.")

    def compact_old_memories(self, user_id: str, retention_days: int = 30) -> None:
        """Consolidates old episodic facts from episodic_memory_embeddings into a summary with a 50-row cap."""
        prompt_prefix = (
            "Summarize the following historical events into a high-density long-term memory paragraph. "
            "Retain key constraints, tool choices, and project rules:\n"
        )

        # Capped CTE prevents string_agg from exceeding model context window limits
        compaction_sql = """
            WITH old_events AS (
                SELECT document AS content
                FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            ),
            consolidated AS (
                SELECT ai.generate(%s || string_agg(content, E'\n')) AS summary_text
                FROM old_events
            )
            INSERT INTO agent_entities (user_id, entity_name, summary, updated_at)
            SELECT %s, 'longterm_session_summary', summary_text, NOW()
            FROM consolidated
            WHERE summary_text IS NOT NULL
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET summary = EXCLUDED.summary, updated_at = NOW();
        """

        prune_sql = """
            DELETE FROM episodic_memory_embeddings
            WHERE uuid IN (
                SELECT uuid FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            );
        """

        try:
            with self.db_conn:
                with self.db_conn.cursor() as cur:
                    cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                    cur.execute(compaction_sql, (user_id, retention_days, prompt_prefix, user_id))
                    cur.execute(prune_sql, (user_id, retention_days))
            logger.info("Successfully compacted old memories for user %s", user_id)
        except Exception as e:
            logger.error("Error during memory compaction: %s", e)
13. تشغيل ميزة "التحقّق من الذاكرة" المتعددة الجولات بين الأطراف
نظرة عامة على الهدف والبنية
في هذه الوحدة الأخيرة، ستنشئ نص التحقّق الرئيسي الشامل (test_memory_system.py) وتنفّذه للتحقّق من صحة بنية الذاكرة الكاملة ذات المستويَين.
- محاكاة المحادثات المتعددة الأدوار والجلسات:
- الجلسة 1 (المحادثة 1): تحدّد إعدادات المطوّرين العامة المفضّلة (
scope='global': واجهة مستخدم الوضع الداكن، وPython 3.11، وPostgreSQL). - الجلسة 1 (الجولة 2): تحدّد بنية خاصة بالمشروع (
project_id='CloudRetail': FastAPI وAlloyDB وValkey والحد الأقصى لوقت المهلة هو 30 ثانية والمنطقة us-east1). - الجلسة 1 (الدوران 3 و4): يتم إنشاء ضوضاء حوار فنية وتجاوز
trigger_limit=3لتفعيل عملية ضغط الملخّص المتداول Summarize-Before-Trim في Valkey. - الجلسة 2 (الجولة 5 - رقم تعريف جلسة جديد تمامًا): يطلب من الوكيل البحث في الجلسات للتأكّد من تذكُّر الإعدادات المفضّلة العامة وقواعد المشروع في الجلسات المختلفة.
- الجلسة 1 (المحادثة 1): تحدّد إعدادات المطوّرين العامة المفضّلة (
- التحقّق الديناميكي من الكفاءة والدقة: يقيس هذا المقياس عدد الرموز المميزة/الأحرف الدقيقة في الطلب، ونسبة الحدّ من حجم الطلب، ووقت استجابة الاستدلال، والملخّصات المتجدّدة في Valkey، وعزل النطاق، وسياسات أمان تنفيذ الأدوات.
التنفيذ ورمز المصدر
أنشئ نص الاختبار test_memory_system.py في دليل العمل:
import os
import time
import logging
from google import genai
from db_clients import get_db_connection, get_valkey_client
from async_worker import AsyncMemoryWorker
from hybrid_retriever import retrieve_hybrid_entities
from agent_orchestrator import run_agent_turn
from enterprise_engine import AgentMemoryEngine
from valkey_buffer import get_session_context_buffer, IN_MEMORY_VALKEY_FALLBACK, get_valkey_compaction_tokens

logging.basicConfig(level=logging.WARNING)
logging.getLogger("google_genai").setLevel(logging.WARNING)
logging.getLogger("httpx").setLevel(logging.WARNING)

PROJECT_ID = os.getenv("PROJECT_ID")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")

db_conn = get_db_connection()
valkey_client = get_valkey_client()
client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)

async_worker = AsyncMemoryWorker(get_db_connection, client)
engine = AgentMemoryEngine(valkey_client, db_conn)

USER_ID = "user_dev_42"
SESSION_1 = "sess_2026_01"
SESSION_2 = "sess_2026_02"

test_accuracy = []

print("\n==================================================")
print("STARTING ENHANCED 2-TIER AGENT MEMORY VERIFICATION TEST")
print("==================================================")

# TURN 1: Universal Global Developer Preference Definition
print("\n[SESSION 1 - TURN 1: Global Preference Definition]")
prompt_1 = "Hi! As universal coding preferences across all my projects, I prefer Dark Mode UI and standardizing on Python 3.11 with PostgreSQL."
print(f"User Prompt:\n{prompt_1}")
resp_1, sys_prompt_1, latency_1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_1, project_id=None, trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_1[:140]}...")
time.sleep(2)

# TURN 2: Project-Specific Architecture Definition
print("\n[SESSION 1 - TURN 2: Project CloudRetail Architecture Definition]")
prompt_2 = (
    "Now I am starting project CloudRetail. Here are the specific project requirements:\n"
    "1. Backend Stack: Python with FastAPI on AlloyDB.\n"
    "2. Short-Term Cache: Memorystore for Valkey.\n"
    "3. Security Rules: All tool execution timeouts must be capped at 30 seconds.\n"
    f"4. Deployment Region: {REGION}."
)
print(f"User Prompt:\n{prompt_2}")
resp_2, sys_prompt_2, latency_2 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_2, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_2[:140]}...")
time.sleep(2)

# TURN 3: Context Inflation / Technical Dialogue Noise
print("\n[SESSION 1 - TURN 3: Large Context Inflation (Dialogue Noise)]")
prompt_3 = (
    "Let's draft a sample 50-line PostgreSQL DDL script for product catalog indexes, "
    "including HNSW vector index tuning parameters (m = 16, ef_construction = 64), "
    "and full-text RUM search indexes on item title and description columns."
)
print(f"User Prompt:\n{prompt_3}")
resp_3, sys_prompt_3, latency_3 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_3, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_3[:140]}...")
time.sleep(2)

# TURN 4: Triggering Valkey Summarize-Before-Trim Threshold (8 messages > 6 message trigger limit)
print("\n[SESSION 1 - TURN 4: Triggering Valkey Rolling Summary Compaction]")
prompt_4_s1 = "Can you also add rate-limiting middleware rules for API endpoints?"
print(f"User Prompt:\n{prompt_4_s1}")
resp_4_s1, sys_prompt_4_s1, latency_4_s1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_4_s1, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_4_s1[:140]}...")

# VERIFY VALKEY SHORT-TERM ROLLING SUMMARY
print("\n==================================================")
print("VALKEY SHORT-TERM ROLLING SUMMARY VERIFICATION")
print("==================================================")
buffer_data = get_session_context_buffer(valkey_client, SESSION_1)
valkey_summary_text = buffer_data["rolling_summary"]
valkey_turns = buffer_data["recent_turns"]

used_fallback = bool(IN_MEMORY_VALKEY_FALLBACK)
storage_backend = "Local In-Memory Fallback (Outside VPC)" if used_fallback else "Memorystore for Valkey (VPC Network)"

has_valkey_summary = bool(valkey_summary_text)
print(f" • Short-Term Cache Storage Target:             [{storage_backend}]")
print(f" • Valkey Rolling Summary Generated for Session 1: {has_valkey_summary}")
print(f"   Summary Content: {valkey_summary_text}")
print(f" • Remaining Raw Turns in Valkey Sliding Window:  {len(valkey_turns)} messages (Trimmed from 8)")

test_accuracy.append(("Valkey Rolling Summary Compaction Test", "PASS" if has_valkey_summary else "FAIL"))

# Wait for background entity extraction worker
print("\n[Waiting for background entity extraction worker to process & vectorize all extracted entities...]")
time.sleep(6)

print("\n==================================================")
print("EXTRACTED ENTITIES STORED IN ALLOYDB LONG-TERM MEMORY")
print("==================================================")
with db_conn.cursor() as cur:
    cur.execute(
        "SELECT entity_name, project_id, scope, summary, (summary_embedding IS NOT NULL) FROM agent_entities WHERE user_id = %s ORDER BY updated_at DESC;",
        (USER_ID,)
    )
    extracted = cur.fetchall()
    for name, p_id, s_scope, summary, has_vector in extracted:
        print(f" • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}' | Vector Generated: {has_vector}")
        print(f"   Summary: {summary}")

# TURN 5: Cross-Session Temporal & Scope Recall (Brand New Session ID)
print("\n[SESSION 2 - TURN 5 (Cross-Session Query in New Session ID)]")
prompt_4 = "What are my general coding preferences and the backend/timeout rules I chose for CloudRetail in my previous session?"
print(f"User Prompt:\n{prompt_4}")
resp_4, sys_prompt_4, latency_4 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_2, prompt_4, prev_session_id=SESSION_1, project_id="CloudRetail")
print(f"\nAI Answer:\n{resp_4}")

# VERIFICATION OF RETRIEVED ENTITIES (Checking Scope Precision)
retrieved_scoped_entities = retrieve_hybrid_entities(
    conn=db_conn,
    llm_client=client,
    user_id=USER_ID,
    active_session_id=SESSION_2,
    query_text=prompt_4,
    prev_session_id=SESSION_1,
    project_id="CloudRetail",
    k=20
)

print("\n==================================================")
print("DIAGNOSTIC SCOPE VERIFICATION DETAILS (EXPECTED vs ACTUAL)")
print("==================================================")
print("EXPECTED SPECIFIC ENTITIES & SCOPE:")
print("  1. Global Preference Entity: Retrieved entity with scope == 'global' containing preference facts ('dark mode', 'python 3.11', or 'postgres')")
print("  2. Project Architecture Entity: Retrieved entity with project_id == 'CloudRetail' containing tech stack facts ('fastapi', 'alloydb', 'valkey', or 'timeout')")
print(f"\nACTUAL RETRIEVED ENTITIES (Count: {len(retrieved_scoped_entities)}):")
if not retrieved_scoped_entities:
    print("  [NONE RETRIEVED! Vector/Fulltext search returned 0 matches]")
for ent_name, ent_info in retrieved_scoped_entities.items():
    print(f"  • Entity Name: '{ent_name}'")
    print(f"    - scope:      '{ent_info.get('scope')}'")
    print(f"    - project_id: '{ent_info.get('project_id')}'")
    print(f"    - summary:    '{ent_info.get('summary')}'")

print("\nDATABASE CHECK - ALL ROWS STORED IN agent_entities TABLE:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    db_rows = cur.fetchall()
    if not db_rows:
        print("  [DATABASE TABLE IS EMPTY! No entities were upserted by background worker]")
    for r in db_rows:
        print(f"  • DB Row: entity_name='{r[0]}' | project_id='{r[1]}' | scope='{r[2]}' | summary='{r[3]}'")

# SPECIFIC FACT & SCOPE VERIFICATION LOGIC
found_global_preference = False
matched_global_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("scope") == "global" and any(kw in combined_text for kw in ["dark mode", "python", "postgres"]):
        found_global_preference = True
        matched_global_entity = ent_name
        break

found_project_architecture = False
matched_project_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("project_id") == "CloudRetail" and any(kw in combined_text for kw in ["fastapi", "alloydb", "valkey", "timeout"]):
        found_project_architecture = True
        matched_project_entity = ent_name
        break

print("\n--------------------------------------------------")
print("METADATA SCOPE PRECISION VERIFICATION RESULTS:")
print(f" • Global Preference Fact Retrieved (scope='global'):        {found_global_preference} (Matched Entity: '{matched_global_entity}')")
print(f" • Project Architecture Fact Retrieved (project_id='CloudRetail'): {found_project_architecture} (Matched Entity: '{matched_project_entity}')")
print("--------------------------------------------------")

test_accuracy.append(("Global Coding Preference Recall Test (scope='global')", "PASS" if found_global_preference else "FAIL"))
test_accuracy.append(("Project CloudRetail Architecture Recall Test (project_id='CloudRetail')", "PASS" if found_project_architecture else "FAIL"))

# PERMISSION TEST
perm_action, reason = engine.evaluate_tool_permission(
    user_id=USER_ID, project_id="CloudRetail", session_id=SESSION_2,
    tool_name="run_command", tool_args={"CommandLine": "pytest --timeout=30"}
)
test_accuracy.append(("Tool Permission Policy Test", "PASS" if perm_action in ("allow", "PROMPT_USER") else "FAIL"))

# DYNAMIC TOKEN & LATENCY METRICS CALCULATION
active_prompt_chars_turn5 = len(sys_prompt_4)
active_tokens_turn5 = max(1, active_prompt_chars_turn5 // 4)

# Naive Un-compacted Full History Prompt Tokens for Turn 5
raw_history_chars = len(prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4)
naive_turn5_chars = raw_history_chars + 18000
naive_tokens_turn5 = naive_turn5_chars // 4

active_prompt_reduction_pct = ((naive_tokens_turn5 - active_tokens_turn5) / naive_tokens_turn5) * 100

# Cumulative Multi-Turn Tokens Comparison (Active Read-Path Prompts + Background Extraction & Compacting)
total_active_tokens = sum([
    len(p) // 4 for p in [sys_prompt_1, sys_prompt_2, sys_prompt_3, sys_prompt_4_s1, sys_prompt_4]
])
background_extraction_tokens = async_worker.total_extraction_tokens
background_valkey_summary_tokens = get_valkey_compaction_tokens()

total_tiered_system_tokens = total_active_tokens + background_extraction_tokens + background_valkey_summary_tokens

# Naive Cumulative Tokens across all 5 turns as full transcript grows continuously
naive_cumulative_tokens = sum([
    (len(p) + 18000) // 4 for p in [
        prompt_1,
        prompt_1 + resp_1 + prompt_2,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4
    ]
])

total_system_token_savings_pct = ((naive_cumulative_tokens - total_tiered_system_tokens) / naive_cumulative_tokens) * 100

# FINAL SUMMARY REPORT
print("\n==================================================")
print("FINAL AGENT MEMORY SYSTEM SUMMARY REPORT")
print("==================================================")

print("\n1. STORED ALLOYDB ENTITIES:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    for name, p_id, s_scope, summary in cur.fetchall():
        print(f"   • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}'")
        print(f"     Summary: {summary}")

print("\n2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:")
print(f"   • Naive Full-Context Turn 5 Tokens:    ~{naive_tokens_turn5:,} tokens ({naive_turn5_chars:,} chars)")
print(f"   • Tiered Memory Active Prompt Tokens:  ~{active_tokens_turn5:,} tokens ({active_prompt_chars_turn5:,} chars)")
print(f"   • Active Turn 5 Prompt Reduction:      {active_prompt_reduction_pct:.1f}% Reduction")
print(f"   • Measured Turn 5 Inference Latency:   {latency_4:.2f} seconds")

print("\n3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):")
print(f"   • Naive Cumulative Multi-Turn Tokens:  ~{naive_cumulative_tokens:,} tokens")
print(f"   • Active Read-Path Prompt Tokens:      ~{total_active_tokens:,} tokens (Across 5 Turns)")
print(f"   • Background Worker Tokens (Extraction):~{background_extraction_tokens:,} tokens (4 Background Turns)")
print(f"   • Background Compaction Tokens (Valkey):~{background_valkey_summary_tokens:,} tokens (1 Compaction Call)")
print(f"   • Total Tiered System Token Footprint: ~{total_tiered_system_tokens:,} tokens")
print(f"   • Overall System Token Savings:        {total_system_token_savings_pct:.1f}% Total Reduction")

print("\n4. ACCURACY & VERIFICATION TESTS:")
all_pass = True
for name, status in test_accuracy:
    print(f"   • {name}: [{status}]")
    if status != "PASS":
        all_pass = False

print("\n==================================================")
print(f"OVERALL STATUS: {'ALL TESTS PASSED ✔' if all_pass else 'VERIFICATION FAILED ✖'}")
print("==================================================")
تشغيل نص التحقّق
شغِّل النص البرمجي في Cloud Shell:
python3 test_memory_system.py
الناتج المتوقّع في وحدة التحكّم
في نهاية نتائج الاختبار، سيتم عرض ملخّص للنتائج. في ما يلي مثال على هذه النسخة المطبوعة مع توضيحات
1. STORED ALLOYDB ENTITIES: <A List of all stored entities,>
   • Entity: '<name of entity>' | Project: '<which project does this relate to>' | Scope: '<global/project/session>'
     Summary: <The entity summary>
    ....

2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:
   • Naive Full-Context Turn 5 Tokens:    <Number of tokens in naive approach on the last turn>
   • Tiered Memory Active Prompt Tokens:  <Number of tokens in tiered approach on the last turn>
   • Active Turn 5 Prompt Reduction:      <Savings on tokens in %>
   • Measured Turn 5 Inference Latency:   <Latency in last turn>

3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):
   • Naive Cumulative Multi-Turn Tokens:  <Total tokens in the naive approach>
   • Active Read-Path Prompt Tokens:      <Read path tokens in the tiered approach>
   • Background Worker Tokens (Extraction): <Backround process tokens usage in tiered approach>
   • Background Compaction Tokens (Valkey): <Backround process tokens usage for compaction in tiered approach>
   • Total Tiered System Token Footprint: <Total tokens usage in tiered approach>
   • Overall System Token Savings:        <Savings on tokens in %>

4. ACCURACY & VERIFICATION TESTS:
   • Valkey Rolling Summary Compaction Test: <Did the roling summary work>
   • Global Coding Preference Recall Test (scope='global'): <Was it able to retrieve global scoped memories>
   • Project CloudRetail Architecture Recall Test (project_id='CloudRetail'): <Was it able to retrieve project specific scoped entities>
   • Tool Permission Policy Test: <Was it able to retrieve permissions policies>
إعادة ضبط "متاجر الذاكرة" (اختياري)
إذا أردت محو جميع الذكريات المخزّنة وإعادة ضبط حالة Valkey وAlloyDB بين عمليات التشغيل التجريبية، أنشئ cleanup_memory_system.py وشغِّله:
import logging
from db_clients import get_db_connection, get_valkey_client
from valkey_buffer import IN_MEMORY_VALKEY_FALLBACK

logging.basicConfig(level=logging.INFO)

def reset_memory_system():
    # 1. Flush short-term Valkey cache or clear local in-memory fallback
    try:
        valkey = get_valkey_client()
        valkey.flushdb()
        print("✔ Flushed Valkey short-term cache.")
    except Exception:
        IN_MEMORY_VALKEY_FALLBACK.clear()
        print("✔ Cleared local in-memory short-term fallback buffer.")

    # 2. Truncate long-term AlloyDB memory tables
    try:
        conn = get_db_connection()
        with conn:
            with conn.cursor() as cur:
                cur.execute("TRUNCATE TABLE agent_entities CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_embeddings CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_collections CASCADE;")
                cur.execute("TRUNCATE TABLE user_permissions CASCADE;")
                print("✔ Truncated AlloyDB long-term memory tables.")
        conn.close()
    except Exception as e:
        print(f"✖ AlloyDB cleanup error: {e}")

if __name__ == "__main__":
    reset_memory_system()
شغِّل نص التنظيف البرمجي:
python3 cleanup_memory_system.py
14. توسيع نطاق الذاكرة ذات المستويات إلى "حزمة تطوير التطبيقات من Google"
في الخطوات السابقة، أنشأت نظام ذاكرة من مستويَين:
- المستوى 1 (ذاكرة تخزين مؤقت قصيرة الأجل): تخزّن خدمة Memorystore for Valkey أحدث أدوار المحادثة وتنشئ ملخّصات متجدّدة للحفاظ على حجم الطلبات صغيرًا.
- المستوى 2 (متجر مختلط طويل الأمد): تخزّن AlloyDB AI إعدادات المستخدمين المفضّلة الدائمة وقواعد المشاريع وعمليات التضمين المتّجهة باستخدام البحث المختلط.
في هذا الدليل، ستربط محرك الذاكرة هذا بعميل مخصّص تم إنشاؤه باستخدام Google Agent Development Kit .
مشكلة الذاكرة البسيطة
يؤدي ربط وكيل بالذاكرة عادةً إلى الوقوع في أحد فخَّين:
- التركيز على الأدوات فقط: إجبار الوكيل على استخدام الأدوات (مثل
search_memory) في كل شيء غالبًا ما ينسى الوكلاء استدعاء الأدوات لتحديد الإعدادات المفضّلة الأساسية (مثل أسلوب الترميز أو المهلات)، ما يؤدي إلى حدوث أخطاء وإجراء رحلات إضافية بطيئة. - فخّ حشو الطلبات: إدراج كل السجلّ السابق في كل طلب. يؤدي ذلك إلى ارتفاع تكاليف الرموز المميزة بسرعة، وإبطاء الردود، وتدهور قدرة النموذج على الاستدلال.
الحلّ المختلط
نستخدم نهجًا مختلطًا يمنح الوكيل الذاكرة المناسبة في الوقت المناسب:
- السياق المحيط (تلقائي): قبل كل دورة، يتم استرداد قواعد المشروع ذات الصلة وملخّصات الجلسات الأخيرة من Memorystore (ملخّص متجدّد) وAlloyDB (القواعد والإعدادات المفضّلة)، ثم يتم إدراجها في طلب وكيل الذكاء الاصطناعي بدون أي طلبات إضافية من نماذج اللغات الكبيرة.
- البحث الطويل الأمد عند الطلب (أداة): للعثور على حقائق قديمة أو غير واضحة (مثل قرار معماري تم اتخاذه قبل أسبوعين)، يستدعي الوكيل
long_term_memory_toolلتنفيذ بحث متّجه في جدول الذاكرة الطويلة الأمد في AlloyDB. - ضوابط التنفيذ: قبل أن ينفّذ الوكيل أداةً، يتحقّق أحد الضوابط من الأذونات ذات الاستخدام الواحد في Valkey وقواعد الأمان في AlloyDB لمنع الإجراءات الخطيرة، مثل
rm -rf.
الإعداد والضبط
ثبِّت حزمة google-adk (تم تثبيت التبعيات الأخرى مسبقًا):
pip3 install google-adk
اضبط منطقة Google Cloud التي سيتم توجيه عميل الذكاء الاصطناعي التوليدي في "حزمة تطوير التطبيقات" من خلالها إلى Vertex AI:
# ADK agent platform backend
export GEMINI_MODEL="gemini-3.5-flash"
export GOOGLE_GENAI_USE_VERTEXAI="true"
export GOOGLE_CLOUD_PROJECT="${PROJECT_ID}"
export GOOGLE_CLOUD_LOCATION="${GENAI_LOCATION}"
15. مقدّم خدمة "الذاكرة المحيطة"
إنشاء adk_memory_provider.py يتعامل هذا الصف مع مراحل النشاط التلقائية للذاكرة:
- قبل بدء المحادثة: يتم استرداد مخزن مؤقت لمحادثة Valkey (<1ms) والاستعلام من AlloyDB عن الإعدادات المفضّلة وقواعد المشروع المطابقة، ثم يتم تجميعها في طلب النظام.
- بعد انتهاء الدور: يتم إلحاق المحادثة بـ Valkey وتشغيل عامل في الخلفية لاستخراج الحقائق الدائمة إلى AlloyDB بدون إبطاء استجابة المستخدم.
import logging
from typing import Any, Dict, Optional
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

class ADKTieredMemoryProvider:
    """Provides ambient memory context before turns and saves history after turns."""

    def __init__(self, db_conn_factory, valkey_client: redis.Redis, genai_client: Any, trigger_limit: int = 10, window_size: int = 4):
        self.conn_factory = db_conn_factory
        self.valkey_client = valkey_client
        self.genai_client = genai_client
        self.trigger_limit = trigger_limit
        self.window_size = window_size
        self.async_worker = AsyncMemoryWorker(db_conn_factory, genai_client)

    def get_context_for_turn(self, user_id: str, project_id: Optional[str], session_id: str, user_query: str, prev_session_id: Optional[str] = None) -> Dict[str, Any]:
        """Reads Valkey buffer (<1ms) and AlloyDB hybrid entities before agent reasoning."""
        buffer_data = get_session_context_buffer(self.valkey_client, session_id)
        rolling_summary = buffer_data["rolling_summary"]

        # Carry over prior session summary when starting a fresh session
        if not rolling_summary and prev_session_id:
            prev_buffer = get_session_context_buffer(self.valkey_client, prev_session_id)
            if prev_buffer["rolling_summary"]:
                rolling_summary = f"[From prior session {prev_session_id}]:\n" + prev_buffer["rolling_summary"]

        conn = self.conn_factory()
        try:
            entities = retrieve_hybrid_entities(
                conn=conn, llm_client=self.genai_client, user_id=user_id,
                active_session_id=session_id, query_text=user_query,
                prev_session_id=prev_session_id, project_id=project_id, k=20
            )
        finally:
            conn.close()

        return {
            "rolling_summary": rolling_summary,
            "recent_turns": buffer_data["recent_turns"],
            "retrieved_entities": entities
        }

    def format_system_instruction(self, context: Dict[str, Any], base_prompt: str = "") -> str:
        """Injects ambient entities and short-term summaries into the agent's prompt."""
        entity_lines = [f"- {name}: {info['summary']}" for name, info in context["retrieved_entities"].items()]
        entity_str = "\n".join(entity_lines) if entity_lines else "No relevant long-term entities."
        summary_str = context["rolling_summary"] or "No prior summary."

        return f"""{base_prompt}

[LONG-TERM PREFERENCES & ENTITIES]
{entity_str}

[SHORT-TERM ROLLING SUMMARY]
{summary_str}

[NOTE ON TOOLS & MEMORY]
Memory persistence is managed automatically by the platform behind the scenes. Do not attempt to invoke non-existent tools like 'set_preference' or 'save_fact'. Only invoke explicitly declared tools when needed.
""".strip()

    def record_turn_async(self, user_id: str, project_id: Optional[str], session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None) -> None:
        """Updates Valkey sliding window and triggers background AlloyDB extraction."""
        append_session_turn_with_rolling_summary(
            valkey_client=self.valkey_client, llm_client=self.genai_client,
            session_id=session_id, user_msg=user_msg, ai_msg=ai_msg,
            trigger_limit=self.trigger_limit, window_size=self.window_size
        )
        self.async_worker.enqueue_extraction(
            user_id=user_id, session_id=session_id, user_msg=user_msg,
            ai_msg=ai_msg, prev_session_id=prev_session_id
        )
16. أداة الذاكرة الطويلة الأمد عند الطلب
تحافظ ميزة "الذاكرة المحيطة" على حجم الطلب النشط صغيرًا، ولكن يحتاج الوكيل أحيانًا إلى البحث في الملاحظات السابقة أو قرارات التصميم أو سجلّات الحوادث.
إنشاء adk_memory_tools.py يؤدي ذلك إلى تضمين جدول المتجهات episodic_memory_embeddings في AlloyDB ضمن FunctionTool في ADK:
from typing import Any, Dict, List, Optional
from google.adk.tools import FunctionTool

def make_long_term_memory_tool(db_conn_factory, embed_client: Any, user_id: str) -> FunctionTool:
    """Creates an ADK FunctionTool for vector search over AlloyDB historical records."""

    def search_archived_memory(query: str, project_id: Optional[str] = None, limit: int = 3) -> List[Dict[str, Any]]:
        """Searches past architecture decisions, historical notes, and old discussions."""
        # 1. Embed query with text-embedding-005
        emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=query)
        query_vector = emb_resp.embeddings[0].values

        # 2. Cosine distance search on AlloyDB HNSW vector index
        sql = """
            SELECT document, cmetadata, created_at, 1 - (embedding <=> %s::vector) AS similarity
            FROM episodic_memory_embeddings
            WHERE cmetadata->>'user_id' = %s
              AND (%s IS NULL OR cmetadata->>'project_id' = %s)
            ORDER BY embedding <=> %s::vector ASC
            LIMIT %s;
        """
        conn = db_conn_factory()
        results = []
        try:
            with conn.cursor() as cur:
                cur.execute(sql, (str(query_vector), user_id, project_id, project_id, str(query_vector), limit))
                for doc, meta, created_at, similarity in cur.fetchall():
                    results.append({
                        "document": doc,
                        "metadata": meta,
                        "timestamp": created_at.isoformat() if created_at else None,
                        "similarity": round(float(similarity), 4)
                    })
        finally:
            conn.close()
        return results

    return FunctionTool(search_archived_memory)
17. إجراءات وقائية متعلقة بأذونات المؤسسة
يجب ألا تنفّذ البرامج المستقلة إجراءات مضرة بالمضيف (مثل rm -rf أو حذف الجداول) بدون التحقّق.
طريقة عمل before_tool_callback في "حزمة تطوير التطبيقات"
توفّر "حزمة تطوير البرامج الإعلانية" خطاف اعتراض يتم تنفيذه قبل تنفيذ أي أداة:
- الرد
None: تسمح حزمة تطوير التطبيقات بتنفيذ الأداة. - عرض قاموس (مثل
{"status": "DENIED", "error": ...}): يوقف ADK التنفيذ على الفور. لا يتم تنفيذ أي أمر، ويتم إرجاع سبب الرفض إلى النموذج حتى يتمكّن من شرح القيود للمستخدم.
ترتيب التحقّق من الأذونات
- التحقّق من 0 (إضافة أدوات آمنة إلى القائمة المسموح بها): تتم الموافقة مسبقًا على الأدوات الآمنة للقراءة فقط، مثل
search_archived_memory، في الذاكرة، ما يتيح للوكيل الاستعلام عن الذاكرة الخاصة به في جميع الأوقات. - المستوى 1 (أذونات "السماح لمرة واحدة" المؤقتة في Valkey): عندما يوافق مشغّل بشري على إجراء محفوف بالمخاطر، يتم تخزين مفتاح مؤقت
one_time_perm:{session_id}:{cmd_hash}في Valkey مع مدة بقاء (TTL) تبلغ 5 دقائق. يقرأ نظام الحماية ويحذف المفتاح في عملية ذرية واحدة. يسمح ذلك بتنفيذ الأمر مرة واحدة، ما يمنع الزيادة الدائمة في الامتيازات. - المستوى 2 (قواعد المشاريع في AlloyDB): يتحقّق من قواعد التعبيرات العادية في
user_permissionsللمشروع النشط (على سبيل المثال، السماح بـpytest.*--timeout=30، وحظرrm -rf.*). - المستوى 3 (القواعد العامة في AlloyDB): يتحقّق من قواعد الاحتياط التي تنطبق على جميع المشاريع.
- الخيار الاحتياطي "الرفض عند التعذّر": إذا لم تتطابق أي قاعدة، يتم رفض التنفيذ مع عرض
PENDING، ما يتطلّب مراجعة من قِبل مراجع.
التنفيذ
إنشاء adk_guardrails.py:
import logging
from typing import Any, Dict, Optional, Tuple, Set
from enterprise_engine import AgentMemoryEngine

logger = logging.getLogger(__name__)

class ADKPermissionGuardrail:
    """Evaluates tool permissions using Valkey allow-once tokens and AlloyDB rules."""

    def __init__(self, memory_engine: AgentMemoryEngine, exempt_tools: Optional[Set[str]] = None):
        self.engine = memory_engine
        self.exempt_tools = exempt_tools or {"search_archived_memory"}

    def evaluate(self, user_id: str, project_id: str, session_id: str, tool_name: str, tool_args: Dict[str, Any]) -> Tuple[bool, str]:
        # 1. Allowlist safe internal tools
        if tool_name in self.exempt_tools:
            return True, f"Internal tool '{tool_name}' is pre-approved."

        # 2. Check 3-tier policy engine
        action, reason = self.engine.evaluate_tool_permission(
            user_id=user_id, project_id=project_id, session_id=session_id,
            tool_name=tool_name, tool_args=tool_args
        )
        if action.upper() == "ALLOW":
            return True, f"Permission ALLOWED: {reason}"
        elif action.upper() == "BLOCK":
            return False, f"Permission BLOCKED: {reason}"
        return False, f"Permission PENDING: {reason} (requires human confirmation)"

    def create_before_tool_callback(self, user_id: str, default_project_id: str = "global"):
        """Creates the callback hook for Agent(before_tool_callback=...)."""
        def before_tool_callback(tool: Any, args: Dict[str, Any], tool_context: Any) -> Optional[Dict[str, Any]]:
            tool_name = getattr(tool, "name", str(tool))
            session_id = getattr(getattr(tool_context, "session", None), "id", "default_session")

            allowed, msg = self.evaluate(user_id, default_project_id, session_id, tool_name, args)
            if not allowed:
                logger.warning("Guardrail blocked '%s': %s", tool_name, msg)
                return {"status": "DENIED", "tool": tool_name, "error": msg}

            return None  # Returning None permits execution in ADK
        return before_tool_callback
18 تشغيل اختبار وكيل ADK
إنشاء test_adk_agent.py يربط هذا النص البرمجي الكامل المكوّنات ببعضها، ويضيف قرارًا مؤرشفًا وقواعد أمان، ويجري محادثة من جلستَين، ويختبر ضغط الذاكرة واسترجاعها، ويتأكّد من تطبيق حدود الأمان:
import asyncio
import os
import time
from google import genai
from google.genai import types
from google.adk.agents import Agent
from google.adk.runners import Runner
from google.adk.sessions import InMemorySessionService
from google.adk.tools import FunctionTool

from db_clients import get_db_connection, get_valkey_client
from enterprise_engine import AgentMemoryEngine
from adk_memory_provider import ADKTieredMemoryProvider
from adk_memory_tools import make_long_term_memory_tool
from adk_guardrails import ADKPermissionGuardrail
from valkey_buffer import get_session_context_buffer

# Configuration & clients
PROJECT_ID = os.getenv("PROJECT_ID", "chunking-poc-alloydb")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")
GEMINI_MODEL = os.getenv("GEMINI_MODEL", "gemini-3.5-flash")
USER_ID, SESSION_1, SESSION_2 = "user_adk_dev", "sess_adk_001", "sess_adk_002"

db_conn = get_db_connection()
valkey_client = get_valkey_client()
# LLM client for Gemini 3.5 Flash via global multi-region
genai_client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)
# Embeddings client (requires specific regional presence)
embed_client = genai.Client(vertexai=True, project=PROJECT_ID, location=REGION)

tiered_provider = ADKTieredMemoryProvider(get_db_connection, valkey_client, genai_client, trigger_limit=3, window_size=2)
memory_engine = AgentMemoryEngine(valkey_client, db_conn)
guardrail = ADKPermissionGuardrail(memory_engine)

# Tools: Long-term memory search and mock terminal command
long_term_memory_tool = make_long_term_memory_tool(get_db_connection, embed_client, USER_ID)

def run_command(CommandLine: str) -> str:
    """Executes a shell command on the host."""
    return f"Executed: {CommandLine}"

run_command_tool = FunctionTool(run_command)

def seed_database():
    """Seeds a 14-day-old architecture decision and permission rules."""
    doc = "Archived Decision: CloudRetail services must use gRPC keepalive ping intervals of 15 seconds."
    emb = embed_client.models.embed_content(model="text-embedding-005", contents=doc).embeddings[0].values
    conn = get_db_connection()
    try:
        with conn.cursor() as cur:
            cur.execute("""
                INSERT INTO episodic_memory_embeddings (uuid, document, cmetadata, created_at, embedding)
                VALUES (gen_random_uuid(), %s, jsonb_build_object('user_id', %s, 'project_id', 'CloudRetail'), NOW() - INTERVAL '14 days', %s::vector);
            """, (doc, USER_ID, str(emb)))
            cur.execute("""
                INSERT INTO user_permissions (user_id, project_id, tool_name, command_pattern, action)
                VALUES (%s, 'CloudRetail', 'run_command', 'pytest.*--timeout=30', 'ALLOW'),
                       (%s, 'CloudRetail', 'run_command', 'rm -rf.*', 'BLOCK'),
                       (%s, 'global', 'search_archived_memory', '.*', 'ALLOW')
                ON CONFLICT DO NOTHING;
            """, (USER_ID, USER_ID, USER_ID))
        conn.commit()
    finally:
        conn.close()

async def run_turn(runner: Runner, session_id: str, query: str, prev_session_id: str = None) -> str:
    """Fetches ambient memory, executes turn, and saves history in the background."""
    ctx = tiered_provider.get_context_for_turn(USER_ID, "CloudRetail", session_id, query, prev_session_id)
    runner.agent.instruction = tiered_provider.format_system_instruction(
        ctx,
        base_prompt="You are an intelligent Google ADK enterprise developer assistant."
    )
    msg = types.Content(role="user", parts=[types.Part.from_text(text=query)])
    parts = []
    async for event in runner.run_async(user_id=USER_ID, session_id=session_id, new_message=msg):
        if event.content and event.content.parts:
            parts.extend([p.text for p in event.content.parts if p.text])

    response = "".join(parts).strip()
    tiered_provider.record_turn_async(USER_ID, "CloudRetail", session_id, query, response, prev_session_id)
    return response

async def main():
    seed_database()
    sessions = InMemorySessionService()
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_1)

    agent = Agent(
        name="adk_memory_agent", model=GEMINI_MODEL, instruction="Initial instruction",
        tools=[long_term_memory_tool, run_command_tool],
        before_tool_callback=guardrail.create_before_tool_callback(USER_ID, "CloudRetail")
    )
    runner = Runner(agent=agent, session_service=sessions, app_name="agents")

    print("\n--- Session 1: Storing Preferences & Triggering Compaction ---")
    await run_turn(runner, SESSION_1, "I standardize on Python 3.11 with PostgreSQL and Dark Mode UI.")
    await run_turn(runner, SESSION_1, "For project CloudRetail, our backend stack is FastAPI on AlloyDB with Valkey cache and 30s timeouts.")
    await run_turn(runner, SESSION_1, "Draft a quick 5-line SQL table for products.")
    await run_turn(runner, SESSION_1, "Add rate-limiting rules for API endpoints.")

    buf = get_session_context_buffer(valkey_client, SESSION_1)
    print(f"Valkey rolling summary generated: {bool(buf['rolling_summary'])}")
    print(f"Turns in buffer: {len(buf['recent_turns'])} (compacted from 8)")

    print("\nWaiting 6s for background worker entity extraction into AlloyDB...")
    await asyncio.sleep(6)

    print("\n--- Session 2: Cold-Start Ambient Recall ---")
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_2)
    resp = await run_turn(runner, SESSION_2, "What are my coding preferences and the CloudRetail stack from my previous session?", prev_session_id=SESSION_1)
    print(f"Agent response:\n{resp}\n")

    print("\n--- On-Demand Archival Vector Search ---")
    resp_search = await run_turn(runner, SESSION_2, "What was the agreed gRPC keepalive interval from 2 weeks ago?")
    print(f"Agent response:\n{resp_search}\n")

    print("\n--- Guardrail Verification ---")
    blocked, b_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "rm -rf /tmp/data"})
    allowed, a_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "pytest --timeout=30"})
    print(f"rm -rf /tmp/data:    Allowed={blocked} ({b_msg})")
    print(f"pytest --timeout=30: Allowed={allowed} ({a_msg})")

if __name__ == "__main__":
    asyncio.run(main())
تنظيف الاختبارات المتكرّرة
بما أنّ النظام يسجّل السياق الثابت، سيؤدي تنفيذ الاختبار عدة مرات إلى إضافة أجزاء الحوار بشكل متكرر إلى Valkey وإدراج قواعد مكررة في AlloyDB.
لإعادة ضبط حالتك بسهولة بين عمليات التشغيل، شغِّل النص البرمجي cleanup_memory_system.py الذي أنشأته في خطوة سابقة:
python3 cleanup_memory_system.py
python3 test_adk_agent.py
نتائج إثبات الهوية
يتحقّق الاختبار من أربعة سلوكيات إنتاجية أساسية:
- انخفاض كبير في عدد الرموز المميزة للطلبات: أدّى ضغط Valkey إلى ضغط سجلّ الحوار في ملخّص موجز متجدّد. في اختباراتنا، أدّى ذلك إلى تقليل حجم الطلب النشط بأكثر من %92 (من حوالي 6,956 رمزًا مميزًا إلى حوالي 544 رمزًا مميزًا)، وقد تختلف نتائجك.
- استرجاع فوري للذاكرة عند بدء التشغيل البارد: في جلسة جديدة تمامًا (الجلسة 2)، استرجع الوكيل على الفور الإعدادات المفضّلة للمستخدم (Python 3.11 وPostgreSQL و"الوضع الداكن") وبنية المشروع (مهلات FastAPI لمدة 30 ثانية) بدون استدعاء أي أدوات. تم تفعيل هذه الميزة من خلال
ADKTieredMemoryProvider.get_context_for_turn، التي تسترد السياق من Memorystore وAlloyDB قبل استدعاء النموذج اللغوي الكبير. - استرجاع المتجهات عند الطلب: عندما سُئل الوكيل عن قرار اتُخذ قبل 14 يومًا، استدعى
search_archived_memoryواسترجع قاعدة إبقاء اتصال gRPC نشطًا لمدة 15 ثانية. - الأمان الحتمي: نفّذ الوكيل
pytest --timeout=30، ولكن تم منعه بشكل صارم من تنفيذrm -rf /tmp/data.
19. تَنظيم
لتجنُّب تحصيل رسوم فوترة مستمرة من حسابك على Google Cloud مقابل مثيلات AlloyDB وMemorystore، عليك حذف الموارد التي تم إنشاؤها.
نفِّذ الأوامر التالية في Cloud Shell:
# Exit VM and return to Cloud Shell
exit
# Delete Compute Engine development VM
gcloud compute instances delete $VM_NAME \
  --zone=$ZONE \
  --quiet

# Delete AlloyDB primary instance and cluster
gcloud alloydb instances delete $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --quiet

gcloud alloydb clusters delete $ADBCLUSTER \
  --region=$REGION \
  --quiet

# Delete Memorystore for Valkey instance
gcloud memorystore instances delete $VALKEYINSTANCE \
  --location=$REGION \
  --quiet
20. تهانينا
تهانينا! لقد أنشأت بنجاح بنية ذاكرة وكيل الذكاء الاصطناعي طويلة الأمد ذات مستويَين تجمع بين Memorystore for Valkey وAlloyDB AI.
ما تعلّمته
- تم تنفيذ بنية ذاكرة ذات مستويَين تفصل حالة الجلسة النشطة القصيرة الأجل عن الحقائق الثابتة الطويلة الأجل.
- حقّقنا انخفاضًا كبيرًا في حجم الطلب النشط، وتوفيرًا في إجمالي استخدام الرموز المميزة مقارنةً بالحشو البسيط للسياق، بدون فقدان الدقة.
- عمليات التضمين التلقائي للمعاملات على مستوى قاعدة بيانات AlloyDB AI (
ai.initialize_embeddings) - تم إجراء بحث مختلط أصلي باستخدام Reciprocal Rank Fusion (
ai.hybrid_search) يجمع بين التشابه المتجهي (<=>) والبحث عن النص الكامل في PostgreSQL (tsvector). - أنشأنا أداة استخراج كيانات في الخلفية خارج سلسلة التعليمات الرئيسية (
AsyncMemoryWorker)، وأداة تقييم أذونات تنفيذ الأدوات بثلاث طبقات، ومحرّك ضغط ذاكرة قاعدة البيانات. - ربط نظام الذاكرة المتدرّجة بوكيل مستقل باستخدام مجموعة أدوات تطوير الوكلاء (ADK) من Google لفرض ضوابط الأدوات وتوفير ذاكرة محيطة