

১. শুরু করার আগে
যেহেতু এআই এজেন্টরা একাধিক দিন ধরে চলা দীর্ঘ ও বহু-পর্যায়ের মিথস্ক্রিয়া পরিচালনা করে এবং দীর্ঘমেয়াদী বহু-ধাপের কাজ সম্পাদন করে, তাই লার্জ ল্যাঙ্গুয়েজ মডেল (এলএলএম) সেশন জুড়ে স্বভাবতই স্টেটলেস থাকে। যখন একজন ব্যবহারকারী পরের দিন কোনো এজেন্টের কাছে ফিরে আসে, তখন মডেলটি একেবারে শুরু থেকে কাজ শুরু করে, যদি না অ্যাপ্লিকেশনটি প্রয়োজনীয় প্রেক্ষাপট পুনর্গঠন করতে পারে।
এই সমস্যার একটি সরল সমাধান হলো টোকেন স্টাফিং — অর্থাৎ, প্রতিটি সক্রিয় প্রম্পটের সাথে সরাসরি সম্পূর্ণ কথোপকথনের ইতিহাস, টুল এক্সিকিউশন লগ এবং কোডবেস যুক্ত করা। যদিও লক্ষ লক্ষ টোকেনের বিশাল কনটেক্সট উইন্ডো এটিকে প্রযুক্তিগতভাবে সম্ভব করে তোলে, কনটেক্সট স্টাফিং কার্যকারিতার ক্ষেত্রে মারাত্মক প্রতিবন্ধকতা সৃষ্টি করে: প্রতিটি ধাপে টোকেনের খরচ বর্গীয় হারে বাড়তে থাকে, প্রতিক্রিয়ার বিলম্ব কয়েক দশ সেকেন্ড পর্যন্ত বেড়ে যায়, এবং মডেলগুলো "মাঝপথে হারিয়ে যাওয়া" জনিত কনটেক্সট অবক্ষয়ের শিকার হয়।
নির্ভরযোগ্য এআই এজেন্ট তৈরি করতে আপনার একটি ২-স্তরীয় মেমরি আর্কিটেকচার প্রয়োজন:
- স্বল্প-মেয়াদী সেশন বাফার : একটি টোকেন-সীমাবদ্ধ স্লাইডিং উইন্ডো ব্যবহার করে সক্রিয় মেমরিতে সাম্প্রতিক কথোপকথনের পালাগুলো ক্যাশ করে রাখে। এই স্তরে প্রতিটি পালায় সাব-মিলিসেকেন্ড, উচ্চ-থ্রুপুট ইন-মেমরি লুকআপের প্রয়োজন হয়, যা ভ্যালকির জন্য মেমোরিস্টোরকে আদর্শ পছন্দ করে তোলে।
- দীর্ঘমেয়াদী স্থায়ী মেমরি : এটি বিভিন্ন সেশন জুড়ে কাঠামোগত সত্তা, ব্যবহারকারীর পছন্দ এবং ঘটনাভিত্তিক তথ্য সংরক্ষণ করে। এই স্তরে লেনদেনের অখণ্ডতা, মাল্টি-টেন্যান্ট নিরাপত্তা এবং রিলেশনাল ডেটা ও ভেক্টরের মধ্যে হাইব্রিড পুনরুদ্ধারের প্রয়োজন হয় — যা AlloyDB for PostgreSQL-কে সঠিক পছন্দ করে তোলে।
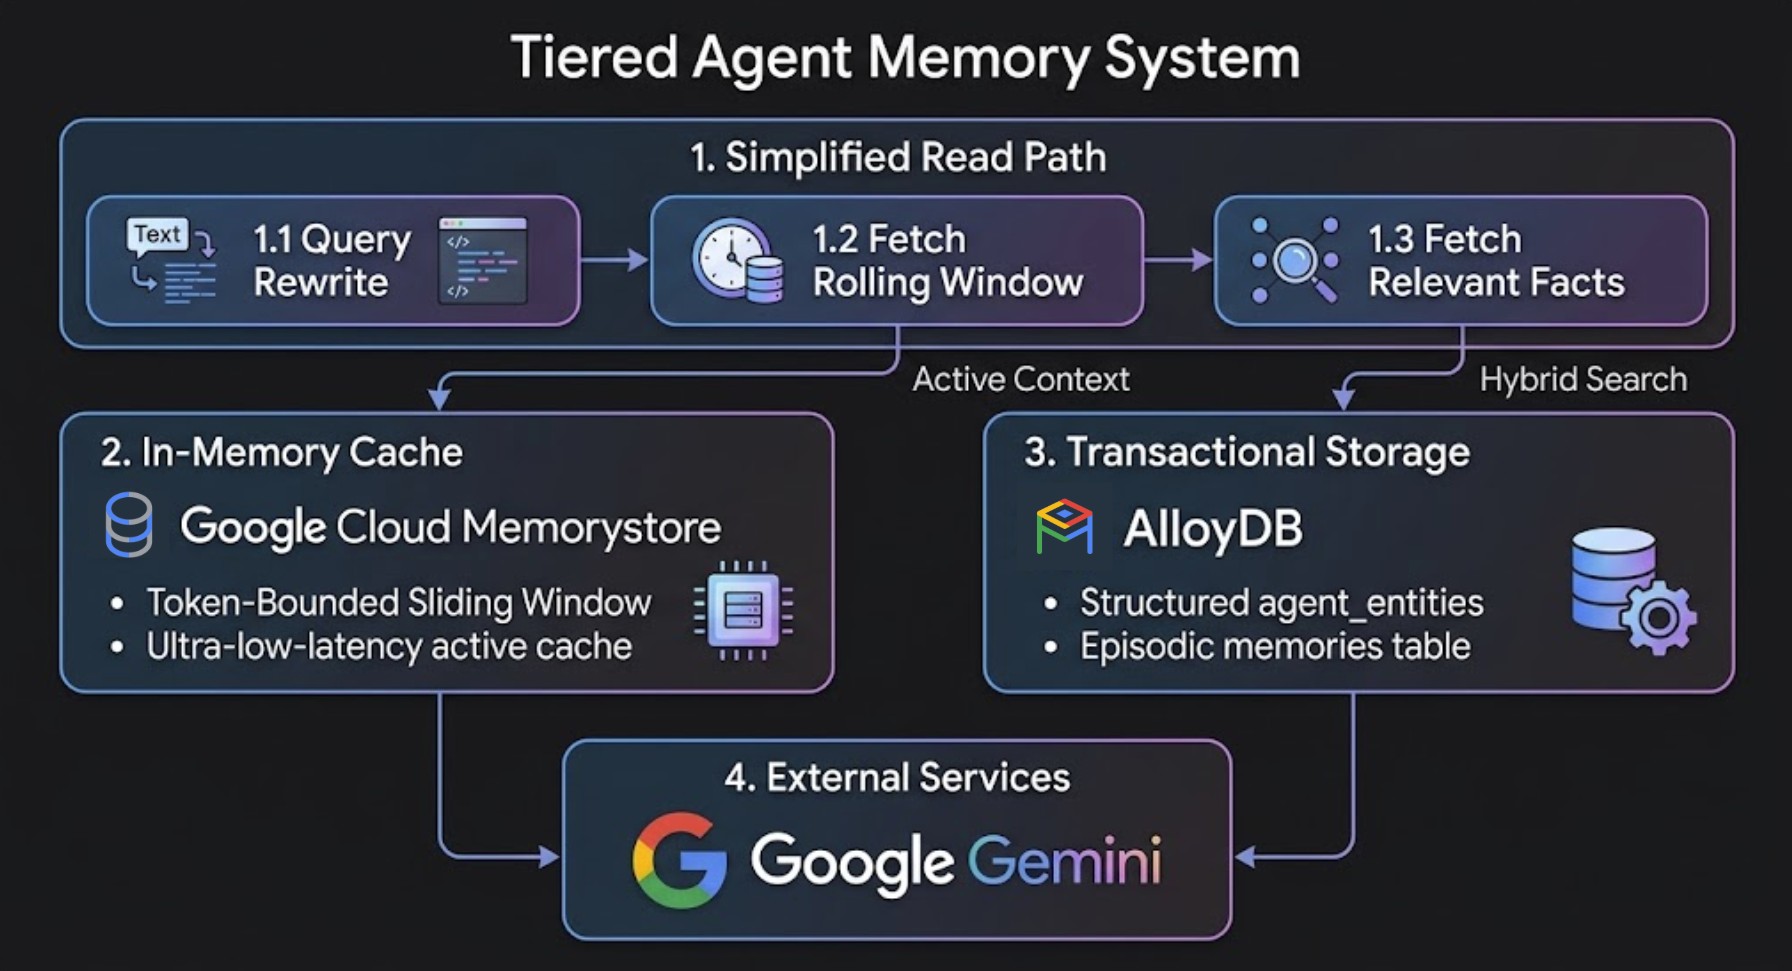
চার ধরনের স্মৃতি বোঝা
একটি শক্তিশালী মেমরি আর্কিটেকচার ব্যবহারকারীর যাত্রাপথে চারটি পরিপূরক মেমরি ধরনের উপর নির্ভর করে:
স্মৃতির ধরণ | এটি যা সংরক্ষণ করে | স্টোরেজ স্তর | জীবনকাল |
বাফার (স্বল্পমেয়াদী) | সাম্প্রতিক অমার্জিত কথোপকথন মোড় নেয় | ভ্যালকির জন্য মেমোরিস্টোর | সক্রিয় সেশন |
সারসংক্ষেপ স্মৃতি | পুরোনো পালাগুলির সংকুচিত ইতিহাস | ভ্যালকির জন্য মেমোরিস্টোর | মাল্টি-টার্ন উইন্ডো |
এপিসোডিক স্মৃতি | অতীতের কার্যকলাপ, ঘটনা এবং সরঞ্জামের ফলাফল | PostgreSQL-এর জন্য AlloyDB (ভেক্টর) | স্থায়ী |
সত্তা ও নিয়ম স্মৃতি | ব্যবহারকারীর পছন্দ, সীমাবদ্ধতা এবং ভেটো | PostgreSQL-এর জন্য AlloyDB (স্ট্রাকচার্ড SQL + ভেক্টর) | স্থায়ী |
স্তরযুক্ত স্মৃতির পরিমাপকৃত প্রভাব
একাধিক টার্নব্যাপী উন্নয়নমূলক সংলাপে (প্রচুর টুল আউটপুট লগ সহ ৪৫টিরও বেশি টার্ন) অভ্যন্তরীণ বেঞ্চমার্ক পরীক্ষা, সাধারণ কনটেক্সট স্টাফিংয়ের তুলনায় উল্লেখযোগ্য সাশ্রয় প্রদর্শন করে:
মেট্রিক / মাত্রা | সরল প্রসঙ্গ ঠাসা | স্তরযুক্ত মেমরি (অ্যালয়ডিবি + মেমোরিস্টোর) | পরীক্ষায় নিট প্রভাব |
সক্রিয় প্রম্পটের আকার (টার্ন ৪৫) | ৭৪৭,০৩৩ টোকেন | ৮৩,২৬২ টোকেন | ৮৮.৯% ছোট প্রম্পট |
টার্ন ৪৫ প্রতিক্রিয়া বিলম্ব | ৩৩.৫ সেকেন্ড | ৬.৭ সেকেন্ড | ৮০.০% দ্রুততর প্রতিক্রিয়া |
ক্রমবর্ধমান সেশন টোকেন | ১৭.৯ মিলিয়ন টোকেন | ৪.০৯ মিলিয়ন টোকেন | মোট ৭২.০% টোকেন ও খরচ সাশ্রয় |
নিয়ম ও সীমাবদ্ধতা স্মরণ | মোড় ঘোরার সাথে সাথে অবনতি ঘটে | সারাংশের মধ্যে গুরুত্বপূর্ণ জ্ঞান হারিয়ে যাওয়া রোধ করে। | হাইব্রিড অনুসন্ধানের মাধ্যমে সংরক্ষিত |
আপনি যা করবেন
- PostgreSQL-এর জন্য AlloyDB এবং Valkey-এর জন্য Memorystore প্রোভিশন করুন।
-
google_ml_integrationসক্রিয় করুন এবং ডাটাবেস-সাইড ট্রানজ্যাকশনাল অটো-এম্বেডিংস (ai.initialize_embeddings) কনফিগার করুন। - summarize-before-trim পাইপলাইন প্যাটার্ন ব্যবহার করে একটি স্বল্পমেয়াদী Valkey সেশন বাফার বাস্তবায়ন করুন।
- AlloyDB-এর নিজস্ব AI ফাংশন (যেমন
ai.generate) ব্যবহার করে দীর্ঘমেয়াদী এনটিটিগুলো স্বাভাবিকভাবেই বের করুন। - AlloyDB-এর নিজস্ব হাইব্রিড সার্চ ফাংশন (
ai.hybrid_search) এবং রেসিপ্রোকাল র্যাঙ্ক ফিউশন (RRF) রির্যাঙ্কিং ব্যবহার করে উচ্চ নির্ভুলতা ও প্রাসঙ্গিকতার সাথে দীর্ঘমেয়াদী তথ্য অনুসন্ধান করুন। - একটি ৩-স্তরীয় এন্টারপ্রাইজ টুল পারমিশন ইভ্যালুয়েটর এবং একটি ব্যাকগ্রাউন্ড মেমরি কম্প্যাকশন ইঞ্জিন তৈরি করুন।
- গুগল এজেন্ট ডেভেলপমেন্ট কিট (ADK) ব্যবহার করে ২-স্তরীয় মেমরি আর্কিটেকচার সরাসরি একটি স্বায়ত্তশাসিত এজেন্টের সাথে সংহত করুন।
আপনার যা যা লাগবে
- বিলিং সক্ষম একটি গুগল ক্লাউড প্রজেক্ট।
- ক্রোমের মতো একটি ওয়েব ব্রাউজার।
- পাইথন এবং এসকিউএল-এর প্রাথমিক জ্ঞান, সেইসাথে স্টুডিও, সিএলআই ইত্যাদি থেকে অ্যালয়ডিবি-তে এসকিউএল কোয়েরি চালানোর অভিজ্ঞতা।
দর্শক ও খরচ
- পাঠকবৃন্দ : এআই ডেভেলপার, ব্যাকএন্ড ইঞ্জিনিয়ার এবং ডেটাবেস আর্কিটেক্ট।
- আনুমানিক খরচ : এই কোডল্যাবে তৈরি করা গুগল ক্লাউড রিসোর্সগুলোর জন্য প্রায় ১.৫০ মার্কিন ডলার খরচ হবে।
২. সেটআপ এবং প্রয়োজনীয়তা
ক্লাউড শেল শুরু করুন
এই কোডল্যাবে, আপনি গুগল ক্লাউড শেল-এ কমান্ড চালাবেন, যা হলো একটি ক্লাউড-হোস্টেড টার্মিনাল এবং এতে gcloud , psql ও python3 আগে থেকেই কনফিগার করা আছে।
- গুগল ক্লাউড কনসোল খুলুন।
- ক্লাউড কনসোলের উপরের ডানদিকে থাকা ‘Activate Cloud Shell’- এ ক্লিক করুন।
- প্রমাণীকরণ যাচাই করুন:
gcloud auth list
export PROJECT_ID=<YOUR_PROJECT_ID>
gcloud config set project $PROJECT_ID

export REGION=us-east1
export GENAI_LOCATION=us
export ZONE=us-east1-b
export ADBCLUSTER=agent-memory-cluster
export ADBINSTANCE=agent-memory-instance
export VALKEYINSTANCE=agent-memory-cache
export VM_NAME=agent-dev-vm
গুগল ক্লাউড এপিআই সক্রিয় করুন এবং ডেভেলপমেন্ট ভিএম তৈরি করুন
প্রয়োজনীয় API-গুলো সক্রিয় করতে ক্লাউড শেলে নিম্নলিখিত কমান্ডটি চালান:
gcloud services enable \
  alloydb.googleapis.com \
  memorystore.googleapis.com \
  aiplatform.googleapis.com \
  compute.googleapis.com \
  servicenetworking.googleapis.com \
  networkconnectivity.googleapis.com
আপনার পাইথন ডেভেলপমেন্ট এনভায়রনমেন্ট হোস্ট করার জন্য এবং Valkey-এর জন্য AlloyDB ও Memorystore ব্যবহার করতে default VPC নেটওয়ার্কে একটি Compute Engine VM ইনস্ট্যান্স তৈরি করুন:
gcloud compute instances create $VM_NAME \
    --zone=$ZONE \
    --machine-type=e2-standard-2 \
    --scopes=cloud-platform \
    --network=default \
    --shielded-secure-boot
৩. ভ্যালকির জন্য অ্যালয়ডিবি এবং মেমোরিস্টোর প্রস্তুত করুন।
এই ধাপে, আপনি আপনার AlloyDB for PostgreSQL ক্লাস্টার ও প্রাইমারি ইনস্ট্যান্স প্রস্তুত করবেন, প্রাইভেট সার্ভিস নেটওয়ার্কিং স্থাপন করবেন এবং একটি Memorystore for Valkey ইনস্ট্যান্স চালু করবেন।
ব্যক্তিগত পরিষেবা অ্যাক্সেস আইপি রেঞ্জ তৈরি করুন
AlloyDB-এর জন্য আপনার ভার্চুয়াল প্রাইভেট ক্লাউড (VPC) নেটওয়ার্কে একটি প্রাইভেট আইপি রেঞ্জ প্রয়োজন। ধরে নেওয়া হচ্ছে আপনি default VPC নেটওয়ার্ক ব্যবহার করছেন:
- ব্যক্তিগত আইপি রেঞ্জ বরাদ্দ তৈরি করুন:
gcloud compute addresses create psa-range \
    --global \
    --purpose=VPC_PEERING \
    --prefix-length=24 \
    --description="VPC private service access" \
    --network=default
- ব্যক্তিগত VPC পিয়ারিং সংযোগ স্থাপন করুন:
gcloud services vpc-peerings connect \
    --service=servicenetworking.googleapis.com \
    --ranges=psa-range \
    --network=default
AlloyDB ক্লাস্টার এবং প্রাইমারি ইনস্ট্যান্স তৈরি করুন
- সিস্টেম চালু করার জন্য একটি প্রাথমিক ক্লাস্টার পাসওয়ার্ড তৈরি করুন:
export PGPASSWORD=`openssl rand -hex 12`
- একটি বিনামূল্যে ট্রায়াল ক্লাস্টার তৈরি করুন:
gcloud alloydb clusters create $ADBCLUSTER \
    --password=$PGPASSWORD \
    --network=default \
    --region=$REGION \
    --subscription-type=TRIAL
- প্রাথমিক ইনস্ট্যান্স তৈরি করুন:
gcloud alloydb instances create $ADBINSTANCE \
    --instance-type=PRIMARY \
    --cpu-count=2 \
    --region=$REGION \
    --cluster=$ADBCLUSTER
ভ্যালকি ইনস্ট্যান্সের জন্য মেমোরিস্টোর সরবরাহ করুন
ইনস্ট্যান্স তৈরির আগে Valkey-এর জন্য Memorystore-এর ক্ষেত্রে আপনার নেটওয়ার্ক এবং অঞ্চলে একটি সার্ভিস কানেকশন পলিসি ( gcp-memorystore ) থাকা আবশ্যক।
- মেমোরিস্টোরের জন্য পরিষেবা সংযোগ নীতি তৈরি করুন:
gcloud network-connectivity service-connection-policies create memorystore-policy \
    --network=default \
    --region=$REGION \
    --service-class=gcp-memorystore \
    --subnets=projects/$PROJECT_ID/regions/$REGION/subnetworks/default
- Valkey ইনস্ট্যান্সের জন্য মেমোরিস্টোর তৈরি করুন:
gcloud memorystore instances create $VALKEYINSTANCE \
    --location=$REGION \
    --shard-count=1 \
    --replica-count=0 \
    --node-type=SHARED_CORE_NANO \
    --psc-auto-connections="network=projects/$PROJECT_ID/global/networks/default,projectId=$PROJECT_ID"
ভার্টেক্স এআই আইএএম অনুমতি প্রদান করুন
এজেন্ট প্ল্যাটফর্মের এম্বেডিং মডেলগুলো আহ্বান করার জন্য AlloyDB পরিষেবা অ্যাকাউন্টকে প্রয়োজনীয় IAM অনুমতি প্রদান করুন:
PROJECT_ID=$(gcloud config get-value project)

gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:service-$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")@gcp-sa-alloydb.iam.gserviceaccount.com" \
  --role="roles/aiplatform.user"
৪. পরিবেশ এবং অ্যাক্সেস এন্ডপয়েন্টগুলি প্রারম্ভিকীকরণ করুন
AlloyDB IAM প্রমাণীকরণ এবং ডেটাবেস ফ্ল্যাগ সেট আপ করুন
আপনার AlloyDB ইনস্ট্যান্সে IAM ডেটাবেস অথেনটিকেশন ( alloydb.iam_authentication=on ) এবং AI কোয়েরি ইঞ্জিন ( google_ml_integration.enable_ai_query_engine=on ) সক্রিয় করুন:
gcloud beta alloydb instances update $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --update-mode=FORCE_APPLY \
  --database-flags=alloydb.iam_authentication=on,google_ml_integration.enable_ai_query_engine=on
এরপরে, আপনার Google Cloud অ্যাকাউন্টটিকে সুপারইউজার অনুমতিসহ একটি IAM-ভিত্তিক ডাটাবেস ব্যবহারকারী হিসেবে যুক্ত করুন:
export USER_ACCOUNT=$(gcloud config get-value account)

gcloud alloydb users create $USER_ACCOUNT \
    --cluster=$ADBCLUSTER \
    --region=$REGION \
    --type=IAM_BASED \
    --db-roles=alloydbsuperuser
ক্লাউড শেলে অভ্যন্তরীণ VPC এন্ডপয়েন্টগুলি পুনরুদ্ধার করুন
আপনার ডেভেলপমেন্ট ভিএম-এ SSH করার আগে, ক্লাউড শেল থেকে AlloyDB এবং Valkey-এর জন্য Memorystore-এর অভ্যন্তরীণ VPC IP অ্যাড্রেসগুলো সংগ্রহ করুন:
# Export GCP Project ID, Region, and IAM User
export PROJECT_ID=$(gcloud config get-value project)
export REGION=us-east1
export DB_USER=$(gcloud config get-value account)

# Retrieve Internal VPC IP Addresses for AlloyDB & Memorystore for Valkey
export DB_HOST=$(gcloud alloydb instances describe $ADBINSTANCE --cluster=$ADBCLUSTER --region=$REGION --format="value(ipAddress)")
export DB_PORT=5432
export DB_NAME=postgres

export VALKEY_HOST=$(gcloud memorystore instances describe $VALKEYINSTANCE --location=$REGION --format="value(discoveryEndpoints[0].address)")
export VALKEY_PORT=6379

# Verify exported endpoints
echo "Project ID:        $PROJECT_ID"
echo "Region:            $REGION"
echo "AlloyDB Private IP: $DB_HOST"
echo "IAM DB User:       $DB_USER"
echo "Valkey Private IP:  $VALKEY_HOST"
ডেভেলপমেন্ট ভিএম-এ SSH করুন এবং কানেকশন ভেরিয়েবলগুলো এক্সপোর্ট করুন
একই VPC নেটওয়ার্কে অবস্থিত আপনার Compute Engine ডেভেলপমেন্ট VM ( agent-dev-vm )-এ Cloud Shell থেকে SSH করুন:
gcloud compute ssh $VM_NAME --zone=$ZONE
আপনার ডেভেলপমেন্ট ভিএম-এ লগ ইন করার পর, উপরে প্রাপ্ত প্রোজেক্ট কনফিগারেশন এবং কানেকশন এন্ডপয়েন্ট আউটপুটটি এক্সপোর্ট করুন (প্রতিস্থাপন করে)
export PROJECT_ID=<YOUR_PROJECT_ID>
export REGION=us-east1
export GENAI_LOCATION=us
export DB_HOST=<YOUR_ALLOYDB_PRIVATE_IP>
export DB_PORT=5432
export DB_NAME=postgres
export DB_USER=<YOUR_IAM_DB_USER>
export VALKEY_HOST=<YOUR_VALKEY_PRIVATE_IP>
export VALKEY_PORT=6379
পাইথন ভার্চুয়াল পরিবেশ শুরু করুন
আপনার ডেভেলপমেন্ট ভিএম-এর ভিতরে, প্রথমে আপনার লোকাল ওয়ার্কিং ডিরেক্টরি তৈরি করে নিন:
mkdir -p ~/alloydb_agent_memory && cd ~/alloydb_agent_memory
এখন, চলুন সিস্টেম পাইথন ভার্চুয়াল এনভায়রনমেন্ট প্যাকেজগুলো ইনস্টল করি, অ্যাপ্লিকেশন ডিফল্ট ক্রেডেনশিয়ালস (ADC) দিয়ে প্রমাণীকরণ করি এবং আপনার ওয়ার্কস্পেস সেট আপ করি:
sudo apt-get update && sudo apt-get install -y python3-venv python3-pip

python3 -m venv venv
source venv/bin/activate
সবশেষে, নতুন ভার্চুয়াল পরিবেশে আমরা ডিপেন্ডেন্সিগুলো ইনস্টল করব:
gcloud auth application-default login
pip install psycopg2-binary valkey redis google-genai
৫. সিস্টেম আর্কিটেকচার এবং কোড মডিউল হায়ারার্কি
আপনি যা তৈরি করছেন তার সংক্ষিপ্ত বিবরণ
স্বতন্ত্র পাইথন স্ক্রিপ্টগুলো প্রয়োগ করার আগে, নিচের সিস্টেম আর্কিটেকচারটি পর্যালোচনা করুন। এই নমুনা অ্যাপ্লিকেশনটি ৭টি মডিউলার পাইথন স্ক্রিপ্টে বিভক্ত, যা দুটি প্রধান এক্সিকিউশন পাথে একই AlloyDB for PostgreSQL ডাটাবেস ইনস্ট্যান্সের সাথে কাজ করে।
- রিড পাথ (
hybrid_retriever.py) : এটি AlloyDB AIai.generate()ব্যবহার করে সরাসরি PostgreSQL-এর ভিতরে যৌগিক বহু-অংশযুক্ত প্রশ্নগুলিকে একক-দিকের সাব-কোয়েরিতে বিভক্ত করে এবং AlloyDB-এর নেটিভ হাইব্রিড সার্চ (ai.hybrid_search) ব্যবহার করে দীর্ঘমেয়াদী মেমোরি কোয়েরি করে। - রাইট পাথ (
async_worker.py) : অফ-থ্রেড ব্যাকগ্রাউন্ড কিউ ওয়ার্কার যা জেমিনি ফ্ল্যাশ ব্যবহার করে ডায়ালগ এক্সচেঞ্জ থেকে অ্যাসিঙ্ক্রোনাসভাবে স্ট্রাকচার্ড এনটিটি ফ্যাক্টস এক্সট্র্যাক্ট করে এবং সেগুলোকেagent_entitiesএ আপসার্ট করে।
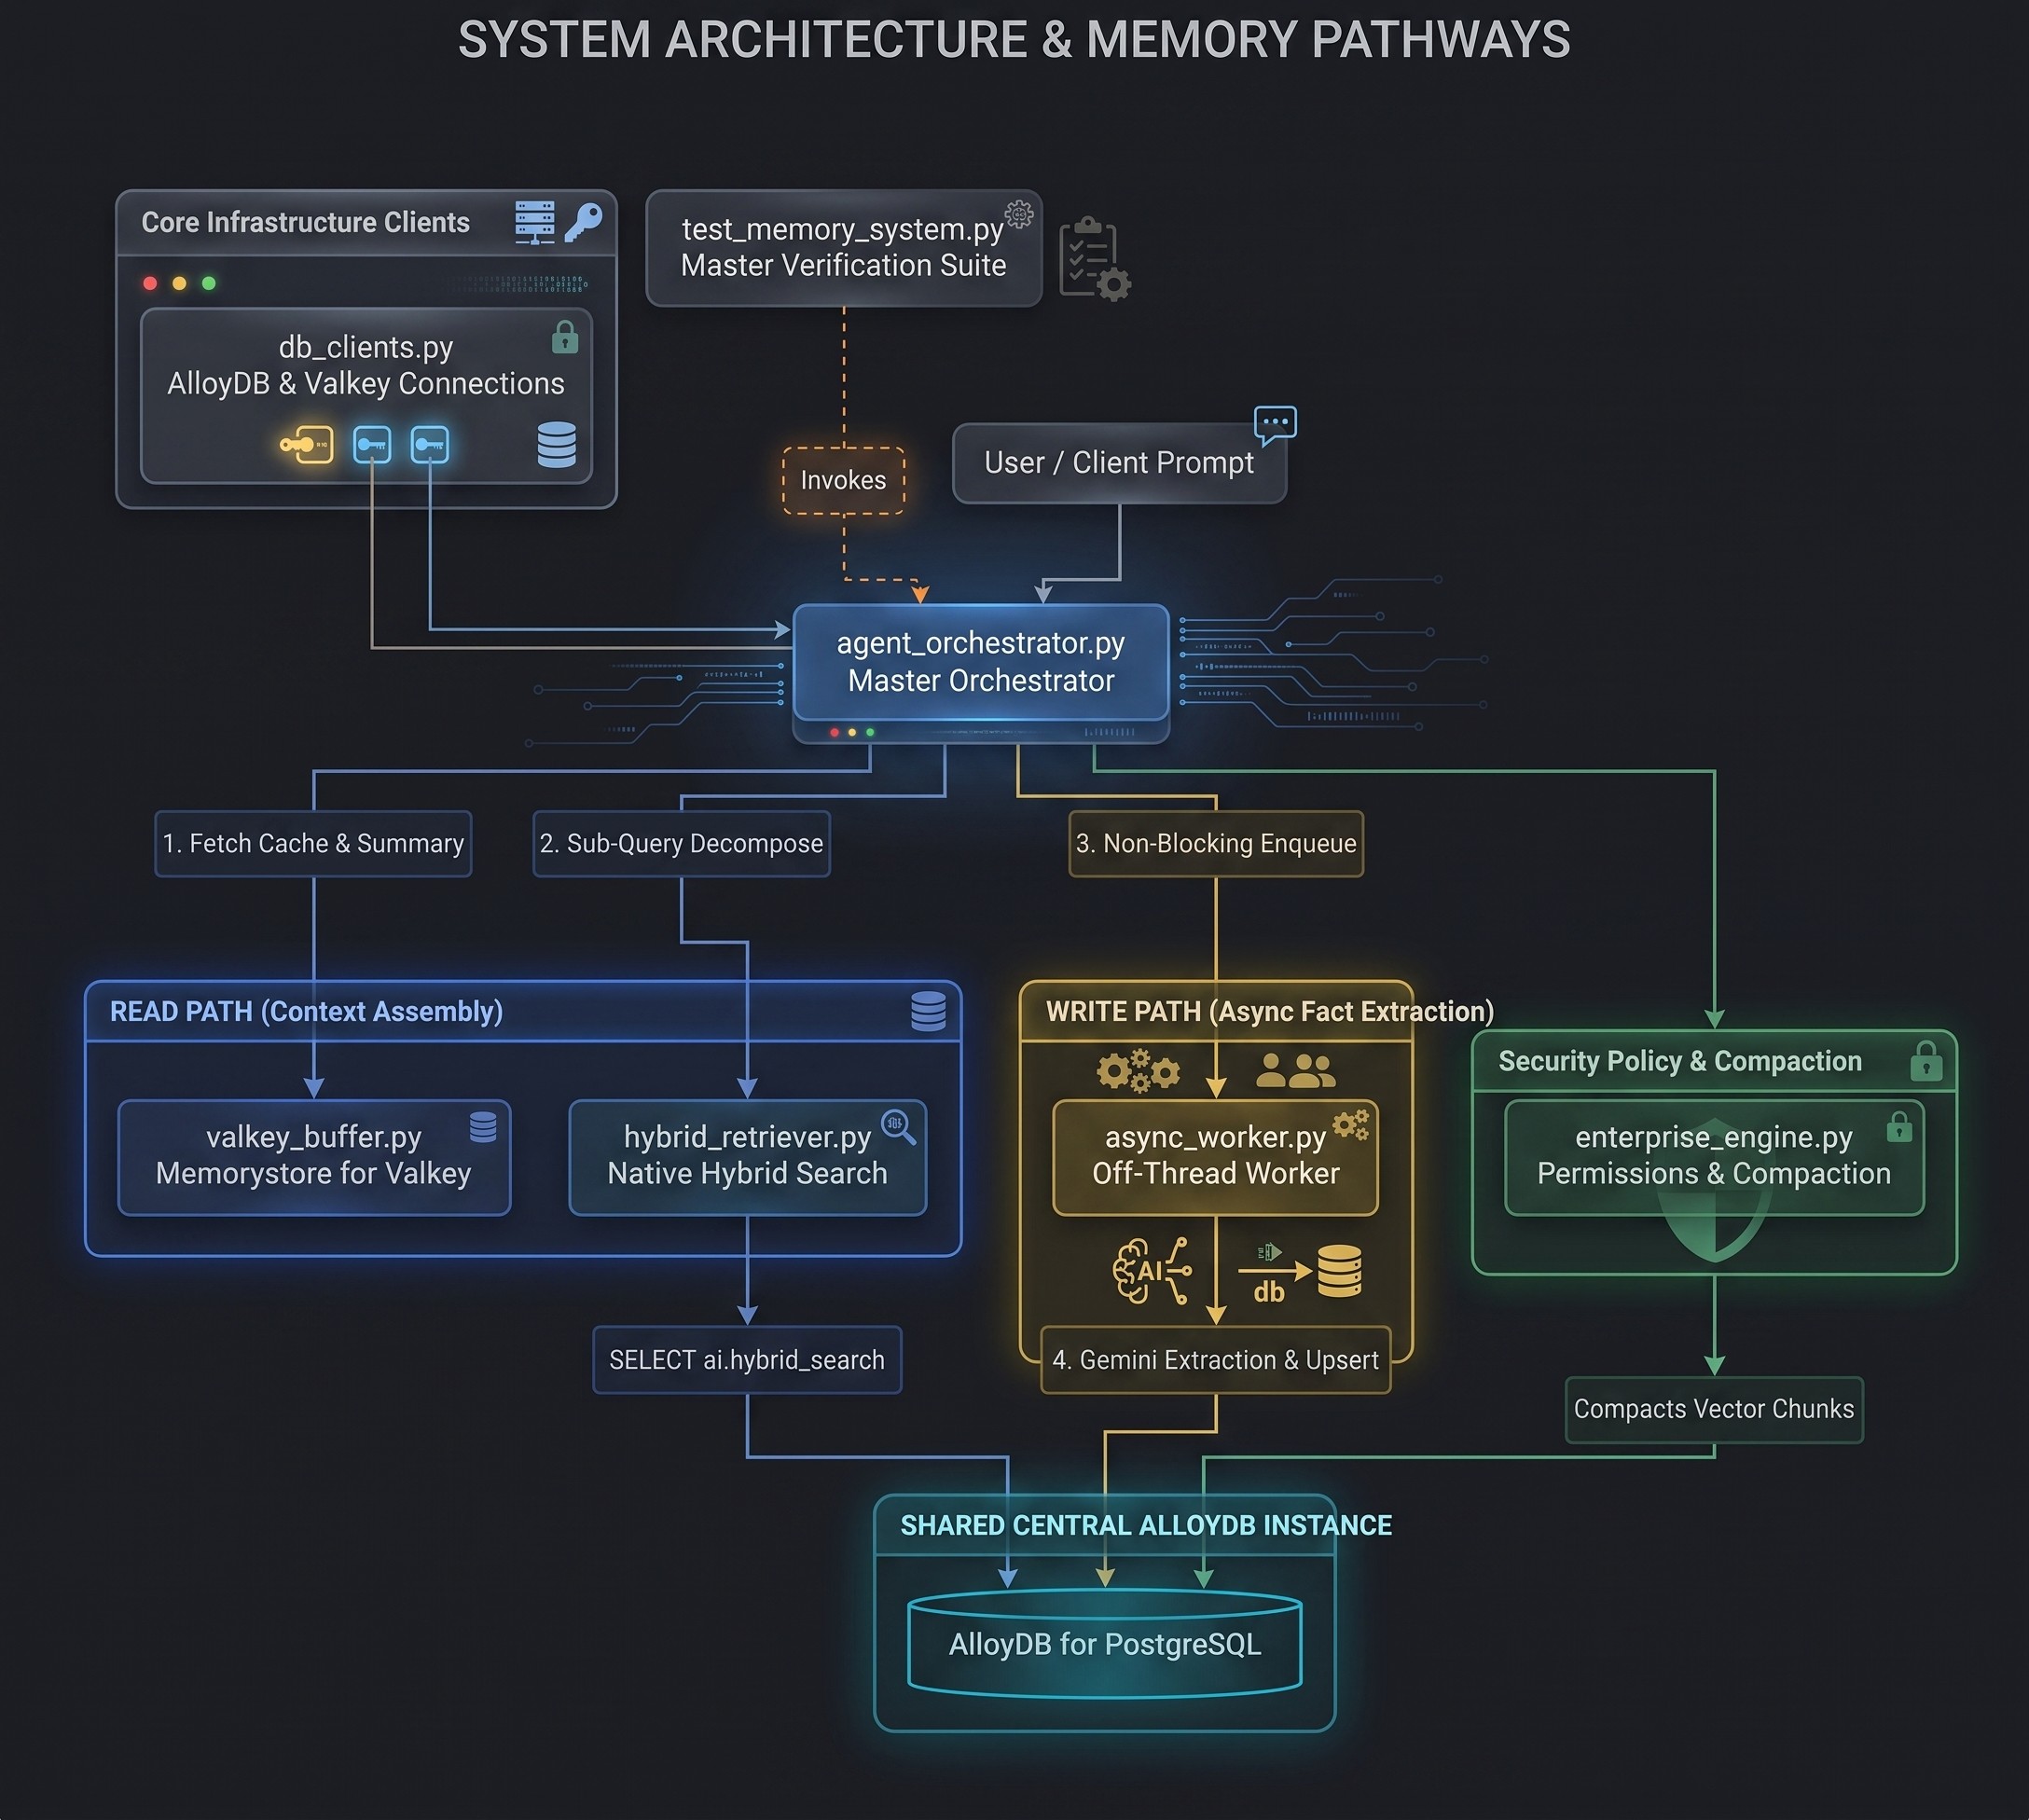
মডিউলের স্তরবিন্যাস এবং সিস্টেমের ভূমিকা
মডিউল ফাইল | সিস্টেম স্তর | প্রাথমিক দায়িত্ব |
| সংযোগ স্তর | AlloyDB-এর জন্য SSL-এনক্রিপ্টেড IAM প্রমাণীকরণ এবং Valkey-এর জন্য Memorystore-এ সকেট-রেসিলিয়েন্ট সংযোগ স্থাপন করে। |
| স্বল্পমেয়াদী স্মৃতি | Valkey-তে সাব-মিলিসেকেন্ড সেশন হিস্ট্রি পরিচালনা করে, এবং Summarize-Before-Trim রোলিং সামারি প্রয়োগ করে। |
| রাইট পাথ কর্মী | এটি একটি অফ-থ্রেড ডেমন ব্যাকগ্রাউন্ড কিউ ওয়ার্কার চালায়, যা জেমিনি ফ্ল্যাশ ব্যবহার করে এনটিটি ফ্যাক্টস এক্সট্র্যাক্ট করে এবং সেগুলোকে অ্যালয়ডিবি-তে আপসার্ট করে। |
| রিড পাথ রিট্রিভার | ইন-ডাটাবেস AlloyDB AI |
| প্রধান এজেন্ট লুপ | এন্ড-টু-এন্ড টার্ন এক্সিকিউশন লুপের সমন্বয় সাধন করে: স্বল্পমেয়াদী ফেচ, দীর্ঘমেয়াদী সার্চ, প্রম্পট অ্যাসেম্বলি, এলএলএম এক্সিকিউশন, এবং অ্যাসিঙ্ক এনকিউ। |
| শাসন ও প্রশাসন | টুল নির্বাহের জন্য ত্রি-স্তরীয় নিরাপত্তা নীতি প্রয়োগ করে এবং ঐতিহাসিক স্মৃতি একত্রিত করে। |
| পরীক্ষা ও মূল্যায়ন | মাস্টার ভেরিফিকেশন স্যুট একাধিক টার্ন ও একাধিক সেশনের সিনারিও সম্পাদন করে, টোকেন সাশ্রয়ের শতাংশ পরিমাপ করে এবং মেমরির নির্ভুলতা যাচাই করে। |
৬. AlloyDB AI স্কিমা এবং ট্রানজ্যাকশনাল অটো-এম্বেডিংস সেট আপ করুন
উদ্দেশ্য ও স্থাপত্যের সংক্ষিপ্ত বিবরণ
এই মডিউলে, আপনি এপিসোডিক ও লং-টার্ম মেমরির জন্য AlloyDB-এর ডাটাবেস স্কিমা, ইনডেক্স স্ট্র্যাটেজি এবং ডাটাবেস-সাইড অটো-এমবেডিং সংজ্ঞায়িত করবেন।
- এপিসোডিক ভেক্টর স্টোর (
episodic_memory_embeddings) : HNSW ভেক্টর সূচক (vector_cosine_ops) দ্বারা সূচিত অসংগঠিত চ্যাট প্রতিলিপির খণ্ডাংশ। - দীর্ঘমেয়াদী এনটিটি স্টোর (
agent_entities) : স্কোপ মেটাডেটা (global,project,session) সহ সংরক্ষিত স্ট্রাকচার্ড ফ্যাক্ট, ব্যবহারকারীর পছন্দ এবং প্রোজেক্টের নিয়মাবলী। এতে RUM-এর মাধ্যমে ইনডেক্স করা একটি স্বয়ংক্রিয়ভাবে তৈরি PostgreSQL ফুল-টেক্সট সার্চ কলাম (summary_tsv) অন্তর্ভুক্ত রয়েছে। - ডাটাবেস-সাইড অটো-এম্বেডিংস (
ai.initialize_embeddings) : ব্যাকগ্রাউন্ডে এজেন্ট প্ল্যাটফর্মtext-embedding-005) ব্যবহার করে নতুন বা আপডেট করা প্লেইন-টেক্সট সারিগুলোকে স্বয়ংক্রিয়ভাবেsummary_embeddingএ এম্বেড করে।
AlloyDB Studio-এর সাথে সংযোগ করুন
- Google Cloud Console-এ AlloyDB for Postgres পৃষ্ঠায় যান।
- আপনার প্রাথমিক ইনস্ট্যান্সটিতে ক্লিক করুন।
- বাম দিকের নেভিগেশনে, AlloyDB Studio- তে ক্লিক করুন।
-
postgresডাটাবেস নির্বাচন করুন -
IAM database authenticationমাধ্যমে প্রমাণীকরণ করুন
বাস্তবায়ন এবং সোর্স কোড
আপনার AlloyDB PostgreSQL ডাটাবেসের সাথে সংযুক্ত হওয়ার পরে, নিচের DDL কোয়েরিগুলি চালান:
-- 1. Enable google_ml_integration extension
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;
CREATE EXTENSION IF NOT EXISTS vector CASCADE;
CREATE EXTENSION IF NOT EXISTS rum CASCADE;
SET google_ml_integration.enable_preview_ai_functions = true;

-- 2. Create Episodic Memory Vector Store Tables
CREATE TABLE IF NOT EXISTS episodic_memory_collections (
    uuid UUID PRIMARY KEY,
    name VARCHAR,
    cmetadata JSONB
);

CREATE TABLE IF NOT EXISTS episodic_memory_embeddings (
    uuid UUID PRIMARY KEY,
    collection_id UUID REFERENCES episodic_memory_collections(uuid) ON DELETE CASCADE,
    embedding VECTOR(768),
    document VARCHAR,
    cmetadata JSONB,
    custom_id VARCHAR,
    created_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS episodic_memory_embedding_idx
ON episodic_memory_embeddings
USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);

-- 3. Create Entity & Preference Table with Metadata Scope & Auto-Generated TSVector Column
CREATE TABLE IF NOT EXISTS agent_entities (
    entity_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    entity_name TEXT NOT NULL,
    project_id TEXT DEFAULT 'global',
    session_id TEXT,
    scope TEXT NOT NULL DEFAULT 'project', -- 'global', 'project', 'session'
    summary TEXT NOT NULL,
    summary_embedding VECTOR(768),
    summary_tsv TSVECTOR GENERATED ALWAYS AS (
        to_tsvector('english', entity_name || ' ' || summary)
    ) STORED,
    updated_at TIMESTAMPTZ DEFAULT NOW(),
    UNIQUE (user_id, entity_name)
);

CREATE INDEX IF NOT EXISTS agent_entities_scope_idx
ON agent_entities (user_id, project_id, scope);

CREATE INDEX IF NOT EXISTS agent_entities_embedding_idx
ON agent_entities USING hnsw (summary_embedding vector_cosine_ops);

CREATE INDEX IF NOT EXISTS agent_entities_tsv_idx
ON agent_entities USING rum (summary_tsv rum_tsvector_ops);

-- 4. Create User Permissions Table for Tool Execution Controls
CREATE TABLE IF NOT EXISTS user_permissions (
    permission_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    project_id TEXT NOT NULL DEFAULT 'global',
    tool_name TEXT NOT NULL,
    command_pattern TEXT NOT NULL,
    action TEXT NOT NULL CHECK (action IN ('ALLOW', 'BLOCK')),
    created_at TIMESTAMPTZ DEFAULT NOW(),
    updated_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS idx_user_permissions_lookup
ON user_permissions (user_id, project_id, tool_name);
-- 5. Register Gemini 3.5 Flash Model Endpoint in AlloyDB
-- Replace PROJECT_ID with your Google Cloud project ID
CALL google_ml.create_model(
    model_id => 'gemini-3.5-flash',
    model_request_url => 'https://aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/global/publishers/google/models/gemini-3.5-flash:generateContent',
    model_qualified_name => 'gemini-3.5-flash',
    model_provider => 'google',
    model_type => 'llm',
    model_auth_type => 'alloydb_service_agent_iam'
);
ট্রানজ্যাকশনাল অটো-এম্বেডিংস প্রারম্ভিকীকরণ করুন এবং জেমিনি মডেল নিবন্ধন করুন
এরপরে, অটো-এম্বেডিং ব্যাকগ্রাউন্ড প্রসেস এবং জেমিনি ৩.৫ ফ্ল্যাশ মডেল এন্ডপয়েন্টটি রেজিস্টার করার জন্য আলাদা কোয়েরি এক্সিকিউশন ব্লকে CALL স্টেটমেন্টগুলো এক্সিকিউট করুন:
-- 6. Register Database-Side Transactional Auto-Embedding
CALL ai.initialize_embeddings(
    model_id => 'text-embedding-005',
    table_name => 'agent_entities',
    content_column => 'summary',
    embedding_column => 'summary_embedding',
    incremental_refresh_mode => 'transactional',
    batch_size => 10
);
৭. AlloyDB এবং Valkey সংযোগ ক্লায়েন্ট কনফিগার করুন
উদ্দেশ্য ও স্থাপত্যের সংক্ষিপ্ত বিবরণ
এই মডিউলে, আপনি AlloyDB for PostgreSQL (দীর্ঘমেয়াদী মেমরি) এবং Memorystore for Valkey (স্বল্পমেয়াদী ক্যাশে) উভয়ের সাথেই সুরক্ষিত নেটওয়ার্ক সংযোগ স্থাপন করবেন।
- AlloyDB IAM প্রমাণীকরণ : পাসওয়ার্ডবিহীন, SSL-এনক্রিপ্টেড ডাটাবেস সংযোগের (
sslmode="require") জন্য একটি স্বল্পস্থায়ী OAuth2 টোকেন পেতেgcloud auth application-default print-access-tokenব্যবহার করে। - ভ্যালকি নেটওয়ার্ক রেজিলিয়েন্স : একক-নোড বা ক্লাস্টারড ভ্যালকি ইনস্ট্যান্স জুড়ে ভিপিসি নেটওয়ার্ক অপারেশন নিরাপদে পরিচালনা করার জন্য
redis.Redisএকটি ৫.০-সেকেন্ডের সকেট টাইমআউট (socket_timeout=5.0) দিয়ে কনফিগার করে।
বাস্তবায়ন এবং সোর্স কোড
আপনার ওয়ার্কিং ডিরেক্টরিতে db_clients.py স্ক্রিপ্টটি তৈরি করুন:
import os
import subprocess
import psycopg2
import redis

# Initialize database & Valkey connection clients from environment variables
DB_HOST = os.getenv("DB_HOST", "127.0.0.1")
DB_PORT = os.getenv("DB_PORT", "5432")
DB_NAME = os.getenv("DB_NAME", "postgres")
DB_USER = os.getenv("DB_USER")

VALKEY_HOST = os.getenv("VALKEY_HOST", "127.0.0.1")
VALKEY_PORT = int(os.getenv("VALKEY_PORT", "6379"))

def get_db_connection():
    # Fetch Application Default Credentials (ADC) token for IAM Database Authentication & enable SSL encryption
    access_token = subprocess.check_output(
        ["gcloud", "auth", "application-default", "print-access-token"], text=True
    ).strip()
    return psycopg2.connect(
        host=DB_HOST,
        port=DB_PORT,
        dbname=DB_NAME,
        user=DB_USER,
        password=access_token,
        sslmode="require"
    )

def get_valkey_client():
    return redis.Redis(
        host=VALKEY_HOST,
        port=VALKEY_PORT,
        db=0,
        socket_timeout=5.0,
        socket_connect_timeout=5.0
    )

if __name__ == "__main__":
    print(f"Connecting to AlloyDB via IAM Auth ({DB_USER}) at {DB_HOST}:{DB_PORT} and Valkey at {VALKEY_HOST}:{VALKEY_PORT}...")
    print("Database and Valkey connection client modules loaded successfully.")
৮. ভ্যালকির জন্য মেমোরিস্টোরে স্বল্পমেয়াদী সেশন স্টেট ক্যাশে করুন।
উদ্দেশ্য ও স্থাপত্যের সংক্ষিপ্ত বিবরণ
এই মডিউলে, আপনি একটি স্বয়ংক্রিয় Summarize-Before-Trim প্যাটার্ন প্রয়োগ করে Valkey-এর জন্য Memorystore- এ একটি সাব-মিলিসেকেন্ড স্বল্পমেয়াদী কনটেক্সট ক্যাশে তৈরি করবেন।
- ভ্যালকি স্লাইডিং উইন্ডো : সক্রিয় কথোপকথনের পালাগুলো `
session:{session_id}:turnsকী-তে JSON স্ট্রিং হিসেবে সংরক্ষিত হয়। - রেডিস হ্যাশ ট্যাগ (
{session_id}) :session:{session_id}:turnsএবংsession:{session_id}:summaryএই কী ফরম্যাটিং-এর জন্য রেডিস ক্লাস্টার হ্যাশ ট্যাগ ({...}) ব্যবহৃত হয়, যা উভয় কী-কে একই হ্যাশ স্লটে রাখতে বাধ্য করে। এর ফলে যেকোনো একক-নোড বা ক্লাস্টারড ভ্যালকি ডেপ্লয়মেন্ট জুড়ে অ্যাটমিক এক্সিকিউশন নিশ্চিত হয়। - ছাঁটাই করার আগে সারসংক্ষেপ : যখন টার্ন সংখ্যা
trigger_limitঅতিক্রম করে, তখন ছাঁটাই হতে যাওয়া পুরোনো টার্নগুলোকে Gemini Flash একটি চলমান টেক্সট সারসংক্ষেপে (session:{session_id}:summary) সারসংক্ষেপ করে, মূল হিস্ট্রিকেwindow_sizeআকারে ছাঁটাই করার আগে।
বাস্তবায়ন এবং সোর্স কোড
আপনার ওয়ার্কিং ডিরেক্টরিতে valkey_buffer.py স্ক্রিপ্টটি তৈরি করুন:
import json
import logging
import time
from typing import Any, Dict, List
import redis

logger = logging.getLogger(__name__)

IN_MEMORY_VALKEY_FALLBACK: Dict[str, Any] = {}
VALKEY_COMPACTION_TOKENS = 0

def get_valkey_compaction_tokens() -> int:
    return VALKEY_COMPACTION_TOKENS

def append_session_turn_with_rolling_summary(
    valkey_client: redis.Redis,
    llm_client: Any,
    session_id: str,
    user_msg: str,
    ai_msg: str,
    trigger_limit: int = 10,
    window_size: int = 4
) -> None:
    """Appends turn to Valkey. Before trimming old turns, summarizes them into a rolling summary."""
    global VALKEY_COMPACTION_TOKENS
    # Use Redis Hash Tags {session_id} so both keys hash to the same cluster slot
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        # 1. Append new turn messages
        valkey_client.rpush(turns_key, json.dumps({"role": "user", "content": user_msg}))
        valkey_client.rpush(turns_key, json.dumps({"role": "assistant", "content": ai_msg}))

        raw_turns = valkey_client.lrange(turns_key, 0, -1)

        # 2. Check if total turns exceed summary trigger threshold
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2

        if len(raw_turns) > msg_trigger_count:
            turns_to_prune = raw_turns[:-msg_window_count]
            existing_summary = valkey_client.get(summary_key)
            existing_summary_text = (
                existing_summary.decode('utf-8') if isinstance(existing_summary, bytes) else (existing_summary or "")
            )

            pruned_text = "\n".join([
                f"{json.loads(t)['role']}: {json.loads(t)['content']}" for t in turns_to_prune
            ])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            updated_summary_text = llm_client.models.generate_content(
                model="gemini-3.5-flash", contents=prompt
            ).text.strip()
            # Execute commands directly to support all Redis/Valkey cluster topologies
            valkey_client.set(summary_key, updated_summary_text)
            valkey_client.ltrim(turns_key, -msg_window_count, -1)
            logger.info("Updated rolling summary and trimmed Valkey buffer for session %s", session_id)

    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey operation warning (%s). Falling back to in-memory short-term buffer.", e)
        if turns_key not in IN_MEMORY_VALKEY_FALLBACK:
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = []
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "user", "content": user_msg})
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "assistant", "content": ai_msg})

        # In-memory summarize-before-trim fallback logic
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2
        raw_fallback_turns = IN_MEMORY_VALKEY_FALLBACK[turns_key]

        if len(raw_fallback_turns) > msg_trigger_count:
            turns_to_prune = raw_fallback_turns[:-msg_window_count]
            existing_summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
            pruned_text = "\n".join([f"{t['role']}: {t['content']}" for t in turns_to_prune])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            for attempt in range(4):
                try:
                    updated_summary_text = llm_client.models.generate_content(
                        model="gemini-3.5-flash", contents=prompt
                    ).text.strip()
                    break
                except Exception as e:
                    if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                        time.sleep(3 * (2 ** attempt))
                    else:
                        raise

            IN_MEMORY_VALKEY_FALLBACK[summary_key] = updated_summary_text
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = raw_fallback_turns[-msg_window_count:]

def get_session_context_buffer(
    valkey_client: redis.Redis,
    session_id: str
) -> Dict[str, Any]:
    """Retrieves rolling summary + sliding window history from Valkey to build prompt context."""
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        summary = valkey_client.get(summary_key)
        summary_text = summary.decode('utf-8') if isinstance(summary, bytes) else (summary or "")

        raw_turns = valkey_client.lrange(turns_key, 0, -1)
        recent_turns = [json.loads(t) for t in raw_turns]

        return {
            "rolling_summary": summary_text,
            "recent_turns": recent_turns
        }
    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey read error (%s). Using in-memory short-term fallback buffer.", e)
        summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
        recent_turns = IN_MEMORY_VALKEY_FALLBACK.get(turns_key, [])
        return {"rolling_summary": summary_text, "recent_turns": recent_turns}
৯. অফ-থ্রেডে এনটিটি নিষ্কাশন (ব্যাকগ্রাউন্ড মেমরি ওয়ার্কার)
উদ্দেশ্য ও স্থাপত্যের সংক্ষিপ্ত বিবরণ
এই মডিউলে, আপনি একটি অফ-থ্রেড রাইট-পাথ ব্যাকগ্রাউন্ড এক্সট্র্যাকশন ওয়ার্কার ( AsyncMemoryWorker ) তৈরি করবেন, যা ইন্টারেক্টিভ এআই প্রতিক্রিয়ার গতি না কমিয়েই দীর্ঘমেয়াদী এনটিটি ফ্যাক্টস এক্সট্র্যাক্ট করে।
- নন-ব্লকিং কিউ ওয়ার্কার : একটি ডেমন থ্রেড (
queue.Queue) চালু করে, যাতে LLM এক্সট্র্যাকশন বা ডেটাবেসে লেখার জন্য অপেক্ষা না করে ডেভেলপার চ্যাটের কাজ অবিলম্বে সম্পন্ন হয়। - অফ-থ্রেড এনটিটি ফ্যাক্ট এক্সট্র্যাকশন : ব্যবহারকারীর সামনে চলমান কথোপকথনকে বাধা না দিয়ে, স্ট্রাকচার্ড এনটিটি পার্স করার জন্য ব্যাকগ্রাউন্ডে জেমিনি ফ্ল্যাশ (
model="gemini-3.5-flash",response_mime_type="application/json") কল করে। - টেম্পোরাল কোরেফারেন্স রেজোলিউশন (
build_temporal_rules_prompt) : এমন নিয়ম প্রয়োগ করে যা আপেক্ষিক টেম্পোরাল এক্সপ্রেশন (যেমন "বর্তমানে" , "শেষ সেশন" ) কে সুস্পষ্ট সেশন আইডিতে (যেমনsession_id) রূপান্তর করে। - স্কিমা আপসার্টস : এটি জেমিনি ফ্ল্যাশকে এনটিটিগুলোর (
entity_name,project_id,scope,summary) একটি JSON অ্যারে ফেরত দিতে নির্দেশ দেয় এবং প্যারামিটারাইজড PostgreSQLON CONFLICT DO UPDATEস্টেটমেন্টের মাধ্যমেagent_entitiesফোল্ডারে সাধারণ টেক্সট লিখে রাখে।
বাস্তবায়ন এবং সোর্স কোড
আপনার ওয়ার্কিং ডিরেক্টরিতে async_worker.py স্ক্রিপ্টটি তৈরি করুন:
import json
import logging
import queue
import threading
import time
from typing import Dict, Any, Optional
import psycopg2

logger = logging.getLogger(__name__)

def build_temporal_rules_prompt(active_session_id: str, prev_session_id: Optional[str] = None) -> str:
    """REUSABLE PROMPT HELPER: Defines temporal coreference rules for both Read and Write paths."""
    return f"""TEMPORAL COREFERENCE RULES:
1. Do not use relative temporal words like 'currently', 'now', 'this session', 'previous session', or 'last session'.
2. Replace any relative temporal reference with explicit session identifiers:
   - Active Session: '{active_session_id}'
   - Previous Session: '{prev_session_id if prev_session_id else active_session_id}'
   (e.g., write 'User prefers Python in session {active_session_id}' instead of 'User currently prefers Python')."""

class AsyncMemoryWorker:
    """Off-thread daemon queue worker performing background entity extraction and upserts into AlloyDB."""
    def __init__(self, conn_factory, llm_client):
        self.conn_factory = conn_factory
        self.llm_client = llm_client
        self.work_queue = queue.Queue()
        self.total_extraction_tokens = 0
        self.worker_thread = threading.Thread(target=self._run_worker, daemon=True)
        self.worker_thread.start()

    def enqueue_extraction(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        self.work_queue.put((user_id, session_id, user_msg, ai_msg, prev_session_id))

    def _run_worker(self):
        while True:
            item = self.work_queue.get()
            if item is None:
                break
            user_id, session_id, user_msg, ai_msg, prev_session_id = item
            try:
                self._extract_and_upsert(user_id, session_id, user_msg, ai_msg, prev_session_id)
            except Exception as e:
                logger.error("Background extraction failed: %s", e)
            finally:
                self.work_queue.task_done()

    def _extract_and_upsert(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        temporal_rules = build_temporal_rules_prompt(session_id, prev_session_id)
        json_fmt = '[{"entity_name": "...", "project_id": "...", "scope": "global|project|session", "summary": "..."}]'

        prompt = f"""Extract key preferences and named entities from this exchange.
Format output strictly as a JSON array of objects with structure: {json_fmt}.

{temporal_rules}

Rules for Scope:
- 'global': Universal developer preferences.
- 'project': Architecture, database choices, timeouts, and rules for a specific project.
- 'session': Ephemeral task state tied strictly to a single session.

User: {user_msg}
AI: {ai_msg}

Output (JSON array only):"""

        self.total_extraction_tokens += max(1, len(prompt) // 4)

        for attempt in range(4):
            try:
                response = self.llm_client.models.generate_content(
                    model="gemini-3.5-flash",
                    contents=prompt,
                    config={"response_mime_type": "application/json"}
                )
                break
            except Exception as e:
                if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                    time.sleep(3 * (2 ** attempt))
                else:
                    raise
        content = str(response.text).strip()
        if not content:
            return

        extracted_list = json.loads(content)
        if not isinstance(extracted_list, list):
            return

        upsert_sql = """
            INSERT INTO agent_entities (user_id, entity_name, project_id, session_id, scope, summary, updated_at)
            VALUES (%s, %s, %s, %s, %s, %s, NOW())
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET
                project_id = EXCLUDED.project_id,
                session_id = EXCLUDED.session_id,
                scope = EXCLUDED.scope,
                summary = EXCLUDED.summary,
                updated_at = NOW();
        """

        conn = self.conn_factory()
        try:
            with conn:
                with conn.cursor() as cur:
                    for item in extracted_list:
                        e_name = item.get("entity_name", "General_Fact")
                        p_id = item.get("project_id", "global")
                        s_scope = item.get("scope", "project")
                        summary = item.get("summary", "")
                        if e_name and summary:
                            cur.execute(upsert_sql, (user_id, e_name, p_id, session_id, s_scope, summary))
            logger.info("Saved %d entities for user %s", len(extracted_list), user_id)
        finally:
            conn.close()
১০. নেটিভ হাইব্রিড সার্চের মাধ্যমে দীর্ঘমেয়াদী স্মৃতি অনুসন্ধান করুন
উদ্দেশ্য ও স্থাপত্যের সংক্ষিপ্ত বিবরণ
এই মডিউলে, আপনি রিড-পাথ সাব-কোয়েরি ডিকম্পোজিশন, টেম্পোরাল কোয়েরি রিরাইটিং, মেটাডেটা স্কোপ আইসোলেশন প্রয়োগ করবেন এবং AlloyDB-এর নেটিভ হাইব্রিড সার্চ ( ai.hybrid_search ) ব্যবহার করবেন।
- ইন-ডাটাবেস সাব-কোয়েরি ডিকম্পোজিশন (
rewrite_and_decompose_query) : এটি PostgreSQL-এর ভিতরে সরাসরি AlloyDB AI-এর বিল্ট-ইন ফাংশনai.generate()ব্যবহার করে যৌগিক প্রশ্নগুলোকে নর্মালাইজড সেশন আইডি সহ একক-দিকের সাব-কোয়েরিতে বিভক্ত করে, যা মাল্টি-টপিক কোয়েরির কারণে ভেক্টর সার্চের নির্ভুলতা কমে যাওয়া প্রতিরোধ করে। - ইনডেক্স-স্তরের স্কোপ ফিল্টারিং : গ্লোবাল ডেভেলপার প্রেফারেন্স অন্তর্ভুক্ত রেখে, ব্যবহারকারী ও প্রজেক্ট অনুযায়ী মেমোরি আলাদা করার জন্য ডাটাবেস-সাইড SQL ফিল্টার (
filter_condition => "user_id = '%s' AND (project_id = '%s' OR scope = 'global')") তৈরি করে। - অ্যালয়ডিবি নেটিভ হাইব্রিড সার্চ (
ai.hybrid_search) : এটি রেসিপ্রোকাল র্যাঙ্ক ফিউশন (RRF) ব্যবহার করে অ্যালয়ডিবি-র ভেতরে ভেক্টর কোসাইন সিমিলারিটি (public.<=>) এবং ফুল-টেক্সট সার্চ (rum)-কে একত্রিত করে সর্বোত্তম অ্যাকুরেসি, রিকল এবং রিলেভেন্স প্রদান করে।
বাস্তবায়ন এবং সোর্স কোড
আপনার ওয়ার্কিং ডিরেক্টরিতে hybrid_retriever.py স্ক্রিপ্টটি তৈরি করুন:
import os
import json
import logging
from typing import Any, Dict, List, Optional
import psycopg2
from psycopg2.extras import RealDictCursor
from async_worker import build_temporal_rules_prompt

logger = logging.getLogger(__name__)

def rewrite_and_decompose_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> List[str]:
    """Read-Path LLM Query Normalizer & Sub-Query Decomposer using AlloyDB AI ai.generate() directly in PostgreSQL."""
    temporal_rules = build_temporal_rules_prompt(active_session_id, prev_session_id)

    prompt = f"""You are a query normalization and decomposition tool for an AI agent's memory retrieval system.

Tasks:
1. Normalize any relative temporal phrases in the user query into explicit session identifiers.
{temporal_rules}

2. Decompose compound user queries asking about multiple distinct topics into up to 4 concise, single-topic search queries. Ensure all distinct questions (both general developer preferences and project-specific architecture/rules) are preserved as separate sub-queries.
3. Return ONLY a valid JSON array of strings containing the sub-queries.

Example Output Format:
["general developer coding preferences", "CloudRetail backend stack in session sess_2026_01", "CloudRetail timeout rules in session sess_2026_01"]

Text to Process: {text}
JSON Output:"""

    try:
        with conn.cursor() as cur:
            cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
            cur.execute("SELECT ai.generate(prompt => %s::text, model_id => 'gemini-3.5-flash'::varchar(100));", (prompt,))
            row = cur.fetchone()
            if row and row[0]:
                res_text = str(row[0]).strip()
                clean_text = res_text
                if clean_text.startswith("```"):
                    clean_text = clean_text.removeprefix("```json").removeprefix("```").removesuffix("```").strip()
                parsed = json.loads(clean_text)
                if isinstance(parsed, list) and len(parsed) > 0:
                    return [str(q).strip() for q in parsed]
        return [text]
    except Exception as e:
        logger.error("Error in in-database ai.generate sub-query decomposition: %s", e)
        return [text]

def rewrite_temporal_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> str:
    """Backward-compatible wrapper returning first decomposed query string."""
    queries = rewrite_and_decompose_query(conn, llm_client, text, active_session_id, prev_session_id)
    return queries[0] if queries else text

def retrieve_hybrid_entities(
    conn,
    llm_client: Any,
    user_id: str,
    active_session_id: str,
    query_text: str,
    query_embedding: Optional[List[float]] = None,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    k: int = 20
) -> Dict[str, Any]:
    """Queries long-term entities using Sub-Query Decomposition, metadata scope filtering, and parameterized AlloyDB hybrid search."""
    sub_queries = rewrite_and_decompose_query(
        conn=conn, llm_client=llm_client, text=query_text, active_session_id=active_session_id, prev_session_id=prev_session_id
    )
    all_search_queries = list(dict.fromkeys(sub_queries + [query_text]))

    retrieved_entities: Dict[str, Any] = {}

    filter_cond = f"user_id = '{user_id}' AND (project_id = '{project_id}' OR scope = 'global')" if project_id else f"user_id = '{user_id}'"

    query_sql = """
        SELECT e.entity_name, e.summary, e.project_id, e.scope, e.updated_at
        FROM ai.hybrid_search(
          search_inputs => %s::JSONB[],
          include_json_output => false
        ) h
        JOIN agent_entities e ON e.entity_name = h.id
        WHERE e.user_id = %s
        LIMIT %s;
    """

    from google import genai
    embed_client = genai.Client(
        vertexai=True,
        project=os.getenv("PROJECT_ID"),
        location=os.getenv("REGION", "us-east1")
    )

    for sq in all_search_queries:
        try:
            emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=sq)
            sq_embedding = emb_resp.embeddings[0].values
            vector_literal = f"'{sq_embedding}'::vector"
        except Exception as e:
            logger.error(f"Failed to generate embedding for sub-query: {sq}. Error: {e}")
            # Fallback to zero vector to prevent Postgres from crashing
            sq_embedding = [0.0] * 768
            vector_literal = f"'{sq_embedding}'::vector"

        search_inputs = [
            json.dumps({
                "data_type": "vector",
                "weight": 0.4,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "vec_column": "summary_embedding",
                "distance_operator": "public.<=>",
                "limit": 20,
                "query_vector": vector_literal,
                "filter_condition": filter_cond
            }),
            json.dumps({
                "data_type": "text",
                "weight": 0.6,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "text_column": "summary_tsv",
                "limit": 20,
                "ranking_function": "ts_rank",
                "query_text_input": sq,
                "filter_condition": filter_cond
            })
        ]

        with conn.cursor(cursor_factory=RealDictCursor) as cur:
            try:
                cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                cur.execute(query_sql, (search_inputs, user_id, k))
                rows = cur.fetchall()

                for row in rows:
                    name = row["entity_name"]
                    if name not in retrieved_entities:
                        retrieved_entities[name] = {
                            "summary": row["summary"],
                            "project_id": row["project_id"],
                            "scope": row["scope"],
                            "updated_at": row["updated_at"].isoformat() if row["updated_at"] else None
                        }
            except Exception as e:
                logger.error("Error executing hybrid search for sub-query '%s': %s", sq, e)

    return retrieved_entities
১১. এন্ড-টু-এন্ড এজেন্ট মেমরি লুপ তৈরি ও চালান
উদ্দেশ্য ও স্থাপত্যের সংক্ষিপ্ত বিবরণ
এই মডিউলে, আপনি প্রধান এজেন্ট অর্কেস্ট্রেশন ফাংশন ( run_agent_turn ) তৈরি করবেন, যা স্বল্পমেয়াদী ক্যাশে পুনরুদ্ধার, দীর্ঘমেয়াদী মেমরি অনুসন্ধান, প্রম্পট অ্যাসেম্বলি, এলএলএম জেনারেশন এবং ব্যাকগ্রাউন্ড মেমরি এক্সট্র্যাকশনকে একত্রিত করে।
- স্বল্পমেয়াদী প্রেক্ষাপট : সক্রিয় ভ্যালকি ডায়ালগের পালা এবং চলমান সারাংশ সংগ্রহ করে (
get_session_context_buffer)। - দীর্ঘমেয়াদী অনুসন্ধান : সক্রিয় প্রজেক্ট আইডি এবং গ্লোবাল স্কোপ দ্বারা ফিল্টার করা ডিকম্পোজড সাব-কোয়েরি ব্যবহার করে
retrieve_hybrid_entitiesএর মাধ্যমে AlloyDB-তে কোয়েরি করা হয়। - সিস্টেম প্রম্পট ফরম্যাটিং : দীর্ঘমেয়াদী এনটিটি, স্বল্পমেয়াদী সারাংশ, সাম্প্রতিক ডায়ালগ এবং ব্যবহারকারীর প্রম্পট সম্বলিত
build_agent_promptএকত্রিত করে একটি টোকেন-সাশ্রয়ী সিস্টেম প্রম্পট তৈরি করে। - Async Queue Enqueue : Valkey-তে টার্নটি ক্যাশ করে এবং রিটার্ন পেলোডকে ব্লক না করেই ব্যাকগ্রাউন্ড এক্সট্র্যাকশনকে
AsyncMemoryWorkerএ এনকিউ করে।
বাস্তবায়ন এবং সোর্স কোড
আপনার ওয়ার্কিং ডিরেক্টরিতে agent_orchestrator.py স্ক্রিপ্টটি তৈরি করুন:
import logging
import time
from typing import Any, Dict, Optional, Tuple
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import rewrite_temporal_query, retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

logger = logging.getLogger(__name__)

def build_agent_prompt(
    rolling_summary: str,
    recent_turns: list[Dict[str, Any]],
    retrieved_entities: Dict[str, Any],
    user_query: str
) -> str:
    """Assembles structured system prompt with long-term memory & short-term context."""
    entity_lines = [
        f"- {name}: {info['summary']}" for name, info in retrieved_entities.items()
    ]
    entity_context = "\n".join(entity_lines) if entity_lines else "No relevant entity facts."
    history_lines = [f"{t['role']}: {t['content']}" for t in recent_turns]
    history_str = "\n".join(history_lines)

    return f"""You are an intelligent, context-aware AI assistant.

[LONG-TERM PREFERENCES & ENTITIES]
{entity_context}

[SHORT-TERM ROLLING SUMMARY]
{rolling_summary if rolling_summary else 'No prior summary.'}

[RECENT DIALOGUE]
{history_str}

User: {user_query}
AI:"""

def run_agent_turn(
    db_conn,
    valkey_client: redis.Redis,
    async_worker: AsyncMemoryWorker,
    genai_client: Any,
    user_id: str,
    session_id: str,
    user_query: str,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    trigger_limit: int = 10,
    window_size: int = 4
) -> Tuple[str, str, float]:
    """Executes a complete 2-tier agent memory turn loop, returning (response_text, system_prompt, latency_seconds)."""
    import time
    start_time = time.time()

    # 1. Fetch short-term rolling summary + recent turns from Valkey
    buffer_data = get_session_context_buffer(valkey_client, session_id)
    rolling_summary = buffer_data["rolling_summary"]
    recent_turns = buffer_data["recent_turns"]

    # 2. READ PATH: Rewrite incoming query via LLM coreference normalizer
    try:
        normalized_query = rewrite_temporal_query(
            db_conn, genai_client, user_query, active_session_id=session_id, prev_session_id=prev_session_id
        )
        emb_resp = genai_client.models.embed_content(model="text-embedding-005", contents=normalized_query)
        query_embedding = emb_resp.embeddings[0].values
    except Exception:
        query_embedding = None

    # Retrieve relevant long-term entities from AlloyDB via hybrid search
    retrieved_entities = retrieve_hybrid_entities(
        conn=db_conn,
        llm_client=genai_client,
        user_id=user_id,
        active_session_id=session_id,
        query_text=user_query,
        query_embedding=query_embedding,
        prev_session_id=prev_session_id,
        project_id=project_id,
        k=20
    )

    # 3. Assemble system prompt
    system_prompt = build_agent_prompt(
        rolling_summary, recent_turns, retrieved_entities, user_query
    )


    # 4. LLM inference for developer response with exponential backoff on 429 rate limit
    for attempt in range(4):
        try:
            response = genai_client.models.generate_content(
                model="gemini-3.5-flash", contents=system_prompt
            )
            break
        except Exception as e:
            if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                time.sleep(3 * (2 ** attempt))
            else:
                raise
    ai_response = str(response.text)

    # 5. Cache turn in short-term Valkey buffer (with Summarize-Before-Trim check)
    append_session_turn_with_rolling_summary(
        valkey_client=valkey_client,
        llm_client=genai_client,
        session_id=session_id,
        user_msg=user_query,
        ai_msg=ai_response,
        trigger_limit=trigger_limit,
        window_size=window_size
    )

    # 6. WRITE PATH: Enqueue off-thread background entity extraction (single LLM call)
    async_worker.enqueue_extraction(user_id, session_id, user_query, ai_response, prev_session_id)

    latency = time.time() - start_time
    return ai_response, system_prompt, latency
১২. এন্টারপ্রাইজ অনুমতি নিয়ন্ত্রণ এবং মেমরি কম্প্যাকশন বাস্তবায়ন করুন
উদ্দেশ্য ও স্থাপত্যের সংক্ষিপ্ত বিবরণ
এই মডিউলে, আপনি টুল এক্সিকিউশন এবং ডাটাবেস মেমরি কম্প্যাকশনের ( AgentMemoryEngine ) জন্য এন্টারপ্রাইজ নিরাপত্তা নিয়ন্ত্রণ তৈরি করবেন।
- ৩-স্তরীয় অনুমতি মূল্যায়ন (
evaluate_tool_permission) :- স্তর ১ (একবার-ব্যবহারযোগ্য ভ্যালকি গ্রান্ট) : ৩০০-সেকেন্ডের TTL সহ একবার-ব্যবহারযোগ্য গ্রান্ট কী (
one_time_perm:{session_id}:{cmd_hash}) পরীক্ষা করে। যদি উপস্থিত থাকে, তাহলে কী-টি অবিলম্বে মুছে ফেলে এবংALLOWরিটার্ন করে। - স্তর ২ ও ৩ (PostgreSQL পলিসি রুলস) : কোয়েরিগুলো প্রথমে প্রজেক্ট-ভিত্তিক রুলস (
project_id)-এর সাথে মেলে এমনuser_permissionsখোঁজে, তারপর গ্লোবাল রুলস ('global') খোঁজে। - ফলব্যাক : যদি কোনো মিলযুক্ত পলিসি না থাকে, তাহলে
PROMPT_USERরিটার্ন করে।
- স্তর ১ (একবার-ব্যবহারযোগ্য ভ্যালকি গ্রান্ট) : ৩০০-সেকেন্ডের TTL সহ একবার-ব্যবহারযোগ্য গ্রান্ট কী (
- মেমোরি কম্প্যাকশন (
compact_old_memories) : একটি নির্দিষ্ট ৫০-সারি বিশিষ্ট SQL CTE কোয়েরি ব্যবহার করে,episodic_memory_embeddingsএ থাকাretention_daysচেয়ে পুরোনো ঐতিহাসিক র ভেক্টর ইভেন্টগুলোকেagent_entitiesএ একটি একক সমন্বিত সারাংশে একত্রিত করে।
বাস্তবায়ন এবং সোর্স কোড
আপনার ওয়ার্কিং ডিরেক্টরিতে enterprise_engine.py স্ক্রিপ্টটি তৈরি করুন:
import hashlib
import logging
import re
from typing import Any, Dict, Tuple
import psycopg2
import redis

logger = logging.getLogger(__name__)

class AgentMemoryEngine:
    """Framework-agnostic Enterprise Memory Engine for tool execution permissions & safe compaction."""

    def __init__(self, valkey_client: redis.Redis, db_conn: Any):
        self.valkey_client = valkey_client
        self.db_conn = db_conn

    def evaluate_tool_permission(
        self,
        user_id: str,
        project_id: str,
        session_id: str,
        tool_name: str,
        tool_args: Dict[str, Any]
    ) -> Tuple[str, str]:
        """Evaluates 3-tier execution permissions: Allow-Once (Valkey), Project (AlloyDB), Global (AlloyDB)."""
        command_str = str(tool_args.get("CommandLine", "") or tool_args)

        # Tier 1: Allow-Once (Single-Use Valkey Check with 300s TTL)
        cmd_hash = hashlib.sha256(command_str.encode("utf-8")).hexdigest()[:16]
        valkey_key = f"one_time_perm:{session_id}:{cmd_hash}"

        if self.valkey_client.get(valkey_key):
            self.valkey_client.delete(valkey_key)  # Consume key immediately
            return ("ALLOW", "Single-use 'Allow Once' grant consumed.")

        # Tier 2 & Tier 3: Query AlloyDB user_permissions table
        query_sql = """
            SELECT command_pattern, action, project_id
            FROM user_permissions
            WHERE user_id = %s AND tool_name = %s AND project_id IN (%s, 'global')
            ORDER BY CASE WHEN project_id = %s THEN 1 ELSE 2 END;
        """

        with self.db_conn.cursor() as cur:
            cur.execute(query_sql, (user_id, tool_name, project_id, project_id))
            rules = cur.fetchall()
            for pattern, action, scope in rules:
                if re.search(pattern, command_str, flags=re.IGNORECASE):
                    return (action, f"Matched {scope}-scoped rule: {pattern}")

        # Fallback: Prompt Human User
        return ("PROMPT_USER", "No matching permission rule found.")

    def compact_old_memories(self, user_id: str, retention_days: int = 30) -> None:
        """Consolidates old episodic facts from episodic_memory_embeddings into a summary with a 50-row cap."""
        prompt_prefix = (
            "Summarize the following historical events into a high-density long-term memory paragraph. "
            "Retain key constraints, tool choices, and project rules:\n"
        )

        # Capped CTE prevents string_agg from exceeding model context window limits
        compaction_sql = """
            WITH old_events AS (
                SELECT document AS content
                FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            ),
            consolidated AS (
                SELECT ai.generate(%s || string_agg(content, E'\n')) AS summary_text
                FROM old_events
            )
            INSERT INTO agent_entities (user_id, entity_name, summary, updated_at)
            SELECT %s, 'longterm_session_summary', summary_text, NOW()
            FROM consolidated
            WHERE summary_text IS NOT NULL
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET summary = EXCLUDED.summary, updated_at = NOW();
        """

        prune_sql = """
            DELETE FROM episodic_memory_embeddings
            WHERE uuid IN (
                SELECT uuid FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            );
        """

        try:
            with self.db_conn:
                with self.db_conn.cursor() as cur:
                    cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                    cur.execute(compaction_sql, (user_id, retention_days, prompt_prefix, user_id))
                    cur.execute(prune_sql, (user_id, retention_days))
            logger.info("Successfully compacted old memories for user %s", user_id)
        except Exception as e:
            logger.error("Error during memory compaction: %s", e)
১৩. এন্ড-টু-এন্ড মাল্টি-টার্ন মেমরি ভেরিফিকেশন চালান
উদ্দেশ্য ও স্থাপত্যের সংক্ষিপ্ত বিবরণ
এই চূড়ান্ত মডিউলে, আপনি সম্পূর্ণ ২-স্তরীয় মেমরি আর্কিটেকচারটি যাচাই করার জন্য মাস্টার এন্ড-টু-এন্ড ভেরিফিকেশন স্ক্রিপ্ট ( test_memory_system.py ) তৈরি এবং এক্সিকিউট করবেন।
- মাল্টি-টার্ন ও মাল্টি-সেশন সিমুলেশন :
- সেশন ১ (টার্ন ১) : সার্বজনীন ডেভেলপার পছন্দসমূহ সংজ্ঞায়িত করে (
scope='global': ডার্ক মোড ইউআই, পাইথন ৩.১১, পোস্টগ্রেসকিউএল)। - সেশন ১ (টার্ন ২) : প্রজেক্ট-নির্দিষ্ট আর্কিটেকচার নির্ধারণ করে (
project_id='CloudRetail': FastAPI, AlloyDB, Valkey, 30s timeout cap, us-east1)। - সেশন ১ (টার্ন ৩ ও ৪) : প্রযুক্তিগত কথোপকথনের শব্দ তৈরি করে এবং
trigger_limit=3অতিক্রম করার ফলে Valkey Summarize-Before-Trim রোলিং সামারি কম্প্যাকশন চালু হয়। - সেশন ২ (টার্ন ৫ - একেবারে নতুন সেশন আইডি) : গ্লোবাল প্রেফারেন্স এবং প্রোজেক্ট রুলস-এর ক্রস-সেশন রিকল যাচাই করার জন্য বিভিন্ন সেশন জুড়ে এজেন্টকে কোয়েরি করে।
- সেশন ১ (টার্ন ১) : সার্বজনীন ডেভেলপার পছন্দসমূহ সংজ্ঞায়িত করে (
- ডাইনামিক এফিসিয়েন্সি ও অ্যাকুরেসি ভেরিফিকেশন : এটি সঠিক প্রম্পট ক্যারেক্টার/টোকেন, প্রম্পট সাইজ হ্রাসের শতাংশ, ইনফারেন্স ল্যাটেন্সি, ভ্যালকি রোলিং সামারি, স্কোপ আইসোলেশন এবং টুল এক্সিকিউশন সিকিউরিটি পলিসি পরিমাপ করে।
বাস্তবায়ন এবং সোর্স কোড
আপনার ওয়ার্কিং ডিরেক্টরিতে test_memory_system.py টেস্ট স্ক্রিপ্টটি তৈরি করুন:
import os
import time
import logging
from google import genai
from db_clients import get_db_connection, get_valkey_client
from async_worker import AsyncMemoryWorker
from hybrid_retriever import retrieve_hybrid_entities
from agent_orchestrator import run_agent_turn
from enterprise_engine import AgentMemoryEngine
from valkey_buffer import get_session_context_buffer, IN_MEMORY_VALKEY_FALLBACK, get_valkey_compaction_tokens

logging.basicConfig(level=logging.WARNING)
logging.getLogger("google_genai").setLevel(logging.WARNING)
logging.getLogger("httpx").setLevel(logging.WARNING)

PROJECT_ID = os.getenv("PROJECT_ID")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")

db_conn = get_db_connection()
valkey_client = get_valkey_client()
client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)

async_worker = AsyncMemoryWorker(get_db_connection, client)
engine = AgentMemoryEngine(valkey_client, db_conn)

USER_ID = "user_dev_42"
SESSION_1 = "sess_2026_01"
SESSION_2 = "sess_2026_02"

test_accuracy = []

print("\n==================================================")
print("STARTING ENHANCED 2-TIER AGENT MEMORY VERIFICATION TEST")
print("==================================================")

# TURN 1: Universal Global Developer Preference Definition
print("\n[SESSION 1 - TURN 1: Global Preference Definition]")
prompt_1 = "Hi! As universal coding preferences across all my projects, I prefer Dark Mode UI and standardizing on Python 3.11 with PostgreSQL."
print(f"User Prompt:\n{prompt_1}")
resp_1, sys_prompt_1, latency_1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_1, project_id=None, trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_1[:140]}...")
time.sleep(2)

# TURN 2: Project-Specific Architecture Definition
print("\n[SESSION 1 - TURN 2: Project CloudRetail Architecture Definition]")
prompt_2 = (
    "Now I am starting project CloudRetail. Here are the specific project requirements:\n"
    "1. Backend Stack: Python with FastAPI on AlloyDB.\n"
    "2. Short-Term Cache: Memorystore for Valkey.\n"
    "3. Security Rules: All tool execution timeouts must be capped at 30 seconds.\n"
    f"4. Deployment Region: {REGION}."
)
print(f"User Prompt:\n{prompt_2}")
resp_2, sys_prompt_2, latency_2 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_2, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_2[:140]}...")
time.sleep(2)

# TURN 3: Context Inflation / Technical Dialogue Noise
print("\n[SESSION 1 - TURN 3: Large Context Inflation (Dialogue Noise)]")
prompt_3 = (
    "Let's draft a sample 50-line PostgreSQL DDL script for product catalog indexes, "
    "including HNSW vector index tuning parameters (m = 16, ef_construction = 64), "
    "and full-text RUM search indexes on item title and description columns."
)
print(f"User Prompt:\n{prompt_3}")
resp_3, sys_prompt_3, latency_3 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_3, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_3[:140]}...")
time.sleep(2)

# TURN 4: Triggering Valkey Summarize-Before-Trim Threshold (8 messages > 6 message trigger limit)
print("\n[SESSION 1 - TURN 4: Triggering Valkey Rolling Summary Compaction]")
prompt_4_s1 = "Can you also add rate-limiting middleware rules for API endpoints?"
print(f"User Prompt:\n{prompt_4_s1}")
resp_4_s1, sys_prompt_4_s1, latency_4_s1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_4_s1, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_4_s1[:140]}...")

# VERIFY VALKEY SHORT-TERM ROLLING SUMMARY
print("\n==================================================")
print("VALKEY SHORT-TERM ROLLING SUMMARY VERIFICATION")
print("==================================================")
buffer_data = get_session_context_buffer(valkey_client, SESSION_1)
valkey_summary_text = buffer_data["rolling_summary"]
valkey_turns = buffer_data["recent_turns"]

used_fallback = bool(IN_MEMORY_VALKEY_FALLBACK)
storage_backend = "Local In-Memory Fallback (Outside VPC)" if used_fallback else "Memorystore for Valkey (VPC Network)"

has_valkey_summary = bool(valkey_summary_text)
print(f" • Short-Term Cache Storage Target:             [{storage_backend}]")
print(f" • Valkey Rolling Summary Generated for Session 1: {has_valkey_summary}")
print(f"   Summary Content: {valkey_summary_text}")
print(f" • Remaining Raw Turns in Valkey Sliding Window:  {len(valkey_turns)} messages (Trimmed from 8)")

test_accuracy.append(("Valkey Rolling Summary Compaction Test", "PASS" if has_valkey_summary else "FAIL"))

# Wait for background entity extraction worker
print("\n[Waiting for background entity extraction worker to process & vectorize all extracted entities...]")
time.sleep(6)

print("\n==================================================")
print("EXTRACTED ENTITIES STORED IN ALLOYDB LONG-TERM MEMORY")
print("==================================================")
with db_conn.cursor() as cur:
    cur.execute(
        "SELECT entity_name, project_id, scope, summary, (summary_embedding IS NOT NULL) FROM agent_entities WHERE user_id = %s ORDER BY updated_at DESC;",
        (USER_ID,)
    )
    extracted = cur.fetchall()
    for name, p_id, s_scope, summary, has_vector in extracted:
        print(f" • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}' | Vector Generated: {has_vector}")
        print(f"   Summary: {summary}")

# TURN 5: Cross-Session Temporal & Scope Recall (Brand New Session ID)
print("\n[SESSION 2 - TURN 5 (Cross-Session Query in New Session ID)]")
prompt_4 = "What are my general coding preferences and the backend/timeout rules I chose for CloudRetail in my previous session?"
print(f"User Prompt:\n{prompt_4}")
resp_4, sys_prompt_4, latency_4 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_2, prompt_4, prev_session_id=SESSION_1, project_id="CloudRetail")
print(f"\nAI Answer:\n{resp_4}")

# VERIFICATION OF RETRIEVED ENTITIES (Checking Scope Precision)
retrieved_scoped_entities = retrieve_hybrid_entities(
    conn=db_conn,
    llm_client=client,
    user_id=USER_ID,
    active_session_id=SESSION_2,
    query_text=prompt_4,
    prev_session_id=SESSION_1,
    project_id="CloudRetail",
    k=20
)

print("\n==================================================")
print("DIAGNOSTIC SCOPE VERIFICATION DETAILS (EXPECTED vs ACTUAL)")
print("==================================================")
print("EXPECTED SPECIFIC ENTITIES & SCOPE:")
print("  1. Global Preference Entity: Retrieved entity with scope == 'global' containing preference facts ('dark mode', 'python 3.11', or 'postgres')")
print("  2. Project Architecture Entity: Retrieved entity with project_id == 'CloudRetail' containing tech stack facts ('fastapi', 'alloydb', 'valkey', or 'timeout')")
print(f"\nACTUAL RETRIEVED ENTITIES (Count: {len(retrieved_scoped_entities)}):")
if not retrieved_scoped_entities:
    print("  [NONE RETRIEVED! Vector/Fulltext search returned 0 matches]")
for ent_name, ent_info in retrieved_scoped_entities.items():
    print(f"  • Entity Name: '{ent_name}'")
    print(f"    - scope:      '{ent_info.get('scope')}'")
    print(f"    - project_id: '{ent_info.get('project_id')}'")
    print(f"    - summary:    '{ent_info.get('summary')}'")

print("\nDATABASE CHECK - ALL ROWS STORED IN agent_entities TABLE:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    db_rows = cur.fetchall()
    if not db_rows:
        print("  [DATABASE TABLE IS EMPTY! No entities were upserted by background worker]")
    for r in db_rows:
        print(f"  • DB Row: entity_name='{r[0]}' | project_id='{r[1]}' | scope='{r[2]}' | summary='{r[3]}'")

# SPECIFIC FACT & SCOPE VERIFICATION LOGIC
found_global_preference = False
matched_global_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("scope") == "global" and any(kw in combined_text for kw in ["dark mode", "python", "postgres"]):
        found_global_preference = True
        matched_global_entity = ent_name
        break

found_project_architecture = False
matched_project_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("project_id") == "CloudRetail" and any(kw in combined_text for kw in ["fastapi", "alloydb", "valkey", "timeout"]):
        found_project_architecture = True
        matched_project_entity = ent_name
        break

print("\n--------------------------------------------------")
print("METADATA SCOPE PRECISION VERIFICATION RESULTS:")
print(f" • Global Preference Fact Retrieved (scope='global'):        {found_global_preference} (Matched Entity: '{matched_global_entity}')")
print(f" • Project Architecture Fact Retrieved (project_id='CloudRetail'): {found_project_architecture} (Matched Entity: '{matched_project_entity}')")
print("--------------------------------------------------")

test_accuracy.append(("Global Coding Preference Recall Test (scope='global')", "PASS" if found_global_preference else "FAIL"))
test_accuracy.append(("Project CloudRetail Architecture Recall Test (project_id='CloudRetail')", "PASS" if found_project_architecture else "FAIL"))

# PERMISSION TEST
perm_action, reason = engine.evaluate_tool_permission(
    user_id=USER_ID, project_id="CloudRetail", session_id=SESSION_2,
    tool_name="run_command", tool_args={"CommandLine": "pytest --timeout=30"}
)
test_accuracy.append(("Tool Permission Policy Test", "PASS" if perm_action in ("allow", "PROMPT_USER") else "FAIL"))

# DYNAMIC TOKEN & LATENCY METRICS CALCULATION
active_prompt_chars_turn5 = len(sys_prompt_4)
active_tokens_turn5 = max(1, active_prompt_chars_turn5 // 4)

# Naive Un-compacted Full History Prompt Tokens for Turn 5
raw_history_chars = len(prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4)
naive_turn5_chars = raw_history_chars + 18000
naive_tokens_turn5 = naive_turn5_chars // 4

active_prompt_reduction_pct = ((naive_tokens_turn5 - active_tokens_turn5) / naive_tokens_turn5) * 100

# Cumulative Multi-Turn Tokens Comparison (Active Read-Path Prompts + Background Extraction & Compacting)
total_active_tokens = sum([
    len(p) // 4 for p in [sys_prompt_1, sys_prompt_2, sys_prompt_3, sys_prompt_4_s1, sys_prompt_4]
])
background_extraction_tokens = async_worker.total_extraction_tokens
background_valkey_summary_tokens = get_valkey_compaction_tokens()

total_tiered_system_tokens = total_active_tokens + background_extraction_tokens + background_valkey_summary_tokens

# Naive Cumulative Tokens across all 5 turns as full transcript grows continuously
naive_cumulative_tokens = sum([
    (len(p) + 18000) // 4 for p in [
        prompt_1,
        prompt_1 + resp_1 + prompt_2,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4
    ]
])

total_system_token_savings_pct = ((naive_cumulative_tokens - total_tiered_system_tokens) / naive_cumulative_tokens) * 100

# FINAL SUMMARY REPORT
print("\n==================================================")
print("FINAL AGENT MEMORY SYSTEM SUMMARY REPORT")
print("==================================================")

print("\n1. STORED ALLOYDB ENTITIES:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    for name, p_id, s_scope, summary in cur.fetchall():
        print(f"   • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}'")
        print(f"     Summary: {summary}")

print("\n2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:")
print(f"   • Naive Full-Context Turn 5 Tokens:    ~{naive_tokens_turn5:,} tokens ({naive_turn5_chars:,} chars)")
print(f"   • Tiered Memory Active Prompt Tokens:  ~{active_tokens_turn5:,} tokens ({active_prompt_chars_turn5:,} chars)")
print(f"   • Active Turn 5 Prompt Reduction:      {active_prompt_reduction_pct:.1f}% Reduction")
print(f"   • Measured Turn 5 Inference Latency:   {latency_4:.2f} seconds")

print("\n3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):")
print(f"   • Naive Cumulative Multi-Turn Tokens:  ~{naive_cumulative_tokens:,} tokens")
print(f"   • Active Read-Path Prompt Tokens:      ~{total_active_tokens:,} tokens (Across 5 Turns)")
print(f"   • Background Worker Tokens (Extraction):~{background_extraction_tokens:,} tokens (4 Background Turns)")
print(f"   • Background Compaction Tokens (Valkey):~{background_valkey_summary_tokens:,} tokens (1 Compaction Call)")
print(f"   • Total Tiered System Token Footprint: ~{total_tiered_system_tokens:,} tokens")
print(f"   • Overall System Token Savings:        {total_system_token_savings_pct:.1f}% Total Reduction")

print("\n4. ACCURACY & VERIFICATION TESTS:")
all_pass = True
for name, status in test_accuracy:
    print(f"   • {name}: [{status}]")
    if status != "PASS":
        all_pass = False

print("\n==================================================")
print(f"OVERALL STATUS: {'ALL TESTS PASSED ✔' if all_pass else 'VERIFICATION FAILED ✖'}")
print("==================================================")
যাচাইকরণ স্ক্রিপ্টটি চালান
ক্লাউড শেলে স্ক্রিপ্টটি চালান:
python3 test_memory_system.py
প্রত্যাশিত কনসোল আউটপুট
পরীক্ষার ফলাফল শেষে, প্রাপ্ত তথ্যের একটি সারসংক্ষেপ প্রিন্ট করা হবে। নিচে ব্যাখ্যাসহ এই ধরনের একটি প্রিন্টআউটের উদাহরণ দেওয়া হলো।
1. STORED ALLOYDB ENTITIES: <A List of all stored entities,>
   • Entity: '<name of entity>' | Project: '<which project does this relate to>' | Scope: '<global/project/session>'
     Summary: <The entity summary>
    ....

2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:
   • Naive Full-Context Turn 5 Tokens:    <Number of tokens in naive approach on the last turn>
   • Tiered Memory Active Prompt Tokens:  <Number of tokens in tiered approach on the last turn>
   • Active Turn 5 Prompt Reduction:      <Savings on tokens in %>
   • Measured Turn 5 Inference Latency:   <Latency in last turn>

3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):
   • Naive Cumulative Multi-Turn Tokens:  <Total tokens in the naive approach>
   • Active Read-Path Prompt Tokens:      <Read path tokens in the tiered approach>
   • Background Worker Tokens (Extraction): <Backround process tokens usage in tiered approach>
   • Background Compaction Tokens (Valkey): <Backround process tokens usage for compaction in tiered approach>
   • Total Tiered System Token Footprint: <Total tokens usage in tiered approach>
   • Overall System Token Savings:        <Savings on tokens in %>

4. ACCURACY & VERIFICATION TESTS:
   • Valkey Rolling Summary Compaction Test: <Did the roling summary work>
   • Global Coding Preference Recall Test (scope='global'): <Was it able to retrieve global scoped memories>
   • Project CloudRetail Architecture Recall Test (project_id='CloudRetail'): <Was it able to retrieve project specific scoped entities>
   • Tool Permission Policy Test: <Was it able to retrieve permissions policies>
মেমরি স্টোর রিসেট করুন (ঐচ্ছিক)
টেস্ট রানের মাঝে সমস্ত সংরক্ষিত মেমরি মুছে ফেলতে এবং Valkey ও AlloyDB-এর অবস্থা রিসেট করতে চাইলে, cleanup_memory_system.py ফাইলটি তৈরি করে চালান:
import logging
from db_clients import get_db_connection, get_valkey_client
from valkey_buffer import IN_MEMORY_VALKEY_FALLBACK

logging.basicConfig(level=logging.INFO)

def reset_memory_system():
    # 1. Flush short-term Valkey cache or clear local in-memory fallback
    try:
        valkey = get_valkey_client()
        valkey.flushdb()
        print("✔ Flushed Valkey short-term cache.")
    except Exception:
        IN_MEMORY_VALKEY_FALLBACK.clear()
        print("✔ Cleared local in-memory short-term fallback buffer.")

    # 2. Truncate long-term AlloyDB memory tables
    try:
        conn = get_db_connection()
        with conn:
            with conn.cursor() as cur:
                cur.execute("TRUNCATE TABLE agent_entities CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_embeddings CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_collections CASCADE;")
                cur.execute("TRUNCATE TABLE user_permissions CASCADE;")
                print("✔ Truncated AlloyDB long-term memory tables.")
        conn.close()
    except Exception as e:
        print(f"✖ AlloyDB cleanup error: {e}")

if __name__ == "__main__":
    reset_memory_system()
ক্লিনআপ স্ক্রিপ্টটি চালান:
python3 cleanup_memory_system.py
১৪. গুগল এডিকে-তে স্তরযুক্ত মেমরি সম্প্রসারণ
পূর্ববর্তী ধাপগুলোতে, আপনি একটি ২-স্তর বিশিষ্ট মেমরি সিস্টেম তৈরি করেছেন:
- স্তর ১ (স্বল্পমেয়াদী বাফার) : ভ্যালকির মেমোরিস্টোর সাম্প্রতিক কথোপকথনের পালাগুলো সংরক্ষণ করে এবং প্রম্পটগুলো সংক্ষিপ্ত রাখার জন্য চলমান সারাংশ তৈরি করে।
- স্তর ২ (দীর্ঘমেয়াদী হাইব্রিড স্টোর) : AlloyDB AI হাইব্রিড সার্চ ব্যবহার করে ব্যবহারকারীর স্থায়ী পছন্দ, প্রকল্পের নিয়মাবলী এবং ভেক্টর এমবেডিং সংরক্ষণ করে।
এই নির্দেশিকায়, আপনি গুগল এজেন্ট ডেভেলপমেন্ট কিট (Google Agent Development Kit) দিয়ে তৈরি একটি কাস্টম এজেন্টের সাথে এই মেমরি ইঞ্জিনটিকে সংযুক্ত করবেন।
সরল স্মৃতির সমস্যা
কোনো এজেন্টকে মেমরির সাথে সংযুক্ত করলে সাধারণত দুটি ফাঁদের মধ্যে একটি ঘটে:
- শুধুমাত্র টুল ব্যবহারের ফাঁদ : এজেন্টকে সবকিছুর জন্য টুল (যেমন
search_memory) কল করতে বাধ্য করা। এজেন্টরা প্রায়শই সাধারণ পছন্দগুলোর (যেমন কোডিং স্টাইল বা টাইমআউট) জন্য টুল কল করতে ভুলে যায়, যার ফলে ভুল হয় এবং অতিরিক্ত রাউন্ড-ট্রিপ ধীরগতির হয়ে পড়ে। - প্রম্পট-স্টাফিং ফাঁদ : প্রতিটি প্রম্পটে অতীতের সমস্ত ইতিহাস ঢুকিয়ে দেওয়া। এর ফলে দ্রুত টোকেন খরচ বেড়ে যায়, প্রতিক্রিয়ার গতি কমে যায় এবং মডেলের যুক্তিবোধের অবনতি ঘটে।
হাইব্রিড সমাধান
আমরা একটি হাইব্রিড পদ্ধতি ব্যবহার করি যা এজেন্টকে সঠিক সময়ে সঠিক স্মৃতি প্রদান করে:
- পারিপার্শ্বিক প্রেক্ষাপট (স্বয়ংক্রিয়) : প্রতিটি পালা শুরুর আগে, মেমোরিস্টোর (রোলিং সামারি) এবং অ্যালয়ডিবি (রুলস অ্যান্ড প্রেফারেন্সেস) থেকে প্রাসঙ্গিক প্রোজেক্ট রুলস এবং সাম্প্রতিক সেশন সামারি সংগ্রহ করা হয়, যা পরবর্তীতে কোনো অতিরিক্ত এলএলএম কল ছাড়াই এজেন্টের প্রম্পটে যুক্ত করা হয়।
- অন-ডিমান্ড দীর্ঘমেয়াদী অনুসন্ধান (টুল) : পুরোনো বা অস্পষ্ট তথ্যের (যেমন দুই সপ্তাহ আগের কোনো স্থাপত্যগত সিদ্ধান্ত) জন্য, এজেন্ট AlloyDB-এর দীর্ঘমেয়াদী মেমরি টেবিলে একটি ভেক্টর অনুসন্ধান চালানোর জন্য
long_term_memory_toolকে কল করে। - এক্সিকিউশন গার্ডরেল : এজেন্ট কোনো টুল চালানোর আগে, একটি গার্ডরেল Valkey-তে থাকা সিঙ্গেল-ইউজ গ্রান্ট এবং AlloyDB-তে থাকা সিকিউরিটি রুলগুলো পরীক্ষা করে
rm -rfমতো বিপজ্জনক অ্যাকশনগুলোকে ব্লক করে।
সেটআপ এবং কনফিগারেশন
google-adk প্যাকেজটি ইনস্টল করুন (অন্যান্য নির্ভরতাগুলি ইতিমধ্যেই ইনস্টল করা আছে):
pip3 install google-adk
ADK GenAI ক্লায়েন্টকে Vertex AI-এর মাধ্যমে রাউট করার জন্য Google Cloud অঞ্চলটি সেট করুন:
# ADK agent platform backend
export GEMINI_MODEL="gemini-3.5-flash"
export GOOGLE_GENAI_USE_VERTEXAI="true"
export GOOGLE_CLOUD_PROJECT="${PROJECT_ID}"
export GOOGLE_CLOUD_LOCATION="${GENAI_LOCATION}"
১৫. পারিপার্শ্বিক স্মৃতি প্রদানকারী
adk_memory_provider.py তৈরি করুন। এই ক্লাসটি স্বয়ংক্রিয় মেমরি লাইফসাইকেল পরিচালনা করে:
- পালা শুরুর আগে : Valkey কথোপকথন বাফার (<১ms) থেকে তথ্য সংগ্রহ করে এবং মিলে যাওয়া প্রেফারেন্স ও প্রোজেক্ট রুলসের জন্য AlloyDB-তে কোয়েরি করে, সেগুলোকে সিস্টেম প্রম্পটে একত্রিত করে।
- পালা শেষে : কথোপকথনটি Valkey-তে যুক্ত করে এবং ব্যবহারকারীর প্রতিক্রিয়ার গতি না কমিয়ে AlloyDB-তে টেকসই তথ্য নিষ্কাশন করার জন্য একটি ব্যাকগ্রাউন্ড ওয়ার্কার চালু করে।
import logging
from typing import Any, Dict, Optional
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

class ADKTieredMemoryProvider:
    """Provides ambient memory context before turns and saves history after turns."""

    def __init__(self, db_conn_factory, valkey_client: redis.Redis, genai_client: Any, trigger_limit: int = 10, window_size: int = 4):
        self.conn_factory = db_conn_factory
        self.valkey_client = valkey_client
        self.genai_client = genai_client
        self.trigger_limit = trigger_limit
        self.window_size = window_size
        self.async_worker = AsyncMemoryWorker(db_conn_factory, genai_client)

    def get_context_for_turn(self, user_id: str, project_id: Optional[str], session_id: str, user_query: str, prev_session_id: Optional[str] = None) -> Dict[str, Any]:
        """Reads Valkey buffer (<1ms) and AlloyDB hybrid entities before agent reasoning."""
        buffer_data = get_session_context_buffer(self.valkey_client, session_id)
        rolling_summary = buffer_data["rolling_summary"]

        # Carry over prior session summary when starting a fresh session
        if not rolling_summary and prev_session_id:
            prev_buffer = get_session_context_buffer(self.valkey_client, prev_session_id)
            if prev_buffer["rolling_summary"]:
                rolling_summary = f"[From prior session {prev_session_id}]:\n" + prev_buffer["rolling_summary"]

        conn = self.conn_factory()
        try:
            entities = retrieve_hybrid_entities(
                conn=conn, llm_client=self.genai_client, user_id=user_id,
                active_session_id=session_id, query_text=user_query,
                prev_session_id=prev_session_id, project_id=project_id, k=20
            )
        finally:
            conn.close()

        return {
            "rolling_summary": rolling_summary,
            "recent_turns": buffer_data["recent_turns"],
            "retrieved_entities": entities
        }

    def format_system_instruction(self, context: Dict[str, Any], base_prompt: str = "") -> str:
        """Injects ambient entities and short-term summaries into the agent's prompt."""
        entity_lines = [f"- {name}: {info['summary']}" for name, info in context["retrieved_entities"].items()]
        entity_str = "\n".join(entity_lines) if entity_lines else "No relevant long-term entities."
        summary_str = context["rolling_summary"] or "No prior summary."

        return f"""{base_prompt}

[LONG-TERM PREFERENCES & ENTITIES]
{entity_str}

[SHORT-TERM ROLLING SUMMARY]
{summary_str}

[NOTE ON TOOLS & MEMORY]
Memory persistence is managed automatically by the platform behind the scenes. Do not attempt to invoke non-existent tools like 'set_preference' or 'save_fact'. Only invoke explicitly declared tools when needed.
""".strip()

    def record_turn_async(self, user_id: str, project_id: Optional[str], session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None) -> None:
        """Updates Valkey sliding window and triggers background AlloyDB extraction."""
        append_session_turn_with_rolling_summary(
            valkey_client=self.valkey_client, llm_client=self.genai_client,
            session_id=session_id, user_msg=user_msg, ai_msg=ai_msg,
            trigger_limit=self.trigger_limit, window_size=self.window_size
        )
        self.async_worker.enqueue_extraction(
            user_id=user_id, session_id=session_id, user_msg=user_msg,
            ai_msg=ai_msg, prev_session_id=prev_session_id
        )
১৬. চাহিদা অনুযায়ী দীর্ঘমেয়াদী স্মৃতি সরঞ্জাম
অ্যাম্বিয়েন্ট মেমোরি সক্রিয় প্রম্পটটিকে ছোট রাখে, কিন্তু একজন এজেন্টের মাঝে মাঝে পুরোনো ঐতিহাসিক নোট, স্থাপত্যগত সিদ্ধান্ত বা ঘটনার লগ ঘেঁটে দেখার প্রয়োজন হয়।
adk_memory_tools.py তৈরি করুন। এটি AlloyDB-এর episodic_memory_embeddings ভেক্টর টেবিলটিকে একটি ADK FunctionTool এ রূপান্তর করে।
from typing import Any, Dict, List, Optional
from google.adk.tools import FunctionTool

def make_long_term_memory_tool(db_conn_factory, embed_client: Any, user_id: str) -> FunctionTool:
    """Creates an ADK FunctionTool for vector search over AlloyDB historical records."""

    def search_archived_memory(query: str, project_id: Optional[str] = None, limit: int = 3) -> List[Dict[str, Any]]:
        """Searches past architecture decisions, historical notes, and old discussions."""
        # 1. Embed query with text-embedding-005
        emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=query)
        query_vector = emb_resp.embeddings[0].values

        # 2. Cosine distance search on AlloyDB HNSW vector index
        sql = """
            SELECT document, cmetadata, created_at, 1 - (embedding <=> %s::vector) AS similarity
            FROM episodic_memory_embeddings
            WHERE cmetadata->>'user_id' = %s
              AND (%s IS NULL OR cmetadata->>'project_id' = %s)
            ORDER BY embedding <=> %s::vector ASC
            LIMIT %s;
        """
        conn = db_conn_factory()
        results = []
        try:
            with conn.cursor() as cur:
                cur.execute(sql, (str(query_vector), user_id, project_id, project_id, str(query_vector), limit))
                for doc, meta, created_at, similarity in cur.fetchall():
                    results.append({
                        "document": doc,
                        "metadata": meta,
                        "timestamp": created_at.isoformat() if created_at else None,
                        "similarity": round(float(similarity), 4)
                    })
        finally:
            conn.close()
        return results

    return FunctionTool(search_archived_memory)
১৭. এন্টারপ্রাইজ অনুমতি সুরক্ষা ব্যবস্থা
স্বায়ত্তশাসিত এজেন্টরা যাচাইকরণ ছাড়া হোস্টের কোনো ক্ষতিকর কাজ (যেমন rm -rf বা টেবিল ড্রপ করা) সম্পাদন করতে পারবে না।
ADK-এর before_tool_callback কীভাবে কাজ করে
ADK একটি ইন্টারসেপশন হুক প্রদান করে যা যেকোনো টুল কার্যকর হওয়ার আগে রান করে:
- কোনো ফলাফল
Noneদিলে: ADK টুলটি চালানোর অনুমতি দেয়। - একটি ডিকশনারি রিটার্ন করলে (যেমন
{"status": "DENIED", "error": ...}): ADK সাথে সাথে এক্সিকিউশন বন্ধ করে দেয় । কোনো কমান্ড রান হয় না, এবং প্রত্যাখ্যানের কারণটি মডেলে ফেরত পাঠানো হয় যাতে এটি ব্যবহারকারীকে এই সীমাবদ্ধতার কারণ ব্যাখ্যা করতে পারে।
অনুমতি যাচাইয়ের ক্রম
- চেক ০ (নিরাপদ টুলের অনুমোদন) :
search_archived_memoryমতো নিরাপদ রিড-অনলি টুলগুলো মেমরিতে আগে থেকেই অনুমোদিত থাকে, যাতে এজেন্ট সর্বদা তার নিজের মেমরি কোয়েরি করতে পারে। - স্তর ১ (Valkey-তে ক্ষণস্থায়ী "একবার-অনুমতি" প্রদান) : যখন কোনো মানব অপারেটর একটি ঝুঁকিপূর্ণ কাজ অনুমোদন করেন, তখন ৫-মিনিটের TTL সহ একটি অস্থায়ী কী
one_time_perm:{session_id}:{cmd_hash}Valkey-তে সংরক্ষিত হয়। গার্ডরেলটি একটিমাত্র অ্যাটমিক অপারেশনে কী-টি পড়ে এবং মুছে ফেলে । এটি কমান্ডটিকে একবার চালানোর অনুমতি দেয়, যা স্থায়ী প্রিভিলেজ ক্রিপ প্রতিরোধ করে। - স্তর ২ (অ্যালয়ডিবি-তে প্রোজেক্টের নিয়মাবলী) : সক্রিয় প্রোজেক্টের
user_permissionsএ থাকা রেজেক্স (regex) নিয়মগুলো পরীক্ষা করে (যেমন, allowpytest.*--timeout=30, blockrm -rf.*)। - স্তর ৩ (অ্যালয়ডিবি-তে গ্লোবাল রুলস) : সেইসব ফলব্যাক রুলস পরীক্ষা করে যা সকল প্রোজেক্ট জুড়ে প্রযোজ্য।
- ব্যর্থতা-বন্ধ ফলব্যাক : যদি কোনো নিয়ম না মেলে, তাহলে
PENDINGসহ এক্সিকিউশন প্রত্যাখ্যান করা হয় এবং মানব পর্যালোচনার প্রয়োজন হয়।
বাস্তবায়ন
adk_guardrails.py তৈরি করুন:
import logging
from typing import Any, Dict, Optional, Tuple, Set
from enterprise_engine import AgentMemoryEngine

logger = logging.getLogger(__name__)

class ADKPermissionGuardrail:
    """Evaluates tool permissions using Valkey allow-once tokens and AlloyDB rules."""

    def __init__(self, memory_engine: AgentMemoryEngine, exempt_tools: Optional[Set[str]] = None):
        self.engine = memory_engine
        self.exempt_tools = exempt_tools or {"search_archived_memory"}

    def evaluate(self, user_id: str, project_id: str, session_id: str, tool_name: str, tool_args: Dict[str, Any]) -> Tuple[bool, str]:
        # 1. Allowlist safe internal tools
        if tool_name in self.exempt_tools:
            return True, f"Internal tool '{tool_name}' is pre-approved."

        # 2. Check 3-tier policy engine
        action, reason = self.engine.evaluate_tool_permission(
            user_id=user_id, project_id=project_id, session_id=session_id,
            tool_name=tool_name, tool_args=tool_args
        )
        if action.upper() == "ALLOW":
            return True, f"Permission ALLOWED: {reason}"
        elif action.upper() == "BLOCK":
            return False, f"Permission BLOCKED: {reason}"
        return False, f"Permission PENDING: {reason} (requires human confirmation)"

    def create_before_tool_callback(self, user_id: str, default_project_id: str = "global"):
        """Creates the callback hook for Agent(before_tool_callback=...)."""
        def before_tool_callback(tool: Any, args: Dict[str, Any], tool_context: Any) -> Optional[Dict[str, Any]]:
            tool_name = getattr(tool, "name", str(tool))
            session_id = getattr(getattr(tool_context, "session", None), "id", "default_session")

            allowed, msg = self.evaluate(user_id, default_project_id, session_id, tool_name, args)
            if not allowed:
                logger.warning("Guardrail blocked '%s': %s", tool_name, msg)
                return {"status": "DENIED", "tool": tool_name, "error": msg}

            return None  # Returning None permits execution in ADK
        return before_tool_callback
১৮. ADK এজেন্ট পরীক্ষা চালানো
test_adk_agent.py তৈরি করুন। এই সম্পূর্ণ স্ক্রিপ্টটি উপাদানগুলোকে একসাথে সংযুক্ত করে, একটি আর্কাইভ করা সিদ্ধান্ত এবং নিরাপত্তা নিয়মগুলোকে স্থাপন করে, একটি ২-সেশনের কথোপকথন চালায়, মেমরি কম্প্যাকশন ও রিকল পরীক্ষা করে এবং গার্ডরেল প্রয়োগ যাচাই করে:
import asyncio
import os
import time
from google import genai
from google.genai import types
from google.adk.agents import Agent
from google.adk.runners import Runner
from google.adk.sessions import InMemorySessionService
from google.adk.tools import FunctionTool

from db_clients import get_db_connection, get_valkey_client
from enterprise_engine import AgentMemoryEngine
from adk_memory_provider import ADKTieredMemoryProvider
from adk_memory_tools import make_long_term_memory_tool
from adk_guardrails import ADKPermissionGuardrail
from valkey_buffer import get_session_context_buffer

# Configuration & clients
PROJECT_ID = os.getenv("PROJECT_ID", "chunking-poc-alloydb")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")
GEMINI_MODEL = os.getenv("GEMINI_MODEL", "gemini-3.5-flash")
USER_ID, SESSION_1, SESSION_2 = "user_adk_dev", "sess_adk_001", "sess_adk_002"

db_conn = get_db_connection()
valkey_client = get_valkey_client()
# LLM client for Gemini 3.5 Flash via global multi-region
genai_client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)
# Embeddings client (requires specific regional presence)
embed_client = genai.Client(vertexai=True, project=PROJECT_ID, location=REGION)

tiered_provider = ADKTieredMemoryProvider(get_db_connection, valkey_client, genai_client, trigger_limit=3, window_size=2)
memory_engine = AgentMemoryEngine(valkey_client, db_conn)
guardrail = ADKPermissionGuardrail(memory_engine)

# Tools: Long-term memory search and mock terminal command
long_term_memory_tool = make_long_term_memory_tool(get_db_connection, embed_client, USER_ID)

def run_command(CommandLine: str) -> str:
    """Executes a shell command on the host."""
    return f"Executed: {CommandLine}"

run_command_tool = FunctionTool(run_command)

def seed_database():
    """Seeds a 14-day-old architecture decision and permission rules."""
    doc = "Archived Decision: CloudRetail services must use gRPC keepalive ping intervals of 15 seconds."
    emb = embed_client.models.embed_content(model="text-embedding-005", contents=doc).embeddings[0].values
    conn = get_db_connection()
    try:
        with conn.cursor() as cur:
            cur.execute("""
                INSERT INTO episodic_memory_embeddings (uuid, document, cmetadata, created_at, embedding)
                VALUES (gen_random_uuid(), %s, jsonb_build_object('user_id', %s, 'project_id', 'CloudRetail'), NOW() - INTERVAL '14 days', %s::vector);
            """, (doc, USER_ID, str(emb)))
            cur.execute("""
                INSERT INTO user_permissions (user_id, project_id, tool_name, command_pattern, action)
                VALUES (%s, 'CloudRetail', 'run_command', 'pytest.*--timeout=30', 'ALLOW'),
                       (%s, 'CloudRetail', 'run_command', 'rm -rf.*', 'BLOCK'),
                       (%s, 'global', 'search_archived_memory', '.*', 'ALLOW')
                ON CONFLICT DO NOTHING;
            """, (USER_ID, USER_ID, USER_ID))
        conn.commit()
    finally:
        conn.close()

async def run_turn(runner: Runner, session_id: str, query: str, prev_session_id: str = None) -> str:
    """Fetches ambient memory, executes turn, and saves history in the background."""
    ctx = tiered_provider.get_context_for_turn(USER_ID, "CloudRetail", session_id, query, prev_session_id)
    runner.agent.instruction = tiered_provider.format_system_instruction(
        ctx,
        base_prompt="You are an intelligent Google ADK enterprise developer assistant."
    )
    msg = types.Content(role="user", parts=[types.Part.from_text(text=query)])
    parts = []
    async for event in runner.run_async(user_id=USER_ID, session_id=session_id, new_message=msg):
        if event.content and event.content.parts:
            parts.extend([p.text for p in event.content.parts if p.text])

    response = "".join(parts).strip()
    tiered_provider.record_turn_async(USER_ID, "CloudRetail", session_id, query, response, prev_session_id)
    return response

async def main():
    seed_database()
    sessions = InMemorySessionService()
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_1)

    agent = Agent(
        name="adk_memory_agent", model=GEMINI_MODEL, instruction="Initial instruction",
        tools=[long_term_memory_tool, run_command_tool],
        before_tool_callback=guardrail.create_before_tool_callback(USER_ID, "CloudRetail")
    )
    runner = Runner(agent=agent, session_service=sessions, app_name="agents")

    print("\n--- Session 1: Storing Preferences & Triggering Compaction ---")
    await run_turn(runner, SESSION_1, "I standardize on Python 3.11 with PostgreSQL and Dark Mode UI.")
    await run_turn(runner, SESSION_1, "For project CloudRetail, our backend stack is FastAPI on AlloyDB with Valkey cache and 30s timeouts.")
    await run_turn(runner, SESSION_1, "Draft a quick 5-line SQL table for products.")
    await run_turn(runner, SESSION_1, "Add rate-limiting rules for API endpoints.")

    buf = get_session_context_buffer(valkey_client, SESSION_1)
    print(f"Valkey rolling summary generated: {bool(buf['rolling_summary'])}")
    print(f"Turns in buffer: {len(buf['recent_turns'])} (compacted from 8)")

    print("\nWaiting 6s for background worker entity extraction into AlloyDB...")
    await asyncio.sleep(6)

    print("\n--- Session 2: Cold-Start Ambient Recall ---")
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_2)
    resp = await run_turn(runner, SESSION_2, "What are my coding preferences and the CloudRetail stack from my previous session?", prev_session_id=SESSION_1)
    print(f"Agent response:\n{resp}\n")

    print("\n--- On-Demand Archival Vector Search ---")
    resp_search = await run_turn(runner, SESSION_2, "What was the agreed gRPC keepalive interval from 2 weeks ago?")
    print(f"Agent response:\n{resp_search}\n")

    print("\n--- Guardrail Verification ---")
    blocked, b_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "rm -rf /tmp/data"})
    allowed, a_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "pytest --timeout=30"})
    print(f"rm -rf /tmp/data:    Allowed={blocked} ({b_msg})")
    print(f"pytest --timeout=30: Allowed={allowed} ({a_msg})")

if __name__ == "__main__":
    asyncio.run(main())
পুনরাবৃত্তিমূলক পরীক্ষার পরিচ্ছন্নতা
যেহেতু সিস্টেমটি স্থায়ী কনটেক্সট ধারণ করে, তাই একাধিকবার পরীক্ষাটি চালালে তা Valkey-তে অবিরাম ডায়ালগ চাঙ্ক যুক্ত করতে থাকবে এবং AlloyDB-তে ডুপ্লিকেট রুলস প্রবেশ করাবে।
দুটি রানের মাঝে আপনার স্টেট সহজে রিসেট করতে, আগের ধাপে তৈরি করা cleanup_memory_system.py স্ক্রিপ্টটি চালান:
python3 cleanup_memory_system.py
python3 test_adk_agent.py
যাচাইয়ের ফলাফল
পরীক্ষাটি চারটি গুরুত্বপূর্ণ উৎপাদন আচরণ যাচাই করে:
- প্রম্পট টোকেনের উল্লেখযোগ্য হ্রাস : ভ্যালকি কম্প্যাকশন ডায়ালগ হিস্ট্রিকে একটি সংক্ষিপ্ত চলমান সারাংশে সংকুচিত করেছে। আমাদের পরীক্ষায়, এটি সক্রিয় প্রম্পটের আকার ৯২%-এর বেশি কমিয়েছে (প্রায় ৬,৯৫৬ টোকেন থেকে প্রায় ৫৪৪ টোকেনে) -- আপনার ক্ষেত্রে ফলাফল ভিন্ন হতে পারে।
- তাৎক্ষণিক কোল্ড-স্টার্ট রিকল : একটি একেবারে নতুন সেশনে (সেশন ২), এজেন্ট কোনো টুল কল না করেই ব্যবহারকারীর পছন্দসমূহ (পাইথন ৩.১১, পোস্টগ্রেসকিউএল, ডার্ক মোড) এবং প্রোজেক্ট আর্কিটেকচার (ফাস্টএপিআই, ৩০ সেকেন্ডের টাইমআউট) অবিলম্বে রিকল করে। এটি
ADKTieredMemoryProvider.get_context_for_turnদ্বারা সক্ষম করা হয়েছিল, যা LLM কল করার আগে মেমোরিস্টোর এবং অ্যালয়ডিবি থেকে কনটেক্সট পুনরুদ্ধার করে। - অন-ডিমান্ড ভেক্টর রিকল : ১৪ দিন আগের কোনো সিদ্ধান্ত সম্পর্কে জিজ্ঞাসা করা হলে, এজেন্ট
search_archived_memoryচালু করে এবং ১৫-সেকেন্ডের gRPC কিপঅ্যালাইভ রুলটি পুনরুদ্ধার করে। - সুনির্দিষ্ট নিরাপত্তা : এজেন্টটি
pytest --timeout=30সম্পাদন করেছিল, কিন্তুrm -rf /tmp/dataচালানোর ক্ষেত্রে কঠোরভাবে বাধা দেওয়া হয়েছিল।
১৯. পরিষ্কার করা
AlloyDB এবং Memorystore ইনস্ট্যান্সগুলির জন্য আপনার Google Cloud অ্যাকাউন্টে চলমান বিলিং চার্জ এড়াতে, তৈরি করা রিসোর্সগুলি মুছে ফেলুন।
ক্লাউড শেলে নিম্নলিখিত কমান্ডগুলি চালান:
# Exit VM and return to Cloud Shell
exit
# Delete Compute Engine development VM
gcloud compute instances delete $VM_NAME \
  --zone=$ZONE \
  --quiet

# Delete AlloyDB primary instance and cluster
gcloud alloydb instances delete $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --quiet

gcloud alloydb clusters delete $ADBCLUSTER \
  --region=$REGION \
  --quiet

# Delete Memorystore for Valkey instance
gcloud memorystore instances delete $VALKEYINSTANCE \
  --location=$REGION \
  --quiet
২০. অভিনন্দন
অভিনন্দন! আপনি Valkey-এর জন্য Memorystore এবং AlloyDB AI-কে একত্রিত করে সফলভাবে একটি ২-স্তর বিশিষ্ট দীর্ঘমেয়াদী এআই এজেন্ট মেমরি আর্কিটেকচার তৈরি করেছেন।
আপনি যা শিখেছেন
- একটি ২-স্তরীয় মেমরি আর্কিটেকচার বাস্তবায়ন করা হয়েছে, যা স্বল্পমেয়াদী সক্রিয় সেশন স্টেটকে দীর্ঘমেয়াদী স্থায়ী ফ্যাক্টস থেকে পৃথক করে।
- সাধারণ কনটেক্সট স্টাফিংয়ের তুলনায় নির্ভুলতা না কমিয়েই সক্রিয় প্রম্পটের আকারে উল্লেখযোগ্য হ্রাস এবং মোট টোকেন ব্যবহারে সাশ্রয় অর্জন করা সম্ভব হয়েছে।
- AlloyDB AI ডাটাবেস-স্তরের ট্রানজ্যাকশনাল অটো-এম্বেডিংস (
ai.initialize_embeddings) কনফিগার করা হয়েছে। - ভেক্টর সাদৃশ্য (
<=>) এবং PostgreSQL পূর্ণ-পাঠ্য অনুসন্ধান (tsvector) এর সমন্বয়ে নেটিভ রেসিপ্রোকাল র্যাঙ্ক ফিউশন হাইব্রিড অনুসন্ধান (ai.hybrid_search) চালানো হয়েছে। - একটি অফ-থ্রেড ব্যাকগ্রাউন্ড এনটিটি এক্সট্র্যাক্টর (
AsyncMemoryWorker), একটি ৩-স্তরীয় টুল এক্সিকিউশন পারমিশন ইভ্যালুয়েটর এবং একটি ডাটাবেস মেমরি কম্প্যাকশন ইঞ্জিন তৈরি করেছি। - টুল গার্ডরেইল প্রয়োগ করতে এবং অ্যাম্বিয়েন্ট মেমরি সরবরাহ করতে গুগল এজেন্ট ডেভেলপমেন্ট কিট (ADK) ব্যবহার করে একটি স্বায়ত্তশাসিত এজেন্টের সাথে স্তরযুক্ত মেমরি সিস্টেম সংযুক্ত করা হয়েছে।
পরবর্তী পদক্ষেপ ও তথ্যসূত্র
- AlloyDB AI ডকুমেন্টেশনটি পড়ুন।
- AlloyDB-তে কীভাবে হাইব্রিড ভেক্টর সার্চ চালাতে হয় তা শিখুন।
- Valkey-এর জন্য Memorystore সম্পর্কে আরও জানুন।