

1. Antes de comenzar
A medida que los agentes de IA manejan interacciones largas de varios turnos que abarcan varios días y ejecutan tareas de varios pasos a largo plazo, los modelos de lenguaje grandes (LLM) siguen siendo inherentemente sin estado en todas las sesiones. Cuando un usuario regresa a un agente al día siguiente, el modelo comienza desde cero, a menos que la aplicación pueda reconstruir el contexto necesario.
El enfoque ingenuo para este problema es el relleno de tokens, que consiste en agregar historiales de conversaciones completos, registros de ejecución de herramientas y bases de código directamente a cada instrucción activa. Si bien las grandes ventanas de contexto de millones de tokens hacen que esto sea técnicamente posible, el relleno de contexto introduce una grave resistencia operativa: los costos de tokens se ajustan de forma cuadrática en cada turno, las latencias de respuesta crecen a decenas de segundos y los modelos sufren una degradación del contexto "perdido en el medio".
Para crear agentes de IA confiables, necesitas una arquitectura de memoria de 2 niveles:
- Búfer de sesión a corto plazo: Almacena en caché los turnos de conversación recientes en la memoria activa con una ventana deslizante limitada por tokens. Este nivel requiere búsquedas en memoria de alto rendimiento y con una latencia inferior a un milisegundo en cada turno, lo que convierte a Memorystore for Valkey en la opción ideal.
- Memoria persistente a largo plazo: Almacena entidades estructuradas, preferencias del usuario y hechos episódicos en todas las sesiones. Este nivel requiere integridad transaccional, seguridad de múltiples inquilinos y recuperación híbrida en datos relacionales y vectores, lo que convierte a AlloyDB para PostgreSQL en la opción correcta.
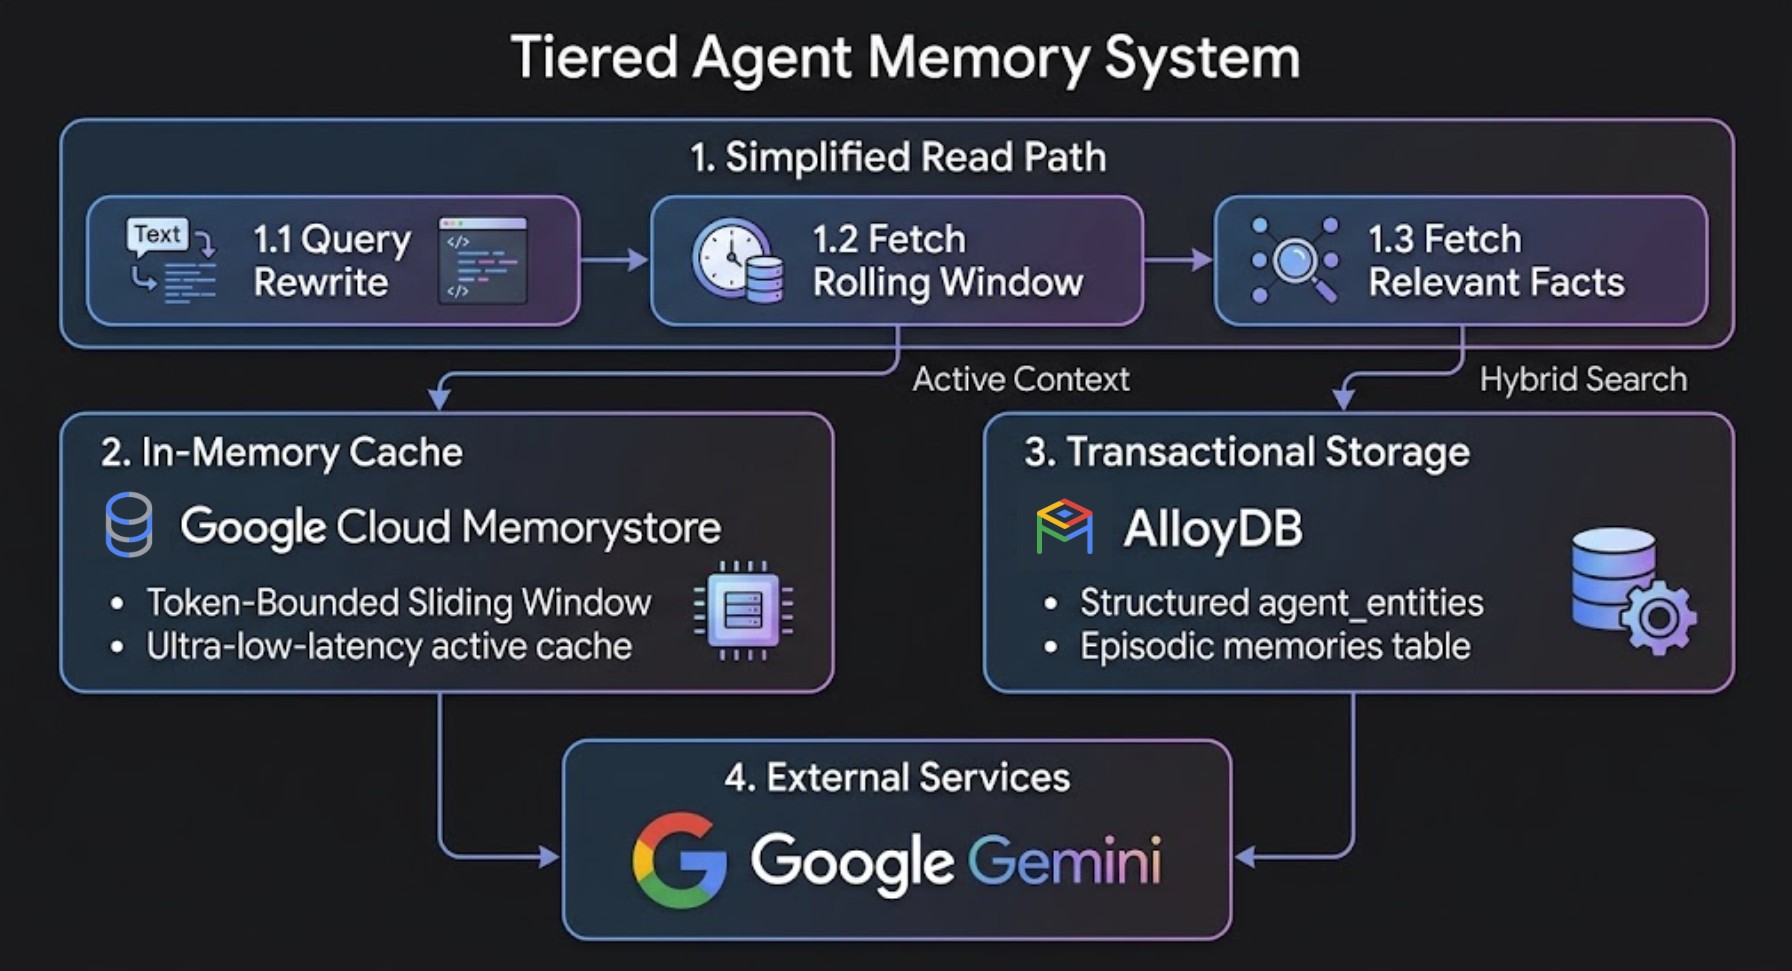
Acerca de los cuatro tipos de memoria
Una arquitectura de memoria sólida se basa en cuatro tipos de memoria complementarios a lo largo del recorrido del usuario:
Tipo de memoria | Qué almacena | Capa de almacenamiento | Vida útil |
Buffer (Short-term) | Intercambios de conversación sin procesar recientes | Memorystore for Valkey | Sesión activa |
Memoria de resumen | Historial comprimido de los giros anteriores | Memorystore for Valkey | Ventana de varios turnos |
Memoria episódica | Acciones, eventos y resultados de herramientas anteriores | AlloyDB para PostgreSQL (Vector) | Permanente |
Memoria de entidades y reglas | Preferencias, restricciones y vetos del usuario | AlloyDB para PostgreSQL (SQL estructurado + vector) | Permanente |
Impacto medido de la memoria por niveles
Las pruebas comparativas internas en diálogos de desarrollo de varios turnos (más de 45 turnos con registros de salida de herramientas pesados) demuestran ahorros significativos en comparación con el relleno de contexto ingenuo:
Métrica o dimensión | Relleno de contexto ingenuo | Memoria por niveles (AlloyDB + Memorystore) | Impacto neto en las pruebas |
Tamaño del mensaje activo (turno 45) | 747,033 tokens | 83,262 tokens | Instrucción un 88.9% más pequeña |
Latencia de respuesta del giro 45 | 33.5 segundos | 6.7 segundos | Respuesta un 80% más rápida |
Tokens de sesión acumulativos | 17.9 millones de tokens | 4.09 millones de tokens | Ahorro total del 72% en costos y tokens |
Recuperación de reglas y restricciones | Se degrada con el tiempo | Evita que se pierda información importante en el resumen | Se conserva a través de la búsqueda híbrida |
Actividades
- Aprovisiona AlloyDB para PostgreSQL y Memorystore para Valkey.
- Habilita
google_ml_integrationy configura las incorporaciones automáticas transaccionales del lado de la base de datos (ai.initialize_embeddings). - Implementa un búfer de sesión de Valkey a corto plazo con un patrón de canalización de resumen antes de recortar.
- Extrae entidades a largo plazo de forma nativa con las funciones IA nativas de AlloyDB (es decir,
ai.generate). - Consultar hechos a largo plazo con alta precisión y relevancia usando la función de búsqueda híbrida nativa de AlloyDB (
ai.hybrid_search) y la fusión por clasificación recíproca (RRF). - Crea un evaluador de permisos de herramientas empresariales de 3 niveles y un motor de compactación de memoria en segundo plano.
- Integra la arquitectura de memoria de 2 niveles directamente en un agente autónomo con el Kit de desarrollo de agentes (ADK) de Google.
Requisitos
- Un proyecto de Google Cloud con facturación habilitada.
- Un navegador web, como Chrome
- Conocimientos básicos de Python y SQL, incluida la experiencia en la ejecución de consultas de SQL en AlloyDB, ya sea desde Studio, la CLI, etcétera
Público y costo
- Público: Desarrolladores de IA, ingenieros de backend y arquitectos de bases de datos.
- Costo estimado: Los recursos de Google Cloud creados en este codelab costarán aproximadamente USD 1.50.
2. Configuración y requisitos
Inicie Cloud Shell
En este codelab, ejecutarás comandos en Google Cloud Shell, una terminal alojada en la nube y preconfigurada con gcloud, psql y python3.
- Abre la consola de Google Cloud.
- Haz clic en Activar Cloud Shell en la parte superior derecha de la consola de Cloud.
- Verifica la autenticación:
gcloud auth list
export PROJECT_ID=<YOUR_PROJECT_ID>
gcloud config set project $PROJECT_ID

export REGION=us-east1
export GENAI_LOCATION=us
export ZONE=us-east1-b
export ADBCLUSTER=agent-memory-cluster
export ADBINSTANCE=agent-memory-instance
export VALKEYINSTANCE=agent-memory-cache
export VM_NAME=agent-dev-vm
Habilita las APIs de Google Cloud y crea una VM de desarrollo
Ejecuta el siguiente comando en Cloud Shell para habilitar las APIs requeridas:
gcloud services enable \
  alloydb.googleapis.com \
  memorystore.googleapis.com \
  aiplatform.googleapis.com \
  compute.googleapis.com \
  servicenetworking.googleapis.com \
  networkconnectivity.googleapis.com
Crea una instancia de VM de Compute Engine en la red de VPC default para alojar tu entorno de desarrollo de Python junto con AlloyDB y Memorystore para Valkey:
gcloud compute instances create $VM_NAME \
    --zone=$ZONE \
    --machine-type=e2-standard-2 \
    --scopes=cloud-platform \
    --network=default \
    --shielded-secure-boot
3. Aprovisiona AlloyDB y Memorystore for Valkey
En este paso, aprovisionarás tu clúster y tu instancia principal de AlloyDB para PostgreSQL, establecerás redes de servicios privadas y activarás una instancia de Memorystore para Valkey.
Crea un rango de IP de acceso privado a servicios
AlloyDB requiere un rango de IP privada en tu red de nube privada virtual (VPC). Si suponemos que usas la red de VPC default, haz lo siguiente:
- Crea la asignación del rango de IP privada:
gcloud compute addresses create psa-range \
    --global \
    --purpose=VPC_PEERING \
    --prefix-length=24 \
    --description="VPC private service access" \
    --network=default
- Establece la conexión privada de intercambio de tráfico entre VPC:
gcloud services vpc-peerings connect \
    --service=servicenetworking.googleapis.com \
    --ranges=psa-range \
    --network=default
Crea un clúster y una instancia principal de AlloyDB
- Crea una contraseña inicial del clúster para la inicialización del sistema:
export PGPASSWORD=`openssl rand -hex 12`
- Crea un clúster de prueba gratuita:
gcloud alloydb clusters create $ADBCLUSTER \
    --password=$PGPASSWORD \
    --network=default \
    --region=$REGION \
    --subscription-type=TRIAL
- Crea la instancia principal:
gcloud alloydb instances create $ADBINSTANCE \
    --instance-type=PRIMARY \
    --cpu-count=2 \
    --region=$REGION \
    --cluster=$ADBCLUSTER
Aprovisiona una instancia de Memorystore for Valkey
Memorystore para Valkey requiere una política de conexión de servicio (gcp-memorystore) en tu red y región antes de la creación de la instancia.
- Crea la política de conexión de servicio para Memorystore:
gcloud network-connectivity service-connection-policies create memorystore-policy \
    --network=default \
    --region=$REGION \
    --service-class=gcp-memorystore \
    --subnets=projects/$PROJECT_ID/regions/$REGION/subnetworks/default
- Crea la instancia de Memorystore for Valkey:
gcloud memorystore instances create $VALKEYINSTANCE \
    --location=$REGION \
    --shard-count=1 \
    --replica-count=0 \
    --node-type=SHARED_CORE_NANO \
    --psc-auto-connections="network=projects/$PROJECT_ID/global/networks/default,projectId=$PROJECT_ID"
Otorga permisos de IAM de Vertex AI
Otorga a la cuenta de servicio de AlloyDB los permisos de IAM necesarios para invocar los modelos de incorporación de Agent Platform:
PROJECT_ID=$(gcloud config get-value project)

gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:service-$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")@gcp-sa-alloydb.iam.gserviceaccount.com" \
  --role="roles/aiplatform.user"
4. Inicializa el entorno y accede a los extremos
Configura la autenticación de IAM y las marcas de base de datos de AlloyDB
Habilita la autenticación de la base de datos de IAM (alloydb.iam_authentication=on) y el motor de consultas de IA (google_ml_integration.enable_ai_query_engine=on) en tu instancia de AlloyDB:
gcloud beta alloydb instances update $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --update-mode=FORCE_APPLY \
  --database-flags=alloydb.iam_authentication=on,google_ml_integration.enable_ai_query_engine=on
A continuación, agrega tu cuenta de Google Cloud como un usuario de la base de datos basado en IAM con permisos de superusuario:
export USER_ACCOUNT=$(gcloud config get-value account)

gcloud alloydb users create $USER_ACCOUNT \
    --cluster=$ADBCLUSTER \
    --region=$REGION \
    --type=IAM_BASED \
    --db-roles=alloydbsuperuser
Recupera extremos de VPC internos en Cloud Shell
Antes de establecer una conexión SSH con tu VM de desarrollo, recupera las direcciones IP internas de la VPC para AlloyDB y Memorystore para Valkey en Cloud Shell:
# Export GCP Project ID, Region, and IAM User
export PROJECT_ID=$(gcloud config get-value project)
export REGION=us-east1
export DB_USER=$(gcloud config get-value account)

# Retrieve Internal VPC IP Addresses for AlloyDB & Memorystore for Valkey
export DB_HOST=$(gcloud alloydb instances describe $ADBINSTANCE --cluster=$ADBCLUSTER --region=$REGION --format="value(ipAddress)")
export DB_PORT=5432
export DB_NAME=postgres

export VALKEY_HOST=$(gcloud memorystore instances describe $VALKEYINSTANCE --location=$REGION --format="value(discoveryEndpoints[0].address)")
export VALKEY_PORT=6379

# Verify exported endpoints
echo "Project ID:        $PROJECT_ID"
echo "Region:            $REGION"
echo "AlloyDB Private IP: $DB_HOST"
echo "IAM DB User:       $DB_USER"
echo "Valkey Private IP:  $VALKEY_HOST"
Conéctate a la VM de desarrollo a través de SSH y exporta las variables de conexión
Establece una conexión SSH desde Cloud Shell a tu VM de desarrollo de Compute Engine (agent-dev-vm) ubicada en la misma red de VPC:
gcloud compute ssh $VM_NAME --zone=$ZONE
Una vez que accedas a tu VM de desarrollo, exporta la configuración del proyecto y los resultados de conexión que se muestran arriba (reemplaza
export PROJECT_ID=<YOUR_PROJECT_ID>
export REGION=us-east1
export GENAI_LOCATION=us
export DB_HOST=<YOUR_ALLOYDB_PRIVATE_IP>
export DB_PORT=5432
export DB_NAME=postgres
export DB_USER=<YOUR_IAM_DB_USER>
export VALKEY_HOST=<YOUR_VALKEY_PRIVATE_IP>
export VALKEY_PORT=6379
Inicializa el entorno virtual de Python
Dentro de tu VM de desarrollo, primero crearemos tu directorio de trabajo local:
mkdir -p ~/alloydb_agent_memory && cd ~/alloydb_agent_memory
Ahora, instalemos los paquetes del entorno virtual de Python del sistema, autentiquemos las credenciales predeterminadas de la aplicación (ADC) y configuremos tu espacio de trabajo:
sudo apt-get update && sudo apt-get install -y python3-venv python3-pip

python3 -m venv venv
source venv/bin/activate
Por último, en el nuevo entorno virtual, instalaremos las dependencias:
gcloud auth application-default login
pip install psycopg2-binary valkey redis google-genai
5. Arquitectura del sistema y jerarquía de módulos de código
Descripción general de lo que crearás
Antes de implementar las secuencias de comandos de Python individuales, revisa la arquitectura del sistema que se muestra a continuación. Esta aplicación de ejemplo se estructura en 7 secuencias de comandos modulares de Python que operan en dos rutas de ejecución principales que interactúan con la misma instancia de base de datos de AlloyDB para PostgreSQL:
- Ruta de lectura (
hybrid_retriever.py): Descompone preguntas compuestas de varias partes en subpreguntas de un solo aspecto directamente dentro de PostgreSQL con AlloyDB AIai.generate()y consulta recuerdos a largo plazo con la búsqueda híbrida nativa de AlloyDB (ai.hybrid_search). - Ruta de escritura (
async_worker.py): Es un trabajador de cola en segundo plano fuera del subproceso que extrae de forma asíncrona hechos de entidades estructuradas de los intercambios de diálogo con Gemini Flash y los inserta enagent_entities.
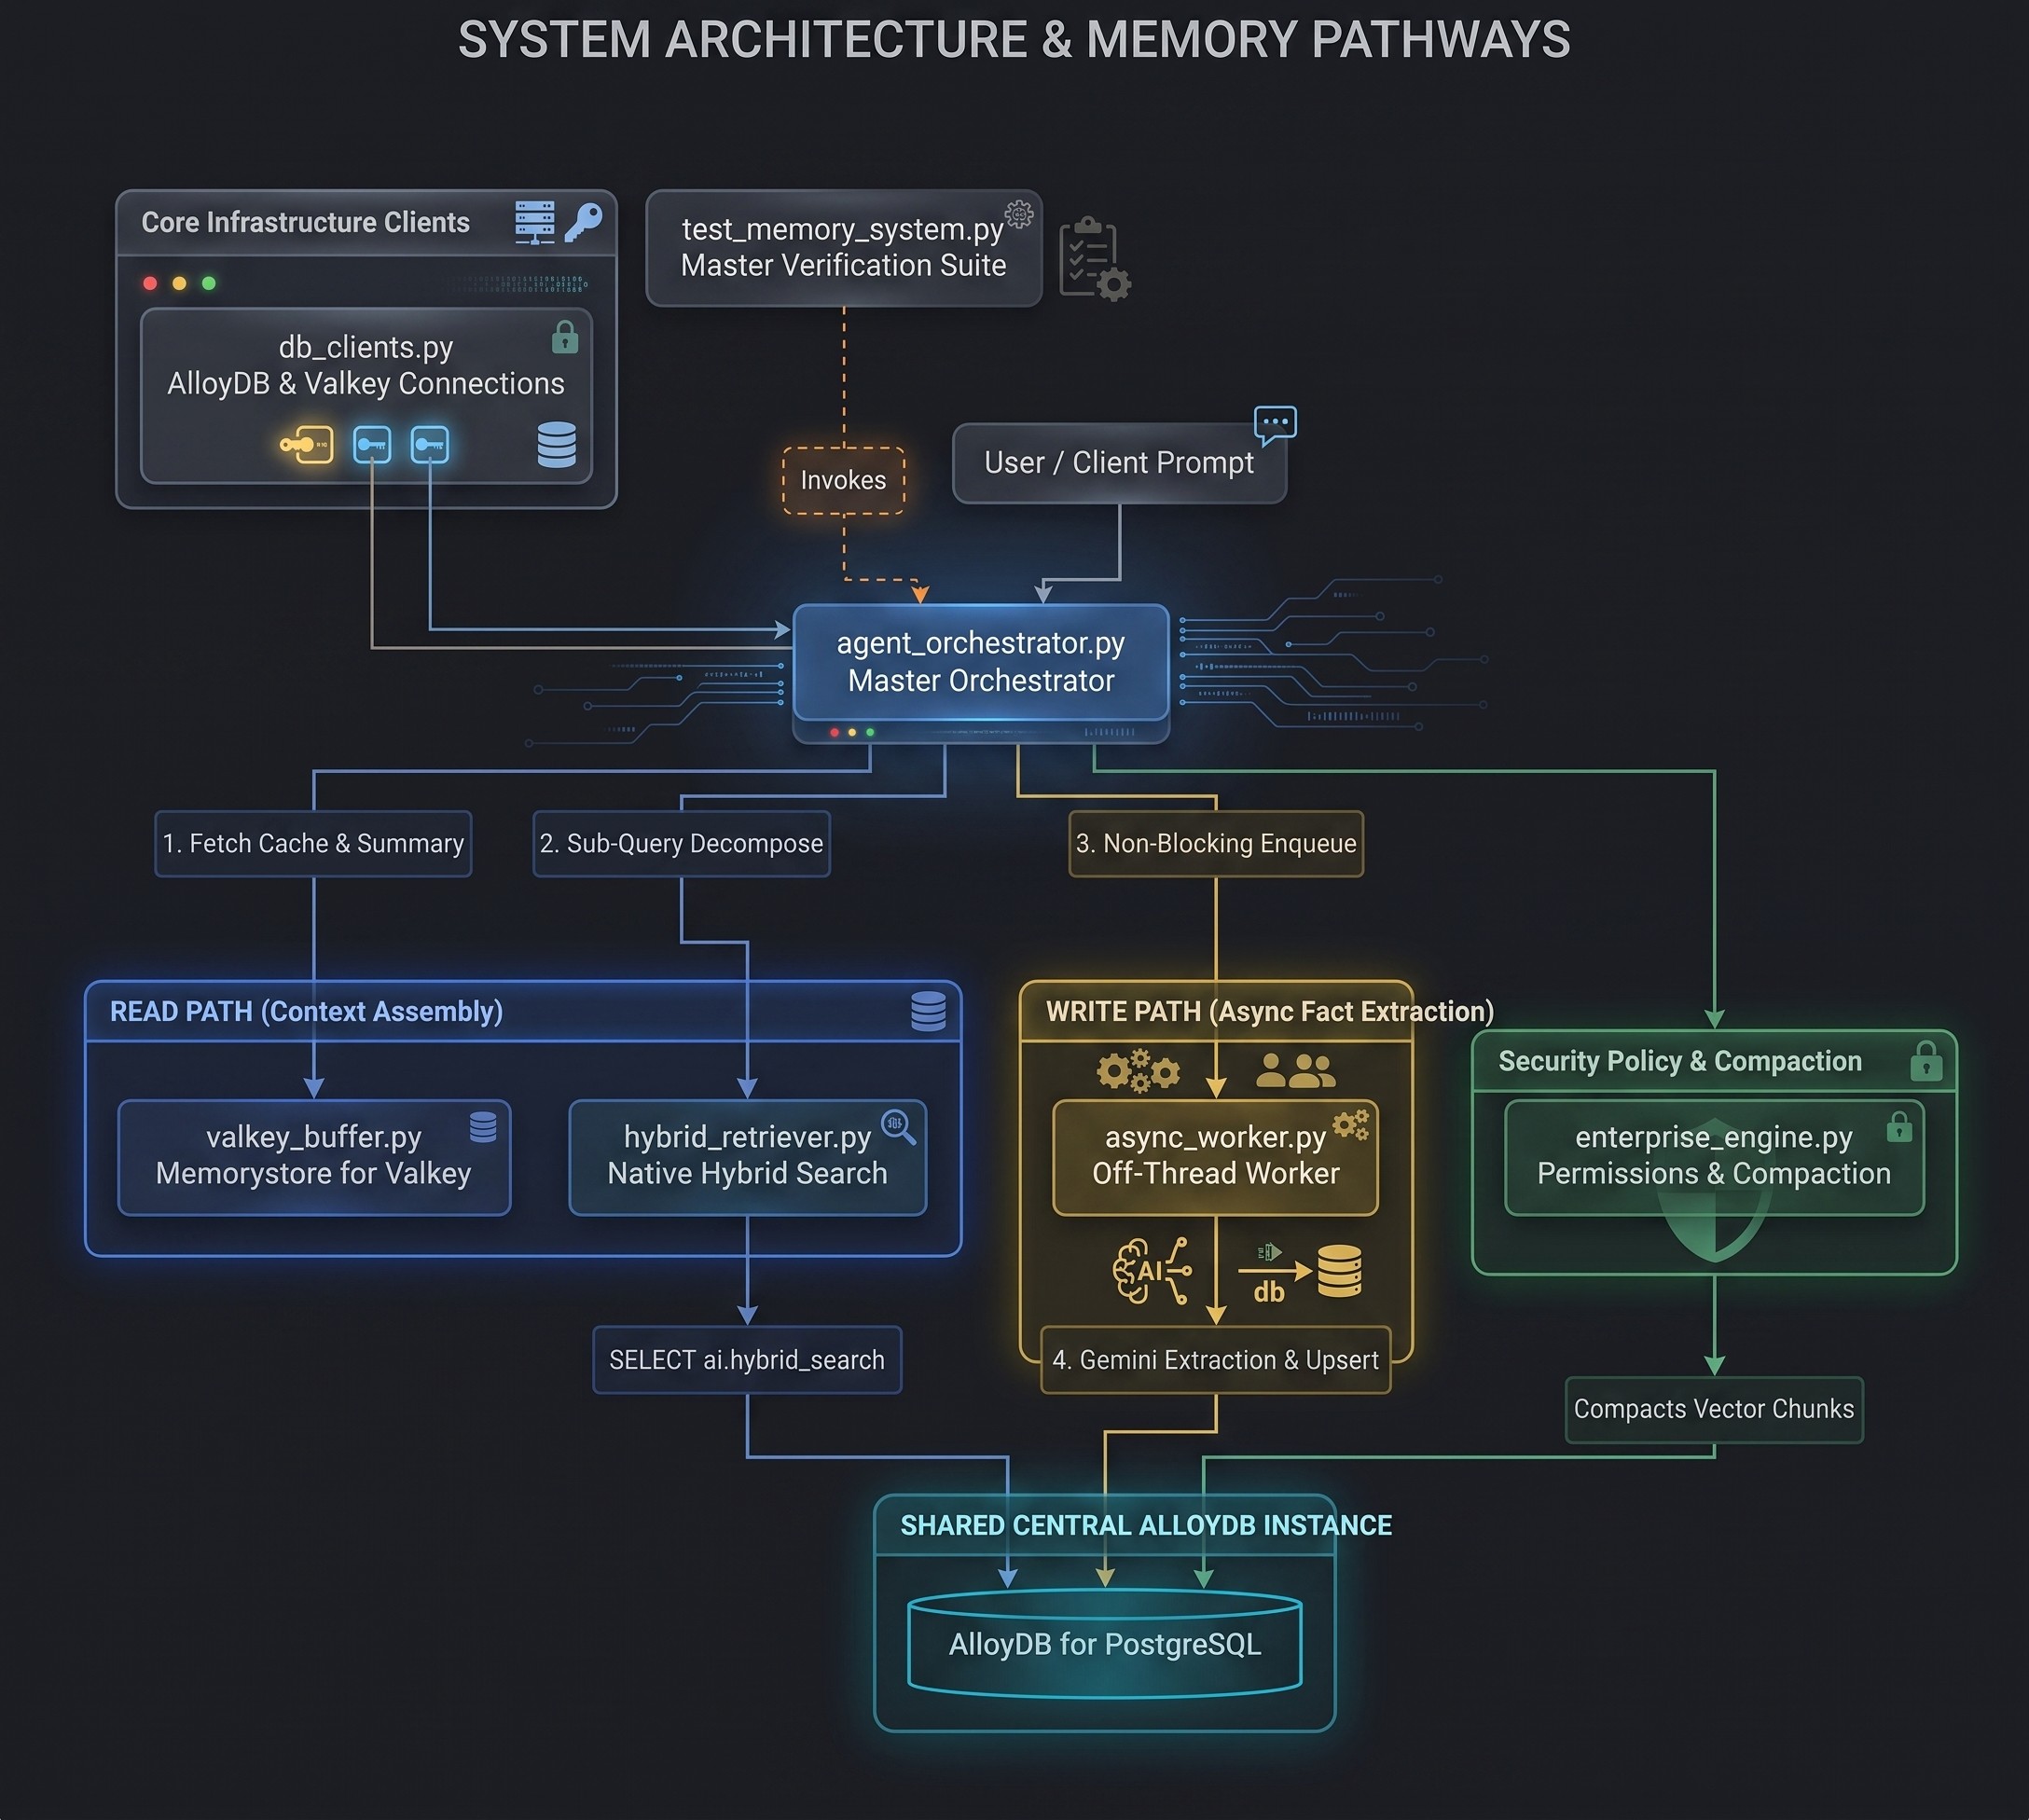
Jerarquía de módulos y roles del sistema
Archivo del módulo | Capa del sistema | Responsabilidad principal |
| Capa de conexión | Establece la autenticación de IAM encriptada con SSL en AlloyDB y conexiones resistentes a los sockets en Memorystore para Valkey. |
| Memoria a corto plazo | Administra el historial de sesiones de menos de un milisegundo en Valkey, implementando resúmenes continuos de Summarize-Before-Trim. |
| Worker de ruta de escritura | Ejecuta un trabajador de cola en segundo plano del daemon fuera del subproceso que extrae hechos de entidades con Gemini Flash y los inserta en AlloyDB. |
| Recuperador de rutas de lectura | Descompone las preguntas compuestas en subpreguntas de un solo aspecto con |
| Bucle principal del agente | Coordina el bucle de ejecución de turnos de extremo a extremo: recuperación a corto plazo, búsqueda a largo plazo, ensamblaje de instrucciones, ejecución de LLM y encolamiento asíncrono. |
| Administración y control | Aplica políticas de seguridad de 3 niveles para la ejecución de herramientas y agrega memoria histórica. |
| Pruebas y evaluación | Conjunto de pruebas de verificación principal que ejecuta situaciones de varios turnos y varias sesiones, mide el porcentaje de ahorro de tokens y verifica la precisión de la memoria. |
6. Configura el esquema de AlloyDB AI y los autoembeddings transaccionales
Descripción general del objetivo y la arquitectura
En este módulo, definirás el esquema de la base de datos de AlloyDB para la memoria episódica y a largo plazo, las estrategias de indexación y la generación automática de embeddings del lado de la base de datos.
- Almacén de vectores episódicos (
episodic_memory_embeddings): Fragmentos no estructurados de transcripciones de chat indexados con índices de vectores HNSW (vector_cosine_ops). - Almacén de entidades a largo plazo (
agent_entities): Hechos estructurados, opciones del usuario y reglas del proyecto almacenados con metadatos de alcance (global,project,session). Incluye una columna de búsqueda de texto completo de PostgreSQL generada automáticamente (summary_tsv) indexada a través de RUM. - Incorporación automática del lado de la base de datos (
ai.initialize_embeddings): Incorpora automáticamente filas de texto sin formato nuevas o actualizadas ensummary_embeddinga través detext-embedding-005de Agent Platform en segundo plano.
Conéctate a AlloyDB Studio
- Navega a la página AlloyDB para PostgreSQL en la consola de Google Cloud.
- Haz clic en tu instancia principal.
- En la navegación lateral izquierda, haz clic en AlloyDB Studio.
- Selecciona la base de datos
postgres. - Autenticar con
IAM database authentication
Implementación y código fuente
Una vez que te hayas conectado a tu base de datos de AlloyDB PostgreSQL, ejecuta las siguientes consultas de DDL:
-- 1. Enable google_ml_integration extension
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;
CREATE EXTENSION IF NOT EXISTS vector CASCADE;
CREATE EXTENSION IF NOT EXISTS rum CASCADE;
SET google_ml_integration.enable_preview_ai_functions = true;

-- 2. Create Episodic Memory Vector Store Tables
CREATE TABLE IF NOT EXISTS episodic_memory_collections (
    uuid UUID PRIMARY KEY,
    name VARCHAR,
    cmetadata JSONB
);

CREATE TABLE IF NOT EXISTS episodic_memory_embeddings (
    uuid UUID PRIMARY KEY,
    collection_id UUID REFERENCES episodic_memory_collections(uuid) ON DELETE CASCADE,
    embedding VECTOR(768),
    document VARCHAR,
    cmetadata JSONB,
    custom_id VARCHAR,
    created_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS episodic_memory_embedding_idx
ON episodic_memory_embeddings
USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);

-- 3. Create Entity & Preference Table with Metadata Scope & Auto-Generated TSVector Column
CREATE TABLE IF NOT EXISTS agent_entities (
    entity_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    entity_name TEXT NOT NULL,
    project_id TEXT DEFAULT 'global',
    session_id TEXT,
    scope TEXT NOT NULL DEFAULT 'project', -- 'global', 'project', 'session'
    summary TEXT NOT NULL,
    summary_embedding VECTOR(768),
    summary_tsv TSVECTOR GENERATED ALWAYS AS (
        to_tsvector('english', entity_name || ' ' || summary)
    ) STORED,
    updated_at TIMESTAMPTZ DEFAULT NOW(),
    UNIQUE (user_id, entity_name)
);

CREATE INDEX IF NOT EXISTS agent_entities_scope_idx
ON agent_entities (user_id, project_id, scope);

CREATE INDEX IF NOT EXISTS agent_entities_embedding_idx
ON agent_entities USING hnsw (summary_embedding vector_cosine_ops);

CREATE INDEX IF NOT EXISTS agent_entities_tsv_idx
ON agent_entities USING rum (summary_tsv rum_tsvector_ops);

-- 4. Create User Permissions Table for Tool Execution Controls
CREATE TABLE IF NOT EXISTS user_permissions (
    permission_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    project_id TEXT NOT NULL DEFAULT 'global',
    tool_name TEXT NOT NULL,
    command_pattern TEXT NOT NULL,
    action TEXT NOT NULL CHECK (action IN ('ALLOW', 'BLOCK')),
    created_at TIMESTAMPTZ DEFAULT NOW(),
    updated_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS idx_user_permissions_lookup
ON user_permissions (user_id, project_id, tool_name);
-- 5. Register Gemini 3.5 Flash Model Endpoint in AlloyDB
-- Replace PROJECT_ID with your Google Cloud project ID
CALL google_ml.create_model(
    model_id => 'gemini-3.5-flash',
    model_request_url => 'https://aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/global/publishers/google/models/gemini-3.5-flash:generateContent',
    model_qualified_name => 'gemini-3.5-flash',
    model_provider => 'google',
    model_type => 'llm',
    model_auth_type => 'alloydb_service_agent_iam'
);
Inicializa los Auto-embeddings transaccionales y registra el modelo de Gemini
A continuación, ejecuta las instrucciones CALL en bloques de ejecución de consultas separados para registrar el proceso en segundo plano de la incorporación automática y el extremo del modelo Gemini 3.5 Flash:
-- 6. Register Database-Side Transactional Auto-Embedding
CALL ai.initialize_embeddings(
    model_id => 'text-embedding-005',
    table_name => 'agent_entities',
    content_column => 'summary',
    embedding_column => 'summary_embedding',
    incremental_refresh_mode => 'transactional',
    batch_size => 10
);
7. Configura clientes de conexión de AlloyDB y Valkey
Descripción general del objetivo y la arquitectura
En este módulo, establecerás conexiones de red seguras tanto con AlloyDB para PostgreSQL (memoria a largo plazo) como con Memorystore para Valkey (caché a corto plazo).
- Autenticación de IAM de AlloyDB: Usa
gcloud auth application-default print-access-tokenpara recuperar un token de OAuth2 de corta duración para conexiones de bases de datos sin contraseña y encriptadas con SSL (sslmode="require"). - Resistencia de la red de Valkey: Configura
redis.Rediscon un tiempo de espera de socket de 5.0 segundos (socket_timeout=5.0) para controlar las operaciones de la red de VPC de forma segura en instancias de Valkey de un solo nodo o en clúster.
Implementación y código fuente
Crea el script db_clients.py en tu directorio de trabajo:
import os
import subprocess
import psycopg2
import redis

# Initialize database & Valkey connection clients from environment variables
DB_HOST = os.getenv("DB_HOST", "127.0.0.1")
DB_PORT = os.getenv("DB_PORT", "5432")
DB_NAME = os.getenv("DB_NAME", "postgres")
DB_USER = os.getenv("DB_USER")

VALKEY_HOST = os.getenv("VALKEY_HOST", "127.0.0.1")
VALKEY_PORT = int(os.getenv("VALKEY_PORT", "6379"))

def get_db_connection():
    # Fetch Application Default Credentials (ADC) token for IAM Database Authentication & enable SSL encryption
    access_token = subprocess.check_output(
        ["gcloud", "auth", "application-default", "print-access-token"], text=True
    ).strip()
    return psycopg2.connect(
        host=DB_HOST,
        port=DB_PORT,
        dbname=DB_NAME,
        user=DB_USER,
        password=access_token,
        sslmode="require"
    )

def get_valkey_client():
    return redis.Redis(
        host=VALKEY_HOST,
        port=VALKEY_PORT,
        db=0,
        socket_timeout=5.0,
        socket_connect_timeout=5.0
    )

if __name__ == "__main__":
    print(f"Connecting to AlloyDB via IAM Auth ({DB_USER}) at {DB_HOST}:{DB_PORT} and Valkey at {VALKEY_HOST}:{VALKEY_PORT}...")
    print("Database and Valkey connection client modules loaded successfully.")
8. Cómo almacenar en caché el estado de la sesión a corto plazo en Memorystore for Valkey
Descripción general del objetivo y la arquitectura
En este módulo, compilarás una caché de contexto a corto plazo con una latencia inferior a un milisegundo en Memorystore for Valkey que implementa un patrón Summarize-Before-Trim automatizado.
- Ventana deslizante de Valkey: Los turnos de conversación activos se almacenan como cadenas JSON en la clave
session:{session_id}:turns. - Etiquetas hash de Redis (
{session_id}): El formato de clavessession:{session_id}:turnsysession:{session_id}:summaryusa etiquetas hash de clúster de Redis ({...}), lo que obliga a ambas claves a usar la misma ranura hash para garantizar la ejecución atómica en cualquier implementación de Valkey de un solo nodo o en clúster. - Summarize-Before-Trim: Cuando el recuento de turnos supera
trigger_limit, Gemini Flash resume los turnos más antiguos que se están por descartar en un resumen de texto continuo (session:{session_id}:summary) antes de reducir el historial sin procesar awindow_size.
Implementación y código fuente
Crea el script valkey_buffer.py en tu directorio de trabajo:
import json
import logging
import time
from typing import Any, Dict, List
import redis

logger = logging.getLogger(__name__)

IN_MEMORY_VALKEY_FALLBACK: Dict[str, Any] = {}
VALKEY_COMPACTION_TOKENS = 0

def get_valkey_compaction_tokens() -> int:
    return VALKEY_COMPACTION_TOKENS

def append_session_turn_with_rolling_summary(
    valkey_client: redis.Redis,
    llm_client: Any,
    session_id: str,
    user_msg: str,
    ai_msg: str,
    trigger_limit: int = 10,
    window_size: int = 4
) -> None:
    """Appends turn to Valkey. Before trimming old turns, summarizes them into a rolling summary."""
    global VALKEY_COMPACTION_TOKENS
    # Use Redis Hash Tags {session_id} so both keys hash to the same cluster slot
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        # 1. Append new turn messages
        valkey_client.rpush(turns_key, json.dumps({"role": "user", "content": user_msg}))
        valkey_client.rpush(turns_key, json.dumps({"role": "assistant", "content": ai_msg}))

        raw_turns = valkey_client.lrange(turns_key, 0, -1)

        # 2. Check if total turns exceed summary trigger threshold
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2

        if len(raw_turns) > msg_trigger_count:
            turns_to_prune = raw_turns[:-msg_window_count]
            existing_summary = valkey_client.get(summary_key)
            existing_summary_text = (
                existing_summary.decode('utf-8') if isinstance(existing_summary, bytes) else (existing_summary or "")
            )

            pruned_text = "\n".join([
                f"{json.loads(t)['role']}: {json.loads(t)['content']}" for t in turns_to_prune
            ])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            updated_summary_text = llm_client.models.generate_content(
                model="gemini-3.5-flash", contents=prompt
            ).text.strip()
            # Execute commands directly to support all Redis/Valkey cluster topologies
            valkey_client.set(summary_key, updated_summary_text)
            valkey_client.ltrim(turns_key, -msg_window_count, -1)
            logger.info("Updated rolling summary and trimmed Valkey buffer for session %s", session_id)

    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey operation warning (%s). Falling back to in-memory short-term buffer.", e)
        if turns_key not in IN_MEMORY_VALKEY_FALLBACK:
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = []
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "user", "content": user_msg})
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "assistant", "content": ai_msg})

        # In-memory summarize-before-trim fallback logic
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2
        raw_fallback_turns = IN_MEMORY_VALKEY_FALLBACK[turns_key]

        if len(raw_fallback_turns) > msg_trigger_count:
            turns_to_prune = raw_fallback_turns[:-msg_window_count]
            existing_summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
            pruned_text = "\n".join([f"{t['role']}: {t['content']}" for t in turns_to_prune])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            for attempt in range(4):
                try:
                    updated_summary_text = llm_client.models.generate_content(
                        model="gemini-3.5-flash", contents=prompt
                    ).text.strip()
                    break
                except Exception as e:
                    if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                        time.sleep(3 * (2 ** attempt))
                    else:
                        raise

            IN_MEMORY_VALKEY_FALLBACK[summary_key] = updated_summary_text
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = raw_fallback_turns[-msg_window_count:]

def get_session_context_buffer(
    valkey_client: redis.Redis,
    session_id: str
) -> Dict[str, Any]:
    """Retrieves rolling summary + sliding window history from Valkey to build prompt context."""
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        summary = valkey_client.get(summary_key)
        summary_text = summary.decode('utf-8') if isinstance(summary, bytes) else (summary or "")

        raw_turns = valkey_client.lrange(turns_key, 0, -1)
        recent_turns = [json.loads(t) for t in raw_turns]

        return {
            "rolling_summary": summary_text,
            "recent_turns": recent_turns
        }
    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey read error (%s). Using in-memory short-term fallback buffer.", e)
        summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
        recent_turns = IN_MEMORY_VALKEY_FALLBACK.get(turns_key, [])
        return {"rolling_summary": summary_text, "recent_turns": recent_turns}
9. Extract Entities Off-Thread (trabajador de memoria en segundo plano)
Descripción general del objetivo y la arquitectura
En este módulo, compilarás un trabajador de extracción en segundo plano de la ruta de escritura fuera del subproceso (AsyncMemoryWorker) que extrae hechos de entidades a largo plazo sin ralentizar las respuestas interactivas de la IA.
- Non-Blocking Queue Worker: Inicia un subproceso de daemon (
queue.Queue) para que las respuestas del chat para desarrolladores se muestren de inmediato sin esperar la extracción del LLM ni las escrituras en la base de datos. - Extracción de hechos de entidades fuera del hilo: Llama a Gemini Flash (
model="gemini-3.5-flash",response_mime_type="application/json") en segundo plano para analizar entidades estructuradas sin bloquear los turnos de diálogo visibles para el usuario. - Resolución de correferencia temporal (
build_temporal_rules_prompt): Aplica reglas que convierten expresiones temporales relativas (p.ej., "actualmente", "última sesión") en IDs de sesión explícitos (p.ej.,session_id). - Upserts de esquema: Le indica a Gemini Flash que muestre un array JSON de entidades (
entity_name,project_id,scope,summary) y escribe texto sin formato enagent_entitiesa través de instruccionesON CONFLICT DO UPDATEde PostgreSQL parametrizadas.
Implementación y código fuente
Crea el script async_worker.py en tu directorio de trabajo:
import json
import logging
import queue
import threading
import time
from typing import Dict, Any, Optional
import psycopg2

logger = logging.getLogger(__name__)

def build_temporal_rules_prompt(active_session_id: str, prev_session_id: Optional[str] = None) -> str:
    """REUSABLE PROMPT HELPER: Defines temporal coreference rules for both Read and Write paths."""
    return f"""TEMPORAL COREFERENCE RULES:
1. Do not use relative temporal words like 'currently', 'now', 'this session', 'previous session', or 'last session'.
2. Replace any relative temporal reference with explicit session identifiers:
   - Active Session: '{active_session_id}'
   - Previous Session: '{prev_session_id if prev_session_id else active_session_id}'
   (e.g., write 'User prefers Python in session {active_session_id}' instead of 'User currently prefers Python')."""

class AsyncMemoryWorker:
    """Off-thread daemon queue worker performing background entity extraction and upserts into AlloyDB."""
    def __init__(self, conn_factory, llm_client):
        self.conn_factory = conn_factory
        self.llm_client = llm_client
        self.work_queue = queue.Queue()
        self.total_extraction_tokens = 0
        self.worker_thread = threading.Thread(target=self._run_worker, daemon=True)
        self.worker_thread.start()

    def enqueue_extraction(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        self.work_queue.put((user_id, session_id, user_msg, ai_msg, prev_session_id))

    def _run_worker(self):
        while True:
            item = self.work_queue.get()
            if item is None:
                break
            user_id, session_id, user_msg, ai_msg, prev_session_id = item
            try:
                self._extract_and_upsert(user_id, session_id, user_msg, ai_msg, prev_session_id)
            except Exception as e:
                logger.error("Background extraction failed: %s", e)
            finally:
                self.work_queue.task_done()

    def _extract_and_upsert(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        temporal_rules = build_temporal_rules_prompt(session_id, prev_session_id)
        json_fmt = '[{"entity_name": "...", "project_id": "...", "scope": "global|project|session", "summary": "..."}]'

        prompt = f"""Extract key preferences and named entities from this exchange.
Format output strictly as a JSON array of objects with structure: {json_fmt}.

{temporal_rules}

Rules for Scope:
- 'global': Universal developer preferences.
- 'project': Architecture, database choices, timeouts, and rules for a specific project.
- 'session': Ephemeral task state tied strictly to a single session.

User: {user_msg}
AI: {ai_msg}

Output (JSON array only):"""

        self.total_extraction_tokens += max(1, len(prompt) // 4)

        for attempt in range(4):
            try:
                response = self.llm_client.models.generate_content(
                    model="gemini-3.5-flash",
                    contents=prompt,
                    config={"response_mime_type": "application/json"}
                )
                break
            except Exception as e:
                if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                    time.sleep(3 * (2 ** attempt))
                else:
                    raise
        content = str(response.text).strip()
        if not content:
            return

        extracted_list = json.loads(content)
        if not isinstance(extracted_list, list):
            return

        upsert_sql = """
            INSERT INTO agent_entities (user_id, entity_name, project_id, session_id, scope, summary, updated_at)
            VALUES (%s, %s, %s, %s, %s, %s, NOW())
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET
                project_id = EXCLUDED.project_id,
                session_id = EXCLUDED.session_id,
                scope = EXCLUDED.scope,
                summary = EXCLUDED.summary,
                updated_at = NOW();
        """

        conn = self.conn_factory()
        try:
            with conn:
                with conn.cursor() as cur:
                    for item in extracted_list:
                        e_name = item.get("entity_name", "General_Fact")
                        p_id = item.get("project_id", "global")
                        s_scope = item.get("scope", "project")
                        summary = item.get("summary", "")
                        if e_name and summary:
                            cur.execute(upsert_sql, (user_id, e_name, p_id, session_id, s_scope, summary))
            logger.info("Saved %d entities for user %s", len(extracted_list), user_id)
        finally:
            conn.close()
10. Cómo consultar la memoria a largo plazo con la búsqueda híbrida nativa
Descripción general del objetivo y la arquitectura
En este módulo, implementarás la descomposición de subconsultas de la ruta de lectura, la reescritura de consultas temporales, el aislamiento del alcance de los metadatos y usarás la búsqueda híbrida nativa de AlloyDB (ai.hybrid_search).
- Descomposición de subconsultas en la base de datos (
rewrite_and_decompose_query): Usa la función integradaai.generate()de AlloyDB AI directamente dentro de PostgreSQL para dividir las preguntas compuestas en subconsultas de un solo aspecto con IDs de sesión normalizados, lo que evita que las consultas de varios temas reduzcan la precisión de la búsqueda de vectores. - Filtrado de alcance a nivel del índice: Crea filtros de SQL del lado de la base de datos (
filter_condition => "user_id = '%s' AND (project_id = '%s' OR scope = 'global')") para aislar los recuerdos por usuario y proyecto, y, al mismo tiempo, incluir las preferencias globales de los desarrolladores. - Búsqueda híbrida nativa de AlloyDB (
ai.hybrid_search): Combina la similitud del coseno del vector (public.<=>) con la búsqueda de texto completo (rum) dentro de AlloyDB usando la fusión por clasificación recíproca (RRF) para proporcionar una exactitud, una recuperación y una relevancia óptimas.
Implementación y código fuente
Crea el script hybrid_retriever.py en tu directorio de trabajo:
import os
import json
import logging
from typing import Any, Dict, List, Optional
import psycopg2
from psycopg2.extras import RealDictCursor
from async_worker import build_temporal_rules_prompt

logger = logging.getLogger(__name__)

def rewrite_and_decompose_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> List[str]:
    """Read-Path LLM Query Normalizer & Sub-Query Decomposer using AlloyDB AI ai.generate() directly in PostgreSQL."""
    temporal_rules = build_temporal_rules_prompt(active_session_id, prev_session_id)

    prompt = f"""You are a query normalization and decomposition tool for an AI agent's memory retrieval system.

Tasks:
1. Normalize any relative temporal phrases in the user query into explicit session identifiers.
{temporal_rules}

2. Decompose compound user queries asking about multiple distinct topics into up to 4 concise, single-topic search queries. Ensure all distinct questions (both general developer preferences and project-specific architecture/rules) are preserved as separate sub-queries.
3. Return ONLY a valid JSON array of strings containing the sub-queries.

Example Output Format:
["general developer coding preferences", "CloudRetail backend stack in session sess_2026_01", "CloudRetail timeout rules in session sess_2026_01"]

Text to Process: {text}
JSON Output:"""

    try:
        with conn.cursor() as cur:
            cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
            cur.execute("SELECT ai.generate(prompt => %s::text, model_id => 'gemini-3.5-flash'::varchar(100));", (prompt,))
            row = cur.fetchone()
            if row and row[0]:
                res_text = str(row[0]).strip()
                clean_text = res_text
                if clean_text.startswith("```"):
                    clean_text = clean_text.removeprefix("```json").removeprefix("```").removesuffix("```").strip()
                parsed = json.loads(clean_text)
                if isinstance(parsed, list) and len(parsed) > 0:
                    return [str(q).strip() for q in parsed]
        return [text]
    except Exception as e:
        logger.error("Error in in-database ai.generate sub-query decomposition: %s", e)
        return [text]

def rewrite_temporal_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> str:
    """Backward-compatible wrapper returning first decomposed query string."""
    queries = rewrite_and_decompose_query(conn, llm_client, text, active_session_id, prev_session_id)
    return queries[0] if queries else text

def retrieve_hybrid_entities(
    conn,
    llm_client: Any,
    user_id: str,
    active_session_id: str,
    query_text: str,
    query_embedding: Optional[List[float]] = None,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    k: int = 20
) -> Dict[str, Any]:
    """Queries long-term entities using Sub-Query Decomposition, metadata scope filtering, and parameterized AlloyDB hybrid search."""
    sub_queries = rewrite_and_decompose_query(
        conn=conn, llm_client=llm_client, text=query_text, active_session_id=active_session_id, prev_session_id=prev_session_id
    )
    all_search_queries = list(dict.fromkeys(sub_queries + [query_text]))

    retrieved_entities: Dict[str, Any] = {}

    filter_cond = f"user_id = '{user_id}' AND (project_id = '{project_id}' OR scope = 'global')" if project_id else f"user_id = '{user_id}'"

    query_sql = """
        SELECT e.entity_name, e.summary, e.project_id, e.scope, e.updated_at
        FROM ai.hybrid_search(
          search_inputs => %s::JSONB[],
          include_json_output => false
        ) h
        JOIN agent_entities e ON e.entity_name = h.id
        WHERE e.user_id = %s
        LIMIT %s;
    """

    from google import genai
    embed_client = genai.Client(
        vertexai=True,
        project=os.getenv("PROJECT_ID"),
        location=os.getenv("REGION", "us-east1")
    )

    for sq in all_search_queries:
        try:
            emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=sq)
            sq_embedding = emb_resp.embeddings[0].values
            vector_literal = f"'{sq_embedding}'::vector"
        except Exception as e:
            logger.error(f"Failed to generate embedding for sub-query: {sq}. Error: {e}")
            # Fallback to zero vector to prevent Postgres from crashing
            sq_embedding = [0.0] * 768
            vector_literal = f"'{sq_embedding}'::vector"

        search_inputs = [
            json.dumps({
                "data_type": "vector",
                "weight": 0.4,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "vec_column": "summary_embedding",
                "distance_operator": "public.<=>",
                "limit": 20,
                "query_vector": vector_literal,
                "filter_condition": filter_cond
            }),
            json.dumps({
                "data_type": "text",
                "weight": 0.6,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "text_column": "summary_tsv",
                "limit": 20,
                "ranking_function": "ts_rank",
                "query_text_input": sq,
                "filter_condition": filter_cond
            })
        ]

        with conn.cursor(cursor_factory=RealDictCursor) as cur:
            try:
                cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                cur.execute(query_sql, (search_inputs, user_id, k))
                rows = cur.fetchall()

                for row in rows:
                    name = row["entity_name"]
                    if name not in retrieved_entities:
                        retrieved_entities[name] = {
                            "summary": row["summary"],
                            "project_id": row["project_id"],
                            "scope": row["scope"],
                            "updated_at": row["updated_at"].isoformat() if row["updated_at"] else None
                        }
            except Exception as e:
                logger.error("Error executing hybrid search for sub-query '%s': %s", sq, e)

    return retrieved_entities
11. Compila y ejecuta el bucle de memoria del agente de extremo a extremo
Descripción general del objetivo y la arquitectura
En este módulo, compilarás la función principal de orquestación del agente (run_agent_turn) que combina la recuperación de la caché a corto plazo, la búsqueda en la memoria a largo plazo, el ensamblaje de instrucciones, la generación de LLM y la extracción de la memoria en segundo plano.
- Contexto a corto plazo: Recupera los turnos de diálogo activos de Valkey y el resumen continuo (
get_session_context_buffer). - Búsqueda a largo plazo: Consulta AlloyDB a través de
retrieve_hybrid_entitiescon subconsultas descompuestas filtradas por el ID del proyecto activo y el alcance global. - Formato de instrucciones del sistema: Ensambla
build_agent_promptque contiene entidades a largo plazo, un resumen a corto plazo, un diálogo reciente y la instrucción del usuario en una instrucción del sistema eficiente en términos de tokens. - Async Queue Enqueue: Almacena en caché el turno en Valkey y pone en cola la extracción en segundo plano en
AsyncMemoryWorkersin bloquear la carga útil de devolución.
Implementación y código fuente
Crea el script agent_orchestrator.py en tu directorio de trabajo:
import logging
import time
from typing import Any, Dict, Optional, Tuple
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import rewrite_temporal_query, retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

logger = logging.getLogger(__name__)

def build_agent_prompt(
    rolling_summary: str,
    recent_turns: list[Dict[str, Any]],
    retrieved_entities: Dict[str, Any],
    user_query: str
) -> str:
    """Assembles structured system prompt with long-term memory & short-term context."""
    entity_lines = [
        f"- {name}: {info['summary']}" for name, info in retrieved_entities.items()
    ]
    entity_context = "\n".join(entity_lines) if entity_lines else "No relevant entity facts."
    history_lines = [f"{t['role']}: {t['content']}" for t in recent_turns]
    history_str = "\n".join(history_lines)

    return f"""You are an intelligent, context-aware AI assistant.

[LONG-TERM PREFERENCES & ENTITIES]
{entity_context}

[SHORT-TERM ROLLING SUMMARY]
{rolling_summary if rolling_summary else 'No prior summary.'}

[RECENT DIALOGUE]
{history_str}

User: {user_query}
AI:"""

def run_agent_turn(
    db_conn,
    valkey_client: redis.Redis,
    async_worker: AsyncMemoryWorker,
    genai_client: Any,
    user_id: str,
    session_id: str,
    user_query: str,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    trigger_limit: int = 10,
    window_size: int = 4
) -> Tuple[str, str, float]:
    """Executes a complete 2-tier agent memory turn loop, returning (response_text, system_prompt, latency_seconds)."""
    import time
    start_time = time.time()

    # 1. Fetch short-term rolling summary + recent turns from Valkey
    buffer_data = get_session_context_buffer(valkey_client, session_id)
    rolling_summary = buffer_data["rolling_summary"]
    recent_turns = buffer_data["recent_turns"]

    # 2. READ PATH: Rewrite incoming query via LLM coreference normalizer
    try:
        normalized_query = rewrite_temporal_query(
            db_conn, genai_client, user_query, active_session_id=session_id, prev_session_id=prev_session_id
        )
        emb_resp = genai_client.models.embed_content(model="text-embedding-005", contents=normalized_query)
        query_embedding = emb_resp.embeddings[0].values
    except Exception:
        query_embedding = None

    # Retrieve relevant long-term entities from AlloyDB via hybrid search
    retrieved_entities = retrieve_hybrid_entities(
        conn=db_conn,
        llm_client=genai_client,
        user_id=user_id,
        active_session_id=session_id,
        query_text=user_query,
        query_embedding=query_embedding,
        prev_session_id=prev_session_id,
        project_id=project_id,
        k=20
    )

    # 3. Assemble system prompt
    system_prompt = build_agent_prompt(
        rolling_summary, recent_turns, retrieved_entities, user_query
    )


    # 4. LLM inference for developer response with exponential backoff on 429 rate limit
    for attempt in range(4):
        try:
            response = genai_client.models.generate_content(
                model="gemini-3.5-flash", contents=system_prompt
            )
            break
        except Exception as e:
            if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                time.sleep(3 * (2 ** attempt))
            else:
                raise
    ai_response = str(response.text)

    # 5. Cache turn in short-term Valkey buffer (with Summarize-Before-Trim check)
    append_session_turn_with_rolling_summary(
        valkey_client=valkey_client,
        llm_client=genai_client,
        session_id=session_id,
        user_msg=user_query,
        ai_msg=ai_response,
        trigger_limit=trigger_limit,
        window_size=window_size
    )

    # 6. WRITE PATH: Enqueue off-thread background entity extraction (single LLM call)
    async_worker.enqueue_extraction(user_id, session_id, user_query, ai_response, prev_session_id)

    latency = time.time() - start_time
    return ai_response, system_prompt, latency
12. Implementa controles de permisos empresariales y compactación de memoria
Descripción general del objetivo y la arquitectura
En este módulo, crearás controles de seguridad empresariales para la ejecución de herramientas y la compactación de la memoria de la base de datos (AgentMemoryEngine).
- Evaluación de permisos de 3 niveles (
evaluate_tool_permission):- Nivel 1 (otorgamiento de Valkey de un solo uso): Verifica las claves de otorgamiento de un solo uso (
one_time_perm:{session_id}:{cmd_hash}) con un TTL de 300 segundos. Si está presente, borra la clave de inmediato y devuelveALLOW. - Nivel 2 y 3 (reglas de política de PostgreSQL): Las consultas
user_permissionsprimero coinciden con las reglas de alcance del proyecto (project_id) y, luego, con las reglas globales ('global'). - Respaldo: Devuelve
PROMPT_USERsi no existe una política coincidente.
- Nivel 1 (otorgamiento de Valkey de un solo uso): Verifica las claves de otorgamiento de un solo uso (
- Compactación de memoria (
compact_old_memories): Agrega eventos históricos de vectores sin procesar enepisodic_memory_embeddingsanteriores aretention_daysen un solo resumen consolidado enagent_entitiescon una consulta de CTE de SQL limitada a 50 filas.
Implementación y código fuente
Crea el script enterprise_engine.py en tu directorio de trabajo:
import hashlib
import logging
import re
from typing import Any, Dict, Tuple
import psycopg2
import redis

logger = logging.getLogger(__name__)

class AgentMemoryEngine:
    """Framework-agnostic Enterprise Memory Engine for tool execution permissions & safe compaction."""

    def __init__(self, valkey_client: redis.Redis, db_conn: Any):
        self.valkey_client = valkey_client
        self.db_conn = db_conn

    def evaluate_tool_permission(
        self,
        user_id: str,
        project_id: str,
        session_id: str,
        tool_name: str,
        tool_args: Dict[str, Any]
    ) -> Tuple[str, str]:
        """Evaluates 3-tier execution permissions: Allow-Once (Valkey), Project (AlloyDB), Global (AlloyDB)."""
        command_str = str(tool_args.get("CommandLine", "") or tool_args)

        # Tier 1: Allow-Once (Single-Use Valkey Check with 300s TTL)
        cmd_hash = hashlib.sha256(command_str.encode("utf-8")).hexdigest()[:16]
        valkey_key = f"one_time_perm:{session_id}:{cmd_hash}"

        if self.valkey_client.get(valkey_key):
            self.valkey_client.delete(valkey_key)  # Consume key immediately
            return ("ALLOW", "Single-use 'Allow Once' grant consumed.")

        # Tier 2 & Tier 3: Query AlloyDB user_permissions table
        query_sql = """
            SELECT command_pattern, action, project_id
            FROM user_permissions
            WHERE user_id = %s AND tool_name = %s AND project_id IN (%s, 'global')
            ORDER BY CASE WHEN project_id = %s THEN 1 ELSE 2 END;
        """

        with self.db_conn.cursor() as cur:
            cur.execute(query_sql, (user_id, tool_name, project_id, project_id))
            rules = cur.fetchall()
            for pattern, action, scope in rules:
                if re.search(pattern, command_str, flags=re.IGNORECASE):
                    return (action, f"Matched {scope}-scoped rule: {pattern}")

        # Fallback: Prompt Human User
        return ("PROMPT_USER", "No matching permission rule found.")

    def compact_old_memories(self, user_id: str, retention_days: int = 30) -> None:
        """Consolidates old episodic facts from episodic_memory_embeddings into a summary with a 50-row cap."""
        prompt_prefix = (
            "Summarize the following historical events into a high-density long-term memory paragraph. "
            "Retain key constraints, tool choices, and project rules:\n"
        )

        # Capped CTE prevents string_agg from exceeding model context window limits
        compaction_sql = """
            WITH old_events AS (
                SELECT document AS content
                FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            ),
            consolidated AS (
                SELECT ai.generate(%s || string_agg(content, E'\n')) AS summary_text
                FROM old_events
            )
            INSERT INTO agent_entities (user_id, entity_name, summary, updated_at)
            SELECT %s, 'longterm_session_summary', summary_text, NOW()
            FROM consolidated
            WHERE summary_text IS NOT NULL
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET summary = EXCLUDED.summary, updated_at = NOW();
        """

        prune_sql = """
            DELETE FROM episodic_memory_embeddings
            WHERE uuid IN (
                SELECT uuid FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            );
        """

        try:
            with self.db_conn:
                with self.db_conn.cursor() as cur:
                    cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                    cur.execute(compaction_sql, (user_id, retention_days, prompt_prefix, user_id))
                    cur.execute(prune_sql, (user_id, retention_days))
            logger.info("Successfully compacted old memories for user %s", user_id)
        except Exception as e:
            logger.error("Error during memory compaction: %s", e)
13. Ejecuta la verificación de memoria de varios turnos de extremo a extremo
Descripción general del objetivo y la arquitectura
En este módulo final, crearás y ejecutarás la secuencia de comandos de verificación integral principal (test_memory_system.py) para validar la arquitectura de memoria completa de 2 niveles.
- Simulación de varias sesiones y varios turnos:
- Sesión 1 (turno 1): Define las preferencias universales del desarrollador (
scope='global': IU en modo oscuro, Python 3.11, PostgreSQL). - Sesión 1 (turno 2): Define la arquitectura específica del proyecto (
project_id='CloudRetail': FastAPI, AlloyDB, Valkey, límite de tiempo de espera de 30 s, us-east1). - Sesión 1 (turnos 3 y 4): Genera ruido de diálogo técnico y supera
trigger_limit=3para activar la compactación del resumen continuo de Summarize-Before-Trim de Valkey. - Sesión 2 (turno 5, ID de sesión nuevo): Consulta al agente en todas las sesiones para verificar la recuperación entre sesiones de las preferencias globales Y las reglas del proyecto.
- Sesión 1 (turno 1): Define las preferencias universales del desarrollador (
- Verificación dinámica de eficiencia y precisión: Mide los caracteres o tokens exactos de la instrucción, el porcentaje de reducción del tamaño de la instrucción, la latencia de inferencia, los resúmenes acumulativos de Valkey, el aislamiento del alcance y las políticas de seguridad de ejecución de herramientas.
Implementación y código fuente
Crea la secuencia de comandos de prueba test_memory_system.py en tu directorio de trabajo:
import os
import time
import logging
from google import genai
from db_clients import get_db_connection, get_valkey_client
from async_worker import AsyncMemoryWorker
from hybrid_retriever import retrieve_hybrid_entities
from agent_orchestrator import run_agent_turn
from enterprise_engine import AgentMemoryEngine
from valkey_buffer import get_session_context_buffer, IN_MEMORY_VALKEY_FALLBACK, get_valkey_compaction_tokens

logging.basicConfig(level=logging.WARNING)
logging.getLogger("google_genai").setLevel(logging.WARNING)
logging.getLogger("httpx").setLevel(logging.WARNING)

PROJECT_ID = os.getenv("PROJECT_ID")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")

db_conn = get_db_connection()
valkey_client = get_valkey_client()
client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)

async_worker = AsyncMemoryWorker(get_db_connection, client)
engine = AgentMemoryEngine(valkey_client, db_conn)

USER_ID = "user_dev_42"
SESSION_1 = "sess_2026_01"
SESSION_2 = "sess_2026_02"

test_accuracy = []

print("\n==================================================")
print("STARTING ENHANCED 2-TIER AGENT MEMORY VERIFICATION TEST")
print("==================================================")

# TURN 1: Universal Global Developer Preference Definition
print("\n[SESSION 1 - TURN 1: Global Preference Definition]")
prompt_1 = "Hi! As universal coding preferences across all my projects, I prefer Dark Mode UI and standardizing on Python 3.11 with PostgreSQL."
print(f"User Prompt:\n{prompt_1}")
resp_1, sys_prompt_1, latency_1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_1, project_id=None, trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_1[:140]}...")
time.sleep(2)

# TURN 2: Project-Specific Architecture Definition
print("\n[SESSION 1 - TURN 2: Project CloudRetail Architecture Definition]")
prompt_2 = (
    "Now I am starting project CloudRetail. Here are the specific project requirements:\n"
    "1. Backend Stack: Python with FastAPI on AlloyDB.\n"
    "2. Short-Term Cache: Memorystore for Valkey.\n"
    "3. Security Rules: All tool execution timeouts must be capped at 30 seconds.\n"
    f"4. Deployment Region: {REGION}."
)
print(f"User Prompt:\n{prompt_2}")
resp_2, sys_prompt_2, latency_2 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_2, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_2[:140]}...")
time.sleep(2)

# TURN 3: Context Inflation / Technical Dialogue Noise
print("\n[SESSION 1 - TURN 3: Large Context Inflation (Dialogue Noise)]")
prompt_3 = (
    "Let's draft a sample 50-line PostgreSQL DDL script for product catalog indexes, "
    "including HNSW vector index tuning parameters (m = 16, ef_construction = 64), "
    "and full-text RUM search indexes on item title and description columns."
)
print(f"User Prompt:\n{prompt_3}")
resp_3, sys_prompt_3, latency_3 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_3, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_3[:140]}...")
time.sleep(2)

# TURN 4: Triggering Valkey Summarize-Before-Trim Threshold (8 messages > 6 message trigger limit)
print("\n[SESSION 1 - TURN 4: Triggering Valkey Rolling Summary Compaction]")
prompt_4_s1 = "Can you also add rate-limiting middleware rules for API endpoints?"
print(f"User Prompt:\n{prompt_4_s1}")
resp_4_s1, sys_prompt_4_s1, latency_4_s1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_4_s1, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_4_s1[:140]}...")

# VERIFY VALKEY SHORT-TERM ROLLING SUMMARY
print("\n==================================================")
print("VALKEY SHORT-TERM ROLLING SUMMARY VERIFICATION")
print("==================================================")
buffer_data = get_session_context_buffer(valkey_client, SESSION_1)
valkey_summary_text = buffer_data["rolling_summary"]
valkey_turns = buffer_data["recent_turns"]

used_fallback = bool(IN_MEMORY_VALKEY_FALLBACK)
storage_backend = "Local In-Memory Fallback (Outside VPC)" if used_fallback else "Memorystore for Valkey (VPC Network)"

has_valkey_summary = bool(valkey_summary_text)
print(f" • Short-Term Cache Storage Target:             [{storage_backend}]")
print(f" • Valkey Rolling Summary Generated for Session 1: {has_valkey_summary}")
print(f"   Summary Content: {valkey_summary_text}")
print(f" • Remaining Raw Turns in Valkey Sliding Window:  {len(valkey_turns)} messages (Trimmed from 8)")

test_accuracy.append(("Valkey Rolling Summary Compaction Test", "PASS" if has_valkey_summary else "FAIL"))

# Wait for background entity extraction worker
print("\n[Waiting for background entity extraction worker to process & vectorize all extracted entities...]")
time.sleep(6)

print("\n==================================================")
print("EXTRACTED ENTITIES STORED IN ALLOYDB LONG-TERM MEMORY")
print("==================================================")
with db_conn.cursor() as cur:
    cur.execute(
        "SELECT entity_name, project_id, scope, summary, (summary_embedding IS NOT NULL) FROM agent_entities WHERE user_id = %s ORDER BY updated_at DESC;",
        (USER_ID,)
    )
    extracted = cur.fetchall()
    for name, p_id, s_scope, summary, has_vector in extracted:
        print(f" • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}' | Vector Generated: {has_vector}")
        print(f"   Summary: {summary}")

# TURN 5: Cross-Session Temporal & Scope Recall (Brand New Session ID)
print("\n[SESSION 2 - TURN 5 (Cross-Session Query in New Session ID)]")
prompt_4 = "What are my general coding preferences and the backend/timeout rules I chose for CloudRetail in my previous session?"
print(f"User Prompt:\n{prompt_4}")
resp_4, sys_prompt_4, latency_4 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_2, prompt_4, prev_session_id=SESSION_1, project_id="CloudRetail")
print(f"\nAI Answer:\n{resp_4}")

# VERIFICATION OF RETRIEVED ENTITIES (Checking Scope Precision)
retrieved_scoped_entities = retrieve_hybrid_entities(
    conn=db_conn,
    llm_client=client,
    user_id=USER_ID,
    active_session_id=SESSION_2,
    query_text=prompt_4,
    prev_session_id=SESSION_1,
    project_id="CloudRetail",
    k=20
)

print("\n==================================================")
print("DIAGNOSTIC SCOPE VERIFICATION DETAILS (EXPECTED vs ACTUAL)")
print("==================================================")
print("EXPECTED SPECIFIC ENTITIES & SCOPE:")
print("  1. Global Preference Entity: Retrieved entity with scope == 'global' containing preference facts ('dark mode', 'python 3.11', or 'postgres')")
print("  2. Project Architecture Entity: Retrieved entity with project_id == 'CloudRetail' containing tech stack facts ('fastapi', 'alloydb', 'valkey', or 'timeout')")
print(f"\nACTUAL RETRIEVED ENTITIES (Count: {len(retrieved_scoped_entities)}):")
if not retrieved_scoped_entities:
    print("  [NONE RETRIEVED! Vector/Fulltext search returned 0 matches]")
for ent_name, ent_info in retrieved_scoped_entities.items():
    print(f"  • Entity Name: '{ent_name}'")
    print(f"    - scope:      '{ent_info.get('scope')}'")
    print(f"    - project_id: '{ent_info.get('project_id')}'")
    print(f"    - summary:    '{ent_info.get('summary')}'")

print("\nDATABASE CHECK - ALL ROWS STORED IN agent_entities TABLE:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    db_rows = cur.fetchall()
    if not db_rows:
        print("  [DATABASE TABLE IS EMPTY! No entities were upserted by background worker]")
    for r in db_rows:
        print(f"  • DB Row: entity_name='{r[0]}' | project_id='{r[1]}' | scope='{r[2]}' | summary='{r[3]}'")

# SPECIFIC FACT & SCOPE VERIFICATION LOGIC
found_global_preference = False
matched_global_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("scope") == "global" and any(kw in combined_text for kw in ["dark mode", "python", "postgres"]):
        found_global_preference = True
        matched_global_entity = ent_name
        break

found_project_architecture = False
matched_project_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("project_id") == "CloudRetail" and any(kw in combined_text for kw in ["fastapi", "alloydb", "valkey", "timeout"]):
        found_project_architecture = True
        matched_project_entity = ent_name
        break

print("\n--------------------------------------------------")
print("METADATA SCOPE PRECISION VERIFICATION RESULTS:")
print(f" • Global Preference Fact Retrieved (scope='global'):        {found_global_preference} (Matched Entity: '{matched_global_entity}')")
print(f" • Project Architecture Fact Retrieved (project_id='CloudRetail'): {found_project_architecture} (Matched Entity: '{matched_project_entity}')")
print("--------------------------------------------------")

test_accuracy.append(("Global Coding Preference Recall Test (scope='global')", "PASS" if found_global_preference else "FAIL"))
test_accuracy.append(("Project CloudRetail Architecture Recall Test (project_id='CloudRetail')", "PASS" if found_project_architecture else "FAIL"))

# PERMISSION TEST
perm_action, reason = engine.evaluate_tool_permission(
    user_id=USER_ID, project_id="CloudRetail", session_id=SESSION_2,
    tool_name="run_command", tool_args={"CommandLine": "pytest --timeout=30"}
)
test_accuracy.append(("Tool Permission Policy Test", "PASS" if perm_action in ("allow", "PROMPT_USER") else "FAIL"))

# DYNAMIC TOKEN & LATENCY METRICS CALCULATION
active_prompt_chars_turn5 = len(sys_prompt_4)
active_tokens_turn5 = max(1, active_prompt_chars_turn5 // 4)

# Naive Un-compacted Full History Prompt Tokens for Turn 5
raw_history_chars = len(prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4)
naive_turn5_chars = raw_history_chars + 18000
naive_tokens_turn5 = naive_turn5_chars // 4

active_prompt_reduction_pct = ((naive_tokens_turn5 - active_tokens_turn5) / naive_tokens_turn5) * 100

# Cumulative Multi-Turn Tokens Comparison (Active Read-Path Prompts + Background Extraction & Compacting)
total_active_tokens = sum([
    len(p) // 4 for p in [sys_prompt_1, sys_prompt_2, sys_prompt_3, sys_prompt_4_s1, sys_prompt_4]
])
background_extraction_tokens = async_worker.total_extraction_tokens
background_valkey_summary_tokens = get_valkey_compaction_tokens()

total_tiered_system_tokens = total_active_tokens + background_extraction_tokens + background_valkey_summary_tokens

# Naive Cumulative Tokens across all 5 turns as full transcript grows continuously
naive_cumulative_tokens = sum([
    (len(p) + 18000) // 4 for p in [
        prompt_1,
        prompt_1 + resp_1 + prompt_2,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4
    ]
])

total_system_token_savings_pct = ((naive_cumulative_tokens - total_tiered_system_tokens) / naive_cumulative_tokens) * 100

# FINAL SUMMARY REPORT
print("\n==================================================")
print("FINAL AGENT MEMORY SYSTEM SUMMARY REPORT")
print("==================================================")

print("\n1. STORED ALLOYDB ENTITIES:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    for name, p_id, s_scope, summary in cur.fetchall():
        print(f"   • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}'")
        print(f"     Summary: {summary}")

print("\n2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:")
print(f"   • Naive Full-Context Turn 5 Tokens:    ~{naive_tokens_turn5:,} tokens ({naive_turn5_chars:,} chars)")
print(f"   • Tiered Memory Active Prompt Tokens:  ~{active_tokens_turn5:,} tokens ({active_prompt_chars_turn5:,} chars)")
print(f"   • Active Turn 5 Prompt Reduction:      {active_prompt_reduction_pct:.1f}% Reduction")
print(f"   • Measured Turn 5 Inference Latency:   {latency_4:.2f} seconds")

print("\n3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):")
print(f"   • Naive Cumulative Multi-Turn Tokens:  ~{naive_cumulative_tokens:,} tokens")
print(f"   • Active Read-Path Prompt Tokens:      ~{total_active_tokens:,} tokens (Across 5 Turns)")
print(f"   • Background Worker Tokens (Extraction):~{background_extraction_tokens:,} tokens (4 Background Turns)")
print(f"   • Background Compaction Tokens (Valkey):~{background_valkey_summary_tokens:,} tokens (1 Compaction Call)")
print(f"   • Total Tiered System Token Footprint: ~{total_tiered_system_tokens:,} tokens")
print(f"   • Overall System Token Savings:        {total_system_token_savings_pct:.1f}% Total Reduction")

print("\n4. ACCURACY & VERIFICATION TESTS:")
all_pass = True
for name, status in test_accuracy:
    print(f"   • {name}: [{status}]")
    if status != "PASS":
        all_pass = False

print("\n==================================================")
print(f"OVERALL STATUS: {'ALL TESTS PASSED ✔' if all_pass else 'VERIFICATION FAILED ✖'}")
print("==================================================")
Ejecuta la secuencia de comandos de verificación
Ejecuta la secuencia de comandos en Cloud Shell:
python3 test_memory_system.py
Resultado esperado en la consola
Al final del resultado de la prueba, se imprimirá un resumen de los hallazgos. A continuación, se muestra un ejemplo de una impresión de este tipo, con explicaciones
1. STORED ALLOYDB ENTITIES: <A List of all stored entities,>
   • Entity: '<name of entity>' | Project: '<which project does this relate to>' | Scope: '<global/project/session>'
     Summary: <The entity summary>
    ....

2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:
   • Naive Full-Context Turn 5 Tokens:    <Number of tokens in naive approach on the last turn>
   • Tiered Memory Active Prompt Tokens:  <Number of tokens in tiered approach on the last turn>
   • Active Turn 5 Prompt Reduction:      <Savings on tokens in %>
   • Measured Turn 5 Inference Latency:   <Latency in last turn>

3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):
   • Naive Cumulative Multi-Turn Tokens:  <Total tokens in the naive approach>
   • Active Read-Path Prompt Tokens:      <Read path tokens in the tiered approach>
   • Background Worker Tokens (Extraction): <Backround process tokens usage in tiered approach>
   • Background Compaction Tokens (Valkey): <Backround process tokens usage for compaction in tiered approach>
   • Total Tiered System Token Footprint: <Total tokens usage in tiered approach>
   • Overall System Token Savings:        <Savings on tokens in %>

4. ACCURACY & VERIFICATION TESTS:
   • Valkey Rolling Summary Compaction Test: <Did the roling summary work>
   • Global Coding Preference Recall Test (scope='global'): <Was it able to retrieve global scoped memories>
   • Project CloudRetail Architecture Recall Test (project_id='CloudRetail'): <Was it able to retrieve project specific scoped entities>
   • Tool Permission Policy Test: <Was it able to retrieve permissions policies>
Cómo restablecer los almacenes de memoria (opcional)
Si deseas borrar todos los recuerdos almacenados y restablecer el estado de Valkey y AlloyDB entre las ejecuciones de prueba, crea y ejecuta cleanup_memory_system.py:
import logging
from db_clients import get_db_connection, get_valkey_client
from valkey_buffer import IN_MEMORY_VALKEY_FALLBACK

logging.basicConfig(level=logging.INFO)

def reset_memory_system():
    # 1. Flush short-term Valkey cache or clear local in-memory fallback
    try:
        valkey = get_valkey_client()
        valkey.flushdb()
        print("✔ Flushed Valkey short-term cache.")
    except Exception:
        IN_MEMORY_VALKEY_FALLBACK.clear()
        print("✔ Cleared local in-memory short-term fallback buffer.")

    # 2. Truncate long-term AlloyDB memory tables
    try:
        conn = get_db_connection()
        with conn:
            with conn.cursor() as cur:
                cur.execute("TRUNCATE TABLE agent_entities CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_embeddings CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_collections CASCADE;")
                cur.execute("TRUNCATE TABLE user_permissions CASCADE;")
                print("✔ Truncated AlloyDB long-term memory tables.")
        conn.close()
    except Exception as e:
        print(f"✖ AlloyDB cleanup error: {e}")

if __name__ == "__main__":
    reset_memory_system()
Ejecuta la secuencia de comandos de limpieza:
python3 cleanup_memory_system.py
14. Extensión de la memoria por niveles al ADK de Google
En los pasos anteriores, creaste un sistema de memoria de 2 niveles:
- Nivel 1 (búfer a corto plazo): Memorystore for Valkey almacena los turnos de conversación recientes y crea resúmenes continuos para mantener las instrucciones pequeñas.
- Nivel 2 (tienda híbrida a largo plazo): La IA de AlloyDB almacena preferencias duraderas del usuario, reglas del proyecto y embeddings de vectores con la búsqueda híbrida.
En esta guía, conectarás este motor de memoria a un agente personalizado creado con el Kit de desarrollo de agentes de Google .
El problema con la memoria simple
Conectar un agente a la memoria suele generar una de estas dos trampas:
- La trampa de solo herramientas: Obligar al agente a llamar a herramientas (como
search_memory) para todo. Los agentes suelen olvidar llamar a las herramientas para las preferencias básicas (como el estilo de programación o los tiempos de espera), lo que genera errores y viajes de ida y vuelta adicionales lentos. - La trampa del relleno de instrucciones: Volcar todo el historial pasado en cada instrucción. Esto aumenta rápidamente los costos de los tokens, ralentiza las respuestas y degrada el razonamiento del modelo.
La solución híbrida
Usamos un enfoque híbrido que le brinda al agente la memoria adecuada en el momento oportuno:
- Contexto ambiental (automático): Antes de cada turno, se recuperan de Memorystore (resumen continuo) y AlloyDB (reglas y preferencias) las reglas del proyecto pertinentes y los resúmenes de sesión recientes, que luego se insertan en la instrucción del agente con cero llamadas adicionales al LLM.
- Búsqueda a largo plazo a pedido (herramienta): Para hechos antiguos o poco conocidos (como una decisión arquitectónica de hace dos semanas), el agente llama a
long_term_memory_toolpara ejecutar una búsqueda de vectores en la tabla de memoria a largo plazo de AlloyDB. - Protecciones de ejecución: Antes de que el agente ejecute una herramienta, una protección verifica los permisos de un solo uso en Valkey y las reglas de seguridad en AlloyDB para bloquear acciones peligrosas, como
rm -rf.
Instalación y configuración
Instala el paquete google-adk (las otras dependencias ya están instaladas):
pip3 install google-adk
Establece la región de Google Cloud para que el cliente de IA generativa del ADK enrute a través de Vertex AI:
# ADK agent platform backend
export GEMINI_MODEL="gemini-3.5-flash"
export GOOGLE_GENAI_USE_VERTEXAI="true"
export GOOGLE_CLOUD_PROJECT="${PROJECT_ID}"
export GOOGLE_CLOUD_LOCATION="${GENAI_LOCATION}"
15. Proveedor de memoria ambiente
Crea adk_memory_provider.py. Esta clase controla el ciclo de vida automático de la memoria:
- Antes del turno: Recupera el búfer de conversación de Valkey (menos de 1 ms) y consulta AlloyDB para obtener las preferencias y las reglas del proyecto coincidentes, y las ensambla en la instrucción del sistema.
- Después del turno: Agrega la conversación a Valkey y activa un proceso en segundo plano para extraer hechos duraderos en AlloyDB sin ralentizar la respuesta del usuario.
import logging
from typing import Any, Dict, Optional
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

class ADKTieredMemoryProvider:
    """Provides ambient memory context before turns and saves history after turns."""

    def __init__(self, db_conn_factory, valkey_client: redis.Redis, genai_client: Any, trigger_limit: int = 10, window_size: int = 4):
        self.conn_factory = db_conn_factory
        self.valkey_client = valkey_client
        self.genai_client = genai_client
        self.trigger_limit = trigger_limit
        self.window_size = window_size
        self.async_worker = AsyncMemoryWorker(db_conn_factory, genai_client)

    def get_context_for_turn(self, user_id: str, project_id: Optional[str], session_id: str, user_query: str, prev_session_id: Optional[str] = None) -> Dict[str, Any]:
        """Reads Valkey buffer (<1ms) and AlloyDB hybrid entities before agent reasoning."""
        buffer_data = get_session_context_buffer(self.valkey_client, session_id)
        rolling_summary = buffer_data["rolling_summary"]

        # Carry over prior session summary when starting a fresh session
        if not rolling_summary and prev_session_id:
            prev_buffer = get_session_context_buffer(self.valkey_client, prev_session_id)
            if prev_buffer["rolling_summary"]:
                rolling_summary = f"[From prior session {prev_session_id}]:\n" + prev_buffer["rolling_summary"]

        conn = self.conn_factory()
        try:
            entities = retrieve_hybrid_entities(
                conn=conn, llm_client=self.genai_client, user_id=user_id,
                active_session_id=session_id, query_text=user_query,
                prev_session_id=prev_session_id, project_id=project_id, k=20
            )
        finally:
            conn.close()

        return {
            "rolling_summary": rolling_summary,
            "recent_turns": buffer_data["recent_turns"],
            "retrieved_entities": entities
        }

    def format_system_instruction(self, context: Dict[str, Any], base_prompt: str = "") -> str:
        """Injects ambient entities and short-term summaries into the agent's prompt."""
        entity_lines = [f"- {name}: {info['summary']}" for name, info in context["retrieved_entities"].items()]
        entity_str = "\n".join(entity_lines) if entity_lines else "No relevant long-term entities."
        summary_str = context["rolling_summary"] or "No prior summary."

        return f"""{base_prompt}

[LONG-TERM PREFERENCES & ENTITIES]
{entity_str}

[SHORT-TERM ROLLING SUMMARY]
{summary_str}

[NOTE ON TOOLS & MEMORY]
Memory persistence is managed automatically by the platform behind the scenes. Do not attempt to invoke non-existent tools like 'set_preference' or 'save_fact'. Only invoke explicitly declared tools when needed.
""".strip()

    def record_turn_async(self, user_id: str, project_id: Optional[str], session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None) -> None:
        """Updates Valkey sliding window and triggers background AlloyDB extraction."""
        append_session_turn_with_rolling_summary(
            valkey_client=self.valkey_client, llm_client=self.genai_client,
            session_id=session_id, user_msg=user_msg, ai_msg=ai_msg,
            trigger_limit=self.trigger_limit, window_size=self.window_size
        )
        self.async_worker.enqueue_extraction(
            user_id=user_id, session_id=session_id, user_msg=user_msg,
            ai_msg=ai_msg, prev_session_id=prev_session_id
        )
16. Herramienta de memoria a largo plazo a pedido
La memoria ambiental mantiene la instrucción activa pequeña, pero, en ocasiones, un agente necesita buscar notas históricas anteriores, decisiones de arquitectura o registros de incidentes.
Crea adk_memory_tools.py. Esto encapsula la tabla de vectores episodic_memory_embeddings de AlloyDB en un FunctionTool del ADK:
from typing import Any, Dict, List, Optional
from google.adk.tools import FunctionTool

def make_long_term_memory_tool(db_conn_factory, embed_client: Any, user_id: str) -> FunctionTool:
    """Creates an ADK FunctionTool for vector search over AlloyDB historical records."""

    def search_archived_memory(query: str, project_id: Optional[str] = None, limit: int = 3) -> List[Dict[str, Any]]:
        """Searches past architecture decisions, historical notes, and old discussions."""
        # 1. Embed query with text-embedding-005
        emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=query)
        query_vector = emb_resp.embeddings[0].values

        # 2. Cosine distance search on AlloyDB HNSW vector index
        sql = """
            SELECT document, cmetadata, created_at, 1 - (embedding <=> %s::vector) AS similarity
            FROM episodic_memory_embeddings
            WHERE cmetadata->>'user_id' = %s
              AND (%s IS NULL OR cmetadata->>'project_id' = %s)
            ORDER BY embedding <=> %s::vector ASC
            LIMIT %s;
        """
        conn = db_conn_factory()
        results = []
        try:
            with conn.cursor() as cur:
                cur.execute(sql, (str(query_vector), user_id, project_id, project_id, str(query_vector), limit))
                for doc, meta, created_at, similarity in cur.fetchall():
                    results.append({
                        "document": doc,
                        "metadata": meta,
                        "timestamp": created_at.isoformat() if created_at else None,
                        "similarity": round(float(similarity), 4)
                    })
        finally:
            conn.close()
        return results

    return FunctionTool(search_archived_memory)
17. Protecciones de permisos empresariales
Los agentes autónomos no deben ejecutar acciones destructivas del host (como rm -rf o descartar tablas) sin verificación.
Cómo funciona before_tool_callback del ADK
El ADK proporciona un hook de interceptación que se ejecuta antes de que se ejecute cualquier herramienta:
- Devuelve
None: El ADK permite la ejecución de la herramienta. - Devuelve un diccionario (p.ej.,
{"status": "DENIED", "error": ...}): El ADK anula la ejecución de inmediato. No se ejecuta ningún comando y se devuelve el motivo del rechazo al modelo para que pueda explicarle la restricción al usuario.
Orden de verificación de permisos
- Verificación 0 (Lista de entidades permitidas de herramientas seguras): Las herramientas seguras de solo lectura, como
search_archived_memory, se aprueban previamente en la memoria para que el agente siempre pueda consultar su propia memoria. - Nivel 1 (otorgamientos efímeros de "permitir una vez" en Valkey): Cuando un operador humano aprueba una acción riesgosa, se almacena una clave temporal
one_time_perm:{session_id}:{cmd_hash}en Valkey con un TTL de 5 minutos. La protección lee y borra la clave en una operación atómica. Esto permite que el comando se ejecute una vez, lo que evita la acumulación permanente de privilegios. - Nivel 2 (reglas del proyecto en AlloyDB): Verifica las reglas de regex en
user_permissionspara el proyecto activo (p.ej., permitirpytest.*--timeout=30, bloquearrm -rf.*). - Nivel 3 (reglas globales en AlloyDB): Verifica las reglas de resguardo que se aplican a todos los proyectos.
- Respaldo de cierre ante fallas: Si no coincide ninguna regla, se deniega la ejecución con
PENDING, lo que requiere una revisión humana.
Implementación
Crea adk_guardrails.py:
import logging
from typing import Any, Dict, Optional, Tuple, Set
from enterprise_engine import AgentMemoryEngine

logger = logging.getLogger(__name__)

class ADKPermissionGuardrail:
    """Evaluates tool permissions using Valkey allow-once tokens and AlloyDB rules."""

    def __init__(self, memory_engine: AgentMemoryEngine, exempt_tools: Optional[Set[str]] = None):
        self.engine = memory_engine
        self.exempt_tools = exempt_tools or {"search_archived_memory"}

    def evaluate(self, user_id: str, project_id: str, session_id: str, tool_name: str, tool_args: Dict[str, Any]) -> Tuple[bool, str]:
        # 1. Allowlist safe internal tools
        if tool_name in self.exempt_tools:
            return True, f"Internal tool '{tool_name}' is pre-approved."

        # 2. Check 3-tier policy engine
        action, reason = self.engine.evaluate_tool_permission(
            user_id=user_id, project_id=project_id, session_id=session_id,
            tool_name=tool_name, tool_args=tool_args
        )
        if action.upper() == "ALLOW":
            return True, f"Permission ALLOWED: {reason}"
        elif action.upper() == "BLOCK":
            return False, f"Permission BLOCKED: {reason}"
        return False, f"Permission PENDING: {reason} (requires human confirmation)"

    def create_before_tool_callback(self, user_id: str, default_project_id: str = "global"):
        """Creates the callback hook for Agent(before_tool_callback=...)."""
        def before_tool_callback(tool: Any, args: Dict[str, Any], tool_context: Any) -> Optional[Dict[str, Any]]:
            tool_name = getattr(tool, "name", str(tool))
            session_id = getattr(getattr(tool_context, "session", None), "id", "default_session")

            allowed, msg = self.evaluate(user_id, default_project_id, session_id, tool_name, args)
            if not allowed:
                logger.warning("Guardrail blocked '%s': %s", tool_name, msg)
                return {"status": "DENIED", "tool": tool_name, "error": msg}

            return None  # Returning None permits execution in ADK
        return before_tool_callback
18. Cómo ejecutar la prueba del agente del ADK
Crea test_adk_agent.py. Este script completo conecta los componentes, inicializa una decisión archivada y reglas de seguridad, ejecuta una conversación de 2 sesiones, prueba la compactación y la recuperación de la memoria, y verifica el cumplimiento de los parámetros de protección:
import asyncio
import os
import time
from google import genai
from google.genai import types
from google.adk.agents import Agent
from google.adk.runners import Runner
from google.adk.sessions import InMemorySessionService
from google.adk.tools import FunctionTool

from db_clients import get_db_connection, get_valkey_client
from enterprise_engine import AgentMemoryEngine
from adk_memory_provider import ADKTieredMemoryProvider
from adk_memory_tools import make_long_term_memory_tool
from adk_guardrails import ADKPermissionGuardrail
from valkey_buffer import get_session_context_buffer

# Configuration & clients
PROJECT_ID = os.getenv("PROJECT_ID", "chunking-poc-alloydb")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")
GEMINI_MODEL = os.getenv("GEMINI_MODEL", "gemini-3.5-flash")
USER_ID, SESSION_1, SESSION_2 = "user_adk_dev", "sess_adk_001", "sess_adk_002"

db_conn = get_db_connection()
valkey_client = get_valkey_client()
# LLM client for Gemini 3.5 Flash via global multi-region
genai_client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)
# Embeddings client (requires specific regional presence)
embed_client = genai.Client(vertexai=True, project=PROJECT_ID, location=REGION)

tiered_provider = ADKTieredMemoryProvider(get_db_connection, valkey_client, genai_client, trigger_limit=3, window_size=2)
memory_engine = AgentMemoryEngine(valkey_client, db_conn)
guardrail = ADKPermissionGuardrail(memory_engine)

# Tools: Long-term memory search and mock terminal command
long_term_memory_tool = make_long_term_memory_tool(get_db_connection, embed_client, USER_ID)

def run_command(CommandLine: str) -> str:
    """Executes a shell command on the host."""
    return f"Executed: {CommandLine}"

run_command_tool = FunctionTool(run_command)

def seed_database():
    """Seeds a 14-day-old architecture decision and permission rules."""
    doc = "Archived Decision: CloudRetail services must use gRPC keepalive ping intervals of 15 seconds."
    emb = embed_client.models.embed_content(model="text-embedding-005", contents=doc).embeddings[0].values
    conn = get_db_connection()
    try:
        with conn.cursor() as cur:
            cur.execute("""
                INSERT INTO episodic_memory_embeddings (uuid, document, cmetadata, created_at, embedding)
                VALUES (gen_random_uuid(), %s, jsonb_build_object('user_id', %s, 'project_id', 'CloudRetail'), NOW() - INTERVAL '14 days', %s::vector);
            """, (doc, USER_ID, str(emb)))
            cur.execute("""
                INSERT INTO user_permissions (user_id, project_id, tool_name, command_pattern, action)
                VALUES (%s, 'CloudRetail', 'run_command', 'pytest.*--timeout=30', 'ALLOW'),
                       (%s, 'CloudRetail', 'run_command', 'rm -rf.*', 'BLOCK'),
                       (%s, 'global', 'search_archived_memory', '.*', 'ALLOW')
                ON CONFLICT DO NOTHING;
            """, (USER_ID, USER_ID, USER_ID))
        conn.commit()
    finally:
        conn.close()

async def run_turn(runner: Runner, session_id: str, query: str, prev_session_id: str = None) -> str:
    """Fetches ambient memory, executes turn, and saves history in the background."""
    ctx = tiered_provider.get_context_for_turn(USER_ID, "CloudRetail", session_id, query, prev_session_id)
    runner.agent.instruction = tiered_provider.format_system_instruction(
        ctx,
        base_prompt="You are an intelligent Google ADK enterprise developer assistant."
    )
    msg = types.Content(role="user", parts=[types.Part.from_text(text=query)])
    parts = []
    async for event in runner.run_async(user_id=USER_ID, session_id=session_id, new_message=msg):
        if event.content and event.content.parts:
            parts.extend([p.text for p in event.content.parts if p.text])

    response = "".join(parts).strip()
    tiered_provider.record_turn_async(USER_ID, "CloudRetail", session_id, query, response, prev_session_id)
    return response

async def main():
    seed_database()
    sessions = InMemorySessionService()
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_1)

    agent = Agent(
        name="adk_memory_agent", model=GEMINI_MODEL, instruction="Initial instruction",
        tools=[long_term_memory_tool, run_command_tool],
        before_tool_callback=guardrail.create_before_tool_callback(USER_ID, "CloudRetail")
    )
    runner = Runner(agent=agent, session_service=sessions, app_name="agents")

    print("\n--- Session 1: Storing Preferences & Triggering Compaction ---")
    await run_turn(runner, SESSION_1, "I standardize on Python 3.11 with PostgreSQL and Dark Mode UI.")
    await run_turn(runner, SESSION_1, "For project CloudRetail, our backend stack is FastAPI on AlloyDB with Valkey cache and 30s timeouts.")
    await run_turn(runner, SESSION_1, "Draft a quick 5-line SQL table for products.")
    await run_turn(runner, SESSION_1, "Add rate-limiting rules for API endpoints.")

    buf = get_session_context_buffer(valkey_client, SESSION_1)
    print(f"Valkey rolling summary generated: {bool(buf['rolling_summary'])}")
    print(f"Turns in buffer: {len(buf['recent_turns'])} (compacted from 8)")

    print("\nWaiting 6s for background worker entity extraction into AlloyDB...")
    await asyncio.sleep(6)

    print("\n--- Session 2: Cold-Start Ambient Recall ---")
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_2)
    resp = await run_turn(runner, SESSION_2, "What are my coding preferences and the CloudRetail stack from my previous session?", prev_session_id=SESSION_1)
    print(f"Agent response:\n{resp}\n")

    print("\n--- On-Demand Archival Vector Search ---")
    resp_search = await run_turn(runner, SESSION_2, "What was the agreed gRPC keepalive interval from 2 weeks ago?")
    print(f"Agent response:\n{resp_search}\n")

    print("\n--- Guardrail Verification ---")
    blocked, b_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "rm -rf /tmp/data"})
    allowed, a_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "pytest --timeout=30"})
    print(f"rm -rf /tmp/data:    Allowed={blocked} ({b_msg})")
    print(f"pytest --timeout=30: Allowed={allowed} ({a_msg})")

if __name__ == "__main__":
    asyncio.run(main())
Limpieza de pruebas iterativas
Dado que el sistema captura el contexto persistente, ejecutar la prueba varias veces agregará fragmentos de diálogo a Valkey y reglas duplicadas a AlloyDB de forma indefinida.
Para restablecer fácilmente tu estado entre ejecuciones, ejecuta la secuencia de comandos cleanup_memory_system.py que creaste en un paso anterior:
python3 cleanup_memory_system.py
python3 test_adk_agent.py
Resultados de la verificación
La prueba verifica cuatro comportamientos críticos de producción:
- Reducción significativa de tokens de instrucciones: La compactación de Valkey compactó el historial de diálogo en un resumen continuo conciso. En nuestras pruebas, esto redujo el tamaño de la instrucción activa en más del 92% (de alrededor de 6,956 tokens a alrededor de 544 tokens). Tus resultados pueden variar.
- Recuperación instantánea de inicio en frío: En una sesión completamente nueva (sesión 2), el agente recordó de inmediato las preferencias del usuario (Python 3.11, PostgreSQL, modo oscuro) y la arquitectura del proyecto (FastAPI, tiempos de espera de 30 s) sin llamar a ninguna herramienta. Esto se habilitó con
ADKTieredMemoryProvider.get_context_for_turn, que recupera el contexto de Memorystore y AlloyDB antes de que se llame al LLM. - Recuperación de vectores a pedido: Cuando se le preguntó sobre una decisión de hace 14 días, el agente invocó
search_archived_memoryy recuperó la regla de keepalive de gRPC de 15 segundos. - Seguridad determinística: El agente ejecutó
pytest --timeout=30, pero se le impidió estrictamente ejecutarrm -rf /tmp/data.
19. Limpia
Para evitar que se apliquen cargos continuos a tu cuenta de Google Cloud por las instancias de AlloyDB y Memorystore, borra los recursos creados.
Ejecute los siguientes comandos en Cloud Shell:
# Exit VM and return to Cloud Shell
exit
# Delete Compute Engine development VM
gcloud compute instances delete $VM_NAME \
  --zone=$ZONE \
  --quiet

# Delete AlloyDB primary instance and cluster
gcloud alloydb instances delete $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --quiet

gcloud alloydb clusters delete $ADBCLUSTER \
  --region=$REGION \
  --quiet

# Delete Memorystore for Valkey instance
gcloud memorystore instances delete $VALKEYINSTANCE \
  --location=$REGION \
  --quiet
20. Felicitaciones
¡Felicitaciones! Creaste correctamente una arquitectura de memoria de agente de IA a largo plazo de 2 niveles que combina Memorystore for Valkey y AlloyDB AI.
Qué aprendiste
- Se implementó una arquitectura de memoria de 2 niveles que separa el estado de sesión activo a corto plazo de los hechos persistentes a largo plazo.
- Se logró una reducción significativa en el tamaño de la instrucción activa y ahorros en el uso total de tokens en comparación con el relleno de contexto ingenuo, sin pérdida de exactitud.
- Se configuraron incorporaciones automáticas transaccionales (
ai.initialize_embeddings) a nivel de la base de datos de AlloyDB AI. - Se realizó una búsqueda híbrida de fusión de clasificación recíproca (
ai.hybrid_search) nativa que combina la similitud de vectores (<=>) con la búsqueda de texto completo de PostgreSQL (tsvector). - Se creó un extractor de entidades en segundo plano fuera del subproceso (
AsyncMemoryWorker), un evaluador de permisos de ejecución de herramientas de 3 niveles y un motor de compactación de memoria de la base de datos. - Se adjuntó el sistema de memoria por niveles a un agente autónomo con el Kit de desarrollo de agentes (ADK) de Google para aplicar los rieles de seguridad de las herramientas y proporcionar memoria ambiental.
Próximos pasos y referencias
- Lee la documentación de AlloyDB AI.
- Aprende a ejecutar la búsqueda híbrida de vectores en AlloyDB.
- Obtén más información sobre Memorystore para Valkey.