

1. Avant de commencer
Alors que les agents IA gèrent de longues interactions multitours qui s'étendent sur plusieurs jours et exécutent des tâches à long terme en plusieurs étapes, les grands modèles de langage (LLM) restent intrinsèquement sans état d'une session à l'autre. Lorsqu'un utilisateur revient vers un agent le lendemain, le modèle repart de zéro, sauf si l'application peut reconstruire le contexte nécessaire.
L'approche naïve de ce problème est le bourrage de jetons, qui consiste à ajouter l'intégralité de l'historique des conversations, des journaux d'exécution des outils et des bases de code directement à chaque requête active. Bien que les grandes fenêtres de contexte d'un million de jetons rendent cela techniquement possible, le bourrage de contexte introduit un frein opérationnel important : les coûts de jetons augmentent de manière quadratique à chaque tour, les latences de réponse atteignent des dizaines de secondes et les modèles souffrent d'une dégradation du contexte "perdu au milieu".
Pour créer des agents IA fiables, vous avez besoin d'une architecture de mémoire à deux niveaux :
- Tampon de session à court terme : met en cache les tours de conversation récents dans la mémoire active à l'aide d'une fenêtre glissante limitée par des jetons. Ce niveau nécessite des recherches en mémoire à faible latence et à haut débit à chaque tour, ce qui fait de Memorystore pour Valkey le choix idéal.
- Mémoire persistante à long terme : stocke les entités structurées, les préférences utilisateur et les faits épisodiques d'une session à l'autre. Ce niveau nécessite une intégrité transactionnelle, une sécurité multitenant et une récupération hybride entre les données relationnelles et les vecteurs. AlloyDB pour PostgreSQL est donc le bon choix.
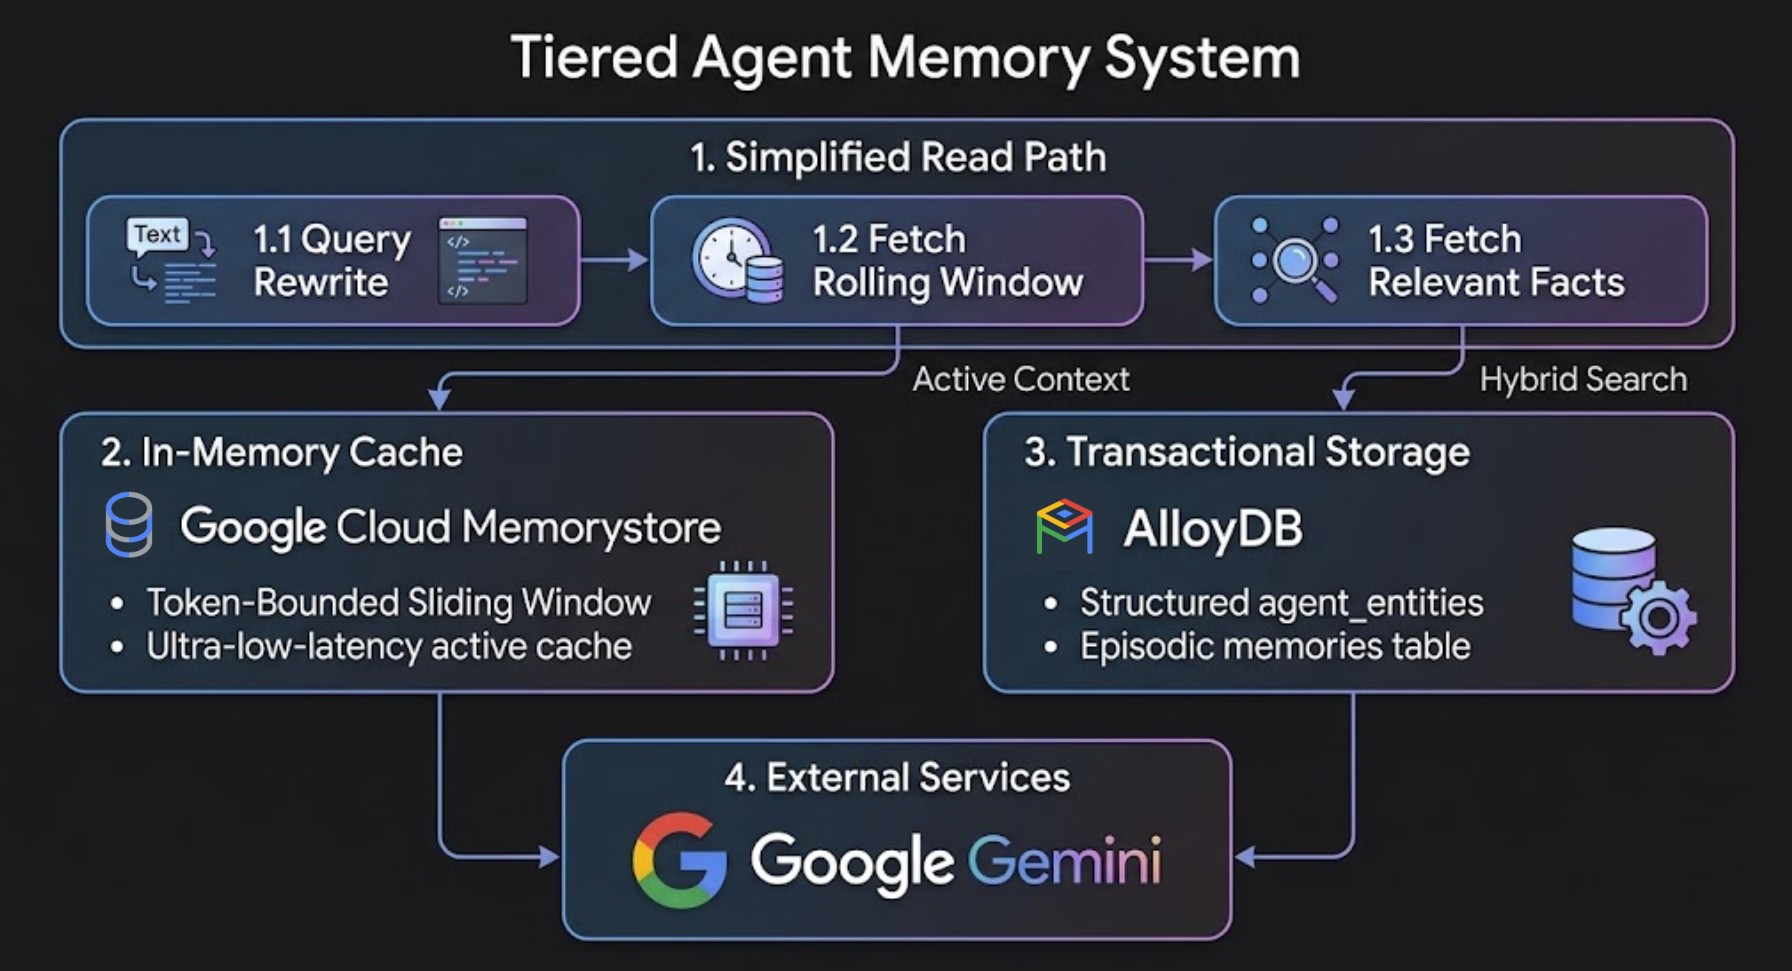
Comprendre les quatre types de mémoire
Une architecture de mémoire robuste repose sur quatre types de mémoire complémentaires tout au long du parcours utilisateur :
Type de mémoire | Informations stockées | Couche de stockage | Durée de vie |
Tampon (court terme) | Tours de conversation bruts récents | Memorystore pour Valkey | Session active |
Mémoire de synthèse | Historique compressé des tours plus anciens | Memorystore pour Valkey | Fenêtre multitours |
Mémoire épisodique | Actions, événements et résultats d'outils passés | AlloyDB pour PostgreSQL (vecteur) | Permanente |
Mémoire des entités et des règles | Préférences, contraintes et refus de l'utilisateur | AlloyDB pour PostgreSQL (SQL structuré + vecteur) | Permanente |
Impact mesuré de la mémoire hiérarchisée
Des tests comparatifs internes sur des dialogues de développement multitours (plus de 45 tours avec des journaux de sortie d'outils volumineux) montrent des économies importantes par rapport au bourrage de contexte naïf :
Métrique / Dimension | Accumulation naïve de contexte | Mémoire hiérarchisée (AlloyDB + Memorystore) | Impact net dans les tests |
Taille du prompt actif (tour 45) | 747 033 jetons | 83 262 jetons | Requête 88,9% plus petite |
Latence de réponse de 45 tours | 33,5 secondes | 6,7 secondes | Réponse 80% plus rapide |
Jetons de session cumulés | 17,9 millions de jetons | 4,09 millions de jetons | 72% d'économies totales en termes de jetons et de coûts |
Rappel des règles et des contraintes | Dégradation au fil des tours | Évite que des informations importantes ne soient perdues dans le résumé | Préservés grâce à la recherche hybride |
Objectifs de l'atelier
- Provisionnez AlloyDB pour PostgreSQL et Memorystore pour Valkey.
- Activez
google_ml_integrationet configurez les auto-intégrations transactionnelles côté base de données (ai.initialize_embeddings). - Implémentez un tampon de session Valkey à court terme avec un modèle de pipeline "résumer avant de couper".
- Extraire des entités à long terme de manière native à l'aide des fonctions d'IA natives d'AlloyDB (par exemple,
ai.generate) - Interrogez des faits à long terme avec un haut niveau de précision et de pertinence à l'aide de la fonction de recherche hybride native d'AlloyDB (
ai.hybrid_search) et du reclassement par Reciprocal Rank Fusion (RRF). - Créez un évaluateur d'autorisations d'outil d'entreprise à trois niveaux et un moteur de compaction de la mémoire en arrière-plan.
- Intégrez l'architecture de mémoire à deux niveaux directement dans un agent autonome à l'aide de Google Agent Development Kit (ADK).
Prérequis
- Un projet Google Cloud avec facturation activée.
- Un navigateur Web tel que Chrome.
- Connaissances de base de Python et de SQL, y compris expérience de l'exécution de requêtes SQL sur AlloyDB (à partir de Studio, de la CLI, etc.)
Audience et coût
- Audience : développeurs d'IA, ingénieurs backend et architectes de bases de données.
- Coût estimé : les ressources Google Cloud créées dans cet atelier de programmation coûteront environ 1,50 $.
2. Préparation
Démarrer Cloud Shell
Dans cet atelier de programmation, vous allez exécuter des commandes dans Google Cloud Shell, un terminal hébergé dans le cloud et préconfiguré avec gcloud, psql et python3.
- Ouvrez la console Google Cloud.
- Cliquez sur Activer Cloud Shell en haut à droite de la console Cloud.
- Vérifiez l'authentification :
gcloud auth list
export PROJECT_ID=<YOUR_PROJECT_ID>
gcloud config set project $PROJECT_ID

export REGION=us-east1
export GENAI_LOCATION=us
export ZONE=us-east1-b
export ADBCLUSTER=agent-memory-cluster
export ADBINSTANCE=agent-memory-instance
export VALKEYINSTANCE=agent-memory-cache
export VM_NAME=agent-dev-vm
Activer les API Google Cloud et créer une VM de développement
Exécutez la commande suivante dans Cloud Shell pour activer les API requises :
gcloud services enable \
  alloydb.googleapis.com \
  memorystore.googleapis.com \
  aiplatform.googleapis.com \
  compute.googleapis.com \
  servicenetworking.googleapis.com \
  networkconnectivity.googleapis.com
Créez une instance de VM Compute Engine dans le réseau VPC default pour héberger votre environnement de développement Python aux côtés d'AlloyDB et de Memorystore pour Valkey :
gcloud compute instances create $VM_NAME \
    --zone=$ZONE \
    --machine-type=e2-standard-2 \
    --scopes=cloud-platform \
    --network=default \
    --shielded-secure-boot
3. Provisionner AlloyDB et Memorystore pour Valkey
À cette étape, vous allez provisionner votre cluster et votre instance principale AlloyDB pour PostgreSQL, établir une mise en réseau de services privés et lancer une instance Memorystore pour Valkey.
Créer une plage d'adresses IP pour l'accès aux services privés
AlloyDB nécessite une plage d'adresses IP privées dans votre réseau cloud privé virtuel (VPC). En supposant que vous utilisiez le réseau VPC default :
- Créez l'allocation de la plage d'adresses IP privées :
gcloud compute addresses create psa-range \
    --global \
    --purpose=VPC_PEERING \
    --prefix-length=24 \
    --description="VPC private service access" \
    --network=default
- Établissez la connexion d'appairage VPC privée :
gcloud services vpc-peerings connect \
    --service=servicenetworking.googleapis.com \
    --ranges=psa-range \
    --network=default
Créer un cluster et une instance principale AlloyDB
- Créez un mot de passe de cluster initial pour l'initialisation du système :
export PGPASSWORD=`openssl rand -hex 12`
- Créez un cluster d'essai sans frais :
gcloud alloydb clusters create $ADBCLUSTER \
    --password=$PGPASSWORD \
    --network=default \
    --region=$REGION \
    --subscription-type=TRIAL
- Créez l'instance principale :
gcloud alloydb instances create $ADBINSTANCE \
    --instance-type=PRIMARY \
    --cpu-count=2 \
    --region=$REGION \
    --cluster=$ADBCLUSTER
Provisionner une instance Memorystore pour Valkey
Memorystore pour Valkey nécessite une règle de connexion de service (gcp-memorystore) dans votre réseau et votre région avant la création de l'instance.
- Créez la règle de connexion de service pour Memorystore :
gcloud network-connectivity service-connection-policies create memorystore-policy \
    --network=default \
    --region=$REGION \
    --service-class=gcp-memorystore \
    --subnets=projects/$PROJECT_ID/regions/$REGION/subnetworks/default
- Créez l'instance Memorystore pour Valkey :
gcloud memorystore instances create $VALKEYINSTANCE \
    --location=$REGION \
    --shard-count=1 \
    --replica-count=0 \
    --node-type=SHARED_CORE_NANO \
    --psc-auto-connections="network=projects/$PROJECT_ID/global/networks/default,projectId=$PROJECT_ID"
Accorder des autorisations IAM Vertex AI
Accordez au compte de service AlloyDB les autorisations IAM nécessaires pour appeler les modèles d'embedding d'Agent Platform :
PROJECT_ID=$(gcloud config get-value project)

gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:service-$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")@gcp-sa-alloydb.iam.gserviceaccount.com" \
  --role="roles/aiplatform.user"
4. Initialiser l'environnement et accéder aux points de terminaison
Configurer l'authentification IAM et les indicateurs de base de données AlloyDB
Activez l'authentification IAM pour les bases de données (alloydb.iam_authentication=on) et le moteur de requêtes d'IA (google_ml_integration.enable_ai_query_engine=on) sur votre instance AlloyDB :
gcloud beta alloydb instances update $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --update-mode=FORCE_APPLY \
  --database-flags=alloydb.iam_authentication=on,google_ml_integration.enable_ai_query_engine=on
Ensuite, ajoutez votre compte Google Cloud en tant qu'utilisateur de base de données basé sur IAM avec des autorisations de super-utilisateur :
export USER_ACCOUNT=$(gcloud config get-value account)

gcloud alloydb users create $USER_ACCOUNT \
    --cluster=$ADBCLUSTER \
    --region=$REGION \
    --type=IAM_BASED \
    --db-roles=alloydbsuperuser
Récupérer les points de terminaison VPC internes dans Cloud Shell
Avant de vous connecter en SSH à votre VM de développement, récupérez les adresses IP VPC internes pour AlloyDB et Memorystore pour Valkey dans Cloud Shell :
# Export GCP Project ID, Region, and IAM User
export PROJECT_ID=$(gcloud config get-value project)
export REGION=us-east1
export DB_USER=$(gcloud config get-value account)

# Retrieve Internal VPC IP Addresses for AlloyDB & Memorystore for Valkey
export DB_HOST=$(gcloud alloydb instances describe $ADBINSTANCE --cluster=$ADBCLUSTER --region=$REGION --format="value(ipAddress)")
export DB_PORT=5432
export DB_NAME=postgres

export VALKEY_HOST=$(gcloud memorystore instances describe $VALKEYINSTANCE --location=$REGION --format="value(discoveryEndpoints[0].address)")
export VALKEY_PORT=6379

# Verify exported endpoints
echo "Project ID:        $PROJECT_ID"
echo "Region:            $REGION"
echo "AlloyDB Private IP: $DB_HOST"
echo "IAM DB User:       $DB_USER"
echo "Valkey Private IP:  $VALKEY_HOST"
Se connecter en SSH à la VM de développement et exporter les variables de connexion
À partir de Cloud Shell, connectez-vous en SSH à votre VM de développement Compute Engine (agent-dev-vm) située dans le même réseau VPC :
gcloud compute ssh $VM_NAME --zone=$ZONE
Une fois connecté à votre VM de développement, exportez la configuration du projet et les points de terminaison de connexion ci-dessus (en remplaçant
export PROJECT_ID=<YOUR_PROJECT_ID>
export REGION=us-east1
export GENAI_LOCATION=us
export DB_HOST=<YOUR_ALLOYDB_PRIVATE_IP>
export DB_PORT=5432
export DB_NAME=postgres
export DB_USER=<YOUR_IAM_DB_USER>
export VALKEY_HOST=<YOUR_VALKEY_PRIVATE_IP>
export VALKEY_PORT=6379
Initialiser l'environnement virtuel Python
Dans votre VM de développement, commençons par créer votre répertoire de travail local :
mkdir -p ~/alloydb_agent_memory && cd ~/alloydb_agent_memory
Installons maintenant les packages de l'environnement virtuel Python du système, authentifions les identifiants par défaut de l'application (ADC) et configurons votre espace de travail :
sudo apt-get update && sudo apt-get install -y python3-venv python3-pip

python3 -m venv venv
source venv/bin/activate
Enfin, dans le nouvel environnement virtuel, nous allons installer les dépendances :
gcloud auth application-default login
pip install psycopg2-binary valkey redis google-genai
5. Architecture du système et hiérarchie des modules de code
Présentation de ce que vous allez créer
Avant d'implémenter les scripts Python individuels, examinez l'architecture système ci-dessous. Cet exemple d'application est structuré en sept scripts Python modulaires fonctionnant sur deux principaux chemins d'exécution qui interagissent avec la même instance de base de données AlloyDB pour PostgreSQL :
- Chemin de lecture (
hybrid_retriever.py) : décompose les questions complexes en sous-requêtes à un seul aspect directement dans PostgreSQL à l'aide d'AlloyDB AIai.generate()et interroge les mémoires à long terme à l'aide de la recherche hybride native d'AlloyDB (ai.hybrid_search). - Chemin d'écriture (
async_worker.py) : worker de file d'attente en arrière-plan hors thread qui extrait de manière asynchrone les faits d'entités structurées des échanges de dialogue à l'aide de Gemini Flash et les insère dansagent_entities.
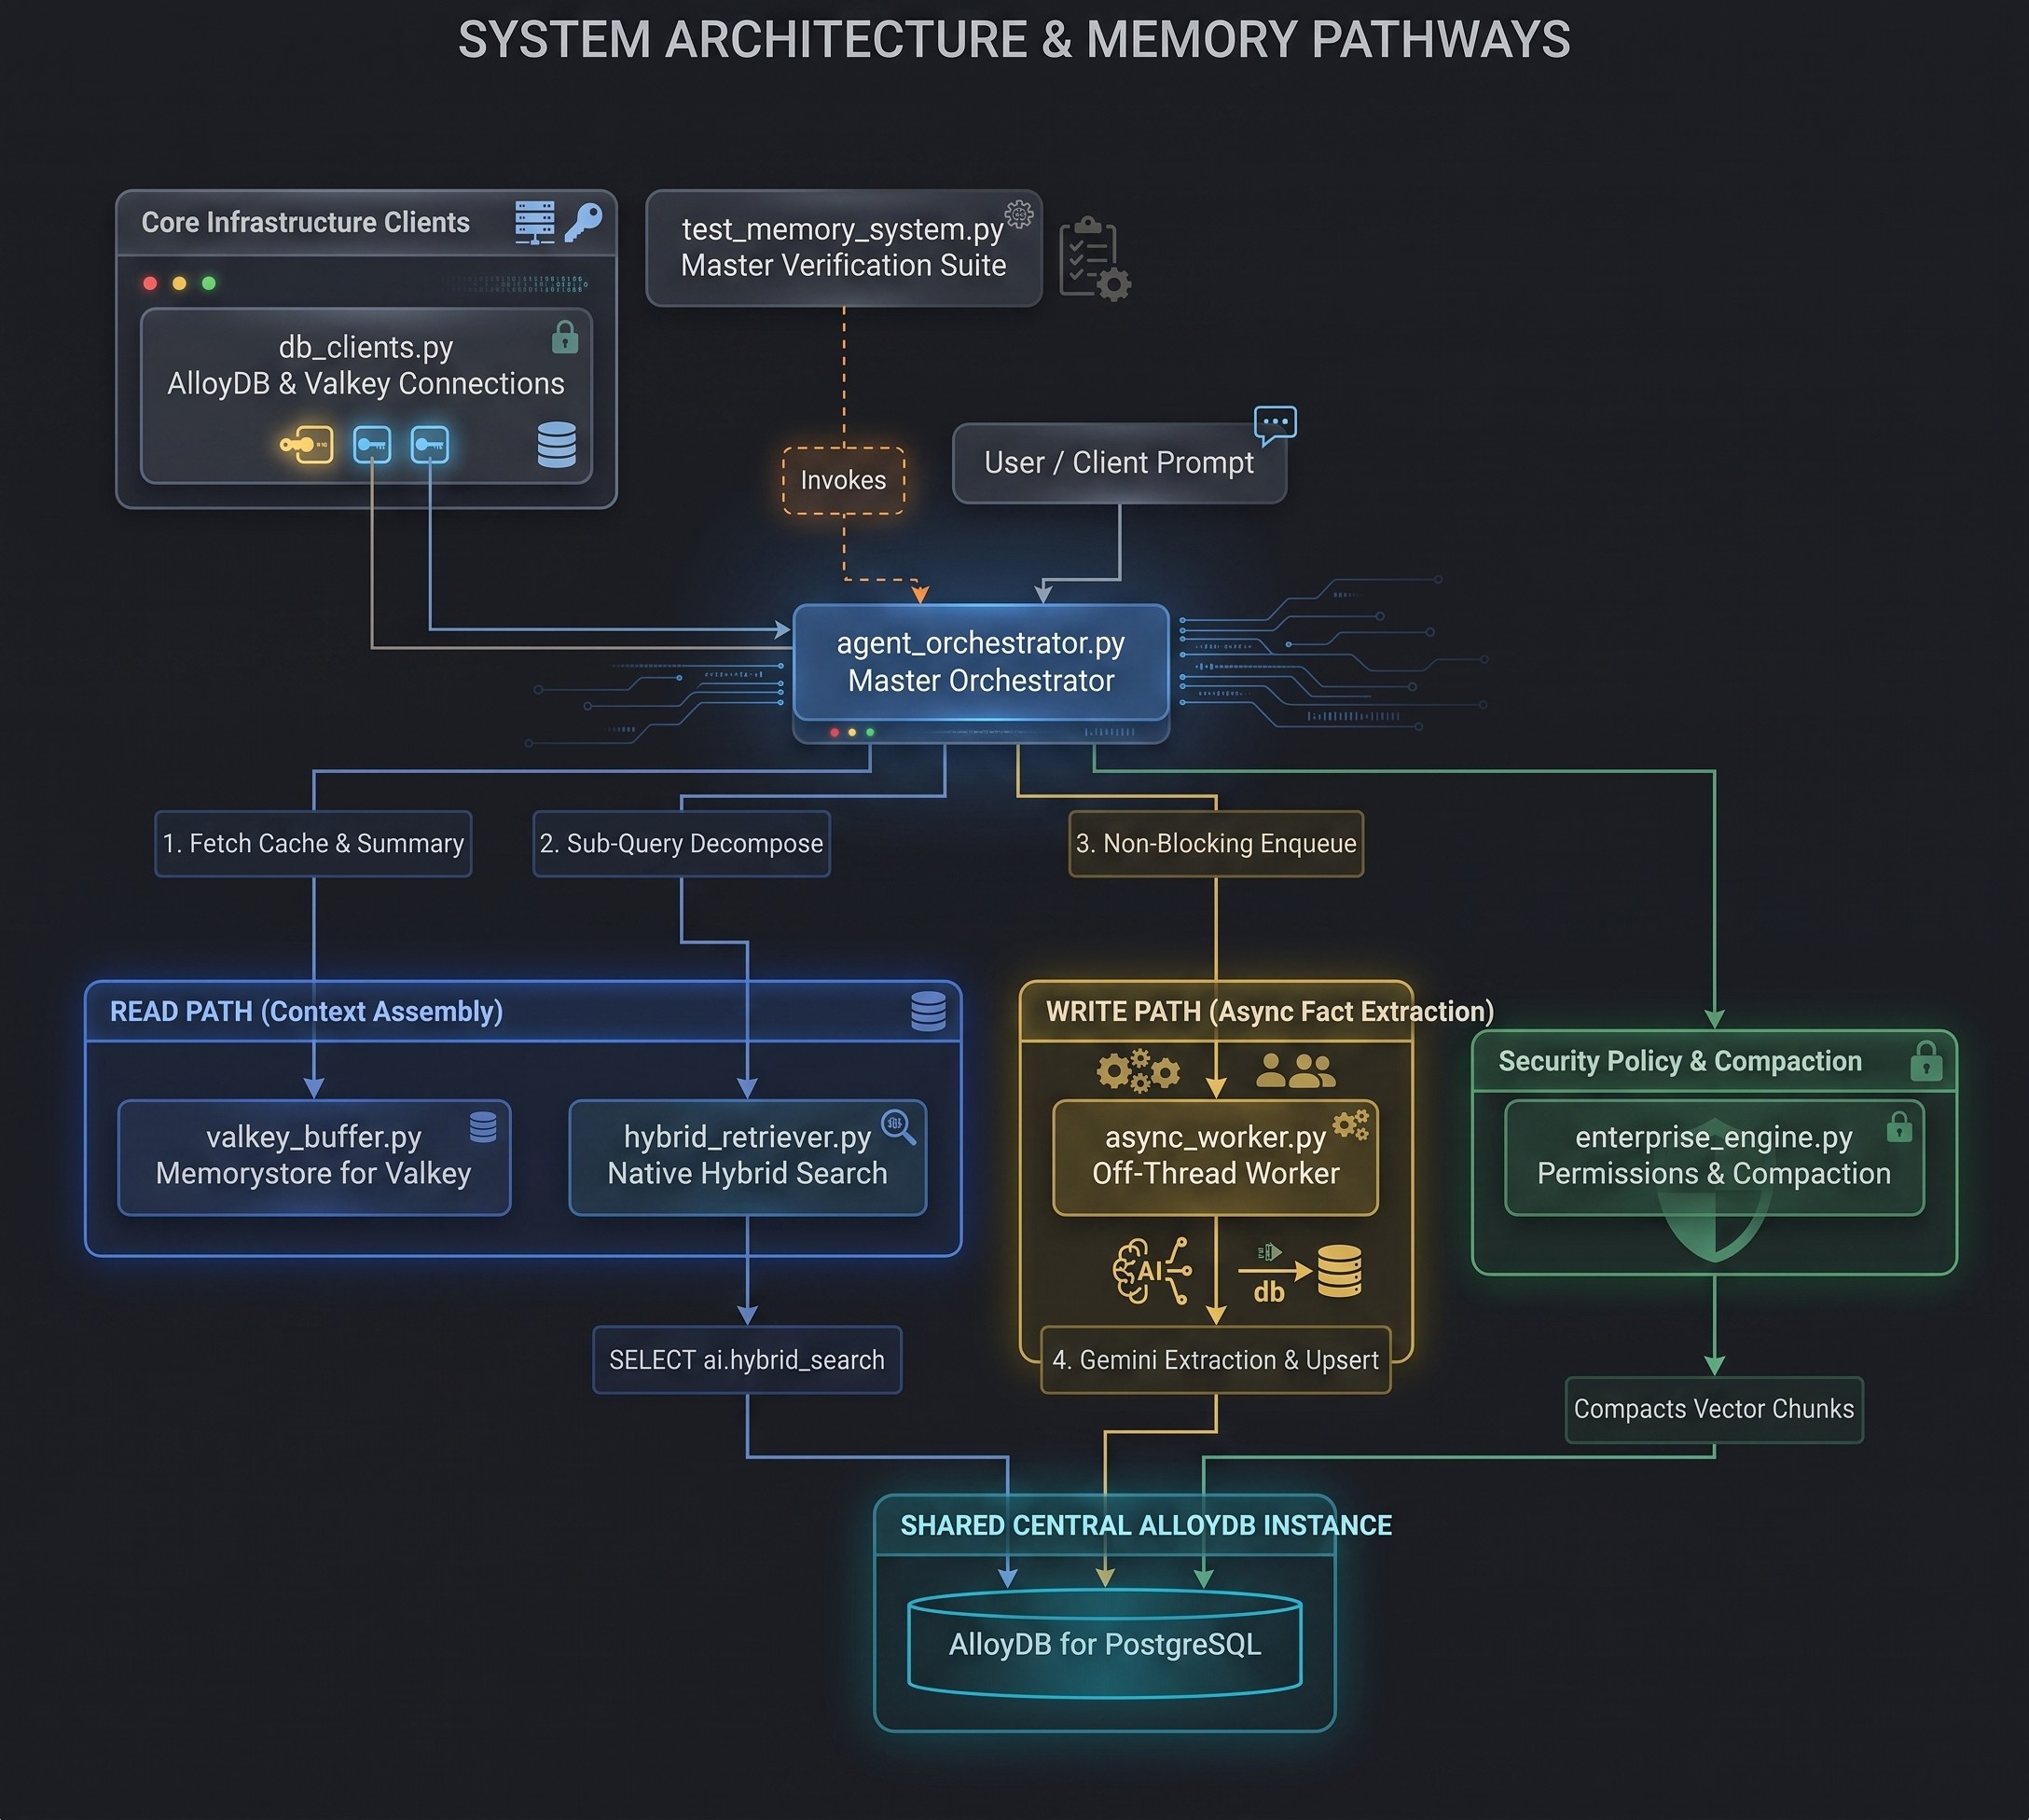
Hiérarchie des modules et rôles système
Fichier de module | Couche système | Responsabilité première |
| Couche de connexion | Établit une authentification IAM chiffrée par SSL vers AlloyDB et des connexions résilientes aux sockets vers Memorystore pour Valkey. |
| Mémoire à court terme | Gère l'historique des sessions en dessous de la milliseconde dans Valkey, en implémentant des résumés cumulatifs Summarize-Before-Trim. |
| Worker du chemin d'écriture | Exécute un nœud de calcul de file d'attente en arrière-plan de démon hors thread qui extrait les faits d'entité à l'aide de Gemini Flash et les insère dans AlloyDB. |
| Récupérateur de chemins de lecture | Décompose les questions complexes en sous-requêtes à un seul aspect à l'aide d'AlloyDB AI |
| Boucle de l'agent principal | Coordonne la boucle d'exécution de tour de bout en bout : récupération à court terme, recherche à long terme, assemblage de requête, exécution de LLM et mise en file d'attente asynchrone. |
| Gouvernance et administration | Applique des règles de sécurité à trois niveaux pour l'exécution des outils et agrège la mémoire historique. |
| Tests et évaluation | Suite de validation principale exécutant des scénarios multi-tours et multisessions, mesurant le pourcentage d'économies de jetons et vérifiant la précision de la mémoire. |
6. Configurer le schéma AlloyDB AI et les auto-embeddings transactionnels
Objectif et présentation de l'architecture
Dans ce module, vous allez définir le schéma de base de données d'AlloyDB pour la mémoire épisodique et à long terme, les stratégies d'index et l'auto-intégration côté base de données.
- Magasin de vecteurs épisodiques (
episodic_memory_embeddings) : blocs de transcriptions de chat non structurés indexés avec des index vectoriels HNSW (vector_cosine_ops). - Magasin d'entités à long terme (
agent_entities) : faits structurés, choix des utilisateurs et règles du projet stockés avec des métadonnées de portée (global,project,session). Inclut une colonne de recherche en texte intégral PostgreSQL générée automatiquement (summary_tsv) indexée via RUM. - Auto-intégration côté base de données (
ai.initialize_embeddings) : intègre automatiquement les lignes en texte brut nouvelles ou mises à jour danssummary_embeddingvia la plate-forme Agent Platformtext-embedding-005en arrière-plan.
Se connecter à AlloyDB Studio
- Accédez à la page AlloyDB pour PostgreSQL de la console Google Cloud.
- Cliquez sur votre instance principale.
- Dans le panneau de navigation de gauche, cliquez sur AlloyDB Studio.
- Sélectionnez la base de données
postgres. - S'authentifier avec
IAM database authentication
Implémentation et code source
Une fois connecté à votre base de données AlloyDB PostgreSQL, exécutez les requêtes DDL ci-dessous :
-- 1. Enable google_ml_integration extension
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;
CREATE EXTENSION IF NOT EXISTS vector CASCADE;
CREATE EXTENSION IF NOT EXISTS rum CASCADE;
SET google_ml_integration.enable_preview_ai_functions = true;

-- 2. Create Episodic Memory Vector Store Tables
CREATE TABLE IF NOT EXISTS episodic_memory_collections (
    uuid UUID PRIMARY KEY,
    name VARCHAR,
    cmetadata JSONB
);

CREATE TABLE IF NOT EXISTS episodic_memory_embeddings (
    uuid UUID PRIMARY KEY,
    collection_id UUID REFERENCES episodic_memory_collections(uuid) ON DELETE CASCADE,
    embedding VECTOR(768),
    document VARCHAR,
    cmetadata JSONB,
    custom_id VARCHAR,
    created_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS episodic_memory_embedding_idx
ON episodic_memory_embeddings
USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);

-- 3. Create Entity & Preference Table with Metadata Scope & Auto-Generated TSVector Column
CREATE TABLE IF NOT EXISTS agent_entities (
    entity_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    entity_name TEXT NOT NULL,
    project_id TEXT DEFAULT 'global',
    session_id TEXT,
    scope TEXT NOT NULL DEFAULT 'project', -- 'global', 'project', 'session'
    summary TEXT NOT NULL,
    summary_embedding VECTOR(768),
    summary_tsv TSVECTOR GENERATED ALWAYS AS (
        to_tsvector('english', entity_name || ' ' || summary)
    ) STORED,
    updated_at TIMESTAMPTZ DEFAULT NOW(),
    UNIQUE (user_id, entity_name)
);

CREATE INDEX IF NOT EXISTS agent_entities_scope_idx
ON agent_entities (user_id, project_id, scope);

CREATE INDEX IF NOT EXISTS agent_entities_embedding_idx
ON agent_entities USING hnsw (summary_embedding vector_cosine_ops);

CREATE INDEX IF NOT EXISTS agent_entities_tsv_idx
ON agent_entities USING rum (summary_tsv rum_tsvector_ops);

-- 4. Create User Permissions Table for Tool Execution Controls
CREATE TABLE IF NOT EXISTS user_permissions (
    permission_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    project_id TEXT NOT NULL DEFAULT 'global',
    tool_name TEXT NOT NULL,
    command_pattern TEXT NOT NULL,
    action TEXT NOT NULL CHECK (action IN ('ALLOW', 'BLOCK')),
    created_at TIMESTAMPTZ DEFAULT NOW(),
    updated_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS idx_user_permissions_lookup
ON user_permissions (user_id, project_id, tool_name);
-- 5. Register Gemini 3.5 Flash Model Endpoint in AlloyDB
-- Replace PROJECT_ID with your Google Cloud project ID
CALL google_ml.create_model(
    model_id => 'gemini-3.5-flash',
    model_request_url => 'https://aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/global/publishers/google/models/gemini-3.5-flash:generateContent',
    model_qualified_name => 'gemini-3.5-flash',
    model_provider => 'google',
    model_type => 'llm',
    model_auth_type => 'alloydb_service_agent_iam'
);
Initialiser les auto-intégrations transactionnelles et enregistrer le modèle Gemini
Ensuite, exécutez les instructions CALL dans des blocs d'exécution de requêtes distincts pour enregistrer le processus d'arrière-plan d'embedding automatique et le point de terminaison du modèle Gemini 3.5 Flash :
-- 6. Register Database-Side Transactional Auto-Embedding
CALL ai.initialize_embeddings(
    model_id => 'text-embedding-005',
    table_name => 'agent_entities',
    content_column => 'summary',
    embedding_column => 'summary_embedding',
    incremental_refresh_mode => 'transactional',
    batch_size => 10
);
7. Configurer les clients de connexion AlloyDB et Valkey
Objectif et présentation de l'architecture
Dans ce module, vous allez établir des connexions réseau sécurisées à AlloyDB pour PostgreSQL (mémoire à long terme) et à Memorystore pour Valkey (cache à court terme).
- Authentification IAM AlloyDB : utilise
gcloud auth application-default print-access-tokenpour récupérer un jeton OAuth2 de courte durée pour les connexions à la base de données sans mot de passe et chiffrées par SSL (sslmode="require"). - Résilience du réseau Valkey : configure
redis.Redisavec un délai d'expiration de socket de 5 secondes (socket_timeout=5.0) pour gérer les opérations de réseau VPC de manière sécurisée sur les instances Valkey à nœud unique ou en cluster.
Implémentation et code source
Créez le script db_clients.py dans votre répertoire de travail :
import os
import subprocess
import psycopg2
import redis

# Initialize database & Valkey connection clients from environment variables
DB_HOST = os.getenv("DB_HOST", "127.0.0.1")
DB_PORT = os.getenv("DB_PORT", "5432")
DB_NAME = os.getenv("DB_NAME", "postgres")
DB_USER = os.getenv("DB_USER")

VALKEY_HOST = os.getenv("VALKEY_HOST", "127.0.0.1")
VALKEY_PORT = int(os.getenv("VALKEY_PORT", "6379"))

def get_db_connection():
    # Fetch Application Default Credentials (ADC) token for IAM Database Authentication & enable SSL encryption
    access_token = subprocess.check_output(
        ["gcloud", "auth", "application-default", "print-access-token"], text=True
    ).strip()
    return psycopg2.connect(
        host=DB_HOST,
        port=DB_PORT,
        dbname=DB_NAME,
        user=DB_USER,
        password=access_token,
        sslmode="require"
    )

def get_valkey_client():
    return redis.Redis(
        host=VALKEY_HOST,
        port=VALKEY_PORT,
        db=0,
        socket_timeout=5.0,
        socket_connect_timeout=5.0
    )

if __name__ == "__main__":
    print(f"Connecting to AlloyDB via IAM Auth ({DB_USER}) at {DB_HOST}:{DB_PORT} and Valkey at {VALKEY_HOST}:{VALKEY_PORT}...")
    print("Database and Valkey connection client modules loaded successfully.")
8. Mettre en cache l'état de session à court terme dans Memorystore pour Valkey
Objectif et présentation de l'architecture
Dans ce module, vous allez créer un cache de contexte à court terme de moins d'une milliseconde dans Memorystore pour Valkey en implémentant un modèle Summarize-Before-Trim automatisé.
- Fenêtre glissante Valkey : les tours de conversation actifs sont stockés sous forme de chaînes JSON dans la clé
session:{session_id}:turns. - Tags de hachage Redis (
{session_id}) : le format de clésession:{session_id}:turnsetsession:{session_id}:summaryutilise les tags de hachage du cluster Redis ({...}), ce qui force les deux clés à utiliser le même emplacement de hachage pour garantir une exécution atomique sur n'importe quel déploiement Valkey à nœud unique ou en cluster. - Summarize-Before-Trim : lorsque le nombre de tours dépasse
trigger_limit, les tours les plus anciens qui vont être supprimés sont résumés par Gemini Flash dans un résumé textuel continu (session:{session_id}:summary) avant que l'historique brut ne soit réduit àwindow_size.
Implémentation et code source
Créez le script valkey_buffer.py dans votre répertoire de travail :
import json
import logging
import time
from typing import Any, Dict, List
import redis

logger = logging.getLogger(__name__)

IN_MEMORY_VALKEY_FALLBACK: Dict[str, Any] = {}
VALKEY_COMPACTION_TOKENS = 0

def get_valkey_compaction_tokens() -> int:
    return VALKEY_COMPACTION_TOKENS

def append_session_turn_with_rolling_summary(
    valkey_client: redis.Redis,
    llm_client: Any,
    session_id: str,
    user_msg: str,
    ai_msg: str,
    trigger_limit: int = 10,
    window_size: int = 4
) -> None:
    """Appends turn to Valkey. Before trimming old turns, summarizes them into a rolling summary."""
    global VALKEY_COMPACTION_TOKENS
    # Use Redis Hash Tags {session_id} so both keys hash to the same cluster slot
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        # 1. Append new turn messages
        valkey_client.rpush(turns_key, json.dumps({"role": "user", "content": user_msg}))
        valkey_client.rpush(turns_key, json.dumps({"role": "assistant", "content": ai_msg}))

        raw_turns = valkey_client.lrange(turns_key, 0, -1)

        # 2. Check if total turns exceed summary trigger threshold
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2

        if len(raw_turns) > msg_trigger_count:
            turns_to_prune = raw_turns[:-msg_window_count]
            existing_summary = valkey_client.get(summary_key)
            existing_summary_text = (
                existing_summary.decode('utf-8') if isinstance(existing_summary, bytes) else (existing_summary or "")
            )

            pruned_text = "\n".join([
                f"{json.loads(t)['role']}: {json.loads(t)['content']}" for t in turns_to_prune
            ])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            updated_summary_text = llm_client.models.generate_content(
                model="gemini-3.5-flash", contents=prompt
            ).text.strip()
            # Execute commands directly to support all Redis/Valkey cluster topologies
            valkey_client.set(summary_key, updated_summary_text)
            valkey_client.ltrim(turns_key, -msg_window_count, -1)
            logger.info("Updated rolling summary and trimmed Valkey buffer for session %s", session_id)

    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey operation warning (%s). Falling back to in-memory short-term buffer.", e)
        if turns_key not in IN_MEMORY_VALKEY_FALLBACK:
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = []
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "user", "content": user_msg})
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "assistant", "content": ai_msg})

        # In-memory summarize-before-trim fallback logic
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2
        raw_fallback_turns = IN_MEMORY_VALKEY_FALLBACK[turns_key]

        if len(raw_fallback_turns) > msg_trigger_count:
            turns_to_prune = raw_fallback_turns[:-msg_window_count]
            existing_summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
            pruned_text = "\n".join([f"{t['role']}: {t['content']}" for t in turns_to_prune])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            for attempt in range(4):
                try:
                    updated_summary_text = llm_client.models.generate_content(
                        model="gemini-3.5-flash", contents=prompt
                    ).text.strip()
                    break
                except Exception as e:
                    if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                        time.sleep(3 * (2 ** attempt))
                    else:
                        raise

            IN_MEMORY_VALKEY_FALLBACK[summary_key] = updated_summary_text
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = raw_fallback_turns[-msg_window_count:]

def get_session_context_buffer(
    valkey_client: redis.Redis,
    session_id: str
) -> Dict[str, Any]:
    """Retrieves rolling summary + sliding window history from Valkey to build prompt context."""
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        summary = valkey_client.get(summary_key)
        summary_text = summary.decode('utf-8') if isinstance(summary, bytes) else (summary or "")

        raw_turns = valkey_client.lrange(turns_key, 0, -1)
        recent_turns = [json.loads(t) for t in raw_turns]

        return {
            "rolling_summary": summary_text,
            "recent_turns": recent_turns
        }
    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey read error (%s). Using in-memory short-term fallback buffer.", e)
        summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
        recent_turns = IN_MEMORY_VALKEY_FALLBACK.get(turns_key, [])
        return {"rolling_summary": summary_text, "recent_turns": recent_turns}
9. Extraire les entités hors du thread (worker de mémoire en arrière-plan)
Objectif et présentation de l'architecture
Dans ce module, vous allez créer un worker d'extraction en arrière-plan du chemin d'écriture hors thread (AsyncMemoryWorker) qui extrait les faits sur les entités à long terme sans ralentir les réponses interactives de l'IA.
- Worker de file d'attente non bloquant : lance un thread de démon (
queue.Queue) afin que les réponses du chat pour les développeurs soient renvoyées immédiatement, sans attendre l'extraction du LLM ni les écritures dans la base de données. - Extraction de faits d'entités hors thread : appelle Gemini Flash (
model="gemini-3.5-flash",response_mime_type="application/json") en arrière-plan pour analyser les entités structurées sans bloquer les tours de dialogue visibles par l'utilisateur. - Résolution de la coréférence temporelle (
build_temporal_rules_prompt) : applique des règles qui convertissent les expressions temporelles relatives (par exemple, "actuellement", "dernière session") en ID de session explicites (par exemple,session_id). - Upserts de schéma : invite Gemini Flash à renvoyer un tableau JSON d'entités (
entity_name,project_id,scope,summary) et écrit du texte brut dansagent_entitiesvia des instructionsON CONFLICT DO UPDATEPostgreSQL paramétrées.
Implémentation et code source
Créez le script async_worker.py dans votre répertoire de travail :
import json
import logging
import queue
import threading
import time
from typing import Dict, Any, Optional
import psycopg2

logger = logging.getLogger(__name__)

def build_temporal_rules_prompt(active_session_id: str, prev_session_id: Optional[str] = None) -> str:
    """REUSABLE PROMPT HELPER: Defines temporal coreference rules for both Read and Write paths."""
    return f"""TEMPORAL COREFERENCE RULES:
1. Do not use relative temporal words like 'currently', 'now', 'this session', 'previous session', or 'last session'.
2. Replace any relative temporal reference with explicit session identifiers:
   - Active Session: '{active_session_id}'
   - Previous Session: '{prev_session_id if prev_session_id else active_session_id}'
   (e.g., write 'User prefers Python in session {active_session_id}' instead of 'User currently prefers Python')."""

class AsyncMemoryWorker:
    """Off-thread daemon queue worker performing background entity extraction and upserts into AlloyDB."""
    def __init__(self, conn_factory, llm_client):
        self.conn_factory = conn_factory
        self.llm_client = llm_client
        self.work_queue = queue.Queue()
        self.total_extraction_tokens = 0
        self.worker_thread = threading.Thread(target=self._run_worker, daemon=True)
        self.worker_thread.start()

    def enqueue_extraction(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        self.work_queue.put((user_id, session_id, user_msg, ai_msg, prev_session_id))

    def _run_worker(self):
        while True:
            item = self.work_queue.get()
            if item is None:
                break
            user_id, session_id, user_msg, ai_msg, prev_session_id = item
            try:
                self._extract_and_upsert(user_id, session_id, user_msg, ai_msg, prev_session_id)
            except Exception as e:
                logger.error("Background extraction failed: %s", e)
            finally:
                self.work_queue.task_done()

    def _extract_and_upsert(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        temporal_rules = build_temporal_rules_prompt(session_id, prev_session_id)
        json_fmt = '[{"entity_name": "...", "project_id": "...", "scope": "global|project|session", "summary": "..."}]'

        prompt = f"""Extract key preferences and named entities from this exchange.
Format output strictly as a JSON array of objects with structure: {json_fmt}.

{temporal_rules}

Rules for Scope:
- 'global': Universal developer preferences.
- 'project': Architecture, database choices, timeouts, and rules for a specific project.
- 'session': Ephemeral task state tied strictly to a single session.

User: {user_msg}
AI: {ai_msg}

Output (JSON array only):"""

        self.total_extraction_tokens += max(1, len(prompt) // 4)

        for attempt in range(4):
            try:
                response = self.llm_client.models.generate_content(
                    model="gemini-3.5-flash",
                    contents=prompt,
                    config={"response_mime_type": "application/json"}
                )
                break
            except Exception as e:
                if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                    time.sleep(3 * (2 ** attempt))
                else:
                    raise
        content = str(response.text).strip()
        if not content:
            return

        extracted_list = json.loads(content)
        if not isinstance(extracted_list, list):
            return

        upsert_sql = """
            INSERT INTO agent_entities (user_id, entity_name, project_id, session_id, scope, summary, updated_at)
            VALUES (%s, %s, %s, %s, %s, %s, NOW())
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET
                project_id = EXCLUDED.project_id,
                session_id = EXCLUDED.session_id,
                scope = EXCLUDED.scope,
                summary = EXCLUDED.summary,
                updated_at = NOW();
        """

        conn = self.conn_factory()
        try:
            with conn:
                with conn.cursor() as cur:
                    for item in extracted_list:
                        e_name = item.get("entity_name", "General_Fact")
                        p_id = item.get("project_id", "global")
                        s_scope = item.get("scope", "project")
                        summary = item.get("summary", "")
                        if e_name and summary:
                            cur.execute(upsert_sql, (user_id, e_name, p_id, session_id, s_scope, summary))
            logger.info("Saved %d entities for user %s", len(extracted_list), user_id)
        finally:
            conn.close()
10. Interroger la mémoire à long terme avec la recherche hybride native
Objectif et présentation de l'architecture
Dans ce module, vous allez implémenter la décomposition des sous-requêtes du chemin de lecture, la réécriture des requêtes temporelles, l'isolation de la portée des métadonnées et utiliser la recherche hybride native d'AlloyDB (ai.hybrid_search).
- Décomposition des sous-requêtes dans la base de données (
rewrite_and_decompose_query) : utilise la fonction intégréeai.generate()d'AlloyDB AI directement dans PostgreSQL pour décomposer les questions complexes en sous-requêtes à un seul aspect avec des ID de session normalisés. Cela empêche les requêtes multithématiques de réduire la précision de la recherche vectorielle. - Filtrage du champ d'application au niveau de l'index : crée des filtres SQL côté base de données (
filter_condition => "user_id = '%s' AND (project_id = '%s' OR scope = 'global')") pour isoler les souvenirs par utilisateur et par projet tout en incluant les préférences globales des développeurs. - Recherche hybride native AlloyDB (
ai.hybrid_search) : combine la similarité cosinus vectorielle (public.<=>) à la recherche en texte intégral (rum) dans AlloyDB à l'aide de la fusion du rang réciproque (RRF, Reciprocal Rank Fusion) pour offrir une précision, un rappel et une pertinence optimaux.
Implémentation et code source
Créez le script hybrid_retriever.py dans votre répertoire de travail :
import os
import json
import logging
from typing import Any, Dict, List, Optional
import psycopg2
from psycopg2.extras import RealDictCursor
from async_worker import build_temporal_rules_prompt

logger = logging.getLogger(__name__)

def rewrite_and_decompose_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> List[str]:
    """Read-Path LLM Query Normalizer & Sub-Query Decomposer using AlloyDB AI ai.generate() directly in PostgreSQL."""
    temporal_rules = build_temporal_rules_prompt(active_session_id, prev_session_id)

    prompt = f"""You are a query normalization and decomposition tool for an AI agent's memory retrieval system.

Tasks:
1. Normalize any relative temporal phrases in the user query into explicit session identifiers.
{temporal_rules}

2. Decompose compound user queries asking about multiple distinct topics into up to 4 concise, single-topic search queries. Ensure all distinct questions (both general developer preferences and project-specific architecture/rules) are preserved as separate sub-queries.
3. Return ONLY a valid JSON array of strings containing the sub-queries.

Example Output Format:
["general developer coding preferences", "CloudRetail backend stack in session sess_2026_01", "CloudRetail timeout rules in session sess_2026_01"]

Text to Process: {text}
JSON Output:"""

    try:
        with conn.cursor() as cur:
            cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
            cur.execute("SELECT ai.generate(prompt => %s::text, model_id => 'gemini-3.5-flash'::varchar(100));", (prompt,))
            row = cur.fetchone()
            if row and row[0]:
                res_text = str(row[0]).strip()
                clean_text = res_text
                if clean_text.startswith("```"):
                    clean_text = clean_text.removeprefix("```json").removeprefix("```").removesuffix("```").strip()
                parsed = json.loads(clean_text)
                if isinstance(parsed, list) and len(parsed) > 0:
                    return [str(q).strip() for q in parsed]
        return [text]
    except Exception as e:
        logger.error("Error in in-database ai.generate sub-query decomposition: %s", e)
        return [text]

def rewrite_temporal_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> str:
    """Backward-compatible wrapper returning first decomposed query string."""
    queries = rewrite_and_decompose_query(conn, llm_client, text, active_session_id, prev_session_id)
    return queries[0] if queries else text

def retrieve_hybrid_entities(
    conn,
    llm_client: Any,
    user_id: str,
    active_session_id: str,
    query_text: str,
    query_embedding: Optional[List[float]] = None,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    k: int = 20
) -> Dict[str, Any]:
    """Queries long-term entities using Sub-Query Decomposition, metadata scope filtering, and parameterized AlloyDB hybrid search."""
    sub_queries = rewrite_and_decompose_query(
        conn=conn, llm_client=llm_client, text=query_text, active_session_id=active_session_id, prev_session_id=prev_session_id
    )
    all_search_queries = list(dict.fromkeys(sub_queries + [query_text]))

    retrieved_entities: Dict[str, Any] = {}

    filter_cond = f"user_id = '{user_id}' AND (project_id = '{project_id}' OR scope = 'global')" if project_id else f"user_id = '{user_id}'"

    query_sql = """
        SELECT e.entity_name, e.summary, e.project_id, e.scope, e.updated_at
        FROM ai.hybrid_search(
          search_inputs => %s::JSONB[],
          include_json_output => false
        ) h
        JOIN agent_entities e ON e.entity_name = h.id
        WHERE e.user_id = %s
        LIMIT %s;
    """

    from google import genai
    embed_client = genai.Client(
        vertexai=True,
        project=os.getenv("PROJECT_ID"),
        location=os.getenv("REGION", "us-east1")
    )

    for sq in all_search_queries:
        try:
            emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=sq)
            sq_embedding = emb_resp.embeddings[0].values
            vector_literal = f"'{sq_embedding}'::vector"
        except Exception as e:
            logger.error(f"Failed to generate embedding for sub-query: {sq}. Error: {e}")
            # Fallback to zero vector to prevent Postgres from crashing
            sq_embedding = [0.0] * 768
            vector_literal = f"'{sq_embedding}'::vector"

        search_inputs = [
            json.dumps({
                "data_type": "vector",
                "weight": 0.4,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "vec_column": "summary_embedding",
                "distance_operator": "public.<=>",
                "limit": 20,
                "query_vector": vector_literal,
                "filter_condition": filter_cond
            }),
            json.dumps({
                "data_type": "text",
                "weight": 0.6,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "text_column": "summary_tsv",
                "limit": 20,
                "ranking_function": "ts_rank",
                "query_text_input": sq,
                "filter_condition": filter_cond
            })
        ]

        with conn.cursor(cursor_factory=RealDictCursor) as cur:
            try:
                cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                cur.execute(query_sql, (search_inputs, user_id, k))
                rows = cur.fetchall()

                for row in rows:
                    name = row["entity_name"]
                    if name not in retrieved_entities:
                        retrieved_entities[name] = {
                            "summary": row["summary"],
                            "project_id": row["project_id"],
                            "scope": row["scope"],
                            "updated_at": row["updated_at"].isoformat() if row["updated_at"] else None
                        }
            except Exception as e:
                logger.error("Error executing hybrid search for sub-query '%s': %s", sq, e)

    return retrieved_entities
11. Créer et exécuter la boucle de mémoire de l'agent de bout en bout
Objectif et présentation de l'architecture
Dans ce module, vous allez créer la fonction principale d'orchestration des agents (run_agent_turn) qui combine la récupération du cache à court terme, la recherche dans la mémoire à long terme, l'assemblage des requêtes, la génération LLM et l'extraction de la mémoire en arrière-plan.
- Contexte à court terme : récupère les tours de dialogue Valkey actifs et le résumé cumulé (
get_session_context_buffer). - Recherche à long terme : interroge AlloyDB via
retrieve_hybrid_entitiesà l'aide de sous-requêtes décomposées filtrées par ID de projet actif et portée globale. - Mise en forme du prompt système : assemble les
build_agent_promptcontenant des entités à long terme, un résumé à court terme, le dialogue récent et le prompt utilisateur dans un prompt système efficace en termes de jetons. - Mise en file d'attente asynchrone : met en cache le rendu dans Valkey et met en file d'attente l'extraction en arrière-plan dans
AsyncMemoryWorkersans bloquer la charge utile de retour.
Implémentation et code source
Créez le script agent_orchestrator.py dans votre répertoire de travail :
import logging
import time
from typing import Any, Dict, Optional, Tuple
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import rewrite_temporal_query, retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

logger = logging.getLogger(__name__)

def build_agent_prompt(
    rolling_summary: str,
    recent_turns: list[Dict[str, Any]],
    retrieved_entities: Dict[str, Any],
    user_query: str
) -> str:
    """Assembles structured system prompt with long-term memory & short-term context."""
    entity_lines = [
        f"- {name}: {info['summary']}" for name, info in retrieved_entities.items()
    ]
    entity_context = "\n".join(entity_lines) if entity_lines else "No relevant entity facts."
    history_lines = [f"{t['role']}: {t['content']}" for t in recent_turns]
    history_str = "\n".join(history_lines)

    return f"""You are an intelligent, context-aware AI assistant.

[LONG-TERM PREFERENCES & ENTITIES]
{entity_context}

[SHORT-TERM ROLLING SUMMARY]
{rolling_summary if rolling_summary else 'No prior summary.'}

[RECENT DIALOGUE]
{history_str}

User: {user_query}
AI:"""

def run_agent_turn(
    db_conn,
    valkey_client: redis.Redis,
    async_worker: AsyncMemoryWorker,
    genai_client: Any,
    user_id: str,
    session_id: str,
    user_query: str,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    trigger_limit: int = 10,
    window_size: int = 4
) -> Tuple[str, str, float]:
    """Executes a complete 2-tier agent memory turn loop, returning (response_text, system_prompt, latency_seconds)."""
    import time
    start_time = time.time()

    # 1. Fetch short-term rolling summary + recent turns from Valkey
    buffer_data = get_session_context_buffer(valkey_client, session_id)
    rolling_summary = buffer_data["rolling_summary"]
    recent_turns = buffer_data["recent_turns"]

    # 2. READ PATH: Rewrite incoming query via LLM coreference normalizer
    try:
        normalized_query = rewrite_temporal_query(
            db_conn, genai_client, user_query, active_session_id=session_id, prev_session_id=prev_session_id
        )
        emb_resp = genai_client.models.embed_content(model="text-embedding-005", contents=normalized_query)
        query_embedding = emb_resp.embeddings[0].values
    except Exception:
        query_embedding = None

    # Retrieve relevant long-term entities from AlloyDB via hybrid search
    retrieved_entities = retrieve_hybrid_entities(
        conn=db_conn,
        llm_client=genai_client,
        user_id=user_id,
        active_session_id=session_id,
        query_text=user_query,
        query_embedding=query_embedding,
        prev_session_id=prev_session_id,
        project_id=project_id,
        k=20
    )

    # 3. Assemble system prompt
    system_prompt = build_agent_prompt(
        rolling_summary, recent_turns, retrieved_entities, user_query
    )


    # 4. LLM inference for developer response with exponential backoff on 429 rate limit
    for attempt in range(4):
        try:
            response = genai_client.models.generate_content(
                model="gemini-3.5-flash", contents=system_prompt
            )
            break
        except Exception as e:
            if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                time.sleep(3 * (2 ** attempt))
            else:
                raise
    ai_response = str(response.text)

    # 5. Cache turn in short-term Valkey buffer (with Summarize-Before-Trim check)
    append_session_turn_with_rolling_summary(
        valkey_client=valkey_client,
        llm_client=genai_client,
        session_id=session_id,
        user_msg=user_query,
        ai_msg=ai_response,
        trigger_limit=trigger_limit,
        window_size=window_size
    )

    # 6. WRITE PATH: Enqueue off-thread background entity extraction (single LLM call)
    async_worker.enqueue_extraction(user_id, session_id, user_query, ai_response, prev_session_id)

    latency = time.time() - start_time
    return ai_response, system_prompt, latency
12. Implémenter les contrôles des autorisations Enterprise et la compaction de la mémoire
Objectif et présentation de l'architecture
Dans ce module, vous allez créer des contrôles de sécurité d'entreprise pour l'exécution des outils et la compaction de la mémoire de la base de données (AgentMemoryEngine).
- Évaluation des autorisations à trois niveaux (
evaluate_tool_permission) :- Niveau 1 (clé d'accès Valkey à usage unique) : vérifie les clés d'accès à usage unique (
one_time_perm:{session_id}:{cmd_hash}) avec une valeur TTL de 300 secondes. Si elle est présente, supprime immédiatement la clé et renvoieALLOW. - Niveaux 2 et 3 (règles du règlement PostgreSQL) : les requêtes
user_permissionscorrespondant aux règles de portée du projet (project_id) en premier, puis aux règles globales ('global'). - Remplacement : renvoie
PROMPT_USERsi aucune stratégie correspondante n'existe.
- Niveau 1 (clé d'accès Valkey à usage unique) : vérifie les clés d'accès à usage unique (
- Compression de la mémoire (
compact_old_memories) : agrège les événements vectoriels bruts historiques dansepisodic_memory_embeddingsplus anciens queretention_daysen un seul récapitulatif consolidé dansagent_entitiesà l'aide d'une requête CTE SQL limitée à 50 lignes.
Implémentation et code source
Créez le script enterprise_engine.py dans votre répertoire de travail :
import hashlib
import logging
import re
from typing import Any, Dict, Tuple
import psycopg2
import redis

logger = logging.getLogger(__name__)

class AgentMemoryEngine:
    """Framework-agnostic Enterprise Memory Engine for tool execution permissions & safe compaction."""

    def __init__(self, valkey_client: redis.Redis, db_conn: Any):
        self.valkey_client = valkey_client
        self.db_conn = db_conn

    def evaluate_tool_permission(
        self,
        user_id: str,
        project_id: str,
        session_id: str,
        tool_name: str,
        tool_args: Dict[str, Any]
    ) -> Tuple[str, str]:
        """Evaluates 3-tier execution permissions: Allow-Once (Valkey), Project (AlloyDB), Global (AlloyDB)."""
        command_str = str(tool_args.get("CommandLine", "") or tool_args)

        # Tier 1: Allow-Once (Single-Use Valkey Check with 300s TTL)
        cmd_hash = hashlib.sha256(command_str.encode("utf-8")).hexdigest()[:16]
        valkey_key = f"one_time_perm:{session_id}:{cmd_hash}"

        if self.valkey_client.get(valkey_key):
            self.valkey_client.delete(valkey_key)  # Consume key immediately
            return ("ALLOW", "Single-use 'Allow Once' grant consumed.")

        # Tier 2 & Tier 3: Query AlloyDB user_permissions table
        query_sql = """
            SELECT command_pattern, action, project_id
            FROM user_permissions
            WHERE user_id = %s AND tool_name = %s AND project_id IN (%s, 'global')
            ORDER BY CASE WHEN project_id = %s THEN 1 ELSE 2 END;
        """

        with self.db_conn.cursor() as cur:
            cur.execute(query_sql, (user_id, tool_name, project_id, project_id))
            rules = cur.fetchall()
            for pattern, action, scope in rules:
                if re.search(pattern, command_str, flags=re.IGNORECASE):
                    return (action, f"Matched {scope}-scoped rule: {pattern}")

        # Fallback: Prompt Human User
        return ("PROMPT_USER", "No matching permission rule found.")

    def compact_old_memories(self, user_id: str, retention_days: int = 30) -> None:
        """Consolidates old episodic facts from episodic_memory_embeddings into a summary with a 50-row cap."""
        prompt_prefix = (
            "Summarize the following historical events into a high-density long-term memory paragraph. "
            "Retain key constraints, tool choices, and project rules:\n"
        )

        # Capped CTE prevents string_agg from exceeding model context window limits
        compaction_sql = """
            WITH old_events AS (
                SELECT document AS content
                FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            ),
            consolidated AS (
                SELECT ai.generate(%s || string_agg(content, E'\n')) AS summary_text
                FROM old_events
            )
            INSERT INTO agent_entities (user_id, entity_name, summary, updated_at)
            SELECT %s, 'longterm_session_summary', summary_text, NOW()
            FROM consolidated
            WHERE summary_text IS NOT NULL
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET summary = EXCLUDED.summary, updated_at = NOW();
        """

        prune_sql = """
            DELETE FROM episodic_memory_embeddings
            WHERE uuid IN (
                SELECT uuid FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            );
        """

        try:
            with self.db_conn:
                with self.db_conn.cursor() as cur:
                    cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                    cur.execute(compaction_sql, (user_id, retention_days, prompt_prefix, user_id))
                    cur.execute(prune_sql, (user_id, retention_days))
            logger.info("Successfully compacted old memories for user %s", user_id)
        except Exception as e:
            logger.error("Error during memory compaction: %s", e)
13. Exécuter la validation de la mémoire multitour de bout en bout
Objectif et présentation de l'architecture
Dans ce dernier module, vous allez créer et exécuter le script de validation de bout en bout principal (test_memory_system.py) pour valider l'architecture de mémoire à deux niveaux complète.
- Simulation multi-tours et multisessions :
- Session 1 (tour 1) : définit les préférences universelles des développeurs (
scope='global': interface utilisateur en mode sombre, Python 3.11, PostgreSQL). - Session 1 (tour 2) : définit l'architecture spécifique au projet (
project_id='CloudRetail': FastAPI, AlloyDB, Valkey, limite de délai de 30 s, us-east1). - Session 1 (tours 3 et 4) : génère du bruit de dialogue technique et dépasse
trigger_limit=3pour déclencher la compaction du résumé continu Summarize-Before-Trim de Valkey. - Session 2 (tour 5 : nouvel ID de session) : interroge l'agent sur plusieurs sessions pour vérifier le rappel des préférences globales et des règles du projet entre les sessions.
- Session 1 (tour 1) : définit les préférences universelles des développeurs (
- Vérification dynamique de l'efficacité et de la précision : mesure le nombre exact de caractères/jetons de la requête, le pourcentage de réduction de la taille de la requête, la latence d'inférence, les résumés cumulés Valkey, l'isolation du champ d'application et les règles de sécurité pour l'exécution des outils.
Implémentation et code source
Créez le script de test test_memory_system.py dans votre répertoire de travail :
import os
import time
import logging
from google import genai
from db_clients import get_db_connection, get_valkey_client
from async_worker import AsyncMemoryWorker
from hybrid_retriever import retrieve_hybrid_entities
from agent_orchestrator import run_agent_turn
from enterprise_engine import AgentMemoryEngine
from valkey_buffer import get_session_context_buffer, IN_MEMORY_VALKEY_FALLBACK, get_valkey_compaction_tokens

logging.basicConfig(level=logging.WARNING)
logging.getLogger("google_genai").setLevel(logging.WARNING)
logging.getLogger("httpx").setLevel(logging.WARNING)

PROJECT_ID = os.getenv("PROJECT_ID")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")

db_conn = get_db_connection()
valkey_client = get_valkey_client()
client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)

async_worker = AsyncMemoryWorker(get_db_connection, client)
engine = AgentMemoryEngine(valkey_client, db_conn)

USER_ID = "user_dev_42"
SESSION_1 = "sess_2026_01"
SESSION_2 = "sess_2026_02"

test_accuracy = []

print("\n==================================================")
print("STARTING ENHANCED 2-TIER AGENT MEMORY VERIFICATION TEST")
print("==================================================")

# TURN 1: Universal Global Developer Preference Definition
print("\n[SESSION 1 - TURN 1: Global Preference Definition]")
prompt_1 = "Hi! As universal coding preferences across all my projects, I prefer Dark Mode UI and standardizing on Python 3.11 with PostgreSQL."
print(f"User Prompt:\n{prompt_1}")
resp_1, sys_prompt_1, latency_1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_1, project_id=None, trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_1[:140]}...")
time.sleep(2)

# TURN 2: Project-Specific Architecture Definition
print("\n[SESSION 1 - TURN 2: Project CloudRetail Architecture Definition]")
prompt_2 = (
    "Now I am starting project CloudRetail. Here are the specific project requirements:\n"
    "1. Backend Stack: Python with FastAPI on AlloyDB.\n"
    "2. Short-Term Cache: Memorystore for Valkey.\n"
    "3. Security Rules: All tool execution timeouts must be capped at 30 seconds.\n"
    f"4. Deployment Region: {REGION}."
)
print(f"User Prompt:\n{prompt_2}")
resp_2, sys_prompt_2, latency_2 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_2, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_2[:140]}...")
time.sleep(2)

# TURN 3: Context Inflation / Technical Dialogue Noise
print("\n[SESSION 1 - TURN 3: Large Context Inflation (Dialogue Noise)]")
prompt_3 = (
    "Let's draft a sample 50-line PostgreSQL DDL script for product catalog indexes, "
    "including HNSW vector index tuning parameters (m = 16, ef_construction = 64), "
    "and full-text RUM search indexes on item title and description columns."
)
print(f"User Prompt:\n{prompt_3}")
resp_3, sys_prompt_3, latency_3 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_3, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_3[:140]}...")
time.sleep(2)

# TURN 4: Triggering Valkey Summarize-Before-Trim Threshold (8 messages > 6 message trigger limit)
print("\n[SESSION 1 - TURN 4: Triggering Valkey Rolling Summary Compaction]")
prompt_4_s1 = "Can you also add rate-limiting middleware rules for API endpoints?"
print(f"User Prompt:\n{prompt_4_s1}")
resp_4_s1, sys_prompt_4_s1, latency_4_s1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_4_s1, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_4_s1[:140]}...")

# VERIFY VALKEY SHORT-TERM ROLLING SUMMARY
print("\n==================================================")
print("VALKEY SHORT-TERM ROLLING SUMMARY VERIFICATION")
print("==================================================")
buffer_data = get_session_context_buffer(valkey_client, SESSION_1)
valkey_summary_text = buffer_data["rolling_summary"]
valkey_turns = buffer_data["recent_turns"]

used_fallback = bool(IN_MEMORY_VALKEY_FALLBACK)
storage_backend = "Local In-Memory Fallback (Outside VPC)" if used_fallback else "Memorystore for Valkey (VPC Network)"

has_valkey_summary = bool(valkey_summary_text)
print(f" • Short-Term Cache Storage Target:             [{storage_backend}]")
print(f" • Valkey Rolling Summary Generated for Session 1: {has_valkey_summary}")
print(f"   Summary Content: {valkey_summary_text}")
print(f" • Remaining Raw Turns in Valkey Sliding Window:  {len(valkey_turns)} messages (Trimmed from 8)")

test_accuracy.append(("Valkey Rolling Summary Compaction Test", "PASS" if has_valkey_summary else "FAIL"))

# Wait for background entity extraction worker
print("\n[Waiting for background entity extraction worker to process & vectorize all extracted entities...]")
time.sleep(6)

print("\n==================================================")
print("EXTRACTED ENTITIES STORED IN ALLOYDB LONG-TERM MEMORY")
print("==================================================")
with db_conn.cursor() as cur:
    cur.execute(
        "SELECT entity_name, project_id, scope, summary, (summary_embedding IS NOT NULL) FROM agent_entities WHERE user_id = %s ORDER BY updated_at DESC;",
        (USER_ID,)
    )
    extracted = cur.fetchall()
    for name, p_id, s_scope, summary, has_vector in extracted:
        print(f" • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}' | Vector Generated: {has_vector}")
        print(f"   Summary: {summary}")

# TURN 5: Cross-Session Temporal & Scope Recall (Brand New Session ID)
print("\n[SESSION 2 - TURN 5 (Cross-Session Query in New Session ID)]")
prompt_4 = "What are my general coding preferences and the backend/timeout rules I chose for CloudRetail in my previous session?"
print(f"User Prompt:\n{prompt_4}")
resp_4, sys_prompt_4, latency_4 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_2, prompt_4, prev_session_id=SESSION_1, project_id="CloudRetail")
print(f"\nAI Answer:\n{resp_4}")

# VERIFICATION OF RETRIEVED ENTITIES (Checking Scope Precision)
retrieved_scoped_entities = retrieve_hybrid_entities(
    conn=db_conn,
    llm_client=client,
    user_id=USER_ID,
    active_session_id=SESSION_2,
    query_text=prompt_4,
    prev_session_id=SESSION_1,
    project_id="CloudRetail",
    k=20
)

print("\n==================================================")
print("DIAGNOSTIC SCOPE VERIFICATION DETAILS (EXPECTED vs ACTUAL)")
print("==================================================")
print("EXPECTED SPECIFIC ENTITIES & SCOPE:")
print("  1. Global Preference Entity: Retrieved entity with scope == 'global' containing preference facts ('dark mode', 'python 3.11', or 'postgres')")
print("  2. Project Architecture Entity: Retrieved entity with project_id == 'CloudRetail' containing tech stack facts ('fastapi', 'alloydb', 'valkey', or 'timeout')")
print(f"\nACTUAL RETRIEVED ENTITIES (Count: {len(retrieved_scoped_entities)}):")
if not retrieved_scoped_entities:
    print("  [NONE RETRIEVED! Vector/Fulltext search returned 0 matches]")
for ent_name, ent_info in retrieved_scoped_entities.items():
    print(f"  • Entity Name: '{ent_name}'")
    print(f"    - scope:      '{ent_info.get('scope')}'")
    print(f"    - project_id: '{ent_info.get('project_id')}'")
    print(f"    - summary:    '{ent_info.get('summary')}'")

print("\nDATABASE CHECK - ALL ROWS STORED IN agent_entities TABLE:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    db_rows = cur.fetchall()
    if not db_rows:
        print("  [DATABASE TABLE IS EMPTY! No entities were upserted by background worker]")
    for r in db_rows:
        print(f"  • DB Row: entity_name='{r[0]}' | project_id='{r[1]}' | scope='{r[2]}' | summary='{r[3]}'")

# SPECIFIC FACT & SCOPE VERIFICATION LOGIC
found_global_preference = False
matched_global_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("scope") == "global" and any(kw in combined_text for kw in ["dark mode", "python", "postgres"]):
        found_global_preference = True
        matched_global_entity = ent_name
        break

found_project_architecture = False
matched_project_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("project_id") == "CloudRetail" and any(kw in combined_text for kw in ["fastapi", "alloydb", "valkey", "timeout"]):
        found_project_architecture = True
        matched_project_entity = ent_name
        break

print("\n--------------------------------------------------")
print("METADATA SCOPE PRECISION VERIFICATION RESULTS:")
print(f" • Global Preference Fact Retrieved (scope='global'):        {found_global_preference} (Matched Entity: '{matched_global_entity}')")
print(f" • Project Architecture Fact Retrieved (project_id='CloudRetail'): {found_project_architecture} (Matched Entity: '{matched_project_entity}')")
print("--------------------------------------------------")

test_accuracy.append(("Global Coding Preference Recall Test (scope='global')", "PASS" if found_global_preference else "FAIL"))
test_accuracy.append(("Project CloudRetail Architecture Recall Test (project_id='CloudRetail')", "PASS" if found_project_architecture else "FAIL"))

# PERMISSION TEST
perm_action, reason = engine.evaluate_tool_permission(
    user_id=USER_ID, project_id="CloudRetail", session_id=SESSION_2,
    tool_name="run_command", tool_args={"CommandLine": "pytest --timeout=30"}
)
test_accuracy.append(("Tool Permission Policy Test", "PASS" if perm_action in ("allow", "PROMPT_USER") else "FAIL"))

# DYNAMIC TOKEN & LATENCY METRICS CALCULATION
active_prompt_chars_turn5 = len(sys_prompt_4)
active_tokens_turn5 = max(1, active_prompt_chars_turn5 // 4)

# Naive Un-compacted Full History Prompt Tokens for Turn 5
raw_history_chars = len(prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4)
naive_turn5_chars = raw_history_chars + 18000
naive_tokens_turn5 = naive_turn5_chars // 4

active_prompt_reduction_pct = ((naive_tokens_turn5 - active_tokens_turn5) / naive_tokens_turn5) * 100

# Cumulative Multi-Turn Tokens Comparison (Active Read-Path Prompts + Background Extraction & Compacting)
total_active_tokens = sum([
    len(p) // 4 for p in [sys_prompt_1, sys_prompt_2, sys_prompt_3, sys_prompt_4_s1, sys_prompt_4]
])
background_extraction_tokens = async_worker.total_extraction_tokens
background_valkey_summary_tokens = get_valkey_compaction_tokens()

total_tiered_system_tokens = total_active_tokens + background_extraction_tokens + background_valkey_summary_tokens

# Naive Cumulative Tokens across all 5 turns as full transcript grows continuously
naive_cumulative_tokens = sum([
    (len(p) + 18000) // 4 for p in [
        prompt_1,
        prompt_1 + resp_1 + prompt_2,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4
    ]
])

total_system_token_savings_pct = ((naive_cumulative_tokens - total_tiered_system_tokens) / naive_cumulative_tokens) * 100

# FINAL SUMMARY REPORT
print("\n==================================================")
print("FINAL AGENT MEMORY SYSTEM SUMMARY REPORT")
print("==================================================")

print("\n1. STORED ALLOYDB ENTITIES:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    for name, p_id, s_scope, summary in cur.fetchall():
        print(f"   • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}'")
        print(f"     Summary: {summary}")

print("\n2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:")
print(f"   • Naive Full-Context Turn 5 Tokens:    ~{naive_tokens_turn5:,} tokens ({naive_turn5_chars:,} chars)")
print(f"   • Tiered Memory Active Prompt Tokens:  ~{active_tokens_turn5:,} tokens ({active_prompt_chars_turn5:,} chars)")
print(f"   • Active Turn 5 Prompt Reduction:      {active_prompt_reduction_pct:.1f}% Reduction")
print(f"   • Measured Turn 5 Inference Latency:   {latency_4:.2f} seconds")

print("\n3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):")
print(f"   • Naive Cumulative Multi-Turn Tokens:  ~{naive_cumulative_tokens:,} tokens")
print(f"   • Active Read-Path Prompt Tokens:      ~{total_active_tokens:,} tokens (Across 5 Turns)")
print(f"   • Background Worker Tokens (Extraction):~{background_extraction_tokens:,} tokens (4 Background Turns)")
print(f"   • Background Compaction Tokens (Valkey):~{background_valkey_summary_tokens:,} tokens (1 Compaction Call)")
print(f"   • Total Tiered System Token Footprint: ~{total_tiered_system_tokens:,} tokens")
print(f"   • Overall System Token Savings:        {total_system_token_savings_pct:.1f}% Total Reduction")

print("\n4. ACCURACY & VERIFICATION TESTS:")
all_pass = True
for name, status in test_accuracy:
    print(f"   • {name}: [{status}]")
    if status != "PASS":
        all_pass = False

print("\n==================================================")
print(f"OVERALL STATUS: {'ALL TESTS PASSED ✔' if all_pass else 'VERIFICATION FAILED ✖'}")
print("==================================================")
Exécuter le script de validation
Exécutez le script dans Cloud Shell :
python3 test_memory_system.py
Résultat attendu sur la console
À la fin du résultat du test, un récapitulatif des conclusions sera imprimé. Vous trouverez ci-dessous un exemple d'impression de ce type, avec des explications.
1. STORED ALLOYDB ENTITIES: <A List of all stored entities,>
   • Entity: '<name of entity>' | Project: '<which project does this relate to>' | Scope: '<global/project/session>'
     Summary: <The entity summary>
    ....

2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:
   • Naive Full-Context Turn 5 Tokens:    <Number of tokens in naive approach on the last turn>
   • Tiered Memory Active Prompt Tokens:  <Number of tokens in tiered approach on the last turn>
   • Active Turn 5 Prompt Reduction:      <Savings on tokens in %>
   • Measured Turn 5 Inference Latency:   <Latency in last turn>

3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):
   • Naive Cumulative Multi-Turn Tokens:  <Total tokens in the naive approach>
   • Active Read-Path Prompt Tokens:      <Read path tokens in the tiered approach>
   • Background Worker Tokens (Extraction): <Backround process tokens usage in tiered approach>
   • Background Compaction Tokens (Valkey): <Backround process tokens usage for compaction in tiered approach>
   • Total Tiered System Token Footprint: <Total tokens usage in tiered approach>
   • Overall System Token Savings:        <Savings on tokens in %>

4. ACCURACY & VERIFICATION TESTS:
   • Valkey Rolling Summary Compaction Test: <Did the roling summary work>
   • Global Coding Preference Recall Test (scope='global'): <Was it able to retrieve global scoped memories>
   • Project CloudRetail Architecture Recall Test (project_id='CloudRetail'): <Was it able to retrieve project specific scoped entities>
   • Tool Permission Policy Test: <Was it able to retrieve permissions policies>
Réinitialiser les systèmes de stockage en mémoire (facultatif)
Si vous souhaitez effacer toutes les mémoires stockées et réinitialiser l'état de Valkey et AlloyDB entre les exécutions de test, créez et exécutez cleanup_memory_system.py :
import logging
from db_clients import get_db_connection, get_valkey_client
from valkey_buffer import IN_MEMORY_VALKEY_FALLBACK

logging.basicConfig(level=logging.INFO)

def reset_memory_system():
    # 1. Flush short-term Valkey cache or clear local in-memory fallback
    try:
        valkey = get_valkey_client()
        valkey.flushdb()
        print("✔ Flushed Valkey short-term cache.")
    except Exception:
        IN_MEMORY_VALKEY_FALLBACK.clear()
        print("✔ Cleared local in-memory short-term fallback buffer.")

    # 2. Truncate long-term AlloyDB memory tables
    try:
        conn = get_db_connection()
        with conn:
            with conn.cursor() as cur:
                cur.execute("TRUNCATE TABLE agent_entities CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_embeddings CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_collections CASCADE;")
                cur.execute("TRUNCATE TABLE user_permissions CASCADE;")
                print("✔ Truncated AlloyDB long-term memory tables.")
        conn.close()
    except Exception as e:
        print(f"✖ AlloyDB cleanup error: {e}")

if __name__ == "__main__":
    reset_memory_system()
Exécutez le script de nettoyage :
python3 cleanup_memory_system.py
14. Extension de la mémoire hiérarchisée à Google ADK
Lors des étapes précédentes, vous avez créé un système de mémoire à deux niveaux :
- Niveau 1 (tampon à court terme) : Memorystore for Valkey stocke les tours de conversation récents et crée des résumés glissants pour que les requêtes restent petites.
- Niveau 2 (magasin hybride à long terme) : AlloyDB AI stocke les préférences utilisateur durables, les règles de projet et les embeddings vectoriels à l'aide de la recherche hybride.
Dans ce guide, vous allez connecter ce moteur de mémoire à un agent personnalisé créé avec le Google Agent Development Kit .
Le problème avec la mémoire simple
La connexion d'un agent à la mémoire conduit généralement à l'un des deux pièges suivants :
- Le piège de l'outil uniquement : forcer l'agent à appeler des outils (comme
search_memory) pour tout. Les agents oublient souvent d'appeler des outils pour les préférences de base (comme le style de codage ou les délais d'attente), ce qui entraîne des erreurs et des allers-retours supplémentaires lents. - Le piège du bourrage d'invite : insérer tout l'historique passé dans chaque requête. Cela fait rapidement exploser les coûts en jetons, ralentit les réponses et dégrade le raisonnement du modèle.
La solution hybride
Nous utilisons une approche hybride qui donne à l'agent la bonne mémoire au bon moment :
- Contexte ambiant (automatique) : avant chaque tour, les règles de projet pertinentes et les résumés de session récents sont récupérés à partir de Memorystore (résumé continu) et d'AlloyDB (règles et préférences), puis injectés dans l'invite de l'agent sans aucun appel LLM supplémentaire.
- Recherche à long terme à la demande (outil) : pour les faits anciens ou obscurs (comme une décision architecturale prise il y a deux semaines), l'agent appelle
long_term_memory_toolpour exécuter une recherche vectorielle dans la table de mémoire à long terme d'AlloyDB. - Garde-fous d'exécution : avant que l'agent n'exécute un outil, un garde-fou vérifie les autorisations à usage unique dans Valkey et les règles de sécurité dans AlloyDB pour bloquer les actions dangereuses telles que
rm -rf.
Configuration
Installez le package google-adk (les autres dépendances sont déjà installées) :
pip3 install google-adk
Définissez la région Google Cloud pour que le client ADK GenAI soit routé via Vertex AI :
# ADK agent platform backend
export GEMINI_MODEL="gemini-3.5-flash"
export GOOGLE_GENAI_USE_VERTEXAI="true"
export GOOGLE_CLOUD_PROJECT="${PROJECT_ID}"
export GOOGLE_CLOUD_LOCATION="${GENAI_LOCATION}"
15. Fournisseur de mémoire ambiante
Créez des adk_memory_provider.py. Cette classe gère le cycle de vie de la mémoire automatique :
- Avant le tour : récupère le tampon de conversation Valkey (< 1 ms) et interroge AlloyDB pour trouver les préférences et les règles de projet correspondantes, puis les assemble dans l'invite système.
- Après le tour : ajoute la conversation à Valkey et déclenche un processus en arrière-plan pour extraire des faits durables dans AlloyDB sans ralentir la réponse de l'utilisateur.
import logging
from typing import Any, Dict, Optional
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

class ADKTieredMemoryProvider:
    """Provides ambient memory context before turns and saves history after turns."""

    def __init__(self, db_conn_factory, valkey_client: redis.Redis, genai_client: Any, trigger_limit: int = 10, window_size: int = 4):
        self.conn_factory = db_conn_factory
        self.valkey_client = valkey_client
        self.genai_client = genai_client
        self.trigger_limit = trigger_limit
        self.window_size = window_size
        self.async_worker = AsyncMemoryWorker(db_conn_factory, genai_client)

    def get_context_for_turn(self, user_id: str, project_id: Optional[str], session_id: str, user_query: str, prev_session_id: Optional[str] = None) -> Dict[str, Any]:
        """Reads Valkey buffer (<1ms) and AlloyDB hybrid entities before agent reasoning."""
        buffer_data = get_session_context_buffer(self.valkey_client, session_id)
        rolling_summary = buffer_data["rolling_summary"]

        # Carry over prior session summary when starting a fresh session
        if not rolling_summary and prev_session_id:
            prev_buffer = get_session_context_buffer(self.valkey_client, prev_session_id)
            if prev_buffer["rolling_summary"]:
                rolling_summary = f"[From prior session {prev_session_id}]:\n" + prev_buffer["rolling_summary"]

        conn = self.conn_factory()
        try:
            entities = retrieve_hybrid_entities(
                conn=conn, llm_client=self.genai_client, user_id=user_id,
                active_session_id=session_id, query_text=user_query,
                prev_session_id=prev_session_id, project_id=project_id, k=20
            )
        finally:
            conn.close()

        return {
            "rolling_summary": rolling_summary,
            "recent_turns": buffer_data["recent_turns"],
            "retrieved_entities": entities
        }

    def format_system_instruction(self, context: Dict[str, Any], base_prompt: str = "") -> str:
        """Injects ambient entities and short-term summaries into the agent's prompt."""
        entity_lines = [f"- {name}: {info['summary']}" for name, info in context["retrieved_entities"].items()]
        entity_str = "\n".join(entity_lines) if entity_lines else "No relevant long-term entities."
        summary_str = context["rolling_summary"] or "No prior summary."

        return f"""{base_prompt}

[LONG-TERM PREFERENCES & ENTITIES]
{entity_str}

[SHORT-TERM ROLLING SUMMARY]
{summary_str}

[NOTE ON TOOLS & MEMORY]
Memory persistence is managed automatically by the platform behind the scenes. Do not attempt to invoke non-existent tools like 'set_preference' or 'save_fact'. Only invoke explicitly declared tools when needed.
""".strip()

    def record_turn_async(self, user_id: str, project_id: Optional[str], session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None) -> None:
        """Updates Valkey sliding window and triggers background AlloyDB extraction."""
        append_session_turn_with_rolling_summary(
            valkey_client=self.valkey_client, llm_client=self.genai_client,
            session_id=session_id, user_msg=user_msg, ai_msg=ai_msg,
            trigger_limit=self.trigger_limit, window_size=self.window_size
        )
        self.async_worker.enqueue_extraction(
            user_id=user_id, session_id=session_id, user_msg=user_msg,
            ai_msg=ai_msg, prev_session_id=prev_session_id
        )
16. Outil de mémoire à long terme à la demande
La mémoire ambiante permet de limiter la taille de la requête active, mais un agent doit parfois rechercher des notes historiques plus anciennes, des décisions architecturales ou des journaux d'incidents.
Créez des adk_memory_tools.py. Cela encapsule la table vectorielle episodic_memory_embeddings d'AlloyDB dans un FunctionTool ADK :
from typing import Any, Dict, List, Optional
from google.adk.tools import FunctionTool

def make_long_term_memory_tool(db_conn_factory, embed_client: Any, user_id: str) -> FunctionTool:
    """Creates an ADK FunctionTool for vector search over AlloyDB historical records."""

    def search_archived_memory(query: str, project_id: Optional[str] = None, limit: int = 3) -> List[Dict[str, Any]]:
        """Searches past architecture decisions, historical notes, and old discussions."""
        # 1. Embed query with text-embedding-005
        emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=query)
        query_vector = emb_resp.embeddings[0].values

        # 2. Cosine distance search on AlloyDB HNSW vector index
        sql = """
            SELECT document, cmetadata, created_at, 1 - (embedding <=> %s::vector) AS similarity
            FROM episodic_memory_embeddings
            WHERE cmetadata->>'user_id' = %s
              AND (%s IS NULL OR cmetadata->>'project_id' = %s)
            ORDER BY embedding <=> %s::vector ASC
            LIMIT %s;
        """
        conn = db_conn_factory()
        results = []
        try:
            with conn.cursor() as cur:
                cur.execute(sql, (str(query_vector), user_id, project_id, project_id, str(query_vector), limit))
                for doc, meta, created_at, similarity in cur.fetchall():
                    results.append({
                        "document": doc,
                        "metadata": meta,
                        "timestamp": created_at.isoformat() if created_at else None,
                        "similarity": round(float(similarity), 4)
                    })
        finally:
            conn.close()
        return results

    return FunctionTool(search_archived_memory)
17. Garde-fous pour les autorisations Enterprise
Les agents autonomes ne doivent pas exécuter d'actions destructrices sur l'hôte (comme rm -rf ou la suppression de tables) sans vérification.
Fonctionnement de before_tool_callback dans ADK
L'ADK fournit un hook d'interception qui s'exécute avant l'exécution de tout outil :
- Retourne
None: l'ADK autorise l'exécution de l'outil. - Renvoyer un dictionnaire (par exemple,
{"status": "DENIED", "error": ...}) : l'ADK interrompt immédiatement l'exécution. Aucune commande n'est exécutée et le motif du refus est renvoyé au modèle afin qu'il puisse expliquer la restriction à l'utilisateur.
Ordre de vérification des autorisations
- Vérification 0 (liste d'autorisation des outils sûrs) : les outils sûrs en lecture seule, comme
search_archived_memory, sont préapprouvés en mémoire. L'agent peut donc toujours interroger sa propre mémoire. - Niveau 1 (autorisations éphémères "autoriser une fois" dans Valkey) : lorsqu'un opérateur humain approuve une action risquée, une clé temporaire
one_time_perm:{session_id}:{cmd_hash}est stockée dans Valkey avec un TTL de cinq minutes. Le garde-fou lit et supprime la clé en une seule opération atomique. Cela permet à la commande de s'exécuter une seule fois, ce qui évite une augmentation permanente des privilèges. - Niveau 2 (Règles de projet dans AlloyDB) : vérifie les règles d'expression régulière dans
user_permissionspour le projet actif (par exemple, autoriserpytest.*--timeout=30, bloquerrm -rf.*). - Niveau 3 (Règles globales dans AlloyDB) : vérifie les règles de remplacement qui s'appliquent à tous les projets.
- Fail-closed fallback : si aucune règle ne correspond, l'exécution est refusée avec
PENDING, ce qui nécessite un examen manuel.
Implémentation
Créez adk_guardrails.py :
import logging
from typing import Any, Dict, Optional, Tuple, Set
from enterprise_engine import AgentMemoryEngine

logger = logging.getLogger(__name__)

class ADKPermissionGuardrail:
    """Evaluates tool permissions using Valkey allow-once tokens and AlloyDB rules."""

    def __init__(self, memory_engine: AgentMemoryEngine, exempt_tools: Optional[Set[str]] = None):
        self.engine = memory_engine
        self.exempt_tools = exempt_tools or {"search_archived_memory"}

    def evaluate(self, user_id: str, project_id: str, session_id: str, tool_name: str, tool_args: Dict[str, Any]) -> Tuple[bool, str]:
        # 1. Allowlist safe internal tools
        if tool_name in self.exempt_tools:
            return True, f"Internal tool '{tool_name}' is pre-approved."

        # 2. Check 3-tier policy engine
        action, reason = self.engine.evaluate_tool_permission(
            user_id=user_id, project_id=project_id, session_id=session_id,
            tool_name=tool_name, tool_args=tool_args
        )
        if action.upper() == "ALLOW":
            return True, f"Permission ALLOWED: {reason}"
        elif action.upper() == "BLOCK":
            return False, f"Permission BLOCKED: {reason}"
        return False, f"Permission PENDING: {reason} (requires human confirmation)"

    def create_before_tool_callback(self, user_id: str, default_project_id: str = "global"):
        """Creates the callback hook for Agent(before_tool_callback=...)."""
        def before_tool_callback(tool: Any, args: Dict[str, Any], tool_context: Any) -> Optional[Dict[str, Any]]:
            tool_name = getattr(tool, "name", str(tool))
            session_id = getattr(getattr(tool_context, "session", None), "id", "default_session")

            allowed, msg = self.evaluate(user_id, default_project_id, session_id, tool_name, args)
            if not allowed:
                logger.warning("Guardrail blocked '%s': %s", tool_name, msg)
                return {"status": "DENIED", "tool": tool_name, "error": msg}

            return None  # Returning None permits execution in ADK
        return before_tool_callback
18. Exécuter le test de l'agent ADK
Créez des test_adk_agent.py. Ce script complet relie les composants entre eux, amorce une décision archivée et des règles de sécurité, exécute une conversation de deux sessions, teste la compaction et le rappel de la mémoire, et vérifie l'application des mesures de protection :
import asyncio
import os
import time
from google import genai
from google.genai import types
from google.adk.agents import Agent
from google.adk.runners import Runner
from google.adk.sessions import InMemorySessionService
from google.adk.tools import FunctionTool

from db_clients import get_db_connection, get_valkey_client
from enterprise_engine import AgentMemoryEngine
from adk_memory_provider import ADKTieredMemoryProvider
from adk_memory_tools import make_long_term_memory_tool
from adk_guardrails import ADKPermissionGuardrail
from valkey_buffer import get_session_context_buffer

# Configuration & clients
PROJECT_ID = os.getenv("PROJECT_ID", "chunking-poc-alloydb")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")
GEMINI_MODEL = os.getenv("GEMINI_MODEL", "gemini-3.5-flash")
USER_ID, SESSION_1, SESSION_2 = "user_adk_dev", "sess_adk_001", "sess_adk_002"

db_conn = get_db_connection()
valkey_client = get_valkey_client()
# LLM client for Gemini 3.5 Flash via global multi-region
genai_client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)
# Embeddings client (requires specific regional presence)
embed_client = genai.Client(vertexai=True, project=PROJECT_ID, location=REGION)

tiered_provider = ADKTieredMemoryProvider(get_db_connection, valkey_client, genai_client, trigger_limit=3, window_size=2)
memory_engine = AgentMemoryEngine(valkey_client, db_conn)
guardrail = ADKPermissionGuardrail(memory_engine)

# Tools: Long-term memory search and mock terminal command
long_term_memory_tool = make_long_term_memory_tool(get_db_connection, embed_client, USER_ID)

def run_command(CommandLine: str) -> str:
    """Executes a shell command on the host."""
    return f"Executed: {CommandLine}"

run_command_tool = FunctionTool(run_command)

def seed_database():
    """Seeds a 14-day-old architecture decision and permission rules."""
    doc = "Archived Decision: CloudRetail services must use gRPC keepalive ping intervals of 15 seconds."
    emb = embed_client.models.embed_content(model="text-embedding-005", contents=doc).embeddings[0].values
    conn = get_db_connection()
    try:
        with conn.cursor() as cur:
            cur.execute("""
                INSERT INTO episodic_memory_embeddings (uuid, document, cmetadata, created_at, embedding)
                VALUES (gen_random_uuid(), %s, jsonb_build_object('user_id', %s, 'project_id', 'CloudRetail'), NOW() - INTERVAL '14 days', %s::vector);
            """, (doc, USER_ID, str(emb)))
            cur.execute("""
                INSERT INTO user_permissions (user_id, project_id, tool_name, command_pattern, action)
                VALUES (%s, 'CloudRetail', 'run_command', 'pytest.*--timeout=30', 'ALLOW'),
                       (%s, 'CloudRetail', 'run_command', 'rm -rf.*', 'BLOCK'),
                       (%s, 'global', 'search_archived_memory', '.*', 'ALLOW')
                ON CONFLICT DO NOTHING;
            """, (USER_ID, USER_ID, USER_ID))
        conn.commit()
    finally:
        conn.close()

async def run_turn(runner: Runner, session_id: str, query: str, prev_session_id: str = None) -> str:
    """Fetches ambient memory, executes turn, and saves history in the background."""
    ctx = tiered_provider.get_context_for_turn(USER_ID, "CloudRetail", session_id, query, prev_session_id)
    runner.agent.instruction = tiered_provider.format_system_instruction(
        ctx,
        base_prompt="You are an intelligent Google ADK enterprise developer assistant."
    )
    msg = types.Content(role="user", parts=[types.Part.from_text(text=query)])
    parts = []
    async for event in runner.run_async(user_id=USER_ID, session_id=session_id, new_message=msg):
        if event.content and event.content.parts:
            parts.extend([p.text for p in event.content.parts if p.text])

    response = "".join(parts).strip()
    tiered_provider.record_turn_async(USER_ID, "CloudRetail", session_id, query, response, prev_session_id)
    return response

async def main():
    seed_database()
    sessions = InMemorySessionService()
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_1)

    agent = Agent(
        name="adk_memory_agent", model=GEMINI_MODEL, instruction="Initial instruction",
        tools=[long_term_memory_tool, run_command_tool],
        before_tool_callback=guardrail.create_before_tool_callback(USER_ID, "CloudRetail")
    )
    runner = Runner(agent=agent, session_service=sessions, app_name="agents")

    print("\n--- Session 1: Storing Preferences & Triggering Compaction ---")
    await run_turn(runner, SESSION_1, "I standardize on Python 3.11 with PostgreSQL and Dark Mode UI.")
    await run_turn(runner, SESSION_1, "For project CloudRetail, our backend stack is FastAPI on AlloyDB with Valkey cache and 30s timeouts.")
    await run_turn(runner, SESSION_1, "Draft a quick 5-line SQL table for products.")
    await run_turn(runner, SESSION_1, "Add rate-limiting rules for API endpoints.")

    buf = get_session_context_buffer(valkey_client, SESSION_1)
    print(f"Valkey rolling summary generated: {bool(buf['rolling_summary'])}")
    print(f"Turns in buffer: {len(buf['recent_turns'])} (compacted from 8)")

    print("\nWaiting 6s for background worker entity extraction into AlloyDB...")
    await asyncio.sleep(6)

    print("\n--- Session 2: Cold-Start Ambient Recall ---")
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_2)
    resp = await run_turn(runner, SESSION_2, "What are my coding preferences and the CloudRetail stack from my previous session?", prev_session_id=SESSION_1)
    print(f"Agent response:\n{resp}\n")

    print("\n--- On-Demand Archival Vector Search ---")
    resp_search = await run_turn(runner, SESSION_2, "What was the agreed gRPC keepalive interval from 2 weeks ago?")
    print(f"Agent response:\n{resp_search}\n")

    print("\n--- Guardrail Verification ---")
    blocked, b_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "rm -rf /tmp/data"})
    allowed, a_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "pytest --timeout=30"})
    print(f"rm -rf /tmp/data:    Allowed={blocked} ({b_msg})")
    print(f"pytest --timeout=30: Allowed={allowed} ({a_msg})")

if __name__ == "__main__":
    asyncio.run(main())
Nettoyage des tests itératifs
Étant donné que le système capture le contexte persistant, l'exécution du test à plusieurs reprises ajoutera sans cesse des blocs de dialogue à Valkey et insérera des règles en double dans AlloyDB.
Pour réinitialiser facilement votre état entre les exécutions, exécutez le script cleanup_memory_system.py que vous avez créé à l'étape précédente :
python3 cleanup_memory_system.py
python3 test_adk_agent.py
Résultats de la validation
Le test vérifie quatre comportements de production critiques :
- Réduction importante des jetons d'invite : la compression Valkey a permis de condenser l'historique des dialogues en un résumé concis. Lors de nos tests, cela a réduit la taille des invites actives de plus de 92% (de 6 956 jetons à 544 jetons environ). Vos résultats peuvent varier.
- Rappel instantané au démarrage à froid : dans une toute nouvelle session (session 2), l'agent a immédiatement rappelé les préférences de l'utilisateur (Python 3.11, PostgreSQL, mode sombre) et l'architecture du projet (FastAPI, délais d'expiration de 30 s) sans appeler aucun outil. Cela a été rendu possible par
ADKTieredMemoryProvider.get_context_for_turn, qui récupère le contexte de Memorystore et AlloyDB avant l'appel du LLM. - Rappel de vecteurs à la demande : lorsqu'on lui a posé une question sur une décision vieille de 14 jours, l'agent a invoqué
search_archived_memoryet récupéré la règle de keepalive gRPC de 15 secondes. - Sécurité déterministe : l'agent a exécuté
pytest --timeout=30, mais l'exécution derm -rf /tmp/dataa été strictement bloquée.
19. Effectuer un nettoyage
Pour éviter que des frais de facturation ne soient facturés en permanence sur votre compte Google Cloud pour les instances AlloyDB et Memorystore, supprimez les ressources créées.
Exécutez les commandes suivantes dans Cloud Shell :
# Exit VM and return to Cloud Shell
exit
# Delete Compute Engine development VM
gcloud compute instances delete $VM_NAME \
  --zone=$ZONE \
  --quiet

# Delete AlloyDB primary instance and cluster
gcloud alloydb instances delete $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --quiet

gcloud alloydb clusters delete $ADBCLUSTER \
  --region=$REGION \
  --quiet

# Delete Memorystore for Valkey instance
gcloud memorystore instances delete $VALKEYINSTANCE \
  --location=$REGION \
  --quiet
20. Félicitations
Félicitations ! Vous avez créé une architecture de mémoire d'agent IA à long terme à deux niveaux combinant Memorystore pour Valkey et AlloyDB AI.
Connaissances acquises
- Nous avons implémenté une architecture de mémoire à deux niveaux qui sépare l'état de session actif à court terme des faits persistants à long terme.
- Nous avons réussi à réduire considérablement la taille des invites actives et à économiser sur l'utilisation totale des jetons par rapport au bourrage de contexte naïf, sans perte de précision.
- Auto-intégrations transactionnelles (
ai.initialize_embeddings) configurées au niveau de la base de données AlloyDB AI. - Effectué une recherche hybride avec fusion du rang réciproque native (
ai.hybrid_search) combinant la similarité vectorielle (<=>) à la recherche en texte intégral PostgreSQL (tsvector). - Création d'un extracteur d'entités d'arrière-plan hors thread (
AsyncMemoryWorker), d'un évaluateur d'autorisations d'exécution d'outils à trois niveaux et d'un moteur de compaction de la mémoire de la base de données. - Associez le système de mémoire par niveaux à un agent autonome à l'aide du Google Agent Development Kit (ADK) pour appliquer des consignes concernant les outils et fournir une mémoire ambiante.
Étapes suivantes et références
- Consultez la documentation AlloyDB/AI.
- Découvrez comment exécuter une recherche vectorielle hybride dans AlloyDB.
- En savoir plus sur Memorystore pour Valkey