

1. לפני שמתחילים
סוכני AI מטפלים באינטראקציות ארוכות ומרובות שלבים שנמשכות כמה ימים ומבצעים משימות ארוכות טווח שמורכבות מכמה שלבים. עם זאת, מודלים גדולים של שפה (LLM) הם חסרי מצב באופן מובנה בין סשנים. כשמשתמש חוזר לאמצעי תקשורת עם נציג מחר, המודל מתחיל מאפס אלא אם האפליקציה יכולה לשחזר את ההקשר הנדרש.
הגישה הפשוטה לפתרון הבעיה הזו היא token stuffing – הוספה של היסטוריית שיחות מלאה, יומני הפעלה של כלים ובסיסי קוד ישירות לכל הנחיה פעילה. חלונות הקשר הגדולים של מיליון טוקנים מאפשרים זאת מבחינה טכנית, אבל הכנסת הקשר גורמת לבעיות תפעוליות חמורות: עלויות הטוקנים גדלות באופן ריבועי בכל תור, זמן האחזור של התגובות גדל לעשרות שניות, והמודלים סובלים מהידרדרות הקשר בגלל 'אובדן באמצע'.
כדי לבנות סוכני AI אמינים, אתם צריכים ארכיטקטורת זיכרון דו-שכבתית:
- מאגר זמני של נתוני סשן: מטמון של תפניות שיחה מהזמן האחרון בזיכרון הפעיל באמצעות חלון הזזה מוגבל בטוקנים. השכבה הזו מחייבת חיפושים בזיכרון עם זמן אחזור של פחות ממילי-שנייה וקצב העברת נתונים גבוה בכל תור, ולכן Memorystore for Valkey היא הבחירה האידיאלית.
- זיכרון לטווח ארוך: מאחסן ישויות מובנות, העדפות משתמשים ועובדות אפיזודיות בסשנים שונים. השכבה הזו דורשת שלמות טרנזקציונלית, אבטחה של ריבוי דיירים ואחזור היברידי של נתונים רלציוניים ווקטורים – ולכן AlloyDB ל-PostgreSQL היא הבחירה הנכונה.
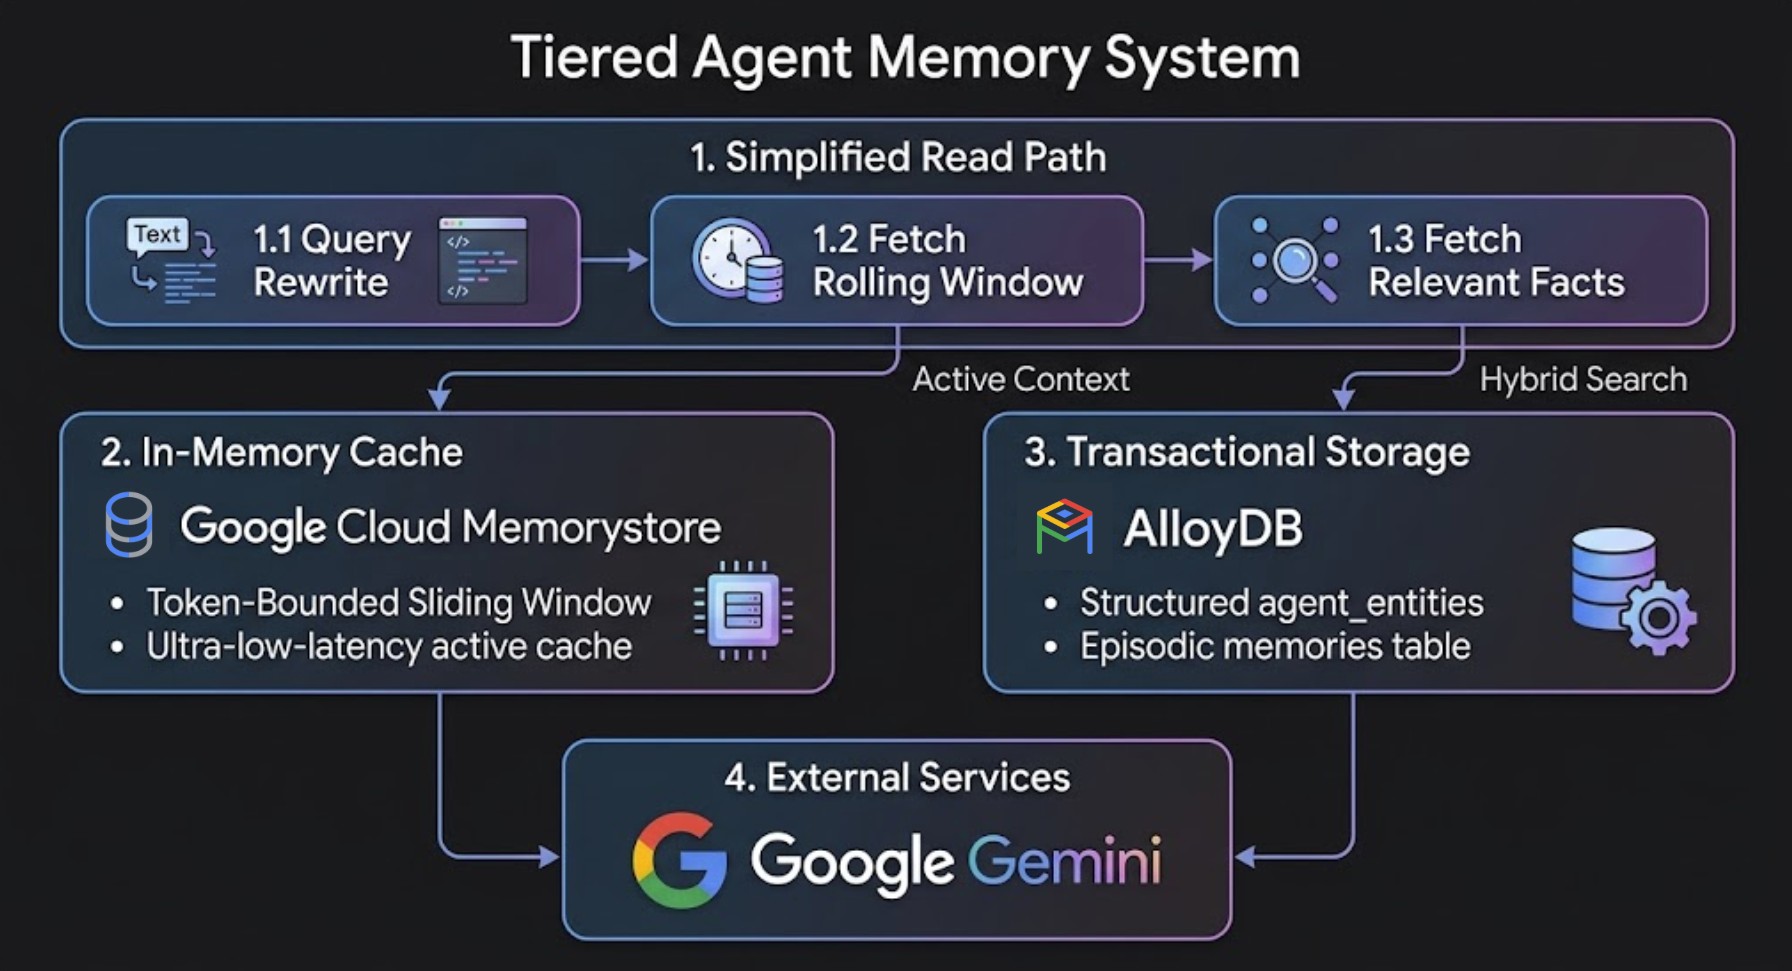
הסבר על ארבעת סוגי הזיכרונות
ארכיטקטורת זיכרון חזקה מסתמכת על ארבעה סוגי זיכרון משלימים לאורך התהליך שעובר המשתמש:
סוג הזיכרון | מה נשמר | שכבת אחסון | תוחלת חיים |
מאגר (טווח קצר) | שלבי שיחה גולמיים מהזמן האחרון | Memorystore for Valkey | סשן פעיל |
סיכום זיכרון | היסטוריה דחוסה של הודעות קודמות | Memorystore for Valkey | חלון רב-שלבי |
זיכרון אפיזודי | פעולות, אירועים ותוצאות של כלים מהעבר | AlloyDB ל-PostgreSQL (וקטור) | קבוע |
זיכרון של ישויות וכללים | העדפות משתמש, אילוצים ופסילות | AlloyDB ל-PostgreSQL (SQL מובנה + וקטור) | קבוע |
ההשפעה הנמדדת של זיכרון מדורג
בדיקות השוואה פנימיות של דיאלוגים רב-שלביים בפיתוח (45 תורות ומעלה עם יומני פלט של כלי כבדים) מראות חיסכון משמעותי בהשוואה להוספת הקשר לא מתוחכמת:
מדד / מאפיין | דחיסת הקשר בצורה לא מתוחכמת | זיכרון מדורג (AlloyDB + Memorystore) | ההשפעה נטו בבדיקה |
גודל ההצעה הפעילה לפעולה (תור 45) | 747,033 טוקנים | 83,262 טוקנים | פרומפט קטן יותר ב-88.9% |
הפעלת זמן אחזור של 45 שניות | 33.5 שניות | 6.7 שניות | מהירות התגובה מהירה ב-80.0% |
טוקנים מצטברים לסשנים | 17.9M טוקנים | 4.09M טוקנים | חיסכון כולל של 72.0% בעלויות ובטוקנים |
החזרה של כלל ואילוץ | האיכות יורדת ככל שהסיבובים נמשכים | מונעים אובדן של ידע חשוב בסיכום | נשמר באמצעות חיפוש היברידי |
הפעולות שתבצעו:
- הקצאת AlloyDB ל-PostgreSQL ו-Memorystore for Valkey.
- מפעילים את
google_ml_integrationומגדירים הטבעות אוטומטיות טרנזקציונליות בצד מסד הנתונים (ai.initialize_embeddings). - הטמעה של מאגר זמני של סשנים ב-Valkey באמצעות תבנית של צינור לעיבוד נתונים מסוג summarize-before-trim.
- שליפת ישויות לטווח ארוך באופן מקורי באמצעות פונקציות AI מקוריות של AlloyDB (כלומר
ai.generate) - הפעלת שאילתות על עובדות לטווח ארוך, עם רמת דיוק ורלוונטיות גבוהות, באמצעות פונקציית החיפוש ההיברידי המקורית של AlloyDB (
ai.hybrid_search) ודירוג מחדש של מיזוג דירוגים הדדיים (RRF). - פיתוח כלי להערכת הרשאות ברמת הארגון עם 3 רמות, ומנוע לדחיסת זיכרון ברקע.
- שילוב ארכיטקטורת זיכרון דו-שכבתית ישירות בסוכן אוטונומי באמצעות הערכה לפיתוח סוכנים (ADK) של Google.
הדרישות
- פרויקט ב-Google Cloud שהחיוב בו מופעל.
- דפדפן אינטרנט כמו Chrome.
- ידע בסיסי ב-Python וב-SQL, כולל ניסיון בהרצת שאילתות SQL ב-AlloyDB – מ-Studio, מ-CLI וכו'.
קהל ועלות
- קהל היעד: מפתחי AI, מהנדסי backend ואדריכלי מסדי נתונים.
- עלות משוערת: העלות של המשאבים ב-Google Cloud שייווצרו ב-Codelab הזה היא בערך 1.50 דולר ארה"ב.
2. הגדרה ודרישות
הפעלת Cloud Shell
ב-Codelab הזה תריצו פקודות ב-Google Cloud Shell, טרמינל שמתארח בענן ומוגדר מראש עם gcloud, psql ו-python3.
- פותחים את מסוף Google Cloud.
- לוחצים על Activate Cloud Shell (הפעלת Cloud Shell) בפינה הימנית העליונה של Cloud Console.
- אימות האימות:
gcloud auth list
export PROJECT_ID=<YOUR_PROJECT_ID>
gcloud config set project $PROJECT_ID

export REGION=us-east1
export GENAI_LOCATION=us
export ZONE=us-east1-b
export ADBCLUSTER=agent-memory-cluster
export ADBINSTANCE=agent-memory-instance
export VALKEYINSTANCE=agent-memory-cache
export VM_NAME=agent-dev-vm
הפעלת Google Cloud APIs ויצירת מכונה וירטואלית לפיתוח
מריצים את הפקודה הבאה ב-Cloud Shell כדי להפעיל את ממשקי ה-API הנדרשים:
gcloud services enable \
  alloydb.googleapis.com \
  memorystore.googleapis.com \
  aiplatform.googleapis.com \
  compute.googleapis.com \
  servicenetworking.googleapis.com \
  networkconnectivity.googleapis.com
יוצרים מכונה וירטואלית ב-Compute Engine ברשת ה-VPC default כדי לארח את סביבת הפיתוח של Python לצד AlloyDB ו-Memorystore for Valkey:
gcloud compute instances create $VM_NAME \
    --zone=$ZONE \
    --machine-type=e2-standard-2 \
    --scopes=cloud-platform \
    --network=default \
    --shielded-secure-boot
3. הקצאת משאבים ב-AlloyDB וב-Memorystore for Valkey
בשלב הזה תספקו את האשכול ואת המכונה הראשית של AlloyDB ל-PostgreSQL, תקימו רשת שירותים פרטית ותתחילו הרצה של מכונה של Memorystore for Valkey.
יצירת טווח כתובות IP לגישה לשירותים פרטיים
AlloyDB דורש טווח של כתובות IP פרטיות ברשת של הענן הווירטואלי הפרטי (VPC). בהנחה שאתם משתמשים ברשת default VPC:
- יוצרים את הקצאת טווח כתובות ה-IP הפרטיות:
gcloud compute addresses create psa-range \
    --global \
    --purpose=VPC_PEERING \
    --prefix-length=24 \
    --description="VPC private service access" \
    --network=default
- יוצרים את חיבור ה-VPC הפרטי:
gcloud services vpc-peerings connect \
    --service=servicenetworking.googleapis.com \
    --ranges=psa-range \
    --network=default
יצירת אשכול ומכונה ראשית ב-AlloyDB
- יוצרים סיסמה ראשונית לאשכול לצורך אתחול המערכת:
export PGPASSWORD=`openssl rand -hex 12`
- יצירת אשכול עם תקופת ניסיון בחינם:
gcloud alloydb clusters create $ADBCLUSTER \
    --password=$PGPASSWORD \
    --network=default \
    --region=$REGION \
    --subscription-type=TRIAL
- יוצרים את המופע הראשי:
gcloud alloydb instances create $ADBINSTANCE \
    --instance-type=PRIMARY \
    --cpu-count=2 \
    --region=$REGION \
    --cluster=$ADBCLUSTER
הקצאת מכונה של Memorystore for Valkey
כדי ליצור מכונה ב-Memorystore for Valkey, צריך להגדיר מדיניות חיבור לשירות (gcp-memorystore) ברשת ובאזור.
- יוצרים את מדיניות חיבור השירות ל-Memorystore:
gcloud network-connectivity service-connection-policies create memorystore-policy \
    --network=default \
    --region=$REGION \
    --service-class=gcp-memorystore \
    --subnets=projects/$PROJECT_ID/regions/$REGION/subnetworks/default
- יוצרים את מכונת Memorystore for Valkey:
gcloud memorystore instances create $VALKEYINSTANCE \
    --location=$REGION \
    --shard-count=1 \
    --replica-count=0 \
    --node-type=SHARED_CORE_NANO \
    --psc-auto-connections="network=projects/$PROJECT_ID/global/networks/default,projectId=$PROJECT_ID"
מתן הרשאות IAM ב-Vertex AI
נותנים לחשבון השירות של AlloyDB את הרשאות ה-IAM הנדרשות להפעלת מודלים להטמעה של Agent Platform:
PROJECT_ID=$(gcloud config get-value project)

gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:service-$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")@gcp-sa-alloydb.iam.gserviceaccount.com" \
  --role="roles/aiplatform.user"
4. אתחול של נקודות קצה של סביבה וגישה
הגדרה של אימות IAM וסימוני מסד נתונים ב-AlloyDB
מפעילים את אימות מסד הנתונים של IAM (alloydb.iam_authentication=on) ואת מנוע השאילתות מבוסס ה-AI (google_ml_integration.enable_ai_query_engine=on) במופע AlloyDB:
gcloud beta alloydb instances update $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --update-mode=FORCE_APPLY \
  --database-flags=alloydb.iam_authentication=on,google_ml_integration.enable_ai_query_engine=on
לאחר מכן, מוסיפים את חשבון Google Cloud כמשתמש במסד נתונים מבוסס-IAM עם הרשאות סופר-משתמש:
export USER_ACCOUNT=$(gcloud config get-value account)

gcloud alloydb users create $USER_ACCOUNT \
    --cluster=$ADBCLUSTER \
    --region=$REGION \
    --type=IAM_BASED \
    --db-roles=alloydbsuperuser
אחזור נקודות קצה פנימיות של VPC ב-Cloud Shell
לפני שמתחברים באמצעות SSH למכונה הווירטואלית לפיתוח, מאחזרים את כתובות ה-IP הפנימיות של ה-VPC עבור AlloyDB ו-Memorystore for Valkey ב-Cloud Shell:
# Export GCP Project ID, Region, and IAM User
export PROJECT_ID=$(gcloud config get-value project)
export REGION=us-east1
export DB_USER=$(gcloud config get-value account)

# Retrieve Internal VPC IP Addresses for AlloyDB & Memorystore for Valkey
export DB_HOST=$(gcloud alloydb instances describe $ADBINSTANCE --cluster=$ADBCLUSTER --region=$REGION --format="value(ipAddress)")
export DB_PORT=5432
export DB_NAME=postgres

export VALKEY_HOST=$(gcloud memorystore instances describe $VALKEYINSTANCE --location=$REGION --format="value(discoveryEndpoints[0].address)")
export VALKEY_PORT=6379

# Verify exported endpoints
echo "Project ID:        $PROJECT_ID"
echo "Region:            $REGION"
echo "AlloyDB Private IP: $DB_HOST"
echo "IAM DB User:       $DB_USER"
echo "Valkey Private IP:  $VALKEY_HOST"
התחברות ב-SSH למכונה וירטואלית לפיתוח וייצוא של משתני חיבור
מתחברים באמצעות SSH מ-Cloud Shell למכונה וירטואלית לפיתוח ב-Compute Engine (agent-dev-vm) שנמצאת באותה רשת VPC:
gcloud compute ssh $VM_NAME --zone=$ZONE
אחרי שנכנסים למכונת ה-VM לפיתוח, מייצאים את הגדרות הפרויקט ואת נקודות הקצה של החיבור שמופיעות למעלה (מחליפים את
export PROJECT_ID=<YOUR_PROJECT_ID>
export REGION=us-east1
export GENAI_LOCATION=us
export DB_HOST=<YOUR_ALLOYDB_PRIVATE_IP>
export DB_PORT=5432
export DB_NAME=postgres
export DB_USER=<YOUR_IAM_DB_USER>
export VALKEY_HOST=<YOUR_VALKEY_PRIVATE_IP>
export VALKEY_PORT=6379
אתחול סביבה וירטואלית של Python
בתוך מכונת ה-VM לפיתוח, קודם יוצרים את ספריית העבודה המקומית:
mkdir -p ~/alloydb_agent_memory && cd ~/alloydb_agent_memory
עכשיו נתקין את חבילות הסביבה הווירטואלית של Python, נאמת את Application Default Credentials (ADC) ונגדיר את סביבת העבודה:
sudo apt-get update && sudo apt-get install -y python3-venv python3-pip

python3 -m venv venv
source venv/bin/activate
בסוף, בסביבה הווירטואלית החדשה, נתקין את יחסי התלות:
gcloud auth application-default login
pip install psycopg2-binary valkey redis google-genai
5. ארכיטקטורת המערכת והיררכיה של מודולי קוד
סקירה כללית של מה שתבנו
לפני שמטמיעים את סקריפטים נפרדים של Python, כדאי לעיין בארכיטקטורת המערכת שבהמשך. אפליקציית הדוגמה הזו בנויה מ-7 סקריפטים מודולריים של Python שפועלים בשני נתיבי ביצוע עיקריים, ומנהלים אינטראקציה עם אותה מכונת מסד נתונים של AlloyDB ל-PostgreSQL:
- נתיב קריאה (
hybrid_retriever.py): פירוק של שאלות מורכבות עם כמה חלקים לשאילתות משנה עם היבט יחיד ישירות בתוך PostgreSQL באמצעות AlloyDB AIai.generate()ושאילתות של זיכרונות לטווח ארוך באמצעות חיפוש היברידי מקורי של AlloyDB (ai.hybrid_search). - נתיב הכתיבה (
async_worker.py): תהליך עבודה ברקע מחוץ לשרשור, שבאופן אסינכרוני מחלץ עובדות של ישויות מובנות משיחות באמצעות Gemini Flash, ומבצע פעולת upsert שלהן ב-agent_entities.
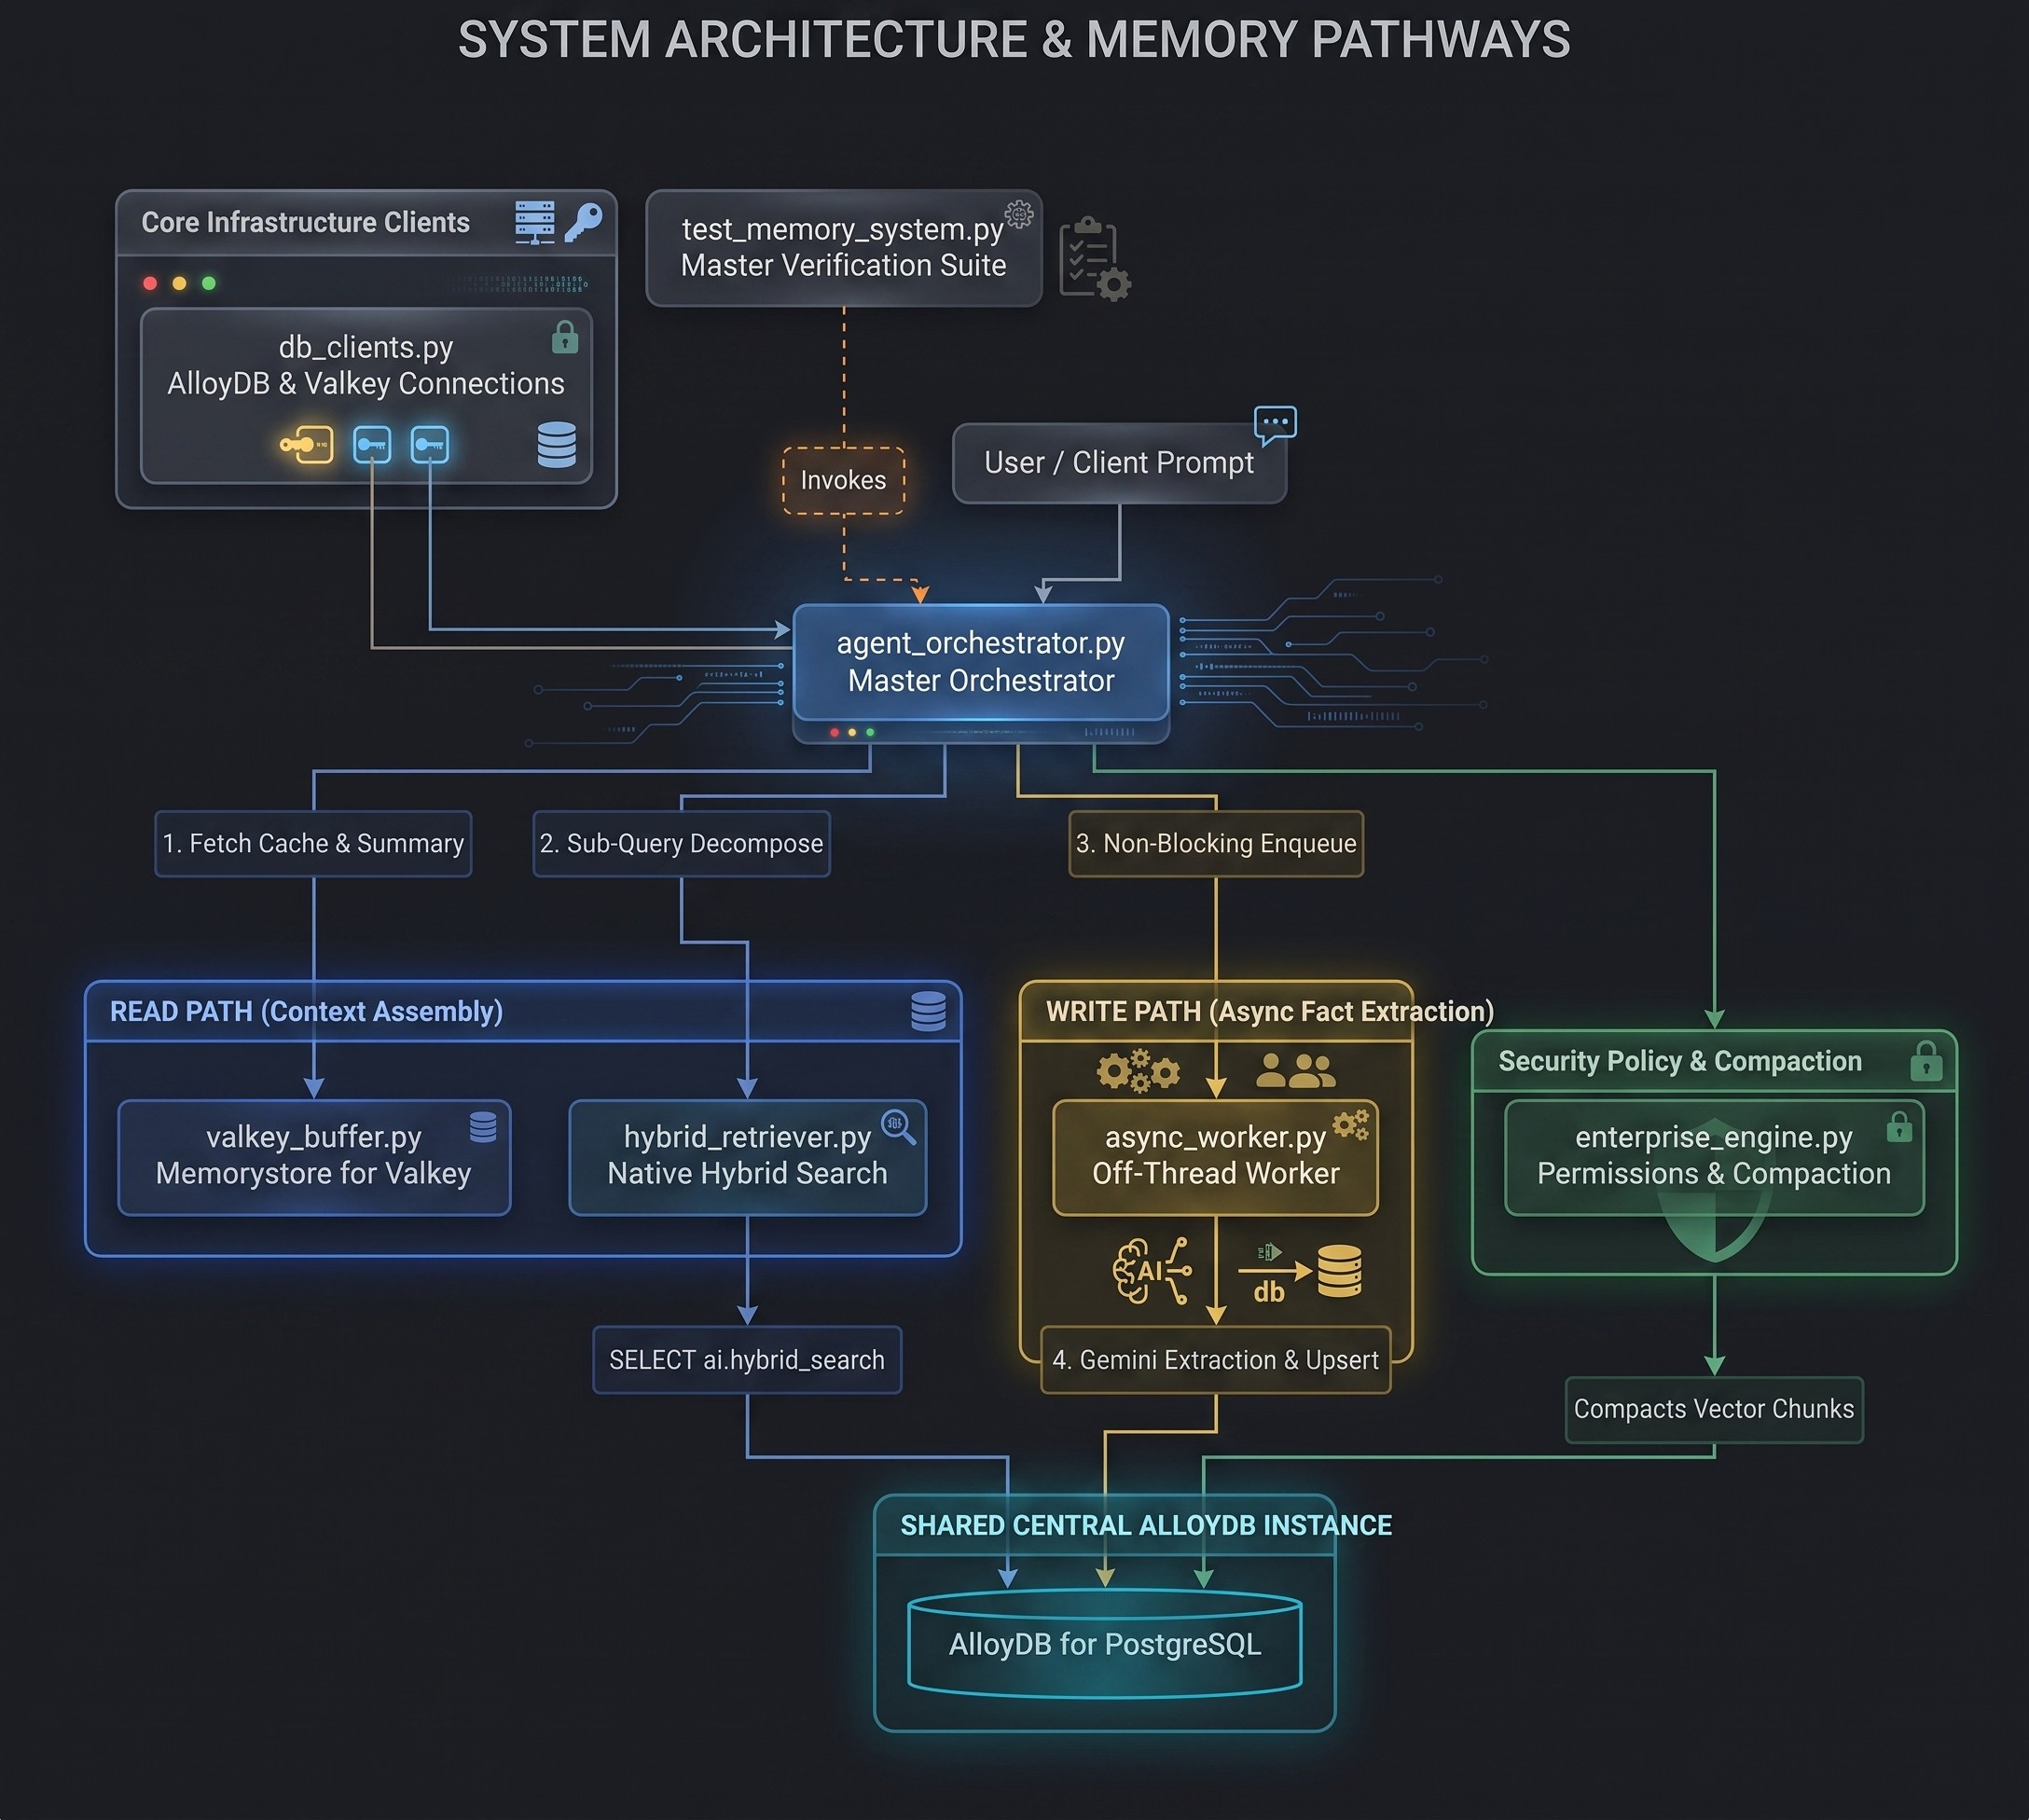
היררכיית המודולים ותפקידי המערכת
קובץ מודול | שכבת המערכת | אחריות ראשונית |
| שכבת החיבור | השירות יוצר אימות IAM מוצפן ב-SSL ל-AlloyDB וחיבורים עמידים לשקע ל-Memorystore for Valkey. |
| זיכרון לטווח קצר | מנהל את היסטוריית הסשנים ברמת דיוק של אלפיות השנייה ב-Valkey, ומיישם סיכומים מצטברים של Summarize-Before-Trim. |
| Write Path Worker | מריץ תהליך רקע של תור עבודה של דמון מחוץ לשרשור, ששולף עובדות על ישויות באמצעות Gemini Flash ומבצע פעולת upsert שלהן ב-AlloyDB. |
| קריאת Path Retriever | מפרק שאלות מורכבות לשאילתות משנה עם היבט יחיד באמצעות AlloyDB AI |
| לולאת הסוכן הראשית | מתאם את לולאת הביצוע של התור מקצה לקצה: אחזור לטווח קצר, חיפוש לטווח ארוך, הרכבת הנחיה, ביצוע LLM והוספה לתור אסינכרוני. |
| ממשל ואדמין | אכיפה של כללי מדיניות אבטחה ברמה 3 להרצת כלי וצבירה של זיכרון היסטורי. |
| בדיקה והערכה | חבילת אימות ראשית שמבצעת תרחישים רב-שלביים וכמה סשנים, מודדת את אחוז החיסכון בטוקנים ומאמתת את הדיוק של הזיכרון. |
6. הגדרת סכימה של AlloyDB AI והטמעות אוטומטיות טרנזקציונליות
סקירה כללית של המטרה והארכיטקטורה
במודול הזה נגדיר את סכמת מסד הנתונים של AlloyDB לזיכרון אפיזודי ולזיכרון לטווח ארוך, אסטרטגיות של אינדקסים והטמעה אוטומטית בצד מסד הנתונים.
- מאגר וקטורים אפיזודי (
episodic_memory_embeddings): נתחי תמליל לא מובנים של צ'אט שעברו אינדוקס באמצעות אינדקסים של וקטורים מסוג HNSW (vector_cosine_ops). - מאגר ישויות לטווח ארוך (
agent_entities): עובדות מובְנות, בחירות של משתמשים וכללי פרויקט שמאוחסנים עם מטא-נתונים של היקף (global,project,session). כולל עמודה של חיפוש טקסט מלא ב-PostgreSQL שנוצרת באופן אוטומטי (summary_tsv) ומאונדקסת באמצעות RUM. - הטמעה אוטומטית בצד מסד הנתונים (
ai.initialize_embeddings): הטמעה אוטומטית של שורות חדשות או מעודכנות של טקסט פשוט ב-summary_embeddingדרך Agent Platformtext-embedding-005ברקע.
התחברות ל-AlloyDB Studio
- נכנסים לדף AlloyDB for Postgres במסוף Google Cloud.
- לוחצים על המופע הראשי.
- בסרגל הניווט הימני, לוחצים על AlloyDB Studio.
- בוחרים את מסד הנתונים
postgres - אימות באמצעות
IAM database authentication
הטמעה וקוד מקור
אחרי שמתחברים למסד הנתונים של AlloyDB PostgreSQL, מריצים את שאילתות ה-DDL הבאות:
-- 1. Enable google_ml_integration extension
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;
CREATE EXTENSION IF NOT EXISTS vector CASCADE;
CREATE EXTENSION IF NOT EXISTS rum CASCADE;
SET google_ml_integration.enable_preview_ai_functions = true;

-- 2. Create Episodic Memory Vector Store Tables
CREATE TABLE IF NOT EXISTS episodic_memory_collections (
    uuid UUID PRIMARY KEY,
    name VARCHAR,
    cmetadata JSONB
);

CREATE TABLE IF NOT EXISTS episodic_memory_embeddings (
    uuid UUID PRIMARY KEY,
    collection_id UUID REFERENCES episodic_memory_collections(uuid) ON DELETE CASCADE,
    embedding VECTOR(768),
    document VARCHAR,
    cmetadata JSONB,
    custom_id VARCHAR,
    created_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS episodic_memory_embedding_idx
ON episodic_memory_embeddings
USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);

-- 3. Create Entity & Preference Table with Metadata Scope & Auto-Generated TSVector Column
CREATE TABLE IF NOT EXISTS agent_entities (
    entity_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    entity_name TEXT NOT NULL,
    project_id TEXT DEFAULT 'global',
    session_id TEXT,
    scope TEXT NOT NULL DEFAULT 'project', -- 'global', 'project', 'session'
    summary TEXT NOT NULL,
    summary_embedding VECTOR(768),
    summary_tsv TSVECTOR GENERATED ALWAYS AS (
        to_tsvector('english', entity_name || ' ' || summary)
    ) STORED,
    updated_at TIMESTAMPTZ DEFAULT NOW(),
    UNIQUE (user_id, entity_name)
);

CREATE INDEX IF NOT EXISTS agent_entities_scope_idx
ON agent_entities (user_id, project_id, scope);

CREATE INDEX IF NOT EXISTS agent_entities_embedding_idx
ON agent_entities USING hnsw (summary_embedding vector_cosine_ops);

CREATE INDEX IF NOT EXISTS agent_entities_tsv_idx
ON agent_entities USING rum (summary_tsv rum_tsvector_ops);

-- 4. Create User Permissions Table for Tool Execution Controls
CREATE TABLE IF NOT EXISTS user_permissions (
    permission_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    project_id TEXT NOT NULL DEFAULT 'global',
    tool_name TEXT NOT NULL,
    command_pattern TEXT NOT NULL,
    action TEXT NOT NULL CHECK (action IN ('ALLOW', 'BLOCK')),
    created_at TIMESTAMPTZ DEFAULT NOW(),
    updated_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS idx_user_permissions_lookup
ON user_permissions (user_id, project_id, tool_name);
-- 5. Register Gemini 3.5 Flash Model Endpoint in AlloyDB
-- Replace PROJECT_ID with your Google Cloud project ID
CALL google_ml.create_model(
    model_id => 'gemini-3.5-flash',
    model_request_url => 'https://aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/global/publishers/google/models/gemini-3.5-flash:generateContent',
    model_qualified_name => 'gemini-3.5-flash',
    model_provider => 'google',
    model_type => 'llm',
    model_auth_type => 'alloydb_service_agent_iam'
);
הפעלת הטמעה אוטומטית של נתונים טרנזקציונליים ורישום מודל Gemini
לאחר מכן, מריצים את ההצהרות CALL בבלוקים נפרדים של ביצוע שאילתות כדי לרשום את תהליך הרקע של ההטמעה האוטומטית ואת נקודת הקצה של מודל Gemini 3.5 Flash:
-- 6. Register Database-Side Transactional Auto-Embedding
CALL ai.initialize_embeddings(
    model_id => 'text-embedding-005',
    table_name => 'agent_entities',
    content_column => 'summary',
    embedding_column => 'summary_embedding',
    incremental_refresh_mode => 'transactional',
    batch_size => 10
);
7. הגדרת לקוחות חיבור ל-AlloyDB ול-Valkey
סקירה כללית של המטרה והארכיטקטורה
במודול הזה, תקימו חיבורים מאובטחים לרשת אל AlloyDB ל-PostgreSQL (זיכרון לטווח ארוך) וגם אל Memorystore for Valkey (מטמון לטווח קצר).
- אימות IAM ב-AlloyDB: משתמש ב-
gcloud auth application-default print-access-tokenכדי לאחזר אסימון OAuth2 לזמן קצר לחיבורי מסד נתונים מוצפנים ב-SSL ללא סיסמה (sslmode="require"). - Valkey Network Resilience: מגדיר את
redis.Redisעם פסק זמן של 5 שניות לשקע (socket_timeout=5.0) כדי לטפל בבטחה בפעולות של רשת VPC במכונות Valkey עם צומת יחיד או עם צומת מקובץ.
הטמעה וקוד מקור
יוצרים את הסקריפט db_clients.py בספריית העבודה:
import os
import subprocess
import psycopg2
import redis

# Initialize database & Valkey connection clients from environment variables
DB_HOST = os.getenv("DB_HOST", "127.0.0.1")
DB_PORT = os.getenv("DB_PORT", "5432")
DB_NAME = os.getenv("DB_NAME", "postgres")
DB_USER = os.getenv("DB_USER")

VALKEY_HOST = os.getenv("VALKEY_HOST", "127.0.0.1")
VALKEY_PORT = int(os.getenv("VALKEY_PORT", "6379"))

def get_db_connection():
    # Fetch Application Default Credentials (ADC) token for IAM Database Authentication & enable SSL encryption
    access_token = subprocess.check_output(
        ["gcloud", "auth", "application-default", "print-access-token"], text=True
    ).strip()
    return psycopg2.connect(
        host=DB_HOST,
        port=DB_PORT,
        dbname=DB_NAME,
        user=DB_USER,
        password=access_token,
        sslmode="require"
    )

def get_valkey_client():
    return redis.Redis(
        host=VALKEY_HOST,
        port=VALKEY_PORT,
        db=0,
        socket_timeout=5.0,
        socket_connect_timeout=5.0
    )

if __name__ == "__main__":
    print(f"Connecting to AlloyDB via IAM Auth ({DB_USER}) at {DB_HOST}:{DB_PORT} and Valkey at {VALKEY_HOST}:{VALKEY_PORT}...")
    print("Database and Valkey connection client modules loaded successfully.")
8. שמירת מצב הסשן לטווח קצר במטמון ב-Memorystore for Valkey
סקירה כללית של המטרה והארכיטקטורה
במודול הזה תבנו מטמון קצר טווח של הקשר עם זמן תגובה של פחות ממילי-שנייה ב-Memorystore for Valkey, ותטמיעו דפוס אוטומטי של Summarize-Before-Trim.
- חלון הזזה של Valkey: תורות פעילות בשיחה מאוחסנות כמחרוזות JSON במפתח
session:{session_id}:turns. - Redis Hash Tags (
{session_id}): עיצוב מפתחsession:{session_id}:turnsו-session:{session_id}:summaryמשתמש בתגי hash של אשכול Redis ({...}), ומכריח את שני המפתחות להיכנס לאותו משבצת hash כדי להבטיח ביצוע אטומי בכל פריסת Valkey של צומת יחיד או של אשכול. - Summarize-Before-Trim: כשמספר התורות חורג מ-
trigger_limit, Gemini Flash מסכם את התורות הישנות שעומדות להימחק לסיכום טקסט מתגלגל (session:{session_id}:summary) לפני שהוא מצמצם את ההיסטוריה הגולמית ל-window_size.
הטמעה וקוד מקור
יוצרים את הסקריפט valkey_buffer.py בספריית העבודה:
import json
import logging
import time
from typing import Any, Dict, List
import redis

logger = logging.getLogger(__name__)

IN_MEMORY_VALKEY_FALLBACK: Dict[str, Any] = {}
VALKEY_COMPACTION_TOKENS = 0

def get_valkey_compaction_tokens() -> int:
    return VALKEY_COMPACTION_TOKENS

def append_session_turn_with_rolling_summary(
    valkey_client: redis.Redis,
    llm_client: Any,
    session_id: str,
    user_msg: str,
    ai_msg: str,
    trigger_limit: int = 10,
    window_size: int = 4
) -> None:
    """Appends turn to Valkey. Before trimming old turns, summarizes them into a rolling summary."""
    global VALKEY_COMPACTION_TOKENS
    # Use Redis Hash Tags {session_id} so both keys hash to the same cluster slot
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        # 1. Append new turn messages
        valkey_client.rpush(turns_key, json.dumps({"role": "user", "content": user_msg}))
        valkey_client.rpush(turns_key, json.dumps({"role": "assistant", "content": ai_msg}))

        raw_turns = valkey_client.lrange(turns_key, 0, -1)

        # 2. Check if total turns exceed summary trigger threshold
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2

        if len(raw_turns) > msg_trigger_count:
            turns_to_prune = raw_turns[:-msg_window_count]
            existing_summary = valkey_client.get(summary_key)
            existing_summary_text = (
                existing_summary.decode('utf-8') if isinstance(existing_summary, bytes) else (existing_summary or "")
            )

            pruned_text = "\n".join([
                f"{json.loads(t)['role']}: {json.loads(t)['content']}" for t in turns_to_prune
            ])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            updated_summary_text = llm_client.models.generate_content(
                model="gemini-3.5-flash", contents=prompt
            ).text.strip()
            # Execute commands directly to support all Redis/Valkey cluster topologies
            valkey_client.set(summary_key, updated_summary_text)
            valkey_client.ltrim(turns_key, -msg_window_count, -1)
            logger.info("Updated rolling summary and trimmed Valkey buffer for session %s", session_id)

    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey operation warning (%s). Falling back to in-memory short-term buffer.", e)
        if turns_key not in IN_MEMORY_VALKEY_FALLBACK:
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = []
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "user", "content": user_msg})
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "assistant", "content": ai_msg})

        # In-memory summarize-before-trim fallback logic
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2
        raw_fallback_turns = IN_MEMORY_VALKEY_FALLBACK[turns_key]

        if len(raw_fallback_turns) > msg_trigger_count:
            turns_to_prune = raw_fallback_turns[:-msg_window_count]
            existing_summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
            pruned_text = "\n".join([f"{t['role']}: {t['content']}" for t in turns_to_prune])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            for attempt in range(4):
                try:
                    updated_summary_text = llm_client.models.generate_content(
                        model="gemini-3.5-flash", contents=prompt
                    ).text.strip()
                    break
                except Exception as e:
                    if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                        time.sleep(3 * (2 ** attempt))
                    else:
                        raise

            IN_MEMORY_VALKEY_FALLBACK[summary_key] = updated_summary_text
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = raw_fallback_turns[-msg_window_count:]

def get_session_context_buffer(
    valkey_client: redis.Redis,
    session_id: str
) -> Dict[str, Any]:
    """Retrieves rolling summary + sliding window history from Valkey to build prompt context."""
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        summary = valkey_client.get(summary_key)
        summary_text = summary.decode('utf-8') if isinstance(summary, bytes) else (summary or "")

        raw_turns = valkey_client.lrange(turns_key, 0, -1)
        recent_turns = [json.loads(t) for t in raw_turns]

        return {
            "rolling_summary": summary_text,
            "recent_turns": recent_turns
        }
    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey read error (%s). Using in-memory short-term fallback buffer.", e)
        summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
        recent_turns = IN_MEMORY_VALKEY_FALLBACK.get(turns_key, [])
        return {"rolling_summary": summary_text, "recent_turns": recent_turns}
9. חילוץ ישויות מחוץ לשרשור (תהליך זיכרון ברקע)
סקירה כללית של המטרה והארכיטקטורה
במודול הזה תבנו תהליך עבודה ברקע לחילוץ נתונים מחוץ לשרשור (AsyncMemoryWorker) שיחלץ עובדות על ישויות לטווח ארוך בלי להאט את התשובות האינטראקטיביות של ה-AI.
- Non-Blocking Queue Worker: מפעיל שרשור דמון (
queue.Queue) כדי שהתשובות בצ'אט למפתחים יחזרו באופן מיידי בלי לחכות לחילוץ מ-LLM או לכתיבה במסד הנתונים. - חילוץ עובדות לגבי ישויות מחוץ לשרשור: מתבצעות קריאות ל-Gemini Flash (
model="gemini-3.5-flash",response_mime_type="application/json") ברקע כדי לנתח ישויות מובנות בלי לחסום את תפניות הדיאלוג שמוצגות למשתמש. - פתרון בעיות של הפניות חוזרות זמניות (
build_temporal_rules_prompt): המערכת אוכפת כללים שממירים ביטויים זמניים יחסיים (לדוגמה, "בזמן הנוכחי", "בסשן האחרון") למזהי סשנים מפורשים (לדוגמה,session_id). - Schema Upserts: הנחיה ל-Gemini Flash להחזיר מערך JSON של ישויות (
entity_name, project_id, scope, summary) וכתיבת טקסט פשוט לתוךagent_entitiesבאמצעות הצהרות PostgreSQLON CONFLICT DO UPDATEעם פרמטרים.
הטמעה וקוד מקור
יוצרים את הסקריפט async_worker.py בספריית העבודה:
import json
import logging
import queue
import threading
import time
from typing import Dict, Any, Optional
import psycopg2

logger = logging.getLogger(__name__)

def build_temporal_rules_prompt(active_session_id: str, prev_session_id: Optional[str] = None) -> str:
    """REUSABLE PROMPT HELPER: Defines temporal coreference rules for both Read and Write paths."""
    return f"""TEMPORAL COREFERENCE RULES:
1. Do not use relative temporal words like 'currently', 'now', 'this session', 'previous session', or 'last session'.
2. Replace any relative temporal reference with explicit session identifiers:
   - Active Session: '{active_session_id}'
   - Previous Session: '{prev_session_id if prev_session_id else active_session_id}'
   (e.g., write 'User prefers Python in session {active_session_id}' instead of 'User currently prefers Python')."""

class AsyncMemoryWorker:
    """Off-thread daemon queue worker performing background entity extraction and upserts into AlloyDB."""
    def __init__(self, conn_factory, llm_client):
        self.conn_factory = conn_factory
        self.llm_client = llm_client
        self.work_queue = queue.Queue()
        self.total_extraction_tokens = 0
        self.worker_thread = threading.Thread(target=self._run_worker, daemon=True)
        self.worker_thread.start()

    def enqueue_extraction(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        self.work_queue.put((user_id, session_id, user_msg, ai_msg, prev_session_id))

    def _run_worker(self):
        while True:
            item = self.work_queue.get()
            if item is None:
                break
            user_id, session_id, user_msg, ai_msg, prev_session_id = item
            try:
                self._extract_and_upsert(user_id, session_id, user_msg, ai_msg, prev_session_id)
            except Exception as e:
                logger.error("Background extraction failed: %s", e)
            finally:
                self.work_queue.task_done()

    def _extract_and_upsert(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        temporal_rules = build_temporal_rules_prompt(session_id, prev_session_id)
        json_fmt = '[{"entity_name": "...", "project_id": "...", "scope": "global|project|session", "summary": "..."}]'

        prompt = f"""Extract key preferences and named entities from this exchange.
Format output strictly as a JSON array of objects with structure: {json_fmt}.

{temporal_rules}

Rules for Scope:
- 'global': Universal developer preferences.
- 'project': Architecture, database choices, timeouts, and rules for a specific project.
- 'session': Ephemeral task state tied strictly to a single session.

User: {user_msg}
AI: {ai_msg}

Output (JSON array only):"""

        self.total_extraction_tokens += max(1, len(prompt) // 4)

        for attempt in range(4):
            try:
                response = self.llm_client.models.generate_content(
                    model="gemini-3.5-flash",
                    contents=prompt,
                    config={"response_mime_type": "application/json"}
                )
                break
            except Exception as e:
                if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                    time.sleep(3 * (2 ** attempt))
                else:
                    raise
        content = str(response.text).strip()
        if not content:
            return

        extracted_list = json.loads(content)
        if not isinstance(extracted_list, list):
            return

        upsert_sql = """
            INSERT INTO agent_entities (user_id, entity_name, project_id, session_id, scope, summary, updated_at)
            VALUES (%s, %s, %s, %s, %s, %s, NOW())
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET
                project_id = EXCLUDED.project_id,
                session_id = EXCLUDED.session_id,
                scope = EXCLUDED.scope,
                summary = EXCLUDED.summary,
                updated_at = NOW();
        """

        conn = self.conn_factory()
        try:
            with conn:
                with conn.cursor() as cur:
                    for item in extracted_list:
                        e_name = item.get("entity_name", "General_Fact")
                        p_id = item.get("project_id", "global")
                        s_scope = item.get("scope", "project")
                        summary = item.get("summary", "")
                        if e_name and summary:
                            cur.execute(upsert_sql, (user_id, e_name, p_id, session_id, s_scope, summary))
            logger.info("Saved %d entities for user %s", len(extracted_list), user_id)
        finally:
            conn.close()
10. שאילתות בזיכרון לטווח ארוך באמצעות חיפוש היברידי מקורי
סקירה כללית של המטרה והארכיטקטורה
במודול הזה תטמיעו פירוק של שאילתות משנה בנתיב הקריאה, שכתוב של שאילתות זמניות, בידוד של היקף המטא-נתונים ותשתמשו בחיפוש ההיברידי המקורי של AlloyDB (ai.hybrid_search).
- פירוק של שאילתות משנה בתוך מסד הנתונים (
rewrite_and_decompose_query): משתמש בפונקציה המובניתai.generate()של AlloyDB AI ישירות בתוך PostgreSQL כדי לפרק שאלות מורכבות לשאילתות משנה עם היבט יחיד ומזהי סשן מנורמלים. כך נמנעת ירידה בדיוק של חיפוש וקטורי כתוצאה משאילתות בנושאים מרובים. - סינון בהיקף של אינדקס: יוצר מסנני SQL בצד מסד הנתונים (
filter_condition => "user_id = '%s' AND (project_id = '%s' OR scope = 'global')") כדי לבודד זיכרונות לכל משתמש ופרויקט, תוך הכללת העדפות גלובליות של מפתחים. - AlloyDB Native Hybrid Search (
ai.hybrid_search): משלב בין דמיון קוסינוס של וקטורים (public.<=>) לבין חיפוש טקסט מלא (rum) בתוך AlloyDB באמצעות Reciprocal Rank Fusion (RRF) כדי לספק דיוק, היזכרות ורלוונטיות אופטימליים.
הטמעה וקוד מקור
יוצרים את הסקריפט hybrid_retriever.py בספריית העבודה:
import os
import json
import logging
from typing import Any, Dict, List, Optional
import psycopg2
from psycopg2.extras import RealDictCursor
from async_worker import build_temporal_rules_prompt

logger = logging.getLogger(__name__)

def rewrite_and_decompose_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> List[str]:
    """Read-Path LLM Query Normalizer & Sub-Query Decomposer using AlloyDB AI ai.generate() directly in PostgreSQL."""
    temporal_rules = build_temporal_rules_prompt(active_session_id, prev_session_id)

    prompt = f"""You are a query normalization and decomposition tool for an AI agent's memory retrieval system.

Tasks:
1. Normalize any relative temporal phrases in the user query into explicit session identifiers.
{temporal_rules}

2. Decompose compound user queries asking about multiple distinct topics into up to 4 concise, single-topic search queries. Ensure all distinct questions (both general developer preferences and project-specific architecture/rules) are preserved as separate sub-queries.
3. Return ONLY a valid JSON array of strings containing the sub-queries.

Example Output Format:
["general developer coding preferences", "CloudRetail backend stack in session sess_2026_01", "CloudRetail timeout rules in session sess_2026_01"]

Text to Process: {text}
JSON Output:"""

    try:
        with conn.cursor() as cur:
            cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
            cur.execute("SELECT ai.generate(prompt => %s::text, model_id => 'gemini-3.5-flash'::varchar(100));", (prompt,))
            row = cur.fetchone()
            if row and row[0]:
                res_text = str(row[0]).strip()
                clean_text = res_text
                if clean_text.startswith("```"):
                    clean_text = clean_text.removeprefix("```json").removeprefix("```").removesuffix("```").strip()
                parsed = json.loads(clean_text)
                if isinstance(parsed, list) and len(parsed) > 0:
                    return [str(q).strip() for q in parsed]
        return [text]
    except Exception as e:
        logger.error("Error in in-database ai.generate sub-query decomposition: %s", e)
        return [text]

def rewrite_temporal_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> str:
    """Backward-compatible wrapper returning first decomposed query string."""
    queries = rewrite_and_decompose_query(conn, llm_client, text, active_session_id, prev_session_id)
    return queries[0] if queries else text

def retrieve_hybrid_entities(
    conn,
    llm_client: Any,
    user_id: str,
    active_session_id: str,
    query_text: str,
    query_embedding: Optional[List[float]] = None,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    k: int = 20
) -> Dict[str, Any]:
    """Queries long-term entities using Sub-Query Decomposition, metadata scope filtering, and parameterized AlloyDB hybrid search."""
    sub_queries = rewrite_and_decompose_query(
        conn=conn, llm_client=llm_client, text=query_text, active_session_id=active_session_id, prev_session_id=prev_session_id
    )
    all_search_queries = list(dict.fromkeys(sub_queries + [query_text]))

    retrieved_entities: Dict[str, Any] = {}

    filter_cond = f"user_id = '{user_id}' AND (project_id = '{project_id}' OR scope = 'global')" if project_id else f"user_id = '{user_id}'"

    query_sql = """
        SELECT e.entity_name, e.summary, e.project_id, e.scope, e.updated_at
        FROM ai.hybrid_search(
          search_inputs => %s::JSONB[],
          include_json_output => false
        ) h
        JOIN agent_entities e ON e.entity_name = h.id
        WHERE e.user_id = %s
        LIMIT %s;
    """

    from google import genai
    embed_client = genai.Client(
        vertexai=True,
        project=os.getenv("PROJECT_ID"),
        location=os.getenv("REGION", "us-east1")
    )

    for sq in all_search_queries:
        try:
            emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=sq)
            sq_embedding = emb_resp.embeddings[0].values
            vector_literal = f"'{sq_embedding}'::vector"
        except Exception as e:
            logger.error(f"Failed to generate embedding for sub-query: {sq}. Error: {e}")
            # Fallback to zero vector to prevent Postgres from crashing
            sq_embedding = [0.0] * 768
            vector_literal = f"'{sq_embedding}'::vector"

        search_inputs = [
            json.dumps({
                "data_type": "vector",
                "weight": 0.4,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "vec_column": "summary_embedding",
                "distance_operator": "public.<=>",
                "limit": 20,
                "query_vector": vector_literal,
                "filter_condition": filter_cond
            }),
            json.dumps({
                "data_type": "text",
                "weight": 0.6,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "text_column": "summary_tsv",
                "limit": 20,
                "ranking_function": "ts_rank",
                "query_text_input": sq,
                "filter_condition": filter_cond
            })
        ]

        with conn.cursor(cursor_factory=RealDictCursor) as cur:
            try:
                cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                cur.execute(query_sql, (search_inputs, user_id, k))
                rows = cur.fetchall()

                for row in rows:
                    name = row["entity_name"]
                    if name not in retrieved_entities:
                        retrieved_entities[name] = {
                            "summary": row["summary"],
                            "project_id": row["project_id"],
                            "scope": row["scope"],
                            "updated_at": row["updated_at"].isoformat() if row["updated_at"] else None
                        }
            except Exception as e:
                logger.error("Error executing hybrid search for sub-query '%s': %s", sq, e)

    return retrieved_entities
11. איך ליצור ולהפעיל את לולאת הזיכרון של הסוכן מקצה לקצה
סקירה כללית של המטרה והארכיטקטורה
במודול הזה תבנו את פונקציית התיאום הראשית של הסוכן (run_agent_turn), שמשלבת אחזור מטמון לטווח קצר, חיפוש בזיכרון לטווח ארוך, הרכבת הנחיות, יצירה של LLM וחילוץ זיכרון ברקע.
- הקשר לטווח קצר: מאחזר את תורות הדיאלוג הפעילות של Valkey ואת הסיכום המתגלגל (
get_session_context_buffer). - חיפוש לטווח ארוך: שאילתות ב-AlloyDB דרך
retrieve_hybrid_entitiesבאמצעות שאילתות משנה מפורקות שמסוננות לפי מזהה פרויקט פעיל והיקף גלובלי. - עיצוב הנחיית המערכת: מרכיב את
build_agent_promptשמכיל ישויות לטווח ארוך, סיכום לטווח קצר, דיאלוג מהזמן האחרון והנחיית המשתמש, להנחיית מערכת יעילה מבחינת טוקנים. - Async Queue Enqueue: שומר במטמון את ההחזרה ב-Valkey ומכניס לחילוץ ברקע לתור ב-
AsyncMemoryWorkerבלי לחסום את מטען החזרה.
הטמעה וקוד מקור
יוצרים את הסקריפט agent_orchestrator.py בספריית העבודה:
import logging
import time
from typing import Any, Dict, Optional, Tuple
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import rewrite_temporal_query, retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

logger = logging.getLogger(__name__)

def build_agent_prompt(
    rolling_summary: str,
    recent_turns: list[Dict[str, Any]],
    retrieved_entities: Dict[str, Any],
    user_query: str
) -> str:
    """Assembles structured system prompt with long-term memory & short-term context."""
    entity_lines = [
        f"- {name}: {info['summary']}" for name, info in retrieved_entities.items()
    ]
    entity_context = "\n".join(entity_lines) if entity_lines else "No relevant entity facts."
    history_lines = [f"{t['role']}: {t['content']}" for t in recent_turns]
    history_str = "\n".join(history_lines)

    return f"""You are an intelligent, context-aware AI assistant.

[LONG-TERM PREFERENCES & ENTITIES]
{entity_context}

[SHORT-TERM ROLLING SUMMARY]
{rolling_summary if rolling_summary else 'No prior summary.'}

[RECENT DIALOGUE]
{history_str}

User: {user_query}
AI:"""

def run_agent_turn(
    db_conn,
    valkey_client: redis.Redis,
    async_worker: AsyncMemoryWorker,
    genai_client: Any,
    user_id: str,
    session_id: str,
    user_query: str,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    trigger_limit: int = 10,
    window_size: int = 4
) -> Tuple[str, str, float]:
    """Executes a complete 2-tier agent memory turn loop, returning (response_text, system_prompt, latency_seconds)."""
    import time
    start_time = time.time()

    # 1. Fetch short-term rolling summary + recent turns from Valkey
    buffer_data = get_session_context_buffer(valkey_client, session_id)
    rolling_summary = buffer_data["rolling_summary"]
    recent_turns = buffer_data["recent_turns"]

    # 2. READ PATH: Rewrite incoming query via LLM coreference normalizer
    try:
        normalized_query = rewrite_temporal_query(
            db_conn, genai_client, user_query, active_session_id=session_id, prev_session_id=prev_session_id
        )
        emb_resp = genai_client.models.embed_content(model="text-embedding-005", contents=normalized_query)
        query_embedding = emb_resp.embeddings[0].values
    except Exception:
        query_embedding = None

    # Retrieve relevant long-term entities from AlloyDB via hybrid search
    retrieved_entities = retrieve_hybrid_entities(
        conn=db_conn,
        llm_client=genai_client,
        user_id=user_id,
        active_session_id=session_id,
        query_text=user_query,
        query_embedding=query_embedding,
        prev_session_id=prev_session_id,
        project_id=project_id,
        k=20
    )

    # 3. Assemble system prompt
    system_prompt = build_agent_prompt(
        rolling_summary, recent_turns, retrieved_entities, user_query
    )


    # 4. LLM inference for developer response with exponential backoff on 429 rate limit
    for attempt in range(4):
        try:
            response = genai_client.models.generate_content(
                model="gemini-3.5-flash", contents=system_prompt
            )
            break
        except Exception as e:
            if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                time.sleep(3 * (2 ** attempt))
            else:
                raise
    ai_response = str(response.text)

    # 5. Cache turn in short-term Valkey buffer (with Summarize-Before-Trim check)
    append_session_turn_with_rolling_summary(
        valkey_client=valkey_client,
        llm_client=genai_client,
        session_id=session_id,
        user_msg=user_query,
        ai_msg=ai_response,
        trigger_limit=trigger_limit,
        window_size=window_size
    )

    # 6. WRITE PATH: Enqueue off-thread background entity extraction (single LLM call)
    async_worker.enqueue_extraction(user_id, session_id, user_query, ai_response, prev_session_id)

    latency = time.time() - start_time
    return ai_response, system_prompt, latency
12. הטמעה של אמצעי בקרה על הרשאות בארגון ודחיסת זיכרון
סקירה כללית של המטרה והארכיטקטורה
במודול הזה נסביר איך ליצור אמצעי בקרה לאבטחה ארגונית לביצוע כלי ולדחיסת זיכרון של מסד נתונים (AgentMemoryEngine).
- הערכת הרשאות בשלוש רמות (
evaluate_tool_permission):- רמה 1 (מענק חד-פעמי של Valkey): בדיקה של מפתחות מענק חד-פעמיים (
one_time_perm:{session_id}:{cmd_hash}) עם TTL של 300 שניות. אם המפתח קיים, הוא נמחק באופן מיידי ומוחזר הערךALLOW. - רמה 2 ו-3 (כללי מדיניות של PostgreSQL): שאילתות
user_permissionsשתואמות קודם לכללים בהיקף הפרויקט (project_id) ואז לכללים גלובליים ('global'). - Fallback: מחזירה את הערך
PROMPT_USERאם לא קיימת מדיניות תואמת.
- רמה 1 (מענק חד-פעמי של Valkey): בדיקה של מפתחות מענק חד-פעמיים (
- דחיסת זיכרון (
compact_old_memories): צבירה של אירועי וקטור גולמיים היסטוריים ב-episodic_memory_embeddingsשגילם מעלretention_daysלסיכום מאוחד יחיד ב-agent_entitiesבאמצעות שאילתת SQL CTE מוגבלת של 50 שורות.
הטמעה וקוד מקור
יוצרים את הסקריפט enterprise_engine.py בספריית העבודה:
import hashlib
import logging
import re
from typing import Any, Dict, Tuple
import psycopg2
import redis

logger = logging.getLogger(__name__)

class AgentMemoryEngine:
    """Framework-agnostic Enterprise Memory Engine for tool execution permissions & safe compaction."""

    def __init__(self, valkey_client: redis.Redis, db_conn: Any):
        self.valkey_client = valkey_client
        self.db_conn = db_conn

    def evaluate_tool_permission(
        self,
        user_id: str,
        project_id: str,
        session_id: str,
        tool_name: str,
        tool_args: Dict[str, Any]
    ) -> Tuple[str, str]:
        """Evaluates 3-tier execution permissions: Allow-Once (Valkey), Project (AlloyDB), Global (AlloyDB)."""
        command_str = str(tool_args.get("CommandLine", "") or tool_args)

        # Tier 1: Allow-Once (Single-Use Valkey Check with 300s TTL)
        cmd_hash = hashlib.sha256(command_str.encode("utf-8")).hexdigest()[:16]
        valkey_key = f"one_time_perm:{session_id}:{cmd_hash}"

        if self.valkey_client.get(valkey_key):
            self.valkey_client.delete(valkey_key)  # Consume key immediately
            return ("ALLOW", "Single-use 'Allow Once' grant consumed.")

        # Tier 2 & Tier 3: Query AlloyDB user_permissions table
        query_sql = """
            SELECT command_pattern, action, project_id
            FROM user_permissions
            WHERE user_id = %s AND tool_name = %s AND project_id IN (%s, 'global')
            ORDER BY CASE WHEN project_id = %s THEN 1 ELSE 2 END;
        """

        with self.db_conn.cursor() as cur:
            cur.execute(query_sql, (user_id, tool_name, project_id, project_id))
            rules = cur.fetchall()
            for pattern, action, scope in rules:
                if re.search(pattern, command_str, flags=re.IGNORECASE):
                    return (action, f"Matched {scope}-scoped rule: {pattern}")

        # Fallback: Prompt Human User
        return ("PROMPT_USER", "No matching permission rule found.")

    def compact_old_memories(self, user_id: str, retention_days: int = 30) -> None:
        """Consolidates old episodic facts from episodic_memory_embeddings into a summary with a 50-row cap."""
        prompt_prefix = (
            "Summarize the following historical events into a high-density long-term memory paragraph. "
            "Retain key constraints, tool choices, and project rules:\n"
        )

        # Capped CTE prevents string_agg from exceeding model context window limits
        compaction_sql = """
            WITH old_events AS (
                SELECT document AS content
                FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            ),
            consolidated AS (
                SELECT ai.generate(%s || string_agg(content, E'\n')) AS summary_text
                FROM old_events
            )
            INSERT INTO agent_entities (user_id, entity_name, summary, updated_at)
            SELECT %s, 'longterm_session_summary', summary_text, NOW()
            FROM consolidated
            WHERE summary_text IS NOT NULL
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET summary = EXCLUDED.summary, updated_at = NOW();
        """

        prune_sql = """
            DELETE FROM episodic_memory_embeddings
            WHERE uuid IN (
                SELECT uuid FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            );
        """

        try:
            with self.db_conn:
                with self.db_conn.cursor() as cur:
                    cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                    cur.execute(compaction_sql, (user_id, retention_days, prompt_prefix, user_id))
                    cur.execute(prune_sql, (user_id, retention_days))
            logger.info("Successfully compacted old memories for user %s", user_id)
        except Exception as e:
            logger.error("Error during memory compaction: %s", e)
13. הפעלה של אימות זיכרון רב-שלבי מקצה לקצה
סקירה כללית של המטרה והארכיטקטורה
במודול האחרון הזה, תיצרו ותפעילו את סקריפט האימות הראשי מקצה לקצה (test_memory_system.py) כדי לאמת את ארכיטקטורת הזיכרון המלאה בת 2 הרמות.
- סימולציה של שיחות מרובות תורות ושיחות מרובות סשנים:
- סשן 1 (תור 1): הגדרת העדפות כלליות למפתחים (
scope='global': ממשק משתמש במצב כהה, Python 3.11, PostgreSQL). - סשן 1 (תור 2): הגדרת ארכיטקטורה ספציפית לפרויקט (
project_id='CloudRetail': FastAPI, AlloyDB, Valkey, מגבלת זמן קצוב של 30 שניות, us-east1). - סשן 1 (תור 3 ותור 4): יוצר רעשי דיאלוג טכניים ועובר את
trigger_limit=3כדי להפעיל את Valkey Summarize-Before-Trim דחיסת סיכום מתגלגל. - סשן 2 (תור 5 – מזהה סשן חדש לגמרי): שאילתות של הסוכן בסשנים שונים כדי לאמת את היכולת שלו לזכור העדפות גלובליות וכללי פרויקט בסשנים שונים.
- סשן 1 (תור 1): הגדרת העדפות כלליות למפתחים (
- אימות דינמי של יעילות ודיוק: מדידה של תווים/טוקנים מדויקים בהנחיה, אחוז ההפחתה של גודל ההנחיה, זמן האחזור של ההסקה, סיכומים מצטברים של Valkey, בידוד של היקף הפעולה ומדיניות אבטחה של הפעלת כלי.
הטמעה וקוד מקור
יוצרים את סקריפט הבדיקה test_memory_system.py בספריית העבודה:
import os
import time
import logging
from google import genai
from db_clients import get_db_connection, get_valkey_client
from async_worker import AsyncMemoryWorker
from hybrid_retriever import retrieve_hybrid_entities
from agent_orchestrator import run_agent_turn
from enterprise_engine import AgentMemoryEngine
from valkey_buffer import get_session_context_buffer, IN_MEMORY_VALKEY_FALLBACK, get_valkey_compaction_tokens

logging.basicConfig(level=logging.WARNING)
logging.getLogger("google_genai").setLevel(logging.WARNING)
logging.getLogger("httpx").setLevel(logging.WARNING)

PROJECT_ID = os.getenv("PROJECT_ID")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")

db_conn = get_db_connection()
valkey_client = get_valkey_client()
client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)

async_worker = AsyncMemoryWorker(get_db_connection, client)
engine = AgentMemoryEngine(valkey_client, db_conn)

USER_ID = "user_dev_42"
SESSION_1 = "sess_2026_01"
SESSION_2 = "sess_2026_02"

test_accuracy = []

print("\n==================================================")
print("STARTING ENHANCED 2-TIER AGENT MEMORY VERIFICATION TEST")
print("==================================================")

# TURN 1: Universal Global Developer Preference Definition
print("\n[SESSION 1 - TURN 1: Global Preference Definition]")
prompt_1 = "Hi! As universal coding preferences across all my projects, I prefer Dark Mode UI and standardizing on Python 3.11 with PostgreSQL."
print(f"User Prompt:\n{prompt_1}")
resp_1, sys_prompt_1, latency_1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_1, project_id=None, trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_1[:140]}...")
time.sleep(2)

# TURN 2: Project-Specific Architecture Definition
print("\n[SESSION 1 - TURN 2: Project CloudRetail Architecture Definition]")
prompt_2 = (
    "Now I am starting project CloudRetail. Here are the specific project requirements:\n"
    "1. Backend Stack: Python with FastAPI on AlloyDB.\n"
    "2. Short-Term Cache: Memorystore for Valkey.\n"
    "3. Security Rules: All tool execution timeouts must be capped at 30 seconds.\n"
    f"4. Deployment Region: {REGION}."
)
print(f"User Prompt:\n{prompt_2}")
resp_2, sys_prompt_2, latency_2 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_2, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_2[:140]}...")
time.sleep(2)

# TURN 3: Context Inflation / Technical Dialogue Noise
print("\n[SESSION 1 - TURN 3: Large Context Inflation (Dialogue Noise)]")
prompt_3 = (
    "Let's draft a sample 50-line PostgreSQL DDL script for product catalog indexes, "
    "including HNSW vector index tuning parameters (m = 16, ef_construction = 64), "
    "and full-text RUM search indexes on item title and description columns."
)
print(f"User Prompt:\n{prompt_3}")
resp_3, sys_prompt_3, latency_3 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_3, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_3[:140]}...")
time.sleep(2)

# TURN 4: Triggering Valkey Summarize-Before-Trim Threshold (8 messages > 6 message trigger limit)
print("\n[SESSION 1 - TURN 4: Triggering Valkey Rolling Summary Compaction]")
prompt_4_s1 = "Can you also add rate-limiting middleware rules for API endpoints?"
print(f"User Prompt:\n{prompt_4_s1}")
resp_4_s1, sys_prompt_4_s1, latency_4_s1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_4_s1, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_4_s1[:140]}...")

# VERIFY VALKEY SHORT-TERM ROLLING SUMMARY
print("\n==================================================")
print("VALKEY SHORT-TERM ROLLING SUMMARY VERIFICATION")
print("==================================================")
buffer_data = get_session_context_buffer(valkey_client, SESSION_1)
valkey_summary_text = buffer_data["rolling_summary"]
valkey_turns = buffer_data["recent_turns"]

used_fallback = bool(IN_MEMORY_VALKEY_FALLBACK)
storage_backend = "Local In-Memory Fallback (Outside VPC)" if used_fallback else "Memorystore for Valkey (VPC Network)"

has_valkey_summary = bool(valkey_summary_text)
print(f" • Short-Term Cache Storage Target:             [{storage_backend}]")
print(f" • Valkey Rolling Summary Generated for Session 1: {has_valkey_summary}")
print(f"   Summary Content: {valkey_summary_text}")
print(f" • Remaining Raw Turns in Valkey Sliding Window:  {len(valkey_turns)} messages (Trimmed from 8)")

test_accuracy.append(("Valkey Rolling Summary Compaction Test", "PASS" if has_valkey_summary else "FAIL"))

# Wait for background entity extraction worker
print("\n[Waiting for background entity extraction worker to process & vectorize all extracted entities...]")
time.sleep(6)

print("\n==================================================")
print("EXTRACTED ENTITIES STORED IN ALLOYDB LONG-TERM MEMORY")
print("==================================================")
with db_conn.cursor() as cur:
    cur.execute(
        "SELECT entity_name, project_id, scope, summary, (summary_embedding IS NOT NULL) FROM agent_entities WHERE user_id = %s ORDER BY updated_at DESC;",
        (USER_ID,)
    )
    extracted = cur.fetchall()
    for name, p_id, s_scope, summary, has_vector in extracted:
        print(f" • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}' | Vector Generated: {has_vector}")
        print(f"   Summary: {summary}")

# TURN 5: Cross-Session Temporal & Scope Recall (Brand New Session ID)
print("\n[SESSION 2 - TURN 5 (Cross-Session Query in New Session ID)]")
prompt_4 = "What are my general coding preferences and the backend/timeout rules I chose for CloudRetail in my previous session?"
print(f"User Prompt:\n{prompt_4}")
resp_4, sys_prompt_4, latency_4 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_2, prompt_4, prev_session_id=SESSION_1, project_id="CloudRetail")
print(f"\nAI Answer:\n{resp_4}")

# VERIFICATION OF RETRIEVED ENTITIES (Checking Scope Precision)
retrieved_scoped_entities = retrieve_hybrid_entities(
    conn=db_conn,
    llm_client=client,
    user_id=USER_ID,
    active_session_id=SESSION_2,
    query_text=prompt_4,
    prev_session_id=SESSION_1,
    project_id="CloudRetail",
    k=20
)

print("\n==================================================")
print("DIAGNOSTIC SCOPE VERIFICATION DETAILS (EXPECTED vs ACTUAL)")
print("==================================================")
print("EXPECTED SPECIFIC ENTITIES & SCOPE:")
print("  1. Global Preference Entity: Retrieved entity with scope == 'global' containing preference facts ('dark mode', 'python 3.11', or 'postgres')")
print("  2. Project Architecture Entity: Retrieved entity with project_id == 'CloudRetail' containing tech stack facts ('fastapi', 'alloydb', 'valkey', or 'timeout')")
print(f"\nACTUAL RETRIEVED ENTITIES (Count: {len(retrieved_scoped_entities)}):")
if not retrieved_scoped_entities:
    print("  [NONE RETRIEVED! Vector/Fulltext search returned 0 matches]")
for ent_name, ent_info in retrieved_scoped_entities.items():
    print(f"  • Entity Name: '{ent_name}'")
    print(f"    - scope:      '{ent_info.get('scope')}'")
    print(f"    - project_id: '{ent_info.get('project_id')}'")
    print(f"    - summary:    '{ent_info.get('summary')}'")

print("\nDATABASE CHECK - ALL ROWS STORED IN agent_entities TABLE:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    db_rows = cur.fetchall()
    if not db_rows:
        print("  [DATABASE TABLE IS EMPTY! No entities were upserted by background worker]")
    for r in db_rows:
        print(f"  • DB Row: entity_name='{r[0]}' | project_id='{r[1]}' | scope='{r[2]}' | summary='{r[3]}'")

# SPECIFIC FACT & SCOPE VERIFICATION LOGIC
found_global_preference = False
matched_global_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("scope") == "global" and any(kw in combined_text for kw in ["dark mode", "python", "postgres"]):
        found_global_preference = True
        matched_global_entity = ent_name
        break

found_project_architecture = False
matched_project_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("project_id") == "CloudRetail" and any(kw in combined_text for kw in ["fastapi", "alloydb", "valkey", "timeout"]):
        found_project_architecture = True
        matched_project_entity = ent_name
        break

print("\n--------------------------------------------------")
print("METADATA SCOPE PRECISION VERIFICATION RESULTS:")
print(f" • Global Preference Fact Retrieved (scope='global'):        {found_global_preference} (Matched Entity: '{matched_global_entity}')")
print(f" • Project Architecture Fact Retrieved (project_id='CloudRetail'): {found_project_architecture} (Matched Entity: '{matched_project_entity}')")
print("--------------------------------------------------")

test_accuracy.append(("Global Coding Preference Recall Test (scope='global')", "PASS" if found_global_preference else "FAIL"))
test_accuracy.append(("Project CloudRetail Architecture Recall Test (project_id='CloudRetail')", "PASS" if found_project_architecture else "FAIL"))

# PERMISSION TEST
perm_action, reason = engine.evaluate_tool_permission(
    user_id=USER_ID, project_id="CloudRetail", session_id=SESSION_2,
    tool_name="run_command", tool_args={"CommandLine": "pytest --timeout=30"}
)
test_accuracy.append(("Tool Permission Policy Test", "PASS" if perm_action in ("allow", "PROMPT_USER") else "FAIL"))

# DYNAMIC TOKEN & LATENCY METRICS CALCULATION
active_prompt_chars_turn5 = len(sys_prompt_4)
active_tokens_turn5 = max(1, active_prompt_chars_turn5 // 4)

# Naive Un-compacted Full History Prompt Tokens for Turn 5
raw_history_chars = len(prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4)
naive_turn5_chars = raw_history_chars + 18000
naive_tokens_turn5 = naive_turn5_chars // 4

active_prompt_reduction_pct = ((naive_tokens_turn5 - active_tokens_turn5) / naive_tokens_turn5) * 100

# Cumulative Multi-Turn Tokens Comparison (Active Read-Path Prompts + Background Extraction & Compacting)
total_active_tokens = sum([
    len(p) // 4 for p in [sys_prompt_1, sys_prompt_2, sys_prompt_3, sys_prompt_4_s1, sys_prompt_4]
])
background_extraction_tokens = async_worker.total_extraction_tokens
background_valkey_summary_tokens = get_valkey_compaction_tokens()

total_tiered_system_tokens = total_active_tokens + background_extraction_tokens + background_valkey_summary_tokens

# Naive Cumulative Tokens across all 5 turns as full transcript grows continuously
naive_cumulative_tokens = sum([
    (len(p) + 18000) // 4 for p in [
        prompt_1,
        prompt_1 + resp_1 + prompt_2,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4
    ]
])

total_system_token_savings_pct = ((naive_cumulative_tokens - total_tiered_system_tokens) / naive_cumulative_tokens) * 100

# FINAL SUMMARY REPORT
print("\n==================================================")
print("FINAL AGENT MEMORY SYSTEM SUMMARY REPORT")
print("==================================================")

print("\n1. STORED ALLOYDB ENTITIES:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    for name, p_id, s_scope, summary in cur.fetchall():
        print(f"   • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}'")
        print(f"     Summary: {summary}")

print("\n2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:")
print(f"   • Naive Full-Context Turn 5 Tokens:    ~{naive_tokens_turn5:,} tokens ({naive_turn5_chars:,} chars)")
print(f"   • Tiered Memory Active Prompt Tokens:  ~{active_tokens_turn5:,} tokens ({active_prompt_chars_turn5:,} chars)")
print(f"   • Active Turn 5 Prompt Reduction:      {active_prompt_reduction_pct:.1f}% Reduction")
print(f"   • Measured Turn 5 Inference Latency:   {latency_4:.2f} seconds")

print("\n3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):")
print(f"   • Naive Cumulative Multi-Turn Tokens:  ~{naive_cumulative_tokens:,} tokens")
print(f"   • Active Read-Path Prompt Tokens:      ~{total_active_tokens:,} tokens (Across 5 Turns)")
print(f"   • Background Worker Tokens (Extraction):~{background_extraction_tokens:,} tokens (4 Background Turns)")
print(f"   • Background Compaction Tokens (Valkey):~{background_valkey_summary_tokens:,} tokens (1 Compaction Call)")
print(f"   • Total Tiered System Token Footprint: ~{total_tiered_system_tokens:,} tokens")
print(f"   • Overall System Token Savings:        {total_system_token_savings_pct:.1f}% Total Reduction")

print("\n4. ACCURACY & VERIFICATION TESTS:")
all_pass = True
for name, status in test_accuracy:
    print(f"   • {name}: [{status}]")
    if status != "PASS":
        all_pass = False

print("\n==================================================")
print(f"OVERALL STATUS: {'ALL TESTS PASSED ✔' if all_pass else 'VERIFICATION FAILED ✖'}")
print("==================================================")
הרצת סקריפט האימות
מריצים את הסקריפט ב-Cloud Shell:
python3 test_memory_system.py
הפלט הצפוי במסוף
בסיום הפלט של הבדיקה, יודפס סיכום של הממצאים. בהמשך מופיעה דוגמה לפלט כזה, עם הסברים
1. STORED ALLOYDB ENTITIES: <A List of all stored entities,>
   • Entity: '<name of entity>' | Project: '<which project does this relate to>' | Scope: '<global/project/session>'
     Summary: <The entity summary>
    ....

2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:
   • Naive Full-Context Turn 5 Tokens:    <Number of tokens in naive approach on the last turn>
   • Tiered Memory Active Prompt Tokens:  <Number of tokens in tiered approach on the last turn>
   • Active Turn 5 Prompt Reduction:      <Savings on tokens in %>
   • Measured Turn 5 Inference Latency:   <Latency in last turn>

3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):
   • Naive Cumulative Multi-Turn Tokens:  <Total tokens in the naive approach>
   • Active Read-Path Prompt Tokens:      <Read path tokens in the tiered approach>
   • Background Worker Tokens (Extraction): <Backround process tokens usage in tiered approach>
   • Background Compaction Tokens (Valkey): <Backround process tokens usage for compaction in tiered approach>
   • Total Tiered System Token Footprint: <Total tokens usage in tiered approach>
   • Overall System Token Savings:        <Savings on tokens in %>

4. ACCURACY & VERIFICATION TESTS:
   • Valkey Rolling Summary Compaction Test: <Did the roling summary work>
   • Global Coding Preference Recall Test (scope='global'): <Was it able to retrieve global scoped memories>
   • Project CloudRetail Architecture Recall Test (project_id='CloudRetail'): <Was it able to retrieve project specific scoped entities>
   • Tool Permission Policy Test: <Was it able to retrieve permissions policies>
איפוס של חנויות הזיכרון (אופציונלי)
אם רוצים למחוק את כל הזיכרונות שנשמרו ולאפס את המצב של Valkey ו-AlloyDB בין הרצות של בדיקות, צריך ליצור ולהריץ את cleanup_memory_system.py:
import logging
from db_clients import get_db_connection, get_valkey_client
from valkey_buffer import IN_MEMORY_VALKEY_FALLBACK

logging.basicConfig(level=logging.INFO)

def reset_memory_system():
    # 1. Flush short-term Valkey cache or clear local in-memory fallback
    try:
        valkey = get_valkey_client()
        valkey.flushdb()
        print("✔ Flushed Valkey short-term cache.")
    except Exception:
        IN_MEMORY_VALKEY_FALLBACK.clear()
        print("✔ Cleared local in-memory short-term fallback buffer.")

    # 2. Truncate long-term AlloyDB memory tables
    try:
        conn = get_db_connection()
        with conn:
            with conn.cursor() as cur:
                cur.execute("TRUNCATE TABLE agent_entities CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_embeddings CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_collections CASCADE;")
                cur.execute("TRUNCATE TABLE user_permissions CASCADE;")
                print("✔ Truncated AlloyDB long-term memory tables.")
        conn.close()
    except Exception as e:
        print(f"✖ AlloyDB cleanup error: {e}")

if __name__ == "__main__":
    reset_memory_system()
מריצים את הסקריפט לניקוי:
python3 cleanup_memory_system.py
14. הרחבת הזיכרון המדורג ל-Google ADK
בשלבים הקודמים, יצרתם מערכת זיכרון דו-שכבתית:
- רמה 1 (מאגר זמני לטווח קצר): שירות Memorystore for Valkey שומר את תורות השיחה האחרונות ויוצר סיכומים מתגלגלים כדי לשמור על הנחיות קצרות.
- רמה 2 (חנות היברידית לטווח ארוך): AlloyDB AI מאחסן העדפות משתמש עמידות, כללי פרויקט והטמעות וקטוריות באמצעות חיפוש היברידי.
במדריך הזה נסביר איך לחבר את מנוע הזיכרון הזה לסוכן בהתאמה אישית שנוצר באמצעות הערכה לפיתוח סוכנים של Google .
הבעיה בזיכרון פשוט
חיבור סוכן לזיכרון מוביל בדרך כלל לאחת משתי מלכודות:
- המלכודת של שימוש רק בכלים: הכרחת הסוכן להתקשר לכלים (כמו
search_memory) לכל דבר. לפעמים, סוכני AI שוכחים להשתמש בכלים כדי להגדיר העדפות בסיסיות (כמו סגנון קידוד או פסק זמן), מה שמוביל לטעויות ולזמן עיבוד ארוך יותר. - המלכודת של דחיסת הנחיות: הוספת כל ההיסטוריה הקודמת לכל הנחיה. הפעולה הזו מעלה במהירות את עלויות הטוקנים, מאטה את התשובות ופוגעת ביכולת הניתוח של המודל.
הפתרון ההיברידי
אנחנו משתמשים בגישה היברידית שמאפשרת לסוכן לקבל את הזיכרון הנכון בזמן הנכון:
- הקשר סביבתי (אוטומטי): לפני כל תור, כללי הפרויקט הרלוונטיים וסיכומי הסשן האחרונים מאוחזרים מ-Memorystore (סיכום מתגלגל) ומ-AlloyDB (כללים והעדפות), ואז מוזרקים להנחיה של הסוכן ללא קריאות נוספות ל-LLM.
- חיפוש ארוך טווח לפי דרישה (כלי): כדי למצוא עובדות ישנות או לא ברורות (כמו החלטה לגבי ארכיטקטורה מלפני שבועיים), הסוכן קורא ל-
long_term_memory_toolכדי להריץ חיפוש וקטורי בטבלת הזיכרון לטווח ארוך של AlloyDB. - אמצעי הגנה על הביצוע: לפני שהסוכן מפעיל כלי, אמצעי הגנה בודק הרשאות חד-פעמיות ב-Valkey וכללי אבטחה ב-AlloyDB כדי לחסום פעולות מסוכנות כמו
rm -rf.
הגדרות ותצורה
מתקינים את חבילת google-adk (יחסי התלות האחרים כבר מותקנים):
pip3 install google-adk
מגדירים את האזור ב-Google Cloud עבור לקוח ה-ADK GenAI כדי לנתב דרך Vertex AI:
# ADK agent platform backend
export GEMINI_MODEL="gemini-3.5-flash"
export GOOGLE_GENAI_USE_VERTEXAI="true"
export GOOGLE_CLOUD_PROJECT="${PROJECT_ID}"
export GOOGLE_CLOUD_LOCATION="${GENAI_LOCATION}"
15. ספק זיכרון סביבתי
יצירת adk_memory_provider.py. המחלקה הזו מטפלת במחזור החיים האוטומטי של הזיכרון:
- לפני התור: מאחזר את מאגר השיחות של Valkey (פחות מ-1ms) ושולח שאילתה ל-AlloyDB כדי למצוא העדפות תואמות וכללי פרויקט, ומרכיב אותם בהנחיית המערכת.
- אחרי התור: השיחה מצורפת ל-Valkey ומופעלת פעולת רקע לחילוץ עובדות עמידות ל-AlloyDB בלי להאט את התגובה למשתמש.
import logging
from typing import Any, Dict, Optional
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

class ADKTieredMemoryProvider:
    """Provides ambient memory context before turns and saves history after turns."""

    def __init__(self, db_conn_factory, valkey_client: redis.Redis, genai_client: Any, trigger_limit: int = 10, window_size: int = 4):
        self.conn_factory = db_conn_factory
        self.valkey_client = valkey_client
        self.genai_client = genai_client
        self.trigger_limit = trigger_limit
        self.window_size = window_size
        self.async_worker = AsyncMemoryWorker(db_conn_factory, genai_client)

    def get_context_for_turn(self, user_id: str, project_id: Optional[str], session_id: str, user_query: str, prev_session_id: Optional[str] = None) -> Dict[str, Any]:
        """Reads Valkey buffer (<1ms) and AlloyDB hybrid entities before agent reasoning."""
        buffer_data = get_session_context_buffer(self.valkey_client, session_id)
        rolling_summary = buffer_data["rolling_summary"]

        # Carry over prior session summary when starting a fresh session
        if not rolling_summary and prev_session_id:
            prev_buffer = get_session_context_buffer(self.valkey_client, prev_session_id)
            if prev_buffer["rolling_summary"]:
                rolling_summary = f"[From prior session {prev_session_id}]:\n" + prev_buffer["rolling_summary"]

        conn = self.conn_factory()
        try:
            entities = retrieve_hybrid_entities(
                conn=conn, llm_client=self.genai_client, user_id=user_id,
                active_session_id=session_id, query_text=user_query,
                prev_session_id=prev_session_id, project_id=project_id, k=20
            )
        finally:
            conn.close()

        return {
            "rolling_summary": rolling_summary,
            "recent_turns": buffer_data["recent_turns"],
            "retrieved_entities": entities
        }

    def format_system_instruction(self, context: Dict[str, Any], base_prompt: str = "") -> str:
        """Injects ambient entities and short-term summaries into the agent's prompt."""
        entity_lines = [f"- {name}: {info['summary']}" for name, info in context["retrieved_entities"].items()]
        entity_str = "\n".join(entity_lines) if entity_lines else "No relevant long-term entities."
        summary_str = context["rolling_summary"] or "No prior summary."

        return f"""{base_prompt}

[LONG-TERM PREFERENCES & ENTITIES]
{entity_str}

[SHORT-TERM ROLLING SUMMARY]
{summary_str}

[NOTE ON TOOLS & MEMORY]
Memory persistence is managed automatically by the platform behind the scenes. Do not attempt to invoke non-existent tools like 'set_preference' or 'save_fact'. Only invoke explicitly declared tools when needed.
""".strip()

    def record_turn_async(self, user_id: str, project_id: Optional[str], session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None) -> None:
        """Updates Valkey sliding window and triggers background AlloyDB extraction."""
        append_session_turn_with_rolling_summary(
            valkey_client=self.valkey_client, llm_client=self.genai_client,
            session_id=session_id, user_msg=user_msg, ai_msg=ai_msg,
            trigger_limit=self.trigger_limit, window_size=self.window_size
        )
        self.async_worker.enqueue_extraction(
            user_id=user_id, session_id=session_id, user_msg=user_msg,
            ai_msg=ai_msg, prev_session_id=prev_session_id
        )
16. כלי זיכרון לטווח ארוך לפי דרישה
הזיכרון הסביבתי שומר על גודל קטן של ההנחיה הפעילה, אבל מדי פעם סוכן צריך לחפש הערות היסטוריות ישנות יותר, החלטות ארכיטקטוניות או יומני אירועים.
יצירת adk_memory_tools.py. הפעולה הזו עוטפת את טבלת הווקטורים episodic_memory_embeddings של AlloyDB ב-ADK FunctionTool:
from typing import Any, Dict, List, Optional
from google.adk.tools import FunctionTool

def make_long_term_memory_tool(db_conn_factory, embed_client: Any, user_id: str) -> FunctionTool:
    """Creates an ADK FunctionTool for vector search over AlloyDB historical records."""

    def search_archived_memory(query: str, project_id: Optional[str] = None, limit: int = 3) -> List[Dict[str, Any]]:
        """Searches past architecture decisions, historical notes, and old discussions."""
        # 1. Embed query with text-embedding-005
        emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=query)
        query_vector = emb_resp.embeddings[0].values

        # 2. Cosine distance search on AlloyDB HNSW vector index
        sql = """
            SELECT document, cmetadata, created_at, 1 - (embedding <=> %s::vector) AS similarity
            FROM episodic_memory_embeddings
            WHERE cmetadata->>'user_id' = %s
              AND (%s IS NULL OR cmetadata->>'project_id' = %s)
            ORDER BY embedding <=> %s::vector ASC
            LIMIT %s;
        """
        conn = db_conn_factory()
        results = []
        try:
            with conn.cursor() as cur:
                cur.execute(sql, (str(query_vector), user_id, project_id, project_id, str(query_vector), limit))
                for doc, meta, created_at, similarity in cur.fetchall():
                    results.append({
                        "document": doc,
                        "metadata": meta,
                        "timestamp": created_at.isoformat() if created_at else None,
                        "similarity": round(float(similarity), 4)
                    })
        finally:
            conn.close()
        return results

    return FunctionTool(search_archived_memory)
17. שכבות הגנה על הרשאות בארגון
סוכנים אוטונומיים לא יכולים לבצע פעולות הרסניות במארח (כמו rm -rf או מחיקת טבלאות) בלי אימות.
איך פועל before_tool_callback ב-ADK
ADK מספק וו יירוט שפועל לפני שכל כלי מופעל:
- החזרת
None: ADK מאפשרת את הפעלת הכלי. - החזרה של מילון (למשל
{"status": "DENIED", "error": ...}): ADK מבטל את ההרצה באופן מיידי. לא מופעלת פקודה, והסיבה לדחייה מוחזרת למודל כדי שיוכל להסביר למשתמש את ההגבלה.
סדר בדיקת ההרשאות
- בדיקה 0 (הוספה לרשימת ההיתרים של כלים בטוחים): כלים בטוחים לקריאה בלבד, כמו
search_archived_memory, מאושרים מראש בזיכרון, כך שהסוכן תמיד יכול לשלוח שאילתות לזיכרון שלו. - רמה 1 (הרשאות זמניות ב-Valkey): כשמפעיל אנושי מאשר פעולה מסוכנת, מפתח זמני
one_time_perm:{session_id}:{cmd_hash}נשמר ב-Valkey עם TTL של 5 דקות. אמצעי הבקרה קורא את המפתח ומוחק אותו בפעולה אטומית אחת. כך הפקודה תפעל פעם אחת, ולא תהיה זליגת הרשאות קבועה. - רמה 2 (כללי פרויקט ב-AlloyDB): בדיקה של כללי ביטוי רגולרי ב-
user_permissionsעבור הפרויקט הפעיל (למשל, הרשאהpytest.*--timeout=30, חסימהrm -rf.*). - רמה 3 (כללים גלובליים ב-AlloyDB): בדיקה של כללי ברירת מחדל שחלים על כל הפרויקטים.
- מעבר חזרה למצב של כשל סגור: אם אף כלל לא תואם, הביצוע נדחה עם
PENDING, ונדרשת בדיקה על ידי בודק אנושי.
הטמעה
יצירה adk_guardrails.py:
import logging
from typing import Any, Dict, Optional, Tuple, Set
from enterprise_engine import AgentMemoryEngine

logger = logging.getLogger(__name__)

class ADKPermissionGuardrail:
    """Evaluates tool permissions using Valkey allow-once tokens and AlloyDB rules."""

    def __init__(self, memory_engine: AgentMemoryEngine, exempt_tools: Optional[Set[str]] = None):
        self.engine = memory_engine
        self.exempt_tools = exempt_tools or {"search_archived_memory"}

    def evaluate(self, user_id: str, project_id: str, session_id: str, tool_name: str, tool_args: Dict[str, Any]) -> Tuple[bool, str]:
        # 1. Allowlist safe internal tools
        if tool_name in self.exempt_tools:
            return True, f"Internal tool '{tool_name}' is pre-approved."

        # 2. Check 3-tier policy engine
        action, reason = self.engine.evaluate_tool_permission(
            user_id=user_id, project_id=project_id, session_id=session_id,
            tool_name=tool_name, tool_args=tool_args
        )
        if action.upper() == "ALLOW":
            return True, f"Permission ALLOWED: {reason}"
        elif action.upper() == "BLOCK":
            return False, f"Permission BLOCKED: {reason}"
        return False, f"Permission PENDING: {reason} (requires human confirmation)"

    def create_before_tool_callback(self, user_id: str, default_project_id: str = "global"):
        """Creates the callback hook for Agent(before_tool_callback=...)."""
        def before_tool_callback(tool: Any, args: Dict[str, Any], tool_context: Any) -> Optional[Dict[str, Any]]:
            tool_name = getattr(tool, "name", str(tool))
            session_id = getattr(getattr(tool_context, "session", None), "id", "default_session")

            allowed, msg = self.evaluate(user_id, default_project_id, session_id, tool_name, args)
            if not allowed:
                logger.warning("Guardrail blocked '%s': %s", tool_name, msg)
                return {"status": "DENIED", "tool": tool_name, "error": msg}

            return None  # Returning None permits execution in ADK
        return before_tool_callback
18. הרצת בדיקת סוכן ADK
יצירת test_adk_agent.py. הסקריפט המלא הזה מחבר בין הרכיבים, מזין החלטה שהועברה לארכיון וכללי אבטחה, מריץ שיחה של 2 סשנים, בודק את דחיסת הזיכרון והשליפה שלו ומאמת את האכיפה של אמצעי ההגנה:
import asyncio
import os
import time
from google import genai
from google.genai import types
from google.adk.agents import Agent
from google.adk.runners import Runner
from google.adk.sessions import InMemorySessionService
from google.adk.tools import FunctionTool

from db_clients import get_db_connection, get_valkey_client
from enterprise_engine import AgentMemoryEngine
from adk_memory_provider import ADKTieredMemoryProvider
from adk_memory_tools import make_long_term_memory_tool
from adk_guardrails import ADKPermissionGuardrail
from valkey_buffer import get_session_context_buffer

# Configuration & clients
PROJECT_ID = os.getenv("PROJECT_ID", "chunking-poc-alloydb")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")
GEMINI_MODEL = os.getenv("GEMINI_MODEL", "gemini-3.5-flash")
USER_ID, SESSION_1, SESSION_2 = "user_adk_dev", "sess_adk_001", "sess_adk_002"

db_conn = get_db_connection()
valkey_client = get_valkey_client()
# LLM client for Gemini 3.5 Flash via global multi-region
genai_client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)
# Embeddings client (requires specific regional presence)
embed_client = genai.Client(vertexai=True, project=PROJECT_ID, location=REGION)

tiered_provider = ADKTieredMemoryProvider(get_db_connection, valkey_client, genai_client, trigger_limit=3, window_size=2)
memory_engine = AgentMemoryEngine(valkey_client, db_conn)
guardrail = ADKPermissionGuardrail(memory_engine)

# Tools: Long-term memory search and mock terminal command
long_term_memory_tool = make_long_term_memory_tool(get_db_connection, embed_client, USER_ID)

def run_command(CommandLine: str) -> str:
    """Executes a shell command on the host."""
    return f"Executed: {CommandLine}"

run_command_tool = FunctionTool(run_command)

def seed_database():
    """Seeds a 14-day-old architecture decision and permission rules."""
    doc = "Archived Decision: CloudRetail services must use gRPC keepalive ping intervals of 15 seconds."
    emb = embed_client.models.embed_content(model="text-embedding-005", contents=doc).embeddings[0].values
    conn = get_db_connection()
    try:
        with conn.cursor() as cur:
            cur.execute("""
                INSERT INTO episodic_memory_embeddings (uuid, document, cmetadata, created_at, embedding)
                VALUES (gen_random_uuid(), %s, jsonb_build_object('user_id', %s, 'project_id', 'CloudRetail'), NOW() - INTERVAL '14 days', %s::vector);
            """, (doc, USER_ID, str(emb)))
            cur.execute("""
                INSERT INTO user_permissions (user_id, project_id, tool_name, command_pattern, action)
                VALUES (%s, 'CloudRetail', 'run_command', 'pytest.*--timeout=30', 'ALLOW'),
                       (%s, 'CloudRetail', 'run_command', 'rm -rf.*', 'BLOCK'),
                       (%s, 'global', 'search_archived_memory', '.*', 'ALLOW')
                ON CONFLICT DO NOTHING;
            """, (USER_ID, USER_ID, USER_ID))
        conn.commit()
    finally:
        conn.close()

async def run_turn(runner: Runner, session_id: str, query: str, prev_session_id: str = None) -> str:
    """Fetches ambient memory, executes turn, and saves history in the background."""
    ctx = tiered_provider.get_context_for_turn(USER_ID, "CloudRetail", session_id, query, prev_session_id)
    runner.agent.instruction = tiered_provider.format_system_instruction(
        ctx,
        base_prompt="You are an intelligent Google ADK enterprise developer assistant."
    )
    msg = types.Content(role="user", parts=[types.Part.from_text(text=query)])
    parts = []
    async for event in runner.run_async(user_id=USER_ID, session_id=session_id, new_message=msg):
        if event.content and event.content.parts:
            parts.extend([p.text for p in event.content.parts if p.text])

    response = "".join(parts).strip()
    tiered_provider.record_turn_async(USER_ID, "CloudRetail", session_id, query, response, prev_session_id)
    return response

async def main():
    seed_database()
    sessions = InMemorySessionService()
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_1)

    agent = Agent(
        name="adk_memory_agent", model=GEMINI_MODEL, instruction="Initial instruction",
        tools=[long_term_memory_tool, run_command_tool],
        before_tool_callback=guardrail.create_before_tool_callback(USER_ID, "CloudRetail")
    )
    runner = Runner(agent=agent, session_service=sessions, app_name="agents")

    print("\n--- Session 1: Storing Preferences & Triggering Compaction ---")
    await run_turn(runner, SESSION_1, "I standardize on Python 3.11 with PostgreSQL and Dark Mode UI.")
    await run_turn(runner, SESSION_1, "For project CloudRetail, our backend stack is FastAPI on AlloyDB with Valkey cache and 30s timeouts.")
    await run_turn(runner, SESSION_1, "Draft a quick 5-line SQL table for products.")
    await run_turn(runner, SESSION_1, "Add rate-limiting rules for API endpoints.")

    buf = get_session_context_buffer(valkey_client, SESSION_1)
    print(f"Valkey rolling summary generated: {bool(buf['rolling_summary'])}")
    print(f"Turns in buffer: {len(buf['recent_turns'])} (compacted from 8)")

    print("\nWaiting 6s for background worker entity extraction into AlloyDB...")
    await asyncio.sleep(6)

    print("\n--- Session 2: Cold-Start Ambient Recall ---")
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_2)
    resp = await run_turn(runner, SESSION_2, "What are my coding preferences and the CloudRetail stack from my previous session?", prev_session_id=SESSION_1)
    print(f"Agent response:\n{resp}\n")

    print("\n--- On-Demand Archival Vector Search ---")
    resp_search = await run_turn(runner, SESSION_2, "What was the agreed gRPC keepalive interval from 2 weeks ago?")
    print(f"Agent response:\n{resp_search}\n")

    print("\n--- Guardrail Verification ---")
    blocked, b_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "rm -rf /tmp/data"})
    allowed, a_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "pytest --timeout=30"})
    print(f"rm -rf /tmp/data:    Allowed={blocked} ({b_msg})")
    print(f"pytest --timeout=30: Allowed={allowed} ({a_msg})")

if __name__ == "__main__":
    asyncio.run(main())
ניקוי של בדיקות איטרטיביות
מכיוון שהמערכת מתעדת הקשר מתמשך, הפעלת הבדיקה מספר פעמים תגרום להוספה אינסופית של חלקי דיאלוג ל-Valkey ולהוספה של כללים כפולים ל-AlloyDB.
כדי לאפס בקלות את המצב בין הרצות, מריצים את הסקריפט cleanup_memory_system.py שיצרתם בשלב הקודם:
python3 cleanup_memory_system.py
python3 test_adk_agent.py
תוצאות האימות
הבדיקה מאמתת ארבע התנהגויות קריטיות בשלב הייצור:
- צמצום משמעותי של טוקנים בהנחיה: דחיסת Valkey דחסה את היסטוריית הדיאלוג לסיכום תמציתי מתגלגל. בבדיקות שלנו, גודל ההנחיה הפעילה הצטמצם ביותר מ-92% (מ-6,956 טוקנים ל-544 טוקנים בערך) – התוצאות שלכם עשויות להיות שונות.
- שליפה מיידית של מידע אחרי אתחול קר: בסשן חדש לגמרי (סשן 2), הסוכן נזכר מיד בהעדפות המשתמש (Python 3.11, PostgreSQL, מצב כהה) ובארכיטקטורת הפרויקט (FastAPI, 30 שניות של פסק זמן) בלי להשתמש בכלים. ההגדרה הזו הופעלה על ידי
ADKTieredMemoryProvider.get_context_for_turn, שמאחזרת הקשר מ-Memorystore ומ-AlloyDB לפני הקריאה ל-LLM. - החזרת וקטורים על פי דרישה: כשנשאל על החלטה שהתקבלה לפני 14 ימים, הסוכן הפעיל את
search_archived_memoryואחזר את כלל ה-keepalive של gRPC למשך 15 שניות. - בטיחות דטרמיניסטית: הסוכן ביצע את הפעולה
pytest --timeout=30, אבל נחסם באופן מוחלט מביצוע הפעולהrm -rf /tmp/data.
19. הסרת המשאבים
כדי להימנע מחיובים שוטפים בחשבון Google Cloud על מופעי AlloyDB ו-Memorystore, צריך למחוק את המשאבים שנוצרו.
מריצים את הפקודות הבאות ב-Cloud Shell:
# Exit VM and return to Cloud Shell
exit
# Delete Compute Engine development VM
gcloud compute instances delete $VM_NAME \
  --zone=$ZONE \
  --quiet

# Delete AlloyDB primary instance and cluster
gcloud alloydb instances delete $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --quiet

gcloud alloydb clusters delete $ADBCLUSTER \
  --region=$REGION \
  --quiet

# Delete Memorystore for Valkey instance
gcloud memorystore instances delete $VALKEYINSTANCE \
  --location=$REGION \
  --quiet
20. מזל טוב
מעולה! הצלחתם ליצור ארכיטקטורה של זיכרון לטווח ארוך של סוכן AI בשתי רמות, שמשלבת בין Memorystore for Valkey לבין AlloyDB AI.
מה למדתם
- הטמענו ארכיטקטורת זיכרון דו-שכבתית שמפרידה בין מצב הסשן הפעיל לטווח קצר לבין עובדות קבועות לטווח ארוך.
- השגנו צמצום משמעותי בגודל ההנחיה הפעילה וחיסכון בשימוש הכולל בטוקנים בהשוואה לשימוש פשוט בהקשר, בלי לפגוע בדיוק.
- הטמעות אוטומטיות טרנזקציונליות ברמת מסד הנתונים של AlloyDB AI (
ai.initialize_embeddings). - בוצע חיפוש היברידי מקורי של מיזוג דירוג הדדי (
ai.hybrid_search) שמשלב דמיון וקטורי (<=>) עם חיפוש טקסט מלא ב-PostgreSQL (tsvector). - יצרנו כלי לחילוץ ישויות ברקע (
AsyncMemoryWorker) שלא פועל בשרשור, כלי להערכת הרשאות להרצת כלי עם 3 רמות ומנוע לדחיסת זיכרון של מסד נתונים. - מצמידים את מערכת הזיכרון המדורגת לסוכן אוטונומי באמצעות הערכה לפיתוח סוכנים (ADK) של Google כדי לאכוף אמצעי הגנה על כלים ולספק זיכרון סביבתי.