

1. Sebelum memulai
Saat agen AI menangani interaksi multi-giliran yang panjang yang berlangsung selama beberapa hari dan menjalankan tugas multi-langkah dengan cakupan yang luas, Model Bahasa Besar (LLM) pada dasarnya tetap tidak memiliki status di seluruh sesi. Saat pengguna kembali ke agen besok, model akan dimulai dari awal kecuali jika aplikasi dapat merekonstruksi konteks yang diperlukan.
Pendekatan sederhana untuk masalah ini adalah penyisipan token — menambahkan histori percakapan lengkap, log eksekusi alat, dan codebase langsung ke setiap perintah aktif. Meskipun jendela konteks besar dengan jutaan token memungkinkan hal ini secara teknis, penyisipan konteks menimbulkan hambatan operasional yang parah: biaya token meningkat secara kuadratik di setiap giliran, latensi respons meningkat hingga puluhan detik, dan model mengalami penurunan kualitas konteks "hilang di tengah".
Untuk membangun agen AI yang andal, Anda memerlukan arsitektur memori 2 tingkat:
- Buffer sesi jangka pendek: Meng-cache giliran percakapan terbaru dalam memori aktif menggunakan jendela geser yang dibatasi token. Tingkat ini memerlukan pencarian dalam memori dengan throughput tinggi dan sub-milidetik pada setiap giliran, sehingga Memorystore for Valkey menjadi pilihan yang ideal.
- Memori persisten jangka panjang: Menyimpan entitas terstruktur, preferensi pengguna, dan fakta episodik di seluruh sesi. Tingkat ini memerlukan integritas transaksional, keamanan multi-tenant, dan pengambilan hybrid di seluruh data relasional dan vektor — sehingga AlloyDB untuk PostgreSQL menjadi pilihan yang tepat.
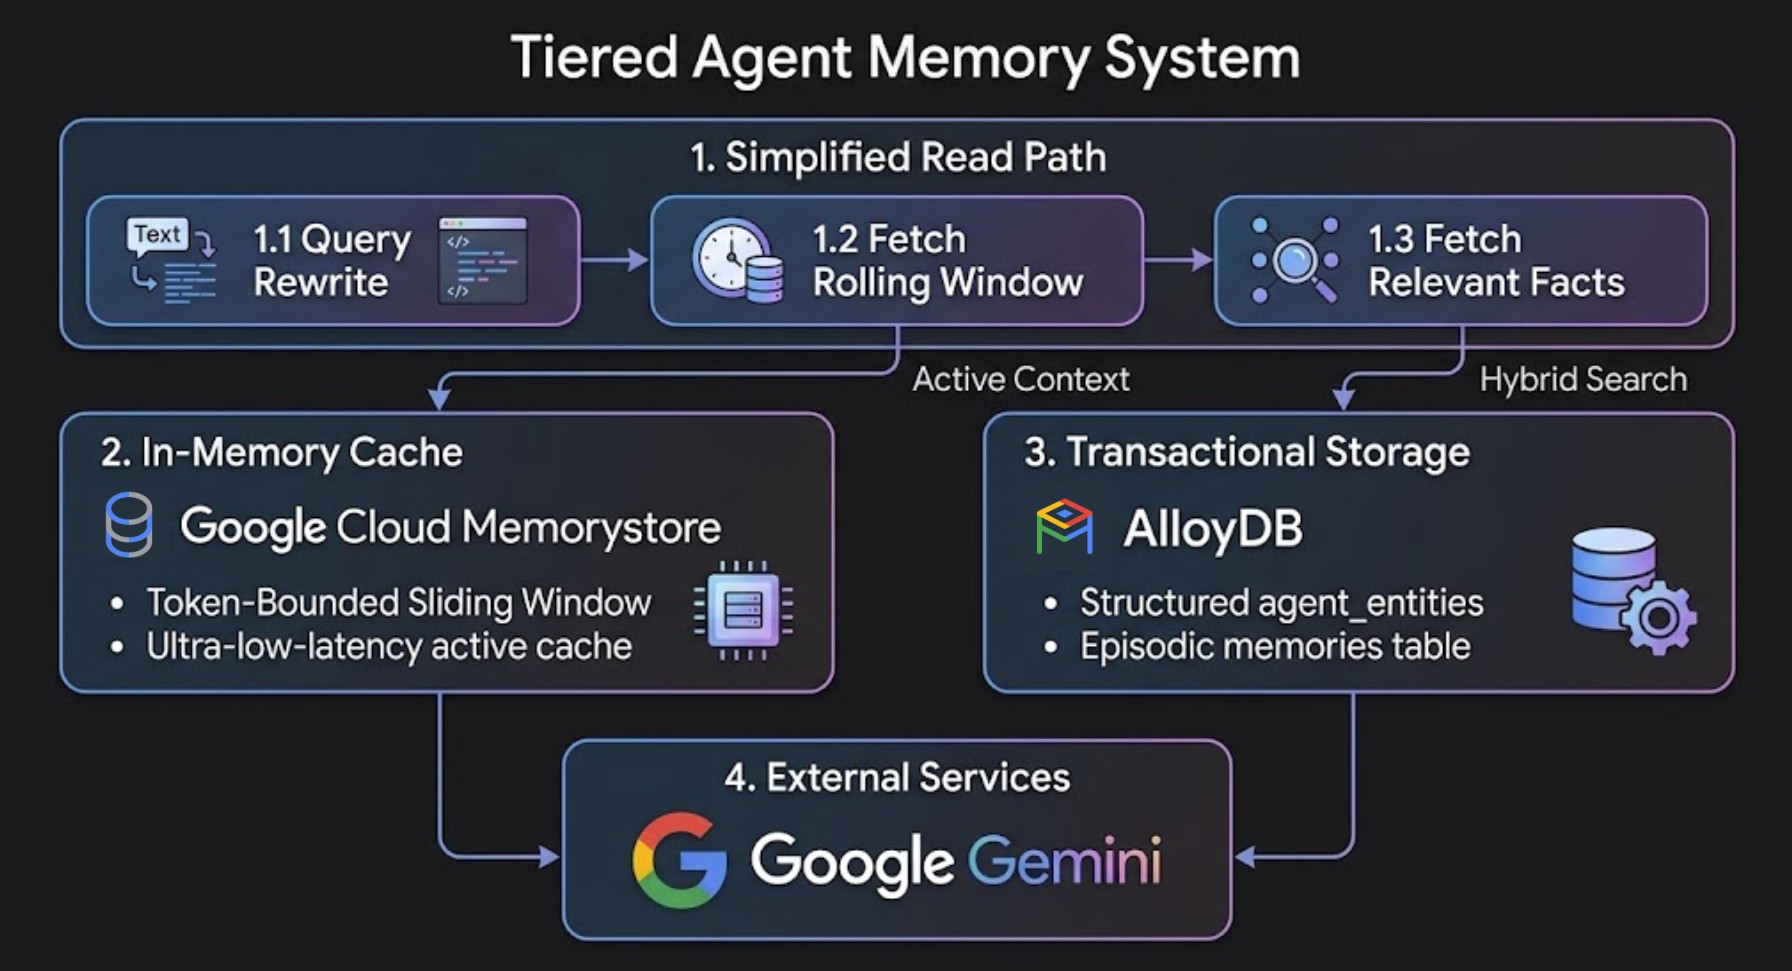
Memahami Empat Jenis Memori
Arsitektur memori yang andal mengandalkan empat jenis memori pelengkap di seluruh perjalanan pengguna:
Jenis memori | Yang disimpan | Lapisan penyimpanan | Masa aktif |
Buffer (Jangka pendek) | Perubahan percakapan mentah terbaru | Memorystore for Valkey | Sesi aktif |
Memori ringkasan | Histori terkompresi dari giliran sebelumnya | Memorystore for Valkey | Jendela multi-turn |
Memori episodik | Tindakan, peristiwa, dan output alat sebelumnya | AlloyDB untuk PostgreSQL (Vektor) | Permanen |
Memori entitas & aturan | Preferensi, batasan, dan penolakan pengguna | AlloyDB untuk PostgreSQL (SQL Terstruktur + Vektor) | Permanen |
Dampak Terukur Memori Bertingkat
Pengujian tolok ukur internal di seluruh dialog pengembangan multi-turn (lebih dari 45 turn dengan log output alat yang berat) menunjukkan penghematan yang signifikan dibandingkan dengan pengisian konteks yang sederhana:
Metrik / dimensi | Penjejalan konteks yang tidak canggih | Memori bertingkat (AlloyDB + Memorystore) | Dampak bersih dalam pengujian |
Ukuran dialog aktif (belok 45) | 747.033 token | 83.262 token | Perintah 88,9% lebih kecil |
Latensi respons 45 belokan | 33,5 detik | 6,7 detik | Respons 80,0% lebih cepat |
Token sesi kumulatif | 17,9 juta token | 4,09 Juta token | Penghematan total token & biaya sebesar 72,0% |
Mengingat aturan & batasan | Menurun seiring waktu | Mencegah hilangnya pengetahuan penting dalam ringkasan | Dipertahankan melalui penelusuran campuran |
Yang akan Anda lakukan
- Sediakan AlloyDB untuk PostgreSQL dan Memorystore untuk Valkey.
- Aktifkan
google_ml_integrationdan konfigurasi sematan otomatis transaksional sisi database (ai.initialize_embeddings). - Terapkan buffer sesi Valkey jangka pendek dengan pola pipeline ringkas sebelum pemangkasan.
- Mengekstrak entity jangka panjang secara native menggunakan Fungsi AI native AlloyDB (yaitu
ai.generate) - Buat kueri fakta jangka panjang, dengan akurasi dan relevansi tinggi, menggunakan fungsi Penelusuran Hybrid native AlloyDB (
ai.hybrid_search) dan pemeringkatan ulang Reciprocal Rank Fusion (RRF). - Membangun evaluator izin alat perusahaan 3 tingkat dan mesin pemadatan memori latar belakang.
- Mengintegrasikan arsitektur memori 2 tingkat langsung ke agen otonom menggunakan Agent Development Kit (ADK) Google.
Yang Anda butuhkan
- Project Google Cloud yang mengaktifkan penagihan.
- Browser web seperti Chrome.
- Pengetahuan dasar tentang Python dan SQL, termasuk pengalaman dalam menjalankan kueri SQL terhadap AlloyDB - dari Studio, CLI, dll.
Audiens & Biaya
- Audiens: Developer AI, engineer backend, dan arsitek database.
- Perkiraan Biaya: Resource Google Cloud yang dibuat dalam codelab ini akan dikenai biaya sekitar $1,50 USD.
2. Penyiapan dan Persyaratan
Mulai Cloud Shell
Dalam codelab ini, Anda akan menjalankan perintah di Google Cloud Shell, terminal yang dihosting di cloud dan telah dikonfigurasi sebelumnya dengan gcloud, psql, dan python3.
- Buka Konsol Google Cloud.
- Klik Activate Cloud Shell di kanan atas Konsol Cloud.
- Verifikasi autentikasi:
gcloud auth list
export PROJECT_ID=<YOUR_PROJECT_ID>
gcloud config set project $PROJECT_ID

export REGION=us-east1
export GENAI_LOCATION=us
export ZONE=us-east1-b
export ADBCLUSTER=agent-memory-cluster
export ADBINSTANCE=agent-memory-instance
export VALKEYINSTANCE=agent-memory-cache
export VM_NAME=agent-dev-vm
Mengaktifkan Google Cloud API & Membuat VM Pengembangan
Jalankan perintah berikut di Cloud Shell untuk mengaktifkan API yang diperlukan:
gcloud services enable \
  alloydb.googleapis.com \
  memorystore.googleapis.com \
  aiplatform.googleapis.com \
  compute.googleapis.com \
  servicenetworking.googleapis.com \
  networkconnectivity.googleapis.com
Buat instance VM Compute Engine di jaringan VPC default untuk menghosting lingkungan pengembangan Python Anda bersama AlloyDB dan Memorystore untuk Valkey:
gcloud compute instances create $VM_NAME \
    --zone=$ZONE \
    --machine-type=e2-standard-2 \
    --scopes=cloud-platform \
    --network=default \
    --shielded-secure-boot
3. Menyediakan AlloyDB dan Memorystore for Valkey
Pada langkah ini, Anda akan menyediakan cluster dan instance utama AlloyDB untuk PostgreSQL, membuat jaringan layanan pribadi, dan menjalankan instance Memorystore for Valkey.
Buat Rentang IP Akses Layanan Pribadi
AlloyDB memerlukan rentang IP pribadi di jaringan Virtual Private Cloud (VPC) Anda. Dengan asumsi Anda menggunakan jaringan VPC default:
- Buat alokasi rentang IP pribadi:
gcloud compute addresses create psa-range \
    --global \
    --purpose=VPC_PEERING \
    --prefix-length=24 \
    --description="VPC private service access" \
    --network=default
- Buat koneksi peering VPC pribadi:
gcloud services vpc-peerings connect \
    --service=servicenetworking.googleapis.com \
    --ranges=psa-range \
    --network=default
Buat Cluster AlloyDB dan Instance Utama
- Buat sandi cluster awal untuk inisialisasi sistem:
export PGPASSWORD=`openssl rand -hex 12`
- Buat Cluster Uji Coba Gratis:
gcloud alloydb clusters create $ADBCLUSTER \
    --password=$PGPASSWORD \
    --network=default \
    --region=$REGION \
    --subscription-type=TRIAL
- Buat Instance Utama:
gcloud alloydb instances create $ADBINSTANCE \
    --instance-type=PRIMARY \
    --cpu-count=2 \
    --region=$REGION \
    --cluster=$ADBCLUSTER
Menyediakan Instance Memorystore for Valkey
Memorystore untuk Valkey memerlukan Kebijakan Koneksi Layanan (gcp-memorystore) di jaringan dan region Anda sebelum pembuatan instance.
- Buat Kebijakan Koneksi Layanan untuk Memorystore:
gcloud network-connectivity service-connection-policies create memorystore-policy \
    --network=default \
    --region=$REGION \
    --service-class=gcp-memorystore \
    --subnets=projects/$PROJECT_ID/regions/$REGION/subnetworks/default
- Buat instance Memorystore for Valkey:
gcloud memorystore instances create $VALKEYINSTANCE \
    --location=$REGION \
    --shard-count=1 \
    --replica-count=0 \
    --node-type=SHARED_CORE_NANO \
    --psc-auto-connections="network=projects/$PROJECT_ID/global/networks/default,projectId=$PROJECT_ID"
Memberikan Izin IAM Vertex AI
Beri akun layanan AlloyDB izin IAM yang diperlukan untuk memanggil model penyematan Agent Platform:
PROJECT_ID=$(gcloud config get-value project)

gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:service-$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")@gcp-sa-alloydb.iam.gserviceaccount.com" \
  --role="roles/aiplatform.user"
4. Menginisialisasi Endpoint Lingkungan dan Akses
Menyiapkan Autentikasi IAM & Flag Database AlloyDB
Aktifkan Autentikasi Database IAM (alloydb.iam_authentication=on) dan mesin kueri AI (google_ml_integration.enable_ai_query_engine=on) di instance AlloyDB Anda:
gcloud beta alloydb instances update $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --update-mode=FORCE_APPLY \
  --database-flags=alloydb.iam_authentication=on,google_ml_integration.enable_ai_query_engine=on
Selanjutnya, tambahkan akun Google Cloud Anda sebagai pengguna database berbasis IAM dengan izin superuser:
export USER_ACCOUNT=$(gcloud config get-value account)

gcloud alloydb users create $USER_ACCOUNT \
    --cluster=$ADBCLUSTER \
    --region=$REGION \
    --type=IAM_BASED \
    --db-roles=alloydbsuperuser
Mengambil Endpoint VPC Internal di Cloud Shell
Sebelum melakukan SSH ke VM pengembangan, ambil alamat IP VPC internal untuk AlloyDB dan Memorystore untuk Valkey di Cloud Shell:
# Export GCP Project ID, Region, and IAM User
export PROJECT_ID=$(gcloud config get-value project)
export REGION=us-east1
export DB_USER=$(gcloud config get-value account)

# Retrieve Internal VPC IP Addresses for AlloyDB & Memorystore for Valkey
export DB_HOST=$(gcloud alloydb instances describe $ADBINSTANCE --cluster=$ADBCLUSTER --region=$REGION --format="value(ipAddress)")
export DB_PORT=5432
export DB_NAME=postgres

export VALKEY_HOST=$(gcloud memorystore instances describe $VALKEYINSTANCE --location=$REGION --format="value(discoveryEndpoints[0].address)")
export VALKEY_PORT=6379

# Verify exported endpoints
echo "Project ID:        $PROJECT_ID"
echo "Region:            $REGION"
echo "AlloyDB Private IP: $DB_HOST"
echo "IAM DB User:       $DB_USER"
echo "Valkey Private IP:  $VALKEY_HOST"
SSH ke VM Pengembangan & Mengekspor Variabel Koneksi
Lakukan SSH dari Cloud Shell ke VM pengembangan Compute Engine (agent-dev-vm) yang berada di jaringan VPC yang sama:
gcloud compute ssh $VM_NAME --zone=$ZONE
Setelah login ke VM pengembangan, ekspor konfigurasi project dan output endpoint koneksi di atas (ganti
export PROJECT_ID=<YOUR_PROJECT_ID>
export REGION=us-east1
export GENAI_LOCATION=us
export DB_HOST=<YOUR_ALLOYDB_PRIVATE_IP>
export DB_PORT=5432
export DB_NAME=postgres
export DB_USER=<YOUR_IAM_DB_USER>
export VALKEY_HOST=<YOUR_VALKEY_PRIVATE_IP>
export VALKEY_PORT=6379
Melakukan Inisialisasi Lingkungan Virtual Python
Di dalam VM pengembangan, buat direktori kerja lokal Anda terlebih dahulu:
mkdir -p ~/alloydb_agent_memory && cd ~/alloydb_agent_memory
Sekarang, mari kita instal paket lingkungan virtual Python sistem, autentikasi Kredensial Default Aplikasi (ADC), dan siapkan ruang kerja Anda:
sudo apt-get update && sudo apt-get install -y python3-venv python3-pip

python3 -m venv venv
source venv/bin/activate
Terakhir, di lingkungan virtual baru, kita akan menginstal dependensi:
gcloud auth application-default login
pip install psycopg2-binary valkey redis google-genai
5. Arsitektur Sistem dan Hierarki Modul Kode
Ringkasan yang Akan Anda Buat
Sebelum menerapkan setiap skrip Python, tinjau arsitektur sistem di bawah. Aplikasi contoh ini disusun menjadi 7 skrip Python modular yang beroperasi di dua jalur eksekusi utama yang berinteraksi dengan instance database AlloyDB untuk PostgreSQL yang sama:
- Jalur Baca (
hybrid_retriever.py): Menguraikan pertanyaan multi-bagian gabungan menjadi sub-kueri aspek tunggal langsung di dalam PostgreSQL menggunakanai.generate()AlloyDB AI dan mengkueri memori jangka panjang menggunakan penelusuran hibrida native AlloyDB (ai.hybrid_search). - Jalur Penulisan (
async_worker.py): Pekerja antrean latar belakang di luar thread yang secara asinkron mengekstrak fakta entitas terstruktur dari pertukaran dialog menggunakan Gemini Flash dan meng-upsert-nya keagent_entities.
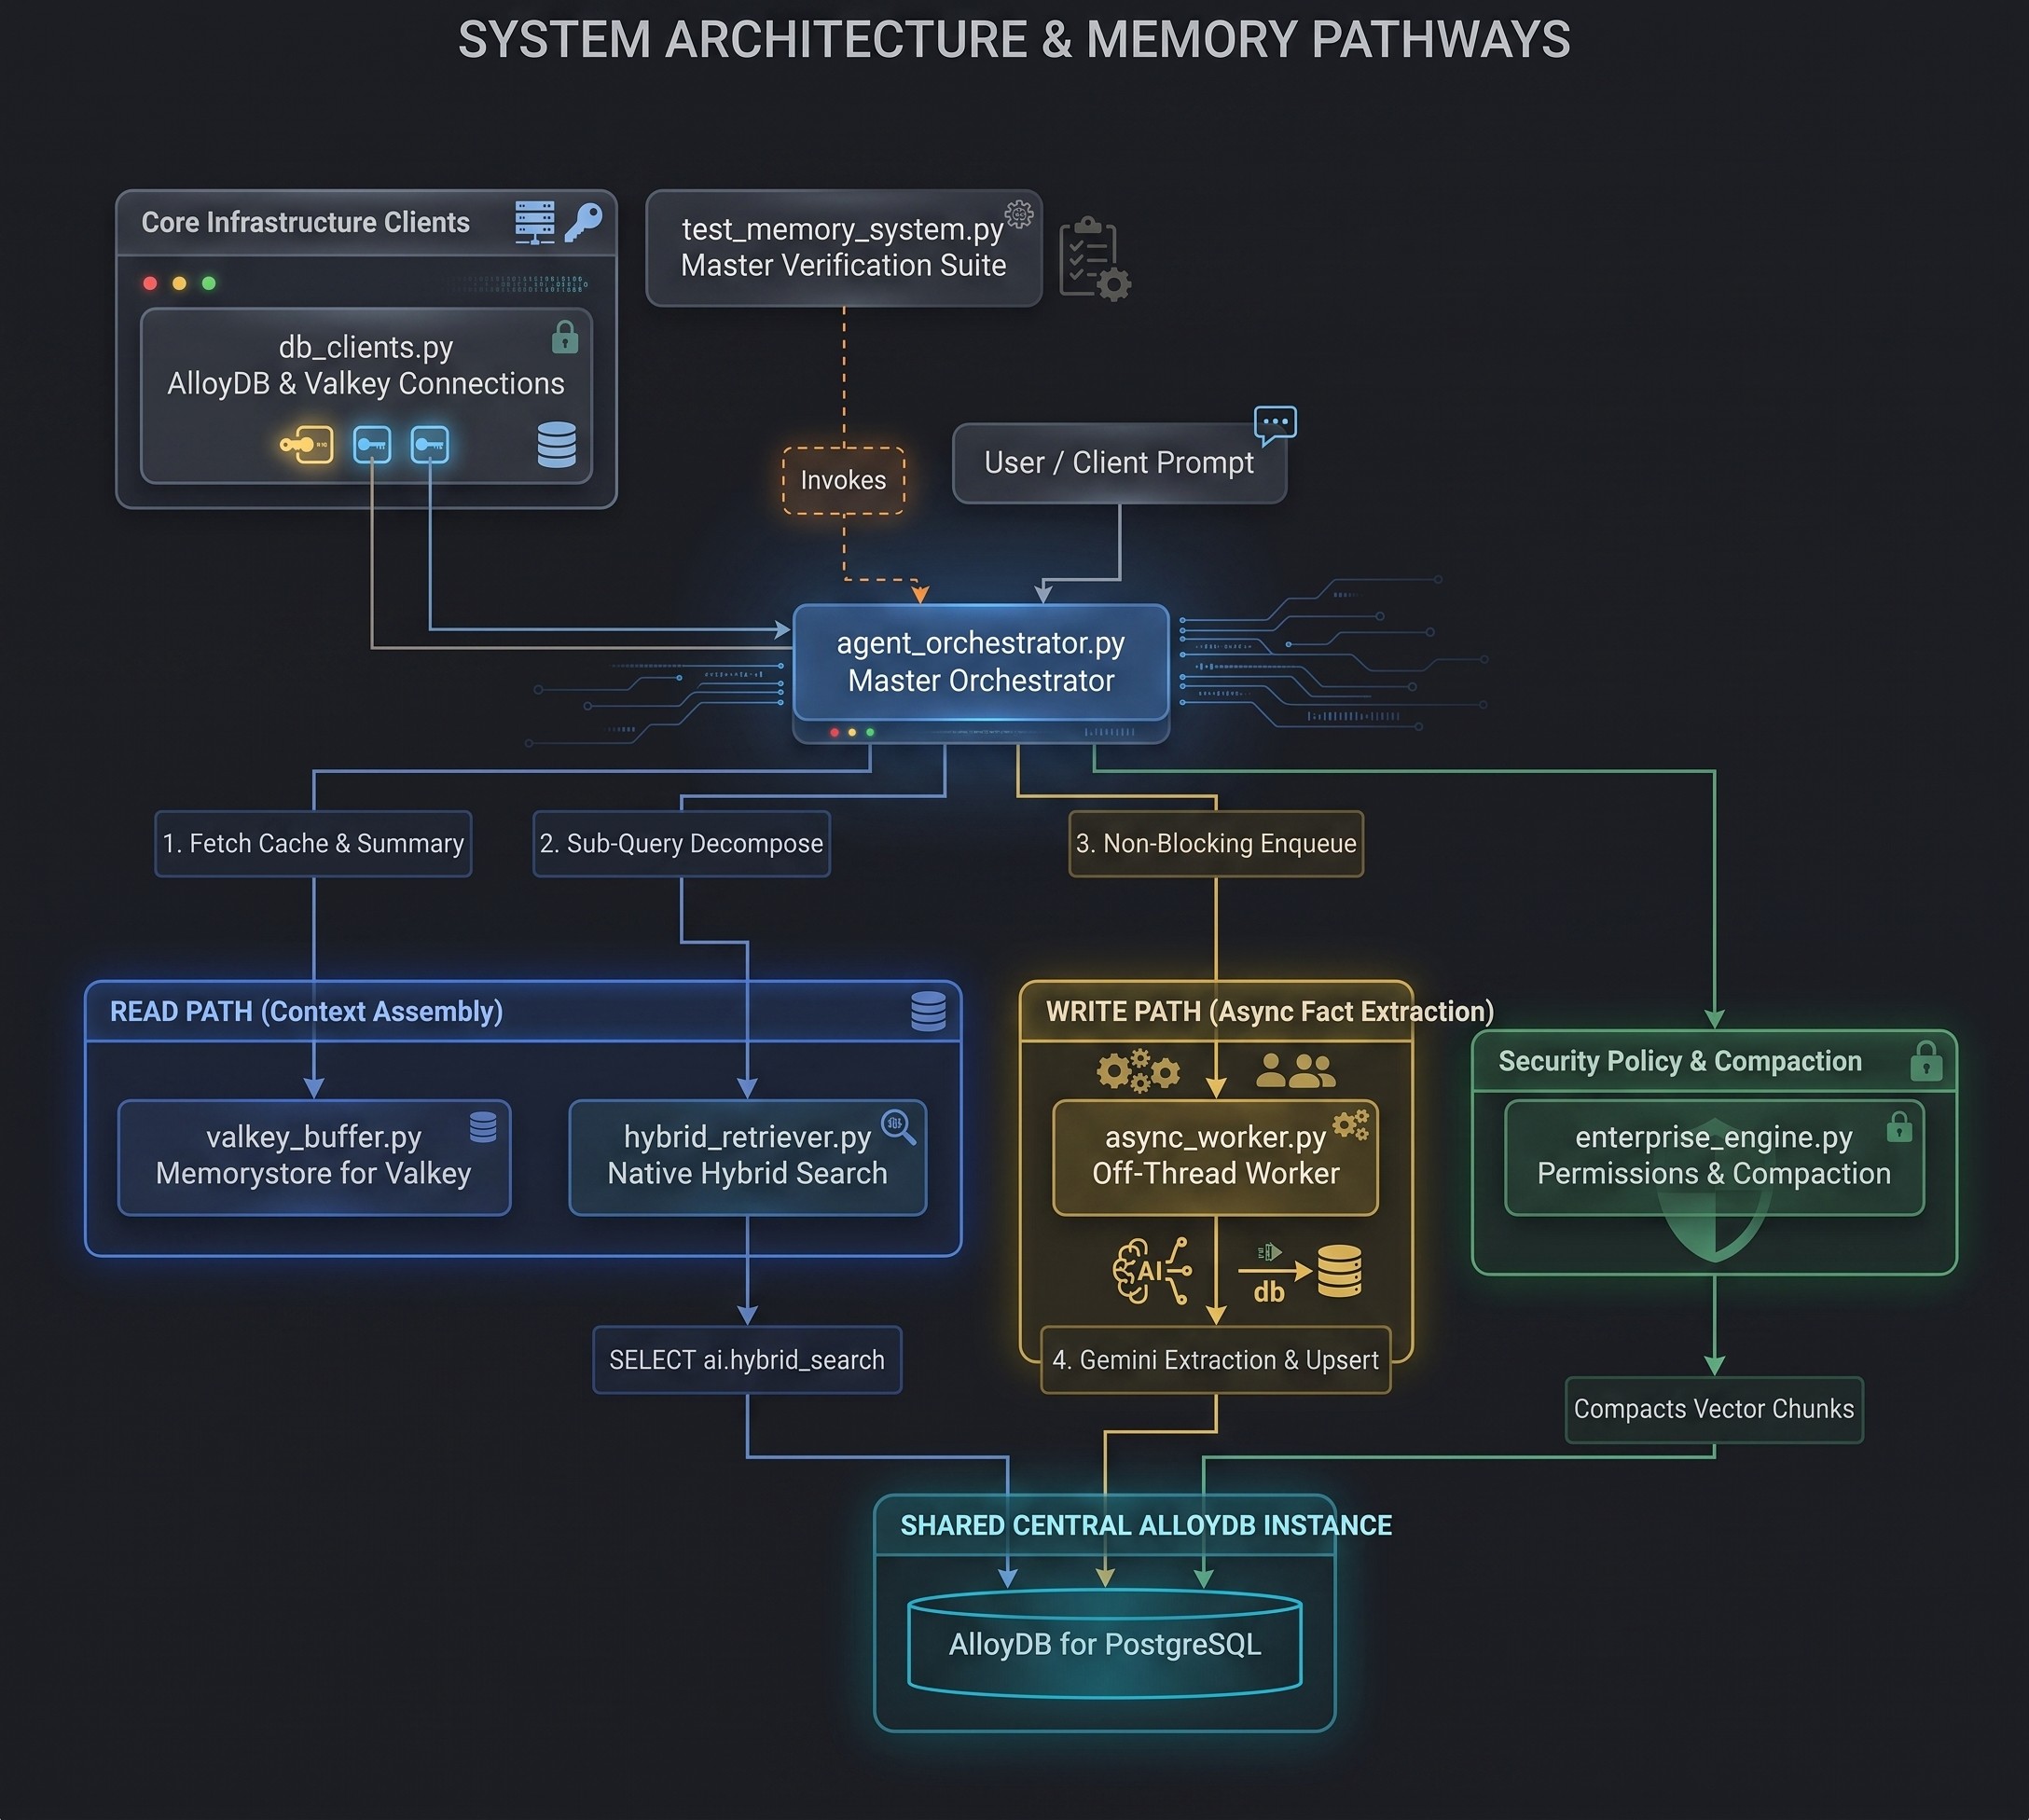
Hierarki Modul & Peran Sistem
File Modul | Lapisan Sistem | Tanggung Jawab Utama |
| Lapisan Koneksi | Membuat autentikasi IAM yang dienkripsi SSL ke AlloyDB dan koneksi yang tahan soket ke Memorystore untuk Valkey. |
| Memori Jangka Pendek | Mengelola histori sesi sub-milidetik di Valkey, menerapkan ringkasan bergulir Summarize-Before-Trim. |
| Pekerja Jalur Tulis | Menjalankan pekerja antrean latar belakang daemon di luar thread yang mengekstrak fakta entity menggunakan Gemini Flash dan meng-upsert-nya ke AlloyDB. |
| Pengambil Jalur Baca | Menguraikan pertanyaan gabungan menjadi sub-kueri aspek tunggal menggunakan |
| Loop Agen Utama | Mengoordinasikan loop eksekusi giliran secara end-to-end: pengambilan jangka pendek, penelusuran jangka panjang, perakitan perintah, eksekusi LLM, dan antrean asinkron. |
| Tata Kelola & Admin | Menerapkan kebijakan keamanan 3 tingkat untuk eksekusi alat dan menggabungkan memori historis. |
| Pengujian & Evaluasi | Master verification suite yang menjalankan skenario multi-turn & multi-session, mengukur penghematan token %, dan memverifikasi presisi memori. |
6. Menyiapkan Skema AlloyDB AI dan Embedding Otomatis Transaksional
Ringkasan Tujuan & Arsitektur
Dalam modul ini, Anda akan menentukan skema database AlloyDB untuk memori episodik dan jangka panjang, strategi indeks, serta penyematan otomatis sisi database.
- Episodic Vector Store (
episodic_memory_embeddings): Chunk transkrip chat tidak terstruktur yang diindeks dengan indeks vektor HNSW (vector_cosine_ops). - Long-Term Entity Store (
agent_entities): Fakta terstruktur, pilihan pengguna, dan aturan project yang disimpan dengan metadata cakupan (global,project,session). Mencakup kolom penelusuran teks lengkap PostgreSQL yang dibuat otomatis (summary_tsv) yang diindeks melalui RUM. - Penyematan Otomatis Sisi Database (
ai.initialize_embeddings): Secara otomatis menyematkan baris teks biasa yang baru atau diperbarui kesummary_embeddingmelaluitext-embedding-005Agent Platform di latar belakang.
Menghubungkan ke AlloyDB Studio
- Buka halaman AlloyDB for Postgres di Konsol Google Cloud.
- Klik instance utama Anda.
- Di navigasi sisi kiri, klik AlloyDB Studio.
- Pilih database
postgres - Mengautentikasi dengan
IAM database authentication
Implementasi & Kode Sumber
Setelah terhubung ke database AlloyDB PostgreSQL, jalankan kueri DDL di bawah:
-- 1. Enable google_ml_integration extension
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;
CREATE EXTENSION IF NOT EXISTS vector CASCADE;
CREATE EXTENSION IF NOT EXISTS rum CASCADE;
SET google_ml_integration.enable_preview_ai_functions = true;

-- 2. Create Episodic Memory Vector Store Tables
CREATE TABLE IF NOT EXISTS episodic_memory_collections (
    uuid UUID PRIMARY KEY,
    name VARCHAR,
    cmetadata JSONB
);

CREATE TABLE IF NOT EXISTS episodic_memory_embeddings (
    uuid UUID PRIMARY KEY,
    collection_id UUID REFERENCES episodic_memory_collections(uuid) ON DELETE CASCADE,
    embedding VECTOR(768),
    document VARCHAR,
    cmetadata JSONB,
    custom_id VARCHAR,
    created_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS episodic_memory_embedding_idx
ON episodic_memory_embeddings
USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);

-- 3. Create Entity & Preference Table with Metadata Scope & Auto-Generated TSVector Column
CREATE TABLE IF NOT EXISTS agent_entities (
    entity_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    entity_name TEXT NOT NULL,
    project_id TEXT DEFAULT 'global',
    session_id TEXT,
    scope TEXT NOT NULL DEFAULT 'project', -- 'global', 'project', 'session'
    summary TEXT NOT NULL,
    summary_embedding VECTOR(768),
    summary_tsv TSVECTOR GENERATED ALWAYS AS (
        to_tsvector('english', entity_name || ' ' || summary)
    ) STORED,
    updated_at TIMESTAMPTZ DEFAULT NOW(),
    UNIQUE (user_id, entity_name)
);

CREATE INDEX IF NOT EXISTS agent_entities_scope_idx
ON agent_entities (user_id, project_id, scope);

CREATE INDEX IF NOT EXISTS agent_entities_embedding_idx
ON agent_entities USING hnsw (summary_embedding vector_cosine_ops);

CREATE INDEX IF NOT EXISTS agent_entities_tsv_idx
ON agent_entities USING rum (summary_tsv rum_tsvector_ops);

-- 4. Create User Permissions Table for Tool Execution Controls
CREATE TABLE IF NOT EXISTS user_permissions (
    permission_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    project_id TEXT NOT NULL DEFAULT 'global',
    tool_name TEXT NOT NULL,
    command_pattern TEXT NOT NULL,
    action TEXT NOT NULL CHECK (action IN ('ALLOW', 'BLOCK')),
    created_at TIMESTAMPTZ DEFAULT NOW(),
    updated_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS idx_user_permissions_lookup
ON user_permissions (user_id, project_id, tool_name);
-- 5. Register Gemini 3.5 Flash Model Endpoint in AlloyDB
-- Replace PROJECT_ID with your Google Cloud project ID
CALL google_ml.create_model(
    model_id => 'gemini-3.5-flash',
    model_request_url => 'https://aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/global/publishers/google/models/gemini-3.5-flash:generateContent',
    model_qualified_name => 'gemini-3.5-flash',
    model_provider => 'google',
    model_type => 'llm',
    model_auth_type => 'alloydb_service_agent_iam'
);
Menginisialisasi Sematan Otomatis Transaksional dan Mendaftarkan Model Gemini
Selanjutnya, jalankan pernyataan CALL dalam blok eksekusi kueri terpisah untuk mendaftarkan proses latar belakang penyematan otomatis dan endpoint model Gemini 3.5 Flash:
-- 6. Register Database-Side Transactional Auto-Embedding
CALL ai.initialize_embeddings(
    model_id => 'text-embedding-005',
    table_name => 'agent_entities',
    content_column => 'summary',
    embedding_column => 'summary_embedding',
    incremental_refresh_mode => 'transactional',
    batch_size => 10
);
7. Mengonfigurasi Klien Koneksi AlloyDB dan Valkey
Ringkasan Tujuan & Arsitektur
Dalam modul ini, Anda akan membuat koneksi jaringan yang aman ke AlloyDB untuk PostgreSQL (memori jangka panjang) dan Memorystore untuk Valkey (cache jangka pendek).
- Autentikasi IAM AlloyDB: Menggunakan
gcloud auth application-default print-access-tokenuntuk mengambil token OAuth2 berumur pendek untuk koneksi database terenkripsi SSL tanpa sandi (sslmode="require"). - Ketahanan Jaringan Valkey: Mengonfigurasi
redis.Redisdengan waktu tunggu soket 5,0 detik (socket_timeout=5.0) untuk menangani operasi jaringan VPC dengan aman di seluruh instance Valkey node tunggal atau berkluster.
Implementasi & Kode Sumber
Buat skrip db_clients.py di direktori kerja Anda:
import os
import subprocess
import psycopg2
import redis

# Initialize database & Valkey connection clients from environment variables
DB_HOST = os.getenv("DB_HOST", "127.0.0.1")
DB_PORT = os.getenv("DB_PORT", "5432")
DB_NAME = os.getenv("DB_NAME", "postgres")
DB_USER = os.getenv("DB_USER")

VALKEY_HOST = os.getenv("VALKEY_HOST", "127.0.0.1")
VALKEY_PORT = int(os.getenv("VALKEY_PORT", "6379"))

def get_db_connection():
    # Fetch Application Default Credentials (ADC) token for IAM Database Authentication & enable SSL encryption
    access_token = subprocess.check_output(
        ["gcloud", "auth", "application-default", "print-access-token"], text=True
    ).strip()
    return psycopg2.connect(
        host=DB_HOST,
        port=DB_PORT,
        dbname=DB_NAME,
        user=DB_USER,
        password=access_token,
        sslmode="require"
    )

def get_valkey_client():
    return redis.Redis(
        host=VALKEY_HOST,
        port=VALKEY_PORT,
        db=0,
        socket_timeout=5.0,
        socket_connect_timeout=5.0
    )

if __name__ == "__main__":
    print(f"Connecting to AlloyDB via IAM Auth ({DB_USER}) at {DB_HOST}:{DB_PORT} and Valkey at {VALKEY_HOST}:{VALKEY_PORT}...")
    print("Database and Valkey connection client modules loaded successfully.")
8. Meng-cache Status Sesi Jangka Pendek di Memorystore for Valkey
Ringkasan Tujuan & Arsitektur
Dalam modul ini, Anda akan membuat cache konteks jangka pendek sub-milidetik di Memorystore untuk Valkey yang menerapkan pola Ringkas-Sebelum-Pangkas otomatis.
- Jendela Geser Valkey: Giliran percakapan aktif disimpan sebagai string JSON dalam kunci
session:{session_id}:turns. - Tag Hash Redis (
{session_id}): Pemformatan kuncisession:{session_id}:turnsdansession:{session_id}:summarymenggunakan tag hash cluster Redis ({...}), yang memaksa kedua kunci berada di slot hash yang sama untuk memastikan eksekusi atomik di seluruh deployment Valkey node tunggal atau cluster. - Ringkas-Sebelum-Pangkas: Jika jumlah giliran melebihi
trigger_limit, giliran lama yang akan dipangkas akan diringkas oleh Gemini Flash menjadi ringkasan teks bergulir (session:{session_id}:summary) sebelum memangkas histori mentah menjadiwindow_size.
Implementasi & Kode Sumber
Buat skrip valkey_buffer.py di direktori kerja Anda:
import json
import logging
import time
from typing import Any, Dict, List
import redis

logger = logging.getLogger(__name__)

IN_MEMORY_VALKEY_FALLBACK: Dict[str, Any] = {}
VALKEY_COMPACTION_TOKENS = 0

def get_valkey_compaction_tokens() -> int:
    return VALKEY_COMPACTION_TOKENS

def append_session_turn_with_rolling_summary(
    valkey_client: redis.Redis,
    llm_client: Any,
    session_id: str,
    user_msg: str,
    ai_msg: str,
    trigger_limit: int = 10,
    window_size: int = 4
) -> None:
    """Appends turn to Valkey. Before trimming old turns, summarizes them into a rolling summary."""
    global VALKEY_COMPACTION_TOKENS
    # Use Redis Hash Tags {session_id} so both keys hash to the same cluster slot
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        # 1. Append new turn messages
        valkey_client.rpush(turns_key, json.dumps({"role": "user", "content": user_msg}))
        valkey_client.rpush(turns_key, json.dumps({"role": "assistant", "content": ai_msg}))

        raw_turns = valkey_client.lrange(turns_key, 0, -1)

        # 2. Check if total turns exceed summary trigger threshold
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2

        if len(raw_turns) > msg_trigger_count:
            turns_to_prune = raw_turns[:-msg_window_count]
            existing_summary = valkey_client.get(summary_key)
            existing_summary_text = (
                existing_summary.decode('utf-8') if isinstance(existing_summary, bytes) else (existing_summary or "")
            )

            pruned_text = "\n".join([
                f"{json.loads(t)['role']}: {json.loads(t)['content']}" for t in turns_to_prune
            ])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            updated_summary_text = llm_client.models.generate_content(
                model="gemini-3.5-flash", contents=prompt
            ).text.strip()
            # Execute commands directly to support all Redis/Valkey cluster topologies
            valkey_client.set(summary_key, updated_summary_text)
            valkey_client.ltrim(turns_key, -msg_window_count, -1)
            logger.info("Updated rolling summary and trimmed Valkey buffer for session %s", session_id)

    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey operation warning (%s). Falling back to in-memory short-term buffer.", e)
        if turns_key not in IN_MEMORY_VALKEY_FALLBACK:
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = []
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "user", "content": user_msg})
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "assistant", "content": ai_msg})

        # In-memory summarize-before-trim fallback logic
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2
        raw_fallback_turns = IN_MEMORY_VALKEY_FALLBACK[turns_key]

        if len(raw_fallback_turns) > msg_trigger_count:
            turns_to_prune = raw_fallback_turns[:-msg_window_count]
            existing_summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
            pruned_text = "\n".join([f"{t['role']}: {t['content']}" for t in turns_to_prune])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            for attempt in range(4):
                try:
                    updated_summary_text = llm_client.models.generate_content(
                        model="gemini-3.5-flash", contents=prompt
                    ).text.strip()
                    break
                except Exception as e:
                    if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                        time.sleep(3 * (2 ** attempt))
                    else:
                        raise

            IN_MEMORY_VALKEY_FALLBACK[summary_key] = updated_summary_text
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = raw_fallback_turns[-msg_window_count:]

def get_session_context_buffer(
    valkey_client: redis.Redis,
    session_id: str
) -> Dict[str, Any]:
    """Retrieves rolling summary + sliding window history from Valkey to build prompt context."""
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        summary = valkey_client.get(summary_key)
        summary_text = summary.decode('utf-8') if isinstance(summary, bytes) else (summary or "")

        raw_turns = valkey_client.lrange(turns_key, 0, -1)
        recent_turns = [json.loads(t) for t in raw_turns]

        return {
            "rolling_summary": summary_text,
            "recent_turns": recent_turns
        }
    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey read error (%s). Using in-memory short-term fallback buffer.", e)
        summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
        recent_turns = IN_MEMORY_VALKEY_FALLBACK.get(turns_key, [])
        return {"rolling_summary": summary_text, "recent_turns": recent_turns}
9. Mengekstrak Entity di Luar Thread (Pekerja Memori Latar Belakang)
Ringkasan Tujuan & Arsitektur
Dalam modul ini, Anda akan membangun pekerja ekstraksi latar belakang jalur penulisan di luar thread (AsyncMemoryWorker) yang mengekstrak fakta entity jangka panjang tanpa memperlambat respons AI interaktif.
- Pekerja Antrean Non-Blocking: Meluncurkan thread daemon (
queue.Queue) sehingga respons chat developer langsung ditampilkan tanpa menunggu ekstraksi LLM atau penulisan database. - Ekstraksi Fakta Entity di Luar Thread: Memanggil Gemini Flash (
model="gemini-3.5-flash",response_mime_type="application/json") di latar belakang untuk mengurai entity terstruktur tanpa memblokir giliran dialog yang ditampilkan kepada pengguna. - Penyelesaian Koreferensi Temporal (
build_temporal_rules_prompt): Menerapkan aturan yang mengonversi ekspresi temporal relatif (misalnya, "saat ini", "sesi terakhir") menjadi ID sesi eksplisit (misalnya,session_id). - Pembaruan Skema: Meminta Gemini Flash untuk menampilkan array JSON entitas (
entity_name,project_id,scope,summary) dan menulis teks biasa keagent_entitiesmelalui pernyataanON CONFLICT DO UPDATEPostgreSQL yang diberi parameter.
Implementasi & Kode Sumber
Buat skrip async_worker.py di direktori kerja Anda:
import json
import logging
import queue
import threading
import time
from typing import Dict, Any, Optional
import psycopg2

logger = logging.getLogger(__name__)

def build_temporal_rules_prompt(active_session_id: str, prev_session_id: Optional[str] = None) -> str:
    """REUSABLE PROMPT HELPER: Defines temporal coreference rules for both Read and Write paths."""
    return f"""TEMPORAL COREFERENCE RULES:
1. Do not use relative temporal words like 'currently', 'now', 'this session', 'previous session', or 'last session'.
2. Replace any relative temporal reference with explicit session identifiers:
   - Active Session: '{active_session_id}'
   - Previous Session: '{prev_session_id if prev_session_id else active_session_id}'
   (e.g., write 'User prefers Python in session {active_session_id}' instead of 'User currently prefers Python')."""

class AsyncMemoryWorker:
    """Off-thread daemon queue worker performing background entity extraction and upserts into AlloyDB."""
    def __init__(self, conn_factory, llm_client):
        self.conn_factory = conn_factory
        self.llm_client = llm_client
        self.work_queue = queue.Queue()
        self.total_extraction_tokens = 0
        self.worker_thread = threading.Thread(target=self._run_worker, daemon=True)
        self.worker_thread.start()

    def enqueue_extraction(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        self.work_queue.put((user_id, session_id, user_msg, ai_msg, prev_session_id))

    def _run_worker(self):
        while True:
            item = self.work_queue.get()
            if item is None:
                break
            user_id, session_id, user_msg, ai_msg, prev_session_id = item
            try:
                self._extract_and_upsert(user_id, session_id, user_msg, ai_msg, prev_session_id)
            except Exception as e:
                logger.error("Background extraction failed: %s", e)
            finally:
                self.work_queue.task_done()

    def _extract_and_upsert(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        temporal_rules = build_temporal_rules_prompt(session_id, prev_session_id)
        json_fmt = '[{"entity_name": "...", "project_id": "...", "scope": "global|project|session", "summary": "..."}]'

        prompt = f"""Extract key preferences and named entities from this exchange.
Format output strictly as a JSON array of objects with structure: {json_fmt}.

{temporal_rules}

Rules for Scope:
- 'global': Universal developer preferences.
- 'project': Architecture, database choices, timeouts, and rules for a specific project.
- 'session': Ephemeral task state tied strictly to a single session.

User: {user_msg}
AI: {ai_msg}

Output (JSON array only):"""

        self.total_extraction_tokens += max(1, len(prompt) // 4)

        for attempt in range(4):
            try:
                response = self.llm_client.models.generate_content(
                    model="gemini-3.5-flash",
                    contents=prompt,
                    config={"response_mime_type": "application/json"}
                )
                break
            except Exception as e:
                if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                    time.sleep(3 * (2 ** attempt))
                else:
                    raise
        content = str(response.text).strip()
        if not content:
            return

        extracted_list = json.loads(content)
        if not isinstance(extracted_list, list):
            return

        upsert_sql = """
            INSERT INTO agent_entities (user_id, entity_name, project_id, session_id, scope, summary, updated_at)
            VALUES (%s, %s, %s, %s, %s, %s, NOW())
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET
                project_id = EXCLUDED.project_id,
                session_id = EXCLUDED.session_id,
                scope = EXCLUDED.scope,
                summary = EXCLUDED.summary,
                updated_at = NOW();
        """

        conn = self.conn_factory()
        try:
            with conn:
                with conn.cursor() as cur:
                    for item in extracted_list:
                        e_name = item.get("entity_name", "General_Fact")
                        p_id = item.get("project_id", "global")
                        s_scope = item.get("scope", "project")
                        summary = item.get("summary", "")
                        if e_name and summary:
                            cur.execute(upsert_sql, (user_id, e_name, p_id, session_id, s_scope, summary))
            logger.info("Saved %d entities for user %s", len(extracted_list), user_id)
        finally:
            conn.close()
10. Membuat Kueri Memori Jangka Panjang dengan Penelusuran Campuran Native
Ringkasan Tujuan & Arsitektur
Dalam modul ini, Anda akan menerapkan dekomposisi sub-kueri jalur baca, penulisan ulang kueri temporal, isolasi cakupan metadata, dan menggunakan penelusuran campuran native AlloyDB (ai.hybrid_search).
- Dekomposisi Sub-Kueri Dalam Database (
rewrite_and_decompose_query): Menggunakan fungsi bawaan AlloyDB AIai.generate()langsung di dalam PostgreSQL untuk memecah pertanyaan gabungan menjadi sub-kueri satu aspek dengan ID sesi yang dinormalisasi, sehingga mencegah kueri multi-topik mengurangi akurasi penelusuran vektor. - Pemfilteran Cakupan Tingkat Indeks: Membuat filter SQL sisi database (
filter_condition => "user_id = '%s' AND (project_id = '%s' OR scope = 'global')") untuk mengisolasi kenangan per pengguna dan project sekaligus menyertakan preferensi developer global. - Penelusuran Hibrida Native AlloyDB (
ai.hybrid_search): Menggabungkan kesamaan kosinus vektor (public.<=>) dengan penelusuran teks lengkap (rum) di dalam AlloyDB menggunakan Reciprocal Rank Fusion (RRF) untuk memberikan akurasi, perolehan, dan relevansi yang optimal.
Implementasi & Kode Sumber
Buat skrip hybrid_retriever.py di direktori kerja Anda:
import os
import json
import logging
from typing import Any, Dict, List, Optional
import psycopg2
from psycopg2.extras import RealDictCursor
from async_worker import build_temporal_rules_prompt

logger = logging.getLogger(__name__)

def rewrite_and_decompose_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> List[str]:
    """Read-Path LLM Query Normalizer & Sub-Query Decomposer using AlloyDB AI ai.generate() directly in PostgreSQL."""
    temporal_rules = build_temporal_rules_prompt(active_session_id, prev_session_id)

    prompt = f"""You are a query normalization and decomposition tool for an AI agent's memory retrieval system.

Tasks:
1. Normalize any relative temporal phrases in the user query into explicit session identifiers.
{temporal_rules}

2. Decompose compound user queries asking about multiple distinct topics into up to 4 concise, single-topic search queries. Ensure all distinct questions (both general developer preferences and project-specific architecture/rules) are preserved as separate sub-queries.
3. Return ONLY a valid JSON array of strings containing the sub-queries.

Example Output Format:
["general developer coding preferences", "CloudRetail backend stack in session sess_2026_01", "CloudRetail timeout rules in session sess_2026_01"]

Text to Process: {text}
JSON Output:"""

    try:
        with conn.cursor() as cur:
            cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
            cur.execute("SELECT ai.generate(prompt => %s::text, model_id => 'gemini-3.5-flash'::varchar(100));", (prompt,))
            row = cur.fetchone()
            if row and row[0]:
                res_text = str(row[0]).strip()
                clean_text = res_text
                if clean_text.startswith("```"):
                    clean_text = clean_text.removeprefix("```json").removeprefix("```").removesuffix("```").strip()
                parsed = json.loads(clean_text)
                if isinstance(parsed, list) and len(parsed) > 0:
                    return [str(q).strip() for q in parsed]
        return [text]
    except Exception as e:
        logger.error("Error in in-database ai.generate sub-query decomposition: %s", e)
        return [text]

def rewrite_temporal_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> str:
    """Backward-compatible wrapper returning first decomposed query string."""
    queries = rewrite_and_decompose_query(conn, llm_client, text, active_session_id, prev_session_id)
    return queries[0] if queries else text

def retrieve_hybrid_entities(
    conn,
    llm_client: Any,
    user_id: str,
    active_session_id: str,
    query_text: str,
    query_embedding: Optional[List[float]] = None,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    k: int = 20
) -> Dict[str, Any]:
    """Queries long-term entities using Sub-Query Decomposition, metadata scope filtering, and parameterized AlloyDB hybrid search."""
    sub_queries = rewrite_and_decompose_query(
        conn=conn, llm_client=llm_client, text=query_text, active_session_id=active_session_id, prev_session_id=prev_session_id
    )
    all_search_queries = list(dict.fromkeys(sub_queries + [query_text]))

    retrieved_entities: Dict[str, Any] = {}

    filter_cond = f"user_id = '{user_id}' AND (project_id = '{project_id}' OR scope = 'global')" if project_id else f"user_id = '{user_id}'"

    query_sql = """
        SELECT e.entity_name, e.summary, e.project_id, e.scope, e.updated_at
        FROM ai.hybrid_search(
          search_inputs => %s::JSONB[],
          include_json_output => false
        ) h
        JOIN agent_entities e ON e.entity_name = h.id
        WHERE e.user_id = %s
        LIMIT %s;
    """

    from google import genai
    embed_client = genai.Client(
        vertexai=True,
        project=os.getenv("PROJECT_ID"),
        location=os.getenv("REGION", "us-east1")
    )

    for sq in all_search_queries:
        try:
            emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=sq)
            sq_embedding = emb_resp.embeddings[0].values
            vector_literal = f"'{sq_embedding}'::vector"
        except Exception as e:
            logger.error(f"Failed to generate embedding for sub-query: {sq}. Error: {e}")
            # Fallback to zero vector to prevent Postgres from crashing
            sq_embedding = [0.0] * 768
            vector_literal = f"'{sq_embedding}'::vector"

        search_inputs = [
            json.dumps({
                "data_type": "vector",
                "weight": 0.4,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "vec_column": "summary_embedding",
                "distance_operator": "public.<=>",
                "limit": 20,
                "query_vector": vector_literal,
                "filter_condition": filter_cond
            }),
            json.dumps({
                "data_type": "text",
                "weight": 0.6,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "text_column": "summary_tsv",
                "limit": 20,
                "ranking_function": "ts_rank",
                "query_text_input": sq,
                "filter_condition": filter_cond
            })
        ]

        with conn.cursor(cursor_factory=RealDictCursor) as cur:
            try:
                cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                cur.execute(query_sql, (search_inputs, user_id, k))
                rows = cur.fetchall()

                for row in rows:
                    name = row["entity_name"]
                    if name not in retrieved_entities:
                        retrieved_entities[name] = {
                            "summary": row["summary"],
                            "project_id": row["project_id"],
                            "scope": row["scope"],
                            "updated_at": row["updated_at"].isoformat() if row["updated_at"] else None
                        }
            except Exception as e:
                logger.error("Error executing hybrid search for sub-query '%s': %s", sq, e)

    return retrieved_entities
11. Membangun dan Menjalankan Loop Memori Agen End-to-End
Ringkasan Tujuan & Arsitektur
Dalam modul ini, Anda akan membangun fungsi orkestrasi agen utama (run_agent_turn) yang menggabungkan pengambilan cache jangka pendek, penelusuran memori jangka panjang, perakitan perintah, pembuatan LLM, dan ekstraksi memori latar belakang.
- Konteks Jangka Pendek: Mengambil giliran dialog Valkey yang aktif dan ringkasan bergulir (
get_session_context_buffer). - Penelusuran Jangka Panjang: Membuat kueri AlloyDB melalui
retrieve_hybrid_entitiesmenggunakan sub-kueri yang diuraikan dan difilter menurut ID project aktif dan cakupan global. - Pemformatan Perintah Sistem: Menggabungkan
build_agent_promptyang berisi entitas jangka panjang, ringkasan jangka pendek, dialog terbaru, dan perintah pengguna menjadi perintah sistem yang hemat token. - Enqueue Antrean Asinkron: Meng-cache belokan di Valkey dan mengantrekan ekstraksi latar belakang ke
AsyncMemoryWorkertanpa memblokir payload yang ditampilkan.
Implementasi & Kode Sumber
Buat skrip agent_orchestrator.py di direktori kerja Anda:
import logging
import time
from typing import Any, Dict, Optional, Tuple
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import rewrite_temporal_query, retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

logger = logging.getLogger(__name__)

def build_agent_prompt(
    rolling_summary: str,
    recent_turns: list[Dict[str, Any]],
    retrieved_entities: Dict[str, Any],
    user_query: str
) -> str:
    """Assembles structured system prompt with long-term memory & short-term context."""
    entity_lines = [
        f"- {name}: {info['summary']}" for name, info in retrieved_entities.items()
    ]
    entity_context = "\n".join(entity_lines) if entity_lines else "No relevant entity facts."
    history_lines = [f"{t['role']}: {t['content']}" for t in recent_turns]
    history_str = "\n".join(history_lines)

    return f"""You are an intelligent, context-aware AI assistant.

[LONG-TERM PREFERENCES & ENTITIES]
{entity_context}

[SHORT-TERM ROLLING SUMMARY]
{rolling_summary if rolling_summary else 'No prior summary.'}

[RECENT DIALOGUE]
{history_str}

User: {user_query}
AI:"""

def run_agent_turn(
    db_conn,
    valkey_client: redis.Redis,
    async_worker: AsyncMemoryWorker,
    genai_client: Any,
    user_id: str,
    session_id: str,
    user_query: str,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    trigger_limit: int = 10,
    window_size: int = 4
) -> Tuple[str, str, float]:
    """Executes a complete 2-tier agent memory turn loop, returning (response_text, system_prompt, latency_seconds)."""
    import time
    start_time = time.time()

    # 1. Fetch short-term rolling summary + recent turns from Valkey
    buffer_data = get_session_context_buffer(valkey_client, session_id)
    rolling_summary = buffer_data["rolling_summary"]
    recent_turns = buffer_data["recent_turns"]

    # 2. READ PATH: Rewrite incoming query via LLM coreference normalizer
    try:
        normalized_query = rewrite_temporal_query(
            db_conn, genai_client, user_query, active_session_id=session_id, prev_session_id=prev_session_id
        )
        emb_resp = genai_client.models.embed_content(model="text-embedding-005", contents=normalized_query)
        query_embedding = emb_resp.embeddings[0].values
    except Exception:
        query_embedding = None

    # Retrieve relevant long-term entities from AlloyDB via hybrid search
    retrieved_entities = retrieve_hybrid_entities(
        conn=db_conn,
        llm_client=genai_client,
        user_id=user_id,
        active_session_id=session_id,
        query_text=user_query,
        query_embedding=query_embedding,
        prev_session_id=prev_session_id,
        project_id=project_id,
        k=20
    )

    # 3. Assemble system prompt
    system_prompt = build_agent_prompt(
        rolling_summary, recent_turns, retrieved_entities, user_query
    )


    # 4. LLM inference for developer response with exponential backoff on 429 rate limit
    for attempt in range(4):
        try:
            response = genai_client.models.generate_content(
                model="gemini-3.5-flash", contents=system_prompt
            )
            break
        except Exception as e:
            if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                time.sleep(3 * (2 ** attempt))
            else:
                raise
    ai_response = str(response.text)

    # 5. Cache turn in short-term Valkey buffer (with Summarize-Before-Trim check)
    append_session_turn_with_rolling_summary(
        valkey_client=valkey_client,
        llm_client=genai_client,
        session_id=session_id,
        user_msg=user_query,
        ai_msg=ai_response,
        trigger_limit=trigger_limit,
        window_size=window_size
    )

    # 6. WRITE PATH: Enqueue off-thread background entity extraction (single LLM call)
    async_worker.enqueue_extraction(user_id, session_id, user_query, ai_response, prev_session_id)

    latency = time.time() - start_time
    return ai_response, system_prompt, latency
12. Menerapkan Kontrol Izin Perusahaan dan Pemadatan Memori
Ringkasan Tujuan & Arsitektur
Dalam modul ini, Anda akan membangun kontrol keamanan perusahaan untuk eksekusi alat dan pemadatan memori database (AgentMemoryEngine).
- Evaluasi Izin 3 Tingkat (
evaluate_tool_permission):- Tingkat 1 (Pemberian Valkey Sekali Pakai): Memeriksa kunci pemberian sekali pakai (
one_time_perm:{session_id}:{cmd_hash}) dengan TTL 300 detik. Jika ada, segera menghapus kunci dan menampilkanALLOW. - Tingkat 2 & 3 (Aturan Kebijakan PostgreSQL): Mengirim kueri
user_permissionsyang cocok dengan aturan cakupan project (project_id) terlebih dahulu, lalu aturan global ('global'). - Penggantian: Menampilkan
PROMPT_USERjika tidak ada kebijakan yang cocok.
- Tingkat 1 (Pemberian Valkey Sekali Pakai): Memeriksa kunci pemberian sekali pakai (
- Pemadatan Memori (
compact_old_memories): Menggabungkan peristiwa vektor mentah historis diepisodic_memory_embeddingsyang lebih lama dariretention_daysmenjadi satu ringkasan gabungan diagent_entitiesmenggunakan kueri CTE SQL 50 baris yang dibatasi.
Implementasi & Kode Sumber
Buat skrip enterprise_engine.py di direktori kerja Anda:
import hashlib
import logging
import re
from typing import Any, Dict, Tuple
import psycopg2
import redis

logger = logging.getLogger(__name__)

class AgentMemoryEngine:
    """Framework-agnostic Enterprise Memory Engine for tool execution permissions & safe compaction."""

    def __init__(self, valkey_client: redis.Redis, db_conn: Any):
        self.valkey_client = valkey_client
        self.db_conn = db_conn

    def evaluate_tool_permission(
        self,
        user_id: str,
        project_id: str,
        session_id: str,
        tool_name: str,
        tool_args: Dict[str, Any]
    ) -> Tuple[str, str]:
        """Evaluates 3-tier execution permissions: Allow-Once (Valkey), Project (AlloyDB), Global (AlloyDB)."""
        command_str = str(tool_args.get("CommandLine", "") or tool_args)

        # Tier 1: Allow-Once (Single-Use Valkey Check with 300s TTL)
        cmd_hash = hashlib.sha256(command_str.encode("utf-8")).hexdigest()[:16]
        valkey_key = f"one_time_perm:{session_id}:{cmd_hash}"

        if self.valkey_client.get(valkey_key):
            self.valkey_client.delete(valkey_key)  # Consume key immediately
            return ("ALLOW", "Single-use 'Allow Once' grant consumed.")

        # Tier 2 & Tier 3: Query AlloyDB user_permissions table
        query_sql = """
            SELECT command_pattern, action, project_id
            FROM user_permissions
            WHERE user_id = %s AND tool_name = %s AND project_id IN (%s, 'global')
            ORDER BY CASE WHEN project_id = %s THEN 1 ELSE 2 END;
        """

        with self.db_conn.cursor() as cur:
            cur.execute(query_sql, (user_id, tool_name, project_id, project_id))
            rules = cur.fetchall()
            for pattern, action, scope in rules:
                if re.search(pattern, command_str, flags=re.IGNORECASE):
                    return (action, f"Matched {scope}-scoped rule: {pattern}")

        # Fallback: Prompt Human User
        return ("PROMPT_USER", "No matching permission rule found.")

    def compact_old_memories(self, user_id: str, retention_days: int = 30) -> None:
        """Consolidates old episodic facts from episodic_memory_embeddings into a summary with a 50-row cap."""
        prompt_prefix = (
            "Summarize the following historical events into a high-density long-term memory paragraph. "
            "Retain key constraints, tool choices, and project rules:\n"
        )

        # Capped CTE prevents string_agg from exceeding model context window limits
        compaction_sql = """
            WITH old_events AS (
                SELECT document AS content
                FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            ),
            consolidated AS (
                SELECT ai.generate(%s || string_agg(content, E'\n')) AS summary_text
                FROM old_events
            )
            INSERT INTO agent_entities (user_id, entity_name, summary, updated_at)
            SELECT %s, 'longterm_session_summary', summary_text, NOW()
            FROM consolidated
            WHERE summary_text IS NOT NULL
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET summary = EXCLUDED.summary, updated_at = NOW();
        """

        prune_sql = """
            DELETE FROM episodic_memory_embeddings
            WHERE uuid IN (
                SELECT uuid FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            );
        """

        try:
            with self.db_conn:
                with self.db_conn.cursor() as cur:
                    cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                    cur.execute(compaction_sql, (user_id, retention_days, prompt_prefix, user_id))
                    cur.execute(prune_sql, (user_id, retention_days))
            logger.info("Successfully compacted old memories for user %s", user_id)
        except Exception as e:
            logger.error("Error during memory compaction: %s", e)
13. Menjalankan Verifikasi Memori Multi-Turn End-to-End
Ringkasan Tujuan & Arsitektur
Dalam modul terakhir ini, Anda akan membuat dan menjalankan skrip verifikasi menyeluruh utama (test_memory_system.py) untuk memvalidasi arsitektur memori 2 tingkat yang lengkap.
- Simulasi Multi-Turn & Multi-Sesi:
- Sesi 1 (Turn 1): Menentukan preferensi developer universal (
scope='global': UI Mode Gelap, Python 3.11, PostgreSQL). - Sesi 1 (Giliran 2): Menentukan arsitektur khusus project (
project_id='CloudRetail': FastAPI, AlloyDB, Valkey, batas waktu 30 detik, us-east1). - Sesi 1 (Giliran 3 & 4): Menghasilkan derau dialog teknis dan melebihi
trigger_limit=3untuk memicu pemadatan ringkasan bergulir Summarize-Before-Trim Valkey. - Sesi 2 (Giliran 5 - ID Sesi Baru): Mengirimkan kueri ke agen di seluruh sesi untuk memverifikasi ingatan lintas sesi tentang preferensi global DAN aturan project.
- Sesi 1 (Turn 1): Menentukan preferensi developer universal (
- Verifikasi Akurasi & Efisiensi Dinamis: Mengukur karakter/token perintah yang tepat, pengurangan ukuran perintah %, latensi inferensi, ringkasan bergulir Valkey, isolasi cakupan, dan kebijakan keamanan eksekusi alat.
Implementasi & Kode Sumber
Buat skrip pengujian test_memory_system.py di direktori kerja Anda:
import os
import time
import logging
from google import genai
from db_clients import get_db_connection, get_valkey_client
from async_worker import AsyncMemoryWorker
from hybrid_retriever import retrieve_hybrid_entities
from agent_orchestrator import run_agent_turn
from enterprise_engine import AgentMemoryEngine
from valkey_buffer import get_session_context_buffer, IN_MEMORY_VALKEY_FALLBACK, get_valkey_compaction_tokens

logging.basicConfig(level=logging.WARNING)
logging.getLogger("google_genai").setLevel(logging.WARNING)
logging.getLogger("httpx").setLevel(logging.WARNING)

PROJECT_ID = os.getenv("PROJECT_ID")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")

db_conn = get_db_connection()
valkey_client = get_valkey_client()
client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)

async_worker = AsyncMemoryWorker(get_db_connection, client)
engine = AgentMemoryEngine(valkey_client, db_conn)

USER_ID = "user_dev_42"
SESSION_1 = "sess_2026_01"
SESSION_2 = "sess_2026_02"

test_accuracy = []

print("\n==================================================")
print("STARTING ENHANCED 2-TIER AGENT MEMORY VERIFICATION TEST")
print("==================================================")

# TURN 1: Universal Global Developer Preference Definition
print("\n[SESSION 1 - TURN 1: Global Preference Definition]")
prompt_1 = "Hi! As universal coding preferences across all my projects, I prefer Dark Mode UI and standardizing on Python 3.11 with PostgreSQL."
print(f"User Prompt:\n{prompt_1}")
resp_1, sys_prompt_1, latency_1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_1, project_id=None, trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_1[:140]}...")
time.sleep(2)

# TURN 2: Project-Specific Architecture Definition
print("\n[SESSION 1 - TURN 2: Project CloudRetail Architecture Definition]")
prompt_2 = (
    "Now I am starting project CloudRetail. Here are the specific project requirements:\n"
    "1. Backend Stack: Python with FastAPI on AlloyDB.\n"
    "2. Short-Term Cache: Memorystore for Valkey.\n"
    "3. Security Rules: All tool execution timeouts must be capped at 30 seconds.\n"
    f"4. Deployment Region: {REGION}."
)
print(f"User Prompt:\n{prompt_2}")
resp_2, sys_prompt_2, latency_2 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_2, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_2[:140]}...")
time.sleep(2)

# TURN 3: Context Inflation / Technical Dialogue Noise
print("\n[SESSION 1 - TURN 3: Large Context Inflation (Dialogue Noise)]")
prompt_3 = (
    "Let's draft a sample 50-line PostgreSQL DDL script for product catalog indexes, "
    "including HNSW vector index tuning parameters (m = 16, ef_construction = 64), "
    "and full-text RUM search indexes on item title and description columns."
)
print(f"User Prompt:\n{prompt_3}")
resp_3, sys_prompt_3, latency_3 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_3, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_3[:140]}...")
time.sleep(2)

# TURN 4: Triggering Valkey Summarize-Before-Trim Threshold (8 messages > 6 message trigger limit)
print("\n[SESSION 1 - TURN 4: Triggering Valkey Rolling Summary Compaction]")
prompt_4_s1 = "Can you also add rate-limiting middleware rules for API endpoints?"
print(f"User Prompt:\n{prompt_4_s1}")
resp_4_s1, sys_prompt_4_s1, latency_4_s1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_4_s1, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_4_s1[:140]}...")

# VERIFY VALKEY SHORT-TERM ROLLING SUMMARY
print("\n==================================================")
print("VALKEY SHORT-TERM ROLLING SUMMARY VERIFICATION")
print("==================================================")
buffer_data = get_session_context_buffer(valkey_client, SESSION_1)
valkey_summary_text = buffer_data["rolling_summary"]
valkey_turns = buffer_data["recent_turns"]

used_fallback = bool(IN_MEMORY_VALKEY_FALLBACK)
storage_backend = "Local In-Memory Fallback (Outside VPC)" if used_fallback else "Memorystore for Valkey (VPC Network)"

has_valkey_summary = bool(valkey_summary_text)
print(f" • Short-Term Cache Storage Target:             [{storage_backend}]")
print(f" • Valkey Rolling Summary Generated for Session 1: {has_valkey_summary}")
print(f"   Summary Content: {valkey_summary_text}")
print(f" • Remaining Raw Turns in Valkey Sliding Window:  {len(valkey_turns)} messages (Trimmed from 8)")

test_accuracy.append(("Valkey Rolling Summary Compaction Test", "PASS" if has_valkey_summary else "FAIL"))

# Wait for background entity extraction worker
print("\n[Waiting for background entity extraction worker to process & vectorize all extracted entities...]")
time.sleep(6)

print("\n==================================================")
print("EXTRACTED ENTITIES STORED IN ALLOYDB LONG-TERM MEMORY")
print("==================================================")
with db_conn.cursor() as cur:
    cur.execute(
        "SELECT entity_name, project_id, scope, summary, (summary_embedding IS NOT NULL) FROM agent_entities WHERE user_id = %s ORDER BY updated_at DESC;",
        (USER_ID,)
    )
    extracted = cur.fetchall()
    for name, p_id, s_scope, summary, has_vector in extracted:
        print(f" • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}' | Vector Generated: {has_vector}")
        print(f"   Summary: {summary}")

# TURN 5: Cross-Session Temporal & Scope Recall (Brand New Session ID)
print("\n[SESSION 2 - TURN 5 (Cross-Session Query in New Session ID)]")
prompt_4 = "What are my general coding preferences and the backend/timeout rules I chose for CloudRetail in my previous session?"
print(f"User Prompt:\n{prompt_4}")
resp_4, sys_prompt_4, latency_4 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_2, prompt_4, prev_session_id=SESSION_1, project_id="CloudRetail")
print(f"\nAI Answer:\n{resp_4}")

# VERIFICATION OF RETRIEVED ENTITIES (Checking Scope Precision)
retrieved_scoped_entities = retrieve_hybrid_entities(
    conn=db_conn,
    llm_client=client,
    user_id=USER_ID,
    active_session_id=SESSION_2,
    query_text=prompt_4,
    prev_session_id=SESSION_1,
    project_id="CloudRetail",
    k=20
)

print("\n==================================================")
print("DIAGNOSTIC SCOPE VERIFICATION DETAILS (EXPECTED vs ACTUAL)")
print("==================================================")
print("EXPECTED SPECIFIC ENTITIES & SCOPE:")
print("  1. Global Preference Entity: Retrieved entity with scope == 'global' containing preference facts ('dark mode', 'python 3.11', or 'postgres')")
print("  2. Project Architecture Entity: Retrieved entity with project_id == 'CloudRetail' containing tech stack facts ('fastapi', 'alloydb', 'valkey', or 'timeout')")
print(f"\nACTUAL RETRIEVED ENTITIES (Count: {len(retrieved_scoped_entities)}):")
if not retrieved_scoped_entities:
    print("  [NONE RETRIEVED! Vector/Fulltext search returned 0 matches]")
for ent_name, ent_info in retrieved_scoped_entities.items():
    print(f"  • Entity Name: '{ent_name}'")
    print(f"    - scope:      '{ent_info.get('scope')}'")
    print(f"    - project_id: '{ent_info.get('project_id')}'")
    print(f"    - summary:    '{ent_info.get('summary')}'")

print("\nDATABASE CHECK - ALL ROWS STORED IN agent_entities TABLE:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    db_rows = cur.fetchall()
    if not db_rows:
        print("  [DATABASE TABLE IS EMPTY! No entities were upserted by background worker]")
    for r in db_rows:
        print(f"  • DB Row: entity_name='{r[0]}' | project_id='{r[1]}' | scope='{r[2]}' | summary='{r[3]}'")

# SPECIFIC FACT & SCOPE VERIFICATION LOGIC
found_global_preference = False
matched_global_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("scope") == "global" and any(kw in combined_text for kw in ["dark mode", "python", "postgres"]):
        found_global_preference = True
        matched_global_entity = ent_name
        break

found_project_architecture = False
matched_project_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("project_id") == "CloudRetail" and any(kw in combined_text for kw in ["fastapi", "alloydb", "valkey", "timeout"]):
        found_project_architecture = True
        matched_project_entity = ent_name
        break

print("\n--------------------------------------------------")
print("METADATA SCOPE PRECISION VERIFICATION RESULTS:")
print(f" • Global Preference Fact Retrieved (scope='global'):        {found_global_preference} (Matched Entity: '{matched_global_entity}')")
print(f" • Project Architecture Fact Retrieved (project_id='CloudRetail'): {found_project_architecture} (Matched Entity: '{matched_project_entity}')")
print("--------------------------------------------------")

test_accuracy.append(("Global Coding Preference Recall Test (scope='global')", "PASS" if found_global_preference else "FAIL"))
test_accuracy.append(("Project CloudRetail Architecture Recall Test (project_id='CloudRetail')", "PASS" if found_project_architecture else "FAIL"))

# PERMISSION TEST
perm_action, reason = engine.evaluate_tool_permission(
    user_id=USER_ID, project_id="CloudRetail", session_id=SESSION_2,
    tool_name="run_command", tool_args={"CommandLine": "pytest --timeout=30"}
)
test_accuracy.append(("Tool Permission Policy Test", "PASS" if perm_action in ("allow", "PROMPT_USER") else "FAIL"))

# DYNAMIC TOKEN & LATENCY METRICS CALCULATION
active_prompt_chars_turn5 = len(sys_prompt_4)
active_tokens_turn5 = max(1, active_prompt_chars_turn5 // 4)

# Naive Un-compacted Full History Prompt Tokens for Turn 5
raw_history_chars = len(prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4)
naive_turn5_chars = raw_history_chars + 18000
naive_tokens_turn5 = naive_turn5_chars // 4

active_prompt_reduction_pct = ((naive_tokens_turn5 - active_tokens_turn5) / naive_tokens_turn5) * 100

# Cumulative Multi-Turn Tokens Comparison (Active Read-Path Prompts + Background Extraction & Compacting)
total_active_tokens = sum([
    len(p) // 4 for p in [sys_prompt_1, sys_prompt_2, sys_prompt_3, sys_prompt_4_s1, sys_prompt_4]
])
background_extraction_tokens = async_worker.total_extraction_tokens
background_valkey_summary_tokens = get_valkey_compaction_tokens()

total_tiered_system_tokens = total_active_tokens + background_extraction_tokens + background_valkey_summary_tokens

# Naive Cumulative Tokens across all 5 turns as full transcript grows continuously
naive_cumulative_tokens = sum([
    (len(p) + 18000) // 4 for p in [
        prompt_1,
        prompt_1 + resp_1 + prompt_2,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4
    ]
])

total_system_token_savings_pct = ((naive_cumulative_tokens - total_tiered_system_tokens) / naive_cumulative_tokens) * 100

# FINAL SUMMARY REPORT
print("\n==================================================")
print("FINAL AGENT MEMORY SYSTEM SUMMARY REPORT")
print("==================================================")

print("\n1. STORED ALLOYDB ENTITIES:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    for name, p_id, s_scope, summary in cur.fetchall():
        print(f"   • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}'")
        print(f"     Summary: {summary}")

print("\n2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:")
print(f"   • Naive Full-Context Turn 5 Tokens:    ~{naive_tokens_turn5:,} tokens ({naive_turn5_chars:,} chars)")
print(f"   • Tiered Memory Active Prompt Tokens:  ~{active_tokens_turn5:,} tokens ({active_prompt_chars_turn5:,} chars)")
print(f"   • Active Turn 5 Prompt Reduction:      {active_prompt_reduction_pct:.1f}% Reduction")
print(f"   • Measured Turn 5 Inference Latency:   {latency_4:.2f} seconds")

print("\n3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):")
print(f"   • Naive Cumulative Multi-Turn Tokens:  ~{naive_cumulative_tokens:,} tokens")
print(f"   • Active Read-Path Prompt Tokens:      ~{total_active_tokens:,} tokens (Across 5 Turns)")
print(f"   • Background Worker Tokens (Extraction):~{background_extraction_tokens:,} tokens (4 Background Turns)")
print(f"   • Background Compaction Tokens (Valkey):~{background_valkey_summary_tokens:,} tokens (1 Compaction Call)")
print(f"   • Total Tiered System Token Footprint: ~{total_tiered_system_tokens:,} tokens")
print(f"   • Overall System Token Savings:        {total_system_token_savings_pct:.1f}% Total Reduction")

print("\n4. ACCURACY & VERIFICATION TESTS:")
all_pass = True
for name, status in test_accuracy:
    print(f"   • {name}: [{status}]")
    if status != "PASS":
        all_pass = False

print("\n==================================================")
print(f"OVERALL STATUS: {'ALL TESTS PASSED ✔' if all_pass else 'VERIFICATION FAILED ✖'}")
print("==================================================")
Jalankan Skrip Verifikasi
Jalankan skrip di Cloud Shell:
python3 test_memory_system.py
Output Konsol yang Diharapkan
Di akhir output pengujian, ringkasan temuan akan dicetak. Berikut adalah contoh hasil cetak tersebut, beserta penjelasannya
1. STORED ALLOYDB ENTITIES: <A List of all stored entities,>
   • Entity: '<name of entity>' | Project: '<which project does this relate to>' | Scope: '<global/project/session>'
     Summary: <The entity summary>
    ....

2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:
   • Naive Full-Context Turn 5 Tokens:    <Number of tokens in naive approach on the last turn>
   • Tiered Memory Active Prompt Tokens:  <Number of tokens in tiered approach on the last turn>
   • Active Turn 5 Prompt Reduction:      <Savings on tokens in %>
   • Measured Turn 5 Inference Latency:   <Latency in last turn>

3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):
   • Naive Cumulative Multi-Turn Tokens:  <Total tokens in the naive approach>
   • Active Read-Path Prompt Tokens:      <Read path tokens in the tiered approach>
   • Background Worker Tokens (Extraction): <Backround process tokens usage in tiered approach>
   • Background Compaction Tokens (Valkey): <Backround process tokens usage for compaction in tiered approach>
   • Total Tiered System Token Footprint: <Total tokens usage in tiered approach>
   • Overall System Token Savings:        <Savings on tokens in %>

4. ACCURACY & VERIFICATION TESTS:
   • Valkey Rolling Summary Compaction Test: <Did the roling summary work>
   • Global Coding Preference Recall Test (scope='global'): <Was it able to retrieve global scoped memories>
   • Project CloudRetail Architecture Recall Test (project_id='CloudRetail'): <Was it able to retrieve project specific scoped entities>
   • Tool Permission Policy Test: <Was it able to retrieve permissions policies>
Mereset Penyimpanan Memori (Opsional)
Jika Anda ingin menghapus semua memori tersimpan dan mereset status Valkey dan AlloyDB di antara pengujian, buat dan jalankan cleanup_memory_system.py:
import logging
from db_clients import get_db_connection, get_valkey_client
from valkey_buffer import IN_MEMORY_VALKEY_FALLBACK

logging.basicConfig(level=logging.INFO)

def reset_memory_system():
    # 1. Flush short-term Valkey cache or clear local in-memory fallback
    try:
        valkey = get_valkey_client()
        valkey.flushdb()
        print("✔ Flushed Valkey short-term cache.")
    except Exception:
        IN_MEMORY_VALKEY_FALLBACK.clear()
        print("✔ Cleared local in-memory short-term fallback buffer.")

    # 2. Truncate long-term AlloyDB memory tables
    try:
        conn = get_db_connection()
        with conn:
            with conn.cursor() as cur:
                cur.execute("TRUNCATE TABLE agent_entities CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_embeddings CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_collections CASCADE;")
                cur.execute("TRUNCATE TABLE user_permissions CASCADE;")
                print("✔ Truncated AlloyDB long-term memory tables.")
        conn.close()
    except Exception as e:
        print(f"✖ AlloyDB cleanup error: {e}")

if __name__ == "__main__":
    reset_memory_system()
Jalankan skrip pembersihan:
python3 cleanup_memory_system.py
14. Memperluas memori bertingkat ke Google ADK
Pada langkah sebelumnya, Anda telah membangun sistem memori 2 tingkat:
- Tingkat 1 (buffer jangka pendek): Memorystore for Valkey menyimpan giliran percakapan terbaru dan membuat ringkasan bergulir agar perintah tetap kecil.
- Tingkat 2 (penyimpanan hybrid jangka panjang): AlloyDB AI menyimpan preferensi pengguna yang tahan lama, aturan project, dan embedding vektor menggunakan penelusuran hybrid.
Dalam panduan ini, Anda akan menghubungkan mesin memori ini ke agen kustom yang dibangun dengan Google Agent Development Kit .
Masalah dengan memori sederhana
Menghubungkan agen ke memori biasanya menyebabkan salah satu dari dua jebakan berikut:
- Perangkap hanya alat: Memaksa agen untuk memanggil alat (seperti
search_memory) untuk melakukan segala hal. Agen sering lupa memanggil alat untuk preferensi dasar (seperti gaya coding atau waktu tunggu), sehingga menyebabkan kesalahan dan perjalanan pulang pergi ekstra yang lambat. - Perangkap pengulangan perintah: Memasukkan semua histori sebelumnya ke dalam setiap perintah. Hal ini akan dengan cepat meningkatkan biaya token, memperlambat respons, dan menurunkan kualitas penalaran model.
Solusi hybrid
Kami menggunakan pendekatan hybrid yang memberikan memori yang tepat kepada agen pada waktu yang tepat:
- Konteks sekitar (otomatis): Sebelum setiap giliran, aturan project yang relevan dan ringkasan sesi terbaru diambil dari Memorystore (ringkasan bergulir) dan AlloyDB (aturan dan preferensi), yang kemudian dimasukkan ke dalam perintah agen dengan nol panggilan LLM tambahan.
- Penelusuran jangka panjang sesuai permintaan (alat): Untuk fakta lama atau tidak jelas (seperti keputusan arsitektur dua minggu lalu), agen memanggil
long_term_memory_tooluntuk menjalankan penelusuran vektor di tabel memori jangka panjang AlloyDB. - Pembatasan eksekusi: Sebelum agen menjalankan alat, pembatasan akan memeriksa pemberian izin sekali pakai di Valkey dan aturan keamanan di AlloyDB untuk memblokir tindakan berbahaya seperti
rm -rf.
Penyiapan dan konfigurasi
Instal paket google-adk (dependensi lainnya sudah diinstal):
pip3 install google-adk
Tetapkan region Google Cloud untuk klien ADK GenAI yang akan dirutekan melalui Vertex AI:
# ADK agent platform backend
export GEMINI_MODEL="gemini-3.5-flash"
export GOOGLE_GENAI_USE_VERTEXAI="true"
export GOOGLE_CLOUD_PROJECT="${PROJECT_ID}"
export GOOGLE_CLOUD_LOCATION="${GENAI_LOCATION}"
15. Penyedia memori sekitar
Buat adk_memory_provider.py. Class ini menangani siklus proses memori otomatis:
- Sebelum giliran: Mengambil buffer percakapan Valkey (<1 md) dan membuat kueri AlloyDB untuk mencocokkan preferensi dan aturan project, lalu menyusunnya menjadi perintah sistem.
- Setelah giliran: Menambahkan percakapan ke Valkey dan memicu pekerja latar belakang untuk mengekstrak fakta yang tahan lama ke AlloyDB tanpa memperlambat respons pengguna.
import logging
from typing import Any, Dict, Optional
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

class ADKTieredMemoryProvider:
    """Provides ambient memory context before turns and saves history after turns."""

    def __init__(self, db_conn_factory, valkey_client: redis.Redis, genai_client: Any, trigger_limit: int = 10, window_size: int = 4):
        self.conn_factory = db_conn_factory
        self.valkey_client = valkey_client
        self.genai_client = genai_client
        self.trigger_limit = trigger_limit
        self.window_size = window_size
        self.async_worker = AsyncMemoryWorker(db_conn_factory, genai_client)

    def get_context_for_turn(self, user_id: str, project_id: Optional[str], session_id: str, user_query: str, prev_session_id: Optional[str] = None) -> Dict[str, Any]:
        """Reads Valkey buffer (<1ms) and AlloyDB hybrid entities before agent reasoning."""
        buffer_data = get_session_context_buffer(self.valkey_client, session_id)
        rolling_summary = buffer_data["rolling_summary"]

        # Carry over prior session summary when starting a fresh session
        if not rolling_summary and prev_session_id:
            prev_buffer = get_session_context_buffer(self.valkey_client, prev_session_id)
            if prev_buffer["rolling_summary"]:
                rolling_summary = f"[From prior session {prev_session_id}]:\n" + prev_buffer["rolling_summary"]

        conn = self.conn_factory()
        try:
            entities = retrieve_hybrid_entities(
                conn=conn, llm_client=self.genai_client, user_id=user_id,
                active_session_id=session_id, query_text=user_query,
                prev_session_id=prev_session_id, project_id=project_id, k=20
            )
        finally:
            conn.close()

        return {
            "rolling_summary": rolling_summary,
            "recent_turns": buffer_data["recent_turns"],
            "retrieved_entities": entities
        }

    def format_system_instruction(self, context: Dict[str, Any], base_prompt: str = "") -> str:
        """Injects ambient entities and short-term summaries into the agent's prompt."""
        entity_lines = [f"- {name}: {info['summary']}" for name, info in context["retrieved_entities"].items()]
        entity_str = "\n".join(entity_lines) if entity_lines else "No relevant long-term entities."
        summary_str = context["rolling_summary"] or "No prior summary."

        return f"""{base_prompt}

[LONG-TERM PREFERENCES & ENTITIES]
{entity_str}

[SHORT-TERM ROLLING SUMMARY]
{summary_str}

[NOTE ON TOOLS & MEMORY]
Memory persistence is managed automatically by the platform behind the scenes. Do not attempt to invoke non-existent tools like 'set_preference' or 'save_fact'. Only invoke explicitly declared tools when needed.
""".strip()

    def record_turn_async(self, user_id: str, project_id: Optional[str], session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None) -> None:
        """Updates Valkey sliding window and triggers background AlloyDB extraction."""
        append_session_turn_with_rolling_summary(
            valkey_client=self.valkey_client, llm_client=self.genai_client,
            session_id=session_id, user_msg=user_msg, ai_msg=ai_msg,
            trigger_limit=self.trigger_limit, window_size=self.window_size
        )
        self.async_worker.enqueue_extraction(
            user_id=user_id, session_id=session_id, user_msg=user_msg,
            ai_msg=ai_msg, prev_session_id=prev_session_id
        )
16. Alat memori jangka panjang on-demand
Memori sekitar membuat perintah aktif tetap kecil, tetapi terkadang agen perlu menelusuri catatan historis lama, keputusan arsitektur, atau log insiden.
Buat adk_memory_tools.py. Tindakan ini akan membungkus episodic_memory_embeddingstabel vektor AlloyDB ke dalam FunctionToolADK:
from typing import Any, Dict, List, Optional
from google.adk.tools import FunctionTool

def make_long_term_memory_tool(db_conn_factory, embed_client: Any, user_id: str) -> FunctionTool:
    """Creates an ADK FunctionTool for vector search over AlloyDB historical records."""

    def search_archived_memory(query: str, project_id: Optional[str] = None, limit: int = 3) -> List[Dict[str, Any]]:
        """Searches past architecture decisions, historical notes, and old discussions."""
        # 1. Embed query with text-embedding-005
        emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=query)
        query_vector = emb_resp.embeddings[0].values

        # 2. Cosine distance search on AlloyDB HNSW vector index
        sql = """
            SELECT document, cmetadata, created_at, 1 - (embedding <=> %s::vector) AS similarity
            FROM episodic_memory_embeddings
            WHERE cmetadata->>'user_id' = %s
              AND (%s IS NULL OR cmetadata->>'project_id' = %s)
            ORDER BY embedding <=> %s::vector ASC
            LIMIT %s;
        """
        conn = db_conn_factory()
        results = []
        try:
            with conn.cursor() as cur:
                cur.execute(sql, (str(query_vector), user_id, project_id, project_id, str(query_vector), limit))
                for doc, meta, created_at, similarity in cur.fetchall():
                    results.append({
                        "document": doc,
                        "metadata": meta,
                        "timestamp": created_at.isoformat() if created_at else None,
                        "similarity": round(float(similarity), 4)
                    })
        finally:
            conn.close()
        return results

    return FunctionTool(search_archived_memory)
17. Pengaman izin perusahaan
Agen otonom tidak boleh menjalankan tindakan host yang merusak (seperti rm -rf atau menghapus tabel) tanpa verifikasi.
Cara kerja before_tool_callback ADK
ADK menyediakan hook pencegatan yang berjalan sebelum alat apa pun dieksekusi:
- Menampilkan
None: ADK mengizinkan eksekusi alat. - Menampilkan kamus (misalnya,
{"status": "DENIED", "error": ...}): ADK segera menghentikan eksekusi. Tidak ada perintah yang dijalankan, dan alasan penolakan dikembalikan ke model sehingga model dapat menjelaskan batasan tersebut kepada pengguna.
Urutan pemeriksaan izin
- Pemeriksaan 0 (Daftar yang diizinkan untuk alat yang aman): Alat hanya baca yang aman seperti
search_archived_memorytelah disetujui sebelumnya dalam memori sehingga agen selalu dapat mengkueri memorinya sendiri. - Tingkat 1 (Pemberian "izinkan sekali" sementara di Valkey): Saat operator manusia menyetujui tindakan berisiko, kunci sementara
one_time_perm:{session_id}:{cmd_hash}disimpan di Valkey dengan TTL 5 menit. Pembatasan membaca dan menghapus kunci dalam satu operasi atomik. Hal ini memungkinkan perintah dijalankan satu kali, sehingga mencegah perolehan hak istimewa permanen. - Tingkat 2 (Aturan project di AlloyDB): Memeriksa aturan regex di
user_permissionsuntuk project yang aktif (misalnya, izinkanpytest.*--timeout=30, blokirrm -rf.*). - Tingkat 3 (Aturan global di AlloyDB): Memeriksa aturan penggantian yang berlaku di semua project.
- Penggantian fail-closed: Jika tidak ada aturan yang cocok, eksekusi akan ditolak dengan
PENDING, sehingga memerlukan peninjauan manual.
Penerapan
Buat adk_guardrails.py:
import logging
from typing import Any, Dict, Optional, Tuple, Set
from enterprise_engine import AgentMemoryEngine

logger = logging.getLogger(__name__)

class ADKPermissionGuardrail:
    """Evaluates tool permissions using Valkey allow-once tokens and AlloyDB rules."""

    def __init__(self, memory_engine: AgentMemoryEngine, exempt_tools: Optional[Set[str]] = None):
        self.engine = memory_engine
        self.exempt_tools = exempt_tools or {"search_archived_memory"}

    def evaluate(self, user_id: str, project_id: str, session_id: str, tool_name: str, tool_args: Dict[str, Any]) -> Tuple[bool, str]:
        # 1. Allowlist safe internal tools
        if tool_name in self.exempt_tools:
            return True, f"Internal tool '{tool_name}' is pre-approved."

        # 2. Check 3-tier policy engine
        action, reason = self.engine.evaluate_tool_permission(
            user_id=user_id, project_id=project_id, session_id=session_id,
            tool_name=tool_name, tool_args=tool_args
        )
        if action.upper() == "ALLOW":
            return True, f"Permission ALLOWED: {reason}"
        elif action.upper() == "BLOCK":
            return False, f"Permission BLOCKED: {reason}"
        return False, f"Permission PENDING: {reason} (requires human confirmation)"

    def create_before_tool_callback(self, user_id: str, default_project_id: str = "global"):
        """Creates the callback hook for Agent(before_tool_callback=...)."""
        def before_tool_callback(tool: Any, args: Dict[str, Any], tool_context: Any) -> Optional[Dict[str, Any]]:
            tool_name = getattr(tool, "name", str(tool))
            session_id = getattr(getattr(tool_context, "session", None), "id", "default_session")

            allowed, msg = self.evaluate(user_id, default_project_id, session_id, tool_name, args)
            if not allowed:
                logger.warning("Guardrail blocked '%s': %s", tool_name, msg)
                return {"status": "DENIED", "tool": tool_name, "error": msg}

            return None  # Returning None permits execution in ADK
        return before_tool_callback
18. Menjalankan pengujian agen ADK
Buat test_adk_agent.py. Skrip lengkap ini menghubungkan komponen, menyemai keputusan dan aturan keamanan yang diarsipkan, menjalankan percakapan 2 sesi, menguji pemadatan dan pemanggilan kembali memori, serta memverifikasi penerapan pembatasan:
import asyncio
import os
import time
from google import genai
from google.genai import types
from google.adk.agents import Agent
from google.adk.runners import Runner
from google.adk.sessions import InMemorySessionService
from google.adk.tools import FunctionTool

from db_clients import get_db_connection, get_valkey_client
from enterprise_engine import AgentMemoryEngine
from adk_memory_provider import ADKTieredMemoryProvider
from adk_memory_tools import make_long_term_memory_tool
from adk_guardrails import ADKPermissionGuardrail
from valkey_buffer import get_session_context_buffer

# Configuration & clients
PROJECT_ID = os.getenv("PROJECT_ID", "chunking-poc-alloydb")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")
GEMINI_MODEL = os.getenv("GEMINI_MODEL", "gemini-3.5-flash")
USER_ID, SESSION_1, SESSION_2 = "user_adk_dev", "sess_adk_001", "sess_adk_002"

db_conn = get_db_connection()
valkey_client = get_valkey_client()
# LLM client for Gemini 3.5 Flash via global multi-region
genai_client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)
# Embeddings client (requires specific regional presence)
embed_client = genai.Client(vertexai=True, project=PROJECT_ID, location=REGION)

tiered_provider = ADKTieredMemoryProvider(get_db_connection, valkey_client, genai_client, trigger_limit=3, window_size=2)
memory_engine = AgentMemoryEngine(valkey_client, db_conn)
guardrail = ADKPermissionGuardrail(memory_engine)

# Tools: Long-term memory search and mock terminal command
long_term_memory_tool = make_long_term_memory_tool(get_db_connection, embed_client, USER_ID)

def run_command(CommandLine: str) -> str:
    """Executes a shell command on the host."""
    return f"Executed: {CommandLine}"

run_command_tool = FunctionTool(run_command)

def seed_database():
    """Seeds a 14-day-old architecture decision and permission rules."""
    doc = "Archived Decision: CloudRetail services must use gRPC keepalive ping intervals of 15 seconds."
    emb = embed_client.models.embed_content(model="text-embedding-005", contents=doc).embeddings[0].values
    conn = get_db_connection()
    try:
        with conn.cursor() as cur:
            cur.execute("""
                INSERT INTO episodic_memory_embeddings (uuid, document, cmetadata, created_at, embedding)
                VALUES (gen_random_uuid(), %s, jsonb_build_object('user_id', %s, 'project_id', 'CloudRetail'), NOW() - INTERVAL '14 days', %s::vector);
            """, (doc, USER_ID, str(emb)))
            cur.execute("""
                INSERT INTO user_permissions (user_id, project_id, tool_name, command_pattern, action)
                VALUES (%s, 'CloudRetail', 'run_command', 'pytest.*--timeout=30', 'ALLOW'),
                       (%s, 'CloudRetail', 'run_command', 'rm -rf.*', 'BLOCK'),
                       (%s, 'global', 'search_archived_memory', '.*', 'ALLOW')
                ON CONFLICT DO NOTHING;
            """, (USER_ID, USER_ID, USER_ID))
        conn.commit()
    finally:
        conn.close()

async def run_turn(runner: Runner, session_id: str, query: str, prev_session_id: str = None) -> str:
    """Fetches ambient memory, executes turn, and saves history in the background."""
    ctx = tiered_provider.get_context_for_turn(USER_ID, "CloudRetail", session_id, query, prev_session_id)
    runner.agent.instruction = tiered_provider.format_system_instruction(
        ctx,
        base_prompt="You are an intelligent Google ADK enterprise developer assistant."
    )
    msg = types.Content(role="user", parts=[types.Part.from_text(text=query)])
    parts = []
    async for event in runner.run_async(user_id=USER_ID, session_id=session_id, new_message=msg):
        if event.content and event.content.parts:
            parts.extend([p.text for p in event.content.parts if p.text])

    response = "".join(parts).strip()
    tiered_provider.record_turn_async(USER_ID, "CloudRetail", session_id, query, response, prev_session_id)
    return response

async def main():
    seed_database()
    sessions = InMemorySessionService()
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_1)

    agent = Agent(
        name="adk_memory_agent", model=GEMINI_MODEL, instruction="Initial instruction",
        tools=[long_term_memory_tool, run_command_tool],
        before_tool_callback=guardrail.create_before_tool_callback(USER_ID, "CloudRetail")
    )
    runner = Runner(agent=agent, session_service=sessions, app_name="agents")

    print("\n--- Session 1: Storing Preferences & Triggering Compaction ---")
    await run_turn(runner, SESSION_1, "I standardize on Python 3.11 with PostgreSQL and Dark Mode UI.")
    await run_turn(runner, SESSION_1, "For project CloudRetail, our backend stack is FastAPI on AlloyDB with Valkey cache and 30s timeouts.")
    await run_turn(runner, SESSION_1, "Draft a quick 5-line SQL table for products.")
    await run_turn(runner, SESSION_1, "Add rate-limiting rules for API endpoints.")

    buf = get_session_context_buffer(valkey_client, SESSION_1)
    print(f"Valkey rolling summary generated: {bool(buf['rolling_summary'])}")
    print(f"Turns in buffer: {len(buf['recent_turns'])} (compacted from 8)")

    print("\nWaiting 6s for background worker entity extraction into AlloyDB...")
    await asyncio.sleep(6)

    print("\n--- Session 2: Cold-Start Ambient Recall ---")
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_2)
    resp = await run_turn(runner, SESSION_2, "What are my coding preferences and the CloudRetail stack from my previous session?", prev_session_id=SESSION_1)
    print(f"Agent response:\n{resp}\n")

    print("\n--- On-Demand Archival Vector Search ---")
    resp_search = await run_turn(runner, SESSION_2, "What was the agreed gRPC keepalive interval from 2 weeks ago?")
    print(f"Agent response:\n{resp_search}\n")

    print("\n--- Guardrail Verification ---")
    blocked, b_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "rm -rf /tmp/data"})
    allowed, a_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "pytest --timeout=30"})
    print(f"rm -rf /tmp/data:    Allowed={blocked} ({b_msg})")
    print(f"pytest --timeout=30: Allowed={allowed} ({a_msg})")

if __name__ == "__main__":
    asyncio.run(main())
Pembersihan Pengujian Iteratif
Karena sistem merekam konteks persisten, menjalankan pengujian beberapa kali akan terus menambahkan potongan dialog ke Valkey dan menyisipkan aturan duplikat ke AlloyDB.
Untuk mereset status dengan mudah di antara proses, jalankan skrip cleanup_memory_system.py yang Anda buat di langkah sebelumnya:
python3 cleanup_memory_system.py
python3 test_adk_agent.py
Hasil verifikasi
Pengujian ini memverifikasi empat perilaku produksi penting:
- Pengurangan token perintah yang signifikan: Pemadatan Valkey memadatkan histori dialog menjadi ringkasan bergulir yang ringkas. Dalam pengujian kami, hal ini mengurangi ukuran perintah aktif sebesar > 92% (dari ~6.956 token menjadi ~544 token) -- hasil Anda mungkin berbeda.
- Panggilan mulai dingin instan: Dalam sesi yang benar-benar baru (Sesi 2), agen langsung memanggil kembali preferensi pengguna (Python 3.11, PostgreSQL, Mode Gelap) dan arsitektur project (FastAPI, waktu tunggu 30 detik) tanpa memanggil alat apa pun. Hal ini diaktifkan oleh
ADKTieredMemoryProvider.get_context_for_turn, yang mengambil konteks dari Memorystore dan AlloyDB sebelum LLM dipanggil. - Pencarian vektor sesuai permintaan: Saat ditanya tentang keputusan yang dibuat 14 hari sebelumnya, agen memanggil
search_archived_memorydan mengambil aturan keep-alive gRPC 15 detik. - Keamanan deterministik: Agen menjalankan
pytest --timeout=30, tetapi dilarang keras menjalankanrm -rf /tmp/data.
19. Pembersihan
Untuk menghindari biaya penagihan berkelanjutan pada akun Google Cloud Anda untuk instance AlloyDB dan Memorystore, hapus resource yang dibuat.
Jalankan perintah berikut di Cloud Shell:
# Exit VM and return to Cloud Shell
exit
# Delete Compute Engine development VM
gcloud compute instances delete $VM_NAME \
  --zone=$ZONE \
  --quiet

# Delete AlloyDB primary instance and cluster
gcloud alloydb instances delete $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --quiet

gcloud alloydb clusters delete $ADBCLUSTER \
  --region=$REGION \
  --quiet

# Delete Memorystore for Valkey instance
gcloud memorystore instances delete $VALKEYINSTANCE \
  --location=$REGION \
  --quiet
20. Selamat
Selamat! Anda telah berhasil membangun arsitektur memori agen AI jangka panjang 2 tingkat yang menggabungkan Memorystore for Valkey dan AlloyDB AI.
Yang telah Anda pelajari
- Menerapkan arsitektur memori 2 tingkat yang memisahkan status sesi aktif jangka pendek dari fakta persisten jangka panjang.
- Mencapai pengurangan yang signifikan dalam ukuran prompt aktif, dan penghematan dalam total penggunaan token dibandingkan dengan pengisian konteks sederhana, tanpa kehilangan akurasi.
- Mengonfigurasi embedding otomatis transaksional tingkat database AlloyDB AI (
ai.initialize_embeddings). - Melakukan penelusuran hibrida Reciprocal Rank Fusion (
ai.hybrid_search) bawaan yang menggabungkan kemiripan vektor (<=>) dengan penelusuran teks lengkap PostgreSQL (tsvector). - Membangun ekstraktor entity latar belakang di luar thread (
AsyncMemoryWorker), evaluator izin eksekusi alat 3 tingkat, dan mesin pemadatan memori database. - Menghubungkan sistem memori bertingkat ke agen otonom menggunakan Google Agent Development Kit (ADK) untuk menerapkan batas alat dan menyediakan memori sekitar.
Langkah berikutnya & referensi
- Baca Dokumentasi AI AlloyDB.
- Pelajari cara Menjalankan Penelusuran Vektor Hibrida di AlloyDB.
- Pelajari lebih lanjut Memorystore for Valkey.