

1. 始める前に
AI エージェントが複数日にわたる長いマルチターンのインタラクションを処理し、長期的な複数ステップのタスクを実行する一方で、大規模言語モデル(LLM)はセッション間で本質的にステートレスのままです。ユーザーが翌日エージェントに戻ると、アプリケーションが必要なコンテキストを再構築できない限り、モデルは最初からやり直します。
この問題に対する単純なアプローチは、トークン スタッフィングです。これは、完全な会話履歴、ツール実行ログ、コードベースをすべてのアクティブなプロンプトに直接追加する方法です。100 万トークンのコンテキスト ウィンドウが大きければ、技術的には可能ですが、コンテキスト スタッフィングは運用上の大きな負担をもたらします。トークン費用はターンごとに 2 乗で増加し、レスポンスのレイテンシは数十秒にまで増加し、モデルは「lost in the middle」コンテキストの劣化に苦しみます。
信頼性の高い AI エージェントを構築するには、2 階層のメモリ アーキテクチャが必要です。
- 短期セッション バッファ: トークン境界のスライディング ウィンドウを使用して、最近の会話のターンをアクティブ メモリにキャッシュに保存します。この階層では、すべてのターンでミリ秒未満の高スループットのインメモリ ルックアップが必要になるため、Memorystore for Valkey が最適です。
- 長期永続メモリ: セッション間で構造化されたエンティティ、ユーザー設定、エピソード的事実を保存します。この階層では、トランザクションの完全性、マルチテナント セキュリティ、リレーショナル データとベクトル間のハイブリッド取得が必要になるため、AlloyDB for PostgreSQL が適切な選択肢となります。
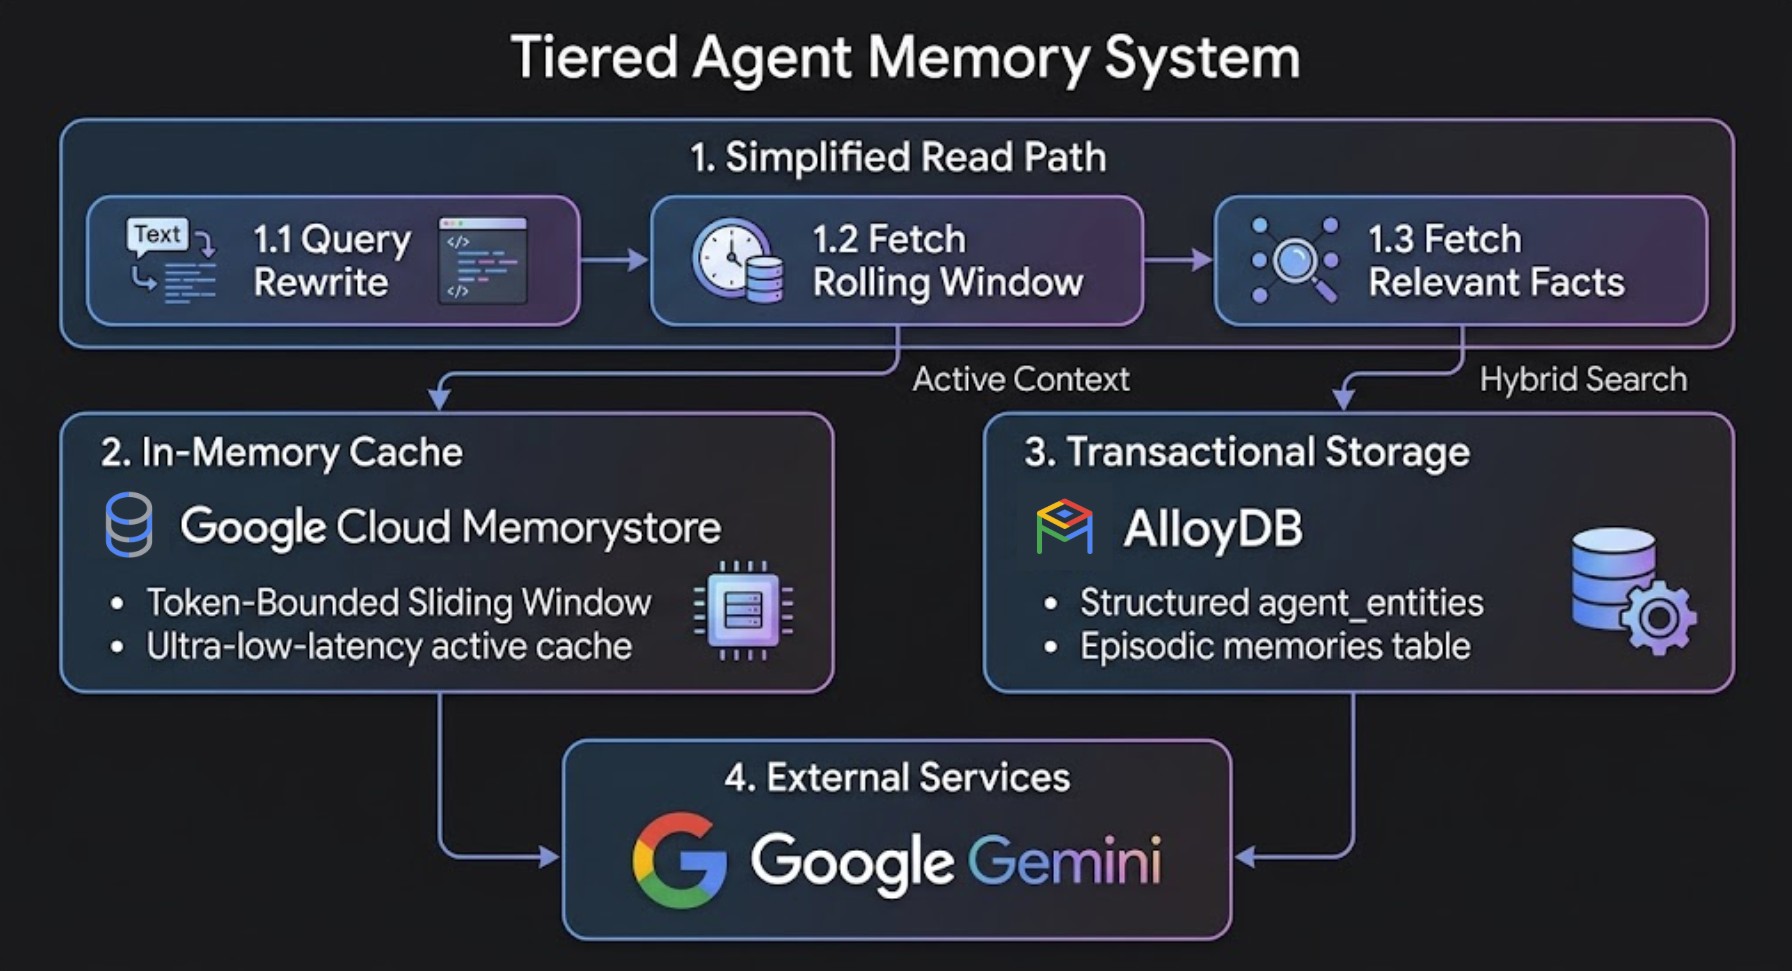
4 種類のメモリについて
堅牢なメモリ アーキテクチャは、ユーザー ジャーニー全体にわたる 4 つの補完的なメモリタイプに依存しています。
メモリのタイプ | 保存されるデータ | ストレージ レイヤ | 寿命 |
バッファ(短期) | 最近の未加工の会話 | Memorystore for Valkey | アクティブなセッション |
概要メモリ | 古いターンの圧縮された履歴 | Memorystore for Valkey | マルチターン ウィンドウ |
エピソード記憶 | 過去のアクション、イベント、ツール出力 | AlloyDB for PostgreSQL(ベクトル) | 永続的 |
エンティティとルールのメモリ | ユーザー設定、制約、拒否 | AlloyDB for PostgreSQL(構造化 SQL + ベクトル) | 永続的 |
階層化メモリの効果の測定
マルチターンの開発ダイアログ(45 ターン以上、ツール出力ログが多い)での内部ベンチマーク テストでは、ナイーブなコンテキスト スタッフィングよりも大幅な節約が実証されています。
指標 / ディメンション | 単純なコンテキストの詰め込み | 階層型メモリ(AlloyDB + Memorystore) | テストでの最終的な影響 |
アクティブなプロンプトのサイズ(45 度回転) | 747,033 個のトークン | 83,262 個のトークン | 88.9% 小さいプロンプト |
Turn 45 response latency | 33.5 秒 | 6.7 秒 | 80.0% 高速な応答 |
累積セッション トークン | 1,790 万トークン | 409 万トークン | トークンとコストの合計削減率 72.0% |
ルールと制約の再現率 | ターンごとに劣化する | 重要な知識が要約で失われるのを防ぐ | ハイブリッド検索で保持 |
演習内容
- AlloyDB for PostgreSQL と Memorystore for Valkey をプロビジョニングします。
google_ml_integrationを有効にして、データベース側のトランザクション自動エンベディング(ai.initialize_embeddings)を構成します。- 要約してからトリミングするパイプライン パターンを使用して、短期間の Valkey セッション バッファを実装します。
- AlloyDB のネイティブ AI 関数(
ai.generateなど)を使用して、長期的なエンティティをネイティブに抽出する - AlloyDB のネイティブ ハイブリッド検索関数(
ai.hybrid_search)と Reciprocal Rank Fusion(RRF)の再ランキングを使用して、長期的な事実を高い精度と関連性でクエリします。 - 3 階層のエンタープライズ ツール権限評価ツールとバックグラウンド メモリ圧縮エンジンを構築します。
- Google Agent Development Kit(ADK)を使用して、2 階層のメモリ アーキテクチャを自律エージェントに直接統合します。
必要なもの
- 課金を有効にした Google Cloud プロジェクト
- ウェブブラウザ(Chrome など)。
- Python と SQL の基本的な知識。AlloyDB に対して SQL クエリを実行した経験(Studio、CLI など)。
オーディエンスと費用
- 対象者: AI デベロッパー、バックエンド エンジニア、データベース アーキテクト。
- 推定費用: この Codelab で作成する Google Cloud リソースの費用は約 $1.50 USD です。
2. 設定と要件
Cloud Shell の起動
この Codelab では、gcloud、psql、python3 が事前に構成されたクラウドホスト型ターミナルである Google Cloud Shell でコマンドを実行します。
- Google Cloud Console を開きます。
- Cloud Console の右上にある [Cloud Shell をアクティブにする] をクリックします。
- 認証を確認します。
gcloud auth list
export PROJECT_ID=<YOUR_PROJECT_ID>
gcloud config set project $PROJECT_ID

export REGION=us-east1
export GENAI_LOCATION=us
export ZONE=us-east1-b
export ADBCLUSTER=agent-memory-cluster
export ADBINSTANCE=agent-memory-instance
export VALKEYINSTANCE=agent-memory-cache
export VM_NAME=agent-dev-vm
Google Cloud APIs を有効にして開発 VM を作成する
Cloud Shell で次のコマンドを実行して、必要な API を有効にします。
gcloud services enable \
  alloydb.googleapis.com \
  memorystore.googleapis.com \
  aiplatform.googleapis.com \
  compute.googleapis.com \
  servicenetworking.googleapis.com \
  networkconnectivity.googleapis.com
default VPC ネットワークに Compute Engine VM インスタンスを作成して、AlloyDB と Memorystore for Valkey とともに Python 開発環境をホストします。
gcloud compute instances create $VM_NAME \
    --zone=$ZONE \
    --machine-type=e2-standard-2 \
    --scopes=cloud-platform \
    --network=default \
    --shielded-secure-boot
3. AlloyDB と Memorystore for Valkey をプロビジョニングする
このステップでは、AlloyDB for PostgreSQL クラスタとプライマリ インスタンスをプロビジョニングし、限定公開サービス ネットワーキングを確立して、Memorystore for Valkey インスタンスをスピンアップします。
プライベート サービス アクセス IP 範囲を作成する
AlloyDB には、Virtual Private Cloud(VPC)ネットワークのプライベート IP 範囲が必要です。default VPC ネットワークを使用しているとします。
- プライベート IP 範囲の割り振りを作成します。
gcloud compute addresses create psa-range \
    --global \
    --purpose=VPC_PEERING \
    --prefix-length=24 \
    --description="VPC private service access" \
    --network=default
- プライベート VPC ピアリング接続を確立します。
gcloud services vpc-peerings connect \
    --service=servicenetworking.googleapis.com \
    --ranges=psa-range \
    --network=default
AlloyDB クラスタとプライマリ インスタンスを作成する
- システム初期化用の初期クラスタ パスワードを作成します。
export PGPASSWORD=`openssl rand -hex 12`
- 無料トライアル クラスタを作成します。
gcloud alloydb clusters create $ADBCLUSTER \
    --password=$PGPASSWORD \
    --network=default \
    --region=$REGION \
    --subscription-type=TRIAL
- プライマリ インスタンスを作成します。
gcloud alloydb instances create $ADBINSTANCE \
    --instance-type=PRIMARY \
    --cpu-count=2 \
    --region=$REGION \
    --cluster=$ADBCLUSTER
Memorystore for Valkey インスタンスをプロビジョニングする
Memorystore for Valkey では、インスタンスを作成する前に、ネットワークとリージョンにサービス接続ポリシー(gcp-memorystore)が必要です。
- Memorystore のサービス接続ポリシーを作成します。
gcloud network-connectivity service-connection-policies create memorystore-policy \
    --network=default \
    --region=$REGION \
    --service-class=gcp-memorystore \
    --subnets=projects/$PROJECT_ID/regions/$REGION/subnetworks/default
- Memorystore for Valkey インスタンスを作成します。
gcloud memorystore instances create $VALKEYINSTANCE \
    --location=$REGION \
    --shard-count=1 \
    --replica-count=0 \
    --node-type=SHARED_CORE_NANO \
    --psc-auto-connections="network=projects/$PROJECT_ID/global/networks/default,projectId=$PROJECT_ID"
Vertex AI IAM 権限を付与する
Agent Platform のエンベディング モデルを呼び出すために必要な IAM 権限を AlloyDB サービス アカウントに付与します。
PROJECT_ID=$(gcloud config get-value project)

gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:service-$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")@gcp-sa-alloydb.iam.gserviceaccount.com" \
  --role="roles/aiplatform.user"
4. 環境とアクセス エンドポイントを初期化する
AlloyDB IAM 認証とデータベース フラグを設定する
AlloyDB インスタンスで IAM データベース認証(alloydb.iam_authentication=on)と AI クエリエンジン(google_ml_integration.enable_ai_query_engine=on)を有効にします。
gcloud beta alloydb instances update $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --update-mode=FORCE_APPLY \
  --database-flags=alloydb.iam_authentication=on,google_ml_integration.enable_ai_query_engine=on
次に、Google Cloud アカウントをスーパーユーザー権限を持つ IAM ベースのデータベース ユーザーとして追加します。
export USER_ACCOUNT=$(gcloud config get-value account)

gcloud alloydb users create $USER_ACCOUNT \
    --cluster=$ADBCLUSTER \
    --region=$REGION \
    --type=IAM_BASED \
    --db-roles=alloydbsuperuser
Cloud Shell で内部 VPC エンドポイントを取得する
開発 VM に SSH 接続する前に、Cloud Shell で AlloyDB と Memorystore for Valkey の内部 VPC IP アドレスを取得します。
# Export GCP Project ID, Region, and IAM User
export PROJECT_ID=$(gcloud config get-value project)
export REGION=us-east1
export DB_USER=$(gcloud config get-value account)

# Retrieve Internal VPC IP Addresses for AlloyDB & Memorystore for Valkey
export DB_HOST=$(gcloud alloydb instances describe $ADBINSTANCE --cluster=$ADBCLUSTER --region=$REGION --format="value(ipAddress)")
export DB_PORT=5432
export DB_NAME=postgres

export VALKEY_HOST=$(gcloud memorystore instances describe $VALKEYINSTANCE --location=$REGION --format="value(discoveryEndpoints[0].address)")
export VALKEY_PORT=6379

# Verify exported endpoints
echo "Project ID:        $PROJECT_ID"
echo "Region:            $REGION"
echo "AlloyDB Private IP: $DB_HOST"
echo "IAM DB User:       $DB_USER"
echo "Valkey Private IP:  $VALKEY_HOST"
開発 VM に SSH 接続して接続変数をエクスポートする
同じ VPC ネットワークにある Compute Engine 開発 VM(agent-dev-vm)に Cloud Shell から SSH 接続します。
gcloud compute ssh $VM_NAME --zone=$ZONE
開発用 VM にログインしたら、上記のプロジェクト構成と接続エンドポイントの出力をエクスポートします(
export PROJECT_ID=<YOUR_PROJECT_ID>
export REGION=us-east1
export GENAI_LOCATION=us
export DB_HOST=<YOUR_ALLOYDB_PRIVATE_IP>
export DB_PORT=5432
export DB_NAME=postgres
export DB_USER=<YOUR_IAM_DB_USER>
export VALKEY_HOST=<YOUR_VALKEY_PRIVATE_IP>
export VALKEY_PORT=6379
Python 仮想環境を初期化する
開発 VM 内で、まずローカル作業ディレクトリを作成します。
mkdir -p ~/alloydb_agent_memory && cd ~/alloydb_agent_memory
次に、システム Python 仮想環境パッケージをインストールし、アプリケーションのデフォルト認証情報(ADC)を認証して、ワークスペースを設定します。
sudo apt-get update && sudo apt-get install -y python3-venv python3-pip

python3 -m venv venv
source venv/bin/activate
最後に、新しい仮想環境に依存関係をインストールします。
gcloud auth application-default login
pip install psycopg2-binary valkey redis google-genai
5. システム アーキテクチャとコード モジュールの階層
構築する内容の概要
個々の Python スクリプトを実装する前に、以下のシステム アーキテクチャを確認してください。このサンプル アプリケーションは、同じ AlloyDB for PostgreSQL データベース インスタンスとやり取りする 2 つの主要な実行パスで動作する 7 つのモジュール式 Python スクリプトに構造化されています。
- 読み取りパス(
hybrid_retriever.py): AlloyDB AIai.generate()を使用して、複合的な複数部分の質問を PostgreSQL 内で単一の側面を持つサブクエリに分解し、AlloyDB のネイティブ ハイブリッド検索(ai.hybrid_search)を使用して長期記憶をクエリします。 - 書き込みパス(
async_worker.py): Gemini Flash を使用して会話のやり取りから構造化されたエンティティ ファクトを非同期で抽出し、agent_entitiesに upsert するオフスレッドのバックグラウンド キュー ワーカー。
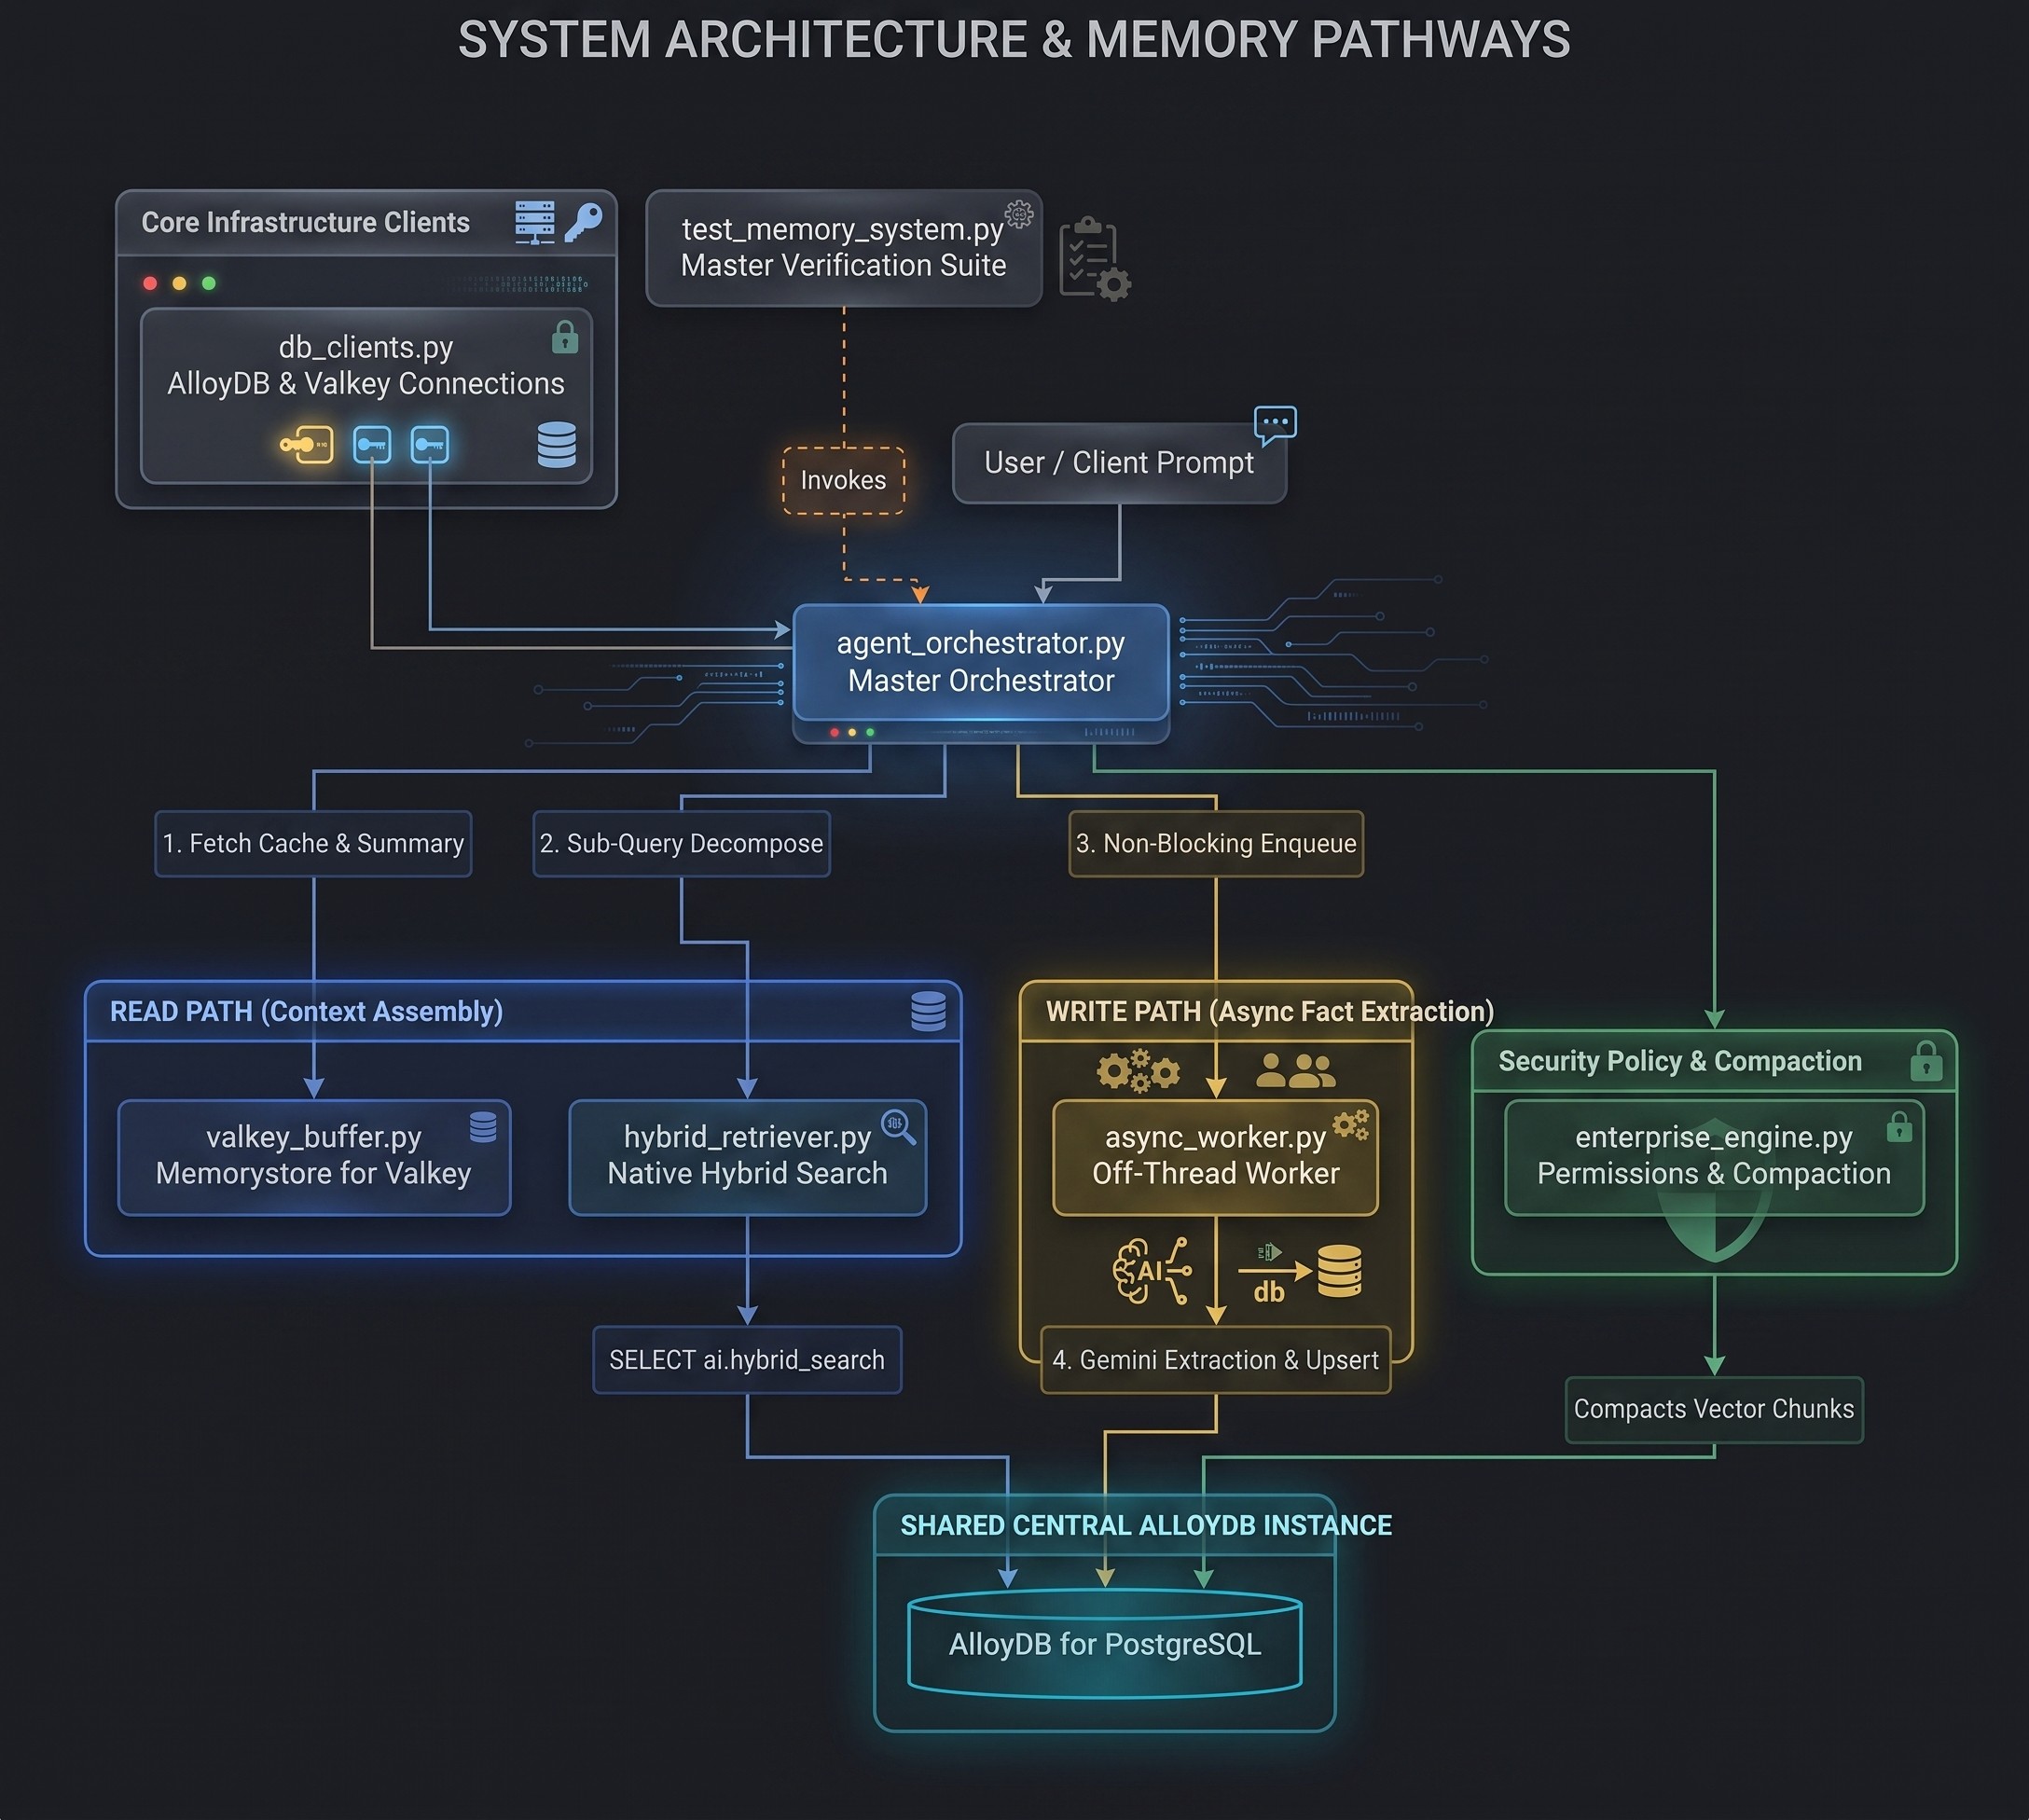
モジュールの階層とシステムロール
モジュール ファイル | システムレイヤ | 主な責任 |
| 接続レイヤ | AlloyDB への SSL 暗号化された IAM 認証と、Memorystore for Valkey へのソケット復元接続を確立します。 |
| 短期記憶 | Valkey でミリ秒未満のセッション履歴を管理し、Summarize-Before-Trim ローリング サマリーを実装します。 |
| 書き込みパス ワーカー | Gemini Flash を使用してエンティティ ファクトを抽出し、AlloyDB に upsert するオフスレッド デーモン バックグラウンド キュー ワーカーを実行します。 |
| 読み取りパス リトリーバー | データベース内の AlloyDB AI |
| メイン エージェント ループ | エンドツーエンドのターン実行ループ(短期フェッチ、長期検索、プロンプト アセンブリ、LLM 実行、非同期キューイング)を調整します。 |
| ガバナンスと管理 | ツールの実行に 3 階層のセキュリティ ポリシーを適用し、過去のメモリを集約します。 |
| テストと評価 | マルチターンとマルチセッションのシナリオを実行し、トークンの節約率を測定し、メモリの精度を検証するマスター検証スイート。 |
6. AlloyDB AI スキーマとトランザクション自動エンベディングを設定する
目標とアーキテクチャの概要
このモジュールでは、エピソード記憶と長期記憶、インデックス戦略、データベース側の自動エンベディング用に AlloyDB のデータベース スキーマを定義します。
- エピソード ベクトル ストア(
episodic_memory_embeddings): HNSW ベクトル インデックス(vector_cosine_ops)でインデックス登録された非構造化チャット文字起こしチャンク。 - 長期エンティティ ストア(
agent_entities): スコープ メタデータ(global、project、session)とともに保存される構造化されたファクト、ユーザーの選択、プロジェクト ルール。RUM を介してインデックス登録された自動生成の PostgreSQL 全文検索列(summary_tsv)が含まれます。 - データベース側の自動エンベディング(
ai.initialize_embeddings): 新規または更新されたプレーン テキストの行を、バックグラウンドで Agent Platformtext-embedding-005を介してsummary_embeddingに自動的にエンベディングします。
AlloyDB Studio に接続する
- Google Cloud コンソールで AlloyDB for Postgres ページに移動します。
- プライマリ インスタンスをクリックします。
- 左側のナビゲーションで、[AlloyDB Studio] をクリックします。
postgresデータベースを選択するIAM database authenticationによる認証
実装とソースコード
AlloyDB PostgreSQL データベースに接続したら、次の DDL クエリを実行します。
-- 1. Enable google_ml_integration extension
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;
CREATE EXTENSION IF NOT EXISTS vector CASCADE;
CREATE EXTENSION IF NOT EXISTS rum CASCADE;
SET google_ml_integration.enable_preview_ai_functions = true;

-- 2. Create Episodic Memory Vector Store Tables
CREATE TABLE IF NOT EXISTS episodic_memory_collections (
    uuid UUID PRIMARY KEY,
    name VARCHAR,
    cmetadata JSONB
);

CREATE TABLE IF NOT EXISTS episodic_memory_embeddings (
    uuid UUID PRIMARY KEY,
    collection_id UUID REFERENCES episodic_memory_collections(uuid) ON DELETE CASCADE,
    embedding VECTOR(768),
    document VARCHAR,
    cmetadata JSONB,
    custom_id VARCHAR,
    created_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS episodic_memory_embedding_idx
ON episodic_memory_embeddings
USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);

-- 3. Create Entity & Preference Table with Metadata Scope & Auto-Generated TSVector Column
CREATE TABLE IF NOT EXISTS agent_entities (
    entity_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    entity_name TEXT NOT NULL,
    project_id TEXT DEFAULT 'global',
    session_id TEXT,
    scope TEXT NOT NULL DEFAULT 'project', -- 'global', 'project', 'session'
    summary TEXT NOT NULL,
    summary_embedding VECTOR(768),
    summary_tsv TSVECTOR GENERATED ALWAYS AS (
        to_tsvector('english', entity_name || ' ' || summary)
    ) STORED,
    updated_at TIMESTAMPTZ DEFAULT NOW(),
    UNIQUE (user_id, entity_name)
);

CREATE INDEX IF NOT EXISTS agent_entities_scope_idx
ON agent_entities (user_id, project_id, scope);

CREATE INDEX IF NOT EXISTS agent_entities_embedding_idx
ON agent_entities USING hnsw (summary_embedding vector_cosine_ops);

CREATE INDEX IF NOT EXISTS agent_entities_tsv_idx
ON agent_entities USING rum (summary_tsv rum_tsvector_ops);

-- 4. Create User Permissions Table for Tool Execution Controls
CREATE TABLE IF NOT EXISTS user_permissions (
    permission_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    project_id TEXT NOT NULL DEFAULT 'global',
    tool_name TEXT NOT NULL,
    command_pattern TEXT NOT NULL,
    action TEXT NOT NULL CHECK (action IN ('ALLOW', 'BLOCK')),
    created_at TIMESTAMPTZ DEFAULT NOW(),
    updated_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS idx_user_permissions_lookup
ON user_permissions (user_id, project_id, tool_name);
-- 5. Register Gemini 3.5 Flash Model Endpoint in AlloyDB
-- Replace PROJECT_ID with your Google Cloud project ID
CALL google_ml.create_model(
    model_id => 'gemini-3.5-flash',
    model_request_url => 'https://aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/global/publishers/google/models/gemini-3.5-flash:generateContent',
    model_qualified_name => 'gemini-3.5-flash',
    model_provider => 'google',
    model_type => 'llm',
    model_auth_type => 'alloydb_service_agent_iam'
);
トランザクション自動エンベディングを初期化して Gemini モデルを登録する
次に、別のクエリ実行ブロックで CALL ステートメントを実行して、自動エンベディング バックグラウンド プロセスと Gemini 3.5 Flash モデル エンドポイントを登録します。
-- 6. Register Database-Side Transactional Auto-Embedding
CALL ai.initialize_embeddings(
    model_id => 'text-embedding-005',
    table_name => 'agent_entities',
    content_column => 'summary',
    embedding_column => 'summary_embedding',
    incremental_refresh_mode => 'transactional',
    batch_size => 10
);
7. AlloyDB と Valkey 接続クライアントを構成する
目標とアーキテクチャの概要
このモジュールでは、AlloyDB for PostgreSQL(長期メモリ)と Memorystore for Valkey(短期キャッシュ)の両方に安全なネットワーク接続を確立します。
- AlloyDB IAM 認証:
gcloud auth application-default print-access-tokenを使用して、パスワードなしの SSL 暗号化データベース接続(sslmode="require")用の有効期間の短い OAuth2 トークンを取得します。 - Valkey ネットワークの復元力:
redis.Redisを 5.0 秒のソケット タイムアウト(socket_timeout=5.0)で構成し、単一ノードまたはクラスタ化された Valkey インスタンス間で VPC ネットワーク オペレーションを安全に処理します。
実装とソースコード
作業ディレクトリにスクリプト db_clients.py を作成します。
import os
import subprocess
import psycopg2
import redis

# Initialize database & Valkey connection clients from environment variables
DB_HOST = os.getenv("DB_HOST", "127.0.0.1")
DB_PORT = os.getenv("DB_PORT", "5432")
DB_NAME = os.getenv("DB_NAME", "postgres")
DB_USER = os.getenv("DB_USER")

VALKEY_HOST = os.getenv("VALKEY_HOST", "127.0.0.1")
VALKEY_PORT = int(os.getenv("VALKEY_PORT", "6379"))

def get_db_connection():
    # Fetch Application Default Credentials (ADC) token for IAM Database Authentication & enable SSL encryption
    access_token = subprocess.check_output(
        ["gcloud", "auth", "application-default", "print-access-token"], text=True
    ).strip()
    return psycopg2.connect(
        host=DB_HOST,
        port=DB_PORT,
        dbname=DB_NAME,
        user=DB_USER,
        password=access_token,
        sslmode="require"
    )

def get_valkey_client():
    return redis.Redis(
        host=VALKEY_HOST,
        port=VALKEY_PORT,
        db=0,
        socket_timeout=5.0,
        socket_connect_timeout=5.0
    )

if __name__ == "__main__":
    print(f"Connecting to AlloyDB via IAM Auth ({DB_USER}) at {DB_HOST}:{DB_PORT} and Valkey at {VALKEY_HOST}:{VALKEY_PORT}...")
    print("Database and Valkey connection client modules loaded successfully.")
8. Memorystore for Valkey で短期セッション状態をキャッシュに保存する
目標とアーキテクチャの概要
このモジュールでは、自動化された Summarize-Before-Trim パターンを実装する Memorystore for Valkey で、ミリ秒未満の短期コンテキスト キャッシュを構築します。
- Valkey スライディング ウィンドウ: アクティブな会話のターンは、キー
session:{session_id}:turnsに JSON 文字列として保存されます。 - Redis ハッシュタグ(
{session_id}): キー形式session:{session_id}:turnsとsession:{session_id}:summaryは Redis クラスタ ハッシュタグ({...})を使用し、両方のキーを同じハッシュスロットに強制的に配置して、単一ノードまたはクラスタ化された Valkey デプロイ全体でアトミック実行を保証します。 - Summarize-Before-Trim: ターン数が
trigger_limitを超えると、Gemini Flash によって、削除される古いターンがローリング テキストの要約(session:{session_id}:summary)に要約され、その後、未加工の履歴がwindow_sizeに削減されます。
実装とソースコード
作業ディレクトリにスクリプト valkey_buffer.py を作成します。
import json
import logging
import time
from typing import Any, Dict, List
import redis

logger = logging.getLogger(__name__)

IN_MEMORY_VALKEY_FALLBACK: Dict[str, Any] = {}
VALKEY_COMPACTION_TOKENS = 0

def get_valkey_compaction_tokens() -> int:
    return VALKEY_COMPACTION_TOKENS

def append_session_turn_with_rolling_summary(
    valkey_client: redis.Redis,
    llm_client: Any,
    session_id: str,
    user_msg: str,
    ai_msg: str,
    trigger_limit: int = 10,
    window_size: int = 4
) -> None:
    """Appends turn to Valkey. Before trimming old turns, summarizes them into a rolling summary."""
    global VALKEY_COMPACTION_TOKENS
    # Use Redis Hash Tags {session_id} so both keys hash to the same cluster slot
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        # 1. Append new turn messages
        valkey_client.rpush(turns_key, json.dumps({"role": "user", "content": user_msg}))
        valkey_client.rpush(turns_key, json.dumps({"role": "assistant", "content": ai_msg}))

        raw_turns = valkey_client.lrange(turns_key, 0, -1)

        # 2. Check if total turns exceed summary trigger threshold
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2

        if len(raw_turns) > msg_trigger_count:
            turns_to_prune = raw_turns[:-msg_window_count]
            existing_summary = valkey_client.get(summary_key)
            existing_summary_text = (
                existing_summary.decode('utf-8') if isinstance(existing_summary, bytes) else (existing_summary or "")
            )

            pruned_text = "\n".join([
                f"{json.loads(t)['role']}: {json.loads(t)['content']}" for t in turns_to_prune
            ])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            updated_summary_text = llm_client.models.generate_content(
                model="gemini-3.5-flash", contents=prompt
            ).text.strip()
            # Execute commands directly to support all Redis/Valkey cluster topologies
            valkey_client.set(summary_key, updated_summary_text)
            valkey_client.ltrim(turns_key, -msg_window_count, -1)
            logger.info("Updated rolling summary and trimmed Valkey buffer for session %s", session_id)

    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey operation warning (%s). Falling back to in-memory short-term buffer.", e)
        if turns_key not in IN_MEMORY_VALKEY_FALLBACK:
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = []
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "user", "content": user_msg})
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "assistant", "content": ai_msg})

        # In-memory summarize-before-trim fallback logic
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2
        raw_fallback_turns = IN_MEMORY_VALKEY_FALLBACK[turns_key]

        if len(raw_fallback_turns) > msg_trigger_count:
            turns_to_prune = raw_fallback_turns[:-msg_window_count]
            existing_summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
            pruned_text = "\n".join([f"{t['role']}: {t['content']}" for t in turns_to_prune])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            for attempt in range(4):
                try:
                    updated_summary_text = llm_client.models.generate_content(
                        model="gemini-3.5-flash", contents=prompt
                    ).text.strip()
                    break
                except Exception as e:
                    if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                        time.sleep(3 * (2 ** attempt))
                    else:
                        raise

            IN_MEMORY_VALKEY_FALLBACK[summary_key] = updated_summary_text
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = raw_fallback_turns[-msg_window_count:]

def get_session_context_buffer(
    valkey_client: redis.Redis,
    session_id: str
) -> Dict[str, Any]:
    """Retrieves rolling summary + sliding window history from Valkey to build prompt context."""
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        summary = valkey_client.get(summary_key)
        summary_text = summary.decode('utf-8') if isinstance(summary, bytes) else (summary or "")

        raw_turns = valkey_client.lrange(turns_key, 0, -1)
        recent_turns = [json.loads(t) for t in raw_turns]

        return {
            "rolling_summary": summary_text,
            "recent_turns": recent_turns
        }
    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey read error (%s). Using in-memory short-term fallback buffer.", e)
        summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
        recent_turns = IN_MEMORY_VALKEY_FALLBACK.get(turns_key, [])
        return {"rolling_summary": summary_text, "recent_turns": recent_turns}
9. エンティティをスレッド外で抽出(バックグラウンド メモリ ワーカー)
目標とアーキテクチャの概要
このモジュールでは、インタラクティブな AI のレスポンスを遅くすることなく、長期的なエンティティの事実を抽出するオフスレッドの書き込みパスのバックグラウンド抽出ワーカー(AsyncMemoryWorker)を構築します。
- 非ブロック キュー ワーカー: デベロッパー チャットが LLM の抽出やデータベースの書き込みを待たずにすぐに戻るように、デーモン スレッド(
queue.Queue)を起動します。 - オフスレッド エンティティ事実抽出: バックグラウンドで Gemini Flash(
model="gemini-3.5-flash"、response_mime_type="application/json")を呼び出して、ユーザー向けの会話ターンをブロックせずに構造化エンティティを解析します。 - 時間的照応解決(
build_temporal_rules_prompt): 相対的な時間表現(「現在」、「前回のセッション」など)を明示的なセッション ID(session_idなど)に変換するルールを適用します。 - スキーマの更新: Gemini Flash にエンティティ(
entity_name、project_id、scope、summary)の JSON 配列を返すようプロンプトし、パラメータ化された PostgreSQLON CONFLICT DO UPDATEステートメントを使用してagent_entitiesにプレーン テキストを書き込みます。
実装とソースコード
作業ディレクトリにスクリプト async_worker.py を作成します。
import json
import logging
import queue
import threading
import time
from typing import Dict, Any, Optional
import psycopg2

logger = logging.getLogger(__name__)

def build_temporal_rules_prompt(active_session_id: str, prev_session_id: Optional[str] = None) -> str:
    """REUSABLE PROMPT HELPER: Defines temporal coreference rules for both Read and Write paths."""
    return f"""TEMPORAL COREFERENCE RULES:
1. Do not use relative temporal words like 'currently', 'now', 'this session', 'previous session', or 'last session'.
2. Replace any relative temporal reference with explicit session identifiers:
   - Active Session: '{active_session_id}'
   - Previous Session: '{prev_session_id if prev_session_id else active_session_id}'
   (e.g., write 'User prefers Python in session {active_session_id}' instead of 'User currently prefers Python')."""

class AsyncMemoryWorker:
    """Off-thread daemon queue worker performing background entity extraction and upserts into AlloyDB."""
    def __init__(self, conn_factory, llm_client):
        self.conn_factory = conn_factory
        self.llm_client = llm_client
        self.work_queue = queue.Queue()
        self.total_extraction_tokens = 0
        self.worker_thread = threading.Thread(target=self._run_worker, daemon=True)
        self.worker_thread.start()

    def enqueue_extraction(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        self.work_queue.put((user_id, session_id, user_msg, ai_msg, prev_session_id))

    def _run_worker(self):
        while True:
            item = self.work_queue.get()
            if item is None:
                break
            user_id, session_id, user_msg, ai_msg, prev_session_id = item
            try:
                self._extract_and_upsert(user_id, session_id, user_msg, ai_msg, prev_session_id)
            except Exception as e:
                logger.error("Background extraction failed: %s", e)
            finally:
                self.work_queue.task_done()

    def _extract_and_upsert(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        temporal_rules = build_temporal_rules_prompt(session_id, prev_session_id)
        json_fmt = '[{"entity_name": "...", "project_id": "...", "scope": "global|project|session", "summary": "..."}]'

        prompt = f"""Extract key preferences and named entities from this exchange.
Format output strictly as a JSON array of objects with structure: {json_fmt}.

{temporal_rules}

Rules for Scope:
- 'global': Universal developer preferences.
- 'project': Architecture, database choices, timeouts, and rules for a specific project.
- 'session': Ephemeral task state tied strictly to a single session.

User: {user_msg}
AI: {ai_msg}

Output (JSON array only):"""

        self.total_extraction_tokens += max(1, len(prompt) // 4)

        for attempt in range(4):
            try:
                response = self.llm_client.models.generate_content(
                    model="gemini-3.5-flash",
                    contents=prompt,
                    config={"response_mime_type": "application/json"}
                )
                break
            except Exception as e:
                if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                    time.sleep(3 * (2 ** attempt))
                else:
                    raise
        content = str(response.text).strip()
        if not content:
            return

        extracted_list = json.loads(content)
        if not isinstance(extracted_list, list):
            return

        upsert_sql = """
            INSERT INTO agent_entities (user_id, entity_name, project_id, session_id, scope, summary, updated_at)
            VALUES (%s, %s, %s, %s, %s, %s, NOW())
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET
                project_id = EXCLUDED.project_id,
                session_id = EXCLUDED.session_id,
                scope = EXCLUDED.scope,
                summary = EXCLUDED.summary,
                updated_at = NOW();
        """

        conn = self.conn_factory()
        try:
            with conn:
                with conn.cursor() as cur:
                    for item in extracted_list:
                        e_name = item.get("entity_name", "General_Fact")
                        p_id = item.get("project_id", "global")
                        s_scope = item.get("scope", "project")
                        summary = item.get("summary", "")
                        if e_name and summary:
                            cur.execute(upsert_sql, (user_id, e_name, p_id, session_id, s_scope, summary))
            logger.info("Saved %d entities for user %s", len(extracted_list), user_id)
        finally:
            conn.close()
10. ネイティブ ハイブリッド検索で長期記憶に対してクエリを実行する
目標とアーキテクチャの概要
このモジュールでは、読み取りパスのサブクエリ分解、時間クエリの書き換え、メタデータ スコープの分離を実装し、AlloyDB のネイティブ ハイブリッド検索(ai.hybrid_search)を使用します。
- データベース内サブクエリ分解(
rewrite_and_decompose_query): AlloyDB AI の組み込み関数ai.generate()を PostgreSQL 内で直接使用して、複合質問を正規化されたセッション ID を持つ単一の側面サブクエリに分割し、マルチトピック クエリによるベクトル検索の精度の低下を防ぎます。 - インデックス レベルのスコープ フィルタリング: データベース側の SQL フィルタ(
filter_condition => "user_id = '%s' AND (project_id = '%s' OR scope = 'global')")を構築して、グローバルなデベロッパー設定を含めながら、ユーザーとプロジェクトごとにメモリを分離します。 - AlloyDB ネイティブ ハイブリッド検索(
ai.hybrid_search): AlloyDB 内でベクトル コサイン類似度(public.<=>)と全文検索(rum)を相互ランク融合(RRF)を使用して組み合わせ、最適な精度、再現率、関連性を提供します。
実装とソースコード
作業ディレクトリにスクリプト hybrid_retriever.py を作成します。
import os
import json
import logging
from typing import Any, Dict, List, Optional
import psycopg2
from psycopg2.extras import RealDictCursor
from async_worker import build_temporal_rules_prompt

logger = logging.getLogger(__name__)

def rewrite_and_decompose_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> List[str]:
    """Read-Path LLM Query Normalizer & Sub-Query Decomposer using AlloyDB AI ai.generate() directly in PostgreSQL."""
    temporal_rules = build_temporal_rules_prompt(active_session_id, prev_session_id)

    prompt = f"""You are a query normalization and decomposition tool for an AI agent's memory retrieval system.

Tasks:
1. Normalize any relative temporal phrases in the user query into explicit session identifiers.
{temporal_rules}

2. Decompose compound user queries asking about multiple distinct topics into up to 4 concise, single-topic search queries. Ensure all distinct questions (both general developer preferences and project-specific architecture/rules) are preserved as separate sub-queries.
3. Return ONLY a valid JSON array of strings containing the sub-queries.

Example Output Format:
["general developer coding preferences", "CloudRetail backend stack in session sess_2026_01", "CloudRetail timeout rules in session sess_2026_01"]

Text to Process: {text}
JSON Output:"""

    try:
        with conn.cursor() as cur:
            cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
            cur.execute("SELECT ai.generate(prompt => %s::text, model_id => 'gemini-3.5-flash'::varchar(100));", (prompt,))
            row = cur.fetchone()
            if row and row[0]:
                res_text = str(row[0]).strip()
                clean_text = res_text
                if clean_text.startswith("```"):
                    clean_text = clean_text.removeprefix("```json").removeprefix("```").removesuffix("```").strip()
                parsed = json.loads(clean_text)
                if isinstance(parsed, list) and len(parsed) > 0:
                    return [str(q).strip() for q in parsed]
        return [text]
    except Exception as e:
        logger.error("Error in in-database ai.generate sub-query decomposition: %s", e)
        return [text]

def rewrite_temporal_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> str:
    """Backward-compatible wrapper returning first decomposed query string."""
    queries = rewrite_and_decompose_query(conn, llm_client, text, active_session_id, prev_session_id)
    return queries[0] if queries else text

def retrieve_hybrid_entities(
    conn,
    llm_client: Any,
    user_id: str,
    active_session_id: str,
    query_text: str,
    query_embedding: Optional[List[float]] = None,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    k: int = 20
) -> Dict[str, Any]:
    """Queries long-term entities using Sub-Query Decomposition, metadata scope filtering, and parameterized AlloyDB hybrid search."""
    sub_queries = rewrite_and_decompose_query(
        conn=conn, llm_client=llm_client, text=query_text, active_session_id=active_session_id, prev_session_id=prev_session_id
    )
    all_search_queries = list(dict.fromkeys(sub_queries + [query_text]))

    retrieved_entities: Dict[str, Any] = {}

    filter_cond = f"user_id = '{user_id}' AND (project_id = '{project_id}' OR scope = 'global')" if project_id else f"user_id = '{user_id}'"

    query_sql = """
        SELECT e.entity_name, e.summary, e.project_id, e.scope, e.updated_at
        FROM ai.hybrid_search(
          search_inputs => %s::JSONB[],
          include_json_output => false
        ) h
        JOIN agent_entities e ON e.entity_name = h.id
        WHERE e.user_id = %s
        LIMIT %s;
    """

    from google import genai
    embed_client = genai.Client(
        vertexai=True,
        project=os.getenv("PROJECT_ID"),
        location=os.getenv("REGION", "us-east1")
    )

    for sq in all_search_queries:
        try:
            emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=sq)
            sq_embedding = emb_resp.embeddings[0].values
            vector_literal = f"'{sq_embedding}'::vector"
        except Exception as e:
            logger.error(f"Failed to generate embedding for sub-query: {sq}. Error: {e}")
            # Fallback to zero vector to prevent Postgres from crashing
            sq_embedding = [0.0] * 768
            vector_literal = f"'{sq_embedding}'::vector"

        search_inputs = [
            json.dumps({
                "data_type": "vector",
                "weight": 0.4,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "vec_column": "summary_embedding",
                "distance_operator": "public.<=>",
                "limit": 20,
                "query_vector": vector_literal,
                "filter_condition": filter_cond
            }),
            json.dumps({
                "data_type": "text",
                "weight": 0.6,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "text_column": "summary_tsv",
                "limit": 20,
                "ranking_function": "ts_rank",
                "query_text_input": sq,
                "filter_condition": filter_cond
            })
        ]

        with conn.cursor(cursor_factory=RealDictCursor) as cur:
            try:
                cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                cur.execute(query_sql, (search_inputs, user_id, k))
                rows = cur.fetchall()

                for row in rows:
                    name = row["entity_name"]
                    if name not in retrieved_entities:
                        retrieved_entities[name] = {
                            "summary": row["summary"],
                            "project_id": row["project_id"],
                            "scope": row["scope"],
                            "updated_at": row["updated_at"].isoformat() if row["updated_at"] else None
                        }
            except Exception as e:
                logger.error("Error executing hybrid search for sub-query '%s': %s", sq, e)

    return retrieved_entities
11. エンドツーエンド エージェント メモリ ループをビルドして実行する
目標とアーキテクチャの概要
このモジュールでは、短期キャッシュの取得、長期記憶の検索、プロンプトの組み立て、LLM の生成、バックグラウンド メモリの抽出を組み合わせたメイン エージェント オーケストレーション関数(run_agent_turn)を構築します。
- 短期コンテキスト: アクティブな Valkey の会話ターンとローリング サマリー(
get_session_context_buffer)を取得します。 - 長期検索: アクティブなプロジェクト ID とグローバル スコープでフィルタされた分解されたサブクエリを使用して、
retrieve_hybrid_entities経由で AlloyDB をクエリします。 - システム プロンプトのフォーマット: 長期的なエンティティ、短期的な要約、最近の会話、ユーザー プロンプトを含む
build_agent_promptを、トークン効率の高いシステム プロンプトに組み立てます。 - Async Queue Enqueue: Valkey でターンをキャッシュに保存し、戻りペイロードをブロックせずにバックグラウンド抽出を
AsyncMemoryWorkerにキューに追加します。
実装とソースコード
作業ディレクトリにスクリプト agent_orchestrator.py を作成します。
import logging
import time
from typing import Any, Dict, Optional, Tuple
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import rewrite_temporal_query, retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

logger = logging.getLogger(__name__)

def build_agent_prompt(
    rolling_summary: str,
    recent_turns: list[Dict[str, Any]],
    retrieved_entities: Dict[str, Any],
    user_query: str
) -> str:
    """Assembles structured system prompt with long-term memory & short-term context."""
    entity_lines = [
        f"- {name}: {info['summary']}" for name, info in retrieved_entities.items()
    ]
    entity_context = "\n".join(entity_lines) if entity_lines else "No relevant entity facts."
    history_lines = [f"{t['role']}: {t['content']}" for t in recent_turns]
    history_str = "\n".join(history_lines)

    return f"""You are an intelligent, context-aware AI assistant.

[LONG-TERM PREFERENCES & ENTITIES]
{entity_context}

[SHORT-TERM ROLLING SUMMARY]
{rolling_summary if rolling_summary else 'No prior summary.'}

[RECENT DIALOGUE]
{history_str}

User: {user_query}
AI:"""

def run_agent_turn(
    db_conn,
    valkey_client: redis.Redis,
    async_worker: AsyncMemoryWorker,
    genai_client: Any,
    user_id: str,
    session_id: str,
    user_query: str,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    trigger_limit: int = 10,
    window_size: int = 4
) -> Tuple[str, str, float]:
    """Executes a complete 2-tier agent memory turn loop, returning (response_text, system_prompt, latency_seconds)."""
    import time
    start_time = time.time()

    # 1. Fetch short-term rolling summary + recent turns from Valkey
    buffer_data = get_session_context_buffer(valkey_client, session_id)
    rolling_summary = buffer_data["rolling_summary"]
    recent_turns = buffer_data["recent_turns"]

    # 2. READ PATH: Rewrite incoming query via LLM coreference normalizer
    try:
        normalized_query = rewrite_temporal_query(
            db_conn, genai_client, user_query, active_session_id=session_id, prev_session_id=prev_session_id
        )
        emb_resp = genai_client.models.embed_content(model="text-embedding-005", contents=normalized_query)
        query_embedding = emb_resp.embeddings[0].values
    except Exception:
        query_embedding = None

    # Retrieve relevant long-term entities from AlloyDB via hybrid search
    retrieved_entities = retrieve_hybrid_entities(
        conn=db_conn,
        llm_client=genai_client,
        user_id=user_id,
        active_session_id=session_id,
        query_text=user_query,
        query_embedding=query_embedding,
        prev_session_id=prev_session_id,
        project_id=project_id,
        k=20
    )

    # 3. Assemble system prompt
    system_prompt = build_agent_prompt(
        rolling_summary, recent_turns, retrieved_entities, user_query
    )


    # 4. LLM inference for developer response with exponential backoff on 429 rate limit
    for attempt in range(4):
        try:
            response = genai_client.models.generate_content(
                model="gemini-3.5-flash", contents=system_prompt
            )
            break
        except Exception as e:
            if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                time.sleep(3 * (2 ** attempt))
            else:
                raise
    ai_response = str(response.text)

    # 5. Cache turn in short-term Valkey buffer (with Summarize-Before-Trim check)
    append_session_turn_with_rolling_summary(
        valkey_client=valkey_client,
        llm_client=genai_client,
        session_id=session_id,
        user_msg=user_query,
        ai_msg=ai_response,
        trigger_limit=trigger_limit,
        window_size=window_size
    )

    # 6. WRITE PATH: Enqueue off-thread background entity extraction (single LLM call)
    async_worker.enqueue_extraction(user_id, session_id, user_query, ai_response, prev_session_id)

    latency = time.time() - start_time
    return ai_response, system_prompt, latency
12. エンタープライズ権限制御とメモリ圧縮を実装
目標とアーキテクチャの概要
このモジュールでは、ツールの実行とデータベース メモリの圧縮(AgentMemoryEngine)のためのエンタープライズ セキュリティ管理を構築します。
- 3 階層の権限評価(
evaluate_tool_permission):- Tier 1(1 回限りの Valkey 権限付与): 300 秒の TTL で 1 回限りの権限付与キー(
one_time_perm:{session_id}:{cmd_hash})をチェックします。存在する場合は、キーを直ちに削除してALLOWを返します。 - Tier 2 と Tier 3(PostgreSQL ポリシー ルール):
user_permissionsクエリは、まずプロジェクト スコープのルール(project_id)に一致し、次にグローバル ルール('global')に一致します。 - フォールバック: 一致するポリシーが存在しない場合は
PROMPT_USERを返します。
- Tier 1(1 回限りの Valkey 権限付与): 300 秒の TTL で 1 回限りの権限付与キー(
- メモリ圧縮(
compact_old_memories):retention_daysより古いepisodic_memory_embeddingsの過去の未加工ベクトル イベントを、上限が 50 行の SQL CTE クエリを使用してagent_entitiesの単一の統合された概要に集約します。
実装とソースコード
作業ディレクトリにスクリプト enterprise_engine.py を作成します。
import hashlib
import logging
import re
from typing import Any, Dict, Tuple
import psycopg2
import redis

logger = logging.getLogger(__name__)

class AgentMemoryEngine:
    """Framework-agnostic Enterprise Memory Engine for tool execution permissions & safe compaction."""

    def __init__(self, valkey_client: redis.Redis, db_conn: Any):
        self.valkey_client = valkey_client
        self.db_conn = db_conn

    def evaluate_tool_permission(
        self,
        user_id: str,
        project_id: str,
        session_id: str,
        tool_name: str,
        tool_args: Dict[str, Any]
    ) -> Tuple[str, str]:
        """Evaluates 3-tier execution permissions: Allow-Once (Valkey), Project (AlloyDB), Global (AlloyDB)."""
        command_str = str(tool_args.get("CommandLine", "") or tool_args)

        # Tier 1: Allow-Once (Single-Use Valkey Check with 300s TTL)
        cmd_hash = hashlib.sha256(command_str.encode("utf-8")).hexdigest()[:16]
        valkey_key = f"one_time_perm:{session_id}:{cmd_hash}"

        if self.valkey_client.get(valkey_key):
            self.valkey_client.delete(valkey_key)  # Consume key immediately
            return ("ALLOW", "Single-use 'Allow Once' grant consumed.")

        # Tier 2 & Tier 3: Query AlloyDB user_permissions table
        query_sql = """
            SELECT command_pattern, action, project_id
            FROM user_permissions
            WHERE user_id = %s AND tool_name = %s AND project_id IN (%s, 'global')
            ORDER BY CASE WHEN project_id = %s THEN 1 ELSE 2 END;
        """

        with self.db_conn.cursor() as cur:
            cur.execute(query_sql, (user_id, tool_name, project_id, project_id))
            rules = cur.fetchall()
            for pattern, action, scope in rules:
                if re.search(pattern, command_str, flags=re.IGNORECASE):
                    return (action, f"Matched {scope}-scoped rule: {pattern}")

        # Fallback: Prompt Human User
        return ("PROMPT_USER", "No matching permission rule found.")

    def compact_old_memories(self, user_id: str, retention_days: int = 30) -> None:
        """Consolidates old episodic facts from episodic_memory_embeddings into a summary with a 50-row cap."""
        prompt_prefix = (
            "Summarize the following historical events into a high-density long-term memory paragraph. "
            "Retain key constraints, tool choices, and project rules:\n"
        )

        # Capped CTE prevents string_agg from exceeding model context window limits
        compaction_sql = """
            WITH old_events AS (
                SELECT document AS content
                FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            ),
            consolidated AS (
                SELECT ai.generate(%s || string_agg(content, E'\n')) AS summary_text
                FROM old_events
            )
            INSERT INTO agent_entities (user_id, entity_name, summary, updated_at)
            SELECT %s, 'longterm_session_summary', summary_text, NOW()
            FROM consolidated
            WHERE summary_text IS NOT NULL
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET summary = EXCLUDED.summary, updated_at = NOW();
        """

        prune_sql = """
            DELETE FROM episodic_memory_embeddings
            WHERE uuid IN (
                SELECT uuid FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            );
        """

        try:
            with self.db_conn:
                with self.db_conn.cursor() as cur:
                    cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                    cur.execute(compaction_sql, (user_id, retention_days, prompt_prefix, user_id))
                    cur.execute(prune_sql, (user_id, retention_days))
            logger.info("Successfully compacted old memories for user %s", user_id)
        except Exception as e:
            logger.error("Error during memory compaction: %s", e)
13. エンドツーエンドのマルチターン メモリ検証を実行する
目標とアーキテクチャの概要
この最後のモジュールでは、完全な 2 階層メモリ アーキテクチャを検証するために、マスター エンドツーエンド検証スクリプト(test_memory_system.py)を作成して実行します。
- 複数ターンの複数セッションのシミュレーション:
- セッション 1(ターン 1): 汎用的なデベロッパー設定(
scope='global': ダークモード UI、Python 3.11、PostgreSQL)を定義します。 - セッション 1(ターン 2): プロジェクト固有のアーキテクチャ(
project_id='CloudRetail': FastAPI、AlloyDB、Valkey、30 秒のタイムアウト上限、us-east1)を定義します。 - セッション 1(ターン 3 と 4): 技術的な会話のノイズを生成し、
trigger_limit=3を超えて Valkey の Summarize-Before-Trim ローリング サマリー圧縮をトリガーします。 - セッション 2(ターン 5 - 新しいセッション ID): セッション間でエージェントにクエリを実行し、グローバル設定とプロジェクト ルールのセッション間の呼び出しを確認します。
- セッション 1(ターン 1): 汎用的なデベロッパー設定(
- 動的効率と精度の検証: 正確なプロンプト文字数/トークン数、プロンプト サイズの削減率、推論レイテンシ、Valkey のローリング サマリー、スコープの分離、ツール実行のセキュリティ ポリシーを測定します。
実装とソースコード
作業ディレクトリにテスト スクリプト test_memory_system.py を作成します。
import os
import time
import logging
from google import genai
from db_clients import get_db_connection, get_valkey_client
from async_worker import AsyncMemoryWorker
from hybrid_retriever import retrieve_hybrid_entities
from agent_orchestrator import run_agent_turn
from enterprise_engine import AgentMemoryEngine
from valkey_buffer import get_session_context_buffer, IN_MEMORY_VALKEY_FALLBACK, get_valkey_compaction_tokens

logging.basicConfig(level=logging.WARNING)
logging.getLogger("google_genai").setLevel(logging.WARNING)
logging.getLogger("httpx").setLevel(logging.WARNING)

PROJECT_ID = os.getenv("PROJECT_ID")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")

db_conn = get_db_connection()
valkey_client = get_valkey_client()
client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)

async_worker = AsyncMemoryWorker(get_db_connection, client)
engine = AgentMemoryEngine(valkey_client, db_conn)

USER_ID = "user_dev_42"
SESSION_1 = "sess_2026_01"
SESSION_2 = "sess_2026_02"

test_accuracy = []

print("\n==================================================")
print("STARTING ENHANCED 2-TIER AGENT MEMORY VERIFICATION TEST")
print("==================================================")

# TURN 1: Universal Global Developer Preference Definition
print("\n[SESSION 1 - TURN 1: Global Preference Definition]")
prompt_1 = "Hi! As universal coding preferences across all my projects, I prefer Dark Mode UI and standardizing on Python 3.11 with PostgreSQL."
print(f"User Prompt:\n{prompt_1}")
resp_1, sys_prompt_1, latency_1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_1, project_id=None, trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_1[:140]}...")
time.sleep(2)

# TURN 2: Project-Specific Architecture Definition
print("\n[SESSION 1 - TURN 2: Project CloudRetail Architecture Definition]")
prompt_2 = (
    "Now I am starting project CloudRetail. Here are the specific project requirements:\n"
    "1. Backend Stack: Python with FastAPI on AlloyDB.\n"
    "2. Short-Term Cache: Memorystore for Valkey.\n"
    "3. Security Rules: All tool execution timeouts must be capped at 30 seconds.\n"
    f"4. Deployment Region: {REGION}."
)
print(f"User Prompt:\n{prompt_2}")
resp_2, sys_prompt_2, latency_2 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_2, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_2[:140]}...")
time.sleep(2)

# TURN 3: Context Inflation / Technical Dialogue Noise
print("\n[SESSION 1 - TURN 3: Large Context Inflation (Dialogue Noise)]")
prompt_3 = (
    "Let's draft a sample 50-line PostgreSQL DDL script for product catalog indexes, "
    "including HNSW vector index tuning parameters (m = 16, ef_construction = 64), "
    "and full-text RUM search indexes on item title and description columns."
)
print(f"User Prompt:\n{prompt_3}")
resp_3, sys_prompt_3, latency_3 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_3, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_3[:140]}...")
time.sleep(2)

# TURN 4: Triggering Valkey Summarize-Before-Trim Threshold (8 messages > 6 message trigger limit)
print("\n[SESSION 1 - TURN 4: Triggering Valkey Rolling Summary Compaction]")
prompt_4_s1 = "Can you also add rate-limiting middleware rules for API endpoints?"
print(f"User Prompt:\n{prompt_4_s1}")
resp_4_s1, sys_prompt_4_s1, latency_4_s1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_4_s1, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_4_s1[:140]}...")

# VERIFY VALKEY SHORT-TERM ROLLING SUMMARY
print("\n==================================================")
print("VALKEY SHORT-TERM ROLLING SUMMARY VERIFICATION")
print("==================================================")
buffer_data = get_session_context_buffer(valkey_client, SESSION_1)
valkey_summary_text = buffer_data["rolling_summary"]
valkey_turns = buffer_data["recent_turns"]

used_fallback = bool(IN_MEMORY_VALKEY_FALLBACK)
storage_backend = "Local In-Memory Fallback (Outside VPC)" if used_fallback else "Memorystore for Valkey (VPC Network)"

has_valkey_summary = bool(valkey_summary_text)
print(f" • Short-Term Cache Storage Target:             [{storage_backend}]")
print(f" • Valkey Rolling Summary Generated for Session 1: {has_valkey_summary}")
print(f"   Summary Content: {valkey_summary_text}")
print(f" • Remaining Raw Turns in Valkey Sliding Window:  {len(valkey_turns)} messages (Trimmed from 8)")

test_accuracy.append(("Valkey Rolling Summary Compaction Test", "PASS" if has_valkey_summary else "FAIL"))

# Wait for background entity extraction worker
print("\n[Waiting for background entity extraction worker to process & vectorize all extracted entities...]")
time.sleep(6)

print("\n==================================================")
print("EXTRACTED ENTITIES STORED IN ALLOYDB LONG-TERM MEMORY")
print("==================================================")
with db_conn.cursor() as cur:
    cur.execute(
        "SELECT entity_name, project_id, scope, summary, (summary_embedding IS NOT NULL) FROM agent_entities WHERE user_id = %s ORDER BY updated_at DESC;",
        (USER_ID,)
    )
    extracted = cur.fetchall()
    for name, p_id, s_scope, summary, has_vector in extracted:
        print(f" • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}' | Vector Generated: {has_vector}")
        print(f"   Summary: {summary}")

# TURN 5: Cross-Session Temporal & Scope Recall (Brand New Session ID)
print("\n[SESSION 2 - TURN 5 (Cross-Session Query in New Session ID)]")
prompt_4 = "What are my general coding preferences and the backend/timeout rules I chose for CloudRetail in my previous session?"
print(f"User Prompt:\n{prompt_4}")
resp_4, sys_prompt_4, latency_4 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_2, prompt_4, prev_session_id=SESSION_1, project_id="CloudRetail")
print(f"\nAI Answer:\n{resp_4}")

# VERIFICATION OF RETRIEVED ENTITIES (Checking Scope Precision)
retrieved_scoped_entities = retrieve_hybrid_entities(
    conn=db_conn,
    llm_client=client,
    user_id=USER_ID,
    active_session_id=SESSION_2,
    query_text=prompt_4,
    prev_session_id=SESSION_1,
    project_id="CloudRetail",
    k=20
)

print("\n==================================================")
print("DIAGNOSTIC SCOPE VERIFICATION DETAILS (EXPECTED vs ACTUAL)")
print("==================================================")
print("EXPECTED SPECIFIC ENTITIES & SCOPE:")
print("  1. Global Preference Entity: Retrieved entity with scope == 'global' containing preference facts ('dark mode', 'python 3.11', or 'postgres')")
print("  2. Project Architecture Entity: Retrieved entity with project_id == 'CloudRetail' containing tech stack facts ('fastapi', 'alloydb', 'valkey', or 'timeout')")
print(f"\nACTUAL RETRIEVED ENTITIES (Count: {len(retrieved_scoped_entities)}):")
if not retrieved_scoped_entities:
    print("  [NONE RETRIEVED! Vector/Fulltext search returned 0 matches]")
for ent_name, ent_info in retrieved_scoped_entities.items():
    print(f"  • Entity Name: '{ent_name}'")
    print(f"    - scope:      '{ent_info.get('scope')}'")
    print(f"    - project_id: '{ent_info.get('project_id')}'")
    print(f"    - summary:    '{ent_info.get('summary')}'")

print("\nDATABASE CHECK - ALL ROWS STORED IN agent_entities TABLE:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    db_rows = cur.fetchall()
    if not db_rows:
        print("  [DATABASE TABLE IS EMPTY! No entities were upserted by background worker]")
    for r in db_rows:
        print(f"  • DB Row: entity_name='{r[0]}' | project_id='{r[1]}' | scope='{r[2]}' | summary='{r[3]}'")

# SPECIFIC FACT & SCOPE VERIFICATION LOGIC
found_global_preference = False
matched_global_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("scope") == "global" and any(kw in combined_text for kw in ["dark mode", "python", "postgres"]):
        found_global_preference = True
        matched_global_entity = ent_name
        break

found_project_architecture = False
matched_project_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("project_id") == "CloudRetail" and any(kw in combined_text for kw in ["fastapi", "alloydb", "valkey", "timeout"]):
        found_project_architecture = True
        matched_project_entity = ent_name
        break

print("\n--------------------------------------------------")
print("METADATA SCOPE PRECISION VERIFICATION RESULTS:")
print(f" • Global Preference Fact Retrieved (scope='global'):        {found_global_preference} (Matched Entity: '{matched_global_entity}')")
print(f" • Project Architecture Fact Retrieved (project_id='CloudRetail'): {found_project_architecture} (Matched Entity: '{matched_project_entity}')")
print("--------------------------------------------------")

test_accuracy.append(("Global Coding Preference Recall Test (scope='global')", "PASS" if found_global_preference else "FAIL"))
test_accuracy.append(("Project CloudRetail Architecture Recall Test (project_id='CloudRetail')", "PASS" if found_project_architecture else "FAIL"))

# PERMISSION TEST
perm_action, reason = engine.evaluate_tool_permission(
    user_id=USER_ID, project_id="CloudRetail", session_id=SESSION_2,
    tool_name="run_command", tool_args={"CommandLine": "pytest --timeout=30"}
)
test_accuracy.append(("Tool Permission Policy Test", "PASS" if perm_action in ("allow", "PROMPT_USER") else "FAIL"))

# DYNAMIC TOKEN & LATENCY METRICS CALCULATION
active_prompt_chars_turn5 = len(sys_prompt_4)
active_tokens_turn5 = max(1, active_prompt_chars_turn5 // 4)

# Naive Un-compacted Full History Prompt Tokens for Turn 5
raw_history_chars = len(prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4)
naive_turn5_chars = raw_history_chars + 18000
naive_tokens_turn5 = naive_turn5_chars // 4

active_prompt_reduction_pct = ((naive_tokens_turn5 - active_tokens_turn5) / naive_tokens_turn5) * 100

# Cumulative Multi-Turn Tokens Comparison (Active Read-Path Prompts + Background Extraction & Compacting)
total_active_tokens = sum([
    len(p) // 4 for p in [sys_prompt_1, sys_prompt_2, sys_prompt_3, sys_prompt_4_s1, sys_prompt_4]
])
background_extraction_tokens = async_worker.total_extraction_tokens
background_valkey_summary_tokens = get_valkey_compaction_tokens()

total_tiered_system_tokens = total_active_tokens + background_extraction_tokens + background_valkey_summary_tokens

# Naive Cumulative Tokens across all 5 turns as full transcript grows continuously
naive_cumulative_tokens = sum([
    (len(p) + 18000) // 4 for p in [
        prompt_1,
        prompt_1 + resp_1 + prompt_2,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4
    ]
])

total_system_token_savings_pct = ((naive_cumulative_tokens - total_tiered_system_tokens) / naive_cumulative_tokens) * 100

# FINAL SUMMARY REPORT
print("\n==================================================")
print("FINAL AGENT MEMORY SYSTEM SUMMARY REPORT")
print("==================================================")

print("\n1. STORED ALLOYDB ENTITIES:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    for name, p_id, s_scope, summary in cur.fetchall():
        print(f"   • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}'")
        print(f"     Summary: {summary}")

print("\n2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:")
print(f"   • Naive Full-Context Turn 5 Tokens:    ~{naive_tokens_turn5:,} tokens ({naive_turn5_chars:,} chars)")
print(f"   • Tiered Memory Active Prompt Tokens:  ~{active_tokens_turn5:,} tokens ({active_prompt_chars_turn5:,} chars)")
print(f"   • Active Turn 5 Prompt Reduction:      {active_prompt_reduction_pct:.1f}% Reduction")
print(f"   • Measured Turn 5 Inference Latency:   {latency_4:.2f} seconds")

print("\n3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):")
print(f"   • Naive Cumulative Multi-Turn Tokens:  ~{naive_cumulative_tokens:,} tokens")
print(f"   • Active Read-Path Prompt Tokens:      ~{total_active_tokens:,} tokens (Across 5 Turns)")
print(f"   • Background Worker Tokens (Extraction):~{background_extraction_tokens:,} tokens (4 Background Turns)")
print(f"   • Background Compaction Tokens (Valkey):~{background_valkey_summary_tokens:,} tokens (1 Compaction Call)")
print(f"   • Total Tiered System Token Footprint: ~{total_tiered_system_tokens:,} tokens")
print(f"   • Overall System Token Savings:        {total_system_token_savings_pct:.1f}% Total Reduction")

print("\n4. ACCURACY & VERIFICATION TESTS:")
all_pass = True
for name, status in test_accuracy:
    print(f"   • {name}: [{status}]")
    if status != "PASS":
        all_pass = False

print("\n==================================================")
print(f"OVERALL STATUS: {'ALL TESTS PASSED ✔' if all_pass else 'VERIFICATION FAILED ✖'}")
print("==================================================")
検証スクリプトを実行する
Cloud Shell でスクリプトを実行します。
python3 test_memory_system.py
想定されるコンソール出力
テスト出力の最後に、結果の概要が出力されます。以下に、このようなプリントアウトの例と説明を示します。
1. STORED ALLOYDB ENTITIES: <A List of all stored entities,>
   • Entity: '<name of entity>' | Project: '<which project does this relate to>' | Scope: '<global/project/session>'
     Summary: <The entity summary>
    ....

2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:
   • Naive Full-Context Turn 5 Tokens:    <Number of tokens in naive approach on the last turn>
   • Tiered Memory Active Prompt Tokens:  <Number of tokens in tiered approach on the last turn>
   • Active Turn 5 Prompt Reduction:      <Savings on tokens in %>
   • Measured Turn 5 Inference Latency:   <Latency in last turn>

3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):
   • Naive Cumulative Multi-Turn Tokens:  <Total tokens in the naive approach>
   • Active Read-Path Prompt Tokens:      <Read path tokens in the tiered approach>
   • Background Worker Tokens (Extraction): <Backround process tokens usage in tiered approach>
   • Background Compaction Tokens (Valkey): <Backround process tokens usage for compaction in tiered approach>
   • Total Tiered System Token Footprint: <Total tokens usage in tiered approach>
   • Overall System Token Savings:        <Savings on tokens in %>

4. ACCURACY & VERIFICATION TESTS:
   • Valkey Rolling Summary Compaction Test: <Did the roling summary work>
   • Global Coding Preference Recall Test (scope='global'): <Was it able to retrieve global scoped memories>
   • Project CloudRetail Architecture Recall Test (project_id='CloudRetail'): <Was it able to retrieve project specific scoped entities>
   • Tool Permission Policy Test: <Was it able to retrieve permissions policies>
メモリストアをリセットする(省略可)
保存されたすべてのメモリをクリアし、テスト実行間で Valkey と AlloyDB の状態をリセットする場合は、cleanup_memory_system.py を作成して実行します。
import logging
from db_clients import get_db_connection, get_valkey_client
from valkey_buffer import IN_MEMORY_VALKEY_FALLBACK

logging.basicConfig(level=logging.INFO)

def reset_memory_system():
    # 1. Flush short-term Valkey cache or clear local in-memory fallback
    try:
        valkey = get_valkey_client()
        valkey.flushdb()
        print("✔ Flushed Valkey short-term cache.")
    except Exception:
        IN_MEMORY_VALKEY_FALLBACK.clear()
        print("✔ Cleared local in-memory short-term fallback buffer.")

    # 2. Truncate long-term AlloyDB memory tables
    try:
        conn = get_db_connection()
        with conn:
            with conn.cursor() as cur:
                cur.execute("TRUNCATE TABLE agent_entities CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_embeddings CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_collections CASCADE;")
                cur.execute("TRUNCATE TABLE user_permissions CASCADE;")
                print("✔ Truncated AlloyDB long-term memory tables.")
        conn.close()
    except Exception as e:
        print(f"✖ AlloyDB cleanup error: {e}")

if __name__ == "__main__":
    reset_memory_system()
クリーンアップ スクリプトを実行します。
python3 cleanup_memory_system.py
14. 階層化メモリを Google ADK に拡張する
前の手順では、2 階層のメモリ システムを構築しました。
- Tier 1(短期バッファ): Memorystore for Valkey は、最近の会話のターンを保存し、ローリング サマリーを作成して、プロンプトを小さく保ちます。
- Tier 2(長期ハイブリッド ストア): AlloyDB AI は、ハイブリッド検索を使用して、永続的なユーザー設定、プロジェクト ルール、ベクトル エンベディングを保存します。
このガイドでは、このメモリ エンジンを Google Agent Development Kit で構築されたカスタム エージェントに接続します。
単純なメモリの問題
エージェントをメモリに接続すると、通常、次の 2 つの落とし穴のいずれかにはまります。
- ツールのみのトラップ: エージェントにすべての処理でツール(
search_memoryなど)を呼び出すことを強制します。エージェントは、コーディング スタイルやタイムアウトなどの基本的な設定でツールを呼び出すことを忘れることが多く、ミスが発生したり、余分なラウンド トリップが遅くなったりします。 - プロンプト スタッフィングの罠: 過去の履歴をすべてプロンプトにダンプすること。これにより、トークン費用が急増し、応答が遅くなり、モデルの推論が低下します。
ハイブリッド ソリューション
エージェントに適切なタイミングで適切なメモリを提供するハイブリッド アプローチを使用します。
- 周囲のコンテキスト(自動): ターンごとに、関連するプロジェクト ルールと最近のセッションの要約が Memorystore(ローリング要約)と AlloyDB(ルールと設定)から取得され、追加の LLM 呼び出しなしでエージェントのプロンプトに挿入されます。
- オンデマンドの長期検索(ツール): 古い事実や不明瞭な事実(2 週間前のアーキテクチャ上の決定など)については、エージェントが
long_term_memory_toolを呼び出して、AlloyDB の長期メモリ テーブルでベクトル検索を実行します。 - 実行ガードレール: エージェントがツールを実行する前に、ガードレールが Valkey の 1 回限りの権限付与と AlloyDB のセキュリティ ルールをチェックして、
rm -rfなどの危険なアクションをブロックします。
セットアップと構成
google-adk パッケージをインストールします(他の依存関係はすでにインストールされています)。
pip3 install google-adk
ADK GenAI クライアントの Google Cloud リージョンを設定して、Vertex AI を介してルーティングします。
# ADK agent platform backend
export GEMINI_MODEL="gemini-3.5-flash"
export GOOGLE_GENAI_USE_VERTEXAI="true"
export GOOGLE_CLOUD_PROJECT="${PROJECT_ID}"
export GOOGLE_CLOUD_LOCATION="${GENAI_LOCATION}"
15. アンビエント メモリ プロバイダ
adk_memory_provider.py を作成します。このクラスは、自動メモリ ライフサイクルを処理します。
- ターンの前: Valkey 会話バッファ(1 ミリ秒未満)を取得し、一致する設定とプロジェクト ルールについて AlloyDB にクエリを実行して、それらをシステム プロンプトに組み立てます。
- ターン後: 会話を Valkey に追加し、バックグラウンド ワーカーをトリガーして、ユーザーのレスポンスを遅らせることなく、永続的なファクトを AlloyDB に抽出します。
import logging
from typing import Any, Dict, Optional
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

class ADKTieredMemoryProvider:
    """Provides ambient memory context before turns and saves history after turns."""

    def __init__(self, db_conn_factory, valkey_client: redis.Redis, genai_client: Any, trigger_limit: int = 10, window_size: int = 4):
        self.conn_factory = db_conn_factory
        self.valkey_client = valkey_client
        self.genai_client = genai_client
        self.trigger_limit = trigger_limit
        self.window_size = window_size
        self.async_worker = AsyncMemoryWorker(db_conn_factory, genai_client)

    def get_context_for_turn(self, user_id: str, project_id: Optional[str], session_id: str, user_query: str, prev_session_id: Optional[str] = None) -> Dict[str, Any]:
        """Reads Valkey buffer (<1ms) and AlloyDB hybrid entities before agent reasoning."""
        buffer_data = get_session_context_buffer(self.valkey_client, session_id)
        rolling_summary = buffer_data["rolling_summary"]

        # Carry over prior session summary when starting a fresh session
        if not rolling_summary and prev_session_id:
            prev_buffer = get_session_context_buffer(self.valkey_client, prev_session_id)
            if prev_buffer["rolling_summary"]:
                rolling_summary = f"[From prior session {prev_session_id}]:\n" + prev_buffer["rolling_summary"]

        conn = self.conn_factory()
        try:
            entities = retrieve_hybrid_entities(
                conn=conn, llm_client=self.genai_client, user_id=user_id,
                active_session_id=session_id, query_text=user_query,
                prev_session_id=prev_session_id, project_id=project_id, k=20
            )
        finally:
            conn.close()

        return {
            "rolling_summary": rolling_summary,
            "recent_turns": buffer_data["recent_turns"],
            "retrieved_entities": entities
        }

    def format_system_instruction(self, context: Dict[str, Any], base_prompt: str = "") -> str:
        """Injects ambient entities and short-term summaries into the agent's prompt."""
        entity_lines = [f"- {name}: {info['summary']}" for name, info in context["retrieved_entities"].items()]
        entity_str = "\n".join(entity_lines) if entity_lines else "No relevant long-term entities."
        summary_str = context["rolling_summary"] or "No prior summary."

        return f"""{base_prompt}

[LONG-TERM PREFERENCES & ENTITIES]
{entity_str}

[SHORT-TERM ROLLING SUMMARY]
{summary_str}

[NOTE ON TOOLS & MEMORY]
Memory persistence is managed automatically by the platform behind the scenes. Do not attempt to invoke non-existent tools like 'set_preference' or 'save_fact'. Only invoke explicitly declared tools when needed.
""".strip()

    def record_turn_async(self, user_id: str, project_id: Optional[str], session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None) -> None:
        """Updates Valkey sliding window and triggers background AlloyDB extraction."""
        append_session_turn_with_rolling_summary(
            valkey_client=self.valkey_client, llm_client=self.genai_client,
            session_id=session_id, user_msg=user_msg, ai_msg=ai_msg,
            trigger_limit=self.trigger_limit, window_size=self.window_size
        )
        self.async_worker.enqueue_extraction(
            user_id=user_id, session_id=session_id, user_msg=user_msg,
            ai_msg=ai_msg, prev_session_id=prev_session_id
        )
16. オンデマンド長期記憶ツール
アンビエント メモリはアクティブなプロンプトを小さく保ちますが、エージェントは古い履歴メモ、アーキテクチャの決定、インシデント ログを検索する必要がある場合があります。
adk_memory_tools.py を作成します。これにより、AlloyDB の episodic_memory_embeddings ベクトル テーブルが ADK FunctionTool にラップされます。
from typing import Any, Dict, List, Optional
from google.adk.tools import FunctionTool

def make_long_term_memory_tool(db_conn_factory, embed_client: Any, user_id: str) -> FunctionTool:
    """Creates an ADK FunctionTool for vector search over AlloyDB historical records."""

    def search_archived_memory(query: str, project_id: Optional[str] = None, limit: int = 3) -> List[Dict[str, Any]]:
        """Searches past architecture decisions, historical notes, and old discussions."""
        # 1. Embed query with text-embedding-005
        emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=query)
        query_vector = emb_resp.embeddings[0].values

        # 2. Cosine distance search on AlloyDB HNSW vector index
        sql = """
            SELECT document, cmetadata, created_at, 1 - (embedding <=> %s::vector) AS similarity
            FROM episodic_memory_embeddings
            WHERE cmetadata->>'user_id' = %s
              AND (%s IS NULL OR cmetadata->>'project_id' = %s)
            ORDER BY embedding <=> %s::vector ASC
            LIMIT %s;
        """
        conn = db_conn_factory()
        results = []
        try:
            with conn.cursor() as cur:
                cur.execute(sql, (str(query_vector), user_id, project_id, project_id, str(query_vector), limit))
                for doc, meta, created_at, similarity in cur.fetchall():
                    results.append({
                        "document": doc,
                        "metadata": meta,
                        "timestamp": created_at.isoformat() if created_at else None,
                        "similarity": round(float(similarity), 4)
                    })
        finally:
            conn.close()
        return results

    return FunctionTool(search_archived_memory)
17. エンタープライズ権限のガードレール
自律エージェントは、検証なしで破壊的なホスト アクション(rm -rf やテーブルの削除など)を実行してはなりません。
ADK の before_tool_callback の仕組み
ADK には、ツールが実行される前に実行されるインターセプト フックが用意されています。
Noneを返す: ADK はツールの実行を許可します。- 辞書(
{"status": "DENIED", "error": ...}など)を返す: ADK は直ちに実行を中止します。コマンドは実行されず、制限の理由がモデルに返されるため、モデルはユーザーに制限を説明できます。
権限の確認順序
- チェック 0(安全なツールの許可リスト):
search_archived_memoryなどの安全な読み取り専用ツールはメモリ内で事前に承認されているため、エージェントは常に自身のメモリをクエリできます。 - Tier 1(Valkey での「1 回限りの」一時的な権限付与): 人間のオペレーターがリスクの高いアクションを承認すると、一時キー
one_time_perm:{session_id}:{cmd_hash}が 5 分の TTL で Valkey に保存されます。ガードレールは、1 つのアトミック オペレーションでキーを読み取り、削除します。これにより、コマンドを 1 回だけ実行して、永続的な権限の拡大を防ぐことができます。 - Tier 2(AlloyDB のプロジェクト ルール): アクティブなプロジェクトの
user_permissionsで正規表現ルールを確認します(pytest.*--timeout=30を許可、rm -rf.*をブロックなど)。 - Tier 3(AlloyDB のグローバル ルール): すべてのプロジェクトに適用されるフォールバック ルールをチェックします。
- Fail-closed フォールバック: 一致するルールがない場合、
PENDINGで実行が拒否され、人間による審査が必要になります。
実装
adk_guardrails.py を作成します。
import logging
from typing import Any, Dict, Optional, Tuple, Set
from enterprise_engine import AgentMemoryEngine

logger = logging.getLogger(__name__)

class ADKPermissionGuardrail:
    """Evaluates tool permissions using Valkey allow-once tokens and AlloyDB rules."""

    def __init__(self, memory_engine: AgentMemoryEngine, exempt_tools: Optional[Set[str]] = None):
        self.engine = memory_engine
        self.exempt_tools = exempt_tools or {"search_archived_memory"}

    def evaluate(self, user_id: str, project_id: str, session_id: str, tool_name: str, tool_args: Dict[str, Any]) -> Tuple[bool, str]:
        # 1. Allowlist safe internal tools
        if tool_name in self.exempt_tools:
            return True, f"Internal tool '{tool_name}' is pre-approved."

        # 2. Check 3-tier policy engine
        action, reason = self.engine.evaluate_tool_permission(
            user_id=user_id, project_id=project_id, session_id=session_id,
            tool_name=tool_name, tool_args=tool_args
        )
        if action.upper() == "ALLOW":
            return True, f"Permission ALLOWED: {reason}"
        elif action.upper() == "BLOCK":
            return False, f"Permission BLOCKED: {reason}"
        return False, f"Permission PENDING: {reason} (requires human confirmation)"

    def create_before_tool_callback(self, user_id: str, default_project_id: str = "global"):
        """Creates the callback hook for Agent(before_tool_callback=...)."""
        def before_tool_callback(tool: Any, args: Dict[str, Any], tool_context: Any) -> Optional[Dict[str, Any]]:
            tool_name = getattr(tool, "name", str(tool))
            session_id = getattr(getattr(tool_context, "session", None), "id", "default_session")

            allowed, msg = self.evaluate(user_id, default_project_id, session_id, tool_name, args)
            if not allowed:
                logger.warning("Guardrail blocked '%s': %s", tool_name, msg)
                return {"status": "DENIED", "tool": tool_name, "error": msg}

            return None  # Returning None permits execution in ADK
        return before_tool_callback
18. ADK エージェントのテストを実行する
test_adk_agent.py を作成します。この完全なスクリプトは、コンポーネントを接続し、アーカイブされた意思決定とセキュリティ ルールをシードし、2 セッションの会話を実行し、メモリの圧縮と呼び出しをテストし、ガードレールの適用を検証します。
import asyncio
import os
import time
from google import genai
from google.genai import types
from google.adk.agents import Agent
from google.adk.runners import Runner
from google.adk.sessions import InMemorySessionService
from google.adk.tools import FunctionTool

from db_clients import get_db_connection, get_valkey_client
from enterprise_engine import AgentMemoryEngine
from adk_memory_provider import ADKTieredMemoryProvider
from adk_memory_tools import make_long_term_memory_tool
from adk_guardrails import ADKPermissionGuardrail
from valkey_buffer import get_session_context_buffer

# Configuration & clients
PROJECT_ID = os.getenv("PROJECT_ID", "chunking-poc-alloydb")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")
GEMINI_MODEL = os.getenv("GEMINI_MODEL", "gemini-3.5-flash")
USER_ID, SESSION_1, SESSION_2 = "user_adk_dev", "sess_adk_001", "sess_adk_002"

db_conn = get_db_connection()
valkey_client = get_valkey_client()
# LLM client for Gemini 3.5 Flash via global multi-region
genai_client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)
# Embeddings client (requires specific regional presence)
embed_client = genai.Client(vertexai=True, project=PROJECT_ID, location=REGION)

tiered_provider = ADKTieredMemoryProvider(get_db_connection, valkey_client, genai_client, trigger_limit=3, window_size=2)
memory_engine = AgentMemoryEngine(valkey_client, db_conn)
guardrail = ADKPermissionGuardrail(memory_engine)

# Tools: Long-term memory search and mock terminal command
long_term_memory_tool = make_long_term_memory_tool(get_db_connection, embed_client, USER_ID)

def run_command(CommandLine: str) -> str:
    """Executes a shell command on the host."""
    return f"Executed: {CommandLine}"

run_command_tool = FunctionTool(run_command)

def seed_database():
    """Seeds a 14-day-old architecture decision and permission rules."""
    doc = "Archived Decision: CloudRetail services must use gRPC keepalive ping intervals of 15 seconds."
    emb = embed_client.models.embed_content(model="text-embedding-005", contents=doc).embeddings[0].values
    conn = get_db_connection()
    try:
        with conn.cursor() as cur:
            cur.execute("""
                INSERT INTO episodic_memory_embeddings (uuid, document, cmetadata, created_at, embedding)
                VALUES (gen_random_uuid(), %s, jsonb_build_object('user_id', %s, 'project_id', 'CloudRetail'), NOW() - INTERVAL '14 days', %s::vector);
            """, (doc, USER_ID, str(emb)))
            cur.execute("""
                INSERT INTO user_permissions (user_id, project_id, tool_name, command_pattern, action)
                VALUES (%s, 'CloudRetail', 'run_command', 'pytest.*--timeout=30', 'ALLOW'),
                       (%s, 'CloudRetail', 'run_command', 'rm -rf.*', 'BLOCK'),
                       (%s, 'global', 'search_archived_memory', '.*', 'ALLOW')
                ON CONFLICT DO NOTHING;
            """, (USER_ID, USER_ID, USER_ID))
        conn.commit()
    finally:
        conn.close()

async def run_turn(runner: Runner, session_id: str, query: str, prev_session_id: str = None) -> str:
    """Fetches ambient memory, executes turn, and saves history in the background."""
    ctx = tiered_provider.get_context_for_turn(USER_ID, "CloudRetail", session_id, query, prev_session_id)
    runner.agent.instruction = tiered_provider.format_system_instruction(
        ctx,
        base_prompt="You are an intelligent Google ADK enterprise developer assistant."
    )
    msg = types.Content(role="user", parts=[types.Part.from_text(text=query)])
    parts = []
    async for event in runner.run_async(user_id=USER_ID, session_id=session_id, new_message=msg):
        if event.content and event.content.parts:
            parts.extend([p.text for p in event.content.parts if p.text])

    response = "".join(parts).strip()
    tiered_provider.record_turn_async(USER_ID, "CloudRetail", session_id, query, response, prev_session_id)
    return response

async def main():
    seed_database()
    sessions = InMemorySessionService()
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_1)

    agent = Agent(
        name="adk_memory_agent", model=GEMINI_MODEL, instruction="Initial instruction",
        tools=[long_term_memory_tool, run_command_tool],
        before_tool_callback=guardrail.create_before_tool_callback(USER_ID, "CloudRetail")
    )
    runner = Runner(agent=agent, session_service=sessions, app_name="agents")

    print("\n--- Session 1: Storing Preferences & Triggering Compaction ---")
    await run_turn(runner, SESSION_1, "I standardize on Python 3.11 with PostgreSQL and Dark Mode UI.")
    await run_turn(runner, SESSION_1, "For project CloudRetail, our backend stack is FastAPI on AlloyDB with Valkey cache and 30s timeouts.")
    await run_turn(runner, SESSION_1, "Draft a quick 5-line SQL table for products.")
    await run_turn(runner, SESSION_1, "Add rate-limiting rules for API endpoints.")

    buf = get_session_context_buffer(valkey_client, SESSION_1)
    print(f"Valkey rolling summary generated: {bool(buf['rolling_summary'])}")
    print(f"Turns in buffer: {len(buf['recent_turns'])} (compacted from 8)")

    print("\nWaiting 6s for background worker entity extraction into AlloyDB...")
    await asyncio.sleep(6)

    print("\n--- Session 2: Cold-Start Ambient Recall ---")
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_2)
    resp = await run_turn(runner, SESSION_2, "What are my coding preferences and the CloudRetail stack from my previous session?", prev_session_id=SESSION_1)
    print(f"Agent response:\n{resp}\n")

    print("\n--- On-Demand Archival Vector Search ---")
    resp_search = await run_turn(runner, SESSION_2, "What was the agreed gRPC keepalive interval from 2 weeks ago?")
    print(f"Agent response:\n{resp_search}\n")

    print("\n--- Guardrail Verification ---")
    blocked, b_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "rm -rf /tmp/data"})
    allowed, a_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "pytest --timeout=30"})
    print(f"rm -rf /tmp/data:    Allowed={blocked} ({b_msg})")
    print(f"pytest --timeout=30: Allowed={allowed} ({a_msg})")

if __name__ == "__main__":
    asyncio.run(main())
反復テストのクリーンアップ
システムは永続的なコンテキストをキャプチャするため、テストを複数回実行すると、ダイアログ チャンクが Valkey に無限に追加され、重複するルールが AlloyDB に挿入されます。
実行間で状態を簡単にリセットするには、前の手順で作成した cleanup_memory_system.py スクリプトを実行します。
python3 cleanup_memory_system.py
python3 test_adk_agent.py
検証結果
このテストでは、次の 4 つの重要な本番環境の動作を検証します。
- プロンプト トークンの大幅な削減: Valkey の圧縮により、会話履歴が簡潔なローリング サマリーに圧縮されました。Google のテストでは、アクティブなプロンプトのサイズが 92% 以上縮小されました(約 6,956 個のトークンから約 544 個のトークンに)。結果は異なる場合があります。
- コールド スタートの即時呼び出し: 新しいセッション(セッション 2)で、エージェントはツールを呼び出すことなく、ユーザー設定(Python 3.11、PostgreSQL、ダークモード)とプロジェクト アーキテクチャ(FastAPI、30 秒のタイムアウト)をすぐに呼び出しました。これは、LLM が呼び出される前に Memorystore と AlloyDB からコンテキストを取得する
ADKTieredMemoryProvider.get_context_for_turnによって有効になりました。 - オンデマンド ベクトル リコール: 14 日前の決定について質問された場合、エージェントは
search_archived_memoryを呼び出し、15 秒の gRPC キープアライブ ルールを取得しました。 - 決定論的な安全性: エージェントは
pytest --timeout=30を実行しましたが、rm -rf /tmp/dataの実行は厳密にブロックされました。
19. クリーンアップ
AlloyDB インスタンスと Memorystore インスタンスについて Google Cloud アカウントに継続的に課金されないようにするには、作成したリソースを削除します。
Cloud Shell で次のコマンドを実行します。
# Exit VM and return to Cloud Shell
exit
# Delete Compute Engine development VM
gcloud compute instances delete $VM_NAME \
  --zone=$ZONE \
  --quiet

# Delete AlloyDB primary instance and cluster
gcloud alloydb instances delete $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --quiet

gcloud alloydb clusters delete $ADBCLUSTER \
  --region=$REGION \
  --quiet

# Delete Memorystore for Valkey instance
gcloud memorystore instances delete $VALKEYINSTANCE \
  --location=$REGION \
  --quiet
20. 完了
おめでとうございます!Memorystore for Valkey と AlloyDB AI を組み合わせた 2 階層の長期 AI エージェント メモリ アーキテクチャを構築しました。
学習した内容
- 短期的なアクティブ セッション状態と長期的な永続的事実を分離する2 階層のメモリ アーキテクチャを実装しました。
- 精度を損なうことなく、アクティブなプロンプト サイズを大幅に削減し、ナイーブなコンテキスト スタッフィングよりもトークン使用量を削減しました。
- 構成された AlloyDB AI データベース レベルのトランザクション自動エンベディング(
ai.initialize_embeddings)。 - ベクトル類似性(
<=>)と PostgreSQL 全文検索(tsvector)を組み合わせたネイティブの相互ランク融合ハイブリッド検索(ai.hybrid_search)を実行しました。 - オフスレッドのバックグラウンド エンティティ抽出ツール(
AsyncMemoryWorker)、3 階層のツール実行権限評価ツール、データベース メモリ圧縮エンジンを構築しました。 - Google Agent Development Kit(ADK)を使用して、階層型メモリ システムを自律型エージェントに接続し、ツール ガードレールを適用してアンビエント メモリを提供します。
次のステップと参照
- AlloyDB AI のドキュメントを読む。
- AlloyDB でハイブリッド ベクトル検索を実行する方法について説明します。
- Memorystore for Valkey の詳細を確認する。