

1. 시작하기 전에
AI 에이전트가 여러 날에 걸쳐 긴 멀티턴 상호작용을 처리하고 장기적인 다단계 작업을 실행할 때 대규모 언어 모델 (LLM)은 세션 전반에서 본질적으로 상태가 없는 상태로 유지됩니다. 사용자가 내일 상담사에게 돌아오면 애플리케이션이 필요한 컨텍스트를 재구성할 수 없는 한 모델이 처음부터 시작됩니다.
이 문제에 대한 단순한 접근 방식은 토큰 스터핑입니다. 즉, 모든 활성 프롬프트에 전체 대화 기록, 도구 실행 로그, 코드베이스를 직접 추가하는 것입니다. 토큰이 수백만 개에 달하는 대규모 컨텍스트 윈도우를 사용하면 기술적으로 가능하지만 컨텍스트 스터핑은 심각한 운영상의 문제를 야기합니다. 턴마다 토큰 비용이 2차 함수로 증가하고, 응답 지연 시간이 수십 초로 늘어나며, 모델이 '미들 로스트' 컨텍스트 저하를 겪습니다.
신뢰할 수 있는 AI 에이전트를 빌드하려면 2단계 메모리 아키텍처가 필요합니다.
- 단기 세션 버퍼: 토큰으로 제한된 슬라이딩 윈도우를 사용하여 활성 메모리에 최근 대화 턴을 캐시합니다. 이 등급에서는 매 턴마다 밀리초 미만의 높은 처리량의 인메모리 조회가 필요하므로 Memorystore for Valkey가 이상적입니다.
- 장기 영구 메모리: 세션 간에 구조화된 항목, 사용자 환경설정, 에피소드 사실을 저장합니다. 이 등급에는 트랜잭션 무결성, 멀티 테넌트 보안, 관계형 데이터와 벡터 간의 하이브리드 검색이 필요하므로 PostgreSQL용 AlloyDB가 적합합니다.
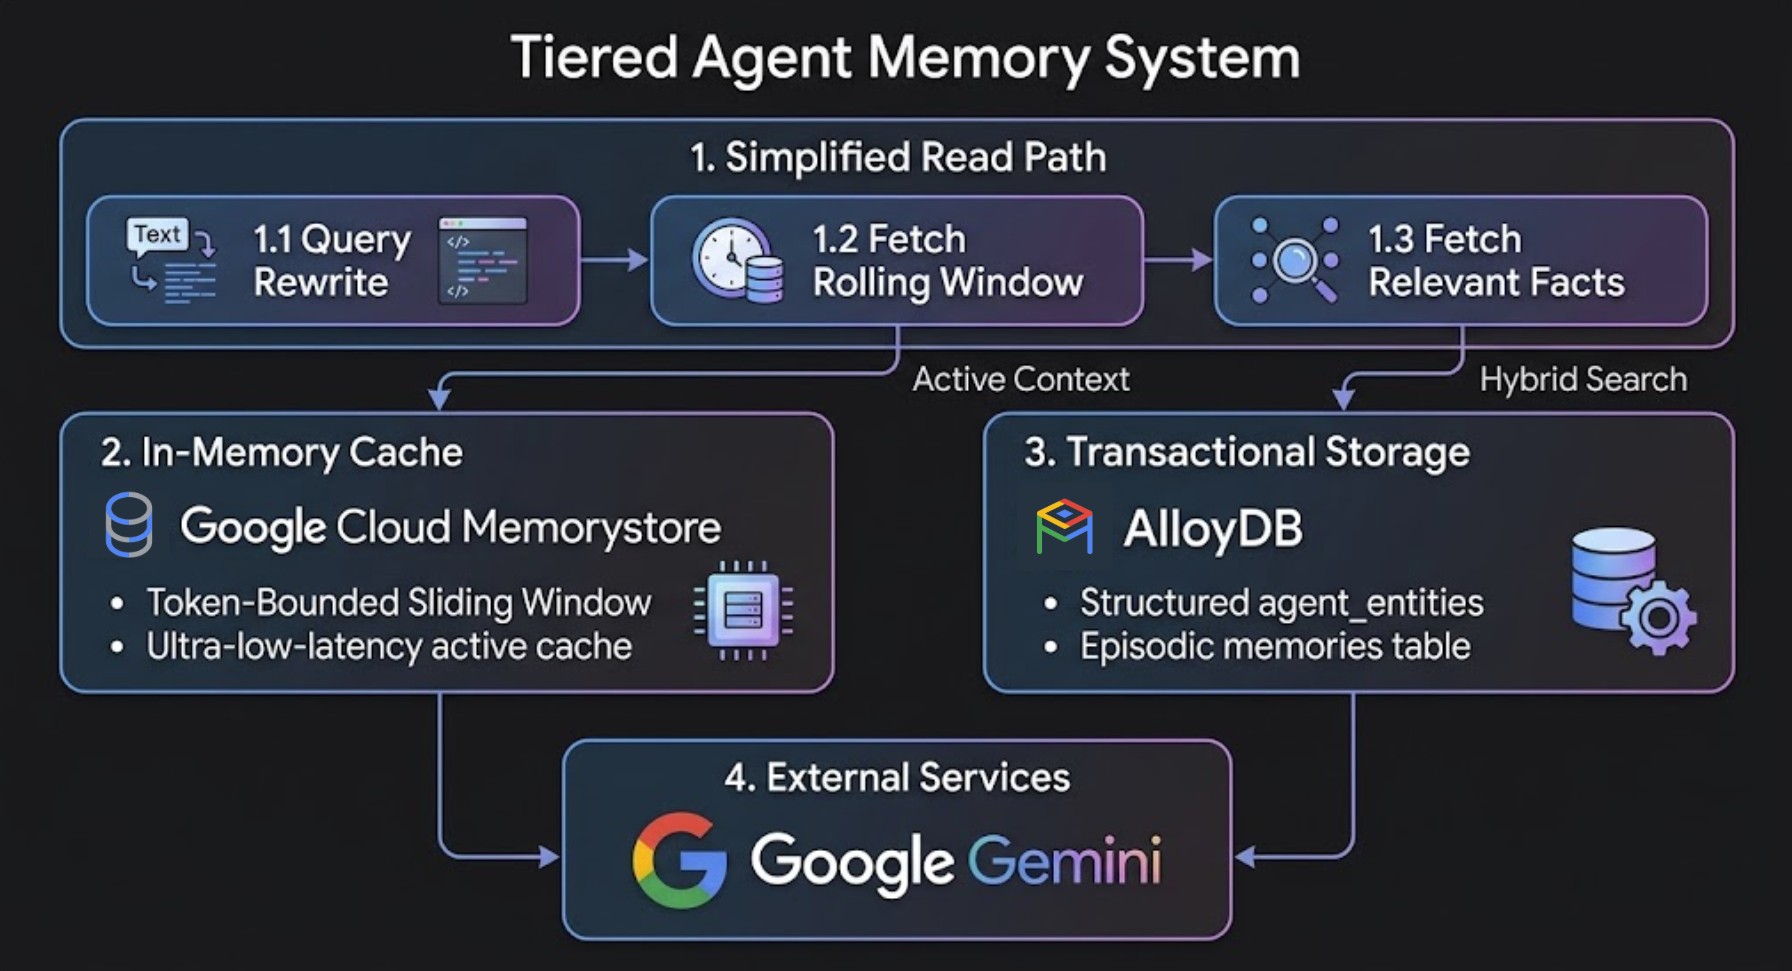
4가지 메모리 유형 이해하기
강력한 메모리 아키텍처는 사용자 여정 전반에 걸쳐 네 가지 상호 보완적인 메모리 유형을 사용합니다.
메모리 유형 | 저장되는 항목 | 스토리지 레이어 | 수명 |
버퍼 (단기) | 최근 원시 대화 턴 | Memorystore for Valkey | 활성 세션 |
요약 메모리 | 이전 대화 턴의 압축된 기록 | Memorystore for Valkey | 멀티턴 윈도우 |
에피소드 기억 | 이전 작업, 이벤트, 도구 출력 | PostgreSQL용 AlloyDB (벡터) | 영구 |
엔티티 및 규칙 메모리 | 사용자 환경설정, 제약 조건, 거부 | PostgreSQL용 AlloyDB (구조화된 SQL + 벡터) | 영구 |
계층화된 메모리의 측정된 영향
멀티턴 개발 대화 (도구 출력 로그가 많은 45개 이상의 턴)에 걸친 내부 벤치마크 테스트에서는 단순한 컨텍스트 스터핑에 비해 상당한 절감 효과가 있는 것으로 나타났습니다.
측정항목 / 측정기준 | 단순한 컨텍스트 스터핑 | 계층화된 메모리 (AlloyDB + Memorystore) | 테스트의 순 영향 |
활성 프롬프트 크기 (45도 회전) | 토큰 747,033개 | 토큰 83,262개 | 프롬프트가 88.9% 더 작음 |
45턴 응답 지연 시간 | 33.5초 | 6.7초 | 80.0% 더 빠른 응답 |
누적 세션 토큰 | 1,790만 토큰 | 409만 토큰 | 총 토큰 및 비용 절감 72.0% |
규칙 및 제약 조건 회수 | 턴이 지나면 성능이 저하됨 | 중요한 지식이 요약에서 누락되지 않도록 방지 | 하이브리드 검색을 통해 보존됨 |
실습할 내용
- PostgreSQL용 AlloyDB 및 Valkey용 Memorystore를 프로비저닝합니다.
google_ml_integration를 사용 설정하고 데이터베이스 측 트랜잭션 자동 삽입 (ai.initialize_embeddings)을 구성합니다.- 요약 후 트리밍 파이프라인 패턴을 사용하여 단기 Valkey 세션 버퍼를 구현합니다.
- AlloyDB의 기본 AI 함수 (예:
ai.generate)를 사용하여 장기 항목을 기본적으로 추출합니다. - AlloyDB의 기본 하이브리드 검색 기능 (
ai.hybrid_search)과 상호 순위 융합 (RRF) 재순위 지정을 사용하여 정확성과 관련성이 높은 장기적 사실을 쿼리합니다. - 3계층 엔터프라이즈 도구 권한 평가기 및 백그라운드 메모리 압축 엔진을 빌드합니다.
- Google 에이전트 개발 키트 (ADK)를 사용하여 2단계 메모리 아키텍처를 자율 에이전트에 직접 통합합니다.
필요한 항목
- 결제가 사용 설정된 Google Cloud 프로젝트.
- 웹브라우저(예: Chrome)
- Studio, CLI 등에서 AlloyDB에 대해 SQL 쿼리를 실행한 경험을 포함하여 Python 및 SQL에 대한 기본 지식
잠재고객 및 비용
- 대상: AI 개발자, 백엔드 엔지니어, 데이터베이스 설계자
- 예상 비용: 이 Codelab에서 생성된 Google Cloud 리소스의 비용은 약 $1.50(USD)입니다.
2. 설정 및 요구사항
Cloud Shell 시작
이 Codelab에서는 gcloud, psql, python3로 사전 구성된 클라우드 호스팅 터미널인 Google Cloud Shell에서 명령어를 실행합니다.
- Google Cloud Console을 엽니다.
- Cloud Console 오른쪽 상단에서 Cloud Shell 활성화를 클릭합니다.
- 인증을 확인합니다.
gcloud auth list
export PROJECT_ID=<YOUR_PROJECT_ID>
gcloud config set project $PROJECT_ID

export REGION=us-east1
export GENAI_LOCATION=us
export ZONE=us-east1-b
export ADBCLUSTER=agent-memory-cluster
export ADBINSTANCE=agent-memory-instance
export VALKEYINSTANCE=agent-memory-cache
export VM_NAME=agent-dev-vm
Google Cloud API 사용 설정 및 개발 VM 만들기
Cloud Shell에서 다음 명령어를 실행하여 필요한 API를 사용 설정합니다.
gcloud services enable \
  alloydb.googleapis.com \
  memorystore.googleapis.com \
  aiplatform.googleapis.com \
  compute.googleapis.com \
  servicenetworking.googleapis.com \
  networkconnectivity.googleapis.com
default VPC 네트워크에 Compute Engine VM 인스턴스를 만들어 AlloyDB 및 Memorystore for Valkey와 함께 Python 개발 환경을 호스팅합니다.
gcloud compute instances create $VM_NAME \
    --zone=$ZONE \
    --machine-type=e2-standard-2 \
    --scopes=cloud-platform \
    --network=default \
    --shielded-secure-boot
3. AlloyDB 및 Memorystore for Valkey 프로비저닝
이 단계에서는 PostgreSQL용 AlloyDB 클러스터와 기본 인스턴스를 프로비저닝하고, 비공개 서비스 네트워킹을 설정하고, Memorystore for Valkey 인스턴스를 가동합니다.
비공개 서비스 액세스 IP 범위 만들기
AlloyDB에는 Virtual Private Cloud (VPC) 네트워크의 비공개 IP 범위가 필요합니다. default VPC 네트워크를 사용한다고 가정합니다.
- 비공개 IP 범위 할당을 만듭니다.
gcloud compute addresses create psa-range \
    --global \
    --purpose=VPC_PEERING \
    --prefix-length=24 \
    --description="VPC private service access" \
    --network=default
- 비공개 VPC 피어링 연결을 설정합니다.
gcloud services vpc-peerings connect \
    --service=servicenetworking.googleapis.com \
    --ranges=psa-range \
    --network=default
AlloyDB 클러스터 및 기본 인스턴스 만들기
- 시스템 초기화를 위한 초기 클러스터 비밀번호를 만듭니다.
export PGPASSWORD=`openssl rand -hex 12`
- 무료 체험판 클러스터를 만듭니다.
gcloud alloydb clusters create $ADBCLUSTER \
    --password=$PGPASSWORD \
    --network=default \
    --region=$REGION \
    --subscription-type=TRIAL
- 기본 인스턴스를 만듭니다.
gcloud alloydb instances create $ADBINSTANCE \
    --instance-type=PRIMARY \
    --cpu-count=2 \
    --region=$REGION \
    --cluster=$ADBCLUSTER
Memorystore for Valkey 인스턴스 프로비저닝
Memorystore for Valkey를 사용하려면 인스턴스를 만들기 전에 네트워크와 리전에 서비스 연결 정책 (gcp-memorystore)이 필요합니다.
- Memorystore의 서비스 연결 정책을 만듭니다.
gcloud network-connectivity service-connection-policies create memorystore-policy \
    --network=default \
    --region=$REGION \
    --service-class=gcp-memorystore \
    --subnets=projects/$PROJECT_ID/regions/$REGION/subnetworks/default
- Memorystore for Valkey 인스턴스를 만듭니다.
gcloud memorystore instances create $VALKEYINSTANCE \
    --location=$REGION \
    --shard-count=1 \
    --replica-count=0 \
    --node-type=SHARED_CORE_NANO \
    --psc-auto-connections="network=projects/$PROJECT_ID/global/networks/default,projectId=$PROJECT_ID"
Vertex AI IAM 권한 부여
AlloyDB 서비스 계정에 에이전트 플랫폼의 삽입 모델을 호출하는 데 필요한 IAM 권한을 부여합니다.
PROJECT_ID=$(gcloud config get-value project)

gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:service-$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")@gcp-sa-alloydb.iam.gserviceaccount.com" \
  --role="roles/aiplatform.user"
4. 환경 및 액세스 엔드포인트 초기화
AlloyDB IAM 인증 및 데이터베이스 플래그 설정
AlloyDB 인스턴스에서 IAM 데이터베이스 인증 (alloydb.iam_authentication=on)과 AI 쿼리 엔진 (google_ml_integration.enable_ai_query_engine=on)을 사용 설정합니다.
gcloud beta alloydb instances update $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --update-mode=FORCE_APPLY \
  --database-flags=alloydb.iam_authentication=on,google_ml_integration.enable_ai_query_engine=on
다음으로, Google Cloud 계정을 슈퍼 사용자 권한이 있는 IAM 기반 데이터베이스 사용자로 추가합니다.
export USER_ACCOUNT=$(gcloud config get-value account)

gcloud alloydb users create $USER_ACCOUNT \
    --cluster=$ADBCLUSTER \
    --region=$REGION \
    --type=IAM_BASED \
    --db-roles=alloydbsuperuser
Cloud Shell에서 내부 VPC 엔드포인트 가져오기
개발 VM에 SSH로 연결하기 전에 Cloud Shell에서 AlloyDB 및 Memorystore for Valkey의 내부 VPC IP 주소를 가져옵니다.
# Export GCP Project ID, Region, and IAM User
export PROJECT_ID=$(gcloud config get-value project)
export REGION=us-east1
export DB_USER=$(gcloud config get-value account)

# Retrieve Internal VPC IP Addresses for AlloyDB & Memorystore for Valkey
export DB_HOST=$(gcloud alloydb instances describe $ADBINSTANCE --cluster=$ADBCLUSTER --region=$REGION --format="value(ipAddress)")
export DB_PORT=5432
export DB_NAME=postgres

export VALKEY_HOST=$(gcloud memorystore instances describe $VALKEYINSTANCE --location=$REGION --format="value(discoveryEndpoints[0].address)")
export VALKEY_PORT=6379

# Verify exported endpoints
echo "Project ID:        $PROJECT_ID"
echo "Region:            $REGION"
echo "AlloyDB Private IP: $DB_HOST"
echo "IAM DB User:       $DB_USER"
echo "Valkey Private IP:  $VALKEY_HOST"
개발 VM에 SSH로 연결하고 연결 변수 내보내기
동일한 VPC 네트워크에 있는 Compute Engine 개발 VM (agent-dev-vm)에 Cloud Shell에서 SSH로 연결합니다.
gcloud compute ssh $VM_NAME --zone=$ZONE
개발 VM에 로그인한 후 위의 프로젝트 구성 및 연결 엔드포인트 출력을 내보냅니다 (
export PROJECT_ID=<YOUR_PROJECT_ID>
export REGION=us-east1
export GENAI_LOCATION=us
export DB_HOST=<YOUR_ALLOYDB_PRIVATE_IP>
export DB_PORT=5432
export DB_NAME=postgres
export DB_USER=<YOUR_IAM_DB_USER>
export VALKEY_HOST=<YOUR_VALKEY_PRIVATE_IP>
export VALKEY_PORT=6379
Python 가상 환경 초기화
개발 VM 내에서 먼저 로컬 작업 디렉터리를 만듭니다.
mkdir -p ~/alloydb_agent_memory && cd ~/alloydb_agent_memory
이제 시스템 Python 가상 환경 패키지를 설치하고, 애플리케이션 기본 사용자 인증 정보 (ADC)를 인증하고, 워크스페이스를 설정합니다.
sudo apt-get update && sudo apt-get install -y python3-venv python3-pip

python3 -m venv venv
source venv/bin/activate
마지막으로 새 가상 환경에 종속 항목을 설치합니다.
gcloud auth application-default login
pip install psycopg2-binary valkey redis google-genai
5. 시스템 아키텍처 및 코드 모듈 계층 구조
빌드할 항목 개요
개별 Python 스크립트를 구현하기 전에 아래 시스템 아키텍처를 검토하세요. 이 샘플 애플리케이션은 동일한 PostgreSQL용 AlloyDB 데이터베이스 인스턴스와 상호작용하는 두 가지 기본 실행 경로에서 작동하는 7개의 모듈식 Python 스크립트로 구성됩니다.
- 읽기 경로 (
hybrid_retriever.py): AlloyDB AIai.generate()를 사용하여 PostgreSQL 내에서 직접 복합 다중 파트 질문을 단일 측면 하위 질문으로 분해하고 AlloyDB의 기본 하이브리드 검색 (ai.hybrid_search)을 사용하여 장기 기억을 쿼리합니다. - 쓰기 경로 (
async_worker.py): Gemini Flash를 사용하여 대화 교환에서 구조화된 엔티티 사실을 비동기적으로 추출하고agent_entities에 upsert하는 오프스레드 백그라운드 대기열 작업자입니다.
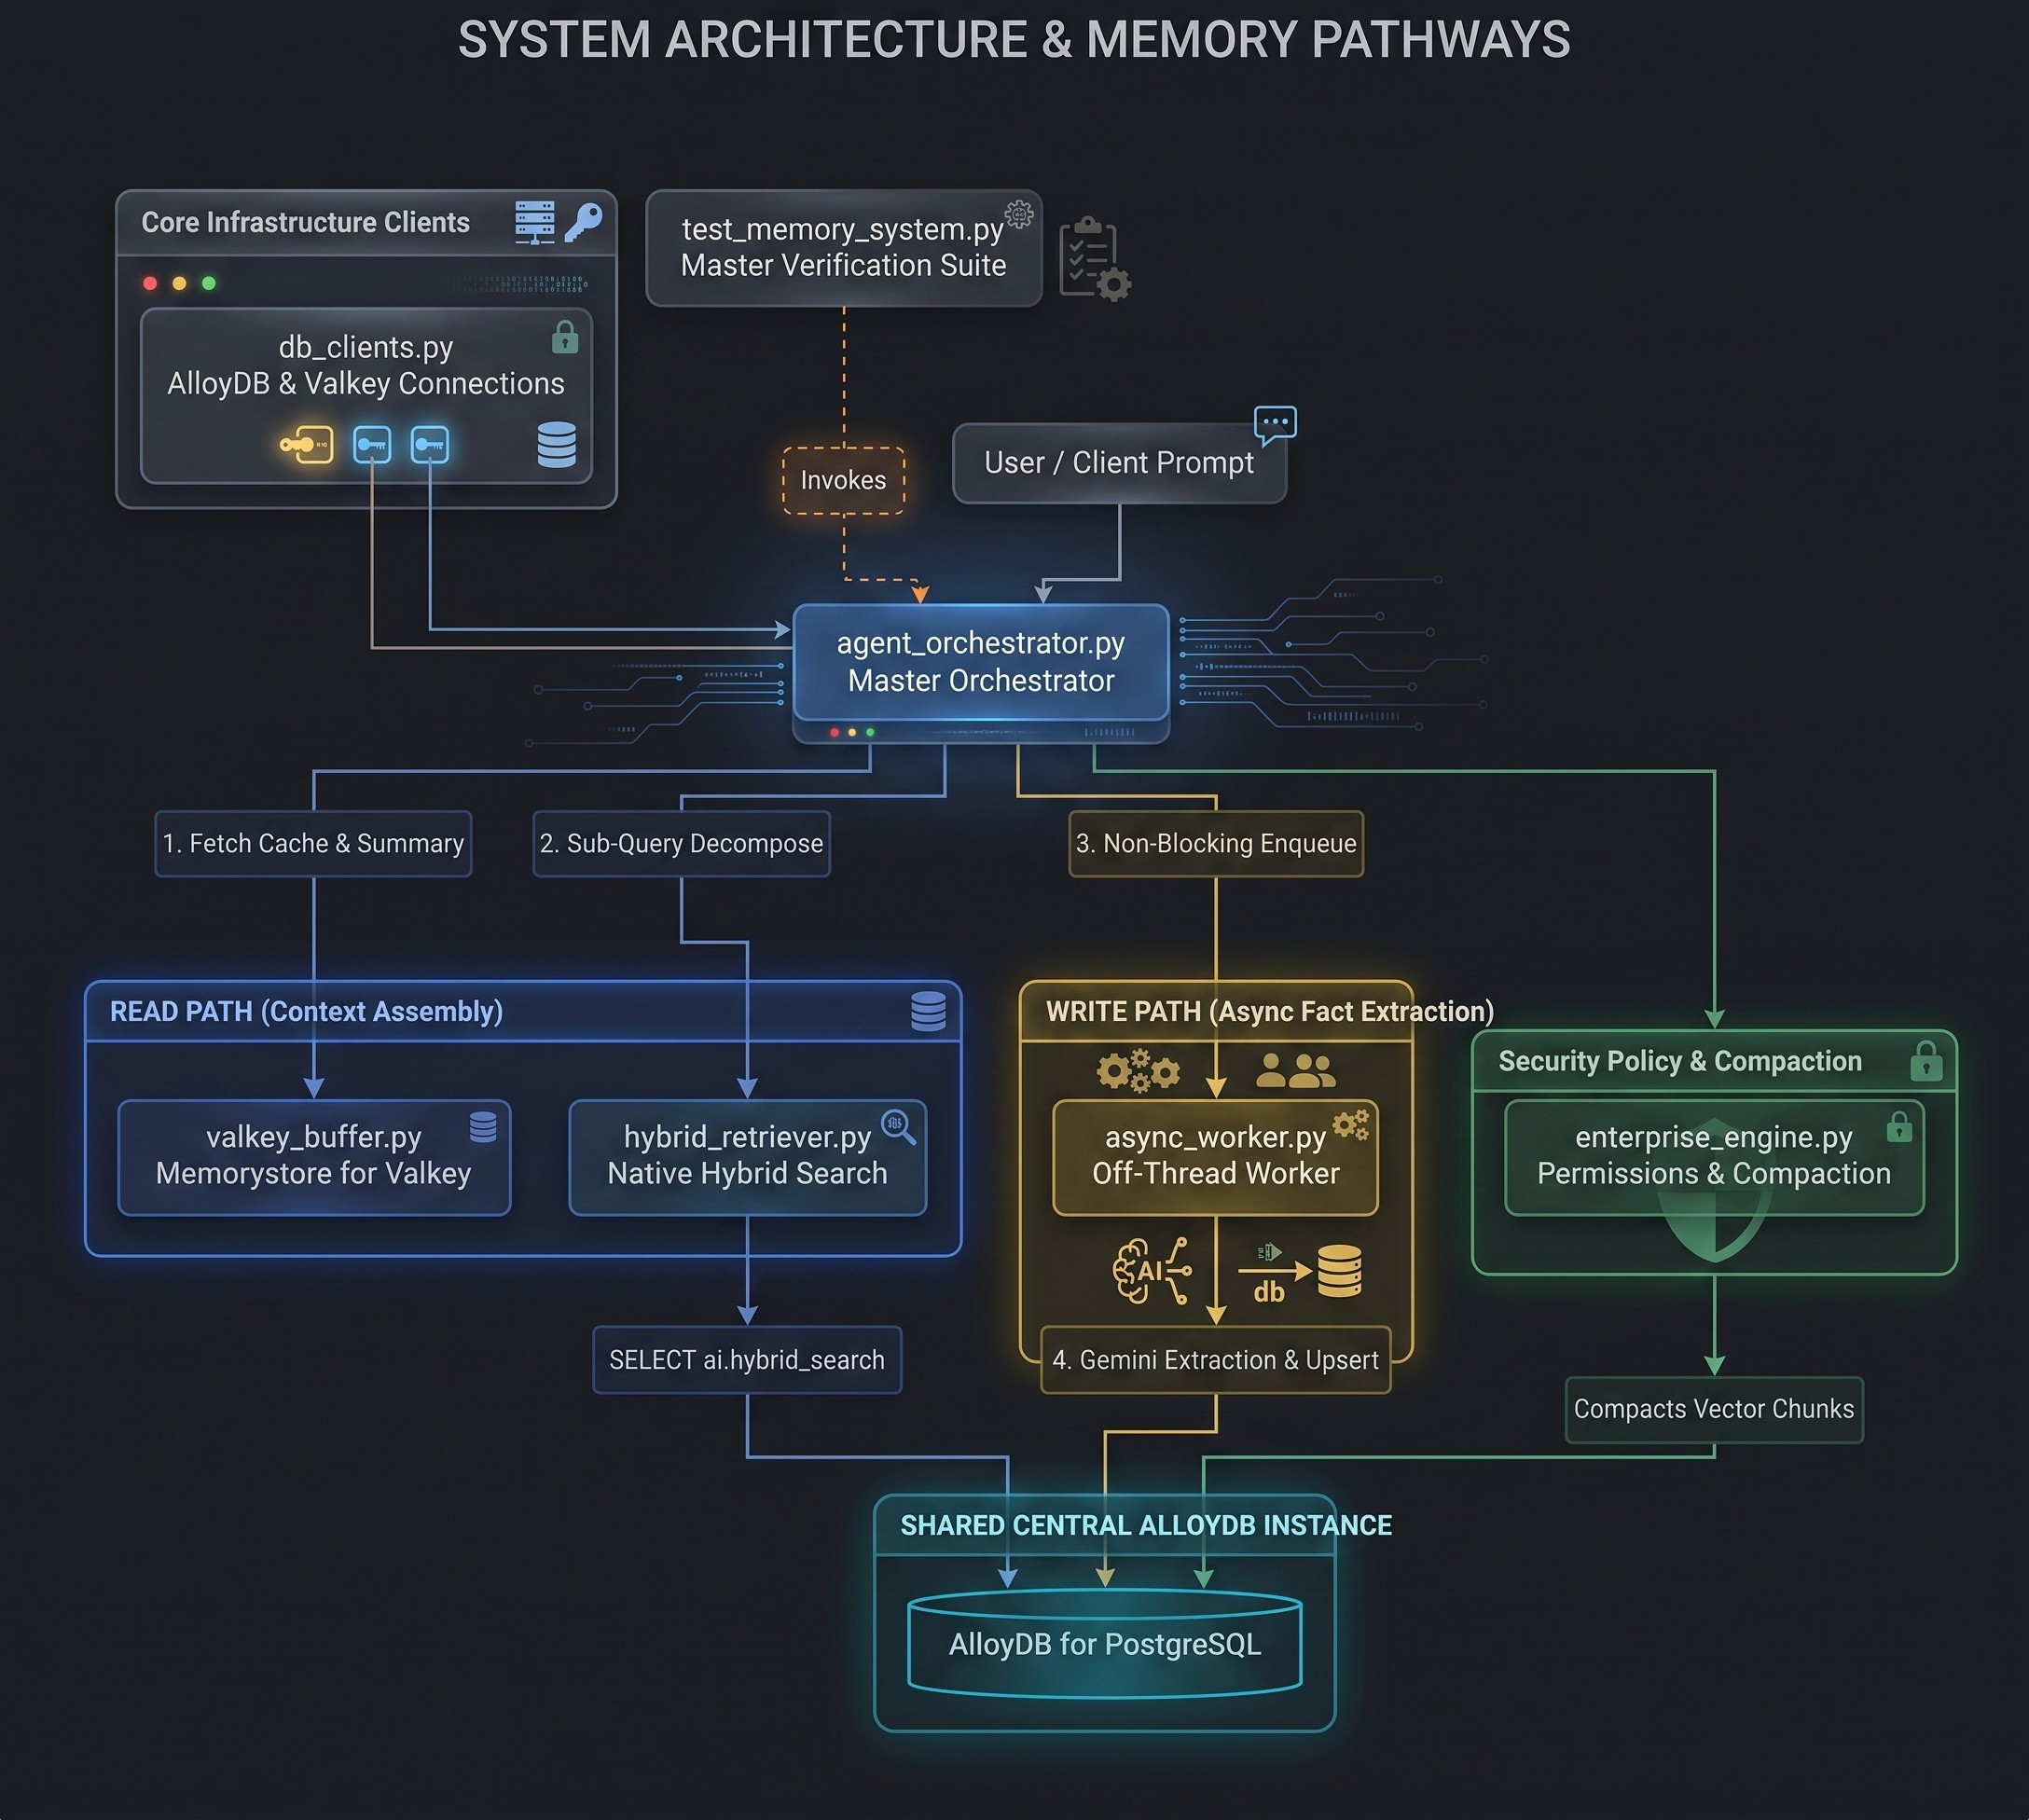
모듈 계층 구조 및 시스템 역할
모듈 파일 | 시스템 레이어 | 기본 책임 |
| 연결 레이어 | AlloyDB에 대한 SSL 암호화 IAM 인증과 Memorystore for Valkey에 대한 소켓 복원력 연결을 설정합니다. |
| 단기 메모리 | Summarize-Before-Trim 롤링 요약을 구현하여 Valkey에서 1밀리초 미만의 세션 기록을 관리합니다. |
| 쓰기 경로 작업자 | Gemini Flash를 사용하여 항목 사실을 추출하고 AlloyDB에 삽입하는 스레드 외 데몬 백그라운드 큐 작업자를 실행합니다. |
| 읽기 경로 리트리버 | 인-데이터베이스 AlloyDB AI |
| 기본 에이전트 루프 | 엔드 투 엔드 턴 실행 루프(단기 가져오기, 장기 검색, 프롬프트 어셈블리, LLM 실행, 비동기 대기열 추가)를 조정합니다. |
| 거버넌스 및 관리 | 도구 실행을 위한 3단계 보안 정책을 적용하고 이전 메모리를 집계합니다. |
| 테스트 및 평가 | 멀티턴 및 다중 세션 시나리오를 실행하고, 토큰 절약 비율을 측정하고, 메모리 정확도를 검증하는 마스터 검증 모음입니다. |
6. AlloyDB AI 스키마 및 트랜잭션 자동 임베딩 설정
목표 및 아키텍처 개요
이 모듈에서는 에피소드 및 장기 기억을 위한 AlloyDB의 데이터베이스 스키마, 색인 전략, 데이터베이스 측 자동 임베딩을 정의합니다.
- 에피소드 벡터 스토어 (
episodic_memory_embeddings): HNSW 벡터 색인 (vector_cosine_ops)으로 색인이 생성된 구조화되지 않은 채팅 스크립트 청크입니다. - 장기 엔티티 저장소 (
agent_entities): 범위 메타데이터 (global,project,session)와 함께 저장된 구조화된 사실, 사용자 선택, 프로젝트 규칙입니다. RUM을 통해 색인이 생성된 자동 생성 PostgreSQL 전체 텍스트 검색 열 (summary_tsv)이 포함됩니다. - 데이터베이스 측 자동 삽입 (
ai.initialize_embeddings): 백그라운드에서 Agent Platformtext-embedding-005를 통해 새 일반 텍스트 행 또는 업데이트된 일반 텍스트 행을summary_embedding에 자동으로 삽입합니다.
AlloyDB Studio에 연결
- Google Cloud 콘솔에서 Postgres용 AlloyDB 페이지로 이동합니다.
- 기본 인스턴스를 클릭합니다.
- 왼쪽 탐색에서 AlloyDB Studio를 클릭합니다.
postgres데이터베이스를 선택합니다.IAM database authentication(으)로 인증
구현 및 소스 코드
AlloyDB PostgreSQL 데이터베이스에 연결되면 아래 DDL 쿼리를 실행합니다.
-- 1. Enable google_ml_integration extension
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;
CREATE EXTENSION IF NOT EXISTS vector CASCADE;
CREATE EXTENSION IF NOT EXISTS rum CASCADE;
SET google_ml_integration.enable_preview_ai_functions = true;

-- 2. Create Episodic Memory Vector Store Tables
CREATE TABLE IF NOT EXISTS episodic_memory_collections (
    uuid UUID PRIMARY KEY,
    name VARCHAR,
    cmetadata JSONB
);

CREATE TABLE IF NOT EXISTS episodic_memory_embeddings (
    uuid UUID PRIMARY KEY,
    collection_id UUID REFERENCES episodic_memory_collections(uuid) ON DELETE CASCADE,
    embedding VECTOR(768),
    document VARCHAR,
    cmetadata JSONB,
    custom_id VARCHAR,
    created_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS episodic_memory_embedding_idx
ON episodic_memory_embeddings
USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);

-- 3. Create Entity & Preference Table with Metadata Scope & Auto-Generated TSVector Column
CREATE TABLE IF NOT EXISTS agent_entities (
    entity_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    entity_name TEXT NOT NULL,
    project_id TEXT DEFAULT 'global',
    session_id TEXT,
    scope TEXT NOT NULL DEFAULT 'project', -- 'global', 'project', 'session'
    summary TEXT NOT NULL,
    summary_embedding VECTOR(768),
    summary_tsv TSVECTOR GENERATED ALWAYS AS (
        to_tsvector('english', entity_name || ' ' || summary)
    ) STORED,
    updated_at TIMESTAMPTZ DEFAULT NOW(),
    UNIQUE (user_id, entity_name)
);

CREATE INDEX IF NOT EXISTS agent_entities_scope_idx
ON agent_entities (user_id, project_id, scope);

CREATE INDEX IF NOT EXISTS agent_entities_embedding_idx
ON agent_entities USING hnsw (summary_embedding vector_cosine_ops);

CREATE INDEX IF NOT EXISTS agent_entities_tsv_idx
ON agent_entities USING rum (summary_tsv rum_tsvector_ops);

-- 4. Create User Permissions Table for Tool Execution Controls
CREATE TABLE IF NOT EXISTS user_permissions (
    permission_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    project_id TEXT NOT NULL DEFAULT 'global',
    tool_name TEXT NOT NULL,
    command_pattern TEXT NOT NULL,
    action TEXT NOT NULL CHECK (action IN ('ALLOW', 'BLOCK')),
    created_at TIMESTAMPTZ DEFAULT NOW(),
    updated_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS idx_user_permissions_lookup
ON user_permissions (user_id, project_id, tool_name);
-- 5. Register Gemini 3.5 Flash Model Endpoint in AlloyDB
-- Replace PROJECT_ID with your Google Cloud project ID
CALL google_ml.create_model(
    model_id => 'gemini-3.5-flash',
    model_request_url => 'https://aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/global/publishers/google/models/gemini-3.5-flash:generateContent',
    model_qualified_name => 'gemini-3.5-flash',
    model_provider => 'google',
    model_type => 'llm',
    model_auth_type => 'alloydb_service_agent_iam'
);
트랜잭션 자동 삽입 초기화 및 Gemini 모델 등록
그런 다음 별도의 쿼리 실행 블록에서 CALL 문을 실행하여 자동 임베딩 백그라운드 프로세스와 Gemini 3.5 Flash 모델 엔드포인트를 등록합니다.
-- 6. Register Database-Side Transactional Auto-Embedding
CALL ai.initialize_embeddings(
    model_id => 'text-embedding-005',
    table_name => 'agent_entities',
    content_column => 'summary',
    embedding_column => 'summary_embedding',
    incremental_refresh_mode => 'transactional',
    batch_size => 10
);
7. AlloyDB 및 Valkey 연결 클라이언트 구성
목표 및 아키텍처 개요
이 모듈에서는 PostgreSQL용 AlloyDB (장기 메모리)와 Valkey용 Memorystore (단기 캐시)에 대한 보안 네트워크 연결을 설정합니다.
- AlloyDB IAM 인증:
gcloud auth application-default print-access-token를 사용하여 비밀번호가 없고 SSL로 암호화된 데이터베이스 연결 (sslmode="require")을 위한 수명이 짧은 OAuth2 토큰을 가져옵니다. - Valkey 네트워크 복원력: 단일 노드 또는 클러스터형 Valkey 인스턴스에서 VPC 네트워크 작업을 안전하게 처리할 수 있도록 5.0초 소켓 시간 제한 (
socket_timeout=5.0)으로redis.Redis를 구성합니다.
구현 및 소스 코드
작업 디렉터리에 db_clients.py 스크립트를 만듭니다.
import os
import subprocess
import psycopg2
import redis

# Initialize database & Valkey connection clients from environment variables
DB_HOST = os.getenv("DB_HOST", "127.0.0.1")
DB_PORT = os.getenv("DB_PORT", "5432")
DB_NAME = os.getenv("DB_NAME", "postgres")
DB_USER = os.getenv("DB_USER")

VALKEY_HOST = os.getenv("VALKEY_HOST", "127.0.0.1")
VALKEY_PORT = int(os.getenv("VALKEY_PORT", "6379"))

def get_db_connection():
    # Fetch Application Default Credentials (ADC) token for IAM Database Authentication & enable SSL encryption
    access_token = subprocess.check_output(
        ["gcloud", "auth", "application-default", "print-access-token"], text=True
    ).strip()
    return psycopg2.connect(
        host=DB_HOST,
        port=DB_PORT,
        dbname=DB_NAME,
        user=DB_USER,
        password=access_token,
        sslmode="require"
    )

def get_valkey_client():
    return redis.Redis(
        host=VALKEY_HOST,
        port=VALKEY_PORT,
        db=0,
        socket_timeout=5.0,
        socket_connect_timeout=5.0
    )

if __name__ == "__main__":
    print(f"Connecting to AlloyDB via IAM Auth ({DB_USER}) at {DB_HOST}:{DB_PORT} and Valkey at {VALKEY_HOST}:{VALKEY_PORT}...")
    print("Database and Valkey connection client modules loaded successfully.")
8. Memorystore for Valkey에 단기 세션 상태 캐시
목표 및 아키텍처 개요
이 모듈에서는 자동화된 트리밍 전 요약 패턴을 구현하여 Memorystore for Valkey에서 1밀리초 미만의 단기 컨텍스트 캐시를 빌드합니다.
- Valkey 슬라이딩 윈도우: 활성 대화 턴이 키
session:{session_id}:turns에 JSON 문자열로 저장됩니다. - Redis 해시 태그 (
{session_id}): 키 형식session:{session_id}:turns및session:{session_id}:summary는 Redis 클러스터 해시 태그 ({...})를 사용하여 단일 노드 또는 클러스터형 Valkey 배포 전반에서 원자적 실행을 보장하기 위해 두 키를 동일한 해시 슬롯으로 강제합니다. - 요약 후 자르기: 턴 수가
trigger_limit를 초과하면 잘려나갈 오래된 턴이 Gemini Flash에 의해 롤링 텍스트 요약 (session:{session_id}:summary)으로 요약된 후 원시 기록이window_size로 잘립니다.
구현 및 소스 코드
작업 디렉터리에 valkey_buffer.py 스크립트를 만듭니다.
import json
import logging
import time
from typing import Any, Dict, List
import redis

logger = logging.getLogger(__name__)

IN_MEMORY_VALKEY_FALLBACK: Dict[str, Any] = {}
VALKEY_COMPACTION_TOKENS = 0

def get_valkey_compaction_tokens() -> int:
    return VALKEY_COMPACTION_TOKENS

def append_session_turn_with_rolling_summary(
    valkey_client: redis.Redis,
    llm_client: Any,
    session_id: str,
    user_msg: str,
    ai_msg: str,
    trigger_limit: int = 10,
    window_size: int = 4
) -> None:
    """Appends turn to Valkey. Before trimming old turns, summarizes them into a rolling summary."""
    global VALKEY_COMPACTION_TOKENS
    # Use Redis Hash Tags {session_id} so both keys hash to the same cluster slot
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        # 1. Append new turn messages
        valkey_client.rpush(turns_key, json.dumps({"role": "user", "content": user_msg}))
        valkey_client.rpush(turns_key, json.dumps({"role": "assistant", "content": ai_msg}))

        raw_turns = valkey_client.lrange(turns_key, 0, -1)

        # 2. Check if total turns exceed summary trigger threshold
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2

        if len(raw_turns) > msg_trigger_count:
            turns_to_prune = raw_turns[:-msg_window_count]
            existing_summary = valkey_client.get(summary_key)
            existing_summary_text = (
                existing_summary.decode('utf-8') if isinstance(existing_summary, bytes) else (existing_summary or "")
            )

            pruned_text = "\n".join([
                f"{json.loads(t)['role']}: {json.loads(t)['content']}" for t in turns_to_prune
            ])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            updated_summary_text = llm_client.models.generate_content(
                model="gemini-3.5-flash", contents=prompt
            ).text.strip()
            # Execute commands directly to support all Redis/Valkey cluster topologies
            valkey_client.set(summary_key, updated_summary_text)
            valkey_client.ltrim(turns_key, -msg_window_count, -1)
            logger.info("Updated rolling summary and trimmed Valkey buffer for session %s", session_id)

    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey operation warning (%s). Falling back to in-memory short-term buffer.", e)
        if turns_key not in IN_MEMORY_VALKEY_FALLBACK:
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = []
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "user", "content": user_msg})
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "assistant", "content": ai_msg})

        # In-memory summarize-before-trim fallback logic
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2
        raw_fallback_turns = IN_MEMORY_VALKEY_FALLBACK[turns_key]

        if len(raw_fallback_turns) > msg_trigger_count:
            turns_to_prune = raw_fallback_turns[:-msg_window_count]
            existing_summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
            pruned_text = "\n".join([f"{t['role']}: {t['content']}" for t in turns_to_prune])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            for attempt in range(4):
                try:
                    updated_summary_text = llm_client.models.generate_content(
                        model="gemini-3.5-flash", contents=prompt
                    ).text.strip()
                    break
                except Exception as e:
                    if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                        time.sleep(3 * (2 ** attempt))
                    else:
                        raise

            IN_MEMORY_VALKEY_FALLBACK[summary_key] = updated_summary_text
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = raw_fallback_turns[-msg_window_count:]

def get_session_context_buffer(
    valkey_client: redis.Redis,
    session_id: str
) -> Dict[str, Any]:
    """Retrieves rolling summary + sliding window history from Valkey to build prompt context."""
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        summary = valkey_client.get(summary_key)
        summary_text = summary.decode('utf-8') if isinstance(summary, bytes) else (summary or "")

        raw_turns = valkey_client.lrange(turns_key, 0, -1)
        recent_turns = [json.loads(t) for t in raw_turns]

        return {
            "rolling_summary": summary_text,
            "recent_turns": recent_turns
        }
    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey read error (%s). Using in-memory short-term fallback buffer.", e)
        summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
        recent_turns = IN_MEMORY_VALKEY_FALLBACK.get(turns_key, [])
        return {"rolling_summary": summary_text, "recent_turns": recent_turns}
9. Extract Entities Off-Thread (백그라운드 메모리 작업자)
목표 및 아키텍처 개요
이 모듈에서는 대화형 AI 응답 속도를 늦추지 않고 장기적인 엔티티 사실을 추출하는 오프스레드 쓰기 경로 배경 추출 작업자 (AsyncMemoryWorker)를 빌드합니다.
- 비차단 대기열 작업자: LLM 추출 또는 데이터베이스 쓰기를 기다리지 않고 개발자 채팅이 즉시 반환되도록 데몬 스레드 (
queue.Queue)를 실행합니다. - 스레드 외 항목 사실 추출: 백그라운드에서 Gemini Flash (
model="gemini-3.5-flash",response_mime_type="application/json")를 호출하여 사용자 대상 대화 턴을 차단하지 않고 구조화된 항목을 파싱합니다. - 시간적 공지 참조 해결 (
build_temporal_rules_prompt): 상대적인 시간 표현 (예: '현재', '마지막 세션')을 명시적인 세션 ID (예:session_id)로 변환하는 규칙을 적용합니다. - 스키마 업데이트: Gemini Flash에 엔티티 (
entity_name,project_id,scope,summary)의 JSON 배열을 반환하도록 프롬프트를 표시하고 매개변수화된 PostgreSQLON CONFLICT DO UPDATE문을 통해agent_entities에 일반 텍스트를 작성합니다.
구현 및 소스 코드
작업 디렉터리에 async_worker.py 스크립트를 만듭니다.
import json
import logging
import queue
import threading
import time
from typing import Dict, Any, Optional
import psycopg2

logger = logging.getLogger(__name__)

def build_temporal_rules_prompt(active_session_id: str, prev_session_id: Optional[str] = None) -> str:
    """REUSABLE PROMPT HELPER: Defines temporal coreference rules for both Read and Write paths."""
    return f"""TEMPORAL COREFERENCE RULES:
1. Do not use relative temporal words like 'currently', 'now', 'this session', 'previous session', or 'last session'.
2. Replace any relative temporal reference with explicit session identifiers:
   - Active Session: '{active_session_id}'
   - Previous Session: '{prev_session_id if prev_session_id else active_session_id}'
   (e.g., write 'User prefers Python in session {active_session_id}' instead of 'User currently prefers Python')."""

class AsyncMemoryWorker:
    """Off-thread daemon queue worker performing background entity extraction and upserts into AlloyDB."""
    def __init__(self, conn_factory, llm_client):
        self.conn_factory = conn_factory
        self.llm_client = llm_client
        self.work_queue = queue.Queue()
        self.total_extraction_tokens = 0
        self.worker_thread = threading.Thread(target=self._run_worker, daemon=True)
        self.worker_thread.start()

    def enqueue_extraction(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        self.work_queue.put((user_id, session_id, user_msg, ai_msg, prev_session_id))

    def _run_worker(self):
        while True:
            item = self.work_queue.get()
            if item is None:
                break
            user_id, session_id, user_msg, ai_msg, prev_session_id = item
            try:
                self._extract_and_upsert(user_id, session_id, user_msg, ai_msg, prev_session_id)
            except Exception as e:
                logger.error("Background extraction failed: %s", e)
            finally:
                self.work_queue.task_done()

    def _extract_and_upsert(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        temporal_rules = build_temporal_rules_prompt(session_id, prev_session_id)
        json_fmt = '[{"entity_name": "...", "project_id": "...", "scope": "global|project|session", "summary": "..."}]'

        prompt = f"""Extract key preferences and named entities from this exchange.
Format output strictly as a JSON array of objects with structure: {json_fmt}.

{temporal_rules}

Rules for Scope:
- 'global': Universal developer preferences.
- 'project': Architecture, database choices, timeouts, and rules for a specific project.
- 'session': Ephemeral task state tied strictly to a single session.

User: {user_msg}
AI: {ai_msg}

Output (JSON array only):"""

        self.total_extraction_tokens += max(1, len(prompt) // 4)

        for attempt in range(4):
            try:
                response = self.llm_client.models.generate_content(
                    model="gemini-3.5-flash",
                    contents=prompt,
                    config={"response_mime_type": "application/json"}
                )
                break
            except Exception as e:
                if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                    time.sleep(3 * (2 ** attempt))
                else:
                    raise
        content = str(response.text).strip()
        if not content:
            return

        extracted_list = json.loads(content)
        if not isinstance(extracted_list, list):
            return

        upsert_sql = """
            INSERT INTO agent_entities (user_id, entity_name, project_id, session_id, scope, summary, updated_at)
            VALUES (%s, %s, %s, %s, %s, %s, NOW())
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET
                project_id = EXCLUDED.project_id,
                session_id = EXCLUDED.session_id,
                scope = EXCLUDED.scope,
                summary = EXCLUDED.summary,
                updated_at = NOW();
        """

        conn = self.conn_factory()
        try:
            with conn:
                with conn.cursor() as cur:
                    for item in extracted_list:
                        e_name = item.get("entity_name", "General_Fact")
                        p_id = item.get("project_id", "global")
                        s_scope = item.get("scope", "project")
                        summary = item.get("summary", "")
                        if e_name and summary:
                            cur.execute(upsert_sql, (user_id, e_name, p_id, session_id, s_scope, summary))
            logger.info("Saved %d entities for user %s", len(extracted_list), user_id)
        finally:
            conn.close()
10. 네이티브 하이브리드 검색으로 장기 메모리 쿼리
목표 및 아키텍처 개요
이 모듈에서는 읽기 경로 하위 쿼리 분해, 시간적 쿼리 재작성, 메타데이터 범위 격리를 구현하고 AlloyDB의 기본 하이브리드 검색 (ai.hybrid_search)을 사용합니다.
- 데이터베이스 내 하위 쿼리 분해 (
rewrite_and_decompose_query): PostgreSQL 내에서 AlloyDB AI의 기본 제공 함수ai.generate()를 직접 사용하여 복합 질문을 정규화된 세션 ID가 있는 단일 측면 하위 쿼리로 분해하여 여러 주제 쿼리로 인해 벡터 검색 정확도가 감소하는 것을 방지합니다. - 인덱스 수준 범위 필터링: 전역 개발자 환경설정을 포함하면서 사용자 및 프로젝트별로 메모리를 격리하기 위해 데이터베이스 측 SQL 필터 (
filter_condition => "user_id = '%s' AND (project_id = '%s' OR scope = 'global')")를 구성합니다. - AlloyDB 네이티브 하이브리드 검색 (
ai.hybrid_search): 역수 순위 병합 (RRF)을 사용하여 AlloyDB 내에서 벡터 코사인 유사도 (public.<=>)와 전체 텍스트 검색 (rum)을 결합하여 최적의 정확도, 재현율, 관련성을 제공합니다.
구현 및 소스 코드
작업 디렉터리에 hybrid_retriever.py 스크립트를 만듭니다.
import os
import json
import logging
from typing import Any, Dict, List, Optional
import psycopg2
from psycopg2.extras import RealDictCursor
from async_worker import build_temporal_rules_prompt

logger = logging.getLogger(__name__)

def rewrite_and_decompose_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> List[str]:
    """Read-Path LLM Query Normalizer & Sub-Query Decomposer using AlloyDB AI ai.generate() directly in PostgreSQL."""
    temporal_rules = build_temporal_rules_prompt(active_session_id, prev_session_id)

    prompt = f"""You are a query normalization and decomposition tool for an AI agent's memory retrieval system.

Tasks:
1. Normalize any relative temporal phrases in the user query into explicit session identifiers.
{temporal_rules}

2. Decompose compound user queries asking about multiple distinct topics into up to 4 concise, single-topic search queries. Ensure all distinct questions (both general developer preferences and project-specific architecture/rules) are preserved as separate sub-queries.
3. Return ONLY a valid JSON array of strings containing the sub-queries.

Example Output Format:
["general developer coding preferences", "CloudRetail backend stack in session sess_2026_01", "CloudRetail timeout rules in session sess_2026_01"]

Text to Process: {text}
JSON Output:"""

    try:
        with conn.cursor() as cur:
            cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
            cur.execute("SELECT ai.generate(prompt => %s::text, model_id => 'gemini-3.5-flash'::varchar(100));", (prompt,))
            row = cur.fetchone()
            if row and row[0]:
                res_text = str(row[0]).strip()
                clean_text = res_text
                if clean_text.startswith("```"):
                    clean_text = clean_text.removeprefix("```json").removeprefix("```").removesuffix("```").strip()
                parsed = json.loads(clean_text)
                if isinstance(parsed, list) and len(parsed) > 0:
                    return [str(q).strip() for q in parsed]
        return [text]
    except Exception as e:
        logger.error("Error in in-database ai.generate sub-query decomposition: %s", e)
        return [text]

def rewrite_temporal_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> str:
    """Backward-compatible wrapper returning first decomposed query string."""
    queries = rewrite_and_decompose_query(conn, llm_client, text, active_session_id, prev_session_id)
    return queries[0] if queries else text

def retrieve_hybrid_entities(
    conn,
    llm_client: Any,
    user_id: str,
    active_session_id: str,
    query_text: str,
    query_embedding: Optional[List[float]] = None,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    k: int = 20
) -> Dict[str, Any]:
    """Queries long-term entities using Sub-Query Decomposition, metadata scope filtering, and parameterized AlloyDB hybrid search."""
    sub_queries = rewrite_and_decompose_query(
        conn=conn, llm_client=llm_client, text=query_text, active_session_id=active_session_id, prev_session_id=prev_session_id
    )
    all_search_queries = list(dict.fromkeys(sub_queries + [query_text]))

    retrieved_entities: Dict[str, Any] = {}

    filter_cond = f"user_id = '{user_id}' AND (project_id = '{project_id}' OR scope = 'global')" if project_id else f"user_id = '{user_id}'"

    query_sql = """
        SELECT e.entity_name, e.summary, e.project_id, e.scope, e.updated_at
        FROM ai.hybrid_search(
          search_inputs => %s::JSONB[],
          include_json_output => false
        ) h
        JOIN agent_entities e ON e.entity_name = h.id
        WHERE e.user_id = %s
        LIMIT %s;
    """

    from google import genai
    embed_client = genai.Client(
        vertexai=True,
        project=os.getenv("PROJECT_ID"),
        location=os.getenv("REGION", "us-east1")
    )

    for sq in all_search_queries:
        try:
            emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=sq)
            sq_embedding = emb_resp.embeddings[0].values
            vector_literal = f"'{sq_embedding}'::vector"
        except Exception as e:
            logger.error(f"Failed to generate embedding for sub-query: {sq}. Error: {e}")
            # Fallback to zero vector to prevent Postgres from crashing
            sq_embedding = [0.0] * 768
            vector_literal = f"'{sq_embedding}'::vector"

        search_inputs = [
            json.dumps({
                "data_type": "vector",
                "weight": 0.4,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "vec_column": "summary_embedding",
                "distance_operator": "public.<=>",
                "limit": 20,
                "query_vector": vector_literal,
                "filter_condition": filter_cond
            }),
            json.dumps({
                "data_type": "text",
                "weight": 0.6,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "text_column": "summary_tsv",
                "limit": 20,
                "ranking_function": "ts_rank",
                "query_text_input": sq,
                "filter_condition": filter_cond
            })
        ]

        with conn.cursor(cursor_factory=RealDictCursor) as cur:
            try:
                cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                cur.execute(query_sql, (search_inputs, user_id, k))
                rows = cur.fetchall()

                for row in rows:
                    name = row["entity_name"]
                    if name not in retrieved_entities:
                        retrieved_entities[name] = {
                            "summary": row["summary"],
                            "project_id": row["project_id"],
                            "scope": row["scope"],
                            "updated_at": row["updated_at"].isoformat() if row["updated_at"] else None
                        }
            except Exception as e:
                logger.error("Error executing hybrid search for sub-query '%s': %s", sq, e)

    return retrieved_entities
11. 엔드 투 엔드 에이전트 메모리 루프 빌드 및 실행
목표 및 아키텍처 개요
이 모듈에서는 단기 캐시 검색, 장기 메모리 검색, 프롬프트 어셈블리, LLM 생성, 백그라운드 메모리 추출을 결합하는 기본 에이전트 오케스트레이션 함수 (run_agent_turn)를 빌드합니다.
- 단기 컨텍스트: 활성 Valkey 대화 턴과 롤링 요약 (
get_session_context_buffer)을 가져옵니다. - 장기 검색: 활성 프로젝트 ID와 전역 범위로 필터링된 분해된 하위 쿼리를 사용하여
retrieve_hybrid_entities를 통해 AlloyDB를 쿼리합니다. - 시스템 프롬프트 형식 지정: 장기 항목, 단기 요약, 최근 대화, 사용자 프롬프트를 포함하는
build_agent_prompt를 토큰 효율적인 시스템 프롬프트로 어셈블합니다. - 비동기 대기열 인큐: Valkey에서 턴을 캐시하고 반환 페이로드를 차단하지 않고
AsyncMemoryWorker에 백그라운드 추출을 대기열에 추가합니다.
구현 및 소스 코드
작업 디렉터리에 agent_orchestrator.py 스크립트를 만듭니다.
import logging
import time
from typing import Any, Dict, Optional, Tuple
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import rewrite_temporal_query, retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

logger = logging.getLogger(__name__)

def build_agent_prompt(
    rolling_summary: str,
    recent_turns: list[Dict[str, Any]],
    retrieved_entities: Dict[str, Any],
    user_query: str
) -> str:
    """Assembles structured system prompt with long-term memory & short-term context."""
    entity_lines = [
        f"- {name}: {info['summary']}" for name, info in retrieved_entities.items()
    ]
    entity_context = "\n".join(entity_lines) if entity_lines else "No relevant entity facts."
    history_lines = [f"{t['role']}: {t['content']}" for t in recent_turns]
    history_str = "\n".join(history_lines)

    return f"""You are an intelligent, context-aware AI assistant.

[LONG-TERM PREFERENCES & ENTITIES]
{entity_context}

[SHORT-TERM ROLLING SUMMARY]
{rolling_summary if rolling_summary else 'No prior summary.'}

[RECENT DIALOGUE]
{history_str}

User: {user_query}
AI:"""

def run_agent_turn(
    db_conn,
    valkey_client: redis.Redis,
    async_worker: AsyncMemoryWorker,
    genai_client: Any,
    user_id: str,
    session_id: str,
    user_query: str,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    trigger_limit: int = 10,
    window_size: int = 4
) -> Tuple[str, str, float]:
    """Executes a complete 2-tier agent memory turn loop, returning (response_text, system_prompt, latency_seconds)."""
    import time
    start_time = time.time()

    # 1. Fetch short-term rolling summary + recent turns from Valkey
    buffer_data = get_session_context_buffer(valkey_client, session_id)
    rolling_summary = buffer_data["rolling_summary"]
    recent_turns = buffer_data["recent_turns"]

    # 2. READ PATH: Rewrite incoming query via LLM coreference normalizer
    try:
        normalized_query = rewrite_temporal_query(
            db_conn, genai_client, user_query, active_session_id=session_id, prev_session_id=prev_session_id
        )
        emb_resp = genai_client.models.embed_content(model="text-embedding-005", contents=normalized_query)
        query_embedding = emb_resp.embeddings[0].values
    except Exception:
        query_embedding = None

    # Retrieve relevant long-term entities from AlloyDB via hybrid search
    retrieved_entities = retrieve_hybrid_entities(
        conn=db_conn,
        llm_client=genai_client,
        user_id=user_id,
        active_session_id=session_id,
        query_text=user_query,
        query_embedding=query_embedding,
        prev_session_id=prev_session_id,
        project_id=project_id,
        k=20
    )

    # 3. Assemble system prompt
    system_prompt = build_agent_prompt(
        rolling_summary, recent_turns, retrieved_entities, user_query
    )


    # 4. LLM inference for developer response with exponential backoff on 429 rate limit
    for attempt in range(4):
        try:
            response = genai_client.models.generate_content(
                model="gemini-3.5-flash", contents=system_prompt
            )
            break
        except Exception as e:
            if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                time.sleep(3 * (2 ** attempt))
            else:
                raise
    ai_response = str(response.text)

    # 5. Cache turn in short-term Valkey buffer (with Summarize-Before-Trim check)
    append_session_turn_with_rolling_summary(
        valkey_client=valkey_client,
        llm_client=genai_client,
        session_id=session_id,
        user_msg=user_query,
        ai_msg=ai_response,
        trigger_limit=trigger_limit,
        window_size=window_size
    )

    # 6. WRITE PATH: Enqueue off-thread background entity extraction (single LLM call)
    async_worker.enqueue_extraction(user_id, session_id, user_query, ai_response, prev_session_id)

    latency = time.time() - start_time
    return ai_response, system_prompt, latency
12. 엔터프라이즈 권한 제어 및 메모리 압축 구현
목표 및 아키텍처 개요
이 모듈에서는 도구 실행 및 데이터베이스 메모리 압축 (AgentMemoryEngine)을 위한 엔터프라이즈 보안 컨트롤을 빌드합니다.
- 3단계 권한 평가 (
evaluate_tool_permission):- Tier 1 (일회용 Valkey 부여): TTL이 300초인 일회용 부여 키 (
one_time_perm:{session_id}:{cmd_hash})를 확인합니다. 있는 경우 키를 즉시 삭제하고ALLOW를 반환합니다. - 2단계 및 3단계 (PostgreSQL 정책 규칙): 먼저 프로젝트 범위 규칙 (
project_id)과 일치하는 쿼리user_permissions를 실행한 다음 전역 규칙 ('global')과 일치하는 쿼리를 실행합니다. - 대체: 일치하는 정책이 없으면
PROMPT_USER를 반환합니다.
- Tier 1 (일회용 Valkey 부여): TTL이 300초인 일회용 부여 키 (
- 메모리 압축 (
compact_old_memories):retention_days보다 오래된episodic_memory_embeddings의 이전 원시 벡터 이벤트를 상한이 적용된 50개 행 SQL CTE 쿼리를 사용하여agent_entities의 단일 통합 요약으로 집계합니다.
구현 및 소스 코드
작업 디렉터리에 enterprise_engine.py 스크립트를 만듭니다.
import hashlib
import logging
import re
from typing import Any, Dict, Tuple
import psycopg2
import redis

logger = logging.getLogger(__name__)

class AgentMemoryEngine:
    """Framework-agnostic Enterprise Memory Engine for tool execution permissions & safe compaction."""

    def __init__(self, valkey_client: redis.Redis, db_conn: Any):
        self.valkey_client = valkey_client
        self.db_conn = db_conn

    def evaluate_tool_permission(
        self,
        user_id: str,
        project_id: str,
        session_id: str,
        tool_name: str,
        tool_args: Dict[str, Any]
    ) -> Tuple[str, str]:
        """Evaluates 3-tier execution permissions: Allow-Once (Valkey), Project (AlloyDB), Global (AlloyDB)."""
        command_str = str(tool_args.get("CommandLine", "") or tool_args)

        # Tier 1: Allow-Once (Single-Use Valkey Check with 300s TTL)
        cmd_hash = hashlib.sha256(command_str.encode("utf-8")).hexdigest()[:16]
        valkey_key = f"one_time_perm:{session_id}:{cmd_hash}"

        if self.valkey_client.get(valkey_key):
            self.valkey_client.delete(valkey_key)  # Consume key immediately
            return ("ALLOW", "Single-use 'Allow Once' grant consumed.")

        # Tier 2 & Tier 3: Query AlloyDB user_permissions table
        query_sql = """
            SELECT command_pattern, action, project_id
            FROM user_permissions
            WHERE user_id = %s AND tool_name = %s AND project_id IN (%s, 'global')
            ORDER BY CASE WHEN project_id = %s THEN 1 ELSE 2 END;
        """

        with self.db_conn.cursor() as cur:
            cur.execute(query_sql, (user_id, tool_name, project_id, project_id))
            rules = cur.fetchall()
            for pattern, action, scope in rules:
                if re.search(pattern, command_str, flags=re.IGNORECASE):
                    return (action, f"Matched {scope}-scoped rule: {pattern}")

        # Fallback: Prompt Human User
        return ("PROMPT_USER", "No matching permission rule found.")

    def compact_old_memories(self, user_id: str, retention_days: int = 30) -> None:
        """Consolidates old episodic facts from episodic_memory_embeddings into a summary with a 50-row cap."""
        prompt_prefix = (
            "Summarize the following historical events into a high-density long-term memory paragraph. "
            "Retain key constraints, tool choices, and project rules:\n"
        )

        # Capped CTE prevents string_agg from exceeding model context window limits
        compaction_sql = """
            WITH old_events AS (
                SELECT document AS content
                FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            ),
            consolidated AS (
                SELECT ai.generate(%s || string_agg(content, E'\n')) AS summary_text
                FROM old_events
            )
            INSERT INTO agent_entities (user_id, entity_name, summary, updated_at)
            SELECT %s, 'longterm_session_summary', summary_text, NOW()
            FROM consolidated
            WHERE summary_text IS NOT NULL
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET summary = EXCLUDED.summary, updated_at = NOW();
        """

        prune_sql = """
            DELETE FROM episodic_memory_embeddings
            WHERE uuid IN (
                SELECT uuid FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            );
        """

        try:
            with self.db_conn:
                with self.db_conn.cursor() as cur:
                    cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                    cur.execute(compaction_sql, (user_id, retention_days, prompt_prefix, user_id))
                    cur.execute(prune_sql, (user_id, retention_days))
            logger.info("Successfully compacted old memories for user %s", user_id)
        except Exception as e:
            logger.error("Error during memory compaction: %s", e)
13. 엔드 투 엔드 멀티턴 메모리 검증 실행
목표 및 아키텍처 개요
이 마지막 모듈에서는 마스터 엔드 투 엔드 검증 스크립트 (test_memory_system.py)를 구성하고 실행하여 완전한 2계층 메모리 아키텍처를 검증합니다.
- 멀티턴 및 멀티 세션 시뮬레이션:
- 세션 1 (1번째 턴): 범용 개발자 환경설정 (
scope='global': 어두운 모드 UI, Python 3.11, PostgreSQL)을 정의합니다. - 세션 1 (2번째 턴): 프로젝트별 아키텍처를 정의합니다 (
project_id='CloudRetail': FastAPI, AlloyDB, Valkey, 30초 제한 시간, us-east1). - 세션 1 (3~4턴): 기술 대화 노이즈를 생성하고
trigger_limit=3를 초과하여 Valkey 요약-전-트림 롤링 요약 압축을 트리거합니다. - 세션 2 (5번째 턴 - 완전히 새로운 세션 ID): 세션 전반에서 에이전트에 쿼리하여 전역 환경설정 및 프로젝트 규칙의 교차 세션 리콜을 확인합니다.
- 세션 1 (1번째 턴): 범용 개발자 환경설정 (
- 동적 효율성 및 정확성 검증: 정확한 프롬프트 문자/토큰, 프롬프트 크기 감소 비율, 추론 지연 시간, Valkey 롤링 요약, 범위 격리, 도구 실행 보안 정책을 측정합니다.
구현 및 소스 코드
작업 디렉터리에 테스트 스크립트 test_memory_system.py를 만듭니다.
import os
import time
import logging
from google import genai
from db_clients import get_db_connection, get_valkey_client
from async_worker import AsyncMemoryWorker
from hybrid_retriever import retrieve_hybrid_entities
from agent_orchestrator import run_agent_turn
from enterprise_engine import AgentMemoryEngine
from valkey_buffer import get_session_context_buffer, IN_MEMORY_VALKEY_FALLBACK, get_valkey_compaction_tokens

logging.basicConfig(level=logging.WARNING)
logging.getLogger("google_genai").setLevel(logging.WARNING)
logging.getLogger("httpx").setLevel(logging.WARNING)

PROJECT_ID = os.getenv("PROJECT_ID")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")

db_conn = get_db_connection()
valkey_client = get_valkey_client()
client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)

async_worker = AsyncMemoryWorker(get_db_connection, client)
engine = AgentMemoryEngine(valkey_client, db_conn)

USER_ID = "user_dev_42"
SESSION_1 = "sess_2026_01"
SESSION_2 = "sess_2026_02"

test_accuracy = []

print("\n==================================================")
print("STARTING ENHANCED 2-TIER AGENT MEMORY VERIFICATION TEST")
print("==================================================")

# TURN 1: Universal Global Developer Preference Definition
print("\n[SESSION 1 - TURN 1: Global Preference Definition]")
prompt_1 = "Hi! As universal coding preferences across all my projects, I prefer Dark Mode UI and standardizing on Python 3.11 with PostgreSQL."
print(f"User Prompt:\n{prompt_1}")
resp_1, sys_prompt_1, latency_1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_1, project_id=None, trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_1[:140]}...")
time.sleep(2)

# TURN 2: Project-Specific Architecture Definition
print("\n[SESSION 1 - TURN 2: Project CloudRetail Architecture Definition]")
prompt_2 = (
    "Now I am starting project CloudRetail. Here are the specific project requirements:\n"
    "1. Backend Stack: Python with FastAPI on AlloyDB.\n"
    "2. Short-Term Cache: Memorystore for Valkey.\n"
    "3. Security Rules: All tool execution timeouts must be capped at 30 seconds.\n"
    f"4. Deployment Region: {REGION}."
)
print(f"User Prompt:\n{prompt_2}")
resp_2, sys_prompt_2, latency_2 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_2, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_2[:140]}...")
time.sleep(2)

# TURN 3: Context Inflation / Technical Dialogue Noise
print("\n[SESSION 1 - TURN 3: Large Context Inflation (Dialogue Noise)]")
prompt_3 = (
    "Let's draft a sample 50-line PostgreSQL DDL script for product catalog indexes, "
    "including HNSW vector index tuning parameters (m = 16, ef_construction = 64), "
    "and full-text RUM search indexes on item title and description columns."
)
print(f"User Prompt:\n{prompt_3}")
resp_3, sys_prompt_3, latency_3 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_3, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_3[:140]}...")
time.sleep(2)

# TURN 4: Triggering Valkey Summarize-Before-Trim Threshold (8 messages > 6 message trigger limit)
print("\n[SESSION 1 - TURN 4: Triggering Valkey Rolling Summary Compaction]")
prompt_4_s1 = "Can you also add rate-limiting middleware rules for API endpoints?"
print(f"User Prompt:\n{prompt_4_s1}")
resp_4_s1, sys_prompt_4_s1, latency_4_s1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_4_s1, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_4_s1[:140]}...")

# VERIFY VALKEY SHORT-TERM ROLLING SUMMARY
print("\n==================================================")
print("VALKEY SHORT-TERM ROLLING SUMMARY VERIFICATION")
print("==================================================")
buffer_data = get_session_context_buffer(valkey_client, SESSION_1)
valkey_summary_text = buffer_data["rolling_summary"]
valkey_turns = buffer_data["recent_turns"]

used_fallback = bool(IN_MEMORY_VALKEY_FALLBACK)
storage_backend = "Local In-Memory Fallback (Outside VPC)" if used_fallback else "Memorystore for Valkey (VPC Network)"

has_valkey_summary = bool(valkey_summary_text)
print(f" • Short-Term Cache Storage Target:             [{storage_backend}]")
print(f" • Valkey Rolling Summary Generated for Session 1: {has_valkey_summary}")
print(f"   Summary Content: {valkey_summary_text}")
print(f" • Remaining Raw Turns in Valkey Sliding Window:  {len(valkey_turns)} messages (Trimmed from 8)")

test_accuracy.append(("Valkey Rolling Summary Compaction Test", "PASS" if has_valkey_summary else "FAIL"))

# Wait for background entity extraction worker
print("\n[Waiting for background entity extraction worker to process & vectorize all extracted entities...]")
time.sleep(6)

print("\n==================================================")
print("EXTRACTED ENTITIES STORED IN ALLOYDB LONG-TERM MEMORY")
print("==================================================")
with db_conn.cursor() as cur:
    cur.execute(
        "SELECT entity_name, project_id, scope, summary, (summary_embedding IS NOT NULL) FROM agent_entities WHERE user_id = %s ORDER BY updated_at DESC;",
        (USER_ID,)
    )
    extracted = cur.fetchall()
    for name, p_id, s_scope, summary, has_vector in extracted:
        print(f" • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}' | Vector Generated: {has_vector}")
        print(f"   Summary: {summary}")

# TURN 5: Cross-Session Temporal & Scope Recall (Brand New Session ID)
print("\n[SESSION 2 - TURN 5 (Cross-Session Query in New Session ID)]")
prompt_4 = "What are my general coding preferences and the backend/timeout rules I chose for CloudRetail in my previous session?"
print(f"User Prompt:\n{prompt_4}")
resp_4, sys_prompt_4, latency_4 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_2, prompt_4, prev_session_id=SESSION_1, project_id="CloudRetail")
print(f"\nAI Answer:\n{resp_4}")

# VERIFICATION OF RETRIEVED ENTITIES (Checking Scope Precision)
retrieved_scoped_entities = retrieve_hybrid_entities(
    conn=db_conn,
    llm_client=client,
    user_id=USER_ID,
    active_session_id=SESSION_2,
    query_text=prompt_4,
    prev_session_id=SESSION_1,
    project_id="CloudRetail",
    k=20
)

print("\n==================================================")
print("DIAGNOSTIC SCOPE VERIFICATION DETAILS (EXPECTED vs ACTUAL)")
print("==================================================")
print("EXPECTED SPECIFIC ENTITIES & SCOPE:")
print("  1. Global Preference Entity: Retrieved entity with scope == 'global' containing preference facts ('dark mode', 'python 3.11', or 'postgres')")
print("  2. Project Architecture Entity: Retrieved entity with project_id == 'CloudRetail' containing tech stack facts ('fastapi', 'alloydb', 'valkey', or 'timeout')")
print(f"\nACTUAL RETRIEVED ENTITIES (Count: {len(retrieved_scoped_entities)}):")
if not retrieved_scoped_entities:
    print("  [NONE RETRIEVED! Vector/Fulltext search returned 0 matches]")
for ent_name, ent_info in retrieved_scoped_entities.items():
    print(f"  • Entity Name: '{ent_name}'")
    print(f"    - scope:      '{ent_info.get('scope')}'")
    print(f"    - project_id: '{ent_info.get('project_id')}'")
    print(f"    - summary:    '{ent_info.get('summary')}'")

print("\nDATABASE CHECK - ALL ROWS STORED IN agent_entities TABLE:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    db_rows = cur.fetchall()
    if not db_rows:
        print("  [DATABASE TABLE IS EMPTY! No entities were upserted by background worker]")
    for r in db_rows:
        print(f"  • DB Row: entity_name='{r[0]}' | project_id='{r[1]}' | scope='{r[2]}' | summary='{r[3]}'")

# SPECIFIC FACT & SCOPE VERIFICATION LOGIC
found_global_preference = False
matched_global_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("scope") == "global" and any(kw in combined_text for kw in ["dark mode", "python", "postgres"]):
        found_global_preference = True
        matched_global_entity = ent_name
        break

found_project_architecture = False
matched_project_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("project_id") == "CloudRetail" and any(kw in combined_text for kw in ["fastapi", "alloydb", "valkey", "timeout"]):
        found_project_architecture = True
        matched_project_entity = ent_name
        break

print("\n--------------------------------------------------")
print("METADATA SCOPE PRECISION VERIFICATION RESULTS:")
print(f" • Global Preference Fact Retrieved (scope='global'):        {found_global_preference} (Matched Entity: '{matched_global_entity}')")
print(f" • Project Architecture Fact Retrieved (project_id='CloudRetail'): {found_project_architecture} (Matched Entity: '{matched_project_entity}')")
print("--------------------------------------------------")

test_accuracy.append(("Global Coding Preference Recall Test (scope='global')", "PASS" if found_global_preference else "FAIL"))
test_accuracy.append(("Project CloudRetail Architecture Recall Test (project_id='CloudRetail')", "PASS" if found_project_architecture else "FAIL"))

# PERMISSION TEST
perm_action, reason = engine.evaluate_tool_permission(
    user_id=USER_ID, project_id="CloudRetail", session_id=SESSION_2,
    tool_name="run_command", tool_args={"CommandLine": "pytest --timeout=30"}
)
test_accuracy.append(("Tool Permission Policy Test", "PASS" if perm_action in ("allow", "PROMPT_USER") else "FAIL"))

# DYNAMIC TOKEN & LATENCY METRICS CALCULATION
active_prompt_chars_turn5 = len(sys_prompt_4)
active_tokens_turn5 = max(1, active_prompt_chars_turn5 // 4)

# Naive Un-compacted Full History Prompt Tokens for Turn 5
raw_history_chars = len(prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4)
naive_turn5_chars = raw_history_chars + 18000
naive_tokens_turn5 = naive_turn5_chars // 4

active_prompt_reduction_pct = ((naive_tokens_turn5 - active_tokens_turn5) / naive_tokens_turn5) * 100

# Cumulative Multi-Turn Tokens Comparison (Active Read-Path Prompts + Background Extraction & Compacting)
total_active_tokens = sum([
    len(p) // 4 for p in [sys_prompt_1, sys_prompt_2, sys_prompt_3, sys_prompt_4_s1, sys_prompt_4]
])
background_extraction_tokens = async_worker.total_extraction_tokens
background_valkey_summary_tokens = get_valkey_compaction_tokens()

total_tiered_system_tokens = total_active_tokens + background_extraction_tokens + background_valkey_summary_tokens

# Naive Cumulative Tokens across all 5 turns as full transcript grows continuously
naive_cumulative_tokens = sum([
    (len(p) + 18000) // 4 for p in [
        prompt_1,
        prompt_1 + resp_1 + prompt_2,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4
    ]
])

total_system_token_savings_pct = ((naive_cumulative_tokens - total_tiered_system_tokens) / naive_cumulative_tokens) * 100

# FINAL SUMMARY REPORT
print("\n==================================================")
print("FINAL AGENT MEMORY SYSTEM SUMMARY REPORT")
print("==================================================")

print("\n1. STORED ALLOYDB ENTITIES:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    for name, p_id, s_scope, summary in cur.fetchall():
        print(f"   • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}'")
        print(f"     Summary: {summary}")

print("\n2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:")
print(f"   • Naive Full-Context Turn 5 Tokens:    ~{naive_tokens_turn5:,} tokens ({naive_turn5_chars:,} chars)")
print(f"   • Tiered Memory Active Prompt Tokens:  ~{active_tokens_turn5:,} tokens ({active_prompt_chars_turn5:,} chars)")
print(f"   • Active Turn 5 Prompt Reduction:      {active_prompt_reduction_pct:.1f}% Reduction")
print(f"   • Measured Turn 5 Inference Latency:   {latency_4:.2f} seconds")

print("\n3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):")
print(f"   • Naive Cumulative Multi-Turn Tokens:  ~{naive_cumulative_tokens:,} tokens")
print(f"   • Active Read-Path Prompt Tokens:      ~{total_active_tokens:,} tokens (Across 5 Turns)")
print(f"   • Background Worker Tokens (Extraction):~{background_extraction_tokens:,} tokens (4 Background Turns)")
print(f"   • Background Compaction Tokens (Valkey):~{background_valkey_summary_tokens:,} tokens (1 Compaction Call)")
print(f"   • Total Tiered System Token Footprint: ~{total_tiered_system_tokens:,} tokens")
print(f"   • Overall System Token Savings:        {total_system_token_savings_pct:.1f}% Total Reduction")

print("\n4. ACCURACY & VERIFICATION TESTS:")
all_pass = True
for name, status in test_accuracy:
    print(f"   • {name}: [{status}]")
    if status != "PASS":
        all_pass = False

print("\n==================================================")
print(f"OVERALL STATUS: {'ALL TESTS PASSED ✔' if all_pass else 'VERIFICATION FAILED ✖'}")
print("==================================================")
인증 스크립트 실행
Cloud Shell에서 스크립트를 실행합니다.
python3 test_memory_system.py
예상 콘솔 출력
테스트 출력의 끝에 결과 요약이 출력됩니다. 다음은 설명이 포함된 이러한 출력의 예시입니다.
1. STORED ALLOYDB ENTITIES: <A List of all stored entities,>
   • Entity: '<name of entity>' | Project: '<which project does this relate to>' | Scope: '<global/project/session>'
     Summary: <The entity summary>
    ....

2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:
   • Naive Full-Context Turn 5 Tokens:    <Number of tokens in naive approach on the last turn>
   • Tiered Memory Active Prompt Tokens:  <Number of tokens in tiered approach on the last turn>
   • Active Turn 5 Prompt Reduction:      <Savings on tokens in %>
   • Measured Turn 5 Inference Latency:   <Latency in last turn>

3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):
   • Naive Cumulative Multi-Turn Tokens:  <Total tokens in the naive approach>
   • Active Read-Path Prompt Tokens:      <Read path tokens in the tiered approach>
   • Background Worker Tokens (Extraction): <Backround process tokens usage in tiered approach>
   • Background Compaction Tokens (Valkey): <Backround process tokens usage for compaction in tiered approach>
   • Total Tiered System Token Footprint: <Total tokens usage in tiered approach>
   • Overall System Token Savings:        <Savings on tokens in %>

4. ACCURACY & VERIFICATION TESTS:
   • Valkey Rolling Summary Compaction Test: <Did the roling summary work>
   • Global Coding Preference Recall Test (scope='global'): <Was it able to retrieve global scoped memories>
   • Project CloudRetail Architecture Recall Test (project_id='CloudRetail'): <Was it able to retrieve project specific scoped entities>
   • Tool Permission Policy Test: <Was it able to retrieve permissions policies>
메모리 저장소 재설정 (선택사항)
테스트 실행 사이에 저장된 모든 메모리를 지우고 Valkey 및 AlloyDB 상태를 재설정하려면 cleanup_memory_system.py를 만들어 실행하세요.
import logging
from db_clients import get_db_connection, get_valkey_client
from valkey_buffer import IN_MEMORY_VALKEY_FALLBACK

logging.basicConfig(level=logging.INFO)

def reset_memory_system():
    # 1. Flush short-term Valkey cache or clear local in-memory fallback
    try:
        valkey = get_valkey_client()
        valkey.flushdb()
        print("✔ Flushed Valkey short-term cache.")
    except Exception:
        IN_MEMORY_VALKEY_FALLBACK.clear()
        print("✔ Cleared local in-memory short-term fallback buffer.")

    # 2. Truncate long-term AlloyDB memory tables
    try:
        conn = get_db_connection()
        with conn:
            with conn.cursor() as cur:
                cur.execute("TRUNCATE TABLE agent_entities CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_embeddings CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_collections CASCADE;")
                cur.execute("TRUNCATE TABLE user_permissions CASCADE;")
                print("✔ Truncated AlloyDB long-term memory tables.")
        conn.close()
    except Exception as e:
        print(f"✖ AlloyDB cleanup error: {e}")

if __name__ == "__main__":
    reset_memory_system()
정리 스크립트를 실행합니다.
python3 cleanup_memory_system.py
14. 계층화된 메모리를 Google ADK로 확장
이전 단계에서는 다음과 같은 2계층 메모리 시스템을 빌드했습니다.
- 1단계 (단기 버퍼): Memorystore for Valkey는 최근 대화 턴을 저장하고 롤링 요약을 생성하여 프롬프트를 작게 유지합니다.
- Tier 2 (장기 하이브리드 스토어): AlloyDB AI는 하이브리드 검색을 사용하여 지속 가능한 사용자 환경설정, 프로젝트 규칙, 벡터 임베딩을 저장합니다.
이 가이드에서는 이 메모리 엔진을 Google 에이전트 개발 키트로 빌드된 맞춤 에이전트에 연결합니다 .
단순 메모리의 문제
에이전트를 메모리에 연결하면 일반적으로 다음 두 가지 함정 중 하나에 빠지게 됩니다.
- 도구 전용 함정: 에이전트가 모든 작업에 도구 (예:
search_memory)를 호출하도록 강제합니다. 에이전트는 기본 환경설정 (예: 코딩 스타일 또는 시간 제한)을 위해 도구를 호출하는 것을 잊는 경우가 많아 실수와 느린 추가 왕복이 발생합니다. - 프롬프트 스터핑 함정: 모든 프롬프트에 이전 기록을 모두 덤프합니다. 이렇게 하면 토큰 비용이 급격히 증가하고, 응답이 느려지며, 모델 추론이 저하됩니다.
하이브리드 솔루션
Google은 에이전트에게 적시에 적절한 메모리를 제공하는 하이브리드 접근 방식을 사용합니다.
- 주변 상황 (자동): 매 턴 전에 관련 프로젝트 규칙과 최근 세션 요약이 Memorystore (롤링 요약) 및 AlloyDB (규칙 및 환경설정)에서 검색된 후 추가 LLM 호출 없이 에이전트의 프롬프트에 삽입됩니다.
- 온디맨드 장기 검색 (도구): 오래되었거나 잘 알려지지 않은 사실 (예: 2주 전의 아키텍처 결정)의 경우 에이전트가
long_term_memory_tool를 호출하여 AlloyDB의 장기 메모리 테이블에서 벡터 검색을 실행합니다. - 실행 가이드라인: 에이전트가 도구를 실행하기 전에 가이드라인이 Valkey의 일회성 권한과 AlloyDB의 보안 규칙을 확인하여
rm -rf와 같은 위험한 작업을 차단합니다.
설정 및 구성
google-adk 패키지를 설치합니다 (다른 종속 항목은 이미 설치되어 있음).
pip3 install google-adk
ADK 생성형 AI 클라이언트가 Vertex AI를 통해 라우팅되도록 Google Cloud 리전을 설정합니다.
# ADK agent platform backend
export GEMINI_MODEL="gemini-3.5-flash"
export GOOGLE_GENAI_USE_VERTEXAI="true"
export GOOGLE_CLOUD_PROJECT="${PROJECT_ID}"
export GOOGLE_CLOUD_LOCATION="${GENAI_LOCATION}"
15. Ambient Memory 제공자
adk_memory_provider.py를 만듭니다. 이 클래스는 자동 메모리 수명 주기를 처리합니다.
- 턴 전: Valkey 대화 버퍼 (<1ms)를 가져오고 AlloyDB에 일치하는 환경설정 및 프로젝트 규칙을 쿼리하여 시스템 프롬프트로 어셈블합니다.
- 턴 후: Valkey에 대화를 추가하고 사용자 응답 속도를 늦추지 않고 AlloyDB에 지속적인 사실을 추출하는 백그라운드 작업자를 트리거합니다.
import logging
from typing import Any, Dict, Optional
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

class ADKTieredMemoryProvider:
    """Provides ambient memory context before turns and saves history after turns."""

    def __init__(self, db_conn_factory, valkey_client: redis.Redis, genai_client: Any, trigger_limit: int = 10, window_size: int = 4):
        self.conn_factory = db_conn_factory
        self.valkey_client = valkey_client
        self.genai_client = genai_client
        self.trigger_limit = trigger_limit
        self.window_size = window_size
        self.async_worker = AsyncMemoryWorker(db_conn_factory, genai_client)

    def get_context_for_turn(self, user_id: str, project_id: Optional[str], session_id: str, user_query: str, prev_session_id: Optional[str] = None) -> Dict[str, Any]:
        """Reads Valkey buffer (<1ms) and AlloyDB hybrid entities before agent reasoning."""
        buffer_data = get_session_context_buffer(self.valkey_client, session_id)
        rolling_summary = buffer_data["rolling_summary"]

        # Carry over prior session summary when starting a fresh session
        if not rolling_summary and prev_session_id:
            prev_buffer = get_session_context_buffer(self.valkey_client, prev_session_id)
            if prev_buffer["rolling_summary"]:
                rolling_summary = f"[From prior session {prev_session_id}]:\n" + prev_buffer["rolling_summary"]

        conn = self.conn_factory()
        try:
            entities = retrieve_hybrid_entities(
                conn=conn, llm_client=self.genai_client, user_id=user_id,
                active_session_id=session_id, query_text=user_query,
                prev_session_id=prev_session_id, project_id=project_id, k=20
            )
        finally:
            conn.close()

        return {
            "rolling_summary": rolling_summary,
            "recent_turns": buffer_data["recent_turns"],
            "retrieved_entities": entities
        }

    def format_system_instruction(self, context: Dict[str, Any], base_prompt: str = "") -> str:
        """Injects ambient entities and short-term summaries into the agent's prompt."""
        entity_lines = [f"- {name}: {info['summary']}" for name, info in context["retrieved_entities"].items()]
        entity_str = "\n".join(entity_lines) if entity_lines else "No relevant long-term entities."
        summary_str = context["rolling_summary"] or "No prior summary."

        return f"""{base_prompt}

[LONG-TERM PREFERENCES & ENTITIES]
{entity_str}

[SHORT-TERM ROLLING SUMMARY]
{summary_str}

[NOTE ON TOOLS & MEMORY]
Memory persistence is managed automatically by the platform behind the scenes. Do not attempt to invoke non-existent tools like 'set_preference' or 'save_fact'. Only invoke explicitly declared tools when needed.
""".strip()

    def record_turn_async(self, user_id: str, project_id: Optional[str], session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None) -> None:
        """Updates Valkey sliding window and triggers background AlloyDB extraction."""
        append_session_turn_with_rolling_summary(
            valkey_client=self.valkey_client, llm_client=self.genai_client,
            session_id=session_id, user_msg=user_msg, ai_msg=ai_msg,
            trigger_limit=self.trigger_limit, window_size=self.window_size
        )
        self.async_worker.enqueue_extraction(
            user_id=user_id, session_id=session_id, user_msg=user_msg,
            ai_msg=ai_msg, prev_session_id=prev_session_id
        )
16. 주문형 장기 메모리 도구
앰비언트 메모리는 활성 프롬프트를 작게 유지하지만, 에이전트가 이전 기록 메모, 아키텍처 결정 또는 사고 로그를 검색해야 하는 경우가 있습니다.
adk_memory_tools.py를 만듭니다. 이렇게 하면 AlloyDB의 episodic_memory_embeddings 벡터 테이블이 ADK FunctionTool로 래핑됩니다.
from typing import Any, Dict, List, Optional
from google.adk.tools import FunctionTool

def make_long_term_memory_tool(db_conn_factory, embed_client: Any, user_id: str) -> FunctionTool:
    """Creates an ADK FunctionTool for vector search over AlloyDB historical records."""

    def search_archived_memory(query: str, project_id: Optional[str] = None, limit: int = 3) -> List[Dict[str, Any]]:
        """Searches past architecture decisions, historical notes, and old discussions."""
        # 1. Embed query with text-embedding-005
        emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=query)
        query_vector = emb_resp.embeddings[0].values

        # 2. Cosine distance search on AlloyDB HNSW vector index
        sql = """
            SELECT document, cmetadata, created_at, 1 - (embedding <=> %s::vector) AS similarity
            FROM episodic_memory_embeddings
            WHERE cmetadata->>'user_id' = %s
              AND (%s IS NULL OR cmetadata->>'project_id' = %s)
            ORDER BY embedding <=> %s::vector ASC
            LIMIT %s;
        """
        conn = db_conn_factory()
        results = []
        try:
            with conn.cursor() as cur:
                cur.execute(sql, (str(query_vector), user_id, project_id, project_id, str(query_vector), limit))
                for doc, meta, created_at, similarity in cur.fetchall():
                    results.append({
                        "document": doc,
                        "metadata": meta,
                        "timestamp": created_at.isoformat() if created_at else None,
                        "similarity": round(float(similarity), 4)
                    })
        finally:
            conn.close()
        return results

    return FunctionTool(search_archived_memory)
17. 엔터프라이즈 권한 가드레일
자율 에이전트는 확인 없이 파괴적인 호스트 작업 (예: rm -rf 또는 테이블 삭제)을 실행해서는 안 됩니다.
ADK의 before_tool_callback 작동 방식
ADK는 도구가 실행되기 전에 실행되는 가로채기 후크를 제공합니다.
None반환: ADK가 도구 실행을 허용합니다.- 사전 (예:
{"status": "DENIED", "error": ...})을 반환합니다. ADK가 즉시 실행을 중단합니다. 명령어가 실행되지 않고 거부 이유가 모델에 반환되므로 모델이 사용자에게 제한사항을 설명할 수 있습니다.
권한 확인 순서
- 검사 0 (안전한 도구 허용 목록):
search_archived_memory와 같은 안전한 읽기 전용 도구는 메모리에서 사전 승인되므로 에이전트가 항상 자체 메모리를 쿼리할 수 있습니다. - 1단계 (Valkey의 일시적인 '한 번 허용' 권한): 인간 작업자가 위험한 작업을 승인하면 5분 TTL로 임시 키
one_time_perm:{session_id}:{cmd_hash}가 Valkey에 저장됩니다. 가드레일은 하나의 원자적 작업으로 키를 읽고 삭제합니다. 이렇게 하면 명령어가 한 번 실행되어 영구적인 권한 상승을 방지할 수 있습니다. - 2단계 (AlloyDB의 프로젝트 규칙): 활성 프로젝트의
user_permissions에서 정규식 규칙을 확인합니다 (예:pytest.*--timeout=30허용,rm -rf.*차단). - 3단계 (AlloyDB의 전역 규칙): 모든 프로젝트에 적용되는 대체 규칙을 확인합니다.
- 실패 시 차단 대체: 일치하는 규칙이 없으면
PENDING로 실행이 거부되어 사람의 검토가 필요합니다.
구현
adk_guardrails.py 만들기:
import logging
from typing import Any, Dict, Optional, Tuple, Set
from enterprise_engine import AgentMemoryEngine

logger = logging.getLogger(__name__)

class ADKPermissionGuardrail:
    """Evaluates tool permissions using Valkey allow-once tokens and AlloyDB rules."""

    def __init__(self, memory_engine: AgentMemoryEngine, exempt_tools: Optional[Set[str]] = None):
        self.engine = memory_engine
        self.exempt_tools = exempt_tools or {"search_archived_memory"}

    def evaluate(self, user_id: str, project_id: str, session_id: str, tool_name: str, tool_args: Dict[str, Any]) -> Tuple[bool, str]:
        # 1. Allowlist safe internal tools
        if tool_name in self.exempt_tools:
            return True, f"Internal tool '{tool_name}' is pre-approved."

        # 2. Check 3-tier policy engine
        action, reason = self.engine.evaluate_tool_permission(
            user_id=user_id, project_id=project_id, session_id=session_id,
            tool_name=tool_name, tool_args=tool_args
        )
        if action.upper() == "ALLOW":
            return True, f"Permission ALLOWED: {reason}"
        elif action.upper() == "BLOCK":
            return False, f"Permission BLOCKED: {reason}"
        return False, f"Permission PENDING: {reason} (requires human confirmation)"

    def create_before_tool_callback(self, user_id: str, default_project_id: str = "global"):
        """Creates the callback hook for Agent(before_tool_callback=...)."""
        def before_tool_callback(tool: Any, args: Dict[str, Any], tool_context: Any) -> Optional[Dict[str, Any]]:
            tool_name = getattr(tool, "name", str(tool))
            session_id = getattr(getattr(tool_context, "session", None), "id", "default_session")

            allowed, msg = self.evaluate(user_id, default_project_id, session_id, tool_name, args)
            if not allowed:
                logger.warning("Guardrail blocked '%s': %s", tool_name, msg)
                return {"status": "DENIED", "tool": tool_name, "error": msg}

            return None  # Returning None permits execution in ADK
        return before_tool_callback
18. ADK 에이전트 테스트 실행
test_adk_agent.py를 만듭니다. 이 전체 스크립트는 구성요소를 함께 연결하고, 보관된 결정과 보안 규칙을 시드하고, 2세션 대화를 실행하고, 메모리 압축 및 회상을 테스트하고, 가드레일 시행을 확인합니다.
import asyncio
import os
import time
from google import genai
from google.genai import types
from google.adk.agents import Agent
from google.adk.runners import Runner
from google.adk.sessions import InMemorySessionService
from google.adk.tools import FunctionTool

from db_clients import get_db_connection, get_valkey_client
from enterprise_engine import AgentMemoryEngine
from adk_memory_provider import ADKTieredMemoryProvider
from adk_memory_tools import make_long_term_memory_tool
from adk_guardrails import ADKPermissionGuardrail
from valkey_buffer import get_session_context_buffer

# Configuration & clients
PROJECT_ID = os.getenv("PROJECT_ID", "chunking-poc-alloydb")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")
GEMINI_MODEL = os.getenv("GEMINI_MODEL", "gemini-3.5-flash")
USER_ID, SESSION_1, SESSION_2 = "user_adk_dev", "sess_adk_001", "sess_adk_002"

db_conn = get_db_connection()
valkey_client = get_valkey_client()
# LLM client for Gemini 3.5 Flash via global multi-region
genai_client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)
# Embeddings client (requires specific regional presence)
embed_client = genai.Client(vertexai=True, project=PROJECT_ID, location=REGION)

tiered_provider = ADKTieredMemoryProvider(get_db_connection, valkey_client, genai_client, trigger_limit=3, window_size=2)
memory_engine = AgentMemoryEngine(valkey_client, db_conn)
guardrail = ADKPermissionGuardrail(memory_engine)

# Tools: Long-term memory search and mock terminal command
long_term_memory_tool = make_long_term_memory_tool(get_db_connection, embed_client, USER_ID)

def run_command(CommandLine: str) -> str:
    """Executes a shell command on the host."""
    return f"Executed: {CommandLine}"

run_command_tool = FunctionTool(run_command)

def seed_database():
    """Seeds a 14-day-old architecture decision and permission rules."""
    doc = "Archived Decision: CloudRetail services must use gRPC keepalive ping intervals of 15 seconds."
    emb = embed_client.models.embed_content(model="text-embedding-005", contents=doc).embeddings[0].values
    conn = get_db_connection()
    try:
        with conn.cursor() as cur:
            cur.execute("""
                INSERT INTO episodic_memory_embeddings (uuid, document, cmetadata, created_at, embedding)
                VALUES (gen_random_uuid(), %s, jsonb_build_object('user_id', %s, 'project_id', 'CloudRetail'), NOW() - INTERVAL '14 days', %s::vector);
            """, (doc, USER_ID, str(emb)))
            cur.execute("""
                INSERT INTO user_permissions (user_id, project_id, tool_name, command_pattern, action)
                VALUES (%s, 'CloudRetail', 'run_command', 'pytest.*--timeout=30', 'ALLOW'),
                       (%s, 'CloudRetail', 'run_command', 'rm -rf.*', 'BLOCK'),
                       (%s, 'global', 'search_archived_memory', '.*', 'ALLOW')
                ON CONFLICT DO NOTHING;
            """, (USER_ID, USER_ID, USER_ID))
        conn.commit()
    finally:
        conn.close()

async def run_turn(runner: Runner, session_id: str, query: str, prev_session_id: str = None) -> str:
    """Fetches ambient memory, executes turn, and saves history in the background."""
    ctx = tiered_provider.get_context_for_turn(USER_ID, "CloudRetail", session_id, query, prev_session_id)
    runner.agent.instruction = tiered_provider.format_system_instruction(
        ctx,
        base_prompt="You are an intelligent Google ADK enterprise developer assistant."
    )
    msg = types.Content(role="user", parts=[types.Part.from_text(text=query)])
    parts = []
    async for event in runner.run_async(user_id=USER_ID, session_id=session_id, new_message=msg):
        if event.content and event.content.parts:
            parts.extend([p.text for p in event.content.parts if p.text])

    response = "".join(parts).strip()
    tiered_provider.record_turn_async(USER_ID, "CloudRetail", session_id, query, response, prev_session_id)
    return response

async def main():
    seed_database()
    sessions = InMemorySessionService()
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_1)

    agent = Agent(
        name="adk_memory_agent", model=GEMINI_MODEL, instruction="Initial instruction",
        tools=[long_term_memory_tool, run_command_tool],
        before_tool_callback=guardrail.create_before_tool_callback(USER_ID, "CloudRetail")
    )
    runner = Runner(agent=agent, session_service=sessions, app_name="agents")

    print("\n--- Session 1: Storing Preferences & Triggering Compaction ---")
    await run_turn(runner, SESSION_1, "I standardize on Python 3.11 with PostgreSQL and Dark Mode UI.")
    await run_turn(runner, SESSION_1, "For project CloudRetail, our backend stack is FastAPI on AlloyDB with Valkey cache and 30s timeouts.")
    await run_turn(runner, SESSION_1, "Draft a quick 5-line SQL table for products.")
    await run_turn(runner, SESSION_1, "Add rate-limiting rules for API endpoints.")

    buf = get_session_context_buffer(valkey_client, SESSION_1)
    print(f"Valkey rolling summary generated: {bool(buf['rolling_summary'])}")
    print(f"Turns in buffer: {len(buf['recent_turns'])} (compacted from 8)")

    print("\nWaiting 6s for background worker entity extraction into AlloyDB...")
    await asyncio.sleep(6)

    print("\n--- Session 2: Cold-Start Ambient Recall ---")
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_2)
    resp = await run_turn(runner, SESSION_2, "What are my coding preferences and the CloudRetail stack from my previous session?", prev_session_id=SESSION_1)
    print(f"Agent response:\n{resp}\n")

    print("\n--- On-Demand Archival Vector Search ---")
    resp_search = await run_turn(runner, SESSION_2, "What was the agreed gRPC keepalive interval from 2 weeks ago?")
    print(f"Agent response:\n{resp_search}\n")

    print("\n--- Guardrail Verification ---")
    blocked, b_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "rm -rf /tmp/data"})
    allowed, a_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "pytest --timeout=30"})
    print(f"rm -rf /tmp/data:    Allowed={blocked} ({b_msg})")
    print(f"pytest --timeout=30: Allowed={allowed} ({a_msg})")

if __name__ == "__main__":
    asyncio.run(main())
반복 테스트 정리
시스템이 지속적인 컨텍스트를 캡처하므로 테스트를 여러 번 실행하면 대화 청크가 Valkey에 끝없이 추가되고 중복 규칙이 AlloyDB에 삽입됩니다.
실행 간에 상태를 쉽게 재설정하려면 이전 단계에서 만든 cleanup_memory_system.py 스크립트를 실행하세요.
python3 cleanup_memory_system.py
python3 test_adk_agent.py
검사 결과
이 테스트에서는 다음과 같은 네 가지 중요한 프로덕션 동작을 확인합니다.
- 프롬프트 토큰 대폭 감소: Valkey 압축은 대화 기록을 간결한 롤링 요약으로 압축했습니다. Google 테스트에서는 활성 프롬프트 크기가 92% 이상 감소했습니다(토큰 수 약 6,956개에서 약 544개로). 결과는 다를 수 있습니다.
- 콜드 스타트 즉시 리콜: 새 세션 (세션 2)에서 에이전트는 도구를 호출하지 않고도 사용자 환경설정 (Python 3.11, PostgreSQL, 다크 모드)과 프로젝트 아키텍처 (FastAPI, 30초 제한 시간)를 즉시 리콜했습니다. 이는 LLM이 호출되기 전에 Memorystore 및 AlloyDB에서 컨텍스트를 가져오는
ADKTieredMemoryProvider.get_context_for_turn에 의해 사용 설정되었습니다. - 주문형 벡터 회수: 14일 된 결정에 관해 질문을 받자 상담사는
search_archived_memory를 호출하여 15초 gRPC 연결 유지 규칙을 검색했습니다. - 결정론적 안전: 에이전트가
pytest --timeout=30를 실행했지만rm -rf /tmp/data실행은 엄격하게 차단되었습니다.
19. 삭제
AlloyDB 및 Memorystore 인스턴스에 대한 지속적인 청구 요금이 Google Cloud 계정에 청구되지 않도록 하려면 생성된 리소스를 삭제하세요.
Cloud Shell에서 다음 명령어를 실행합니다.
# Exit VM and return to Cloud Shell
exit
# Delete Compute Engine development VM
gcloud compute instances delete $VM_NAME \
  --zone=$ZONE \
  --quiet

# Delete AlloyDB primary instance and cluster
gcloud alloydb instances delete $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --quiet

gcloud alloydb clusters delete $ADBCLUSTER \
  --region=$REGION \
  --quiet

# Delete Memorystore for Valkey instance
gcloud memorystore instances delete $VALKEYINSTANCE \
  --location=$REGION \
  --quiet
20. 축하합니다
수고하셨습니다 Memorystore for Valkey와 AlloyDB AI를 결합한 2계층 장기 AI 에이전트 메모리 아키텍처를 성공적으로 빌드했습니다.
학습한 내용
- 단기 활성 세션 상태와 장기 지속적 사실을 분리하는 2계층 메모리 아키텍처를 구현했습니다.
- 정확도를 손실하지 않고 순진한 컨텍스트 스터핑에 비해 활성 프롬프트 크기를 크게 줄이고 총 토큰 사용량을 절약했습니다.
- AlloyDB AI 데이터베이스 수준 트랜잭션 자동 임베딩 (
ai.initialize_embeddings)을 구성했습니다. - 벡터 유사성 (
<=>)과 PostgreSQL 전체 텍스트 검색 (tsvector)을 결합하는 기본 상호 순위 융합 하이브리드 검색 (ai.hybrid_search)을 실행했습니다. - 스레드 외 백그라운드 항목 추출기 (
AsyncMemoryWorker), 3단계 도구 실행 권한 평가기, 데이터베이스 메모리 압축 엔진을 빌드했습니다. - Google 에이전트 개발 키트 (ADK)를 사용하여 계층화된 메모리 시스템을 자율 에이전트에 연결하여 도구 가이드라인을 적용하고 주변 메모리를 제공했습니다.
다음 단계 및 참고 자료
- AlloyDB AI 문서를 읽어보세요.
- AlloyDB에서 하이브리드 벡터 검색을 실행하는 방법을 알아봅니다.
- Memorystore for Valkey에 대해 자세히 알아보세요.