

1. Zanim zaczniesz
Agenci AI obsługują długie interakcje wieloetapowe, które trwają wiele dni i wykonują długoterminowe zadania wieloetapowe, a duże modele językowe (LLM) pozostają z natury bezstanowe w różnych sesjach. Gdy użytkownik wróci do agenta następnego dnia, model zacznie od zera, chyba że aplikacja będzie w stanie odtworzyć niezbędny kontekst.
Najprostszym podejściem do tego problemu jest wypełnianie tokenami – do każdego aktywnego promptu dołączane są pełne historie rozmów, dzienniki wykonywania narzędzi i bazy kodu. Duże okna kontekstu z milionem tokenów sprawiają, że jest to technicznie możliwe, ale wstawianie kontekstu powoduje poważne problemy operacyjne: koszty tokenów rosną kwadratowo przy każdej turze, opóźnienia w odpowiedziach wydłużają się do kilkudziesięciu sekund, a modele cierpią na degradację kontekstu „zagubionego pośrodku”.
Aby tworzyć niezawodnych agentów AI, potrzebujesz dwupoziomowej architektury pamięci:
- Bufor sesji krótkoterminowej: przechowuje w pamięci aktywnej ostatnie wymiany wiadomości w rozmowie za pomocą okna przesuwnego ograniczonego liczbą tokenów. Ten poziom wymaga wyszukiwania w pamięci o wysokiej przepustowości i czasie dostępu poniżej milisekundy w każdej turze, co sprawia, że Memorystore for Valkey jest idealnym wyborem.
- Pamięć długotrwała: przechowuje strukturalne jednostki, preferencje użytkownika i fakty epizodyczne w różnych sesjach. Ten poziom wymaga integralności transakcyjnej, bezpieczeństwa wielu najemców i hybrydowego pobierania danych relacyjnych i wektorów, dlatego AlloyDB for PostgreSQL jest odpowiednim wyborem.
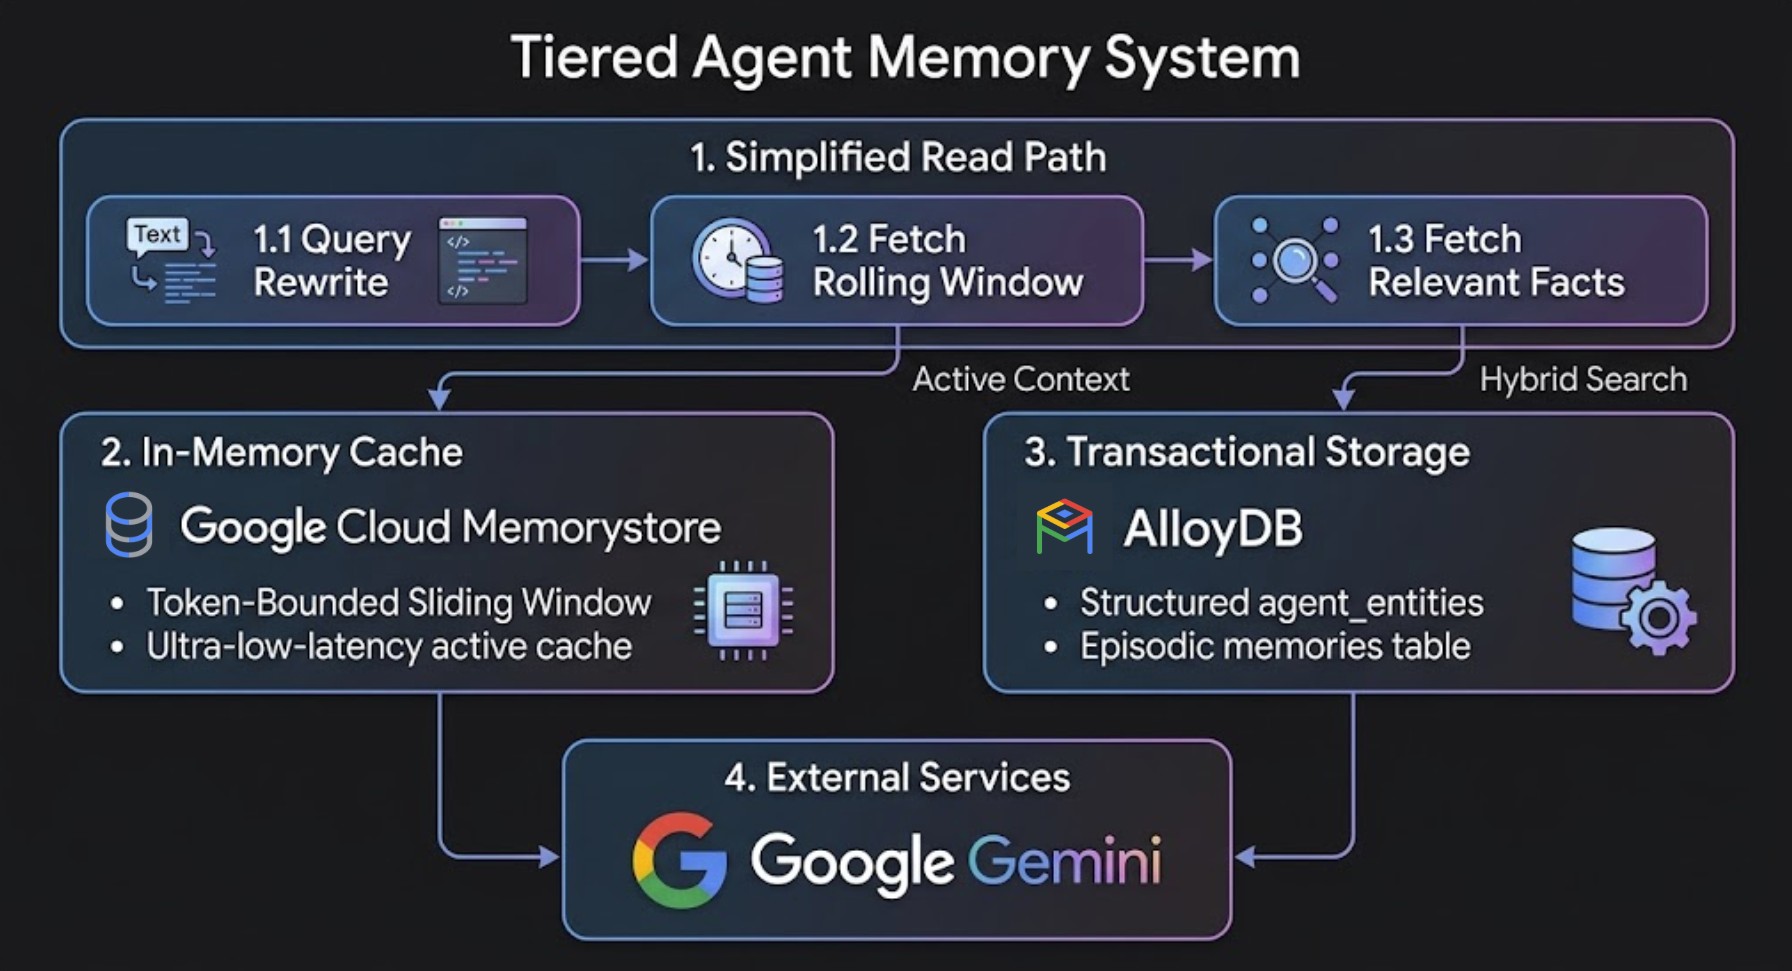
Cztery rodzaje pamięci
Solidna architektura pamięci opiera się na 4 rodzajach pamięci uzupełniających się na całej ścieżce użytkownika:
Typ pamięci | Co przechowuje | Warstwa pamięci masowej | Długość życia |
Bufor (krótkoterminowy) | Ostatnie nieprzetworzone tury rozmowy | Memorystore for Valkey | Aktywna sesja |
Pamięć podsumowania | Skompresowana historia starszych wypowiedzi | Memorystore for Valkey | Okno wieloetapowe |
Pamięć epizodyczna | wcześniejsze działania, zdarzenia i wyniki narzędzi, | AlloyDB for PostgreSQL (wektor) | Na stałe |
Pamięć jednostek i reguł | Preferencje, ograniczenia i odrzucenia użytkownika | AlloyDB for PostgreSQL (strukturalny SQL + wektory) | Na stałe |
Zmierzony wpływ pamięci warstwowej
Wewnętrzne testy porównawcze w przypadku wieloetapowych dialogów deweloperskich (ponad 45 etapów z obszernymi logami danych wyjściowych narzędzi) wykazują znaczne oszczędności w porównaniu z prostym wypełnianiem kontekstu:
Dane / wymiar | Naiwne upychanie kontekstu | Pamięć warstwowa (AlloyDB + Memorystore) | Wpływ netto w testach |
Rozmiar aktywnego promptu (obrót o 45 stopni) | 747 033 tokeny | 83 262 tokeny | O 88,9% mniejszy prompt |
Opóźnienie reakcji przy obrocie o 45 stopni | 33,5 sekundy | 6,7 sekundy | O 80% szybsza reakcja |
Skumulowane tokeny sesji | 17,9 mln tokenów | 4,09 mln tokenów | 72,0% – łączne oszczędności tokenów i kosztów |
Przywoływanie reguł i ograniczeń | Pogarsza się z każdą turą | Zapobiega utracie ważnych informacji w podsumowaniu | Zachowane dzięki wyszukiwaniu hybrydowemu |
Jakie zadania wykonasz
- Zainicjuj AlloyDB for PostgreSQL i Memorystore for Valkey.
- Włącz
google_ml_integrationi skonfiguruj automatyczne wektory dystrybucyjne po stronie bazy danych (ai.initialize_embeddings). - Wdróż krótkoterminowy bufor sesji Valkey z wzorcem potoku „podsumuj przed przycięciem”.
- Wyodrębnianie encji długoterminowych w sposób natywny za pomocą natywnych funkcji AI AlloyDB (np.
ai.generate) - Wysyłaj zapytania o fakty długoterminowe z dużą dokładnością i trafnością, korzystając z natywnej funkcji wyszukiwania hybrydowego AlloyDB (
ai.hybrid_search) i porządkowania przy użyciu wzajemnego scalania pozycji (RRF). - Stworzenie 3-poziomowego narzędzia do oceny uprawnień w firmie oraz silnika kompresji pamięci w tle.
- Zintegruj 2-poziomową architekturę pamięci bezpośrednio z autonomicznym agentem za pomocą pakietu Google Agent Development Kit (ADK).
Czego potrzebujesz
- projekt Google Cloud z włączonymi płatnościami;
- przeglądarka, np. Chrome;
- Podstawowa znajomość języków Python i SQL, w tym doświadczenie w wykonywaniu zapytań SQL w AlloyDB – z poziomu Studio, interfejsu CLI itp.
Odbiorcy i koszty
- Odbiorcy: programiści AI, inżynierowie backendu i architekci baz danych.
- Szacowany koszt: zasoby Google Cloud utworzone w tym ćwiczeniu będą kosztować około 1,50 USD.
2. Konfiguracja i wymagania
Uruchamianie Cloud Shell
W tym ćwiczeniu będziesz uruchamiać polecenia w Google Cloud Shell, czyli terminalu hostowanym w chmurze, który jest wstępnie skonfigurowany za pomocą gcloud, psql i python3.
- Otwórz konsolę Google Cloud.
- W prawym górnym rogu konsoli Cloud kliknij Aktywuj Cloud Shell.
- Potwierdź uwierzytelnianie:
gcloud auth list
export PROJECT_ID=<YOUR_PROJECT_ID>
gcloud config set project $PROJECT_ID

export REGION=us-east1
export GENAI_LOCATION=us
export ZONE=us-east1-b
export ADBCLUSTER=agent-memory-cluster
export ADBINSTANCE=agent-memory-instance
export VALKEYINSTANCE=agent-memory-cache
export VM_NAME=agent-dev-vm
Włączanie interfejsów Google Cloud API i tworzenie maszyny wirtualnej do programowania
Aby włączyć wymagane interfejsy API, uruchom w Cloud Shell to polecenie:
gcloud services enable \
  alloydb.googleapis.com \
  memorystore.googleapis.com \
  aiplatform.googleapis.com \
  compute.googleapis.com \
  servicenetworking.googleapis.com \
  networkconnectivity.googleapis.com
Utwórz instancję maszyny wirtualnej Compute Engine w sieci VPC default, aby hostować środowisko programistyczne w Pythonie wraz z AlloyDB i Memorystore for Valkey:
gcloud compute instances create $VM_NAME \
    --zone=$ZONE \
    --machine-type=e2-standard-2 \
    --scopes=cloud-platform \
    --network=default \
    --shielded-secure-boot
3. Aprowizowanie AlloyDB i Memorystore for Valkey
W tym kroku utworzysz klaster AlloyDB for PostgreSQL i instancję główną, skonfigurujesz sieć usług prywatnych i uruchomisz instancję Memorystore for Valkey.
Tworzenie zakresu adresów IP prywatnego dostępu do usług
AlloyDB wymaga prywatnego zakresu adresów IP w sieci VPC. Załóżmy, że używasz sieci VPC default:
- Utwórz przydział zakresu prywatnych adresów IP:
gcloud compute addresses create psa-range \
    --global \
    --purpose=VPC_PEERING \
    --prefix-length=24 \
    --description="VPC private service access" \
    --network=default
- Nawiąż prywatne połączenie równorzędne VPC:
gcloud services vpc-peerings connect \
    --service=servicenetworking.googleapis.com \
    --ranges=psa-range \
    --network=default
Tworzenie klastra AlloyDB i instancji głównej
- Utwórz początkowe hasło klastra na potrzeby inicjowania systemu:
export PGPASSWORD=`openssl rand -hex 12`
- Utwórz bezpłatny klaster próbny:
gcloud alloydb clusters create $ADBCLUSTER \
    --password=$PGPASSWORD \
    --network=default \
    --region=$REGION \
    --subscription-type=TRIAL
- Utwórz instancję główną:
gcloud alloydb instances create $ADBINSTANCE \
    --instance-type=PRIMARY \
    --cpu-count=2 \
    --region=$REGION \
    --cluster=$ADBCLUSTER
Udostępnianie instancji Memorystore for Valkey
Przed utworzeniem instancji Memorystore for Valkey wymaga zasady połączenia z usługą (gcp-memorystore) w sieci i regionie.
- Utwórz zasadę połączenia z usługą dla Memorystore:
gcloud network-connectivity service-connection-policies create memorystore-policy \
    --network=default \
    --region=$REGION \
    --service-class=gcp-memorystore \
    --subnets=projects/$PROJECT_ID/regions/$REGION/subnetworks/default
- Utwórz instancję Memorystore for Valkey:
gcloud memorystore instances create $VALKEYINSTANCE \
    --location=$REGION \
    --shard-count=1 \
    --replica-count=0 \
    --node-type=SHARED_CORE_NANO \
    --psc-auto-connections="network=projects/$PROJECT_ID/global/networks/default,projectId=$PROJECT_ID"
Przyznawanie uprawnień IAM do Vertex AI
Przyznaj kontu usługi AlloyDB niezbędne uprawnienia IAM do wywoływania modeli osadzania platformy Agent Platform:
PROJECT_ID=$(gcloud config get-value project)

gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:service-$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")@gcp-sa-alloydb.iam.gserviceaccount.com" \
  --role="roles/aiplatform.user"
4. Inicjowanie środowiska i punktów końcowych dostępu
Konfigurowanie uwierzytelniania IAM w AlloyDB i flag bazy danych
Włącz uwierzytelnianie bazy danych uprawnień (alloydb.iam_authentication=on) i silnik zapytań AI (google_ml_integration.enable_ai_query_engine=on) w instancji AlloyDB:
gcloud beta alloydb instances update $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --update-mode=FORCE_APPLY \
  --database-flags=alloydb.iam_authentication=on,google_ml_integration.enable_ai_query_engine=on
Następnie dodaj konto Google Cloud jako użytkownika bazy danych opartego na IAM z uprawnieniami superużytkownika:
export USER_ACCOUNT=$(gcloud config get-value account)

gcloud alloydb users create $USER_ACCOUNT \
    --cluster=$ADBCLUSTER \
    --region=$REGION \
    --type=IAM_BASED \
    --db-roles=alloydbsuperuser
Pobieranie wewnętrznych punktów końcowych VPC w Cloud Shell
Zanim połączysz się z maszyną wirtualną deweloperską za pomocą SSH, pobierz wewnętrzne adresy IP VPC dla AlloyDB i Memorystore for Valkey w Cloud Shell:
# Export GCP Project ID, Region, and IAM User
export PROJECT_ID=$(gcloud config get-value project)
export REGION=us-east1
export DB_USER=$(gcloud config get-value account)

# Retrieve Internal VPC IP Addresses for AlloyDB & Memorystore for Valkey
export DB_HOST=$(gcloud alloydb instances describe $ADBINSTANCE --cluster=$ADBCLUSTER --region=$REGION --format="value(ipAddress)")
export DB_PORT=5432
export DB_NAME=postgres

export VALKEY_HOST=$(gcloud memorystore instances describe $VALKEYINSTANCE --location=$REGION --format="value(discoveryEndpoints[0].address)")
export VALKEY_PORT=6379

# Verify exported endpoints
echo "Project ID:        $PROJECT_ID"
echo "Region:            $REGION"
echo "AlloyDB Private IP: $DB_HOST"
echo "IAM DB User:       $DB_USER"
echo "Valkey Private IP:  $VALKEY_HOST"
Nawiązywanie połączenia SSH z maszyną wirtualną deweloperską i eksportowanie zmiennych połączenia
Połącz się przez SSH z maszyną wirtualną Compute Engine (agent-dev-vm) w tym samym środowisku sieci VPC z Cloud Shell:
gcloud compute ssh $VM_NAME --zone=$ZONE
Po zalogowaniu się na maszynę wirtualną dewelopera wyeksportuj konfigurację projektu i punkty końcowe połączenia (zastępując
export PROJECT_ID=<YOUR_PROJECT_ID>
export REGION=us-east1
export GENAI_LOCATION=us
export DB_HOST=<YOUR_ALLOYDB_PRIVATE_IP>
export DB_PORT=5432
export DB_NAME=postgres
export DB_USER=<YOUR_IAM_DB_USER>
export VALKEY_HOST=<YOUR_VALKEY_PRIVATE_IP>
export VALKEY_PORT=6379
Inicjowanie wirtualnego środowiska Pythona
Na maszynie wirtualnej dewelopera utwórz najpierw lokalny katalog roboczy:
mkdir -p ~/alloydb_agent_memory && cd ~/alloydb_agent_memory
Teraz zainstaluj pakiety wirtualnego środowiska Pythona w systemie, uwierzytelnij domyślne uwierzytelnianie aplikacji (ADC) i skonfiguruj obszar roboczy:
sudo apt-get update && sudo apt-get install -y python3-venv python3-pip

python3 -m venv venv
source venv/bin/activate
Na koniec w nowym środowisku wirtualnym zainstalujemy zależności:
gcloud auth application-default login
pip install psycopg2-binary valkey redis google-genai
5. Architektura systemu i hierarchia modułów kodu
Omówienie tworzonego projektu
Zanim wdrożysz poszczególne skrypty w Pythonie, zapoznaj się z architekturą systemu poniżej. Ta przykładowa aplikacja jest podzielona na 7 modułowych skryptów w Pythonie, które działają w ramach 2 głównych ścieżek wykonywania, które wchodzą w interakcję z tą samą instancją bazy danych AlloyDB for PostgreSQL:
- Ścieżka odczytu (
hybrid_retriever.py): rozkłada złożone pytania wieloczęściowe na zapytania podrzędne dotyczące jednego aspektu bezpośrednio w PostgreSQL za pomocą AlloyDB AIai.generate()i wykonuje zapytania dotyczące pamięci długoterminowej za pomocą natywnego wyszukiwania hybrydowego AlloyDBai.hybrid_search. - Ścieżka zapisu (
async_worker.py): wątek roboczy kolejki w tle, który asynchronicznie wyodrębnia z wymiany zdań uporządkowane fakty dotyczące jednostek za pomocą Gemini Flash i wstawia je doagent_entities.
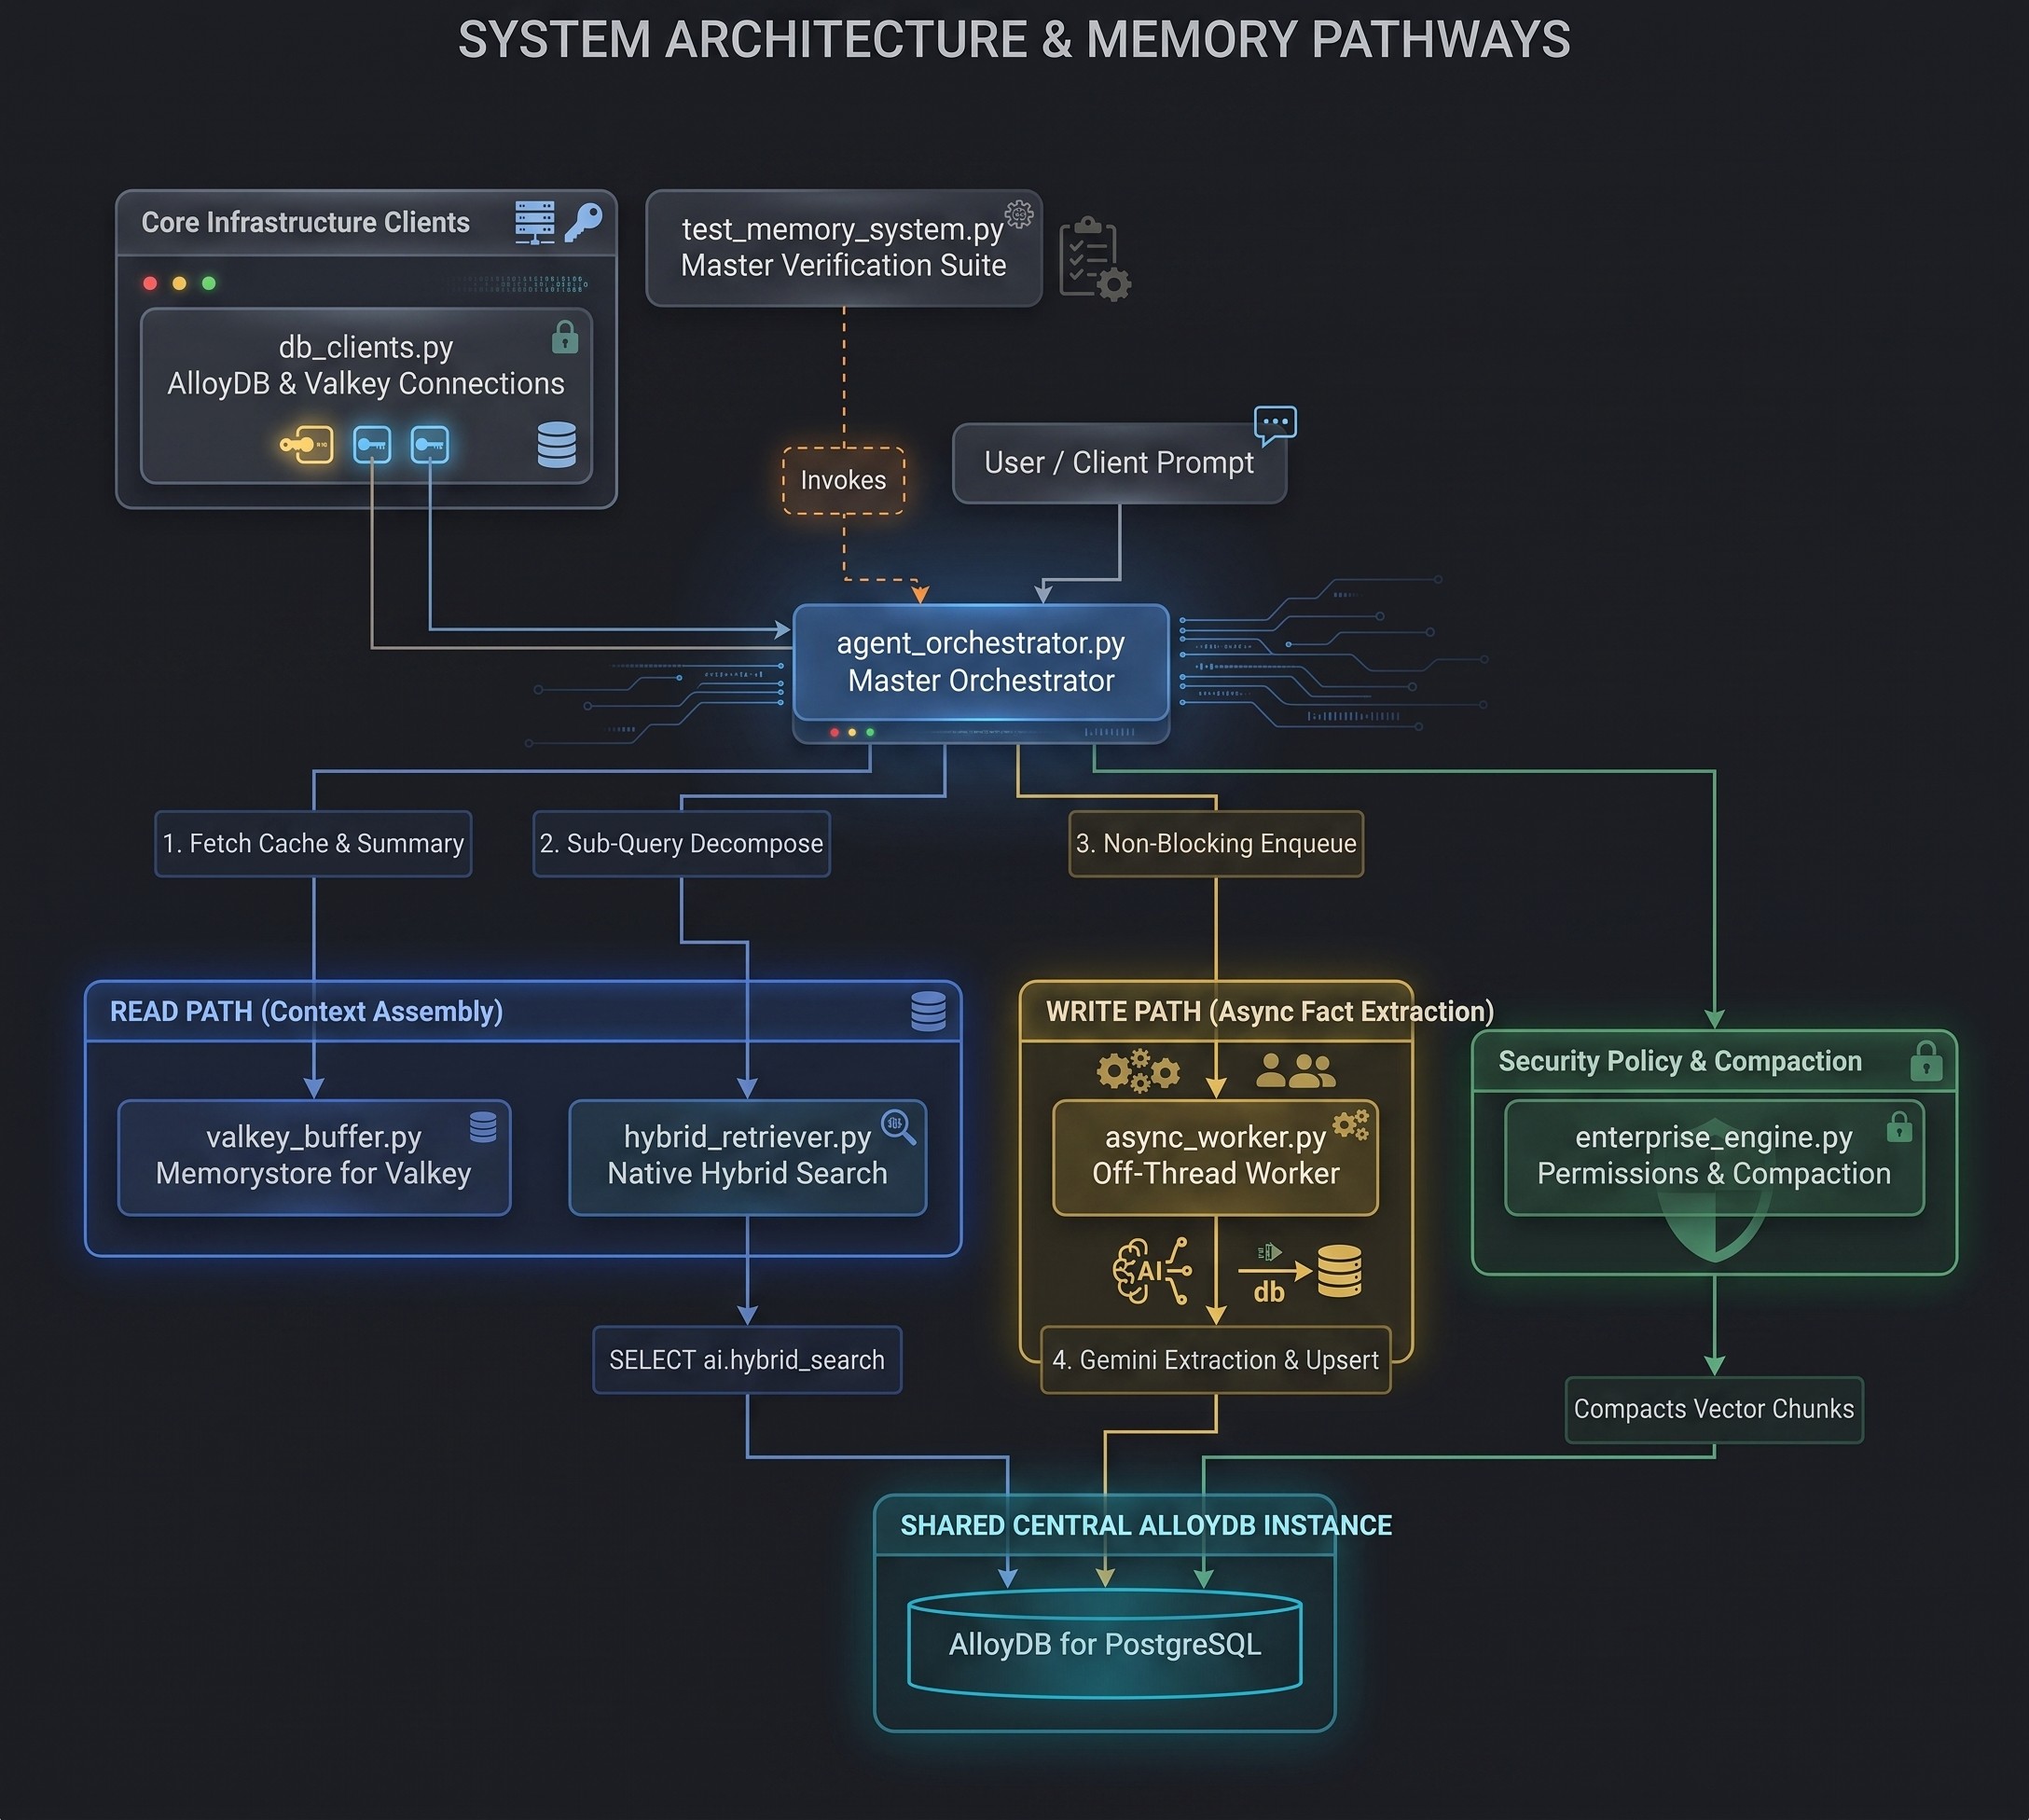
Hierarchia modułów i role systemowe
Plik modułu | Warstwa systemowa | Główna odpowiedzialność |
| Warstwa połączenia | Ustanawia uwierzytelnianie IAM szyfrowane protokołem SSL w AlloyDB i połączenia odporne na gniazda z Memorystore for Valkey. |
| Pamięć krótkotrwała | Zarządza historią sesji z dokładnością do milisekund w Valkey, implementując podsumowania kroczące Summarize-Before-Trim. |
| Proces roboczy ścieżki zapisu | Uruchamia w tle w osobnym wątku proces roboczy kolejki demona, który wyodrębnia fakty o podmiotach za pomocą Gemini Flash i wstawia je do AlloyDB. |
| Read Path Retriever | Rozkłada złożone pytania na zapytania podrzędne dotyczące jednego aspektu za pomocą wbudowanej w bazę danych usługi AlloyDB AI |
| Główna pętla agenta | Koordynuje pełną pętlę wykonywania tury: pobieranie krótkoterminowe, wyszukiwanie długoterminowe, tworzenie promptu, wykonywanie LLM i asynchroniczne kolejkowanie. |
| Zarządzanie i administracja | Wymusza 3-poziomowe zasady zabezpieczeń podczas wykonywania narzędzi i zbiera dane z pamięci historycznej. |
| Testowanie i ocena | Główny zestaw weryfikacyjny wykonujący scenariusze wieloetapowe i wielosesyjne, mierzący oszczędność tokenów w procentach i sprawdzający precyzję pamięci. |
6. Konfigurowanie schematu AlloyDB AI i automatycznych osadzania transakcyjnych
Cel i omówienie architektury
W tym module zdefiniujesz schemat bazy danych AlloyDB dla pamięci epizodycznej i długotrwałej, strategie indeksowania oraz automatyczne osadzanie po stronie bazy danych.
- Episodic Vector Store (
episodic_memory_embeddings): nieustrukturyzowane fragmenty transkrypcji czatu indeksowane za pomocą indeksów wektorowych HNSW (vector_cosine_ops). - Długoterminowy magazyn danych o podmiotach (
agent_entities): uporządkowane fakty, wybory użytkowników i reguły projektu przechowywane z metadanymi zakresu (global,project,session). Zawiera automatycznie generowaną kolumnę wyszukiwania pełnotekstowego PostgreSQL (summary_tsv) indeksowaną za pomocą RUM. - Automatyczne osadzanie po stronie bazy danych (
ai.initialize_embeddings): automatycznie osadza nowe lub zaktualizowane wiersze w formacie zwykłego tekstu wsummary_embeddingza pomocą platformy Agent Platformtext-embedding-005w tle.
Łączenie z AlloyDB Studio
- W konsoli Google Cloud otwórz stronę AlloyDB for Postgres.
- Kliknij instancję główną.
- W panelu nawigacyjnym po lewej stronie kliknij AlloyDB Studio.
- Wybierz bazę danych
postgres. - Uwierzytelnianie za pomocą
IAM database authentication
Implementacja i kod źródłowy
Po połączeniu się z bazą danych AlloyDB PostgreSQL wykonaj te zapytania DDL:
-- 1. Enable google_ml_integration extension
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;
CREATE EXTENSION IF NOT EXISTS vector CASCADE;
CREATE EXTENSION IF NOT EXISTS rum CASCADE;
SET google_ml_integration.enable_preview_ai_functions = true;

-- 2. Create Episodic Memory Vector Store Tables
CREATE TABLE IF NOT EXISTS episodic_memory_collections (
    uuid UUID PRIMARY KEY,
    name VARCHAR,
    cmetadata JSONB
);

CREATE TABLE IF NOT EXISTS episodic_memory_embeddings (
    uuid UUID PRIMARY KEY,
    collection_id UUID REFERENCES episodic_memory_collections(uuid) ON DELETE CASCADE,
    embedding VECTOR(768),
    document VARCHAR,
    cmetadata JSONB,
    custom_id VARCHAR,
    created_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS episodic_memory_embedding_idx
ON episodic_memory_embeddings
USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);

-- 3. Create Entity & Preference Table with Metadata Scope & Auto-Generated TSVector Column
CREATE TABLE IF NOT EXISTS agent_entities (
    entity_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    entity_name TEXT NOT NULL,
    project_id TEXT DEFAULT 'global',
    session_id TEXT,
    scope TEXT NOT NULL DEFAULT 'project', -- 'global', 'project', 'session'
    summary TEXT NOT NULL,
    summary_embedding VECTOR(768),
    summary_tsv TSVECTOR GENERATED ALWAYS AS (
        to_tsvector('english', entity_name || ' ' || summary)
    ) STORED,
    updated_at TIMESTAMPTZ DEFAULT NOW(),
    UNIQUE (user_id, entity_name)
);

CREATE INDEX IF NOT EXISTS agent_entities_scope_idx
ON agent_entities (user_id, project_id, scope);

CREATE INDEX IF NOT EXISTS agent_entities_embedding_idx
ON agent_entities USING hnsw (summary_embedding vector_cosine_ops);

CREATE INDEX IF NOT EXISTS agent_entities_tsv_idx
ON agent_entities USING rum (summary_tsv rum_tsvector_ops);

-- 4. Create User Permissions Table for Tool Execution Controls
CREATE TABLE IF NOT EXISTS user_permissions (
    permission_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    project_id TEXT NOT NULL DEFAULT 'global',
    tool_name TEXT NOT NULL,
    command_pattern TEXT NOT NULL,
    action TEXT NOT NULL CHECK (action IN ('ALLOW', 'BLOCK')),
    created_at TIMESTAMPTZ DEFAULT NOW(),
    updated_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS idx_user_permissions_lookup
ON user_permissions (user_id, project_id, tool_name);
-- 5. Register Gemini 3.5 Flash Model Endpoint in AlloyDB
-- Replace PROJECT_ID with your Google Cloud project ID
CALL google_ml.create_model(
    model_id => 'gemini-3.5-flash',
    model_request_url => 'https://aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/global/publishers/google/models/gemini-3.5-flash:generateContent',
    model_qualified_name => 'gemini-3.5-flash',
    model_provider => 'google',
    model_type => 'llm',
    model_auth_type => 'alloydb_service_agent_iam'
);
Inicjowanie automatycznych osadzonych danych transakcyjnych i rejestrowanie modelu Gemini
Następnie wykonaj instrukcje CALL w osobnych blokach wykonywania zapytań, aby zarejestrować proces w tle automatycznego osadzania i punkt końcowy modelu Gemini 3.5 Flash:
-- 6. Register Database-Side Transactional Auto-Embedding
CALL ai.initialize_embeddings(
    model_id => 'text-embedding-005',
    table_name => 'agent_entities',
    content_column => 'summary',
    embedding_column => 'summary_embedding',
    incremental_refresh_mode => 'transactional',
    batch_size => 10
);
7. Konfigurowanie klientów połączeń AlloyDB i Valkey
Cel i omówienie architektury
W tym module nawiążesz bezpieczne połączenia sieciowe z AlloyDB for PostgreSQL (pamięć długoterminowa) i Memorystore for Valkey (pamięć podręczna krótkoterminowa).
- Uwierzytelnianie IAM w AlloyDB: używa
gcloud auth application-default print-access-tokendo pobierania krótkotrwałego tokena OAuth2 na potrzeby połączeń z bazą danych bez hasła i szyfrowanych protokołem SSL (sslmode="require"). - Odporność sieci Valkey: konfiguruje
redis.Redisz 5-sekundowym limitem czasu gniazda (socket_timeout=5.0), aby bezpiecznie obsługiwać operacje sieci VPC w instancjach Valkey z jednym węzłem lub w klastrach.
Implementacja i kod źródłowy
Utwórz skrypt db_clients.py w katalogu roboczym:
import os
import subprocess
import psycopg2
import redis

# Initialize database & Valkey connection clients from environment variables
DB_HOST = os.getenv("DB_HOST", "127.0.0.1")
DB_PORT = os.getenv("DB_PORT", "5432")
DB_NAME = os.getenv("DB_NAME", "postgres")
DB_USER = os.getenv("DB_USER")

VALKEY_HOST = os.getenv("VALKEY_HOST", "127.0.0.1")
VALKEY_PORT = int(os.getenv("VALKEY_PORT", "6379"))

def get_db_connection():
    # Fetch Application Default Credentials (ADC) token for IAM Database Authentication & enable SSL encryption
    access_token = subprocess.check_output(
        ["gcloud", "auth", "application-default", "print-access-token"], text=True
    ).strip()
    return psycopg2.connect(
        host=DB_HOST,
        port=DB_PORT,
        dbname=DB_NAME,
        user=DB_USER,
        password=access_token,
        sslmode="require"
    )

def get_valkey_client():
    return redis.Redis(
        host=VALKEY_HOST,
        port=VALKEY_PORT,
        db=0,
        socket_timeout=5.0,
        socket_connect_timeout=5.0
    )

if __name__ == "__main__":
    print(f"Connecting to AlloyDB via IAM Auth ({DB_USER}) at {DB_HOST}:{DB_PORT} and Valkey at {VALKEY_HOST}:{VALKEY_PORT}...")
    print("Database and Valkey connection client modules loaded successfully.")
8. Buforowanie krótkoterminowego stanu sesji w Memorystore for Valkey
Cel i omówienie architektury
W tym module utworzysz w Memorystore for Valkey pamięć podręczną kontekstu krótkoterminowego o czasie dostępu poniżej milisekundy, która będzie implementować automatyczny wzorzec Summarize-Before-Trim.
- Valkey Sliding Window: aktywne tury rozmowy są przechowywane jako ciągi znaków JSON w kluczu
session:{session_id}:turns. - Tagi skrótu Redis (
{session_id}): formatowanie kluczysession:{session_id}:turnsisession:{session_id}:summarywykorzystuje tagi skrótu klastra Redis ({...}), co wymusza umieszczenie obu kluczy w tym samym przedziale skrótu, aby zapewnić niepodzielne wykonanie w dowolnym wdrożeniu Valkey z jednym węzłem lub w klastrze. - Summarize-Before-Trim: gdy liczba tur przekroczy
trigger_limit, starsze tury, które mają zostać usunięte, są streszczane przez Gemini Flash w postaci tekstu (session:{session_id}:summary), a następnie historia jest skracana dowindow_size.
Implementacja i kod źródłowy
Utwórz skrypt valkey_buffer.py w katalogu roboczym:
import json
import logging
import time
from typing import Any, Dict, List
import redis

logger = logging.getLogger(__name__)

IN_MEMORY_VALKEY_FALLBACK: Dict[str, Any] = {}
VALKEY_COMPACTION_TOKENS = 0

def get_valkey_compaction_tokens() -> int:
    return VALKEY_COMPACTION_TOKENS

def append_session_turn_with_rolling_summary(
    valkey_client: redis.Redis,
    llm_client: Any,
    session_id: str,
    user_msg: str,
    ai_msg: str,
    trigger_limit: int = 10,
    window_size: int = 4
) -> None:
    """Appends turn to Valkey. Before trimming old turns, summarizes them into a rolling summary."""
    global VALKEY_COMPACTION_TOKENS
    # Use Redis Hash Tags {session_id} so both keys hash to the same cluster slot
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        # 1. Append new turn messages
        valkey_client.rpush(turns_key, json.dumps({"role": "user", "content": user_msg}))
        valkey_client.rpush(turns_key, json.dumps({"role": "assistant", "content": ai_msg}))

        raw_turns = valkey_client.lrange(turns_key, 0, -1)

        # 2. Check if total turns exceed summary trigger threshold
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2

        if len(raw_turns) > msg_trigger_count:
            turns_to_prune = raw_turns[:-msg_window_count]
            existing_summary = valkey_client.get(summary_key)
            existing_summary_text = (
                existing_summary.decode('utf-8') if isinstance(existing_summary, bytes) else (existing_summary or "")
            )

            pruned_text = "\n".join([
                f"{json.loads(t)['role']}: {json.loads(t)['content']}" for t in turns_to_prune
            ])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            updated_summary_text = llm_client.models.generate_content(
                model="gemini-3.5-flash", contents=prompt
            ).text.strip()
            # Execute commands directly to support all Redis/Valkey cluster topologies
            valkey_client.set(summary_key, updated_summary_text)
            valkey_client.ltrim(turns_key, -msg_window_count, -1)
            logger.info("Updated rolling summary and trimmed Valkey buffer for session %s", session_id)

    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey operation warning (%s). Falling back to in-memory short-term buffer.", e)
        if turns_key not in IN_MEMORY_VALKEY_FALLBACK:
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = []
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "user", "content": user_msg})
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "assistant", "content": ai_msg})

        # In-memory summarize-before-trim fallback logic
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2
        raw_fallback_turns = IN_MEMORY_VALKEY_FALLBACK[turns_key]

        if len(raw_fallback_turns) > msg_trigger_count:
            turns_to_prune = raw_fallback_turns[:-msg_window_count]
            existing_summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
            pruned_text = "\n".join([f"{t['role']}: {t['content']}" for t in turns_to_prune])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            for attempt in range(4):
                try:
                    updated_summary_text = llm_client.models.generate_content(
                        model="gemini-3.5-flash", contents=prompt
                    ).text.strip()
                    break
                except Exception as e:
                    if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                        time.sleep(3 * (2 ** attempt))
                    else:
                        raise

            IN_MEMORY_VALKEY_FALLBACK[summary_key] = updated_summary_text
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = raw_fallback_turns[-msg_window_count:]

def get_session_context_buffer(
    valkey_client: redis.Redis,
    session_id: str
) -> Dict[str, Any]:
    """Retrieves rolling summary + sliding window history from Valkey to build prompt context."""
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        summary = valkey_client.get(summary_key)
        summary_text = summary.decode('utf-8') if isinstance(summary, bytes) else (summary or "")

        raw_turns = valkey_client.lrange(turns_key, 0, -1)
        recent_turns = [json.loads(t) for t in raw_turns]

        return {
            "rolling_summary": summary_text,
            "recent_turns": recent_turns
        }
    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey read error (%s). Using in-memory short-term fallback buffer.", e)
        summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
        recent_turns = IN_MEMORY_VALKEY_FALLBACK.get(turns_key, [])
        return {"rolling_summary": summary_text, "recent_turns": recent_turns}
9. Wyodrębnianie encji w wątku pobocznym (proces roboczy pamięci w tle)
Cel i omówienie architektury
W tej części utworzysz działający w tle proces wyodrębniania informacji o podmiotach długoterminowych (AsyncMemoryWorker), który nie spowalnia interaktywnych odpowiedzi AI.
- Non-Blocking Queue Worker: uruchamia wątek demona (
queue.Queue), dzięki czemu odpowiedzi na czacie dla programistów są zwracane natychmiast bez czekania na wyodrębnianie informacji przez LLM ani zapisywanie w bazie danych. - Wyodrębnianie faktów o podmiotach poza wątkiem: wywołuje w tle Gemini Flash (
model="gemini-3.5-flash",response_mime_type="application/json"), aby analizować strukturalne podmioty bez blokowania dialogów widocznych dla użytkownika. - Rozwiązywanie odniesień czasowych
build_temporal_rules_prompt: wymusza reguły, które przekształcają względne wyrażenia czasowe (np. „obecnie”, „ostatnia sesja”) w jawne identyfikatory sesji (np.session_id). - Schema Upserts: prosi Gemini Flash o zwrócenie tablicy JSON z bytami (
entity_name,project_id,scope,summary) i zapisuje zwykły tekst wagent_entitiesza pomocą sparametryzowanych instrukcji PostgreSQLON CONFLICT DO UPDATE.
Implementacja i kod źródłowy
Utwórz skrypt async_worker.py w katalogu roboczym:
import json
import logging
import queue
import threading
import time
from typing import Dict, Any, Optional
import psycopg2

logger = logging.getLogger(__name__)

def build_temporal_rules_prompt(active_session_id: str, prev_session_id: Optional[str] = None) -> str:
    """REUSABLE PROMPT HELPER: Defines temporal coreference rules for both Read and Write paths."""
    return f"""TEMPORAL COREFERENCE RULES:
1. Do not use relative temporal words like 'currently', 'now', 'this session', 'previous session', or 'last session'.
2. Replace any relative temporal reference with explicit session identifiers:
   - Active Session: '{active_session_id}'
   - Previous Session: '{prev_session_id if prev_session_id else active_session_id}'
   (e.g., write 'User prefers Python in session {active_session_id}' instead of 'User currently prefers Python')."""

class AsyncMemoryWorker:
    """Off-thread daemon queue worker performing background entity extraction and upserts into AlloyDB."""
    def __init__(self, conn_factory, llm_client):
        self.conn_factory = conn_factory
        self.llm_client = llm_client
        self.work_queue = queue.Queue()
        self.total_extraction_tokens = 0
        self.worker_thread = threading.Thread(target=self._run_worker, daemon=True)
        self.worker_thread.start()

    def enqueue_extraction(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        self.work_queue.put((user_id, session_id, user_msg, ai_msg, prev_session_id))

    def _run_worker(self):
        while True:
            item = self.work_queue.get()
            if item is None:
                break
            user_id, session_id, user_msg, ai_msg, prev_session_id = item
            try:
                self._extract_and_upsert(user_id, session_id, user_msg, ai_msg, prev_session_id)
            except Exception as e:
                logger.error("Background extraction failed: %s", e)
            finally:
                self.work_queue.task_done()

    def _extract_and_upsert(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        temporal_rules = build_temporal_rules_prompt(session_id, prev_session_id)
        json_fmt = '[{"entity_name": "...", "project_id": "...", "scope": "global|project|session", "summary": "..."}]'

        prompt = f"""Extract key preferences and named entities from this exchange.
Format output strictly as a JSON array of objects with structure: {json_fmt}.

{temporal_rules}

Rules for Scope:
- 'global': Universal developer preferences.
- 'project': Architecture, database choices, timeouts, and rules for a specific project.
- 'session': Ephemeral task state tied strictly to a single session.

User: {user_msg}
AI: {ai_msg}

Output (JSON array only):"""

        self.total_extraction_tokens += max(1, len(prompt) // 4)

        for attempt in range(4):
            try:
                response = self.llm_client.models.generate_content(
                    model="gemini-3.5-flash",
                    contents=prompt,
                    config={"response_mime_type": "application/json"}
                )
                break
            except Exception as e:
                if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                    time.sleep(3 * (2 ** attempt))
                else:
                    raise
        content = str(response.text).strip()
        if not content:
            return

        extracted_list = json.loads(content)
        if not isinstance(extracted_list, list):
            return

        upsert_sql = """
            INSERT INTO agent_entities (user_id, entity_name, project_id, session_id, scope, summary, updated_at)
            VALUES (%s, %s, %s, %s, %s, %s, NOW())
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET
                project_id = EXCLUDED.project_id,
                session_id = EXCLUDED.session_id,
                scope = EXCLUDED.scope,
                summary = EXCLUDED.summary,
                updated_at = NOW();
        """

        conn = self.conn_factory()
        try:
            with conn:
                with conn.cursor() as cur:
                    for item in extracted_list:
                        e_name = item.get("entity_name", "General_Fact")
                        p_id = item.get("project_id", "global")
                        s_scope = item.get("scope", "project")
                        summary = item.get("summary", "")
                        if e_name and summary:
                            cur.execute(upsert_sql, (user_id, e_name, p_id, session_id, s_scope, summary))
            logger.info("Saved %d entities for user %s", len(extracted_list), user_id)
        finally:
            conn.close()
10. Wykonywanie zapytań w pamięci długotrwałej za pomocą natywnego wyszukiwania hybrydowego
Cel i omówienie architektury
W tym module zaimplementujesz dekompozycję podzapytań ścieżki odczytu, przekształcanie zapytań czasowych, izolację zakresu metadanych i użyjesz natywnego wyszukiwania hybrydowego AlloyDB (ai.hybrid_search).
- Dekompozycja podzapytań w bazie danych (
rewrite_and_decompose_query): używa wbudowanej funkcji AlloyDB AIai.generate()bezpośrednio w PostgreSQL, aby dzielić złożone pytania na podzapytania dotyczące jednego aspektu ze znormalizowanymi identyfikatorami sesji, co zapobiega zmniejszaniu dokładności wyszukiwania wektorowego przez zapytania dotyczące wielu tematów. - Filtrowanie na poziomie indeksu: tworzy filtry SQL po stronie bazy danych (
filter_condition => "user_id = '%s' AND (project_id = '%s' OR scope = 'global')"), aby wyodrębniać pamięci poszczególnych użytkowników i projektów, a jednocześnie uwzględniać globalne preferencje programistów. - Natywne wyszukiwanie hybrydowe AlloyDB (
ai.hybrid_search): łączy podobieństwo wektorowe cosinusowe (public.<=>) z wyszukiwaniem pełnotekstowym (rum) w AlloyDB za pomocą fuzji odwrotnych rang (RRF), aby zapewnić optymalną dokładność, przywoływanie i trafność.
Implementacja i kod źródłowy
Utwórz skrypt hybrid_retriever.py w katalogu roboczym:
import os
import json
import logging
from typing import Any, Dict, List, Optional
import psycopg2
from psycopg2.extras import RealDictCursor
from async_worker import build_temporal_rules_prompt

logger = logging.getLogger(__name__)

def rewrite_and_decompose_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> List[str]:
    """Read-Path LLM Query Normalizer & Sub-Query Decomposer using AlloyDB AI ai.generate() directly in PostgreSQL."""
    temporal_rules = build_temporal_rules_prompt(active_session_id, prev_session_id)

    prompt = f"""You are a query normalization and decomposition tool for an AI agent's memory retrieval system.

Tasks:
1. Normalize any relative temporal phrases in the user query into explicit session identifiers.
{temporal_rules}

2. Decompose compound user queries asking about multiple distinct topics into up to 4 concise, single-topic search queries. Ensure all distinct questions (both general developer preferences and project-specific architecture/rules) are preserved as separate sub-queries.
3. Return ONLY a valid JSON array of strings containing the sub-queries.

Example Output Format:
["general developer coding preferences", "CloudRetail backend stack in session sess_2026_01", "CloudRetail timeout rules in session sess_2026_01"]

Text to Process: {text}
JSON Output:"""

    try:
        with conn.cursor() as cur:
            cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
            cur.execute("SELECT ai.generate(prompt => %s::text, model_id => 'gemini-3.5-flash'::varchar(100));", (prompt,))
            row = cur.fetchone()
            if row and row[0]:
                res_text = str(row[0]).strip()
                clean_text = res_text
                if clean_text.startswith("```"):
                    clean_text = clean_text.removeprefix("```json").removeprefix("```").removesuffix("```").strip()
                parsed = json.loads(clean_text)
                if isinstance(parsed, list) and len(parsed) > 0:
                    return [str(q).strip() for q in parsed]
        return [text]
    except Exception as e:
        logger.error("Error in in-database ai.generate sub-query decomposition: %s", e)
        return [text]

def rewrite_temporal_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> str:
    """Backward-compatible wrapper returning first decomposed query string."""
    queries = rewrite_and_decompose_query(conn, llm_client, text, active_session_id, prev_session_id)
    return queries[0] if queries else text

def retrieve_hybrid_entities(
    conn,
    llm_client: Any,
    user_id: str,
    active_session_id: str,
    query_text: str,
    query_embedding: Optional[List[float]] = None,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    k: int = 20
) -> Dict[str, Any]:
    """Queries long-term entities using Sub-Query Decomposition, metadata scope filtering, and parameterized AlloyDB hybrid search."""
    sub_queries = rewrite_and_decompose_query(
        conn=conn, llm_client=llm_client, text=query_text, active_session_id=active_session_id, prev_session_id=prev_session_id
    )
    all_search_queries = list(dict.fromkeys(sub_queries + [query_text]))

    retrieved_entities: Dict[str, Any] = {}

    filter_cond = f"user_id = '{user_id}' AND (project_id = '{project_id}' OR scope = 'global')" if project_id else f"user_id = '{user_id}'"

    query_sql = """
        SELECT e.entity_name, e.summary, e.project_id, e.scope, e.updated_at
        FROM ai.hybrid_search(
          search_inputs => %s::JSONB[],
          include_json_output => false
        ) h
        JOIN agent_entities e ON e.entity_name = h.id
        WHERE e.user_id = %s
        LIMIT %s;
    """

    from google import genai
    embed_client = genai.Client(
        vertexai=True,
        project=os.getenv("PROJECT_ID"),
        location=os.getenv("REGION", "us-east1")
    )

    for sq in all_search_queries:
        try:
            emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=sq)
            sq_embedding = emb_resp.embeddings[0].values
            vector_literal = f"'{sq_embedding}'::vector"
        except Exception as e:
            logger.error(f"Failed to generate embedding for sub-query: {sq}. Error: {e}")
            # Fallback to zero vector to prevent Postgres from crashing
            sq_embedding = [0.0] * 768
            vector_literal = f"'{sq_embedding}'::vector"

        search_inputs = [
            json.dumps({
                "data_type": "vector",
                "weight": 0.4,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "vec_column": "summary_embedding",
                "distance_operator": "public.<=>",
                "limit": 20,
                "query_vector": vector_literal,
                "filter_condition": filter_cond
            }),
            json.dumps({
                "data_type": "text",
                "weight": 0.6,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "text_column": "summary_tsv",
                "limit": 20,
                "ranking_function": "ts_rank",
                "query_text_input": sq,
                "filter_condition": filter_cond
            })
        ]

        with conn.cursor(cursor_factory=RealDictCursor) as cur:
            try:
                cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                cur.execute(query_sql, (search_inputs, user_id, k))
                rows = cur.fetchall()

                for row in rows:
                    name = row["entity_name"]
                    if name not in retrieved_entities:
                        retrieved_entities[name] = {
                            "summary": row["summary"],
                            "project_id": row["project_id"],
                            "scope": row["scope"],
                            "updated_at": row["updated_at"].isoformat() if row["updated_at"] else None
                        }
            except Exception as e:
                logger.error("Error executing hybrid search for sub-query '%s': %s", sq, e)

    return retrieved_entities
11. Tworzenie i uruchamianie pętli pamięci agenta typu end-to-end
Cel i omówienie architektury
W tym module utworzysz główną funkcję orkiestracji agenta (run_agent_turn), która łączy pobieranie z pamięci podręcznej krótkoterminowej, wyszukiwanie w pamięci długoterminowej, tworzenie promptów, generowanie przez LLM i wyodrębnianie pamięci w tle.
- Kontekst krótkoterminowy: pobiera aktywne wypowiedzi Valkey i bieżące podsumowanie (
get_session_context_buffer). - Wyszukiwanie długoterminowe: wysyła zapytania do AlloyDB za pomocą
retrieve_hybrid_entities, używając rozłożonych zapytań podrzędnych filtrowanych według aktywnego identyfikatora projektu i zakresu globalnego. - Formatowanie promptu systemowego: tworzy
build_agent_promptzawierający długoterminowe jednostki, krótkoterminowe podsumowanie, ostatni dialog i prompt użytkownika w postaci promptu systemowego o wysokiej wydajności tokenowej. - Async Queue Enqueue: zapisuje turę w pamięci podręcznej Valkey i umieszcza ekstrakcję w tle w kolejce
AsyncMemoryWorkerbez blokowania zwracanych danych.
Implementacja i kod źródłowy
Utwórz skrypt agent_orchestrator.py w katalogu roboczym:
import logging
import time
from typing import Any, Dict, Optional, Tuple
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import rewrite_temporal_query, retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

logger = logging.getLogger(__name__)

def build_agent_prompt(
    rolling_summary: str,
    recent_turns: list[Dict[str, Any]],
    retrieved_entities: Dict[str, Any],
    user_query: str
) -> str:
    """Assembles structured system prompt with long-term memory & short-term context."""
    entity_lines = [
        f"- {name}: {info['summary']}" for name, info in retrieved_entities.items()
    ]
    entity_context = "\n".join(entity_lines) if entity_lines else "No relevant entity facts."
    history_lines = [f"{t['role']}: {t['content']}" for t in recent_turns]
    history_str = "\n".join(history_lines)

    return f"""You are an intelligent, context-aware AI assistant.

[LONG-TERM PREFERENCES & ENTITIES]
{entity_context}

[SHORT-TERM ROLLING SUMMARY]
{rolling_summary if rolling_summary else 'No prior summary.'}

[RECENT DIALOGUE]
{history_str}

User: {user_query}
AI:"""

def run_agent_turn(
    db_conn,
    valkey_client: redis.Redis,
    async_worker: AsyncMemoryWorker,
    genai_client: Any,
    user_id: str,
    session_id: str,
    user_query: str,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    trigger_limit: int = 10,
    window_size: int = 4
) -> Tuple[str, str, float]:
    """Executes a complete 2-tier agent memory turn loop, returning (response_text, system_prompt, latency_seconds)."""
    import time
    start_time = time.time()

    # 1. Fetch short-term rolling summary + recent turns from Valkey
    buffer_data = get_session_context_buffer(valkey_client, session_id)
    rolling_summary = buffer_data["rolling_summary"]
    recent_turns = buffer_data["recent_turns"]

    # 2. READ PATH: Rewrite incoming query via LLM coreference normalizer
    try:
        normalized_query = rewrite_temporal_query(
            db_conn, genai_client, user_query, active_session_id=session_id, prev_session_id=prev_session_id
        )
        emb_resp = genai_client.models.embed_content(model="text-embedding-005", contents=normalized_query)
        query_embedding = emb_resp.embeddings[0].values
    except Exception:
        query_embedding = None

    # Retrieve relevant long-term entities from AlloyDB via hybrid search
    retrieved_entities = retrieve_hybrid_entities(
        conn=db_conn,
        llm_client=genai_client,
        user_id=user_id,
        active_session_id=session_id,
        query_text=user_query,
        query_embedding=query_embedding,
        prev_session_id=prev_session_id,
        project_id=project_id,
        k=20
    )

    # 3. Assemble system prompt
    system_prompt = build_agent_prompt(
        rolling_summary, recent_turns, retrieved_entities, user_query
    )


    # 4. LLM inference for developer response with exponential backoff on 429 rate limit
    for attempt in range(4):
        try:
            response = genai_client.models.generate_content(
                model="gemini-3.5-flash", contents=system_prompt
            )
            break
        except Exception as e:
            if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                time.sleep(3 * (2 ** attempt))
            else:
                raise
    ai_response = str(response.text)

    # 5. Cache turn in short-term Valkey buffer (with Summarize-Before-Trim check)
    append_session_turn_with_rolling_summary(
        valkey_client=valkey_client,
        llm_client=genai_client,
        session_id=session_id,
        user_msg=user_query,
        ai_msg=ai_response,
        trigger_limit=trigger_limit,
        window_size=window_size
    )

    # 6. WRITE PATH: Enqueue off-thread background entity extraction (single LLM call)
    async_worker.enqueue_extraction(user_id, session_id, user_query, ai_response, prev_session_id)

    latency = time.time() - start_time
    return ai_response, system_prompt, latency
12. Wdrażanie funkcji Enterprise Permission Controls i Memory Compaction
Cel i omówienie architektury
W tym module utworzysz firmowe mechanizmy kontroli bezpieczeństwa na potrzeby wykonywania narzędzi i kompresji pamięci bazy danych (AgentMemoryEngine).
- 3-Tier Permission Evaluation
evaluate_tool_permission:- Poziom 1 (jednorazowe przyznanie klucza Valkey): sprawdza jednorazowe klucze przyznania (
one_time_perm:{session_id}:{cmd_hash}) z czasem życia wynoszącym 300 sekund. Jeśli jest obecny, natychmiast usuwa klucz i zwraca wartośćALLOW. - Poziom 2 i 3 (zasady dotyczące PostgreSQL): zapytania
user_permissionsnajpierw dopasowują się do zasad dotyczących projektu (project_id), a potem do zasad globalnych ('global'). - Wartość zastępcza: zwraca wartość
PROMPT_USER, jeśli nie ma pasujących zasad.
- Poziom 1 (jednorazowe przyznanie klucza Valkey): sprawdza jednorazowe klucze przyznania (
- Kompaktowanie pamięci
compact_old_memories: agreguje historyczne zdarzenia wektorów pierwotnych wepisodic_memory_embeddingsstarsze niżretention_daysw jedno skonsolidowane podsumowanie wagent_entitiesza pomocą ograniczonego zapytania SQL CTE z 50 wierszami.
Implementacja i kod źródłowy
Utwórz skrypt enterprise_engine.py w katalogu roboczym:
import hashlib
import logging
import re
from typing import Any, Dict, Tuple
import psycopg2
import redis

logger = logging.getLogger(__name__)

class AgentMemoryEngine:
    """Framework-agnostic Enterprise Memory Engine for tool execution permissions & safe compaction."""

    def __init__(self, valkey_client: redis.Redis, db_conn: Any):
        self.valkey_client = valkey_client
        self.db_conn = db_conn

    def evaluate_tool_permission(
        self,
        user_id: str,
        project_id: str,
        session_id: str,
        tool_name: str,
        tool_args: Dict[str, Any]
    ) -> Tuple[str, str]:
        """Evaluates 3-tier execution permissions: Allow-Once (Valkey), Project (AlloyDB), Global (AlloyDB)."""
        command_str = str(tool_args.get("CommandLine", "") or tool_args)

        # Tier 1: Allow-Once (Single-Use Valkey Check with 300s TTL)
        cmd_hash = hashlib.sha256(command_str.encode("utf-8")).hexdigest()[:16]
        valkey_key = f"one_time_perm:{session_id}:{cmd_hash}"

        if self.valkey_client.get(valkey_key):
            self.valkey_client.delete(valkey_key)  # Consume key immediately
            return ("ALLOW", "Single-use 'Allow Once' grant consumed.")

        # Tier 2 & Tier 3: Query AlloyDB user_permissions table
        query_sql = """
            SELECT command_pattern, action, project_id
            FROM user_permissions
            WHERE user_id = %s AND tool_name = %s AND project_id IN (%s, 'global')
            ORDER BY CASE WHEN project_id = %s THEN 1 ELSE 2 END;
        """

        with self.db_conn.cursor() as cur:
            cur.execute(query_sql, (user_id, tool_name, project_id, project_id))
            rules = cur.fetchall()
            for pattern, action, scope in rules:
                if re.search(pattern, command_str, flags=re.IGNORECASE):
                    return (action, f"Matched {scope}-scoped rule: {pattern}")

        # Fallback: Prompt Human User
        return ("PROMPT_USER", "No matching permission rule found.")

    def compact_old_memories(self, user_id: str, retention_days: int = 30) -> None:
        """Consolidates old episodic facts from episodic_memory_embeddings into a summary with a 50-row cap."""
        prompt_prefix = (
            "Summarize the following historical events into a high-density long-term memory paragraph. "
            "Retain key constraints, tool choices, and project rules:\n"
        )

        # Capped CTE prevents string_agg from exceeding model context window limits
        compaction_sql = """
            WITH old_events AS (
                SELECT document AS content
                FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            ),
            consolidated AS (
                SELECT ai.generate(%s || string_agg(content, E'\n')) AS summary_text
                FROM old_events
            )
            INSERT INTO agent_entities (user_id, entity_name, summary, updated_at)
            SELECT %s, 'longterm_session_summary', summary_text, NOW()
            FROM consolidated
            WHERE summary_text IS NOT NULL
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET summary = EXCLUDED.summary, updated_at = NOW();
        """

        prune_sql = """
            DELETE FROM episodic_memory_embeddings
            WHERE uuid IN (
                SELECT uuid FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            );
        """

        try:
            with self.db_conn:
                with self.db_conn.cursor() as cur:
                    cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                    cur.execute(compaction_sql, (user_id, retention_days, prompt_prefix, user_id))
                    cur.execute(prune_sql, (user_id, retention_days))
            logger.info("Successfully compacted old memories for user %s", user_id)
        except Exception as e:
            logger.error("Error during memory compaction: %s", e)
13. Przeprowadzanie kompleksowej weryfikacji pamięci w wielu turach
Cel i omówienie architektury
W tym ostatnim module utworzysz i uruchomisz główny skrypt weryfikacji kompleksowej (test_memory_system.py), aby sprawdzić kompletną dwuwarstwową architekturę pamięci.
- Symulacja wielu tur i sesji:
- Sesja 1 (tura 1): określa uniwersalne preferencje dewelopera (
scope='global': interfejs w trybie ciemnym, Python 3.11, PostgreSQL). - Sesja 1 (tura 2): określa architekturę projektu (
project_id='CloudRetail': FastAPI, AlloyDB, Valkey, limit czasu 30 s, us-east1). - Sesja 1 (tury 3 i 4): generuje szum dialogu technicznego i przekracza
trigger_limit=3, aby wywołać kompresję podsumowania Valkey Summarize-Before-Trim. - Sesja 2 (tura 5 – nowy identyfikator sesji): wysyła do agenta zapytania w różnych sesjach, aby sprawdzić, czy pamięta on globalne preferencje ORAZ reguły projektu.
- Sesja 1 (tura 1): określa uniwersalne preferencje dewelopera (
- Dynamiczna weryfikacja wydajności i dokładności: mierzy dokładną liczbę znaków/tokenów w prompcie, procent zmniejszenia rozmiaru promptu, opóźnienie wnioskowania, podsumowania kroczące Valkey, izolację zakresu i zasady bezpieczeństwa wykonywania narzędzi.
Implementacja i kod źródłowy
Utwórz scenariusz testowania test_memory_system.py w katalogu roboczym:
import os
import time
import logging
from google import genai
from db_clients import get_db_connection, get_valkey_client
from async_worker import AsyncMemoryWorker
from hybrid_retriever import retrieve_hybrid_entities
from agent_orchestrator import run_agent_turn
from enterprise_engine import AgentMemoryEngine
from valkey_buffer import get_session_context_buffer, IN_MEMORY_VALKEY_FALLBACK, get_valkey_compaction_tokens

logging.basicConfig(level=logging.WARNING)
logging.getLogger("google_genai").setLevel(logging.WARNING)
logging.getLogger("httpx").setLevel(logging.WARNING)

PROJECT_ID = os.getenv("PROJECT_ID")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")

db_conn = get_db_connection()
valkey_client = get_valkey_client()
client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)

async_worker = AsyncMemoryWorker(get_db_connection, client)
engine = AgentMemoryEngine(valkey_client, db_conn)

USER_ID = "user_dev_42"
SESSION_1 = "sess_2026_01"
SESSION_2 = "sess_2026_02"

test_accuracy = []

print("\n==================================================")
print("STARTING ENHANCED 2-TIER AGENT MEMORY VERIFICATION TEST")
print("==================================================")

# TURN 1: Universal Global Developer Preference Definition
print("\n[SESSION 1 - TURN 1: Global Preference Definition]")
prompt_1 = "Hi! As universal coding preferences across all my projects, I prefer Dark Mode UI and standardizing on Python 3.11 with PostgreSQL."
print(f"User Prompt:\n{prompt_1}")
resp_1, sys_prompt_1, latency_1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_1, project_id=None, trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_1[:140]}...")
time.sleep(2)

# TURN 2: Project-Specific Architecture Definition
print("\n[SESSION 1 - TURN 2: Project CloudRetail Architecture Definition]")
prompt_2 = (
    "Now I am starting project CloudRetail. Here are the specific project requirements:\n"
    "1. Backend Stack: Python with FastAPI on AlloyDB.\n"
    "2. Short-Term Cache: Memorystore for Valkey.\n"
    "3. Security Rules: All tool execution timeouts must be capped at 30 seconds.\n"
    f"4. Deployment Region: {REGION}."
)
print(f"User Prompt:\n{prompt_2}")
resp_2, sys_prompt_2, latency_2 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_2, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_2[:140]}...")
time.sleep(2)

# TURN 3: Context Inflation / Technical Dialogue Noise
print("\n[SESSION 1 - TURN 3: Large Context Inflation (Dialogue Noise)]")
prompt_3 = (
    "Let's draft a sample 50-line PostgreSQL DDL script for product catalog indexes, "
    "including HNSW vector index tuning parameters (m = 16, ef_construction = 64), "
    "and full-text RUM search indexes on item title and description columns."
)
print(f"User Prompt:\n{prompt_3}")
resp_3, sys_prompt_3, latency_3 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_3, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_3[:140]}...")
time.sleep(2)

# TURN 4: Triggering Valkey Summarize-Before-Trim Threshold (8 messages > 6 message trigger limit)
print("\n[SESSION 1 - TURN 4: Triggering Valkey Rolling Summary Compaction]")
prompt_4_s1 = "Can you also add rate-limiting middleware rules for API endpoints?"
print(f"User Prompt:\n{prompt_4_s1}")
resp_4_s1, sys_prompt_4_s1, latency_4_s1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_4_s1, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_4_s1[:140]}...")

# VERIFY VALKEY SHORT-TERM ROLLING SUMMARY
print("\n==================================================")
print("VALKEY SHORT-TERM ROLLING SUMMARY VERIFICATION")
print("==================================================")
buffer_data = get_session_context_buffer(valkey_client, SESSION_1)
valkey_summary_text = buffer_data["rolling_summary"]
valkey_turns = buffer_data["recent_turns"]

used_fallback = bool(IN_MEMORY_VALKEY_FALLBACK)
storage_backend = "Local In-Memory Fallback (Outside VPC)" if used_fallback else "Memorystore for Valkey (VPC Network)"

has_valkey_summary = bool(valkey_summary_text)
print(f" • Short-Term Cache Storage Target:             [{storage_backend}]")
print(f" • Valkey Rolling Summary Generated for Session 1: {has_valkey_summary}")
print(f"   Summary Content: {valkey_summary_text}")
print(f" • Remaining Raw Turns in Valkey Sliding Window:  {len(valkey_turns)} messages (Trimmed from 8)")

test_accuracy.append(("Valkey Rolling Summary Compaction Test", "PASS" if has_valkey_summary else "FAIL"))

# Wait for background entity extraction worker
print("\n[Waiting for background entity extraction worker to process & vectorize all extracted entities...]")
time.sleep(6)

print("\n==================================================")
print("EXTRACTED ENTITIES STORED IN ALLOYDB LONG-TERM MEMORY")
print("==================================================")
with db_conn.cursor() as cur:
    cur.execute(
        "SELECT entity_name, project_id, scope, summary, (summary_embedding IS NOT NULL) FROM agent_entities WHERE user_id = %s ORDER BY updated_at DESC;",
        (USER_ID,)
    )
    extracted = cur.fetchall()
    for name, p_id, s_scope, summary, has_vector in extracted:
        print(f" • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}' | Vector Generated: {has_vector}")
        print(f"   Summary: {summary}")

# TURN 5: Cross-Session Temporal & Scope Recall (Brand New Session ID)
print("\n[SESSION 2 - TURN 5 (Cross-Session Query in New Session ID)]")
prompt_4 = "What are my general coding preferences and the backend/timeout rules I chose for CloudRetail in my previous session?"
print(f"User Prompt:\n{prompt_4}")
resp_4, sys_prompt_4, latency_4 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_2, prompt_4, prev_session_id=SESSION_1, project_id="CloudRetail")
print(f"\nAI Answer:\n{resp_4}")

# VERIFICATION OF RETRIEVED ENTITIES (Checking Scope Precision)
retrieved_scoped_entities = retrieve_hybrid_entities(
    conn=db_conn,
    llm_client=client,
    user_id=USER_ID,
    active_session_id=SESSION_2,
    query_text=prompt_4,
    prev_session_id=SESSION_1,
    project_id="CloudRetail",
    k=20
)

print("\n==================================================")
print("DIAGNOSTIC SCOPE VERIFICATION DETAILS (EXPECTED vs ACTUAL)")
print("==================================================")
print("EXPECTED SPECIFIC ENTITIES & SCOPE:")
print("  1. Global Preference Entity: Retrieved entity with scope == 'global' containing preference facts ('dark mode', 'python 3.11', or 'postgres')")
print("  2. Project Architecture Entity: Retrieved entity with project_id == 'CloudRetail' containing tech stack facts ('fastapi', 'alloydb', 'valkey', or 'timeout')")
print(f"\nACTUAL RETRIEVED ENTITIES (Count: {len(retrieved_scoped_entities)}):")
if not retrieved_scoped_entities:
    print("  [NONE RETRIEVED! Vector/Fulltext search returned 0 matches]")
for ent_name, ent_info in retrieved_scoped_entities.items():
    print(f"  • Entity Name: '{ent_name}'")
    print(f"    - scope:      '{ent_info.get('scope')}'")
    print(f"    - project_id: '{ent_info.get('project_id')}'")
    print(f"    - summary:    '{ent_info.get('summary')}'")

print("\nDATABASE CHECK - ALL ROWS STORED IN agent_entities TABLE:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    db_rows = cur.fetchall()
    if not db_rows:
        print("  [DATABASE TABLE IS EMPTY! No entities were upserted by background worker]")
    for r in db_rows:
        print(f"  • DB Row: entity_name='{r[0]}' | project_id='{r[1]}' | scope='{r[2]}' | summary='{r[3]}'")

# SPECIFIC FACT & SCOPE VERIFICATION LOGIC
found_global_preference = False
matched_global_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("scope") == "global" and any(kw in combined_text for kw in ["dark mode", "python", "postgres"]):
        found_global_preference = True
        matched_global_entity = ent_name
        break

found_project_architecture = False
matched_project_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("project_id") == "CloudRetail" and any(kw in combined_text for kw in ["fastapi", "alloydb", "valkey", "timeout"]):
        found_project_architecture = True
        matched_project_entity = ent_name
        break

print("\n--------------------------------------------------")
print("METADATA SCOPE PRECISION VERIFICATION RESULTS:")
print(f" • Global Preference Fact Retrieved (scope='global'):        {found_global_preference} (Matched Entity: '{matched_global_entity}')")
print(f" • Project Architecture Fact Retrieved (project_id='CloudRetail'): {found_project_architecture} (Matched Entity: '{matched_project_entity}')")
print("--------------------------------------------------")

test_accuracy.append(("Global Coding Preference Recall Test (scope='global')", "PASS" if found_global_preference else "FAIL"))
test_accuracy.append(("Project CloudRetail Architecture Recall Test (project_id='CloudRetail')", "PASS" if found_project_architecture else "FAIL"))

# PERMISSION TEST
perm_action, reason = engine.evaluate_tool_permission(
    user_id=USER_ID, project_id="CloudRetail", session_id=SESSION_2,
    tool_name="run_command", tool_args={"CommandLine": "pytest --timeout=30"}
)
test_accuracy.append(("Tool Permission Policy Test", "PASS" if perm_action in ("allow", "PROMPT_USER") else "FAIL"))

# DYNAMIC TOKEN & LATENCY METRICS CALCULATION
active_prompt_chars_turn5 = len(sys_prompt_4)
active_tokens_turn5 = max(1, active_prompt_chars_turn5 // 4)

# Naive Un-compacted Full History Prompt Tokens for Turn 5
raw_history_chars = len(prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4)
naive_turn5_chars = raw_history_chars + 18000
naive_tokens_turn5 = naive_turn5_chars // 4

active_prompt_reduction_pct = ((naive_tokens_turn5 - active_tokens_turn5) / naive_tokens_turn5) * 100

# Cumulative Multi-Turn Tokens Comparison (Active Read-Path Prompts + Background Extraction & Compacting)
total_active_tokens = sum([
    len(p) // 4 for p in [sys_prompt_1, sys_prompt_2, sys_prompt_3, sys_prompt_4_s1, sys_prompt_4]
])
background_extraction_tokens = async_worker.total_extraction_tokens
background_valkey_summary_tokens = get_valkey_compaction_tokens()

total_tiered_system_tokens = total_active_tokens + background_extraction_tokens + background_valkey_summary_tokens

# Naive Cumulative Tokens across all 5 turns as full transcript grows continuously
naive_cumulative_tokens = sum([
    (len(p) + 18000) // 4 for p in [
        prompt_1,
        prompt_1 + resp_1 + prompt_2,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4
    ]
])

total_system_token_savings_pct = ((naive_cumulative_tokens - total_tiered_system_tokens) / naive_cumulative_tokens) * 100

# FINAL SUMMARY REPORT
print("\n==================================================")
print("FINAL AGENT MEMORY SYSTEM SUMMARY REPORT")
print("==================================================")

print("\n1. STORED ALLOYDB ENTITIES:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    for name, p_id, s_scope, summary in cur.fetchall():
        print(f"   • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}'")
        print(f"     Summary: {summary}")

print("\n2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:")
print(f"   • Naive Full-Context Turn 5 Tokens:    ~{naive_tokens_turn5:,} tokens ({naive_turn5_chars:,} chars)")
print(f"   • Tiered Memory Active Prompt Tokens:  ~{active_tokens_turn5:,} tokens ({active_prompt_chars_turn5:,} chars)")
print(f"   • Active Turn 5 Prompt Reduction:      {active_prompt_reduction_pct:.1f}% Reduction")
print(f"   • Measured Turn 5 Inference Latency:   {latency_4:.2f} seconds")

print("\n3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):")
print(f"   • Naive Cumulative Multi-Turn Tokens:  ~{naive_cumulative_tokens:,} tokens")
print(f"   • Active Read-Path Prompt Tokens:      ~{total_active_tokens:,} tokens (Across 5 Turns)")
print(f"   • Background Worker Tokens (Extraction):~{background_extraction_tokens:,} tokens (4 Background Turns)")
print(f"   • Background Compaction Tokens (Valkey):~{background_valkey_summary_tokens:,} tokens (1 Compaction Call)")
print(f"   • Total Tiered System Token Footprint: ~{total_tiered_system_tokens:,} tokens")
print(f"   • Overall System Token Savings:        {total_system_token_savings_pct:.1f}% Total Reduction")

print("\n4. ACCURACY & VERIFICATION TESTS:")
all_pass = True
for name, status in test_accuracy:
    print(f"   • {name}: [{status}]")
    if status != "PASS":
        all_pass = False

print("\n==================================================")
print(f"OVERALL STATUS: {'ALL TESTS PASSED ✔' if all_pass else 'VERIFICATION FAILED ✖'}")
print("==================================================")
Uruchamianie skryptu weryfikacyjnego
Uruchom skrypt w Cloud Shell:
python3 test_memory_system.py
Oczekiwane dane wyjściowe konsoli
Na końcu danych wyjściowych testu zostanie wydrukowane podsumowanie wyników. Poniżej znajdziesz przykład takiego wydruku wraz z wyjaśnieniami.
1. STORED ALLOYDB ENTITIES: <A List of all stored entities,>
   • Entity: '<name of entity>' | Project: '<which project does this relate to>' | Scope: '<global/project/session>'
     Summary: <The entity summary>
    ....

2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:
   • Naive Full-Context Turn 5 Tokens:    <Number of tokens in naive approach on the last turn>
   • Tiered Memory Active Prompt Tokens:  <Number of tokens in tiered approach on the last turn>
   • Active Turn 5 Prompt Reduction:      <Savings on tokens in %>
   • Measured Turn 5 Inference Latency:   <Latency in last turn>

3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):
   • Naive Cumulative Multi-Turn Tokens:  <Total tokens in the naive approach>
   • Active Read-Path Prompt Tokens:      <Read path tokens in the tiered approach>
   • Background Worker Tokens (Extraction): <Backround process tokens usage in tiered approach>
   • Background Compaction Tokens (Valkey): <Backround process tokens usage for compaction in tiered approach>
   • Total Tiered System Token Footprint: <Total tokens usage in tiered approach>
   • Overall System Token Savings:        <Savings on tokens in %>

4. ACCURACY & VERIFICATION TESTS:
   • Valkey Rolling Summary Compaction Test: <Did the roling summary work>
   • Global Coding Preference Recall Test (scope='global'): <Was it able to retrieve global scoped memories>
   • Project CloudRetail Architecture Recall Test (project_id='CloudRetail'): <Was it able to retrieve project specific scoped entities>
   • Tool Permission Policy Test: <Was it able to retrieve permissions policies>
Resetowanie pamięci (opcjonalnie)
Jeśli chcesz wyczyścić wszystkie zapisane pamięci i zresetować stan Valkey i AlloyDB między uruchomieniami testów, utwórz i uruchom cleanup_memory_system.py:
import logging
from db_clients import get_db_connection, get_valkey_client
from valkey_buffer import IN_MEMORY_VALKEY_FALLBACK

logging.basicConfig(level=logging.INFO)

def reset_memory_system():
    # 1. Flush short-term Valkey cache or clear local in-memory fallback
    try:
        valkey = get_valkey_client()
        valkey.flushdb()
        print("✔ Flushed Valkey short-term cache.")
    except Exception:
        IN_MEMORY_VALKEY_FALLBACK.clear()
        print("✔ Cleared local in-memory short-term fallback buffer.")

    # 2. Truncate long-term AlloyDB memory tables
    try:
        conn = get_db_connection()
        with conn:
            with conn.cursor() as cur:
                cur.execute("TRUNCATE TABLE agent_entities CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_embeddings CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_collections CASCADE;")
                cur.execute("TRUNCATE TABLE user_permissions CASCADE;")
                print("✔ Truncated AlloyDB long-term memory tables.")
        conn.close()
    except Exception as e:
        print(f"✖ AlloyDB cleanup error: {e}")

if __name__ == "__main__":
    reset_memory_system()
Uruchom skrypt czyszczenia:
python3 cleanup_memory_system.py
14. Rozszerzenie pamięci warstwowej na Google ADK
W poprzednich krokach utworzyliśmy 2-poziomowy system pamięci:
- Poziom 1 (bufor krótkoterminowy): Memorystore for Valkey przechowuje ostatnie tury rozmowy i tworzy podsumowania kroczące, aby zmniejszyć rozmiar promptów.
- Poziom 2 (długoterminowy sklep hybrydowy): AlloyDB AI przechowuje trwałe preferencje użytkowników, reguły projektów i wektory dystrybucyjne za pomocą wyszukiwania hybrydowego.
Z tego przewodnika dowiesz się, jak połączyć ten silnik pamięci z agentem niestandardowym utworzonym za pomocą pakietu Google Agent Development Kit .
Problem z prostą pamięcią
Połączenie agenta z pamięcią zwykle prowadzi do jednej z 2 pułapek:
- Pułapka polegająca na używaniu tylko narzędzi: zmuszanie agenta do wywoływania narzędzi (np.
search_memory) w każdej sytuacji. Agenci często zapominają wywoływać narzędzia do określania podstawowych preferencji (takich jak styl kodowania czy limity czasu), co prowadzi do błędów i powolnych dodatkowych podróży w obie strony. - Pułapka przeładowania prompta: umieszczanie całej historii w każdym prompcie. Szybko zwiększa to koszty tokenów, spowalnia odpowiedzi i obniża jakość rozumowania modelu.
Rozwiązanie hybrydowe
Stosujemy podejście hybrydowe, które zapewnia agentowi odpowiednią pamięć we właściwym czasie:
- Kontekst otoczenia (automatyczny): przed każdą turą z Memorystore (podsumowanie kroczące) i AlloyDB (reguły i ustawienia) pobierane są odpowiednie reguły projektu i podsumowania ostatnich sesji, które są następnie wstrzykiwane do promptu agenta bez dodatkowych wywołań LLM.
- Wyszukiwanie długoterminowe na żądanie (narzędzie): w przypadku starszych lub mało znanych faktów (np. decyzji architektonicznej sprzed 2 tygodni) agent wywołuje
long_term_memory_tool, aby przeprowadzić wyszukiwanie wektorowe w tabeli pamięci długoterminowej AlloyDB. - Ograniczenia wykonania: zanim agent uruchomi narzędzie, ograniczenie sprawdza jednorazowe uprawnienia w Valkey i reguły bezpieczeństwa w AlloyDB, aby blokować niebezpieczne działania, takie jak
rm -rf.
Ustawienia i konfiguracja
Zainstaluj pakiet google-adk (pozostałe zależności są już zainstalowane):
pip3 install google-adk
Ustaw region Google Cloud, przez który klient ADK GenAI ma kierować żądania do Vertex AI:
# ADK agent platform backend
export GEMINI_MODEL="gemini-3.5-flash"
export GOOGLE_GENAI_USE_VERTEXAI="true"
export GOOGLE_CLOUD_PROJECT="${PROJECT_ID}"
export GOOGLE_CLOUD_LOCATION="${GENAI_LOCATION}"
15. Dostawca pamięci otoczenia
Utwórz adk_memory_provider.py. Ta klasa obsługuje automatyczny cykl życia pamięci:
- Przed turą: pobiera bufor rozmowy Valkey (<1 ms) i wysyła zapytanie do AlloyDB o pasujące preferencje i reguły projektu, a następnie łączy je w prompt systemowy.
- Po zakończeniu tury: dołącza rozmowę do Valkey i uruchamia proces w tle, aby wyodrębnić trwałe fakty do AlloyDB bez spowalniania odpowiedzi użytkownika.
import logging
from typing import Any, Dict, Optional
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

class ADKTieredMemoryProvider:
    """Provides ambient memory context before turns and saves history after turns."""

    def __init__(self, db_conn_factory, valkey_client: redis.Redis, genai_client: Any, trigger_limit: int = 10, window_size: int = 4):
        self.conn_factory = db_conn_factory
        self.valkey_client = valkey_client
        self.genai_client = genai_client
        self.trigger_limit = trigger_limit
        self.window_size = window_size
        self.async_worker = AsyncMemoryWorker(db_conn_factory, genai_client)

    def get_context_for_turn(self, user_id: str, project_id: Optional[str], session_id: str, user_query: str, prev_session_id: Optional[str] = None) -> Dict[str, Any]:
        """Reads Valkey buffer (<1ms) and AlloyDB hybrid entities before agent reasoning."""
        buffer_data = get_session_context_buffer(self.valkey_client, session_id)
        rolling_summary = buffer_data["rolling_summary"]

        # Carry over prior session summary when starting a fresh session
        if not rolling_summary and prev_session_id:
            prev_buffer = get_session_context_buffer(self.valkey_client, prev_session_id)
            if prev_buffer["rolling_summary"]:
                rolling_summary = f"[From prior session {prev_session_id}]:\n" + prev_buffer["rolling_summary"]

        conn = self.conn_factory()
        try:
            entities = retrieve_hybrid_entities(
                conn=conn, llm_client=self.genai_client, user_id=user_id,
                active_session_id=session_id, query_text=user_query,
                prev_session_id=prev_session_id, project_id=project_id, k=20
            )
        finally:
            conn.close()

        return {
            "rolling_summary": rolling_summary,
            "recent_turns": buffer_data["recent_turns"],
            "retrieved_entities": entities
        }

    def format_system_instruction(self, context: Dict[str, Any], base_prompt: str = "") -> str:
        """Injects ambient entities and short-term summaries into the agent's prompt."""
        entity_lines = [f"- {name}: {info['summary']}" for name, info in context["retrieved_entities"].items()]
        entity_str = "\n".join(entity_lines) if entity_lines else "No relevant long-term entities."
        summary_str = context["rolling_summary"] or "No prior summary."

        return f"""{base_prompt}

[LONG-TERM PREFERENCES & ENTITIES]
{entity_str}

[SHORT-TERM ROLLING SUMMARY]
{summary_str}

[NOTE ON TOOLS & MEMORY]
Memory persistence is managed automatically by the platform behind the scenes. Do not attempt to invoke non-existent tools like 'set_preference' or 'save_fact'. Only invoke explicitly declared tools when needed.
""".strip()

    def record_turn_async(self, user_id: str, project_id: Optional[str], session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None) -> None:
        """Updates Valkey sliding window and triggers background AlloyDB extraction."""
        append_session_turn_with_rolling_summary(
            valkey_client=self.valkey_client, llm_client=self.genai_client,
            session_id=session_id, user_msg=user_msg, ai_msg=ai_msg,
            trigger_limit=self.trigger_limit, window_size=self.window_size
        )
        self.async_worker.enqueue_extraction(
            user_id=user_id, session_id=session_id, user_msg=user_msg,
            ai_msg=ai_msg, prev_session_id=prev_session_id
        )
16. Narzędzie pamięci długotrwałej na żądanie
Pamięć otoczenia utrzymuje aktywny prompt na niewielkim poziomie, ale agent czasami musi przeszukiwać starsze notatki historyczne, decyzje architektoniczne lub dzienniki incydentów.
Utwórz adk_memory_tools.py. Obejmuje to tabelę wektorową episodic_memory_embeddings AlloyDB w FunctionTool ADK:
from typing import Any, Dict, List, Optional
from google.adk.tools import FunctionTool

def make_long_term_memory_tool(db_conn_factory, embed_client: Any, user_id: str) -> FunctionTool:
    """Creates an ADK FunctionTool for vector search over AlloyDB historical records."""

    def search_archived_memory(query: str, project_id: Optional[str] = None, limit: int = 3) -> List[Dict[str, Any]]:
        """Searches past architecture decisions, historical notes, and old discussions."""
        # 1. Embed query with text-embedding-005
        emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=query)
        query_vector = emb_resp.embeddings[0].values

        # 2. Cosine distance search on AlloyDB HNSW vector index
        sql = """
            SELECT document, cmetadata, created_at, 1 - (embedding <=> %s::vector) AS similarity
            FROM episodic_memory_embeddings
            WHERE cmetadata->>'user_id' = %s
              AND (%s IS NULL OR cmetadata->>'project_id' = %s)
            ORDER BY embedding <=> %s::vector ASC
            LIMIT %s;
        """
        conn = db_conn_factory()
        results = []
        try:
            with conn.cursor() as cur:
                cur.execute(sql, (str(query_vector), user_id, project_id, project_id, str(query_vector), limit))
                for doc, meta, created_at, similarity in cur.fetchall():
                    results.append({
                        "document": doc,
                        "metadata": meta,
                        "timestamp": created_at.isoformat() if created_at else None,
                        "similarity": round(float(similarity), 4)
                    })
        finally:
            conn.close()
        return results

    return FunctionTool(search_archived_memory)
17. Bariery uprawnień w przypadku konta Enterprise
Agenci autonomiczni nie mogą wykonywać destrukcyjnych działań na hoście (takich jak rm -rf lub usuwanie tabel) bez weryfikacji.
Jak działa before_tool_callback w ADK
ADK udostępnia punkt przechwytywania, który jest uruchamiany przed wykonaniem jakiegokolwiek narzędzia:
- Zwróć
None: ADK zezwala na wykonanie narzędzia. - Zwróć słownik (np.
{"status": "DENIED", "error": ...}): pakiet ADK natychmiast przerywa wykonywanie. Żadne polecenie nie jest wykonywane, a przyczyna odmowy jest zwracana do modelu, aby mógł on wyjaśnić użytkownikowi ograniczenie.
Kolejność sprawdzania uprawnień
- Sprawdzanie 0 (bezpieczne narzędzia na liście dozwolonych): bezpieczne narzędzia tylko do odczytu, takie jak
search_archived_memory, są wstępnie zatwierdzone w pamięci, dzięki czemu agent może zawsze wysyłać zapytania do własnej pamięci. - Poziom 1 (tymczasowe uprawnienia „jednorazowe” w Valkey): gdy operator zatwierdzi ryzykowne działanie, w Valkey jest przechowywany tymczasowy klucz
one_time_perm:{session_id}:{cmd_hash}z 5-minutowym czasem życia. Mechanizm ochrony odczytuje i usuwa klucz w ramach jednej operacji niepodzielnej. Dzięki temu polecenie zostanie uruchomione tylko raz, co zapobiegnie trwałemu zwiększeniu uprawnień. - Poziom 2 (reguły projektu w AlloyDB): sprawdza reguły wyrażeń regularnych w
user_permissionsw aktywnym projekcie (np. zezwalaj napytest.*--timeout=30, blokujrm -rf.*). - Poziom 3 (reguły globalne w AlloyDB): sprawdza reguły rezerwowe, które obowiązują we wszystkich projektach.
- Fail-closed fallback: jeśli żadna reguła nie pasuje, wykonanie jest odrzucane z kodem
PENDING, co wymaga weryfikacji manualnej.
Implementacja
Utwórz adk_guardrails.py:
import logging
from typing import Any, Dict, Optional, Tuple, Set
from enterprise_engine import AgentMemoryEngine

logger = logging.getLogger(__name__)

class ADKPermissionGuardrail:
    """Evaluates tool permissions using Valkey allow-once tokens and AlloyDB rules."""

    def __init__(self, memory_engine: AgentMemoryEngine, exempt_tools: Optional[Set[str]] = None):
        self.engine = memory_engine
        self.exempt_tools = exempt_tools or {"search_archived_memory"}

    def evaluate(self, user_id: str, project_id: str, session_id: str, tool_name: str, tool_args: Dict[str, Any]) -> Tuple[bool, str]:
        # 1. Allowlist safe internal tools
        if tool_name in self.exempt_tools:
            return True, f"Internal tool '{tool_name}' is pre-approved."

        # 2. Check 3-tier policy engine
        action, reason = self.engine.evaluate_tool_permission(
            user_id=user_id, project_id=project_id, session_id=session_id,
            tool_name=tool_name, tool_args=tool_args
        )
        if action.upper() == "ALLOW":
            return True, f"Permission ALLOWED: {reason}"
        elif action.upper() == "BLOCK":
            return False, f"Permission BLOCKED: {reason}"
        return False, f"Permission PENDING: {reason} (requires human confirmation)"

    def create_before_tool_callback(self, user_id: str, default_project_id: str = "global"):
        """Creates the callback hook for Agent(before_tool_callback=...)."""
        def before_tool_callback(tool: Any, args: Dict[str, Any], tool_context: Any) -> Optional[Dict[str, Any]]:
            tool_name = getattr(tool, "name", str(tool))
            session_id = getattr(getattr(tool_context, "session", None), "id", "default_session")

            allowed, msg = self.evaluate(user_id, default_project_id, session_id, tool_name, args)
            if not allowed:
                logger.warning("Guardrail blocked '%s': %s", tool_name, msg)
                return {"status": "DENIED", "tool": tool_name, "error": msg}

            return None  # Returning None permits execution in ADK
        return before_tool_callback
18. Przeprowadzanie testu agenta ADK
Utwórz test_adk_agent.py. Ten kompletny skrypt łączy komponenty, inicjuje zarchiwizowaną decyzję i reguły zabezpieczeń, przeprowadza rozmowę w 2 sesjach, testuje kompresję i przywoływanie pamięci oraz weryfikuje egzekwowanie zabezpieczeń:
import asyncio
import os
import time
from google import genai
from google.genai import types
from google.adk.agents import Agent
from google.adk.runners import Runner
from google.adk.sessions import InMemorySessionService
from google.adk.tools import FunctionTool

from db_clients import get_db_connection, get_valkey_client
from enterprise_engine import AgentMemoryEngine
from adk_memory_provider import ADKTieredMemoryProvider
from adk_memory_tools import make_long_term_memory_tool
from adk_guardrails import ADKPermissionGuardrail
from valkey_buffer import get_session_context_buffer

# Configuration & clients
PROJECT_ID = os.getenv("PROJECT_ID", "chunking-poc-alloydb")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")
GEMINI_MODEL = os.getenv("GEMINI_MODEL", "gemini-3.5-flash")
USER_ID, SESSION_1, SESSION_2 = "user_adk_dev", "sess_adk_001", "sess_adk_002"

db_conn = get_db_connection()
valkey_client = get_valkey_client()
# LLM client for Gemini 3.5 Flash via global multi-region
genai_client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)
# Embeddings client (requires specific regional presence)
embed_client = genai.Client(vertexai=True, project=PROJECT_ID, location=REGION)

tiered_provider = ADKTieredMemoryProvider(get_db_connection, valkey_client, genai_client, trigger_limit=3, window_size=2)
memory_engine = AgentMemoryEngine(valkey_client, db_conn)
guardrail = ADKPermissionGuardrail(memory_engine)

# Tools: Long-term memory search and mock terminal command
long_term_memory_tool = make_long_term_memory_tool(get_db_connection, embed_client, USER_ID)

def run_command(CommandLine: str) -> str:
    """Executes a shell command on the host."""
    return f"Executed: {CommandLine}"

run_command_tool = FunctionTool(run_command)

def seed_database():
    """Seeds a 14-day-old architecture decision and permission rules."""
    doc = "Archived Decision: CloudRetail services must use gRPC keepalive ping intervals of 15 seconds."
    emb = embed_client.models.embed_content(model="text-embedding-005", contents=doc).embeddings[0].values
    conn = get_db_connection()
    try:
        with conn.cursor() as cur:
            cur.execute("""
                INSERT INTO episodic_memory_embeddings (uuid, document, cmetadata, created_at, embedding)
                VALUES (gen_random_uuid(), %s, jsonb_build_object('user_id', %s, 'project_id', 'CloudRetail'), NOW() - INTERVAL '14 days', %s::vector);
            """, (doc, USER_ID, str(emb)))
            cur.execute("""
                INSERT INTO user_permissions (user_id, project_id, tool_name, command_pattern, action)
                VALUES (%s, 'CloudRetail', 'run_command', 'pytest.*--timeout=30', 'ALLOW'),
                       (%s, 'CloudRetail', 'run_command', 'rm -rf.*', 'BLOCK'),
                       (%s, 'global', 'search_archived_memory', '.*', 'ALLOW')
                ON CONFLICT DO NOTHING;
            """, (USER_ID, USER_ID, USER_ID))
        conn.commit()
    finally:
        conn.close()

async def run_turn(runner: Runner, session_id: str, query: str, prev_session_id: str = None) -> str:
    """Fetches ambient memory, executes turn, and saves history in the background."""
    ctx = tiered_provider.get_context_for_turn(USER_ID, "CloudRetail", session_id, query, prev_session_id)
    runner.agent.instruction = tiered_provider.format_system_instruction(
        ctx,
        base_prompt="You are an intelligent Google ADK enterprise developer assistant."
    )
    msg = types.Content(role="user", parts=[types.Part.from_text(text=query)])
    parts = []
    async for event in runner.run_async(user_id=USER_ID, session_id=session_id, new_message=msg):
        if event.content and event.content.parts:
            parts.extend([p.text for p in event.content.parts if p.text])

    response = "".join(parts).strip()
    tiered_provider.record_turn_async(USER_ID, "CloudRetail", session_id, query, response, prev_session_id)
    return response

async def main():
    seed_database()
    sessions = InMemorySessionService()
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_1)

    agent = Agent(
        name="adk_memory_agent", model=GEMINI_MODEL, instruction="Initial instruction",
        tools=[long_term_memory_tool, run_command_tool],
        before_tool_callback=guardrail.create_before_tool_callback(USER_ID, "CloudRetail")
    )
    runner = Runner(agent=agent, session_service=sessions, app_name="agents")

    print("\n--- Session 1: Storing Preferences & Triggering Compaction ---")
    await run_turn(runner, SESSION_1, "I standardize on Python 3.11 with PostgreSQL and Dark Mode UI.")
    await run_turn(runner, SESSION_1, "For project CloudRetail, our backend stack is FastAPI on AlloyDB with Valkey cache and 30s timeouts.")
    await run_turn(runner, SESSION_1, "Draft a quick 5-line SQL table for products.")
    await run_turn(runner, SESSION_1, "Add rate-limiting rules for API endpoints.")

    buf = get_session_context_buffer(valkey_client, SESSION_1)
    print(f"Valkey rolling summary generated: {bool(buf['rolling_summary'])}")
    print(f"Turns in buffer: {len(buf['recent_turns'])} (compacted from 8)")

    print("\nWaiting 6s for background worker entity extraction into AlloyDB...")
    await asyncio.sleep(6)

    print("\n--- Session 2: Cold-Start Ambient Recall ---")
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_2)
    resp = await run_turn(runner, SESSION_2, "What are my coding preferences and the CloudRetail stack from my previous session?", prev_session_id=SESSION_1)
    print(f"Agent response:\n{resp}\n")

    print("\n--- On-Demand Archival Vector Search ---")
    resp_search = await run_turn(runner, SESSION_2, "What was the agreed gRPC keepalive interval from 2 weeks ago?")
    print(f"Agent response:\n{resp_search}\n")

    print("\n--- Guardrail Verification ---")
    blocked, b_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "rm -rf /tmp/data"})
    allowed, a_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "pytest --timeout=30"})
    print(f"rm -rf /tmp/data:    Allowed={blocked} ({b_msg})")
    print(f"pytest --timeout=30: Allowed={allowed} ({a_msg})")

if __name__ == "__main__":
    asyncio.run(main())
Czyszczenie po testach iteracyjnych
Ponieważ system rejestruje trwały kontekst, wielokrotne uruchamianie testu będzie powodować nieustanne dodawanie fragmentów dialogu do Valkey i wstawianie zduplikowanych reguł do AlloyDB.
Aby łatwo zresetować stan między uruchomieniami, uruchom skrypt cleanup_memory_system.py utworzony w poprzednim kroku:
python3 cleanup_memory_system.py
python3 test_adk_agent.py
Wyniki sprawdzania
Test weryfikuje 4 kluczowe zachowania produkcyjne:
- Znaczne zmniejszenie liczby tokenów promptu: kompresja Valkey kompresuje historię dialogów do zwięzłego podsumowania. W naszych testach zmniejszyło to rozmiar aktywnego promptu o ponad 92% (z ok. 6956 tokenów do ok. 544 tokenów) – Twoje wyniki mogą się różnić.
- Natychmiastowe przywoływanie informacji w przypadku zimnego startu: w nowej sesji (sesja 2) agent natychmiast przywołał preferencje użytkownika (Python 3.11, PostgreSQL, tryb ciemny) i architekturę projektu (FastAPI, 30-sekundowe limity czasu) bez wywoływania żadnych narzędzi. Umożliwiła to funkcja
ADKTieredMemoryProvider.get_context_for_turn, która pobiera kontekst z Memorystore i AlloyDB przed wywołaniem LLM. - Wywoływanie wektorów na żądanie: gdy agent został zapytany o decyzję podjętą 14 dni temu, wywołał
search_archived_memoryi pobrał 15-sekundową regułę gRPC keepalive. - Deterministyczne bezpieczeństwo: agent wykonał działanie
pytest --timeout=30, ale został zablokowany przed wykonaniem działaniarm -rf /tmp/data.
19. Czyszczenie danych
Aby uniknąć obciążenia konta Google Cloud bieżącymi opłatami za instancje AlloyDB i Memorystore, usuń utworzone zasoby.
Uruchom w Cloud Shell te polecenia:
# Exit VM and return to Cloud Shell
exit
# Delete Compute Engine development VM
gcloud compute instances delete $VM_NAME \
  --zone=$ZONE \
  --quiet

# Delete AlloyDB primary instance and cluster
gcloud alloydb instances delete $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --quiet

gcloud alloydb clusters delete $ADBCLUSTER \
  --region=$REGION \
  --quiet

# Delete Memorystore for Valkey instance
gcloud memorystore instances delete $VALKEYINSTANCE \
  --location=$REGION \
  --quiet
20. Gratulacje
Gratulacje! Udało Ci się utworzyć 2-warstwową architekturę pamięci długoterminowej agenta AI, która łączy Memorystore for Valkey i AlloyDB AI.
Czego się nauczysz
- Wdrożyliśmy 2-poziomową architekturę pamięci, która oddziela krótkoterminowy stan aktywnej sesji od długoterminowych trwałych faktów.
- Znacznie zmniejszyliśmy rozmiar aktywnego promptu i zaoszczędziliśmy na łącznym wykorzystaniu tokenów w porównaniu z prostym wypełnianiem kontekstu bez utraty dokładności.
- Skonfigurowana na poziomie bazy danych AlloyDB AI transakcyjna funkcja automatycznego osadzania (
ai.initialize_embeddings). - Przeprowadzono natywne wyszukiwanie hybrydowe z wykorzystaniem wzajemnego scalania pozycji (
ai.hybrid_search), które łączy podobieństwo wektorów (<=>) z wyszukiwaniem pełnotekstowym w PostgreSQL (tsvector). - Stworzyliśmy działający w tle ekstraktor elementów poza wątkiem (
AsyncMemoryWorker), 3-poziomowy moduł oceny uprawnień do wykonywania narzędzi i silnik kompresji pamięci bazy danych. - Połącz system pamięci warstwowej z autonomicznym agentem za pomocą pakietu Google Agent Development Kit (ADK), aby wymusić ograniczenia narzędzi i zapewnić pamięć otoczenia.
Dalsze kroki i materiały
- Zapoznaj się z dokumentacją AlloyDB AI.
- Dowiedz się, jak przeprowadzić hybrydowe wyszukiwanie wektorowe w AlloyDB.
- Dowiedz się więcej o Memorystore for Valkey.