

1. Прежде чем начать
Поскольку агенты ИИ обрабатывают длительные многоэтапные взаимодействия, растянувшиеся на несколько дней, и выполняют многоступенчатые задачи с большим горизонтом планирования, большие языковые модели (LLM) остаются по своей сути безсостоятельными между сессиями. Когда пользователь вернется к агенту завтра, модель начнет работу с нуля, если приложение не сможет восстановить необходимый контекст.
Наивный подход к этой проблеме — это наполнение токенами : добавление полной истории разговоров, журналов выполнения инструментов и кодовых баз непосредственно к каждому активному запросу. Хотя большие контекстные окна, содержащие миллион токенов, технически делают это возможным, наполнение контекстом вносит существенные операционные задержки: стоимость токенов увеличивается квадратично с каждым ходом, задержки ответа возрастают до десятков секунд, а модели страдают от ухудшения контекста из-за «потери данных посередине».
Для создания надежных агентов искусственного интеллекта необходима двухуровневая архитектура памяти :
- Кратковременный буфер сессии : кэширует последние реплики разговора в активной памяти с помощью скользящего окна, ограниченного токенами. Этот уровень требует высокопроизводительных запросов в памяти с интервалом менее миллисекунды на каждой реплике, что делает Memorystore для Valkey идеальным выбором.
- Долговременная постоянная память : хранит структурированные сущности, пользовательские настройки и эпизодические факты в течение нескольких сессий. Этот уровень требует транзакционной целостности, многопользовательской безопасности и гибридного извлечения данных из реляционных баз данных и векторов — поэтому AlloyDB для PostgreSQL является правильным выбором.
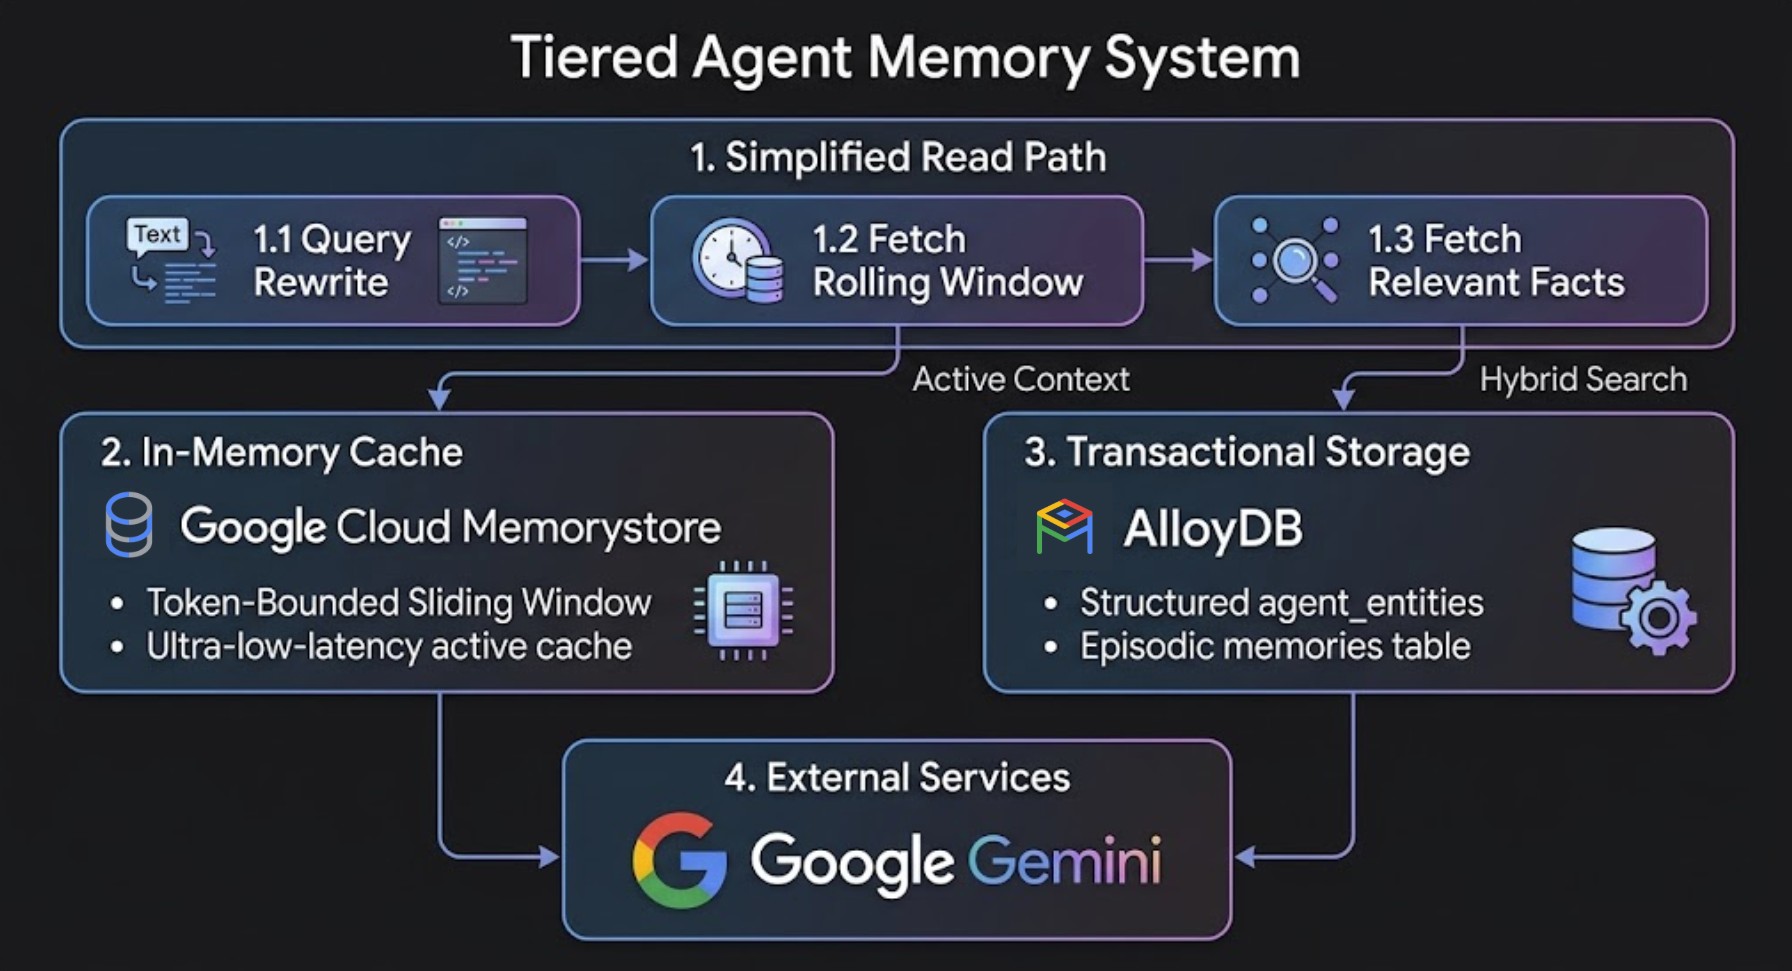
Понимание четырех типов памяти
Надежная архитектура памяти опирается на четыре взаимодополняющих типа памяти на протяжении всего пользовательского процесса:
Тип памяти | Что оно хранит | Уровень хранения | Продолжительность жизни |
Буфер (кратковременный) | Недавние откровенные разговоры переходят на другую тему. | Memorystore для Valkey | Активная сессия |
Сводная память | Сжатая история более ранних поворотов | Memorystore для Valkey | Многооборотное окно |
Эпизодическая память | Предыдущие действия, события и результаты работы инструментов | AlloyDB для PostgreSQL (Vector) | Постоянный |
Память сущностей и правил | Пользовательские предпочтения, ограничения и право вето | AlloyDB для PostgreSQL (структурированный SQL + вектор) | Постоянный |
Измеренное влияние многоуровневой памяти
Внутреннее тестирование производительности в ходе многоэтапных диалогов разработки (более 45 этапов с большим количеством выходных данных от инструментов) демонстрирует значительную экономию по сравнению с простым заполнением контекста:
Метрический/размерный | Наивное наполнение контекста | Многоуровневая память (AlloyDB + Memorystore) | Чистый эффект в процессе тестирования |
Размер активного запроса (поворот 45) | 747 033 токенов | 83 262 токена | На 88,9% меньше подсказка |
Задержка ответа в 45-м повороте | 33,5 секунды | 6,7 секунд | На 80,0% более быстрая реакция |
Накопительные токены сессии | 17,9 млн токенов | 4,09 млн токенов | Общая экономия токенов и затрат составляет 72,0%. |
Напоминание о правилах и ограничениях | Снижается при поворотах. | Предотвращает потерю важной информации в кратком изложении. | Сохранено благодаря гибридному поиску |
Что вы будете делать
- Подготовка AlloyDB для PostgreSQL и Memorystore для Valkey.
- Включите
google_ml_integrationи настройте автоматическое встраивание транзакций на стороне базы данных (ai.initialize_embeddings). - Реализуйте краткосрочный буфер сессии Valkey с использованием шаблона конвейера «обобщение перед обрезкой».
- Извлекайте долговременные сущности с помощью встроенных функций искусственного интеллекта AlloyDB (например,
ai.generate). - Выполняйте запросы к долгосрочным данным с высокой точностью и релевантностью, используя встроенную функцию гибридного поиска AlloyDB (
ai.hybrid_search) и переранжирование с помощью алгоритма Reciprocal Rank Fusion (RRF). - Создайте трехуровневый инструмент оценки разрешений для корпоративных систем и фоновый механизм сжатия памяти.
- Интегрируйте двухуровневую архитектуру памяти непосредственно в автономного агента, используя комплект разработки агентов Google (ADK).
Что вам понадобится
- Проект Google Cloud с включенной функцией выставления счетов.
- Веб-браузер, например Chrome .
- Базовые знания Python и SQL, включая опыт выполнения SQL-запросов к AlloyDB — из Studio, CLI и т.д.
Аудитория и стоимость
- Целевая аудитория : разработчики ИИ, бэкенд-инженеры и архитекторы баз данных.
- Ориентировочная стоимость : ресурсы Google Cloud, созданные в рамках этого практического задания, обойдутся примерно в 1,50 доллара США .
2. Настройка и требования
Запустить Cloud Shell
В этом практическом занятии вы будете выполнять команды в Google Cloud Shell, облачном терминале, предварительно настроенном с использованием gcloud , psql и python3 .
- Откройте консоль Google Cloud .
- Нажмите кнопку «Активировать Cloud Shell» в правом верхнем углу консоли Cloud Console.
- Проверка подлинности:
gcloud auth list
export PROJECT_ID=<YOUR_PROJECT_ID>
gcloud config set project $PROJECT_ID

export REGION=us-east1
export GENAI_LOCATION=us
export ZONE=us-east1-b
export ADBCLUSTER=agent-memory-cluster
export ADBINSTANCE=agent-memory-instance
export VALKEYINSTANCE=agent-memory-cache
export VM_NAME=agent-dev-vm
Включите API Google Cloud и создайте виртуальную машину для разработки.
Для включения необходимых API выполните следующую команду в Cloud Shell:
gcloud services enable \
  alloydb.googleapis.com \
  memorystore.googleapis.com \
  aiplatform.googleapis.com \
  compute.googleapis.com \
  servicenetworking.googleapis.com \
  networkconnectivity.googleapis.com
Создайте экземпляр виртуальной машины Compute Engine в сети VPC default для размещения среды разработки Python вместе с AlloyDB и Memorystore для Valkey:
gcloud compute instances create $VM_NAME \
    --zone=$ZONE \
    --machine-type=e2-standard-2 \
    --scopes=cloud-platform \
    --network=default \
    --shielded-secure-boot
3. Подготовка AlloyDB и Memorystore для Valkey.
На этом этапе вы подготовите кластер AlloyDB для PostgreSQL и основной экземпляр, настроите частную сеть для сервисов и запустите экземпляр Memorystore для Valkey .
Создание диапазона IP-адресов для доступа к частным сервисам
AlloyDB требует наличия диапазона частных IP-адресов в вашей виртуальной частной сети (VPC). Предположим, вы используете сеть VPC default :
- Создайте выделенный диапазон частных IP-адресов:
gcloud compute addresses create psa-range \
    --global \
    --purpose=VPC_PEERING \
    --prefix-length=24 \
    --description="VPC private service access" \
    --network=default
- Установите частное пиринговое соединение VPC:
gcloud services vpc-peerings connect \
    --service=servicenetworking.googleapis.com \
    --ranges=psa-range \
    --network=default
Создайте кластер AlloyDB и основной экземпляр.
- Создайте начальный пароль кластера для инициализации системы:
export PGPASSWORD=`openssl rand -hex 12`
- Создайте кластер для бесплатной пробной версии:
gcloud alloydb clusters create $ADBCLUSTER \
    --password=$PGPASSWORD \
    --network=default \
    --region=$REGION \
    --subscription-type=TRIAL
- Создайте основной экземпляр:
gcloud alloydb instances create $ADBINSTANCE \
    --instance-type=PRIMARY \
    --cpu-count=2 \
    --region=$REGION \
    --cluster=$ADBCLUSTER
Выделение хранилища памяти для экземпляра Valkey
Для работы Memorystore for Valkey перед созданием экземпляра требуется политика подключения к службе ( gcp-memorystore ) в вашей сети и регионе.
- Создайте политику подключения к службе для хранилища памяти:
gcloud network-connectivity service-connection-policies create memorystore-policy \
    --network=default \
    --region=$REGION \
    --service-class=gcp-memorystore \
    --subnets=projects/$PROJECT_ID/regions/$REGION/subnetworks/default
- Создайте экземпляр Memorystore для Valkey:
gcloud memorystore instances create $VALKEYINSTANCE \
    --location=$REGION \
    --shard-count=1 \
    --replica-count=0 \
    --node-type=SHARED_CORE_NANO \
    --psc-auto-connections="network=projects/$PROJECT_ID/global/networks/default,projectId=$PROJECT_ID"
Предоставление Vertex AI разрешений IAM
Предоставьте учетной записи службы AlloyDB необходимые разрешения IAM для вызова моделей встраивания Agent Platform:
PROJECT_ID=$(gcloud config get-value project)

gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:service-$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")@gcp-sa-alloydb.iam.gserviceaccount.com" \
  --role="roles/aiplatform.user"
4. Инициализация среды и конечных точек доступа.
Настройка аутентификации IAM в AlloyDB и флагов базы данных.
Включите аутентификацию базы данных IAM ( alloydb.iam_authentication=on ) и механизм запросов AI ( google_ml_integration.enable_ai_query_engine=on ) в вашем экземпляре AlloyDB:
gcloud beta alloydb instances update $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --update-mode=FORCE_APPLY \
  --database-flags=alloydb.iam_authentication=on,google_ml_integration.enable_ai_query_engine=on
Далее добавьте свою учетную запись Google Cloud в качестве пользователя базы данных на основе IAM с правами суперпользователя:
export USER_ACCOUNT=$(gcloud config get-value account)

gcloud alloydb users create $USER_ACCOUNT \
    --cluster=$ADBCLUSTER \
    --region=$REGION \
    --type=IAM_BASED \
    --db-roles=alloydbsuperuser
Получение доступа к внутренним конечным точкам VPC в Cloud Shell
Перед подключением к виртуальной машине для разработки по SSH получите внутренние IP-адреса VPC для AlloyDB и Memorystore для Valkey в Cloud Shell:
# Export GCP Project ID, Region, and IAM User
export PROJECT_ID=$(gcloud config get-value project)
export REGION=us-east1
export DB_USER=$(gcloud config get-value account)

# Retrieve Internal VPC IP Addresses for AlloyDB & Memorystore for Valkey
export DB_HOST=$(gcloud alloydb instances describe $ADBINSTANCE --cluster=$ADBCLUSTER --region=$REGION --format="value(ipAddress)")
export DB_PORT=5432
export DB_NAME=postgres

export VALKEY_HOST=$(gcloud memorystore instances describe $VALKEYINSTANCE --location=$REGION --format="value(discoveryEndpoints[0].address)")
export VALKEY_PORT=6379

# Verify exported endpoints
echo "Project ID:        $PROJECT_ID"
echo "Region:            $REGION"
echo "AlloyDB Private IP: $DB_HOST"
echo "IAM DB User:       $DB_USER"
echo "Valkey Private IP:  $VALKEY_HOST"
Подключение к виртуальной машине для разработки по SSH и экспорт переменных подключения.
Подключитесь по SSH из Cloud Shell к вашей виртуальной машине разработки Compute Engine ( agent-dev-vm ), расположенной в той же сети VPC:
gcloud compute ssh $VM_NAME --zone=$ZONE
После входа в виртуальную машину для разработки экспортируйте приведенные выше данные о конфигурации проекта и точках подключения (заменив...).
export PROJECT_ID=<YOUR_PROJECT_ID>
export REGION=us-east1
export GENAI_LOCATION=us
export DB_HOST=<YOUR_ALLOYDB_PRIVATE_IP>
export DB_PORT=5432
export DB_NAME=postgres
export DB_USER=<YOUR_IAM_DB_USER>
export VALKEY_HOST=<YOUR_VALKEY_PRIVATE_IP>
export VALKEY_PORT=6379
Инициализация виртуальной среды Python.
Внутри вашей виртуальной машины для разработки давайте сначала создадим локальный рабочий каталог:
mkdir -p ~/alloydb_agent_memory && cd ~/alloydb_agent_memory
Теперь давайте установим пакеты виртуальной среды Python, выполним аутентификацию с помощью учетных данных приложения по умолчанию (ADC) и настроим рабочее пространство:
sudo apt-get update && sudo apt-get install -y python3-venv python3-pip

python3 -m venv venv
source venv/bin/activate
Наконец, в новой виртуальной среде мы установим зависимости:
gcloud auth application-default login
pip install psycopg2-binary valkey redis google-genai
5. Системная архитектура и иерархия кодовых модулей
Обзор того, что вы создаёте.
Перед запуском отдельных скриптов Python ознакомьтесь с архитектурой системы, представленной ниже. Данное примерное приложение состоит из 7 модульных скриптов Python, работающих по двум основным путям выполнения и взаимодействующих с одним и тем же экземпляром базы данных AlloyDB for PostgreSQL :
- Read Path (
hybrid_retriever.py) : Разлагает составные многокомпонентные вопросы на подзапросы с одним аспектом непосредственно в PostgreSQL с помощью функции AlloyDB AIai.generate()и выполняет запросы к долговременной памяти, используя встроенный в AlloyDB гибридный поиск (ai.hybrid_search). - Write Path (
async_worker.py) : Off-thread background queue worker that asynchronously extracts structurally entity facts from dialogue exchanges using Gemini Flash and upserving them intoagent_entities.
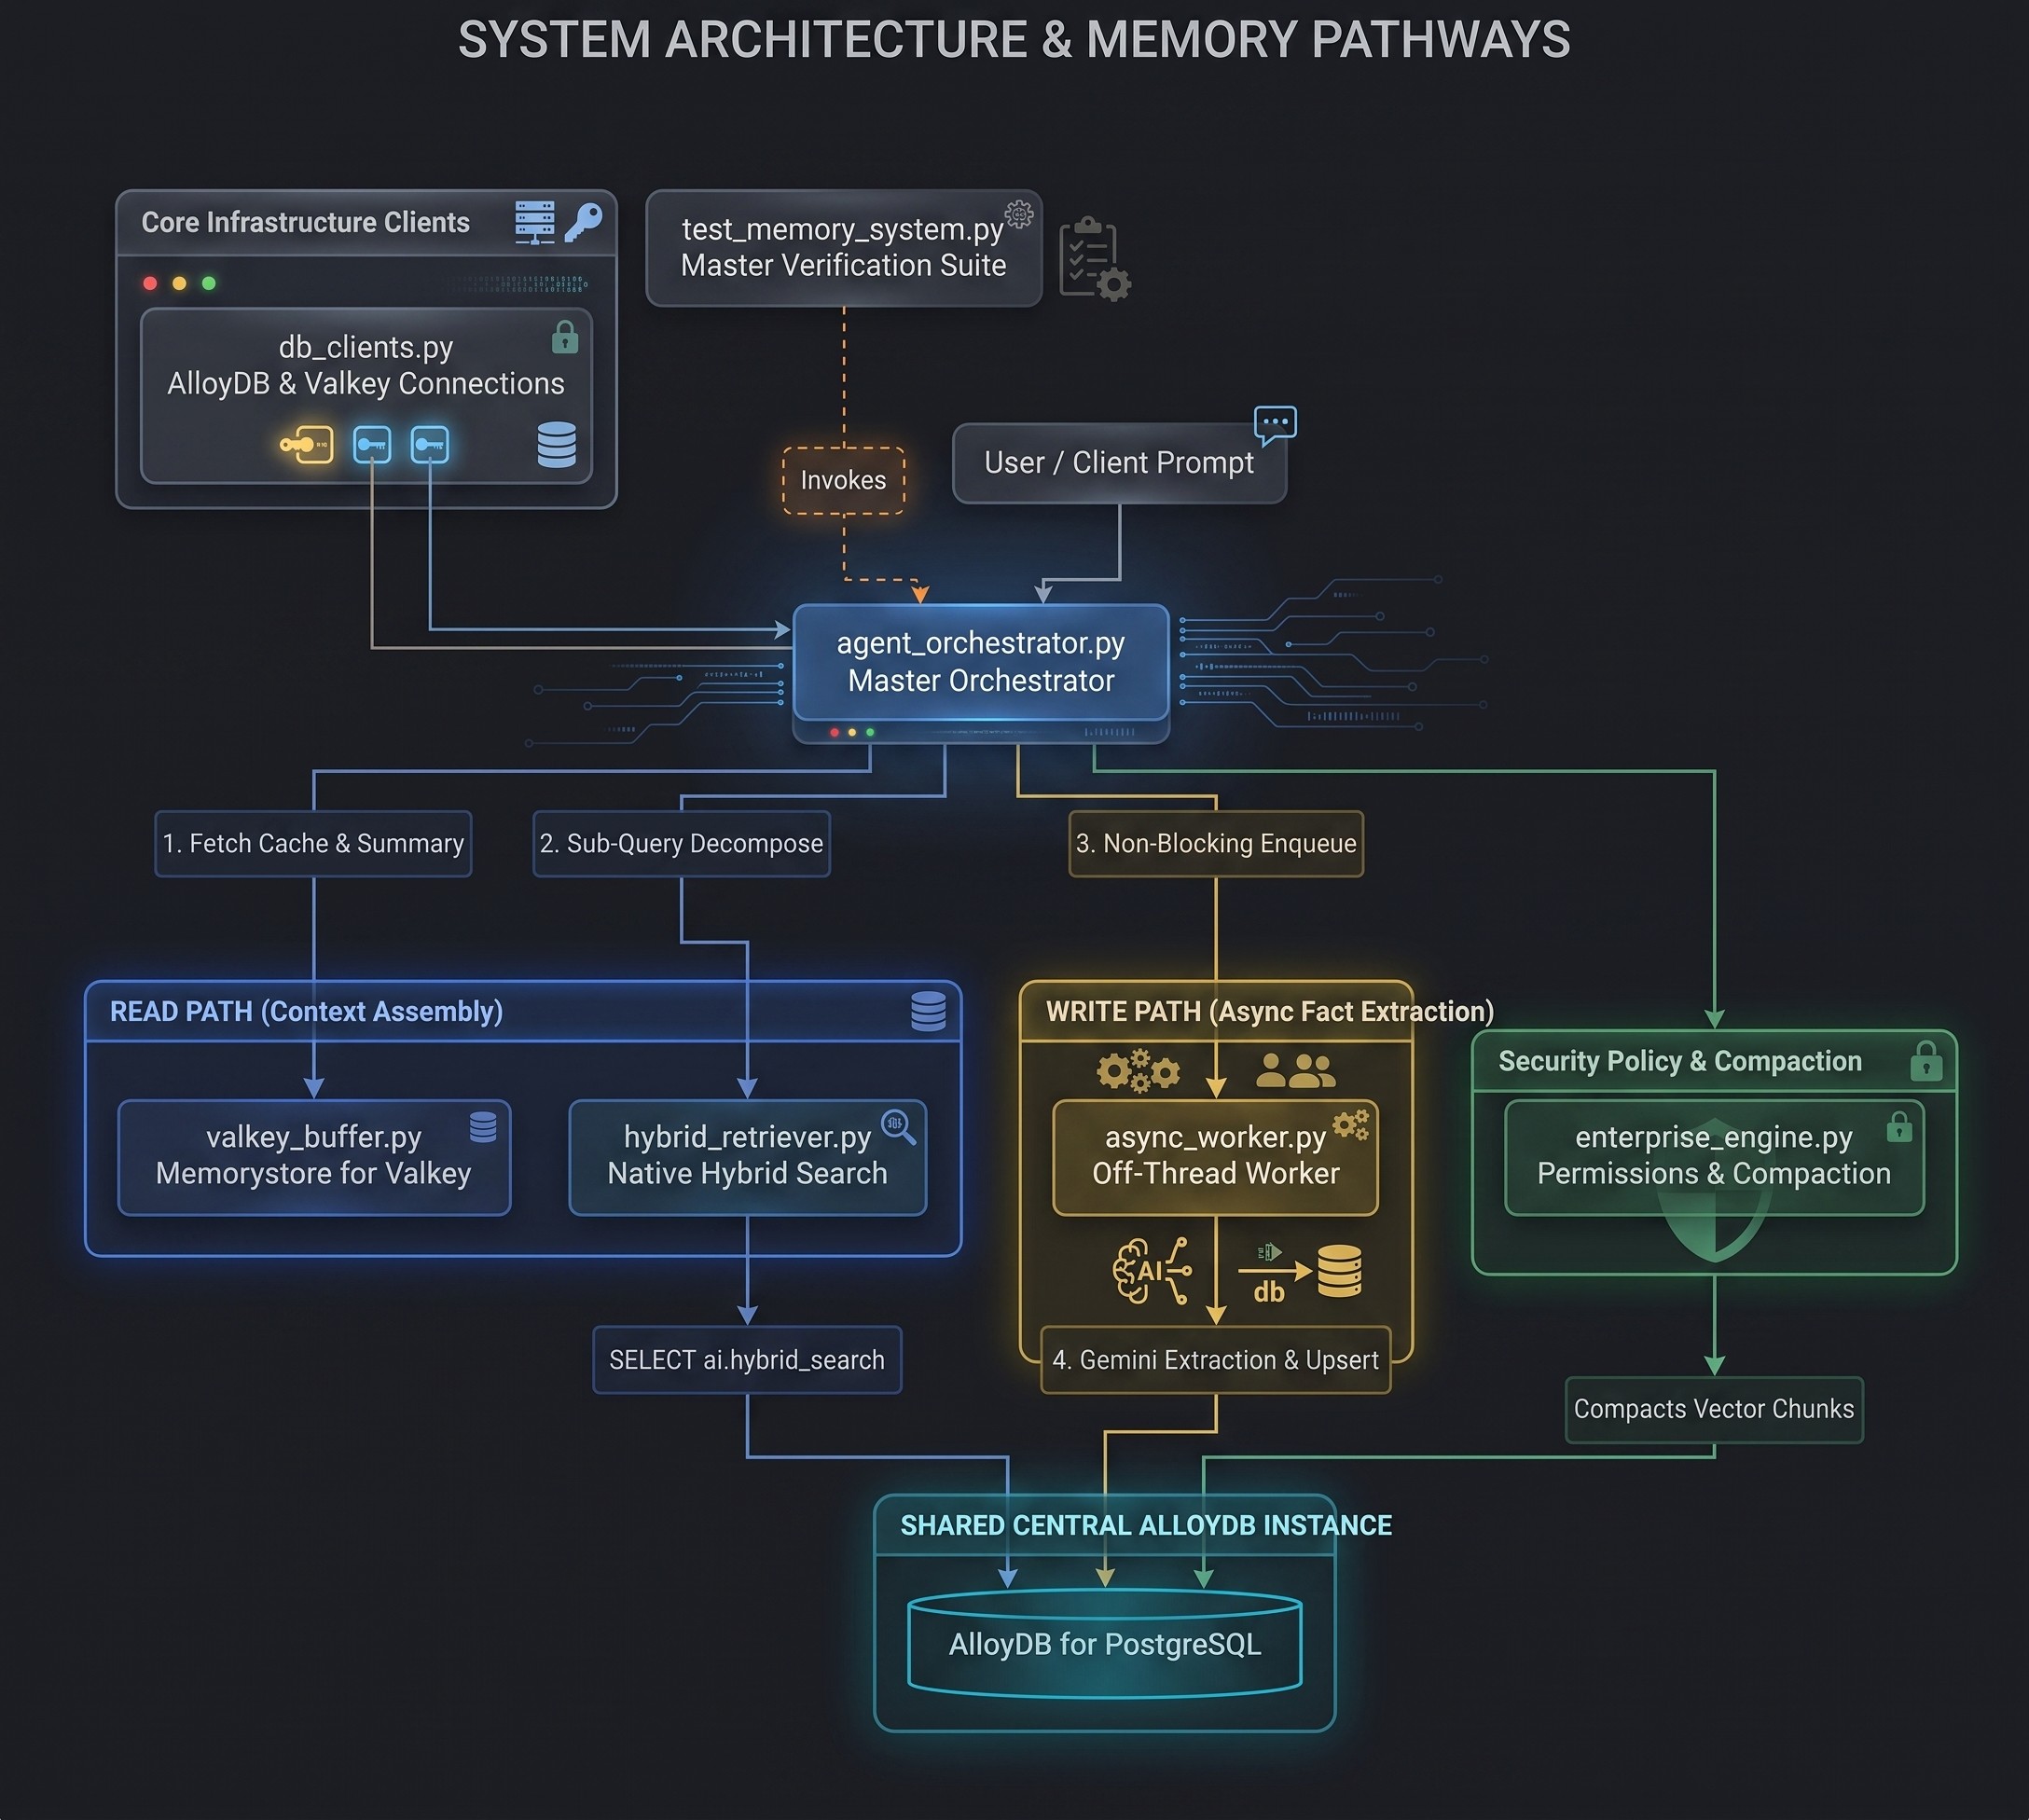
Иерархия модулей и системные роли
Файл модуля | Системный уровень | Основная ответственность |
| Уровень соединения | Устанавливает SSL-шифрованную аутентификацию IAM для AlloyDB и отказоустойчивые соединения с Memorystore для Valkey. |
| Кратковременная память | В Valkey реализована функция управления историей сессий с интервалом менее миллисекунды, использующая скользящие сводки Summarize-Before-Trim . |
| Write Path Worker | Запускает фоновый поток демона, работающего в режиме ожидания, который извлекает информацию о сущностях с помощью Gemini Flash и вставляет её в AlloyDB. |
| Read Path Retriever | Разлагает составные вопросы на подзапросы с одним аспектом, используя встроенную в базу данных функцию AlloyDB AI |
| Основной цикл агента | Координирует сквозной цикл выполнения запроса: краткосрочная выборка, долгосрочный поиск, сборка подсказок, выполнение LLM и асинхронная постановка в очередь. |
| Управление и администрирование | Обеспечивает соблюдение трехуровневых политик безопасности при выполнении инструментов и агрегирует историческую память. |
| Тестирование и оценка | Комплексный пакет инструментов для проверки, выполняющий многоэтапные и многосессионные сценарии, измеряющий процент экономии токенов и проверяющий точность памяти. |
6. Настройка схемы AlloyDB AI и автоматических транзакционных встраиваний.
Обзор целей и архитектуры
В этом модуле вы определите схему базы данных AlloyDB для эпизодической и долговременной памяти, стратегии индексирования и автоматическое встраивание данных на стороне базы данных.
- Эпизодическое векторное хранилище (
episodic_memory_embeddings) : фрагменты неструктурированной стенограммы чата, индексированные с помощью векторных индексов HNSW (vector_cosine_ops). - Долгосрочное хранилище сущностей (
agent_entities) : структурированные факты, выбор пользователя и правила проекта, хранящиеся с метаданными области действия (global,project,session). Включает автоматически генерируемый столбец для полнотекстового поиска PostgreSQL (summary_tsv), индексируемый с помощью RUM. - Автоматическое встраивание данных на стороне базы данных (
ai.initialize_embeddings) : автоматически встраивает новые или обновленные строки в формате обычного текста вsummary_embeddingс помощью функцииtext-embedding-005на платформе агента в фоновом режиме.
Подключитесь к AlloyDB Studio
- Перейдите на страницу AlloyDB for Postgres в консоли Google Cloud.
- Щелкните по своему основному экземпляру.
- В левой боковой панели навигации нажмите AlloyDB Studio .
- Выберите базу данных
postgres - Аутентификация с использованием
IAM database authentication
Реализация и исходный код
После подключения к базе данных AlloyDB PostgreSQL выполните следующие DDL-запросы:
-- 1. Enable google_ml_integration extension
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;
CREATE EXTENSION IF NOT EXISTS vector CASCADE;
CREATE EXTENSION IF NOT EXISTS rum CASCADE;
SET google_ml_integration.enable_preview_ai_functions = true;

-- 2. Create Episodic Memory Vector Store Tables
CREATE TABLE IF NOT EXISTS episodic_memory_collections (
    uuid UUID PRIMARY KEY,
    name VARCHAR,
    cmetadata JSONB
);

CREATE TABLE IF NOT EXISTS episodic_memory_embeddings (
    uuid UUID PRIMARY KEY,
    collection_id UUID REFERENCES episodic_memory_collections(uuid) ON DELETE CASCADE,
    embedding VECTOR(768),
    document VARCHAR,
    cmetadata JSONB,
    custom_id VARCHAR,
    created_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS episodic_memory_embedding_idx
ON episodic_memory_embeddings
USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);

-- 3. Create Entity & Preference Table with Metadata Scope & Auto-Generated TSVector Column
CREATE TABLE IF NOT EXISTS agent_entities (
    entity_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    entity_name TEXT NOT NULL,
    project_id TEXT DEFAULT 'global',
    session_id TEXT,
    scope TEXT NOT NULL DEFAULT 'project', -- 'global', 'project', 'session'
    summary TEXT NOT NULL,
    summary_embedding VECTOR(768),
    summary_tsv TSVECTOR GENERATED ALWAYS AS (
        to_tsvector('english', entity_name || ' ' || summary)
    ) STORED,
    updated_at TIMESTAMPTZ DEFAULT NOW(),
    UNIQUE (user_id, entity_name)
);

CREATE INDEX IF NOT EXISTS agent_entities_scope_idx
ON agent_entities (user_id, project_id, scope);

CREATE INDEX IF NOT EXISTS agent_entities_embedding_idx
ON agent_entities USING hnsw (summary_embedding vector_cosine_ops);

CREATE INDEX IF NOT EXISTS agent_entities_tsv_idx
ON agent_entities USING rum (summary_tsv rum_tsvector_ops);

-- 4. Create User Permissions Table for Tool Execution Controls
CREATE TABLE IF NOT EXISTS user_permissions (
    permission_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    project_id TEXT NOT NULL DEFAULT 'global',
    tool_name TEXT NOT NULL,
    command_pattern TEXT NOT NULL,
    action TEXT NOT NULL CHECK (action IN ('ALLOW', 'BLOCK')),
    created_at TIMESTAMPTZ DEFAULT NOW(),
    updated_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS idx_user_permissions_lookup
ON user_permissions (user_id, project_id, tool_name);
-- 5. Register Gemini 3.5 Flash Model Endpoint in AlloyDB
-- Replace PROJECT_ID with your Google Cloud project ID
CALL google_ml.create_model(
    model_id => 'gemini-3.5-flash',
    model_request_url => 'https://aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/global/publishers/google/models/gemini-3.5-flash:generateContent',
    model_qualified_name => 'gemini-3.5-flash',
    model_provider => 'google',
    model_type => 'llm',
    model_auth_type => 'alloydb_service_agent_iam'
);
Инициализация транзакционных автовстраиваний и регистрация модели Gemini.
Далее выполните операторы CALL в отдельных блоках выполнения запросов, чтобы зарегистрировать фоновый процесс автоматического встраивания и конечную точку модели Gemini 3.5 Flash:
-- 6. Register Database-Side Transactional Auto-Embedding
CALL ai.initialize_embeddings(
    model_id => 'text-embedding-005',
    table_name => 'agent_entities',
    content_column => 'summary',
    embedding_column => 'summary_embedding',
    incremental_refresh_mode => 'transactional',
    batch_size => 10
);
7. Настройка клиентов подключения AlloyDB и Valkey.
Обзор целей и архитектуры
В этом модуле вы научитесь устанавливать безопасные сетевые соединения как с AlloyDB для PostgreSQL (долговременная память), так и с Memorystore для Valkey (кратковременный кэш).
- Аутентификация AlloyDB IAM : использует
gcloud auth application-default print-access-tokenдля получения кратковременного токена OAuth2 для беспарольных, зашифрованных по SSL подключений к базе данных (sslmode="require"). - Valkey Network Resilience : Настраивает
redis.Redisс таймаутом сокета 5,0 секунд (socket_timeout=5.0) для безопасной обработки сетевых операций VPC в одноузловых или кластерных экземплярах Valkey.
Реализация и исходный код
Создайте скрипт db_clients.py в своей рабочей директории:
import os
import subprocess
import psycopg2
import redis

# Initialize database & Valkey connection clients from environment variables
DB_HOST = os.getenv("DB_HOST", "127.0.0.1")
DB_PORT = os.getenv("DB_PORT", "5432")
DB_NAME = os.getenv("DB_NAME", "postgres")
DB_USER = os.getenv("DB_USER")

VALKEY_HOST = os.getenv("VALKEY_HOST", "127.0.0.1")
VALKEY_PORT = int(os.getenv("VALKEY_PORT", "6379"))

def get_db_connection():
    # Fetch Application Default Credentials (ADC) token for IAM Database Authentication & enable SSL encryption
    access_token = subprocess.check_output(
        ["gcloud", "auth", "application-default", "print-access-token"], text=True
    ).strip()
    return psycopg2.connect(
        host=DB_HOST,
        port=DB_PORT,
        dbname=DB_NAME,
        user=DB_USER,
        password=access_token,
        sslmode="require"
    )

def get_valkey_client():
    return redis.Redis(
        host=VALKEY_HOST,
        port=VALKEY_PORT,
        db=0,
        socket_timeout=5.0,
        socket_connect_timeout=5.0
    )

if __name__ == "__main__":
    print(f"Connecting to AlloyDB via IAM Auth ({DB_USER}) at {DB_HOST}:{DB_PORT} and Valkey at {VALKEY_HOST}:{VALKEY_PORT}...")
    print("Database and Valkey connection client modules loaded successfully.")
8. Кэширование краткосрочного состояния сессии в хранилище памяти для Valkey.
Обзор целей и архитектуры
В этом модуле вы создадите в Memorystore для Valkey краткосрочный контекстный кэш с временем отклика менее миллисекунды, реализующий автоматизированный шаблон Summarize-Before-Trim .
- Valkey Sliding Window : Активные реплики в диалоге хранятся в виде JSON-строк в ключе
session:{session_id}:turns. - Хэш-теги Redis (
{session_id}) : форматирование ключейsession:{session_id}:turnsиsession:{session_id}:summaryиспользует кластерные хэш-теги Redis ({...}), заставляя оба ключа находиться в одном и том же хэш-слоте для обеспечения атомарного выполнения в любом одноузловом или кластерном развертывании Valkey. - Summarize-Before-Trim : Когда количество ходов превышает
trigger_limit, старые ходы, которые должны быть удалены, суммируются Gemini Flash в виде прокручиваемого текстового резюме (session:{session_id}:summary) перед тем, как сократить исходную историю доwindow_size.
Реализация и исходный код
Создайте скрипт valkey_buffer.py в своей рабочей директории:
import json
import logging
import time
from typing import Any, Dict, List
import redis

logger = logging.getLogger(__name__)

IN_MEMORY_VALKEY_FALLBACK: Dict[str, Any] = {}
VALKEY_COMPACTION_TOKENS = 0

def get_valkey_compaction_tokens() -> int:
    return VALKEY_COMPACTION_TOKENS

def append_session_turn_with_rolling_summary(
    valkey_client: redis.Redis,
    llm_client: Any,
    session_id: str,
    user_msg: str,
    ai_msg: str,
    trigger_limit: int = 10,
    window_size: int = 4
) -> None:
    """Appends turn to Valkey. Before trimming old turns, summarizes them into a rolling summary."""
    global VALKEY_COMPACTION_TOKENS
    # Use Redis Hash Tags {session_id} so both keys hash to the same cluster slot
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        # 1. Append new turn messages
        valkey_client.rpush(turns_key, json.dumps({"role": "user", "content": user_msg}))
        valkey_client.rpush(turns_key, json.dumps({"role": "assistant", "content": ai_msg}))

        raw_turns = valkey_client.lrange(turns_key, 0, -1)

        # 2. Check if total turns exceed summary trigger threshold
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2

        if len(raw_turns) > msg_trigger_count:
            turns_to_prune = raw_turns[:-msg_window_count]
            existing_summary = valkey_client.get(summary_key)
            existing_summary_text = (
                existing_summary.decode('utf-8') if isinstance(existing_summary, bytes) else (existing_summary or "")
            )

            pruned_text = "\n".join([
                f"{json.loads(t)['role']}: {json.loads(t)['content']}" for t in turns_to_prune
            ])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            updated_summary_text = llm_client.models.generate_content(
                model="gemini-3.5-flash", contents=prompt
            ).text.strip()
            # Execute commands directly to support all Redis/Valkey cluster topologies
            valkey_client.set(summary_key, updated_summary_text)
            valkey_client.ltrim(turns_key, -msg_window_count, -1)
            logger.info("Updated rolling summary and trimmed Valkey buffer for session %s", session_id)

    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey operation warning (%s). Falling back to in-memory short-term buffer.", e)
        if turns_key not in IN_MEMORY_VALKEY_FALLBACK:
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = []
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "user", "content": user_msg})
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "assistant", "content": ai_msg})

        # In-memory summarize-before-trim fallback logic
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2
        raw_fallback_turns = IN_MEMORY_VALKEY_FALLBACK[turns_key]

        if len(raw_fallback_turns) > msg_trigger_count:
            turns_to_prune = raw_fallback_turns[:-msg_window_count]
            existing_summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
            pruned_text = "\n".join([f"{t['role']}: {t['content']}" for t in turns_to_prune])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            for attempt in range(4):
                try:
                    updated_summary_text = llm_client.models.generate_content(
                        model="gemini-3.5-flash", contents=prompt
                    ).text.strip()
                    break
                except Exception as e:
                    if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                        time.sleep(3 * (2 ** attempt))
                    else:
                        raise

            IN_MEMORY_VALKEY_FALLBACK[summary_key] = updated_summary_text
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = raw_fallback_turns[-msg_window_count:]

def get_session_context_buffer(
    valkey_client: redis.Redis,
    session_id: str
) -> Dict[str, Any]:
    """Retrieves rolling summary + sliding window history from Valkey to build prompt context."""
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        summary = valkey_client.get(summary_key)
        summary_text = summary.decode('utf-8') if isinstance(summary, bytes) else (summary or "")

        raw_turns = valkey_client.lrange(turns_key, 0, -1)
        recent_turns = [json.loads(t) for t in raw_turns]

        return {
            "rolling_summary": summary_text,
            "recent_turns": recent_turns
        }
    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey read error (%s). Using in-memory short-term fallback buffer.", e)
        summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
        recent_turns = IN_MEMORY_VALKEY_FALLBACK.get(turns_key, [])
        return {"rolling_summary": summary_text, "recent_turns": recent_turns}
9. Извлечение сущностей вне основного потока (фоновый поток обработки данных в памяти)
Обзор целей и архитектуры
В этом модуле вы создадите фоновый обработчик извлечения данных из памяти ( AsyncMemoryWorker ), работающий в фоновом режиме и осуществляющий запись в отдельный поток, который извлекает долговременные данные об сущностях, не замедляя интерактивные ответы ИИ.
- Неблокирующий обработчик очереди : запускает поток-демон (
queue.Queue), чтобы ответы в чате разработчиков возвращались немедленно, без ожидания извлечения LLM или записи в базу данных. - Внепоточное извлечение фактов о сущностях : вызывает Gemini Flash (
model="gemini-3.5-flash",response_mime_type="application/json") в фоновом режиме для анализа структурированных сущностей без блокировки диалоговых окон, отображаемых пользователю. - Разрешение временной кореференции (
build_temporal_rules_prompt) : Применяет правила, преобразующие относительные временные выражения (например , "currently" , "last session" ) в явные идентификаторы сессий (например,session_id). - Schema Upserts : Запрашивает у Gemini Flash возврат JSON-массива сущностей (
entity_name,project_id,scope,summary) и записывает обычный текст вagent_entitiesс помощью параметризованных операторов PostgreSQLON CONFLICT DO UPDATE.
Реализация и исходный код
Создайте скрипт async_worker.py в своей рабочей директории:
import json
import logging
import queue
import threading
import time
from typing import Dict, Any, Optional
import psycopg2

logger = logging.getLogger(__name__)

def build_temporal_rules_prompt(active_session_id: str, prev_session_id: Optional[str] = None) -> str:
    """REUSABLE PROMPT HELPER: Defines temporal coreference rules for both Read and Write paths."""
    return f"""TEMPORAL COREFERENCE RULES:
1. Do not use relative temporal words like 'currently', 'now', 'this session', 'previous session', or 'last session'.
2. Replace any relative temporal reference with explicit session identifiers:
   - Active Session: '{active_session_id}'
   - Previous Session: '{prev_session_id if prev_session_id else active_session_id}'
   (e.g., write 'User prefers Python in session {active_session_id}' instead of 'User currently prefers Python')."""

class AsyncMemoryWorker:
    """Off-thread daemon queue worker performing background entity extraction and upserts into AlloyDB."""
    def __init__(self, conn_factory, llm_client):
        self.conn_factory = conn_factory
        self.llm_client = llm_client
        self.work_queue = queue.Queue()
        self.total_extraction_tokens = 0
        self.worker_thread = threading.Thread(target=self._run_worker, daemon=True)
        self.worker_thread.start()

    def enqueue_extraction(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        self.work_queue.put((user_id, session_id, user_msg, ai_msg, prev_session_id))

    def _run_worker(self):
        while True:
            item = self.work_queue.get()
            if item is None:
                break
            user_id, session_id, user_msg, ai_msg, prev_session_id = item
            try:
                self._extract_and_upsert(user_id, session_id, user_msg, ai_msg, prev_session_id)
            except Exception as e:
                logger.error("Background extraction failed: %s", e)
            finally:
                self.work_queue.task_done()

    def _extract_and_upsert(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        temporal_rules = build_temporal_rules_prompt(session_id, prev_session_id)
        json_fmt = '[{"entity_name": "...", "project_id": "...", "scope": "global|project|session", "summary": "..."}]'

        prompt = f"""Extract key preferences and named entities from this exchange.
Format output strictly as a JSON array of objects with structure: {json_fmt}.

{temporal_rules}

Rules for Scope:
- 'global': Universal developer preferences.
- 'project': Architecture, database choices, timeouts, and rules for a specific project.
- 'session': Ephemeral task state tied strictly to a single session.

User: {user_msg}
AI: {ai_msg}

Output (JSON array only):"""

        self.total_extraction_tokens += max(1, len(prompt) // 4)

        for attempt in range(4):
            try:
                response = self.llm_client.models.generate_content(
                    model="gemini-3.5-flash",
                    contents=prompt,
                    config={"response_mime_type": "application/json"}
                )
                break
            except Exception as e:
                if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                    time.sleep(3 * (2 ** attempt))
                else:
                    raise
        content = str(response.text).strip()
        if not content:
            return

        extracted_list = json.loads(content)
        if not isinstance(extracted_list, list):
            return

        upsert_sql = """
            INSERT INTO agent_entities (user_id, entity_name, project_id, session_id, scope, summary, updated_at)
            VALUES (%s, %s, %s, %s, %s, %s, NOW())
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET
                project_id = EXCLUDED.project_id,
                session_id = EXCLUDED.session_id,
                scope = EXCLUDED.scope,
                summary = EXCLUDED.summary,
                updated_at = NOW();
        """

        conn = self.conn_factory()
        try:
            with conn:
                with conn.cursor() as cur:
                    for item in extracted_list:
                        e_name = item.get("entity_name", "General_Fact")
                        p_id = item.get("project_id", "global")
                        s_scope = item.get("scope", "project")
                        summary = item.get("summary", "")
                        if e_name and summary:
                            cur.execute(upsert_sql, (user_id, e_name, p_id, session_id, s_scope, summary))
            logger.info("Saved %d entities for user %s", len(extracted_list), user_id)
        finally:
            conn.close()
10. Запрос к долговременной памяти с помощью нативного гибридного поиска.
Обзор целей и архитектуры
В этом модуле вы реализуете декомпозицию подзапросов по пути чтения, временное переписывание запросов, изоляцию области действия метаданных и используете встроенный в AlloyDB гибридный поиск ( ai.hybrid_search ).
- Декомпозиция подзапросов внутри базы данных (
rewrite_and_decompose_query) : использует встроенную функцию AlloyDB AIai.generate()непосредственно в PostgreSQL для разбиения составных вопросов на подзапросы с одним аспектом и нормализованными идентификаторами сессий, предотвращая снижение точности векторного поиска при использовании многотематических запросов. - Фильтрация на уровне индекса : Создает SQL-фильтры на стороне базы данных (
filter_condition => "user_id = '%s' AND (project_id = '%s' OR scope = 'global')") для выделения памяти для каждого пользователя и проекта, включая при этом глобальные настройки разработчика. - Встроенный гибридный поиск AlloyDB (
ai.hybrid_search) : объединяет векторное косинусное сходство (public.<=>) с полнотекстовым поиском (rum) внутри AlloyDB с использованием алгоритма взаимного рангового слияния (RRF) для обеспечения оптимальной точности, полноты и релевантности.
Реализация и исходный код
Создайте скрипт hybrid_retriever.py в своей рабочей директории:
import os
import json
import logging
from typing import Any, Dict, List, Optional
import psycopg2
from psycopg2.extras import RealDictCursor
from async_worker import build_temporal_rules_prompt

logger = logging.getLogger(__name__)

def rewrite_and_decompose_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> List[str]:
    """Read-Path LLM Query Normalizer & Sub-Query Decomposer using AlloyDB AI ai.generate() directly in PostgreSQL."""
    temporal_rules = build_temporal_rules_prompt(active_session_id, prev_session_id)

    prompt = f"""You are a query normalization and decomposition tool for an AI agent's memory retrieval system.

Tasks:
1. Normalize any relative temporal phrases in the user query into explicit session identifiers.
{temporal_rules}

2. Decompose compound user queries asking about multiple distinct topics into up to 4 concise, single-topic search queries. Ensure all distinct questions (both general developer preferences and project-specific architecture/rules) are preserved as separate sub-queries.
3. Return ONLY a valid JSON array of strings containing the sub-queries.

Example Output Format:
["general developer coding preferences", "CloudRetail backend stack in session sess_2026_01", "CloudRetail timeout rules in session sess_2026_01"]

Text to Process: {text}
JSON Output:"""

    try:
        with conn.cursor() as cur:
            cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
            cur.execute("SELECT ai.generate(prompt => %s::text, model_id => 'gemini-3.5-flash'::varchar(100));", (prompt,))
            row = cur.fetchone()
            if row and row[0]:
                res_text = str(row[0]).strip()
                clean_text = res_text
                if clean_text.startswith("```"):
                    clean_text = clean_text.removeprefix("```json").removeprefix("```").removesuffix("```").strip()
                parsed = json.loads(clean_text)
                if isinstance(parsed, list) and len(parsed) > 0:
                    return [str(q).strip() for q in parsed]
        return [text]
    except Exception as e:
        logger.error("Error in in-database ai.generate sub-query decomposition: %s", e)
        return [text]

def rewrite_temporal_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> str:
    """Backward-compatible wrapper returning first decomposed query string."""
    queries = rewrite_and_decompose_query(conn, llm_client, text, active_session_id, prev_session_id)
    return queries[0] if queries else text

def retrieve_hybrid_entities(
    conn,
    llm_client: Any,
    user_id: str,
    active_session_id: str,
    query_text: str,
    query_embedding: Optional[List[float]] = None,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    k: int = 20
) -> Dict[str, Any]:
    """Queries long-term entities using Sub-Query Decomposition, metadata scope filtering, and parameterized AlloyDB hybrid search."""
    sub_queries = rewrite_and_decompose_query(
        conn=conn, llm_client=llm_client, text=query_text, active_session_id=active_session_id, prev_session_id=prev_session_id
    )
    all_search_queries = list(dict.fromkeys(sub_queries + [query_text]))

    retrieved_entities: Dict[str, Any] = {}

    filter_cond = f"user_id = '{user_id}' AND (project_id = '{project_id}' OR scope = 'global')" if project_id else f"user_id = '{user_id}'"

    query_sql = """
        SELECT e.entity_name, e.summary, e.project_id, e.scope, e.updated_at
        FROM ai.hybrid_search(
          search_inputs => %s::JSONB[],
          include_json_output => false
        ) h
        JOIN agent_entities e ON e.entity_name = h.id
        WHERE e.user_id = %s
        LIMIT %s;
    """

    from google import genai
    embed_client = genai.Client(
        vertexai=True,
        project=os.getenv("PROJECT_ID"),
        location=os.getenv("REGION", "us-east1")
    )

    for sq in all_search_queries:
        try:
            emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=sq)
            sq_embedding = emb_resp.embeddings[0].values
            vector_literal = f"'{sq_embedding}'::vector"
        except Exception as e:
            logger.error(f"Failed to generate embedding for sub-query: {sq}. Error: {e}")
            # Fallback to zero vector to prevent Postgres from crashing
            sq_embedding = [0.0] * 768
            vector_literal = f"'{sq_embedding}'::vector"

        search_inputs = [
            json.dumps({
                "data_type": "vector",
                "weight": 0.4,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "vec_column": "summary_embedding",
                "distance_operator": "public.<=>",
                "limit": 20,
                "query_vector": vector_literal,
                "filter_condition": filter_cond
            }),
            json.dumps({
                "data_type": "text",
                "weight": 0.6,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "text_column": "summary_tsv",
                "limit": 20,
                "ranking_function": "ts_rank",
                "query_text_input": sq,
                "filter_condition": filter_cond
            })
        ]

        with conn.cursor(cursor_factory=RealDictCursor) as cur:
            try:
                cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                cur.execute(query_sql, (search_inputs, user_id, k))
                rows = cur.fetchall()

                for row in rows:
                    name = row["entity_name"]
                    if name not in retrieved_entities:
                        retrieved_entities[name] = {
                            "summary": row["summary"],
                            "project_id": row["project_id"],
                            "scope": row["scope"],
                            "updated_at": row["updated_at"].isoformat() if row["updated_at"] else None
                        }
            except Exception as e:
                logger.error("Error executing hybrid search for sub-query '%s': %s", sq, e)

    return retrieved_entities
11. Создайте и запустите сквозной цикл обработки памяти агента.
Обзор целей и архитектуры
В этом модуле вы создадите основную функцию управления агентом ( run_agent_turn ), которая объединяет извлечение данных из краткосрочного кэша, поиск в долговременной памяти, сборку подсказок, генерацию LLM и фоновое извлечение данных из памяти.
- Краткосрочный контекст : Извлекает активные диалоги Valkey и сводную информацию (
get_session_context_buffer). - Долгосрочный поиск : Запросы к AlloyDB через
retrieve_hybrid_entitiesс использованием декомпозированных подзапросов, отфильтрованных по идентификатору активного проекта и глобальной области видимости. - Форматирование системной подсказки : Объединяет содержимое
build_agent_promptвключающее долгосрочные сущности, краткосрочное резюме, недавние диалоги и запрос пользователя, в эффективную с точки зрения использования токенов системную подсказку. - Async Queue Enqueue : кэширует ход в Valkey и ставит фоновое извлечение в
AsyncMemoryWorker, не блокируя возвращаемый полезный груз.
Реализация и исходный код
Создайте скрипт agent_orchestrator.py в своей рабочей директории:
import logging
import time
from typing import Any, Dict, Optional, Tuple
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import rewrite_temporal_query, retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

logger = logging.getLogger(__name__)

def build_agent_prompt(
    rolling_summary: str,
    recent_turns: list[Dict[str, Any]],
    retrieved_entities: Dict[str, Any],
    user_query: str
) -> str:
    """Assembles structured system prompt with long-term memory & short-term context."""
    entity_lines = [
        f"- {name}: {info['summary']}" for name, info in retrieved_entities.items()
    ]
    entity_context = "\n".join(entity_lines) if entity_lines else "No relevant entity facts."
    history_lines = [f"{t['role']}: {t['content']}" for t in recent_turns]
    history_str = "\n".join(history_lines)

    return f"""You are an intelligent, context-aware AI assistant.

[LONG-TERM PREFERENCES & ENTITIES]
{entity_context}

[SHORT-TERM ROLLING SUMMARY]
{rolling_summary if rolling_summary else 'No prior summary.'}

[RECENT DIALOGUE]
{history_str}

User: {user_query}
AI:"""

def run_agent_turn(
    db_conn,
    valkey_client: redis.Redis,
    async_worker: AsyncMemoryWorker,
    genai_client: Any,
    user_id: str,
    session_id: str,
    user_query: str,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    trigger_limit: int = 10,
    window_size: int = 4
) -> Tuple[str, str, float]:
    """Executes a complete 2-tier agent memory turn loop, returning (response_text, system_prompt, latency_seconds)."""
    import time
    start_time = time.time()

    # 1. Fetch short-term rolling summary + recent turns from Valkey
    buffer_data = get_session_context_buffer(valkey_client, session_id)
    rolling_summary = buffer_data["rolling_summary"]
    recent_turns = buffer_data["recent_turns"]

    # 2. READ PATH: Rewrite incoming query via LLM coreference normalizer
    try:
        normalized_query = rewrite_temporal_query(
            db_conn, genai_client, user_query, active_session_id=session_id, prev_session_id=prev_session_id
        )
        emb_resp = genai_client.models.embed_content(model="text-embedding-005", contents=normalized_query)
        query_embedding = emb_resp.embeddings[0].values
    except Exception:
        query_embedding = None

    # Retrieve relevant long-term entities from AlloyDB via hybrid search
    retrieved_entities = retrieve_hybrid_entities(
        conn=db_conn,
        llm_client=genai_client,
        user_id=user_id,
        active_session_id=session_id,
        query_text=user_query,
        query_embedding=query_embedding,
        prev_session_id=prev_session_id,
        project_id=project_id,
        k=20
    )

    # 3. Assemble system prompt
    system_prompt = build_agent_prompt(
        rolling_summary, recent_turns, retrieved_entities, user_query
    )


    # 4. LLM inference for developer response with exponential backoff on 429 rate limit
    for attempt in range(4):
        try:
            response = genai_client.models.generate_content(
                model="gemini-3.5-flash", contents=system_prompt
            )
            break
        except Exception as e:
            if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                time.sleep(3 * (2 ** attempt))
            else:
                raise
    ai_response = str(response.text)

    # 5. Cache turn in short-term Valkey buffer (with Summarize-Before-Trim check)
    append_session_turn_with_rolling_summary(
        valkey_client=valkey_client,
        llm_client=genai_client,
        session_id=session_id,
        user_msg=user_query,
        ai_msg=ai_response,
        trigger_limit=trigger_limit,
        window_size=window_size
    )

    # 6. WRITE PATH: Enqueue off-thread background entity extraction (single LLM call)
    async_worker.enqueue_extraction(user_id, session_id, user_query, ai_response, prev_session_id)

    latency = time.time() - start_time
    return ai_response, system_prompt, latency
12. Внедрить корпоративные средства контроля доступа и оптимизацию памяти.
Обзор целей и архитектуры
В этом модуле вы разработаете корпоративные средства контроля безопасности для выполнения инструментов и уплотнения памяти базы данных ( AgentMemoryEngine ).
- Трехуровневая оценка разрешений (
evaluate_tool_permission) :- Уровень 1 (одноразовое предоставление ключей доступа) : Проверяет одноразовые ключи доступа (
one_time_perm:{session_id}:{cmd_hash}) с временем жизни 300 секунд. Если ключ присутствует, немедленно удаляет его и возвращаетALLOW. - Уровни 2 и 3 (Правила политики PostgreSQL) : Сначала запрашиваются
user_permissionsсоответствующие правилам в рамках проекта (project_id), затем глобальным правилам ('global'). - Резервный вариант : возвращает
PROMPT_USER, если подходящей политики не существует.
- Уровень 1 (одноразовое предоставление ключей доступа) : Проверяет одноразовые ключи доступа (
- Сжатие памяти (
compact_old_memories) : Объединяет исторические необработанные векторные события вepisodic_memory_embeddingsстаршеretention_daysв единое сводное резюме вagent_entitiesс использованием ограниченного 50-строчного SQL CTE-запроса.
Реализация и исходный код
Создайте скрипт enterprise_engine.py в своей рабочей директории:
import hashlib
import logging
import re
from typing import Any, Dict, Tuple
import psycopg2
import redis

logger = logging.getLogger(__name__)

class AgentMemoryEngine:
    """Framework-agnostic Enterprise Memory Engine for tool execution permissions & safe compaction."""

    def __init__(self, valkey_client: redis.Redis, db_conn: Any):
        self.valkey_client = valkey_client
        self.db_conn = db_conn

    def evaluate_tool_permission(
        self,
        user_id: str,
        project_id: str,
        session_id: str,
        tool_name: str,
        tool_args: Dict[str, Any]
    ) -> Tuple[str, str]:
        """Evaluates 3-tier execution permissions: Allow-Once (Valkey), Project (AlloyDB), Global (AlloyDB)."""
        command_str = str(tool_args.get("CommandLine", "") or tool_args)

        # Tier 1: Allow-Once (Single-Use Valkey Check with 300s TTL)
        cmd_hash = hashlib.sha256(command_str.encode("utf-8")).hexdigest()[:16]
        valkey_key = f"one_time_perm:{session_id}:{cmd_hash}"

        if self.valkey_client.get(valkey_key):
            self.valkey_client.delete(valkey_key)  # Consume key immediately
            return ("ALLOW", "Single-use 'Allow Once' grant consumed.")

        # Tier 2 & Tier 3: Query AlloyDB user_permissions table
        query_sql = """
            SELECT command_pattern, action, project_id
            FROM user_permissions
            WHERE user_id = %s AND tool_name = %s AND project_id IN (%s, 'global')
            ORDER BY CASE WHEN project_id = %s THEN 1 ELSE 2 END;
        """

        with self.db_conn.cursor() as cur:
            cur.execute(query_sql, (user_id, tool_name, project_id, project_id))
            rules = cur.fetchall()
            for pattern, action, scope in rules:
                if re.search(pattern, command_str, flags=re.IGNORECASE):
                    return (action, f"Matched {scope}-scoped rule: {pattern}")

        # Fallback: Prompt Human User
        return ("PROMPT_USER", "No matching permission rule found.")

    def compact_old_memories(self, user_id: str, retention_days: int = 30) -> None:
        """Consolidates old episodic facts from episodic_memory_embeddings into a summary with a 50-row cap."""
        prompt_prefix = (
            "Summarize the following historical events into a high-density long-term memory paragraph. "
            "Retain key constraints, tool choices, and project rules:\n"
        )

        # Capped CTE prevents string_agg from exceeding model context window limits
        compaction_sql = """
            WITH old_events AS (
                SELECT document AS content
                FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            ),
            consolidated AS (
                SELECT ai.generate(%s || string_agg(content, E'\n')) AS summary_text
                FROM old_events
            )
            INSERT INTO agent_entities (user_id, entity_name, summary, updated_at)
            SELECT %s, 'longterm_session_summary', summary_text, NOW()
            FROM consolidated
            WHERE summary_text IS NOT NULL
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET summary = EXCLUDED.summary, updated_at = NOW();
        """

        prune_sql = """
            DELETE FROM episodic_memory_embeddings
            WHERE uuid IN (
                SELECT uuid FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            );
        """

        try:
            with self.db_conn:
                with self.db_conn.cursor() as cur:
                    cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                    cur.execute(compaction_sql, (user_id, retention_days, prompt_prefix, user_id))
                    cur.execute(prune_sql, (user_id, retention_days))
            logger.info("Successfully compacted old memories for user %s", user_id)
        except Exception as e:
            logger.error("Error during memory compaction: %s", e)
13. Выполните сквозную многоэтапную проверку памяти.
Обзор целей и архитектуры
В этом заключительном модуле вы создадите и выполните основной скрипт сквозной проверки ( test_memory_system.py ) для проверки всей двухуровневой архитектуры памяти.
- Многоэтапное и многосессионное моделирование :
- Сессия 1 (Шаг 1) : Определяет универсальные настройки разработчика (
scope='global': Темный режим интерфейса, Python 3.11, PostgreSQL). - Сессия 1 (Вершина 2) : Определение архитектуры, специфичной для проекта (
project_id='CloudRetail': FastAPI, AlloyDB, Valkey, ограничение по времени ожидания 30 секунд, us-east1). - Сессия 1 (Шаги 3 и 4) : Генерирует технический диалоговый шум и превышает
trigger_limit=3чтобы запустить скользящее сжатие сводки Valkey Summarize-Before-Trim . - Сессия 2 (Шаг 5 - Новый идентификатор сессии) : Запрашивает у агента данные из разных сессий для проверки возможности сохранения глобальных настроек И правил проекта в разных сессиях.
- Сессия 1 (Шаг 1) : Определяет универсальные настройки разработчика (
- Динамическая проверка эффективности и точности : измеряет точное количество символов/токенов в подсказке, процент уменьшения размера подсказки, задержку вывода, сводные данные Valkey, изоляцию области действия и политики безопасности выполнения инструмента.
Реализация и исходный код
Создайте тестовый скрипт test_memory_system.py в своей рабочей директории:
import os
import time
import logging
from google import genai
from db_clients import get_db_connection, get_valkey_client
from async_worker import AsyncMemoryWorker
from hybrid_retriever import retrieve_hybrid_entities
from agent_orchestrator import run_agent_turn
from enterprise_engine import AgentMemoryEngine
from valkey_buffer import get_session_context_buffer, IN_MEMORY_VALKEY_FALLBACK, get_valkey_compaction_tokens

logging.basicConfig(level=logging.WARNING)
logging.getLogger("google_genai").setLevel(logging.WARNING)
logging.getLogger("httpx").setLevel(logging.WARNING)

PROJECT_ID = os.getenv("PROJECT_ID")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")

db_conn = get_db_connection()
valkey_client = get_valkey_client()
client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)

async_worker = AsyncMemoryWorker(get_db_connection, client)
engine = AgentMemoryEngine(valkey_client, db_conn)

USER_ID = "user_dev_42"
SESSION_1 = "sess_2026_01"
SESSION_2 = "sess_2026_02"

test_accuracy = []

print("\n==================================================")
print("STARTING ENHANCED 2-TIER AGENT MEMORY VERIFICATION TEST")
print("==================================================")

# TURN 1: Universal Global Developer Preference Definition
print("\n[SESSION 1 - TURN 1: Global Preference Definition]")
prompt_1 = "Hi! As universal coding preferences across all my projects, I prefer Dark Mode UI and standardizing on Python 3.11 with PostgreSQL."
print(f"User Prompt:\n{prompt_1}")
resp_1, sys_prompt_1, latency_1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_1, project_id=None, trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_1[:140]}...")
time.sleep(2)

# TURN 2: Project-Specific Architecture Definition
print("\n[SESSION 1 - TURN 2: Project CloudRetail Architecture Definition]")
prompt_2 = (
    "Now I am starting project CloudRetail. Here are the specific project requirements:\n"
    "1. Backend Stack: Python with FastAPI on AlloyDB.\n"
    "2. Short-Term Cache: Memorystore for Valkey.\n"
    "3. Security Rules: All tool execution timeouts must be capped at 30 seconds.\n"
    f"4. Deployment Region: {REGION}."
)
print(f"User Prompt:\n{prompt_2}")
resp_2, sys_prompt_2, latency_2 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_2, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_2[:140]}...")
time.sleep(2)

# TURN 3: Context Inflation / Technical Dialogue Noise
print("\n[SESSION 1 - TURN 3: Large Context Inflation (Dialogue Noise)]")
prompt_3 = (
    "Let's draft a sample 50-line PostgreSQL DDL script for product catalog indexes, "
    "including HNSW vector index tuning parameters (m = 16, ef_construction = 64), "
    "and full-text RUM search indexes on item title and description columns."
)
print(f"User Prompt:\n{prompt_3}")
resp_3, sys_prompt_3, latency_3 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_3, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_3[:140]}...")
time.sleep(2)

# TURN 4: Triggering Valkey Summarize-Before-Trim Threshold (8 messages > 6 message trigger limit)
print("\n[SESSION 1 - TURN 4: Triggering Valkey Rolling Summary Compaction]")
prompt_4_s1 = "Can you also add rate-limiting middleware rules for API endpoints?"
print(f"User Prompt:\n{prompt_4_s1}")
resp_4_s1, sys_prompt_4_s1, latency_4_s1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_4_s1, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_4_s1[:140]}...")

# VERIFY VALKEY SHORT-TERM ROLLING SUMMARY
print("\n==================================================")
print("VALKEY SHORT-TERM ROLLING SUMMARY VERIFICATION")
print("==================================================")
buffer_data = get_session_context_buffer(valkey_client, SESSION_1)
valkey_summary_text = buffer_data["rolling_summary"]
valkey_turns = buffer_data["recent_turns"]

used_fallback = bool(IN_MEMORY_VALKEY_FALLBACK)
storage_backend = "Local In-Memory Fallback (Outside VPC)" if used_fallback else "Memorystore for Valkey (VPC Network)"

has_valkey_summary = bool(valkey_summary_text)
print(f" • Short-Term Cache Storage Target:             [{storage_backend}]")
print(f" • Valkey Rolling Summary Generated for Session 1: {has_valkey_summary}")
print(f"   Summary Content: {valkey_summary_text}")
print(f" • Remaining Raw Turns in Valkey Sliding Window:  {len(valkey_turns)} messages (Trimmed from 8)")

test_accuracy.append(("Valkey Rolling Summary Compaction Test", "PASS" if has_valkey_summary else "FAIL"))

# Wait for background entity extraction worker
print("\n[Waiting for background entity extraction worker to process & vectorize all extracted entities...]")
time.sleep(6)

print("\n==================================================")
print("EXTRACTED ENTITIES STORED IN ALLOYDB LONG-TERM MEMORY")
print("==================================================")
with db_conn.cursor() as cur:
    cur.execute(
        "SELECT entity_name, project_id, scope, summary, (summary_embedding IS NOT NULL) FROM agent_entities WHERE user_id = %s ORDER BY updated_at DESC;",
        (USER_ID,)
    )
    extracted = cur.fetchall()
    for name, p_id, s_scope, summary, has_vector in extracted:
        print(f" • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}' | Vector Generated: {has_vector}")
        print(f"   Summary: {summary}")

# TURN 5: Cross-Session Temporal & Scope Recall (Brand New Session ID)
print("\n[SESSION 2 - TURN 5 (Cross-Session Query in New Session ID)]")
prompt_4 = "What are my general coding preferences and the backend/timeout rules I chose for CloudRetail in my previous session?"
print(f"User Prompt:\n{prompt_4}")
resp_4, sys_prompt_4, latency_4 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_2, prompt_4, prev_session_id=SESSION_1, project_id="CloudRetail")
print(f"\nAI Answer:\n{resp_4}")

# VERIFICATION OF RETRIEVED ENTITIES (Checking Scope Precision)
retrieved_scoped_entities = retrieve_hybrid_entities(
    conn=db_conn,
    llm_client=client,
    user_id=USER_ID,
    active_session_id=SESSION_2,
    query_text=prompt_4,
    prev_session_id=SESSION_1,
    project_id="CloudRetail",
    k=20
)

print("\n==================================================")
print("DIAGNOSTIC SCOPE VERIFICATION DETAILS (EXPECTED vs ACTUAL)")
print("==================================================")
print("EXPECTED SPECIFIC ENTITIES & SCOPE:")
print("  1. Global Preference Entity: Retrieved entity with scope == 'global' containing preference facts ('dark mode', 'python 3.11', or 'postgres')")
print("  2. Project Architecture Entity: Retrieved entity with project_id == 'CloudRetail' containing tech stack facts ('fastapi', 'alloydb', 'valkey', or 'timeout')")
print(f"\nACTUAL RETRIEVED ENTITIES (Count: {len(retrieved_scoped_entities)}):")
if not retrieved_scoped_entities:
    print("  [NONE RETRIEVED! Vector/Fulltext search returned 0 matches]")
for ent_name, ent_info in retrieved_scoped_entities.items():
    print(f"  • Entity Name: '{ent_name}'")
    print(f"    - scope:      '{ent_info.get('scope')}'")
    print(f"    - project_id: '{ent_info.get('project_id')}'")
    print(f"    - summary:    '{ent_info.get('summary')}'")

print("\nDATABASE CHECK - ALL ROWS STORED IN agent_entities TABLE:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    db_rows = cur.fetchall()
    if not db_rows:
        print("  [DATABASE TABLE IS EMPTY! No entities were upserted by background worker]")
    for r in db_rows:
        print(f"  • DB Row: entity_name='{r[0]}' | project_id='{r[1]}' | scope='{r[2]}' | summary='{r[3]}'")

# SPECIFIC FACT & SCOPE VERIFICATION LOGIC
found_global_preference = False
matched_global_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("scope") == "global" and any(kw in combined_text for kw in ["dark mode", "python", "postgres"]):
        found_global_preference = True
        matched_global_entity = ent_name
        break

found_project_architecture = False
matched_project_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("project_id") == "CloudRetail" and any(kw in combined_text for kw in ["fastapi", "alloydb", "valkey", "timeout"]):
        found_project_architecture = True
        matched_project_entity = ent_name
        break

print("\n--------------------------------------------------")
print("METADATA SCOPE PRECISION VERIFICATION RESULTS:")
print(f" • Global Preference Fact Retrieved (scope='global'):        {found_global_preference} (Matched Entity: '{matched_global_entity}')")
print(f" • Project Architecture Fact Retrieved (project_id='CloudRetail'): {found_project_architecture} (Matched Entity: '{matched_project_entity}')")
print("--------------------------------------------------")

test_accuracy.append(("Global Coding Preference Recall Test (scope='global')", "PASS" if found_global_preference else "FAIL"))
test_accuracy.append(("Project CloudRetail Architecture Recall Test (project_id='CloudRetail')", "PASS" if found_project_architecture else "FAIL"))

# PERMISSION TEST
perm_action, reason = engine.evaluate_tool_permission(
    user_id=USER_ID, project_id="CloudRetail", session_id=SESSION_2,
    tool_name="run_command", tool_args={"CommandLine": "pytest --timeout=30"}
)
test_accuracy.append(("Tool Permission Policy Test", "PASS" if perm_action in ("allow", "PROMPT_USER") else "FAIL"))

# DYNAMIC TOKEN & LATENCY METRICS CALCULATION
active_prompt_chars_turn5 = len(sys_prompt_4)
active_tokens_turn5 = max(1, active_prompt_chars_turn5 // 4)

# Naive Un-compacted Full History Prompt Tokens for Turn 5
raw_history_chars = len(prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4)
naive_turn5_chars = raw_history_chars + 18000
naive_tokens_turn5 = naive_turn5_chars // 4

active_prompt_reduction_pct = ((naive_tokens_turn5 - active_tokens_turn5) / naive_tokens_turn5) * 100

# Cumulative Multi-Turn Tokens Comparison (Active Read-Path Prompts + Background Extraction & Compacting)
total_active_tokens = sum([
    len(p) // 4 for p in [sys_prompt_1, sys_prompt_2, sys_prompt_3, sys_prompt_4_s1, sys_prompt_4]
])
background_extraction_tokens = async_worker.total_extraction_tokens
background_valkey_summary_tokens = get_valkey_compaction_tokens()

total_tiered_system_tokens = total_active_tokens + background_extraction_tokens + background_valkey_summary_tokens

# Naive Cumulative Tokens across all 5 turns as full transcript grows continuously
naive_cumulative_tokens = sum([
    (len(p) + 18000) // 4 for p in [
        prompt_1,
        prompt_1 + resp_1 + prompt_2,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4
    ]
])

total_system_token_savings_pct = ((naive_cumulative_tokens - total_tiered_system_tokens) / naive_cumulative_tokens) * 100

# FINAL SUMMARY REPORT
print("\n==================================================")
print("FINAL AGENT MEMORY SYSTEM SUMMARY REPORT")
print("==================================================")

print("\n1. STORED ALLOYDB ENTITIES:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    for name, p_id, s_scope, summary in cur.fetchall():
        print(f"   • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}'")
        print(f"     Summary: {summary}")

print("\n2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:")
print(f"   • Naive Full-Context Turn 5 Tokens:    ~{naive_tokens_turn5:,} tokens ({naive_turn5_chars:,} chars)")
print(f"   • Tiered Memory Active Prompt Tokens:  ~{active_tokens_turn5:,} tokens ({active_prompt_chars_turn5:,} chars)")
print(f"   • Active Turn 5 Prompt Reduction:      {active_prompt_reduction_pct:.1f}% Reduction")
print(f"   • Measured Turn 5 Inference Latency:   {latency_4:.2f} seconds")

print("\n3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):")
print(f"   • Naive Cumulative Multi-Turn Tokens:  ~{naive_cumulative_tokens:,} tokens")
print(f"   • Active Read-Path Prompt Tokens:      ~{total_active_tokens:,} tokens (Across 5 Turns)")
print(f"   • Background Worker Tokens (Extraction):~{background_extraction_tokens:,} tokens (4 Background Turns)")
print(f"   • Background Compaction Tokens (Valkey):~{background_valkey_summary_tokens:,} tokens (1 Compaction Call)")
print(f"   • Total Tiered System Token Footprint: ~{total_tiered_system_tokens:,} tokens")
print(f"   • Overall System Token Savings:        {total_system_token_savings_pct:.1f}% Total Reduction")

print("\n4. ACCURACY & VERIFICATION TESTS:")
all_pass = True
for name, status in test_accuracy:
    print(f"   • {name}: [{status}]")
    if status != "PASS":
        all_pass = False

print("\n==================================================")
print(f"OVERALL STATUS: {'ALL TESTS PASSED ✔' if all_pass else 'VERIFICATION FAILED ✖'}")
print("==================================================")
Запустите скрипт проверки
Запустите скрипт в Cloud Shell:
python3 test_memory_system.py
Ожидаемый вывод в консоль
В конце тестирования будет выведено краткое изложение результатов. Ниже приведен пример такого вывода с пояснениями.
1. STORED ALLOYDB ENTITIES: <A List of all stored entities,>
   • Entity: '<name of entity>' | Project: '<which project does this relate to>' | Scope: '<global/project/session>'
     Summary: <The entity summary>
    ....

2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:
   • Naive Full-Context Turn 5 Tokens:    <Number of tokens in naive approach on the last turn>
   • Tiered Memory Active Prompt Tokens:  <Number of tokens in tiered approach on the last turn>
   • Active Turn 5 Prompt Reduction:      <Savings on tokens in %>
   • Measured Turn 5 Inference Latency:   <Latency in last turn>

3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):
   • Naive Cumulative Multi-Turn Tokens:  <Total tokens in the naive approach>
   • Active Read-Path Prompt Tokens:      <Read path tokens in the tiered approach>
   • Background Worker Tokens (Extraction): <Backround process tokens usage in tiered approach>
   • Background Compaction Tokens (Valkey): <Backround process tokens usage for compaction in tiered approach>
   • Total Tiered System Token Footprint: <Total tokens usage in tiered approach>
   • Overall System Token Savings:        <Savings on tokens in %>

4. ACCURACY & VERIFICATION TESTS:
   • Valkey Rolling Summary Compaction Test: <Did the roling summary work>
   • Global Coding Preference Recall Test (scope='global'): <Was it able to retrieve global scoped memories>
   • Project CloudRetail Architecture Recall Test (project_id='CloudRetail'): <Was it able to retrieve project specific scoped entities>
   • Tool Permission Policy Test: <Was it able to retrieve permissions policies>
Сброс сохраненных данных в памяти (необязательно)
Если вы хотите очистить всю сохраненную память и сбросить состояние Valkey и AlloyDB между запусками тестов, создайте и запустите cleanup_memory_system.py :
import logging
from db_clients import get_db_connection, get_valkey_client
from valkey_buffer import IN_MEMORY_VALKEY_FALLBACK

logging.basicConfig(level=logging.INFO)

def reset_memory_system():
    # 1. Flush short-term Valkey cache or clear local in-memory fallback
    try:
        valkey = get_valkey_client()
        valkey.flushdb()
        print("✔ Flushed Valkey short-term cache.")
    except Exception:
        IN_MEMORY_VALKEY_FALLBACK.clear()
        print("✔ Cleared local in-memory short-term fallback buffer.")

    # 2. Truncate long-term AlloyDB memory tables
    try:
        conn = get_db_connection()
        with conn:
            with conn.cursor() as cur:
                cur.execute("TRUNCATE TABLE agent_entities CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_embeddings CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_collections CASCADE;")
                cur.execute("TRUNCATE TABLE user_permissions CASCADE;")
                print("✔ Truncated AlloyDB long-term memory tables.")
        conn.close()
    except Exception as e:
        print(f"✖ AlloyDB cleanup error: {e}")

if __name__ == "__main__":
    reset_memory_system()
Запустите скрипт очистки:
python3 cleanup_memory_system.py
14. Расширение возможностей многоуровневой памяти для Google ADK
На предыдущих этапах вы создали двухуровневую систему памяти:
- Уровень 1 (кратковременный буфер) : Memorystore для Valkey хранит последние реплики в разговоре и создает сводные данные, чтобы запросы оставались короткими.
- Уровень 2 (долгосрочное гибридное хранилище) : AlloyDB AI хранит устойчивые пользовательские предпочтения, правила проекта и векторные представления с помощью гибридного поиска.
В этом руководстве вы подключите этот механизм обработки данных к пользовательскому агенту, созданному с помощью комплекта разработки Google Agent Development Kit .
Проблема простой памяти
Подключение агента к памяти обычно приводит к одной из двух ловушек:
- Ловушка использования только инструментов : принуждение агента к вызову инструментов (например,
search_memory) для всего. Агенты часто забывают вызывать инструменты для основных настроек (например, стиля кодирования или тайм-аутов), что приводит к ошибкам и дополнительным медленным запросам данных. - Ловушка «напичкания подсказками» : включение всей прошлой истории в каждую подсказку. Это быстро увеличивает стоимость токенов, замедляет ответы и ухудшает качество рассуждений модели.
Гибридное решение
Мы используем гибридный подход, который предоставляет агенту необходимую память в нужное время:
- Контекст окружающей среды (автоматически) : Перед каждым ходом соответствующие правила проекта и сводки последних сессий извлекаются из Memorystore (скользящая сводка) и AlloyDB (правила и настройки), которые затем внедряются в командную строку агента без каких-либо дополнительных вызовов LLM .
- Поиск в долгосрочной памяти по запросу (инструмент) : для более старых или малоизвестных фактов (например, архитектурного решения, принятого две недели назад) агент вызывает
long_term_memory_toolдля выполнения векторного поиска в таблице долговременной памяти AlloyDB. - Контроль выполнения : Перед запуском инструмента агент проверяет права на одноразовое использование в Valkey и правила безопасности в AlloyDB, чтобы заблокировать опасные действия, такие как
rm -rf.
Настройка и конфигурация
Установите пакет google-adk (остальные зависимости уже установлены):
pip3 install google-adk
Настройте регион Google Cloud для клиента ADK GenAI, чтобы маршрутизация осуществлялась через Vertex AI:
# ADK agent platform backend
export GEMINI_MODEL="gemini-3.5-flash"
export GOOGLE_GENAI_USE_VERTEXAI="true"
export GOOGLE_CLOUD_PROJECT="${PROJECT_ID}"
export GOOGLE_CLOUD_LOCATION="${GENAI_LOCATION}"
15. Поставщик внешней памяти
Создайте adk_memory_provider.py . Этот класс обрабатывает автоматический жизненный цикл памяти:
- Перед началом хода : Извлекает буфер диалога Valkey (<1 мс) и запрашивает у AlloyDB соответствующие предпочтения и правила проекта, объединяя их в системную подсказку.
- После завершения хода диалога : добавляет диалог в Valkey и запускает фоновый процесс для извлечения достоверных данных в AlloyDB без замедления реакции пользователя.
import logging
from typing import Any, Dict, Optional
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

class ADKTieredMemoryProvider:
    """Provides ambient memory context before turns and saves history after turns."""

    def __init__(self, db_conn_factory, valkey_client: redis.Redis, genai_client: Any, trigger_limit: int = 10, window_size: int = 4):
        self.conn_factory = db_conn_factory
        self.valkey_client = valkey_client
        self.genai_client = genai_client
        self.trigger_limit = trigger_limit
        self.window_size = window_size
        self.async_worker = AsyncMemoryWorker(db_conn_factory, genai_client)

    def get_context_for_turn(self, user_id: str, project_id: Optional[str], session_id: str, user_query: str, prev_session_id: Optional[str] = None) -> Dict[str, Any]:
        """Reads Valkey buffer (<1ms) and AlloyDB hybrid entities before agent reasoning."""
        buffer_data = get_session_context_buffer(self.valkey_client, session_id)
        rolling_summary = buffer_data["rolling_summary"]

        # Carry over prior session summary when starting a fresh session
        if not rolling_summary and prev_session_id:
            prev_buffer = get_session_context_buffer(self.valkey_client, prev_session_id)
            if prev_buffer["rolling_summary"]:
                rolling_summary = f"[From prior session {prev_session_id}]:\n" + prev_buffer["rolling_summary"]

        conn = self.conn_factory()
        try:
            entities = retrieve_hybrid_entities(
                conn=conn, llm_client=self.genai_client, user_id=user_id,
                active_session_id=session_id, query_text=user_query,
                prev_session_id=prev_session_id, project_id=project_id, k=20
            )
        finally:
            conn.close()

        return {
            "rolling_summary": rolling_summary,
            "recent_turns": buffer_data["recent_turns"],
            "retrieved_entities": entities
        }

    def format_system_instruction(self, context: Dict[str, Any], base_prompt: str = "") -> str:
        """Injects ambient entities and short-term summaries into the agent's prompt."""
        entity_lines = [f"- {name}: {info['summary']}" for name, info in context["retrieved_entities"].items()]
        entity_str = "\n".join(entity_lines) if entity_lines else "No relevant long-term entities."
        summary_str = context["rolling_summary"] or "No prior summary."

        return f"""{base_prompt}

[LONG-TERM PREFERENCES & ENTITIES]
{entity_str}

[SHORT-TERM ROLLING SUMMARY]
{summary_str}

[NOTE ON TOOLS & MEMORY]
Memory persistence is managed automatically by the platform behind the scenes. Do not attempt to invoke non-existent tools like 'set_preference' or 'save_fact'. Only invoke explicitly declared tools when needed.
""".strip()

    def record_turn_async(self, user_id: str, project_id: Optional[str], session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None) -> None:
        """Updates Valkey sliding window and triggers background AlloyDB extraction."""
        append_session_turn_with_rolling_summary(
            valkey_client=self.valkey_client, llm_client=self.genai_client,
            session_id=session_id, user_msg=user_msg, ai_msg=ai_msg,
            trigger_limit=self.trigger_limit, window_size=self.window_size
        )
        self.async_worker.enqueue_extraction(
            user_id=user_id, session_id=session_id, user_msg=user_msg,
            ai_msg=ai_msg, prev_session_id=prev_session_id
        )
16. Инструмент для долговременной памяти по запросу
Благодаря использованию общей памяти активный запрос остается небольшим, но агенту иногда необходимо просматривать старые исторические записи, архитектурные решения или журналы инцидентов.
Создайте adk_memory_tools.py . Он преобразует векторную таблицу episodic_memory_embeddings из AlloyDB в инструмент ADK FunctionTool :
from typing import Any, Dict, List, Optional
from google.adk.tools import FunctionTool

def make_long_term_memory_tool(db_conn_factory, embed_client: Any, user_id: str) -> FunctionTool:
    """Creates an ADK FunctionTool for vector search over AlloyDB historical records."""

    def search_archived_memory(query: str, project_id: Optional[str] = None, limit: int = 3) -> List[Dict[str, Any]]:
        """Searches past architecture decisions, historical notes, and old discussions."""
        # 1. Embed query with text-embedding-005
        emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=query)
        query_vector = emb_resp.embeddings[0].values

        # 2. Cosine distance search on AlloyDB HNSW vector index
        sql = """
            SELECT document, cmetadata, created_at, 1 - (embedding <=> %s::vector) AS similarity
            FROM episodic_memory_embeddings
            WHERE cmetadata->>'user_id' = %s
              AND (%s IS NULL OR cmetadata->>'project_id' = %s)
            ORDER BY embedding <=> %s::vector ASC
            LIMIT %s;
        """
        conn = db_conn_factory()
        results = []
        try:
            with conn.cursor() as cur:
                cur.execute(sql, (str(query_vector), user_id, project_id, project_id, str(query_vector), limit))
                for doc, meta, created_at, similarity in cur.fetchall():
                    results.append({
                        "document": doc,
                        "metadata": meta,
                        "timestamp": created_at.isoformat() if created_at else None,
                        "similarity": round(float(similarity), 4)
                    })
        finally:
            conn.close()
        return results

    return FunctionTool(search_archived_memory)
17. Ограничения доступа на уровне предприятия
Автономные агенты не должны выполнять деструктивные действия на хосте (например, rm -rf или удаление таблиц) без проверки.
Как работает функция before_tool_callback в ADK
ADK предоставляет механизм перехвата, который запускается до выполнения любого инструмента:
- Возвращает
None: ADK разрешает выполнение инструмента. - Возвращает словарь (например
{"status": "DENIED", "error": ...}): ADK немедленно прерывает выполнение . Никакая команда не выполняется, и причина отказа возвращается в модель, чтобы она могла объяснить ограничение пользователю.
Порядок проверки разрешений
- Проверка 0 (Разрешение на использование безопасных инструментов) : Безопасные инструменты только для чтения, такие как
search_archived_memoryпредварительно одобрены в памяти, поэтому агент всегда может запрашивать данные из собственной памяти. - Уровень 1 (временные разрешения «разрешить один раз» в Valkey) : Когда оператор одобряет рискованное действие, в Valkey сохраняется временный ключ
one_time_perm:{session_id}:{cmd_hash}со временем жизни 5 минут. Система защиты считывает и удаляет ключ за одну атомарную операцию . Это позволяет выполнить команду один раз, предотвращая необратимое повышение привилегий. - Уровень 2 (Правила проекта в AlloyDB) : Проверяет правила регулярных выражений в
user_permissionsдля активного проекта (например, allowpytest.*--timeout=30, blockrm -rf.*). - Уровень 3 (глобальные правила в AlloyDB) : проверяет резервные правила, применяемые ко всем проектам.
- Резервный вариант с закрытием ошибки : если ни одно правило не соответствует условию, выполнение отклоняется с
PENDING, требующей проверки человеком.
Выполнение
Создайте adk_guardrails.py :
import logging
from typing import Any, Dict, Optional, Tuple, Set
from enterprise_engine import AgentMemoryEngine

logger = logging.getLogger(__name__)

class ADKPermissionGuardrail:
    """Evaluates tool permissions using Valkey allow-once tokens and AlloyDB rules."""

    def __init__(self, memory_engine: AgentMemoryEngine, exempt_tools: Optional[Set[str]] = None):
        self.engine = memory_engine
        self.exempt_tools = exempt_tools or {"search_archived_memory"}

    def evaluate(self, user_id: str, project_id: str, session_id: str, tool_name: str, tool_args: Dict[str, Any]) -> Tuple[bool, str]:
        # 1. Allowlist safe internal tools
        if tool_name in self.exempt_tools:
            return True, f"Internal tool '{tool_name}' is pre-approved."

        # 2. Check 3-tier policy engine
        action, reason = self.engine.evaluate_tool_permission(
            user_id=user_id, project_id=project_id, session_id=session_id,
            tool_name=tool_name, tool_args=tool_args
        )
        if action.upper() == "ALLOW":
            return True, f"Permission ALLOWED: {reason}"
        elif action.upper() == "BLOCK":
            return False, f"Permission BLOCKED: {reason}"
        return False, f"Permission PENDING: {reason} (requires human confirmation)"

    def create_before_tool_callback(self, user_id: str, default_project_id: str = "global"):
        """Creates the callback hook for Agent(before_tool_callback=...)."""
        def before_tool_callback(tool: Any, args: Dict[str, Any], tool_context: Any) -> Optional[Dict[str, Any]]:
            tool_name = getattr(tool, "name", str(tool))
            session_id = getattr(getattr(tool_context, "session", None), "id", "default_session")

            allowed, msg = self.evaluate(user_id, default_project_id, session_id, tool_name, args)
            if not allowed:
                logger.warning("Guardrail blocked '%s': %s", tool_name, msg)
                return {"status": "DENIED", "tool": tool_name, "error": msg}

            return None  # Returning None permits execution in ADK
        return before_tool_callback
18. Запуск теста агента ADK
Создайте файл test_adk_agent.py . Этот полный скрипт объединяет компоненты, инициализирует архивные правила принятия решений и безопасности, запускает двухсессионный диалог, тестирует сжатие и восстановление памяти, а также проверяет соблюдение защитных механизмов:
import asyncio
import os
import time
from google import genai
from google.genai import types
from google.adk.agents import Agent
from google.adk.runners import Runner
from google.adk.sessions import InMemorySessionService
from google.adk.tools import FunctionTool

from db_clients import get_db_connection, get_valkey_client
from enterprise_engine import AgentMemoryEngine
from adk_memory_provider import ADKTieredMemoryProvider
from adk_memory_tools import make_long_term_memory_tool
from adk_guardrails import ADKPermissionGuardrail
from valkey_buffer import get_session_context_buffer

# Configuration & clients
PROJECT_ID = os.getenv("PROJECT_ID", "chunking-poc-alloydb")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")
GEMINI_MODEL = os.getenv("GEMINI_MODEL", "gemini-3.5-flash")
USER_ID, SESSION_1, SESSION_2 = "user_adk_dev", "sess_adk_001", "sess_adk_002"

db_conn = get_db_connection()
valkey_client = get_valkey_client()
# LLM client for Gemini 3.5 Flash via global multi-region
genai_client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)
# Embeddings client (requires specific regional presence)
embed_client = genai.Client(vertexai=True, project=PROJECT_ID, location=REGION)

tiered_provider = ADKTieredMemoryProvider(get_db_connection, valkey_client, genai_client, trigger_limit=3, window_size=2)
memory_engine = AgentMemoryEngine(valkey_client, db_conn)
guardrail = ADKPermissionGuardrail(memory_engine)

# Tools: Long-term memory search and mock terminal command
long_term_memory_tool = make_long_term_memory_tool(get_db_connection, embed_client, USER_ID)

def run_command(CommandLine: str) -> str:
    """Executes a shell command on the host."""
    return f"Executed: {CommandLine}"

run_command_tool = FunctionTool(run_command)

def seed_database():
    """Seeds a 14-day-old architecture decision and permission rules."""
    doc = "Archived Decision: CloudRetail services must use gRPC keepalive ping intervals of 15 seconds."
    emb = embed_client.models.embed_content(model="text-embedding-005", contents=doc).embeddings[0].values
    conn = get_db_connection()
    try:
        with conn.cursor() as cur:
            cur.execute("""
                INSERT INTO episodic_memory_embeddings (uuid, document, cmetadata, created_at, embedding)
                VALUES (gen_random_uuid(), %s, jsonb_build_object('user_id', %s, 'project_id', 'CloudRetail'), NOW() - INTERVAL '14 days', %s::vector);
            """, (doc, USER_ID, str(emb)))
            cur.execute("""
                INSERT INTO user_permissions (user_id, project_id, tool_name, command_pattern, action)
                VALUES (%s, 'CloudRetail', 'run_command', 'pytest.*--timeout=30', 'ALLOW'),
                       (%s, 'CloudRetail', 'run_command', 'rm -rf.*', 'BLOCK'),
                       (%s, 'global', 'search_archived_memory', '.*', 'ALLOW')
                ON CONFLICT DO NOTHING;
            """, (USER_ID, USER_ID, USER_ID))
        conn.commit()
    finally:
        conn.close()

async def run_turn(runner: Runner, session_id: str, query: str, prev_session_id: str = None) -> str:
    """Fetches ambient memory, executes turn, and saves history in the background."""
    ctx = tiered_provider.get_context_for_turn(USER_ID, "CloudRetail", session_id, query, prev_session_id)
    runner.agent.instruction = tiered_provider.format_system_instruction(
        ctx,
        base_prompt="You are an intelligent Google ADK enterprise developer assistant."
    )
    msg = types.Content(role="user", parts=[types.Part.from_text(text=query)])
    parts = []
    async for event in runner.run_async(user_id=USER_ID, session_id=session_id, new_message=msg):
        if event.content and event.content.parts:
            parts.extend([p.text for p in event.content.parts if p.text])

    response = "".join(parts).strip()
    tiered_provider.record_turn_async(USER_ID, "CloudRetail", session_id, query, response, prev_session_id)
    return response

async def main():
    seed_database()
    sessions = InMemorySessionService()
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_1)

    agent = Agent(
        name="adk_memory_agent", model=GEMINI_MODEL, instruction="Initial instruction",
        tools=[long_term_memory_tool, run_command_tool],
        before_tool_callback=guardrail.create_before_tool_callback(USER_ID, "CloudRetail")
    )
    runner = Runner(agent=agent, session_service=sessions, app_name="agents")

    print("\n--- Session 1: Storing Preferences & Triggering Compaction ---")
    await run_turn(runner, SESSION_1, "I standardize on Python 3.11 with PostgreSQL and Dark Mode UI.")
    await run_turn(runner, SESSION_1, "For project CloudRetail, our backend stack is FastAPI on AlloyDB with Valkey cache and 30s timeouts.")
    await run_turn(runner, SESSION_1, "Draft a quick 5-line SQL table for products.")
    await run_turn(runner, SESSION_1, "Add rate-limiting rules for API endpoints.")

    buf = get_session_context_buffer(valkey_client, SESSION_1)
    print(f"Valkey rolling summary generated: {bool(buf['rolling_summary'])}")
    print(f"Turns in buffer: {len(buf['recent_turns'])} (compacted from 8)")

    print("\nWaiting 6s for background worker entity extraction into AlloyDB...")
    await asyncio.sleep(6)

    print("\n--- Session 2: Cold-Start Ambient Recall ---")
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_2)
    resp = await run_turn(runner, SESSION_2, "What are my coding preferences and the CloudRetail stack from my previous session?", prev_session_id=SESSION_1)
    print(f"Agent response:\n{resp}\n")

    print("\n--- On-Demand Archival Vector Search ---")
    resp_search = await run_turn(runner, SESSION_2, "What was the agreed gRPC keepalive interval from 2 weeks ago?")
    print(f"Agent response:\n{resp_search}\n")

    print("\n--- Guardrail Verification ---")
    blocked, b_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "rm -rf /tmp/data"})
    allowed, a_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "pytest --timeout=30"})
    print(f"rm -rf /tmp/data:    Allowed={blocked} ({b_msg})")
    print(f"pytest --timeout=30: Allowed={allowed} ({a_msg})")

if __name__ == "__main__":
    asyncio.run(main())
Итеративная очистка тестирования
Поскольку система сохраняет постоянный контекст, многократный запуск теста приведет к бесконечному добавлению фрагментов диалога в Valkey и вставке повторяющихся правил в AlloyDB.
Чтобы легко сбросить состояние между запусками, запустите скрипт cleanup_memory_system.py , созданный на предыдущем шаге:
python3 cleanup_memory_system.py
python3 test_adk_agent.py
Результаты проверки
Тест проверяет четыре критически важных производственных процесса:
- Значительное сокращение количества токенов подсказок : функция сжатия Valkey сжала историю диалогов в краткое, постоянно обновляемое резюме. В наших тестах это уменьшило размер активных подсказок более чем на 92% (с ~6956 токенов до ~544 токенов) — ваши результаты могут отличаться.
- Мгновенное восстановление после холодного запуска : В совершенно новой сессии (сессия 2) агент немедленно восстановил пользовательские настройки (Python 3.11, PostgreSQL, темный режим) и архитектуру проекта (FastAPI, таймауты 30 секунд) без вызова каких-либо инструментов. Это стало возможным благодаря
ADKTieredMemoryProvider.get_context_for_turn, который извлекает контекст из Memorystore и AlloyDB перед вызовом LLM. - Функция восстановления вектора по запросу : при запросе решения 14-дневной давности агент активировал
search_archived_memoryи получил правило gRPC keepalive с интервалом в 15 секунд. - Детерминированная безопасность : агент выполнил
pytest --timeout=30, но ему было строго запрещено запускатьrm -rf /tmp/data.
19. Уборка
Чтобы избежать постоянного списания средств с вашего аккаунта Google Cloud за экземпляры AlloyDB и Memorystore, удалите созданные ресурсы.
Выполните следующие команды в Cloud Shell:
# Exit VM and return to Cloud Shell
exit
# Delete Compute Engine development VM
gcloud compute instances delete $VM_NAME \
  --zone=$ZONE \
  --quiet

# Delete AlloyDB primary instance and cluster
gcloud alloydb instances delete $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --quiet

gcloud alloydb clusters delete $ADBCLUSTER \
  --region=$REGION \
  --quiet

# Delete Memorystore for Valkey instance
gcloud memorystore instances delete $VALKEYINSTANCE \
  --location=$REGION \
  --quiet
20. Поздравляем!
Поздравляем! Вы успешно создали двухуровневую архитектуру памяти для долговременного хранения данных ИИ-агента, объединив Memorystore для Valkey и AlloyDB AI.
Что вы узнали
- Реализована двухуровневая архитектура памяти, разделяющая кратковременное состояние активной сессии и долговременные постоянные данные.
- Достигнуто значительное сокращение размера активных подсказок и экономия общего объема используемых токенов по сравнению с простым заполнением контекста, без потери точности.
- Настроены транзакционные автоматические встраивания на уровне базы данных AlloyDB AI (
ai.initialize_embeddings). - Выполнен гибридный поиск с использованием алгоритма взаимного ранжирования (
ai.hybrid_search), сочетающий векторное сходство (<=>) с полнотекстовым поиском PostgreSQL (tsvector). - Разработаны внепотоковый фоновый механизм извлечения сущностей (
AsyncMemoryWorker), трехзвенный инструмент оценки разрешений на выполнение и механизм сжатия памяти базы данных. - Применили многоуровневую систему памяти к автономному агенту с помощью Google Agent Development Kit (ADK) для обеспечения ограничений доступа к инструментам и предоставления общей памяти.
Дальнейшие шаги и ссылки
- Ознакомьтесь с документацией AlloyDB AI .
- Узнайте, как выполнить гибридный векторный поиск в AlloyDB .
- Узнайте больше о Memorystore для Valkey .