

1. ก่อนเริ่มต้น
ในขณะที่ AI Agent จัดการการโต้ตอบแบบหลายรอบที่ยาวนานซึ่งกินเวลาหลายวันและดำเนินการงานแบบหลายขั้นตอนในระยะยาว โมเดลภาษาขนาดใหญ่ (LLM) จะยังคงไม่มีสถานะโดยธรรมชาติในเซสชันต่างๆ เมื่อผู้ใช้กลับมาคุยกับตัวแทนในวันพรุ่งนี้ โมเดลจะเริ่มต้นใหม่ทั้งหมด เว้นแต่แอปพลิเคชันจะสร้างบริบทที่จำเป็นขึ้นมาใหม่ได้
แนวทางที่ง่ายที่สุดในการแก้ปัญหานี้คือการยัดโทเค็น ซึ่งเป็นการต่อท้ายประวัติการสนทนาทั้งหมด บันทึกการดำเนินการเครื่องมือ และโค้ดเบสโดยตรงกับทุกพรอมต์ที่ใช้งานอยู่ แม้ว่าหน้าต่างบริบทขนาดใหญ่หลายล้านโทเค็นจะทำให้การดำเนินการนี้เป็นไปได้ในทางเทคนิค แต่การยัดบริบททำให้เกิดภาระในการดำเนินการอย่างมาก กล่าวคือ ต้นทุนโทเค็นจะเพิ่มขึ้นแบบยกกำลังสองในทุกๆ รอบ เวลาในการตอบสนองจะเพิ่มขึ้นเป็นหลายสิบวินาที และโมเดลจะประสบปัญหาบริบท "หลงทาง"
หากต้องการสร้าง AI Agent ที่เชื่อถือได้ คุณต้องมีสถาปัตยกรรมหน่วยความจำ 2 ระดับ ดังนี้
- บัฟเฟอร์เซสชันระยะสั้น: แคชการสนทนาล่าสุดในหน่วยความจำที่ใช้งานอยู่โดยใช้หน้าต่างเลื่อนที่จำกัดโทเค็น ระดับนี้ต้องมีการค้นหาในหน่วยความจำที่มีปริมาณงานสูงและใช้เวลาไม่ถึงมิลลิวินาทีในทุกๆ เทิร์น Memorystore สำหรับ Valkey จึงเป็นตัวเลือกที่เหมาะสมที่สุด
- หน่วยความจำถาวรระยะยาว: จัดเก็บเอนทิตีที่มีโครงสร้าง ค่ากําหนดของผู้ใช้ และข้อเท็จจริงแบบเป็นตอนในเซสชันต่างๆ ระดับนี้ต้องมีข้อมูลที่สอดคล้องกันในธุรกรรม ความปลอดภัยแบบหลายผู้เช่า และการดึงข้อมูลแบบไฮบริดในข้อมูลเชิงสัมพันธ์และเวกเตอร์ ซึ่งทำให้ AlloyDB สำหรับ PostgreSQL เป็นตัวเลือกที่เหมาะสม
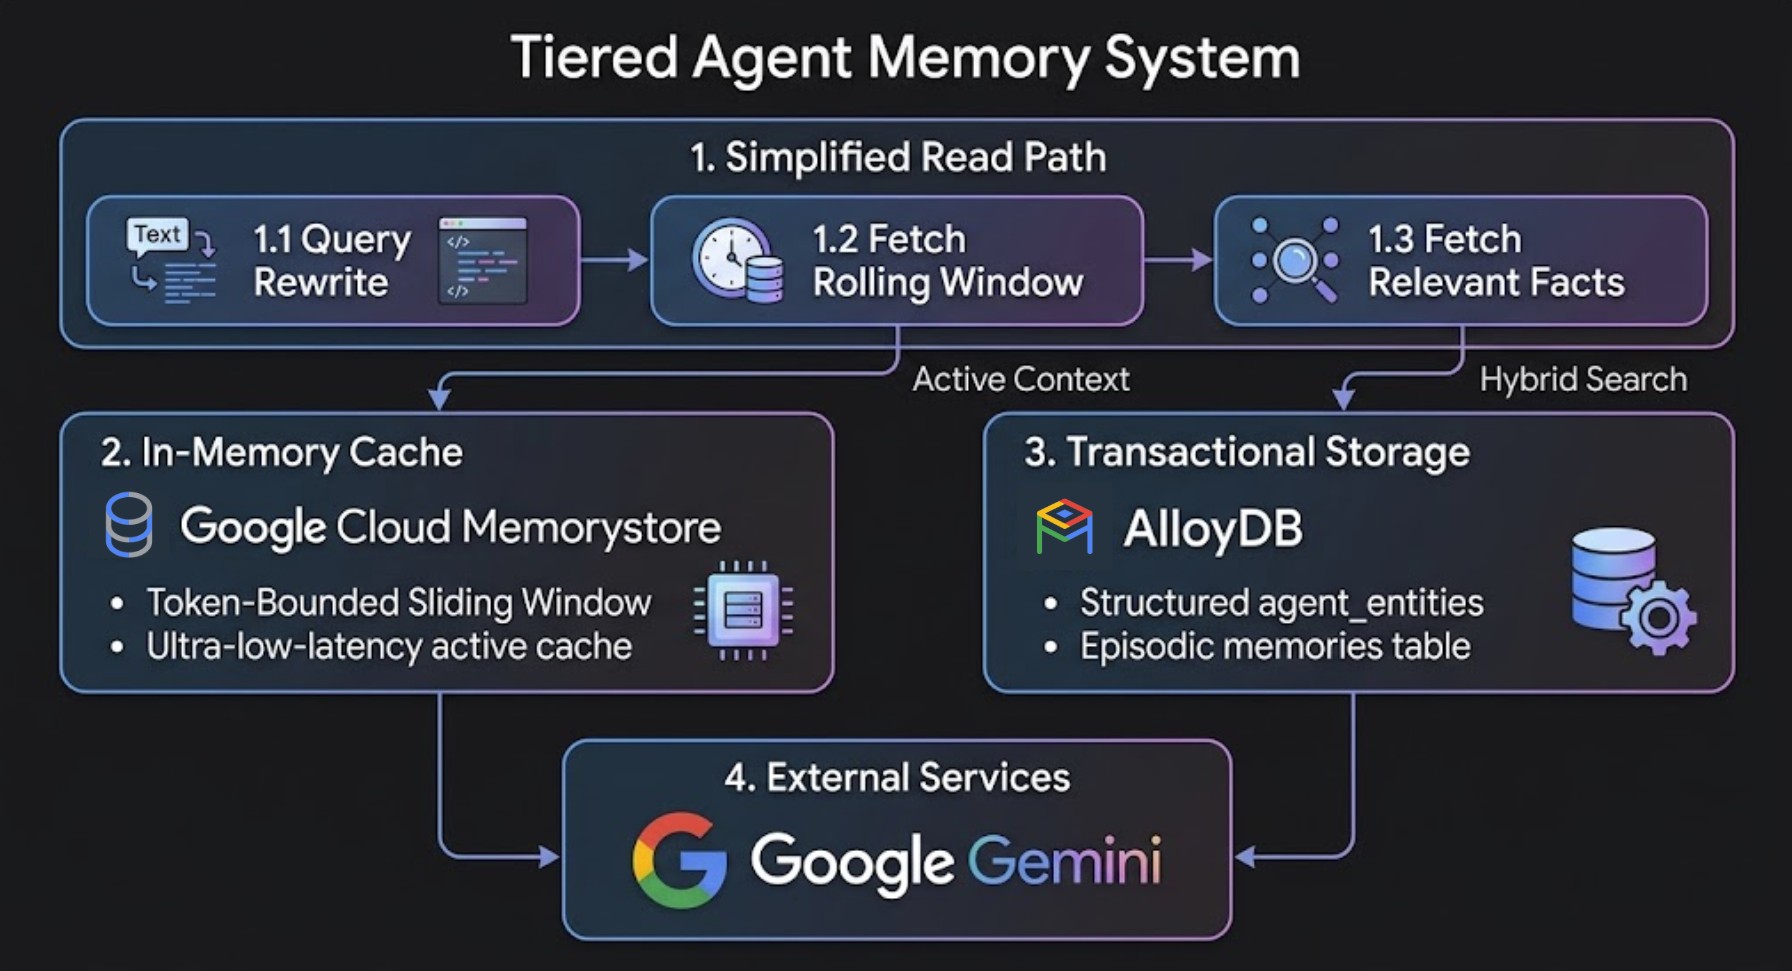
ทำความเข้าใจความทรงจำ 4 ประเภท
สถาปัตยกรรมหน่วยความจำที่มีประสิทธิภาพขึ้นอยู่กับหน่วยความจำ 4 ประเภทที่เสริมกันตลอดเส้นทางของผู้ใช้ ดังนี้
ประเภทหน่วยความจำ | สิ่งที่จัดเก็บ | เลเยอร์พื้นที่เก็บข้อมูล | อายุขัย |
บัฟเฟอร์ (ระยะสั้น) | การสนทนาดิบล่าสุด | Memorystore for Valkey | เซสชันที่ใช้งานอยู่ |
หน่วยความจำสรุป | ประวัติการสนทนาที่บีบอัดของรอบการสนทนาที่เก่ากว่า | Memorystore for Valkey | กรอบเวลาการสนทนาไปมา |
ความทรงจำเกี่ยวกับเหตุการณ์ | การกระทำ เหตุการณ์ และเอาต์พุตของเครื่องมือที่ผ่านมา | AlloyDB สำหรับ PostgreSQL (Vector) | ถาวร |
หน่วยความจำของเอนทิตีและกฎ | ค่ากำหนด ข้อจำกัด และการคัดค้านของผู้ใช้ | AlloyDB สำหรับ PostgreSQL (SQL ที่มีโครงสร้าง + เวกเตอร์) | ถาวร |
ผลลัพธ์ที่วัดได้ของหน่วยความจำแบบแบ่งชั้น
การทดสอบเปรียบเทียบภายในในการสนทนาเพื่อการพัฒนาแบบหลายรอบ (45 รอบขึ้นไปพร้อมบันทึกเอาต์พุตเครื่องมือจำนวนมาก) แสดงให้เห็นว่าการประหยัดค่าใช้จ่ายอย่างมากเมื่อเทียบกับการป้อนบริบทแบบง่ายๆ
เมตริก / มิติข้อมูล | การยัดบริบทแบบง่ายๆ | หน่วยความจำแบบแบ่งชั้น (AlloyDB + Memorystore) | ผลกระทบสุทธิในการทดสอบ |
ขนาดพรอมต์ที่ใช้งานอยู่ (เทิร์น 45) | 747,033 โทเค็น | 83,262 โทเค็น | พรอมต์มีขนาดเล็กลง 88.9% |
เวลาในการตอบสนองของโมเดล | 33.5 วินาที | 6.7 วินาที | ตอบสนองเร็วขึ้น 80.0% |
โทเค็นเซสชันสะสม | 17.9 ล้านโทเค็น | 4.09 ล้านโทเค็น | ประหยัดโทเค็นและค่าใช้จ่ายโดยรวมได้ 72.0% |
การเรียกคืนกฎและข้อจำกัด | เสื่อมสภาพเมื่อผ่านไปหลายรอบ | ป้องกันไม่ให้ความรู้ที่สำคัญสูญหายไปในข้อมูลสรุป | เก็บรักษาผ่านการค้นหาแบบไฮบริด |
สิ่งที่คุณต้องทำ
- จัดสรร AlloyDB สำหรับ PostgreSQL และ Memorystore สำหรับ Valkey
- เปิดใช้
google_ml_integrationและกำหนดค่าการฝังอัตโนมัติแบบธุรกรรมฝั่งฐานข้อมูล (ai.initialize_embeddings) - ใช้บัฟเฟอร์เซสชัน Valkey ระยะสั้นด้วยรูปแบบไปป์ไลน์สรุปก่อนตัด
- แยกเอนทิตีระยะยาวโดยใช้ฟังก์ชัน AI เนทีฟของ AlloyDB (เช่น
ai.generate) - ค้นหาข้อเท็จจริงระยะยาวที่มีความแม่นยำและความเกี่ยวข้องสูงโดยใช้ฟังก์ชัน Hybrid Search ดั้งเดิมของ AlloyDB (
ai.hybrid_search) และการจัดอันดับใหม่ด้วย Reciprocal Rank Fusion (RRF) - สร้างเครื่องมือประเมินสิทธิ์ระดับองค์กรแบบ 3 ชั้นและเครื่องมือลดขนาดหน่วยความจำในเบื้องหลัง
- ผสานรวมสถาปัตยกรรมหน่วยความจำ 2 ระดับเข้ากับ Agent แบบอัตโนมัติโดยตรงโดยใช้ Google Agent Development Kit (ADK)
สิ่งที่คุณต้องมี
- โปรเจ็กต์ Google Cloud ที่เปิดใช้การเรียกเก็บเงิน
- เว็บเบราว์เซอร์ เช่น Chrome
- มีความรู้พื้นฐานเกี่ยวกับ Python และ SQL รวมถึงมีประสบการณ์ในการเรียกใช้การค้นหา SQL กับ AlloyDB จาก Studio, CLI ฯลฯ
กลุ่มเป้าหมายและต้นทุน
- กลุ่มเป้าหมาย: นักพัฒนา AI, วิศวกรแบ็กเอนด์ และสถาปนิกฐานข้อมูล
- ค่าใช้จ่ายโดยประมาณ: ทรัพยากร Google Cloud ที่สร้างขึ้นใน Codelab นี้จะมีค่าใช้จ่ายประมาณ $1.50 USD
2. การตั้งค่าและข้อกำหนด
เริ่มต้น Cloud Shell
ใน Codelab นี้ คุณจะเรียกใช้คำสั่งใน Google Cloud Shell ซึ่งเป็นเทอร์มินัลที่โฮสต์ในระบบคลาวด์ซึ่งกำหนดค่าไว้ล่วงหน้าด้วย gcloud, psql และ python3
- เปิด คอนโซล Google Cloud
- คลิกเปิดใช้งาน Cloud Shell ที่ด้านขวาบนของ Cloud Console
- ยืนยันการตรวจสอบสิทธิ์
gcloud auth list
export PROJECT_ID=<YOUR_PROJECT_ID>
gcloud config set project $PROJECT_ID

export REGION=us-east1
export GENAI_LOCATION=us
export ZONE=us-east1-b
export ADBCLUSTER=agent-memory-cluster
export ADBINSTANCE=agent-memory-instance
export VALKEYINSTANCE=agent-memory-cache
export VM_NAME=agent-dev-vm
เปิดใช้ Google Cloud APIs และสร้าง VM สำหรับการพัฒนา
เรียกใช้คำสั่งต่อไปนี้ใน Cloud Shell เพื่อเปิดใช้ API ที่จำเป็น
gcloud services enable \
  alloydb.googleapis.com \
  memorystore.googleapis.com \
  aiplatform.googleapis.com \
  compute.googleapis.com \
  servicenetworking.googleapis.com \
  networkconnectivity.googleapis.com
สร้างอินสแตนซ์ VM ของ Compute Engine ในdefaultเครือข่าย VPC เพื่อโฮสต์สภาพแวดล้อมในการพัฒนาซอฟต์แวร์ Python ควบคู่กับ AlloyDB และ Memorystore สำหรับ Valkey โดยทำดังนี้
gcloud compute instances create $VM_NAME \
    --zone=$ZONE \
    --machine-type=e2-standard-2 \
    --scopes=cloud-platform \
    --network=default \
    --shielded-secure-boot
3. จัดสรร AlloyDB และ Memorystore for Valkey
ในขั้นตอนนี้ คุณจะจัดสรรคลัสเตอร์และอินสแตนซ์หลักของ AlloyDB for PostgreSQL สร้างเครือข่ายบริการส่วนตัว และเปิดใช้อินสแตนซ์ Memorystore for Valkey
สร้างช่วง IP ของการเข้าถึงบริการส่วนตัว
AlloyDB ต้องมีช่วง IP ส่วนตัวในเครือข่าย Virtual Private Cloud (VPC) หากคุณใช้defaultเครือข่าย VPC ให้ทำดังนี้
- สร้างการจัดสรรช่วง IP ส่วนตัว
gcloud compute addresses create psa-range \
    --global \
    --purpose=VPC_PEERING \
    --prefix-length=24 \
    --description="VPC private service access" \
    --network=default
- สร้างการเชื่อมต่อ VPC Peering ส่วนตัว
gcloud services vpc-peerings connect \
    --service=servicenetworking.googleapis.com \
    --ranges=psa-range \
    --network=default
สร้างคลัสเตอร์และอินสแตนซ์หลักของ AlloyDB
- สร้างรหัสผ่านคลัสเตอร์เริ่มต้นสำหรับการเริ่มต้นระบบ
export PGPASSWORD=`openssl rand -hex 12`
- สร้างคลัสเตอร์ช่วงทดลองใช้ฟรี
gcloud alloydb clusters create $ADBCLUSTER \
    --password=$PGPASSWORD \
    --network=default \
    --region=$REGION \
    --subscription-type=TRIAL
- สร้างอินสแตนซ์หลัก
gcloud alloydb instances create $ADBINSTANCE \
    --instance-type=PRIMARY \
    --cpu-count=2 \
    --region=$REGION \
    --cluster=$ADBCLUSTER
จัดสรรอินสแตนซ์ Memorystore for Valkey
Memorystore สำหรับ Valkey ต้องมีนโยบายการเชื่อมต่อบริการ (gcp-memorystore) ในเครือข่ายและภูมิภาคก่อนที่จะสร้างอินสแตนซ์
- สร้างนโยบายการเชื่อมต่อบริการสำหรับ Memorystore โดยทำดังนี้
gcloud network-connectivity service-connection-policies create memorystore-policy \
    --network=default \
    --region=$REGION \
    --service-class=gcp-memorystore \
    --subnets=projects/$PROJECT_ID/regions/$REGION/subnetworks/default
- สร้างอินสแตนซ์ Memorystore for Valkey
gcloud memorystore instances create $VALKEYINSTANCE \
    --location=$REGION \
    --shard-count=1 \
    --replica-count=0 \
    --node-type=SHARED_CORE_NANO \
    --psc-auto-connections="network=projects/$PROJECT_ID/global/networks/default,projectId=$PROJECT_ID"
ให้สิทธิ์ IAM ของ Vertex AI
ให้สิทธิ์ IAM ที่จำเป็นแก่บัญชีบริการ AlloyDB เพื่อเรียกใช้โมเดลการฝังของ Agent Platform โดยทำดังนี้
PROJECT_ID=$(gcloud config get-value project)

gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:service-$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")@gcp-sa-alloydb.iam.gserviceaccount.com" \
  --role="roles/aiplatform.user"
4. เริ่มต้นสภาพแวดล้อมและเข้าถึงปลายทาง
ตั้งค่าการตรวจสอบสิทธิ์ IAM และแฟล็กฐานข้อมูลของ AlloyDB
เปิดใช้การตรวจสอบสิทธิ์ฐานข้อมูล IAM (alloydb.iam_authentication=on) และเครื่องมือค้นหา AI (google_ml_integration.enable_ai_query_engine=on) ในอินสแตนซ์ AlloyDB โดยทำดังนี้
gcloud beta alloydb instances update $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --update-mode=FORCE_APPLY \
  --database-flags=alloydb.iam_authentication=on,google_ml_integration.enable_ai_query_engine=on
จากนั้นเพิ่มบัญชี Google Cloud เป็นผู้ใช้ฐานข้อมูลที่อิงตาม IAM ที่มีสิทธิ์ของผู้ดูแลระบบ
export USER_ACCOUNT=$(gcloud config get-value account)

gcloud alloydb users create $USER_ACCOUNT \
    --cluster=$ADBCLUSTER \
    --region=$REGION \
    --type=IAM_BASED \
    --db-roles=alloydbsuperuser
ดึงข้อมูลปลายทาง VPC ภายในใน Cloud Shell
ก่อนที่จะ SSH เข้าสู่ VM สำหรับการพัฒนา ให้ดึงข้อมูลที่อยู่ IP ของ VPC ภายในสำหรับ AlloyDB และ Memorystore สำหรับ Valkey ใน Cloud Shell โดยทำดังนี้
# Export GCP Project ID, Region, and IAM User
export PROJECT_ID=$(gcloud config get-value project)
export REGION=us-east1
export DB_USER=$(gcloud config get-value account)

# Retrieve Internal VPC IP Addresses for AlloyDB & Memorystore for Valkey
export DB_HOST=$(gcloud alloydb instances describe $ADBINSTANCE --cluster=$ADBCLUSTER --region=$REGION --format="value(ipAddress)")
export DB_PORT=5432
export DB_NAME=postgres

export VALKEY_HOST=$(gcloud memorystore instances describe $VALKEYINSTANCE --location=$REGION --format="value(discoveryEndpoints[0].address)")
export VALKEY_PORT=6379

# Verify exported endpoints
echo "Project ID:        $PROJECT_ID"
echo "Region:            $REGION"
echo "AlloyDB Private IP: $DB_HOST"
echo "IAM DB User:       $DB_USER"
echo "Valkey Private IP:  $VALKEY_HOST"
SSH เข้าสู่ VM สำหรับการพัฒนาและส่งออกตัวแปรการเชื่อมต่อ
SSH จาก Cloud Shell ไปยัง VM สำหรับการพัฒนา Compute Engine (agent-dev-vm) ที่อยู่ในเครือข่าย VPC เดียวกัน
gcloud compute ssh $VM_NAME --zone=$ZONE
เมื่อเข้าสู่ระบบ VM สำหรับการพัฒนาแล้ว ให้ส่งออกเอาต์พุตการกำหนดค่าโปรเจ็กต์และปลายทางการเชื่อมต่อด้านบน (แทนที่
export PROJECT_ID=<YOUR_PROJECT_ID>
export REGION=us-east1
export GENAI_LOCATION=us
export DB_HOST=<YOUR_ALLOYDB_PRIVATE_IP>
export DB_PORT=5432
export DB_NAME=postgres
export DB_USER=<YOUR_IAM_DB_USER>
export VALKEY_HOST=<YOUR_VALKEY_PRIVATE_IP>
export VALKEY_PORT=6379
เริ่มต้นสภาพแวดล้อมเสมือนของ Python
ใน VM สำหรับการพัฒนา ให้สร้างไดเรกทอรีการทำงานในเครื่องก่อน โดยทำดังนี้
mkdir -p ~/alloydb_agent_memory && cd ~/alloydb_agent_memory
ตอนนี้มาติดตั้งแพ็กเกจสภาพแวดล้อมเสมือนของ Python ในระบบ ตรวจสอบสิทธิ์ข้อมูลรับรองเริ่มต้นของแอปพลิเคชัน (ADC) และตั้งค่าพื้นที่ทำงานกัน
sudo apt-get update && sudo apt-get install -y python3-venv python3-pip

python3 -m venv venv
source venv/bin/activate
สุดท้ายนี้ เราจะติดตั้งทรัพยากร Dependency ในสภาพแวดล้อมเสมือนใหม่
gcloud auth application-default login
pip install psycopg2-binary valkey redis google-genai
5. สถาปัตยกรรมของระบบและลำดับชั้นของโมดูลโค้ด
ภาพรวมของสิ่งที่คุณกำลังสร้าง
โปรดตรวจสอบสถาปัตยกรรมของระบบด้านล่างก่อนติดตั้งใช้งานสคริปต์ Python แต่ละรายการ แอปพลิเคชันตัวอย่างนี้มีโครงสร้างเป็นสคริปต์ Python แบบแยกส่วน 7 รายการที่ทำงานในเส้นทางการดำเนินการหลัก 2 เส้นทางซึ่งโต้ตอบกับอินสแตนซ์ฐานข้อมูล AlloyDB สำหรับ PostgreSQL เดียวกัน
- เส้นทางการอ่าน (
hybrid_retriever.py): แยกคำถามแบบหลายส่วนที่ซับซ้อนออกเป็นคำถามย่อยแบบด้านเดียวภายใน PostgreSQL โดยตรงโดยใช้ AlloyDB AIai.generate()และค้นหาความทรงจำระยะยาวโดยใช้การค้นหาแบบไฮบริดดั้งเดิมของ AlloyDB (ai.hybrid_search) - เส้นทางการเขียน (
async_worker.py): Worker คิวเบื้องหลังแบบออฟเธรดที่ดึงข้อเท็จจริงของเอนทิตีที่มีโครงสร้างจากการแลกเปลี่ยนบทสนทนาโดยใช้ Gemini Flash แบบไม่พร้อมกัน และอัปเดต/แทรกไปยังagent_entities
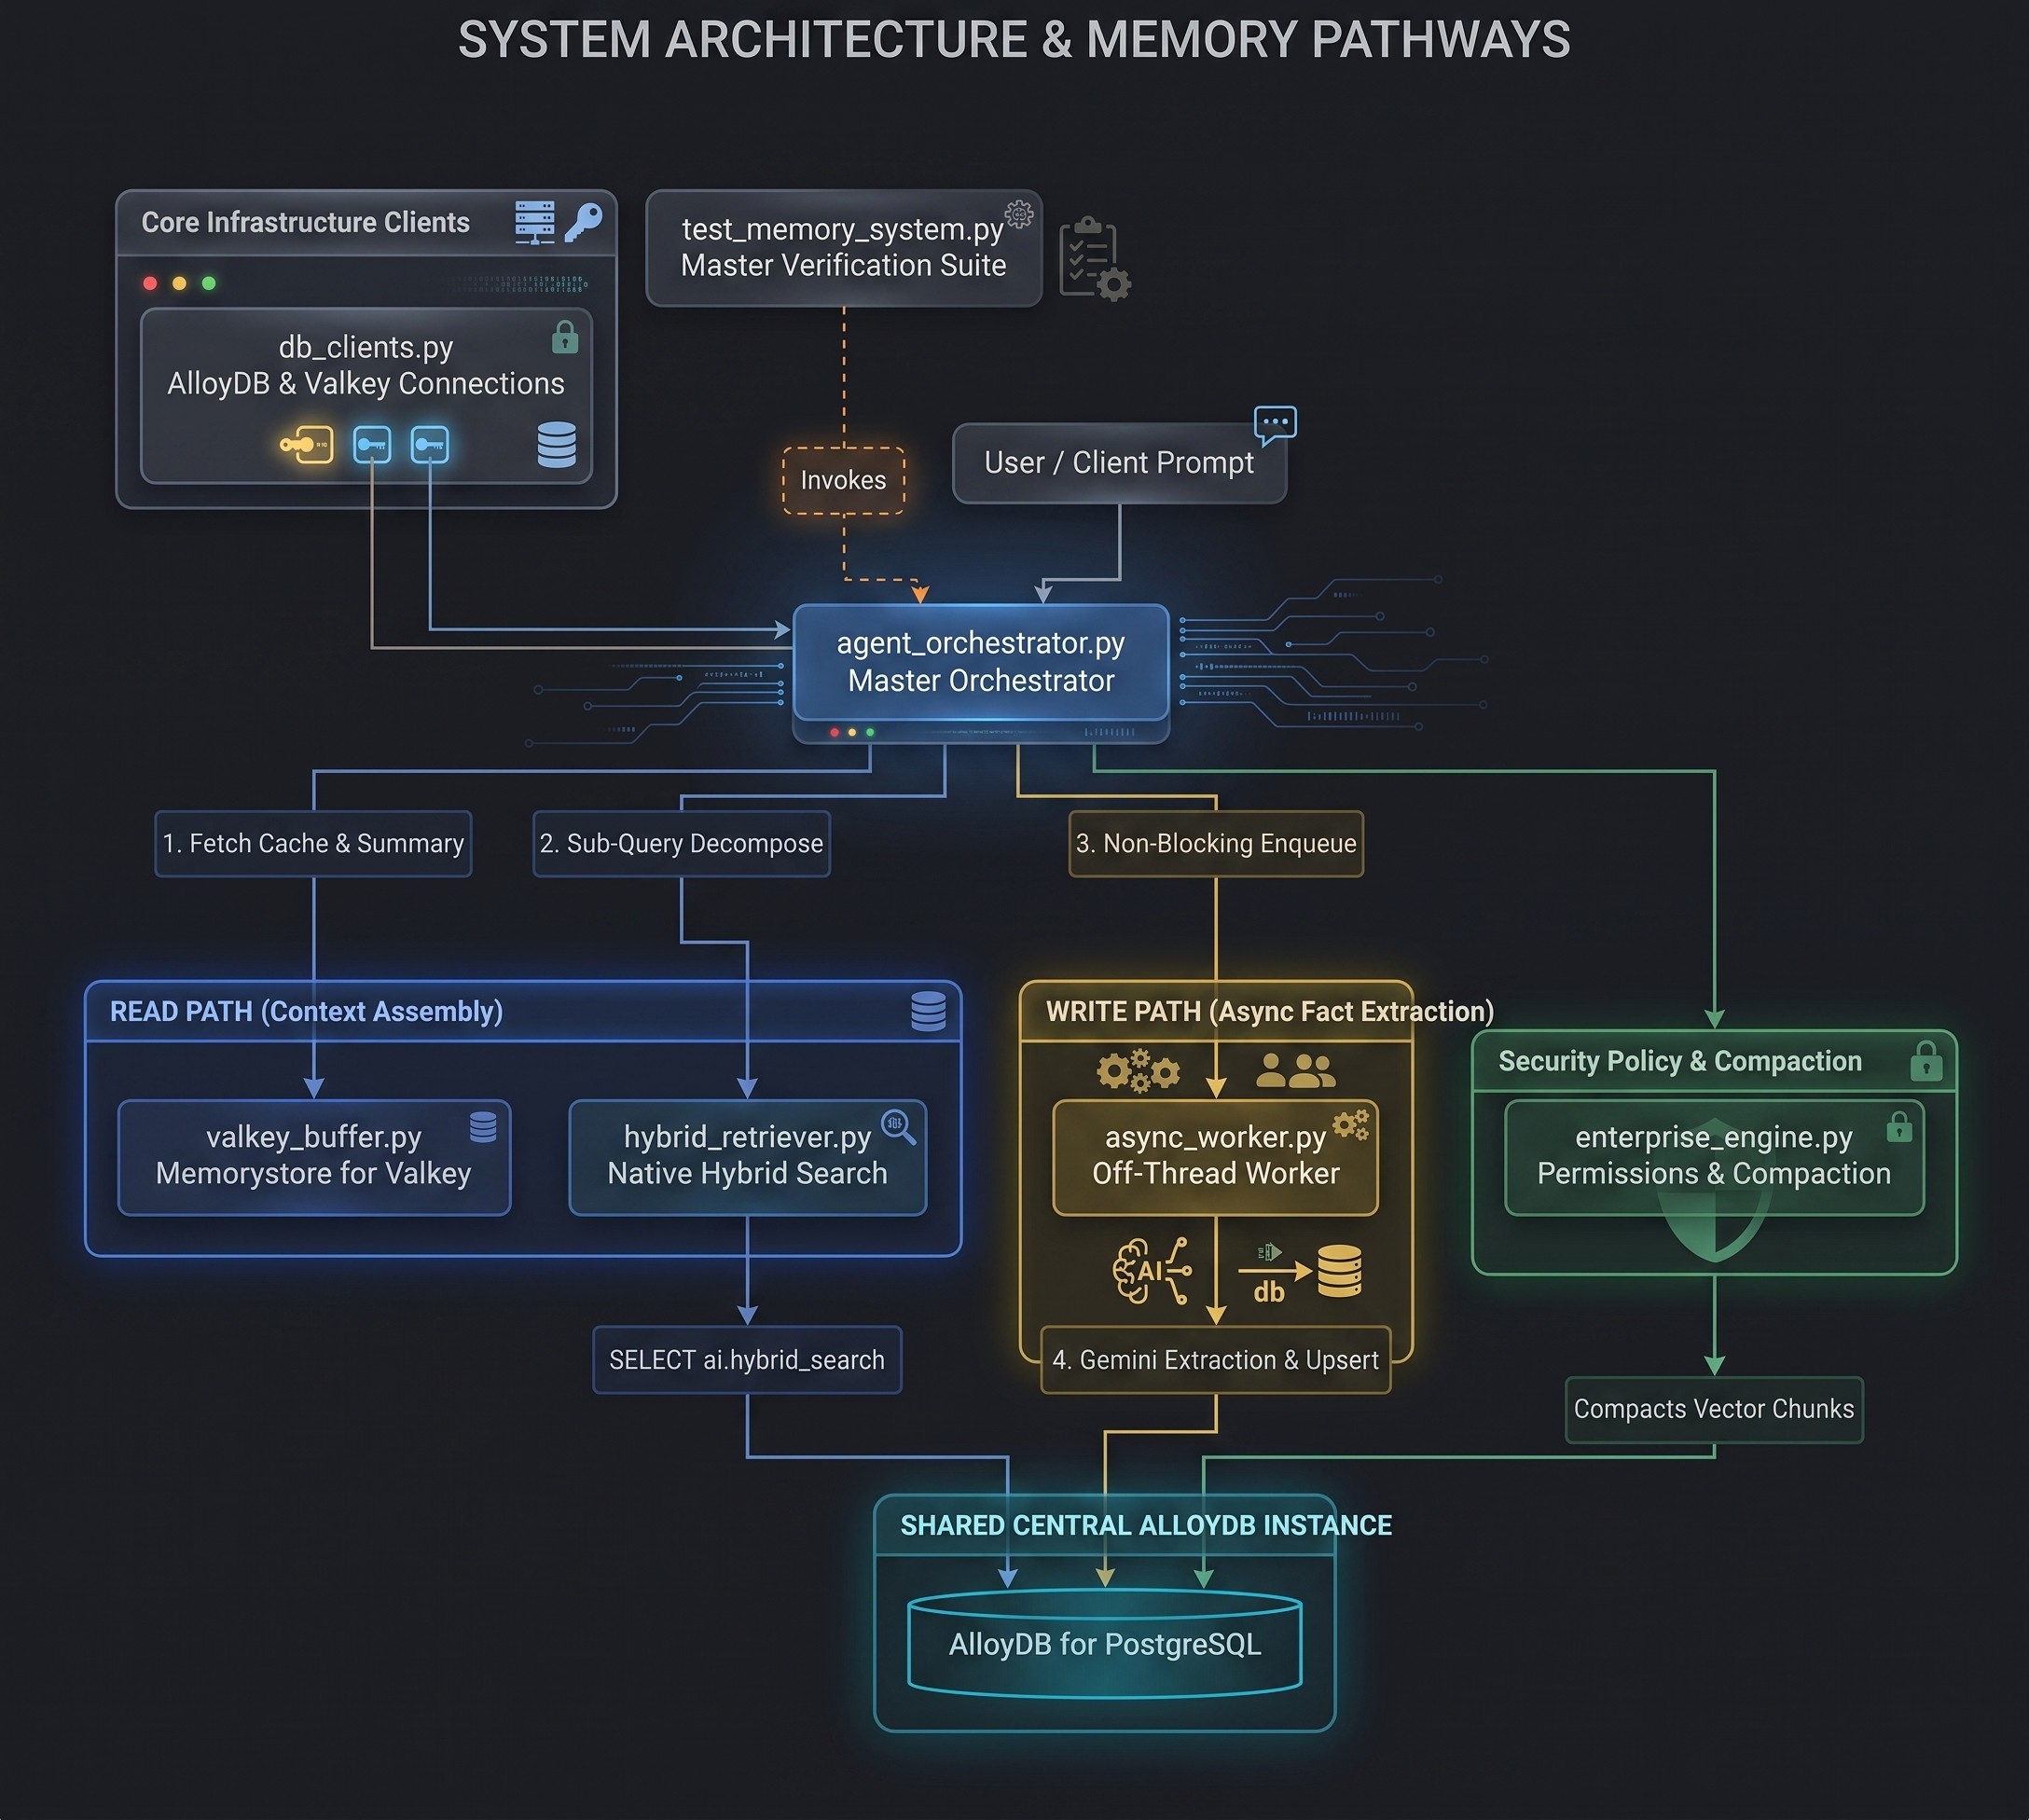
ลำดับชั้นของโมดูลและบทบาทของระบบ
ไฟล์โมดูล | เลเยอร์ระบบ | ความรับผิดชอบหลัก |
| เลเยอร์การเชื่อมต่อ | สร้างการตรวจสอบสิทธิ์ IAM ที่เข้ารหัส SSL กับ AlloyDB และการเชื่อมต่อที่ทนทานต่อซ็อกเก็ตกับ Memorystore สำหรับ Valkey |
| ความจำระยะสั้น | จัดการประวัติเซสชันระดับมิลลิวินาทีใน Valkey โดยใช้สรุปแบบต่อเนื่องของ Summarize-Before-Trim |
| Worker เส้นทางการเขียน | เรียกใช้ Worker คิวพื้นหลังของ Daemon แบบออฟเธรดที่ดึงข้อเท็จจริงของเอนทิตีโดยใช้ Gemini Flash และอัปเดต/แทรกข้อเท็จจริงเหล่านั้นลงใน AlloyDB |
| Read Path Retriever | แยกคำถามแบบผสมเป็นคำถามย่อยแบบด้านเดียวโดยใช้ AlloyDB AI |
| ลูปของเอเจนต์หลัก | ประสานงานวงจรการดำเนินการแบบเลี้ยวต่อเลี้ยวตั้งแต่ต้นจนจบ ได้แก่ การดึงข้อมูลระยะสั้น การค้นหาระยะยาว การประกอบพรอมต์ การดำเนินการ LLM และการจัดคิวแบบไม่พร้อมกัน |
| การกำกับดูแลและการดูแลระบบ | บังคับใช้นโยบายความปลอดภัย 3 ระดับสำหรับการดำเนินการเครื่องมือและรวบรวมหน่วยความจำในอดีต |
| การทดสอบและการประเมิน | ชุดการยืนยันหลักที่ดำเนินการในสถานการณ์แบบการสนทนาไปมาและหลายเซสชัน วัด % การประหยัดโทเค็น และยืนยันความแม่นยำของหน่วยความจำ |
6. ตั้งค่าสคีมา AI ของ AlloyDB และการฝังอัตโนมัติแบบธุรกรรม
ภาพรวมวัตถุประสงค์และสถาปัตยกรรม
ในโมดูลนี้ คุณจะได้กำหนดสคีมาฐานข้อมูลของ AlloyDB สำหรับหน่วยความจำแบบเป็นตอนและระยะยาว กลยุทธ์การจัดทำดัชนี และการฝังอัตโนมัติฝั่งฐานข้อมูล
- ที่เก็บเวกเตอร์แบบตอน (
episodic_memory_embeddings): Chunk ของข้อความแชทที่ไม่มีโครงสร้างซึ่งจัดทำดัชนีด้วยดัชนีเวกเตอร์ HNSW (vector_cosine_ops) - ที่เก็บเอนทิตีระยะยาว (
agent_entities): ข้อเท็จจริงที่มีโครงสร้าง ตัวเลือกของผู้ใช้ และกฎของโปรเจ็กต์ที่จัดเก็บพร้อมกับข้อมูลเมตาของขอบเขต (global,project,session) รวมถึงคอลัมน์การค้นหาข้อความแบบเต็มของ PostgreSQL ที่สร้างขึ้นโดยอัตโนมัติ (summary_tsv) ซึ่งจัดทำดัชนีผ่าน RUM - การฝังอัตโนมัติฝั่งฐานข้อมูล (
ai.initialize_embeddings): ฝังแถวข้อความธรรมดาที่อัปเดตหรือสร้างใหม่ลงในsummary_embeddingโดยอัตโนมัติผ่านแพลตฟอร์มเอเจนต์text-embedding-005ในเบื้องหลัง
เชื่อมต่อกับ AlloyDB Studio
- ไปที่หน้า AlloyDB for Postgres ในคอนโซล Google Cloud
- คลิกอินสแตนซ์หลัก
- คลิก AlloyDB Studio ในการนำทางด้านซ้าย
- เลือกฐานข้อมูล
postgres - ตรวจสอบสิทธิ์ด้วย
IAM database authentication
การติดตั้งใช้งานและซอร์สโค้ด
เมื่อเชื่อมต่อกับฐานข้อมูล AlloyDB PostgreSQL แล้ว ให้เรียกใช้คำค้นหา DDL ด้านล่าง
-- 1. Enable google_ml_integration extension
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;
CREATE EXTENSION IF NOT EXISTS vector CASCADE;
CREATE EXTENSION IF NOT EXISTS rum CASCADE;
SET google_ml_integration.enable_preview_ai_functions = true;

-- 2. Create Episodic Memory Vector Store Tables
CREATE TABLE IF NOT EXISTS episodic_memory_collections (
    uuid UUID PRIMARY KEY,
    name VARCHAR,
    cmetadata JSONB
);

CREATE TABLE IF NOT EXISTS episodic_memory_embeddings (
    uuid UUID PRIMARY KEY,
    collection_id UUID REFERENCES episodic_memory_collections(uuid) ON DELETE CASCADE,
    embedding VECTOR(768),
    document VARCHAR,
    cmetadata JSONB,
    custom_id VARCHAR,
    created_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS episodic_memory_embedding_idx
ON episodic_memory_embeddings
USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);

-- 3. Create Entity & Preference Table with Metadata Scope & Auto-Generated TSVector Column
CREATE TABLE IF NOT EXISTS agent_entities (
    entity_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    entity_name TEXT NOT NULL,
    project_id TEXT DEFAULT 'global',
    session_id TEXT,
    scope TEXT NOT NULL DEFAULT 'project', -- 'global', 'project', 'session'
    summary TEXT NOT NULL,
    summary_embedding VECTOR(768),
    summary_tsv TSVECTOR GENERATED ALWAYS AS (
        to_tsvector('english', entity_name || ' ' || summary)
    ) STORED,
    updated_at TIMESTAMPTZ DEFAULT NOW(),
    UNIQUE (user_id, entity_name)
);

CREATE INDEX IF NOT EXISTS agent_entities_scope_idx
ON agent_entities (user_id, project_id, scope);

CREATE INDEX IF NOT EXISTS agent_entities_embedding_idx
ON agent_entities USING hnsw (summary_embedding vector_cosine_ops);

CREATE INDEX IF NOT EXISTS agent_entities_tsv_idx
ON agent_entities USING rum (summary_tsv rum_tsvector_ops);

-- 4. Create User Permissions Table for Tool Execution Controls
CREATE TABLE IF NOT EXISTS user_permissions (
    permission_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    project_id TEXT NOT NULL DEFAULT 'global',
    tool_name TEXT NOT NULL,
    command_pattern TEXT NOT NULL,
    action TEXT NOT NULL CHECK (action IN ('ALLOW', 'BLOCK')),
    created_at TIMESTAMPTZ DEFAULT NOW(),
    updated_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS idx_user_permissions_lookup
ON user_permissions (user_id, project_id, tool_name);
-- 5. Register Gemini 3.5 Flash Model Endpoint in AlloyDB
-- Replace PROJECT_ID with your Google Cloud project ID
CALL google_ml.create_model(
    model_id => 'gemini-3.5-flash',
    model_request_url => 'https://aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/global/publishers/google/models/gemini-3.5-flash:generateContent',
    model_qualified_name => 'gemini-3.5-flash',
    model_provider => 'google',
    model_type => 'llm',
    model_auth_type => 'alloydb_service_agent_iam'
);
เริ่มต้นการฝังอัตโนมัติแบบธุรกรรมและลงทะเบียนโมเดล Gemini
จากนั้น ให้เรียกใช้คำสั่ง CALL ในบล็อกการเรียกใช้การค้นหาแยกต่างหากเพื่อลงทะเบียนกระบวนการเบื้องหลังการฝังอัตโนมัติและปลายทางโมเดล Gemini 3.5 Flash
-- 6. Register Database-Side Transactional Auto-Embedding
CALL ai.initialize_embeddings(
    model_id => 'text-embedding-005',
    table_name => 'agent_entities',
    content_column => 'summary',
    embedding_column => 'summary_embedding',
    incremental_refresh_mode => 'transactional',
    batch_size => 10
);
7. กำหนดค่าไคลเอ็นต์การเชื่อมต่อ AlloyDB และ Valkey
ภาพรวมวัตถุประสงค์และสถาปัตยกรรม
ในโมดูลนี้ คุณจะสร้างการเชื่อมต่อเครือข่ายที่ปลอดภัยกับทั้ง AlloyDB สำหรับ PostgreSQL (หน่วยความจำระยะยาว) และ Memorystore สำหรับ Valkey (แคชระยะสั้น)
- การตรวจสอบสิทธิ์ IAM ของ AlloyDB: ใช้
gcloud auth application-default print-access-tokenเพื่อดึงโทเค็น OAuth2 ที่มีอายุสั้นสำหรับการเชื่อมต่อฐานข้อมูลที่เข้ารหัส SSL แบบไม่มีรหัสผ่าน (sslmode="require") - ความยืดหยุ่นของเครือข่าย Valkey: กำหนดค่า
redis.Redisด้วยการหมดเวลาของซ็อกเก็ต 5.0 วินาที (socket_timeout=5.0) เพื่อจัดการการดำเนินการเครือข่าย VPC อย่างปลอดภัยในอินสแตนซ์ Valkey แบบโหนดเดียวหรือแบบคลัสเตอร์
การติดตั้งใช้งานและซอร์สโค้ด
สร้างสคริปต์ db_clients.py ในไดเรกทอรีการทำงาน
import os
import subprocess
import psycopg2
import redis

# Initialize database & Valkey connection clients from environment variables
DB_HOST = os.getenv("DB_HOST", "127.0.0.1")
DB_PORT = os.getenv("DB_PORT", "5432")
DB_NAME = os.getenv("DB_NAME", "postgres")
DB_USER = os.getenv("DB_USER")

VALKEY_HOST = os.getenv("VALKEY_HOST", "127.0.0.1")
VALKEY_PORT = int(os.getenv("VALKEY_PORT", "6379"))

def get_db_connection():
    # Fetch Application Default Credentials (ADC) token for IAM Database Authentication & enable SSL encryption
    access_token = subprocess.check_output(
        ["gcloud", "auth", "application-default", "print-access-token"], text=True
    ).strip()
    return psycopg2.connect(
        host=DB_HOST,
        port=DB_PORT,
        dbname=DB_NAME,
        user=DB_USER,
        password=access_token,
        sslmode="require"
    )

def get_valkey_client():
    return redis.Redis(
        host=VALKEY_HOST,
        port=VALKEY_PORT,
        db=0,
        socket_timeout=5.0,
        socket_connect_timeout=5.0
    )

if __name__ == "__main__":
    print(f"Connecting to AlloyDB via IAM Auth ({DB_USER}) at {DB_HOST}:{DB_PORT} and Valkey at {VALKEY_HOST}:{VALKEY_PORT}...")
    print("Database and Valkey connection client modules loaded successfully.")
8. แคชสถานะเซสชันระยะสั้นใน Memorystore for Valkey
ภาพรวมวัตถุประสงค์และสถาปัตยกรรม
ในโมดูลนี้ คุณจะได้สร้างแคชบริบทระยะสั้นที่มีความละเอียดระดับมิลลิวินาทีใน Memorystore สำหรับ Valkey โดยใช้รูปแบบสรุปก่อนตัดอัตโนมัติ
- หน้าต่างเลื่อนของ Valkey: ระบบจะจัดเก็บเทิร์นการสนทนาที่ใช้งานอยู่เป็นสตริง JSON ในคีย์
session:{session_id}:turns - แท็กแฮช Redis (
{session_id}): การจัดรูปแบบคีย์session:{session_id}:turnsและsession:{session_id}:summaryใช้แท็กแฮชคลัสเตอร์ Redis ({...}) ซึ่งบังคับให้คีย์ทั้ง 2 รายการอยู่ในแฮชสล็อตเดียวกันเพื่อให้มั่นใจว่าการดำเนินการจะเกิดขึ้นพร้อมกันในการติดตั้งใช้งาน Valkey แบบโหนดเดียวหรือแบบคลัสเตอร์ - สรุปก่อนตัด: เมื่อจำนวนการโต้ตอบเกิน
trigger_limitGemini Flash จะสรุปการโต้ตอบที่เก่ากว่าซึ่งกำลังจะถูกตัดออกเป็นสรุปข้อความแบบต่อเนื่อง (session:{session_id}:summary) ก่อนที่จะตัดประวัติแบบดิบให้เหลือwindow_size
การติดตั้งใช้งานและซอร์สโค้ด
สร้างสคริปต์ valkey_buffer.py ในไดเรกทอรีการทำงาน
import json
import logging
import time
from typing import Any, Dict, List
import redis

logger = logging.getLogger(__name__)

IN_MEMORY_VALKEY_FALLBACK: Dict[str, Any] = {}
VALKEY_COMPACTION_TOKENS = 0

def get_valkey_compaction_tokens() -> int:
    return VALKEY_COMPACTION_TOKENS

def append_session_turn_with_rolling_summary(
    valkey_client: redis.Redis,
    llm_client: Any,
    session_id: str,
    user_msg: str,
    ai_msg: str,
    trigger_limit: int = 10,
    window_size: int = 4
) -> None:
    """Appends turn to Valkey. Before trimming old turns, summarizes them into a rolling summary."""
    global VALKEY_COMPACTION_TOKENS
    # Use Redis Hash Tags {session_id} so both keys hash to the same cluster slot
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        # 1. Append new turn messages
        valkey_client.rpush(turns_key, json.dumps({"role": "user", "content": user_msg}))
        valkey_client.rpush(turns_key, json.dumps({"role": "assistant", "content": ai_msg}))

        raw_turns = valkey_client.lrange(turns_key, 0, -1)

        # 2. Check if total turns exceed summary trigger threshold
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2

        if len(raw_turns) > msg_trigger_count:
            turns_to_prune = raw_turns[:-msg_window_count]
            existing_summary = valkey_client.get(summary_key)
            existing_summary_text = (
                existing_summary.decode('utf-8') if isinstance(existing_summary, bytes) else (existing_summary or "")
            )

            pruned_text = "\n".join([
                f"{json.loads(t)['role']}: {json.loads(t)['content']}" for t in turns_to_prune
            ])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            updated_summary_text = llm_client.models.generate_content(
                model="gemini-3.5-flash", contents=prompt
            ).text.strip()
            # Execute commands directly to support all Redis/Valkey cluster topologies
            valkey_client.set(summary_key, updated_summary_text)
            valkey_client.ltrim(turns_key, -msg_window_count, -1)
            logger.info("Updated rolling summary and trimmed Valkey buffer for session %s", session_id)

    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey operation warning (%s). Falling back to in-memory short-term buffer.", e)
        if turns_key not in IN_MEMORY_VALKEY_FALLBACK:
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = []
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "user", "content": user_msg})
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "assistant", "content": ai_msg})

        # In-memory summarize-before-trim fallback logic
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2
        raw_fallback_turns = IN_MEMORY_VALKEY_FALLBACK[turns_key]

        if len(raw_fallback_turns) > msg_trigger_count:
            turns_to_prune = raw_fallback_turns[:-msg_window_count]
            existing_summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
            pruned_text = "\n".join([f"{t['role']}: {t['content']}" for t in turns_to_prune])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            for attempt in range(4):
                try:
                    updated_summary_text = llm_client.models.generate_content(
                        model="gemini-3.5-flash", contents=prompt
                    ).text.strip()
                    break
                except Exception as e:
                    if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                        time.sleep(3 * (2 ** attempt))
                    else:
                        raise

            IN_MEMORY_VALKEY_FALLBACK[summary_key] = updated_summary_text
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = raw_fallback_turns[-msg_window_count:]

def get_session_context_buffer(
    valkey_client: redis.Redis,
    session_id: str
) -> Dict[str, Any]:
    """Retrieves rolling summary + sliding window history from Valkey to build prompt context."""
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        summary = valkey_client.get(summary_key)
        summary_text = summary.decode('utf-8') if isinstance(summary, bytes) else (summary or "")

        raw_turns = valkey_client.lrange(turns_key, 0, -1)
        recent_turns = [json.loads(t) for t in raw_turns]

        return {
            "rolling_summary": summary_text,
            "recent_turns": recent_turns
        }
    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey read error (%s). Using in-memory short-term fallback buffer.", e)
        summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
        recent_turns = IN_MEMORY_VALKEY_FALLBACK.get(turns_key, [])
        return {"rolling_summary": summary_text, "recent_turns": recent_turns}
9. แยกเอนทิตีแบบออฟเธรด (Worker หน่วยความจำเบื้องหลัง)
ภาพรวมวัตถุประสงค์และสถาปัตยกรรม
ในโมดูลนี้ คุณจะได้สร้าง Worker การแยกข้อมูลเบื้องหลังเส้นทางการเขียนแบบออฟเธรด (AsyncMemoryWorker) ซึ่งจะแยกข้อเท็จจริงของเอนทิตีระยะยาวโดยไม่ทำให้คำตอบแบบโต้ตอบของ AI ช้าลง
- Non-Blocking Queue Worker: Launches a daemon thread (
queue.Queue) so that developer chat turns return immediately without waiting for LLM extraction or database writes. - การแยกข้อเท็จจริงของเอนทิตีในเธรดอื่น: เรียกใช้ Gemini Flash (
model="gemini-3.5-flash",response_mime_type="application/json") ในเบื้องหลังเพื่อแยกวิเคราะห์เอนทิตีที่มีโครงสร้างโดยไม่บล็อกการสนทนาที่ผู้ใช้มองเห็น - การแก้ปัญหาการอ้างอิงร่วมชั่วคราว (
build_temporal_rules_prompt): บังคับใช้กฎที่แปลงนิพจน์ชั่วคราวแบบสัมพัทธ์ (เช่น "ปัจจุบัน", "เซสชันล่าสุด") เป็นรหัสเซสชันที่ชัดเจน (เช่นsession_id) - การอัปเดต/แทรกสคีมา: พรอมต์ Gemini Flash ให้แสดงผลอาร์เรย์ JSON ของเอนทิตี (
entity_name,project_id,scope,summary) และเขียนข้อความธรรมดาลงในagent_entitiesผ่านคำสั่ง PostgreSQLON CONFLICT DO UPDATEที่กำหนดพารามิเตอร์
การติดตั้งใช้งานและซอร์สโค้ด
สร้างสคริปต์ async_worker.py ในไดเรกทอรีการทำงาน
import json
import logging
import queue
import threading
import time
from typing import Dict, Any, Optional
import psycopg2

logger = logging.getLogger(__name__)

def build_temporal_rules_prompt(active_session_id: str, prev_session_id: Optional[str] = None) -> str:
    """REUSABLE PROMPT HELPER: Defines temporal coreference rules for both Read and Write paths."""
    return f"""TEMPORAL COREFERENCE RULES:
1. Do not use relative temporal words like 'currently', 'now', 'this session', 'previous session', or 'last session'.
2. Replace any relative temporal reference with explicit session identifiers:
   - Active Session: '{active_session_id}'
   - Previous Session: '{prev_session_id if prev_session_id else active_session_id}'
   (e.g., write 'User prefers Python in session {active_session_id}' instead of 'User currently prefers Python')."""

class AsyncMemoryWorker:
    """Off-thread daemon queue worker performing background entity extraction and upserts into AlloyDB."""
    def __init__(self, conn_factory, llm_client):
        self.conn_factory = conn_factory
        self.llm_client = llm_client
        self.work_queue = queue.Queue()
        self.total_extraction_tokens = 0
        self.worker_thread = threading.Thread(target=self._run_worker, daemon=True)
        self.worker_thread.start()

    def enqueue_extraction(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        self.work_queue.put((user_id, session_id, user_msg, ai_msg, prev_session_id))

    def _run_worker(self):
        while True:
            item = self.work_queue.get()
            if item is None:
                break
            user_id, session_id, user_msg, ai_msg, prev_session_id = item
            try:
                self._extract_and_upsert(user_id, session_id, user_msg, ai_msg, prev_session_id)
            except Exception as e:
                logger.error("Background extraction failed: %s", e)
            finally:
                self.work_queue.task_done()

    def _extract_and_upsert(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        temporal_rules = build_temporal_rules_prompt(session_id, prev_session_id)
        json_fmt = '[{"entity_name": "...", "project_id": "...", "scope": "global|project|session", "summary": "..."}]'

        prompt = f"""Extract key preferences and named entities from this exchange.
Format output strictly as a JSON array of objects with structure: {json_fmt}.

{temporal_rules}

Rules for Scope:
- 'global': Universal developer preferences.
- 'project': Architecture, database choices, timeouts, and rules for a specific project.
- 'session': Ephemeral task state tied strictly to a single session.

User: {user_msg}
AI: {ai_msg}

Output (JSON array only):"""

        self.total_extraction_tokens += max(1, len(prompt) // 4)

        for attempt in range(4):
            try:
                response = self.llm_client.models.generate_content(
                    model="gemini-3.5-flash",
                    contents=prompt,
                    config={"response_mime_type": "application/json"}
                )
                break
            except Exception as e:
                if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                    time.sleep(3 * (2 ** attempt))
                else:
                    raise
        content = str(response.text).strip()
        if not content:
            return

        extracted_list = json.loads(content)
        if not isinstance(extracted_list, list):
            return

        upsert_sql = """
            INSERT INTO agent_entities (user_id, entity_name, project_id, session_id, scope, summary, updated_at)
            VALUES (%s, %s, %s, %s, %s, %s, NOW())
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET
                project_id = EXCLUDED.project_id,
                session_id = EXCLUDED.session_id,
                scope = EXCLUDED.scope,
                summary = EXCLUDED.summary,
                updated_at = NOW();
        """

        conn = self.conn_factory()
        try:
            with conn:
                with conn.cursor() as cur:
                    for item in extracted_list:
                        e_name = item.get("entity_name", "General_Fact")
                        p_id = item.get("project_id", "global")
                        s_scope = item.get("scope", "project")
                        summary = item.get("summary", "")
                        if e_name and summary:
                            cur.execute(upsert_sql, (user_id, e_name, p_id, session_id, s_scope, summary))
            logger.info("Saved %d entities for user %s", len(extracted_list), user_id)
        finally:
            conn.close()
10. ค้นหาหน่วยความจำระยะยาวด้วยการค้นหาแบบไฮบริดดั้งเดิม
ภาพรวมวัตถุประสงค์และสถาปัตยกรรม
ในโมดูลนี้ คุณจะใช้การแยกย่อยคำค้นหาย่อยของเส้นทางการอ่าน การเขียนคำค้นหาใหม่ตามเวลา การแยกขอบเขตข้อมูลเมตา และใช้การค้นหาแบบไฮบริดเนทีฟของ AlloyDB (ai.hybrid_search)
- การแยกย่อยการค้นหาแบบย่อยในฐานข้อมูล (
rewrite_and_decompose_query): ใช้ฟังก์ชันในตัวของ AlloyDB AIai.generate()ภายใน PostgreSQL โดยตรงเพื่อแยกคำถามแบบผสมออกเป็นการค้นหาแบบย่อยด้านเดียวที่มีรหัสเซสชันที่ทำให้เป็นมาตรฐาน ซึ่งจะป้องกันไม่ให้การค้นหาหลายหัวข้อลดความแม่นยำของการค้นหาเวกเตอร์ - การกรองขอบเขตระดับดัชนี: สร้างตัวกรอง SQL ฝั่งฐานข้อมูล (
filter_condition => "user_id = '%s' AND (project_id = '%s' OR scope = 'global')") เพื่อแยกความทรงจำต่อผู้ใช้และโปรเจ็กต์ในขณะที่รวมค่ากําหนดของนักพัฒนาซอฟต์แวร์ทั่วโลก - การค้นหาแบบไฮบริดดั้งเดิมของ AlloyDB (
ai.hybrid_search): ผสานความคล้ายคลึงของเวกเตอร์โคไซน์ (public.<=>) กับการค้นหาแบบข้อความแบบเต็ม (rum) ภายใน AlloyDB โดยใช้การผสานอันดับซึ่งกันและกัน (RRF) เพื่อให้ความแม่นยำ การเรียกคืน และความเกี่ยวข้องที่เหมาะสมที่สุด
การติดตั้งใช้งานและซอร์สโค้ด
สร้างสคริปต์ hybrid_retriever.py ในไดเรกทอรีการทำงาน
import os
import json
import logging
from typing import Any, Dict, List, Optional
import psycopg2
from psycopg2.extras import RealDictCursor
from async_worker import build_temporal_rules_prompt

logger = logging.getLogger(__name__)

def rewrite_and_decompose_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> List[str]:
    """Read-Path LLM Query Normalizer & Sub-Query Decomposer using AlloyDB AI ai.generate() directly in PostgreSQL."""
    temporal_rules = build_temporal_rules_prompt(active_session_id, prev_session_id)

    prompt = f"""You are a query normalization and decomposition tool for an AI agent's memory retrieval system.

Tasks:
1. Normalize any relative temporal phrases in the user query into explicit session identifiers.
{temporal_rules}

2. Decompose compound user queries asking about multiple distinct topics into up to 4 concise, single-topic search queries. Ensure all distinct questions (both general developer preferences and project-specific architecture/rules) are preserved as separate sub-queries.
3. Return ONLY a valid JSON array of strings containing the sub-queries.

Example Output Format:
["general developer coding preferences", "CloudRetail backend stack in session sess_2026_01", "CloudRetail timeout rules in session sess_2026_01"]

Text to Process: {text}
JSON Output:"""

    try:
        with conn.cursor() as cur:
            cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
            cur.execute("SELECT ai.generate(prompt => %s::text, model_id => 'gemini-3.5-flash'::varchar(100));", (prompt,))
            row = cur.fetchone()
            if row and row[0]:
                res_text = str(row[0]).strip()
                clean_text = res_text
                if clean_text.startswith("```"):
                    clean_text = clean_text.removeprefix("```json").removeprefix("```").removesuffix("```").strip()
                parsed = json.loads(clean_text)
                if isinstance(parsed, list) and len(parsed) > 0:
                    return [str(q).strip() for q in parsed]
        return [text]
    except Exception as e:
        logger.error("Error in in-database ai.generate sub-query decomposition: %s", e)
        return [text]

def rewrite_temporal_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> str:
    """Backward-compatible wrapper returning first decomposed query string."""
    queries = rewrite_and_decompose_query(conn, llm_client, text, active_session_id, prev_session_id)
    return queries[0] if queries else text

def retrieve_hybrid_entities(
    conn,
    llm_client: Any,
    user_id: str,
    active_session_id: str,
    query_text: str,
    query_embedding: Optional[List[float]] = None,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    k: int = 20
) -> Dict[str, Any]:
    """Queries long-term entities using Sub-Query Decomposition, metadata scope filtering, and parameterized AlloyDB hybrid search."""
    sub_queries = rewrite_and_decompose_query(
        conn=conn, llm_client=llm_client, text=query_text, active_session_id=active_session_id, prev_session_id=prev_session_id
    )
    all_search_queries = list(dict.fromkeys(sub_queries + [query_text]))

    retrieved_entities: Dict[str, Any] = {}

    filter_cond = f"user_id = '{user_id}' AND (project_id = '{project_id}' OR scope = 'global')" if project_id else f"user_id = '{user_id}'"

    query_sql = """
        SELECT e.entity_name, e.summary, e.project_id, e.scope, e.updated_at
        FROM ai.hybrid_search(
          search_inputs => %s::JSONB[],
          include_json_output => false
        ) h
        JOIN agent_entities e ON e.entity_name = h.id
        WHERE e.user_id = %s
        LIMIT %s;
    """

    from google import genai
    embed_client = genai.Client(
        vertexai=True,
        project=os.getenv("PROJECT_ID"),
        location=os.getenv("REGION", "us-east1")
    )

    for sq in all_search_queries:
        try:
            emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=sq)
            sq_embedding = emb_resp.embeddings[0].values
            vector_literal = f"'{sq_embedding}'::vector"
        except Exception as e:
            logger.error(f"Failed to generate embedding for sub-query: {sq}. Error: {e}")
            # Fallback to zero vector to prevent Postgres from crashing
            sq_embedding = [0.0] * 768
            vector_literal = f"'{sq_embedding}'::vector"

        search_inputs = [
            json.dumps({
                "data_type": "vector",
                "weight": 0.4,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "vec_column": "summary_embedding",
                "distance_operator": "public.<=>",
                "limit": 20,
                "query_vector": vector_literal,
                "filter_condition": filter_cond
            }),
            json.dumps({
                "data_type": "text",
                "weight": 0.6,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "text_column": "summary_tsv",
                "limit": 20,
                "ranking_function": "ts_rank",
                "query_text_input": sq,
                "filter_condition": filter_cond
            })
        ]

        with conn.cursor(cursor_factory=RealDictCursor) as cur:
            try:
                cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                cur.execute(query_sql, (search_inputs, user_id, k))
                rows = cur.fetchall()

                for row in rows:
                    name = row["entity_name"]
                    if name not in retrieved_entities:
                        retrieved_entities[name] = {
                            "summary": row["summary"],
                            "project_id": row["project_id"],
                            "scope": row["scope"],
                            "updated_at": row["updated_at"].isoformat() if row["updated_at"] else None
                        }
            except Exception as e:
                logger.error("Error executing hybrid search for sub-query '%s': %s", sq, e)

    return retrieved_entities
11. สร้างและเรียกใช้ลูปหน่วยความจำของ Agent แบบครบวงจร
ภาพรวมวัตถุประสงค์และสถาปัตยกรรม
ในโมดูลนี้ คุณจะได้สร้างฟังก์ชันการจัดระเบียบเอเจนต์หลัก (run_agent_turn) ซึ่งรวมการดึงข้อมูลจากแคชระยะสั้น การค้นหาหน่วยความจำระยะยาว การประกอบพรอมต์ การสร้าง LLM และการแยกหน่วยความจำเบื้องหลัง
- บริบทระยะสั้น: ดึงคำพูดของ Valkey ที่ใช้งานอยู่และสรุปแบบต่อเนื่อง (
get_session_context_buffer) - การค้นหาระยะยาว: ค้นหา AlloyDB ผ่าน
retrieve_hybrid_entitiesโดยใช้คำค้นหาย่อยที่แยกย่อยแล้วซึ่งกรองตามรหัสโปรเจ็กต์ที่ใช้งานอยู่และขอบเขตส่วนกลาง - การจัดรูปแบบพรอมต์ของระบบ: รวบรวม
build_agent_promptที่มีเอนทิตีระยะยาว สรุประยะสั้น บทสนทนาล่าสุด และพรอมต์ของผู้ใช้เป็นพรอมต์ของระบบที่มีประสิทธิภาพด้านโทเค็น - Async Queue Enqueue: แคชการส่งใน Valkey และจัดคิวการแยกข้อมูลเบื้องหลังลงใน
AsyncMemoryWorkerโดยไม่บล็อกเพย์โหลดที่ส่งคืน
การติดตั้งใช้งานและซอร์สโค้ด
สร้างสคริปต์ agent_orchestrator.py ในไดเรกทอรีการทำงาน
import logging
import time
from typing import Any, Dict, Optional, Tuple
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import rewrite_temporal_query, retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

logger = logging.getLogger(__name__)

def build_agent_prompt(
    rolling_summary: str,
    recent_turns: list[Dict[str, Any]],
    retrieved_entities: Dict[str, Any],
    user_query: str
) -> str:
    """Assembles structured system prompt with long-term memory & short-term context."""
    entity_lines = [
        f"- {name}: {info['summary']}" for name, info in retrieved_entities.items()
    ]
    entity_context = "\n".join(entity_lines) if entity_lines else "No relevant entity facts."
    history_lines = [f"{t['role']}: {t['content']}" for t in recent_turns]
    history_str = "\n".join(history_lines)

    return f"""You are an intelligent, context-aware AI assistant.

[LONG-TERM PREFERENCES & ENTITIES]
{entity_context}

[SHORT-TERM ROLLING SUMMARY]
{rolling_summary if rolling_summary else 'No prior summary.'}

[RECENT DIALOGUE]
{history_str}

User: {user_query}
AI:"""

def run_agent_turn(
    db_conn,
    valkey_client: redis.Redis,
    async_worker: AsyncMemoryWorker,
    genai_client: Any,
    user_id: str,
    session_id: str,
    user_query: str,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    trigger_limit: int = 10,
    window_size: int = 4
) -> Tuple[str, str, float]:
    """Executes a complete 2-tier agent memory turn loop, returning (response_text, system_prompt, latency_seconds)."""
    import time
    start_time = time.time()

    # 1. Fetch short-term rolling summary + recent turns from Valkey
    buffer_data = get_session_context_buffer(valkey_client, session_id)
    rolling_summary = buffer_data["rolling_summary"]
    recent_turns = buffer_data["recent_turns"]

    # 2. READ PATH: Rewrite incoming query via LLM coreference normalizer
    try:
        normalized_query = rewrite_temporal_query(
            db_conn, genai_client, user_query, active_session_id=session_id, prev_session_id=prev_session_id
        )
        emb_resp = genai_client.models.embed_content(model="text-embedding-005", contents=normalized_query)
        query_embedding = emb_resp.embeddings[0].values
    except Exception:
        query_embedding = None

    # Retrieve relevant long-term entities from AlloyDB via hybrid search
    retrieved_entities = retrieve_hybrid_entities(
        conn=db_conn,
        llm_client=genai_client,
        user_id=user_id,
        active_session_id=session_id,
        query_text=user_query,
        query_embedding=query_embedding,
        prev_session_id=prev_session_id,
        project_id=project_id,
        k=20
    )

    # 3. Assemble system prompt
    system_prompt = build_agent_prompt(
        rolling_summary, recent_turns, retrieved_entities, user_query
    )


    # 4. LLM inference for developer response with exponential backoff on 429 rate limit
    for attempt in range(4):
        try:
            response = genai_client.models.generate_content(
                model="gemini-3.5-flash", contents=system_prompt
            )
            break
        except Exception as e:
            if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                time.sleep(3 * (2 ** attempt))
            else:
                raise
    ai_response = str(response.text)

    # 5. Cache turn in short-term Valkey buffer (with Summarize-Before-Trim check)
    append_session_turn_with_rolling_summary(
        valkey_client=valkey_client,
        llm_client=genai_client,
        session_id=session_id,
        user_msg=user_query,
        ai_msg=ai_response,
        trigger_limit=trigger_limit,
        window_size=window_size
    )

    # 6. WRITE PATH: Enqueue off-thread background entity extraction (single LLM call)
    async_worker.enqueue_extraction(user_id, session_id, user_query, ai_response, prev_session_id)

    latency = time.time() - start_time
    return ai_response, system_prompt, latency
12. ใช้การควบคุมสิทธิ์ขององค์กรและการบีบอัดหน่วยความจำ
ภาพรวมวัตถุประสงค์และสถาปัตยกรรม
ในโมดูลนี้ คุณจะได้สร้างการควบคุมความปลอดภัยระดับองค์กรสำหรับการดำเนินการเครื่องมือและการบีบอัดหน่วยความจำฐานข้อมูล (AgentMemoryEngine)
- การประเมินสิทธิ์แบบ 3 ระดับ (
evaluate_tool_permission):- ระดับ 1 (การให้สิทธิ์ Valkey แบบใช้ครั้งเดียว): ตรวจสอบคีย์การให้สิทธิ์แบบใช้ครั้งเดียว (
one_time_perm:{session_id}:{cmd_hash}) ที่มี TTL 300 วินาที หากมีอยู่ ระบบจะลบคีย์ทันทีและแสดงผลALLOW - ระดับที่ 2 และ 3 (กฎนโยบาย PostgreSQL): คำค้นหา
user_permissionsที่ตรงกับกฎระดับโปรเจ็กต์ (project_id) ก่อน จากนั้นจึงเป็นกฎส่วนกลาง ('global') - สำรอง: แสดง
PROMPT_USERหากไม่มีนโยบายที่ตรงกัน
- ระดับ 1 (การให้สิทธิ์ Valkey แบบใช้ครั้งเดียว): ตรวจสอบคีย์การให้สิทธิ์แบบใช้ครั้งเดียว (
- การบีบอัดหน่วยความจำ (
compact_old_memories): รวบรวมเหตุการณ์เวกเตอร์ดิบในอดีตในepisodic_memory_embeddingsที่เก่ากว่าretention_daysเป็นสรุปแบบรวมรายการเดียวในagent_entitiesโดยใช้การค้นหา CTE ของ SQL ที่จำกัด 50 แถว
การติดตั้งใช้งานและซอร์สโค้ด
สร้างสคริปต์ enterprise_engine.py ในไดเรกทอรีการทำงาน
import hashlib
import logging
import re
from typing import Any, Dict, Tuple
import psycopg2
import redis

logger = logging.getLogger(__name__)

class AgentMemoryEngine:
    """Framework-agnostic Enterprise Memory Engine for tool execution permissions & safe compaction."""

    def __init__(self, valkey_client: redis.Redis, db_conn: Any):
        self.valkey_client = valkey_client
        self.db_conn = db_conn

    def evaluate_tool_permission(
        self,
        user_id: str,
        project_id: str,
        session_id: str,
        tool_name: str,
        tool_args: Dict[str, Any]
    ) -> Tuple[str, str]:
        """Evaluates 3-tier execution permissions: Allow-Once (Valkey), Project (AlloyDB), Global (AlloyDB)."""
        command_str = str(tool_args.get("CommandLine", "") or tool_args)

        # Tier 1: Allow-Once (Single-Use Valkey Check with 300s TTL)
        cmd_hash = hashlib.sha256(command_str.encode("utf-8")).hexdigest()[:16]
        valkey_key = f"one_time_perm:{session_id}:{cmd_hash}"

        if self.valkey_client.get(valkey_key):
            self.valkey_client.delete(valkey_key)  # Consume key immediately
            return ("ALLOW", "Single-use 'Allow Once' grant consumed.")

        # Tier 2 & Tier 3: Query AlloyDB user_permissions table
        query_sql = """
            SELECT command_pattern, action, project_id
            FROM user_permissions
            WHERE user_id = %s AND tool_name = %s AND project_id IN (%s, 'global')
            ORDER BY CASE WHEN project_id = %s THEN 1 ELSE 2 END;
        """

        with self.db_conn.cursor() as cur:
            cur.execute(query_sql, (user_id, tool_name, project_id, project_id))
            rules = cur.fetchall()
            for pattern, action, scope in rules:
                if re.search(pattern, command_str, flags=re.IGNORECASE):
                    return (action, f"Matched {scope}-scoped rule: {pattern}")

        # Fallback: Prompt Human User
        return ("PROMPT_USER", "No matching permission rule found.")

    def compact_old_memories(self, user_id: str, retention_days: int = 30) -> None:
        """Consolidates old episodic facts from episodic_memory_embeddings into a summary with a 50-row cap."""
        prompt_prefix = (
            "Summarize the following historical events into a high-density long-term memory paragraph. "
            "Retain key constraints, tool choices, and project rules:\n"
        )

        # Capped CTE prevents string_agg from exceeding model context window limits
        compaction_sql = """
            WITH old_events AS (
                SELECT document AS content
                FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            ),
            consolidated AS (
                SELECT ai.generate(%s || string_agg(content, E'\n')) AS summary_text
                FROM old_events
            )
            INSERT INTO agent_entities (user_id, entity_name, summary, updated_at)
            SELECT %s, 'longterm_session_summary', summary_text, NOW()
            FROM consolidated
            WHERE summary_text IS NOT NULL
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET summary = EXCLUDED.summary, updated_at = NOW();
        """

        prune_sql = """
            DELETE FROM episodic_memory_embeddings
            WHERE uuid IN (
                SELECT uuid FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            );
        """

        try:
            with self.db_conn:
                with self.db_conn.cursor() as cur:
                    cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                    cur.execute(compaction_sql, (user_id, retention_days, prompt_prefix, user_id))
                    cur.execute(prune_sql, (user_id, retention_days))
            logger.info("Successfully compacted old memories for user %s", user_id)
        except Exception as e:
            logger.error("Error during memory compaction: %s", e)
13. เรียกใช้การยืนยันความจำแบบหลายรอบจากต้นทางถึงปลายทาง
ภาพรวมวัตถุประสงค์และสถาปัตยกรรม
ในโมดูลสุดท้ายนี้ คุณจะสร้างและเรียกใช้สคริปต์การยืนยันแบบครบวงจรหลัก (test_memory_system.py) เพื่อตรวจสอบสถาปัตยกรรมหน่วยความจำแบบ 2 ระดับที่สมบูรณ์
- การจำลองการสนทนาหลายรอบและหลายเซสชัน:
- เซสชันที่ 1 (เทิร์นที่ 1): กำหนดค่ากำหนดของนักพัฒนาซอฟต์แวร์แบบสากล (
scope='global': UI โหมดมืด, Python 3.11, PostgreSQL) - เซสชันที่ 1 (เทิร์นที่ 2): กำหนดสถาปัตยกรรมเฉพาะโปรเจ็กต์ (
project_id='CloudRetail': FastAPI, AlloyDB, Valkey, ขีดจำกัดการหมดเวลา 30 วินาที, us-east1) - เซสชันที่ 1 (รอบที่ 3 และ 4): สร้างสัญญาณรบกวนจากบทสนทนาทางเทคนิคและเกิน
trigger_limit=3เพื่อทริกเกอร์การบีบอัดข้อมูลสรุปแบบต่อเนื่องของ Valkey Summarize-Before-Trim - เซสชันที่ 2 (เทิร์นที่ 5 - รหัสเซสชันใหม่): ค้นหา Agent ในเซสชันต่างๆ เพื่อยืนยันการเรียกคืนการตั้งค่าส่วนกลางและกฎของโปรเจ็กต์ข้ามเซสชัน
- เซสชันที่ 1 (เทิร์นที่ 1): กำหนดค่ากำหนดของนักพัฒนาซอฟต์แวร์แบบสากล (
- การตรวจสอบประสิทธิภาพและความแม่นยำแบบไดนามิก: วัดอักขระ/โทเค็นของพรอมต์ที่แน่นอน, % การลดขนาดพรอมต์, เวลาในการตอบสนองของการอนุมาน, สรุปการหมุนเวียนของ Valkey, การแยกขอบเขต และนโยบายความปลอดภัยในการเรียกใช้เครื่องมือ
การติดตั้งใช้งานและซอร์สโค้ด
สร้างสคริปต์การทดสอบ test_memory_system.py ในไดเรกทอรีการทำงานของคุณ
import os
import time
import logging
from google import genai
from db_clients import get_db_connection, get_valkey_client
from async_worker import AsyncMemoryWorker
from hybrid_retriever import retrieve_hybrid_entities
from agent_orchestrator import run_agent_turn
from enterprise_engine import AgentMemoryEngine
from valkey_buffer import get_session_context_buffer, IN_MEMORY_VALKEY_FALLBACK, get_valkey_compaction_tokens

logging.basicConfig(level=logging.WARNING)
logging.getLogger("google_genai").setLevel(logging.WARNING)
logging.getLogger("httpx").setLevel(logging.WARNING)

PROJECT_ID = os.getenv("PROJECT_ID")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")

db_conn = get_db_connection()
valkey_client = get_valkey_client()
client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)

async_worker = AsyncMemoryWorker(get_db_connection, client)
engine = AgentMemoryEngine(valkey_client, db_conn)

USER_ID = "user_dev_42"
SESSION_1 = "sess_2026_01"
SESSION_2 = "sess_2026_02"

test_accuracy = []

print("\n==================================================")
print("STARTING ENHANCED 2-TIER AGENT MEMORY VERIFICATION TEST")
print("==================================================")

# TURN 1: Universal Global Developer Preference Definition
print("\n[SESSION 1 - TURN 1: Global Preference Definition]")
prompt_1 = "Hi! As universal coding preferences across all my projects, I prefer Dark Mode UI and standardizing on Python 3.11 with PostgreSQL."
print(f"User Prompt:\n{prompt_1}")
resp_1, sys_prompt_1, latency_1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_1, project_id=None, trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_1[:140]}...")
time.sleep(2)

# TURN 2: Project-Specific Architecture Definition
print("\n[SESSION 1 - TURN 2: Project CloudRetail Architecture Definition]")
prompt_2 = (
    "Now I am starting project CloudRetail. Here are the specific project requirements:\n"
    "1. Backend Stack: Python with FastAPI on AlloyDB.\n"
    "2. Short-Term Cache: Memorystore for Valkey.\n"
    "3. Security Rules: All tool execution timeouts must be capped at 30 seconds.\n"
    f"4. Deployment Region: {REGION}."
)
print(f"User Prompt:\n{prompt_2}")
resp_2, sys_prompt_2, latency_2 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_2, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_2[:140]}...")
time.sleep(2)

# TURN 3: Context Inflation / Technical Dialogue Noise
print("\n[SESSION 1 - TURN 3: Large Context Inflation (Dialogue Noise)]")
prompt_3 = (
    "Let's draft a sample 50-line PostgreSQL DDL script for product catalog indexes, "
    "including HNSW vector index tuning parameters (m = 16, ef_construction = 64), "
    "and full-text RUM search indexes on item title and description columns."
)
print(f"User Prompt:\n{prompt_3}")
resp_3, sys_prompt_3, latency_3 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_3, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_3[:140]}...")
time.sleep(2)

# TURN 4: Triggering Valkey Summarize-Before-Trim Threshold (8 messages > 6 message trigger limit)
print("\n[SESSION 1 - TURN 4: Triggering Valkey Rolling Summary Compaction]")
prompt_4_s1 = "Can you also add rate-limiting middleware rules for API endpoints?"
print(f"User Prompt:\n{prompt_4_s1}")
resp_4_s1, sys_prompt_4_s1, latency_4_s1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_4_s1, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_4_s1[:140]}...")

# VERIFY VALKEY SHORT-TERM ROLLING SUMMARY
print("\n==================================================")
print("VALKEY SHORT-TERM ROLLING SUMMARY VERIFICATION")
print("==================================================")
buffer_data = get_session_context_buffer(valkey_client, SESSION_1)
valkey_summary_text = buffer_data["rolling_summary"]
valkey_turns = buffer_data["recent_turns"]

used_fallback = bool(IN_MEMORY_VALKEY_FALLBACK)
storage_backend = "Local In-Memory Fallback (Outside VPC)" if used_fallback else "Memorystore for Valkey (VPC Network)"

has_valkey_summary = bool(valkey_summary_text)
print(f" • Short-Term Cache Storage Target:             [{storage_backend}]")
print(f" • Valkey Rolling Summary Generated for Session 1: {has_valkey_summary}")
print(f"   Summary Content: {valkey_summary_text}")
print(f" • Remaining Raw Turns in Valkey Sliding Window:  {len(valkey_turns)} messages (Trimmed from 8)")

test_accuracy.append(("Valkey Rolling Summary Compaction Test", "PASS" if has_valkey_summary else "FAIL"))

# Wait for background entity extraction worker
print("\n[Waiting for background entity extraction worker to process & vectorize all extracted entities...]")
time.sleep(6)

print("\n==================================================")
print("EXTRACTED ENTITIES STORED IN ALLOYDB LONG-TERM MEMORY")
print("==================================================")
with db_conn.cursor() as cur:
    cur.execute(
        "SELECT entity_name, project_id, scope, summary, (summary_embedding IS NOT NULL) FROM agent_entities WHERE user_id = %s ORDER BY updated_at DESC;",
        (USER_ID,)
    )
    extracted = cur.fetchall()
    for name, p_id, s_scope, summary, has_vector in extracted:
        print(f" • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}' | Vector Generated: {has_vector}")
        print(f"   Summary: {summary}")

# TURN 5: Cross-Session Temporal & Scope Recall (Brand New Session ID)
print("\n[SESSION 2 - TURN 5 (Cross-Session Query in New Session ID)]")
prompt_4 = "What are my general coding preferences and the backend/timeout rules I chose for CloudRetail in my previous session?"
print(f"User Prompt:\n{prompt_4}")
resp_4, sys_prompt_4, latency_4 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_2, prompt_4, prev_session_id=SESSION_1, project_id="CloudRetail")
print(f"\nAI Answer:\n{resp_4}")

# VERIFICATION OF RETRIEVED ENTITIES (Checking Scope Precision)
retrieved_scoped_entities = retrieve_hybrid_entities(
    conn=db_conn,
    llm_client=client,
    user_id=USER_ID,
    active_session_id=SESSION_2,
    query_text=prompt_4,
    prev_session_id=SESSION_1,
    project_id="CloudRetail",
    k=20
)

print("\n==================================================")
print("DIAGNOSTIC SCOPE VERIFICATION DETAILS (EXPECTED vs ACTUAL)")
print("==================================================")
print("EXPECTED SPECIFIC ENTITIES & SCOPE:")
print("  1. Global Preference Entity: Retrieved entity with scope == 'global' containing preference facts ('dark mode', 'python 3.11', or 'postgres')")
print("  2. Project Architecture Entity: Retrieved entity with project_id == 'CloudRetail' containing tech stack facts ('fastapi', 'alloydb', 'valkey', or 'timeout')")
print(f"\nACTUAL RETRIEVED ENTITIES (Count: {len(retrieved_scoped_entities)}):")
if not retrieved_scoped_entities:
    print("  [NONE RETRIEVED! Vector/Fulltext search returned 0 matches]")
for ent_name, ent_info in retrieved_scoped_entities.items():
    print(f"  • Entity Name: '{ent_name}'")
    print(f"    - scope:      '{ent_info.get('scope')}'")
    print(f"    - project_id: '{ent_info.get('project_id')}'")
    print(f"    - summary:    '{ent_info.get('summary')}'")

print("\nDATABASE CHECK - ALL ROWS STORED IN agent_entities TABLE:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    db_rows = cur.fetchall()
    if not db_rows:
        print("  [DATABASE TABLE IS EMPTY! No entities were upserted by background worker]")
    for r in db_rows:
        print(f"  • DB Row: entity_name='{r[0]}' | project_id='{r[1]}' | scope='{r[2]}' | summary='{r[3]}'")

# SPECIFIC FACT & SCOPE VERIFICATION LOGIC
found_global_preference = False
matched_global_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("scope") == "global" and any(kw in combined_text for kw in ["dark mode", "python", "postgres"]):
        found_global_preference = True
        matched_global_entity = ent_name
        break

found_project_architecture = False
matched_project_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("project_id") == "CloudRetail" and any(kw in combined_text for kw in ["fastapi", "alloydb", "valkey", "timeout"]):
        found_project_architecture = True
        matched_project_entity = ent_name
        break

print("\n--------------------------------------------------")
print("METADATA SCOPE PRECISION VERIFICATION RESULTS:")
print(f" • Global Preference Fact Retrieved (scope='global'):        {found_global_preference} (Matched Entity: '{matched_global_entity}')")
print(f" • Project Architecture Fact Retrieved (project_id='CloudRetail'): {found_project_architecture} (Matched Entity: '{matched_project_entity}')")
print("--------------------------------------------------")

test_accuracy.append(("Global Coding Preference Recall Test (scope='global')", "PASS" if found_global_preference else "FAIL"))
test_accuracy.append(("Project CloudRetail Architecture Recall Test (project_id='CloudRetail')", "PASS" if found_project_architecture else "FAIL"))

# PERMISSION TEST
perm_action, reason = engine.evaluate_tool_permission(
    user_id=USER_ID, project_id="CloudRetail", session_id=SESSION_2,
    tool_name="run_command", tool_args={"CommandLine": "pytest --timeout=30"}
)
test_accuracy.append(("Tool Permission Policy Test", "PASS" if perm_action in ("allow", "PROMPT_USER") else "FAIL"))

# DYNAMIC TOKEN & LATENCY METRICS CALCULATION
active_prompt_chars_turn5 = len(sys_prompt_4)
active_tokens_turn5 = max(1, active_prompt_chars_turn5 // 4)

# Naive Un-compacted Full History Prompt Tokens for Turn 5
raw_history_chars = len(prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4)
naive_turn5_chars = raw_history_chars + 18000
naive_tokens_turn5 = naive_turn5_chars // 4

active_prompt_reduction_pct = ((naive_tokens_turn5 - active_tokens_turn5) / naive_tokens_turn5) * 100

# Cumulative Multi-Turn Tokens Comparison (Active Read-Path Prompts + Background Extraction & Compacting)
total_active_tokens = sum([
    len(p) // 4 for p in [sys_prompt_1, sys_prompt_2, sys_prompt_3, sys_prompt_4_s1, sys_prompt_4]
])
background_extraction_tokens = async_worker.total_extraction_tokens
background_valkey_summary_tokens = get_valkey_compaction_tokens()

total_tiered_system_tokens = total_active_tokens + background_extraction_tokens + background_valkey_summary_tokens

# Naive Cumulative Tokens across all 5 turns as full transcript grows continuously
naive_cumulative_tokens = sum([
    (len(p) + 18000) // 4 for p in [
        prompt_1,
        prompt_1 + resp_1 + prompt_2,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4
    ]
])

total_system_token_savings_pct = ((naive_cumulative_tokens - total_tiered_system_tokens) / naive_cumulative_tokens) * 100

# FINAL SUMMARY REPORT
print("\n==================================================")
print("FINAL AGENT MEMORY SYSTEM SUMMARY REPORT")
print("==================================================")

print("\n1. STORED ALLOYDB ENTITIES:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    for name, p_id, s_scope, summary in cur.fetchall():
        print(f"   • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}'")
        print(f"     Summary: {summary}")

print("\n2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:")
print(f"   • Naive Full-Context Turn 5 Tokens:    ~{naive_tokens_turn5:,} tokens ({naive_turn5_chars:,} chars)")
print(f"   • Tiered Memory Active Prompt Tokens:  ~{active_tokens_turn5:,} tokens ({active_prompt_chars_turn5:,} chars)")
print(f"   • Active Turn 5 Prompt Reduction:      {active_prompt_reduction_pct:.1f}% Reduction")
print(f"   • Measured Turn 5 Inference Latency:   {latency_4:.2f} seconds")

print("\n3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):")
print(f"   • Naive Cumulative Multi-Turn Tokens:  ~{naive_cumulative_tokens:,} tokens")
print(f"   • Active Read-Path Prompt Tokens:      ~{total_active_tokens:,} tokens (Across 5 Turns)")
print(f"   • Background Worker Tokens (Extraction):~{background_extraction_tokens:,} tokens (4 Background Turns)")
print(f"   • Background Compaction Tokens (Valkey):~{background_valkey_summary_tokens:,} tokens (1 Compaction Call)")
print(f"   • Total Tiered System Token Footprint: ~{total_tiered_system_tokens:,} tokens")
print(f"   • Overall System Token Savings:        {total_system_token_savings_pct:.1f}% Total Reduction")

print("\n4. ACCURACY & VERIFICATION TESTS:")
all_pass = True
for name, status in test_accuracy:
    print(f"   • {name}: [{status}]")
    if status != "PASS":
        all_pass = False

print("\n==================================================")
print(f"OVERALL STATUS: {'ALL TESTS PASSED ✔' if all_pass else 'VERIFICATION FAILED ✖'}")
print("==================================================")
เรียกใช้สคริปต์การยืนยัน
เรียกใช้สคริปต์ใน Cloud Shell โดยทำดังนี้
python3 test_memory_system.py
เอาต์พุตคอนโซลที่คาดไว้
ที่ส่วนท้ายของเอาต์พุตการทดสอบ ระบบจะพิมพ์สรุปผลการค้นพบ ด้านล่างนี้คือตัวอย่างเอกสารที่พิมพ์ออกมาพร้อมคำอธิบาย
1. STORED ALLOYDB ENTITIES: <A List of all stored entities,>
   • Entity: '<name of entity>' | Project: '<which project does this relate to>' | Scope: '<global/project/session>'
     Summary: <The entity summary>
    ....

2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:
   • Naive Full-Context Turn 5 Tokens:    <Number of tokens in naive approach on the last turn>
   • Tiered Memory Active Prompt Tokens:  <Number of tokens in tiered approach on the last turn>
   • Active Turn 5 Prompt Reduction:      <Savings on tokens in %>
   • Measured Turn 5 Inference Latency:   <Latency in last turn>

3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):
   • Naive Cumulative Multi-Turn Tokens:  <Total tokens in the naive approach>
   • Active Read-Path Prompt Tokens:      <Read path tokens in the tiered approach>
   • Background Worker Tokens (Extraction): <Backround process tokens usage in tiered approach>
   • Background Compaction Tokens (Valkey): <Backround process tokens usage for compaction in tiered approach>
   • Total Tiered System Token Footprint: <Total tokens usage in tiered approach>
   • Overall System Token Savings:        <Savings on tokens in %>

4. ACCURACY & VERIFICATION TESTS:
   • Valkey Rolling Summary Compaction Test: <Did the roling summary work>
   • Global Coding Preference Recall Test (scope='global'): <Was it able to retrieve global scoped memories>
   • Project CloudRetail Architecture Recall Test (project_id='CloudRetail'): <Was it able to retrieve project specific scoped entities>
   • Tool Permission Policy Test: <Was it able to retrieve permissions policies>
รีเซ็ตร้านค้าความทรงจำ (ไม่บังคับ)
หากต้องการล้างความทรงจำที่จัดเก็บไว้ทั้งหมดและรีเซ็ตสถานะ Valkey และ AlloyDB ระหว่างการทดสอบ ให้สร้างและเรียกใช้ cleanup_memory_system.py
import logging
from db_clients import get_db_connection, get_valkey_client
from valkey_buffer import IN_MEMORY_VALKEY_FALLBACK

logging.basicConfig(level=logging.INFO)

def reset_memory_system():
    # 1. Flush short-term Valkey cache or clear local in-memory fallback
    try:
        valkey = get_valkey_client()
        valkey.flushdb()
        print("✔ Flushed Valkey short-term cache.")
    except Exception:
        IN_MEMORY_VALKEY_FALLBACK.clear()
        print("✔ Cleared local in-memory short-term fallback buffer.")

    # 2. Truncate long-term AlloyDB memory tables
    try:
        conn = get_db_connection()
        with conn:
            with conn.cursor() as cur:
                cur.execute("TRUNCATE TABLE agent_entities CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_embeddings CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_collections CASCADE;")
                cur.execute("TRUNCATE TABLE user_permissions CASCADE;")
                print("✔ Truncated AlloyDB long-term memory tables.")
        conn.close()
    except Exception as e:
        print(f"✖ AlloyDB cleanup error: {e}")

if __name__ == "__main__":
    reset_memory_system()
เรียกใช้สคริปต์การล้างข้อมูล
python3 cleanup_memory_system.py
14. ขยายการใช้งานหน่วยความจำแบบแบ่งชั้นไปยัง Google ADK
ในขั้นตอนก่อนหน้า คุณได้สร้างระบบความจำ 2 ระดับ ดังนี้
- ระดับที่ 1 (บัฟเฟอร์ระยะสั้น): Memorystore สำหรับ Valkey จะจัดเก็บเทิร์นการสนทนาล่าสุดและสร้างข้อมูลสรุปแบบต่อเนื่องเพื่อให้พรอมต์มีขนาดเล็ก
- ระดับ 2 (ร้านค้าแบบไฮบริดระยะยาว): AlloyDB AI จะจัดเก็บค่ากำหนดของผู้ใช้ กฎของโปรเจ็กต์ และการฝังเวกเตอร์ที่คงทนโดยใช้การค้นหาแบบไฮบริด
ในคู่มือนี้ คุณจะได้เชื่อมต่อเครื่องมือความทรงจำนี้กับเอเจนต์ที่กำหนดเองซึ่งสร้างด้วย Google Agent Development Kit
ปัญหาเกี่ยวกับหน่วยความจำแบบง่าย
การเชื่อมต่อเอเจนต์กับหน่วยความจำมักจะนำไปสู่กับดัก 1 ใน 2 อย่างต่อไปนี้
- การใช้เครื่องมือเท่านั้น: บังคับให้ตัวแทนเรียกใช้เครื่องมือ (เช่น
search_memory) สำหรับทุกอย่าง Agent มักลืมเรียกใช้เครื่องมือสำหรับค่ากำหนดพื้นฐาน (เช่น รูปแบบการเขียนโค้ดหรือการหมดเวลา) ซึ่งทำให้เกิดข้อผิดพลาดและรอบการรับส่งเพิ่มเติมที่ช้า - กับดักการยัดพรอมต์: การทิ้งประวัติที่ผ่านมาทั้งหมดลงในทุกพรอมต์ ซึ่งจะทำให้ค่าใช้จ่ายโทเค็นเพิ่มขึ้นอย่างรวดเร็ว ทำให้การตอบกลับช้าลง และลดความสามารถในการให้เหตุผลของโมเดล
โซลูชันแบบผสม
เราใช้แนวทางแบบผสมที่ช่วยให้ตัวแทนมีหน่วยความจำที่เหมาะสมในเวลาที่เหมาะสม ดังนี้
- บริบทแวดล้อม (อัตโนมัติ): ก่อนถึงทุกเทิร์น ระบบจะดึงกฎของโปรเจ็กต์ที่เกี่ยวข้องและสรุปเซสชันล่าสุดจาก Memorystore (สรุปแบบต่อเนื่อง) และ AlloyDB (กฎและการตั้งค่า) จากนั้นจะแทรกข้อมูลดังกล่าวลงในพรอมต์ของเอเจนต์โดยไม่ต้องเรียกใช้ LLM เพิ่มเติม
- การค้นหาระยะยาวแบบออนดีมานด์ (เครื่องมือ): สำหรับข้อเท็จจริงที่เก่าหรือคลุมเครือ (เช่น การตัดสินใจด้านสถาปัตยกรรมเมื่อ 2 สัปดาห์ที่แล้ว) เอเจนต์จะเรียกใช้
long_term_memory_toolเพื่อเรียกใช้การค้นหาเวกเตอร์ในตารางหน่วยความจำระยะยาวของ AlloyDB - การควบคุมการดำเนินการ: ก่อนที่เอเจนต์จะเรียกใช้เครื่องมือ การควบคุมจะตรวจสอบสิทธิ์แบบใช้ครั้งเดียวใน Valkey และกฎความปลอดภัยใน AlloyDB เพื่อบล็อกการดำเนินการที่เป็นอันตราย เช่น
rm -rf
การตั้งค่าและการกำหนดค่า
ติดตั้งแพ็กเกจ google-adk (ระบบติดตั้งการอ้างอิงอื่นๆ ไว้แล้ว)
pip3 install google-adk
ตั้งค่าภูมิภาค Google Cloud สำหรับไคลเอ็นต์ GenAI ของ ADK เพื่อกำหนดเส้นทางผ่าน Vertex AI โดยทำดังนี้
# ADK agent platform backend
export GEMINI_MODEL="gemini-3.5-flash"
export GOOGLE_GENAI_USE_VERTEXAI="true"
export GOOGLE_CLOUD_PROJECT="${PROJECT_ID}"
export GOOGLE_CLOUD_LOCATION="${GENAI_LOCATION}"
15. ผู้ให้บริการหน่วยความจำแอมเบียนท์
สร้าง adk_memory_provider.py คลาสนี้จัดการวงจรของหน่วยความจำอัตโนมัติ
- ก่อนถึงคิว: ดึงข้อมูลบัฟเฟอร์การสนทนาของ Valkey (<1 มิลลิวินาที) และค้นหาค่ากำหนดที่ตรงกันและกฎของโปรเจ็กต์ใน AlloyDB แล้วประกอบเป็นพรอมต์ของระบบ
- หลังจากผลัดกัน: เพิ่มการสนทนาไปยัง Valkey และทริกเกอร์ Worker ที่ทำงานเบื้องหลังเพื่อดึงข้อเท็จจริงที่คงทนลงใน AlloyDB โดยไม่ทำให้การตอบกลับของผู้ใช้ช้าลง
import logging
from typing import Any, Dict, Optional
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

class ADKTieredMemoryProvider:
    """Provides ambient memory context before turns and saves history after turns."""

    def __init__(self, db_conn_factory, valkey_client: redis.Redis, genai_client: Any, trigger_limit: int = 10, window_size: int = 4):
        self.conn_factory = db_conn_factory
        self.valkey_client = valkey_client
        self.genai_client = genai_client
        self.trigger_limit = trigger_limit
        self.window_size = window_size
        self.async_worker = AsyncMemoryWorker(db_conn_factory, genai_client)

    def get_context_for_turn(self, user_id: str, project_id: Optional[str], session_id: str, user_query: str, prev_session_id: Optional[str] = None) -> Dict[str, Any]:
        """Reads Valkey buffer (<1ms) and AlloyDB hybrid entities before agent reasoning."""
        buffer_data = get_session_context_buffer(self.valkey_client, session_id)
        rolling_summary = buffer_data["rolling_summary"]

        # Carry over prior session summary when starting a fresh session
        if not rolling_summary and prev_session_id:
            prev_buffer = get_session_context_buffer(self.valkey_client, prev_session_id)
            if prev_buffer["rolling_summary"]:
                rolling_summary = f"[From prior session {prev_session_id}]:\n" + prev_buffer["rolling_summary"]

        conn = self.conn_factory()
        try:
            entities = retrieve_hybrid_entities(
                conn=conn, llm_client=self.genai_client, user_id=user_id,
                active_session_id=session_id, query_text=user_query,
                prev_session_id=prev_session_id, project_id=project_id, k=20
            )
        finally:
            conn.close()

        return {
            "rolling_summary": rolling_summary,
            "recent_turns": buffer_data["recent_turns"],
            "retrieved_entities": entities
        }

    def format_system_instruction(self, context: Dict[str, Any], base_prompt: str = "") -> str:
        """Injects ambient entities and short-term summaries into the agent's prompt."""
        entity_lines = [f"- {name}: {info['summary']}" for name, info in context["retrieved_entities"].items()]
        entity_str = "\n".join(entity_lines) if entity_lines else "No relevant long-term entities."
        summary_str = context["rolling_summary"] or "No prior summary."

        return f"""{base_prompt}

[LONG-TERM PREFERENCES & ENTITIES]
{entity_str}

[SHORT-TERM ROLLING SUMMARY]
{summary_str}

[NOTE ON TOOLS & MEMORY]
Memory persistence is managed automatically by the platform behind the scenes. Do not attempt to invoke non-existent tools like 'set_preference' or 'save_fact'. Only invoke explicitly declared tools when needed.
""".strip()

    def record_turn_async(self, user_id: str, project_id: Optional[str], session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None) -> None:
        """Updates Valkey sliding window and triggers background AlloyDB extraction."""
        append_session_turn_with_rolling_summary(
            valkey_client=self.valkey_client, llm_client=self.genai_client,
            session_id=session_id, user_msg=user_msg, ai_msg=ai_msg,
            trigger_limit=self.trigger_limit, window_size=self.window_size
        )
        self.async_worker.enqueue_extraction(
            user_id=user_id, session_id=session_id, user_msg=user_msg,
            ai_msg=ai_msg, prev_session_id=prev_session_id
        )
16. เครื่องมือความทรงจำระยะยาวแบบออนดีมานด์
หน่วยความจำแอมเบียนต์จะทำให้พรอมต์ที่ใช้งานอยู่มีขนาดเล็ก แต่บางครั้งเอเจนต์ก็จำเป็นต้องค้นหาโน้ตเก่าๆ ในอดีต การตัดสินใจด้านสถาปัตยกรรม หรือบันทึกเหตุการณ์
สร้าง adk_memory_tools.py ซึ่งจะรวมepisodic_memory_embeddingsตารางเวกเตอร์ของ AlloyDB ไว้ใน FunctionTool ของ ADK ดังนี้
from typing import Any, Dict, List, Optional
from google.adk.tools import FunctionTool

def make_long_term_memory_tool(db_conn_factory, embed_client: Any, user_id: str) -> FunctionTool:
    """Creates an ADK FunctionTool for vector search over AlloyDB historical records."""

    def search_archived_memory(query: str, project_id: Optional[str] = None, limit: int = 3) -> List[Dict[str, Any]]:
        """Searches past architecture decisions, historical notes, and old discussions."""
        # 1. Embed query with text-embedding-005
        emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=query)
        query_vector = emb_resp.embeddings[0].values

        # 2. Cosine distance search on AlloyDB HNSW vector index
        sql = """
            SELECT document, cmetadata, created_at, 1 - (embedding <=> %s::vector) AS similarity
            FROM episodic_memory_embeddings
            WHERE cmetadata->>'user_id' = %s
              AND (%s IS NULL OR cmetadata->>'project_id' = %s)
            ORDER BY embedding <=> %s::vector ASC
            LIMIT %s;
        """
        conn = db_conn_factory()
        results = []
        try:
            with conn.cursor() as cur:
                cur.execute(sql, (str(query_vector), user_id, project_id, project_id, str(query_vector), limit))
                for doc, meta, created_at, similarity in cur.fetchall():
                    results.append({
                        "document": doc,
                        "metadata": meta,
                        "timestamp": created_at.isoformat() if created_at else None,
                        "similarity": round(float(similarity), 4)
                    })
        finally:
            conn.close()
        return results

    return FunctionTool(search_archived_memory)
17. การจำกัดขอบเขตของสิทธิ์ระดับองค์กร
เอเจนต์อัตโนมัติต้องไม่ดำเนินการที่เป็นอันตรายต่อโฮสต์ (เช่น rm -rf หรือการดรอปตาราง) โดยไม่ผ่านการยืนยัน
วิธีการทำงานของ before_tool_callback ใน ADK
ADK มี Hook การสกัดกั้นที่ทำงานก่อนที่เครื่องมือจะดำเนินการ
- ส่งคืน
None: ADK อนุญาตให้ดำเนินการเครื่องมือ - ส่งคืนพจนานุกรม (เช่น
{"status": "DENIED", "error": ...}): ADK จะหยุดการดำเนินการทันที ไม่มีการเรียกใช้คำสั่งใดๆ และระบบจะส่งเหตุผลที่ปฏิเสธกลับไปยังโมเดลเพื่อให้โมเดลอธิบายข้อจำกัดแก่ผู้ใช้ได้
ลำดับการตรวจสอบสิทธิ์
- ตรวจสอบ 0 (การอนุญาตเครื่องมือที่ปลอดภัย): เครื่องมือแบบอ่านอย่างเดียวที่ปลอดภัย เช่น
search_archived_memoryจะได้รับการอนุมัติล่วงหน้าในหน่วยความจำเพื่อให้ตัวแทนค้นหาหน่วยความจำของตัวเองได้เสมอ - ระดับที่ 1 (การให้สิทธิ์แบบ "อนุญาตครั้งเดียว" ชั่วคราวใน Valkey): เมื่อผู้ปฏิบัติงานที่เป็นมนุษย์อนุมัติการดำเนินการที่มีความเสี่ยง ระบบจะจัดเก็บคีย์ชั่วคราว
one_time_perm:{session_id}:{cmd_hash}ไว้ใน Valkey โดยมี TTL 5 นาที การป้องกันจะอ่านและลบคีย์ในการดำเนินการแบบอะตอมิกครั้งเดียว ซึ่งจะช่วยให้คำสั่งทำงานได้เพียงครั้งเดียวและป้องกันไม่ให้มีการเพิ่มสิทธิ์อย่างถาวร - ระดับที่ 2 (กฎของโปรเจ็กต์ใน AlloyDB): ตรวจสอบกฎนิพจน์ทั่วไปใน
user_permissionsสำหรับโปรเจ็กต์ที่ใช้งานอยู่ (เช่น อนุญาตpytest.*--timeout=30บล็อกrm -rf.*) - ระดับที่ 3 (กฎส่วนกลางใน AlloyDB): ตรวจสอบกฎสำรองที่ใช้กับทุกโปรเจ็กต์
- การสำรองข้อมูลแบบปิดล้ม: หากไม่มีกฎใดตรงกัน ระบบจะปฏิเสธการดำเนินการด้วย
PENDINGซึ่งต้องมีการตรวจสอบจากเจ้าหน้าที่
การใช้งาน
สร้าง adk_guardrails.py:
import logging
from typing import Any, Dict, Optional, Tuple, Set
from enterprise_engine import AgentMemoryEngine

logger = logging.getLogger(__name__)

class ADKPermissionGuardrail:
    """Evaluates tool permissions using Valkey allow-once tokens and AlloyDB rules."""

    def __init__(self, memory_engine: AgentMemoryEngine, exempt_tools: Optional[Set[str]] = None):
        self.engine = memory_engine
        self.exempt_tools = exempt_tools or {"search_archived_memory"}

    def evaluate(self, user_id: str, project_id: str, session_id: str, tool_name: str, tool_args: Dict[str, Any]) -> Tuple[bool, str]:
        # 1. Allowlist safe internal tools
        if tool_name in self.exempt_tools:
            return True, f"Internal tool '{tool_name}' is pre-approved."

        # 2. Check 3-tier policy engine
        action, reason = self.engine.evaluate_tool_permission(
            user_id=user_id, project_id=project_id, session_id=session_id,
            tool_name=tool_name, tool_args=tool_args
        )
        if action.upper() == "ALLOW":
            return True, f"Permission ALLOWED: {reason}"
        elif action.upper() == "BLOCK":
            return False, f"Permission BLOCKED: {reason}"
        return False, f"Permission PENDING: {reason} (requires human confirmation)"

    def create_before_tool_callback(self, user_id: str, default_project_id: str = "global"):
        """Creates the callback hook for Agent(before_tool_callback=...)."""
        def before_tool_callback(tool: Any, args: Dict[str, Any], tool_context: Any) -> Optional[Dict[str, Any]]:
            tool_name = getattr(tool, "name", str(tool))
            session_id = getattr(getattr(tool_context, "session", None), "id", "default_session")

            allowed, msg = self.evaluate(user_id, default_project_id, session_id, tool_name, args)
            if not allowed:
                logger.warning("Guardrail blocked '%s': %s", tool_name, msg)
                return {"status": "DENIED", "tool": tool_name, "error": msg}

            return None  # Returning None permits execution in ADK
        return before_tool_callback
18. การเรียกใช้การทดสอบ Agent ของ ADK
สร้าง test_adk_agent.py สคริปต์ที่สมบูรณ์นี้จะเชื่อมต่อคอมโพเนนต์ต่างๆ เข้าด้วยกัน สร้างกฎการตัดสินใจและกฎความปลอดภัยที่เก็บถาวรไว้ เรียกใช้การสนทนา 2 เซสชัน ทดสอบการบีบอัดและการเรียกคืนหน่วยความจำ และยืนยันการบังคับใช้การป้องกัน
import asyncio
import os
import time
from google import genai
from google.genai import types
from google.adk.agents import Agent
from google.adk.runners import Runner
from google.adk.sessions import InMemorySessionService
from google.adk.tools import FunctionTool

from db_clients import get_db_connection, get_valkey_client
from enterprise_engine import AgentMemoryEngine
from adk_memory_provider import ADKTieredMemoryProvider
from adk_memory_tools import make_long_term_memory_tool
from adk_guardrails import ADKPermissionGuardrail
from valkey_buffer import get_session_context_buffer

# Configuration & clients
PROJECT_ID = os.getenv("PROJECT_ID", "chunking-poc-alloydb")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")
GEMINI_MODEL = os.getenv("GEMINI_MODEL", "gemini-3.5-flash")
USER_ID, SESSION_1, SESSION_2 = "user_adk_dev", "sess_adk_001", "sess_adk_002"

db_conn = get_db_connection()
valkey_client = get_valkey_client()
# LLM client for Gemini 3.5 Flash via global multi-region
genai_client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)
# Embeddings client (requires specific regional presence)
embed_client = genai.Client(vertexai=True, project=PROJECT_ID, location=REGION)

tiered_provider = ADKTieredMemoryProvider(get_db_connection, valkey_client, genai_client, trigger_limit=3, window_size=2)
memory_engine = AgentMemoryEngine(valkey_client, db_conn)
guardrail = ADKPermissionGuardrail(memory_engine)

# Tools: Long-term memory search and mock terminal command
long_term_memory_tool = make_long_term_memory_tool(get_db_connection, embed_client, USER_ID)

def run_command(CommandLine: str) -> str:
    """Executes a shell command on the host."""
    return f"Executed: {CommandLine}"

run_command_tool = FunctionTool(run_command)

def seed_database():
    """Seeds a 14-day-old architecture decision and permission rules."""
    doc = "Archived Decision: CloudRetail services must use gRPC keepalive ping intervals of 15 seconds."
    emb = embed_client.models.embed_content(model="text-embedding-005", contents=doc).embeddings[0].values
    conn = get_db_connection()
    try:
        with conn.cursor() as cur:
            cur.execute("""
                INSERT INTO episodic_memory_embeddings (uuid, document, cmetadata, created_at, embedding)
                VALUES (gen_random_uuid(), %s, jsonb_build_object('user_id', %s, 'project_id', 'CloudRetail'), NOW() - INTERVAL '14 days', %s::vector);
            """, (doc, USER_ID, str(emb)))
            cur.execute("""
                INSERT INTO user_permissions (user_id, project_id, tool_name, command_pattern, action)
                VALUES (%s, 'CloudRetail', 'run_command', 'pytest.*--timeout=30', 'ALLOW'),
                       (%s, 'CloudRetail', 'run_command', 'rm -rf.*', 'BLOCK'),
                       (%s, 'global', 'search_archived_memory', '.*', 'ALLOW')
                ON CONFLICT DO NOTHING;
            """, (USER_ID, USER_ID, USER_ID))
        conn.commit()
    finally:
        conn.close()

async def run_turn(runner: Runner, session_id: str, query: str, prev_session_id: str = None) -> str:
    """Fetches ambient memory, executes turn, and saves history in the background."""
    ctx = tiered_provider.get_context_for_turn(USER_ID, "CloudRetail", session_id, query, prev_session_id)
    runner.agent.instruction = tiered_provider.format_system_instruction(
        ctx,
        base_prompt="You are an intelligent Google ADK enterprise developer assistant."
    )
    msg = types.Content(role="user", parts=[types.Part.from_text(text=query)])
    parts = []
    async for event in runner.run_async(user_id=USER_ID, session_id=session_id, new_message=msg):
        if event.content and event.content.parts:
            parts.extend([p.text for p in event.content.parts if p.text])

    response = "".join(parts).strip()
    tiered_provider.record_turn_async(USER_ID, "CloudRetail", session_id, query, response, prev_session_id)
    return response

async def main():
    seed_database()
    sessions = InMemorySessionService()
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_1)

    agent = Agent(
        name="adk_memory_agent", model=GEMINI_MODEL, instruction="Initial instruction",
        tools=[long_term_memory_tool, run_command_tool],
        before_tool_callback=guardrail.create_before_tool_callback(USER_ID, "CloudRetail")
    )
    runner = Runner(agent=agent, session_service=sessions, app_name="agents")

    print("\n--- Session 1: Storing Preferences & Triggering Compaction ---")
    await run_turn(runner, SESSION_1, "I standardize on Python 3.11 with PostgreSQL and Dark Mode UI.")
    await run_turn(runner, SESSION_1, "For project CloudRetail, our backend stack is FastAPI on AlloyDB with Valkey cache and 30s timeouts.")
    await run_turn(runner, SESSION_1, "Draft a quick 5-line SQL table for products.")
    await run_turn(runner, SESSION_1, "Add rate-limiting rules for API endpoints.")

    buf = get_session_context_buffer(valkey_client, SESSION_1)
    print(f"Valkey rolling summary generated: {bool(buf['rolling_summary'])}")
    print(f"Turns in buffer: {len(buf['recent_turns'])} (compacted from 8)")

    print("\nWaiting 6s for background worker entity extraction into AlloyDB...")
    await asyncio.sleep(6)

    print("\n--- Session 2: Cold-Start Ambient Recall ---")
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_2)
    resp = await run_turn(runner, SESSION_2, "What are my coding preferences and the CloudRetail stack from my previous session?", prev_session_id=SESSION_1)
    print(f"Agent response:\n{resp}\n")

    print("\n--- On-Demand Archival Vector Search ---")
    resp_search = await run_turn(runner, SESSION_2, "What was the agreed gRPC keepalive interval from 2 weeks ago?")
    print(f"Agent response:\n{resp_search}\n")

    print("\n--- Guardrail Verification ---")
    blocked, b_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "rm -rf /tmp/data"})
    allowed, a_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "pytest --timeout=30"})
    print(f"rm -rf /tmp/data:    Allowed={blocked} ({b_msg})")
    print(f"pytest --timeout=30: Allowed={allowed} ({a_msg})")

if __name__ == "__main__":
    asyncio.run(main())
การล้างข้อมูลการทดสอบแบบวนซ้ำ
เนื่องจากระบบจะบันทึกบริบทที่ต่อเนื่อง การเรียกใช้การทดสอบหลายครั้งจะต่อท้ายกลุ่มข้อความโต้ตอบไปยัง Valkey อย่างต่อเนื่องและแทรกกฎที่ซ้ำกันลงใน AlloyDB
หากต้องการรีเซ็ตสถานะระหว่างการเรียกใช้ได้อย่างง่ายดาย ให้เรียกใช้สคริปต์ cleanup_memory_system.py ที่คุณสร้างในขั้นตอนก่อนหน้า
python3 cleanup_memory_system.py
python3 test_adk_agent.py
ผลการตรวจสอบ
การทดสอบจะยืนยันลักษณะการทำงานที่สำคัญ 4 อย่างในการทำงานจริง ดังนี้
- ลดโทเค็นพรอมต์ลงอย่างมาก: การบีบอัดของ Valkey จะบีบอัดประวัติการสนทนาให้เป็นสรุปแบบต่อเนื่องที่กระชับ ในการทดสอบของเรา การดำเนินการนี้ช่วยลดขนาดพรอมต์ที่ใช้งานอยู่ได้มากกว่า 92% (จากโทเค็นประมาณ 6,956 โทเค็นเป็นประมาณ 544 โทเค็น) ผลลัพธ์ของคุณอาจแตกต่างกัน
- การเรียกคืนการเริ่มต้นแบบเย็นทันที: ในเซสชันใหม่ (เซสชัน 2) Agent เรียกคืนค่ากําหนดของผู้ใช้ (Python 3.11, PostgreSQL, Dark Mode) และสถาปัตยกรรมโปรเจ็กต์ (FastAPI, การหมดเวลา 30 วินาที) ได้ทันทีโดยไม่ต้องเรียกใช้เครื่องมือใดๆ ฟีเจอร์นี้ทำงานได้ด้วย
ADKTieredMemoryProvider.get_context_for_turnซึ่งดึงบริบทจาก Memorystore และ AlloyDB ก่อนที่จะเรียกใช้ LLM - การเรียกคืนเวกเตอร์ตามต้องการ: เมื่อถูกถามเกี่ยวกับการตัดสินใจเมื่อ 14 วันก่อน Agent ได้เรียกใช้
search_archived_memoryและดึงกฎ Keepalive gRPC ทุก 15 วินาที - ความปลอดภัยที่แน่นอน: เอเจนต์ดำเนินการ
pytest --timeout=30แต่ถูกบล็อกไม่ให้เรียกใช้rm -rf /tmp/dataอย่างเข้มงวด
19. ล้างข้อมูล
หากต้องการหลีกเลี่ยงการเรียกเก็บเงินอย่างต่อเนื่องในบัญชี Google Cloud สำหรับอินสแตนซ์ AlloyDB และ Memorystore ให้ลบทรัพยากรที่สร้างขึ้น
เรียกใช้คำสั่งต่อไปนี้ใน Cloud Shell
# Exit VM and return to Cloud Shell
exit
# Delete Compute Engine development VM
gcloud compute instances delete $VM_NAME \
  --zone=$ZONE \
  --quiet

# Delete AlloyDB primary instance and cluster
gcloud alloydb instances delete $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --quiet

gcloud alloydb clusters delete $ADBCLUSTER \
  --region=$REGION \
  --quiet

# Delete Memorystore for Valkey instance
gcloud memorystore instances delete $VALKEYINSTANCE \
  --location=$REGION \
  --quiet
20. ขอแสดงความยินดี
ยินดีด้วย คุณสร้างสถาปัตยกรรมหน่วยความจำของ AI Agent ระยะยาวแบบ 2 ระดับที่ผสานรวม Memorystore for Valkey และ AlloyDB AI ได้สำเร็จแล้ว
สิ่งที่คุณได้เรียนรู้
- ใช้สถาปัตยกรรมหน่วยความจำ 2 ระดับเพื่อแยกสถานะเซสชันที่ใช้งานระยะสั้นออกจากข้อเท็จจริงแบบถาวรระยะยาว
- ลดขนาดพรอมต์ที่ใช้งานอยู่ได้อย่างมาก และประหยัดการใช้โทเค็นทั้งหมดเมื่อเทียบกับการยัดบริบทแบบง่ายๆ โดยที่ความแม่นยำไม่ลดลง
- การฝังอัตโนมัติแบบธุรกรรมระดับฐานข้อมูล AlloyDB AI ที่กำหนดค่าไว้ (
ai.initialize_embeddings) - ดำเนินการการค้นหาแบบไฮบริด Reciprocal Rank Fusion ดั้งเดิม (
ai.hybrid_search) โดยรวมความคล้ายคลึงของเวกเตอร์ (<=>) กับการค้นหาข้อความแบบเต็มของ PostgreSQL (tsvector) - สร้างเครื่องมือดึงข้อมูลเอนทิตีในเบื้องหลังแบบออฟเธรด (
AsyncMemoryWorker) เครื่องมือประเมินสิทธิ์การดำเนินการของเครื่องมือแบบ 3 ระดับ และเครื่องมือลดขนาดหน่วยความจำของฐานข้อมูล - เชื่อมต่อระบบหน่วยความจำแบบแบ่งชั้นกับ Agent แบบอัตโนมัติโดยใช้ Agent Development Kit (ADK) ของ Google เพื่อบังคับใช้แนวทางเครื่องมือและจัดเตรียมหน่วยความจำแวดล้อม
ขั้นตอนถัดไปและข้อมูลอ้างอิง
- อ่านเอกสารประกอบของ AlloyDB AI
- ดูวิธีเรียกใช้การค้นหาเวกเตอร์แบบไฮบริดใน AlloyDB
- ดูข้อมูลเพิ่มเติมเกี่ยวกับ Memorystore for Valkey