

1. Trước khi bắt đầu
Khi các tác nhân AI xử lý các hoạt động tương tác nhiều lượt kéo dài trong nhiều ngày và thực hiện các tác vụ nhiều bước trong thời gian dài, Mô hình ngôn ngữ lớn (LLM) vẫn vốn dĩ không có trạng thái trong các phiên. Khi người dùng quay lại một tác nhân vào ngày mai, mô hình sẽ bắt đầu từ đầu, trừ phi ứng dụng có thể tái tạo ngữ cảnh cần thiết.
Cách tiếp cận đơn giản đối với vấn đề này là nhồi nhét mã thông báo – nối toàn bộ nhật ký trò chuyện, nhật ký thực thi công cụ và cơ sở mã trực tiếp vào mọi câu lệnh đang hoạt động. Mặc dù cửa sổ ngữ cảnh lớn gồm hàng triệu token giúp điều này có thể thực hiện được về mặt kỹ thuật, nhưng việc nhồi nhét ngữ cảnh sẽ gây ra trở ngại nghiêm trọng về hoạt động: chi phí token tăng theo cấp số nhân ở mỗi lượt, độ trễ phản hồi tăng lên hàng chục giây và các mô hình bị suy giảm ngữ cảnh "mất dấu".
Để xây dựng các tác nhân AI đáng tin cậy, bạn cần có cấu trúc bộ nhớ 2 cấp:
- Bộ nhớ đệm phiên ngắn hạn: Lưu vào bộ nhớ đệm các lượt trò chuyện gần đây trong bộ nhớ đang hoạt động bằng cách sử dụng một cửa sổ trượt có giới hạn mã thông báo. Cấp này yêu cầu các lượt tra cứu trong bộ nhớ có thông lượng cao, dưới một mili giây ở mỗi lượt, khiến Memorystore for Valkey trở thành lựa chọn lý tưởng.
- Bộ nhớ liên tục dài hạn: Lưu trữ các thực thể có cấu trúc, lựa chọn ưu tiên của người dùng và các dữ kiện theo tập trên các phiên. Cấp này yêu cầu tính toàn vẹn giao dịch, bảo mật nhiều người thuê và khả năng truy xuất kết hợp trên dữ liệu quan hệ và vectơ – khiến AlloyDB cho PostgreSQL trở thành lựa chọn phù hợp.
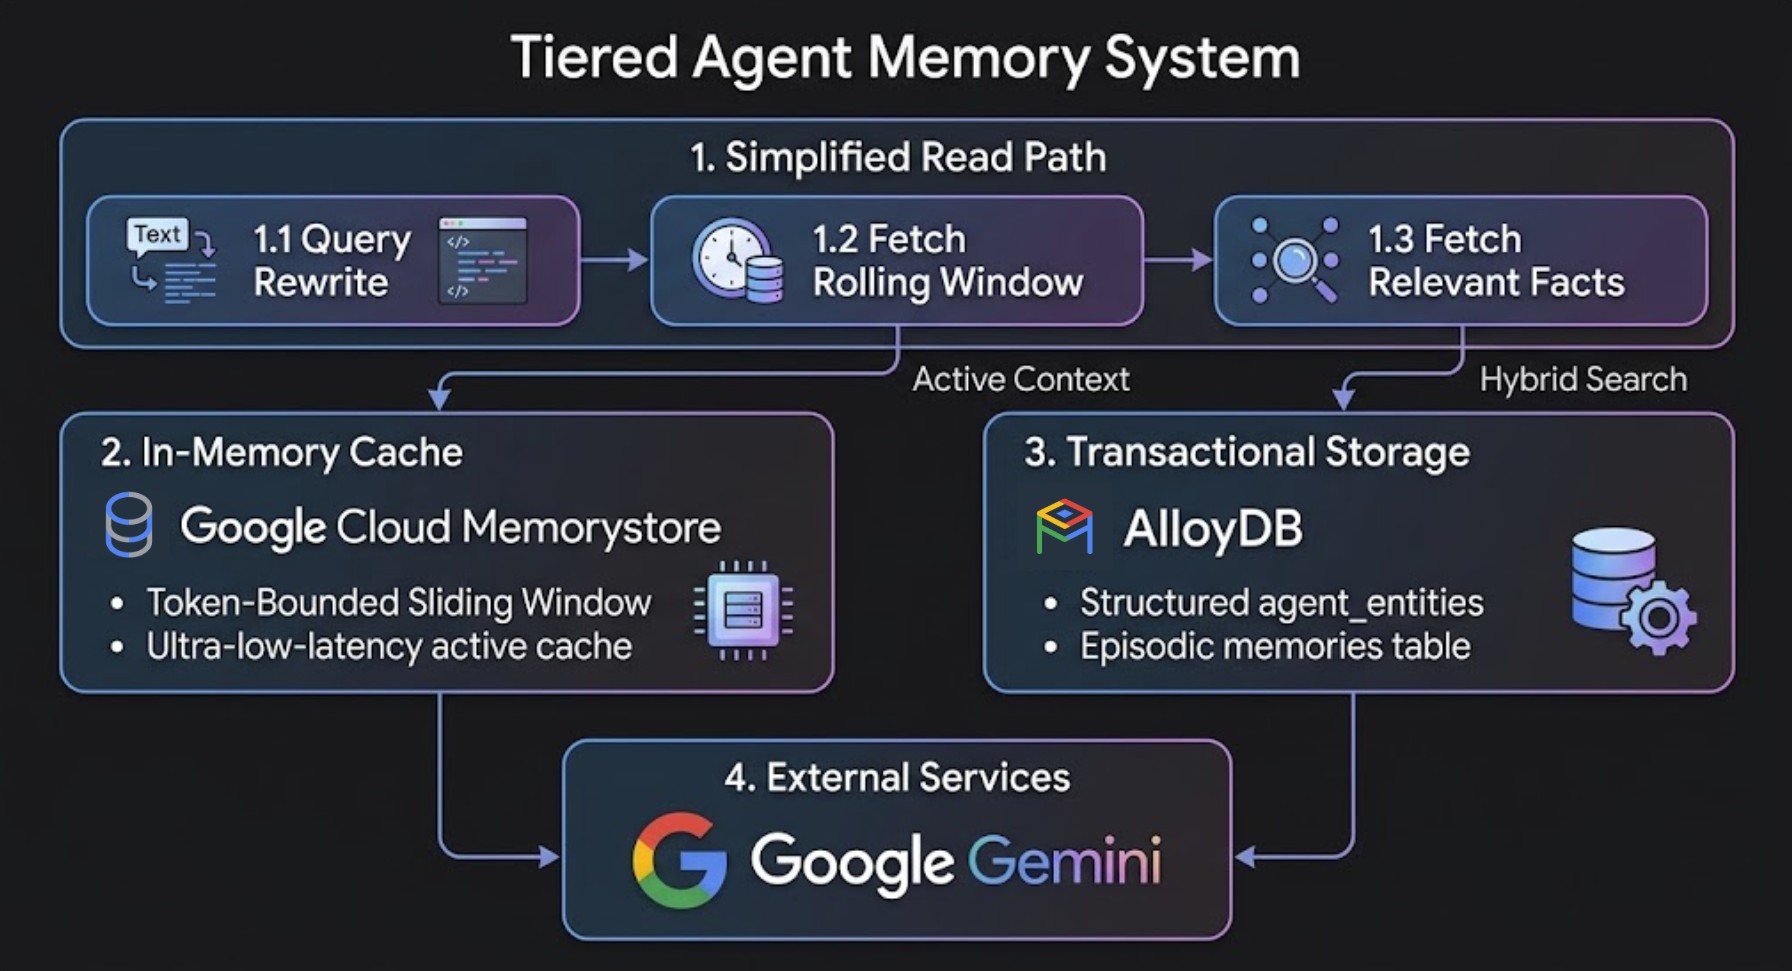
Tìm hiểu về 4 loại kỷ niệm
Một cấu trúc bộ nhớ mạnh mẽ dựa trên 4 loại bộ nhớ bổ sung trong suốt hành trình của người dùng:
Loại bộ nhớ | Nội dung được lưu trữ | Lớp lưu trữ | Tuổi thọ |
Bộ đệm (Ngắn hạn) | Các lượt trò chuyện thô gần đây | Memorystore for Valkey | Phiên đang hoạt động |
Bộ nhớ tóm tắt | Nhật ký nén của các lượt trò chuyện cũ hơn | Memorystore for Valkey | Cửa sổ nhiều lượt |
Trí nhớ tình huống | Các hành động, sự kiện và kết quả của công cụ trước đây | AlloyDB cho PostgreSQL (Vectơ) | Vĩnh viễn |
Bộ nhớ thực thể và quy tắc | Lựa chọn ưu tiên, hạn chế và quyền phủ quyết của người dùng | AlloyDB cho PostgreSQL (SQL có cấu trúc + vectơ) | Vĩnh viễn |
Tác động đo lường được của bộ nhớ theo cấp
Thử nghiệm đo điểm chuẩn nội bộ trên các cuộc trò chuyện phát triển nhiều lượt (hơn 45 lượt với nhật ký đầu ra của công cụ có dung lượng lớn) cho thấy mức tiết kiệm đáng kể so với việc nhồi nhét ngữ cảnh một cách đơn giản:
Chỉ số / phương diện | Nhồi nhét bối cảnh một cách ngây ngô | Bộ nhớ theo cấp (AlloyDB + Memorystore) | Tác động ròng trong quá trình thử nghiệm |
Kích thước lời nhắc đang hoạt động (lượt 45) | 747.033 mã thông báo | 83.262 mã thông báo | Câu lệnh nhỏ hơn 88,9% |
Độ trễ phản hồi 45 | 33,5 giây | 6,7 giây | Phản hồi nhanh hơn 80% |
Mã thông báo phiên tích luỹ | 17,9 triệu mã thông báo | 4.090.000 mã thông báo | Tiết kiệm được 72% tổng số mã thông báo và chi phí |
Nhắc lại quy tắc và ràng buộc | Giảm dần theo lượt | Ngăn chặn việc mất kiến thức quan trọng trong bản tóm tắt | Được giữ lại thông qua tính năng tìm kiếm kết hợp |
Bạn sẽ thực hiện
- Cung cấp AlloyDB cho PostgreSQL và Memorystore cho Valkey.
- Bật
google_ml_integrationvà định cấu hình tính năng tự động nhúng giao dịch phía cơ sở dữ liệu (ai.initialize_embeddings). - Triển khai vùng đệm phiên Valkey ngắn hạn bằng mẫu quy trình tóm tắt trước khi cắt.
- Trích xuất các thực thể dài hạn một cách tự nhiên bằng cách sử dụng các Hàm AI gốc của AlloyDB (tức là
ai.generate) - Truy vấn thông tin thực tế dài hạn, có độ chính xác và mức độ liên quan cao, bằng cách sử dụng hàm Tìm kiếm kết hợp (
ai.hybrid_search) gốc của AlloyDB và tính năng sắp xếp lại Kết hợp thứ hạng tương hỗ (RRF). - Xây dựng một trình đánh giá quyền sử dụng công cụ doanh nghiệp 3 cấp và một công cụ nén bộ nhớ nền.
- Tích hợp trực tiếp cấu trúc bộ nhớ 2 cấp vào một tác nhân tự động bằng Bộ công cụ phát triển tác nhân (ADK) của Google.
Bạn cần có
- Một dự án trên Google Cloud đã bật tính năng thanh toán.
- Một trình duyệt web như Chrome.
- Có kiến thức cơ bản về Python và SQL, bao gồm cả kinh nghiệm chạy các truy vấn SQL đối với AlloyDB – từ Studio, CLI, v.v.
Đối tượng và chi phí
- Đối tượng: Nhà phát triển AI, kỹ sư phụ trợ và kiến trúc sư cơ sở dữ liệu.
- Chi phí ước tính: Các tài nguyên Google Cloud được tạo trong lớp học lập trình này sẽ có chi phí khoảng 1,50 USD.
2. Thiết lập và yêu cầu
Khởi động Cloud Shell
Trong lớp học lập trình này, bạn sẽ chạy các lệnh trong Google Cloud Shell, một cửa sổ dòng lệnh được lưu trữ trên đám mây và được định cấu hình sẵn bằng gcloud, psql và python3.
- Mở Google Cloud Console.
- Nhấp vào Kích hoạt Cloud Shell ở trên cùng bên phải của Bảng điều khiển đám mây.
- Xác minh quy trình xác thực:
gcloud auth list
export PROJECT_ID=<YOUR_PROJECT_ID>
gcloud config set project $PROJECT_ID

export REGION=us-east1
export GENAI_LOCATION=us
export ZONE=us-east1-b
export ADBCLUSTER=agent-memory-cluster
export ADBINSTANCE=agent-memory-instance
export VALKEYINSTANCE=agent-memory-cache
export VM_NAME=agent-dev-vm
Bật Google Cloud API và tạo máy ảo phát triển
Chạy lệnh sau trong Cloud Shell để bật các API bắt buộc:
gcloud services enable \
  alloydb.googleapis.com \
  memorystore.googleapis.com \
  aiplatform.googleapis.com \
  compute.googleapis.com \
  servicenetworking.googleapis.com \
  networkconnectivity.googleapis.com
Tạo một phiên bản máy ảo Compute Engine trong mạng VPC default để lưu trữ môi trường phát triển Python cùng với AlloyDB và Memorystore cho Valkey:
gcloud compute instances create $VM_NAME \
    --zone=$ZONE \
    --machine-type=e2-standard-2 \
    --scopes=cloud-platform \
    --network=default \
    --shielded-secure-boot
3. Cung cấp AlloyDB và Memorystore for Valkey
Trong bước này, bạn sẽ cung cấp cụm và thực thể chính AlloyDB cho PostgreSQL, thiết lập mạng dịch vụ riêng tư và tăng tốc một thực thể Memorystore cho Valkey.
Tạo dải IP cho Private Service Access
AlloyDB yêu cầu một dải IP riêng tư trong mạng Đám mây riêng tư ảo (VPC). Giả sử bạn đang sử dụng mạng VPC default:
- Tạo chế độ phân bổ dải IP riêng tư:
gcloud compute addresses create psa-range \
    --global \
    --purpose=VPC_PEERING \
    --prefix-length=24 \
    --description="VPC private service access" \
    --network=default
- Thiết lập kết nối VPC ngang hàng riêng tư:
gcloud services vpc-peerings connect \
    --service=servicenetworking.googleapis.com \
    --ranges=psa-range \
    --network=default
Tạo Cụm AlloyDB và Thực thể chính
- Tạo mật khẩu cụm ban đầu để khởi tạo hệ thống:
export PGPASSWORD=`openssl rand -hex 12`
- Tạo Cụm dùng thử miễn phí:
gcloud alloydb clusters create $ADBCLUSTER \
    --password=$PGPASSWORD \
    --network=default \
    --region=$REGION \
    --subscription-type=TRIAL
- Tạo phiên bản chính:
gcloud alloydb instances create $ADBINSTANCE \
    --instance-type=PRIMARY \
    --cpu-count=2 \
    --region=$REGION \
    --cluster=$ADBCLUSTER
Cung cấp đối tượng Memorystore for Valkey
Memorystore cho Valkey yêu cầu bạn phải có Chính sách kết nối dịch vụ (gcp-memorystore) trong mạng và khu vực của mình trước khi tạo phiên bản.
- Tạo Chính sách kết nối dịch vụ cho Memorystore:
gcloud network-connectivity service-connection-policies create memorystore-policy \
    --network=default \
    --region=$REGION \
    --service-class=gcp-memorystore \
    --subnets=projects/$PROJECT_ID/regions/$REGION/subnetworks/default
- Tạo phiên bản Memorystore for Valkey:
gcloud memorystore instances create $VALKEYINSTANCE \
    --location=$REGION \
    --shard-count=1 \
    --replica-count=0 \
    --node-type=SHARED_CORE_NANO \
    --psc-auto-connections="network=projects/$PROJECT_ID/global/networks/default,projectId=$PROJECT_ID"
Cấp quyền IAM cho Vertex AI
Cấp cho tài khoản dịch vụ AlloyDB các quyền IAM cần thiết để gọi các mô hình nhúng của Nền tảng tác nhân:
PROJECT_ID=$(gcloud config get-value project)

gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:service-$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")@gcp-sa-alloydb.iam.gserviceaccount.com" \
  --role="roles/aiplatform.user"
4. Khởi động Môi trường và Điểm truy cập
Thiết lập phương thức xác thực IAM và cờ cơ sở dữ liệu AlloyDB
Bật tính năng Xác thực cơ sở dữ liệu IAM (alloydb.iam_authentication=on) và công cụ truy vấn AI (google_ml_integration.enable_ai_query_engine=on) trên phiên bản AlloyDB của bạn:
gcloud beta alloydb instances update $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --update-mode=FORCE_APPLY \
  --database-flags=alloydb.iam_authentication=on,google_ml_integration.enable_ai_query_engine=on
Tiếp theo, hãy thêm tài khoản Google Cloud của bạn làm người dùng cơ sở dữ liệu dựa trên IAM có quyền siêu người dùng:
export USER_ACCOUNT=$(gcloud config get-value account)

gcloud alloydb users create $USER_ACCOUNT \
    --cluster=$ADBCLUSTER \
    --region=$REGION \
    --type=IAM_BASED \
    --db-roles=alloydbsuperuser
Truy xuất điểm cuối VPC nội bộ trong Cloud Shell
Trước khi SSH vào VM phát triển, hãy truy xuất địa chỉ IP VPC nội bộ cho AlloyDB và Memorystore for Valkey trong Cloud Shell:
# Export GCP Project ID, Region, and IAM User
export PROJECT_ID=$(gcloud config get-value project)
export REGION=us-east1
export DB_USER=$(gcloud config get-value account)

# Retrieve Internal VPC IP Addresses for AlloyDB & Memorystore for Valkey
export DB_HOST=$(gcloud alloydb instances describe $ADBINSTANCE --cluster=$ADBCLUSTER --region=$REGION --format="value(ipAddress)")
export DB_PORT=5432
export DB_NAME=postgres

export VALKEY_HOST=$(gcloud memorystore instances describe $VALKEYINSTANCE --location=$REGION --format="value(discoveryEndpoints[0].address)")
export VALKEY_PORT=6379

# Verify exported endpoints
echo "Project ID:        $PROJECT_ID"
echo "Region:            $REGION"
echo "AlloyDB Private IP: $DB_HOST"
echo "IAM DB User:       $DB_USER"
echo "Valkey Private IP:  $VALKEY_HOST"
SSH vào VM phát triển và xuất các biến kết nối
Kết nối SSH từ Cloud Shell vào VM phát triển Compute Engine (agent-dev-vm) nằm trong cùng một mạng VPC:
gcloud compute ssh $VM_NAME --zone=$ZONE
Sau khi đăng nhập vào VM phát triển, hãy xuất cấu hình dự án và đầu ra điểm kết nối ở trên (thay thế
export PROJECT_ID=<YOUR_PROJECT_ID>
export REGION=us-east1
export GENAI_LOCATION=us
export DB_HOST=<YOUR_ALLOYDB_PRIVATE_IP>
export DB_PORT=5432
export DB_NAME=postgres
export DB_USER=<YOUR_IAM_DB_USER>
export VALKEY_HOST=<YOUR_VALKEY_PRIVATE_IP>
export VALKEY_PORT=6379
Khởi chạy Môi trường ảo Python
Trong VM phát triển, trước tiên, hãy tạo thư mục đang làm việc trên máy:
mkdir -p ~/alloydb_agent_memory && cd ~/alloydb_agent_memory
Bây giờ, hãy cài đặt các gói môi trường ảo Python của hệ thống, xác thực Thông tin xác thực mặc định của ứng dụng (ADC) và thiết lập không gian làm việc của bạn:
sudo apt-get update && sudo apt-get install -y python3-venv python3-pip

python3 -m venv venv
source venv/bin/activate
Cuối cùng, trong môi trường ảo mới, chúng ta sẽ cài đặt các phần phụ thuộc:
gcloud auth application-default login
pip install psycopg2-binary valkey redis google-genai
5. Cấu trúc hệ thống và hệ phân cấp mô-đun mã
Tổng quan về những gì bạn đang xây dựng
Trước khi triển khai từng tập lệnh Python, hãy xem xét cấu trúc hệ thống bên dưới. Ứng dụng mẫu này được cấu trúc thành 7 tập lệnh Python theo mô-đun hoạt động trên 2 đường dẫn thực thi chính tương tác với cùng một phiên bản cơ sở dữ liệu AlloyDB cho PostgreSQL:
- Đường dẫn đọc (
hybrid_retriever.py): Phân tách các câu hỏi phức tạp gồm nhiều phần thành các câu hỏi phụ chỉ có một khía cạnh ngay trong PostgreSQL bằng AI của AlloyDBai.generate()và truy vấn bộ nhớ dài hạn bằng tính năng tìm kiếm kết hợp gốc của AlloyDB (ai.hybrid_search). - Đường dẫn ghi (
async_worker.py): Worker hàng đợi ở chế độ nền ngoài luồng, trích xuất không đồng bộ các thông tin thực thể có cấu trúc từ các lượt trao đổi trong cuộc trò chuyện bằng Gemini Flash và chèn chúng vàoagent_entities.
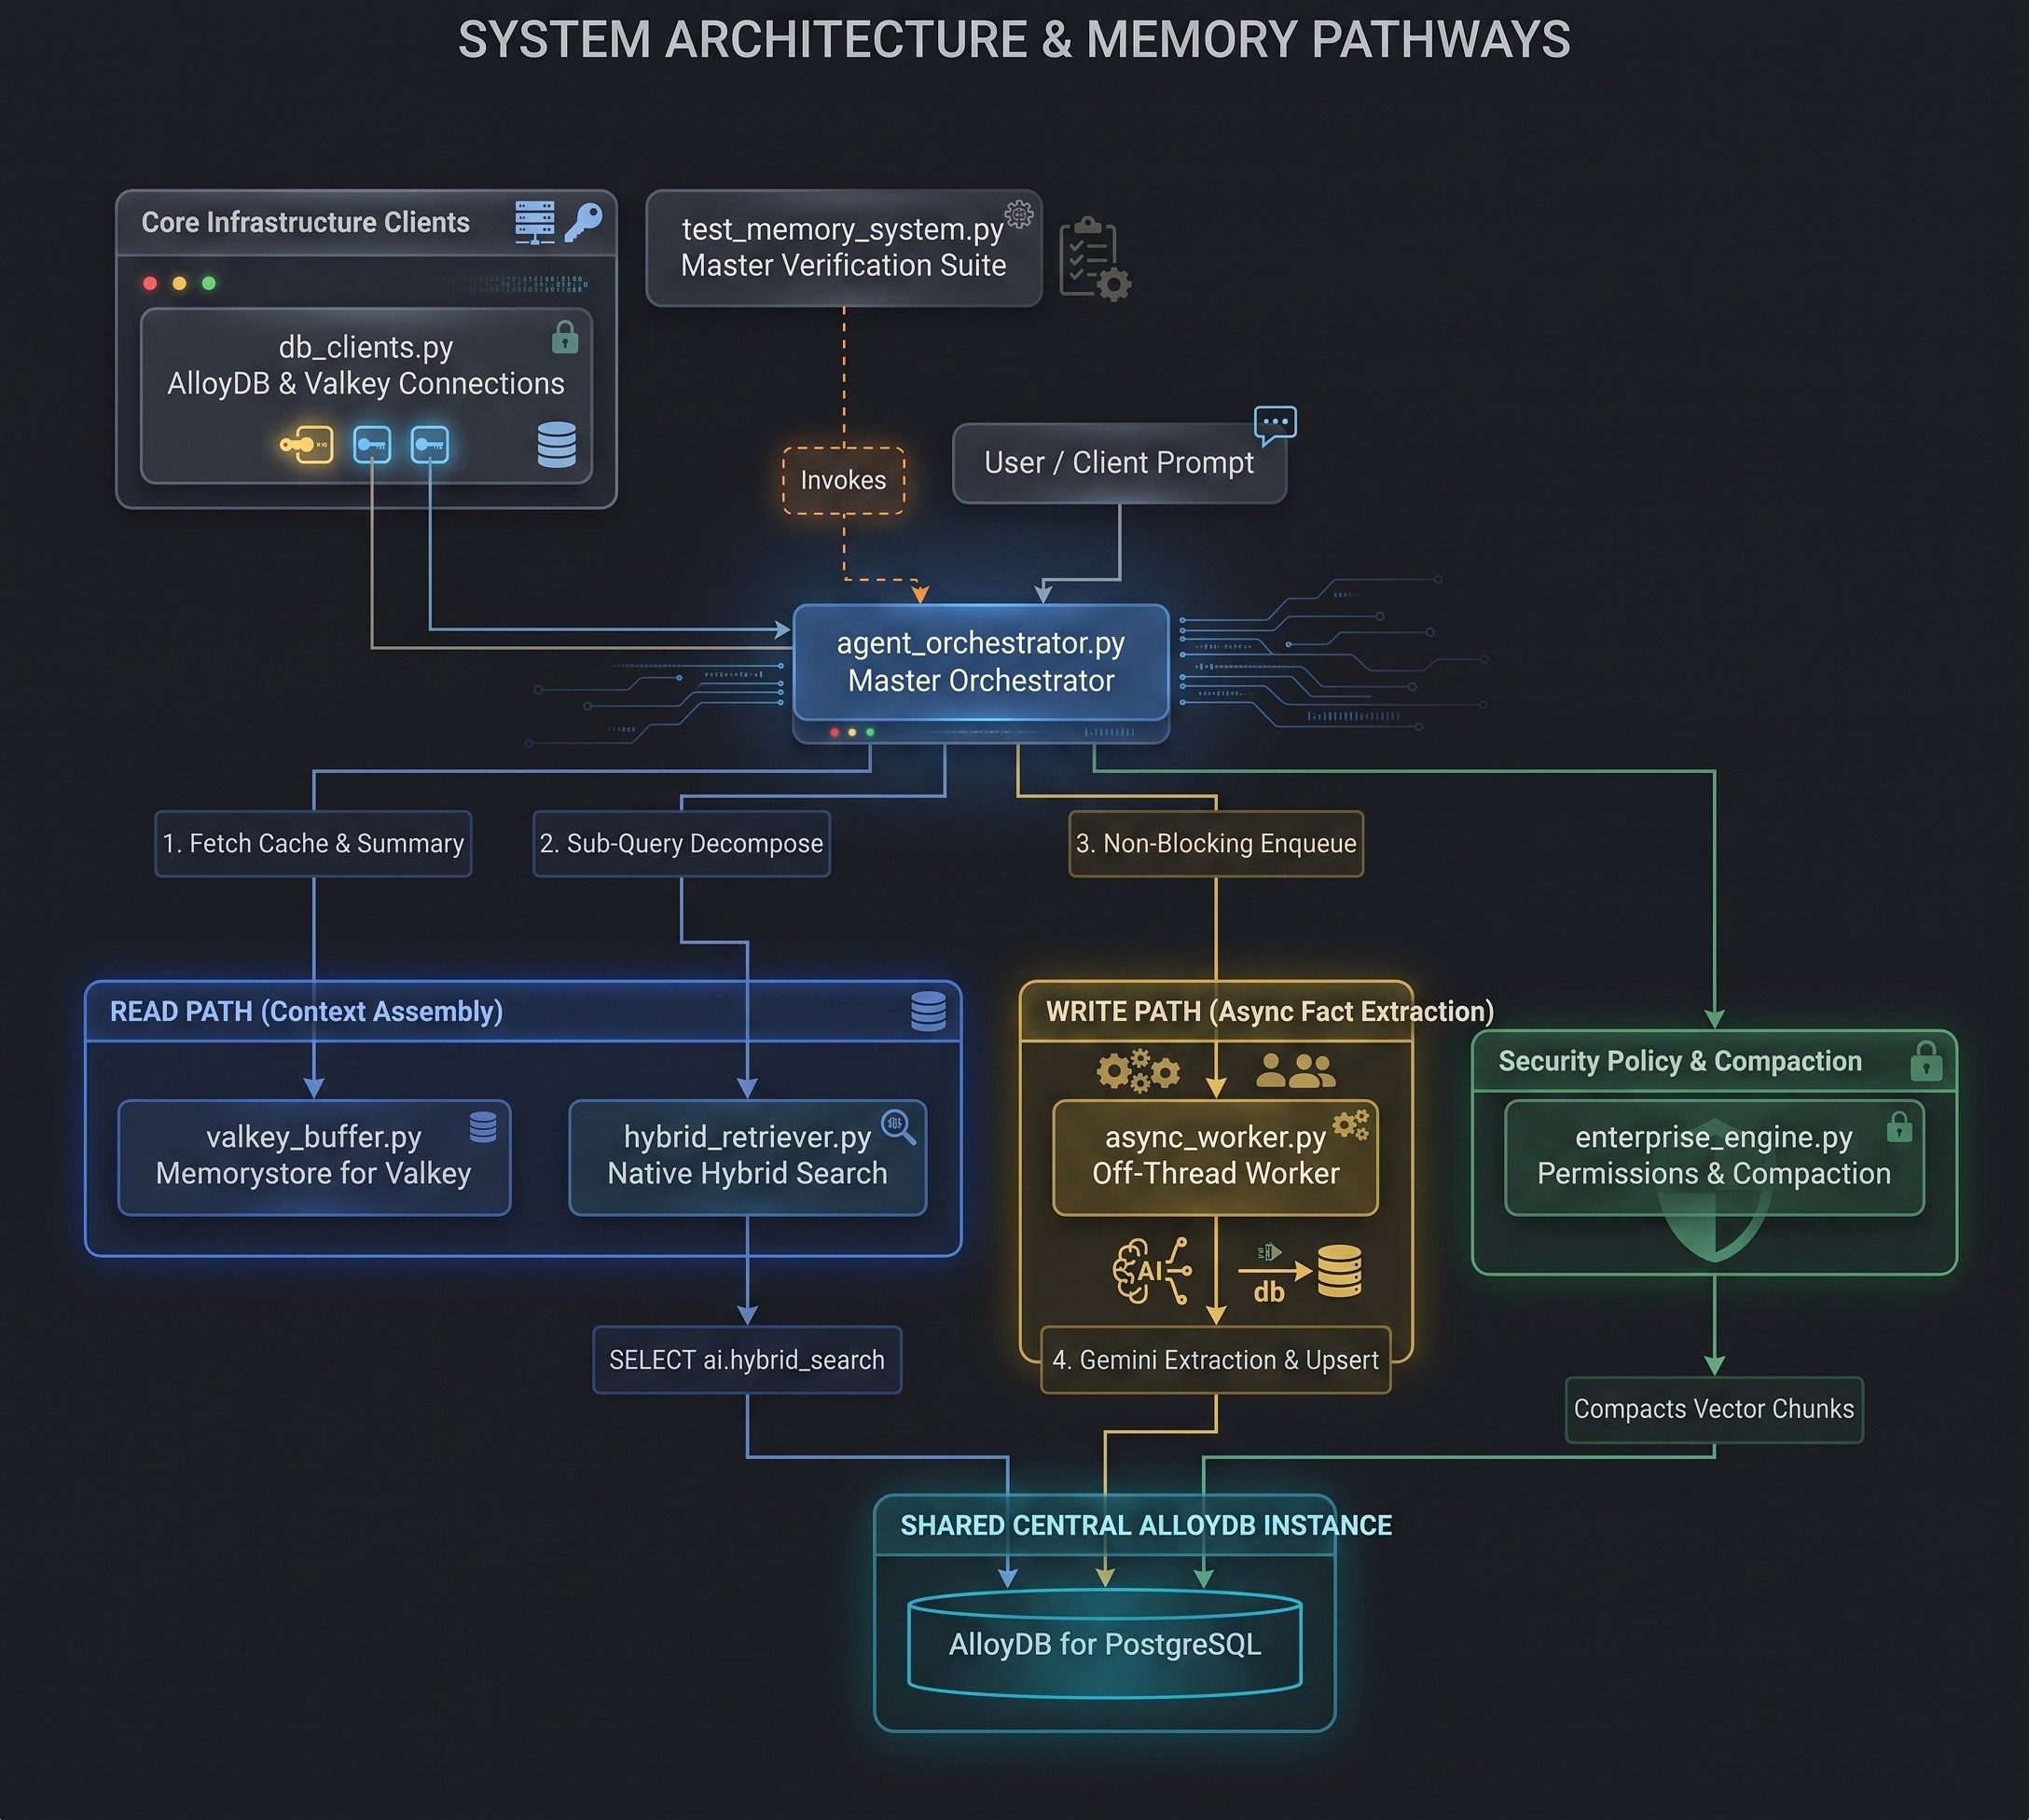
Hệ thống phân cấp mô-đun và vai trò hệ thống
Tệp mô-đun | Lớp hệ thống | Trách nhiệm chính |
| Lớp kết nối | Thiết lập quy trình xác thực IAM được mã hoá bằng SSL cho AlloyDB và các kết nối có khả năng phục hồi ổ cắm cho Memorystore cho Valkey. |
| Trí nhớ ngắn hạn | Quản lý nhật ký phiên có độ trễ dưới một mili giây trong Valkey, triển khai các bản tóm tắt luân phiên Summarize-Before-Trim. |
| Write Path Worker | Chạy một trình xử lý hàng đợi nền của trình nền ngoài luồng, trình xử lý này trích xuất các dữ kiện về thực thể bằng Gemini Flash và chèn chúng vào AlloyDB. |
| Read Path Retriever | Phân tách các câu hỏi phức tạp thành các truy vấn phụ có một khía cạnh bằng cách sử dụng AI AlloyDB |
| Vòng lặp chính của tác nhân | Điều phối vòng lặp thực thi lượt tương tác từ đầu đến cuối: tìm nạp ngắn hạn, tìm kiếm dài hạn, lắp ráp câu lệnh, thực thi LLM và xếp hàng không đồng bộ. |
| Quản trị và quản lý | Thực thi các chính sách bảo mật 3 cấp để thực thi công cụ và tổng hợp bộ nhớ trước đây. |
| Thử nghiệm và đánh giá | Bộ xác minh chính thực thi các tình huống nhiều lượt và nhiều phiên, đo lường tỷ lệ tiết kiệm mã thông báo và xác minh độ chính xác của bộ nhớ. |
6. Thiết lập lược đồ AlloyDB AI và tính năng Tự động nhúng giao dịch
Tổng quan về mục tiêu và cấu trúc
Trong mô-đun này, bạn sẽ xác định giản đồ cơ sở dữ liệu của AlloyDB cho bộ nhớ theo từng tập và bộ nhớ dài hạn, chiến lược lập chỉ mục và tính năng tự động nhúng phía cơ sở dữ liệu.
- Episodic Vector Store (
episodic_memory_embeddings): Các đoạn bản chép lời trò chuyện không có cấu trúc được lập chỉ mục bằng chỉ mục vectơ HNSW (vector_cosine_ops). - Kho thực thể dài hạn (
agent_entities): Các thông tin có cấu trúc, lựa chọn của người dùng và quy tắc của dự án được lưu trữ bằng siêu dữ liệu phạm vi (global,project,session). Bao gồm một cột tìm kiếm toàn văn PostgreSQL được tạo tự động (summary_tsv) được lập chỉ mục thông qua RUM. - Tự động nhúng phía cơ sở dữ liệu (
ai.initialize_embeddings): Tự động nhúng các hàng văn bản thuần tuý mới hoặc đã cập nhật vàosummary_embeddingthông qua Nền tảng tác nhântext-embedding-005ở chế độ nền.
Kết nối với AlloyDB Studio
- Chuyển đến trang AlloyDB for Postgres trong Google Cloud Console.
- Nhấp vào phiên bản chính của bạn.
- Trên bảng điều hướng bên trái, hãy nhấp vào AlloyDB Studio.
- Chọn cơ sở dữ liệu
postgres - Xác thực bằng
IAM database authentication
Triển khai và mã nguồn
Sau khi kết nối với cơ sở dữ liệu AlloyDB PostgreSQL, hãy thực thi các truy vấn DDL bên dưới:
-- 1. Enable google_ml_integration extension
CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE;
CREATE EXTENSION IF NOT EXISTS vector CASCADE;
CREATE EXTENSION IF NOT EXISTS rum CASCADE;
SET google_ml_integration.enable_preview_ai_functions = true;

-- 2. Create Episodic Memory Vector Store Tables
CREATE TABLE IF NOT EXISTS episodic_memory_collections (
    uuid UUID PRIMARY KEY,
    name VARCHAR,
    cmetadata JSONB
);

CREATE TABLE IF NOT EXISTS episodic_memory_embeddings (
    uuid UUID PRIMARY KEY,
    collection_id UUID REFERENCES episodic_memory_collections(uuid) ON DELETE CASCADE,
    embedding VECTOR(768),
    document VARCHAR,
    cmetadata JSONB,
    custom_id VARCHAR,
    created_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS episodic_memory_embedding_idx
ON episodic_memory_embeddings
USING hnsw (embedding vector_cosine_ops)
WITH (m = 16, ef_construction = 64);

-- 3. Create Entity & Preference Table with Metadata Scope & Auto-Generated TSVector Column
CREATE TABLE IF NOT EXISTS agent_entities (
    entity_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    entity_name TEXT NOT NULL,
    project_id TEXT DEFAULT 'global',
    session_id TEXT,
    scope TEXT NOT NULL DEFAULT 'project', -- 'global', 'project', 'session'
    summary TEXT NOT NULL,
    summary_embedding VECTOR(768),
    summary_tsv TSVECTOR GENERATED ALWAYS AS (
        to_tsvector('english', entity_name || ' ' || summary)
    ) STORED,
    updated_at TIMESTAMPTZ DEFAULT NOW(),
    UNIQUE (user_id, entity_name)
);

CREATE INDEX IF NOT EXISTS agent_entities_scope_idx
ON agent_entities (user_id, project_id, scope);

CREATE INDEX IF NOT EXISTS agent_entities_embedding_idx
ON agent_entities USING hnsw (summary_embedding vector_cosine_ops);

CREATE INDEX IF NOT EXISTS agent_entities_tsv_idx
ON agent_entities USING rum (summary_tsv rum_tsvector_ops);

-- 4. Create User Permissions Table for Tool Execution Controls
CREATE TABLE IF NOT EXISTS user_permissions (
    permission_id UUID PRIMARY KEY DEFAULT gen_random_uuid(),
    user_id TEXT NOT NULL,
    project_id TEXT NOT NULL DEFAULT 'global',
    tool_name TEXT NOT NULL,
    command_pattern TEXT NOT NULL,
    action TEXT NOT NULL CHECK (action IN ('ALLOW', 'BLOCK')),
    created_at TIMESTAMPTZ DEFAULT NOW(),
    updated_at TIMESTAMPTZ DEFAULT NOW()
);

CREATE INDEX IF NOT EXISTS idx_user_permissions_lookup
ON user_permissions (user_id, project_id, tool_name);
-- 5. Register Gemini 3.5 Flash Model Endpoint in AlloyDB
-- Replace PROJECT_ID with your Google Cloud project ID
CALL google_ml.create_model(
    model_id => 'gemini-3.5-flash',
    model_request_url => 'https://aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/global/publishers/google/models/gemini-3.5-flash:generateContent',
    model_qualified_name => 'gemini-3.5-flash',
    model_provider => 'google',
    model_type => 'llm',
    model_auth_type => 'alloydb_service_agent_iam'
);
Khởi chạy tính năng Tự động nhúng theo giao dịch và Đăng ký mô hình Gemini
Tiếp theo, hãy thực thi các câu lệnh CALL trong các khối thực thi truy vấn riêng biệt để đăng ký quy trình nền nhúng tự động và điểm cuối mô hình Gemini 3.5 Flash:
-- 6. Register Database-Side Transactional Auto-Embedding
CALL ai.initialize_embeddings(
    model_id => 'text-embedding-005',
    table_name => 'agent_entities',
    content_column => 'summary',
    embedding_column => 'summary_embedding',
    incremental_refresh_mode => 'transactional',
    batch_size => 10
);
7. Định cấu hình AlloyDB và Valkey Connection Clients
Tổng quan về mục tiêu và cấu trúc
Trong mô-đun này, bạn sẽ thiết lập các kết nối mạng an toàn cho cả AlloyDB cho PostgreSQL (bộ nhớ dài hạn) và Memorystore cho Valkey (bộ nhớ đệm ngắn hạn).
- Xác thực IAM AlloyDB: Sử dụng
gcloud auth application-default print-access-tokenđể truy xuất mã thông báo OAuth2 có thời hạn ngắn cho các kết nối cơ sở dữ liệu được mã hoá bằng SSL và không cần mật khẩu (sslmode="require"). - Khả năng phục hồi mạng Valkey: Định cấu hình
redis.Redisvới thời gian chờ của ổ cắm là 5 giây (socket_timeout=5.0) để xử lý an toàn các hoạt động mạng VPC trên các phiên bản Valkey một nút hoặc theo cụm.
Triển khai và mã nguồn
Tạo tập lệnh db_clients.py trong thư mục đang làm việc:
import os
import subprocess
import psycopg2
import redis

# Initialize database & Valkey connection clients from environment variables
DB_HOST = os.getenv("DB_HOST", "127.0.0.1")
DB_PORT = os.getenv("DB_PORT", "5432")
DB_NAME = os.getenv("DB_NAME", "postgres")
DB_USER = os.getenv("DB_USER")

VALKEY_HOST = os.getenv("VALKEY_HOST", "127.0.0.1")
VALKEY_PORT = int(os.getenv("VALKEY_PORT", "6379"))

def get_db_connection():
    # Fetch Application Default Credentials (ADC) token for IAM Database Authentication & enable SSL encryption
    access_token = subprocess.check_output(
        ["gcloud", "auth", "application-default", "print-access-token"], text=True
    ).strip()
    return psycopg2.connect(
        host=DB_HOST,
        port=DB_PORT,
        dbname=DB_NAME,
        user=DB_USER,
        password=access_token,
        sslmode="require"
    )

def get_valkey_client():
    return redis.Redis(
        host=VALKEY_HOST,
        port=VALKEY_PORT,
        db=0,
        socket_timeout=5.0,
        socket_connect_timeout=5.0
    )

if __name__ == "__main__":
    print(f"Connecting to AlloyDB via IAM Auth ({DB_USER}) at {DB_HOST}:{DB_PORT} and Valkey at {VALKEY_HOST}:{VALKEY_PORT}...")
    print("Database and Valkey connection client modules loaded successfully.")
8. Lưu trạng thái phiên ngắn hạn vào bộ nhớ đệm trong Memorystore for Valkey
Tổng quan về mục tiêu và cấu trúc
Trong mô-đun này, bạn sẽ tạo bộ nhớ đệm ngữ cảnh ngắn hạn dưới một mili giây trong Memorystore cho Valkey bằng cách triển khai mẫu Tóm tắt trước khi cắt bớt tự động.
- Valkey Sliding Window: Các lượt cuộc trò chuyện đang diễn ra được lưu trữ dưới dạng chuỗi JSON trong khoá
session:{session_id}:turns. - Thẻ băm Redis (
{session_id}): Định dạng khoásession:{session_id}:turnsvàsession:{session_id}:summarysử dụng thẻ băm cụm Redis ({...}), buộc cả hai khoá vào cùng một khe băm để đảm bảo thực thi nguyên tử trên mọi hoạt động triển khai Valkey một nút hoặc theo cụm. - Tóm tắt trước khi cắt bớt: Khi số lượt tương tác vượt quá
trigger_limit, Gemini Flash sẽ tóm tắt các lượt tương tác cũ sắp bị cắt bớt thành một bản tóm tắt văn bản dạng cuộn (session:{session_id}:summary) trước khi cắt bớt nhật ký thô xuống cònwindow_size.
Triển khai và mã nguồn
Tạo tập lệnh valkey_buffer.py trong thư mục đang làm việc:
import json
import logging
import time
from typing import Any, Dict, List
import redis

logger = logging.getLogger(__name__)

IN_MEMORY_VALKEY_FALLBACK: Dict[str, Any] = {}
VALKEY_COMPACTION_TOKENS = 0

def get_valkey_compaction_tokens() -> int:
    return VALKEY_COMPACTION_TOKENS

def append_session_turn_with_rolling_summary(
    valkey_client: redis.Redis,
    llm_client: Any,
    session_id: str,
    user_msg: str,
    ai_msg: str,
    trigger_limit: int = 10,
    window_size: int = 4
) -> None:
    """Appends turn to Valkey. Before trimming old turns, summarizes them into a rolling summary."""
    global VALKEY_COMPACTION_TOKENS
    # Use Redis Hash Tags {session_id} so both keys hash to the same cluster slot
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        # 1. Append new turn messages
        valkey_client.rpush(turns_key, json.dumps({"role": "user", "content": user_msg}))
        valkey_client.rpush(turns_key, json.dumps({"role": "assistant", "content": ai_msg}))

        raw_turns = valkey_client.lrange(turns_key, 0, -1)

        # 2. Check if total turns exceed summary trigger threshold
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2

        if len(raw_turns) > msg_trigger_count:
            turns_to_prune = raw_turns[:-msg_window_count]
            existing_summary = valkey_client.get(summary_key)
            existing_summary_text = (
                existing_summary.decode('utf-8') if isinstance(existing_summary, bytes) else (existing_summary or "")
            )

            pruned_text = "\n".join([
                f"{json.loads(t)['role']}: {json.loads(t)['content']}" for t in turns_to_prune
            ])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            updated_summary_text = llm_client.models.generate_content(
                model="gemini-3.5-flash", contents=prompt
            ).text.strip()
            # Execute commands directly to support all Redis/Valkey cluster topologies
            valkey_client.set(summary_key, updated_summary_text)
            valkey_client.ltrim(turns_key, -msg_window_count, -1)
            logger.info("Updated rolling summary and trimmed Valkey buffer for session %s", session_id)

    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey operation warning (%s). Falling back to in-memory short-term buffer.", e)
        if turns_key not in IN_MEMORY_VALKEY_FALLBACK:
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = []
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "user", "content": user_msg})
        IN_MEMORY_VALKEY_FALLBACK[turns_key].append({"role": "assistant", "content": ai_msg})

        # In-memory summarize-before-trim fallback logic
        msg_trigger_count = trigger_limit * 2
        msg_window_count = window_size * 2
        raw_fallback_turns = IN_MEMORY_VALKEY_FALLBACK[turns_key]

        if len(raw_fallback_turns) > msg_trigger_count:
            turns_to_prune = raw_fallback_turns[:-msg_window_count]
            existing_summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
            pruned_text = "\n".join([f"{t['role']}: {t['content']}" for t in turns_to_prune])

            prompt = f"""Update the existing rolling conversation summary with the old turns about to be trimmed.
Retain key constraints, user choices, technical decisions, and ongoing goals.

Existing Summary:
{existing_summary_text if existing_summary_text else 'No prior summary.'}

Old turns about to be trimmed:
{pruned_text}

Updated Rolling Summary:"""

            VALKEY_COMPACTION_TOKENS += max(1, len(prompt) // 4)

            for attempt in range(4):
                try:
                    updated_summary_text = llm_client.models.generate_content(
                        model="gemini-3.5-flash", contents=prompt
                    ).text.strip()
                    break
                except Exception as e:
                    if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                        time.sleep(3 * (2 ** attempt))
                    else:
                        raise

            IN_MEMORY_VALKEY_FALLBACK[summary_key] = updated_summary_text
            IN_MEMORY_VALKEY_FALLBACK[turns_key] = raw_fallback_turns[-msg_window_count:]

def get_session_context_buffer(
    valkey_client: redis.Redis,
    session_id: str
) -> Dict[str, Any]:
    """Retrieves rolling summary + sliding window history from Valkey to build prompt context."""
    turns_key = "session:{" + session_id + "}:turns"
    summary_key = "session:{" + session_id + "}:summary"

    try:
        summary = valkey_client.get(summary_key)
        summary_text = summary.decode('utf-8') if isinstance(summary, bytes) else (summary or "")

        raw_turns = valkey_client.lrange(turns_key, 0, -1)
        recent_turns = [json.loads(t) for t in raw_turns]

        return {
            "rolling_summary": summary_text,
            "recent_turns": recent_turns
        }
    except (redis.exceptions.RedisError, Exception) as e:
        logger.warning("Valkey read error (%s). Using in-memory short-term fallback buffer.", e)
        summary_text = IN_MEMORY_VALKEY_FALLBACK.get(summary_key, "")
        recent_turns = IN_MEMORY_VALKEY_FALLBACK.get(turns_key, [])
        return {"rolling_summary": summary_text, "recent_turns": recent_turns}
9. Trích xuất thực thể ngoài luồng (Trình chạy bộ nhớ nền)
Tổng quan về mục tiêu và cấu trúc
Trong mô-đun này, bạn sẽ tạo một trình chạy trích xuất nền đường dẫn ghi ngoài luồng (AsyncMemoryWorker) để trích xuất các thông tin thực thể dài hạn mà không làm chậm các câu trả lời tương tác của AI.
- Non-Blocking Queue Worker (Trình xử lý hàng đợi không chặn): Khởi chạy một trình nền (
queue.Queue) để các lượt trò chuyện với nhà phát triển sẽ trả về ngay lập tức mà không cần chờ LLM trích xuất hoặc ghi vào cơ sở dữ liệu. - Trích xuất thông tin thực thể ngoài luồng: Gọi Gemini Flash (
model="gemini-3.5-flash",response_mime_type="application/json") ở chế độ nền để phân tích cú pháp các thực thể có cấu trúc mà không chặn các lượt đối thoại hướng đến người dùng. - Phân giải đồng tham chiếu theo thời gian (
build_temporal_rules_prompt): Thực thi các quy tắc chuyển đổi biểu thức thời gian tương đối (ví dụ: "hiện tại", "phiên gần nhất") thành mã nhận dạng phiên rõ ràng (ví dụ:session_id). - Schema Upserts: Nhắc Gemini Flash trả về một mảng JSON gồm các thực thể (
entity_name,project_id,scope,summary) và ghi văn bản thuần tuý vàoagent_entitiesthông qua các câu lệnh PostgreSQL được tham số hoáON CONFLICT DO UPDATE.
Triển khai và mã nguồn
Tạo tập lệnh async_worker.py trong thư mục đang làm việc:
import json
import logging
import queue
import threading
import time
from typing import Dict, Any, Optional
import psycopg2

logger = logging.getLogger(__name__)

def build_temporal_rules_prompt(active_session_id: str, prev_session_id: Optional[str] = None) -> str:
    """REUSABLE PROMPT HELPER: Defines temporal coreference rules for both Read and Write paths."""
    return f"""TEMPORAL COREFERENCE RULES:
1. Do not use relative temporal words like 'currently', 'now', 'this session', 'previous session', or 'last session'.
2. Replace any relative temporal reference with explicit session identifiers:
   - Active Session: '{active_session_id}'
   - Previous Session: '{prev_session_id if prev_session_id else active_session_id}'
   (e.g., write 'User prefers Python in session {active_session_id}' instead of 'User currently prefers Python')."""

class AsyncMemoryWorker:
    """Off-thread daemon queue worker performing background entity extraction and upserts into AlloyDB."""
    def __init__(self, conn_factory, llm_client):
        self.conn_factory = conn_factory
        self.llm_client = llm_client
        self.work_queue = queue.Queue()
        self.total_extraction_tokens = 0
        self.worker_thread = threading.Thread(target=self._run_worker, daemon=True)
        self.worker_thread.start()

    def enqueue_extraction(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        self.work_queue.put((user_id, session_id, user_msg, ai_msg, prev_session_id))

    def _run_worker(self):
        while True:
            item = self.work_queue.get()
            if item is None:
                break
            user_id, session_id, user_msg, ai_msg, prev_session_id = item
            try:
                self._extract_and_upsert(user_id, session_id, user_msg, ai_msg, prev_session_id)
            except Exception as e:
                logger.error("Background extraction failed: %s", e)
            finally:
                self.work_queue.task_done()

    def _extract_and_upsert(
        self, user_id: str, session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None
    ):
        temporal_rules = build_temporal_rules_prompt(session_id, prev_session_id)
        json_fmt = '[{"entity_name": "...", "project_id": "...", "scope": "global|project|session", "summary": "..."}]'

        prompt = f"""Extract key preferences and named entities from this exchange.
Format output strictly as a JSON array of objects with structure: {json_fmt}.

{temporal_rules}

Rules for Scope:
- 'global': Universal developer preferences.
- 'project': Architecture, database choices, timeouts, and rules for a specific project.
- 'session': Ephemeral task state tied strictly to a single session.

User: {user_msg}
AI: {ai_msg}

Output (JSON array only):"""

        self.total_extraction_tokens += max(1, len(prompt) // 4)

        for attempt in range(4):
            try:
                response = self.llm_client.models.generate_content(
                    model="gemini-3.5-flash",
                    contents=prompt,
                    config={"response_mime_type": "application/json"}
                )
                break
            except Exception as e:
                if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                    time.sleep(3 * (2 ** attempt))
                else:
                    raise
        content = str(response.text).strip()
        if not content:
            return

        extracted_list = json.loads(content)
        if not isinstance(extracted_list, list):
            return

        upsert_sql = """
            INSERT INTO agent_entities (user_id, entity_name, project_id, session_id, scope, summary, updated_at)
            VALUES (%s, %s, %s, %s, %s, %s, NOW())
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET
                project_id = EXCLUDED.project_id,
                session_id = EXCLUDED.session_id,
                scope = EXCLUDED.scope,
                summary = EXCLUDED.summary,
                updated_at = NOW();
        """

        conn = self.conn_factory()
        try:
            with conn:
                with conn.cursor() as cur:
                    for item in extracted_list:
                        e_name = item.get("entity_name", "General_Fact")
                        p_id = item.get("project_id", "global")
                        s_scope = item.get("scope", "project")
                        summary = item.get("summary", "")
                        if e_name and summary:
                            cur.execute(upsert_sql, (user_id, e_name, p_id, session_id, s_scope, summary))
            logger.info("Saved %d entities for user %s", len(extracted_list), user_id)
        finally:
            conn.close()
10. Truy vấn bộ nhớ dài hạn bằng tính năng Tìm kiếm kết hợp gốc
Tổng quan về mục tiêu và cấu trúc
Trong mô-đun này, bạn sẽ triển khai tính năng phân tách truy vấn phụ theo đường dẫn đọc, viết lại truy vấn tạm thời, cách ly phạm vi siêu dữ liệu và sử dụng tính năng tìm kiếm kết hợp gốc của AlloyDB (ai.hybrid_search).
- Phân tách truy vấn phụ trong cơ sở dữ liệu (
rewrite_and_decompose_query): Sử dụng hàm tích hợpai.generate()của AI AlloyDB ngay trong PostgreSQL để chia các câu hỏi phức tạp thành các truy vấn phụ một khía cạnh với mã nhận dạng phiên được chuẩn hoá, ngăn các truy vấn đa chủ đề làm giảm độ chính xác của tính năng tìm kiếm vectơ. - Lọc theo phạm vi cấp chỉ mục: Tạo bộ lọc SQL phía cơ sở dữ liệu (
filter_condition => "user_id = '%s' AND (project_id = '%s' OR scope = 'global')") để tách biệt các bản ghi theo từng người dùng và dự án trong khi vẫn bao gồm các lựa chọn ưu tiên chung của nhà phát triển. - Tính năng Tìm kiếm kết hợp gốc của AlloyDB (
ai.hybrid_search): Kết hợp độ tương đồng về vectơ cosine (public.<=>) với tính năng tìm kiếm toàn văn (rum) trong AlloyDB bằng cách sử dụng tính năng Kết hợp thứ hạng tương hỗ (RRF) để mang lại độ chính xác, khả năng thu hồi và mức độ liên quan tối ưu.
Triển khai và mã nguồn
Tạo tập lệnh hybrid_retriever.py trong thư mục đang làm việc:
import os
import json
import logging
from typing import Any, Dict, List, Optional
import psycopg2
from psycopg2.extras import RealDictCursor
from async_worker import build_temporal_rules_prompt

logger = logging.getLogger(__name__)

def rewrite_and_decompose_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> List[str]:
    """Read-Path LLM Query Normalizer & Sub-Query Decomposer using AlloyDB AI ai.generate() directly in PostgreSQL."""
    temporal_rules = build_temporal_rules_prompt(active_session_id, prev_session_id)

    prompt = f"""You are a query normalization and decomposition tool for an AI agent's memory retrieval system.

Tasks:
1. Normalize any relative temporal phrases in the user query into explicit session identifiers.
{temporal_rules}

2. Decompose compound user queries asking about multiple distinct topics into up to 4 concise, single-topic search queries. Ensure all distinct questions (both general developer preferences and project-specific architecture/rules) are preserved as separate sub-queries.
3. Return ONLY a valid JSON array of strings containing the sub-queries.

Example Output Format:
["general developer coding preferences", "CloudRetail backend stack in session sess_2026_01", "CloudRetail timeout rules in session sess_2026_01"]

Text to Process: {text}
JSON Output:"""

    try:
        with conn.cursor() as cur:
            cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
            cur.execute("SELECT ai.generate(prompt => %s::text, model_id => 'gemini-3.5-flash'::varchar(100));", (prompt,))
            row = cur.fetchone()
            if row and row[0]:
                res_text = str(row[0]).strip()
                clean_text = res_text
                if clean_text.startswith("```"):
                    clean_text = clean_text.removeprefix("```json").removeprefix("```").removesuffix("```").strip()
                parsed = json.loads(clean_text)
                if isinstance(parsed, list) and len(parsed) > 0:
                    return [str(q).strip() for q in parsed]
        return [text]
    except Exception as e:
        logger.error("Error in in-database ai.generate sub-query decomposition: %s", e)
        return [text]

def rewrite_temporal_query(
    conn: Any,
    llm_client: Any,
    text: str,
    active_session_id: str,
    prev_session_id: Optional[str] = None
) -> str:
    """Backward-compatible wrapper returning first decomposed query string."""
    queries = rewrite_and_decompose_query(conn, llm_client, text, active_session_id, prev_session_id)
    return queries[0] if queries else text

def retrieve_hybrid_entities(
    conn,
    llm_client: Any,
    user_id: str,
    active_session_id: str,
    query_text: str,
    query_embedding: Optional[List[float]] = None,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    k: int = 20
) -> Dict[str, Any]:
    """Queries long-term entities using Sub-Query Decomposition, metadata scope filtering, and parameterized AlloyDB hybrid search."""
    sub_queries = rewrite_and_decompose_query(
        conn=conn, llm_client=llm_client, text=query_text, active_session_id=active_session_id, prev_session_id=prev_session_id
    )
    all_search_queries = list(dict.fromkeys(sub_queries + [query_text]))

    retrieved_entities: Dict[str, Any] = {}

    filter_cond = f"user_id = '{user_id}' AND (project_id = '{project_id}' OR scope = 'global')" if project_id else f"user_id = '{user_id}'"

    query_sql = """
        SELECT e.entity_name, e.summary, e.project_id, e.scope, e.updated_at
        FROM ai.hybrid_search(
          search_inputs => %s::JSONB[],
          include_json_output => false
        ) h
        JOIN agent_entities e ON e.entity_name = h.id
        WHERE e.user_id = %s
        LIMIT %s;
    """

    from google import genai
    embed_client = genai.Client(
        vertexai=True,
        project=os.getenv("PROJECT_ID"),
        location=os.getenv("REGION", "us-east1")
    )

    for sq in all_search_queries:
        try:
            emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=sq)
            sq_embedding = emb_resp.embeddings[0].values
            vector_literal = f"'{sq_embedding}'::vector"
        except Exception as e:
            logger.error(f"Failed to generate embedding for sub-query: {sq}. Error: {e}")
            # Fallback to zero vector to prevent Postgres from crashing
            sq_embedding = [0.0] * 768
            vector_literal = f"'{sq_embedding}'::vector"

        search_inputs = [
            json.dumps({
                "data_type": "vector",
                "weight": 0.4,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "vec_column": "summary_embedding",
                "distance_operator": "public.<=>",
                "limit": 20,
                "query_vector": vector_literal,
                "filter_condition": filter_cond
            }),
            json.dumps({
                "data_type": "text",
                "weight": 0.6,
                "table_name": "agent_entities",
                "key_column": "entity_name",
                "text_column": "summary_tsv",
                "limit": 20,
                "ranking_function": "ts_rank",
                "query_text_input": sq,
                "filter_condition": filter_cond
            })
        ]

        with conn.cursor(cursor_factory=RealDictCursor) as cur:
            try:
                cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                cur.execute(query_sql, (search_inputs, user_id, k))
                rows = cur.fetchall()

                for row in rows:
                    name = row["entity_name"]
                    if name not in retrieved_entities:
                        retrieved_entities[name] = {
                            "summary": row["summary"],
                            "project_id": row["project_id"],
                            "scope": row["scope"],
                            "updated_at": row["updated_at"].isoformat() if row["updated_at"] else None
                        }
            except Exception as e:
                logger.error("Error executing hybrid search for sub-query '%s': %s", sq, e)

    return retrieved_entities
11. Tạo và chạy vòng lặp bộ nhớ của tác nhân từ đầu đến cuối
Tổng quan về mục tiêu và cấu trúc
Trong mô-đun này, bạn sẽ tạo hàm điều phối tác nhân chính (run_agent_turn) kết hợp việc truy xuất bộ nhớ đệm ngắn hạn, tìm kiếm bộ nhớ dài hạn, lắp ráp lời nhắc, tạo LLM và trích xuất bộ nhớ nền.
- Ngữ cảnh ngắn hạn: Tìm nạp các lượt đối thoại đang hoạt động trên Valkey và bản tóm tắt luân phiên (
get_session_context_buffer). - Tìm kiếm dài hạn: Truy vấn AlloyDB thông qua
retrieve_hybrid_entitiesbằng cách sử dụng các truy vấn phụ được phân tách, lọc theo mã dự án đang hoạt động và phạm vi toàn cầu. - Định dạng câu lệnh hệ thống: Tập hợp
build_agent_promptchứa các thực thể dài hạn, bản tóm tắt ngắn hạn, đoạn hội thoại gần đây và câu lệnh của người dùng thành một câu lệnh hệ thống tiết kiệm mã thông báo. - Async Queue Enqueue: Lưu lượt trong Valkey vào bộ nhớ đệm và xếp hàng trích xuất trong nền vào
AsyncMemoryWorkermà không chặn tải trọng trả về.
Triển khai và mã nguồn
Tạo tập lệnh agent_orchestrator.py trong thư mục đang làm việc:
import logging
import time
from typing import Any, Dict, Optional, Tuple
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import rewrite_temporal_query, retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

logger = logging.getLogger(__name__)

def build_agent_prompt(
    rolling_summary: str,
    recent_turns: list[Dict[str, Any]],
    retrieved_entities: Dict[str, Any],
    user_query: str
) -> str:
    """Assembles structured system prompt with long-term memory & short-term context."""
    entity_lines = [
        f"- {name}: {info['summary']}" for name, info in retrieved_entities.items()
    ]
    entity_context = "\n".join(entity_lines) if entity_lines else "No relevant entity facts."
    history_lines = [f"{t['role']}: {t['content']}" for t in recent_turns]
    history_str = "\n".join(history_lines)

    return f"""You are an intelligent, context-aware AI assistant.

[LONG-TERM PREFERENCES & ENTITIES]
{entity_context}

[SHORT-TERM ROLLING SUMMARY]
{rolling_summary if rolling_summary else 'No prior summary.'}

[RECENT DIALOGUE]
{history_str}

User: {user_query}
AI:"""

def run_agent_turn(
    db_conn,
    valkey_client: redis.Redis,
    async_worker: AsyncMemoryWorker,
    genai_client: Any,
    user_id: str,
    session_id: str,
    user_query: str,
    prev_session_id: Optional[str] = None,
    project_id: Optional[str] = None,
    trigger_limit: int = 10,
    window_size: int = 4
) -> Tuple[str, str, float]:
    """Executes a complete 2-tier agent memory turn loop, returning (response_text, system_prompt, latency_seconds)."""
    import time
    start_time = time.time()

    # 1. Fetch short-term rolling summary + recent turns from Valkey
    buffer_data = get_session_context_buffer(valkey_client, session_id)
    rolling_summary = buffer_data["rolling_summary"]
    recent_turns = buffer_data["recent_turns"]

    # 2. READ PATH: Rewrite incoming query via LLM coreference normalizer
    try:
        normalized_query = rewrite_temporal_query(
            db_conn, genai_client, user_query, active_session_id=session_id, prev_session_id=prev_session_id
        )
        emb_resp = genai_client.models.embed_content(model="text-embedding-005", contents=normalized_query)
        query_embedding = emb_resp.embeddings[0].values
    except Exception:
        query_embedding = None

    # Retrieve relevant long-term entities from AlloyDB via hybrid search
    retrieved_entities = retrieve_hybrid_entities(
        conn=db_conn,
        llm_client=genai_client,
        user_id=user_id,
        active_session_id=session_id,
        query_text=user_query,
        query_embedding=query_embedding,
        prev_session_id=prev_session_id,
        project_id=project_id,
        k=20
    )

    # 3. Assemble system prompt
    system_prompt = build_agent_prompt(
        rolling_summary, recent_turns, retrieved_entities, user_query
    )


    # 4. LLM inference for developer response with exponential backoff on 429 rate limit
    for attempt in range(4):
        try:
            response = genai_client.models.generate_content(
                model="gemini-3.5-flash", contents=system_prompt
            )
            break
        except Exception as e:
            if ("429" in str(e) or "RESOURCE_EXHAUSTED" in str(e)) and attempt < 3:
                time.sleep(3 * (2 ** attempt))
            else:
                raise
    ai_response = str(response.text)

    # 5. Cache turn in short-term Valkey buffer (with Summarize-Before-Trim check)
    append_session_turn_with_rolling_summary(
        valkey_client=valkey_client,
        llm_client=genai_client,
        session_id=session_id,
        user_msg=user_query,
        ai_msg=ai_response,
        trigger_limit=trigger_limit,
        window_size=window_size
    )

    # 6. WRITE PATH: Enqueue off-thread background entity extraction (single LLM call)
    async_worker.enqueue_extraction(user_id, session_id, user_query, ai_response, prev_session_id)

    latency = time.time() - start_time
    return ai_response, system_prompt, latency
12. Triển khai tính năng Kiểm soát quyền truy cập của doanh nghiệp và tính năng Nén bộ nhớ
Tổng quan về mục tiêu và cấu trúc
Trong mô-đun này, bạn sẽ tạo các chế độ kiểm soát bảo mật doanh nghiệp để thực thi công cụ và nén bộ nhớ cơ sở dữ liệu (AgentMemoryEngine).
- Đánh giá quyền theo 3 cấp (
evaluate_tool_permission):- Cấp 1 (Khoá cấp một lần Valkey): Kiểm tra khoá cấp một lần (
one_time_perm:{session_id}:{cmd_hash}) với TTL là 300 giây. Nếu có, hãy xoá khoá ngay lập tức và trả vềALLOW. - Cấp 2 và 3 (Quy tắc chính sách PostgreSQL): Truy vấn
user_permissionskhớp với các quy tắc theo phạm vi dự án (project_id) trước, sau đó là các quy tắc chung ('global'). - Dự phòng: Trả về
PROMPT_USERnếu không có chính sách nào phù hợp.
- Cấp 1 (Khoá cấp một lần Valkey): Kiểm tra khoá cấp một lần (
- Nén bộ nhớ (
compact_old_memories): Tổng hợp các sự kiện vectơ thô trước đây trongepisodic_memory_embeddingscó thời gian lưu giữ lâu hơnretention_daysthành một bản tóm tắt hợp nhất duy nhất trongagent_entitiesbằng cách sử dụng truy vấn CTE SQL có giới hạn 50 hàng.
Triển khai và mã nguồn
Tạo tập lệnh enterprise_engine.py trong thư mục đang làm việc:
import hashlib
import logging
import re
from typing import Any, Dict, Tuple
import psycopg2
import redis

logger = logging.getLogger(__name__)

class AgentMemoryEngine:
    """Framework-agnostic Enterprise Memory Engine for tool execution permissions & safe compaction."""

    def __init__(self, valkey_client: redis.Redis, db_conn: Any):
        self.valkey_client = valkey_client
        self.db_conn = db_conn

    def evaluate_tool_permission(
        self,
        user_id: str,
        project_id: str,
        session_id: str,
        tool_name: str,
        tool_args: Dict[str, Any]
    ) -> Tuple[str, str]:
        """Evaluates 3-tier execution permissions: Allow-Once (Valkey), Project (AlloyDB), Global (AlloyDB)."""
        command_str = str(tool_args.get("CommandLine", "") or tool_args)

        # Tier 1: Allow-Once (Single-Use Valkey Check with 300s TTL)
        cmd_hash = hashlib.sha256(command_str.encode("utf-8")).hexdigest()[:16]
        valkey_key = f"one_time_perm:{session_id}:{cmd_hash}"

        if self.valkey_client.get(valkey_key):
            self.valkey_client.delete(valkey_key)  # Consume key immediately
            return ("ALLOW", "Single-use 'Allow Once' grant consumed.")

        # Tier 2 & Tier 3: Query AlloyDB user_permissions table
        query_sql = """
            SELECT command_pattern, action, project_id
            FROM user_permissions
            WHERE user_id = %s AND tool_name = %s AND project_id IN (%s, 'global')
            ORDER BY CASE WHEN project_id = %s THEN 1 ELSE 2 END;
        """

        with self.db_conn.cursor() as cur:
            cur.execute(query_sql, (user_id, tool_name, project_id, project_id))
            rules = cur.fetchall()
            for pattern, action, scope in rules:
                if re.search(pattern, command_str, flags=re.IGNORECASE):
                    return (action, f"Matched {scope}-scoped rule: {pattern}")

        # Fallback: Prompt Human User
        return ("PROMPT_USER", "No matching permission rule found.")

    def compact_old_memories(self, user_id: str, retention_days: int = 30) -> None:
        """Consolidates old episodic facts from episodic_memory_embeddings into a summary with a 50-row cap."""
        prompt_prefix = (
            "Summarize the following historical events into a high-density long-term memory paragraph. "
            "Retain key constraints, tool choices, and project rules:\n"
        )

        # Capped CTE prevents string_agg from exceeding model context window limits
        compaction_sql = """
            WITH old_events AS (
                SELECT document AS content
                FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            ),
            consolidated AS (
                SELECT ai.generate(%s || string_agg(content, E'\n')) AS summary_text
                FROM old_events
            )
            INSERT INTO agent_entities (user_id, entity_name, summary, updated_at)
            SELECT %s, 'longterm_session_summary', summary_text, NOW()
            FROM consolidated
            WHERE summary_text IS NOT NULL
            ON CONFLICT (user_id, entity_name)
            DO UPDATE SET summary = EXCLUDED.summary, updated_at = NOW();
        """

        prune_sql = """
            DELETE FROM episodic_memory_embeddings
            WHERE uuid IN (
                SELECT uuid FROM episodic_memory_embeddings
                WHERE cmetadata->>'user_id' = %s
                  AND created_at < NOW() - (INTERVAL '1 day' * %s)
                ORDER BY created_at ASC
                LIMIT 50
            );
        """

        try:
            with self.db_conn:
                with self.db_conn.cursor() as cur:
                    cur.execute("SET google_ml_integration.enable_preview_ai_functions = true;")
                    cur.execute(compaction_sql, (user_id, retention_days, prompt_prefix, user_id))
                    cur.execute(prune_sql, (user_id, retention_days))
            logger.info("Successfully compacted old memories for user %s", user_id)
        except Exception as e:
            logger.error("Error during memory compaction: %s", e)
13. Chạy quy trình Xác minh bộ nhớ nhiều lượt tương tác từ đầu đến cuối
Tổng quan về mục tiêu và cấu trúc
Trong mô-đun cuối cùng này, bạn sẽ tạo và thực thi tập lệnh xác minh tổng thể toàn diện (test_memory_system.py) để xác thực toàn bộ cấu trúc bộ nhớ 2 cấp.
- Mô phỏng nhiều lượt và nhiều phiên:
- Phiên 1 (Lượt 1): Xác định các lựa chọn ưu tiên chung của nhà phát triển (
scope='global': Giao diện người dùng ở Chế độ tối, Python 3.11, PostgreSQL). - Phiên 1 (Lượt 2): Xác định cấu trúc dành riêng cho dự án (
project_id='CloudRetail': FastAPI, AlloyDB, Valkey, giới hạn thời gian chờ là 30 giây, us-east1). - Phiên 1 (Lượt 3 và 4): Tạo tiếng ồn trong cuộc trò chuyện kỹ thuật và vượt quá
trigger_limit=3để kích hoạt tính năng nén tóm tắt liên tục Tóm tắt trước khi cắt bớt của Valkey. - Phiên 2 (Lượt 5 – Mã phiên hoàn toàn mới): Truy vấn tác nhân trên các phiên để xác minh khả năng nhớ lại các lựa chọn ưu tiên chung VÀ quy tắc dự án trên nhiều phiên.
- Phiên 1 (Lượt 1): Xác định các lựa chọn ưu tiên chung của nhà phát triển (
- Xác minh hiệu suất và độ chính xác linh hoạt: Đo lường chính xác các ký tự/mã thông báo của câu lệnh, mức giảm kích thước câu lệnh (%), độ trễ suy luận, bản tóm tắt luân phiên của Valkey, khả năng cô lập phạm vi và các chính sách bảo mật khi thực thi công cụ.
Triển khai và mã nguồn
Tạo kịch bản kiểm tra test_memory_system.py trong thư mục làm việc:
import os
import time
import logging
from google import genai
from db_clients import get_db_connection, get_valkey_client
from async_worker import AsyncMemoryWorker
from hybrid_retriever import retrieve_hybrid_entities
from agent_orchestrator import run_agent_turn
from enterprise_engine import AgentMemoryEngine
from valkey_buffer import get_session_context_buffer, IN_MEMORY_VALKEY_FALLBACK, get_valkey_compaction_tokens

logging.basicConfig(level=logging.WARNING)
logging.getLogger("google_genai").setLevel(logging.WARNING)
logging.getLogger("httpx").setLevel(logging.WARNING)

PROJECT_ID = os.getenv("PROJECT_ID")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")

db_conn = get_db_connection()
valkey_client = get_valkey_client()
client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)

async_worker = AsyncMemoryWorker(get_db_connection, client)
engine = AgentMemoryEngine(valkey_client, db_conn)

USER_ID = "user_dev_42"
SESSION_1 = "sess_2026_01"
SESSION_2 = "sess_2026_02"

test_accuracy = []

print("\n==================================================")
print("STARTING ENHANCED 2-TIER AGENT MEMORY VERIFICATION TEST")
print("==================================================")

# TURN 1: Universal Global Developer Preference Definition
print("\n[SESSION 1 - TURN 1: Global Preference Definition]")
prompt_1 = "Hi! As universal coding preferences across all my projects, I prefer Dark Mode UI and standardizing on Python 3.11 with PostgreSQL."
print(f"User Prompt:\n{prompt_1}")
resp_1, sys_prompt_1, latency_1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_1, project_id=None, trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_1[:140]}...")
time.sleep(2)

# TURN 2: Project-Specific Architecture Definition
print("\n[SESSION 1 - TURN 2: Project CloudRetail Architecture Definition]")
prompt_2 = (
    "Now I am starting project CloudRetail. Here are the specific project requirements:\n"
    "1. Backend Stack: Python with FastAPI on AlloyDB.\n"
    "2. Short-Term Cache: Memorystore for Valkey.\n"
    "3. Security Rules: All tool execution timeouts must be capped at 30 seconds.\n"
    f"4. Deployment Region: {REGION}."
)
print(f"User Prompt:\n{prompt_2}")
resp_2, sys_prompt_2, latency_2 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_2, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_2[:140]}...")
time.sleep(2)

# TURN 3: Context Inflation / Technical Dialogue Noise
print("\n[SESSION 1 - TURN 3: Large Context Inflation (Dialogue Noise)]")
prompt_3 = (
    "Let's draft a sample 50-line PostgreSQL DDL script for product catalog indexes, "
    "including HNSW vector index tuning parameters (m = 16, ef_construction = 64), "
    "and full-text RUM search indexes on item title and description columns."
)
print(f"User Prompt:\n{prompt_3}")
resp_3, sys_prompt_3, latency_3 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_3, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_3[:140]}...")
time.sleep(2)

# TURN 4: Triggering Valkey Summarize-Before-Trim Threshold (8 messages > 6 message trigger limit)
print("\n[SESSION 1 - TURN 4: Triggering Valkey Rolling Summary Compaction]")
prompt_4_s1 = "Can you also add rate-limiting middleware rules for API endpoints?"
print(f"User Prompt:\n{prompt_4_s1}")
resp_4_s1, sys_prompt_4_s1, latency_4_s1 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_1, prompt_4_s1, project_id="CloudRetail", trigger_limit=3, window_size=2)
print(f"\nAI Answer:   {resp_4_s1[:140]}...")

# VERIFY VALKEY SHORT-TERM ROLLING SUMMARY
print("\n==================================================")
print("VALKEY SHORT-TERM ROLLING SUMMARY VERIFICATION")
print("==================================================")
buffer_data = get_session_context_buffer(valkey_client, SESSION_1)
valkey_summary_text = buffer_data["rolling_summary"]
valkey_turns = buffer_data["recent_turns"]

used_fallback = bool(IN_MEMORY_VALKEY_FALLBACK)
storage_backend = "Local In-Memory Fallback (Outside VPC)" if used_fallback else "Memorystore for Valkey (VPC Network)"

has_valkey_summary = bool(valkey_summary_text)
print(f" • Short-Term Cache Storage Target:             [{storage_backend}]")
print(f" • Valkey Rolling Summary Generated for Session 1: {has_valkey_summary}")
print(f"   Summary Content: {valkey_summary_text}")
print(f" • Remaining Raw Turns in Valkey Sliding Window:  {len(valkey_turns)} messages (Trimmed from 8)")

test_accuracy.append(("Valkey Rolling Summary Compaction Test", "PASS" if has_valkey_summary else "FAIL"))

# Wait for background entity extraction worker
print("\n[Waiting for background entity extraction worker to process & vectorize all extracted entities...]")
time.sleep(6)

print("\n==================================================")
print("EXTRACTED ENTITIES STORED IN ALLOYDB LONG-TERM MEMORY")
print("==================================================")
with db_conn.cursor() as cur:
    cur.execute(
        "SELECT entity_name, project_id, scope, summary, (summary_embedding IS NOT NULL) FROM agent_entities WHERE user_id = %s ORDER BY updated_at DESC;",
        (USER_ID,)
    )
    extracted = cur.fetchall()
    for name, p_id, s_scope, summary, has_vector in extracted:
        print(f" • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}' | Vector Generated: {has_vector}")
        print(f"   Summary: {summary}")

# TURN 5: Cross-Session Temporal & Scope Recall (Brand New Session ID)
print("\n[SESSION 2 - TURN 5 (Cross-Session Query in New Session ID)]")
prompt_4 = "What are my general coding preferences and the backend/timeout rules I chose for CloudRetail in my previous session?"
print(f"User Prompt:\n{prompt_4}")
resp_4, sys_prompt_4, latency_4 = run_agent_turn(db_conn, valkey_client, async_worker, client, USER_ID, SESSION_2, prompt_4, prev_session_id=SESSION_1, project_id="CloudRetail")
print(f"\nAI Answer:\n{resp_4}")

# VERIFICATION OF RETRIEVED ENTITIES (Checking Scope Precision)
retrieved_scoped_entities = retrieve_hybrid_entities(
    conn=db_conn,
    llm_client=client,
    user_id=USER_ID,
    active_session_id=SESSION_2,
    query_text=prompt_4,
    prev_session_id=SESSION_1,
    project_id="CloudRetail",
    k=20
)

print("\n==================================================")
print("DIAGNOSTIC SCOPE VERIFICATION DETAILS (EXPECTED vs ACTUAL)")
print("==================================================")
print("EXPECTED SPECIFIC ENTITIES & SCOPE:")
print("  1. Global Preference Entity: Retrieved entity with scope == 'global' containing preference facts ('dark mode', 'python 3.11', or 'postgres')")
print("  2. Project Architecture Entity: Retrieved entity with project_id == 'CloudRetail' containing tech stack facts ('fastapi', 'alloydb', 'valkey', or 'timeout')")
print(f"\nACTUAL RETRIEVED ENTITIES (Count: {len(retrieved_scoped_entities)}):")
if not retrieved_scoped_entities:
    print("  [NONE RETRIEVED! Vector/Fulltext search returned 0 matches]")
for ent_name, ent_info in retrieved_scoped_entities.items():
    print(f"  • Entity Name: '{ent_name}'")
    print(f"    - scope:      '{ent_info.get('scope')}'")
    print(f"    - project_id: '{ent_info.get('project_id')}'")
    print(f"    - summary:    '{ent_info.get('summary')}'")

print("\nDATABASE CHECK - ALL ROWS STORED IN agent_entities TABLE:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    db_rows = cur.fetchall()
    if not db_rows:
        print("  [DATABASE TABLE IS EMPTY! No entities were upserted by background worker]")
    for r in db_rows:
        print(f"  • DB Row: entity_name='{r[0]}' | project_id='{r[1]}' | scope='{r[2]}' | summary='{r[3]}'")

# SPECIFIC FACT & SCOPE VERIFICATION LOGIC
found_global_preference = False
matched_global_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("scope") == "global" and any(kw in combined_text for kw in ["dark mode", "python", "postgres"]):
        found_global_preference = True
        matched_global_entity = ent_name
        break

found_project_architecture = False
matched_project_entity = None
for ent_name, info in retrieved_scoped_entities.items():
    combined_text = f"{ent_name} {info.get('summary', '')}".lower()
    if info.get("project_id") == "CloudRetail" and any(kw in combined_text for kw in ["fastapi", "alloydb", "valkey", "timeout"]):
        found_project_architecture = True
        matched_project_entity = ent_name
        break

print("\n--------------------------------------------------")
print("METADATA SCOPE PRECISION VERIFICATION RESULTS:")
print(f" • Global Preference Fact Retrieved (scope='global'):        {found_global_preference} (Matched Entity: '{matched_global_entity}')")
print(f" • Project Architecture Fact Retrieved (project_id='CloudRetail'): {found_project_architecture} (Matched Entity: '{matched_project_entity}')")
print("--------------------------------------------------")

test_accuracy.append(("Global Coding Preference Recall Test (scope='global')", "PASS" if found_global_preference else "FAIL"))
test_accuracy.append(("Project CloudRetail Architecture Recall Test (project_id='CloudRetail')", "PASS" if found_project_architecture else "FAIL"))

# PERMISSION TEST
perm_action, reason = engine.evaluate_tool_permission(
    user_id=USER_ID, project_id="CloudRetail", session_id=SESSION_2,
    tool_name="run_command", tool_args={"CommandLine": "pytest --timeout=30"}
)
test_accuracy.append(("Tool Permission Policy Test", "PASS" if perm_action in ("allow", "PROMPT_USER") else "FAIL"))

# DYNAMIC TOKEN & LATENCY METRICS CALCULATION
active_prompt_chars_turn5 = len(sys_prompt_4)
active_tokens_turn5 = max(1, active_prompt_chars_turn5 // 4)

# Naive Un-compacted Full History Prompt Tokens for Turn 5
raw_history_chars = len(prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4)
naive_turn5_chars = raw_history_chars + 18000
naive_tokens_turn5 = naive_turn5_chars // 4

active_prompt_reduction_pct = ((naive_tokens_turn5 - active_tokens_turn5) / naive_tokens_turn5) * 100

# Cumulative Multi-Turn Tokens Comparison (Active Read-Path Prompts + Background Extraction & Compacting)
total_active_tokens = sum([
    len(p) // 4 for p in [sys_prompt_1, sys_prompt_2, sys_prompt_3, sys_prompt_4_s1, sys_prompt_4]
])
background_extraction_tokens = async_worker.total_extraction_tokens
background_valkey_summary_tokens = get_valkey_compaction_tokens()

total_tiered_system_tokens = total_active_tokens + background_extraction_tokens + background_valkey_summary_tokens

# Naive Cumulative Tokens across all 5 turns as full transcript grows continuously
naive_cumulative_tokens = sum([
    (len(p) + 18000) // 4 for p in [
        prompt_1,
        prompt_1 + resp_1 + prompt_2,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1,
        prompt_1 + resp_1 + prompt_2 + resp_2 + prompt_3 + resp_3 + prompt_4_s1 + resp_4_s1 + prompt_4
    ]
])

total_system_token_savings_pct = ((naive_cumulative_tokens - total_tiered_system_tokens) / naive_cumulative_tokens) * 100

# FINAL SUMMARY REPORT
print("\n==================================================")
print("FINAL AGENT MEMORY SYSTEM SUMMARY REPORT")
print("==================================================")

print("\n1. STORED ALLOYDB ENTITIES:")
with db_conn.cursor() as cur:
    cur.execute("SELECT entity_name, project_id, scope, summary FROM agent_entities WHERE user_id = %s;", (USER_ID,))
    for name, p_id, s_scope, summary in cur.fetchall():
        print(f"   • Entity: '{name}' | Project: '{p_id}' | Scope: '{s_scope}'")
        print(f"     Summary: {summary}")

print("\n2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:")
print(f"   • Naive Full-Context Turn 5 Tokens:    ~{naive_tokens_turn5:,} tokens ({naive_turn5_chars:,} chars)")
print(f"   • Tiered Memory Active Prompt Tokens:  ~{active_tokens_turn5:,} tokens ({active_prompt_chars_turn5:,} chars)")
print(f"   • Active Turn 5 Prompt Reduction:      {active_prompt_reduction_pct:.1f}% Reduction")
print(f"   • Measured Turn 5 Inference Latency:   {latency_4:.2f} seconds")

print("\n3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):")
print(f"   • Naive Cumulative Multi-Turn Tokens:  ~{naive_cumulative_tokens:,} tokens")
print(f"   • Active Read-Path Prompt Tokens:      ~{total_active_tokens:,} tokens (Across 5 Turns)")
print(f"   • Background Worker Tokens (Extraction):~{background_extraction_tokens:,} tokens (4 Background Turns)")
print(f"   • Background Compaction Tokens (Valkey):~{background_valkey_summary_tokens:,} tokens (1 Compaction Call)")
print(f"   • Total Tiered System Token Footprint: ~{total_tiered_system_tokens:,} tokens")
print(f"   • Overall System Token Savings:        {total_system_token_savings_pct:.1f}% Total Reduction")

print("\n4. ACCURACY & VERIFICATION TESTS:")
all_pass = True
for name, status in test_accuracy:
    print(f"   • {name}: [{status}]")
    if status != "PASS":
        all_pass = False

print("\n==================================================")
print(f"OVERALL STATUS: {'ALL TESTS PASSED ✔' if all_pass else 'VERIFICATION FAILED ✖'}")
print("==================================================")
Chạy tập lệnh xác minh
Chạy tập lệnh trong Cloud Shell:
python3 test_memory_system.py
Kết quả đầu ra dự kiến trên bảng điều khiển
Khi kết thúc quá trình kiểm thử, một bản tóm tắt về các phát hiện sẽ được in. Dưới đây là ví dụ về bản in như vậy, kèm theo phần giải thích
1. STORED ALLOYDB ENTITIES: <A List of all stored entities,>
   • Entity: '<name of entity>' | Project: '<which project does this relate to>' | Scope: '<global/project/session>'
     Summary: <The entity summary>
    ....

2. DYNAMIC TOKEN USAGE & PROMPT EFFICIENCY METRICS:
   • Naive Full-Context Turn 5 Tokens:    <Number of tokens in naive approach on the last turn>
   • Tiered Memory Active Prompt Tokens:  <Number of tokens in tiered approach on the last turn>
   • Active Turn 5 Prompt Reduction:      <Savings on tokens in %>
   • Measured Turn 5 Inference Latency:   <Latency in last turn>

3. TOTAL CUMULATIVE SYSTEM TOKENS (READ PATH + BACKGROUND WORKERS):
   • Naive Cumulative Multi-Turn Tokens:  <Total tokens in the naive approach>
   • Active Read-Path Prompt Tokens:      <Read path tokens in the tiered approach>
   • Background Worker Tokens (Extraction): <Backround process tokens usage in tiered approach>
   • Background Compaction Tokens (Valkey): <Backround process tokens usage for compaction in tiered approach>
   • Total Tiered System Token Footprint: <Total tokens usage in tiered approach>
   • Overall System Token Savings:        <Savings on tokens in %>

4. ACCURACY & VERIFICATION TESTS:
   • Valkey Rolling Summary Compaction Test: <Did the roling summary work>
   • Global Coding Preference Recall Test (scope='global'): <Was it able to retrieve global scoped memories>
   • Project CloudRetail Architecture Recall Test (project_id='CloudRetail'): <Was it able to retrieve project specific scoped entities>
   • Tool Permission Policy Test: <Was it able to retrieve permissions policies>
Đặt lại Bộ nhớ (Không bắt buộc)
Nếu bạn muốn xoá tất cả bộ nhớ đã lưu trữ và đặt lại trạng thái của Valkey và AlloyDB giữa các lần chạy kiểm thử, hãy tạo và chạy cleanup_memory_system.py:
import logging
from db_clients import get_db_connection, get_valkey_client
from valkey_buffer import IN_MEMORY_VALKEY_FALLBACK

logging.basicConfig(level=logging.INFO)

def reset_memory_system():
    # 1. Flush short-term Valkey cache or clear local in-memory fallback
    try:
        valkey = get_valkey_client()
        valkey.flushdb()
        print("✔ Flushed Valkey short-term cache.")
    except Exception:
        IN_MEMORY_VALKEY_FALLBACK.clear()
        print("✔ Cleared local in-memory short-term fallback buffer.")

    # 2. Truncate long-term AlloyDB memory tables
    try:
        conn = get_db_connection()
        with conn:
            with conn.cursor() as cur:
                cur.execute("TRUNCATE TABLE agent_entities CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_embeddings CASCADE;")
                cur.execute("TRUNCATE TABLE episodic_memory_collections CASCADE;")
                cur.execute("TRUNCATE TABLE user_permissions CASCADE;")
                print("✔ Truncated AlloyDB long-term memory tables.")
        conn.close()
    except Exception as e:
        print(f"✖ AlloyDB cleanup error: {e}")

if __name__ == "__main__":
    reset_memory_system()
Chạy tập lệnh dọn dẹp:
python3 cleanup_memory_system.py
14. Mở rộng bộ nhớ theo cấp sang Google ADK
Trong các bước trước, bạn đã tạo một hệ thống bộ nhớ 2 cấp:
- Cấp 1 (vùng đệm ngắn hạn): Memorystore cho Valkey lưu trữ các lượt trò chuyện gần đây và tạo bản tóm tắt luân phiên để giữ cho câu lệnh có kích thước nhỏ.
- Cấp 2 (cửa hàng kết hợp dài hạn): AI của AlloyDB lưu trữ các lựa chọn ưu tiên bền vững của người dùng, quy tắc dự án và các bản nhúng vectơ bằng tính năng tìm kiếm kết hợp.
Trong hướng dẫn này, bạn sẽ kết nối công cụ bộ nhớ này với một tác nhân tuỳ chỉnh được tạo bằng Bộ công cụ phát triển tác nhân của Google .
Vấn đề với bộ nhớ đơn giản
Việc kết nối một tác nhân với bộ nhớ thường dẫn đến một trong hai cạm bẫy sau:
- Bẫy chỉ dùng công cụ: Buộc trợ lý gọi các công cụ (chẳng hạn như
search_memory) cho mọi việc. Các tác nhân thường quên gọi các công cụ cho các lựa chọn ưu tiên cơ bản (như kiểu mã hoá hoặc thời gian chờ), dẫn đến lỗi và các chuyến khứ hồi bổ sung diễn ra chậm. - Bẫy nhồi nhét câu lệnh: Đổ tất cả nhật ký trước đây vào mọi câu lệnh. Điều này nhanh chóng làm tăng chi phí mã thông báo, làm chậm phản hồi và làm giảm khả năng suy luận của mô hình.
Giải pháp kết hợp
Chúng tôi sử dụng một phương pháp kết hợp để cung cấp cho tác nhân bộ nhớ phù hợp vào đúng thời điểm:
- Bối cảnh xung quanh (tự động): Trước mỗi lượt tương tác, các quy tắc dự án có liên quan và bản tóm tắt phiên gần đây sẽ được truy xuất từ Memorystore (bản tóm tắt luân phiên) và AlloyDB (các quy tắc và lựa chọn ưu tiên), sau đó được đưa vào lời nhắc của tác nhân mà không cần thêm lệnh gọi LLM nào.
- Tìm kiếm dài hạn theo yêu cầu (công cụ): Đối với những thông tin cũ hoặc không rõ ràng (chẳng hạn như một quyết định về kiến trúc cách đây 2 tuần), tác nhân sẽ gọi
long_term_memory_toolđể chạy một tìm kiếm vectơ trong bảng bộ nhớ dài hạn của AlloyDB. - Hàng rào bảo vệ khi thực thi: Trước khi chạy một công cụ, một hàng rào bảo vệ sẽ kiểm tra các lệnh cấp một lần trong Valkey và các quy tắc bảo mật trong AlloyDB để chặn các hành động nguy hiểm như
rm -rf.
Thiết lập và cấu hình
Cài đặt gói google-adk (các phần phụ thuộc khác đã được cài đặt):
pip3 install google-adk
Đặt khu vực Google Cloud cho ứng dụng ADK GenAI để định tuyến thông qua Vertex AI:
# ADK agent platform backend
export GEMINI_MODEL="gemini-3.5-flash"
export GOOGLE_GENAI_USE_VERTEXAI="true"
export GOOGLE_CLOUD_PROJECT="${PROJECT_ID}"
export GOOGLE_CLOUD_LOCATION="${GENAI_LOCATION}"
15. Nhà cung cấp bộ nhớ môi trường xung quanh
Tạo adk_memory_provider.py. Lớp này xử lý vòng đời bộ nhớ tự động:
- Trước lượt phản hồi: Tìm nạp vùng đệm cuộc trò chuyện Valkey (<1 mili giây) và truy vấn AlloyDB để tìm các lựa chọn ưu tiên và quy tắc dự án phù hợp, sau đó tổng hợp các lựa chọn ưu tiên và quy tắc đó thành câu lệnh hệ thống.
- Sau lượt tương tác: Thêm cuộc trò chuyện vào Valkey và kích hoạt một worker chạy ngầm để trích xuất các thông tin bền vững vào AlloyDB mà không làm chậm phản hồi của người dùng.
import logging
from typing import Any, Dict, Optional
import redis
from valkey_buffer import get_session_context_buffer, append_session_turn_with_rolling_summary
from hybrid_retriever import retrieve_hybrid_entities
from async_worker import AsyncMemoryWorker

class ADKTieredMemoryProvider:
    """Provides ambient memory context before turns and saves history after turns."""

    def __init__(self, db_conn_factory, valkey_client: redis.Redis, genai_client: Any, trigger_limit: int = 10, window_size: int = 4):
        self.conn_factory = db_conn_factory
        self.valkey_client = valkey_client
        self.genai_client = genai_client
        self.trigger_limit = trigger_limit
        self.window_size = window_size
        self.async_worker = AsyncMemoryWorker(db_conn_factory, genai_client)

    def get_context_for_turn(self, user_id: str, project_id: Optional[str], session_id: str, user_query: str, prev_session_id: Optional[str] = None) -> Dict[str, Any]:
        """Reads Valkey buffer (<1ms) and AlloyDB hybrid entities before agent reasoning."""
        buffer_data = get_session_context_buffer(self.valkey_client, session_id)
        rolling_summary = buffer_data["rolling_summary"]

        # Carry over prior session summary when starting a fresh session
        if not rolling_summary and prev_session_id:
            prev_buffer = get_session_context_buffer(self.valkey_client, prev_session_id)
            if prev_buffer["rolling_summary"]:
                rolling_summary = f"[From prior session {prev_session_id}]:\n" + prev_buffer["rolling_summary"]

        conn = self.conn_factory()
        try:
            entities = retrieve_hybrid_entities(
                conn=conn, llm_client=self.genai_client, user_id=user_id,
                active_session_id=session_id, query_text=user_query,
                prev_session_id=prev_session_id, project_id=project_id, k=20
            )
        finally:
            conn.close()

        return {
            "rolling_summary": rolling_summary,
            "recent_turns": buffer_data["recent_turns"],
            "retrieved_entities": entities
        }

    def format_system_instruction(self, context: Dict[str, Any], base_prompt: str = "") -> str:
        """Injects ambient entities and short-term summaries into the agent's prompt."""
        entity_lines = [f"- {name}: {info['summary']}" for name, info in context["retrieved_entities"].items()]
        entity_str = "\n".join(entity_lines) if entity_lines else "No relevant long-term entities."
        summary_str = context["rolling_summary"] or "No prior summary."

        return f"""{base_prompt}

[LONG-TERM PREFERENCES & ENTITIES]
{entity_str}

[SHORT-TERM ROLLING SUMMARY]
{summary_str}

[NOTE ON TOOLS & MEMORY]
Memory persistence is managed automatically by the platform behind the scenes. Do not attempt to invoke non-existent tools like 'set_preference' or 'save_fact'. Only invoke explicitly declared tools when needed.
""".strip()

    def record_turn_async(self, user_id: str, project_id: Optional[str], session_id: str, user_msg: str, ai_msg: str, prev_session_id: Optional[str] = None) -> None:
        """Updates Valkey sliding window and triggers background AlloyDB extraction."""
        append_session_turn_with_rolling_summary(
            valkey_client=self.valkey_client, llm_client=self.genai_client,
            session_id=session_id, user_msg=user_msg, ai_msg=ai_msg,
            trigger_limit=self.trigger_limit, window_size=self.window_size
        )
        self.async_worker.enqueue_extraction(
            user_id=user_id, session_id=session_id, user_msg=user_msg,
            ai_msg=ai_msg, prev_session_id=prev_session_id
        )
16. Công cụ bộ nhớ dài hạn theo yêu cầu
Bộ nhớ xung quanh giúp lời nhắc đang hoạt động có kích thước nhỏ, nhưng đôi khi, một tác nhân cần tìm kiếm trong các ghi chú cũ, quyết định về kiến trúc hoặc nhật ký sự cố.
Tạo adk_memory_tools.py. Thao tác này sẽ bao bọc bảng vectơ episodic_memory_embeddings của AlloyDB vào một FunctionTool ADK:
from typing import Any, Dict, List, Optional
from google.adk.tools import FunctionTool

def make_long_term_memory_tool(db_conn_factory, embed_client: Any, user_id: str) -> FunctionTool:
    """Creates an ADK FunctionTool for vector search over AlloyDB historical records."""

    def search_archived_memory(query: str, project_id: Optional[str] = None, limit: int = 3) -> List[Dict[str, Any]]:
        """Searches past architecture decisions, historical notes, and old discussions."""
        # 1. Embed query with text-embedding-005
        emb_resp = embed_client.models.embed_content(model="text-embedding-005", contents=query)
        query_vector = emb_resp.embeddings[0].values

        # 2. Cosine distance search on AlloyDB HNSW vector index
        sql = """
            SELECT document, cmetadata, created_at, 1 - (embedding <=> %s::vector) AS similarity
            FROM episodic_memory_embeddings
            WHERE cmetadata->>'user_id' = %s
              AND (%s IS NULL OR cmetadata->>'project_id' = %s)
            ORDER BY embedding <=> %s::vector ASC
            LIMIT %s;
        """
        conn = db_conn_factory()
        results = []
        try:
            with conn.cursor() as cur:
                cur.execute(sql, (str(query_vector), user_id, project_id, project_id, str(query_vector), limit))
                for doc, meta, created_at, similarity in cur.fetchall():
                    results.append({
                        "document": doc,
                        "metadata": meta,
                        "timestamp": created_at.isoformat() if created_at else None,
                        "similarity": round(float(similarity), 4)
                    })
        finally:
            conn.close()
        return results

    return FunctionTool(search_archived_memory)
17. Các quy định về quyền dành cho doanh nghiệp
Các tác nhân tự trị không được thực hiện các hành động huỷ hoại máy chủ (chẳng hạn như rm -rf hoặc thả bảng) mà không cần xác minh.
Cách hoạt động của before_tool_callback trong ADK
ADK cung cấp một lệnh gọi chặn chạy trước khi bất kỳ công cụ nào thực thi:
- Trả về
None: ADK cho phép thực thi công cụ. - Trả về một từ điển (ví dụ:
{"status": "DENIED", "error": ...}): ADK ngay lập tức huỷ bỏ quá trình thực thi. Không có lệnh nào chạy và lý do từ chối được trả về cho mô hình để mô hình có thể giải thích hạn chế cho người dùng.
Thứ tự kiểm tra quyền
- Kiểm tra 0 (Danh sách cho phép công cụ an toàn): Các công cụ chỉ đọc an toàn như
search_archived_memoryđược phê duyệt trước trong bộ nhớ để tác nhân luôn có thể truy vấn bộ nhớ của chính nó. - Cấp 1 (Quyền "cho phép một lần" tạm thời trong Valkey): Khi một nhân viên vận hành là con người phê duyệt một hành động rủi ro, khoá tạm thời
one_time_perm:{session_id}:{cmd_hash}sẽ được lưu trữ trong Valkey với TTL là 5 phút. Guardrail đọc và xoá khoá trong một thao tác nguyên tử. Điều này cho phép lệnh chạy một lần, ngăn chặn tình trạng leo thang đặc quyền vĩnh viễn. - Cấp 2 (Quy tắc dự án trong AlloyDB): Kiểm tra các quy tắc biểu thức chính quy trong
user_permissionscho dự án đang hoạt động (ví dụ: cho phéppytest.*--timeout=30, chặnrm -rf.*). - Cấp 3 (Quy tắc chung trong AlloyDB): Kiểm tra các quy tắc dự phòng áp dụng cho tất cả dự án.
- Fail-closed fallback: Nếu không có quy tắc nào khớp, quá trình thực thi sẽ bị từ chối bằng
PENDING, yêu cầu đánh giá thủ công.
Triển khai
Tạo adk_guardrails.py:
import logging
from typing import Any, Dict, Optional, Tuple, Set
from enterprise_engine import AgentMemoryEngine

logger = logging.getLogger(__name__)

class ADKPermissionGuardrail:
    """Evaluates tool permissions using Valkey allow-once tokens and AlloyDB rules."""

    def __init__(self, memory_engine: AgentMemoryEngine, exempt_tools: Optional[Set[str]] = None):
        self.engine = memory_engine
        self.exempt_tools = exempt_tools or {"search_archived_memory"}

    def evaluate(self, user_id: str, project_id: str, session_id: str, tool_name: str, tool_args: Dict[str, Any]) -> Tuple[bool, str]:
        # 1. Allowlist safe internal tools
        if tool_name in self.exempt_tools:
            return True, f"Internal tool '{tool_name}' is pre-approved."

        # 2. Check 3-tier policy engine
        action, reason = self.engine.evaluate_tool_permission(
            user_id=user_id, project_id=project_id, session_id=session_id,
            tool_name=tool_name, tool_args=tool_args
        )
        if action.upper() == "ALLOW":
            return True, f"Permission ALLOWED: {reason}"
        elif action.upper() == "BLOCK":
            return False, f"Permission BLOCKED: {reason}"
        return False, f"Permission PENDING: {reason} (requires human confirmation)"

    def create_before_tool_callback(self, user_id: str, default_project_id: str = "global"):
        """Creates the callback hook for Agent(before_tool_callback=...)."""
        def before_tool_callback(tool: Any, args: Dict[str, Any], tool_context: Any) -> Optional[Dict[str, Any]]:
            tool_name = getattr(tool, "name", str(tool))
            session_id = getattr(getattr(tool_context, "session", None), "id", "default_session")

            allowed, msg = self.evaluate(user_id, default_project_id, session_id, tool_name, args)
            if not allowed:
                logger.warning("Guardrail blocked '%s': %s", tool_name, msg)
                return {"status": "DENIED", "tool": tool_name, "error": msg}

            return None  # Returning None permits execution in ADK
        return before_tool_callback
18. Chạy kiểm thử tác nhân ADK
Tạo test_adk_agent.py. Tập lệnh hoàn chỉnh này kết nối các thành phần với nhau, gieo một quyết định và các quy tắc bảo mật đã lưu trữ, chạy một cuộc trò chuyện gồm 2 phiên, kiểm tra khả năng nén và thu hồi bộ nhớ, đồng thời xác minh việc thực thi các quy tắc hạn chế:
import asyncio
import os
import time
from google import genai
from google.genai import types
from google.adk.agents import Agent
from google.adk.runners import Runner
from google.adk.sessions import InMemorySessionService
from google.adk.tools import FunctionTool

from db_clients import get_db_connection, get_valkey_client
from enterprise_engine import AgentMemoryEngine
from adk_memory_provider import ADKTieredMemoryProvider
from adk_memory_tools import make_long_term_memory_tool
from adk_guardrails import ADKPermissionGuardrail
from valkey_buffer import get_session_context_buffer

# Configuration & clients
PROJECT_ID = os.getenv("PROJECT_ID", "chunking-poc-alloydb")
REGION = os.getenv("REGION", "us-east1")
GENAI_LOCATION = os.getenv("GENAI_LOCATION", "us")
GEMINI_MODEL = os.getenv("GEMINI_MODEL", "gemini-3.5-flash")
USER_ID, SESSION_1, SESSION_2 = "user_adk_dev", "sess_adk_001", "sess_adk_002"

db_conn = get_db_connection()
valkey_client = get_valkey_client()
# LLM client for Gemini 3.5 Flash via global multi-region
genai_client = genai.Client(vertexai=True, project=PROJECT_ID, location=GENAI_LOCATION)
# Embeddings client (requires specific regional presence)
embed_client = genai.Client(vertexai=True, project=PROJECT_ID, location=REGION)

tiered_provider = ADKTieredMemoryProvider(get_db_connection, valkey_client, genai_client, trigger_limit=3, window_size=2)
memory_engine = AgentMemoryEngine(valkey_client, db_conn)
guardrail = ADKPermissionGuardrail(memory_engine)

# Tools: Long-term memory search and mock terminal command
long_term_memory_tool = make_long_term_memory_tool(get_db_connection, embed_client, USER_ID)

def run_command(CommandLine: str) -> str:
    """Executes a shell command on the host."""
    return f"Executed: {CommandLine}"

run_command_tool = FunctionTool(run_command)

def seed_database():
    """Seeds a 14-day-old architecture decision and permission rules."""
    doc = "Archived Decision: CloudRetail services must use gRPC keepalive ping intervals of 15 seconds."
    emb = embed_client.models.embed_content(model="text-embedding-005", contents=doc).embeddings[0].values
    conn = get_db_connection()
    try:
        with conn.cursor() as cur:
            cur.execute("""
                INSERT INTO episodic_memory_embeddings (uuid, document, cmetadata, created_at, embedding)
                VALUES (gen_random_uuid(), %s, jsonb_build_object('user_id', %s, 'project_id', 'CloudRetail'), NOW() - INTERVAL '14 days', %s::vector);
            """, (doc, USER_ID, str(emb)))
            cur.execute("""
                INSERT INTO user_permissions (user_id, project_id, tool_name, command_pattern, action)
                VALUES (%s, 'CloudRetail', 'run_command', 'pytest.*--timeout=30', 'ALLOW'),
                       (%s, 'CloudRetail', 'run_command', 'rm -rf.*', 'BLOCK'),
                       (%s, 'global', 'search_archived_memory', '.*', 'ALLOW')
                ON CONFLICT DO NOTHING;
            """, (USER_ID, USER_ID, USER_ID))
        conn.commit()
    finally:
        conn.close()

async def run_turn(runner: Runner, session_id: str, query: str, prev_session_id: str = None) -> str:
    """Fetches ambient memory, executes turn, and saves history in the background."""
    ctx = tiered_provider.get_context_for_turn(USER_ID, "CloudRetail", session_id, query, prev_session_id)
    runner.agent.instruction = tiered_provider.format_system_instruction(
        ctx,
        base_prompt="You are an intelligent Google ADK enterprise developer assistant."
    )
    msg = types.Content(role="user", parts=[types.Part.from_text(text=query)])
    parts = []
    async for event in runner.run_async(user_id=USER_ID, session_id=session_id, new_message=msg):
        if event.content and event.content.parts:
            parts.extend([p.text for p in event.content.parts if p.text])

    response = "".join(parts).strip()
    tiered_provider.record_turn_async(USER_ID, "CloudRetail", session_id, query, response, prev_session_id)
    return response

async def main():
    seed_database()
    sessions = InMemorySessionService()
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_1)

    agent = Agent(
        name="adk_memory_agent", model=GEMINI_MODEL, instruction="Initial instruction",
        tools=[long_term_memory_tool, run_command_tool],
        before_tool_callback=guardrail.create_before_tool_callback(USER_ID, "CloudRetail")
    )
    runner = Runner(agent=agent, session_service=sessions, app_name="agents")

    print("\n--- Session 1: Storing Preferences & Triggering Compaction ---")
    await run_turn(runner, SESSION_1, "I standardize on Python 3.11 with PostgreSQL and Dark Mode UI.")
    await run_turn(runner, SESSION_1, "For project CloudRetail, our backend stack is FastAPI on AlloyDB with Valkey cache and 30s timeouts.")
    await run_turn(runner, SESSION_1, "Draft a quick 5-line SQL table for products.")
    await run_turn(runner, SESSION_1, "Add rate-limiting rules for API endpoints.")

    buf = get_session_context_buffer(valkey_client, SESSION_1)
    print(f"Valkey rolling summary generated: {bool(buf['rolling_summary'])}")
    print(f"Turns in buffer: {len(buf['recent_turns'])} (compacted from 8)")

    print("\nWaiting 6s for background worker entity extraction into AlloyDB...")
    await asyncio.sleep(6)

    print("\n--- Session 2: Cold-Start Ambient Recall ---")
    await sessions.create_session(app_name="agents", user_id=USER_ID, session_id=SESSION_2)
    resp = await run_turn(runner, SESSION_2, "What are my coding preferences and the CloudRetail stack from my previous session?", prev_session_id=SESSION_1)
    print(f"Agent response:\n{resp}\n")

    print("\n--- On-Demand Archival Vector Search ---")
    resp_search = await run_turn(runner, SESSION_2, "What was the agreed gRPC keepalive interval from 2 weeks ago?")
    print(f"Agent response:\n{resp_search}\n")

    print("\n--- Guardrail Verification ---")
    blocked, b_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "rm -rf /tmp/data"})
    allowed, a_msg = guardrail.evaluate(USER_ID, "CloudRetail", SESSION_2, "run_command", {"CommandLine": "pytest --timeout=30"})
    print(f"rm -rf /tmp/data:    Allowed={blocked} ({b_msg})")
    print(f"pytest --timeout=30: Allowed={allowed} ({a_msg})")

if __name__ == "__main__":
    asyncio.run(main())
Dọn dẹp sau kiểm thử lặp lại
Vì hệ thống ghi lại ngữ cảnh liên tục, nên việc chạy thử nhiều lần sẽ liên tục thêm các đoạn hội thoại vào Valkey và chèn các quy tắc trùng lặp vào AlloyDB.
Để dễ dàng đặt lại trạng thái giữa các lần chạy, hãy chạy tập lệnh cleanup_memory_system.py mà bạn đã tạo ở bước trước:
python3 cleanup_memory_system.py
python3 test_adk_agent.py
Kết quả xác minh
Bài kiểm thử này xác minh 4 hành vi quan trọng trong quá trình sản xuất:
- Giảm đáng kể số lượng mã thông báo của câu lệnh: Tính năng nén của Valkey đã nén nhật ký trò chuyện thành một bản tóm tắt ngắn gọn. Trong các thử nghiệm của chúng tôi, kích thước của câu lệnh đang hoạt động đã giảm hơn 92% (từ khoảng 6.956 mã thông báo xuống khoảng 544 mã thông báo) – kết quả của bạn có thể khác.
- Khả năng nhớ lại tức thì khi khởi động nguội: Trong một phiên hoàn toàn mới (Phiên 2), tác nhân này đã nhớ lại ngay lập tức các lựa chọn ưu tiên của người dùng (Python 3.11, PostgreSQL, Chế độ tối) và cấu trúc dự án (FastAPI, thời gian chờ 30 giây) mà không cần gọi bất kỳ công cụ nào. Điều này được thực hiện nhờ
ADKTieredMemoryProvider.get_context_for_turn, giúp truy xuất bối cảnh từ Memorystore và AlloyDB trước khi LLM được gọi. - Truy xuất vectơ theo yêu cầu: Khi được hỏi về một quyết định cách đây 14 ngày, tác nhân đã gọi
search_archived_memoryvà truy xuất quy tắc duy trì kết nối gRPC trong 15 giây. - Độ an toàn xác định: Tác nhân đã thực thi
pytest --timeout=30, nhưng bị chặn hoàn toàn khi chạyrm -rf /tmp/data.
19. Dọn dẹp
Để tránh bị tính phí liên tục cho tài khoản Google Cloud của bạn đối với các phiên bản AlloyDB và Memorystore, hãy xoá các tài nguyên đã tạo.
Chạy các lệnh sau trong Cloud Shell:
# Exit VM and return to Cloud Shell
exit
# Delete Compute Engine development VM
gcloud compute instances delete $VM_NAME \
  --zone=$ZONE \
  --quiet

# Delete AlloyDB primary instance and cluster
gcloud alloydb instances delete $ADBINSTANCE \
  --cluster=$ADBCLUSTER \
  --region=$REGION \
  --quiet

gcloud alloydb clusters delete $ADBCLUSTER \
  --region=$REGION \
  --quiet

# Delete Memorystore for Valkey instance
gcloud memorystore instances delete $VALKEYINSTANCE \
  --location=$REGION \
  --quiet
20. Xin chúc mừng
Xin chúc mừng! Bạn đã xây dựng thành công một cấu trúc bộ nhớ tác nhân AI dài hạn gồm 2 cấp kết hợp Memorystore for Valkey và AI AlloyDB.
Kiến thức bạn học được
- Triển khai cấu trúc bộ nhớ 2 cấp, tách trạng thái phiên hoạt động ngắn hạn khỏi các dữ kiện lâu dài.
- Đạt được mức giảm đáng kể về kích thước câu lệnh đang hoạt động và tiết kiệm tổng số mã thông báo sử dụng so với việc nhồi ngữ cảnh đơn thuần mà không làm giảm độ chính xác.
- Đã định cấu hình các mục nhúng tự động theo giao dịch ở cấp cơ sở dữ liệu AlloyDB AI (
ai.initialize_embeddings). - Thực hiện tìm kiếm kết hợp hợp nhất thứ hạng tương hỗ (
ai.hybrid_search) gốc, kết hợp độ tương tự của vectơ (<=>) với tính năng tìm kiếm toàn văn của PostgreSQL (tsvector). - Xây dựng một trình trích xuất thực thể ở chế độ nền ngoài luồng (
AsyncMemoryWorker), một trình đánh giá quyền thực thi công cụ 3 cấp và một công cụ nén bộ nhớ cơ sở dữ liệu. - Đính kèm hệ thống bộ nhớ theo cấp vào một tác nhân tự động bằng Bộ công cụ phát triển tác nhân (ADK) của Google để thực thi các quy tắc ràng buộc về công cụ và cung cấp bộ nhớ xung quanh.
Các bước tiếp theo và tài liệu tham khảo
- Đọc Tài liệu về AI AlloyDB.
- Tìm hiểu cách Chạy tính năng Tìm kiếm vectơ kết hợp trong AlloyDB.
- Tìm hiểu thêm về Memorystore for Valkey.