

1. Wprowadzenie
W tym ćwiczeniu dowiesz się, jak używać AlloyDB AI, łącząc wyszukiwanie wektorowe z wektorami dystrybucyjnymi Vertex AI. Ten moduł należy do kolekcji modułów poświęconych funkcjom AlloyDB AI. Więcej informacji znajdziesz na stronie AlloyDB AI w dokumentacji.
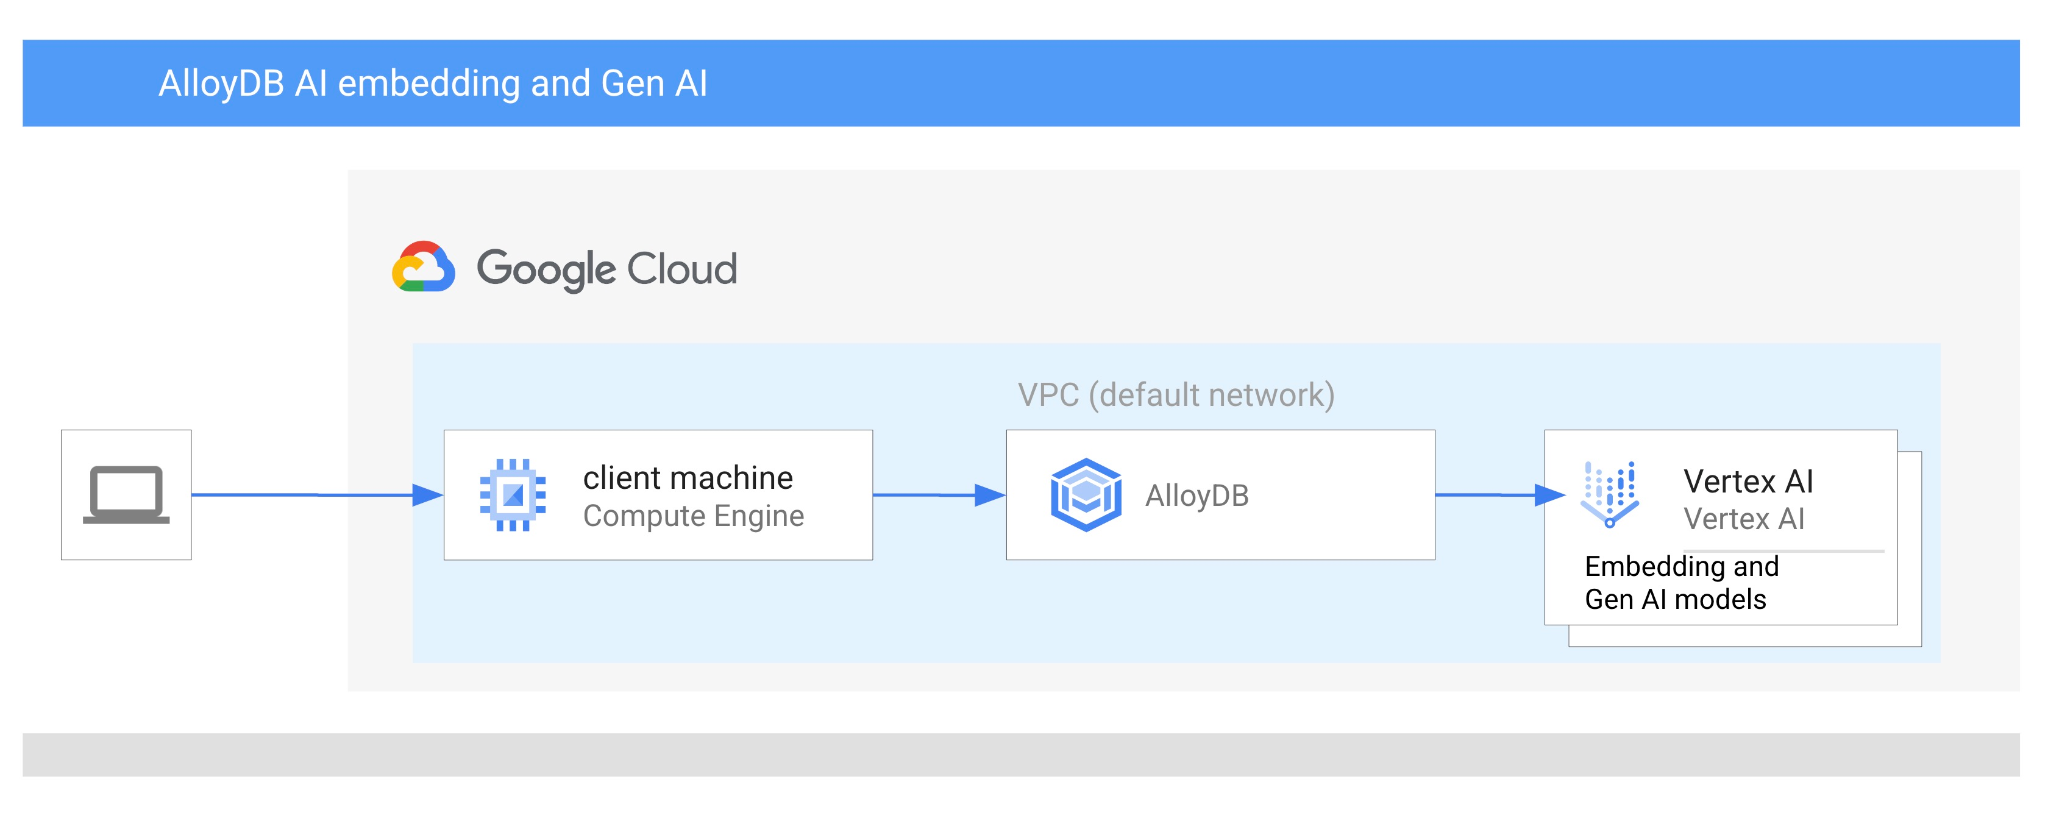
Wymagania wstępne
- Podstawowa wiedza o Google Cloud i konsoli
- Podstawowe umiejętności korzystania z interfejsu wiersza poleceń i Cloud Shell
Czego się nauczysz
- Jak wdrożyć klaster AlloyDB i instancję główną
- Jak połączyć się z AlloyDB z maszyny wirtualnej Google Compute Engine
- Tworzenie bazy danych i włączanie AlloyDB AI
- Wczytywanie danych do bazy danych
- Jak korzystać z AlloyDB Studio
- Jak używać modelu wektorów dystrybucyjnych Gemini Enterprise Agent Platform w AlloyDB
- Jak korzystać z Gemini Enterprise Agent Platform Studio
- Jak wzbogacić wynik za pomocą modelu generatywnego Gemini Enterprise Agent Platform
- Jak poprawić wydajność za pomocą indeksu wektorów
Czego potrzebujesz
- Konto Google Cloud i projekt Google Cloud
- przeglądarka, np. Chrome;
2. Konfiguracja i wymagania
Konfiguracja projektu
- Zaloguj się w konsoli Google Cloud. Jeśli nie masz jeszcze konta Gmail lub Google Workspace, musisz je utworzyć.
Używaj konta osobistego zamiast konta służbowego lub szkolnego.
- Utwórz nowy projekt lub użyj istniejącego. Aby utworzyć nowy projekt w konsoli Google Cloud, w nagłówku kliknij przycisk Wybierz projekt. Otworzy się okno wyskakujące.
W oknie Wybierz projekt kliknij przycisk Nowy projekt, aby otworzyć okno dialogowe nowego projektu.
W oknie dialogowym wpisz preferowaną nazwę projektu i wybierz lokalizację.
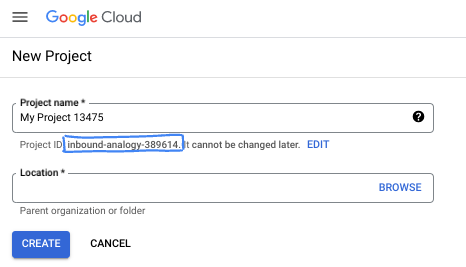
- Nazwa projektu to wyświetlana nazwa dla uczestników tego projektu. Nazwa projektu nie jest używana przez interfejsy API Google i można ją w każdej chwili zmienić.
- Identyfikator projektu jest unikalny we wszystkich projektach Google Cloud i nie można go zmienić po ustawieniu. Konsola Google Cloud automatycznie generuje unikalny identyfikator, ale możesz go dostosować. Jeśli wygenerowany identyfikator Ci się nie podoba, możesz wygenerować kolejny losowy identyfikator lub podać własny, aby sprawdzić jego dostępność. W większości ćwiczeń z programowania musisz odwoływać się do identyfikatora projektu, który jest zwykle oznaczony zmienną PROJECT_ID.
- Warto wiedzieć, że istnieje jeszcze trzecia wartość, numer projektu, której używają niektóre interfejsy API. Więcej informacji o tych 3 wartościach znajdziesz w dokumentacji.
Włącz płatności
Konfigurowanie osobistego konta rozliczeniowego
Jeśli skonfigurujesz płatności za pomocą środków w Google Cloud, możesz pominąć ten krok.
Aby skonfigurować osobiste konto rozliczeniowe, włącz płatności w Cloud Console.
Uwagi:
- Pod względem opłat za zasoby chmury ukończenie tego modułu powinno kosztować mniej niż 3 USD.
- Jeśli chcesz uniknąć dalszych opłat, wykonaj czynności opisane na końcu tego modułu, aby usunąć zasoby.
- Nowi użytkownicy mogą skorzystać z bezpłatnego okresu próbnego, w którym mają do dyspozycji środki w wysokości 300 USD.
Uruchom Cloud Shell
Z Google Cloud można korzystać zdalnie na laptopie, ale w tym ćwiczeniu użyjesz Google Cloud Shell, czyli środowiska wiersza poleceń działającego w chmurze.
W konsoli Google Cloud kliknij ikonę Cloud Shell na pasku narzędzi w prawym górnym rogu:
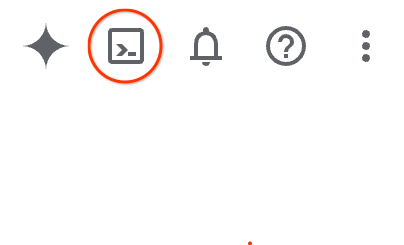
Możesz też nacisnąć G, a potem S. Ta sekwencja aktywuje Cloud Shell, jeśli korzystasz z konsoli Google Cloud. Możesz też użyć tego linku.
Uzyskanie dostępu do środowiska i połączenie się z nim powinno zająć tylko kilka chwil. Po zakończeniu powinno wyświetlić się coś takiego:
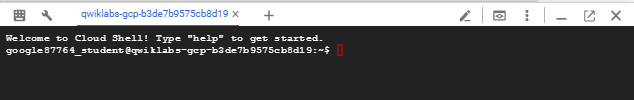
Ta maszyna wirtualna zawiera wszystkie potrzebne narzędzia dla programistów. Zawiera również stały katalog domowy o pojemności 5 GB i działa w Google Cloud, co znacznie zwiększa wydajność sieci i usprawnia proces uwierzytelniania. Wszystkie zadania w tym laboratorium możesz wykonać w przeglądarce. Nie musisz niczego instalować.
3. Zanim zaczniesz
Włącz API
Dane wyjściowe:
Aby korzystać z usług AlloyDB, Compute Engine, usług sieciowych i Gemini Enterprise Agent Platform, musisz włączyć odpowiednie interfejsy API w projekcie Google Cloud.
Włączanie interfejsów API
W terminalu Cloud Shell sprawdź, czy identyfikator projektu jest skonfigurowany:
gcloud config set project [YOUR-PROJECT-ID]
Ustaw zmienną środowiskową PROJECT_ID:
PROJECT_ID=$(gcloud config get-value project)
Włącz wszystkie niezbędne interfejsy API:
gcloud services enable alloydb.googleapis.com \
                       compute.googleapis.com \
                       cloudresourcemanager.googleapis.com \
                       servicenetworking.googleapis.com \
                       aiplatform.googleapis.com
Oczekiwane dane wyjściowe
student@cloudshell:~ (test-project-001-402417)$ gcloud config set project test-project-001-402417
Updated property [core/project].
student@cloudshell:~ (test-project-001-402417)$ PROJECT_ID=$(gcloud config get-value project)
Your active configuration is: [cloudshell-14650]
student@cloudshell:~ (test-project-001-402417)$
student@cloudshell:~ (test-project-001-402417)$ gcloud services enable alloydb.googleapis.com \
                       compute.googleapis.com \
                       cloudresourcemanager.googleapis.com \
                       servicenetworking.googleapis.com \
                       aiplatform.googleapis.com
Operation "operations/acat.p2-4470404856-1f44ebd8-894e-4356-bea7-b84165a57442" finished successfully.
Informacje o każdym włączonym interfejsie API znajdziesz w dokumentacji.
4. Wdrażanie AlloyDB
Przed utworzeniem klastra AlloyDB przydziel dostępny zakres prywatnych adresów IP w sieci VPC, który będzie używany przez przyszłą instancję AlloyDB. Jeśli go nie masz, musisz go utworzyć i przypisać do użytku przez wewnętrzne usługi Google. Dopiero wtedy będziesz mieć możliwość utworzenia klastra i instancji.
Tworzenie prywatnego zakresu IP
Musisz skonfigurować prywatny dostęp do usług w sieci VPC dla AlloyDB. Zakładamy, że w projekcie masz sieć VPC „default” i będzie ona używana do wszystkich działań.
Utwórz zakres prywatnych adresów IP:
gcloud compute addresses create psa-range \
    --global \
    --purpose=VPC_PEERING \
    --prefix-length=24 \
    --description="VPC private service access" \
    --network=default
Utwórz połączenie prywatne, używając przydzielonego zakresu adresów IP:
gcloud services vpc-peerings connect \
    --service=servicenetworking.googleapis.com \
    --ranges=psa-range \
    --network=default
Oczekiwane dane wyjściowe konsoli:
student@cloudshell:~ (test-project-402417)$ gcloud compute addresses create psa-range \
    --global \
    --purpose=VPC_PEERING \
    --prefix-length=24 \
    --description="VPC private service access" \
    --network=default
Created [https://www.googleapis.com/compute/v1/projects/test-project-402417/global/addresses/psa-range].

student@cloudshell:~ (test-project-402417)$ gcloud services vpc-peerings connect \
    --service=servicenetworking.googleapis.com \
    --ranges=psa-range \
    --network=default
Operation "operations/pssn.p24-4470404856-595e209f-19b7-4669-8a71-cbd45de8ba66" finished successfully.

student@cloudshell:~ (test-project-402417)$
Tworzenie klastra AlloyDB
Tworzenie klastra AlloyDB w regionie us-central1
Określ hasło użytkownika postgres. Możesz zdefiniować własne hasło lub użyć funkcji losowej, aby je wygenerować.
export PGPASSWORD=`openssl rand -hex 16`
Oczekiwane dane wyjściowe konsoli:
student@cloudshell:~ (test-project-402417)$ export PGPASSWORD=`openssl rand -hex 12`
Zapamiętaj hasło PostgreSQL, aby użyć go w przyszłości:
echo $PGPASSWORD
To hasło będzie Ci potrzebne w przyszłości do połączenia z instancją jako użytkownik postgres. Zapisz to hasło, aby użyć go w kolejnych krokach.
Oczekiwane dane wyjściowe konsoli:
student@cloudshell:~ (test-project-402417)$ echo $PGPASSWORD
bbefbfde7601985b0dee5723 (Note: Yours will be different!)
Tworzenie bezpłatnego klastra próbnego
Jeśli nie używasz jeszcze AlloyDB, możesz utworzyć bezpłatny klaster wersji próbnej:
Ustaw zmienne środowiskowe dla regionu i nazwy klastra:
export REGION=us-central1
export ADBCLUSTER=alloydb-aip-01
Uruchom polecenie, aby utworzyć klaster:
gcloud alloydb clusters create $ADBCLUSTER \
    --password=$PGPASSWORD \
    --network=default \
    --region=$REGION \
    --subscription-type=TRIAL
Oczekiwane dane wyjściowe konsoli:
export REGION=us-central1
export ADBCLUSTER=alloydb-aip-01
gcloud alloydb clusters create $ADBCLUSTER \
    --password=$PGPASSWORD \
    --network=default \
    --region=$REGION \
    --subscription-type=TRIAL
Operation ID: operation-1697655441138-6080235852277-9e7f04f5-2012fce4
Creating cluster...done.
Utwórz instancję główną AlloyDB dla klastra w tej samej sesji Cloud Shell. Jeśli połączenie zostanie przerwane, musisz ponownie zdefiniować zmienne środowiskowe regionu i nazwy klastra.
gcloud alloydb instances create $ADBCLUSTER-pr \
    --instance-type=PRIMARY \
    --cpu-count=8 \
    --region=$REGION \
    --cluster=$ADBCLUSTER
Oczekiwane dane wyjściowe konsoli:
student@cloudshell:~ (test-project-402417)$ gcloud alloydb instances create $ADBCLUSTER-pr \
    --instance-type=PRIMARY \
    --cpu-count=8 \
    --region=$REGION \
    --availability-type ZONAL \
    --cluster=$ADBCLUSTER
Operation ID: operation-1697659203545-6080315c6e8ee-391805db-25852721
Creating instance...done.
Tworzenie klastra AlloyDB Standard
Jeśli nie jest to Twój pierwszy klaster AlloyDB w projekcie, utwórz standardowy klaster. Jeśli masz już utworzony bezpłatny klaster próbny, pomiń ten krok.
Ustaw zmienne środowiskowe dla regionu i nazwy klastra:
export REGION=us-central1
export ADBCLUSTER=alloydb-aip-01
Uruchom polecenie, aby utworzyć klaster:
gcloud alloydb clusters create $ADBCLUSTER \
    --password=$PGPASSWORD \
    --network=default \
    --region=$REGION
Oczekiwane dane wyjściowe konsoli:
export REGION=us-central1
export ADBCLUSTER=alloydb-aip-01
gcloud alloydb clusters create $ADBCLUSTER \
    --password=$PGPASSWORD \
    --network=default \
    --region=$REGION
Operation ID: operation-1697655441138-6080235852277-9e7f04f5-2012fce4
Creating cluster...done.
Utwórz instancję główną AlloyDB dla klastra w tej samej sesji Cloud Shell. Jeśli połączenie zostanie przerwane, musisz ponownie zdefiniować zmienne środowiskowe regionu i nazwy klastra.
gcloud alloydb instances create $ADBCLUSTER-pr \
    --instance-type=PRIMARY \
    --cpu-count=2 \
    --region=$REGION \
    --cluster=$ADBCLUSTER
Oczekiwane dane wyjściowe konsoli:
student@cloudshell:~ (test-project-402417)$ gcloud alloydb instances create $ADBCLUSTER-pr \
    --instance-type=PRIMARY \
    --cpu-count=2 \
    --region=$REGION \
    --availability-type ZONAL \
    --cluster=$ADBCLUSTER
Operation ID: operation-1697659203545-6080315c6e8ee-391805db-25852721
Creating instance...done.
5. Łączenie z AlloyDB
AlloyDB jest wdrażana przy użyciu połączenia prywatnego, więc do pracy z bazą danych potrzebujesz maszyny wirtualnej Compute Engine z zainstalowanym klientem PostgreSQL.
Wdrażanie maszyny wirtualnej GCE
Utwórz maszynę wirtualną GCE w tym samym regionie i sieci VPC co klaster AlloyDB.
W Cloud Shell wykonaj to polecenie:
export ZONE=us-central1-a
gcloud compute instances create instance-1 \
    --zone=$ZONE \
    --create-disk=auto-delete=yes,boot=yes,image=projects/debian-cloud/global/images/$(gcloud compute images list --filter="family=debian-13 AND family!=debian-13-arm64" --format="value(name)") \
    --scopes=https://www.googleapis.com/auth/cloud-platform
Oczekiwane dane wyjściowe konsoli:
student@cloudshell:~ (test-project-402417)$ export ZONE=us-central1-a
gcloud compute instances create instance-1 \
    --zone=$ZONE \
    --create-disk=auto-delete=yes,boot=yes,image=projects/debian-cloud/global/images/$(gcloud compute images list --filter="family=debian-13 AND family!=debian-13-arm64" --format="value(name)") \
    --scopes=https://www.googleapis.com/auth/cloud-platform

Created [https://www.googleapis.com/compute/v1/projects/test-project-402417/zones/us-central1-a/instances/instance-1].
NAME: instance-1
ZONE: us-central1-a
MACHINE_TYPE: n1-standard-1
PREEMPTIBLE:
INTERNAL_IP: 10.128.0.2
EXTERNAL_IP: 34.71.192.233
STATUS: RUNNING
Zainstaluj klienta Postgres
Zainstaluj oprogramowanie klienta PostgreSQL na wdrożonej maszynie wirtualnej.
Połącz się z maszyną wirtualną:
gcloud compute ssh instance-1 --zone=us-central1-a
Oczekiwane dane wyjściowe konsoli:
student@cloudshell:~ (test-project-402417)$ gcloud compute ssh instance-1 --zone=us-central1-a
Updating project ssh metadata...working..Updated [https://www.googleapis.com/compute/v1/projects/test-project-402417].
Updating project ssh metadata...done.
Waiting for SSH key to propagate.
Warning: Permanently added 'compute.5110295539541121102' (ECDSA) to the list of known hosts.
Linux instance-1 6.12.101+deb13-cloud-amd64 #1 SMP PREEMPT_DYNAMIC Debian 6.12.101-1 (2026-08-05) x86_64

The programs included with the Debian GNU/Linux system are free software;
the exact distribution terms for each program are described in the
individual files in /usr/share/doc/*/copyright.

Debian GNU/Linux comes with ABSOLUTELY NO WARRANTY, to the extent
permitted by applicable law.
student@instance-1:~$
Zainstaluj oprogramowanie, uruchamiając w maszynie wirtualnej to polecenie:
sudo apt-get update
sudo apt-get install --yes postgresql-client
Oczekiwane dane wyjściowe konsoli:
student@instance-1:~$ sudo apt-get update
sudo apt-get install --yes postgresql-client
Get:1 file:/etc/apt/mirrors/debian.list Mirrorlist [30 B]
Get:2 file:/etc/apt/mirrors/debian-security.list Mirrorlist [39 B]
Hit:3 https://deb.debian.org/debian trixie InRelease
Get:4 https://deb.debian.org/debian trixie-updates InRelease [47.3 kB]
Get:5 https://deb.debian.org/debian trixie-backports InRelease [54.0 kB]
Get:6 https://deb.debian.org/debian-security trixie-security InRelease [43.4 kB]
Hit:10 https://packages.cloud.google.com/apt google-compute-engine-trixie-stable InRelease
...redacted...
update-alternatives: using /usr/share/postgresql/17/man/man1/psql.1.gz to provide /usr/share/man/man1/psql.1.gz (psql.1.gz) in auto mode
Setting up postgresql-client (17+278) ...
Processing triggers for man-db (2.13.1-1) ...
Processing triggers for libc-bin (2.41-12+deb13u3) ...
Łączenie się z instancją
Połącz się z instancją podstawową z maszyny wirtualnej za pomocą psql.
Na tej samej karcie Cloud Shell, na której otwarto sesję SSH z maszyną wirtualną instance-1.
Aby połączyć się z AlloyDB z maszyny wirtualnej GCE, użyj podanej wartości hasła AlloyDB (PGPASSWORD) i identyfikatora klastra AlloyDB:
export PGPASSWORD=<Noted password>
export PROJECT_ID=$(gcloud config get-value project)
export REGION=us-central1
export ADBCLUSTER=alloydb-aip-01
export INSTANCE_IP=$(gcloud alloydb instances describe $ADBCLUSTER-pr --cluster=$ADBCLUSTER --region=$REGION --format="value(ipAddress)")
psql "host=$INSTANCE_IP user=postgres sslmode=require"
Oczekiwane dane wyjściowe konsoli:
student@instance-1:~$ export PGPASSWORD=CQhOi5OygD4ps6ty
student@instance-1:~$ export PROJECT_ID=$(gcloud config get-value project)
export REGION=us-central1
export ADBCLUSTER=alloydb-aip-01
export INSTANCE_IP=$(gcloud alloydb instances describe $ADBCLUSTER-pr --cluster=$ADBCLUSTER --region=$REGION --format="value(ipAddress)")
psql "host=$INSTANCE_IP user=postgres sslmode=require"
psql (17.10 (Debian 17.10-0+deb13u1), server 17.9)
SSL connection (protocol: TLSv1.3, cipher: TLS_AES_256_GCM_SHA384, compression: off, ALPN: postgresql)
Type "help" for help.

postgres=>
Zamknij sesję psql:
exit
6. Przygotowywanie bazy danych
Utwórz bazę danych, włącz integrację Agent Platform AI, utwórz obiekty bazy danych i zaimportuj dane.
Przyznawanie niezbędnych uprawnień do AlloyDB
Dodaj uprawnienia Gemini Enterprise Agent Platform do agenta usługi AlloyDB.
Otwórz kolejną kartę Cloud Shell, klikając znak „+” u góry.
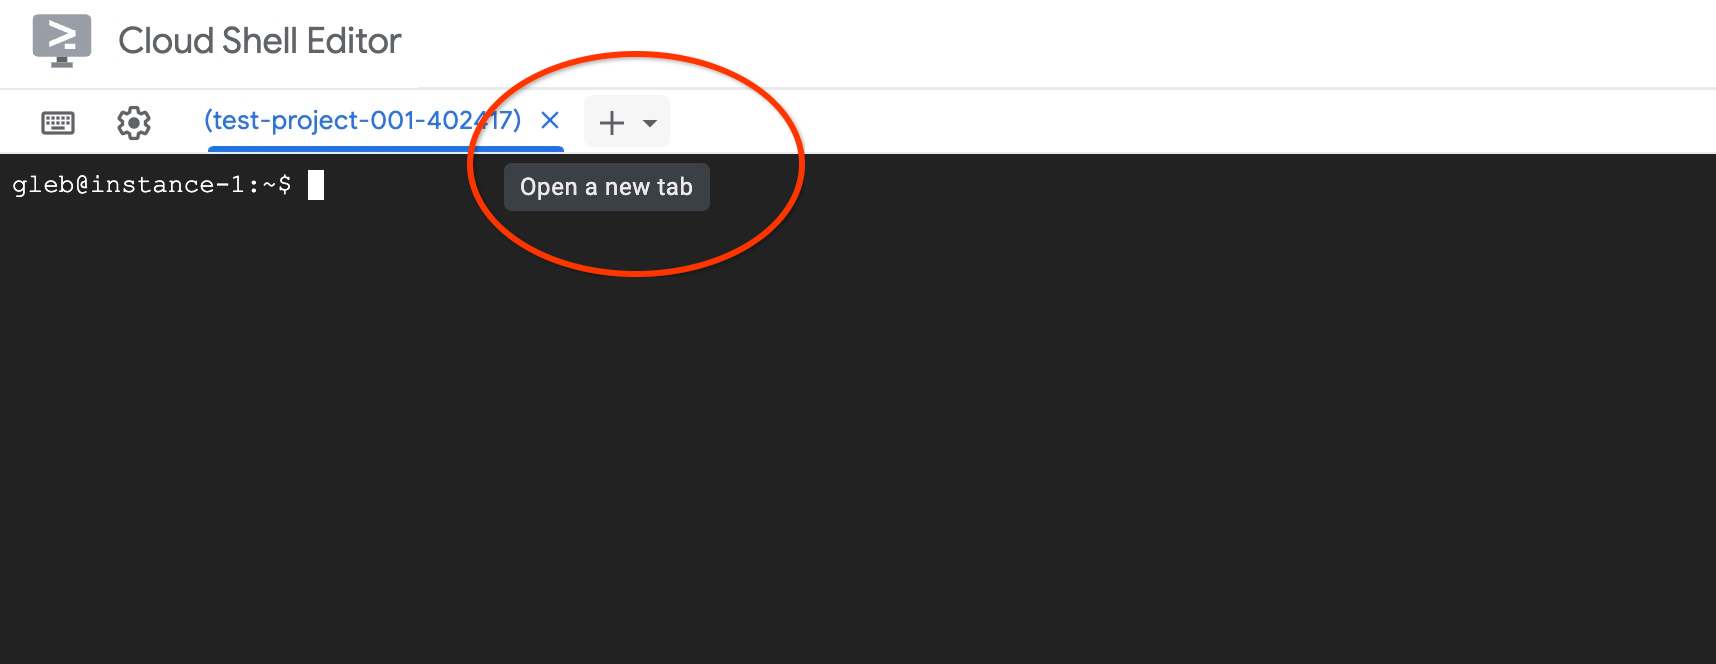
Na nowej karcie Cloud Shell wykonaj to polecenie:
PROJECT_ID=$(gcloud config get-value project)
gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:service-$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")@gcp-sa-alloydb.iam.gserviceaccount.com" \
  --role="roles/aiplatform.user"
Oczekiwane dane wyjściowe konsoli:
student@cloudshell:~ (test-project-001-402417)$ PROJECT_ID=$(gcloud config get-value project)
Your active configuration is: [cloudshell-11039]
student@cloudshell:~ (test-project-001-402417)$ gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:service-$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")@gcp-sa-alloydb.iam.gserviceaccount.com" \
  --role="roles/aiplatform.user"
Updated IAM policy for project [test-project-001-402417].
bindings:
- members:
  - serviceAccount:service-4470404856@gcp-sa-alloydb.iam.gserviceaccount.com
  role: roles/aiplatform.user
- members:
...
etag: BwYIEbe_Z3U=
version: 1
Zamknij kartę, wpisując na niej polecenie „exit”:
exit
Utwórz bazę danych
Szybki start dotyczący tworzenia bazy danych.
W sesji maszyny wirtualnej GCE wykonaj to polecenie:
Utwórz bazę danych:
psql "host=$INSTANCE_IP user=postgres" -c "CREATE DATABASE quickstart_db"
Oczekiwane dane wyjściowe konsoli:
student@instance-1:~$ psql "host=$INSTANCE_IP user=postgres" -c "CREATE DATABASE quickstart_db"
CREATE DATABASE
student@instance-1:~$
Włączanie integracji z Vertex AI
Włącz integrację z Vertex AI i rozszerzenia pgvector w bazie danych.
Na maszynie wirtualnej GCE wykonaj te czynności:
psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db" -c "CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE"
psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db" -c "CREATE EXTENSION IF NOT EXISTS vector"
Oczekiwane dane wyjściowe konsoli:
student@instance-1:~$ psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db" -c "CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE"
psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db" -c "CREATE EXTENSION IF NOT EXISTS vector"
CREATE EXTENSION
CREATE EXTENSION
student@instance-1:~$
Importuj dane
Pobierz przygotowane dane i zaimportuj je do nowej bazy danych.
Na maszynie wirtualnej GCE wykonaj te czynności:
gcloud storage cat gs://cloud-training/gcc/gcc-tech-004/cymbal_demo_schema.sql |psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db"
gcloud storage cat gs://cloud-training/gcc/gcc-tech-004/cymbal_products.csv |psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db" -c "\copy cymbal_products from stdin csv header"
gcloud storage cat gs://cloud-training/gcc/gcc-tech-004/cymbal_inventory.csv |psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db" -c "\copy cymbal_inventory from stdin csv header"
gcloud storage cat gs://cloud-training/gcc/gcc-tech-004/cymbal_stores.csv |psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db" -c "\copy cymbal_stores from stdin csv header"
Oczekiwane dane wyjściowe konsoli:
student@instance-1:~$ gsutil cat gs://cloud-training/gcc/gcc-tech-004/cymbal_demo_schema.sql |psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db"
SET
SET
SET
SET
SET
 set_config
------------

(1 row)
SET
SET
SET
SET
SET
SET
CREATE TABLE
ALTER TABLE
CREATE TABLE
ALTER TABLE
CREATE TABLE
ALTER TABLE
CREATE TABLE
ALTER TABLE
CREATE SEQUENCE
ALTER TABLE
ALTER SEQUENCE
ALTER TABLE
ALTER TABLE
ALTER TABLE
student@instance-1:~$ gsutil cat gs://cloud-training/gcc/gcc-tech-004/cymbal_products.csv |psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db" -c "\copy cymbal_products from stdin csv header"
COPY 941
student@instance-1:~$ gsutil cat gs://cloud-training/gcc/gcc-tech-004/cymbal_inventory.csv |psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db" -c "\copy cymbal_inventory from stdin csv header"
COPY 263861
student@instance-1:~$ gsutil cat gs://cloud-training/gcc/gcc-tech-004/cymbal_stores.csv |psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db" -c "\copy cymbal_stores from stdin csv header"
COPY 4654
student@instance-1:~$
7. Obliczanie wektorów dystrybucyjnych
Po zaimportowaniu danych w tabeli cymbal_products znajdą się dane produktów, w tabeli cymbal_inventory – asortyment z liczbą dostępnych produktów w każdym sklepie, a w tabeli cymbal_stores – lista sklepów. Musisz obliczyć dane wektorowe na podstawie opisów produktów. Możesz do tego użyć funkcji takich jak google_ml.embedding. Więcej informacji o używanej technologii znajdziesz w dokumentacji.
Łatwo jest wygenerować wektory osadzenia dla kilku wierszy, ale jak to zrobić wydajnie, gdy mamy ich tysiące? Z tej sekcji dowiesz się, jak generować i zarządzać osadzaniem w przypadku dużych tabel. Więcej informacji o różnych opcjach i technikach znajdziesz w przewodniku.
Włącz szybkie generowanie osadzania
Połącz się z bazą danych za pomocą psql z maszyny wirtualnej, używając adresu IP instancji AlloyDB i hasła postgres:
psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db"
Sprawdź wersję rozszerzenia google_ml_integration.
SELECT extversion FROM pg_extension WHERE extname = 'google_ml_integration';
Wersja powinna być co najmniej 1.5.2. Oto przykład danych wyjściowych:
quickstart_db=> SELECT extversion FROM pg_extension WHERE extname = 'google_ml_integration';
 extversion
------------
 1.6
(1 row)
Domyślna wersja powinna być co najmniej 1.6, ale jeśli Twoja instancja ma starszą wersję, prawdopodobnie wymaga aktualizacji. Sprawdź, czy konserwacja została wyłączona w przypadku instancji.
Sprawdź, czy flaga bazy danych google_ml_integration.enable_faster_embedding_generation jest włączona. W tej samej sesji psql sprawdź wartość flagi:
show google_ml_integration.enable_faster_embedding_generation;
Jeśli flaga jest w prawidłowej pozycji, oczekiwane dane wyjściowe wyglądają tak:
quickstart_db=> show google_ml_integration.enable_faster_embedding_generation;
 google_ml_integration.enable_faster_embedding_generation
----------------------------------------------------------
 on
(1 row)
Jeśli wartość flagi to „off”, musisz zaktualizować instancję. Zrób to za pomocą konsoli internetowej lub polecenia gcloud, jak opisano w dokumentacji.
Zakończ sesję psql:
exit;
Aby zaktualizować flagę za pomocą gcloud, uruchom to polecenie:
export PROJECT_ID=$(gcloud config get-value project)
export REGION=us-central1
export ADBCLUSTER=alloydb-aip-01
gcloud beta alloydb instances update $ADBCLUSTER-pr \
   --database-flags google_ml_integration.enable_faster_embedding_generation=on \
   --region=$REGION \
   --cluster=$ADBCLUSTER \
   --project=$PROJECT_ID \
   --update-mode=FORCE_APPLY
Może to potrwać kilka minut, ale ostatecznie wartość flagi powinna zmienić się na „włączona”. Następnie możesz przejść do kolejnych kroków.
Tworzenie kolumny wektorów dystrybucyjnych
Połącz się z bazą danych za pomocą psql i utwórz kolumnę wirtualną z typem danych wektorowych, która będzie używana przez funkcję osadzania w tabeli cymbal_products.
psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db"
W sesji psql po połączeniu się z bazą danych wykonaj to polecenie:
ALTER TABLE cymbal_products ADD COLUMN embedding vector(768);
Polecenie tworzy kolumnę wirtualną dla przyszłych osadzeń.
Oczekiwane dane wyjściowe konsoli:
quickstart_db=> ALTER TABLE cymbal_products ADD COLUMN embedding vector(768);
ALTER TABLE
quickstart_db=>
Generuj wektory dystrybucyjne w grupach po 50 wierszy. W tej samej sesji psql wykonaj to polecenie:
Włącz pomiar czasu, aby sprawdzić, ile czasu zajmie wykonanie zadania:
\timing
Uruchom polecenie:
CALL ai.initialize_embeddings(
    model_id => 'text-embedding-005',
    table_name => 'cymbal_products',
    content_column => 'product_description',
    embedding_column => 'embedding',
    batch_size => 50
);
Dane wyjściowe konsoli pokazują, że wygenerowanie osadzenia zajęło mniej niż 2 sekundy:
quickstart_db=> CALL ai.initialize_embeddings(
    model_id => 'text-embedding-005',
    table_name => 'cymbal_products',
    content_column => 'product_description',
    embedding_column => 'embedding',
    batch_size => 50
);
NOTICE:  Initialize embedding completed successfully for table cymbal_products
CALL
Time: 1458.704 ms (00:01.459)
quickstart_db=>
Możesz eksperymentować z różnymi rozmiarami partii i sprawdzać, czy wpływa to na czas wykonania.
Domyślnie osadzanie nie jest odświeżane, jeśli aktualizowana jest odpowiednia kolumna product_description lub wstawiany jest cały nowy wiersz. Możesz to jednak zrobić, ustawiając parametr incremental_refresh_mode.
Utwórz kolumnę „product_embeddings” i ustaw jej automatyczne aktualizowanie:
ALTER TABLE cymbal_products ADD COLUMN product_embedding vector(768);
CALL ai.initialize_embeddings(
    model_id => 'text-embedding-005',
    table_name => 'cymbal_products',
    content_column => 'product_description',
    embedding_column => 'product_embedding',
    batch_size => 50,
    incremental_refresh_mode => 'transactional'
);
Wstaw nowy wiersz do tabeli.
INSERT INTO "cymbal_products" ("uniq_id", "crawl_timestamp", "product_url", "product_name", "product_description", "list_price", "sale_price", "brand", "item_number", "gtin", "package_size", "category", "postal_code", "available", "product_embedding", "embedding") VALUES ('fd604542e04b470f9e6348e640cff794', NOW(), 'https://example.com/new_product', 'New Cymbal Product', 'This is a new cymbal product description.', 199.99, 149.99, 'Example Brand', 'EB123', '1234567890', 'Single', 'Cymbals', '12345', TRUE, NULL, NULL);
Wykonaj zapytanie do tabeli, aby porównać 2 kolumny z wektorami:
SELECT uniq_id,embedding, (product_embedding::real[])[1:5] as product_embedding FROM cymbal_products WHERE uniq_id='fd604542e04b470f9e6348e640cff794';
Dane wyjściowe pokazują, że pole product_embedding jest wypełniane automatycznie, a pole embedding pozostaje puste:
quickstart_db=> SELECT uniq_id,embedding, (product_embedding::real[])[1:5] as product_embedding  FROM cymbal_products WHERE uniq_id='fd604542e04b470f9e6348e640cff794';
             uniq_id              | embedding |                       product_embedding
----------------------------------+-----------+---------------------------------------------------------------
 fd604542e04b470f9e6348e640cff794 |           | {0.015003494,-0.005349732,-0.059790313,-0.0087091,-0.0271452}
(1 row)

Time: 3.295 ms
8. Uruchom wyszukiwanie podobieństw
Przeprowadź wyszukiwanie podobieństwa na podstawie wygenerowanych wektorów dystrybucyjnych za pomocą AlloyDB AI.
Zapytanie SQL można wykonać z tego samego interfejsu wiersza poleceń psql lub alternatywnie z AlloyDB Studio. Wielowierszowe i złożone dane wyjściowe lepiej działają w AlloyDB Studio.
Łączenie z AlloyDB Studio
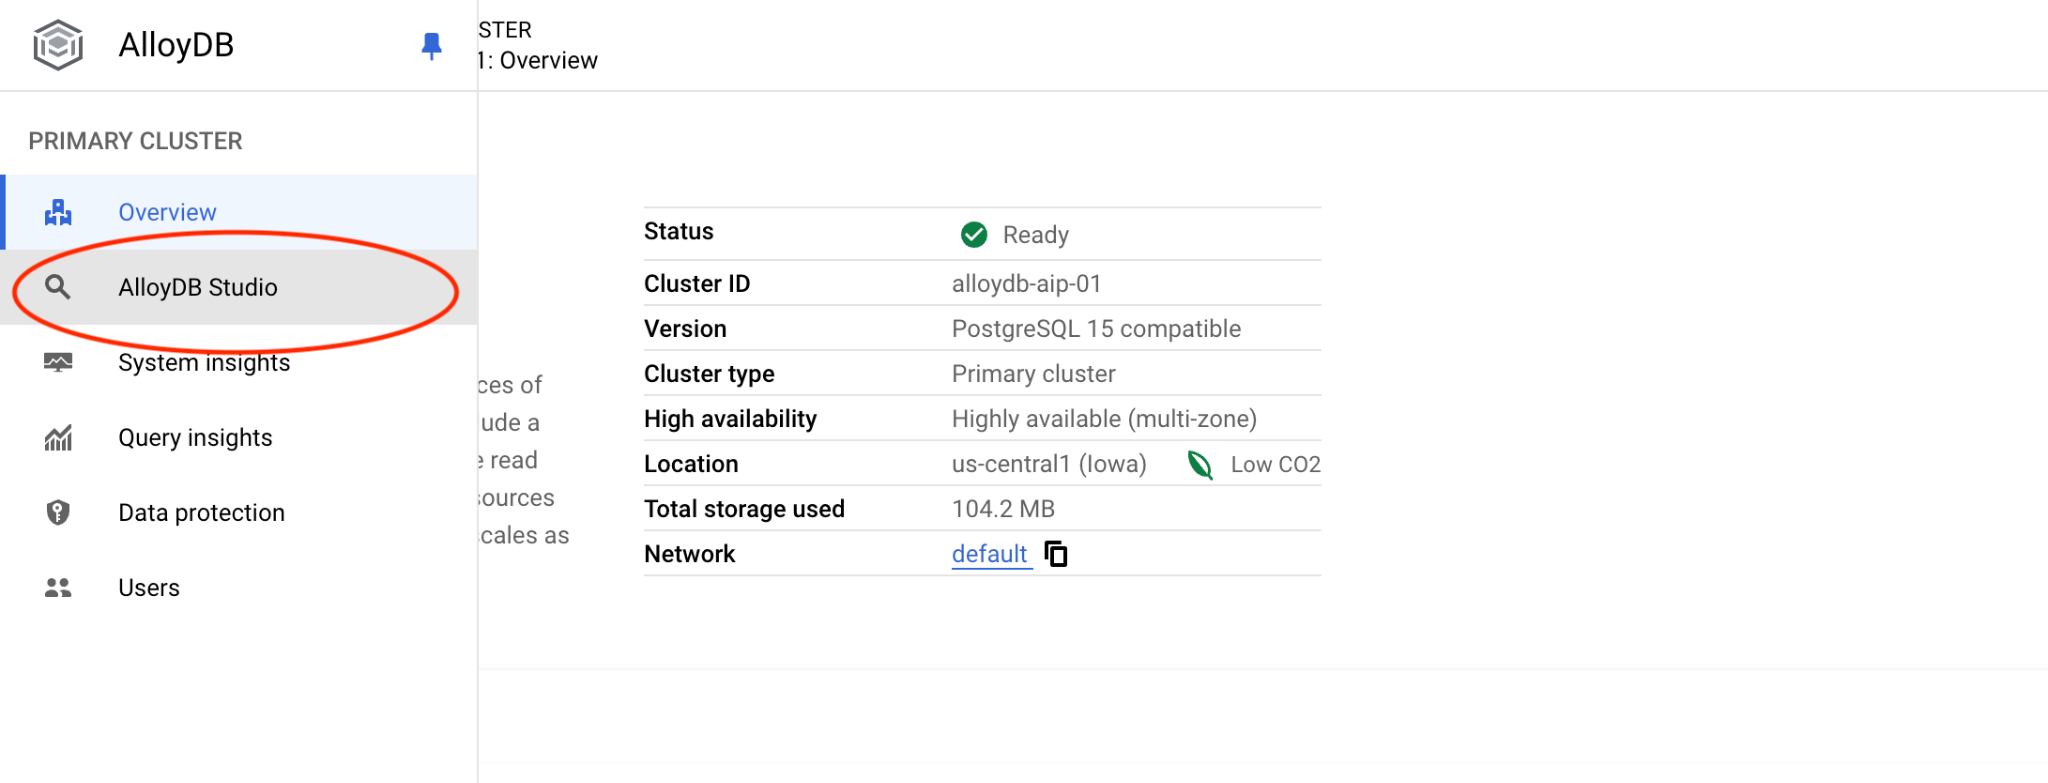
Aby otworzyć AlloyDB Studio, wykonaj te czynności:
- W konsoli Google Cloud otwórz stronę Klastry w AlloyDB for PostgreSQL.
- Wybierz instancję główną, aby otworzyć jej interfejs internetowy.
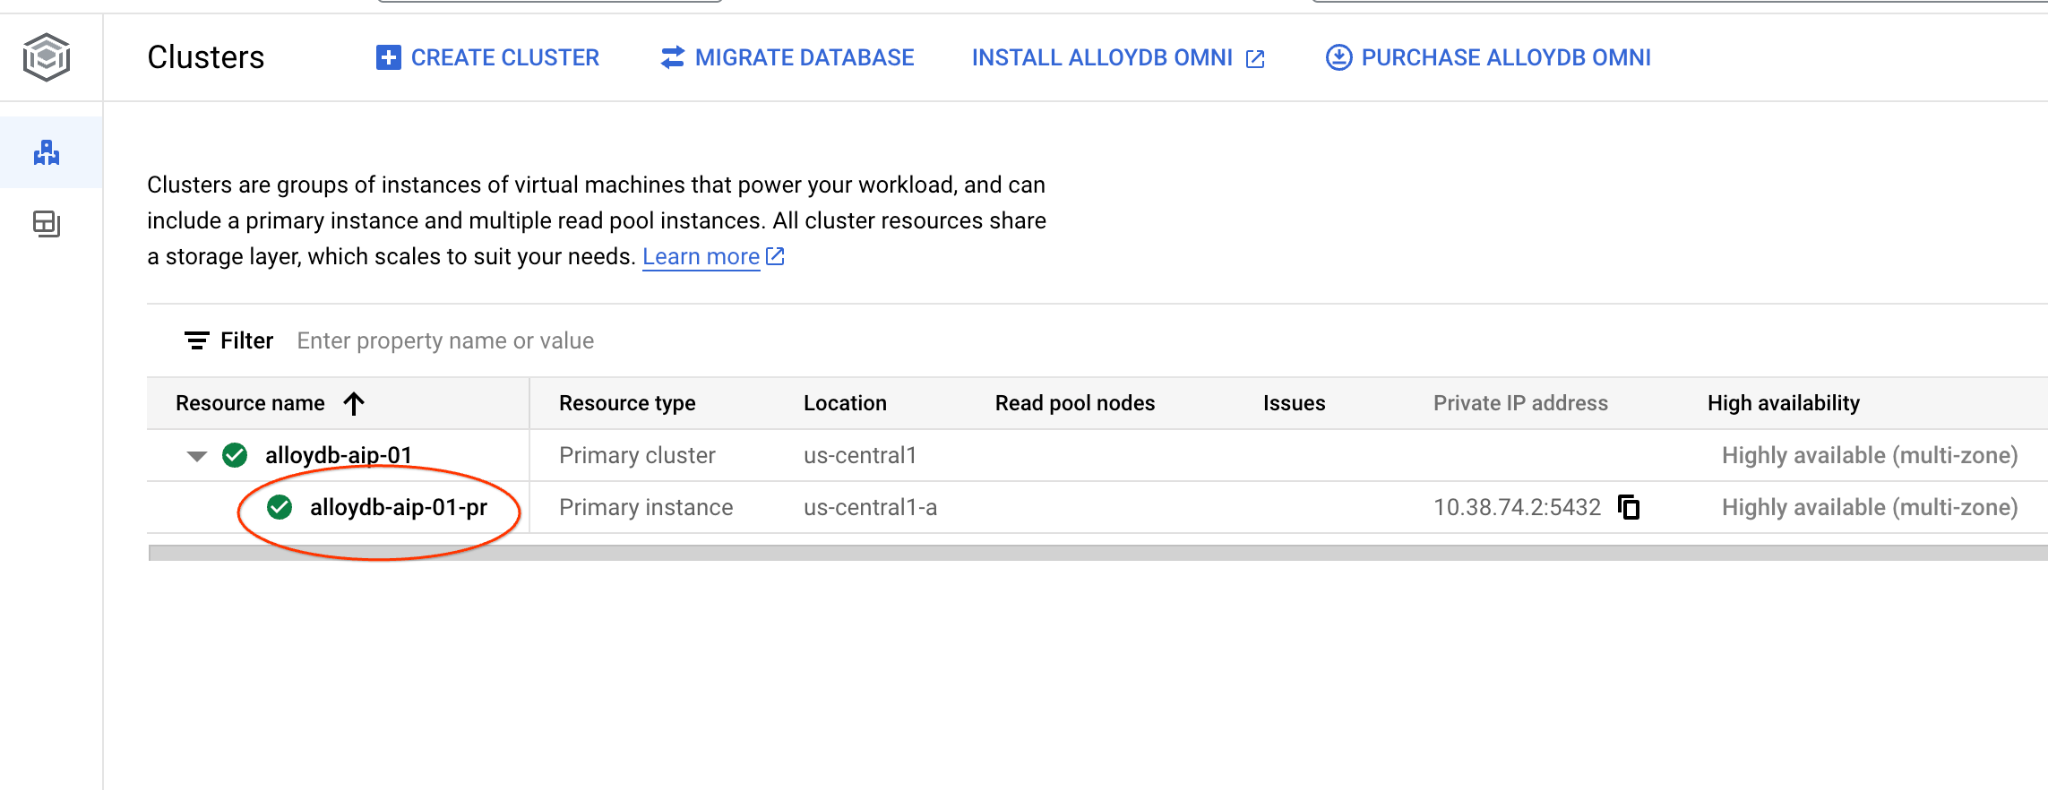 3. Następnie po lewej stronie kliknij AlloyDB Studio:
- Wybierz bazę danych
quickstart_db, użytkownika postgres, podaj podane hasło i kliknij Authenticate (Uwierzytelnij).
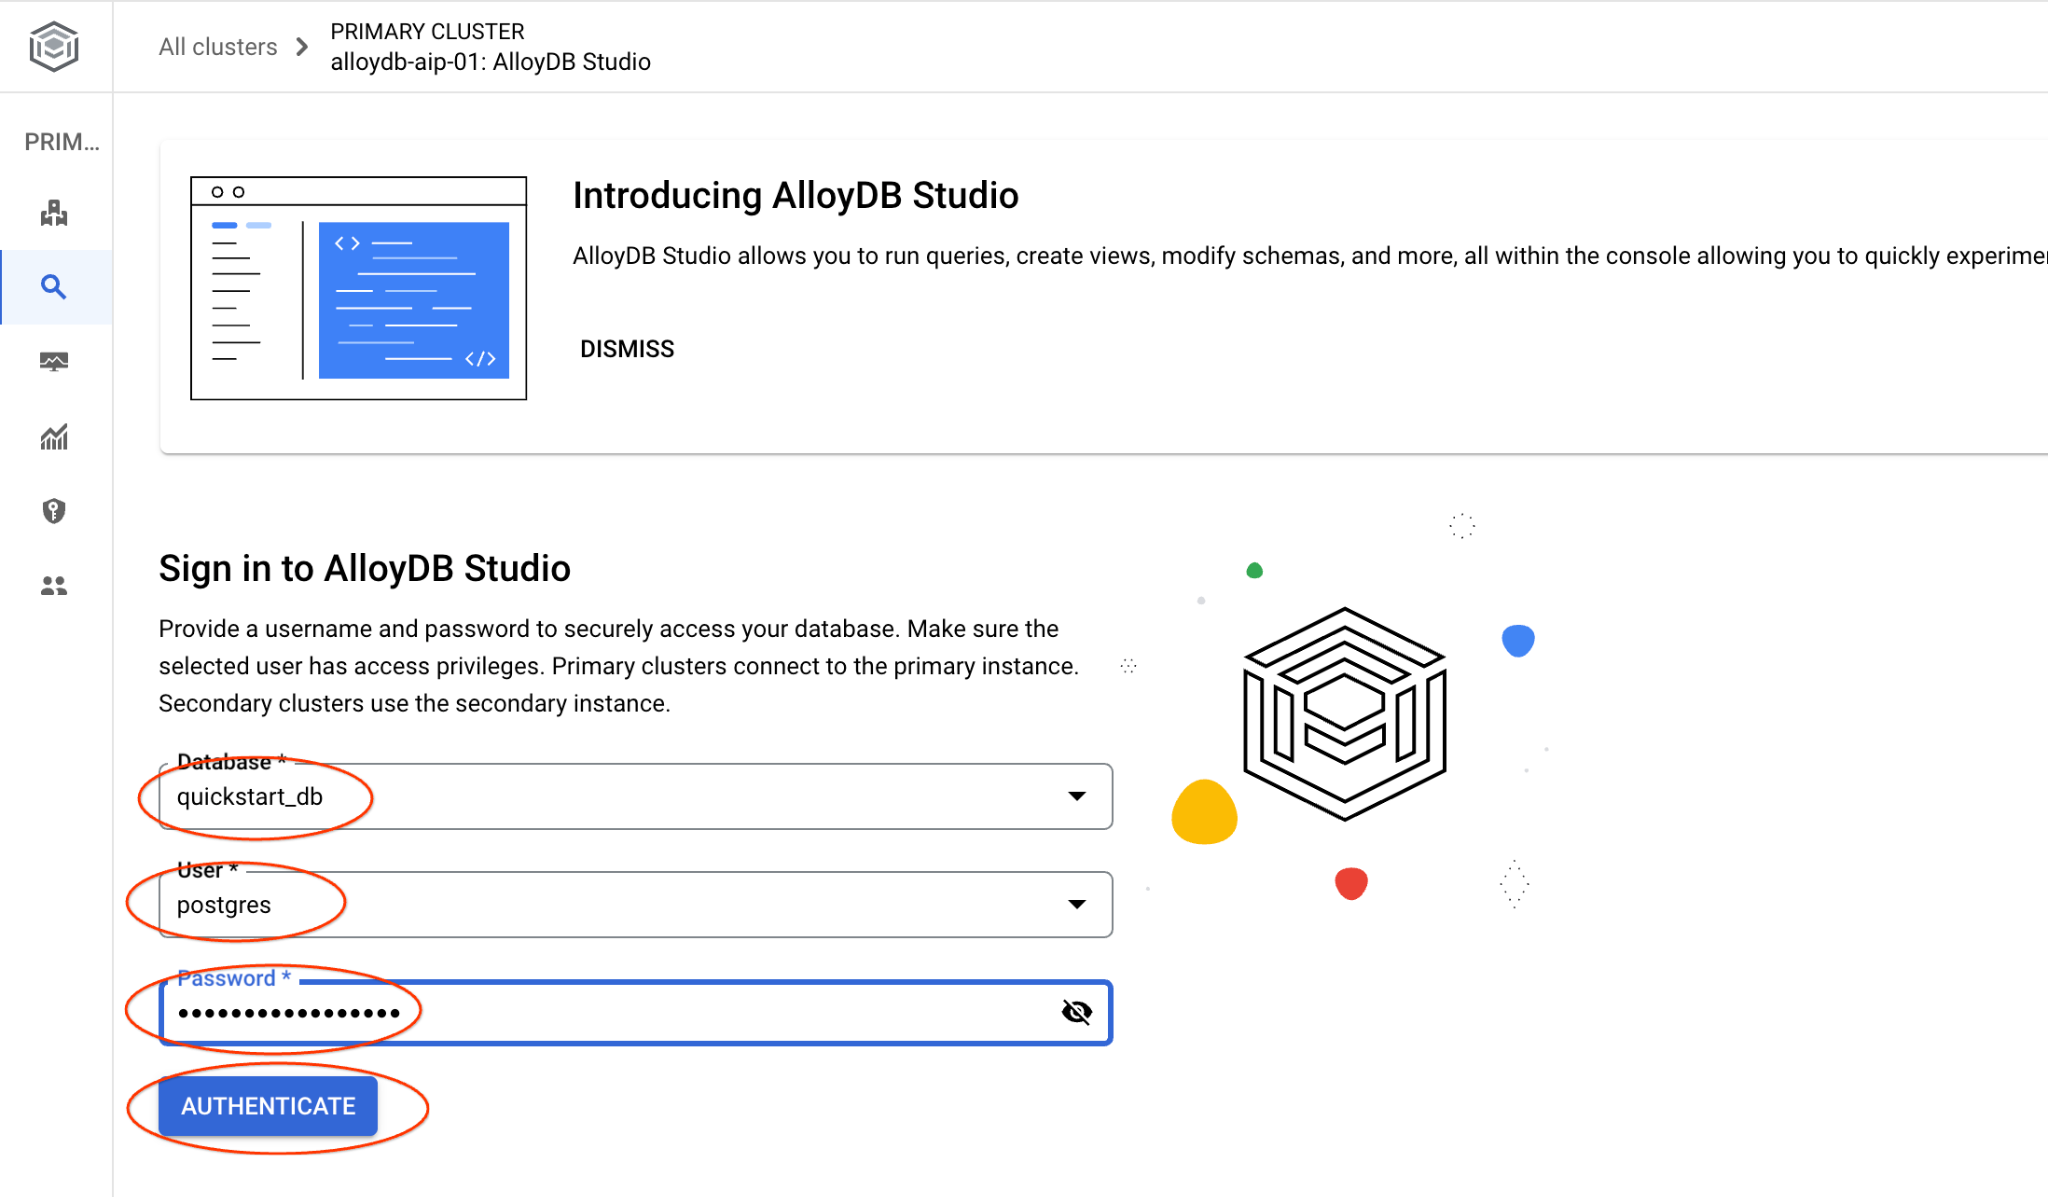
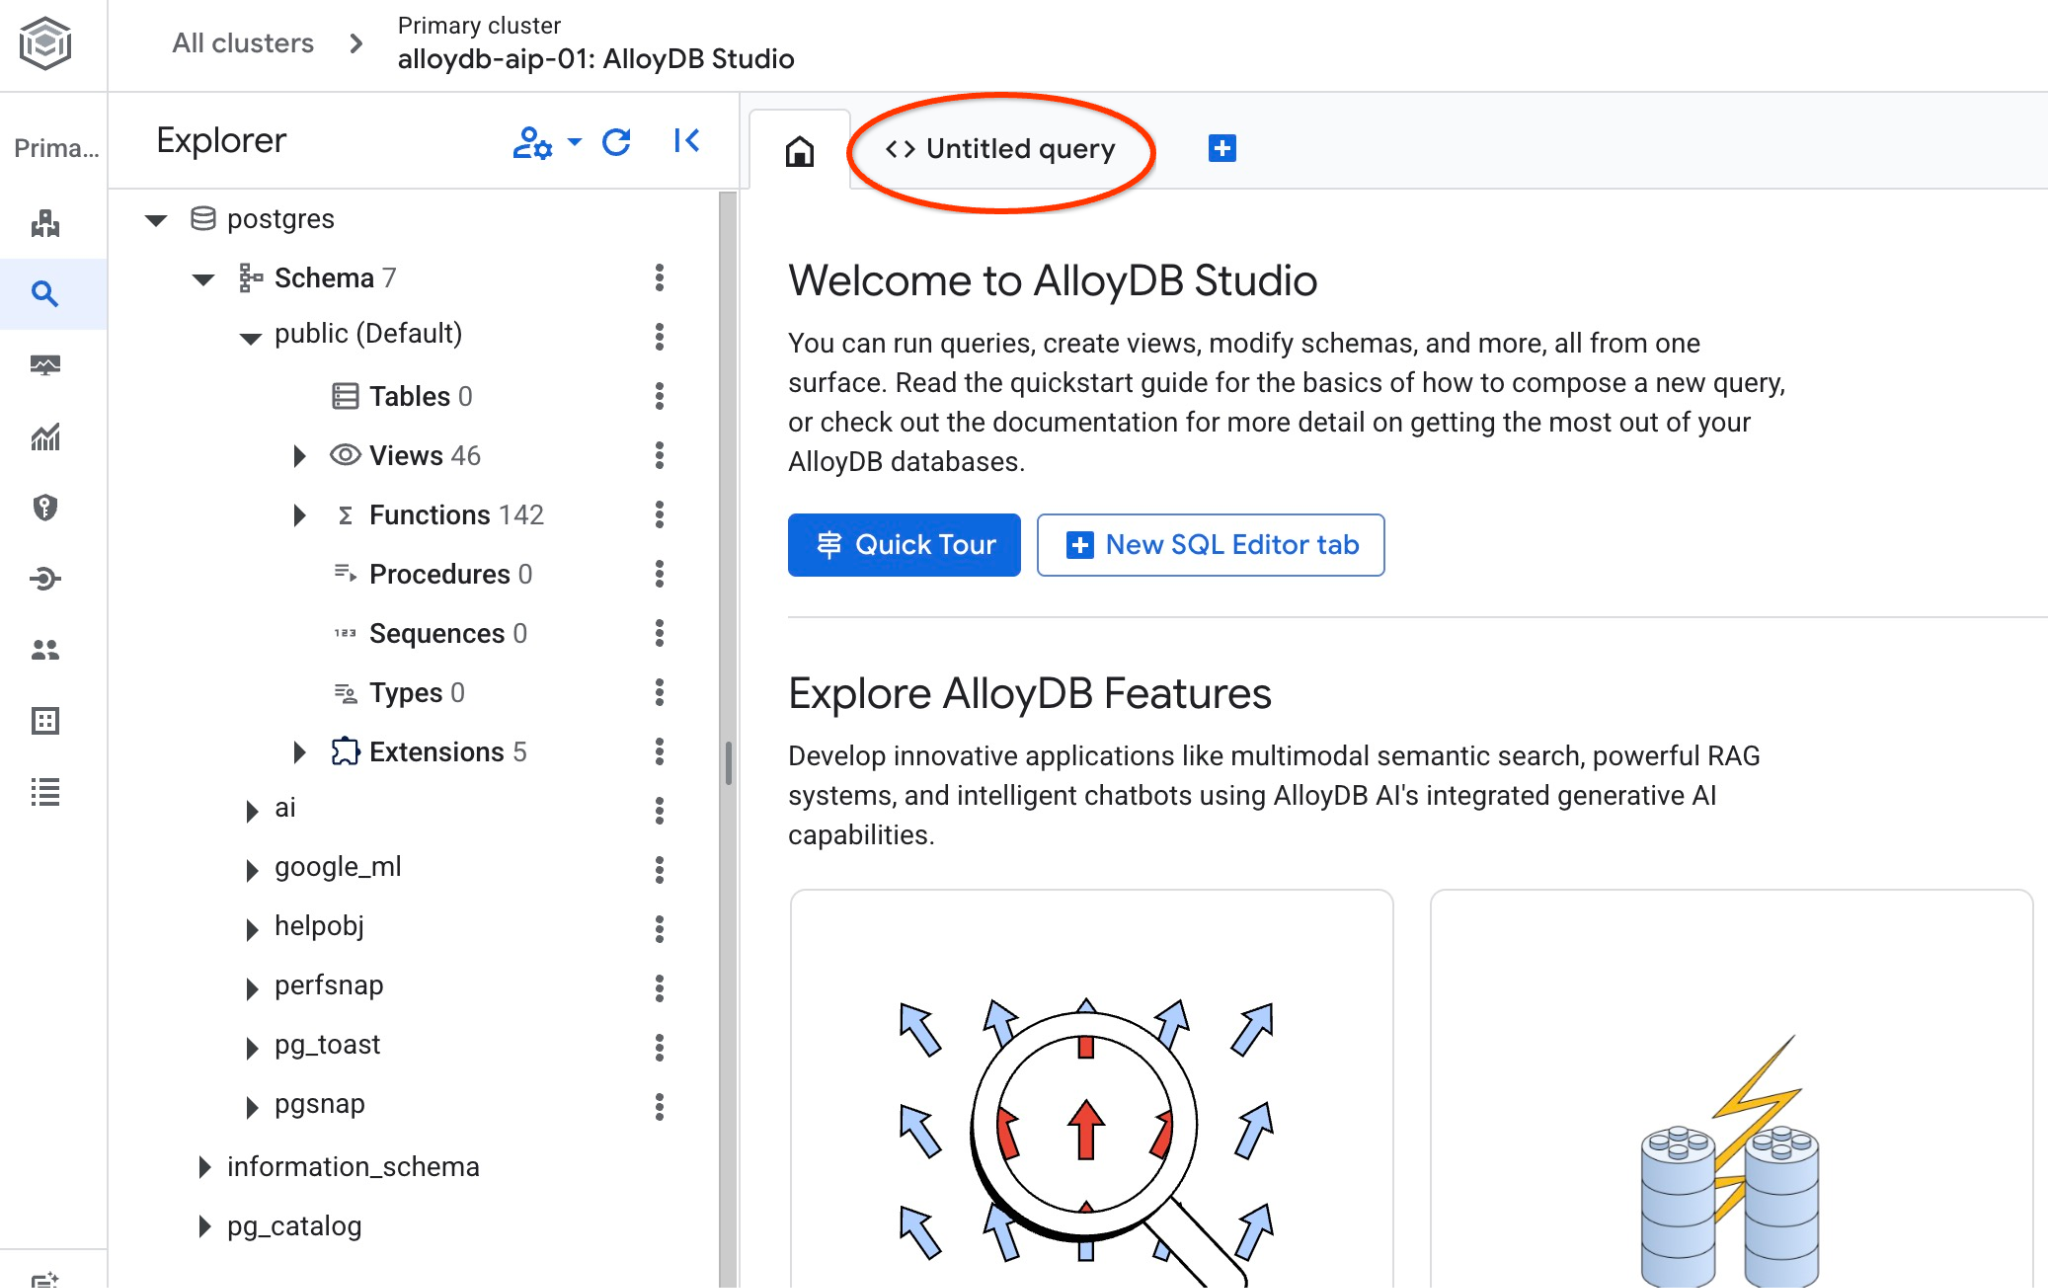
Otworzy się interfejs AlloyDB Studio.
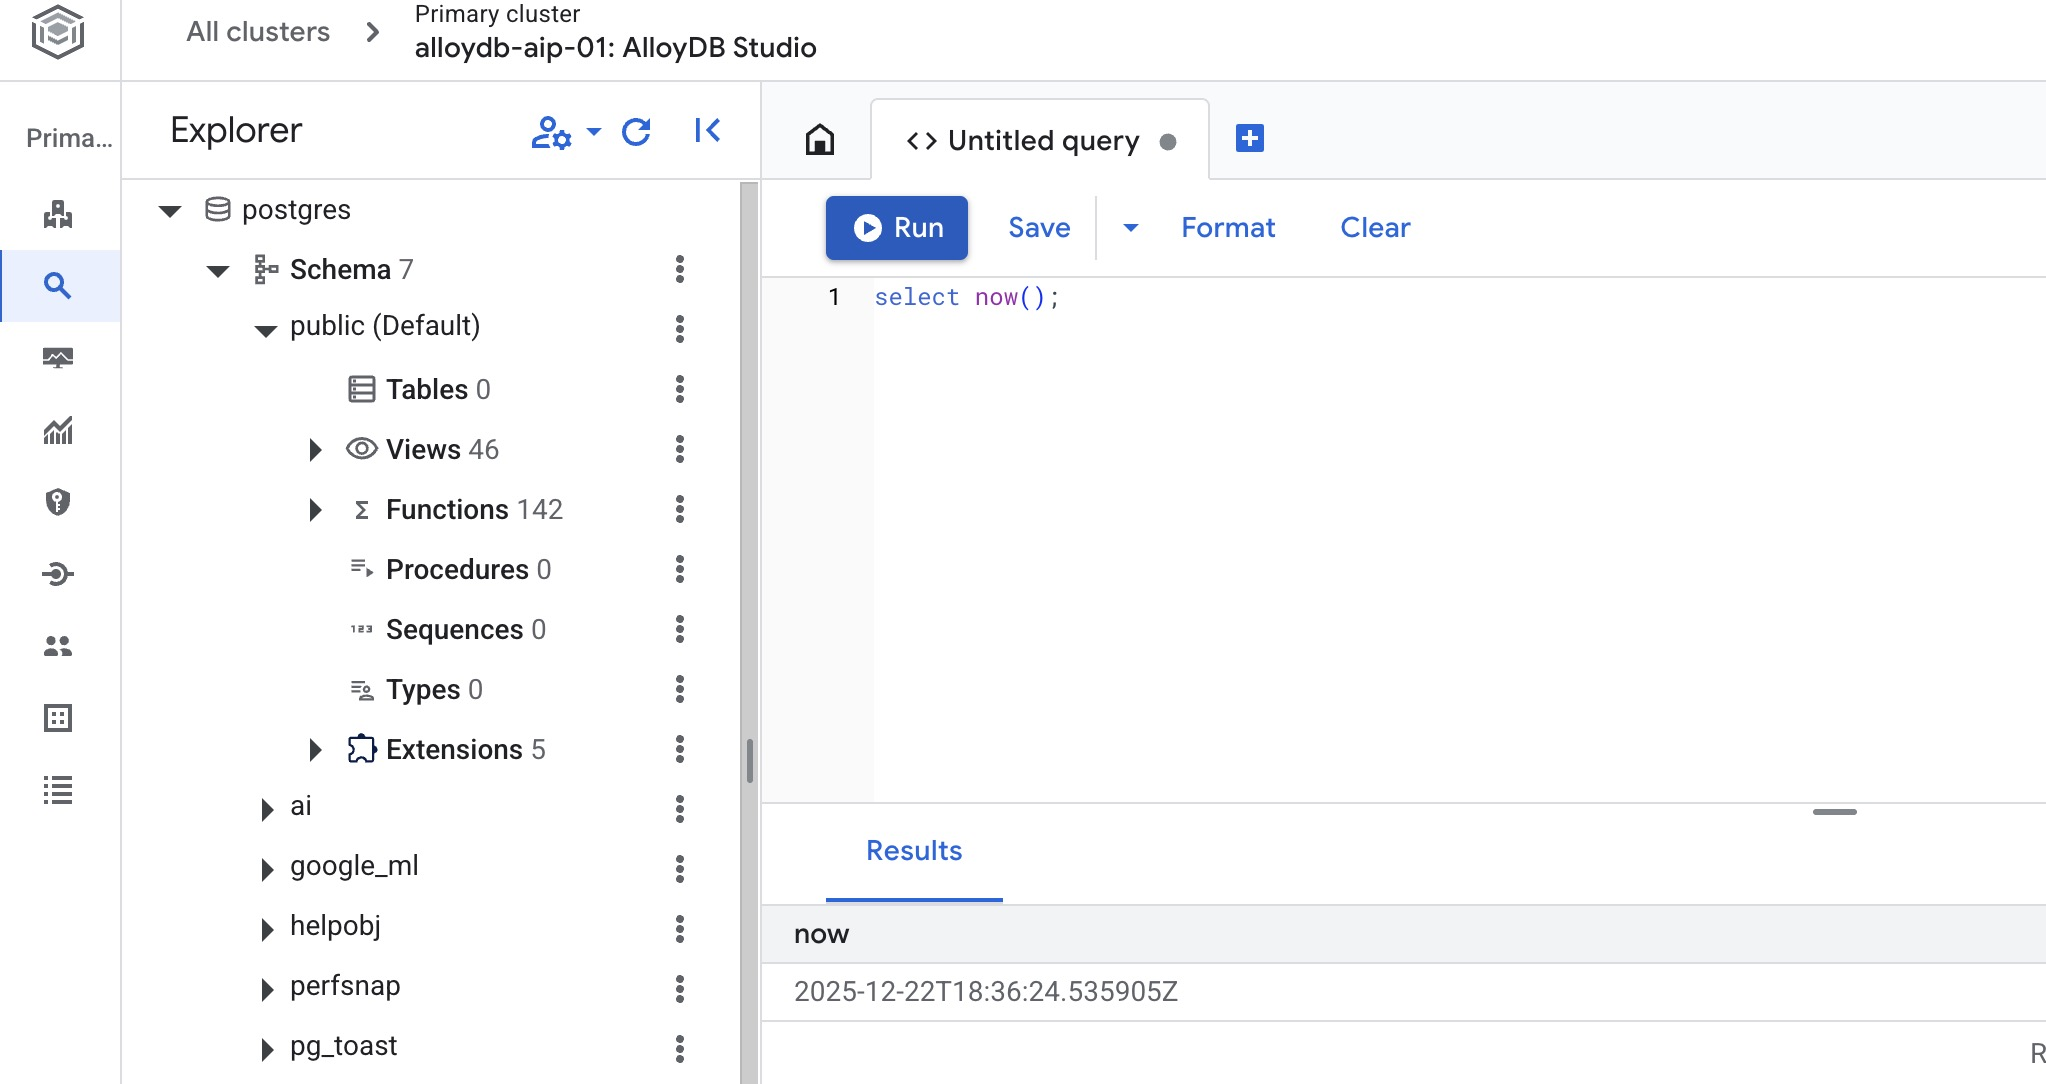
- Aby otworzyć edytor SQL, kliknij kartę Bez tytułu.
Otworzy się edytor, w którym możesz uruchamiać polecenia SQL, jak pokazano na tym obrazie:
Jeśli wolisz używać wiersza poleceń psql, wybierz alternatywną ścieżkę i połącz się z bazą danych z sesji SSH na maszynie wirtualnej, jak opisano w poprzednich rozdziałach.
Uruchom wyszukiwanie podobieństw
Uruchom zapytanie, aby uzyskać listę dostępnych produktów najbardziej związanych z prośbą klienta. Wyszukiwane słowa przekazane do modelu osadzania w Gemini Enterprise Agent Platform (takie samo jak to, którego użyliśmy do wygenerowania osadzania dla naszych produktów), aby uzyskać wartość wektorową dla zapytania „Jakie drzewa owocowe dobrze tu rosną?”.
Uruchom zapytanie:
SELECT
        cp.product_name,
        left(cp.product_description,80) as description,
        cp.sale_price,
        cs.zip_code,
        (cp.embedding <=> embedding('text-embedding-005','What kind of fruit trees grow well here?')::vector) as distance
FROM
        cymbal_products cp
JOIN cymbal_inventory ci on
        ci.uniq_id=cp.uniq_id
JOIN cymbal_stores cs on
        cs.store_id=ci.store_id
        AND ci.inventory>0
        AND cs.store_id = 1583
ORDER BY
        distance ASC
LIMIT 10;
Oto oczekiwane dane wyjściowe:
quickstart_db=> SELECT
        cp.product_name,
        left(cp.product_description,80) as description,
        cp.sale_price,
        cs.zip_code,
        (cp.embedding <=> embedding('text-embedding-005','What kind of fruit trees grow well here?')::vector) as distance
FROM
        cymbal_products cp
JOIN cymbal_inventory ci on
        ci.uniq_id=cp.uniq_id
JOIN cymbal_stores cs on
        cs.store_id=ci.store_id
        AND ci.inventory>0
        AND cs.store_id = 1583
ORDER BY
        distance ASC
LIMIT 10;
      product_name       |                                   description                                    | sale_price | zip_code |      distance
-------------------------+----------------------------------------------------------------------------------+------------+----------+---------------------
 Cherry Tree             | This is a beautiful cherry tree that will produce delicious cherries. It is an d |      75.00 |    93230 | 0.43922018972266397
 Meyer Lemon Tree        | Meyer Lemon trees are California's favorite lemon tree! Grow your own lemons by  |         34 |    93230 |  0.4685112926118228
 Toyon                   | This is a beautiful toyon tree that can grow to be over 20 feet tall. It is an e |      10.00 |    93230 |  0.4835677149651668
 California Lilac        | This is a beautiful lilac tree that can grow to be over 10 feet tall. It is an d |       5.00 |    93230 |  0.4947204525907498
 California Peppertree   | This is a beautiful peppertree that can grow to be over 30 feet tall. It is an e |      25.00 |    93230 |  0.5054166905547247
 California Black Walnut | This is a beautiful walnut tree that can grow to be over 80 feet tall. It is a d |     100.00 |    93230 |  0.5084219510932597
 California Sycamore     | This is a beautiful sycamore tree that can grow to be over 100 feet tall. It is  |     300.00 |    93230 |  0.5140519790508755
 Coast Live Oak          | This is a beautiful oak tree that can grow to be over 100 feet tall. It is an ev |     500.00 |    93230 |  0.5143126438081371
 Fremont Cottonwood      | This is a beautiful cottonwood tree that can grow to be over 100 feet tall. It i |     200.00 |    93230 |  0.5174774727252058
 Madrone                 | This is a beautiful madrona tree that can grow to be over 80 feet tall. It is an |      50.00 |    93230 |  0.5227400803389093
Otrzymasz 10 produktów z opisami semantycznie zbliżonymi do wyszukiwanego hasła, uporządkowanych według odległości, przy czym najbardziej podobne będą na górze.
9. Ulepsz odpowiedź
Możesz ulepszyć odpowiedź dla aplikacji klienta, korzystając z wyniku zapytania, i przygotować sensowne dane wyjściowe, używając dostarczonych wyników zapytania jako części prompta dla podstawowego generatywnego modelu językowego.
Aby to zrobić, wygeneruj plik JSON z najlepszymi wynikami wyszukiwania wektorowego, a następnie użyj go jako dodatku do promptu dla modelu generatywnej AI na platformie Agent Platform, aby uzyskać przydatne dane wyjściowe. Pierwszy krok polega na wygenerowaniu kodu JSON, następnie jest on testowany w Agent Platform Studio, a w ostatnim kroku wszystkie elementy są łączone w jedną instrukcję SQL, którą można wykorzystać w aplikacji.
Generowanie danych wyjściowych w formacie JSON
Zmodyfikuj zapytanie, aby wygenerować dane wyjściowe w formacie JSON i zwrócić tylko jeden wiersz do przekazania do Agent Platform.
Uruchom zapytanie:
WITH trees as (
SELECT
        cp.product_name,
        left(cp.product_description,80) as description,
        cp.sale_price,
        cs.zip_code,
        cp.uniq_id as product_id
FROM
        cymbal_products cp
JOIN cymbal_inventory ci on
        ci.uniq_id=cp.uniq_id
JOIN cymbal_stores cs on
        cs.store_id=ci.store_id
        AND ci.inventory>0
        AND cs.store_id = 1583
ORDER BY
        (cp.embedding <=> embedding('text-embedding-005','What kind of fruit trees grow well here?')::vector) ASC
LIMIT 1)
SELECT json_agg(trees) FROM trees;
JSON w danych wyjściowych:
[{"product_name":"Cherry Tree","description":"This is a beautiful cherry tree that will produce delicious cherries. It is an d","sale_price":75.00,"zip_code":93230,"product_id":"d536e9e823296a2eba198e52dd23e712"}]
Uruchom prompt w Vertex AI Studio
Użyj wygenerowanego kodu JSON jako części prompta dla modelu generatywnej AI w Vertex AI Studio.
Otwórz Gemini Enterprise Agent Platform Studio w konsoli Google Cloud.
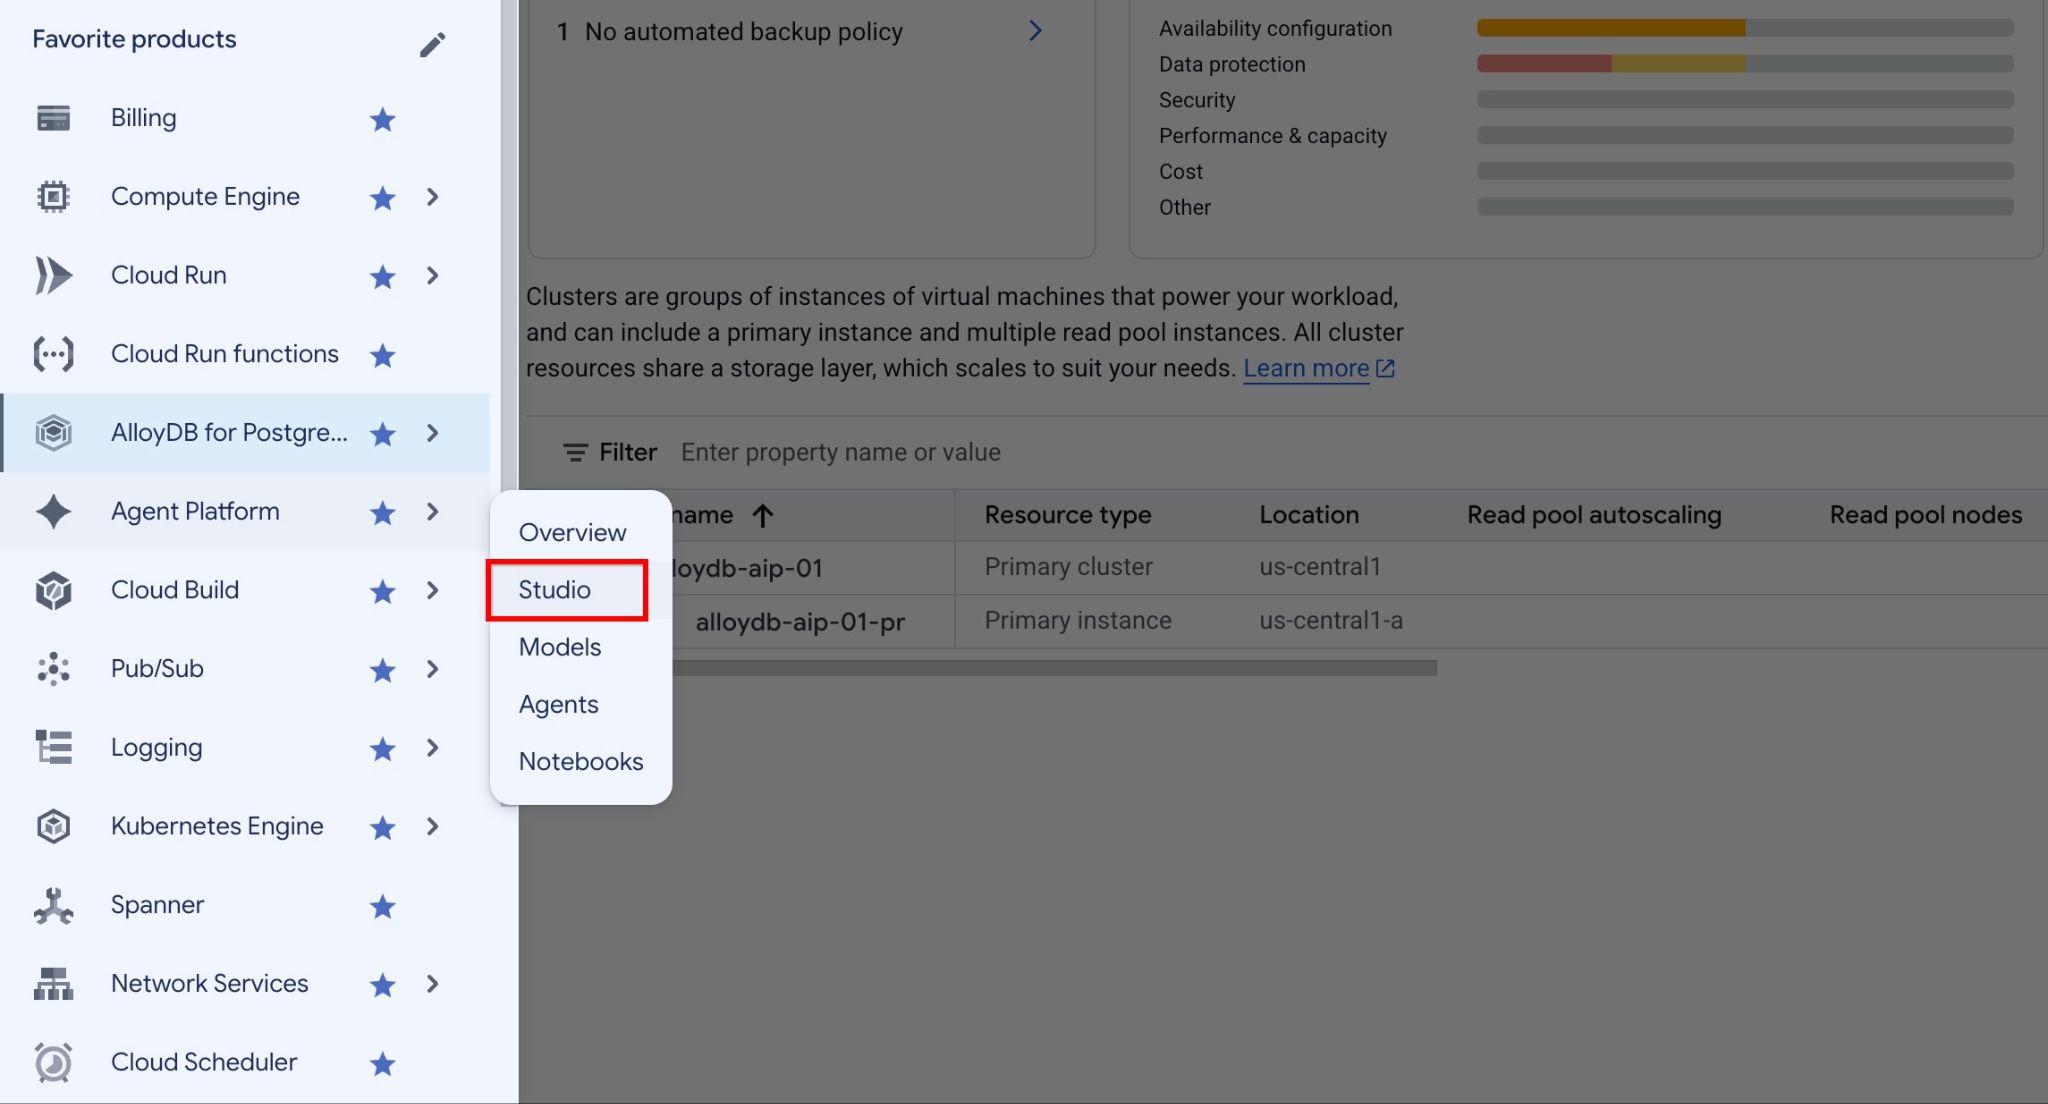
Wpisz prompta w interfejsie:
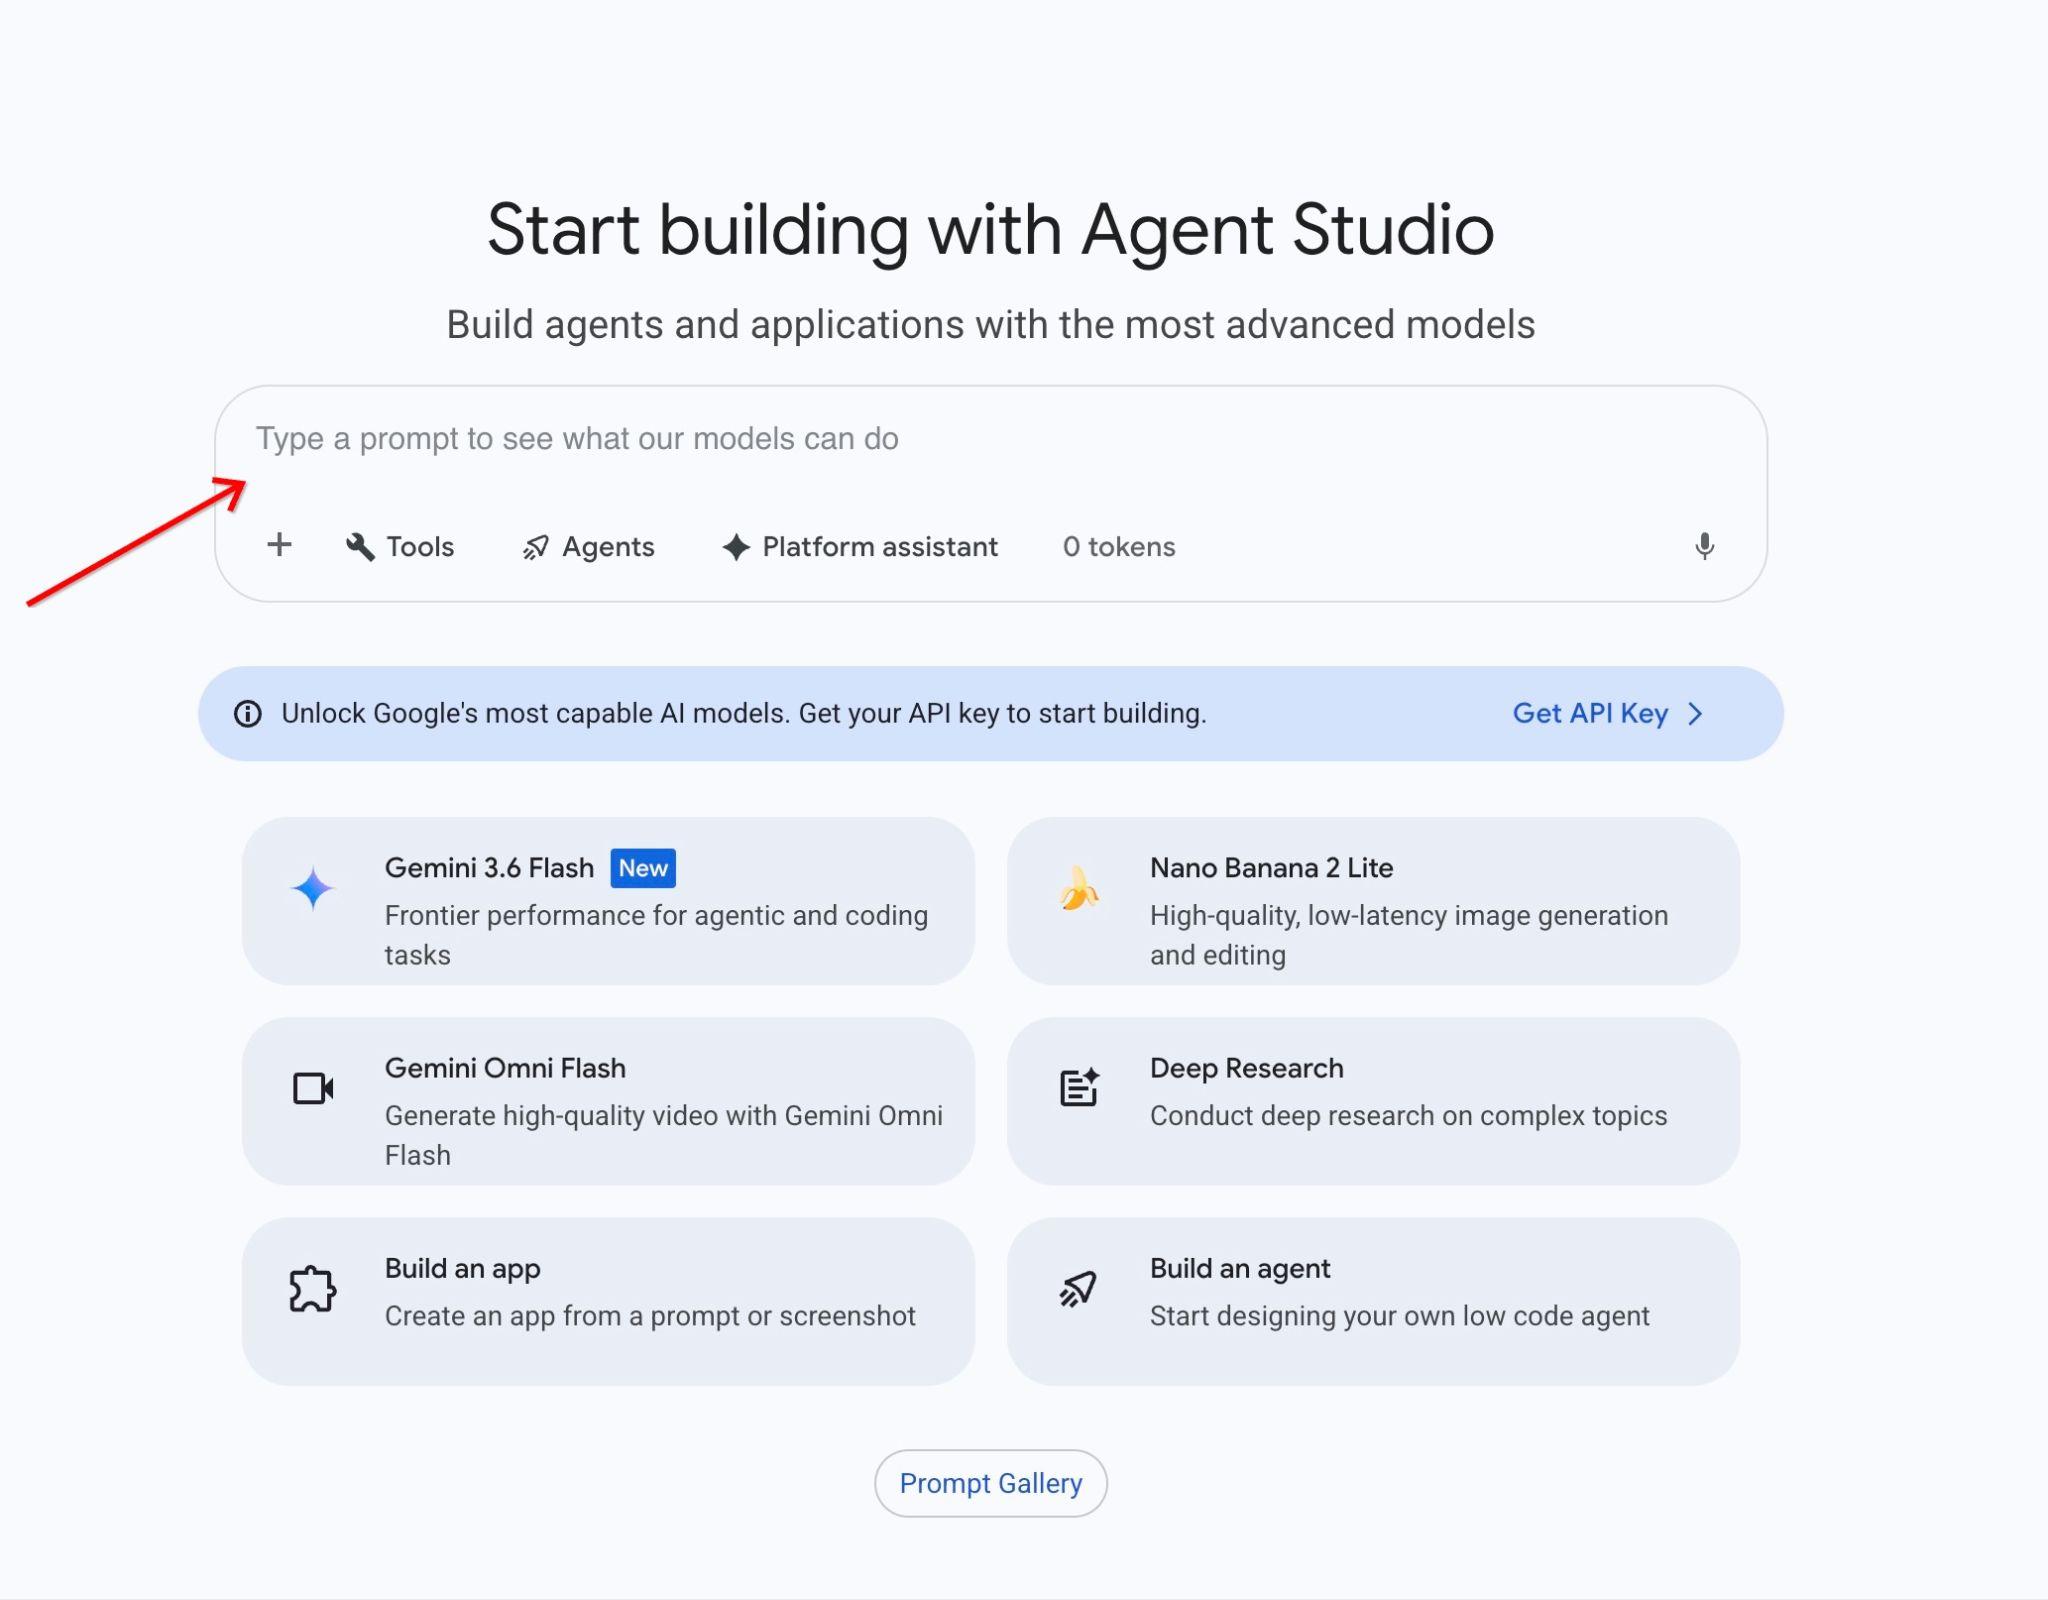
Wpisz ten prompt:
You are a friendly advisor helping to find a product based on the customer's needs.
Based on the client request we have loaded a list of products closely related to search.
The list in JSON format with list of values like {"product_name":"name","description":"some description","sale_price":10,"zip_code": 10234, "produt_id": "02056727942aeb714dc9a2313654e1b0"}
Here is the list of products:
{"product_name":"Cherry Tree","description":"This is a beautiful cherry tree that will produce delicious cherries. It is an d","sale_price":75.00,"zip_code":93230,"product_id":"d536e9e823296a2eba198e52dd23e712"}
The customer asked "What tree is growing the best here?"
You should give information about the product, price and some supplemental information
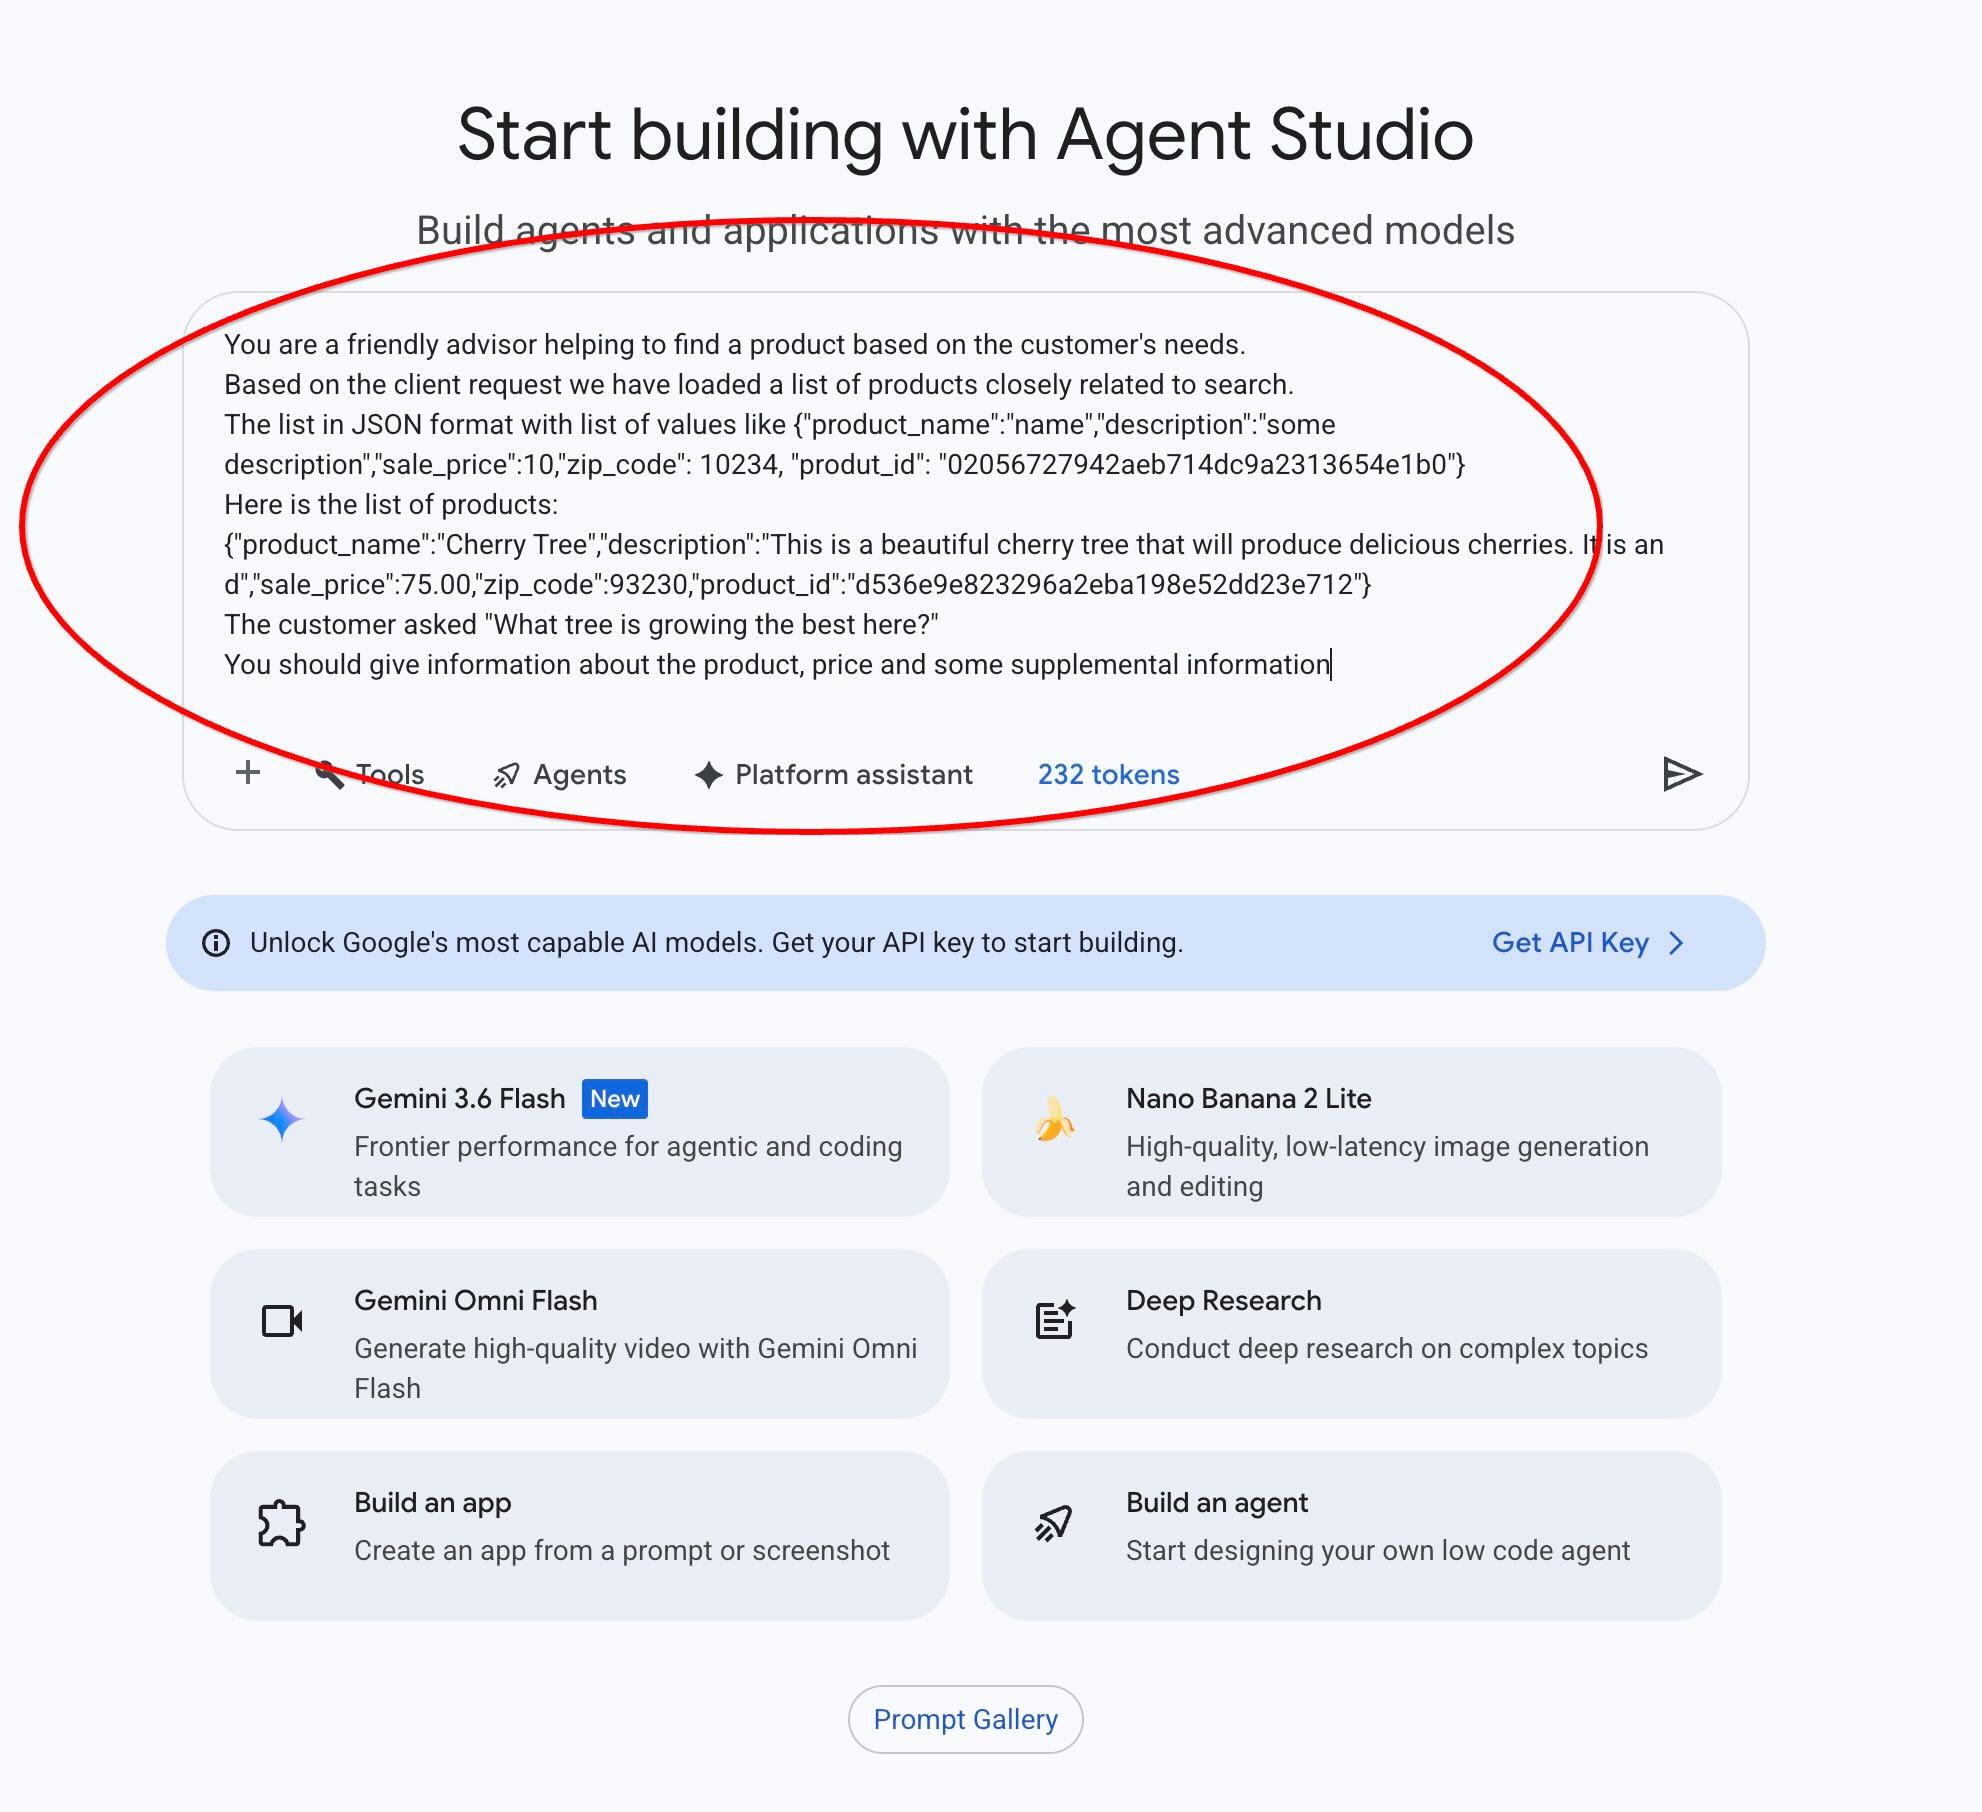
Oto wynik po uruchomieniu promptu :
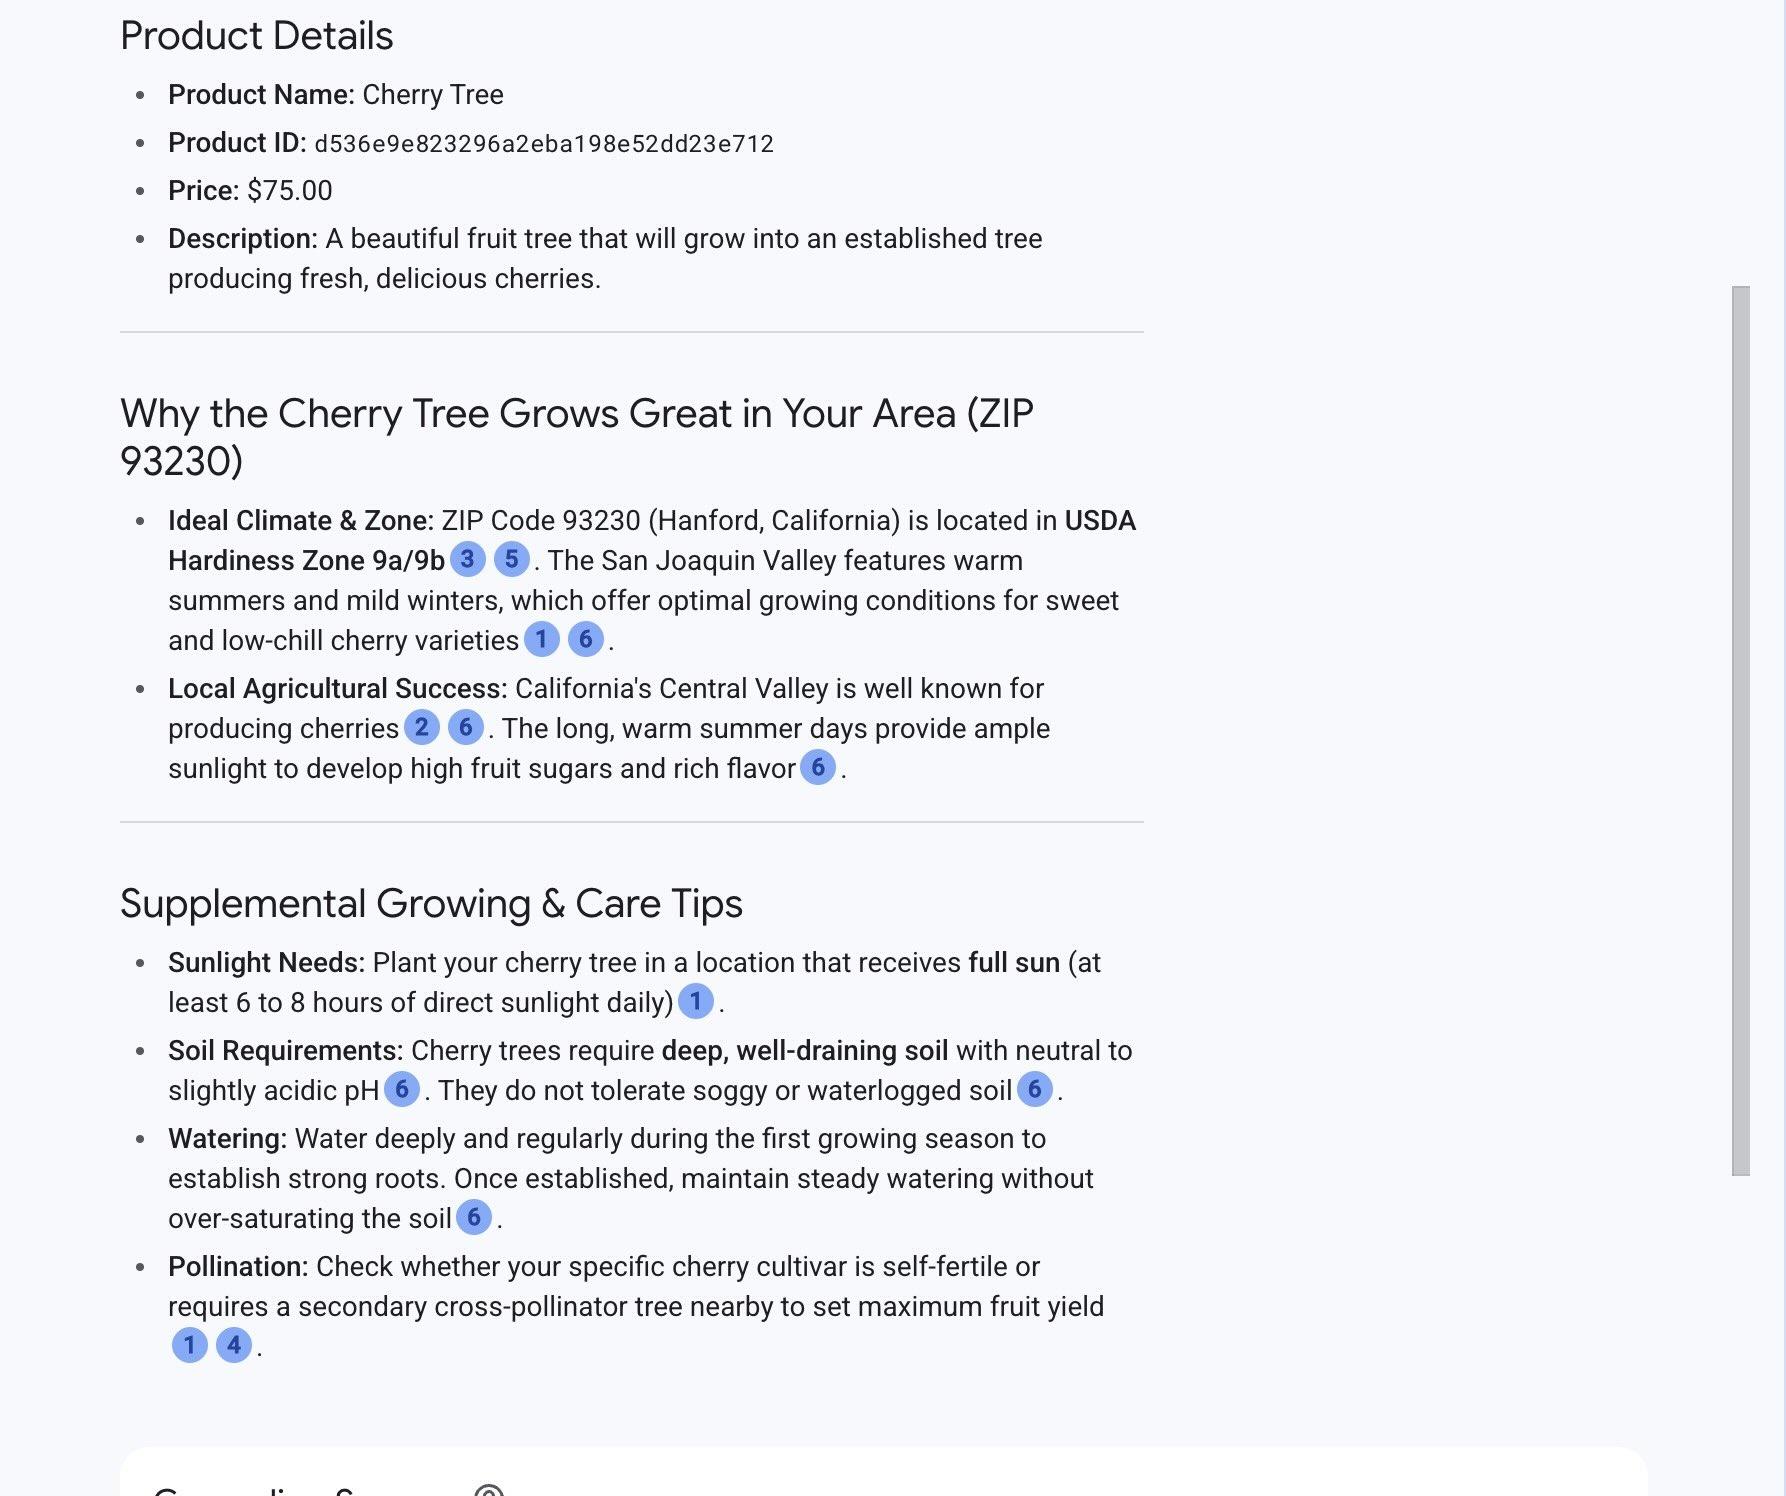
Odpowiedź zawiera cenę, opis i dodatkowe informacje, które model uzyskuje ze źródeł zewnętrznych na podstawie informacji o drzewie i lokalizacji.
Uruchamianie prompta w PSQL
Podobny wynik można uzyskać, uruchamiając integrację AlloyDB AI z platformą agentów Gemini Enterprise, aby uzyskać tę samą odpowiedź z modelu generatywnego przy użyciu kodu SQL bezpośrednio w bazie danych. Aby korzystać z modelu gemini-3.6-flash, musisz go zarejestrować.
Zarejestruj model gemini-3.6-flash:
W przypadku uruchomienia w AlloyDB Studio:
CALL google_ml.create_model(
model_id => 'gemini-3.6-flash',
model_request_url => 'https://aiplatform.googleapis.com/v1/projects/PROJECT_ID/locations/global/publishers/google/models/gemini-3.6-flash:generateContent',
model_provider => 'google',
model_type => 'llm'
);
Listę zarejestrowanych modeli możesz zawsze sprawdzić, wybierając informacje z google_ml.model_info_view.
SELECT model_id,model_type FROM google_ml.model_info_view WHERE model_id ILIKE '%flash%';
Przykładowe dane wyjściowe
quickstart_db=> SELECT model_id,model_type FROM google_ml.model_info_view WHERE model_id ILIKE '%flash%';
       model_id        | model_type
-----------------------+------------
 gemini-3.6-flash      | llm
 gemini-2.0-flash      | llm
 gemini-2.5-flash      | llm
 gemini-2.0-flash-lite | llm
 gemini-2.5-flash-lite | llm
(5 rows)
Możesz teraz używać wygenerowanego w podzapytaniu kodu JSON jako części promptu dla modelu gemini-3.6-flash za pomocą SQL.
W sesji psql lub AlloyDB Studio uruchom to zapytanie:
WITH trees AS (
SELECT
        cp.product_name,
        cp.product_description AS description,
        cp.sale_price,
        cs.zip_code,
        cp.uniq_id AS product_id
FROM
        cymbal_products cp
JOIN cymbal_inventory ci ON
        ci.uniq_id = cp.uniq_id
JOIN cymbal_stores cs ON
        cs.store_id = ci.store_id
        AND ci.inventory>0
        AND cs.store_id = 1583
ORDER BY
        (cp.embedding <=> embedding('text-embedding-005',
        'What kind of fruit trees grow well here?')::vector) ASC
LIMIT 1),
prompt AS (
SELECT
        'You are a friendly advisor helping to find a product based on the customer''s needs.
Based on the client request we have loaded a list of products closely related to search.
The list in JSON format with list of values like {"product_name":"name","product_description":"some description","sale_price":10}
Here is the list of products:' || json_agg(trees) || 'The customer asked "What kind of fruit trees grow well here?"
You should give information about the product, price and some supplemental information' AS prompt_text
FROM
        trees),
response AS (
SELECT
        google_ml.predict_row( model_id =>'gemini-3.6-flash',
        request_body => json_build_object('contents',
        json_build_object('role',
        'user',
        'parts',
        json_build_object('text',
        prompt_text))))->'candidates'->0->'content'->'parts'->0->'text' AS resp
FROM
        prompt)
SELECT
REPLACE(resp::text, '\n', CHR(10))
FROM
        response;
Oto oczekiwane dane wyjściowe. Wyniki mogą się różnić ze względu na niedeterministyczny charakter modeli generatywnej AI:
"Hello there! I'd be delighted to help you pick out a wonderful fruit tree for your space. Based on our local selection, a fantastic option that grows very well is the **Cherry Tree**! Here are the details on this beautiful tree: * **Product:** Cherry Tree * **Price:** $75.00 ### Why it's a great choice: * **Delicious Harvest:** It produces tasty, fresh cherries right in your backyard. * **Size & Benefits:** It's a deciduous tree that grows to about 15 feet tall, making it ideal for providing both lovely shade and a bit of privacy. * **Year-Round Beauty:** It features lush, dark green leaves throughout the summer that transform into a stunning red in the autumn. * **Growing Requirements:** Cherry trees thrive best in cool, moist climates with sandy soil, and are perfectly suited for USDA hardiness zones 4 through 9. Please let me know if you have any questions about planting or if you'd like help adding this to your order!"
10. Utwórz indeks wektorowy
Ponieważ ten zbiór danych jest mały, czas odpowiedzi zależy głównie od interakcji z modelami na platformie Gemini Enterprise Agent Platform. Jeśli jednak wysyłasz zapytania dotyczące milionów wektorów, samo wyszukiwanie wektorowe może zajmować znaczną część czasu odpowiedzi i zwiększać obciążenie bazy danych. Aby zwiększyć wydajność wyszukiwania, możesz utworzyć indeks wektorowy.
Tworzenie indeksu ScaNN
Aby utworzyć indeks ScaNN, musisz włączyć dodatkowe rozszerzenie. Rozszerzenie alloydb_scann udostępnia interfejs do pracy z indeksami wektorowymi przybliżonego najbliższego sąsiada (ANN) przy użyciu algorytmu ScaNN od Google.
Uruchom w AlloyDB Studio:
CREATE EXTENSION IF NOT EXISTS alloydb_scann;
Indeks można utworzyć w trybie RĘCZNYM lub AUTOMATYCZNYM. Tryb RĘCZNY jest domyślnie włączony. Możesz utworzyć indeks i zarządzać nim tak jak każdym innym indeksem. Jeśli jednak włączysz tryb AUTOMATYCZNY, możesz utworzyć indeks, który nie wymaga od Ciebie żadnej konserwacji. Szczegółowe informacje o wszystkich opcjach znajdziesz w dokumentacji. Mamy za mało wierszy, aby utworzyć indeks w trybie AUTOMATYCZNYM, więc utworzysz go w trybie RĘCZNYM.
Uruchom w AlloyDB Studio:
CREATE INDEX cymbal_products_embeddings_scann ON cymbal_products
  USING scann (embedding cosine)
  WITH (num_leaves=10, max_num_levels = 1);
Więcej informacji o dostrajaniu parametrów indeksu znajdziesz w dokumentacji.
Oczekiwane dane wyjściowe:
quickstart_db=> CREATE INDEX cymbal_products_embeddings_scann ON cymbal_products
  USING scann (embedding cosine)
  WITH (num_leaves=10, max_num_levels = 1);
CREATE INDEX
quickstart_db=>
Porównaj odpowiedź
Powtórz zapytanie, którego użyliśmy, aby uzyskać najwyższą wartość w wyszukiwaniu semantycznym:
WITH trees as (
SELECT
        cp.product_name,
        left(cp.product_description,80) as description,
        cp.sale_price,
        cs.zip_code,
        cp.uniq_id as product_id
FROM
        cymbal_products cp
JOIN cymbal_inventory ci on
        ci.uniq_id=cp.uniq_id
JOIN cymbal_stores cs on
        cs.store_id=ci.store_id
        AND ci.inventory>0
        AND cs.store_id = 1583
ORDER BY
        (cp.embedding <=> embedding('text-embedding-005','What kind of fruit trees grow well here?')::vector) ASC
LIMIT 1)
SELECT json_agg(trees) FROM trees;
Oczekiwane dane wyjściowe:
[{"product_name":"Cherry Tree","description":"This is a beautiful cherry tree that will produce delicious cherries. It is an d","sale_price":75.00,"zip_code":93230,"product_id":"d536e9e823296a2eba198e52dd23e712"}]
Ten sam wynik „Cherry Tree”.
Sprawdź wykorzystanie indeksu:
EXPLAIN (analyze)
WITH trees as (
SELECT
        cp.product_name,
        left(cp.product_description,80) as description,
        cp.sale_price,
        cs.zip_code,
        cp.uniq_id as product_id
FROM
        cymbal_products cp
JOIN cymbal_inventory ci on
        ci.uniq_id=cp.uniq_id
JOIN cymbal_stores cs on
        cs.store_id=ci.store_id
        AND ci.inventory>0
        AND cs.store_id = 1583
ORDER BY
        (cp.embedding <=> embedding('text-embedding-005','What kind of fruit trees grow well here?')::vector) ASC
LIMIT 1)
SELECT json_agg(trees) FROM trees;
Oczekiwane dane wyjściowe (z anonimizacją w celu uniknięcia wątpliwości):
...
 Aggregate  (cost=27.24..27.25 rows=1 width=32) (actual time=0.964..0.965 rows=1 loops=1)
   ->  Subquery Scan on trees  (cost=18.91..27.23 rows=1 width=142) (actual time=0.953..0.954 rows=1 loops=1)
         ->  Limit  (cost=18.91..27.22 rows=1 width=158) (actual time=0.948..0.949 rows=1 loops=1)
               ->  Nested Loop  (cost=18.91..7126.86 rows=855 width=158) (actual time=0.948..0.948 rows=1 loops=1)
                     ->  Nested Loop  (cost=18.63..7103.59 rows=855 width=907) (actual time=0.931..0.931 rows=1 loops=1)
                           ->  Index Scan using cymbal_products_embeddings_scann on cymbal_products cp  (cost=18.21..343.15 rows=942 width=903) (actual time=0.906..0.908 rows=2 loops=1)
                                 Order By: (embedding <=> '[-0.106554024,0.035774965,-0.027267234,-0.045653425,-0.03286045,0.02124319...
Z danych wyjściowych widać, że zapytanie używało „Index Scan using cymbal_products_embeddings_scann on cymbal_products”.
Zapytanie zwróci to samo drzewo wiśni, które pojawiło się u góry wyników wyszukiwania przed utworzeniem indeksu. Indeksy przybliżonego najbliższego sąsiada (ANN) zapewniają szybkość wyszukiwania kosztem dokładności, dlatego zapytania oparte na indeksach mogą czasami zwracać nieco inne najlepsze wyniki niż dokładne wyszukiwanie bez indeksu. Indeks wektorowy zapewnia jednak znaczny wzrost wydajności przy zachowaniu wysokiej dokładności.
Aby dowiedzieć się więcej, możesz wypróbować inne typy indeksów wektorowych lub znaleźć więcej laboratoriów i przykładów z integracją LangChain na stronie dokumentacji.
11. Zwalnianie miejsca w środowisku
Po zakończeniu modułu zniszcz instancje i klaster AlloyDB.
Usuwanie klastra AlloyDB i wszystkich instancji
Klaster zostanie zniszczony za pomocą opcji force, która spowoduje też usunięcie wszystkich instancji należących do klastra.
Jeśli terminal został odłączony, połącz się ponownie i zdefiniuj zmienne projektu i środowiska w Cloud Shell:
gcloud config set project <YOUR_PROJECT_ID>
export REGION=us-central1
export ADBCLUSTER=alloydb-aip-01
export PROJECT_ID=$(gcloud config get-value project)
Usuń klaster:
gcloud alloydb clusters delete $ADBCLUSTER --region=$REGION --force
Oczekiwane dane wyjściowe konsoli:
student@cloudshell:~ (test-project-001-402417)$ gcloud alloydb clusters delete $ADBCLUSTER --region=$REGION --force
All of the cluster data will be lost when the cluster is deleted.

Do you want to continue (Y/n)?  Y

Operation ID: operation-1697820178429-6082890a0b570-4a72f7e4-4c5df36f
Deleting cluster...done.
Usuwanie kopii zapasowych AlloyDB
Usuń wszystkie kopie zapasowe AlloyDB dla klastra:
for i in $(gcloud alloydb backups list \
  --filter="CLUSTER_NAME: projects/$PROJECT_ID/locations/$REGION/clusters/$ADBCLUSTER" \
  --format="value(name)" \
  --sort-by=~createTime) ; do \
  gcloud alloydb backups delete $(basename $i) --region $REGION --quiet; done
Oczekiwane dane wyjściowe konsoli:
student@cloudshell:~ (test-project-001-402417)$ for i in $(gcloud alloydb backups list --filter="CLUSTER_NAME: projects/$PROJECT_ID/locations/$REGION/clusters/$ADBCLUSTER" --format="value(name)" --sort-by=~createTime) ; do gcloud alloydb backups delete $(basename $i) --region $REGION --quiet; done
Operation ID: operation-1697826266108-60829fb7b5258-7f99dc0b-99f3c35f
Deleting backup...done.
Teraz możemy usunąć maszynę wirtualną.
Usuwanie maszyny wirtualnej GCE
W Cloud Shell wykonaj to polecenie:
export GCEVM=instance-1
export ZONE=us-central1-a
gcloud compute instances delete $GCEVM \
    --zone=$ZONE \
    --quiet
Oczekiwane dane wyjściowe konsoli:
student@cloudshell:~ (test-project-001-402417)$ export GCEVM=instance-1
export ZONE=us-central1-a
gcloud compute instances delete $GCEVM \
    --zone=$ZONE \
    --quiet
Deleted
12. Gratulacje
Gratulujemy ukończenia ćwiczenia.
Ten moduł jest częścią ścieżki szkoleniowej dotyczącej AI w Google Cloud gotowej do wdrożenia w środowisku produkcyjnym.
- Poznaj pełny program nauczania, aby przejść od prototypu do produkcji.
- Udostępnij swoje postępy z hashtagiem
#ProductionReadyAI.
Omówione zagadnienia
- Jak wdrożyć klaster AlloyDB i instancję główną
- Jak połączyć się z AlloyDB z maszyny wirtualnej Google Compute Engine
- Tworzenie bazy danych i włączanie AlloyDB AI
- Wczytywanie danych do bazy danych
- Jak korzystać z AlloyDB Studio
- Jak używać modelu wektorów dystrybucyjnych Gemini Enterprise Agent Platform w AlloyDB
- Jak korzystać z Gemini Enterprise Agent Platform Studio
- Jak wzbogacić wynik za pomocą modelu generatywnego Gemini Enterprise Agent Platform
- Jak poprawić wydajność za pomocą indeksu wektorów
13. Ankieta
Dane wyjściowe: