

1. Introdução
Neste codelab, você vai aprender a implantar o AlloyDB Omni no Google Kubernetes Engine (GKE) e usá-lo com modelos abertos, como EmbeddingGemma e Gemma 4, para embeddings e previsões. Executar o banco de dados e os modelos no mesmo cluster reduz a latência da rede e evita dependências de serviços de terceiros. Ele também ajuda a atender aos requisitos de compliance e residência de dados, já que seus dados nunca saem do seu ambiente.
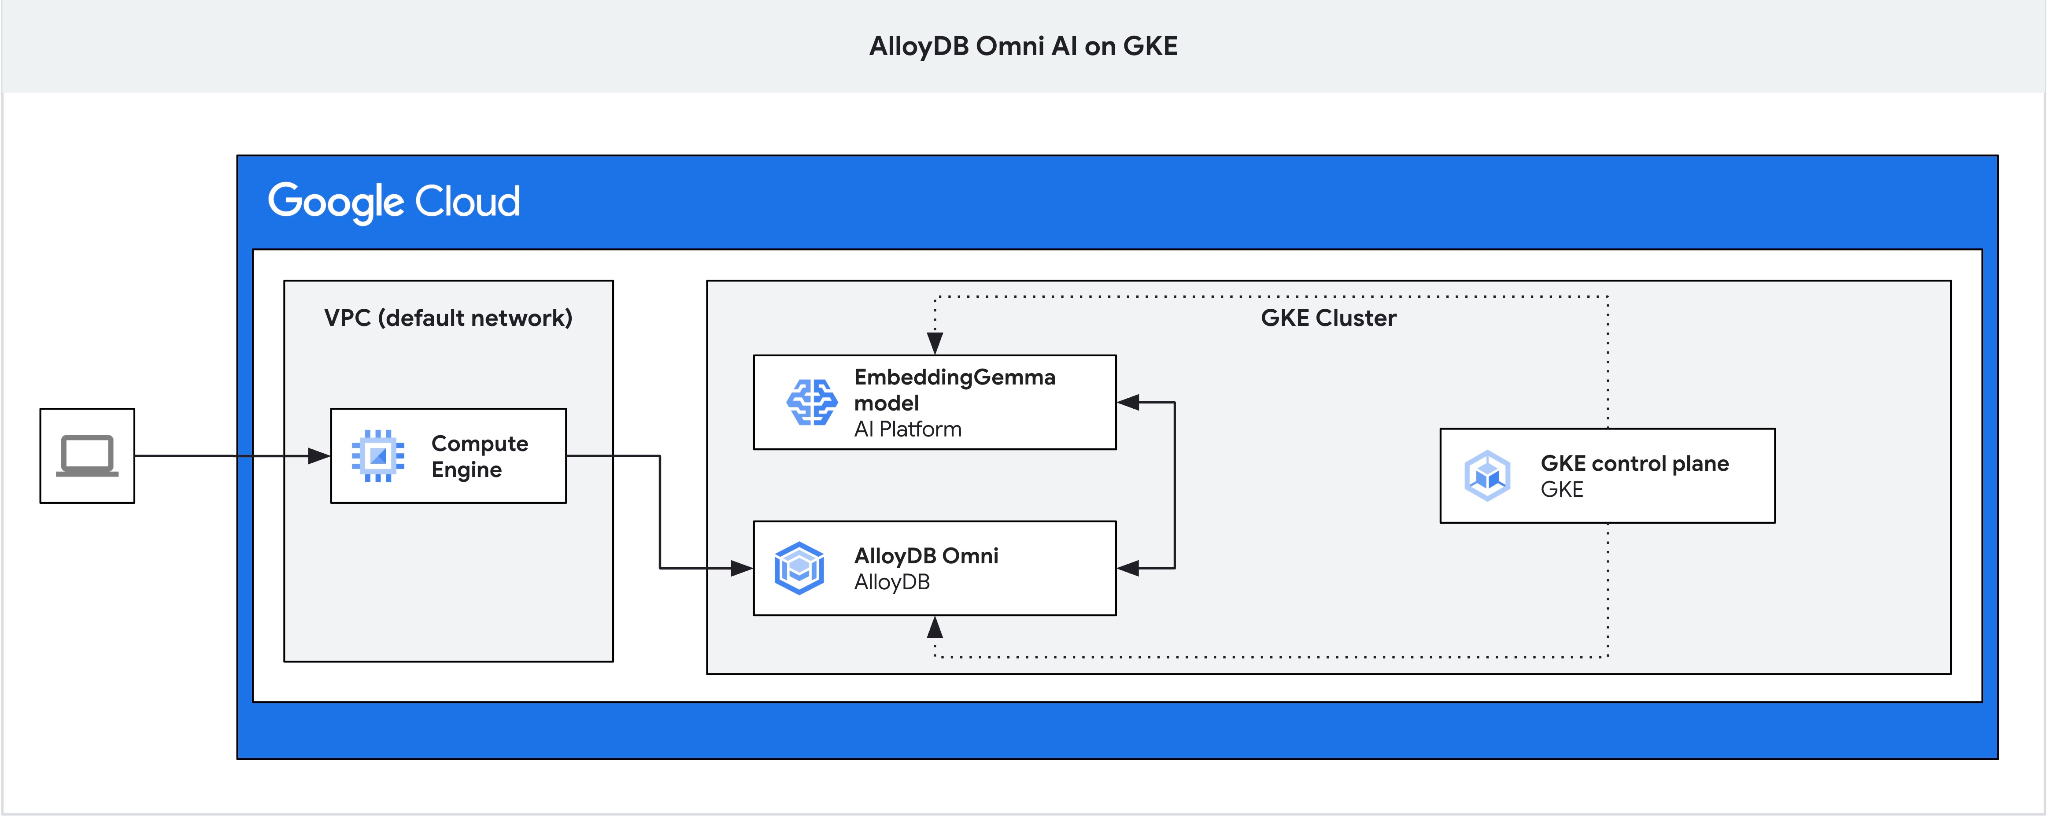
Pré-requisitos
- Conhecimentos básicos sobre o Google Cloud e o console do Google Cloud
- Conhecimento básico do Kubernetes e do GKE
- Familiaridade com a interface de linha de comando e o Google Cloud Shell
O que você vai aprender
- Como implantar o AlloyDB Omni em um cluster do GKE
- Como se conectar ao AlloyDB Omni
- Como carregar dados no AlloyDB Omni
- Como implantar modelos de IA (embeddings e LLM) no GKE
- Como registrar modelos de IA no AlloyDB Omni
- Como gerar embeddings para pesquisa semântica
- Como executar consultas de pesquisa semântica no AlloyDB Omni
- Como criar e usar índices vetoriais no AlloyDB Omni
O que é necessário
- Uma conta do Google Cloud e um projeto na nuvem do Google Cloud
- Um navegador da web, como o Chrome
2. Configuração e requisitos
Configurar o projeto
- Faça login no console do Google Cloud. Se você ainda não tem uma conta do Gmail ou do Google Workspace, crie uma. Use uma conta pessoal em vez de uma conta escolar ou de trabalho.
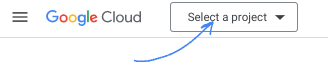
- Crie um projeto ou selecione um atual. No cabeçalho do console do Google Cloud, clique em Selecionar um projeto e em Novo projeto.
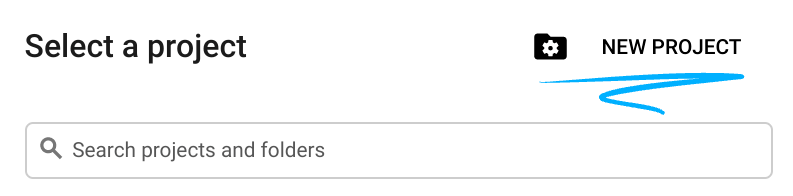
Na janela Selecionar um projeto, clique em Novo projeto para abrir a caixa de diálogo de criação de projetos.
Na caixa de diálogo, insira um Nome do projeto e selecione sua organização ou local.
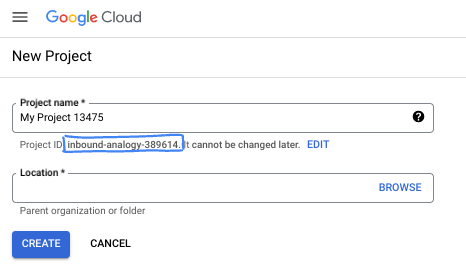
- O Nome do projeto é o nome de exibição para os participantes do projeto. O nome do projeto não é usado pelas APIs do Google e pode ser mudado a qualquer momento.
- O ID do projeto é exclusivo em todos os projetos do Google Cloud e não pode ser mudado após a definição. O console do Google Cloud gera automaticamente um ID exclusivo, mas você pode fornecer um próprio. Neste codelab, você vai referenciar o ID do projeto com o marcador
- O Número do projeto é um terceiro identificador usado por algumas APIs. Para mais informações, consulte a documentação do Resource Manager.
Ativar faturamento
Se você configurou o faturamento usando créditos do Google Cloud, pule esta etapa.
Para configurar uma conta de faturamento pessoal, ative o faturamento no console do Google Cloud.
- Concluir este laboratório custa menos de US $5 em recursos do Google Cloud.
- Siga as etapas de limpeza no final deste laboratório para excluir recursos e evitar mais cobranças.
- Novos usuários podem aproveitar o teste sem custos financeiros de US$300.
Iniciar o Cloud Shell
Neste codelab, você vai usar o Google Cloud Shell, um ambiente de linha de comando executado na nuvem.
No console do Google Cloud, clique no ícone Ativar o Cloud Shell na barra de ferramentas superior à direita:
Como alternativa, pressione G e S ou abra o Google Cloud Shell diretamente.
Quando conectado, o Cloud Shell mostra o prompt do terminal:
O Cloud Shell inclui armazenamento permanente e ferramentas de desenvolvimento. Você pode executar todas as etapas deste codelab no navegador.
3. Ativar APIs
Para usar o Google Kubernetes Engine (GKE) com o AlloyDB Omni e implantações de modelos, ative as APIs Compute Engine e GKE no seu projeto na nuvem do Google Cloud.
No Cloud Shell, verifique se o ID do projeto está configurado:
PROJECT_ID=$(gcloud config get-value project)
echo $PROJECT_ID
Se o ID do projeto não estiver definido, configure-o:
export PROJECT_ID=<YOUR_PROJECT_ID>
gcloud config set project $PROJECT_ID
Ative as APIs necessárias:
gcloud services enable compute.googleapis.com
gcloud services enable container.googleapis.com
Saída esperada:
student@cloudshell:~ (test-project-001-402417)$ PROJECT_ID=test-project-001-402417
student@cloudshell:~ (test-project-001-402417)$ gcloud config set project test-project-001-402417
Updated property [core/project].
student@cloudshell:~ (test-project-001-402417)$ gcloud services enable compute.googleapis.com
gcloud services enable container.googleapis.com
Operation "operations/acat.p2-4470404856-1f44ebd8-894e-4356-bea7-b84165a57442" finished successfully.
Leia sobre cada API ativada na documentação.
4. Implantar o AlloyDB Omni no GKE
Para implantar o AlloyDB Omni no GKE, prepare um cluster do Kubernetes seguindo os requisitos do operador do AlloyDB Omni.
Criar um cluster do GKE
Implante um cluster padrão do GKE com capacidade para executar o AlloyDB Omni, o operador e os contêineres de monitoramento. O AlloyDB Omni requer pelo menos duas CPUs e 8 GB de RAM. Este tutorial usa o tipo de máquina n2-standard-4.
Defina as variáveis de ambiente da implantação:
export PROJECT_ID=$(gcloud config get-value project)
export LOCATION=us-central1
export CLUSTER_NAME=alloydb-ai-gke
export MACHINE_TYPE=n2-standard-4
Crie o cluster do GKE padrão:
gcloud container clusters create ${CLUSTER_NAME} \
  --project=${PROJECT_ID} \
  --region=${LOCATION} \
  --workload-pool=${PROJECT_ID}.svc.id.goog \
  --release-channel=rapid \
  --machine-type=${MACHINE_TYPE} \
  --num-nodes=1
Saída esperada do console:
student@cloudshell:~ (test-project-001-402417)$ export PROJECT_ID=$(gcloud config get project)
export LOCATION=us-central1
export CLUSTER_NAME=alloydb-ai-gke
export MACHINE_TYPE=n2-standard-4
Your active configuration is: [test-project-001-402417]
student@cloudshell:~ (test-project-001-402417)$ gcloud container clusters create ${CLUSTER_NAME} \
  --project=${PROJECT_ID} \
  --region=${LOCATION} \
  --workload-pool=${PROJECT_ID}.svc.id.goog \
  --release-channel=rapid \
  --machine-type=${MACHINE_TYPE} \
  --num-nodes=1
Note: Your Pod address range (`--cluster-ipv4-cidr`) can accommodate at most 1008 node(s).
Creating cluster alloydb-ai-gke in us-central1... Cluster is being health-checked (Kubernetes Control Plane is healthy)...done.
Created [https://container.googleapis.com/v1/projects/test-project-001-402417/zones/us-central1/clusters/alloydb-ai-gke].
To inspect the contents of your cluster, go to: https://console.cloud.google.com/kubernetes/workload_/gcloud/us-central1/alloydb-ai-gke?project=test-project-001-402417
kubeconfig entry generated for alloydb-ai-gke.
NAME: alloydb-ai-gke
LOCATION: us-central1
MASTER_VERSION: 1.36.3-gke.1640000
MASTER_IP: 34.121.243.65
MACHINE_TYPE: n2-standard-4
NODE_VERSION: 1.36.3-gke.1640000
NUM_NODES: 3
STATUS: RUNNING
STACK_TYPE: IPV4
Preparar o cluster
Instale os componentes necessários, como o cert-manager, o controlador de certificados nativo do Kubernetes. Para mais detalhes, consulte a documentação de instalação do cert-manager.
O Cloud Shell inclui a ferramenta de linha de comando do Kubernetes kubectl. Consiga as credenciais do cluster usando gcloud:
gcloud container clusters get-credentials ${CLUSTER_NAME} --region=${LOCATION}
Instale cert-manager usando kubectl:
kubectl apply -f https://github.com/cert-manager/cert-manager/releases/download/v1.21.1/cert-manager.yaml
Saída esperada do console (editada):
student@cloudshell:~$ kubectl apply -f https://github.com/cert-manager/cert-manager/releases/download/v1.21.1/cert-manager.yaml
namespace/cert-manager created
customresourcedefinition.apiextensions.k8s.io/certificaterequests.cert-manager.io created
customresourcedefinition.apiextensions.k8s.io/certificates.cert-manager.io created
customresourcedefinition.apiextensions.k8s.io/challenges.acme.cert-manager.io created
customresourcedefinition.apiextensions.k8s.io/clusterissuers.cert-manager.io created
...
validatingwebhookconfiguration.admissionregistration.k8s.io/cert-manager-webhook created
Instalar o operador do AlloyDB Omni
Instale o operador do AlloyDB Omni usando o Helm.
Faça o download e instale o gráfico do operador do AlloyDB Omni:
helm install alloydbomni-operator oci://gcr.io/alloydb-omni/alloydbomni-operator \
--version 1.8.1 \
--create-namespace \
--namespace alloydb-omni-system \
--atomic \
--timeout 5m
Saída esperada do console (editada):
student@cloudshell:~$ helm install alloydbomni-operator oci://gcr.io/alloydb-omni/alloydbomni-operator \
> --version 1.8.0 \
> --create-namespace \
> --namespace alloydb-omni-system \
> --atomic \
> --timeout 5m
Flag --atomic has been deprecated, use --rollback-on-failure instead
Pulled: gcr.io/alloydb-omni/alloydbomni-operator:1.8.0
Digest: sha256:f2d98fa7a3b08dfc1e83b811582718b94e5c017b81aade700c83e917c59f0395
NAME: alloydbomni-operator
LAST DEPLOYED: Thu Aug 27 17:57:30 2026
NAMESPACE: alloydb-omni-system
STATUS: deployed
REVISION: 1
DESCRIPTION: Install complete
TEST SUITE: None
Implante o cluster de banco de dados.
O manifesto a seguir configura um cluster de banco de dados com o googleMLExtension ativado e um balanceador de carga interno:
cat << 'EOF' > my-omni.yaml
apiVersion: v1
kind: Secret
metadata:
  name: db-pw-my-omni
type: Opaque
data:
  my-omni: "VmVyeVN0cm9uZ1Bhc3N3b3Jk"
---
apiVersion: alloydbomni.dbadmin.goog/v1
kind: DBCluster
metadata:
  name: my-omni
spec:
  databaseVersion: "18.3.0"
  primarySpec:
    adminUser:
      passwordRef:
        name: db-pw-my-omni
    features:
      googleMLExtension:
        enabled: true
    resources:
      cpu: 1
      memory: 8Gi
      disks:
      - name: DataDisk
        size: 20Gi
        storageClass: standard
    dbLoadBalancerOptions:
      annotations:
        networking.gke.io/load-balancer-type: "internal"
  allowExternalIncomingTraffic: true
EOF
O valor secreto da senha é a representação Base64 de VeryStrongPassword. Em ambientes de produção, use o Google Secret Manager para gerenciar senhas. Para mais detalhes, consulte a documentação do Secret Manager.
O manifesto é salvo como my-omni.yaml. No Cloud Shell, clique em Abrir editor no canto superior direito da janela do terminal e leia o arquivo.
Depois de ler o manifesto my-omni.yaml, clique em Abrir terminal para voltar ao prompt de comando.
Aplique o manifesto my-omni.yaml:
kubectl apply -f my-omni.yaml
Saída esperada do console:
secret/db-pw-my-omni created
dbcluster.alloydbomni.dbadmin.goog/my-omni created
Verifique o status do cluster my-omni:
kubectl get dbclusters.alloydbomni.dbadmin.goog my-omni -n default
Durante a implantação, o cluster de banco de dados passa por fases de configuração até atingir o estado DBClusterReady.
Saída esperada do console:
$ kubectl get dbclusters.alloydbomni.dbadmin.goog my-omni -n default
NAME      PRIMARYENDPOINT   PRIMARYPHASE   DBCLUSTERPHASE   HAREADYSTATUS   HAREADYREASON
my-omni   10.131.0.33        Ready          DBClusterReady
Se quiser, monitore a implantação do cluster usando o comando kubectl log:
kubectl logs -l alloydbomni.internal.dbadmin.goog/dbcluster=my-omni --all-containers -f
Conectar-se ao AlloyDB Omni
Quando o cluster estiver pronto, conecte-se ao pod do banco de dados usando o cliente PostgreSQL (psql). A senha é VeryStrongPassword, conforme definido em my-omni.yaml:
DB_CLUSTER_NAME=my-omni
DB_CLUSTER_NAMESPACE=default
DBPOD=`kubectl get pod --selector=alloydbomni.internal.dbadmin.goog/dbcluster=$DB_CLUSTER_NAME,alloydbomni.internal.dbadmin.goog/task-type=database -n $DB_CLUSTER_NAMESPACE -o jsonpath='{.items[0].metadata.name}'`
kubectl exec -ti $DBPOD -n $DB_CLUSTER_NAMESPACE -c database -- psql -h localhost -U postgres
Exemplo de saída do console:
DB_CLUSTER_NAME=my-omni
DB_CLUSTER_NAMESPACE=default
DBPOD=`kubectl get pod --selector=alloydbomni.internal.dbadmin.goog/dbcluster=$DB_CLUSTER_NAME,alloydbomni.internal.dbadmin.goog/task-type=database -n $DB_CLUSTER_NAMESPACE -o jsonpath='{.items[0].metadata.name}'`
kubectl exec -ti $DBPOD -n $DB_CLUSTER_NAMESPACE -c database -- psql -h localhost -U postgres
Password for user postgres:
psql (18.3)
SSL connection (protocol: TLSv1.3, cipher: TLS_AES_128_GCM_SHA256, compression: off, ALPN: postgresql)
Type "help" for help.

postgres=#
Saia da sessão psql digitando \q e pressionando Enter:
postgres=# \q
5. Implantar o modelo EmbeddingGemma no GKE
Para testar a integração da IA do AlloyDB Omni com modelos locais, implante um modelo de embeddings no cluster do GKE. Este tutorial usa o modelo EmbeddingGemma do Google.
Criar um pool de nós para o modelo
Para executar a inferência de modelo, prepare um pool de nós dedicado. É possível usar um pool de nós somente de CPU ou um pool de nós acelerado por GPU, como g2-standard-8 com uma GPU NVIDIA L4. Este tutorial usa um pool de nós baseado em CPU com tipos de máquinas c3-standard-8.
Crie um pool de nós de CPU de nó único:
export PROJECT_ID=$(gcloud config get-value project)
export LOCATION=us-central1
export CLUSTER_NAME=alloydb-ai-gke
gcloud container node-pools create cpupool \
  --project=${PROJECT_ID} \
  --location=${LOCATION} \
  --node-locations=${LOCATION}-a \
  --cluster=${CLUSTER_NAME} \
  --machine-type=c3-standard-8 \
  --num-nodes=1
Saída esperada:
student@cloudshell$ export PROJECT_ID=$(gcloud config get project)
Your active configuration is: [pant]
export LOCATION=us-central1
export CLUSTER_NAME=alloydb-ai-gke
student@cloudshell$ gcloud container node-pools create cpupool \
>   --project=${PROJECT_ID} \
>   --location=${LOCATION} \
>   --node-locations=${LOCATION}-a \
>   --cluster=${CLUSTER_NAME} \
>   --machine-type=c3-standard-8 \
>   --num-nodes=1
Creating node pool cpupool...done.
Created [https://container.googleapis.com/v1/projects/gleb-test-short-003-483115/zones/us-central1/clusters/alloydb-ai-gke/nodePools/cpupool].
NAME     MACHINE_TYPE    DISK_SIZE_GB  NODE_VERSION
cpupool  c3-standard-8  100           1.34.1-gke.3355002
Receber um token do Hugging Face
Este tutorial implanta o modelo EmbeddingGemma da Hugging Face. Para acessar os pesos do modelo, gere um token de acesso do Hugging Face:
- Faça login ou crie uma conta no Hugging Face.
- Acesse Seu perfil > Tokens de acesso.
- Clique em Criar novo token.
- Insira um nome para o token e selecione a função Leitura.
- Clique em Criar token e copie o valor do token gerado.
- Aceite os termos do modelo na página do modelo EmbeddingGemma, se ainda não tiver feito isso.
Crie um secret do Kubernetes que contenha seu token do Hugging Face no Cloud Shell (substitua o marcador de posição do token pelo seu token):
export HF_TOKEN=<YOUR_HUGGING_FACE_TOKEN>
kubectl create secret generic hf-secret \
  --from-literal=hf_api_token=$HF_TOKEN \
  --dry-run=client -o yaml | kubectl apply -f -
Preparar o manifesto de implantação
Para implantar o modelo, use o pacote de contêiner de inferência de embeddings de texto (TEI, na sigla em inglês) da Hugging Face. Para mais informações, consulte a documentação do TEI do GKE do Hugging Face.
Clone o repositório de implantação do GitHub:
git clone https://github.com/huggingface/Google-Cloud-Containers
Inspecione e modifique o manifesto de configuração da CPU:
edit Google-Cloud-Containers/examples/gke/tei-deployment/cpu-config/deployment.yaml
O manifesto atualizado para a implantação de CPU:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: tei-deployment
spec:
  replicas: 1
  selector:
    matchLabels:
      app: tei-server
  template:
    metadata:
      labels:
        app: tei-server
        hf.co/model: Google--embeddinggemma-300m
        hf.co/task: text-embeddings
    spec:
      containers:
        - name: tei-container
          image: ghcr.io/huggingface/text-embeddings-inference:cpu-latest
          resources:
            requests:
              cpu: "6"
              memory: "24Gi"
            limits:
              cpu: "6"
              memory: "24Gi"
          env:
            - name: MODEL_ID
              value: google/embeddinggemma-300m
            - name: NUM_SHARD
              value: "1"
            - name: PORT
              value: "8080"
            - name: HF_TOKEN
              valueFrom:
                secretKeyRef:
                  name: hf-secret
                  key: hf_api_token
          volumeMounts:
            - mountPath: /tmp
              name: tmp
      volumes:
        - name: tmp
          emptyDir: {}
      nodeSelector:
        cloud.google.com/machine-family: "c3"
Salve as mudanças pressionando ctrl+s e volte ao terminal.
Implantar o modelo
Aplique o manifesto para implantar o servidor TEI:
kubectl apply -f Google-Cloud-Containers/examples/gke/tei-deployment/cpu-config
Monitore a implantação até que ela esteja pronta:
printf "Waiting for model to load..."; until kubectl logs -l app=tei-server --tail=50 2>/dev/null | grep -q "Ready"; do printf "."; sleep 3; done; printf '\n\033[1;32m========================================\n[SUCCESS] Model is loaded and ready!\nYou can now proceed to the next step.\n========================================\033[0m\n'
Verifique o serviço do Kubernetes tei-service:
kubectl get service tei-service
Saída esperada:
student@cloudshell$ kubectl get service tei-service
NAME          TYPE        CLUSTER-IP      EXTERNAL-IP   PORT(S)    AGE
tei-service   ClusterIP   34.118.233.48   <none>        8080/TCP   10m
O serviço CLUSTER-IP atende solicitações internamente em http://34.118.233.48:8080/embed.
Teste o endpoint do modelo localmente usando kubectl port-forward:
kubectl port-forward service/tei-service 8080:8080
Abra uma segunda guia do Cloud Shell clicando em + na parte de cima do terminal:
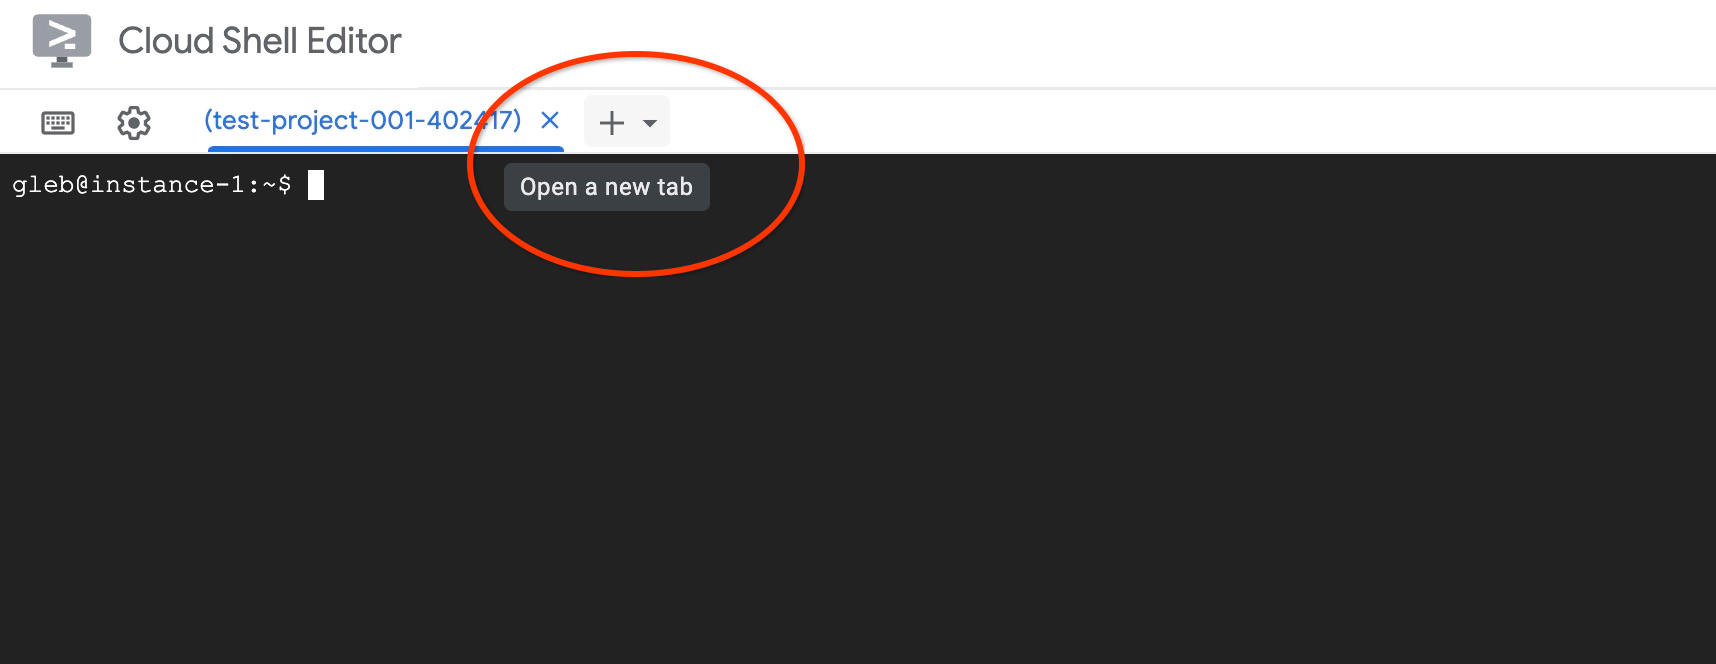
Na nova guia, teste a geração de embeddings com curl:
curl http://localhost:8080/embed \
  -X POST \
  -d '{"inputs":"Test"}' \
  -H 'Content-Type: application/json'
Saída esperada (matriz de vetores):
curl http://localhost:8080/embed \
>     -X POST \
>     -d '{"inputs":"Test"}' \
>     -H 'Content-Type: application/json'
[[-0.018975832,0.0071419072,0.06347208,0.022992613,0.014205903
...
-0.03677433,0.01636146,0.06731572]]
Interrompa o encaminhamento de porta na primeira guia pressionando ctrl+c.
6. Registrar o modelo de incorporação no AlloyDB Omni
Para usar o modelo implantado do AlloyDB Omni, crie um banco de dados, defina funções de transformação e registre o endpoint do modelo.
Criar uma VM cliente e um banco de dados
Crie uma instância de VM do Compute Engine na mesma VPC para atuar como um host de salto do cliente:
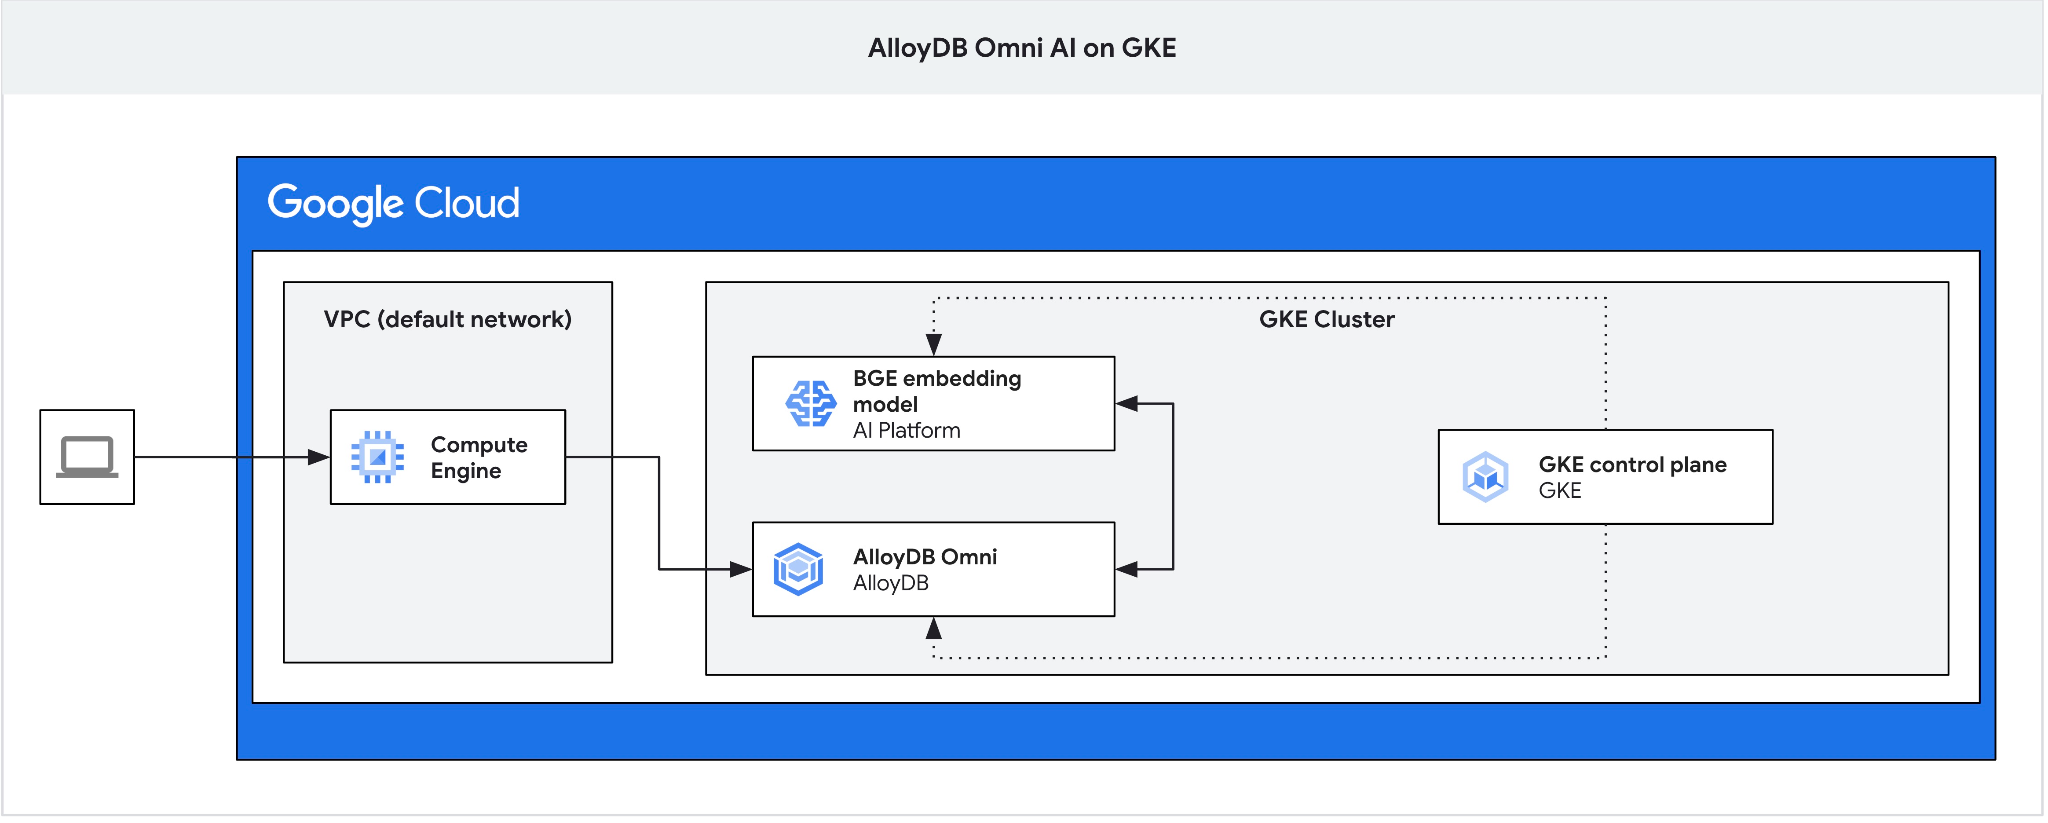
No Cloud Shell, crie a VM cliente:
export ZONE=us-central1-a
gcloud compute instances create instance-1 \
  --zone=$ZONE
Recupere o IP do endpoint do AlloyDB Omni:
echo "INSTANCE_IP=$(kubectl get dbclusters.alloydbomni.dbadmin.goog my-omni -n default -o jsonpath='{.status.primary.endpoint}')"
Saída esperada:
INSTANCE_IP=10.128.0.33
O valor INSTANCE_IP é o IP do balanceador de carga interno do cluster do AlloyDB Omni. Neste exemplo, é 10.131.0.33.
Conecte-se à instância de VM usando o SSH.
gcloud compute ssh instance-1 --zone=$ZONE
Na sessão SSH em instance-1, instale o cliente do PostgreSQL:
sudo apt-get update && sudo apt-get install --yes postgresql-client
Exporte o IP do balanceador de carga do AlloyDB Omni (substitua pelo seu IP PRIMARYENDPOINT):
export INSTANCE_IP=10.131.0.33
Conecte-se ao AlloyDB Omni usando psql (a senha é VeryStrongPassword):
psql "host=$INSTANCE_IP user=postgres sslmode=require"
Na sessão psql, crie o banco de dados demo:
CREATE DATABASE demo;
Mude para o banco de dados demo:
\c demo
Criar funções de transformação
Os endpoints de embedding personalizados exigem funções de transformação de entrada e saída para adaptar os formatos de dados entre o AlloyDB Omni e a API do modelo.
Crie a função de transformação de entrada:
CREATE OR REPLACE FUNCTION tei_text_input_transform(model_id VARCHAR(100), input_text TEXT)
RETURNS JSON
LANGUAGE plpgsql
AS $$
DECLARE
  transformed_input JSON;
BEGIN
  SELECT json_build_object('inputs', input_text, 'truncate', true)::JSON INTO transformed_input;
  RETURN transformed_input;
END;
$$;
Saída esperada:
demo=# CREATE OR REPLACE FUNCTION tei_text_input_transform(model_id VARCHAR(100), input_text TEXT)
RETURNS JSON
LANGUAGE plpgsql
AS $$
DECLARE
  transformed_input JSON;
BEGIN
  SELECT json_build_object('inputs', input_text, 'truncate', true)::JSON INTO transformed_input;
  RETURN transformed_input;
END;
$$;
CREATE FUNCTION
demo=#
Crie a função de transformação de saída para analisar a resposta da matriz de vetores:
CREATE OR REPLACE FUNCTION tei_text_output_transform(model_id VARCHAR(100), response_json JSON)
RETURNS REAL[]
LANGUAGE plpgsql
AS $$
DECLARE
  transformed_output REAL[];
BEGIN
  SELECT ARRAY(SELECT json_array_elements_text(response_json->0)) INTO transformed_output;
  RETURN transformed_output;
END;
$$;
Saída esperada:
demo=# CREATE OR REPLACE FUNCTION tei_text_output_transform(model_id VARCHAR(100), response_json JSON)
RETURNS REAL[]
LANGUAGE plpgsql
AS $$
DECLARE
  transformed_output REAL[];
BEGIN
  SELECT ARRAY(SELECT json_array_elements_text(response_json->0)) INTO transformed_output;
  RETURN transformed_output;
END;
$$;
CREATE FUNCTION
demo=#
Registrar o modelo
Registre o modelo no AlloyDB Omni usando o procedimento google_ml.create_model. Especifique http://tei-service:8080/embed como o model_request_url para rotear solicitações ao serviço de cluster do Kubernetes:
CALL
  google_ml.create_model(
    model_id => 'embeddinggemma',
    model_request_url => 'http://tei-service:8080/embed',
    model_provider => 'custom',
    model_type => 'text_embedding',
    model_in_transform_fn => 'tei_text_input_transform',
    model_out_transform_fn => 'tei_text_output_transform');
Saída esperada:
demo=# CALL
  google_ml.create_model(
    model_id => 'embeddinggemma',
    model_request_url => 'http://tei-service:8080/embed',
    model_provider => 'custom',
    model_type => 'text_embedding',
    model_in_transform_fn => 'tei_text_input_transform',
    model_out_transform_fn => 'tei_text_output_transform');
CALL
demo=#
Teste o modelo registrado com uma consulta SQL de exemplo:
SELECT google_ml.embedding('embeddinggemma', 'What is AlloyDB Omni?');
A função retorna a representação da matriz de números reais gerada pelo modelo EmbeddingGemma local em execução no GKE.
Pressione q para voltar ao prompt da sessão psql.
Saia da sessão psql:
\q
7. Testar o modelo com dados de amostra
Carregar dados de amostra
Este tutorial usa o conjunto de dados de varejo da Cymbal para demonstrar a pesquisa de similaridade de vetores. Você vai usar o SDK Google Cloud e o cliente do PostgreSQL para importar dados para o AlloyDB Omni.
Na sessão SSH em instance-1, conecte-se ao banco de dados de demonstração e ative a extensão vector:
psql "host=$INSTANCE_IP user=postgres sslmode=require dbname=demo"
Na sessão psql:
CREATE EXTENSION IF NOT EXISTS vector;
Saia da sessão psql:
\q
Baixe e aplique o esquema para criar tabelas no banco de dados demo:
gcloud storage cat gs://cloud-training/gcc/gcc-tech-004/cymbal_demo_schema.sql |psql "host=$INSTANCE_IP user=postgres dbname=demo"
Saída esperada:
student@cloudshell:~$ gcloud storage cat gs://cloud-training/gcc/gcc-tech-004/cymbal_demo_schema.sql |psql "host=$INSTANCE_IP user=postgres dbname=demo"
Password for user postgres:
SET
SET
SET
SET
SET
 set_config
------------

(1 row)

SET
SET
SET
SET
SET
SET
CREATE TABLE
ALTER TABLE
CREATE TABLE
ALTER TABLE
CREATE TABLE
ALTER TABLE
CREATE TABLE
ALTER TABLE
CREATE SEQUENCE
ALTER TABLE
ALTER SEQUENCE
ALTER TABLE
ALTER TABLE
ALTER TABLE
student@cloudshell:~$
Verifique as tabelas criadas:
psql "host=$INSTANCE_IP user=postgres dbname=demo" -c "\dt+"
Saída esperada:
student@cloudshell:~$ psql "host=$INSTANCE_IP user=postgres dbname=demo" -c "\dt+"
Password for user postgres:
                                           List of relations
 Schema |       Name       | Type  |  Owner   | Persistence | Access method |    Size    | Description
--------+------------------+-------+----------+-------------+---------------+------------+-------------
 public | cymbal_embedding | table | postgres | permanent   | heap          | 8192 bytes |
 public | cymbal_inventory | table | postgres | permanent   | heap          | 8192 bytes |
 public | cymbal_products  | table | postgres | permanent   | heap          | 8192 bytes |
 public | cymbal_stores    | table | postgres | permanent   | heap          | 8192 bytes |
(4 rows)
Carregue dados na tabela cymbal_products:
gcloud storage cat gs://cloud-training/gcc/gcc-tech-004/cymbal_products.csv |psql "host=$INSTANCE_IP user=postgres dbname=demo" -c "\copy cymbal_products from stdin csv header"
Saída esperada:
student@cloudshell:~$ gcloud storage cat gs://cloud-training/gcc/gcc-tech-004/cymbal_products.csv |psql "host=$INSTANCE_IP user=postgres dbname=demo" -c "\copy cymbal_products from stdin csv header"
COPY 941
student@cloudshell:~$
Confira uma amostra de algumas linhas da tabela cymbal_products.
psql "host=$INSTANCE_IP user=postgres dbname=demo" -c "SELECT uniq_id,left(product_name,30),left(product_description,50),sale_price FROM cymbal_products limit 3"
Saída esperada:
student@cloudshell:~$ psql "host=$INSTANCE_IP user=postgres dbname=demo" -c "SELECT uniq_id,left(product_name,30),left(product_description,50),sale_price FROM cymbal_products limit 3"
Password for user postgres:
             uniq_id              |              left              |                        left                        | sale_price
----------------------------------+--------------------------------+----------------------------------------------------+------------
 a73d5f754f225ecb9fdc64232a57bc37 | Laundry Tub Strainer Cup       |   Laundry tub strainer cup Chrome For 1-.50, drain |      11.74
 41b8993891aa7d39352f092ace8f3a86 | LED Starry Star Night Light La |  LED Starry Star Night Light Laser Projector 3D Oc |      46.97
 ed4a5c1b02990a1bebec908d416fe801 | Surya Horizon HRZ-1060 Area Ru |  The 100% polypropylene construction of the Surya  |       77.4
(3 rows)
student@cloudshell:~$
Carregue dados na tabela cymbal_inventory:
gcloud storage cat gs://cloud-training/gcc/gcc-tech-004/cymbal_inventory.csv |psql "host=$INSTANCE_IP user=postgres dbname=demo" -c "\copy cymbal_inventory from stdin csv header"
Saída esperada:
student@cloudshell:~$ gcloud storage cat gs://cloud-training/gcc/gcc-tech-004/cymbal_inventory.csv |psql "host=$INSTANCE_IP user=postgres dbname=demo" -c "\copy cymbal_inventory from stdin csv header"
Password for user postgres:
COPY 263861
student@cloudshell:~$
Confira uma amostra de algumas linhas da tabela cymbal_inventory.
psql "host=$INSTANCE_IP user=postgres dbname=demo" -c "SELECT * FROM cymbal_inventory LIMIT 3"
Saída:
student@cloudshell:~$ psql "host=$INSTANCE_IP user=postgres dbname=demo" -c "SELECT * FROM cymbal_inventory LIMIT 3"
Password for user postgres:
 store_id |             uniq_id              | inventory
----------+----------------------------------+-----------
     1583 | adc4964a6138d1148b1d98c557546695 |         5
     1490 | adc4964a6138d1148b1d98c557546695 |         4
     1492 | adc4964a6138d1148b1d98c557546695 |         3
(3 rows)
student@cloudshell:~$
Carregue dados na tabela cymbal_stores:
gcloud storage cat gs://cloud-training/gcc/gcc-tech-004/cymbal_stores.csv |psql "host=$INSTANCE_IP user=postgres dbname=demo" -c "\copy cymbal_stores from stdin csv header"
Saída esperada do console:
student@cloudshell:~$ gcloud storage cat gs://cloud-training/gcc/gcc-tech-004/cymbal_stores.csv |psql "host=$INSTANCE_IP user=postgres dbname=demo" -c "\copy cymbal_stores from stdin csv header"
Password for user postgres:
COPY 4654
student@cloudshell:~$
Confira uma amostra de algumas linhas da tabela cymbal_stores.
psql "host=$INSTANCE_IP user=postgres dbname=demo" -c "SELECT store_id, name, zip_code FROM cymbal_stores limit 3"
Saída:
student@cloudshell:~$ psql "host=$INSTANCE_IP user=postgres dbname=demo" -c "SELECT store_id, name, zip_code FROM cymbal_stores limit 3"
Password for user postgres:
 store_id |       name        | zip_code
----------+-------------------+----------
     1990 | Mayaguez Store    |      680
     2267 | Ware Supercenter  |     1082
     4359 | Ponce Supercenter |      780
(3 rows)
student@cloudshell:~$
Criar embeddings
Conecte-se ao banco de dados de demonstração usando psql e crie embeddings para os produtos descritos na tabela "cymbal_products" com base nas descrições dos produtos.
Conecte-se ao banco de dados de demonstração:
psql "host=$INSTANCE_IP user=postgres sslmode=require dbname=demo"
Use a coluna embedding do tipo vector para armazenar os embeddings de texto gerados para as descrições de produtos.
Ativar a medição de tempo de consulta:
\timing
Gere embeddings para cada descrição de produto e armazene-os na tabela cymbal_embedding:
INSERT INTO cymbal_embedding (uniq_id, embedding)
SELECT uniq_id, google_ml.embedding('embeddinggemma', product_description)::vector
FROM cymbal_products;
Saída esperada:
demo=# INSERT INTO cymbal_embedding(uniq_id,embedding)  SELECT uniq_id, google_ml.embedding('embeddinggemma',product_description)::vector FROM cymbal_products;
INSERT 0 941
Time: 497878.136 ms (08:17.878)
demo=#
Executar consultas de pesquisa semântica
Na sessão psql, encontre os cinco principais produtos que correspondem à pergunta "What kind of fruit trees grow well here?" usando a distância do cosseno (<=>):
SELECT
    cp.product_name,
    left(cp.product_description, 80) AS description,
    cp.sale_price,
    cs.zip_code,
    (ce.embedding <=> google_ml.embedding('embeddinggemma', 'What kind of fruit trees grow well here?')::vector) AS distance
FROM
    cymbal_products cp
JOIN cymbal_embedding ce ON ce.uniq_id = cp.uniq_id
JOIN cymbal_inventory ci ON ci.uniq_id = cp.uniq_id
JOIN cymbal_stores cs ON cs.store_id = ci.store_id
WHERE
    ci.inventory > 0
    AND cs.store_id = 1583
ORDER BY
    distance ASC
LIMIT 5;
Saída esperada:
demo=# SELECT
        cp.product_name,
        left(cp.product_description,80) as description,
        cp.sale_price,
        cs.zip_code,
        (ce.embedding <=> google_ml.embedding('embeddinggemma','What kind of fruit trees grow well here?')::vector) as distance
FROM
        cymbal_products cp
JOIN cymbal_embedding ce on ce.uniq_id=cp.uniq_id
JOIN cymbal_inventory ci on ci.uniq_id=cp.uniq_id
JOIN cymbal_stores cs on cs.store_id=ci.store_id
WHERE
    ci.inventory > 0
    AND cs.store_id = 1583
ORDER BY
    distance ASC
LIMIT 5;
     product_name      |                                   description                                    | sale_price | zip_code |      distance
-----------------------+----------------------------------------------------------------------------------+------------+----------+--------------------
 Cherry Tree           | This is a beautiful cherry tree that will produce delicious cherries. It is an d |      75.00 |    93230 | 0.5210549378080666
 California Lilac      | This is a beautiful lilac tree that can grow to be over 10 feet tall. It is an d |       5.00 |    93230 | 0.5639421771781971
 Toyon                 | This is a beautiful toyon tree that can grow to be over 20 feet tall. It is an e |      10.00 |    93230 | 0.5670010914504852
 Rose Bush             | This is a beautiful rose bush that will produce fragrant roses. It is a perennia |      50.00 |    93230 | 0.5731542622882957
 California Peppertree | This is a beautiful peppertree that can grow to be over 30 feet tall. It is an e |      25.00 |    93230 | 0.5750934653011995
(5 rows)

Time: 83.610 ms
demo=#
A consulta foi executada em 83 ms e retornou uma lista de árvores da tabela "cymbal_products" que correspondiam à solicitação e tinham inventário disponível na loja com o número 1583.
Criar índice ANN
Com um pequeno conjunto de dados, é fácil usar a pesquisa exata, que verifica todos os embeddings. No entanto, quando os dados aumentam, o tempo de carregamento e de resposta também aumenta. Para melhorar a performance, crie índices nos seus dados de incorporação. Confira um exemplo de como fazer isso usando o índice ScaNN do Google para dados de vetor.
Reconecte-se ao banco de dados de demonstração se a conexão for perdida:
psql "host=$INSTANCE_IP user=postgres sslmode=require dbname=demo"
Ative a extensão alloydb_scann:
CREATE EXTENSION IF NOT EXISTS alloydb_scann;
Crie o índice ScaNN na coluna embedding:
CREATE INDEX cymbal_products_embeddings_scann ON cymbal_embedding
  USING scann (embedding cosine)
  WITH (num_leaves=10, max_num_levels = 1);
Execute a consulta de pesquisa semântica novamente para comparar a performance de execução:
SELECT
    cp.product_name,
    left(cp.product_description, 80) AS description,
    cp.sale_price,
    cs.zip_code,
    (ce.embedding <=> google_ml.embedding('embeddinggemma', 'What kind of fruit trees grow well here?')::vector) AS distance
FROM
    cymbal_products cp
JOIN cymbal_embedding ce ON ce.uniq_id = cp.uniq_id
JOIN cymbal_inventory ci ON ci.uniq_id = cp.uniq_id
JOIN cymbal_stores cs ON cs.store_id = ci.store_id
WHERE
    ci.inventory > 0
    AND cs.store_id = 1583
ORDER BY
    distance ASC
LIMIT 5;
Saída esperada:
demo=# SELECT
    cp.product_name,
    left(cp.product_description,80) as description,
    cp.sale_price,
    cs.zip_code,
    (ce.embedding <=> google_ml.embedding('embeddinggemma', 'What kind of fruit trees grow well here?')::vector) AS distance
FROM
    cymbal_products cp
JOIN cymbal_embedding ce ON ce.uniq_id = cp.uniq_id
JOIN cymbal_inventory ci ON ci.uniq_id = cp.uniq_id
JOIN cymbal_stores cs ON cs.store_id = ci.store_id
WHERE
    ci.inventory > 0
    AND cs.store_id = 1583
ORDER BY
    distance ASC
LIMIT 5;
     product_name      |                                   description                                    | sale_price | zip_code |      distance
-----------------------+----------------------------------------------------------------------------------+------------+----------+--------------------
 Cherry Tree           | This is a beautiful cherry tree that will produce delicious cherries. It is an d |      75.00 |    93230 | 0.5210549378080666
 California Lilac      | This is a beautiful lilac tree that can grow to be over 10 feet tall. It is an d |       5.00 |    93230 | 0.5639421771781971
 Toyon                 | This is a beautiful toyon tree that can grow to be over 20 feet tall. It is an e |      10.00 |    93230 | 0.5670010914504852
 Rose Bush             | This is a beautiful rose bush that will produce fragrant roses. It is a perennia |      50.00 |    93230 | 0.5731542622882957
 California Peppertree | This is a beautiful peppertree that can grow to be over 30 feet tall. It is an e |      25.00 |    93230 | 0.5750934653011995
(5 rows)

Time: 64.783 ms
O tempo de execução da consulta foi ligeiramente reduzido, e o ganho será mais perceptível com conjuntos de dados maiores. Os dados retornados precisam ser iguais ou muito semelhantes aos que recebemos sem o índice.
Teste outras consultas e leia mais sobre como otimizar o índice de vetor na documentação.
Saia da sessão psql:
\q
Volte ao Google Cloud Shell desconectando-se da sessão ssh instance-1 pressionando CTRL+D ou digitando exit.
8. Implantar o Gemma com o vLLM
Adicionar pool de nós para a Gemma
Primeiro, verifique quais tipos de nós estão disponíveis na sua região:
export LOCATION=us-central1-a
gcloud compute accelerator-types list --filter="zone:${LOCATION}"
Você vai ver uma lista de tipos de aceleradores disponíveis, incluindo o nvidia-l4. Agora crie um pool de nós com o tipo de acelerador nvidia-l4:
export PROJECT_ID=$(gcloud config get project)
export LOCATION=us-central1
export CLUSTER_NAME=alloydb-ai-gke
gcloud container node-pools create gpupool \
    --accelerator type=nvidia-l4,count=1,gpu-driver-version=latest \
    --project=${PROJECT_ID} \
    --location=${LOCATION} \
    --node-locations=${LOCATION}-a \
    --cluster=${CLUSTER_NAME} \
    --machine-type=g2-standard-8 \
    --num-nodes=1
Crie um manifesto de implantação para o modelo Google Gemini 4 12B usando o vLLM:
cat << 'EOF' > gemma-12b-gpu-vllm-deployment.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: gemma-12b-gpu-vllm-deployment
spec:
  replicas: 1
  selector:
    matchLabels:
      app: gemma-12b-gpu-vllm
  template:
    metadata:
      labels:
        app: gemma-12b-gpu-vllm
        ai.gke.io/model: gemma-4-12b-it
        ai.gke.io/inference-server: vllm
        examples.ai.gke.io/source: user-guide
    spec:
      containers:
      - name: inference-server
        image: us-docker.pkg.dev/vertex-ai/vertex-vision-model-garden-dockers/pytorch-vllm-serve:latest
        resources:
          requests:
            cpu: "4"
            memory: "16Gi"
            ephemeral-storage: "30Gi"
            nvidia.com/gpu: "1"
          limits:
            cpu: "8"
            memory: "24Gi"
            ephemeral-storage: "30Gi"
            nvidia.com/gpu: "1"
        command: ["python3", "-m", "vllm.entrypoints.api_server"]
        args:
          - --model=$(MODEL_ID)
          - --host=0.0.0.0
          - --port=8000
          - --tensor-parallel-size=1
          - --enable-log-requests
          - --enable-chunked-prefill
          - --enable-prefix-caching
          - --enable-auto-tool-choice
          - --generation-config=auto
          - --tool-call-parser=gemma4
          - --dtype=bfloat16
          - --max-num-seqs=16
          - --max-model-len=32768
          - --gpu-memory-utilization=0.95
          - --reasoning-parser=gemma4
          - --trust-remote-code
          - --quantization=fp8
        env:
        - name: LD_LIBRARY_PATH
          value: ${LD_LIBRARY_PATH}:/usr/local/nvidia/lib64
        - name: MODEL_ID
          value: google/gemma-4-12b-it
        - name: HF_TOKEN
          valueFrom:
            secretKeyRef:
              name: hf-secret
              key: hf_api_token
        volumeMounts:
        - mountPath: /dev/shm
          name: dshm
      volumes:
      - name: dshm
        emptyDir:
            medium: Memory
      nodeSelector:
        cloud.google.com/gke-accelerator: nvidia-l4
        cloud.google.com/gke-gpu-driver-version: latest
---
apiVersion: v1
kind: Service
metadata:
  name: gemma-12b-gpu-vllm-service
spec:
  selector:
    app: gemma-12b-gpu-vllm
  type: ClusterIP
  ports:
    - protocol: TCP
      port: 8000
      targetPort: 8000
EOF
Aplique a implantação gemma-12b-gpu-vllm-deployment.yaml salva:
kubectl apply -f gemma-12b-gpu-vllm-deployment.yaml
Saída esperada:
$ kubectl apply -f gemma-12b-gpu-vllm-deployment.yaml
deployment.apps/gemma-12b-gpu-vllm-deployment created
service/gemma-12b-gpu-vllm-service created
Aguarde até que a implantação seja concluída e o modelo seja carregado. Isso pode demorar alguns minutos.
printf "Waiting for model to load..."; until kubectl logs -l app=gemma-12b-gpu-vllm --tail=50 2>/dev/null | grep -q "Application startup complete"; do printf "."; sleep 3; done; printf '\n\033[1;32m========================================\n[SUCCESS] Model is loaded and ready!\nYou can now proceed to the next step.\n========================================\033[0m\n'
Saída esperada:
Waiting for model to load...
========================================
[SUCCESS] Model is loaded and ready!
You can now proceed to the next step.
========================================
Testar o modelo. Ative o encaminhamento de portas para acessar o modelo:
kubectl port-forward svc/gemma-12b-gpu-vllm-service 8090:8000
Em outra janela de terminal, use curl para enviar um comando ao modelo:
curl http://localhost:8090/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "messages": [
      {"role": "system", "content": "You are a helpful assistant running on GKE."},
      {"role": "user", "content": "What is AlloyDB Omni."}
    ],
    "temperature": 0.7
  }' | jq -r '.choices[0].message.content'
Saída esperada:
  % Total    % Received % Xferd  Average Speed   Time    Time     Time  Current
                                 Dload  Upload   Total   Spent    Left  Speed
100  3957  100  3761  100   196     85      4  0:00:49  0:00:43  0:00:06   830
**AlloyDB Omni** is a fully managed, PostgreSQL-compatible database engine from Google Cloud that can be run **on-premises, in other clouds, or in your own data centers.**

To understand it simply: It allows you to run the high-performance, enterprise-grade capabilities of Google's **AlloyDB** (a cloud-native database) on your own infrastructure.

Here is a breakdown of what makes it significant:

### 1. The "Best of Both Worlds" Architecture
Normally, you have to choose between:
*   **Managed Cloud Databases:** Easy to scale and manage, but you are locked into the cloud provider's infrastructure.
*   **Self-Managed Databases:** You have full control over the hardware/location, but you are responsible for scaling, patching, and high availability.

**AlloyDB Omni** bridges this gap. It provides the advanced features of a cloud-native database (like intelligent indexing, high availability, and massive scalability) while allowing you to run it anywhere.
Interrompa o encaminhamento de porta no primeiro terminal (se ele ainda estiver em execução) pressionando Ctrl+C.
9. Registrar o modelo Gemma 4 no AlloyDB Omni
Registre o modelo Gemma 12B no AlloyDB Omni usando o procedimento google_ml.create_model. Especifique http://gemma-12b-gpu-vllm-service:8000/v1/chat/completions como o model_request_url para rotear solicitações ao serviço de cluster do Kubernetes:
Recupere o IP do endpoint do AlloyDB Omni:
echo "INSTANCE_IP=$(kubectl get dbclusters.alloydbomni.dbadmin.goog my-omni -n default -o jsonpath='{.status.primary.endpoint}')"
Conecte-se à instância de VM usando o SSH.
export ZONE=us-central1-a
gcloud compute ssh instance-1 --zone=$ZONE
Depois de se conectar à VM, exporte a variável INSTANCE_IP da etapa anterior. O valor 10.128.0.33 é dado como exemplo. Substitua-o pelo seu IP:
export INSTANCE_IP=10.128.0.33
Exportar senha do AlloyDB:
export PGPASSWORD=VeryStrongPassword
Conecte-se ao banco de dados demo:
psql "host=$INSTANCE_IP user=postgres sslmode=require dbname=demo"
Na sessão psql, registre o modelo:
CALL
  google_ml.create_model(
    model_id => 'gemma-12b-gpu',
    model_request_url => 'http://gemma-12b-gpu-vllm-service:8000/v1/chat/completions',
    model_provider => 'custom',
    model_type => 'llm');
Teste o modelo com uma consulta SQL de exemplo:
SELECT google_ml.predict_row(
  model_id => 'gemma-12b-gpu',
  request_body => json_build_object(
    'messages', json_build_array(
      json_build_object('role', 'user', 'content', 'What is AlloyDB Omni?'))))->'choices'->0->'message'->'content';
Pressione q para sair da janela de resultados e voltar ao comando psql.
Combinar a pesquisa vetorial com a RAG de LLM no AlloyDB Omni
Use a busca vetorial com a solicitação de LLM para demonstrar a geração aumentada por recuperação (RAG) com o LLM.
Execute a consulta SQL em plsql:
WITH trees AS (
SELECT
        cp.product_name,
        cp.product_description AS description,
        cp.sale_price,
        cs.zip_code,
        cp.uniq_id AS product_id
FROM
    cymbal_products cp
JOIN cymbal_embedding ce ON ce.uniq_id = cp.uniq_id
JOIN cymbal_inventory ci ON ci.uniq_id = cp.uniq_id
JOIN cymbal_stores cs ON cs.store_id = ci.store_id
WHERE
        ci.inventory>0
        AND cs.store_id = 1583
ORDER BY
        (ce.embedding <=> embedding('embeddinggemma',
        'What kind of fruit trees grow well here?')::vector) ASC
LIMIT 1),
prompt AS (
SELECT
        'You are a friendly advisor helping to find a product based on the customer''s needs.
Based on the client request we have loaded a list of products closely related to search.
The list in JSON format with list of values like {"product_name":"name","product_description":"some description","sale_price":10}
Here is the list of products:' || json_agg(trees) || 'The customer asked "What kind of fruit trees grow well here?"
You should give information about the product, price and some supplemental information' AS prompt_text
FROM
        trees),
response AS (
SELECT
        google_ml.predict_row(
          model_id =>'gemma-12b-gpu',
          request_body => json_build_object(
            'messages', json_build_array(
              json_build_object('role', 'user', 'content',prompt_text)
            )))->'choices'->0->'message'->'content' AS resp
FROM
        prompt)
SELECT
REPLACE(resp::text, '\n', CHR(10))
FROM
        response;
Saída esperada:
----------------------------------------------------------------------------------------------------------------------------------------------
 "Hello there! I'd be happy to help you find the perfect tree for your garden.                                                               +
                                                                                                                                             +
 Based on your location, we have a wonderful option that would grow beautifully in your area:                                                +
                                                                                                                                             +
 **Cherry Tree**                                                                                                                             +
 *   **Price:** $75.00                                                                                                                       +
 *   **Description:** This is a stunning deciduous tree that not only provides a beautiful landscape but also produces delicious cherries.   +
 *   **Supplemental Information:**                                                                                                           +
     *   **Growth:** It grows to about 15 feet tall.                                                                                         +
     *   **Appearance:** You can look forward to dark green leaves in the summer that transform into a vibrant red in the fall.              +
     *   **Benefits:** It's a great choice if you're looking for both fruit and extra shade or privacy in your yard.                         +
     *   **Care Tips:** It performs best in a cool, moist climate with sandy soil. Since you are in a suitable zone, it should thrive nicely!+
                                                                                                                                             +
 Would you like more details on how to plant this, or would you like to proceed with an order?"
(1 row)
A consulta complementa o comando para o LLM com os resultados da pesquisa vetorial.
Teste outras consultas e os padrões de RAG. O benefício da arquitetura apresentada é a autossuficiência total. Os dados não são enviados para fora do cluster, e o serviço pode ser executado em ambientes completamente isolados.
Saia da sessão psql:
\q
Desconecte-se da sessão SSH da VM:
exit
Não se esqueça de que o AlloyDB Omni tem mais recursos e laboratórios.
10. Limpar o ambiente
Para evitar cobranças contínuas na sua conta do Google Cloud, exclua os recursos criados neste codelab.
Excluir o cluster do GKE
No Cloud Shell, exclua o cluster do GKE:
export PROJECT_ID=$(gcloud config get-value project)
export LOCATION=us-central1
export CLUSTER_NAME=alloydb-ai-gke
gcloud container clusters delete ${CLUSTER_NAME} \
  --project=${PROJECT_ID} \
  --region=${LOCATION}
Saída esperada:
student@cloudshell:~$ gcloud container clusters delete ${CLUSTER_NAME} \
>   --project=${PROJECT_ID} \
>   --region=${LOCATION}
The following clusters will be deleted.
 - [alloydb-ai-gke] in [us-central1]

Do you want to continue (Y/n)?  Y

Deleting cluster alloydb-ai-gke...done.
Deleted
Excluir a VM cliente
No Cloud Shell, exclua a instância do Compute Engine:
export PROJECT_ID=$(gcloud config get-value project)
export ZONE=us-central1-a
gcloud compute instances delete instance-1 \
  --project=${PROJECT_ID} \
  --zone=${ZONE}
Saída esperada:
student@cloudshell:~$ export PROJECT_ID=$(gcloud config get project)
export ZONE=us-central1-a
gcloud compute instances delete instance-1 \
  --project=${PROJECT_ID} \
  --zone=${ZONE}
Your active configuration is: [cloudshell-5399]
The following instances will be deleted. Any attached disks configured to be auto-deleted will be deleted unless they are attached to any other instances or the `--keep-disks` flag is given and specifies them for keeping. Deleting a disk
is irreversible and any data on the disk will be lost.
 - [instance-1] in [us-central1-a]

Do you want to continue (Y/n)?  Y

Deleted
Se você criou um novo projeto para este codelab, é possível excluir todo o projeto no Gerenciador de recursos do Google Cloud.
11. Parabéns
Parabéns por concluir o codelab!
Conteúdo abordado
- Como implantar o AlloyDB Omni em um cluster do GKE
- Como se conectar ao AlloyDB Omni
- Como carregar dados no AlloyDB Omni
- Como implantar modelos de IA (embeddings e LLM) no GKE
- Como registrar modelos de IA no AlloyDB Omni
- Como gerar embeddings para pesquisa semântica
- Como executar consultas de pesquisa semântica no AlloyDB Omni
- Como criar e usar índices vetoriais no AlloyDB Omni
Leia mais sobre como trabalhar com IA no AlloyDB Omni na documentação.
Pesquisa
Saída: