

১. ভূমিকা
এই কোডল্যাবে আপনি শিখবেন কিভাবে ফরেন ডেটা র্যাপার (FDW) এর মাধ্যমে অ্যাপাচি সোলারের ফুল-টেক্সট সার্চ ক্ষমতার সাথে পিজিভেক্টর এবং একটি স্কেলেবল নিয়ারেস্ট নেইবার (ScaNN) ইনডেক্সকে একত্রিত করে অ্যালয়ডিবি-তে হাইব্রিড সার্চ করতে হয়। এই ল্যাবটি অ্যালয়ডিবি এআই ফিচারগুলোর জন্য নিবেদিত একটি ল্যাব সংগ্রহের অংশ। আপনি ডকুমেন্টেশনের অ্যালয়ডিবি এআই পেজে এ বিষয়ে আরও পড়তে পারেন।
অ্যাপাচি সোলার হলো অ্যাপাচি লুসিন-এর উপর নির্মিত একটি ওপেন-সোর্স এন্টারপ্রাইজ সার্চ প্ল্যাটফর্ম, যা দ্রুত, স্কেলেবল এবং উচ্চ প্রাপ্যতা সম্পন্ন ফুল-টেক্সট সার্চ ক্ষমতার জন্য ডিজাইন করা হয়েছে। একটি ফরেন ডেটা র্যাপার (FDW)-এর মাধ্যমে অ্যালয়ডিবি-র সাথে সোলারকে ইন্টিগ্রেট করলে, ব্যবহারকারীরা স্ট্রাকচার্ড ডেটাবেস টেবিলের পাশাপাশি পোস্টগ্রেসকিউএল থেকে সরাসরি সোলার ইনডেক্স কোয়েরি করতে পারেন। আরও জানতে, অ্যাপাচি সোলার ডকুমেন্টেশন দেখুন।
পূর্বশর্ত
- গুগল ক্লাউড ও কনসোল সম্পর্কে প্রাথমিক ধারণা
- কমান্ড লাইন ইন্টারফেস এবং গুগল শেলে প্রাথমিক দক্ষতা
আপনি যা শিখবেন
- AlloyDB ক্লাস্টার এবং প্রাইমারি ইনস্ট্যান্স কীভাবে স্থাপন করবেন
- গুগল কম্পিউট ইঞ্জিন ভিএম থেকে অ্যালয়ডিবি-তে কীভাবে সংযোগ করবেন
- কীভাবে ডাটাবেস তৈরি করবেন এবং AlloyDB AI সক্রিয় করবেন
- ডাটাবেসে ডেটা লোড করার পদ্ধতি
- AlloyDB Studio কীভাবে ব্যবহার করবেন
- ভার্টেক্স এআই দিয়ে এমবেডিং তৈরি করুন
- ভেক্টর সার্চকে উন্নত করতে কীভাবে একটি ScanN ভেক্টর ইনডেক্স তৈরি করবেন
- অ্যাপাচি সোলারের জন্য কীভাবে একটি ফরেন ডেটা র্যাপার (FDW) তৈরি করবেন
- AlloyDB-তে সিমান্টিক সার্চের সাথে Solr-এ ফুল টেক্সট সার্চের সমন্বয় করে হাইব্রিড সার্চ সম্পাদন করুন।
আপনার যা যা লাগবে
- একটি গুগল ক্লাউড অ্যাকাউন্ট এবং গুগল ক্লাউড প্রজেক্ট
- ক্রোমের মতো একটি ওয়েব ব্রাউজার
২. সেটআপ এবং প্রয়োজনীয়তা
প্রজেক্ট সেটআপ
Google Cloud Console- এ সাইন-ইন করুন। যদি আপনার আগে থেকে Gmail বা Google Workspace অ্যাকাউন্ট না থাকে, তবে আপনাকে একটি তৈরি করতে হবে।
কর্মক্ষেত্র বা শিক্ষা প্রতিষ্ঠানের অ্যাকাউন্টের পরিবর্তে ব্যক্তিগত অ্যাকাউন্ট ব্যবহার করুন।
- গুগল ক্লাউড কনসোলের প্রজেক্ট সিলেক্টর পেজে, একটি গুগল ক্লাউড প্রজেক্ট নির্বাচন করুন বা তৈরি করুন ।
- আপনার ক্লাউড প্রোজেক্টের জন্য বিলিং চালু আছে কিনা তা নিশ্চিত করুন। কোনো প্রোজেক্টে বিলিং চালু আছে কিনা তা কীভাবে পরীক্ষা করবেন, তা জেনে নিন।
বিলিং সক্ষম করুন
বিলিং চালু করার জন্য আপনার কাছে দুটি বিকল্প আছে। আপনি হয় আপনার ব্যক্তিগত বিলিং অ্যাকাউন্ট ব্যবহার করতে পারেন অথবা নিম্নলিখিত ধাপগুলো অনুসরণ করে ক্রেডিট রিডিম করতে পারেন।
একটি ব্যক্তিগত বিলিং অ্যাকাউন্ট তৈরি করুন
আপনি যদি গুগল ক্লাউড ক্রেডিট ব্যবহার করে বিলিং সেট আপ করেন, তাহলে এই ধাপটি এড়িয়ে যেতে পারেন।
একটি ব্যক্তিগত বিলিং অ্যাকাউন্ট তৈরি করতে, ক্লাউড কনসোলে বিলিং চালু করার জন্য এখানে যান ।
কিছু নোট:
- এই ল্যাবটি সম্পন্ন করতে ক্লাউড রিসোর্সে ৩ মার্কিন ডলারের কম খরচ হওয়া উচিত।
- পরবর্তী চার্জ এড়াতে, এই ল্যাবের শেষে দেওয়া ধাপগুলো অনুসরণ করে আপনি রিসোর্সগুলো মুছে ফেলতে পারেন।
- নতুন ব্যবহারকারীরা ৩০০ মার্কিন ডলারের ফ্রি ট্রায়ালের জন্য যোগ্য।
ক্লাউড শেল শুরু করুন
যদিও গুগল ক্লাউড আপনার ল্যাপটপ থেকে দূরবর্তীভাবে পরিচালনা করা যায়, এই কোডল্যাবে আপনি গুগল ক্লাউড শেল ব্যবহার করবেন, যা ক্লাউডে চালিত একটি কমান্ড লাইন পরিবেশ।
ক্লাউড শেল হলো গুগল ক্লাউডে চালিত একটি কমান্ড-লাইন পরিবেশ, যা প্রয়োজনীয় টুলস সহ আগে থেকেই লোড করা থাকে।
- Google Cloud কনসোলের শীর্ষে থাকা Activate Cloud Shell-এ ক্লিক করুন।
- ক্লাউড শেলে সংযুক্ত হওয়ার পর, আপনার প্রমাণীকরণ যাচাই করুন:
gcloud auth list - আপনার প্রজেক্টটি কনফিগার করা হয়েছে কিনা তা নিশ্চিত করুন:
gcloud config get project - আপনার প্রজেক্টটি প্রত্যাশা অনুযায়ী সেট করা না থাকলে, এটি সেট করুন:
export PROJECT_ID=<YOUR_PROJECT_ID>
gcloud config set project $PROJECT_ID
এই ভার্চুয়াল মেশিনটিতে আপনার প্রয়োজনীয় সমস্ত ডেভেলপমেন্ট টুলস লোড করা আছে। এটি একটি স্থায়ী ৫ জিবি হোম ডিরেক্টরি প্রদান করে এবং গুগল ক্লাউডে চলে, যা নেটওয়ার্ক পারফরম্যান্স ও অথেনটিকেশনকে ব্যাপকভাবে উন্নত করে। এই কোডল্যাবে আপনার সমস্ত কাজ একটি ব্রাউজারের মধ্যেই করা যাবে। আপনাকে কিছুই ইনস্টল করতে হবে না।
৩. শুরু করার আগে
এপিআই সক্ষম করুন
আউটপুট:
AlloyDB , Compute Engine , Networking services , এবং Vertex AI ব্যবহার করার জন্য, আপনাকে আপনার Google Cloud প্রজেক্টে এগুলোর নিজ নিজ API সক্রিয় করতে হবে।
এপিআইগুলি সক্রিয় করা
টার্মিনালে ক্লাউড শেল-এর ভিতরে, নিশ্চিত করুন যে আপনার প্রজেক্ট আইডি সেটআপ করা আছে:
gcloud config set project [YOUR-PROJECT-ID]
PROJECT_ID এনভায়রনমেন্ট ভেরিয়েবল সেট করুন:
PROJECT_ID=$(gcloud config get-value project)
সকল প্রয়োজনীয় এপিআই সক্রিয় করুন:
gcloud services enable alloydb.googleapis.com \
                       compute.googleapis.com \
                       cloudresourcemanager.googleapis.com \
                       servicenetworking.googleapis.com \
                       aiplatform.googleapis.com \
                       secretmanager.googleapis.com
প্রত্যাশিত আউটপুট
student@cloudshell:~ (alloydb-hybrid-search)$ gcloud config set project alloydb-hybrid-search
[environment: untagged] Read more to tag: g.co/cloud/project-env-tag.
Updated property [core/project].
student@cloudshell:~ (alloydb-hybrid-search)$ PROJECT_ID=$(gcloud config get-value project)
Your active configuration is: [cloudshell-32544]
student@cloudshell:~ (alloydb-hybrid-search)$ gcloud services enable alloydb.googleapis.com \
                       compute.googleapis.com \
                       cloudresourcemanager.googleapis.com \
                       servicenetworking.googleapis.com \
                       aiplatform.googleapis.com \
                       secretmanager.googleapis.com
Operation "operations/acat.p2-350113473377-5ffc2f22-caa9-4857-b2f4-018657d8bf6e" finished successfully.
এপিআইগুলো চালু করা হচ্ছে
- AlloyDB API (
alloydb.googleapis.com) আপনাকে AlloyDB for PostgreSQL ক্লাস্টার তৈরি, পরিচালনা এবং স্কেল করতে দেয়। এটি একটি সম্পূর্ণ পরিচালিত, PostgreSQL-সামঞ্জস্যপূর্ণ ডেটাবেস পরিষেবা প্রদান করে, যা উচ্চ চাহিদাসম্পন্ন এন্টারপ্রাইজ ট্রানজ্যাকশনাল এবং অ্যানালিটিক্যাল ওয়ার্কলোডের জন্য ডিজাইন করা হয়েছে। - কম্পিউট ইঞ্জিন এপিআই (
compute.googleapis.com) আপনাকে ভার্চুয়াল মেশিন (VM), পারসিস্টেন্ট ডিস্ক এবং নেটওয়ার্ক সেটিংস তৈরি ও পরিচালনা করার সুযোগ দেয়। এটি আপনার ওয়ার্কলোড চালানোর জন্য এবং অনেক পরিচালিত পরিষেবার অন্তর্নিহিত পরিকাঠামো হোস্ট করার জন্য প্রয়োজনীয় মূল ইনফ্রাস্ট্রাকচার-অ্যাজ-এ-সার্ভিস (IaaS) ভিত্তি প্রদান করে। - ক্লাউড রিসোর্স ম্যানেজার এপিআই (
cloudresourcemanager.googleapis.com) আপনাকে প্রোগ্রাম্যাটিকভাবে আপনার গুগল ক্লাউড প্রজেক্টের মেটাডেটা এবং কনফিগারেশন পরিচালনা করার সুযোগ দেয়। এটি আপনাকে রিসোর্স সংগঠিত করতে, আইডেন্টিটি অ্যান্ড অ্যাক্সেস ম্যানেজমেন্ট (IAM) পলিসি পরিচালনা করতে এবং প্রজেক্টের স্তরবিন্যাস জুড়ে অনুমতি যাচাই করতে সক্ষম করে। - সার্ভিস নেটওয়ার্কিং এপিআই (
servicenetworking.googleapis.com) আপনাকে আপনার ভার্চুয়াল প্রাইভেট ক্লাউড (VPC) নেটওয়ার্ক এবং গুগলের পরিচালিত পরিষেবাগুলির মধ্যে ব্যক্তিগত সংযোগ স্থাপন স্বয়ংক্রিয় করতে সাহায্য করে। AlloyDB-এর মতো পরিষেবাগুলির জন্য ব্যক্তিগত আইপি অ্যাক্সেস স্থাপন করতে এটি বিশেষভাবে প্রয়োজন, যাতে তারা আপনার অন্যান্য রিসোর্সগুলির সাথে নিরাপদে যোগাযোগ করতে পারে। - ভার্টেক্স এআই এপিআই (
aiplatform.googleapis.com) আপনার অ্যাপ্লিকেশনগুলোকে মেশিন লার্নিং মডেল তৈরি, স্থাপন এবং স্কেল করতে সক্ষম করে। এটি গুগল ক্লাউডের সমস্ত এআই পরিষেবার জন্য একটি সমন্বিত ইন্টারফেস প্রদান করে, যার মধ্যে জেনারেটিভ এআই মডেল (যেমন জেমিনি) এবং কাস্টম মডেল প্রশিক্ষণের সুবিধাও রয়েছে। - সিক্রেট ম্যানেজার এপিআই (
secretmanager.googleapis.com) হলো একটি সিক্রেটস এবং ক্রেডেনশিয়াল ম্যানেজমেন্ট পরিষেবা যা আপনাকে এপিআই কী, ইউজারনেম, পাসওয়ার্ড, সার্টিফিকেট এবং আরও অনেক সংবেদনশীল ডেটা সংরক্ষণ ও পরিচালনা করতে দেয়।
ঐচ্ছিকভাবে আপনি ভার্টেক্স এআই এমবেডিং মডেল ব্যবহার করার জন্য আপনার ডিফল্ট অঞ্চল কনফিগার করতে পারেন। ভার্টেক্স এআই-এর জন্য উপলব্ধ অবস্থানগুলো সম্পর্কে আরও পড়ুন। এই উদাহরণে আমরা us-central1 অঞ্চলটি ব্যবহার করছি।
gcloud config set compute/region us-central1
৪. AlloyDB স্থাপন করুন
একটি AlloyDB ক্লাস্টার তৈরি করার আগে, আমাদের VPC-তে একটি উপলব্ধ প্রাইভেট আইপি রেঞ্জ থাকা প্রয়োজন, যা ভবিষ্যতের AlloyDB ইনস্ট্যান্সটি ব্যবহার করবে। যদি আমাদের কাছে এটি না থাকে, তবে আমাদের এটি তৈরি করতে হবে এবং অভ্যন্তরীণ গুগল পরিষেবাগুলির ব্যবহারের জন্য বরাদ্দ করতে হবে। এরপরেই আমরা ক্লাস্টার এবং ইনস্ট্যান্স তৈরি করতে পারব।
ব্যক্তিগত আইপি রেঞ্জ তৈরি করুন
আমাদের AlloyDB-এর জন্য VPC-তে প্রাইভেট সার্ভিস অ্যাক্সেস কনফিগারেশন করতে হবে। এখানে ধরে নেওয়া হচ্ছে যে, প্রজেক্টটিতে 'ডিফল্ট' VPC নেটওয়ার্ক রয়েছে এবং সমস্ত কাজের জন্য এটিই ব্যবহৃত হবে।
ব্যক্তিগত আইপি রেঞ্জ তৈরি করুন:
gcloud compute addresses create psa-range \
    --global \
    --purpose=VPC_PEERING \
    --prefix-length=24 \
    --description="VPC private service access" \
    --network=default
বরাদ্দকৃত আইপি রেঞ্জ ব্যবহার করে ব্যক্তিগত সংযোগ তৈরি করুন:
gcloud services vpc-peerings connect \
    --service=servicenetworking.googleapis.com \
    --ranges=psa-range \
    --network=default
সংযুক্ত হয়ে গেলে, কাস্টম রুট রপ্তানি করতে পিয়ারিং আপডেট করুন:
gcloud compute networks peerings update servicenetworking-googleapis-com \
    --network=default \
    --export-custom-routes
প্রত্যাশিত কনসোল আউটপুট:
student@cloudshell:~ (alloydb-hybrid-search)$ gcloud compute addresses create psa-range \
    --global \
    --purpose=VPC_PEERING \
    --prefix-length=24 \
    --description="VPC private service access" \
    --network=default
Created [https://www.googleapis.com/compute/v1/projects/alloydb-hybrid-search/global/addresses/psa-range].

student@cloudshell:~ (alloydb-hybrid-search)$ gcloud services vpc-peerings connect \
    --service=servicenetworking.googleapis.com \
    --ranges=psa-range \
    --network=default
Operation "operations/pssn.p24-350113473377-fadad49e-7e14-472a-8888-26951e40a1f7" finished successfully.

student@cloudshell:~ (alloydb-hybrid-search)$ gcloud compute networks peerings update servicenetworking-googleapis-com \
    --network=default \
    --export-custom-routes
Updated [https://www.googleapis.com/compute/v1/projects/alloydb-hybrid-search/global/networks/default].
AlloyDB ক্লাস্টার তৈরি করুন
এই অংশে আমরা us-central1 অঞ্চলে একটি AlloyDB ক্লাস্টার তৈরি করছি।
postgres ব্যবহারকারীর জন্য পাসওয়ার্ড নির্ধারণ করুন। আপনি নিজের পাসওয়ার্ড তৈরি করতে পারেন অথবা একটি র্যান্ডম ফাংশন ব্যবহার করে তা তৈরি করতে পারেন।
export PGPASSWORD=`openssl rand -hex 12`
প্রত্যাশিত কনসোল আউটপুট:
student@cloudshell:~ (alloydb-hybrid-search)$ export PGPASSWORD=`openssl rand -hex 12`
ভবিষ্যতে ব্যবহারের জন্য PostgreSQL পাসওয়ার্ডটি লিখে রাখুন।
echo $PGPASSWORD
ভবিষ্যতে postgres ব্যবহারকারী হিসেবে ইনস্ট্যান্সটিতে সংযোগ করতে আপনার ওই পাসওয়ার্ডটি প্রয়োজন হবে। আমি পরামর্শ দিচ্ছি এটি একটি সুরক্ষিত স্থানে (যেমন পাসওয়ার্ড ম্যানেজার) কপি করে রাখতে।
প্রত্যাশিত কনসোল আউটপুট:
student@cloudshell:~ (alloydb-hybrid-search)$ echo $PGPASSWORD
<generated password>
AlloyDB ক্লাস্টার তৈরি করুন
অঞ্চল এবং AlloyDB ক্লাস্টারের নাম নির্ধারণ করুন। আমরা us-central1 অঞ্চল এবং alloydb-hybrid-search কে ক্লাস্টারের নাম হিসেবে ব্যবহার করতে যাচ্ছি:
export REGION=us-central1
export ADBCLUSTER=alloydb-hybrid-search
ক্লাস্টার তৈরি করতে কমান্ডটি চালান:
gcloud alloydb clusters create $ADBCLUSTER \
    --password=$PGPASSWORD \
    --network=default \
    --region=$REGION \
    --database-version=POSTGRES_17
প্রত্যাশিত কনসোল আউটপুট:
student@cloudshell:~ (alloydb-hybrid-search)$ export REGION=us-central1
export ADBCLUSTER=alloydb-hybrid-search
student@cloudshell:~ (alloydb-hybrid-search)$ gcloud alloydb clusters create $ADBCLUSTER \
    --password=$PGPASSWORD \
    --network=default \
    --region=$REGION \
    --database-version=POSTGRES_17
Creating cluster...done.
একই ক্লাউড শেল সেশনে আমাদের ক্লাস্টারের জন্য একটি AlloyDB প্রাইমারি ইনস্ট্যান্স তৈরি করুন। সংযোগ বিচ্ছিন্ন হয়ে গেলে আপনাকে আবার রিজিয়ন এবং ক্লাস্টারের নামের এনভায়রনমেন্ট ভেরিয়েবলগুলো নির্ধারণ করতে হবে।
gcloud alloydb instances create $ADBCLUSTER-pr \
    --instance-type=PRIMARY \
    --cpu-count=2 \
    --region=$REGION \
    --cluster=$ADBCLUSTER
প্রত্যাশিত কনসোল আউটপুট:
admin_@cloudshell:~ (my-project-93954-gke)$ gcloud alloydb instances create $ADBCLUSTER-pr \
    --instance-type=PRIMARY \
    --cpu-count=2 \
    --region=$REGION \
    --availability-type ZONAL \
    --cluster=$ADBCLUSTER
Operation ID: operation-1784244706986-656c2d7f3c8f2-59a9e52a-1e7b1b01
Creating instance...done.
৫. AlloyDB-এর সাথে সংযোগ করুন
AlloyDB একটি প্রাইভেট-অনলি কানেকশন ব্যবহার করে ডেপ্লয় করা হয়, তাই ডাটাবেসটি নিয়ে কাজ করার জন্য আমাদের এমন একটি ভিএম (VM) প্রয়োজন যেখানে PostgreSQL ক্লায়েন্ট ইনস্টল করা আছে। আমরা এই ভিএম-টি একটি Apache Solr ইনস্ট্যান্স চালানোর জন্যও ব্যবহার করব।
GCE VM স্থাপন করুন
AlloyDB ক্লাস্টারের মতো একই অঞ্চল এবং VPC-তে একটি GCE VM তৈরি করুন এবং নিশ্চিত করুন যে Solr চালানোর জন্য বুট ডিস্কটি যথেষ্ট বড়। এখানে আমরা --create-disk ফ্ল্যাগে একটি 20GB বুট ডিস্ক নির্দিষ্ট করেছি।
ক্লাউড শেলে চালান:
export ZONE=us-central1-a
gcloud compute instances create instance-1 \
    --zone=$ZONE \
    --create-disk=auto-delete=yes,boot=yes,size=20,image=projects/debian-cloud/global/images/$(gcloud compute images list --filter="family=debian-12 AND family!=debian-12-arm64" --format="value(name)") \
    --scopes=https://www.googleapis.com/auth/cloud-platform
প্রত্যাশিত কনসোল আউটপুট:
student@cloudshell:~ (alloydb-hybrid-search)$ export ZONE=us-central1-a
gcloud compute instances create instance-1 \
    --zone=$ZONE \
    --network=default \
    --create-disk=auto-delete=yes,boot=yes,image=projects/debian-cloud/global/images/$(gcloud compute images list --filter="family=debian-12 AND family!=debian-12-arm64" --format="value(name)") \
    --scopes=https://www.googleapis.com/auth/cloud-platform

Created [https://www.googleapis.com/compute/v1/projects/test-project-402417/zones/us-central1-a/instances/instance-1].
NAME: instance-1
ZONE: us-central1-a
MACHINE_TYPE: n1-standard-1
PREEMPTIBLE:
INTERNAL_IP: X.X.X.X
EXTERNAL_IP: X.X.X.X
STATUS: RUNNING
পোস্টগ্রেস ক্লায়েন্ট ইনস্টল করুন
ডেপ্লয় করা ভিএম-এ PostgreSQL ক্লায়েন্ট সফটওয়্যারটি ইনস্টল করুন।
ভিএম-এ সংযোগ করুন:
gcloud compute ssh instance-1 --zone=us-central1-a
প্রত্যাশিত কনসোল আউটপুট:
admin_@cloudshell:~ (my-project-93954-gke)$ gcloud compute ssh instance-1 --zone=us-central1-a
Updating project ssh metadata...working..Updated [https://www.googleapis.com/compute/v1/projects/alloydb-hybrid-search].
Updating project ssh metadata...done.
Waiting for SSH key to propagate.
Warning: Permanently added 'compute.5110295539541121102' (ECDSA) to the list of known hosts.
Linux instance-1.us-central1-a.c.gleb-test-short-001-418811.internal 6.1.0-18-cloud-amd64 #1 SMP PREEMPT_DYNAMIC Debian 6.1.76-1 (2024-02-01) x86_64

The programs included with the Debian GNU/Linux system are free software;
the exact distribution terms for each program are described in the
individual files in /usr/share/doc/*/copyright.

Debian GNU/Linux comes with ABSOLUTELY NO WARRANTY, to the extent
permitted by applicable law.
ভিএম-এর ভিতরে কমান্ডটি চালিয়ে সফ্টওয়্যারটি ইনস্টল করুন:
sudo apt-get update
sudo apt-get install --yes postgresql-client
প্রত্যাশিত কনসোল আউটপুট:
student@instance-1:~$ sudo apt-get update
sudo apt-get install --yes postgresql-client
Get:1 https://packages.cloud.google.com/apt google-compute-engine-bullseye-stable InRelease [5146 B]
Get:2 https://packages.cloud.google.com/apt cloud-sdk-bullseye InRelease [6406 B]
Hit:3 https://deb.debian.org/debian bullseye InRelease
Get:4 https://deb.debian.org/debian-security bullseye-security InRelease [48.4 kB]
Get:5 https://packages.cloud.google.com/apt google-compute-engine-bullseye-stable/main amd64 Packages [1930 B]
Get:6 https://deb.debian.org/debian bullseye-updates InRelease [44.1 kB]
Get:7 https://deb.debian.org/debian bullseye-backports InRelease [49.0 kB]
...redacted...
Setting up postgresql-client (15+248+deb12u1) ...
Processing triggers for man-db (2.11.2-2) ...
Processing triggers for libc-bin (2.36-9+deb12u14) ...
ইনস্ট্যান্সের সাথে সংযোগ করুন
psql ব্যবহার করে VM থেকে প্রাইমারি ইনস্ট্যান্সে সংযোগ করুন।
আপনার ইনস্ট্যান্স-১ ভিএম-এর জন্য খোলা SSH সেশন সহ একই ক্লাউড শেল ট্যাবে।
GCE VM থেকে AlloyDB-তে সংযোগ করতে উল্লিখিত AlloyDB পাসওয়ার্ড (PGPASSWORD) এবং AlloyDB ক্লাস্টার আইডি ব্যবহার করুন:
export PGPASSWORD=<Noted password>
export PROJECT_ID=$(gcloud config get-value project)
export REGION=us-central1
export ADBCLUSTER=alloydb-hybrid-search
export INSTANCE_IP=$(gcloud alloydb instances describe $ADBCLUSTER-pr --cluster=$ADBCLUSTER --region=$REGION --format="value(ipAddress)")
psql "host=$INSTANCE_IP user=postgres sslmode=require"
প্রত্যাশিত কনসোল আউটপুট:
student@instance-1:~$ export PROJECT_ID=$(gcloud config get-value project)
export REGION=us-central1
export ADBCLUSTER=alloydb-hybrid-search
export INSTANCE_IP=$(gcloud alloydb instances describe $ADBCLUSTER-pr --cluster=$ADBCLUSTER --region=$REGION --format="value(ipAddress)")
psql "host=$INSTANCE_IP user=postgres sslmode=require"
psql (15.18 (Debian 15.18-0+deb12u1), server 17.9)
WARNING: psql major version 15, server major version 17.
         Some psql features might not work.
SSL connection (protocol: TLSv1.3, cipher: TLS_AES_256_GCM_SHA384, compression: off)
Type "help" for help.

postgres=>
psql সেশনটি বন্ধ করুন:
exit
৬. ডাটাবেস প্রস্তুত করুন
আমাদের একটি ডাটাবেস তৈরি করতে হবে, ভার্টেক্স এআই ইন্টিগ্রেশন সক্রিয় করতে হবে, ডাটাবেস অবজেক্ট তৈরি করতে হবে এবং ডেটা ইম্পোর্ট করতে হবে।
AlloyDB-কে প্রয়োজনীয় অনুমতি প্রদান করুন
AlloyDB সার্ভিস এজেন্টে Vertex AI-এর অনুমতি যোগ করুন।
উপরে থাকা "+" চিহ্নটি ব্যবহার করে আরেকটি ক্লাউড শেল ট্যাব খুলুন।
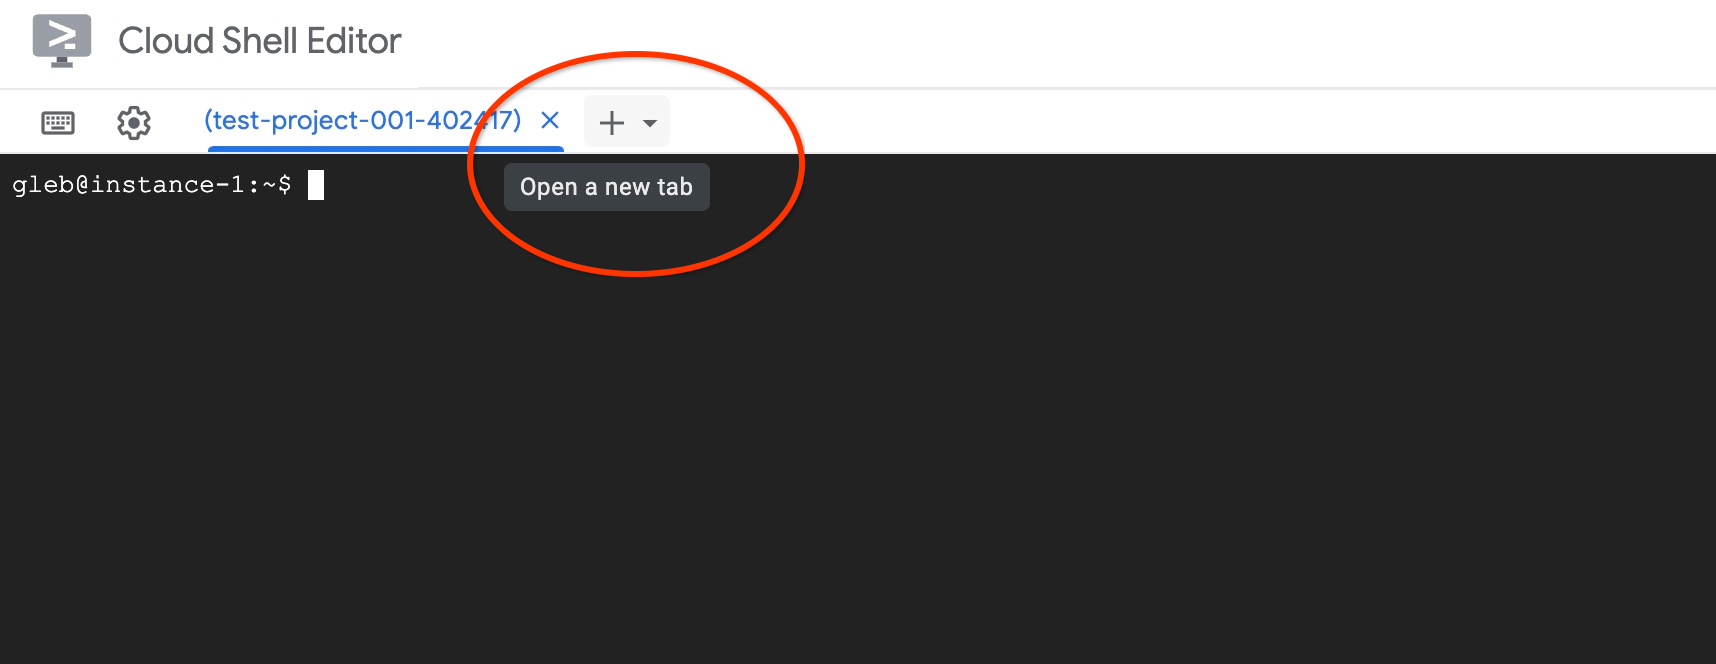
নতুন ক্লাউড শেল ট্যাবে নিম্নলিখিতটি চালান:
PROJECT_ID=$(gcloud config get-value project)
gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:service-$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")@gcp-sa-alloydb.iam.gserviceaccount.com" \
  --role="roles/aiplatform.user"
প্রত্যাশিত কনসোল আউটপুট:
admin_@cloudshell:~ (my-project-93954-gke)$ PROJECT_ID=$(gcloud config get-value project)
gcloud projects add-iam-policy-binding $PROJECT_ID \
  --member="serviceAccount:service-$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")@gcp-sa-alloydb.iam.gserviceaccount.com" \
  --role="roles/aiplatform.user"
Your active configuration is: [cloudshell-30137]

Updated IAM policy for project [my-project-93954-gke].
bindings:
- members:
<redacted>
version: 1
"X"-এ ক্লিক করে অথবা কমান্ডটি চালিয়ে ট্যাবটি বন্ধ করুন:
exit
ডাটাবেস তৈরি করুন
quickstart নামে একটি ডাটাবেস তৈরি করুন।
GCE VM সেশনে নিম্নলিখিতটি সম্পাদন করুন:
ডাটাবেস তৈরি করুন:
psql "host=$INSTANCE_IP user=postgres" -c "CREATE DATABASE quickstart_db"
প্রত্যাশিত কনসোল আউটপুট:
student@instance-1:~$ psql "host=$INSTANCE_IP user=postgres" -c "CREATE DATABASE quickstart_db"
CREATE DATABASE
ভার্টেক্স এআই ইন্টিগ্রেশন সক্ষম করুন
ডাটাবেসে Vertex AI ইন্টিগ্রেশন এবং pgvector এক্সটেনশনগুলো সক্রিয় করুন।
GCE VM-এ নিম্নলিখিতটি চালান:
psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db" -c "CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE"
psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db" -c "CREATE EXTENSION IF NOT EXISTS vector"
প্রত্যাশিত কনসোল আউটপুট:
student@instance-1:~$ psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db" -c "CREATE EXTENSION IF NOT EXISTS google_ml_integration CASCADE"
psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db" -c "CREATE EXTENSION IF NOT EXISTS vector"
NOTICE:  extension "google_ml_integration" already exists, skipping
CREATE EXTENSION
CREATE EXTENSION
ডেটা আমদানি করুন
প্রস্তুতকৃত ডেটা ডাউনলোড করে নতুন ডেটাবেসে ইম্পোর্ট করুন।
GCE VM-এ নিম্নলিখিতটি চালান:
gcloud storage cat gs://cloud-training/gcc/gcc-tech-004/cymbal_demo_schema.sql |psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db"
gcloud storage cat gs://cloud-training/gcc/gcc-tech-004/cymbal_products.csv |psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db" -c "\copy cymbal_products from stdin csv header"
gcloud storage cat gs://cloud-training/gcc/gcc-tech-004/cymbal_inventory.csv |psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db" -c "\copy cymbal_inventory from stdin csv header"
gcloud storage cat gs://cloud-training/gcc/gcc-tech-004/cymbal_stores.csv |psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db" -c "\copy cymbal_stores from stdin csv header"
প্রত্যাশিত কনসোল আউটপুট:
student@instance-1:~$ gcloud storage cat gs://cloud-training/gcc/gcc-tech-004/cymbal_demo_schema.sql |psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db"
gcloud storage cat gs://cloud-training/gcc/gcc-tech-004/cymbal_products.csv |psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db" -c "\copy cymbal_products from stdin csv header"
gcloud storage cat gs://cloud-training/gcc/gcc-tech-004/cymbal_inventory.csv |psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db" -c "\copy cymbal_inventory from stdin csv header"
gcloud storage cat gs://cloud-training/gcc/gcc-tech-004/cymbal_stores.csv |psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db" -c "\copy cymbal_stores from stdin csv header"
SET
SET
SET
SET
SET
 set_config
------------

(1 row)

SET
SET
SET
SET
SET
SET
CREATE TABLE
ALTER TABLE
CREATE TABLE
ALTER TABLE
CREATE TABLE
ALTER TABLE
CREATE TABLE
ALTER TABLE
CREATE SEQUENCE
ALTER TABLE
ALTER SEQUENCE
ALTER TABLE
ALTER TABLE
ALTER TABLE
COPY 941
COPY 263861
COPY 4654
এরপর, চলুন প্রয়োজনীয় ডাটাবেস ফ্ল্যাগগুলো সেট করি। আপনি ওয়েব কনসোল ব্যবহার করে প্রাইমারি ইনস্ট্যান্সে ফ্ল্যাগগুলো পরিচালনা করতে পারেন অথবা নিম্নোক্তভাবে gcloud কমান্ডটি ব্যবহার করতে পারেন:
export PROJECT_ID=$(gcloud config get-value project)
export REGION=us-central1
export ADBCLUSTER=alloydb-hybrid-search
gcloud beta alloydb instances update $ADBCLUSTER-pr \
   --database-flags google_ml_integration.enable_faster_embedding_generation=on,scann.enable_preview_features=on,google_ml_integration.enable_preview_ai_functions=on,google_ml_integration.enable_ai_query_engine=on \
   --region=$REGION \
   --cluster=$ADBCLUSTER \
   --project=$PROJECT_ID \
   --update-mode=FORCE_APPLY
প্রত্যাশিত কনসোল আউটপুট
student@cloudshell:~ (alloydb-hybrid-search)$ export PROJECT_ID=$(gcloud config get-value project)
export REGION=us-central1
export ADBCLUSTER=alloydb-hybrid-search
gcloud beta alloydb instances update $ADBCLUSTER-pr \
   --database-flags google_ml_integration.enable_faster_embedding_generation=on,scann.enable_preview_features=on,google_ml_integration.enable_preview_ai_functions=on,google_ml_integration.enable_ai_query_engine=on \
   --region=$REGION \
   --cluster=$ADBCLUSTER \
   --project=$PROJECT_ID \
   --update-mode=FORCE_APPLY
Your active configuration is: [cloudshell-30137]
Operation ID: operation-1784245853151-656c31c44e12b-6084eb8b-d6611419
ডাটাবেস ফ্ল্যাগ সক্রিয় করার জন্য ইনস্ট্যান্সটি পুনরায় চালু করতে হবে এবং এতে কয়েক মিনিট সময় লাগবে। এটি সম্পন্ন হলে, AlloyDB ইনস্ট্যান্সের স্ট্যাটাস "Ready" দেখাবে।
৭. ভেক্টর এমবেডিং তৈরি করুন
ডেটা ইম্পোর্ট করার পর, আমরা নিম্নলিখিত টেবিলগুলো পাই: cymbal_products , যা পণ্য সম্পর্কিত তথ্য সংরক্ষণ করে; cymbal_inventory , যা প্রতিটি দোকানে আইটেমের স্টক ট্র্যাক করে; এবং cymbal_stores , যা দোকানগুলোর একটি তালিকা। আমাদের পণ্যগুলোর উপর সিমান্টিক সার্চ করার জন্য, initialize_embeddings ফাংশন ব্যবহার করে আমাদের পণ্যের বিবরণের ভেক্টর এমবেডিং তৈরি করতে হবে। আমরা আমাদের পণ্যের বিবরণের উপর ভিত্তি করে ভেক্টর ডেটা গণনা করতে এবং তা টেবিলে যোগ করতে Vertex AI ইন্টিগ্রেশন ব্যবহার করব। ব্যবহৃত প্রযুক্তি সম্পর্কে আপনি ডকুমেন্টেশনে আরও পড়তে পারেন।
ইন্টিগ্রেশনটি ব্যবহার করতে, AlloyDB ইনস্ট্যান্সের IP এবং postgres পাসওয়ার্ড ব্যবহার করে আপনার VM থেকে AlloyDB studio অথবা psql-এর মাধ্যমে ডাটাবেসে সংযোগ করুন:
psql "host=$INSTANCE_IP user=postgres dbname=quickstart_db"
google_ml_integration এক্সটেনশনটির সংস্করণ যাচাই করুন।
SELECT extversion FROM pg_extension WHERE extname = 'google_ml_integration';
সংস্করণটি ১.৫.২ বা তার চেয়ে উচ্চতর হতে হবে। আউটপুটের একটি উদাহরণ নিচে দেওয়া হলো:
quickstart_db=> SELECT extversion FROM pg_extension WHERE extname = 'google_ml_integration';
 extversion
------------
 1.5.9
(1 row)
ডিফল্ট সংস্করণটি ১.৫.২ বা তার বেশি হওয়া উচিত, কিন্তু আপনার ইনস্ট্যান্সে যদি পুরোনো কোনো সংস্করণ দেখা যায়, তবে সম্ভবত এটি আপডেট করা প্রয়োজন। ইনস্ট্যান্সটির জন্য রক্ষণাবেক্ষণ নিষ্ক্রিয় করা হয়েছে কিনা তা পরীক্ষা করুন।
ভেক্টর এক্সটেনশনটি ইনস্টল করুন এবং cymbal_products এ এমবেডিংগুলো সংরক্ষণ করার জন্য একটি নতুন কলাম তৈরি করুন।
CREATE EXTENSION IF NOT EXISTS vector;
ALTER TABLE cymbal_products ADD COLUMN product_embedding vector(768);
প্রত্যাশিত কনসোল আউটপুট:
quickstart_db=> CREATE EXTENSION IF NOT EXISTS vector;
ALTER TABLE cymbal_products ADD COLUMN product_embedding vector(768);
NOTICE:  extension "vector" already exists, skipping
CREATE EXTENSION
ALTER TABLE
আমরা কার্যকারিতা বাড়াতে ব্যাচ এমবেডিং জেনারেশন ব্যবহার করব। আপনি গাইডটিতে বিভিন্ন এমবেডিং জেনারেশন অপশন এবং কৌশল সম্পর্কে আরও পড়তে পারেন। আমরা পূর্বে google_ml_integration.enable_faster_embedding_generation ফ্ল্যাগটি সক্রিয় করেছি, যা আমাদের ব্যাচ এমবেডিং জেনারেশন করতে দেয়।
সবশেষে, আমরা চাই যে ফাংশন কলে incremental_refresh_mode আর্গুমেন্টটি অন্তর্ভুক্ত করার মাধ্যমে কলামের মান পরিবর্তিত হওয়ার সাথে সাথে এমবেডিংগুলোও রিফ্রেশ হোক। এটি আমাদের ডাটাবেসে অতিরিক্ত চাপ সৃষ্টি করে, কিন্তু কন্টেন্টের সাথে এমবেডিংগুলোকে স্বয়ংক্রিয়ভাবে সিঙ্ক রাখার জন্য এটি একটি আপোস। আপনি যদি ম্যানুয়ালি এমবেডিং আপডেট করতে চান, তাহলে ডকুমেন্টেশনে এর নির্দেশাবলী খুঁজে নিতে পারেন।
এখন সবকিছু একত্রিত করে এমবেডিং তৈরি করার জন্য, আমরা initialize_embeddings ফাংশনটি ব্যবহার করি এবং ব্যাচ হিন্ট হিসেবে batch_size 50 পাস করি ও incremental_refresh_mode transactional এ সেট করি।
CALL ai.initialize_embeddings(
    model_id => 'text-embedding-005',
    table_name => 'cymbal_products',
    content_column => 'product_description',
    embedding_column => 'product_embedding',
    batch_size => 50,
    incremental_refresh_mode => 'transactional'
);
এবং এখন যদি আমরা product_embedding কলামের জন্য NULL মান দিয়ে টেবিলটিতে একটি নতুন সারি যোগ করি
INSERT INTO "cymbal_products" ("uniq_id", "crawl_timestamp", "product_url", "product_name", "product_description", "list_price", "sale_price", "brand", "item_number", "gtin", "package_size", "category", "postal_code", "available", "product_embedding") VALUES ('fd604542e04b470f9e6348e640cff794', NOW(), 'https://example.com/new_product', 'New Cymbal Product', 'This is a new cymbal product description.', 199.99, 149.99, 'Example Brand', 'EB123', '1234567890', 'Single', 'Cymbals', '12345', TRUE, NULL);
এখন আমরা যে সারিটি এইমাত্র যোগ করেছি, সেটি কোয়েরি করলে দেখব যে product_embedding কলামটি স্বয়ংক্রিয়ভাবে আপডেট হয়ে গেছে।
SELECT uniq_id, (product_embedding::real[])[1:5] as product_embedding FROM cymbal_products WHERE uniq_id='fd604542e04b470f9e6348e640cff794';
আউটপুটটি নিম্নলিখিতের মতো হওয়া উচিত:
quickstart_db=> SELECT uniq_id,(product_embedding::real[])[1:5] as product_embedding  FROM cymbal_products WHERE uniq_id='fd604542e04b470f9e6348e640cff794';
             uniq_id              |                      product_embedding
----------------------------------+---------------------------------------------------------------
 fd604542e04b470f9e6348e640cff794 | {0.015003494,-0.005349732,-0.059790313,-0.0087091,-0.0271452}
(1 row)
৮. একটি ভেক্টর সূচক তৈরি করুন
ভেক্টর সার্চের পারফরম্যান্স উন্নত করতে, আমরা একটি ScaNN ইনডেক্স যোগ করব।
স্ক্যান সূচক তৈরি করুন
SCANN ইনডেক্স তৈরি করার জন্য আমাদের আরও একটি এক্সটেনশন সক্রিয় করতে হবে। alloydb_scann এক্সটেনশনটি গুগলের ScaNN অ্যালগরিদম ব্যবহার করে ANN টাইপের ভেক্টর ইনডেক্সের সাথে কাজ করার জন্য একটি ইন্টারফেস প্রদান করে।
CREATE EXTENSION IF NOT EXISTS alloydb_scann;
প্রত্যাশিত আউটপুট:
quickstart_db=> CREATE EXTENSION IF NOT EXISTS alloydb_scann;
CREATE EXTENSION
ইনডেক্সটি ম্যানুয়াল (MANUAL) অথবা অটো (AUTO) মোডে তৈরি করা যায়। ম্যানুয়াল মোড ডিফল্টভাবে সক্রিয় থাকে এবং আপনি অন্য যেকোনো ইনডেক্সের মতোই এটি তৈরি ও রক্ষণাবেক্ষণ করতে পারেন। কিন্তু আপনি যদি অটো মোড সক্রিয় করেন, তবে আপনি এমন একটি ইনডেক্স তৈরি করতে পারবেন যার জন্য আপনার পক্ষ থেকে কোনো রক্ষণাবেক্ষণের প্রয়োজন হবে না। আপনি ডকুমেন্টেশনে সমস্ত অপশন সম্পর্কে বিস্তারিত পড়তে পারেন। আমাদের ক্ষেত্রে, অটো মোডে ইনডেক্স তৈরি করার জন্য যথেষ্ট সংখ্যক রো (row) নেই - তাই আমরা এটি ম্যানুয়াল মোডে তৈরি করব এবং টিউনিং প্যারামিটার অন্তর্ভুক্ত করব। আপনি ডকুমেন্টেশনে ইনডেক্স প্যারামিটার টিউনিং সম্পর্কে পড়তে পারেন।
CREATE INDEX cymbal_products_embeddings_scann ON cymbal_products
  USING scann (product_embedding cosine)
  WITH (mode='MANUAL', num_leaves=31, max_num_levels = 2);
প্রত্যাশিত আউটপুট:
quickstart_db=> CREATE INDEX cymbal_products_embeddings_scann ON cymbal_products
  USING scann (product_embedding cosine)
  WITH (num_leaves=31, max_num_levels = 2);
CREATE INDEX
quickstart_db=>
সূচক ব্যবহার পরিদর্শন করুন
এখন আমরা EXPLAIN মোডে ভেক্টর সার্চ কোয়েরিটি চালিয়ে যাচাই করতে পারি যে ইনডেক্সটি ব্যবহৃত হচ্ছে কিনা।
EXPLAIN (analyze)
WITH trees as (
SELECT
        cp.product_name,
        left(cp.product_description,80) as description,
        cp.sale_price,
        cs.zip_code,
        cp.uniq_id as product_id
FROM
        cymbal_products cp
JOIN cymbal_inventory ci on
        ci.uniq_id=cp.uniq_id
JOIN cymbal_stores cs on
        cs.store_id=ci.store_id
        AND ci.inventory>0
        AND cs.store_id = 1583
ORDER BY
        (cp.product_embedding <=> embedding('text-embedding-005','What kind of fruit trees grow well here?')::vector) ASC
LIMIT 1)
SELECT json_agg(trees) FROM trees;
প্রত্যাশিত আউটপুট (স্পষ্টতার জন্য সম্পাদিত):
...
Aggregate (cost=16.59..16.60 rows=1 width=32) (actual time=2.875..2.877 rows=1 loops=1)
-> Subquery Scan on trees (cost=8.42..16.59 rows=1 width=142) (actual time=2.860..2.862 rows=1 loops=1)
-> Limit (cost=8.42..16.58 rows=1 width=158) (actual time=2.855..2.856 rows=1 loops=1)
-> Nested Loop (cost=8.42..6489.19 rows=794 width=158) (actual time=2.854..2.855 rows=1 loops=1)
-> Nested Loop (cost=8.13..6466.99 rows=794 width=938) (actual time=2.742..2.743 rows=1 loops=1)
-> Index Scan using cymbal_products_embeddings_scann on cymbal_products cp (cost=7.71..111.99 rows=876 width=934) (actual time=2.724..2.724 rows=1 loops=1)
Order By: (embedding <=> '[0.008864171,0.03693164,-0.024245683,-0.00355923,0.0055611245,0.015985578,...<redacted>...5685,-0.03914233,-0.018452475,0.00826032,-0.07372604]'::vector)
...
আউটপুট থেকে আমরা পরিষ্কারভাবে দেখতে পাচ্ছি যে কোয়েরিটি "Index Scan using cymbal_products_embeddings_scann on cymbal_products" ব্যবহার করছিল।
৯. একটি Solr ইনস্ট্যান্স তৈরি করা
আমরা হাইব্রিড সার্চের ফুল টেক্সট সার্চ (FTS) অংশের জন্য অ্যাপাচি সোলার ব্যবহার করব। এই ধাপে, আপনি পূর্বে তৈরি করা ভিএম-টিতে একটি স্বতন্ত্র সোলার ইনস্ট্যান্স স্থাপন করবেন।
Solr-এ অ্যাক্সেস সুরক্ষিত করতে, আমরা বেসিক অথেনটিকেশন চালু করব। এটি করার জন্য আমরা একটি security.json কনফিগারেশন ফাইল প্রদান করব, সেটিকে মাউন্ট করব এবং Solr ডকার কন্টেইনারটি চালু করব।
ভিএম-এ SSH করে লগইন করুন এবং ডকার ইনস্টল করুন:
sudo apt-get update
sudo apt-get install -y ca-certificates curl gnupg
sudo install -m 0755 -d /etc/apt/keyrings
curl -fsSL https://download.docker.com/linux/debian/gpg | sudo gpg --dearmor -o /etc/apt/keyrings/docker.gpg
sudo chmod a+r /etc/apt/keyrings/docker.gpg

echo \
  "deb [arch="$(dpkg --print-architecture)" signed-by=/etc/apt/keyrings/docker.gpg] https://download.docker.com/linux/debian \
  "$(. /etc/os-release && echo "$VERSION_CODENAME")" stable" | \
  sudo tee /etc/apt/sources.list.d/docker.list > /dev/null
sudo apt-get update
sudo apt-get install -y docker-ce docker-ce-cli containerd.io docker-buildx-plugin docker-compose-plugin
এখন আপনি আপনার ব্যবহারকারীর দ্বারা চালানোর জন্য ডকার কমান্ডটি পরিবর্তন করতে পারেন:
sudo usermod -aG docker $USER
newgrp docker
এখন, ইউজারনেম solr এবং পাসওয়ার্ড SolrRocks ব্যবহার করে বেসিক অথেনটিকেশন চালু করার জন্য security.json ফাইলটি তৈরি করুন।
nano security.json
ফাইলটিতে নিম্নলিখিত JSON পেস্ট করুন:
{
  "authentication": {
    "blockUnknown": true,
    "class": "solr.BasicAuthPlugin",
    "credentials": {
      "solr": "IV0EHq1OnNrj6gvRCwvFwTrZ1+z1oBbnQdiVC3otuq0= Ndd7LKvVBAaZIF0QAVi1ekCfAJXr1GGfLtRUXhgrF8c="
    }
  },
  "authorization": {
    "class": "solr.RuleBasedAuthorizationPlugin",
    "permissions": [
      { "name": "security-edit", "role": "admin" }
    ],
    "user-role": { "solr": "admin" }
  }
}
ন্যানো সংরক্ষণ করুন এবং প্রস্থান করুন (Ctrl + O, Enter, Ctrl + X)।
docker run ব্যবহার করে Solr ডকার কন্টেইনারটি চালু করুন এবং security.json ফাইলটি কন্টেইনারে মাউন্ট করুন:
docker run -d -p 8983:8983 --name solr --user root -v "$(pwd)/security.json:/var/solr/data/security.json" solr:9 -c -force
কন্টেইনারটি চালু আছে কিনা তা যাচাই করুন:
docker ps
প্রত্যাশিত আউটপুট:
student@instance-1:~$ docker ps
CONTAINER ID   IMAGE     COMMAND                  CREATED         STATUS         PORTS                                         NAMES
90db3c73835e   solr:9    "docker-entrypoint.s..."   7 seconds ago   Up 3 seconds   0.0.0.0:8983->8983/tcp, [::]:8983->8983/tcp   solr
Solr-কে ইনিশিয়ালাইজ হতে কয়েক সেকেন্ড সময় দিন, তারপর আপনার বেসিক অথেন্টিকেশন ক্রেডেনশিয়াল ব্যবহার করে Solr API-তে হিট করে solrindexdemo নামের একটি নতুন কালেকশন তৈরি করুন:
curl --user solr:SolrRocks -X POST "http://localhost:8983/solr/admin/collections?action=CREATE&name=solrindexdemo&numShards=1&replicationFactor=1"
প্রত্যাশিত আউটপুট:
student@instance-1:~$ curl --user solr:SolrRocks -X POST "http://localhost:8983/solr/admin/collections?action=CREATE&name=solrindexdemo&numShards=1&replicationFactor=1"
{
  "responseHeader":{
    "status":0,
    "QTime":3586
  },
  "success":{
    "172.17.0.2:8983_solr":{
      "responseHeader":{
        "status":0,
        "QTime":2405
      },
      "core":"solrindexdemo_shard1_replica_n1"
    }
  },
  "warning":"Using _default configset. Data driven schema functionality is enabled by default, which is NOT RECOMMENDED for production use. To turn it off: curl http://{host:port}/solr/solrindexdemo/config -d '{\"set-user-property\": {\"update.autoCreateFields\":\"false\"}}'"
এখন, আমরা Solr ইনস্ট্যান্সটিতে পণ্যের বিবরণ এবং নাম যুক্ত করব। ক্লাউড স্টোরেজ থেকে পণ্যের CSV ফাইলটি VM-এ কপি করুন।
gcloud storage cp gs://cloud-training/gcc/gcc-tech-004/cymbal_products.csv .
এখন বাল্ক আপডেটের জন্য CSV ফাইলটি এক্সট্র্যাক্ট করে ডেটাগুলোকে একটি JSON লিস্টে ফরম্যাট করতে একটি পাইথন স্ক্রিপ্ট তৈরি করুন।
nano convert.py
ফাইলটিতে নিম্নলিখিতটি পেস্ট করুন:
import csv
import json

# Configuration
input_file = 'cymbal_products.csv'
output_file = 'products.json'

def convert():
    try:
        with open(input_file, mode='r', encoding='utf-8') as f_in, \
             open(output_file, mode='w', encoding='utf-8') as f_out:

            reader = csv.DictReader(f_in)

            products = []
            for row in reader:
                products.append({
                    "id": row['uniq_id'].strip(),
                    "product_name": row['product_name'].strip(),
                    "product_description": row['product_description'].strip()
                })

            json.dump(products, f_out, indent=2)
            print(f"Success: Processed {len(products)} products.")
            print(f"Output saved to: {output_file}")

    except Exception as e:
        print(f"An error occurred: {e}")

if __name__ == "__main__":
    convert()
ফাইলটি সংরক্ষণ করুন এবং এটি চালান:
python3 convert.py
প্রত্যাশিত আউটপুট:
admin_gopalbhutada_altostrat_com@instance-1:~$ python3 convert.py
Success: Processed 941 products.
Output saved to: products.json
এখন আপডেট হ্যান্ডলার ব্যবহার করে JSON ডেটা Apache Solr-এ পাঠান:
curl --user solr:SolrRocks -X POST -H 'Content-Type: application/json' \
  'http://localhost:8983/solr/solrindexdemo/update?commit=true' \
  --data-binary "@products.json"
প্রত্যাশিত আউটপুট:
admin_gopalbhutada_altostrat_com@instance-1:~$ curl --user solr:SolrRocks -X POST -H 'Content-Type: application/json' \
  'http://localhost:8983/solr/solrindexdemo/update?commit=true' \
  --data-binary "@products.json"
{
  "responseHeader":{
    "rf":1,
    "status":0,
    "QTime":3220
  }
}
এখন, আমাদের Solr ক্রেডেনশিয়াল সংরক্ষণের জন্য Secret Manager-এ একটি সিক্রেট তৈরি করতে হবে। যেহেতু AlloyDB বেসিক অথেনটিকেশনের জন্য base64-এনকোডেড username:password ভ্যালু ব্যবহার করে এক্সটার্নাল সার্চ FDW-এর সাথে লিঙ্ক করে, তাই প্রথমে solr:SolrRocks এর জন্য base64-এনকোডেড স্ট্রিংটি সংগ্রহ করা যাক:
echo -n "solr:SolrRocks" | base64
আউটপুট:
admin_gopalbhutada_altostrat_com@instance-1:~$ echo -n "solr:SolrRocks" | base64
c29scjpTb2xyUm9ja3M=
এই বেস৬৪-এনকোডেড ক্রেডেনশিয়ালটি ব্যবহার করে গুগল সিক্রেট ম্যানেজারে একটি সিক্রেট তৈরি করুন। ক্লাউড শেলে, নিম্নলিখিতটি চালান:
echo -n "c29scjpTb2xyUm9ja3M=" | \
gcloud secrets create solr-credentials \
    --replication-policy="automatic" \
    --data-file=-
১০. AlloyDB-তে একটি ফরেন ডেটা র্যাপার তৈরি করা
সময়কাল ১০:০০
AlloyDB থেকে Apache Solr-এ সংরক্ষিত ডেটা কোয়েরি করার জন্য, আমাদের অবশ্যই Solr-এর জন্য একটি Foreign Data Wrapper (FDW) এবং একটি ফরেন টেবিল তৈরি করতে হবে। পূর্বে আপনি Secret Manager-এ Solr-এর ক্রেডেনশিয়ালগুলো সংরক্ষণ করেছিলেন। AlloyDB-কে সিক্রেটটি অ্যাক্সেস করার সুযোগ দিতে, সার্ভিস অ্যাকাউন্টটিকে প্রয়োজনীয় অনুমতি প্রদান করুন।
Cloudshell-এ, সার্ভিস অ্যাকাউন্টকে solr-credentials সিক্রেটটিতে অ্যাক্সেস দিন:
gcloud secrets add-iam-policy-binding solr-credentials \
    --member="serviceAccount:service-$(gcloud projects describe $(gcloud config get-value project) --format='value(projectNumber)')@gcp-sa-alloydb.iam.gserviceaccount.com" \
    --role="roles/secretmanager.secretAccessor"
প্রত্যাশিত আউটপুট:
admin_@cloudshell:~ (my-project-93954-gke)$ gcloud secrets add-iam-policy-binding solr-credentials \
    --member="serviceAccount:service-$(gcloud projects describe $(gcloud config get-value project) --format='value(projectNumber)')@gcp-sa-alloydb.iam.gserviceaccount.com" \
    --role="roles/secretmanager.secretAccessor"
Your active configuration is: [cloudshell-13031]
Updated IAM policy for secret [solr-credentials].
bindings:
- members:
  - serviceAccount:service-350113473377@gcp-sa-alloydb.iam.gserviceaccount.com
  role: roles/secretmanager.secretAccessor
etag: BwZWyKlkx6Q=
version: 1
AlloyDB Studio ব্যবহার করে (অথবা VM থেকে psql ব্যবহার করে) ডাটাবেসে সংযোগ করুন। postgres ব্যবহারকারী হিসেবে quickstart_db তে লগইন করুন।
FDW এক্সটেনশনটি সক্রিয় করুন:
CREATE EXTENSION IF NOT EXISTS external_search_fdw;
প্রত্যাশিত আউটপুট:
CREATE EXTENSION
সংযোগের পরামিতিগুলি পান
AlloyDB-তে ফরেন ডেটা সার্ভার কনফিগার করার আগে, আপনার VM-এর ইন্টারনাল আইপি অ্যাড্রেস (যেখানে Solr চলছে) এবং সিক্রেট পাথ প্রয়োজন হবে।
ভিএম-এর অভ্যন্তরীণ আইপি প্রিন্ট করতে, ক্লাউড শেলে নিম্নলিখিত কমান্ডটি চালান:
gcloud compute instances describe instance-1 \
    --zone=us-central1-a \
    --format="value(networkInterfaces[0].networkIP)"
প্রত্যাশিত আউটপুট:
10.X.X.X
সিক্রেট ম্যানেজারে গোপন রিসোর্স পাথ প্রিন্ট করতে, চালান:
gcloud secrets describe solr-credentials --format="value(name)"
প্রত্যাশিত আউটপুট:
projects/<project_id>/secrets/solr-credentials
অ্যাপাচি সোলার-এ পৌঁছানোর জন্য, একটি ফরেন ডেটা সার্ভার তৈরি করুন। প্রতিস্থাপন করুন/versions/latest যোগ করুন:
CREATE SERVER solr_demo_server
FOREIGN DATA WRAPPER external_search_fdw
OPTIONS(
    server 'http://<VM_INTERNAL_IP_ADDRESS>:8983',
    search_provider 'solr',
    auth_mode 'secret_manager',
    auth_method 'Basic',
    secret_path '<SECRET_PATH>/versions/latest'
);
প্রত্যাশিত আউটপুট:
CREATE SERVER
এরপর, ফরেন টেবিলটি সংজ্ঞায়িত করুন। মেটাডেটার পরে, পূর্বে লোড করা ডেটার সাথে মেলানোর জন্য Solr ফিল্ড স্কিমা ডেফিনিশন প্রদান করুন। রিমোট টেবিলে Solr কালেকশনের নামটি উল্লেখ করুন।
CREATE FOREIGN TABLE solrindexdemo (
    metadata external_search_fdw_schema.OpaqueMetadata,
    id TEXT,
    product_name TEXT,
    product_description TEXT
)
SERVER solr_demo_server
OPTIONS(
    remote_table_name 'solrindexdemo'
);
সার্ভারের জন্য একটি ব্যবহারকারী ম্যাপিং তৈরি করুন:
CREATE USER MAPPING FOR CURRENT_USER SERVER solr_demo_server;
এখন আপনি ফরেন টেবিলটি পরীক্ষা করতে পারেন:
SELECT id, product_name
FROM solrindexdemo
ORDER BY metadata <@> 'product_description:cherry' DESC
limit 10;
প্রত্যাশিত আউটপুট:
"id","product_name"
"d536e9e823296a2eba198e52dd23e712","Cherry Tree"
"390cf08feac229e7b752709fd1f943b3","Woven Round Placemat, Set of Twelve, Grass"
"2c9aa7ac98c30abf78dd9c62a68a34e6","48 Scented Wax Melts Wax Cubes: Jelly Belly Jelly Beans Candy Bulk Soy Wax Melts For Candle Warmer, Wax Warmers, Wax Melt Warmers In 8 Pack Set"
১১. হাইব্রিড সার্চ ব্যবহার করা
সময়কাল ১০:০০
এখন যেহেতু সবকিছু সেট আপ করা হয়ে গেছে, আমরা ভেক্টর সার্চ এবং ফুল টেক্সট সার্চকে একত্রিত করতে ai.hybrid_search() ফাংশনটি ব্যবহার করতে পারি। আপনি ডকুমেন্টেশনে হাইব্রিড সার্চ সম্পর্কে আরও পড়তে পারেন। হাইব্রিড সার্চ ব্যবহার করার সময়, ডিফল্টরূপে একাধিক কোয়েরি থেকে প্রাপ্ত ফলাফলের ক্রম নির্ধারণ করতে রেসিপ্রোকাল র্যাঙ্ক ফিউশন অ্যালগরিদম ব্যবহার করা হয়। প্রথমে, চলুন ভেক্টর সার্চ এবং হাইব্রিড সার্চ আলাদাভাবে চেষ্টা করে তাদের পার্থক্যগুলো বিশ্লেষণ করি।
নিম্নলিখিত কোয়েরিটি চেরির মতো পণ্য খুঁজে বের করার জন্য ভেক্টর সার্চ সম্পাদন করে। অ্যারেটি সম্পাদন করার জন্য সার্চগুলোর একটি তালিকা প্রদান করে। এই ক্ষেত্রে, আমরা শুধুমাত্র ভেক্টর সার্চ ব্যবহার করছি, কিন্তু পরবর্তীতে আমরা ভেক্টর এবং এফটিএস উভয়ই প্রদান করব।
SELECT id, score, cymbal_products.product_name, cymbal_products.product_description
FROM ai.hybrid_search(
  ARRAY[
      '{
        "data_type": "vector",
        "table_name": "cymbal_products",
        "key_column": "uniq_id",
        "vec_column": "product_embedding",
        "distance_operator": "public.<=>",
        "limit": 3,
        "query_vector": "ai.embedding(''text-embedding-005'', ''cherry'')::vector"
      }'::JSONB
  ]
) JOIN cymbal_products ON id = cymbal_products.uniq_id;
আউটপুটে, চেরি গাছ হলো প্রথম ফলাফল, কিন্তু লক্ষ্য করুন যে পরের দুটিও ফলের গাছ। এর কারণ হলো, যখন আমরা product_description কলামে ভেক্টর সার্চ ব্যবহার করি, তখন আমরা আমাদের সার্চ কন্ডিশনের সাথে শব্দার্থগত মিল খুঁজে পাই।
"id","score","product_name","product_description"
"d536e9e823296a2eba198e52dd23e712","0.01639344262295082","Cherry Tree","This is a beautiful cherry tree that will produce delicious cherries. It is an deciduous tree that grows to be about 15 feet tall. The leaves are dark green in the summer and turn a beautiful red in the fall. Cherry trees are known for their beauty and their ability to provide shade and privacy. Cherry trees prefer a cool, moist climate and sandy soil. They are best suited for USDA zones 4-9."
"b70c44b1a38c0a2329fa583c9109a80f","0.016129032258064516","Peach Tree","This is a beautiful peach tree that will produce delicious peaches. It is an evergreen tree that grows to be about 20 feet tall. The leaves are dark green in the summer and turn a beautiful yellow in the fall. Peach trees are known for their beauty and their ability to provide shade and privacy. Peach trees prefer a cool, moist climate and sandy soil. They are best suited for USDA zones 2-9."
"23e41a71d63d8bbc9bdfa1d118cfddc5","0.015873015873015872","Apple Tree","This is a beautiful apple tree that will produce delicious apples. It is a deciduous tree that grows to be about 30 feet tall. The leaves are dark green in the summer and turn a beautiful red, orange, and yellow in the fall. Apple trees are known for their strength and durability. They are also a popular choice for shade trees. Apple trees prefer a cool, moist climate and loamy soil. They are best suited for USDA zones 4-8."
Apache Solr FDW ব্যবহার করে পূর্ণ পাঠ্য অনুসন্ধান (full text search) করতে, নিম্নলিখিত কোয়েরিটি চালান:
SELECT id, score, cymbal_products.product_name, cymbal_products.product_description
FROM ai.hybrid_search(
  ARRAY[
      '{
        "limit": 3,
        "data_type": "external_search_fdw",
        "table_name": "solrindexdemo",
        "key_column": "id",
        "query_text_input": "product_description:cherry"
      }'::JSONB
  ]
) JOIN cymbal_products ON id = cymbal_products.uniq_id;
ফলাফলে লক্ষ্য করুন, যেহেতু পূর্ণ-পাঠ্য অনুসন্ধান টোকেন ম্যাচিং ব্যবহার করে, তাই পণ্যের বিবরণে 'চেরি' শব্দটি আছে এমন সবকিছুই ফলাফলে দেখানো হয়।
"id","score","product_name","product_description"
"d536e9e823296a2eba198e52dd23e712","0.01639344262295082","Cherry Tree","This is a beautiful cherry tree that will produce delicious cherries. It is an deciduous tree that grows to be about 15 feet tall. The leaves are dark green in the summer and turn a beautiful red in the fall. Cherry trees are known for their beauty and their ability to provide shade and privacy. Cherry trees prefer a cool, moist climate and sandy soil. They are best suited for USDA zones 4-9."
"390cf08feac229e7b752709fd1f943b3","0.016129032258064516","Woven Round Placemat, Set of Twelve, Grass","...These placemats are great for special occasions and holidays, but are also perfect to accessorize your everyday place settings.|Measurements. 15-inch round diameter is the perfect size for most table sizes and shapes.|Pop Colors. Choose from 7 pop woven color placemats including: Black, Cherry, Grass, Taupe, Navy, Sun and Graphite."
"2c9aa7ac98c30abf78dd9c62a68a34e6","0.015873015873015872","48 Scented Wax Melts Wax Cubes: Jelly Belly Jelly Beans Candy Bulk Soy Wax Melts For Candle Warmer, Wax Warmers, Wax Melt Warmers In 8 Pack Set","...From These Flavors: Lemon Drop, Mixed Berry Smoothie, Sizzling Cinnamon, Crushed Pineapple, Juicy Pear, Cotton Candy, Toasted Marshmallow, French Vanilla, Watermelon, Red Apple, Very Cherry, Buttered Popcorn..."
এখন আপনি আরও অর্থবহ ফলাফল পেতে সিমান্টিক সার্চ এবং এফটিএস (FTS) উভয়ই একত্রিত করতে পারেন। ধরা যাক, আমরা এমন একটি গাছ খুঁজতে চাই যা একটি বাড়ির চেয়েও লম্বা হতে পারে এবং আমরা চাই গাছটি ক্যালিফোর্নিয়া থেকে আসুক। আক্ষরিক মিলের পরিবর্তে সিমান্টিক অভিপ্রায়কে কাজে লাগানোর জন্য আমরা কোয়েরিটি ভাগ করে নিই। ভেক্টর সার্চ বর্ণনামূলক অংশটি পরিচালনা করে: "এমন গাছ যা একটি বাড়ির চেয়েও লম্বা হতে পারে", কারণ এটি সঠিক কীওয়ার্ডের প্রয়োজন ছাড়াই মাপের ধারণাটি বোঝে। অন্যদিকে, ফুল-টেক্সট সার্চ "ক্যালিফোর্নিয়া"-কে একটি কঠোর ফিল্টার হিসাবে ব্যবহার করে, যাতে আমরা কেবল ধারণাগতভাবে সাদৃশ্যপূর্ণ কিছুর পরিবর্তে একটি সঠিক ভৌগোলিক মিল পাই।
SELECT id, score, cymbal_products.product_name, cymbal_products.product_description
FROM ai.hybrid_search(
  ARRAY[
    '{
        "data_type": "vector",
        "table_name": "cymbal_products",
        "key_column": "uniq_id",
        "vec_column": "product_embedding",
        "distance_operator": "public.<=>",
        "limit": 3,
        "query_vector": "ai.embedding(''text-embedding-005'', ''tree that can grow taller than a house'')::vector"
      }'::JSONB,
      '{
        "limit": 3,
        "data_type": "external_search_fdw",
        "table_name": "solrindexdemo",
        "key_column": "id",
        "query_text_input": "product_description:California"
      }'::JSONB
  ]
) JOIN cymbal_products ON id = cymbal_products.uniq_id;
প্রত্যাশিত ফলাফল:
"id","score","product_name","product_description"
"a589fd36a8a20fd9472d2403d6ed692a","0.00819672631147241","California Redwood","This is a beautiful redwood tree that can grow to be over 300 feet tall. It is an evergreen tree that grows in the coastal forests of California. Redwoods are known for their beauty and their strength. They are best suited for USDA zones 7-10."
"ef9432802da24041594c2cf368dfb4d2","0.008064521129029258","Madrone","This is a beautiful madrona tree that can grow to be over 80 feet tall. It is an evergreen tree that grows in the coastal forests of California. Madronas are known for their beauty and their bark. They are best suited for USDA zones 7-10."
"1360d8642bc218e4ea28e9c32b2e1721","0.007936512936504936","California Sycamore","This is a beautiful sycamore tree that can grow to be over 100 feet tall. It is an deciduous tree that grows in the valleys and foothills of California. California sycamores are known for their beauty and their shade. They are best suited for USDA zones 7-10."
১২. পরিবেশ পরিষ্কার করা
ল্যাবের কাজ শেষ হলে AlloyDB ইনস্ট্যান্স এবং ক্লাস্টারটি ধ্বংস করে দিন।
AlloyDB ক্লাস্টার এবং এর সমস্ত ইনস্ট্যান্স মুছে ফেলুন
আপনি যদি AlloyDB-এর ট্রায়াল সংস্করণ ব্যবহার করে থাকেন এবং সেই ট্রায়াল ক্লাস্টার ব্যবহার করে অন্যান্য ল্যাব ও রিসোর্স পরীক্ষা করার পরিকল্পনা থাকে, তাহলে সেটি ডিলিট করবেন না। আপনি একই প্রজেক্টে আরেকটি ট্রায়াল ক্লাস্টার তৈরি করতে পারবেন না।
`force` অপশনটির মাধ্যমে ক্লাস্টারটি ধ্বংস করা হয়, যা ক্লাস্টারের অন্তর্গত সমস্ত ইনস্ট্যান্সকেও মুছে দেয়।
যদি আপনার সংযোগ বিচ্ছিন্ন হয়ে যায় এবং পূর্বের সমস্ত সেটিংস হারিয়ে যায়, তাহলে ক্লাউড শেলে প্রজেক্ট এবং এনভায়রনমেন্ট ভেরিয়েবলগুলো নির্ধারণ করুন:
gcloud config set project <your project id>
export REGION=us-central1
export ADBCLUSTER=alloydb-hybrid-search
export PROJECT_ID=$(gcloud config get-value project)
ক্লাস্টারটি মুছে ফেলুন:
gcloud alloydb clusters delete $ADBCLUSTER --region=$REGION --force
প্রত্যাশিত কনসোল আউটপুট:
admin_@cloudshell:~ (my-project-93954-gke)$ gcloud alloydb clusters delete $ADBCLUSTER --region=$REGION --force
All of the cluster data will be lost when the cluster is deleted.

Do you want to continue (Y/n)?  Y

Operation ID: operation-1784270790060-656c8ea9fea06-1b93001f-846543e0
Deleting cluster...done.
AlloyDB ব্যাকআপগুলি মুছুন
ক্লাস্টারের সমস্ত AlloyDB ব্যাকআপ মুছে ফেলুন:
for i in $(gcloud alloydb backups list --filter="CLUSTER_NAME: projects/$PROJECT_ID/locations/$REGION/clusters/$ADBCLUSTER" --format="value(name)" --sort-by=~createTime) ; do gcloud alloydb backups delete $(basename $i) --region $REGION --quiet; done
প্রত্যাশিত কনসোল আউটপুট:
admin_@cloudshell:~ (my-project-93954-gke)$ for i in $(gcloud alloydb backups list --filter="CLUSTER_NAME: projects/$PROJECT_ID/locations/$REGION/clusters/$ADBCLUSTER" --format="value(name)" --sort-by=~createTime) ; do gcloud alloydb backups delete $(basename $i) --region $REGION --quiet; done
Operation ID: operation-1784271231983-656c904f71e05-1389a145-f101ceee
Deleting backup...done.
এখন আমরা আমাদের ভিএম ধ্বংস করতে পারি
GCE VM মুছে ফেলুন
ক্লাউড শেলে চালান:
export GCEVM=instance-1
export ZONE=us-central1-a
gcloud compute instances delete $GCEVM \
    --zone=$ZONE \
    --quiet
প্রত্যাশিত কনসোল আউটপুট:
admin_@cloudshell:~ (my-project-93954-gke)$ export GCEVM=instance-1
export ZONE=us-central1-a
gcloud compute instances delete $GCEVM \
    --zone=$ZONE \
    --quiet
Deleted
১৩. অভিনন্দন
কোডল্যাবটি সম্পন্ন করার জন্য অভিনন্দন!
আমরা যা আলোচনা করেছি
- AlloyDB ক্লাস্টার এবং প্রাইমারি ইনস্ট্যান্স কীভাবে স্থাপন করবেন
- গুগল কম্পিউট ইঞ্জিন ভিএম থেকে অ্যালয়ডিবি-তে কীভাবে সংযোগ করবেন
- কীভাবে ডাটাবেস তৈরি করবেন এবং AlloyDB AI সক্রিয় করবেন
- ডাটাবেসে ডেটা লোড করার পদ্ধতি
- AlloyDB Studio কীভাবে ব্যবহার করবেন
- ভার্টেক্স এআই দিয়ে এমবেডিং তৈরি করুন
- ভেক্টর সার্চকে উন্নত করতে কীভাবে একটি ScanN ভেক্টর ইনডেক্স তৈরি করবেন
- অ্যাপাচি সোলারের জন্য কীভাবে একটি ফরেন ডেটা র্যাপার (FDW) তৈরি করবেন
- AlloyDB-তে সিমান্টিক সার্চের সাথে Solr-এ ফুল টেক্সট সার্চের সমন্বয় করে হাইব্রিড সার্চ সম্পাদন করুন।
পরবর্তী পদক্ষেপ
আপনি অফিসিয়াল কোডল্যাব সাইটে (.postgresql) আরও AlloyDB কোডল্যাব দেখতে পারেন।