

1. Introduction
Dans cet atelier de programmation, vous allez sauvegarder un cluster à haute disponibilité (HA) dans un stockage d'objets compatible avec S3 pour AlloyDB Omni à l'aide de l'outil d'orchestration RPM.
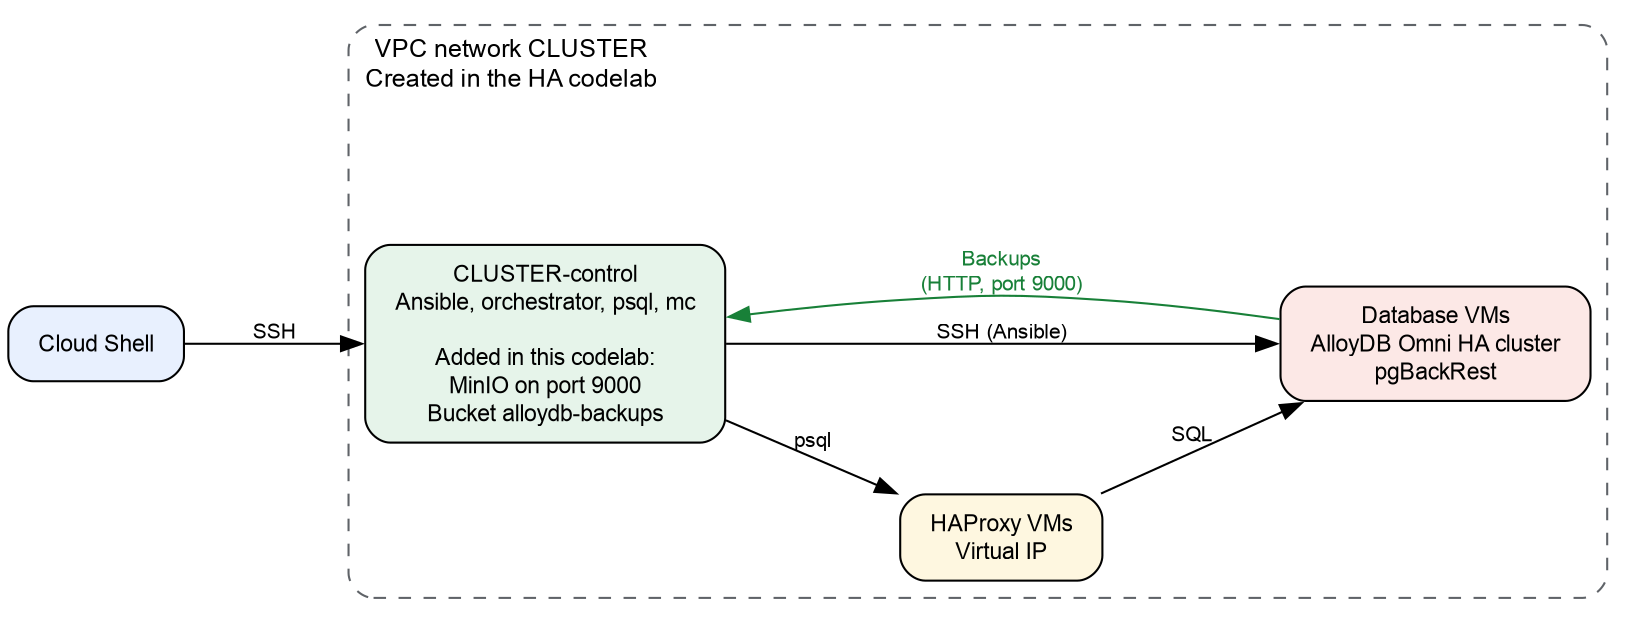
Cet atelier de programmation utilise le cluster de l'atelier de programmation Déployer un cluster AlloyDB Omni à haute disponibilité sur des VM GCE à l'aide de l'outil d'orchestration RPM pour créer un cluster à haute disponibilité sur des machines virtuelles (VM) Compute Engine. Dans cet atelier de programmation, vous allez ajouter un serveur de stockage d'objets compatible avec S3 sur l'une des VM. Vous utilisez le serveur de stockage d'objets pour le cluster à haute disponibilité afin de sauvegarder les données et de restaurer le cluster à partir du serveur.
Prérequis
- Un projet Google Cloud avec facturation activée.
- Rôles IAM listés dans l'atelier de programmation HA.
- Connaissances de base des commandes Linux et de SQL.
Points abordés
- Découvrez comment installer et exécuter un serveur de stockage d'objets compatible S3 pour les sauvegardes.
- Découvrez comment créer un plan de sauvegarde qui écrit les sauvegardes dans un espace de stockage compatible avec S3.
- Découvrez comment créer une sauvegarde à la demande.
- Découvrez comment restaurer un cluster à partir d'une sauvegarde et à un moment précis.
Prérequis
- URL des dépôts de logiciels AlloyDB Omni et de la collection Ansible de l'outil d'orchestration. Pour recevoir les URL, remplissez le formulaire d'inscription à AlloyDB Omni. Pour en savoir plus, consultez Présentation d'AlloyDB Omni avec RPM. Vous utiliserez les URL dans l'atelier de programmation sur la haute disponibilité.
- Cluster HA AlloyDB Omni de l'atelier de programmation Déployer un cluster AlloyDB Omni à haute disponibilité sur des VM GCE à l'aide de l'orchestrateur RPM.
- Un terminal avec accès à Google Cloud et à Cloud Shell.
2. Préparation
- Dans cette étape, vous allez créer un cluster à haute disponibilité à l'aide de l'atelier de programmation Déployer un cluster AlloyDB Omni à haute disponibilité sur des VM GCE à l'aide de l'outil d'orchestration RPM. Procédez comme suit : Si vous disposez déjà d'un cluster créé lors de l'atelier de programmation, passez à l'étape suivante.
- Remarque : N'exécutez pas l'étape Nettoyer les ressources pour le moment. Vous effectuerez cette étape à la fin de cet atelier de programmation.
- Revenir à cet atelier de programmation
3. Se connecter au cluster et ajouter des exemples de données
Au cours de cette étape, vous allez charger les paramètres du cluster sur la VM de contrôle. Vous vous connectez ensuite au cluster et ajoutez une table avec des exemples de données.
- Si vous n'êtes pas connecté à la VM de contrôle, connectez-vous à partir de Cloud Shell :
gcloud compute ssh "$CLUSTER-control" --zone="$ZONE" --project="$PROJECT"CLUSTER,ZONEetPROJECTproviennent de l'étape Préparer les VM pour le déploiement de l'atelier de programmation Déployer un cluster AlloyDB Omni à haute disponibilité sur des VM GCE à l'aide de l'outil d'orchestration RPM. Si Cloud Shell ne comporte pas ces variables, définissez-les à nouveau. - Sur la VM de contrôle, accédez à votre répertoire personnel et chargez les variables d'environnement. Ajoutez ensuite le nom du cluster et l'utilisateur SSH au fichier d'environnement :
cd ~ source /tmp/cluster.conf cat >> ~/.codelab.env <<EOF export CLUSTER="$cluster" export SSH_USER="$service_account" EOF source ~/.codelab.env env | grep -E '^(CLUSTER|SSH_USER|VIRTUAL_IP)='CLUSTER,SSH_USERetVIRTUAL_IP. Remarque : Si vous vous reconnectez à la VM de contrôle ultérieurement, exécutezcd ~etsource ~/.codelab.envavant de continuer. - Ajoutez les paramètres de connexion au fichier d'environnement. Lorsque la commande
readvous demande le mot de passe, saisissez celui de l'utilisateurpostgres. Vous définissez ce mot de passe à l'étape Bootstrap AlloyDB Omni Cluster de l'atelier de programmation Déployer un cluster AlloyDB Omni à haute disponibilité sur des VM GCE à l'aide de l'outil d'orchestration RPM.cat >> ~/.codelab.env <<'EOF' export PATH="/usr/pgsql-18/bin:$PATH" export PGHOST="$VIRTUAL_IP" export PGUSER="postgres" EOF read -rsp "Password of the postgres user: " PGPASSWORD; echo printf 'export PGPASSWORD=%q\n' "$PGPASSWORD" >> ~/.codelab.env source ~/.codelab.env env | grep -E '^(PGHOST|PGUSER|PGPASSWORD)=' - Créez une table et ajoutez 1 000 lignes :
psql <<'SQL' CREATE TABLE public.orders ( id integer PRIMARY KEY, item text NOT NULL, created_at timestamptz NOT NULL DEFAULT pg_catalog.now() ); INSERT INTO public.orders (id, item) SELECT g, 'item-' || g FROM pg_catalog.generate_series(1, 1000) AS g; SQL - Comptez les lignes :
psql -c "SELECT pg_catalog.count(*) FROM public.orders;"1000.
4. Installer et exécuter un stockage d'objets compatible S3
Dans cette étape, vous allez écrire un playbook Ansible qui installe un serveur MinIO sur la VM de contrôle. Le playbook crée également le bucket et l'utilisateur pour les sauvegardes, et s'assure que les VM de base de données peuvent se connecter à MinIO. Exécutez toutes les commandes de cette étape sur la VM de contrôle.
- Sur la VM de contrôle, ajoutez les paramètres de stockage au fichier d'environnement. Les commandes
opensslcréent des mots de passe aléatoires.MD=http://metadata.google.internal/computeMetadata/v1/instance S3_IP=$(curl -s -H "Metadata-Flavor: Google" "$MD/network-interfaces/0/ip") cat >> ~/.codelab.env <<EOF export S3_IP="$S3_IP" export S3_HOST="$CLUSTER-control" export S3_BUCKET="alloydb-backups" export S3_REGION="us-east-1" export MINIO_ROOT_USER="s3admin" export MINIO_ROOT_PASSWORD="$(openssl rand -hex 16)" export S3_ACCESS_KEY_ID="alloydb-backup" export S3_SECRET_ACCESS_KEY="$(openssl rand -hex 16)" export MINIO_URL="https://github.com/minio/minio/releases/download/RELEASE.2024-05-10T01-41-38Z/minio.linux-amd64.RELEASE.2024-05-10T01-41-38Z" export MC_URL="https://github.com/minio/mc/releases/download/RELEASE.2024-05-09T17-04-24Z/mc.linux-amd64.RELEASE.2024-05-09T17-04-24Z" EOF source ~/.codelab.env echo "$S3_HOST $S3_IP"my-cluster-control 10.1.0.2. Les VM de base de données utilisent ce nom d'hôte et cette adresse IP pour se connecter à MinIO. Le serveur de métadonnées de la VM fournit l'adresse IP. Pour en savoir plus, consultez la documentation sur les métadonnées de VM.Les valeursMINIO_URLetMC_URLsont les URL de téléchargement du serveur MinIO et du client MinIO (mc). - Installez la collection Ansible
community.cryptorequise sur la VM de contrôle :ansible-galaxy collection install community.crypto - Créez le playbook
s3_server.yaml:cat > s3_server.yaml <<EOF - name: Install and run MinIO on the control VM hosts: localhost connection: local become: true gather_facts: false tasks: - name: Create MinIO directories ansible.builtin.file: path: "{{ item }}" state: directory mode: "0755" loop: - /var/lib/minio/data - /var/lib/minio/certs - name: Download MinIO server and client ansible.builtin.get_url: url: "{{ item.url }}" dest: "{{ item.dest }}" mode: "0755" loop: - url: "$MINIO_URL" dest: /usr/local/bin/minio - url: "$MC_URL" dest: /usr/local/bin/mc - name: Generate MinIO TLS private key community.crypto.openssl_privatekey: path: /var/lib/minio/certs/private.key size: 2048 mode: "0600" - name: Generate MinIO certificate signing request community.crypto.openssl_csr_pipe: privatekey_path: /var/lib/minio/certs/private.key common_name: "$S3_HOST" subject_alt_name: - "DNS:$S3_HOST" - "DNS:$S3_BUCKET.$S3_HOST" - "DNS:localhost" - "IP:127.0.0.1" - "IP:$S3_IP" register: minio_csr - name: Generate self-signed MinIO TLS certificate community.crypto.x509_certificate: path: /var/lib/minio/certs/public.crt csr_content: "{{ minio_csr.csr }}" privatekey_path: /var/lib/minio/certs/private.key provider: selfsigned selfsigned_not_after: "+365d" mode: "0644" - name: Create MinIO systemd service unit ansible.builtin.copy: dest: /etc/systemd/system/minio.service mode: "0600" content: | [Unit] Description=MinIO Object Storage After=network.target [Service] Environment="MINIO_ROOT_USER=$MINIO_ROOT_USER" Environment="MINIO_ROOT_PASSWORD=$MINIO_ROOT_PASSWORD" Environment="MINIO_DOMAIN=$S3_HOST" ExecStart=/usr/local/bin/minio server /var/lib/minio/data --certs-dir /var/lib/minio/certs Restart=on-failure [Install] WantedBy=multi-user.target - name: Start and enable MinIO service ansible.builtin.systemd_service: name: minio daemon_reload: true state: started enabled: true - name: Add storage host names to /etc/hosts on the control VM ansible.builtin.lineinfile: path: /etc/hosts line: "$S3_IP $S3_HOST $S3_BUCKET.$S3_HOST" state: present - name: Wait for MinIO health endpoint ansible.builtin.uri: url: "https://$S3_HOST:9000/minio/health/live" ca_path: /var/lib/minio/certs/public.crt status_code: 200 register: minio_health until: minio_health.status == 200 retries: 6 delay: 5 - name: Create backup bucket and user in MinIO ansible.builtin.command: argv: "{{ item }}" loop: - - /usr/local/bin/mc - --insecure - alias - set - s3repo - "https://$S3_HOST:9000" - "$MINIO_ROOT_USER" - "$MINIO_ROOT_PASSWORD" - - /usr/local/bin/mc - --insecure - mb - --ignore-existing - "s3repo/$S3_BUCKET" - - /usr/local/bin/mc - --insecure - admin - user - add - s3repo - "$S3_ACCESS_KEY_ID" - "$S3_SECRET_ACCESS_KEY" - - /usr/local/bin/mc - --insecure - admin - policy - attach - s3repo - readwrite - --user - "$S3_ACCESS_KEY_ID" become: false no_log: true - name: Configure database VMs for MinIO hosts: primary_instance_nodes become: true gather_facts: false vars: ansible_user: $SSH_USER ansible_ssh_private_key_file: $HOME/ssh-key-cluster-sa tasks: - name: Set SELinux to permissive mode ansible.builtin.command: cmd: setenforce 0 - name: Add storage host names to /etc/hosts ansible.builtin.lineinfile: path: /etc/hosts line: "$S3_IP $S3_HOST $S3_BUCKET.$S3_HOST" state: present - name: Verify storage host resolution ansible.builtin.getent: database: hosts key: "$S3_BUCKET.$S3_HOST" - name: Verify connection to MinIO ansible.builtin.uri: url: "https://$S3_HOST:9000/minio/health/live" validate_certs: false status_code: 200 EOFMINIO_DOMAINpermet à MinIO d'accepter les requêtes de style hôte virtuel. L'orchestrateur RPM utilise l'utilisateuralloydb-backuppour écrire les sauvegardes. La règlereadwriteest une règle intégrée à MinIO. - Exécutez le playbook :
ansible-playbook s3_server.yaml -i deployment_spec.yamlPLAY RECAPaffichefailed=0pourlocalhostet pour chaque VM de base de données. - Vérifiez que le bucket existe :
mc --insecure ls s3repoalloydb-backups/.
5. Créer un plan de sauvegarde
Un plan de sauvegarde contient l'emplacement de stockage, le calendrier et la période de conservation des sauvegardes d'un cluster. Dans cette étape, vous allez créer un plan de sauvegarde pour le bucket MinIO.
- Sur la VM de contrôle, créez le playbook de sauvegarde et le playbook d'état. Vous utilisez le playbook de sauvegarde pour les ressources
Secret,BackupPlanetBackup. Vous utilisez le playbook d'état pour afficher l'état d'une ressource.cat > backup.yaml <<EOF - name: Manage AlloyDB Omni backups hosts: localhost roles: - role: google.alloydbomni_orchestrator.backup EOF cat > status.yaml <<EOF - name: Get resource status hosts: localhost roles: - role: google.alloydbomni_orchestrator.status EOF - Créez une ressource
Secretpour les identifiants S3. Appliquez ensuite la ressource :S3_KEY_ID_B64=$(printf '%s' "$S3_ACCESS_KEY_ID" | base64 -w 0) S3_KEY_B64=$(printf '%s' "$S3_SECRET_ACCESS_KEY" | base64 -w 0) cat > s3_secret.yaml <<EOF Secret: metadata: name: s3-backup-secret spec: type: Opaque data: access-key-id: "$S3_KEY_ID_B64" access-key: "$S3_KEY_B64" EOF ansible-playbook backup.yaml -i deployment_spec.yaml \ -e resource_spec=s3_secret.yamldatadoivent êtreaccess-key-idetaccess-key. Vous devez appliquer la ressourceSecretavant d'appliquer la ressourceBackupPlan. - Créez la ressource
BackupPlan, puis appliquez-la :cat > backup_plan.yaml <<EOF BackupPlan: metadata: name: s3-backup-plan spec: dbclusterRef: $CLUSTER backupLocation: type: S3 s3Options: bucket: $S3_BUCKET key: /backups endpoint: https://$S3_HOST:9000 region: $S3_REGION secretRef: name: s3-backup-secret caBundle: - | $(sed 's/^/ /' /var/lib/minio/certs/public.crt) EOF ansible-playbook backup.yaml -i deployment_spec.yaml \ -e resource_spec=backup_plan.yamlkeycorrespond au chemin d'accès aux sauvegardes dans le bucket. Ce chemin d'accès doit commencer par une barre oblique (/). Le champcaBundlecontient le certificat CA encodé au format PEM qui valide le certificat du serveur de stockage S3. - Vérifiez que le plan de sauvegarde est prêt :
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=BackupPlan -e resource_name=s3-backup-planphaseafficheReady. Si la phase n'est pasReady, attendez une minute et exécutez à nouveau la commande. - Lorsqu'un plan de sauvegarde est créé, l'orchestrateur RPM lance automatiquement une sauvegarde complète initiale. Vérifiez que cette sauvegarde initiale est terminée avant de créer une sauvegarde à la demande :
ansible-playbook status.yaml -i deployment_spec.yaml \
    -e resource_type=Backup
6. Créer une sauvegarde à la demande
Au cours de cette étape, vous allez créer une sauvegarde à la demande du cluster.
- Sur la VM de contrôle, créez la ressource
Backup. Appliquez ensuite la ressource :cat > create_backup.yaml <<EOF Backup: metadata: name: s3-backup-1 spec: backupPlanRef: s3-backup-plan dbclusterRef: $CLUSTER EOF ansible-playbook backup.yaml -i deployment_spec.yaml \ -e resource_spec=create_backup.yamlbackupPlanRefcorrespond au nom du plan de sauvegarde. Le champdbclusterRefcorrespond au nom du cluster. - Vérifiez que la sauvegarde est terminée :
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=Backup -e resource_name=s3-backup-1phaseafficheSucceeded. Si la phase n'est pasSucceeded, attendez une minute et exécutez à nouveau la commande. - Vérifiez que les fichiers de sauvegarde se trouvent dans le bucket :
mc --insecure tree "s3repo/$S3_BUCKET"backupcontenant un dossierdb.
7. Restaurer le cluster à partir d'une sauvegarde
L'orchestrateur RPM restaure un cluster sur place. Dans cette étape, vous allez supprimer une table et la restaurer à partir de la sauvegarde. Vous pouvez ensuite choisir de restaurer le cluster à un moment précis.
Attention : Une opération de restauration écrase toutes les données du cluster de bases de données.
Restaurer à partir d'une sauvegarde
- Sur la VM de contrôle, supprimez la table
orders. Comptez ensuite les lignes :psql -c "DROP TABLE public.orders;" psql -c "SELECT pg_catalog.count(*) FROM public.orders;" - Créez le playbook de restauration :
cat > restore.yaml <<EOF - name: Restore AlloyDB Omni cluster hosts: localhost roles: - role: google.alloydbomni_orchestrator.restore EOF - Créez une ressource
Restorepour la sauvegardes3-backup-1. Appliquez ensuite la ressource :cat > restore_backup.yaml <<EOF Restore: metadata: name: s3-restore-1 spec: sourceDBCluster: $CLUSTER backup: s3-backup-1 EOF ansible-playbook restore.yaml -i deployment_spec.yaml \ -e resource_spec=restore_backup.yaml - Vérifiez que l'opération de restauration est terminée :
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=Restore -e resource_name=s3-restore-1phaseafficheProvisionSucceeded. Si la phase n'est pasProvisionSucceeded, attendez une minute et exécutez à nouveau la commande. - Comptez les lignes dans la table restaurée :
psql -c "SELECT pg_catalog.count(*) FROM public.orders;"1000.
(Facultatif) Restaurer à un moment précis
Une restauration à un moment précis utilise une sauvegarde et le journal WAL (Write-Ahead Logging) archivé. Vous pouvez restaurer le cluster à n'importe quel moment de la période de récupération du plan de sauvegarde.
Règles concernant l'heure cible
Vous devez respecter toutes les règles pour choisir la valeur et le format de l'heure cible :
- Utilisez le format RFC 3339 en UTC :
YYYY-MM-DDThh:mm:ssZ. Par exemple,2026-06-19T14:30:00Zcorrespond à 14h30 UTC le 19 juin 2026. La lettreTsépare la date et l'heure. La lettreZindique l'heure UTC. - Utilisez une heure passée.
- Utilisez une heure postérieure à la valeur
begindu champrecoveryWindowdu CRDBackupPlan.
Pour afficher l'heure actuelle au format RFC 3339, exécutez la commande suivante :
date -u +%Y-%m-%dT%H:%M:%SZ
Pour convertir une heure locale dans ce format, ajoutez le décalage UTC de l'heure locale à la commande date. Par exemple, la commande suivante modifie 16:30:00 sur 19 June 2026 à UTC+02:00 :
date -u -d "2026-06-19 16:30:00 +0200" +%Y-%m-%dT%H:%M:%SZ
La commande renvoie 2026-06-19T14:30:00Z.
Restaurer à un moment enregistré
Dans cette procédure, vous allez ajouter des lignes au tableau et enregistrer une heure. Lorsque vous enregistrez un instant, vous marquez le moment exact où la base de données est complètement intacte (avec exactement 1 500 lignes).Vous supprimez ensuite des lignes et restaurez le cluster à l'instant enregistré.
- Ajoutez 500 lignes à la table :
psql <<'SQL' INSERT INTO public.orders (id, item) SELECT g, 'item-' || g FROM pg_catalog.generate_series(1001, 1500) AS g; SQL - Enregistrez l'heure. Le tableau comporte actuellement 1 500 lignes.
sleep 5 PITR_TIME=$(date -u +%Y-%m-%dT%H:%M:%SZ) echo "export PITR_TIME=$PITR_TIME" >> ~/.codelab.env echo "$PITR_TIME" sleep 5YYYY-MM-DDThh:mm:ssZ, par exemple2026-10-05T11:16:02Z. - Supprimez des lignes du tableau pour simuler une suppression accidentelle de données. Démarrez ensuite un nouveau fichier WAL :
psql -c "DELETE FROM public.orders WHERE id > 1000;" psql -c "SELECT pg_catalog.count(*) FROM public.orders;" psql -c "SELECT pg_catalog.pg_switch_wal();"countaffiche1000. La fonctionpg_switch_walpermet au serveur de démarrer un nouveau fichier WAL. Le serveur peut ensuite archiver le fichier WAL contenant vos modifications. - Vérifiez que la période de récupération du plan de sauvegarde contient l'heure enregistrée :
test -n "$PITR_TIME" || { echo "PITR_TIME is not set. Run step 2 again."; exit 1; } echo "$PITR_TIME" ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=BackupPlan -e resource_name=s3-backup-planPITR_TIMEest postérieure à la valeurbegindu champrecoveryWindow. - Créez une ressource
Restorepour la durée enregistrée. Appliquez ensuite la ressource :cat > restore_pitr.yaml <<EOF Restore: metadata: name: s3-restore-pitr spec: sourceDBCluster: $CLUSTER pointInTime: "$PITR_TIME" EOF ansible-playbook restore.yaml -i deployment_spec.yaml \ -e resource_spec=restore_pitr.yaml - Vérifiez que l'opération de restauration est terminée :
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=Restore -e resource_name=s3-restore-pitrphaseafficheProvisionSucceeded. Si la phase n'est pasProvisionSucceeded, attendez une minute et exécutez à nouveau la commande. - Comptez les lignes :
psql -c "SELECT pg_catalog.count(*) FROM public.orders;"1500.
8. Nettoyage
Pour éviter que des frais ne soient facturés sur votre compte Google Cloud, supprimez les ressources de cet atelier de programmation et de l'atelier de programmation Déployer un cluster AlloyDB Omni à haute disponibilité sur des VM GCE à l'aide de RPM Orchestrator. Commencez par supprimer les ressources de sauvegarde, puis supprimez le cluster et l'environnement de calcul.
- Sur la VM de contrôle, créez le playbook de suppression :
cat > delete.yaml <<EOF - name: Delete AlloyDB Omni resources hosts: localhost roles: - role: google.alloydbomni_orchestrator.delete EOF - Répertoriez les sauvegardes :
ansible-playbook status.yaml -i deployment_spec.yaml -e resource_type=Backups3-backup-1. - Supprimez la sauvegarde
s3-backup-1:ansible-playbook delete.yaml -i deployment_spec.yaml \ -e resource_type=Backup -e resource_name=s3-backup-1 - Supprimez le plan de sauvegarde :
ansible-playbook delete.yaml -i deployment_spec.yaml \ -e resource_type=BackupPlan -e resource_name=s3-backup-plan - Supprimez le cluster et l'environnement de calcul en suivant l'étape Nettoyer les ressources de l'atelier de programmation Déployer un cluster AlloyDB Omni à haute disponibilité sur des VM GCE à l'aide de l'outil d'orchestration RPM. Le serveur MinIO et les sauvegardes qu'il contient se trouvent sur la VM de contrôle. Lorsque vous supprimez l'environnement de calcul, vous supprimez à la fois le serveur et les sauvegardes.
9. Félicitations
Félicitations, Vous avez sauvegardé un cluster à haute disponibilité (HA) dans un stockage d'objets compatible avec S3 pour AlloyDB Omni à l'aide de l'outil d'orchestration RPM. Vous avez ensuite restauré le cluster à partir des sauvegardes.
Points abordés
- Découvrez comment installer et exécuter MinIO en tant que stockage d'objets compatible S3.
- Découvrez comment créer un plan de sauvegarde et une sauvegarde à la demande.
- Découvrez comment restaurer un cluster à partir d'une sauvegarde et à un moment précis.
Pour en savoir plus, consultez les pages suivantes :