

1. บทนำ
ใน Codelab นี้ คุณจะสำรองข้อมูลคลัสเตอร์ที่มีความพร้อมใช้งานสูง (HA) ไปยังที่เก็บข้อมูลออบเจ็กต์ที่เข้ากันได้กับ S3 สำหรับ AlloyDB Omni โดยใช้ตัวจัดระเบียบ RPM
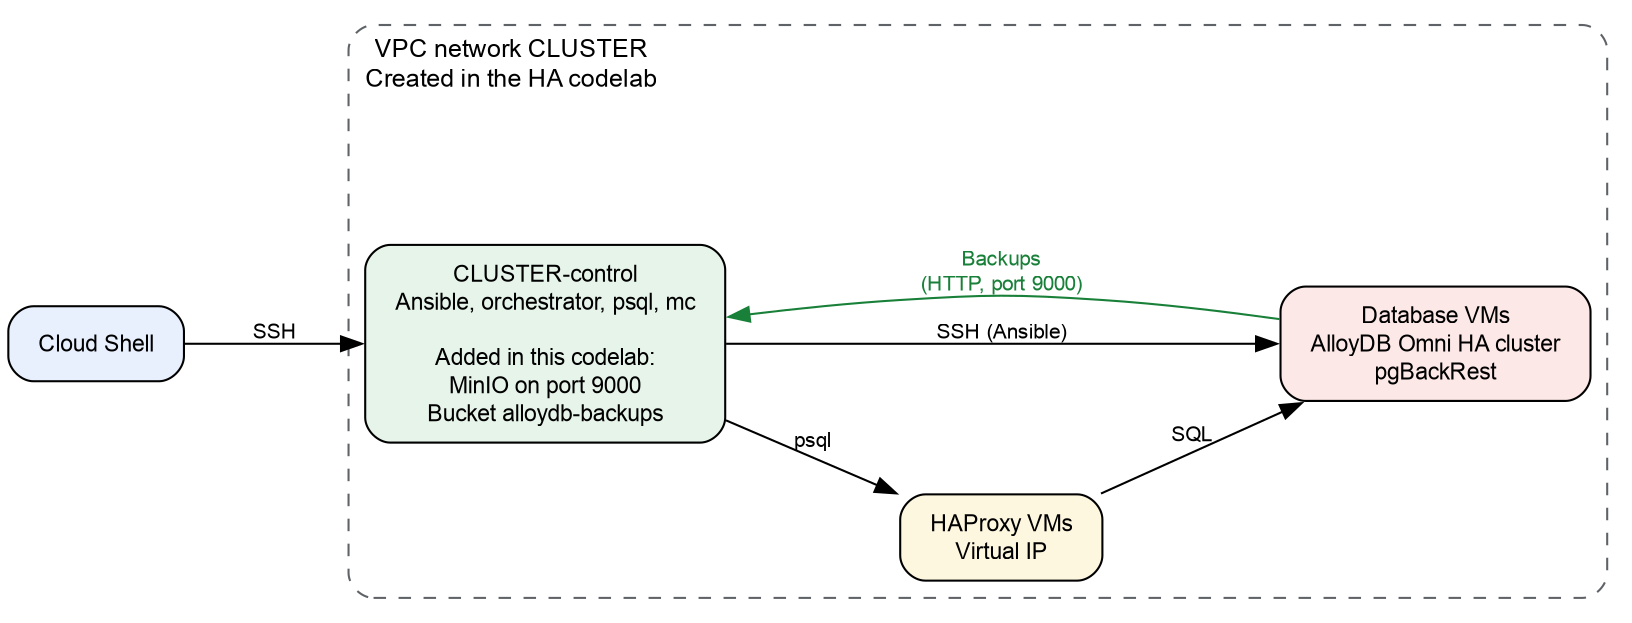
Codelab นี้ใช้คลัสเตอร์จาก Codelab Deploy AlloyDB Omni high availability cluster on GCE VMs using RPM Orchestrator เพื่อสร้างคลัสเตอร์ความพร้อมใช้งานสูงในเครื่องเสมือน (VM) ของ Compute Engine ใน Codelab นี้ คุณจะเพิ่มเซิร์ฟเวอร์ที่เก็บข้อมูลออบเจ็กต์ที่เข้ากันได้กับ S3 ใน VM เครื่องใดเครื่องหนึ่ง คุณใช้เซิร์ฟเวอร์พื้นที่เก็บข้อมูลออบเจ็กต์สำหรับคลัสเตอร์ HA เพื่อสำรองข้อมูลและกู้คืนคลัสเตอร์จากเซิร์ฟเวอร์
ข้อกำหนดเบื้องต้น
- โปรเจ็กต์ Google Cloud ที่เปิดใช้การเรียกเก็บเงิน
- บทบาท IAM ที่ Codelab HA แสดง
- ความรู้พื้นฐานเกี่ยวกับคำสั่ง Linux และ SQL
สิ่งที่คุณจะได้เรียนรู้
- วิธีติดตั้งและเรียกใช้เซิร์ฟเวอร์พื้นที่เก็บข้อมูลออบเจ็กต์ที่เข้ากันได้กับ S3 สำหรับข้อมูลสำรอง
- วิธีสร้างแผนการสำรองข้อมูลที่เขียนข้อมูลสำรองไปยังที่เก็บข้อมูลที่เข้ากันได้กับ S3
- วิธีสร้างข้อมูลสำรองตามต้องการ
- วิธีกู้คืนคลัสเตอร์จากข้อมูลสำรองและไปยังจุดในเวลา
สิ่งที่ต้องมี
- URL ของที่เก็บซอฟต์แวร์ AlloyDB Omni และคอลเล็กชัน Ansible ของ Orchestrator หากต้องการรับ URL ให้กรอกแบบฟอร์มลงชื่อสมัครใช้ AlloyDB Omni ดูข้อมูลเพิ่มเติมได้ที่ภาพรวมการใช้ AlloyDB Omni โดยใช้ RPM คุณใช้ URL ใน Codelab HA
- คลัสเตอร์ความพร้อมใช้งานสูงของ AlloyDB Omni จาก Codelab Deploy AlloyDB Omni high availability cluster on GCE VMs using RPM Orchestrator
- เทอร์มินัลที่มีสิทธิ์เข้าถึง Google Cloud และ Cloud Shell
2. การตั้งค่าและข้อกำหนด
- ในขั้นตอนนี้ คุณจะสร้างคลัสเตอร์ความพร้อมใช้งานสูงโดยใช้ Codelab Deploy AlloyDB Omni high availability cluster on GCE VMs using RPM Orchestrator ทำตามขั้นตอนต่อไปนี้ หากมีคลัสเตอร์จากโค้ดแล็บอยู่แล้ว ให้ทำตามขั้นตอนถัดไป
- หมายเหตุ: อย่าทำตามขั้นตอน "ล้างข้อมูลทรัพยากร" ในขั้นตอนนี้ คุณจะทำตามขั้นตอนนั้นเมื่อสิ้นสุด Codelab นี้
- กลับไปที่ Codelab นี้
3. เชื่อมต่อกับคลัสเตอร์และเพิ่มข้อมูลตัวอย่าง
ในขั้นตอนนี้ คุณจะโหลดการตั้งค่าคลัสเตอร์ใน VM ควบคุม จากนั้นเชื่อมต่อกับคลัสเตอร์และเพิ่มตารางที่มีข้อมูลตัวอย่าง
- หากไม่ได้เชื่อมต่อกับ VM ควบคุม ให้เชื่อมต่อจาก Cloud Shell โดยทำดังนี้
gcloud compute ssh "$CLUSTER-control" --zone="$ZONE" --project="$PROJECT"CLUSTER,ZONEและPROJECTมาจากขั้นตอนเตรียม VM สำหรับการติดตั้งใช้งานใน Codelab ติดตั้งใช้งานคลัสเตอร์ที่มีความพร้อมใช้งานสูงของ AlloyDB Omni ใน VM ของ GCE โดยใช้ RPM Orchestrator หาก Cloud Shell ไม่มีตัวแปรเหล่านี้ ให้ตั้งค่าอีกครั้ง - ใน VM ควบคุม ให้เปลี่ยนไปที่ไดเรกทอรีหลักและโหลดตัวแปรสภาพแวดล้อม จากนั้นเพิ่มชื่อคลัสเตอร์และผู้ใช้ SSH ลงในไฟล์สภาพแวดล้อม
cd ~ source /tmp/cluster.conf cat >> ~/.codelab.env <<EOF export CLUSTER="$cluster" export SSH_USER="$service_account" EOF source ~/.codelab.env env | grep -E '^(CLUSTER|SSH_USER|VIRTUAL_IP)='CLUSTER,SSH_USERและVIRTUAL_IPหมายเหตุ: หากเชื่อมต่อกับ VM ควบคุมอีกครั้งในภายหลัง ให้เรียกใช้cd ~และsource ~/.codelab.envก่อนดำเนินการต่อ - เพิ่มการตั้งค่าการเชื่อมต่อลงในไฟล์สภาพแวดล้อม เมื่อคำสั่ง
readขอรหัสผ่าน ให้ป้อนรหัสผ่านของผู้ใช้postgresคุณตั้งรหัสผ่านนี้ในขั้นตอนBootstrap AlloyDB Omni Cluster ใน Codelab Deploy AlloyDB Omni high availability cluster on GCE VMs using RPM Orchestratorcat >> ~/.codelab.env <<'EOF' export PATH="/usr/pgsql-18/bin:$PATH" export PGHOST="$VIRTUAL_IP" export PGUSER="postgres" EOF read -rsp "Password of the postgres user: " PGPASSWORD; echo printf 'export PGPASSWORD=%q\n' "$PGPASSWORD" >> ~/.codelab.env source ~/.codelab.env env | grep -E '^(PGHOST|PGUSER|PGPASSWORD)=' - สร้างตารางและเพิ่ม 1,000 แถว
psql <<'SQL' CREATE TABLE public.orders ( id integer PRIMARY KEY, item text NOT NULL, created_at timestamptz NOT NULL DEFAULT pg_catalog.now() ); INSERT INTO public.orders (id, item) SELECT g, 'item-' || g FROM pg_catalog.generate_series(1, 1000) AS g; SQL - นับแถว
psql -c "SELECT pg_catalog.count(*) FROM public.orders;"1000
4. ติดตั้งและเรียกใช้ที่เก็บข้อมูลออบเจ็กต์ที่เข้ากันได้กับ S3
ในขั้นตอนนี้ คุณจะเขียน Playbook ของ Ansible ที่ติดตั้งเซิร์ฟเวอร์ MinIO ใน VM ควบคุม นอกจากนี้ Playbook ยังสร้างที่เก็บข้อมูลและผู้ใช้สำหรับการสำรองข้อมูล รวมถึงตรวจสอบว่า VM ของฐานข้อมูลเชื่อมต่อกับ MinIO ได้ เรียกใช้คำสั่งทั้งหมดในขั้นตอนนี้บน VM ควบคุม
- ใน VM ควบคุม ให้เพิ่มการตั้งค่าพื้นที่เก็บข้อมูลลงในไฟล์สภาพแวดล้อม
opensslคำสั่งจะสร้างรหัสผ่านแบบสุ่มMD=http://metadata.google.internal/computeMetadata/v1/instance S3_IP=$(curl -s -H "Metadata-Flavor: Google" "$MD/network-interfaces/0/ip") cat >> ~/.codelab.env <<EOF export S3_IP="$S3_IP" export S3_HOST="$CLUSTER-control" export S3_BUCKET="alloydb-backups" export S3_REGION="us-east-1" export MINIO_ROOT_USER="s3admin" export MINIO_ROOT_PASSWORD="$(openssl rand -hex 16)" export S3_ACCESS_KEY_ID="alloydb-backup" export S3_SECRET_ACCESS_KEY="$(openssl rand -hex 16)" export MINIO_URL="https://github.com/minio/minio/releases/download/RELEASE.2024-05-10T01-41-38Z/minio.linux-amd64.RELEASE.2024-05-10T01-41-38Z" export MC_URL="https://github.com/minio/mc/releases/download/RELEASE.2024-05-09T17-04-24Z/mc.linux-amd64.RELEASE.2024-05-09T17-04-24Z" EOF source ~/.codelab.env echo "$S3_HOST $S3_IP"my-cluster-control 10.1.0.2VM ฐานข้อมูลใช้ชื่อโฮสต์และที่อยู่ IP นี้เพื่อเชื่อมต่อกับ MinIO เซิร์ฟเวอร์ข้อมูลเมตาของ VM จะให้ที่อยู่ IP ดูข้อมูลเพิ่มเติมได้ที่เอกสารประกอบเกี่ยวกับข้อมูลเมตาของ VM ค่าMINIO_URLและMC_URLคือ URL การดาวน์โหลดของเซิร์ฟเวอร์ MinIO และไคลเอ็นต์ MinIO (mc) - ติดตั้งคอลเล็กชัน Ansible ของ
community.cryptoที่จำเป็นใน VM ควบคุมansible-galaxy collection install community.crypto - สร้าง Playbook
s3_server.yamlcat > s3_server.yaml <<EOF - name: Install and run MinIO on the control VM hosts: localhost connection: local become: true gather_facts: false tasks: - name: Create MinIO directories ansible.builtin.file: path: "{{ item }}" state: directory mode: "0755" loop: - /var/lib/minio/data - /var/lib/minio/certs - name: Download MinIO server and client ansible.builtin.get_url: url: "{{ item.url }}" dest: "{{ item.dest }}" mode: "0755" loop: - url: "$MINIO_URL" dest: /usr/local/bin/minio - url: "$MC_URL" dest: /usr/local/bin/mc - name: Generate MinIO TLS private key community.crypto.openssl_privatekey: path: /var/lib/minio/certs/private.key size: 2048 mode: "0600" - name: Generate MinIO certificate signing request community.crypto.openssl_csr_pipe: privatekey_path: /var/lib/minio/certs/private.key common_name: "$S3_HOST" subject_alt_name: - "DNS:$S3_HOST" - "DNS:$S3_BUCKET.$S3_HOST" - "DNS:localhost" - "IP:127.0.0.1" - "IP:$S3_IP" register: minio_csr - name: Generate self-signed MinIO TLS certificate community.crypto.x509_certificate: path: /var/lib/minio/certs/public.crt csr_content: "{{ minio_csr.csr }}" privatekey_path: /var/lib/minio/certs/private.key provider: selfsigned selfsigned_not_after: "+365d" mode: "0644" - name: Create MinIO systemd service unit ansible.builtin.copy: dest: /etc/systemd/system/minio.service mode: "0600" content: | [Unit] Description=MinIO Object Storage After=network.target [Service] Environment="MINIO_ROOT_USER=$MINIO_ROOT_USER" Environment="MINIO_ROOT_PASSWORD=$MINIO_ROOT_PASSWORD" Environment="MINIO_DOMAIN=$S3_HOST" ExecStart=/usr/local/bin/minio server /var/lib/minio/data --certs-dir /var/lib/minio/certs Restart=on-failure [Install] WantedBy=multi-user.target - name: Start and enable MinIO service ansible.builtin.systemd_service: name: minio daemon_reload: true state: started enabled: true - name: Add storage host names to /etc/hosts on the control VM ansible.builtin.lineinfile: path: /etc/hosts line: "$S3_IP $S3_HOST $S3_BUCKET.$S3_HOST" state: present - name: Wait for MinIO health endpoint ansible.builtin.uri: url: "https://$S3_HOST:9000/minio/health/live" ca_path: /var/lib/minio/certs/public.crt status_code: 200 register: minio_health until: minio_health.status == 200 retries: 6 delay: 5 - name: Create backup bucket and user in MinIO ansible.builtin.command: argv: "{{ item }}" loop: - - /usr/local/bin/mc - --insecure - alias - set - s3repo - "https://$S3_HOST:9000" - "$MINIO_ROOT_USER" - "$MINIO_ROOT_PASSWORD" - - /usr/local/bin/mc - --insecure - mb - --ignore-existing - "s3repo/$S3_BUCKET" - - /usr/local/bin/mc - --insecure - admin - user - add - s3repo - "$S3_ACCESS_KEY_ID" - "$S3_SECRET_ACCESS_KEY" - - /usr/local/bin/mc - --insecure - admin - policy - attach - s3repo - readwrite - --user - "$S3_ACCESS_KEY_ID" become: false no_log: true - name: Configure database VMs for MinIO hosts: primary_instance_nodes become: true gather_facts: false vars: ansible_user: $SSH_USER ansible_ssh_private_key_file: $HOME/ssh-key-cluster-sa tasks: - name: Set SELinux to permissive mode ansible.builtin.command: cmd: setenforce 0 - name: Add storage host names to /etc/hosts ansible.builtin.lineinfile: path: /etc/hosts line: "$S3_IP $S3_HOST $S3_BUCKET.$S3_HOST" state: present - name: Verify storage host resolution ansible.builtin.getent: database: hosts key: "$S3_BUCKET.$S3_HOST" - name: Verify connection to MinIO ansible.builtin.uri: url: "https://$S3_HOST:9000/minio/health/live" validate_certs: false status_code: 200 EOFMINIO_DOMAINช่วยให้ MinIO ยอมรับคำขอในรูปแบบโฮสต์เสมือน Orchestrator ของ RPM ใช้ผู้ใช้alloydb-backupเพื่อเขียนข้อมูลสำรอง นโยบายreadwriteเป็นนโยบายในตัวของ MinIO - เรียกใช้ Playbook
ansible-playbook s3_server.yaml -i deployment_spec.yamlPLAY RECAPแสดงfailed=0สำหรับlocalhostและสำหรับ VM ฐานข้อมูลแต่ละรายการ - ตรวจสอบว่ามีที่เก็บอยู่หรือไม่
mc --insecure ls s3repoalloydb-backups/
5. สร้างแผนการสำรองข้อมูล
แผนการสำรองข้อมูลประกอบด้วยตำแหน่งที่เก็บข้อมูล กำหนดการ และระยะเวลาเก็บรักษาสำหรับการสำรองข้อมูลของคลัสเตอร์ ในขั้นตอนนี้ คุณจะสร้างแผนสำรองสำหรับที่เก็บข้อมูล MinIO
- สร้าง Playbook การสำรองข้อมูลและ Playbook สถานะใน VM ควบคุม คุณใช้เพลย์บุ๊กการสำรองข้อมูลสำหรับทรัพยากร
Secret,BackupPlanและBackupคุณใช้เพลย์บุ๊กสถานะเพื่อแสดงสถานะของทรัพยากรcat > backup.yaml <<EOF - name: Manage AlloyDB Omni backups hosts: localhost roles: - role: google.alloydbomni_orchestrator.backup EOF cat > status.yaml <<EOF - name: Get resource status hosts: localhost roles: - role: google.alloydbomni_orchestrator.status EOF - สร้างทรัพยากร
Secretสำหรับข้อมูลเข้าสู่ระบบ S3 จากนั้นใช้แหล่งข้อมูลS3_KEY_ID_B64=$(printf '%s' "$S3_ACCESS_KEY_ID" | base64 -w 0) S3_KEY_B64=$(printf '%s' "$S3_SECRET_ACCESS_KEY" | base64 -w 0) cat > s3_secret.yaml <<EOF Secret: metadata: name: s3-backup-secret spec: type: Opaque data: access-key-id: "$S3_KEY_ID_B64" access-key: "$S3_KEY_B64" EOF ansible-playbook backup.yaml -i deployment_spec.yaml \ -e resource_spec=s3_secret.yamldataต้องเป็นaccess-key-idและaccess-keyคุณต้องใช้ทรัพยากรSecretก่อนใช้ทรัพยากรBackupPlan - สร้าง
BackupPlanแล้วใช้ทรัพยากรโดยทำดังนี้cat > backup_plan.yaml <<EOF BackupPlan: metadata: name: s3-backup-plan spec: dbclusterRef: $CLUSTER backupLocation: type: S3 s3Options: bucket: $S3_BUCKET key: /backups endpoint: https://$S3_HOST:9000 region: $S3_REGION secretRef: name: s3-backup-secret caBundle: - | $(sed 's/^/ /' /var/lib/minio/certs/public.crt) EOF ansible-playbook backup.yaml -i deployment_spec.yaml \ -e resource_spec=backup_plan.yamlkeyคือเส้นทางของข้อมูลสำรองในที่เก็บข้อมูล เส้นทางนี้ต้องขึ้นต้นด้วยเครื่องหมายทับ (/) ฟิลด์caBundleมีใบรับรอง CA ที่เข้ารหัส PEM ซึ่งตรวจสอบใบรับรองของเซิร์ฟเวอร์พื้นที่เก็บข้อมูล S3 - ตรวจสอบว่าแผนการสำรองข้อมูลพร้อมใช้งาน
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=BackupPlan -e resource_name=s3-backup-planphaseแสดงReadyหากเฟสไม่ใช่Readyให้รอ 1 นาทีแล้วเรียกใช้คำสั่งอีกครั้ง - เมื่อสร้างแผนสำรองแล้ว ตัวจัดสรร RPM จะเริ่มการสำรองข้อมูลเต็มรูปแบบครั้งแรกโดยอัตโนมัติ ตรวจสอบว่าการสำรองข้อมูลครั้งแรกนี้เสร็จสมบูรณ์ก่อนที่จะสร้างการสำรองข้อมูลตามต้องการ
ansible-playbook status.yaml -i deployment_spec.yaml \
    -e resource_type=Backup
6. สร้างข้อมูลสำรองตามต้องการ
ในขั้นตอนนี้ คุณจะสร้างข้อมูลสำรองของคลัสเตอร์ตามต้องการ
- สร้าง
Backupใน VM ควบคุม จากนั้นใช้แหล่งข้อมูลcat > create_backup.yaml <<EOF Backup: metadata: name: s3-backup-1 spec: backupPlanRef: s3-backup-plan dbclusterRef: $CLUSTER EOF ansible-playbook backup.yaml -i deployment_spec.yaml \ -e resource_spec=create_backup.yamlbackupPlanRefคือชื่อของแผนการสำรองข้อมูล ฟิลด์dbclusterRefคือชื่อของคลัสเตอร์ - ตรวจสอบว่าการสำรองข้อมูลเสร็จสมบูรณ์แล้ว
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=Backup -e resource_name=s3-backup-1phaseแสดงSucceededหากเฟสไม่ใช่Succeededให้รอ 1 นาทีแล้วเรียกใช้คำสั่งอีกครั้ง - ตรวจสอบว่าไฟล์ข้อมูลสำรองอยู่ใน Bucket โดยทำดังนี้
mc --insecure tree "s3repo/$S3_BUCKET"backupที่มีโฟลเดอร์db
7. กู้คืนคลัสเตอร์จากข้อมูลสำรอง
ผู้ประสานงาน RPM จะกู้คืนคลัสเตอร์ในตำแหน่งเดิม ในขั้นตอนนี้ คุณจะลบตารางและกู้คืนจากข้อมูลสำรอง จากนั้นคุณจะเลือกกู้คืนคลัสเตอร์ไปยังจุดใดจุดหนึ่งในเวลาได้
ข้อควรระวัง: การดำเนินการกู้คืนจะเขียนทับข้อมูลทั้งหมดในคลัสเตอร์ฐานข้อมูล
คืนค่าข้อมูลจากข้อมูลสำรอง
- ใน VM ควบคุม ให้ลบตาราง
ordersจากนั้นนับแถวpsql -c "DROP TABLE public.orders;" psql -c "SELECT pg_catalog.count(*) FROM public.orders;" - สร้าง Playbook การกู้คืน
cat > restore.yaml <<EOF - name: Restore AlloyDB Omni cluster hosts: localhost roles: - role: google.alloydbomni_orchestrator.restore EOF - สร้างทรัพยากร
Restoreสำหรับข้อมูลสำรองs3-backup-1จากนั้นใช้แหล่งข้อมูลcat > restore_backup.yaml <<EOF Restore: metadata: name: s3-restore-1 spec: sourceDBCluster: $CLUSTER backup: s3-backup-1 EOF ansible-playbook restore.yaml -i deployment_spec.yaml \ -e resource_spec=restore_backup.yaml - ตรวจสอบว่าการดำเนินการคืนค่าเสร็จสมบูรณ์แล้ว
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=Restore -e resource_name=s3-restore-1phaseแสดงProvisionSucceededหากเฟสไม่ใช่ProvisionSucceededให้รอ 1 นาทีแล้วเรียกใช้คำสั่งอีกครั้ง - นับแถวในตารางที่กู้คืน
psql -c "SELECT pg_catalog.count(*) FROM public.orders;"1000
(ไม่บังคับ) กู้คืนเป็นช่วงเวลาหนึ่ง
การกู้คืน ณ จุดใดจุดหนึ่งจะใช้ข้อมูลสำรองและบันทึกการเขียนล่วงหน้า (WAL) ที่เก็บถาวร คุณสามารถกู้คืนคลัสเตอร์ไปยังเวลาใดก็ได้ในหน้าต่างการกู้คืนของแผนการสำรองข้อมูล
กฎสำหรับเวลาเป้าหมาย
คุณต้องปฏิบัติตามกฎทั้งหมดเพื่อเลือกค่าและรูปแบบสำหรับเวลาเป้าหมาย
- ใช้รูปแบบ RFC 3339 ใน UTC:
YYYY-MM-DDThh:mm:ssZเช่น2026-06-19T14:30:00Zคือ 14:30:00 UTC ในวันที่ 19 มิถุนายน 2026 ตัวอักษรTคั่นระหว่างวันที่และเวลา ตัวอักษรZแสดงเวลา UTC - ใช้เวลาในอดีต
- ใช้เวลาหลังจากค่า
beginของฟิลด์recoveryWindowของBackupPlanCRD
หากต้องการแสดงเวลาปัจจุบันในรูปแบบ RFC 3339 ให้เรียกใช้คำสั่งนี้
date -u +%Y-%m-%dT%H:%M:%SZ
หากต้องการเปลี่ยนเวลาท้องถิ่นเป็นรูปแบบนี้ ให้เพิ่มออฟเซ็ต UTC ของเวลาท้องถิ่นลงในคำสั่ง date เช่น คำสั่งต่อไปนี้จะเปลี่ยน 16:30:00 ใน 19 June 2026 ที่ UTC+02:00
date -u -d "2026-06-19 16:30:00 +0200" +%Y-%m-%dT%H:%M:%SZ
คำสั่งจะแสดง 2026-06-19T14:30:00Z
กู้คืนเป็นช่วงเวลาที่บันทึกไว้
ในขั้นตอนนี้ คุณจะเพิ่มแถวลงในตารางและบันทึกเวลา เมื่อบันทึกเวลา คุณจะบุ๊กมาร์กช่วงเวลาที่ฐานข้อมูลสมบูรณ์แบบ (มี 1,500 แถวพอดี) จากนั้นลบแถวและกู้คืนคลัสเตอร์ไปยังเวลาที่บันทึกไว้
- เพิ่ม 500 แถวลงในตาราง
psql <<'SQL' INSERT INTO public.orders (id, item) SELECT g, 'item-' || g FROM pg_catalog.generate_series(1001, 1500) AS g; SQL - บันทึกเวลา ขณะนี้ตารางมี 1,500 แถว
sleep 5 PITR_TIME=$(date -u +%Y-%m-%dT%H:%M:%SZ) echo "export PITR_TIME=$PITR_TIME" >> ~/.codelab.env echo "$PITR_TIME" sleep 5YYYY-MM-DDThh:mm:ssZเช่น2026-10-05T11:16:02Z - ลบแถวออกจากตารางเพื่อจำลองการลบข้อมูลโดยไม่ตั้งใจ จากนั้นเริ่มไฟล์ WAL ใหม่
psql -c "DELETE FROM public.orders WHERE id > 1000;" psql -c "SELECT pg_catalog.count(*) FROM public.orders;" psql -c "SELECT pg_catalog.pg_switch_wal();"countแสดง1000ฟังก์ชันpg_switch_walทำให้เซิร์ฟเวอร์เริ่มไฟล์ WAL ใหม่ จากนั้นเซิร์ฟเวอร์จะเก็บไฟล์ WAL ที่มีการเปลี่ยนแปลงของคุณ - ตรวจสอบว่ากรอบเวลาการกู้คืนของแผนการสำรองข้อมูลมีเวลาที่บันทึกไว้หรือไม่ โดยทำดังนี้
test -n "$PITR_TIME" || { echo "PITR_TIME is not set. Run step 2 again."; exit 1; } echo "$PITR_TIME" ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=BackupPlan -e resource_name=s3-backup-planPITR_TIMEอยู่หลังค่าbeginของฟิลด์recoveryWindow - สร้างทรัพยากร
Restoreสำหรับเวลาที่บันทึกไว้ จากนั้นใช้แหล่งข้อมูลcat > restore_pitr.yaml <<EOF Restore: metadata: name: s3-restore-pitr spec: sourceDBCluster: $CLUSTER pointInTime: "$PITR_TIME" EOF ansible-playbook restore.yaml -i deployment_spec.yaml \ -e resource_spec=restore_pitr.yaml - ตรวจสอบว่าการดำเนินการคืนค่าเสร็จสมบูรณ์แล้ว
ansible-playbook status.yaml -i deployment_spec.yaml \ -e resource_type=Restore -e resource_name=s3-restore-pitrphaseแสดงProvisionSucceededหากเฟสไม่ใช่ProvisionSucceededให้รอ 1 นาทีแล้วเรียกใช้คำสั่งอีกครั้ง - นับแถว
psql -c "SELECT pg_catalog.count(*) FROM public.orders;"1500
8. ล้างข้อมูล
โปรดลบทรัพยากรของ Codelab นี้และ Codelab Deploy AlloyDB Omni high availability cluster on GCE VMs using RPM Orchestrator เพื่อป้องกันไม่ให้มีการเรียกเก็บเงินจากบัญชี Google Cloud ก่อนอื่นให้ลบทรัพยากรสำรอง จากนั้นลบคลัสเตอร์และสภาพแวดล้อมการประมวลผล
- สร้าง Playbook การลบใน VM ควบคุมโดยทำดังนี้
cat > delete.yaml <<EOF - name: Delete AlloyDB Omni resources hosts: localhost roles: - role: google.alloydbomni_orchestrator.delete EOF - แสดงรายการข้อมูลสำรอง
ansible-playbook status.yaml -i deployment_spec.yaml -e resource_type=Backups3-backup-1 - ลบข้อมูลสำรองของ
s3-backup-1โดยทำดังนี้ansible-playbook delete.yaml -i deployment_spec.yaml \ -e resource_type=Backup -e resource_name=s3-backup-1 - ลบแผนการสำรองข้อมูล
ansible-playbook delete.yaml -i deployment_spec.yaml \ -e resource_type=BackupPlan -e resource_name=s3-backup-plan - ลบคลาสเตอร์และสภาพแวดล้อมการประมวลผลโดยใช้ขั้นตอนล้างข้อมูลทรัพยากรจาก Codelab ติดตั้งใช้งานคลัสเตอร์ที่มีความพร้อมใช้งานสูงของ AlloyDB Omni ใน VM ของ GCE โดยใช้ RPM Orchestrator เซิร์ฟเวอร์ MinIO และข้อมูลสำรองในเซิร์ฟเวอร์จะอยู่ใน VM ควบคุม เมื่อลบสภาพแวดล้อมการประมวลผล คุณจะลบทั้งเซิร์ฟเวอร์และข้อมูลสำรอง
9. ขอแสดงความยินดี
ยินดีด้วย คุณได้สำรองข้อมูลคลัสเตอร์ที่มีความพร้อมใช้งานสูง (HA) ไปยังที่เก็บข้อมูลออบเจ็กต์ที่เข้ากันได้กับ S3 สำหรับ AlloyDB Omni โดยใช้ตัวจัดระเบียบ RPM จากนั้นคุณได้กู้คืนคลัสเตอร์จากข้อมูลสำรอง
สิ่งที่เราได้พูดถึง
- วิธีติดตั้งและเรียกใช้ MinIO เป็นที่เก็บข้อมูลออบเจ็กต์ที่เข้ากันได้กับ S3
- วิธีสร้างแผนสำรองและข้อมูลสำรองตามต้องการ
- วิธีกู้คืนคลัสเตอร์จากข้อมูลสำรองและไปยังจุดในเวลา
ดูข้อมูลเพิ่มเติมได้ที่หน้าต่อไปนี้