

1. Wprowadzenie
To ćwiczenie pokazuje, jak wdrożyć klaster AlloyDB Omni o wysokiej dostępności w maszynach wirtualnych Google Compute Engine (GCE). Po ukończeniu tego ćwiczenia utworzysz architekturę referencyjną o wysokiej dostępności składającą się z 3 węzłów bazy danych i 2 węzłów HAProxy oraz węzła sterującego do operacji zarządzania.
Wymagania wstępne
- Dostęp do projektu w chmurze Google Cloud i Cloud Shell z konsoli Cloud.
- Zainstalowany i skonfigurowany pakiet SDK Google Cloud (
gcloud). Szczegółowe informacje o instalowaniu gcloud znajdziesz w artykule gcloud-install. - Zainstalowano Terraform w wersji v1.9.8.
Czego się nauczysz
- Jak tworzyć i przygotowywać maszyny wirtualne GCE na potrzeby AlloyDB Omni.
- Jak zainstalować i uruchomić aranżera RPM AlloyDB Omni.
- Instalowanie i konfigurowanie pakietów RPM AlloyDB Omni na potrzeby architektury referencyjnej HA.
Czego potrzebujesz
- Uzyskaj link URL do pakietów RPM AlloyDB Omni i aranżera RPM. Aby to zrobić, wypełnij formularz rejestracji w usłudze AlloyDB Omni. Linki są wysyłane na adres e-mail serwera adresu URL repozytorium. Zainicjuj te zmienne środowiskowe, aby mieć pod ręką adresy URL, które będą używane w tym module.
export ORCHESTRATOR_ANSIBLE_COLLECTION_PATH="..." export ALLOYDB_OMNI_REPOSITORY_URL="..." export ALLOYDB_OMNI_ORCHESTRATOR_REPOSITORY_URL="..." export ALLOYDB_OMNI_COMMON_REPOSITORY_URL="..." export ETCD_REPOSITORY_URL="..." - Działający terminal z dostępem do stosu wdrażania AlloyDB Omni. W tym celu możesz użyć Cloud Shell.
2. Konfiguracja i wymagania
Konfiguracja projektu
Tworzenie projektu Google Cloud
- W konsoli Google Cloud na stronie wyboru projektu wybierz lub utwórz projekt w chmurze Google Cloud.
- Sprawdź, czy w projekcie Cloud włączone są płatności. Dowiedz się, jak sprawdzić, czy w projekcie są włączone płatności.
Uruchamianie Cloud Shell
Z Google Cloud można korzystać zdalnie na laptopie, ale w tym ćwiczeniu użyjesz Google Cloud Shell, czyli środowiska wiersza poleceń działającego w chmurze.
W konsoli Google Cloud kliknij ikonę Cloud Shell na pasku narzędzi w prawym górnym rogu:
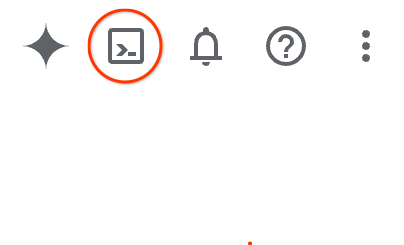
Możesz też nacisnąć G, a potem S. Ta sekwencja aktywuje Cloud Shell, jeśli korzystasz z konsoli Google Cloud. Możesz też użyć tego linku.
Uzyskanie dostępu do środowiska i połączenie się z nim powinno zająć tylko kilka chwil. Po zakończeniu powinny pojawić się dane wyjściowe podobne do tych:
Ta maszyna wirtualna zawiera wszystkie potrzebne narzędzia dla programistów. Zawiera również stały katalog domowy o pojemności 5 GB i działa w Google Cloud, co znacznie zwiększa wydajność sieci i usprawnia proces uwierzytelniania. Wszystkie zadania w tym ćwiczeniu możesz wykonać w przeglądarce. Nie musisz niczego instalować.
3. Tworzenie maszyn wirtualnych Google Cloud Compute Engine
Przygotowywanie skryptów Terraform
- Zdefiniuj zmienne środowiskowe dla identyfikatora projektu i wybranej nazwy klastra. Będziesz ich używać w całym przewodniku.
export PROJECT="your-project-id" export CLUSTER="your-cluster-name" - Zaloguj się jako użytkownik konta Google Cloud.
gcloud auth login - Utwórz katalog roboczy na potrzeby wdrożenia i skopiuj wymagane pliki konfiguracji Terraform ze źródła repozytorium.
mkdir -p ~/alloydb-omni/$PROJECT/$CLUSTER cd ~/alloydb-omni/$PROJECT/$CLUSTER gcloud storage cp gs://alloydb-omni-install/rpm-orchestrator/gce/terraform/*.tf . - Utwórz plik
terraform.tfvars, aby określić wymagane parametry zgodnie z architekturą referencyjną, jak pokazano poniżej:cat > terraform.tfvars <<EOF # Required instance counts for reference architecture db_instance_count = 3 haproxy_instance_count = 2 control_instance_count = 1 # Optional: Customize if needed with the below variables # os_image = "rocky-linux-cloud/rocky-linux-9" # zone = "us-west4-c" # region_1 = "us-west4" # db_instance_type = "c4-highmem-4" # db_disk_type = "hyperdisk-balanced" # db_data_size = "50" # GB # data_dir = "/data" EOF
Wykonaj skrypty Terraform i przeprowadź weryfikację
- Możesz teraz udostępnić maszyny wirtualne.
terraform init - Zanim utworzysz maszyny wirtualne, upewnij się, że masz wymagany dostęp do tworzenia maszyn wirtualnych i innych zasobów. Podsumowując, musisz mieć te uprawnienia:
roles/compute.admin roles/iam.roleAdmin roles/compute.osAdminLogin roles/iam.serviceAccountCreator roles/iam.serviceAccountUser roles/artifactregistry.repoAdmin roles/storage.objectUser roles/resourcemanager.projectIamAdmin roles/serviceusage.serviceUsageAdmin - Sprawdź konfigurację i zastosuj ją, aby udostępnić zasoby.
terraform validate terraform apply --auto-approve - Po zakończeniu działania Terraform sprawdź, czy maszyny wirtualne zostały utworzone. W tym celu wyświetl listę utworzonych instancji za pomocą polecenia
gcloud.gcloud compute instances list --filter="name~$CLUSTER" --project=$PROJECTexport ZONE=$(gcloud compute instances list \ --filter="name=$CLUSTER-control" \ --format="value(zone)" --project=$PROJECT)
4. Przygotowywanie maszyn wirtualnych do wdrożenia
Musisz utworzyć sesję SSH z węzłem sterującym i wykonać czynności, aby włączyć dostęp SSH do wszystkich maszyn wirtualnych (zwanych też węzłami).
- Sprawdź, czy zmienne środowiskowe projektu i klastra są zdefiniowane.
export PROJECT="your-project-id" export CLUSTER="your-cluster-name" - Utwórz klucz SSH i dodaj go, aby zalogować się na maszynie wirtualnej sterowania.
# Replace values with your specific GCP project, cluster and zone details ssh-keygen -t ed25519 -f $HOME/.ssh/google_compute_engine gcloud compute os-login ssh-keys add --key-file=$HOME/.ssh/google_compute_engine.pub --project=$PROJECT - Utwórz regułę zapory sieciowej, która zezwala na połączenia SSH i ruch VRRP.
gcloud compute config-ssh --project=$PROJECT gcloud compute firewall-rules create $CLUSTER-allow-ssh --network=$CLUSTER --project=$PROJECT --direction=INGRESS --action=allow --rules=tcp:22 --source-ranges="0.0.0.0/0" gcloud compute firewall-rules create $CLUSTER-allow-vrrp --network=$CLUSTER --project=$PROJECT --allow=112 --source-ranges="0.0.0.0/0" - Połącz się z maszyną wirtualną sterowania przez SSH:
gcloud compute ssh "$CLUSTER-control" --zone=$ZONE --project=$PROJECT - Utwórz grupę Linux na węźle sterującym o tej samej nazwie co nazwa użytkownika:
sudo groupadd -f $(id -un) sudo usermod -aG $(id -un) $(id -un) - Konfiguracja Terraform tworzy kilka skryptów konfiguracyjnych i umieszcza je w katalogu
/tmp/na maszynie wirtualnej sterowania, który zawiera takie elementy jak nazwa klastra, konto usługi, nazwa projektu itp.Utwórz dostęp SSH bez hasła z węzłów sterowania do wszystkich węzłów klastra za pomocą skryptów konfiguracji w węźle sterowania./tmp/setup-ssh-for-cluster.sh - W tym ćwiczeniu możemy wyłączyć SELinux na wszystkich węzłach. Skrypt Terraform dodaje plik „/tmp/run-all.sh”, którego można użyć w tym celu.
/tmp/run-all.sh sudo setenforce 0 - Jeśli masz już subskrypcję AlloyDB Omni i uzyskałeś linki, dodaj te adresy URL do zmiennych środowiskowych.
cat >> ~/.codelab.env <<EOF export ORCHESTRATOR_ANSIBLE_COLLECTION_PATH="..." export ALLOYDB_OMNI_REPOSITORY_URL="..." export ALLOYDB_OMNI_ORCHESTRATOR_REPOSITORY_URL="..." export ALLOYDB_OMNI_COMMON_REPOSITORY_URL="..." export ETCD_REPOSITORY_URL="..." EOFterraform/variables.tftak, aby nie powodował konfliktu z innymi węzłami, jak pokazano w tym przykładzie:cat >> ~/.codelab.env <<EOF export VIRTUAL_IP="10.1.0.50" EOF
5. Zainstaluj wymagane komponenty oprogramowania na wszystkich maszynach wirtualnych.
Następnym krokiem jest zainstalowanie wymaganych komponentów oprogramowania na maszynach wirtualnych. Można to skoordynować w węźle sterującym. Wszystkie poniższe polecenia muszą być wykonywane na węźle sterującym.
- Połącz się z maszyną wirtualną sterowania przez SSH, jeśli nie jesteś jeszcze na węźle sterowania.
gcloud compute ssh "$CLUSTER-control" --zone=$ZONE --project=$PROJECTsource ~/.codelab.env - Na węźle sterującym zainstaluj Ansible i wymagane biblioteki Pythona.
sudo dnf install -y https://dl.fedoraproject.org/pub/epel/epel-release-latest-9.noarch.rpm -y sudo dnf install -y ansible sudo dnf install -y python3-grpcio python3-protobuf python3-googleapis-common-protos python3-grpcio-status - Następnie pobierz plik tar kolekcji RPM Orchestrator Ansible i zainstaluj go.
gcloud storage cp "gs://${ORCHESTRATOR_ANSIBLE_COLLECTION_PATH#https://storage.googleapis.com/}google-alloydbomni_orchestrator-*.tar.gz" . COLLECTION_FILE=$(ls -1 google-alloydbomni_orchestrator-*.tar.gz \ | sort -V | tail -n 1) ansible-galaxy collection install "$COLLECTION_FILE" ansible-galaxy collection list | grep alloydbomni_orchestratorsort -Vitail -n 1wybierają plik z najnowszą wersją. Uwaga: upewnij się, że zmienna ORCHESTRATOR_ANSIBLE_COLLECTION_PATH kończy się znakiem „/”. - Orchestrator używa pliku specyfikacji wdrożenia w formacie spisu Ansible, aby poznać topologię klastra. Utwórz na węźle sterującym plik o nazwie deployment_spec.yaml ze szczegółami węzła.
cat > deployment_spec.yaml <<EOF alloydbomni: vars: cluster_manager: name: "$CLUSTER" etcd: setup: true config_forcewrite: true alloydbomni: major_version: "18" repo_url: $ALLOYDB_OMNI_REPOSITORY_URL alloydbomni_monitor: repo_url: $ALLOYDB_OMNI_COMMON_REPOSITORY_URL alloydbomni_cluster_manager: repo_url: $ALLOYDB_OMNI_ORCHESTRATOR_REPOSITORY_URL alloydbomni_node_manager: repo_url: $ALLOYDB_OMNI_ORCHESTRATOR_REPOSITORY_URL pgbouncer: repo_url: $ALLOYDB_OMNI_COMMON_REPOSITORY_URL pgbackrest: repo_url: $ALLOYDB_OMNI_COMMON_REPOSITORY_URL children: primary_instance_nodes: hosts: $CLUSTER-db1: $CLUSTER-db2: $CLUSTER-db3: load_balancer_nodes: hosts: $CLUSTER-haproxy1: $CLUSTER-haproxy2: EOF - Utwórz plik playbook o nazwie install.yaml, który odwołuje się do roli instalacji z kolekcji orkiestratora.
cat > install.yaml <<EOF - name: Install AlloyDB Omni cluster components hosts: all vars: ansible_become: true ansible_user: $SSH_USER ansible_ssh_private_key_file: $HOME/ssh-key-cluster-sa roles: - role: google.alloydbomni_orchestrator.install EOF - Uruchom playbooka, używając pliku asortymentu, aby pobrać i zainstalować pakiety RPM na wszystkich określonych węzłach.
ansible-playbook -i deployment_spec.yaml install.yaml
6. Uruchamianie klastra AlloyDB Omni
Na tym etapie na wszystkich węzłach zainstalowaliśmy wszystkie wymagane komponenty. Jesteśmy gotowi do uruchomienia klastra AlloyDB Omni.
- Połącz się z maszyną wirtualną sterowania przez SSH, jeśli nie jesteś jeszcze na węźle sterowania.
gcloud compute ssh "$CLUSTER-control" --zone=$ZONE --project=$PROJECTsource ~/.codelab.env - Wygeneruj skrót hasła i pobierz zainstalowaną wersję bazy danych AlloyDB Omni:
encoded_password=$(echo -n "your unique password" | base64) DB_VERSION=$(/tmp/run-all.sh -t db 'rpm -q --qf "%{VERSION}\n" alloydbomni18' | tail -n 1) echo "$DB_VERSION" - Aby utworzyć klaster, AlloyDB Omni musi wiedzieć, jak go skonfigurować. Utwórz plik o nazwie dbcluster.yaml na potrzeby specyfikacji klastra bazy danych.
cat > dbcluster.yaml <<EOF Secret: metadata: name: db-pw-$CLUSTER spec: type: Opaque data: $CLUSTER: $encoded_password --- DBCluster: metadata: name: $CLUSTER spec: databaseVersion: $DB_VERSION mode: "" availability: numberOfStandbys: 2 enableAutoFailover: true enableAutoHeal: true autoFailoverTriggerThreshold: 2 autoHealTriggerThreshold: 2 healthcheckPeriodSeconds: 5 replayReplicationSlotsOnStandbys: false primarySpec: adminUser: passwordRef: name: db-pw-$CLUSTER resources: cpu: 4 memory: 32Gi disks: - name: DataDisk path: $PGDATA dbLoadBalancerOptions: gcp: loadBalancerIP: "$VIRTUAL_IP" loadBalancerType: "internal" loadBalancerInterface: "eth0" EOF - Utwórz plik playbook o nazwie bootstrap.yaml, który będzie odwoływać się do roli Ansible wczytywania w celu utworzenia klastra AlloyDB Omni.
cat > bootstrap.yaml <<EOF - name: Create DBCluster hosts: localhost roles: - role: google.alloydbomni_orchestrator.bootstrap EOF - Uruchom scenariusz, aby utworzyć klaster
ansible-playbook bootstrap.yaml -i deployment_spec.yaml -e resource_spec=dbcluster.yaml
7. (Opcjonalnie) Skonfiguruj PgBouncer Connection Pooler
AlloyDB Omni obsługuje lekkie pulowanie połączeń za pomocą PgBouncer. PgBouncer możesz skonfigurować i uruchomić od razu po udostępnieniu klastra.
- Utwórz plik specyfikacji zasobów o nazwie pgbouncer.yaml, który powiąże pulę połączeń z klastrem bazy danych:
cat > pgbouncer.yaml <<EOF PgBouncer: metadata: name: pgbouncer-pooler spec: dbclusterRef: $CLUSTER allowSuperUserAccess: true accessMode: "rw" port: 6432 EOF - Uruchom pulę PgBouncer za pomocą tego samego pliku bootstrap.yaml utworzonego wcześniej, przekazując nowy plik specyfikacji:
ansible-playbook bootstrap.yaml -i deployment_spec.yaml -e resource_spec=pgbouncer.yaml
8. Weryfikowanie klastra AlloyDB Omni
Aby sprawdzić, czy klaster działa prawidłowo i jest dostępny za pomocą modułu równoważenia obciążenia, możesz połączyć się z nim za pomocą standardowego klienta PostgreSQL z węzła sterującego.
- Zainstaluj repozytorium klienta PostgreSQL 18 i pakiet na węźle sterującym:
sudo dnf install -y https://download.postgresql.org/pub/repos/yum/reporpms/EL-9-x86_64/pgdg-redhat-repo-latest.noarch.rpm sudo dnf install -y postgresql18 - Połącz się z klastrem, używając zarezerwowanego wcześniej wirtualnego adresu IP. Pojawi się prośba o podanie hasła zakodowanego w pliku dbcluster.yaml:
/usr/pgsql-18/bin/psql -h $VIRTUAL_IP -U postgres -W - Po połączeniu możesz uruchamiać podstawowe zapytania SQL, aby sprawdzić stan klastra, np. wersję bazy danych:
postgres=# SELECT version();\q.
9. (Opcjonalnie) Tworzenie kopii zapasowej danych za pomocą pgBackRest
AlloyDB Omni integruje się z pgBackRest, aby zarządzać kopiami zapasowymi bezpośrednio w Cloud Storage. Możesz skonfigurować plan tworzenia kopii zapasowych i wywołać tworzenie kopii zapasowej na żądanie w zasobniku GCS utworzonym przez konfigurację Terraform.
- Utwórz plik specyfikacji planu tworzenia kopii zapasowych o nazwie backup_plan.yaml, który będzie wskazywać udostępniony zasobnik GCS:
cat > backup_plan.yaml <<EOF BackupPlan: metadata: name: pgb-plan spec: dbclusterRef: $CLUSTER backupLocation: type: GCS gcsOptions: bucket: $CLUSTER-gcs-backups key: /backups EOF - Utwórz poradnik Ansible o nazwie backup.yaml, który odwołuje się do roli zarządzania kopiami zapasowymi:
cat > backup.yaml <<EOF - name: Manage AlloyDB Omni Backups hosts: localhost roles: - role: google.alloydbomni_orchestrator.backup EOF - Zastosuj plan tworzenia kopii zapasowych za pomocą pliku backup.yaml:
ansible-playbook backup.yaml -i deployment_spec.yaml -e resource_spec=backup_plan.yaml - Po utworzeniu planu utwórz plik zasobu kopii zapasowej na żądanie o nazwie create_backup.yaml.
cat > create_backup.yaml <<EOF Backup: metadata: name: on-demand-backup spec: backupPlanRef: pgb-plan dbclusterRef: $CLUSTER EOF - Uruchom scenariusz, aby rozpocząć tworzenie kopii zapasowej:
ansible-playbook backup.yaml -i deployment_spec.yaml -e resource_spec=create_backup.yaml - Aby sprawdzić stan kopii zapasowej, utwórz plik status.yaml:
cat > status.yaml <<EOF
- name: Fetch AlloyDB Omni Resource Status
  hosts: localhost
  roles:
    - role: google.alloydbomni_orchestrator.status
EOF
- Uruchom scenariusz, aby wyświetlić listę wszystkich kopii zapasowych:
ansible-playbook status.yaml -i deployment_spec.yaml -e resource_type=Backup
- Możesz też przekazać
-e resource_name=on-demand-backup, aby uzyskać szczegółowe informacje o konkretnej kopii zapasowej utworzonej wcześniej:
ansible-playbook status.yaml -i deployment_spec.yaml \
  -e resource_type=Backup \
  -e resource_name=on-demand-backup
10. Usuwanie zasobów
Po zakończeniu wdrażania możesz usunąć udostępnione zasoby, aby uniknąć opłat.
- Utwórz scenariusz o nazwie teardown.yaml:
cat > teardown.yaml <<EOF - name: Tear down AlloyDB Omni cluster hosts: localhost roles: - role: google.alloydbomni_orchestrator.delete EOF - Uruchom scenariusz za pomocą polecenia ansible-playbook. Jeśli masz skonfigurowane kopie zapasowe, najpierw usuń zasoby Backup i BackupPlan:
ansible-playbook teardown.yaml -i deployment_spec.yaml -e "resource_type=Backup" -e "resource_name=on-demand-backup" ansible-playbook teardown.yaml -i deployment_spec.yaml -e "resource_type=BackupPlan" -e "resource_name=pgb-plan"ansible-playbook teardown.yaml -i deployment_spec.yaml -e "resource_type=PgBouncer" -e "resource_name=pgbouncer-pooler"ansible-playbook teardown.yaml -i deployment_spec.yaml -e "resource_type=DBCluster" -e "resource_name=$CLUSTER" - Po usunięciu klastra wyloguj się z węzła sterującego, wróć do terminala i przejdź do katalogu roboczego Terraform.
Uwaga: jeśli dopiero co zalogowano się w Cloud Shell, pamiętaj, aby ustawić te wartości:export PROJECT="your-project-id" export CLUSTER="your-cluster-name" - Usuń regułę zapory sieciowej VRRP i zniszcz zasoby zarządzane przez Terraform:
gcloud compute firewall-rules delete -q "$CLUSTER-allow-vrrp" --project="$PROJECT" gcloud compute firewall-rules delete -q "$CLUSTER-allow-ssh" --project="$PROJECT" terraform destroy - Gdy pojawi się odpowiedni komunikat, potwierdź zniszczenie. Ponieważ pozostałe zasoby sieciowe lub trasy mogą czasami uniemożliwiać całkowite wycofanie, uruchom te bezpieczne polecenia czyszczenia, aby upewnić się, że wszystkie powiązane reguły zapory sieciowej, bramy NAT, routery, trasy, podsieci i sieci zostały całkowicie usunięte. Zastąp
REGIONkonkretnym regionem wdrożenia, np. „us-central1”:# Delete any remaining firewall rules associated with the cluster gcloud compute firewall-rules list --project=$PROJECT 2> /dev/null | grep ^$CLUSTER- | cut -f1 -d' ' | \ while read rule; do gcloud compute firewall-rules delete --project=$PROJECT --quiet $rule; done # Delete the Cloud NAT gateway and router if they still exist gcloud compute routers nats describe $CLUSTER-nat-gw --router=$CLUSTER-router --region=REGION --project=$PROJECT 2>/dev/null \ && gcloud compute routers nats delete $CLUSTER-nat-gw --router=$CLUSTER-router --region=REGION --project=$PROJECT --quiet gcloud compute routers describe $CLUSTER-router --region=REGION --project=$PROJECT 2>/dev/null \ && gcloud compute routers delete $CLUSTER-router --region=REGION --project=$PROJECT --quiet # Delete any remaining custom routes gcloud compute routes list --project=$PROJECT --filter="network:$CLUSTER" --format="value(name)" 2>/dev/null | \ while read route; do gcloud compute routes delete --project=$PROJECT --quiet $route 2>/dev/null || true; done # Delete the subnet and network if they still exist gcloud compute networks subnets describe $CLUSTER --region=REGION --project=$PROJECT 2>/dev/null \ && gcloud compute networks subnets delete $CLUSTER --region=REGION --project=$PROJECT --quiet gcloud compute networks describe $CLUSTER --project $PROJECT 2> /dev/null \ && gcloud compute networks delete $CLUSTER --project $PROJECT --quiet
11. Gratulacje
Gratulujemy ukończenia ćwiczenia.
Omówione zagadnienia
- Jak tworzyć i przygotowywać maszyny wirtualne GCE na potrzeby AlloyDB Omni.
- Jak zainstalować i uruchomić aranżera RPM AlloyDB Omni.
- Instalowanie i konfigurowanie pakietów RPM AlloyDB Omni na potrzeby architektury referencyjnej HA.
Więcej informacji o AlloyDB Omni znajdziesz w dokumentacji.