

1. Einführung
In diesem Codelab wird die Bereitstellung eines AlloyDB Omni-Hochverfügbarkeitsclusters (HA) auf Google Compute Engine-VMs (GCE) demonstriert. Am Ende dieses Codelabs haben Sie eine HA-Referenzarchitektur mit drei Datenbankknoten und zwei HAProxy-Knoten sowie einem Steuerknoten für Verwaltungsaufgaben bereitgestellt.
Voraussetzungen
- Zugriff auf ein Google Cloud-Projekt und Cloud Shell über die Cloud Console
- Das Google Cloud SDK (
gcloud) ist installiert und konfiguriert. Weitere Informationen zur Installation von gcloud finden Sie unter gcloud-install. - Terraform v1.9.8 ist installiert.
Lerninhalte
- So erstellen und bereiten Sie GCE-VMs für AlloyDB Omni vor.
- So installieren und führen Sie den AlloyDB Omni RPM-Orchestrator aus.
- So installieren und konfigurieren Sie AlloyDB Omni-RPMs für die HA-Referenzarchitektur.
Voraussetzungen
- URL-Link zu AlloyDB Omni-RPMs und RPM-Orchestrator abrufen Füllen Sie dazu das Anmeldeformular für AlloyDB Omni aus. Die Links werden an die E-Mail-Adresse gesendet, die mit der Repository-URL verknüpft ist. Initialisieren Sie die folgenden Umgebungsvariablen, damit die URLs, die im Codelab verwendet werden, leicht zugänglich sind.
export ORCHESTRATOR_ANSIBLE_COLLECTION_PATH="..." export ALLOYDB_OMNI_REPOSITORY_URL="..." export ALLOYDB_OMNI_ORCHESTRATOR_REPOSITORY_URL="..." export ALLOYDB_OMNI_COMMON_REPOSITORY_URL="..." export ETCD_REPOSITORY_URL="..." - Ein funktionierendes Terminal mit Zugriff auf den AlloyDB Omni-Bereitstellungsstack. Sie können dazu Cloud Shell verwenden.
2. Einrichtung und Anforderungen
Projekteinrichtung
Google Cloud-Projekt erstellen
- Wählen Sie in der Google Cloud Console auf der Seite zur Projektauswahl ein Google Cloud-Projekt aus oder erstellen Sie eines.
- Die Abrechnung für das Cloud-Projekt muss aktiviert sein. So prüfen Sie, ob die Abrechnung für ein Projekt aktiviert ist.
Cloud Shell starten
Google Cloud kann zwar remote von Ihrem Laptop aus bedient werden, in diesem Codelab verwenden Sie jedoch die Google Cloud Shell, eine Befehlszeilenumgebung, die in der Cloud ausgeführt wird.
Klicken Sie in der Google Cloud Console rechts oben in der Symbolleiste auf das Cloud Shell-Symbol:
Alternativ können Sie auch die Tasten „G“ und „S“ drücken. Dadurch wird Cloud Shell aktiviert, wenn Sie sich in der Google Cloud Console befinden oder diesen Link verwenden.
Die Bereitstellung und Verbindung mit der Umgebung sollte nur wenige Augenblicke dauern. Wenn der Vorgang abgeschlossen ist, sollte in etwa Folgendes angezeigt werden:
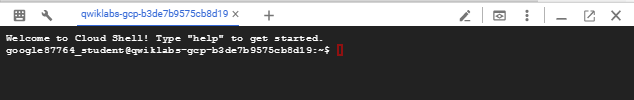
Diese virtuelle Maschine verfügt über sämtliche Entwicklertools, die Sie benötigen. Sie bietet ein Basisverzeichnis mit 5 GB nichtflüchtigem Speicher und läuft in Google Cloud, was die Netzwerkleistung und Authentifizierung erheblich verbessert. Alle Aufgaben in diesem Codelab können in einem Browser erledigt werden. Sie müssen nichts installieren.
3. Google Cloud Compute Engine-VMs erstellen
Terraform-Scripts vorbereiten
- Definieren Sie Umgebungsvariablen für Ihre Projekt-ID und den gewünschten Clusternamen. Sie werden im gesamten Codelab verwendet.
export PROJECT="your-project-id" export CLUSTER="your-cluster-name" - Sie müssen mit einem Google Cloud-Kontonutzer angemeldet sein.
gcloud auth login - Erstellen Sie ein Arbeitsverzeichnis für Ihre Bereitstellung und kopieren Sie die erforderlichen Terraform-Konfigurationsdateien aus Ihrer Repository-Quelle.
mkdir -p ~/alloydb-omni/$PROJECT/$CLUSTER cd ~/alloydb-omni/$PROJECT/$CLUSTER gcloud storage cp gs://alloydb-omni-install/rpm-orchestrator/gce/terraform/*.tf . - Erstellen Sie eine
terraform.tfvars-Datei, um die erforderlichen Parameter gemäß der Referenzarchitektur mit folgendem Inhalt anzugeben:cat > terraform.tfvars <<EOF # Required instance counts for reference architecture db_instance_count = 3 haproxy_instance_count = 2 control_instance_count = 1 # Optional: Customize if needed with the below variables # os_image = "rocky-linux-cloud/rocky-linux-9" # zone = "us-west4-c" # region_1 = "us-west4" # db_instance_type = "c4-highmem-4" # db_disk_type = "hyperdisk-balanced" # db_data_size = "50" # GB # data_dir = "/data" EOF
Terraform-Scripts ausführen und validieren
- Sie können die VMs jetzt bereitstellen.
terraform init - Bevor Sie VMs erstellen, müssen Sie sicherstellen, dass Sie die erforderlichen Berechtigungen zum Erstellen von VMs und anderen Ressourcen haben. Zusammenfassend benötigen Sie die folgenden Berechtigungen.
roles/compute.admin roles/iam.roleAdmin roles/compute.osAdminLogin roles/iam.serviceAccountCreator roles/iam.serviceAccountUser roles/artifactregistry.repoAdmin roles/storage.objectUser roles/resourcemanager.projectIamAdmin roles/serviceusage.serviceUsageAdmin - Validieren Sie die Konfiguration und wenden Sie sie an, um die Ressourcen bereitzustellen.
terraform validate terraform apply --auto-approve - Prüfen Sie nach Abschluss von Terraform, ob die virtuellen Maschinen erfolgreich erstellt wurden. Listen Sie dazu die erstellten Instanzen mit
gcloudauf.gcloud compute instances list --filter="name~$CLUSTER" --project=$PROJECTexport ZONE=$(gcloud compute instances list \ --filter="name=$CLUSTER-control" \ --format="value(zone)" --project=$PROJECT)
4. VMs für die Bereitstellung vorbereiten
Sie müssen eine SSH-Sitzung zum Steuerknoten erstellen und Schritte ausführen, um den SSH-Zugriff auf alle VMs (auch als Knoten bezeichnet) zu aktivieren.
- Prüfen Sie, ob die Umgebungsvariablen für Ihr Projekt und Ihren Cluster definiert sind.
export PROJECT="your-project-id" export CLUSTER="your-cluster-name" - Erstellen Sie einen SSH-Schlüssel und fügen Sie ihn hinzu, um sich auf der Kontroll-VM anzumelden.
# Replace values with your specific GCP project, cluster and zone details ssh-keygen -t ed25519 -f $HOME/.ssh/google_compute_engine gcloud compute os-login ssh-keys add --key-file=$HOME/.ssh/google_compute_engine.pub --project=$PROJECT - Erstellen Sie eine Firewallregel, um SSH-Verbindungen und VRRP-Traffic zuzulassen.
gcloud compute config-ssh --project=$PROJECT gcloud compute firewall-rules create $CLUSTER-allow-ssh --network=$CLUSTER --project=$PROJECT --direction=INGRESS --action=allow --rules=tcp:22 --source-ranges="0.0.0.0/0" gcloud compute firewall-rules create $CLUSTER-allow-vrrp --network=$CLUSTER --project=$PROJECT --allow=112 --source-ranges="0.0.0.0/0" - Stellen Sie eine SSH-Verbindung zur Kontroll-VM her:
gcloud compute ssh "$CLUSTER-control" --zone=$ZONE --project=$PROJECT - Erstellen Sie auf dem Kontrollknoten eine Linux-Gruppe mit demselben Namen wie der Nutzername:
sudo groupadd -f $(id -un) sudo usermod -aG $(id -un) $(id -un) - Beim Einrichten von Terraform werden einige Konfigurationsskripts erstellt und im Verzeichnis
/tmp/der Steuerungs-VM bereitgestellt. Dazu gehören Clustername, Dienstkonto, Projektname usw. Erstellen Sie mithilfe von Setupskripts auf dem Steuerknoten einen passwortlosen SSH-Zugriff von den Steuerknoten auf alle Clusterknoten./tmp/setup-ssh-for-cluster.sh - Für dieses Codelab können wir SELinux auf allen Knoten deaktivieren. Das Terraform-Script fügt „/tmp/run-all.sh“ hinzu, das für diesen Zweck verwendet werden kann.
/tmp/run-all.sh sudo setenforce 0 - Wenn Sie sich für AlloyDB Omni registriert und die Links erhalten haben, müssen Sie diese URLs auch Umgebungsvariablen hinzufügen.
cat >> ~/.codelab.env <<EOF export ORCHESTRATOR_ANSIBLE_COLLECTION_PATH="..." export ALLOYDB_OMNI_REPOSITORY_URL="..." export ALLOYDB_OMNI_ORCHESTRATOR_REPOSITORY_URL="..." export ALLOYDB_OMNI_COMMON_REPOSITORY_URL="..." export ETCD_REPOSITORY_URL="..." EOFterraform/variables.tfaus, die nicht mit den anderen Knoten in Konflikt steht, wie im folgenden Beispiel gezeigt:cat >> ~/.codelab.env <<EOF export VIRTUAL_IP="10.1.0.50" EOF
5. Erforderliche Softwarekomponenten auf allen VMs installieren
Im nächsten Schritt installieren Sie die erforderlichen Softwarekomponenten auf den VMs. Dies kann über den Steuerknoten koordiniert werden. Alle folgenden Befehle müssen auf dem Steuerknoten ausgeführt werden.
- Stellen Sie über SSH eine Verbindung zur Kontroll-VM her, falls Sie sich noch nicht auf dem Kontrollknoten befinden.
gcloud compute ssh "$CLUSTER-control" --zone=$ZONE --project=$PROJECTsource ~/.codelab.env - Installieren Sie Ansible und die erforderlichen Python-Bibliotheken auf dem Steuerknoten.
sudo dnf install -y https://dl.fedoraproject.org/pub/epel/epel-release-latest-9.noarch.rpm -y sudo dnf install -y ansible sudo dnf install -y python3-grpcio python3-protobuf python3-googleapis-common-protos python3-grpcio-status - Laden Sie als Nächstes die TAR-Datei der RPM Orchestrator Ansible-Sammlung herunter und installieren Sie sie.
gcloud storage cp "gs://${ORCHESTRATOR_ANSIBLE_COLLECTION_PATH#https://storage.googleapis.com/}google-alloydbomni_orchestrator-*.tar.gz" . COLLECTION_FILE=$(ls -1 google-alloydbomni_orchestrator-*.tar.gz \ | sort -V | tail -n 1) ansible-galaxy collection install "$COLLECTION_FILE" ansible-galaxy collection list | grep alloydbomni_orchestratorsort -Vundtail -n 1wird die Datei mit der aktuellen Version ausgewählt. Hinweis: Achten Sie darauf, dass die Variable ORCHESTRATOR_ANSIBLE_COLLECTION_PATH am Ende „/“ enthält. - Der Orchestrator verwendet eine Bereitstellungsspezifikationsdatei im Ansible-Inventarformat, um die Clustertopologie zu verstehen. Erstellen Sie auf dem Steuerknoten eine Datei mit dem Namen deployment_spec.yaml mit den Knotendetails.
cat > deployment_spec.yaml <<EOF alloydbomni: vars: cluster_manager: name: "$CLUSTER" etcd: setup: true config_forcewrite: true alloydbomni: major_version: "18" repo_url: $ALLOYDB_OMNI_REPOSITORY_URL alloydbomni_monitor: repo_url: $ALLOYDB_OMNI_COMMON_REPOSITORY_URL alloydbomni_cluster_manager: repo_url: $ALLOYDB_OMNI_ORCHESTRATOR_REPOSITORY_URL alloydbomni_node_manager: repo_url: $ALLOYDB_OMNI_ORCHESTRATOR_REPOSITORY_URL pgbouncer: repo_url: $ALLOYDB_OMNI_COMMON_REPOSITORY_URL pgbackrest: repo_url: $ALLOYDB_OMNI_COMMON_REPOSITORY_URL children: primary_instance_nodes: hosts: $CLUSTER-db1: $CLUSTER-db2: $CLUSTER-db3: load_balancer_nodes: hosts: $CLUSTER-haproxy1: $CLUSTER-haproxy2: EOF - Erstellen Sie ein Playbook mit dem Namen install.yaml, das auf die Installationsrolle aus der Orchestrator-Sammlung verweist.
cat > install.yaml <<EOF - name: Install AlloyDB Omni cluster components hosts: all vars: ansible_become: true ansible_user: $SSH_USER ansible_ssh_private_key_file: $HOME/ssh-key-cluster-sa roles: - role: google.alloydbomni_orchestrator.install EOF - Führen Sie das Playbook mit Ihrer Inventardatei aus, um die RPMs auf allen angegebenen Knoten herunterzuladen und zu installieren.
ansible-playbook -i deployment_spec.yaml install.yaml
6. AlloyDB Omni-Cluster booten
In dieser Phase haben wir alle erforderlichen Komponenten auf allen Knoten installiert. Wir sind bereit, den AlloyDB Omni-Cluster zu booten.
- Stellen Sie über SSH eine Verbindung zur Kontroll-VM her, falls Sie sich noch nicht auf dem Kontrollknoten befinden.
gcloud compute ssh "$CLUSTER-control" --zone=$ZONE --project=$PROJECTsource ~/.codelab.env - Generieren Sie einen Hash für Ihr Passwort und rufen Sie die installierte AlloyDB Omni-Datenbankversion ab:
encoded_password=$(echo -n "your unique password" | base64) DB_VERSION=$(/tmp/run-all.sh -t db 'rpm -q --qf "%{VERSION}\n" alloydbomni18' | tail -n 1) echo "$DB_VERSION" - Damit ein Cluster erstellt werden kann, muss AlloyDB Omni wissen, wie er konfiguriert werden soll. Erstellen Sie einen Dateinamen dbcluster.yaml für die DB-Clusterspezifikationen.
cat > dbcluster.yaml <<EOF Secret: metadata: name: db-pw-$CLUSTER spec: type: Opaque data: $CLUSTER: $encoded_password --- DBCluster: metadata: name: $CLUSTER spec: databaseVersion: $DB_VERSION mode: "" availability: numberOfStandbys: 2 enableAutoFailover: true enableAutoHeal: true autoFailoverTriggerThreshold: 2 autoHealTriggerThreshold: 2 healthcheckPeriodSeconds: 5 replayReplicationSlotsOnStandbys: false primarySpec: adminUser: passwordRef: name: db-pw-$CLUSTER resources: cpu: 4 memory: 32Gi disks: - name: DataDisk path: $PGDATA dbLoadBalancerOptions: gcp: loadBalancerIP: "$VIRTUAL_IP" loadBalancerType: "internal" loadBalancerInterface: "eth0" EOF - Erstellen Sie ein Playbook mit dem Namen bootstrap.yaml, das auf die Bootstrap-Ansible-Rolle zum Erstellen von AlloyDB Omni-Clustern verweist.
cat > bootstrap.yaml <<EOF - name: Create DBCluster hosts: localhost roles: - role: google.alloydbomni_orchestrator.bootstrap EOF - Playbook ausführen, um Cluster zu erstellen
ansible-playbook bootstrap.yaml -i deployment_spec.yaml -e resource_spec=dbcluster.yaml
7. Optional: PgBouncer-Verbindungspooler konfigurieren
AlloyDB Omni unterstützt einfaches Verbindungs-Pooling mit PgBouncer. Sie können PgBouncer direkt nach der Bereitstellung Ihres Clusters konfigurieren und booten.
- Erstellen Sie eine Ressourcenspezifikationsdatei namens pgbouncer.yaml, in der der Verbindungspooler Ihrem Datenbankcluster zugeordnet wird:
cat > pgbouncer.yaml <<EOF PgBouncer: metadata: name: pgbouncer-pooler spec: dbclusterRef: $CLUSTER allowSuperUserAccess: true accessMode: "rw" port: 6432 EOF - Bootstrappen Sie den PgBouncer-Pooler mit demselben bootstrap.yaml-Playbook, das Sie zuvor erstellt haben, und übergeben Sie die neue Spezifikationsdatei:
ansible-playbook bootstrap.yaml -i deployment_spec.yaml -e resource_spec=pgbouncer.yaml
8. AlloyDB Omni-Cluster prüfen
Um zu prüfen, ob Ihr Cluster richtig funktioniert und über den Load-Balancer zugänglich ist, können Sie über den Knoten der Steuerungsebene eine Verbindung mit dem Standard-PostgreSQL-Client herstellen.
- Installieren Sie das PostgreSQL 18-Client-Repository und -Paket auf dem Steuerknoten:
sudo dnf install -y https://download.postgresql.org/pub/repos/yum/reporpms/EL-9-x86_64/pgdg-redhat-repo-latest.noarch.rpm sudo dnf install -y postgresql18 - Stellen Sie mit der zuvor reservierten virtuellen IP-Adresse eine Verbindung zum Cluster her. Sie werden aufgefordert, das Passwort einzugeben, das Sie in dbcluster.yaml codiert haben:
/usr/pgsql-18/bin/psql -h $VIRTUAL_IP -U postgres -W - Nachdem Sie eine Verbindung hergestellt haben, können Sie grundlegende SQL-Abfragen ausführen, um den Clusterstatus zu prüfen, z. B. die Datenbankversion:
postgres=# SELECT version();\qein, um den Prompt zu beenden.
9. Optional: Daten mit pgBackRest sichern
AlloyDB Omni ist in pgBackRest integriert, um Sicherungen direkt in Cloud Storage zu verwalten. Sie können einen Sicherungsplan konfigurieren und eine On-Demand-Sicherung für den GCS-Bucket auslösen, der durch Ihre Terraform-Einrichtung erstellt wurde.
- Erstellen Sie eine Spezifikationsdatei für den Sicherungsplan mit dem Namen backup_plan.yaml, die auf den bereitgestellten GCS-Bucket verweist:
cat > backup_plan.yaml <<EOF BackupPlan: metadata: name: pgb-plan spec: dbclusterRef: $CLUSTER backupLocation: type: GCS gcsOptions: bucket: $CLUSTER-gcs-backups key: /backups EOF - Erstellen Sie ein Ansible-Playbook mit dem Namen backup.yaml, das auf die Rolle für die Sicherungsverwaltung verweist:
cat > backup.yaml <<EOF - name: Manage AlloyDB Omni Backups hosts: localhost roles: - role: google.alloydbomni_orchestrator.backup EOF - Wenden Sie den Sicherungsplan mit dem Playbook backup.yaml an:
ansible-playbook backup.yaml -i deployment_spec.yaml -e resource_spec=backup_plan.yaml - Nachdem der Plan erfolgreich eingerichtet wurde, erstellen Sie eine On-Demand-Sicherungsressourcendatei mit dem Namen create_backup.yaml.
cat > create_backup.yaml <<EOF Backup: metadata: name: on-demand-backup spec: backupPlanRef: pgb-plan dbclusterRef: $CLUSTER EOF - Führen Sie das Playbook aus, um die Sicherung zu starten:
ansible-playbook backup.yaml -i deployment_spec.yaml -e resource_spec=create_backup.yaml - So prüfen Sie den Status des Backups: Erstellen Sie ein status.yaml-Playbook:
cat > status.yaml <<EOF
- name: Fetch AlloyDB Omni Resource Status
  hosts: localhost
  roles:
    - role: google.alloydbomni_orchestrator.status
EOF
- Führen Sie das Playbook aus, um alle Sicherungen aufzulisten:
ansible-playbook status.yaml -i deployment_spec.yaml -e resource_type=Backup
- Alternativ können Sie
-e resource_name=on-demand-backupübergeben, um detaillierte Informationen zu einer bestimmten Sicherung zu erhalten, die zuvor erstellt wurde:
ansible-playbook status.yaml -i deployment_spec.yaml \
  -e resource_type=Backup \
  -e resource_name=on-demand-backup
10. Ressourcen bereinigen
Wenn Sie die Bereitstellung abgeschlossen haben, können Sie die bereitgestellten Ressourcen löschen, um Kosten zu vermeiden.
- Erstellen Sie ein Playbook mit dem Namen teardown.yaml:
cat > teardown.yaml <<EOF - name: Tear down AlloyDB Omni cluster hosts: localhost roles: - role: google.alloydbomni_orchestrator.delete EOF - Führen Sie das Playbook mit „ansible-playbook“ aus. Wenn Sie Sicherungen konfiguriert haben, löschen Sie zuerst die Backup- und BackupPlan-Ressourcen:
ansible-playbook teardown.yaml -i deployment_spec.yaml -e "resource_type=Backup" -e "resource_name=on-demand-backup" ansible-playbook teardown.yaml -i deployment_spec.yaml -e "resource_type=BackupPlan" -e "resource_name=pgb-plan"ansible-playbook teardown.yaml -i deployment_spec.yaml -e "resource_type=PgBouncer" -e "resource_name=pgbouncer-pooler"ansible-playbook teardown.yaml -i deployment_spec.yaml -e "resource_type=DBCluster" -e "resource_name=$CLUSTER" - Sobald der Cluster gelöscht wurde, melden Sie sich vom Steuerknoten ab, wechseln Sie zurück zu Ihrem Terminal und rufen Sie Ihr Terraform-Arbeitsverzeichnis auf.
Hinweis: Wenn Sie sich gerade erst in der Cloud Shell angemeldet haben, müssen Sie Folgendes festlegen:export PROJECT="your-project-id" export CLUSTER="your-cluster-name" - Löschen Sie die VRRP-Firewallregel und löschen Sie die von Terraform verwalteten Ressourcen:
gcloud compute firewall-rules delete -q "$CLUSTER-allow-vrrp" --project="$PROJECT" gcloud compute firewall-rules delete -q "$CLUSTER-allow-ssh" --project="$PROJECT" terraform destroy - Bestätigen Sie die Vernichtung, wenn Sie dazu aufgefordert werden. Da verbleibende Netzwerkressourcen oder Routen gelegentlich ein vollständiges Entfernen verhindern können, führen Sie die folgenden sicheren Bereinigungsbefehle aus, um sicherzustellen, dass alle zugehörigen Firewallregeln, NAT-Gateways, Router, Routen, Subnetze und Netzwerke vollständig entfernt werden. Ersetzen Sie
REGIONdurch Ihre spezifische Bereitstellungsregion, z. B. „us-central1“:# Delete any remaining firewall rules associated with the cluster gcloud compute firewall-rules list --project=$PROJECT 2> /dev/null | grep ^$CLUSTER- | cut -f1 -d' ' | \ while read rule; do gcloud compute firewall-rules delete --project=$PROJECT --quiet $rule; done # Delete the Cloud NAT gateway and router if they still exist gcloud compute routers nats describe $CLUSTER-nat-gw --router=$CLUSTER-router --region=REGION --project=$PROJECT 2>/dev/null \ && gcloud compute routers nats delete $CLUSTER-nat-gw --router=$CLUSTER-router --region=REGION --project=$PROJECT --quiet gcloud compute routers describe $CLUSTER-router --region=REGION --project=$PROJECT 2>/dev/null \ && gcloud compute routers delete $CLUSTER-router --region=REGION --project=$PROJECT --quiet # Delete any remaining custom routes gcloud compute routes list --project=$PROJECT --filter="network:$CLUSTER" --format="value(name)" 2>/dev/null | \ while read route; do gcloud compute routes delete --project=$PROJECT --quiet $route 2>/dev/null || true; done # Delete the subnet and network if they still exist gcloud compute networks subnets describe $CLUSTER --region=REGION --project=$PROJECT 2>/dev/null \ && gcloud compute networks subnets delete $CLUSTER --region=REGION --project=$PROJECT --quiet gcloud compute networks describe $CLUSTER --project $PROJECT 2> /dev/null \ && gcloud compute networks delete $CLUSTER --project $PROJECT --quiet
11. Glückwunsch
Herzlichen Glückwunsch zum Abschluss des Codelabs.
Behandelte Themen
- So erstellen und bereiten Sie GCE-VMs für AlloyDB Omni vor.
- So installieren und führen Sie den AlloyDB Omni RPM-Orchestrator aus.
- So installieren und konfigurieren Sie AlloyDB Omni-RPMs für die HA-Referenzarchitektur.
Weitere Informationen zu AlloyDB Omni finden Sie in der Dokumentation.