

1. परिचय
इस कोडलैब में, Google Compute Engine (GCE) वर्चुअल मशीन (वीएम) पर, AlloyDB Omni के हाई अवेलेबिलिटी (एचए) क्लस्टर को डिप्लॉय करने का तरीका बताया गया है. इस कोडलैब के आखिर में, आपको एचए रेफ़रंस आर्किटेक्चर उपलब्ध कराया जाएगा. इसमें तीन डेटाबेस नोड और दो HAProxy नोड के साथ-साथ मैनेजमेंट ऑपरेशन के लिए एक कंट्रोल नोड होगा.
ज़रूरी शर्तें
- Cloud Console से, Google Cloud प्रोजेक्ट और Cloud Shell को ऐक्सेस करने की सुविधा.
- Google Cloud SDK (
gcloud) इंस्टॉल और कॉन्फ़िगर किया गया हो. gcloud इंस्टॉल करने के बारे में जानकारी के लिए, gcloud-install पर जाएं - Terraform v1.9.8 इंस्टॉल हो.
आपको क्या सीखने को मिलेगा
- AlloyDB Omni के लिए GCE वीएम बनाने और उन्हें तैयार करने का तरीका.
- AlloyDB Omni RPM Orchestrator को इंस्टॉल और चलाने का तरीका.
- एचए रेफ़रंस आर्किटेक्चर के लिए, AlloyDB Omni RPM इंस्टॉल और कॉन्फ़िगर करने का तरीका.
आपको इन चीज़ों की ज़रूरत होगी
- AlloyDB Omni RPM और RPM ऑर्केस्ट्रेटर का यूआरएल लिंक पाएं. इसके लिए, आपको AlloyDB Omni के लिए साइन अप करने का फ़ॉर्म भरना होगा. ये लिंक, आपके ईमेल पते पर भेजे जाते हैं. यह ईमेल पता, रिपॉज़िटरी के यूआरएल सर्वर से जुड़ा होता है. नीचे दिए गए एनवायरमेंट वैरिएबल को शुरू करें, ताकि कोडलैब के दौरान इस्तेमाल किए जाने वाले यूआरएल आसानी से उपलब्ध हों.
export ORCHESTRATOR_ANSIBLE_COLLECTION_PATH="..." export ALLOYDB_OMNI_REPOSITORY_URL="..." export ALLOYDB_OMNI_ORCHESTRATOR_REPOSITORY_URL="..." export ALLOYDB_OMNI_COMMON_REPOSITORY_URL="..." export ETCD_REPOSITORY_URL="..." - AlloyDB Omni डिप्लॉयमेंट स्टैक का ऐक्सेस वाला टर्मिनल. इसके लिए, Cloud Shell का इस्तेमाल किया जा सकता है.
2. सेटअप और ज़रूरी शर्तें
प्रोजेक्ट सेटअप करना
Google Cloud प्रोजेक्ट बनाना
- Google Cloud Console में, प्रोजेक्ट चुनने वाले पेज पर जाकर, Google Cloud प्रोजेक्ट चुनें या बनाएं.
- पक्का करें कि आपके क्लाउड प्रोजेक्ट के लिए बिलिंग की सुविधा चालू हो. किसी प्रोजेक्ट के लिए बिलिंग चालू है या नहीं, यह देखने का तरीका जानें.
Cloud Shell शुरू करें
Google Cloud को अपने लैपटॉप से रिमोटली ऐक्सेस किया जा सकता है. हालांकि, इस कोडलैब में Google Cloud Shell का इस्तेमाल किया जाएगा. यह क्लाउड में चलने वाला कमांड लाइन एनवायरमेंट है.
Google Cloud Console में, सबसे ऊपर दाएं कोने में मौजूद टूलबार पर, Cloud Shell आइकॉन पर क्लिक करें:
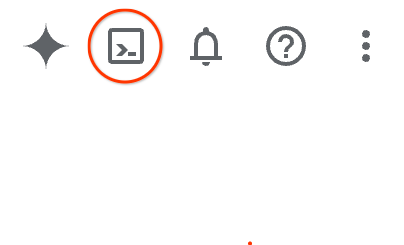
इसके अलावा, G और फिर S दबाकर भी यह सुविधा ऐक्सेस की जा सकती है. अगर Google Cloud Console में हैं या इस लिंक का इस्तेमाल कर रहे हैं, तो इस क्रम से Cloud Shell चालू हो जाएगा.
इसे चालू करने और एनवायरमेंट से कनेक्ट करने में सिर्फ़ कुछ सेकंड लगते हैं. सेट अप पूरा होने के बाद, आपको यह दिखेगा:
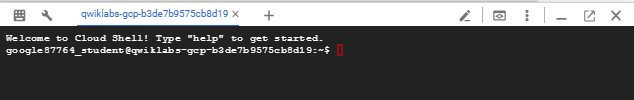
इस वर्चुअल मशीन में, डेवलपमेंट के लिए ज़रूरी सभी टूल पहले से मौजूद हैं. इसमें 5 जीबी की होम डायरेक्ट्री होती है, जो हमेशा उपलब्ध रहती है. साथ ही, यह Google Cloud पर काम करता है. इससे नेटवर्क की परफ़ॉर्मेंस और पुष्टि करने की प्रोसेस बेहतर होती है. इस कोडलैब में मौजूद सभी टास्क, ब्राउज़र में किए जा सकते हैं. आपको कुछ भी इंस्टॉल करने की ज़रूरत नहीं है.
3. Google Cloud Compute Engine वर्चुअल मशीनें बनाना
Terraform स्क्रिप्ट तैयार करना
- अपने प्रोजेक्ट आईडी और पसंद के क्लस्टर के नाम के लिए एनवायरमेंट वैरिएबल तय करें. इनका इस्तेमाल पूरे कोडलैब में किया जाएगा.
export PROJECT="your-project-id" export CLUSTER="your-cluster-name" - पक्का करें कि आपने Google Cloud खाते के उपयोगकर्ता के तौर पर लॉग इन किया हो.
gcloud auth login - डिप्लॉयमेंट के लिए वर्किंग डायरेक्ट्री बनाएं और अपनी रिपॉज़िटरी सोर्स से ज़रूरी Terraform कॉन्फ़िगरेशन फ़ाइलें कॉपी करें.
mkdir -p ~/alloydb-omni/$PROJECT/$CLUSTER cd ~/alloydb-omni/$PROJECT/$CLUSTER gcloud storage cp gs://alloydb-omni-install/rpm-orchestrator/gce/terraform/*.tf . terraform.tfvarsफ़ाइल बनाएं, ताकि यहां दिए गए कॉन्टेंट के हिसाब से रेफ़रंस आर्किटेक्चर के मुताबिक ज़रूरी पैरामीटर तय किए जा सकें:cat > terraform.tfvars <<EOF # Required instance counts for reference architecture db_instance_count = 3 haproxy_instance_count = 2 control_instance_count = 1 # Optional: Customize if needed with the below variables # os_image = "rocky-linux-cloud/rocky-linux-9" # zone = "us-west4-c" # region_1 = "us-west4" # db_instance_type = "c4-highmem-4" # db_disk_type = "hyperdisk-balanced" # db_data_size = "50" # GB # data_dir = "/data" EOF
Terraform स्क्रिप्ट लागू करना और पुष्टि करना
- अब वीएम उपलब्ध कराए जा सकते हैं.
terraform init - वर्चुअल मशीनें बनाने से पहले, पक्का करें कि आपके पास वर्चुअल मशीनें और अन्य संसाधन बनाने का ज़रूरी ऐक्सेस हो. आपको ये अनुमतियां चाहिए होंगी.
roles/compute.admin roles/iam.roleAdmin roles/compute.osAdminLogin roles/iam.serviceAccountCreator roles/iam.serviceAccountUser roles/artifactregistry.repoAdmin roles/storage.objectUser roles/resourcemanager.projectIamAdmin roles/serviceusage.serviceUsageAdmin - कॉन्फ़िगरेशन की पुष्टि करें और संसाधनों को उपलब्ध कराने के लिए, कॉन्फ़िगरेशन लागू करें.
terraform validate terraform apply --auto-approve - Terraform के पूरा होने के बाद, पुष्टि करें कि वर्चुअल मशीनें सही तरीके से बनाई गई हैं. इसके लिए,
gcloudका इस्तेमाल करके बनाए गए इंस्टेंस की सूची बनाएं.gcloud compute instances list --filter="name~$CLUSTER" --project=$PROJECTexport ZONE=$(gcloud compute instances list \ --filter="name=$CLUSTER-control" \ --format="value(zone)" --project=$PROJECT)
4. वीएम को डिप्लॉयमेंट के लिए तैयार करना
आपको कंट्रोल नोड के लिए एक एसएसएच सेशन बनाना होगा. साथ ही, सभी वीएम (इन्हें नोड भी कहा जाता है) के लिए एसएसएच ऐक्सेस चालू करने के लिए, यह तरीका अपनाना होगा.
- पक्का करें कि आपके प्रोजेक्ट और क्लस्टर के लिए एनवायरमेंट वैरिएबल तय किए गए हों.
export PROJECT="your-project-id" export CLUSTER="your-cluster-name" - एसएसएच कुंजी बनाएं और कंट्रोल वीएम पर लॉग इन करने के लिए इसे जोड़ें.
# Replace values with your specific GCP project, cluster and zone details ssh-keygen -t ed25519 -f $HOME/.ssh/google_compute_engine gcloud compute os-login ssh-keys add --key-file=$HOME/.ssh/google_compute_engine.pub --project=$PROJECT - एसएसएच कनेक्शन की अनुमति देने के लिए फ़ायरवॉल का नियम बनाएं. साथ ही, वीआरआरपी ट्रैफ़िक की अनुमति दें.
gcloud compute config-ssh --project=$PROJECT gcloud compute firewall-rules create $CLUSTER-allow-ssh --network=$CLUSTER --project=$PROJECT --direction=INGRESS --action=allow --rules=tcp:22 --source-ranges="0.0.0.0/0" gcloud compute firewall-rules create $CLUSTER-allow-vrrp --network=$CLUSTER --project=$PROJECT --allow=112 --source-ranges="0.0.0.0/0" - एसएसएच के ज़रिए कंट्रोल वीएम से कनेक्ट करें:
gcloud compute ssh "$CLUSTER-control" --zone=$ZONE --project=$PROJECT - कंट्रोल नोड पर, उपयोगकर्ता नाम के नाम से Linux ग्रुप बनाएं:
sudo groupadd -f $(id -un) sudo usermod -aG $(id -un) $(id -un) - Terraform सेटअप, कुछ कॉन्फ़िगरेशन स्क्रिप्ट बनाता है और उन्हें कंट्रोल वीएम की
/tmp/डायरेक्ट्री में स्टेज करता है. इसमें क्लस्टर का नाम, सेवा खाता, प्रोजेक्ट का नाम वगैरह शामिल होता है. कंट्रोल नोड पर सेटअप स्क्रिप्ट का इस्तेमाल करके, कंट्रोल नोड से सभी क्लस्टर नोड तक बिना पासवर्ड के एसएसएच ऐक्सेस बनाएं./tmp/setup-ssh-for-cluster.sh - इस कोडलैब के लिए, हम सभी नोड पर SELinux को बंद कर सकते हैं. Terraform स्क्रिप्ट, ‘/tmp/run-all.sh' जोड़ती है. इसका इस्तेमाल इस काम के लिए किया जा सकता है.
/tmp/run-all.sh sudo setenforce 0 - अगर आपने AlloyDB Omni के लिए साइन अप किया है और आपको लिंक मिल गए हैं, तो अब उन यूआरएल को एनवायरमेंट वैरिएबल में जोड़ने का समय है.
cat >> ~/.codelab.env <<EOF export ORCHESTRATOR_ANSIBLE_COLLECTION_PATH="..." export ALLOYDB_OMNI_REPOSITORY_URL="..." export ALLOYDB_OMNI_ORCHESTRATOR_REPOSITORY_URL="..." export ALLOYDB_OMNI_COMMON_REPOSITORY_URL="..." export ETCD_REPOSITORY_URL="..." EOFterraform/variables.tfमें cidr_range इनपुट वैरिएबल से, अपने एनवायरमेंट के लिए वर्चुअल आईपी तय करें, ताकि यह अन्य नोड के साथ टकराव न करे. उदाहरण के लिए:cat >> ~/.codelab.env <<EOF export VIRTUAL_IP="10.1.0.50" EOF
5. सभी वीएम पर ज़रूरी सॉफ़्टवेयर कॉम्पोनेंट इंस्टॉल करें
अगला चरण, वीएम पर ज़रूरी सॉफ़्टवेयर कॉम्पोनेंट इंस्टॉल करना है. इसे कंट्रोल नोड पर मैनेज किया जा सकता है. यहां दी गई सभी कमांड, कंट्रोल नोड पर एक्ज़ीक्यूट करनी होंगी.
- अगर कंट्रोल नोड पर एसएसएच चालू नहीं है, तो एसएसएच के ज़रिए कंट्रोल वीएम से कनेक्ट करें.
gcloud compute ssh "$CLUSTER-control" --zone=$ZONE --project=$PROJECTsource ~/.codelab.env - कंट्रोल नोड पर, Ansible और ज़रूरी Python लाइब्रेरी इंस्टॉल करें.
sudo dnf install -y https://dl.fedoraproject.org/pub/epel/epel-release-latest-9.noarch.rpm -y sudo dnf install -y ansible sudo dnf install -y python3-grpcio python3-protobuf python3-googleapis-common-protos python3-grpcio-status - इसके बाद, RPM Orchestrator Ansible कलेक्शन की tar फ़ाइल डाउनलोड करें और उसे इंस्टॉल करें.
gcloud storage cp "gs://${ORCHESTRATOR_ANSIBLE_COLLECTION_PATH#https://storage.googleapis.com/}google-alloydbomni_orchestrator-*.tar.gz" .
COLLECTION_FILE=$(ls -1 google-alloydbomni_orchestrator-*.tar.gz \
  | sort -V | tail -n 1)
ansible-galaxy collection install "$COLLECTION_FILE"
ansible-galaxy collection list | grep alloydbomni_orchestrator
sort -Vऔरtail -n 1कमांड, सबसे नए वर्शन वाली फ़ाइल को चुनती हैं. ध्यान दें: पक्का करें कि ORCHESTRATOR_ANSIBLE_COLLECTION_PATH वैरिएबल के आखिर में "/" हो. - ऑर्केस्ट्रेटर, Ansible इन्वेंट्री फ़ॉर्मैट में डिप्लॉयमेंट स्पेसिफ़िकेशन फ़ाइल का इस्तेमाल करता है, ताकि आपके क्लस्टर टोपोलॉजी को समझा जा सके. कंट्रोल नोड पर, नोड की जानकारी के साथ deployment_spec.yaml नाम की एक फ़ाइल बनाएं.
cat > deployment_spec.yaml <<EOF alloydbomni: vars: cluster_manager: name: "$CLUSTER" etcd: setup: true config_forcewrite: true alloydbomni: major_version: "18" repo_url: $ALLOYDB_OMNI_REPOSITORY_URL alloydbomni_monitor: repo_url: $ALLOYDB_OMNI_COMMON_REPOSITORY_URL alloydbomni_cluster_manager: repo_url: $ALLOYDB_OMNI_ORCHESTRATOR_REPOSITORY_URL alloydbomni_node_manager: repo_url: $ALLOYDB_OMNI_ORCHESTRATOR_REPOSITORY_URL pgbouncer: repo_url: $ALLOYDB_OMNI_COMMON_REPOSITORY_URL pgbackrest: repo_url: $ALLOYDB_OMNI_COMMON_REPOSITORY_URL children: primary_instance_nodes: hosts: $CLUSTER-db1: $CLUSTER-db2: $CLUSTER-db3: load_balancer_nodes: hosts: $CLUSTER-haproxy1: $CLUSTER-haproxy2: EOF - install.yaml नाम की एक प्लेबुक बनाएं, जो ऑर्केस्ट्रेटर कलेक्शन से इंस्टॉल करने की भूमिका का रेफ़रंस देती हो.
cat > install.yaml <<EOF - name: Install AlloyDB Omni cluster components hosts: all vars: ansible_become: true ansible_user: $SSH_USER ansible_ssh_private_key_file: $HOME/ssh-key-cluster-sa roles: - role: google.alloydbomni_orchestrator.install EOF - अपनी इन्वेंट्री फ़ाइल का इस्तेमाल करके, प्लेबुक को लागू करें. इससे, सभी तय किए गए नोड पर आरपीएम डाउनलोड और इंस्टॉल किए जा सकेंगे.
ansible-playbook -i deployment_spec.yaml install.yaml
6. AlloyDB Omni क्लस्टर बूटस्ट्रैप करना
इस चरण में, हमने सभी नोड पर ज़रूरी कॉम्पोनेंट इंस्टॉल कर दिए हैं. हम AlloyDB Omni क्लस्टर को बूटस्ट्रैप करने के लिए तैयार हैं.
- अगर कंट्रोल नोड पर एसएसएच चालू नहीं है, तो एसएसएच के ज़रिए कंट्रोल वीएम से कनेक्ट करें.
gcloud compute ssh "$CLUSTER-control" --zone=$ZONE --project=$PROJECTsource ~/.codelab.env - अपने पासवर्ड के लिए हैश जनरेट करें और इंस्टॉल किए गए AlloyDB Omni डेटाबेस का वर्शन पाएं:
encoded_password=$(echo -n "your unique password" | base64) DB_VERSION=$(/tmp/run-all.sh -t db 'rpm -q --qf "%{VERSION}\n" alloydbomni18' | tail -n 1) echo "$DB_VERSION" - क्लस्टर बनाने के लिए, AlloyDB Omni को यह पता होना चाहिए कि इसे कैसे कॉन्फ़िगर किया जाए. डीबी क्लस्टर स्पेसिफ़िकेशन के लिए, dbcluster.yaml नाम की फ़ाइल बनाएं.
cat > dbcluster.yaml <<EOF Secret: metadata: name: db-pw-$CLUSTER spec: type: Opaque data: $CLUSTER: $encoded_password --- DBCluster: metadata: name: $CLUSTER spec: databaseVersion: $DB_VERSION mode: "" availability: numberOfStandbys: 2 enableAutoFailover: true enableAutoHeal: true autoFailoverTriggerThreshold: 2 autoHealTriggerThreshold: 2 healthcheckPeriodSeconds: 5 replayReplicationSlotsOnStandbys: false primarySpec: adminUser: passwordRef: name: db-pw-$CLUSTER resources: cpu: 4 memory: 32Gi disks: - name: DataDisk path: $PGDATA dbLoadBalancerOptions: gcp: loadBalancerIP: "$VIRTUAL_IP" loadBalancerType: "internal" loadBalancerInterface: "eth0" EOF - bootstrap.yaml नाम की एक प्लेबुक बनाएं. यह AlloyDB Omni क्लस्टर बनाने के लिए, बूटस्ट्रैप ऐन्सिबल रोल को रेफ़र करेगी.
cat > bootstrap.yaml <<EOF - name: Create DBCluster hosts: localhost roles: - role: google.alloydbomni_orchestrator.bootstrap EOF - क्लस्टर बनाने के लिए, अपनी प्लेबुक चलाएं
ansible-playbook bootstrap.yaml -i deployment_spec.yaml -e resource_spec=dbcluster.yaml
7. (ज़रूरी नहीं) PgBouncer Connection Pooler को कॉन्फ़िगर करना
AlloyDB Omni, PgBouncer का इस्तेमाल करके लाइटवेट कनेक्शन पूलिंग की सुविधा देता है. क्लस्टर का प्रावधान होने के तुरंत बाद, PgBouncer को कॉन्फ़िगर और बूटस्ट्रैप किया जा सकता है.
- pgbouncer.yaml नाम की एक संसाधन स्पेसिफ़िकेशन फ़ाइल बनाएं. यह फ़ाइल, कनेक्शन पूलर को आपके डेटाबेस क्लस्टर से जोड़ती है:
cat > pgbouncer.yaml <<EOF PgBouncer: metadata: name: pgbouncer-pooler spec: dbclusterRef: $CLUSTER allowSuperUserAccess: true accessMode: "rw" port: 6432 EOF - पहले बनाई गई bootstrap.yaml प्लेबुक का इस्तेमाल करके, PgBouncer पूलर को बूटस्ट्रैप करें. इसके लिए, नई स्पेसिफ़िकेशन फ़ाइल पास करें:
ansible-playbook bootstrap.yaml -i deployment_spec.yaml -e resource_spec=pgbouncer.yaml
8. AlloyDB Omni क्लस्टर की पुष्टि करना
यह पुष्टि करने के लिए कि आपका क्लस्टर सही तरीके से काम कर रहा है और लोड बैलेंसर का इस्तेमाल करके इसे ऐक्सेस किया जा सकता है, कंट्रोल नोड से स्टैंडर्ड PostgreSQL क्लाइंट का इस्तेमाल करके इससे कनेक्ट किया जा सकता है.
- कंट्रोल नोड पर PostgreSQL 18 क्लाइंट रिपॉज़िटरी और पैकेज इंस्टॉल करें:
sudo dnf install -y https://download.postgresql.org/pub/repos/yum/reporpms/EL-9-x86_64/pgdg-redhat-repo-latest.noarch.rpm sudo dnf install -y postgresql18 - पहले से रिज़र्व किए गए वर्चुअल आईपी का इस्तेमाल करके, क्लस्टर से कनेक्ट करें. आपको dbcluster.yaml में सेव किया गया पासवर्ड डालने के लिए कहा जाएगा:
/usr/pgsql-18/bin/psql -h $VIRTUAL_IP -U postgres -W - कनेक्ट होने के बाद, क्लस्टर की स्थिति की पुष्टि करने के लिए, बुनियादी SQL क्वेरी चलाई जा सकती हैं. उदाहरण के लिए, डेटाबेस का वर्शन देखना:
postgres=# SELECT version();\qटाइप करें.
9. (ज़रूरी नहीं) pgBackRest का इस्तेमाल करके डेटा का बैक अप लेना
AlloyDB Omni, pgBackRest के साथ इंटिग्रेट होता है, ताकि बैकअप को सीधे Cloud Storage में मैनेज किया जा सके. बैकअप प्लान कॉन्फ़िगर किया जा सकता है. साथ ही, Terraform सेटअप से बनाए गए GCS बकेट में, मांग पर बैकअप लेने की सुविधा चालू की जा सकती है.
- backup_plan.yaml नाम की बैकअप प्लान स्पेसिफ़िकेशन फ़ाइल बनाएं. यह फ़ाइल, आपके प्रोविज़न किए गए GCS बकेट की ओर ले जाती है:
cat > backup_plan.yaml <<EOF BackupPlan: metadata: name: pgb-plan spec: dbclusterRef: $CLUSTER backupLocation: type: GCS gcsOptions: bucket: $CLUSTER-gcs-backups key: /backups EOF - बैकअप मैनेज करने की भूमिका का रेफ़रंस देने वाली, backup.yaml नाम की Ansible प्लेबुक बनाएं:
cat > backup.yaml <<EOF - name: Manage AlloyDB Omni Backups hosts: localhost roles: - role: google.alloydbomni_orchestrator.backup EOF - backup.yaml प्लेबुक का इस्तेमाल करके, बैकअप प्लान लागू करें:
ansible-playbook backup.yaml -i deployment_spec.yaml -e resource_spec=backup_plan.yaml - प्लान सेट अप हो जाने के बाद, create_backup.yaml नाम की एक मांग पर बैकअप संसाधन फ़ाइल बनाएं.
cat > create_backup.yaml <<EOF Backup: metadata: name: on-demand-backup spec: backupPlanRef: pgb-plan dbclusterRef: $CLUSTER EOF - बैकअप लेने की प्रोसेस शुरू करने के लिए, प्लेबुक को लागू करें:
ansible-playbook backup.yaml -i deployment_spec.yaml -e resource_spec=create_backup.yaml - बैकअप के स्टेटस की पुष्टि करने के लिए, status.yaml प्लेबुक बनाएं:
cat > status.yaml <<EOF
- name: Fetch AlloyDB Omni Resource Status
  hosts: localhost
  roles:
    - role: google.alloydbomni_orchestrator.status
EOF
- सभी बैकअप की सूची बनाने के लिए, प्लेबुक चलाएं:
ansible-playbook status.yaml -i deployment_spec.yaml -e resource_type=Backup
- इसके अलावा, पहले बनाए गए किसी खास बैकअप के बारे में ज़्यादा जानकारी पाने के लिए,
-e resource_name=on-demand-backupपास करें:
ansible-playbook status.yaml -i deployment_spec.yaml \
  -e resource_type=Backup \
  -e resource_name=on-demand-backup
10. संसाधन हटाना
डिप्लॉयमेंट पूरा होने के बाद, उपलब्ध कराए गए संसाधनों को डिस्ट्रॉय किया जा सकता है, ताकि आपको शुल्क न देना पड़े.
- teardown.yaml नाम की प्लेबुक बनाएं:
cat > teardown.yaml <<EOF - name: Tear down AlloyDB Omni cluster hosts: localhost roles: - role: google.alloydbomni_orchestrator.delete EOF - ansible-playbook का इस्तेमाल करके, प्लेबुक को लागू करें. अगर आपने बैकअप कॉन्फ़िगर किए हैं, तो सबसे पहले Backup और BackupPlan संसाधन मिटाएं:
ansible-playbook teardown.yaml -i deployment_spec.yaml -e "resource_type=Backup" -e "resource_name=on-demand-backup" ansible-playbook teardown.yaml -i deployment_spec.yaml -e "resource_type=BackupPlan" -e "resource_name=pgb-plan"ansible-playbook teardown.yaml -i deployment_spec.yaml -e "resource_type=PgBouncer" -e "resource_name=pgbouncer-pooler"ansible-playbook teardown.yaml -i deployment_spec.yaml -e "resource_type=DBCluster" -e "resource_name=$CLUSTER" - क्लस्टर मिटाने के बाद, कंट्रोल नोड से लॉग आउट करें. इसके बाद, अपने टर्मिनल पर वापस जाएं और Terraform की वर्क डायरेक्ट्री पर जाएं.
ध्यान दें: अगर आपने Cloud Shell में अभी-अभी लॉग इन किया है, तो इन सेटिंग को सेट करना न भूलें:export PROJECT="your-project-id" export CLUSTER="your-cluster-name" - वीआरआरपी फ़ायरवॉल का नियम मिटाएं और Terraform से मैनेज किए जा रहे संसाधनों को डिस्ट्रॉय करें:
gcloud compute firewall-rules delete -q "$CLUSTER-allow-vrrp" --project="$PROJECT" gcloud compute firewall-rules delete -q "$CLUSTER-allow-ssh" --project="$PROJECT" terraform destroy - जब कहा जाए, तब डेटा को हमेशा के लिए मिटाने की पुष्टि करें. कभी-कभी, नेटवर्क के बचे हुए संसाधनों या रास्तों की वजह से, पूरी तरह से बंद नहीं किया जा सकता. इसलिए, यह पक्का करने के लिए कि फ़ायरवॉल के सभी जुड़े हुए नियम, NAT गेटवे, राऊटर, रास्ते, सबनेट, और नेटवर्क पूरी तरह से हटा दिए गए हैं, नीचे दिए गए सुरक्षित क्लीनअप कमांड चलाएं.
REGIONकी जगह, डिप्लॉयमेंट का कोई खास क्षेत्र डालें. जैसे, ‘us-central1':# Delete any remaining firewall rules associated with the cluster gcloud compute firewall-rules list --project=$PROJECT 2> /dev/null | grep ^$CLUSTER- | cut -f1 -d' ' | \ while read rule; do gcloud compute firewall-rules delete --project=$PROJECT --quiet $rule; done # Delete the Cloud NAT gateway and router if they still exist gcloud compute routers nats describe $CLUSTER-nat-gw --router=$CLUSTER-router --region=REGION --project=$PROJECT 2>/dev/null \ && gcloud compute routers nats delete $CLUSTER-nat-gw --router=$CLUSTER-router --region=REGION --project=$PROJECT --quiet gcloud compute routers describe $CLUSTER-router --region=REGION --project=$PROJECT 2>/dev/null \ && gcloud compute routers delete $CLUSTER-router --region=REGION --project=$PROJECT --quiet # Delete any remaining custom routes gcloud compute routes list --project=$PROJECT --filter="network:$CLUSTER" --format="value(name)" 2>/dev/null | \ while read route; do gcloud compute routes delete --project=$PROJECT --quiet $route 2>/dev/null || true; done # Delete the subnet and network if they still exist gcloud compute networks subnets describe $CLUSTER --region=REGION --project=$PROJECT 2>/dev/null \ && gcloud compute networks subnets delete $CLUSTER --region=REGION --project=$PROJECT --quiet gcloud compute networks describe $CLUSTER --project $PROJECT 2> /dev/null \ && gcloud compute networks delete $CLUSTER --project $PROJECT --quiet
11. बधाई हो
कोडलैब पूरा करने के लिए बधाई.
हमने क्या-क्या बताया
- AlloyDB Omni के लिए GCE वीएम बनाने और उन्हें तैयार करने का तरीका.
- AlloyDB Omni RPM Orchestrator को इंस्टॉल और चलाने का तरीका.
- एचए रेफ़रंस आर्किटेक्चर के लिए, AlloyDB Omni RPM इंस्टॉल और कॉन्फ़िगर करने का तरीका.
AlloyDB Omni के बारे में ज़्यादा जानने के लिए, दस्तावेज़ पढ़ें.