

1. Introduzione
Questo codelab mostra il deployment del cluster ad alta affidabilità (HA) di AlloyDB Omni su macchine virtuali (VM) di Google Compute Engine (GCE). Al termine di questo codelab, eseguirai il provisioning di un'architettura di riferimento ad alta affidabilità composta da 3 nodi di database e 2 nodi HAProxy, insieme a un nodo di controllo per le operazioni di gestione.
Prerequisiti
- Accesso a un progetto cloud Google Cloud e a Cloud Shell da console Cloud.
- Google Cloud SDK (
gcloud) installato e configurato. Per informazioni dettagliate sull'installazione di gcloud, consulta gcloud-install. - Terraform v1.9.8 installato.
Cosa imparerai a fare
- Come creare e preparare le VM GCE per AlloyDB Omni.
- Come installare ed eseguire l'orchestratore RPM di AlloyDB Omni.
- Come installare e configurare i pacchetti RPM di AlloyDB Omni per l'architettura di riferimento ad alta disponibilità.
Che cosa ti serve
- Ottieni il link URL agli RPM di AlloyDB Omni e all'orchestratore RPM. Per farlo, devi compilare il modulo di registrazione di AlloyDB Omni. I link vengono inviati all'email del server URL del repository. Inizializza le seguenti variabili di ambiente per avere a portata di mano gli URL che verranno utilizzati durante il codelab.
export ORCHESTRATOR_ANSIBLE_COLLECTION_PATH="..." export ALLOYDB_OMNI_REPOSITORY_URL="..." export ALLOYDB_OMNI_ORCHESTRATOR_REPOSITORY_URL="..." export ALLOYDB_OMNI_COMMON_REPOSITORY_URL="..." export ETCD_REPOSITORY_URL="..." - Un terminale funzionante con accesso allo stack di deployment di AlloyDB Omni. A questo scopo, puoi utilizzare Cloud Shell.
2. Configurazione e requisiti
Configurazione del progetto
Crea un progetto Google Cloud
- Nella console Google Cloud, nella pagina di selezione del progetto, seleziona o crea un progetto Google Cloud.
- Verifica che la fatturazione sia attivata per il tuo progetto Cloud. Scopri come verificare se la fatturazione è abilitata per un progetto.
Avvia Cloud Shell
Sebbene Google Cloud possa essere gestito da remoto dal tuo laptop, in questo codelab utilizzerai Google Cloud Shell, un ambiente a riga di comando in esecuzione nel cloud.
Nella console Google Cloud, fai clic sull'icona di Cloud Shell nella barra degli strumenti in alto a destra:
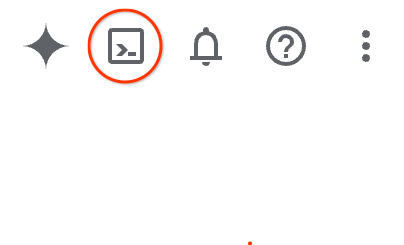
In alternativa, puoi premere G e poi S. Questa sequenza attiverà Cloud Shell se ti trovi nella console Google Cloud o utilizza questo link.
Bastano pochi istanti per eseguire il provisioning e connettersi all'ambiente. Al termine, dovresti vedere un risultato simile a questo:
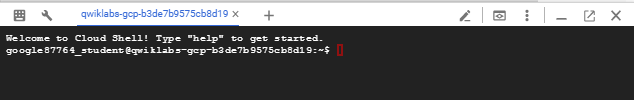
Questa macchina virtuale è caricata con tutti gli strumenti per sviluppatori di cui avrai bisogno. Offre una home directory permanente da 5 GB e viene eseguita su Google Cloud, migliorando notevolmente le prestazioni e l'autenticazione della rete. Tutto il lavoro in questo codelab può essere svolto all'interno di un browser. Non devi installare nulla.
3. Creare macchine virtuali Google Cloud Compute Engine
Prepara gli script Terraform
- Definisci le variabili di ambiente per l'ID progetto e il nome del cluster che preferisci. Li utilizzerai durante tutto il codelab.
export PROJECT="your-project-id" export CLUSTER="your-cluster-name" - Assicurati di aver eseguito l'accesso con l'utente dell'account Google Cloud.
gcloud auth login - Crea una directory di lavoro per il deployment e copia i file di configurazione Terraform richiesti dall'origine del repository.
mkdir -p ~/alloydb-omni/$PROJECT/$CLUSTER cd ~/alloydb-omni/$PROJECT/$CLUSTER gcloud storage cp gs://alloydb-omni-install/rpm-orchestrator/gce/terraform/*.tf . - Crea un file
terraform.tfvarsper specificare i parametri richiesti in base all'architettura di riferimento, come indicato di seguito:cat > terraform.tfvars <<EOF # Required instance counts for reference architecture db_instance_count = 3 haproxy_instance_count = 2 control_instance_count = 1 # Optional: Customize if needed with the below variables # os_image = "rocky-linux-cloud/rocky-linux-9" # zone = "us-west4-c" # region_1 = "us-west4" # db_instance_type = "c4-highmem-4" # db_disk_type = "hyperdisk-balanced" # db_data_size = "50" # GB # data_dir = "/data" EOF
Esegui gli script Terraform e convalida
- Ora puoi eseguire il provisioning delle VM.
terraform init - Prima di creare le VM, assicurati di disporre dell'accesso necessario per creare VM e altre risorse. In sintesi, avrai bisogno delle seguenti autorizzazioni.
roles/compute.admin roles/iam.roleAdmin roles/compute.osAdminLogin roles/iam.serviceAccountCreator roles/iam.serviceAccountUser roles/artifactregistry.repoAdmin roles/storage.objectUser roles/resourcemanager.projectIamAdmin roles/serviceusage.serviceUsageAdmin - Convalida la configurazione e applicala per eseguire il provisioning delle risorse.
terraform validate terraform apply --auto-approve - Al termine dell'operazione di Terraform, verifica che le macchine virtuali siano state create correttamente elencando le istanze create utilizzando
gcloud.gcloud compute instances list --filter="name~$CLUSTER" --project=$PROJECTexport ZONE=$(gcloud compute instances list \ --filter="name=$CLUSTER-control" \ --format="value(zone)" --project=$PROJECT)
4. Prepara le VM per il deployment
Devi creare una sessione SSH al nodo di controllo ed eseguire i passaggi per attivare l'accesso SSH a tutte le VM (chiamate anche nodi).
- Assicurati che le variabili di ambiente per il progetto e il cluster siano definite.
export PROJECT="your-project-id" export CLUSTER="your-cluster-name" - Crea la chiave SSH e aggiungila per accedere alla VM di controllo.
# Replace values with your specific GCP project, cluster and zone details ssh-keygen -t ed25519 -f $HOME/.ssh/google_compute_engine gcloud compute os-login ssh-keys add --key-file=$HOME/.ssh/google_compute_engine.pub --project=$PROJECT - Crea una regola firewall per consentire le connessioni SSH e il traffico VRRP.
gcloud compute config-ssh --project=$PROJECT gcloud compute firewall-rules create $CLUSTER-allow-ssh --network=$CLUSTER --project=$PROJECT --direction=INGRESS --action=allow --rules=tcp:22 --source-ranges="0.0.0.0/0" gcloud compute firewall-rules create $CLUSTER-allow-vrrp --network=$CLUSTER --project=$PROJECT --allow=112 --source-ranges="0.0.0.0/0" - Connettiti alla VM di controllo tramite SSH:
gcloud compute ssh "$CLUSTER-control" --zone=$ZONE --project=$PROJECT - Crea un gruppo Linux sul nodo di controllo con lo stesso nome dell'username:
sudo groupadd -f $(id -un) sudo usermod -aG $(id -un) $(id -un) - La configurazione di Terraform crea alcuni script di configurazione e li organizza nella directory
/tmp/della VM di controllo, che include elementi come il nome del cluster, l'account di servizio, il nome del progetto e così via.Crea l'accesso SSH senza password dai nodi di controllo a tutti i nodi del cluster utilizzando gli script di configurazione sul nodo di controllo./tmp/setup-ssh-for-cluster.sh - Per questo codelab, possiamo disattivare SELinux su tutti i nodi. Lo script Terraform aggiunge "/tmp/run-all.sh", che può essere utilizzato a questo scopo.
/tmp/run-all.sh sudo setenforce 0 - Se hai eseguito la registrazione ad AlloyDB Omni e hai ottenuto i link, è il momento di aggiungere anche questi URL alle variabili di ambiente.
cat >> ~/.codelab.env <<EOF export ORCHESTRATOR_ANSIBLE_COLLECTION_PATH="..." export ALLOYDB_OMNI_REPOSITORY_URL="..." export ALLOYDB_OMNI_ORCHESTRATOR_REPOSITORY_URL="..." export ALLOYDB_OMNI_COMMON_REPOSITORY_URL="..." export ETCD_REPOSITORY_URL="..." EOFterraform/variables.tfin modo che non entri in conflitto con gli altri nodi, come mostrato nell'esempio seguente:cat >> ~/.codelab.env <<EOF export VIRTUAL_IP="10.1.0.50" EOF
5. Installa i componenti software richiesti su tutte le VM
Il passaggio successivo consiste nell'installare i componenti software richiesti sulle VM. Questa operazione può essere coordinata sul nodo di controllo. Tutti i comandi seguenti devono essere eseguiti sul nodo di controllo.
- Connettiti alla VM di controllo tramite SSH, se non ti trovi già sul nodo di controllo.
gcloud compute ssh "$CLUSTER-control" --zone=$ZONE --project=$PROJECTsource ~/.codelab.env - Sul nodo di controllo, installa Ansible e le librerie Python richieste.
sudo dnf install -y https://dl.fedoraproject.org/pub/epel/epel-release-latest-9.noarch.rpm -y sudo dnf install -y ansible sudo dnf install -y python3-grpcio python3-protobuf python3-googleapis-common-protos python3-grpcio-status - Quindi, scarica il file tar della raccolta Ansible di RPM Orchestrator e installalo.
gcloud storage cp "gs://${ORCHESTRATOR_ANSIBLE_COLLECTION_PATH#https://storage.googleapis.com/}google-alloydbomni_orchestrator-*.tar.gz" . COLLECTION_FILE=$(ls -1 google-alloydbomni_orchestrator-*.tar.gz \ | sort -V | tail -n 1) ansible-galaxy collection install "$COLLECTION_FILE" ansible-galaxy collection list | grep alloydbomni_orchestratorsort -Vetail -n 1selezionano il file con l'ultima versione. Nota: assicurati che la variabile ORCHESTRATOR_ANSIBLE_COLLECTION_PATH contenga "/" alla fine. - L'orchestratore utilizza un file di specifica di deployment in formato inventario Ansible per comprendere la topologia del cluster. Crea un file denominato deployment_spec.yaml con i dettagli del nodo sul nodo di controllo.
cat > deployment_spec.yaml <<EOF alloydbomni: vars: cluster_manager: name: "$CLUSTER" etcd: setup: true config_forcewrite: true alloydbomni: major_version: "18" repo_url: $ALLOYDB_OMNI_REPOSITORY_URL alloydbomni_monitor: repo_url: $ALLOYDB_OMNI_COMMON_REPOSITORY_URL alloydbomni_cluster_manager: repo_url: $ALLOYDB_OMNI_ORCHESTRATOR_REPOSITORY_URL alloydbomni_node_manager: repo_url: $ALLOYDB_OMNI_ORCHESTRATOR_REPOSITORY_URL pgbouncer: repo_url: $ALLOYDB_OMNI_COMMON_REPOSITORY_URL pgbackrest: repo_url: $ALLOYDB_OMNI_COMMON_REPOSITORY_URL children: primary_instance_nodes: hosts: $CLUSTER-db1: $CLUSTER-db2: $CLUSTER-db3: load_balancer_nodes: hosts: $CLUSTER-haproxy1: $CLUSTER-haproxy2: EOF - Crea un playbook denominato install.yaml che fa riferimento al ruolo di installazione della raccolta dell'orchestratore.
cat > install.yaml <<EOF - name: Install AlloyDB Omni cluster components hosts: all vars: ansible_become: true ansible_user: $SSH_USER ansible_ssh_private_key_file: $HOME/ssh-key-cluster-sa roles: - role: google.alloydbomni_orchestrator.install EOF - Esegui il playbook utilizzando il file di inventario per scaricare e installare gli RPM in tutti i nodi specificati.
ansible-playbook -i deployment_spec.yaml install.yaml
6. Bootstrap del cluster AlloyDB Omni
A questo punto, abbiamo installato tutti i componenti necessari su tutti i nodi. Siamo pronti per il bootstrap del cluster AlloyDB Omni.
- Connettiti alla VM di controllo tramite SSH, se non ti trovi già sul nodo di controllo.
gcloud compute ssh "$CLUSTER-control" --zone=$ZONE --project=$PROJECTsource ~/.codelab.env - Genera un hash per la password e recupera la versione del database AlloyDB Omni installata:
encoded_password=$(echo -n "your unique password" | base64) DB_VERSION=$(/tmp/run-all.sh -t db 'rpm -q --qf "%{VERSION}\n" alloydbomni18' | tail -n 1) echo "$DB_VERSION" - Per creare il cluster, AlloyDB Omni deve sapere come configurarlo. Crea un nome file dbcluster.yaml per le specifiche del cluster di database.
cat > dbcluster.yaml <<EOF Secret: metadata: name: db-pw-$CLUSTER spec: type: Opaque data: $CLUSTER: $encoded_password --- DBCluster: metadata: name: $CLUSTER spec: databaseVersion: $DB_VERSION mode: "" availability: numberOfStandbys: 2 enableAutoFailover: true enableAutoHeal: true autoFailoverTriggerThreshold: 2 autoHealTriggerThreshold: 2 healthcheckPeriodSeconds: 5 replayReplicationSlotsOnStandbys: false primarySpec: adminUser: passwordRef: name: db-pw-$CLUSTER resources: cpu: 4 memory: 32Gi disks: - name: DataDisk path: $PGDATA dbLoadBalancerOptions: gcp: loadBalancerIP: "$VIRTUAL_IP" loadBalancerType: "internal" loadBalancerInterface: "eth0" EOF - Crea un playbook denominato bootstrap.yaml, che farà riferimento al ruolo Ansible di bootstrap per la creazione del cluster AlloyDB Omni.
cat > bootstrap.yaml <<EOF - name: Create DBCluster hosts: localhost roles: - role: google.alloydbomni_orchestrator.bootstrap EOF - Esegui il playbook per creare il cluster
ansible-playbook bootstrap.yaml -i deployment_spec.yaml -e resource_spec=dbcluster.yaml
7. (Facoltativo) Configura PgBouncer Connection Pooler
AlloyDB Omni supporta il pooling di connessioni leggero utilizzando PgBouncer. Puoi configurare e avviare PgBouncer subito dopo il provisioning del cluster.
- Crea un file di specifiche delle risorse denominato pgbouncer.yaml che associa il pool di connessioni al cluster di database:
cat > pgbouncer.yaml <<EOF PgBouncer: metadata: name: pgbouncer-pooler spec: dbclusterRef: $CLUSTER allowSuperUserAccess: true accessMode: "rw" port: 6432 EOF - Esegui il bootstrap del pooler PgBouncer utilizzando lo stesso playbook bootstrap.yaml creato in precedenza, passando il nuovo file di specifica:
ansible-playbook bootstrap.yaml -i deployment_spec.yaml -e resource_spec=pgbouncer.yaml
8. Verifica il cluster AlloyDB Omni
Per verificare che il cluster funzioni correttamente e sia accessibile utilizzando il bilanciatore del carico, puoi connetterti utilizzando il client PostgreSQL standard dal nodo di controllo.
- Installa il repository e il pacchetto client PostgreSQL 18 sul nodo di controllo:
sudo dnf install -y https://download.postgresql.org/pub/repos/yum/reporpms/EL-9-x86_64/pgdg-redhat-repo-latest.noarch.rpm sudo dnf install -y postgresql18 - Connettiti al cluster utilizzando l'IP virtuale prenotato in precedenza. Ti verrà chiesta la password che hai codificato in dbcluster.yaml:
/usr/pgsql-18/bin/psql -h $VIRTUAL_IP -U postgres -W - Una volta connesso, puoi eseguire query SQL di base per verificare lo stato del cluster, ad esempio controllando la versione del database:
postgres=# SELECT version();\qper uscire dal prompt.
9. (Facoltativo) Esegui il backup dei dati utilizzando pgBackRest
AlloyDB Omni si integra con pgBackRest per gestire i backup direttamente in Cloud Storage. Puoi configurare un piano di backup e attivare un backup on demand nel bucket GCS creato dalla configurazione di Terraform.
- Crea un file di specifiche del piano di backup denominato backup_plan.yaml che rimandi al bucket GCS di cui è stato eseguito il provisioning:
cat > backup_plan.yaml <<EOF BackupPlan: metadata: name: pgb-plan spec: dbclusterRef: $CLUSTER backupLocation: type: GCS gcsOptions: bucket: $CLUSTER-gcs-backups key: /backups EOF - Crea un playbook Ansible denominato backup.yaml che faccia riferimento al ruolo di gestione dei backup:
cat > backup.yaml <<EOF - name: Manage AlloyDB Omni Backups hosts: localhost roles: - role: google.alloydbomni_orchestrator.backup EOF - Applica il piano di backup utilizzando il playbook backup.yaml:
ansible-playbook backup.yaml -i deployment_spec.yaml -e resource_spec=backup_plan.yaml - Una volta stabilito il piano, crea un file di risorse di backup on demand denominato create_backup.yaml.
cat > create_backup.yaml <<EOF Backup: metadata: name: on-demand-backup spec: backupPlanRef: pgb-plan dbclusterRef: $CLUSTER EOF - Esegui il playbook per avviare il backup:
ansible-playbook backup.yaml -i deployment_spec.yaml -e resource_spec=create_backup.yaml - Per verificare lo stato del backup, crea un playbook status.yaml:
cat > status.yaml <<EOF
- name: Fetch AlloyDB Omni Resource Status
  hosts: localhost
  roles:
    - role: google.alloydbomni_orchestrator.status
EOF
- Esegui il playbook per elencare tutti i backup:
ansible-playbook status.yaml -i deployment_spec.yaml -e resource_type=Backup
- In alternativa, per ottenere informazioni dettagliate su un backup specifico creato in precedenza, passa
-e resource_name=on-demand-backup:
ansible-playbook status.yaml -i deployment_spec.yaml \
  -e resource_type=Backup \
  -e resource_name=on-demand-backup
10. Esegui la pulizia delle risorse
Al termine del deployment, puoi eliminare le risorse di cui è stato eseguito il provisioning per evitare addebiti.
- Crea un playbook denominato teardown.yaml:
cat > teardown.yaml <<EOF - name: Tear down AlloyDB Omni cluster hosts: localhost roles: - role: google.alloydbomni_orchestrator.delete EOF - Esegui il playbook utilizzando ansible-playbook. Se hai configurato i backup, elimina prima le risorse Backup e BackupPlan:
ansible-playbook teardown.yaml -i deployment_spec.yaml -e "resource_type=Backup" -e "resource_name=on-demand-backup" ansible-playbook teardown.yaml -i deployment_spec.yaml -e "resource_type=BackupPlan" -e "resource_name=pgb-plan"ansible-playbook teardown.yaml -i deployment_spec.yaml -e "resource_type=PgBouncer" -e "resource_name=pgbouncer-pooler"ansible-playbook teardown.yaml -i deployment_spec.yaml -e "resource_type=DBCluster" -e "resource_name=$CLUSTER" - Una volta eliminato il cluster, esci dal nodo di controllo, torna al terminale e vai alla directory di lavoro di Terraform.
Nota: se hai appena eseguito l'accesso a Cloud Shell, ricordati di impostare questi valori:export PROJECT="your-project-id" export CLUSTER="your-cluster-name" - Elimina la regola firewall VRRP ed elimina le risorse gestite da Terraform:
gcloud compute firewall-rules delete -q "$CLUSTER-allow-vrrp" --project="$PROJECT" gcloud compute firewall-rules delete -q "$CLUSTER-allow-ssh" --project="$PROJECT" terraform destroy - Conferma la distruzione quando ti viene richiesto. Poiché le risorse o le route di rete rimanenti potrebbero occasionalmente impedire l'eliminazione completa, esegui i seguenti comandi di pulizia sicuri per assicurarti che tutte le regole firewall, i gateway NAT, i router, le route, le subnet e le reti associati vengano rimossi completamente. Sostituisci
REGIONcon la regione di deployment specifica, ad esempio "us-central1":# Delete any remaining firewall rules associated with the cluster gcloud compute firewall-rules list --project=$PROJECT 2> /dev/null | grep ^$CLUSTER- | cut -f1 -d' ' | \ while read rule; do gcloud compute firewall-rules delete --project=$PROJECT --quiet $rule; done # Delete the Cloud NAT gateway and router if they still exist gcloud compute routers nats describe $CLUSTER-nat-gw --router=$CLUSTER-router --region=REGION --project=$PROJECT 2>/dev/null \ && gcloud compute routers nats delete $CLUSTER-nat-gw --router=$CLUSTER-router --region=REGION --project=$PROJECT --quiet gcloud compute routers describe $CLUSTER-router --region=REGION --project=$PROJECT 2>/dev/null \ && gcloud compute routers delete $CLUSTER-router --region=REGION --project=$PROJECT --quiet # Delete any remaining custom routes gcloud compute routes list --project=$PROJECT --filter="network:$CLUSTER" --format="value(name)" 2>/dev/null | \ while read route; do gcloud compute routes delete --project=$PROJECT --quiet $route 2>/dev/null || true; done # Delete the subnet and network if they still exist gcloud compute networks subnets describe $CLUSTER --region=REGION --project=$PROJECT 2>/dev/null \ && gcloud compute networks subnets delete $CLUSTER --region=REGION --project=$PROJECT --quiet gcloud compute networks describe $CLUSTER --project $PROJECT 2> /dev/null \ && gcloud compute networks delete $CLUSTER --project $PROJECT --quiet
11. Complimenti
Congratulazioni per aver completato il codelab.
Argomenti trattati
- Come creare e preparare le VM GCE per AlloyDB Omni.
- Come installare ed eseguire l'orchestratore RPM di AlloyDB Omni.
- Come installare e configurare i pacchetti RPM di AlloyDB Omni per l'architettura di riferimento ad alta disponibilità.
Per saperne di più su AlloyDB Omni, consulta la documentazione.