

1. Introdução
Este codelab demonstra a implantação de um cluster de alta disponibilidade (HA) do AlloyDB Omni em máquinas virtuais (VMs) do Google Compute Engine (GCE). Ao final deste codelab, você vai provisionar uma arquitetura de referência de alta disponibilidade com três nós de banco de dados e dois nós HAProxy, além de um nó de controle para operações de gerenciamento.
Pré-requisitos
- Acesso a um projeto na nuvem do Google Cloud e ao Cloud Shell no console do Cloud.
- SDK Google Cloud (
gcloud) instalado e configurado. Para detalhes sobre como instalar o gcloud, consulte gcloud-install. - O Terraform v1.9.8 instalado.
O que você vai aprender
- Como criar e preparar VMs do GCE para o AlloyDB Omni.
- Como instalar e executar o orquestrador RPM do AlloyDB Omni.
- Como instalar e configurar RPMs do AlloyDB Omni para arquitetura de referência de alta disponibilidade.
O que é necessário
- Receba o link da URL para RPMs do AlloyDB Omni e o orquestrador de RPMs. Para isso, preencha o formulário de inscrição do AlloyDB Omni. Os links são enviados para o e-mail do servidor de URL do repositório. Inicialize as seguintes variáveis de ambiente para manter os URLs à mão, que serão usados durante o codelab.
export ORCHESTRATOR_ANSIBLE_COLLECTION_PATH="..." export ALLOYDB_OMNI_REPOSITORY_URL="..." export ALLOYDB_OMNI_ORCHESTRATOR_REPOSITORY_URL="..." export ALLOYDB_OMNI_COMMON_REPOSITORY_URL="..." export ETCD_REPOSITORY_URL="..." - Um terminal funcional com acesso à pilha de implantação do AlloyDB Omni. Você pode usar o Cloud Shell para essa finalidade.
2. Configuração e requisitos
Configuração do projeto
Criar um projeto do Google Cloud
- No console do Google Cloud, na página do seletor de projetos, selecione ou crie um projeto na nuvem do Google Cloud.
- Verifique se o faturamento está ativado para seu projeto do Cloud. Saiba como verificar se o faturamento está ativado em um projeto.
Inicie o Cloud Shell
Embora o Google Cloud possa ser operado remotamente do seu laptop, neste codelab vamos usar o Google Cloud Shell, um ambiente de linha de comando executado no Cloud.
No console do Google Cloud, clique no ícone do Cloud Shell na barra de ferramentas superior à direita:
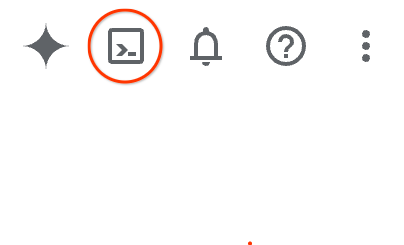
Ou pressione G e S. Essa sequência vai ativar o Cloud Shell se você estiver no console do Google Cloud ou usar este link.
O provisionamento e a conexão com o ambiente levarão apenas alguns instantes para serem concluídos: Quando o processamento for concluído, você verá algo como:
Essa máquina virtual contém todas as ferramentas para desenvolvedores necessárias. Ela oferece um diretório principal persistente de 5 GB, além de ser executada no Google Cloud. Isso aprimora o desempenho e a autenticação da rede. Neste codelab, todo o trabalho pode ser feito com um navegador. Você não precisa instalar nada.
3. Criar máquinas virtuais do Google Cloud Compute Engine
Preparar scripts do Terraform
- Defina variáveis de ambiente para o ID do projeto e o nome do cluster desejado. Você vai usar esses recursos ao longo do codelab.
export PROJECT="your-project-id" export CLUSTER="your-cluster-name" - Verifique se você fez login com o usuário da conta do Google Cloud.
gcloud auth login - Crie um diretório de trabalho para sua implantação e copie os arquivos de configuração do Terraform necessários da origem do repositório.
mkdir -p ~/alloydb-omni/$PROJECT/$CLUSTER cd ~/alloydb-omni/$PROJECT/$CLUSTER gcloud storage cp gs://alloydb-omni-install/rpm-orchestrator/gce/terraform/*.tf . - Crie um arquivo
terraform.tfvarspara especificar os parâmetros necessários de acordo com a arquitetura de referência, conforme o conteúdo a seguir:cat > terraform.tfvars <<EOF # Required instance counts for reference architecture db_instance_count = 3 haproxy_instance_count = 2 control_instance_count = 1 # Optional: Customize if needed with the below variables # os_image = "rocky-linux-cloud/rocky-linux-9" # zone = "us-west4-c" # region_1 = "us-west4" # db_instance_type = "c4-highmem-4" # db_disk_type = "hyperdisk-balanced" # db_data_size = "50" # GB # data_dir = "/data" EOF
Executar scripts do Terraform e validar
- Agora é possível provisionar as VMs.
terraform init - Antes de criar VMs, verifique se você tem o acesso necessário para criar VMs e outros recursos. Em resumo, você vai precisar das seguintes permissões.
roles/compute.admin roles/iam.roleAdmin roles/compute.osAdminLogin roles/iam.serviceAccountCreator roles/iam.serviceAccountUser roles/artifactregistry.repoAdmin roles/storage.objectUser roles/resourcemanager.projectIamAdmin roles/serviceusage.serviceUsageAdmin - Valide a configuração e aplique-a para provisionar os recursos.
terraform validate terraform apply --auto-approve - Quando o Terraform for concluído, verifique se as máquinas virtuais foram criadas listando as instâncias criadas usando
gcloud.gcloud compute instances list --filter="name~$CLUSTER" --project=$PROJECTexport ZONE=$(gcloud compute instances list \ --filter="name=$CLUSTER-control" \ --format="value(zone)" --project=$PROJECT)
4. Preparar as VMs para a implantação
Você precisa criar uma sessão SSH para o nó de controle e realizar etapas para ativar o acesso SSH a todas as VMs (também chamadas de nós).
- Verifique se as variáveis de ambiente do projeto e do cluster estão definidas.
export PROJECT="your-project-id" export CLUSTER="your-cluster-name" - Crie uma chave SSH e adicione a mesma para fazer login na VM de controle.
# Replace values with your specific GCP project, cluster and zone details ssh-keygen -t ed25519 -f $HOME/.ssh/google_compute_engine gcloud compute os-login ssh-keys add --key-file=$HOME/.ssh/google_compute_engine.pub --project=$PROJECT - Crie uma regra de firewall para permitir conexões SSH e tráfego VRRP.
gcloud compute config-ssh --project=$PROJECT gcloud compute firewall-rules create $CLUSTER-allow-ssh --network=$CLUSTER --project=$PROJECT --direction=INGRESS --action=allow --rules=tcp:22 --source-ranges="0.0.0.0/0" gcloud compute firewall-rules create $CLUSTER-allow-vrrp --network=$CLUSTER --project=$PROJECT --allow=112 --source-ranges="0.0.0.0/0" - Conecte-se à VM de controle por SSH:
gcloud compute ssh "$CLUSTER-control" --zone=$ZONE --project=$PROJECT - Crie um grupo do Linux no nó de controle com o mesmo nome do nome de usuário:
sudo groupadd -f $(id -un) sudo usermod -aG $(id -un) $(id -un) - A configuração do Terraform cria alguns scripts de configuração e os organiza no diretório
/tmp/da VM de controle, que inclui itens como nome do cluster, conta de serviço, nome do projeto etc.Crie acesso SSH sem senha dos nós de controle a todos os nós do cluster usando scripts de configuração no nó de controle./tmp/setup-ssh-for-cluster.sh - Neste codelab, podemos desativar o SELinux em todos os nós. O script do Terraform adiciona "/tmp/run-all.sh", que pode ser usado para essa finalidade.
/tmp/run-all.sh sudo setenforce 0 - Se você assinou o AlloyDB Omni e recebeu os links, é hora de adicionar esses URLs também às variáveis de ambiente.
cat >> ~/.codelab.env <<EOF export ORCHESTRATOR_ANSIBLE_COLLECTION_PATH="..." export ALLOYDB_OMNI_REPOSITORY_URL="..." export ALLOYDB_OMNI_ORCHESTRATOR_REPOSITORY_URL="..." export ALLOYDB_OMNI_COMMON_REPOSITORY_URL="..." export ETCD_REPOSITORY_URL="..." EOFterraform/variables.tfpara que ele não entre em conflito com os outros nós, conforme mostrado no exemplo a seguir:cat >> ~/.codelab.env <<EOF export VIRTUAL_IP="10.1.0.50" EOF
5. Instale os componentes de software necessários em todas as VMs
A próxima etapa é instalar os componentes de software necessários nas VMs. Isso pode ser coordenado no nó de controle. Todos os comandos a seguir precisam ser executados no nó de controle.
- Conecte-se à VM de controle por SSH, se ainda não estiver no nó de controle.
gcloud compute ssh "$CLUSTER-control" --zone=$ZONE --project=$PROJECTsource ~/.codelab.env - No nó de controle, instale o Ansible e as bibliotecas necessárias do Python.
sudo dnf install -y https://dl.fedoraproject.org/pub/epel/epel-release-latest-9.noarch.rpm -y sudo dnf install -y ansible sudo dnf install -y python3-grpcio python3-protobuf python3-googleapis-common-protos python3-grpcio-status - Em seguida, faça o download do arquivo tar da coleção Ansible do RPM Orchestrator e instale-o.
gcloud storage cp "gs://${ORCHESTRATOR_ANSIBLE_COLLECTION_PATH#https://storage.googleapis.com/}google-alloydbomni_orchestrator-*.tar.gz" . COLLECTION_FILE=$(ls -1 google-alloydbomni_orchestrator-*.tar.gz \ | sort -V | tail -n 1) ansible-galaxy collection install "$COLLECTION_FILE" ansible-galaxy collection list | grep alloydbomni_orchestratorsort -Vetail -n 1selecionam o arquivo com a versão mais recente. Observação: verifique se a variável ORCHESTRATOR_ANSIBLE_COLLECTION_PATH termina com "/". - O orquestrador usa um arquivo de especificação da implantação no formato de inventário do Ansible para entender a topologia do cluster. Crie um arquivo chamado deployment_spec.yaml com os detalhes do nó no nó de controle.
cat > deployment_spec.yaml <<EOF alloydbomni: vars: cluster_manager: name: "$CLUSTER" etcd: setup: true config_forcewrite: true alloydbomni: major_version: "18" repo_url: $ALLOYDB_OMNI_REPOSITORY_URL alloydbomni_monitor: repo_url: $ALLOYDB_OMNI_COMMON_REPOSITORY_URL alloydbomni_cluster_manager: repo_url: $ALLOYDB_OMNI_ORCHESTRATOR_REPOSITORY_URL alloydbomni_node_manager: repo_url: $ALLOYDB_OMNI_ORCHESTRATOR_REPOSITORY_URL pgbouncer: repo_url: $ALLOYDB_OMNI_COMMON_REPOSITORY_URL pgbackrest: repo_url: $ALLOYDB_OMNI_COMMON_REPOSITORY_URL children: primary_instance_nodes: hosts: $CLUSTER-db1: $CLUSTER-db2: $CLUSTER-db3: load_balancer_nodes: hosts: $CLUSTER-haproxy1: $CLUSTER-haproxy2: EOF - Crie um playbook chamado install.yaml que faça referência à função de instalação da coleção do orquestrador.
cat > install.yaml <<EOF - name: Install AlloyDB Omni cluster components hosts: all vars: ansible_become: true ansible_user: $SSH_USER ansible_ssh_private_key_file: $HOME/ssh-key-cluster-sa roles: - role: google.alloydbomni_orchestrator.install EOF - Execute o playbook usando o arquivo de inventário para fazer o download e instalar os RPMs em todos os nós especificados.
ansible-playbook -i deployment_spec.yaml install.yaml
6. Inicializar o cluster do AlloyDB Omni
Nesta etapa, instalamos todos os componentes necessários em todos os nós. Estamos prontos para fazer o bootstrap do cluster do AlloyDB Omni.
- Conecte-se à VM de controle por SSH, se ainda não estiver no nó de controle.
gcloud compute ssh "$CLUSTER-control" --zone=$ZONE --project=$PROJECTsource ~/.codelab.env - Gere um hash para sua senha e busque a versão instalada do banco de dados do AlloyDB Omni:
encoded_password=$(echo -n "your unique password" | base64) DB_VERSION=$(/tmp/run-all.sh -t db 'rpm -q --qf "%{VERSION}\n" alloydbomni18' | tail -n 1) echo "$DB_VERSION" - Para criar um cluster, o AlloyDB Omni precisa saber como configurá-lo. Crie um nome de arquivo dbcluster.yaml para as especificações do cluster de banco de dados.
cat > dbcluster.yaml <<EOF Secret: metadata: name: db-pw-$CLUSTER spec: type: Opaque data: $CLUSTER: $encoded_password --- DBCluster: metadata: name: $CLUSTER spec: databaseVersion: $DB_VERSION mode: "" availability: numberOfStandbys: 2 enableAutoFailover: true enableAutoHeal: true autoFailoverTriggerThreshold: 2 autoHealTriggerThreshold: 2 healthcheckPeriodSeconds: 5 replayReplicationSlotsOnStandbys: false primarySpec: adminUser: passwordRef: name: db-pw-$CLUSTER resources: cpu: 4 memory: 32Gi disks: - name: DataDisk path: $PGDATA dbLoadBalancerOptions: gcp: loadBalancerIP: "$VIRTUAL_IP" loadBalancerType: "internal" loadBalancerInterface: "eth0" EOF - Crie um playbook chamado bootstrap.yaml, que vai se referir à função de inicialização do Ansible para criar o cluster do AlloyDB Omni.
cat > bootstrap.yaml <<EOF - name: Create DBCluster hosts: localhost roles: - role: google.alloydbomni_orchestrator.bootstrap EOF - Executar o playbook para criar o cluster
ansible-playbook bootstrap.yaml -i deployment_spec.yaml -e resource_spec=dbcluster.yaml
7. (Opcional) Configurar o pooler de conexões do PgBouncer
O AlloyDB Omni oferece suporte ao pool de conexões leves usando o PgBouncer. É possível configurar e fazer o bootstrap do PgBouncer logo após o provisionamento do cluster.
- Crie um arquivo de especificação de recursos chamado pgbouncer.yaml que associa o pool de conexões ao cluster de banco de dados:
cat > pgbouncer.yaml <<EOF PgBouncer: metadata: name: pgbouncer-pooler spec: dbclusterRef: $CLUSTER allowSuperUserAccess: true accessMode: "rw" port: 6432 EOF - Inicialize o pooler do PgBouncer usando o mesmo playbook bootstrap.yaml criado anteriormente, transmitindo o novo arquivo de especificação:
ansible-playbook bootstrap.yaml -i deployment_spec.yaml -e resource_spec=pgbouncer.yaml
8. Verificar o cluster do AlloyDB Omni
Para verificar se o cluster está funcionando corretamente e acessível usando o balanceador de carga, conecte-se a ele usando o cliente padrão do PostgreSQL no nó de controle.
- Instale o repositório e o pacote do cliente PostgreSQL 18 no nó de controle:
sudo dnf install -y https://download.postgresql.org/pub/repos/yum/reporpms/EL-9-x86_64/pgdg-redhat-repo-latest.noarch.rpm sudo dnf install -y postgresql18 - Conecte-se ao cluster usando o IP virtual reservado anteriormente. Você vai precisar digitar a senha codificada em dbcluster.yaml:
/usr/pgsql-18/bin/psql -h $VIRTUAL_IP -U postgres -W - Depois de se conectar, execute consultas SQL básicas para verificar o estado do cluster, por exemplo, verificando a versão do banco de dados:
postgres=# SELECT version();\qpara sair do comando.
9. (Opcional) Fazer backup de dados usando pgBackRest
O AlloyDB Omni se integra ao pgBackRest para gerenciar backups diretamente no Cloud Storage. É possível configurar um plano de backup e acionar um backup sob demanda para o bucket do GCS criado pela configuração do Terraform.
- Crie um arquivo de especificação de plano de backup chamado backup_plan.yaml apontando para o bucket provisionado do GCS:
cat > backup_plan.yaml <<EOF BackupPlan: metadata: name: pgb-plan spec: dbclusterRef: $CLUSTER backupLocation: type: GCS gcsOptions: bucket: $CLUSTER-gcs-backups key: /backups EOF - Crie um playbook do Ansible chamado backup.yaml que faça referência à função de gerenciamento de backup:
cat > backup.yaml <<EOF - name: Manage AlloyDB Omni Backups hosts: localhost roles: - role: google.alloydbomni_orchestrator.backup EOF - Aplique o plano de backup usando o playbook backup.yaml:
ansible-playbook backup.yaml -i deployment_spec.yaml -e resource_spec=backup_plan.yaml - Depois que o plano for estabelecido, crie um arquivo de recurso de backup on demand chamado create_backup.yaml.
cat > create_backup.yaml <<EOF Backup: metadata: name: on-demand-backup spec: backupPlanRef: pgb-plan dbclusterRef: $CLUSTER EOF - Execute o playbook para iniciar o backup:
ansible-playbook backup.yaml -i deployment_spec.yaml -e resource_spec=create_backup.yaml - Para verificar o status do backup, crie um playbook status.yaml:
cat > status.yaml <<EOF
- name: Fetch AlloyDB Omni Resource Status
  hosts: localhost
  roles:
    - role: google.alloydbomni_orchestrator.status
EOF
- Execute o playbook para listar todos os backups:
ansible-playbook status.yaml -i deployment_spec.yaml -e resource_type=Backup
- Como alternativa, para receber informações detalhadas sobre um backup específico criado anteriormente, transmita
-e resource_name=on-demand-backup:
ansible-playbook status.yaml -i deployment_spec.yaml \
  -e resource_type=Backup \
  -e resource_name=on-demand-backup
10. Limpar recursos
Quando terminar a implantação, destrua os recursos provisionados para evitar cobranças.
- Crie um playbook chamado teardown.yaml:
cat > teardown.yaml <<EOF - name: Tear down AlloyDB Omni cluster hosts: localhost roles: - role: google.alloydbomni_orchestrator.delete EOF - Execute o playbook usando ansible-playbook. Se você configurou backups, exclua os recursos Backup e BackupPlan primeiro:
ansible-playbook teardown.yaml -i deployment_spec.yaml -e "resource_type=Backup" -e "resource_name=on-demand-backup" ansible-playbook teardown.yaml -i deployment_spec.yaml -e "resource_type=BackupPlan" -e "resource_name=pgb-plan"ansible-playbook teardown.yaml -i deployment_spec.yaml -e "resource_type=PgBouncer" -e "resource_name=pgbouncer-pooler"ansible-playbook teardown.yaml -i deployment_spec.yaml -e "resource_type=DBCluster" -e "resource_name=$CLUSTER" - Depois que o cluster for excluído, faça logout do nó de controle, volte para o terminal e navegue até o diretório de trabalho do Terraform.
Observação: se você acabou de fazer login no Cloud Shell, defina o seguinte:export PROJECT="your-project-id" export CLUSTER="your-cluster-name" - Exclua a regra de firewall do VRRP e destrua os recursos gerenciados pelo Terraform:
gcloud compute firewall-rules delete -q "$CLUSTER-allow-vrrp" --project="$PROJECT" gcloud compute firewall-rules delete -q "$CLUSTER-allow-ssh" --project="$PROJECT" terraform destroy - Confirme a destruição quando solicitado. Como recursos ou rotas de rede persistentes podem impedir a desmontagem completa, execute os seguintes comandos de limpeza segura para garantir que todas as regras de firewall, gateways NAT, roteadores, rotas, sub-redes e redes associadas sejam totalmente removidos. Substitua
REGIONpela sua região de implantação específica, como "us-central1":# Delete any remaining firewall rules associated with the cluster gcloud compute firewall-rules list --project=$PROJECT 2> /dev/null | grep ^$CLUSTER- | cut -f1 -d' ' | \ while read rule; do gcloud compute firewall-rules delete --project=$PROJECT --quiet $rule; done # Delete the Cloud NAT gateway and router if they still exist gcloud compute routers nats describe $CLUSTER-nat-gw --router=$CLUSTER-router --region=REGION --project=$PROJECT 2>/dev/null \ && gcloud compute routers nats delete $CLUSTER-nat-gw --router=$CLUSTER-router --region=REGION --project=$PROJECT --quiet gcloud compute routers describe $CLUSTER-router --region=REGION --project=$PROJECT 2>/dev/null \ && gcloud compute routers delete $CLUSTER-router --region=REGION --project=$PROJECT --quiet # Delete any remaining custom routes gcloud compute routes list --project=$PROJECT --filter="network:$CLUSTER" --format="value(name)" 2>/dev/null | \ while read route; do gcloud compute routes delete --project=$PROJECT --quiet $route 2>/dev/null || true; done # Delete the subnet and network if they still exist gcloud compute networks subnets describe $CLUSTER --region=REGION --project=$PROJECT 2>/dev/null \ && gcloud compute networks subnets delete $CLUSTER --region=REGION --project=$PROJECT --quiet gcloud compute networks describe $CLUSTER --project $PROJECT 2> /dev/null \ && gcloud compute networks delete $CLUSTER --project $PROJECT --quiet
11. Parabéns
Parabéns por concluir o codelab.
O que vimos
- Como criar e preparar VMs do GCE para o AlloyDB Omni.
- Como instalar e executar o orquestrador RPM do AlloyDB Omni.
- Como instalar e configurar RPMs do AlloyDB Omni para arquitetura de referência de alta disponibilidade.
Leia mais sobre o AlloyDB Omni na documentação.