

1- مقدمة
تتيح لك وظائف الذكاء الاصطناعي التوليدي في BigQuery استخدام لغة SQL للاستدلال على بياناتك باستخدام النماذج اللغوية الكبيرة (LLM). يمكنك تحليل المشاعر وإنشاء الملخصات وإضافة شرح للصور في ملايين الصفوف بدون نقل بياناتك.
ولكن ماذا لو كان طلبك يحتاج إلى قدر كبير من السياق (مثل السياسات أو الأدلة أو الفيديو) للحصول على نتائج دقيقة وموثوقة؟
يحلّ تخزين سياق Gemini مؤقتًا هذه المشكلة من خلال تخزين هذا السياق الكبير في ذاكرة تخزين مؤقت. تشير الطلبات اللاحقة إلى ذاكرة التخزين المؤقت بدلاً من معالجة المحتوى الكامل في كل مرة، ما يؤدي إلى تقليل وقت الاستجابة وتقديم خصم يصل إلى% 90 على الرموز المميّزة للإدخال.
في هذا الدرس التطبيقي حول الترميز، ستنشئ أداة للتحقّق من سياسة الإرجاع "المكتوبة بخط صغير" تستخدم تخزين السياق الصريح مؤقتًا لتحليل طلبات إرجاع العملاء مقابل مستند كبير وثابت لسياسة الإرجاع في BigQuery.

الإجراءات التي ستنفذّها
- إنشاء مجموعة بيانات BigQuery وملؤها بنماذج لطلبات إرجاع العملاء
- إنشاء ذاكرة تخزين مؤقت للسياق في Gemini Enterprise Agent Platform (المعروف سابقًا باسم Vertex AI)، مع الإشارة إلى مستند سياسة الإرجاع المخزّن في Cloud Storage
- تشغيل طلب بحث باستخدام
AI.GENERATEيشير إلى ذاكرة التخزين المؤقت لتقييم الطلبات صفًا بصف بكفاءة
المتطلبات
- متصفّح ويب، مثل Chrome
- مشروع على Google Cloud تم تفعيل الفوترة له
- الوصول إلى Google Cloud Shell
هذا الدرس التطبيقي حول الترميز مخصّص للمطوّرين من جميع المستويات، بما في ذلك المبتدئون.
يجب أن تقلّ تكلفة الموارد التي تم إنشاؤها في هذا الدرس التطبيقي حول الترميز عن 2 دولار أمريكي.
المدة المقدّرة: سيستغرق إكمال هذا الدرس التطبيقي حول الترميز 30 دقيقة تقريبًا.
2. قبل البدء
إنشاء مشروع على Google Cloud
- في Google Cloud Console، في صفحة اختيار المشروع، اختَر مشروعًا على السحابة الإلكترونية أو أنشِئ مشروعًا على السحابة الإلكترونية.
- تأكَّد من تفعيل الفوترة لمشروعك على السحابة الإلكترونية. تعرّف على كيفية التحقّق مما إذا كانت الفوترة مفعّلة في مشروع.
بدء Cloud Shell
Cloud Shell هي بيئة سطر أوامر تعمل في Google Cloud ومحمّلة مسبقًا بالأدوات اللازمة.
- انقر على تفعيل Cloud Shell في أعلى Google Cloud Console.
- بعد الاتصال بـ Cloud Shell، تحقَّق من عملية المصادقة:
gcloud auth list - تأكَّد من ضبط مشروعك:
gcloud config get project - إذا لم يتم ضبط مشروعك على النحو المتوقّع، اضبطه:
gcloud config set project <YOUR_PROJECT_ID>
ضبط رقم تعريف مشروعك وموقعه الجغرافي
نفِّذ الأمر التالي لاسترداد رقم تعريف مشروعك النشط على Google Cloud وضبط الموقع الجغرافي التلقائي كمتغيّرات بيئية لاستخدامها خلال هذا الدرس التطبيقي حول الترميز:
export PROJECT_ID=$(gcloud config get-value project)
export PROJECT_NUMBER=$(gcloud projects describe $PROJECT_ID --format="value(projectNumber)")
export LOCATION="us-central1"
تفعيل واجهات برمجة التطبيقات
نفِّذ هذا الأمر لتفعيل واجهات برمجة التطبيقات المطلوبة:
gcloud services enable \
 bigquery.googleapis.com \
 aiplatform.googleapis.com
3. إعداد بيانات BigQuery
قبل أن نتمكّن من اختبار تخزين السياق مؤقتًا، نحتاج إلى مجموعة بيانات وجدول مملوءين بنماذج لطلبات إرجاع العملاء لتشغيل طلبات البحث عليها.
1. إنشاء مجموعة بيانات
نفِّذ الأمر التالي في Cloud Shell لإنشاء مجموعة بيانات BigQuery باسم caching_demo:
bq mk --dataset $PROJECT_ID:caching_demo
2. إنشاء الجدول وملؤه
نفِّذ الأمر التالي لإنشاء جدول باسم return_requests وإدراج نماذج لطلبات إرجاع العملاء:
bq query \
  --use_legacy_sql=false \
  "CREATE OR REPLACE TABLE \`caching_demo.return_requests\` AS
SELECT
  10001 AS return_id,
  'P-1001' AS purchase_id,
  'I bought this jacket on Black Friday but it was too small.' AS return_comment,
  DATE('2025-11-28') AS purchase_date,
  DATE('2025-12-05') AS return_date,
  'ApexWear' AS product_brand,
  'Gold' AS customer_tier
UNION ALL
  SELECT
  10002 AS return_id,
  'P-1002' AS purchase_id,
  'The item arrived broken, I want a refund. I don\'t have photos because I threw it away.' AS return_comment,
  DATE('2026-04-01') AS purchase_date,
  DATE('2026-04-02') AS return_date,
  'GenericBrand' AS product_brand,
  'Standard' AS customer_tier
UNION ALL
  SELECT
  10003 AS return_id,
  'P-1003' AS purchase_id,
  'I bought this ApexWear jacket, took the tags off to wear it once, but it doesn\'t fit well.' AS return_comment,
  DATE('2026-02-15') AS purchase_date,
  DATE('2026-02-20') AS return_date,
  'ApexWear' AS product_brand,
  'Standard' AS customer_tier
UNION ALL
  SELECT
  10004 AS return_id,
  'P-1004' AS purchase_id,
  'This was a holiday gift but doesn\'t fit.' AS return_comment,
  DATE('2025-12-20') AS purchase_date,
  DATE('2026-01-28') AS return_date,
  'StyleCorp' AS product_brand,
  'Standard' AS customer_tier
UNION ALL
  SELECT
  10005 AS return_id,
  'P-1005' AS purchase_id,
  'I realized this doesn\'t fit' AS return_comment,
  DATE('2026-02-01') AS purchase_date,
  DATE('2026-03-15') AS return_date,
  'ApexWear' AS product_brand,
  'Gold' AS customer_tier;"
يجب أن تظهر لك رسالة نجاح:
Created your-project-id.caching_demo.return_requests
نحن الآن مستعدون لإنشاء ذاكرة التخزين المؤقت.
4. إنشاء ذاكرة التخزين المؤقت للسياق
ستنشئ ذاكرة التخزين المؤقت باستخدام طلب REST إلى نقطة نهاية نموذج Gemini Enterprise Agent Platform (المعروف سابقًا باسم Vertex AI) باستخدام curl.
نفِّذ الأمر التالي في Cloud Shell لإنشاء مستودع تخزين جديد. سيتم استخدام هذا المستودع لتخزين الملفات التي نريد تخزينها مؤقتًا:
gcloud storage buckets create gs://${PROJECT_ID}-caching-demo --location=${LOCATION}
بعد ذلك، انسخ مستند السياسة النموذجية إلى المستودع الذي أنشأته حديثًا:
gcloud storage cp gs://sample-data-and-media/context_caching_demo/return_policy.md gs://${PROJECT_ID}-caching-demo/
الآن، نفِّذ الأمر التالي لإنشاء ذاكرة التخزين المؤقت التي تشير إلى مستند السياسة الذي تم إعداده حديثًا (قد يستغرق ذلك دقيقة أو أكثر):
curl -X POST \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  -H "Content-Type: application/json" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1/projects/${PROJECT_ID}/locations/${LOCATION}/cachedContents" \
  -d '{
    "model": "projects/'"${PROJECT_ID}"'/locations/'"${LOCATION}"'/publishers/google/models/gemini-2.5-flash",
    "contents": [
      {
        "role": "user",
        "parts": [
          {
            "fileData": {
              "mimeType": "text/markdown",
              "fileUri": "gs://'"${PROJECT_ID}"'-caching-demo/return_policy.md"
            }
          }
        ]
      }
    ],
    "ttl": "3600s"
  }'
دوِّن name الذي تم عرضه في استجابة JSON، والذي سيبدو على النحو التالي: projects/PROJECT_NUMBER/locations/LOCATION/cachedContents/CACHE_ID. ستحتاج إلى CACHE_ID في الخطوة التالية.
{
  "name": "projects/123456789012/locations/us-central1/cachedContents/123456789012345"
}
احفَظ CACHE_ID كمتغيّر بيئي في Cloud Shell:
export CACHE_ID="<YOUR_CACHE_ID>"
5. تشغيل `AI.GENERATE` باستخدام المحتوى المخزّن مؤقتًا
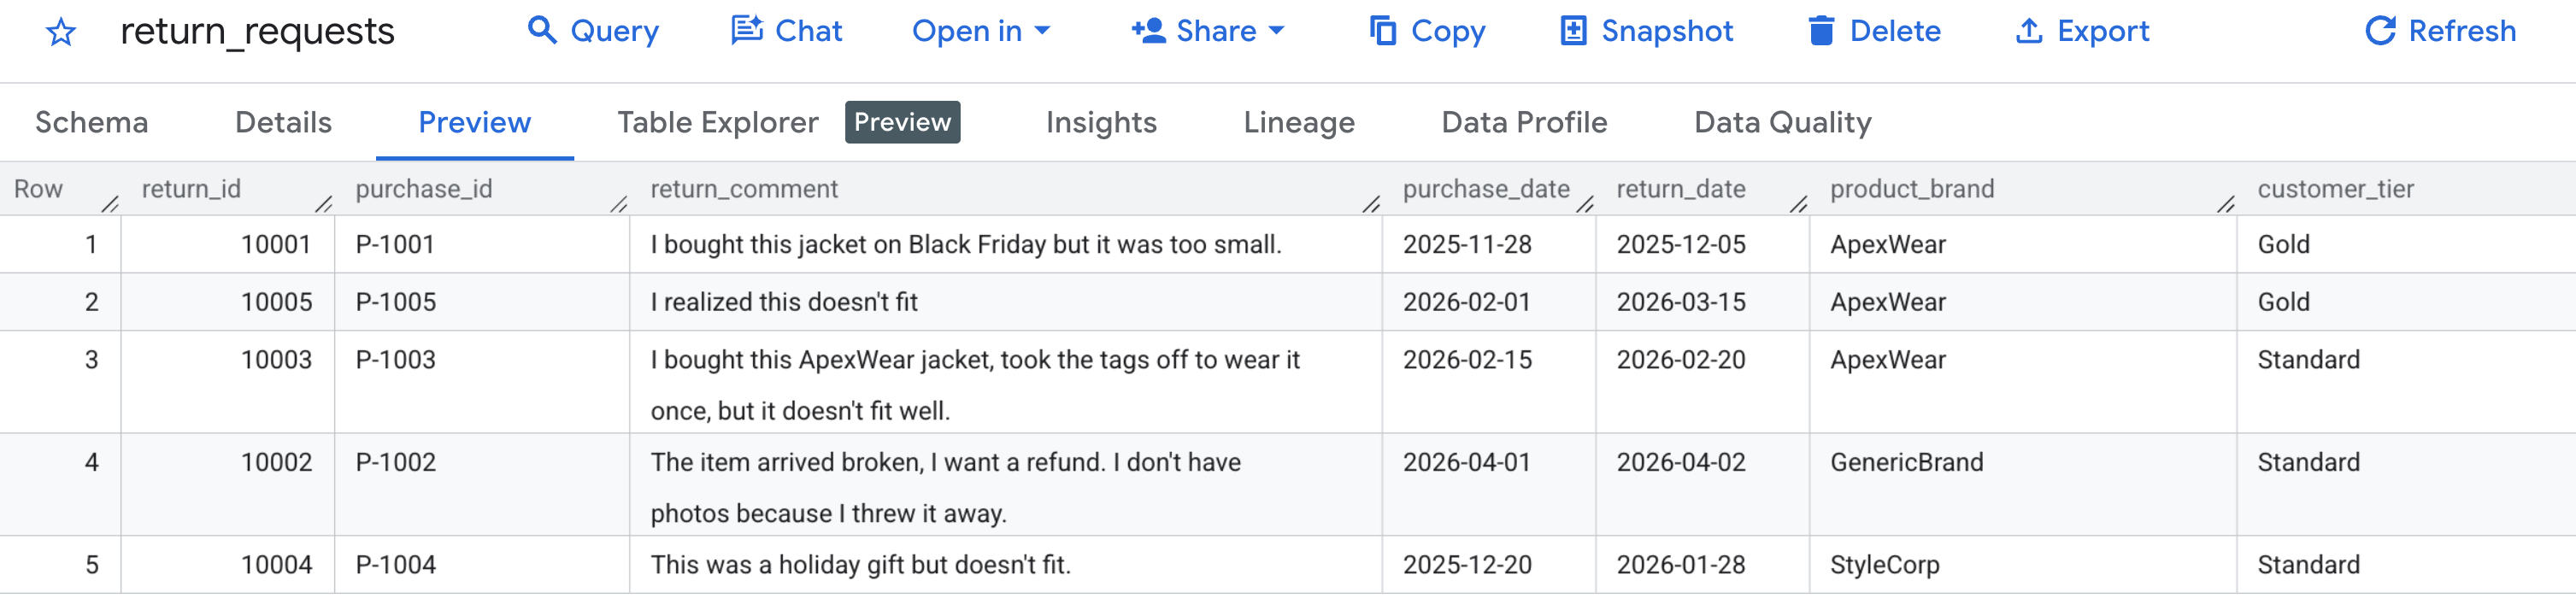
أولاً، نتأكّد من إنشاء بياناتنا النموذجية بشكل صحيح. انتقِل إلى BigQuery Console، وحدِّد مجموعة بيانات caching_demo، وانقر على جدول return_requests
ضمن علامة التبويب معاينة ، يجب أن تظهر لك طلبات إرجاع العملاء التي أنشأناها سابقًا:
بعد إنشاء ذاكرة التخزين المؤقت وملئها، يمكنك إجراء طلب بحث باستخدام AI.GENERATE لتقييم طلب استرداد الأموال من خلال الإشارة ببساطة إلى رقم تعريف ذاكرة التخزين المؤقت.
لتجنُّب العثور على المتغيّرات واستبدالها يدويًا، نفِّذ الأمر التالي في Cloud Shell. سيؤدي ذلك إلى إنشاء طلب بحث SQL ديناميكيًا باستخدام المتغيّرات البيئية الحالية وطباعته على الشاشة لتتمكّن من نسخه بسهولة.
cat << EOF > query.sql
WITH generated_returns AS (
  SELECT
    *,
    -- Call AI.GENERATE with the prompt, schema, and cache ID
    AI.GENERATE(
      -- Construct the prompt referencing the cached policy
      prompt => CONCAT(
        'Analyze this return request using the cached Return Policy. ',
        'Return Comment: "', return_comment, '". ',
        'Purchase Date: ', purchase_date, '. ',
        'Brand: ', product_brand, '. ',
        'Customer Tier: ', customer_tier, '. '
      ),
      -- Define the structured output schema
      output_schema => """
        eligible_for_refund STRING OPTIONS(description = 'True/False whether the request is eligible for a refund based on the policy'),
        refund_type STRING OPTIONS(description = 'Classify as Full, Store Credit, or None'),
        reason_citation STRING OPTIONS(description = 'Quote the specific rule from the policy applied to this decision')
      """,
      -- Construct the endpoint string dynamically using variables
      endpoint => 'gemini-2.5-flash',

      -- Pass the cached content ID using bash interpolation for the literal
      model_params => JSON '{"cachedContent": "projects/$PROJECT_NUMBER/locations/$LOCATION/cachedContents/$CACHE_ID"}'
    ) AS results
  FROM \`caching_demo.return_requests\`
)
SELECT
  *,
  -- Extract token usage metrics from the raw JSON response
  CAST(JSON_EXTRACT_SCALAR(results.full_response, '$.usage_metadata.prompt_token_count') AS INT64) AS prompt_token_count,
  CAST(JSON_EXTRACT_SCALAR(results.full_response, '$.usage_metadata.cached_content_token_count') AS INT64) AS cached_content_token_count,
  CAST(JSON_EXTRACT_SCALAR(results.full_response, '$.usage_metadata.candidates_token_count') AS INT64) AS output_token_count,
  CAST(JSON_EXTRACT_SCALAR(results.full_response, '$.usage_metadata.total_token_count') AS INT64) AS total_token_count,
  CAST(JSON_EXTRACT_SCALAR(results.full_response, '$.usage_metadata.thoughts_token_count') AS INT64) AS thoughts_token_count,
  CAST(JSON_EXTRACT_SCALAR(results.full_response, '$.usage_metadata.billable_prompt_usage.text_count') AS INT64) AS billable_prompt_text_count,
  CAST(JSON_EXTRACT_SCALAR(results.full_response, '$.usage_metadata.billable_cached_content_usage.text_count') AS INT64) AS billable_cached_text_count

FROM generated_returns;
EOF

cat query.sql
الآن، انسخ لغة SQL في الوحدة الطرفية، وانتقِل إلى BigQuery Console في متصفّحك، ونفِّذ طلب البحث في علامة التبويب "محرِّر طلبات البحث".
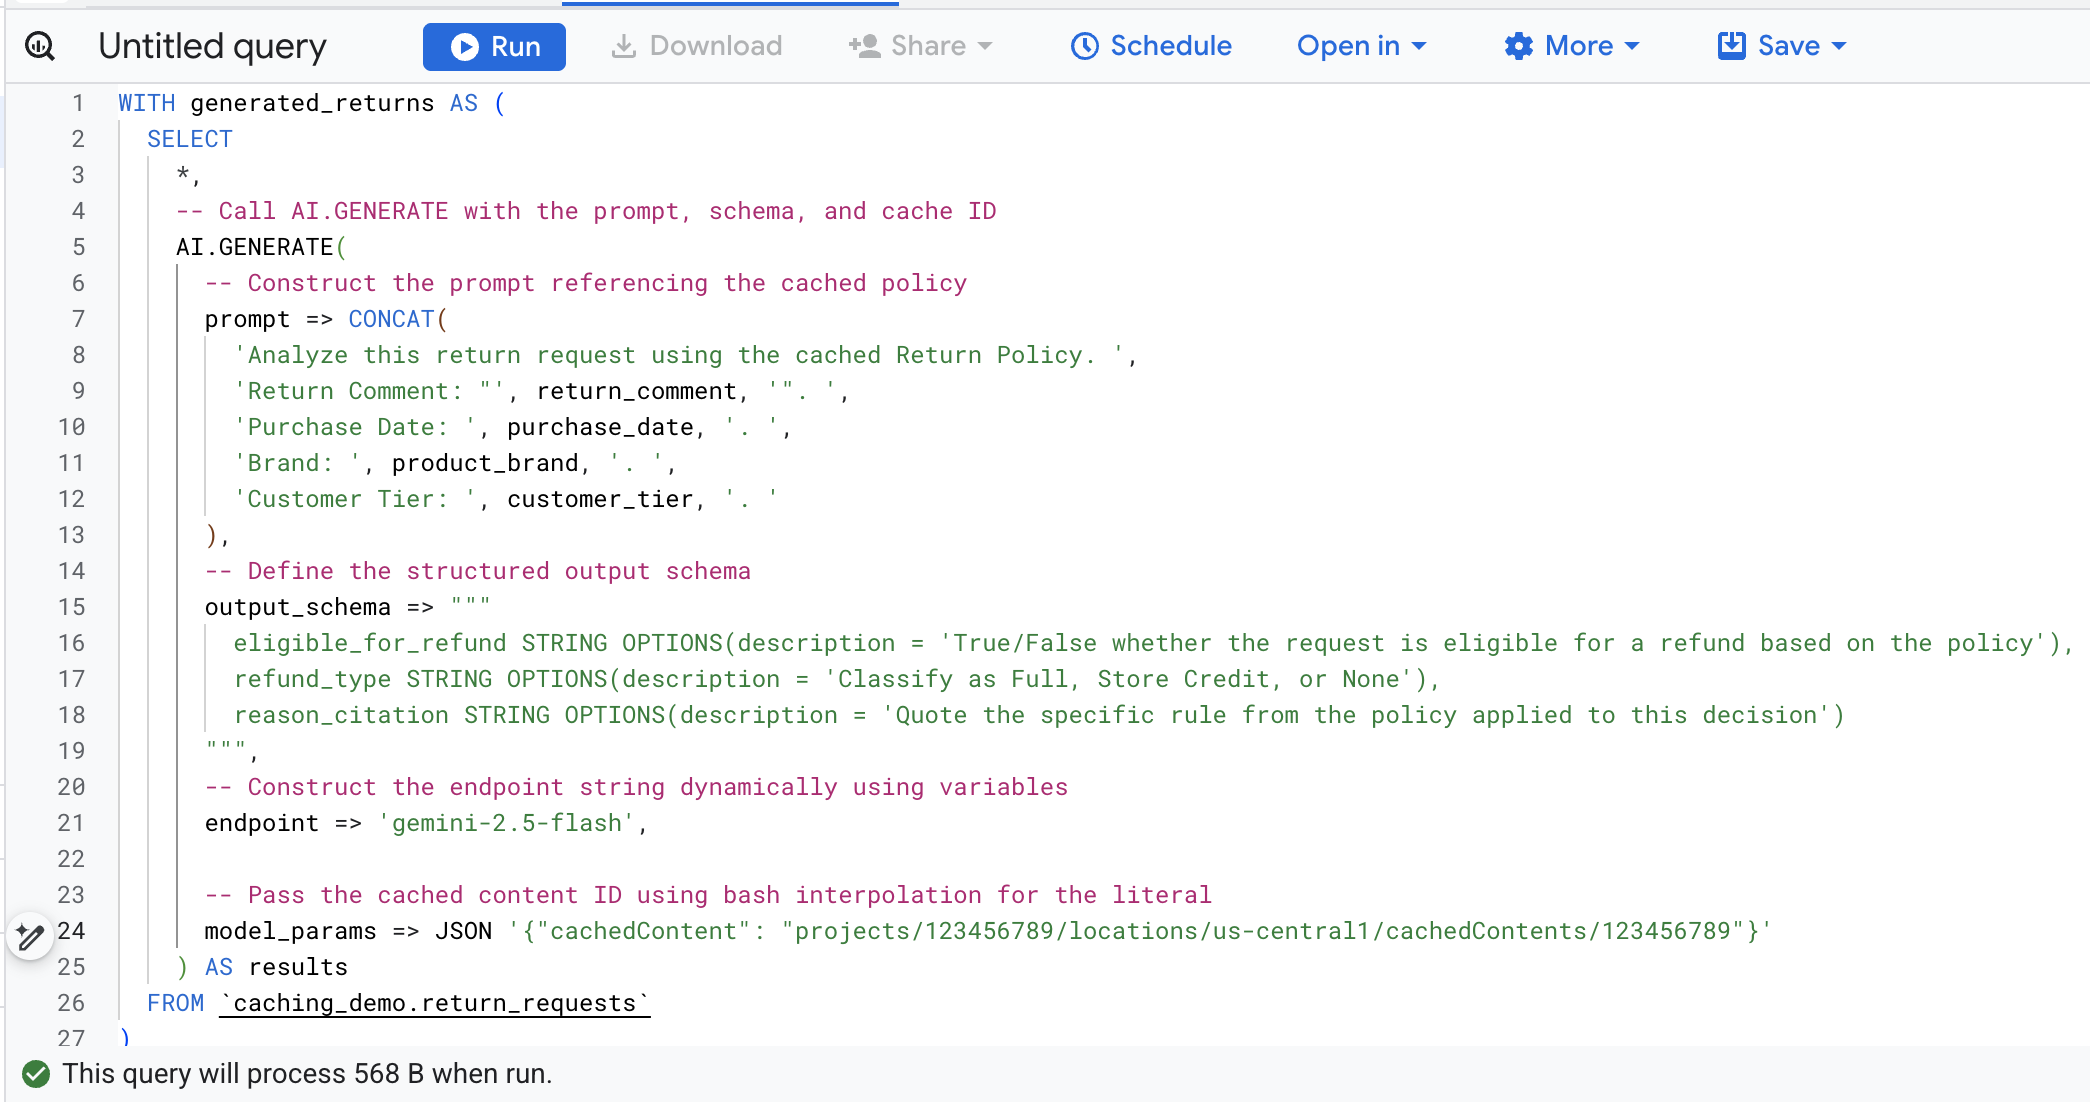
في ما يلي شرح تفصيلي للحجج الرئيسية في استدعاء الدالة هذا:
prompt: يحتوي على المعلومات المحدّدة لكل صف من صفوف العملاء. يتم إلحاق هذا النص بشكل فعّال بمستند "سياسة الإرجاع" الكبير الموجود في ذاكرة التخزين المؤقت.output_schema: يحدِّد بنية JSON المتوقّعة لاستجابة النموذج.endpoint: يحدِّد نقطة نهاية نموذج الذكاء الاصطناعي في Agent Platform (Gemini 2.5 Flash في حالتنا) المستخدَمة للإنشاء.model_params: مَعلمة مهمة تمرِّر رقم تعريف ذاكرة التخزين المؤقت الذي تم إنشاؤه باستخدام الحقلcachedContent.
يجب أن تظهر لك النتائج التي تم إنشاؤها والتي تحلّل كل طلب إرجاع سلع وفقًا للسياسة المخزّنة. مرِّر سريعًا إلى اليسار للاطّلاع على مقاييس الرموز المميّزة المستخرَجة.
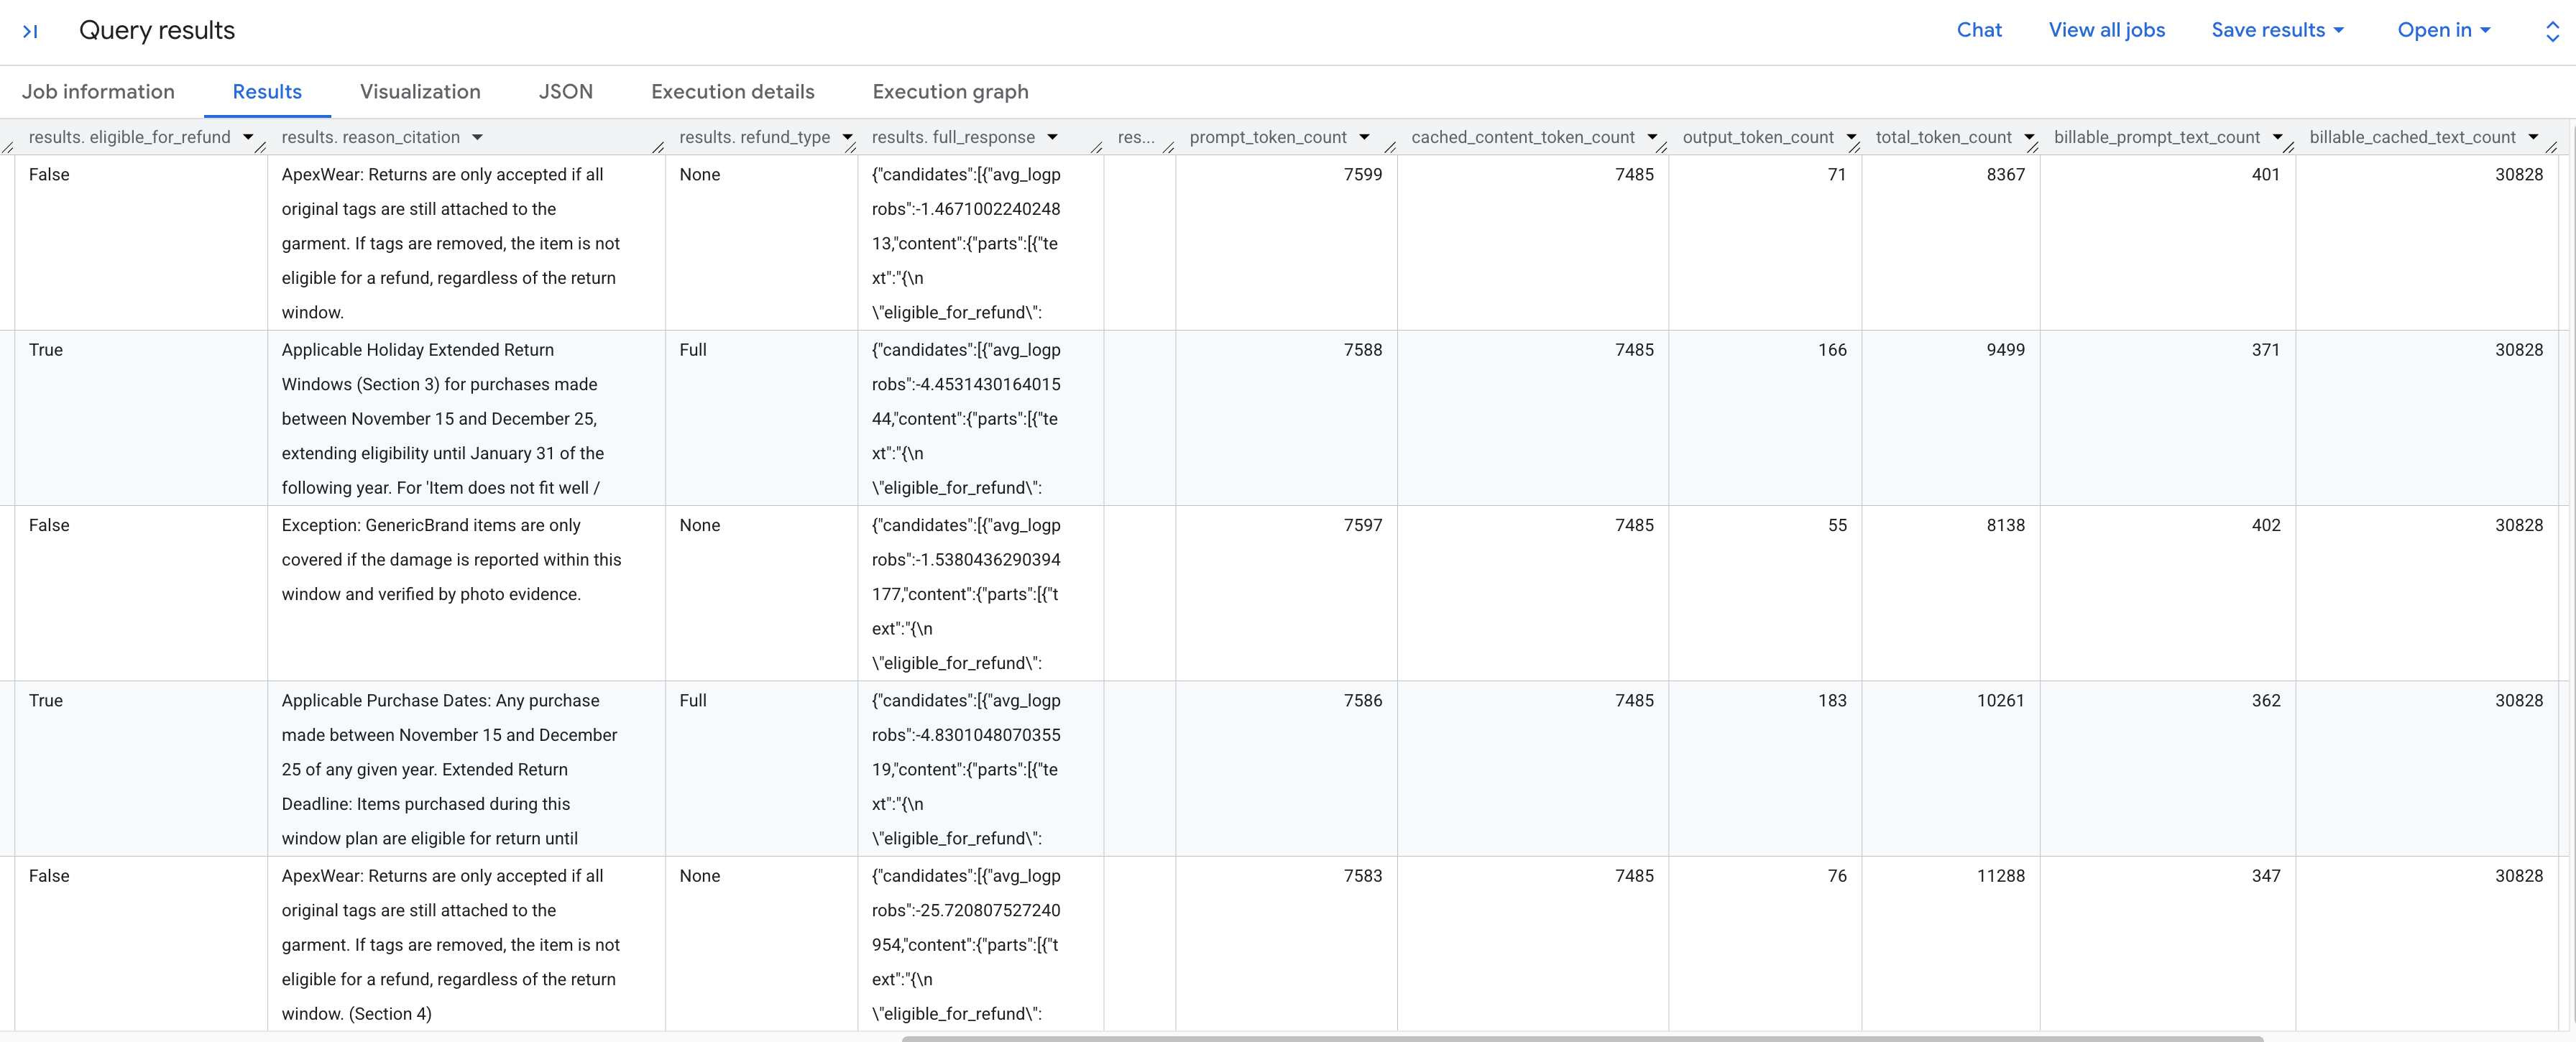
في ما يلي شرح تفصيلي لمقاييس الرموز المميّزة التي تظهر لك:
prompt_token_count: إجمالي عدد الرموز المميّزة التي تمت معالجتها في طلب الإدخال (بما في ذلك المحتوى المخزّن مؤقتًا)cached_content_token_count: عدد الرموز المميّزة التي تم عرضها من ذاكرة التخزين المؤقت (تمثّل مستند "سياسة الإرجاع" الثابت)output_token_count: عدد الرموز المميّزة التي أنشأها النموذج في الاستجابةtotal_token_count: مجموع الرموز المميّزة للطلب والناتجbillable_prompt_text_count: عدد الأحرف القابلة للفوترة في الجزء غير المخزّن مؤقتًا من الطلبbillable_cached_text_count: عدد الأحرف القابلة للفوترة في المحتوى المخزّن مؤقتًا
انظر إلى عمود billable_prompt_text_count : لا يعرض سوى بضع مئات من الأحرف لكل صف، وهو مجرد طلب العميل المحدّد. قارِن ذلك بعمود billable_cached_text_count الذي يتضمّن أكثر من 30,000 حرف لسياسة الإرجاع الكاملة. بدون تخزين السياق مؤقتًا، ستدفع مقابل معالجة مستند السياسة الكامل هذا لكل صف على حدة. من خلال تخزينه مؤقتًا، ستدفع مقابل المستند الكبير مرة واحدة، ولن يتم تحصيل رسوم منك في الصفوف اللاحقة إلا مقابل نص الطلب الصغير والمتغيّر.
يؤدي ذلك إلى تحقيق وفورات كبيرة في مهام الدُفعات.
6. تَنظيم
لتجنُّب فرض رسوم مستمرة على حسابك على Google Cloud، احذف الموارد التي تم إنشاؤها خلال هذا الدرس التطبيقي حول الترميز.
نفِّذ الأمر التالي في Cloud Shell لحذف مجموعة بيانات BigQuery وجداولها:
bq rm -r -f -d caching_demo
احذف مستودع الإعداد الذي تم إنشاؤه لمستند السياسة:
gcloud storage rm --recursive gs://${PROJECT_ID}-caching-demo
أخيرًا، احذف ذاكرة التخزين المؤقت للسياق لتجنُّب فرض رسوم تخزين مستمرة باستخدام المتغيّرات التي خزّنتها سابقًا:
curl -X DELETE \
  -H "Authorization: Bearer $(gcloud auth print-access-token)" \
  "https://${LOCATION}-aiplatform.googleapis.com/v1/projects/${PROJECT_ID}/locations/${LOCATION}/cachedContents/${CACHE_ID}"
7. تهانينا
تهانينا! لقد أنشأت بنجاح ذاكرة تخزين مؤقت للسياق في Agent Platform وأشرت إليها في دالة ذكاء اصطناعي في BigQuery لتسريع التحليل مع خفض تكاليف معالجة الرموز المميّزة للإدخال.
ما تعلّمته
- كيفية إعداد جداول البيئة لتحليلات طلبات إرجاع السلع
- كيفية استدعاء Agent Platform (Vertex AI) API باستخدام
curlلإنشاء ذاكرة تخزين مؤقت صريحة لسياق مستند ثابت - كيفية استخدام رقم تعريف ذاكرة التخزين المؤقت الذي تم إنشاؤه في طلب بحث
AI.GENERATEبلغة SQL لإزالة الرموز المميّزة للإدخال الزائدة في الطلبات النشطة