

1. Willkommen
In diesem Codelab erfahren Sie, wie Sie die Suite der verwalteten KI-Funktionen von BigQuery verwenden, um direkt in BigQuery Studio mit SQL anspruchsvolle semantische Analysen, kategoriale Klassifizierungen, multimodale Filterungen, semantische Joins und Zusammenfassungen mehrerer Zeilen durchzuführen.
Mit dem öffentlichen Dataset bigquery-public-data.cymbal_pets schlüpfen Sie in die Rolle eines Datenanalysten bei Cymbal Pets, einem E-Commerce-Händler für Tierbedarf und ‑zubehör.
Semantische Analyse direkt in SQL-Abfragen
Bisher mussten zum Anwenden von Machine Learning oder Large Language Models (LLMs) auf Unternehmensdatasets Daten aus dem Data Warehouse in externe Python-Notebook-Umgebungen verschoben werden. Dazu waren spezielle Data-Engineering-Pipelines und ML-Expertise erforderlich.
Die verwalteten KI-Funktionen von BigQuery, darunter AI.SCORE, AI.CLASSIFY, AI.IF und AI.AGG, bringen die Intelligenz von Foundation Models direkt zu Ihren Daten. BigQuery optimiert automatisch die Modellauswahl und wendet interne Strategien zum Umschreiben von Prompts an, um hochgenaue Ergebnisse aus einfachen Prompts in natürlicher Sprache zu liefern.
Für Datasets mit hohem Volumen bietet BigQuery den optimierten Modus, bei dem die Modelldistillation und einfache Proxymodelle im laufenden Betrieb verwendet werden, um bis zu 100-mal schnellere und kostengünstigere Abfragen zu ermöglichen.
Aufgaben
- Multimodale Einzelhandelsdaten mit SQL in BigQuery Studio untersuchen.
- Semantische Rangfolge mit
AI.SCOREerstellen, um subjektive Produktattribute wie „Geschenkfähigkeit“ zu bewerten. - Unstrukturierte Daten kategorisieren mit
AI.CLASSIFY, um Produkte bestimmten Tierarten zuzuordnen. - Multimodale Bild-Assets filtern mit
AI.IFinWHEREKlauseln. - Semantische Joins über Tabellen hinweg ausführen mit
AI.IFinJOIN ... ONKlauseln, um Textproduktdatensätze mit externen Bilddateien abzugleichen. - Zusammenfassungen aus mehreren Zeilen erstellen mit der Aggregatfunktion
AI.AGG. - Abfragelatenz und ‑kosten für große Datasets mit
AI.IFim optimierten Modus (optimization_mode => 'MINIMIZE_COST') und der Proxymodelldistillation optimieren.
Voraussetzungen
- Google Cloud-Projekt mit aktivierter Abrechnungsfunktion.
- Ein Webbrowser wie Chrome.
2. Einrichtung und Anforderungen
Bevor Sie Daten mit verwalteten KI-Funktionen abfragen können, müssen Sie Ihr Google Cloud-Projekt konfigurieren und die erforderlichen APIs aktivieren.
Google Cloud-Projekt erstellen und APIs aktivieren
- Wählen Sie in der Google Cloud Console auf der Seite der Projektauswahl ein Google Cloud-Projekt aus oder erstellen Sie eines.
- Die Abrechnung für das Cloud-Projekt muss aktiviert sein. So prüfen Sie, ob die Abrechnung für ein Projekt aktiviert ist.
- Aktivieren Sie die BigQuery-, BigQuery Connection- und Agent Platform-APIs.
BigQuery Studio öffnen
- Klicken Sie im Navigationsmenü der Google Cloud Console auf BigQuery, um BigQuery Studio zu öffnen.
- Klicken Sie in der Symbolleiste des BigQuery Studio-Editors auf + SQL-Abfrage, um einen neuen SQL-Abfragetab zu öffnen. In diesen SQL-Tabs schreiben und führen Sie in diesem Codelab alle SQL-Abfragen aus.
Cloud-Ressourcenverbindung in SQL erstellen
BigQuery wird innerhalb eines sicheren Datenperimeters ausgeführt. Beim Untersuchen externer multimodaler Dateien (z. B. Bilder, die in Google Cloud Storage gespeichert sind) verwendet BigQuery eine Cloud-Ressourcenverbindung , um sicher auf Objektreferenzen zuzugreifen, ohne Anmeldedaten preiszugeben.
Führen Sie die folgende Anweisung in Ihrem SQL-Tab aus, um eine Verbindung mit dem Namen us.conn zu erstellen:
CREATE CONNECTION IF NOT EXISTS `us.conn`
OPTIONS (
  connection_type = "CLOUD_RESOURCE"
);
3. Das Cymbal Pets-Dataset
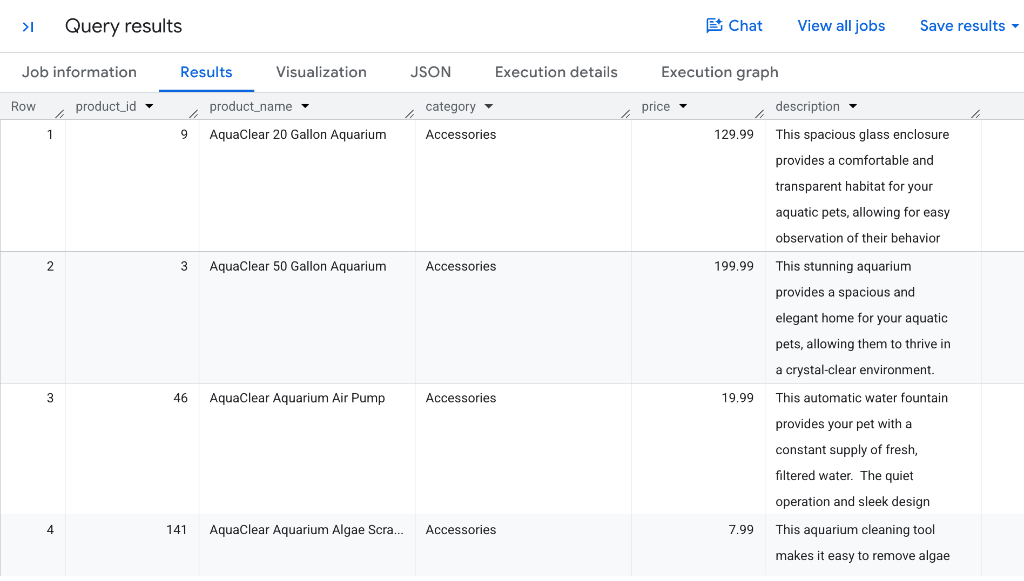
Cymbal Pets führt einen umfangreichen Produktkatalog im öffentlichen Dataset in der Tabelle bigquery-public-data.cymbal_pets.products. Jeder Produktdatensatz enthält strukturierte Attribute wie Produkt-ID, Titel, Einzelhandelskategorie, Preis und beschreibenden Text.
Produktkatalog abfragen
Öffnen Sie in BigQuery Studio einen SQL-Tab und führen Sie die folgende Abfrage aus, um die Produkttabelle zu untersuchen:
SELECT
  product_id,
  product_name,
  category,
  price,
  description
FROM
  `bigquery-public-data.cymbal_pets.products`;
Die Ergebnisse sehen in etwa so aus:
Produktbilder untersuchen
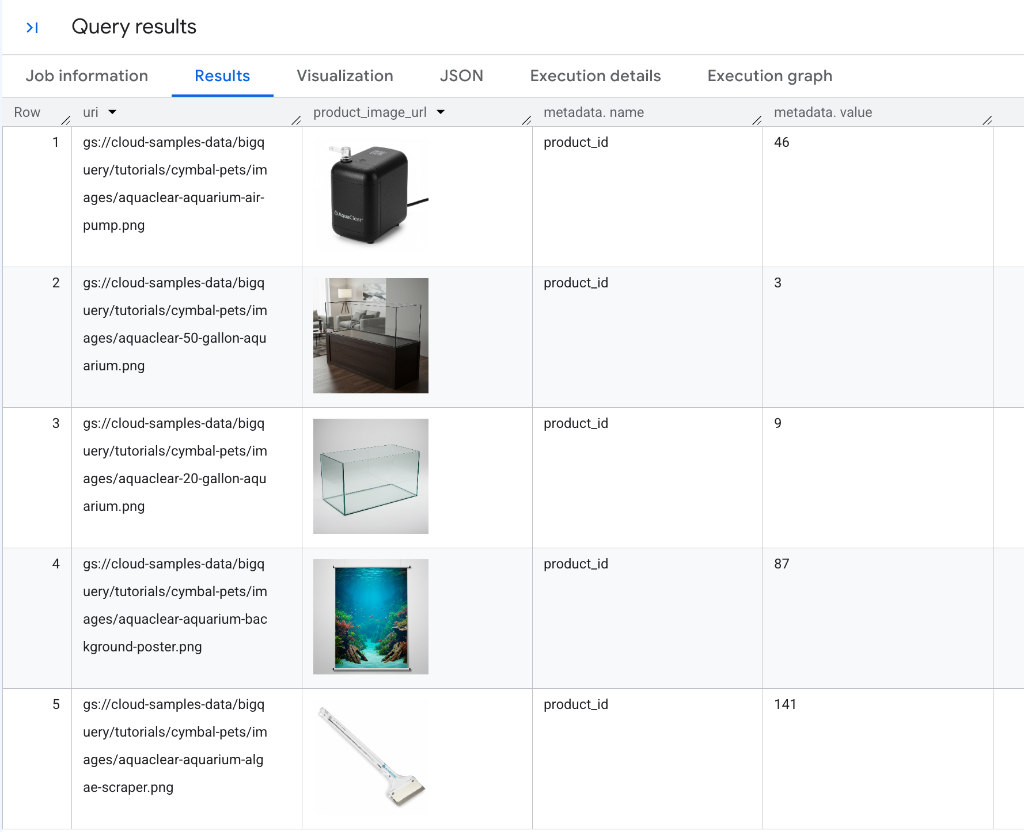
Cymbal Pets speichert auch Produktbildreferenzen in bigquery-public-data.cymbal_pets.product_images. Führen Sie die folgende Abfrage aus, um die Bilddatensätze aufzurufen:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`;
Die Ergebnisse sehen in etwa so aus:
Als Nächstes verwenden Sie verwaltete BigQuery-Funktionen, um sowohl Text- als auch Bilddaten aus dem Data Warehouse von Cymbal Pets zu analysieren.
4. Produkte nach semantischen Kriterien mit AI.SCORE bewerten
Die AI.SCORE-Funktion akzeptiert Texteingaben und bewertet sie mit einem Gemini-Modell anhand einer Bewertungsrubrik in natürlicher Sprache. Dabei wird ein numerischer FLOAT64-Wert zurückgegeben.
Wenn Sie keine explizite Bewertungsrubrik angeben, wendet BigQuery automatisch Strategien zum Umschreiben von Prompts an, um eine optimale Rubrik für das Modell zu generieren.
Produkte auf „Geschenkfähigkeit“ bewerten
Angenommen, das Marketingteam von Cymbal Pets möchte einen Geschenkratgeber für die Feiertage erstellen. Dazu soll jeder Artikel im Katalog auf einer Skala von 1 bis 10 bewertet werden, je nachdem, wie gut er sich als Geschenk für einen Tierhalter eignet.
Führen Sie die folgende Abfrage in Ihrem SQL-Tab aus:
SELECT
  product_name,
  description,
  AI.SCORE(
    ('How "giftable" is this product for a pet owner? ', description,
    'Use a scale from 1-10.')
  ) AS giftability_score
FROM
  `bigquery-public-data.cymbal_pets.products`
ORDER BY
  giftability_score DESC;
Was bedeuten die Ergebnisse?
Die Ergebnisse sehen in etwa so aus:
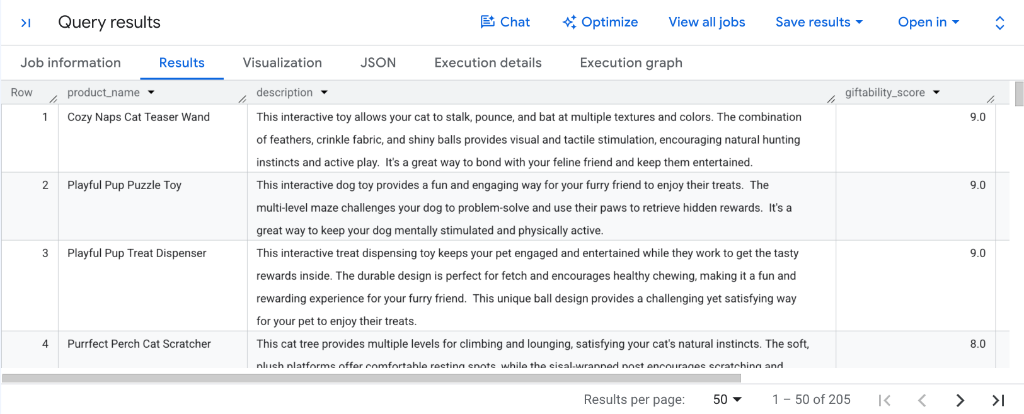
Sehen Sie sich die Spalte giftability_score in den Abfrageergebnissen an:
- Interaktives Spielzeug mit hohem Reiz: Artikel wie der
Cozy Naps Cat Teaser Wand, dasPlayful Pup Puzzle Toyund derPlayful Pup Treat Dispensererhalten Topbewertungen (9.0). - Spezielle Komfort- und Kratzartikel: Beliebte Essentials wie der
Purrfect Perch Cat Scratchererzielen mit8.0eine gute Bewertung. - Umsetzbare nachgelagerte Rangfolge: Da
AI.SCOREnormalisierteFLOAT64Werte erzeugt, können Sie die Ergebnisse sofort mitORDER BY giftability_score DESCoder Kandidaten mitWHERE AI.SCORE(...) >= 8.0filtern, um automatisierte Geschenkratgeber zu erstellen.
5. Katalogartikel mit AI.CLASSIFY kategorisieren
Die AI.CLASSIFY Funktion verwendet Gemini, um Eingabedatensätze in einer diskreten Liste von Zielkategorien zu klassifizieren, die als SQL-Array bereitgestellt werden.
AI.CLASSIFY unterstützt multimodale Eingaben (Text, Bilder, Audio, Video) und macht es überflüssig, benutzerdefinierte Klassifizierungsmodelle für die Taxonomieverwaltung zu erstellen, zu trainieren oder bereitzustellen.
Spielzeug nach Zieltierart klassifizieren (einzelnes Label)
Angenommen, einige Produkte im Cymbal Pets-Katalog sind allgemein als „Spielzeug“ getaggt, ohne dass das Zieltier angegeben ist. Mit AI.CLASSIFY können Sie jedes Spielzeug anhand seines Namens und seiner Beschreibung kategorisieren.
Führen Sie die folgende Abfrage in BigQuery Studio aus:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('What animal is this product for?', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "All Pets"]
  ) AS animal_type
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys"
LIMIT 20;
Ergebnisse ansehen
Die Ergebnisse sehen in etwa so aus:
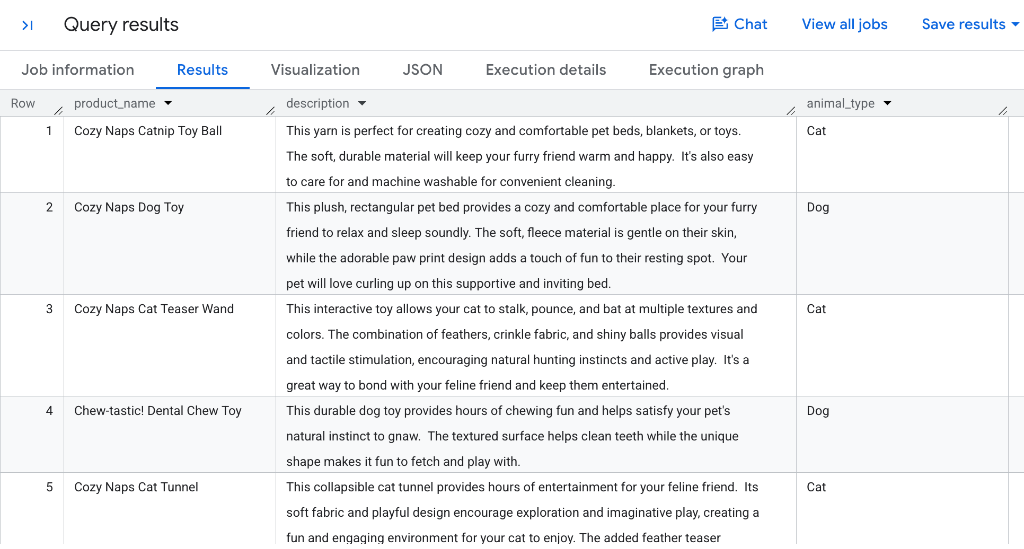
Standardmäßig führt AI.CLASSIFY eine Klassifizierung mit einem einzelnen Label durch und gibt einen STRING zurück, der die relevanteste Kategorie aus Ihrem Kandidatenarray enthält. Gemini ordnet Katzenminzebälle und Federstäbe der Kategorie Cat zu, während Kau- und Apportierspielzeug der Kategorie Dog zugeordnet wird.
Mehrere Tags mit der Klassifizierung mit mehreren Labels zuweisen
Viele Produkte in einem Einzelhandelskatalog sind für mehrere Tierarten gleichzeitig geeignet (z. B. ein Plüschbett oder ein Tunnel, der sowohl für Katzen als auch für Kleintiere geeignet ist).
Wenn Sie einem einzelnen Datensatz mehrere Kategorien zuweisen möchten, legen Sie den optionalen Parameter output_mode => 'multi' fest. Im Modus mit mehreren Labels gibt AI.CLASSIFY ein ARRAY mit allen übereinstimmenden Kategorien zurück.
Führen Sie die folgende Abfrage in Ihrem SQL-Tab aus:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('Identify all pet types that this product is suitable for: ', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "Reptile"],
    output_mode => 'multi'
  ) AS pet_types
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys";
Die Ergebnisse sehen in etwa so aus:
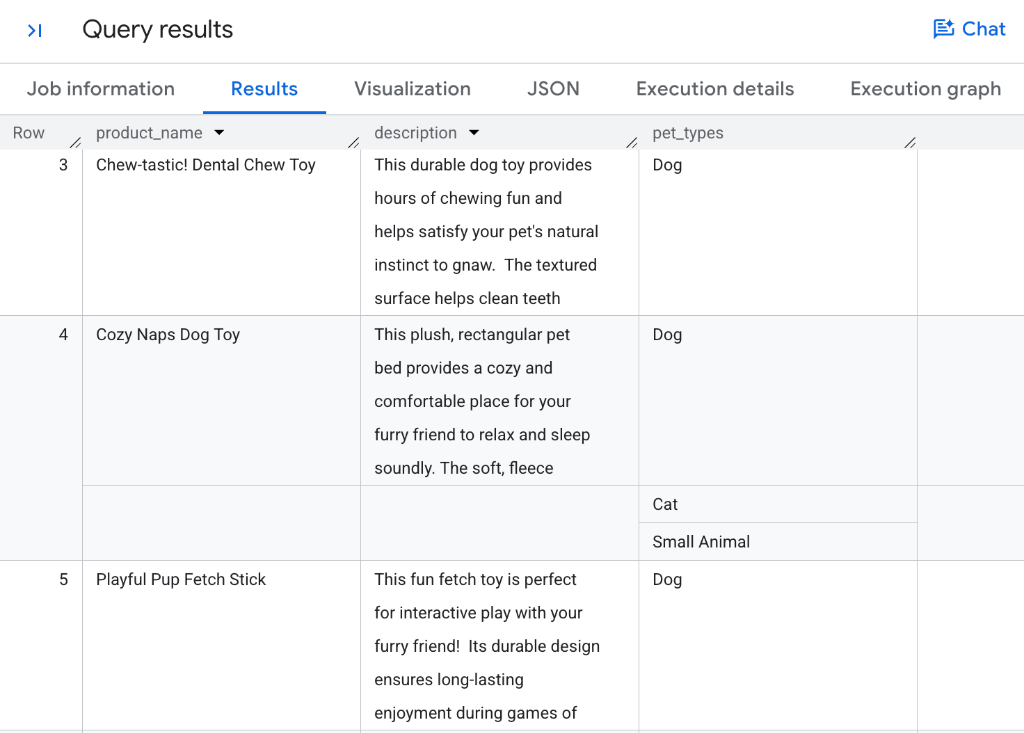
Klassifizierungsmechanismen überprüfen
- Einzelnes Label vs. mehrere Labels: Ohne
output_mode,AI.CLASSIFYgibt einen skalarenSTRINGzurück. Wenn Sieoutput_mode => 'multi'festlegen, wird einARRAYmit keinem, einem oder mehreren übereinstimmenden Labels zurückgegeben. - Mehrere Kategorien zuweisen: Artikel wie
Chew-tastic! Dental Chew ToyundPlayful Pup Fetch Stickerhalten das Label[Dog], während vielseitige Komfortartikel wieCozy Naps Dog Toy(ein rechteckiges Plüschbett) korrekt mehrere Tags erhalten:[Dog, Cat, Small Animal]. - Zero-Shot-Abgleich: Das Modell bewertet den kombinierten Text und Prompt anhand des bereitgestellten
categories-Arrays, ohne dass vortrainierte benutzerdefinierte ML-Modelle erforderlich sind. - Nachgelagerte SQL-Array-Vorgänge: Sie können Standard-SQL-Array-Funktionen von BigQuery wie
WHERE 'Cat' IN UNNEST(pet_types)oderCROSS JOIN UNNEST(pet_types)verwenden, um Datensätze mit mehreren Labels zu filtern, zu erweitern und zu aggregieren.
6. Multimodale Produktbilder mit AI.IF filtern
Die AI.IF Funktion verwendet Gemini, um eine Bedingung in natürlicher Sprache auszuwerten und einen booleschen Wert (TRUE oder FALSE) zurückzugeben.
Da AI.IF multimodale Eingaben akzeptiert, können Sie sie direkt in einer SQL-WHERE-Klausel verwenden, um unstrukturierte Bilddateien zu filtern, die in Cloud Storage gespeichert sind.
Bilder filtern, die bestimmte Objekte enthalten
Angenommen, das Merchandising-Team möchte alle Produktbilder im Katalog finden, die Tierfutter oder Snacks enthalten.
Führen Sie die folgende Abfrage in Ihrem SQL-Tab aus:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`
WHERE
  AI.IF(
    ('Does this product image contain pet food or snacks? ', OBJ.MAKE_REF(uri, 'us.conn'))
  );
Die Ergebnisse sehen in etwa so aus:
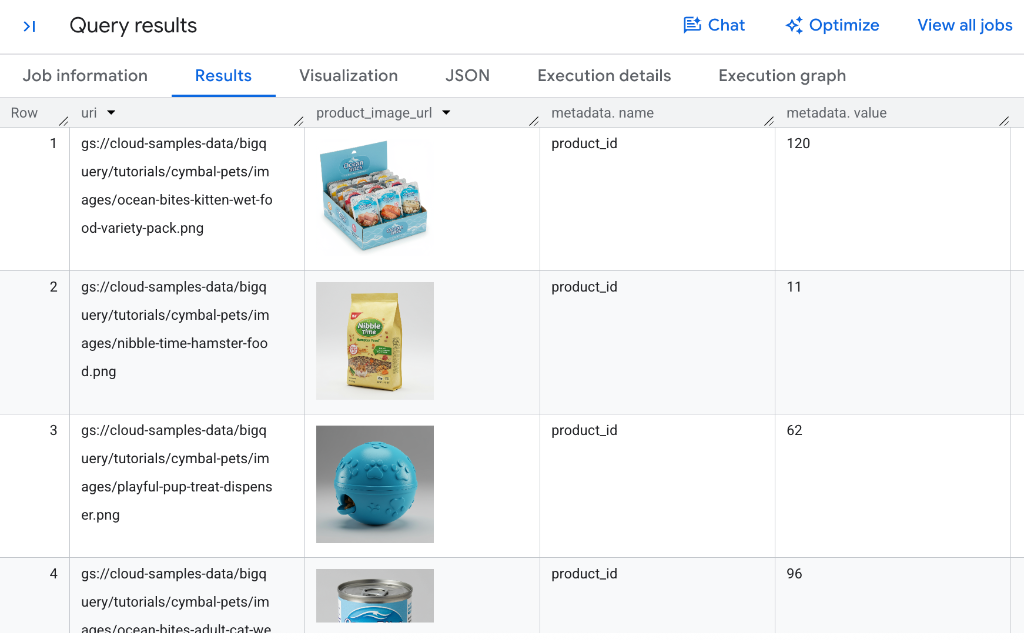
Funktionsweise der multimodalen Filterung
- Objektreferenzen im laufenden Betrieb: Hier erstellen wir Objektreferenzen im laufenden Betrieb mit
OBJ.MAKE_REF(uri, 'us.conn'). Sie können aber auchObjectRef-Spalten direkt in Ihren BigQuery-Tabellen erstellen und speichern, damit sie sofort für die Analyse verwendet werden können, ohne dass die FunktionOBJ.MAKE_REFin jeder Abfrage erforderlich ist. - Detaillierte visuelle Objekterkennung: Gemini erkennt verschiedene Verpackungsformate (z. B. die Box mit Nassfutter, den Beutel mit Trockenfutter für Hamster und die Dose mit Katzenfutter) und erkennt auch essbare Snacks, die in Spielzeug wie dem blauen Leckerli-Spender enthalten sind.
- Prädikatauswertung auf Zeilenebene: BigQuery wertet die Bedingung in natürlicher Sprache direkt in der
WHEREKlausel für jede Cloud Storage-Bildreferenz aus. - Boolesche Filterung: Im Ergebnissatz werden nur Datensätze zurückgegeben, bei denen Gemini die Bedingung als
TRUEbewertet.
7. Semantische Joins über Tabellen hinweg mit AI.IF ausführen
Für herkömmliche Joins in relationalen Datenbanken ist eine genaue Gleichheit der Schlüssel erforderlich (z. B. products.product_id = images.product_id). Unternehmensdatasets enthalten jedoch oft unstrukturierte Assets, denen explizite Fremdschlüssel fehlen.
Da AI.IF einen booleschen Wert zurückgibt, können Sie sie direkt in einer SQL-INNER JOIN ... ON-Klausel platzieren, um semantische Joins auszuführen.
Produktbeschreibungen semantisch mit Bild-Assets verknüpfen
Angenommen, Sie möchten Produktbeschreibungen aus der Tabelle products mit nicht verknüpften Bilddateien in product_images für Produkte der Marke Fluffy Buns abgleichen.
Führen Sie die folgende Abfrage in Ihrem BigQuery Studio-SQL-Tab aus. Die Ausführung dauert einige Minuten:
SELECT
  products.product_id,
  products.product_name,
  products.description,
  products.brand,
  images.uri AS image_uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(images.uri, 'us.conn')).url AS product_image_url
FROM
  `bigquery-public-data.cymbal_pets.products` AS products
INNER JOIN
  `bigquery-public-data.cymbal_pets.product_images` AS images
ON
  AI.IF(
    ('You will be provided an image of a pet product. ',
    'Determine if the image is of the following pet toy: ',
    products.product_name,
    products.description,
    OBJ.MAKE_REF(images.uri, 'us.conn')
    )
  )
WHERE
  products.category = "Toys" AND
  products.brand = "Fluffy Buns";
Die Ergebnisse sehen in etwa so aus:
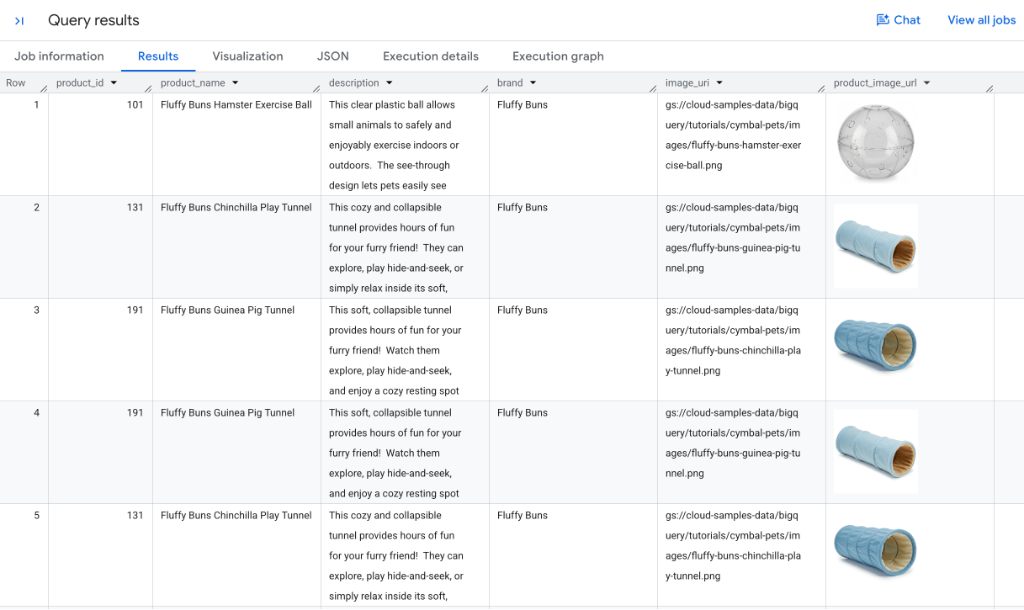
Semantische Joins in SQL
- Modellübergreifende Bedingungsauswertung: Für Kandidatendatensatzpaare sendet BigQuery sowohl die Textmetadaten aus
productsals auch die Bildreferenz (OBJ.MAKE_REF(...)) an Gemini. - Genaue visuelle Übereinstimmung: Wie in den Ergebnissen zu sehen ist, wird der
Fluffy Buns Hamster Exercise Ballmit dem Bild des durchsichtigen Plastikballs abgeglichen, während derFluffy Buns Chinchilla Play Tunnelund derGuinea Pig Tunnelmit den Fotos des blauen Plüschtunnels abgeglichen werden. Aufgrund der Standard-SQL-Semantik vonINNER JOINkann ein Produkt mehrere Zeilen in der Ausgabe erzeugen, wenn es mit mehr als einem Bild-Asset im Katalog übereinstimmt (z. B. mehrere Fotoansichten oder ähnliche Aufnahmen). - Inline-Bildrendering: BigQuery Studio rendert die autorisierten Lese-URLs in der
product_image_urlSpalte automatisch direkt in der Ergebnistabelle, sodass Sie sie sofort visuell überprüfen können. - Auflösung unstrukturierter Entitäten: Dadurch werden leistungsstarke Workflows zur Auflösung von Entitäten in älteren Katalogen, gescrapten Datasets und Medienarchiven ohne manuelle Kennzeichnung oder explizite Fremdschlüssel ermöglicht.
8. Zusammenfassungen aus mehreren Zeilen mit AI.AGG erstellen
Während Funktionen wie AI.SCORE, AI.CLASSIFY und AI.IF einzelne Zeilen auswerten (skalare Vorgänge), erfordert die Analyse von Unternehmensdaten oft die Zusammenfassung von Mustern aus mehreren Datensätzen.
Die AI.AGG Funktion ist eine Aggregatfunktion, die Anweisungen in natürlicher Sprache verwendet, um Zusammenfassungen, Cluster oder Zusammenfassungen aus Tausenden oder Millionen unstrukturierter Zeilen zu erstellen und in einer einheitlichen Antwort zusammenzufassen.
Kategorienzusammenfassungen neben herkömmlichen SQL-Messwerten erstellen
AI.AGG lässt sich nahtlos in herkömmliche SQL-GROUP BY- und Aggregatfunktionen einbinden. So können Sie beispielsweise herkömmliche Messwerte (z. B. Artikelanzahlen) direkt neben einer Zusammenfassung mit generativer KI berechnen, in der beschrieben wird, was die Produkte in den einzelnen Kategorien gemeinsam haben.
Führen Sie die folgende Abfrage in BigQuery Studio aus:
SELECT
  category,
  COUNT(*) AS item_count,
  AI.AGG(
    ('Product: ', product_name, ' - Description: ', description),
    'Write a concise, one-sentence summary describing the common characteristics or purpose of the products in this category.'
  ) AS category_summary
FROM
  `bigquery-public-data.cymbal_pets.products`
GROUP BY
  category
ORDER BY
  item_count DESC;
Die Ergebnisse sehen in etwa so aus:
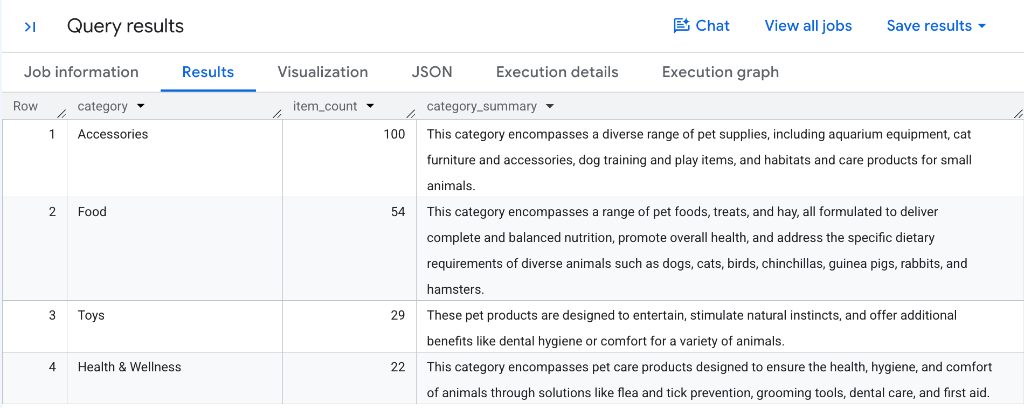
So aggregiert AI.AGG unstrukturierte Daten
- Hierarchische Aggregation: BigQuery gruppiert Zeilendaten nach Kategoriepartition, erstellt strukturierte Kontextfenster und verwendet Gemini, um die gesamte Sammlung von Produktdatensätzen zusammenzufassen.
- Automatisierte Katalogsynthese: Jede Kategorie erhält eine eigene, genaue Zusammenfassung. So werden unter
Accessoriesbeispielsweise Lebensräume und Trainingsausrüstung erfasst, während unterFoodeine ausgewogene Ernährung für mehrere Tierarten hervorgehoben wird. - Hybride quantitative und qualitative Berichte: Durch die Kombination von Standardaggregationen wie
COUNT(*)mitAI.AGGlassen sich umfassende Katalogübersichten in einer einzigen Abfrage ohne benutzerdefinierte ETL-Pipelines erstellen. - Flexible Partitionierung: Sie können
AI.AGGauf jede Gruppierungsdimension anwenden (z. B.GROUP BY brand,GROUP BY categoryoder auf die gesamte Tabelle), um in Sekundenschnelle Erkenntnisse auf Führungsebene zu gewinnen.
9. Abfragen mit dem optimierten Modus und Proxymodellen beschleunigen
Beim Verarbeiten großer Datasets mit Tausenden oder Millionen von Zeilen kann das Aufrufen eines Remote-LLM für jede einzelne Zeile zu Latenz und Kosten führen.
Um dieses Problem zu beheben, bietet BigQuery den optimierten Modus für AI.IF und AI.CLASSIFY. Im optimierten Modus werden Proxymodelle und die Modelldistillation im laufenden Betrieb verwendet, um eine über 100-mal schnellere Ausführung bei geringeren LLM-Tokenkosten zu ermöglichen.
Funktionsweise des optimierten Modus
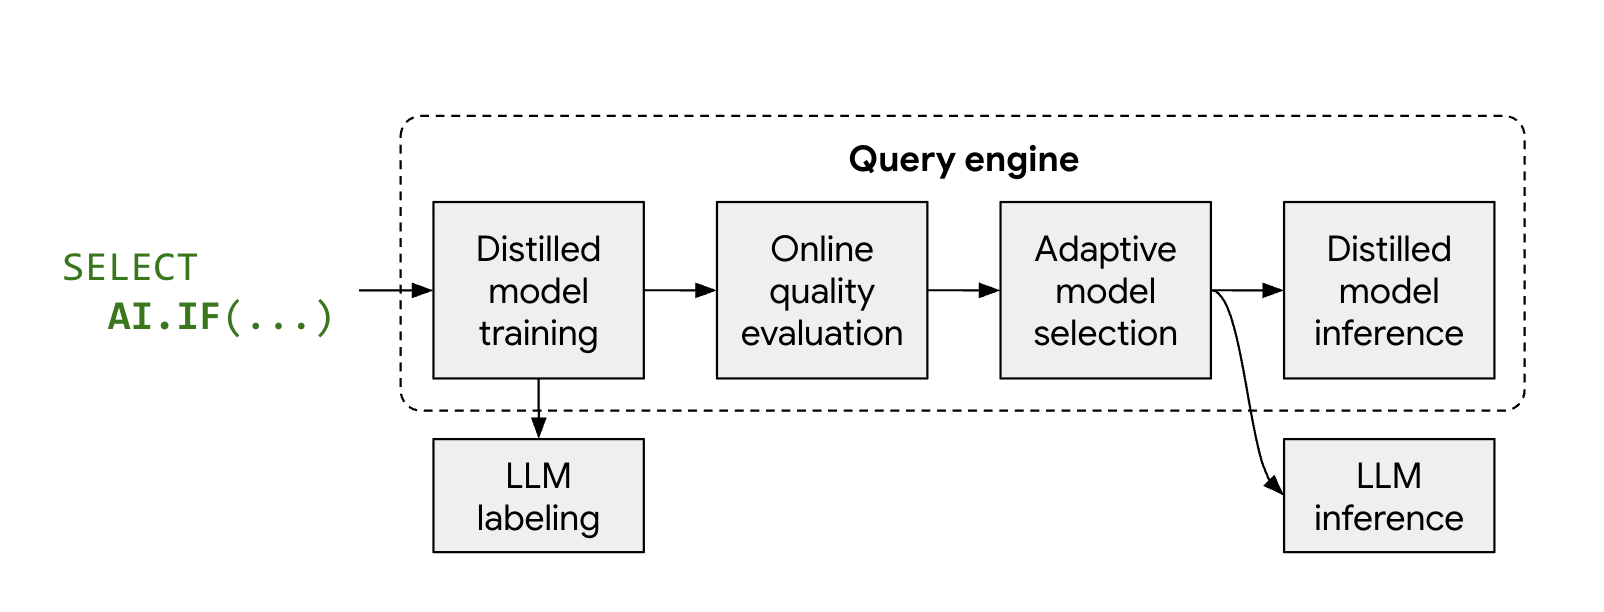
- Repräsentative Stichprobenerhebung und Kennzeichnung: BigQuery wählt automatisch eine repräsentative Stichprobe von Zeilen aus und ruft Labels von Gemini ab.
- Distillation des Modells: BigQuery trainiert ein extrem einfaches Proxymodell (z. B. logistische Regression) just in time auf der CPU und verwendet Texteinbettungen als Features.
- Qualitätsprüfung: BigQuery vergleicht die Genauigkeit des distanzierten Modells mit der von Gemini. Wenn die Qualitätsschwellenwerte erfüllt sind, wird es von BigQuery verwendet, um den Rest des Datasets zu verarbeiten.
- Lokale Hochgeschwindigkeitsinferenz: Das Proxymodell wertet die verbleibenden Zeilen lokal aus, ohne dass Kosten für Remote-LLM-Tokens anfallen und mit extrem niedriger Latenz.
Baseline-Abfrage ohne Optimierung ausführen
Da der Beispielkatalog bigquery-public-data.cymbal_pets.products zu wenige Zeilen enthält, um die Proxymodelldistillation auszulösen,verwenden wir das größere öffentliche Dataset bigquery-public-data.bbc_news.fulltext mit über 2.200 Nachrichtenartikeln.
Führen Sie zuerst die Standardabfrage ohne Optimierung aus, um Nachrichtenartikel zu Naturkatastrophen zu finden:
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body)
  );
Details zum Baseline-Job und zur Tokennutzung prüfen
Prüfen Sie nach Abschluss der Baseline-Abfrage die Ausführungsstatistiken:
- Wählen Sie im unteren Ergebnisbereich von BigQuery Studio den Tab Jobinformationen aus.
- Scrollen Sie nach unten zu den Abschnitten Anzahl der Eingabetokens und Anzahl der Ausgabetokens.
Die Ergebnisse sehen in etwa so aus:
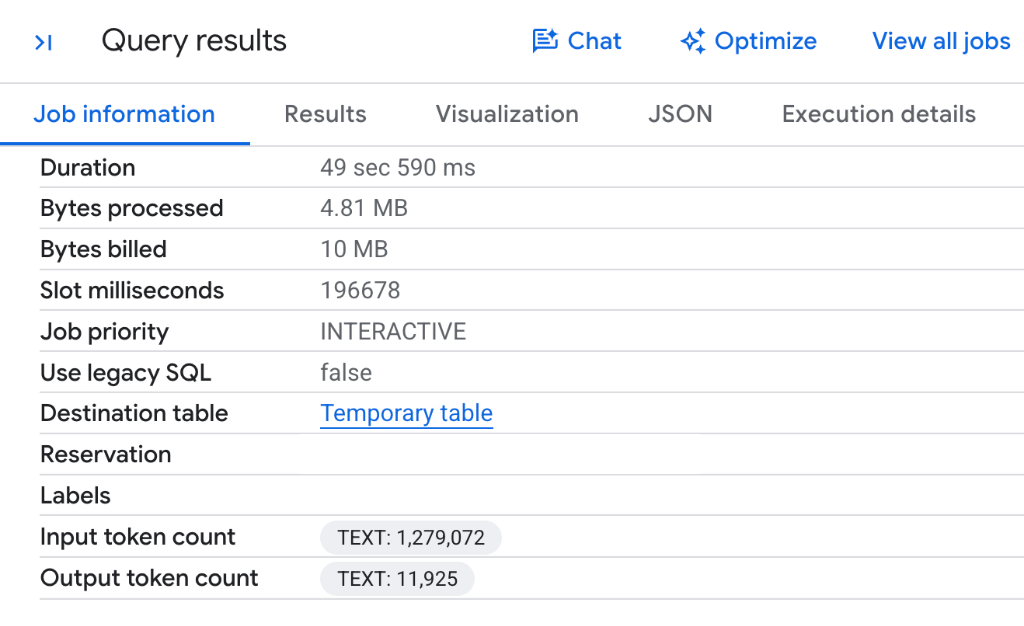
- Tokenverbrauch für das gesamte Dataset: Da BigQuery das Remote-Gemini-Modell für jede Zeile in allen 2.225 Nachrichtenartikeln ohne Proxyoptimierung aufruft, verbraucht die Abfrage 1.279.072 Eingabetokens und 11.925 Ausgabetokens.
- Kein Optimierungsabschnitt: Es gibt keinen Eintrag
Gen AI Function Optimizations, da bei der Standardausführung jede einzelne Zeile mit dem Remote-LLM-Endpunkt verglichen wird.
Abfrage mit optimiertem Modus ausführen
Um den Tokenverbrauch zu senken und die Proxymodelldistillation zu nutzen, aktivieren Sie den optimierten Modus, indem Sie embeddings => AI.EMBED(...) übergeben und optimization_mode => 'MINIMIZE_COST' festlegen:
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body),
    embeddings => AI.EMBED(body, endpoint => 'text-embedding-005', task_type => 'CLASSIFICATION').result,
    optimization_mode => 'MINIMIZE_COST'
  );
Optimierung prüfen und geringere Tokennutzung beobachten
Wechseln Sie nach dem Ausführen der optimierten Abfrage zum Tab Jobinformationen von BigQuery Studio, um die Tokennutzung und die Ausführungsstatistiken zu vergleichen:
- Wählen Sie im unteren Ergebnisbereich von BigQuery Studio den Tab Jobinformationen aus.
- Scrollen Sie zum Abschnitt Gen AI Function Optimizations und zu den Tokenanzahlen.
Die Ergebnisse sehen in etwa so aus:
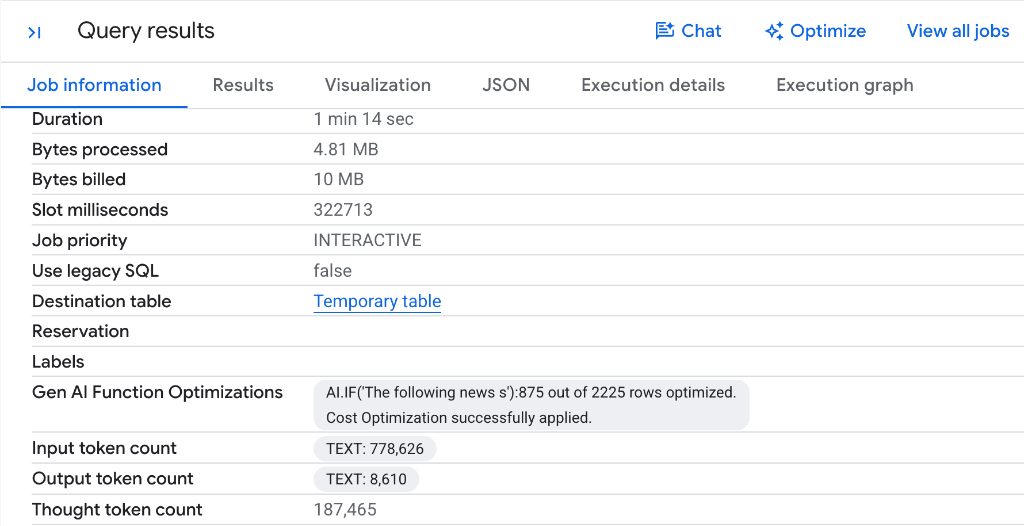
- Deutliche Reduzierung der Tokens: Die Anzahl der Eingabetokens ist von 1.279.072 Tokens auf 778.626 Tokens gesunken. Das entspricht einer Einsparung von 500.446 Eingabetokens (fast 40% Reduzierung) bei einer einzigen Abfrageausführung. Auch die Anzahl der Ausgabetokens ist gesunken.
- Automatische Proxydistillation: Das Label
AI.IF('The following news s'): 875 out of 2225 rows optimized. Cost Optimization successfully applied.zeigt, dass BigQuery das Dataset in Stichproben erhoben, repräsentative Artikel mit Gemini gelabelt, einen schnellen, einfachen Proxyklassifikator erstellt und 875 von 2.225 Zeilen lokal auf der CPU verarbeitet hat, ohne Remote-LLM-Endpunkte aufzurufen. - Direkte Kosteneinsparungen: Da die verwalteten KI-Funktionen von BigQuery auf Grundlage des Volumens der verarbeiteten Modell-Tokens abgerechnet werden, führt eine Reduzierung des Tokenverbrauchs direkt zu niedrigeren Kosten für die Abfrageausführung.
- Qualitätsprüfung: BigQuery hat die Genauigkeit des Proxymodells automatisch mit Gemini verglichen, bevor es verwendet wurde, um die verbleibenden Zeilen auszuwerten. So wird die Klassifizierungsqualität beibehalten.
Noch größere Tokenreduzierung und Latenzskalierung bei größeren Tabellen
Die Einsparung von über 500.000 Tokens bei 2.225 Zeilen ist zwar erheblich, aber die Tokenreduzierung und die Leistungssteigerungen sind bei größeren Tabellen noch höher:
- Warum die Tokenreduzierung mit der Dataset-Größe skaliert: Bei Abfragen, die in BigQuery ausgeführt werden, werden Proxymodelle im laufenden Betrieb anhand einer ersten Stichprobe von etwa 1.000 Zeilen trainiert, die vom LLM gelabelt wurden. Nach dem Training und der Validierung ersetzt das Proxymodell direkte LLM-Aufrufe für die verbleibenden Zeilen. Bei größeren Abfragen (z. B. typischen Datasets mit 1 Million Zeilen) werden so LLM-Aufrufe für den Großteil der Daten vermieden, wodurch bis zu 400-mal weniger Tokens verbraucht und die Kosten drastisch gesenkt werden.
- Erhebliche Latenzbeschleunigung: Durch die Verlagerung der Inferenz von spezieller LLM-Hardware auf extrem einfache Proxymodelle, die direkt auf Standard-Datenbank-Worker-CPUs ausgeführt werden (unter Verwendung vorab berechneter Gemini-Einbettungen), reduziert BigQuery die Gesamtlaufzeiten von Abfragen um das 30- bis 100-Fache.
10. Ressourcen bereinigen
Wenn Sie die Ressourcen bereinigen möchten, die während dieses Codelabs erstellt wurden, führen Sie die folgende Anweisung in einem BigQuery Studio-SQL-Tab aus, um die Cloud-Ressourcenverbindung zu entfernen:
DROP CONNECTION IF EXISTS `us.conn`;
Wenn Sie ein temporäres Google Cloud-Projekt nur für dieses Codelab erstellt haben, können Sie alternativ das gesamte Projekt im Cloud Resource Manager herunterfahren.
11. Glückwunsch
Glückwunsch! Sie haben das Codelab zur semantischen Analyse in BigQuery mit verwalteten KI-Funktionen und SQL abgeschlossen.
Sie haben die verwalteten generativen KI-Funktionen von BigQuery kennengelernt:
AI.SCORE: Produkte anhand subjektiver Kriterien wie Geschenkfähigkeit auf einer Skala von 1 bis 10 mit automatischer Prompt-Umschreibung bewertet.AI.CLASSIFY: Unstrukturierte Katalogartikel in Zieltierklassifizierungen kategorisiert.AI.IF(Multimodale Filterung): Cloud Storage-Bild-Assets in SQL-WHERE-Klauseln basierend auf visuellen Inhalten gefiltert.AI.IF(Semantische Joins): Modellübergreifende Joins in SQL-ON-Klauseln ausgeführt, um Textproduktbeschreibungen mit Bilddateien zu verknüpfen.AI.AGG: Unstrukturierter Katalogtext aus mehreren Zeilen zu einer prägnanten Zusammenfassung für Führungskräfte zusammengefasst.- Optimierter Modus und Proxymodelle: Abfragen beschleunigt und Tokenkosten mit
optimization_mode => 'MINIMIZE_COST'mit Modelldistillation im laufenden Betrieb undAI.EMBEDminimiert.
Weitere Informationen
- Übersicht über generative KI in BigQuery
- Leitfaden zu verwalteten KI-Funktionen von BigQuery
AI.SCORESQL-SyntaxdokumentationAI.CLASSIFYSQL-SyntaxdokumentationAI.IFSQL-SyntaxdokumentationAI.AGGSQL-Syntaxdokumentation- KI-Funktionen mit Modelldistillation optimieren
- Google Cloud-Blog: Mehr als 100-mal schnellere und kostengünstigere LLM-basierte SQL-Abfragen mit Proxymodellen
- Google Cloud-Blog: Detaillierte Informationen zur BigQuery-Funktion AI.AGG