

1. Te damos la bienvenida
En este codelab, aprenderás a usar el conjunto de funciones de IA administradas de BigQuery para realizar análisis semánticos sofisticados, clasificación categórica, filtrado multimodal, uniones semánticas y resúmenes de varias filas directamente en BigQuery Studio con SQL.
Con el conjunto de datos públicos bigquery-public-data.cymbal_pets, te pondrás en la piel de un analista de datos de Cymbal Pets, un comercio electrónico minorista de artículos y accesorios para mascotas.
Análisis semántico directamente en consultas en SQL
Tradicionalmente, la aplicación de aprendizaje automático o modelos de lenguaje grandes (LLM) a conjuntos de datos empresariales requería mover datos del almacén de datos a entornos externos de notebooks de Python. Esto requería canalizaciones de ingeniería de datos dedicadas y experiencia en AA.
Las funciones de IA administradas de BigQuery, incluidas AI.SCORE, AI.CLASSIFY, AI.IF y AI.AGG, llevan la inteligencia del modelo base directamente a tus datos. BigQuery optimiza automáticamente la selección de modelos y aplica estrategias internas de reescritura de instrucciones para ofrecer resultados de alta precisión a partir de instrucciones simples en lenguaje natural.
Para conjuntos de datos de gran volumen, BigQuery proporciona el modo optimizado, que usa la destilación de modelos sobre la marcha y modelos proxy ligeros para ofrecer consultas hasta 100 veces más rápidas y económicas.
Actividades
- Explorar datos minoristas multimodales en BigQuery Studio con SQL
- Realizar una clasificación semántica con
AI.SCOREpara evaluar atributos subjetivos de productos, como la "idoneidad para regalar". - Categorizar datos no estructurados con
AI.CLASSIFYpara asignar productos a especies animales objetivo - Filtrar recursos de imagen multimodales con
AI.IFdentro de las cláusulasWHERE. - Ejecutar uniones semánticas en tablas con
AI.IFen cláusulasJOIN ... ONpara hacer coincidir registros de productos de texto con archivos de imagen externos - Sintetizar estadísticas de varias filas con la función agregada
AI.AGG - Optimizar la latencia y el costo de las consultas en conjuntos de datos grandes con
AI.IFcon el modo optimizado (optimization_mode => 'MINIMIZE_COST') y la destilación de modelos proxy
Requisitos
- Un proyecto de Google Cloud con facturación habilitada.
- Un navegador web, como Chrome
2. Configuración y requisitos
Antes de consultar datos con funciones de IA administradas, debes configurar tu proyecto de Google Cloud y habilitar las APIs requeridas.
Crea un proyecto de Google Cloud y habilita las APIs
- En la página del selector de proyectos de la consola de Google Cloud, selecciona o crea un proyecto de Google Cloud.
- Asegúrate de que la facturación esté habilitada para tu proyecto de Cloud. Obtén información para verificar si la facturación está habilitada en un proyecto.
- Habilita las APIs de BigQuery, BigQuery Connection y Agent Platform.
Abre BigQuery Studio
- En el menú de navegación de la consola de Google Cloud, haz clic en BigQuery para abrir BigQuery Studio.
- En la barra de herramientas del editor de BigQuery Studio, haz clic en + Consulta en SQL para abrir una pestaña de consulta en SQL nueva. Escribirás y ejecutarás todas las consultas en SQL en estas pestañas de SQL a lo largo de este codelab.
Crea una conexión a recursos de Cloud en SQL
BigQuery opera dentro de un perímetro de datos seguro. Cuando inspecciona archivos multimodales externos (como imágenes almacenadas en Google Cloud Storage), BigQuery usa una conexión a recursos de Cloud para acceder de forma segura a las referencias de objetos sin exponer las credenciales.
Ejecuta la siguiente instrucción en tu pestaña de SQL para crear una conexión llamada us.conn:
CREATE CONNECTION IF NOT EXISTS `us.conn`
OPTIONS (
  connection_type = "CLOUD_RESOURCE"
);
3. Explora el conjunto de datos de Cymbal Pets
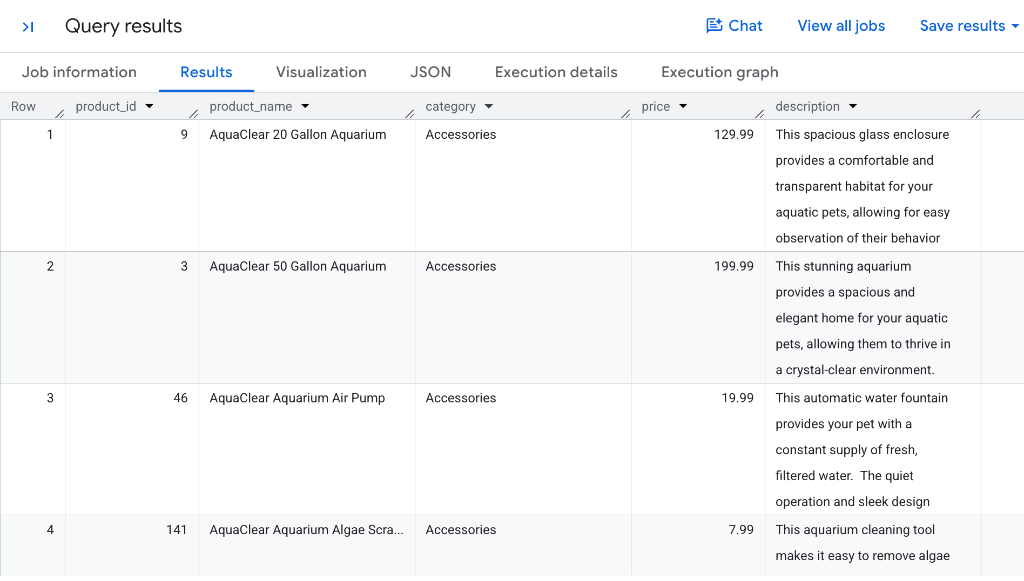
Cymbal Pets mantiene un catálogo de productos enriquecido en el conjunto de datos públicos dentro de la tabla llamada bigquery-public-data.cymbal_pets.products. Cada registro de producto contiene atributos estructurados, como el ID del producto, el título, la categoría minorista, el precio y el texto descriptivo.
Consulta el catálogo de productos
Abre una pestaña de SQL en BigQuery Studio y ejecuta la siguiente consulta para inspeccionar la tabla de productos:
SELECT
  product_id,
  product_name,
  category,
  price,
  description
FROM
  `bigquery-public-data.cymbal_pets.products`;
Los resultados se verán de la siguiente manera:
Inspecciona las imágenes de los productos
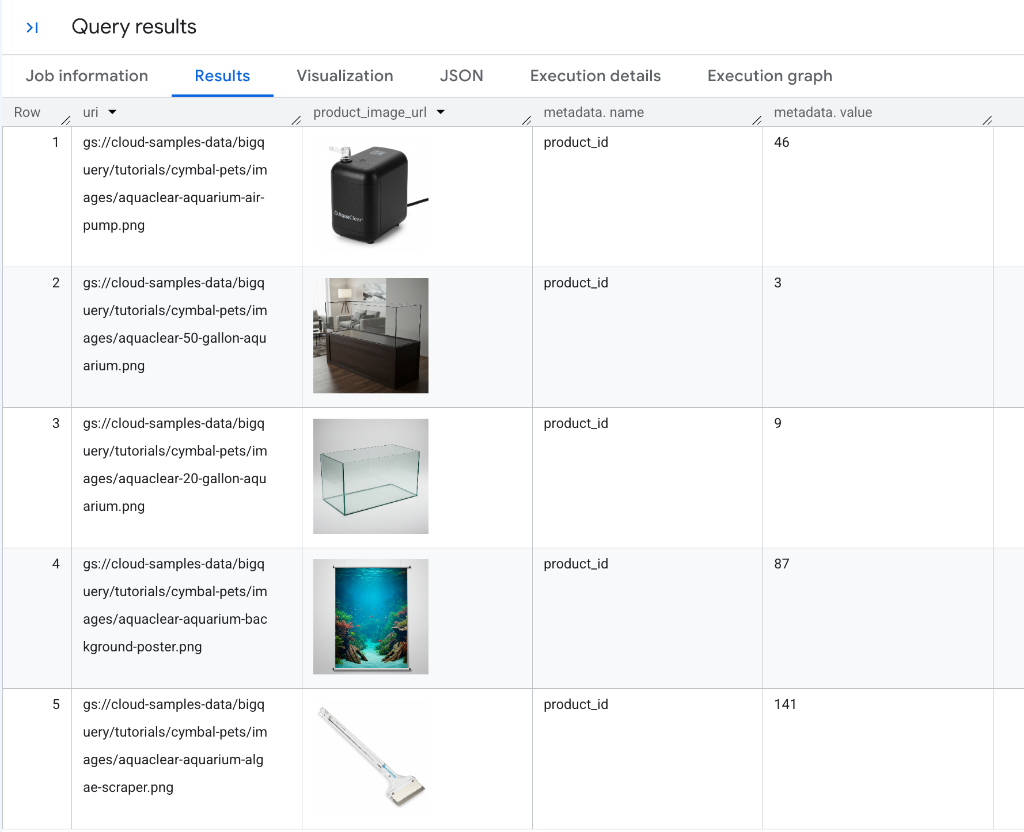
Cymbal Pets también almacena referencias de imágenes de productos en bigquery-public-data.cymbal_pets.product_images. Ejecuta la siguiente consulta para ver los registros de imágenes:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`;
Los resultados se verán de la siguiente manera:
A continuación, usarás las funciones administradas de BigQuery para analizar datos de texto y de imágenes del almacén de datos de Cymbal Pets.
4. Clasifica los productos según criterios semánticos con AI.SCORE
La función AI.SCORE acepta entradas de texto y usa un modelo de Gemini para calificarlas según una rúbrica de puntuación en lenguaje natural, y muestra una puntuación numérica FLOAT64 score.
Si no proporcionas una rúbrica de puntuación explícita, BigQuery aplica automáticamente estrategias de reescritura de instrucciones para generar una rúbrica óptima para el modelo.
Califica los productos según su "idoneidad para regalar"
Supongamos que el equipo de marketing de Cymbal Pets quiere crear una guía de regalos para las fiestas. Desean clasificar cada artículo del catálogo según su idoneidad como regalo para un dueño de mascotas en una escala del 1 al 10.
Ejecuta la siguiente consulta en tu pestaña de SQL:
SELECT
  product_name,
  description,
  AI.SCORE(
    ('How "giftable" is this product for a pet owner? ', description,
    'Use a scale from 1-10.')
  ) AS giftability_score
FROM
  `bigquery-public-data.cymbal_pets.products`
ORDER BY
  giftability_score DESC;
Cómo interpretar los resultados
Los resultados se verán de la siguiente manera:
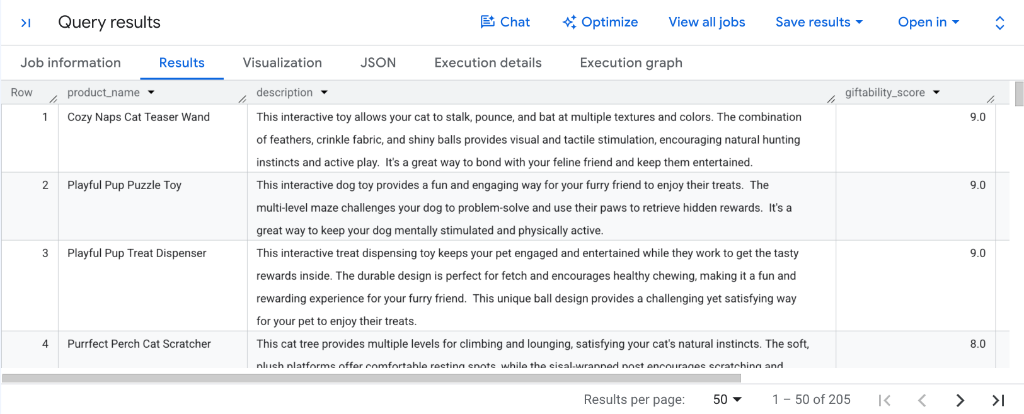
Examina la columna giftability_score en los resultados de la consulta:
- Juguetes interactivos de gran atractivo: Los artículos atractivos, como el
Cozy Naps Cat Teaser Wand, elPlayful Pup Puzzle Toyy elPlayful Pup Treat Dispenser, reciben las calificaciones más altas (9.0). - Artículos especiales de comodidad y rascado: Los elementos esenciales populares, como el
Purrfect Perch Cat Scratcher, obtienen una puntuación alta de8.0. - Clasificación descendente procesable: Debido a que
AI.SCOREproduce puntuacionesFLOAT64normalizadas, puedes ordenar los resultados de inmediato conORDER BY giftability_score DESCo filtrar candidatos conWHERE AI.SCORE(...) >= 8.0para generar guías de regalos automatizadas.
5. Categoriza los artículos del catálogo con AI.CLASSIFY
La función AI.CLASSIFY usa Gemini para clasificar los registros de entrada en una lista discreta de categorías objetivo proporcionadas como un array de SQL.
AI.CLASSIFY admite entradas multimodales (texto, imágenes, audio, video) y elimina la necesidad de compilar, entrenar o implementar modelos de clasificación personalizados para la administración de taxonomías.
Clasifica los juguetes por especie animal objetivo (una sola etiqueta)
Supongamos que algunos productos del catálogo de Cymbal Pets están etiquetados de forma genérica como "Juguetes" sin especificar el animal objetivo. Puedes usar AI.CLASSIFY para categorizar cada juguete según su nombre y descripción.
Ejecuta la siguiente consulta en BigQuery Studio:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('What animal is this product for?', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "All Pets"]
  ) AS animal_type
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys"
LIMIT 20;
Consultar los resultados
Los resultados se verán de la siguiente manera:
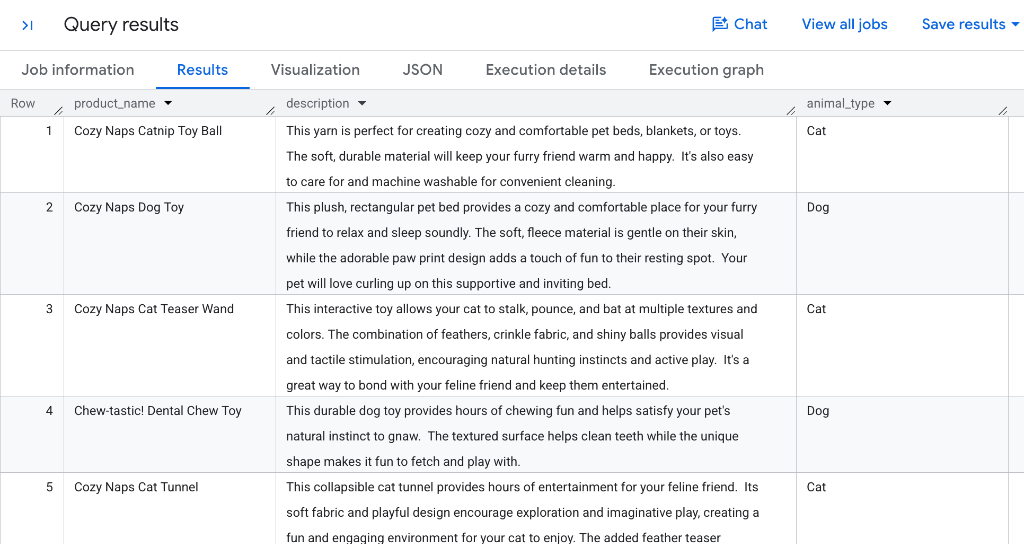
De forma predeterminada, AI.CLASSIFY realiza una clasificación de una sola etiqueta y muestra una STRING que contiene la única categoría más relevante de tu array de candidatos. Observa cómo Gemini asigna las bolas de hierba gatera y los juguetes de plumas a Cat, mientras que los juguetes para masticar y los palos para buscar se asignan a Dog.
Asigna varias etiquetas con la clasificación de varias etiquetas
Muchos productos de un catálogo minorista se aplican a varios tipos de mascotas de forma simultánea (por ejemplo, una cama o un túnel de felpa adecuados para gatos y animales pequeños).
Para asignar varias categorías a un solo registro, configura el parámetro opcional output_mode => 'multi'. En el modo de varias etiquetas, AI.CLASSIFY muestra un ARRAY que contiene todas las categorías coincidentes.
Ejecuta la siguiente consulta en tu pestaña de SQL:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('Identify all pet types that this product is suitable for: ', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "Reptile"],
    output_mode => 'multi'
  ) AS pet_types
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys";
Los resultados se verán de la siguiente manera:
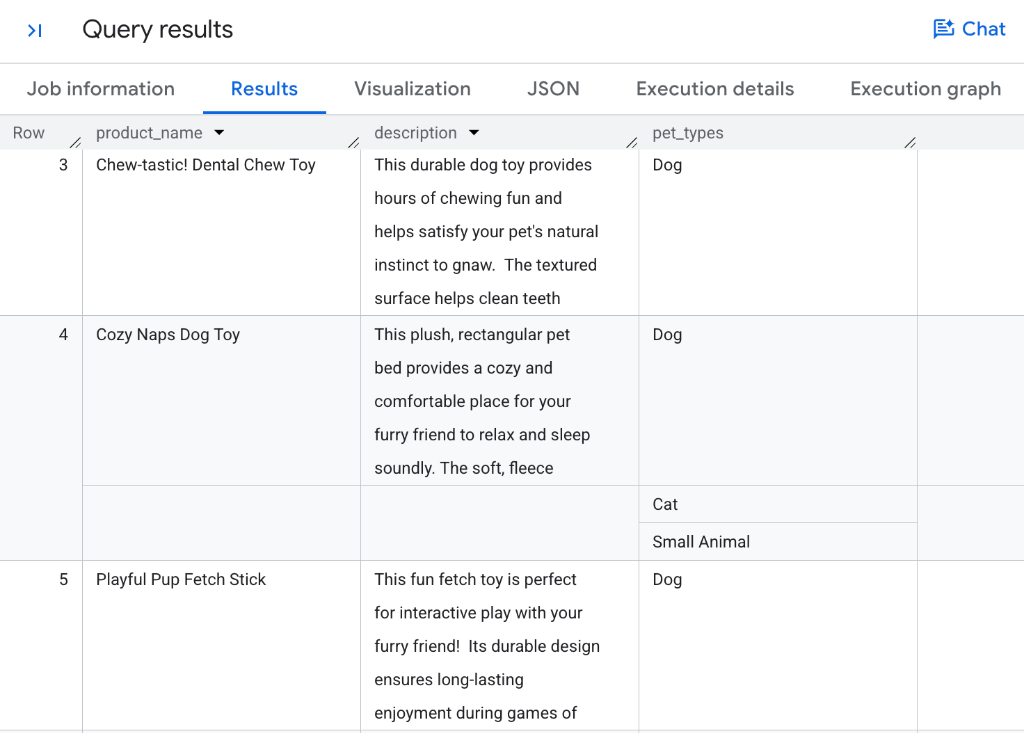
Revisa la mecánica de clasificación
- Una sola etiqueta vs. varias etiquetas: Sin
output_mode,AI.CLASSIFYmuestra unaSTRINGescalar. Si configurasoutput_mode => 'multi', se muestra unARRAYque contiene cero, una o varias etiquetas coincidentes. - Asignación de varias categorías: Observa cómo los artículos dedicados, como
Chew-tastic! Dental Chew ToyyPlayful Pup Fetch Stick, reciben[Dog], mientras que los artículos de comodidad versátiles, comoCozy Naps Dog Toy(una cama rectangular de felpa), reciben correctamente varias etiquetas:[Dog, Cat, Small Animal]. - Coincidencia de cero disparos: El modelo evalúa el texto y la instrucción combinados con el array
categoriesproporcionado sin requerir modelos de AA personalizados entrenados previamente. - Operaciones de array de SQL descendentes: Puedes usar funciones de array de SQL estándar de BigQuery, como
WHERE 'Cat' IN UNNEST(pet_types)oCROSS JOIN UNNEST(pet_types), para filtrar, expandir y agregar registros con varias etiquetas.
6. Filtra imágenes de productos multimodales con AI.IF
La función AI.IF usa Gemini para evaluar una condición en lenguaje natural y muestra un valor booleano (TRUE o FALSE).
Debido a que AI.IF acepta entradas multimodales, puedes usarla directamente dentro de una cláusula WHERE de SQL para filtrar archivos de imágenes no estructurados almacenados en Cloud Storage.
Filtra imágenes que contengan objetos específicos
Supongamos que el equipo de comercialización quiere encontrar todas las imágenes de productos del catálogo que contengan visualmente comida o bocadillos para mascotas.
Ejecuta la siguiente consulta en tu pestaña de SQL:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`
WHERE
  AI.IF(
    ('Does this product image contain pet food or snacks? ', OBJ.MAKE_REF(uri, 'us.conn'))
  );
Los resultados se verán de la siguiente manera:
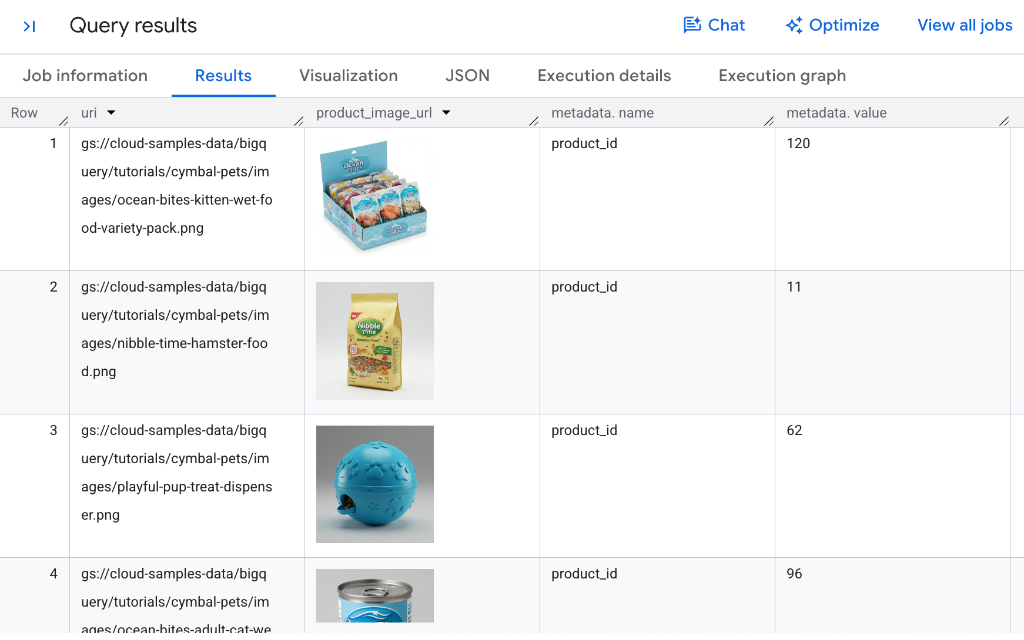
Cómo funciona el filtrado multimodal
- Referencias de objetos sobre la marcha: Si bien creamos referencias de objetos sobre la marcha aquí con
OBJ.MAKE_REF(uri, 'us.conn'), también puedes crear y almacenar columnasObjectRefdirectamente en tus tablas de BigQuery para que estén listas para usar en el análisis sin necesidad de la funciónOBJ.MAKE_REFen cada consulta. - Reconocimiento visual profundo de objetos: Observa cómo Gemini identifica con precisión diversos formatos de empaque (como la caja de paquetes variados de comida húmeda, la bolsa de comida seca para hámsteres y la comida enlatada para gatos) y reconoce los bocadillos comestibles cargados dentro de los juguetes, como el dispensador de bocadillos azul.
- Evaluación de predicados a nivel de fila: BigQuery evalúa la condición en lenguaje natural con cada referencia de imagen de Cloud Storage directamente dentro de la cláusula
WHERE. - Filtrado booleano: Solo los registros en los que Gemini evalúa la condición como
TRUEse muestran en el conjunto de resultados.
7. Realiza uniones semánticas en tablas con AI.IF
Las uniones tradicionales de bases de datos relacionales requieren una igualdad de claves exacta (como products.product_id = images.product_id). Sin embargo, los conjuntos de datos empresariales del mundo real suelen contener recursos no estructurados que carecen de claves externas explícitas.
Debido a que AI.IF muestra un valor booleano, puedes colocarlo directamente dentro de una cláusula INNER JOIN ... ON de SQL para realizar uniones semánticas.
Une semánticamente las descripciones de productos con los recursos de imagen
Supongamos que deseas hacer coincidir las descripciones de productos de la tabla products con archivos de imágenes no vinculados en product_images para los productos de la marca Fluffy Buns.
Ejecuta la siguiente consulta en tu pestaña de SQL de BigQuery Studio (ten en cuenta que tarda unos minutos en completarse):
SELECT
  products.product_id,
  products.product_name,
  products.description,
  products.brand,
  images.uri AS image_uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(images.uri, 'us.conn')).url AS product_image_url
FROM
  `bigquery-public-data.cymbal_pets.products` AS products
INNER JOIN
  `bigquery-public-data.cymbal_pets.product_images` AS images
ON
  AI.IF(
    ('You will be provided an image of a pet product. ',
    'Determine if the image is of the following pet toy: ',
    products.product_name,
    products.description,
    OBJ.MAKE_REF(images.uri, 'us.conn')
    )
  )
WHERE
  products.category = "Toys" AND
  products.brand = "Fluffy Buns";
Los resultados se verán de la siguiente manera:
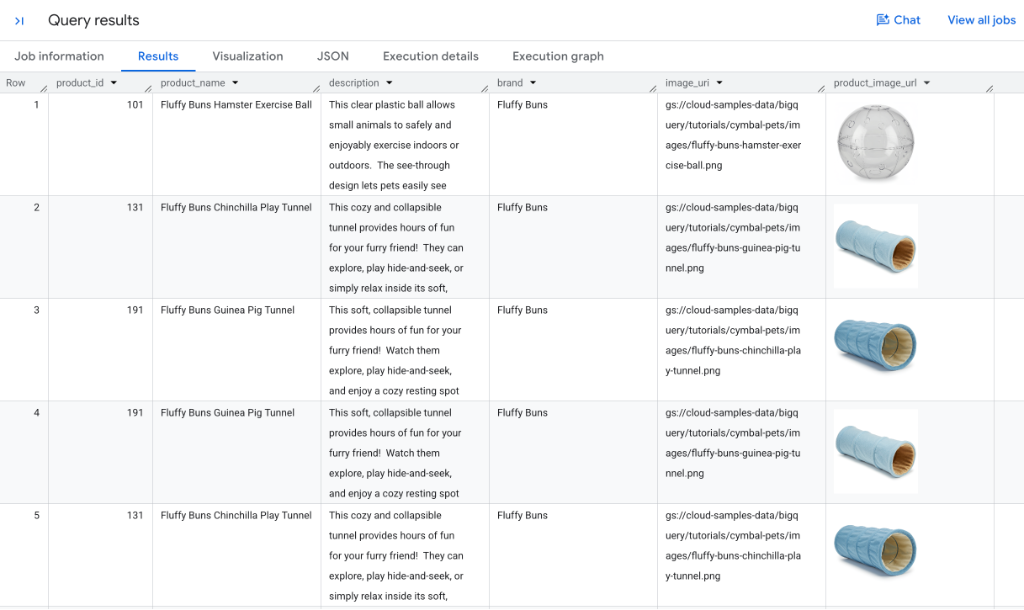
Comprende las uniones semánticas en SQL
- Evaluación de condiciones entre modalidades: Para los pares de registros candidatos, BigQuery envía los metadatos textuales de
productsy la referencia de imagen (OBJ.MAKE_REF(...)) a Gemini. - Coincidencia visual precisa: Como se muestra en los resultados, el
Fluffy Buns Hamster Exercise Ballcoincide con la imagen de la bola de plástico transparente, mientras que elFluffy Buns Chinchilla Play Tunnely elGuinea Pig Tunnelcoinciden con las fotos del túnel de felpa azul. Debido a la semánticaINNER JOINde SQL estándar, un producto puede producir varias filas en el resultado si coincide con más de un recurso de imagen en el catálogo (como varios ángulos de fotos o tomas similares). - Procesamiento de imágenes intercaladas: BigQuery Studio procesa automáticamente las URLs de lectura autorizadas en la columna
product_image_urldirectamente en la cuadrícula de resultados para la verificación visual instantánea. - Resolución de entidades no estructuradas: Esto desbloquea flujos de trabajo potentes de resolución de entidades en catálogos heredados, conjuntos de datos extraídos y archivos multimedia sin etiquetas manuales ni claves externas explícitas.
8. Sintetiza estadísticas en filas con AI.AGG
Si bien las funciones como AI.SCORE, AI.CLASSIFY y AI.IF evalúan filas individuales (operaciones escalares), el análisis de datos empresariales suele requerir la síntesis de patrones en varios registros.
La función AI.AGG es una función agregada que usa instrucciones en lenguaje natural para resumir, agrupar o sintetizar estadísticas en miles o millones de filas no estructuradas en una respuesta unificada.
Sintetiza resúmenes de categorías junto con métricas tradicionales de SQL
AI.AGG se integra sin problemas con las funciones tradicionales GROUP BY y agregadas de SQL. Por ejemplo, puedes calcular métricas tradicionales (como recuentos de artículos) junto con un resumen de IA generativa que describa lo que tienen en común los productos de cada categoría.
Ejecuta la siguiente consulta en BigQuery Studio:
SELECT
  category,
  COUNT(*) AS item_count,
  AI.AGG(
    ('Product: ', product_name, ' - Description: ', description),
    'Write a concise, one-sentence summary describing the common characteristics or purpose of the products in this category.'
  ) AS category_summary
FROM
  `bigquery-public-data.cymbal_pets.products`
GROUP BY
  category
ORDER BY
  item_count DESC;
Los resultados se verán de la siguiente manera:
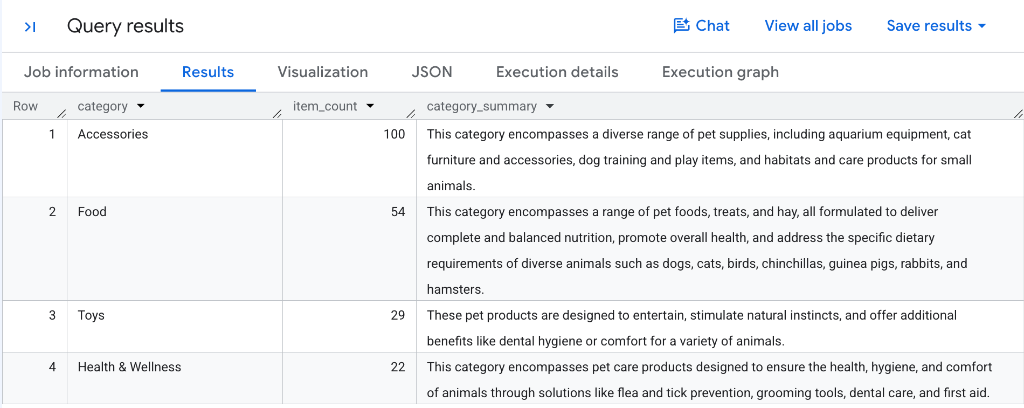
Cómo AI.AGG agrega datos no estructurados
- Agregación jerárquica: BigQuery agrupa los datos de las filas por partición de categoría, construye ventanas de contexto estructuradas y usa Gemini para sintetizar toda la colección de registros de productos.
- Síntesis automatizada de catálogos: Observa cómo cada categoría recibe un resumen preciso y distinto, como
Accessoriesque captura hábitats y equipo de entrenamiento, oFoodque destaca la nutrición equilibrada en varias especies animales. - Informes híbridos cuantitativos y cualitativos: La combinación de agregaciones estándar como
COUNT(*)conAI.AGGproduce descripciones generales completas del catálogo en una sola consulta sin canalizaciones de ETL personalizadas. - Partición flexible: Puedes aplicar
AI.AGGen cualquier dimensión de agrupación (comoGROUP BY brand,GROUP BY categoryo en toda la tabla) para generar estadísticas a nivel ejecutivo en segundos.
9. Acelera las consultas con el modo optimizado y los modelos proxy
Cuando se procesan conjuntos de datos grandes que contienen miles o millones de filas, invocar un LLM remoto para cada fila puede generar latencia y costo.
Para resolver este problema, BigQuery proporciona el modo optimizado para AI.IF y AI.CLASSIFY. El modo optimizado utiliza modelos proxy y destilación de modelos sobre la marcha para ofrecer una ejecución más de 100 veces más rápida con un costo reducido de tokens de LLM.
Cómo funciona el modo optimizado
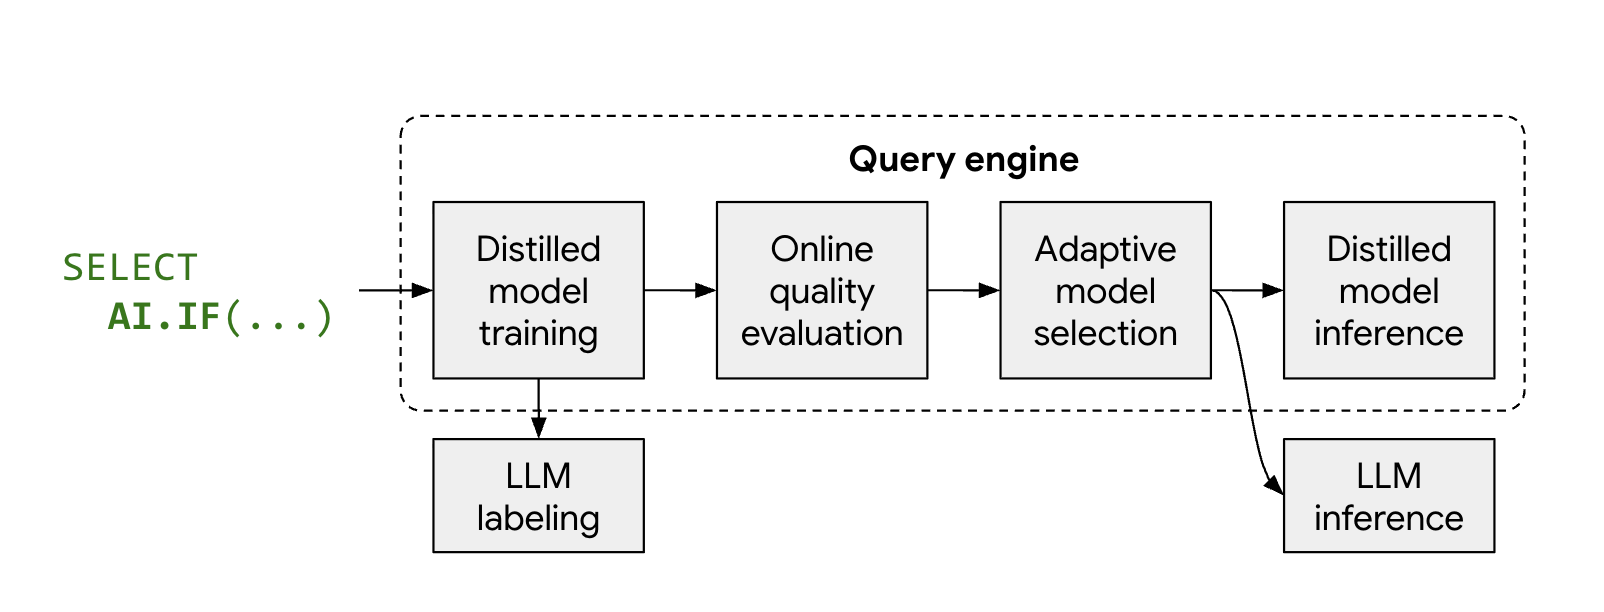
- Muestreo y etiquetado representativos: BigQuery selecciona automáticamente una muestra representativa de filas y obtiene etiquetas de Gemini.
- Entrenamiento de modelos destilados: BigQuery entrena un modelo proxy ultraligero (como la regresión logística) justo a tiempo en la CPU con incorporaciones de texto como atributos.
- Verificación de calidad: BigQuery evalúa la exactitud del modelo destilado en comparación con Gemini. Si cumple con los umbrales de calidad, BigQuery lo promueve para procesar el resto del conjunto de datos.
- Inferencia local de alta velocidad: El modelo proxy evalúa las filas restantes de forma local con un costo de token de LLM remoto de cero y una latencia muy baja.
Ejecuta una consulta de referencia sin optimización
Debido a que el catálogo de muestra bigquery-public-data.cymbal_pets.products contiene muy pocas filas para activar la destilación de modelos proxy, usaremos el conjunto de datos públicos más grande bigquery-public-data.bbc_news.fulltext (que contiene más de 2,200 artículos de noticias).
Primero, ejecuta la consulta estándar sin optimización para identificar artículos de noticias sobre desastres naturales:
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body)
  );
Inspecciona los detalles del trabajo de referencia y el uso de tokens
Una vez que se complete la consulta de referencia, inspecciona las métricas de ejecución:
- En el panel de resultados inferior de BigQuery Studio, selecciona la pestaña Información del trabajo.
- Desplázate hacia abajo hasta las secciones Recuento de tokens de entrada y Recuento de tokens de salida.
Los resultados se verán de la siguiente manera:
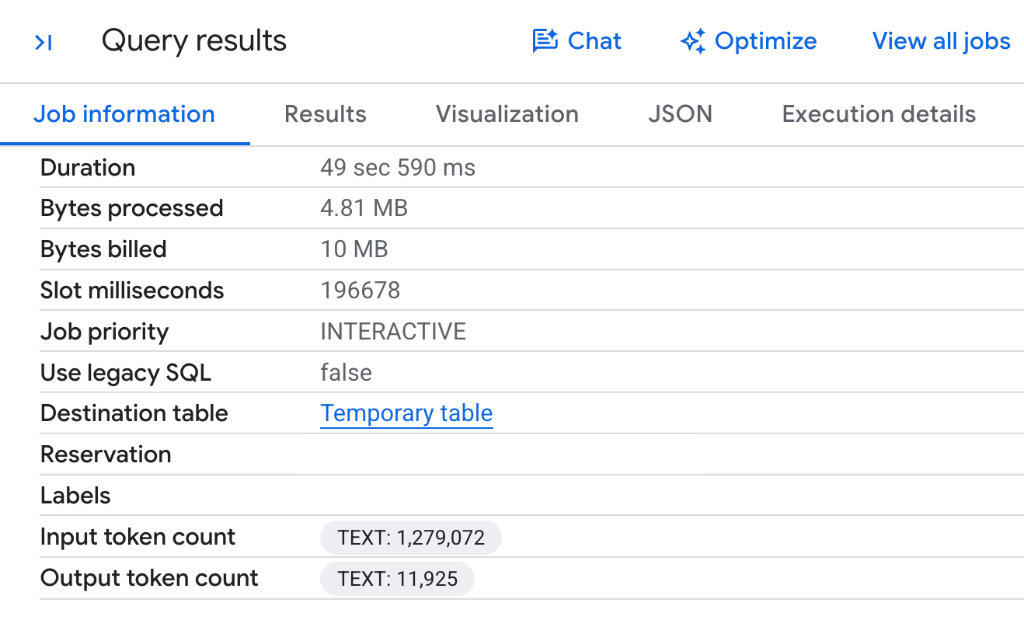
- Consumo de tokens del conjunto de datos completo: Debido a que BigQuery invoca el modelo remoto de Gemini para cada fila en los 2,225 artículos de noticias sin optimización de proxy, la consulta consume 1,279,072 tokens de entrada y 11,925 tokens de salida .
- Sin sección de optimización: Observa que no hay ninguna entrada
Gen AI Function Optimizationsporque la ejecución estándar evalúa cada fila individual con el extremo de LLM remoto.
Ejecuta la consulta con el modo optimizado
Para reducir el consumo de tokens y aprovechar la destilación de modelos proxy, habilita el modo optimizado pasando embeddings => AI.EMBED(...) y configurando optimization_mode => 'MINIMIZE_COST':
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body),
    embeddings => AI.EMBED(body, endpoint => 'text-embedding-005', task_type => 'CLASSIFICATION').result,
    optimization_mode => 'MINIMIZE_COST'
  );
Verifica la optimización y observa el uso reducido de tokens
Después de ejecutar la consulta optimizada, cambia a la pestaña Información del trabajo de BigQuery Studio para observar cómo se comparan el uso de tokens y las métricas de ejecución:
- En el panel de resultados inferior de BigQuery Studio, selecciona la pestaña Información del trabajo.
- Desplázate hasta la sección Optimizaciones de funciones de IA generativa, así como los recuentos de tokens.
Los resultados se verán de la siguiente manera:
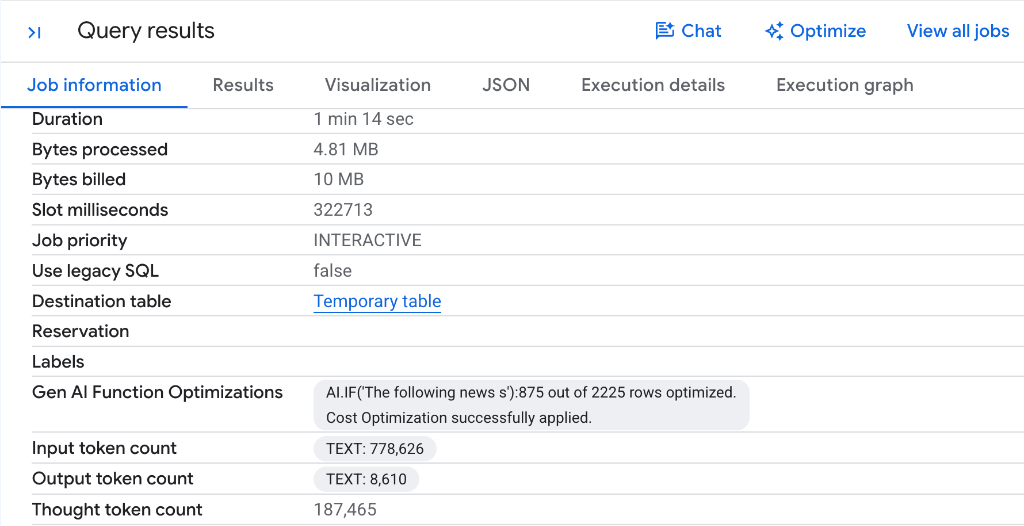
- Reducción significativa de tokens: Observa cómo el recuento de tokens de entrada disminuyó de 1,279,072 tokens a 778,626 tokens, lo que ahorra 500,446 tokens de entrada (casi un 40% de reducción) en una sola ejecución de consulta. Del mismo modo, hubo una disminución en los tokens de salida.
- Destilación automática de proxy: Observa la etiqueta
AI.IF('The following news s'): 875 out of 2225 rows optimized. Cost Optimization successfully applied.BigQuery tomó muestras del conjunto de datos, etiquetó artículos representativos con Gemini, destiló un clasificador proxy rápido y ligero, y procesó 875 de 2,225 filas de forma local en la CPU sin llamar a extremos de LLM remotos. - Ahorro directo de costos: Debido a que las funciones de IA administradas de BigQuery se facturan según el volumen de tokens de modelos procesados, la reducción del consumo de tokens se traduce directamente en costos de ejecución de consultas más bajos.
- Validación de calidad: BigQuery verificó automáticamente la exactitud del modelo proxy en comparación con Gemini antes de ascenderlo para evaluar las filas restantes, lo que garantiza que se mantenga la calidad de la clasificación.
Aún más reducción de tokens y escalamiento de latencia en tablas más grandes
Si bien ahorrar más de 500,000 tokens en 2,225 filas es considerable, la reducción de tokens y las ganancias de rendimiento son aún mayores en tablas más grandes:
- Por qué la reducción de tokens se escala con el tamaño del conjunto de datos: Para las consultas ejecutadas en BigQuery, los modelos proxy se entrenan sobre la marcha con una muestra inicial de aproximadamente 1,000 filas etiquetadas por el LLM. Una vez entrenado y validado, el modelo proxy reemplaza las llamadas directas de LLM en las filas restantes. Para consultas más grandes (como los conjuntos de datos típicos de 1 millón de filas), esto elimina las invocaciones de LLM para la mayor parte de los datos, lo que consume hasta 400 veces menos tokens y reduce drásticamente los costos.
- Aceleración sustancial de la latencia: Al cambiar la inferencia del hardware LLM especializado a modelos proxy ultraligeros que se ejecutan directamente en las CPUs de trabajo de la base de datos estándar (aprovechando las incorporaciones precalculadas de Gemini), BigQuery reduce los tiempos de ejecución generales de las consultas de 30 a 100 veces.
10. Limpia los recursos
Para liberar espacio de los recursos creados durante este codelab, ejecuta la siguiente sentencia en una pestaña de SQL de BigQuery Studio para quitar la conexión a recursos de Cloud:
DROP CONNECTION IF EXISTS `us.conn`;
Como alternativa, si creaste un proyecto temporal de Google Cloud exclusivamente para este instructivo, puedes cerrar todo el proyecto en el Cloud Resource Manager.
11. Felicitaciones
¡Felicitaciones! Completaste correctamente el codelab sobre análisis semántico en BigQuery con funciones de IA administradas y SQL.
Dominaste las funciones de IA generativa administradas de BigQuery:
AI.SCORE: Clasificó los productos según criterios subjetivos, como la idoneidad para regalar en una escala del 1 al 10, con la reescritura automática de instrucciones.AI.CLASSIFY: Categorizó los artículos no estructurados del catálogo en clasificaciones de animales objetivo.AI.IF(filtrado multimodal): Filtró los recursos de imagen de Cloud Storage en cláusulasWHEREde SQL según el contenido visual.AI.IF(uniones semánticas): Realizó uniones entre modalidades en cláusulasONde SQL para vincular descripciones textuales de productos con archivos de imágenes.AI.AGG: Sintetizó texto no estructurado de catálogos de varias filas en un resumen ejecutivo conciso.- Modo optimizado y modelos proxy: Aceleró las consultas y minimizó los costos de tokens con
optimization_mode => 'MINIMIZE_COST'con la destilación de modelos sobre la marcha yAI.EMBED.
Más información
- Descripción general de la IA generativa de BigQuery
- Guía de funciones de IA administradas de BigQuery
AI.SCOREDocumentación sobre la sintaxis de SQLAI.CLASSIFYDocumentación sobre la sintaxis de SQLAI.IFDocumentación sobre la sintaxis de SQLAI.AGGDocumentación sobre la sintaxis de SQL- Optimiza las funciones de IA con la destilación de modelos
- Blog de Google Cloud: Consultas en SQL potenciadas por LLM más de 100 veces más rápidas y económicas con modelos proxy
- Blog de Google Cloud: Análisis detallado de la función AI.AGG de BigQuery