

۱. خوش آمدید
در این آزمایشگاه کد، شما یاد خواهید گرفت که چگونه از مجموعه توابع هوش مصنوعی مدیریتشده BigQuery برای انجام تحلیل معنایی پیچیده، طبقهبندی طبقهبندیشده، فیلتر چندوجهی، اتصال معنایی و خلاصهسازی چندردیفی بهطور مستقیم در BigQuery Studio با استفاده از SQL استفاده کنید.
با استفاده از مجموعه داده عمومی bigquery-public-data.cymbal_pets ، شما در نقش یک تحلیلگر داده در Cymbal Pets ، یک خردهفروش تجارت الکترونیک برای لوازم و لوازم جانبی حیوانات خانگی، قرار خواهید گرفت.
تحلیل معنایی مستقیماً درون کوئریهای SQL
به طور سنتی، اعمال یادگیری ماشین یا مدلهای زبان بزرگ (LLM) به مجموعه دادههای سازمانی مستلزم انتقال دادهها از انبار داده به محیطهای خارجی نوتبوک پایتون بود. این امر مستلزم خطوط لوله مهندسی داده اختصاصی و تخصص ML بود.
توابع هوش مصنوعی مدیریتشدهی BigQuery - شامل AI.SCORE ، AI.CLASSIFY ، AI.IF و AI.AGG - هوش مدل پایه را مستقیماً به دادههای شما میآورند. BigQuery بهطور خودکار انتخاب مدل را بهینه میکند و استراتژیهای بازنویسی داخلی prompt را اعمال میکند تا نتایج با دقت بالا را از promptهای ساده به زبان طبیعی ارائه دهد.
برای مجموعه دادههای با حجم بالا، BigQuery حالت بهینهسازیشدهای را ارائه میدهد که با استفاده از تقطیر مدل در حین کار و مدلهای پروکسی سبک، پرسوجوهایی تا ۱۰۰ برابر سریعتر و ارزانتر ارائه میدهد.
کاری که انجام خواهید داد
- دادههای خردهفروشی چندوجهی را در BigQuery Studio با استفاده از SQL کاوش کنید .
- با استفاده از
AI.SCOREرتبهبندی معنایی را برای ارزیابی ویژگیهای ذهنی محصول مانند «قابلیت هدیه دادن» انجام دهید . - با استفاده از
AI.CLASSIFYدادههای بدون ساختار را دستهبندی کنید تا محصولات را بر اساس گونههای جانوری هدف، نگاشت کنید. - فیلتر کردن تصاویر چندوجهی با استفاده از
AI.IFدر عباراتWHERE. - با استفاده از
AI.IFدر عبارتهایJOIN ... ON، پیوند معنایی بین جداول اجرا کنید تا رکوردهای محصول متنی را با فایلهای تصویری خارجی مطابقت دهید. - با استفاده از تابع تجمیع
AI.AGGدادههای چند ردیفی را ترکیب کنید . - با استفاده از
AI.IFبا حالت بهینهشده (optimization_mode => 'MINIMIZE_COST') و تقطیر مدل پروکسی ، تأخیر و هزینه پرسوجو را در مجموعه دادههای بزرگ بهینه کنید .
آنچه نیاز دارید
- یک پروژه گوگل کلود با قابلیت پرداخت.
- یک مرورگر وب مانند کروم.
۲. تنظیمات و الزامات
قبل از جستجوی دادهها با توابع هوش مصنوعی مدیریتشده، باید پروژه Google Cloud خود را پیکربندی کرده و APIهای مورد نیاز را فعال کنید.
یک پروژه Google Cloud ایجاد کنید و API ها را فعال کنید
- در کنسول گوگل کلود ، در صفحه انتخاب پروژه، یک پروژه گوگل کلود را انتخاب یا ایجاد کنید .
- مطمئن شوید که صورتحساب برای پروژه ابری شما فعال است. یاد بگیرید که چگونه بررسی کنید که آیا صورتحساب در یک پروژه فعال است یا خیر .
- APIهای BigQuery، BigQuery Connection و Agent Platform را فعال کنید .
استودیوی BigQuery را باز کنید
- در منوی ناوبری کنسول ابری گوگل ، روی BigQuery کلیک کنید تا BigQuery Studio باز شود.
- در نوار ابزار ویرایشگر BigQuery Studio، روی + SQL query کلیک کنید تا یک تب جدید SQL query باز شود. شما تمام کوئریهای SQL را در این تبهای SQL در سراسر این codelab خواهید نوشت و اجرا خواهید کرد.
ایجاد اتصال منابع ابری در SQL
بیگکوئری در یک محیط دادهای امن عمل میکند. هنگام بررسی فایلهای چندوجهی خارجی (مانند تصاویر ذخیره شده در فضای ابری گوگل)، بیگکوئری از یک اتصال منابع ابری (Cloud Resource Connection) برای دسترسی ایمن به ارجاعات اشیاء بدون افشای اطلاعات احراز هویت استفاده میکند.
دستور زیر را در تب SQL خود اجرا کنید تا یک اتصال به نام us.conn ایجاد شود:
CREATE CONNECTION IF NOT EXISTS `us.conn`
OPTIONS (
  connection_type = "CLOUD_RESOURCE"
);
۳. مجموعه دادههای Cymbal Pets را بررسی کنید
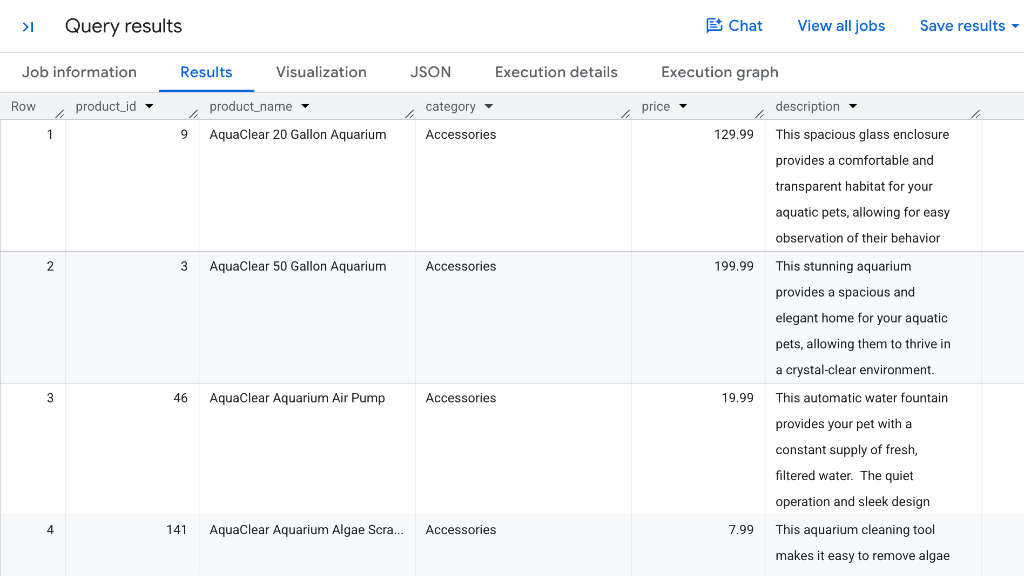
Cymbal Pets یک کاتالوگ غنی از محصولات را در مجموعه دادههای عمومی درون جدولی به نام bigquery-public-data.cymbal_pets.products نگهداری میکند. هر رکورد محصول شامل ویژگیهای ساختاریافتهای مانند شناسه محصول، عنوان، دستهبندی خردهفروشی، قیمت و متن توصیفی است.
کاتالوگ محصولات را استعلام کنید
یک تب SQL در BigQuery Studio باز کنید و کوئری زیر را برای بررسی جدول محصولات اجرا کنید:
SELECT
  product_id,
  product_name,
  category,
  price,
  description
FROM
  `bigquery-public-data.cymbal_pets.products`;
نتایج شما مشابه موارد زیر خواهد بود:
تصاویر محصول را بررسی کنید
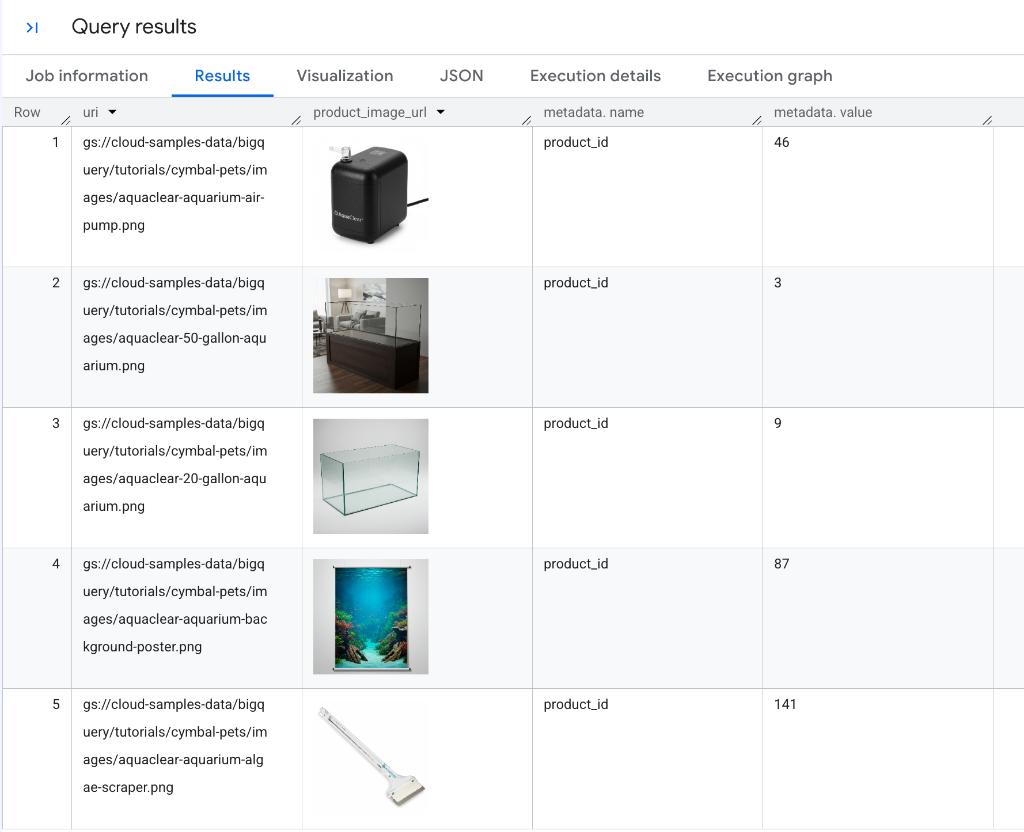
Cymbal Pets همچنین ارجاعات تصویر محصول را در bigquery-public-data.cymbal_pets.product_images ذخیره میکند. برای مشاهده سوابق تصویر، کوئری زیر را اجرا کنید:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`;
نتایج شما مشابه موارد زیر خواهد بود:
در مرحله بعد، از توابع مدیریتشده BigQuery برای تجزیه و تحلیل دادههای متنی و تصویری از انبار داده Cymbal Pets استفاده خواهید کرد.
۴. رتبهبندی محصولات بر اساس معیارهای معنایی با AI.SCORE
تابع AI.SCORE ورودیهای متنی را میپذیرد و از یک مدل Gemini برای امتیازدهی به آنها بر اساس یک معیار امتیازدهی زبان طبیعی استفاده میکند و یک امتیاز عددی FLOAT64 برمیگرداند.
اگر یک معیار امتیازدهی صریح ارائه ندهید، BigQuery به طور خودکار استراتژیهای بازنویسی سریع را برای ایجاد یک معیار بهینه برای مدل اعمال میکند.
به محصولات از نظر «قابلیت هدیه دادن» امتیاز دهید
فرض کنید تیم بازاریابی Cymbal Pets میخواهد یک راهنمای هدیه برای تعطیلات تهیه کند. آنها میخواهند هر کالای موجود در کاتالوگ را بر اساس میزان مناسب بودن آن به عنوان هدیه برای صاحب حیوان خانگی، در مقیاس ۱ تا ۱۰ رتبهبندی کنند.
کوئری زیر را در تب SQL خود اجرا کنید:
SELECT
  product_name,
  description,
  AI.SCORE(
    ('How "giftable" is this product for a pet owner? ', description,
    'Use a scale from 1-10.')
  ) AS giftability_score
FROM
  `bigquery-public-data.cymbal_pets.products`
ORDER BY
  giftability_score DESC;
نتایج را درک کنید
نتایج شما مشابه موارد زیر خواهد بود:
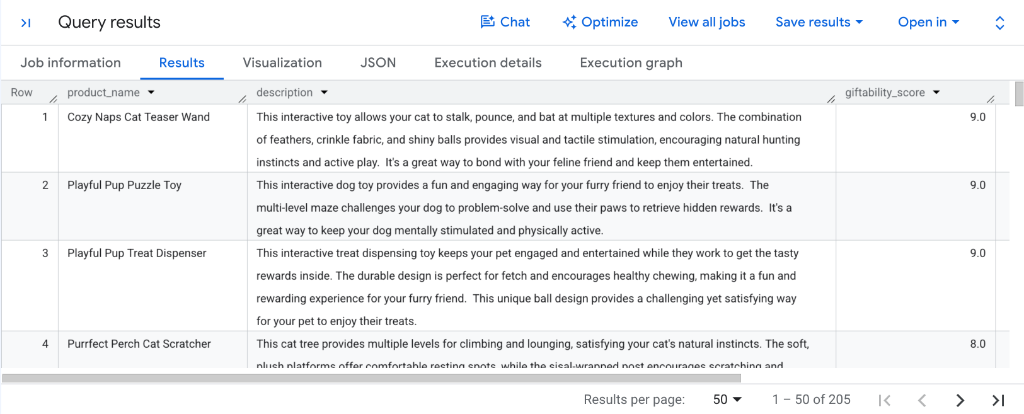
ستون giftability_score را در نتایج پرس و جو بررسی کنید:
- اسباببازیهای تعاملی با جذابیت بالا : اقلام جذابی مانند
Cozy Naps Cat Teaser Wand،Playful Pup Puzzle ToyوPlayful Pup Treat Dispenserبالاترین امتیاز (9.0) را دریافت میکنند. - راحتی ویژه و اقلام مخصوص خراشیدگی : ملزومات محبوبی مانند
Purrfect Perch Cat Scratcherامتیاز بالای8.0را کسب کردهاند. - رتبهبندی پاییندستی قابل اجرا : از آنجا که
AI.SCOREنمرات نرمالشدهFLOAT64تولید میکند، میتوانید بلافاصله نتایج را باORDER BY giftability_score DESCمرتب کنید یا نامزدها را باWHERE AI.SCORE(...) >= 8.0فیلتر کنید تا راهنماهای هدیه خودکار ایجاد شود.
۵. اقلام کاتالوگ را با AI.CLASSIFY دستهبندی کنید
تابع AI.CLASSIFY از Gemini برای طبقهبندی رکوردهای ورودی در یک لیست گسسته از دستههای هدف که به صورت یک آرایه SQL ارائه میشوند، استفاده میکند.
AI.CLASSIFY از ورودیهای چندوجهی (متن، تصاویر، صدا، ویدیو) پشتیبانی میکند و نیاز به ساخت، آموزش یا استقرار مدلهای طبقهبندی سفارشی برای مدیریت طبقهبندی را از بین میبرد.
دستهبندی اسباببازیها بر اساس گونههای جانوری هدف (تکبرچسبی)
فرض کنید برخی از محصولات موجود در کاتالوگ Cymbal Pets به صورت کلی با عنوان "اسباببازی" برچسبگذاری شدهاند، بدون اینکه حیوان مورد نظر مشخص شود. میتوانید از AI.CLASSIFY برای دستهبندی هر اسباببازی بر اساس نام و توضیحات آن استفاده کنید.
کوئری زیر را در BigQuery Studio اجرا کنید:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('What animal is this product for?', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "All Pets"]
  ) AS animal_type
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys"
LIMIT 20;
نتایج را مشاهده کنید
نتایج شما مشابه موارد زیر خواهد بود:
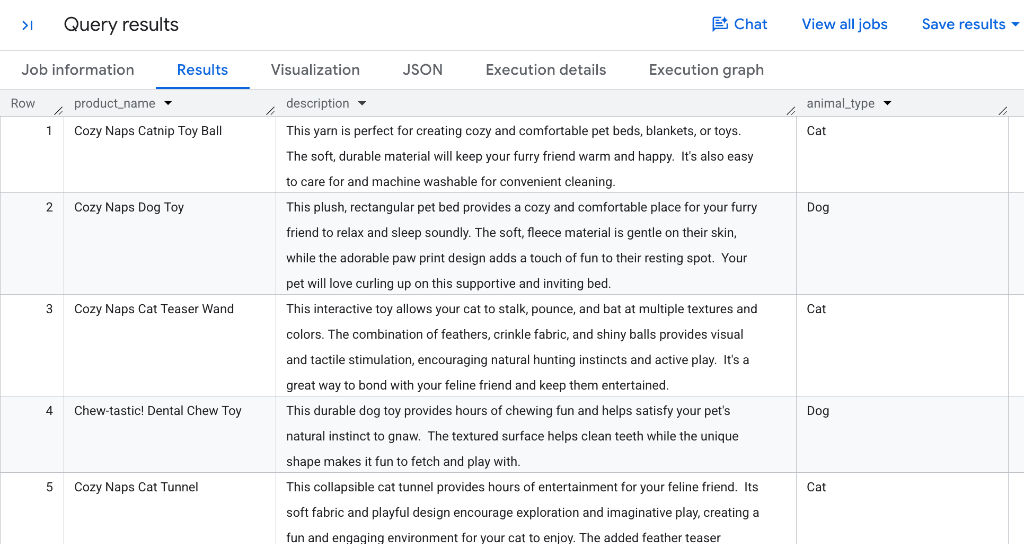
به طور پیشفرض، AI.CLASSIFY طبقهبندی تکبرچسبی را انجام میدهد و یک STRING حاوی مرتبطترین دستهبندی از آرایه کاندید شما را برمیگرداند. توجه کنید که چگونه Gemini توپهای علف گربه و اسباببازیهای پردار را به Cat نگاشت میکند، در حالی که chew toys و fetch sticks را به Dog نگاشت میکند.
چندین برچسب را با طبقهبندی چند برچسبی اختصاص دهید
بسیاری از محصولات موجود در کاتالوگ خرده فروشی به طور همزمان برای چندین نوع حیوان خانگی کاربرد دارند (برای مثال، یک تخت خواب یا تونل مخملی مناسب برای گربه ها و حیوانات کوچک).
برای اختصاص چندین دسته به یک رکورد، پارامتر اختیاری output_mode => 'multi' را تنظیم کنید. در حالت چند برچسبی، AI.CLASSIFY یک ARRAY برمیگرداند. ARRAY شامل تمام دسته بندی های منطبق.
کوئری زیر را در تب SQL خود اجرا کنید:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('Identify all pet types that this product is suitable for: ', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "Reptile"],
    output_mode => 'multi'
  ) AS pet_types
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys";
نتایج شما مشابه موارد زیر خواهد بود:
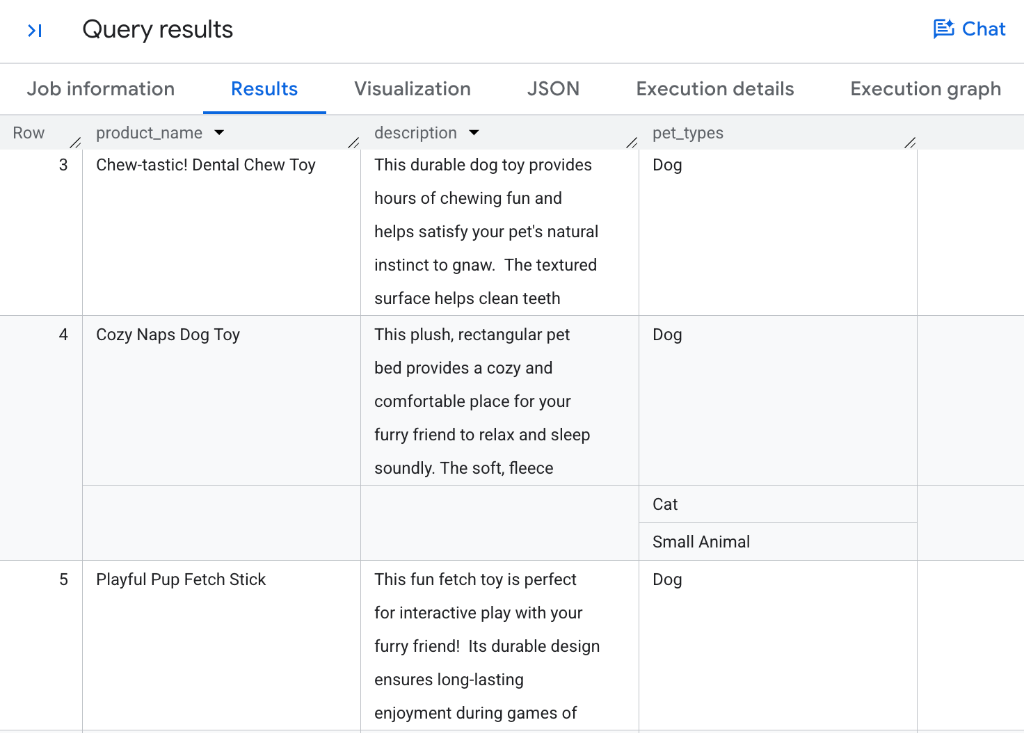
بررسی مکانیک طبقهبندی
- تک برچسبی در مقابل چند برچسبی : بدون
output_mode،AI.CLASSIFYیکSTRINGاسکالر برمیگرداند. تنظیمoutput_mode => 'multi'یکARRAYبرمیگرداند.ARRAYشامل صفر، یک یا چند برچسب منطبق. - تکلیف چند دستهای : توجه کنید که چگونه اقلام اختصاصی مانند
Chew-tastic! Dental Chew ToyوPlayful Pup Fetch Stick[Dog]را دریافت میکنند، در حالی که اقلام راحتی همهکاره مانندCozy Naps Dog Toy(یک تخت مستطیلی مخملی) به درستی برچسبهای متعددی دریافت میکنند:[Dog, Cat, Small Animal]. - تطبیق صفر-شات : مدل، متن و اعلان ترکیبی را در برابر آرایه
categoriesارائه شده بدون نیاز به مدلهای یادگیری ماشین سفارشی از پیش آموزشدیده ارزیابی میکند. - عملیات آرایهای SQL در پاییندست : میتوانید از توابع آرایهای استاندارد BigQuery SQL مانند
WHERE 'Cat' IN UNNEST(pet_types)یاCROSS JOIN UNNEST(pet_types)برای فیلتر کردن، بسط دادن و تجمیع رکوردهای چندبرچسبی استفاده کنید.
۶. تصاویر محصولات چندوجهی را با AI.IF فیلتر کنید
تابع AI.IF از Gemini برای ارزیابی یک شرط به زبان طبیعی استفاده میکند و یک مقدار بولی ( TRUE یا FALSE ) برمیگرداند.
از آنجا که AI.IF ورودیهای چندوجهی را میپذیرد، میتوانید از آن مستقیماً در یک عبارت SQL WHERE برای فیلتر کردن فایلهای تصویری بدون ساختار ذخیره شده در Cloud Storage استفاده کنید.
تصاویر حاوی اشیاء خاص را فیلتر کنید
فرض کنید تیم بازاریابی میخواهد تمام تصاویر محصولاتی را که از نظر بصری حاوی غذای حیوانات خانگی یا تنقلات هستند، در کاتالوگ پیدا کند.
کوئری زیر را در تب SQL خود اجرا کنید:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`
WHERE
  AI.IF(
    ('Does this product image contain pet food or snacks? ', OBJ.MAKE_REF(uri, 'us.conn'))
  );
نتایج شما مشابه موارد زیر خواهد بود:
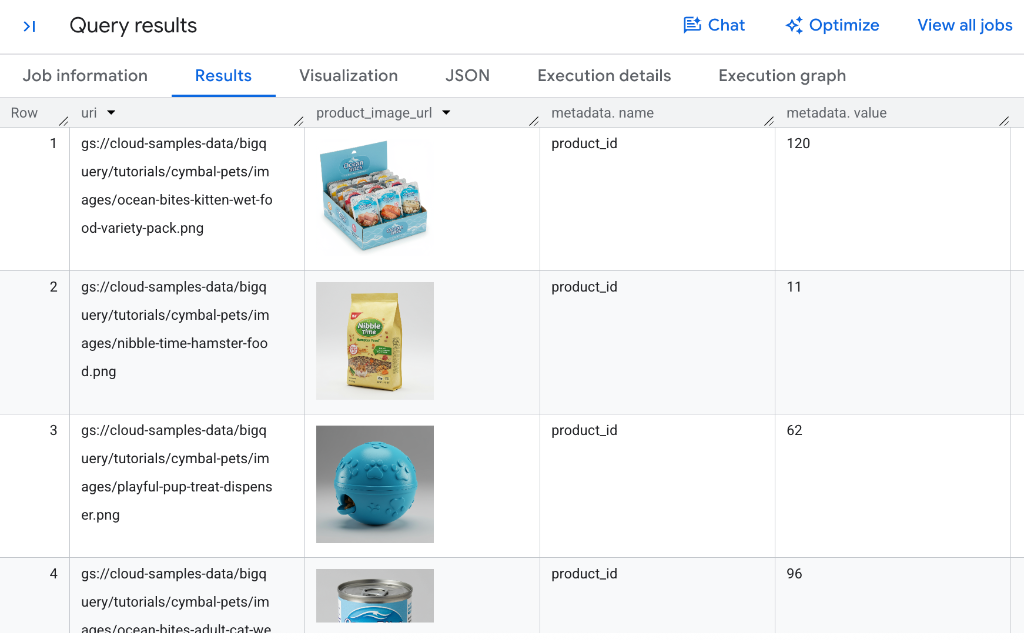
نحوه عملکرد فیلتر چندوجهی
- ارجاعات شیء درجا : اگرچه ما در اینجا با استفاده از
OBJ.MAKE_REF(uri, 'us.conn')ارجاعات شیء را درجا ایجاد میکنیم، اما میتوانید ستونهایObjectRefرا مستقیماً در جداول BigQuery خود ایجاد و ذخیره کنید تا آنها بلافاصله آماده استفاده در تجزیه و تحلیل باشند و نیازی به تابعOBJ.MAKE_REFدر هر پرسوجو نداشته باشند. - تشخیص بصری عمیق اشیا : توجه کنید که چگونه Gemini به طور دقیق قالبهای بستهبندی متنوع (مانند جعبه بستهبندی انواع غذای مرطوب، کیسه غذای خشک همستر و غذای کنسروی گربه) را شناسایی میکند و در عین حال تنقلات خوراکی موجود در اسباببازیهایی مانند ظرف خوراکی آبی را نیز تشخیص میدهد.
- ارزیابی گزارهای سطح سطر : BigQuery شرایط زبان طبیعی را در برابر هر ارجاع تصویر Cloud Storage مستقیماً درون عبارت
WHEREارزیابی میکند. - فیلتر بولی : فقط رکوردهایی که Gemini شرط آنها را
TRUEارزیابی میکند، در مجموعه نتایج بازگردانده میشوند.
۷. انجام پیوند معنایی بین جداول با AI.IF
پیوندهای پایگاه داده رابطهای سنتی نیاز به برابری دقیق کلید دارند (مانند products.product_id = images.product_id ). با این حال، مجموعه دادههای سازمانی در دنیای واقعی اغلب حاوی داراییهای بدون ساختار هستند که فاقد کلیدهای خارجی صریح هستند.
از آنجا که AI.IF یک مقدار بولی برمیگرداند، میتوانید آن را مستقیماً درون یک عبارت SQL INNER JOIN ... ON قرار دهید تا پیوند معنایی انجام شود.
به صورت معنایی توضیحات محصول را با تصاویر مرتبط کنید
فرض کنید میخواهید توضیحات محصول را از جدول products با فایلهای تصویری بدون لینک در product_images برای محصولات تولید شده توسط برند Fluffy Buns مطابقت دهید.
کوئری زیر را در تب SQL در BigQuery Studio اجرا کنید (توجه داشته باشید که تکمیل آن چند دقیقه طول میکشد):
SELECT
  products.product_id,
  products.product_name,
  products.description,
  products.brand,
  images.uri AS image_uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(images.uri, 'us.conn')).url AS product_image_url
FROM
  `bigquery-public-data.cymbal_pets.products` AS products
INNER JOIN
  `bigquery-public-data.cymbal_pets.product_images` AS images
ON
  AI.IF(
    ('You will be provided an image of a pet product. ',
    'Determine if the image is of the following pet toy: ',
    products.product_name,
    products.description,
    OBJ.MAKE_REF(images.uri, 'us.conn')
    )
  )
WHERE
  products.category = "Toys" AND
  products.brand = "Fluffy Buns";
نتایج شما مشابه موارد زیر خواهد بود:
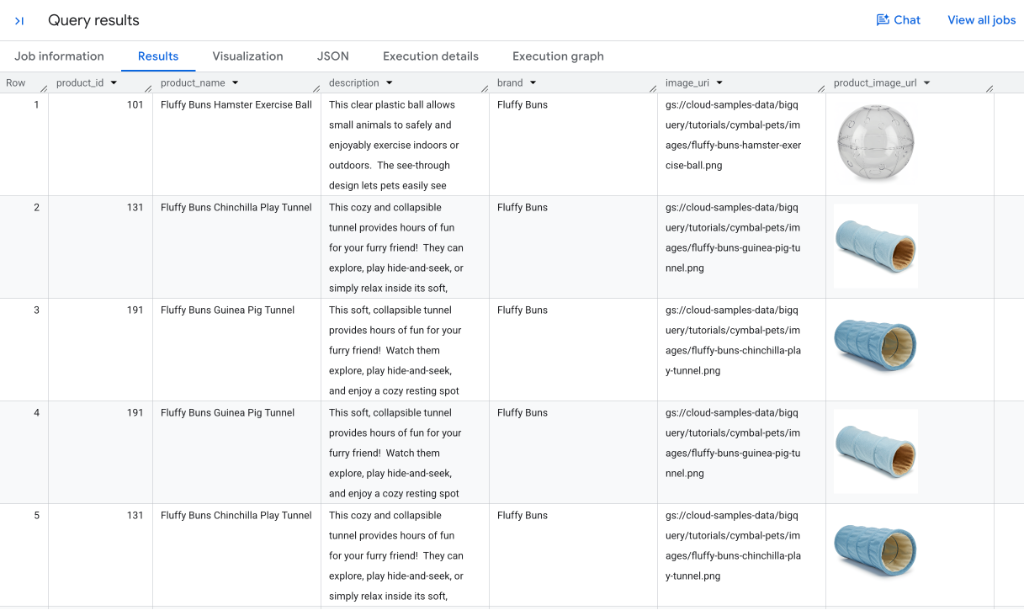
درک پیوندهای معنایی در SQL
- ارزیابی شرایط بین حالتی : برای جفت رکوردهای کاندید، BigQuery هم فراداده متنی از
productsو هم مرجع تصویر (OBJ.MAKE_REF(...)) را به Gemini ارسال میکند. - تطبیق بصری دقیق : همانطور که در نتایج نشان داده شده است،
Fluffy Buns Hamster Exercise Ballبا تصویر توپ پلاستیکی شفاف مطابقت دارد، در حالی کهFluffy Buns Chinchilla Play TunnelوGuinea Pig TunnelFluffy Buns با عکسهای تونل مخمل آبی مطابقت دارند. به دلیل معناشناسی استاندارد SQLINNER JOIN، اگر یک محصول با بیش از یک تصویر در کاتالوگ (مانند زوایای مختلف عکس یا نماهای مشابه) مطابقت داشته باشد، میتواند چندین ردیف در خروجی تولید کند. - رندرینگ تصویر درونخطی : BigQuery Studio بهطور خودکار URLهای مجاز خواندهشده در ستون
product_image_urlرا مستقیماً در شبکه نتایج شما رندر میکند تا تأیید بصری فوری انجام شود. - تفکیکپذیری بدون ساختار موجودیت : این قابلیت، گردشهای کاری قدرتمند تفکیکپذیری موجودیت را در کاتالوگهای قدیمی، مجموعه دادههای خراشیده شده و آرشیوهای رسانهای، بدون برچسبگذاری دستی یا کلیدهای خارجی صریح، فراهم میکند.
۸. با استفاده از AI.AGG، بینشها را در سطرهای مختلف ترکیب کنید
در حالی که توابعی مانند AI.SCORE ، AI.CLASSIFY و AI.IF سطرهای منفرد (عملیات اسکالر) را ارزیابی میکنند، تجزیه و تحلیل دادههای سازمانی اغلب نیاز به ترکیب الگوها در چندین رکورد دارد.
تابع AI.AGG یک تابع تجمیعی است که از دستورالعملهای زبان طبیعی برای خلاصهسازی، خوشهبندی یا ترکیب بینشهای موجود در هزاران یا میلیونها ردیف بدون ساختار در قالب یک پاسخ یکپارچه استفاده میکند.
خلاصههای دستهبندی را در کنار معیارهای سنتی SQL ترکیب کنید
AI.AGG به طور یکپارچه با توابع سنتی SQL GROUP BY و توابع تجمیعی ادغام میشود. به عنوان مثال، میتوانید معیارهای سنتی (مانند تعداد اقلام) را درست در کنار یک خلاصه هوش مصنوعی مولد که نقاط مشترک محصولات در هر دسته را توصیف میکند، محاسبه کنید.
کوئری زیر را در BigQuery Studio اجرا کنید:
SELECT
  category,
  COUNT(*) AS item_count,
  AI.AGG(
    ('Product: ', product_name, ' - Description: ', description),
    'Write a concise, one-sentence summary describing the common characteristics or purpose of the products in this category.'
  ) AS category_summary
FROM
  `bigquery-public-data.cymbal_pets.products`
GROUP BY
  category
ORDER BY
  item_count DESC;
نتایج شما مشابه موارد زیر خواهد بود:
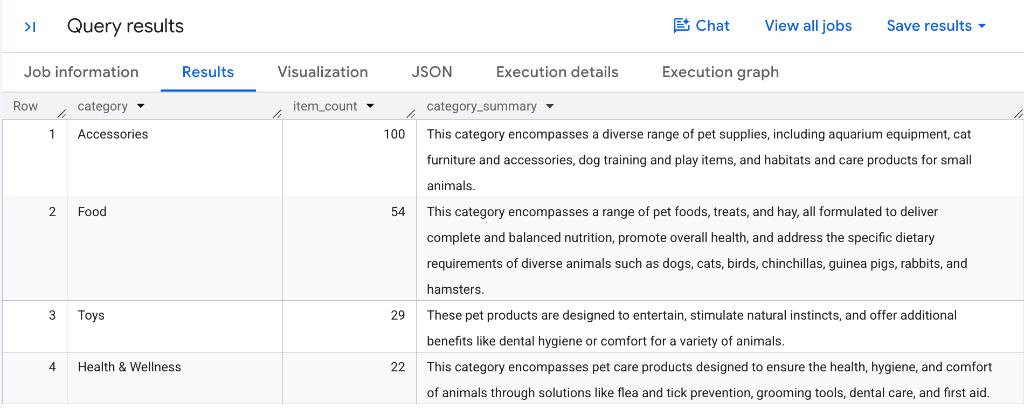
چگونه AI.AGG دادههای بدون ساختار را جمعآوری میکند
- تجمیع سلسله مراتبی : BigQuery دادههای ردیف را بر اساس پارتیشن دستهبندی گروهبندی میکند، پنجرههای زمینه ساختاریافته میسازد و از Gemini برای ترکیب کل مجموعه رکوردهای محصول استفاده میکند.
- ترکیب خودکار کاتالوگ : توجه کنید که چگونه هر دسته خلاصهای دقیق و متمایز دریافت میکند، مانند
Accessoriesکه زیستگاهها و تجهیزات آموزشی را ثبت میکنند، یاFoodتغذیه متعادل را در بین گونههای مختلف جانوری برجسته میکند. - گزارشدهی ترکیبی کمی و کیفی : ترکیب تجمیعهای استاندارد مانند
COUNT(*)باAI.AGG، نمای کلی جامعی از کاتالوگ را در یک پرسوجوی واحد و بدون نیاز به خطوط لوله ETL سفارشی ایجاد میکند. - پارتیشنبندی انعطافپذیر : شما میتوانید
AI.AGGدر هر بُعد گروهبندی (مانندGROUP BY brand،GROUP BY categoryیا در کل جدول خود) اعمال کنید تا در عرض چند ثانیه بینشهایی در سطح مدیران ایجاد کنید.
۹. سرعت بخشیدن به کوئریها با حالت بهینه و مدلهای پروکسی
هنگام پردازش مجموعه دادههای بزرگ حاوی هزاران یا میلیونها ردیف، فراخوانی یک LLM از راه دور برای هر ردیف میتواند باعث تأخیر و هزینه شود.
برای حل این مشکل، BigQuery حالت بهینهسازیشدهای را برای AI.IF و AI.CLASSIFY ارائه میدهد. حالت بهینهسازیشده از مدلهای پروکسی و تقطیر مدل در حین اجرا استفاده میکند تا اجرای بیش از ۱۰۰ برابر سریعتر را با هزینه توکن LLM کاهشیافته ارائه دهد.
نحوه عملکرد حالت بهینه
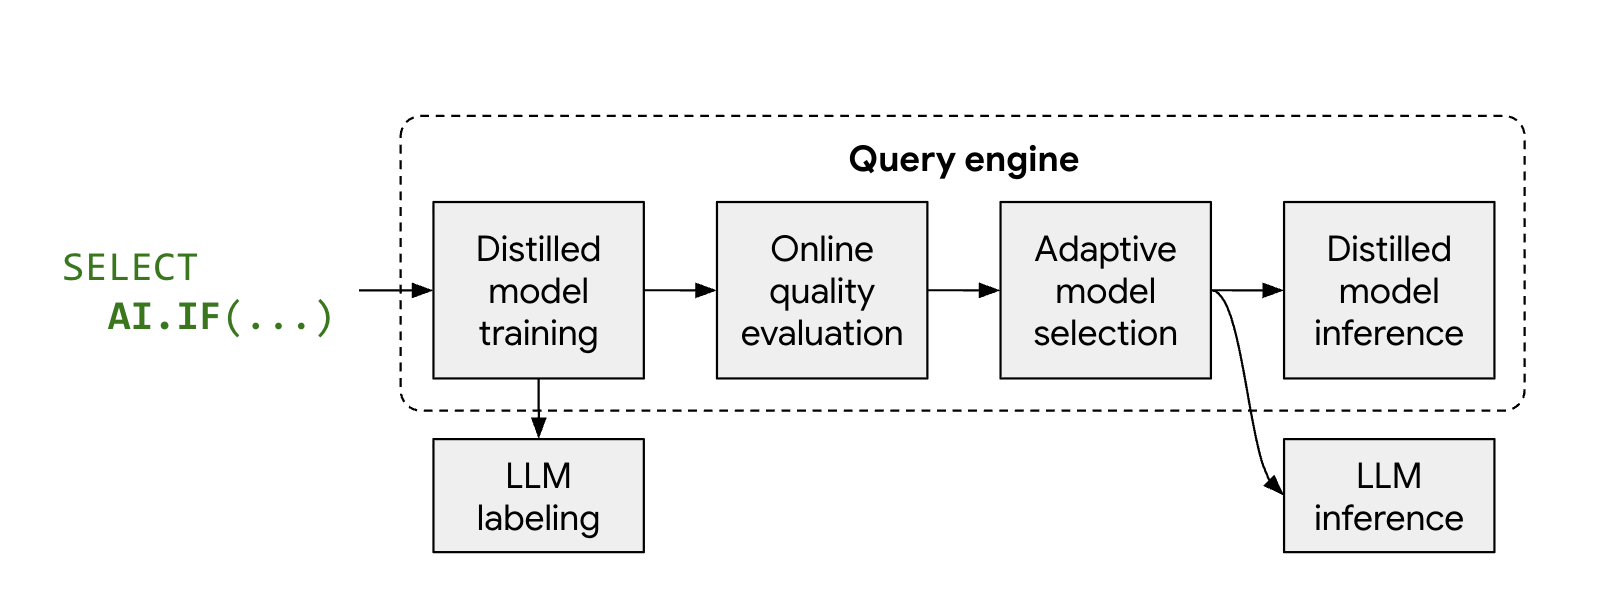
- نمونهگیری و برچسبگذاری نماینده : BigQuery به طور خودکار یک نمونه نماینده از ردیفها را انتخاب میکند و برچسبها را از Gemini دریافت میکند.
- آموزش مدل خلاصهشده : بیگکوئری یک مدل پروکسی فوقالعاده سبک (مانند رگرسیون لجستیک) را بهصورت لحظهای روی CPU با استفاده از جاسازیهای متنی به عنوان ویژگی آموزش میدهد.
- تأیید کیفیت : BigQuery دقت مدل خلاصهشده را با Gemini مقایسه میکند. اگر به آستانههای کیفیت برسد، BigQuery آن را برای پردازش بقیه مجموعه دادهها ارتقا میدهد.
- استنتاج محلی پرسرعت : مدل پروکسی، ردیفهای باقیمانده را به صورت محلی با هزینه توکن LLM از راه دور صفر و تأخیر بسیار کم ارزیابی میکند.
اجرای یک کوئری پایه بدون بهینهسازی
از آنجا که کاتالوگ نمونه bigquery-public-data.cymbal_pets.products شامل ردیفهای بسیار کمی برای شروع تقطیر مدل پروکسی است، ما از مجموعه داده عمومی بزرگتر bigquery-public-data.bbc_news.fulltext (که شامل بیش از ۲۲۰۰ مقاله خبری است) استفاده خواهیم کرد.
ابتدا، کوئری استاندارد را بدون بهینهسازی اجرا کنید تا مقالات خبری مربوط به بلایای طبیعی را شناسایی کنید:
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body)
  );
جزئیات اولیه کار و میزان استفاده از توکن را بررسی کنید
پس از تکمیل پرس و جوی پایه، معیارهای اجرا را بررسی کنید:
- در پنل نتایج پایین BigQuery Studio، تب اطلاعات شغلی (Job information ) را انتخاب کنید.
- به پایین اسکرول کنید تا به بخشهای تعداد توکنهای ورودی (Input token) و تعداد توکنهای خروجی (Output token) برسید .
نتایج شما مشابه موارد زیر خواهد بود:
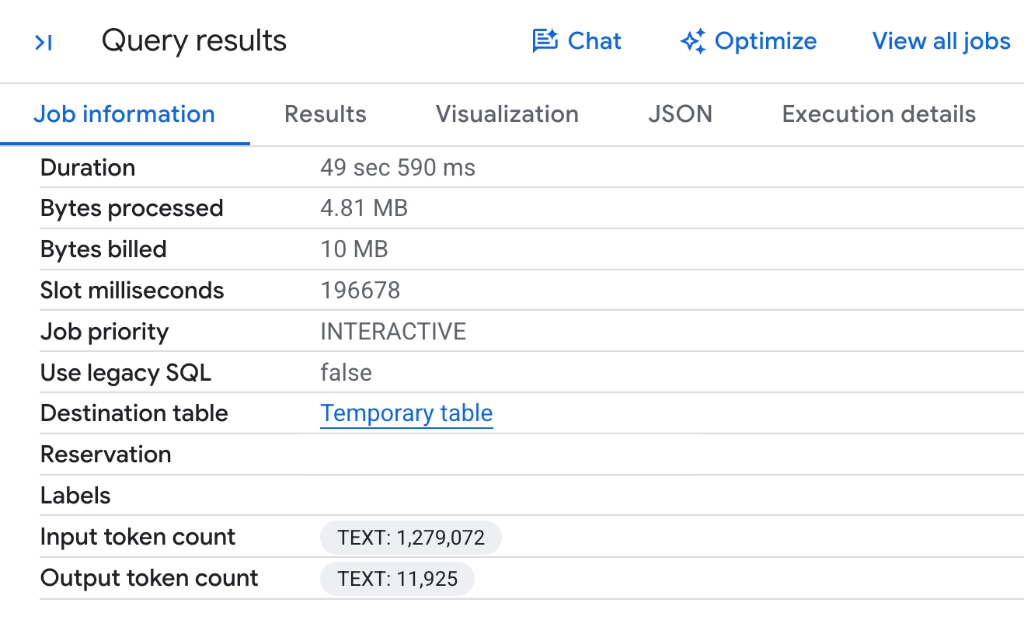
- مصرف کامل توکن مجموعه داده : از آنجا که BigQuery مدل Gemini از راه دور را برای هر سطر در تمام ۲۲۲۵ مقاله خبری بدون بهینهسازی پروکسی فراخوانی میکند، این پرسوجو ۱,۲۷۹,۰۷۲ توکن ورودی و ۱۱۹۲۵ توکن خروجی مصرف میکند.
- بخش بهینهسازی وجود ندارد : توجه داشته باشید که هیچ ورودی
Gen AI Function Optimizationsوجود ندارد زیرا اجرای استاندارد هر سطر را به صورت جداگانه در برابر نقطه پایانی LLM از راه دور ارزیابی میکند.
اجرای کوئری با حالت بهینه
برای کاهش مصرف توکن و بهرهگیری از خلاصهسازی مدل پروکسی، با ارسال embeddings => AI.EMBED(...) و تنظیم optimization_mode => 'MINIMIZE_COST' ، حالت بهینهسازیشده را فعال کنید:
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body),
    embeddings => AI.EMBED(body, endpoint => 'text-embedding-005', task_type => 'CLASSIFICATION').result,
    optimization_mode => 'MINIMIZE_COST'
  );
بهینهسازی را تأیید کنید و کاهش استفاده از توکن را مشاهده کنید
پس از اجرای کوئری بهینهسازیشده، به تب اطلاعات شغلی BigQuery Studio بروید تا نحوه مقایسه معیارهای استفاده و اجرای توکن را مشاهده کنید:
- در پنل نتایج پایین BigQuery Studio، تب اطلاعات شغلی (Job information ) را انتخاب کنید.
- به بخش بهینهسازیهای عملکرد هوش مصنوعی نسل بعدی و همچنین تعداد توکنها بروید.
نتایج شما مشابه موارد زیر خواهد بود:
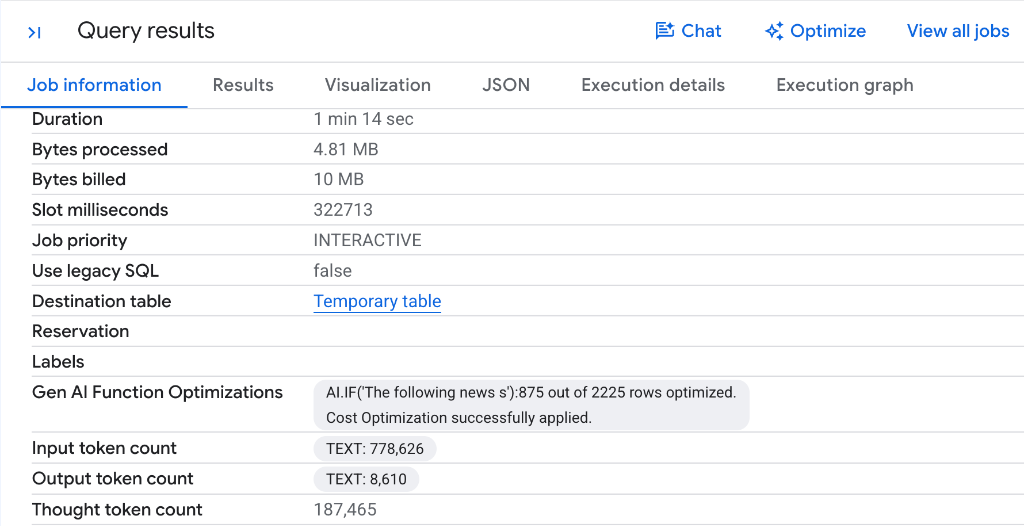
- کاهش قابل توجه توکنها : توجه کنید که چگونه تعداد توکنهای ورودی از ۱,۲۷۹,۰۷۲ توکن به ۷۷۸,۶۲۶ توکن کاهش یافته است - که منجر به صرفهجویی ۵۰۰,۴۴۶ توکن ورودی (تقریباً ۴۰٪ کاهش) در یک اجرای پرسوجو میشود! به طور مشابه، کاهشی در توکنهای خروجی نیز وجود داشته است.
- خلاصهسازی خودکار پروکسی : به برچسب
AI.IF('The following news s'): 875 out of 2225 rows optimized. Cost Optimization successfully applied.BigQuery مجموعه دادهها را نمونهبرداری کرد، مقالات نمونه را با Gemini برچسبگذاری کرد، یک طبقهبندیکننده پروکسی سبک و سریع را خلاصه کرد و ۸۷۵ از ۲۲۲۵ ردیف را به صورت محلی روی CPU بدون فراخوانی نقاط پایانی LLM از راه دور پردازش کرد. - صرفهجویی مستقیم در هزینهها : از آنجا که توابع هوش مصنوعی مدیریتشده توسط BigQuery بر اساس حجم توکنهای مدل پردازششده محاسبه میشوند، کاهش مصرف توکن مستقیماً به کاهش هزینههای اجرای کوئری منجر میشود.
- اعتبارسنجی کیفیت : BigQuery قبل از اینکه مدل پروکسی را برای ارزیابی ردیفهای باقیمانده ارتقا دهد، بهطور خودکار دقت آن را در برابر Gemini تأیید کرد و از حفظ کیفیت طبقهبندی اطمینان حاصل کرد.
کاهش بیشتر توکن و مقیاسبندی تأخیر در جداول بزرگتر
اگرچه صرفهجویی بیش از ۵۰۰۰۰۰ توکن در ۲۲۲۵ ردیف قابل توجه است، اما کاهش توکن و افزایش عملکرد در جداول بزرگتر حتی بیشتر است:
- چرا کاهش توکن با اندازه مجموعه داده مقیاسپذیر است : برای پرسوجوهای اجرا شده در BigQuery، مدلهای پروکسی با استفاده از یک نمونه اولیه حدود ۱۰۰۰ ردیف که توسط LLM برچسبگذاری شدهاند، به صورت همزمان آموزش داده میشوند. پس از آموزش و اعتبارسنجی، مدل پروکسی جایگزین فراخوانیهای مستقیم LLM در ردیفهای باقیمانده میشود. برای پرسوجوهای بزرگتر (مانند مجموعه دادههای معمولی ۱ میلیون ردیفی)، این امر فراخوانیهای LLM را برای بخش عمدهای از دادهها حذف میکند و تا ۴۰۰ برابر توکن کمتری مصرف میکند و هزینهها را به شدت کاهش میدهد.
- شتاب قابل توجه در زمان تأخیر : با تغییر استنتاج از سختافزار تخصصی LLM به مدلهای پروکسی فوقالعاده سبک که مستقیماً روی پردازندههای استاندارد پایگاه داده اجرا میشوند (با بهرهگیری از تعبیههای از پیش محاسبهشده Gemini)، BigQuery زمان اجرای کلی پرسوجو را 30 تا 100 برابر کاهش میدهد.
۱۰. منابع را پاکسازی کنید
برای پاک کردن منابع ایجاد شده در طول این آزمایش کد، دستور زیر را در تب SQL در BigQuery Studio اجرا کنید تا اتصال منابع ابری (Cloud Resource Connection) حذف شود:
DROP CONNECTION IF EXISTS `us.conn`;
از طرف دیگر، اگر یک پروژه موقت Google Cloud را منحصراً برای این آموزش ایجاد کردهاید، میتوانید کل پروژه را در Cloud Resource Manager خاموش کنید.
۱۱. تبریک
تبریک! شما با موفقیت آزمایشگاه کدنویسی تحلیل معنایی در BigQuery با توابع هوش مصنوعی مدیریتشده و SQL را به پایان رساندید.
شما بر توابع هوش مصنوعی مولد مدیریتشدهی BigQuery مسلط شدید:
-
AI.SCORE: محصولات را بر اساس معیارهای ذهنی مانند قابلیت هدیه دادن در مقیاس ۱ تا ۱۰ با استفاده از بازنویسی خودکار سریع رتبهبندی میکند. -
AI.CLASSIFYطبقهبندی: اقلام کاتالوگ بدون ساختار را در طبقهبندیهای حیوانات هدف دستهبندی کرد. -
AI.IF(فیلترینگ چندوجهی) : تصاویر ذخیره سازی ابری فیلتر شده در عبارات SQLWHEREبر اساس محتوای بصری. -
AI.IF(پیوندهای معنایی) : پیوندهای بین وجهی را در عبارات SQLONانجام داد تا توضیحات متنی محصول را با فایلهای تصویری پیوند دهد. -
AI.AGG: متن کاتالوگ بدون ساختار چند ردیفی را به یک خلاصه اجرایی مختصر تبدیل میکند. - مدلهای حالت و پروکسی بهینهشده : پرسوجوهای تسریعشده و هزینههای توکن به حداقل رسیده با استفاده از
optimization_mode => 'MINIMIZE_COST'با تقطیر مدل در لحظه وAI.EMBED.
بیشتر بدانید
- بررسی اجمالی هوش مصنوعی مولد BigQuery
- راهنمای توابع هوش مصنوعی مدیریتشدهی BigQuery
- مستندات سینتکس SQL
AI.SCORE - مستندات نحو SQL
AI.CLASSIFY - مستندات سینتکس SQL
AI.IF - مستندات نحوی SQL
AI.AGG - بهینهسازی توابع هوش مصنوعی با تقطیر مدل
- وبلاگ گوگل کلود: کوئریهای SQL مبتنی بر LLM با مدلهای پروکسی، بیش از ۱۰۰ برابر سریعتر و ارزانتر
- وبلاگ گوگل کلود: بررسی عمیق تابع BigQuery AI.AGG