

1. Bienvenue
Dans cet atelier de programmation, vous allez découvrir comment utiliser la suite de fonctions d'IA gérées BigQuery pour effectuer des analyses sémantiques sophistiquées, des classifications catégorielles, des filtrages multimodaux, des jointures sémantiques et des synthèses de plusieurs lignes directement dans BigQuery Studio à l'aide de SQL.
À l'aide de l'ensemble de données public bigquery-public-data.cymbal_pets, vous vous mettrez dans la peau d'un analyste de données chez Cymbal Pets, un détaillant en ligne d'articles et d'accessoires pour animaux de compagnie.
Analyse sémantique directement dans les requêtes SQL
Traditionnellement, l'application de modèles de machine learning ou de grands modèles de langage (LLM) à des ensembles de données d'entreprise nécessitait de déplacer les données de l'entrepôt de données vers des environnements de notebook Python externes. Cela nécessitait des pipelines d'ingénierie des données dédiés et une expertise en ML.
Les fonctions d'IA gérées de BigQuery, y compris AI.SCORE, AI.CLASSIFY, AI.IF et AI.AGG, apportent l'intelligence du modèle de base directement à vos données. BigQuery optimise automatiquement la sélection du modèle et applique des stratégies de réécriture de prompt internes pour fournir des résultats très précis à partir de prompts simples en langage naturel.
Pour les ensembles de données volumineux, BigQuery fournit un mode optimisé, qui utilise la distillation de modèle à la volée et des modèles proxy légers pour fournir des requêtes jusqu'à 100 fois plus rapides et moins coûteuses.
Objectifs de l'atelier
- Explorer les données de vente au détail multimodales dans BigQuery Studio à l'aide de SQL.
- Effectuer un classement sémantique à l'aide de
AI.SCOREpour évaluer les attributs subjectifs des produits, tels que "cadeau idéal". - Catégoriser les données non structurées à l'aide de
AI.CLASSIFYpour mapper les produits aux espèces animales cibles. - Filtrer les composants Image multimodaux à l'aide de
AI.IFdans les clausesWHERE. - Exécuter des jointures sémantiques entre les tables à l'aide de
AI.IFdans les clausesJOIN ... ONpour faire correspondre les enregistrements de produits textuels avec des fichiers image externes. - Synthétiser des insights sur plusieurs lignes à l'aide de la fonction d'agrégation
AI.AGG. - Optimiser la latence et le coût des requêtes sur des ensembles de données volumineux à l’aide de
AI.IFavec le mode optimisé (optimization_mode => 'MINIMIZE_COST') et la distillation de modèle proxy.
Prérequis
- Un projet Google Cloud avec facturation activée.
- Un navigateur Web tel que Chrome.
2. Préparation
Avant d'interroger des données avec des fonctions d'IA gérées, vous devez configurer votre projet Google Cloud et activer les API requises.
Créer un projet Google Cloud et activer les API
- Dans la console Google Cloud, sur la page du sélecteur de projet, sélectionnez ou créez un projet Google Cloud.
- Assurez-vous que la facturation est activée pour votre projet Cloud. Découvrez comment vérifier si la facturation est activée sur un projet.
- Activez les API BigQuery, BigQuery Connection et Agent Platform.
Ouvrir BigQuery Studio
- Dans le menu de navigation de la console Google Cloud, cliquez sur BigQuery pour ouvrir BigQuery Studio.
- Dans la barre d'outils de l'éditeur BigQuery Studio, cliquez sur + Requête SQL pour ouvrir un nouvel onglet de requête SQL. Vous écrirez et exécuterez toutes les requêtes SQL dans ces onglets SQL tout au long de cet atelier de programmation.
Créer une connexion aux ressources Cloud en SQL
BigQuery fonctionne dans un périmètre de données sécurisé. Lors de l'inspection de fichiers multimodaux externes (tels que des images stockées dans Google Cloud Storage), BigQuery utilise une connexion aux ressources Cloud pour accéder de manière sécurisée aux références d'objet sans exposer les identifiants.
Exécutez l'instruction suivante dans votre onglet SQL pour créer une connexion nommée us.conn :
CREATE CONNECTION IF NOT EXISTS `us.conn`
OPTIONS (
  connection_type = "CLOUD_RESOURCE"
);
3. Explorer l'ensemble de données Cymbal Pets
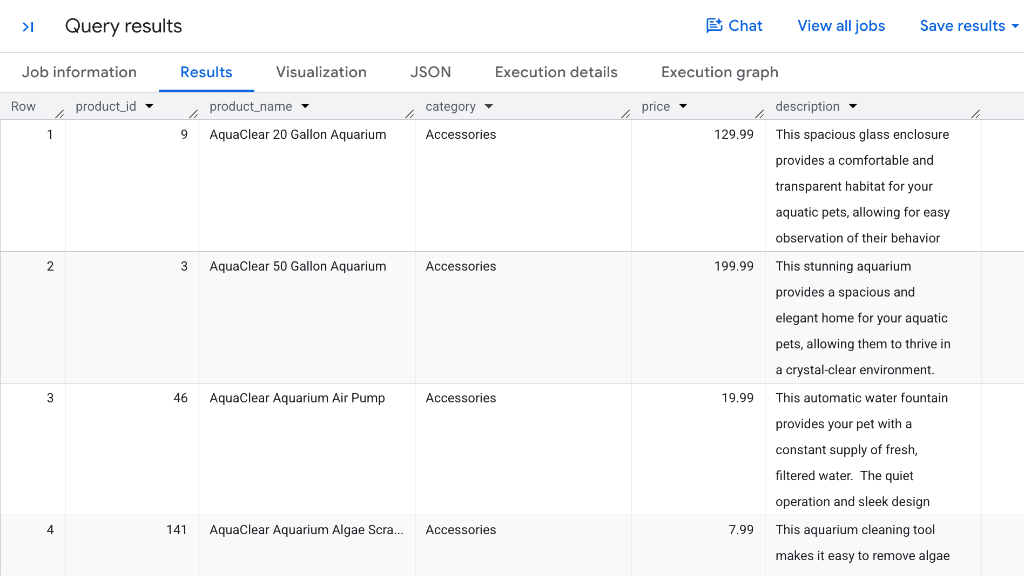
Cymbal Pets gère un catalogue de produits riche dans l'ensemble de données public, dans la table nommée bigquery-public-data.cymbal_pets.products. Chaque enregistrement de produit contient des attributs structurés tels que l'ID du produit, le titre, la catégorie de vente au détail, le prix et le texte descriptif.
Interroger le catalogue de produits
Ouvrez un onglet SQL dans BigQuery Studio et exécutez la requête suivante pour inspecter la table des produits :
SELECT
  product_id,
  product_name,
  category,
  price,
  description
FROM
  `bigquery-public-data.cymbal_pets.products`;
Vos résultats ressembleront à ce qui suit :
Inspecter les images des produits
Cymbal Pets stocke également des références d'images de produits dans bigquery-public-data.cymbal_pets.product_images. Exécutez la requête suivante pour afficher les enregistrements d'images :
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`;
Vos résultats ressembleront à ce qui suit :
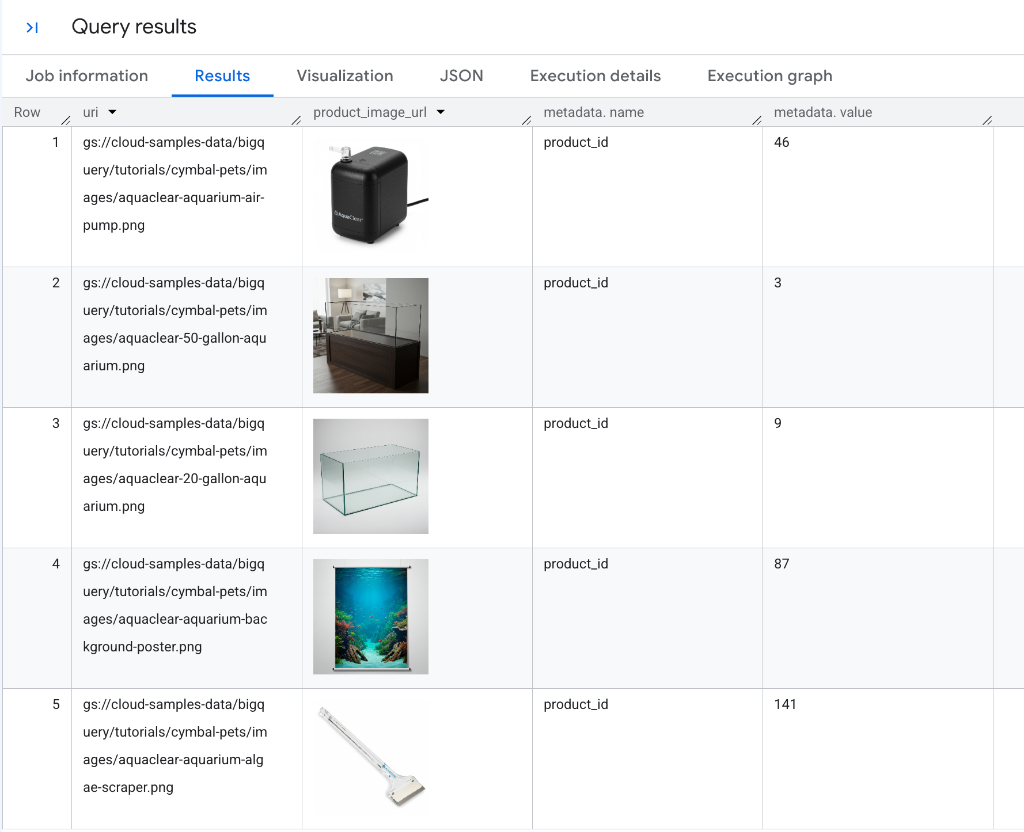
Vous utiliserez ensuite les fonctions gérées de BigQuery pour analyser les données textuelles et les données d'image de l'entrepôt de données Cymbal Pets.
4. Classer les produits selon des critères sémantiques avec AI.SCORE
La fonction AI.SCORE accepte les entrées de texte et utilise un modèle Gemini pour les évaluer en fonction d'une grille d'évaluation en langage naturel, en renvoyant un score numérique FLOAT64.
Si vous ne fournissez pas de grille d'évaluation explicite, BigQuery applique automatiquement des stratégies de reformulation de prompt pour générer une grille optimale pour le modèle.
Évaluer les produits en fonction de leur "cadeau idéal"
Supposons que l'équipe marketing de Cymbal Pets souhaite créer un guide de cadeaux pour les fêtes de fin d'année. Elle souhaite classer chaque article du catalogue en fonction de son adéquation en tant que cadeau pour un propriétaire d'animal de compagnie sur une échelle de 1 à 10.
Exécutez la requête suivante dans votre onglet SQL :
SELECT
  product_name,
  description,
  AI.SCORE(
    ('How "giftable" is this product for a pet owner? ', description,
    'Use a scale from 1-10.')
  ) AS giftability_score
FROM
  `bigquery-public-data.cymbal_pets.products`
ORDER BY
  giftability_score DESC;
Comprendre les résultats
Vos résultats ressembleront à ce qui suit :
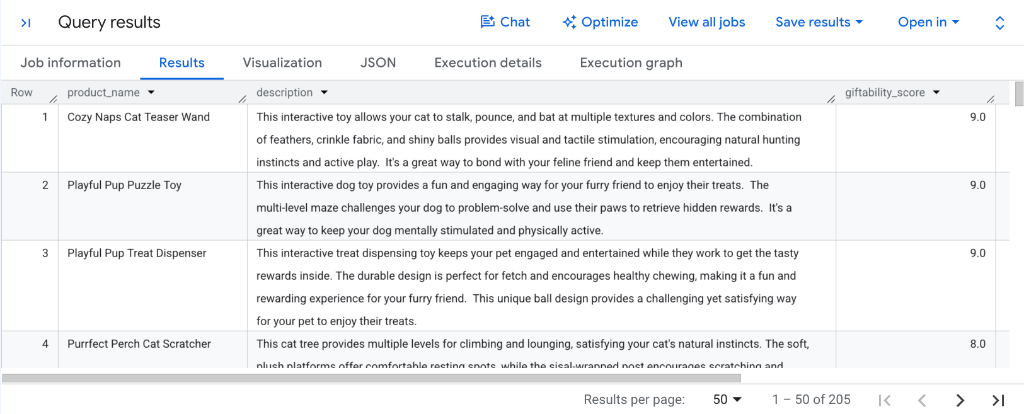
Examinez la colonne giftability_score dans les résultats de la requête :
- Jouets interactifs très attrayants : les articles attrayants tels que
Cozy Naps Cat Teaser Wand,Playful Pup Puzzle ToyetPlayful Pup Treat Dispenserreçoivent les meilleures notes (9.0). - Articles de confort et de grattage spécialisés : les articles essentiels populaires tels que le
Purrfect Perch Cat Scratcherobtiennent un score élevé de8.0. - Classement en aval exploitable : étant donné que
AI.SCOREproduit des scoresFLOAT64normalisés, vous pouvez trier immédiatement les résultats avecORDER BY giftability_score DESCou filtrer les candidats avecWHERE AI.SCORE(...) >= 8.0pour générer des guides de cadeaux automatisés.
5. Catégoriser les articles du catalogue avec AI.CLASSIFY
La fonction AI.CLASSIFY utilise Gemini pour classer les enregistrements d'entrée dans une liste discrète de catégories cibles fournies sous forme de tableau SQL.
AI.CLASSIFY accepte les entrées multimodales (texte, images, audio, vidéo) et élimine le besoin de créer, d'entraîner ou de déployer des modèles de classification personnalisés pour la gestion de la taxonomie.
Classer les jouets par espèce animale cible (étiquette unique)
Supposons que certains produits du catalogue Cymbal Pets soient étiquetés de manière générique comme "Jouets" sans spécifier l'animal cible. Vous pouvez utiliser AI.CLASSIFY pour classer chaque jouet en fonction de son nom et de sa description.
Exécutez la requête suivante dans BigQuery Studio :
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('What animal is this product for?', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "All Pets"]
  ) AS animal_type
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys"
LIMIT 20;
Afficher les résultats
Vos résultats ressembleront à ce qui suit :
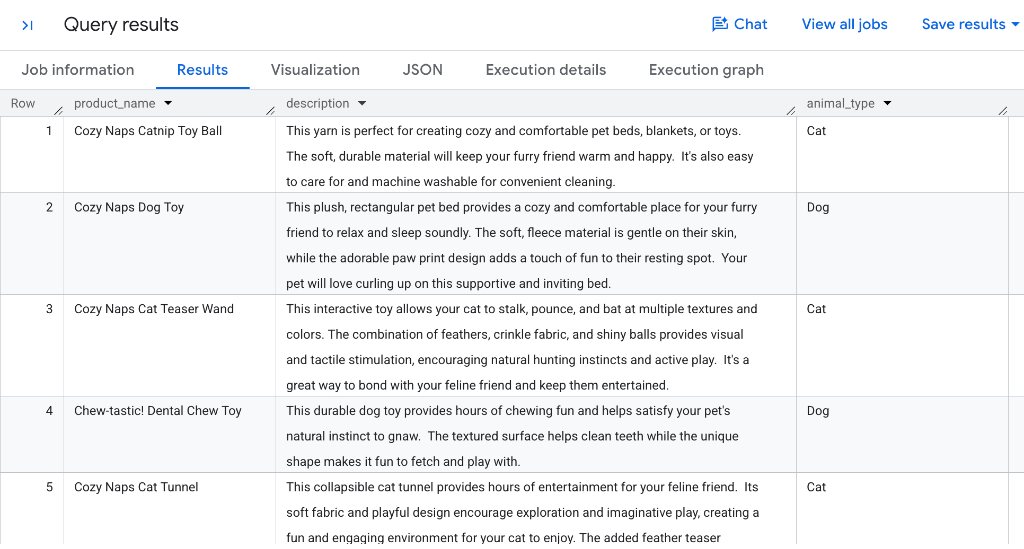
Par défaut, AI.CLASSIFY effectue une classification à étiquette unique et renvoie une STRING contenant la catégorie unique la plus pertinente de votre tableau de candidats. Notez comment Gemini mappe les balles d'herbe à chat et les plumeaux à Cat, tandis que les jouets à mâcher et les bâtons de jeu sont mappés à Dog.
Attribuer plusieurs tags avec la classification multi-étiquette
De nombreux produits d'un catalogue de vente au détail s'appliquent simultanément à plusieurs types d'animaux de compagnie (par exemple, un lit ou un tunnel en peluche adapté aux chats et aux petits animaux).
Pour attribuer plusieurs catégories à un seul enregistrement, définissez le paramètre facultatif output_mode => 'multi'. En mode multi-étiquette, AI.CLASSIFY renvoie un ARRAY contenant toutes les catégories correspondantes.
Exécutez la requête suivante dans votre onglet SQL :
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('Identify all pet types that this product is suitable for: ', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "Reptile"],
    output_mode => 'multi'
  ) AS pet_types
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys";
Vos résultats ressembleront à ce qui suit :
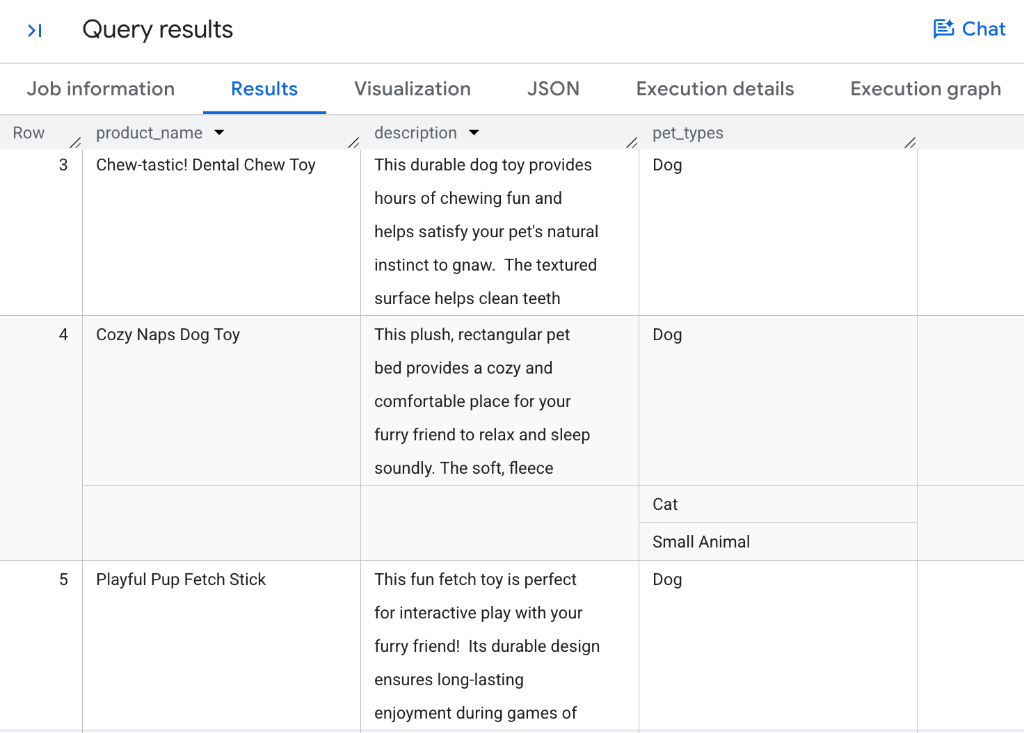
Examiner les mécanismes de classification
- Étiquette unique ou multiple : sans
output_mode,AI.CLASSIFYrenvoie uneSTRINGscalaire. La définition deoutput_mode => 'multi'renvoie unARRAYcontenant zéro, une ou plusieurs étiquettes correspondantes. - Attribution multi-catégorie : notez que les articles dédiés tels que
Chew-tastic! Dental Chew ToyetPlayful Pup Fetch Stickreçoivent[Dog], tandis que les articles de confort polyvalents tels queCozy Naps Dog Toy(un lit rectangulaire en peluche) reçoivent correctement plusieurs tags :[Dog, Cat, Small Animal]. - Correspondance sans exemple : le modèle évalue le texte et le prompt combinés par rapport au tableau
categoriesfourni sans nécessiter de modèles de ML personnalisés pré-entraînés. - Opérations de tableau SQL en aval : vous pouvez utiliser des fonctions de tableau SQL BigQuery standards telles que
WHERE 'Cat' IN UNNEST(pet_types)ouCROSS JOIN UNNEST(pet_types)pour filtrer, développer et agréger des enregistrements multi-étiquetés.
6. Filtrer les images de produits multimodales avec AI.IF
La fonction AI.IF utilise Gemini pour évaluer une condition en langage naturel et renvoie une valeur booléenne (TRUE ou FALSE).
Étant donné qu'AI.IF accepte les entrées multimodales, vous pouvez l'utiliser directement dans une clause SQL WHERE pour filtrer les fichiers image non structurés stockés dans Cloud Storage.
Filtrer les images contenant des objets spécifiques
Supposons que l'équipe de merchandising souhaite trouver toutes les images de produits du catalogue qui contiennent visuellement des aliments ou des friandises pour animaux de compagnie.
Exécutez la requête suivante dans votre onglet SQL :
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`
WHERE
  AI.IF(
    ('Does this product image contain pet food or snacks? ', OBJ.MAKE_REF(uri, 'us.conn'))
  );
Vos résultats ressembleront à ce qui suit :
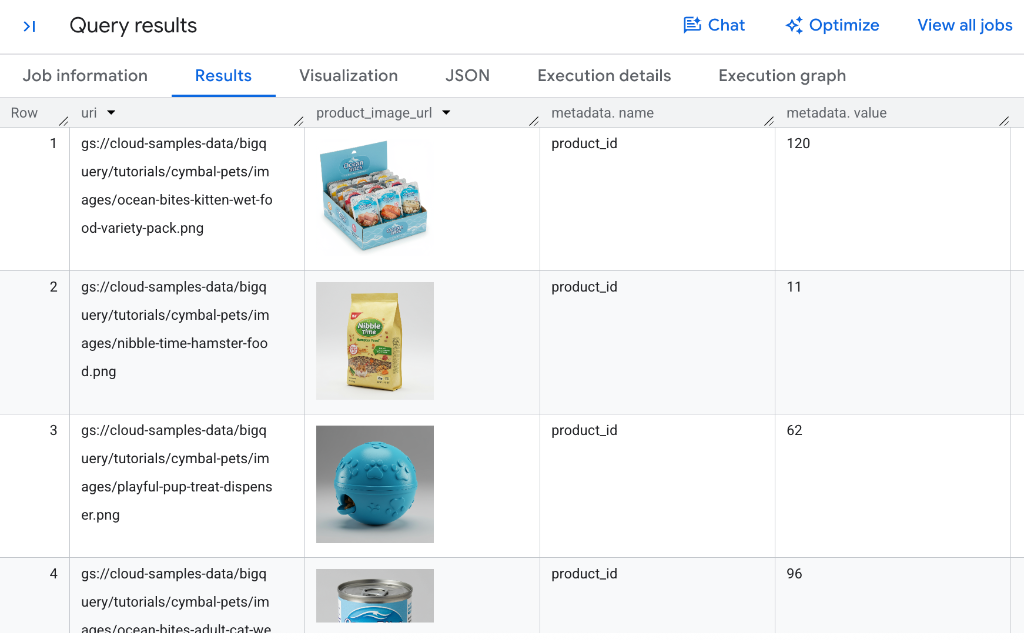
Fonctionnement du filtrage multimodal
- Références d'objet à la volée : bien que nous créions des références d'objet à la volée ici à l'aide de
OBJ.MAKE_REF(uri, 'us.conn'), vous pouvez également créer et stocker des colonnesObjectRefdirectement dans vos tables BigQuery afin qu'elles soient immédiatement prêtes à être utilisées dans l'analyse sans avoir besoin de la fonctionOBJ.MAKE_REFdans chaque requête. - Reconnaissance visuelle approfondie des objets : notez comment Gemini identifie avec précision différents formats d'emballage (tels que la boîte d'aliments humides, le sac d'aliments secs pour hamster et la boîte d'aliments pour chats) tout en reconnaissant les friandises comestibles chargées dans des jouets comme le distributeur de friandises bleu.
- Évaluation des prédicats au niveau des lignes : BigQuery évalue la condition en langage naturel par rapport à chaque référence d'image Cloud Storage directement dans la clause
WHERE. - Filtrage booléen : seuls les enregistrements pour lesquels Gemini évalue la condition comme
TRUEsont renvoyés dans l'ensemble de résultats.
7. Effectuer des jointures sémantiques entre les tables avec AI.IF
Les jointures de base de données relationnelles traditionnelles nécessitent une égalité exacte des clés (telle que products.product_id = images.product_id). Toutefois, les ensembles de données d'entreprise réels contiennent souvent des assets non structurés qui ne comportent pas de clés étrangères explicites.
Étant donné qu'AI.IF renvoie une valeur booléenne, vous pouvez la placer directement dans une clause SQL INNER JOIN ... ON pour effectuer des jointures sémantiques.
Joindre sémantiquement les descriptions de produits aux composants Image
Supposons que vous souhaitiez faire correspondre les descriptions de produits de la table products avec des fichiers image non liés dans product_images pour les produits de la marque Fluffy Buns.
Exécutez la requête suivante dans votre onglet SQL BigQuery Studio (notez que l'opération prend quelques minutes) :
SELECT
  products.product_id,
  products.product_name,
  products.description,
  products.brand,
  images.uri AS image_uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(images.uri, 'us.conn')).url AS product_image_url
FROM
  `bigquery-public-data.cymbal_pets.products` AS products
INNER JOIN
  `bigquery-public-data.cymbal_pets.product_images` AS images
ON
  AI.IF(
    ('You will be provided an image of a pet product. ',
    'Determine if the image is of the following pet toy: ',
    products.product_name,
    products.description,
    OBJ.MAKE_REF(images.uri, 'us.conn')
    )
  )
WHERE
  products.category = "Toys" AND
  products.brand = "Fluffy Buns";
Vos résultats ressembleront à ce qui suit :
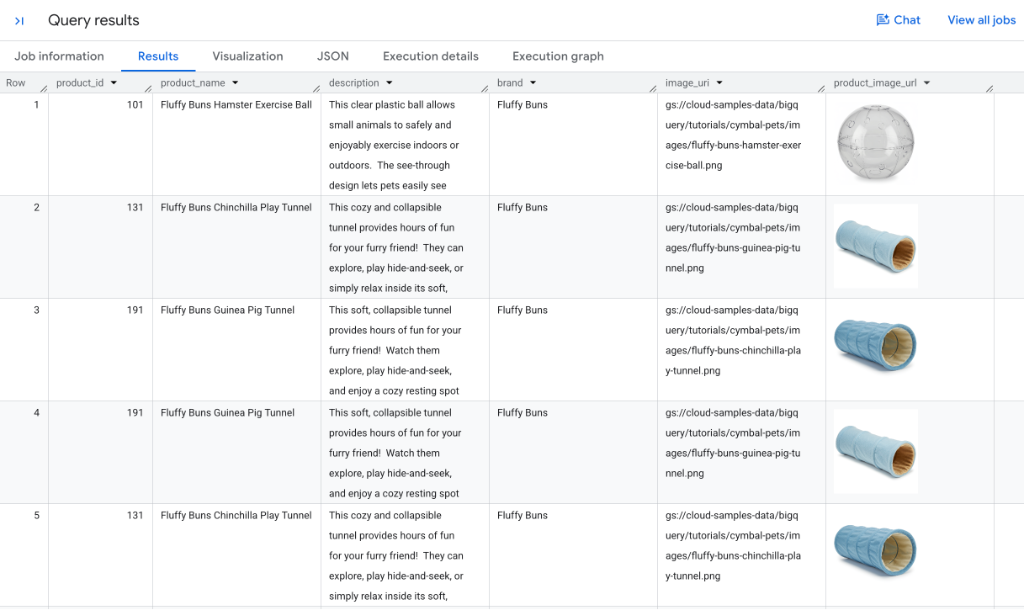
Comprendre les jointures sémantiques en SQL
- Évaluation des conditions intermodales : pour les paires d'enregistrements candidats, BigQuery envoie à la fois les métadonnées textuelles de
productset la référence d'image (OBJ.MAKE_REF(...)) à Gemini. - Correspondance visuelle précise : comme le montrent les résultats, le
Fluffy Buns Hamster Exercise Ballcorrespond à l'image de la balle en plastique transparent, tandis que leFluffy Buns Chinchilla Play Tunnelet leGuinea Pig Tunnelcorrespondent aux photos du tunnel en peluche bleu. En raison de la sémantiqueINNER JOINSQL standard, un produit peut générer plusieurs lignes dans le résultat s'il correspond à plusieurs composants Image du catalogue (par exemple, plusieurs angles de prise de vue ou des prises de vue similaires). - Affichage d'images intégrées : BigQuery Studio affiche automatiquement les URL de lecture autorisées dans la colonne
product_image_urldirectement dans la grille des résultats pour une vérification visuelle instantanée. - Résolution d'entités non structurées : cela permet de débloquer des workflows de résolution d'entités puissants dans les catalogues existants, les ensembles de données extraits et les archives multimédias sans étiquetage manuel ni clés étrangères explicites.
8. Synthétiser des insights sur plusieurs lignes avec AI.AGG
Alors que des fonctions telles que AI.SCORE, AI.CLASSIFY et AI.IF évaluent des lignes individuelles (opérations scalaires), l'analyse des données d'entreprise nécessite souvent de synthétiser des modèles sur plusieurs enregistrements.
La fonction AI.AGG est une fonction d'agrégation qui utilise des instructions en langage naturel pour résumer, regrouper ou synthétiser des insights sur des milliers ou des millions de lignes non structurées dans une réponse unifiée.
Synthétiser des résumés de catégories avec des métriques SQL traditionnelles
AI.AGG s'intègre de manière transparente aux fonctions d'agrégation et GROUP BY SQL traditionnelles. Par exemple, vous pouvez calculer des métriques traditionnelles (telles que le nombre d'articles) juste à côté d'un résumé d'IA générative décrivant ce que les produits de chaque catégorie ont en commun.
Exécutez la requête suivante dans BigQuery Studio :
SELECT
  category,
  COUNT(*) AS item_count,
  AI.AGG(
    ('Product: ', product_name, ' - Description: ', description),
    'Write a concise, one-sentence summary describing the common characteristics or purpose of the products in this category.'
  ) AS category_summary
FROM
  `bigquery-public-data.cymbal_pets.products`
GROUP BY
  category
ORDER BY
  item_count DESC;
Vos résultats ressembleront à ce qui suit :
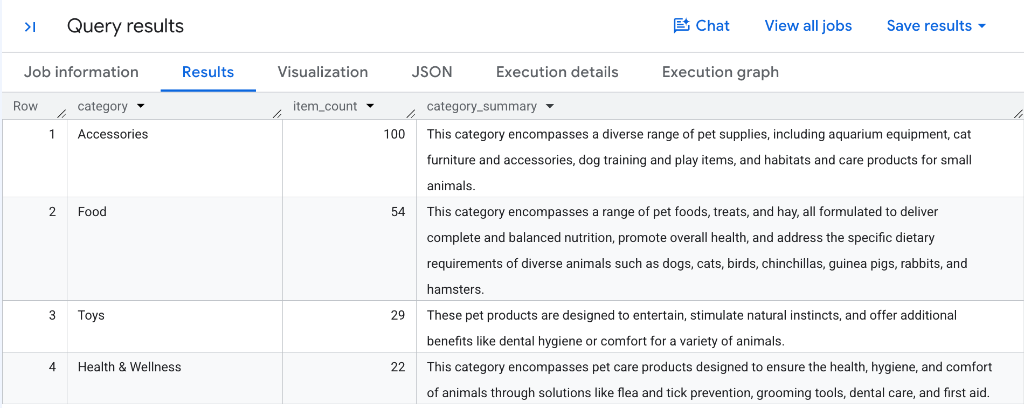
Comment AI.AGG agrège les données non structurées
- Agrégation hiérarchique : BigQuery regroupe les données de ligne par partition de catégorie, construit des fenêtres de contexte structurées et utilise Gemini pour synthétiser l'ensemble des enregistrements de produits.
- Synthèse automatisée du catalogue : notez que chaque catégorie reçoit un résumé distinct et précis, tel que
Accessoriesqui capture les habitats et les équipements d'entraînement, ouFoodqui met en évidence une nutrition équilibrée pour plusieurs espèces animales. - Rapports hybrides quantitatifs et qualitatifs : la combinaison d'agrégations standards telles que
COUNT(*)avecAI.AGGproduit des aperçus complets du catalogue dans une seule requête sans pipelines ETL personnalisés. - Partitionnement flexible : vous pouvez appliquer
AI.AGGà n'importe quelle dimension de regroupement (telle queGROUP BY brand,GROUP BY categoryou sur l'ensemble de votre table) pour générer des insights de niveau exécutif en quelques secondes.
9. Accélérer les requêtes avec le mode optimisé et les modèles proxy
Lors du traitement de grands ensembles de données contenant des milliers ou des millions de lignes, l'appel d'un LLM distant pour chaque ligne peut entraîner une latence et un coût.
Pour résoudre ce problème, BigQuery fournit un mode optimisé pour AI.IF et AI.CLASSIFY. Le mode optimisé utilise des modèles proxy et la distillation de modèle à la volée pour fournir une exécution plus de 100 fois plus rapide à un coût de jeton LLM réduit.
Fonctionnement du mode optimisé
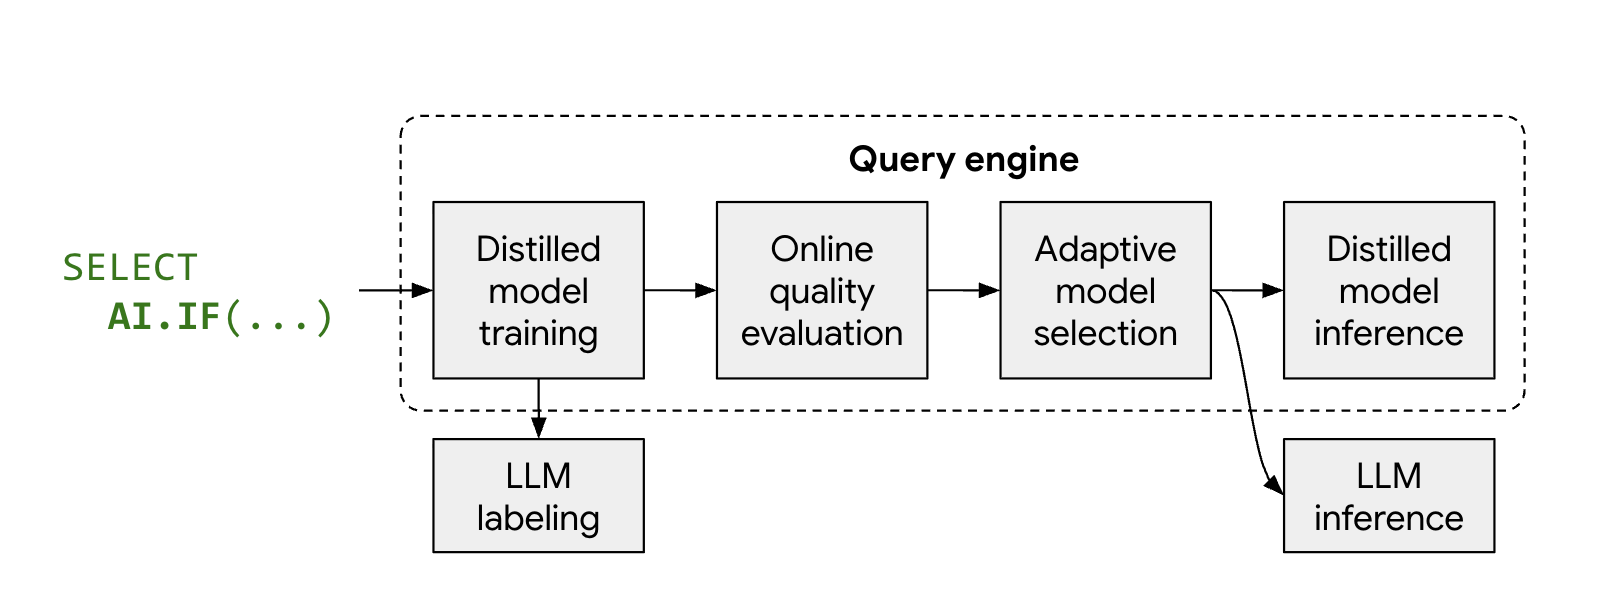
- Échantillonnage et étiquetage représentatifs : BigQuery sélectionne automatiquement un échantillon représentatif de lignes et obtient des étiquettes de Gemini.
- Entraînement de modèle distillé : BigQuery entraîne un modèle proxy ultra-léger (tel que la régression logistique) juste à temps sur le processeur à l'aide de représentations vectorielles continues de texte comme caractéristiques.
- Vérification de la qualité : BigQuery évalue la précision du modèle distillé par rapport à Gemini. S'il répond aux seuils de qualité, BigQuery le promeut pour traiter le reste de l'ensemble de données.
- Inférence locale à haute vitesse : le modèle proxy évalue les lignes restantes localement avec un coût de jeton LLM distant nul et une latence ultra-faible.
Exécuter une requête de référence sans optimisation
Étant donné que l'exemple de catalogue bigquery-public-data.cymbal_pets.products contient trop peu de lignes pour déclencher la distillation du modèle proxy, nous utiliserons l'ensemble de données public plus volumineux bigquery-public-data.bbc_news.fulltext (qui contient plus de 2 200 articles d'actualité).
Commencez par exécuter la requête standard sans optimisation pour identifier les articles d'actualité sur les catastrophes naturelles :
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body)
  );
Inspecter les détails de la tâche de référence et l'utilisation des jetons
Une fois la requête de référence terminée, inspectez les métriques d'exécution :
- Dans le volet de résultats inférieur de BigQuery Studio, sélectionnez l'onglet Informations sur la tâche.
- Faites défiler la page jusqu'aux sections Nombre de jetons d'entrée et Nombre de jetons de sortie.
Vos résultats ressembleront à ce qui suit :
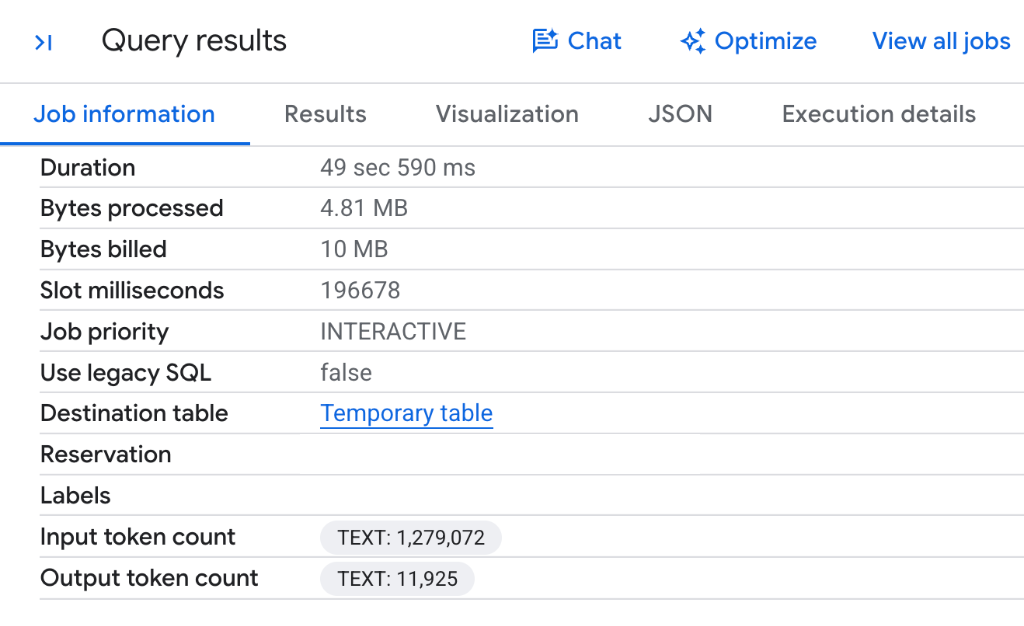
- Consommation de jetons pour l'ensemble de données complet : étant donné que BigQuery appelle le modèle Gemini distant pour chaque ligne dans les 2 225 articles d'actualité sans optimisation proxy, la requête consomme 1 279 072 jetons d'entrée et 11 925 jetons de sortie .
- Aucune section d'optimisation : notez qu'il n'y a pas d'entrée
Gen AI Function Optimizations, car l'exécution standard évalue chaque ligne individuelle par rapport au point de terminaison LLM distant.
Exécuter la requête avec le mode optimisé
Pour réduire la consommation de jetons et tirer parti de la distillation du modèle proxy, activez le mode optimisé en transmettant embeddings => AI.EMBED(...) et en définissant optimization_mode => 'MINIMIZE_COST' :
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body),
    embeddings => AI.EMBED(body, endpoint => 'text-embedding-005', task_type => 'CLASSIFICATION').result,
    optimization_mode => 'MINIMIZE_COST'
  );
Vérifier l'optimisation et observer la réduction de l'utilisation des jetons
Après avoir exécuté la requête optimisée, passez à l'onglet Informations sur la tâche de BigQuery Studio pour observer la comparaison entre l'utilisation des jetons et les métriques d'exécution :
- Dans le volet de résultats inférieur de BigQuery Studio, sélectionnez l'onglet Informations sur la tâche.
- Faites défiler la page jusqu'à la section Optimisations des fonctions d'IA générative, ainsi qu'aux nombres de jetons.
Vos résultats ressembleront à ce qui suit :
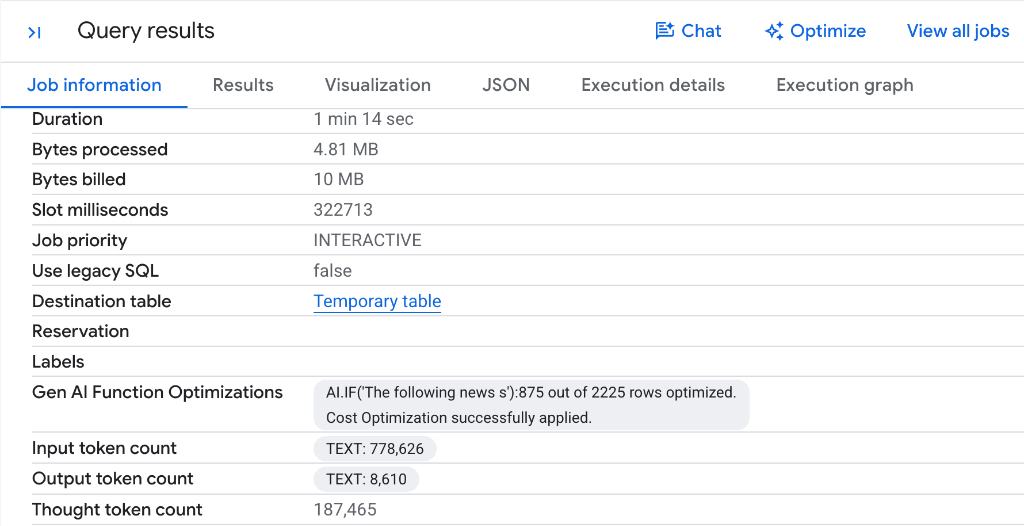
- Réduction significative des jetons : notez que le nombre de jetons d'entrée est passé de 1 279 072 jetons à 778 626 jetons , ce qui représente une économie de 500 446 jetons d'entrée (soit une réduction de près de 40 %) sur une seule exécution de requête. De même, le nombre de jetons de sortie a diminué.
- Distillation automatique du proxy : notez le libellé
AI.IF('The following news s'): 875 out of 2225 rows optimized. Cost Optimization successfully applied.BigQuery a échantillonné l'ensemble de données, étiqueté des articles représentatifs avec Gemini, distillé un classificateur proxy léger et rapide, et traité 875 lignes sur 2 225 localement sur le processeur sans appeler de points de terminaison LLM distants. - Économies directes : étant donné que les fonctions d'IA gérées de BigQuery sont facturées en fonction du volume de jetons de modèle traités, la réduction de la consommation de jetons se traduit directement par une baisse des coûts d'exécution des requêtes.
- Validation de la qualité : BigQuery a automatiquement vérifié la justesse du modèle proxy par rapport à Gemini avant de le promouvoir pour évaluer les lignes restantes, ce qui garantit le maintien de la qualité de la classification.
Réduction encore plus importante des jetons et scaling de la latence sur les tables plus volumineuses
Bien que l'économie de plus de 500 000 jetons sur 2 225 lignes soit considérable, la réduction des jetons et les gains de performances sont encore plus élevés sur les tables plus volumineuses :
- Pourquoi la réduction des jetons évolue avec la taille de l'ensemble de données : pour les requêtes exécutées dans BigQuery, les modèles proxy sont entraînés à la volée à l'aide d'un échantillon initial d'environ 1 000 lignes étiquetées par le LLM. Une fois entraîné et validé, le modèle proxy remplace les appels LLM directs sur les lignes restantes. Pour les requêtes plus volumineuses (telles que les ensembles de données types de 1 million de lignes), cela élimine les appels LLM pour la majeure partie des données, ce qui consomme jusqu'à 400 fois moins de jetons et réduit considérablement les coûts.
- Accélération substantielle de la latence : en déplaçant l'inférence du matériel LLM spécialisé vers des modèles proxy ultra-légers s'exécutant directement sur les processeurs de nœud de calcul de base de données standards (en tirant parti des représentations vectorielles continues Gemini précalculées), BigQuery réduit les durées d'exécution globales des requêtes de 30 à 100 fois.
10. Effectuer un nettoyage des ressources
Pour nettoyer les ressources créées lors de cet atelier de programmation, exécutez l'instruction suivante dans un onglet SQL BigQuery Studio afin de supprimer la connexion à la ressource Cloud :
DROP CONNECTION IF EXISTS `us.conn`;
Si vous avez créé un projet Google Cloud temporaire exclusivement pour ce tutoriel, vous pouvez également arrêter l'intégralité du projet dans le gestionnaire de ressources Cloud.
11. Félicitations
Félicitations ! Vous avez terminé l'atelier de programmation sur l'analyse sémantique dans BigQuery avec des fonctions d'IA gérées et SQL.
Vous avez maîtrisé les fonctions d'IA générative gérées de BigQuery :
AI.SCORE: classement des produits selon des critères subjectifs tels que le caractère idéal du cadeau sur une échelle de 1 à 10 à l'aide de la réécriture automatique des prompts.AI.CLASSIFY: catégorisation des articles de catalogue non structurés dans des classifications d'animaux cibles.AI.IF(filtrage multimodal) : filtrage des composants Image Cloud Storage dans les clauses SQLWHEREen fonction du contenu visuel.AI.IF(jointures sémantiques) : exécution de jointures intermodales dans les clauses SQLONpour lier des descriptions de produits textuelles à des fichiers image.AI.AGG: synthèse du texte de catalogue non structuré sur plusieurs lignes dans un résumé concis pour les cadres.- Mode optimisé et modèles proxy : accélération des requêtes et réduction des coûts de jetons à l'aide de
optimization_mode => 'MINIMIZE_COST'avec la distillation de modèle à la volée etAI.EMBED.
En savoir plus
- Présentation de l'IA générative BigQuery
- Guide des fonctions d'IA gérées de BigQuery
AI.SCOREDocumentation sur la syntaxe SQLAI.CLASSIFYDocumentation sur la syntaxe SQL- Documentation sur la syntaxe SQL
AI.IF AI.AGGDocumentation sur la syntaxe SQL- Optimiser les fonctions d'IA avec la distillation de modèle
- Blog Google Cloud : Requêtes SQL optimisées par LLM plus de 100 fois plus rapides et moins coûteuses avec des modèles proxy
- Blog Google Cloud : Présentation détaillée de la fonction AI.AGG de BigQuery