

1. היי!
בשיעור Codelab הזה נסביר איך להשתמש בחבילת פונקציות ה-AI המנוהלות של BigQuery כדי לבצע ניתוח סמנטי מתוחכם, סיווג קטגורי, סינון מולטימודאלי, צירופים סמנטיים וסיכום של כמה שורות ישירות ב-BigQuery Studio באמצעות SQL.
תשתמשו במערך הנתונים הציבורי bigquery-public-data.cymbal_pets ותיכנסו לנעליו של אנליסט נתונים ב-Cymbal Pets, קמעונאית מסחר אלקטרוני שמוכרת ציוד ואביזרים לחיות מחמד.
ניתוח סמנטי ישירות בשאילתות SQL
באופן מסורתי, כדי להחיל למידת מכונה או מודלים גדולים של שפה (LLM) על מערכי נתונים ארגוניים, היה צריך להעביר את הנתונים ממחסן הנתונים לסביבות חיצוניות של מחברות Python. היה צורך בצינורות ייעודיים להנדסת נתונים ובמומחיות בתחום למידת המכונה.
פונקציות ה-AI המנוהלות של BigQuery – כולל AI.SCORE, AI.CLASSIFY, AI.IF ו-AI.AGG – מביאות את האינטליגנציה של מודלים בסיסיים ישירות אל הנתונים שלכם. BigQuery מבצע אופטימיזציה אוטומטית של בחירת המודל ומחיל אסטרטגיות פנימיות של שכתוב הנחיות כדי לספק תוצאות מדויקות מהנחיות פשוטות בשפה טבעית.
למערכי נתונים גדולים, BigQuery מספק מצב אופטימלי, שמשתמש בזיקוק מודלים תוך כדי תנועה ובמודלים קלים של שרת proxy כדי לספק שאילתות מהירות פי 100 וזולות יותר.
מה עושים
- סקירת נתונים רב-אופניים של קמעונאות ב-BigQuery Studio באמצעות SQL.
- ביצוע דירוג סמנטי באמצעות
AI.SCOREכדי להעריך מאפייני מוצר סובייקטיביים כמו 'מתאים כמתנה'. - סיווג נתונים לא מובְנים באמצעות
AI.CLASSIFYכדי למפות מוצרים למינים של בעלי חיים שהם קהל היעד. - סינון נכסי תמונות מולטימודאליים באמצעות
AI.IFבסעיפים שלWHERE. - ביצוע צירופים סמנטיים בין טבלאות באמצעות
AI.IFבסעיפיJOIN ... ONכדי להתאים רשומות של מוצרי טקסט לקבצי תמונה חיצוניים. - סינתזה של תובנות בכמה שורות באמצעות פונקציית הצבירה
AI.AGG. - אופטימיזציה של זמן האחזור והעלות של שאילתות במערכי נתונים גדולים באמצעות
AI.IFעם מצב אופטימלי (optimization_mode => 'MINIMIZE_COST') וזיקוק של מודל פרוקסי.
מה תצטרכו
- פרויקט ב-Google Cloud שהחיוב בו מופעל.
- דפדפן אינטרנט כמו Chrome.
2. הגדרה ודרישות
לפני שמבצעים שאילתות של נתונים באמצעות פונקציות AI מנוהלות, צריך להגדיר את הפרויקט בענן ב-Google Cloud ולהפעיל את ממשקי ה-API הנדרשים.
איך יוצרים פרויקט בענן ב-Google Cloud ומפעילים ממשקי API
- במסוף Google Cloud, בדף לבחירת הפרויקט, בוחרים פרויקט או יוצרים פרויקט חדש ב-Google Cloud.
- הקפידו לוודא שהחיוב מופעל בפרויקט שלכם ב-Cloud. כך בודקים אם החיוב מופעל בפרויקט
- מפעילים את BigQuery API, BigQuery Connection API ו-Agent Platform API.
פתיחת BigQuery Studio
- בתפריט הניווט של מסוף Google Cloud, לוחצים על BigQuery כדי לפתוח את BigQuery Studio.
- בסרגל הכלים של העורך ב-BigQuery Studio, לוחצים על + SQL query כדי לפתוח כרטיסייה חדשה של שאילתת SQL. במהלך ה-codelab הזה תכתבו ותריצו את כל שאילתות ה-SQL בכרטיסיות ה-SQL האלה.
יצירת חיבור למשאב בענן ב-SQL
BigQuery פועל בתוך היקף נתונים מאובטח. כשבודקים קבצים חיצוניים מולטי-מודאליים (כמו תמונות שמאוחסנות ב-Google Cloud Storage), BigQuery משתמש בקישור למשאבים ב-Cloud כדי לגשת בצורה מאובטחת להפניות לאובייקטים בלי לחשוף את פרטי הכניסה.
מריצים את ההצהרה הבאה בכרטיסיית ה-SQL כדי ליצור חיבור בשם us.conn:
CREATE CONNECTION IF NOT EXISTS `us.conn`
OPTIONS (
  connection_type = "CLOUD_RESOURCE"
);
3. עיון במערך הנתונים Cymbal Pets
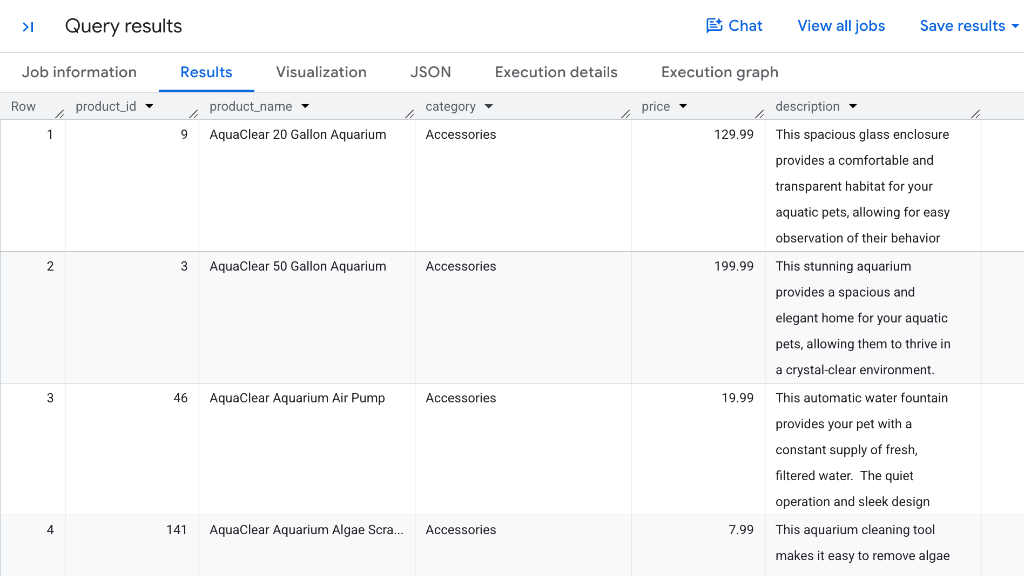
חברת Cymbal Pets מחזיקה קטלוג מוצרים עשיר במערך הנתונים הציבורי בטבלה שנקראת bigquery-public-data.cymbal_pets.products. כל רשומת מוצר מכילה מאפיינים מובְנים כמו מזהה מוצר, שם, קטגוריה קמעונאית, מחיר וטקסט תיאורי.
שליחת שאילתה לקטלוג המוצרים
פותחים כרטיסיית SQL ב-BigQuery Studio ומריצים את השאילתה הבאה כדי לבדוק את טבלת המוצרים:
SELECT
  product_id,
  product_name,
  category,
  price,
  description
FROM
  `bigquery-public-data.cymbal_pets.products`;
התוצאות ייראו בערך כך:
בדיקת תמונות מוצרים
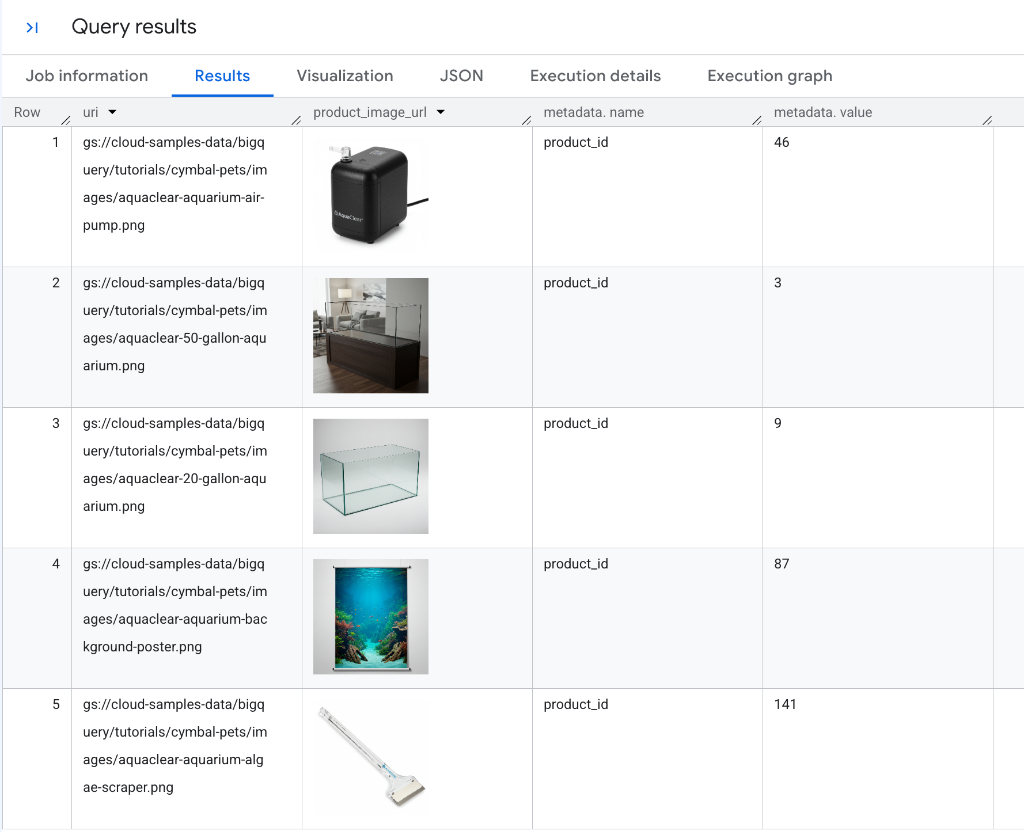
בנוסף, חברת Cymbal Pets מאחסנת הפניות לתמונות מוצרים ב-bigquery-public-data.cymbal_pets.product_images. מריצים את השאילתה הבאה כדי לראות את רשומות התמונות:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`;
התוצאות ייראו בערך כך:
בשלב הבא, תשתמשו בפונקציות מנוהלות של BigQuery כדי לנתח נתוני טקסט ותמונות ממחסן הנתונים של Cymbal Pets.
4. דירוג מוצרים לפי קריטריונים סמנטיים באמצעות AI.SCORE
הפונקציה AI.SCORE מקבלת קלט טקסט ומשתמשת במודל Gemini כדי לדרג אותו על סמך קריטריון להערכה בשפה טבעית, ומחזירה ציון מספרי FLOAT64.
אם לא מספקים קריטריון הערכה מפורש לניקוד, BigQuery מחיל באופן אוטומטי אסטרטגיות של שכתוב פרומפט כדי ליצור קריטריון אופטימלי למודל.
הערכת מוצרים לפי מידת ההתאמה שלהם כמתנה
נניח שצוות השיווק של Cymbal Pets רוצה ליצור מדריך למתנות לחגים. הם רוצים לדרג כל פריט בקטלוג לפי מידת ההתאמה שלו כמתנה לבעלי חיות מחמד, בסולם של 1 עד 10.
מריצים את השאילתה הבאה בכרטיסיית ה-SQL:
SELECT
  product_name,
  description,
  AI.SCORE(
    ('How "giftable" is this product for a pet owner? ', description,
    'Use a scale from 1-10.')
  ) AS giftability_score
FROM
  `bigquery-public-data.cymbal_pets.products`
ORDER BY
  giftability_score DESC;
הסבר על התוצאות
התוצאות ייראו בערך כך:
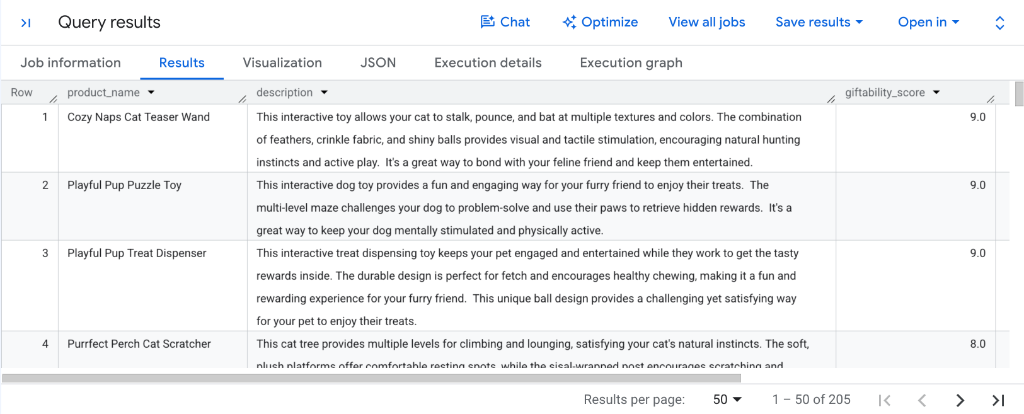
בודקים את העמודה giftability_score בתוצאות השאילתה:
- צעצועים אינטראקטיביים שמושכים תשומת לב: פריטים מעניינים כמו
Cozy Naps Cat Teaser Wand,Playful Pup Puzzle Toyו-Playful Pup Treat Dispenserמקבלים דירוגים גבוהים (9.0). - פריטים מיוחדים לגירוד ולנוחות: פריטים חיוניים פופולריים כמו
Purrfect Perch Cat Scratcherמקבלים ציון גבוה של8.0. - דירוג שניתן לפעולה בהמשך: מכיוון ש-
AI.SCOREמייצר ציונים מנורמלים שלFLOAT64, אפשר למיין את התוצאות באופן מיידי באמצעותORDER BY giftability_score DESCאו לסנן מועמדים באמצעותWHERE AI.SCORE(...) >= 8.0כדי ליצור מדריכי מתנות אוטומטיים.
5. סיווג פריטים בקטלוג באמצעות AI.CLASSIFY
הפונקציה AI.CLASSIFY משתמשת ב-Gemini כדי לסווג רשומות קלט לרשימה נפרדת של קטגוריות יעד שמוגדרות כמערך SQL.
AI.CLASSIFY תומך בקלט מולטי-מודאלי (טקסט, תמונות, אודיו, וידאו) ומבטל את הצורך בבנייה, באימון או בפריסה של מודלים מותאמים אישית לסיווג לצורך ניהול טקסונומיה.
סיווג צעצועים לפי מיני בעלי חיים מטורגטים (תווית אחת)
נניח שחלק מהמוצרים בקטלוג של Cymbal Pets מתויגים באופן כללי כ'צעצועים' בלי לציין את חיית היעד. אתם יכולים להשתמש ב-AI.CLASSIFY כדי לסווג כל צעצוע לפי השם והתיאור שלו.
מריצים את השאילתה הבאה ב-BigQuery Studio:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('What animal is this product for?', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "All Pets"]
  ) AS animal_type
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys"
LIMIT 20;
איך רואים את התוצאות
התוצאות ייראו בערך כך:
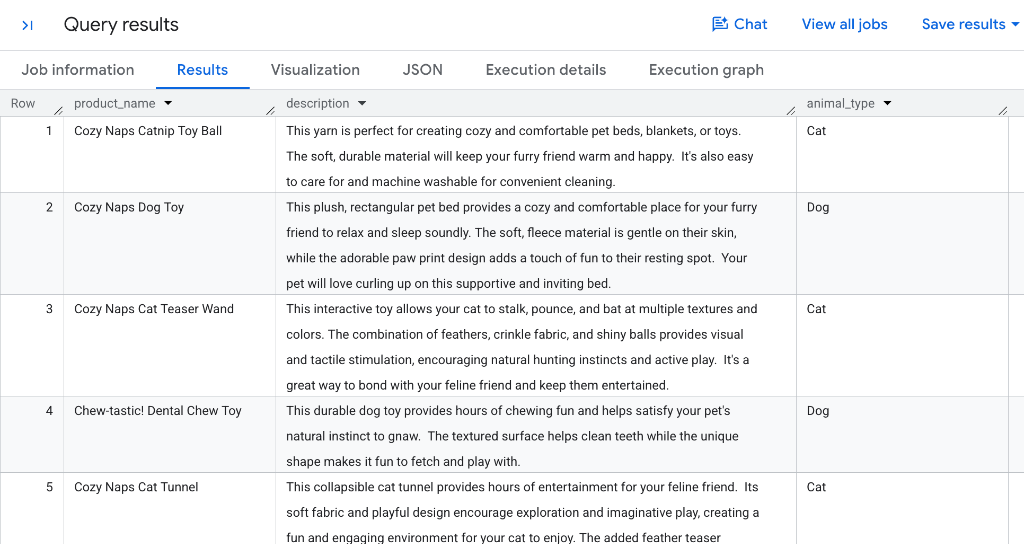
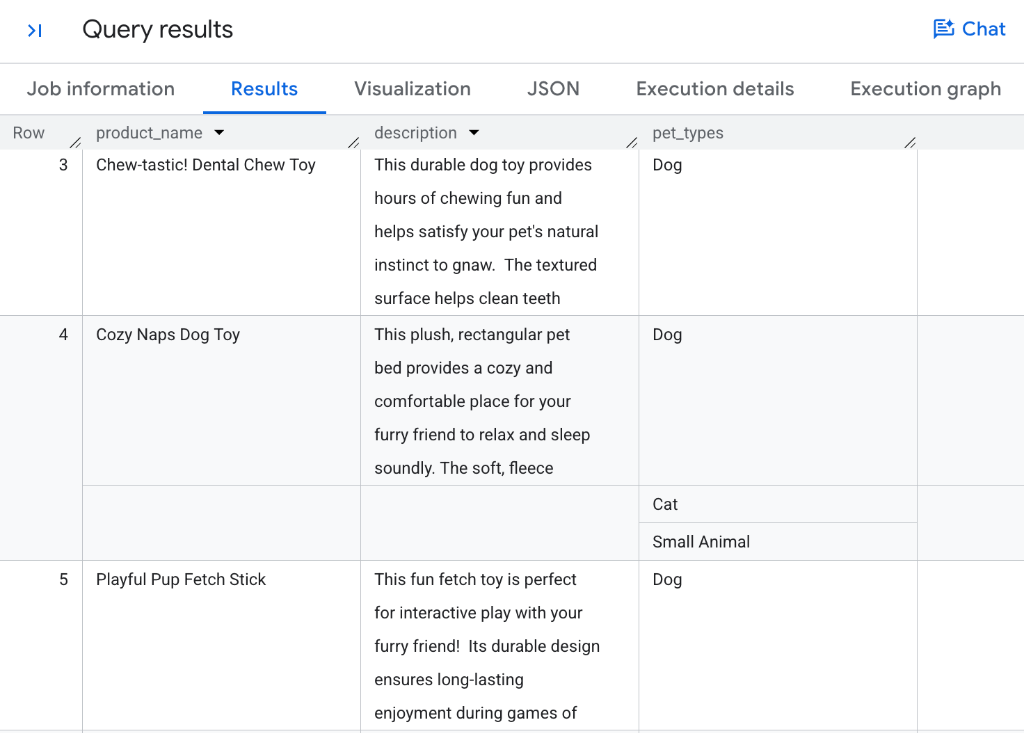
כברירת מחדל, הפונקציה AI.CLASSIFY מבצעת סיווג של תווית אחת ומחזירה STRING שמכיל את הקטגוריה הרלוונטית ביותר מתוך מערך המועמדים. שימו לב איך Gemini ממפה כדורי קטניפ וצעצועים עם נוצות ל-Cat, וצעצועי לעיסה ומקלות לזריקה ל-Dog.
הקצאת כמה תגים באמצעות סיווג רב-תוויות
מוצרים רבים בקטלוג קמעונאי מתאימים לכמה סוגים של חיות מחמד בו-זמנית (לדוגמה, מיטה או מנהרה מבד קטיפה שמתאימות גם לחתולים וגם לחיות קטנות).
כדי להקצות כמה קטגוריות לרשומה אחת, מגדירים את הפרמטר האופציונלי output_mode => 'multi'. במצב רב-תוויות, הפונקציה AI.CLASSIFY מחזירה ARRAY שמכיל את כל הקטגוריות התואמות.
מריצים את השאילתה הבאה בכרטיסיית ה-SQL:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('Identify all pet types that this product is suitable for: ', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "Reptile"],
    output_mode => 'multi'
  ) AS pet_types
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys";
התוצאות ייראו בערך כך:
בדיקת מנגנוני הסיווג
- תווית יחידה לעומת כמה תוויות: בלי
output_mode, הפונקציהAI.CLASSIFYמחזירה ערך סקלריSTRING. הגדרתoutput_mode => 'multi'מחזירהARRAYשמכיל אפס, תווית אחת או כמה תוויות תואמות. - שיוך לכמה קטגוריות: שימו לב איך פריטים ייעודיים כמו
Chew-tastic! Dental Chew Toyו-Playful Pup Fetch Stickמקבלים את התג[Dog], בעוד שפריטים רב-תכליתיים כמוCozy Naps Dog Toy(מיטה מלבנית מבד קטיפה) מקבלים בצורה נכונה כמה תגים:[Dog, Cat, Small Animal]. - התאמה ללא אימון: המודל מעריך את הטקסט המשולב ואת ההנחיה בהשוואה למערך
categoriesשסופק, בלי לדרוש מודלים מותאמים אישית של ML שעברו אימון מראש. - פעולות במערך SQL במורד הזרם: אפשר להשתמש בפונקציות מערך SQL סטנדרטיות של BigQuery כמו
WHERE 'Cat' IN UNNEST(pet_types)אוCROSS JOIN UNNEST(pet_types)כדי לסנן, לפצל ולצבור רשומות עם כמה תוויות.
6. סינון תמונות מוצרים מרובות מצבים באמצעות AI.IF
הפונקציה AI.IF משתמשת ב-Gemini כדי להעריך תנאי בשפה טבעית ומחזירה ערך בוליאני (TRUE או FALSE).
מכיוון ש-AI.IF מקבל קלט מולטי-מודאלי, אפשר להשתמש בו ישירות בפסוקית SQL WHERE כדי לסנן קובצי תמונות לא מובנים שמאוחסנים ב-Cloud Storage.
סינון תמונות שמכילות אובייקטים ספציפיים
נניח שצוות המרצ'נדייז רוצה למצוא בקטלוג את כל תמונות המוצרים שמוצגים בהן חטיפים או מזון לחיות מחמד.
מריצים את השאילתה הבאה בכרטיסיית ה-SQL:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`
WHERE
  AI.IF(
    ('Does this product image contain pet food or snacks? ', OBJ.MAKE_REF(uri, 'us.conn'))
  );
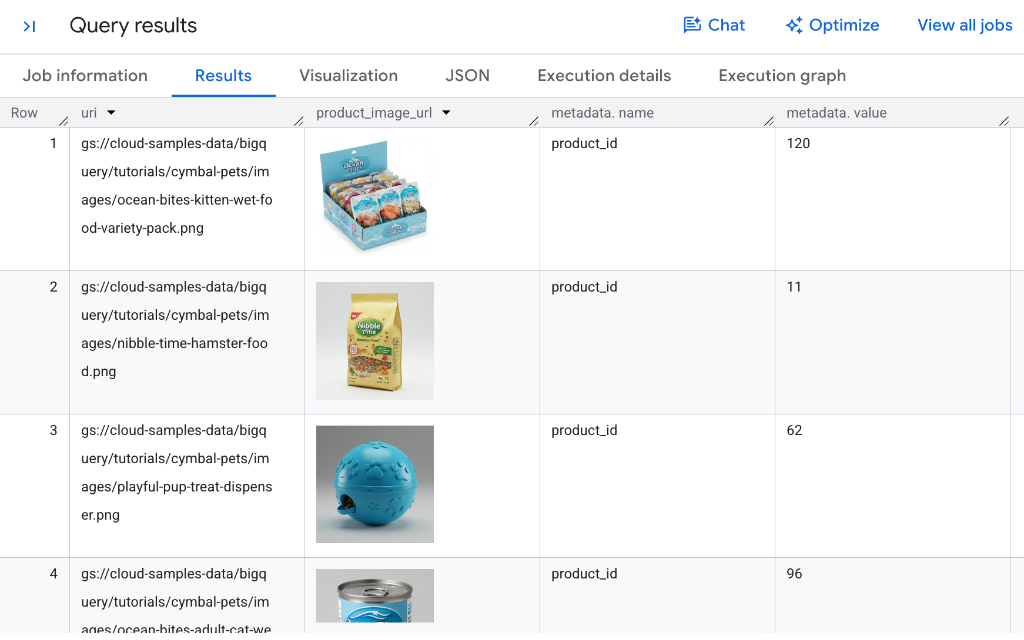
התוצאות ייראו בערך כך:
איך פועל סינון רב-אופני
- הפניות לאובייקטים תוך כדי תנועה: אנחנו יוצרים כאן הפניות לאובייקטים תוך כדי תנועה באמצעות
OBJ.MAKE_REF(uri, 'us.conn'), אבל אפשר גם ליצור ולאחסן עמודותObjectRefישירות בטבלאות BigQuery, כך שהן יהיו מוכנות לשימוש בניתוח באופן מיידי, בלי שתצטרכו להשתמש בפונקציהOBJ.MAKE_REFבכל שאילתה. - זיהוי חזותי עמוק של אובייקטים: שימו לב איך Gemini מזהה במדויק פורמטים שונים של אריזות (כמו קופסת חטיפים רטובים לכלבים, שקית של מזון יבש לאוגרים וקופסת שימורים של מזון לחתולים), וגם מזהה חטיפים אכילים שמוכנסים לתוך צעצועים כמו מתקן החטיפים הכחול.
- הערכת פרדיקט ברמת השורה: מערכת BigQuery מעריכה את התנאי בשפה טבעית מול כל הפניה לתמונה ב-Cloud Storage ישירות בסעיף
WHERE. - סינון בוליאני: רק רשומות שבהן Gemini מעריך שהתנאי הוא
TRUEמוחזרות בקבוצת התוצאות.
7. ביצוע צירופים סמנטיים בין טבלאות באמצעות AI.IF
בחיבורים מסורתיים של מסדי נתונים רלציוניים נדרשת שוויון מדויק של מפתחות (כמו products.product_id = images.product_id). עם זאת, מערכי נתונים ארגוניים בעולם האמיתי מכילים לעיתים קרובות נכסים לא מובנים שחסרים בהם מפתחות זרים מפורשים.
הפונקציה AI.IF מחזירה ערך בוליאני, ולכן אפשר להציב אותה ישירות בתוך פסקה של INNER JOIN ... ON SQL כדי לבצע שאילתות איחוד סמנטיות.
שילוב סמנטי של תיאורי מוצרים עם נכסי תמונות
נניח שאתם רוצים להתאים תיאורי מוצרים מהטבלה products לקובצי תמונות לא מקושרים ב-product_images של מוצרים שמיוצרים על ידי המותג Fluffy Buns.
מריצים את השאילתה הבאה בכרטיסיית ה-SQL ב-BigQuery Studio (שימו לב שההרצה נמשכת כמה דקות):
SELECT
  products.product_id,
  products.product_name,
  products.description,
  products.brand,
  images.uri AS image_uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(images.uri, 'us.conn')).url AS product_image_url
FROM
  `bigquery-public-data.cymbal_pets.products` AS products
INNER JOIN
  `bigquery-public-data.cymbal_pets.product_images` AS images
ON
  AI.IF(
    ('You will be provided an image of a pet product. ',
    'Determine if the image is of the following pet toy: ',
    products.product_name,
    products.description,
    OBJ.MAKE_REF(images.uri, 'us.conn')
    )
  )
WHERE
  products.category = "Toys" AND
  products.brand = "Fluffy Buns";
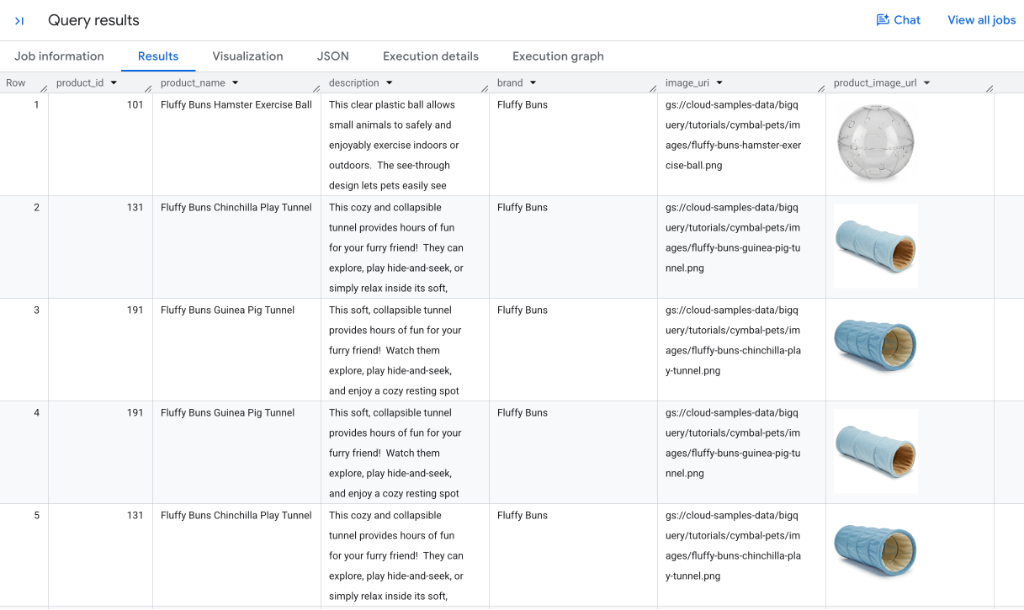
התוצאות ייראו בערך כך:
הסבר על שאילתות איחוד סמנטיות ב-SQL
- הערכת תנאים חוצה-אופנים: עבור זוגות רשומות מועמדות, BigQuery שולח ל-Gemini גם את המטא-נתונים הטקסטואליים מ-
productsוגם את הפניה לתמונה (OBJ.MAKE_REF(...)). - התאמה ויזואלית מדויקת: כפי שמוצג בתוצאות, התמונה
Fluffy Buns Hamster Exercise Ballתואמת לתמונה של הכדור מפלסטיק שקוף, ואילו התמונותFluffy Buns Chinchilla Play Tunnelו-Guinea Pig Tunnelתואמות לתמונות של מנהרת הקטיפה הכחולה. בגלל הסמנטיקה של SQL סטנדרטיINNER JOIN, מוצר יכול ליצור כמה שורות בפלט אם הוא תואם ליותר מנכס תמונות אחד בקטלוג (למשל, כמה זוויות צילום או תמונות דומות). - עיבוד תמונות בשורה: BigQuery Studio מעבד אוטומטית את כתובות ה-URL המורשות לקריאה בעמודה
product_image_urlישירות ברשת התוצאות, כדי לאפשר אימות חזותי מיידי. - זיהוי ישויות לא מובְנות: התכונה הזו מאפשרת לכם להשתמש בתהליכי עבודה מתקדמים לזיהוי ישויות בקטלוגים קודמים, במערכי נתונים שנאספו ובארכיוני מדיה, בלי להוסיף תוויות ידנית או להשתמש במפתחות זרים מפורשים.
8. סיכום תובנות בשורות באמצעות AI.AGG
פונקציות כמו AI.SCORE, AI.CLASSIFY ו-AI.IF מעריכות שורות בודדות (פעולות סקלריות), אבל כדי לנתח נתונים של ארגונים צריך לעיתים קרובות לסנתז דפוסים בכמה רשומות.
הפונקציה AI.AGG היא פונקציית צבירה שמשתמשת בהוראות בשפה טבעית כדי לסכם, לקבץ או לסנתז תובנות על פני אלפי או מיליוני שורות לא מובנות לתשובה מאוחדת.
סיכומים של קטגוריות לצד מדדי SQL מסורתיים
AI.AGG משתלבת בצורה חלקה עם SQL מסורתי GROUP BY ועם פונקציות מצטברות. לדוגמה, אתם יכולים לחשב מדדים מסורתיים (כמו מספר הפריטים) לצד סיכום AI שנוצר על ידי AI גנרטיבי שמתאר מה משותף למוצרים בכל קטגוריה.
מריצים את השאילתה הבאה ב-BigQuery Studio:
SELECT
  category,
  COUNT(*) AS item_count,
  AI.AGG(
    ('Product: ', product_name, ' - Description: ', description),
    'Write a concise, one-sentence summary describing the common characteristics or purpose of the products in this category.'
  ) AS category_summary
FROM
  `bigquery-public-data.cymbal_pets.products`
GROUP BY
  category
ORDER BY
  item_count DESC;
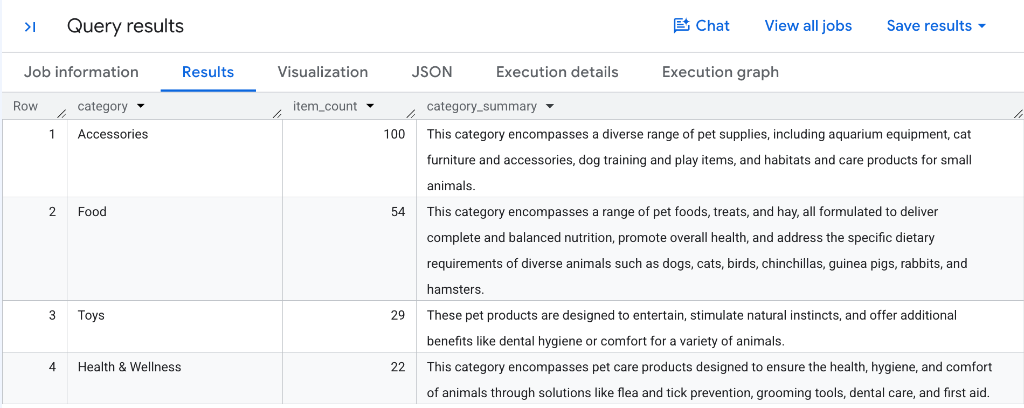
התוצאות ייראו בערך כך:
איך AI.AGG מסכם נתונים לא מובנים
- צבירה היררכית: BigQuery מקבץ נתונים בשורות לפי מחיצה של קטגוריה, בונה חלונות הקשר מובנים ומשתמש ב-Gemini כדי לסנתז את כל אוסף רשומות המוצרים.
- סיכום אוטומטי של קטלוג: שימו לב איך כל קטגוריה מקבלת סיכום מדויק ושונה, כמו
Accessoriesתיאור של בתי גידול וציוד לאימון, אוFoodהדגשה של תזונה מאוזנת בקרב מינים שונים של בעלי חיים. - דיווח היברידי כמותי ואיכותי: שילוב של צבירות רגילות כמו
COUNT(*)עםAI.AGGיוצר סקירות מקיפות של הקטלוג בשאילתה אחת, בלי צינורות ETL מותאמים אישית. - חלוקה גמישה למחיצות: אפשר להחיל את
AI.AGGעל כל ממד קיבוץ (כמוGROUP BY brand,GROUP BY categoryאו על הטבלה כולה) כדי להפיק תובנות ברמת ההנהלה תוך שניות.
9. האצת שאילתות באמצעות מצב אופטימלי ומודלים של שרת proxy
כשמעבדים מערכי נתונים גדולים שמכילים אלפים או מיליוני שורות, הפעלה של מודל שפה גדול מרוחק לכל שורה בנפרד עלולה לגרום לזמן אחזור ולעלויות.
כדי לפתור את הבעיה הזו, ב-BigQuery יש מצב אופטימלי ל-AI.IF ול-AI.CLASSIFY. במצב האופטימלי נעשה שימוש במודלים של שרת proxy וזיקוק מודלים תוך כדי תנועה כדי לספק ביצוע מהיר פי 100 בעלות נמוכה יותר של טוקנים ב-LLM.
איך פועל מצב אופטימלי

- דגימה ותיוג מייצגים: BigQuery בוחר באופן אוטומטי מדגם מייצג של שורות ומקבל תוויות מ-Gemini.
- אימון מודל מזוקק: מערכת BigQuery מאמנת מודל proxy קל במיוחד (כמו רגרסיה לוגיסטית) בזמן אמת במעבד, באמצעות הטמעות טקסט כתכונות.
- אימות האיכות: מערכת BigQuery מעריכה את רמת הדיוק של המודל המזוקק בהשוואה ל-Gemini. אם הוא עומד בסף האיכות, מערכת BigQuery מקדמת אותו כדי לעבד את שאר מערך הנתונים.
- הסקת מסקנות מקומית במהירות גבוהה: מודל ה-proxy מעריך את השורות שנותרו באופן מקומי, ללא עלות טוקנים של LLM מרחוק ועם חביון נמוך במיוחד.
הפעלת שאילתת בסיס ללא אופטימיזציה
קטלוג הדגימות bigquery-public-data.cymbal_pets.products מכיל מעט מדי שורות כדי להפעיל זיקוק של מודל פרוקסי, ולכן נשתמש במערך הנתונים הציבורי הגדול יותר bigquery-public-data.bbc_news.fulltext (שמכיל יותר מ-2,200 מאמרי חדשות).
קודם מריצים את השאילתה הרגילה בלי אופטימיזציה כדי לזהות כתבות חדשותיות על אסונות טבע:
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body)
  );
בדיקת פרטי המשימה הראשונית ושימוש באסימונים
אחרי שהשאילתה של נתוני הבסיס מסתיימת, בודקים את מדדי הביצוע:
- בחלונית התוצאות התחתונה של BigQuery Studio, בוחרים בכרטיסייה Job information (פרטי המשימה).
- גוללים למטה לקטעים כמות טוקנים של קלט וכמות טוקנים של פלט.
התוצאות ייראו בערך כך:
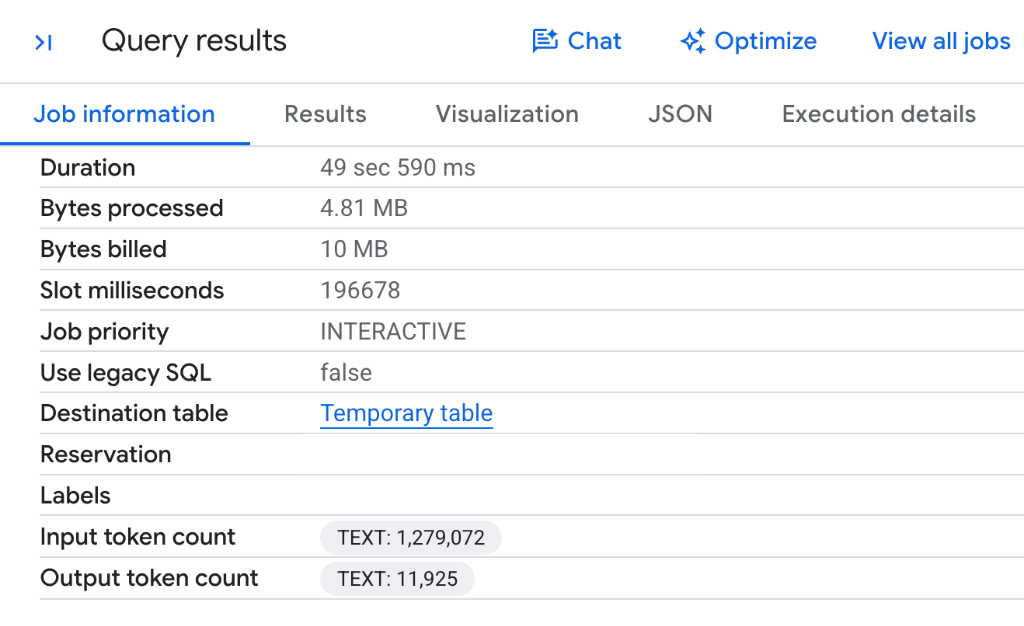
- צריכת טוקנים של מערך נתונים מלא: מכיוון ש-BigQuery מפעיל את מודל Gemini המרוחק לכל שורה בכל 2,225 כתבות החדשות ללא אופטימיזציה של פרוקסי, השאילתה צורכת 1,279,072 טוקנים של קלט ו-11,925 טוקנים של פלט .
- No optimization section: Notice that there is no
Gen AI Function Optimizationsentry because standard execution evaluates every individual row against the remote LLM endpoint.
הפעלת השאילתה במצב אופטימיזציה
כדי לצמצם את צריכת הטוקנים ולהשתמש בזיקוק של מודל proxy, צריך להפעיל את המצב המותאם על ידי העברת embeddings => AI.EMBED(...) והגדרת optimization_mode => 'MINIMIZE_COST':
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body),
    embeddings => AI.EMBED(body, endpoint => 'text-embedding-005', task_type => 'CLASSIFICATION').result,
    optimization_mode => 'MINIMIZE_COST'
  );
אימות האופטימיזציה ובדיקה של השימוש המופחת בטוקנים
אחרי שמריצים את השאילתה שעברה אופטימיזציה, עוברים לכרטיסייה Job information (פרטי המשימה) ב-BigQuery Studio כדי לראות את ההשוואה בין השימוש באסימונים לבין מדדי הביצוע:
- בחלונית התוצאות התחתונה של BigQuery Studio, בוחרים בכרטיסייה Job information (פרטי המשימה).
- גוללים לקטע Gen AI Function Optimizations (אופטימיזציות של פונקציות AI גנרטיבי) וגם לספירת הטוקנים.
התוצאות ייראו בערך כך:
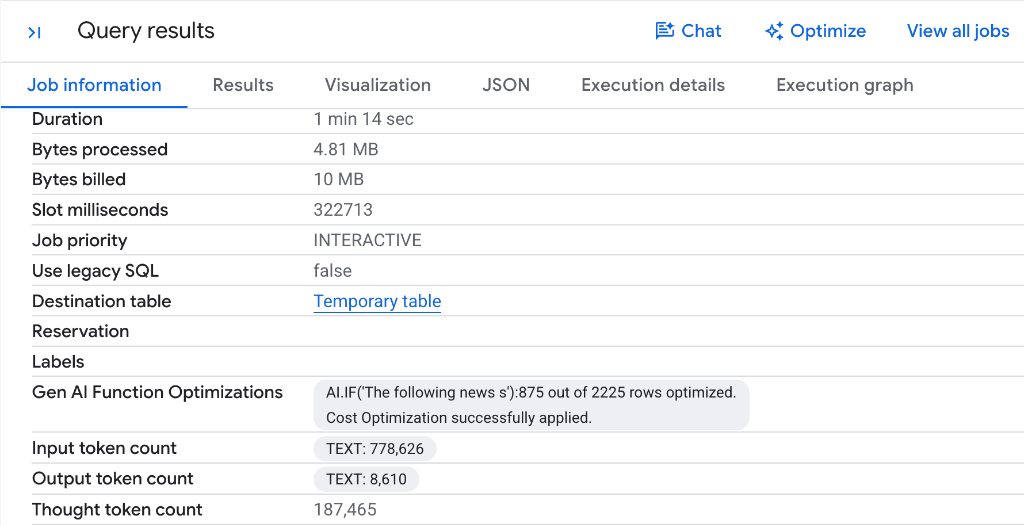
- צמצום משמעותי של הטוקנים: שימו לב איך כמות הטוקנים של הקלט ירד מ-1,279,072 טוקנים ל-778,626 טוקנים – חיסכון של 500,446 טוקנים של קלט (כמעט 40% פחות) בהרצת שאילתה אחת! באופן דומה, הייתה ירידה בטוקנים של הפלט.
- זיקוק אוטומטי של פרוקסי: שימו לב לתווית
AI.IF('The following news s'): 875 out of 2225 rows optimized. Cost Optimization successfully applied.BigQuery דגם את מערך הנתונים, תייג מאמרים מייצגים באמצעות Gemini, זיקק מסווג פרוקסי מהיר וקל משקל, ועיבד 875 מתוך 2,225 שורות באופן מקומי ב-CPU בלי להפעיל נקודות קצה מרוחקות של LLM. - חיסכון ישיר בעלויות: הפונקציות המנוהלות של AI ב-BigQuery מחויבות על סמך נפח הטוקנים של המודל שעובר עיבוד, ולכן צמצום צריכת הטוקנים מוביל ישירות להפחתת עלויות הביצוע של השאילתות.
- אימות האיכות: מערכת BigQuery אימתה אוטומטית את הדיוק של מודל ה-proxy בהשוואה ל-Gemini לפני שהעלתה אותו לרמה גבוהה יותר כדי להעריך את השורות שנותרו, וכך הבטיחה שרמת האיכות של הסיווג נשמרת.
צמצום גדול עוד יותר של הטוקנים ושינוי קנה מידה של זמן האחזור בטבלאות גדולות יותר
החיסכון של יותר מ-500,000 טוקנים ב-2,225 שורות הוא משמעותי, אבל החיסכון בטוקנים והשיפור בביצועים גבוהים עוד יותר בטבלאות גדולות יותר:
- למה צמצום הטוקנים גדל עם גודל מערך הנתונים: בשביל שאילתות שמופעלות ב-BigQuery, מודלים של פרוקסי מאומנים תוך כדי תנועה באמצעות מדגם ראשוני של כ-1,000 שורות שתויגו על ידי מודל שפה גדול (LLM). אחרי שהמודל הפרוקסי מאומן ומאומת, הוא מחליף את הקריאות הישירות ל-LLM בשורות הנותרות. בשאילתות גדולות יותר (כמו מערכי נתונים טיפוסיים של מיליון שורות), השיטה הזו מבטלת את ההפעלות של LLM עבור רוב הנתונים, צורכת עד פי 400 פחות טוקנים ומפחיתה משמעותית את העלויות.
- האצת זמן האחזור באופן משמעותי: על ידי העברת ההסקה מחומרה ייעודית של מודלים גדולים של שפה (LLM) למודלים קלים במיוחד של שרת proxy שפועלים ישירות במעבדי עובדים של מסדי נתונים רגילים (תוך שימוש בהטמעות של Gemini שחושבו מראש), BigQuery מקצר את זמני הריצה הכוללים של השאילתות פי 30 עד פי 100.
10. פינוי משאבים
כדי למחוק את המשאבים שנוצרו במהלך ה-Codelab הזה, מריצים את ההצהרה הבאה בכרטיסיית SQL ב-BigQuery Studio כדי להסיר את הקישור למשאבים ב-Cloud:
DROP CONNECTION IF EXISTS `us.conn`;
לחלופין, אם יצרתם פרויקט זמני ב-Google Cloud רק בשביל המדריך הזה, אתם יכולים להשבית את הפרויקט כולו במנהל המשאבים של Cloud.
11. מזל טוב
מעולה! סיימתם בהצלחה את שיעור ה-Codelab בנושא ניתוח סמנטי ב-BigQuery באמצעות פונקציות AI מנוהלות ו-SQL.
התמחתם בפונקציות מבוססות-AI גנרטיבי המנוהלות על ידי BigQuery:
-
AI.SCORE: דירוג מוצרים לפי קריטריונים סובייקטיביים כמו התאמה כמתנה בסולם של 1 עד 10 באמצעות שכתוב אוטומטי של הנחיה. -
AI.CLASSIFY: סיווג פריטים לא מובנים בקטלוג לסיווגים של בעלי חיים. -
AI.IF(Multimodal Filtering): סינון נכסי תמונות ב-Cloud Storage בסעיפי SQLWHEREעל סמך תוכן חזותי. -
AI.IF(Semantic Joins): בוצעו צירופים חוצי-אופנים בסעיפי SQLONכדי לקשר בין תיאורי מוצרים טקסטואליים לבין קובצי תמונות. -
AI.AGG: סיכום תמציתי של טקסט לא מובנה מקטלוג רב-שורה. - מצב אופטימלי ומודלים של Proxy: שאילתות מהירות יותר ועלויות טוקנים נמוכות יותר באמצעות
optimization_mode => 'MINIMIZE_COST'עם זיקוק מודלים תוך כדי תנועה ו-AI.EMBED.
מידע נוסף
- סקירת AI גנרטיבי ב-BigQuery
- מדריך לפונקציות AI מנוהלות ב-BigQuery
AI.SCOREמסמכי תחביר SQLAI.CLASSIFYמסמכי תחביר SQLAI.IFמסמכי תחביר SQLAI.AGGמסמכי תחביר SQL- אופטימיזציה של פונקציות AI באמצעות זיקוק מודלים
- בלוג Google Cloud: שאילתות SQL שמבוססות על מודלים של LLM מהירות פי 100 וזולות יותר עם מודלים של proxy
- בלוג Google Cloud: מידע מעמיק על הפונקציה AI.AGG ב-BigQuery