

1. आपका स्वागत है
इस कोडलैब में, आपको BigQuery के मैनेज किए गए एआई फ़ंक्शन के सुइट का इस्तेमाल करके, बेहतर सेमैंटिक विश्लेषण, कैटगरी के हिसाब से क्लासिफ़िकेशन, मल्टीमॉडल फ़िल्टरिंग, सेमैंटिक जॉइन, और एक से ज़्यादा लाइनों की खास जानकारी पाने का तरीका बताया जाएगा. इसके लिए, आपको सीधे BigQuery Studio में एसक्यूएल का इस्तेमाल करना होगा.
पब्लिक डेटासेट bigquery-public-data.cymbal_pets का इस्तेमाल करके, आपको Cymbal Pets में डेटा ऐनलिसिस की भूमिका निभानी होगी. यह कंपनी, पालतू जानवरों के सामान और ऐक्सेसरीज़ की ई-कॉमर्स रिटेलर है.
एसक्यूएल क्वेरी में सीधे सेमैंटिक विश्लेषण करना
पहले, एंटरप्राइज़ डेटासेट पर मशीन लर्निंग या लार्ज लैंग्वेज मॉडल (एलएलएम) लागू करने के लिए, डेटा वेयरहाउस से डेटा को बाहरी Python नोटबुक एनवायरमेंट में ले जाना पड़ता था. इसके लिए, डेटा इंजीनियरिंग की खास पाइपलाइन और एमएल की विशेषज्ञता की ज़रूरत होती थी.
BigQuery के मैनेज किए गए एआई फ़ंक्शन—जैसे कि AI.SCORE, AI.CLASSIFY, AI.IF, और AI.AGG—आपके डेटा में सीधे फ़ाउंडेशन मॉडल की इंटेलिजेंस लाते हैं. BigQuery, मॉडल के चुनाव को अपने-आप ऑप्टिमाइज़ करता है. साथ ही, आसान सामान्य भाषा वाले प्रॉम्प्ट से सटीक नतीजे देने के लिए, इंटरनल प्रॉम्प्ट-रीराइटिंग की रणनीतियां लागू करता है.
ज़्यादा वॉल्यूम वाले डेटासेट के लिए, BigQuery ऑप्टिमाइज़ किए गए मोड की सुविधा देता है. इसमें, ऑन-द-फ़्लाई मॉडल डिस्टिलेशन और हल्के प्रॉक्सी मॉडल का इस्तेमाल किया जाता है. इससे क्वेरी 100 गुना ज़्यादा तेज़ी से और कम लागत में की जा सकती हैं.
इस कोडलैब में आपको ये काम करने होंगे
- एसक्यूएल का इस्तेमाल करके, BigQuery Studio में मल्टीमॉडल रीटेल डेटा एक्सप्लोर करना.
- सेमैंटिक रैंकिंग करना के लिए,
AI.SCOREका इस्तेमाल करके "गिफ़्ट के तौर पर देने की संभावना" जैसे प्रॉडक्ट के राय पर आधारित एट्रिब्यूट का आकलन करना. - टारगेट एनिमल स्पीशीज़ के हिसाब से प्रॉडक्ट को मैप करने के लिए,
AI.CLASSIFYका इस्तेमाल करकेअनस्ट्रक्चर्ड डेटा को कैटगरी में बांटना. - मल्टीमॉडल इमेज ऐसेट को फ़िल्टर करना,
WHEREक्लॉज़ मेंAI.IFका इस्तेमाल करके. - टेक्स्ट वाले प्रॉडक्ट रिकॉर्ड को बाहरी इमेज फ़ाइलों से मैच करने के लिए,
JOIN ... ONक्लॉज़ मेंAI.IFका इस्तेमाल करके, टेबल में सेमैंटिक जॉइन करना. - एक से ज़्यादा लाइनों की अहम जानकारी को सिंथेसाइज़ करना
AI.AGGएग्रीगेट फ़ंक्शन का इस्तेमाल करके. - ऑप्टिमाइज़ किए गए मोड (
optimization_mode => 'MINIMIZE_COST') और प्रॉक्सी मॉडल डिस्टिलेशन के साथAI.IFका इस्तेमाल करके, बड़े डेटासेट पर क्वेरी की लेटेन्सी और लागत को ऑप्टिमाइज़ करना.
इस कोडलैब के लिए, आपको इनकी ज़रूरत होगी
- बिलिंग की सुविधा वाला Google क्लाउड प्रोजेक्ट.
- Chrome जैसे वेब ब्राउज़र.
2. सेटअप और ज़रूरी शर्तें
मैनेज किए गए एआई फ़ंक्शन की मदद से डेटा की क्वेरी करने से पहले, आपको अपना Google Cloud प्रोजेक्ट कॉन्फ़िगर करना होगा और ज़रूरी एपीआई चालू करने होंगे.
Google Cloud प्रोजेक्ट बनाना और एपीआई चालू करना
- Google Cloud Console में, प्रोजेक्ट सिलेक्टर पेज पर जाकर, कोई Google Cloud प्रोजेक्ट चुनें या बनाएं.
- पक्का करें कि आपके Cloud प्रोजेक्ट के लिए बिलिंग चालू है. किसी प्रोजेक्ट के लिए बिलिंग चालू है या नहीं, यह देखने का तरीका जानें.
- BigQuery, BigQuery Connection, और Agent Platform API चालू करें.
BigQuery Studio खोलना
- Google Cloud Console के नेविगेशन मेन्यू में, BigQuery पर क्लिक करके BigQuery Studio खोलें.
- BigQuery Studio के एडिटर टूलबार में, + SQL क्वेरी पर क्लिक करके, एक नया एसक्यूएल क्वेरी टैब खोलें. इस कोडलैब के दौरान, आपको इन एसक्यूएल टैब में सभी एसक्यूएल क्वेरी लिखनी और चलानी होंगी.
एसक्यूएल में Cloud Resource Connection बनाना
BigQuery, सुरक्षित डेटा पेरीमीटर में काम करता है. बाहरी मल्टीमॉडल फ़ाइलों (जैसे, Google Cloud Storage में सेव की गई इमेज) की जांच करते समय, BigQuery, Cloud Resource Connection का इस्तेमाल करके, क्रेडेंशियल दिखाए बिना ऑब्जेक्ट रेफ़रंस को सुरक्षित तरीके से ऐक्सेस करता है.
us.conn नाम का कनेक्शन बनाने के लिए, अपने एसक्यूएल टैब में यह स्टेटमेंट चलाएं:
CREATE CONNECTION IF NOT EXISTS `us.conn`
OPTIONS (
  connection_type = "CLOUD_RESOURCE"
);
3. Cymbal Pets के डेटासेट के बारे में जानकारी पाना
Cymbal Pets, पब्लिक डेटासेट में प्रॉडक्ट का एक बड़ा कैटलॉग रखता है. यह कैटलॉग, bigquery-public-data.cymbal_pets.products नाम की टेबल में मौजूद है. हर प्रॉडक्ट रिकॉर्ड में, स्ट्रक्चर्ड एट्रिब्यूट शामिल होते हैं. जैसे, प्रॉडक्ट आईडी, टाइटल, रीटेल कैटगरी, कीमत, और ब्यौरा.
प्रॉडक्ट कैटलॉग की क्वेरी करना
BigQuery Studio में कोई एसक्यूएल टैब खोलें और प्रॉडक्ट की टेबल की जांच करने के लिए, यह क्वेरी चलाएं:
SELECT
  product_id,
  product_name,
  category,
  price,
  description
FROM
  `bigquery-public-data.cymbal_pets.products`;
आपको नतीजे इस तरह दिखेंगे:
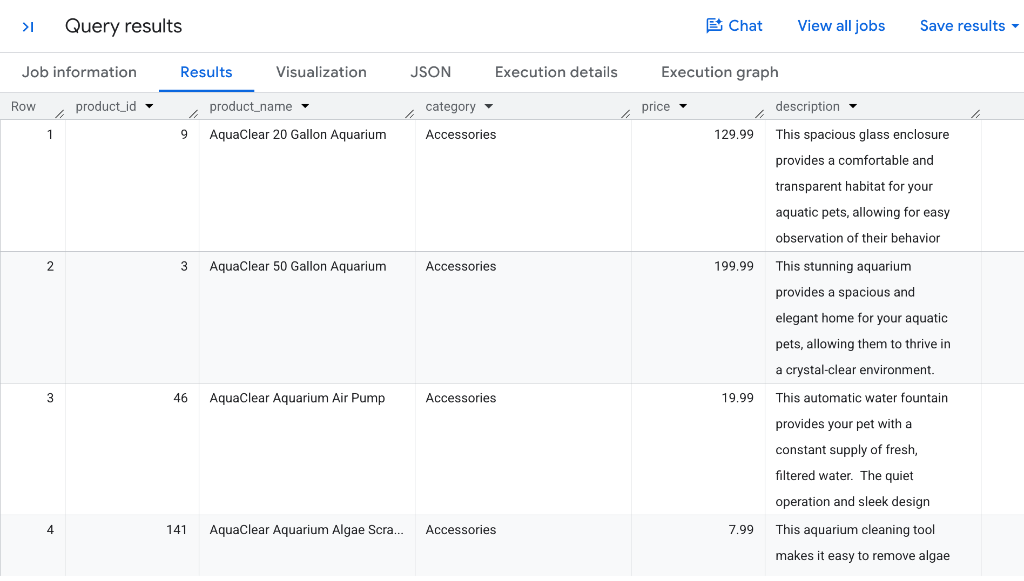
प्रॉडक्ट की इमेज की जांच करना
Cymbal Pets, प्रॉडक्ट की इमेज के रेफ़रंस को bigquery-public-data.cymbal_pets.product_images में भी सेव करता है. इमेज के रिकॉर्ड देखने के लिए, यह क्वेरी चलाएं:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`;
आपको नतीजे इस तरह दिखेंगे:
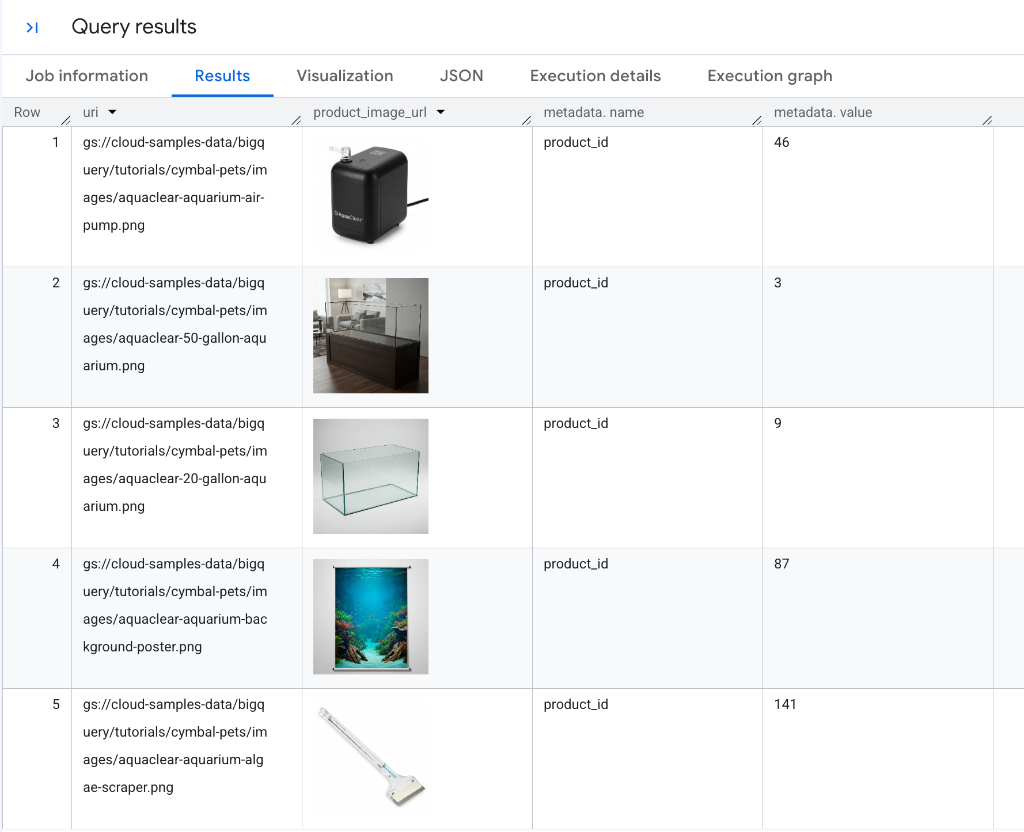
इसके बाद, आपको Cymbal Pets के डेटा वेयरहाउस से टेक्स्ट और इमेज, दोनों तरह के डेटा का विश्लेषण करने के लिए, BigQuery के मैनेज किए गए फ़ंक्शन का इस्तेमाल करना होगा.
4. AI.SCORE की मदद से, सेमैंटिक शर्तों के आधार पर प्रॉडक्ट की रैंकिंग करना
The AI.SCORE फ़ंक्शन, टेक्स्ट इनपुट स्वीकार करता है. साथ ही, Gemini मॉडल का इस्तेमाल करके, सामान्य भाषा वाले स्कोरिंग रूब्रिक के आधार पर उन्हें रेटिंग देता है. इससे, संख्या वाला FLOAT64 स्कोर मिलता है.
अगर आपने स्कोरिंग रूब्रिक साफ़ तौर पर नहीं दिया है, तो BigQuery, मॉडल के लिए ऑप्टिमाइज़ किया गया रूब्रिक जनरेट करने के लिए, प्रॉम्प्ट-रीराइटिंग की रणनीतियां अपने-आप लागू करता है.
"गिफ़्ट के तौर पर देने की संभावना" के आधार पर प्रॉडक्ट को स्कोर करना
मान लीजिए कि Cymbal Pets की मार्केटिंग टीम, छुट्टियों के लिए गिफ़्ट गाइड बनाना चाहती है. उन्हें कैटलॉग में मौजूद हर आइटम की रैंकिंग करनी है. यह रैंकिंग, इस आधार पर की जाएगी कि वह आइटम, पालतू जानवर के मालिक के लिए गिफ़्ट के तौर पर कितना सही है. इसके लिए, 1 से 10 तक का स्केल इस्तेमाल किया जाएगा.
अपने एसक्यूएल टैब में यह क्वेरी चलाएं:
SELECT
  product_name,
  description,
  AI.SCORE(
    ('How "giftable" is this product for a pet owner? ', description,
    'Use a scale from 1-10.')
  ) AS giftability_score
FROM
  `bigquery-public-data.cymbal_pets.products`
ORDER BY
  giftability_score DESC;
नतीजों को समझना
आपको नतीजे इस तरह दिखेंगे:
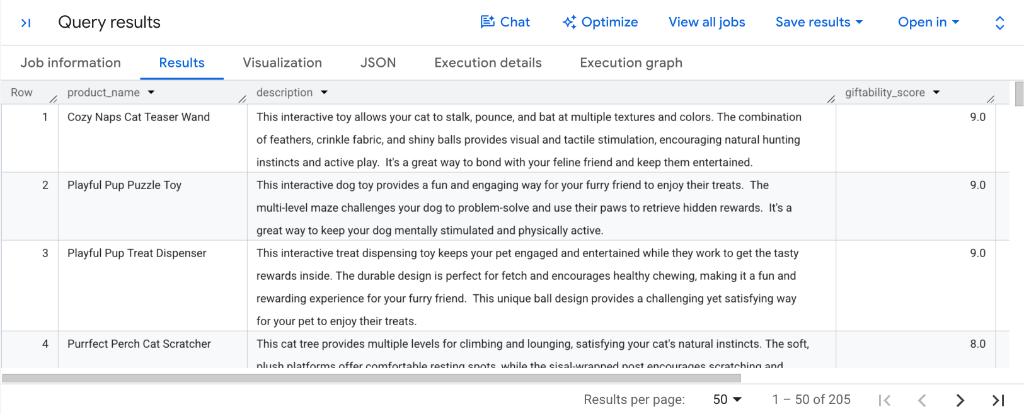
क्वेरी के नतीजों में मौजूद giftability_score कॉलम की जांच करें:
- इंटरैक्टिव खिलौने:
Cozy Naps Cat Teaser Wand,Playful Pup Puzzle Toy, औरPlayful Pup Treat Dispenserजैसे आइटम को सबसे ज़्यादा रेटिंग (9.0) मिलती है. - खास तरह के आरामदायक और खरोंचने वाले आइटम:
Purrfect Perch Cat Scratcherजैसे लोकप्रिय आइटम को8.0की रेटिंग मिलती है. - डाउनस्ट्रीम रैंकिंग:
AI.SCOREसे सामान्य किए गएFLOAT64स्कोर मिलते हैं. इसलिए, गिफ़्ट गाइड अपने-आप जनरेट करने के लिए, नतीजों कोORDER BY giftability_score DESCकी मदद से तुरंत क्रम में लगाया जा सकता है याWHERE AI.SCORE(...) >= 8.0की मदद से, संभावित आइटम को फ़िल्टर किया जा सकता है.
5. AI.CLASSIFY की मदद से, कैटलॉग में मौजूद आइटम को कैटगरी में बांटना
The AI.CLASSIFY फ़ंक्शन, इनपुट रिकॉर्ड को टारगेट कैटगरी की अलग-अलग लिस्ट में क्लासिफ़ाई करने के लिए, Gemini का इस्तेमाल करता है. यह लिस्ट, एसक्यूएल ऐरे के तौर पर दी जाती है.
AI.CLASSIFY, मल्टीमॉडल इनपुट (टेक्स्ट, इमेज, ऑडियो, वीडियो) के साथ काम करता है. साथ ही, टैक्सोनॉमी मैनेजमेंट के लिए, खास तौर पर बनाए गए क्लासिफ़िकेशन मॉडल बनाने, उन्हें ट्रेन करने या डिप्लॉय करने की ज़रूरत नहीं होती.
टारगेट एनिमल स्पीशीज़ के हिसाब से खिलौनों को कैटगरी में बांटना (सिंगल-लेबल)
मान लीजिए कि Cymbal Pets के कैटलॉग में मौजूद कुछ प्रॉडक्ट को सामान्य तौर पर "खिलौने" के तौर पर टैग किया गया है. हालांकि, इनमें टारगेट एनिमल के बारे में नहीं बताया गया है. AI.CLASSIFY का इस्तेमाल करके, हर खिलौने को उसके नाम और ब्यौरे के आधार पर कैटगरी में बांटा जा सकता है.
BigQuery Studio में यह क्वेरी चलाएं:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('What animal is this product for?', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "All Pets"]
  ) AS animal_type
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys"
LIMIT 20;
नतीजे देखना
आपको नतीजे इस तरह दिखेंगे:
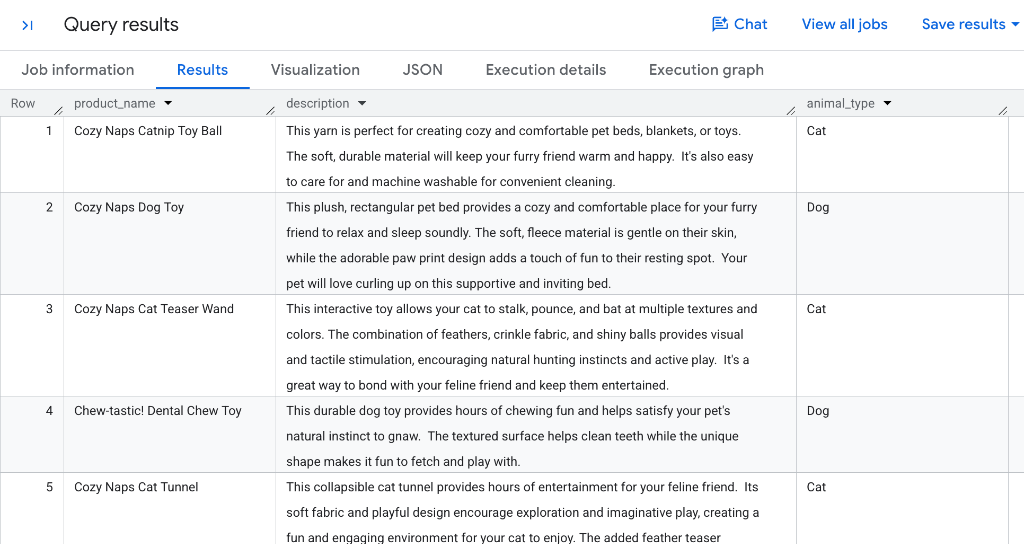
डिफ़ॉल्ट रूप से, AI.CLASSIFY, सिंगल-लेबल क्लासिफ़िकेशन करता है. साथ ही, आपके संभावित ऐरे से सबसे सही कैटगरी वाली STRING दिखाता है. ध्यान दें कि Gemini, कैटनिप बॉल और फ़ेदर टीज़र को Cat से मैप करता है. वहीं, च्यू टॉय और फ़ेच स्टिक को Dog से मैप करता है.
मल्टी-लेबल क्लासिफ़िकेशन की मदद से, एक से ज़्यादा टैग असाइन करना
रीटेल कैटलॉग में मौजूद कई प्रॉडक्ट, एक साथ कई तरह के पालतू जानवरों के लिए इस्तेमाल किए जा सकते हैं. उदाहरण के लिए, प्लश बेड या टनल, बिल्लियों और छोटे जानवरों, दोनों के लिए सही हो सकता है.
किसी एक रिकॉर्ड को एक से ज़्यादा कैटगरी असाइन करने के लिए, output_mode => 'multi' का वैकल्पिक पैरामीटर सेट करें. मल्टी-लेबल मोड में, AI.CLASSIFY, मैच करने वाली सभी कैटगरी वाला ARRAY दिखाता है.
अपने एसक्यूएल टैब में यह क्वेरी चलाएं:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('Identify all pet types that this product is suitable for: ', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "Reptile"],
    output_mode => 'multi'
  ) AS pet_types
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys";
आपको नतीजे इस तरह दिखेंगे:
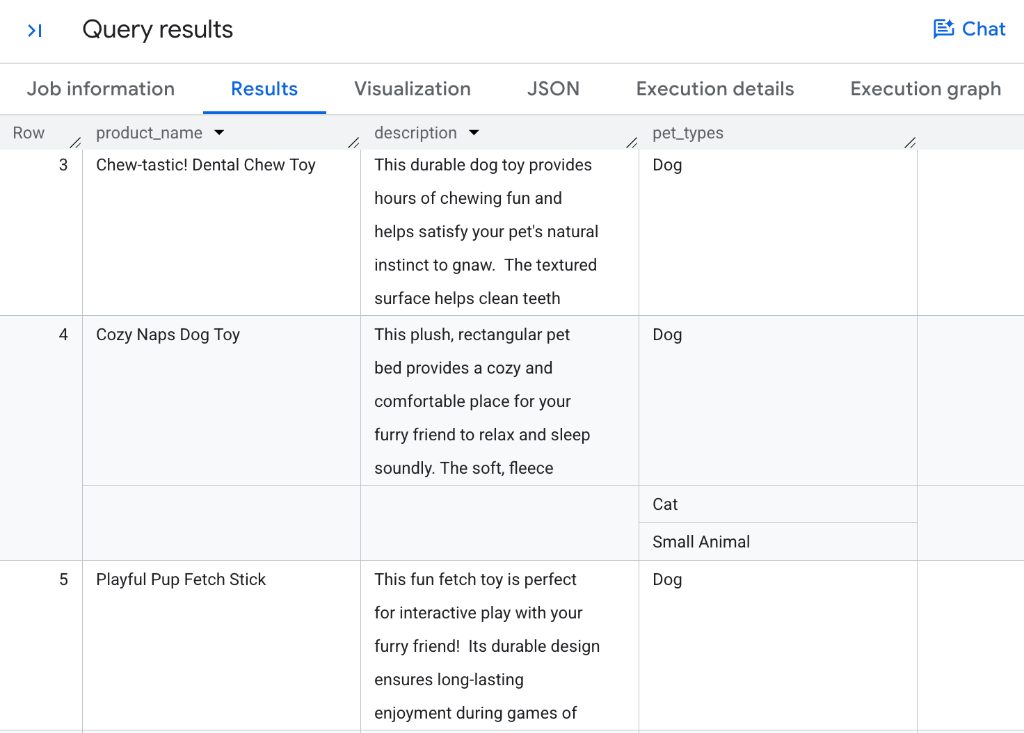
क्लासिफ़िकेशन के तरीके की समीक्षा करना
- सिंगल-लेबल बनाम मल्टी-लेबल:
output_modeके बिना,AI.CLASSIFYस्केलरSTRINGदिखाता है.output_mode => 'multi'सेट करने पर, मैच करने वाले शून्य, एक या एक से ज़्यादा लेबल वालाARRAYमिलता है. - मल्टी-कैटगरी असाइनमेंट: ध्यान दें कि
Chew-tastic! Dental Chew ToyऔरPlayful Pup Fetch Stickजैसे आइटम को[Dog]लेबल मिलता है. वहीं,Cozy Naps Dog Toy(प्लश रेक्टैंगुलर बेड) जैसे आरामदायक आइटम को एक से ज़्यादा टैग मिलते हैं:[Dog, Cat, Small Animal]. - ज़ीरो-शॉट मैचिंग: मॉडल, पहले से ट्रेन किए गए कस्टम एमएल मॉडल की ज़रूरत के बिना, दिए गए
categoriesऐरे के हिसाब से, टेक्स्ट और प्रॉम्प्ट के कॉम्बिनेशन का आकलन करता है. - डाउनस्ट्रीम एसक्यूएल ऐरे ऑपरेशन: मल्टी-लेबल वाले रिकॉर्ड को फ़िल्टर करने, एक्सप्लोर करने, और एग्रीगेट करने के लिए, BigQuery SQL के स्टैंडर्ड ऐरे फ़ंक्शन का इस्तेमाल किया जा सकता है. जैसे,
WHERE 'Cat' IN UNNEST(pet_types)याCROSS JOIN UNNEST(pet_types).
6. AI.IF की मदद से, मल्टीमॉडल प्रॉडक्ट इमेज को फ़िल्टर करना
AI.IF फ़ंक्शन, सामान्य भाषा वाली किसी शर्त का आकलन करने के लिए, Gemini का इस्तेमाल करता है. साथ ही, बूलियन (TRUE या FALSE) वैल्यू दिखाता है.
AI.IF, मल्टीमॉडल इनपुट स्वीकार करता है. इसलिए, Cloud Storage में सेव की गई अनस्ट्रक्चर्ड इमेज फ़ाइलों को फ़िल्टर करने के लिए, इसका इस्तेमाल सीधे एसक्यूएल के WHERE क्लॉज़ में किया जा सकता है.
खास ऑब्जेक्ट वाली इमेज को फ़िल्टर करना
मान लीजिए कि मर्चेंडाइज़िंग टीम, कैटलॉग में मौजूद प्रॉडक्ट की उन सभी इमेज को ढूंढना चाहती है जिनमें पालतू जानवरों का खाना या स्नैक दिख रहा हो.
अपने एसक्यूएल टैब में यह क्वेरी चलाएं:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`
WHERE
  AI.IF(
    ('Does this product image contain pet food or snacks? ', OBJ.MAKE_REF(uri, 'us.conn'))
  );
आपको नतीजे इस तरह दिखेंगे:
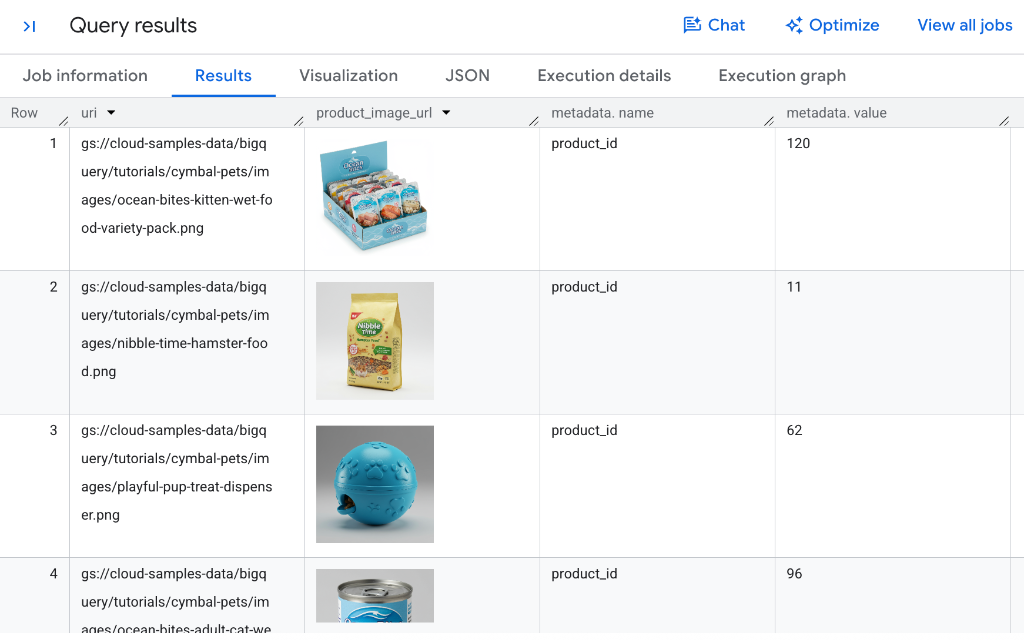
मल्टीमॉडल फ़िल्टरिंग की सुविधा कैसे काम करती है
- ऑन-द-फ़्लाई ऑब्जेक्ट रेफ़रंस: यहां
OBJ.MAKE_REF(uri, 'us.conn')का इस्तेमाल करके, ऑन-द-फ़्लाई ऑब्जेक्ट रेफ़रंस बनाए जाते हैं. हालांकि,ObjectRefकॉलम को सीधे अपनी BigQuery टेबल में बनाया और सेव भी किया जा सकता है. इससे, हर क्वेरी मेंOBJ.MAKE_REFफ़ंक्शन की ज़रूरत के बिना, विश्लेषण में तुरंत इस्तेमाल किया जा सकता है. - डीप विज़ुअल ऑब्जेक्ट रिकॉग्निशन: ध्यान दें कि Gemini, पैकेजिंग के अलग-अलग फ़ॉर्मैट (जैसे, वेट फ़ूड वैराइटी पैक बॉक्स, ड्राई हैम्स्टर फ़ूड बैग, और कैन्ड कैट फ़ूड) की सटीक पहचान करता है. साथ ही, नीले रंग के ट्रीट डिस्पेंसर जैसे खिलौनों में मौजूद खाने लायक स्नैक की भी पहचान करता है.
- रो-लेवल प्रेडिकेट इवैल्युएशन: BigQuery, सामान्य भाषा वाली शर्त का आकलन,
WHEREक्लॉज़ में सीधे तौर पर, Cloud Storage में मौजूद हर इमेज रेफ़रंस के हिसाब से करता है. - बूलियन फ़िल्टरिंग: नतीजों के सेट में सिर्फ़ वे रिकॉर्ड दिखते हैं जिनमें Gemini, शर्त का आकलन
TRUEके तौर पर करता है.
7. AI.IF की मदद से, टेबल में सेमैंटिक जॉइन करना
रिलेशनल डेटाबेस में जॉइन करने के लिए, सटीक कुंजी की समानता ज़रूरी होती है. जैसे, products.product_id = images.product_id. हालांकि, असल दुनिया के एंटरप्राइज़ डेटासेट में अक्सर अनस्ट्रक्चर्ड ऐसेट शामिल होती हैं. इनमें साफ़ तौर पर फ़ॉरेन की मौजूद नहीं होती हैं.
AI.IF, बूलियन वैल्यू दिखाता है. इसलिए, सेमैंटिक जॉइन करने के लिए, इसे सीधे एसक्यूएल के INNER JOIN ... ON क्लॉज़ में रखा जा सकता है.
प्रॉडक्ट के ब्यौरे को इमेज ऐसेट के साथ सेमैंटिक तौर पर जॉइन करना
मान लीजिए कि आपको Fluffy Buns ब्रैंड के प्रॉडक्ट के लिए, products टेबल में मौजूद प्रॉडक्ट के ब्यौरे को product_images में मौजूद बिना लिंक की गई इमेज फ़ाइलों से मैच करना है.
अपने BigQuery Studio के एसक्यूएल टैब में यह क्वेरी चलाएं. ध्यान दें कि इसे पूरा होने में कुछ मिनट लग सकते हैं:
SELECT
  products.product_id,
  products.product_name,
  products.description,
  products.brand,
  images.uri AS image_uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(images.uri, 'us.conn')).url AS product_image_url
FROM
  `bigquery-public-data.cymbal_pets.products` AS products
INNER JOIN
  `bigquery-public-data.cymbal_pets.product_images` AS images
ON
  AI.IF(
    ('You will be provided an image of a pet product. ',
    'Determine if the image is of the following pet toy: ',
    products.product_name,
    products.description,
    OBJ.MAKE_REF(images.uri, 'us.conn')
    )
  )
WHERE
  products.category = "Toys" AND
  products.brand = "Fluffy Buns";
आपको नतीजे इस तरह दिखेंगे:
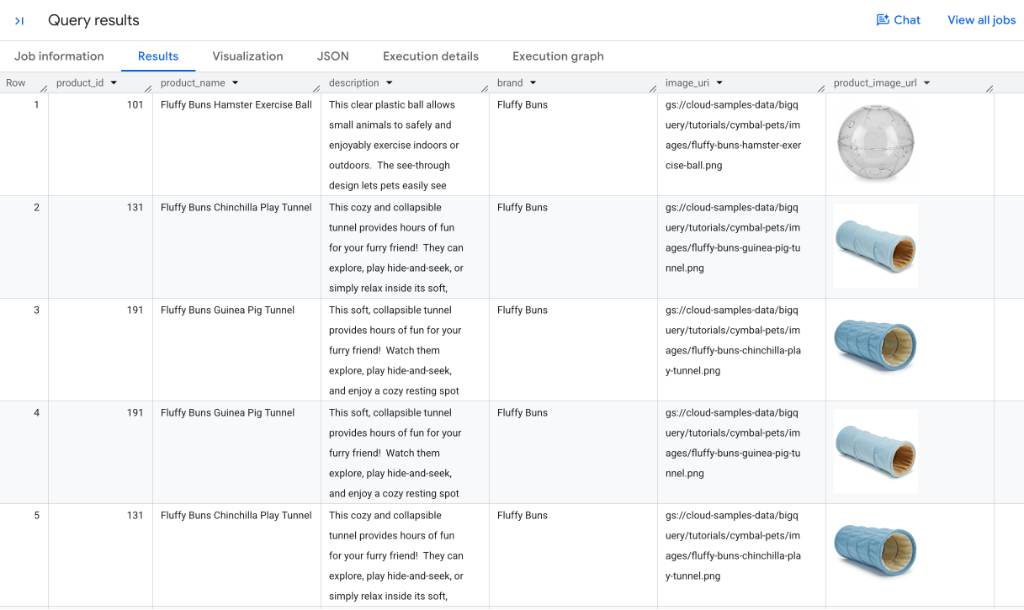
एसक्यूएल में सेमैंटिक जॉइन को समझना
- क्रॉस-मॉडल कंडीशन इवैल्युएशन: संभावित रिकॉर्ड पेयर के लिए, BigQuery,
productsटेक्स्ट वाले मेटाडेटा और इमेज रेफ़रंस (OBJ.MAKE_REF(...)) , दोनों को Gemini पर भेजता है. - सटीक विज़ुअल मैचिंग: नतीजों में दिखाया गया है कि
Fluffy Buns Hamster Exercise Ballको साफ़ प्लास्टिक बॉल की इमेज से मैच किया गया है. वहीं,Fluffy Buns Chinchilla Play TunnelऔरGuinea Pig Tunnelको नीले रंग के प्लश टनल की फ़ोटो से मैच किया गया है. स्टैंडर्ड एसक्यूएलINNER JOINसिमैंटिक की वजह से, अगर कोई प्रॉडक्ट, कैटलॉग में एक से ज़्यादा इमेज ऐसेट से मैच करता है, तो आउटपुट में एक से ज़्यादा लाइनें दिख सकती हैं. जैसे, अलग-अलग ऐंगल से ली गई फ़ोटो या मिलती-जुलती इमेज. - इनलाइन इमेज रेंडरिंग: BigQuery Studio, अनुमति वाले यूआरएल को
product_image_urlकॉलम में सीधे तौर पर, नतीजों के ग्रिड में रेंडर करता है. इससे तुरंत विज़ुअल पुष्टि की जा सकती है. - अनस्ट्रक्चर्ड एंटिटी रिज़ॉल्यूशन: इससे, लेगसी कैटलॉग, स्क्रैप किए गए डेटासेट, और मीडिया आर्काइव में, एंटिटी रिज़ॉल्यूशन के बेहतर वर्कफ़्लो अनलॉक होते हैं. इसके लिए, मैन्युअल लेबलिंग या साफ़ तौर पर फ़ॉरेन की की ज़रूरत नहीं होती.
8. AI.AGG की मदद से, लाइनों में अहम जानकारी को सिंथेसाइज़ करना
AI.SCORE, AI.CLASSIFY, और AI.IF जैसे फ़ंक्शन, अलग-अलग लाइनों का आकलन करते हैं. वहीं, एंटरप्राइज़ डेटा का विश्लेषण करने के लिए, अक्सर एक से ज़्यादा रिकॉर्ड में पैटर्न को सिंथेसाइज़ करने की ज़रूरत होती है.
AI.AGG फ़ंक्शन, एक एग्रीगेट फ़ंक्शन है. यह सामान्य भाषा वाले निर्देशों का इस्तेमाल करके, हज़ारों या लाखों अनस्ट्रक्चर्ड लाइनों की खास जानकारी को एक ही जवाब में समराइज़, क्लस्टर या सिंथेसाइज़ करता है.
कैटगरी की खास जानकारी को, एसक्यूएल की पारंपरिक मेट्रिक के साथ सिंथेसाइज़ करना
AI.AGG, एसक्यूएल के पारंपरिक GROUP BY और एग्रीगेट फ़ंक्शन के साथ आसानी से इंटिग्रेट हो जाता है. उदाहरण के लिए, पारंपरिक मेट्रिक (जैसे, आइटम की संख्या) की गणना, जनरेटिव एआई की मदद से जनरेट की गई खास जानकारी के साथ की जा सकती है. इस खास जानकारी में, हर कैटगरी में मौजूद प्रॉडक्ट में क्या समानताएं हैं, यह बताया जाता है.
BigQuery Studio में यह क्वेरी चलाएं:
SELECT
  category,
  COUNT(*) AS item_count,
  AI.AGG(
    ('Product: ', product_name, ' - Description: ', description),
    'Write a concise, one-sentence summary describing the common characteristics or purpose of the products in this category.'
  ) AS category_summary
FROM
  `bigquery-public-data.cymbal_pets.products`
GROUP BY
  category
ORDER BY
  item_count DESC;
आपको नतीजे इस तरह दिखेंगे:
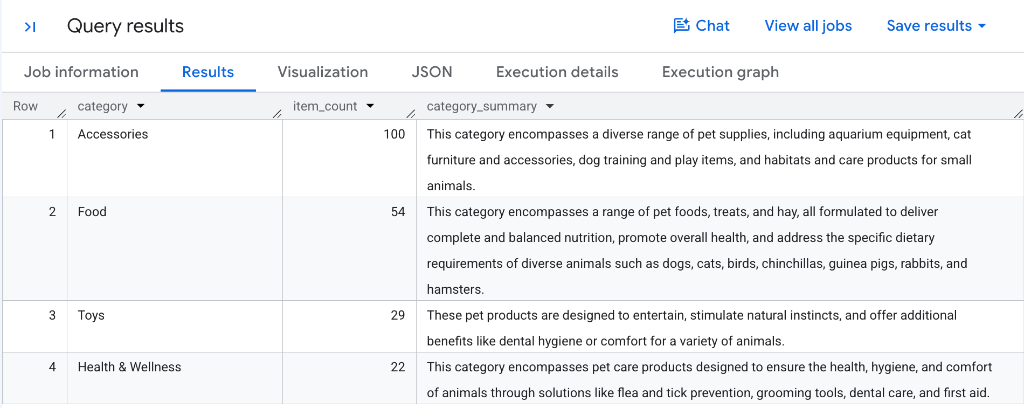
AI.AGG, अनस्ट्रक्चर्ड डेटा को कैसे एग्रीगेट करता है
- हायरार्किकल एग्रीगेशन: BigQuery, कैटगरी के हिसाब से बांटे गए डेटा के आधार पर, लाइनों के डेटा को ग्रुप करता है. साथ ही, स्ट्रक्चर्ड कॉन्टेक्स्ट विंडो बनाता है. इसके बाद, Gemini का इस्तेमाल करके, प्रॉडक्ट रिकॉर्ड के पूरे कलेक्शन को सिंथेसाइज़ करता है.
- कैटलॉग सिंथेसिस की सुविधा: ध्यान दें कि हर कैटगरी के लिए, सटीक और अलग खास जानकारी मिलती है. जैसे,
Accessoriesमें हैबिटैट और ट्रेनिंग गियर शामिल हैं. वहीं,Foodमें अलग-अलग एनिमल स्पीशीज़ के लिए, संतुलित पोषण की जानकारी दी गई है. - हाइब्रिड क्वांटिटेटिव और क्वालिटेटिव रिपोर्टिंग:
COUNT(*)जैसे स्टैंडर्ड एग्रीगेशन कोAI.AGGके साथ मिलाकर, कस्टम ईटीएल पाइपलाइन के बिना, एक ही क्वेरी में कैटलॉग की पूरी जानकारी मिलती है. - फ़्लेक्सिबल पार्टीशनिंग: एक्ज़ेक्यूटिव-लेवल की अहम जानकारी कुछ ही सेकंड में जनरेट करने के लिए,
AI.AGGको किसी भी ग्रुपिंग डाइमेंशन पर लागू किया जा सकता है. जैसे,GROUP BY brand,GROUP BY category, या पूरी टेबल पर.
9. ऑप्टिमाइज़ किए गए मोड और प्रॉक्सी मॉडल की मदद से, क्वेरी की स्पीड बढ़ाना
हज़ारों या लाखों लाइनों वाले बड़े डेटासेट को प्रोसेस करते समय, हर लाइन के लिए रिमोट एलएलएम को कॉल करने पर, लेटेन्सी और लागत बढ़ सकती है.
इस समस्या को हल करने के लिए, BigQuery, ऑप्टिमाइज़ किए गए मोड की सुविधा देता है और AI.IF के लिए AI.CLASSIFY. ऑप्टिमाइज़ किए गए मोड में, प्रॉक्सी मॉडल और ऑन-द-फ़्लाई मॉडल डिस्टिलेशन का इस्तेमाल किया जाता है. इससे, एलएलएम टोकन की लागत कम होने के साथ-साथ, 100 गुना ज़्यादा तेज़ी से क्वेरी को एक्ज़ीक्यूट किया जा सकता है.
ऑप्टिमाइज़ किया गया मोड कैसे काम करता है
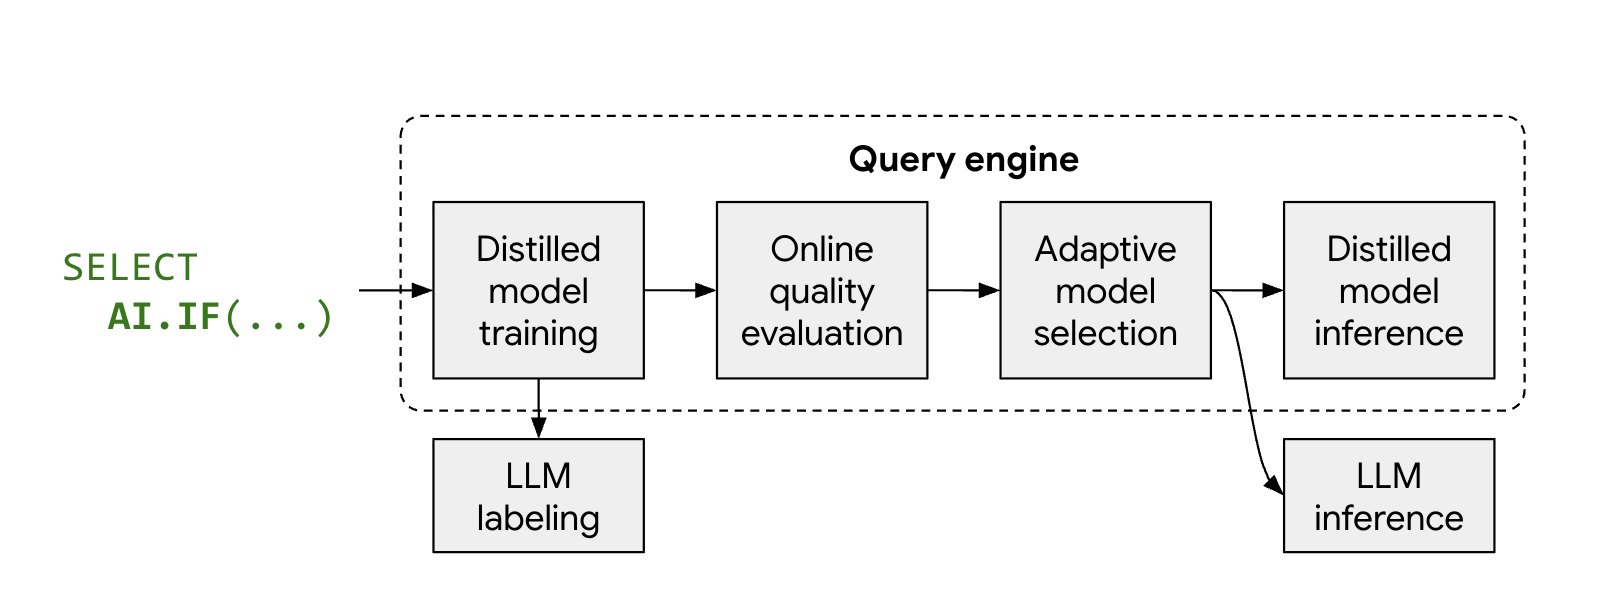
- प्रतिनिधि सैंपलिंग और लेबलिंग: BigQuery, लाइनों का प्रतिनिधि सैंपल अपने-आप चुनता है और Gemini से लेबल हासिल करता है.
- डिस्टिल्ड मॉडल ट्रेनिंग: BigQuery, सीपीयू पर, टेक्स्ट एम्बेडिंग को सुविधाओं के तौर पर इस्तेमाल करके, अल्ट्रा-लाइटवेट प्रॉक्सी मॉडल (जैसे, लॉजिस्टिक रिग्रेशन) को ठीक उसी समय ट्रेन करता है.
- क्वालिटी की पुष्टि: BigQuery, डिस्टिल्ड मॉडल की सटीक जानकारी का आकलन, Gemini के हिसाब से करता है. अगर यह क्वालिटी की ज़रूरी शर्तों को पूरा करता है, तो BigQuery, डेटासेट के बाकी हिस्से को प्रोसेस करने के लिए, इसे प्रमोट करता है.
- लोकल हाई-स्पीड इन्फ़रंस: प्रॉक्सी मॉडल, बाकी लाइनों का आकलन लोकल तौर पर करता है. इसके लिए, रिमोट एलएलएम टोकन की लागत नहीं लगती और लेटेन्सी बहुत कम होती है.
ऑप्टिमाइज़ेशन के बिना, बेसलाइन क्वेरी चलाना
bigquery-public-data.cymbal_pets.products कैटलॉग में, प्रॉक्सी मॉडल डिस्टिलेशन को ट्रिगर करने के लिए बहुत कम लाइनें हैं. इसलिए, हम bigquery-public-data.bbc_news.fulltext के बड़े पब्लिक डेटासेट का इस्तेमाल करेंगे. इसमें 2,200 से ज़्यादा खबरों के लेख शामिल हैं.
सबसे पहले, प्राकृतिक आपदाओं के बारे में खबरों के लेखों की पहचान करने के लिए, ऑप्टिमाइज़ेशन के बिना स्टैंडर्ड क्वेरी चलाएं:
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body)
  );
बेसलाइन जॉब की जानकारी और टोकन के इस्तेमाल की जांच करना
बेसलाइन क्वेरी पूरी होने के बाद, एक्ज़ीक्यूशन मेट्रिक की जांच करें:
- BigQuery Studio के नतीजों वाले सबसे नीचे के पैन में, जॉब की जानकारी टैब चुनें.
- नीचे स्क्रोल करके, इनपुट टोकन की गिनती और आउटपुट टोकन की गिनती सेक्शन पर जाएं.
आपको नतीजे इस तरह दिखेंगे:
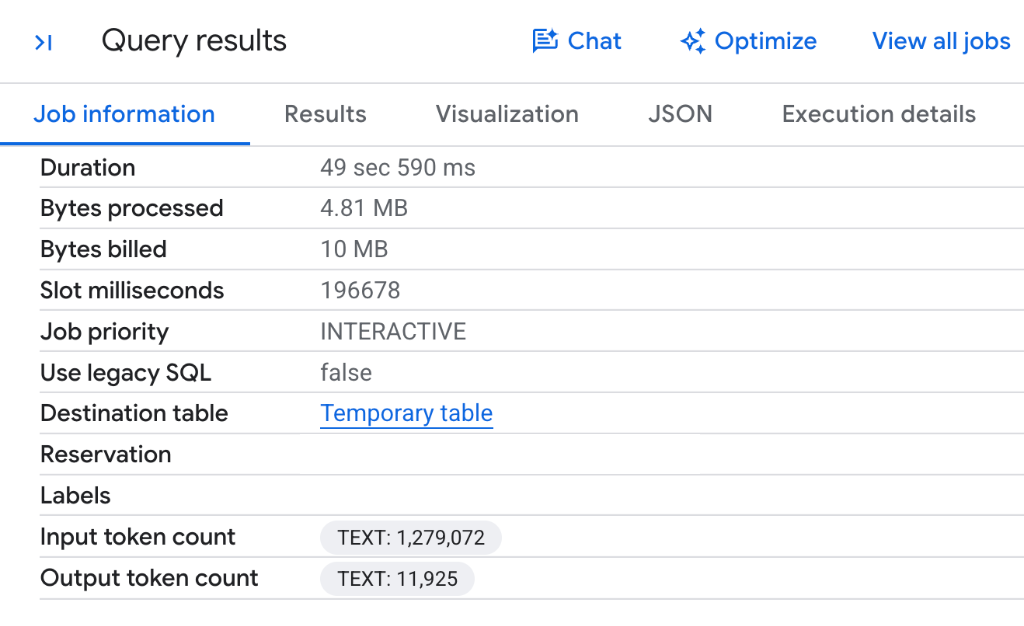
- पूरे डेटासेट के लिए टोकन की खपत: प्रॉक्सी ऑप्टिमाइज़ेशन के बिना, BigQuery, 2,225 खबरों के लेखों में मौजूद हर लाइन के लिए, रिमोट Gemini मॉडल को कॉल करता है. इसलिए, क्वेरी में 12,79,072 इनपुट टोकन और 11,925 आउटपुट टोकन की खपत होती है.
- ऑप्टिमाइज़ेशन सेक्शन नहीं है: ध्यान दें कि
Gen AI Function Optimizationsएंट्री नहीं है. ऐसा इसलिए, क्योंकि स्टैंडर्ड एक्ज़ीक्यूशन में, रिमोट एलएलएम एंडपॉइंट के हिसाब से, हर लाइन का आकलन किया जाता है.
ऑप्टिमाइज़ किए गए मोड के साथ क्वेरी को एक्ज़ीक्यूट करना
टोकन की खपत कम करने और प्रॉक्सी मॉडल डिस्टिलेशन का फ़ायदा पाने के लिए, ऑप्टिमाइज़ किए गए मोड को चालू करें. इसके लिए, embeddings => AI.EMBED(...) पास करें और optimization_mode => 'MINIMIZE_COST' सेट करें:
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body),
    embeddings => AI.EMBED(body, endpoint => 'text-embedding-005', task_type => 'CLASSIFICATION').result,
    optimization_mode => 'MINIMIZE_COST'
  );
ऑप्टिमाइज़ेशन की पुष्टि करना और टोकन के इस्तेमाल में कमी देखना
ऑप्टिमाइज़ की गई क्वेरी चलाने के बाद, BigQuery Studio के जॉब की जानकारी टैब पर जाएं. यहां आपको टोकन के इस्तेमाल और एक्ज़ीक्यूशन मेट्रिक की तुलना दिखेगी:
- BigQuery Studio के नतीजों वाले सबसे नीचे के पैन में, जॉब की जानकारी टैब चुनें.
- Gen AI Function Optimizations सेक्शन के साथ-साथ, टोकन की संख्या तक स्क्रोल करें.
आपको नतीजे इस तरह दिखेंगे:
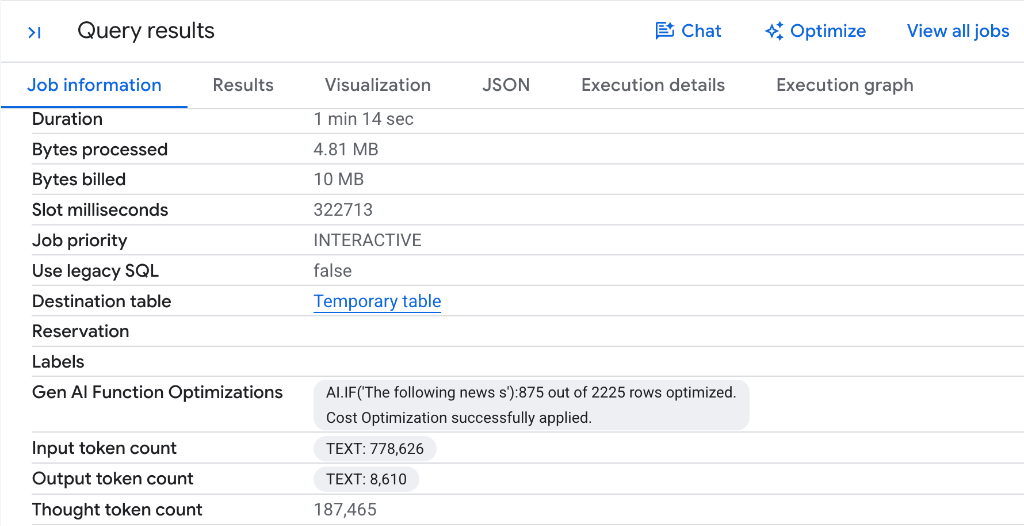
- टोकन में काफ़ी कमी: ध्यान दें कि इनपुट टोकन की गिनती, 12,79,072 टोकन से घटकर 7,78,626 टोकन हो गई है. इसका मतलब है कि एक क्वेरी चलाने पर 5,00,446 इनपुट टोकन (करीब 40% की कमी) की बचत हुई! इसी तरह, आउटपुट टोकन में भी कमी आई है.
- प्रॉक्सी डिस्टिलेशन की सुविधा: लेबल पर ध्यान दें
AI.IF('The following news s'): 875 out of 2225 rows optimized. Cost Optimization successfully applied.BigQuery ने डेटासेट का सैंपल लिया, Gemini की मदद से प्रतिनिधि के तौर पर लेखों को लेबल किया, तेज़ और हल्के प्रॉक्सी क्लासिफ़ायर को डिस्टिल किया, और रिमोट एलएलएम एंडपॉइंट को कॉल किए बिना, सीपीयू पर 2,225 में से 875 लाइनों को लोकल तौर पर प्रोसेस किया. - लागत में सीधे बचत: BigQuery के मैनेज किए गए एआई फ़ंक्शन के लिए, प्रोसेस किए गए मॉडल टोकन के वॉल्यूम के आधार पर बिल भेजा जाता है. इसलिए, टोकन की खपत कम करने से, क्वेरी के एक्ज़ीक्यूशन की लागत सीधे तौर पर कम हो जाती है.
- क्वालिटी की पुष्टि: BigQuery ने प्रॉक्सी मॉडल की सटीक जानकारी की पुष्टि, Gemini के हिसाब से अपने-आप की. इसके बाद, बाकी लाइनों का आकलन करने के लिए, इसे प्रमोट किया. इससे, क्लासिफ़िकेशन की क्वालिटी बनी रहती है.
बड़ी टेबल पर, टोकन में और भी ज़्यादा कमी और लेटेन्सी स्केलिंग
2,225 लाइनों पर 5,00,000 से ज़्यादा टोकन की बचत करना काफ़ी है. हालांकि, बड़ी टेबल पर टोकन में कमी और परफ़ॉर्मेंस में बढ़ोतरी और भी ज़्यादा होती है:
- डेटासेट के साइज़ के हिसाब से टोकन में कमी क्यों होती है: BigQuery में एक्ज़ीक्यूट की गई क्वेरी के लिए, एलएलएम से लेबल की गई करीब 1,000 लाइनों के शुरुआती सैंपल का इस्तेमाल करके, प्रॉक्सी मॉडल को ऑन-द-फ़्लाई ट्रेन किया जाता है. ट्रेन होने और पुष्टि होने के बाद, प्रॉक्सी मॉडल, बाकी लाइनों के लिए सीधे एलएलएम कॉल की जगह लेता है. बड़ी क्वेरी (जैसे, आम तौर पर 10 लाख लाइनों वाले डेटासेट) के लिए, इससे ज़्यादातर डेटा के लिए एलएलएम कॉल की ज़रूरत नहीं होती. साथ ही, 400 गुना कम टोकन की खपत होती है और लागत में काफ़ी कमी आती है.
- लेटेन्सी में काफ़ी कमी: इन्फ़रंस को खास एलएलएम हार्डवेयर से हटाकर, स्टैंडर्ड डेटाबेस वर्कर सीपीयू पर सीधे तौर पर चलने वाले अल्ट्रा-लाइटवेट प्रॉक्सी मॉडल पर ले जाने से (पहले से कंप्यूट की गई Gemini एम्बेडिंग का इस्तेमाल करके), BigQuery, क्वेरी के रनटाइम को 30 से 100 गुना तक कम करता है.
10. संसाधन साफ़ करना
इस कोडलैब के दौरान बनाए गए संसाधनों को साफ़ करने के लिए, Cloud Resource Connection हटाने के लिए, BigQuery Studio के किसी एसक्यूएल टैब में यह स्टेटमेंट चलाएं:
DROP CONNECTION IF EXISTS `us.conn`;
इसके अलावा, अगर आपने इस ट्यूटोरियल के लिए, अस्थायी Google Cloud प्रोजेक्ट बनाया है, तो Cloud Resource Manager में पूरे प्रोजेक्ट को बंद किया जा सकता है.
11. बधाई हो
बधाई हो! आपने मैनेज किए गए एआई फ़ंक्शन और एसक्यूएल की मदद से, BigQuery में सेमैंटिक विश्लेषण पर कोडलैब पूरा कर लिया है.
आपने BigQuery के मैनेज किए गए जनरेटिव एआई फ़ंक्शन के बारे में सीखा:
AI.SCORE: प्रॉम्प्ट रीराइटिंग की सुविधा का इस्तेमाल करके, गिफ़्ट के तौर पर देने की संभावना जैसे राय पर आधारित शर्तों के आधार पर, प्रॉडक्ट की रैंकिंग करना. इसके लिए, 1 से 10 तक का स्केल इस्तेमाल करना.AI.CLASSIFY: अनस्ट्रक्चर्ड कैटलॉग आइटम को, टारगेट एनिमल क्लासिफ़िकेशन के हिसाब से कैटगरी में बांटना.AI.IF(मल्टीमॉडल फ़िल्टरिंग): विज़ुअल कॉन्टेंट के आधार पर, एसक्यूएल केWHEREक्लॉज़ में, Cloud Storage में मौजूद इमेज ऐसेट को फ़िल्टर करना.AI.IF(सेमैंटिक जॉइन): टेक्स्ट वाले प्रॉडक्ट के ब्यौरे को इमेज फ़ाइलों से लिंक करने के लिए, एसक्यूएल केONक्लॉज़ में, क्रॉस-मॉडल जॉइन करना.AI.AGG: एक से ज़्यादा लाइनों वाले अनस्ट्रक्चर्ड कैटलॉग टेक्स्ट को, एक्ज़ेक्यूटिव खास जानकारी में सिंथेसाइज़ करना.- ऑप्टिमाइज़ किया गया मोड और प्रॉक्सी मॉडल: ऑन-द-फ़्लाई मॉडल डिस्टिलेशन और
AI.EMBEDके साथ,optimization_mode => 'MINIMIZE_COST'का इस्तेमाल करके, क्वेरी की स्पीड बढ़ाना और टोकन की लागत कम करना.
ज़्यादा जानें
- जनरेटिव एआई की खास जानकारी
- BigQuery के मैनेज किए गए एआई फ़ंक्शन के लिए गाइड
AI.SCOREके एसक्यूएल सिंटैक्स का दस्तावेज़AI.CLASSIFYके एसक्यूएल सिंटैक्स का दस्तावेज़AI.IFके एसक्यूएल सिंटैक्स का दस्तावेज़AI.AGGके एसक्यूएल सिंटैक्स का दस्तावेज़- मॉडल डिस्टिलेशन की मदद से, एआई फ़ंक्शन को ऑप्टिमाइज़ करना
- Google Cloud का ब्लॉग: प्रॉक्सी मॉडल की मदद से, एलएलएम की मदद से चलने वाली एसक्यूएल क्वेरी, 100 गुना ज़्यादा तेज़ी से और कम लागत में करना
- Google Cloud का ब्लॉग: BigQuery के AI.AGG फ़ंक्शन के बारे में ज़्यादा जानकारी