

1. Selamat Datang
Dalam codelab ini, Anda akan mempelajari cara menggunakan rangkaian fungsi AI terkelola BigQuery untuk melakukan analisis semantik yang canggih, klasifikasi kategoris, pemfilteran multimodal, gabungan semantik, dan peringkasan multi-baris langsung dalam BigQuery Studio menggunakan SQL.
Dengan menggunakan set data publik bigquery-public-data.cymbal_pets, Anda akan berperan sebagai analis data di Cymbal Pets, retailer e-commerce untuk perlengkapan dan aksesori hewan peliharaan.
Analisis semantik langsung di dalam kueri SQL
Biasanya, penerapan machine learning atau model bahasa besar (LLM) ke set data perusahaan memerlukan pemindahan data dari data warehouse ke lingkungan notebook Python eksternal. Hal ini memerlukan pipeline rekayasa data khusus dan keahlian ML.
Fungsi AI terkelola BigQuery—termasuk AI.SCORE, AI.CLASSIFY, AI.IF, dan AI.AGG—membawa kecerdasan model dasar langsung ke data Anda. BigQuery secara otomatis mengoptimalkan pemilihan model dan menerapkan strategi penulisan ulang perintah internal untuk memberikan hasil dengan akurasi tinggi dari perintah bahasa alami yang sederhana.
Untuk set data bervolume tinggi, BigQuery menyediakan mode yang dioptimalkan, menggunakan distilasi model secara langsung dan model proxy ringan untuk menghasilkan kueri yang hingga 100 kali lebih cepat dan lebih murah.
Yang akan Anda lakukan
- Jelajahi data retail multimodal di BigQuery Studio menggunakan SQL.
- Lakukan peringkat semantik menggunakan
AI.SCOREuntuk mengevaluasi atribut produk subjektif seperti "cocok sebagai hadiah". - Mengategorikan data tidak terstruktur menggunakan
AI.CLASSIFYuntuk memetakan produk ke spesies hewan target. - Memfilter aset gambar multimodal menggunakan
AI.IFdalam klausaWHERE. - Jalankan gabungan semantik di seluruh tabel menggunakan
AI.IFdalam klausaJOIN ... ONuntuk mencocokkan rekaman produk teks dengan file gambar eksternal. - Sintesis insight multi-baris menggunakan fungsi agregat
AI.AGG. - Mengoptimalkan latensi dan biaya kueri pada set data besar menggunakan
AI.IFdengan mode yang dioptimalkan (optimization_mode => 'MINIMIZE_COST') dan distilasi model proxy.
Yang Anda butuhkan
- Project Google Cloud yang mengaktifkan penagihan.
- Browser web seperti Chrome.
2. Penyiapan dan persyaratan
Sebelum membuat kueri data dengan fungsi AI terkelola, Anda harus mengonfigurasi project Google Cloud dan mengaktifkan API yang diperlukan.
Buat project Google Cloud dan aktifkan API
- Di Konsol Google Cloud, di halaman pemilih project, pilih atau buat project Google Cloud.
- Pastikan penagihan diaktifkan untuk project Cloud Anda. Pelajari cara memeriksa apakah penagihan telah diaktifkan pada suatu project.
- Aktifkan BigQuery API, BigQuery Connection API, dan Agent Platform API.
Membuka BigQuery Studio
- Di menu navigasi Konsol Google Cloud, klik BigQuery untuk membuka BigQuery Studio.
- Di toolbar editor BigQuery Studio, klik + SQL query untuk membuka tab kueri SQL baru. Anda akan menulis dan menjalankan semua kueri SQL di tab SQL ini selama codelab ini.
Membuat Koneksi Resource Cloud di SQL
BigQuery beroperasi dalam perimeter data yang aman. Saat memeriksa file multimodal eksternal (seperti gambar yang disimpan di Google Cloud Storage), BigQuery menggunakan Koneksi Resource Cloud untuk mengakses referensi objek secara aman tanpa mengekspos kredensial.
Jalankan pernyataan berikut di tab SQL Anda untuk membuat koneksi bernama us.conn:
CREATE CONNECTION IF NOT EXISTS `us.conn`
OPTIONS (
  connection_type = "CLOUD_RESOURCE"
);
3. Jelajahi set data Cymbal Pets
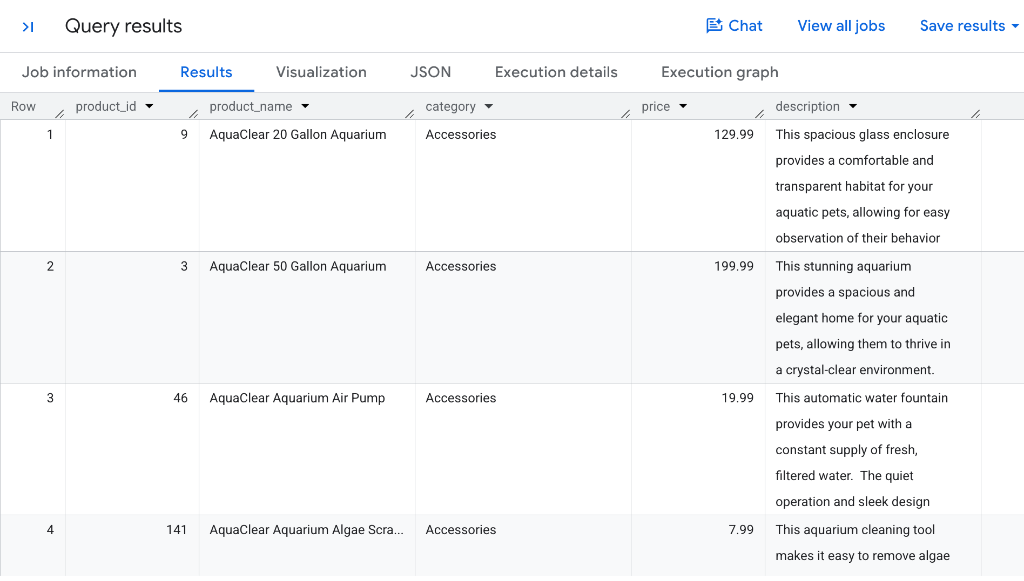
Cymbal Pets memiliki katalog produk yang lengkap dalam set data publik di dalam tabel bernama bigquery-public-data.cymbal_pets.products. Setiap data produk berisi atribut terstruktur seperti ID produk, judul, kategori retail, harga, dan teks deskriptif.
Membuat kueri katalog produk
Buka tab SQL di BigQuery Studio dan jalankan kueri berikut untuk memeriksa tabel produk:
SELECT
  product_id,
  product_name,
  category,
  price,
  description
FROM
  `bigquery-public-data.cymbal_pets.products`;
Hasil Anda akan terlihat seperti berikut:
Periksa gambar produk
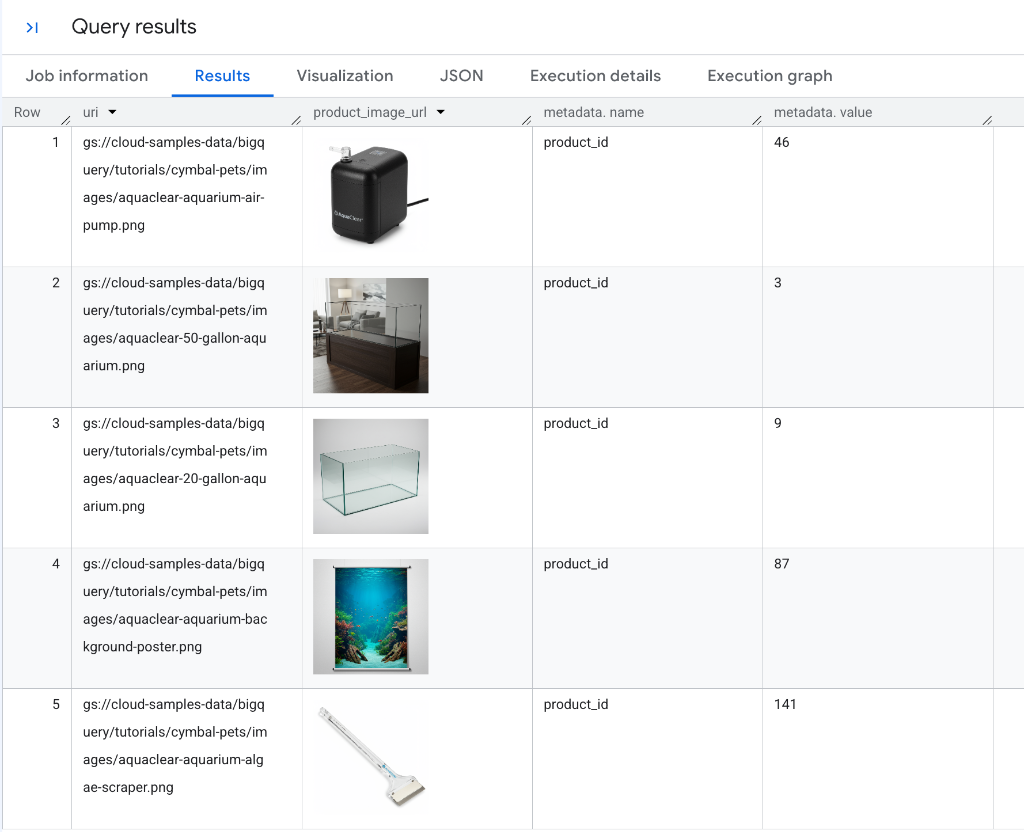
Cymbal Pets juga menyimpan referensi gambar produk di bigquery-public-data.cymbal_pets.product_images. Jalankan kueri berikut untuk melihat rekaman gambar:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`;
Hasil Anda akan terlihat seperti berikut:
Selanjutnya, Anda akan menggunakan fungsi terkelola BigQuery untuk menganalisis data teks dan gambar dari data warehouse Cymbal Pets.
4. Peringkat produk berdasarkan kriteria semantik dengan AI.SCORE
Fungsi AI.SCORE menerima input teks dan menggunakan model Gemini untuk memberi peringkat berdasarkan rubrik penilaian bahasa natural, yang menampilkan skor FLOAT64 numerik.
Jika Anda tidak memberikan rubrik penilaian eksplisit, BigQuery akan otomatis menerapkan strategi penulisan ulang perintah untuk membuat rubrik yang optimal bagi model.
Beri skor produk untuk "kesesuaian sebagai hadiah"
Misalkan tim pemasaran Cymbal Pets ingin membuat panduan hadiah liburan. Mereka ingin memberi peringkat setiap item dalam katalog berdasarkan seberapa cocoknya item tersebut sebagai hadiah untuk pemilik hewan peliharaan dalam skala 1 hingga 10.
Jalankan kueri berikut di tab SQL Anda:
SELECT
  product_name,
  description,
  AI.SCORE(
    ('How "giftable" is this product for a pet owner? ', description,
    'Use a scale from 1-10.')
  ) AS giftability_score
FROM
  `bigquery-public-data.cymbal_pets.products`
ORDER BY
  giftability_score DESC;
Memahami hasil
Hasil Anda akan terlihat seperti berikut:
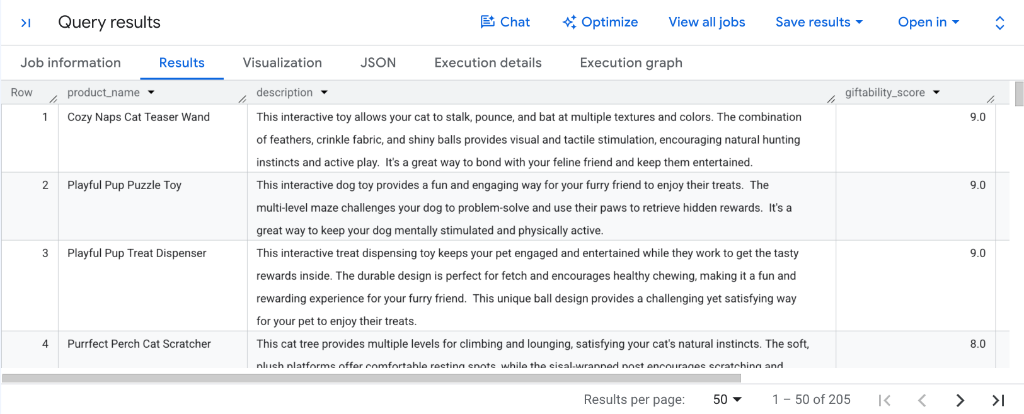
Periksa kolom giftability_score dalam hasil kueri:
- Mainan interaktif yang sangat menarik: Item yang menarik seperti
Cozy Naps Cat Teaser Wand,Playful Pup Puzzle Toy, danPlayful Pup Treat Dispensermenerima rating tertinggi (9.0). - Item kenyamanan dan garukan khusus: Item penting yang populer seperti
Purrfect Perch Cat Scratchermendapatkan skor tinggi di8.0. - Peringkat hilir yang dapat ditindaklanjuti: Karena
AI.SCOREmenghasilkan skorFLOAT64yang dinormalisasi, Anda dapat langsung mengurutkan hasil denganORDER BY giftability_score DESCatau memfilter kandidat denganWHERE AI.SCORE(...) >= 8.0untuk membuat panduan hadiah otomatis.
5. Mengategorikan item katalog dengan AI.CLASSIFY
Fungsi AI.CLASSIFY menggunakan Gemini untuk mengklasifikasikan rekaman input ke dalam daftar target kategori diskrit yang disediakan sebagai array SQL.
AI.CLASSIFY mendukung input multimodal (teks, gambar, audio, video) dan menghilangkan kebutuhan untuk membangun, melatih, atau men-deploy model klasifikasi khusus untuk pengelolaan taksonomi.
Mengklasifikasikan mainan berdasarkan spesies hewan target (label tunggal)
Misalkan beberapa produk dalam katalog Cymbal Pets diberi tag secara umum sebagai "Mainan" tanpa menentukan hewan target. Anda dapat menggunakan AI.CLASSIFY untuk mengategorikan setiap mainan berdasarkan nama dan deskripsinya.
Jalankan kueri berikut di BigQuery Studio:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('What animal is this product for?', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "All Pets"]
  ) AS animal_type
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys"
LIMIT 20;
Melihat hasil
Hasil Anda akan terlihat seperti berikut:
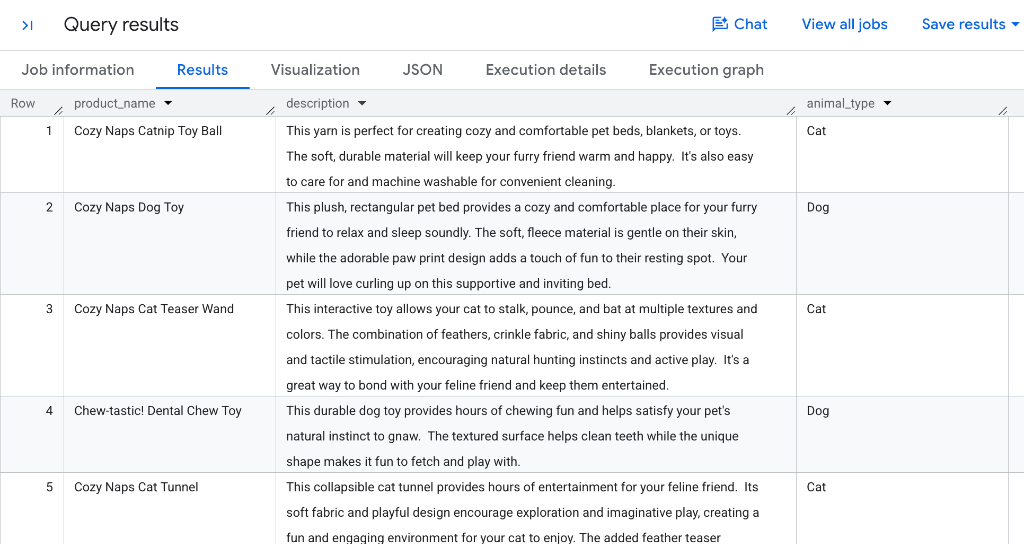
Secara default, AI.CLASSIFY melakukan klasifikasi satu label dan menampilkan STRING yang berisi satu kategori paling relevan dari array kandidat Anda. Perhatikan bagaimana Gemini memetakan bola catnip dan mainan bulu ke Cat, sementara mainan kunyah dan tongkat lempar dipetakan ke Dog.
Menetapkan beberapa tag dengan klasifikasi multi-label
Banyak produk dalam katalog retail berlaku untuk beberapa jenis hewan peliharaan secara bersamaan (misalnya, tempat tidur atau terowongan empuk yang cocok untuk kucing dan hewan kecil).
Untuk menetapkan beberapa kategori ke satu data, tetapkan parameter opsional output_mode => 'multi'. Dalam mode multi-label, AI.CLASSIFY menampilkan ARRAY yang berisi semua kategori yang cocok.
Jalankan kueri berikut di tab SQL Anda:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('Identify all pet types that this product is suitable for: ', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "Reptile"],
    output_mode => 'multi'
  ) AS pet_types
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys";
Hasil Anda akan terlihat seperti berikut:
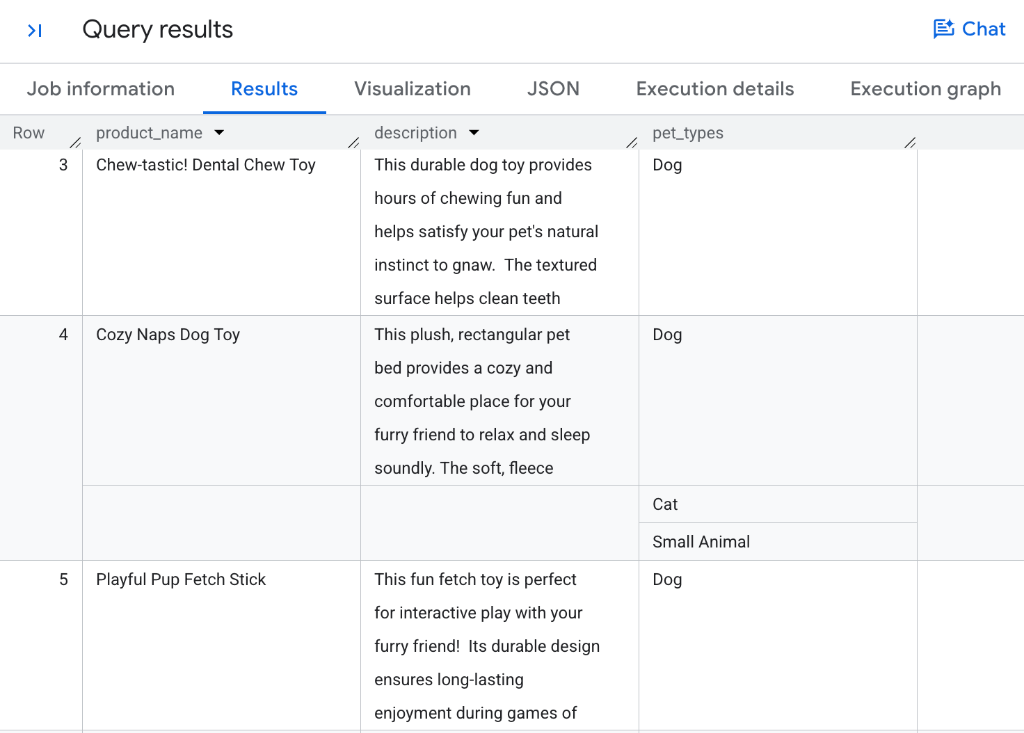
Meninjau mekanisme klasifikasi
- Label tunggal vs. multi-label: Tanpa
output_mode,AI.CLASSIFYmenampilkanSTRINGskalar. Menetapkanoutput_mode => 'multi'akan menampilkanARRAYyang berisi nol, satu, atau beberapa label yang cocok. - Penetapan multi-kategori: Perhatikan bagaimana item khusus seperti
Chew-tastic! Dental Chew ToydanPlayful Pup Fetch Stickmenerima[Dog], sementara item kenyamanan serbaguna sepertiCozy Naps Dog Toy(tempat tidur persegi panjang yang lembut) menerima beberapa tag dengan benar:[Dog, Cat, Small Animal]. - Pencocokan zero-shot: Model mengevaluasi gabungan teks dan perintah terhadap array
categoriesyang diberikan tanpa memerlukan model ML kustom terlatih. - Operasi array SQL hilir: Anda dapat menggunakan fungsi array SQL BigQuery standar seperti
WHERE 'Cat' IN UNNEST(pet_types)atauCROSS JOIN UNNEST(pet_types)untuk memfilter, menguraikan, dan menggabungkan rekaman multi-label.
6. Memfilter gambar produk multimodal dengan AI.IF
Fungsi AI.IF menggunakan Gemini untuk mengevaluasi kondisi bahasa alami dan menampilkan nilai boolean (TRUE atau FALSE).
Karena AI.IF menerima input multimodal, Anda dapat menggunakannya langsung dalam klausa SQL WHERE untuk memfilter file gambar tidak terstruktur yang disimpan di Cloud Storage.
Memfilter gambar yang berisi objek tertentu
Misalkan tim merchandising ingin menemukan semua gambar produk dalam katalog yang secara visual berisi makanan atau camilan hewan peliharaan.
Jalankan kueri berikut di tab SQL Anda:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`
WHERE
  AI.IF(
    ('Does this product image contain pet food or snacks? ', OBJ.MAKE_REF(uri, 'us.conn'))
  );
Hasil Anda akan terlihat seperti berikut:
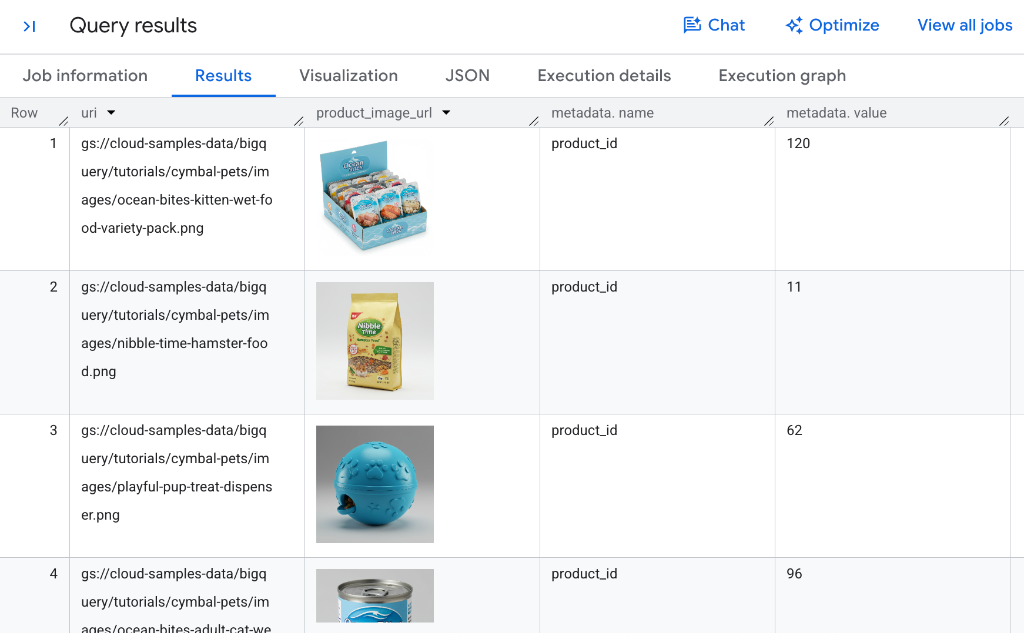
Cara kerja pemfilteran multimodal
- Referensi Objek Langsung: Meskipun kita membuat referensi objek langsung di sini menggunakan
OBJ.MAKE_REF(uri, 'us.conn'), Anda juga dapat membuat dan menyimpan kolomObjectReflangsung di tabel BigQuery sehingga kolom tersebut langsung siap digunakan dalam analisis tanpa memerlukan fungsiOBJ.MAKE_REFdi setiap kueri. - Pengenalan objek visual yang mendalam: Perhatikan bagaimana Gemini secara akurat mengidentifikasi berbagai format kemasan (seperti kotak paket makanan basah, kantong makanan hamster kering, dan makanan kucing kalengan) sekaligus mengenali camilan yang dapat dimakan yang dimasukkan ke dalam mainan seperti dispenser camilan biru.
- Evaluasi predikat tingkat baris: BigQuery mengevaluasi kondisi bahasa alami terhadap setiap referensi gambar Cloud Storage secara langsung dalam klausa
WHERE. - Pemfilteran Boolean: Hanya data yang kondisinya dievaluasi Gemini sebagai
TRUEyang ditampilkan dalam set hasil.
7. Melakukan gabungan semantik di seluruh tabel dengan AI.IF
Penggabungan database relasional tradisional memerlukan kesamaan kunci yang tepat (seperti products.product_id = images.product_id). Namun, set data perusahaan di dunia nyata sering kali berisi aset tidak terstruktur yang tidak memiliki kunci asing eksplisit.
Karena AI.IF menampilkan nilai boolean, Anda dapat menempatkannya langsung di dalam klausa INNER JOIN ... ON SQL untuk melakukan gabungan semantik.
Menggabungkan deskripsi produk dengan aset gambar secara semantik
Misalkan Anda ingin mencocokkan deskripsi produk dari tabel products dengan file gambar yang tidak ditautkan di product_images untuk produk yang dibuat oleh merek Fluffy Buns.
Jalankan kueri berikut di tab SQL BigQuery Studio Anda (perhatikan bahwa kueri ini memerlukan waktu beberapa menit untuk diselesaikan):
SELECT
  products.product_id,
  products.product_name,
  products.description,
  products.brand,
  images.uri AS image_uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(images.uri, 'us.conn')).url AS product_image_url
FROM
  `bigquery-public-data.cymbal_pets.products` AS products
INNER JOIN
  `bigquery-public-data.cymbal_pets.product_images` AS images
ON
  AI.IF(
    ('You will be provided an image of a pet product. ',
    'Determine if the image is of the following pet toy: ',
    products.product_name,
    products.description,
    OBJ.MAKE_REF(images.uri, 'us.conn')
    )
  )
WHERE
  products.category = "Toys" AND
  products.brand = "Fluffy Buns";
Hasil Anda akan terlihat seperti berikut:
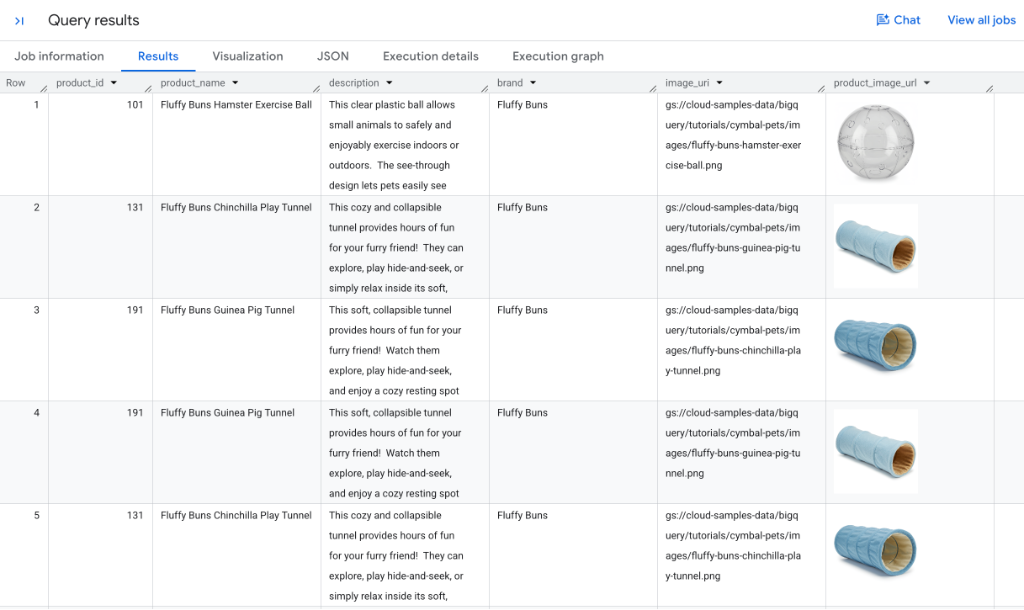
Memahami gabungan semantik di SQL
- Evaluasi kondisi lintas-modal: Untuk pasangan data kandidat, BigQuery mengirimkan metadata tekstual dari
productsdan referensi gambar (OBJ.MAKE_REF(...)) ke Gemini. - Pencocokan visual yang akurat: Seperti yang ditunjukkan dalam hasil,
Fluffy Buns Hamster Exercise Balldicocokkan dengan gambar bola plastik bening, sedangkanFluffy Buns Chinchilla Play TunneldanGuinea Pig Tunneldicocokkan dengan foto terowongan boneka biru. Karena semantik SQLINNER JOINstandar, produk dapat menghasilkan beberapa baris dalam output jika cocok dengan lebih dari satu aset gambar dalam katalog (seperti beberapa sudut foto atau bidikan serupa). - Rendering gambar inline: BigQuery Studio secara otomatis merender URL baca yang diizinkan di kolom
product_image_urllangsung dalam petak hasil Anda untuk verifikasi visual instan. - Penyelesaian entitas tidak terstruktur: Hal ini memungkinkan alur kerja penyelesaian entitas yang efektif di seluruh katalog lama, set data yang di-scraping, dan arsip media tanpa pelabelan manual atau kunci asing eksplisit.
8. Gabungkan insight di seluruh baris dengan AI.AGG
Meskipun fungsi seperti AI.SCORE, AI.CLASSIFY, dan AI.IF mengevaluasi setiap baris (operasi skalar), menganalisis data perusahaan sering kali memerlukan sintesis pola di beberapa catatan.
Fungsi AI.AGG adalah fungsi agregat yang menggunakan petunjuk bahasa alami untuk meringkas, mengelompokkan, atau menyintesis insight di ribuan atau jutaan baris tidak terstruktur menjadi satu respons terpadu.
Mensintesis ringkasan kategori bersama metrik SQL tradisional
AI.AGG terintegrasi secara lancar dengan GROUP BY SQL tradisional dan fungsi agregat. Misalnya, Anda dapat menghitung metrik tradisional (seperti jumlah item) tepat di samping ringkasan AI generatif yang menjelaskan kesamaan produk dalam setiap kategori.
Jalankan kueri berikut di BigQuery Studio:
SELECT
  category,
  COUNT(*) AS item_count,
  AI.AGG(
    ('Product: ', product_name, ' - Description: ', description),
    'Write a concise, one-sentence summary describing the common characteristics or purpose of the products in this category.'
  ) AS category_summary
FROM
  `bigquery-public-data.cymbal_pets.products`
GROUP BY
  category
ORDER BY
  item_count DESC;
Hasil Anda akan terlihat seperti berikut:
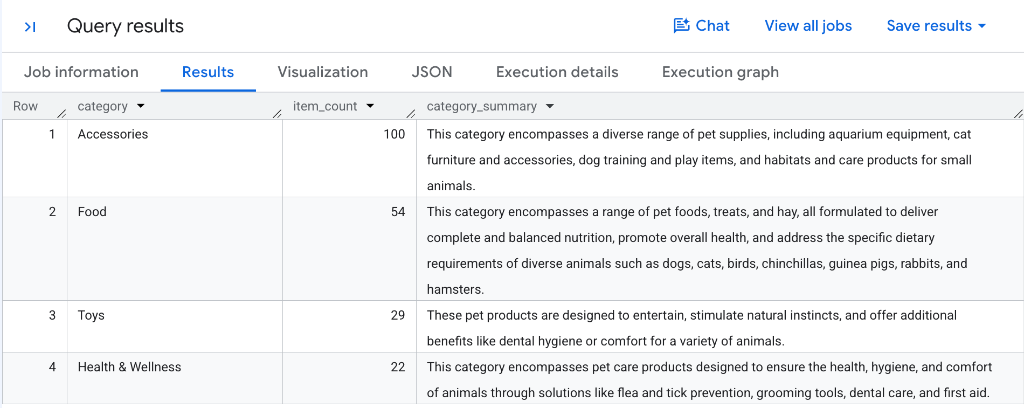
Cara AI.AGG mengagregasi data tidak terstruktur
- Agregasi hierarkis: BigQuery mengelompokkan data baris per partisi kategori, membuat jendela konteks terstruktur, dan menggunakan Gemini untuk menyintesis seluruh kumpulan data produk.
- Sintesis katalog otomatis: Perhatikan bagaimana setiap kategori menerima ringkasan yang berbeda dan akurat, seperti
Accessoriesmencakup habitat dan perlengkapan pelatihan, atauFoodmenyoroti nutrisi seimbang di berbagai spesies hewan. - Pelaporan kuantitatif dan kualitatif hibrida: Menggabungkan agregasi standar seperti
COUNT(*)denganAI.AGGmenghasilkan ringkasan katalog yang komprehensif dalam satu kueri tanpa pipeline ETL kustom. - Partisi fleksibel: Anda dapat menerapkan
AI.AGGdi seluruh dimensi pengelompokan (sepertiGROUP BY brand,GROUP BY category, atau di seluruh tabel) untuk menghasilkan insight tingkat eksekutif dalam hitungan detik.
9. Mempercepat kueri dengan mode yang dioptimalkan dan model proxy
Saat memproses set data besar yang berisi ribuan atau jutaan baris, pemanggilan LLM jarak jauh untuk setiap baris dapat menyebabkan latensi dan biaya.
Untuk mengatasi hal ini, BigQuery menyediakan mode yang dioptimalkan untuk AI.IF dan AI.CLASSIFY. Mode yang dioptimalkan menggunakan model proxy dan distilasi model secara langsung untuk memberikan eksekusi 100x lebih cepat dengan biaya token LLM yang lebih rendah.
Cara kerja mode yang dioptimalkan

- Pengambilan sampel dan pelabelan perwakilan: BigQuery secara otomatis memilih sampel baris perwakilan dan mendapatkan label dari Gemini.
- Pelatihan model yang disederhanakan: BigQuery melatih model proxy yang sangat ringan (seperti regresi logistik) tepat waktu di CPU menggunakan sematan teks sebagai fitur.
- Verifikasi kualitas: BigQuery mengevaluasi akurasi model yang disederhanakan terhadap Gemini. Jika memenuhi nilai minimum kualitas, BigQuery akan mempromosikannya untuk memproses sisa set data.
- Inferensi berkecepatan tinggi lokal: Model proxy mengevaluasi baris yang tersisa secara lokal dengan biaya token LLM jarak jauh nol dan latensi ultra-rendah.
Menjalankan kueri dasar tanpa pengoptimalan
Karena katalog sampel bigquery-public-data.cymbal_pets.products berisi terlalu sedikit baris untuk memicu distilasi model proxy, kita akan menggunakan set data publik yang lebih besar bigquery-public-data.bbc_news.fulltext (yang berisi lebih dari 2.200 artikel berita).
Pertama, jalankan kueri standar tanpa pengoptimalan untuk mengidentifikasi artikel berita tentang bencana alam:
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body)
  );
Memeriksa detail tugas dasar pengukuran dan penggunaan token
Setelah kueri dasar selesai, periksa metrik eksekusi:
- Di panel hasil bawah BigQuery Studio, pilih tab Informasi tugas.
- Scroll ke bawah ke bagian jumlah token input dan jumlah token output.
Hasil Anda akan terlihat seperti berikut:
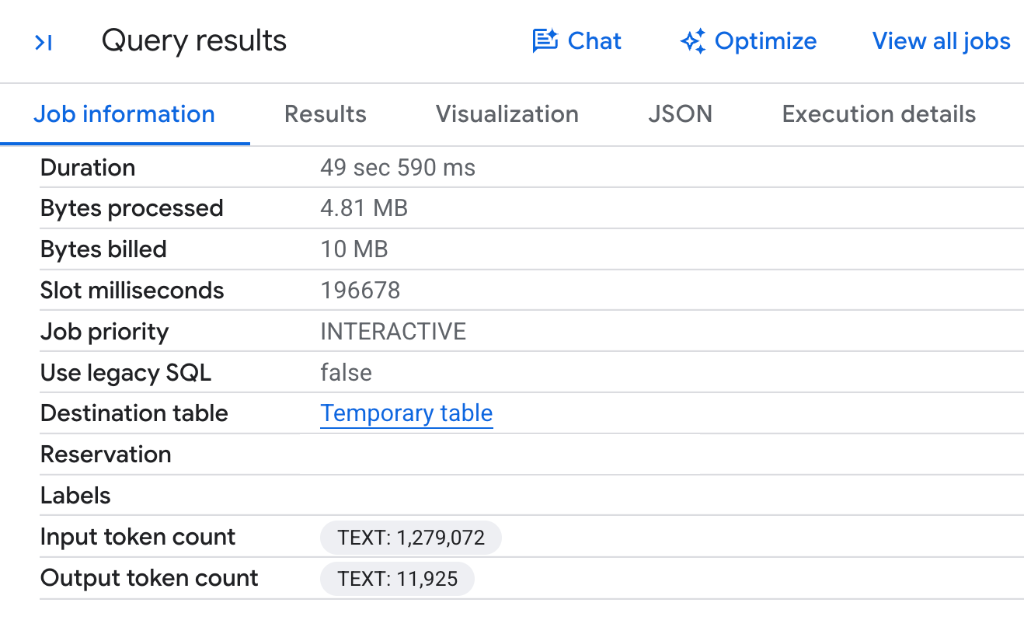
- Penggunaan token set data lengkap: Karena BigQuery memanggil model Gemini jarak jauh untuk setiap baris di semua 2.225 artikel berita tanpa pengoptimalan proxy, kueri menggunakan 1.279.072 token input dan 11.925 token output.
- Tidak ada bagian pengoptimalan: Perhatikan bahwa tidak ada entri
Gen AI Function Optimizationskarena eksekusi standar mengevaluasi setiap baris satu per satu terhadap endpoint LLM jarak jauh.
Menjalankan kueri dengan mode yang dioptimalkan
Untuk mengurangi konsumsi token dan memanfaatkan distilasi model proxy, aktifkan mode yang dioptimalkan dengan meneruskan embeddings => AI.EMBED(...) dan menyetel optimization_mode => 'MINIMIZE_COST':
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body),
    embeddings => AI.EMBED(body, endpoint => 'text-embedding-005', task_type => 'CLASSIFICATION').result,
    optimization_mode => 'MINIMIZE_COST'
  );
Verifikasi pengoptimalan dan amati pengurangan penggunaan token
Setelah menjalankan kueri yang dioptimalkan, beralihlah ke tab Informasi tugas BigQuery Studio untuk mengamati perbandingan penggunaan token dan metrik eksekusi:
- Di panel hasil bawah BigQuery Studio, pilih tab Informasi tugas.
- Scroll ke bagian Pengoptimalan Fungsi AI Generatif, serta jumlah token.
Hasil Anda akan terlihat seperti berikut:
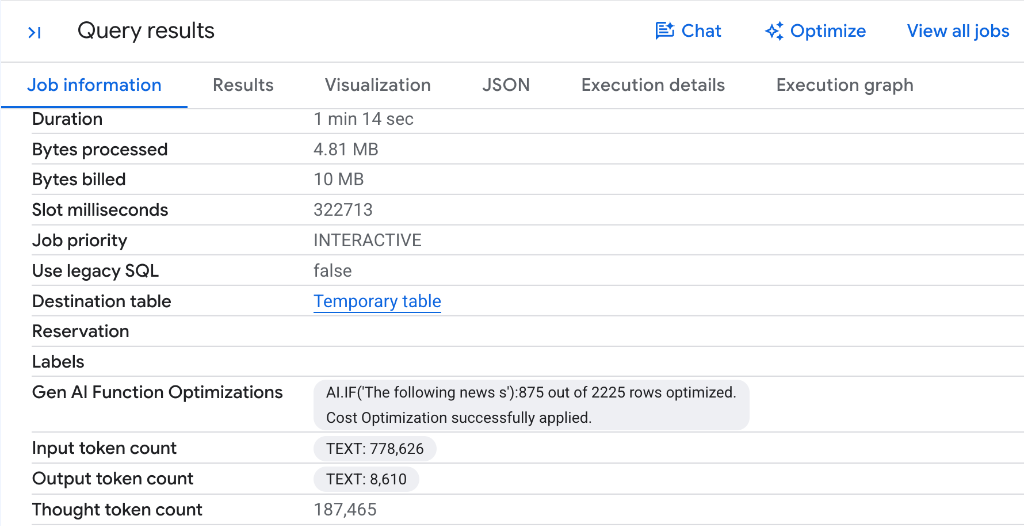
- Pengurangan token yang signifikan: Perhatikan bagaimana Jumlah token input turun dari 1.279.072 token menjadi 778.626 token—menghemat 500.446 token input (hampir 40% pengurangan) dalam satu eksekusi kueri. Demikian pula, ada penurunan token output.
- Penyulingan proxy otomatis: Perhatikan label
AI.IF('The following news s'): 875 out of 2225 rows optimized. Cost Optimization successfully applied.BigQuery mengambil sampel set data, memberi label pada artikel representatif dengan Gemini, menyuling pengklasifikasi proxy ringan yang cepat, dan memproses 875 dari 2.225 baris secara lokal di CPU tanpa memanggil endpoint LLM jarak jauh. - Penghematan biaya langsung: Karena fungsi AI terkelola BigQuery ditagih berdasarkan volume token model yang diproses, pengurangan konsumsi token secara langsung akan menurunkan biaya eksekusi kueri.
- Validasi kualitas: BigQuery secara otomatis memverifikasi akurasi model proxy terhadap Gemini sebelum mempromosikannya untuk mengevaluasi baris yang tersisa, sehingga memastikan kualitas klasifikasi tetap terjaga.
Pengurangan token dan penskalaan latensi yang lebih besar pada tabel yang lebih besar
Meskipun menyimpan lebih dari 500.000 token pada 2.225 baris adalah hal yang signifikan, pengurangan token dan peningkatan performa bahkan lebih tinggi pada tabel yang lebih besar:
- Mengapa pengurangan token diskalakan dengan ukuran set data: Untuk kueri yang dijalankan di BigQuery, model proxy dilatih secara langsung menggunakan sampel awal sekitar 1.000 baris yang diberi label oleh LLM. Setelah dilatih dan divalidasi, model proxy akan menggantikan panggilan LLM langsung di seluruh baris yang tersisa. Untuk kueri yang lebih besar (seperti set data 1 juta baris yang umum), hal ini menghilangkan pemanggilan LLM untuk sebagian besar data, sehingga menggunakan token hingga 400x lebih sedikit dan mengurangi biaya secara drastis.
- Percepatan latensi yang signifikan: Dengan mengalihkan inferensi dari hardware LLM khusus ke model proxy yang sangat ringan yang berjalan langsung di CPU pekerja database standar (dengan memanfaatkan sematan Gemini yang telah dihitung sebelumnya), BigQuery mengurangi runtime kueri secara keseluruhan hingga 30x hingga 100x.
10. Membersihkan resource
Untuk membersihkan resource yang dibuat selama codelab ini, jalankan pernyataan berikut di tab SQL BigQuery Studio untuk menghapus Koneksi Resource Cloud:
DROP CONNECTION IF EXISTS `us.conn`;
Atau, jika Anda membuat project Google Cloud sementara khusus untuk tutorial ini, Anda dapat menonaktifkan seluruh project di Cloud Resource Manager.
11. Selamat
Selamat! Anda telah berhasil menyelesaikan codelab tentang Analisis Semantik di BigQuery dengan fungsi AI terkelola dan SQL.
Anda telah menguasai fungsi AI generatif terkelola BigQuery:
AI.SCORE: Meranking produk berdasarkan kriteria subjektif seperti kesesuaian sebagai hadiah dalam skala 1-10 menggunakan penulisan ulang perintah otomatis.AI.CLASSIFY: Mengategorikan item katalog tidak terstruktur ke dalam klasifikasi hewan target.AI.IF(Pemfilteran Multimodal): Aset gambar Cloud Storage yang difilter dalam klausa SQLWHEREberdasarkan konten visual.AI.IF(Gabungan Semantik): Melakukan gabungan lintas modalitas dalam klausa SQLONuntuk menautkan deskripsi produk tekstual dengan file gambar.AI.AGG: Mensintesis teks katalog tidak terstruktur multi-baris menjadi ringkasan eksekutif yang ringkas.- Mode yang Dioptimalkan & Model Proxy: Kueri yang dipercepat dan biaya token yang diminimalkan menggunakan
optimization_mode => 'MINIMIZE_COST'dengan distilasi model secara langsung danAI.EMBED.
Pelajari lebih lanjut
- Ringkasan AI Generatif BigQuery
- Panduan Fungsi AI Terkelola BigQuery
AI.SCOREDokumentasi Sintaksis SQLAI.CLASSIFYDokumentasi Sintaksis SQLAI.IFDokumentasi Sintaksis SQLAI.AGGDokumentasi Sintaksis SQL- Mengoptimalkan fungsi AI dengan distilasi model
- Blog Google Cloud: More than 100x faster and cheaper LLM-powered SQL queries with proxy models
- Blog Google Cloud: Pembahasan mendalam tentang fungsi AI.AGG BigQuery