

1. Ti diamo il benvenuto
In questo codelab, imparerai a utilizzare la suite di funzioni AI gestite di BigQuery per eseguire analisi semantiche sofisticate, classificazioni categoriali, filtri multimodali, join semantici e riepiloghi di più righe direttamente in BigQuery Studio utilizzando SQL.
Utilizzando il set di dati pubblico bigquery-public-data.cymbal_pets, ti metterai nei panni di un analista di dati di Cymbal Pets, un rivenditore di e-commerce di forniture e accessori per animali domestici.
Analisi semantica direttamente nelle query SQL
Tradizionalmente, l'applicazione di machine learning o modelli linguistici di grandi dimensioni (LLM) ai set di dati aziendali richiedeva lo spostamento dei dati dal data warehouse in ambienti di notebook Python esterni. Ciò richiedeva pipeline di data engineering dedicate ed esperienza in ML.
Le funzioni AI gestite di BigQuery, tra cui AI.SCORE, AI.CLASSIFY, AI.IF e AI.AGG, portano l'intelligenza dei foundation model direttamente ai tuoi dati. BigQuery ottimizza automaticamente la selezione dei modelli e applica strategie di riscrittura dei prompt interni per fornire risultati di elevata precisione da semplici prompt in linguaggio naturale.
Per i set di dati di grandi dimensioni, BigQuery fornisce la modalità ottimizzata, utilizzando la distillazione dei modelli on-the-fly e i modelli proxy leggeri per fornire query fino a 100 volte più veloci ed economiche.
Attività previste
- Esplora i dati di vendita al dettaglio multimodali in BigQuery Studio utilizzando SQL.
- Esegui la classificazione semantica utilizzando
AI.SCOREper valutare gli attributi soggettivi dei prodotti come "regalabilità". - Classifica i dati non strutturati utilizzando
AI.CLASSIFYper mappare i prodotti alle specie animali di destinazione. - Filtra gli asset immagine multimodali utilizzando
AI.IFall'interno delle clausoleWHERE. - Esegui join semantici tra le tabelle utilizzando
AI.IFnelle clausoleJOIN ... ONper abbinare i record di prodotti di testo ai file immagine esterni. - Sintetizza gli insight di più righe utilizzando la funzione di aggregazione
AI.AGG. - Ottimizza la latenza e il costo delle query su set di dati di grandi dimensioni utilizzando
AI.IFcon la modalità ottimizzata (optimization_mode => 'MINIMIZE_COST') e la distillazione dei modelli proxy.
Che cosa ti serve
- Un progetto Google Cloud con la fatturazione abilitata.
- Un browser web come Chrome.
2. Configurazione e requisiti
Prima di eseguire query sui dati con le funzioni AI gestite, devi configurare il progetto Google Cloud e abilitare le API richieste.
Crea un progetto Google Cloud e abilita le API
- Nella console Google Cloud, nella pagina di selezione del progetto, seleziona o crea un progetto Google Cloud.
- Verifica che la fatturazione sia attivata per il tuo progetto Cloud. Scopri come verificare se la fatturazione è abilitata per un progetto.
- Abilita le API BigQuery, BigQuery Connection e Agent Platform.
Apri BigQuery Studio
- Nel menu di navigazione della console Google Cloud, fai clic su BigQuery per aprire BigQuery Studio.
- Nella barra degli strumenti dell'editor di BigQuery Studio, fai clic su + Query SQL per aprire una nuova scheda Query SQL. In queste schede SQL scriverai ed eseguirai tutte le query SQL in questo codelab.
Crea una connessione alle risorse Cloud in SQL
BigQuery opera all'interno di un perimetro di dati sicuro. Quando ispeziona i file multimodali esterni (ad esempio le immagini archiviate in Google Cloud Storage), BigQuery utilizza una connessione alle risorse Cloud per accedere in modo sicuro ai riferimenti agli oggetti senza esporre le credenziali.
Esegui la seguente istruzione nella scheda SQL per creare una connessione denominata us.conn:
CREATE CONNECTION IF NOT EXISTS `us.conn`
OPTIONS (
  connection_type = "CLOUD_RESOURCE"
);
3. Esplora il set di dati Cymbal Pets
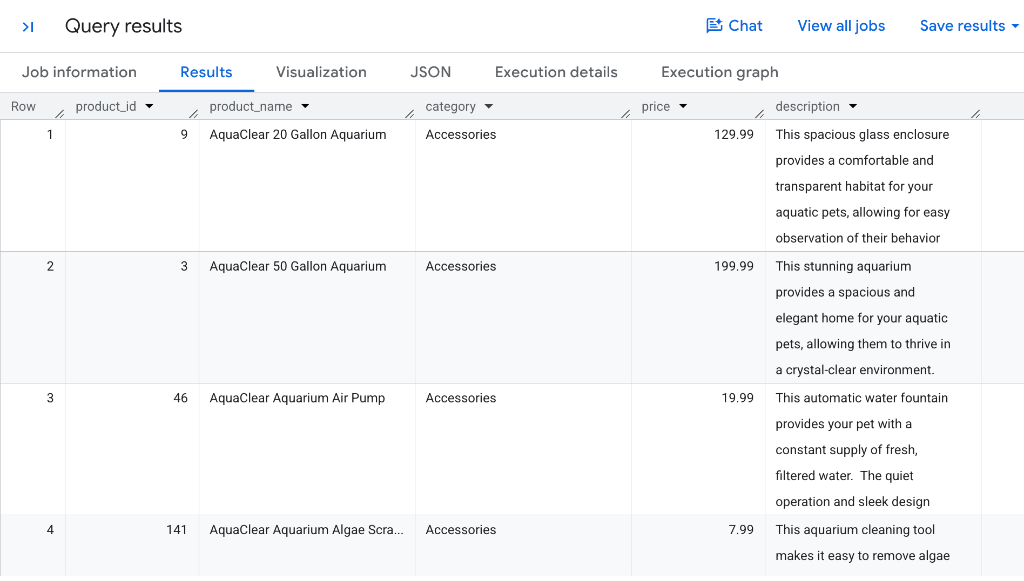
Cymbal Pets gestisce un catalogo di prodotti completo nel set di dati pubblico all'interno della tabella denominata bigquery-public-data.cymbal_pets.products. Ogni record di prodotto contiene attributi strutturati come ID prodotto, titolo, categoria di vendita al dettaglio, prezzo e testo descrittivo.
Esegui query sul catalogo dei prodotti
Apri una scheda SQL in BigQuery Studio ed esegui la seguente query per ispezionare la tabella dei prodotti:
SELECT
  product_id,
  product_name,
  category,
  price,
  description
FROM
  `bigquery-public-data.cymbal_pets.products`;
I risultati saranno simili ai seguenti:
Ispeziona le immagini dei prodotti
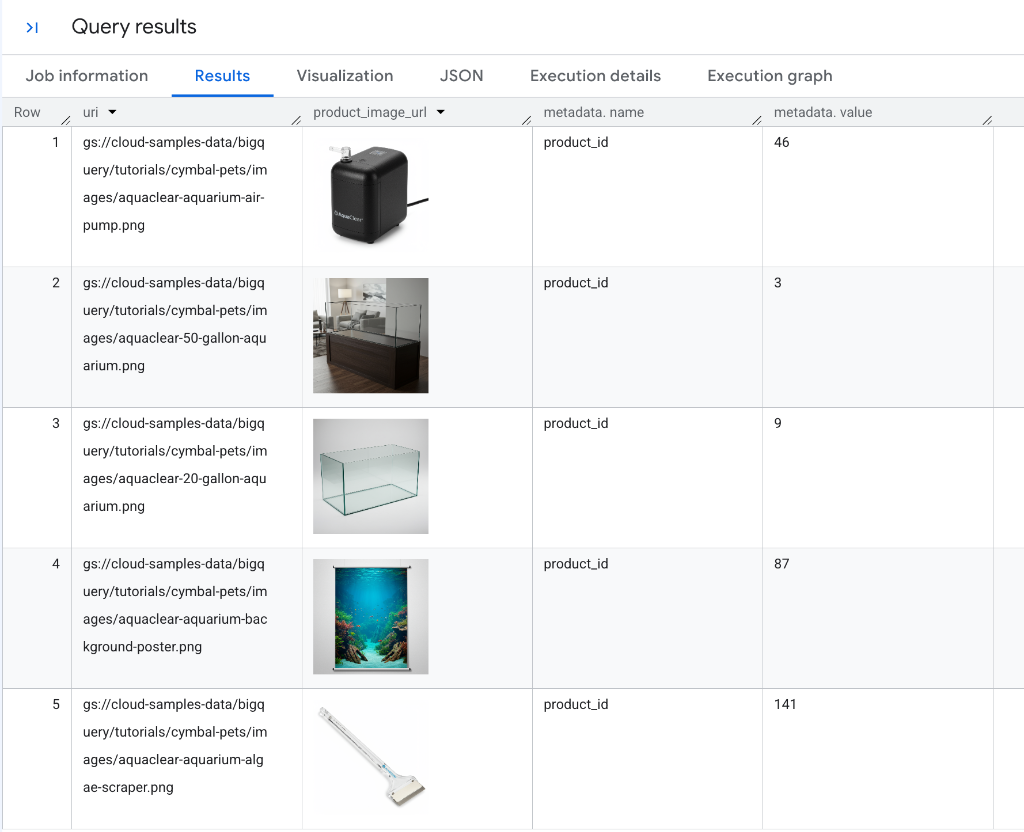
Cymbal Pets archivia anche i riferimenti alle immagini prodotto in bigquery-public-data.cymbal_pets.product_images. Esegui la seguente query per visualizzare i record delle immagini:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`;
I risultati saranno simili ai seguenti:
Ora utilizzerai le funzioni gestite di BigQuery per analizzare i dati di testo e immagine del data warehouse di Cymbal Pets.
4. Classifica i prodotti in base a criteri semantici con AI.SCORE
La funzione AI.SCORE accetta input di testo e utilizza un modello Gemini per valutarli in base a una rubrica di punteggio in linguaggio naturale, restituendo un punteggio numerico FLOAT64.
Se non fornisci una rubrica di punteggio esplicita, BigQuery applica automaticamente strategie di riscrittura dei prompt per generare una rubrica ottimale per il modello.
Assegna un punteggio ai prodotti per "regalabilità"
Supponiamo che il team di marketing di Cymbal Pets voglia creare una guida ai regali per le festività. Vogliono classificare ogni articolo del catalogo in base alla sua idoneità come regalo per un proprietario di animali domestici su una scala da 1 a 10.
Esegui la seguente query nella scheda SQL:
SELECT
  product_name,
  description,
  AI.SCORE(
    ('How "giftable" is this product for a pet owner? ', description,
    'Use a scale from 1-10.')
  ) AS giftability_score
FROM
  `bigquery-public-data.cymbal_pets.products`
ORDER BY
  giftability_score DESC;
Informazioni sui risultati
I risultati saranno simili ai seguenti:
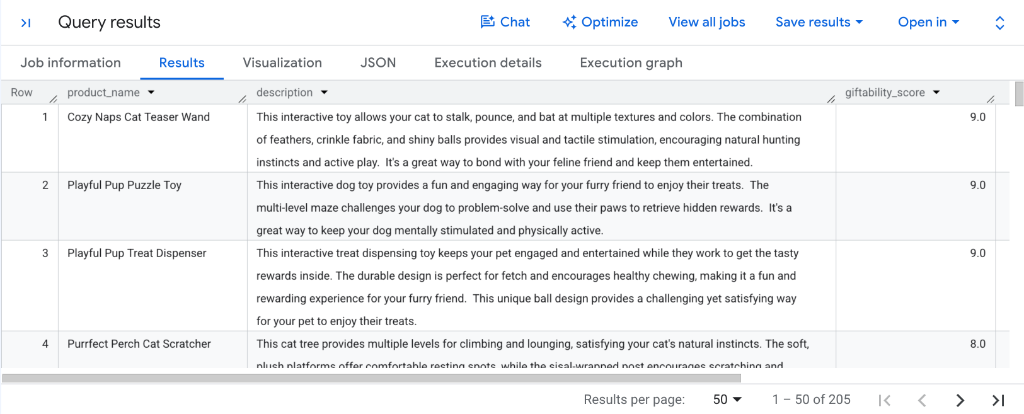
Esamina la colonna giftability_score nei risultati della query:
- Giocattoli interattivi di grande appeal: gli articoli coinvolgenti come
Cozy Naps Cat Teaser Wand,Playful Pup Puzzle ToyePlayful Pup Treat Dispenserricevono le valutazioni più alte (9.0). - Articoli speciali per il comfort e il graffio: gli elementi essenziali più diffusi come il
Purrfect Perch Cat Scratcherottengono un punteggio elevato pari a8.0. - Classificazione downstream utilizzabile: poiché
AI.SCOREproduce punteggiFLOAT64normalizzati, puoi ordinare immediatamente i risultati conORDER BY giftability_score DESCo filtrare i candidati conWHERE AI.SCORE(...) >= 8.0per generare guide ai regali automatiche.
5. Classifica gli articoli del catalogo con AI.CLASSIFY
La funzione AI.CLASSIFY utilizza Gemini per classificare i record di input in un elenco discreto di categorie di destinazione fornite come array SQL.
AI.CLASSIFY supporta input multimodali (testo, immagini, audio, video) ed elimina la necessità di creare, addestrare o eseguire il deployment di modelli di classificazione personalizzati per la gestione della tassonomia.
Classifica i giocattoli in base alla specie animale di destinazione (etichetta singola)
Supponiamo che alcuni prodotti del catalogo Cymbal Pets siano taggati genericamente come "Giocattoli" senza specificare l'animale di destinazione. Puoi utilizzare AI.CLASSIFY per classificare ogni giocattolo in base al nome e alla descrizione.
Esegui la seguente query in BigQuery Studio:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('What animal is this product for?', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "All Pets"]
  ) AS animal_type
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys"
LIMIT 20;
Visualizza i risultati
I risultati saranno simili ai seguenti:
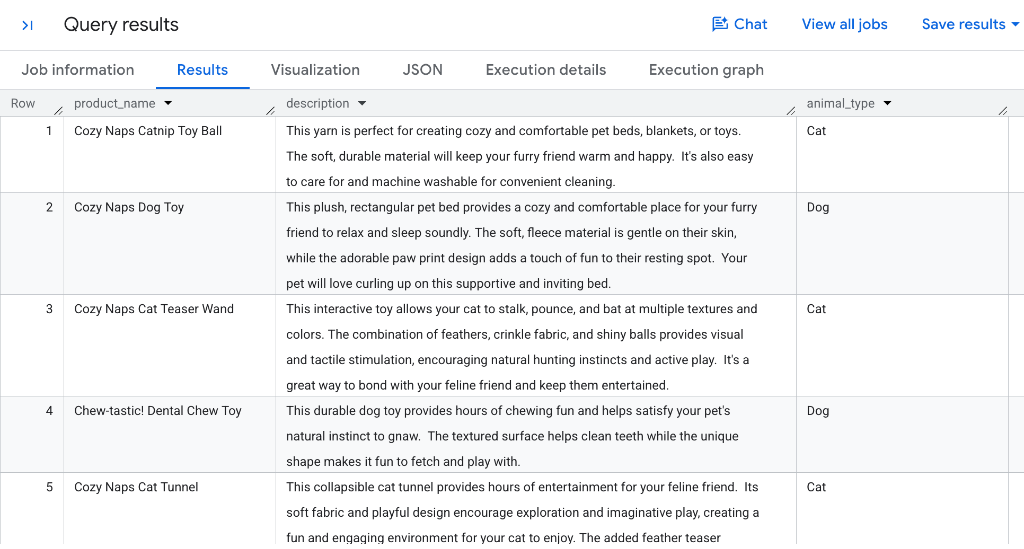
Per impostazione predefinita, AI.CLASSIFY esegue la classificazione con etichetta singola e restituisce una STRING contenente la singola categoria più pertinente dell'array di candidati. Nota come Gemini mappa le palline di erba gatta e i giocattoli con piume a Cat, mentre i giocattoli da masticare e i bastoncini da riporto a Dog.
Assegna più tag con la classificazione con più etichette
Molti prodotti di un catalogo di vendita al dettaglio si applicano contemporaneamente a più tipi di animali domestici (ad esempio, un letto o un tunnel di peluche adatto sia a gatti che a piccoli animali).
Per assegnare più categorie a un singolo record, imposta il parametro facoltativo output_mode => 'multi'. In modalità con più etichette, AI.CLASSIFY restituisce un ARRAY contenente tutte le categorie corrispondenti.
Esegui la seguente query nella scheda SQL:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('Identify all pet types that this product is suitable for: ', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "Reptile"],
    output_mode => 'multi'
  ) AS pet_types
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys";
I risultati saranno simili ai seguenti:
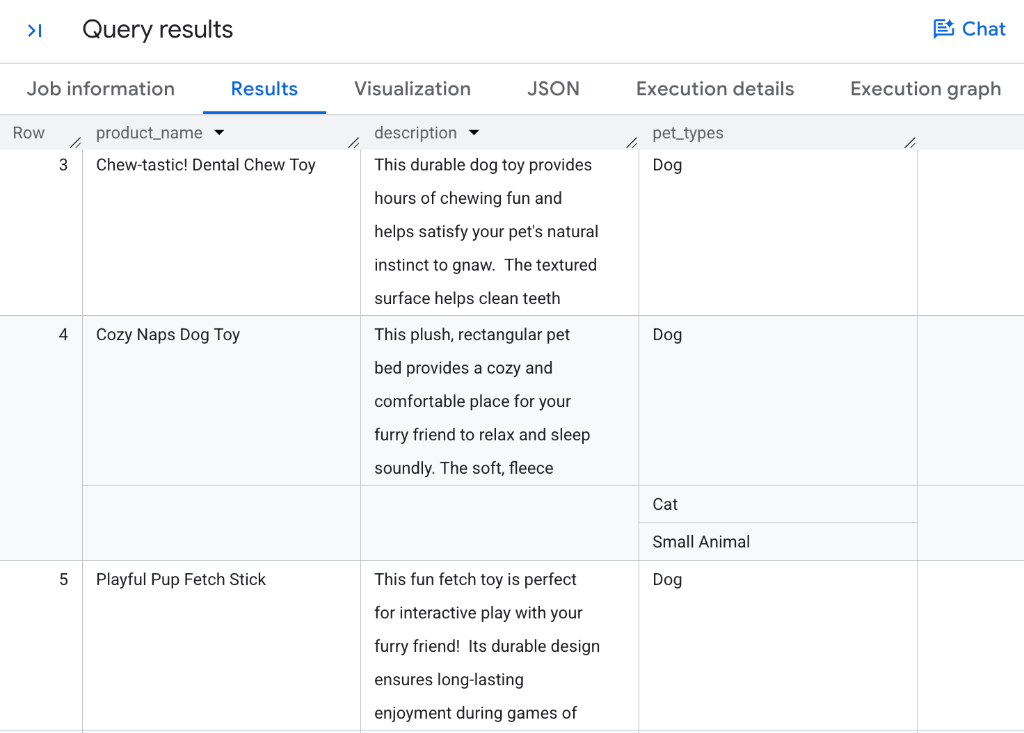
Esamina i meccanismi di classificazione
- Etichetta singola vs. più etichette: senza
output_mode,AI.CLASSIFYrestituisce unaSTRINGscalare. L'impostazione dioutput_mode => 'multi'restituisce unARRAYcontenente zero, una o più etichette corrispondenti. - Assegnazione di più categorie: nota come gli articoli dedicati come
Chew-tastic! Dental Chew ToyePlayful Pup Fetch Stickricevono[Dog], mentre gli articoli di comfort versatili comeCozy Naps Dog Toy(un letto rettangolare di peluche) ricevono correttamente più tag:[Dog, Cat, Small Animal]. - Corrispondenza zero-shot: il modello valuta il testo e il prompt combinati rispetto all'array
categoriesfornito senza richiedere modelli ML personalizzati pre-addestrati. - Operazioni di array SQL downstream: puoi utilizzare le funzioni di array SQL standard di BigQuery come
WHERE 'Cat' IN UNNEST(pet_types)oCROSS JOIN UNNEST(pet_types)per filtrare, espandere e aggregare i record con più etichette.
6. Filtra le immagini di prodotti multimodali con AI.IF
La funzione AI.IF utilizza Gemini per valutare una condizione in linguaggio naturale e restituisce un valore booleano (TRUE o FALSE).
Poiché AI.IF accetta input multimodali, puoi utilizzarlo direttamente all'interno di una clausola WHERE SQL per filtrare i file immagine non strutturati archiviati in Cloud Storage.
Filtra le immagini contenenti oggetti specifici
Supponiamo che il team di merchandising voglia trovare tutte le immagini dei prodotti nel catalogo che contengono visivamente cibo o snack per animali domestici.
Esegui la seguente query nella scheda SQL:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`
WHERE
  AI.IF(
    ('Does this product image contain pet food or snacks? ', OBJ.MAKE_REF(uri, 'us.conn'))
  );
I risultati saranno simili ai seguenti:
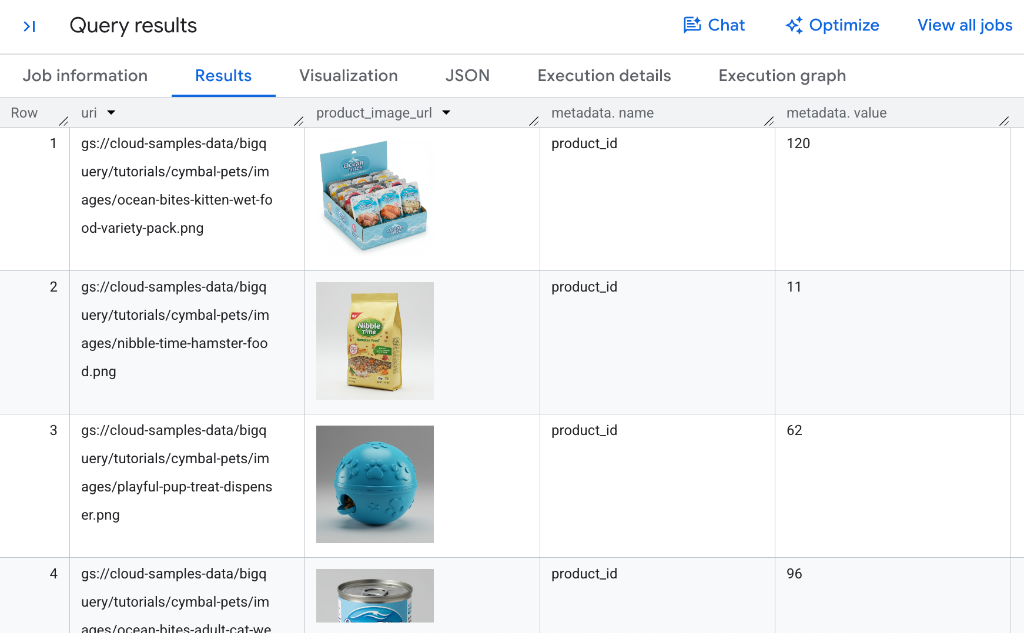
Come funziona il filtro multimodale
- Riferimenti agli oggetti on-the-fly: anche se qui creiamo riferimenti agli oggetti on-the-fly utilizzando
OBJ.MAKE_REF(uri, 'us.conn'), puoi anche creare e archiviare le colonneObjectRefdirettamente nelle tabelle BigQuery in modo che siano immediatamente pronte per l'uso nell'analisi senza la necessità della funzioneOBJ.MAKE_REFin ogni query. - Riconoscimento degli oggetti visivi approfondito: nota come Gemini identifica con precisione diversi formati di packaging (ad esempio la confezione di cibo umido, il sacchetto di cibo secco per criceti e il cibo in scatola per gatti), riconoscendo anche gli snack commestibili caricati all'interno di giocattoli come il distributore di snack blu.
- Valutazione dei predicati a livello di riga: BigQuery valuta la condizione in linguaggio naturale rispetto a ogni riferimento all'immagine di Cloud Storage direttamente all'interno della clausola
WHERE. - Filtro booleano: nel set di risultati vengono restituiti solo i record in cui Gemini valuta la condizione come
TRUE.
7. Esegui join semantici tra le tabelle con AI.IF
I join tradizionali dei database relazionali richiedono l'uguaglianza esatta delle chiavi (ad esempio products.product_id = images.product_id). Tuttavia, i set di dati aziendali del mondo reale spesso contengono asset non strutturati privi di chiavi esterne esplicite.
Poiché AI.IF restituisce un valore booleano, puoi inserirlo direttamente all'interno di una clausola SQL INNER JOIN ... ON per eseguire join semantici.
Esegui il join semantico delle descrizioni dei prodotti con gli asset immagine
Supponiamo che tu voglia abbinare le descrizioni dei prodotti della tabella products ai file immagine non collegati in product_images per i prodotti realizzati dal brand Fluffy Buns.
Esegui la seguente query nella scheda SQL di BigQuery Studio (tieni presente che il completamento richiede alcuni minuti):
SELECT
  products.product_id,
  products.product_name,
  products.description,
  products.brand,
  images.uri AS image_uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(images.uri, 'us.conn')).url AS product_image_url
FROM
  `bigquery-public-data.cymbal_pets.products` AS products
INNER JOIN
  `bigquery-public-data.cymbal_pets.product_images` AS images
ON
  AI.IF(
    ('You will be provided an image of a pet product. ',
    'Determine if the image is of the following pet toy: ',
    products.product_name,
    products.description,
    OBJ.MAKE_REF(images.uri, 'us.conn')
    )
  )
WHERE
  products.category = "Toys" AND
  products.brand = "Fluffy Buns";
I risultati saranno simili ai seguenti:
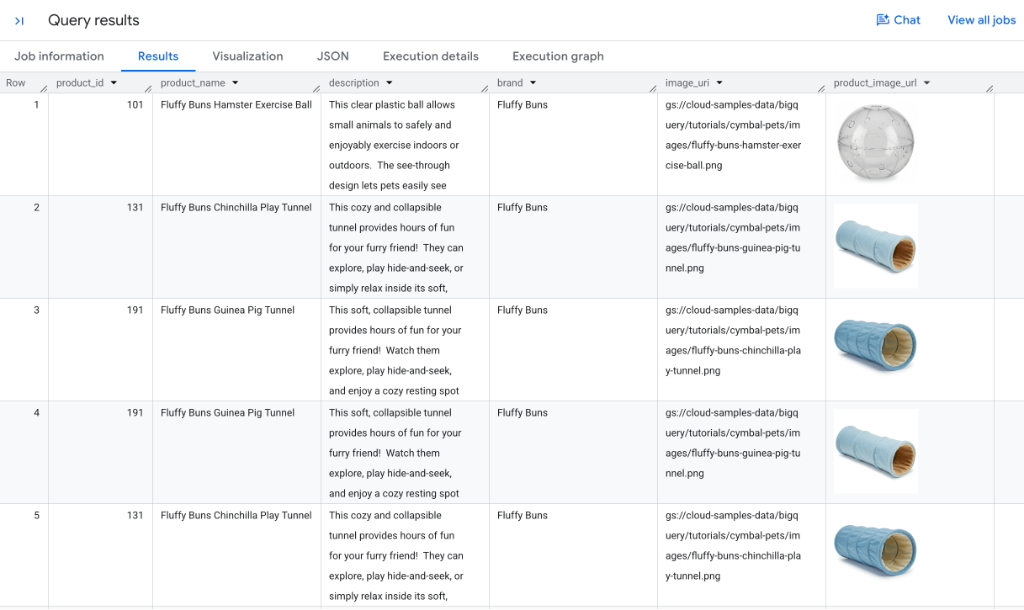
Informazioni sui join semantici in SQL
- Valutazione delle condizioni cross-modali: per le coppie di record candidati, BigQuery invia sia i metadati di testo di
productssia il riferimento all'immagine (OBJ.MAKE_REF(...)) a Gemini. - Corrispondenza visiva precisa: come mostrato nei risultati, la
Fluffy Buns Hamster Exercise Ballviene abbinata all'immagine della pallina di plastica trasparente, mentreFluffy Buns Chinchilla Play TunneleGuinea Pig Tunnelvengono abbinate alle foto del tunnel di peluche blu. A causa della semanticaINNER JOINSQL standard, un prodotto può generare più righe nell'output se corrisponde a più asset immagine nel catalogo (ad esempio più angolazioni delle foto o scatti simili). - Rendering delle immagini in linea: BigQuery Studio esegue automaticamente il rendering degli URL di lettura autorizzati nella colonna
product_image_urldirettamente nella griglia dei risultati per la verifica visiva immediata. - Risoluzione delle entità non strutturate: in questo modo è possibile sbloccare workflow di risoluzione delle entità efficaci in cataloghi legacy, set di dati sottoposti a scraping e archivi multimediali senza etichettatura manuale o chiavi esterne esplicite.
8. Sintetizza gli insight tra le righe con AI.AGG
Mentre funzioni come AI.SCORE, AI.CLASSIFY e AI.IF valutano le singole righe (operazioni scalari), l'analisi dei dati aziendali spesso richiede la sintesi di pattern in più record.
La funzione AI.AGG è una funzione di aggregazione che utilizza istruzioni in linguaggio naturale per riepilogare, raggruppare o sintetizzare gli insight in migliaia o milioni di righe non strutturate in una risposta unificata.
Sintetizza i riepiloghi delle categorie insieme alle metriche SQL tradizionali
AI.AGG si integra perfettamente con le funzioni di aggregazione e GROUP BY SQL tradizionali. Ad esempio, puoi calcolare le metriche tradizionali (come i conteggi degli articoli) insieme a un riepilogo di AI generativa che descrive cosa hanno in comune i prodotti di ogni categoria.
Esegui la seguente query in BigQuery Studio:
SELECT
  category,
  COUNT(*) AS item_count,
  AI.AGG(
    ('Product: ', product_name, ' - Description: ', description),
    'Write a concise, one-sentence summary describing the common characteristics or purpose of the products in this category.'
  ) AS category_summary
FROM
  `bigquery-public-data.cymbal_pets.products`
GROUP BY
  category
ORDER BY
  item_count DESC;
I risultati saranno simili ai seguenti:
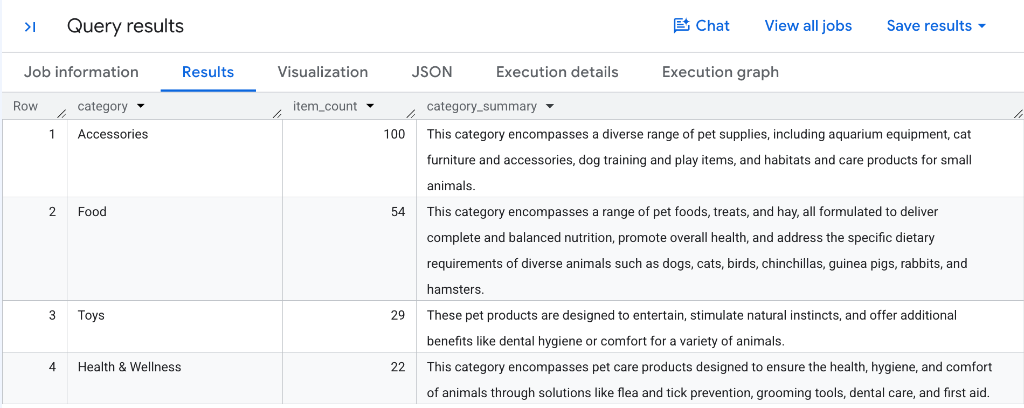
Come AI.AGG aggrega i dati non strutturati
- Aggregazione gerarchica: BigQuery raggruppa i dati delle righe per partizione di categoria, crea finestre di contesto strutturate e utilizza Gemini per sintetizzare l'intera raccolta di record di prodotti.
- Sintesi automatica del catalogo: nota come ogni categoria riceve un riepilogo distinto e preciso, ad esempio
Accessoriesche acquisisce habitat e attrezzature di addestramento, oFoodche evidenzia una nutrizione equilibrata in più specie animali. - Report ibridi quantitativi e qualitativi: la combinazione di aggregazioni standard come
COUNT(*)conAI.AGGproduce panoramiche complete del catalogo in una singola query senza pipeline ETL personalizzate. - Partizionamento flessibile: puoi applicare
AI.AGGa qualsiasi dimensione di raggruppamento (ad esempioGROUP BY brand,GROUP BY categoryo all'intera tabella) per generare insight a livello di executive in pochi secondi.
9. Accelera le query con la modalità ottimizzata e i modelli proxy
Quando si elaborano set di dati di grandi dimensioni contenenti migliaia o milioni di righe, l'invocazione di un LLM remoto per ogni singola riga può introdurre latenza e costi.
Per risolvere questo problema, BigQuery fornisce modalità ottimizzata per AI.IF e AI.CLASSIFY. La modalità ottimizzata utilizza modelli proxy e la distillazione dei modelli on-the-fly per fornire un'esecuzione 100 volte più veloce a un costo dei token LLM ridotto.
Come funziona la modalità ottimizzata
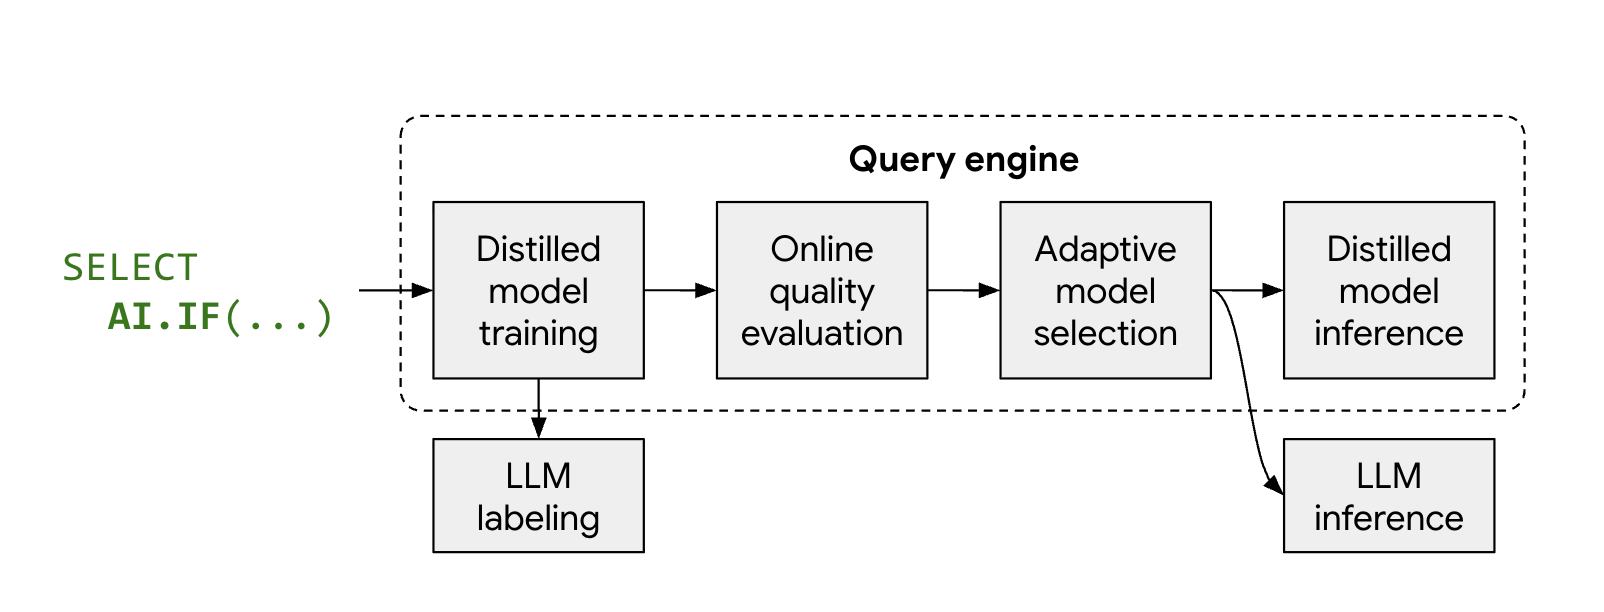
- Campionamento e etichettatura rappresentativi: BigQuery seleziona automaticamente un campione rappresentativo di righe e ottiene le etichette da Gemini.
- Addestramento del modello distillato: BigQuery addestra un modello proxy ultraleggero (ad esempio la regressione logistica) just-in-time sulla CPU utilizzando gli embedding di testo come caratteristiche.
- Verifica della qualità: BigQuery valuta l'accuratezza del modello distillato rispetto a Gemini. Se soddisfa le soglie di qualità, BigQuery lo promuove per elaborare il resto del set di dati.
- Inferenza locale ad alta velocità: il modello proxy valuta le righe rimanenti localmente con un costo dei token LLM remoto pari a zero e una latenza bassissima.
Esegui una query di base senza ottimizzazione
Poiché il catalogo di esempio bigquery-public-data.cymbal_pets.products contiene un numero di righe troppo basso per attivare la distillazione del modello proxy, utilizzeremo il set di dati pubblico più grande bigquery-public-data.bbc_news.fulltext (che contiene oltre 2200 articoli di notizie).
Innanzitutto, esegui la query standard senza ottimizzazione per identificare gli articoli di notizie sui disastri naturali:
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body)
  );
Esamina i dettagli del job di base e l'utilizzo dei token
Al termine della query di base, esamina le metriche di esecuzione:
- Nel riquadro dei risultati in basso di BigQuery Studio, seleziona la scheda Informazioni sul job.
- Scorri verso il basso fino alle sezioni Conteggio dei token di input e Conteggio dei token di output.
I risultati saranno simili ai seguenti:
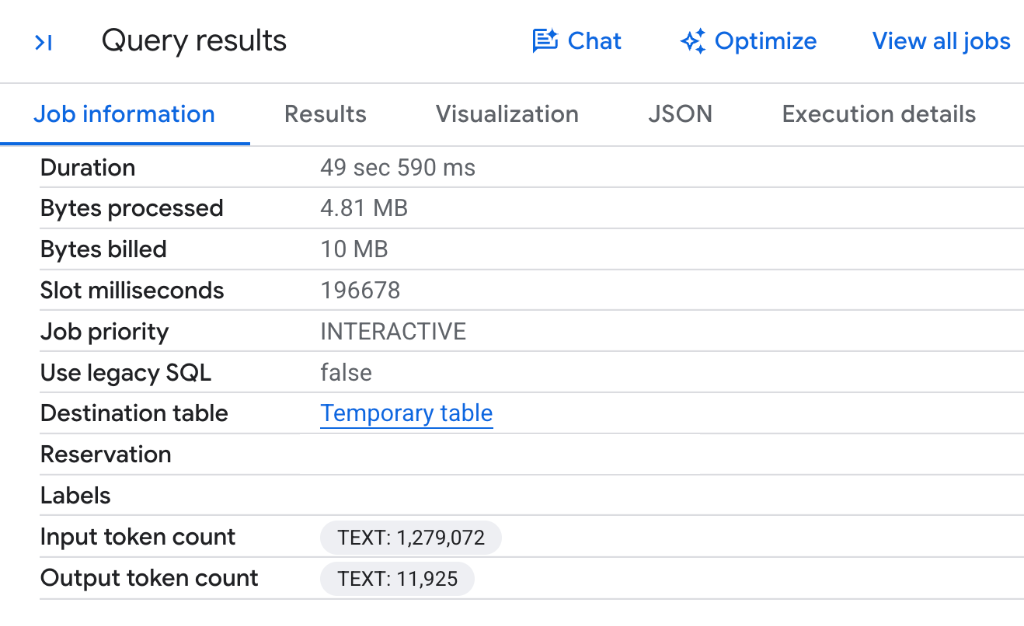
- Consumo di token del set di dati completo: poiché BigQuery richiama il modello Gemini remoto per ogni riga in tutti i 2225 articoli di notizie senza ottimizzazione proxy, la query consuma 1.279.072 token di input e 11.925 token di output.
- Nessuna sezione di ottimizzazione: nota che non è presente una voce
Gen AI Function Optimizationsperché l'esecuzione standard valuta ogni singola riga rispetto all'endpoint LLM remoto.
Esegui la query con la modalità ottimizzata
Per ridurre il consumo di token e sfruttare la distillazione del modello proxy, abilita la modalità ottimizzata passando embeddings => AI.EMBED(...) e impostando optimization_mode => 'MINIMIZE_COST':
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body),
    embeddings => AI.EMBED(body, endpoint => 'text-embedding-005', task_type => 'CLASSIFICATION').result,
    optimization_mode => 'MINIMIZE_COST'
  );
Verifica l'ottimizzazione e osserva la riduzione dell'utilizzo dei token
Dopo aver eseguito la query ottimizzata, passa alla scheda Informazioni sul job di BigQuery Studio per osservare il confronto tra l'utilizzo dei token e le metriche di esecuzione:
- Nel riquadro dei risultati in basso di BigQuery Studio, seleziona la scheda Informazioni sul job.
- Scorri fino alla sezione Gen AI Function Optimizations, nonché ai conteggi dei token.
I risultati saranno simili ai seguenti:
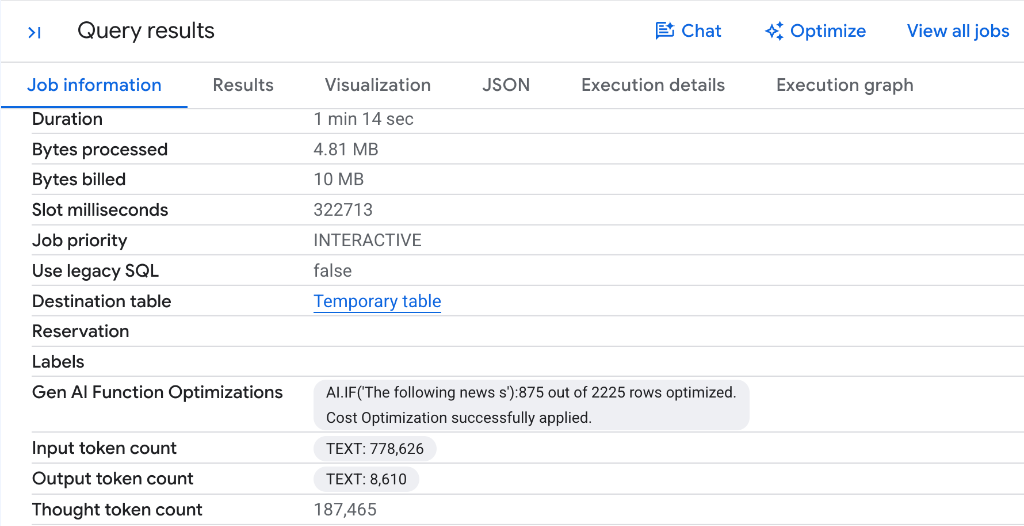
- Riduzione significativa dei token: nota come il conteggio dei token di input è sceso da 1.279.072 token a 778.626 token, risparmiando 500.446 token di input (quasi il 40% di riduzione) in una singola esecuzione della query. Allo stesso modo, si è verificata una diminuzione dei token di output.
- Distillazione automatica del proxy: nota l'etichetta
AI.IF('The following news s'): 875 out of 2225 rows optimized. Cost Optimization successfully applied.BigQuery ha campionato il set di dati, ha etichettato gli articoli rappresentativi con Gemini, ha distillato un classificatore proxy leggero e veloce e ha elaborato 875 righe su 2225 localmente sulla CPU senza chiamare gli endpoint LLM remoti. - Risparmio sui costi diretto: poiché le funzioni AI gestite di BigQuery vengono fatturate in base al volume di token del modello elaborati, la riduzione del consumo di token si traduce direttamente in costi di esecuzione delle query inferiori.
- Convalida della qualità: BigQuery ha verificato automaticamente l'accuratezza del modello proxy rispetto a Gemini prima di promuoverlo per valutare le righe rimanenti, garantendo il mantenimento della qualità della classificazione.
Riduzione ancora maggiore dei token e scalabilità della latenza su tabelle più grandi
Anche se il risparmio di oltre 500.000 token su 2225 righe è sostanziale, la riduzione dei token e i miglioramenti delle prestazioni sono ancora maggiori su tabelle più grandi:
- Perché la riduzione dei token aumenta con le dimensioni del set di dati: per le query eseguite in BigQuery, i modelli proxy vengono addestrati on-the-fly utilizzando un campione iniziale di circa 1000 righe etichettate dall'LLM. Una volta addestrato e convalidato, il modello proxy sostituisce le chiamate LLM dirette nelle righe rimanenti. Per le query più grandi (ad esempio i set di dati tipici di 1 milione di righe), questo elimina le invocazioni LLM per la maggior parte dei dati, consumando fino a 400 volte meno token e riducendo drasticamente i costi.
- Accelerazione sostanziale della latenza: spostando l'inferenza dall'hardware LLM specializzato ai modelli proxy ultraleggeri in esecuzione direttamente sulle CPU dei worker di database standard (sfruttando gli embedding Gemini precalcolati), BigQuery riduce i tempi di esecuzione complessivi delle query da 30 a 100 volte.
10. Libera spazio
Per liberare spazio dalle risorse create durante questo codelab, esegui la seguente istruzione in una scheda SQL di BigQuery Studio per rimuovere la connessione alla risorsa Cloud:
DROP CONNECTION IF EXISTS `us.conn`;
In alternativa, se hai creato un progetto Google Cloud temporaneo esclusivamente per questo tutorial, puoi arrestare l'intero progetto in Cloud Resource Manager.
11. Complimenti
Complimenti! Hai completato correttamente il codelab sull'analisi semantica in BigQuery con funzioni AI gestite e SQL.
Hai imparato a utilizzare le funzioni di AI generativa gestite di BigQuery:
AI.SCORE: hai classificato i prodotti in base a criteri soggettivi come la regalabilità su una scala da 1 a 10 utilizzando la riscrittura automatica dei prompt.AI.CLASSIFY: hai classificato gli articoli del catalogo non strutturati in classificazioni di animali di destinazione.AI.IF(filtro multimodale): hai filtrato gli asset immagine di Cloud Storage nelle clausoleWHERESQL in base ai contenuti visivi.AI.IF(join semantici): hai eseguito join cross-modali nelle clausoleONSQL per collegare le descrizioni dei prodotti di testo ai file immagine.AI.AGG: hai sintetizzato il testo del catalogo non strutturato di più righe in un riepilogo esecutivo conciso.- Modalità ottimizzata e modelli proxy: hai accelerato le query e ridotto al minimo i costi dei token utilizzando
optimization_mode => 'MINIMIZE_COST'con la distillazione dei modelli on-the-fly eAI.EMBED.
Scopri di più
- Panoramica di BigQuery AI generativa
- Guida alle funzioni AI gestite di BigQuery
AI.SCOREDocumentazione sulla sintassi SQLAI.CLASSIFYDocumentazione sulla sintassi SQLAI.IFDocumentazione sulla sintassi SQLAI.AGGDocumentazione sulla sintassi SQL- Ottimizzare le funzioni AI con la distillazione dei modelli
- Blog di Google Cloud: query SQL basate su LLM 100 volte più veloci ed economiche con i modelli proxy
- Blog di Google Cloud: approfondimento della funzione AI.AGG di BigQuery