

1. ようこそ
この Codelab では、BigQuery マネージド AI 関数 のスイートを使用して、SQL を使用して BigQuery Studio 内で直接、高度なセマンティック分析、カテゴリ分類、マルチモーダル フィルタリング、セマンティック結合、複数行の要約を行う方法について説明します。
一般公開データセット bigquery-public-data.cymbal_pets を使用して、ペット用品やアクセサリーの e コマース小売業者である Cymbal Pets のデータ アナリストの役割を体験します。
SQL クエリ内で直接セマンティック分析を行う
従来、エンタープライズ データセットに機械学習や大規模言語モデル(LLM)を適用するには、データ ウェアハウスから外部の Python ノートブック環境にデータを移動する必要がありました。これには、専用のデータ エンジニアリング パイプラインと ML の専門知識が必要でした。
BigQuery のマネージド AI 関数(AI.SCORE、AI.CLASSIFY、AI.IF、AI.AGG など)は、基盤モデルのインテリジェンスをデータに直接提供します。BigQuery は、モデルの選択を自動的に最適化し、内部のプロンプト書き換え戦略を適用して、簡単な自然言語プロンプトから高精度の結果を提供します。
大量のデータセットの場合、BigQuery は 最適化モード を提供します。このモードでは、オンザフライのモデル蒸留と軽量プロキシモデルを使用して、クエリを最大 100 倍高速化し、コストを削減します。
演習内容
- SQL を使用して BigQuery Studio でマルチモーダル小売データを探索 します。
- セマンティック ランキング を実行し、
AI.SCOREを使用して「ギフト性」などの主観的な商品属性を評価します。 - 非構造化データを分類するために、
AI.CLASSIFYを使用して商品を対象の動物種にマッピングします。 - 句内で
AI.IFを使用してWHEREをフィルタリング します。 - テーブル間でセマンティック結合を実行 し、
AI.IFJOIN ... ON句を使用してテキストの商品レコードを外部画像ファイルと照合します。 - 複数行の分析情報を合成 します。
AI.AGG集計関数を使用して - 最適化モード (
optimization_mode => 'MINIMIZE_COST')とプロキシモデルの蒸留でAI.IFを使用して、大規模なデータセットのクエリのレイテンシと費用を最適化 します。
必要なもの
- 課金を有効にした Google Cloud プロジェクト
- ウェブブラウザ(Chrome など)
2. 設定と要件
マネージド AI 関数を使用してデータをクエリする前に、Google Cloud プロジェクトを構成し、必要な API を有効にする必要があります。
Google Cloud プロジェクトを作成し、API を有効にする
- Google Cloud コンソールのプロジェクト選択ページで、Google Cloud プロジェクトを選択または作成します。
- Cloud プロジェクトに対して課金が有効になっていることを確認します。プロジェクトで課金が有効になっているかどうかを確認する方法をご覧ください。
- BigQuery、BigQuery Connection、Agent Platform API を有効にします。
BigQuery Studio を開く
- Google Cloud コンソールのナビゲーション メニューで [BigQuery] をクリックして BigQuery Studio を開きます。
- BigQuery Studio エディタのツールバーで、[+ SQL クエリ] をクリックして新しい [SQL クエリタブ] を開きます。この Codelab では、これらの SQL タブですべての SQL クエリを作成して実行します。
SQL で Cloud リソース接続を作成する
BigQuery は、安全なデータ境界内で動作します。外部のマルチモーダル ファイル(Google Cloud Storage に保存されている画像など)を検査する場合、BigQuery はCloud リソース接続 を使用して、認証情報を公開せずにオブジェクト参照に安全にアクセスします。
SQL タブで次のステートメントを実行して、us.conn という名前の接続を作成します。
CREATE CONNECTION IF NOT EXISTS `us.conn`
OPTIONS (
  connection_type = "CLOUD_RESOURCE"
);
3. Cymbal Pets データセットを確認する
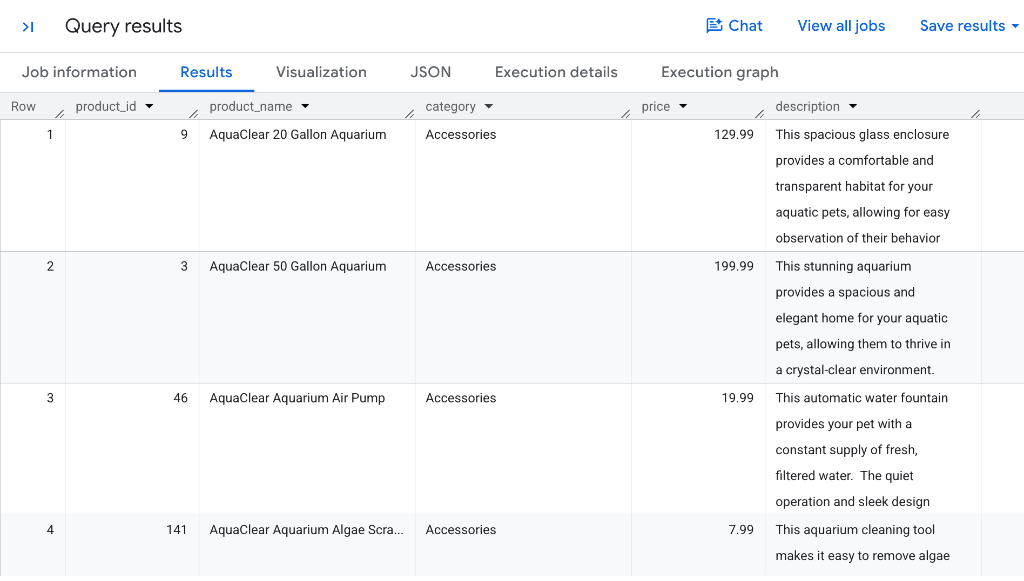
Cymbal Pets は、bigquery-public-data.cymbal_pets.products という名前のテーブル内の一般公開データセットに豊富な商品カタログを保持しています。各商品レコードには、商品 ID、タイトル、小売カテゴリ、価格、説明テキストなどの構造化属性が含まれています。
商品カタログをクエリする
BigQuery Studio で SQL タブを開き、次のクエリを実行して products テーブルを検査します。
SELECT
  product_id,
  product_name,
  category,
  price,
  description
FROM
  `bigquery-public-data.cymbal_pets.products`;
結果は次のようになります。
商品画像を検査する
Cymbal Pets は、商品画像参照を bigquery-public-data.cymbal_pets.product_images にも保存します。次のクエリを実行して、画像レコードを表示します。
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`;
結果は次のようになります。
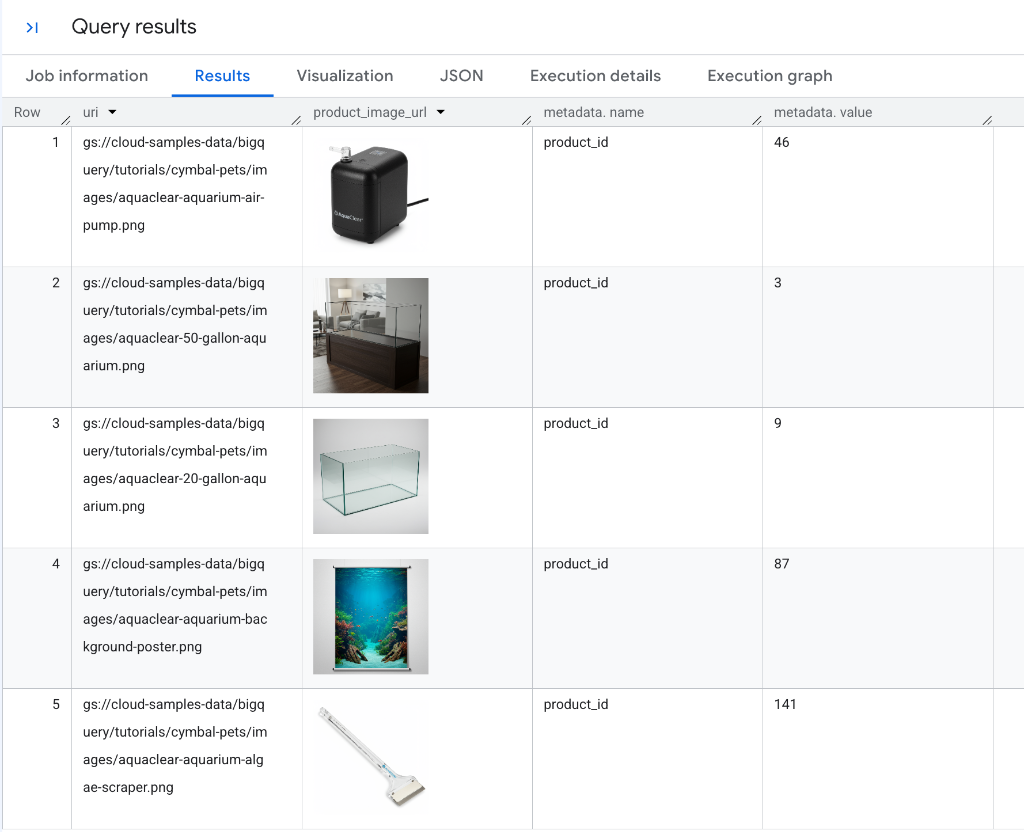
次に、BigQuery マネージド関数を使用して、Cymbal Pets データ ウェアハウスのテキストデータと画像データの両方を分析します。
4. AI.SCORE を使用してセマンティック条件で商品をランク付けする
The AI.SCORE 関数はテキスト入力を受け取り、Gemini モデルを使用して自然言語のスコアリング ルーブリックに基づいて評価し、数値の FLOAT64 スコアを返します。
明示的なスコアリング ルーブリックを指定しない場合、BigQuery はプロンプト書き換え戦略を自動的に適用して、モデルに最適なルーブリックを生成します。
「ギフト性」の商品をスコアリングする
Cymbal Pets のマーケティング チームがホリデー ギフトガイドを作成するとします。ペットの飼い主へのギフトとして適しているかどうかに基づいて、カタログ内のすべてのアイテムを 1 ~ 10 のスケールでランク付けします。
SQL タブで次のクエリを実行します。
SELECT
  product_name,
  description,
  AI.SCORE(
    ('How "giftable" is this product for a pet owner? ', description,
    'Use a scale from 1-10.')
  ) AS giftability_score
FROM
  `bigquery-public-data.cymbal_pets.products`
ORDER BY
  giftability_score DESC;
結果を分析する
結果は次のようになります。
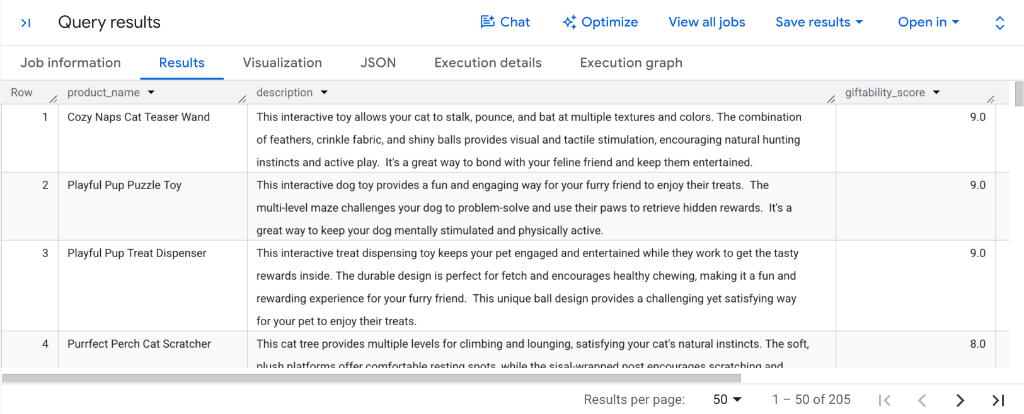
クエリ結果の giftability_score 列を確認します。
- 魅力的なインタラクティブなおもちゃ:
Cozy Naps Cat Teaser Wand、Playful Pup Puzzle Toy、Playful Pup Treat Dispenserなどの魅力的なアイテムは、最高評価(9.0)を受けます。 - 特別な快適さと引っ掻きアイテム:
Purrfect Perch Cat Scratcherなどの人気の必需品は、8.0と高いスコアを獲得しています。 - 実行可能なダウンストリーム ランキング:
AI.SCOREは正規化されたFLOAT64スコアを生成するため、ORDER BY giftability_score DESCで結果をすぐに並べ替えたり、WHERE AI.SCORE(...) >= 8.0で候補をフィルタしたりして、自動ギフトガイドを生成できます。
5. AI.CLASSIFY を使用してカタログ アイテムを分類する
The AI.CLASSIFY 関数は Gemini を使用して、入力レコードを SQL 配列として提供されるターゲット カテゴリの個別のリストに分類します。
AI.CLASSIFY はマルチモーダル入力(テキスト、画像、音声、動画)をサポートしており、分類管理用のカスタム分類モデルの構築、トレーニング、デプロイの必要がありません。
対象の動物種で玩具を分類する(単一ラベル)
Cymbal Pets カタログの一部の商品には、対象の動物を指定せずに「おもちゃ」という一般的なタグが付けられているとします。AI.CLASSIFY を使用して、名前と説明に基づいて各おもちゃを分類できます。
BigQuery Studio で次のクエリを実行します。
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('What animal is this product for?', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "All Pets"]
  ) AS animal_type
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys"
LIMIT 20;
結果を表示する
結果は次のようになります。
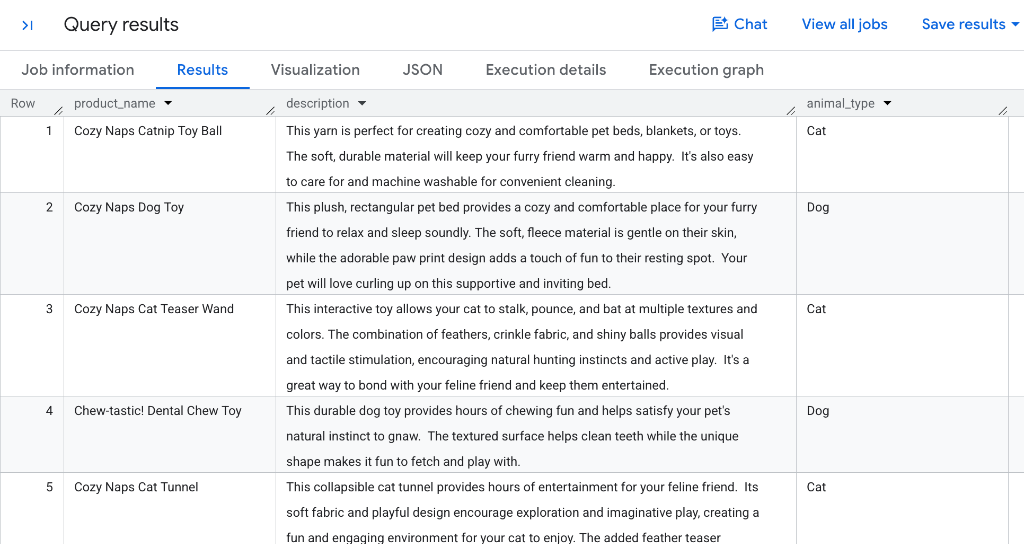
デフォルトでは、AI.CLASSIFY は単一ラベル分類を実行し、候補配列から最も関連性の高い単一のカテゴリを含む STRING を返します。Gemini がキャットニップ ボールとフェザー ティーザーを Cat にマッピングし、噛むおもちゃとフェッチ スティックを Dog にマッピングしていることに注目してください。
マルチラベル分類で複数のタグを割り当てる
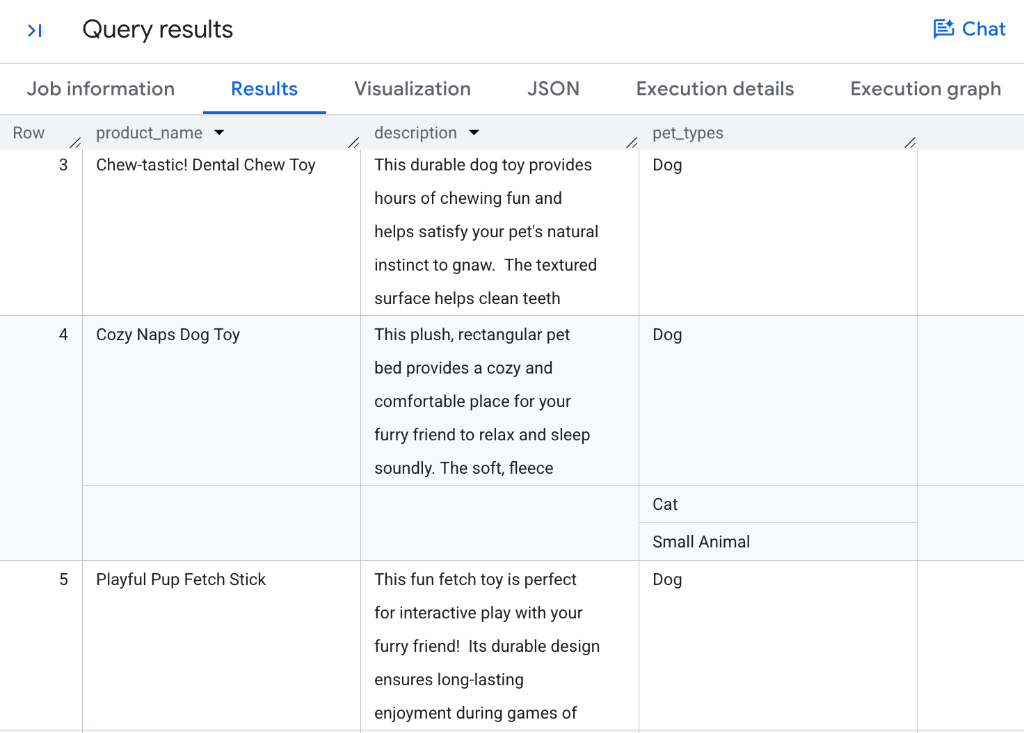
小売カタログの多くの商品は、複数のペットの種類に同時に適用されます(たとえば、猫と小動物の両方に適したぬいぐるみやトンネルなど)。
1 つのレコードに複数のカテゴリを割り当てるには、オプションのパラメータ output_mode => 'multi' を設定します。マルチラベルモードでは、AI.CLASSIFY は一致するすべてのカテゴリを含む ARRAY を返します。
SQL タブで次のクエリを実行します。
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('Identify all pet types that this product is suitable for: ', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "Reptile"],
    output_mode => 'multi'
  ) AS pet_types
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys";
結果は次のようになります。
分類の仕組みを確認する
- 単一ラベルとマルチラベル:
output_modeがない場合、AI.CLASSIFYはスカラーSTRINGを返します。output_mode => 'multi'を設定すると、一致するラベルが 0 個、1 個、または複数個含まれるARRAYが返されます。 - 複数カテゴリの割り当て:
Chew-tastic! Dental Chew ToyやPlayful Pup Fetch Stickなどの専用アイテムには[Dog]が割り当てられますが、Cozy Naps Dog Toy(長方形のぬいぐるみ)などの汎用性の高い快適アイテムには、[Dog, Cat, Small Animal]という複数のタグが正しく割り当てられます。 - ゼロショット マッチング: モデルは、事前トレーニング済みのカスタム ML モデルを必要とせずに、指定された
categories配列に対して結合されたテキストとプロンプトを評価します。 - ダウンストリーム SQL 配列オペレーション:
WHERE 'Cat' IN UNNEST(pet_types)やCROSS JOIN UNNEST(pet_types)などの標準の BigQuery SQL 配列関数を使用して、マルチラベル レコードをフィルタ、展開、集計できます。
6. AI.IF を使用してマルチモーダル商品画像をフィルタリングする
AI.IF 関数は Gemini を使用して自然言語条件を評価し、ブール値(TRUE または FALSE)を返します。
AI.IF はマルチモーダル入力を受け入れるため、SQL WHERE 句内で直接使用して、Cloud Storage に保存されている非構造化画像ファイルをフィルタできます。
特定のオブジェクトを含む画像をフィルタする
マーチャンダイジング チームが、ペットフードやスナックを視覚的に含むカタログ内のすべての商品画像を検索するとします。
SQL タブで次のクエリを実行します。
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`
WHERE
  AI.IF(
    ('Does this product image contain pet food or snacks? ', OBJ.MAKE_REF(uri, 'us.conn'))
  );
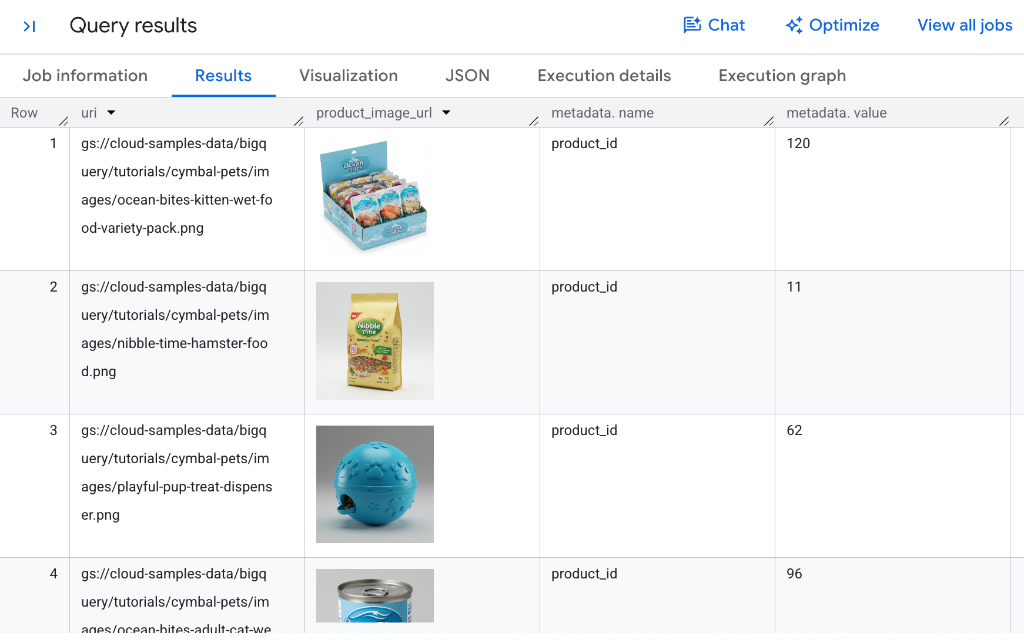
結果は次のようになります。
マルチモーダル フィルタリングの仕組み
- オンザフライのオブジェクト参照: ここでは
OBJ.MAKE_REF(uri, 'us.conn')を使用してオブジェクト参照をオンザフライで作成しますが、ObjectRef列を BigQuery テーブルに直接作成して保存することもできます。これにより、すべてのクエリでOBJ.MAKE_REF関数を使用しなくても、分析ですぐに使用できるようになります。 - 高度な視覚的オブジェクト認識: Gemini は、さまざまなパッケージ形式(ウェットフードのバラエティ パック ボックス、ドライ ハムスター フード バッグ、缶詰の猫用フードなど)を正確に識別し、青いおやつディスペンサーなどのおもちゃに詰められた食用スナックも認識します。
- 行レベルの述語評価: BigQuery は、
WHERE句内で各 Cloud Storage 画像参照に対して自然言語条件を直接評価します。 - ブール値フィルタリング: Gemini が条件を
TRUEと評価したレコードのみが結果セットに返されます。
7. AI.IF を使用してテーブル間でセマンティック結合を実行する
従来のリレーショナル データベース結合では、正確なキーの等価性(products.product_id = images.product_id など)が必要です。ただし、実際のエンタープライズ データセットには、明示的な外部キーがない非構造化アセットが含まれていることがよくあります。
AI.IF はブール値を返すため、SQL INNER JOIN ... ON 句内に直接配置してセマンティック結合 を実行できます。
商品情報と画像アセットをセマンティックに結合する
ブランド Fluffy Buns が製造した商品について、products テーブルの商品情報と product_images のリンクされていない画像ファイルを照合するとします。
BigQuery Studio の SQL タブで次のクエリを実行します(完了までに数分かかります)。
SELECT
  products.product_id,
  products.product_name,
  products.description,
  products.brand,
  images.uri AS image_uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(images.uri, 'us.conn')).url AS product_image_url
FROM
  `bigquery-public-data.cymbal_pets.products` AS products
INNER JOIN
  `bigquery-public-data.cymbal_pets.product_images` AS images
ON
  AI.IF(
    ('You will be provided an image of a pet product. ',
    'Determine if the image is of the following pet toy: ',
    products.product_name,
    products.description,
    OBJ.MAKE_REF(images.uri, 'us.conn')
    )
  )
WHERE
  products.category = "Toys" AND
  products.brand = "Fluffy Buns";
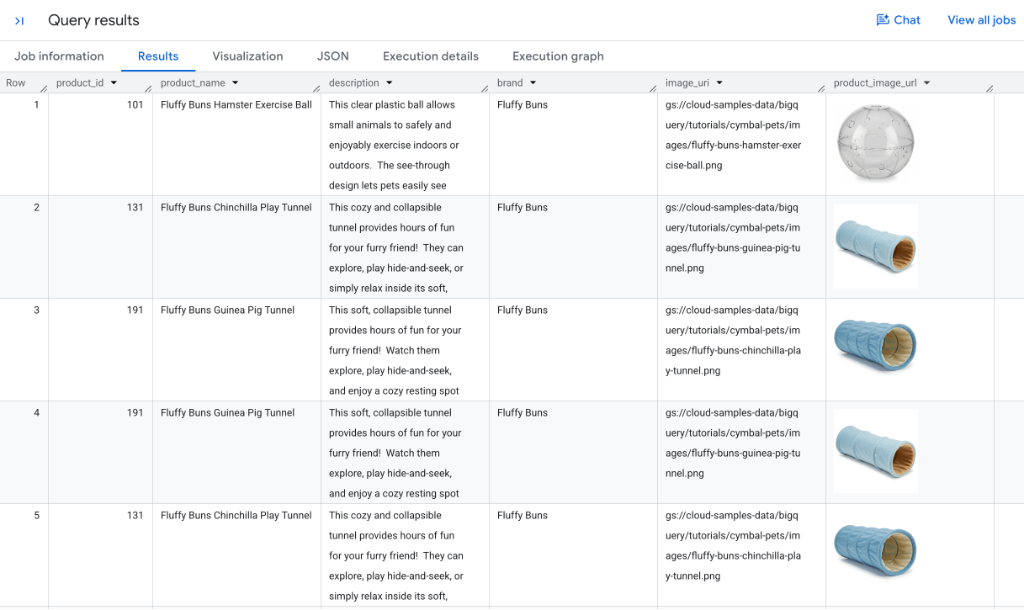
結果は次のようになります。
SQL でのセマンティック結合について
- クロスモーダル条件評価: 候補レコード ペアの場合、BigQuery は
productsのテキスト メタデータと画像参照(OBJ.MAKE_REF(...))の両方を Gemini に送信します。 - 正確な視覚的照合: 結果に示すように、
Fluffy Buns Hamster Exercise Ballは透明なプラスチック ボールの画像と照合され、Fluffy Buns Chinchilla Play TunnelとGuinea Pig Tunnelは青いぬいぐるみトンネルの写真と照合されます。標準 SQL のINNER JOINセマンティクスにより、商品がカタログ内の複数の画像アセット(複数の写真アングルや類似のショットなど)と一致する場合、出力に複数の行が生成されることがあります。 - インライン画像レンダリング: BigQuery Studio は、承認済みの読み取り URL を
product_image_url列の結果グリッド内に自動的にレンダリングし、視覚的にすぐに確認できるようにします。 - 非構造化エンティティ解決: これにより、手動ラベリングや明示的な外部キーを使用せずに、レガシー カタログ、スクレイピングされたデータセット、メディア アーカイブ全体で強力なエンティティ解決ワークフローを実現できます。
8. AI.AGG を使用して行全体の分析情報を合成する
AI.SCORE、AI.CLASSIFY、AI.IF などの関数は個々の行を評価しますが(スカラー オペレーション)、エンタープライズ データの分析では、複数のレコードにわたるパターンを合成することが必要になることがよくあります。
The AI.AGG 関数は、自然言語の指示を使用して、数千または数百万の非構造化行にわたる分析情報を要約、クラスタ化、合成して、統合されたレスポンスを生成する集計関数です。
従来の SQL 指標とともにカテゴリの概要を合成する
AI.AGG は、従来の SQL GROUP BY 関数と集計関数とシームレスに統合されます。たとえば、各カテゴリの商品に共通する点を説明する生成 AI の概要とともに、従来の指標(アイテム数など)を計算できます。
BigQuery Studio で次のクエリを実行します。
SELECT
  category,
  COUNT(*) AS item_count,
  AI.AGG(
    ('Product: ', product_name, ' - Description: ', description),
    'Write a concise, one-sentence summary describing the common characteristics or purpose of the products in this category.'
  ) AS category_summary
FROM
  `bigquery-public-data.cymbal_pets.products`
GROUP BY
  category
ORDER BY
  item_count DESC;
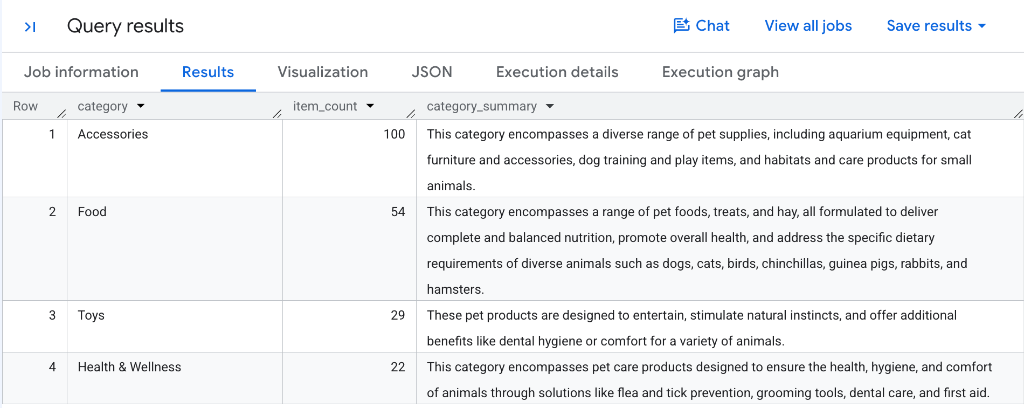
結果は次のようになります。
AI.AGG が非構造化データを集計する方法
- 階層型集計: BigQuery は、カテゴリ パーティションごとにロウデータをグループ化し、構造化されたコンテキスト ウィンドウを構築し、Gemini を使用して商品レコードのコレクション全体を合成します。
- 自動カタログ合成: 各カテゴリに、
Accessoriesが生息地とトレーニング用具をキャプチャしたり、Foodが複数の動物種にわたるバランスの取れた栄養をハイライトしたりするなど、明確で正確な概要が表示されます。 - 定量的レポートと定性的レポートのハイブリッド:
COUNT(*)などの標準集計とAI.AGGを組み合わせることで、カスタム ETL パイプラインを使用せずに、1 つのクエリで包括的なカタログの概要を生成できます。 - 柔軟なパーティショニング: 任意のグループ化ディメンション(
GROUP BY brand、GROUP BY category、テーブル全体など)にAI.AGGを適用して、数秒でエグゼクティブ レベルの分析情報を生成できます。
9. 最適化モードとプロキシモデルでクエリを高速化する
数千または数百万の行を含む大規模なデータセットを処理する場合、すべての行に対してリモート LLM を呼び出すと、レイテンシとコストが発生する可能性があります。
この問題を解決するため、BigQuery は 最適化モード を AI.IF と AI.CLASSIFY に提供しています。最適化モードでは、プロキシモデルとオンザフライのモデル蒸留 を使用して、LLM トークン費用を削減しながら 100 倍以上の高速化を実現します。
最適化モードの仕組み
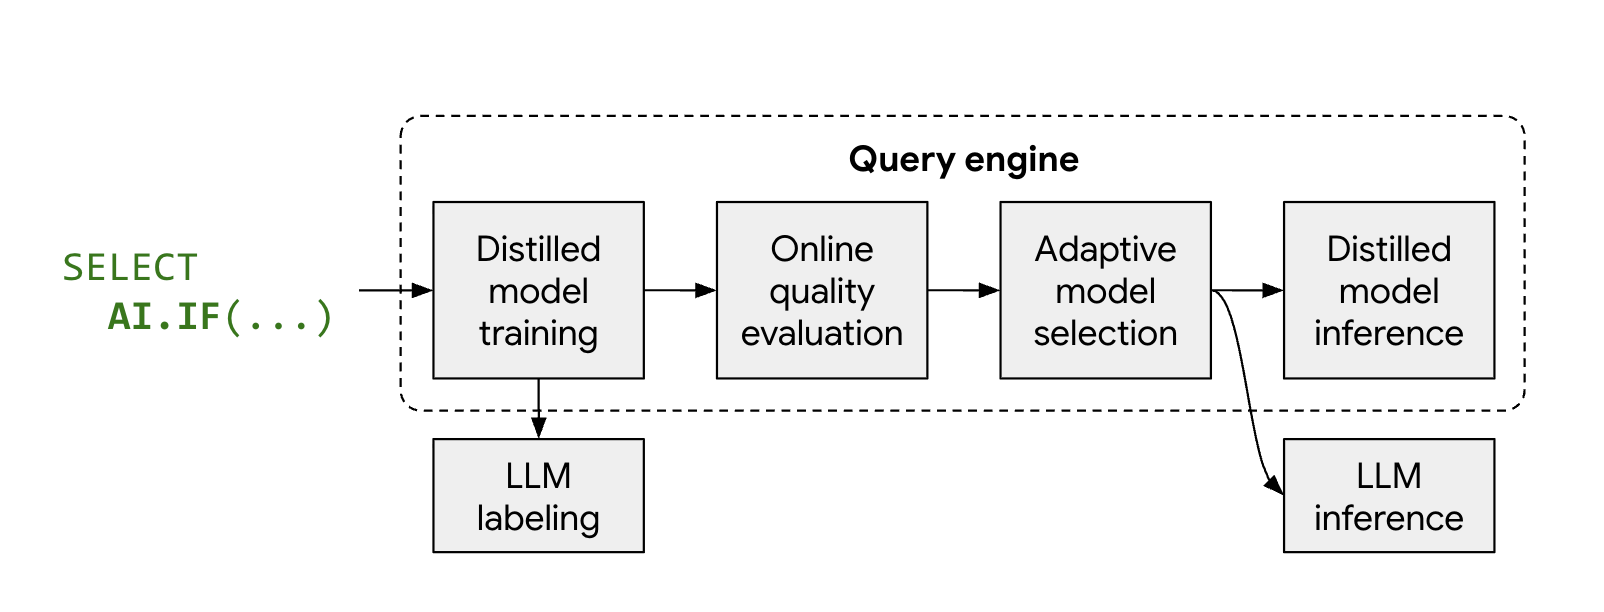
- 代表サンプルとラベリング: BigQuery は、行の代表サンプルを自動的に選択し、Gemini からラベルを取得します。
- 蒸留モデルのトレーニング: BigQuery は、テキスト エンベディングを特徴として使用して、CPU 上で超軽量プロキシモデル(ロジスティック回帰など)をジャストインタイムでトレーニングします。
- 品質検証: BigQuery は、蒸留モデルの精度を Gemini と比較して評価します。品質のしきい値を満たしている場合、BigQuery はデータセットの残りの部分を処理するように昇格させます。
- ローカル高速推論: プロキシモデルは、残りの行をローカルで評価します。リモート LLM トークン費用はゼロで、超低レイテンシになります。
最適化なしでベースライン クエリを実行する
サンプルの bigquery-public-data.cymbal_pets.products カタログには、プロキシモデルの蒸留をトリガーするのに十分な行が含まれていないため、より大規模な一般公開データセット bigquery-public-data.bbc_news.fulltext (2,200 件以上のニュース記事を含む)を使用します。
まず、最適化なしで標準クエリを実行して、自然災害に関するニュース記事を特定します。
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body)
  );
ベースライン ジョブの詳細とトークンの使用量を確認する
ベースライン クエリが完了したら、実行指標を確認します。
- BigQuery Studio の下部の結果ペインで、[ジョブ情報] タブを選択します。
- [入力トークン数] セクションと [出力トークン数] セクションまでスクロールします。
結果は次のようになります。
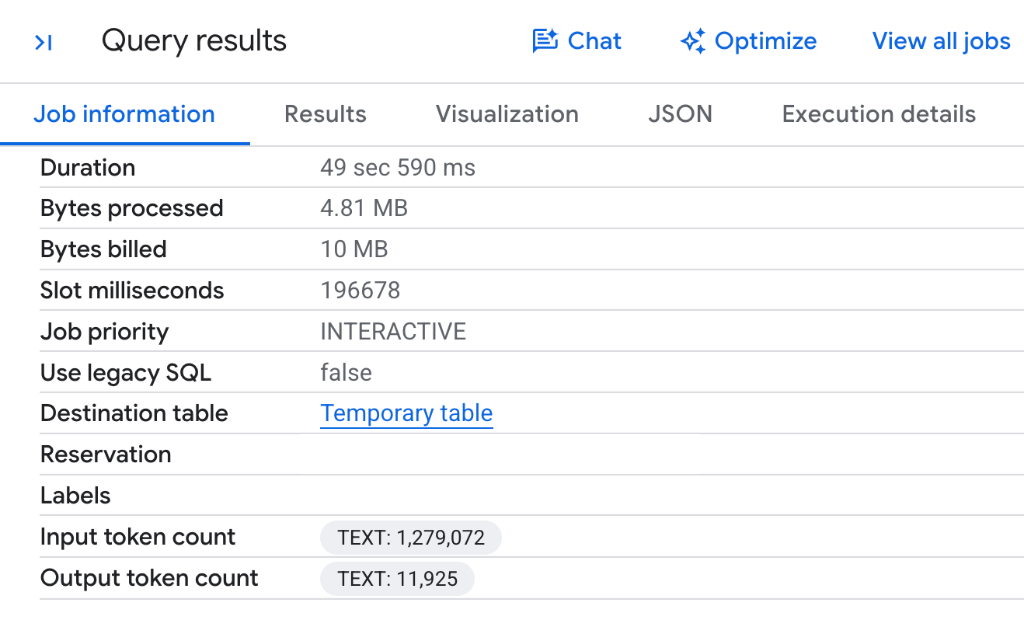
- データセット全体のトークン消費量: BigQuery は、プロキシの最適化なしで 2,225 件のニュース記事すべての行に対してリモート Gemini モデルを呼び出すため、クエリは1,279,072 個の入力トークン と 11,925 個の出力トークン を消費します。
- 最適化セクションなし: 標準実行ではリモート LLM エンドポイントに対して個々の行が評価されるため、
Gen AI Function Optimizationsエントリはありません。
最適化モードでクエリを実行する
トークンの消費量を削減し、プロキシモデルの蒸留を活用するには、embeddings => AI.EMBED(...) を渡して optimization_mode => 'MINIMIZE_COST' を設定して、最適化モードを有効にします。
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body),
    embeddings => AI.EMBED(body, endpoint => 'text-embedding-005', task_type => 'CLASSIFICATION').result,
    optimization_mode => 'MINIMIZE_COST'
  );
最適化を確認し、トークンの使用量が減少していることを確認する
最適化されたクエリを実行したら、BigQuery Studio の [ジョブ情報] タブに切り替えて、トークンの使用量と実行指標を比較します。
- BigQuery Studio の下部の結果ペインで、[ジョブ情報] タブを選択します。
- [Gen AI Function Optimizations] セクションとトークン数までスクロールします。
結果は次のようになります。
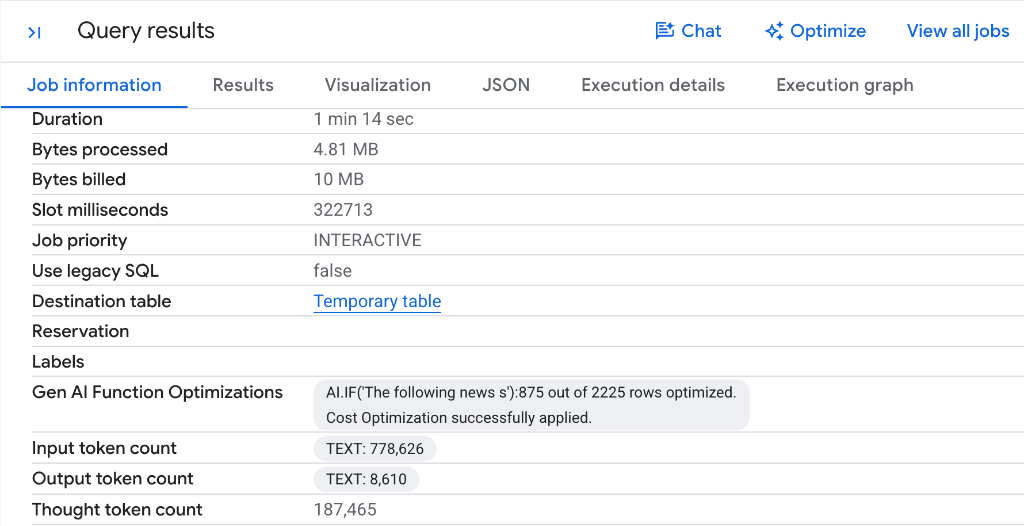
- トークンの大幅な削減: 入力トークン数 が 1,279,072 トークン から 778,626 トークン に減少しました。1 回のクエリ実行で 500,446 個の入力トークン が削減されました(約 40% の削減)。同様に、出力トークンも減少しました。
- 自動プロキシ蒸留: ラベル
AI.IF('The following news s'): 875 out of 2225 rows optimized. Cost Optimization successfully applied.を確認します。BigQuery はデータセットをサンプリングし、Gemini で代表的な記事にラベルを付け、高速で軽量なプロキシ分類器を蒸留し、リモート LLM エンドポイントを呼び出すことなく、CPU 上で 2,225 行のうち 875 行をローカルで処理 しました。 - 直接的なコスト削減: BigQuery マネージド AI 関数は、処理されたモデル トークンの量に基づいて課金されるため、トークンの消費量を削減すると、クエリ実行費用が直接削減されます。
- 品質検証: BigQuery は、残りの行を評価するように昇格させる前に、Gemini と比較してプロキシモデルの精度を自動的に検証し、分類品質が維持されるようにしました。
大規模なテーブルでのトークン削減とレイテンシ スケーリングの向上
2,225 行で 50 万個以上のトークンを節約できますが、大規模なテーブルではトークンの削減とパフォーマンスの向上がさらに大きくなります 。
- データセット サイズに応じてトークンの削減がスケーリングされる理由: BigQuery で実行されるクエリの場合、プロキシモデルは、LLM によってラベル付けされた約 1,000 行の初期サンプルを使用してオンザフライでトレーニングされます。トレーニングと検証が完了すると、プロキシモデルは残りの行で LLM の直接呼び出しを置き換えます。大規模なクエリ(一般的な 100 万行のデータセットなど)の場合、これにより、データの大部分に対する LLM の呼び出しが不要になり、トークンの消費量が最大 400 分の 1 になり、コストが大幅に削減されます。
- レイテンシの大幅な高速化: 推論を専用の LLM ハードウェアから、標準データベース ワーカー CPU で直接実行される超軽量プロキシモデル(事前計算された Gemini エンベディングを活用)に移行することで、BigQuery はクエリの実行時間を全体で 30 ~ 100 倍短縮します。
10. リソースのクリーンアップ
この Codelab で作成したリソースをクリーンアップするには、BigQuery Studio の SQL タブで次のステートメントを実行して、Cloud リソース接続を削除します。
DROP CONNECTION IF EXISTS `us.conn`;
または、このチュートリアル専用の一時的な Google Cloud プロジェクトを作成した場合は、Cloud Resource Manager でプロジェクト全体をシャットダウンできます。
11. 完了
おめでとうございます!マネージド AI 関数と SQL を使用した BigQuery でのセマンティック分析 に関する Codelab を完了しました。
BigQuery のマネージド生成 AI 関数を習得しました。
AI.SCORE: 自動プロンプト書き換えを使用して、ギフト性などの主観的な基準で商品を 1 ~ 10 のスケールでランク付けしました。AI.CLASSIFY: 非構造化カタログ アイテムを対象の動物分類に分類しました。AI.IF(マルチモーダル フィルタリング): SQLWHERE句で、視覚的なコンテンツに基づいて Cloud Storage 画像アセットをフィルタリングしました。AI.IF(セマンティック結合): SQLON句でクロスモーダル結合を実行して、テキストの商品情報と画像ファイルをリンクしました。AI.AGG: 複数行の非構造化カタログ テキストを簡潔なエグゼクティブ サマリーに合成しました。- 最適化モードとプロキシモデル: オンザフライのモデル蒸留と
AI.EMBEDでoptimization_mode => 'MINIMIZE_COST'を使用して、クエリを高速化し、トークン費用を最小限に抑えました。