

1. 환영합니다
이 Codelab에서는 BigQuery 관리형 AI 함수 모음을 사용하여 SQL을 통해 BigQuery Studio 내에서 직접 정교한 시맨틱 분석, 카테고리 분류, 멀티모달 필터링, 시맨틱 조인, 다중 행 요약을 수행하는 방법을 알아봅니다.
공개 데이터 세트 bigquery-public-data.cymbal_pets를 사용하여 반려동물 용품 및 액세서리 전자상거래 소매업체인 Cymbal Pets의 데이터 분석가 역할을 맡게 됩니다.
SQL 쿼리 내에서 직접 시맨틱 분석
기존에는 엔터프라이즈 데이터 세트에 머신러닝 또는 대규모 언어 모델 (LLM)을 적용하려면 데이터 웨어하우스에서 외부 Python 노트북 환경으로 데이터를 이동해야 했습니다. 이를 위해서는 전용 데이터 엔지니어링 파이프라인과 ML 전문 지식이 필요했습니다.
AI.SCORE, AI.CLASSIFY, AI.IF, AI.AGG를 비롯한 BigQuery의 관리형 AI 함수는 파운데이션 모델 인텔리전스를 데이터에 직접 제공합니다. BigQuery는 모델 선택을 자동으로 최적화하고 내부 프롬프트 재작성 전략을 적용하여 간단한 자연어 프롬프트에서 높은 정확도의 결과를 제공합니다.
대용량 데이터 세트의 경우 BigQuery는 즉석 모델 증류 및 경량 프록시 모델을 사용하여 최대 100배 더 빠르고 저렴한 쿼리를 제공하는 최적화된 모드를 제공합니다.
실행할 작업
- SQL을 사용하여 BigQuery Studio에서 멀티모달 소매 데이터 탐색
- 시맨틱 순위 지정을(를) 사용하여 '선물 가능성'과 같은 주관적인 제품 속성을 평가하는
AI.SCORE - 구조화되지 않은 데이터 분류를 사용하여 제품을 타겟 동물 종에 매핑하는
AI.CLASSIFY - 멀티모달 이미지 확장 소재 필터링을(를)
WHERE절 내에서AI.IF을(를) 사용하여 - 테이블 간 시맨틱 조인 실행을(를)
AI.IFJOIN ... ON절에서 사용하여 텍스트 제품 레코드를 외부 이미지 파일과 일치시킵니다. - 다중 행 통계 합성을(를)
AI.AGG집계 함수를 사용하여 - 쿼리 지연 시간 및 비용 최적화를 대규모 데이터 세트에서
AI.IF를 사용하여 최적화된 모드 (optimization_mode => 'MINIMIZE_COST') 및 프록시 모델 증류와 함께
필요한 항목
- 결제가 사용 설정된 Google Cloud 프로젝트.
- 웹브라우저(예: Chrome)
2. 설정 및 요건
관리형 AI 함수로 데이터를 쿼리하기 전에 Google Cloud 프로젝트를 구성하고 필요한 API를 사용 설정해야 합니다.
Google Cloud 프로젝트를 만들고 API를 사용 설정합니다.
- Google Cloud 콘솔의 프로젝트 선택기 페이지에서 Google Cloud 프로젝트를 선택하거나 만듭니다.
- Cloud 프로젝트에 결제가 사용 설정되어 있는지 확인합니다. 프로젝트에 결제가 사용 설정되어 있는지 확인하는 방법을 알아보세요.
- BigQuery, BigQuery Connection, Agent Platform API를 사용 설정합니다.
BigQuery Studio 열기
- Google Cloud 콘솔 탐색 메뉴에서 BigQuery를 클릭하여 BigQuery Studio를 엽니다.
- BigQuery Studio 편집기 툴바에서 + SQL 쿼리 를 클릭하여 새 SQL 쿼리 탭 을 엽니다. 이 Codelab 전반에서 이러한 SQL 탭에 모든 SQL 쿼리를 작성하고 실행합니다.
SQL에서 Cloud 리소스 연결 만들기
BigQuery는 보안 데이터 경계 내에서 작동합니다. BigQuery는 외부 멀티모달 파일 (예: Google Cloud Storage에 저장된 이미지)을 검사할 때 Cloud 리소스 연결 을 사용하여 사용자 인증 정보를 노출하지 않고 객체 참조에 안전하게 액세스합니다.
SQL 탭에서 다음 문을 실행하여 us.conn이라는 연결을 만듭니다.
CREATE CONNECTION IF NOT EXISTS `us.conn`
OPTIONS (
  connection_type = "CLOUD_RESOURCE"
);
3. Cymbal Pets 데이터 세트 탐색
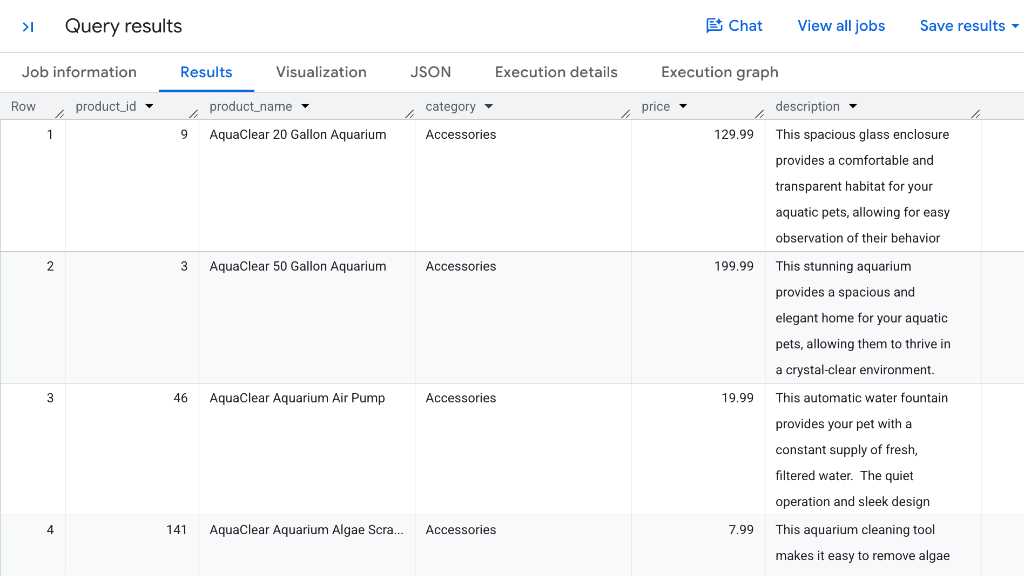
Cymbal Pets는 bigquery-public-data.cymbal_pets.products라는 테이블 내의 공개 데이터 세트에 풍부한 제품 카탈로그를 유지합니다. 각 제품 레코드에는 제품 ID, 제목, 소매 카테고리, 가격, 설명 텍스트와 같은 구조화된 속성이 포함되어 있습니다.
제품 카탈로그 쿼리
BigQuery Studio에서 SQL 탭을 열고 다음 쿼리를 실행하여 제품 테이블을 검사합니다.
SELECT
  product_id,
  product_name,
  category,
  price,
  description
FROM
  `bigquery-public-data.cymbal_pets.products`;
결과는 다음과 비슷하게 표시됩니다.
제품 이미지 검사
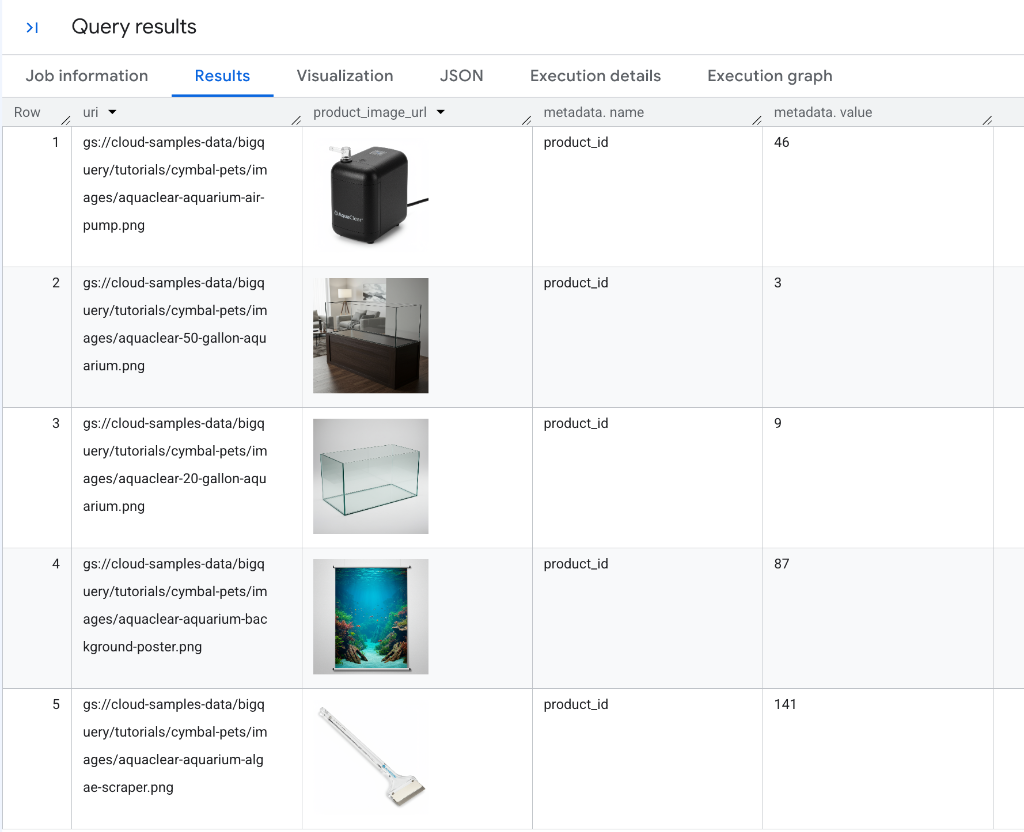
Cymbal Pets는 bigquery-public-data.cymbal_pets.product_images에도 제품 이미지 참조를 저장합니다. 다음 쿼리를 실행하여 이미지 레코드를 확인합니다.
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`;
결과는 다음과 비슷하게 표시됩니다.
다음으로 BigQuery 관리형 함수를 사용하여 Cymbal Pets 데이터 웨어하우스의 텍스트 및 이미지 데이터를 모두 분석합니다.
4. AI.SCORE로 시맨틱 기준에 따라 제품 순위 지정
AI.SCORE 함수는 텍스트 입력을 허용하고 Gemini 모델을 사용하여 자연어 점수 매기기 기준표를 기반으로 평가하여 숫자 FLOAT64 점수를 반환합니다.
명시적 기준표를 제공하지 않으면 BigQuery는 프롬프트 재작성 전략을 자동으로 적용하여 모델에 최적의 기준표를 생성합니다.
'선물 가능성'에 대한 제품 점수 매기기
Cymbal Pets 마케팅팀이 연말연시 선물 가이드를 만들려고 한다고 가정해 보겠습니다. 카탈로그의 모든 항목을 반려동물 보호자에게 선물로 적합한 정도에 따라 1~10점으로 순위를 지정하려고 합니다.
SQL 탭에서 다음 쿼리를 실행합니다.
SELECT
  product_name,
  description,
  AI.SCORE(
    ('How "giftable" is this product for a pet owner? ', description,
    'Use a scale from 1-10.')
  ) AS giftability_score
FROM
  `bigquery-public-data.cymbal_pets.products`
ORDER BY
  giftability_score DESC;
결과 이해
결과는 다음과 비슷하게 표시됩니다.
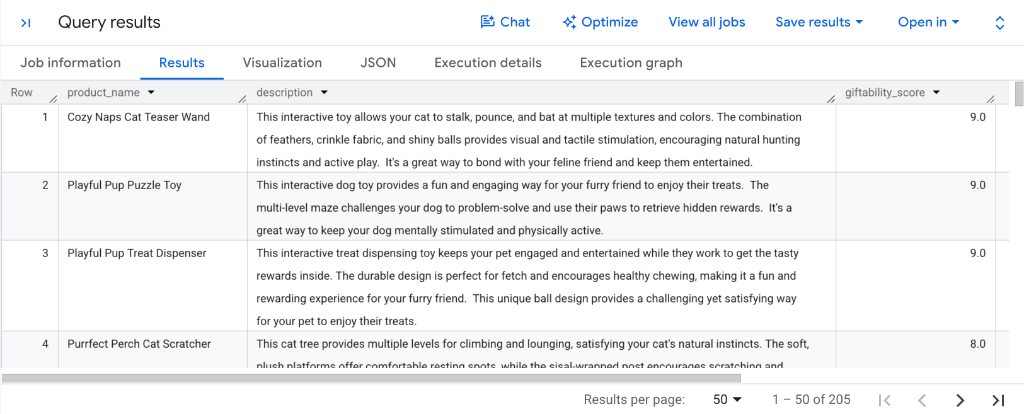
쿼리 결과에서 giftability_score 열을 검사합니다.
- 높은 호소력을 가진 양방향 장난감:
Cozy Naps Cat Teaser Wand,Playful Pup Puzzle Toy,Playful Pup Treat Dispenser와 같은 매력적인 항목은 최고 등급 (9.0)을 받습니다. - 특수 편안함 및 긁기 항목:
Purrfect Perch Cat Scratcher와 같은 인기 있는 필수 항목은8.0으로 높은 점수를 받습니다. - 실행 가능한 다운스트림 순위:
AI.SCORE정규화된FLOAT64점수를 생성하므로ORDER BY giftability_score DESC로 결과를 즉시 정렬하거나WHERE AI.SCORE(...) >= 8.0로 후보를 필터링하여 자동화된 선물 가이드를 생성할 수 있습니다.
5. AI.CLASSIFY로 카탈로그 항목 분류
The AI.CLASSIFY 함수는 Gemini를 사용하여 입력 레코드를 SQL 배열로 제공되는 개별 타겟 카테고리 목록으로 분류합니다.
AI.CLASSIFY는 멀티모달 입력 (텍스트, 이미지, 오디오, 동영상)을 지원하며 분류 관리용 맞춤 분류 모델을 빌드, 학습 또는 배포할 필요가 없습니다.
타겟 동물 종별 장난감 분류 (단일 라벨)
Cymbal Pets 카탈로그의 일부 제품이 타겟 동물을 지정하지 않고 '장난감'으로 일반 태그가 지정되어 있다고 가정해 보겠습니다. AI.CLASSIFY를 사용하여 이름과 설명을 기반으로 각 장난감을 분류할 수 있습니다.
BigQuery Studio에서 다음 쿼리를 실행합니다.
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('What animal is this product for?', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "All Pets"]
  ) AS animal_type
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys"
LIMIT 20;
결과 보기
결과는 다음과 비슷하게 표시됩니다.
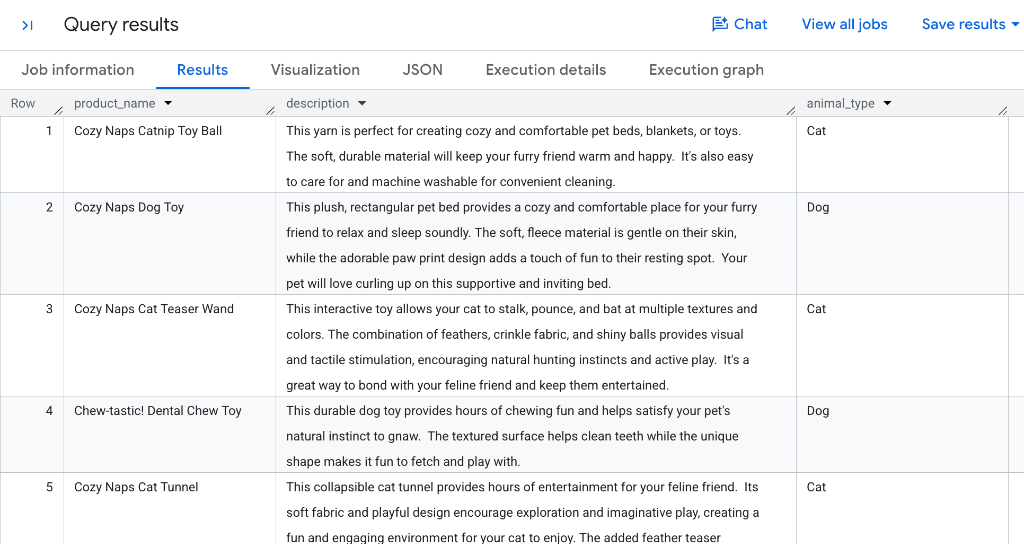
기본적으로 AI.CLASSIFY는 단일 라벨 분류를 실행하고 후보 배열에서 가장 관련성이 높은 단일 카테고리가 포함된 STRING을 반환합니다. Gemini가 캣닙 볼과 깃털 장난감을 Cat에 매핑하고, 씹는 장난감과 던지기 스틱을 Dog에 매핑하는 방법을 확인하세요.
멀티 라벨 분류로 여러 태그 할당
소매 카탈로그의 많은 제품이 여러 반려동물 유형에 동시에 적용됩니다 (예: 고양이와 소형 동물 모두에게 적합한 플러시 침대 또는 터널).
단일 레코드에 여러 카테고리를 할당하려면 선택적 매개변수 output_mode => 'multi'를 설정합니다. 멀티 라벨 모드에서 AI.CLASSIFY는 일치하는 모든 카테고리가 포함된 ARRAY를 반환합니다.
SQL 탭에서 다음 쿼리를 실행합니다.
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('Identify all pet types that this product is suitable for: ', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "Reptile"],
    output_mode => 'multi'
  ) AS pet_types
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys";
결과는 다음과 비슷하게 표시됩니다.
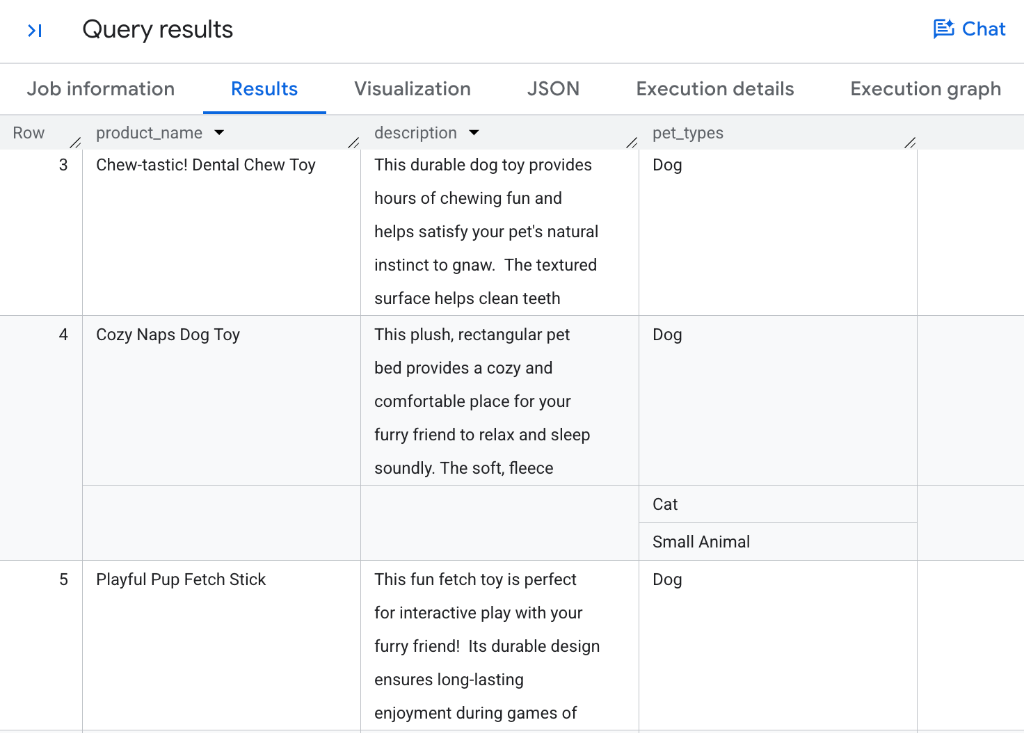
분류 메커니즘 검토
- 단일 라벨과 멀티 라벨:
output_mode가 없으면AI.CLASSIFY는 스칼라STRING를 반환합니다.output_mode => 'multi'를 설정하면 일치하는 라벨이 0개, 1개 또는 여러 개 포함된ARRAY가 반환됩니다. - 다중 카테고리 할당:
Chew-tastic! Dental Chew Toy및Playful Pup Fetch Stick과 같은 전용 항목은[Dog]를 받는 반면,Cozy Naps Dog Toy(플러시 직사각형 침대)와 같은 다용도 편안함 항목은[Dog, Cat, Small Animal]과 같은 여러 태그를 올바르게 받습니다. - 제로샷 일치: 모델은 사전 학습된 맞춤 ML 모델이 필요하지 않고 제공된
categories배열에 대해 결합된 텍스트와 프롬프트를 평가합니다. - 다운스트림 SQL 배열 작업:
WHERE 'Cat' IN UNNEST(pet_types)또는CROSS JOIN UNNEST(pet_types)와 같은 표준 BigQuery SQL 배열 함수를 사용하여 멀티 라벨이 지정된 레코드를 필터링, 확장, 집계할 수 있습니다.
6. AI.IF로 멀티모달 제품 이미지 필터링
AI.IF 함수는 Gemini를 사용하여 자연어 조건을 평가하고 불리언 (TRUE 또는 FALSE)을 반환합니다.
AI.IF는 멀티모달 입력을 허용하므로 SQL WHERE 절 내에서 직접 사용하여 Cloud Storage에 저장된 구조화되지 않은 이미지 파일을 필터링할 수 있습니다.
특정 객체가 포함된 이미지 필터링
상품화팀이 카탈로그에서 반려동물 사료 또는 간식이 시각적으로 포함된 모든 제품 이미지를 찾으려고 한다고 가정해 보겠습니다.
SQL 탭에서 다음 쿼리를 실행합니다.
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`
WHERE
  AI.IF(
    ('Does this product image contain pet food or snacks? ', OBJ.MAKE_REF(uri, 'us.conn'))
  );
결과는 다음과 비슷하게 표시됩니다.
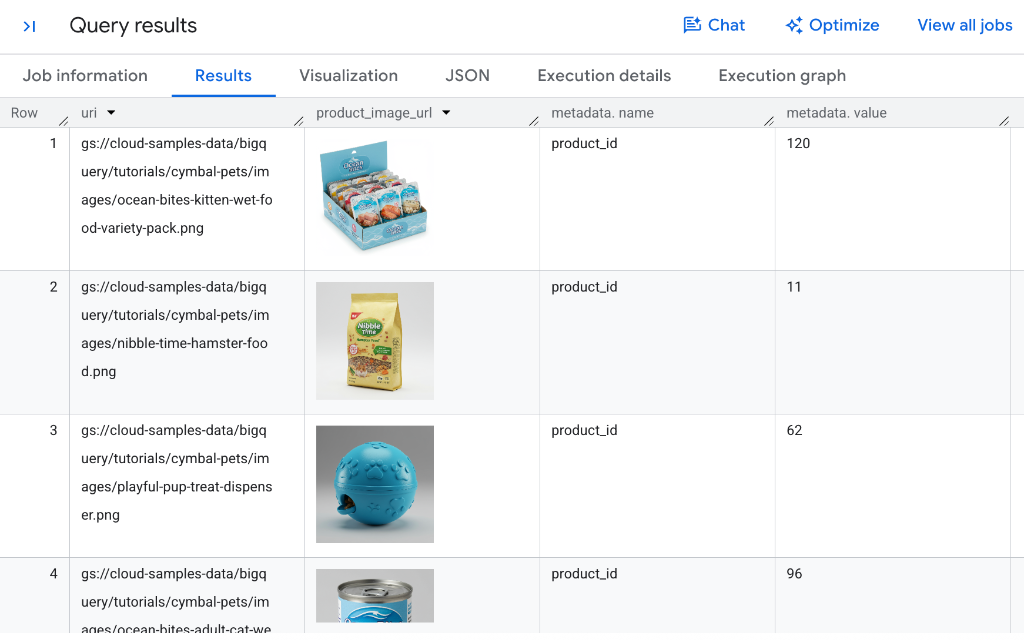
멀티모달 필터링의 작동 방식
- 즉석 객체 참조: 여기서는
OBJ.MAKE_REF(uri, 'us.conn')를 사용하여 객체 참조를 즉석에서 만들지만 BigQuery 테이블에서 직접ObjectRef열을 만들고 저장할 수도 있으므로 모든 쿼리에서OBJ.MAKE_REF함수가 필요하지 않고 분석에 즉시 사용할 수 있습니다. - 심층 시각적 객체 인식: Gemini가 다양한 포장 형식 (예: 습식 사료 버라이어티 팩 상자, 건조 햄스터 사료 봉투, 통조림 고양이 사료)을 정확하게 식별하는 동시에 파란색 간식 디스펜서와 같은 장난감 내부에 로드된 식용 간식을 인식하는 방법을 확인하세요.
- 행 수준 술어 평가: BigQuery는
WHERE절 내에서 직접 각 Cloud Storage 이미지 참조에 대해 자연어 조건을 평가합니다. - 불리언 필터링: Gemini가 조건을
TRUE로 평가하는 레코드만 결과 집합에 반환됩니다.
7. AI.IF로 테이블 간 시맨틱 조인 실행
기존 관계형 데이터베이스 조인에는 정확한 키 동일성 (예: products.product_id = images.product_id)이 필요합니다. 하지만 실제 엔터프라이즈 데이터 세트에는 명시적 외래 키가 없는 구조화되지 않은 확장 소재가 포함되어 있는 경우가 많습니다.
AI.IF는 불리언 값을 반환하므로 SQL INNER JOIN ... ON 절 내에 직접 배치하여 시맨틱 조인을 실행할 수 있습니다.
제품 설명과 이미지 확장 소재를 시맨틱 방식으로 조인
Fluffy Buns 브랜드에서 만든 제품의 products 테이블에 있는 제품 설명을 product_images의 연결되지 않은 이미지 파일과 일치시키려고 한다고 가정해 보겠습니다.
BigQuery Studio SQL 탭에서 다음 쿼리를 실행합니다 (완료하는 데 몇 분 정도 걸릴 수 있음).
SELECT
  products.product_id,
  products.product_name,
  products.description,
  products.brand,
  images.uri AS image_uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(images.uri, 'us.conn')).url AS product_image_url
FROM
  `bigquery-public-data.cymbal_pets.products` AS products
INNER JOIN
  `bigquery-public-data.cymbal_pets.product_images` AS images
ON
  AI.IF(
    ('You will be provided an image of a pet product. ',
    'Determine if the image is of the following pet toy: ',
    products.product_name,
    products.description,
    OBJ.MAKE_REF(images.uri, 'us.conn')
    )
  )
WHERE
  products.category = "Toys" AND
  products.brand = "Fluffy Buns";
결과는 다음과 비슷하게 표시됩니다.
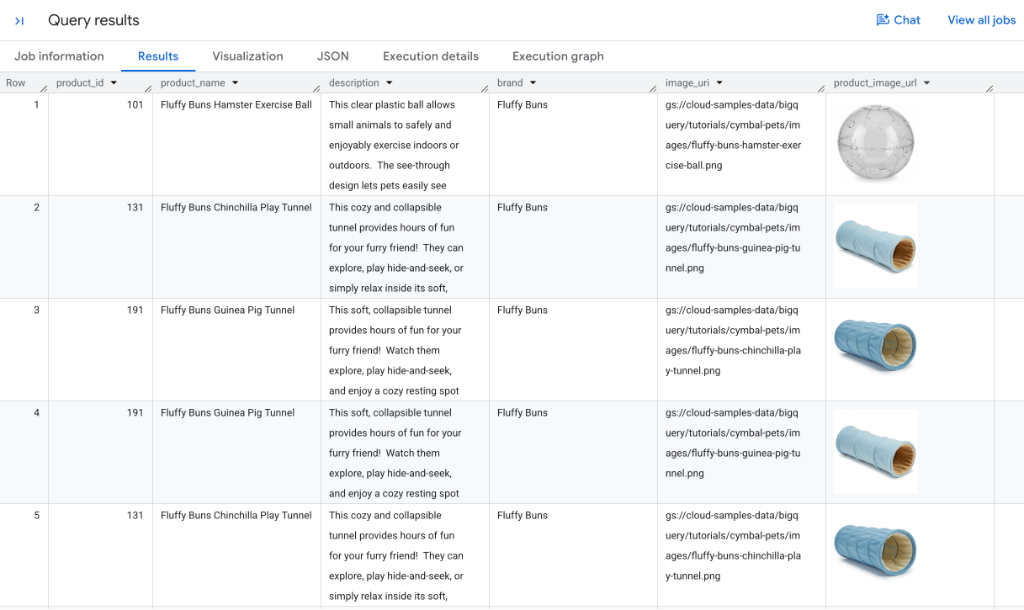
SQL의 시맨틱 조인 이해
- 교차 모드 조건 평가: 후보 레코드 쌍의 경우 BigQuery는
products의 텍스트 메타데이터와 이미지 참조 (OBJ.MAKE_REF(...))를 모두 Gemini로 전송합니다. - 정확한 시각적 일치: 결과에 표시된 것처럼
Fluffy Buns Hamster Exercise Ball은 투명한 플라스틱 볼 이미지와 일치하고,Fluffy Buns Chinchilla Play Tunnel과Guinea Pig Tunnel은 파란색 플러시 터널 사진과 일치합니다. 표준 SQLINNER JOIN시맨틱으로 인해 제품이 카탈로그에서 둘 이상의 이미지 확장 소재 (예: 여러 사진 각도 또는 유사한 사진)와 일치하는 경우 출력에서 여러 행을 생성할 수 있습니다. - 인라인 이미지 렌더링: BigQuery Studio는 즉각적인 시각적 확인을 위해 결과 그리드 내에서 직접
product_image_url열의 승인된 읽기 URL을 자동으로 렌더링합니다. - 구조화되지 않은 항목 확인: 이를 통해 수동 라벨링 또는 명시적 외래 키 없이 기존 카탈로그, 스크레이핑된 데이터 세트, 미디어 보관 파일 전반에서 강력한 항목 확인 워크플로를 사용할 수 있습니다.
8. AI.AGG로 행 간 통계 합성
AI.SCORE, AI.CLASSIFY, AI.IF와 같은 함수는 개별 행 (스칼라 작업)을 평가하지만 엔터프라이즈 데이터를 분석하려면 여러 레코드에서 패턴을 합성해야 하는 경우가 많습니다.
AI.AGG 함수는 자연어 안내를 사용하여 수천 또는 수백만 개의 구조화되지 않은 행에서 통계를 요약, 클러스터링 또는 합성하여 통합된 응답을 생성하는 집계 함수입니다.
기존 SQL 측정항목과 함께 카테고리 요약 합성
AI.AGG는 기존 SQL GROUP BY 및 집계 함수와 원활하게 통합됩니다. 예를 들어 각 카테고리의 제품에 공통점이 무엇인지 설명하는 생성형 AI 요약과 함께 기존 측정항목 (예: 항목 수)을 계산할 수 있습니다.
BigQuery Studio에서 다음 쿼리를 실행합니다.
SELECT
  category,
  COUNT(*) AS item_count,
  AI.AGG(
    ('Product: ', product_name, ' - Description: ', description),
    'Write a concise, one-sentence summary describing the common characteristics or purpose of the products in this category.'
  ) AS category_summary
FROM
  `bigquery-public-data.cymbal_pets.products`
GROUP BY
  category
ORDER BY
  item_count DESC;
결과는 다음과 비슷하게 표시됩니다.
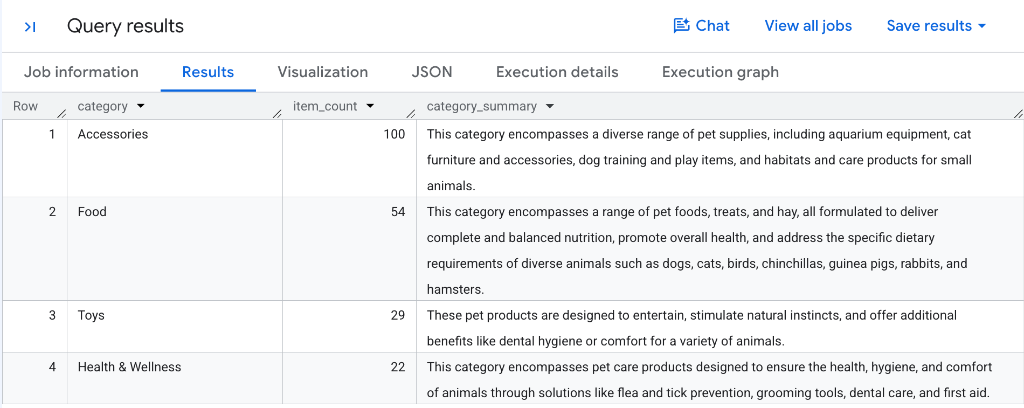
AI.AGG가 구조화되지 않은 데이터를 집계하는 방법
- 계층적 집계: BigQuery는 카테고리 파티션별로 행 데이터를 그룹화하고, 구조화된 컨텍스트 창을 구성하고, Gemini를 사용하여 전체 제품 레코드를 합성합니다.
- 자동화된 카탈로그 합성: 각 카테고리가 서식지와 훈련 장비를 캡처하는
Accessories또는 여러 동물 종에 걸쳐 균형 잡힌 영양을 강조하는Food와 같은 고유하고 정확한 요약을 받는 방법을 확인하세요. - 하이브리드 정량적 및 정성적 보고:
COUNT(*)와 같은 표준 집계를AI.AGG와 결합하면 맞춤 ETL 파이프라인 없이 단일 쿼리에서 포괄적인 카탈로그 개요를 생성할 수 있습니다. - 유연한 파티션 나누기: 모든 그룹화 측정기준 (예:
GROUP BY brand,GROUP BY category또는 전체 테이블)에AI.AGG를 적용하여 임원 수준의 통계를 몇 초 만에 생성할 수 있습니다.
9. 최적화된 모드 및 프록시 모델로 쿼리 가속화
수천 또는 수백만 개의 행이 포함된 대규모 데이터 세트를 처리할 때 모든 단일 행에 대해 원격 LLM을 호출하면 지연 시간과 비용이 발생할 수 있습니다.
이 문제를 해결하기 위해 BigQuery는 최적화된 모드를 AI.IF 및 AI.CLASSIFY에 제공합니다. 최적화된 모드는 프록시 모델 및 즉석 모델 증류를 활용하여 LLM 토큰 비용을 절감하면서 100배 이상 빠른 실행을 제공합니다.
최적화된 모드의 작동 방식
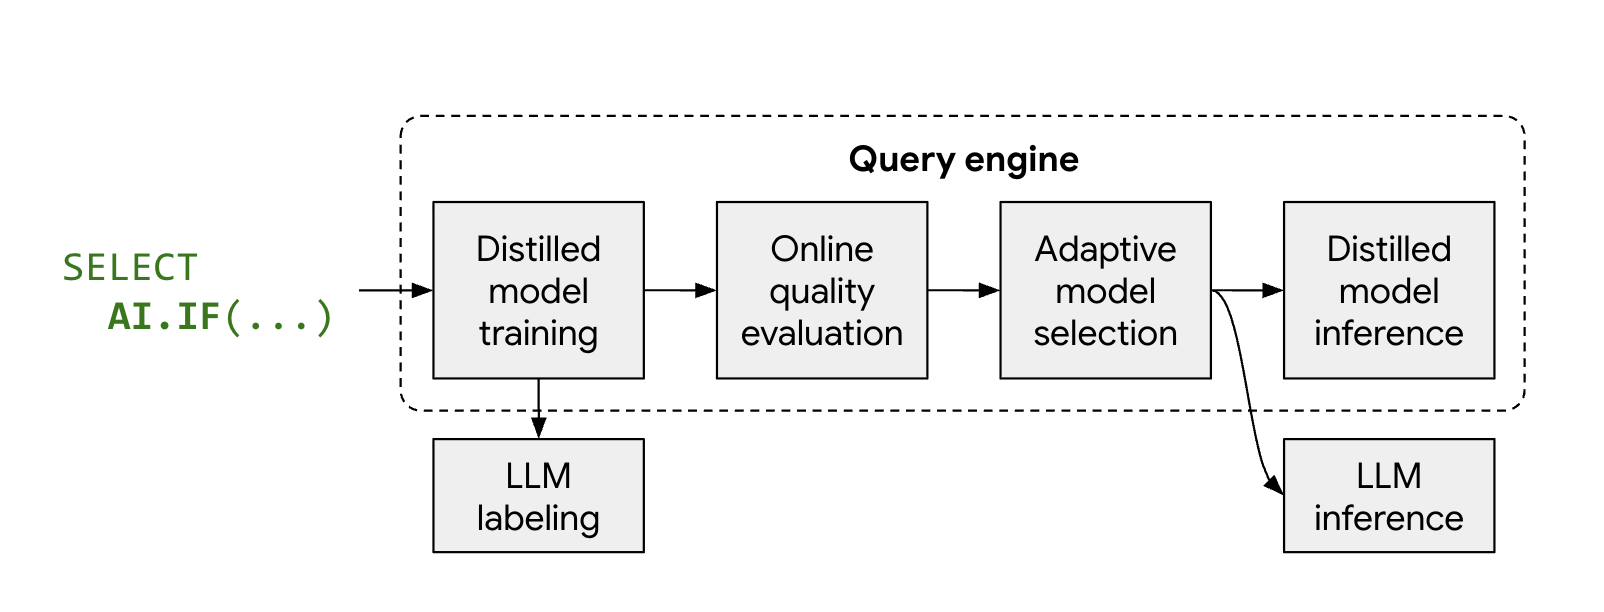
- 대표 샘플링 및 라벨링: BigQuery는 행의 대표 샘플을 자동으로 선택하고 Gemini에서 라벨을 가져옵니다.
- 증류된 모델 학습: BigQuery는 텍스트 임베딩을 특성으로 사용하여 CPU에서 적시에 초경량 프록시 모델 (예: 로지스틱 회귀)을 학습시킵니다.
- 품질 확인: BigQuery는 증류된 모델의 정확성을 Gemini와 비교하여 평가합니다. 품질 기준점을 충족하면 BigQuery는 데이터 세트의 나머지 부분을 처리하도록 승격합니다.
- 로컬 고속 추론: 프록시 모델은 원격 LLM 토큰 비용이 0이고 지연 시간이 매우 짧은 상태로 나머지 행을 로컬에서 평가합니다.
최적화 없이 기준 쿼리 실행
샘플 bigquery-public-data.cymbal_pets.products 카탈로그에는 프록시 모델 증류를 트리거할 행이 너무 적으므로 2,200개가 넘는 뉴스 기사가 포함된 더 큰 공개 데이터 세트 bigquery-public-data.bbc_news.fulltext 를 사용합니다.
먼저 최적화 없이 표준 쿼리를 실행하여 자연재해에 관한 뉴스 기사를 식별합니다.
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body)
  );
기준 작업 세부정보 및 토큰 사용량 검사
기준 쿼리가 완료되면 실행 측정항목을 검사합니다.
- BigQuery Studio의 하단 결과 창에서 작업 정보 탭을 선택합니다.
- 입력 토큰 수 및 출력 토큰 수 섹션으로 스크롤합니다.
결과는 다음과 비슷하게 표시됩니다.
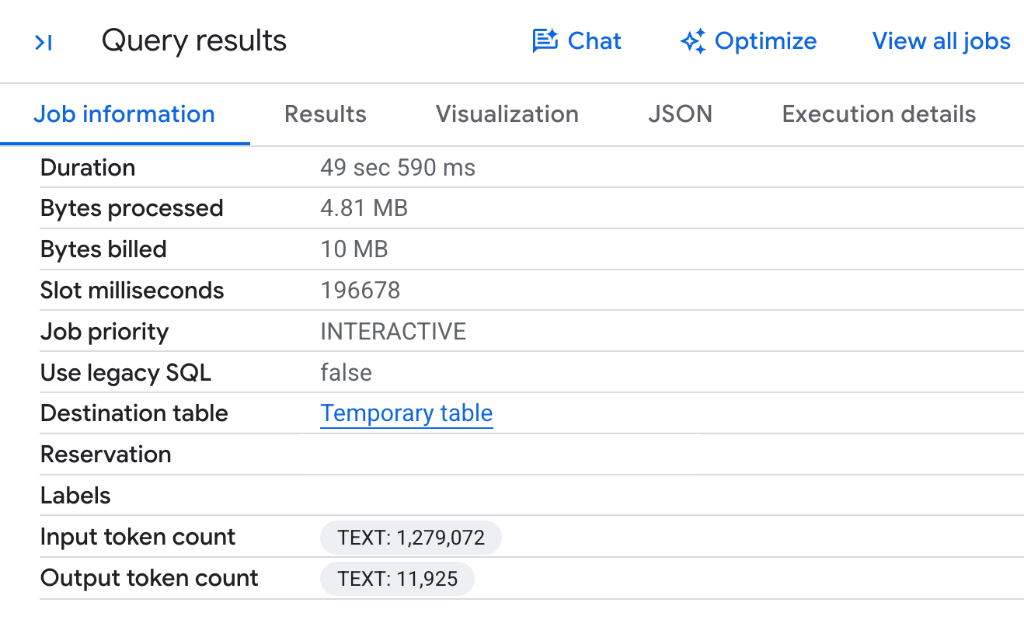
- 전체 데이터 세트 토큰 소비: BigQuery는 프록시 최적화 없이 모든 2,225개 뉴스 기사에 걸쳐 각 행에 대해 원격 Gemini 모델을 호출하므로 쿼리는 1,279,072개의 입력 토큰과 11,925개의 출력 토큰을 소비합니다 .
- 최적화 섹션 없음: 표준 실행은 원격 LLM 엔드포인트에 대해 모든 개별 행을 평가하므로
Gen AI Function Optimizations항목이 없습니다.
최적화된 모드로 쿼리 실행
토큰 소비를 줄이고 프록시 모델 증류를 활용하려면 embeddings => AI.EMBED(...)를 전달하고 optimization_mode => 'MINIMIZE_COST'를 설정하여 최적화된 모드를 사용 설정합니다.
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body),
    embeddings => AI.EMBED(body, endpoint => 'text-embedding-005', task_type => 'CLASSIFICATION').result,
    optimization_mode => 'MINIMIZE_COST'
  );
최적화 확인 및 토큰 사용량 감소 관찰
최적화된 쿼리를 실행한 후 BigQuery Studio 작업 정보 탭으로 전환하여 토큰 사용량과 실행 측정항목을 비교하는 방법을 관찰합니다.
- BigQuery Studio의 하단 결과 창에서 작업 정보 탭을 선택합니다.
- 토큰 수뿐만 아니라 생성형 AI 함수 최적화 섹션으로 스크롤합니다.
결과는 다음과 비슷하게 표시됩니다.
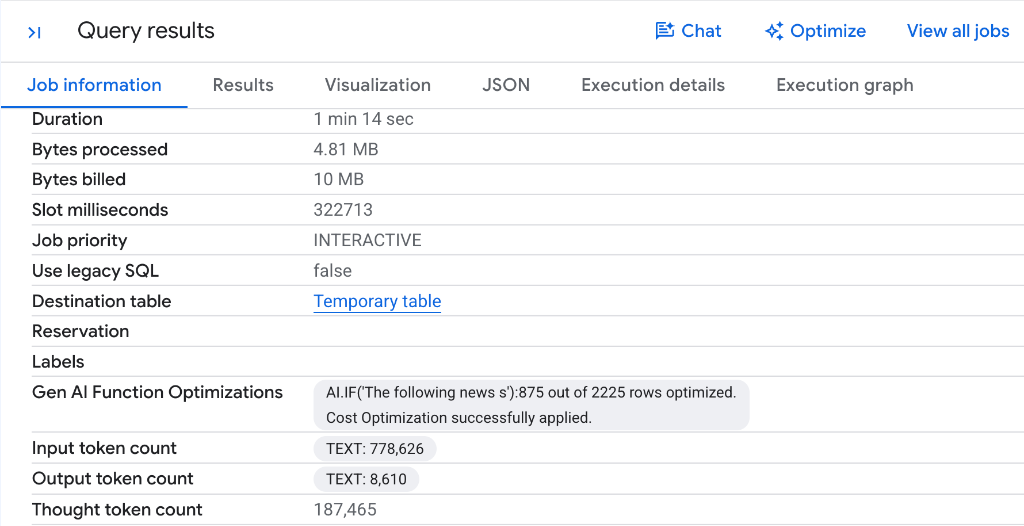
- 토큰 수의 상당한 감소: 입력 토큰 수가 1,279,072개 토큰에서 778,626개 토큰으로 감소하여 단일 쿼리 실행에서 500,446개의 입력 토큰 (거의 40% 감소)이 절약된 것을 확인하세요. 마찬가지로 출력 토큰도 감소했습니다.
- 자동 프록시 증류: 라벨을 확인하세요.
AI.IF('The following news s'): 875 out of 2225 rows optimized. Cost Optimization successfully applied.BigQuery는 데이터 세트를 샘플링하고, Gemini로 대표 기사에 라벨을 지정하고, 빠른 경량 프록시 분류기를 증류하고, 원격 LLM 엔드포인트를 호출하지 않고 CPU에서 2,225개 행 중 875개 행을 로컬로 처리했습니다. - 직접적인 비용 절감: BigQuery 관리형 AI 함수는 처리된 모델 토큰의 양을 기준으로 청구되므로 토큰 소비를 줄이면 쿼리 실행 비용이 직접적으로 절감됩니다.
- 품질 검증: BigQuery는 나머지 행을 평가하도록 승격하기 전에 Gemini와 비교하여 프록시 모델의 정확성을 자동으로 검증하여 분류 품질이 유지되도록 했습니다.
더 큰 테이블에서 토큰 감소 및 지연 시간 확장
2,225개 행에서 500,000개가 넘는 토큰을 절약하는 것은 상당하지만 토큰 감소 및 성능 향상은 더 큰 테이블에서 훨씬 더 높습니다.
- 데이터 세트 크기에 따라 토큰 감소가 확장되는 이유: BigQuery에서 실행되는 쿼리의 경우 프록시 모델은 LLM에서 라벨이 지정된 약 1,000개 행의 초기 샘플을 사용하여 즉석에서 학습됩니다. 학습 및 검증이 완료되면 프록시 모델은 나머지 행에서 직접 LLM 호출을 대체합니다. 더 큰 쿼리 (예: 일반적인 100만 행 데이터 세트)의 경우 이렇게 하면 대부분의 데이터에 대한 LLM 호출이 삭제되어 최대 400배 적은 토큰을 소비하고 비용을 크게 절감할 수 있습니다.
- 상당한 지연 시간 가속화: BigQuery는 추론을 전문 LLM 하드웨어에서 표준 데이터베이스 작업자 CPU에서 직접 실행되는 초경량 프록시 모델 (사전 계산된 Gemini 임베딩 활용)로 전환하여 전체 쿼리 런타임을 30배에서 100배까지 줄입니다.
10. 리소스 정리
이 Codelab 중에 생성된 리소스를 정리하려면 BigQuery Studio SQL 탭에서 다음 문을 실행하여 Cloud 리소스 연결을 삭제합니다.
DROP CONNECTION IF EXISTS `us.conn`;
또는 이 튜토리얼 전용으로 임시 Google Cloud 프로젝트를 만든 경우 Cloud Resource Manager에서 전체 프로젝트를 종료할 수 있습니다.
11. 마무리
수고하셨습니다 관리형 AI 함수 및 SQL을 사용한 BigQuery의 시맨틱 분석 에 관한 Codelab을 완료하셨습니다.
BigQuery의 관리형 생성형 AI 함수를 숙달했습니다.
AI.SCORE: 자동 프롬프트 재작성을 사용하여 선물 가능성과 같은 주관적인 기준에 따라 1~10점 척도로 제품 순위를 지정했습니다.AI.CLASSIFY: 구조화되지 않은 카탈로그 항목을 타겟 동물 분류로 분류했습니다.AI.IF(멀티모달 필터링): 시각적 콘텐츠를 기반으로 SQLWHERE절에서 Cloud Storage 이미지 확장 소재를 필터링했습니다.AI.IF(시맨틱 조인): SQLON절에서 교차 모드 조인을 실행하여 텍스트 제품 설명을 이미지 파일과 연결했습니다.AI.AGG: 다중 행 구조화되지 않은 카탈로그 텍스트를 간결한 임원 요약으로 합성했습니다.- 최적화된 모드 및 프록시 모델: 즉석 모델 증류 및
AI.EMBED와 함께optimization_mode => 'MINIMIZE_COST'를 사용하여 쿼리를 가속화하고 토큰 비용을 최소화했습니다.