

1. Witamy
W tym module dowiesz się, jak używać pakietu zarządzanych funkcji AI w BigQuery do przeprowadzania zaawansowanych analiz semantycznych, klasyfikacji kategorycznej, filtrowania multimodalnego, złączeń semantycznych i podsumowywania wielu wierszy bezpośrednio w BigQuery Studio za pomocą SQL.
Korzystając z publicznego zbioru danych bigquery-public-data.cymbal_pets, wcielisz się w rolę analityka danych w Cymbal Pets, czyli sklepie internetowym z akcesoriami i karmą dla zwierząt.
Analiza semantyczna bezpośrednio w zapytaniach SQL
Tradycyjnie stosowanie uczenia maszynowego lub dużych modeli językowych (LLM) do zbiorów danych przedsiębiorstwa wymagało przenoszenia danych z hurtowni danych do zewnętrznych środowisk notatników Pythona. Wymagało to specjalnych potoków inżynierii danych i wiedzy z zakresu uczenia maszynowego.
Zarządzane funkcje AI w BigQuery, w tym AI.SCORE, AI.CLASSIFY, AI.IF i AI.AGG, wprowadzają inteligencję modelu podstawowego bezpośrednio do Twoich danych. BigQuery automatycznie optymalizuje wybór modelu i stosuje wewnętrzne strategie przepisywania promptów, aby uzyskiwać bardzo dokładne wyniki na podstawie prostych promptów w języku naturalnym.
W przypadku zbiorów danych o dużej ilości danych BigQuery udostępnia tryb zoptymalizowany, który wykorzystuje destylację modelu w czasie rzeczywistym i uproszczone modele proxy, aby wykonywać zapytania nawet 100 razy szybciej i taniej.
Co zrobisz
- Przeglądanie multimodalnych danych handlowych w BigQuery Studio za pomocą SQL.
- Przeprowadzanie rankingu semantycznego za pomocą
AI.SCOREw celu oceny subiektywnych atrybutów produktu, takich jak „nadaje się na prezent”. - Kategoryzowanie danych nieustrukturyzowanych za pomocą
AI.CLASSIFYw celu przypisania produktów do docelowych gatunków zwierząt. - Filtrowanie multimodalnych komponentów z obrazem za pomocą
AI.IFw klauzulachWHERE. - Wykonywanie złączeń semantycznych w tabelach za pomocą
AI.IFw klauzulachJOIN ... ONw celu dopasowania tekstowych rekordów produktów do zewnętrznych plików obrazów. - Synteza statystyk z wielu wierszy za pomocą funkcji agregującej
AI.AGG. - Optymalizacja czasu oczekiwania i kosztów zapytań w przypadku dużych zbiorów danych za pomocą
AI.IFw trybie zoptymalizowanym (optimization_mode => 'MINIMIZE_COST') i destylacji modelu proxy.
Czego potrzebujesz
- Projekt Google Cloud z włączonymi płatnościami.
- Przeglądarka internetowa, np. Chrome.
2. Konfiguracja i wymagania
Zanim zaczniesz wysyłać zapytania o dane za pomocą zarządzanych funkcji AI, musisz skonfigurować projekt w chmurze Google i włączyć wymagane interfejsy API.
Tworzenie projektu Google Cloud i włączanie interfejsów API
- W konsoli Google Cloud na stronie selektora projektów wybierz lub utwórz projekt w chmurze Google Cloud.
- Sprawdź, czy w projekcie w chmurze włączone są płatności. Dowiedz się, jak sprawdzić, czy w projekcie są włączone płatności.
- Włącz interfejsy BigQuery, BigQuery Connection i Agent Platform API.
Otwieranie BigQuery Studio
- W menu nawigacyjnym konsoli Google Cloud kliknij BigQuery, aby otworzyć BigQuery Studio.
- Na pasku narzędzi edytora BigQuery Studio kliknij + Zapytanie SQL, aby otworzyć nową kartę zapytania SQL. W tym module będziesz pisać i uruchamiać wszystkie zapytania SQL na tych kartach SQL.
Tworzenie połączenia z zasobem Cloud w SQL
BigQuery działa w bezpiecznym obszarze danych. Podczas sprawdzania zewnętrznych plików multimodalnych (np. obrazów przechowywanych w Google Cloud Storage) BigQuery używa połączenia z zasobem Cloud , aby bezpiecznie uzyskiwać dostęp do odniesień do obiektów bez ujawniania danych logowania.
Aby utworzyć połączenie o nazwie us.conn, wykonaj w karcie SQL tę instrukcję:
CREATE CONNECTION IF NOT EXISTS `us.conn`
OPTIONS (
  connection_type = "CLOUD_RESOURCE"
);
3. Przeglądanie zbioru danych Cymbal Pets
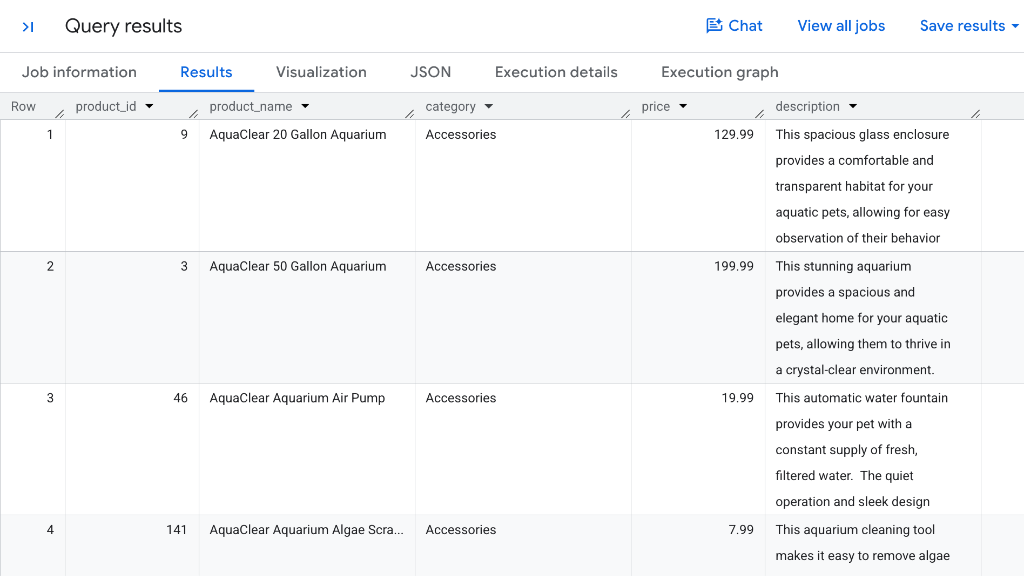
Cymbal Pets prowadzi bogaty katalog produktów w publicznym zbiorze danych w tabeli o nazwie bigquery-public-data.cymbal_pets.products. Każdy rekord produktu zawiera atrybuty strukturalne, takie jak identyfikator produktu, tytuł, kategoria detaliczna, cena i tekst opisowy.
Wysyłanie zapytań do katalogu produktów
Otwórz kartę SQL w BigQuery Studio i uruchom to zapytanie, aby sprawdzić tabelę produktów:
SELECT
  product_id,
  product_name,
  category,
  price,
  description
FROM
  `bigquery-public-data.cymbal_pets.products`;
Wyniki będą podobne do tych:
Sprawdzanie zdjęć produktów
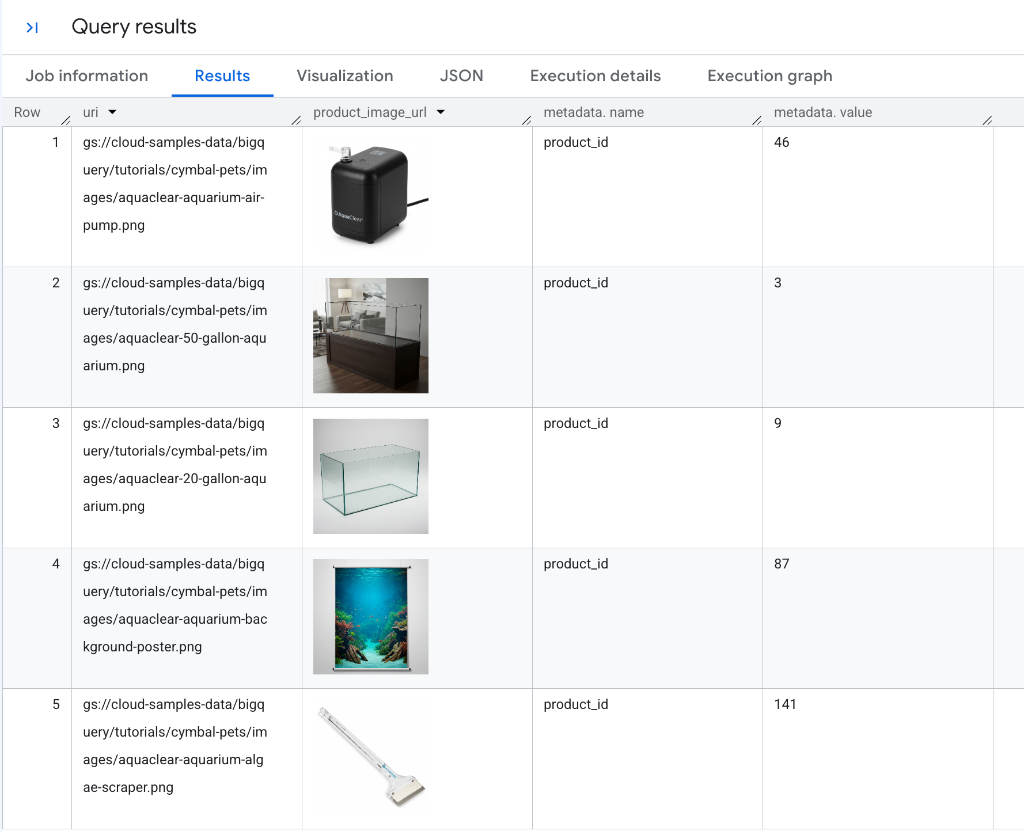
Cymbal Pets przechowuje też odniesienia do zdjęć produktów w bigquery-public-data.cymbal_pets.product_images. Uruchom to zapytanie, aby wyświetlić rekordy obrazów:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`;
Wyniki będą podobne do tych:
Następnie użyjesz zarządzanych funkcji BigQuery do analizowania zarówno tekstu, jak i danych obrazów z hurtowni danych Cymbal Pets.
4. Ranking produktów według kryteriów semantycznych za pomocą AI.SCORE
Funkcja AI.SCORE przyjmuje dane wejściowe w postaci tekstu i używa modelu Gemini do oceniania ich na podstawie kryteriów oceny w języku naturalnym, zwracając wynik liczbowy FLOAT64.
Jeśli nie podasz wyraźnych kryteriów oceny, BigQuery automatycznie zastosuje strategie przeredagowania promptów, aby wygenerować optymalne kryteria oceny dla modelu.
Ocenianie produktów pod kątem „nadaje się na prezent”
Załóżmy, że zespół marketingowy Cymbal Pets chce stworzyć przewodnik po prezentach świątecznych. Chce on uszeregować wszystkie produkty w katalogu na podstawie tego, jak bardzo nadają się na prezent dla właściciela zwierzęcia, w skali od 1 do 10.
Uruchom to zapytanie w karcie SQL:
SELECT
  product_name,
  description,
  AI.SCORE(
    ('How "giftable" is this product for a pet owner? ', description,
    'Use a scale from 1-10.')
  ) AS giftability_score
FROM
  `bigquery-public-data.cymbal_pets.products`
ORDER BY
  giftability_score DESC;
Interpretowanie wyników
Wyniki będą podobne do tych:
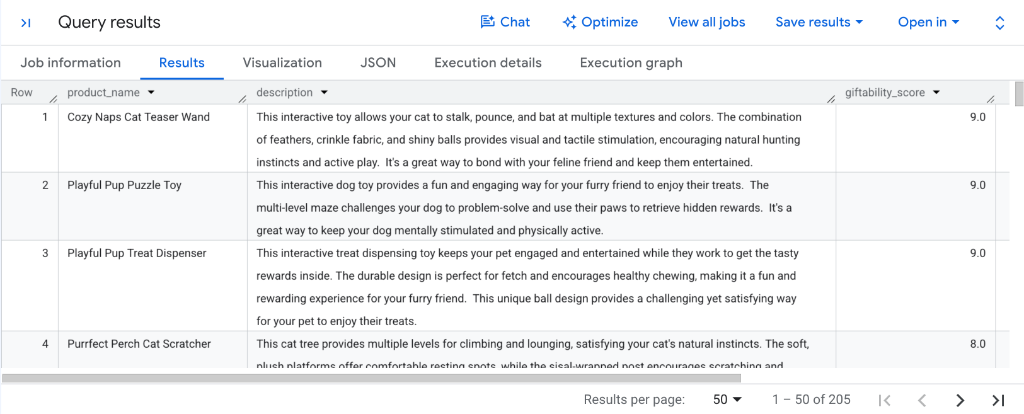
Sprawdź kolumnę giftability_score w wynikach zapytania:
- Atrakcyjne zabawki interaktywne: angażujące produkty, takie jak
Cozy Naps Cat Teaser Wand,Playful Pup Puzzle ToyiPlayful Pup Treat Dispenser, otrzymują najwyższe oceny (9.0). - Specjalistyczne produkty zapewniające wygodę i drapanie: popularne produkty, takie jak
Purrfect Perch Cat Scratcher, uzyskują wysoką ocenę8.0. - Działanie w rankingu: ponieważ
AI.SCOREgeneruje znormalizowane wynikiFLOAT64, możesz od razu posortować wyniki za pomocąORDER BY giftability_score DESClub odfiltrować kandydatów za pomocąWHERE AI.SCORE(...) >= 8.0, aby automatycznie generować przewodniki po prezentach.
5. Kategoryzowanie produktów z katalogu za pomocą AI.CLASSIFY
Funkcja AI.CLASSIFY używa Gemini do klasyfikowania rekordów wejściowych na podstawie dyskretnej listy kategorii docelowych podanych jako tablica SQL.
AI.CLASSIFY obsługuje dane wejściowe multimodalne (tekst, obrazy, dźwięk, wideo) i eliminuje potrzebę tworzenia, trenowania lub wdrażania niestandardowych modeli klasyfikacji na potrzeby zarządzania taksonomią.
Klasyfikowanie zabawek według docelowego gatunku zwierzęcia (jedna etykieta)
Załóżmy, że niektóre produkty w katalogu Cymbal Pets są ogólnie oznaczone jako „Zabawki” bez określenia docelowego zwierzęcia. Możesz użyć AI.CLASSIFY, aby skategoryzować każdą zabawkę na podstawie jej nazwy i opisu.
Uruchom to zapytanie w BigQuery Studio:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('What animal is this product for?', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "All Pets"]
  ) AS animal_type
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys"
LIMIT 20;
Wyświetlanie wyników
Wyniki będą podobne do tych:
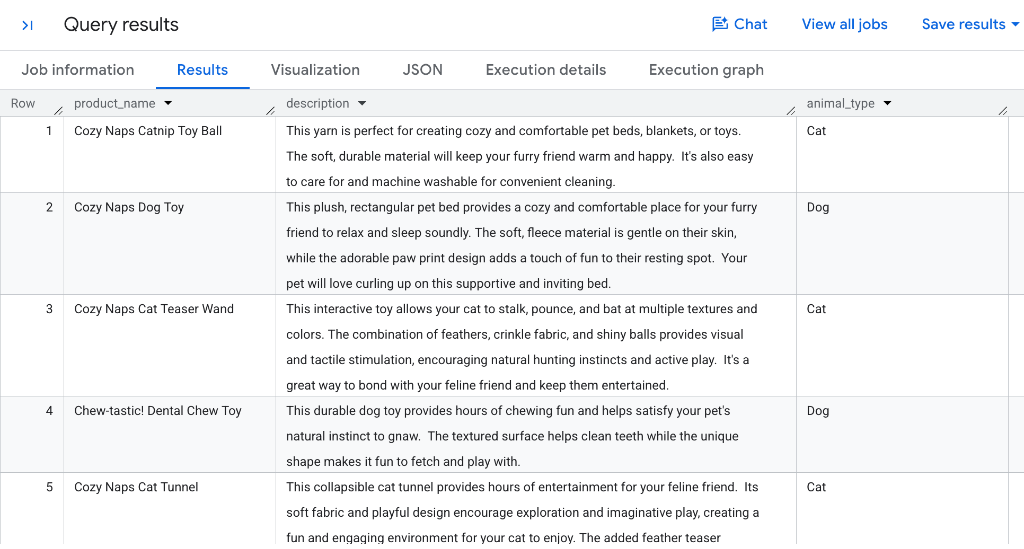
Domyślnie AI.CLASSIFY wykonuje klasyfikację z jedną etykietą i zwraca STRING zawierający jedną najbardziej odpowiednią kategorię z tablicy kandydatów. Zwróć uwagę, jak Gemini przypisuje piłki z kocimiętką i piórka do Cat, a zabawki do gryzienia i patyki do aportowania do Dog.
Przypisywanie wielu tagów za pomocą klasyfikacji z wieloma etykietami
Wiele produktów w katalogu detalicznym dotyczy jednocześnie kilku rodzajów zwierząt (np. pluszowe legowisko lub tunel odpowiedni zarówno dla kotów, jak i małych zwierząt).
Aby przypisać wiele kategorii do jednego rekordu, ustaw opcjonalny parametr output_mode => 'multi'. W trybie z wieloma etykietami AI.CLASSIFY zwraca ARRAY zawierający wszystkie pasujące kategorie.
Uruchom to zapytanie w karcie SQL:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('Identify all pet types that this product is suitable for: ', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "Reptile"],
    output_mode => 'multi'
  ) AS pet_types
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys";
Wyniki będą podobne do tych:
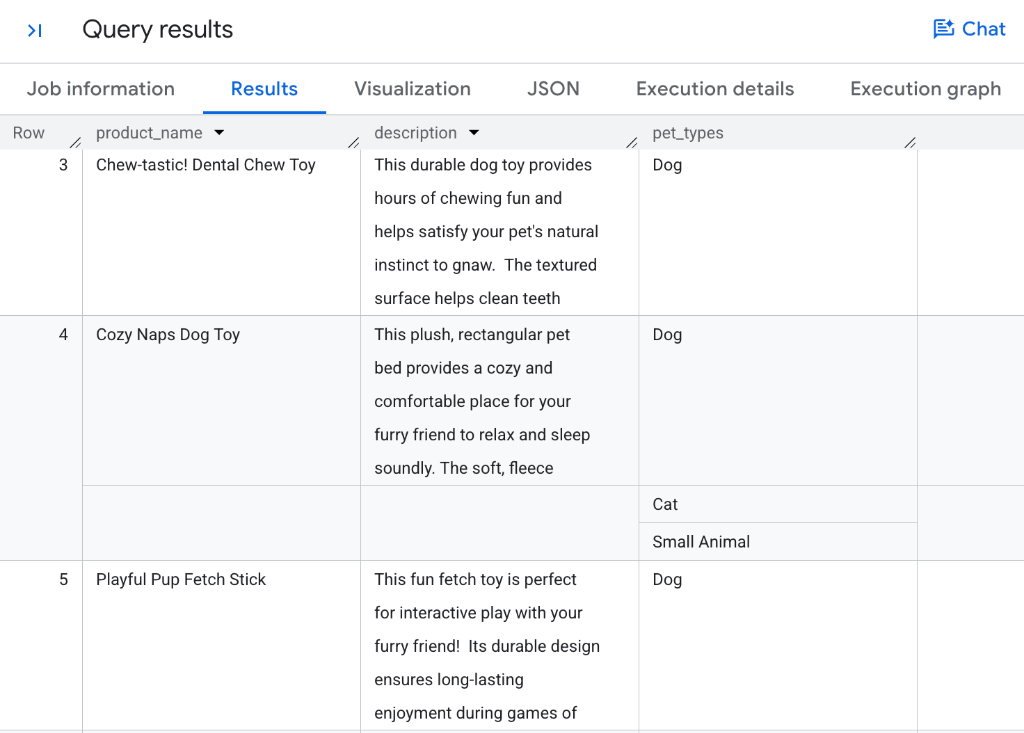
Sprawdzanie mechanizmów klasyfikacji
- Jedna etykieta a wiele etykiet: bez
output_mode,AI.CLASSIFYzwraca skalarnySTRING. Ustawienieoutput_mode => 'multi'zwracaARRAYzawierający zero, jedną lub kilka pasujących etykiet. - Przypisywanie do wielu kategorii: zwróć uwagę, jak produkty specjalistyczne, takie jak
Chew-tastic! Dental Chew ToyiPlayful Pup Fetch Stick, otrzymują et4/}, a uniwersalne produkty zapewniające wygodę, takie jakCozy Naps Dog Toy(pluszowe prostokątne legowisko), prawidłowo otrzymują wiele tagów:[Dog, Cat, Small Animal].[Dog] - Dopasowywanie bez przykładów: model ocenia połączony tekst i prompt na podstawie podanej tablicy
categoriesbez konieczności korzystania z wstępnie wytrenowanych niestandardowych modeli uczenia maszynowego. - Operacje na tablicach SQL: możesz używać standardowych funkcji tablic SQL w BigQuery, takich jak
WHERE 'Cat' IN UNNEST(pet_types)lubCROSS JOIN UNNEST(pet_types), aby filtrować, rozdzielać i agregować rekordy z wieloma etykietami.
6. Filtrowanie multimodalnych zdjęć produktów za pomocą AI.IF
Funkcja AI.IF używa Gemini do oceny warunku w języku naturalnym i zwraca wartość logiczną (TRUE lub FALSE).
Ponieważ AI.IF przyjmuje dane wejściowe multimodalne, możesz używać jej bezpośrednio w klauzuli SQL WHERE do filtrowania nieustrukturyzowanych plików obrazów przechowywanych w Cloud Storage.
Filtrowanie obrazów zawierających określone obiekty
Załóżmy, że zespół ds. merchandisingu chce znaleźć w katalogu wszystkie zdjęcia produktów, które wizualnie zawierają karmę dla zwierząt lub przekąski.
Uruchom to zapytanie w karcie SQL:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`
WHERE
  AI.IF(
    ('Does this product image contain pet food or snacks? ', OBJ.MAKE_REF(uri, 'us.conn'))
  );
Wyniki będą podobne do tych:
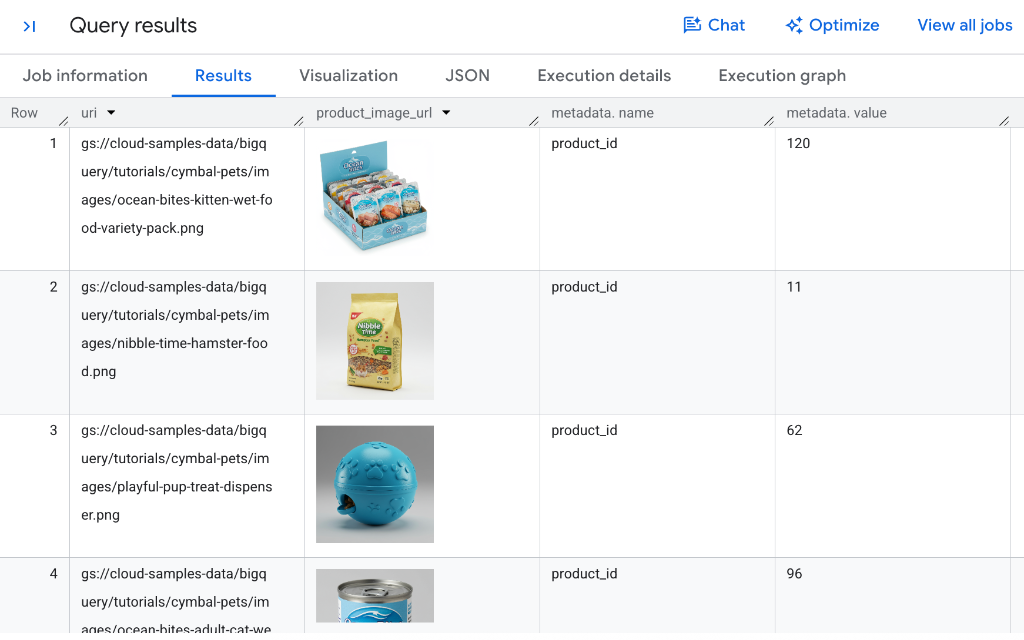
Jak działa filtrowanie multimodalne
- Odniesienia do obiektów w czasie rzeczywistym: odniesienia do obiektów tworzymy w czasie rzeczywistym za pomocą
OBJ.MAKE_REF(uri, 'us.conn'), ale możesz też tworzyć i przechowywać kolumnyObjectRefbezpośrednio w tabelach BigQuery, aby były od razu gotowe do użycia w analizie bez konieczności używania funkcjiOBJ.MAKE_REFw każdym zapytaniu. - Głębokie rozpoznawanie obiektów wizualnych: zwróć uwagę, jak Gemini dokładnie rozpoznaje różne formaty opakowań (np. pudełko z karmą dla zwierząt, torbę z suchą karmą dla chomików i puszkę z karmą dla kotów), a także rozpoznaje jadalne przekąski umieszczone w zabawkach, takich jak niebieski dozownik smakołyków.
- Ocena predykatu na poziomie wiersza: BigQuery ocenia warunek w języku naturalnym na podstawie każdego odniesienia do obrazu Cloud Storage bezpośrednio w klauzuli
WHERE. - Filtrowanie logiczne: w zbiorze wyników zwracane są tylko rekordy, w których Gemini ocenia warunek jako
TRUE.
7. Wykonywanie złączeń semantycznych w tabelach za pomocą AI.IF
Tradycyjne złączenia relacyjnych baz danych wymagają dokładnej równości kluczy (np. products.product_id = images.product_id). Jednak rzeczywiste zbiory danych przedsiębiorstw często zawierają nieustrukturyzowane zasoby, które nie mają jawnych kluczy obcych.
Ponieważ AI.IF zwraca wartość logiczną, możesz umieścić ją bezpośrednio w klauzuli SQL INNER JOIN ... ON, aby wykonywać złączenia semantyczne.
Semantyczne łączenie opisów produktów z komponentami z obrazem
Załóżmy, że chcesz dopasować opisy produktów z tabeli products do niepowiązanych plików obrazów w product_images w przypadku produktów marki Fluffy Buns.
Uruchom to zapytanie w karcie SQL BigQuery Studio (zwróć uwagę, że jego wykonanie zajmie kilka minut):
SELECT
  products.product_id,
  products.product_name,
  products.description,
  products.brand,
  images.uri AS image_uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(images.uri, 'us.conn')).url AS product_image_url
FROM
  `bigquery-public-data.cymbal_pets.products` AS products
INNER JOIN
  `bigquery-public-data.cymbal_pets.product_images` AS images
ON
  AI.IF(
    ('You will be provided an image of a pet product. ',
    'Determine if the image is of the following pet toy: ',
    products.product_name,
    products.description,
    OBJ.MAKE_REF(images.uri, 'us.conn')
    )
  )
WHERE
  products.category = "Toys" AND
  products.brand = "Fluffy Buns";
Wyniki będą podobne do tych:
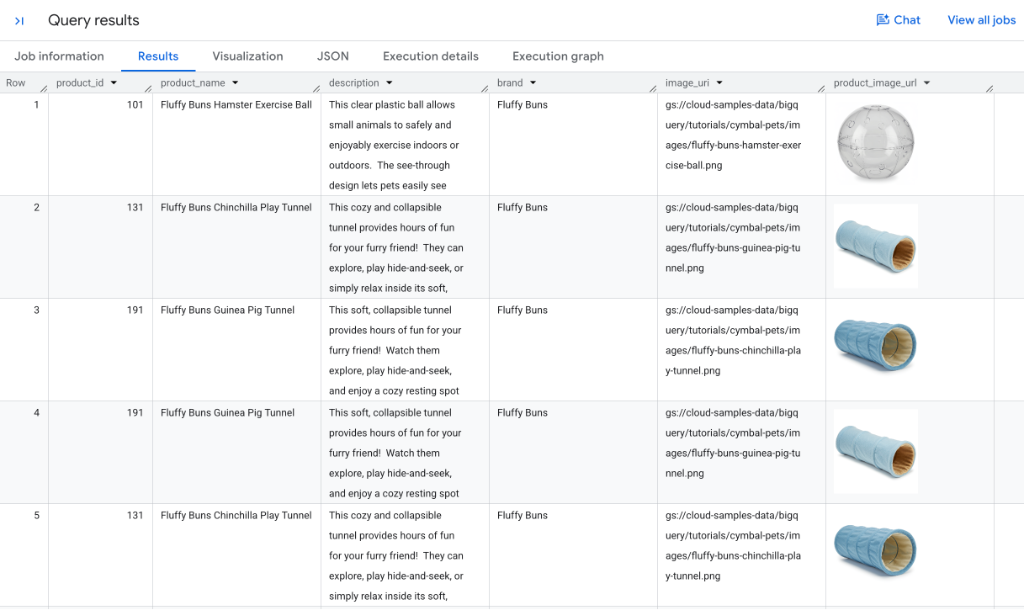
Interpretowanie złączeń semantycznych w SQL
- Ocena warunku między różnymi rodzajami danych: w przypadku par rekordów kandydatów BigQuery wysyła do Gemini zarówno metadane tekstowe z
products, jak i odniesienie do obrazu (OBJ.MAKE_REF(...)). - Dokładne dopasowywanie wizualne: jak widać w wynikach,
Fluffy Buns Hamster Exercise Balljest dopasowana do obrazu przezroczystej plastikowej kuli, aFluffy Buns Chinchilla Play TunneliGuinea Pig Tunnelsą dopasowane do zdjęć niebieskiego pluszowego tunelu. Ze względu na semantykę standardowej wersji SQLINNER JOINprodukt może generować wiele wierszy w danych wyjściowych, jeśli pasuje do więcej niż 1 komponentu z obrazem w katalogu (np. do wielu ujęć lub podobnych zdjęć). - Renderowanie obrazu w tekście: BigQuery Studio automatycznie renderuje autoryzowane adresy URL do odczytu w kolumnie
product_image_urlbezpośrednio w siatce wyników, aby umożliwić natychmiastową weryfikację wizualną. - Rozpoznawanie nieustrukturyzowanych encji: umożliwia to tworzenie zaawansowanych przepływów pracy związanych z rozpoznawaniem encji w starszych katalogach, zbiorach danych pobranych ze stron internetowych i archiwach multimediów bez ręcznego oznaczania lub jawnych kluczy obcych.
8. Synteza statystyk w wierszach za pomocą AI.AGG
Funkcje takie jak AI.SCORE, AI.CLASSIFY i AI.IF oceniają poszczególne wiersze (operacje skalarne), ale analiza danych przedsiębiorstwa często wymaga syntezy wzorców w wielu rekordach.
Funkcja AI.AGG to funkcja agregująca, która używa instrukcji w języku naturalnym do podsumowywania, grupowania lub syntezy statystyk w tysiącach lub milionach nieustrukturyzowanych wierszy w jedną odpowiedź.
Synteza podsumowań kategorii obok tradycyjnych danych SQL
AI.AGG bezproblemowo integruje się z tradycyjnymi funkcjami SQL GROUP BY i agregującymi. Możesz na przykład obliczać tradycyjne dane (np. liczbę produktów) obok podsumowania wygenerowanego przez AI opisującego, co łączy produkty w każdej kategorii.
Uruchom to zapytanie w BigQuery Studio:
SELECT
  category,
  COUNT(*) AS item_count,
  AI.AGG(
    ('Product: ', product_name, ' - Description: ', description),
    'Write a concise, one-sentence summary describing the common characteristics or purpose of the products in this category.'
  ) AS category_summary
FROM
  `bigquery-public-data.cymbal_pets.products`
GROUP BY
  category
ORDER BY
  item_count DESC;
Wyniki będą podobne do tych:
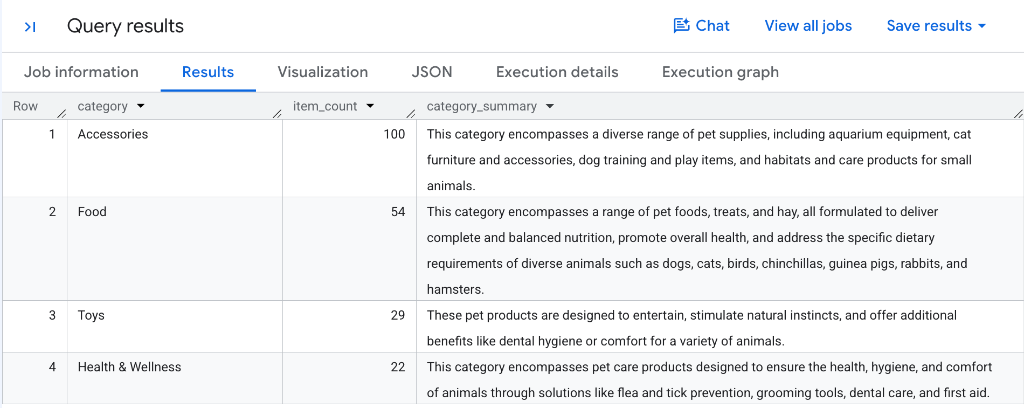
Jak AI.AGG agreguje dane nieustrukturyzowane
- Agregacja hierarchiczna: BigQuery grupuje dane wierszy według partycji kategorii, tworzy strukturalne okna kontekstu i używa Gemini do syntezy całej kolekcji rekordów produktów.
- Automatyczna synteza katalogu: zwróć uwagę, jak każda kategoria otrzymuje odrębne, dokładne podsumowanie, np.
Accessoriesobejmuje siedliska i sprzęt treningowy, aFoodpodkreśla zbilansowane odżywianie w przypadku wielu gatunków zwierząt. - Hybrydowe raportowanie ilościowe i jakościowe: połączenie standardowych agregacji, takich jak
COUNT(*), zAI.AGGtworzy kompleksowe przeglądy katalogu w jednym zapytaniu bez niestandardowych potoków ETL. - Elastyczne partycjonowanie: możesz zastosować
AI.AGGw dowolnym wymiarze grupowania (np.GROUP BY brand,GROUP BY categorylub w całej tabeli), aby w ciągu kilku sekund wygenerować statystyki na poziomie kierowniczym.
9. Przyspieszanie zapytań za pomocą trybu zoptymalizowanego i modeli proxy
Podczas przetwarzania dużych zbiorów danych zawierających tysiące lub miliony wierszy wywoływanie zdalnego LLM dla każdego wiersza może powodować opóźnienia i zwiększać koszty.
Aby rozwiązać ten problem, BigQuery udostępnia tryb zoptymalizowany dla AI.IF i AI.CLASSIFY. Tryb zoptymalizowany wykorzystuje modele proxy i destylację modelu w czasie rzeczywistym, aby zapewnić ponad 100 razy szybsze wykonywanie zapytań przy niższych kosztach tokenów LLM.
Jak działa tryb zoptymalizowany
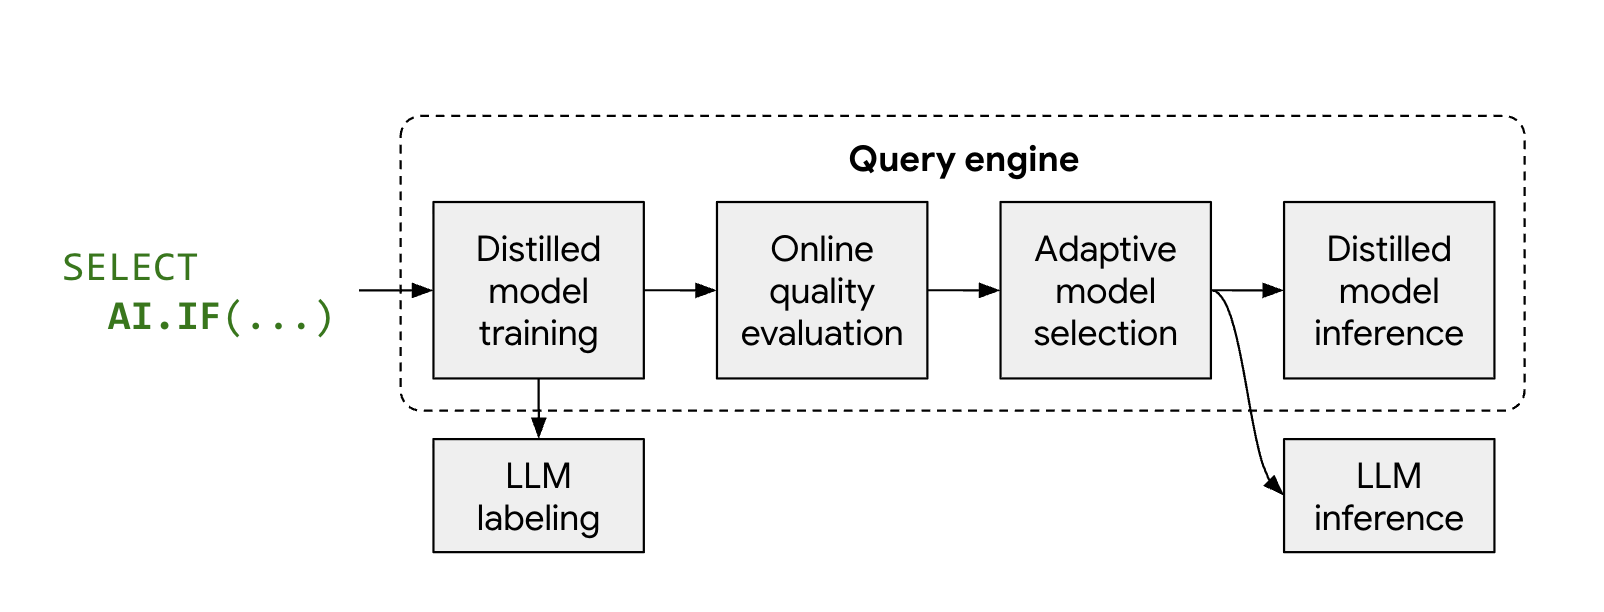
- Reprezentatywne próbkowanie i oznaczanie: BigQuery automatycznie wybiera reprezentatywną próbkę wierszy i pobiera etykiety z Gemini.
- Trenowanie modelu destylowanego: BigQuery trenuje ultralekki model proxy (np. regresję logistyczną) w czasie rzeczywistym na procesorze, używając osadzeń tekstu jako cech.
- Weryfikacja jakości: BigQuery ocenia dokładność modelu destylowanego na podstawie Gemini. Jeśli model spełnia progi jakości, BigQuery promuje go do przetwarzania pozostałej części zbioru danych.
- Lokalne wnioskowanie z dużą szybkością: model proxy ocenia pozostałe wiersze lokalnie bez kosztów tokenów zdalnego LLM i przy bardzo małym opóźnieniu.
Uruchamianie zapytania podstawowego bez optymalizacji
Ponieważ przykładowy katalog bigquery-public-data.cymbal_pets.products zawiera zbyt mało wierszy, aby uruchomić destylację modelu proxy,użyjemy większego publicznego zbioru danych bigquery-public-data.bbc_news.fulltext (który zawiera ponad 2200 artykułów).
Najpierw uruchom standardowe zapytanie bez optymalizacji, aby zidentyfikować artykuły o katastrofach naturalnych:
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body)
  );
Sprawdzanie szczegółów zadania podstawowego i wykorzystania tokenów
Po zakończeniu zapytania podstawowego sprawdź dane wykonania:
- W dolnym panelu wyników BigQuery Studio wybierz kartę Informacje o zadaniu.
- Przewiń w dół do sekcji Liczba tokenów wejściowych i Liczba tokenów wyjściowych.
Wyniki będą podobne do tych:
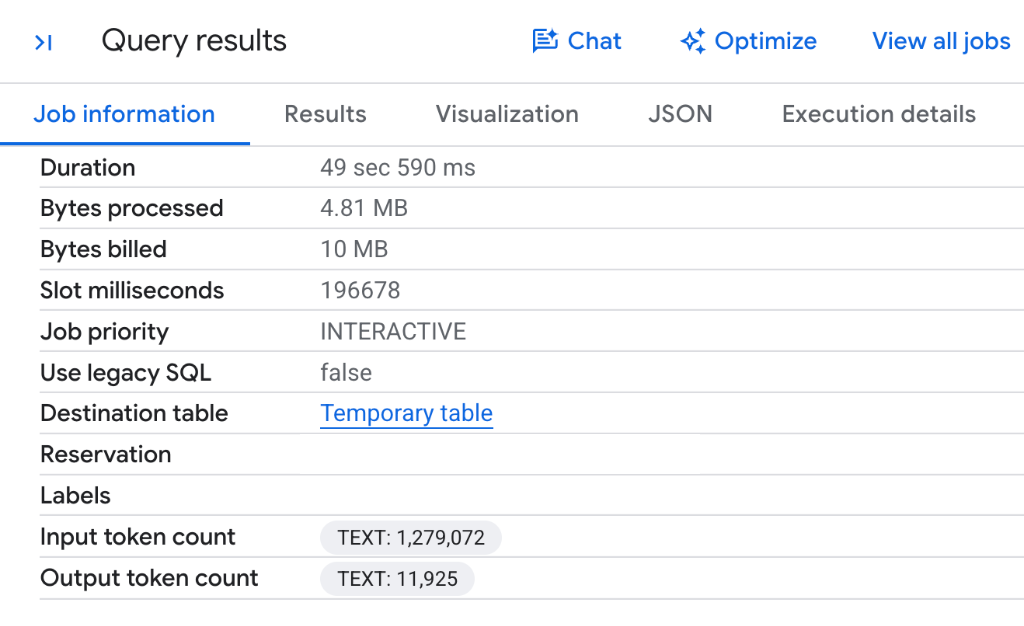
- Zużycie tokenów w całym zbiorze danych: ponieważ BigQuery wywołuje zdalny model Gemini dla każdego wiersza we wszystkich 2225 artykułach bez optymalizacji proxy, zapytanie zużywa 1 279 072 tokeny wejściowe i 11 925 tokenów wyjściowych .
- Brak sekcji optymalizacji: zwróć uwagę, że nie ma wpisu
Gen AI Function Optimizations, ponieważ standardowe wykonanie ocenia każdy wiersz na podstawie zdalnego punktu końcowego LLM.
Wykonywanie zapytania w trybie zoptymalizowanym
Aby zmniejszyć zużycie tokenów i wykorzystać destylację modelu proxy, włącz tryb zoptymalizowany, przekazując embeddings => AI.EMBED(...) i ustawiając optimization_mode => 'MINIMIZE_COST':
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body),
    embeddings => AI.EMBED(body, endpoint => 'text-embedding-005', task_type => 'CLASSIFICATION').result,
    optimization_mode => 'MINIMIZE_COST'
  );
Sprawdzanie optymalizacji i zmniejszonego zużycia tokenów
Po uruchomieniu zoptymalizowanego zapytania przejdź do karty Informacje o zadaniu w BigQuery Studio, aby sprawdzić, jak porównać zużycie tokenów i dane wykonania:
- W dolnym panelu wyników BigQuery Studio wybierz kartę Informacje o zadaniu.
- Przewiń do sekcji Gen AI Function Optimizations oraz do liczby tokenów.
Wyniki będą podobne do tych:
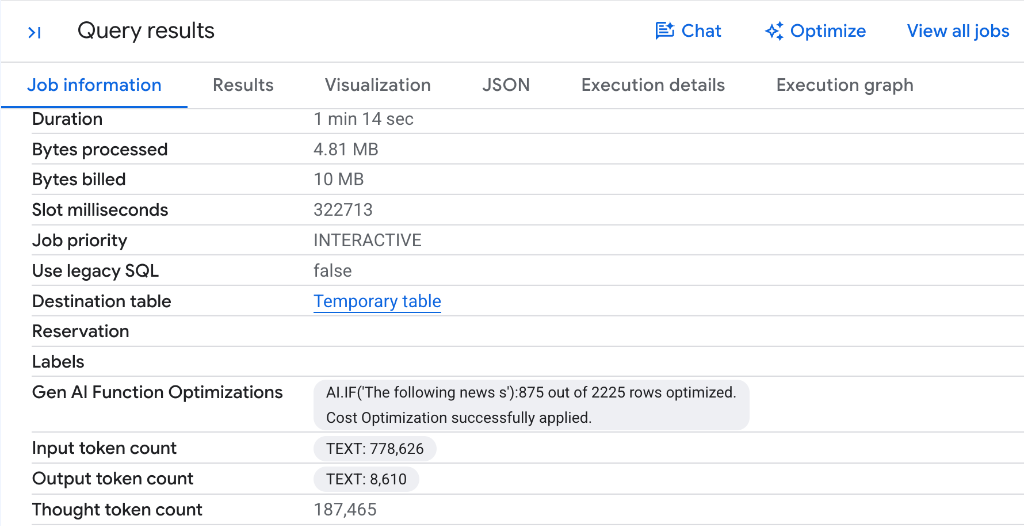
- Znaczne zmniejszenie liczby tokenów: zwróć uwagę, jak Liczba tokenów wejściowych spadła z 1 279 072 tokenów do 778 626 tokenów, co oznacza oszedłność 500 446 tokenów wejściowych (prawie 40% redukcji) w przypadku jednego uruchomienia zapytania. Podobnie zmniejszyła się liczba tokenów wyjściowych.
- Automatyczna destylacja proxy: zwróć uwagę na etykietę
AI.IF('The following news s'): 875 out of 2225 rows optimized. Cost Optimization successfully applied.BigQuery pobrało próbkę zbioru danych, oznaczyło reprezentatywne artykuły za pomocą Gemini, destylowało szybki, lekki klasyfikator proxy i przetworzyło 875 z 2225 wierszy lokalnie na procesorze bez wywoływania zdalnych punktów końcowych LLM. - Bezpośrednie oszczędności: ponieważ zarządzane funkcje AI w BigQuery są rozliczane na podstawie liczby przetwarzanych tokenów modelu, zmniejszenie zużycia tokenów bezpośrednio przekłada się na niższe koszty wykonywania zapytań.
- Weryfikacja jakości: BigQuery automatycznie zweryfikowało dokładność modelu proxy na podstawie Gemini, zanim promowało go do oceny pozostałych wierszy, co zapewnia utrzymanie jakości klasyfikacji.
Jeszcze większe zmniejszenie liczby tokenów i skalowanie czasu oczekiwania w przypadku większych tabel
Oszczędność ponad 500 tys. tokenów w przypadku 2225 wierszy jest znacząca, ale zmniejszenie liczby tokenów i wzrost wydajności są jeszcze większe w przypadku większych tabel:
- Dlaczego zmniejszenie liczby tokenów skaluje się wraz z rozmiarem zbioru danych: w przypadku zapytań wykonywanych w BigQuery modele proxy są trenowane w czasie rzeczywistym na podstawie początkowej próbki około 1000 wierszy oznaczonych przez LLM. Po wytrenowaniu i zweryfikowaniu model proxy zastępuje bezpośrednie wywołania LLM w pozostałych wierszach. W przypadku większych zapytań (np. typowych zbiorów danych zawierających 1 milion wierszy) eliminuje to wywołania LLM w przypadku większości danych, co pozwala zużywać nawet 400 razy mniej tokenów i znacznie obniża koszty.
- Znaczne przyspieszenie czasu oczekiwania: dzięki przeniesieniu wnioskowania ze specjalistycznego sprzętu LLM do ultralekkich modeli proxy działających bezpośrednio na standardowych procesorach roboczych bazy danych (z wykorzystaniem wstępnie obliczonych osadzeń Gemini) BigQuery skraca ogólny czas wykonywania zapytań od 30 do 100 razy.
10. Zwalnianie miejsca
Aby zwolnić miejsce zajmowane przez zasoby utworzone w tym ćwiczeniu, uruchom w karcie SQL BigQuery Studio tę instrukcję, aby usunąć połączenie z zasobem Cloud:
DROP CONNECTION IF EXISTS `us.conn`;
Jeśli projekt Google Cloud został utworzony tymczasowo wyłącznie na potrzeby tego samouczka, możesz zamknąć cały projekt w Cloud Resource Manager.
11. Gratulacje
Gratulacje! Udało Ci się ukończyć moduł Analiza semantyczna w BigQuery za pomocą zarządzanych funkcji AI i SQL.
Poznałeś(-aś) zarządzane funkcje generatywnej AI w BigQuery:
AI.SCORE: ranking produktów według subiektywnych kryteriów, takich jak „nadaje się na prezent”, w skali od 1 do 10 za pomocą automatycznego przepisywania promptów.AI.CLASSIFY: kategoryzowanie nieustrukturyzowanych produktów z katalogu według docelowych klasyfikacji zwierząt.AI.IF(filtrowanie multimodalne): filtrowanie komponentów z obrazem Cloud Storage w klauzulach SQLWHEREna podstawie treści wizualnych.AI.IF(złączenia semantyczne): wykonywanie złączeń między różnymi rodzajami danych w klauzulach SQLONw celu połączenia tekstowych opisów produktów z plikami obrazów.AI.AGG: synteza nieustrukturyzowanego tekstu katalogu z wielu wierszy w zwięzłe podsumowanie.- Tryb zoptymalizowany i modele proxy: przyspieszanie zapytań i minimalizowanie kosztów tokenów za pomocą
optimization_mode => 'MINIMIZE_COST'z destylacją modelu w czasie rzeczywistym iAI.EMBED.
Więcej informacji
- Przegląd od AI w BigQuery
- Przewodnik po zarządzanych funkcjach AI w BigQuery
AI.SCOREDokumentacja składni SQLAI.CLASSIFYDokumentacja składni SQLAI.IFDokumentacja składni SQLAI.AGGDokumentacja składni SQL- Optymalizowanie funkcji AI za pomocą destylacji modelu
- Blog Google Cloud: ponad 100 razy szybsze i tańsze zapytania SQL oparte na LLM dzięki modelom proxy
- Blog Google Cloud: szczegółowe informacje o funkcji AI.AGG w BigQuery