

1. Boas-vindas
Neste codelab, você vai aprender a usar o conjunto de funções de IA gerenciadas do BigQuery para realizar análises semânticas sofisticadas, classificação categórica, filtragem multimodal, junções semânticas e resumo de várias linhas diretamente no BigQuery Studio usando SQL.
Usando o conjunto de dados público bigquery-public-data.cymbal_pets, você vai assumir o papel de um analista de dados da Cymbal Pets, uma loja de comércio eletrônico de produtos e acessórios para animais de estimação.
Análise semântica diretamente em consultas SQL
Tradicionalmente, a aplicação de machine learning ou modelos de linguagem grandes (LLMs) a conjuntos de dados empresariais exigia a migração de dados do data warehouse para ambientes externos de notebooks Python. Isso exigia pipelines de engenharia de dados dedicados e experiência em ML.
As funções de IA gerenciadas do BigQuery, incluindo AI.SCORE, AI.CLASSIFY, AI.IF e AI.AGG, trazem a inteligência do modelo de fundação diretamente para seus dados. O BigQuery otimiza automaticamente a seleção de modelos e aplica estratégias internas de reescrita de comandos para oferecer resultados de alta precisão com comandos simples de linguagem natural.
Para conjuntos de dados de alto volume, o BigQuery oferece o modo otimizado, usando destilação de modelos on-the-fly e modelos de proxy leves para oferecer consultas até 100 vezes mais rápidas e baratas.
O que você aprenderá
- Analisar dados de varejo multimodais no BigQuery Studio usando SQL.
- Realizar classificação semântica usando
AI.SCOREpara avaliar atributos subjetivos do produto, como "capacidade de presente". - Categorizar dados não estruturados usando
AI.CLASSIFYpara mapear produtos para espécies de animais de destino. - Filtrar recursos de imagem multimodais usando
AI.IFemWHEREcláusulas. - Executar junções semânticas em tabelas usando
AI.IFem cláusulasJOIN ... ONpara corresponder registros de produtos de texto a arquivos de imagem externos. - Sintetizar insights de várias linhas usando a função agregada
AI.AGG. - Otimizar a latência e o custo da consulta em conjuntos de dados grandes usando
AI.IFcom o modo otimizado (optimization_mode => 'MINIMIZE_COST') e a destilação de modelos de proxy.
O que é necessário
- Ter um projeto do Google Cloud com o faturamento ativado.
- Um navegador da Web, como o Chrome.
2. Configuração e requisitos
Antes de consultar dados com funções de IA gerenciadas, configure seu projeto na nuvem do Google Cloud e ative as APIs necessárias.
Criar um projeto do Google Cloud e ativar APIs
- No Google Cloud Console, na página de seletor de projetos, selecione ou crie um projeto do Google Cloud.
- Verifique se o faturamento está ativado para seu projeto na nuvem. Saiba como verificar se o faturamento está ativado em um projeto.
- Ative as APIs BigQuery, BigQuery Connection e Agent Platform.
Abrir o BigQuery Studio
- No menu de navegação do console do Google Cloud, clique em BigQuery para abrir o BigQuery Studio.
- Na barra de ferramentas do editor do BigQuery Studio, clique em + Consulta SQL para abrir uma nova guia de consulta SQL. Você vai escrever e executar todas as consultas SQL nessas guias SQL ao longo deste codelab.
Criar uma conexão a recursos do Cloud no SQL
O BigQuery opera em um perímetro de dados seguro. Ao inspecionar arquivos multimodais externos (como imagens armazenadas no Google Cloud Storage), o BigQuery usa uma conexão a recursos do Cloud para acessar referências de objetos com segurança sem expor credenciais.
Execute a instrução a seguir na guia SQL para criar uma conexão chamada us.conn:
CREATE CONNECTION IF NOT EXISTS `us.conn`
OPTIONS (
  connection_type = "CLOUD_RESOURCE"
);
3. Analisar o conjunto de dados da Cymbal Pets
A Cymbal Pets mantém um catálogo de produtos avançado no conjunto de dados público dentro da tabela chamada bigquery-public-data.cymbal_pets.products. Cada registro de produto contém atributos estruturados, como ID do produto, título, categoria de varejo, preço e texto descritivo.
Consultar o catálogo de produtos
Abra uma guia SQL no BigQuery Studio e execute a consulta a seguir para inspecionar a tabela de produtos:
SELECT
  product_id,
  product_name,
  category,
  price,
  description
FROM
  `bigquery-public-data.cymbal_pets.products`;
Os resultados serão semelhantes a estes:
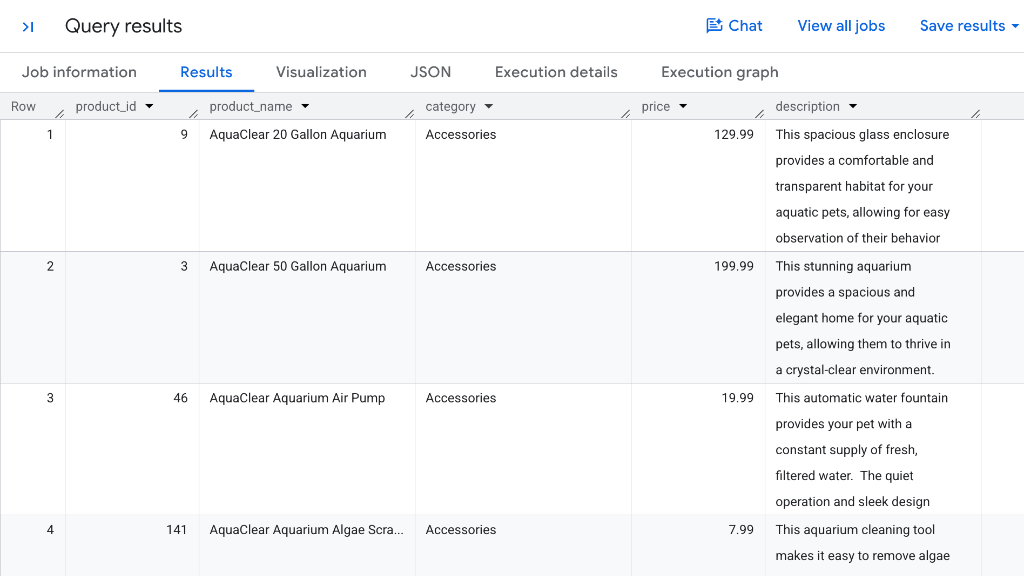
Inspecionar imagens de produtos
A Cymbal Pets também armazena referências de imagens de produtos em bigquery-public-data.cymbal_pets.product_images. Execute a consulta a seguir para conferir os registros de imagem:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`;
Os resultados serão semelhantes a estes:
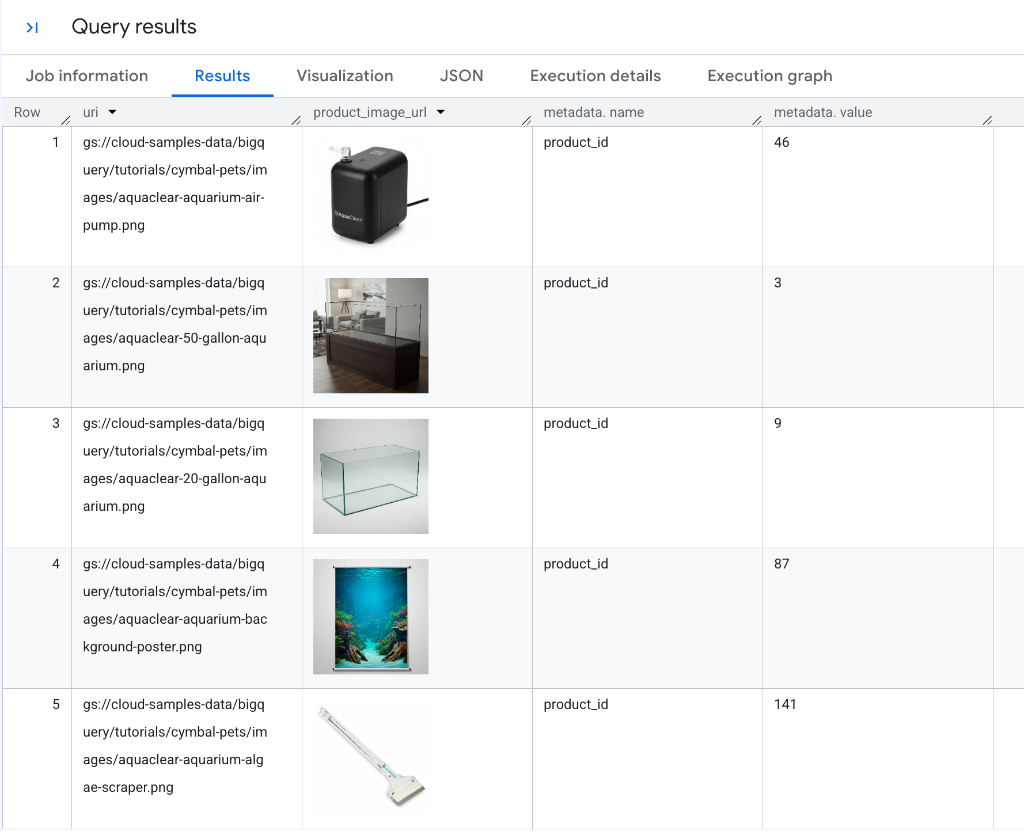
Em seguida, você vai usar as funções gerenciadas do BigQuery para analisar dados de texto e imagem do data warehouse da Cymbal Pets.
4. Classificar produtos por critérios semânticos com AI.SCORE
A função AI.SCORE aceita entradas de texto e usa um modelo do Gemini para classificá-las com base em uma rubrica de pontuação de linguagem natural, retornando uma pontuação numérica FLOAT64
Se você não fornecer uma rubrica de pontuação explícita, o BigQuery vai aplicar automaticamente estratégias de reescrita de comandos para gerar uma rubrica ideal para o modelo.
Pontuar produtos para "capacidade de presente"
Suponha que a equipe de marketing da Cymbal Pets queira criar um guia de presentes de Natal. Eles querem classificar cada item no catálogo com base na adequação como presente para um proprietário de animais de estimação em uma escala de 1 a 10.
Execute a consulta a seguir na guia SQL:
SELECT
  product_name,
  description,
  AI.SCORE(
    ('How "giftable" is this product for a pet owner? ', description,
    'Use a scale from 1-10.')
  ) AS giftability_score
FROM
  `bigquery-public-data.cymbal_pets.products`
ORDER BY
  giftability_score DESC;
Entender os resultados
Os resultados serão semelhantes a estes:
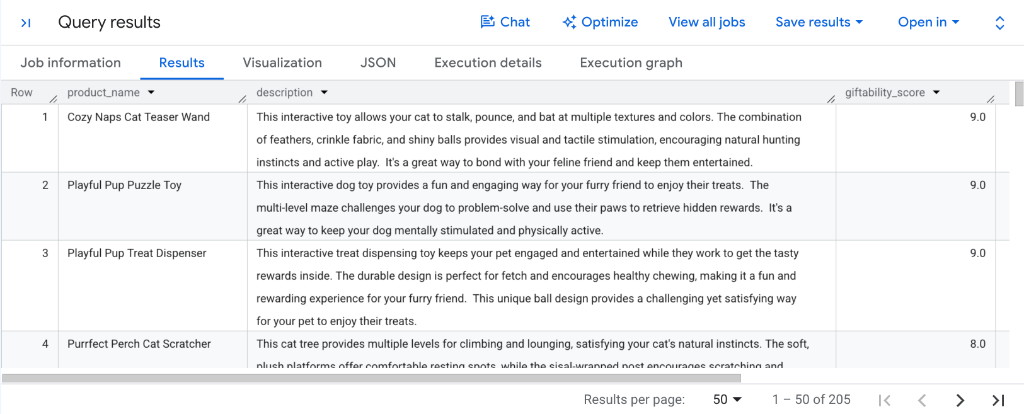
Examine a coluna giftability_score nos resultados da consulta:
- Brinquedos interativos de alta atração: itens envolventes, como o
Cozy Naps Cat Teaser Wand,Playful Pup Puzzle ToyePlayful Pup Treat Dispenser, recebem as melhores classificações (9.0). - Itens especiais de conforto e arranhões: itens essenciais populares, como o
Purrfect Perch Cat Scratcher, têm uma pontuação alta de8.0. - Classificação downstream acionável: como
AI.SCOREproduz pontuaçõesFLOAT64normalizadas, você pode classificar imediatamente os resultados comORDER BY giftability_score DESCou filtrar candidatos comWHERE AI.SCORE(...) >= 8.0para gerar guias de presentes automatizados.
5. Categorizar itens do catálogo com AI.CLASSIFY
A função AI.CLASSIFY usa o Gemini para classificar registros de entrada em uma lista discreta de categorias de destino fornecidas como uma matriz SQL.
AI.CLASSIFY oferece suporte a entradas multimodais (texto, imagens, áudio, vídeo) e elimina a necessidade de criar, treinar ou implantar modelos de classificação personalizados para gerenciamento de taxonomia.
Classificar brinquedos por espécie de animal de destino (rótulo único)
Suponha que alguns produtos no catálogo da Cymbal Pets sejam marcados genericamente como "Brinquedos" sem especificar o animal de destino. Você pode usar AI.CLASSIFY para categorizar cada brinquedo com base no nome e na descrição.
Execute a consulta a seguir no BigQuery Studio:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('What animal is this product for?', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "All Pets"]
  ) AS animal_type
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys"
LIMIT 20;
Conferir os resultados
Os resultados serão semelhantes a estes:
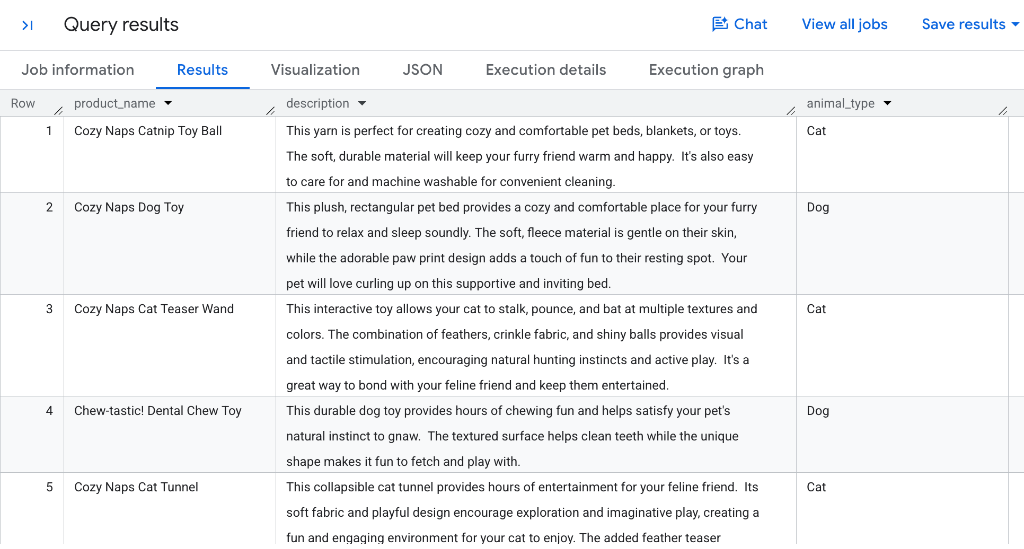
Por padrão, AI.CLASSIFY realiza a classificação de rótulo único e retorna uma STRING que contém a categoria mais relevante da matriz de candidatos. Observe como o Gemini mapeia bolas de catnip e brinquedos de penas para Cat, enquanto brinquedos de mastigar e bastões de busca são mapeados para Dog.
Atribuir várias tags com classificação de vários rótulos
Muitos produtos em um catálogo de varejo se aplicam a vários tipos de animais de estimação simultaneamente (por exemplo, uma cama ou túnel de pelúcia adequado para gatos e pequenos animais).
Para atribuir várias categorias a um único registro, defina o parâmetro opcional output_mode => 'multi'. No modo de vários rótulos, AI.CLASSIFY retorna uma ARRAY que contém todas as categorias correspondentes.
Execute a consulta a seguir na guia SQL:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('Identify all pet types that this product is suitable for: ', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "Reptile"],
    output_mode => 'multi'
  ) AS pet_types
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys";
Os resultados serão semelhantes a estes:
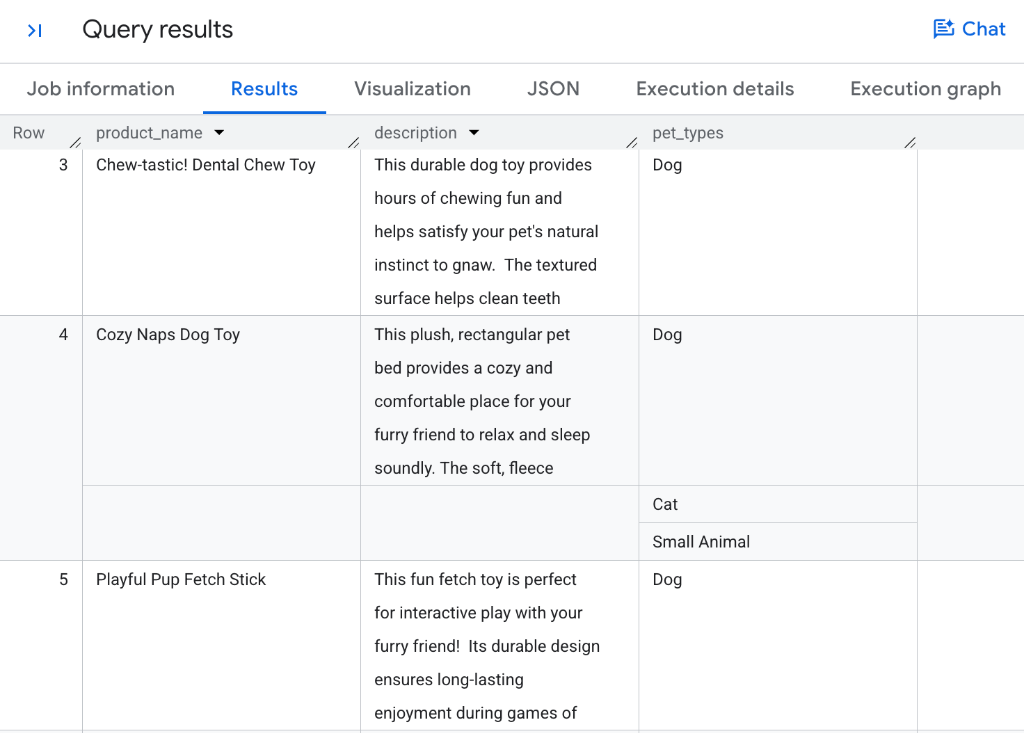
Analisar a mecânica de classificação
- Rótulo único x vários rótulos: sem
output_mode,AI.CLASSIFYretorna umaSTRINGescalar. Definiroutput_mode => 'multi'retorna umaARRAYque contém zero, um ou vários rótulos correspondentes. - Atribuição de várias categorias: observe como itens dedicados, como
Chew-tastic! Dental Chew ToyePlayful Pup Fetch Stick, recebem[Dog], enquanto itens de conforto versátil, comoCozy Naps Dog Toy(uma cama retangular de pelúcia), recebem várias tags corretamente:[Dog, Cat, Small Animal]. - Correspondência zero-shot: o modelo avalia o texto combinado e o comando na matriz
categoriesfornecida sem exigir modelos de ML personalizados pré-treinados. - Operações de matriz SQL downstream: você pode usar funções de matriz SQL padrão do BigQuery, como
WHERE 'Cat' IN UNNEST(pet_types)ouCROSS JOIN UNNEST(pet_types), para filtrar, expandir e agregar registros com vários rótulos.
6. Filtrar imagens de produtos multimodais com AI.IF
A função AI.IF usa o Gemini para avaliar uma condição de linguagem natural e retorna um booleano (TRUE ou FALSE).
Como AI.IF aceita entradas multimodais, você pode usá-la diretamente em uma cláusula WHERE SQL para filtrar arquivos de imagem não estruturados armazenados no Cloud Storage.
Filtrar imagens que contêm objetos específicos
Suponha que a equipe de merchandising queira encontrar todas as imagens de produtos no catálogo que contenham visualmente comida ou petiscos para animais de estimação.
Execute a consulta a seguir na guia SQL:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`
WHERE
  AI.IF(
    ('Does this product image contain pet food or snacks? ', OBJ.MAKE_REF(uri, 'us.conn'))
  );
Os resultados serão semelhantes a estes:
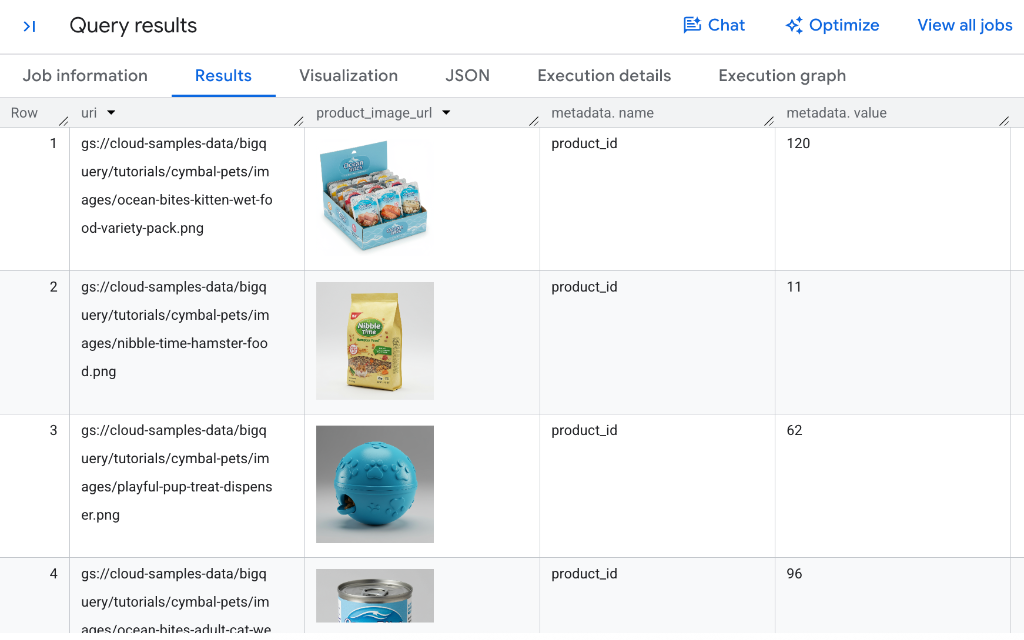
Como funciona a filtragem multimodal
- Referências de objetos on-the-fly: embora criemos referências de objetos on-the-fly aqui usando
OBJ.MAKE_REF(uri, 'us.conn'), também é possível criar e armazenar colunasObjectRefdiretamente nas tabelas do BigQuery para que elas estejam imediatamente prontas para uso na análise sem precisar da funçãoOBJ.MAKE_REFem todas as consultas. - Reconhecimento de objetos visuais profundos: observe como o Gemini identifica com precisão diversos formatos de embalagem (como a caixa de alimentos úmidos, o saco de comida seca para hamster e a lata de comida para gatos), além de reconhecer petiscos comestíveis carregados em brinquedos, como o dispensador de petiscos azul.
- Avaliação de predicados no nível da linha: o BigQuery avalia a condição de linguagem natural em relação a cada referência de imagem do Cloud Storage diretamente na cláusula
WHERE. - Filtragem booleana: apenas os registros em que o Gemini avalia a condição como
TRUEsão retornados no conjunto de resultados.
7. Realizar junções semânticas em tabelas com AI.IF
As junções de banco de dados relacionais tradicionais exigem igualdade de chave exata (como products.product_id = images.product_id). No entanto, os conjuntos de dados empresariais do mundo real geralmente contêm recursos não estruturados que não têm chaves estrangeiras explícitas.
Como AI.IF retorna um valor booleano, você pode colocá-lo diretamente em uma cláusula INNER JOIN ... ON SQL para realizar junções semânticas.
Unir semanticamente descrições de produtos com recursos de imagem
Suponha que você queira corresponder descrições de produtos da tabela products a arquivos de imagem não vinculados em product_images para produtos fabricados pela marca Fluffy Buns.
Execute a consulta a seguir na guia SQL do BigQuery Studio. Ela leva alguns minutos para ser concluída:
SELECT
  products.product_id,
  products.product_name,
  products.description,
  products.brand,
  images.uri AS image_uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(images.uri, 'us.conn')).url AS product_image_url
FROM
  `bigquery-public-data.cymbal_pets.products` AS products
INNER JOIN
  `bigquery-public-data.cymbal_pets.product_images` AS images
ON
  AI.IF(
    ('You will be provided an image of a pet product. ',
    'Determine if the image is of the following pet toy: ',
    products.product_name,
    products.description,
    OBJ.MAKE_REF(images.uri, 'us.conn')
    )
  )
WHERE
  products.category = "Toys" AND
  products.brand = "Fluffy Buns";
Os resultados serão semelhantes a estes:
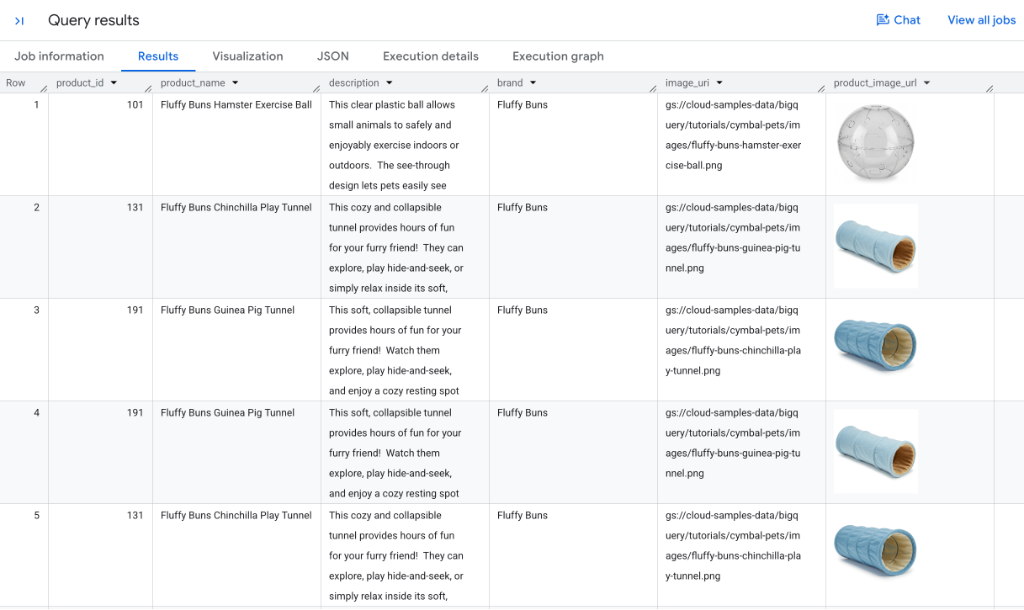
Entender junções semânticas no SQL
- Avaliação de condições entre modalidades: para pares de registros candidatos, o BigQuery envia os metadados textuais de
productse a referência da imagem (OBJ.MAKE_REF(...)) para o Gemini. - Correspondência visual precisa: conforme mostrado nos resultados, o
Fluffy Buns Hamster Exercise Ballé correspondido à imagem da bola de plástico transparente, enquanto oFluffy Buns Chinchilla Play Tunnele oGuinea Pig Tunnelsão correspondidos às fotos do túnel de pelúcia azul. Devido à semânticaINNER JOINdo SQL padrão, um produto pode produzir várias linhas na saída se corresponder a mais de um recurso de imagem no catálogo (como vários ângulos de foto ou fotos semelhantes). - Renderização de imagens inline: o BigQuery Studio renderiza automaticamente os URLs de leitura autorizados na coluna
product_image_urldiretamente na grade de resultados para verificação visual instantânea. - Resolução de entidades não estruturadas: isso desbloqueia fluxos de trabalho de resolução de entidades avançados em catálogos legados, conjuntos de dados extraídos e arquivos de mídia sem rótulos manuais ou chaves estrangeiras explícitas.
8. Sintetizar insights em linhas com AI.AGG
Embora funções como AI.SCORE, AI.CLASSIFY e AI.IF avaliem linhas individuais (operações escalares), a análise de dados empresariais geralmente exige a síntese de padrões em vários registros.
A função AI.AGG é uma função agregada que usa instruções de linguagem natural para resumir, agrupar ou sintetizar insights em milhares ou milhões de linhas não estruturadas em uma resposta unificada.
Sintetizar resumos de categorias junto com métricas SQL tradicionais
AI.AGG se integra perfeitamente às funções agregadas e GROUP BY SQL tradicionais. Por exemplo, é possível calcular métricas tradicionais (como contagens de itens) junto com um resumo de IA generativa que descreve o que os produtos em cada categoria têm em comum.
Execute a consulta a seguir no BigQuery Studio:
SELECT
  category,
  COUNT(*) AS item_count,
  AI.AGG(
    ('Product: ', product_name, ' - Description: ', description),
    'Write a concise, one-sentence summary describing the common characteristics or purpose of the products in this category.'
  ) AS category_summary
FROM
  `bigquery-public-data.cymbal_pets.products`
GROUP BY
  category
ORDER BY
  item_count DESC;
Os resultados serão semelhantes a estes:
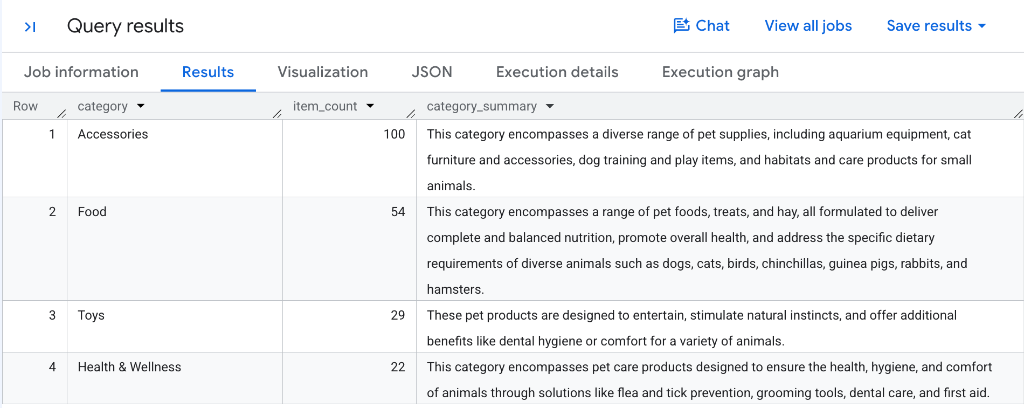
Como o AI.AGG agrega dados não estruturados
- Agregação hierárquica: o BigQuery agrupa dados de linhas por partição de categoria, cria janelas de contexto estruturadas e usa o Gemini para sintetizar toda a coleção de registros de produtos.
- Síntese automatizada de catálogos: observe como cada categoria recebe um resumo distinto e preciso, como
Accessoriesque captura habitats e equipamentos de treinamento, ouFoodque destaca a nutrição equilibrada em várias espécies de animais. - Relatórios quantitativos e qualitativos híbridos: a combinação de agregações padrão, como
COUNT(*)comAI.AGG, produz visões gerais abrangentes do catálogo em uma única consulta sem pipelines ETL personalizados. - Particionamento flexível: é possível aplicar
AI.AGGem qualquer dimensão de agrupamento (comoGROUP BY brand,GROUP BY categoryou em toda a tabela) para gerar insights executivos em segundos.
9. Acelerar consultas com o modo otimizado e modelos de proxy
Ao processar conjuntos de dados grandes que contêm milhares ou milhões de linhas, invocar um LLM remoto para cada linha pode introduzir latência e custo.
Para resolver isso, o BigQuery oferece o modo otimizado para AI.IF e AI.CLASSIFY. O modo otimizado usa modelos de proxy e destilação de modelos on-the-fly para oferecer uma execução mais de 100 vezes mais rápida com custo reduzido de tokens LLM.
Como funciona o modo otimizado
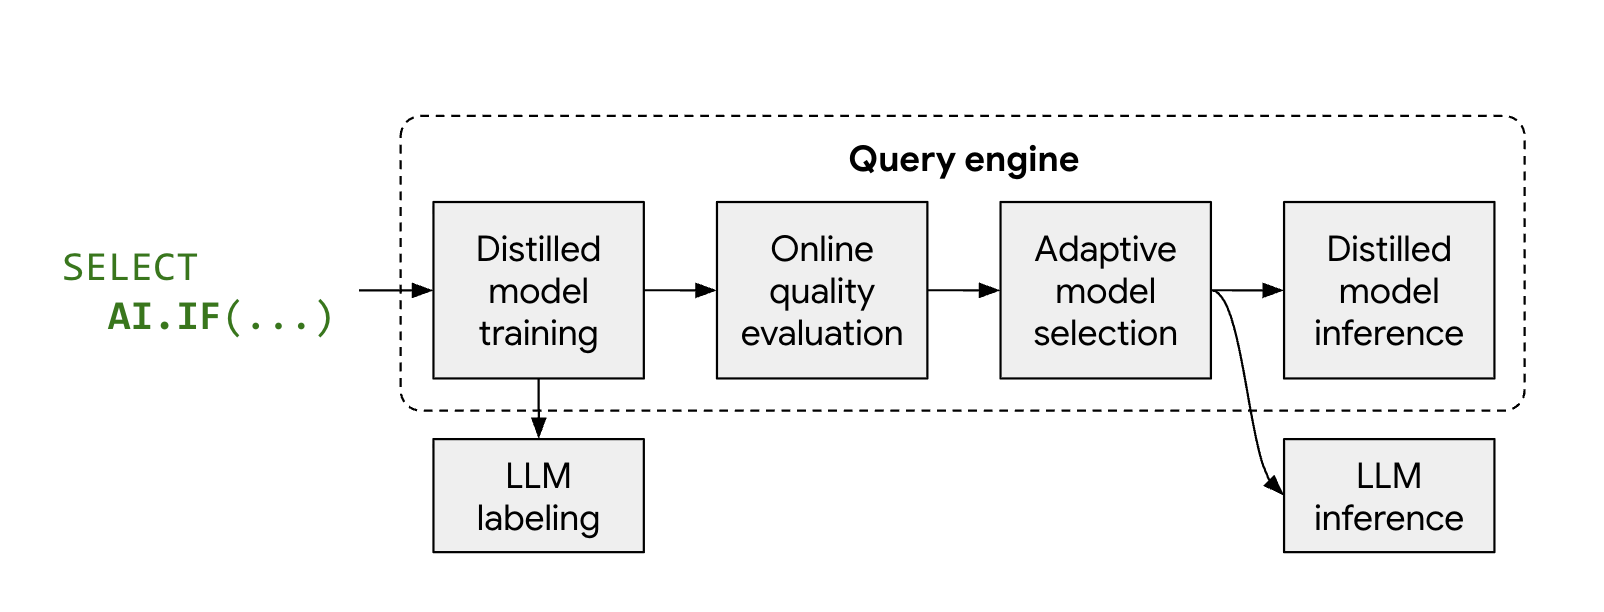
- Amostragem e rotulagem representativas: o BigQuery seleciona automaticamente uma amostra representativa de linhas e recebe rótulos do Gemini.
- Treinamento de modelos destilados: o BigQuery treina um modelo de proxy ultraleve (como regressão logística) no momento certo na CPU usando embeddings de texto como recursos.
- Verificação de qualidade: o BigQuery avalia a acurácia do modelo destilado em relação ao Gemini. Se ele atender aos limites de qualidade, o BigQuery vai promovê-lo para processar o restante do conjunto de dados.
- Inferência local de alta velocidade: o modelo de proxy avalia as linhas restantes localmente com custo zero de tokens LLM remotos e latência ultrabaixa.
Executar uma consulta de referência sem otimização
Como o catálogo de amostras bigquery-public-data.cymbal_pets.products contém poucas linhas para acionar a destilação do modelo de proxy, vamos usar o conjunto de dados público maior bigquery-public-data.bbc_news.fulltext (que contém mais de 2.200 artigos de notícias).
Primeiro, execute a consulta padrão sem otimização para identificar artigos de notícias sobre desastres naturais:
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body)
  );
Inspecionar detalhes do job de referência e uso de tokens
Depois que a consulta de referência for concluída, inspecione as métricas de execução:
- No painel de resultados da parte de baixo do BigQuery Studio, selecione a guia Informações do job.
- Role para baixo até as seções Contagem de tokens de entrada e Contagem de tokens de saída.
Os resultados serão semelhantes a estes:
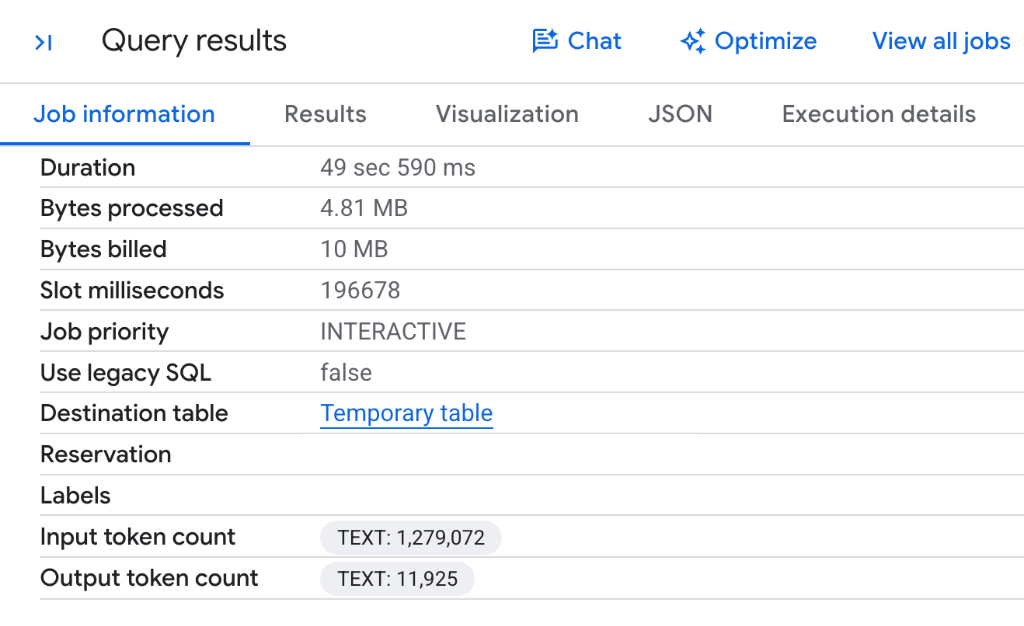
- Consumo de tokens do conjunto de dados completo: como o BigQuery invoca o modelo Gemini remoto para cada linha em todos os 2.225 artigos de notícias sem otimização de proxy, a consulta consome 1.279.072 tokens de entrada e 11.925 tokens de saída.
- Nenhuma seção de otimização: observe que não há entrada
Gen AI Function Optimizationsporque a execução padrão avalia cada linha individual em relação ao endpoint LLM remoto.
Executar a consulta com o modo otimizado
Para reduzir o consumo de tokens e aproveitar a destilação do modelo de proxy, ative o modo otimizado transmitindo embeddings => AI.EMBED(...) e definindo optimization_mode => 'MINIMIZE_COST':
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body),
    embeddings => AI.EMBED(body, endpoint => 'text-embedding-005', task_type => 'CLASSIFICATION').result,
    optimization_mode => 'MINIMIZE_COST'
  );
Verificar a otimização e observar o uso reduzido de tokens
Depois de executar a consulta otimizada, mude para a guia Informações do job do BigQuery Studio para observar como o uso de tokens e as métricas de execução são comparados:
- No painel de resultados da parte de baixo do BigQuery Studio, selecione a guia Informações do job.
- Role até a seção Otimizações de função da IA generativa, bem como as contagens de tokens.
Os resultados serão semelhantes a estes:
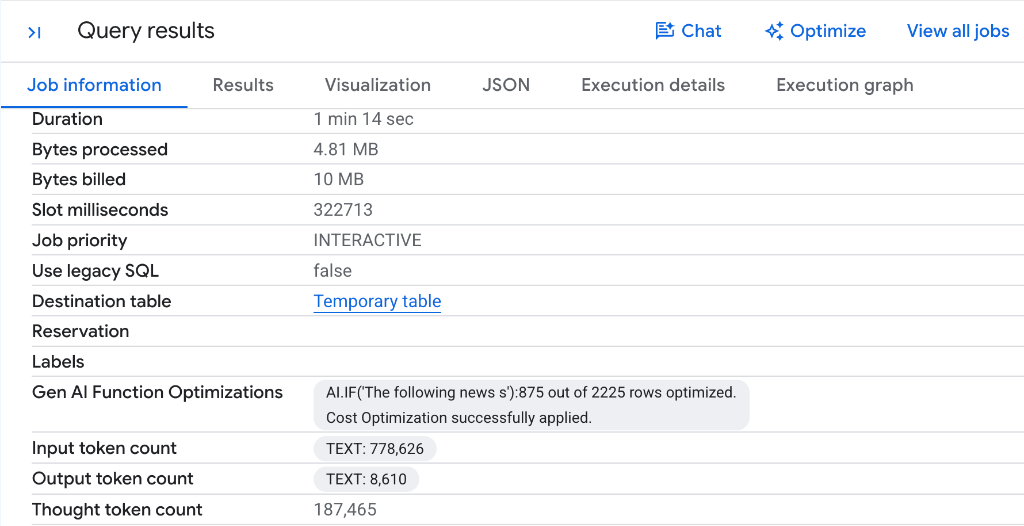
- Redução significativa de tokens: observe como a Contagem de tokens de entrada caiu de 1.279.072 tokens para 778.626 tokens, economizando 500.446 tokens de entrada (quase 40% de redução) em uma única execução de consulta. Da mesma forma, houve uma diminuição nos tokens de saída.
- Destilação automática de proxy: observe o rótulo
AI.IF('The following news s'): 875 out of 2225 rows optimized. Cost Optimization successfully applied.O BigQuery amostrou o conjunto de dados, rotulou artigos representativos com o Gemini, destilou um classificador de proxy rápido e leve e processou 875 de 2.225 linhas localmente na CPU sem chamar endpoints LLM remotos. - Economia de custos diretos: como as funções de IA gerenciadas do BigQuery são faturadas com base no volume de tokens de modelo processados, a redução do consumo de tokens se traduz diretamente em custos de execução de consulta mais baixos.
- Validação de qualidade: o BigQuery verificou automaticamente a acurácia do modelo de proxy em relação ao Gemini antes de promovê-lo para avaliar as linhas restantes, garantindo a manutenção da qualidade da classificação.
Redução ainda maior de tokens e escalonamento de latência em tabelas maiores
Embora a economia de mais de 500.000 tokens em 2.225 linhas seja substancial, a redução de tokens e os ganhos de desempenho são ainda maiores em tabelas maiores:
- Por que a redução de tokens é escalonada com o tamanho do conjunto de dados: para consultas executadas no BigQuery, os modelos de proxy são treinados on-the-fly usando uma amostra inicial de cerca de 1.000 linhas rotuladas pelo LLM. Depois de treinado e validado, o modelo de proxy substitui as chamadas diretas de LLM nas linhas restantes. Para consultas maiores (como conjuntos de dados típicos de 1 milhão de linhas), isso elimina as invocações de LLM para a maior parte dos dados, consumindo até 400 vezes menos tokens e reduzindo drasticamente os custos.
- Aceleração substancial da latência: ao mudar a inferência do hardware LLM especializado para modelos de proxy ultraleves executados diretamente nas CPUs de worker de banco de dados padrão (aproveitando embeddings pré-computados do Gemini), o BigQuery reduz os tempos de execução gerais da consulta em 30 a 100 vezes.
10. Limpar recursos
Para limpar os recursos criados durante este codelab, execute a instrução a seguir em uma guia SQL do BigQuery Studio para remover a conexão a recursos do Cloud:
DROP CONNECTION IF EXISTS `us.conn`;
Como alternativa, se você criou um projeto temporário do Google Cloud exclusivamente para este tutorial, poderá encerrar todo o projeto no Cloud Resource Manager.
11. Parabéns
Parabéns! Você concluiu o codelab sobre Análise semântica no BigQuery com funções de IA gerenciadas e SQL.
Você aprendeu a usar as funções de IA generativa gerenciadas do BigQuery:
AI.SCORE: produtos classificados por critérios subjetivos, como capacidade de presente, em uma escala de 1 a 10, usando a reescrita automática de comandos.AI.CLASSIFY: itens de catálogo não estruturados categorizados em classificações de animais de destino.AI.IF(filtragem multimodal): recursos de imagem do Cloud Storage filtrados em cláusulasWHERESQL com base no conteúdo visual.AI.IF(junções semânticas): junções entre modalidades realizadas em cláusulasONSQL para vincular descrições de produtos textuais a arquivos de imagem.AI.AGG: texto de catálogo não estruturado de várias linhas sintetizado em um resumo executivo conciso.- Modo otimizado e modelos de proxy: consultas aceleradas e custos de tokens minimizados usando
optimization_mode => 'MINIMIZE_COST'com destilação de modelos on-the-fly eAI.EMBED.
Saiba mais
- Visão geral da IA generativa do BigQuery
- Guia de funções de IA gerenciadas do BigQuery
- Documentação da sintaxe SQL
AI.SCORE - Documentação da sintaxe SQL
AI.CLASSIFY - Documentação da sintaxe SQL
AI.IF - Documentação da sintaxe SQL
AI.AGG - Otimizar funções de IA com destilação de modelos
- Blog do Google Cloud: consultas SQL com tecnologia de LLM mais de 100 vezes mais rápidas e baratas com modelos de proxy
- Blog do Google Cloud: análise detalhada da função AI.AGG do BigQuery