

1. Добро пожаловать
В этом практическом занятии вы узнаете, как использовать набор управляемых функций искусственного интеллекта BigQuery для выполнения сложного семантического анализа, категориальной классификации, мультимодальной фильтрации, семантических объединений и суммирования нескольких строк непосредственно в BigQuery Studio с помощью SQL.
Используя общедоступный набор данных bigquery-public-data.cymbal_pets , вы сможете почувствовать себя на месте аналитика данных в компании Cymbal Pets , интернет-магазине товаров и аксессуаров для домашних животных.
Семантический анализ непосредственно внутри SQL-запросов
Традиционно применение машинного обучения или больших языковых моделей (LLM) к корпоративным наборам данных требовало перемещения данных из хранилища данных во внешние среды Python Notebook. Это требовало специализированных конвейеров обработки данных и экспертных знаний в области машинного обучения.
Управляемые функции искусственного интеллекта BigQuery, включая AI.SCORE , AI.CLASSIFY , AI.IF и AI.AGG , обеспечивают базовый интеллект моделей непосредственно для ваших данных. BigQuery автоматически оптимизирует выбор модели и применяет внутренние стратегии переписывания подсказок для получения высокоточных результатов на основе простых подсказок на естественном языке.
Для больших объемов данных BigQuery предоставляет оптимизированный режим , использующий автоматическую обработку моделей и облегченные прокси-модели, что позволяет выполнять запросы до 100 раз быстрее и дешевле.
Что вы будете делать
- Изучайте мультимодальные данные розничной торговли в BigQuery Studio с помощью SQL.
- Используйте
AI.SCOREдля семантического ранжирования , чтобы оценить субъективные характеристики продукта, такие как «возможность подарить». - Классифицируйте неструктурированные данные с помощью
AI.CLASSIFY, чтобы сопоставить продукты с целевыми видами животных. - Фильтрация мультимодальных изображений с использованием
AI.IFв рамках условийWHERE. - Выполняйте семантические объединения таблиц, используя
AI.IFв предложенияхJOIN ... ON, чтобы сопоставить текстовые записи о товарах с внешними файлами изображений. - Обобщите результаты анализа нескольких строк данных с помощью агрегатной функции
AI.AGG. - Оптимизируйте задержку и стоимость запросов на больших наборах данных с помощью
AI.IFв оптимизированном режиме (optimization_mode => 'MINIMIZE_COST') и дистилляции прокси-модели.
Что вам понадобится
- Проект Google Cloud с включенной функцией выставления счетов.
- Веб-браузер, например Chrome.
2. Настройка и требования
Перед тем как запрашивать данные с помощью управляемых функций ИИ, необходимо настроить свой проект Google Cloud и включить необходимые API.
Создайте проект в Google Cloud и включите API.
- В консоли Google Cloud на странице выбора проекта выберите или создайте проект Google Cloud .
- Убедитесь, что для вашего облачного проекта включена функция выставления счетов. Узнайте, как проверить, включена ли функция выставления счетов для проекта .
- Включите API BigQuery, BigQuery Connection и Agent Platform .
Откройте BigQuery Studio
- В меню навигации консоли Google Cloud нажмите BigQuery , чтобы открыть BigQuery Studio .
- На панели инструментов редактора BigQuery Studio нажмите кнопку «+ SQL-запрос» , чтобы открыть новую вкладку с SQL-запросами . В ходе этого практического занятия вы будете писать и выполнять все SQL-запросы на этих вкладках.
Создание подключения к облачному ресурсу в SQL
BigQuery работает в защищенной среде обработки данных. При просмотре внешних мультимодальных файлов (например, изображений, хранящихся в Google Cloud Storage) BigQuery использует Cloud Resource Connection для безопасного доступа к ссылкам на объекты без раскрытия учетных данных.
Выполните следующее выражение на вкладке SQL, чтобы создать соединение с именем us.conn :
CREATE CONNECTION IF NOT EXISTS `us.conn`
OPTIONS (
  connection_type = "CLOUD_RESOURCE"
);
3. Изучите набор данных Cymbal Pets.
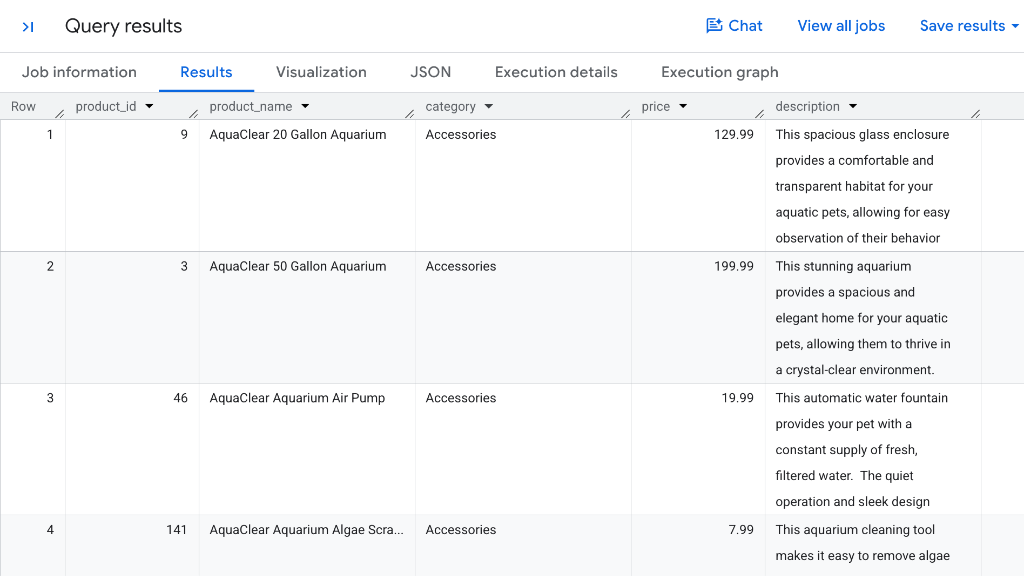
Компания Cymbal Pets хранит обширный каталог товаров в общедоступном наборе данных в таблице bigquery-public-data.cymbal_pets.products . Каждая запись о товаре содержит структурированные атрибуты, такие как идентификатор товара, название, категория розничной торговли, цена и описательный текст.
Запрос к каталогу продукции
Откройте вкладку SQL в BigQuery Studio и выполните следующий запрос, чтобы просмотреть таблицу products:
SELECT
  product_id,
  product_name,
  category,
  price,
  description
FROM
  `bigquery-public-data.cymbal_pets.products`;
Ваши результаты будут выглядеть примерно так:
Просмотрите изображения товара.
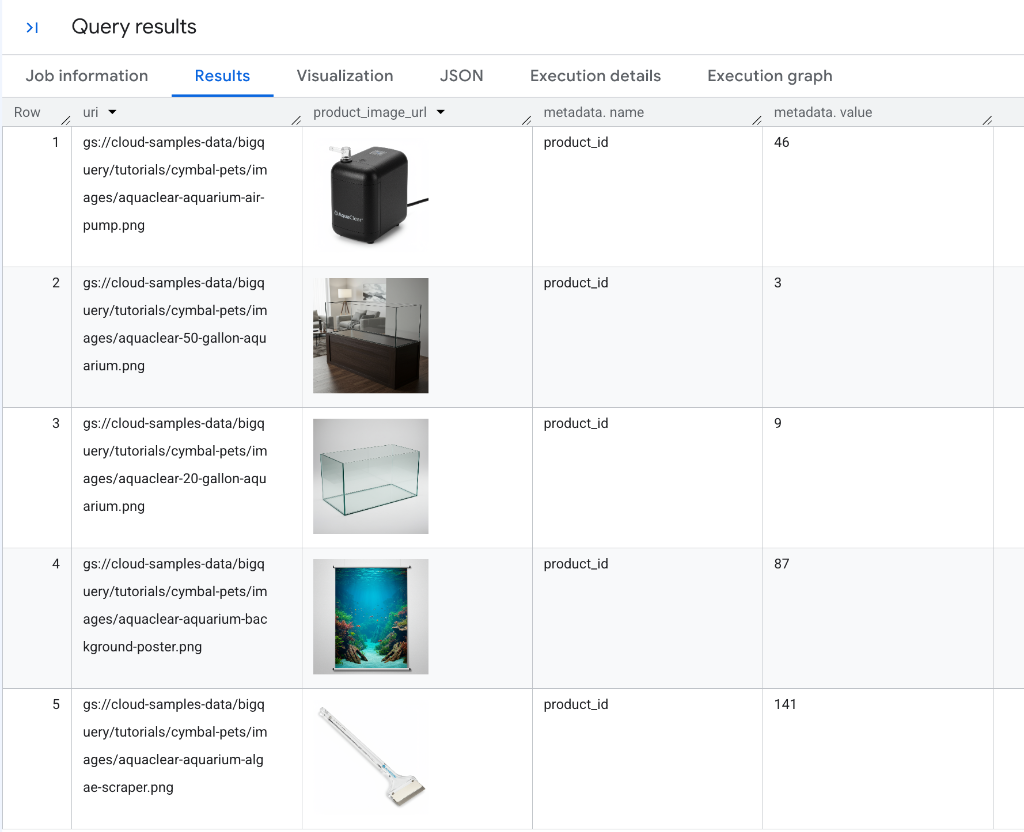
Cymbal Pets также хранит ссылки на изображения товаров в bigquery-public-data.cymbal_pets.product_images . Выполните следующий запрос, чтобы просмотреть записи с изображениями:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`;
Ваши результаты будут выглядеть примерно так:
Далее вы воспользуетесь функциями, управляемыми BigQuery, для анализа текстовых и графических данных из хранилища данных Cymbal Pets.
4. Ранжируйте товары по семантическим критериям с помощью AI.SCORE.
Функция AI.SCORE принимает текстовые данные и использует модель Gemini для их оценки на основе критериев оценки естественного языка, возвращая числовой балл в формате FLOAT64 .
Если вы не укажете явную оценочную шкалу, BigQuery автоматически применит стратегии перефразирования подсказок для генерации оптимальной шкалы оценки для модели.
Оценивайте товары по тому, насколько они подходят в качестве подарка.
Предположим, маркетинговая команда Cymbal Pets хочет составить путеводитель по подаркам к праздникам. Они хотят оценить каждый товар в каталоге по шкале от 1 до 10, исходя из того, насколько он подходит в качестве подарка для владельца питомца.
Выполните следующий запрос на вкладке SQL:
SELECT
  product_name,
  description,
  AI.SCORE(
    ('How "giftable" is this product for a pet owner? ', description,
    'Use a scale from 1-10.')
  ) AS giftability_score
FROM
  `bigquery-public-data.cymbal_pets.products`
ORDER BY
  giftability_score DESC;
Разберитесь в результатах.
Ваши результаты будут выглядеть примерно так:
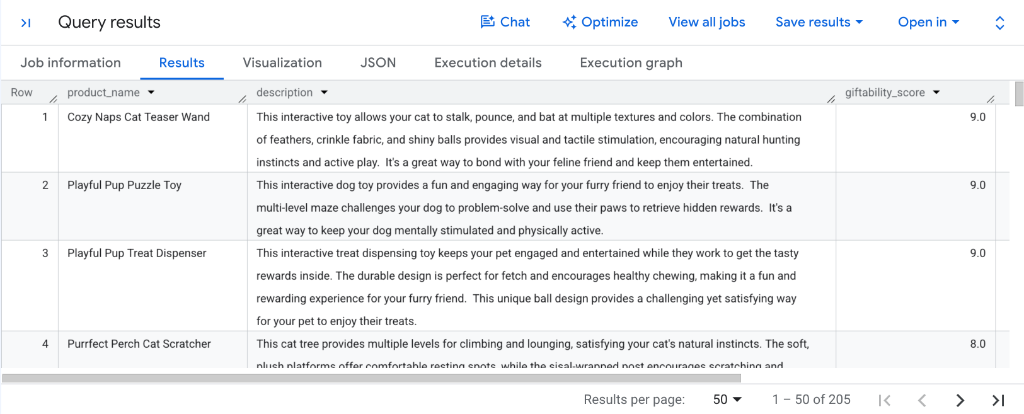
Изучите столбец giftability_score в результатах запроса:
- Привлекательные интерактивные игрушки : такие интересные предметы, как
Cozy Naps Cat Teaser Wand,Playful Pup Puzzle ToyиPlayful Pup Treat Dispenser, получают высшие оценки (9.0). - Специальные предметы для комфорта и царапания : Популярные товары первой необходимости, такие как когтеточка
Purrfect Perch Cat Scratcherполучили высокую оценку —8.0. - Применимый на практике рейтинг на последующих этапах : Поскольку
AI.SCOREгенерирует нормализованные оценки в форматеFLOAT64, вы можете сразу же отсортировать результаты с помощьюORDER BY giftability_score DESCили отфильтровать кандидатов с помощьюWHERE AI.SCORE(...) >= 8.0для автоматического создания подарочных гидов.
5. Классификация товаров каталога с помощью AI.CLASSIFY
Функция AI.CLASSIFY использует Gemini для классификации входных записей по дискретному списку целевых категорий, предоставленных в виде SQL-массива.
AI.CLASSIFY поддерживает мультимодальные входные данные (текст, изображения, аудио, видео) и устраняет необходимость в создании, обучении или развертывании специализированных моделей классификации для управления таксономией.
Классифицируйте игрушки по целевым видам животных (с использованием одной метки).
Предположим, что некоторые товары в каталоге Cymbal Pets помечены общим тегом «Игрушки» без указания конкретного животного. Вы можете использовать AI.CLASSIFY для классификации каждой игрушки на основе ее названия и описания.
Выполните следующий запрос в BigQuery Studio:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('What animal is this product for?', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "All Pets"]
  ) AS animal_type
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys"
LIMIT 20;
Посмотреть результаты
Ваши результаты будут выглядеть примерно так:
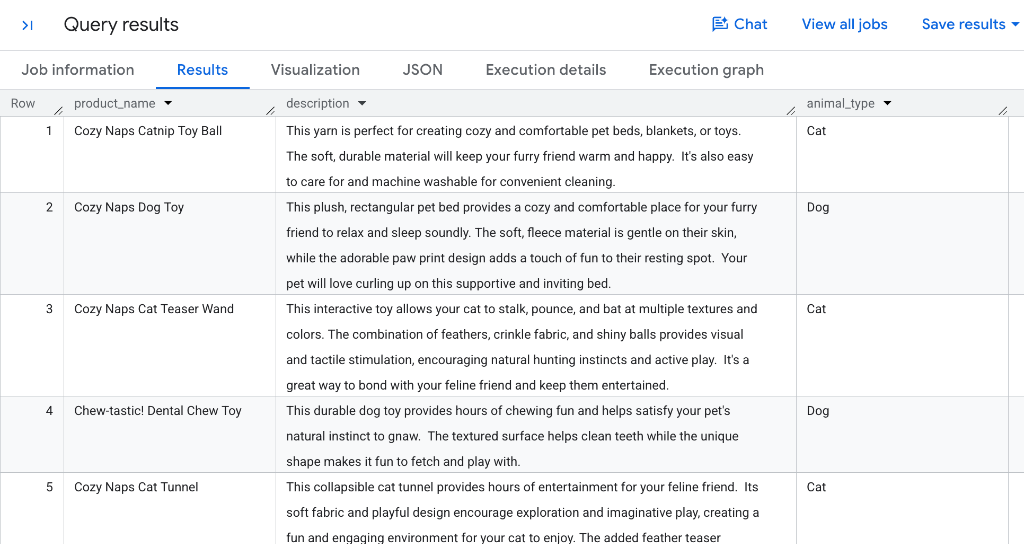
По умолчанию AI.CLASSIFY выполняет классификацию по одной метке и возвращает STRING содержащую единственную наиболее релевантную категорию из вашего массива кандидатов. Обратите внимание, как Gemini сопоставляет шарики с кошачьей мятой и перьевые дразнилки с категорией Cat , а жевательные игрушки и палочки для апортировки — с категорией Dog .
Присваивание нескольких тегов с многоклассовой классификацией
Многие товары в розничном каталоге подходят одновременно для нескольких видов домашних животных (например, мягкая лежанка или туннель, подходящие как для кошек, так и для мелких животных).
Чтобы присвоить одной записи несколько категорий, установите необязательный параметр output_mode => 'multi' . В режиме множественной метки AI.CLASSIFY возвращает ARRAY содержащий все совпадающие категории.
Выполните следующий запрос на вкладке SQL:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('Identify all pet types that this product is suitable for: ', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "Reptile"],
    output_mode => 'multi'
  ) AS pet_types
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys";
Ваши результаты будут выглядеть примерно так:
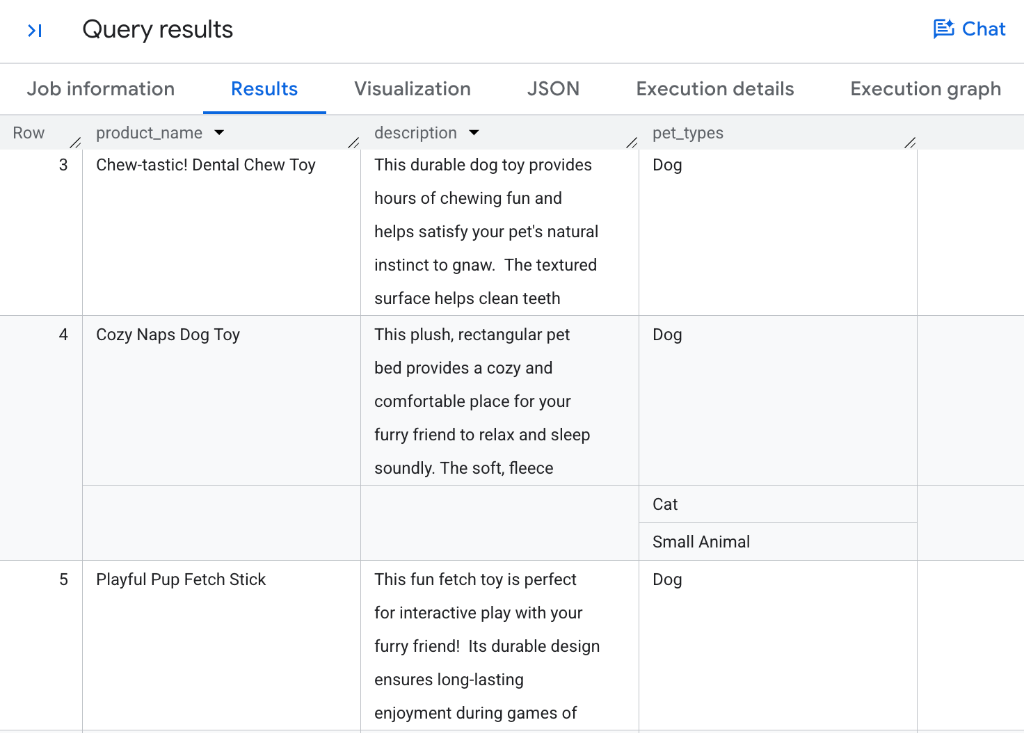
Обзор механизмов классификации
- Одноклассовая и многоклассовая классификация : без
output_modeметодAI.CLASSIFYвозвращает скалярнуюSTRING. Установкаoutput_mode => 'multi'возвращаетARRAYсодержащий ноль, одну или несколько совпадающих меток. - Многокатегорийное присвоение : Обратите внимание, как специализированные товары, такие как игрушка
Chew-tastic! Dental Chew ToyиPlayful Pup Fetch Stickполучают тег[Dog], в то время как универсальные предметы для комфортного сна, такие какCozy Naps Dog Toy(плюшевая прямоугольная лежанка), правильно получают несколько тегов:[Dog, Cat, Small Animal]. - Сопоставление без предварительного обучения : модель оценивает объединенный текст и подсказку по отношению к предоставленному массиву
categoriesбез необходимости использования предварительно обученных пользовательских моделей машинного обучения. - Операции с массивами SQL : Вы можете использовать стандартные функции BigQuery для работы с массивами SQL, такие как
WHERE 'Cat' IN UNNEST(pet_types)илиCROSS JOIN UNNEST(pet_types)для фильтрации, развертывания и агрегирования записей с несколькими метками.
6. Фильтрация мультимодальных изображений товаров с помощью AI.IF
Функция AI.IF использует Gemini для оценки условия на естественном языке и возвращает логическое значение ( TRUE или FALSE ).
Поскольку AI.IF принимает многомодальные входные данные, вы можете использовать его непосредственно в предложении SQL WHERE для фильтрации неструктурированных файлов изображений, хранящихся в Cloud Storage.
Фильтрация изображений, содержащих определенные объекты.
Предположим, отдел мерчандайзинга хочет найти все изображения товаров в каталоге, на которых визуально присутствует корм или лакомства для домашних животных.
Выполните следующий запрос на вкладке SQL:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`
WHERE
  AI.IF(
    ('Does this product image contain pet food or snacks? ', OBJ.MAKE_REF(uri, 'us.conn'))
  );
Ваши результаты будут выглядеть примерно так:
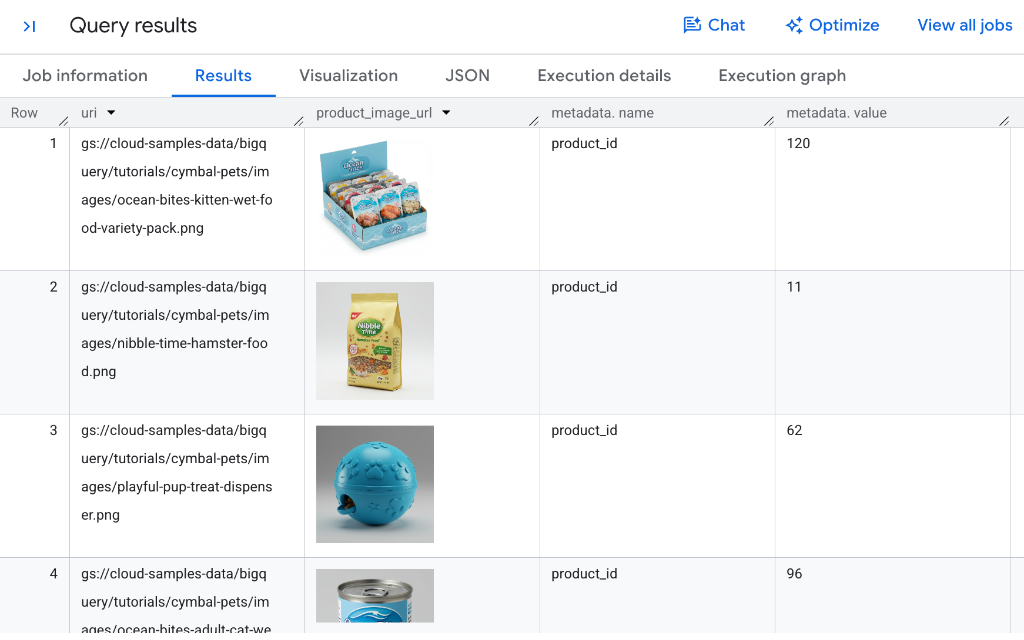
Как работает многомодальная фильтрация
- Ссылки на объекты «на лету» : Хотя здесь мы создаем ссылки на объекты «на лету» с помощью
OBJ.MAKE_REF(uri, 'us.conn'), вы также можете создавать и сохранять столбцыObjectRefнепосредственно в таблицах BigQuery, чтобы они были немедленно готовы к использованию в анализе без необходимости применения функцииOBJ.MAKE_REFв каждом запросе. - Глубокое визуальное распознавание объектов : обратите внимание, как Gemini точно распознает различные форматы упаковки (например, коробку с набором влажного корма, пакет с сухим кормом для хомяков и банку кошачьего корма), а также распознает съедобные лакомства, помещенные внутрь игрушек, таких как синий диспенсер для лакомств.
- Оценка предикатов на уровне строк : BigQuery оценивает условие на естественном языке по отношению к каждой ссылке на образ Cloud Storage непосредственно в предложении
WHERE. - Булевы параметры фильтрации : в результирующий набор возвращаются только те записи, в которых Gemini оценивает условие как
TRUE.
7. Выполняйте семантические объединения таблиц с помощью AI.IF.
В традиционных реляционных базах данных для объединения требуется точное равенство ключей (например, products.product_id = images.product_id ). Однако в реальных корпоративных наборах данных часто встречаются неструктурированные активы, для которых отсутствуют явные внешние ключи.
Поскольку AI.IF возвращает логическое значение, вы можете использовать его непосредственно в предложении SQL INNER JOIN ... ON для выполнения семантических соединений .
Семантически свяжите описания товаров с графическими элементами.
Предположим, вы хотите сопоставить описания товаров из таблицы products с несвязанными файлами изображений в product_images для товаров, производимых брендом Fluffy Buns .
Выполните следующий запрос на вкладке SQL в BigQuery Studio (обратите внимание, что выполнение займет несколько минут):
SELECT
  products.product_id,
  products.product_name,
  products.description,
  products.brand,
  images.uri AS image_uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(images.uri, 'us.conn')).url AS product_image_url
FROM
  `bigquery-public-data.cymbal_pets.products` AS products
INNER JOIN
  `bigquery-public-data.cymbal_pets.product_images` AS images
ON
  AI.IF(
    ('You will be provided an image of a pet product. ',
    'Determine if the image is of the following pet toy: ',
    products.product_name,
    products.description,
    OBJ.MAKE_REF(images.uri, 'us.conn')
    )
  )
WHERE
  products.category = "Toys" AND
  products.brand = "Fluffy Buns";
Ваши результаты будут выглядеть примерно так:
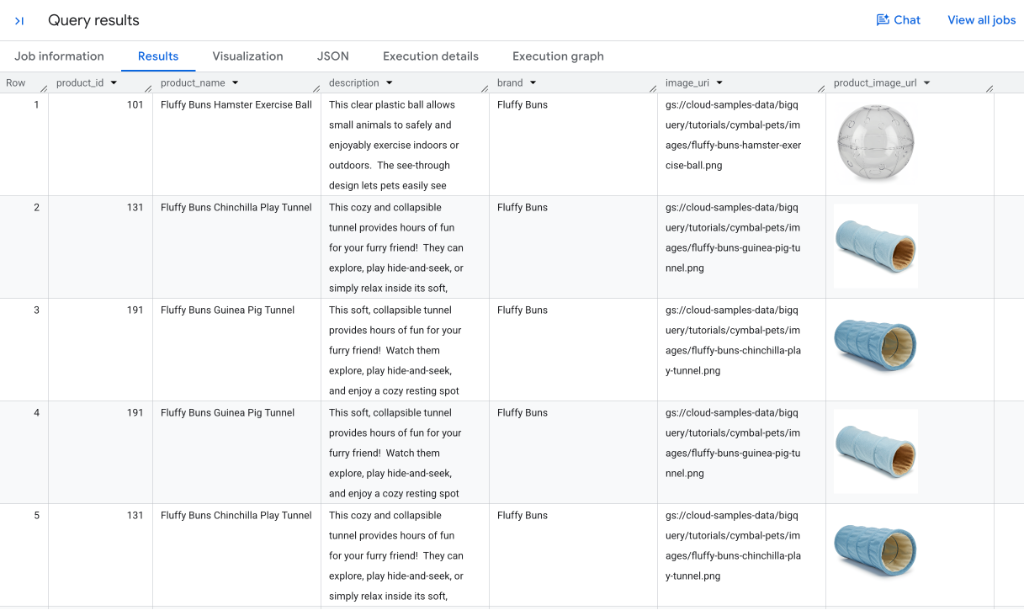
Разберитесь в семантических объединениях в SQL.
- Межмодальная оценка условий : для пар записей-кандидатов BigQuery отправляет в Gemini как текстовые метаданные о
products, так и ссылку на изображение (OBJ.MAKE_REF(...)). - Точное визуальное сопоставление : как показано в результатах,
Fluffy Buns Hamster Exercise Ballсопоставлен с изображением прозрачного пластикового мяча, аFluffy Buns Chinchilla Play TunnelиGuinea Pig TunnelFluffy Buns — с фотографиями синего плюшевого туннеля. Из-за стандартной семантики SQLINNER JOIN, продукт может выдавать несколько строк в выходных данных, если он соответствует более чем одному графическому ресурсу в каталоге (например, нескольким ракурсам фотографий или похожим снимкам). - Встроенное отображение изображений : BigQuery Studio автоматически отображает авторизованные URL-адреса для чтения из столбца
product_image_urlнепосредственно в таблице результатов для мгновенной визуальной проверки. - Разрешение неструктурированных сущностей : это открывает доступ к мощным рабочим процессам разрешения сущностей в устаревших каталогах, собранных наборах данных и медиаархивах без ручной разметки или явных внешних ключей.
8. Обобщайте аналитические данные по строкам с помощью AI.AGG
В то время как такие функции, как AI.SCORE , AI.CLASSIFY и AI.IF , оценивают отдельные строки (скалярные операции), анализ корпоративных данных часто требует синтеза закономерностей в нескольких записях.
Функция AI.AGG — это агрегатная функция, которая использует инструкции на естественном языке для обобщения, кластеризации или синтеза данных из тысяч или миллионов неструктурированных строк в единый ответ.
Обобщение категорийных данных наряду с традиционными метриками SQL.
AI.AGG легко интегрируется с традиционными функциями SQL GROUP BY и агрегатными функциями. Например, вы можете рассчитывать традиционные метрики (такие как количество товаров) одновременно с обобщенным ИИ-резюме, описывающим общие черты товаров в каждой категории.
Выполните следующий запрос в BigQuery Studio:
SELECT
  category,
  COUNT(*) AS item_count,
  AI.AGG(
    ('Product: ', product_name, ' - Description: ', description),
    'Write a concise, one-sentence summary describing the common characteristics or purpose of the products in this category.'
  ) AS category_summary
FROM
  `bigquery-public-data.cymbal_pets.products`
GROUP BY
  category
ORDER BY
  item_count DESC;
Ваши результаты будут выглядеть примерно так:
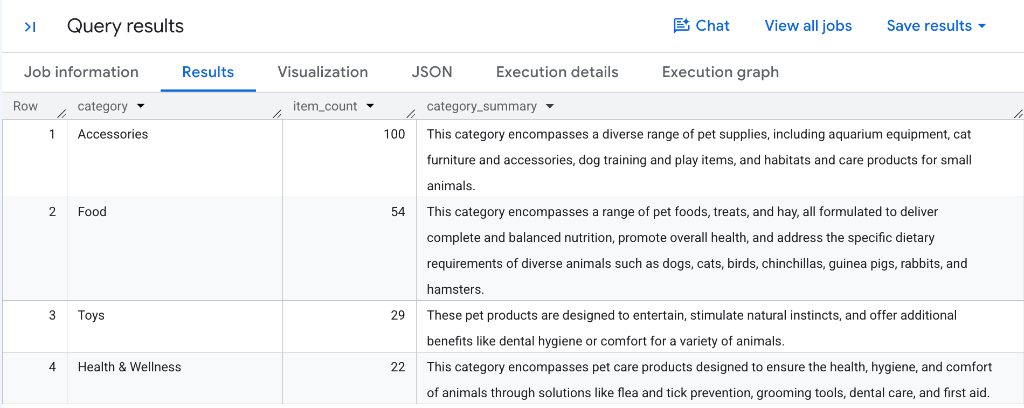
Как AI.AGG агрегирует неструктурированные данные
- Иерархическая агрегация : BigQuery группирует данные строк по категориям, формирует структурированные контекстные окна и использует Gemini для синтеза всей коллекции записей о товарах.
- Автоматизированный синтез каталога : Обратите внимание, как каждая категория получает отдельное, точное описание, например,
Accessoriesотражает среду обитания и тренировочное снаряжение, аFood— сбалансированное питание для различных видов животных. - Гибридная количественная и качественная отчетность : сочетание стандартных агрегаций, таких как
COUNT(*)сAI.AGGпозволяет получить исчерпывающие обзоры каталога в одном запросе без необходимости создания собственных ETL-конвейеров. - Гибкое разбиение на разделы : вы можете применять
AI.AGGк любому параметру группировки (например,GROUP BY brand,GROUP BY categoryили ко всей таблице) для получения аналитических данных для руководителей за считанные секунды.
9. Ускорьте запросы с помощью оптимизированного режима и прокси-моделей.
При обработке больших наборов данных, содержащих тысячи или миллионы строк, вызов удаленного LLM для каждой отдельной строки может привести к задержкам и увеличению затрат.
Для решения этой проблемы BigQuery предоставляет оптимизированный режим для AI.IF и AI.CLASSIFY . Оптимизированный режим использует прокси-модели и дистилляцию моделей в режиме реального времени , обеспечивая более чем в 100 раз более быстрое выполнение при сниженной стоимости токенов LLM.
Как работает оптимизированный режим
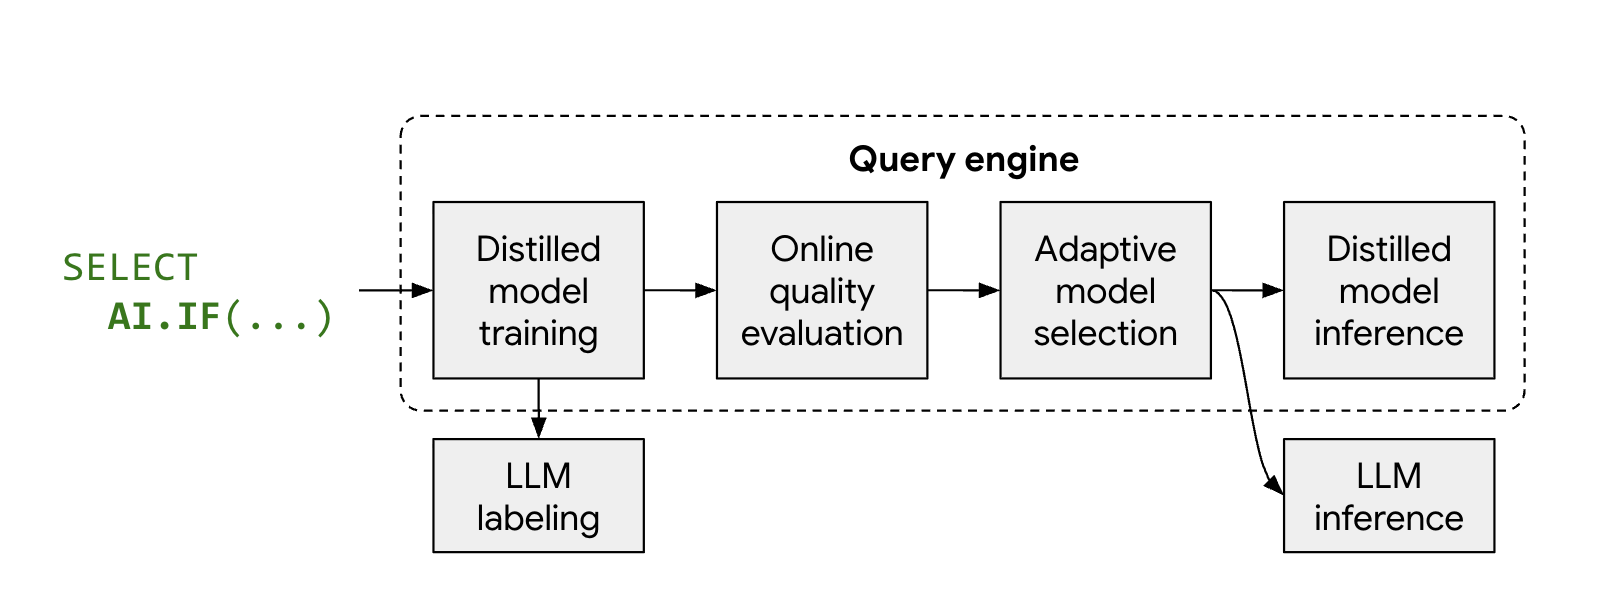
- Репрезентативная выборка и маркировка : BigQuery автоматически выбирает репрезентативную выборку строк и получает метки из Gemini.
- Обучение упрощенной модели : BigQuery обучает сверхлегкую прокси-модель (например, логистическую регрессию) непосредственно на процессоре, используя текстовые векторные представления в качестве признаков.
- Проверка качества : BigQuery оценивает точность оптимизированной модели по сравнению с Gemini. Если она соответствует пороговым значениям качества, BigQuery передает ее для обработки оставшейся части набора данных.
- Высокоскоростной локальный вывод : прокси-модель оценивает оставшиеся строки локально с нулевой стоимостью удаленного токена LLM и сверхнизкой задержкой.
Выполните базовый запрос без оптимизации.
Поскольку в каталоге bigquery-public-data.cymbal_pets.products слишком мало строк для запуска дистилляции прокси-модели, мы будем использовать более крупный общедоступный набор данных bigquery-public-data.bbc_news.fulltext (который содержит более 2200 новостных статей).
Сначала выполните стандартный запрос без оптимизации, чтобы найти новостные статьи о стихийных бедствиях:
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body)
  );
Проверьте базовые параметры задания и использование токенов.
После завершения базового запроса проверьте метрики выполнения:
- В нижней панели результатов BigQuery Studio выберите вкладку «Информация о задании» .
- Прокрутите вниз до разделов «Количество входящих токенов» и «Количество исходящих токенов» .
Ваши результаты будут выглядеть примерно так:
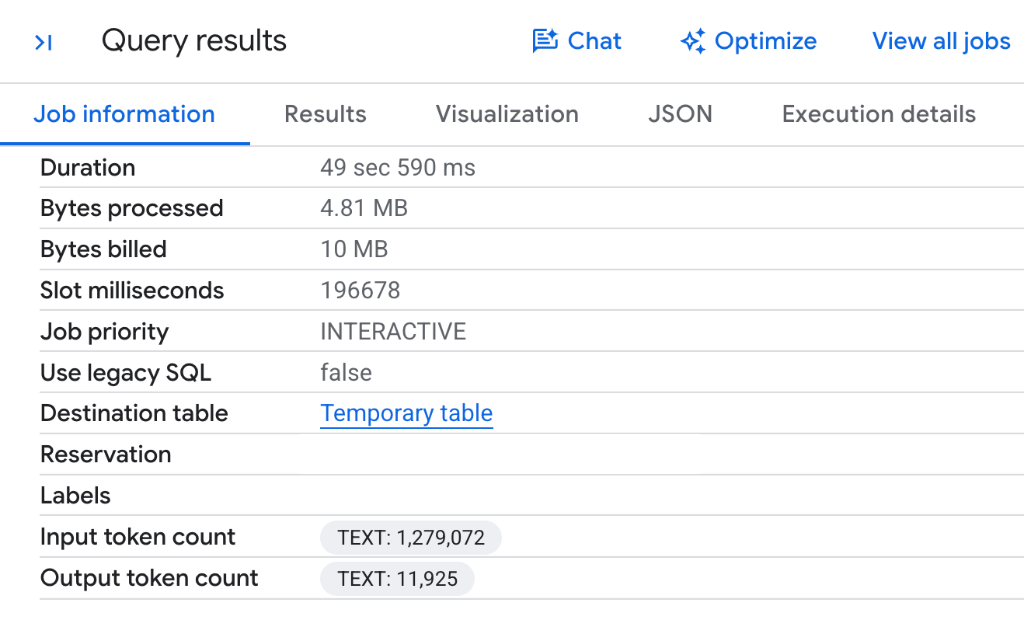
- Потребление токенов для всего набора данных : Поскольку BigQuery вызывает удаленную модель Gemini для каждой строки во всех 2225 новостных статьях без оптимизации прокси, запрос потребляет 1 279 072 входных токена и 11 925 выходных токенов .
- Отсутствует раздел оптимизации : Обратите внимание, что запись
Gen AI Function Optimizationsотсутствует, поскольку стандартное выполнение оценивает каждую отдельную строку относительно удаленной конечной точки LLM.
Выполните запрос в оптимизированном режиме.
Чтобы уменьшить потребление токенов и использовать дистилляцию прокси-моделей, включите оптимизированный режим, передав embeddings => AI.EMBED(...) и установив optimization_mode => 'MINIMIZE_COST' :
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body),
    embeddings => AI.EMBED(body, endpoint => 'text-embedding-005', task_type => 'CLASSIFICATION').result,
    optimization_mode => 'MINIMIZE_COST'
  );
Проверьте оптимизацию и отметьте снижение использования токенов.
После выполнения оптимизированного запроса перейдите на вкладку «Информация о задании BigQuery Studio», чтобы сравнить показатели использования токенов и выполнения:
- В нижней панели результатов BigQuery Studio выберите вкладку «Информация о задании» .
- Прокрутите страницу до раздела «Оптимизация функций искусственного интеллекта» , а также до количества токенов.
Ваши результаты будут выглядеть примерно так:
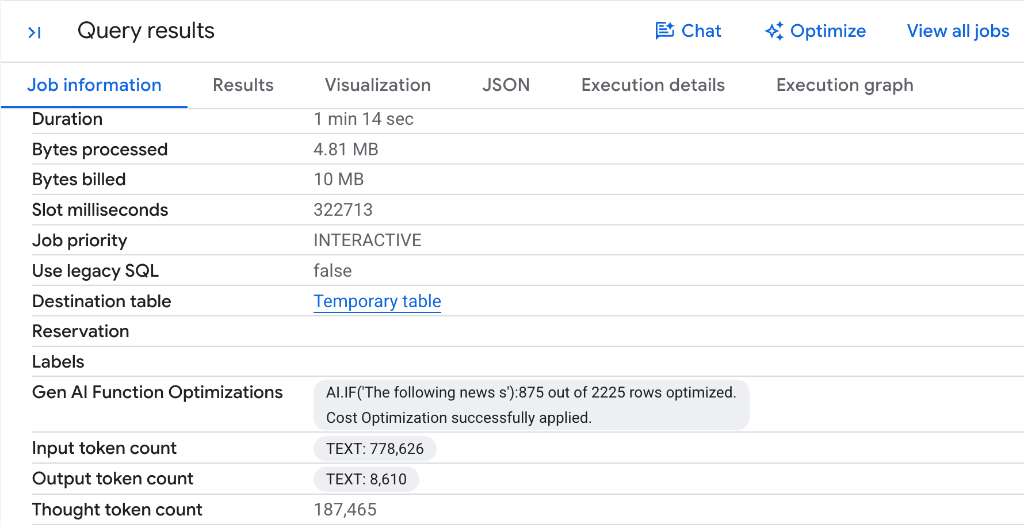
- Значительное сокращение количества токенов : Обратите внимание, как количество входных токенов уменьшилось с 1 279 072 до 778 626 — сэкономив 500 446 входных токенов (почти 40% сокращение) за один запрос! Аналогично, уменьшилось и количество выходных токенов.
- Автоматическая дистилляция прокси : Обратите внимание на метку
AI.IF('The following news s'): 875 out of 2225 rows optimized. Cost Optimization successfully applied.BigQuery отобрал данные из набора данных, пометил репрезентативные статьи с помощью Gemini, создал быстрый и легковесный классификатор прокси и обработал 875 из 2225 строк локально на ЦП без вызова удаленных конечных точек LLM. - Прямая экономия средств : поскольку функции управляемого ИИ в BigQuery оплачиваются в зависимости от объема обработанных токенов модели, сокращение потребления токенов напрямую приводит к снижению затрат на выполнение запросов.
- Проверка качества : BigQuery автоматически проверил точность прокси-модели по сравнению с Gemini, прежде чем передать ее на оценку оставшихся строк, обеспечивая поддержание качества классификации.
Ещё большее сокращение количества токенов и масштабирование задержки при работе с большими таблицами.
Хотя экономия более 500 000 токенов на 2225 строках является существенной, сокращение количества токенов и повышение производительности еще выше на таблицах большего размера :
- Почему сокращение количества токенов масштабируется с размером набора данных : Для запросов, выполняемых в BigQuery, прокси-модели обучаются в режиме реального времени, используя начальную выборку примерно из 1000 строк, размеченных с помощью LLM. После обучения и проверки прокси-модель заменяет прямые вызовы LLM для оставшихся строк. Для больших запросов (например, типичных наборов данных из 1 миллиона строк) это исключает вызовы LLM для большей части данных, потребляя до 400 раз меньше токенов и значительно сокращая затраты.
- Значительное ускорение задержки : благодаря переносу вывода данных со специализированного оборудования LLM на сверхлегкие прокси-модели, работающие непосредственно на стандартных процессорах рабочих узлов баз данных (с использованием предварительно вычисленных эмбеддингов Gemini), BigQuery сокращает общее время выполнения запросов в 30–100 раз.
10. Очистка ресурсов
Для очистки ресурсов, созданных в ходе этого практического занятия, выполните следующее выражение на вкладке SQL в BigQuery Studio, чтобы удалить подключение к облачным ресурсам:
DROP CONNECTION IF EXISTS `us.conn`;
В качестве альтернативы, если вы создали временный проект Google Cloud специально для этого руководства, вы можете остановить весь проект в Cloud Resource Manager .
11. Поздравляем!
Поздравляем! Вы успешно завершили практическое занятие по семантическому анализу в BigQuery с использованием управляемых функций ИИ и SQL .
Вы освоили управляемые функции генеративного ИИ в BigQuery:
-
AI.SCORE: Рейтинг товаров на основе субъективных критериев, таких как пригодность в качестве подарка, по шкале от 1 до 10 с использованием автоматического переписывания подсказок. -
AI.CLASSIFY: Классификация неструктурированных элементов каталога по целевым категориям животных. -
AI.IF(мультимодальная фильтрация) : фильтрация изображений из облачного хранилища в SQL-запросахWHEREна основе визуального контента. -
AI.IF(семантические объединения) : Выполнены кросс-модальные объединения в SQL-запросахONдля связывания текстовых описаний товаров с файлами изображений. -
AI.AGG: Синтезирует многострочный неструктурированный текст каталога в краткое резюме для руководителей. - Оптимизированный режим и прокси-модели : ускорение запросов и минимизация стоимости токенов с помощью
optimization_mode => 'MINIMIZE_COST'с дистилляцией модели в режиме реального времени иAI.EMBED.
Узнать больше
- Обзор генеративного ИИ BigQuery
- Руководство по управляемым функциям искусственного интеллекта в BigQuery
- Документация по синтаксису SQL
AI.SCORE - Документация по синтаксису SQL
AI.CLASSIFY - Документация по синтаксису SQL
AI.IF - Документация по синтаксису SQL
AI.AGG - Оптимизация функций ИИ с помощью дистилляции моделей.
- Блог Google Cloud: SQL-запросы на основе LLM с использованием прокси-моделей стали более чем в 100 раз быстрее и дешевле.
- Блог Google Cloud: Подробный анализ функции AI.AGG в BigQuery