

1. ยินดีต้อนรับ
ใน Codelab นี้ คุณจะได้เรียนรู้วิธีใช้ชุดฟังก์ชัน AI ที่มีการจัดการของ BigQuery เพื่อทำการวิเคราะห์เชิงความหมายที่ซับซ้อน การแยกประเภท การกรองแบบหลายรูปแบบ การรวมเชิงความหมาย และการสรุปหลายแถวภายใน BigQuery Studio โดยใช้ SQL
คุณจะได้สวมบทบาทเป็นนักวิเคราะห์ข้อมูลที่ Cymbal Pets ซึ่งเป็นผู้ค้าปลีกอีคอมเมิร์ซสำหรับอุปกรณ์และเครื่องประดับสำหรับสัตว์เลี้ยง โดยใช้ชุดข้อมูลสาธารณะ bigquery-public-data.cymbal_pets
การวิเคราะห์เชิงความหมายภายในคำค้นหา SQL โดยตรง
โดยปกติแล้ว การใช้แมชชีนเลิร์นนิงหรือโมเดลภาษาขนาดใหญ่ (LLM) กับชุดข้อมูลระดับองค์กรกำหนดให้ต้องย้ายข้อมูลออกจากคลังข้อมูลไปยังสภาพแวดล้อมสมุดบันทึก Python ภายนอก ซึ่งต้องใช้ไปป์ไลน์วิศวกรรมข้อมูลเฉพาะและผู้เชี่ยวชาญด้าน ML
ฟังก์ชัน AI ที่มีการจัดการของ BigQuery ซึ่งรวมถึง AI.SCORE, AI.CLASSIFY, AI.IF และ AI.AGG จะนำข้อมูลเชิงลึกของโมเดลพื้นฐานมาสู่ข้อมูลของคุณโดยตรง BigQuery จะเพิ่มประสิทธิภาพการเลือกโมเดลโดยอัตโนมัติและใช้กลยุทธ์การเขียนข้อความแจ้งใหม่ภายในเพื่อแสดงผลลัพธ์ที่มีความแม่นยำสูงจากข้อความแจ้งภาษาธรรมชาติแบบง่ายๆ
สำหรับชุดข้อมูลขนาดใหญ่ BigQuery มีโหมดที่เพิ่มประสิทธิภาพ ซึ่งใช้การกลั่นโมเดลแบบทันทีและโมเดลพร็อกซีแบบเบาเพื่อแสดงผลการค้นหาที่เร็วขึ้นและถูกลงสูงสุด 100 เท่า
สิ่งที่คุณจะได้ทำ
- สำรวจข้อมูลการค้าปลีกแบบหลายรูปแบบ ใน BigQuery Studio โดยใช้ SQL
- ทำการจัดอันดับเชิงความหมาย โดยใช้
AI.SCOREเพื่อประเมินแอตทริบิวต์ผลิตภัณฑ์เชิงอัตวิสัย เช่น "ความเหมาะสมที่จะเป็นของขวัญ" - แยกประเภทข้อมูลที่ไม่มีโครงสร้าง โดยใช้
AI.CLASSIFYเพื่อจับคู่ผลิตภัณฑ์กับสัตว์สายพันธุ์เป้าหมาย - กรองชิ้นงานรูปภาพแบบหลายรูปแบบ โดยใช้
AI.IFภายในอนุประโยคWHERE - ดำเนินการรวมเชิงความหมายในตารางต่างๆ โดยใช้
AI.IFในอนุประโยคJOIN ... ONเพื่อจับคู่ระเบียนผลิตภัณฑ์ที่เป็นข้อความกับไฟล์ภาพจากภายนอก - สังเคราะห์ข้อมูลเชิงลึกหลายแถว โดยใช้ฟังก์ชันการรวม
AI.AGG - เพิ่มประสิทธิภาพเวลาในการตอบสนองและค่าใช้จ่ายในการค้นหา ในชุดข้อมูลขนาดใหญ่โดยใช้
AI.IFกับ โหมดที่เพิ่มประสิทธิภาพ (optimization_mode => 'MINIMIZE_COST') และการกลั่นโมเดลพร็อกซี
สิ่งที่คุณต้องมี
- โปรเจ็กต์ Google Cloud ที่เปิดใช้การเรียกเก็บเงินแล้ว
- เว็บเบราว์เซอร์ เช่น Chrome
2. การตั้งค่าและข้อกำหนด
ก่อนที่จะค้นหาข้อมูลด้วยฟังก์ชัน AI ที่มีการจัดการ คุณต้องกำหนดค่าโปรเจ็กต์ที่อยู่ในระบบคลาวด์ของ Google และเปิดใช้ API ที่จำเป็น
สร้างโปรเจ็กต์ที่อยู่ในระบบคลาวด์ของ Google และเปิดใช้ API
- ใน คอนโซล Google Cloud ในหน้าตัวเลือกโปรเจ็กต์ ให้เลือกหรือสร้างโปรเจ็กต์ Google Cloud
- ตรวจสอบว่าโปรเจ็กต์ที่อยู่ในระบบคลาวด์เปิดใช้การเรียกเก็บเงินแล้ว ดูวิธีตรวจสอบว่าโปรเจ็กต์เปิดใช้การเรียกเก็บเงินแล้วหรือไม่
- เปิดใช้ BigQuery, BigQuery Connection และ Agent Platform API
เปิด BigQuery Studio
- ในเมนูการนำทางของ คอนโซล Google Cloud ให้คลิก BigQuery เพื่อเปิด BigQuery Studio
- ในแถบเครื่องมือของตัวแก้ไข BigQuery Studio ให้คลิก + การค้นหา SQL เพื่อเปิด แท็บการค้นหา SQL ใหม่ คุณจะเขียนและเรียกใช้การค้นหา SQL ทั้งหมดในแท็บ SQL เหล่านี้ตลอด Codelab นี้
สร้างการเชื่อมต่อทรัพยากร Cloud ใน SQL
BigQuery ทำงานภายในขอบเขตข้อมูลที่ปลอดภัย เมื่อตรวจสอบไฟล์แบบหลายรูปแบบภายนอก (เช่น รูปภาพที่เก็บไว้ใน Google Cloud Storage) BigQuery จะใช้การเชื่อมต่อทรัพยากร Cloud เพื่อเข้าถึงการอ้างอิงออบเจ็กต์อย่างปลอดภัยโดยไม่เปิดเผยข้อมูลเข้าสู่ระบบ
เรียกใช้คำสั่งต่อไปนี้ในแท็บ SQL เพื่อสร้างการเชื่อมต่อชื่อ us.conn
CREATE CONNECTION IF NOT EXISTS `us.conn`
OPTIONS (
  connection_type = "CLOUD_RESOURCE"
);
3. สำรวจชุดข้อมูล Cymbal Pets
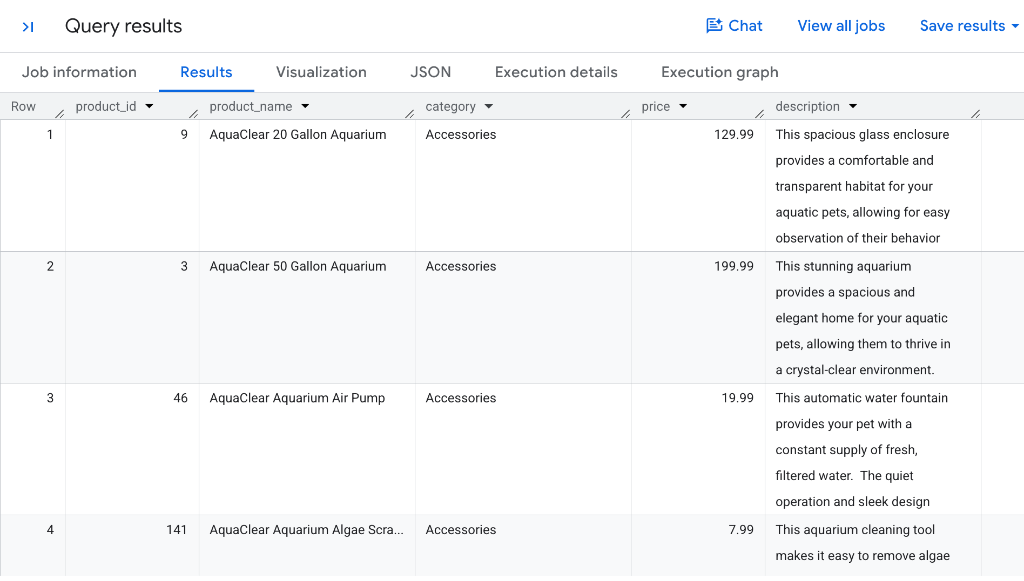
Cymbal Pets มีแคตตาล็อกผลิตภัณฑ์ที่สมบูรณ์ในชุดข้อมูลสาธารณะภายในตารางชื่อ bigquery-public-data.cymbal_pets.products ระเบียนผลิตภัณฑ์แต่ละรายการจะมีแอตทริบิวต์ที่มีโครงสร้าง เช่น รหัสผลิตภัณฑ์ ชื่อ หมวดหมู่การค้าปลีก ราคา และข้อความอธิบาย
ค้นหาแคตตาล็อกผลิตภัณฑ์
เปิดแท็บ SQL ใน BigQuery Studio แล้วเรียกใช้การค้นหาต่อไปนี้เพื่อตรวจสอบตารางผลิตภัณฑ์
SELECT
  product_id,
  product_name,
  category,
  price,
  description
FROM
  `bigquery-public-data.cymbal_pets.products`;
ผลลัพธ์จะมีลักษณะคล้ายกับผลลัพธ์ต่อไปนี้
ตรวจสอบรูปภาพผลิตภัณฑ์
Cymbal Pets ยังเก็บข้อมูลอ้างอิงรูปภาพสินค้าไว้ใน bigquery-public-data.cymbal_pets.product_images ด้วย เรียกใช้การค้นหาต่อไปนี้เพื่อดูระเบียนรูปภาพ
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`;
ผลลัพธ์จะมีลักษณะคล้ายกับผลลัพธ์ต่อไปนี้
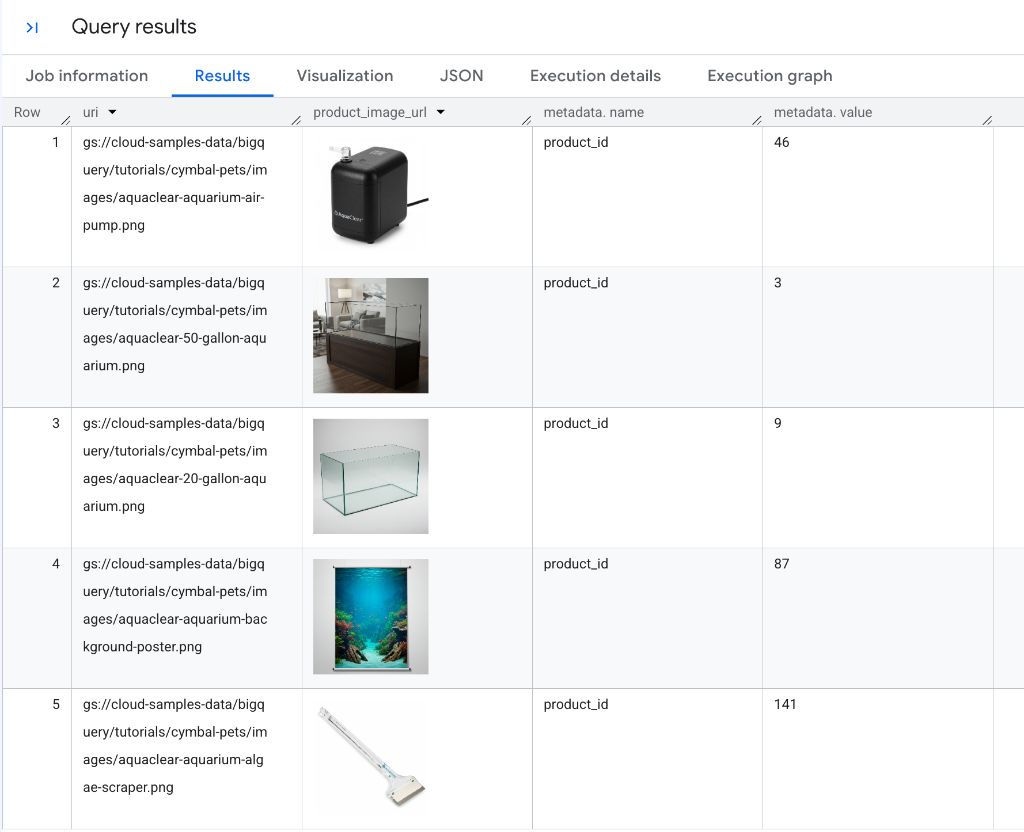
จากนั้นคุณจะใช้ฟังก์ชันที่มีการจัดการของ BigQuery เพื่อวิเคราะห์ทั้งข้อมูลข้อความและข้อมูลรูปภาพจากคลังข้อมูลของ Cymbal Pets
4. จัดอันดับผลิตภัณฑ์ตามเกณฑ์เชิงความหมายด้วย AI.SCORE
ฟังก์ชัน AI.SCORE รับอินพุตข้อความและใช้โมเดล Gemini เพื่อให้คะแนนตามเกณฑ์การให้คะแนนภาษาธรรมชาติ โดยแสดงผลคะแนนตัวเลข FLOAT64
หากคุณไม่ได้ระบุเกณฑ์การให้คะแนนอย่างชัดเจน BigQuery จะใช้กลยุทธ์การเขียนข้อความแจ้งใหม่โดยอัตโนมัติเพื่อสร้างเกณฑ์ที่เหมาะสมที่สุดสำหรับโมเดล
ให้คะแนนผลิตภัณฑ์สำหรับ "ความเหมาะสมที่จะเป็นของขวัญ"
สมมติว่าทีมการตลาดของ Cymbal Pets ต้องการสร้างคู่มือของขวัญสำหรับวันหยุด ทีมต้องการจัดอันดับสินค้าทุกรายการในแคตตาล็อกตามความเหมาะสมที่จะเป็นของขวัญสำหรับเจ้าของสัตว์เลี้ยงในระดับ 1 ถึง 10
เรียกใช้การค้นหาต่อไปนี้ในแท็บ SQL
SELECT
  product_name,
  description,
  AI.SCORE(
    ('How "giftable" is this product for a pet owner? ', description,
    'Use a scale from 1-10.')
  ) AS giftability_score
FROM
  `bigquery-public-data.cymbal_pets.products`
ORDER BY
  giftability_score DESC;
ทำความเข้าใจผลลัพธ์
ผลลัพธ์จะมีลักษณะคล้ายกับผลลัพธ์ต่อไปนี้
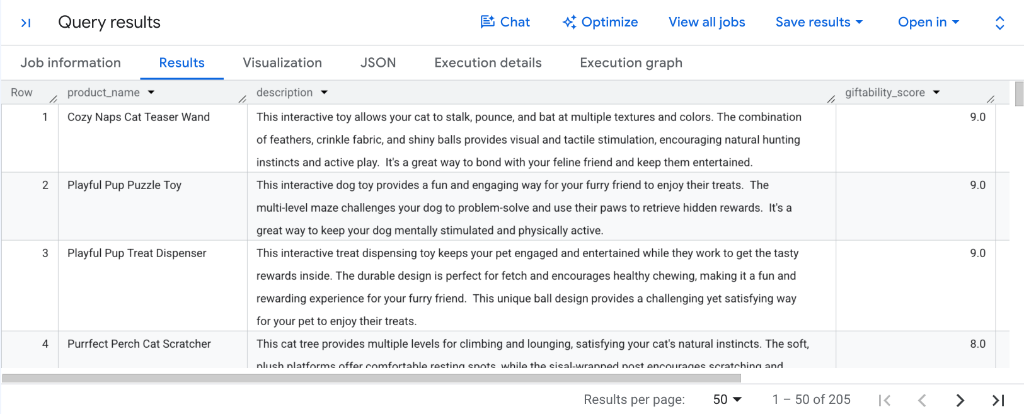
ตรวจสอบคอลัมน์ giftability_score ในผลการค้นหา
- ของเล่นแบบอินเทอร์แอกทีฟที่น่าสนใจ: สินค้าที่น่าสนใจ เช่น
Cozy Naps Cat Teaser Wand,Playful Pup Puzzle ToyและPlayful Pup Treat Dispenserได้รับคะแนนสูงสุด (9.0) - สินค้าพิเศษเพื่อความสบายและการขีดข่วน: สินค้าจำเป็นยอดนิยม เช่น
Purrfect Perch Cat Scratcherได้คะแนนสูงที่8.0 - การจัดอันดับปลายทางที่นำไปใช้ได้: เนื่องจาก
AI.SCOREแสดงผลคะแนนFLOAT64ที่เป็นค่าปกติ คุณจึงจัดเรียงผลลัพธ์ด้วยORDER BY giftability_score DESCหรือกรองรายการที่อาจเป็นไปได้ด้วยWHERE AI.SCORE(...) >= 8.0ได้ทันทีเพื่อสร้างคู่มือของขวัญอัตโนมัติ
5. แยกประเภทสินค้าในแคตตาล็อกด้วย AI.CLASSIFY
ฟังก์ชัน AI.CLASSIFY ใช้ Gemini เพื่อแยกประเภทระเบียนอินพุตเป็นรายการหมวดหมู่เป้าหมายที่ไม่ต่อเนื่อง ซึ่งระบุเป็นอาร์เรย์ SQL
AI.CLASSIFY รองรับอินพุตแบบหลายรูปแบบ (ข้อความ รูปภาพ เสียง วิดีโอ) และไม่จำเป็นต้องสร้าง ฝึก หรือติดตั้งใช้งานโมเดลการแยกประเภทที่กำหนดเองสำหรับการจัดการอนุกรมวิธาน
แยกประเภทของเล่นตามสัตว์สายพันธุ์เป้าหมาย (ป้ายกำกับเดียว)
สมมติว่าผลิตภัณฑ์บางรายการในแคตตาล็อกของ Cymbal Pets ติดแท็กทั่วไปว่า "ของเล่น" โดยไม่ได้ระบุสัตว์เป้าหมาย คุณสามารถใช้ AI.CLASSIFY เพื่อแยกประเภทของเล่นแต่ละชิ้นตามชื่อและคำอธิบาย
เรียกใช้การค้นหาต่อไปนี้ใน BigQuery Studio
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('What animal is this product for?', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "All Pets"]
  ) AS animal_type
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys"
LIMIT 20;
ดูผลลัพธ์
ผลลัพธ์จะมีลักษณะคล้ายกับผลลัพธ์ต่อไปนี้
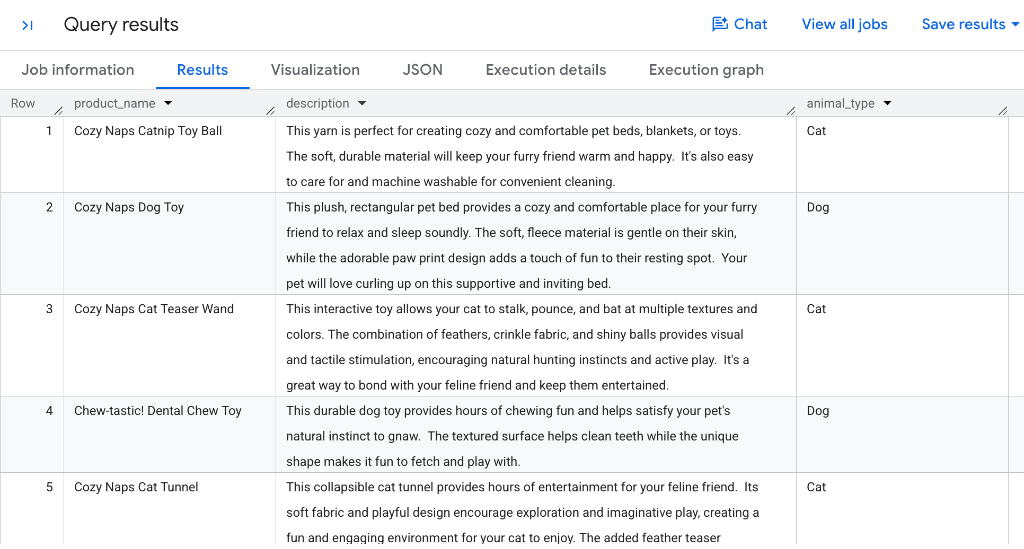
โดยค่าเริ่มต้น AI.CLASSIFY จะทำการแยกประเภทแบบป้ายกำกับเดียวและแสดงผล STRING ที่มีหมวดหมู่ที่เกี่ยวข้องมากที่สุดรายการเดียวจากอาร์เรย์รายการที่อาจเป็นไปได้ โปรดสังเกตว่า Gemini จับคู่ลูกบอลแคทนิปและของเล่นล่อแมวด้วยขนนกกับ Cat ในขณะที่ของเล่นสำหรับกัดและไม้สำหรับคาบจะจับคู่กับ Dog
กำหนดแท็กหลายรายการด้วยการแยกประเภทแบบหลายป้ายกำกับ
ผลิตภัณฑ์จำนวนมากในแคตตาล็อกการค้าปลีกใช้ได้กับสัตว์เลี้ยงหลายประเภทพร้อมกัน (เช่น เตียงหรืออุโมงค์แบบนุ่มที่เหมาะสำหรับทั้งแมวและสัตว์ขนาดเล็ก)
หากต้องการกำหนดหมวดหมู่หลายรายการให้กับระเบียนเดียว ให้ตั้งค่าพารามิเตอร์ที่ไม่บังคับ output_mode => 'multi' ในโหมดหลายป้ายกำกับ AI.CLASSIFY จะแสดงผล ARRAY ที่มีหมวดหมู่ที่ตรงกันทั้งหมด
เรียกใช้การค้นหาต่อไปนี้ในแท็บ SQL
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('Identify all pet types that this product is suitable for: ', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "Reptile"],
    output_mode => 'multi'
  ) AS pet_types
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys";
ผลลัพธ์จะมีลักษณะคล้ายกับผลลัพธ์ต่อไปนี้
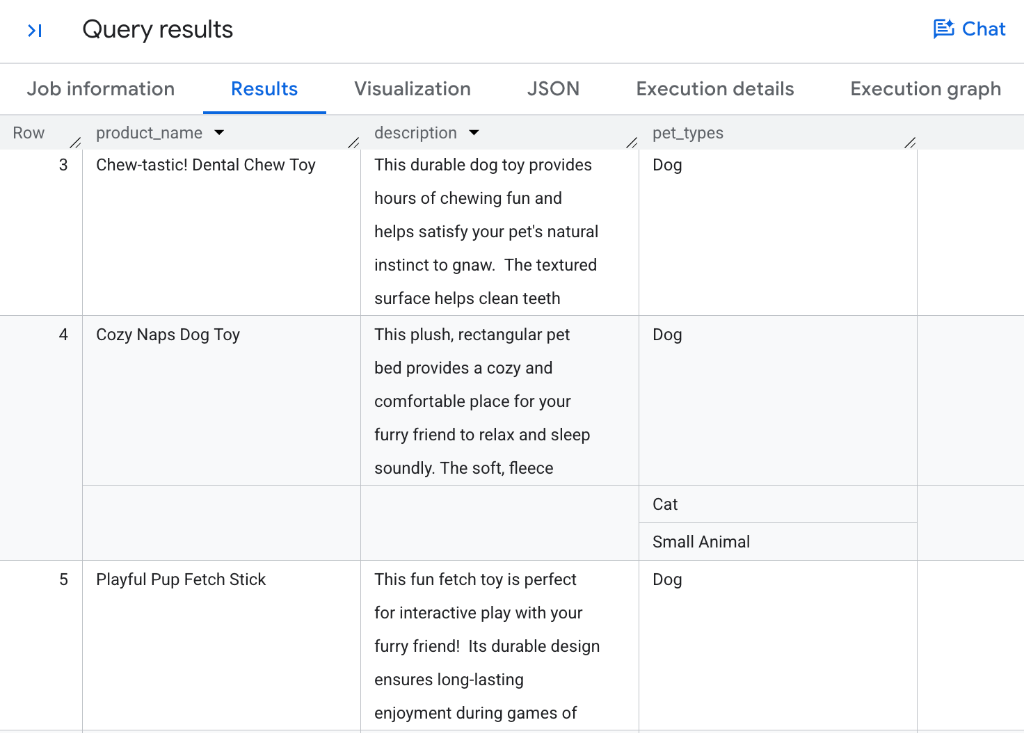
ตรวจสอบกลไกการแยกประเภท
- ป้ายกำกับเดียวเทียบกับหลายป้ายกำกับ: หากไม่มี
output_modeฟังก์ชันAI.CLASSIFYจะแสดงผลSTRINGแบบสเกลาร์ การตั้งค่าoutput_mode => 'multi'จะแสดงผลARRAYที่มีป้ายกำกับที่ตรงกัน 0, 1 หรือหลายรายการ - การกำหนดหลายหมวดหมู่: โปรดสังเกตว่าสินค้าเฉพาะ เช่น
Chew-tastic! Dental Chew ToyและPlayful Pup Fetch Stickได้รับ[Dog]ในขณะที่สินค้าอเนกประสงค์เพื่อความสบาย เช่นCozy Naps Dog Toy(เตียงสี่เหลี่ยมแบบนุ่ม) ได้รับแท็กหลายรายการอย่างถูกต้อง[Dog, Cat, Small Animal] - การจับคู่แบบ Zero-Shot: โมเดลจะประเมินข้อความและข้อความแจ้งที่รวมกันกับอาร์เรย์
categoriesที่ระบุโดยไม่จำเป็นต้องใช้โมเดล ML ที่กำหนดเองซึ่งได้รับการฝึกไว้ล่วงหน้า - การดำเนินการอาร์เรย์ SQL ปลายทาง: คุณสามารถใช้ฟังก์ชันอาร์เรย์ SQL มาตรฐานของ BigQuery เช่น
WHERE 'Cat' IN UNNEST(pet_types)หรือCROSS JOIN UNNEST(pet_types)เพื่อกรอง แยก และรวมระเบียนที่มีหลายป้ายกำกับ
6. กรองรูปภาพผลิตภัณฑ์แบบหลายรูปแบบด้วย AI.IF
ฟังก์ชัน AI.IF ใช้ Gemini เพื่อประเมินเงื่อนไขภาษาธรรมชาติและแสดงผลบูลีน (TRUE หรือ FALSE)
เนื่องจาก AI.IF รับอินพุตแบบหลายรูปแบบ คุณจึงใช้ฟังก์ชันนี้ได้โดยตรงภายในอนุประโยค WHERE ของ SQL เพื่อกรองไฟล์รูปภาพที่ไม่มีโครงสร้างซึ่งเก็บไว้ใน Cloud Storage
กรองรูปภาพที่มีออบเจ็กต์ที่เฉพาะเจาะจง
สมมติว่าทีมการค้าต้องการค้นหารูปภาพผลิตภัณฑ์ทั้งหมดในแคตตาล็อกที่มีอาหารหรือขนมสำหรับสัตว์เลี้ยง
เรียกใช้การค้นหาต่อไปนี้ในแท็บ SQL
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`
WHERE
  AI.IF(
    ('Does this product image contain pet food or snacks? ', OBJ.MAKE_REF(uri, 'us.conn'))
  );
ผลลัพธ์จะมีลักษณะคล้ายกับผลลัพธ์ต่อไปนี้
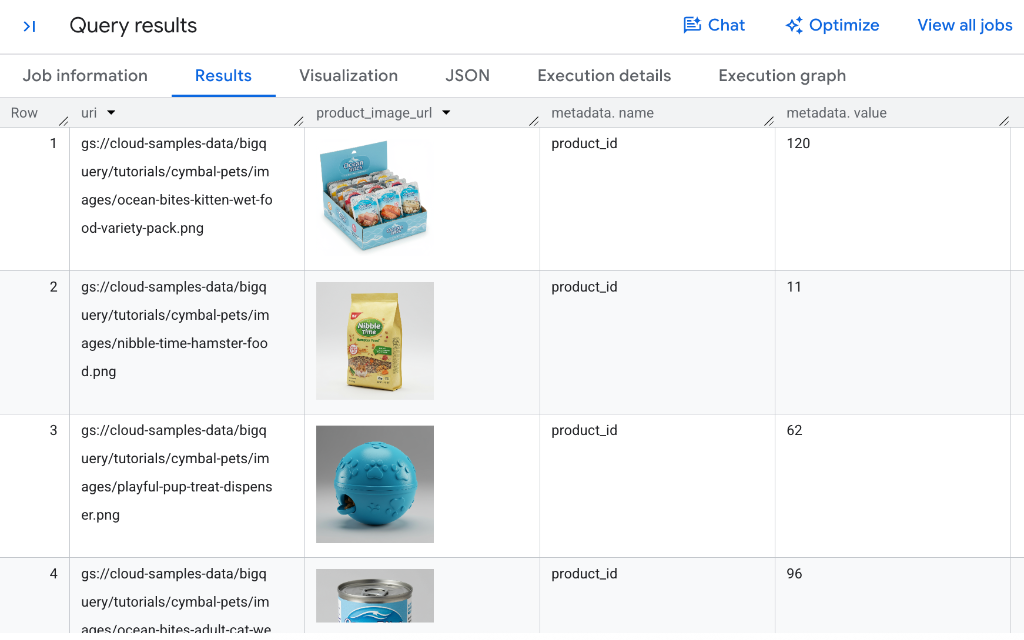
วิธีการทำงานของการกรองแบบหลายรูปแบบ
- การอ้างอิงออบเจ็กต์แบบทันที: แม้ว่าเราจะสร้างการอ้างอิงออบเจ็กต์แบบทันทีที่นี่โดยใช้
OBJ.MAKE_REF(uri, 'us.conn')แต่คุณยังสร้างและจัดเก็บคอลัมน์ObjectRefในตาราง BigQuery ได้โดยตรงเพื่อให้พร้อมใช้งานในการวิเคราะห์ได้ทันทีโดยไม่จำเป็นต้องใช้ฟังก์ชันOBJ.MAKE_REFในการค้นหาทุกครั้ง - การจดจำออบเจ็กต์ด้วยภาพเชิงลึก: โปรดสังเกตว่า Gemini ระบุรูปแบบบรรจุภัณฑ์ที่หลากหลายได้อย่างแม่นยำ (เช่น กล่องรวมอาหารเปียก ถุงอาหารแฮมสเตอร์แบบแห้ง และอาหารกระป๋องสำหรับแมว) พร้อมทั้งจดจำขนมที่กินได้ซึ่งบรรจุไว้ในของเล่น เช่น เครื่องจ่ายขนมสีน้ำเงิน
- การประเมินเพรดิเคตระดับแถว: BigQuery จะประเมินเงื่อนไขภาษาธรรมชาติเทียบกับการอ้างอิงรูปภาพ Cloud Storage แต่ละรายการโดยตรงภายในอนุประโยค
WHERE - การกรองแบบบูลีน: ระบบจะแสดงผลเฉพาะระเบียนที่ Gemini ประเมินเงื่อนไขเป็น
TRUEในชุดผลลัพธ์
7. ทำการรวมเชิงความหมายในตารางต่างๆ ด้วย AI.IF
การรวมฐานข้อมูลเชิงสัมพันธ์แบบเดิมกำหนดให้ต้องมีความเท่ากันของคีย์ที่แน่นอน (เช่น products.product_id = images.product_id) อย่างไรก็ตาม ชุดข้อมูลระดับองค์กรในโลกแห่งความเป็นจริงมักจะมีเนื้อหาที่ไม่มีโครงสร้างซึ่งไม่มีคีย์นอกที่ชัดเจน
เนื่องจาก AI.IF แสดงผลค่าบูลีน คุณจึงวางฟังก์ชันนี้ไว้ภายในอนุประโยค INNER JOIN ... ON ของ SQL ได้โดยตรงเพื่อทำการรวมเชิงความหมาย
รวมคำอธิบายผลิตภัณฑ์กับชิ้นงานรูปภาพเชิงความหมาย
สมมติว่าคุณต้องการจับคู่คำอธิบายผลิตภัณฑ์จากตาราง products กับไฟล์รูปภาพที่ไม่ได้ลิงก์ใน product_images สำหรับผลิตภัณฑ์ที่ผลิตโดยแบรนด์ Fluffy Buns
เรียกใช้การค้นหาต่อไปนี้ในแท็บ SQL ของ BigQuery Studio (โปรดทราบว่าการดำเนินการนี้จะใช้เวลา 2-3 นาที)
SELECT
  products.product_id,
  products.product_name,
  products.description,
  products.brand,
  images.uri AS image_uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(images.uri, 'us.conn')).url AS product_image_url
FROM
  `bigquery-public-data.cymbal_pets.products` AS products
INNER JOIN
  `bigquery-public-data.cymbal_pets.product_images` AS images
ON
  AI.IF(
    ('You will be provided an image of a pet product. ',
    'Determine if the image is of the following pet toy: ',
    products.product_name,
    products.description,
    OBJ.MAKE_REF(images.uri, 'us.conn')
    )
  )
WHERE
  products.category = "Toys" AND
  products.brand = "Fluffy Buns";
ผลลัพธ์จะมีลักษณะคล้ายกับผลลัพธ์ต่อไปนี้
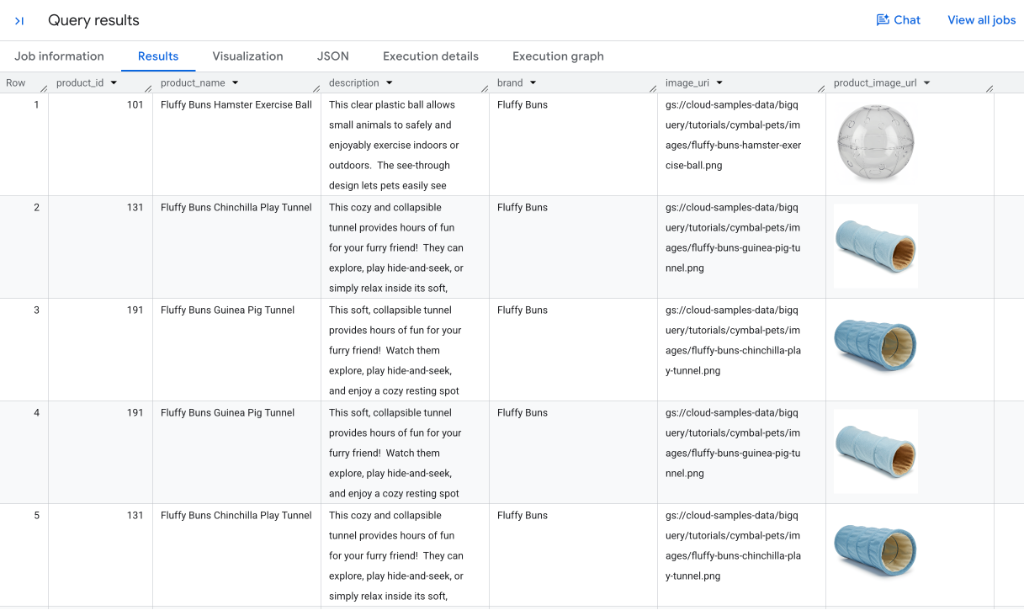
ทำความเข้าใจการรวมเชิงความหมายใน SQL
- การประเมินเงื่อนไขแบบข้ามรูปแบบ: สำหรับคู่ระเบียนที่อาจเป็นไปได้ BigQuery จะส่งทั้งข้อมูลเมตาที่เป็นข้อความจาก
productsและข้อมูลอ้างอิงรูปภาพ (OBJ.MAKE_REF(...)) ไปยัง Gemini - การจับคู่ด้วยภาพที่แม่นยำ: ดังที่แสดงในผลลัพธ์
Fluffy Buns Hamster Exercise Ballจะจับคู่กับรูปภาพลูกบอลพลาสติกใส ในขณะที่Fluffy Buns Chinchilla Play TunnelและGuinea Pig Tunnelจะจับคู่กับรูปภาพอุโมงค์แบบนุ่มสีน้ำเงิน เนื่องจากความหมายของINNER JOINใน SQL มาตรฐาน ผลิตภัณฑ์จึงแสดงผลหลายแถวได้หากตรงกับชิ้นงานรูปภาพมากกว่า 1 รายการในแคตตาล็อก (เช่น รูปภาพหลายมุมหรือภาพที่คล้ายกัน) - การแสดงรูปภาพแบบอินไลน์: BigQuery Studio จะแสดงผล URL การอ่านที่ได้รับอนุญาตในคอลัมน์
product_image_urlภายในกริดผลลัพธ์โดยอัตโนมัติเพื่อให้ยืนยันด้วยภาพได้ทันที - การแก้ปัญหาเอนทิตีที่ไม่มีโครงสร้าง: การดำเนินการนี้จะปลดล็อกเวิร์กโฟลว์การแก้ปัญหาเอนทิตีที่มีประสิทธิภาพในแคตตาล็อกเดิม ชุดข้อมูลที่ดึงข้อมูล และคลังสื่อโดยไม่ต้องติดป้ายกำกับด้วยตนเองหรือใช้คีย์นอกที่ชัดเจน
8. สังเคราะห์ข้อมูลเชิงลึกในแถวต่างๆ ด้วย AI.AGG
แม้ว่าฟังก์ชันต่างๆ เช่น AI.SCORE, AI.CLASSIFY และ AI.IF จะประเมินแถวแต่ละแถว (การดำเนินการแบบสเกลาร์) แต่การวิเคราะห์ข้อมูลระดับองค์กรมักจะต้องสังเคราะห์รูปแบบในระเบียนหลายรายการ
ฟังก์ชัน AI.AGG เป็นฟังก์ชันการรวมที่ใช้คำแนะนำภาษาธรรมชาติเพื่อสรุป จัดกลุ่ม หรือสังเคราะห์ข้อมูลเชิงลึกในแถวที่ไม่มีโครงสร้างหลายพันหรือหลายล้านแถวเป็นคำตอบเดียว
สังเคราะห์ข้อมูลสรุปหมวดหมู่ควบคู่ไปกับเมตริก SQL แบบเดิม
AI.AGG ผสานรวมกับฟังก์ชัน GROUP BY และฟังก์ชันการรวม SQL แบบเดิมได้อย่างราบรื่น ตัวอย่างเช่น คุณสามารถคำนวณเมตริกแบบเดิม (เช่น จำนวนสินค้า) ควบคู่ไปกับข้อมูลสรุป Generative AI ที่อธิบายสิ่งที่ผลิตภัณฑ์ในแต่ละหมวดหมู่มีเหมือนกัน
เรียกใช้การค้นหาต่อไปนี้ใน BigQuery Studio
SELECT
  category,
  COUNT(*) AS item_count,
  AI.AGG(
    ('Product: ', product_name, ' - Description: ', description),
    'Write a concise, one-sentence summary describing the common characteristics or purpose of the products in this category.'
  ) AS category_summary
FROM
  `bigquery-public-data.cymbal_pets.products`
GROUP BY
  category
ORDER BY
  item_count DESC;
ผลลัพธ์จะมีลักษณะคล้ายกับผลลัพธ์ต่อไปนี้
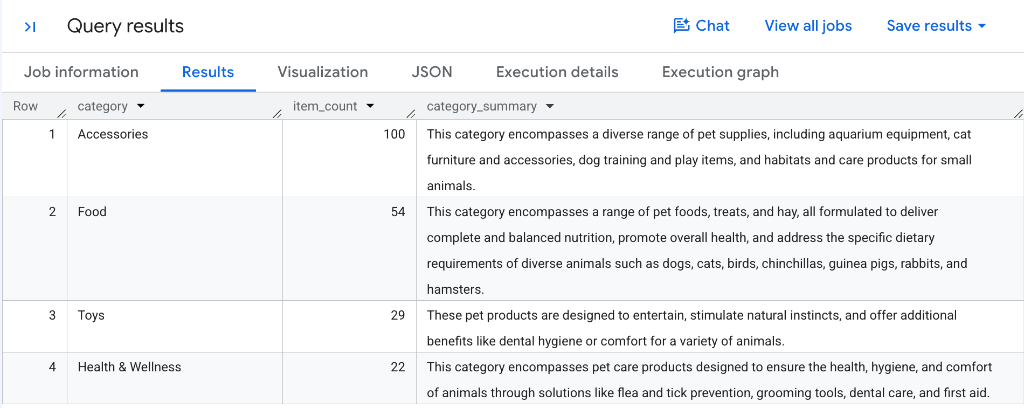
วิธีที่ AI.AGG รวมข้อมูลที่ไม่มีโครงสร้าง
- การรวมแบบลำดับชั้น: BigQuery จะจัดกลุ่มข้อมูลแถวตามพาร์ติชันหมวดหมู่ สร้างหน้าต่างบริบทที่มีโครงสร้าง และใช้ Gemini เพื่อสังเคราะห์คอลเล็กชันระเบียนผลิตภัณฑ์ทั้งหมด
- การสังเคราะห์แคตตาล็อกอัตโนมัติ: โปรดสังเกตว่าแต่ละหมวดหมู่จะได้รับข้อมูลสรุปที่แตกต่างกันและแม่นยำ เช่น
Accessoriesที่รวบรวมที่อยู่อาศัยและอุปกรณ์การฝึก หรือFoodที่เน้นโภชนาการที่สมดุลในสัตว์หลายสายพันธุ์ - การรายงานเชิงปริมาณและเชิงคุณภาพแบบไฮบริด: การรวมการรวมมาตรฐาน เช่น
COUNT(*)กับAI.AGGจะสร้างภาพรวมแคตตาล็อกที่ครอบคลุมในการค้นหาเดียวโดยไม่ต้องใช้ไปป์ไลน์ ETL ที่กำหนดเอง - การแบ่งพาร์ติชันที่ยืดหยุ่น: คุณสามารถใช้
AI.AGGในมิติข้อมูลการจัดกลุ่มใดก็ได้ (เช่นGROUP BY brand,GROUP BY categoryหรือในตารางทั้งหมด) เพื่อสร้างข้อมูลเชิงลึกระดับผู้บริหารในไม่กี่วินาที
9. เพิ่มความเร็วในการค้นหาด้วยโหมดที่เพิ่มประสิทธิภาพและโมเดลพร็อกซี
เมื่อประมวลผลชุดข้อมูลขนาดใหญ่ที่มีแถวหลายพันหรือหลายล้านแถว การเรียกใช้ LLM ระยะไกลสำหรับทุกแถวอาจทำให้เกิดเวลาในการตอบสนองและค่าใช้จ่าย
BigQuery จึงมีโหมดที่เพิ่มประสิทธิภาพ สำหรับ AI.IF และ AI.CLASSIFY เพื่อแก้ปัญหานี้ โหมดที่เพิ่มประสิทธิภาพใช้โมเดลพร็อกซีและการกลั่นโมเดลแบบทันที เพื่อแสดงผลการดำเนินการที่เร็วขึ้นกว่า 100 เท่าโดยมีค่าใช้จ่ายโทเค็น LLM ลดลง
วิธีการทำงานของโหมดที่เพิ่มประสิทธิภาพ
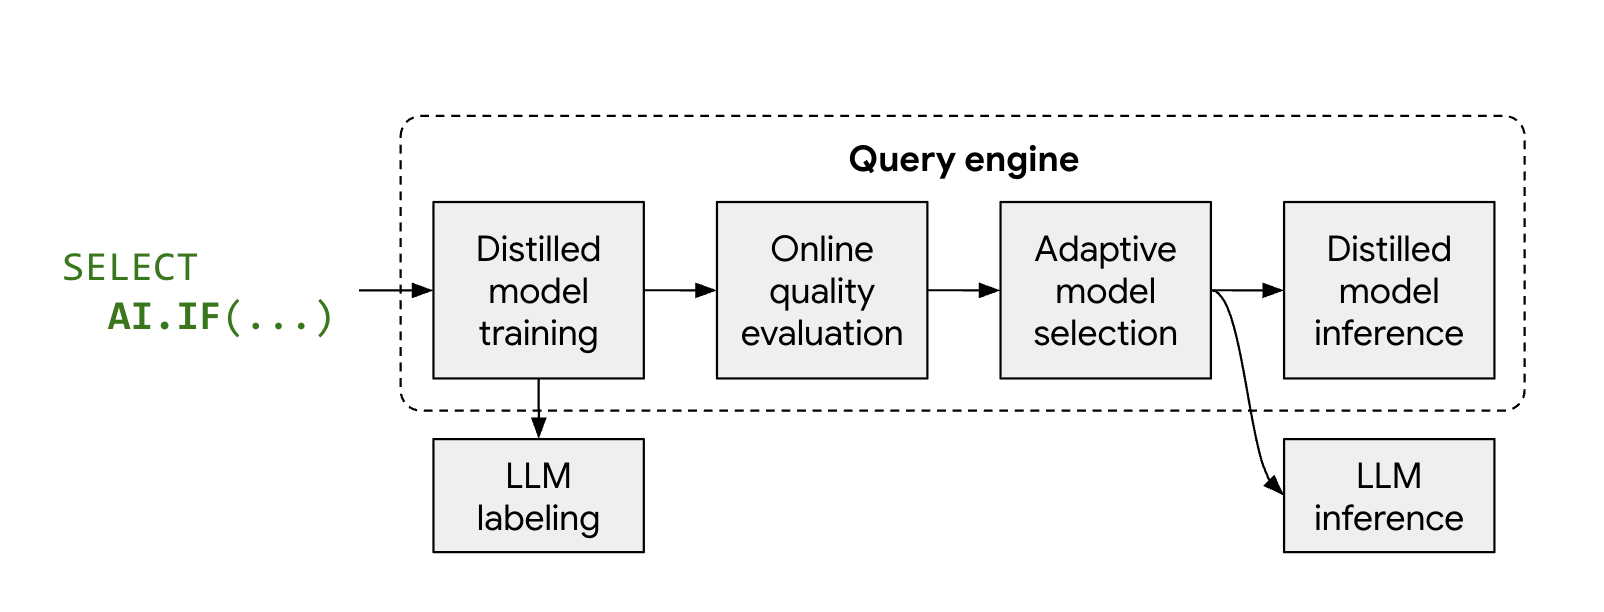
- การสุ่มตัวอย่างและการติดป้ายกำกับแบบเป็นตัวแทน: BigQuery จะเลือกตัวอย่างแถวแบบเป็นตัวแทนโดยอัตโนมัติและรับป้ายกำกับจาก Gemini
- การฝึกโมเดลที่กลั่นแล้ว: BigQuery จะฝึกโมเดลพร็อกซีแบบเบามาก (เช่น การถดถอยแบบโลจิสติก) แบบทันเวลาใน CPU โดยใช้การฝังข้อความเป็นฟีเจอร์
- การยืนยันคุณภาพ: BigQuery จะประเมินความแม่นยำของโมเดลที่กลั่นแล้วเทียบกับ Gemini หากโมเดลเป็นไปตามเกณฑ์คุณภาพ BigQuery จะเลื่อนระดับโมเดลเพื่อประมวลผลชุดข้อมูลที่เหลือ
- การอนุมานความเร็วสูงในเครื่อง: โมเดลพร็อกซีจะประเมินแถวที่เหลือในเครื่องโดยไม่มีค่าใช้จ่ายโทเค็น LLM ระยะไกลและมีเวลาในการตอบสนองต่ำมาก
เรียกใช้การค้นหาพื้นฐานโดยไม่มีการเพิ่มประสิทธิภาพ
เนื่องจากแคตตาล็อก bigquery-public-data.cymbal_pets.products ตัวอย่างมีแถวน้อยเกินไปที่จะทริกเกอร์การกลั่นโมเดลพร็อกซี เราจึงจะใช้ชุดข้อมูลสาธารณะขนาดใหญ่ขึ้น bigquery-public-data.bbc_news.fulltext (ซึ่งมีบทความข่าวมากกว่า 2,200 รายการ)
ขั้นแรก ให้เรียกใช้การค้นหามาตรฐานโดยไม่มีการเพิ่มประสิทธิภาพเพื่อระบุบทความข่าวเกี่ยวกับภัยพิบัติทางธรรมชาติ
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body)
  );
ตรวจสอบรายละเอียดงานพื้นฐานและการใช้โทเค็น
หลังจากที่การค้นหาพื้นฐานเสร็จสมบูรณ์แล้ว ให้ตรวจสอบเมตริกการดำเนินการ
- ในบานหน้าต่างผลลัพธ์ด้านล่างของ BigQuery Studio ให้เลือกแท็บข้อมูลงาน
- เลื่อนลงไปที่ส่วนจำนวนโทเค็นอินพุต และจำนวนโทเค็นเอาต์พุต
ผลลัพธ์จะมีลักษณะคล้ายกับผลลัพธ์ต่อไปนี้
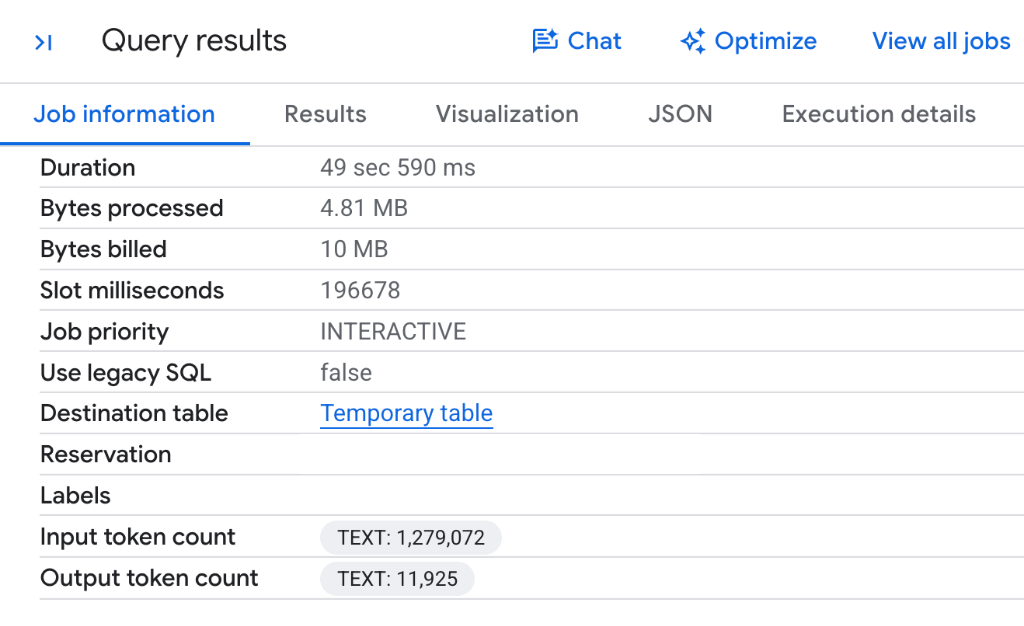
- การใช้โทเค็นชุดข้อมูลทั้งหมด: เนื่องจาก BigQuery เรียกใช้โมเดล Gemini ระยะไกลสำหรับแต่ละแถวในบทความข่าวทั้งหมด 2,225 รายการโดยไม่มีการเพิ่มประสิทธิภาพพร็อกซี การค้นหาจึงใช้โทเค็นอินพุต 1,279,072 รายการ และโทเค็นเอาต์พุต 11,925 รายการ
- ไม่มีส่วนการเพิ่มประสิทธิภาพ: โปรดสังเกตว่าไม่มีรายการ
Gen AI Function Optimizationsเนื่องจากมีการดำเนินการมาตรฐานจะประเมินแต่ละแถวเทียบกับปลายทาง LLM ระยะไกล
เรียกใช้การค้นหาด้วยโหมดที่เพิ่มประสิทธิภาพ
หากต้องการลดการใช้โทเค็นและใช้ประโยชน์จากการกลั่นโมเดลพร็อกซี ให้เปิดใช้โหมดที่เพิ่มประสิทธิภาพโดยส่ง embeddings => AI.EMBED(...) และตั้งค่า optimization_mode => 'MINIMIZE_COST'
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body),
    embeddings => AI.EMBED(body, endpoint => 'text-embedding-005', task_type => 'CLASSIFICATION').result,
    optimization_mode => 'MINIMIZE_COST'
  );
ยืนยันการเพิ่มประสิทธิภาพและสังเกตการใช้โทเค็นที่ลดลง
หลังจากเรียกใช้การค้นหาที่เพิ่มประสิทธิภาพแล้ว ให้เปลี่ยนไปที่แท็บข้อมูลงาน ของ BigQuery Studio เพื่อดูการเปรียบเทียบการใช้โทเค็นและเมตริกการดำเนินการ
- ในบานหน้าต่างผลลัพธ์ด้านล่างของ BigQuery Studio ให้เลือกแท็บข้อมูลงาน
- เลื่อนไปที่ส่วนการเพิ่มประสิทธิภาพฟังก์ชัน Gen AI รวมถึงจำนวนโทเค็น
ผลลัพธ์จะมีลักษณะคล้ายกับผลลัพธ์ต่อไปนี้
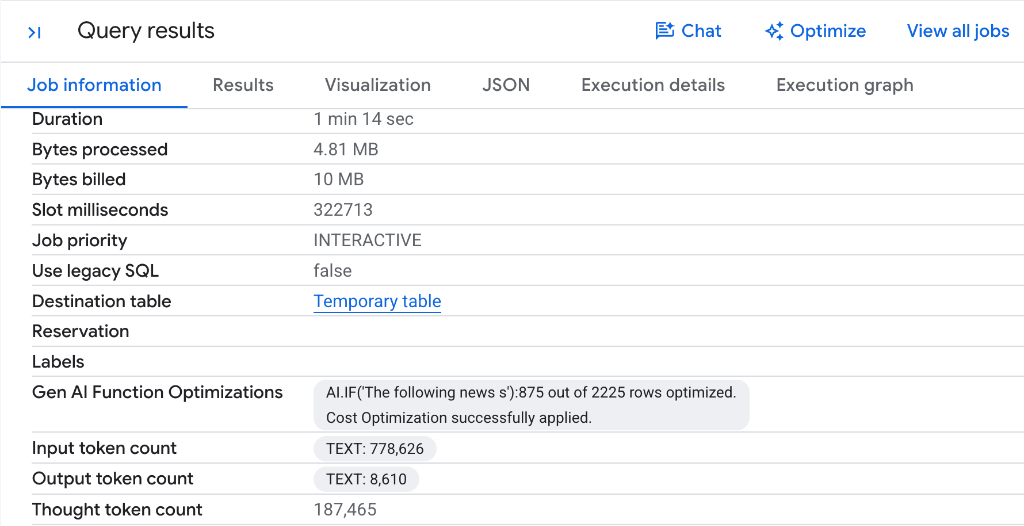
- การลดโทเค็นอย่างมาก: โปรดสังเกตว่าจำนวนโทเค็นอินพุต ลดลงจากโทเค็น 1,279,072 รายการ เหลือโทเค็น 778,626 รายการ ซึ่งช่วยประหยัดโทเค็นอินพุต 500,446 รายการ (ลดลงเกือบ 40%) ในการเรียกใช้การค้นหาครั้งเดียว เช่นเดียวกัน โทเค็นเอาต์พุตก็ลดลงด้วย
- การกลั่นพร็อกซีอัตโนมัติ: โปรดสังเกตป้ายกำกับ
AI.IF('The following news s'): 875 out of 2225 rows optimized. Cost Optimization successfully applied.BigQuery สุ่มตัวอย่างชุดข้อมูล ติดป้ายกำกับบทความที่เป็นตัวแทนด้วย Gemini กลั่นตัวแยกประเภทพร็อกซีแบบเบาที่รวดเร็ว และประมวลผลแถว 875 จาก 2,225 แถวในเครื่อง ใน CPU โดยไม่ต้องเรียกปลายทาง LLM ระยะไกล - การประหยัดค่าใช้จ่ายโดยตรง: เนื่องจากระบบจะเรียกเก็บเงินฟังก์ชัน AI ที่มีการจัดการของ BigQuery ตามปริมาณโทเค็นโมเดลที่ประมวลผล การลดการใช้โทเค็นจึงหมายถึงค่าใช้จ่ายในการดำเนินการค้นหาที่ลดลงโดยตรง
- การตรวจสอบคุณภาพ: BigQuery จะตรวจสอบความแม่นยำของโมเดลพร็อกซีเทียบกับ Gemini โดยอัตโนมัติก่อนที่จะเลื่อนระดับโมเดลเพื่อประเมินแถวที่เหลือ ซึ่งจะช่วยรักษาคุณภาพการแยกประเภท
การลดโทเค็นและการปรับขนาดเวลาในการตอบสนองที่มากขึ้นในตารางขนาดใหญ่
แม้ว่าการประหยัดโทเค็นมากกว่า 500,000 รายการใน 2,225 แถวจะเป็นจำนวนมาก แต่การลดโทเค็นและประสิทธิภาพที่เพิ่มขึ้นจะสูงขึ้นในตารางขนาดใหญ่
- เหตุผลที่การลดโทเค็นปรับขนาดตามขนาดชุดข้อมูล: สำหรับการค้นหาที่ดำเนินการใน BigQuery โมเดลพร็อกซีจะได้รับการฝึกแบบทันทีโดยใช้ตัวอย่างเริ่มต้นประมาณ 1,000 แถวที่ LLM ติดป้ายกำกับ เมื่อได้รับการฝึกและตรวจสอบแล้ว โมเดลพร็อกซีจะแทนที่การเรียกใช้ LLM โดยตรงในแถวที่เหลือ สำหรับการค้นหาขนาดใหญ่ (เช่น ชุดข้อมูลทั่วไป 1 ล้านแถว) การดำเนินการนี้จะขจัดการเรียกใช้ LLM สำหรับข้อมูลส่วนใหญ่ ซึ่งใช้โทเค็นน้อยลงสูงสุด 400 เท่าและลดค่าใช้จ่ายลงอย่างมาก
- การเพิ่มความเร็วในการตอบสนองอย่างมาก: การเปลี่ยนการอนุมานจากฮาร์ดแวร์ LLM เฉพาะทางไปยังโมเดลพร็อกซีแบบเบามากที่ทำงานโดยตรงใน CPU ของ Worker ฐานข้อมูลมาตรฐาน (ใช้ประโยชน์จากการฝัง Gemini ที่คำนวณไว้ล่วงหน้า) BigQuery จะลดเวลาในการเรียกใช้การค้นหาโดยรวมลง 30-100 เท่า
10. ล้างข้อมูลทรัพยากร
หากต้องการล้างข้อมูลทรัพยากรที่สร้างขึ้นระหว่าง Codelab นี้ ให้เรียกใช้คำสั่งต่อไปนี้ในแท็บ SQL ของ BigQuery Studio เพื่อนำการเชื่อมต่อทรัพยากร Cloud ออก
DROP CONNECTION IF EXISTS `us.conn`;
หรือหากคุณสร้างโปรเจ็กต์ที่อยู่ในระบบคลาวด์ Google ชั่วคราวสำหรับบทแนะนำนี้โดยเฉพาะ คุณสามารถปิดโปรเจ็กต์ทั้งหมดใน Cloud Resource Manager ได้
11. ขอแสดงความยินดี
ขอแสดงความยินดี คุณทำ Codelab เรื่องการวิเคราะห์เชิงความหมายใน BigQuery ด้วยฟังก์ชัน AI ที่มีการจัดการและ SQL สำเร็จแล้ว
คุณเชี่ยวชาญฟังก์ชัน Generative AI ที่มีการจัดการของ BigQuery แล้ว ดังนี้
AI.SCORE: จัดอันดับผลิตภัณฑ์ตามเกณฑ์เชิงอัตวิสัย เช่น ความเหมาะสมที่จะเป็นของขวัญในระดับ 1-10 โดยใช้การเขียนข้อความแจ้งใหม่โดยอัตโนมัติAI.CLASSIFY: แยกประเภทสินค้าในแคตตาล็อกที่ไม่มีโครงสร้างเป็นการแยกประเภทสัตว์เป้าหมายAI.IF(การกรองแบบหลายรูปแบบ): กรองชิ้นงานรูปภาพ Cloud Storage ในอนุประโยคWHEREของ SQL ตามเนื้อหาภาพAI.IF(การรวมเชิงความหมาย): ทำการรวมแบบข้ามรูปแบบในอนุประโยคONของ SQL เพื่อลิงก์คำอธิบายผลิตภัณฑ์ที่เป็นข้อความกับไฟล์รูปภาพAI.AGG: สังเคราะห์ข้อความแคตตาล็อกที่ไม่มีโครงสร้างหลายแถวเป็นข้อมูลสรุปสำหรับผู้บริหารที่กระชับ- โหมดที่เพิ่มประสิทธิภาพและโมเดลพร็อกซี: เพิ่มความเร็วในการค้นหาและลดค่าใช้จ่ายโทเค็นโดยใช้
optimization_mode => 'MINIMIZE_COST'กับการกลั่นโมเดลแบบทันทีและAI.EMBED
ดูข้อมูลเพิ่มเติม
- ภาพรวม Generative AI ของ BigQuery
- คู่มือฟังก์ชัน AI ที่มีการจัดการของ BigQuery
AI.SCOREเอกสารประกอบไวยากรณ์ SQL- เอกสารประกอบไวยากรณ์ SQL ของ
AI.CLASSIFY AI.IFเอกสารประกอบไวยากรณ์ SQLAI.AGGเอกสารประกอบไวยากรณ์ SQL- เพิ่มประสิทธิภาพฟังก์ชัน AI ด้วยการกลั่นโมเดล
- บล็อก Google Cloud: การค้นหา SQL ที่ขับเคลื่อนโดย LLM เร็วขึ้นและถูกลงกว่า 100 เท่าด้วยโมเดลพร็อกซี
- บล็อก Google Cloud: เจาะลึกฟังก์ชัน AI.AGG ของ BigQuery