

1. Chào mừng bạn
Trong lớp học lập trình này, bạn sẽ tìm hiểu cách sử dụng bộ các hàm AI được quản lý của BigQuery để thực hiện phân tích ngữ nghĩa phức tạp, phân loại theo danh mục, lọc đa phương thức, kết hợp ngữ nghĩa và tóm tắt nhiều hàng ngay trong BigQuery Studio bằng SQL.
Bằng cách sử dụng tập dữ liệu công khai bigquery-public-data.cymbal_pets, bạn sẽ vào vai một nhà phân tích dữ liệu tại Cymbal Pets, một nhà bán lẻ thương mại điện tử chuyên cung cấp đồ dùng và phụ kiện cho thú cưng.
Phân tích ngữ nghĩa ngay trong các truy vấn SQL
Theo cách truyền thống, việc áp dụng học máy hoặc các mô hình ngôn ngữ lớn (LLM) cho các tập dữ liệu doanh nghiệp đòi hỏi phải di chuyển dữ liệu ra khỏi kho dữ liệu vào các môi trường sổ tay Python bên ngoài. Điều này đòi hỏi các quy trình kỹ thuật dữ liệu chuyên dụng và kiến thức chuyên môn về học máy.
Các hàm AI được quản lý của BigQuery (bao gồm AI.SCORE, AI.CLASSIFY, AI.IF và AI.AGG) mang trí thông minh của mô hình cơ sở trực tiếp đến dữ liệu của bạn. BigQuery tự động tối ưu hoá việc lựa chọn mô hình và áp dụng các chiến lược viết lại câu lệnh nội bộ để đưa ra kết quả có độ chính xác cao từ các câu lệnh đơn giản bằng ngôn ngữ tự nhiên.
Đối với các tập dữ liệu có dung lượng lớn, BigQuery cung cấp chế độ được tối ưu hoá, sử dụng tính năng chưng cất mô hình tức thì và các mô hình proxy đơn giản để cung cấp các truy vấn nhanh hơn và rẻ hơn gấp 100 lần.
Bạn sẽ thực hiện
- Khám phá dữ liệu bán lẻ đa phương thức trong BigQuery Studio bằng SQL.
- Thực hiện xếp hạng ngữ nghĩa bằng cách sử dụng
AI.SCOREđể đánh giá các thuộc tính chủ quan của sản phẩm, chẳng hạn như "phù hợp để làm quà tặng". - Phân loại dữ liệu không có cấu trúc bằng cách sử dụng
AI.CLASSIFYđể liên kết sản phẩm với loài động vật mục tiêu. - Lọc thành phần hình ảnh đa phương thức bằng cách sử dụng
AI.IFtrong các mệnh đềWHERE. - Thực hiện các phép kết hợp ngữ nghĩa trên các bảng bằng cách sử dụng
AI.IFtrong các mệnh đềJOIN ... ONđể so khớp các bản ghi sản phẩm dạng văn bản với các tệp hình ảnh từ bên ngoài. - Tổng hợp thông tin chi tiết trên nhiều hàng bằng hàm tổng hợp
AI.AGG. - Tối ưu hoá độ trễ và chi phí truy vấn trên các tập dữ liệu lớn bằng cách sử dụng
AI.IFvới chế độ được tối ưu hoá (optimization_mode => 'MINIMIZE_COST') và phương pháp chưng cất mô hình proxy.
Bạn cần có
- Một dự án trên Google Cloud đã bật tính năng thanh toán.
- Một trình duyệt web như Chrome.
2. Thiết lập và yêu cầu
Trước khi truy vấn dữ liệu bằng các hàm AI được quản lý, bạn phải định cấu hình dự án trên đám mây của Google Cloud và bật các API bắt buộc.
Tạo một dự án trên Google Cloud và bật API
- Trong Google Cloud Console, trên trang chọn dự án, hãy chọn hoặc tạo một dự án trên Google Cloud.
- Đảm bảo bạn đã bật tính năng thanh toán cho dự án trên Cloud. Tìm hiểu cách kiểm tra xem tính năng thanh toán có được bật trong một dự án hay không.
- Bật BigQuery API, BigQuery Connection API và Agent Platform API.
Mở BigQuery Studio
- Trong trình đơn điều hướng của Google Cloud Console, hãy nhấp vào BigQuery để mở BigQuery Studio.
- Trong thanh công cụ của trình chỉnh sửa BigQuery Studio, hãy nhấp vào + SQL query (Truy vấn SQL) để mở một thẻ truy vấn SQL mới. Bạn sẽ viết và chạy tất cả các truy vấn SQL trong các thẻ SQL này trong suốt lớp học lập trình này.
Tạo mối kết nối tài nguyên trên đám mây trong SQL
BigQuery hoạt động trong một ranh giới dữ liệu an toàn. Khi kiểm tra các tệp đa phương thức bên ngoài (chẳng hạn như hình ảnh được lưu trữ trong Google Cloud Storage), BigQuery sẽ sử dụng Cloud Resource Connection để truy cập an toàn vào các tham chiếu đối tượng mà không làm lộ thông tin đăng nhập.
Thực thi câu lệnh sau trong thẻ SQL để tạo một mối kết nối có tên là us.conn:
CREATE CONNECTION IF NOT EXISTS `us.conn`
OPTIONS (
  connection_type = "CLOUD_RESOURCE"
);
3. Khám phá tập dữ liệu Cymbal Pets
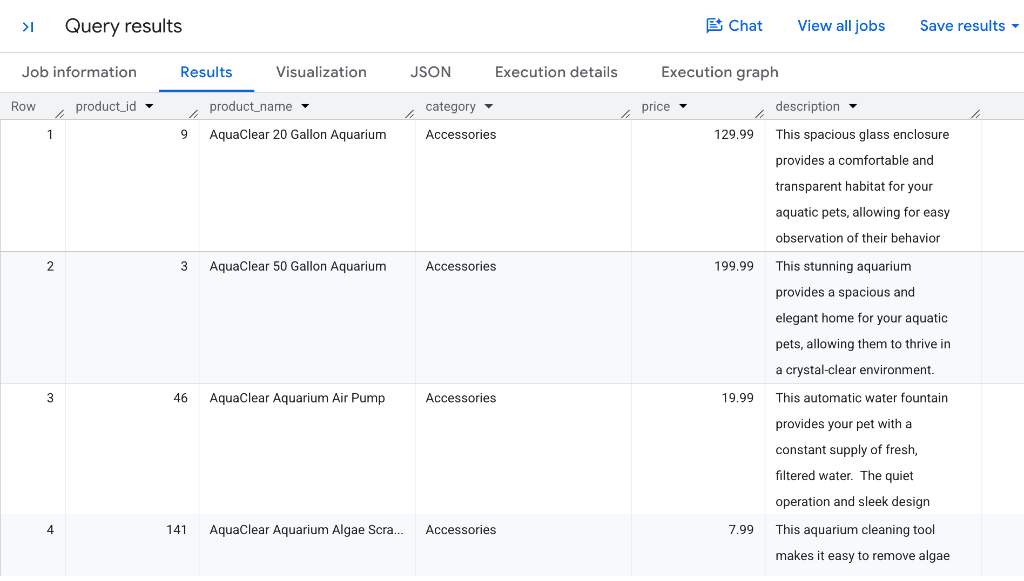
Cymbal Pets duy trì một danh mục sản phẩm phong phú trong tập dữ liệu công khai bên trong bảng có tên là bigquery-public-data.cymbal_pets.products. Mỗi bản ghi sản phẩm chứa các thuộc tính có cấu trúc như mã sản phẩm, tiêu đề, danh mục bán lẻ, giá và văn bản mô tả.
Truy vấn danh mục sản phẩm
Mở thẻ SQL trong BigQuery Studio rồi chạy truy vấn sau để kiểm tra bảng sản phẩm:
SELECT
  product_id,
  product_name,
  category,
  price,
  description
FROM
  `bigquery-public-data.cymbal_pets.products`;
Kết quả sẽ có dạng tương tự như sau:
Kiểm tra hình ảnh sản phẩm
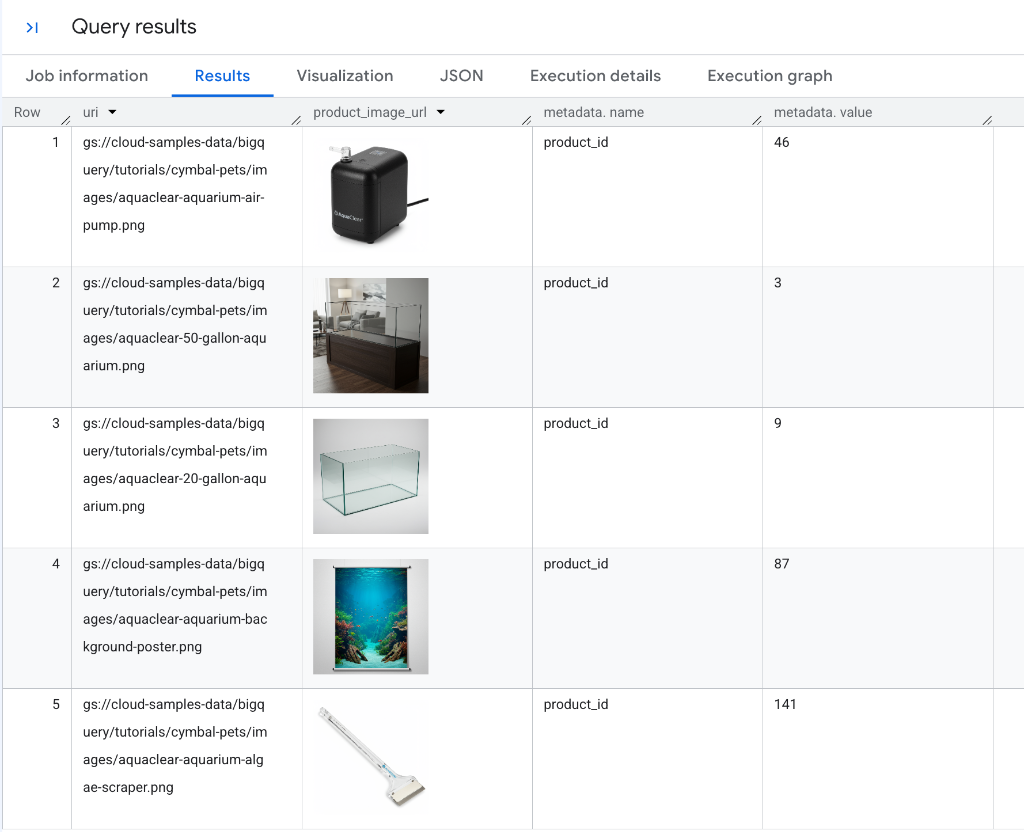
Cymbal Pets cũng lưu trữ thông tin tham chiếu về hình ảnh sản phẩm ở bigquery-public-data.cymbal_pets.product_images. Chạy truy vấn sau để xem các bản ghi hình ảnh:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`;
Kết quả sẽ có dạng tương tự như sau:
Tiếp theo, bạn sẽ sử dụng các hàm do BigQuery quản lý để phân tích cả dữ liệu văn bản và hình ảnh từ kho dữ liệu Cymbal Pets.
4. Xếp hạng sản phẩm theo tiêu chí ngữ nghĩa bằng AI.SCORE
Hàm AI.SCORE chấp nhận thông tin đầu vào là văn bản và sử dụng mô hình Gemini để đánh giá thông tin đầu vào đó dựa trên một tiêu chí chấm điểm bằng ngôn ngữ tự nhiên, đồng thời trả về điểm số bằng số FLOAT64.
Nếu bạn không cung cấp một tiêu chí chấm điểm rõ ràng, BigQuery sẽ tự động áp dụng các chiến lược viết lại câu lệnh để tạo ra một tiêu chí chấm điểm tối ưu cho mô hình.
Chấm điểm sản phẩm theo "khả năng làm quà tặng"
Giả sử nhóm tiếp thị của Cymbal Pets muốn xây dựng một hướng dẫn mua quà tặng cho dịp lễ. Họ muốn xếp hạng mọi mặt hàng trong danh mục dựa trên mức độ phù hợp của mặt hàng đó làm quà tặng cho chủ sở hữu thú cưng theo thang điểm từ 1 đến 10.
Chạy truy vấn sau trong thẻ SQL:
SELECT
  product_name,
  description,
  AI.SCORE(
    ('How "giftable" is this product for a pet owner? ', description,
    'Use a scale from 1-10.')
  ) AS giftability_score
FROM
  `bigquery-public-data.cymbal_pets.products`
ORDER BY
  giftability_score DESC;
Tìm hiểu các kết quả
Kết quả sẽ có dạng tương tự như sau:
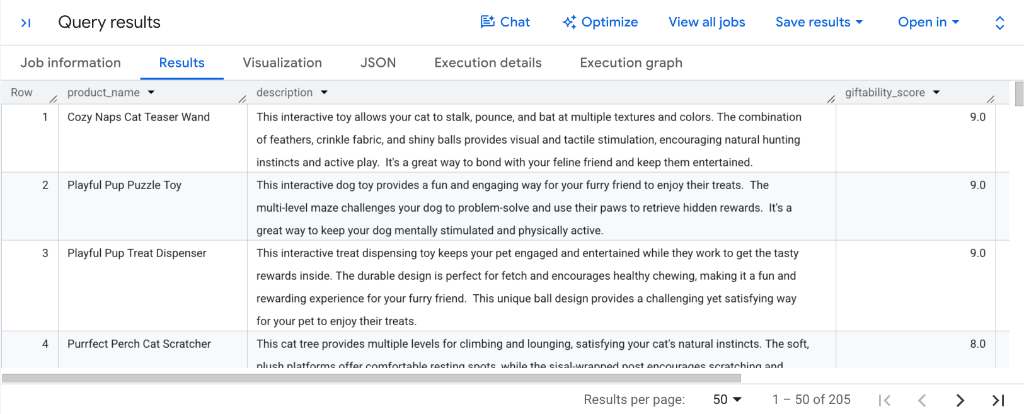
Kiểm tra cột giftability_score trong kết quả truy vấn:
- Đồ chơi tương tác có sức hấp dẫn cao: Những mặt hàng hấp dẫn như
Cozy Naps Cat Teaser Wand,Playful Pup Puzzle ToyvàPlayful Pup Treat Dispensernhận được điểm đánh giá cao nhất (9.0). - Các vật dụng đặc biệt giúp thú cưng thoải mái và có thể cào: Các vật dụng thiết yếu phổ biến như
Purrfect Perch Cat Scratcherđạt điểm cao ở mức8.0. - Xếp hạng có thể hành động ở hạ nguồn: Vì
AI.SCOREtạo ra điểm sốFLOAT64được chuẩn hoá, nên bạn có thể sắp xếp ngay kết quả bằngORDER BY giftability_score DESChoặc lọc các đề xuất bằngWHERE AI.SCORE(...) >= 8.0để tạo hướng dẫn mua quà tự động.
5. Phân loại các mục trong danh mục bằng AI.CLASSIFY
Hàm AI.CLASSIFY sử dụng Gemini để phân loại các bản ghi đầu vào thành một danh sách rời rạc gồm các danh mục mục tiêu được cung cấp dưới dạng một mảng SQL.
AI.CLASSIFY hỗ trợ dữ liệu đầu vào đa phương thức (văn bản, hình ảnh, âm thanh, video) và loại bỏ nhu cầu xây dựng, huấn luyện hoặc triển khai các mô hình phân loại riêng biệt để quản lý phân loại.
Phân loại đồ chơi theo loài động vật mục tiêu (một nhãn)
Giả sử một số sản phẩm trong danh mục Cymbal Pets được gắn thẻ chung chung là "Đồ chơi" mà không chỉ định động vật mục tiêu. Bạn có thể dùng AI.CLASSIFY để phân loại từng đồ chơi dựa trên tên và nội dung mô tả.
Chạy truy vấn sau trong BigQuery Studio:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('What animal is this product for?', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "All Pets"]
  ) AS animal_type
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys"
LIMIT 20;
Xem kết quả
Kết quả sẽ có dạng tương tự như sau:
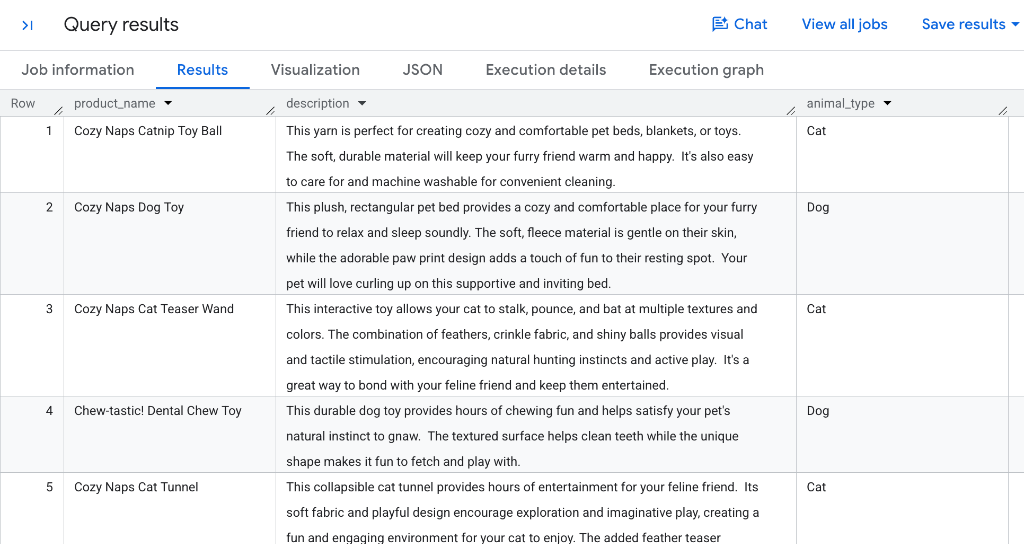
Theo mặc định, AI.CLASSIFY thực hiện phân loại một nhãn và trả về một STRING chứa danh mục phù hợp nhất trong mảng đề xuất của bạn. Lưu ý cách Gemini liên kết bóng đồ chơi và đồ chơi lông vũ với Cat, còn đồ chơi nhai và gậy ném/bắt thì liên kết với Dog.
Chỉ định nhiều thẻ bằng tính năng phân loại nhiều nhãn
Nhiều sản phẩm trong danh mục bán lẻ áp dụng cho nhiều loại thú cưng cùng lúc (ví dụ: giường hoặc đường hầm bằng vải nhung phù hợp cho cả mèo và động vật nhỏ).
Để chỉ định nhiều danh mục cho một bản ghi, hãy đặt tham số không bắt buộc output_mode => 'multi'. Ở chế độ nhiều nhãn, AI.CLASSIFY sẽ trả về một ARRAY chứa tất cả các danh mục trùng khớp.
Chạy truy vấn sau trong thẻ SQL:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('Identify all pet types that this product is suitable for: ', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "Reptile"],
    output_mode => 'multi'
  ) AS pet_types
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys";
Kết quả sẽ có dạng tương tự như sau:
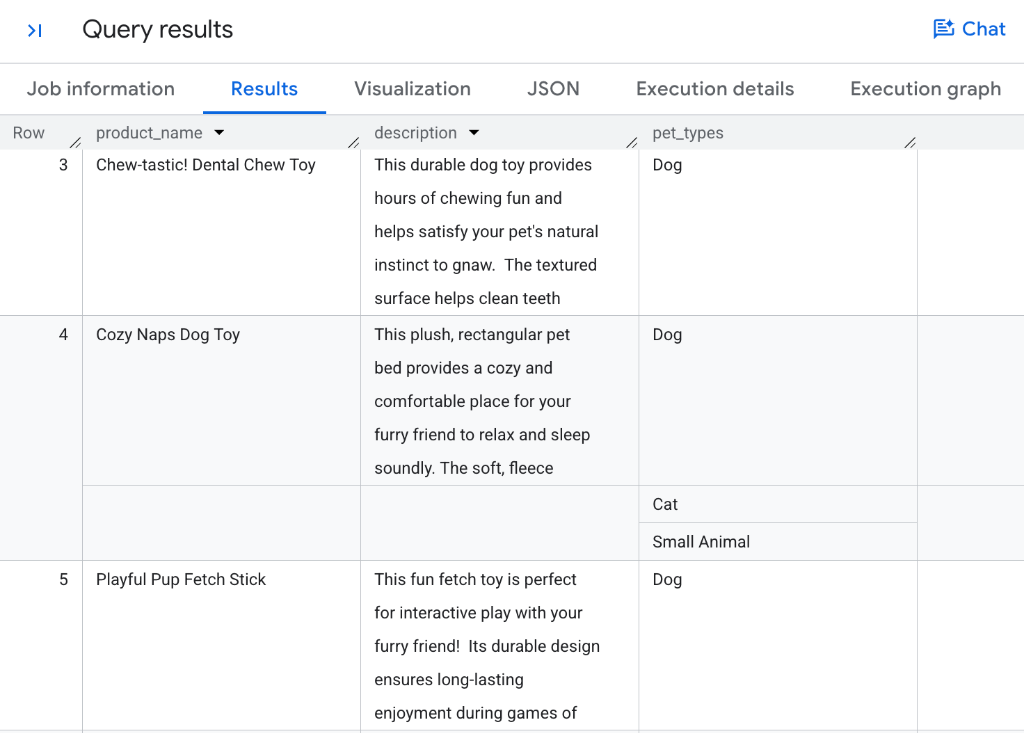
Xem xét cơ chế phân loại
- Nhãn đơn và nhãn đa: Nếu không có
output_mode,AI.CLASSIFYsẽ trả về một đại lượng vô hướngSTRING. Việc đặtoutput_mode => 'multi'sẽ trả về mộtARRAYchứa 0, 1 hoặc nhiều nhãn khớp. - Phân loại nhiều danh mục: Lưu ý cách các mặt hàng chuyên dụng như
Chew-tastic! Dental Chew ToyvàPlayful Pup Fetch Sticknhận được[Dog], trong khi các mặt hàng thoải mái đa năng nhưCozy Naps Dog Toy(giường hình chữ nhật mềm mại) nhận được nhiều thẻ một cách chính xác:[Dog, Cat, Small Animal]. - So khớp không cần dữ liệu đầu vào: Mô hình đánh giá văn bản và câu lệnh kết hợp dựa trên mảng
categoriesđược cung cấp mà không yêu cầu các mô hình học máy tuỳ chỉnh được huấn luyện trước. - Các thao tác trên mảng SQL ở hạ nguồn: Bạn có thể sử dụng các hàm mảng SQL chuẩn của BigQuery như
WHERE 'Cat' IN UNNEST(pet_types)hoặcCROSS JOIN UNNEST(pet_types)để lọc, mở rộng và tổng hợp các bản ghi có nhiều nhãn.
6. Lọc hình ảnh sản phẩm đa phương thức bằng AI.IF
Hàm AI.IF sử dụng Gemini để đánh giá một điều kiện bằng ngôn ngữ tự nhiên và trả về một giá trị boolean (TRUE hoặc FALSE).
Vì AI.IF chấp nhận dữ liệu đầu vào đa phương thức, nên bạn có thể sử dụng trực tiếp trong một mệnh đề SQL WHERE để lọc các tệp hình ảnh không có cấu trúc được lưu trữ trong Cloud Storage.
Lọc những hình ảnh có chứa các đối tượng cụ thể
Giả sử nhóm bán hàng muốn tìm tất cả hình ảnh sản phẩm trong danh mục có chứa thức ăn hoặc đồ ăn vặt cho thú cưng.
Chạy truy vấn sau trong thẻ SQL:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`
WHERE
  AI.IF(
    ('Does this product image contain pet food or snacks? ', OBJ.MAKE_REF(uri, 'us.conn'))
  );
Kết quả sẽ có dạng tương tự như sau:
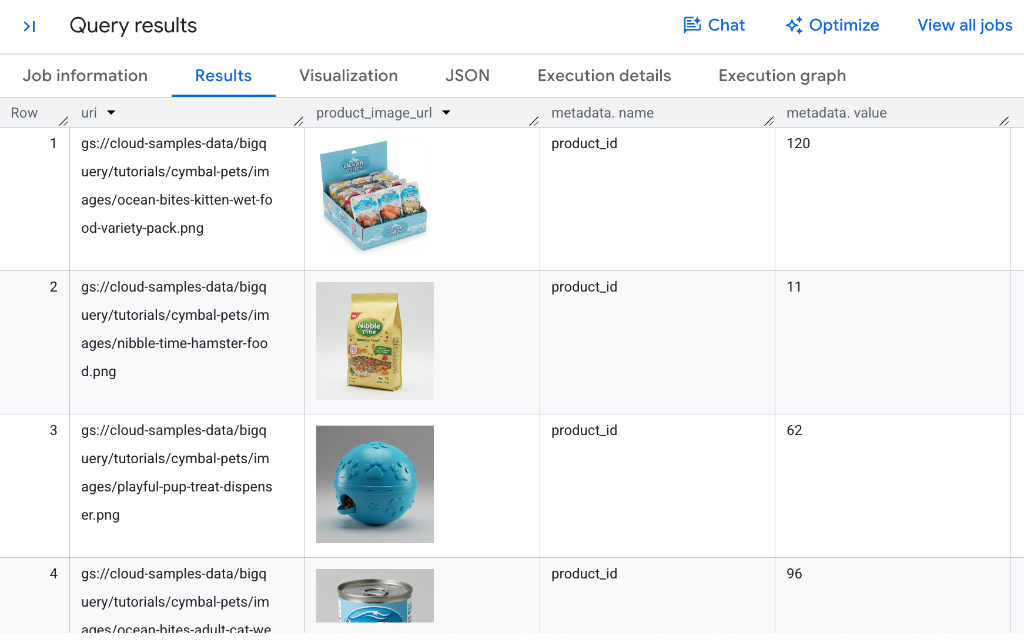
Cách hoạt động của tính năng lọc nội dung đa phương thức
- Tham chiếu đối tượng tức thì: Mặc dù chúng ta tạo tham chiếu đối tượng tức thì ở đây bằng cách sử dụng
OBJ.MAKE_REF(uri, 'us.conn'), nhưng bạn cũng có thể tạo và lưu trữ các cộtObjectRefngay trong bảng BigQuery để có thể sử dụng ngay trong quá trình phân tích mà không cần hàmOBJ.MAKE_REFtrong mọi truy vấn. - Nhận dạng đối tượng trực quan chuyên sâu: Lưu ý cách Gemini nhận dạng chính xác nhiều định dạng đóng gói (chẳng hạn như hộp thức ăn ướt, túi thức ăn khô cho chuột hamster và thức ăn đóng hộp cho mèo) đồng thời nhận dạng các món ăn vặt có thể ăn được bên trong đồ chơi như hộp đựng thức ăn màu xanh dương.
- Đánh giá vị từ ở cấp hàng: BigQuery đánh giá điều kiện bằng ngôn ngữ tự nhiên dựa trên từng tham chiếu hình ảnh trong Cloud Storage ngay trong mệnh đề
WHERE. - Lọc bằng giá trị boolean: Chỉ những bản ghi mà Gemini đánh giá điều kiện là
TRUEmới được trả về trong tập kết quả.
7. Thực hiện thao tác kết hợp ngữ nghĩa trên các bảng bằng AI.IF
Các phép kết hợp cơ sở dữ liệu quan hệ truyền thống yêu cầu sự bình đẳng chính xác về khoá (chẳng hạn như products.product_id = images.product_id). Tuy nhiên, các tập dữ liệu doanh nghiệp trong thế giới thực thường chứa các tài sản không có cấu trúc và thiếu khoá ngoài rõ ràng.
Vì AI.IF trả về một giá trị boolean, nên bạn có thể đặt giá trị này trực tiếp bên trong một mệnh đề INNER JOIN ... ON SQL để thực hiện các phép kết hợp ngữ nghĩa.
Kết hợp nội dung mô tả sản phẩm với thành phần hình ảnh theo ngữ nghĩa
Giả sử bạn muốn so khớp nội dung mô tả sản phẩm trong bảng products với các tệp hình ảnh chưa được liên kết trong product_images cho các sản phẩm do thương hiệu Fluffy Buns sản xuất.
Chạy truy vấn sau trong thẻ SQL của BigQuery Studio (lưu ý rằng quá trình này mất vài phút để hoàn tất):
SELECT
  products.product_id,
  products.product_name,
  products.description,
  products.brand,
  images.uri AS image_uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(images.uri, 'us.conn')).url AS product_image_url
FROM
  `bigquery-public-data.cymbal_pets.products` AS products
INNER JOIN
  `bigquery-public-data.cymbal_pets.product_images` AS images
ON
  AI.IF(
    ('You will be provided an image of a pet product. ',
    'Determine if the image is of the following pet toy: ',
    products.product_name,
    products.description,
    OBJ.MAKE_REF(images.uri, 'us.conn')
    )
  )
WHERE
  products.category = "Toys" AND
  products.brand = "Fluffy Buns";
Kết quả sẽ có dạng tương tự như sau:
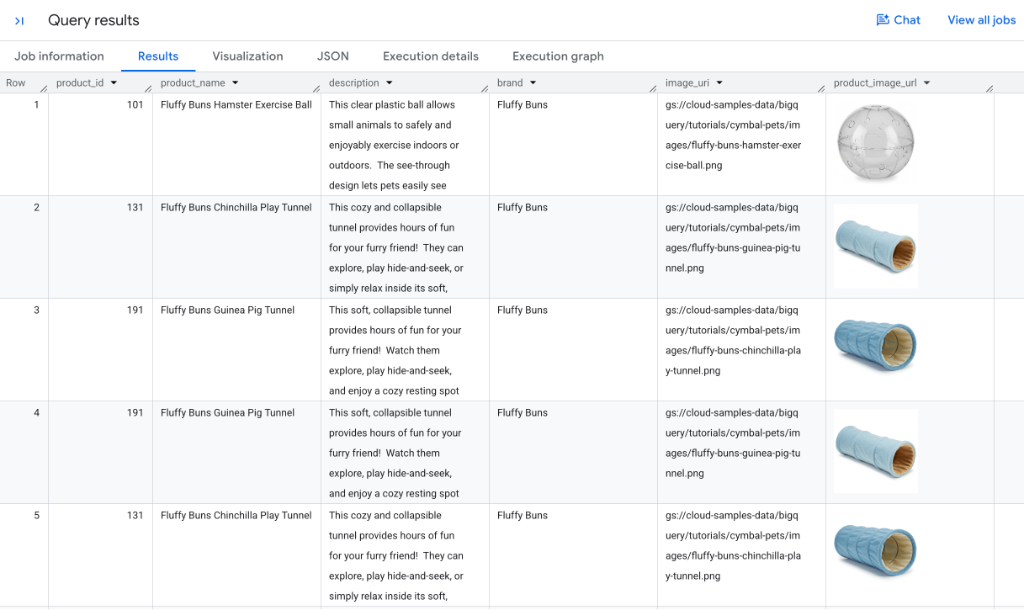
Tìm hiểu về các phép kết hợp ngữ nghĩa trong SQL
- Đánh giá điều kiện đa phương thức: Đối với các cặp bản ghi đề xuất, BigQuery sẽ gửi cả siêu dữ liệu dạng văn bản từ
productsvà thông tin tham chiếu về hình ảnh (OBJ.MAKE_REF(...)) đến Gemini. - Kết quả trùng khớp chính xác về mặt hình ảnh: Như trong kết quả,
Fluffy Buns Hamster Exercise Balltrùng khớp với hình ảnh quả bóng nhựa trong suốt, cònFluffy Buns Chinchilla Play TunnelvàGuinea Pig Tunneltrùng khớp với ảnh chụp đường hầm bằng vải nhung màu xanh dương. Do ngữ nghĩa SQLINNER JOINtiêu chuẩn, một sản phẩm có thể tạo ra nhiều hàng trong đầu ra nếu sản phẩm đó khớp với nhiều thành phần hình ảnh trong danh mục (chẳng hạn như nhiều góc chụp ảnh hoặc ảnh chụp tương tự). - Kết xuất hình ảnh nội tuyến: BigQuery Studio tự động kết xuất các URL đọc được uỷ quyền trong cột
product_image_urlngay trong lưới kết quả để xác minh bằng hình ảnh tức thì. - Phân giải thực thể không có cấu trúc: Tính năng này mở ra các quy trình phân giải thực thể mạnh mẽ trên các danh mục cũ, tập dữ liệu được trích xuất và kho lưu trữ nội dung nghe nhìn mà không cần gắn nhãn thủ công hoặc khoá ngoại rõ ràng.
8. Tổng hợp thông tin chi tiết trên các hàng bằng hàm AI.AGG
Mặc dù các hàm như AI.SCORE, AI.CLASSIFY và AI.IF đánh giá các hàng riêng lẻ (thao tác vô hướng), nhưng việc phân tích dữ liệu doanh nghiệp thường đòi hỏi phải tổng hợp các mẫu trên nhiều bản ghi.
Hàm AI.AGG là một hàm tổng hợp sử dụng hướng dẫn bằng ngôn ngữ tự nhiên để tóm tắt, phân cụm hoặc tổng hợp thông tin chi tiết trên hàng nghìn hoặc hàng triệu hàng không có cấu trúc thành một phản hồi thống nhất.
Tổng hợp thông tin tóm tắt về danh mục cùng với các chỉ số SQL truyền thống
AI.AGG tích hợp liền mạch với SQL truyền thống GROUP BY và các hàm tổng hợp. Ví dụ: bạn có thể tính toán các chỉ số truyền thống (chẳng hạn như số lượng mặt hàng) ngay bên cạnh bản tóm tắt do AI tạo sinh mô tả điểm chung của các sản phẩm trong từng danh mục.
Chạy truy vấn sau trong BigQuery Studio:
SELECT
  category,
  COUNT(*) AS item_count,
  AI.AGG(
    ('Product: ', product_name, ' - Description: ', description),
    'Write a concise, one-sentence summary describing the common characteristics or purpose of the products in this category.'
  ) AS category_summary
FROM
  `bigquery-public-data.cymbal_pets.products`
GROUP BY
  category
ORDER BY
  item_count DESC;
Kết quả sẽ có dạng tương tự như sau:
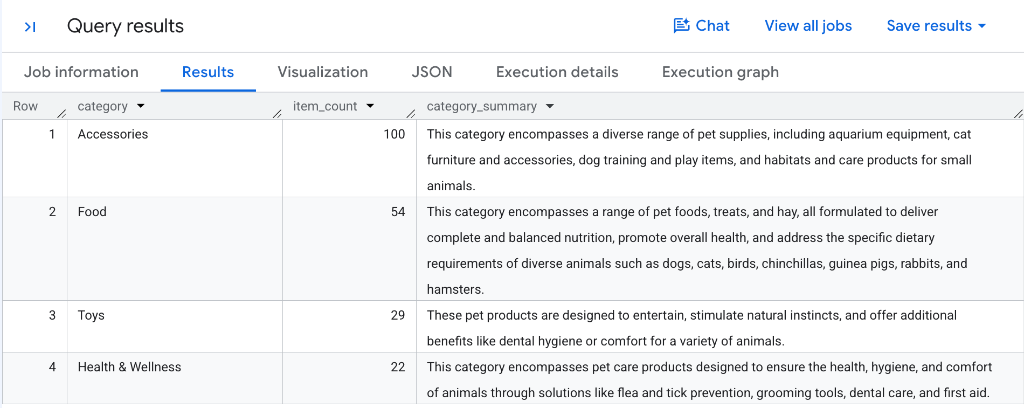
Cách AI.AGG tổng hợp dữ liệu không có cấu trúc
- Tổng hợp theo hệ phân cấp: BigQuery nhóm dữ liệu hàng theo phân vùng danh mục, tạo các cửa sổ ngữ cảnh có cấu trúc và sử dụng Gemini để tổng hợp toàn bộ tập hợp bản ghi sản phẩm.
- Tổng hợp danh mục tự động: Lưu ý cách mỗi danh mục nhận được một bản tóm tắt riêng biệt và chính xác, chẳng hạn như
Accessoriesghi lại môi trường sống và thiết bị huấn luyện, hoặcFoodlàm nổi bật chế độ dinh dưỡng cân bằng cho nhiều loài động vật. - Báo cáo định lượng và định tính kết hợp: Việc kết hợp các hoạt động tổng hợp tiêu chuẩn như
COUNT(*)vớiAI.AGGsẽ tạo ra thông tin tổng quan toàn diện về danh mục trong một truy vấn duy nhất mà không cần các quy trình ETL tuỳ chỉnh. - Phân vùng linh hoạt: Bạn có thể áp dụng
AI.AGGcho mọi phương diện nhóm (chẳng hạn nhưGROUP BY brand,GROUP BY categoryhoặc trên toàn bộ bảng) để tạo thông tin chi tiết ở cấp điều hành trong vài giây.
9. Tăng tốc truy vấn bằng chế độ được tối ưu hoá và các mô hình proxy
Khi xử lý các tập dữ liệu lớn chứa hàng nghìn hoặc hàng triệu hàng, việc gọi một LLM từ xa cho từng hàng có thể làm tăng độ trễ và chi phí.
Để giải quyết vấn đề này, BigQuery cung cấp chế độ được tối ưu hoá cho AI.IF và AI.CLASSIFY. Chế độ được tối ưu hoá sử dụng các mô hình proxy và quy trình chưng cất mô hình tức thì để mang lại tốc độ thực thi nhanh hơn gấp 100 lần với chi phí mã thông báo LLM thấp hơn.
Cách hoạt động của chế độ được tối ưu hoá
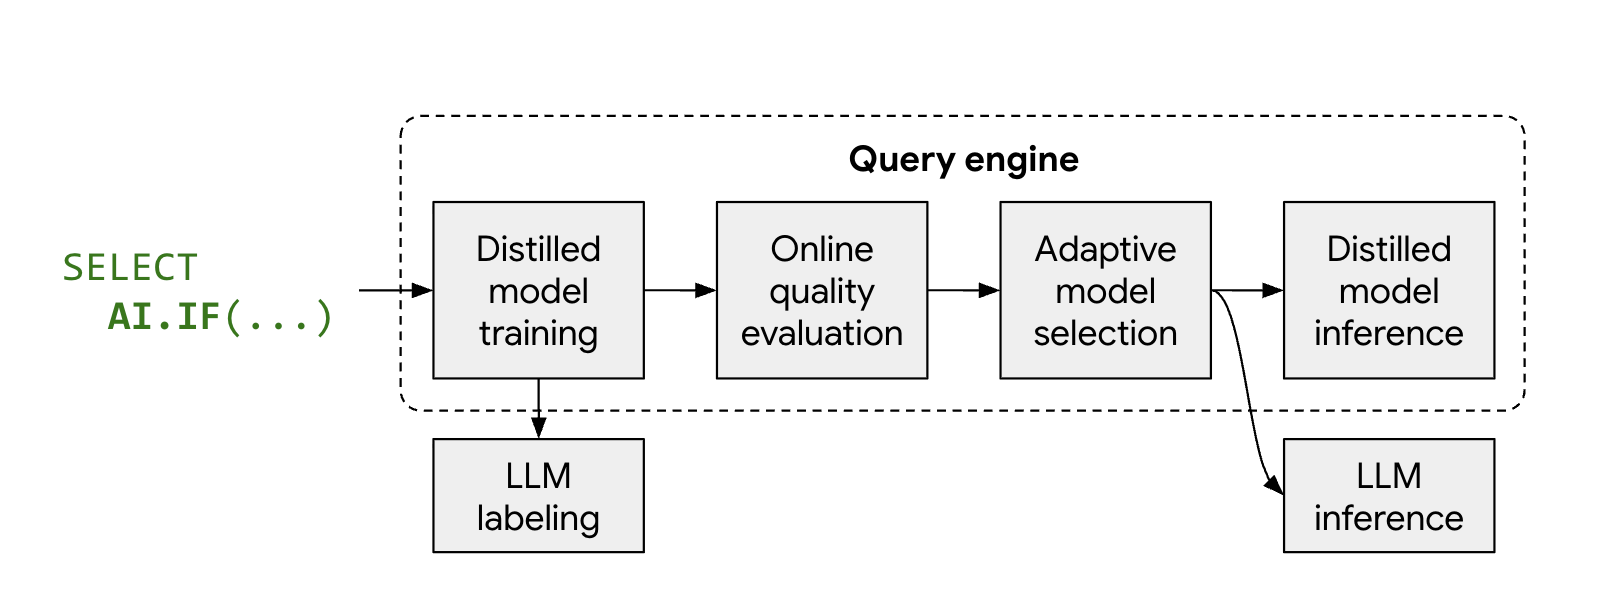
- Lấy mẫu và gắn nhãn đại diện: BigQuery tự động chọn một mẫu đại diện gồm các hàng và lấy nhãn từ Gemini.
- Huấn luyện mô hình tinh chỉnh: BigQuery huấn luyện một mô hình proxy siêu nhẹ (chẳng hạn như hồi quy logistic) ngay lập tức trên CPU bằng cách sử dụng các tính năng nhúng văn bản.
- Xác minh chất lượng: BigQuery đánh giá độ chính xác của mô hình tinh chỉnh so với Gemini. Nếu đáp ứng các ngưỡng chất lượng, BigQuery sẽ chuyển đổi tập dữ liệu đó để xử lý phần còn lại của tập dữ liệu.
- Suy luận tốc độ cao tại địa phương: Mô hình proxy đánh giá các hàng còn lại tại địa phương mà không tốn chi phí mã thông báo LLM từ xa và có độ trễ cực thấp.
Chạy một truy vấn cơ sở mà không cần tối ưu hoá
Vì danh mục bigquery-public-data.cymbal_pets.products mẫu có quá ít hàng để kích hoạt quy trình chưng cất mô hình proxy, nên chúng ta sẽ sử dụng tập dữ liệu công khai lớn hơn bigquery-public-data.bbc_news.fulltext (chứa hơn 2.200 bài viết tin tức).
Trước tiên, hãy chạy truy vấn chuẩn mà không cần tối ưu hoá để xác định các bài viết tin tức về thảm hoạ thiên nhiên:
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body)
  );
Kiểm tra thông tin chi tiết về công việc cơ sở và mức sử dụng mã thông báo
Sau khi truy vấn cơ sở hoàn tất, hãy kiểm tra các chỉ số thực thi:
- Trong ngăn kết quả ở dưới cùng của BigQuery Studio, hãy chọn thẻ Thông tin về công việc.
- Cuộn xuống phần Số token đầu vào và Số token đầu ra.
Kết quả sẽ có dạng tương tự như sau:
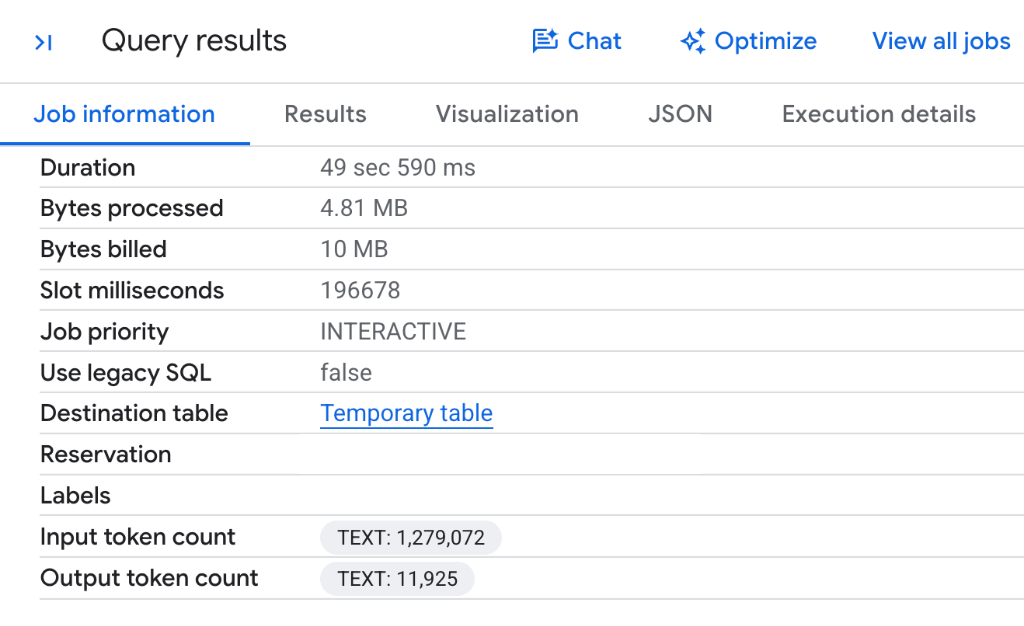
- Mức tiêu thụ mã thông báo của toàn bộ tập dữ liệu: Vì BigQuery gọi mô hình Gemini từ xa cho từng hàng trong số 2.225 bài viết tin tức mà không có tính năng tối ưu hoá proxy, nên truy vấn này tiêu thụ 1.279.072 mã thông báo đầu vào và 11.925 mã thông báo đầu ra.
- Không có mục tối ưu hoá: Lưu ý rằng không có mục nhập
Gen AI Function Optimizationsvì quá trình thực thi tiêu chuẩn đánh giá từng hàng riêng lẻ dựa trên điểm cuối LLM từ xa.
Thực thi truy vấn ở chế độ được tối ưu hoá
Để giảm mức tiêu thụ mã thông báo và tận dụng tính năng chưng cất mô hình proxy, hãy bật chế độ tối ưu hoá bằng cách truyền embeddings => AI.EMBED(...) và đặt optimization_mode => 'MINIMIZE_COST':
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body),
    embeddings => AI.EMBED(body, endpoint => 'text-embedding-005', task_type => 'CLASSIFICATION').result,
    optimization_mode => 'MINIMIZE_COST'
  );
Xác minh quá trình tối ưu hoá và quan sát mức sử dụng mã thông báo giảm
Sau khi chạy truy vấn được tối ưu hoá, hãy chuyển sang thẻ Thông tin về công việc của BigQuery Studio để xem mức sử dụng mã thông báo và các chỉ số thực thi so với nhau:
- Trong ngăn kết quả ở dưới cùng của BigQuery Studio, hãy chọn thẻ Thông tin về công việc.
- Di chuyển đến phần Tối ưu hoá hàm AI tạo sinh, cũng như số lượng mã thông báo.
Kết quả sẽ có dạng tương tự như sau:
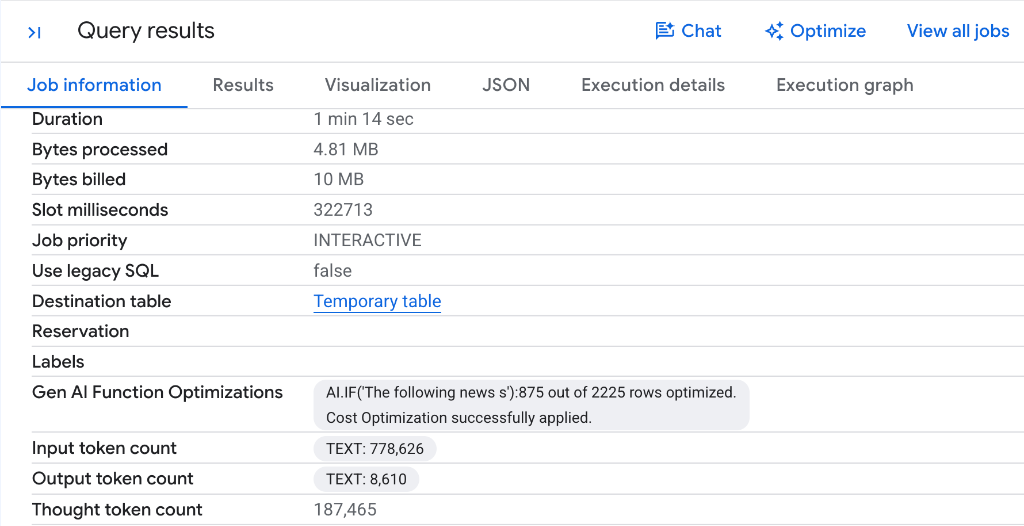
- Giảm đáng kể số token: Lưu ý cách Số token đầu vào giảm từ 1.279.072 token xuống 778.626 token – tiết kiệm 500.446 token đầu vào (giảm gần 40%) trong một lần chạy truy vấn! Tương tự, số lượng mã thông báo đầu ra cũng giảm.
- Chưng cất proxy tự động: Lưu ý nhãn
AI.IF('The following news s'): 875 out of 2225 rows optimized. Cost Optimization successfully applied.BigQuery lấy mẫu tập dữ liệu, gắn nhãn các bài viết đại diện bằng Gemini, chưng cất một trình phân loại proxy nhanh, gọn nhẹ và xử lý 875 trong số 2.225 hàng cục bộ trên CPU mà không cần gọi các điểm cuối LLM từ xa. - Tiết kiệm chi phí trực tiếp: Vì các hàm AI do BigQuery quản lý được tính phí dựa trên số lượng mã thông báo mô hình được xử lý, nên việc giảm mức tiêu thụ mã thông báo sẽ giúp giảm chi phí thực thi truy vấn.
- Xác thực chất lượng: BigQuery tự động xác minh độ chính xác của mô hình proxy so với Gemini trước khi quảng bá mô hình đó để đánh giá các hàng còn lại, đảm bảo duy trì chất lượng phân loại.
Giảm mã thông báo và mở rộng quy mô độ trễ hơn nữa trên các bảng lớn hơn
Mặc dù việc tiết kiệm hơn 500.000 mã thông báo trên 2.225 hàng là đáng kể, nhưng mức giảm mã thông báo và mức tăng hiệu suất còn cao hơn nữa trên các bảng lớn hơn:
- Tại sao việc giảm mã thông báo lại tỷ lệ thuận với quy mô tập dữ liệu: Đối với các truy vấn được thực thi trong BigQuery, các mô hình proxy được huấn luyện ngay lập tức bằng cách sử dụng mẫu ban đầu gồm khoảng 1.000 hàng do LLM gắn nhãn. Sau khi được huấn luyện và xác thực, mô hình proxy sẽ thay thế các lệnh gọi LLM trực tiếp trên các hàng còn lại. Đối với các truy vấn lớn hơn (chẳng hạn như tập dữ liệu điển hình có 1 triệu hàng), điều này giúp loại bỏ các lệnh gọi LLM cho phần lớn dữ liệu, tiêu thụ ít hơn tới 400 lần số lượng mã thông báo và giảm đáng kể chi phí.
- Tăng tốc đáng kể độ trễ: Bằng cách chuyển suy luận từ phần cứng LLM chuyên dụng sang các mô hình proxy siêu nhẹ chạy trực tiếp trên CPU của worker cơ sở dữ liệu tiêu chuẩn (tận dụng các vectơ nhúng Gemini được tính toán trước), BigQuery giảm thời gian chạy truy vấn tổng thể từ 30 đến 100 lần.
10. Dọn dẹp tài nguyên
Để dọn dẹp các tài nguyên được tạo trong lớp học lập trình này, hãy chạy câu lệnh sau trong thẻ SQL của BigQuery Studio để xoá Cloud Resource Connection:
DROP CONNECTION IF EXISTS `us.conn`;
Ngoài ra, nếu đã tạo một dự án trên đám mây Google tạm thời chỉ dành riêng cho hướng dẫn này, bạn có thể tắt toàn bộ dự án trong Cloud Resource Manager.
11. Xin chúc mừng
Xin chúc mừng! Bạn đã hoàn tất thành công lớp học lập trình về Phân tích ngữ nghĩa trong BigQuery bằng các hàm AI được quản lý và SQL.
Bạn đã nắm vững các hàm AI tạo sinh được quản lý của BigQuery:
AI.SCORE: Xếp hạng sản phẩm theo các tiêu chí chủ quan như khả năng làm quà tặng trên thang điểm từ 1 đến 10 bằng cách sử dụng tính năng viết lại câu lệnh tự động.AI.CLASSIFY: Phân loại các mục không có cấu trúc trong danh mục thành các phân loại động vật mục tiêu.AI.IF(Lọc đa phương thức): Lọc các thành phần hình ảnh trong Cloud Storage trong các mệnh đề SQLWHEREdựa trên nội dung trực quan.AI.IF(Kết hợp ngữ nghĩa): Thực hiện các thao tác kết hợp đa phương thức trong các mệnh đề SQLONđể liên kết nội dung mô tả sản phẩm bằng văn bản với các tệp hình ảnh.AI.AGG: Tổng hợp văn bản danh mục không có cấu trúc gồm nhiều hàng thành một bản tóm tắt ngắn gọn.- Chế độ được tối ưu hoá và mô hình proxy: Tăng tốc truy vấn và giảm thiểu chi phí token bằng cách sử dụng
optimization_mode => 'MINIMIZE_COST'với tính năng chưng cất mô hình tức thì vàAI.EMBED.
Tìm hiểu thêm
- Tổng quan về AI tạo sinh của BigQuery
- Hướng dẫn về các hàm AI được quản lý của BigQuery
AI.SCORETài liệu về cú pháp SQLAI.CLASSIFYTài liệu về cú pháp SQLAI.IFTài liệu về cú pháp SQLAI.AGGTài liệu về cú pháp SQL- Tối ưu hoá các hàm AI bằng phương pháp chưng cất mô hình
- Blog của Google Cloud: Truy vấn SQL nhanh hơn và rẻ hơn gấp 100 lần nhờ các mô hình proxy dựa trên LLM
- Blog Google Cloud: Nghiên cứu chuyên sâu về hàm AI.AGG của BigQuery