

1. 欢迎
在此 Codelab 中,您将学习如何使用 BigQuery 托管式 AI 函数套件,直接在 BigQuery Studio 中使用 SQL 执行复杂的语义分析、类别分类、多模态过滤、语义联接和多行汇总。
您将使用公开数据集 bigquery-public-data.cymbal_pets,扮演 Cymbal Pets(一家宠物用品和配件电子商务零售商)的数据分析师。
直接在 SQL 查询中进行语义分析
过去,将机器学习或大语言模型 (LLM) 应用于企业数据集需要将数据从数据仓库迁移到外部 Python 笔记本环境。这需要专门的数据工程流水线和机器学习专业知识。
BigQuery 的托管 AI 函数(包括 AI.SCORE、AI.CLASSIFY、AI.IF 和 AI.AGG)可直接将基础模型智能引入您的数据。BigQuery 会自动优化模型选择并应用内部提示重写策略,以便通过简单的自然语言提示提供高准确度的结果。
对于海量数据集,BigQuery 提供优化模式,该模式使用实时模型蒸馏和轻量级代理模型,可将查询速度提高多达 100 倍,并降低查询费用。
实践内容
- 使用 SQL 在 BigQuery Studio 中探索多模态零售数据。
- 使用
AI.SCORE执行语义排名,以评估“是否适合作为礼物”等主观商品属性。 - 使用
AI.CLASSIFY将产品映射到目标动物物种,从而对非结构化数据进行分类。 - 使用
WHERE子句中的AI.IF过滤多模态图片素材资源。 - 使用
JOIN ... ON子句中的AI.IF跨表执行语义联接,以将文本商品记录与外来图片文件进行匹配。 - 使用
AI.AGG聚合函数合成多行数据洞见。 - 使用
AI.IF和优化模式 (optimization_mode => 'MINIMIZE_COST') 以及代理模型蒸馏,优化大型数据集的查询延迟时间和费用。
所需条件
- 启用了结算功能的 Google Cloud 项目。
- 网络浏览器,例如 Chrome。
2. 设置和要求
在使用受管 AI 函数查询数据之前,您必须配置 Google Cloud 项目并启用所需的 API。
创建 Google Cloud 项目并启用 API
- 在 Google Cloud 控制台的项目选择器页面上,选择或创建一个 Google Cloud 项目。
- 确保您的 Cloud 项目已启用结算功能。了解如何检查项目是否已启用结算功能。
- 启用 BigQuery、BigQuery Connection 和 Agent Platform API。
打开 BigQuery Studio
- 在 Google Cloud 控制台导航菜单中,点击 BigQuery 以打开 BigQuery Studio。
- 在 BigQuery Studio 编辑器工具栏中,点击 + SQL 查询,打开新的 SQL 查询标签页。在整个 Codelab 中,您将在这些 SQL 标签页中编写并运行所有 SQL 查询。
在 SQL 中创建 Cloud 资源连接
BigQuery 在安全的数据边界内运行。检查外部多模态文件(例如存储在 Google Cloud Storage 中的图片)时,BigQuery 会使用 Cloud 资源连接来安全地访问对象引用,而不会泄露凭据。
在 SQL 标签页中执行以下语句,以创建名为 us.conn 的连接:
CREATE CONNECTION IF NOT EXISTS `us.conn`
OPTIONS (
  connection_type = "CLOUD_RESOURCE"
);
3. 探索 Cymbal Pets 数据集
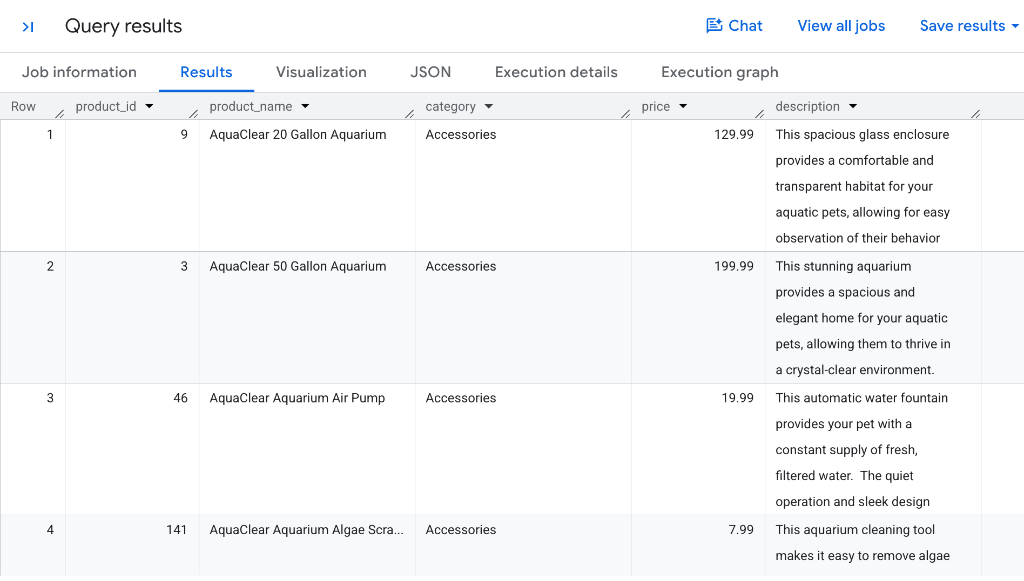
Cymbal Pets 在名为 bigquery-public-data.cymbal_pets.products 的表中的公开数据集中维护着丰富的产品目录。每条商品记录都包含结构化属性,例如商品 ID、商品名、零售类别、价格和描述性文本。
查询商品清单
在 BigQuery Studio 中打开 SQL 标签页,然后运行以下查询来检查 products 表:
SELECT
  product_id,
  product_name,
  category,
  price,
  description
FROM
  `bigquery-public-data.cymbal_pets.products`;
结果将如下所示:
检查商品图片
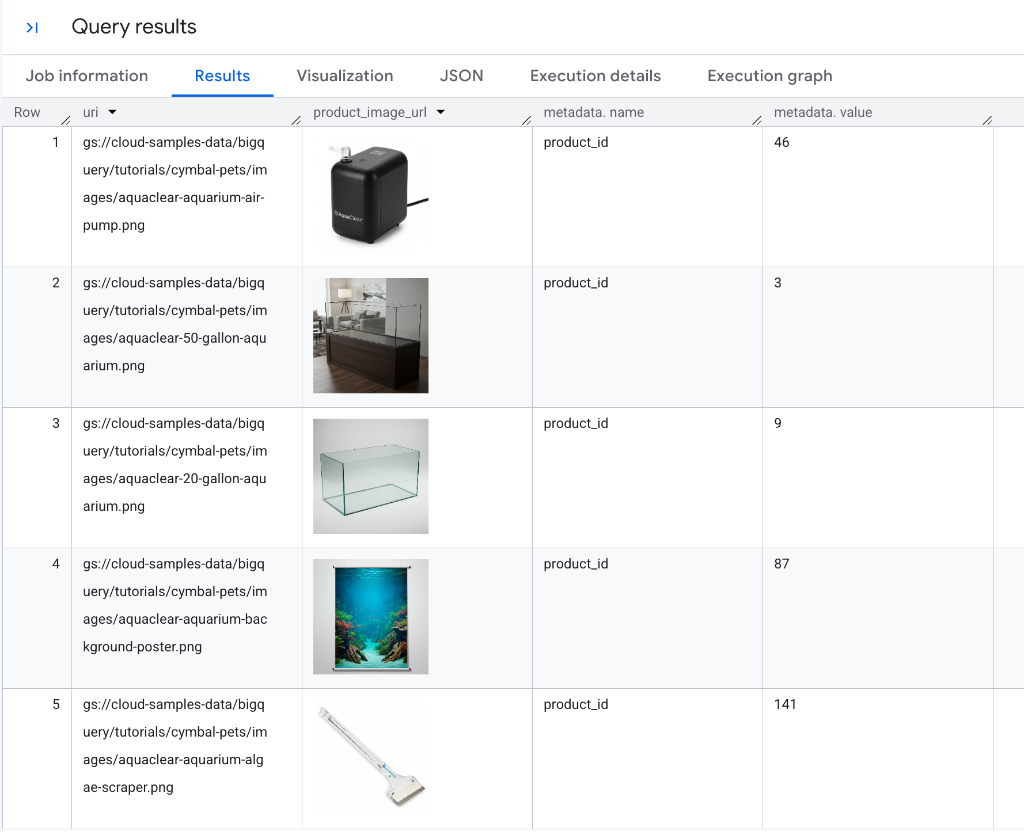
Cymbal Pets 还在 bigquery-public-data.cymbal_pets.product_images 中存储产品图片引用。运行以下查询以查看图片记录:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`;
结果将如下所示:
接下来,您将使用 BigQuery 受管函数来分析 Cymbal Pets 数据仓库中的文本和图片数据。
4. 使用 AI.SCORE 按语义标准对商品进行排名
AI.SCORE 函数接受文本输入,并使用 Gemini 模型根据自然语言评分准则对文本进行评分,返回数值 FLOAT64 分数。
如果您未提供明确的评分准则,BigQuery 会自动应用提示重写策略,为模型生成最佳评分准则。
为商品“礼品属性”评分
假设 Cymbal Pets 营销团队想要制作一份节日礼物指南。他们希望根据目录中每件商品作为宠物主人礼物的合适程度(从 1 到 10 的等级)对每件商品进行排名。
在 SQL 标签页中运行以下查询:
SELECT
  product_name,
  description,
  AI.SCORE(
    ('How "giftable" is this product for a pet owner? ', description,
    'Use a scale from 1-10.')
  ) AS giftability_score
FROM
  `bigquery-public-data.cymbal_pets.products`
ORDER BY
  giftability_score DESC;
了解测试结果
结果将如下所示:
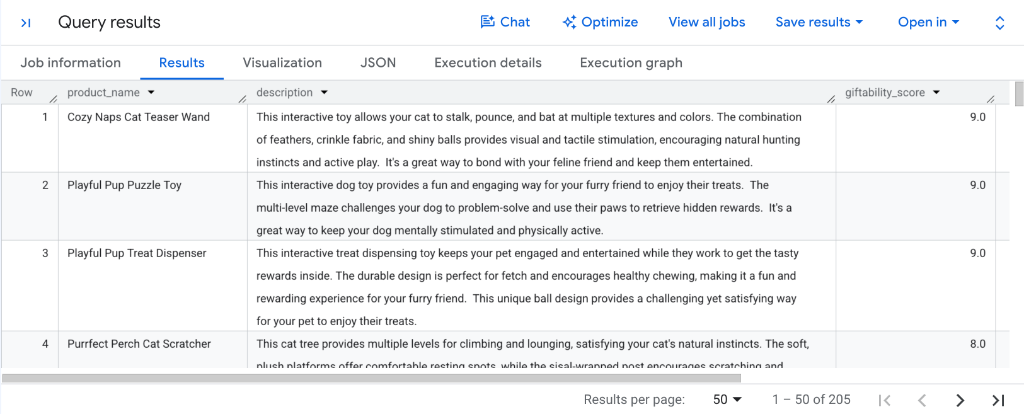
检查查询结果中的 giftability_score 列:
- 高吸引力的互动玩具:
Cozy Naps Cat Teaser Wand、Playful Pup Puzzle Toy和Playful Pup Treat Dispenser等吸引人的商品获得了最高评分 (9.0)。 - 特殊舒适和挠痒物品:
Purrfect Perch Cat Scratcher等热门必需品在8.0方面表现出色。 - 可操作的下游排名:由于
AI.SCORE会生成归一化的FLOAT64分数,因此您可以立即使用ORDER BY giftability_score DESC对结果进行排序,或使用WHERE AI.SCORE(...) >= 8.0过滤候选商品,以生成自动化礼品指南。
5. 使用 AI.CLASSIFY 对目录商品进行分类
AI.CLASSIFY 函数使用 Gemini 将输入记录分类为以 SQL 数组形式提供的离散目标类别列表。
AI.CLASSIFY 支持多模态输入(文本、图片、音频、视频),无需构建、训练或部署用于分类法管理的自定义分类模型。
按目标动物物种对玩具进行分类(单标签)
假设 Cymbal Pets 目录中的某些产品被笼统地标记为“玩具”,而未指定目标动物。您可以使用 AI.CLASSIFY 根据每个玩具的名称和说明对其进行分类。
在 BigQuery Studio 中运行以下查询:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('What animal is this product for?', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "All Pets"]
  ) AS animal_type
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys"
LIMIT 20;
查看结果
结果将如下所示:
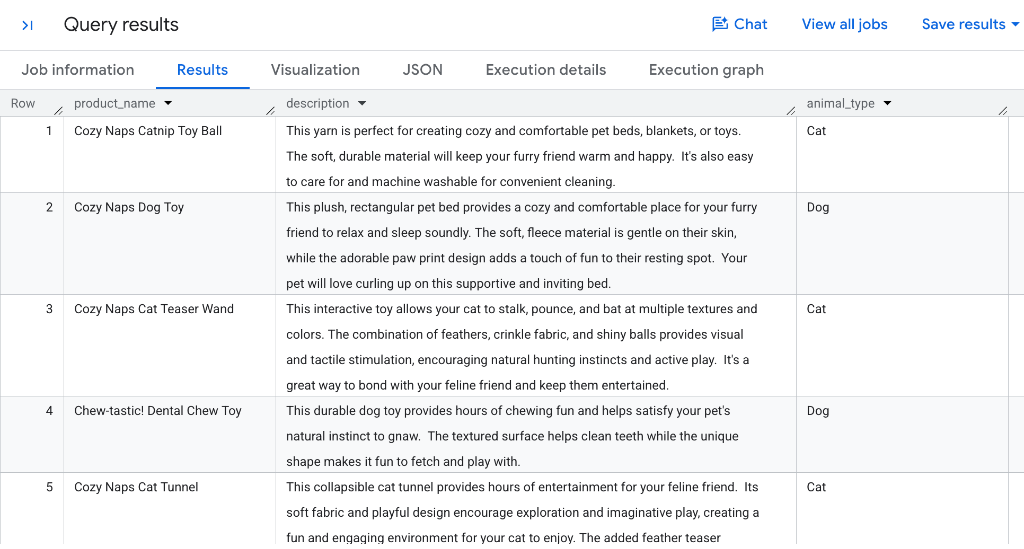
默认情况下,AI.CLASSIFY 执行单标签分类,并返回一个 STRING,其中包含候选数组中最相关的单个类别。请注意,Gemini 如何将猫薄荷球和羽毛逗猫棒映射到 Cat,同时将磨牙玩具和拾取棒映射到 Dog。
通过多标签分类分配多个标记
零售目录中的许多商品同时适用于多种宠物类型(例如,适合猫和小动物的毛绒床或隧道)。
如需为单个记录分配多个类别,请设置可选参数 output_mode => 'multi'。在多标签模式下,AI.CLASSIFY 会返回一个 ARRAY,其中包含所有匹配的类别。
在 SQL 标签页中运行以下查询:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('Identify all pet types that this product is suitable for: ', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "Reptile"],
    output_mode => 'multi'
  ) AS pet_types
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys";
结果将如下所示:
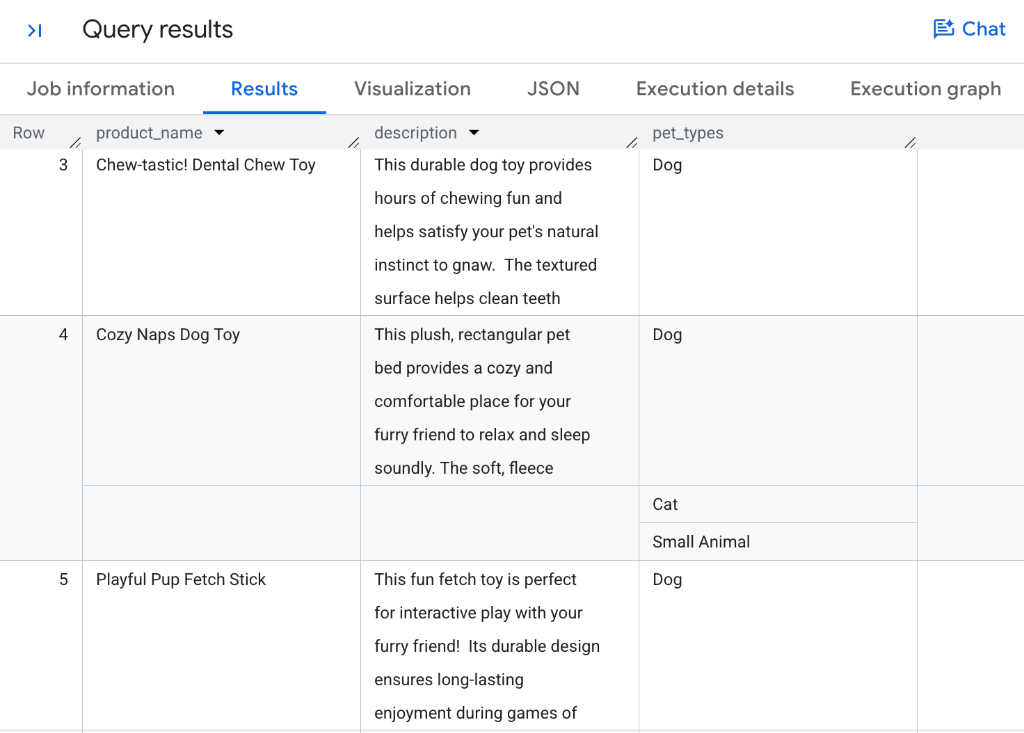
查看分类机制
- 单标签与多标签:如果不使用
output_mode,AI.CLASSIFY会返回标量STRING。设置output_mode => 'multi'会返回一个ARRAY,其中包含零个、一个或多个匹配的标签。 - 多类别分配:请注意,专用物品(如
Chew-tastic! Dental Chew Toy和Playful Pup Fetch Stick)会收到[Dog],而多功能舒适物品(如Cozy Naps Dog Toy,即长方形的毛绒床)会正确收到多个标签:[Dog, Cat, Small Animal]。 - 零样本匹配:模型根据提供的
categories数组评估组合文本和提示,而无需预训练的自定义机器学习模型。 - 下游 SQL 数组操作:您可以使用标准 BigQuery SQL 数组函数(例如
WHERE 'Cat' IN UNNEST(pet_types)或CROSS JOIN UNNEST(pet_types))来过滤、展开和聚合多标签记录。
6. 使用 AI 过滤多模态商品图片。IF
AI.IF 函数使用 Gemini 评估自然语言条件,并返回布尔值(TRUE 或 FALSE)。
由于 AI.IF 接受多模态输入,因此您可以直接在 SQL WHERE 子句中使用它来过滤存储在 Cloud Storage 中的非结构化图片文件。
过滤包含特定对象的图片
假设商品推销团队想要查找目录中包含宠物食品或零食的所有产品图片。
在 SQL 标签页中运行以下查询:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`
WHERE
  AI.IF(
    ('Does this product image contain pet food or snacks? ', OBJ.MAKE_REF(uri, 'us.conn'))
  );
结果将如下所示:
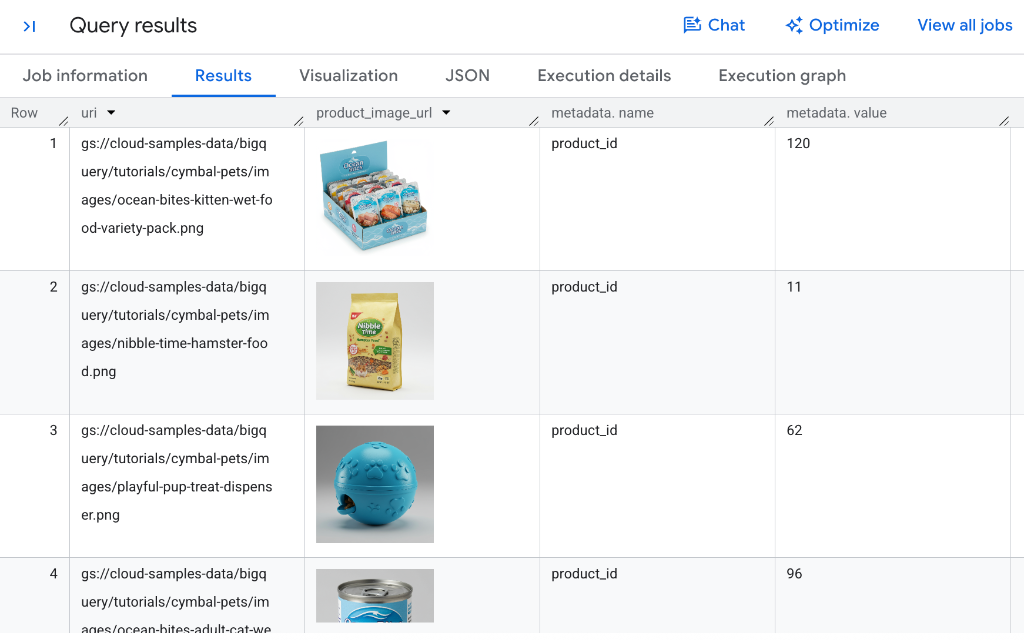
多模态过滤功能的运作方式
- 即时对象引用:虽然我们在此处使用
OBJ.MAKE_REF(uri, 'us.conn')即时创建对象引用,但您也可以直接在 BigQuery 表中创建和存储ObjectRef列,这样一来,这些列便可立即用于分析,而无需在每个查询中使用OBJ.MAKE_REF函数。 - 深度视觉对象识别:请注意,Gemini 不仅能准确识别各种包装形式(例如湿粮组合装盒、仓鼠干粮袋和猫罐头),还能识别装在玩具(例如蓝色零食分配器)中的可食用零食。
- 行级谓词评估:BigQuery 直接在
WHERE子句中针对每个 Cloud Storage 图片引用评估自然语言条件。 - 布尔值过滤:结果集中仅包含 Gemini 将条件评估为
TRUE的记录。
7. 使用 AI.IF 在表之间执行语义联接
传统的关系型数据库联接需要精确的键相等性(例如 products.product_id = images.product_id)。不过,现实世界的企业数据集通常包含缺少显式外键的非结构化资产。
由于 AI.IF 会返回布尔值,因此您可以将其直接放在 SQL INNER JOIN ... ON 子句中,以执行语义联接。
以语义方式将商品描述与图片素材资源相关联
假设您想将 products 表中的商品描述与 product_images 中未关联的图片文件进行匹配,以查找品牌 Fluffy Buns 生产的商品。
在 BigQuery Studio SQL 标签页中运行以下查询(请注意,此查询需要几分钟才能完成):
SELECT
  products.product_id,
  products.product_name,
  products.description,
  products.brand,
  images.uri AS image_uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(images.uri, 'us.conn')).url AS product_image_url
FROM
  `bigquery-public-data.cymbal_pets.products` AS products
INNER JOIN
  `bigquery-public-data.cymbal_pets.product_images` AS images
ON
  AI.IF(
    ('You will be provided an image of a pet product. ',
    'Determine if the image is of the following pet toy: ',
    products.product_name,
    products.description,
    OBJ.MAKE_REF(images.uri, 'us.conn')
    )
  )
WHERE
  products.category = "Toys" AND
  products.brand = "Fluffy Buns";
结果将如下所示:
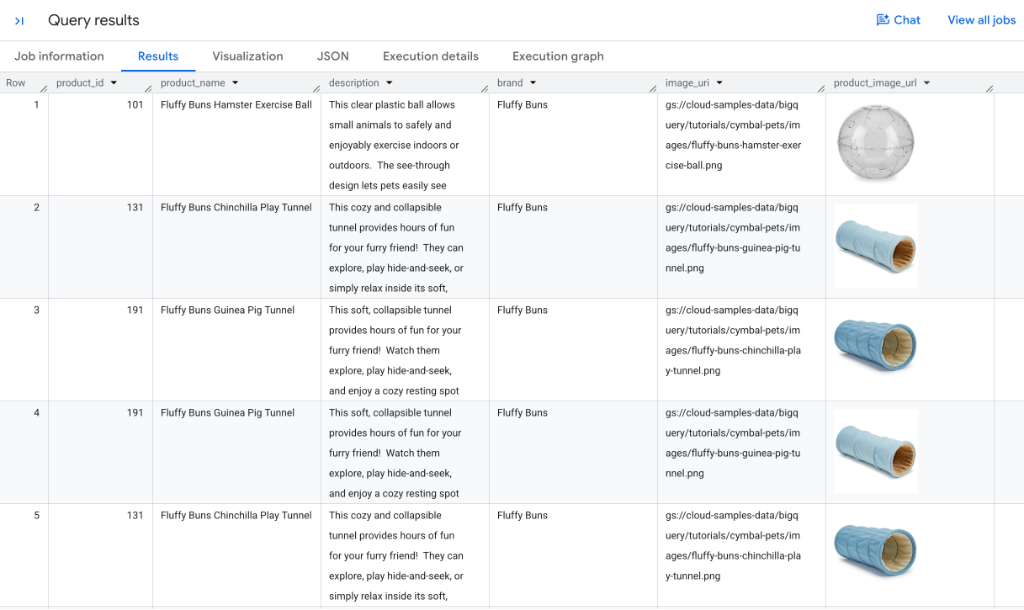
了解 SQL 中的语义联接
- 跨模态条件评估:对于候选记录对,BigQuery 会将来自
products的文本元数据和图片引用 (OBJ.MAKE_REF(...)) 一起发送给 Gemini。 - 准确的视觉匹配:如结果所示,
Fluffy Buns Hamster Exercise Ball与透明塑料球图片匹配,而Fluffy Buns Chinchilla Play Tunnel和Guinea Pig Tunnel与蓝色毛绒隧道照片匹配。由于标准 SQLINNER JOIN语义,如果产品与目录中的多个图片素材资源(例如多个拍摄角度或类似的照片)匹配,则可以在输出中生成多行。 - 内嵌图片呈现:BigQuery Studio 会自动呈现
product_image_url列中已获授权的读取网址,直接在结果网格中进行即时视觉验证。 - 非结构化实体解析:此功能可实现强大的实体解析工作流,无需手动标记或显式外键,即可处理旧版目录、抓取的数据集和媒体归档。
8. 使用 AI.AGG 跨行合成数据洞见
虽然 AI.SCORE、AI.CLASSIFY 和 AI.IF 等函数会评估各个行(标量运算),但分析企业数据通常需要综合多个记录中的模式。
AI.AGG 函数是一种聚合函数,它使用自然语言指令来汇总、聚类或合成数千或数百万个非结构化行中的数据洞见,从而生成统一的回答。
在传统 SQL 指标旁边合成类别摘要
AI.AGG 可与传统 SQL GROUP BY 和聚合函数无缝集成。例如,您可以同时计算传统指标(例如商品数量),并生成 AI 摘要来描述每个类别中的产品有哪些共同点。
在 BigQuery Studio 中运行以下查询:
SELECT
  category,
  COUNT(*) AS item_count,
  AI.AGG(
    ('Product: ', product_name, ' - Description: ', description),
    'Write a concise, one-sentence summary describing the common characteristics or purpose of the products in this category.'
  ) AS category_summary
FROM
  `bigquery-public-data.cymbal_pets.products`
GROUP BY
  category
ORDER BY
  item_count DESC;
结果将如下所示:
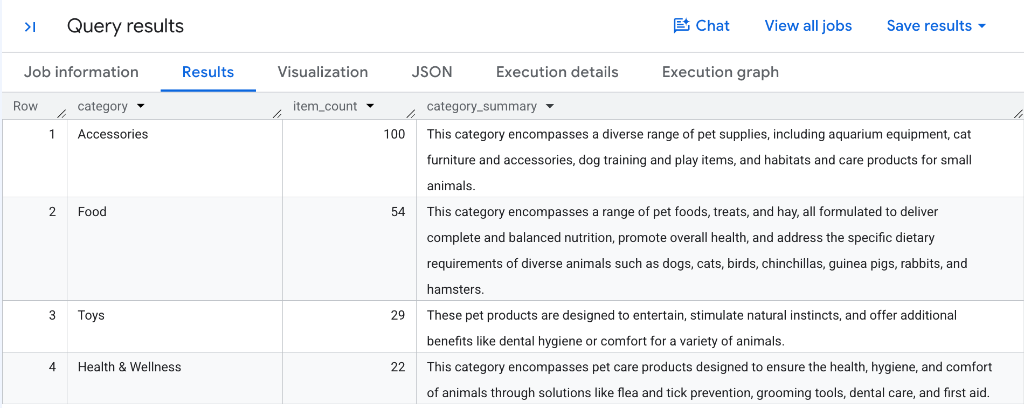
AI.AGG 如何汇总非结构化数据
- 分层汇总:BigQuery 按类别分区对行数据进行分组,构建结构化上下文窗口,并使用 Gemini 合成整个商品记录集合。
- 自动生成目录摘要:请注意,每个类别都获得了独特而准确的摘要,例如
Accessories捕捉栖息地和训练装备,或Food强调多种动物物种的均衡营养。 - 混合定量和定性报告:将
COUNT(*)等标准汇总与AI.AGG相结合,可在单个查询中生成全面的目录概览,而无需自定义 ETL 流水线。 - 灵活的分区:您可以将
AI.AGG应用于任何分组维度(例如GROUP BY brand、GROUP BY category或整个表格),以便在几秒钟内生成高管级数据洞见。
9. 利用优化模式和代理模型加快查询速度
在处理包含数千行或数百万行的大型数据集时,为每一行调用远程 LLM 可能会导致延迟和费用。
为解决此问题,BigQuery 为 AI.IF 和 AI.CLASSIFY 提供了优化模式。优化模式利用代理模型和实时模型蒸馏,以更低的 LLM token 费用实现超过 100 倍的执行速度。
优化模式的运作方式
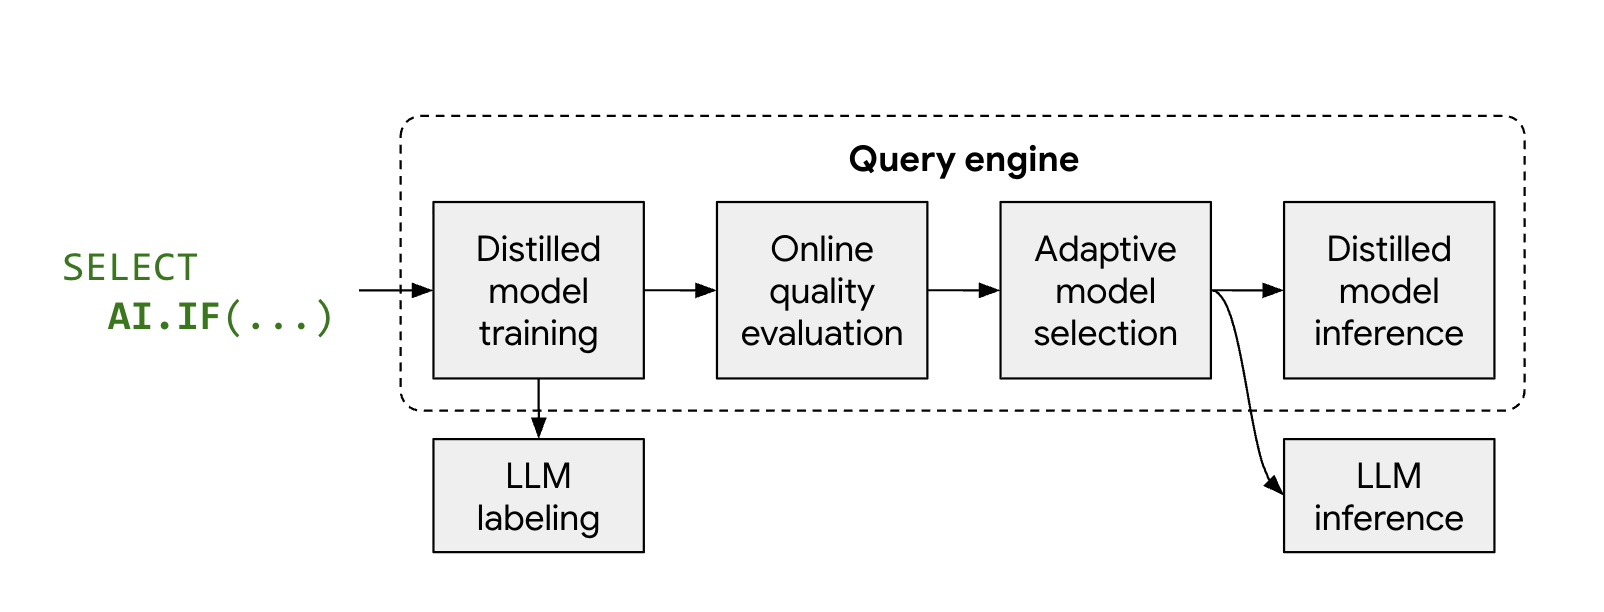
- 代表性抽样和标签:BigQuery 会自动选择代表性样本的行,并从 Gemini 获取标签。
- 精简模型训练:BigQuery 使用文本嵌入作为特征,在 CPU 上及时训练超轻量级代理模型(例如逻辑回归)。
- 质量验证:BigQuery 会根据 Gemini 评估精简模型的准确率。如果它符合质量阈值,BigQuery 会将其升级以处理数据集的其余部分。
- 本地高速推理:代理模型在本地评估剩余的行,无需支付远程 LLM token 费用,且延迟极低。
运行未优化的基准查询
由于示例 bigquery-public-data.cymbal_pets.products 目录包含的行太少,无法触发代理模型蒸馏,因此我们将使用更大的公开数据集 bigquery-public-data.bbc_news.fulltext(其中包含 2,200 多篇新闻报道)。
首先,运行未经过优化的标准查询,以识别有关自然灾害的新闻报道:
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body)
  );
检查基准作业详情和 token 用量
基准查询完成后,检查执行指标:
- 在 BigQuery Studio 的底部结果窗格中,选择作业信息标签页。
- 向下滚动到输入 token 数量和输出 token 数量部分。
结果将如下所示:
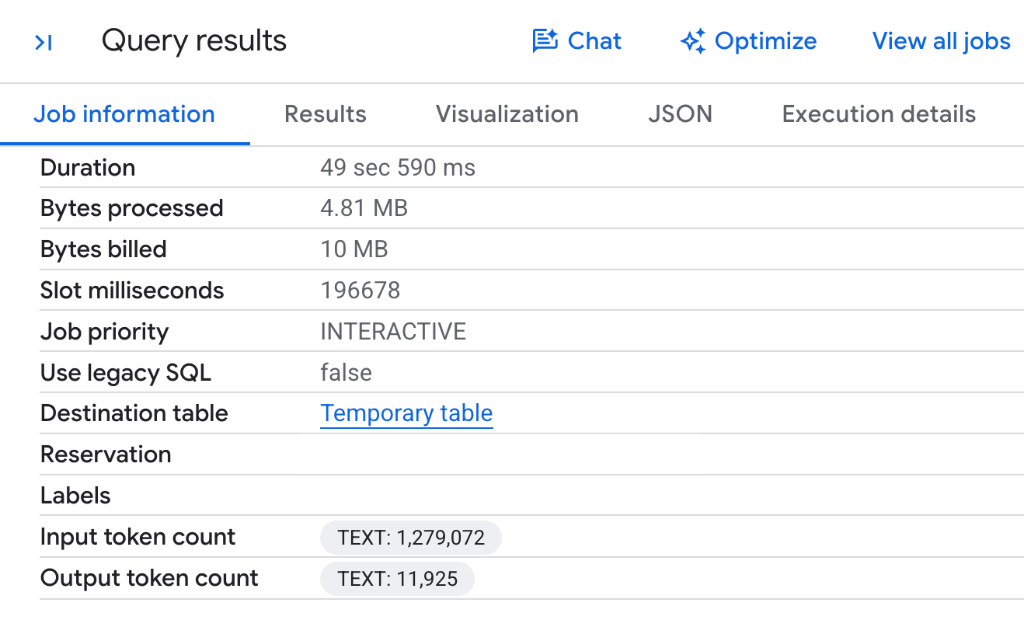
- 完整数据集的令牌消耗量:由于 BigQuery 会针对所有 2,225 篇新闻报道中的每一行调用远程 Gemini 模型,而没有代理优化,因此该查询会消耗 1,279,072 个输入令牌和 11,925 个输出令牌。
- 没有优化部分:请注意,没有
Gen AI Function Optimizations条目,因为标准执行会针对远程 LLM 端点评估每个单独的行。
以优化模式执行查询
如需减少令牌消耗并利用代理模型蒸馏,请传递 embeddings => AI.EMBED(...) 并设置 optimization_mode => 'MINIMIZE_COST' 以启用优化模式:
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body),
    embeddings => AI.EMBED(body, endpoint => 'text-embedding-005', task_type => 'CLASSIFICATION').result,
    optimization_mode => 'MINIMIZE_COST'
  );
验证优化效果并观察令牌使用量是否减少
运行优化后的查询后,切换到 BigQuery Studio 的作业信息标签页,观察令牌用量和执行指标的比较情况:
- 在 BigQuery Studio 的底部结果窗格中,选择作业信息标签页。
- 滚动到生成式 AI 函数优化部分,以及 token 数量。
结果将如下所示:
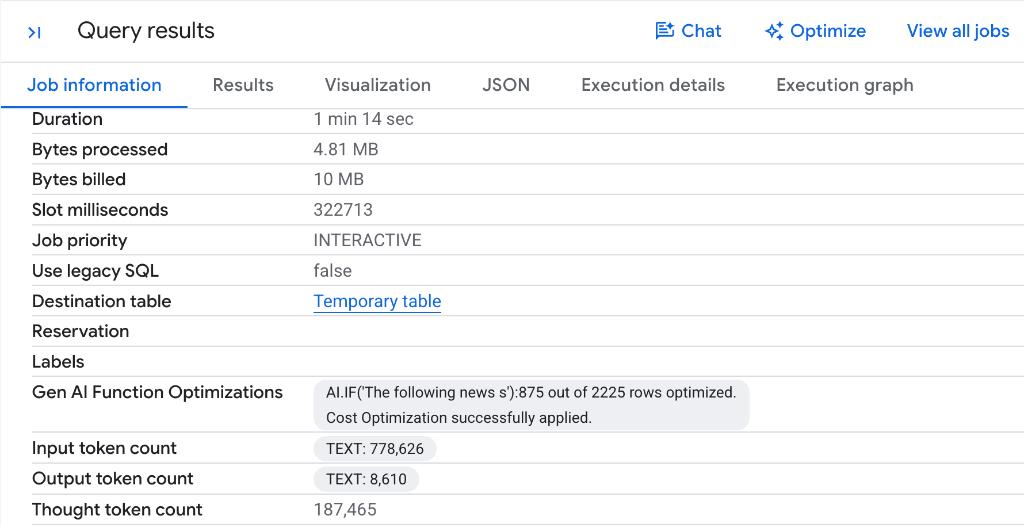
- 显著减少 token 数量:请注意,输入 token 数量从 1,279,072 个 token 降至 778,626 个 token,单次查询运行节省了 500,446 个输入 token(减少了近 40%)!同样,输出词元数也有所减少。
- 自动代理知识蒸馏:请注意标签
AI.IF('The following news s'): 875 out of 2225 rows optimized. Cost Optimization successfully applied.。BigQuery 对数据集进行了抽样,使用 Gemini 标记了代表性文章,蒸馏出了一个快速轻量级代理分类器,并在本地 CPU 上处理了 2,225 行中的 875 行,而无需调用远程 LLM 端点。 - 直接节省费用:由于 BigQuery 受管 AI 函数的费用是根据处理的模型令牌数量计算的,因此减少令牌消耗量可直接降低查询执行费用。
- 质量验证:BigQuery 会在提升代理模型以评估剩余行之前,自动验证该模型相对于 Gemini 的准确率,从而确保分类质量。
在更大的表格上,可进一步减少 token 消耗量并缩短延迟时间
虽然在 2,225 行数据上节省了 50 多万个 token 已经很可观了,但在更大的表格上,token 减少量和性能提升幅度会更高:
- 为什么令牌缩减会随数据集大小而变化:对于在 BigQuery 中执行的查询,代理模型会使用 LLM 标记的约 1,000 行初始样本进行实时训练。经过训练和验证后,代理模型会替换剩余行中的直接 LLM 调用。对于较大的查询(例如典型的 100 万行数据集),此功能可消除大部分数据的 LLM 调用,从而将词元消耗量减少多达 400 倍,并大幅降低费用。
- 大幅缩短延迟时间:通过将推理从专用 LLM 硬件转移到直接在标准数据库工作器 CPU 上运行的超轻量级代理模型(利用预计算的 Gemini 嵌入),BigQuery 将整体查询运行时缩短了 30 倍到 100 倍。
10. 清理资源
如需清理在此 Codelab 期间创建的资源,请在 BigQuery Studio SQL 标签页中运行以下语句以移除 Cloud 资源连接:
DROP CONNECTION IF EXISTS `us.conn`;
或者,如果您专门为本教程创建了一个临时 Google Cloud 项目,可以在 Cloud Resource Manager 中关停整个项目。
11. 恭喜
恭喜!您已成功完成有关使用托管式 AI 函数和 SQL 在 BigQuery 中进行语义分析的 Codelab。
您已熟练掌握 BigQuery 的托管式生成式 AI 函数:
AI.SCORE:使用自动提示重写功能,根据主观标准(例如礼品价值)按 1-10 的等级对商品进行排名。AI.CLASSIFY:将非结构化目录项分类到目标动物类别中。AI.IF(多模态过滤):根据视觉内容在 SQLWHERE子句中过滤 Cloud Storage 图片素材资源。AI.IF(语义联接):在 SQLON子句中执行跨模态联接,以将文本商品说明与图片文件相关联。AI.AGG:将合成的多行非结构化目录文本转换为简明扼要的执行摘要。- 优化模式和代理模型:使用
optimization_mode => 'MINIMIZE_COST'通过实时模型蒸馏和AI.EMBED加速查询并最大限度地降低 token 费用。