

1. 歡迎
在本程式碼研究室中,您將瞭解如何使用一系列 BigQuery 管理的 AI 函式,直接在 BigQuery Studio 中使用 SQL 執行複雜的語意分析、類別分類、多模態篩選、語意聯結和多列摘要。
您將使用公開資料集 bigquery-public-data.cymbal_pets,扮演 Cymbal Pets 的資料分析師。Cymbal Pets 是一家電子商務零售商,專門販售寵物用品和配件。
直接在 SQL 查詢中進行語意分析
傳統上,如要將機器學習或大型語言模型 (LLM) 套用至企業資料集,必須將資料從資料倉儲移至外部 Python 筆記本環境。這需要專屬的資料工程管道和機器學習專業知識。
BigQuery 的代管式 AI 函式 (包括 AI.SCORE、AI.CLASSIFY、AI.IF 和 AI.AGG) 可直接為資料提供基礎模型智慧。BigQuery 會自動選取最佳模型,並套用內部提示重寫策略,確保您只要輸入簡單的自然語言提示,就能獲得高精確度的結果。
對於大量資料集,BigQuery 提供最佳化模式,可使用即時模型蒸餾和輕量型 Proxy 模型,以高達 100 倍的速度執行查詢,且費用更低。
執行步驟
- 使用 SQL 在 BigQuery Studio 中探索多模態零售資料。
- 使用
AI.SCORE執行語意排名,評估「適合送禮」等主觀產品屬性。 - 使用
AI.CLASSIFY分類非結構化資料,將產品對應至目標動物物種。 - 使用
WHERE子句中的AI.IF,篩選多模態圖片素材資源。 - 使用
JOIN ... ON子句中的AI.IF,在資料表之間執行語意聯結,將文字產品記錄與外部圖片檔案相符。 - 使用
AI.AGG匯總函式彙整多列深入分析結果。 - 使用
AI.IF搭配最佳化模式 (optimization_mode => 'MINIMIZE_COST') 和代理模型蒸餾,縮短查詢延遲時間並降低成本。
軟硬體需求
- 已啟用計費功能的 Google Cloud 專案。
- 網路瀏覽器,例如 Chrome。
2. 設定和需求條件
使用受管理 AI 函式查詢資料前,請先設定 Google Cloud 專案並啟用必要 API。
建立 Google Cloud 雲端專案並啟用 API
- 在 Google Cloud 控制台的專案選取器頁面中,選取或建立 Google Cloud 雲端專案。
- 確認 Cloud 專案已啟用計費功能。瞭解如何檢查專案是否已啟用計費功能。
- 啟用 BigQuery、BigQuery Connection 和 Agent Platform API。
開啟 BigQuery Studio
- 在 Google Cloud 控制台的導覽選單中,按一下「BigQuery」,開啟 BigQuery Studio。
- 在 BigQuery Studio 編輯器工具列中,按一下「+ SQL 查詢」,開啟新的「SQL 查詢」分頁。在本程式碼研究室中,您將在這些 SQL 分頁中撰寫及執行所有 SQL 查詢。
在 SQL 中建立 Cloud 資源連結
BigQuery 會在安全的資料周邊運作。檢查外部多模態檔案 (例如儲存在 Google Cloud Storage 中的圖片) 時,BigQuery 會使用 Cloud 資源連結安全地存取物件參照,不會公開憑證。
在 SQL 分頁中執行下列陳述式,建立名為 us.conn 的連線:
CREATE CONNECTION IF NOT EXISTS `us.conn`
OPTIONS (
  connection_type = "CLOUD_RESOURCE"
);
3. 探索 Cymbal Pets 資料集
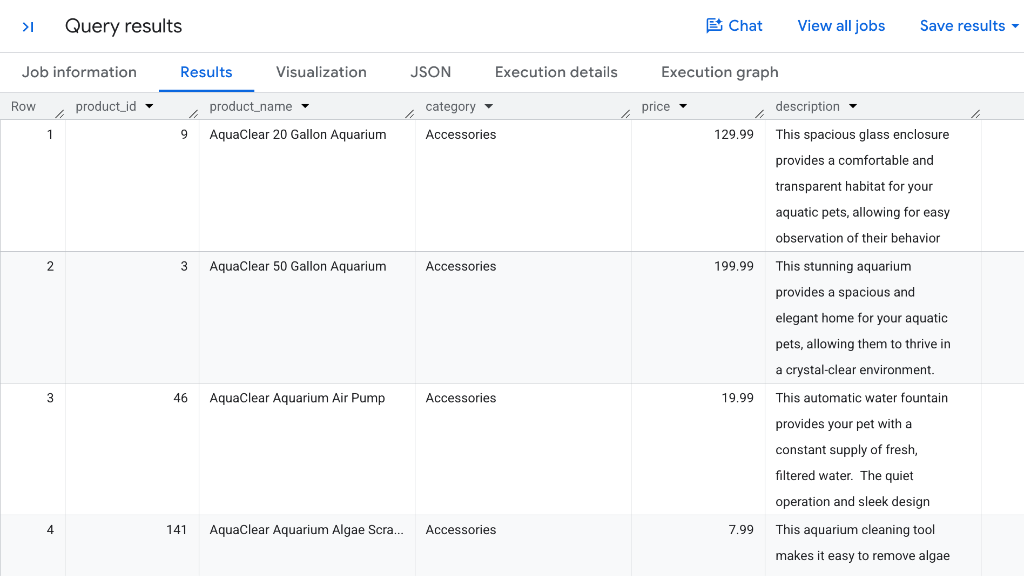
Cymbal Pets 在名為 bigquery-public-data.cymbal_pets.products 的資料表內,維護公開資料集中的豐富產品目錄。每筆產品記錄都包含結構化屬性,例如產品 ID、名稱、零售類別、價格和說明文字。
查詢產品目錄
在 BigQuery Studio 中開啟 SQL 分頁,然後執行下列查詢來檢查產品資料表:
SELECT
  product_id,
  product_name,
  category,
  price,
  description
FROM
  `bigquery-public-data.cymbal_pets.products`;
結果應如下所示:
檢查產品圖片
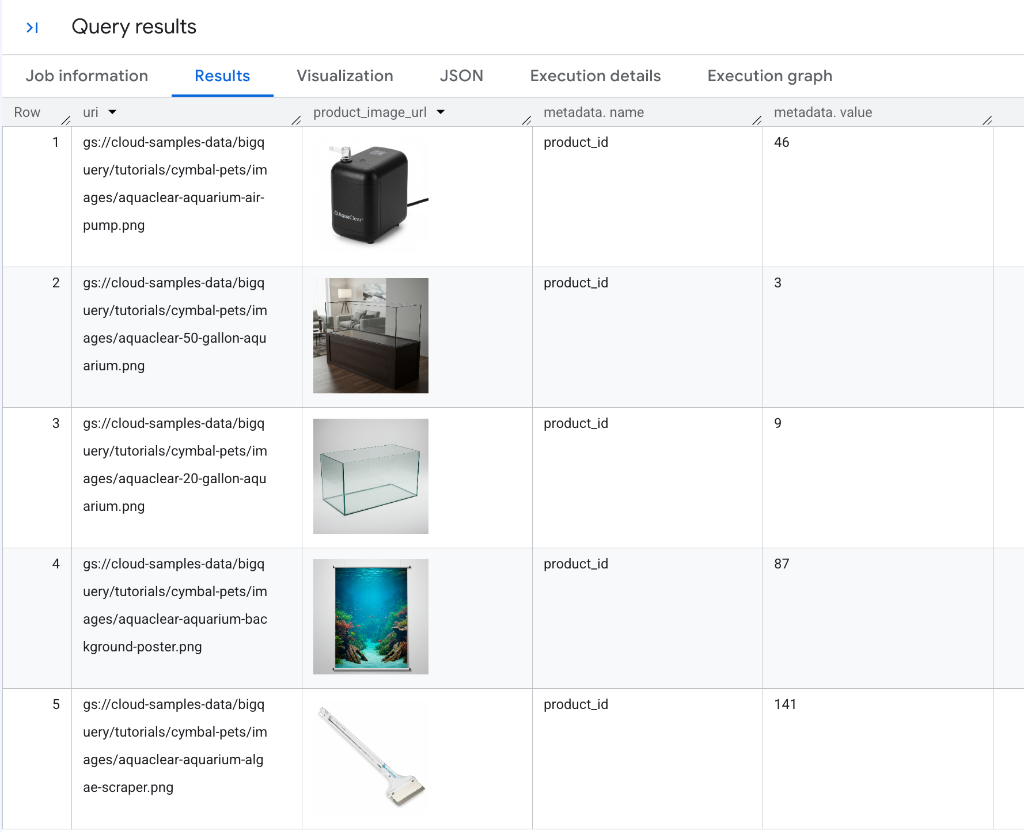
Cymbal Pets 也會在 bigquery-public-data.cymbal_pets.product_images 中儲存產品圖片參照。執行下列查詢,查看圖片記錄:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`;
結果應如下所示:
接著,您將使用 BigQuery 管理函式,分析 Cymbal Pets 資料倉儲中的文字和圖片資料。
4. 使用 AI.SCORE 依語意條件為產品排序
AI.SCORE 函式會接受文字輸入內容,並使用 Gemini 模型根據自然語言評分標準評估內容,然後傳回 FLOAT64 分數。
如果未提供明確的評分標準,BigQuery 會自動套用提示重寫策略,為模型產生最佳評分標準。
為「適合送禮」的產品評分
假設 Cymbal Pets 行銷團隊想製作節慶禮物指南,他們想根據目錄中每個項目做為寵物主人禮物的合適程度,以 1 到 10 分的評分標準進行排序。
在 SQL 分頁中執行下列查詢:
SELECT
  product_name,
  description,
  AI.SCORE(
    ('How "giftable" is this product for a pet owner? ', description,
    'Use a scale from 1-10.')
  ) AS giftability_score
FROM
  `bigquery-public-data.cymbal_pets.products`
ORDER BY
  giftability_score DESC;
判讀結果
結果應如下所示:
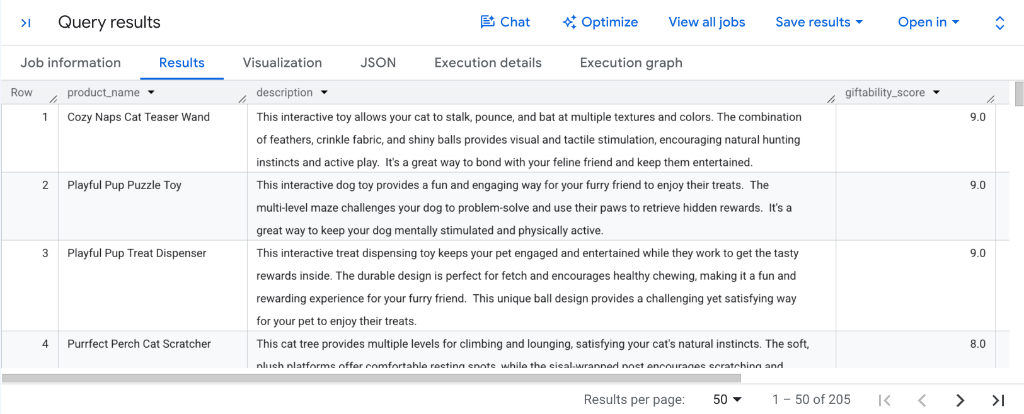
檢查查詢結果中的 giftability_score 欄:
- 高吸引力的互動式玩具:
Cozy Naps Cat Teaser Wand、Playful Pup Puzzle Toy和Playful Pup Treat Dispenser等吸引人的商品獲得最高評分 (9.0)。 - 特殊舒適和抓癢用品:熱門必備用品 (例如
Purrfect Perch Cat Scratcher) 在8.0獲得高分。 - 可執行的下游排名:由於
AI.SCORE會產生正規化的FLOAT64分數,因此您可以立即使用ORDER BY giftability_score DESC排序結果,或使用WHERE AI.SCORE(...) >= 8.0篩選候選人,自動生成禮物指南。
5. 使用 AI.CLASSIFY 為目錄項目分類
AI.CLASSIFY 函式會使用 Gemini,將輸入記錄分類到以 SQL 陣列形式提供的目標類別清單中。
AI.CLASSIFY 支援多模態輸入 (文字、圖片、音訊、影片),因此您不必為分類管理建立、訓練或部署專屬分類模型。
依目標動物物種分類玩具 (單一標籤)
假設 Cymbal Pets 目錄中的部分產品標記為「玩具」,但未指定目標動物。你可以使用 AI.CLASSIFY,根據名稱和說明將每個玩具分類。
在 BigQuery Studio 中執行下列查詢:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('What animal is this product for?', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "All Pets"]
  ) AS animal_type
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys"
LIMIT 20;
查看結果
結果應如下所示:
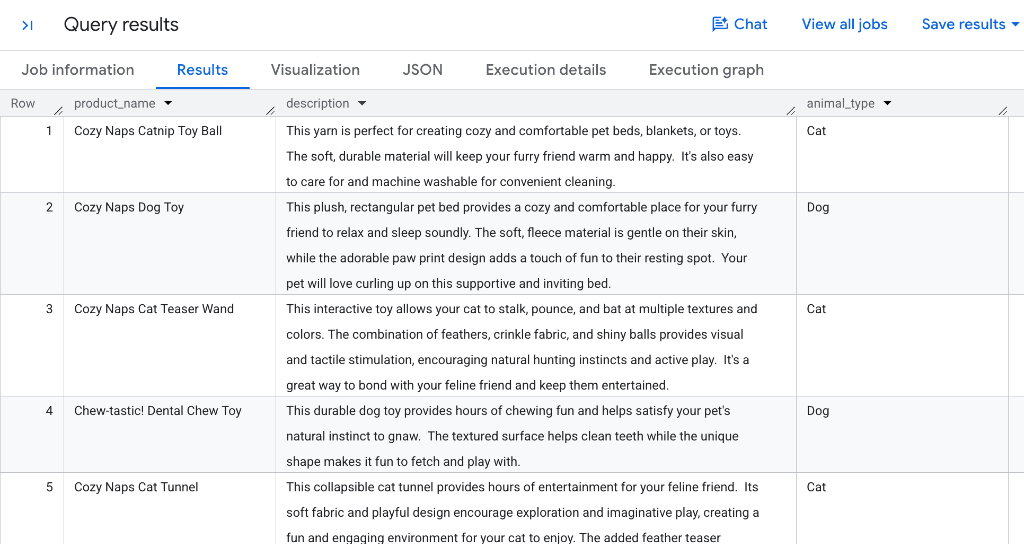
根據預設,AI.CLASSIFY 會執行單一標籤分類,並傳回 STRING,其中包含候選陣列中最相關的單一類別。請注意,Gemini 會將貓薄荷球和羽毛逗貓棒對應至 Cat,而將耐咬玩具和撿球棒對應至 Dog。
使用多標籤分類指派多個標籤
零售目錄中的許多產品可同時適用於多種寵物類型 (例如適合貓咪和小型動物的絨毛床或隧道)。
如要為單一記錄指派多個類別,請設定選用參數 output_mode => 'multi'。在多標籤模式中,AI.CLASSIFY 會傳回 ARRAY,內含所有相符類別。
在 SQL 分頁中執行下列查詢:
SELECT
  product_name,
  description,
  AI.CLASSIFY(
    ('Identify all pet types that this product is suitable for: ', product_name, ' ', description),
    categories => ["Dog", "Cat", "Bird", "Fish", "Small Animal", "Reptile"],
    output_mode => 'multi'
  ) AS pet_types
FROM
  `bigquery-public-data.cymbal_pets.products`
WHERE
  category = "Toys";
結果應如下所示:
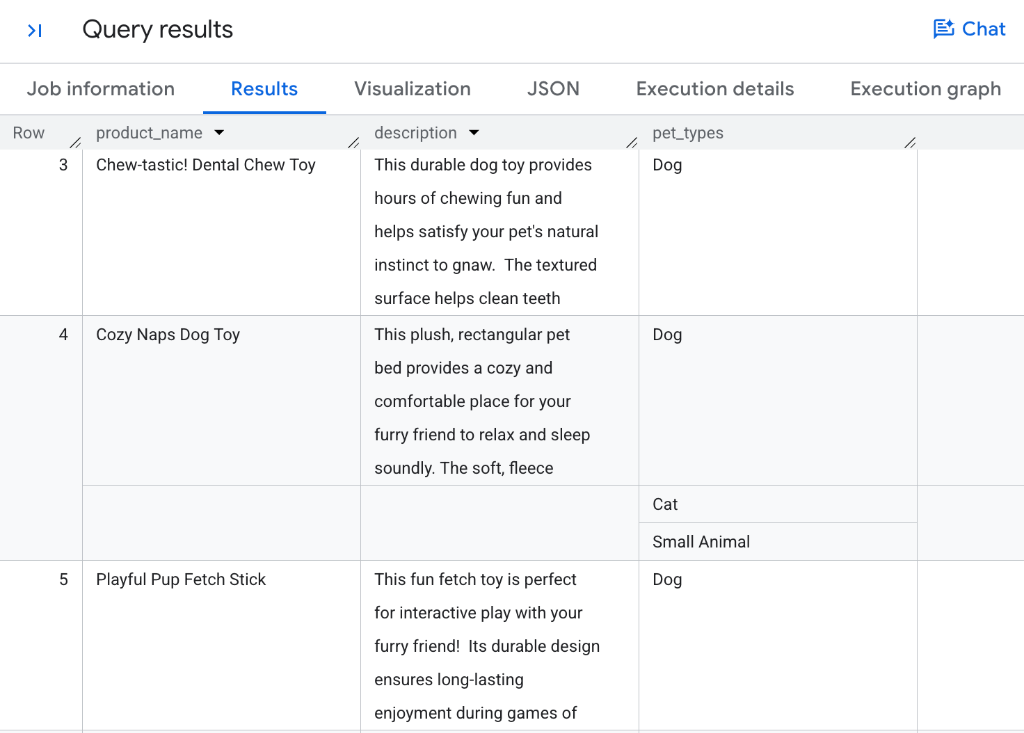
查看分類機制
- 單一標籤與多個標籤:如果沒有
output_mode,AI.CLASSIFY會傳回純量STRING。設定output_mode => 'multi'會傳回ARRAY,其中包含零個、一個或多個相符標籤。 - 多類別指派:請注意,專用商品 (如
Chew-tastic! Dental Chew Toy和Playful Pup Fetch Stick) 會收到[Dog],而多功能舒適商品 (如Cozy Naps Dog Toy,即長方形絨毛床) 則會正確收到多個標記:[Dog, Cat, Small Animal]。 - 零樣本比對:模型會根據提供的
categories陣列評估合併後的文字和提示,不需要預先訓練的自訂機器學習模型。 - 下游 SQL 陣列作業:您可以使用標準 BigQuery SQL 陣列函式 (例如
WHERE 'Cat' IN UNNEST(pet_types)或CROSS JOIN UNNEST(pet_types)) 篩選、擴展及彙整多標籤記錄。
6. 使用 AI.IF 篩選多模態產品圖片
AI.IF 函式會使用 Gemini 評估自然語言條件,並傳回布林值 (TRUE 或 FALSE)。
由於 AI.IF 接受多模態輸入內容,因此您可以在 SQL WHERE 子句中直接使用這項功能,篩選儲存在 Cloud Storage 中的非結構化圖片檔案。
篩選含有特定物件的圖片
假設商品團隊想在目錄中找出所有含有寵物食品或零食的產品圖片。
在 SQL 分頁中執行下列查詢:
SELECT
  uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(uri, 'us.conn')).url AS product_image_url,
  metadata
FROM
  `bigquery-public-data.cymbal_pets.product_images`
WHERE
  AI.IF(
    ('Does this product image contain pet food or snacks? ', OBJ.MAKE_REF(uri, 'us.conn'))
  );
結果應如下所示:
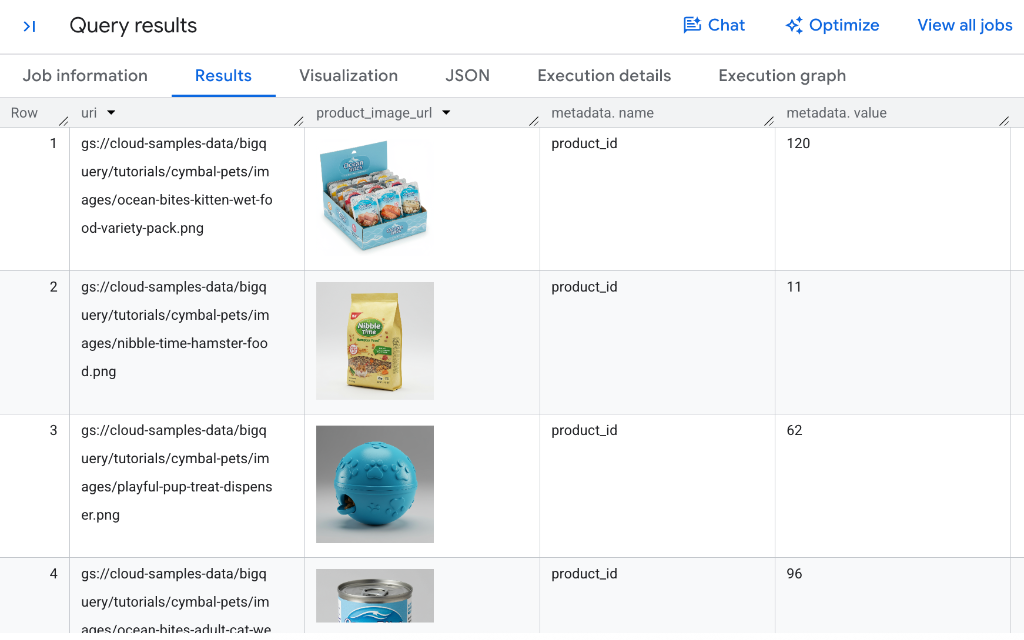
多模態篩選功能的運作方式
- 即時物件參照:我們在此使用
OBJ.MAKE_REF(uri, 'us.conn')即時建立物件參照,您也可以直接在 BigQuery 資料表中建立及儲存ObjectRef欄,這樣就能立即在分析中使用,不必在每個查詢中使用OBJ.MAKE_REF函式。 - 深入辨識視覺物件:請注意,Gemini 不僅能準確辨識各種包裝格式 (例如濕糧綜合包裝盒、倉鼠乾糧袋和貓罐頭),還能辨識玩具內裝的可食用零食,例如藍色零食分配器。
- 資料列層級述詞評估:BigQuery 會直接在
WHERE子句中,針對每個 Cloud Storage 圖片參照評估自然語言條件。 - 布林篩選:只有 Gemini 將條件評估為
TRUE的記錄,才會在結果集中傳回。
7. 使用 AI.IF 跨資料表執行語意聯結。
傳統關聯式資料庫聯結需要完全相等的鍵 (例如 products.product_id = images.product_id)。不過,現實世界的企業資料集通常包含缺少明確外部鍵的非結構化資產。
由於 AI.IF 會傳回布林值,因此您可以直接將其放在 SQL INNER JOIN ... ON 子句中,執行語意聯結。
從語意上將產品說明與圖片素材資源連結
假設您想將 products 資料表中的產品說明,與 product_images 中未連結的圖片檔案進行比對,找出 Fluffy Buns 品牌製造的產品。
在 BigQuery Studio 的 SQL 分頁中執行下列查詢 (請注意,這需要幾分鐘才能完成):
SELECT
  products.product_id,
  products.product_name,
  products.description,
  products.brand,
  images.uri AS image_uri,
  OBJ.GET_READ_URL(OBJ.MAKE_REF(images.uri, 'us.conn')).url AS product_image_url
FROM
  `bigquery-public-data.cymbal_pets.products` AS products
INNER JOIN
  `bigquery-public-data.cymbal_pets.product_images` AS images
ON
  AI.IF(
    ('You will be provided an image of a pet product. ',
    'Determine if the image is of the following pet toy: ',
    products.product_name,
    products.description,
    OBJ.MAKE_REF(images.uri, 'us.conn')
    )
  )
WHERE
  products.category = "Toys" AND
  products.brand = "Fluffy Buns";
結果應如下所示:
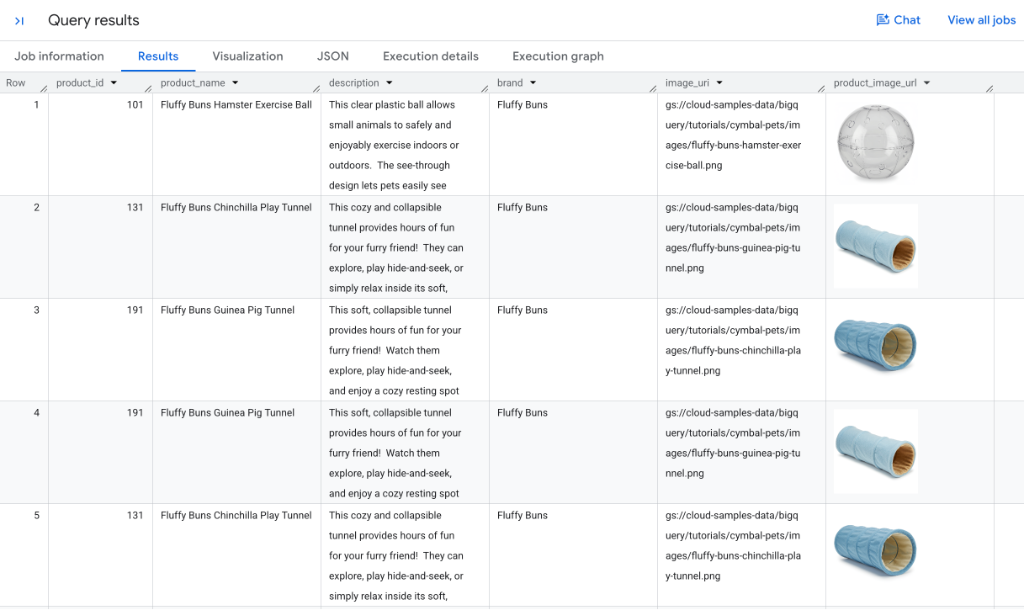
瞭解 SQL 中的語意聯結
- 跨模態條件評估:針對候選記錄配對,BigQuery 會將
products中的文字中繼資料和圖片參照 (OBJ.MAKE_REF(...)) 一併傳送至 Gemini。 - 準確的圖像比對:如結果所示,
Fluffy Buns Hamster Exercise Ball與透明塑膠球圖片相符,而Fluffy Buns Chinchilla Play Tunnel和Guinea Pig Tunnel則與藍色絨毛隧道照片相符。由於標準 SQLINNER JOIN語意,如果產品符合目錄中的多個圖片素材資源 (例如多個拍攝角度或類似的拍攝內容),則可能會在輸出內容中產生多個資料列。 - 內嵌圖片算繪:BigQuery Studio 會自動在結果格線中,直接算繪
product_image_url欄的授權讀取網址,方便您立即進行視覺化驗證。 - 非結構化實體解析:這項功能可跨舊版目錄、擷取的資料集和媒體封存檔,解鎖強大的實體解析工作流程,無須手動標記或明確的外鍵。
8. 使用 AI.AGG 彙整各列的洞察資料。
AI.SCORE、AI.CLASSIFY 和 AI.IF 等函式會評估個別資料列 (純量運算),但分析企業資料時,通常需要綜合多筆記錄的模式。
AI.AGG 函式是匯總函式,可使用自然語言指令,將數千或數百萬個非結構化資料列的洞察資料匯總、分組或合成,產生統一的回應。
除了傳統 SQL 指標,還可綜合分析類別摘要
AI.AGG 可與傳統 SQL GROUP BY 和匯總函式完美整合。舉例來說,您可以計算傳統指標 (例如項目數量),同時取得生成式 AI 摘要,瞭解各類別產品的共同點。
在 BigQuery Studio 中執行下列查詢:
SELECT
  category,
  COUNT(*) AS item_count,
  AI.AGG(
    ('Product: ', product_name, ' - Description: ', description),
    'Write a concise, one-sentence summary describing the common characteristics or purpose of the products in this category.'
  ) AS category_summary
FROM
  `bigquery-public-data.cymbal_pets.products`
GROUP BY
  category
ORDER BY
  item_count DESC;
結果應如下所示:
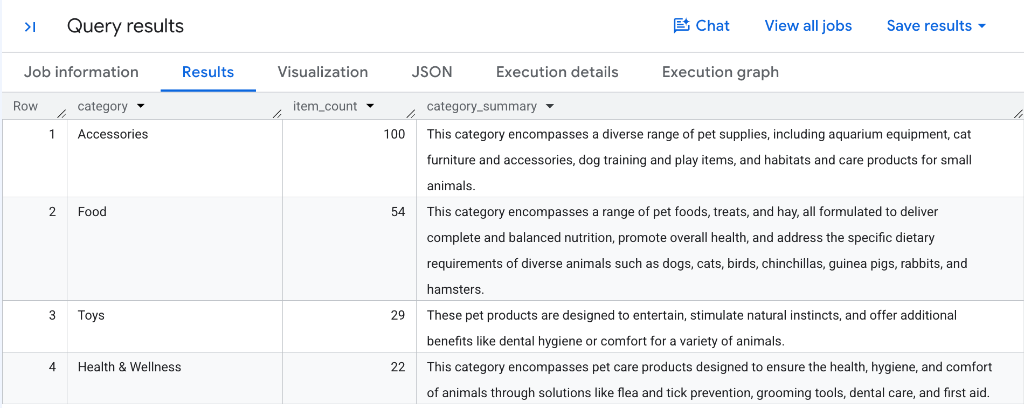
AI.AGG 如何彙整非結構化資料
- 階層式匯總:BigQuery 會依類別分割區分組列資料、建構結構化內容視窗,並使用 Gemini 合成整個產品記錄集合。
- 自動合成目錄:請注意,每個類別都會收到準確的摘要,例如
Accessories擷取棲息地和訓練裝備,或Food強調多種動物的均衡營養。 - 混合式量化和質性報表:將
COUNT(*)等標準匯總與AI.AGG結合,即可在單一查詢中產生完整的目錄總覽,不必使用自訂 ETL 管道。 - 彈性分割:您可以對任何分組維度 (例如
GROUP BY brand、GROUP BY category或整個表格) 套用AI.AGG,在幾秒內產生高階洞察資料。
9. 使用最佳化模式和 Proxy 模型加快查詢速度
處理含有成千上萬個資料列的大型資料集時,為每個資料列叫用遠端 LLM 可能會導致延遲和產生費用。
為解決這個問題,BigQuery 提供 最佳化模式,適用於 AI.IF 和 AI.CLASSIFY。最佳化模式會運用代理模型和即時模型蒸餾,以降低 LLM 權杖成本,並將執行速度提升 100 倍以上。
最佳化模式的運作方式
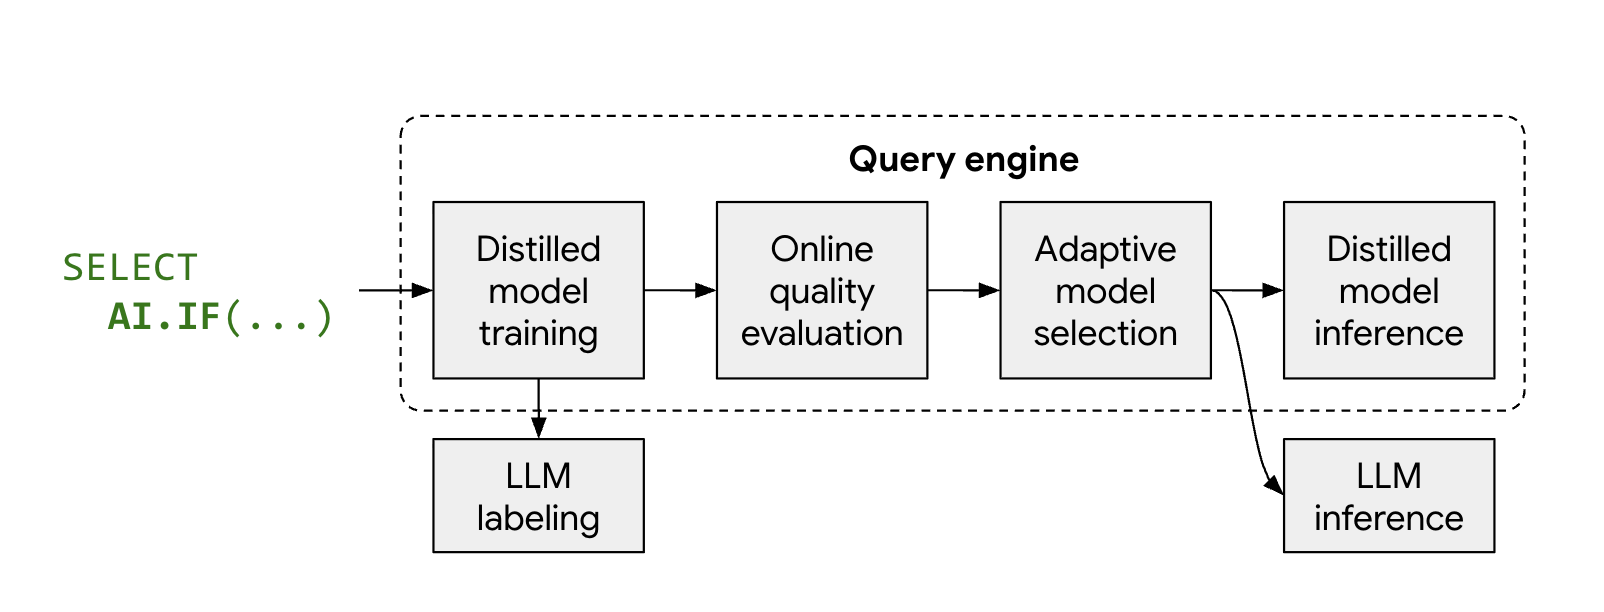
- 代表性樣本和標記:BigQuery 會自動選取代表性資料列樣本,並從 Gemini 取得標籤。
- 模型蒸餾訓練:BigQuery 會使用文字嵌入做為特徵,在 CPU 上即時訓練超輕量型代理模型 (例如邏輯迴歸)。
- 品質驗證:BigQuery 會根據 Gemini 評估精簡模型的準確度。如果符合品質門檻,BigQuery 會升級該資料,以處理資料集的其餘部分。
- 本機高速推論:代理模型會在本地評估其餘資料列,完全不會產生遠端 LLM 權杖費用,且延遲時間極短。
執行未最佳化的基準查詢
由於範例 bigquery-public-data.cymbal_pets.products 目錄的資料列太少,無法觸發 Proxy 模型蒸餾,因此我們會使用較大的公開資料集 bigquery-public-data.bbc_news.fulltext (內含超過 2,200 篇新聞報導)。
首先,請執行未經最佳化的標準查詢,找出有關天災的新聞報導:
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body)
  );
檢查基準工作詳細資料和權杖用量
基準查詢完成後,請檢查執行指標:
- 在 BigQuery Studio 的底部結果窗格中,選取「Job information」(工作資訊) 分頁標籤。
- 向下捲動至「輸入詞元數」和「輸出詞元數」部分。
結果應如下所示:
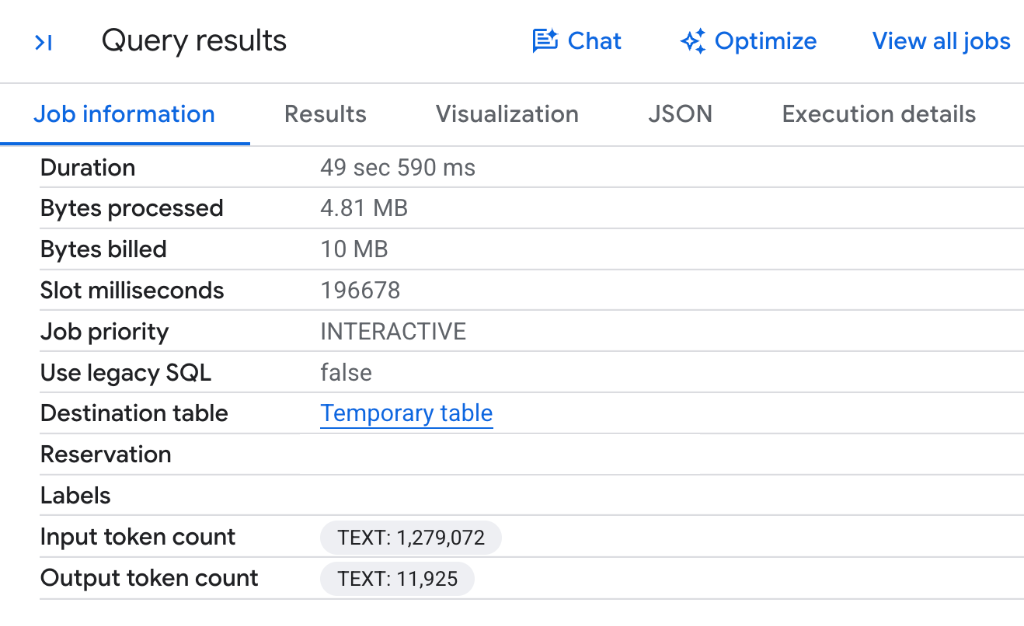
- 完整資料集權杖消耗量:由於 BigQuery 會針對所有 2,225 篇新聞文章的每一列叫用遠端 Gemini 模型,且未進行 Proxy 最佳化,因此查詢會消耗 1,279,072 個輸入權杖和 11,925 個輸出權杖。
- 沒有最佳化部分:請注意,沒有
Gen AI Function Optimizations項目,因為標準執行會根據遠端 LLM 端點評估每個資料列。
以最佳化模式執行查詢
如要減少權杖用量並善用代理模型蒸餾,請傳遞 embeddings => AI.EMBED(...) 並設定 optimization_mode => 'MINIMIZE_COST',啟用最佳化模式:
SELECT
  title,
  body
FROM
  `bigquery-public-data.bbc_news.fulltext`
WHERE
  AI.IF(
    ('The following news story is about a natural disaster: ', body),
    embeddings => AI.EMBED(body, endpoint => 'text-embedding-005', task_type => 'CLASSIFICATION').result,
    optimization_mode => 'MINIMIZE_COST'
  );
驗證最佳化結果,並觀察權杖用量是否減少
執行最佳化查詢後,切換至 BigQuery Studio 的「工作資訊」分頁,觀察權杖用量和執行指標的比較結果:
- 在 BigQuery Studio 的底部結果窗格中,選取「Job information」(工作資訊) 分頁標籤。
- 捲動至「生成式 AI 函式最佳化調整」部分,以及權杖計數。
結果應如下所示:
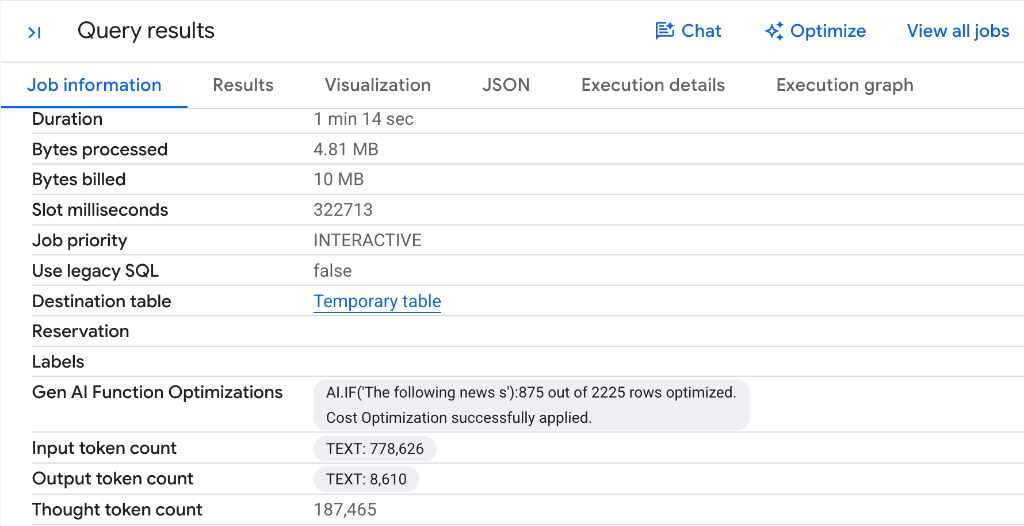
- 大幅減少詞元:請注意,「輸入詞元數」從 1,279,072 個詞元降至 778,626 個詞元,單次查詢執行節省了 500,446 個輸入詞元 (減少近 40%)!輸出權杖也同樣減少。
- 自動代理模型蒸餾:請注意
AI.IF('The following news s'): 875 out of 2225 rows optimized. Cost Optimization successfully applied.標籤。BigQuery 對資料集進行取樣、使用 Gemini 標示代表性文章、蒸餾出快速輕量的代理分類器,並在 CPU 上處理 2,225 列中的 875 列,完全不必呼叫遠端 LLM 端點。 - 直接節省成本:BigQuery 管理的 AI 函式是根據處理的模型權杖數量計費,因此減少權杖消耗量可直接降低查詢執行成本。
- 品質驗證:BigQuery 會先根據 Gemini 自動驗證 Proxy 模型的準確率,再升級模型來評估其餘資料列,確保分類品質。
在較大的表格上,可進一步減少權杖數量和延遲時間
在 2,225 個資料列中節省超過 50 萬個權杖,這已相當可觀,但在較大的資料表中,權杖減少量和效能增幅會更高:
- 為什麼權杖減少量會隨著資料集大小而變化:在 BigQuery 中執行的查詢,會使用 LLM 標記的約 1,000 列初始樣本,即時訓練 Proxy 模型。經過訓練和驗證後,代理模型會取代其餘列中的直接 LLM 呼叫。如果是較大的查詢 (例如典型的 100 萬列資料集),這項功能可避免對大量資料叫用 LLM,最多可減少 400 倍的權杖用量,大幅降低成本。
- 大幅加快延遲速度:將推論作業從專用 LLM 硬體轉移至直接在標準資料庫工作站 CPU 上執行的超輕量型 Proxy 模型 (利用預先計算的 Gemini 嵌入),BigQuery 可將整體查詢執行時間縮短 30 到 100 倍。
10. 清理資源
如要清理在本程式碼實驗室中建立的資源,請在 BigQuery Studio SQL 分頁中執行下列陳述式,移除 Cloud 資源連結:
DROP CONNECTION IF EXISTS `us.conn`;
或者,如果您專為本教學課程建立了暫時的 Google Cloud 專案,可以在 Cloud Resource Manager 中關閉整個專案。
11. 恭喜
恭喜!您已順利完成「使用受管理 AI 函式和 SQL 在 BigQuery 中進行語意分析」程式碼研究室。
您已掌握 BigQuery 的代管生成式 AI 函式:
AI.SCORE:使用自動提示重寫功能,根據主觀條件 (例如適合作為禮物) 將產品評分 (1 到 10 分)。AI.CLASSIFY:將未分類的目錄項目歸入目標動物分類。AI.IF(多模態篩選):根據視覺內容,篩選 SQLWHERE子句中的 Cloud Storage 圖片資產。AI.IF(語意聯結):在 SQLON子句中執行跨模式聯結,將文字產品說明與圖片檔案連結。AI.AGG:將多列非結構化目錄文字合成為簡潔的執行摘要。- 最佳化模式和代理模型:使用
optimization_mode => 'MINIMIZE_COST'搭配即時模型蒸餾和AI.EMBED,加快查詢速度並盡量降低權杖成本。