
1. Введение
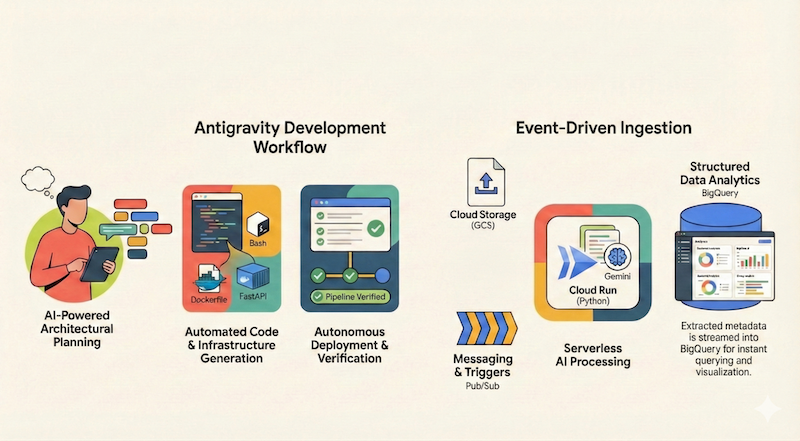
В этом практическом занятии вы узнаете, как использовать Google Antigravity для проектирования, создания и развертывания бессерверного приложения в Google Cloud. Мы создадим бессерверный и событийно-ориентированный конвейер обработки документов, который будет получать файлы из Google Cloud Storage (GCS), обрабатывать их с помощью Cloud Run и Gemini и передавать их метаданные в BigQuery.
Что вы узнаете
- Как использовать антигравитацию в архитектурном планировании и проектировании.
- Создание инфраструктуры в виде кода (сценариев командной оболочки) с помощью агента искусственного интеллекта.
- Создайте и разверните облачный сервис Cloud Run на основе Python.
- Интегрируйте Gemini с Vertex AI для мультимодального анализа документов.
- Проверьте весь конвейер обработки данных, используя артефакт Walkthrough от Antigravity.
Что вам понадобится
- Установлена функция Google Antigravity .
- Проект в Google Cloud с включенной функцией выставления счетов.
- Интерфейс командной строки gcloud установлен и авторизован.
2. Обзор приложения
Прежде чем приступить к проектированию и реализации приложения с использованием Antigravity, давайте сначала определим, какое приложение мы хотим для себя создать.
Мы хотим создать бессерверный и событийно-ориентированный конвейер обработки документов, который будет получать файлы из Google Cloud Storage (GCS), обрабатывать их с помощью Cloud Run и Gemini и передавать их метаданные в BigQuery.
Архитектурная схема высокого уровня для этого приложения может выглядеть следующим образом:
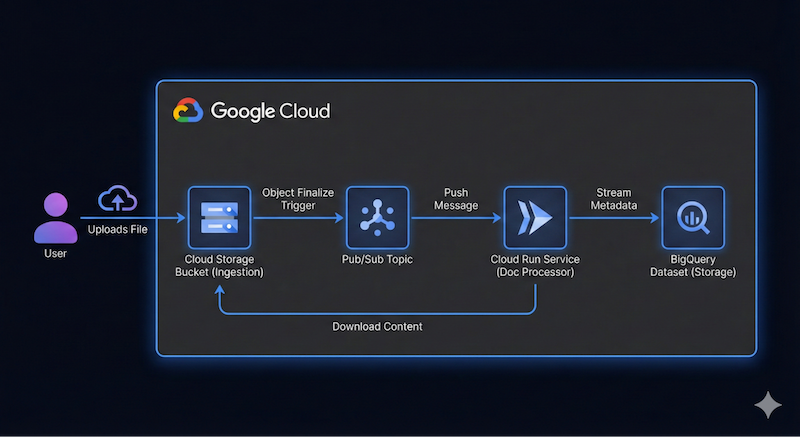
Точность не обязательна. Antigravity может помочь нам проработать детали архитектуры по ходу работы. Однако полезно иметь представление о том, что вы хотите построить. Чем больше деталей вы предоставите, тем лучше будут результаты, которые вы получите от Antigravity с точки зрения архитектуры и кода.
3. Спланируйте архитектуру.
Мы готовы приступить к планированию архитектурных деталей с помощью Antigravity!
Antigravity превосходно справляется с планированием сложных систем. Вместо того чтобы сразу писать код, мы можем начать с определения высокоуровневой архитектуры и использовать одну из функций, чтобы помочь Antigravity оценить наш запрос, задать нам уточняющие вопросы, а затем перейти к его планированию и реализации.
Предполагая, что вы запустили Antigravity, мы создадим новый проект для этого практического занятия.
Нажмите на значок нового проекта рядом с разделом Projects , а затем выберите New Project , как показано ниже:
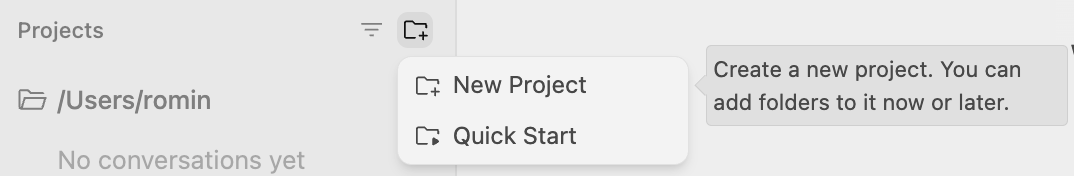
После этого появится опция Add Folder , как показано ниже:
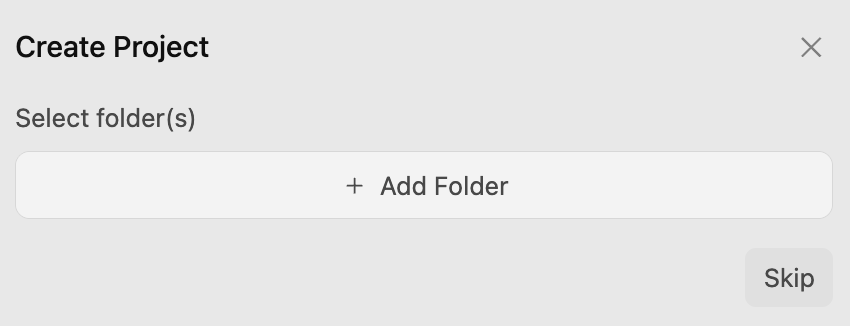
Нажмите кнопку «Добавить папку» , чтобы добавить папку в ваш проект. На моем компьютере я создал папку google-cloud-serverless-app и добавил ее в этот проект.
Это открывает дискуссию в рамках проекта google-cloud-serverless-app .
Нажмите на значок основных настроек ⚙️ в левом нижнем углу экрана и перейдите в раздел «Настройки проекта». Если вы не видите проект google-cloud-serverless-app в списке, проведите только одну беседу, а затем вернитесь в раздел «Настройки проекта».
Установите для параметра «Настройки агента / Предварительные настройки безопасности» значение «По умолчанию» , а для параметра «Поведение агента / Политика проверки артефактов» — значение «Всегда запрашивать» , как показано ниже:
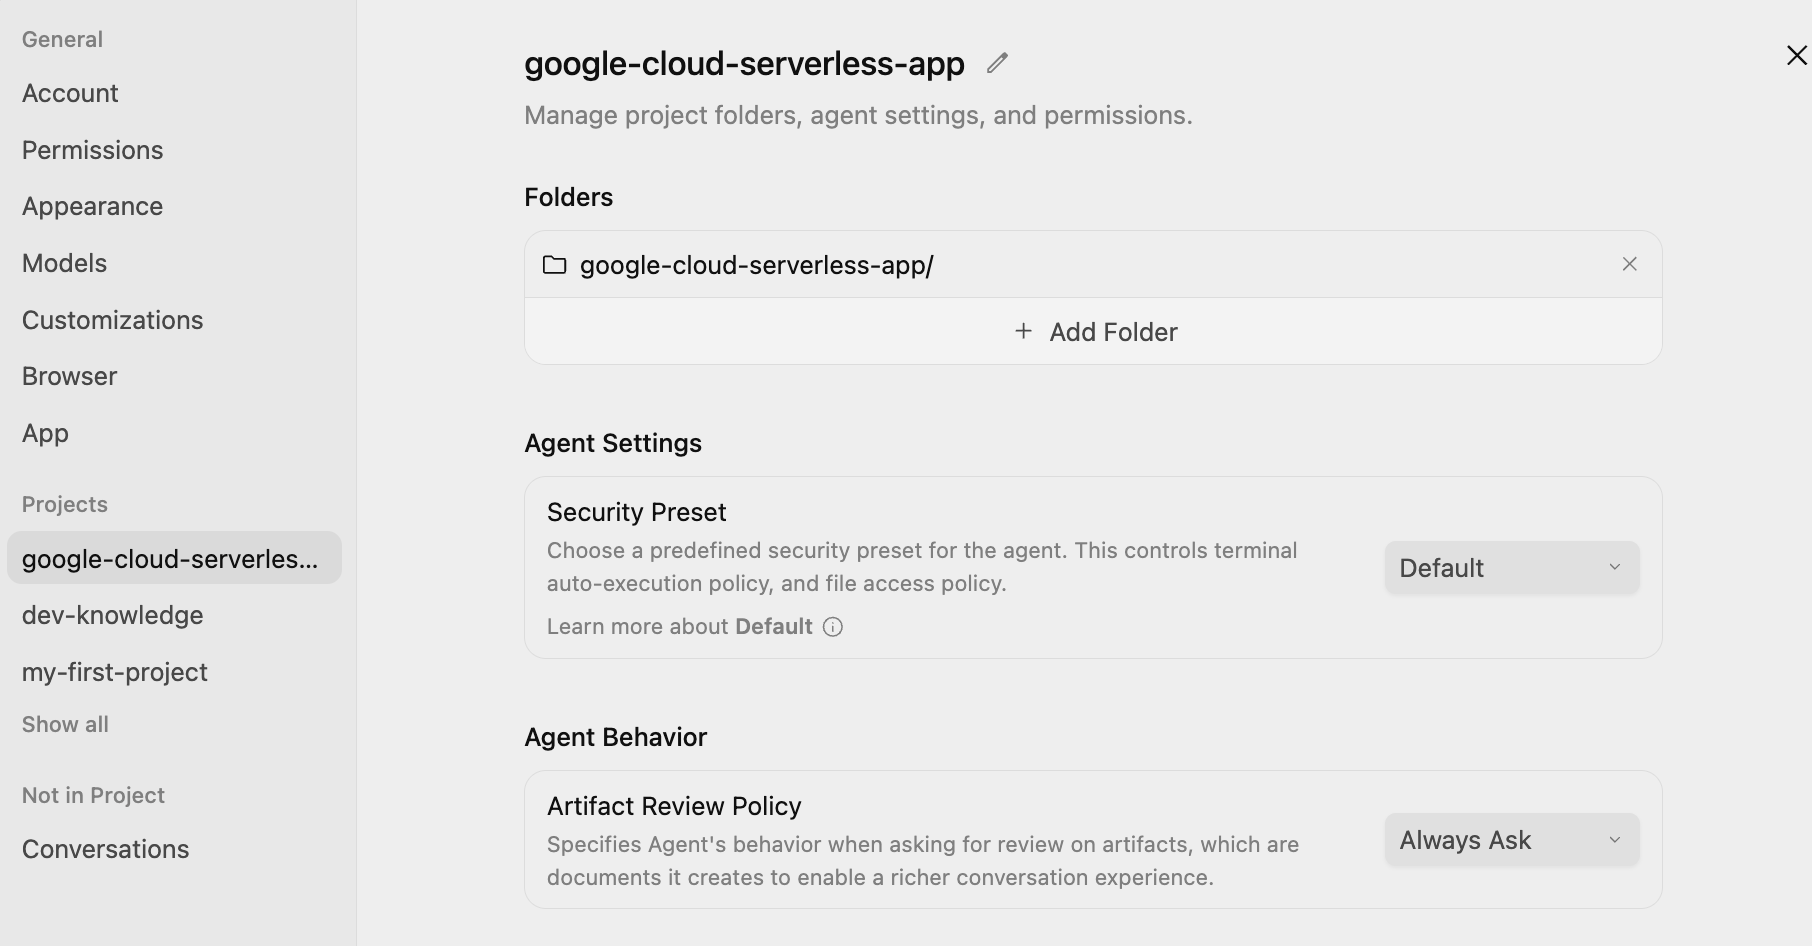
Это гарантирует, что на каждом этапе вы сможете просмотреть и утвердить план до того, как агент начнет его реализацию.
Быстрый
Теперь мы готовы отправить первый запрос в Antigravity. Для оценки нашего запроса мы будем использовать команду /grill-me .
Введите /grill-me , затем введите следующий запрос и нажмите кнопку «Отправить»:
/grill-me

I want to build a serverless event-driven document processing pipeline on Google Cloud.
Architecture:
- Ingestion: Users upload files to a Cloud Storage bucket.
- Trigger: File uploads trigger a Pub/Sub message.
- Processor: A Python-based Cloud Run service receives the message, processes the file (simulated OCR), and extracts metadata.
- Storage: Stream the metadata (filename, date, tags, word_count) into a BigQuery dataset.
Команда /grill-me задает ряд дополнительных вопросов, на которые вы можете попытаться ответить, насколько это в ваших силах. Она также предлагает рекомендуемые ответы , и вы можете воспользоваться ими, если хотите.
Ниже приведён пример выполнения моей команды /grill-me :
How would you like the Cloud Run service to receive events from Cloud Storage and Pub/Sub?
(Recommended) Cloud Storage Pub/Sub Notification with a Pub/Sub Push Subscription (HTTP POST to Cloud Run)

How should access to the Cloud Run service endpoint be secured for Pub/Sub push requests?
Publicly accessible Cloud Run service without authentication (for prototyping/quick testing only)

How should the Python processor handle file inspection and the simulated OCR logic?
(Recommended) Download file from GCS: if plain text/utf-8, extract actual words and tags; if binary/image/PDF, simulate OCR processing (mock latency, generate synthetic text & tags, count words)

How should the processor write metadata to BigQuery and handle table/schema provisioning?
(Recommended) Use BigQuery Streaming Inserts (`insert_rows_json`) with auto-creation of the dataset and table if they do not exist

How should the Cloud Run service handle processing failures and retries from Pub/Sub?
(Recommended) Return HTTP 500 on transient errors for Pub/Sub automatic retry; return HTTP 200/204 on non-retryable errors (e.g., file not found, bad event format) to avoid poison pill loops

Which web framework would you prefer for the Python Cloud Run service?
Flask with Gunicorn: minimal, classic lightweight standard for GCP microservices

How would you like the cloud infrastructure (Bucket, Pub/Sub, Cloud Run, BigQuery) to be provisioned and deployed?
(Recommended) Provide both: automated `gcloud` CLI setup/deploy scripts for quick manual rollout AND Terraform manifests for reproducible IaC

How would you like to handle local testing and development before deploying to Google Cloud?
(Recommended) Include a local mock test suite and script (`test_local.py`) that can simulate Pub/Sub push envelopes and test processing with both mocked GCP clients and actual files
Обратите внимание, что я попросил компанию Antigravity использовать следующее:
- Простой CLI-скрипт gcloud для выделения ресурсов.
- Встроенные уведомления Pub/Sub облачного хранилища + подписка Pub/Sub на Cloud Run
- Используйте Flask (с Gunicorn) в качестве фреймворка.
- Вместо данных оптического распознавания текста в реальном времени используйте локальное моделирование с текстовым файлом в качестве источника данных.
- Используйте метод `table.insert_rows()` в BigQuery для вставки строк в BigQuery.
- Неаутентифицированное развертывание Cloud Run
а также другие рекомендуемые варианты.
План реализации и перечень задач
Теперь Antigravity приступит к работе и сгенерирует план реализации . Он будет представлен на ваше рассмотрение, выведя сообщение, подобное приведенному ниже:
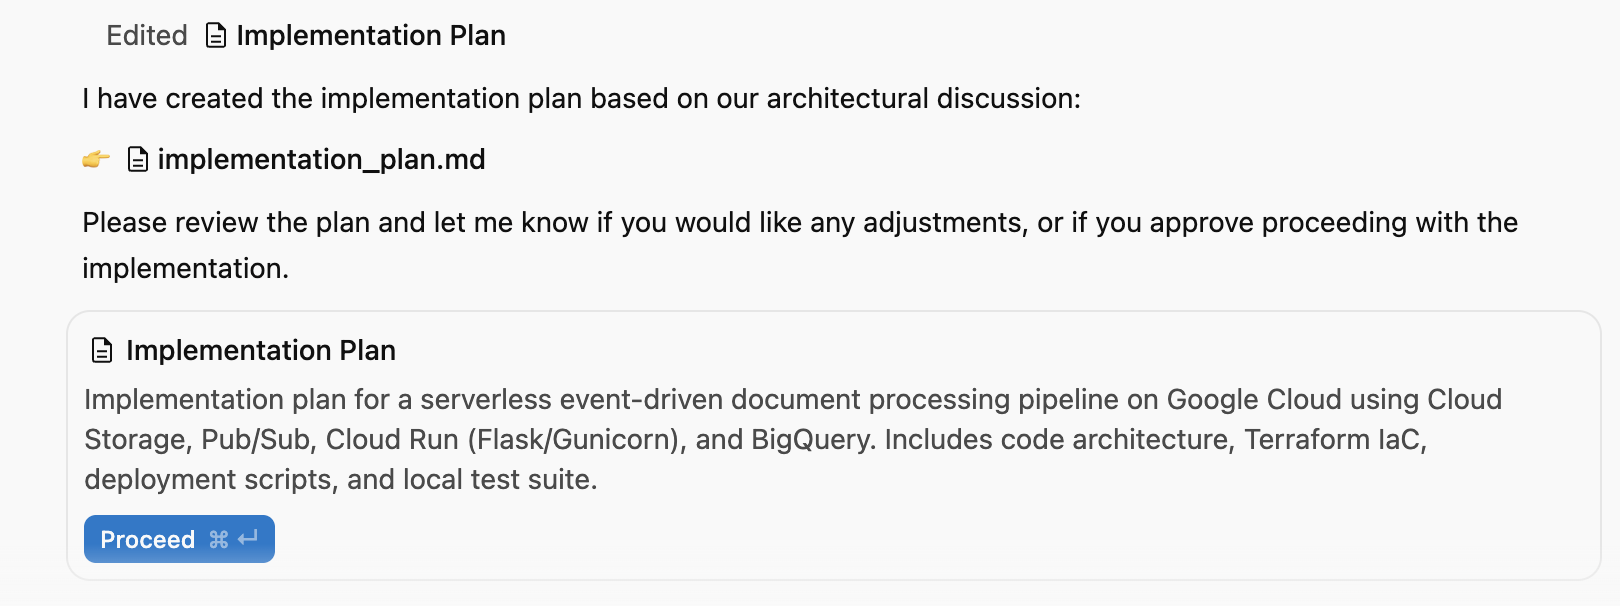
Вы можете щелкнуть переключатель «Вспомогательная панель» в правом верхнем углу окна и просмотреть сгенерированные артефакты, которыми на данный момент является только план реализации.
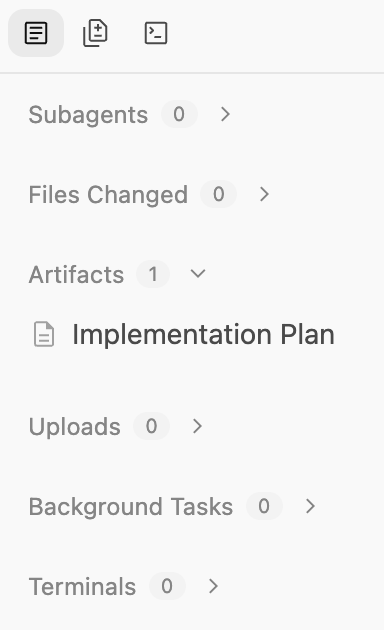
В этом плане изложены следующие положения:
- Инфраструктура : хранилище GCS, тема Pub/Sub, набор данных BigQuery.
- Процессор : приложение на Python/Flask, Dockerfile, необходимые зависимости.
- Интеграция : GCS Notifications → Pub/Sub → Cloud Run.
Вы должны увидеть что-то похожее на следующее. Ниже представлен частичный список плана внедрения на нашем компьютере:
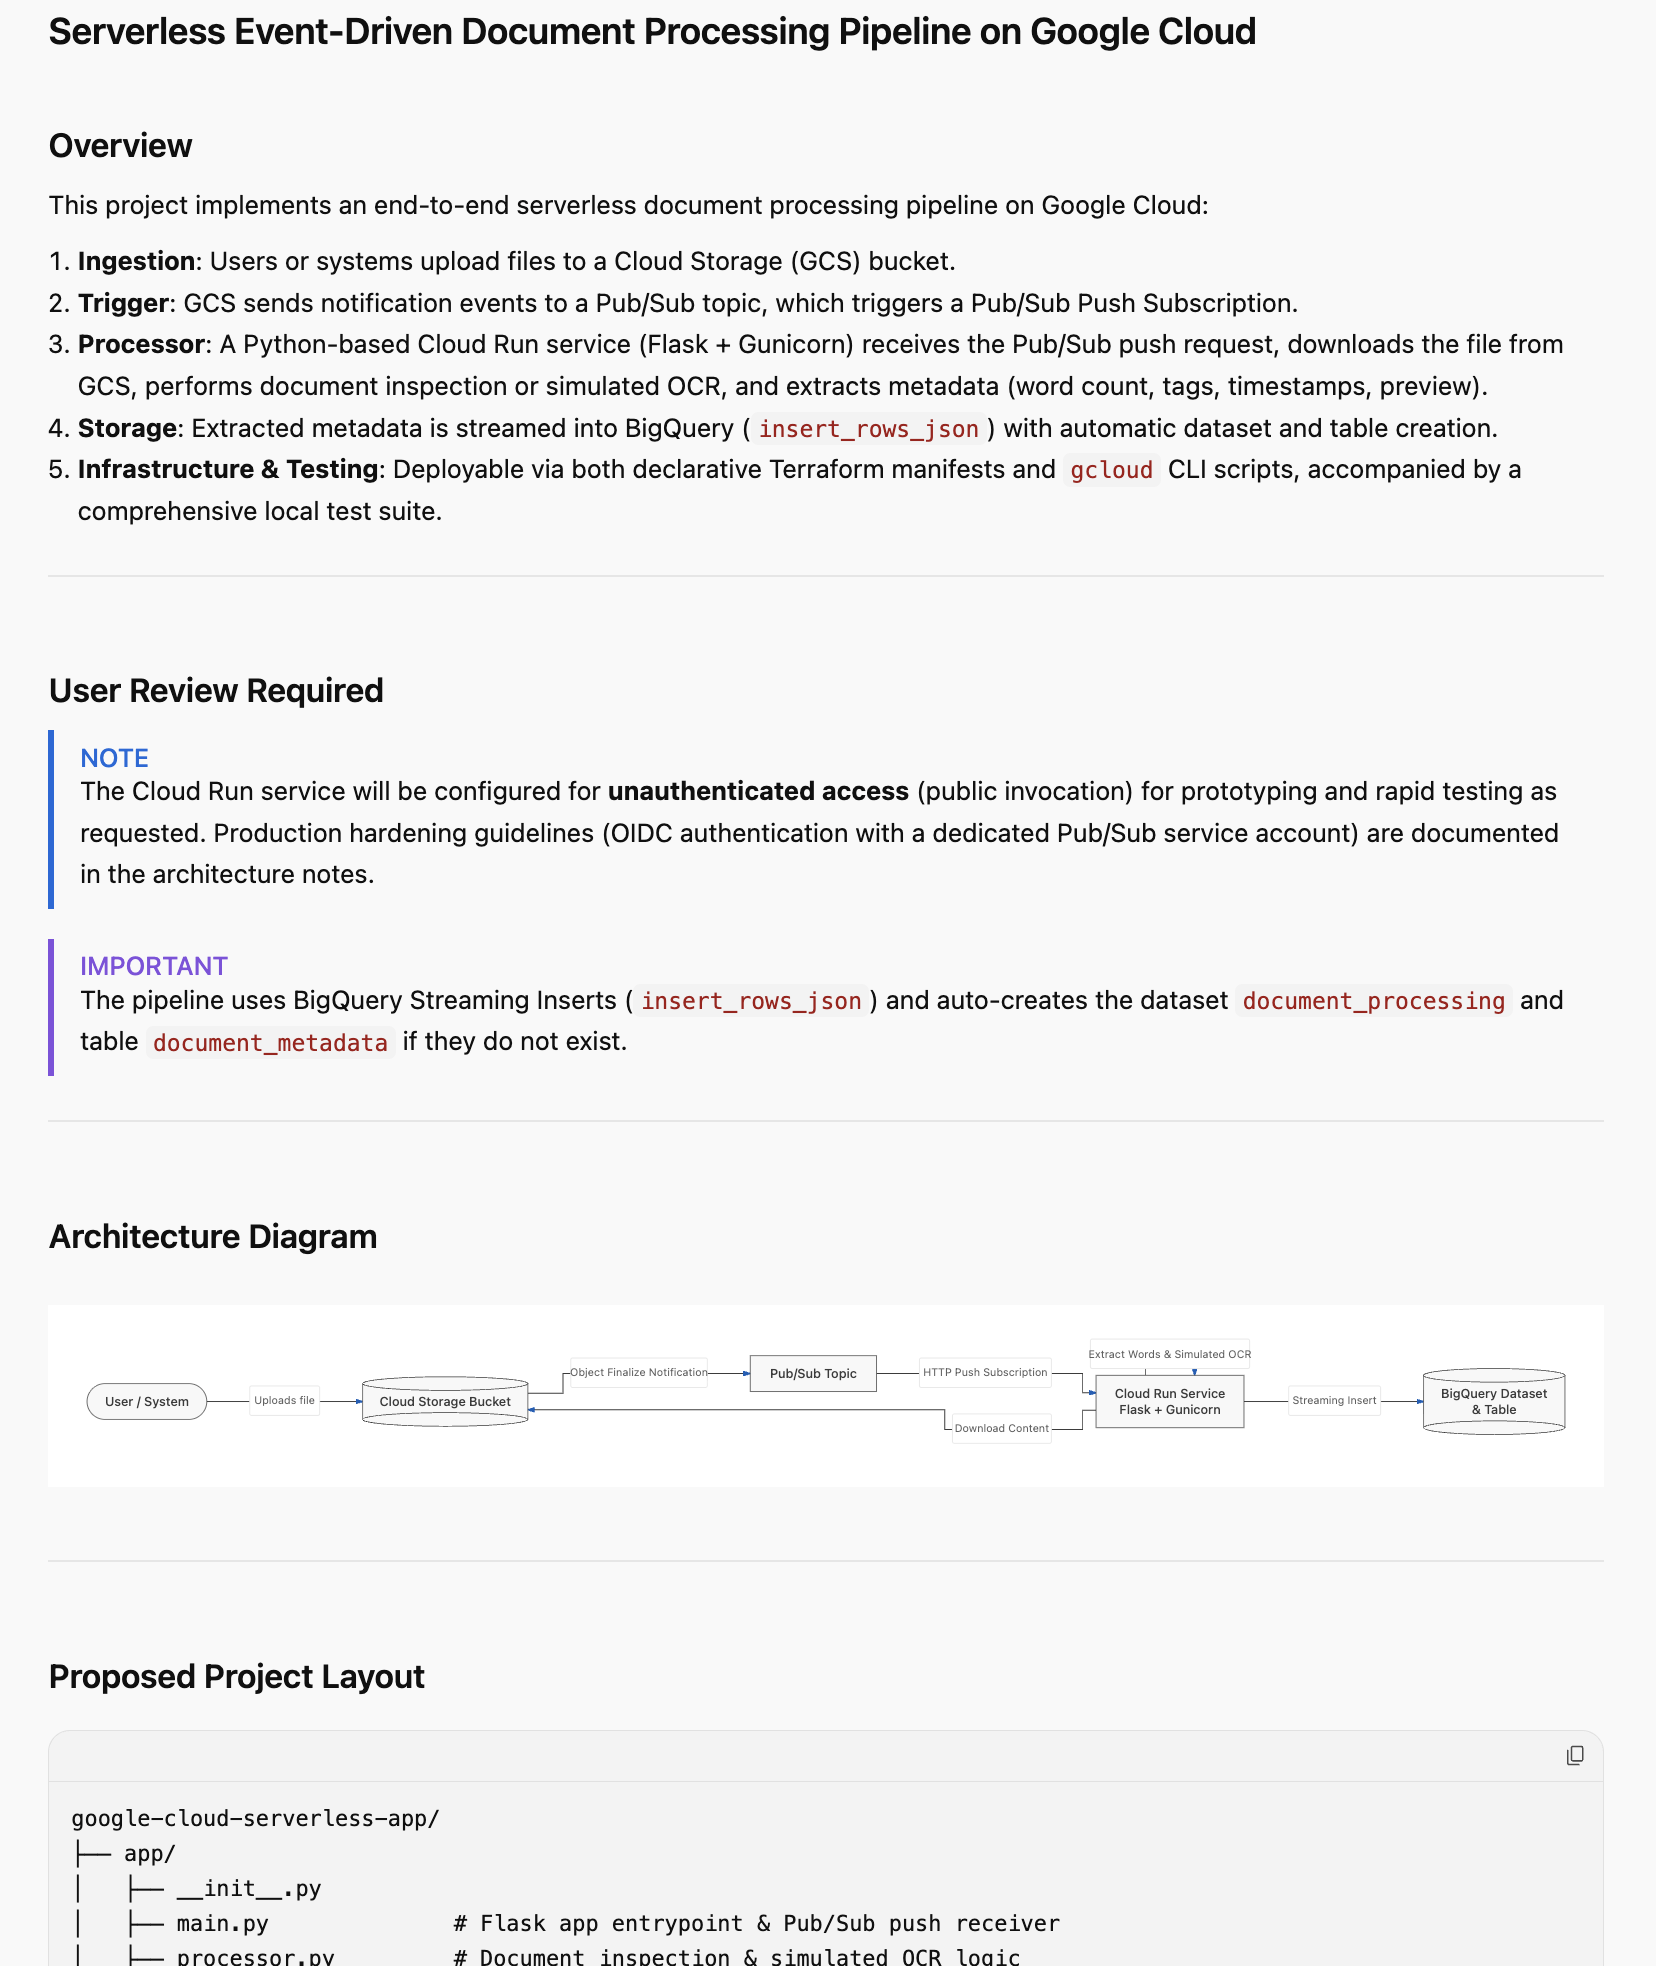
Внимательно прочтите план. Это ваш шанс оставить отзыв о его реализации. Вы можете щелкнуть по любой части плана и добавить комментарии. После добавления комментариев обязательно отправьте на рассмотрение любые изменения, которые вы хотели бы внести, особенно касающиеся именования, идентификатора проекта Google Cloud, региона и т. д.
Если все будет выглядеть нормально, дайте агенту разрешение продолжить выполнение плана внедрения, нажав кнопку Proceed .
4. Создайте приложение.
После утверждения плана компания Antigravity начинает генерировать файлы, необходимые для работы приложения, от скриптов инициализации до кода приложения.
Antigravity создаст папку и начнёт создавать файлы, необходимые для проекта. Если вы посмотрите на раздел «Артефакты», то увидите, что генерируется несколько файлов (исходный код, скриптовые файлы и т. д.).
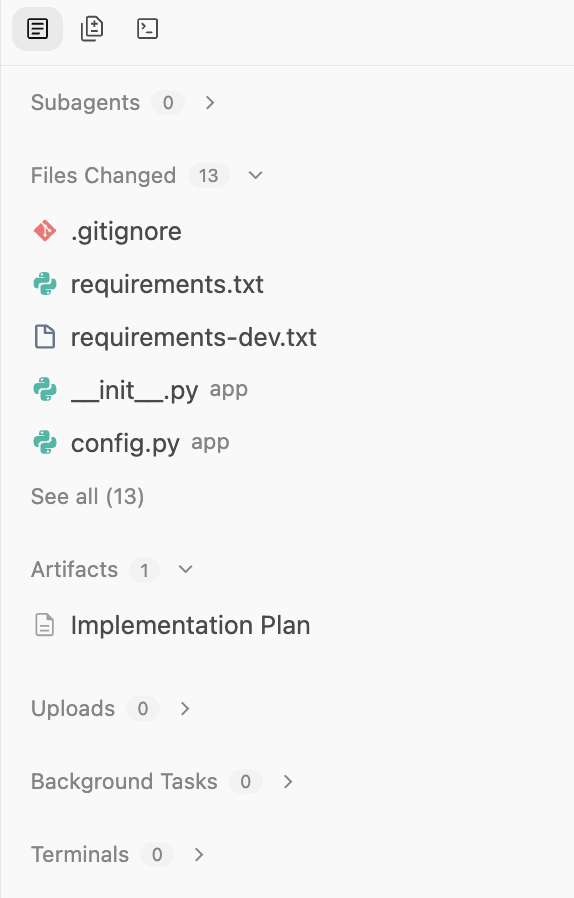
После завершения работы программа сообщит об этом и создаст документ с пошаговым руководством , с которым вы сможете ознакомиться. Пример выходных данных показан ниже:
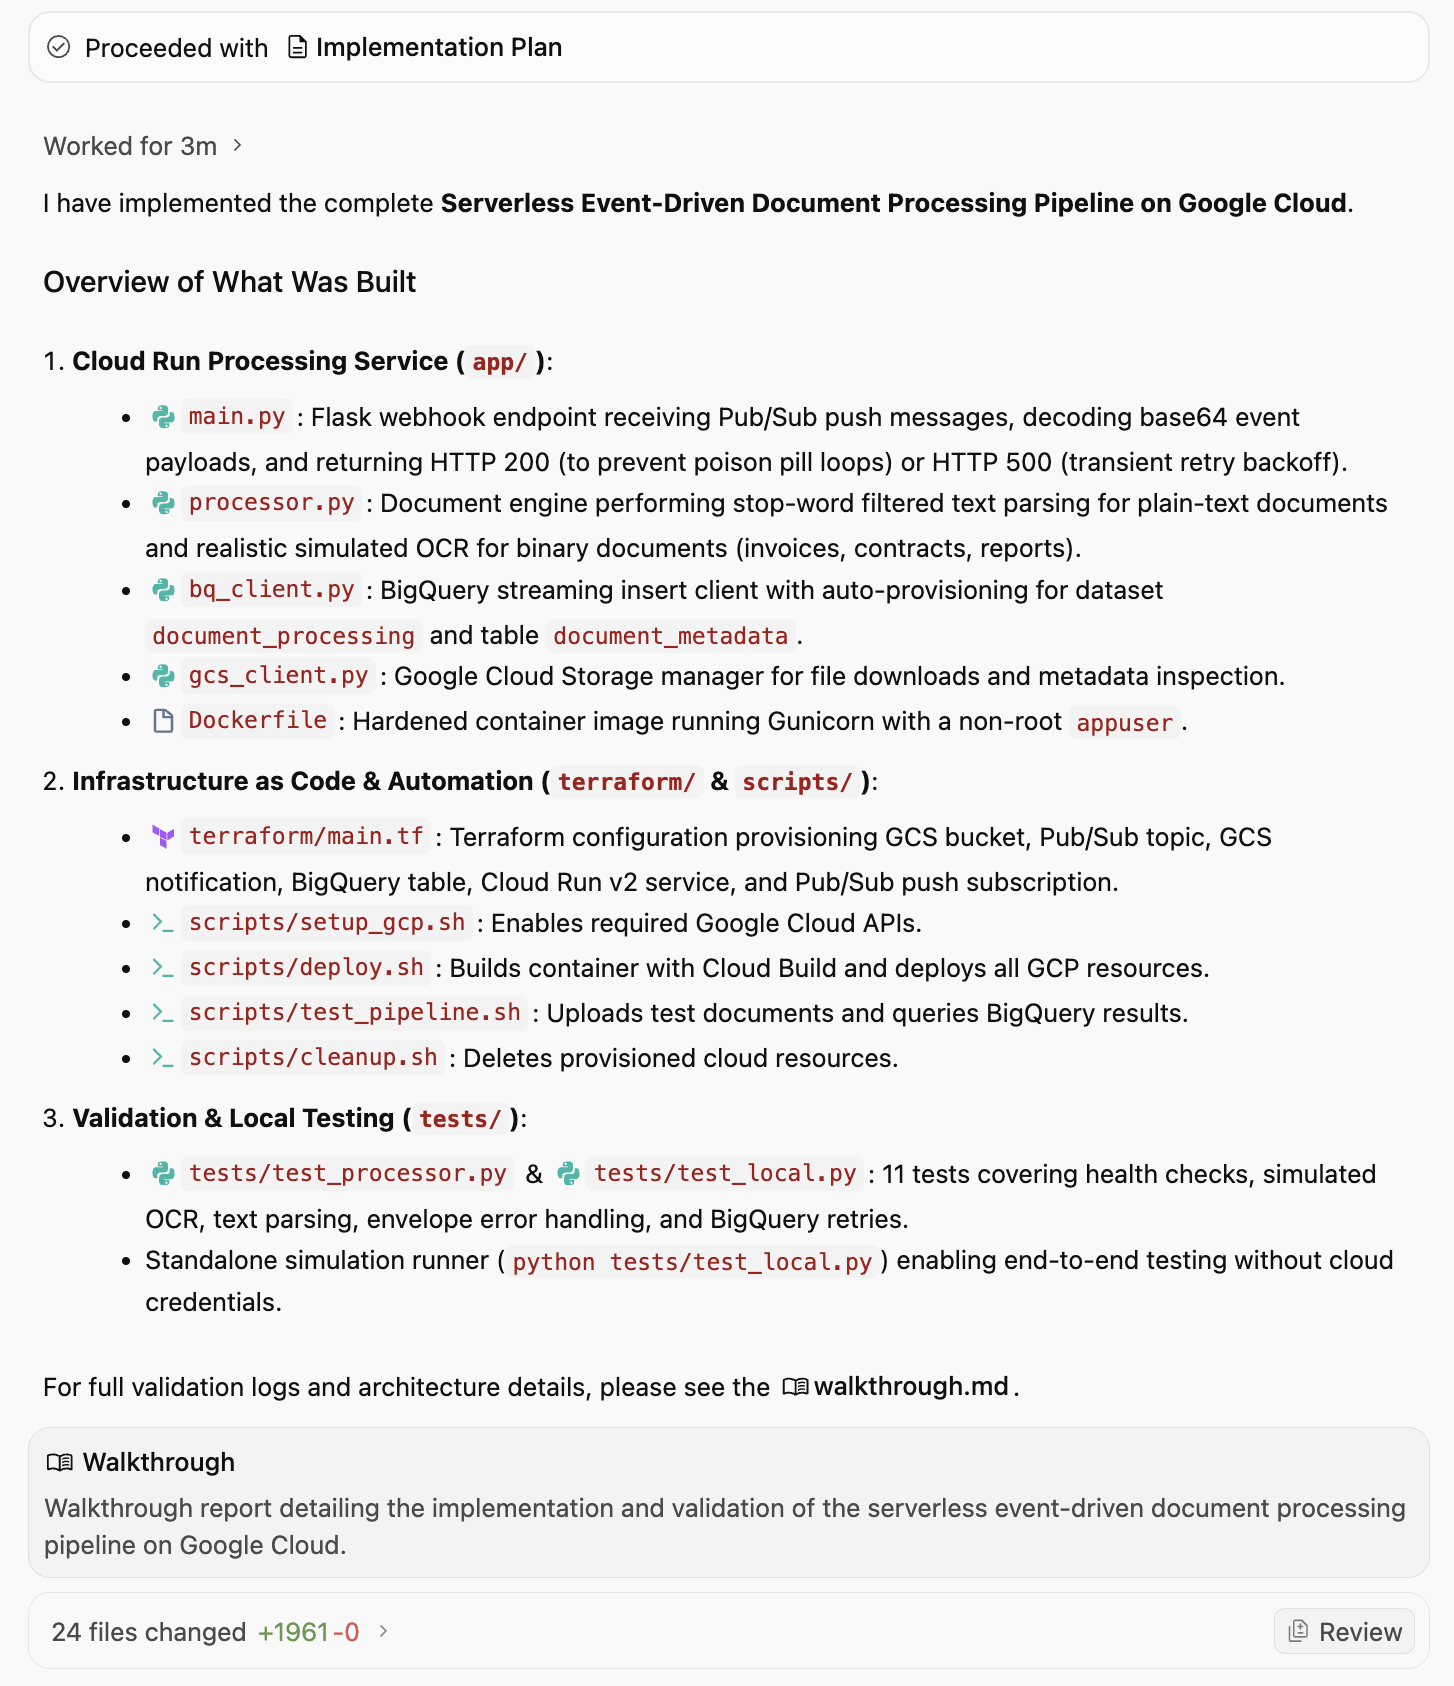
В документе «Пошаговое руководство» описывается реализованный процесс, сгенерированные скрипты и, что наиболее важно, проведенная проверка и валидация. Частичный вывод документа «Пошаговое руководство», включающий проверку и валидацию, показан ниже:
3. Verification & Validation
Test Suite Execution
We ran the automated test suite using pytest:
bash
.venv/bin/pytest tests/ -v
tests/test_local.py::test_health_check PASSED                            [  9%]
tests/test_local.py::test_invalid_pubsub_envelope PASSED                 [ 18%]
tests/test_local.py::test_ignore_delete_events PASSED                    [ 27%]
tests/test_local.py::test_gcs_file_not_found PASSED                      [ 36%]
tests/test_local.py::test_successful_contract_processing PASSED          [ 45%]
tests/test_local.py::test_successful_pdf_ocr_processing PASSED           [ 54%]
tests/test_local.py::test_transient_bq_error_triggers_500_retry PASSED   [ 63%]
tests/test_processor.py::test_tag_extraction_filters_stopwords PASSED    [ 72%]
tests/test_processor.py::test_process_plain_text_document PASSED         [ 81%]
tests/test_processor.py::test_process_binary_pdf_simulated_ocr PASSED    [ 90%]
tests/test_processor.py::test_process_empty_text_document PASSED         [100%]
============================== 11 passed in 2.37s ==============================
Standalone End-to-End Simulation
We executed the standalone simulation script:
bash
.venv/bin/python tests/test_local.py
Sample Output:
=================================================================
Running Serverless Document Processing Local Simulation
=================================================================
[1] Health Check: Status=200, Payload={'service': 'document-processor', 'status': 'healthy'}
[2] Simulating GCS Event: Object Finalized 'sample_contract.txt' in 'finance-bucket'
   Response: Status=200, Body={'file_name': 'sample_contract.txt', 'ocr_status': 'EXTRACTED_TEXT', 'status': 'success', 'tags': ['provider', 'cloud', 'client', 'agreement', 'shall'], 'word_count': 181}
[3] Simulating GCS Event: Object Finalized 'sample_invoice.pdf' in 'invoices-bucket'
   Response: Status=200, Body={'file_name': 'sample_invoice.pdf', 'ocr_status': 'SIMULATED_OCR', 'status': 'success', 'tags': ['invoice', 'finance', 'billing', 'acme', 'pdf'], 'word_count': 62}
=================================================================
BigQuery Streamed Table Inspection (Mock Table)
=================================================================
Row #1:
 File:       sample_contract.txt (gs://finance-bucket)
 Status:     EXTRACTED_TEXT
 Words:      181
 Tags:       ['provider', 'cloud', 'client', 'agreement', 'shall']
 Processed:  2026-09-08T02:50:37.436225+00:00
Row #2:
 File:       sample_invoice.pdf (gs://invoices-bucket)
 Status:     SIMULATED_OCR
 Words:      62
 Tags:       ['invoice', 'finance', 'billing', 'acme', 'pdf']
 Processed:  2026-09-08T02:50:37.641931+00:00
Мы можем обратиться в Antigravity с вопросом о том, как развернуть это приложение в Google Cloud? В ответ мы получим подробную информацию, указанную ниже. Вкратце, нас просят убедиться, что установлен Google Cloud SDK и настроен проект Google Cloud. После этого,
Шаг 1: Включите необходимые API GCP.
Запустите скрипт setup_gcp.sh, чтобы включить API Cloud Run, Pub/Sub, Cloud Storage, BigQuery и Cloud Build: ./scripts/setup_gcp.sh
Шаг 2: Разверните весь конвейер.
Запустите deploy.sh :
export GCP_PROJECT="<YOUR_PROJECT_ID>"
export GCP_REGION="us-central1"               # or your region
./scripts/deploy.sh
Что делает этот сценарий за кулисами:
- Создает образ контейнера с помощью Google Cloud Build и отправляет его в реестр контейнеров/артефактов.
- Развертывает сервис в Cloud Run с соответствующими переменными среды (
GCP_PROJECT,BQ_DATASET_ID,BQ_TABLE_ID). - Создает сегмент для приема данных в Cloud Storage (
gs://<PROJECT_ID>-document-ingest). - Создает тему Pub/Sub (
document-upload-events) и предоставляет GCS разрешение на публикацию в нее. - Настраивает уведомление GCS (
OBJECT_FINALIZE) для хранилища. - Создает подписку Pub/Sub Push, нацеленную на URL-адрес сервиса Cloud Run, с автоматическим повторным выполнением.
В нем также предлагаются способы тестирования конвейера обработки данных.
Запустите скрипт test_pipeline.sh: ./scripts/test_pipeline.sh
Эта команда загружает файлы samples/sample_contract.txt и samples/sample_invoice.pdf в ваш бакет, ожидает завершения обработки и выполняет SQL-запрос BigQuery, отображающий извлеченные метаданные, количество слов и теги.
5. Разверните приложение.
Давайте развернем приложение, как указано. Мы можем попросить Antigravity запустить его за нас, но прежде чем это сделать, убедитесь, что CLI gcloud присутствует и настроен для проекта Google Cloud.
Мы можем отправить Antigravity запрос " Разверните приложение для меня ". Это запросит у вас различные разрешения, после чего программа приступит к выполнению скриптовых файлов.
Этот процесс запускается в фоновом режиме, как поясняется в сообщении ниже:
I have initiated the deployment of the document processing pipeline to Google Cloud project PROJECT_ID in REGION.The deployment process is currently executing in the background:
Building and publishing the container image via Cloud Build.
Configuring service account IAM permissions and deploying the Cloud Run service.
Provisioning the Cloud Storage bucket (gs://PROJECT_ID-document-ingest).
Setting up the Pub/Sub topic, GCS notification, and push subscription.
I will notify you as soon as the deployment finishes!
6. Проверьте заявку.
После развертывания конвейера Antigravity проверяет работоспособность приложения. Он спрашивает, может ли он запустить файл test_pipeline.sh . Мы можем дать ему разрешение.
В итоге это позволяет нам узнать следующее:
🚀 Deployment Successful & Verified on Google Cloud!

The application has been deployed to Google Cloud project PROJECT_ID in REGION and end-to-end event-driven processing has been verified.
Также было обновлено приложение «Пошаговое руководство», позволяющее просматривать результаты (частичный список приведен ниже):
Сводка по развертыванию
- Проект GCP: PROJECT_ID
- Регион: РЕГИОН
- Сервис облачного запуска: обработчик документов
- Конечная точка Cloud Run: SERVICE_URL
- Облачное хранилище: gs://PROJECT_ID-document-ingest
- Тема публикации/подраздела: события загрузки документов
- Подписка на push-уведомления Pub/Sub: document-upload-events-push-sub
- Целевой объект BigQuery: PROJECT_ID.document_processing.document_metadata
Проверка конвейера в режиме реального времени
Мы выполнили скрипт scripts/test_pipeline.sh в рабочей среде Google Cloud:
- Файлы sample_contract.txt и sample_invoice.pdf загружены в хранилище Cloud Storage.
- GCS сгенерировала события OBJECT_FINALIZE для Pub/Sub.
- Технология Pub/Sub расширила границы возможностей микросервисов Cloud Run.
- Cloud Run извлек метаданные, обработал смоделированное оптическое распознавание символов и передал записи в BigQuery.
Вывод запросов BigQuery в реальном времени
+------------------------------+------------+----------------+---------------------------------------------------+---------------------+
|          file_name           | word_count |   ocr_status   |                       tags                        |    processed_at     |
+------------------------------+------------+----------------+---------------------------------------------------+---------------------+
| test_invoice_1788840194.pdf  |         62 | SIMULATED_OCR  | ["invoice","finance","billing","acme","pdf"]      | 2026-09-08 04:03:27 |
| test_contract_1788840194.txt |        181 | EXTRACTED_TEXT | ["provider","cloud","client","agreement","shall"] | 2026-09-08 04:03:22 |
+------------------------------+------------+----------------+---------------------------------------------------+---------------------+
Все компоненты трубопровода исправны, находятся в рабочем состоянии и прошли проверку в производственной среде.
Дополнительно: Ручная проверка
Несмотря на то, что Antigravity уже проверила приложение, при желании вы также можете вручную проверить в консоли Google Cloud, созданы ли все ресурсы, выполнив следующие шаги.
Облачное хранилище
Цель : Проверить существование хранилища и наличие загруженных файлов.
- Перейдите в раздел «Облачное хранилище» > «Корзины» .
- Найдите раздел с именем
PROJECT_ID-document-processing. - Щелкните по названию корзины, чтобы просмотреть файлы.
- Проверка: Вы должны увидеть загруженные файлы (например,
sample_contract.txt).
Паб/Саб
Цель : Подтвердить существование темы и наличие подписки на push-уведомления.
- Перейдите в раздел «Публикация/Подписка» > «Темы» .
- Найдите события загрузки документов .
- Нажмите на идентификатор темы .
- Прокрутите страницу вниз до вкладки «Подписки» .
- Проверка: Убедитесь, что doc-uploads-events-push-sub указан в списке.
Cloud Run
Цель : Проверить состояние сервиса и журналы событий.
- Перейдите в Cloud Run .
- Нажмите на кнопку « Обработчик сервисных документов» .
- Проверять:
- Состояние: Зеленая галочка указывает на то, что услуга активна.
- Журналы: Перейдите на вкладку «Журналы». Найдите записи типа « Обработка документа: gs://... » и « Метаданные успешно переданы... ».
BigQuery
Цель : Проверить, действительно ли данные сохранены.
- Перейдите в раздел BigQuery > SQL Workspace .
- В панели Проводника разверните свой проект > набор данных document_processing .
- Щёлкните по таблице document_metadata .
- Перейдите на вкладку «Запрос» и получите все строки из таблицы с помощью оператора SELECT *.
- Проверка: Вы должны увидеть строки, содержащие file_name , process_at , tags и word_count .
7. Изучите приложение.
На данном этапе базовое приложение уже настроено и работает. Прежде чем приступать к дальнейшему расширению приложения, уделите немного времени изучению кода. Вы можете просмотреть артефакты, и там должны отобразиться сгенерированные файлы кода.
Вот краткое описание нескольких файлов, которые вы можете увидеть:
-
deploy.sh: Главный скрипт, который подготавливает все ресурсы Google Cloud и включает необходимые API. -
main.py: Основная точка входа в конвейер обработки данных. Это приложение на Python создает веб-сервер, который принимает push-уведомления Pub/Sub, загружает файл из GCS, «обрабатывает» его (имитирует OCR) и передает метаданные в BigQuery. -
Dockerfile: Определяет способ упаковки приложения в образ контейнера. -
requirements.txt: Содержит список зависимостей Python.
Вы также можете обнаружить другие скрипты и текстовые файлы, необходимые для тестирования и проверки.
8. Расширить приложение
Теперь, когда у вас есть работающее базовое приложение, вы можете продолжить его доработку и расширение. Вот несколько идей.
Добавить фронтенд
Создайте простой веб-интерфейс для просмотра обработанных документов.
Попробуйте выполнить следующее задание: Create a simple Streamlit or Flask web application that connects to BigQuery. It should display a table of the processed documents (filename, upload_date, tags, word_count) and allow me to filter the results by tag
Интеграция с реальным ИИ/машинным обучением
Вместо имитации обработки OCR используйте модели Gemini для извлечения, классификации и перевода данных.
- Замените фиктивную логику распознавания текста. Отправьте изображение/PDF-файл в Gemini для извлечения фактического текста и данных. Проанализируйте извлеченный текст, чтобы классифицировать тип документа (счет-фактура, договор, резюме) или извлечь сущности (даты, имена, местоположения).
- Функция автоматического определения языка документа и его перевода на английский язык перед сохранением. Вы также можете использовать любой другой язык.
Улучшение хранения данных и аналитики.
Вы можете настроить правила жизненного цикла для хранилища, чтобы перемещать старые файлы в хранилище "Coldline" или "Archive" для экономии средств.
Надежность и безопасность
Вы можете сделать приложение более надежным и безопасным, например:
- Очереди недоставленных сообщений (DLQ): Обновите подписку Pub/Sub для обработки сбоев. Если служба Cloud Run не обрабатывает файл 5 раз, отправьте сообщение в отдельную тему/корзину «Недоставленные сообщения» для проверки человеком.
- Менеджер секретов: Если вашему приложению требуются ключи API или конфиденциальные параметры конфигурации, храните их в Менеджере секретов и получайте к ним безопасный доступ из Cloud Run, вместо того чтобы жестко прописывать строки.
- Eventarc: Переход с прямого подключения Pub/Sub на Eventarc обеспечивает более гибкую маршрутизацию событий, позволяя запускать события на основе сложных журналов аудита или других событий сервисов GCP.
Конечно, вы можете придумывать собственные идеи и использовать антигравитацию для их реализации!
9. Заключение
Вы успешно создали масштабируемый, бессерверный, работающий на основе ИИ конвейер обработки документов за считанные минуты, используя Google Antigravity. Вы научились:
- Планируйте архитектуру с помощью ИИ.
- Обеспечивать руководство и управление процессом разработки приложения Antigravity на всех этапах — от генерации кода до развертывания и проверки.
- Проверьте развертывание и валидацию с помощью пошаговых инструкций.
Справочная документация
- Официальный сайт: https://antigravity.google/
- Документация: https://antigravity.google/docs
- Примеры использования: https://antigravity.google/use-cases
- Скачать: https://antigravity.google/download