

۱. نمای کلی
بیشتر اشکالات SQL که از بازبینی کد جان سالم بهدر میبرند، اشکالات تجمیع هستند. عددی در جدولی که در آن قرار دارد درست است، پیوندی آن را کپی میکند، و مجموع بهطور نامحسوس اشتباه است.
با BigQuery Graph میتوانید نحوه اتصال جدولهایتان را یکبار بهعنوان گراف خصوصیت توصیف کنید و سپس اتصالها را پُرسمان کنید. سنجههای گراف یک چیز دیگر به آن شرح اضافه میکنند: خود تجمیع. MEASURE(SUM(streams)) را در گرهی که مالک شماره است اعلام میکنید، و هر پُرسمانی که گراف را میخواند مجموع درست را در دانه درست دریافت میکند — بدون ترفند GROUP BY، بدون عبارت جدولی مشترکی که کسی باید بهخاطر بسپارد.
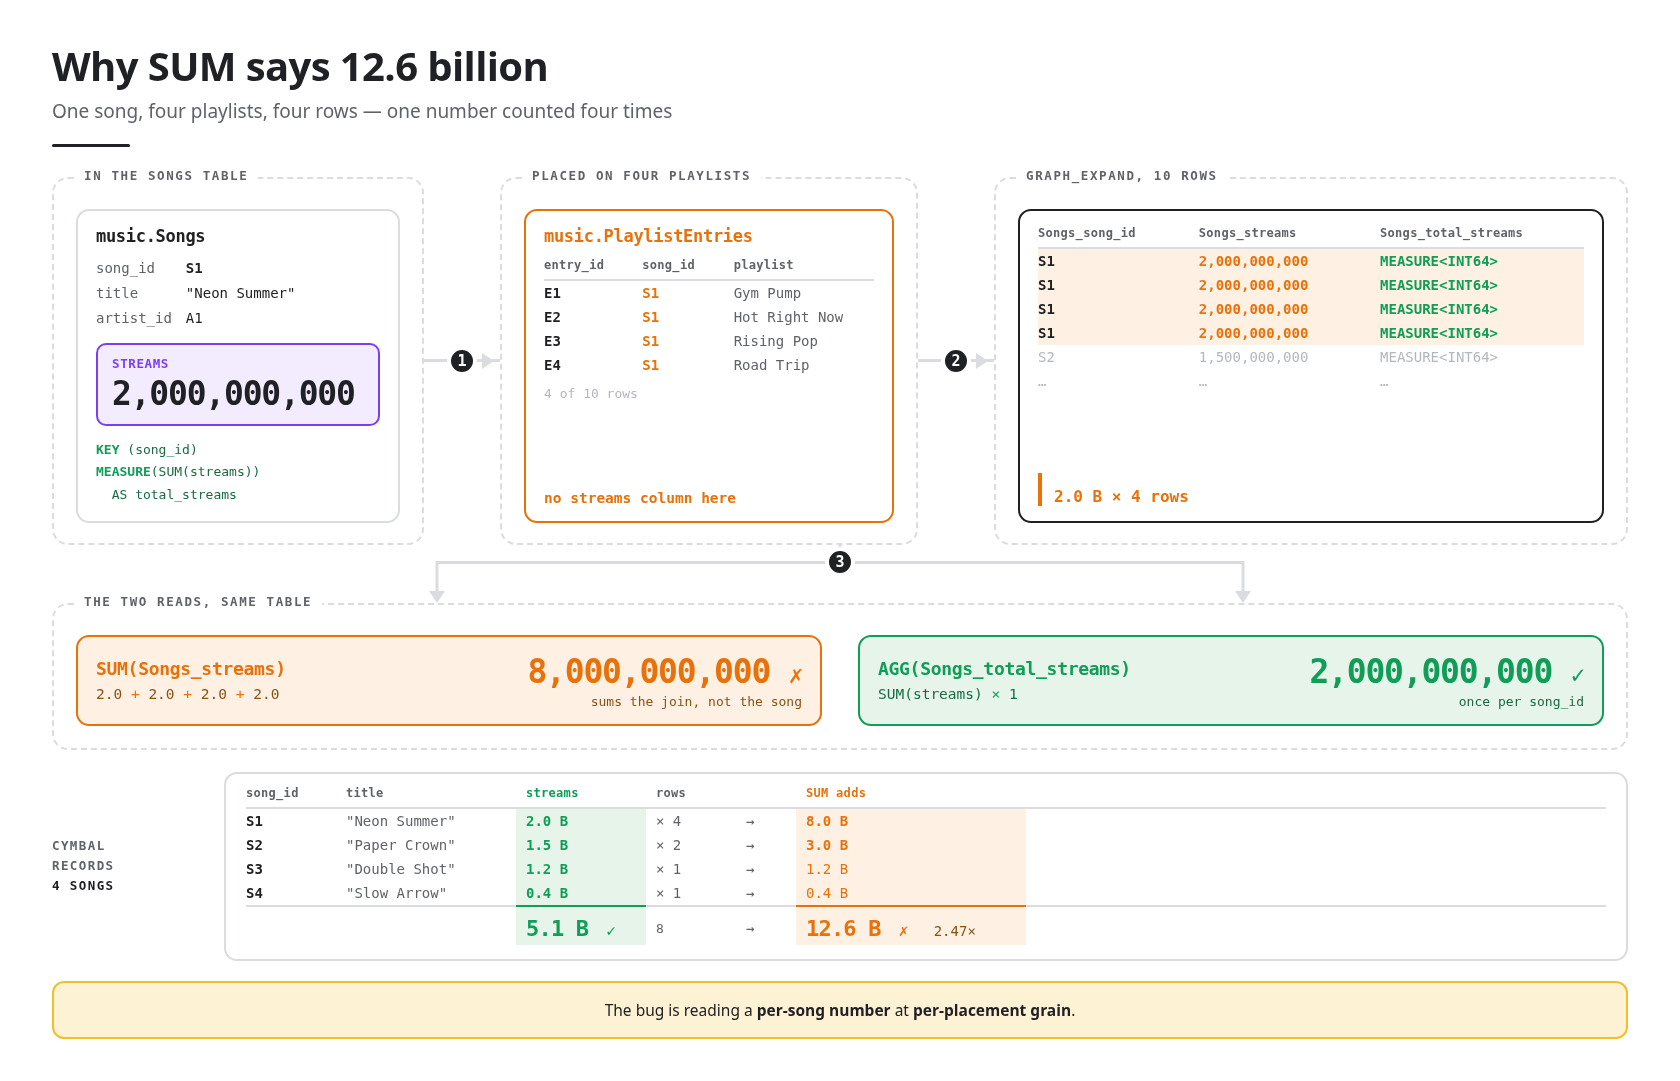
در این کدآزمایی، کاتالوگ موسیقی پنج جدولی میسازید، یک میزان موسیقی در آن قرار میدهید، و میبینید که همان پرسش دو پاسخ متفاوت برمیگرداند: ۱۲٫۶ میلیارد با SUM، ۵٫۱ میلیارد با AGG. این فاصله شکل کاتالوگ است — آهنگی که در چهار فهرست پخش قرار دارد وقتی نمودار مسطح میشود به چهار ردیف تبدیل میشود و SUM هر چهار ردیف را اضافه میکند. سپس قوانینی را یاد میگیرید که مورد دوم را درست میکند.
جایی که چیزها را تایپ میکنید
این آزمایشگاه دقیقاً از دو مکان به این ترتیب استفاده میکند:
کجا | کاری که در آنجا انجام میدهید | |
1 | ترمینال Cloud Shell | تعداد کمی فرمان، فقط در مرحله راهاندازی |
2 | کنسول BigQuery | هر چیز دیگری: جایگذاری پُرسمانها در ویرایشگر پُرسمان، کلیک کردن در مدلساز گراف، گپ زدن با عامل |
هر دستورالعمل برچسبگذاری شده است تا همیشه بدانید کدام دستورالعمل است:
- 👉💻 Cloud Shell — این را در ترمینال Cloud Shell تایپ کنید.
- 👉📋 ویرایشگر پُرسمان — این را در ویرایشگر پُرسمان BigQuery جایگذاری کنید و روی اجرا کلیک کنید.
- 👉🌐 کنسول — در کنسول BigQuery کلیک کنید. چیزی برای تایپ کردن وجود ندارد، مگراینکه مرحله این را بگوید.
- 👀 — به نتیجه نگاه کنید.
آنچه خواهید آموخت
- نحوه تعریف کردن سنجه در جدول گره — در مدلساز گراف دیداری یا در SQL
-
GRAPH_EXPANDچگونه نمودار را به یک جدول پهن تبدیل میکند - چرا
AGGتنها تابعی است که میتواند یک سنجه را بخواند، و هر تلاش دیگری چه میگوید - شش تجمیعی که سنجه پشتیبانی میکند و نحوه انجام محاسبات ریاضی روی آنها
- نحوه پاسخ یک معیار به پرسشی که بهصورت متفاوت گروهبندی شده است بدون هیچ تغییری
- اختیاری: اینکه GQL و برگه «گراف» چگونه به سؤالی پاسخ میدهند که مجموع نمیتواند، و اینکه عامل داده BigQuery چگونه بدون اینکه به او گفته شود از سنجههای شما استفاده میکند
آنچه نیاز خواهید داشت
- حساب Google با صورتحساب دردسترس و مرورگر. در ابتدا به پروژه Google Cloud نیاز ندارید — «راهاندازی» یکی برایتان ایجاد میکند.
- فقط برای مرحله اختیاری گپ: «میانای برنامهسازی کاربردی Gemini Data Analytics» فعال باشد و نقش سازنده عامل داده Gemini Data Analytics را داشته باشید.
چیزی برای نصب در ماشین شما وجود ندارد. همه چیز در Cloud Shell و کنسول BigQuery اجرا میشود.
وضعیت و هزینه محصول
BigQuery Graph بهطور کلی دردسترس است. سنجههای گراف، مدلساز گراف دیداری، دیداریسازی گراف، و استفاده از گراف بهعنوان منبع دانش عامل داده در حالت پیشنمایش است و تحت پوشش «شرایط پیشنهادهای پیشاز GA» قرار دارد.
GRAPH_EXPAND و AGG تحت قیمتگذاری درصورت تقاضا اجرا میشوند. پُرسمانهای GQL (مرحله مسیر اختیاری) طبق مستندات، به رزرو بااستفاده از نسخه Enterprise یا Enterprise Plus نیاز دارد — به همین دلیل این مرحله اختیاری است.
مجموعه داده چند کیلوبایت است. در قیمتگذاری براساس تقاضا، هزینه هر پُرسمان براساس حداقل ۱۰ مگابایت محاسبه میشود، بنابراین هزینه کل این آزمایش کد کسری از یک سنت است.
۲. راهاندازی
این تنها مرحلهای است که از Cloud Shell استفاده میکند. این کار پروژهای ایجاد میکند، صورتحساب را روی آن قرار میدهد، و جدولهای خام را میسازد. گراف، معیار، و هر پُرسمانی که بعداً در کنسول BigQuery اجرا میکنید متعلق به شما است.
این آزمایشگاه یک چیز را نمیتواند به شما ارائه دهد: پروژه Google Cloud با صورتحساب. مرحله ۱ حسابی را دراختیارتان قرار میدهد که میتواند هزینه آن را پرداخت کند؛ مرحله ۴ آن حساب را به پروژه تبدیل میکند. آنها را به همین ترتیب انجام دهید — هر مرحله بعداز ۴، پروژهای را که مرحله ۴ ایجاد میکند میخواند.
۱ · دریافت حساب با صورتحساب (~۱ دقیقه)
👉🌐 این کار را قبلاز هر چیز دیگری انجام دهید. با «حساب Google» که صورتحساب در آن فعال است به سیستم وارد شوید. هر حسابی از این نوع کار میکند. اگر حساب شما این ویژگی را ندارد، دوره آزمایشی رایگان را شروع کنید؛ این دوره به شما حساب صورتحساب میدهد که تمام چیزی است که مرحله ۴ نیاز دارد.
۲ · باز کردن Cloud Shell (حدود ۱ دقیقه)
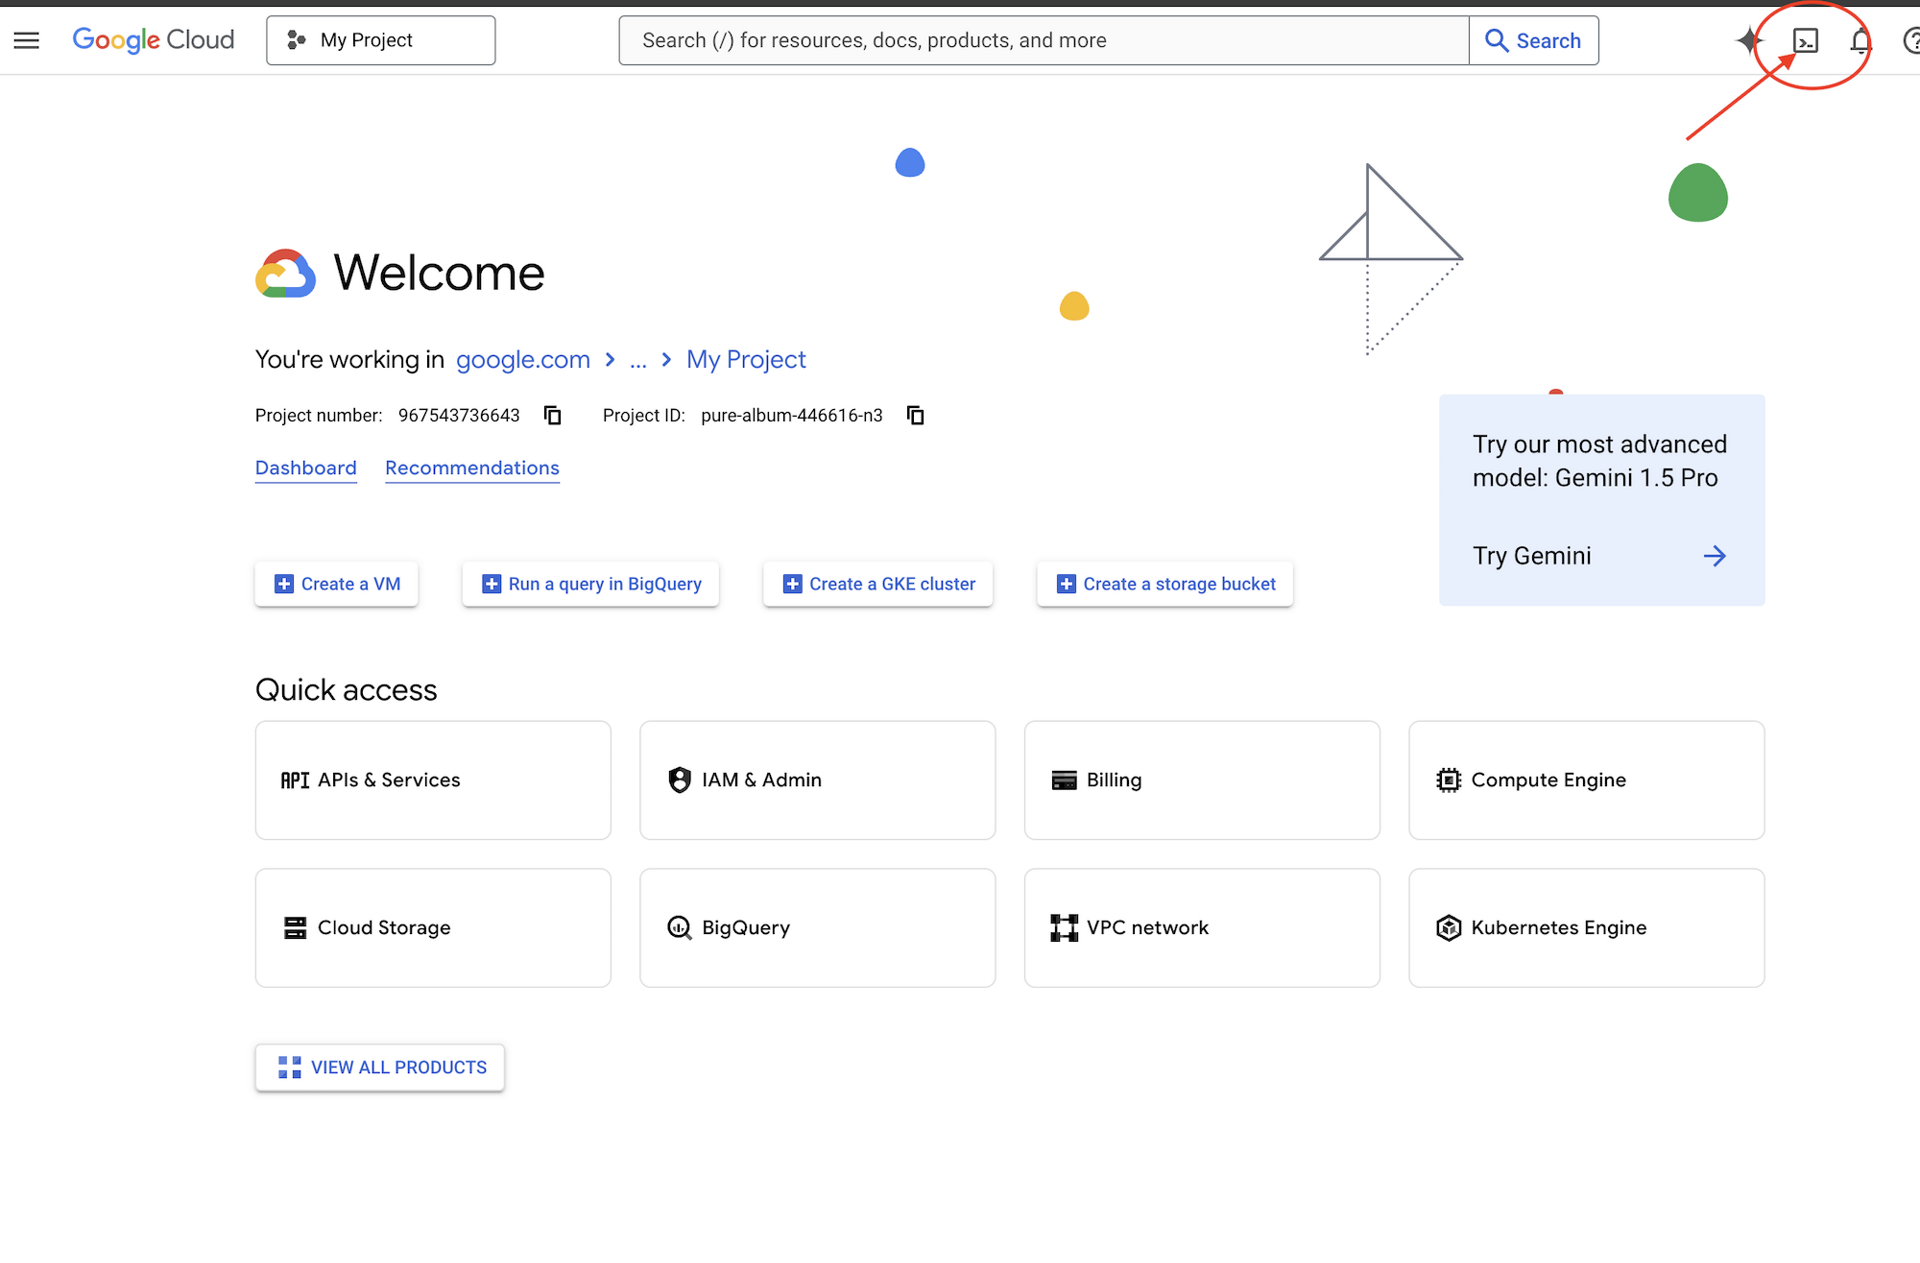
👉🌐 کنسول — در بالای کنسول Google Cloud روی فعال کردن Cloud Shell کلیک کنید — این نماد ترمینالشکل در سرایند است. پایانهای در پایین صفحه باز میشود.
👉🌐 کنسول — اگر در هر زمانی از امروز از شما خواسته شد که مجوز دهید، برای ادامه دادن روی مجوز دادن کلیک کنید.
👉💻 Cloud Shell — بررسی کنید که Cloud Shell با کدام حساب وارد سیستم شده است:
gcloud auth list
👀 انتظار داشته باشید حساب خودتان با * علامتگذاری شود و باید همان حسابی باشد که با آن به سیستم وارد شدید در مرحله ۱. اگر این حساب نیست، gcloud auth login را اجرا کنید و حساب درست را انتخاب کنید.
۳ · دریافت آزمایشگاه (~۱ دقیقه)
👉💻 Cloud Shell — مخزن را همسانهسازی کنید:
cd ~
rm -rf ~/bq-graph-measures-lab
git clone https://github.com/cuppibla/bq-graph-measures-lab.git
cd ~/bq-graph-measures-lab
۴ · ایجاد پروژه (~۲ دقیقه)
👉💻 Cloud Shell — یک دستورگان حساب صورتحساب شما را پیدا میکند، پروژهای در آن ایجاد میکند، و Cloud Shell را به آن پروژه هدایت میکند:
cd ~/bq-graph-measures-lab
./setup_project.sh
👀 انتظار داشته باشید که ✓ برای حساب صورتحسابی که انتخاب کرده است، ✓ برای پروژهای که ایجاد کرده است، و پایانی مانند این داشته باشد:
Project ready: bq-graph-4271
  Next:  ./setup.sh
bq-graph-4271 شناسه پروژه شما است — شناسه شما ارقام متفاوتی خواهد داشت. چهار چیز در آنجا اتفاق میافتد:
صورتحساب | اگر حساب | |
پروژه | | |
انتخاب میکند | شناسه را در | |
منتظر میماند | نظرسنجی تا زمانی که پروژه کاملاً جدید اجازه ارائه را دریافت کند، حداکثر تا دو دقیقه | |
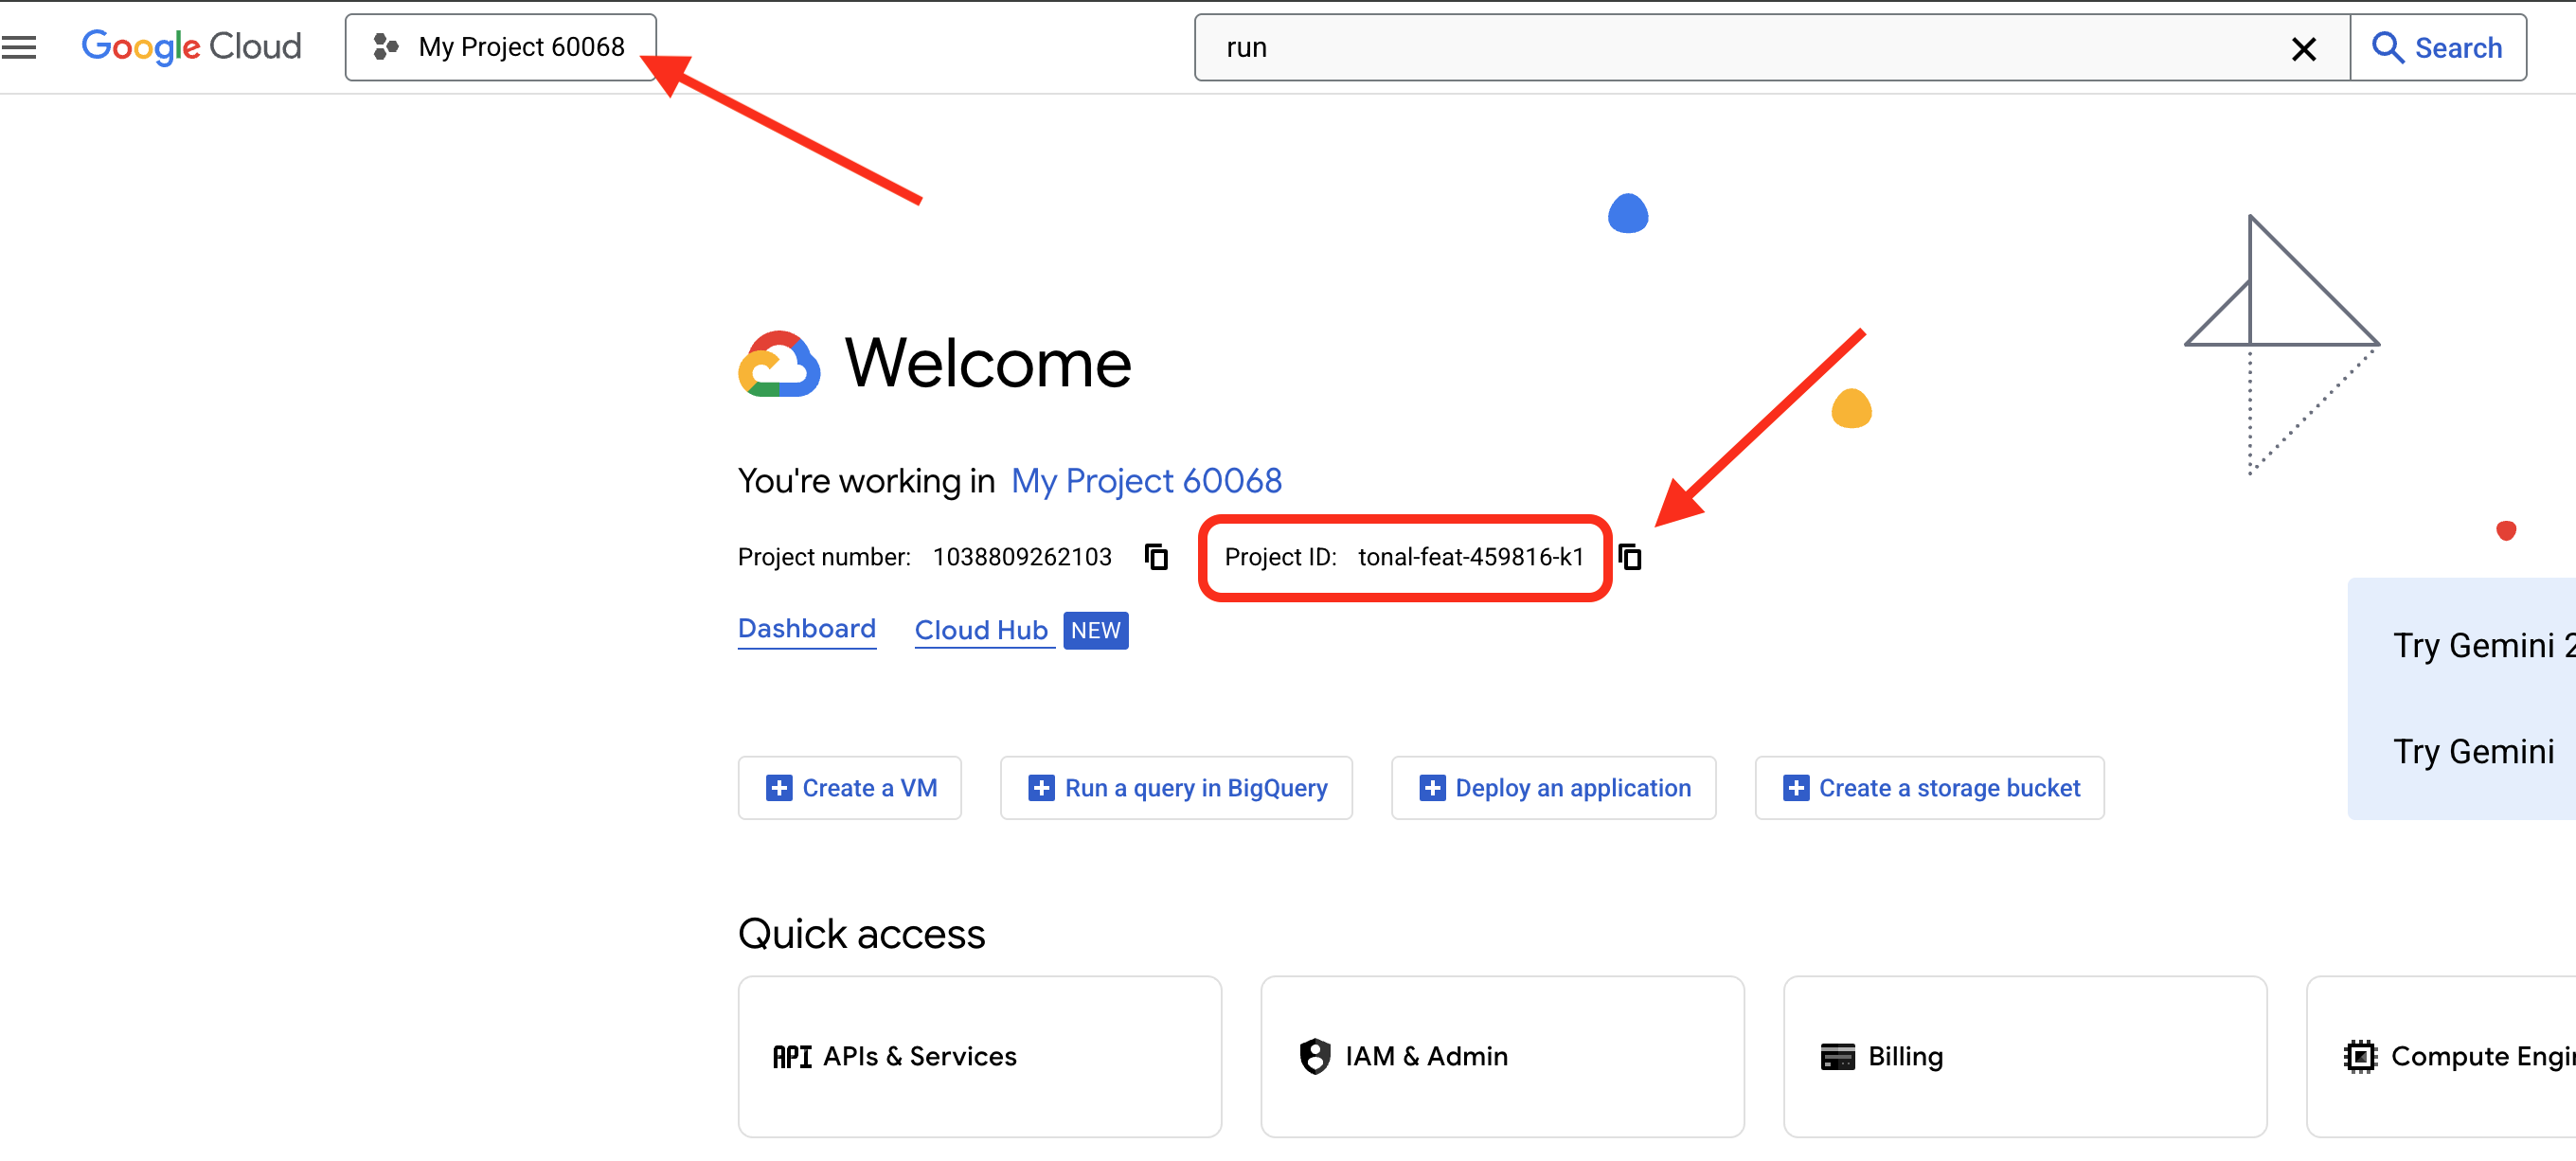
🌐 اکنون همان پروژه در کنسول است — شناسه آن در کارت اطلاعات پروژه در «داشبورد» قرار دارد:
۵ · ایجاد مجموعه داده (~۳ دقیقه)
👉💻 Cloud Shell — یک دستورگان دیگر جدولها را میسازد:
cd ~/bq-graph-measures-lab
./setup.sh
این دستورگان هر مرحله را هنگام اجرا چاپ میکند. آنچه بهترتیب انجام میدهد:
پروژه | پروژه را از | |
میانای برنامهسازی کاربردی | | |
مجموعه داده | مجموعه داده | |
بررسی | تعداد ردیفهای هر جدول را میشمارد و اگر تعداد ردیفها درست نباشد متوقف میشود | |
👀 انتظار میرود:
BigQuery Graph Measures · setup
  ✓ project: bq-graph-4271
  ✓ BigQuery API enabled

Creating dataset music (US) and five tables...
  ✓ music.Labels              2 rows
  ✓ music.Artists             3 rows
  ✓ music.Songs               5 rows
  ✓ music.Playlists           4 rows
  ✓ music.PlaylistEntries    10 rows

🎉 ready — open BigQuery Studio: https://console.cloud.google.com/bigquery?project=bq-graph-4271
کار با Cloud Shell تمام شد. میتوانید آن را ببندید.
۶ · BigQuery و ویرایشگر پُرسمان را باز کنید
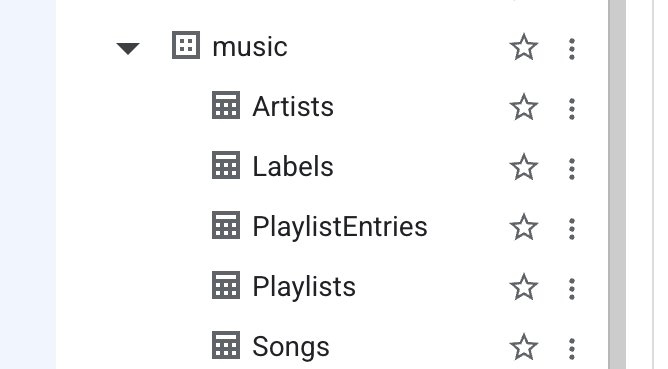
👉🌐 کنسول — روی پیوند انتهای برونداد کلیک کنید، یا BigQuery را از منو پیمایش باز کنید. در قاب کاوشگر در سمت راست، پروژه خود را ازهم باز کنید: مجموعه داده music با پنج جدول.
👉🌐 کنسول — در بالای BigQuery Studio، در ردیف ایجاد جدید، روی پُرسمان SQL کلیک کنید. زبانه ویرایشگر خالی باز میشود.
این زبانه را نگه دارید. هر 👉📋 بلوک در این آزمایشگاه به اینجا میرود: هر آنچه در ویرایشگر است را انتخاب کنید، بلوک جدید را روی آن جایگذاری کنید، روی اجرا کلیک کنید. نتیجه در پانل زیر نشان داده میشود.
با جدولها آشنا شوید
دو چیز درباره این جدولها بعداً اهمیت پیدا میکند. هر جدولی کلید اصلی خود را بهعنوان NOT ENFORCED اعلام میکند: BigQuery آن را بررسی نمیکند، اما گراف دارایی که میخواهید بسازید برای اینکه بداند چه چیزی یک ردیف را شناسایی میکند به کلید صریحی نیاز دارد. و جدول آخر، PlaylistEntries، یک جدول اتصال است: آهنگی که در چهار فهرست پخش قرار دارد، چهار ردیف در آن دارد. کل داستان در آن جدول اتفاق میافتد.
جدولها بهاینصورت بههم متصل میشوند: یک ناشر با هنرمندان قرارداد میبندد، یک هنرمند آهنگ منتشر میکند، یک آهنگ ازطریق PlaylistEntries در فهرستهای پخش قرار میگیرد. شرکت Cymbal Records مالک Ava Sterling و Mina Okafor و ازطریق آنها مالک چهار آهنگ است. Northwind Audio مالک Kai Nakamura و یک آهنگ، Midnight Drive است.
جدول | ردیفها | کلید | آنچه دربردارد |
برچسبها | 2 |
| نام، بودجه بازاریابی |
هنرمندان | 3 |
| نام، کدام برچسب |
آهنگها | 5 |
| عنوان، کدام هنرمند، جاریسازیها |
فهرستهای پخش | 4 |
| نام، دنبالکنندگان |
PlaylistEntries | 10 |
| کدام آهنگ در کدام فهرست پخش قرار دارد |
✅ ایست بازرسی: 🎉 ready در Cloud Shell، پنج جدول در music در «کاوشگر»، و زبانه ویرایشگر پُرسمان خالی باز است.
۳. ایجاد گراف — گزینه الف: مدلساز دیداری
گراف ویژگی شرحی از نحوه اتصال جدولها است. میتوانید آن را در مدلساز گراف دیداری (این مرحله، همه کلیکها) باهم کلیک کنید یا آن را بهصورت SQL بنویسید (مرحله بعدی، یک جایگذاری). هر دو شیء یکسانی تولید میکنند — یکی از آنها را انجام دهید، نه هر دو.
۱. ایجاد پوسته گراف
👉🌐 کنسول — در BigQuery Studio، در ردیف ایجاد جدید، منو هوش مصنوعی و دانش را باز کنید و روی گراف کلیک کنید.
👉🌐 کنسول — MusicGraph را بهعنوان نام گراف و music را بهعنوان مقصد گراف در مجموعه داده وارد کنید. منطقه از مجموعه داده (ایالات متحده) تکمیل میشود.
👉🌐 Console — در بخش منابع داده، پنج جدول — Artists (هنرمندان)، Labels (برچسبها)، PlaylistEntries (ورودیهای فهرست پخش)، Playlists (فهرستهای پخش)، Songs (آهنگها) — را انتخاب کنید و روی ایجاد کلیک کنید.
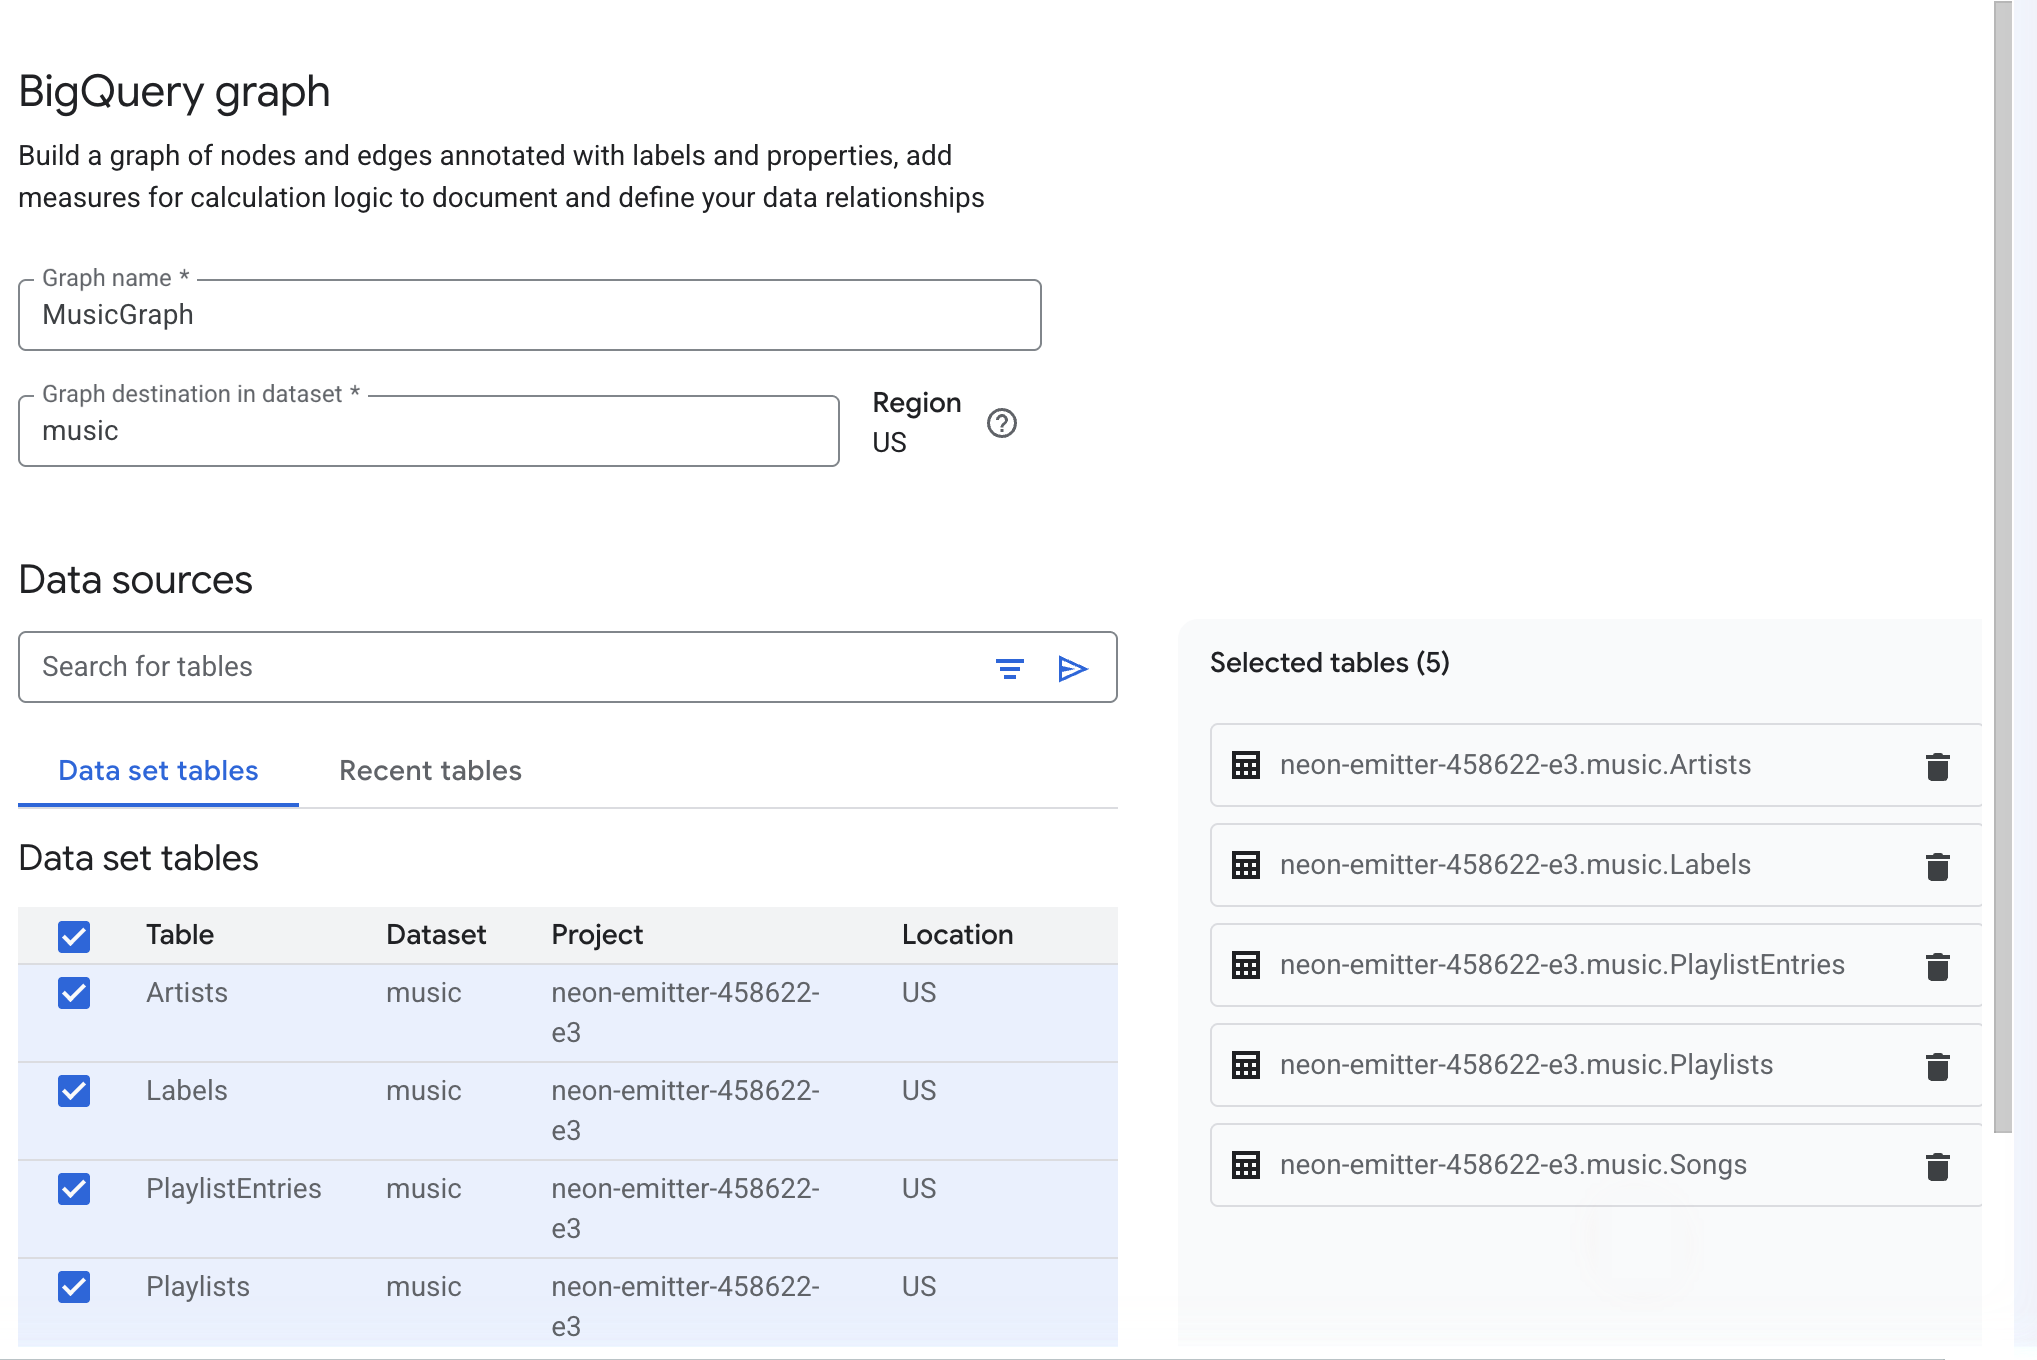
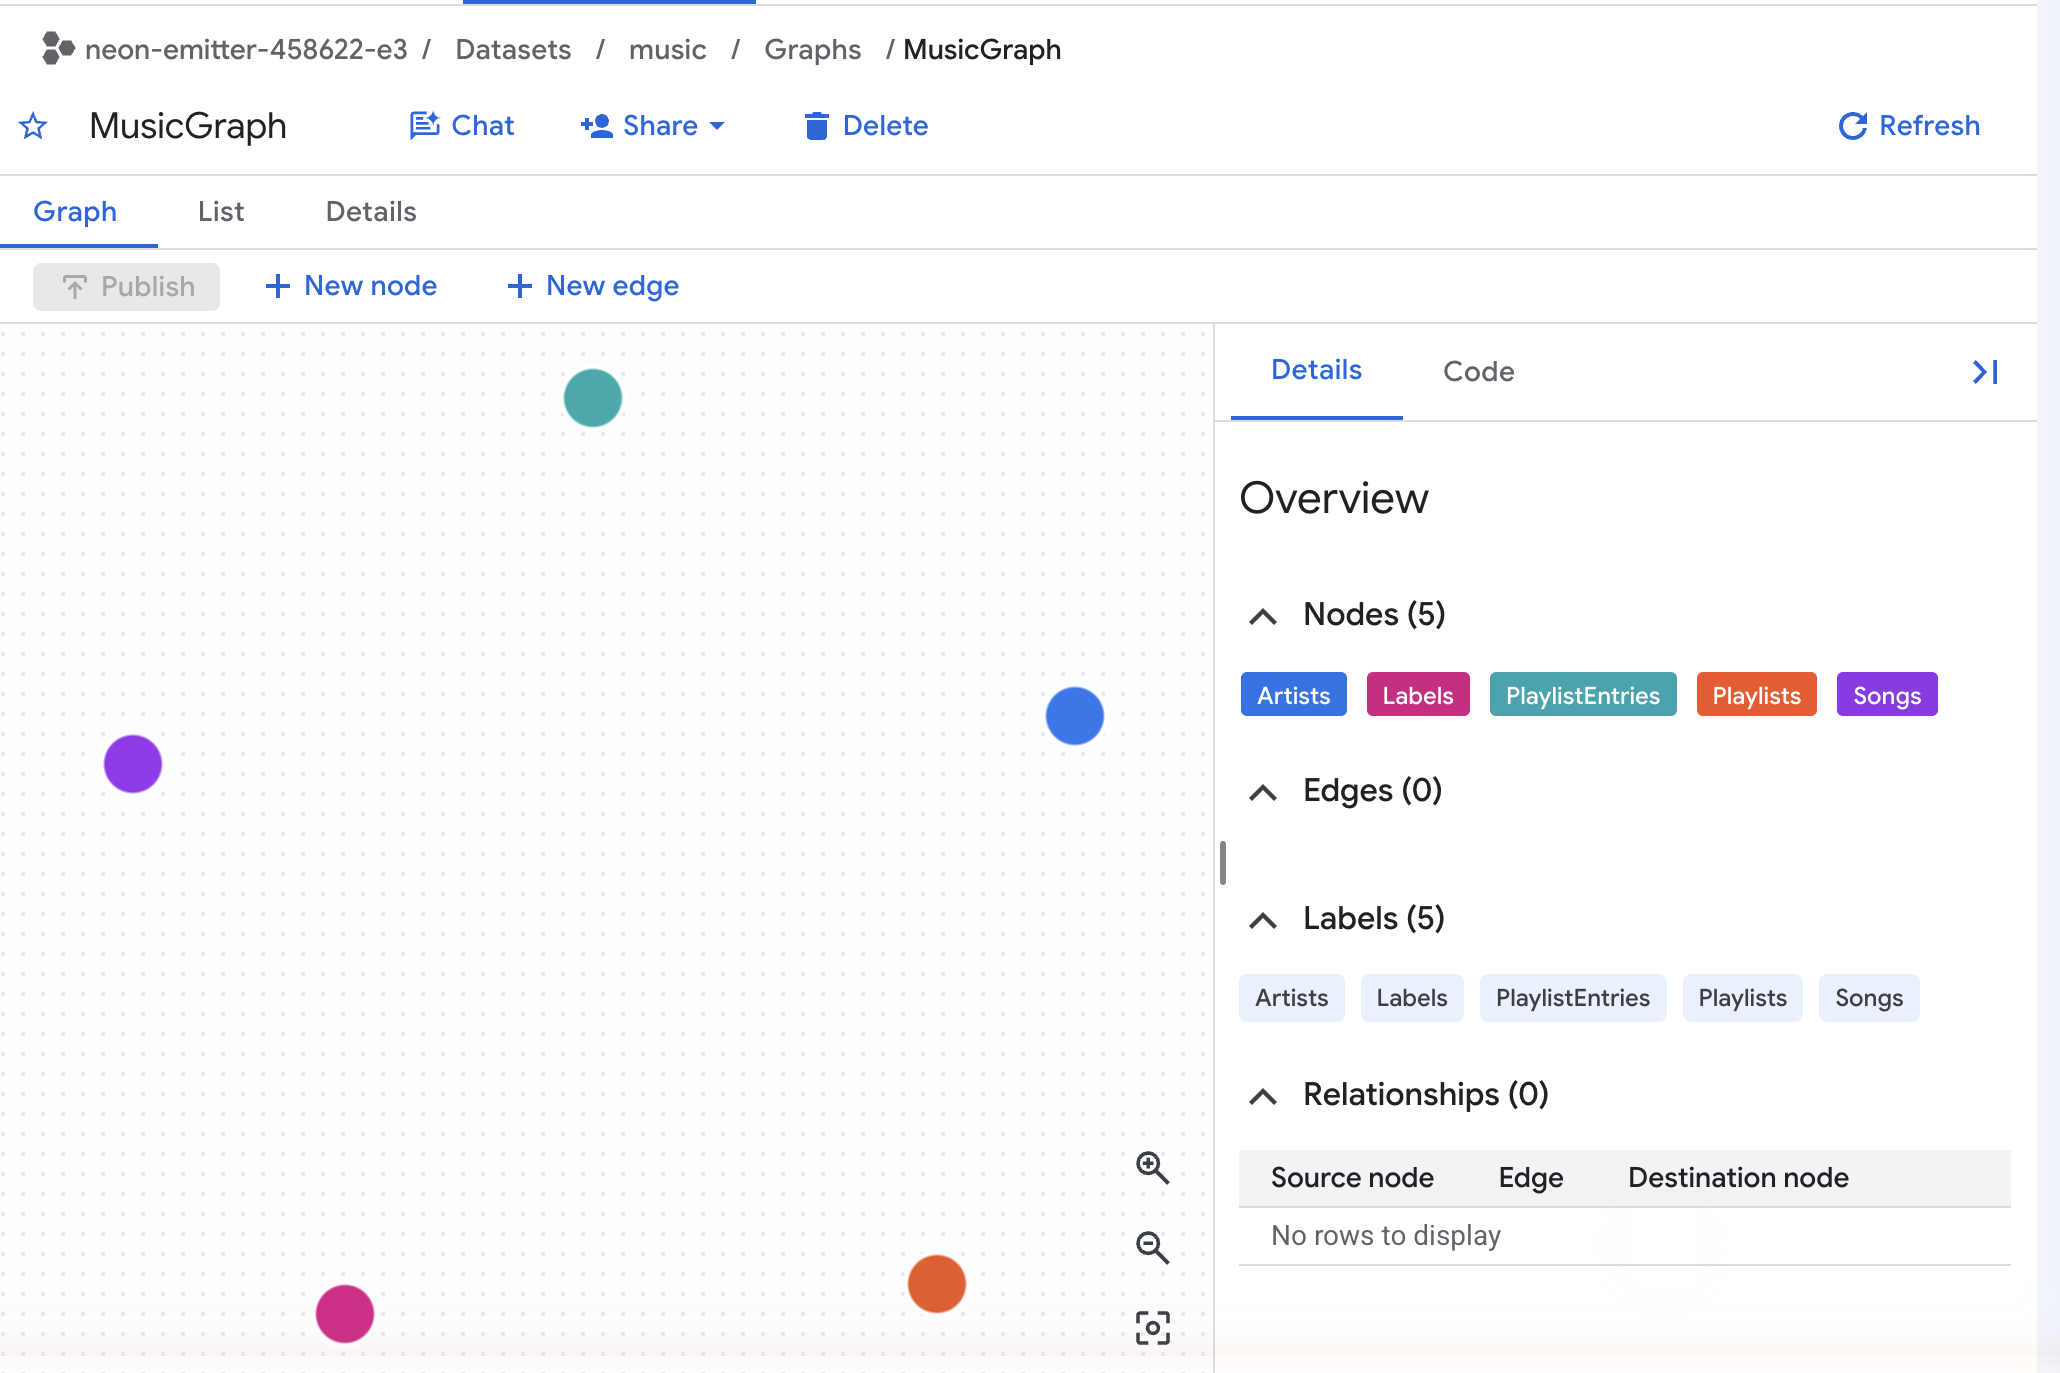
👀 بوم با پنج گره رنگی و بدون خط بین آنها باز میشود. پانل جزئیات در سمت چپ گرهها (۵) و یالها (۰) را فهرست میکند. هر گره ازقبل کلید اصلی جدول خود و همه ستونهای آن را بهعنوان ویژگی حمل میکند — برای دیدن آنها روی هر گرهای کلیک کنید.
۲. چهار لبه را بکشید
لبه یک کلید خارجی است که کشیده شده است. هرکدام از جدولی که کلید را نگه میدارد به جدولی که به آن اشاره میکند میرود.
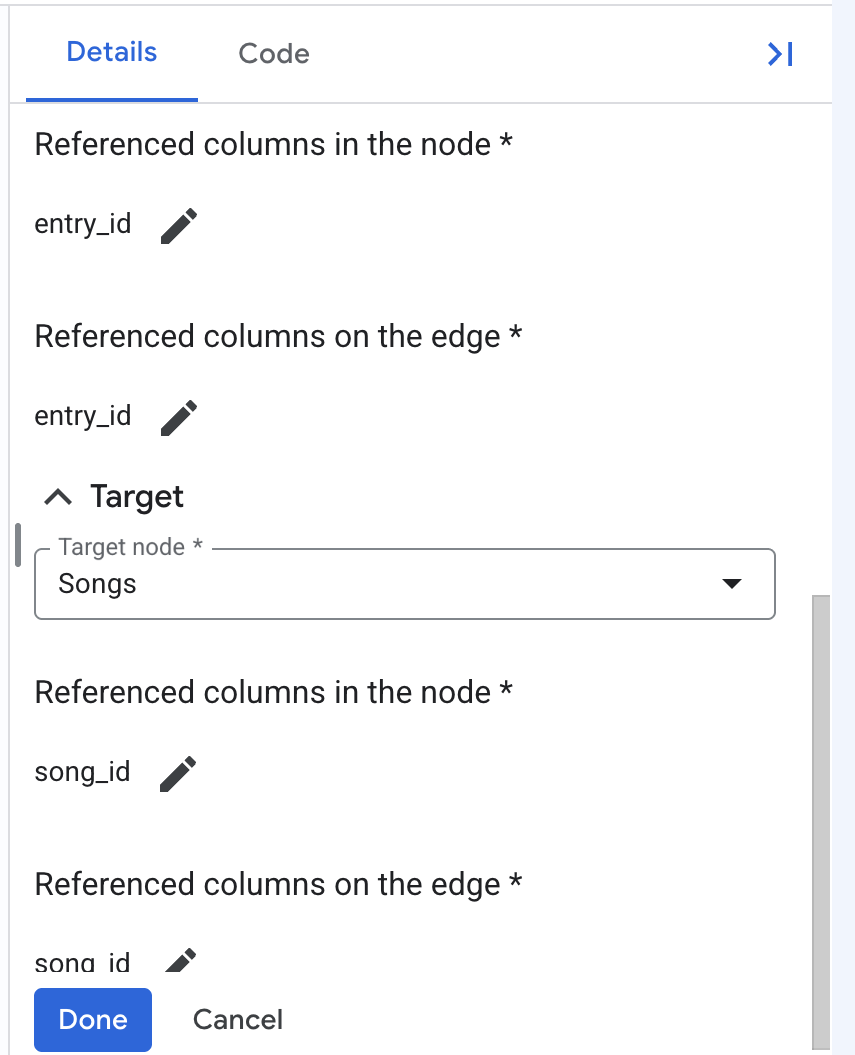
👉🌐 کنسول — روی لبه جدید کلیک کنید. در چارگوش گفتگوی انتخاب جدول، PlaylistEntries را انتخاب کنید و روی افزودن کلیک کنید. در پانل افزودن لبه:
- نام را روی
EntryToSongتنظیم کنید. - روی افزودن کلید اصلی کلیک کنید و
entry_idرا بپذیرید. - در بخش منبع، گره منبع را روی PlaylistEntries تنظیم کنید، سپس از افزودن ستونهای ارجاعشده به گره و افزودن ستونهای ارجاعشده در لبه برای انتخاب
entry_idبرای هر دو استفاده کنید. - در بخش هدف، گره هدف را روی «آهنگها» تنظیم کنید، سپس
song_idرا هم برای ستونهای ارجاعشده در گره و هم برای ستونهای ارجاعشده در لبه انتخاب کنید. - روی تمام کلیک کنید.
👉🌐 کنسول — سه بار دیگر تکرار کنید:
نام لبه | جدول | گره منبع → گره مقصد | ستون برای انتخاب در هر دو طرف |
| PlaylistEntries | PlaylistEntries → Playlists | منبع |
| آهنگها | آهنگها → هنرمندان | منبع |
| هنرمندان | هنرمندان → برچسبها | منبع |
همه لبهها را بدون داراییهای اضافی بگذارید.
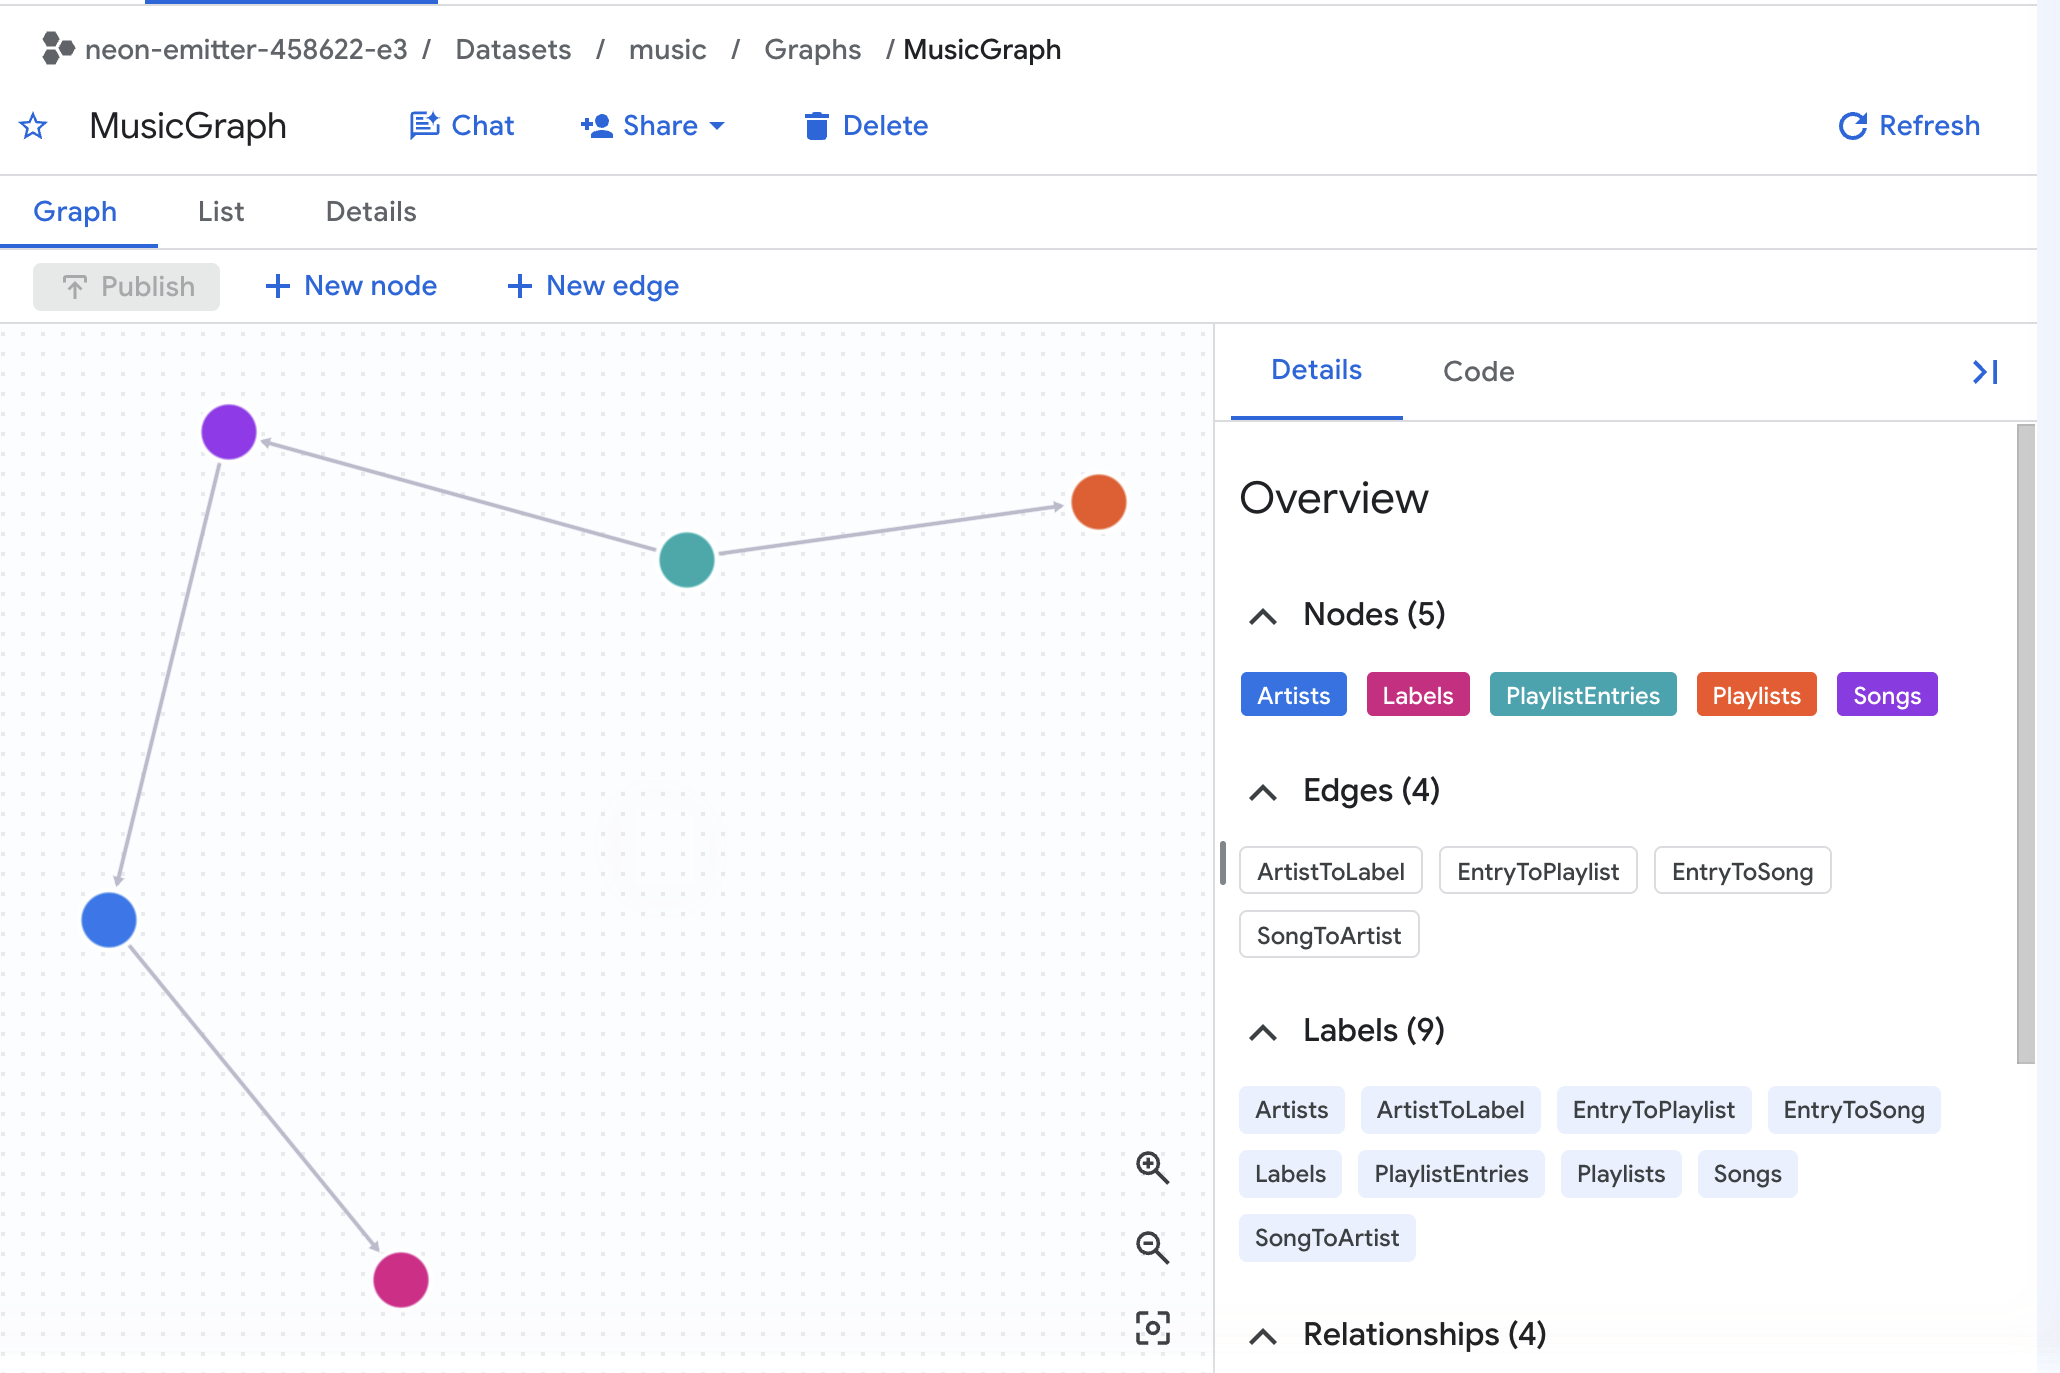
👀 پانل «جزئیات» اکنون میگوید لبهها (۴)، و بوم زنجیره را نشان میدهد: برچسبها ← هنرمندان ← آهنگها ← ورودیهای فهرست پخش → فهرستهای پخش.
۳. سنجه را اضافه کنید
👉🌐 کنسول — روی گره آهنگها و سپس روی نماد ویرایش (مداد) در بالای پانل «جزئیات» کلیک کنید. در بخش داراییهای برچسب، روی افزودن دارایی و سپس افزودن فیلد کلیک کنید.
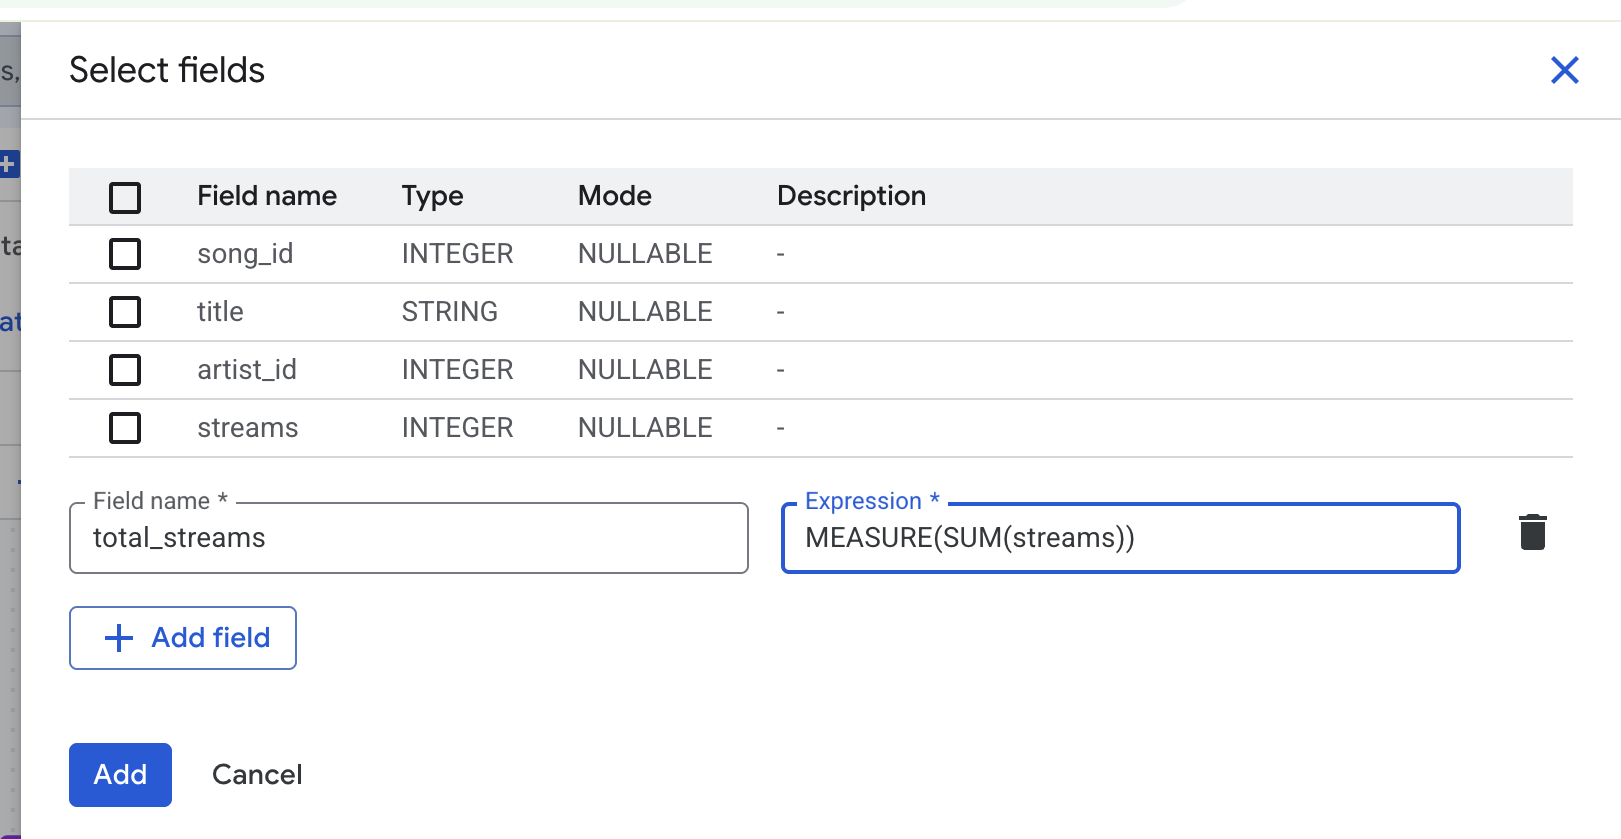
👉🌐 کنسول — total_streams را بهعنوان نام فیلد وارد کنید و این را در چارگوش عبارت تایپ کنید:
MEASURE(SUM(streams))
👉🌐 کنسول — روی افزودن و سپس تمام کلیک کنید.
۴. کدی را که نوشته است بخوانید، سپس منتشر کنید
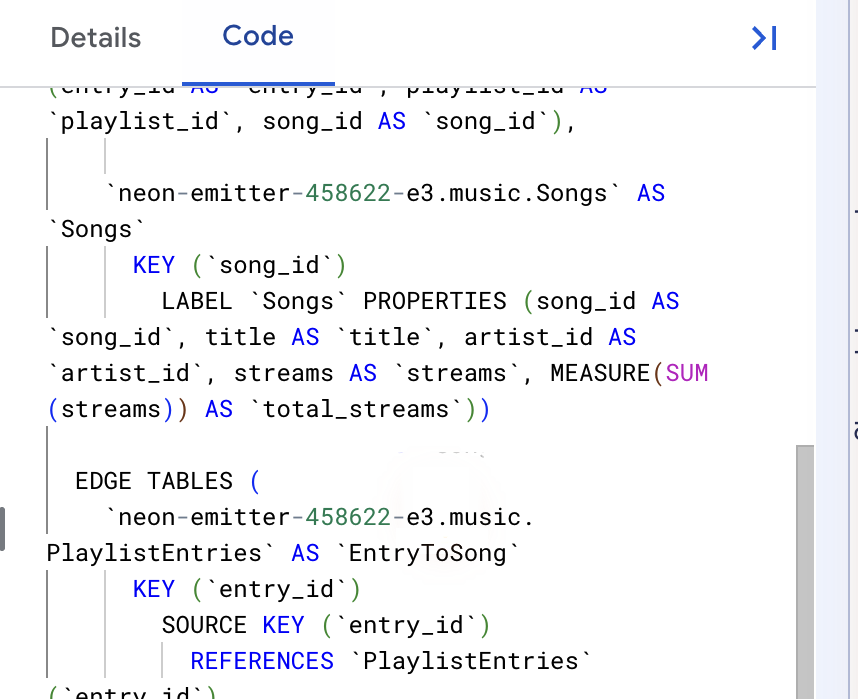
👉🌐 کنسول — برگه کد را در پانل سمت چپ باز کنید. مدلساز بیانیه CREATE PROPERTY GRAPH را برای شما نوشته است. به گره «آهنگها» پیمایش کنید: فهرست خصوصیات آن اکنون با این موارد پایان مییابد
MEASURE(SUM(streams)) AS `total_streams`
این کل ویژگی در یک خط است. هر چیزی که بعداز این مرحله میآید درباره کاری است که آن خط انجام میدهد.
👉🌐 کنسول — روی منتشر کردن کلیک کنید.
✅ ایست بازرسی: در «کاوشگر»، music اکنون پوشه نمودارها دارد که حاوی MusicGraph است. روی آن کلیک کنید: پنج گره، چهار لبه، و خط MEASURE(SUM(streams)) در برگه «کد». از مرحله بعدی رد شوید و به مجموع و تجمیع، کنار هم بروید.
۴. ایجاد گراف — گزینه B: SQL
اگر نمودار را در مدلساز ساختهاید، این مرحله را رد کنید.
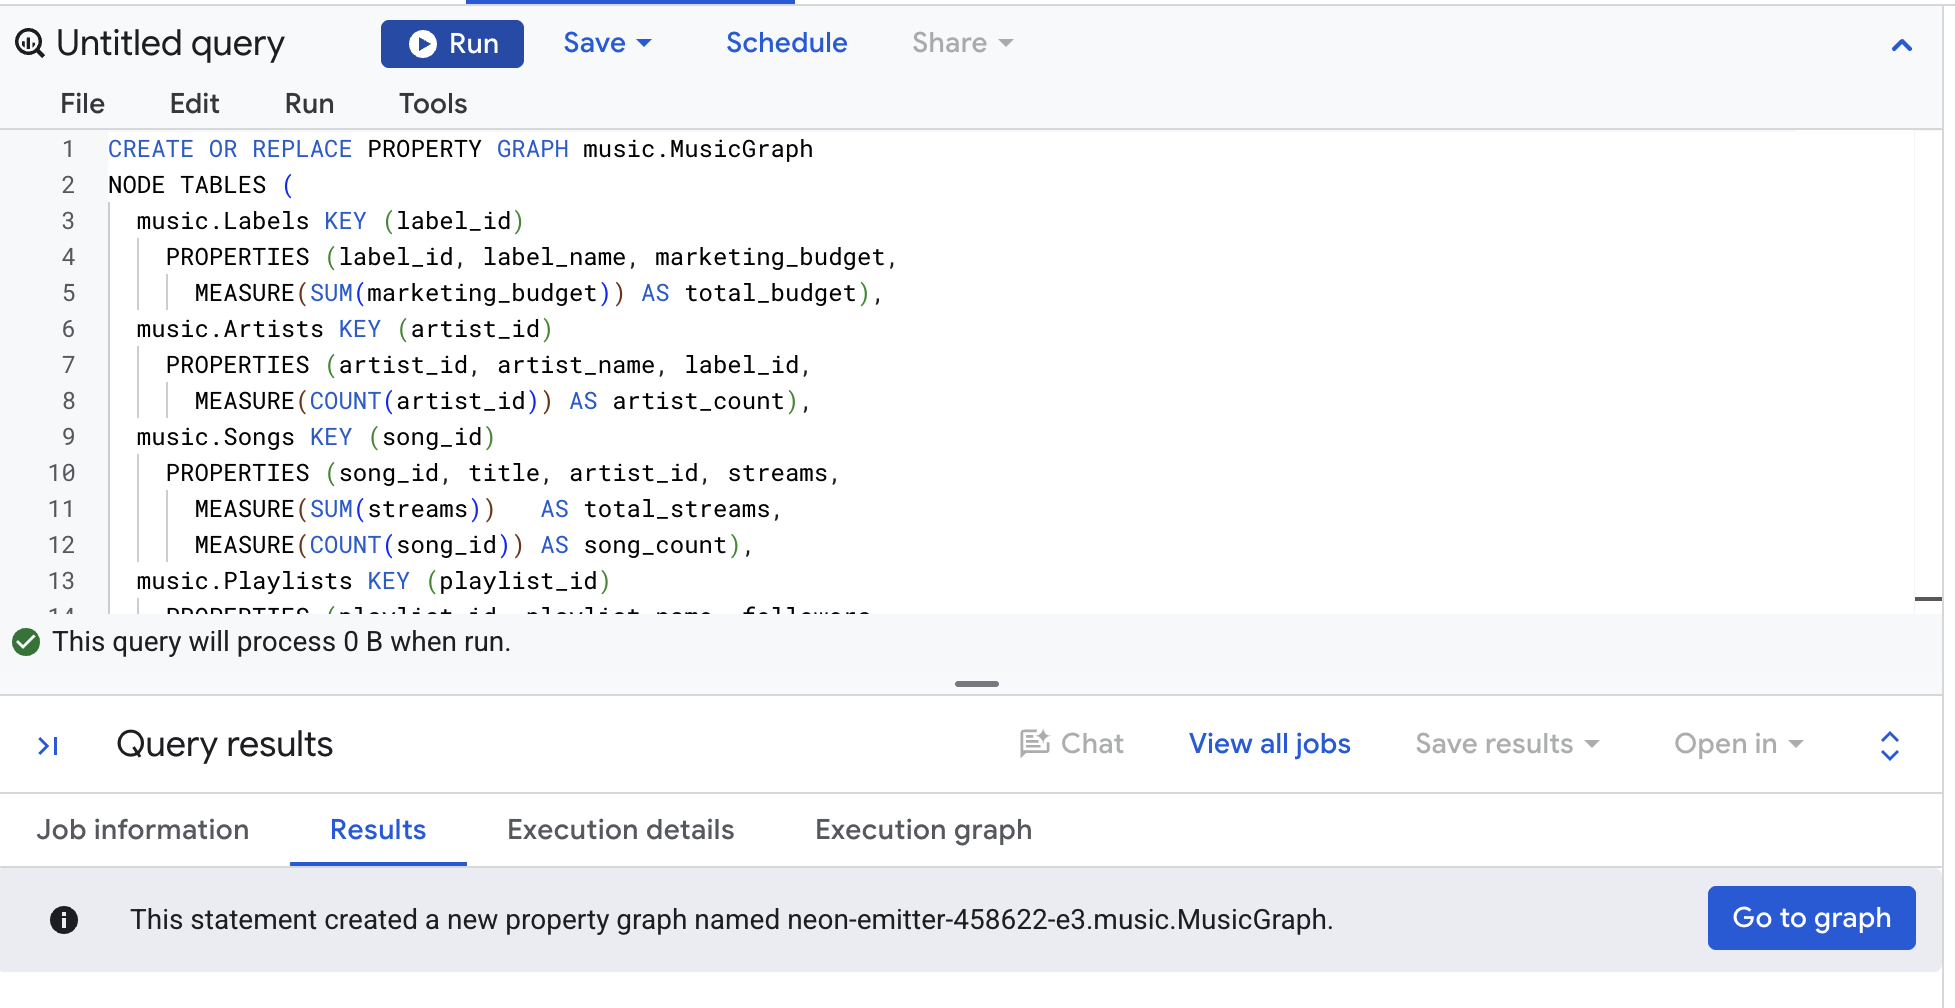
👉📋 ویرایشگر پُرسمان — جایگذاری کنید، سپس روی اجرا کردن کلیک کنید:
CREATE OR REPLACE PROPERTY GRAPH music.MusicGraph
  NODE TABLES (
    music.Labels KEY (label_id)
      PROPERTIES (label_id, label_name, marketing_budget,
        MEASURE(SUM(marketing_budget)) AS total_budget),
    music.Artists KEY (artist_id)
      PROPERTIES (artist_id, artist_name, label_id,
        MEASURE(COUNT(artist_id)) AS artist_count),
    music.Songs KEY (song_id)
      PROPERTIES (song_id, title, artist_id, streams,
        MEASURE(SUM(streams))   AS total_streams,
        MEASURE(COUNT(song_id)) AS song_count),
    music.Playlists KEY (playlist_id)
      PROPERTIES (playlist_id, playlist_name, followers,
        MEASURE(SUM(followers)) AS total_followers),
    music.PlaylistEntries KEY (entry_id)
      PROPERTIES (entry_id, playlist_id, song_id,
        MEASURE(COUNT(entry_id)) AS placement_count)
  )
  EDGE TABLES (
    music.PlaylistEntries AS EntryToSong
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (song_id) REFERENCES Songs(song_id) NO PROPERTIES,
    music.PlaylistEntries AS EntryToPlaylist
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (playlist_id) REFERENCES Playlists(playlist_id) NO PROPERTIES,
    music.Songs AS SongToArtist
      SOURCE KEY (song_id) REFERENCES Songs(song_id)
      DESTINATION KEY (artist_id) REFERENCES Artists(artist_id) NO PROPERTIES,
    music.Artists AS ArtistToLabel
      SOURCE KEY (artist_id) REFERENCES Artists(artist_id)
      DESTINATION KEY (label_id) REFERENCES Labels(label_id) NO PROPERTIES
  )
👀 پانل نتایج میگوید که گراف دارایی ایجاد شده است.
یکبار خوانده شود
این گراف پنج جدول گره و چهار جدول لبه دارد. هر جدول گره KEY خود را نامگذاری میکند و PROPERTIES خود را فهرست میکند. خطوطی که با MEASURE شروع میشوند بخش جدید هستند: هریک از آنها یکی از تجمیعهای پشتیبانیشده را پیرامون یک دارایی میپیچد و به آن نام مستعار میدهد که الزامی است.
هر جدول لبهای کلید خارجی است، بهصورت کامل نوشته شده است: SOURCE KEY در جدولی که کلید را نگه میدارد، DESTINATION KEY در جدولی که به آن اشاره میکند. NO PROPERTIES یعنی لبه هیچچیز از خودش ندارد.
توجه داشته باشید که PlaylistEntries سه بار ظاهر میشود: یک بار بهعنوان جدول گره، و دو بار دیگر بهعنوان جدول فیزیکی پشت لبههای EntryToSong و EntryToPlaylist. این کار عمدی است و بعداً توضیح خواهیم داد که چرا.
ببینید چه چیزی ساختهاید
👉🌐 کنسول — در قاب «کاوشگر»، music، سپس نمودارها را ازهم باز کنید و روی MusicGraph کلیک کنید. صفحه گراف روی بوم با پنج گره و چهار لبه باز میشود. روی گرهی کلیک کنید تا ویژگیهای آن را ببینید — معیارها با مجموع آنها فهرست شدهاند. برای دیدن بیانیه پشت تصویر، زبانه کد را باز کنید.
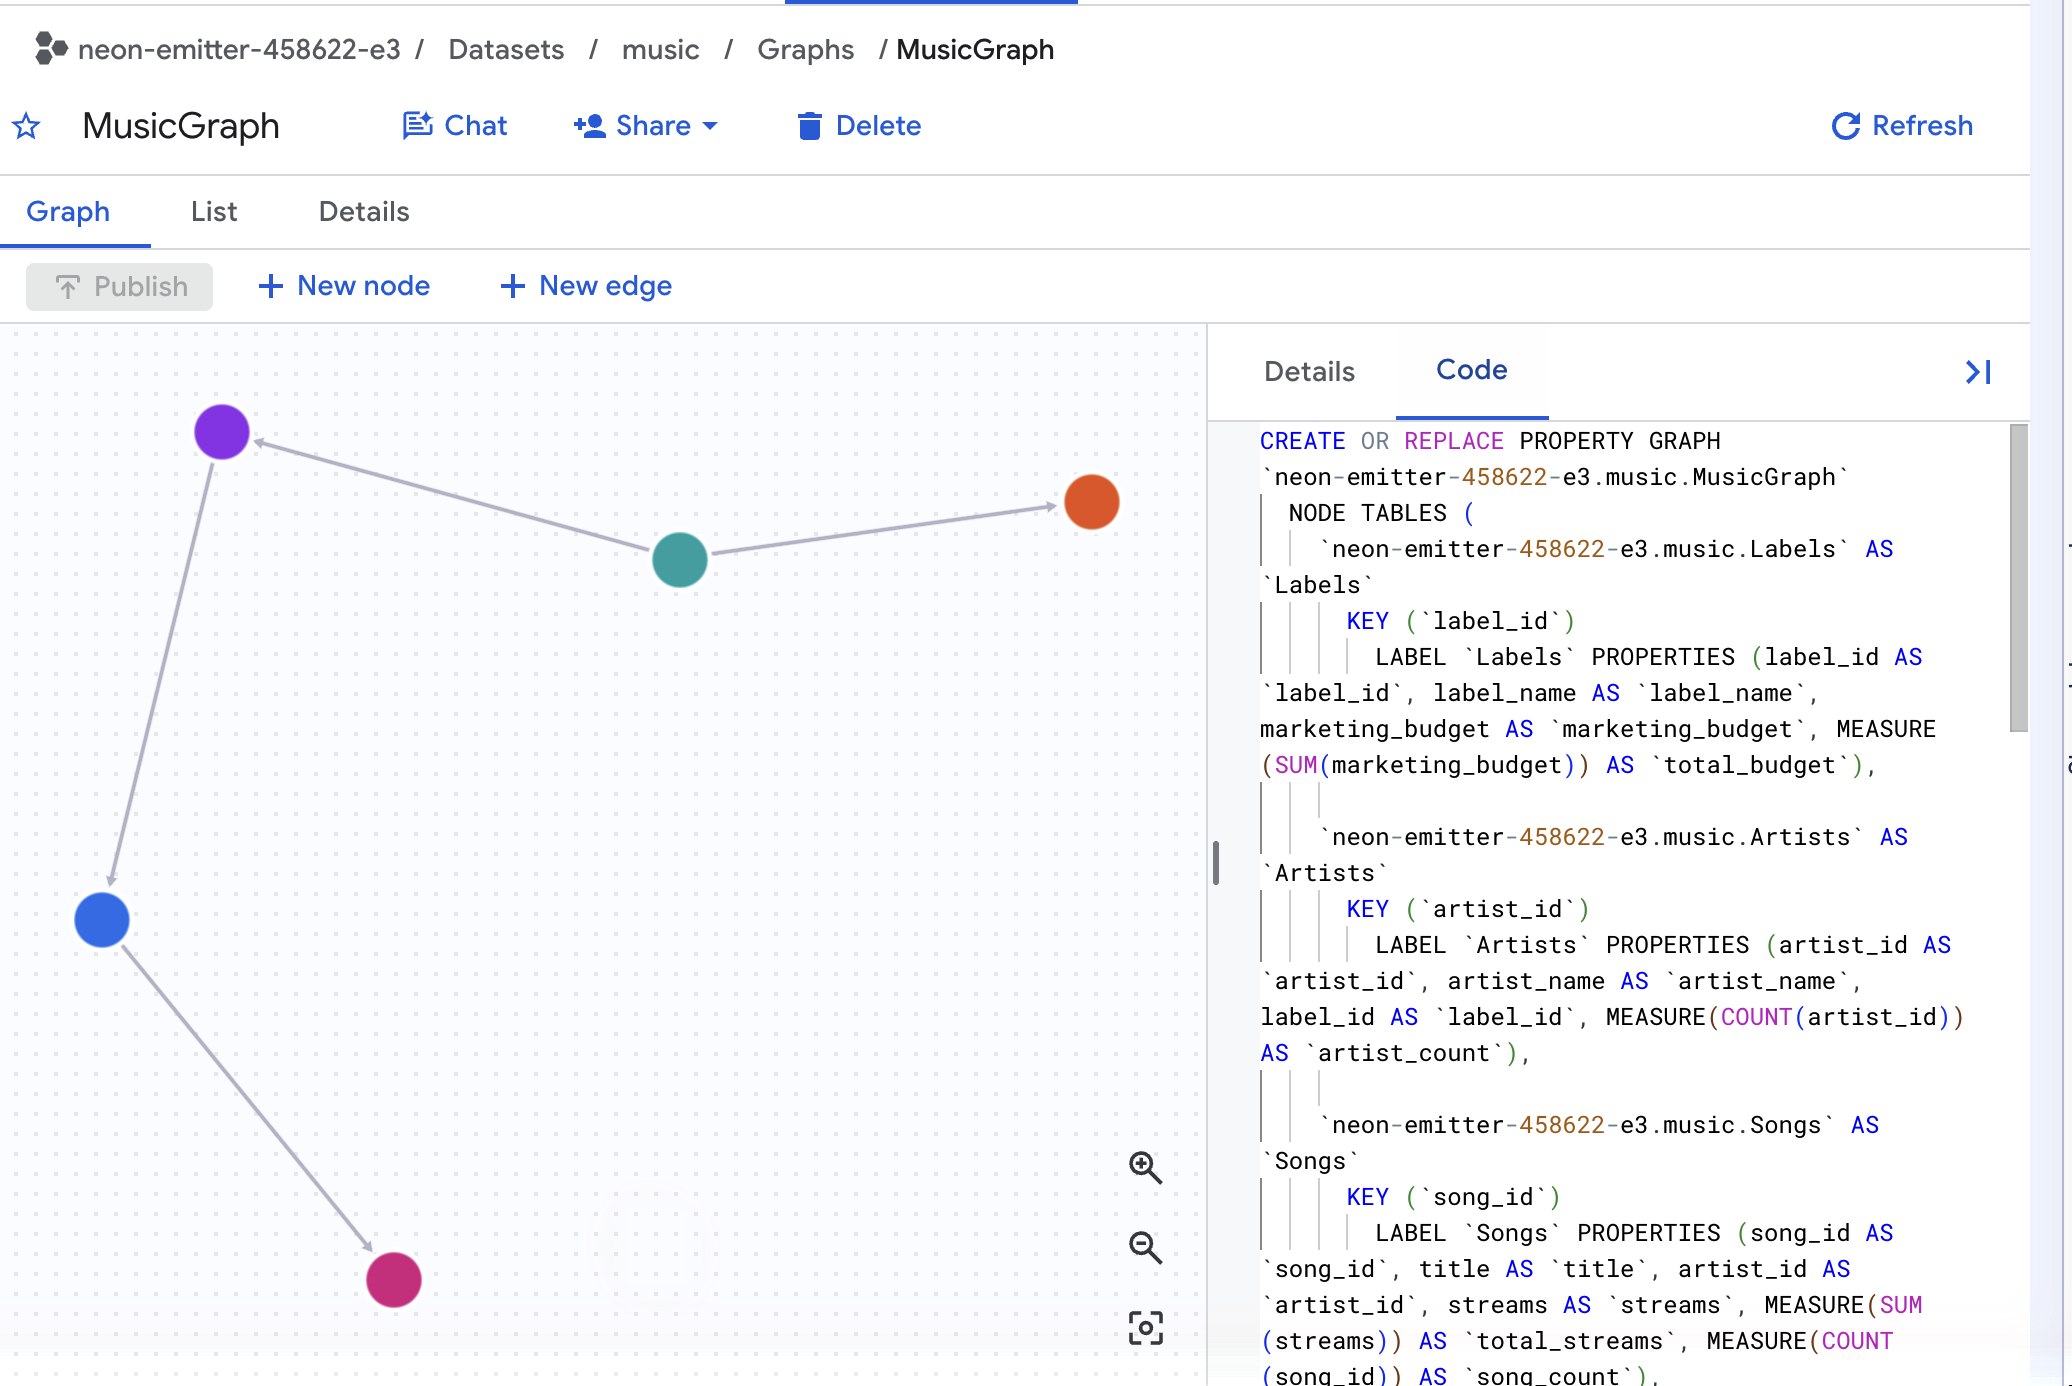
✅ ایست بازرسی: music پوشه نمودارها دارد که حاوی MusicGraph است و برگه «کد» MEASURE(SUM(streams)) AS total_streams را نشان میدهد.
۵. SUM و AGG، پهلوبهپهلو
این کل دستورالعمل گامبهگام در یک پُرسمان است. هر دو ستون سعی میکنند به یک سؤال پاسخ دهند — مجموع جاریسازیها برای هر برچسب — از یک جدول.
آن جدول همان جدولی است که GRAPH_EXPAND تولید میکند. این ویژگی نمودار را مسطح میکند: از یک جدول شروع میشود و هر یال را بهصورت LEFT JOIN بهسمت بیرون دنبال میکند تا اینکه همه جدولهای متصل در یک نتیجه گسترده در کنار هم قرار میگیرند. یک ردیف برای هر جای آگهی، نه یک ردیف برای هر آهنگ، و هر ستون با نام TableLabel_property. قبلاز پُرسمان کردن، آن را ببینید.
👉📋 ویرایشگر پُرسمان — جایگذاری کنید، سپس روی اجرا کردن کلیک کنید:
SELECT Labels_label_name, Songs_title, Songs_streams, Playlists_playlist_name
FROM GRAPH_EXPAND("music.MusicGraph")
ORDER BY Songs_title, Playlists_playlist_name
👀 انتظار ۱۰ ردیف دارید — یک ردیف برای هر جای آگهی در PlaylistEntries، که دقیقاً همان چیزی است که «راهاندازی» بار کرده است. «تابستان نئونی» چهار مورد از آنها را بهخود اختصاص داده است، یکی برای هر فهرست پخشی که در آن قرار دارد، و Songs_streams در هریک از آنها ۲٬۰۰۰٬۰۰۰٬۰۰۰ بار خوانده شده است. هیچ مشکلی در این ردیفها وجود ندارد؛ فهرستهای پخش واقعاً چهارتا هستند. اما ستونی که متعلق به یک آهنگ است اکنون در ردیفهایی که متعلق به جای آگهیها هستند تکرار میشود، و این کل مشکلی است که پُرسمان بعدی اندازهگیری میکند.
اکنون مقایسه.
👉📋 ویرایشگر پُرسمان — جایگذاری کنید، سپس روی اجرا کردن کلیک کنید:
SELECT
  Labels_label_name,
  SUM(Songs_streams)       AS with_sum,
  AGG(Songs_total_streams) AS with_agg
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1 ORDER BY 1
👀 نتیجه:
Labels_label_name | with_sum | with_agg |
Cymbal Records | ۱۲٬۶۰۰٬۰۰۰٬۰۰۰ | ۵٬۱۰۰٬۰۰۰٬۰۰۰ |
Northwind Audio | ۹٬۰۰۰٬۰۰۰٬۰۰۰ | ۴٬۵۰۰٬۰۰۰٬۰۰۰ |
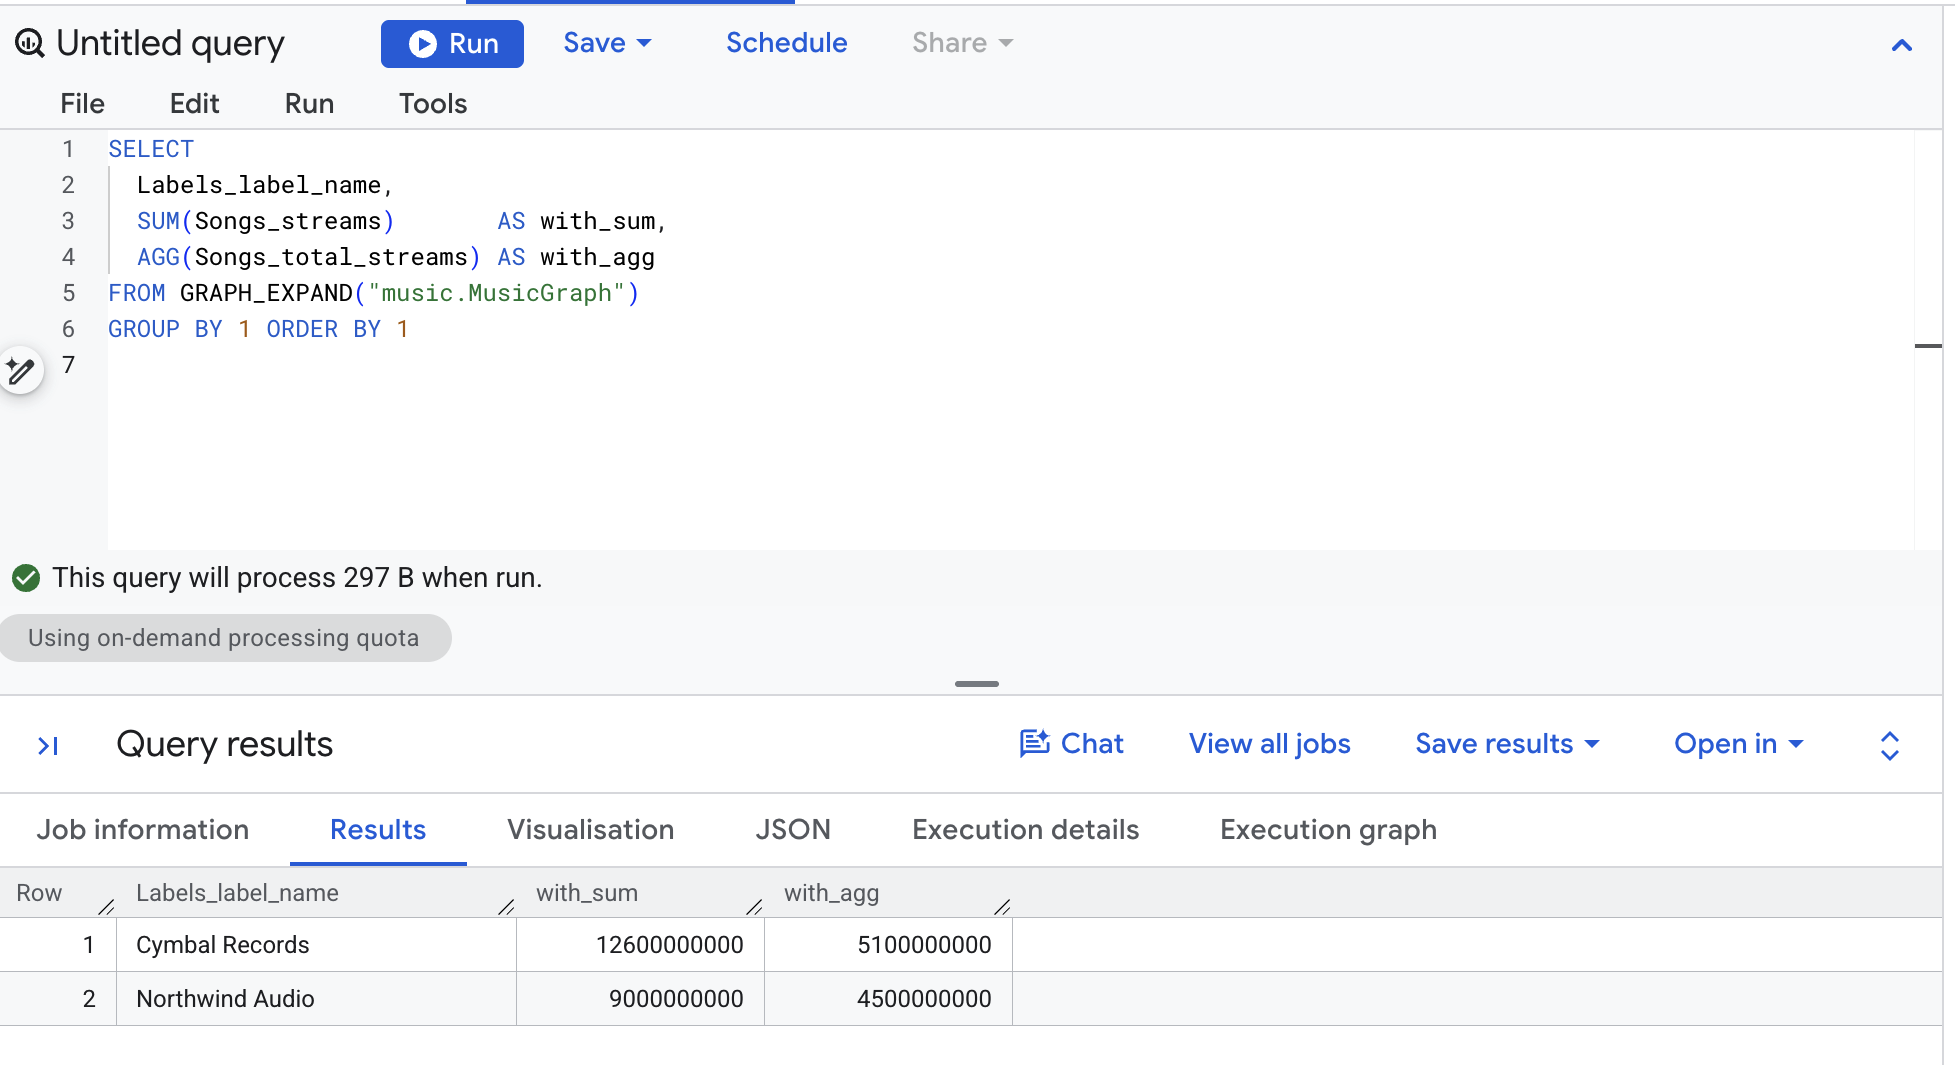
آن را بهصورت دستی بررسی کنید. چهار آهنگ Cymbal بهترتیب ۲٫۰ میلیارد، ۱٫۵ میلیارد، ۱٫۲ میلیارد، و ۰٫۴ میلیارد جاریسازی داشتهاند. این رقم ۵٫۱ میلیارد است. AGG درست است. SUM دو و نیم برابر بزرگتر است و تکآهنگ Northwind دوبرابر شده است.
سه بخش جدید از دستورگان
-
GRAPH_EXPAND("music.MusicGraph")تابع مقدار جدولی است که با دنبال کردن هر یال بهعنوانLEFT JOIN، گراف را به یک جدول عریض تبدیل میکند. همه ستونهاTableLabel_propertyنامگذاری شدهاند، بنابراینSongs_streamsستون خام از جدول «آهنگها» وSongs_total_streamsسنجهای است که اعلام کردهاید. -
SUM(Songs_streams)SQL معمولی روی آن جدول گسترده است — و هر تکراری را که مسطحسازی تولید کرده است بهارث میبرد. -
AGG(Songs_total_streams)معیار را به همان روشی که اعلام شده است ارزیابی میکند:SUM(streams)یکبار در هرsong_id، صرفنظر از اینکه یک آهنگ چند ردیف را در جدول گسترده اشغال میکند.
✅ ایست بازرسی: دو برچسب، دو ستون، و with_agg عدد با تعداد دستها مطابقت دارد.
۶. چرا SUM بیشازحد شمارش میکند
یک آهنگ را انتخاب کنید و ببینید این پیوندها چه تأثیری روی آن میگذارند.
👉📋 ویرایشگر پُرسمان — جایگذاری کنید، سپس روی اجرا کردن کلیک کنید:
SELECT 'BEFORE - the Songs table' AS step, title, streams, CAST(NULL AS STRING) AS playlist
FROM music.Songs WHERE title = 'Neon Summer'
UNION ALL
SELECT 'AFTER - joined to playlists', s.title, s.streams, pl.playlist_name
FROM music.Songs s
LEFT JOIN music.PlaylistEntries e ON e.song_id = s.song_id
LEFT JOIN music.Playlists pl ON pl.playlist_id = e.playlist_id
WHERE s.title = 'Neon Summer'
ORDER BY step DESC, playlist
👀 نتیجه:
مرحله | عنوان | جاریسازی | فهرست پخش |
«قبلاز» - جدول «آهنگها» | تابستان نئونی | ۲٬۰۰۰٬۰۰۰٬۰۰۰ | تهی |
پساز - به فهرستهای پخش پیوست | تابستان نئونی | ۲٬۰۰۰٬۰۰۰٬۰۰۰ | Gym Pump |
پساز - به فهرستهای پخش پیوست | تابستان نئونی | ۲٬۰۰۰٬۰۰۰٬۰۰۰ | پرطرفدار درحالحاضر |
پساز - به فهرستهای پخش پیوست | تابستان نئونی | ۲٬۰۰۰٬۰۰۰٬۰۰۰ | پاپ نوظهور |
پساز - به فهرستهای پخش پیوست | تابستان نئونی | ۲٬۰۰۰٬۰۰۰٬۰۰۰ | سفر جادهای |
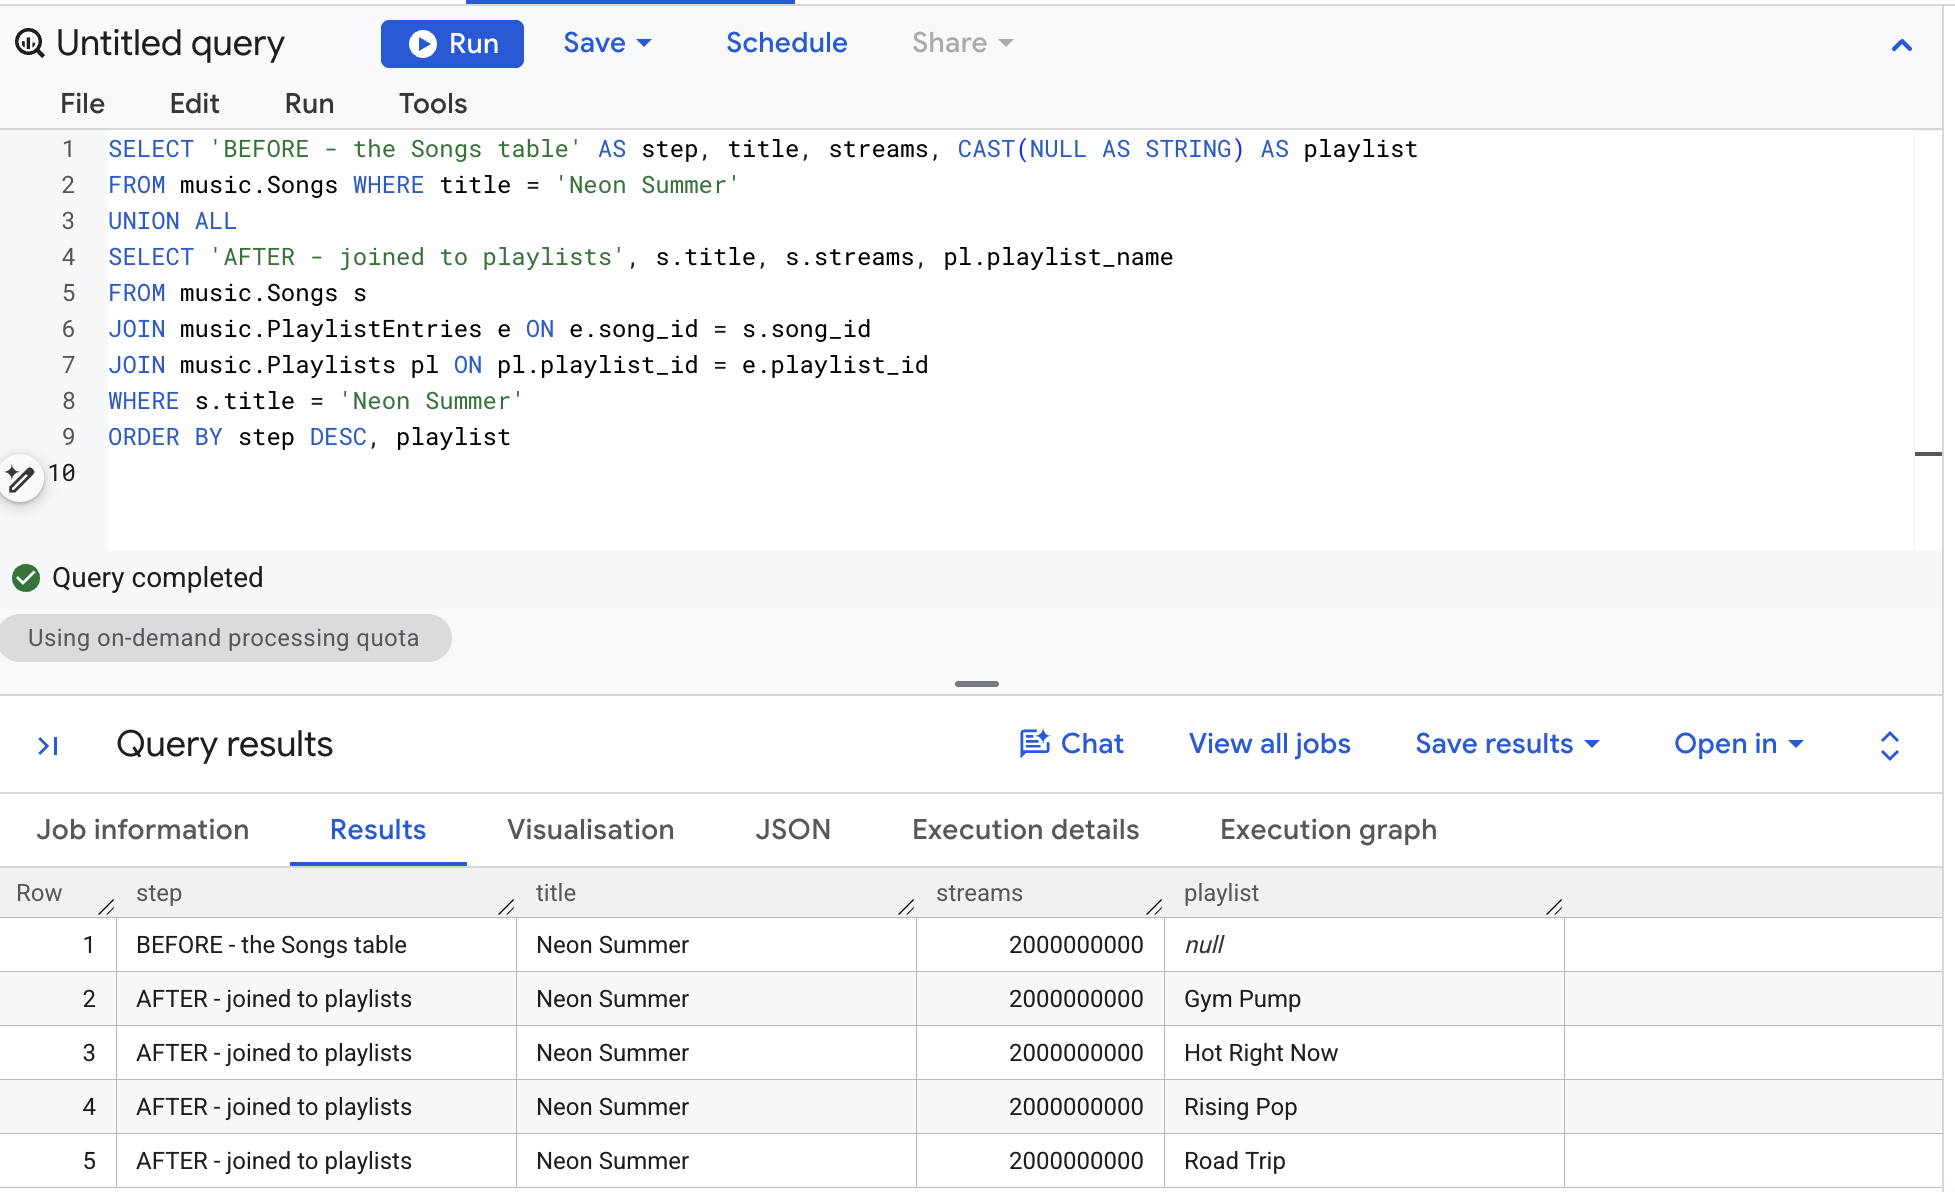
یک ردیف به چهار ردیف تبدیل شد. تعداد جاریسازیها تغییر نکرد — کپی شد. مجموع کاری که نسخههای کپی برای Cymbal Records انجام دادهاند: «تابستان نئونی» ۲ میلیارد در چهار فهرست پخش ۸ میلیارد، «تاج کاغذی» ۱٫۵ میلیارد در دو فهرست پخش ۳ میلیارد، «شات دوتایی» ۱٫۲ در یک فهرست پخش، «تیر آهسته» ۰٫۴ در یک فهرست پخش. این عدد ۱۲٫۶ میلیارد است، عددی که SUM برگرداند. Northwind's Midnight Drive در دو فهرست پخش قرار دارد، بنابراین ۴٫۵ میلیارد به ۹٫۰ تبدیل شد.
این فنآوت است و اشکالی در پیوستن وجود ندارد. ردیفهای فهرست پخش واقعی هستند. اشتباه این است که عددی که متعلق به یک آهنگ است را در ردیفهایی که متعلق به جای آگهی هستند جمع میکنید.
این معیار آن را اصلاح میکند زیرا در گره «ترانهها» بههمراه KEY (song_id) اعلام شده است. نکته کلیدی، دانه است. وقتی AGG مقدار total_streams را ارزیابی میکند، یکبار در هر کلید آهنگ تجمیع میشود و فقط در آن زمان به هر چیزی که براساس آن گروهبندی کردهاید جمع میشود.
آنچه تغییر کرده
قبلاً مینوشتید | با یک معیار |
| |
| |
۳ | |
یک CTE که قبلاز پیوستن تجمیع میکند | هیچچیز. |
✅ ایست بازرسی: پنج ردیف — یک ردیف «قبلاز»، چهار ردیف «بعداز» — و میتوانید ۱۲٫۶ میلیارد را از آنها بازسازی کنید.
۷. قانون: فقط AGG یک معیار را میخواند
سنجهها نوع خودشان را دارند، MEASURE، و دقیقاً یک تابع آن را میپذیرد. چهار پُرسمان زیر عمداً ناموفق است — هریک را اجرا کنید و خطای قرمز را بخوانید. این چهار روشی است که همه ابتدا امتحان میکنند و دانستن اینکه چه میگویند باعث صرفهجویی در زمان میشود.
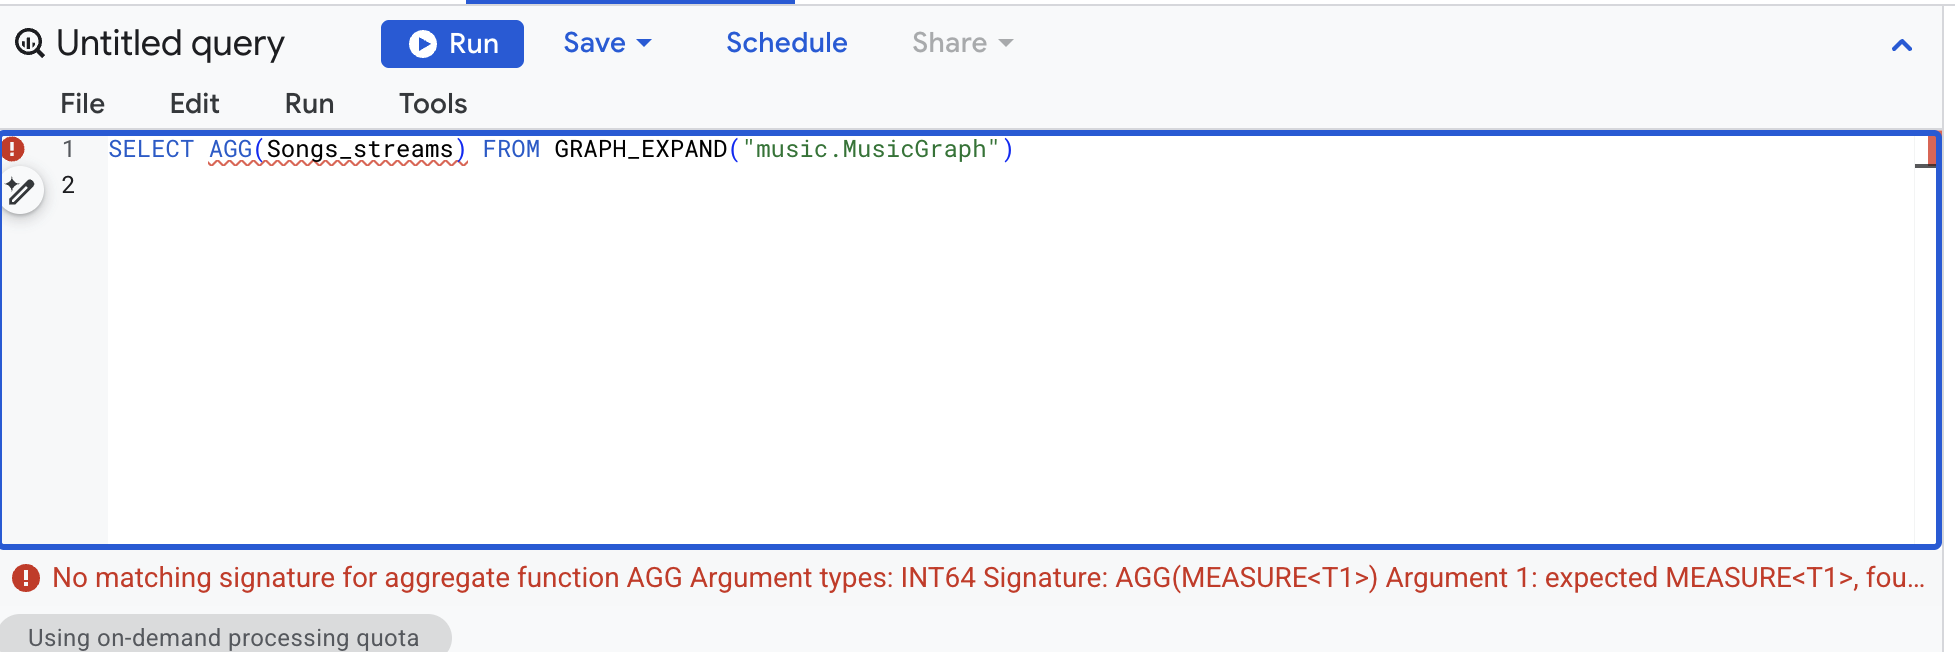
👉📋 ویرایشگر پُرسمان — AGG در ستون ساده:
SELECT AGG(Songs_streams) FROM GRAPH_EXPAND("music.MusicGraph")
👀 No matching signature for aggregate function AGG ... Argument 1: expected MEASURE
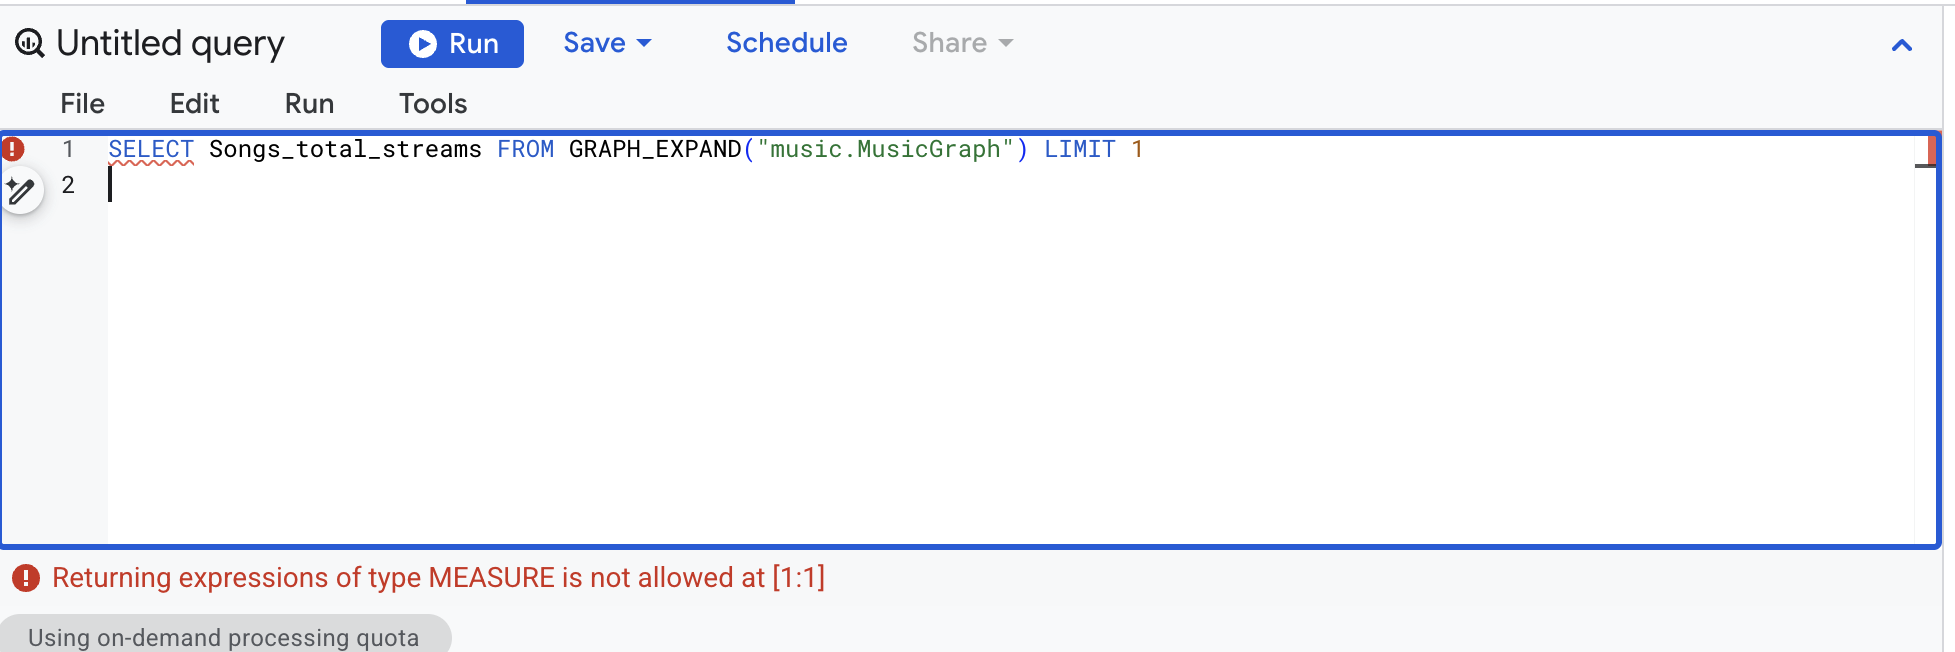
👉📋 ویرایشگر پُرسمان — ستون اندازهگیری بدون AGG:
SELECT Songs_total_streams FROM GRAPH_EXPAND("music.MusicGraph") LIMIT 1
👀 Returning expressions of type MEASURE is not allowed
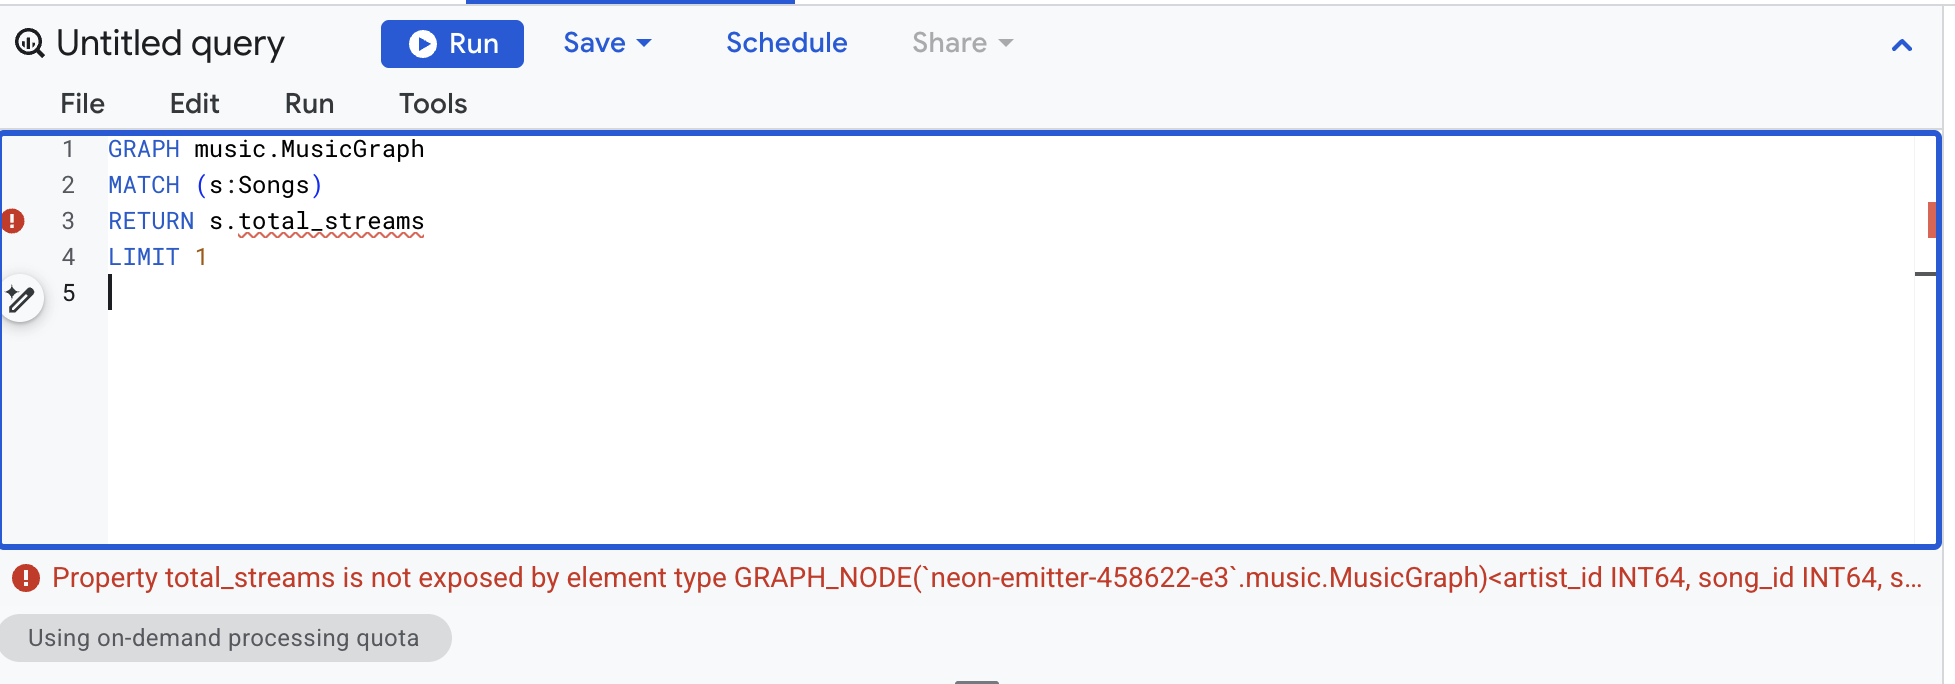
👉📋 ویرایشگر پُرسمان — سنجهای که در GQL به آن ارجاع داده شده است و هرگز سنجهها را نمیبیند (این یکی پُرسمان GQL است — یادداشت ویرایش را در نمای کلی ببینید):
GRAPH music.MusicGraph
MATCH (s:Songs)
RETURN s.total_streams
LIMIT 1
👀 total_streams is not exposed by element type GRAPH_NODE(...)
👉📋 ویرایشگر پُرسمان — SUM روی ستون اندازهگیری، ستون وسوسهانگیز:
SELECT Labels_label_name, SUM(Songs_total_streams)
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1
👀 MEASURE-typed arguments are only permitted in the AGG function
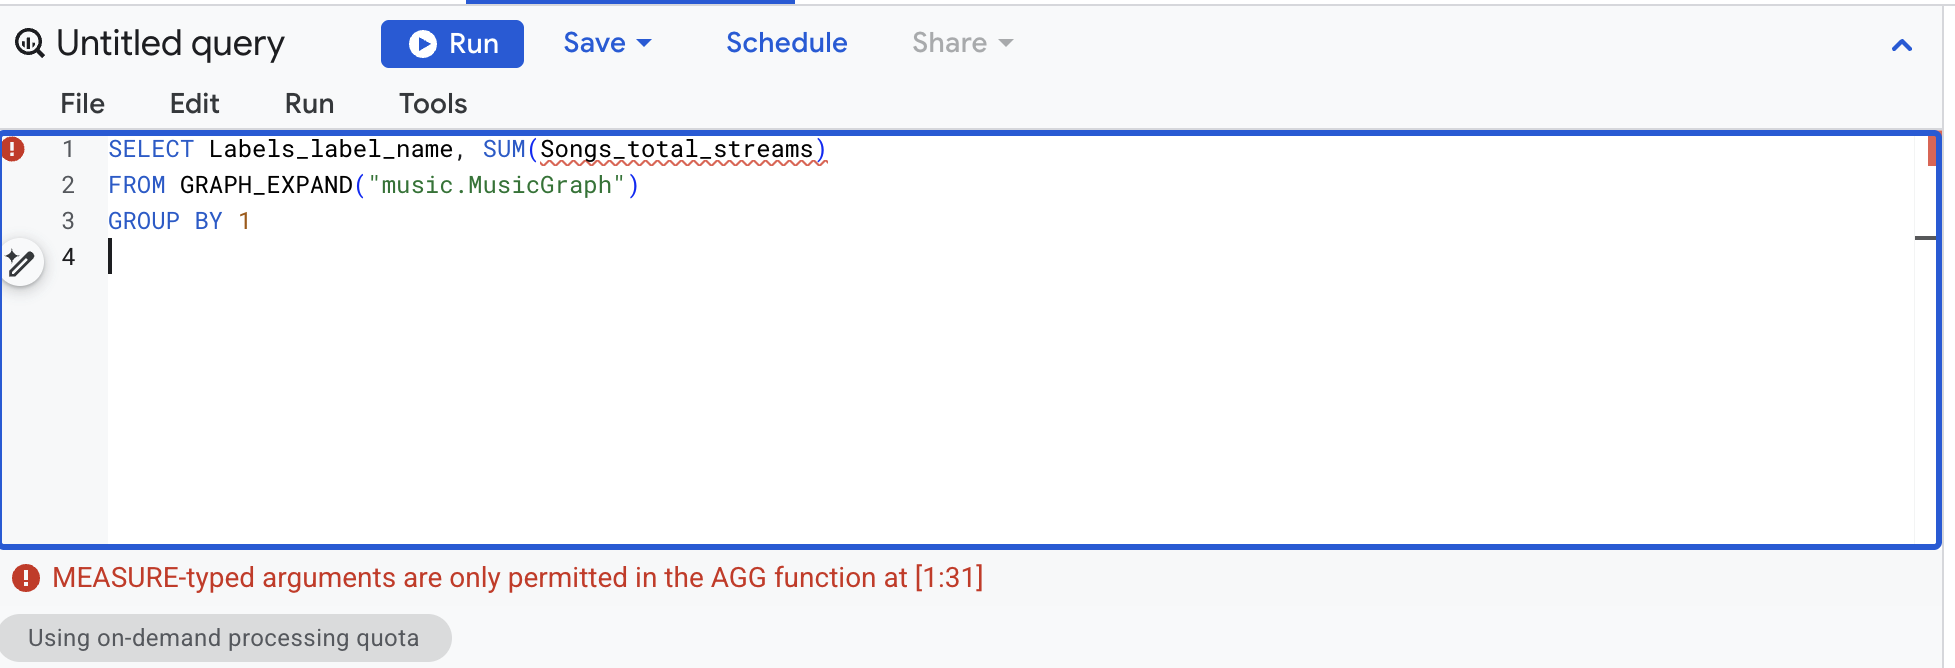
بنابراین سیستم نوع این قانون را برای شما اجرا میکند. سنجه فقط ازطریق GRAPH_EXPAND قابلمشاهده است و فقط ازطریق AGG قابلخواندن است. ۱۲٫۶ میلیارد شمارش اضافی قبلی فقط میتواند از جمع کردن ستون دادههای خام ناشی شود — نه از مدیریت نادرست اندازهگیری.
✅ ایست بازرسی: چهار خطای قرمز، و میتوانید بگویید هرکدام کدام قانون را اجرا میکنند.
۸. هر تجمیعی که سنجه پشتیبانی میکند
MEASURE() یکی از شش تجمیع را میپیچد: SUM، AVG، MIN، MAX، COUNT، و COUNT(DISTINCT). گراف را با هر شش مورد در گره «آهنگها» بازسازی کنید. لبهها NO PROPERTIES باقی میمانند که روال مطلوب مستندشدهای است وقتی لبه جدول فیزیکیاش را با گره همرسانی میکند.
👉📋 ویرایشگر پُرسمان — جایگذاری کنید، سپس روی اجرا کردن کلیک کنید:
CREATE OR REPLACE PROPERTY GRAPH music.MusicGraph
  NODE TABLES (
    music.Labels KEY (label_id)
      PROPERTIES (label_id, label_name, marketing_budget,
        MEASURE(SUM(marketing_budget)) AS total_budget),
    music.Artists KEY (artist_id)
      PROPERTIES (artist_id, artist_name, label_id,
        MEASURE(COUNT(artist_id)) AS artist_count),
    music.Songs KEY (song_id)
      PROPERTIES (song_id, title, artist_id, streams,
        MEASURE(SUM(streams))              AS total_streams,
        MEASURE(AVG(streams))              AS avg_streams,
        MEASURE(MIN(streams))              AS min_streams,
        MEASURE(MAX(streams))              AS max_streams,
        MEASURE(COUNT(song_id))            AS song_count,
        MEASURE(COUNT(DISTINCT artist_id)) AS distinct_artists),
    music.Playlists KEY (playlist_id)
      PROPERTIES (playlist_id, playlist_name, followers,
        MEASURE(SUM(followers)) AS total_followers),
    music.PlaylistEntries KEY (entry_id)
      PROPERTIES (entry_id, playlist_id, song_id,
        MEASURE(COUNT(entry_id)) AS placement_count)
  )
  EDGE TABLES (
    music.PlaylistEntries AS EntryToSong
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (song_id) REFERENCES Songs(song_id) NO PROPERTIES,
    music.PlaylistEntries AS EntryToPlaylist
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (playlist_id) REFERENCES Playlists(playlist_id) NO PROPERTIES,
    music.Songs AS SongToArtist
      SOURCE KEY (song_id) REFERENCES Songs(song_id)
      DESTINATION KEY (artist_id) REFERENCES Artists(artist_id) NO PROPERTIES,
    music.Artists AS ArtistToLabel
      SOURCE KEY (artist_id) REFERENCES Artists(artist_id)
      DESTINATION KEY (label_id) REFERENCES Labels(label_id) NO PROPERTIES
  )
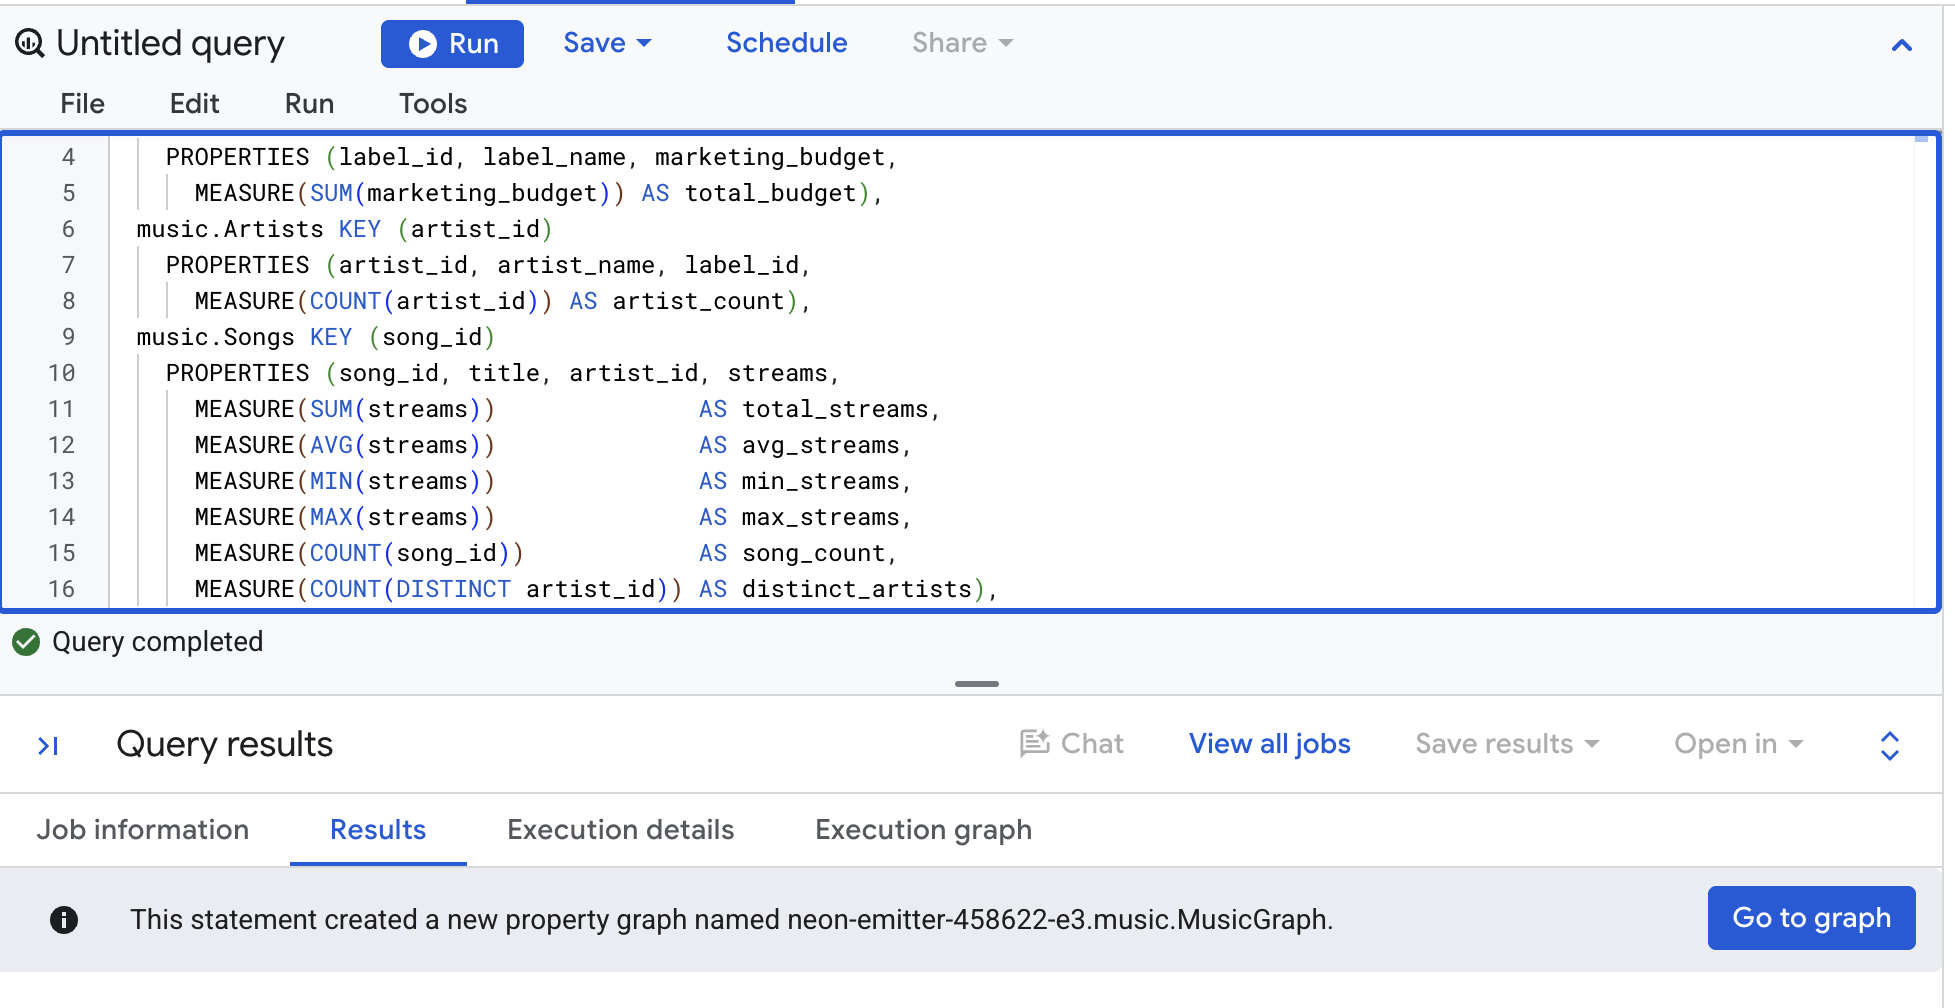
اکنون همه آنها را برگردان. هر سنجهای از AGG عبور میکند و ستون آخر نشان میدهد که AGG نتیجه مقدارهای معمولی است که میتوانید با آنها محاسبات انجام دهید. گراف بهتازگی تغییر کرده است، بنابراین ابتدا استفاده از نتایج ذخیرهشده را پاک کنید (بیشتر → تنظیمات پُرسمان).
👉📋 ویرایشگر پُرسمان — جایگذاری کنید، سپس روی اجرا کردن کلیک کنید:
SELECT
  Labels_label_name,
  AGG(Songs_total_streams)    AS total_streams,
  AGG(Songs_avg_streams)      AS avg_streams,
  AGG(Songs_min_streams)      AS min_streams,
  AGG(Songs_max_streams)      AS max_streams,
  AGG(Songs_song_count)       AS songs,
  AGG(Songs_distinct_artists) AS artists,
  AGG(Songs_total_streams) / AGG(Songs_song_count) AS streams_per_song
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1
ORDER BY 1
👀 نتیجه:
Labels_label_name | total_streams | avg_streams | min_streams | max_streams | آهنگ | هنرمندان | streams_per_song |
Cymbal Records | ۵٬۱۰۰٬۰۰۰٬۰۰۰ | ۱٬۲۷۵٬۰۰۰٬۰۰۰ | ۴۰۰٬۰۰۰٬۰۰۰ | ۲٬۰۰۰٬۰۰۰٬۰۰۰ | 4 | 2 | ۱٬۲۷۵٬۰۰۰٬۰۰۰ |
Northwind Audio | ۴٬۵۰۰٬۰۰۰٬۰۰۰ | ۴٬۵۰۰٬۰۰۰٬۰۰۰ | ۴٬۵۰۰٬۰۰۰٬۰۰۰ | ۴٬۵۰۰٬۰۰۰٬۰۰۰ | 1 | 1 | ۴٬۵۰۰٬۰۰۰٬۰۰۰ |
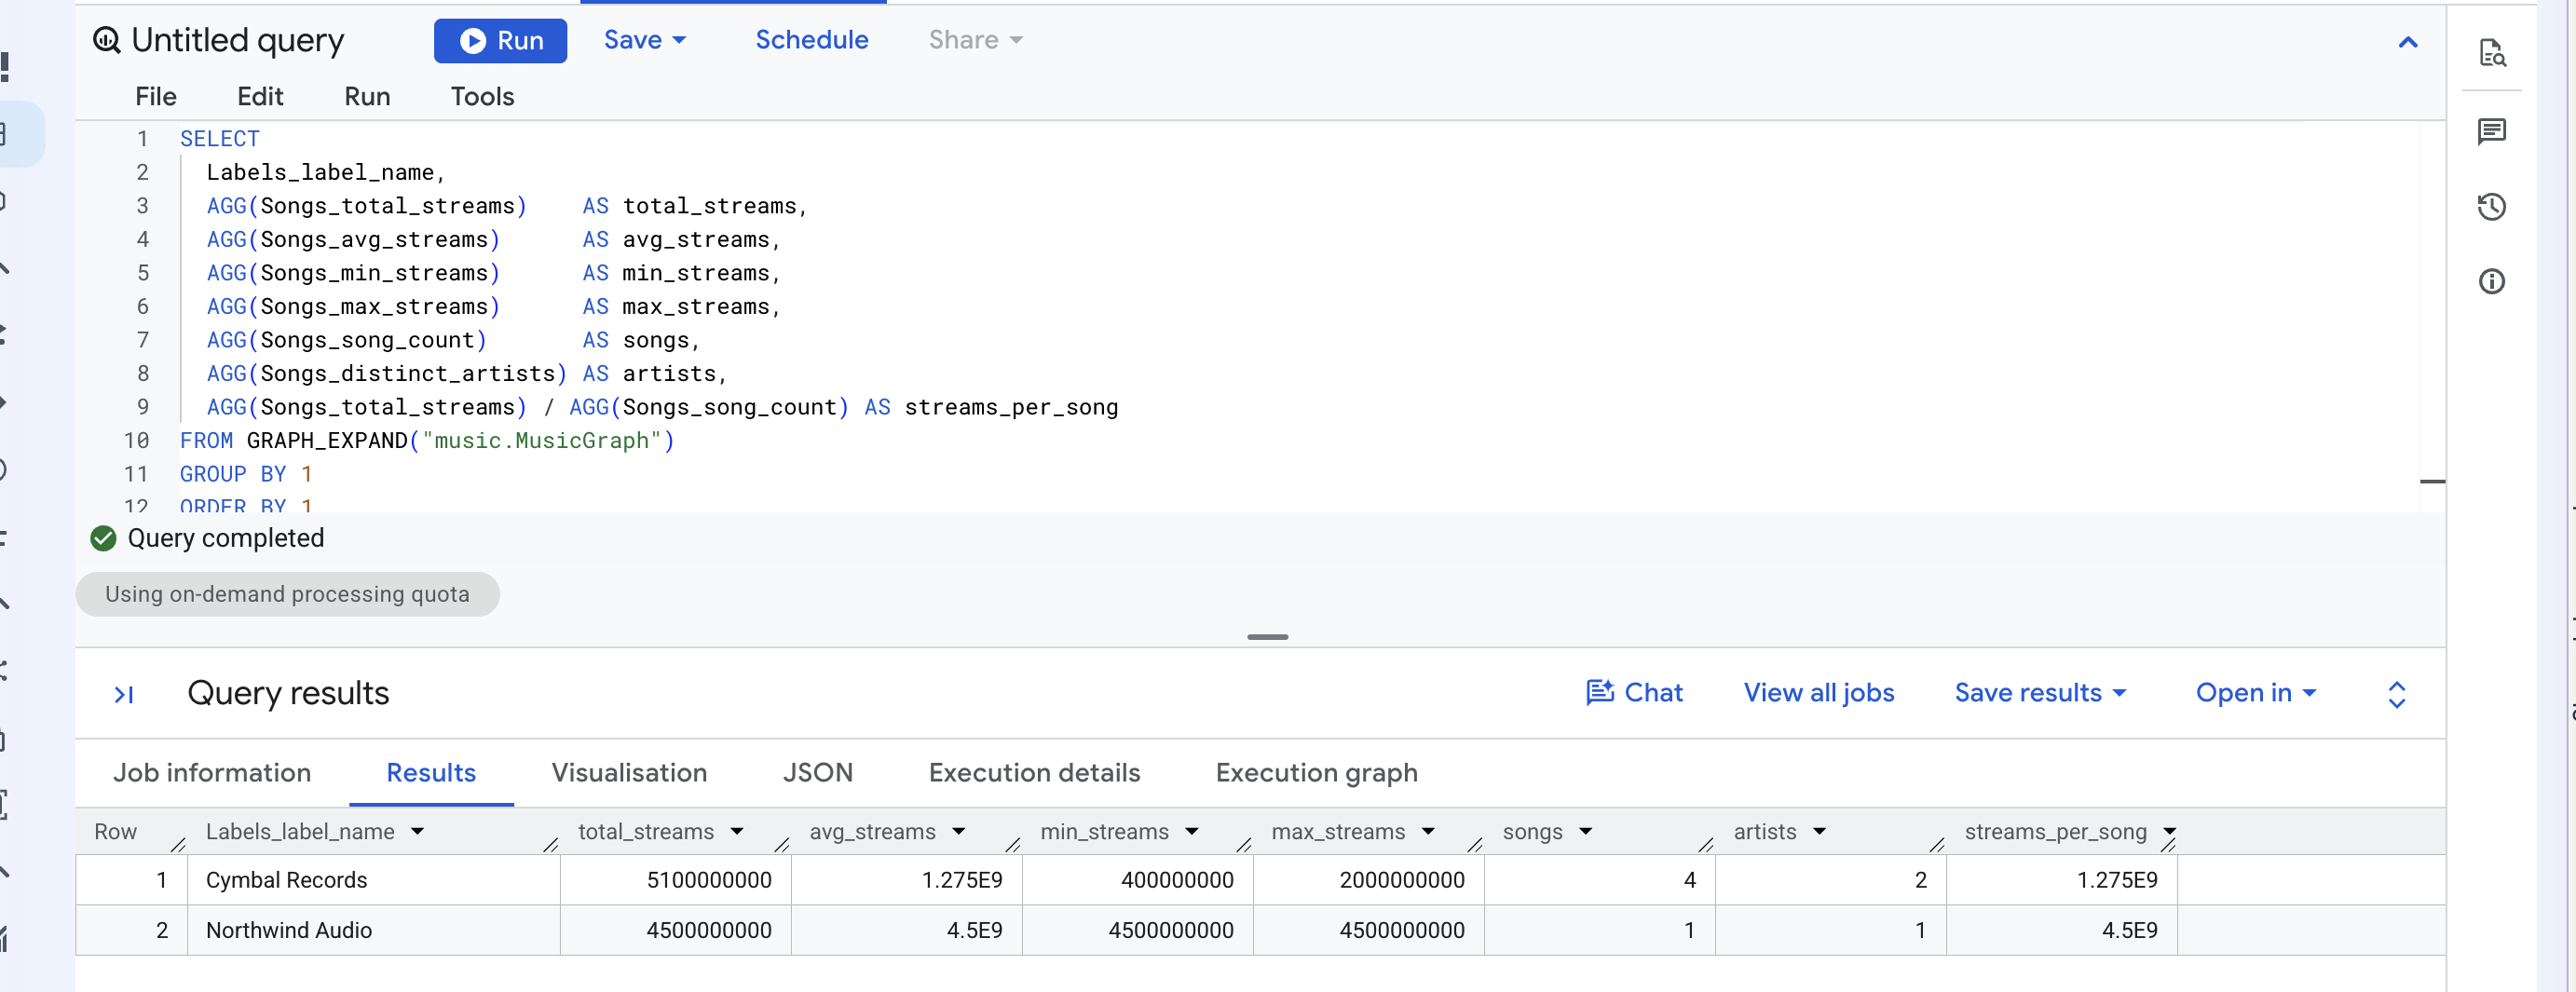
هر عدد برای چهار آهنگ Cymbal و یک آهنگ Northwind محاسبه میشود — نه برای ده ردیف جای آگهی. بهطور خاص، AVG در جهت دیگر اشتباه خواهد بود: میانگینگیری ستون خام در ردیفهای جای آگهی، ۱٫۵۷۵ میلیارد برای «سنج» بهدست میدهد، زیرا ۲ میلیارد «تابستان نئونی» چهار بار محاسبه میشود.
بنابراین «جایگزین کردن SUM با AGG» درواقع دو تصمیم است. وقتی سنجه را اعلام میکنید، همچنان انتخاب میکنید که کدامیک از شش تجمیع است. وقتی آن را میخوانید، تابع همیشه AGG است.
✅ ایست بازرسی: یک ردیف برای هر برچسب، هفت عدد در هر ردیف، و streams_per_song برابر با avg_streams.
۹. گروهبندی را تغییر دهید، نه اندازهگیری را
همان سنجه به سؤال دیگری پاسخ میدهد. بهجای برچسب، براساس فهرست پخش گروهبندی کنید.
👉📋 ویرایشگر پُرسمان — جایگذاری کنید، سپس روی اجرا کردن کلیک کنید:
SELECT
  Playlists_playlist_name,
  AGG(Songs_total_streams) AS streams,
  AGG(Songs_song_count)    AS songs
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1
ORDER BY 2 DESC
👀 نتیجه:
Playlists_playlist_name | جاریسازی | آهنگ |
سفر جادهای | ۶٬۹۰۰٬۰۰۰٬۰۰۰ | 3 |
Gym Pump | ۶٬۵۰۰٬۰۰۰٬۰۰۰ | 2 |
پرطرفدار درحالحاضر | ۴٬۷۰۰٬۰۰۰٬۰۰۰ | 3 |
پاپ نوظهور | ۳٬۵۰۰٬۰۰۰٬۰۰۰ | 2 |
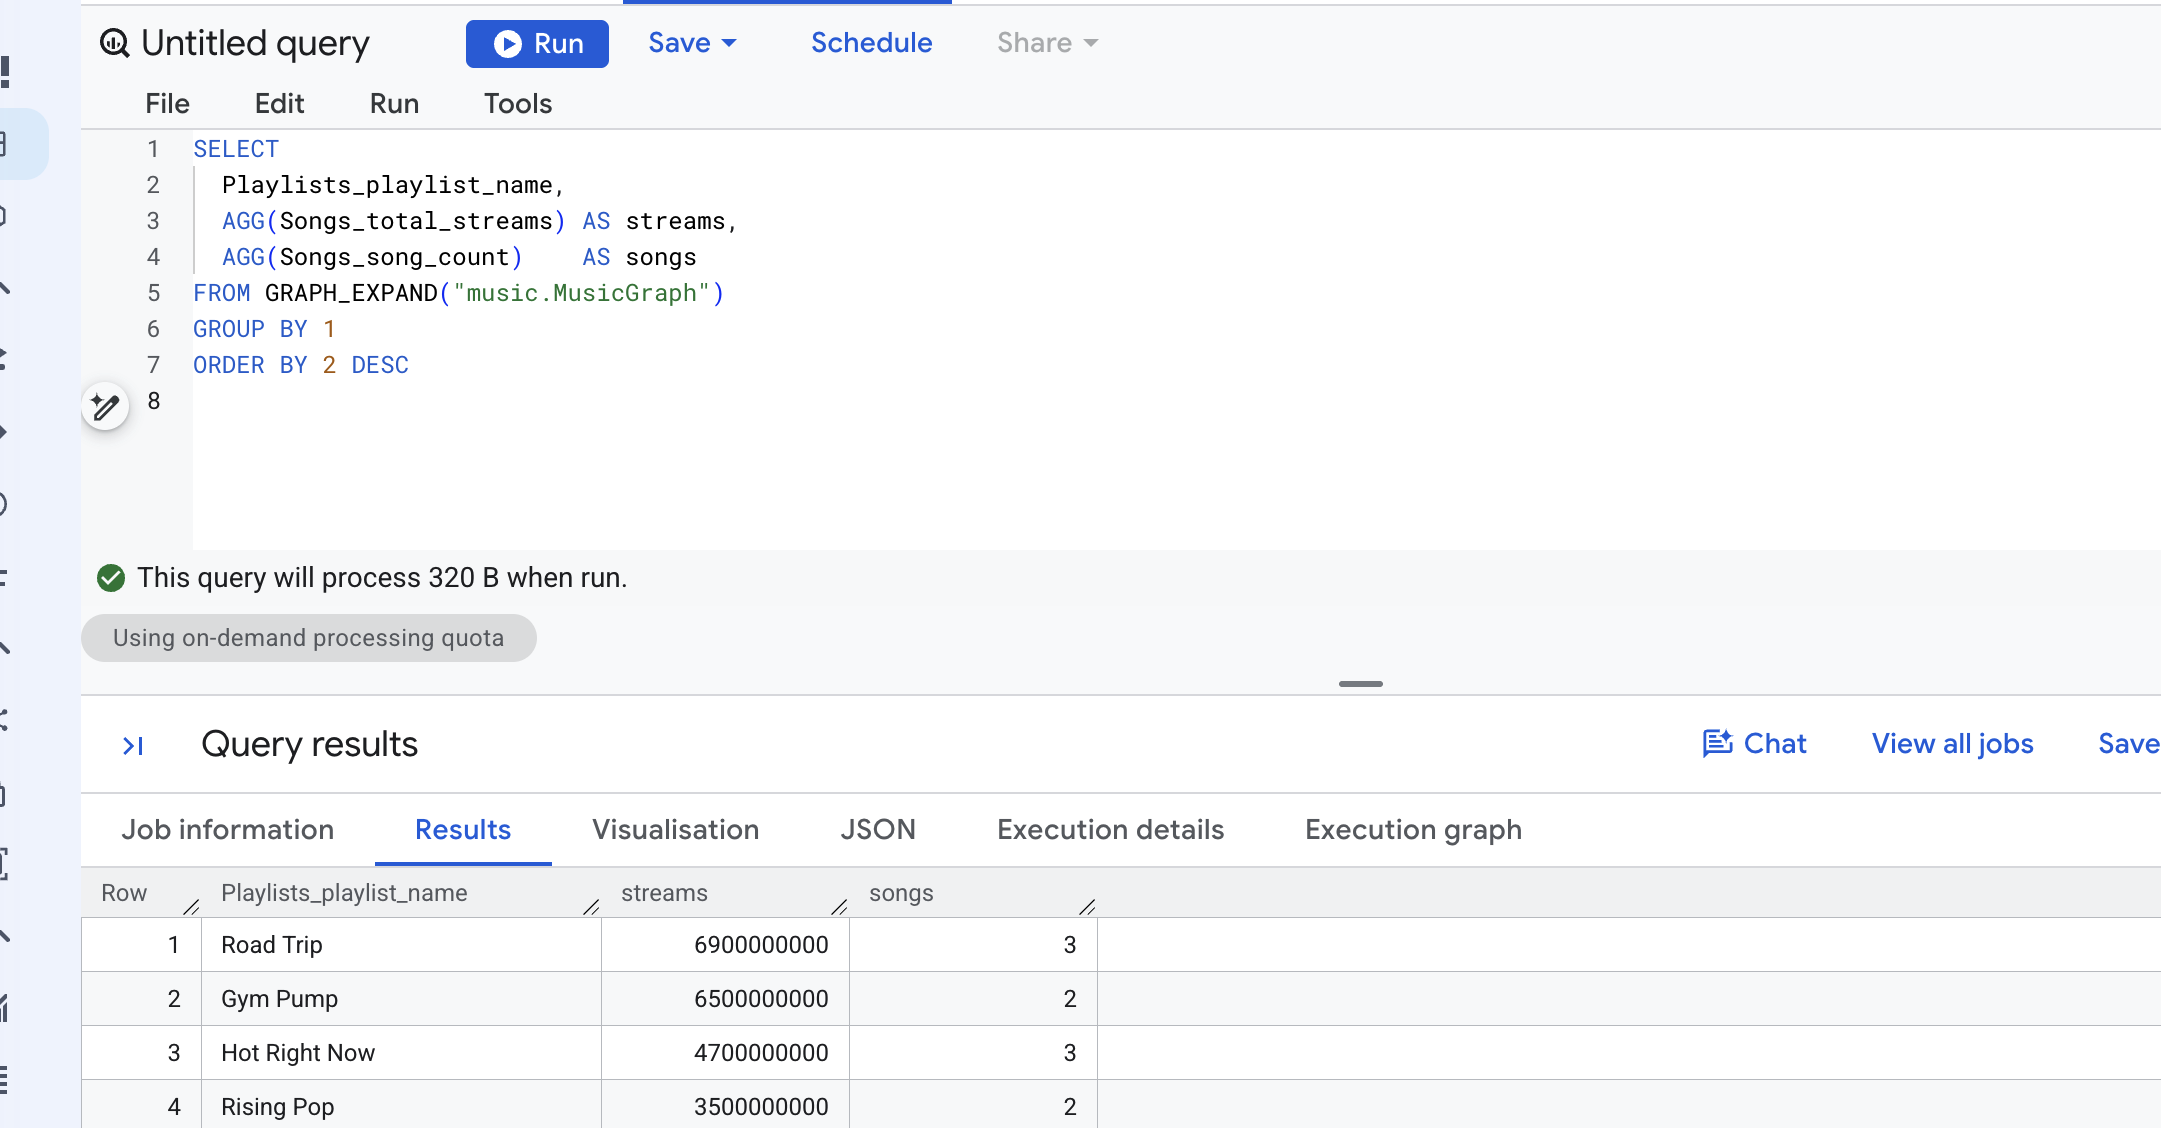
دو خط AGG دقیقاً همان خطوط SUM و AGG هستند که در کنار هم قرار گرفتهاند. فقط GROUP BY منتقل شد. «سفر جادهای» شامل «تابستان نئونی»، «رانندگی نیمهشب»، و «تیر آهسته» است و هر آهنگ یک بار در آن فهرست پخش محاسبه میشود — که دقیقاً همان چیزی است که «جاریسازیهای رسیدن به این فهرست پخش» باید به آن معنا باشد.
فردی که این معیار را نوشته است یکبار دانه را تعیین کرده است. هر پُرسمان بعدی، توسط هر کسی، آن را به ارث میبرد.
✅ ایست بازرسی: «سفر جادهای» با ۶٫۹ میلیارد در صدر قرار دارد.
۱۰. ببینید GRAPH_EXPAND چه چیزی به شما میدهد
برای یادگیری شکل آن، لازم نیست GRAPH_EXPAND را اجرا کنید. روال سیستم BQ.SHOW_GRAPH_EXPAND_SCHEMA فهرست ستون را در متغیری مینویسد.
👉📋 ویرایشگر پُرسمان — هر سه خط را جایگذاری کنید، سپس روی اجرا کلیک کنید:
DECLARE schema STRING DEFAULT '';
CALL BQ.SHOW_GRAPH_EXPAND_SCHEMA('music.MusicGraph', schema);
SELECT schema;
👀 نتیجه یک رشته JSON است. هر فیلد نام، نوع، و حالت دارد و هر ستون اندازهگیری "is_measure": true را حمل میکند. برای نموداری که بهتازگی ساختهاید، این موارد را دریافت میکنید، ازجمله:
نام | نوع | is_measure | |
Songs_title | رشته | ||
Songs_streams | عدد صحیح | ||
Songs_total_streams | عدد صحیح | درست | |
Songs_avg_streams | شناور | درست | |
Songs_distinct_artists | عدد صحیح | درست | |
PlaylistEntries_placement_count | عدد صحیح | درست | |
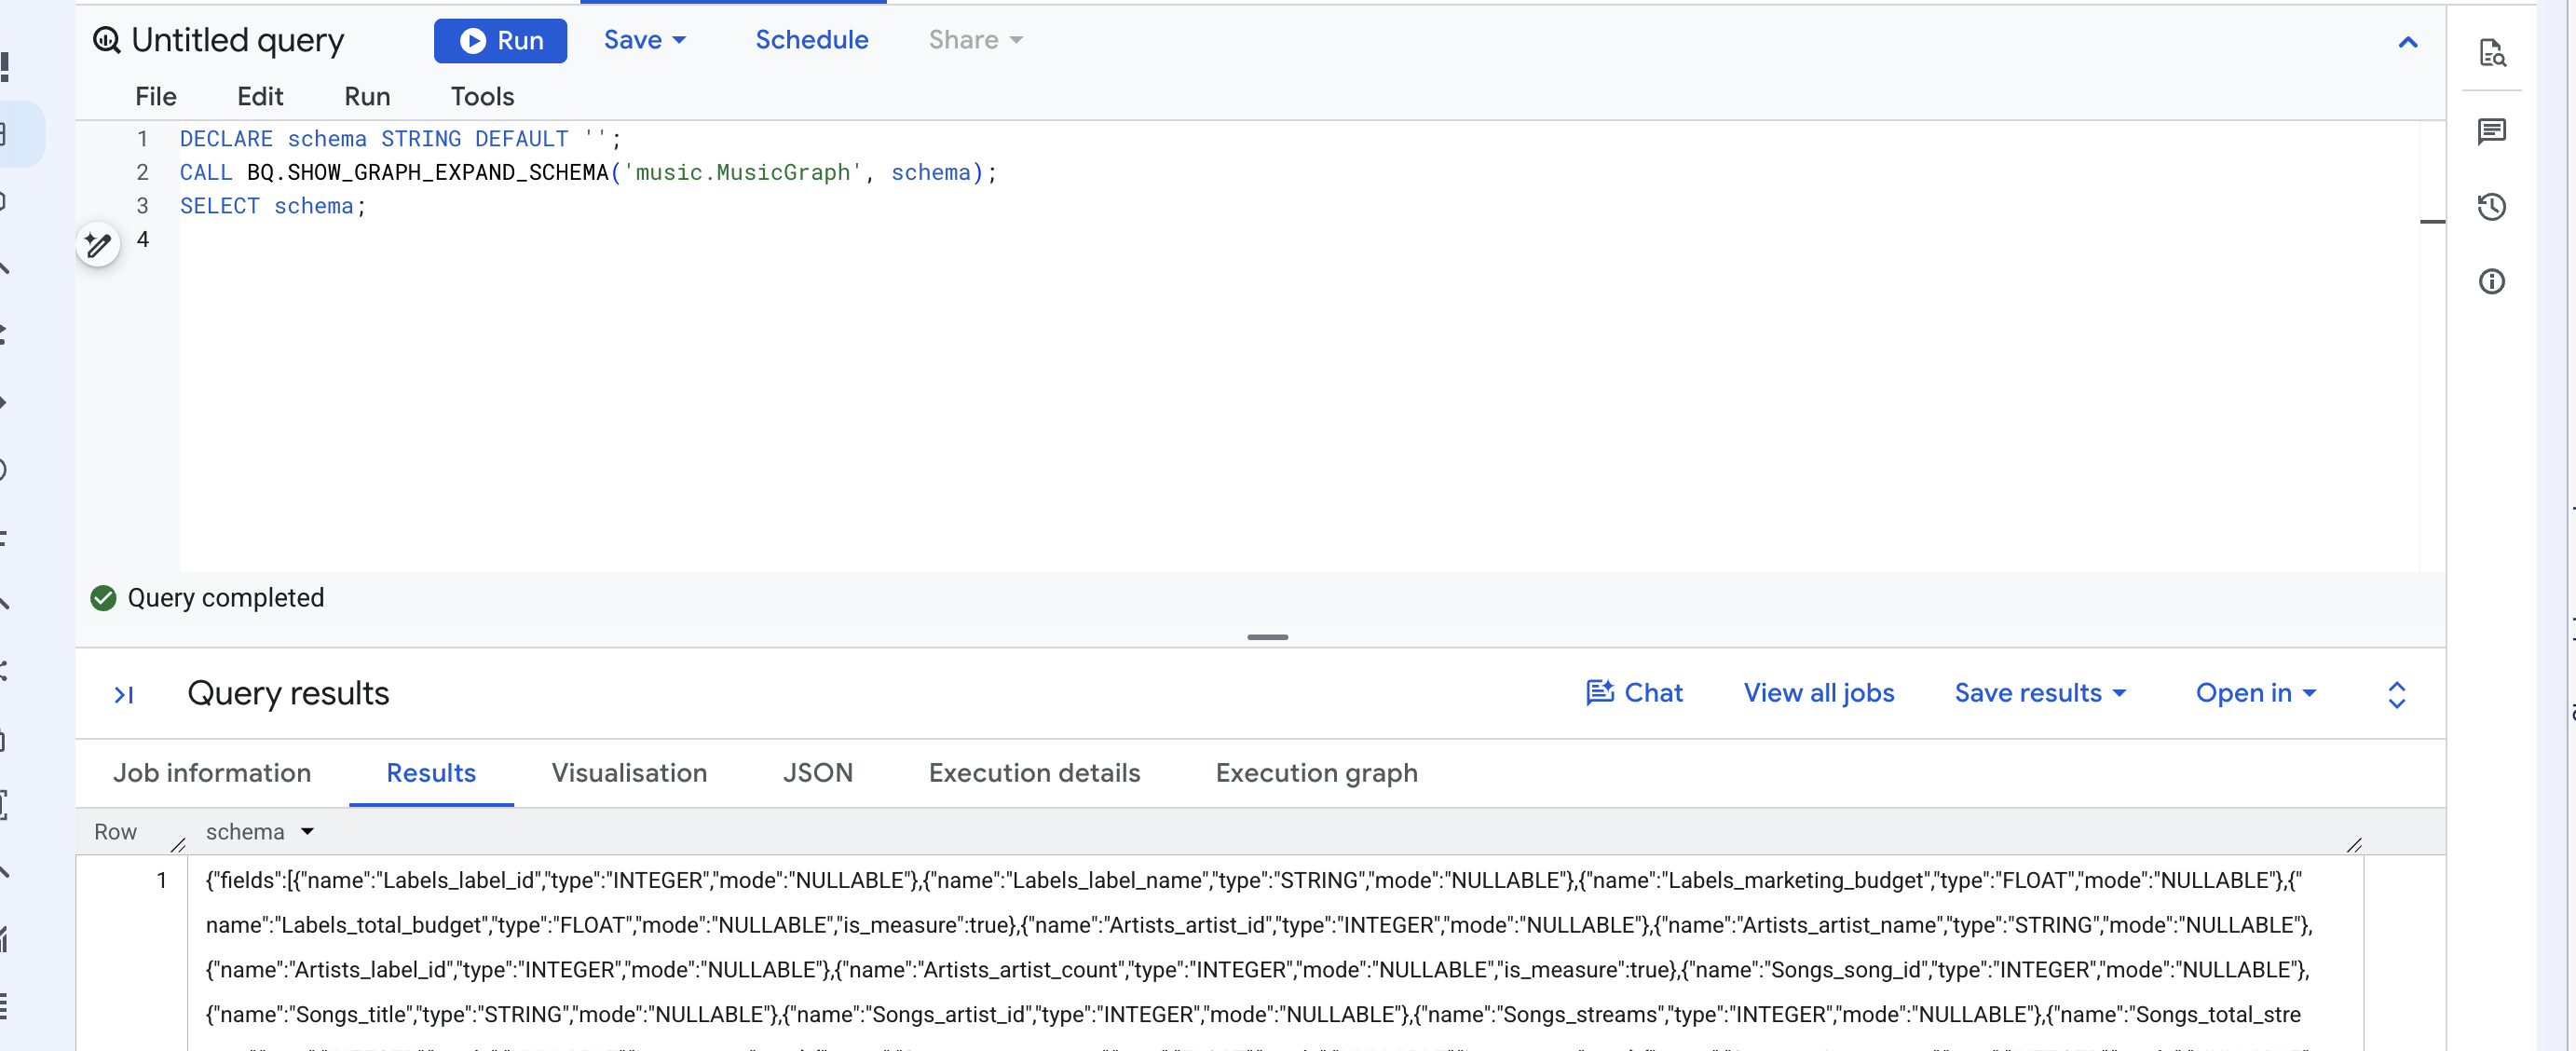
هر شرح یا مترادفی که برای دارایی تنظیم میکنید نیز در اینجا نشان داده میشود. مرحله اختیاری گپ نشان میدهد چه کسی آنها را میخواند.
✅ ایست بازرسی: رشته JSON با is_measure در هر ستونی که با MEASURE اعلام کردهاید.
۱۱. آنچه GRAPH_EXPAND از شکل یک گراف نیاز دارد
چیزی برای اجرا در این مرحله وجود ندارد — فقط بخوانید. GRAPH_EXPAND جدول عریض خود را با زنجیرهای از LEFT JOIN میسازد، از یک جدول شروع میکند و لبهها را بهسمت بیرون دنبال میکند. سه قانون از آن پیروی میکند و MusicGraph همه آنها را برآورده میکند.
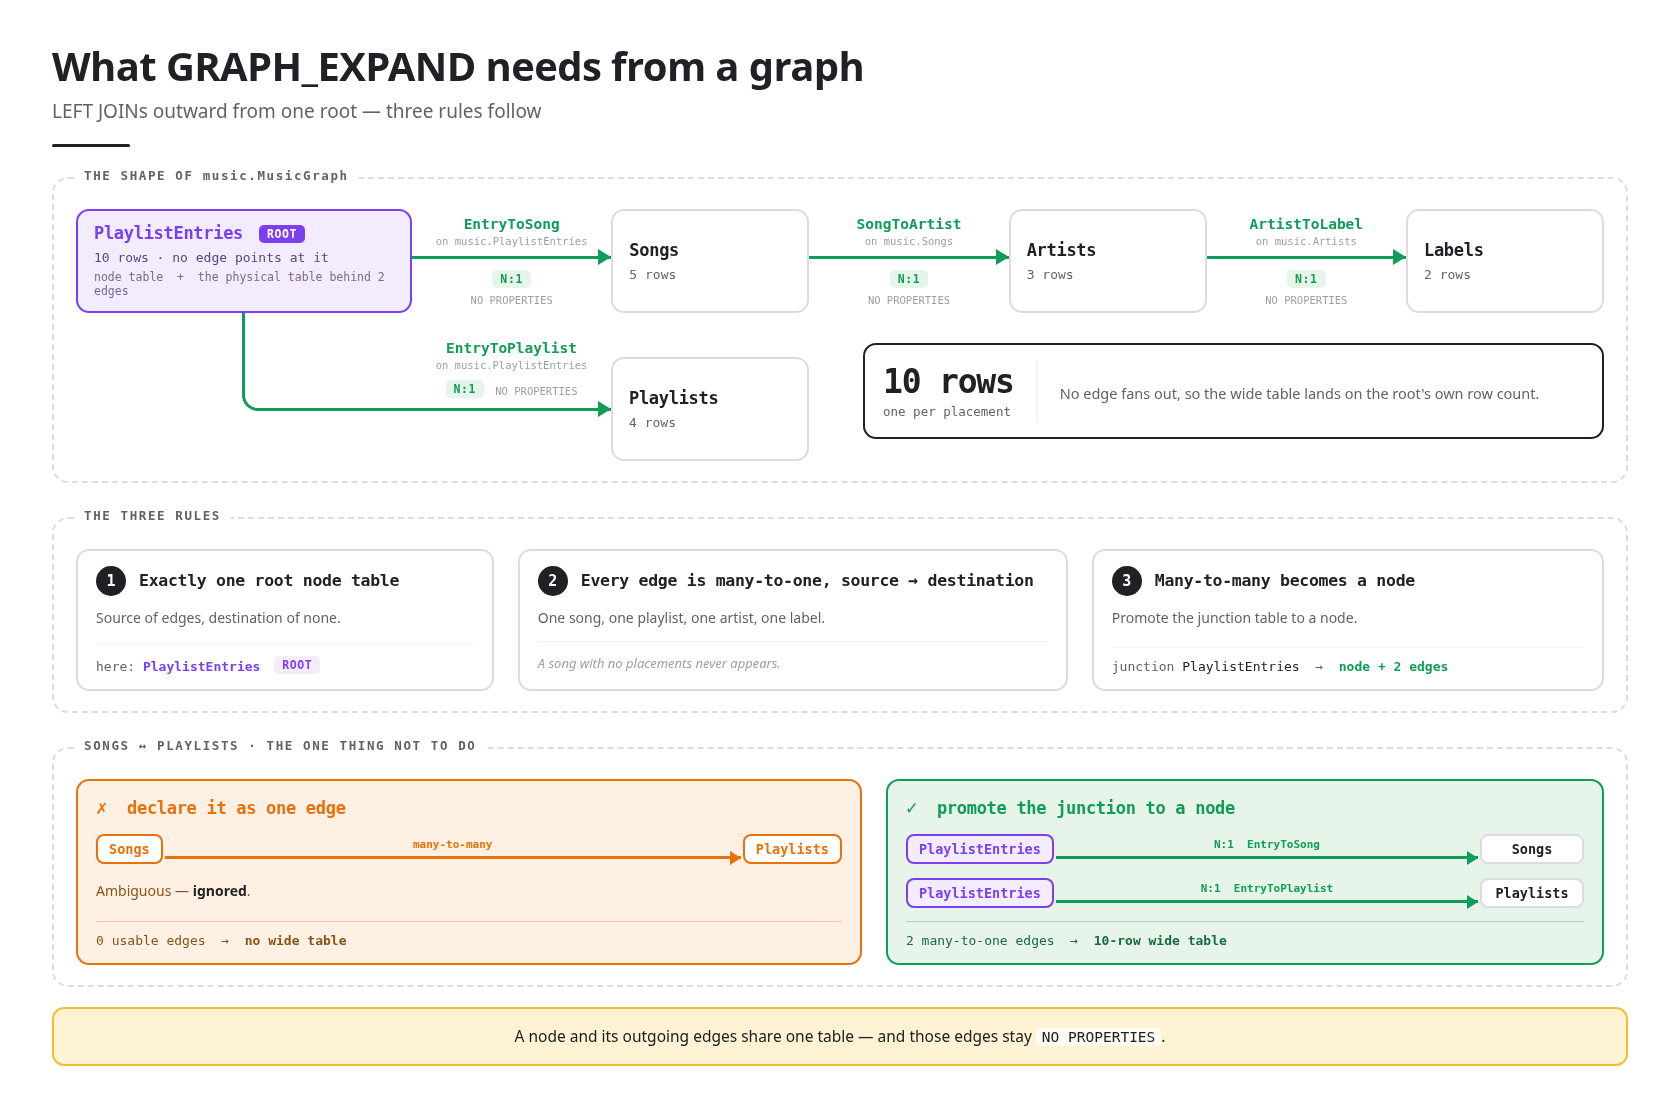
دقیقاً یک جدول گره ریشه. ریشه جدول گرهی است که کلید آن در هیچ جدول دیگری ظاهر نمیشود — جدولی که هیچ لبهای به آن اشاره نمیکند. در MusicGraph که PlaylistEntries است: منبع دو لبه و مقصد هیچ لبهای نیست. جدول عریض ۱۰ ردیف دارد، یک ردیف برای هر جای آگهی.
هر لبه یکبهچند است، از منبع به مقصد. هر ورودی یک آهنگ و یک فهرست پخش دارد، هر آهنگ یک هنرمند دارد، هر هنرمند یک برچسب دارد. به همین دلیل است که جدول عریض هرگز فراتر از ردیفهای ریشه گسترش نمییابد. دادههایی که ریشه نمیتواند به آنها دسترسی پیدا کند نمایش داده نمیشود: آهنگی که جایگاه ندارد در جدول گسترده وجود نخواهد داشت.
روابط چند به چند به گره تبدیل میشوند. آهنگها و فهرستهای پخش بسیاری به بسیاری هستند. اگر جدول پیوند را بهعنوان یک لبه واحد از «قطعههای موسیقی» به «فهرستهای پخش» اعلام کنید، GRAPH_EXPAND آن را بهعنوان مبهم نادیده میگیرد و چون لبه قابلاستفادهای باقی نمیماند، ناموفق خواهد بود. ارتقا دادن PlaylistEntries به جدول گره با دو لبه یکبهچند خارج از آن الگوی مستند است و همان کاری است که هنگام ساختن گراف انجام دادید.
۱۲. (اختیاری) مسیرها با GQL
تاکنون پاسخ همه سؤالات عدد بوده است. این یکی ندارد. جریانهای Cymbal به کجا میرسند؟ سؤالی درباره مسیرها در نمودار است و مجموع نمیتواند به آن پاسخ دهد — تا زمانی که جمع کنید، مسیر ازبین رفته است.
۱. بپرسید جاریسازیها کجا قرار میگیرند
👉📋 ویرایشگر پُرسمان — جایگذاری کنید، سپس روی اجرا کردن کلیک کنید:
GRAPH music.MusicGraph
MATCH (l:Labels)<-[:ArtistToLabel]-(a:Artists)<-[:SongToArtist]-(s:Songs)
      <-[:EntryToSong]-(e:PlaylistEntries)-[:EntryToPlaylist]->(pl:Playlists)
WHERE l.label_name = 'Cymbal Records'
RETURN pl.playlist_name, pl.followers,
       SUM(s.streams) AS streams_reaching_this_playlist,
       STRING_AGG(s.title, ', ') AS songs
GROUP BY pl.playlist_name, pl.followers
ORDER BY streams_reaching_this_playlist DESC
👀 انتظار چهار فهرست پخش را داشته باشید:
pl.playlist_name | pl.followers | streams_reaching_this_playlist | آهنگ |
پرطرفدار درحالحاضر | ۳۵٬۰۰۰٬۰۰۰ | ۴٬۷۰۰٬۰۰۰٬۰۰۰ | Double Shot (شات دوتایی)، Neon Summer (تابستان نئونی)، Paper Crown (تاج کاغذی) |
پاپ نوظهور | ۲٬۰۰۰٬۰۰۰ | ۳٬۵۰۰٬۰۰۰٬۰۰۰ | تابستان نئونی، تاج کاغذی |
سفر جادهای | ۵٬۰۰۰٬۰۰۰ | ۲٬۴۰۰٬۰۰۰٬۰۰۰ | تابستان نئونی، پیکان آهسته |
Gym Pump | ۳٬۰۰۰٬۰۰۰ | ۲٬۰۰۰٬۰۰۰٬۰۰۰ | تابستان نئونی |
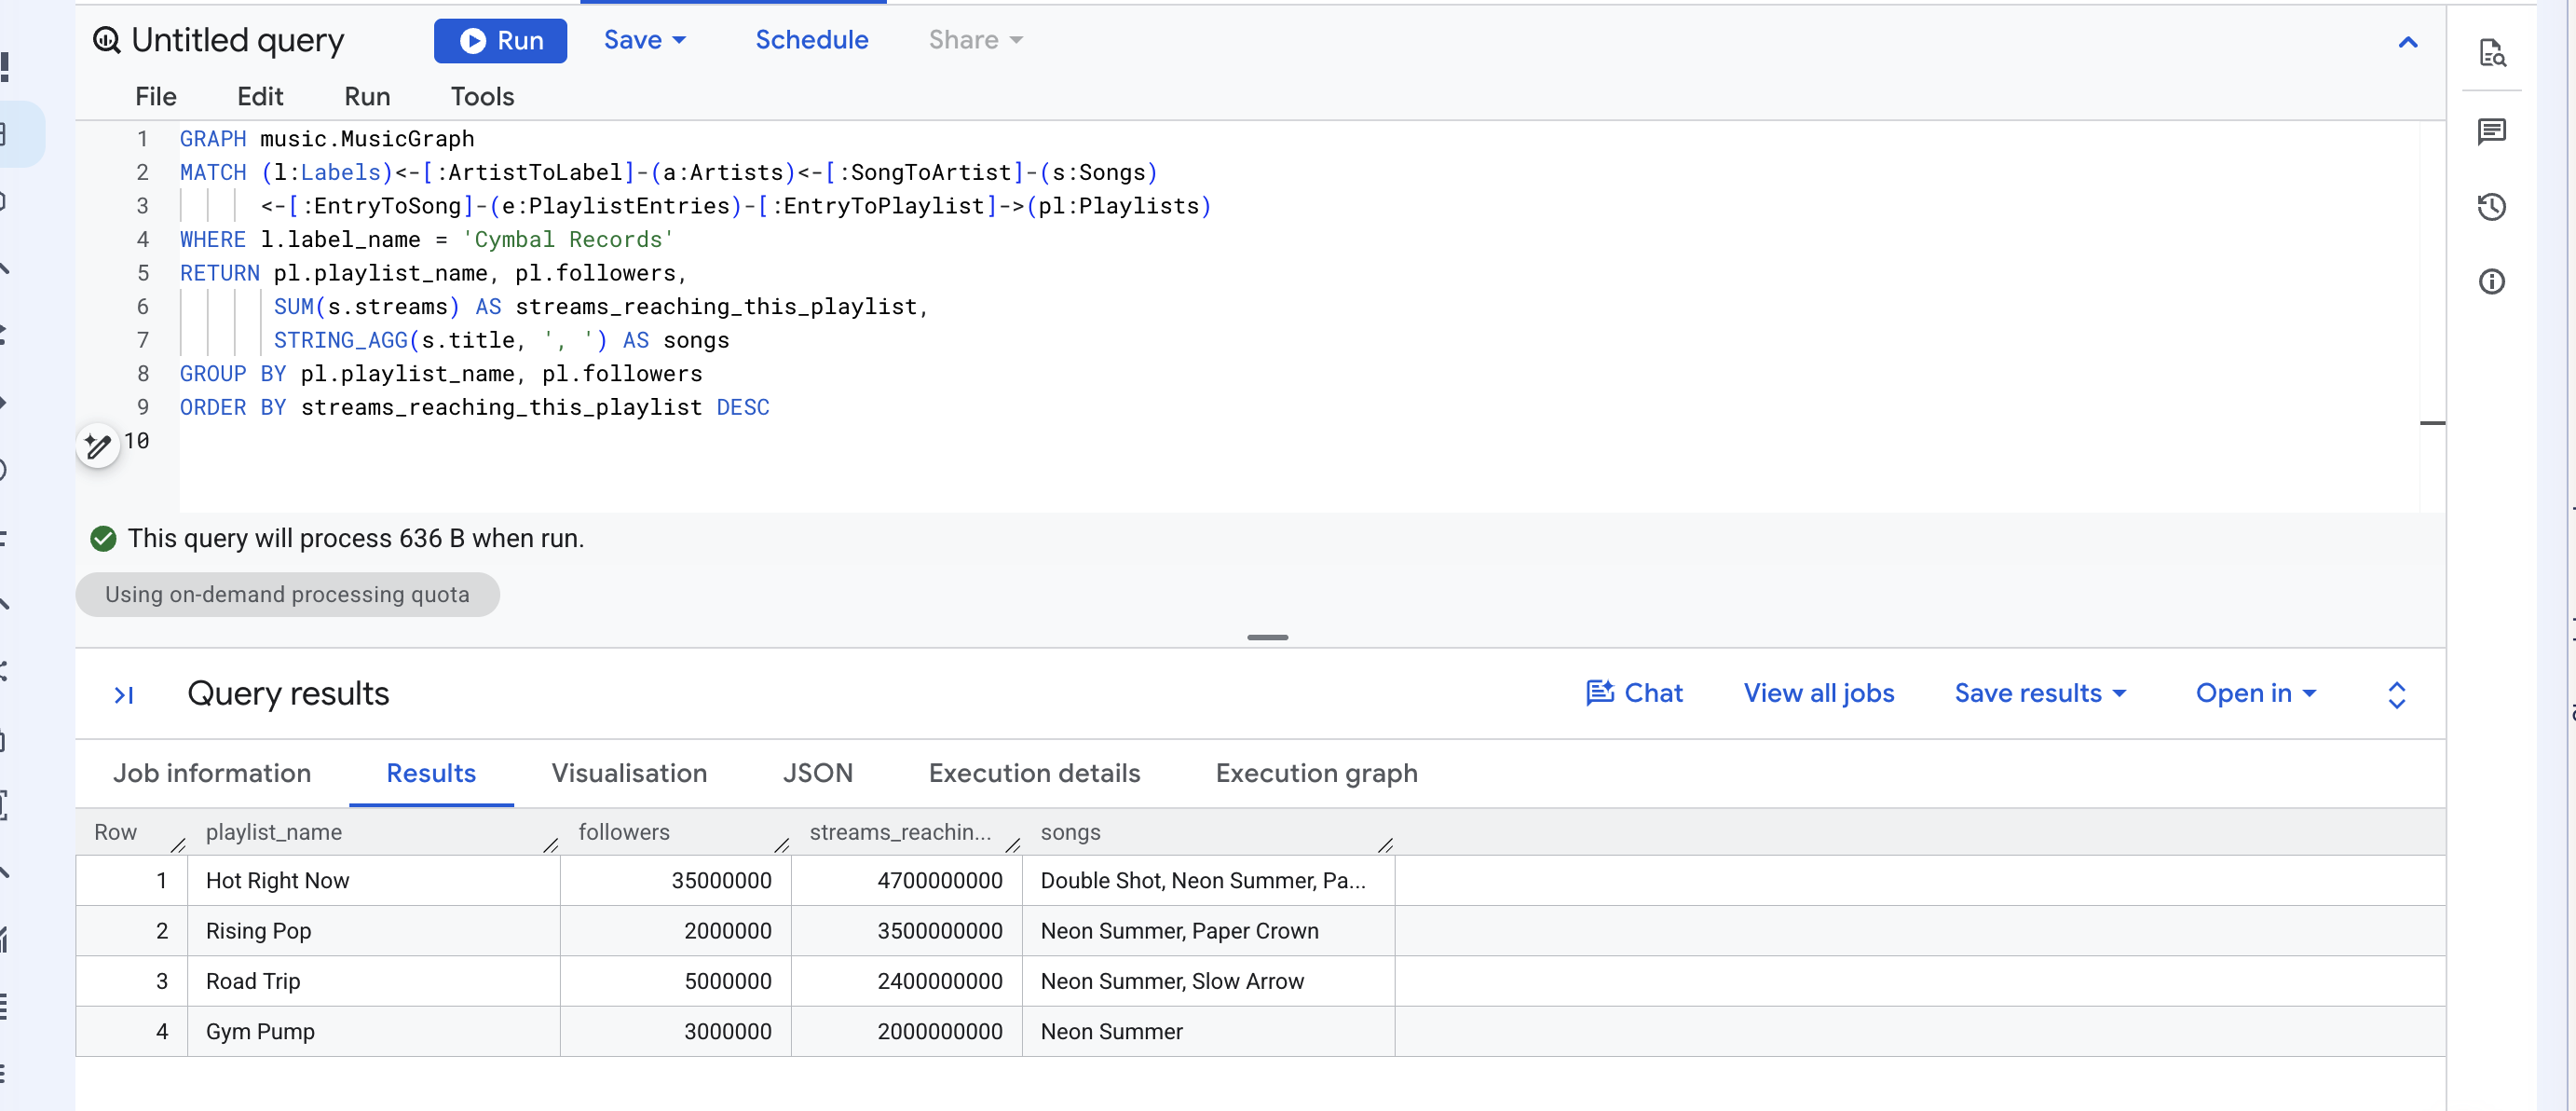
خط MATCH را بهعنوان جمله بخوانید: از برچسب شروع کنید، به هنرمندان آن برگردید، به آهنگهای آنها برگردید، به ورودیهای فهرست پخشی که آن آهنگها در آن قرار دارند برگردید، سپس به فهرستهای پخش بروید. جهت فلشها نشاندهنده نحوه اعلام لبهها است؛ <- یکی را به عقب میبرد.
اکنون ستون سوم را اضافه کنید. ۱۲٫۶ میلیارد — عددی که SUM در مرحله چهارم به شما داد، همان عدد اشتباه.
اینجا درست است. در آن زمان، سؤال این بود که Cymbal چقدر جاریسازی داشته است، و یک آهنگ صرفنظر از اینکه در چند فهرست پخش قرار داشته باشد، یک بار حساب میشد. این پرسش این است که این جاریسازیها به کجا میرسند، و یک آهنگ در چهار فهرست پخش واقعاً به چهار مخاطب میرسد. تکرار GRAPH_EXPAND خطایی برای یک سؤال و پاسخ به سؤال دیگر است. AGG هرگز درباره بد بودن موارد تکراری نبوده است — بلکه درباره مطابقت دادن محاسبات با سؤال بوده است.
۲. مسیرها را برمیگرداند
انبوهش را رها کنید و مسیرها را درخواست کنید.
👉📋 ویرایشگر پُرسمان — جایگذاری کنید، سپس روی اجرا کردن کلیک کنید:
GRAPH music.MusicGraph
MATCH p = (l:Labels)<-[:ArtistToLabel]-(a:Artists)<-[:SongToArtist]-(s:Songs)
          <-[:EntryToSong]-(e:PlaylistEntries)-[:EntryToPlaylist]->(pl:Playlists)
WHERE l.label_name = 'Cymbal Records'
RETURN TO_JSON(p) AS path
p = کل مطابقت را نامگذاری میکند و TO_JSON آن را ارائه میکند.
👀 انتظار ۸ ردیف، یک ستون path. هر سلول آرایهای از گرهها و یالهای JSON درطول یک مسیر است و هر گره labels و properties خود را حمل میکند.
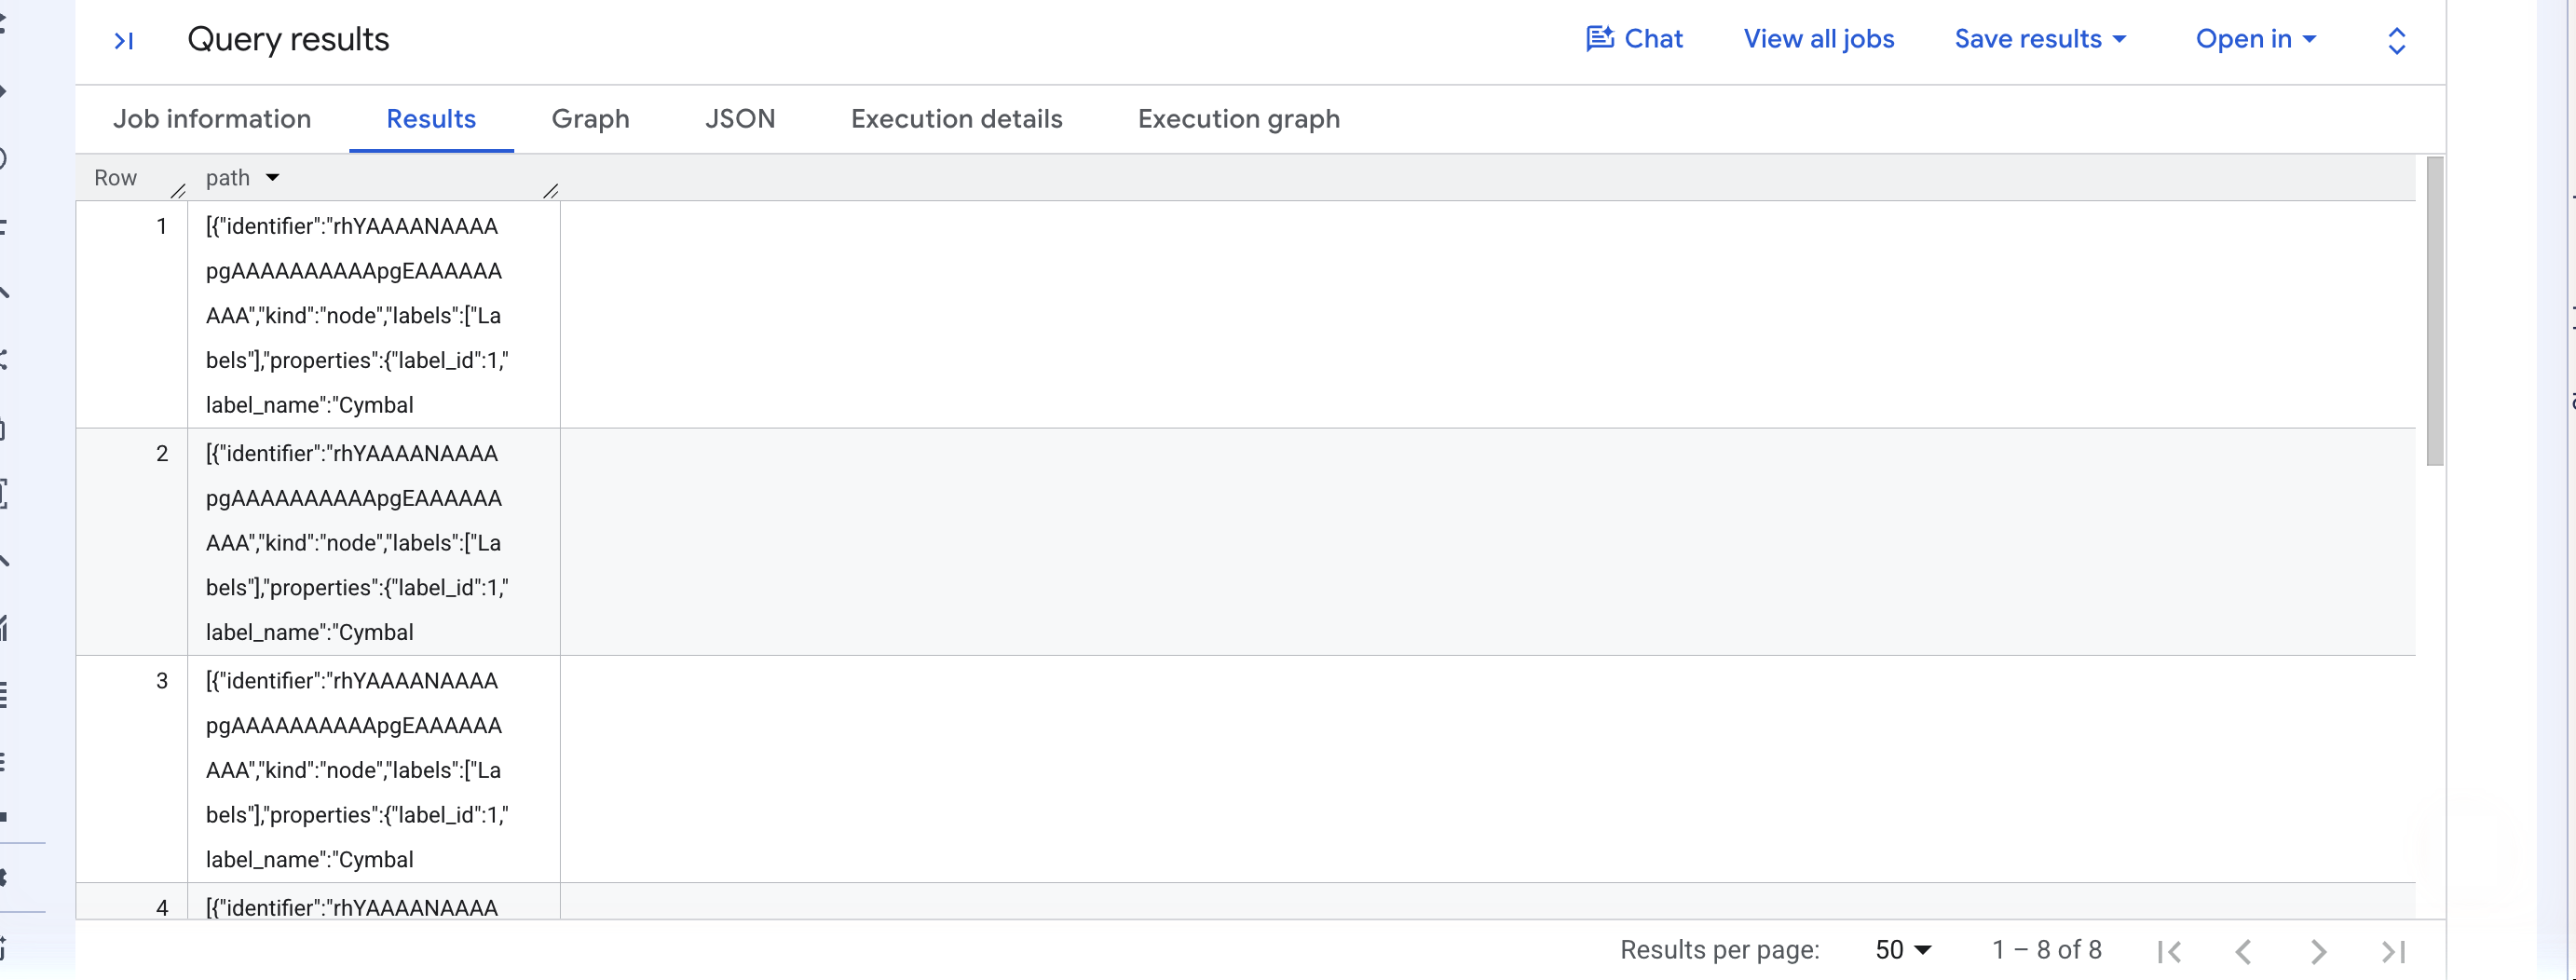
هشت ردیف برای چهار آهنگ، زیرا مسیر براساس جای آگهی وجود دارد، نه براساس آهنگ.
۳. باز کردن زبانه «نمودار»
👉🌐 کنسول — بالای نتایج، روی نمودار کلیک کنید.
این برگه فقط زمانی ظاهر میشود که نتیجهای حاوی عناصر گراف باشد. پُرسمان قبلی اعداد را برگرداند، بنابراین برگه «گراف» نداشت؛ این پُرسمان مسیرها را برمیگرداند، بنابراین برگه «گراف» دارد.
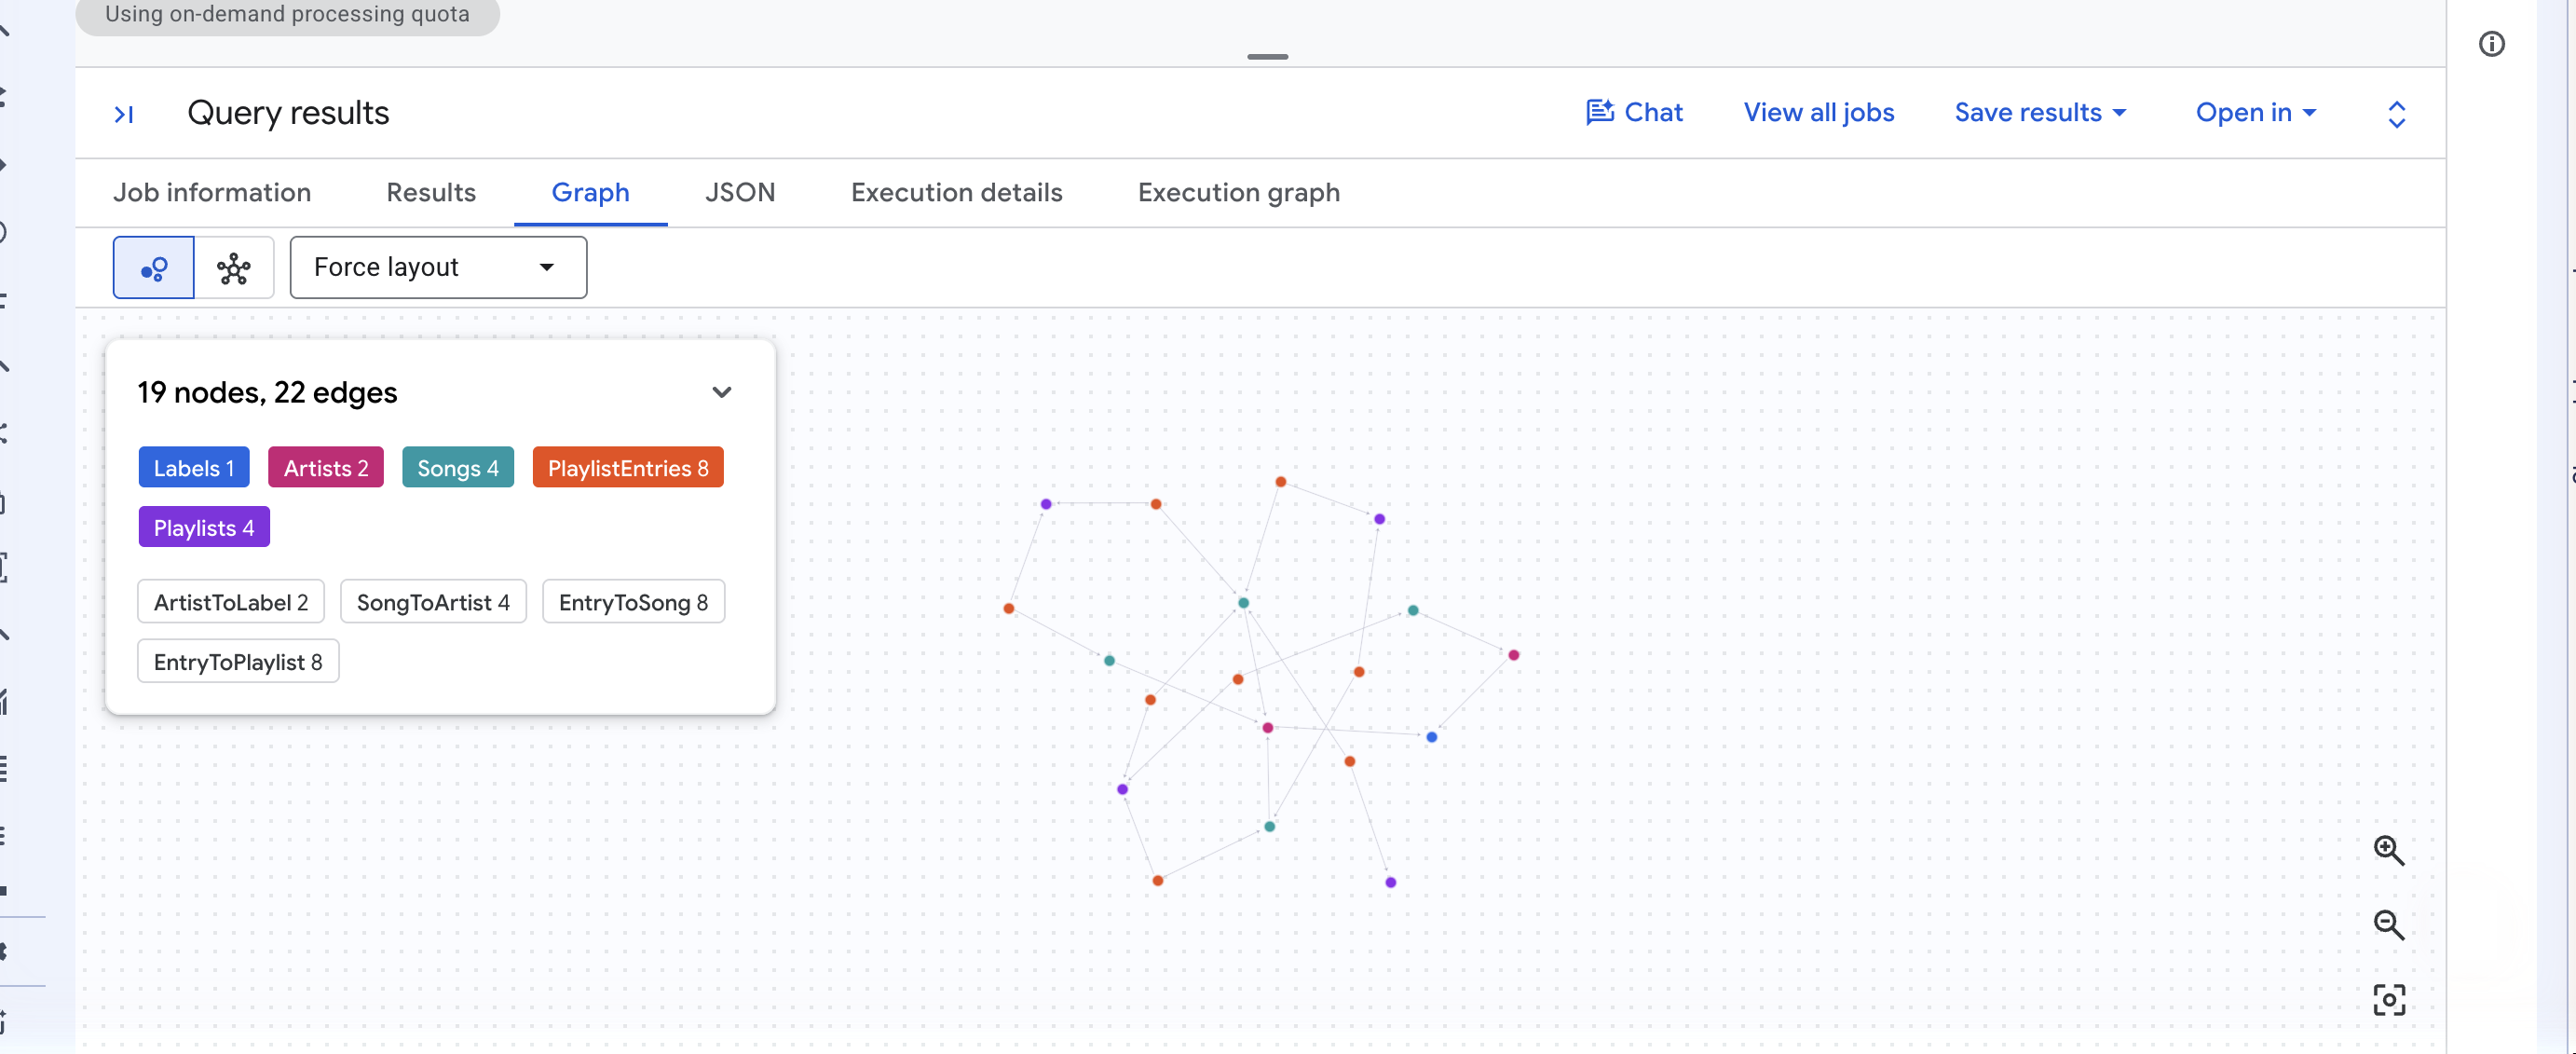
گوشه نمودار Cymbal را بهصورت چیدمان نیرویی دریافت میکنید، با تعداد گرهها و لبههای موجود در نما و یک تراشه برای هر برچسب. گرهای را بکشید تا چیدمان ازهم جدا شود؛ روی گرهای کلیک کنید تا ویژگیهای آن را بخوانید.
✅ ایست بازرسی: ستون سوم اولین پُرسمان به ۱۲٫۶ میلیارد میرسد، پُرسمان دوم ۸ مسیر را برمیگرداند، و برگه «نمودار» آنها را رسم میکند.
۱۳. (اختیاری) گپ زدن با نمودار
در این مرحله SQL وجود ندارد. عاملهای داده BigQuery میتوانند از گراف بهعنوان منبع دانش خود استفاده کنند و مستندات میگوید که آنها از معیارها برای تجمیع چندسطحی استفاده میکنند. بیایید ببینیم این درست است یا نه.
۱. ایجاد عامل
👉🌐 کنسول — در منو پیمایش BigQuery در سمت راست، روی عاملها، سپس کاتالوگ عامل، سپس ایجاد عامل کلیک کنید.
👉🌐 کنسول — Music graph agent را در نام نماینده تایپ کنید و این را در شرح نماینده تایپ کنید:
Ask questions about labels, artists, songs and playlists in the music property graph.
👉🌐 Console — در بخش منابع دانش، روی افزودن منبع کلیک کنید. در کادر گفتگوی انتخاب منابع، پروژه خود را ازهم باز کنید، music را ازهم باز کنید، نمودارها را ازهم باز کنید، MusicGraph را علامت بزنید، و روی تأیید کلیک کنید.
👀 دکمه افزودن منبع خاکستری میشود. کارگزار میتواند حداکثر یک گراف داشته باشد و نمیتواند گرافها را با جدولها ترکیب کند.
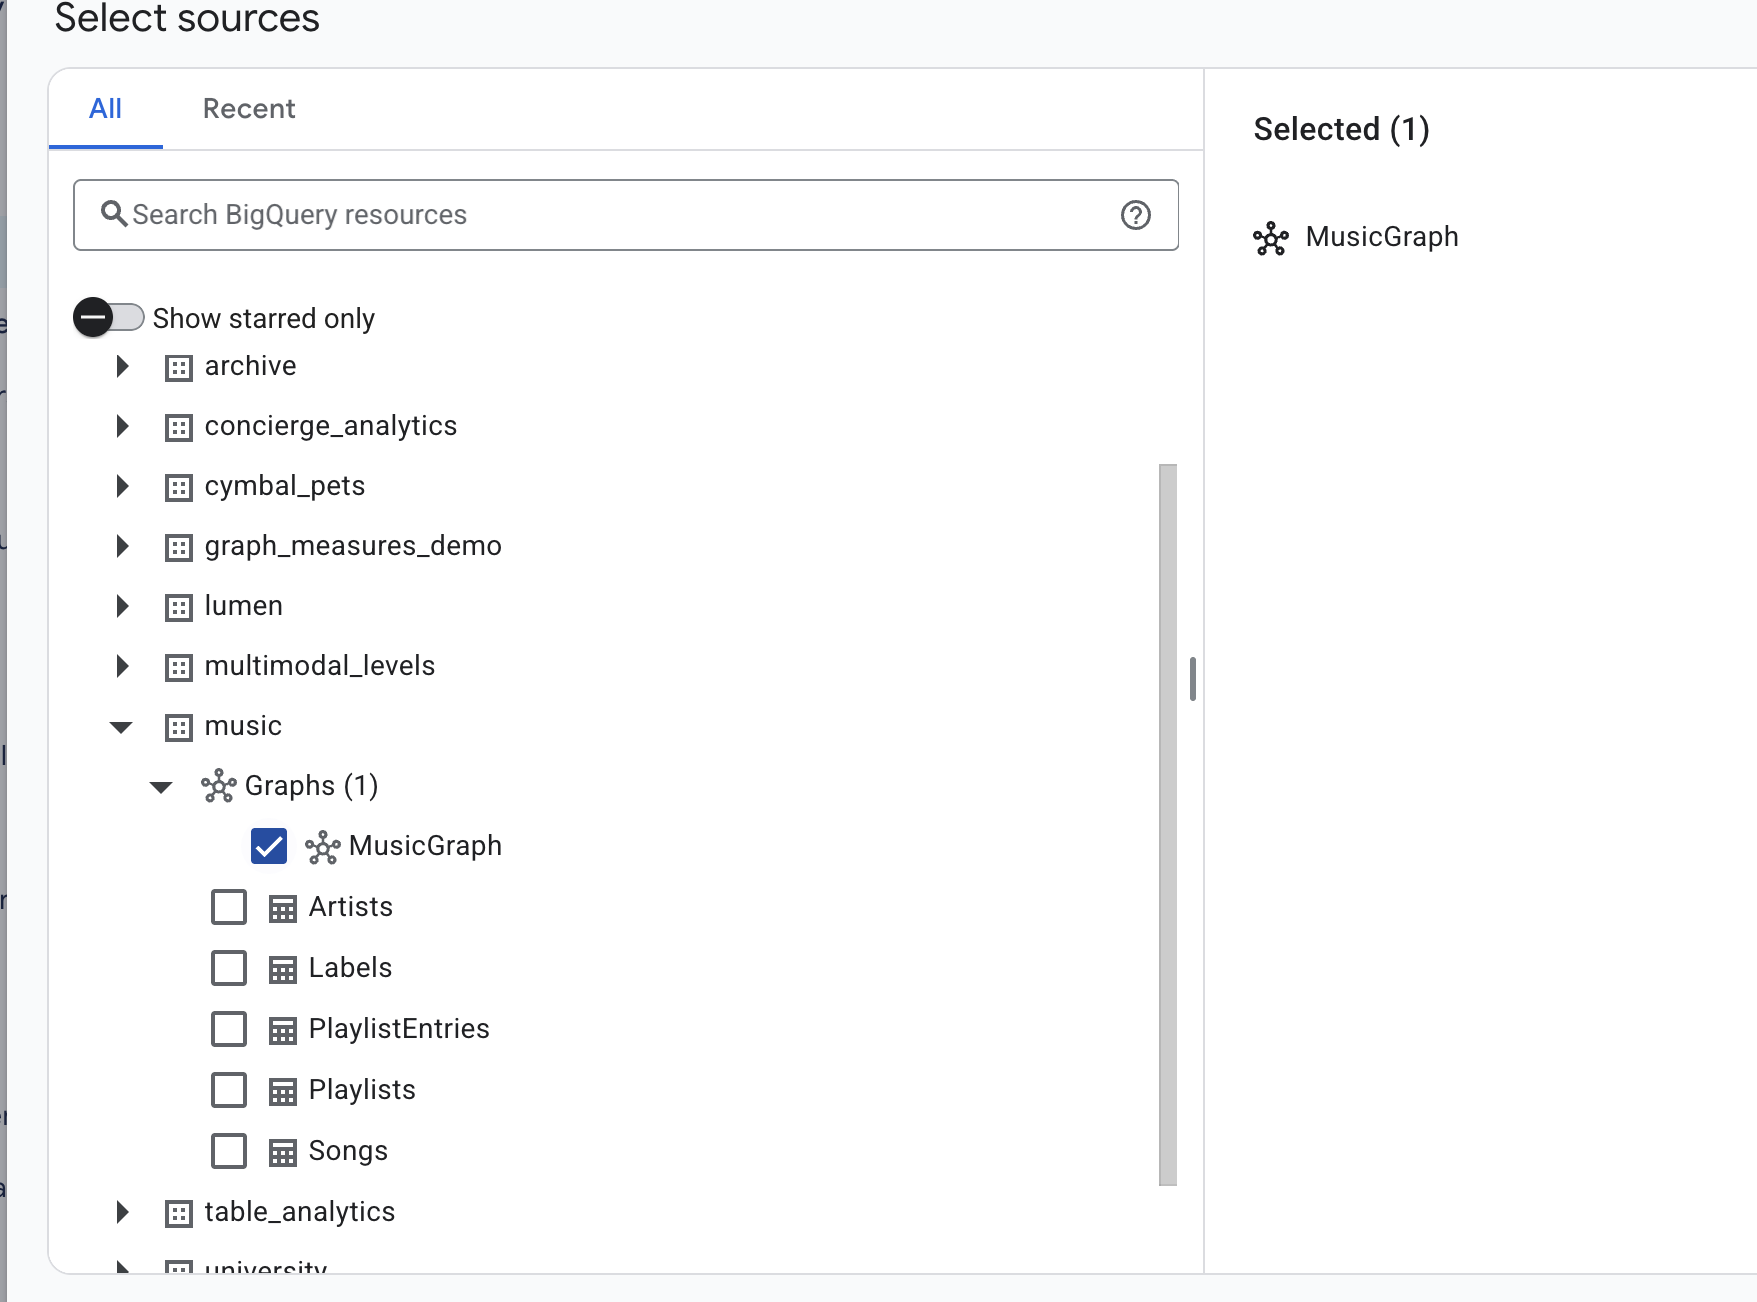
👉🌐 کنسول — منطقه را همانگونه که از مکان نمودار تنظیم شده است بگذارید. روی ذخیره کردن و سپس منتشر کردن کلیک کنید. در پانل انتشار کانالها، روی انتشار عامل کلیک کنید و تأیید را ببندید.
۲. سؤال را بپرسید
👉🌐 کنسول — روی ایجاد مکالمه کلیک کنید. صفحه گپی باز میشود. این را در چارگوش پرسیدن سؤال در پایین تایپ کنید و کلید Enter را فشار دهید:
For each label, show total streams and how many playlists their songs are on
👀 نماینده جدولی و خلاصهای یکجملهای برمیگرداند:
label_name | total_streams | playlist_placements |
Cymbal Records | ۵٬۱۰۰٬۰۰۰٬۰۰۰ | 8 |
Northwind Audio | ۴٬۵۰۰٬۰۰۰٬۰۰۰ | 2 |
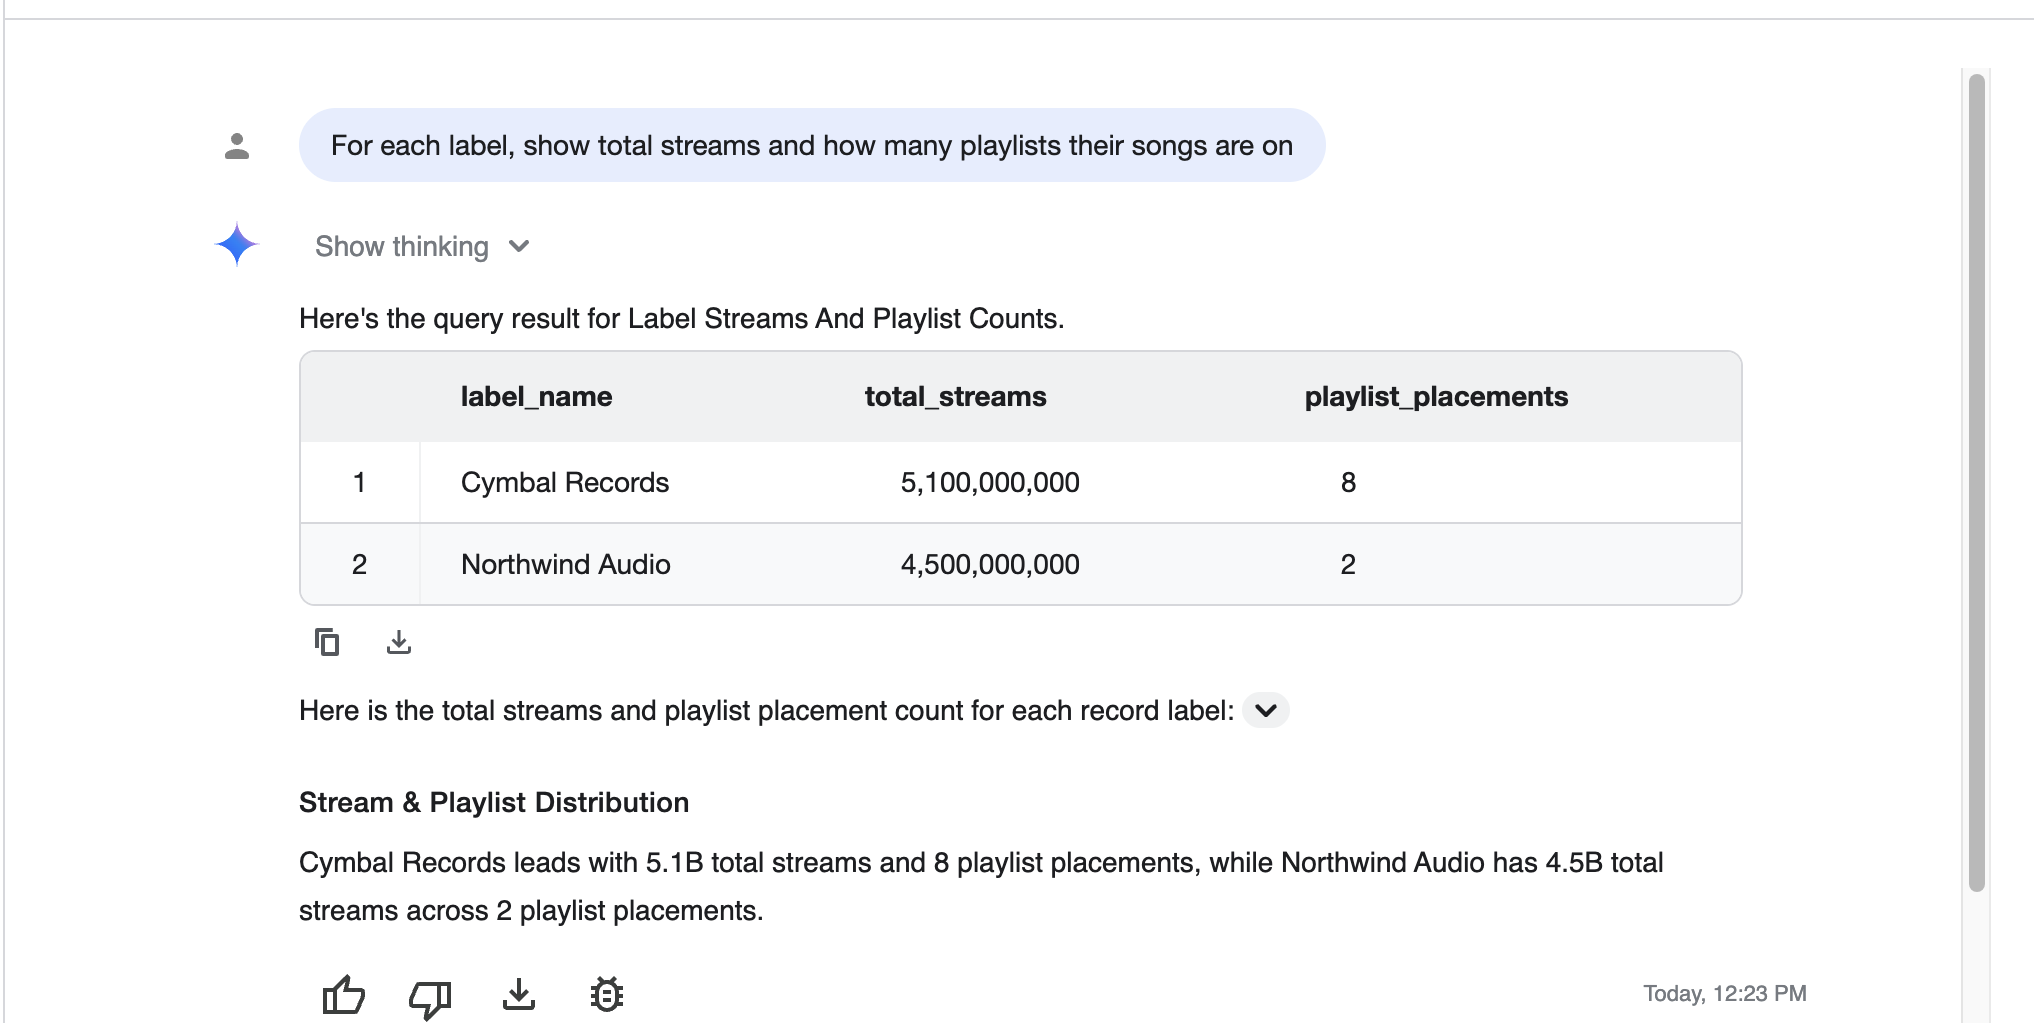
۵٫۱ میلیارد. هیچکس به کارگزار درباره توزیع گسترده نگفته بود و در آن قرار نگرفت.
۳. خواندن پُرسمانی که نوشته است
👉🌐 Console — در منو پیمایش، روی کاوشگر مشاغل کلیک کنید و جدیدترین شغل را انتخاب کنید. برچسبهای آن شامل ca-bq-job: true و data-agent-id با شناسه کارگزار شما است و پرسمان آن این است:
SELECT
  Labels_label_name AS label_name,
  AGG(Songs_total_streams) AS total_streams,
  AGG(PlaylistEntries_placement_count) AS playlist_placements
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY label_name
ORDER BY total_streams DESC
این مورد بهتنهایی از GRAPH_EXPAND و AGG استفاده کرد، زیرا این سنجهها در طرحوارهای که خوانده بود وجود داشت. هیچچیز در شرح کارگزار به آنها اشاره نمیکند.
✅ ایست بازرسی: ۵٫۱ میلیارد در پاسخ گپ، و AGG(...) در SQL کار.
۱۴. مرتبسازی
👉💻 Cloud Shell — مجموعه داده، جدولهای آن، و گراف دارایی را رها کنید:
cd ~/bq-graph-measures-lab
./cleanup.sh
👀 منتظر ✓ dropped YOUR_PROJECT_ID.music (tables and graph) باشید.
اگر عامل داده اختیاری را ایجاد کردهاید، آن را در کنسول در بخش عاملها → کاتالوگ عامل حذف کنید. و اگر ./setup_project.sh پروژهای فقط برای این آزمایشگاه ایجاد کرده است، مرتبترین پاکسازی این است که کل پروژه را تعطیل کنید — شناسه در ~/project_id.txt است.
۱۵. تبریک میگوییم
یک خط، MEASURE(SUM(streams))، را اعلام کردید و آن خط ۱۲٫۶ میلیارد را به ۵٫۱ میلیارد تغییر داد — برای شما و برای هر پُرسمانی که هر کسی پساز آن دربرابر آن گراف مینویسد، ازجمله پُرسمانهایی که یک نماینده مینویسد.
آنچه آموختید
- سنجهای یک تجمیع است که در گرهای، در کنار
KEYکه دانه آن را تنظیم میکند، اعلام میشود. -
GRAPH_EXPANDنمودار را به یک جدول پهن باTableLabel_propertyستون مسطح میکند. -
AGGتنها تابعی است که مقدار را میخواند و سیستم نوع آن را به چهار روش مختلف اعمال میکند. - ۶ تجمیع دردسترس است و
AGGنتیجه مقدار معمولی است که میتوانید تقسیم کنید. - تغییر
GROUP BYبدون دست زدن به معیار، سؤال را دوباره میپرسد. -
GRAPH_EXPANDیک ریشه، لبههای یک به چند، و اتصالهای ارتقایافته به گرهها میخواهد.
جدول تصمیم
نشانه | علت | رفع اشکال |
مجموعی که خیلی بزرگ است | | اعلام کردن یک میزان، خواندن آن با |
«MEASURE موردانتظار بود، INT64 پیدا شد» | | از |
«برگرداندن عبارتهای نوع MEASURE مجاز نیست» | ستون اندازهگیری بدون | پیچیدن آن: |
«توسط نوع عنصر آشکار نشده است» | سنجه ارجاعشده در GQL | فقط |
| اتصال بهعنوان لبه مدلسازی شده است | ارتقا دادن جدول پیوند به گره |
عدد قدیمی پساز تغییر گراف | نتیجه ذخیرهشده | پاک کردن استفاده از نتایج ذخیرهشده در حافظه نهان |
آنچه (بهعمد) پوشش ندادیم
توضیحات و مترادفهای داراییها · پُرسمانهای تأییدشده و واژهنامههای مأموران داده · GQL فراتر از یک MATCH · سنجهها در بیشاز یک نمودار. هرکدام آزمایشگاه خودشان هستند.
بیشتر بدانید
- کار کردن با معیارها
- ایجاد و پُرسمان کردن گراف دارایی
- نمای کلی تجزیهوتحلیل مکالمهای
- مخزن آزمایشگاه — همه پُرسمانهای این codelab، شمارهگذاریشده براساس مرحله