

1. סקירה כללית
רוב הבאגים ב-SQL שלא מתגלים בבדיקת הקוד הם באגים של צבירה. מספר מסוים נכון בטבלה שבה הוא נמצא, פעולת הצטרפות מעתיקה אותו, והסכום הכולל שגוי בלי שזה יצוין.
בעזרת BigQuery Graph, אפשר לתאר את הקשר בין הטבלאות פעם אחת, כתרשים מאפיינים, ואז להריץ שאילתות לגבי הקשרים. מדדים של גרפים מוסיפים עוד דבר לתיאור הזה: הצבירה עצמה. מצהירים על MEASURE(SUM(streams)) בצומת שבבעלותו המספר, וכל שאילתה שקוראת את הגרף מקבלת את הסכום הנכון ברמת הפירוט הנכונה – בלי טריק GROUP BY, בלי CTE שמישהו צריך לזכור.
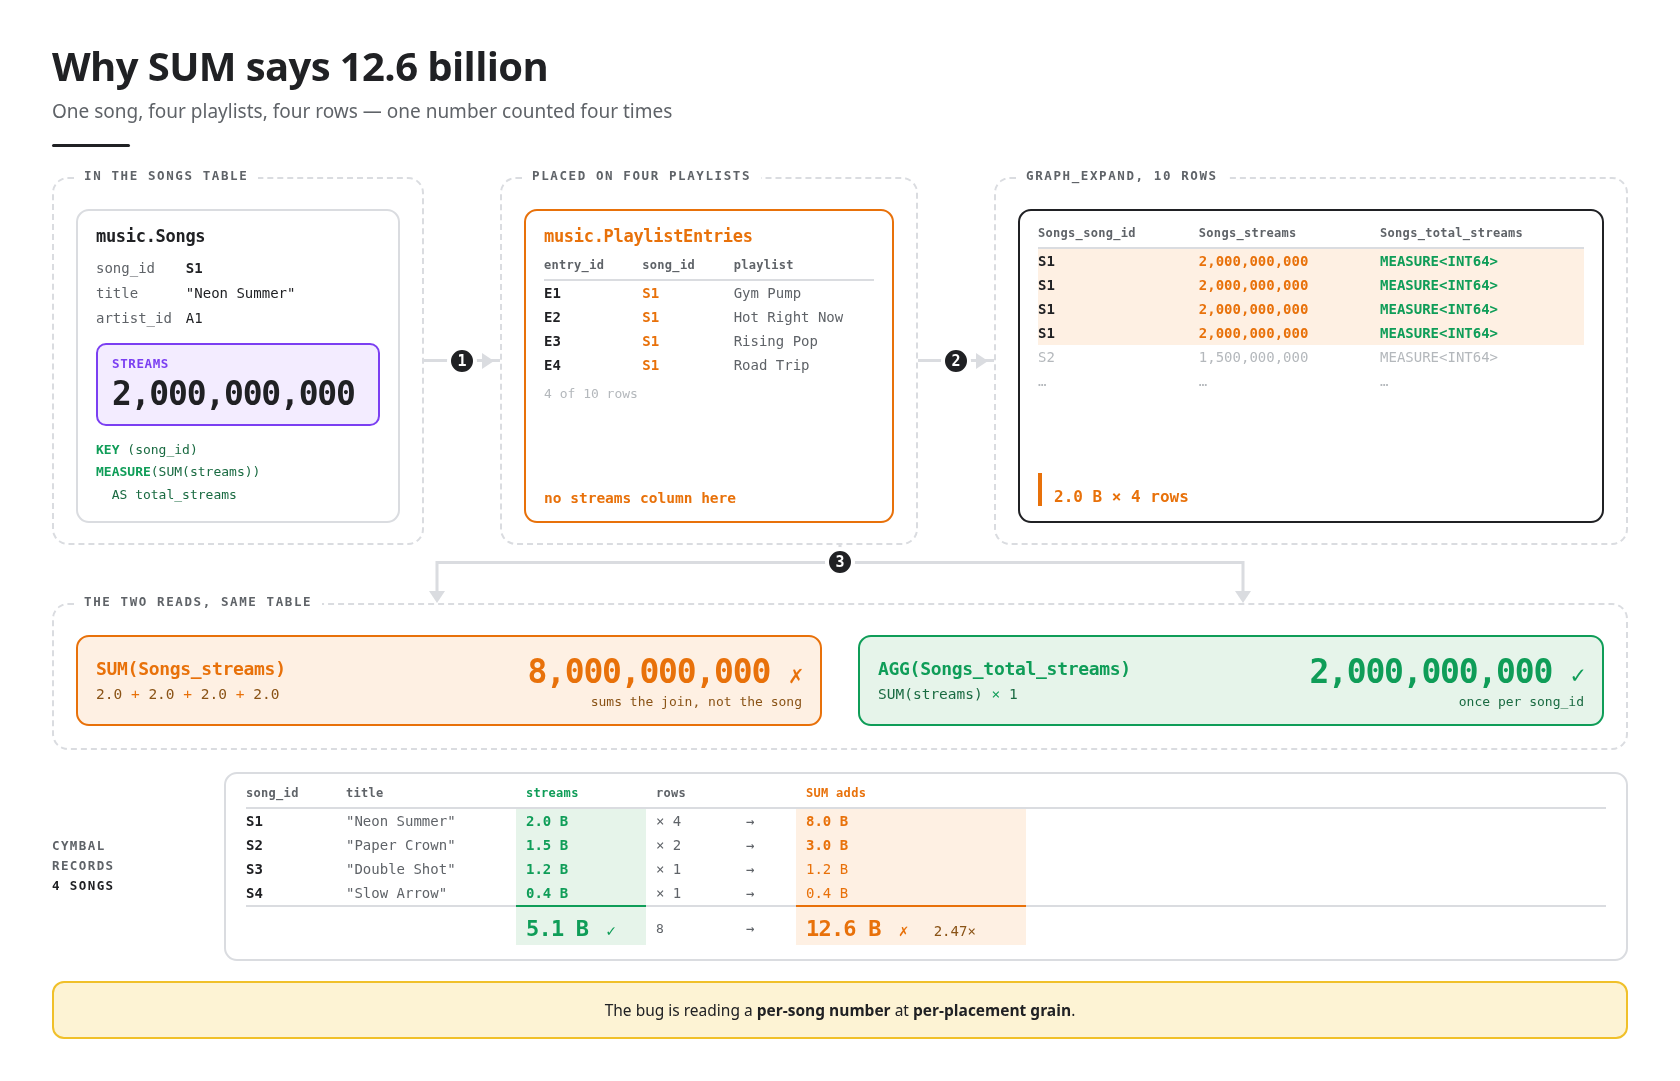
ב-codelab הזה תיצרו קטלוג מוזיקה עם חמישה טבלאות, תוסיפו לו מדד אחד ותראו איך אותה שאלה מחזירה שתי תשובות שונות: 12.6 מיליארד עם SUM ו-5.1 מיליארד עם AGG. הפער הוא הצורה של הקטלוג – שיר שמופיע בארבעה פלייליסטים הופך לארבע שורות אחרי שהתרשים משוטח, ו-SUM מוסיף את כל הארבע. אחר כך לומדים את הכללים שהופכים את השנייה לנכונה.
איפה מקלידים דברים
בשיעור ה-Lab הזה נשתמש בדיוק בשני מקומות, בסדר הזה:
איפה | מה עושים שם | |
1 | מסוף Cloud Shell | כמה פקודות, רק בשלב ההגדרה |
2 | מסוף BigQuery | כל השאר: הדבקת שאילתות בעורך השאילתות, לחיצה על האפשרויות בכלי ליצירת מודלים של גרפים, צ'אט עם סוכן |
כל הוראה מתויגת, כך שתמיד אפשר לדעת למה היא מתייחסת:
- 👈💻 Cloud Shell – מקלידים את הפקודה הזו במסוף Cloud Shell.
- 👈📋 עורך השאילתות – מדביקים את השאילתה הזו בעורך השאילתות של BigQuery ולוחצים על הפעלה.
- 👈🌐 מסוף – לוחצים על האפשרויות במסוף BigQuery. לא מקלידים כלום אלא אם מצוין אחרת בשלב.
- 👀 – בודקים את התוצאה.
מה תלמדו
- איך להגדיר מדד בטבלת צמתים – בכלי ליצירת מודלים של תרשימים חזותיים או ב-SQL
- איך
GRAPH_EXPANDמשטח גרף לטבלה רחבה אחת - למה
AGGהיא הפונקציה היחידה שיכולה לקרוא מדד, ומה קורה בכל ניסיון אחר - ששת הצבירים שמדד תומך בהם, ואיך לבצע פעולות אריתמטיות ביניהם
- איך מדד אחד עונה על שאלה שמקובצת בצורה שונה בלי שינויים
- אופציונלי: איך GQL והכרטיסייה 'גרף' עונים על שאלה שלא ניתן לענות עליה באמצעות סה"כ, ואיך סוכן נתונים של BigQuery משתמש במדדים שלכם בלי לקבל עליהם מידע
הדרישות
- חשבון Google עם אפשרות לחיוב ודפדפן. לא צריך פרויקט בענן ב-Google Cloud מראש – תהליך ההגדרה יוצר פרויקט בשבילכם.
- רק לשלב האופציונלי של הצ'אט: Gemini Data Analytics API מופעל, והתפקיד Gemini Data Analytics Data Agent Creator.
לא צריך להתקין שום דבר במחשב. הכול פועל ב-Cloud Shell ובמסוף BigQuery.
סטטוס המוצר והעלות שלו
השירות BigQuery Graph זמין לכלל המשתמשים. המדדים של הגרף, הכלי הגרפי ליצירת מודלים של גרפים, ההמחשה של הגרף והשימוש בגרף כמקור ידע של סוכן נתונים נמצאים בתצוגה מקדימה, והם כפופים לתנאי המבצע בכל הנוגע למוצרים בגרסת טרום-GA.
השימוש ב-GRAPH_EXPAND וב-AGG כרוך בתשלום לפי דרישה. שאילתות GQL (שלב הנתיב האופציונלי) דורשות הזמנה שמשתמשת במהדורת Enterprise או Enterprise Plus, בהתאם לתיעוד – ולכן השלב הזה הוא אופציונלי.
מערך הנתונים הוא כמה קילובייט. בתמחור על פי דרישה, כל שאילתה מחויבת במינימום של 10MB, כך שעלות ה-codelab כולו היא חלק קטן מסנט.
2. הגדרה
זה השלב היחיד שבו משתמשים ב-Cloud Shell. הוא יוצר פרויקט, מגדיר בו חיוב ובונה את הטבלאות הגולמיות. אחרי כן, תוכלו להריץ את הגרף, המדד וכל שאילתה במסוף BigQuery.
יש דבר אחד שלא תוכלו לקבל במעבדה הזו: פרויקט בענן של Google עם חיוב מופעל. בשלב 1 מקבלים חשבון שאפשר לשלם דרכו, ובשלב 4 הופכים את החשבון הזה לפרויקט. חשוב לבצע את השלבים לפי הסדר הזה – כל שלב אחרי 4 קורא את הפרויקט שנוצר בשלב 4.
1 · יצירת חשבון עם חיוב (~דקה)
👉🌐 חשוב לעשות את זה לפני הכול. נכנסים לחשבון Google שמוגדר בו חיוב. כל חשבון כזה יתאים. אם אין לכם חשבון כזה, תוכלו להתחיל תקופת ניסיון בחינם. תקבלו חשבון לחיוב, וזה כל מה שצריך בשלב 4.
2 · פתיחת Cloud Shell (כדקה)
👈🌐 Console – לוחצים על Activate Cloud Shell בחלק העליון של מסוף Google Cloud – זהו הסמל בצורת טרמינל בכותרת. חלון טרמינל ייפתח בחלק התחתון של הדף.
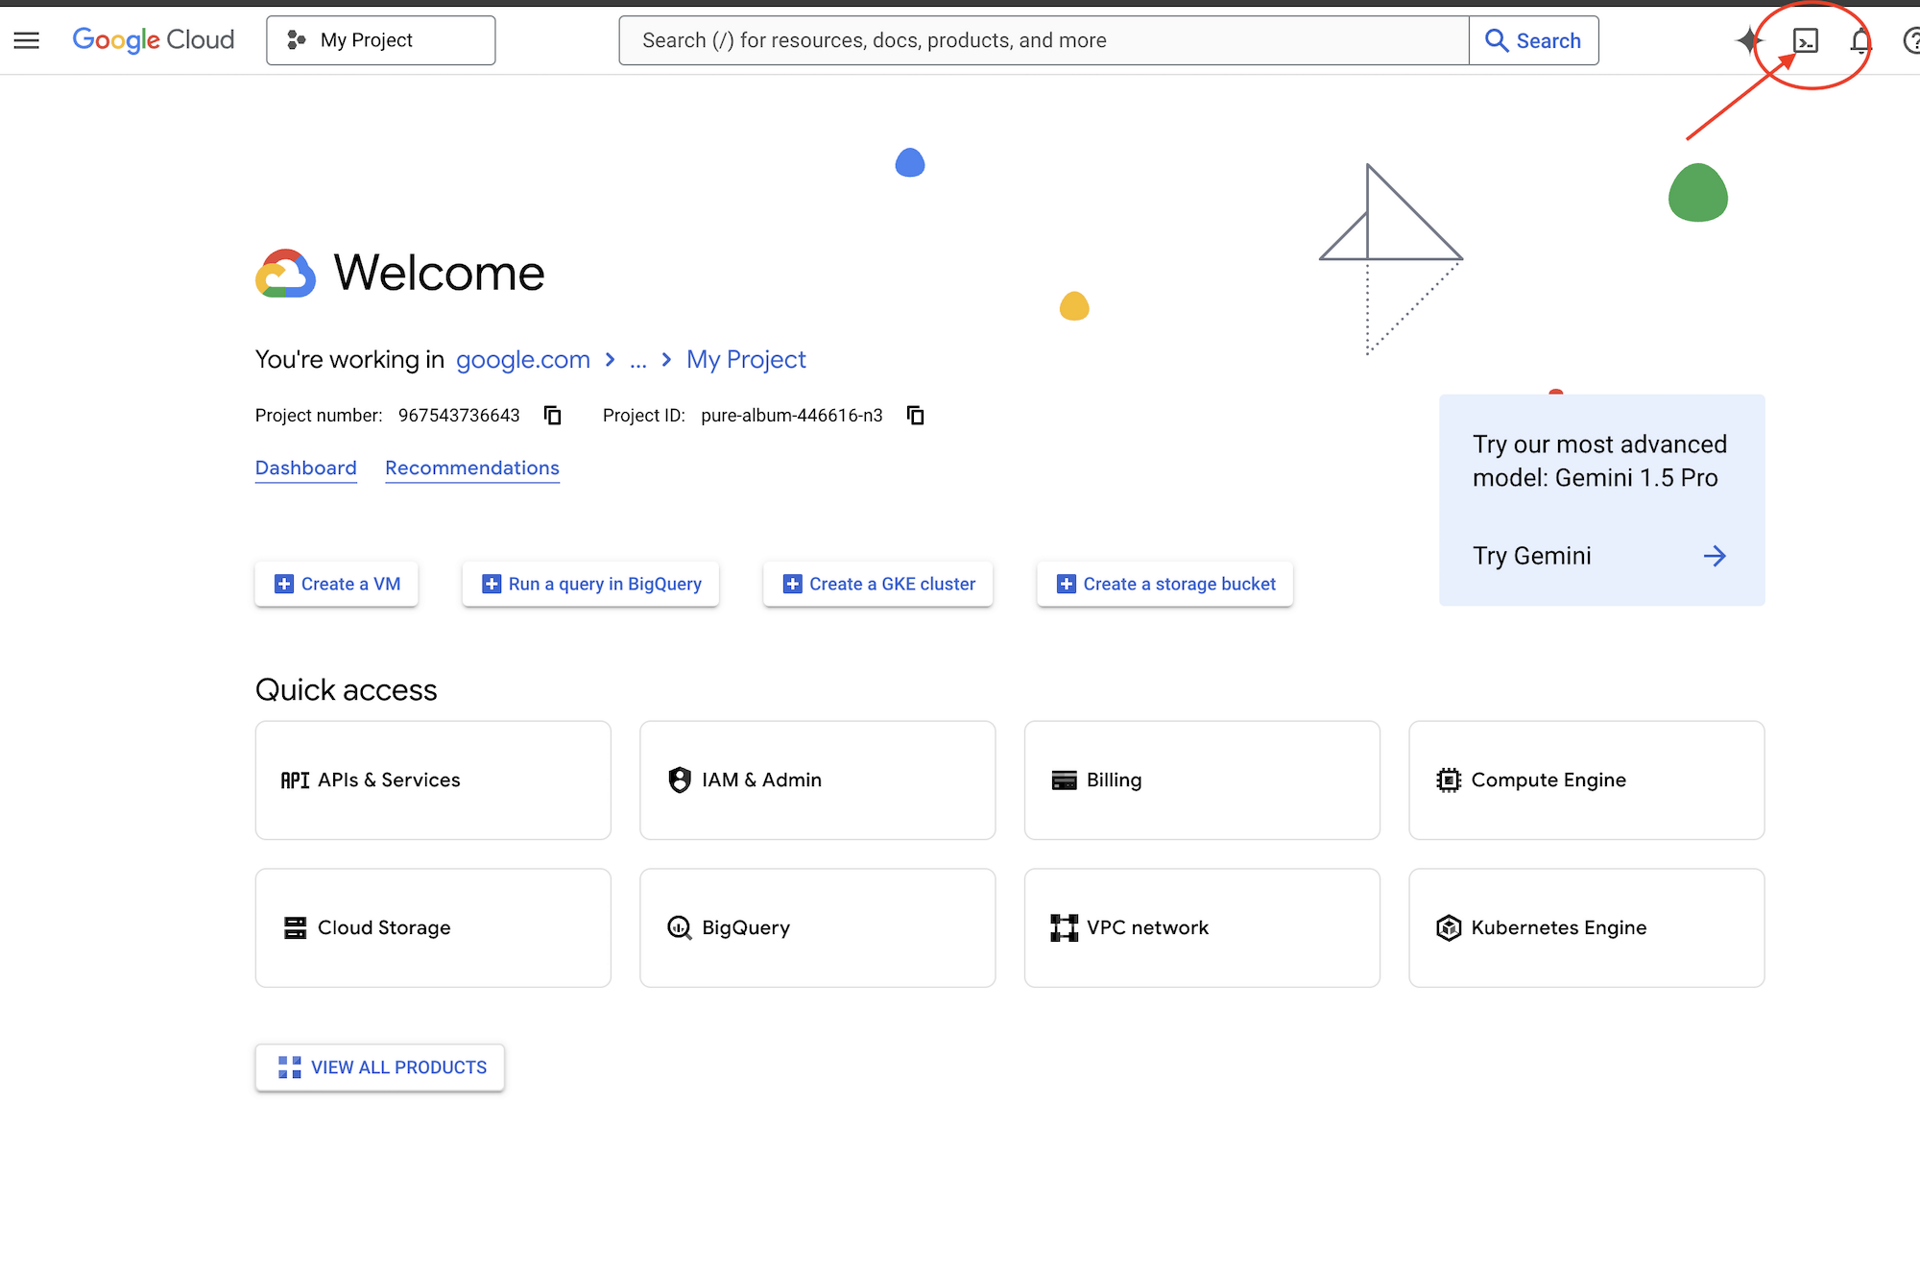
👉🌐 Console – אם תתבקשו לאשר הרשאה בשלב כלשהו היום, לחצו על אישור כדי להמשיך.
👉💻 Cloud Shell – כדי לבדוק לאיזה חשבון מחוברים ב-Cloud Shell:
gcloud auth list
👀 צפוי שהחשבון שלכם יסומן בסמל *, וזה צריך להיות אותו חשבון שאליו נכנסתם בשלב 1. אם הוא לא מוגדר, מריצים את הפקודה gcloud auth login ובוחרים את האפשרות הנכונה.
3 · קבלת המעבדה (~1 min)
👈💻 Cloud Shell – משכפלים את מאגר התוכן:
cd ~
rm -rf ~/bq-graph-measures-lab
git clone https://github.com/cuppibla/bq-graph-measures-lab.git
cd ~/bq-graph-measures-lab
4 · יצירת הפרויקט (כ-2 דקות)
👉💻 Cloud Shell – סקריפט אחד מוצא את החשבון לחיוב, יוצר בו פרויקט ומפנה את Cloud Shell לפרויקט הזה:
cd ~/bq-graph-measures-lab
./setup_project.sh
👀 צפוי ✓ לחשבון לחיוב שנבחר, ✓ לפרויקט שנוצר וסיום כמו:
Project ready: bq-graph-4271
  Next:  ./setup.sh
bq-graph-4271 הוא מזהה הפרויקט – המזהה שלכם יהיה שונה. ארבעה דברים קורים שם:
billing | מערכת Google Ads תבחר את חשבון | |
project | יוצר חשבון | |
selects | כותב את המזהה ל- | |
waits | עד שהפרויקט החדש יקבל אישור להצגת מודעות, למשך עד שתי דקות | |
🌐 אותו פרויקט מופיע עכשיו במסוף – המזהה שלו נמצא בכרטיס Project info במרכז הבקרה:
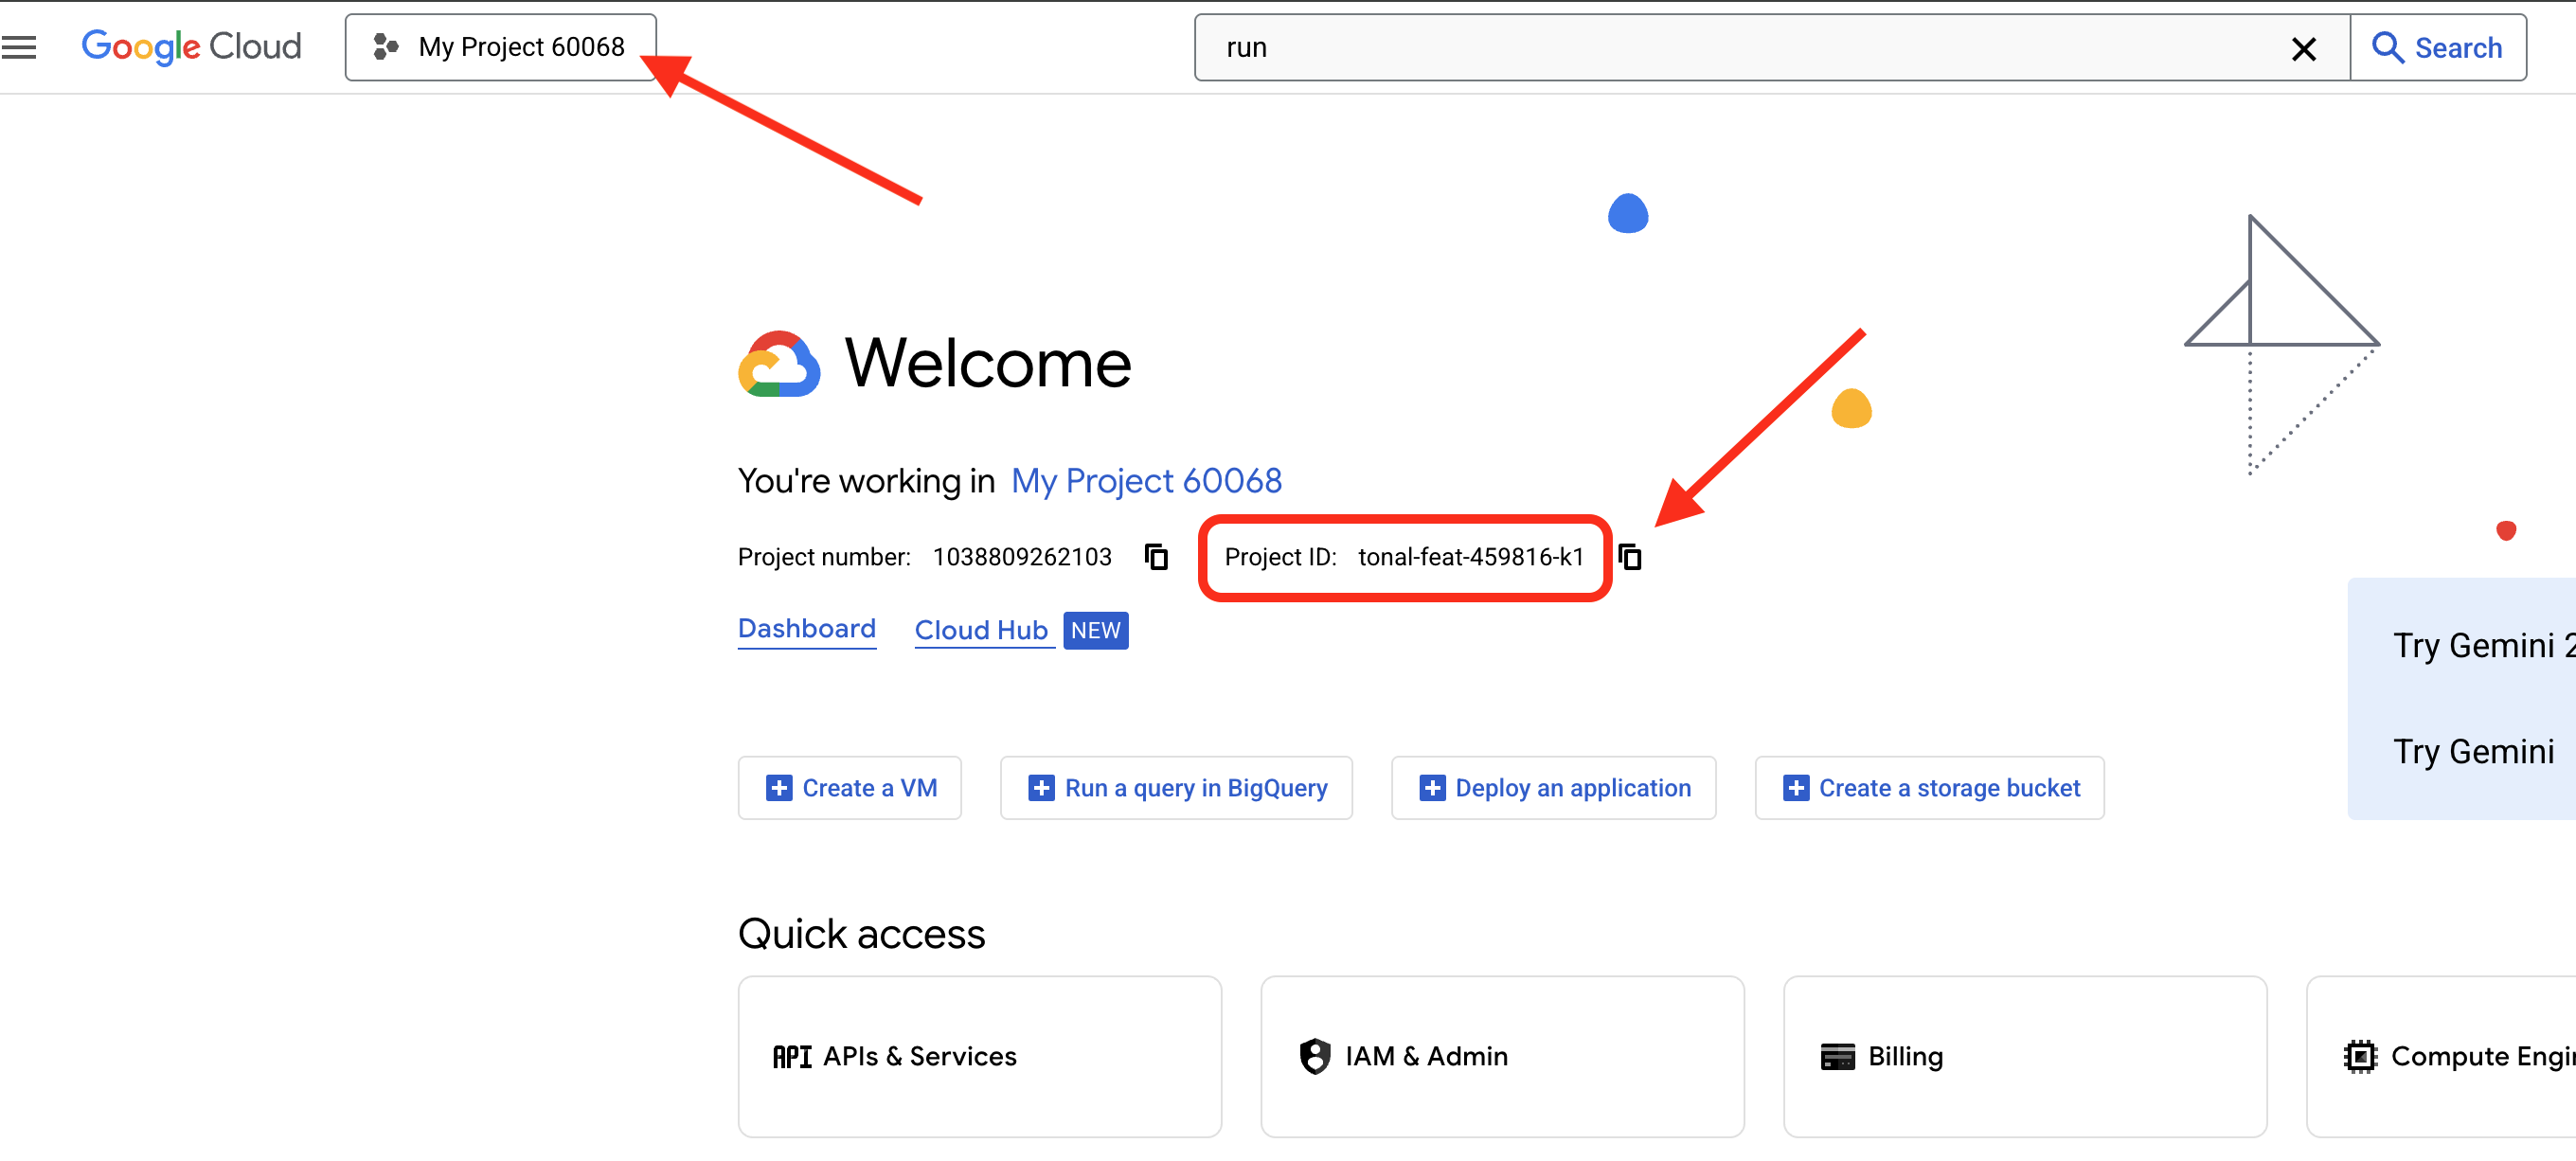
5 · יצירת מערך הנתונים (~3 min)
👉💻 Cloud Shell – עוד סקריפט שיוצר את הטבלאות:
cd ~/bq-graph-measures-lab
./setup.sh
הסקריפט מדפיס כל שלב בזמן שהוא פועל. מה קורה, לפי הסדר:
project | קורא את הפרויקט מ- | |
API | מאפשרת | |
dataset | יוצר את מערך הנתונים | |
בדיקה | סופר את השורות בכל טבלה ומפסיק אם יש הבדל בספירה | |
👀 מה צפוי:
BigQuery Graph Measures · setup
  ✓ project: bq-graph-4271
  ✓ BigQuery API enabled

Creating dataset music (US) and five tables...
  ✓ music.Labels              2 rows
  ✓ music.Artists             3 rows
  ✓ music.Songs               5 rows
  ✓ music.Playlists           4 rows
  ✓ music.PlaylistEntries    10 rows

🎉 ready — open BigQuery Studio: https://console.cloud.google.com/bigquery?project=bq-graph-4271
סיימתם את השימוש ב-Cloud Shell. אפשר לסגור אותו.
6. פותחים את BigQuery ואת עורך השאילתות.
👈🌐 Console – לוחצים על הקישור בסוף הפלט או פותחים את BigQuery מתפריט הניווט. בחלונית Explorer בצד ימין, מרחיבים את הפרויקט: מערך נתונים music עם חמש טבלאות.
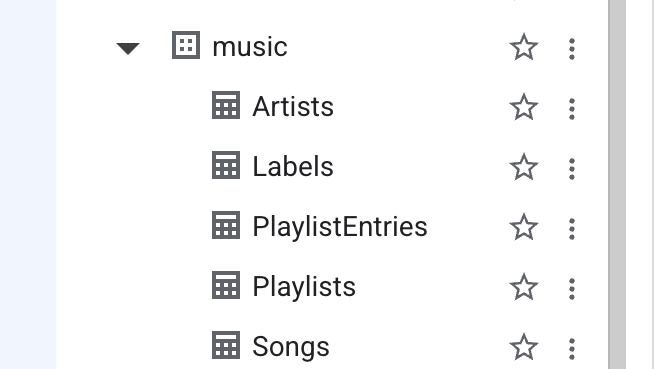
👈🌐 מסוף – בחלק העליון של BigQuery Studio, בשורה יצירה של שאילתה חדשה, לוחצים על שאילתת SQL. תיפתח כרטיסייה ריקה של העורך.
משאירים את הכרטיסייה הזו. כל בלוק 👈📋 במעבדה הזו מועבר לכאן: בוחרים את מה שמופיע בכלי העריכה, מדביקים את הבלוק החדש מעליו ולוחצים על הפעלה. התוצאה מופיעה בחלונית שמתחת.
היכרות עם הטבלאות
בהמשך נתייחס לשני דברים שקשורים לטבלאות האלה. כל טבלה מגדירה את המפתח הראשי שלה כ-NOT ENFORCED: מערכת BigQuery לא בודקת את זה, אבל לגרף המאפיינים שאתם עומדים ליצור נדרש מפתח מפורש כדי לדעת מה מזהה שורה. הטבלה האחרונה, PlaylistEntries, היא טבלת צומת: שיר שמופיע בארבע פלייליסטים יופיע בה בארבע שורות. בטבלה הזו מתרחש הסיפור כולו.
הטבלאות מקושרות זו לזו באופן הבא: לייבל מחתימה אומנים, אומן מפרסם שירים, שיר מוצב בפלייליסטים באמצעות PlaylistEntries. חברת Cymbal Records היא הבעלים של Ava Sterling ושל Mina Okafor, ודרכן של ארבעה שירים. חברת Northwind Audio היא הבעלים של קאי נאקמורה ושל השיר Midnight Drive.
שולחן | שורות | מקש | מה הוא מכיל |
תוויות | 2 |
| שם, תקציב שיווק |
אומנים | 3 |
| name, which label |
שירים | 5 |
| שם השיר, שם האומן, הזרמות |
פלייליסטים | 4 |
| name, followers |
PlaylistEntries | 10 |
| איזה שיר נמצא באיזה פלייליסט |
✅ נקודת ביקורת: 🎉 ready ב-Cloud Shell, חמש טבלאות מתחת ל-music בסייר, וכרטיסייה ריקה של עורך שאילתות פתוחה.
3. יצירת הגרף – אפשרות א': הכלי ליצירת מודלים חזותיים
גרף נכסים הוא תיאור של אופן החיבור בין הטבלאות. אפשר ללחוץ עליו ביחד בכלי ליצירת מודלים של גרפים חזותיים (השלב הזה, כל הלחיצות) או לכתוב אותו כ-SQL (השלב הבא, הדבקה אחת). שניהם יוצרים את אותו אובייקט – צריך להשתמש באחד מהם, לא בשניהם.
1. יצירת מעטפת הגרף
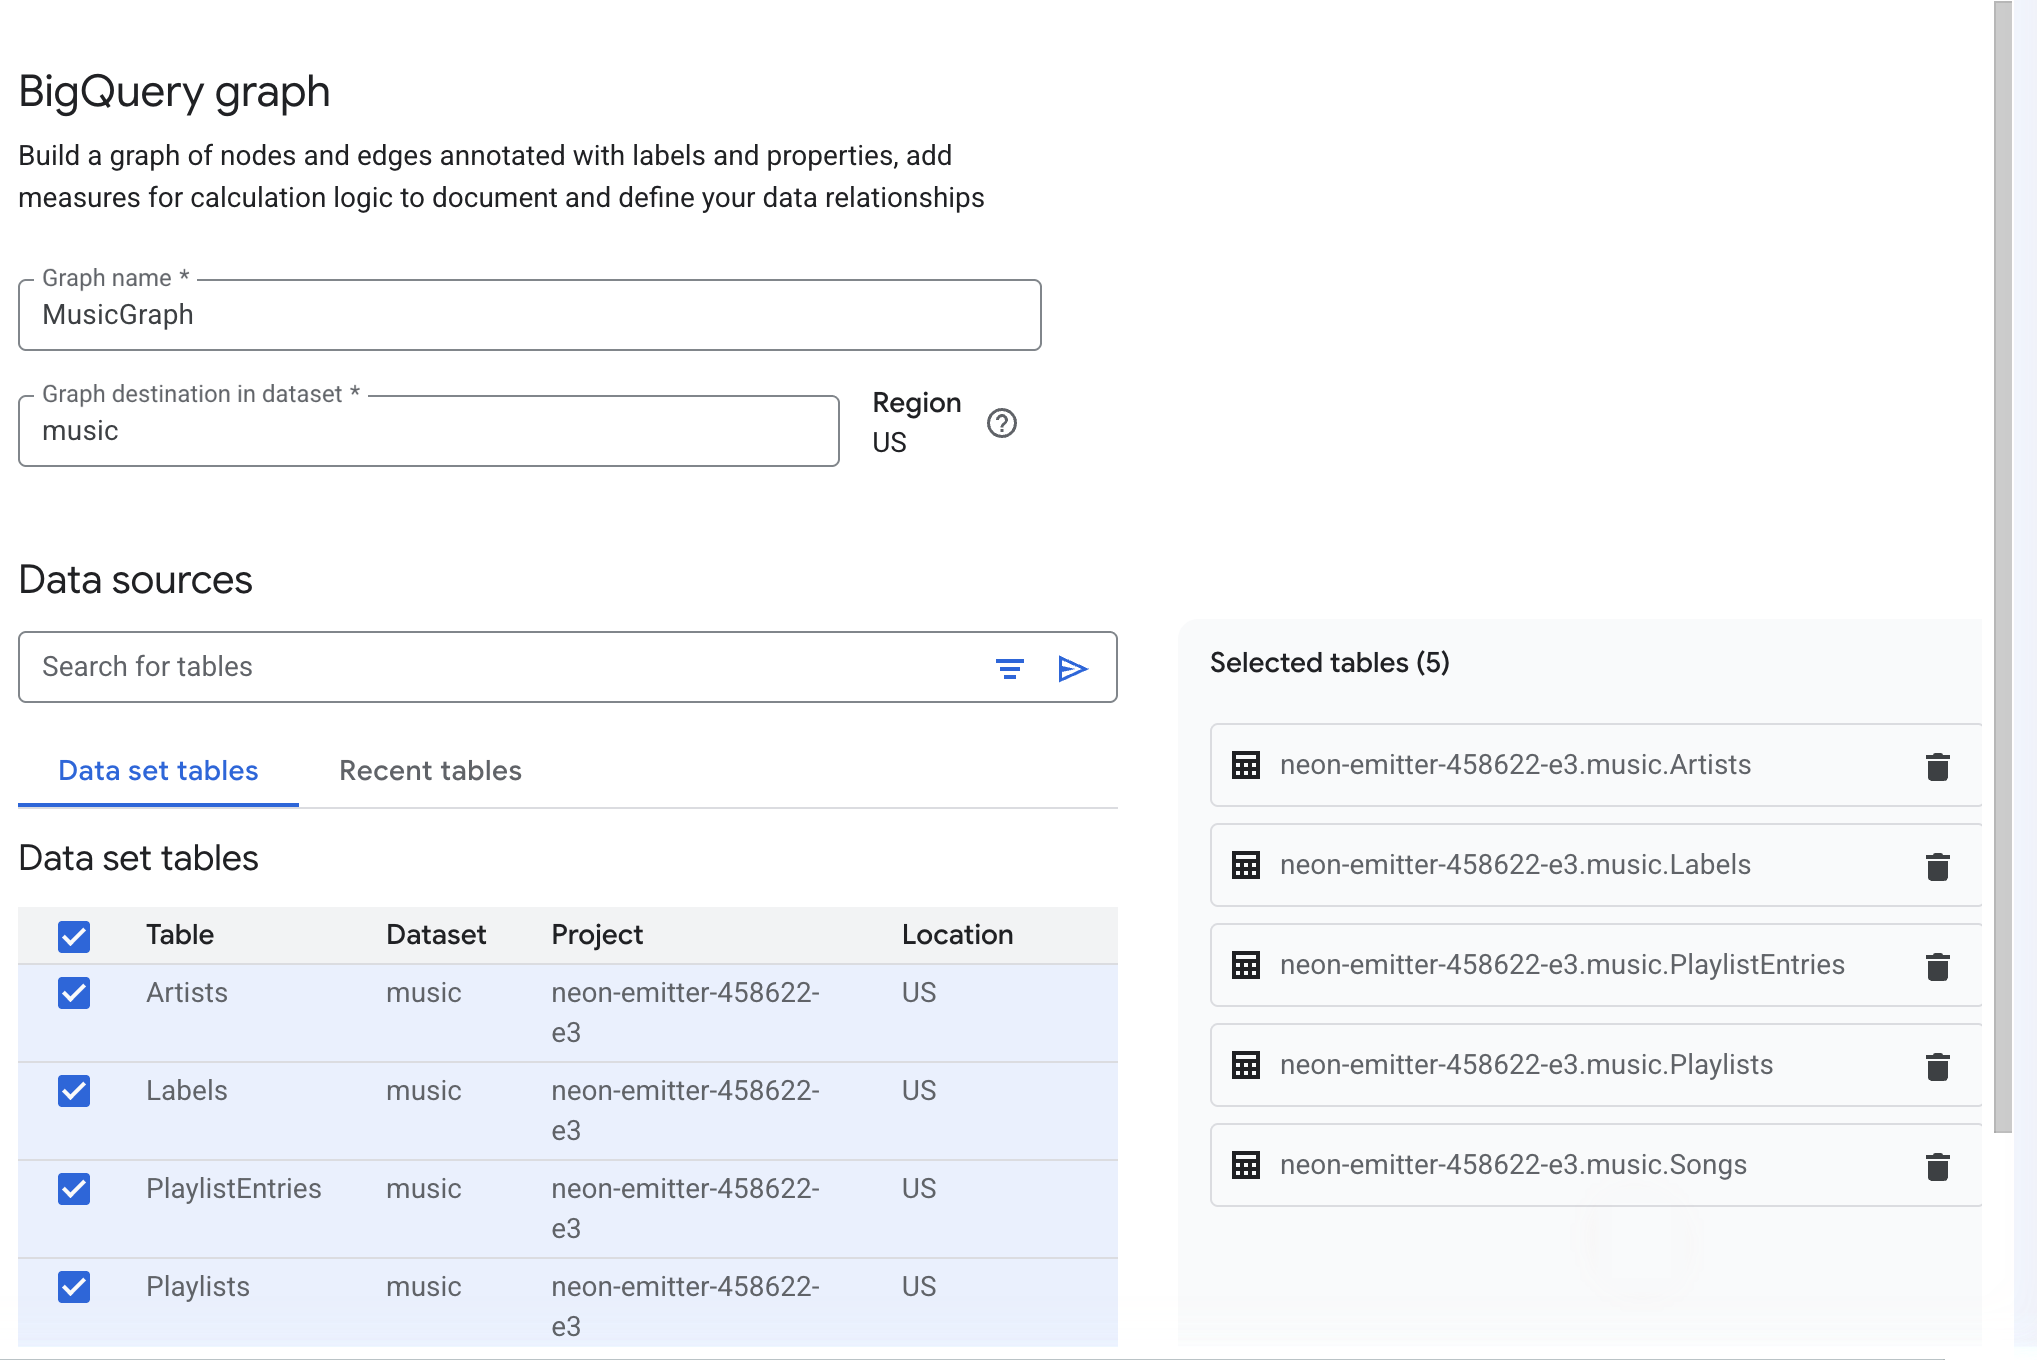
👈🌐 Console – ב-BigQuery Studio, בשורה Create new, פותחים את התפריט AI and knowledge ולוחצים על Graph.
👈🌐 Console – מזינים MusicGraph בתור שם התרשים ו-music בתור יעד התרשים במערך הנתונים. האזור מתמלא מתוך מערך הנתונים (ארה"ב).
👈🌐 Console – בקטע מקורות נתונים, בוחרים את חמשת הטבלאות – Artists, Labels, PlaylistEntries, Playlists, Songs – ולוחצים על יצירה.
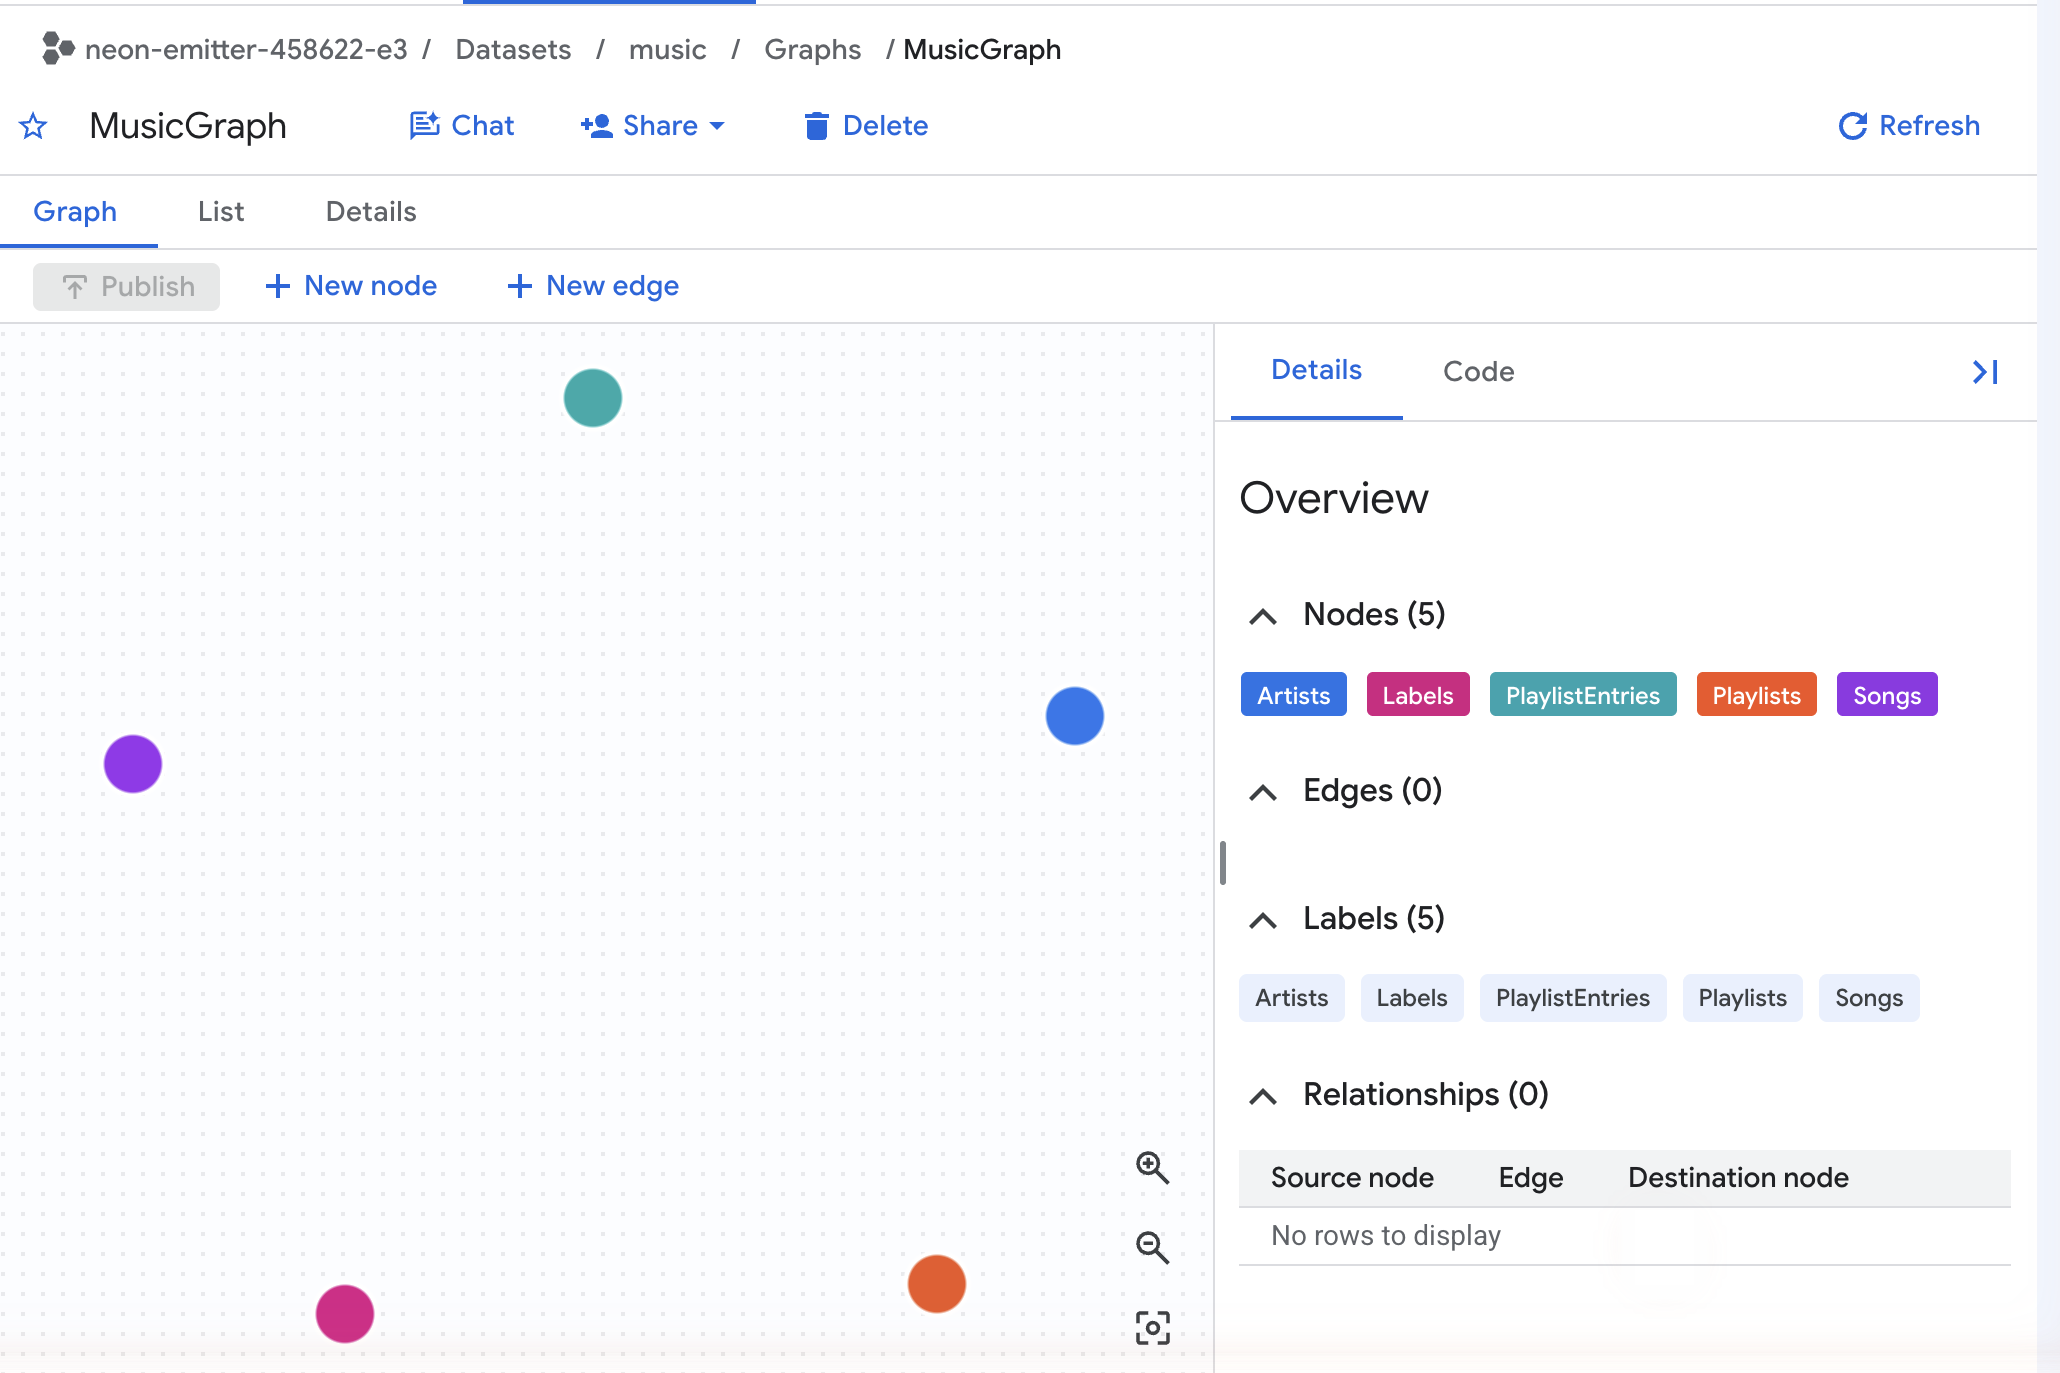
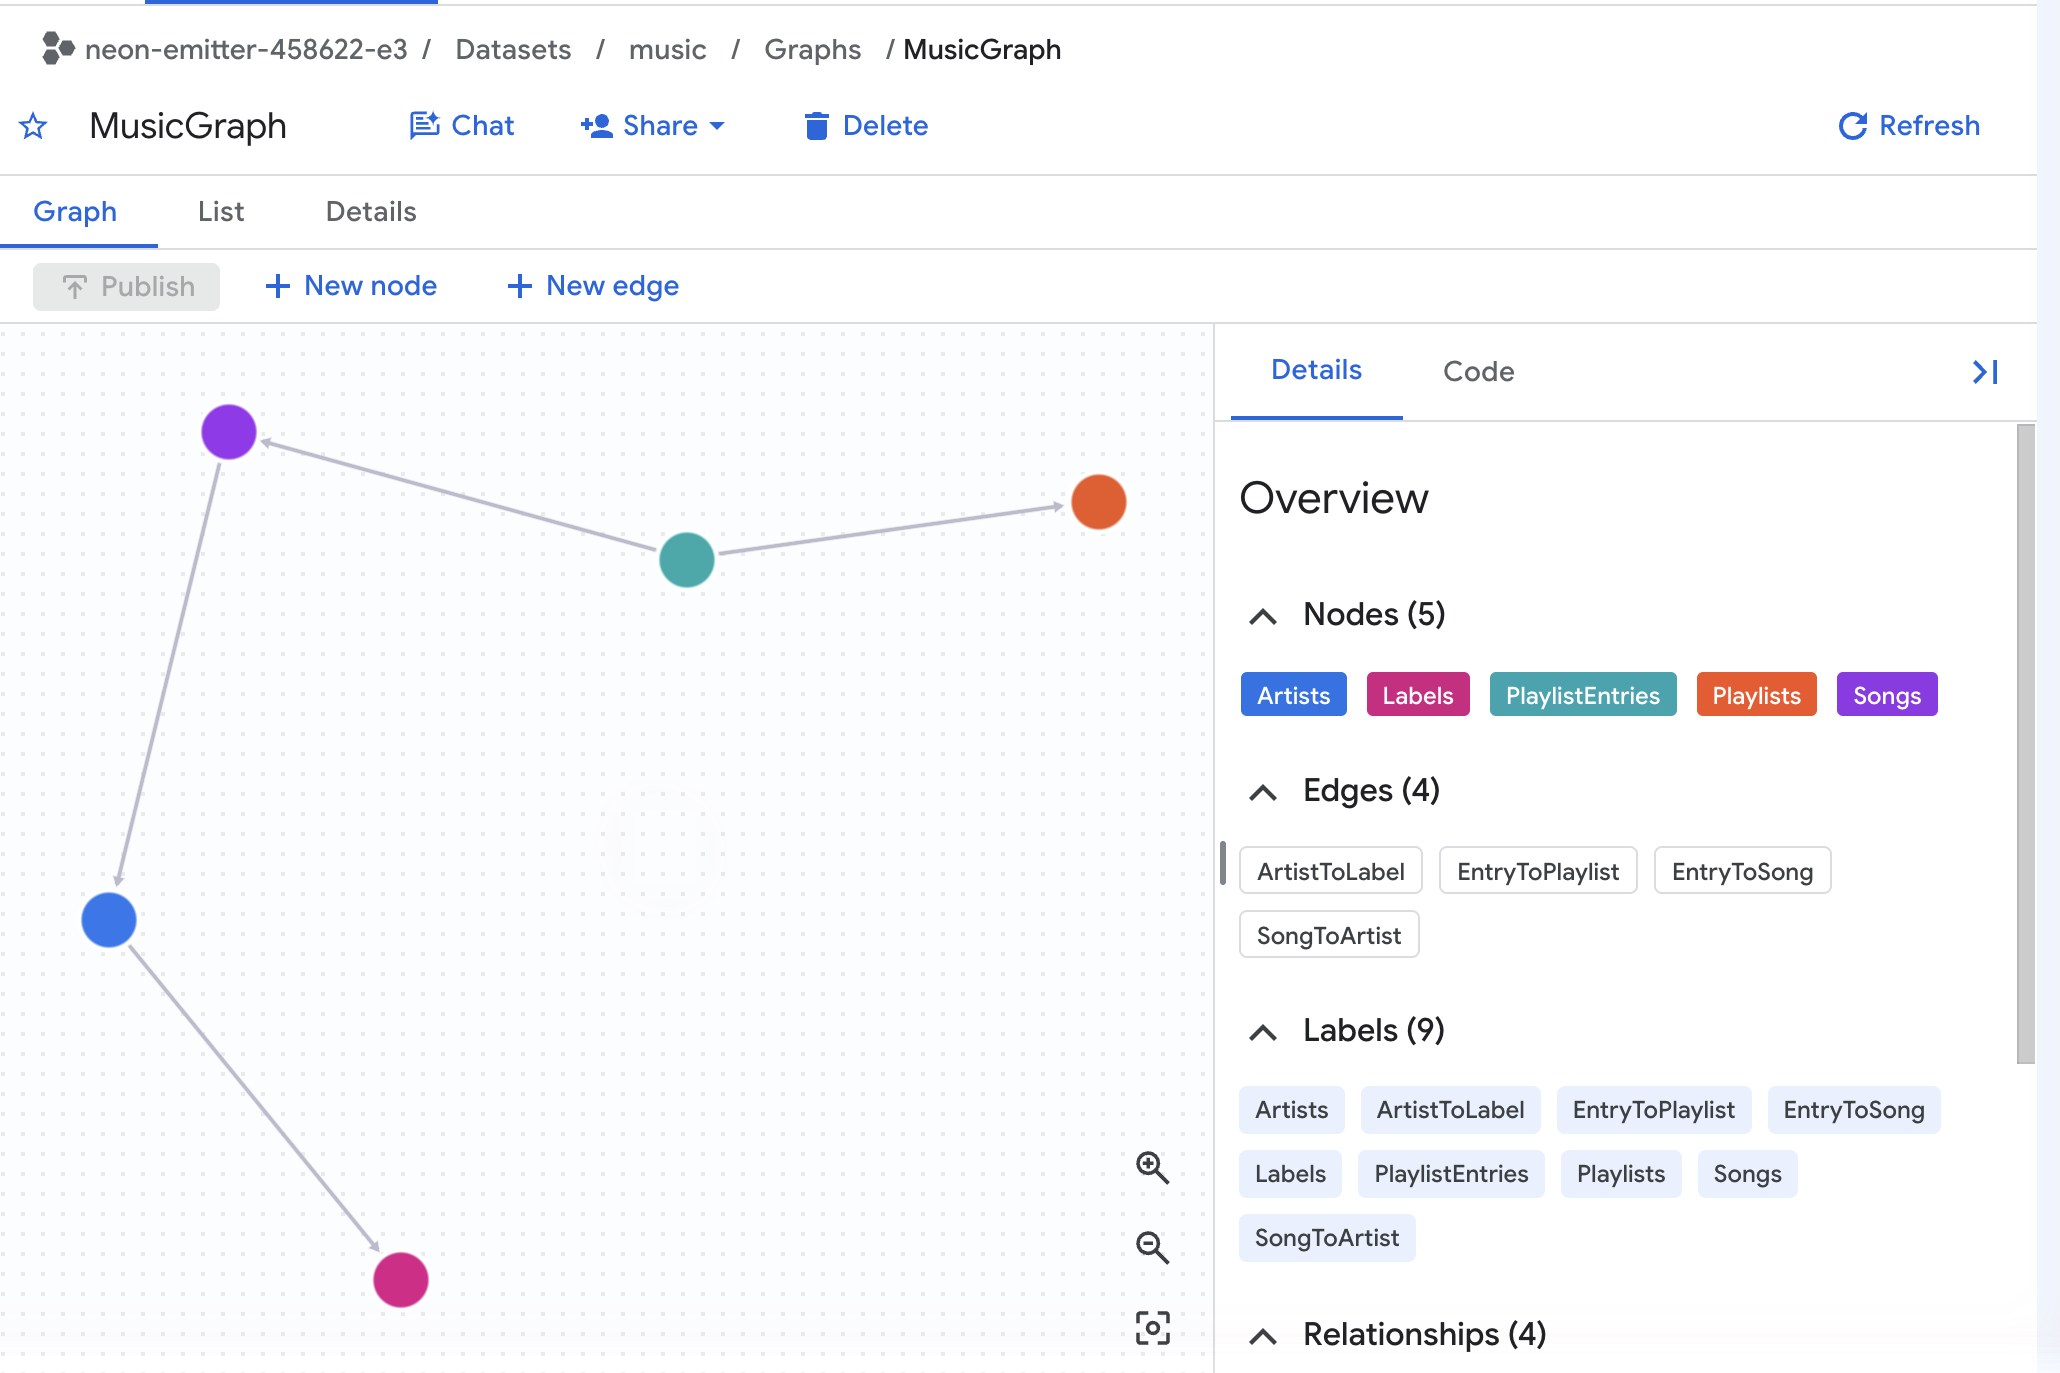
👀 הלוח הדיגיטלי נפתח עם חמישה צמתים צבעוניים בלי קווים ביניהם. בחלונית Details שמשמאל מופיעים Nodes (5) ו-Edges (0). כל צומת כבר מכיל את המפתח הראשי של הטבלה ואת כל העמודות שלה כמאפיינים – אפשר ללחוץ על כל צומת כדי לראות אותם.
2. משרטטים את ארבעת הקצוות
קצה הוא מפתח זר, שמוצג. כל אחד מהם עובר מהטבלה שמכילה את המפתח לטבלה שאליה הוא מצביע.
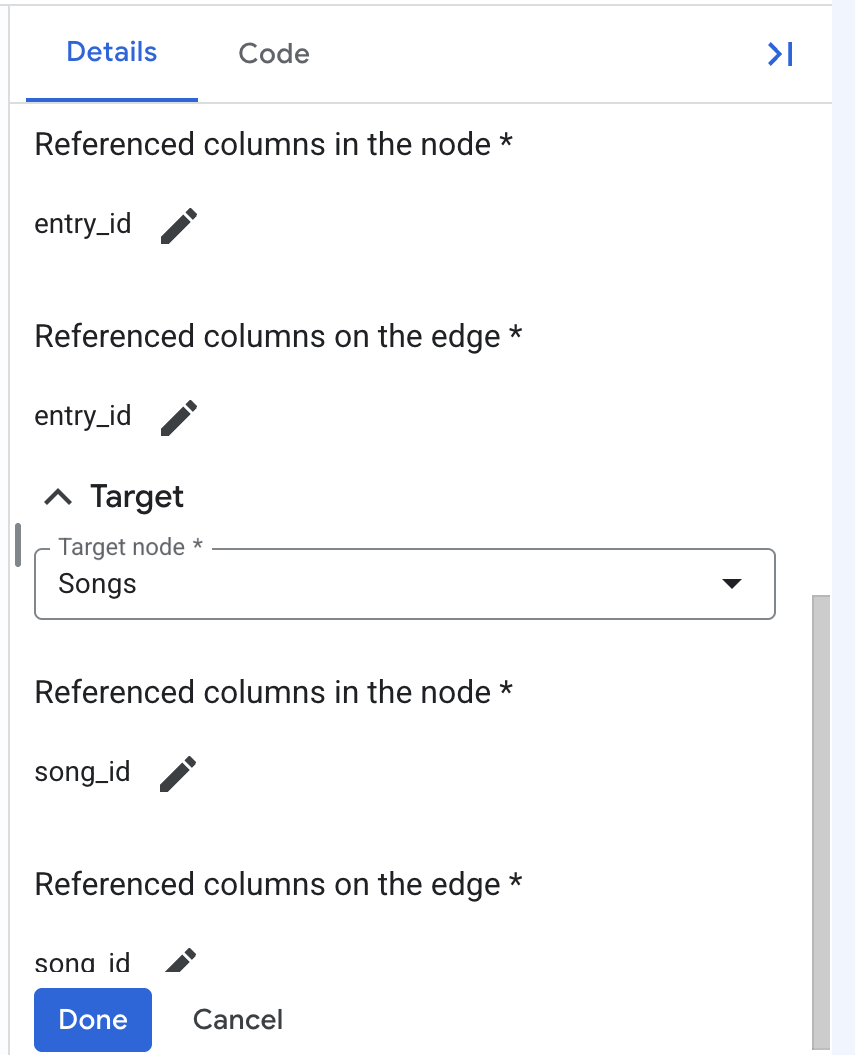
👈🌐 Console (מסוף) – לוחצים על New edge (קצה חדש). בתיבת הדו-שיח בחירת טבלה, בוחרים באפשרות PlaylistEntries ולוחצים על הוספה. בחלונית Add edge (הוספת קצה):
- מגדירים את Name לערך
EntryToSong. - לוחצים על הוספת מפתח ראשי ומאשרים את
entry_id. - בקטע מקור, מגדירים את צומת המקור ל-PlaylistEntries, ואז משתמשים באפשרויות הוספת עמודות עם הפניה לצומת והוספת עמודות עם הפניה לקצה כדי לבחור
entry_idבשתי האפשרויות. - בקטע יעד, מגדירים את צומת היעד לערך Songs (שירים), ואז בוחרים באפשרות
song_idגם עבור עמודות בהפניה בצומת וגם עבור עמודות בהפניה בקצה. - לוחצים על סיום.
👉🌐 Console — repeat three more times:
שם הקצה | שולחן | צומת מקור ← צומת יעד | העמודה לבחירה משני הצדדים |
| PlaylistEntries | PlaylistEntries → Playlists | מקור |
| שירים | שירים ← אומנים | מקור |
| אומנים | אומנים ← תוויות | מקור |
לא להוסיף מאפיינים מיותרים לכל קצה.
👀 בחלונית הפרטים מופיע עכשיו הכיתוב קצוות (4), ובאזור העריכה מוצגת השרשרת: תוויות ← אומנים ← שירים ← רשומות בפלייליסט ← פלייליסטים.
3. הוספת המדד
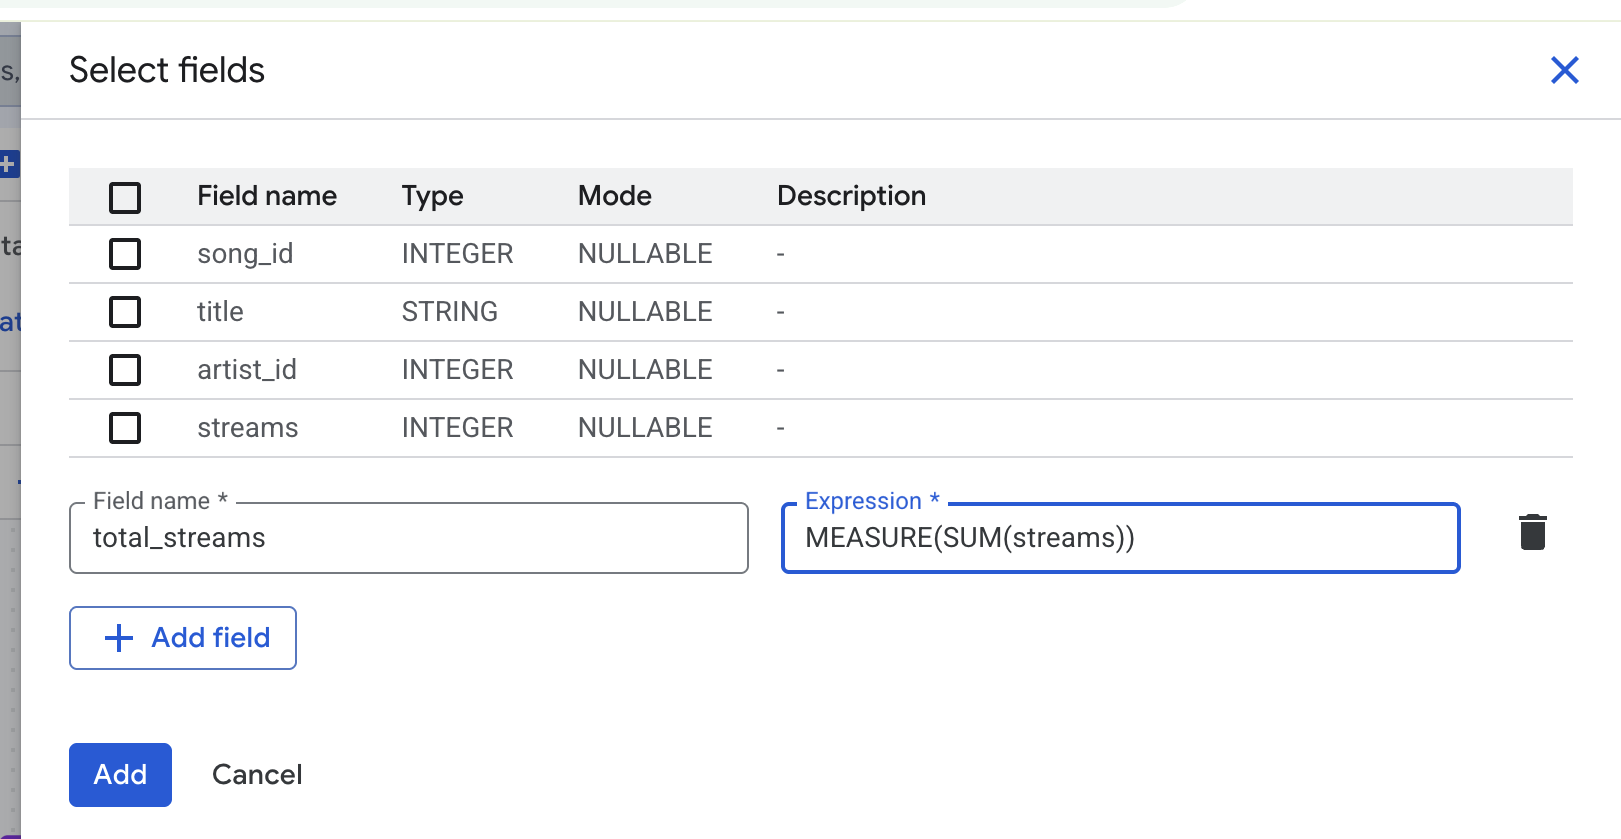
👈🌐 Console – לוחצים על הצומת Songs ואז על סמל העריכה (עיפרון) בחלק העליון של החלונית Details. בקטע מאפיינים של התווית, לוחצים על הוספת מאפיין ואז על הוספת שדה.
👈🌐 Console – מזינים total_streams בתור Field name, ומקלידים את הטקסט הבא בתיבה Expression:
MEASURE(SUM(streams))
👈🌐 Console – לוחצים על Add (הוספה) ואז על Done (סיום).
4. קוראים את הקוד שנכתב ומפרסמים אותו
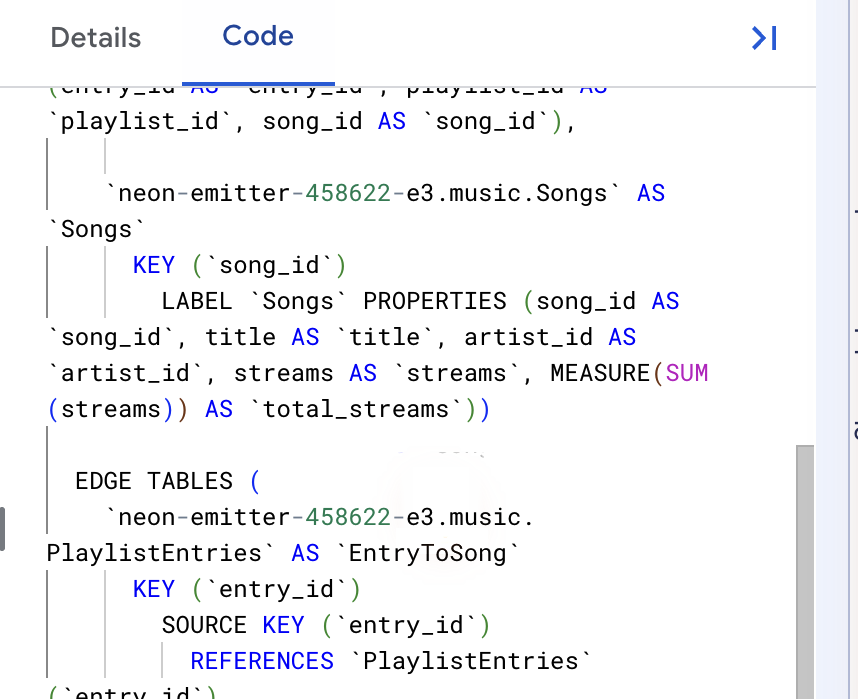
👈🌐 Console (מסוף) – פותחים את הכרטיסייה Code (קוד) בחלונית השמאלית. המודלר כתב בשבילכם את ההצהרה CREATE PROPERTY GRAPH. גוללים לצומת Songs: רשימת המאפיינים שלו מסתיימת עכשיו ב-
MEASURE(SUM(streams)) AS `total_streams`
זו כל התכונה, בשורה אחת. כל מה שמופיע אחרי השלב הזה מתייחס לפעולה של השורה הזו.
👈🌐 Console – לוחצים על Publish (פרסום).
✅ נקודת ביקורת: בסייר, ל-music יש עכשיו תיקייה בשם Graphs (גרפים) שכוללת את MusicGraph. לוחצים עליו: חמישה צמתים, ארבעה קצוות והקו MEASURE(SUM(streams)) בכרטיסייה Code (קוד). מדלגים לשלב הבא ועוברים אל SUM ו-AGG, זה לצד זה.
4. יצירת הגרף – אפשרות ב': SQL
אפשר לדלג על השלב הזה אם יצרתם את הגרף בכלי ליצירת מודלים.
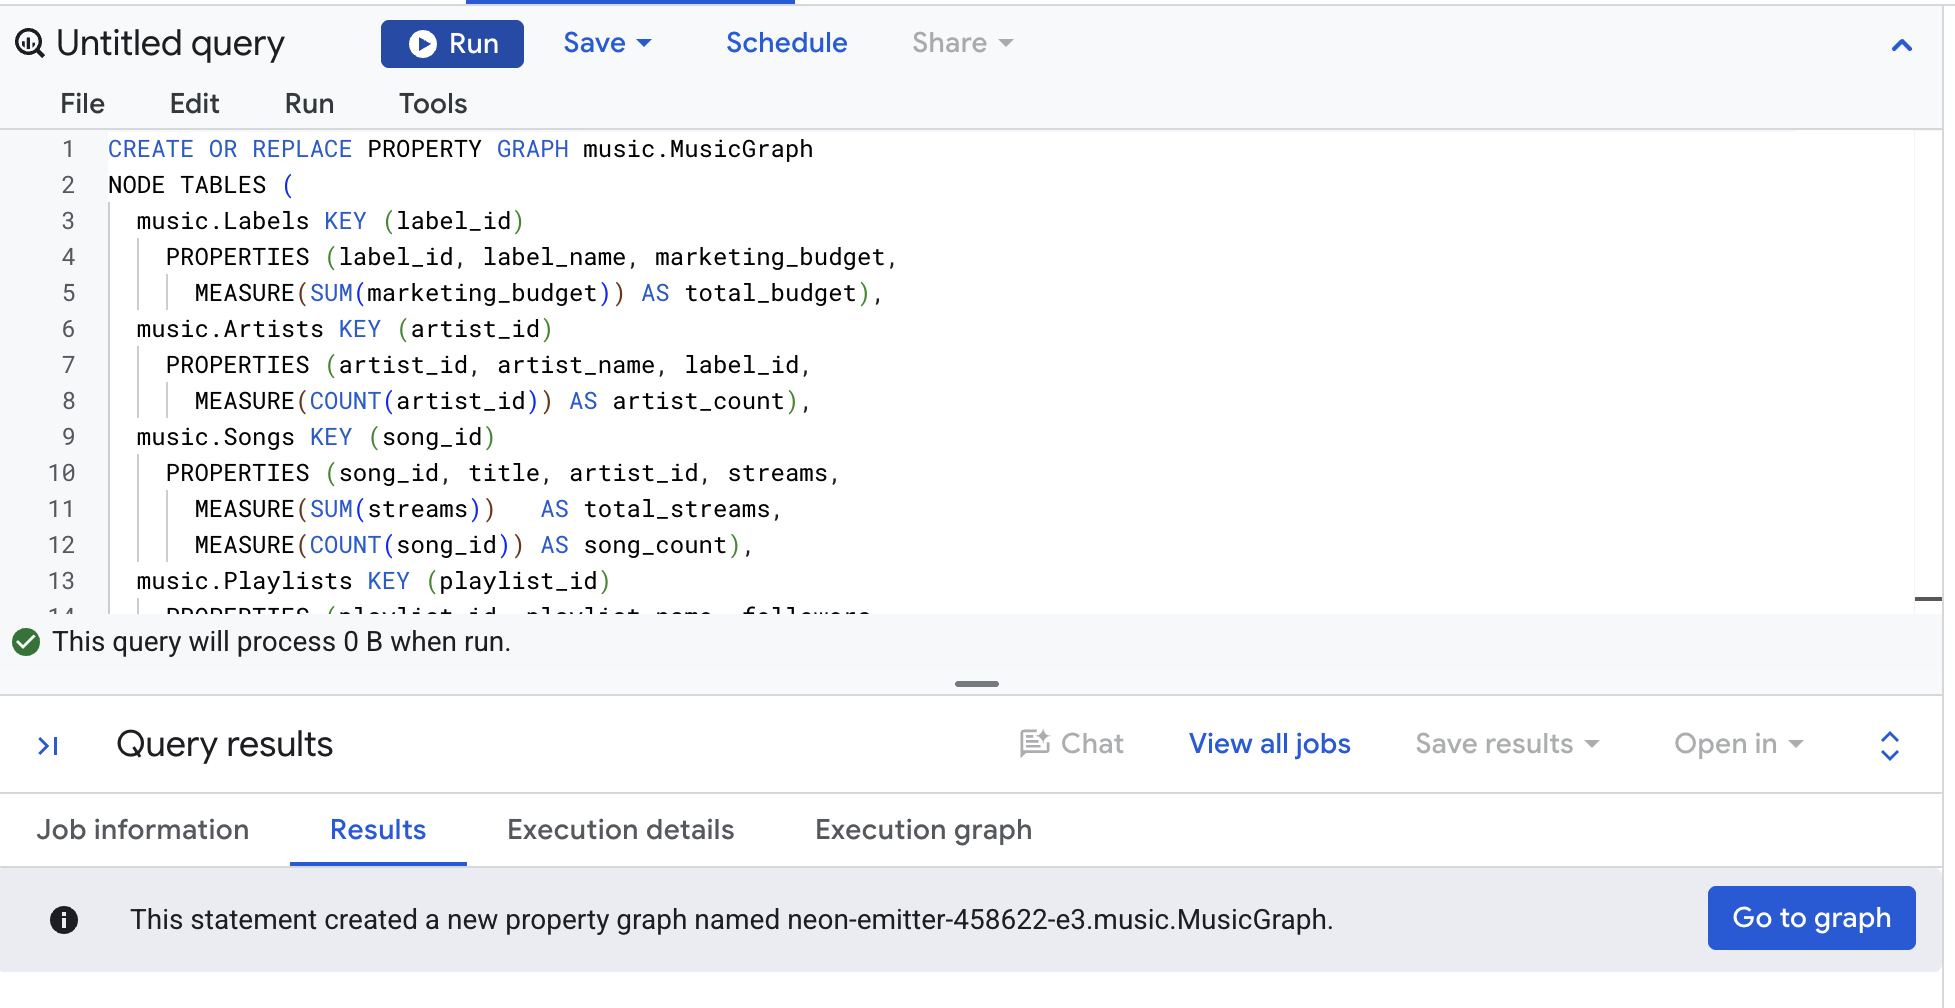
👈📋 Query editor — paste, then click Run:
CREATE OR REPLACE PROPERTY GRAPH music.MusicGraph
  NODE TABLES (
    music.Labels KEY (label_id)
      PROPERTIES (label_id, label_name, marketing_budget,
        MEASURE(SUM(marketing_budget)) AS total_budget),
    music.Artists KEY (artist_id)
      PROPERTIES (artist_id, artist_name, label_id,
        MEASURE(COUNT(artist_id)) AS artist_count),
    music.Songs KEY (song_id)
      PROPERTIES (song_id, title, artist_id, streams,
        MEASURE(SUM(streams))   AS total_streams,
        MEASURE(COUNT(song_id)) AS song_count),
    music.Playlists KEY (playlist_id)
      PROPERTIES (playlist_id, playlist_name, followers,
        MEASURE(SUM(followers)) AS total_followers),
    music.PlaylistEntries KEY (entry_id)
      PROPERTIES (entry_id, playlist_id, song_id,
        MEASURE(COUNT(entry_id)) AS placement_count)
  )
  EDGE TABLES (
    music.PlaylistEntries AS EntryToSong
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (song_id) REFERENCES Songs(song_id) NO PROPERTIES,
    music.PlaylistEntries AS EntryToPlaylist
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (playlist_id) REFERENCES Playlists(playlist_id) NO PROPERTIES,
    music.Songs AS SongToArtist
      SOURCE KEY (song_id) REFERENCES Songs(song_id)
      DESTINATION KEY (artist_id) REFERENCES Artists(artist_id) NO PROPERTIES,
    music.Artists AS ArtistToLabel
      SOURCE KEY (artist_id) REFERENCES Artists(artist_id)
      DESTINATION KEY (label_id) REFERENCES Labels(label_id) NO PROPERTIES
  )
👀 בחלונית התוצאות כתוב שגרף הנכסים נוצר.
קריאה פעם אחת
בתרשים יש חמש טבלאות צמתים וארבע טבלאות קשתות. בכל טבלת צמתים מופיע השם של KEY ורשימה של PROPERTIES. השורות שמתחילות ב-MEASURE הן החלק החדש: כל אחת מהן עוטפת אחד מהצבירים הנתמכים סביב מאפיין ומעניקה לו כינוי, שנדרש.
כל טבלת קצה היא מפתח זר, שמאוית כך: SOURCE KEY בטבלה שמכילה את המפתח, DESTINATION KEY בטבלה שאליה הוא מצביע. NO PROPERTIES פירושו שהקצה לא נושא שום דבר משלו.
שימו לב שהטבלה PlaylistEntries מופיעה שלוש פעמים: פעם אחת כטבלת צומת, ועוד פעמיים כטבלה הפיזית שמאחורי הקצוות EntryToSong ו-EntryToPlaylist. זה נעשה בכוונה, ובהמשך נסביר למה.
רוצה לראות משהו שיצרת?
👈🌐 Console – בחלונית Explorer, מרחיבים את music ואז את Graphs ולוחצים על MusicGraph. דף התרשים נפתח על אזור ציור עם חמישה צמתים וארבעה קצוות. לוחצים על צומת כדי לראות את המאפיינים שלו – המדדים מופיעים עם הערך המצטבר שלהם. פותחים את הכרטיסייה קוד כדי לראות את ההצהרה שמאחורי התמונה.
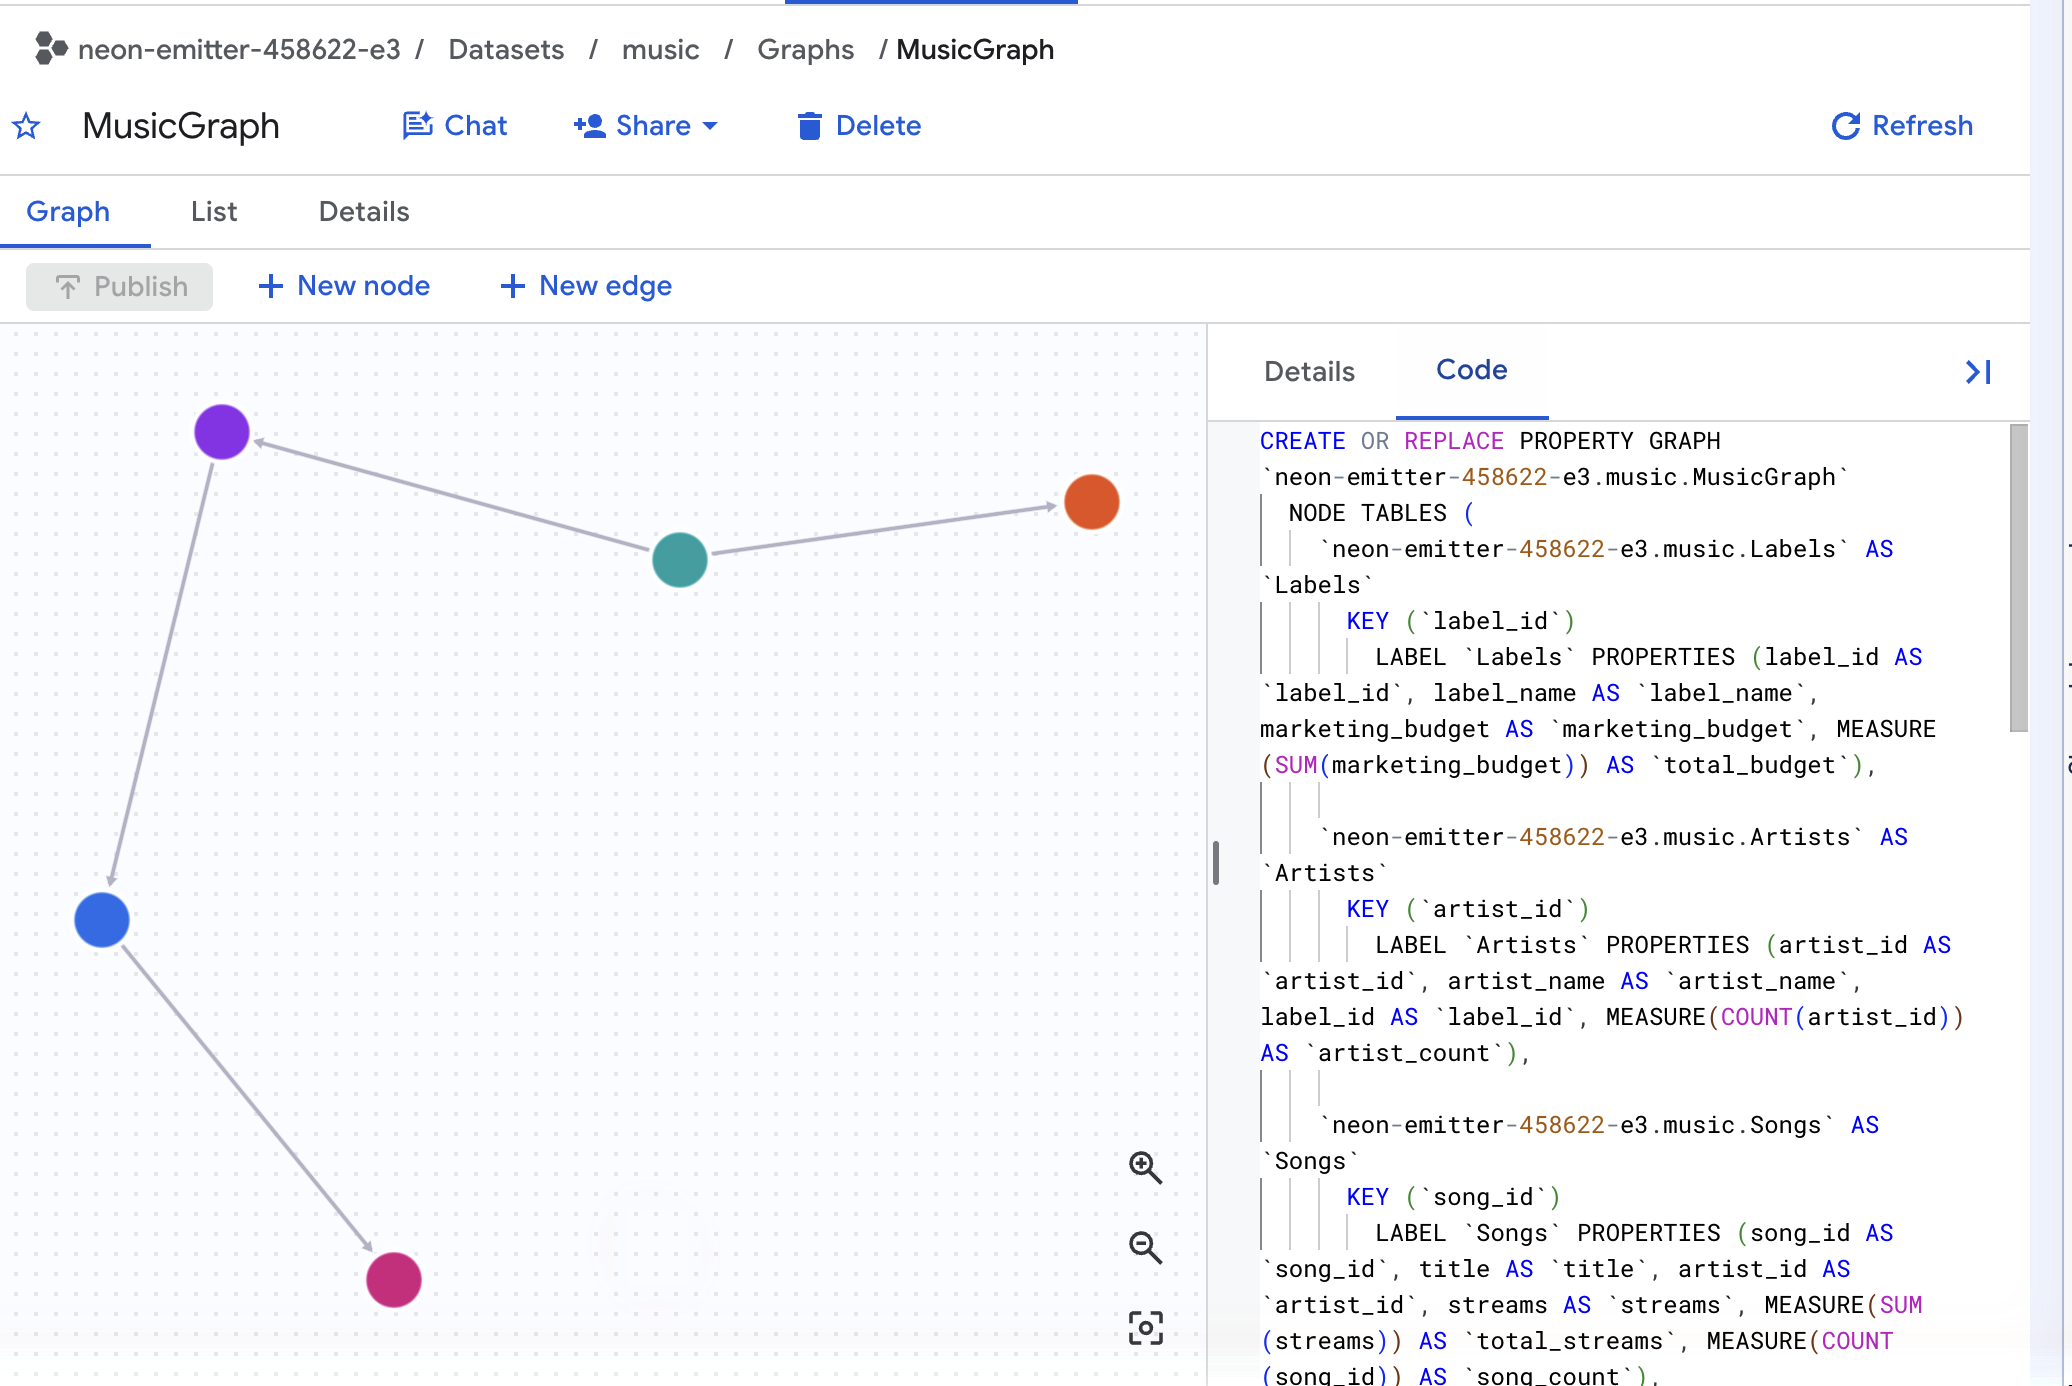
✅ נקודת ביקורת: ב-music יש תיקייה בשם Graphs עם MusicGraph, ובכרטיסייה Code מוצג MEASURE(SUM(streams)) AS total_streams.
5. SUM ו-AGG, זו לצד זו
זוהי כל סדנת הקוד בשאילתה אחת. שתי העמודות מנסות לענות על אותה שאלה – סך הצפיות בכל תווית – מאותה טבלה.
זו הטבלה ש-GRAPH_EXPAND יוצר. היא משטחת את הגרף: היא מתחילה מטבלה אחת ועוקבת אחרי כל קצה החוצה כ-LEFT JOIN, עד שכל הטבלאות המחוברות מופיעות זו לצד זו בתוצאה רחבה אחת. שורה אחת לכל מיקום, לא אחת לכל שיר, וכל העמודות נקראות TableLabel_property. כדאי להסתכל על הנתונים לפני שמריצים שאילתה.
👈📋 Query editor — paste, then click Run:
SELECT Labels_label_name, Songs_title, Songs_streams, Playlists_playlist_name
FROM GRAPH_EXPAND("music.MusicGraph")
ORDER BY Songs_title, Playlists_playlist_name
👀 צפוי שיהיו 10 שורות – אחת לכל מיקום ב-PlaylistEntries, וזה בדיוק מה שנטען בהגדרה. השיר Neon Summer תופס ארבעה מהם, אחד לכל פלייליסט שבו הוא מופיע, ו-Songs_streams קורא 2,000,000,000 בכל אחד מהם. אין שום בעיה בשורות האלה, באמת יש ארבעה פלייליסטים. אבל עמודה ששייכת לשיר חוזרת עכשיו על פני שורות ששייכות למיקומי מודעות, וזו בדיוק הבעיה שהשאילתה הבאה מודדת.
עכשיו להשוואה.
👈📋 Query editor — paste, then click Run:
SELECT
  Labels_label_name,
  SUM(Songs_streams)       AS with_sum,
  AGG(Songs_total_streams) AS with_agg
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1 ORDER BY 1
👀 תוצאה:
Labels_label_name | with_sum | with_agg |
Cymbal Records | 12,600,000,000 | 5,100,000,000 |
Northwind Audio | 9,000,000,000 | 4,500,000,000 |
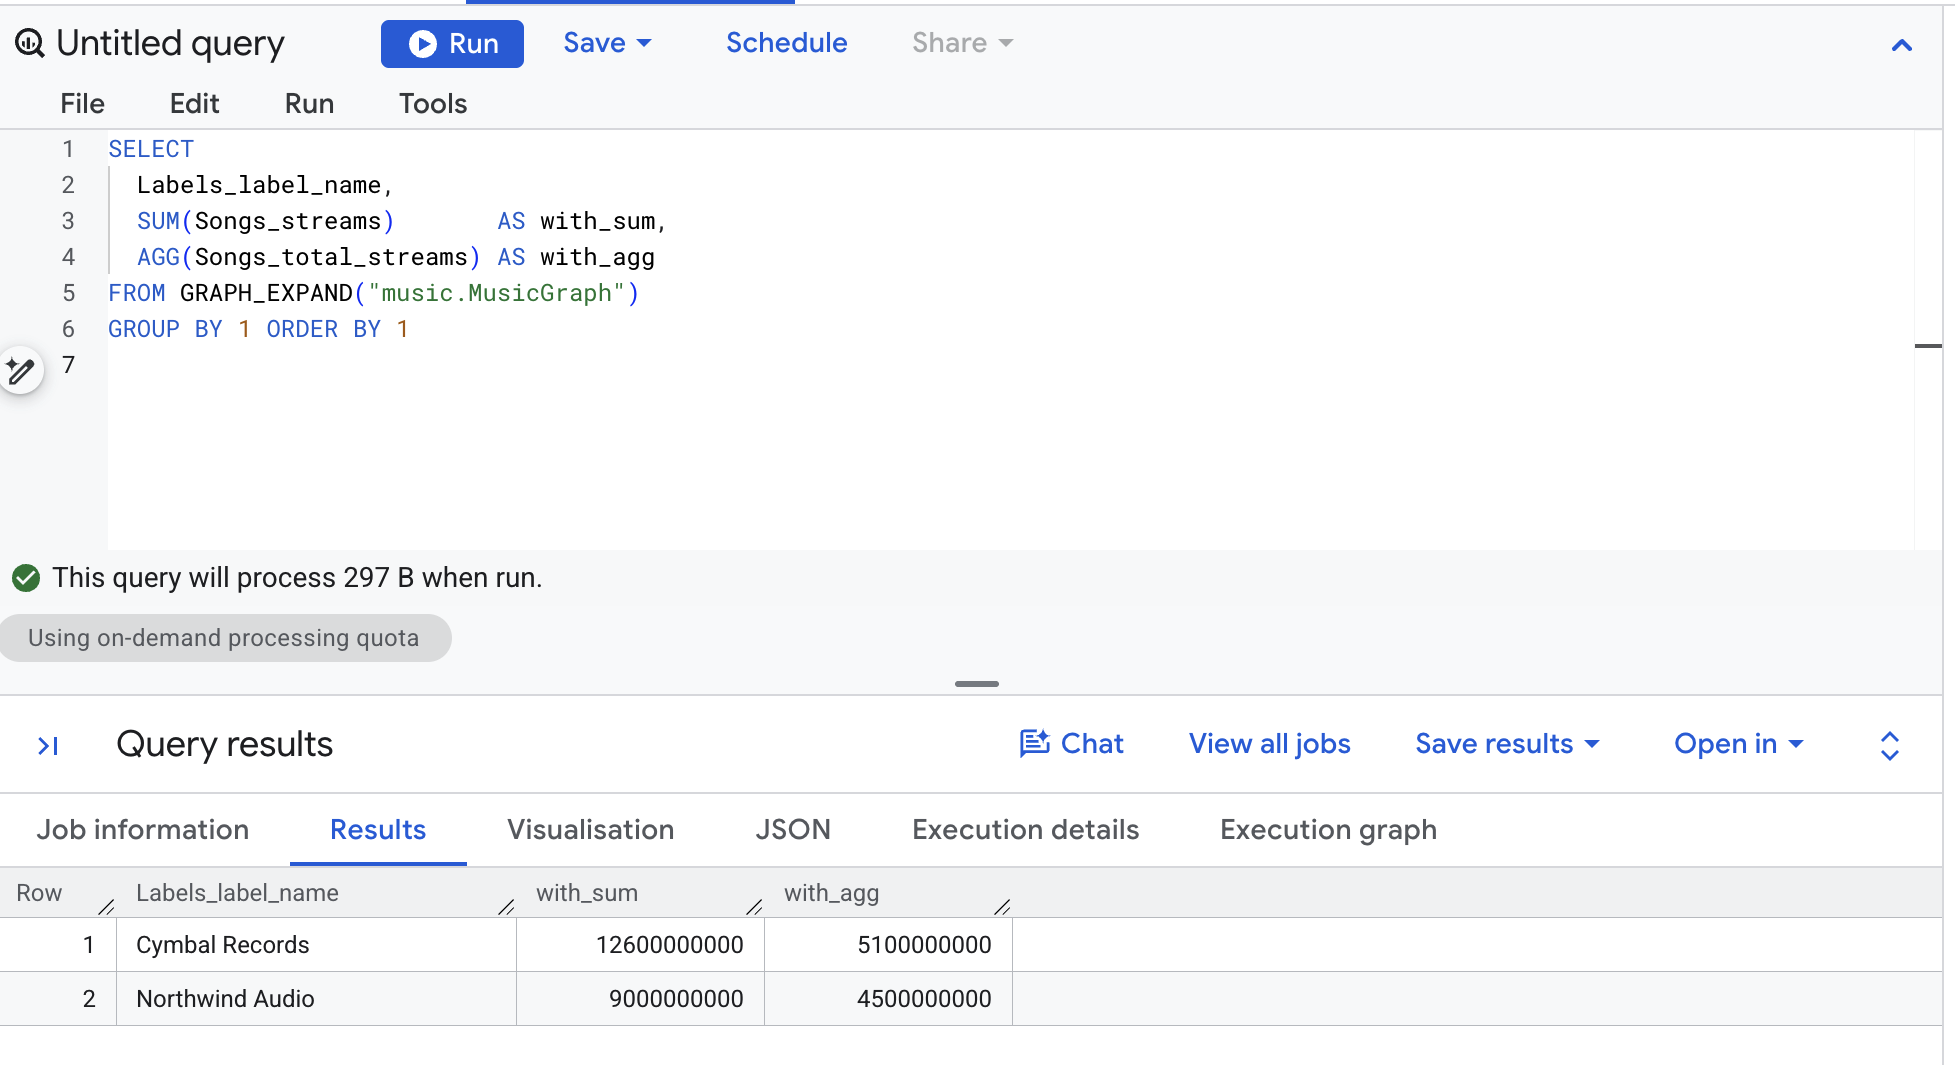
בודקים את זה ידנית. ארבעת השירים של Cymbal זכו ל-2 מיליארד, 1.5 מיליארד, 1.2 מיליארד ו-0.4 מיליארד סטרימינג. כלומר 5.1 מיליארד. התשובה AGG נכונה. הקובץ SUM גדול פי שניים וחצי מהמגבלה, והשיר היחיד של Northwind גדול פי שניים מהמגבלה.
שלושה רכיבי תחביר חדשים
-
GRAPH_EXPAND("music.MusicGraph")היא פונקציה שמחזירה ערך של טבלה, והיא הופכת את הגרף לטבלה רחבה אחת על ידי מעקב אחרי כל קצה כ-LEFT JOIN. לכל עמודה יש שםTableLabel_property, ולכןSongs_streamsהיא העמודה הגולמית מהטבלה Songs ו-Songs_total_streamsהוא המדד שהצהרתם עליו. -
SUM(Songs_streams)היא שאילתת SQL רגילה על הטבלה הרחבה הזו – והיא יורשת כל כפילות שההשטחה יצרה. - הפונקציה
AGG(Songs_total_streams)מעריכה את המדד באופן שבו הוא הוגדר:SUM(streams)פעם אחת לכלsong_id, לא משנה כמה שורות שיר תופס בטבלה הרחבה.
✅ נקודת ביניים: שתי תוויות, שתי עמודות ומספר התוצאות with_agg תואם למספר האצבעות.
6. למה הפונקציה SUM סופרת יותר מדי
בוחרים שיר אחד וצופים בהשפעה של ההצטרפות על השיר.
👈📋 Query editor — paste, then click Run:
SELECT 'BEFORE - the Songs table' AS step, title, streams, CAST(NULL AS STRING) AS playlist
FROM music.Songs WHERE title = 'Neon Summer'
UNION ALL
SELECT 'AFTER - joined to playlists', s.title, s.streams, pl.playlist_name
FROM music.Songs s
LEFT JOIN music.PlaylistEntries e ON e.song_id = s.song_id
LEFT JOIN music.Playlists pl ON pl.playlist_id = e.playlist_id
WHERE s.title = 'Neon Summer'
ORDER BY step DESC, playlist
👀 תוצאה:
שלב | title | שידורים | פלייליסט |
לפני – טבלת השירים | קיץ ניאון | 2,000,000,000 | null |
אחרי – הצטרפות לפלייליסטים | קיץ ניאון | 2,000,000,000 | Gym Pump |
אחרי – הצטרפות לפלייליסטים | קיץ ניאון | 2,000,000,000 | הכי פופולריים עכשיו |
אחרי – הצטרפות לפלייליסטים | קיץ ניאון | 2,000,000,000 | פופ עולה |
אחרי – הצטרפות לפלייליסטים | קיץ ניאון | 2,000,000,000 | טיול בנסיעה |
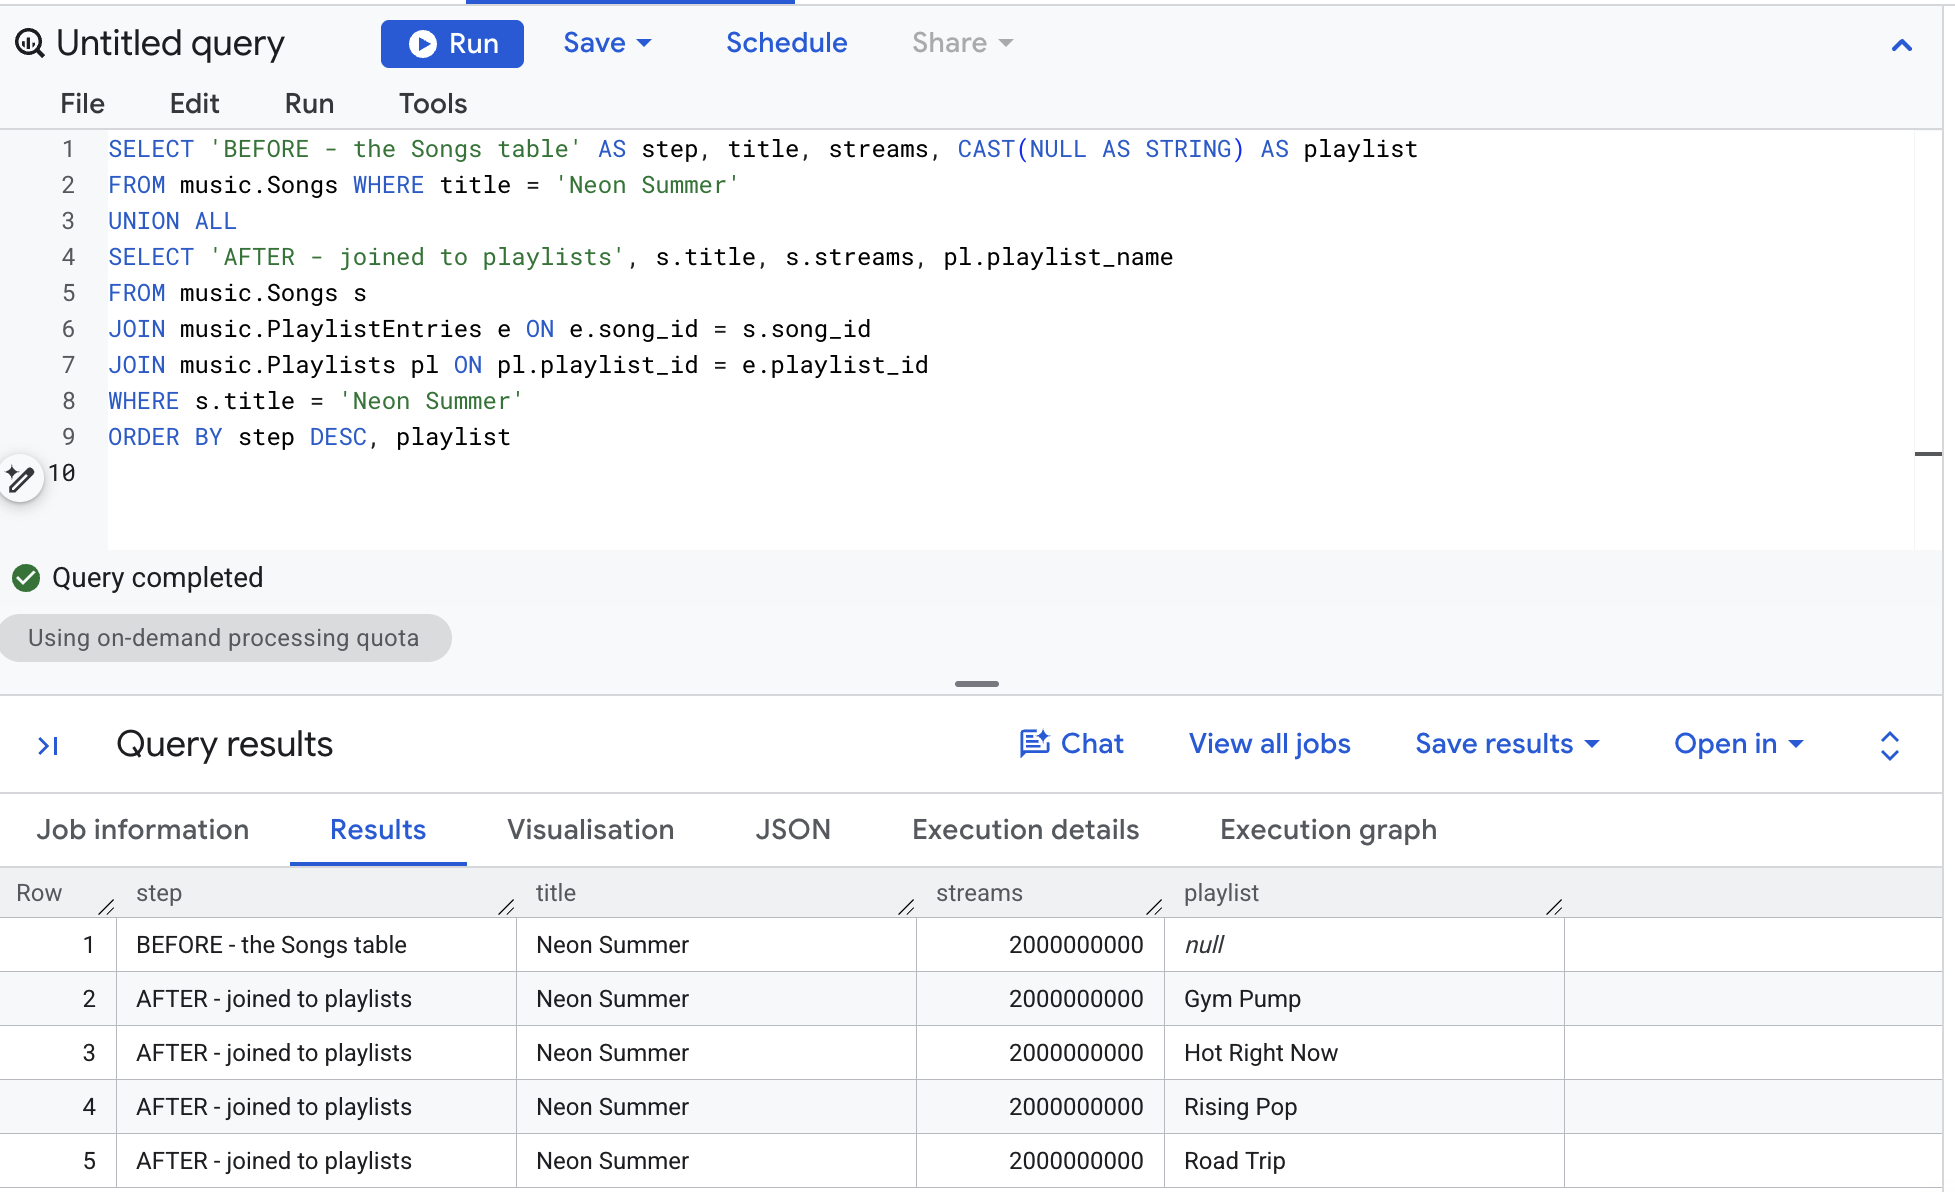
שורה אחת הפכה לארבע. מספר הזרמים לא השתנה – הוא הועתק. תסכם את הפעולות של העותקים ב-Cymbal Records: Neon Summer 2.0 מיליארד בארבע פלייליסטים זה 8.0, Paper Crown 1.5 מיליארד בשני פלייליסטים זה 3.0, Double Shot 1.2 במיליארד באחד, Slow Arrow 0.4 במיליארד באחד. זהו המספר 12.6 מיליארד, המספר SUM שמוחזר. השיר Northwind's Midnight Drive נמצא בשני פלייליסטים, ולכן 4.5 מיליארד הפכו ל-9.0 מיליארד.
זהו fan-out, וזו לא שגיאה בצירוף. שורות הפלייליסט הן אמיתיות. הטעות היא סיכום של מספר ששייך לשיר על פני שורות ששייכות למיקומי מודעות.
המדד מתקן את הבעיה כי הוא הוגדר בצומת Songs יחד עם KEY (song_id). הגרעין הוא המפתח. כשהפונקציה AGG מבצעת הערכה של total_streams, היא צוברת נתונים פעם אחת לכל מפתח שיר, ורק אז מסכמת את הנתונים לפי הקבוצה שהגדרתם.
מה השתנה
היית כותב | עם מדד |
|
|
|
|
3 שניות | |
ביטוי CTE שמבצע צבירה לפני הצטרפות | שום דבר. הפרמטר |
✅ נקודת ביקורת: חמש שורות – אחת לפני וארבע אחרי – ואפשר לשחזר מהן 12.6 מיליארד.
7. הכלל: רק AGG קורא מדד
למדדים יש סוג משלהם, MEASURE, ופונקציה אחת בלבד מקבלת אותו. ארבע השאילתות שבהמשך נכשלות בכוונה – מריצים כל אחת מהן וקוראים את השגיאה באדום. אלה ארבע הדרכים שכולם מנסים קודם, וכדאי לדעת מה הן אומרות כדי לחסוך זמן בהמשך.
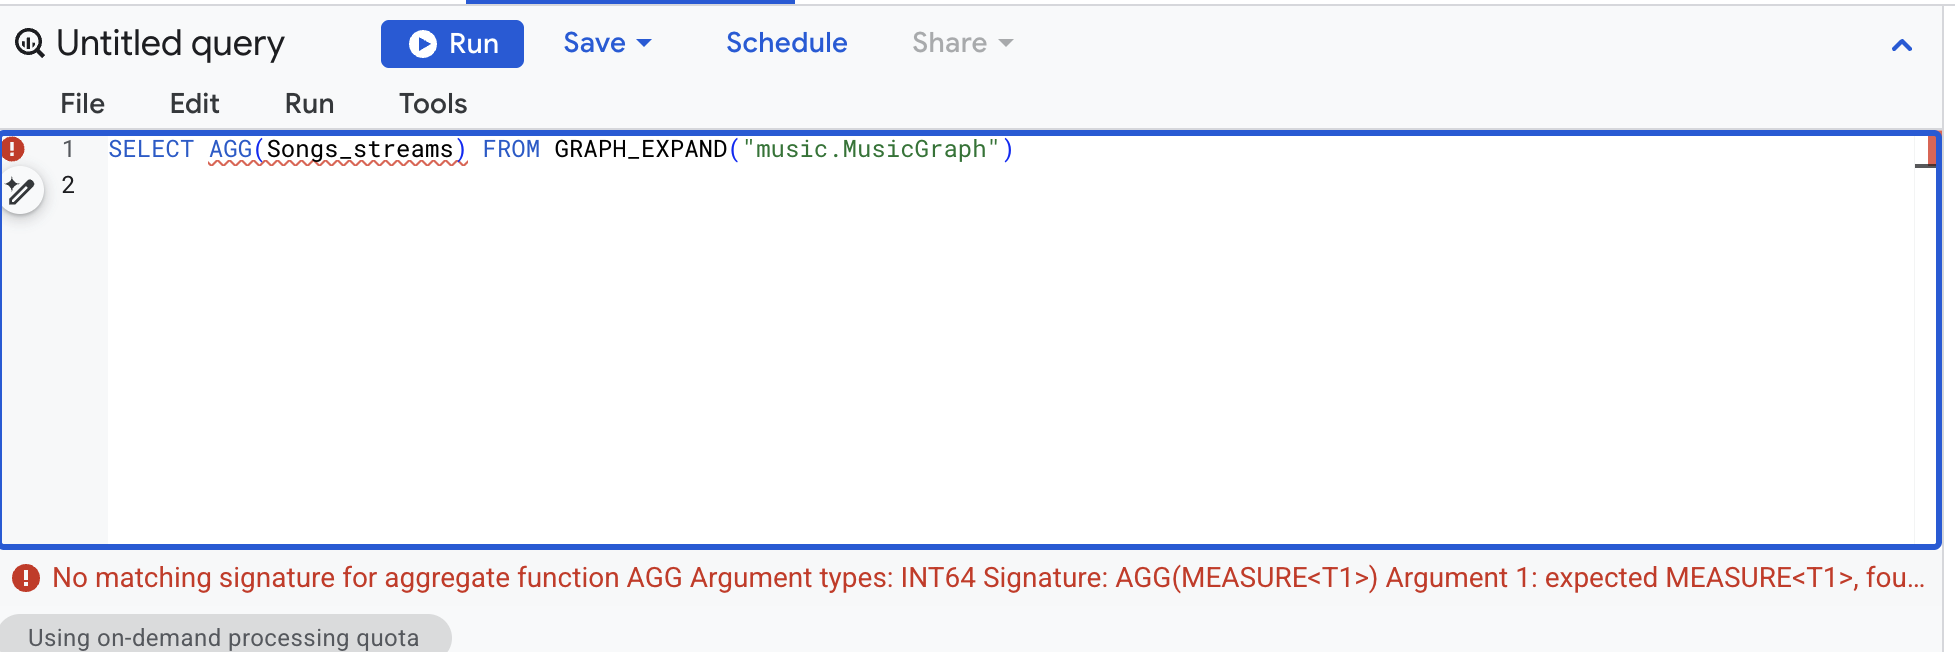
👉📋 עורך השאילתות — AGG בעמודה רגילה:
SELECT AGG(Songs_streams) FROM GRAPH_EXPAND("music.MusicGraph")
👀 No matching signature for aggregate function AGG ... Argument 1: expected MEASURE
👈📋 עורך השאילתות – עמודת מדדים ללא AGG:
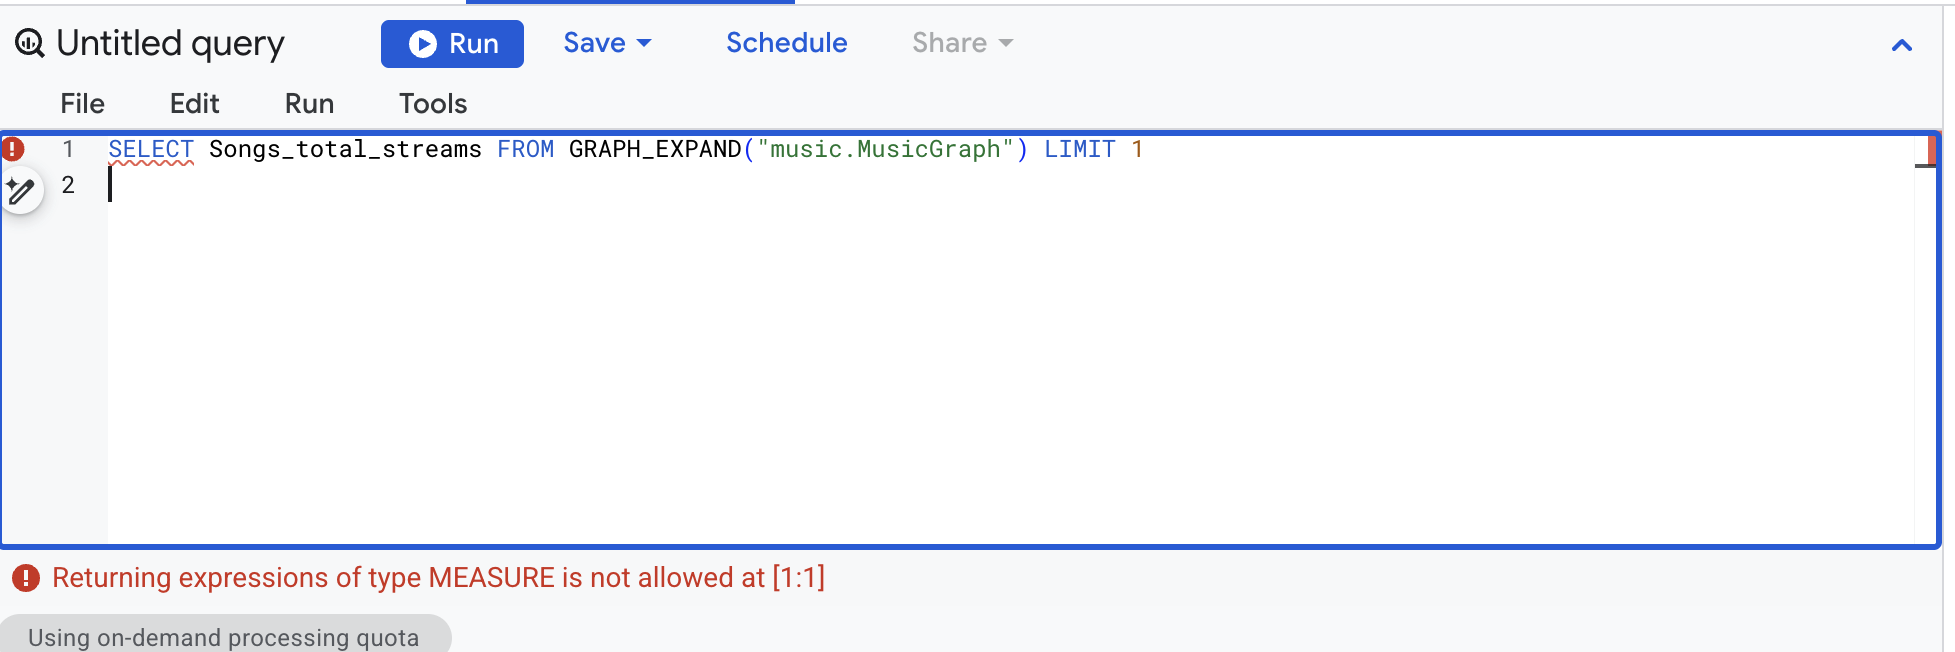
SELECT Songs_total_streams FROM GRAPH_EXPAND("music.MusicGraph") LIMIT 1
👀 Returning expressions of type MEASURE is not allowed
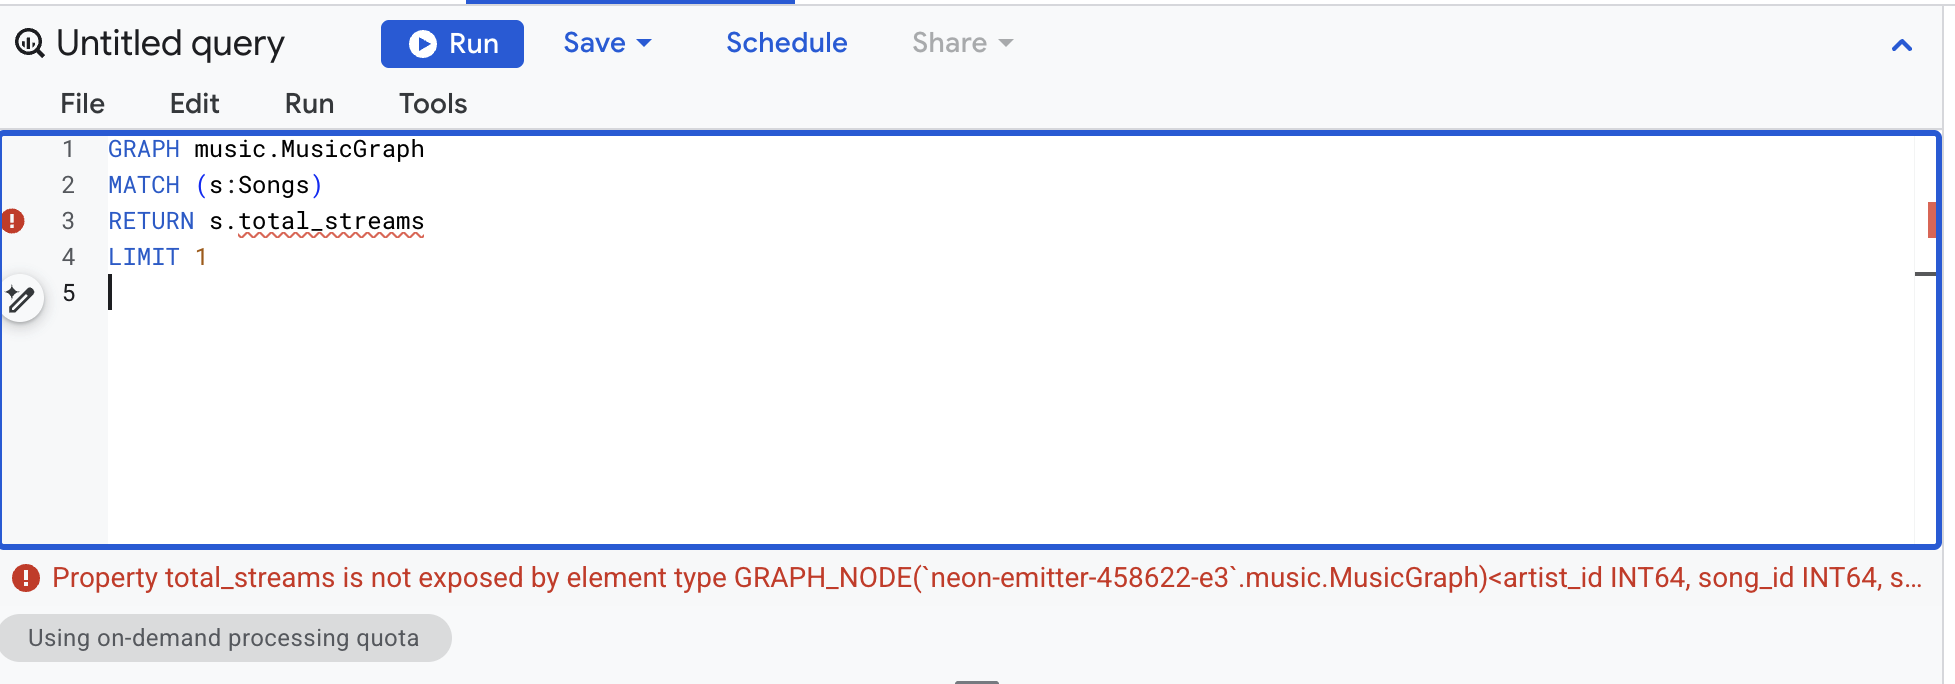
👈📋 עורך השאילתות – מדד שאליו מתייחסים ב-GQL, אבל הוא אף פעם לא רואה מדדים (זהו שאילתת GQL – אפשר לעיין בהערת העריכה בסקירה הכללית):
GRAPH music.MusicGraph
MATCH (s:Songs)
RETURN s.total_streams
LIMIT 1
👀 total_streams is not exposed by element type GRAPH_NODE(...)
👈📋 עורך השאילתות — SUM over a measure column, the tempting one:
SELECT Labels_label_name, SUM(Songs_total_streams)
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1
👀 MEASURE-typed arguments are only permitted in the AGG function
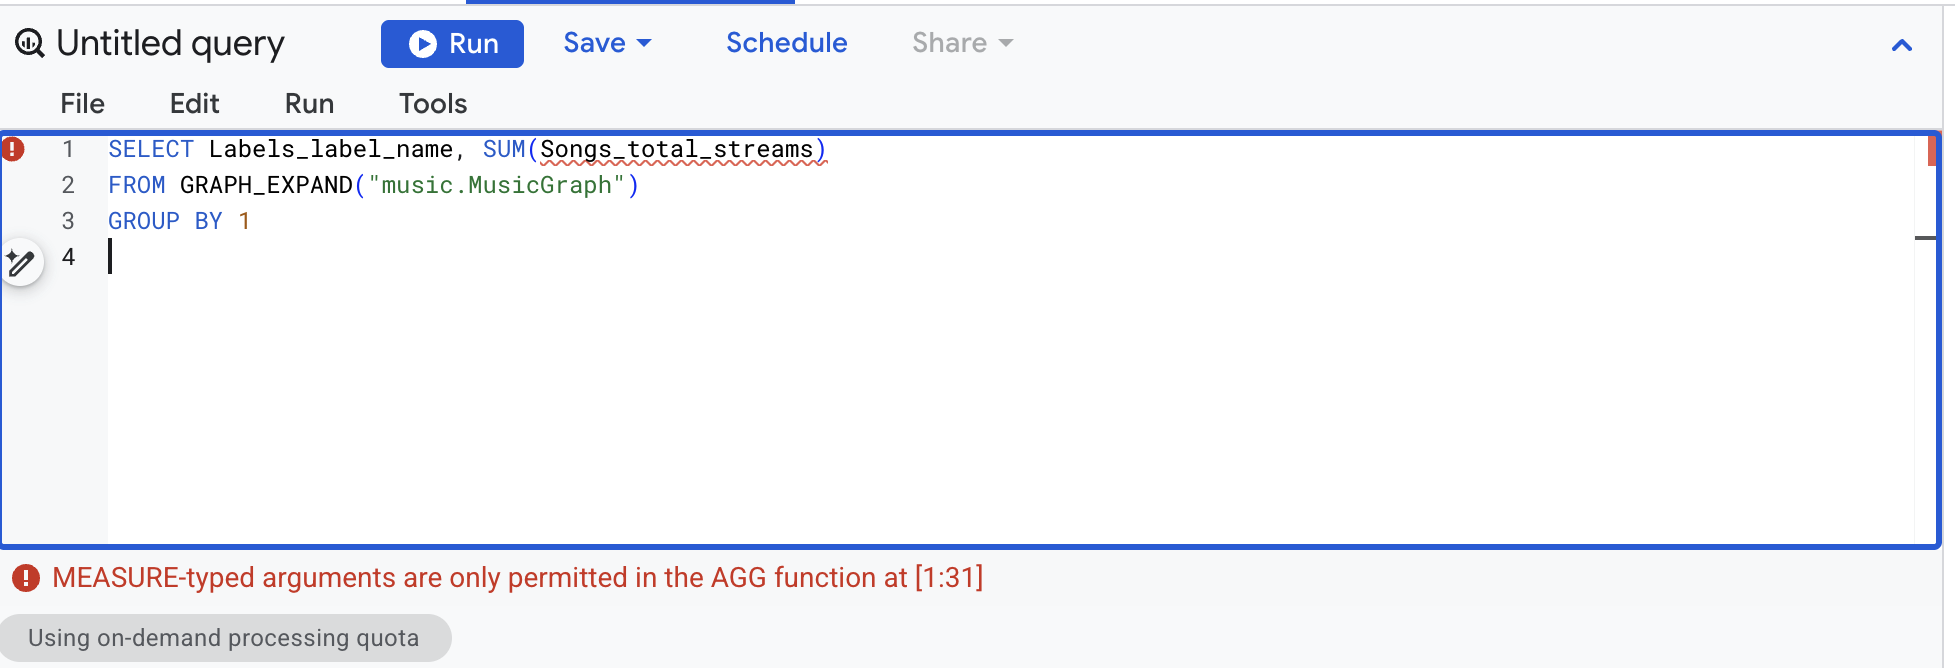
כך מערכת הסוגים אוכפת את הכלל בשבילכם. מדד גלוי רק דרך GRAPH_EXPAND, ואפשר לקרוא אותו רק דרך AGG. הספירה העודפת של 12.6 מיליארד מהנתונים הקודמים יכולה לנבוע רק מסיכום של העמודה עם הנתונים הגולמיים – אף פעם לא מטיפול לא נכון במדד.
✅ נקודת ביניים: ארבע שגיאות באדום, ואתם יכולים לומר איזה כלל כל אחת מהן אוכפת.
8. כל צבירה שנתמכת על ידי מדד
MEASURE() wraps one of six aggregates: SUM, AVG, MIN, MAX, COUNT, and COUNT(DISTINCT). יוצרים מחדש את הגרף עם כל ששת השירים בצומת Songs. הקצוות נשארים NO PROPERTIES, וזו השיטה המומלצת שמתועדת כשקצה חולק את הטבלה הפיזית שלו עם צומת.
👈📋 Query editor — paste, then click Run:
CREATE OR REPLACE PROPERTY GRAPH music.MusicGraph
  NODE TABLES (
    music.Labels KEY (label_id)
      PROPERTIES (label_id, label_name, marketing_budget,
        MEASURE(SUM(marketing_budget)) AS total_budget),
    music.Artists KEY (artist_id)
      PROPERTIES (artist_id, artist_name, label_id,
        MEASURE(COUNT(artist_id)) AS artist_count),
    music.Songs KEY (song_id)
      PROPERTIES (song_id, title, artist_id, streams,
        MEASURE(SUM(streams))              AS total_streams,
        MEASURE(AVG(streams))              AS avg_streams,
        MEASURE(MIN(streams))              AS min_streams,
        MEASURE(MAX(streams))              AS max_streams,
        MEASURE(COUNT(song_id))            AS song_count,
        MEASURE(COUNT(DISTINCT artist_id)) AS distinct_artists),
    music.Playlists KEY (playlist_id)
      PROPERTIES (playlist_id, playlist_name, followers,
        MEASURE(SUM(followers)) AS total_followers),
    music.PlaylistEntries KEY (entry_id)
      PROPERTIES (entry_id, playlist_id, song_id,
        MEASURE(COUNT(entry_id)) AS placement_count)
  )
  EDGE TABLES (
    music.PlaylistEntries AS EntryToSong
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (song_id) REFERENCES Songs(song_id) NO PROPERTIES,
    music.PlaylistEntries AS EntryToPlaylist
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (playlist_id) REFERENCES Playlists(playlist_id) NO PROPERTIES,
    music.Songs AS SongToArtist
      SOURCE KEY (song_id) REFERENCES Songs(song_id)
      DESTINATION KEY (artist_id) REFERENCES Artists(artist_id) NO PROPERTIES,
    music.Artists AS ArtistToLabel
      SOURCE KEY (artist_id) REFERENCES Artists(artist_id)
      DESTINATION KEY (label_id) REFERENCES Labels(label_id) NO PROPERTIES
  )
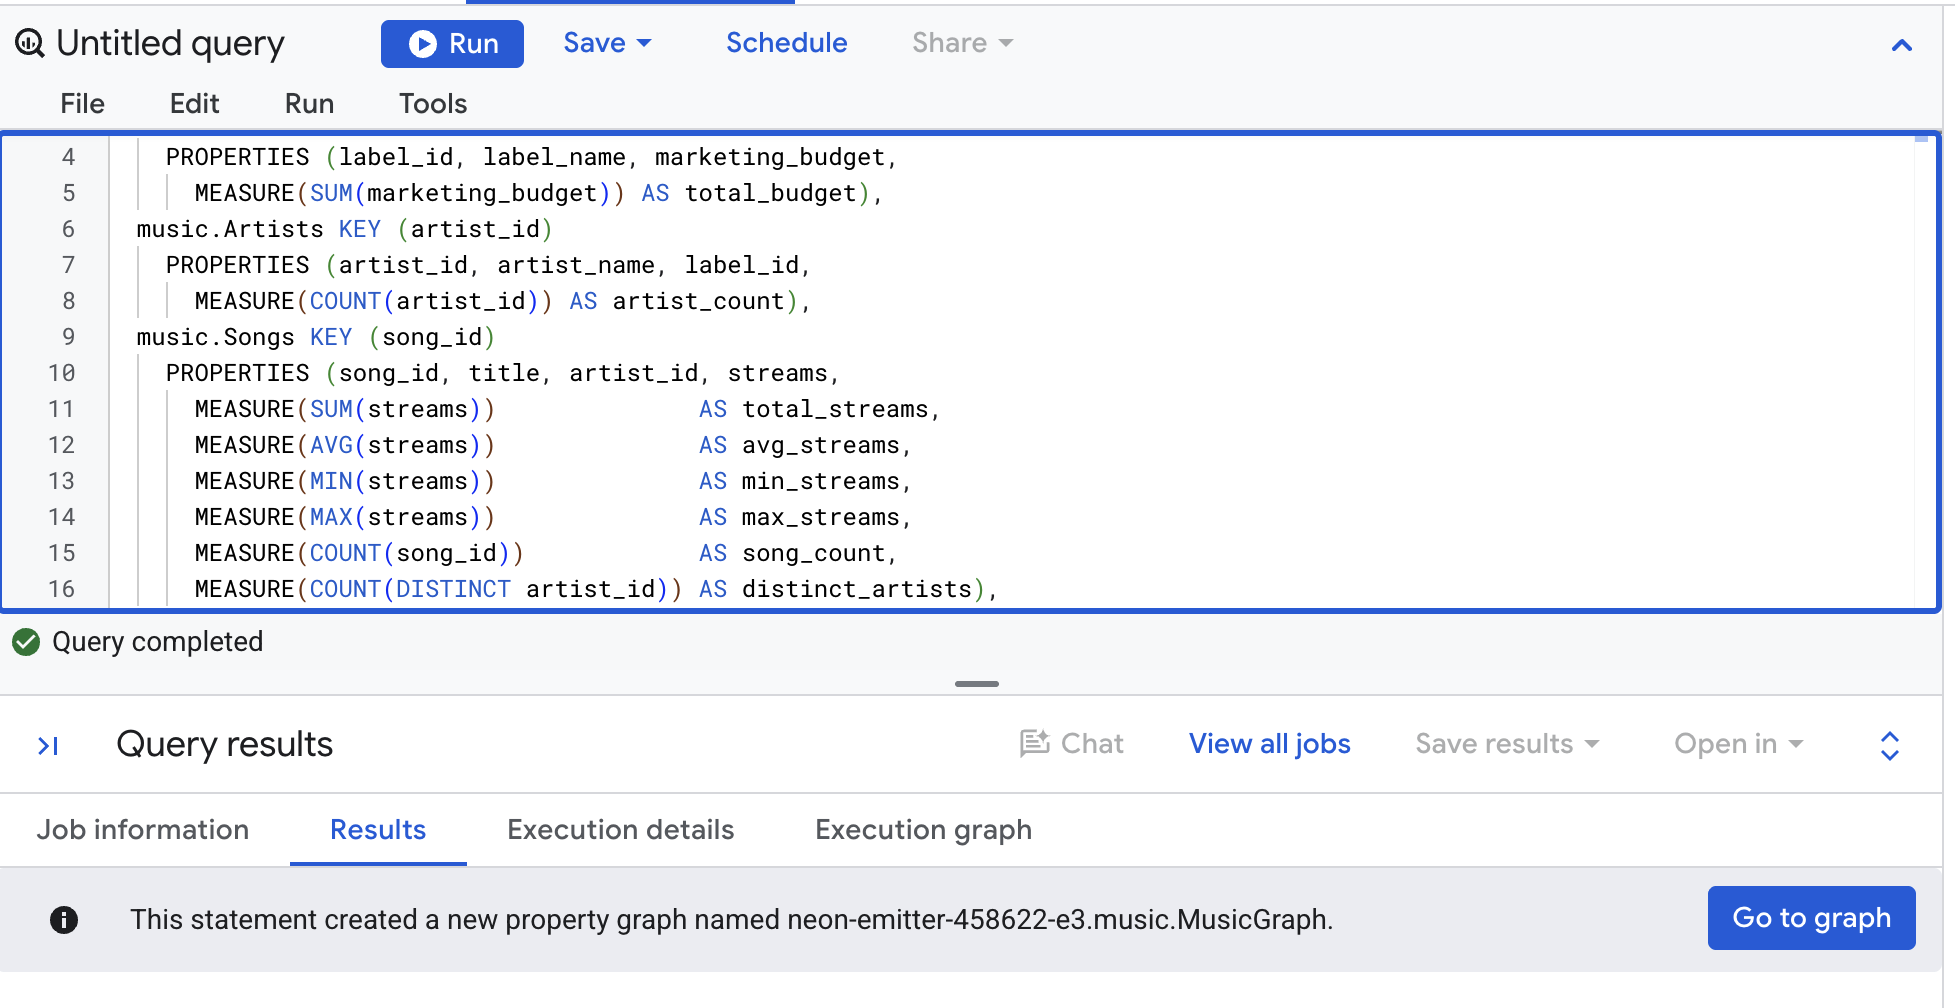
עכשיו תקרא את כולם. כל מדד עובר AGG, ובעמודה האחרונה מוצגות AGG תוצאות שהן ערכים רגילים שאפשר לבצע איתם פעולות אריתמטיות. הגרף השתנה, אז קודם צריך לבטל את הסימון של Use cached results (More → Query settings).
👈📋 Query editor — paste, then click Run:
SELECT
  Labels_label_name,
  AGG(Songs_total_streams)    AS total_streams,
  AGG(Songs_avg_streams)      AS avg_streams,
  AGG(Songs_min_streams)      AS min_streams,
  AGG(Songs_max_streams)      AS max_streams,
  AGG(Songs_song_count)       AS songs,
  AGG(Songs_distinct_artists) AS artists,
  AGG(Songs_total_streams) / AGG(Songs_song_count) AS streams_per_song
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1
ORDER BY 1
👀 תוצאה:
Labels_label_name | total_streams | avg_streams | min_streams | max_streams | שירים | artists | streams_per_song |
Cymbal Records | 5,100,000,000 | 1,275,000,000 | 400,000,000 | 2,000,000,000 | 4 | 2 | 1,275,000,000 |
Northwind Audio | 4,500,000,000 | 4,500,000,000 | 4,500,000,000 | 4,500,000,000 | 1 | 1 | 4,500,000,000 |
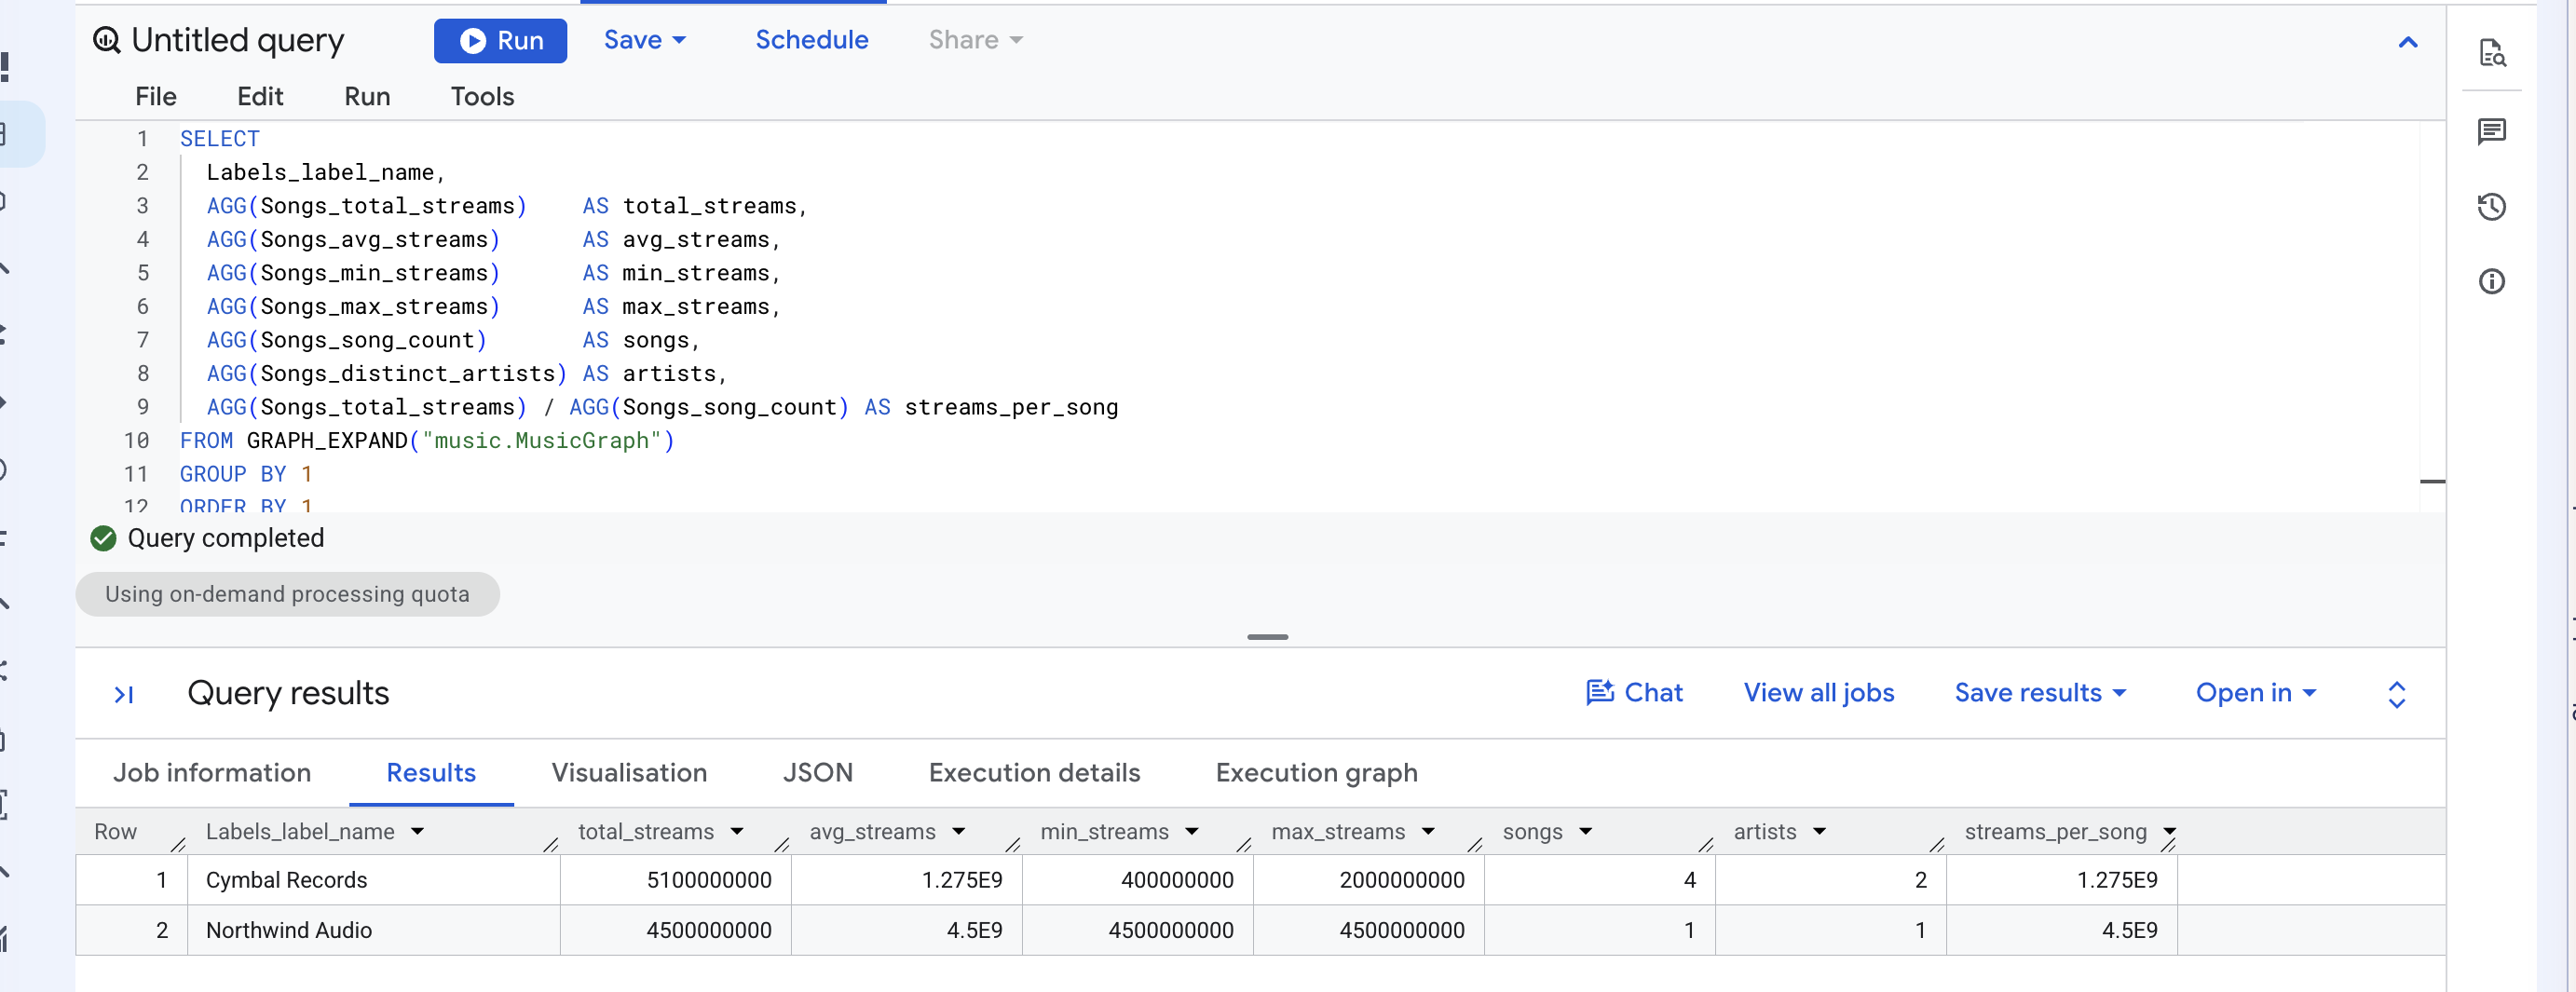
כל מספר מחושב על סמך ארבעה שירים ב-Cymbal ושיר אחד ב-Northwind – ולא על סמך עשר השורות של מיקומי המודעות. AVG במיוחד היה שגוי אם היינו מחשבים את הממוצע של העמודה הגולמית על פני שורות המיקום, כי הערך של 2 מיליארד של Neon Summer נספר ארבע פעמים.
לכן, ההחלפה של SUM ב-AGG היא בעצם שתי החלטות. כשמגדירים את המדד, עדיין בוחרים איזו מבין שש האגרגציות הוא. כשקוראים אותו, הפונקציה היא תמיד AGG.
✅ נקודת ביקורת: שורה אחת לכל תווית, שבעה מספרים בכל שורה, ו-streams_per_song שווה ל-avg_streams.
9. שינוי הקיבוץ, לא המדד
אותו מדד עונה על שאלה אחרת. קיבוץ לפי פלייליסט במקום לפי תווית.
👈📋 Query editor — paste, then click Run:
SELECT
  Playlists_playlist_name,
  AGG(Songs_total_streams) AS streams,
  AGG(Songs_song_count)    AS songs
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1
ORDER BY 2 DESC
👀 תוצאה:
Playlists_playlist_name | שידורים | שירים |
טיול בנסיעה | 6,900,000,000 | 3 |
Gym Pump | 6,500,000,000 | 2 |
הכי פופולריים עכשיו | 4,700,000,000 | 3 |
פופ עולה | 3,500,000,000 | 2 |
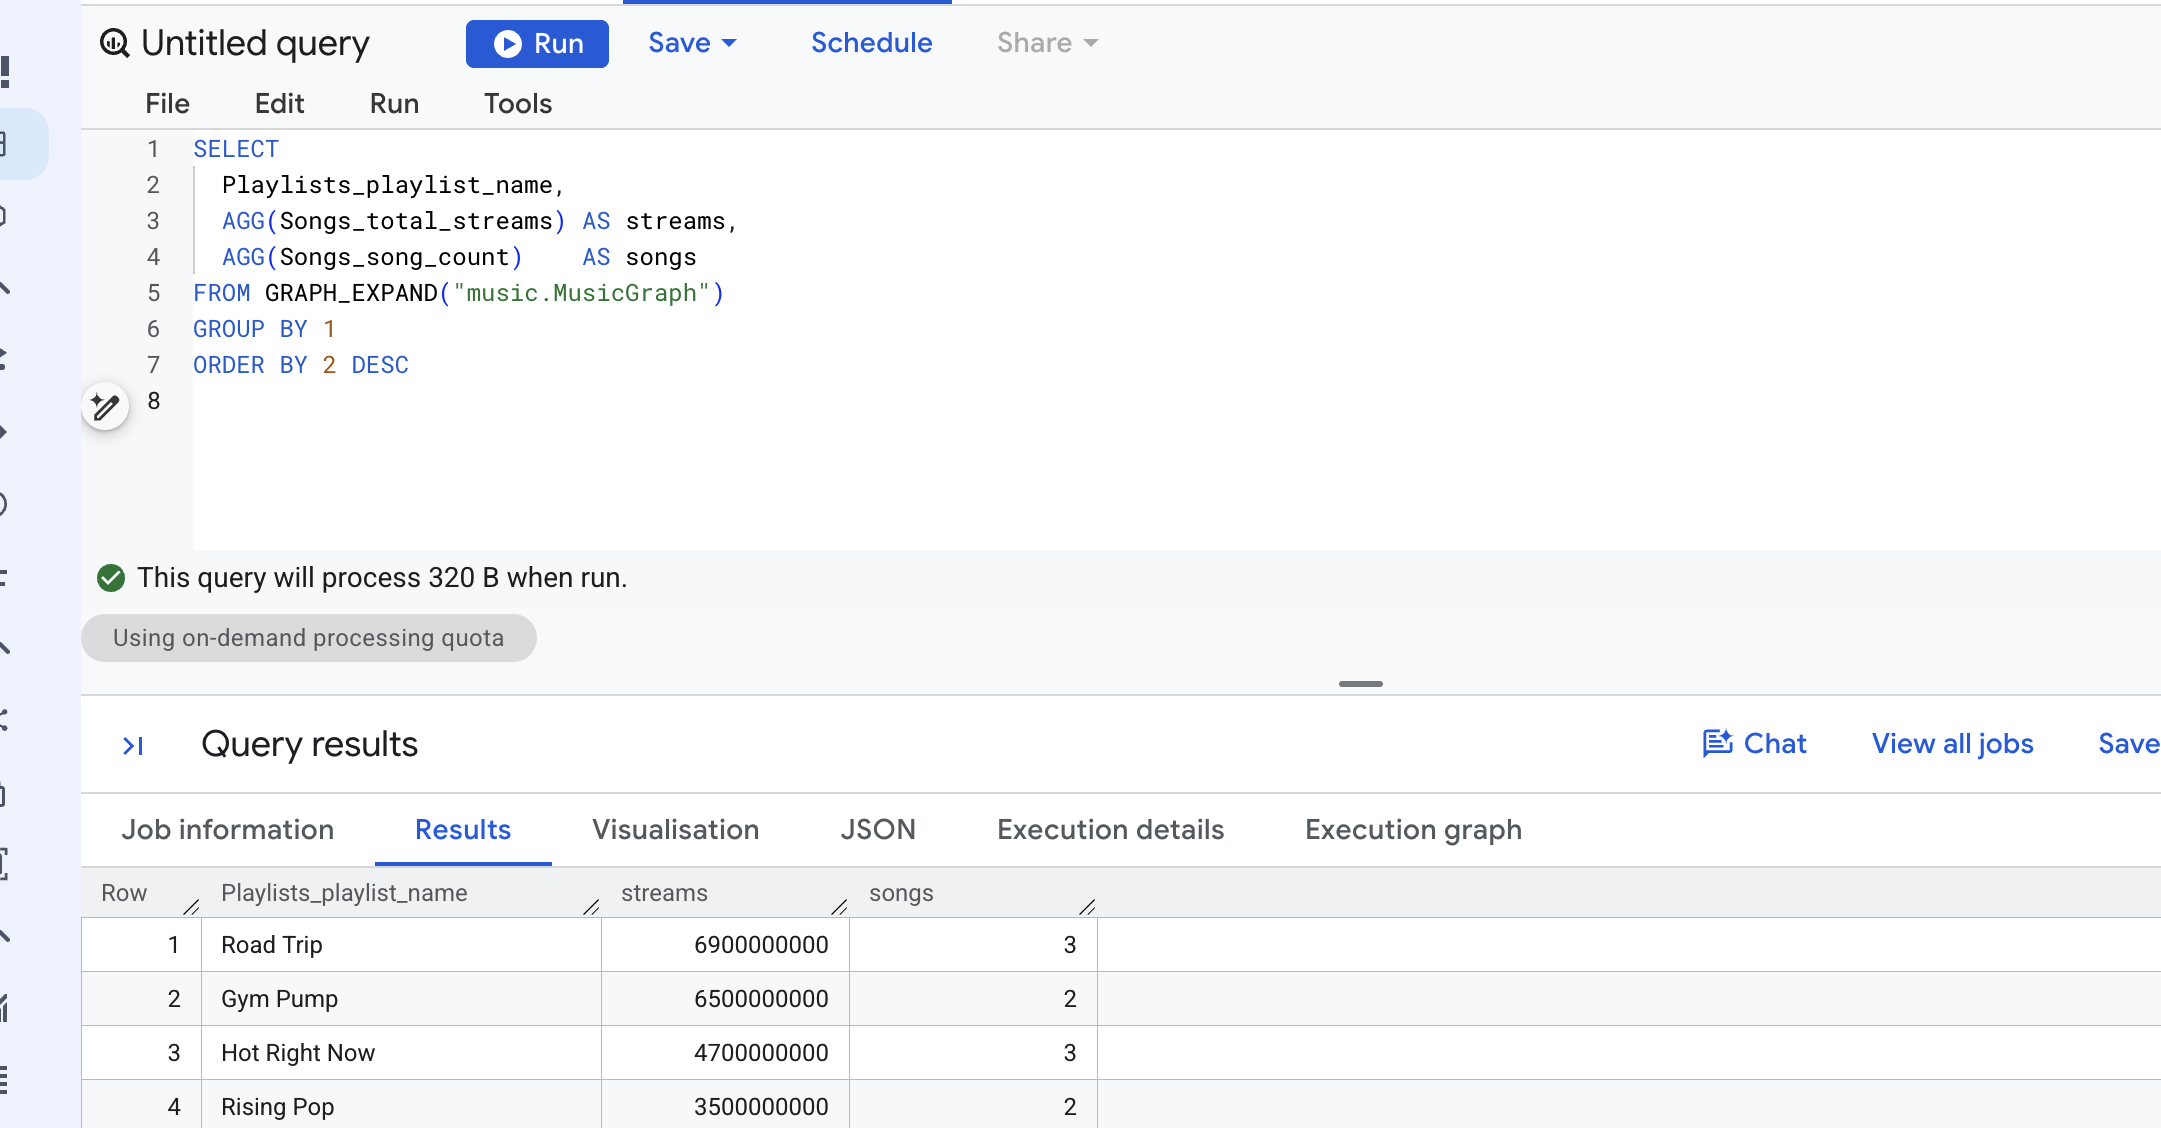
שתי השורות AGG הן בדיוק אותן שורות מ-SUM and AGG, side by side. רק GROUP BY הועבר. הפלייליסט Road Trip כולל את השירים Neon Summer, Midnight Drive ו-Slow Arrow, וכל שיר נספר פעם אחת בתוך הפלייליסט הזה – וזה בדיוק מה שצריך להיות המשמעות של 'סטרימינג שהגיע לפלייליסט הזה'.
האדם שכתב את המדד החליט על רמת הפירוט פעם אחת. כל שאילתה שתבוצע לאחר מכן, על ידי כל אחד, תכלול את ההגדרה הזו.
✅ Checkpoint: Road Trip on top with 6.9 billion.
10. מה אפשר לעשות עם GRAPH_EXPAND
לא צריך להריץ את GRAPH_EXPAND כדי לדעת מה הצורה שלו. הפרוצדורה של המערכת BQ.SHOW_GRAPH_EXPAND_SCHEMA כותבת את רשימת העמודות למשתנה.
👉📋 Query editor — paste all three lines, then click Run:
DECLARE schema STRING DEFAULT '';
CALL BQ.SHOW_GRAPH_EXPAND_SCHEMA('music.MusicGraph', schema);
SELECT schema;
👀 התוצאה היא מחרוזת JSON אחת. לכל שדה יש שם, סוג ומצב, ולכל עמודת מדד יש "is_measure": true. לגרף שיצרתם הרגע, תקבלו את הנתונים הבאים, בין היתר:
שם | סוג | is_measure | |
Songs_title | מחרוזת | ||
Songs_streams | מספר שלם | ||
Songs_total_streams | מספר שלם | true | |
Songs_avg_streams | מספר ממשי (float) | true | |
Songs_distinct_artists | מספר שלם | true | |
PlaylistEntries_placement_count | מספר שלם | true | |
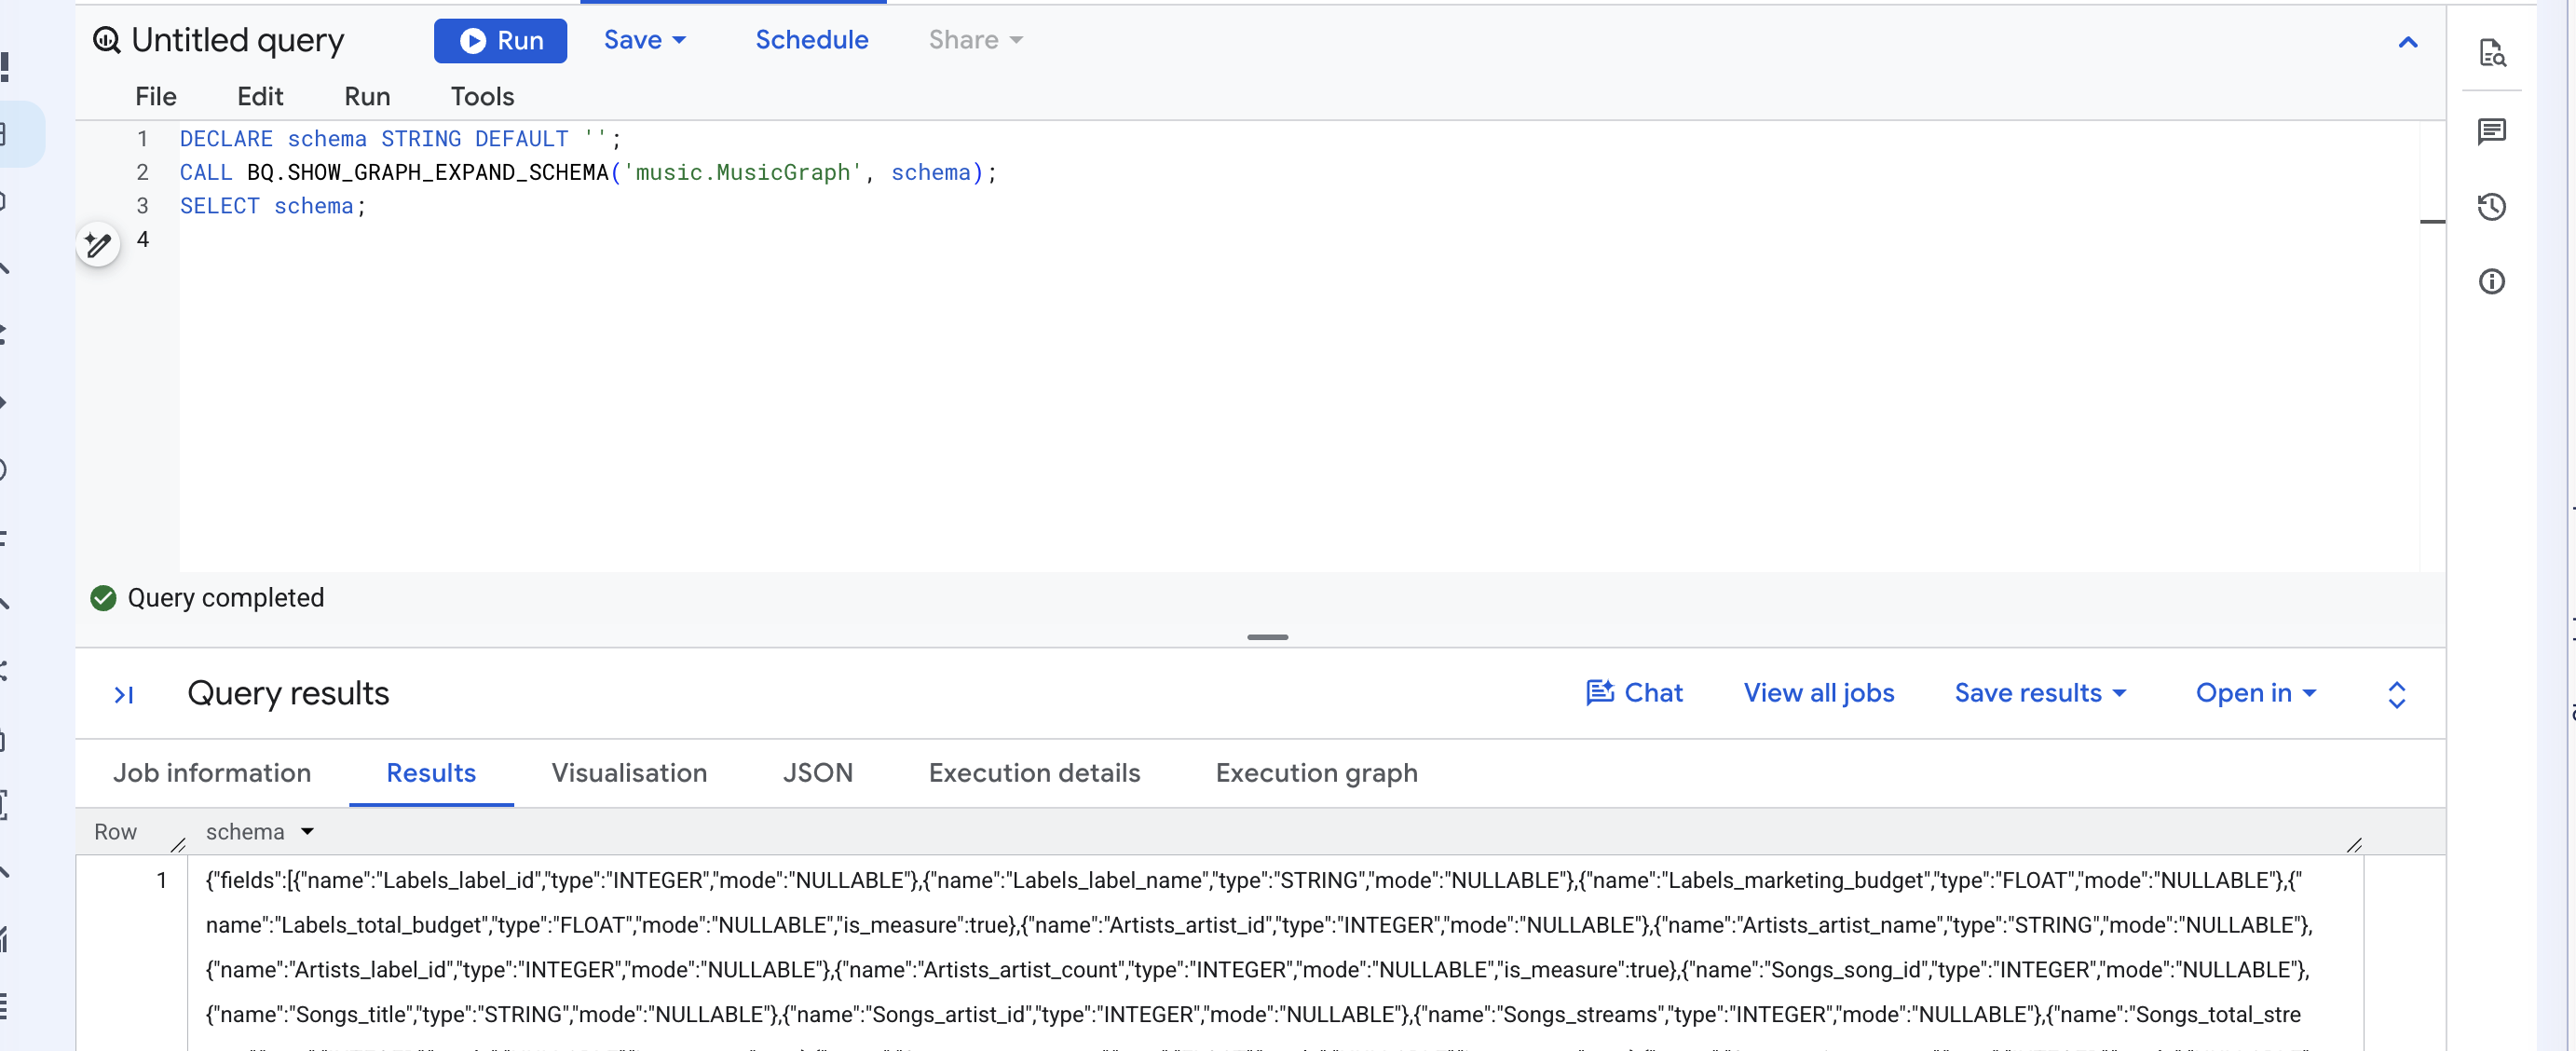
גם תיאורים או מילים נרדפות שהגדרתם בנכס מופיעים כאן. בשלב האופציונלי של הצ'אט אפשר לראות מי קורא את ההודעות.
✅ נקודת ביקורת: מחרוזת JSON עם is_measure בכל עמוד שהצהרתם עליו באמצעות MEASURE.
11. מה הפונקציה GRAPH_EXPAND צריכה מהצורה של תרשים
אין מה להריץ בשלב הזה – רק קוראים. GRAPH_EXPAND יוצר טבלה רחבה עם שרשרת של LEFT JOIN, החל מטבלה אחת ומעקב אחרי קצוות כלפי חוץ. מכאן נגזרים שלושה כללים, ו-MusicGraph עומד בכולם.
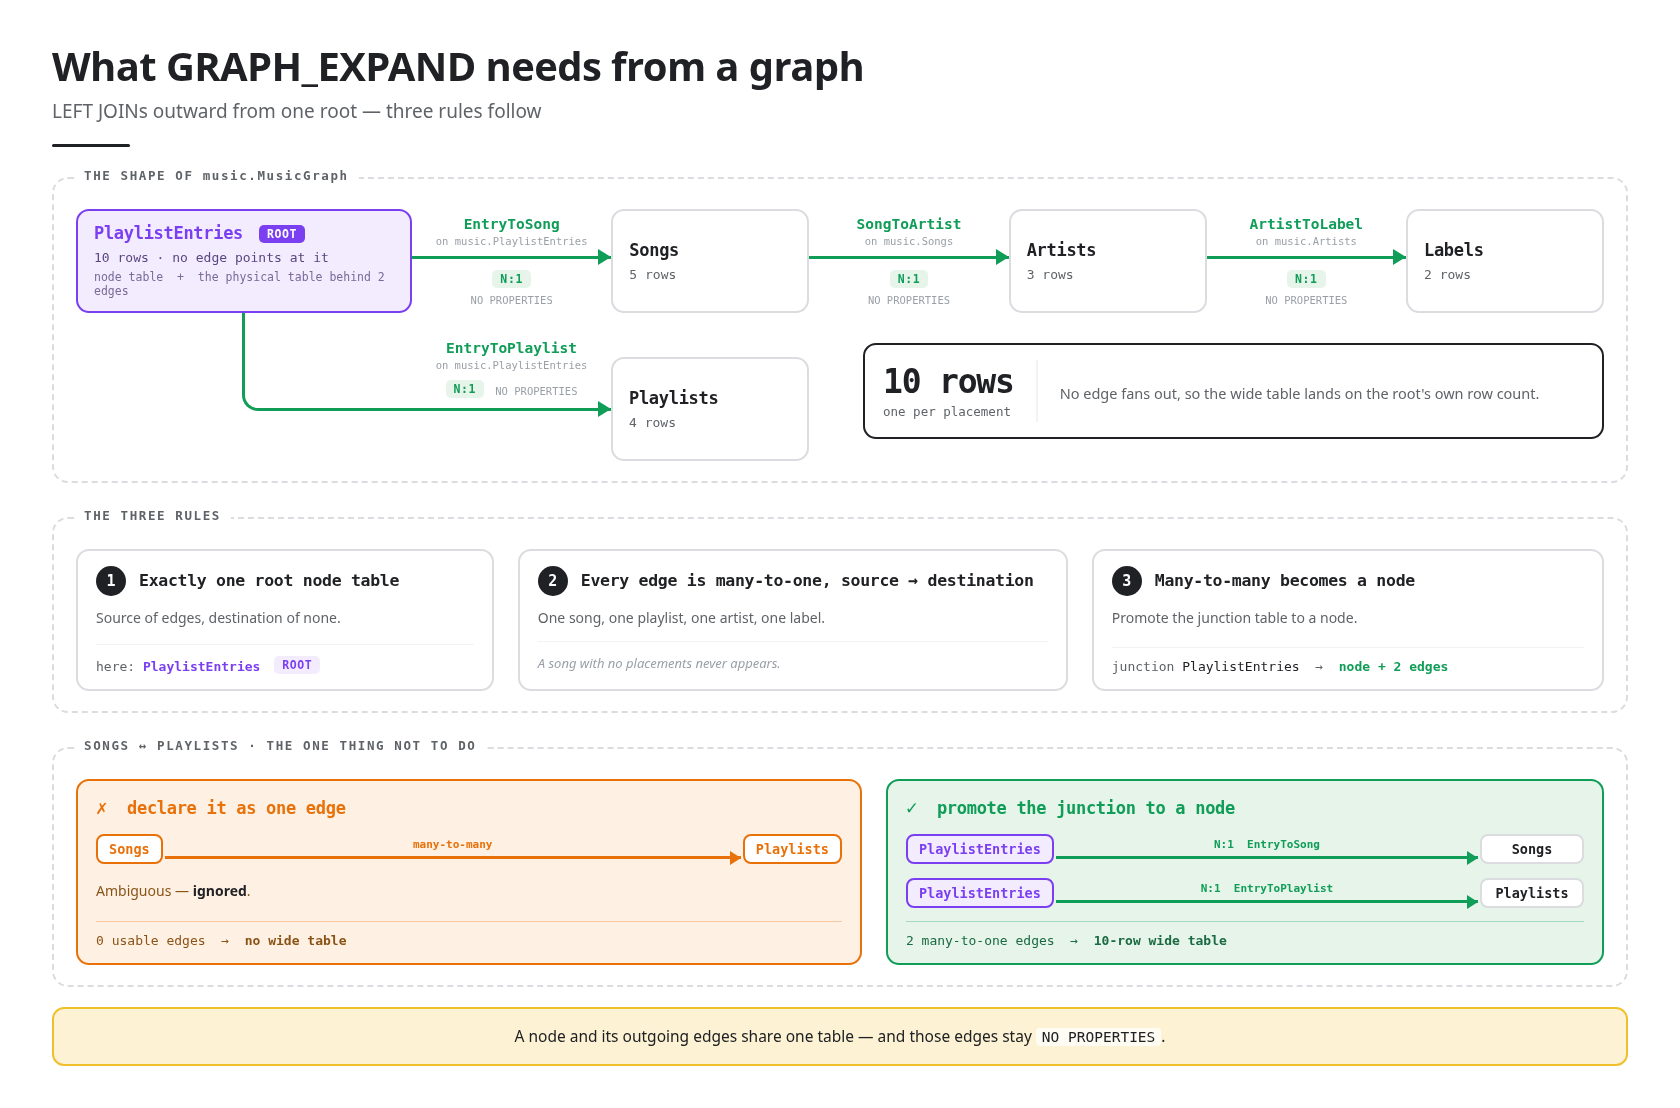
טבלה אחת של צומת הרמה הבסיסית (root). השורש הוא טבלת הצמתים שהמפתח שלה לא מופיע באף טבלה אחרת – הטבלה שאף קצה לא מצביע עליה. ב-MusicGraph, PlaylistEntries הוא המקור של שני קצוות והיעד של אף קצה. הטבלה הרחבה כוללת 10 שורות, שורה אחת לכל מיקום.
כל קצה הוא מסוג רבים לאחד, ממקור ליעד. כל רשומה מכילה שיר אחד ופלייליסט אחד, כל שיר משויך לאומן אחד, וכל אומן משויך לתווית אחת. לכן, הטבלה הרחבה אף פעם לא מתרחבת מעבר לשורות של שורש העץ. נתונים שלא מגיעים לרמת הבסיס לא מופיעים: שיר ללא מיקומי מודעות לא יופיע בטבלה הרחבה.
קשרים מסוג רבים לרבים הופכים לצומת. היחס בין שירים לפלייליסטים הוא רבים-לרבים. אם הצהרתם על טבלת הצומת כקצה יחיד מ-Songs ל-Playlists, GRAPH_EXPAND יתעלם ממנה כי היא לא חד-משמעית – ואם לא יישארו קצוות שניתן להשתמש בהם, הפעולה תיכשל. הקידום של PlaylistEntries לטבלת צמתים עם יותר מדי קצוות מסוג 'רבים לאחד' הוא הדפוס המתועד, וזה מה שעשיתם כשבניתם את הגרף.
12. (אופציונלי) נתיבים עם GQL
עד עכשיו, התשובה לכל שאלה הייתה מספר. האפשרות הזו לא זמינה. לאן מגיעים הסטרימים של Cymbal למאזינים? היא שאלה לגבי מסלולים בתרשים, וסכום לא יכול לענות עליה – עד שמסכמים, המסלול נעלם.
1. שליחת שאלה לגבי המיקום של הזרמים
👈📋 Query editor — paste, then click Run:
GRAPH music.MusicGraph
MATCH (l:Labels)<-[:ArtistToLabel]-(a:Artists)<-[:SongToArtist]-(s:Songs)
      <-[:EntryToSong]-(e:PlaylistEntries)-[:EntryToPlaylist]->(pl:Playlists)
WHERE l.label_name = 'Cymbal Records'
RETURN pl.playlist_name, pl.followers,
       SUM(s.streams) AS streams_reaching_this_playlist,
       STRING_AGG(s.title, ', ') AS songs
GROUP BY pl.playlist_name, pl.followers
ORDER BY streams_reaching_this_playlist DESC
👀 צפויים ארבעה פלייליסטים:
pl.playlist_name | pl.followers | streams_reaching_this_playlist | שירים |
הכי פופולריים עכשיו | 35,000,000 | 4,700,000,000 | Double Shot, Neon Summer, Paper Crown |
פופ עולה | 2,000,000 | 3,500,000,000 | Neon Summer, Paper Crown |
טיול בנסיעה | 5,000,000 | 2,400,000,000 | קיץ ניאון, חץ איטי |
Gym Pump | 3,000,000 | 2,000,000,000 | קיץ ניאון |
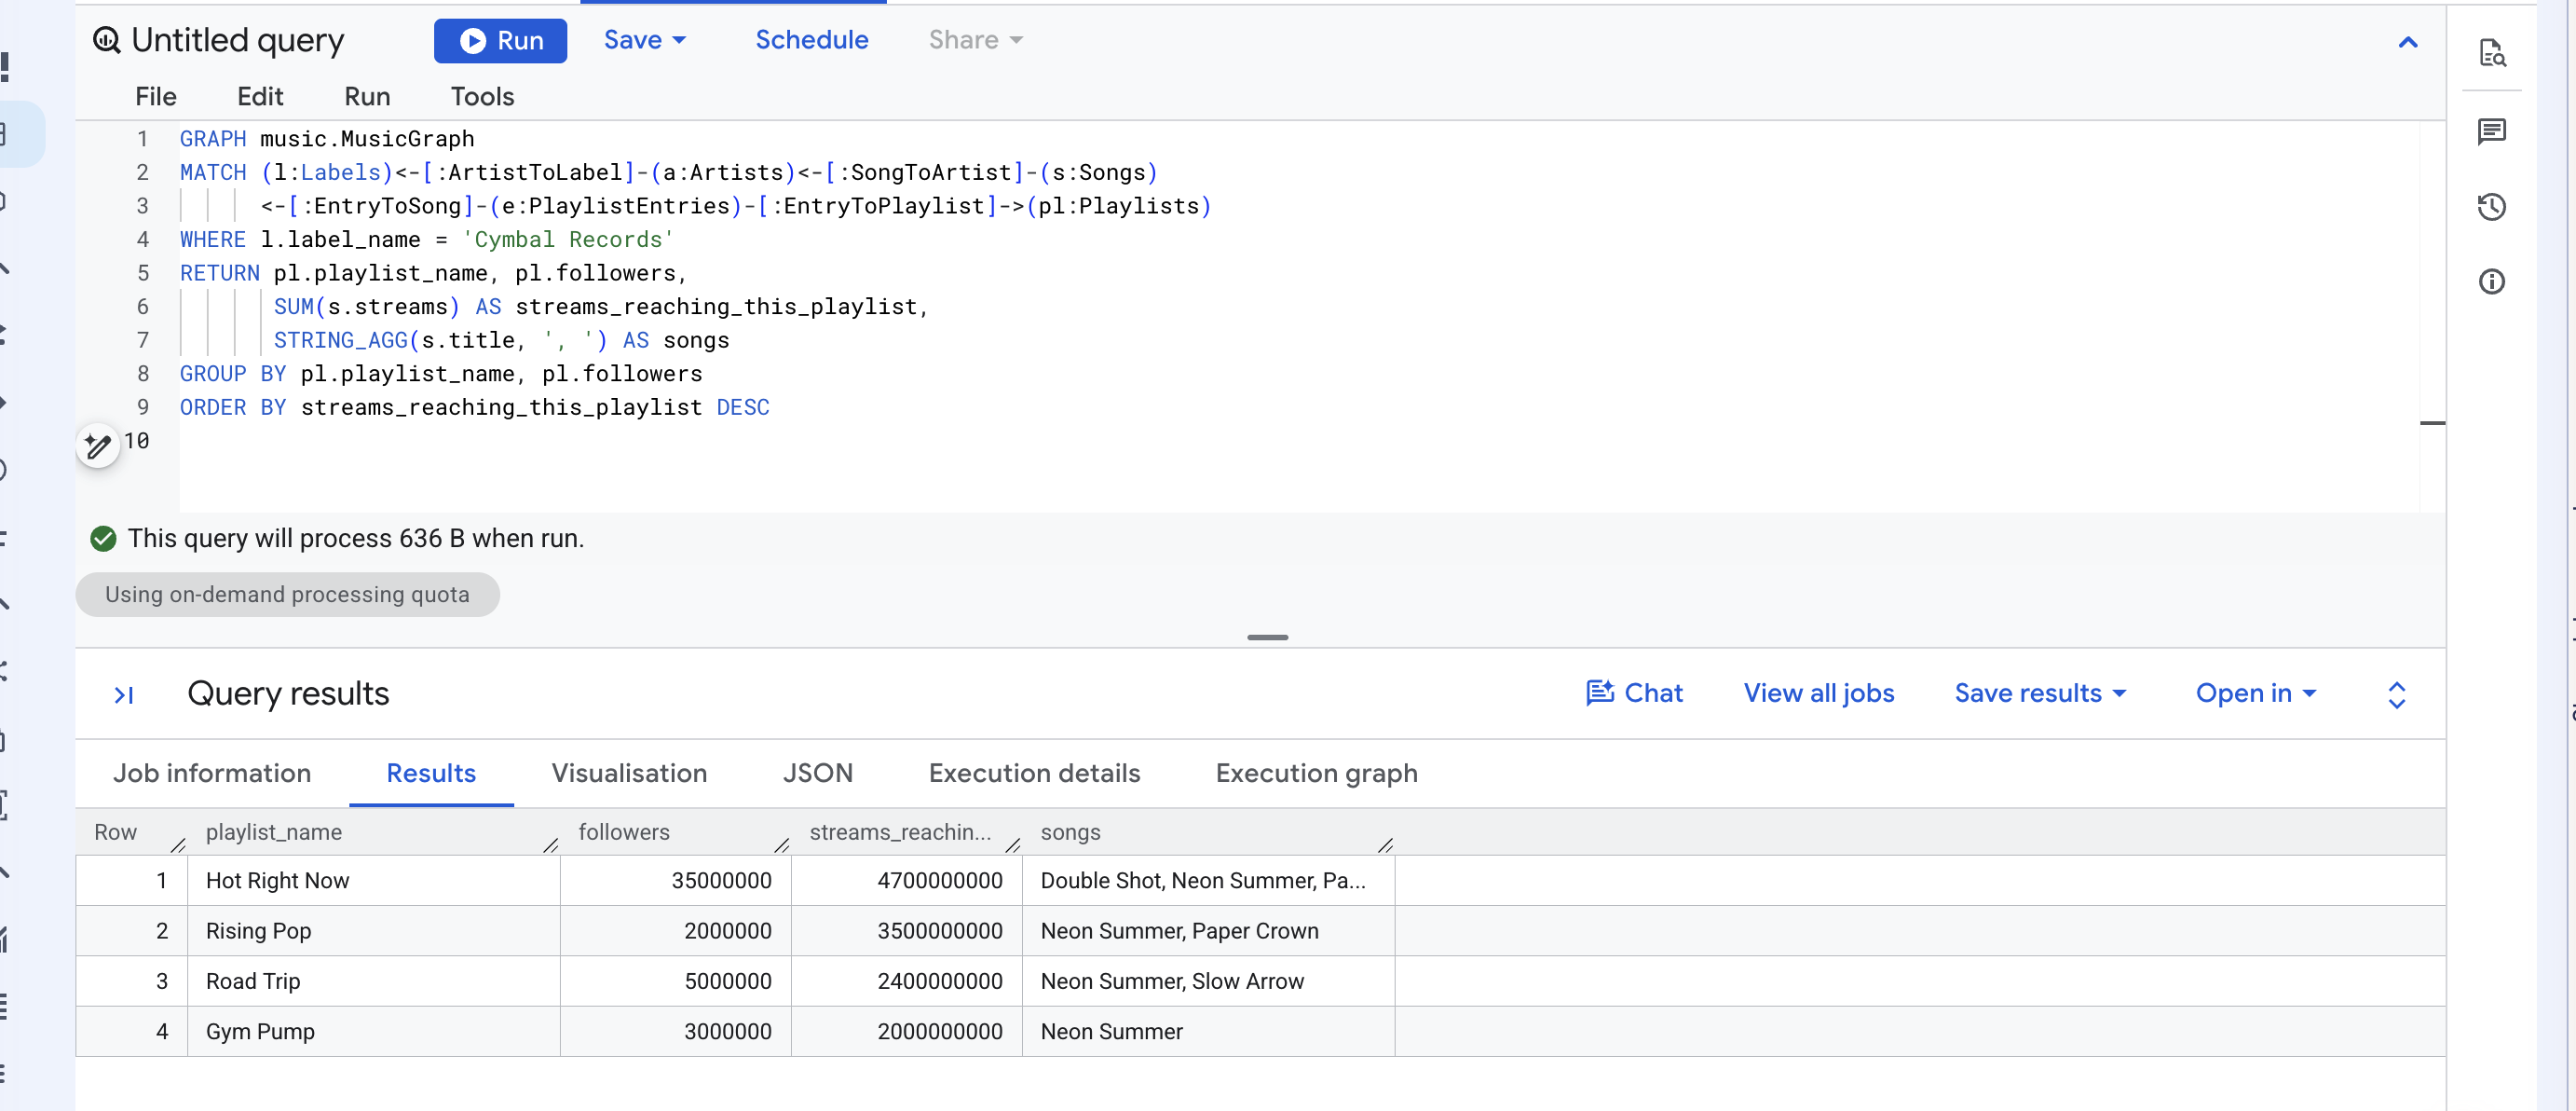
קוראים את השורה MATCH כמשפט: מתחילים בתווית, חוזרים לאומנים שלה, חוזרים לשירים שלהם, חוזרים לרשומות של הפלייליסטים שבהם השירים מופיעים, ואז עוברים קדימה לפלייליסטים. החיצים מציינים את הכיוון שבו הקצוות הוכרזו; <- הולך אחורה.
עכשיו מחברים את העמודה השלישית. 12.6 מיליארד – המספר שSUM נתן לכם בשלב הרביעי, המספר השגוי.
הנה, זה נכון. בזמנו, השאלה הייתה כמה סטרימינג בוצע לשיר של Cymbal, והשיר נספר פעם אחת לא משנה בכמה פלייליסטים הוא הופיע. השאלה היא לאיזה קהל הסטרימינג מגיע, ושיר שנמצא בארבעה פלייליסטים מגיע באמת לארבעה קהלים. השכפול GRAPH_EXPAND שנוצר הוא שגיאה בשאלה אחת והתשובה לשאלה השנייה. AGG אף פעם לא אמרתי שפריטים כפולים הם דבר רע – אלא שצריך להתאים את החישוב לשאלה.
2. החזרת הנתיבים עצמם
מבטלים את הצבירה ומבקשים את המסלולים.
👈📋 Query editor — paste, then click Run:
GRAPH music.MusicGraph
MATCH p = (l:Labels)<-[:ArtistToLabel]-(a:Artists)<-[:SongToArtist]-(s:Songs)
          <-[:EntryToSong]-(e:PlaylistEntries)-[:EntryToPlaylist]->(pl:Playlists)
WHERE l.label_name = 'Cymbal Records'
RETURN TO_JSON(p) AS path
p = נותן שם להתאמה כולה, ו-TO_JSON מעבד אותה.
👀 Expect 8 rows, one path column. כל תא הוא מערך JSON של הצמתים והקצוות לאורך מסלול אחד, וכל צומת מכיל את הערכים labels ו-properties.
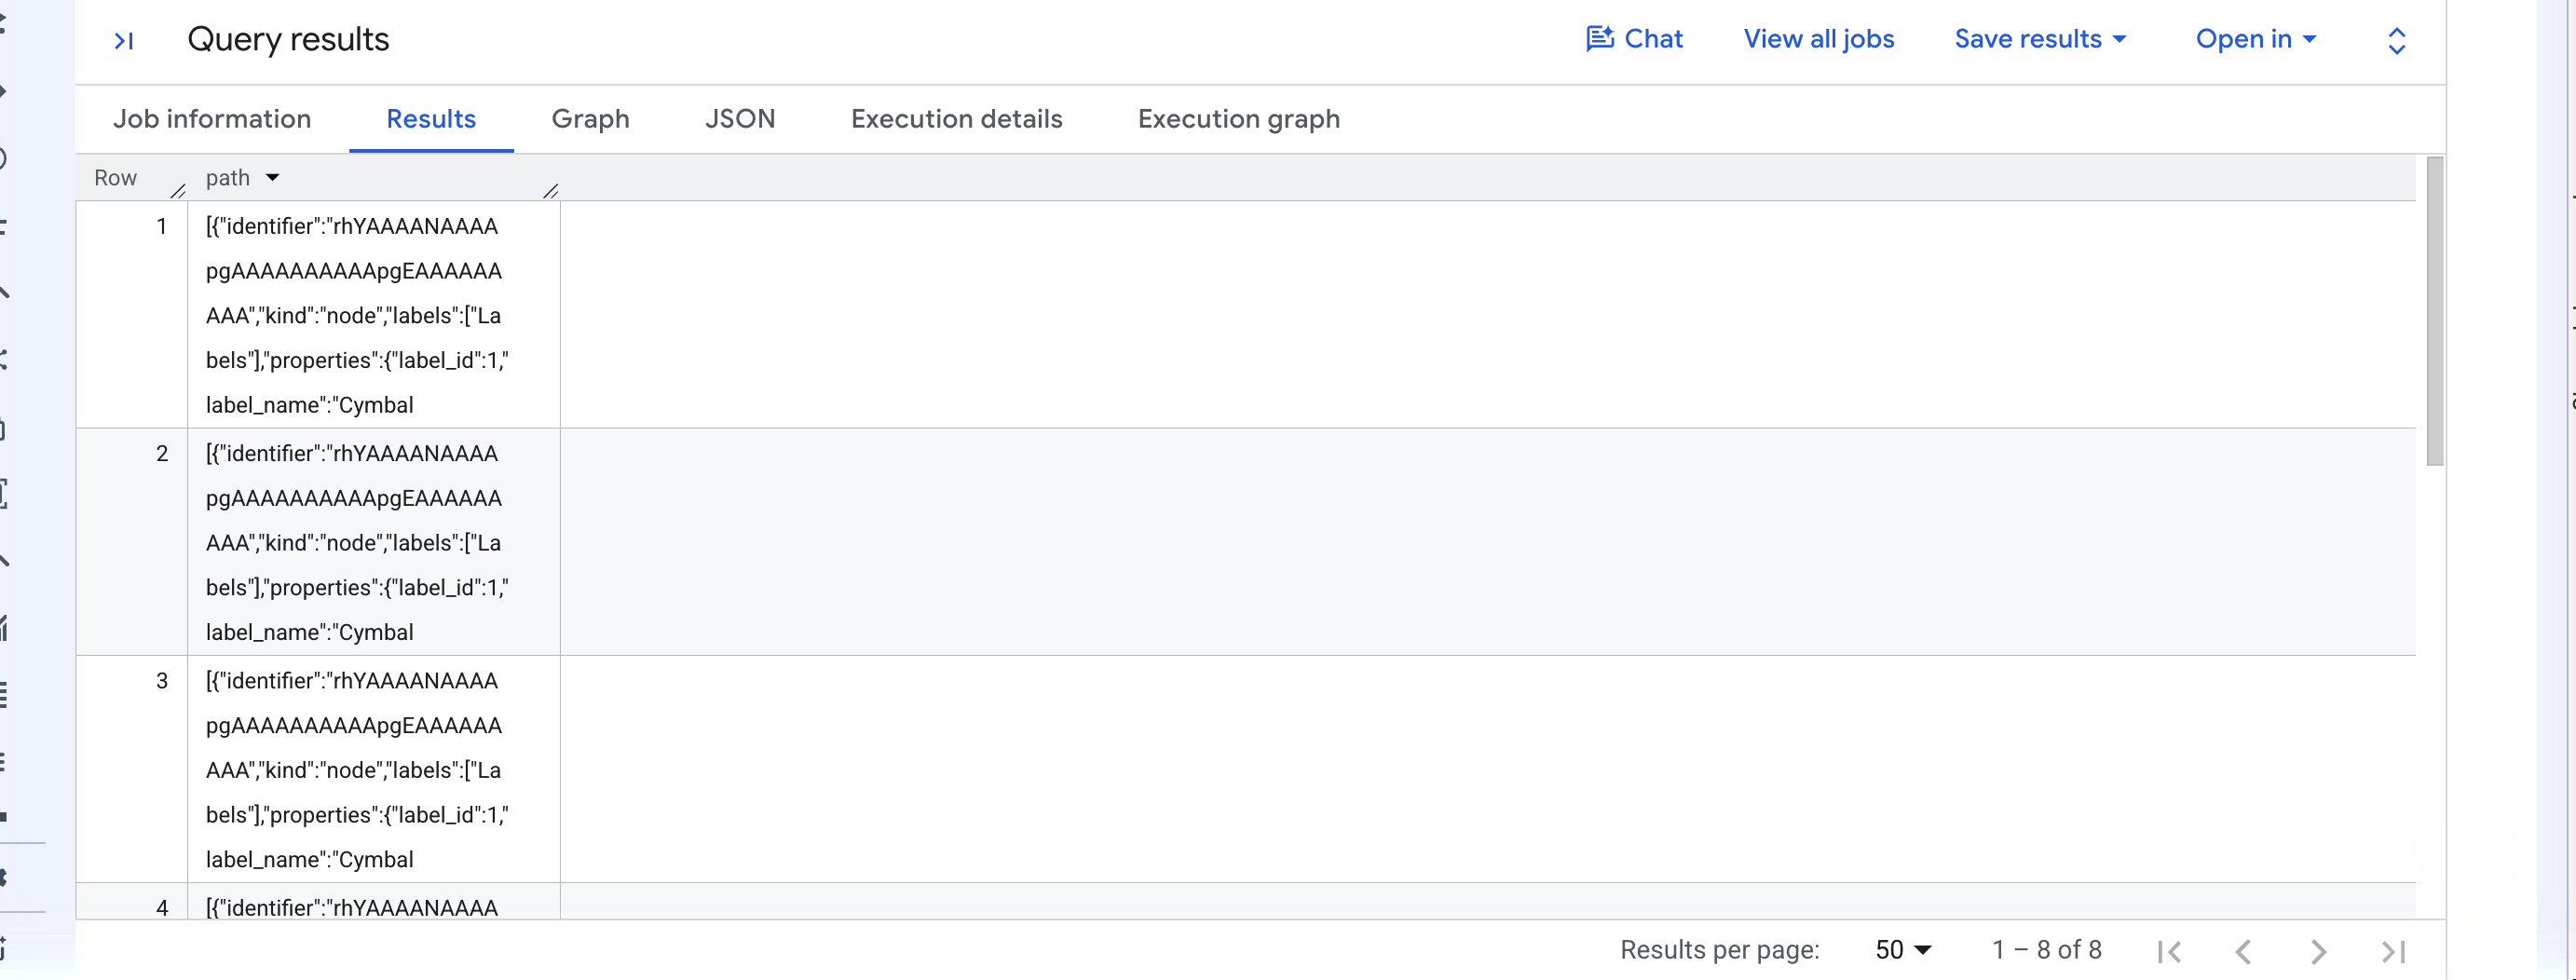
שמונה שורות לארבעה שירים, כי יש נתיב לכל מיקום מודעה ולא לכל שיר.
3. פתיחת הכרטיסייה 'גרף'
👈🌐 Console — מעל התוצאות, לוחצים על Graph.
הכרטיסייה הזו מופיעה רק אם התוצאה מכילה רכיבי תרשים. השאילתה הקודמת החזירה מספרים, ולכן לא הייתה לה כרטיסיית תרשים. השאילתה הזו מחזירה נתיבים, ולכן יש לה כרטיסיית תרשים.
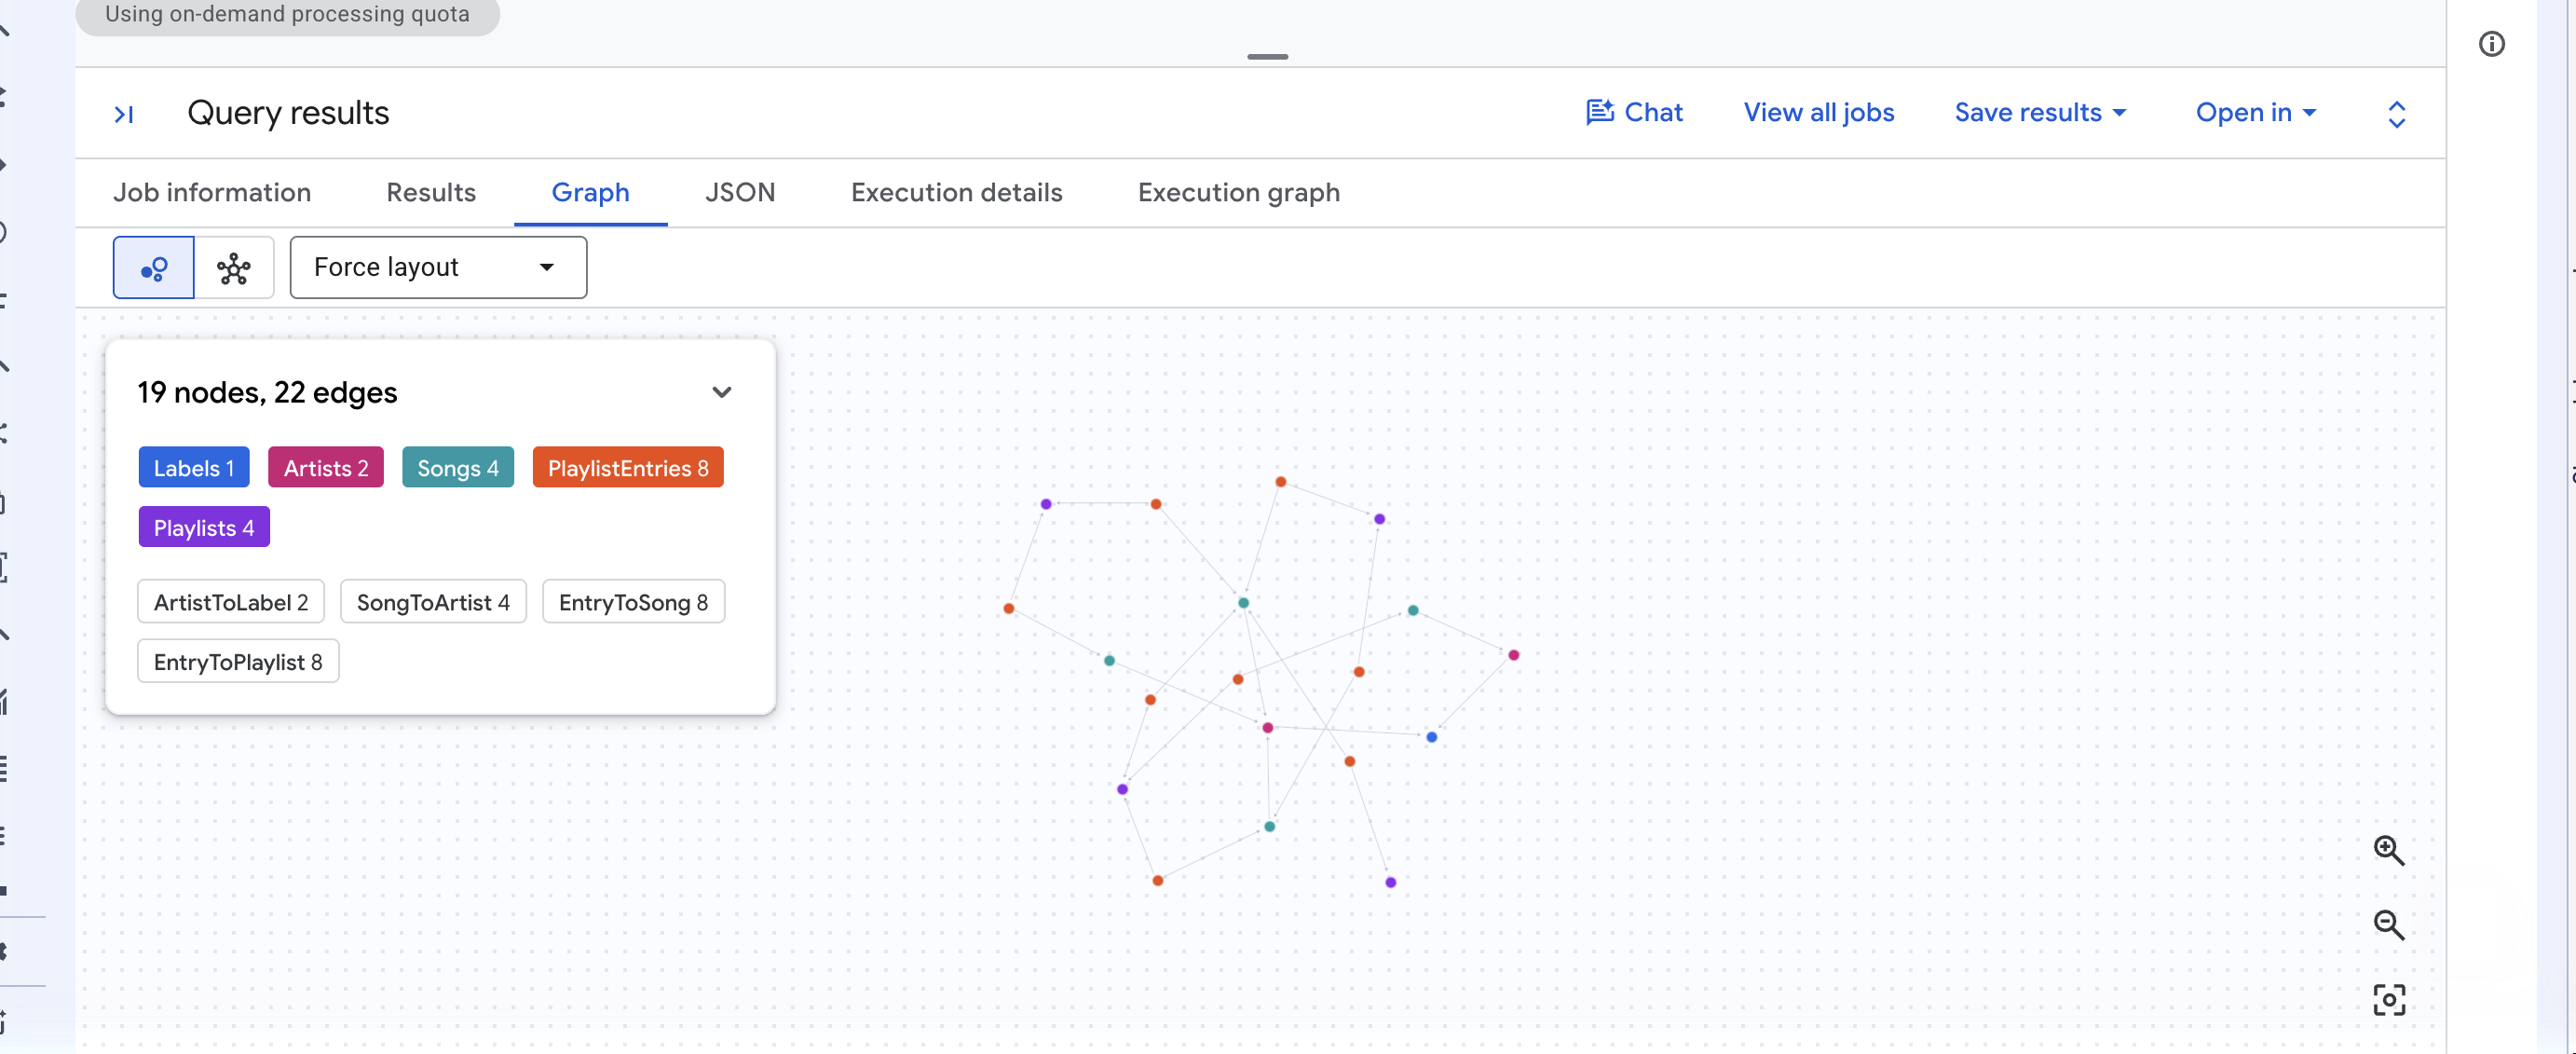
הפינה של Cymbal בגרף מוצגת כפריסת כוח, עם ספירה של הצמתים והקצוות בתצוגה וצ'יפ לכל תווית. גוררים צומת כדי להפריד את הפריסה, או לוחצים על צומת כדי לקרוא את המאפיינים שלו.
✅ נקודת ביקורת: הסכום של העמודה השלישית בשאילתה הראשונה הוא 12.6 מיליארד, השאילתה השנייה מחזירה 8 נתיבים, והם מוצגים בכרטיסייה 'תרשים'.
13. (אופציונלי) צ'אט עם הגרף
אין SQL בשלב הזה. סוכני נתונים של BigQuery יכולים להשתמש בתרשים כמקור הידע שלהם, ובמסמכי התיעוד מצוין שהם משתמשים במדדים לצורך צבירה רב-רמתית. בואו נבדוק אם זה נכון.
1. יצירת הסוכן
👈🌐 Console – בתפריט הניווט של BigQuery בצד ימין, לוחצים על Agents (סוכנים), ואז על Agent catalog (קטלוג סוכנים) ואז על Create agent (יצירת סוכן).
👉🌐 Console — type Music graph agent into Agent name, and this into Agent description:
Ask questions about labels, artists, songs and playlists in the music property graph.
👈🌐 Console – בקטע מקורות מידע, לוחצים על הוספת מקור. בתיבת הדו-שיח Select sources, מרחיבים את הפרויקט, מרחיבים את music, מרחיבים את Graphs, מסמנים את MusicGraph ולוחצים על Confirm.
👀 הלחצן הוספת מקור הופך לאפור. סוכן יכול להכיל לכל היותר תרשים אחד, ואי אפשר לערבב תרשימים עם טבלאות.
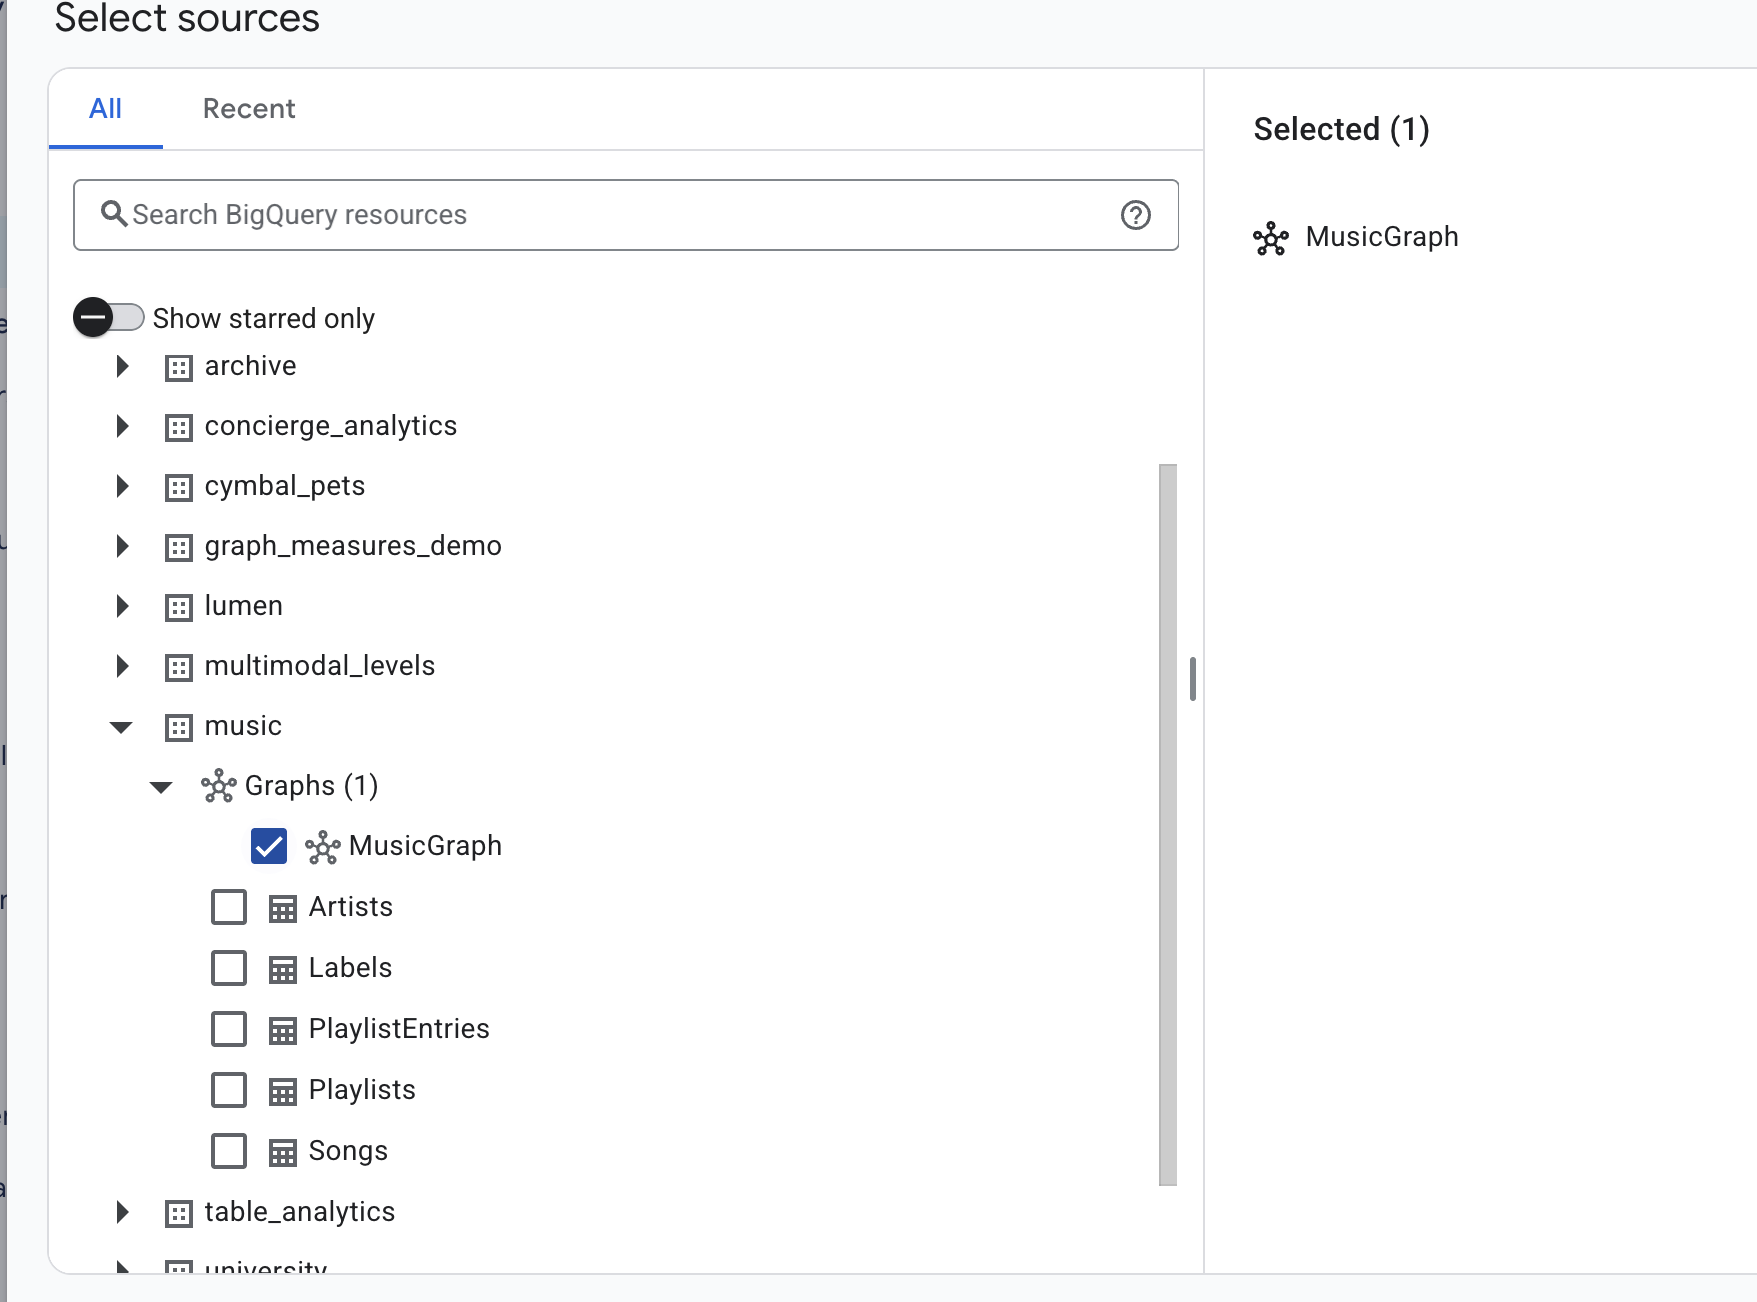
👈🌐 Console – לא משנים את Region (אזור) כפי שהוגדר ממיקום הגרף. לוחצים על שמירה ואז על פרסום. בחלונית ערוצי פרסום, לוחצים על פרסום הסוכן וסוגרים את האישור.
2. שואלים את השאלה
👈🌐 Console – לוחצים על Create conversation (יצירת שיחה). ייפתח דף צ'אט. מקלידים את הטקסט הבא בתיבה אפשר לשאול שאלה שבתחתית המסך ולוחצים על Enter:
For each label, show total streams and how many playlists their songs are on
👀 הסוכן מחזיר טבלה וסיכום במשפט אחד:
label_name | total_streams | playlist_placements |
Cymbal Records | 5,100,000,000 | 8 |
Northwind Audio | 4,500,000,000 | 2 |
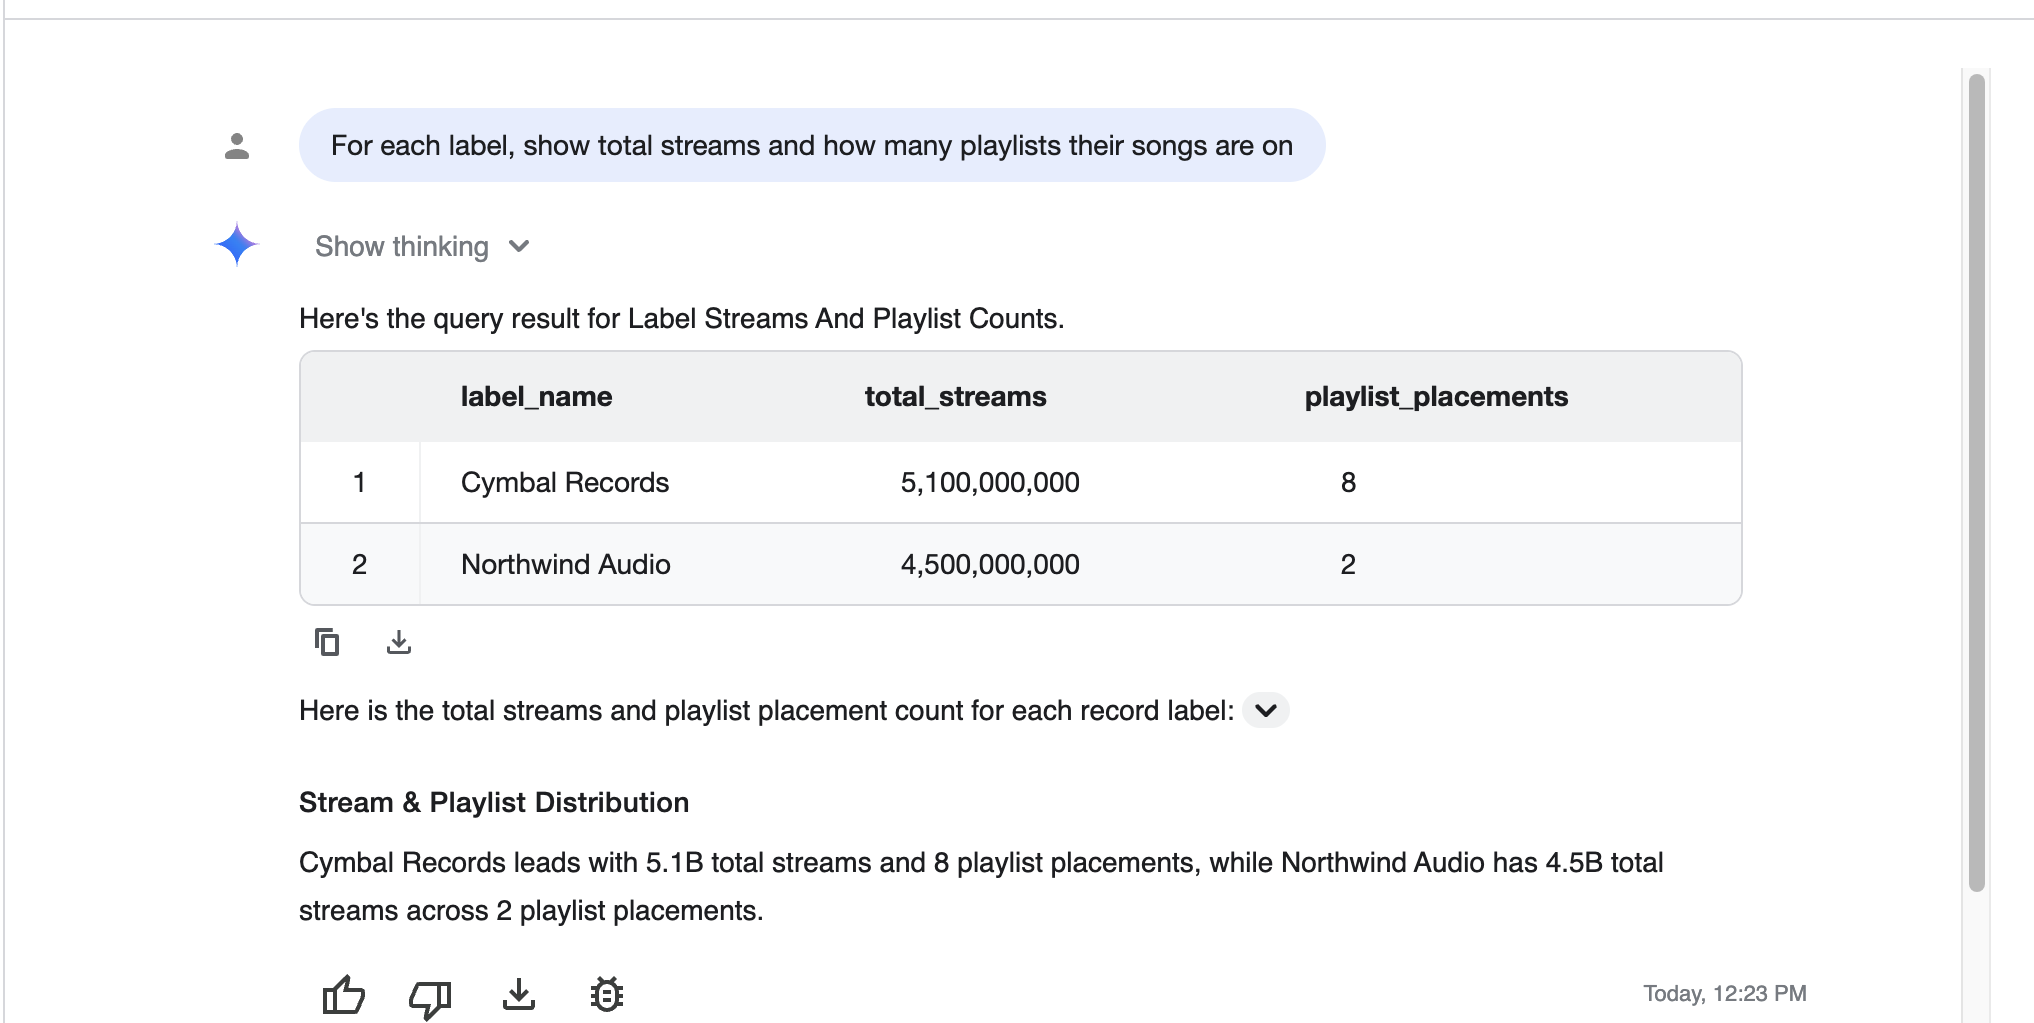
5.1 מיליארד. אף אחד לא אמר לסוכן על fan-out, והוא לא נכלל בו.
3. קריאת השאילתה שנכתבה
👈🌐 Console – בתפריט הניווט, לוחצים על Jobs explorer ואז על העבודה החדשה ביותר. התוויות שלו כוללות את ca-bq-job: true ואת data-agent-id עם המזהה של הסוכן, והשאילתה שלו היא:
SELECT
  Labels_label_name AS label_name,
  AGG(Songs_total_streams) AS total_streams,
  AGG(PlaylistEntries_placement_count) AS playlist_placements
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY label_name
ORDER BY total_streams DESC
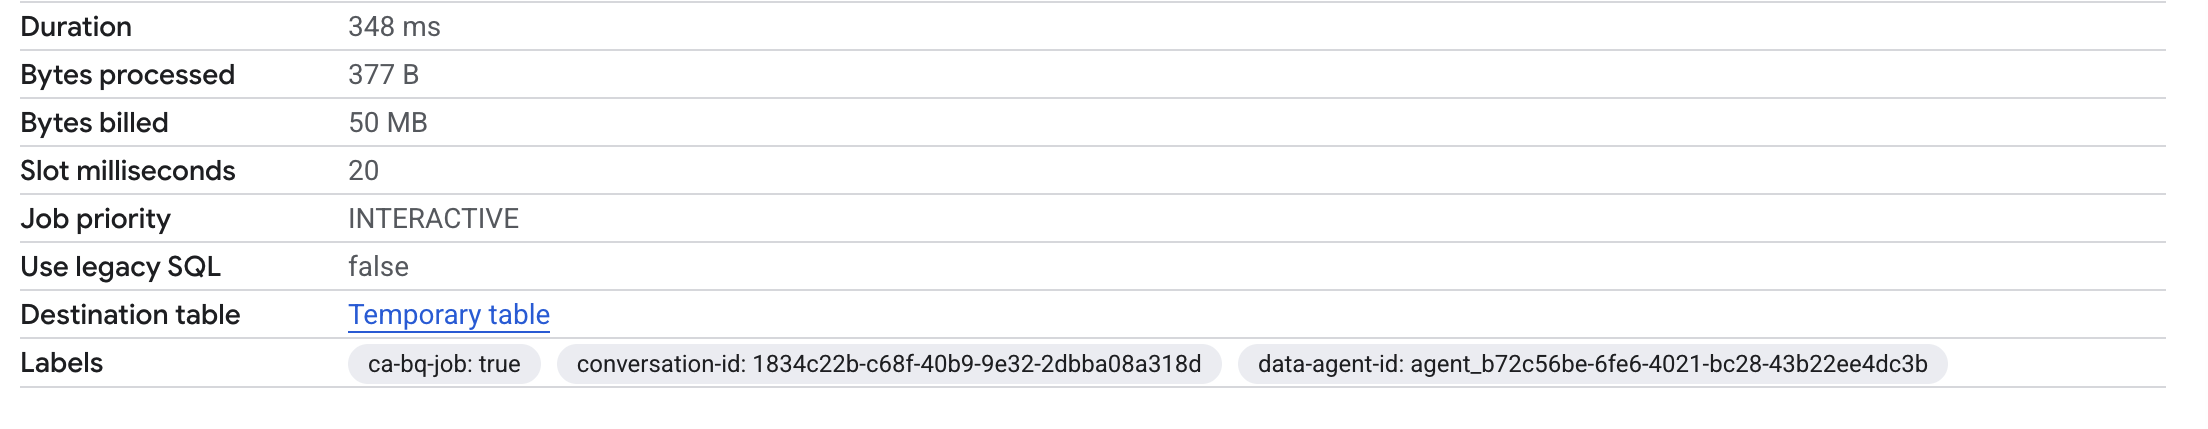
הוא השתמש ב-GRAPH_EXPAND וב-AGG לבד, כי המדדים היו בסכימה שהוא קרא. הם לא מוזכרים בשום מקום בתיאור של הסוכן.
✅ נקודת ביקורת: 5.1 מיליארד בתשובה בצ'אט, ו-AGG(...) ב-SQL של המשימה.
14. הסרת המשאבים
👉💻 Cloud Shell – מחיקת מערך הנתונים, הטבלאות וגרף המאפיינים:
cd ~/bq-graph-measures-lab
./cleanup.sh
👀 צפוי ✓ dropped YOUR_PROJECT_ID.music (tables and graph).
אם יצרתם סוכן נתונים אופציונלי, צריך למחוק אותו במסוף בקטע סוכנים → קטלוג הסוכנים. אם ./setup_project.sh יצרתם פרויקט רק בשביל ה-Lab הזה, הדרך הכי טובה לנקות את כל המשאבים היא להשבית את הפרויקט כולו – המזהה מופיע ב-~/project_id.txt.
15. מזל טוב
הצהרת על שורה אחת, MEASURE(SUM(streams)), והיא שינתה את הערך 12.6 מיליארד ל-5.1 מיליארד – בשבילך, ובשביל כל שאילתה שמישהו יכתוב בהמשך לגבי התרשים הזה, כולל שאילתות שסוכן יכתוב.
מה למדתם
- מדד הוא צבירה שמוצהרת בצומת, לצד הסמל
KEYשמגדיר את רמת הפירוט שלו. -
GRAPH_EXPANDמשטח את התרשים לטבלה רחבה אחת עםTableLabel_propertyעמודות. -
AGGהיא הפונקציה היחידה שקוראת מדד, ומערכת הסוגים אוכפת את זה בארבע דרכים שונות. - יש 6 ערכים מצטברים, והתוצאות של
AGGהן ערכים רגילים שאפשר לחלק. - שינוי ה-
GROUP BYישאל מחדש את השאלה בלי לשנות את המדד. GRAPH_EXPANDרוצה שיהיה שורש אחד, הרבה קצוות מסוג 'רבים לאחד' וצמתים שיועברו לצמתים.
טבלת ההחלטות
תיאור הבעיה | סיבה | תיקון |
סכום גדול מדי |
| להגדיר מדד, לקרוא אותו באמצעות |
"expected MEASURE, found INT64" |
| משתמשים ב- |
"Returning expressions of type MEASURE is not allowed" (אסור להחזיר ביטויים מסוג MEASURE) | עמודת מידה ללא | לגלוש אותו: |
"not exposed by element type" (לא נחשף לפי סוג הרכיב) | מדידה שאליה מתייחסים ב-GQL | מדידה של אירועים חיים רק מאחורי |
הפונקציה | צומת שמודל כקצה | קידום טבלת הצמתים לצומת |
מספר ישן אחרי שינוי התרשים | תוצאה שמורה במטמון | מבטלים את הסימון של Use cached results |
מה לא כיסינו (בכוונה)
תיאורים ומילים נרדפות במאפיינים · שאילתות מאומתות ומילוני מונחים לסוכני נתונים · GQL מעבר ל-MATCH · מדדים ביותר מתרשים אחד. כל אחד הוא שיעור Lab בפני עצמו.
מידע נוסף
- עבודה עם מדדים
- יצירה של גרף נכסים והרצת שאילתות עליו
- סקירה כללית של ניתוח נתוני השיחות
- מאגר ה-Lab – כל שאילתה ב-Codelab הזה, ממוספרת לפי שלב