

1. Panoramica
La maggior parte dei bug SQL che superano la revisione del codice sono bug di aggregazione. Un numero è corretto nella tabella in cui si trova, un join lo copia e il totale è errato.
BigQuery Graph ti consente di descrivere come si collegano le tabelle una sola volta, come un grafico delle proprietà, e poi di eseguire query sulle connessioni. Misure del grafico aggiungi un altro elemento alla descrizione: l'aggregazione stessa. Dichiari MEASURE(SUM(streams)) sul nodo proprietario del numero e ogni query che legge il grafico ottiene il totale corretto con la granularità giusta, senza trucchi GROUP BY e senza CTE che qualcuno deve ricordare.
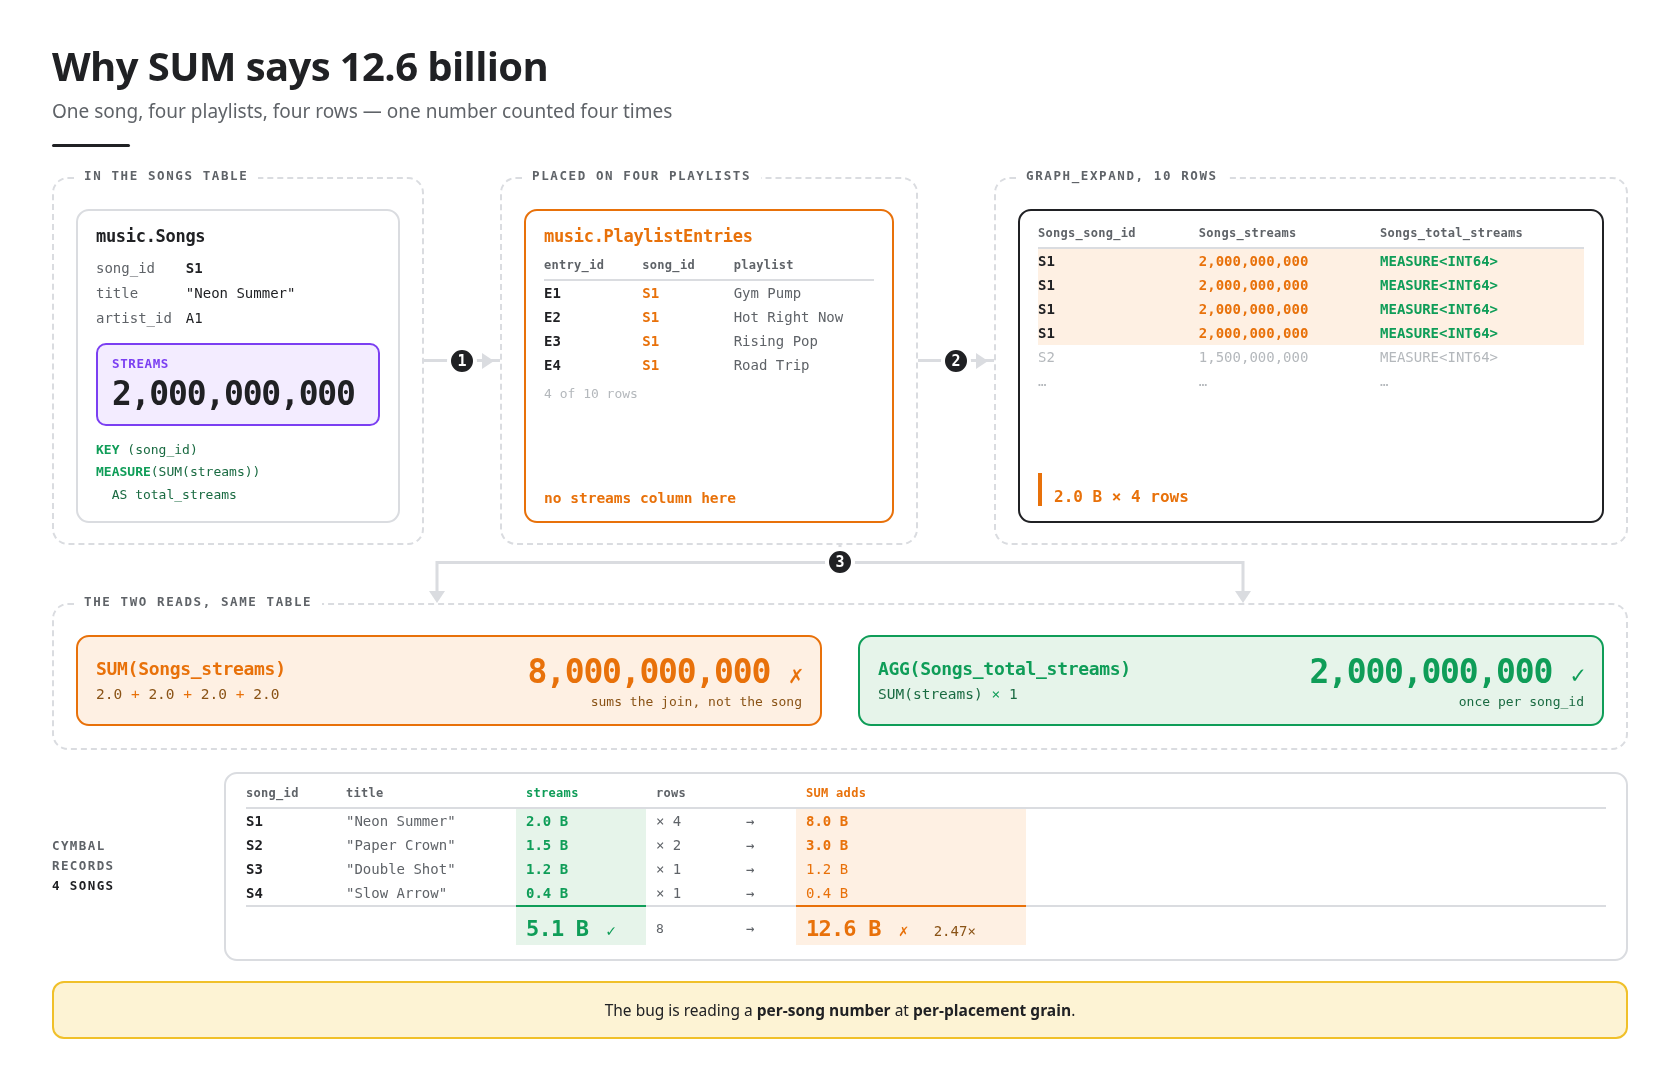
In questo codelab crei un catalogo musicale di cinque tabelle, inserisci una misura e vedi la stessa domanda restituire due risposte diverse: 12, 6 miliardi con SUM e 5, 1 miliardi con AGG. Il divario è la forma del catalogo: un brano presente in quattro playlist diventa quattro righe una volta appiattito il grafico e SUM le aggiunge tutte e quattro. Poi impari le regole che rendono corretta la seconda.
Dove digiterai
Questo lab utilizza esattamente due luoghi, in questo ordine:
dove | cosa fai lì | |
1 | Terminale Cloud Shell | una manciata di comandi, solo nel passaggio Configurazione |
2 | Console BigQuery | Tutto il resto: incollare query nell'editor di query, fare clic nel modellatore di grafici, chattare con un agente |
Ogni istruzione è taggata, così sai sempre a quale si riferisce:
- 👉💻 Cloud Shell: digita questo comando nel terminale Cloud Shell.
- 👉📋 Editor di query: incolla questo codice nell'editor di query BigQuery e fai clic su Esegui.
- 👉🌐 Console: esplora la console BigQuery. Non devi digitare nulla, a meno che non sia indicato nel passaggio.
- 👀: guarda il risultato.
Obiettivi didattici
- Come dichiarare una misura in una tabella dei nodi: nello strumento di creazione di grafici visivi o in SQL
- Come
GRAPH_EXPANDappiattisce un grafico in un'unica tabella ampia - Perché
AGGè l'unica funzione che può leggere una misura e cosa dice ogni altro tentativo - I sei aggregati supportati da una misura e come eseguire operazioni aritmetiche tra loro
- Come una misura risponde a una domanda raggruppata in modo diverso senza modifiche
- (Facoltativo) In che modo GQL e la scheda Grafico rispondono a una domanda a cui un totale non può rispondere e in che modo un agente dati BigQuery utilizza le misure senza che gli vengano comunicate
Che cosa ti serve
- Un Account Google con fatturazione disponibile e un browser. Non hai bisogno di un progetto Google Cloud in anticipo: la configurazione ne crea uno per te.
- Solo per il passaggio facoltativo della chat: l'API Gemini Data Analytics abilitata e il ruolo Gemini Data Analytics Data Agent Creator.
Non devi installare nulla sul tuo computer. Tutto viene eseguito in Cloud Shell e nella console BigQuery.
Stato e costo del prodotto
BigQuery Graph è in disponibilità generale. Le misure del grafico, il modellatore visivo del grafico, la visualizzazione del grafico e l'utilizzo di un grafico come origine di conoscenza dell'agente di dati sono in anteprima e sono coperti dai Termini dell'offerta pre-GA.
GRAPH_EXPAND e AGG vengono eseguiti con prezzi on demand. Le query GQL (il passaggio del percorso facoltativo) richiedono una prenotazione che utilizzi la versione Enterprise o Enterprise Plus, come indicato nella documentazione, motivo per cui questo passaggio è facoltativo.
Il set di dati è di pochi kilobyte. Con i prezzi on demand, ogni query viene fatturata al minimo di 10 MB, quindi l'intero codelab costa una frazione di centesimo.
2. Configurazione
Questo è l'unico passaggio che utilizza Cloud Shell. Crea un progetto, vi addebita la fatturazione e crea le tabelle non elaborate. Il grafico, la misura e ogni query possono essere eseguiti in un secondo momento nella console BigQuery.
C'è una cosa che questo lab non può fornirti: un progetto cloud Google con la fatturazione abilitata. Il passaggio 1 ti consente di creare un account che può pagare il progetto, mentre il passaggio 4 trasforma l'account in un progetto. Eseguili in questo ordine: ogni passaggio dopo il 4 legge il progetto creato dal passaggio 4.
1. Ottieni un account con fatturazione (~1 minuto)
👉🌐 Esegui questa operazione prima di qualsiasi altra. Accedi con un Account Google con la fatturazione abilitata. Qualsiasi account di questo tipo va bene. Se il tuo non lo è, inizia una prova senza costi, che ti offre un account di fatturazione, ovvero tutto ciò che serve per il passaggio 4.
2. Apri Cloud Shell (~1 minuto)
👉🌐 Console: fai clic su Attiva Cloud Shell nella parte superiore della console Google Cloud. Si tratta dell'icona a forma di terminale nell'intestazione. Si apre un terminale nella parte inferiore della pagina.
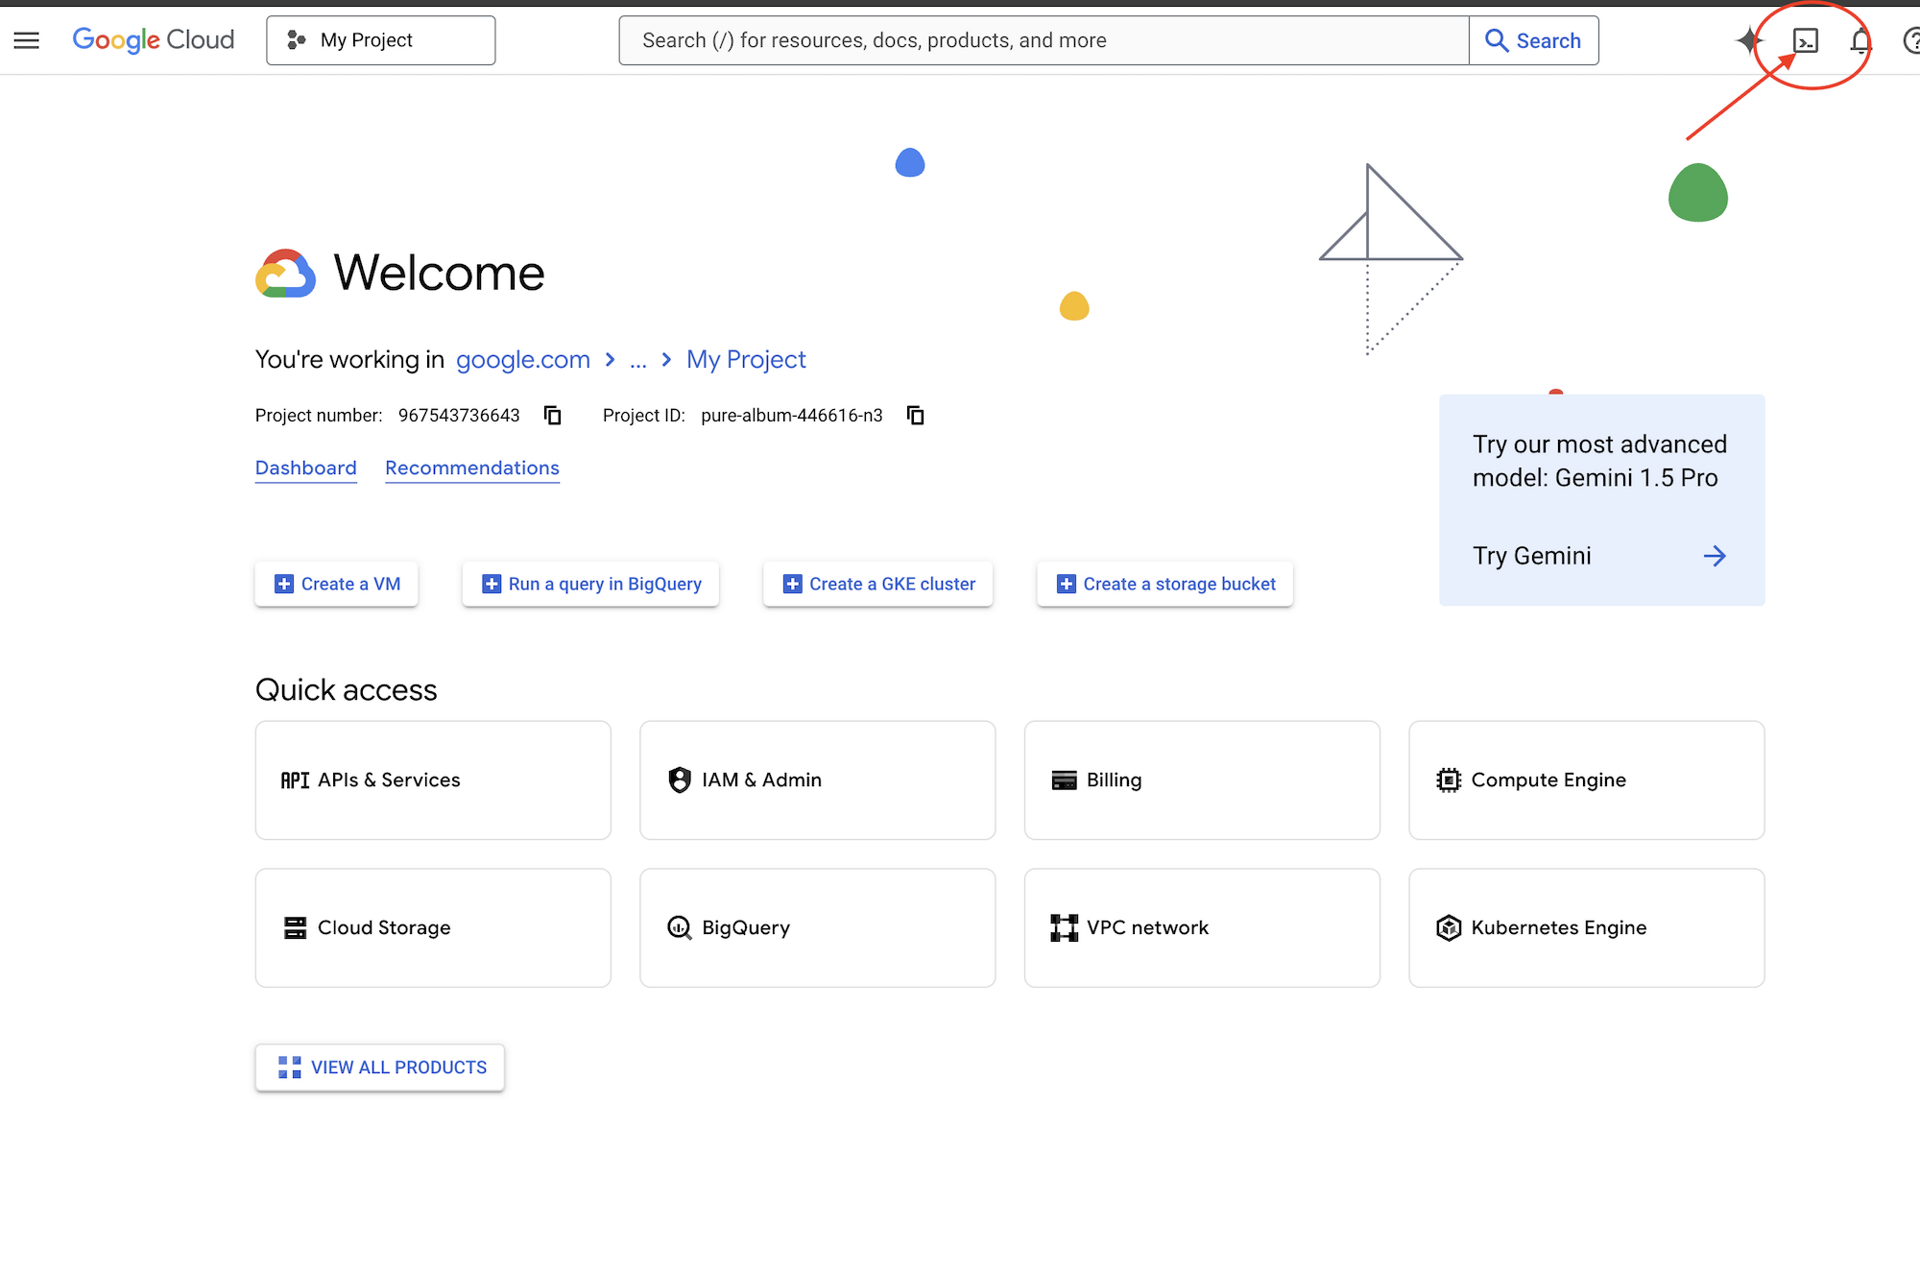
👉🌐 Console: se ti viene chiesto di autorizzare in qualsiasi momento della giornata, fai clic su Autorizza per continuare.
👉💻 Cloud Shell: controlla con quale account è stato eseguito l'accesso a Cloud Shell:
gcloud auth list
👀 Aspettati che il tuo account sia contrassegnato con un * e che sia lo stesso con cui hai eseguito l'accesso nel passaggio 1. In caso contrario, esegui gcloud auth login e scegli quello giusto.
3. Ottieni il lab (~1 min)
👉💻 Cloud Shell: clona il repository:
cd ~
rm -rf ~/bq-graph-measures-lab
git clone https://github.com/cuppibla/bq-graph-measures-lab.git
cd ~/bq-graph-measures-lab
4. Crea il tuo progetto (~2 minuti)
👉💻 Cloud Shell: uno script trova il tuo account di fatturazione, crea un progetto e indirizza Cloud Shell a quel progetto:
cd ~/bq-graph-measures-lab
./setup_project.sh
👀 Aspettati un ✓ per l'account di fatturazione scelto, un ✓ per il progetto creato e una chiusura come:
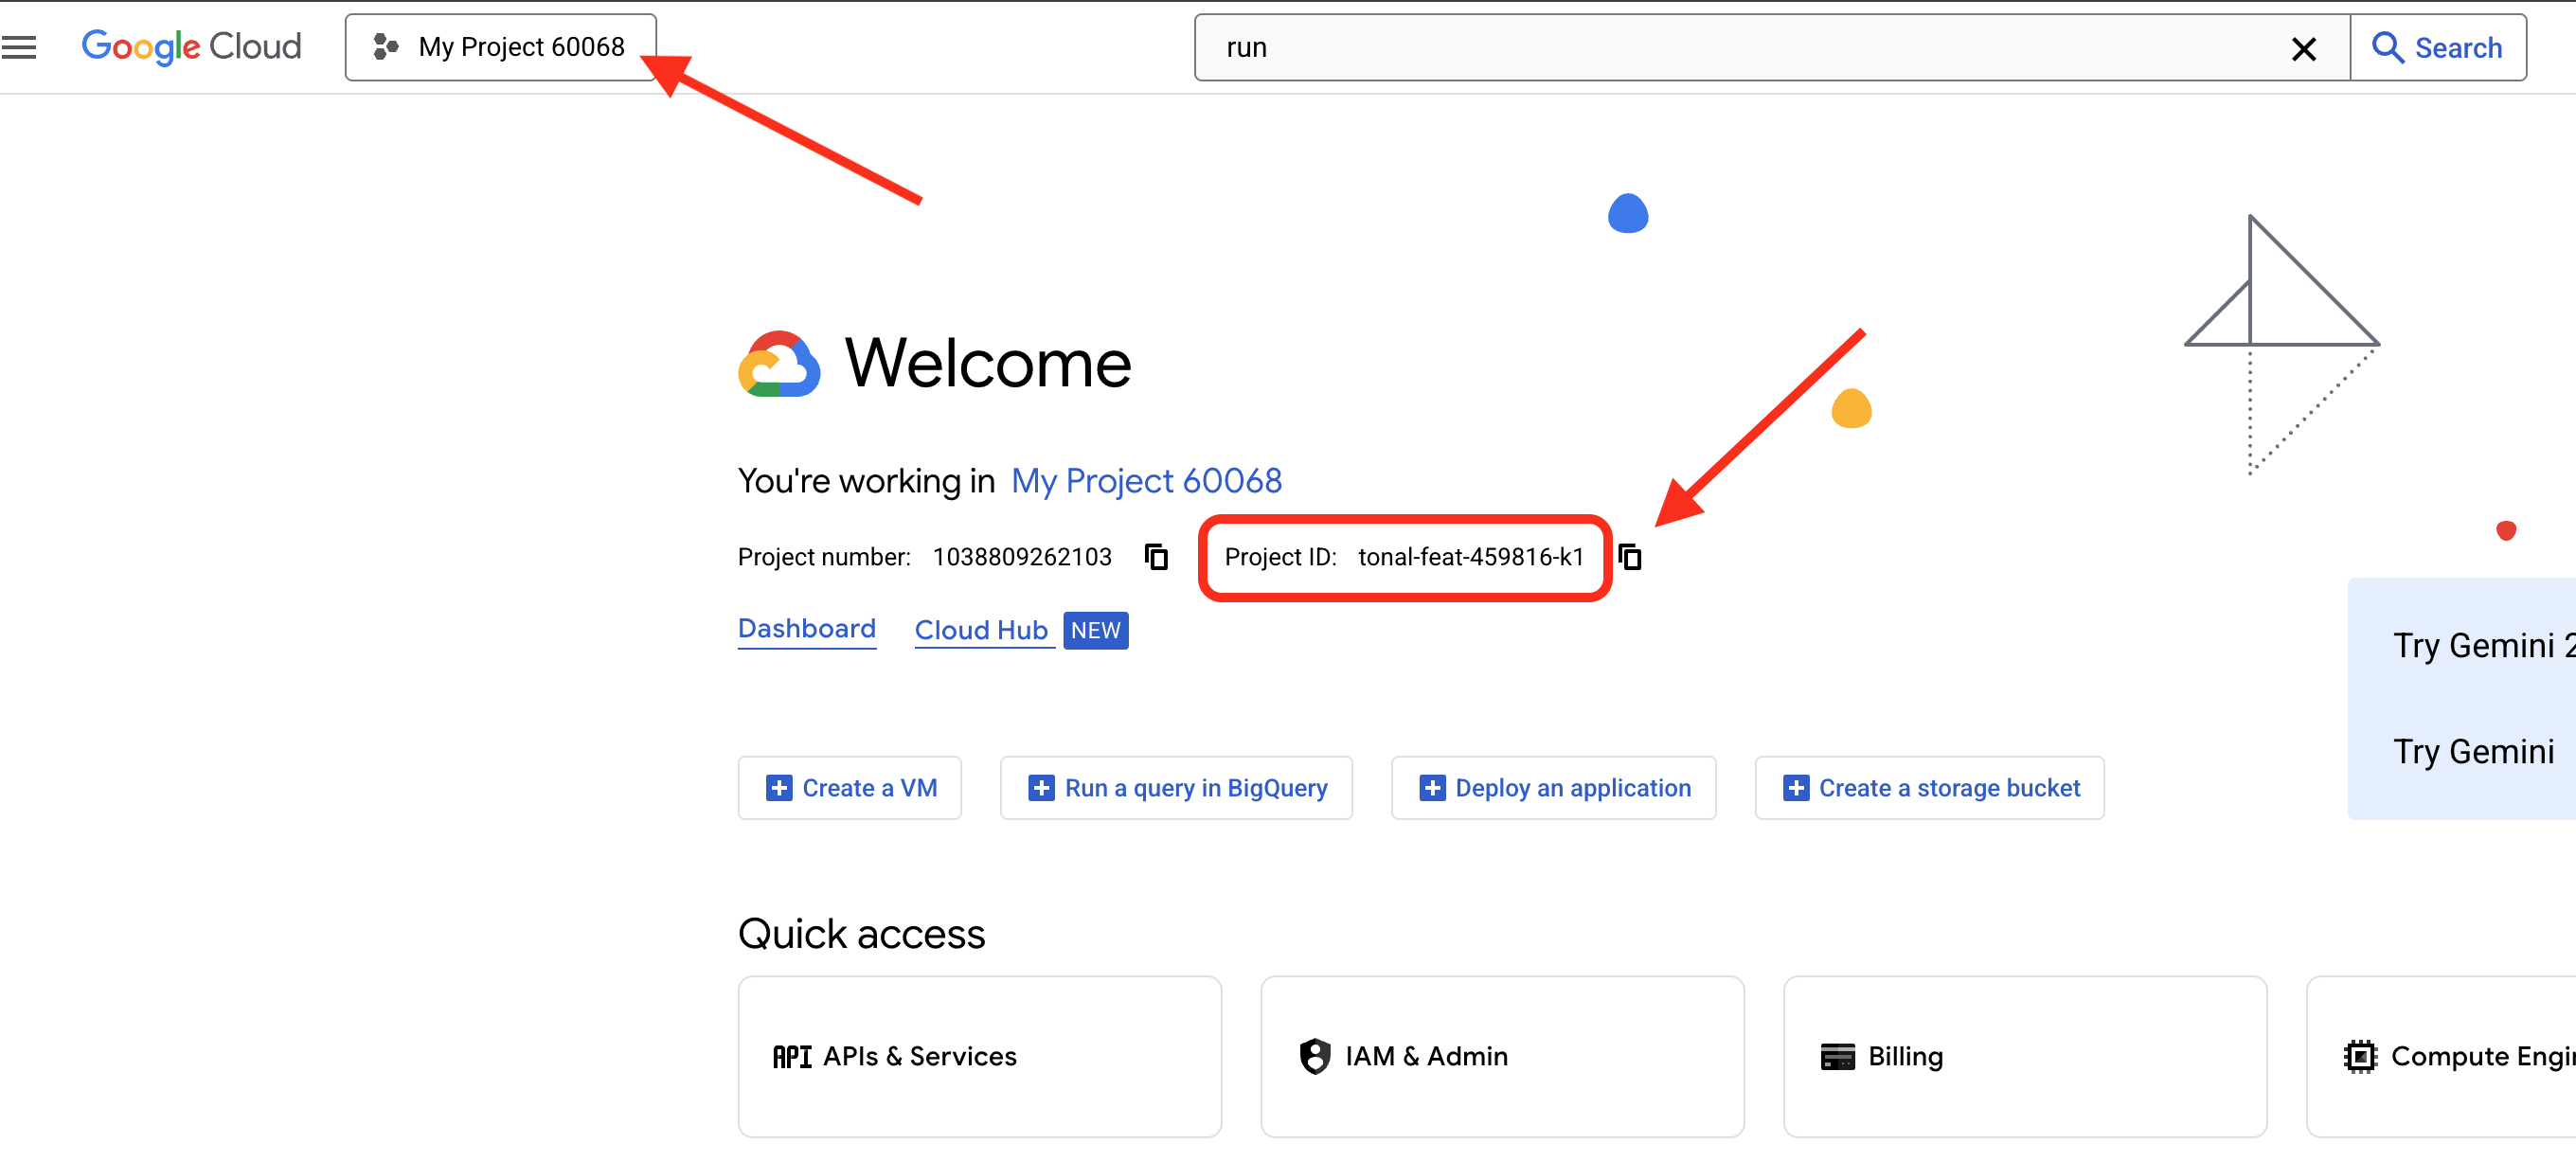
Project ready: bq-graph-4271
  Next:  ./setup.sh
bq-graph-4271 è l'ID progetto, che avrà cifre diverse. All'interno succedono quattro cose:
fatturazione | prende l'account | |
project | crea | |
seleziona | scrive l'ID in | |
waits | esegue il polling fino a quando il nuovo progetto non è effettivamente autorizzato a pubblicare annunci, per un massimo di due minuti | |
🌐 Lo stesso progetto è ora nella console: il suo ID si trova nella scheda Informazioni sul progetto della dashboard:
5. Crea il set di dati (~3 min)
👉💻 Cloud Shell: un altro script crea le tabelle:
cd ~/bq-graph-measures-lab
./setup.sh
Lo script stampa ogni passaggio durante l'esecuzione. Cosa fa, in ordine:
project | legge il progetto da | |
API | consente di | |
dataset | crea il set di dati | |
assegno | conta le righe di ogni tabella e si interrompe se un conteggio non corrisponde | |
👀 Cosa aspettarsi:
BigQuery Graph Measures · setup
  ✓ project: bq-graph-4271
  ✓ BigQuery API enabled

Creating dataset music (US) and five tables...
  ✓ music.Labels              2 rows
  ✓ music.Artists             3 rows
  ✓ music.Songs               5 rows
  ✓ music.Playlists           4 rows
  ✓ music.PlaylistEntries    10 rows

🎉 ready — open BigQuery Studio: https://console.cloud.google.com/bigquery?project=bq-graph-4271
Hai finito di utilizzare Cloud Shell. Puoi chiuderla.
6. Apri BigQuery e un editor di query
👉🌐 Console: fai clic sul link alla fine dell'output o apri BigQuery dal menu di navigazione. Nel riquadro Explorer a sinistra, espandi il progetto: un set di dati music con cinque tabelle.
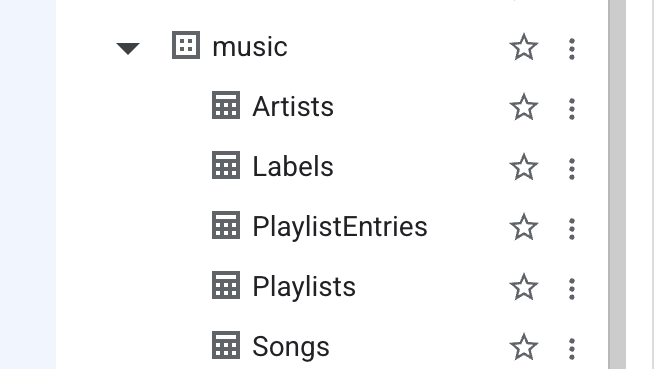
👉🌐 Console: nella parte superiore di BigQuery Studio, nella riga Crea nuovo, fai clic su Query SQL. Si apre una scheda dell'editor vuota.
Mantieni questa scheda. Ogni blocco 👉📋 di questo lab va inserito qui: seleziona tutto ciò che è presente nell'editor, incolla il nuovo blocco, quindi fai clic su Esegui. Il risultato viene visualizzato nel riquadro sottostante.
Scopri le tabelle
Due aspetti di queste tabelle saranno importanti in seguito. Ogni tabella dichiara la propria chiave primaria come NOT ENFORCED: BigQuery non la controlla, ma il grafico delle proprietà che stai per creare ha bisogno di una chiave esplicita per sapere cosa identifica una riga. L'ultima tabella, PlaylistEntries, è una tabella di unione: un brano presente in quattro playlist ha quattro righe. In questa tabella si svolge l'intera storia.
Le tabelle sono collegate in questo modo: un'etichetta mette sotto contratto degli artisti, un artista pubblica dei brani e un brano viene inserito nelle playlist tramite PlaylistEntries. Cymbal Records possiede Ava Sterling e Mina Okafor e, tramite loro, quattro canzoni. Northwind Audio possiede Kai Nakamura e una canzone, Midnight Drive.
tavolo | righe | chiave | cosa contiene |
Etichette | 2 |
| nome, budget di marketing |
Artisti | 3 |
| nome, quale etichetta |
Brani | 5 |
| titolo, artista, stream |
Playlist | 4 |
| name, followers |
PlaylistEntries | 10 |
| quale brano si trova in quale playlist |
✅ Checkpoint: 🎉 ready in Cloud Shell, cinque tabelle in music in Explorer e una scheda dell'editor di query vuota aperta.
3. Crea il grafico - Opzione A: il modello visivo
Un grafico delle proprietà è una descrizione di come sono collegate le tabelle. Puoi fare clic insieme nel modellatore di grafici visivi (questo passaggio, tutti i clic) o scriverlo come SQL (il passaggio successivo, un incolla). Entrambi producono lo stesso oggetto. Esegui una delle due operazioni, non entrambe.
1. Crea la struttura del grafico
👉🌐 Console: in BigQuery Studio, nella riga Crea nuovo, apri il menu AI e conoscenza e fai clic su Grafico.
👉🌐 Console: inserisci MusicGraph come Nome grafico e music come Destinazione del grafico nel set di dati. La regione viene compilata dal set di dati (Stati Uniti).
👉🌐 Console: in Origini dati, seleziona le cinque tabelle (Artisti, Etichette, Voci playlist, Playlist, Brani) e fai clic su Crea.
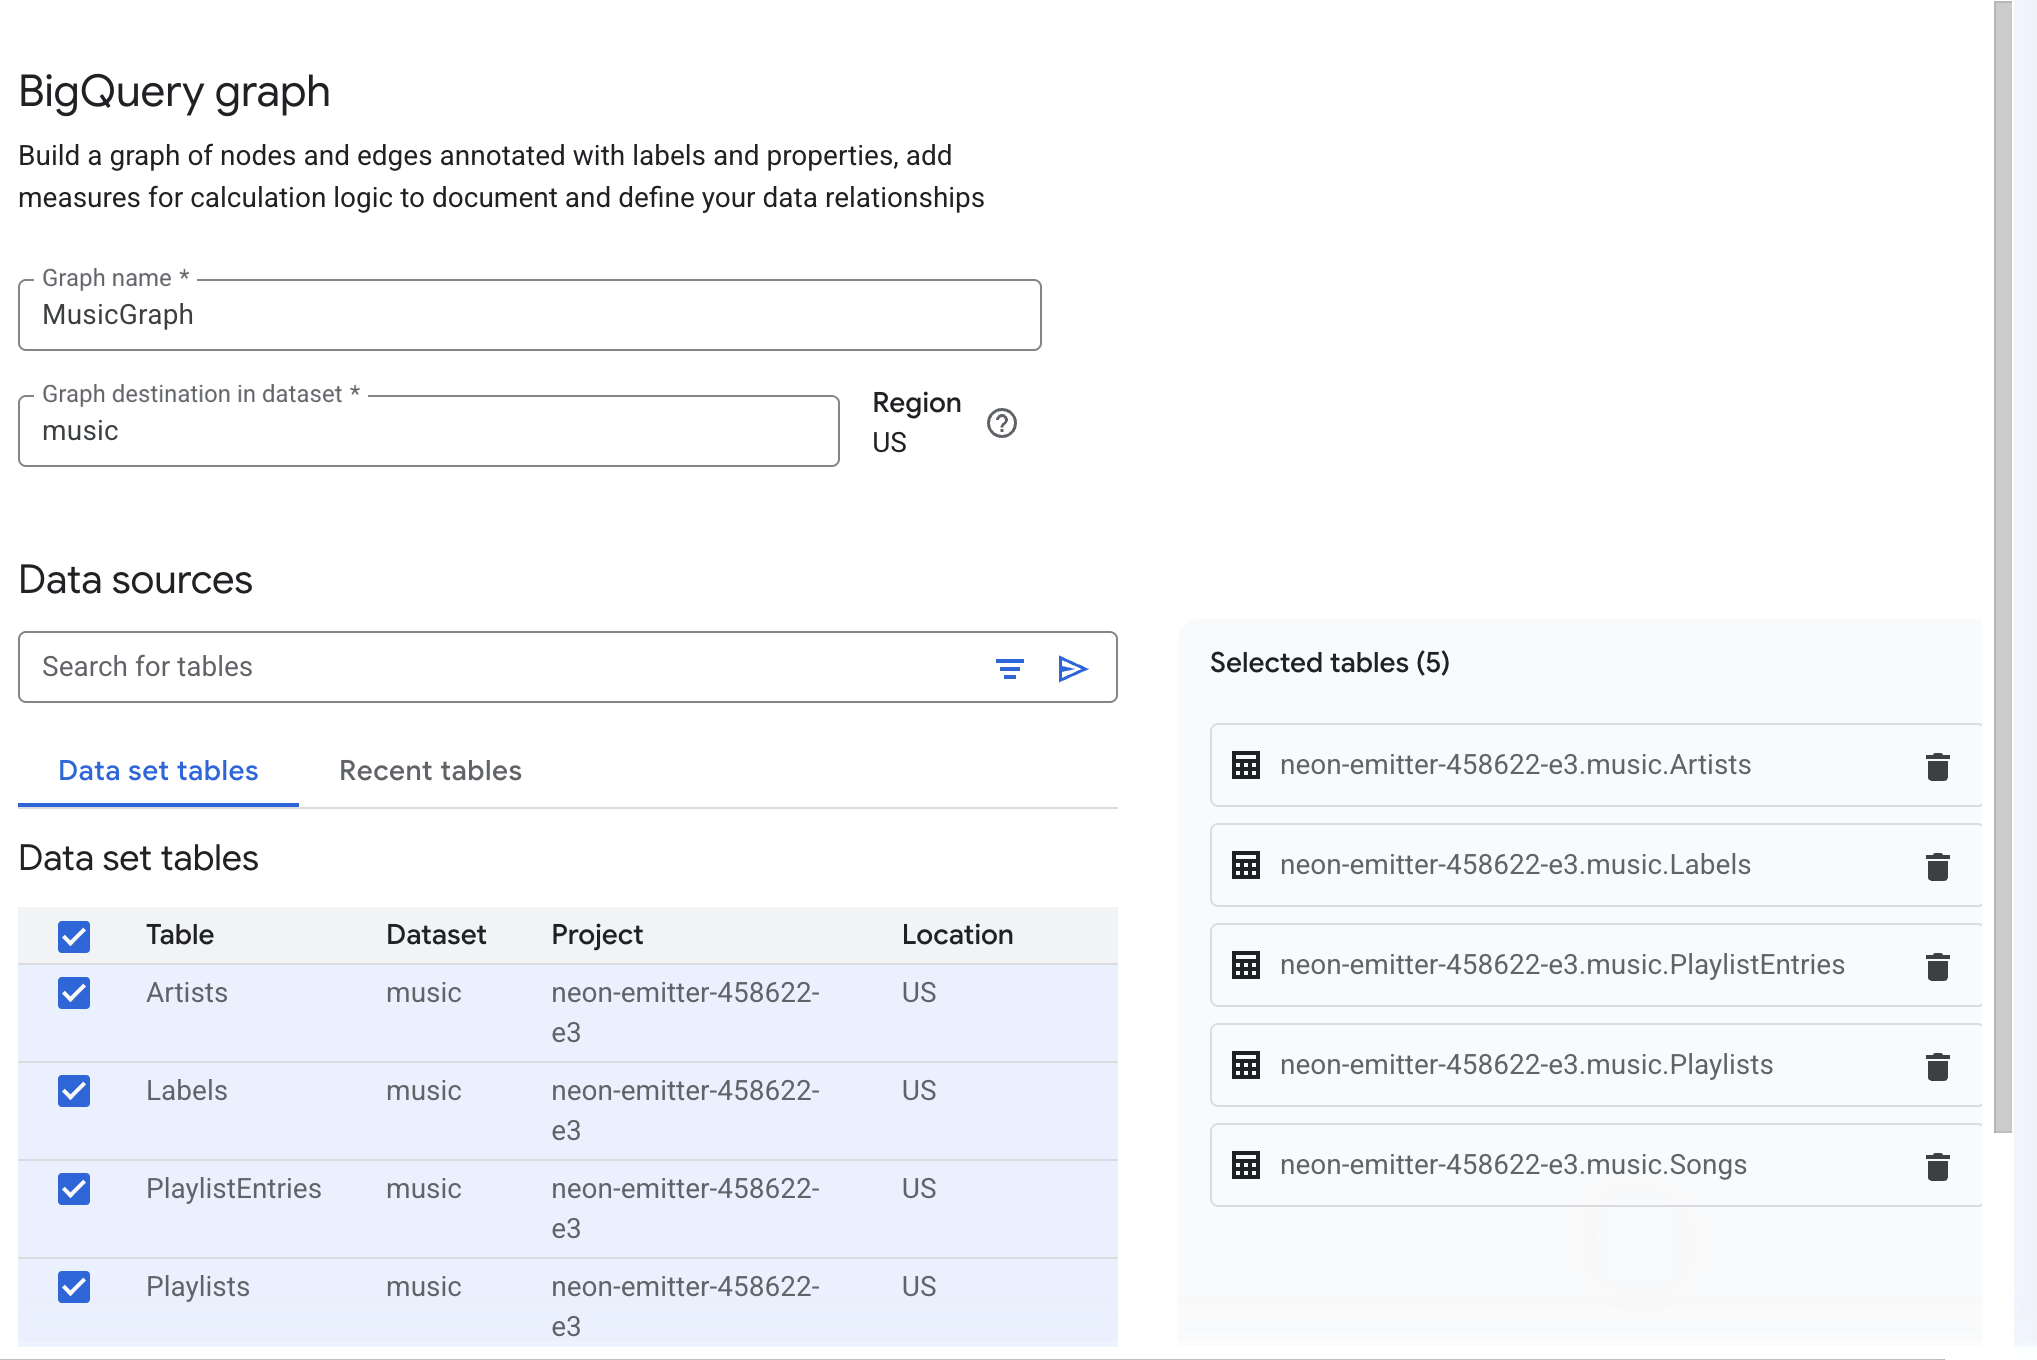
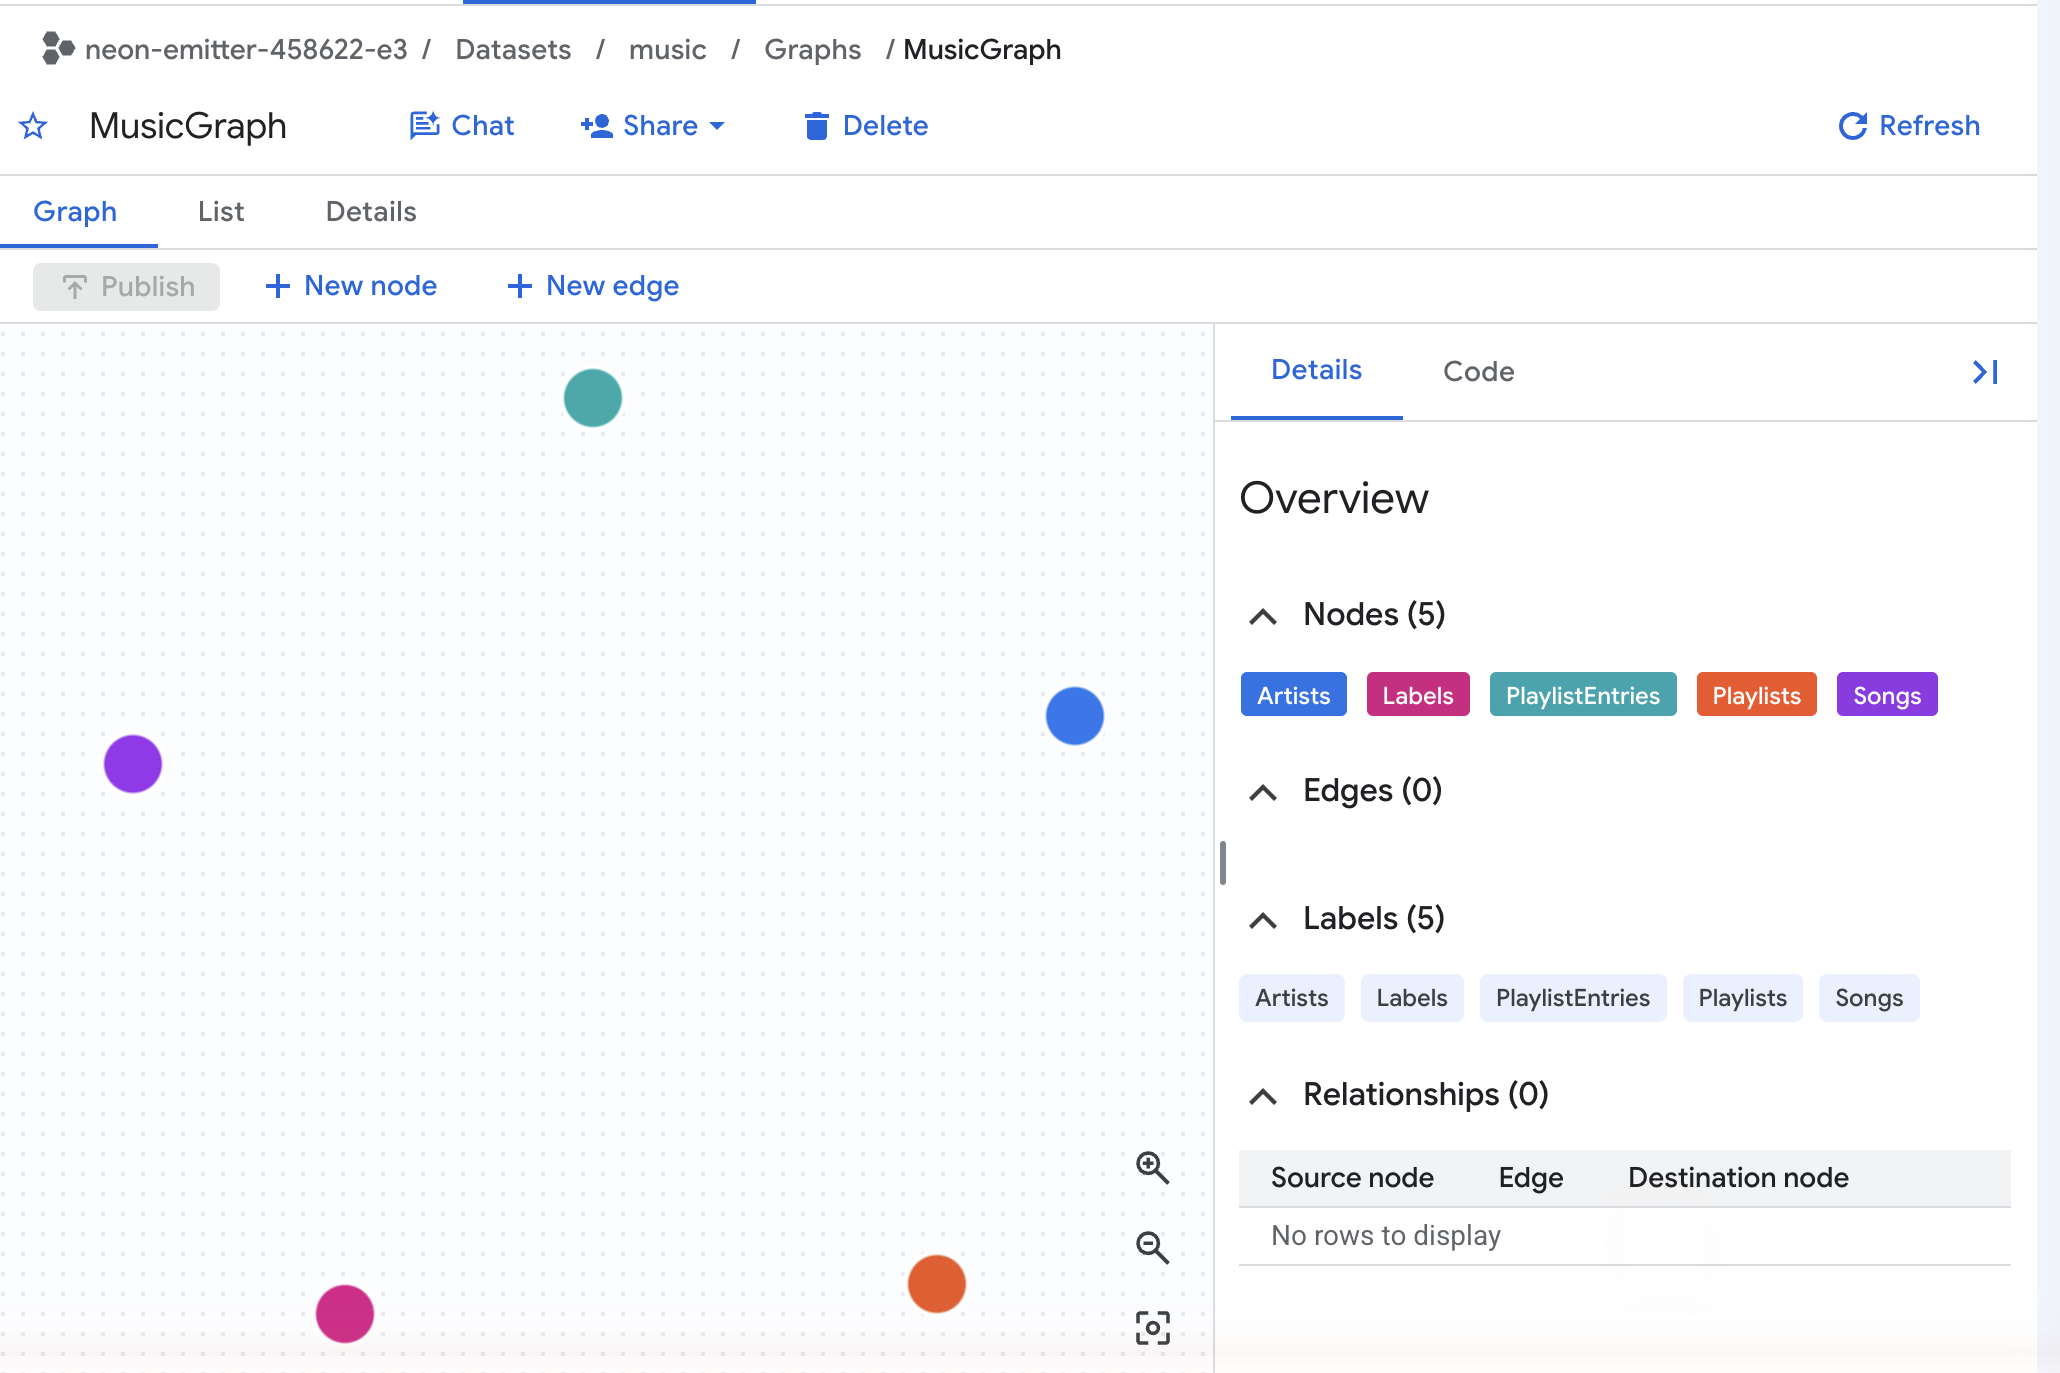
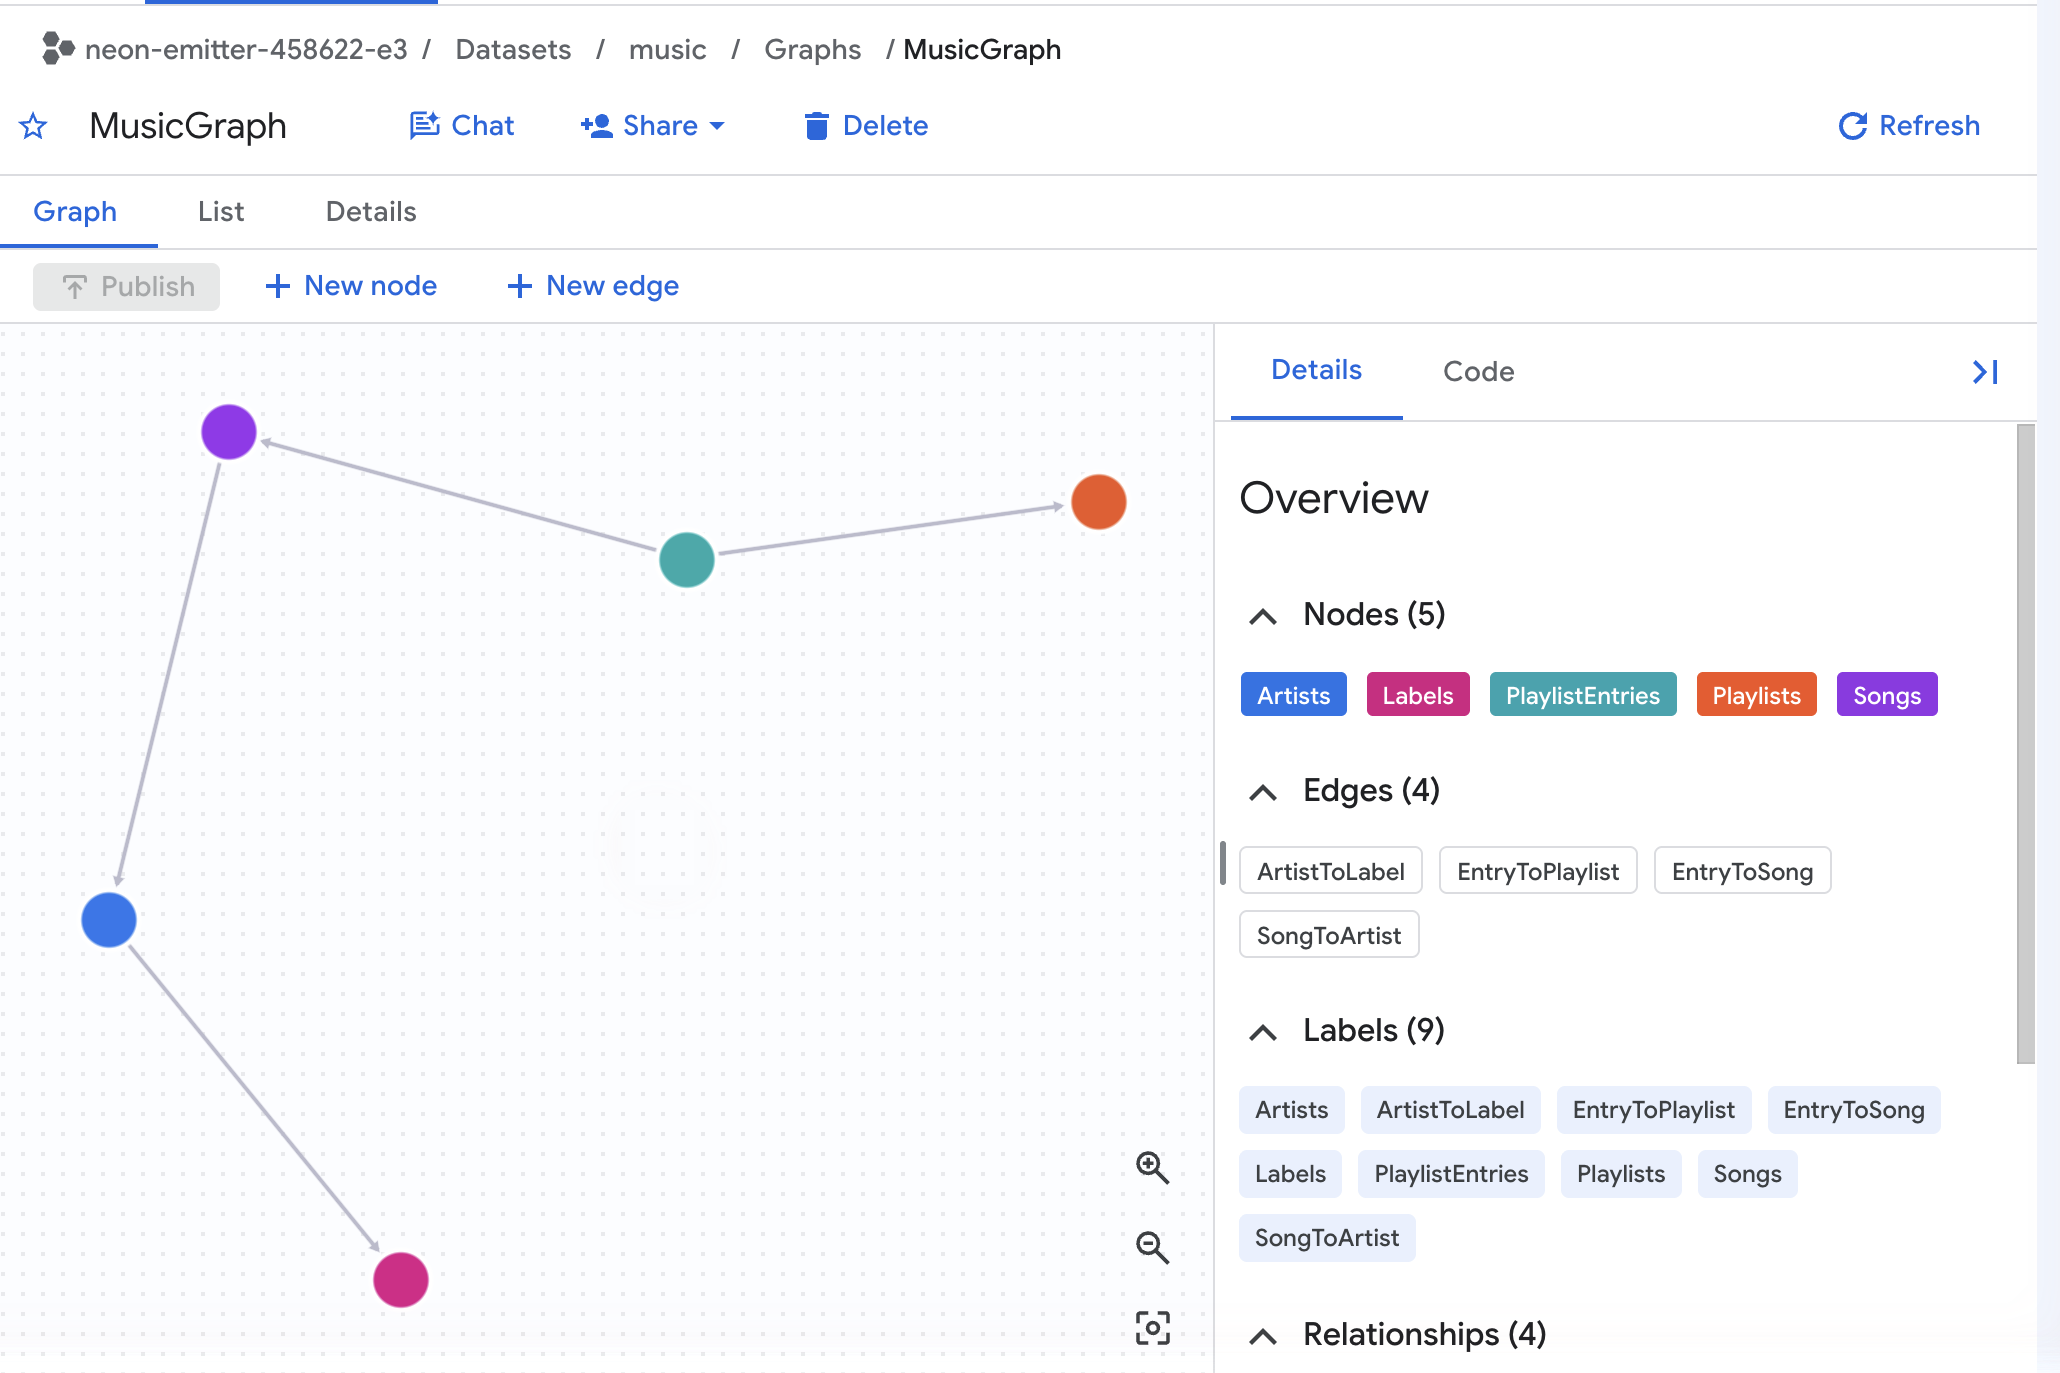
👀 La tela si apre con cinque nodi colorati e nessuna linea tra loro. Il riquadro Dettagli a destra elenca Nodi (5) e Archi (0). Ogni nodo contiene già la chiave primaria della tabella e tutte le relative colonne come proprietà. Fai clic su un nodo per visualizzarle.
2. Disegna i quattro lati
Un bordo è una chiave esterna disegnata. Ognuna va dalla tabella che contiene la chiave alla tabella a cui punta.
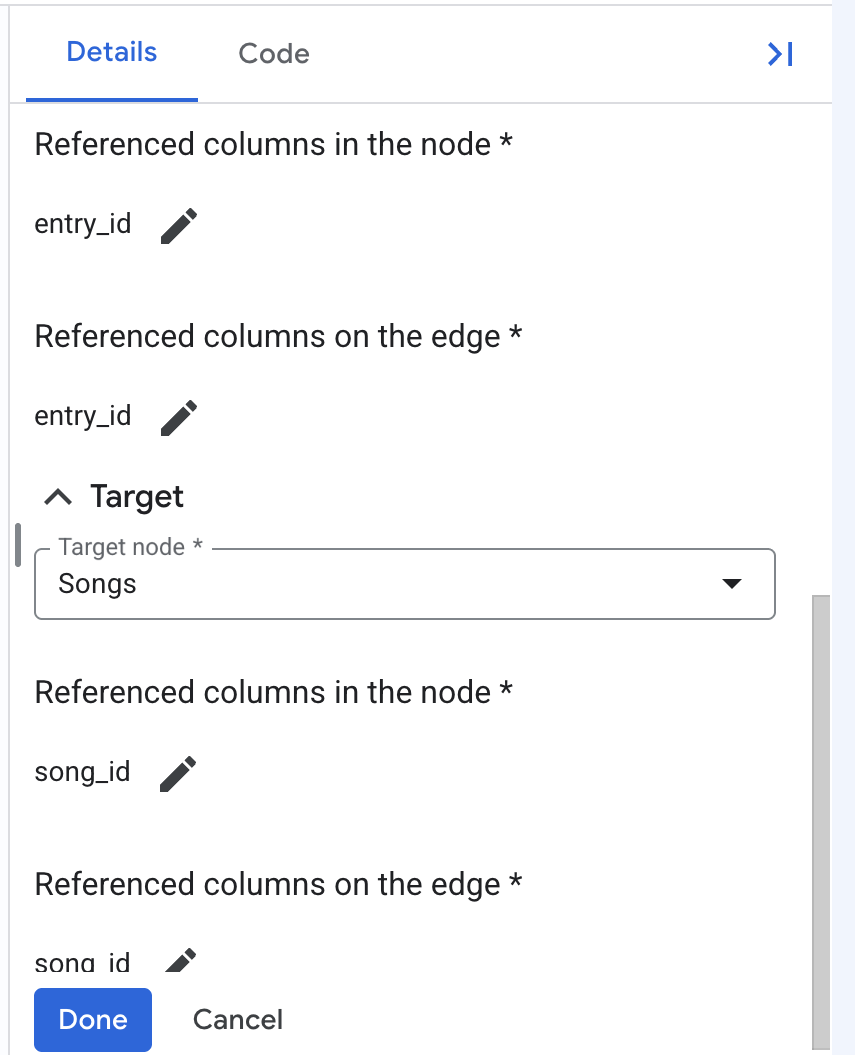
👉🌐 Console: fai clic su Nuovo bordo. Nella finestra di dialogo Seleziona tabella, scegli PlaylistEntries e fai clic su Aggiungi. Nel riquadro Aggiungi bordo:
- Imposta Nome su
EntryToSong. - Fai clic su Aggiungi chiave primaria e accetta
entry_id. - In Origine, imposta Nodo di origine su PlaylistEntries, poi utilizza Aggiungi colonne a cui viene fatto riferimento al nodo e Aggiungi colonne a cui viene fatto riferimento all'arco per selezionare
entry_idper entrambi. - In Target, imposta Nodo target su Brani, quindi scegli
song_idsia per Colonne a cui viene fatto riferimento nel nodo sia per Colonne a cui viene fatto riferimento sul bordo. - Fai clic su Fine.
👉🌐 Console: ripeti altre tre volte:
nome edge | tavolo | nodo di origine → nodo di destinazione | la colonna da selezionare su entrambi i lati |
| PlaylistEntries | PlaylistEntries → Playlists | origine |
| Brani | Brani → Artisti | origine |
| Artisti | Artisti → Etichette | origine |
Lascia ogni bordo senza proprietà aggiuntive.
👀 Il riquadro Dettagli ora mostra Spigoli (4) e il canvas mostra la catena: Etichette ← Artisti ← Brani ← Voci playlist → Playlist.
3. Aggiungere la misura
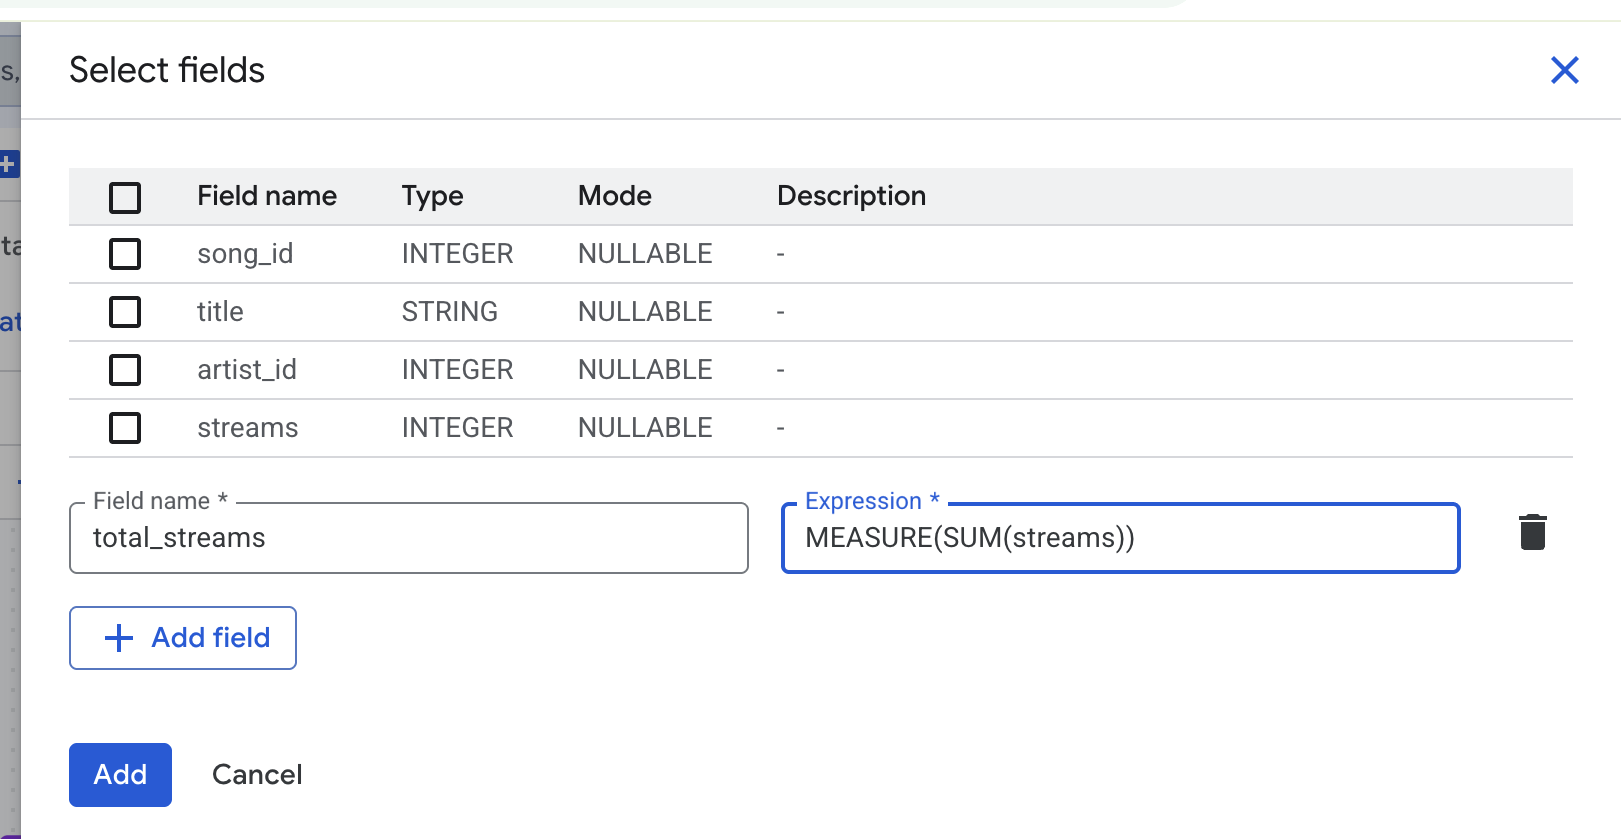
👉🌐 Console: fai clic sul nodo Brani, poi sull'icona Modifica (a forma di matita) nella parte superiore del riquadro Dettagli. In Proprietà dell'etichetta, fai clic su Aggiungi proprietà, poi su Aggiungi campo.
👉🌐 Console: inserisci total_streams come Nome campo e digita questo valore nella casella Espressione:
MEASURE(SUM(streams))
👉🌐 Console: fai clic su Aggiungi, poi su Fine.
4. Leggi il codice che ha scritto e pubblicalo
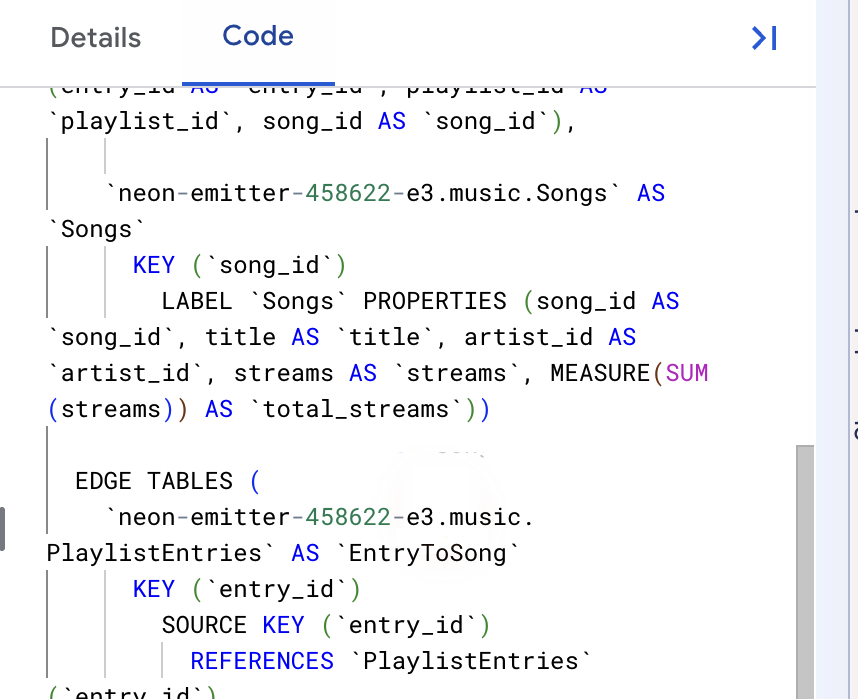
👉🌐 Console: apri la scheda Codice nel riquadro a destra. Il modellatore ha scritto l'istruzione CREATE PROPERTY GRAPH per te. Scorri fino al nodo Brani: l'elenco delle proprietà ora termina con
MEASURE(SUM(streams)) AS `total_streams`
Questa è l'intera funzionalità, in una sola riga. Tutto ciò che segue questo passaggio riguarda la funzione di questa riga.
👉🌐 Console: fai clic su Pubblica.
✅ Checkpoint: in Explorer, music ora ha una cartella Grafici contenente MusicGraph. Fai clic: cinque nodi, quattro archi e la riga MEASURE(SUM(streams)) nella scheda Codice. Salta il passaggio successivo e vai a SOMMA e AGG, affiancati.
4. Crea il grafico - Opzione B: SQL
Salta questo passaggio se hai creato il grafico nel modeler.
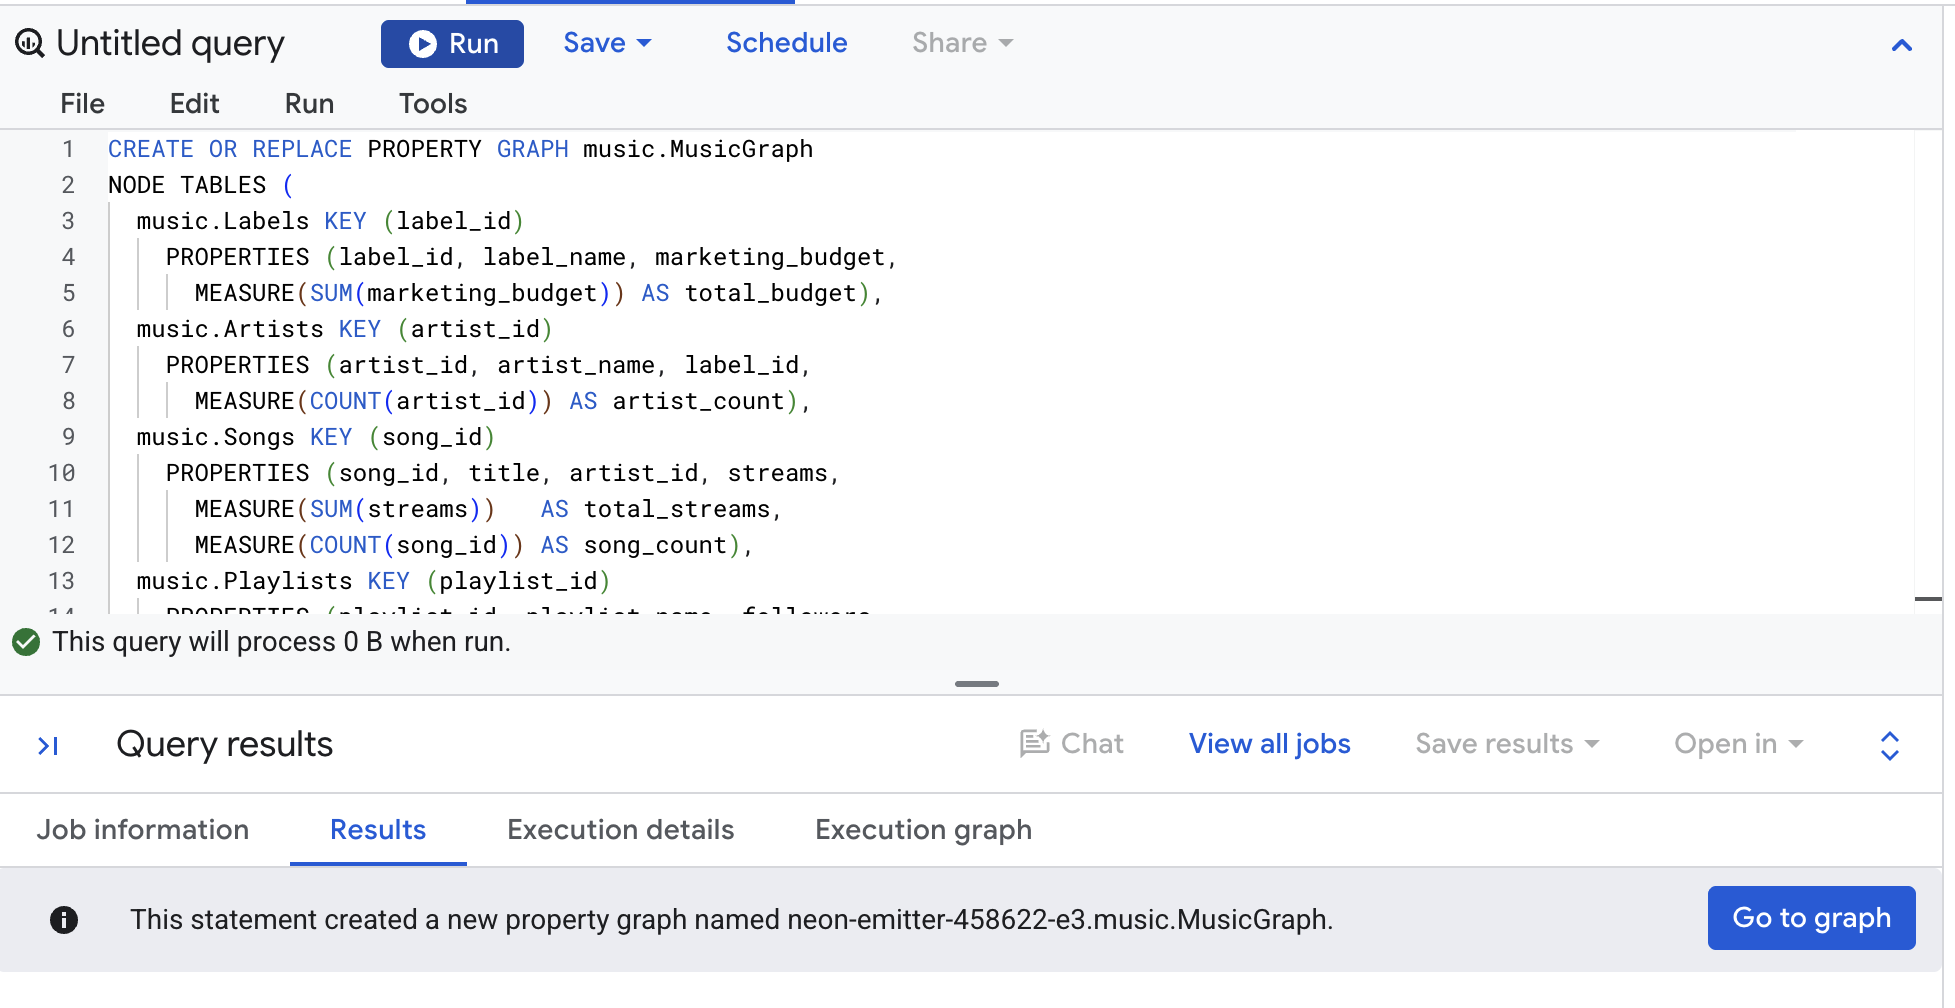
👉📋 Editor di query: incolla, poi fai clic su Esegui:
CREATE OR REPLACE PROPERTY GRAPH music.MusicGraph
  NODE TABLES (
    music.Labels KEY (label_id)
      PROPERTIES (label_id, label_name, marketing_budget,
        MEASURE(SUM(marketing_budget)) AS total_budget),
    music.Artists KEY (artist_id)
      PROPERTIES (artist_id, artist_name, label_id,
        MEASURE(COUNT(artist_id)) AS artist_count),
    music.Songs KEY (song_id)
      PROPERTIES (song_id, title, artist_id, streams,
        MEASURE(SUM(streams))   AS total_streams,
        MEASURE(COUNT(song_id)) AS song_count),
    music.Playlists KEY (playlist_id)
      PROPERTIES (playlist_id, playlist_name, followers,
        MEASURE(SUM(followers)) AS total_followers),
    music.PlaylistEntries KEY (entry_id)
      PROPERTIES (entry_id, playlist_id, song_id,
        MEASURE(COUNT(entry_id)) AS placement_count)
  )
  EDGE TABLES (
    music.PlaylistEntries AS EntryToSong
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (song_id) REFERENCES Songs(song_id) NO PROPERTIES,
    music.PlaylistEntries AS EntryToPlaylist
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (playlist_id) REFERENCES Playlists(playlist_id) NO PROPERTIES,
    music.Songs AS SongToArtist
      SOURCE KEY (song_id) REFERENCES Songs(song_id)
      DESTINATION KEY (artist_id) REFERENCES Artists(artist_id) NO PROPERTIES,
    music.Artists AS ArtistToLabel
      SOURCE KEY (artist_id) REFERENCES Artists(artist_id)
      DESTINATION KEY (label_id) REFERENCES Labels(label_id) NO PROPERTIES
  )
👀 Il riquadro dei risultati indica che il grafico delle proprietà è stato creato.
Leggila una volta
Il grafico ha cinque tabelle dei nodi e quattro tabelle degli archi. Ogni tabella dei nodi indica il KEY ed elenca i PROPERTIES. Le righe che iniziano con MEASURE sono la nuova parte: ognuna racchiude uno degli aggregati supportati intorno a una proprietà e gli assegna un alias, che è obbligatorio.
Ogni tabella edge è una chiave esterna, indicata come SOURCE KEY nella tabella che contiene la chiave e DESTINATION KEY nella tabella a cui punta. NO PROPERTIES significa che l'edge non trasporta nulla di proprio.
Nota che PlaylistEntries viene visualizzato tre volte: una volta come tabella dei nodi e altre due volte come tabella fisica dietro i bordi EntryToSong e EntryToPlaylist. Si tratta di una scelta intenzionale, di cui spiegheremo il motivo più avanti.
Guarda cosa hai creato
👉🌐 Console: nel riquadro Explorer, espandi music, poi Grafici e fai clic su MusicGraph. La pagina del grafico si apre su un canvas con cinque nodi e quattro archi. Fai clic su un nodo per visualizzarne le proprietà. Le metriche sono elencate con il relativo aggregato. Apri la scheda Codice per visualizzare la dichiarazione dietro l'immagine.
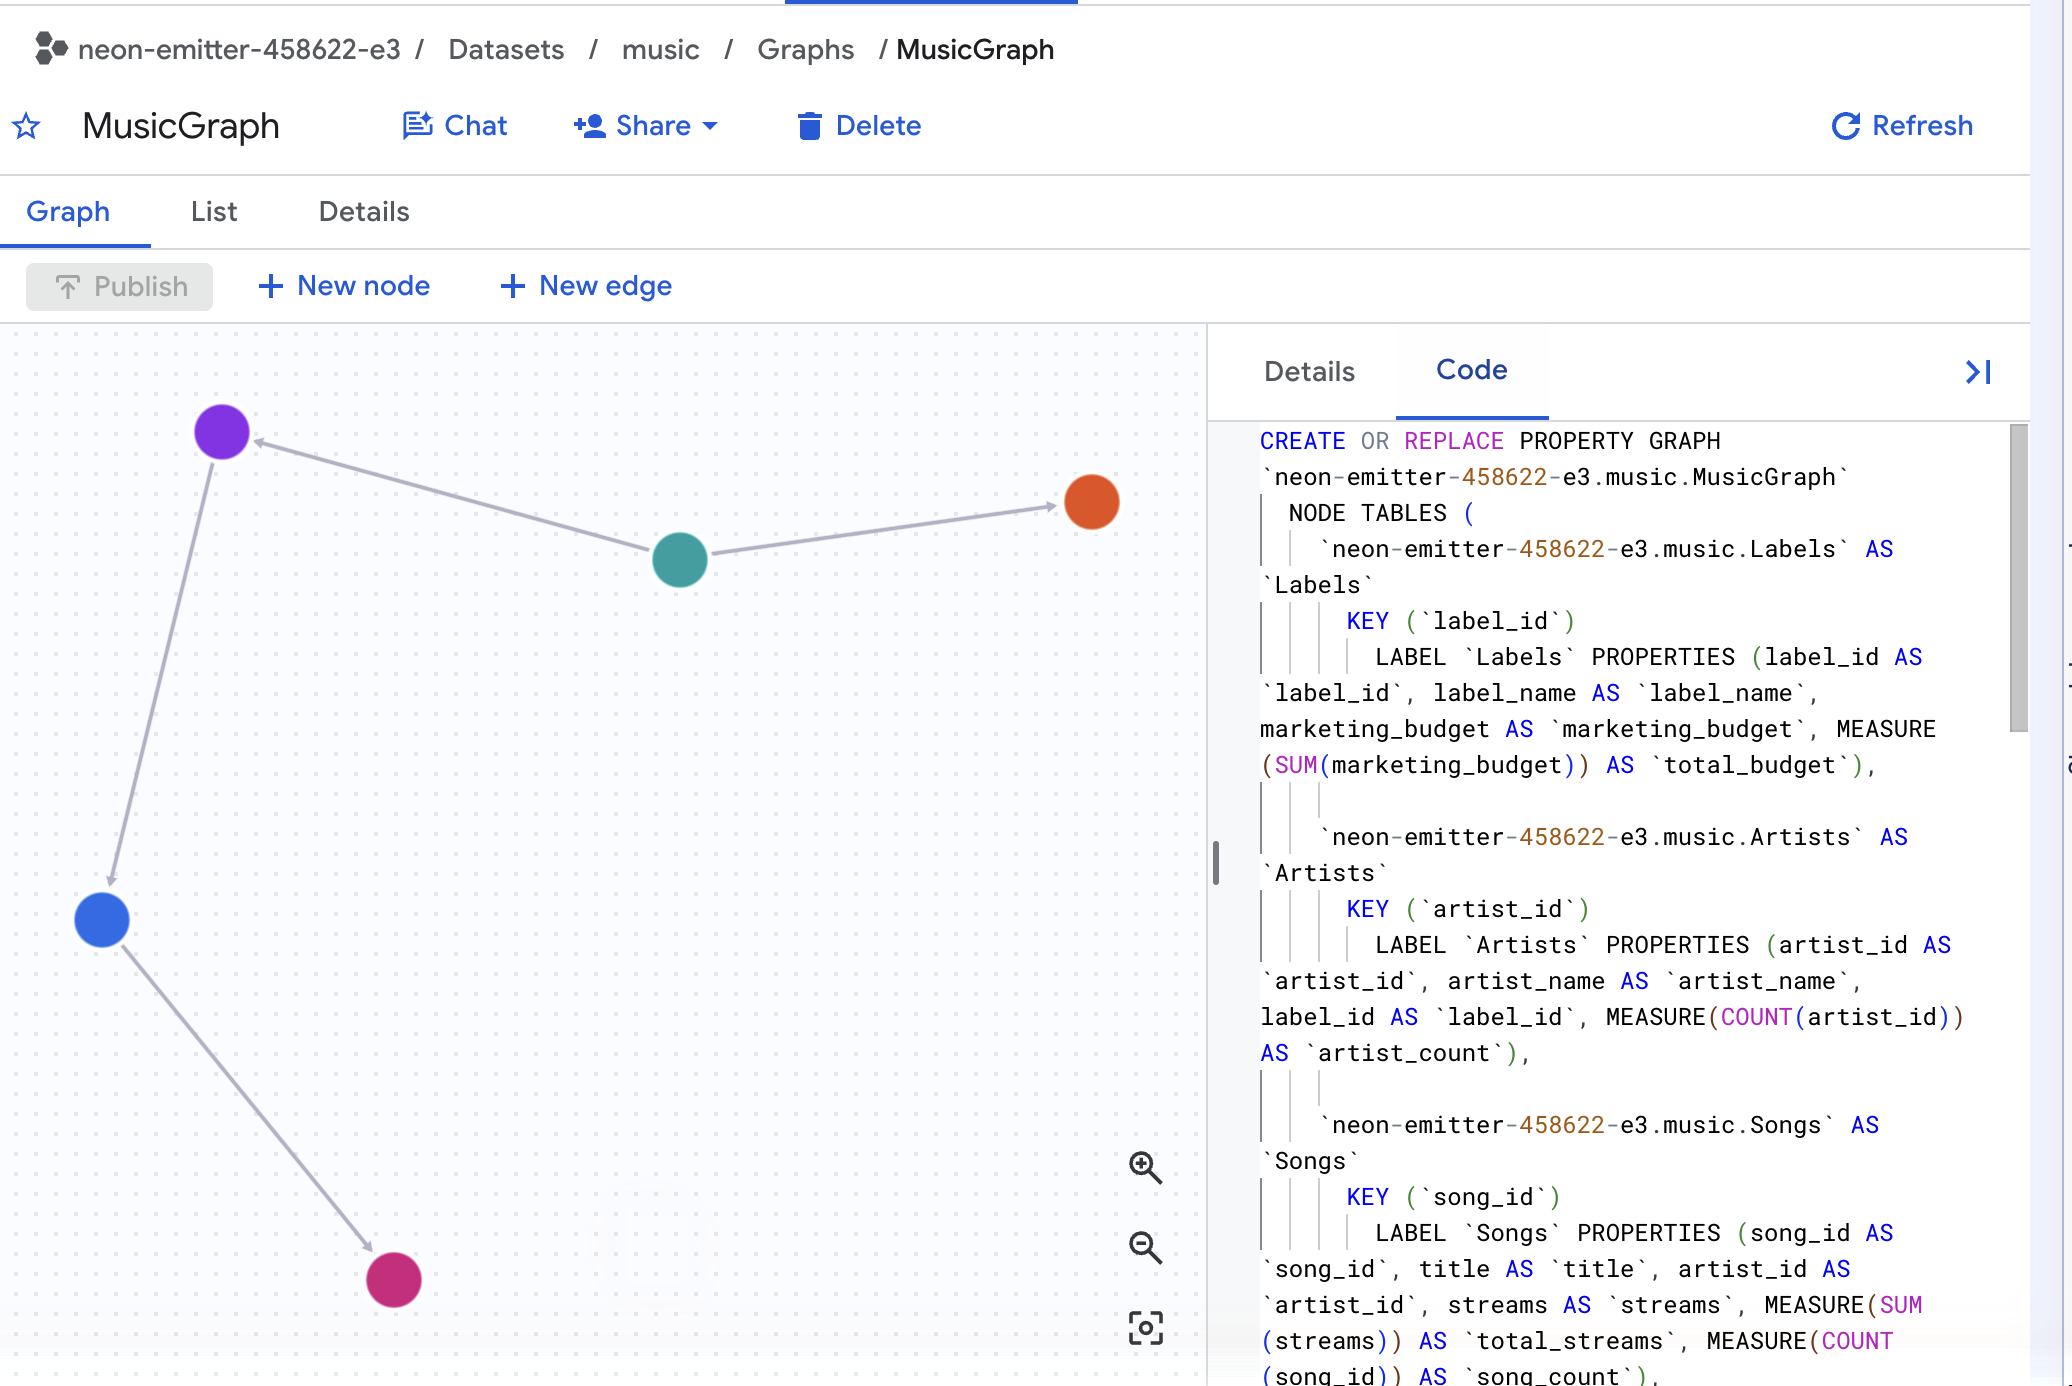
✅ Checkpoint: music ha una cartella Grafici contenente MusicGraph e la scheda Codice mostra MEASURE(SUM(streams)) AS total_streams.
5. SOMMA e AGG, affiancati
Questo è l'intero codelab in una sola query. Entrambe le colonne cercano di rispondere alla stessa domanda (totale degli stream per etichetta) dalla stessa tabella.
Questa tabella è quella prodotta da GRAPH_EXPAND. Appiattisce il grafico: inizia da una tabella e segue ogni bordo verso l'esterno come LEFT JOIN, finché ogni tabella connessa non si trova affiancata in un unico risultato ampio. Una riga per posizionamento, non una per brano, e ogni colonna denominata TableLabel_property. Esaminalo prima di eseguire la query.
👉📋 Editor di query: incolla, poi fai clic su Esegui:
SELECT Labels_label_name, Songs_title, Songs_streams, Playlists_playlist_name
FROM GRAPH_EXPAND("music.MusicGraph")
ORDER BY Songs_title, Playlists_playlist_name
👀 Prevedi 10 righe, una per ogni posizionamento in PlaylistEntries, ovvero esattamente ciò che è stato caricato nella configurazione. Neon Summer ne occupa quattro, uno per ogni playlist in cui è presente, e Songs_streams ne conta 2.000.000.000 in ognuna. Non c'è nulla di sbagliato in queste righe: le playlist sono effettivamente quattro. Tuttavia, una colonna appartenente a un brano viene ora ripetuta nelle righe appartenenti ai posizionamenti, ed è questo il problema che misura la query successiva.
Ora il confronto.
👉📋 Editor di query: incolla, poi fai clic su Esegui:
SELECT
  Labels_label_name,
  SUM(Songs_streams)       AS with_sum,
  AGG(Songs_total_streams) AS with_agg
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1 ORDER BY 1
👀 Risultato:
Labels_label_name | with_sum | with_agg |
Cymbal Records | 12.600.000.000 | 5.100.000.000 |
Northwind Audio | 9.000.000.000 | 4.500.000.000 |
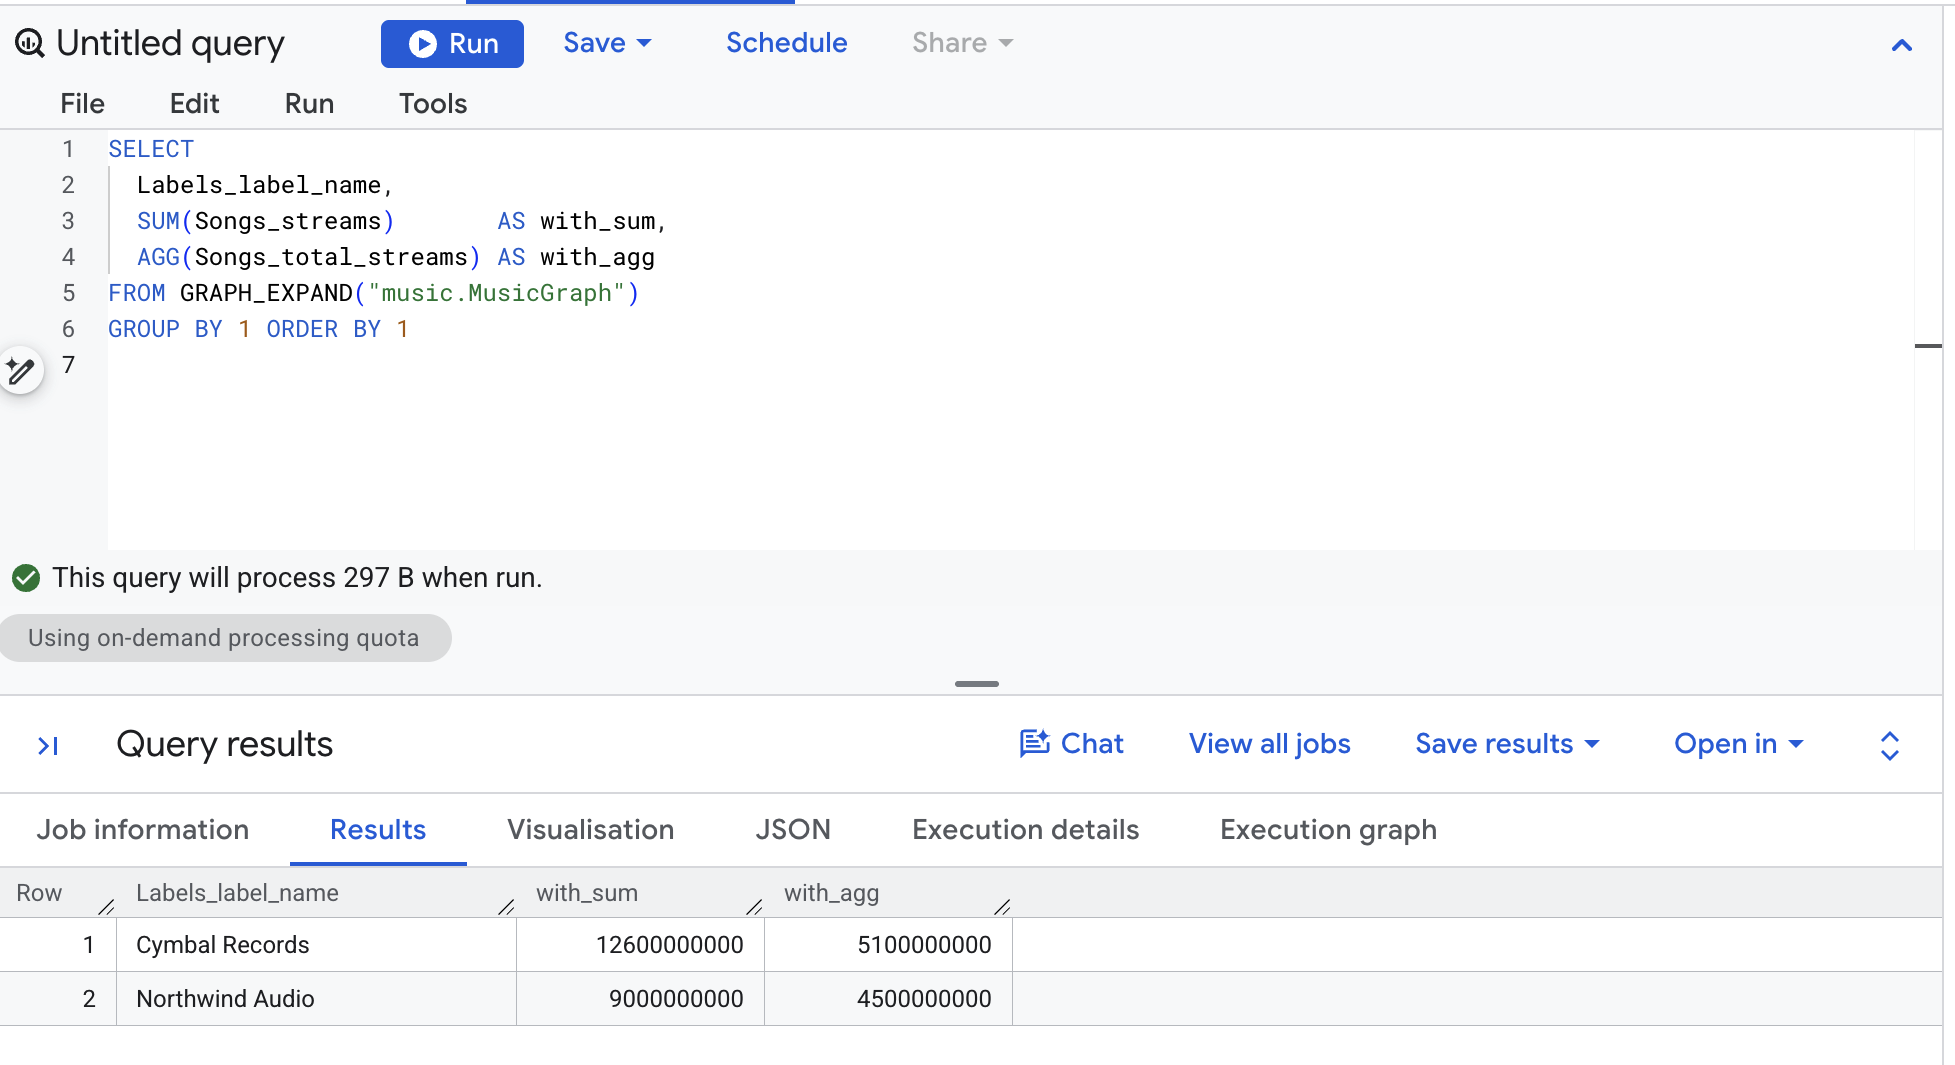
Controllalo manualmente. I quattro brani di Cymbal hanno totalizzato 2 miliardi, 1,5 miliardi, 1,2 miliardi e 0,4 miliardi di stream. Sono 5,1 miliardi. AGG è corretto. SUM è due volte e mezzo troppo grande e il singolo di Northwind è raddoppiato.
Tre nuove sintassi
GRAPH_EXPAND("music.MusicGraph")è una funzione con valori di tabella che trasforma il grafico in una tabella ampia, seguendo ogni arco comeLEFT JOIN. Ogni colonna è denominataTableLabel_property, quindiSongs_streamsè la colonna non elaborata della tabella Songs eSongs_total_streamsè la misura che hai dichiarato.SUM(Songs_streams)è SQL ordinario su quella tabella ampia ed eredita ogni duplicato prodotto dall'appiattimento.AGG(Songs_total_streams)valuta la misura nel modo in cui è stata dichiarata:SUM(streams)una volta persong_id, indipendentemente dal numero di righe occupate da un brano nella tabella larga.
✅ Checkpoint: due etichette, due colonne e i numeri with_agg corrispondono al conteggio delle mani.
6. Perché SOMMA conteggia in modo eccessivo
Prendi un brano e guarda cosa succede quando lo unisci ad altri.
👉📋 Editor di query: incolla, poi fai clic su Esegui:
SELECT 'BEFORE - the Songs table' AS step, title, streams, CAST(NULL AS STRING) AS playlist
FROM music.Songs WHERE title = 'Neon Summer'
UNION ALL
SELECT 'AFTER - joined to playlists', s.title, s.streams, pl.playlist_name
FROM music.Songs s
LEFT JOIN music.PlaylistEntries e ON e.song_id = s.song_id
LEFT JOIN music.Playlists pl ON pl.playlist_id = e.playlist_id
WHERE s.title = 'Neon Summer'
ORDER BY step DESC, playlist
👀 Risultato:
a terra | titolo | applicazioni. | playlist |
PRIMA: la tabella Brani | Neon Summer | 2.000.000.000 | null |
DOPO - joined to playlists | Neon Summer | 2.000.000.000 | Gym Pump |
DOPO - joined to playlists | Neon Summer | 2.000.000.000 | Hot Right Now |
DOPO - joined to playlists | Neon Summer | 2.000.000.000 | Rising Pop |
DOPO - joined to playlists | Neon Summer | 2.000.000.000 | Viaggio in macchina |
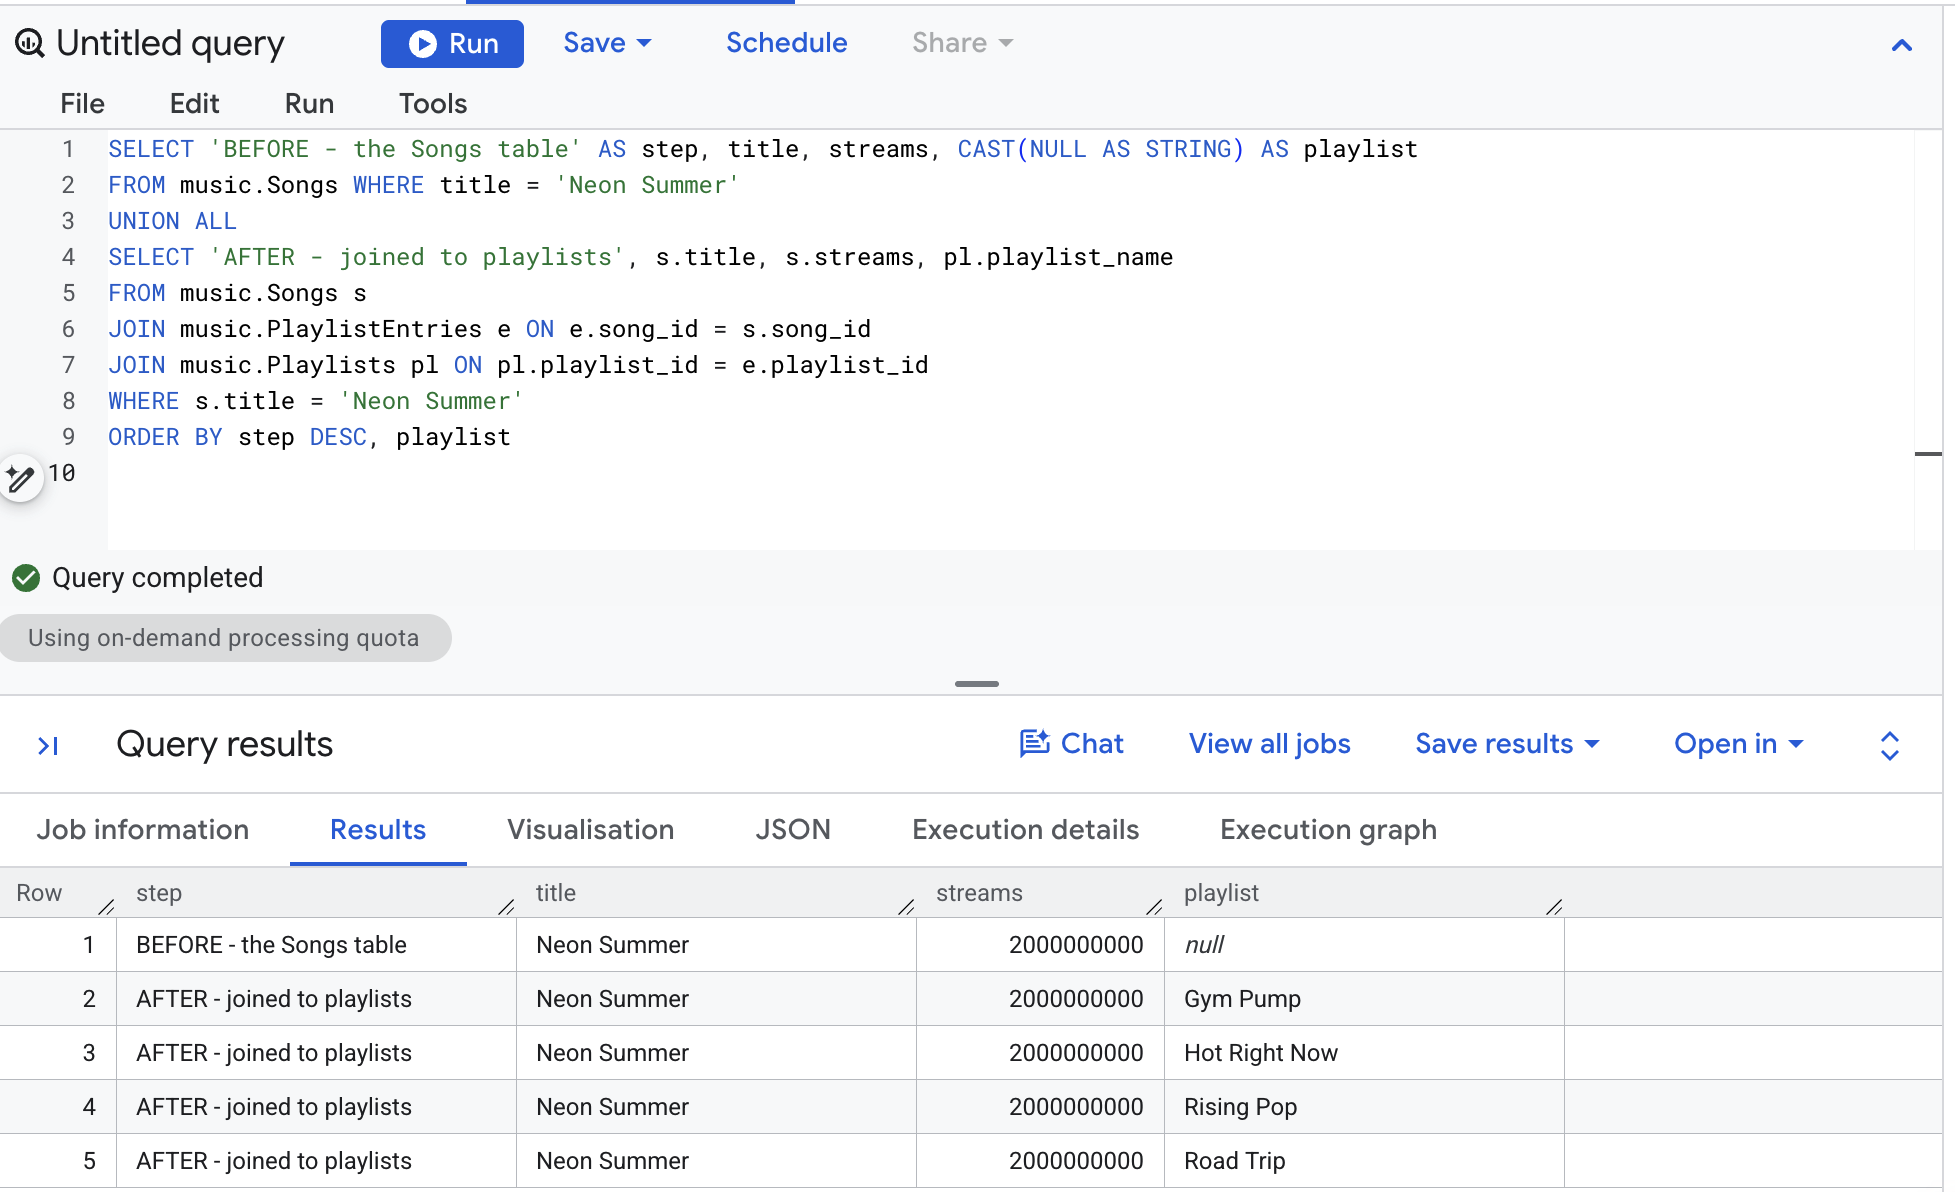
Una riga è diventata quattro. Il conteggio dei flussi non è cambiato, è stato copiato. Somma le visualizzazioni delle copie di Cymbal Records: Neon Summer 2 miliardi su quattro playlist sono 8, Paper Crown 1,5 miliardi su due sono 3, Double Shot 1,2 su una, Slow Arrow 0,4 su una. ovvero 12,6 miliardi, il numero SUM restituito. Northwind's Midnight Drive è presente in due playlist, quindi 4,5 miliardi sono diventati 9 miliardi.
Si tratta di fan-out e non di un bug nel join. Le righe delle playlist sono reali. L'errore consiste nel sommare un numero che appartiene a un brano in righe che appartengono a posizionamenti.
La misura risolve il problema perché è stata dichiarata nel nodo Songs insieme a KEY (song_id). La chiave è la grana. Quando AGG valuta total_streams, esegue l'aggregazione una volta per ogni tonalità del brano e solo dopo esegue il rollup in base al raggruppamento.
Che cosa è cambiato
Scrivevi | Con una misura |
|
|
|
|
Tre |
|
Un'espressione CTE che aggrega prima dell'unione | Niente. |
✅ Checkpoint:cinque righe, una PRIMA e quattro DOPO, e puoi ricostruire 12,6 miliardi di dati.
7. La regola: solo AGG legge una misura
Le misure hanno un proprio tipo, MEASURE, e solo una funzione lo accetta. Le quattro query riportate di seguito non vengono eseguite di proposito: esegui ciascuna query e leggi l'errore in rosso. Questi sono i quattro modi che tutti provano per primi e sapere cosa dicono fa risparmiare tempo in seguito.
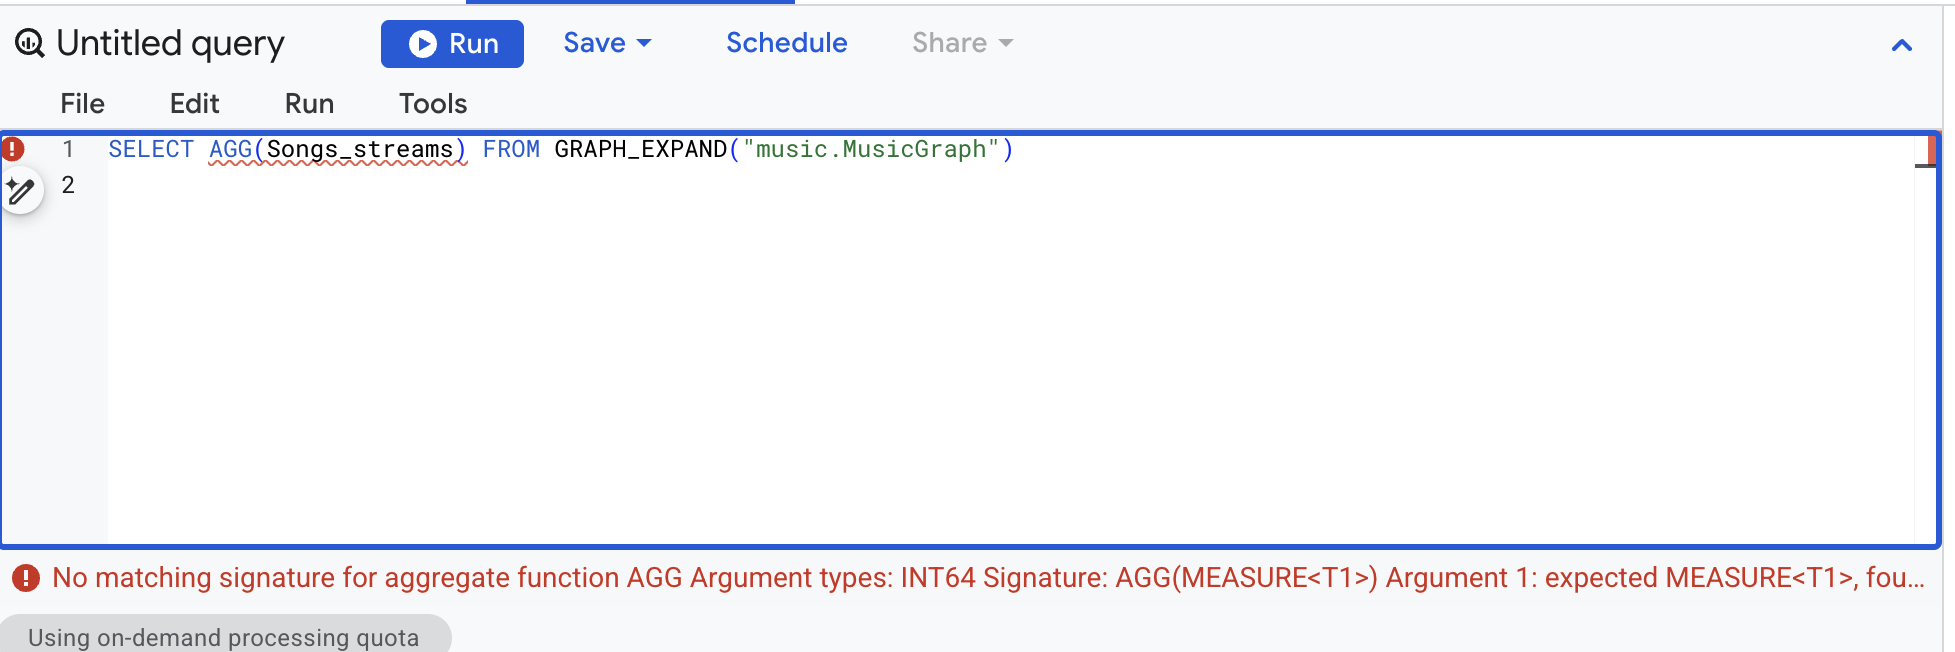
👉📋 Editor di query: AGG su una colonna semplice:
SELECT AGG(Songs_streams) FROM GRAPH_EXPAND("music.MusicGraph")
👀 No matching signature for aggregate function AGG ... Argument 1: expected MEASURE
👉📋 Editor di query: una colonna di misura senza AGG:
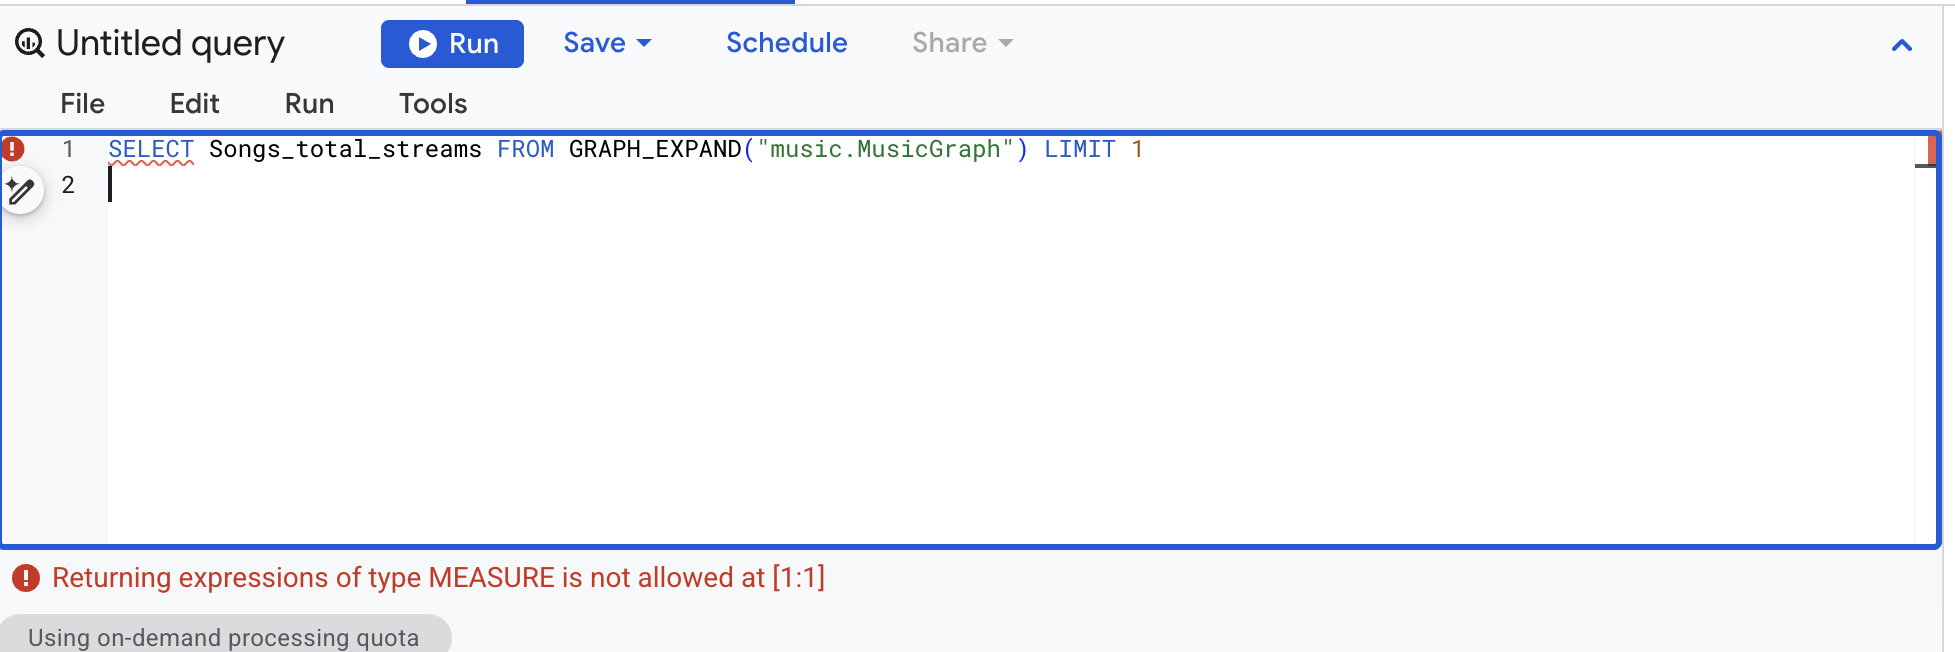
SELECT Songs_total_streams FROM GRAPH_EXPAND("music.MusicGraph") LIMIT 1
👀 Returning expressions of type MEASURE is not allowed
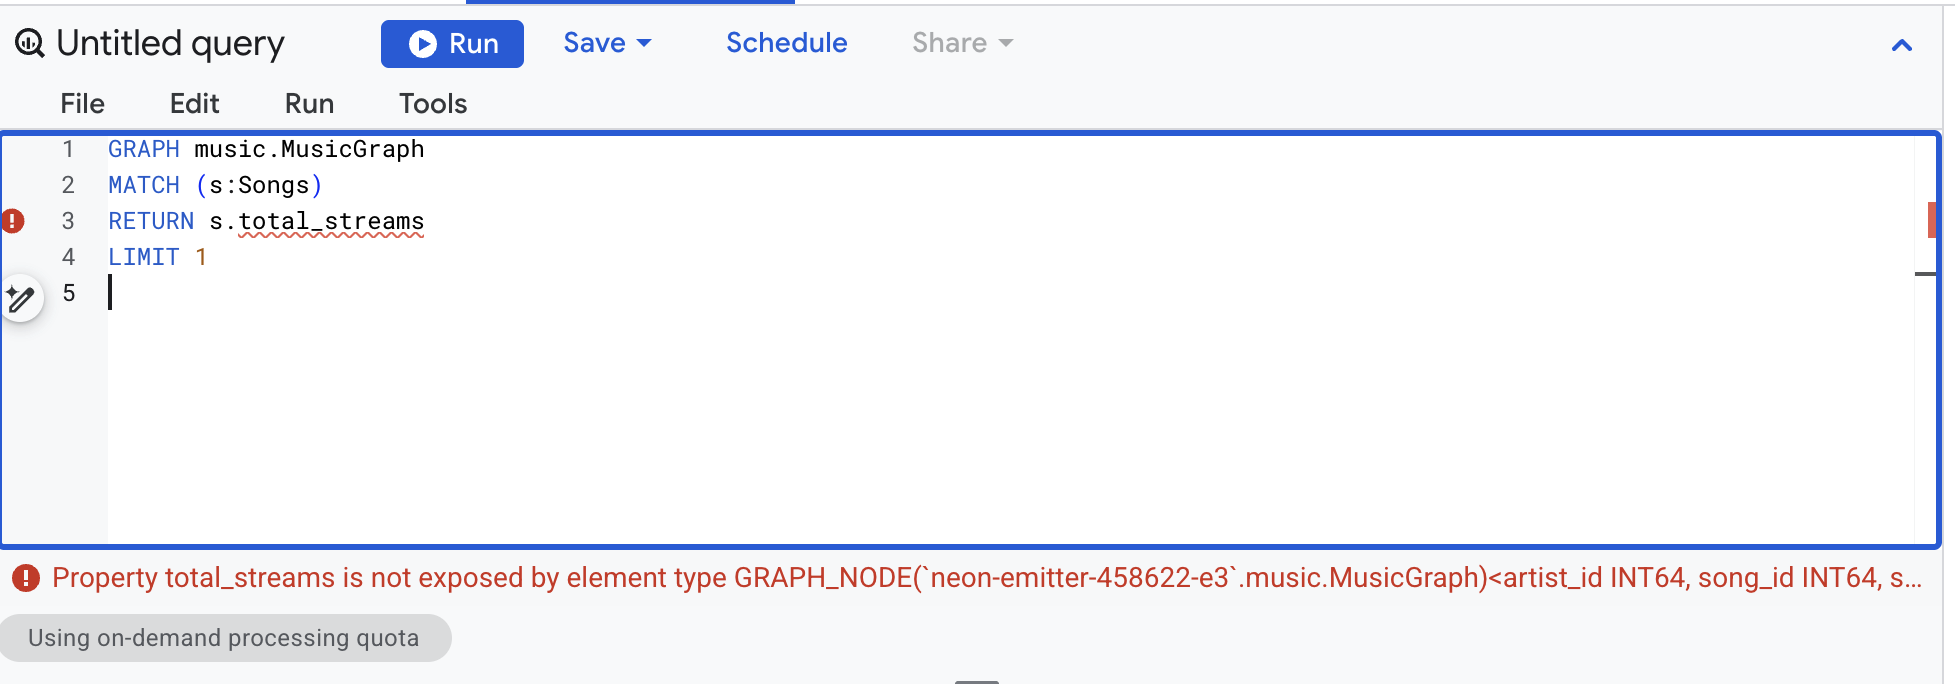
👉📋 Editor di query: una misura a cui viene fatto riferimento in GQL, che non vede mai le misure (questa è una query GQL. Vedi la nota di modifica nella panoramica):
GRAPH music.MusicGraph
MATCH (s:Songs)
RETURN s.total_streams
LIMIT 1
👀 total_streams is not exposed by element type GRAPH_NODE(...)
👉📋 Editor di query: SUM su una colonna di misura, quella più allettante:
SELECT Labels_label_name, SUM(Songs_total_streams)
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1
👀 MEASURE-typed arguments are only permitted in the AGG function
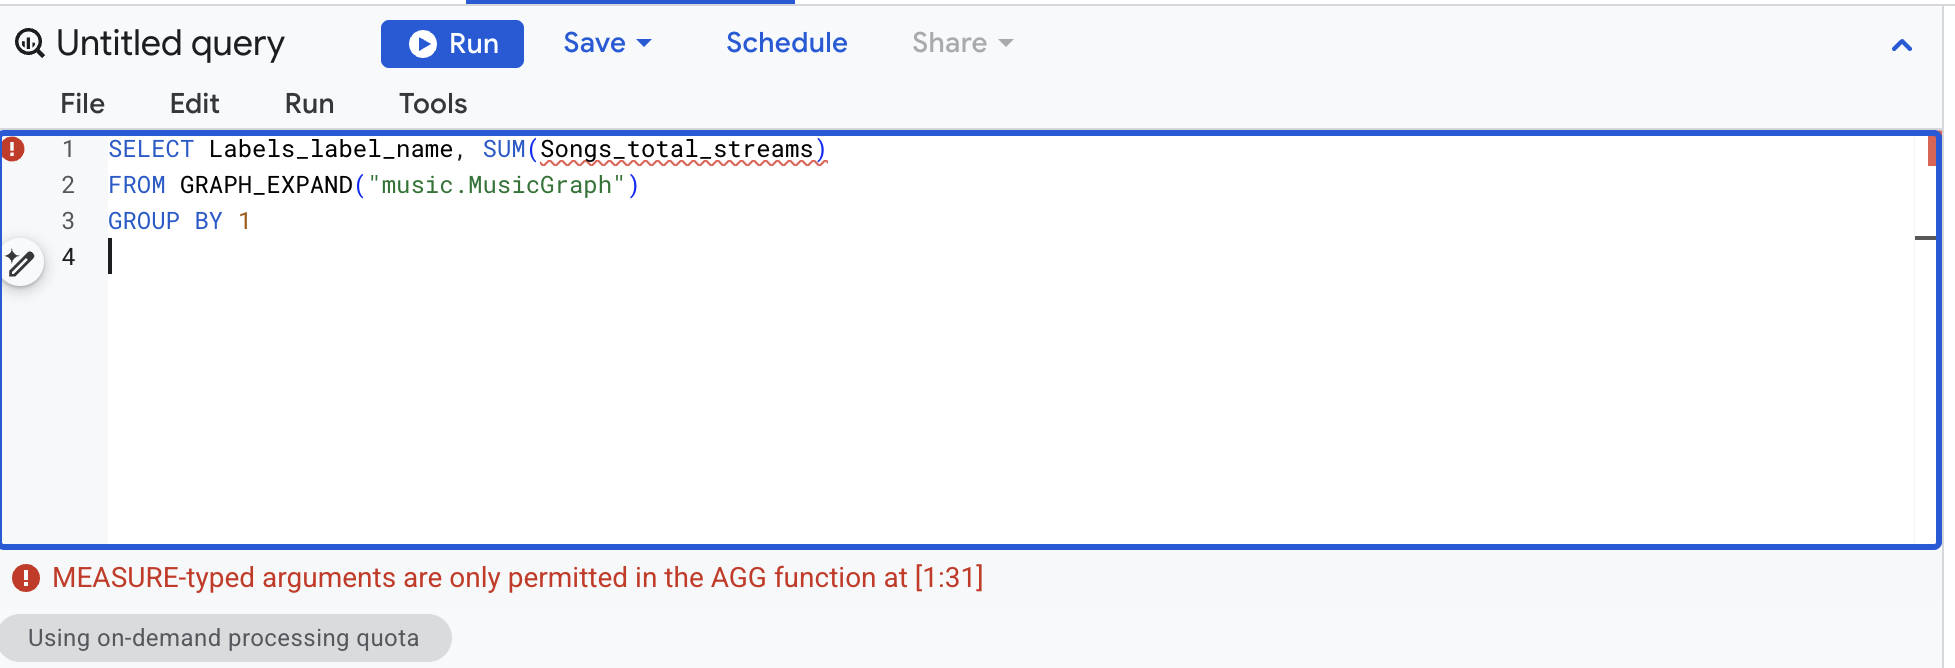
In questo modo, il sistema di tipi applica la regola per te. Una misura è visibile solo tramite GRAPH_EXPAND e leggibile solo tramite AGG. I 12,6 miliardi conteggiati in eccesso in precedenza possono derivare solo dalla somma della colonna non elaborata, mai dalla gestione errata della metrica.
✅ Checkpoint: quattro errori rossi e puoi indicare quale regola viene applicata a ciascuno.
8. Ogni aggregazione supportata da una metrica
MEASURE() include uno dei sei aggregati: SUM, AVG, MIN, MAX, COUNT e COUNT(DISTINCT). Ricrea il grafico con tutti e sei i brani nel nodo Brani. I bordi rimangono NO PROPERTIES, che è la best practice documentata quando un bordo condivide la sua tabella fisica con un nodo.
👉📋 Editor di query: incolla, poi fai clic su Esegui:
CREATE OR REPLACE PROPERTY GRAPH music.MusicGraph
  NODE TABLES (
    music.Labels KEY (label_id)
      PROPERTIES (label_id, label_name, marketing_budget,
        MEASURE(SUM(marketing_budget)) AS total_budget),
    music.Artists KEY (artist_id)
      PROPERTIES (artist_id, artist_name, label_id,
        MEASURE(COUNT(artist_id)) AS artist_count),
    music.Songs KEY (song_id)
      PROPERTIES (song_id, title, artist_id, streams,
        MEASURE(SUM(streams))              AS total_streams,
        MEASURE(AVG(streams))              AS avg_streams,
        MEASURE(MIN(streams))              AS min_streams,
        MEASURE(MAX(streams))              AS max_streams,
        MEASURE(COUNT(song_id))            AS song_count,
        MEASURE(COUNT(DISTINCT artist_id)) AS distinct_artists),
    music.Playlists KEY (playlist_id)
      PROPERTIES (playlist_id, playlist_name, followers,
        MEASURE(SUM(followers)) AS total_followers),
    music.PlaylistEntries KEY (entry_id)
      PROPERTIES (entry_id, playlist_id, song_id,
        MEASURE(COUNT(entry_id)) AS placement_count)
  )
  EDGE TABLES (
    music.PlaylistEntries AS EntryToSong
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (song_id) REFERENCES Songs(song_id) NO PROPERTIES,
    music.PlaylistEntries AS EntryToPlaylist
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (playlist_id) REFERENCES Playlists(playlist_id) NO PROPERTIES,
    music.Songs AS SongToArtist
      SOURCE KEY (song_id) REFERENCES Songs(song_id)
      DESTINATION KEY (artist_id) REFERENCES Artists(artist_id) NO PROPERTIES,
    music.Artists AS ArtistToLabel
      SOURCE KEY (artist_id) REFERENCES Artists(artist_id)
      DESTINATION KEY (label_id) REFERENCES Labels(label_id) NO PROPERTIES
  )
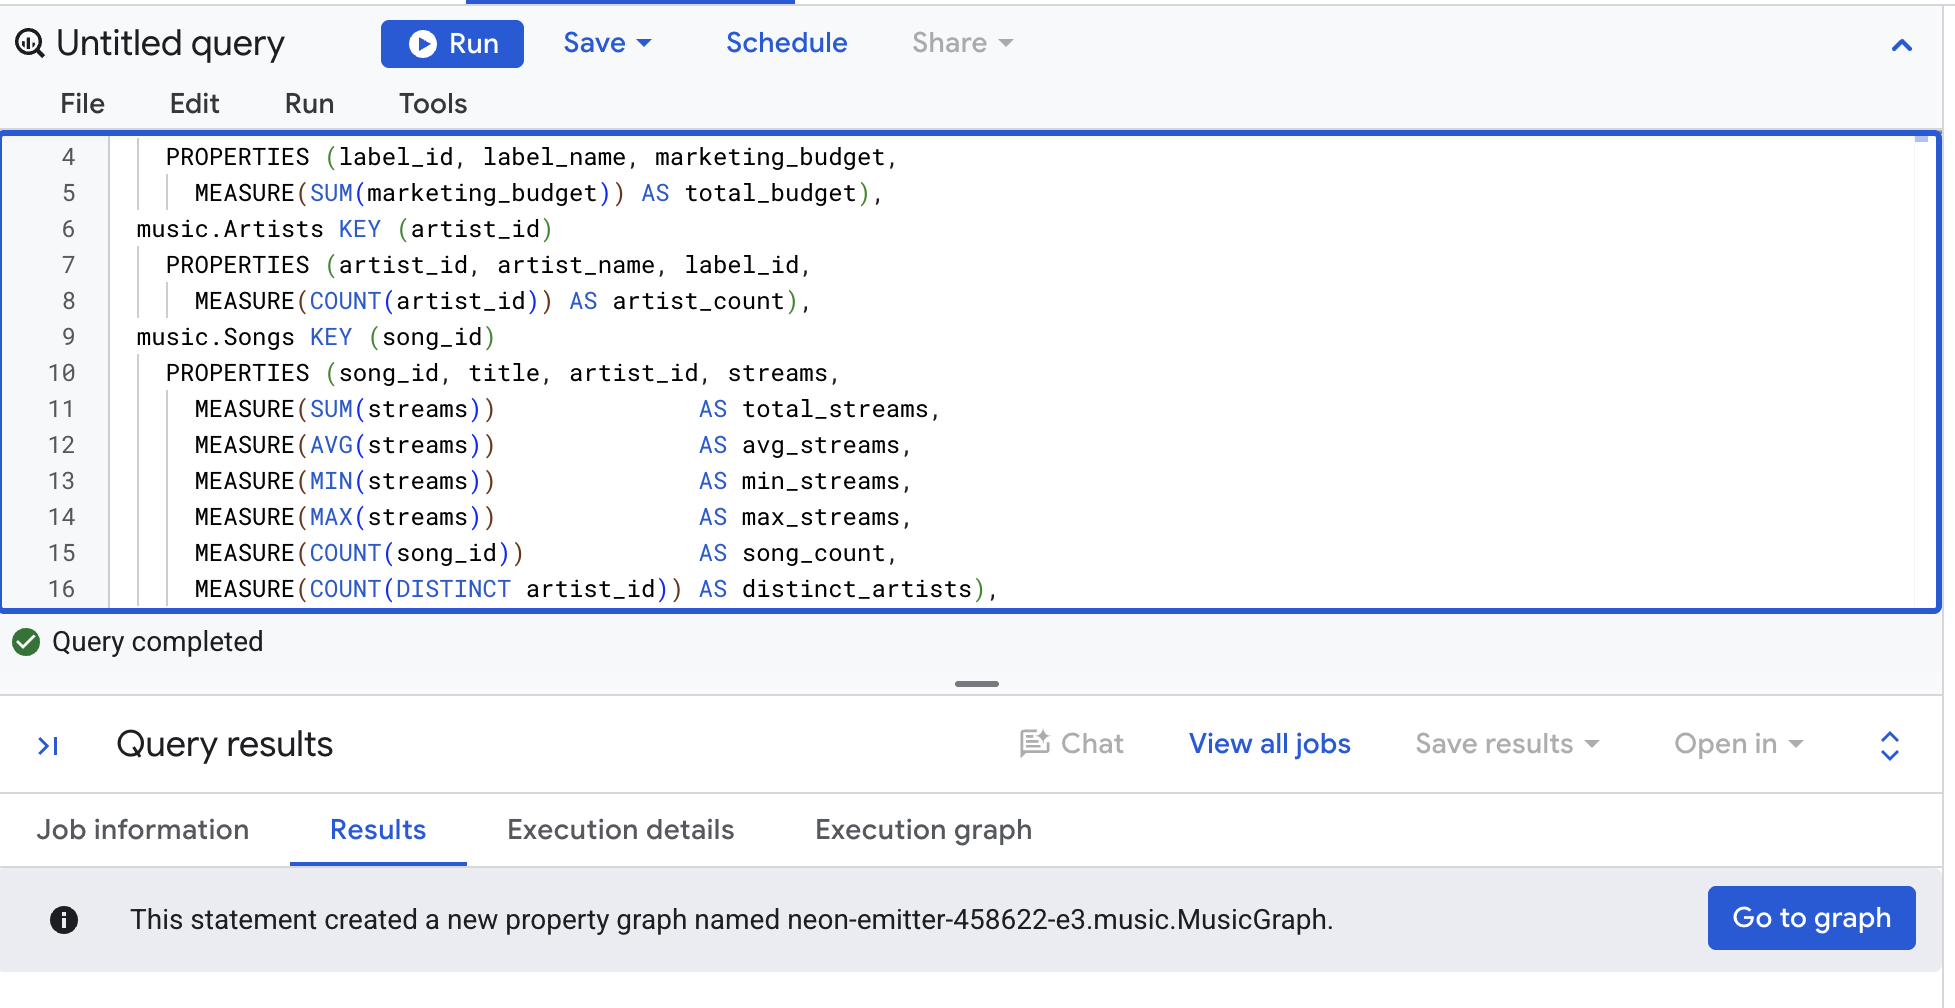
Ora rileggili tutti. Ogni misura passa attraverso AGG e l'ultima colonna mostra che i risultati di AGG sono valori ordinari con cui puoi fare calcoli aritmetici. Il grafico è appena cambiato, quindi deseleziona prima Utilizza risultati memorizzati nella cache (Altro → Impostazioni query).
👉📋 Editor di query: incolla, poi fai clic su Esegui:
SELECT
  Labels_label_name,
  AGG(Songs_total_streams)    AS total_streams,
  AGG(Songs_avg_streams)      AS avg_streams,
  AGG(Songs_min_streams)      AS min_streams,
  AGG(Songs_max_streams)      AS max_streams,
  AGG(Songs_song_count)       AS songs,
  AGG(Songs_distinct_artists) AS artists,
  AGG(Songs_total_streams) / AGG(Songs_song_count) AS streams_per_song
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1
ORDER BY 1
👀 Risultato:
Labels_label_name | total_streams | avg_streams | min_streams | max_streams | canzoni | artisti | streams_per_song |
Cymbal Records | 5.100.000.000 | 1.275.000.000 | 400.000.000 | 2.000.000.000 | 4 | 2 | 1.275.000.000 |
Northwind Audio | 4.500.000.000 | 4.500.000.000 | 4.500.000.000 | 4.500.000.000 | 1 | 1 | 4.500.000.000 |
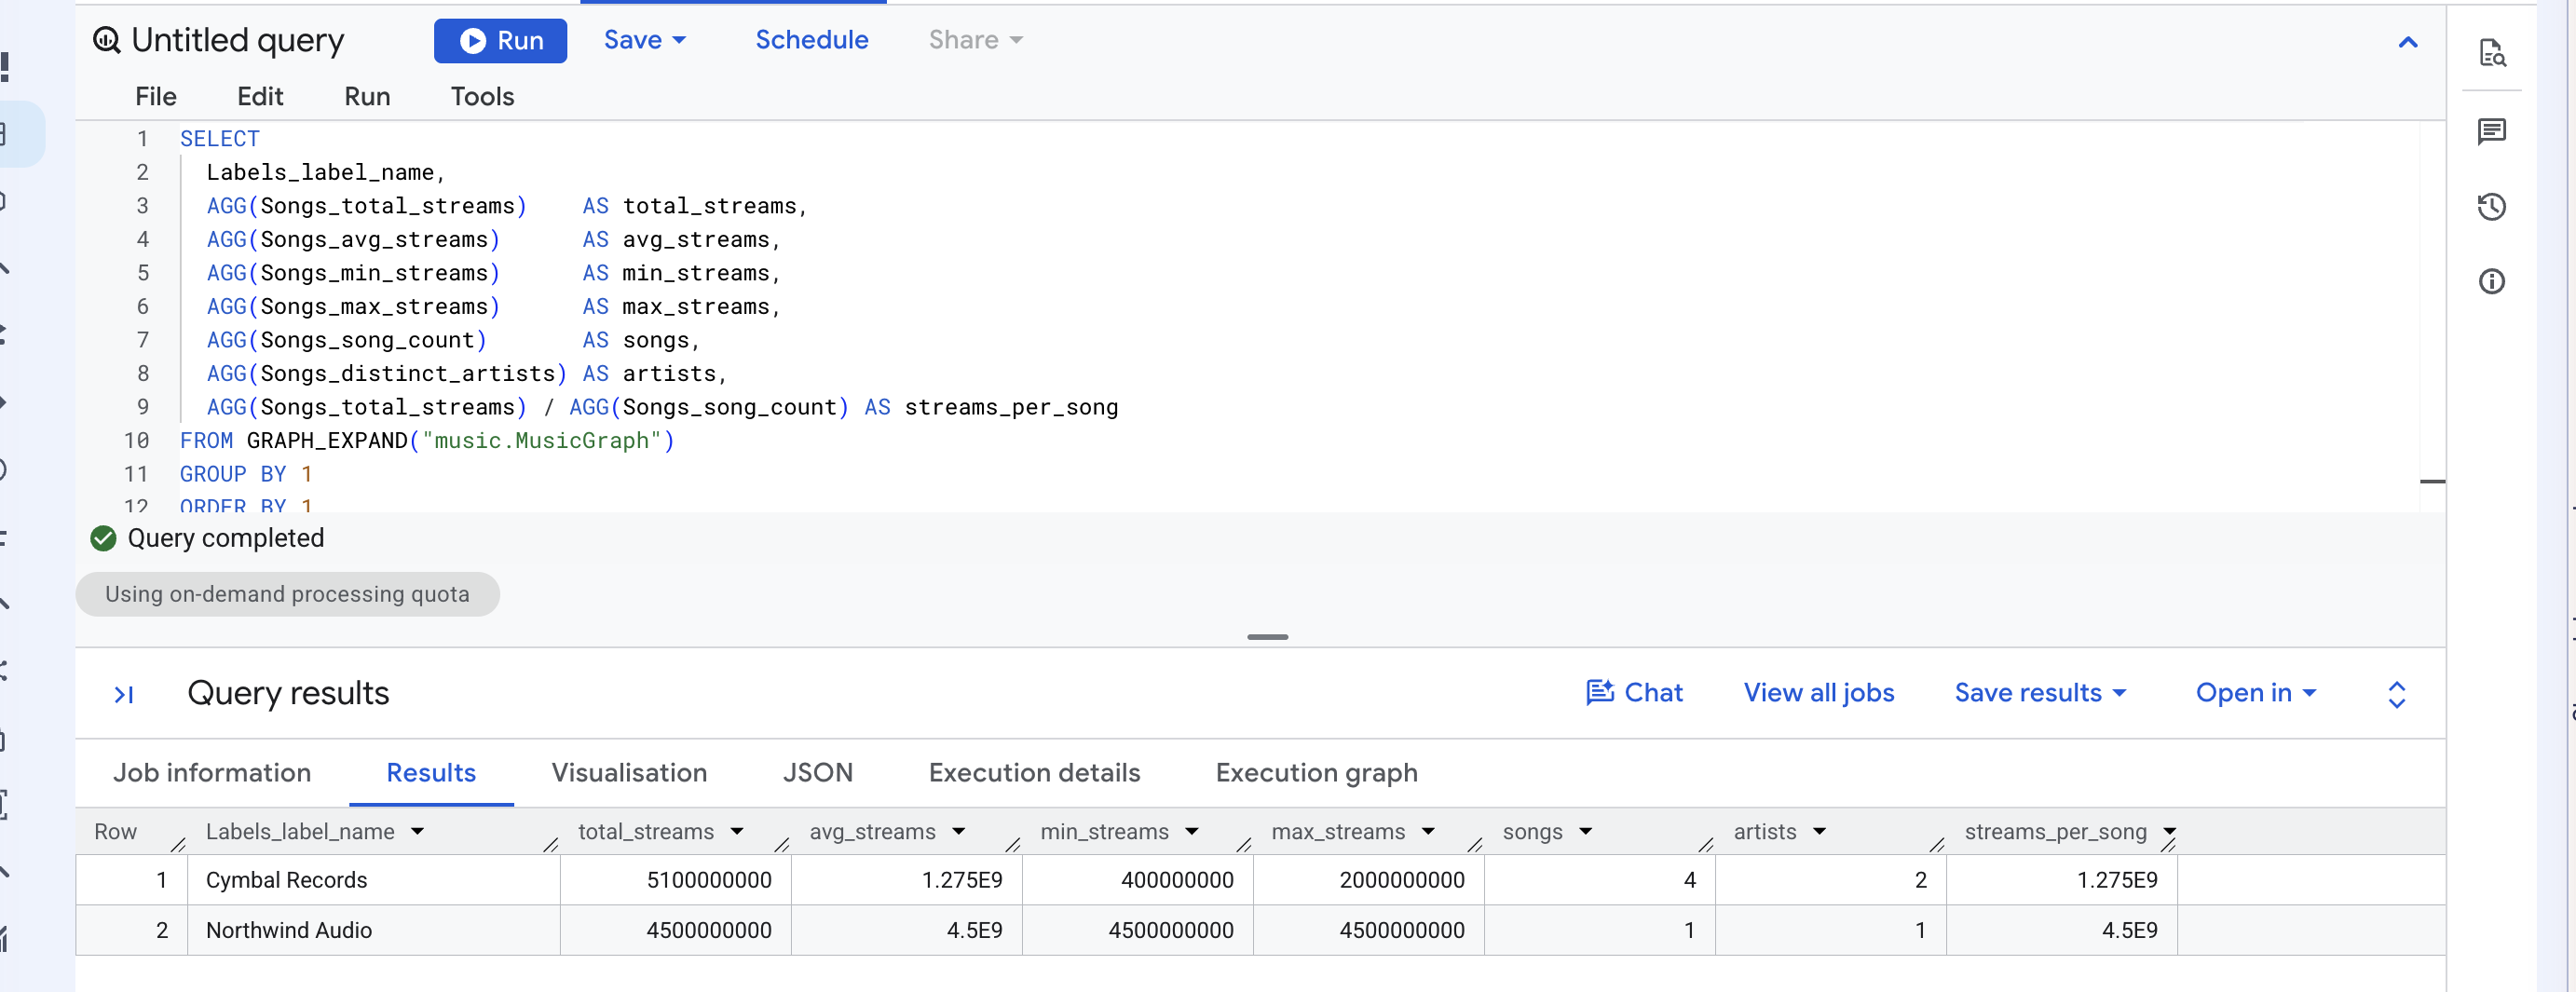
Ogni numero viene calcolato su quattro brani per Cymbal e uno per Northwind, non sulle dieci righe di posizionamento. AVG in particolare sarebbe stato sbagliato nell'altro modo: la media della colonna non elaborata sulle righe di posizionamento dà 1,575 miliardi per Cymbal, perché i 2 miliardi di Neon Summer vengono conteggiati quattro volte.
Quindi "sostituisci SOMMA con AGG" sono in realtà due decisioni. Quando dichiari la misura, scegli comunque quale dei sei aggregati è. Quando la leggi, la funzione è sempre AGG.
✅ Checkpoint:una riga per etichetta, sette numeri ciascuna e streams_per_song uguale a avg_streams.
9. Modifica il raggruppamento, non la misura
La stessa metrica risponde a una domanda diversa. Raggruppa per playlist anziché per etichetta.
👉📋 Editor di query: incolla, poi fai clic su Esegui:
SELECT
  Playlists_playlist_name,
  AGG(Songs_total_streams) AS streams,
  AGG(Songs_song_count)    AS songs
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1
ORDER BY 2 DESC
👀 Risultato:
Playlists_playlist_name | applicazioni. | canzoni |
Viaggio in macchina | 6.900.000.000 | 3 |
Gym Pump | 6.500.000.000 | 2 |
Hot Right Now | 4.700.000.000 | 3 |
Rising Pop | 3.500.000.000 | 2 |
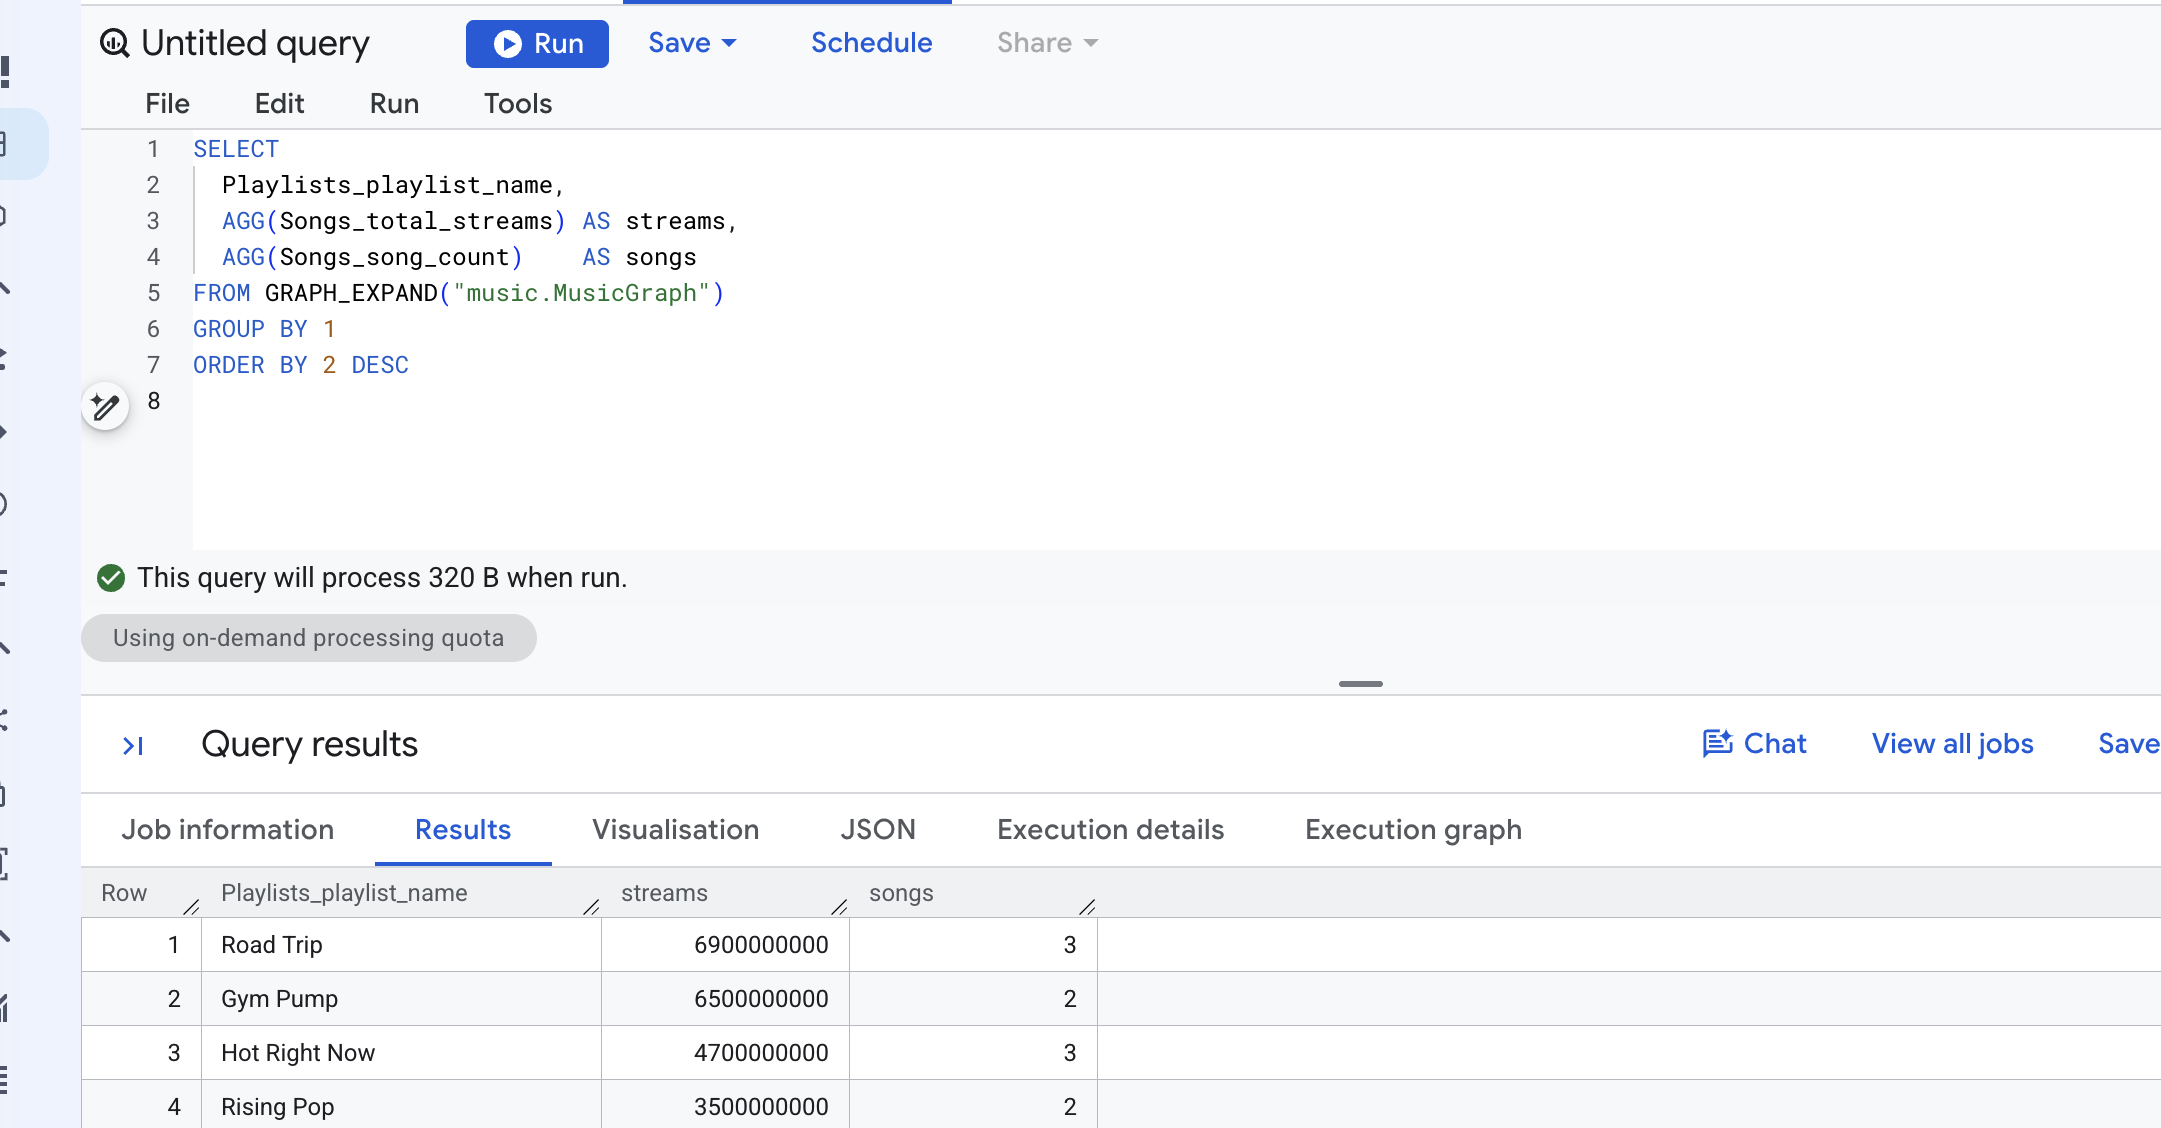
Le due righe AGGsono byte per byte quelle di SOMMA e AGG, una accanto all'altra. È stato spostato solo GROUP BY. Road Trip include Neon Summer, Midnight Drive e Slow Arrow e ogni brano viene conteggiato una volta all'interno della playlist, che è esattamente ciò che dovrebbe significare "stream che raggiungono questa playlist".
La persona che ha scritto la misura ha deciso la grana una volta. Ogni query successiva, di chiunque, la eredita.
✅ Checkpoint: Road Trip in cima alla classifica con 6,9 miliardi.
10. Scopri cosa ti offre GRAPH_EXPAND
Non devi eseguire GRAPH_EXPAND per impararne la forma. La procedura di sistema BQ.SHOW_GRAPH_EXPAND_SCHEMA scrive l'elenco delle colonne in una variabile.
👉📋 Editor di query: incolla tutte e tre le righe, quindi fai clic su Esegui:
DECLARE schema STRING DEFAULT '';
CALL BQ.SHOW_GRAPH_EXPAND_SCHEMA('music.MusicGraph', schema);
SELECT schema;
👀 Il risultato è una stringa JSON. Ogni campo ha un nome, un tipo e una modalità e ogni colonna di misura contiene "is_measure": true. Per il grafico che hai appena creato, ottieni, tra gli altri:
nome | tipo | is_measure | |
Songs_title | STRING | ||
Songs_streams | NUMERO INTERO | ||
Songs_total_streams | NUMERO INTERO | true | |
Songs_avg_streams | FLOAT | true | |
Songs_distinct_artists | NUMERO INTERO | true | |
PlaylistEntries_placement_count | NUMERO INTERO | true | |
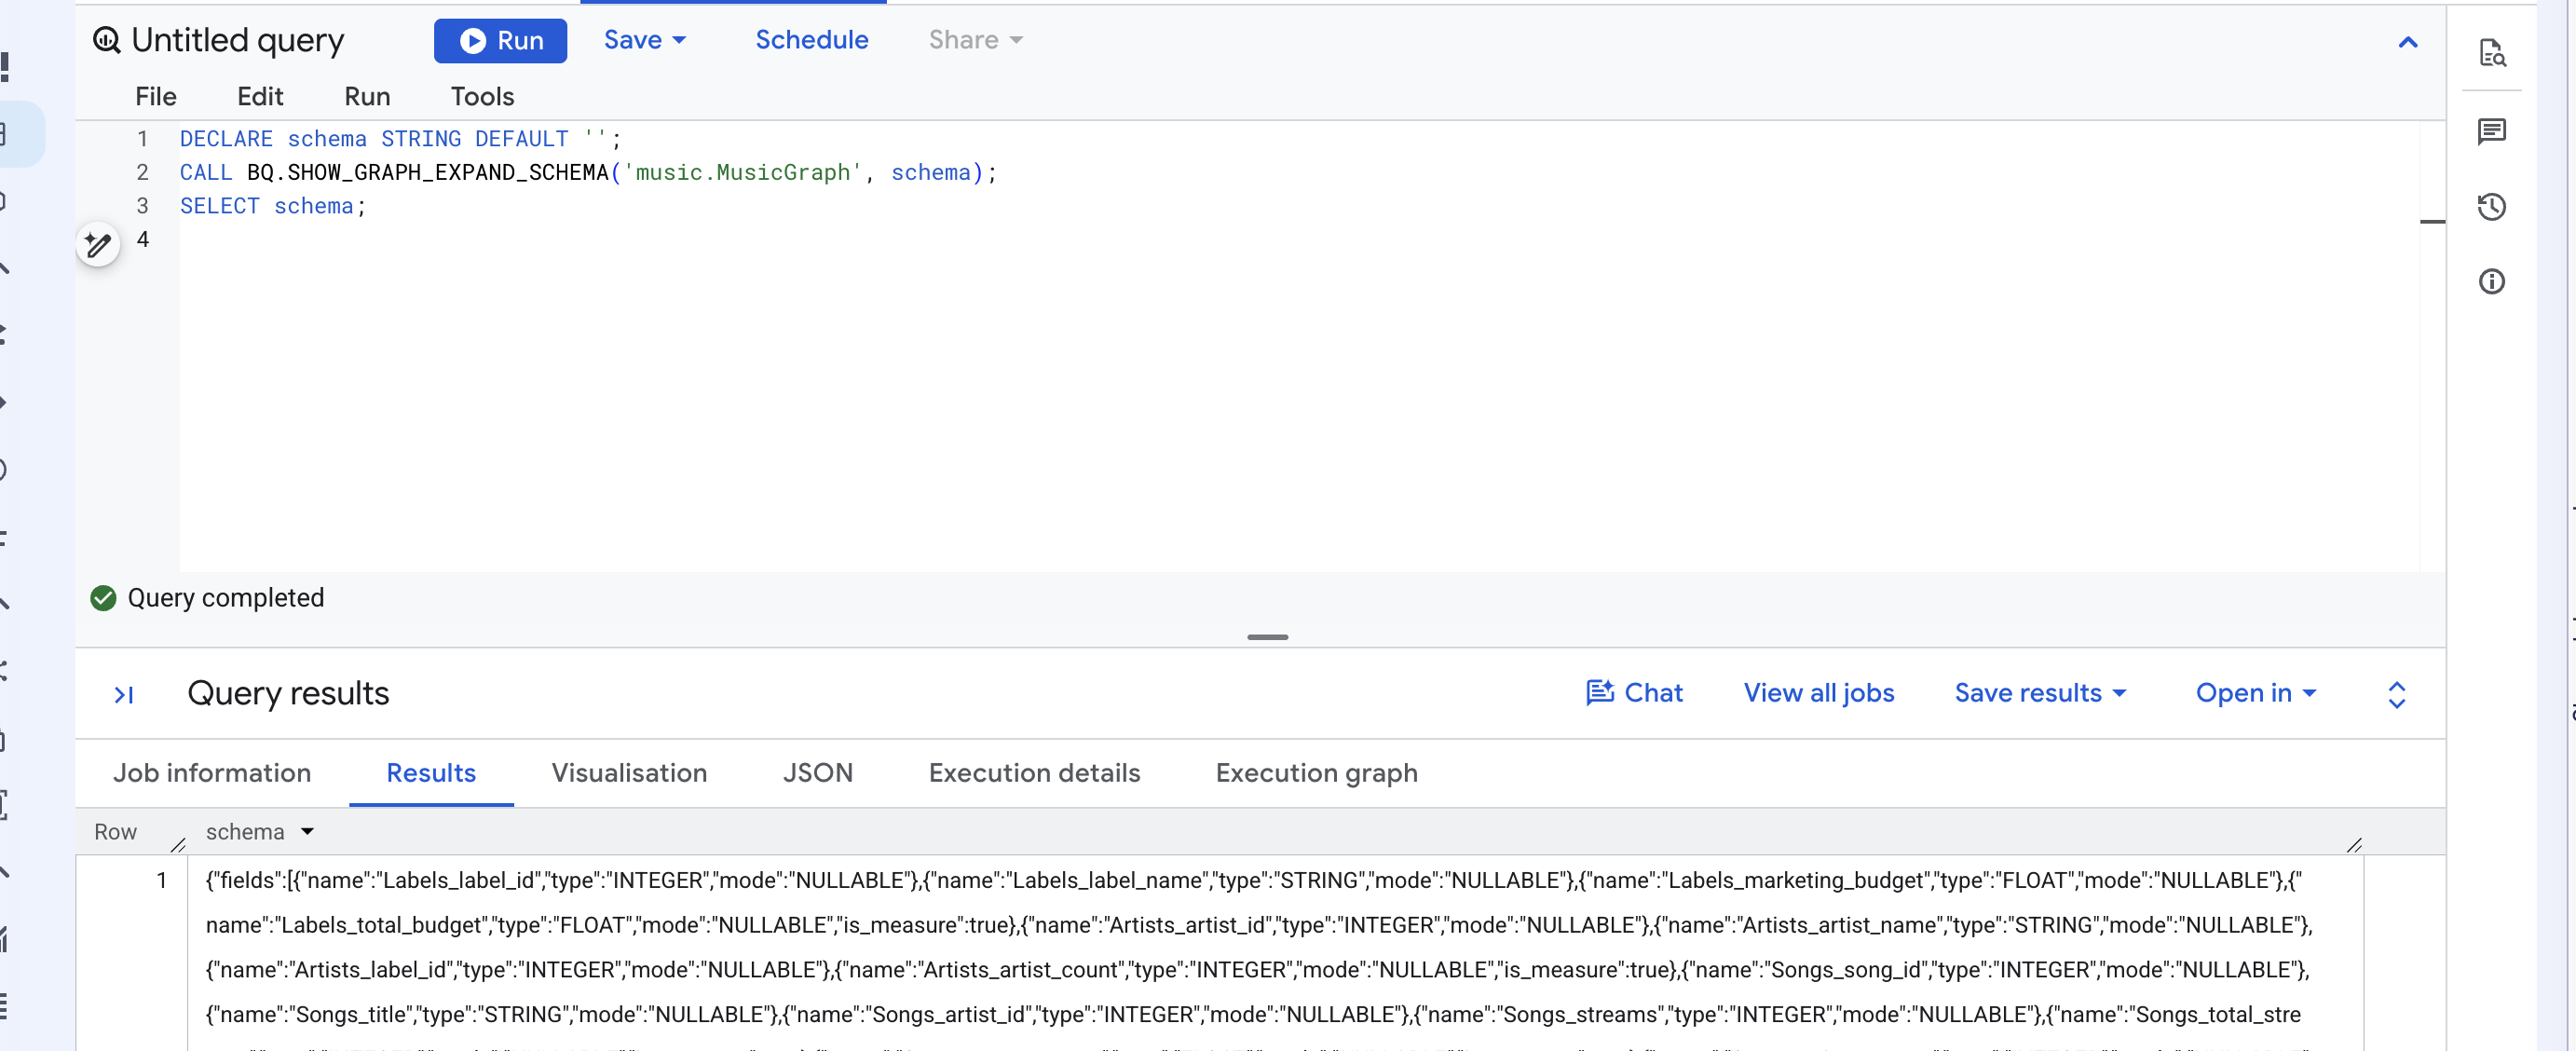
Qui vengono visualizzate anche le descrizioni o i sinonimi impostati in una proprietà. Il passaggio facoltativo della chat mostra chi li legge.
✅ Checkpoint:una stringa JSON con is_measure in ogni colonna dichiarata con MEASURE.
11. Cosa richiede GRAPH_EXPAND dalla forma di un grafico
Non c'è nulla da eseguire in questo passaggio, devi solo leggere. GRAPH_EXPAND crea la tabella ampia con una catena di LEFT JOIN, a partire da una tabella e seguendo i bordi verso l'esterno. Da questa regola ne derivano altre tre, che MusicGraph soddisfa tutte.
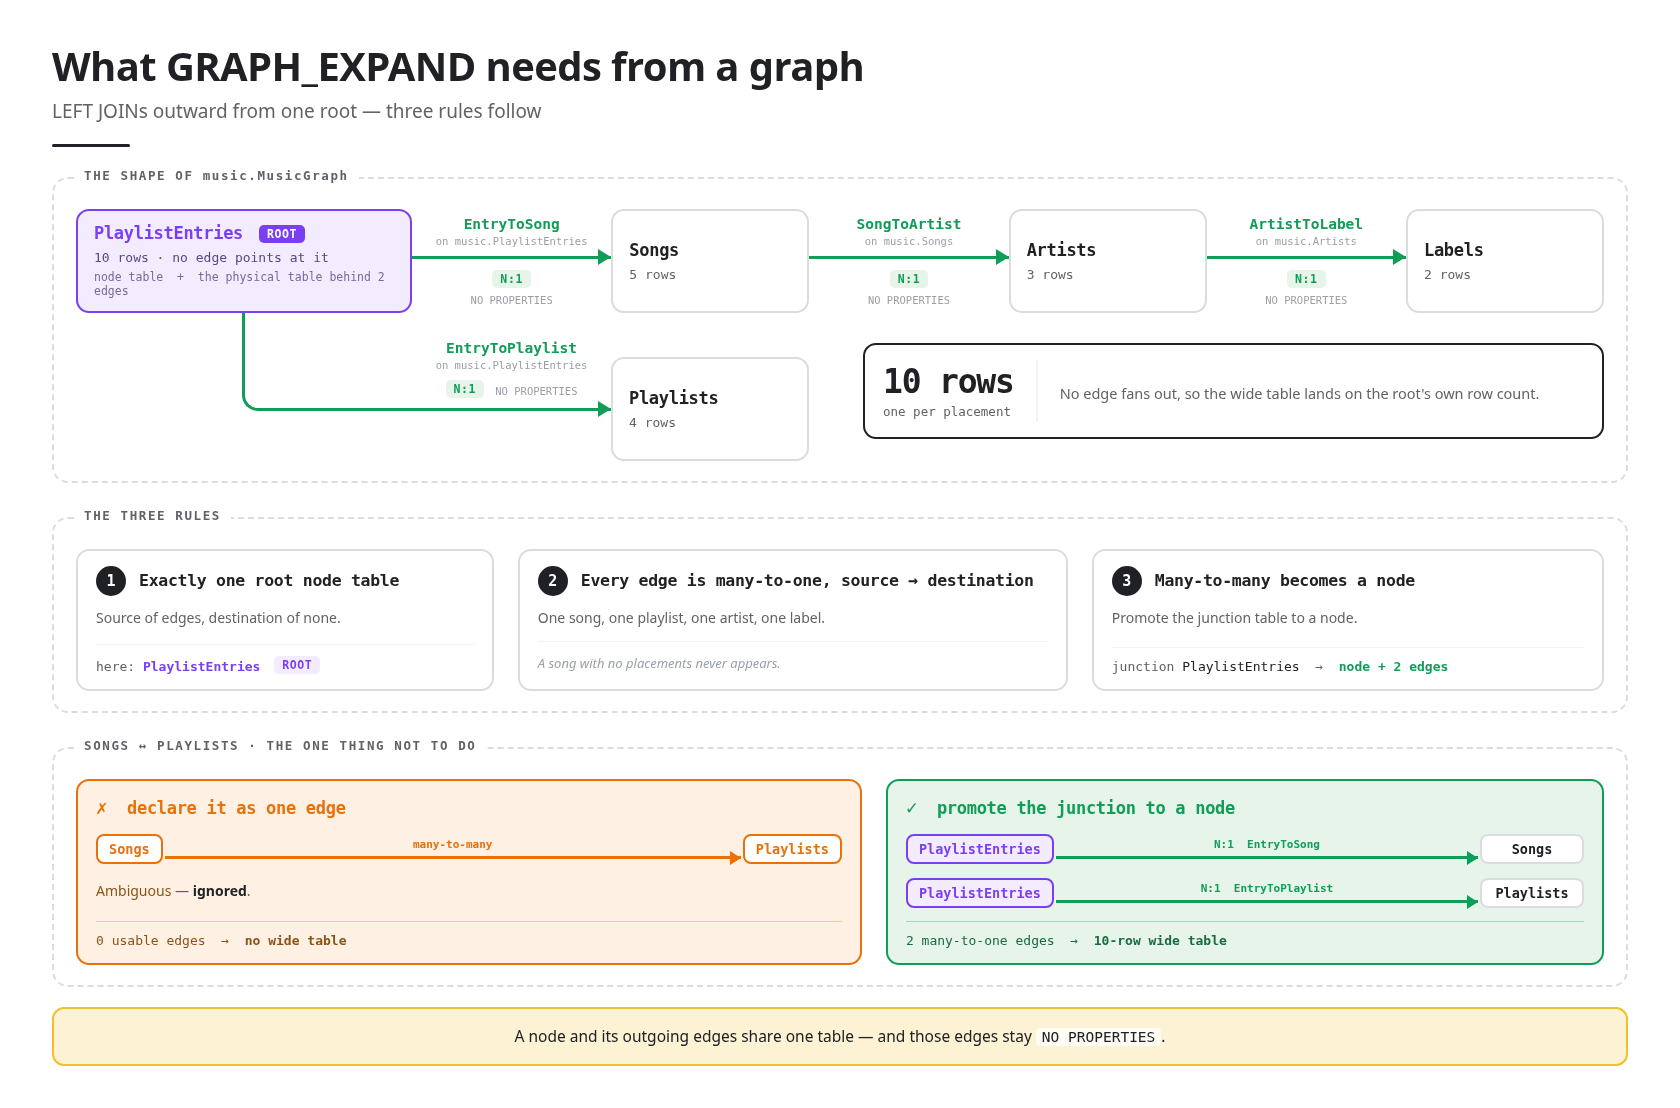
Esattamente una tabella del nodo principale. La radice è la tabella dei nodi la cui chiave non compare in nessun'altra tabella, quella a cui non punta nessun edge. In MusicGraph è PlaylistEntries: l'origine di due archi e la destinazione di nessuno. La tabella larga ha 10 righe, una per posizionamento.
Ogni bordo è di tipo molti-a-uno, dall'origine alla destinazione. Ogni voce ha un brano e una playlist, ogni brano ha un artista e ogni artista ha un'etichetta. Ecco perché la tabella larga non si estende mai oltre le righe della radice. I dati che la radice non può raggiungere non vengono visualizzati: un brano senza posizionamenti non sarebbe presente nella tabella larga.
Le relazioni many-to-many diventano un nodo. I brani e le playlist sono molti a molti. Se hai dichiarato la tabella di unione come un singolo bordo da Brani a Playlist, GRAPH_EXPAND la ignorerebbe in quanto ambigua e, non rimanendo bordi utilizzabili, l'operazione non andrebbe a buon fine. La promozione di PlaylistEntries a una tabella dei nodi con due archi many-to-one è il pattern documentato ed è quello che hai fatto quando hai creato il grafico.
12. (FACOLTATIVO) Percorsi con GQL
Finora, ogni domanda ha avuto un numero come risposta. Questo no. Dove raggiungono gli ascoltatori gli stream di Cymbal? è una domanda sulle rotte nel grafico e un totale non può rispondere, perché quando hai eseguito la somma, la rotta non è più disponibile.
1. Chiedi dove vengono pubblicati gli stream
👉📋 Editor di query: incolla, poi fai clic su Esegui:
GRAPH music.MusicGraph
MATCH (l:Labels)<-[:ArtistToLabel]-(a:Artists)<-[:SongToArtist]-(s:Songs)
      <-[:EntryToSong]-(e:PlaylistEntries)-[:EntryToPlaylist]->(pl:Playlists)
WHERE l.label_name = 'Cymbal Records'
RETURN pl.playlist_name, pl.followers,
       SUM(s.streams) AS streams_reaching_this_playlist,
       STRING_AGG(s.title, ', ') AS songs
GROUP BY pl.playlist_name, pl.followers
ORDER BY streams_reaching_this_playlist DESC
👀 Aspettati quattro playlist:
pl.playlist_name | pl.followers | streams_reaching_this_playlist | canzoni |
Hot Right Now | 35.000.000 | 4.700.000.000 | Doppio Shot, Neon Summer, Paper Crown |
Rising Pop | 2.000.000 | 3.500.000.000 | Estate al neon, corona di carta |
Viaggio in macchina | 5.000.000 | 2.400.000.000 | Neon Summer, Slow Arrow |
Gym Pump | 3.000.000 | 2.000.000.000 | Neon Summer |
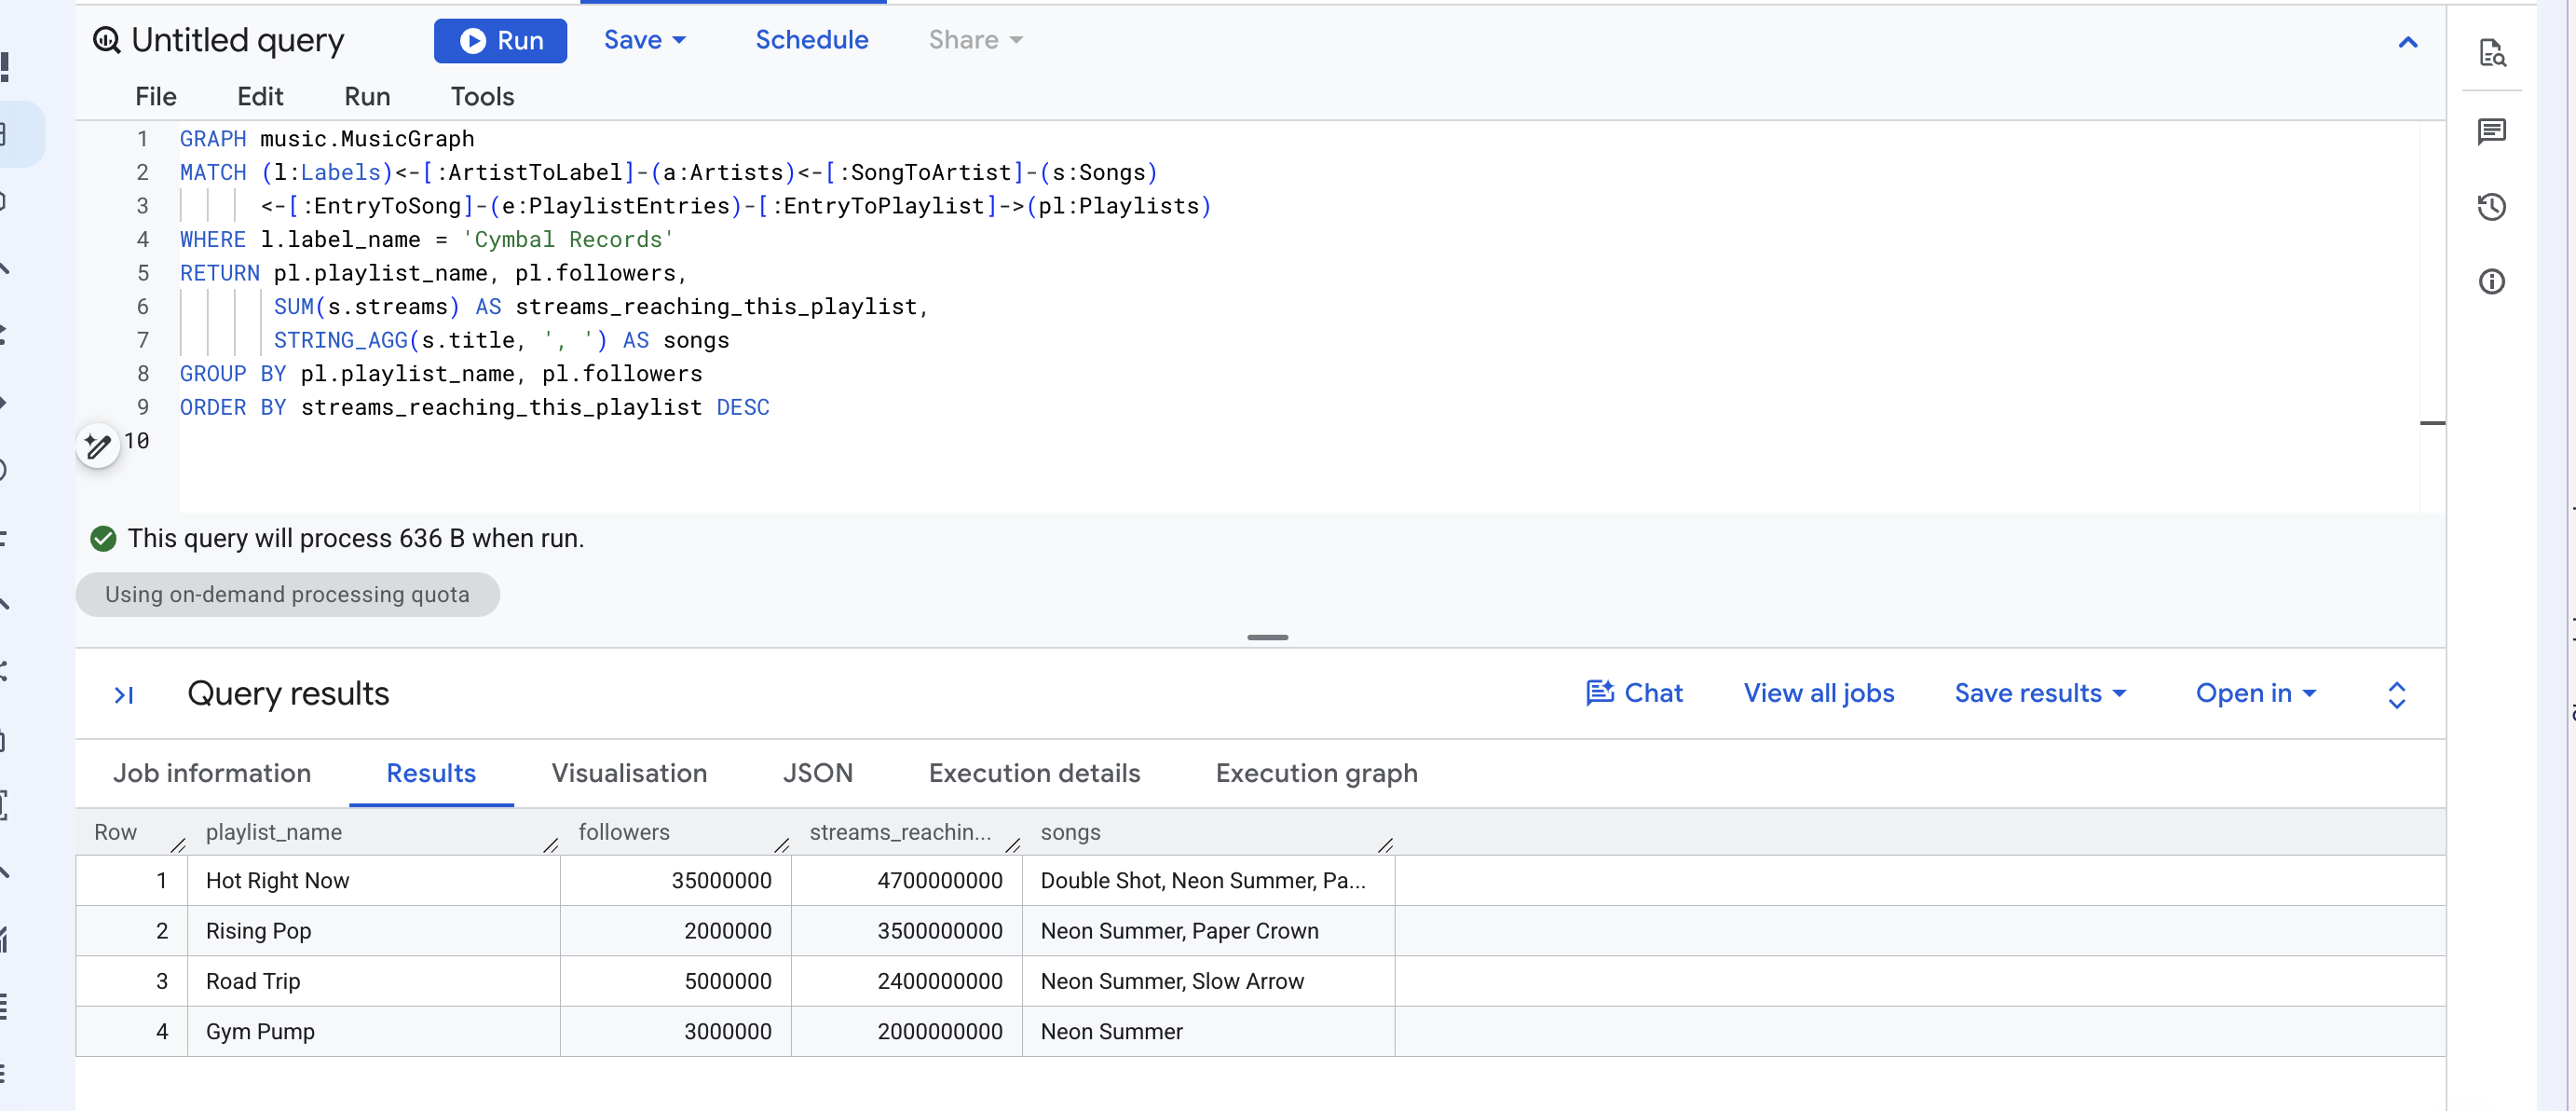
Leggi la riga MATCH come una frase: inizia da un'etichetta, torna ai suoi artisti, poi ai loro brani, poi alle voci della playlist in cui si trovano i brani e infine vai avanti fino alle playlist. Le frecce indicano la direzione in cui sono stati dichiarati i bordi; <- si sposta di uno indietro.
Ora somma la terza colonna. 12,6 miliardi: il numero SUM che ti è stato fornito nel passaggio 4, quello errato.
Ecco la risposta corretta. All'epoca la domanda era quanti stream avesse Cymbal e un brano veniva conteggiato una sola volta, indipendentemente dal numero di playlist in cui era presente. Questa domanda riguarda la portata degli stream e una traccia presente in quattro playlist raggiunge effettivamente quattro segmenti di pubblico. La duplicazione GRAPH_EXPAND produce un errore per una domanda e la risposta all'altra. AGG non ha mai riguardato la negatività dei duplicati, ma la corrispondenza dell'aritmetica alla domanda.
2. Restituisci i percorsi stessi
Interrompi l'aggregazione e chiedi i percorsi.
👉📋 Editor di query: incolla, poi fai clic su Esegui:
GRAPH music.MusicGraph
MATCH p = (l:Labels)<-[:ArtistToLabel]-(a:Artists)<-[:SongToArtist]-(s:Songs)
          <-[:EntryToSong]-(e:PlaylistEntries)-[:EntryToPlaylist]->(pl:Playlists)
WHERE l.label_name = 'Cymbal Records'
RETURN TO_JSON(p) AS path
p = assegna un nome all'intera corrispondenza e TO_JSON la visualizza.
👀 Prevedi 8 righe e una colonna path. Ogni cella è un array JSON dei nodi e dei bordi lungo un percorso, ogni nodo con il relativo labels e properties.
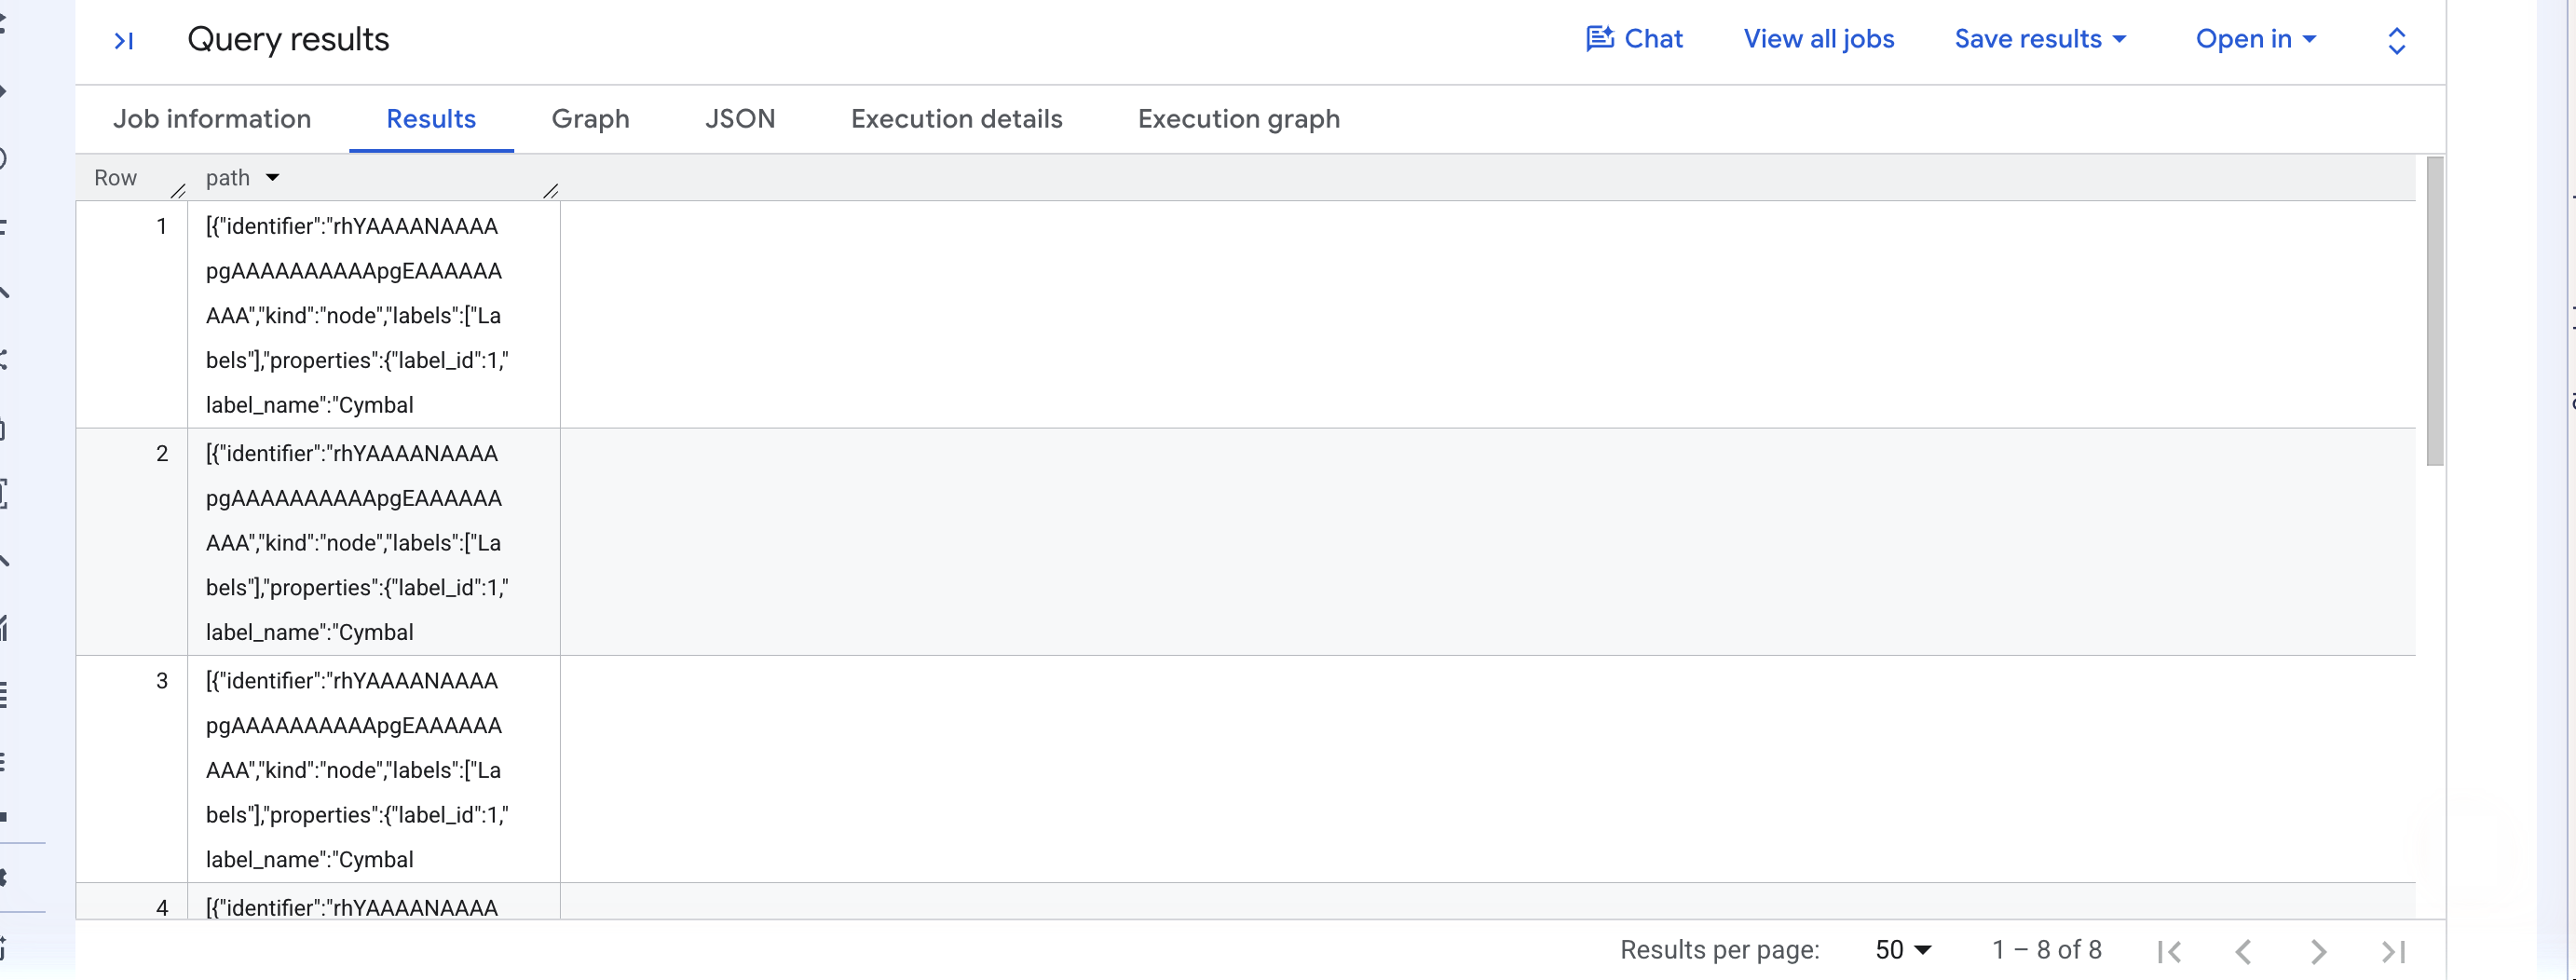
Otto righe per quattro brani, perché esiste una route per posizionamento, non per brano.
3. Apri la scheda Grafico
👉🌐 Console: sopra i risultati, fai clic su Grafico.
Questa scheda viene visualizzata solo quando un risultato contiene elementi del grafico. La query precedente restituiva numeri, quindi non aveva una scheda Grafico; questa restituisce percorsi, quindi ce l'ha.
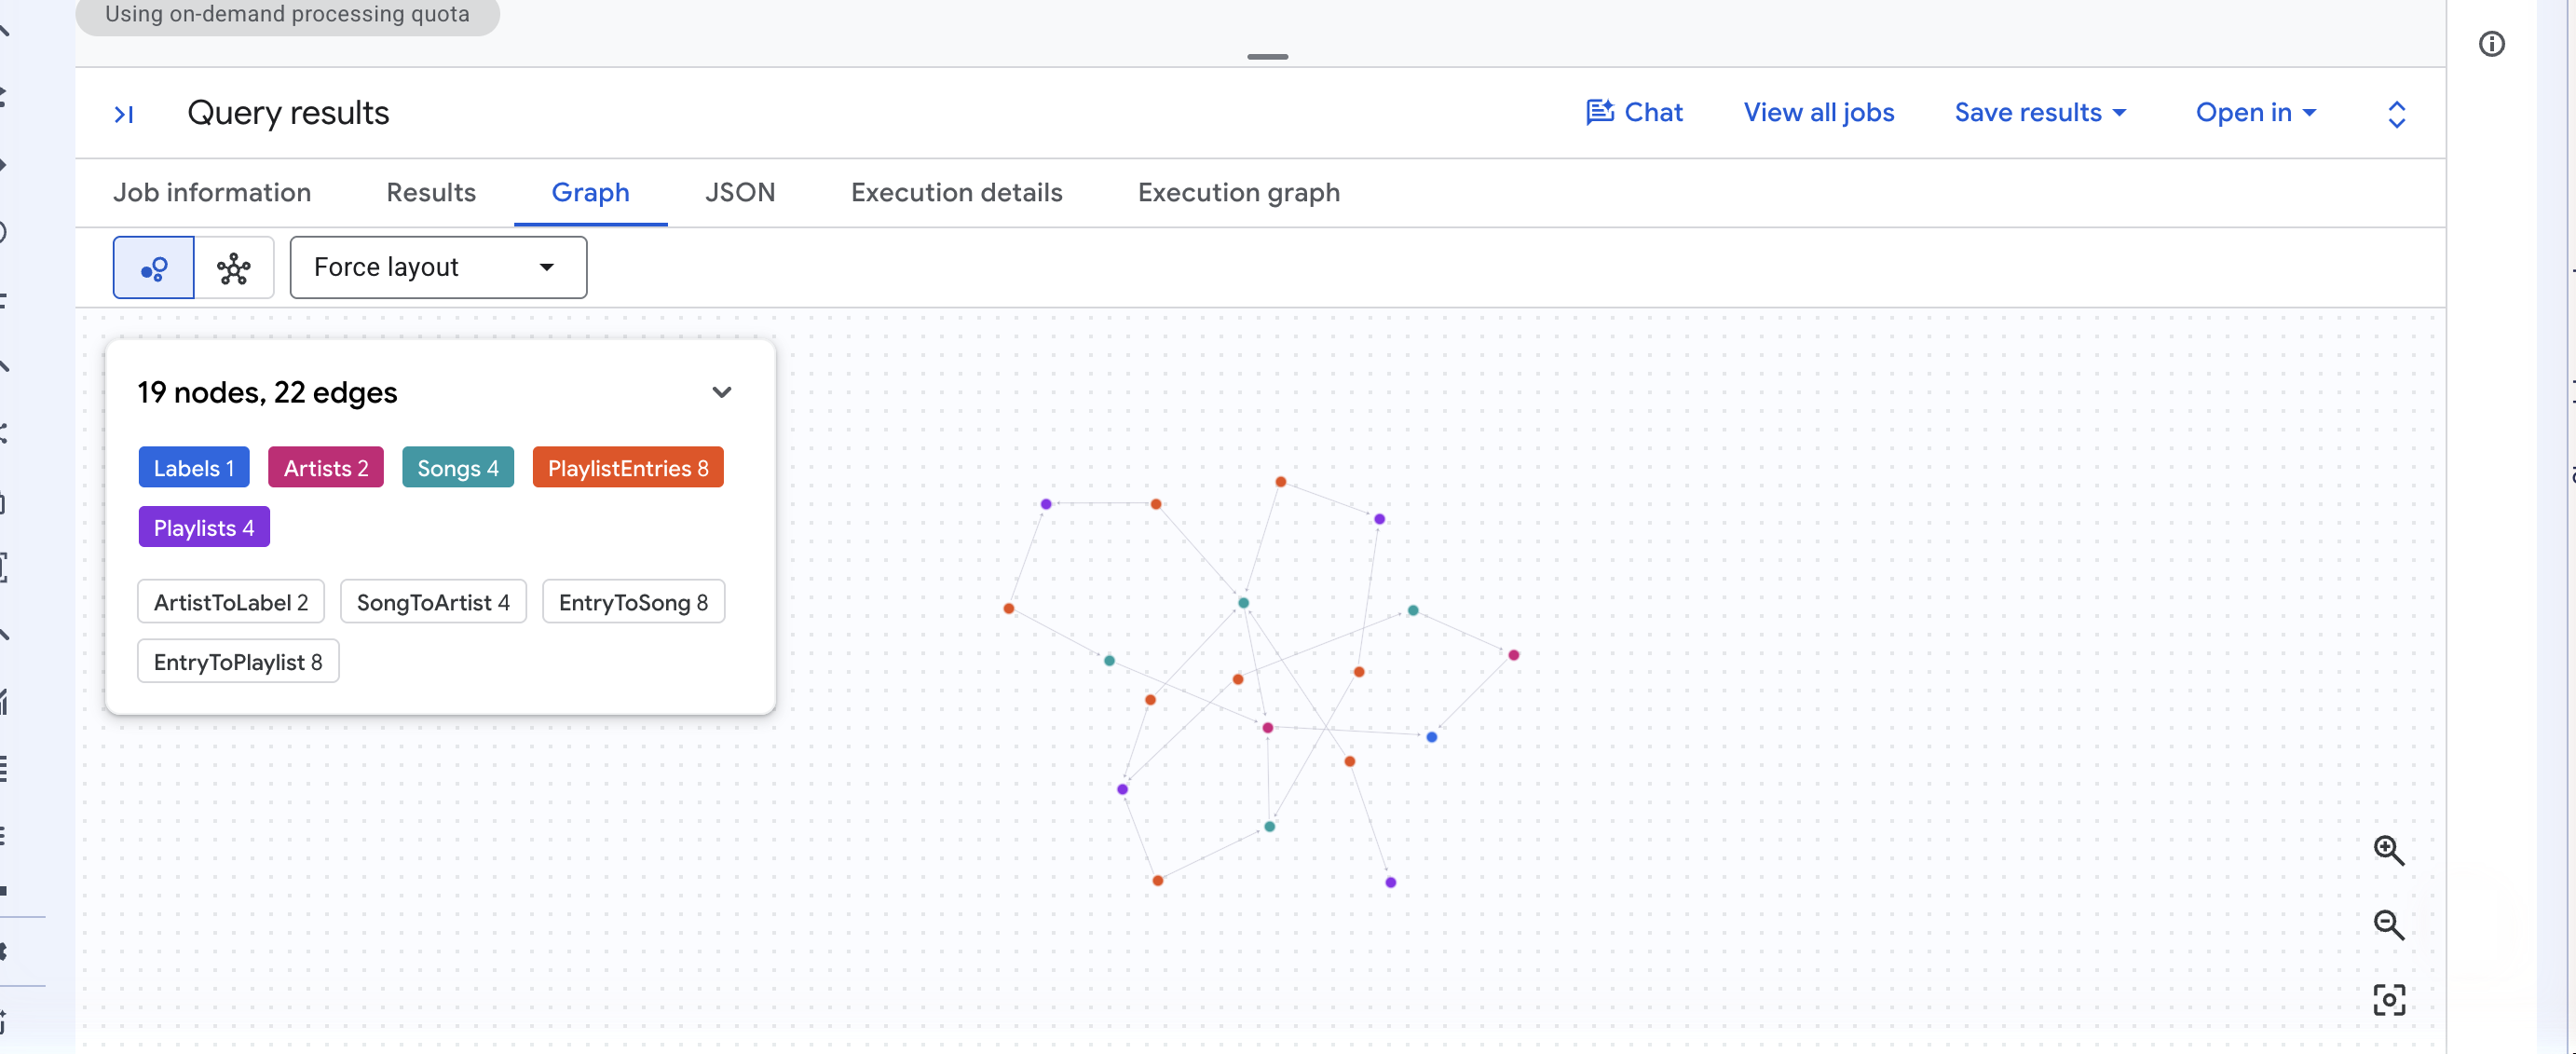
L'angolo del grafico di Cymbal viene disegnato come un layout forzato, con un conteggio dei nodi e degli archi in visualizzazione e un chip per etichetta. Trascina un nodo per separare il layout; fai clic su uno per leggerne le proprietà.
✅ Checkpoint: la terza colonna della prima query dà come risultato 12, 6 miliardi, la seconda query restituisce 8 percorsi e la scheda Grafico li disegna.
13. (FACOLTATIVO) Chatta con il grafico
Nessun SQL in questo passaggio. Gli agenti dati di BigQuery possono utilizzare un grafico come fonte di conoscenza e la documentazione indica che utilizzano le misure per l'aggregazione multilivello. Vediamo se è vero.
1. Crea l'agente
👉🌐 Console: nel menu di navigazione di BigQuery a sinistra, fai clic su Agenti, poi su Catalogo agenti e infine su Crea agente.
👉🌐 Console: digita Music graph agent in Nome agente e questo in Descrizione agente:
Ask questions about labels, artists, songs and playlists in the music property graph.
👉🌐 Console: in Fonti di conoscenza, fai clic su Aggiungi origine. Nella finestra di dialogo Seleziona fonti, espandi il progetto, espandi music, espandi Grafici, seleziona MusicGraph e fai clic su Conferma.
👀 Il pulsante Aggiungi fonte viene visualizzato in grigio. Un agente può contenere al massimo un grafico e non può combinare grafici e tabelle.
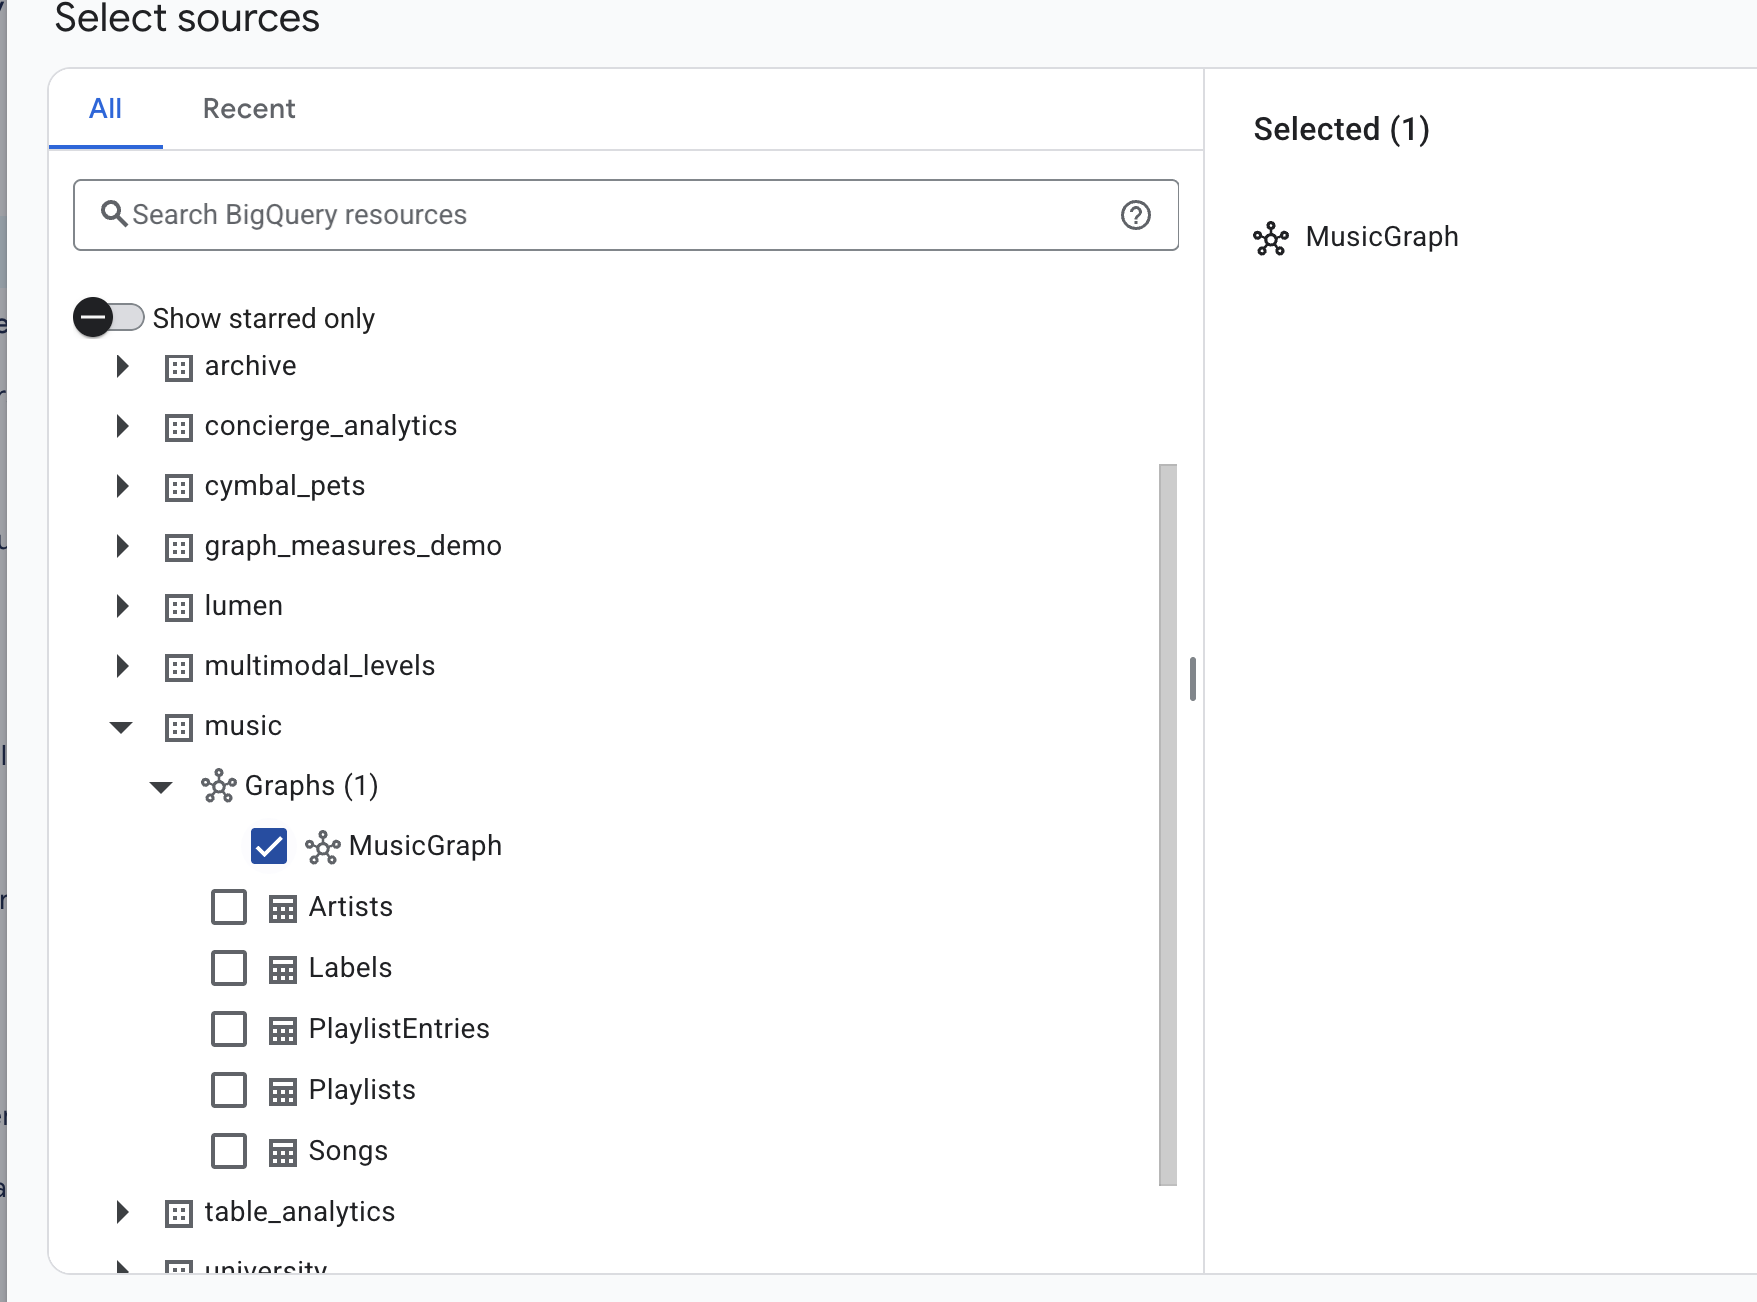
👉🌐 Console: lascia Regione così com'è impostata dalla posizione del grafico. Fai clic su Salva, quindi su Pubblica. Nel riquadro Canali di pubblicazione, fai clic su Pubblica agente e chiudi la conferma.
2. Fai la domanda
👉🌐 Console: fai clic su Crea conversazione. Si apre una pagina di chat. Digita questo testo nella casella Fai una domanda in basso e premi Invio:
For each label, show total streams and how many playlists their songs are on
👀 L'agente restituisce una tabella e un riepilogo di una frase:
label_name | total_streams | playlist_placements |
Cymbal Records | 5.100.000.000 | 8 |
Northwind Audio | 4.500.000.000 | 2 |
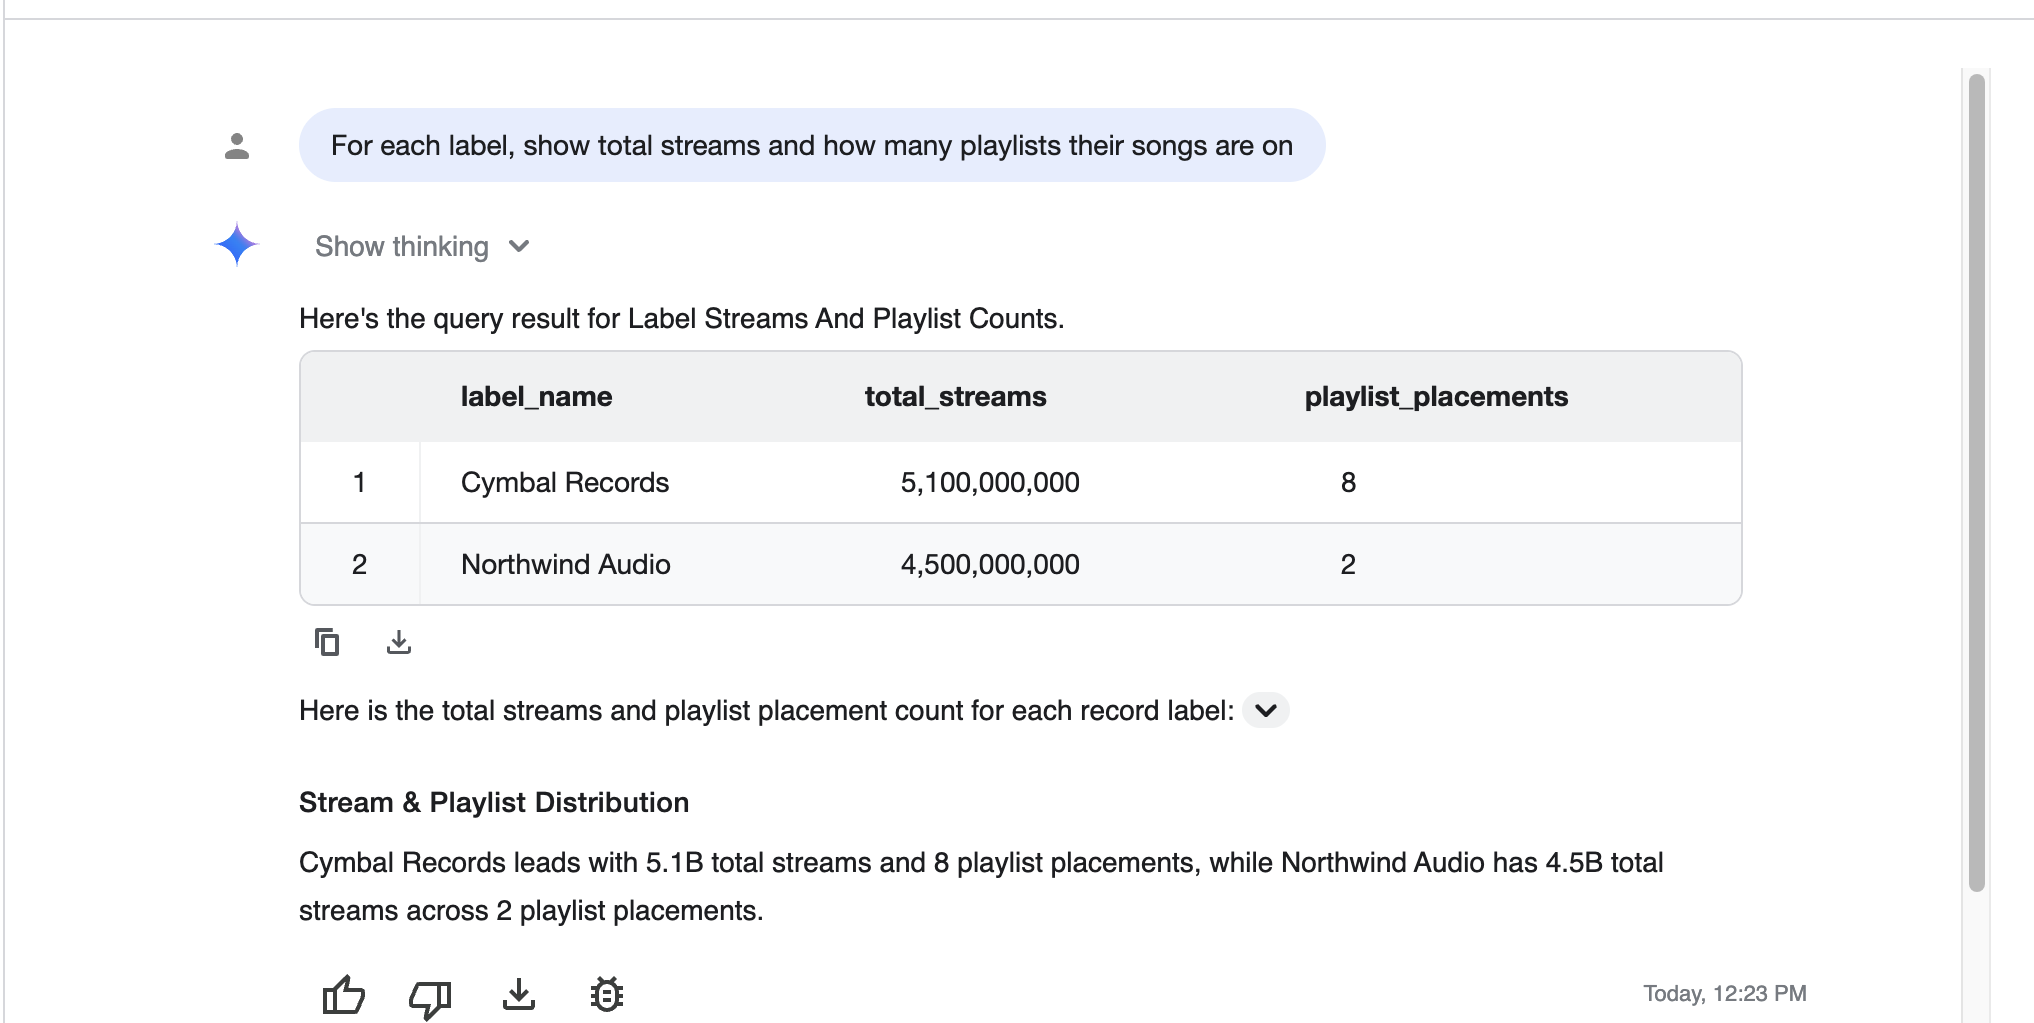
5,1 miliardi. Nessuno ha informato l'agente del fan-out e non è rientrato in questa categoria.
3. Leggi la query che ha scritto
👉🌐 Console: nel menu di navigazione, fai clic su Esplora job e poi sul job più recente. Le relative etichette includono ca-bq-job: true e data-agent-id con l'ID dell'agente e la query è:
SELECT
  Labels_label_name AS label_name,
  AGG(Songs_total_streams) AS total_streams,
  AGG(PlaylistEntries_placement_count) AS playlist_placements
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY label_name
ORDER BY total_streams DESC
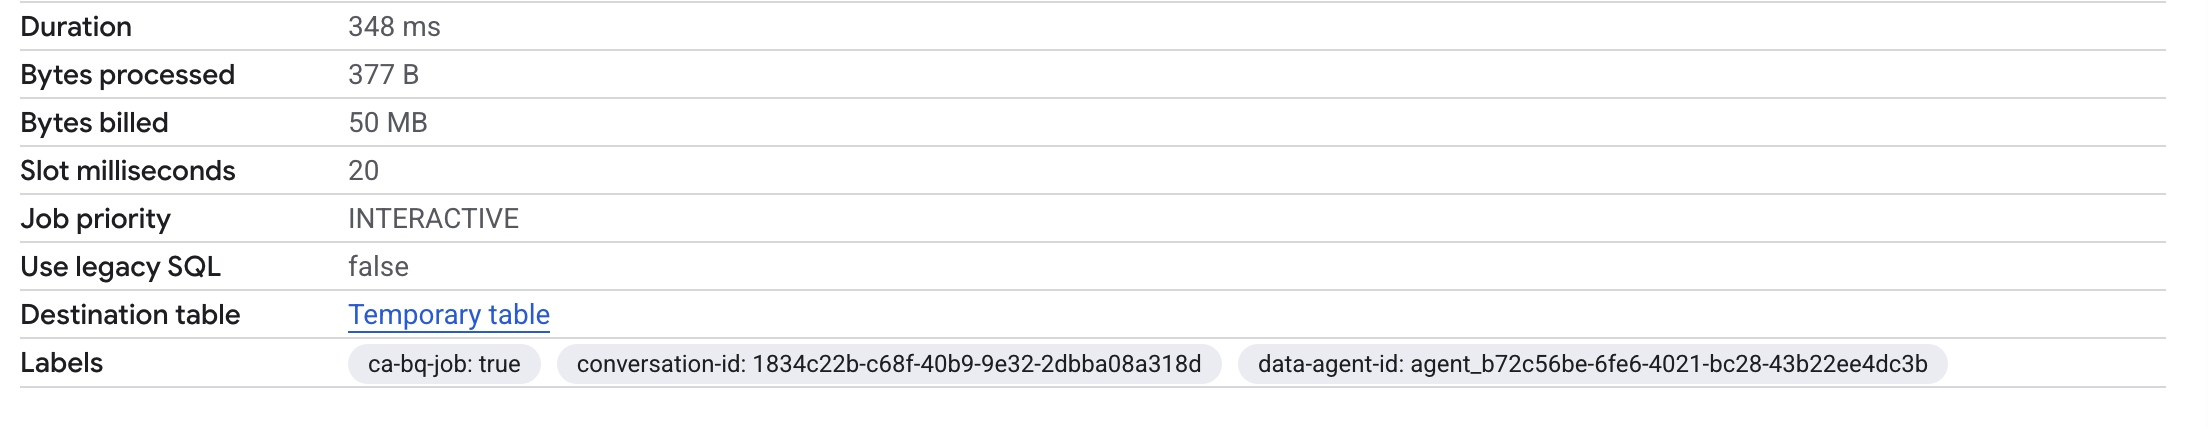
Ha utilizzato GRAPH_EXPAND e AGG da soli, perché le misure erano nello schema che ha letto. Nessun elemento nella descrizione dell'agente li menziona.
✅ Checkpoint: 5, 1 miliardi nella risposta della chat e AGG(...) nell'SQL del job.
14. Esegui la pulizia
👉💻 Cloud Shell: rilascia il set di dati, le relative tabelle e il grafico delle proprietà:
cd ~/bq-graph-measures-lab
./cleanup.sh
👀 Aspettati ✓ dropped YOUR_PROJECT_ID.music (tables and graph).
Se hai creato l'agente di dati facoltativo, eliminalo nella console in Agenti → Catalogo agenti. Se ./setup_project.sh ha creato un progetto solo per questo lab, la pulizia più ordinata di tutte è chiudere l'intero progetto. L'ID si trova in ~/project_id.txt.
15. Complimenti
Hai dichiarato una riga, MEASURE(SUM(streams)), e ha trasformato 12,6 miliardi in 5,1 miliardi, per te e per ogni query che chiunque scriverà in seguito su quel grafico, comprese quelle scritte da un agente.
Che cosa hai imparato
- Una misura è un aggregato dichiarato su un nodo, accanto a
KEYche ne imposta la granularità. GRAPH_EXPANDappiattisce il grafico in un'unica tabella ampia conTableLabel_propertycolonne.AGGè l'unica funzione che legge una misura e il sistema di tipi la applica in quattro modi diversi.- Sono disponibili sei aggregazioni e i risultati di
AGGsono valori ordinari che puoi dividere. - La modifica di
GROUP BYripropone la domanda senza toccare la misura. GRAPH_EXPANDvuole una radice, bordi many-to-one e giunzioni promosse a nodi.
La tabella delle decisioni
Sintomo | Causa | Correggi |
Un totale troppo elevato |
| dichiarare una misura, leggerla con |
"expected MEASURE, found INT64" (previsto MEASURE, trovato INT64) |
| utilizza |
"Non è consentito restituire espressioni di tipo MISURA" | colonna di misurazione senza | wrap it: |
"non esposto per tipo di elemento" | misura a cui viene fatto riferimento in GQL | misura il ritardo rispetto a |
| incrocio modellato come un arco | promuovere la tabella di giunzione a nodo |
Un numero precedente dopo aver modificato il grafico | risultato memorizzato nella cache | deseleziona Utilizza risultati memorizzati nella cache |
Argomenti non trattati (di proposito)
Descrizioni e sinonimi delle proprietà, query verificate e glossari per gli agenti di dati, GQL oltre un MATCH, misure in più grafici. Ciascuno è un lab a sé stante.
Scopri di più
- Utilizzare le misure
- Creare ed eseguire query su un grafico delle proprietà
- Panoramica dell'analisi conversazionale
- Il repository del lab: ogni query di questo codelab, numerata per passaggio