

1. 概要
コードレビューを通過する SQL バグのほとんどは、集計バグです。ある数値が、その数値が存在するテーブルでは正しいが、結合によってコピーされ、合計が間違っている。
BigQuery Graph を使用すると、テーブルの接続方法をプロパティ グラフとして 1 回記述し、接続をクエリできます。グラフの指標では、集計自体が説明に追加されます。数値を所有するノードで MEASURE(SUM(streams)) を宣言すると、グラフを読み取るすべてのクエリが適切な粒度で正しい合計を取得します。GROUP BY のトリックや、誰かが覚えておく必要のある CTE はありません。
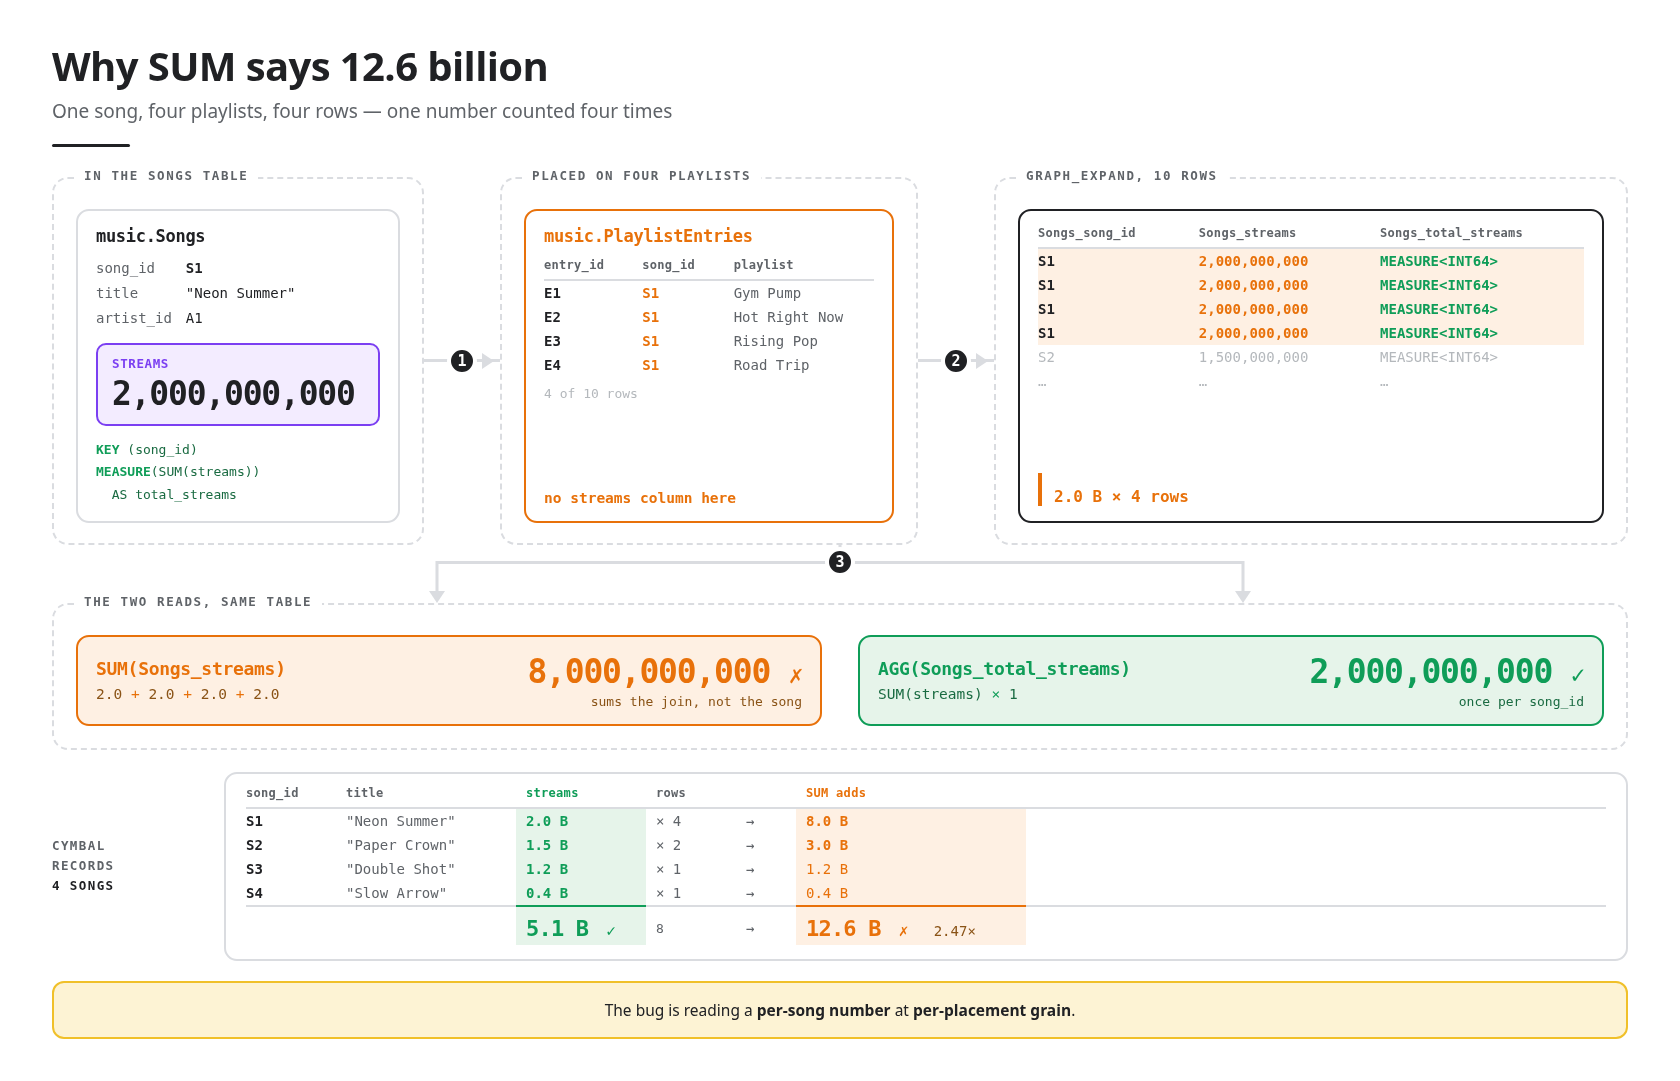
この Codelab では、5 つのテーブルからなる音楽カタログを作成し、1 つの指標を配置して、同じ質問に対して 2 つの異なる回答(SUM の場合は 126 億、AGG の場合は 51 億)が返されることを確認します。このギャップはカタログの形状です。4 つのプレイリストに登録されている曲は、グラフが平坦化されると 4 行になり、SUM はその 4 行すべてを追加します。次に、2 つ目の文が正しい理由を学びます。
入力する場所
このラボでは、次の順序で 2 つの場所を使用します。
ここで | その中で何をするか | |
1 | Cloud Shell ターミナル | セットアップ ステップでのみ、少数のコマンド |
2 | BigQuery コンソール | その他: クエリエディタへのクエリの貼り付け、グラフ モデラーのクリック、エージェントとのチャット |
すべての指示にはタグが付けられているため、どの指示を意味するのかを常に把握できます。
- 👉💻 Cloud Shell - Cloud Shell ターミナルに次のように入力します。
- 👉📋 クエリエディタ - BigQuery クエリエディタに貼り付けて、[実行] をクリックします。
- 👉🌐 コンソール - BigQuery コンソールでクリックします。手順に記載がない限り、何も入力しないでください。
- 👀 - 結果を確認します。
学習内容
- ノードテーブルで指標を宣言する方法(ビジュアル グラフ モデラーまたは SQL)
GRAPH_EXPANDがグラフを 1 つのワイドテーブルにフラット化する方法AGGが指標を読み取ることができる唯一の関数である理由と、他の試行で返される内容- 指標がサポートする 6 つの集計と、それらに対する算術演算の方法
- グループ化された質問に対する回答が変更されていない場合
- 省略可: GQL と [グラフ] タブで合計では答えられない質問に回答する方法、BigQuery データ エージェントが指標を認識せずに使用する方法
必要なもの
- 課金が有効になっている Google アカウントとブラウザ。Google Cloud プロジェクトを事前に用意する必要はありません。セットアップで自動的に作成されます。
- 省略可能なチャット ステップの場合のみ: Gemini Data Analytics API が有効になっていることと、Gemini Data Analytics Data Agent Creatorロール。
マシンにインストールするものはありません。すべて Cloud Shell と BigQuery コンソールで実行されます。
サービスのステータスと費用
BigQuery Graph の一般提供が開始されました。グラフ指標、ビジュアル グラフ モデラー、グラフの可視化、グラフをデータ エージェントのナレッジソースとして使用することは、プレビュー版であり、pre-GA サービス規約が適用されます。
GRAPH_EXPAND と AGG はオンデマンド料金で実行されます。ドキュメントによると、GQL クエリ(オプションのパスステップ)には Enterprise エディションまたは Enterprise Plus エディションを使用する予約が必要です。そのため、このステップは省略可能です。
データセットは数キロバイトです。オンデマンド料金では、各クエリに 10 MB の最小料金が課金されるため、このコードラボ全体の費用は 1 セントの数分の 1 になります。
2. セットアップ
Cloud Shell を使用するのはこの手順のみです。プロジェクトを作成し、請求を有効にして、未加工のテーブルを構築します。グラフ、指標、すべてのクエリは、BigQuery コンソールで後から実行できます。
このラボでは、課金が設定された Google Cloud プロジェクトは提供されません。ステップ 1 で支払い可能なアカウントを取得し、ステップ 4 でそのアカウントをプロジェクトに変換します。この順序で実行します。手順 4 以降のすべての手順で、手順 4 で作成したプロジェクトが読み取られます。
1 · 請求先アカウントを取得する (約 1 分)
👉🌐 まずはこちらの手順をお試しください。課金が有効になっている Google アカウントでログインします。このようなアカウントはすべて機能します。お持ちでない場合は、無料トライアルを開始してください。これにより、請求先アカウントが作成されます。これは、手順 4 で必要なものです。
2 · Cloud Shell を開く (約 1 分)
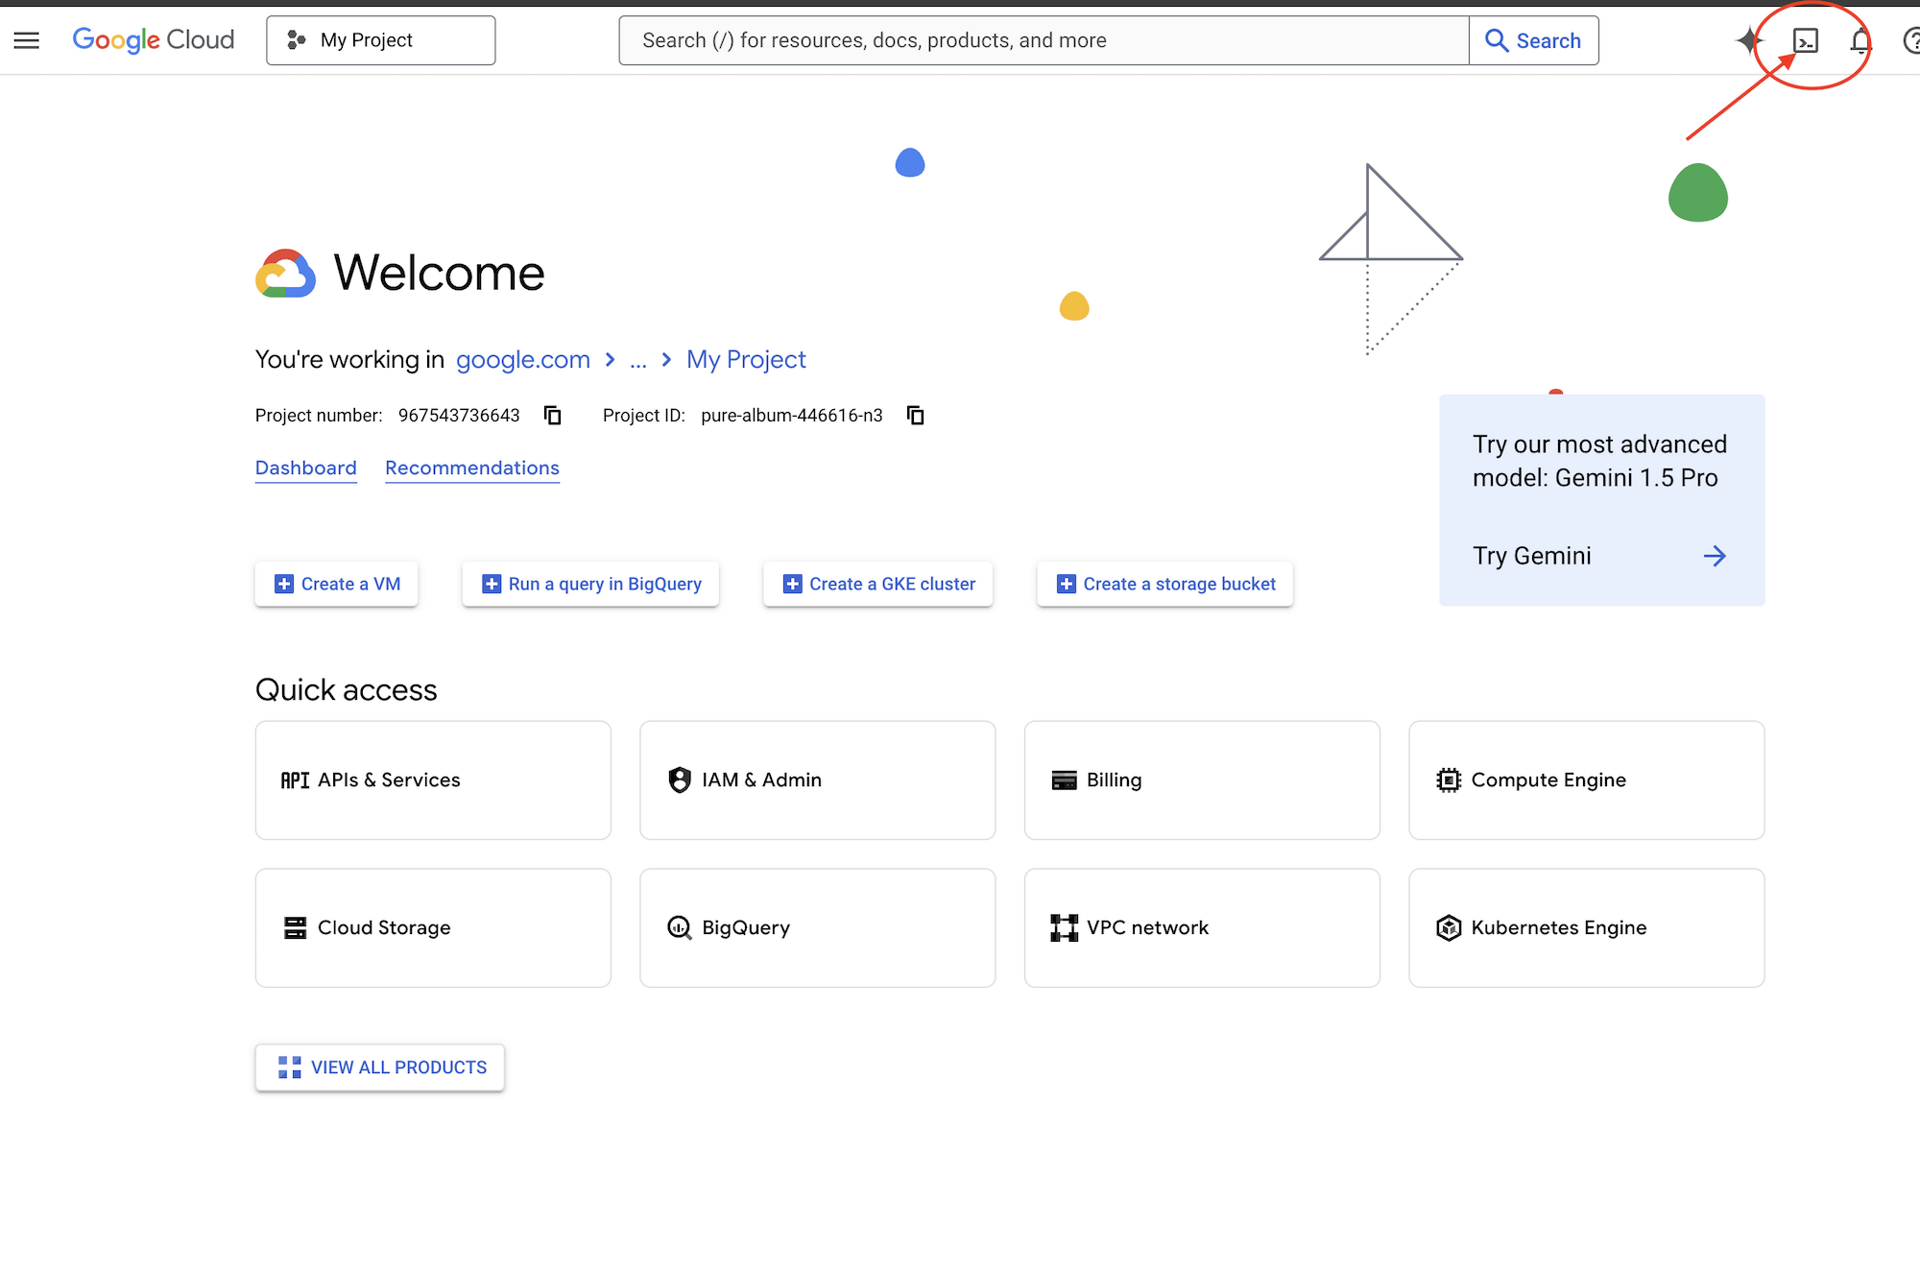
👉🌐 コンソール - Google Cloud コンソールの最上部にある [Cloud Shell をアクティブにする] をクリックします。これはヘッダーにあるターミナル型のアイコンです。ページの下部にターミナルが開きます。
👉🌐 コンソール - 今日、承認を求めるプロンプトがいつか表示されたら、[承認] をクリックして続行します。
👉💻 Cloud Shell - Cloud Shell にログインしているアカウントを確認します。
gcloud auth list
👀 ご自身のアカウントには * が付いています。これは、ステップ 1 でログインしたアカウントと同じである必要があります。正しくない場合は、gcloud auth login を実行して正しいものを選択します。
3 · ラボを入手する (約 1 分)
👉💻 Cloud Shell - リポジトリのクローンを作成します。
cd ~
rm -rf ~/bq-graph-measures-lab
git clone https://github.com/cuppibla/bq-graph-measures-lab.git
cd ~/bq-graph-measures-lab
4 · プロジェクトを作成する (約 2 分)
👉💻 Cloud Shell - 1 つのスクリプトで請求先アカウントを検索し、そのアカウントにプロジェクトを作成して、Cloud Shell をそのプロジェクトに設定します。
cd ~/bq-graph-measures-lab
./setup_project.sh
👀 選択した請求先アカウントの ✓、作成したプロジェクトの ✓、次のような終了が返されることを想定しています。
Project ready: bq-graph-4271
  Next:  ./setup.sh
bq-graph-4271 はプロジェクト ID です。実際のプロジェクト ID は異なる数字になります。この中で次の 4 つの処理が行われます。
請求 | 最新の | |
project |
| |
選択 | ID を | |
waits | 新しいプロジェクトが実際にサービングを許可されるまで、最大 2 分間ポーリングします。 | |
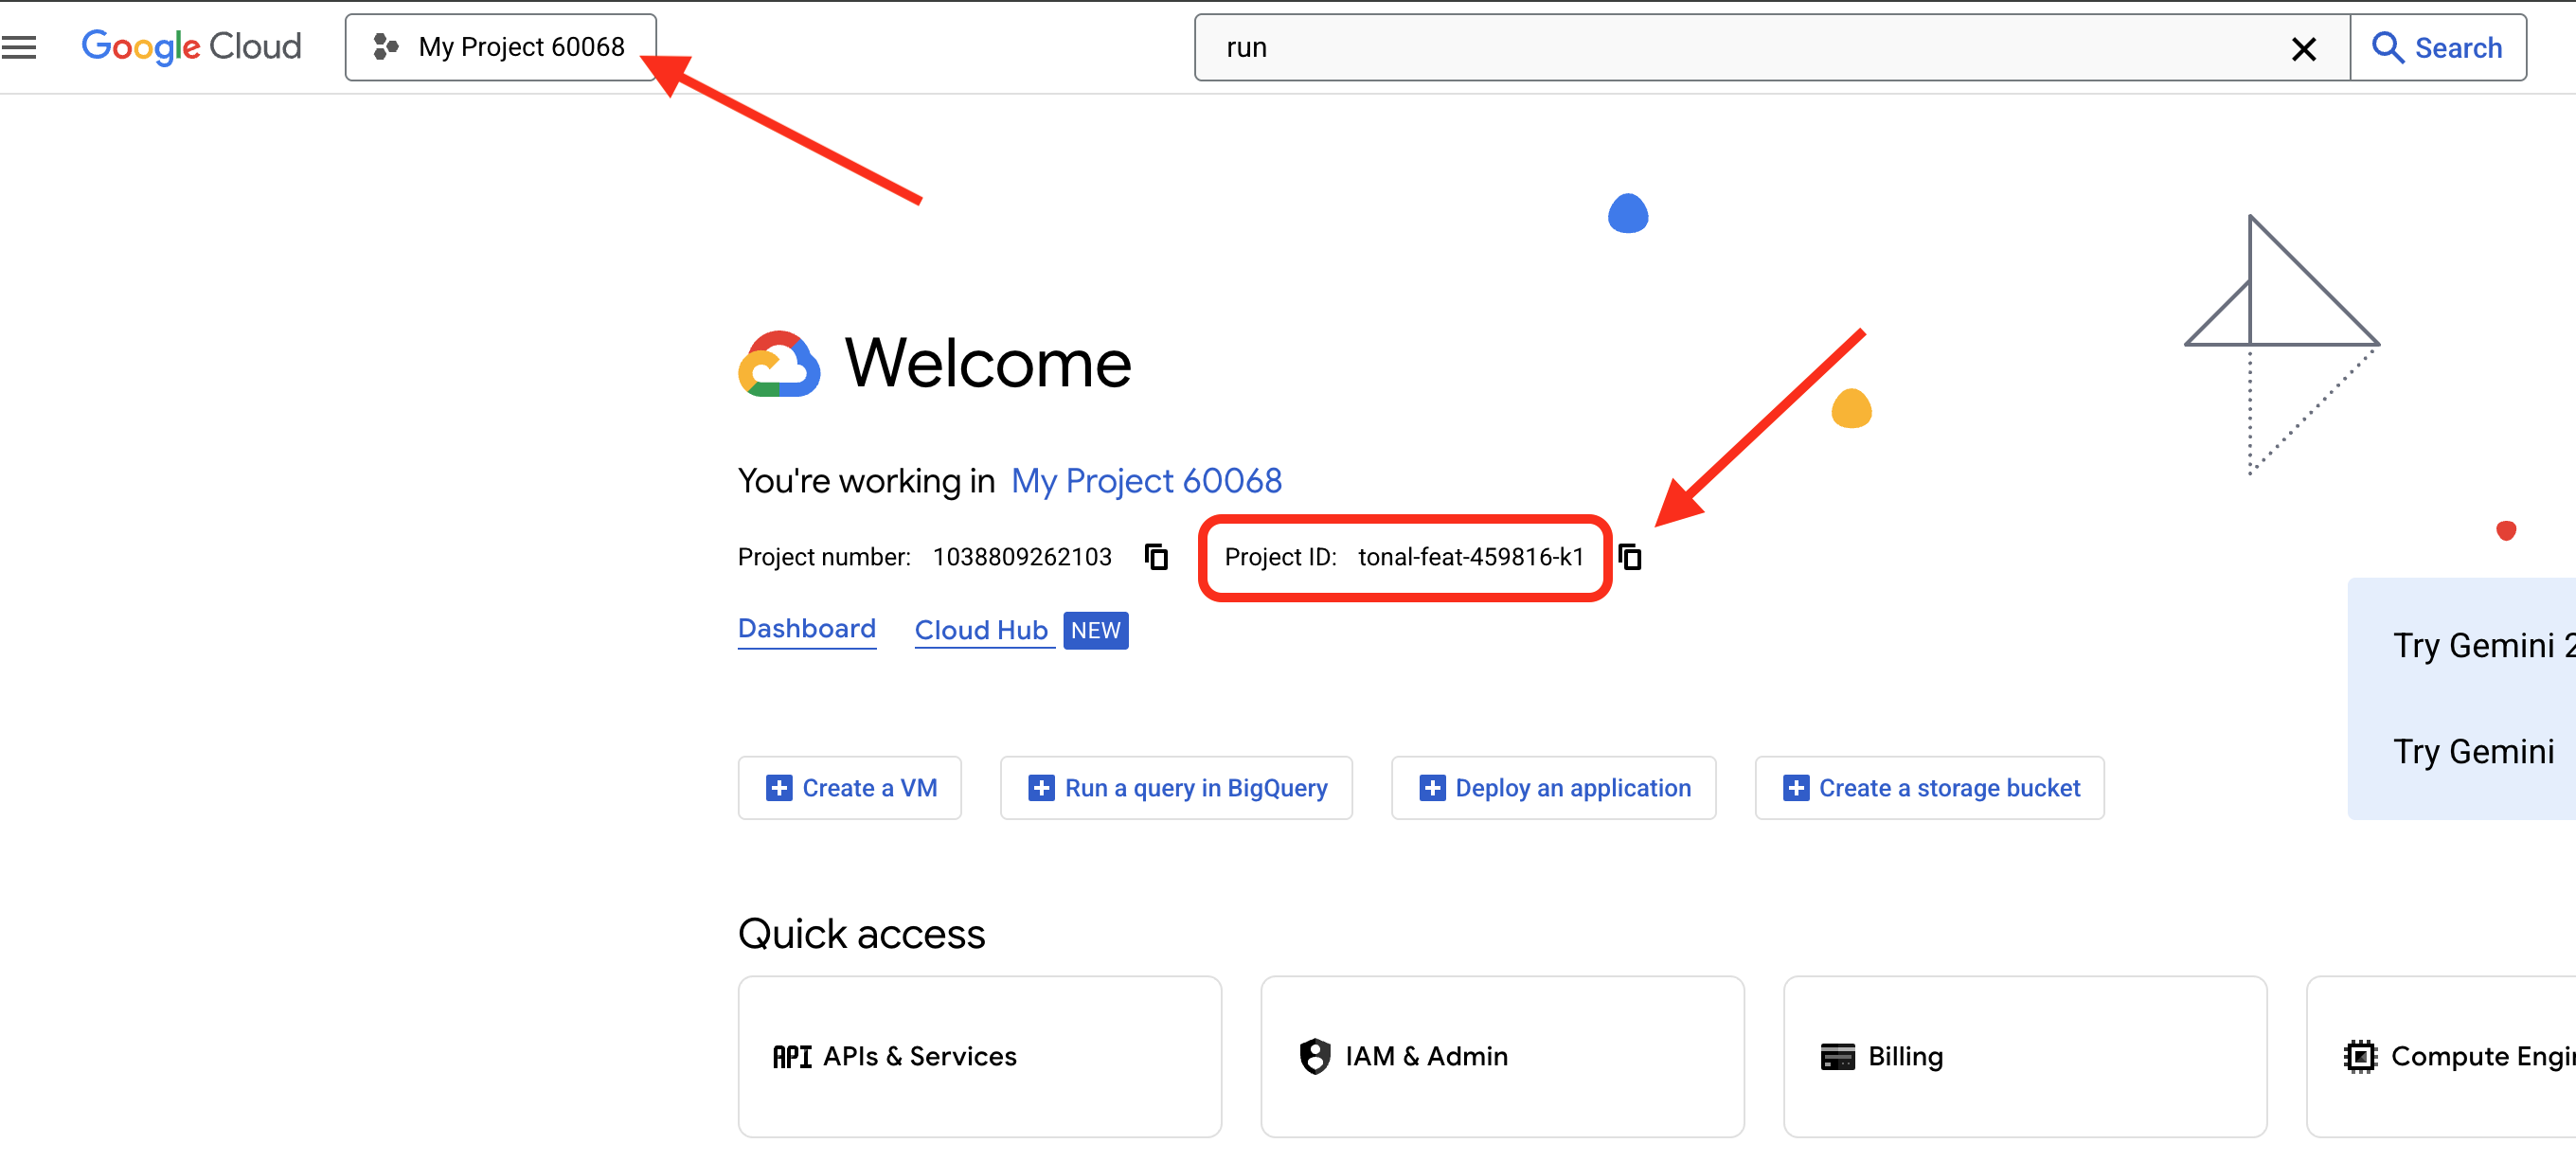
🌐 同じプロジェクトがコンソールに表示されます。その ID は、ダッシュボードの [プロジェクト情報] カードに表示されます。
5 · データセットを作成する (約 3 分)
👉💻 Cloud Shell - もう 1 つのスクリプトでテーブルをビルドします。
cd ~/bq-graph-measures-lab
./setup.sh
スクリプトは、実行時に各ステップを出力します。処理内容(順序どおり):
project |
| |
API |
| |
データセット | 米国マルチリージョンに | |
確認 | すべてのテーブルの行数をカウントし、カウントが一致しない場合は停止します。 | |
👀 期待される動作:
BigQuery Graph Measures · setup
  ✓ project: bq-graph-4271
  ✓ BigQuery API enabled

Creating dataset music (US) and five tables...
  ✓ music.Labels              2 rows
  ✓ music.Artists             3 rows
  ✓ music.Songs               5 rows
  ✓ music.Playlists           4 rows
  ✓ music.PlaylistEntries    10 rows

🎉 ready — open BigQuery Studio: https://console.cloud.google.com/bigquery?project=bq-graph-4271
Cloud Shell の操作は完了しました。閉じることができます。
6 · BigQuery とクエリエディタを開く
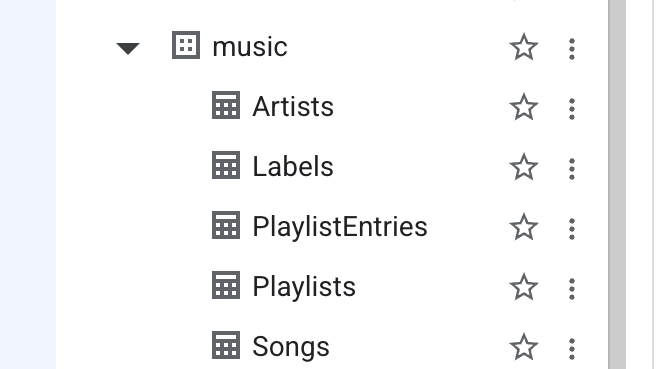
👉🌐 コンソール - 出力の末尾にあるリンクをクリックするか、ナビゲーション メニューから BigQuery を開きます。左側の [エクスプローラ] ペインで、プロジェクトを開きます。5 つのテーブルを含む music データセットが表示されます。
👉🌐 コンソール - BigQuery Studio の上部にある [新規作成] 行で、[SQL クエリ] をクリックします。空のエディタタブが開きます。
このタブはそのままにします。このラボのすべての 👉📋 ブロックはここにあります。エディタの内容を選択し、新しいブロックを貼り付けて、[実行] をクリックします。結果は下のパネルに表示されます。
テーブルについて
これらのテーブルについては、後で 2 つの点が重要になります。すべてのテーブルは主キーを NOT ENFORCED として宣言します。BigQuery はこれをチェックしませんが、これから作成するプロパティ グラフでは、行を識別するものを把握するために明示的なキーが必要です。最後のテーブル PlaylistEntries はジャンクション テーブルです。4 つのプレイリストにある曲は、4 つの行を持ちます。このテーブルでストーリー全体が展開されます。
テーブルは次のように連鎖しています。レーベルがアーティストと契約し、アーティストが曲をリリースし、PlaylistEntries を介して曲がプレイリストに配置されます。Cymbal Records は Ava Sterling と Mina Okafor を所有しており、この 2 人を通じて 4 曲を所有しています。Northwind Audio は Kai Nakamura と 1 曲「Midnight Drive」を所有しています。
テーブル | 行 | key | 保持しているもの |
ラベル | 2 |
| 名前、マーケティング予算 |
アーティスト | 3 |
| 名前、どのラベル |
曲 | 5 |
| タイトル、アーティスト、ストリーム数 |
再生リスト | 4 |
| name, followers |
PlaylistEntries | 10 |
| どの曲がどのプレイリストにあるか |
✅ チェックポイント: Cloud Shell に 🎉 ready があり、エクスプローラの music に 5 つのテーブルがあり、空のクエリ エディタのタブが開いている。
3. グラフを作成する - オプション A: ビジュアル モデラー
プロパティ グラフは、テーブルの接続方法を記述したものです。ビジュアル グラフ モデラーで一緒にクリックするか(このステップ、すべてクリック)、SQL として記述します(次のステップ、1 回貼り付け)。どちらも同じオブジェクトを生成します。両方ではなく、どちらか一方を使用してください。
1. グラフシェルを作成する
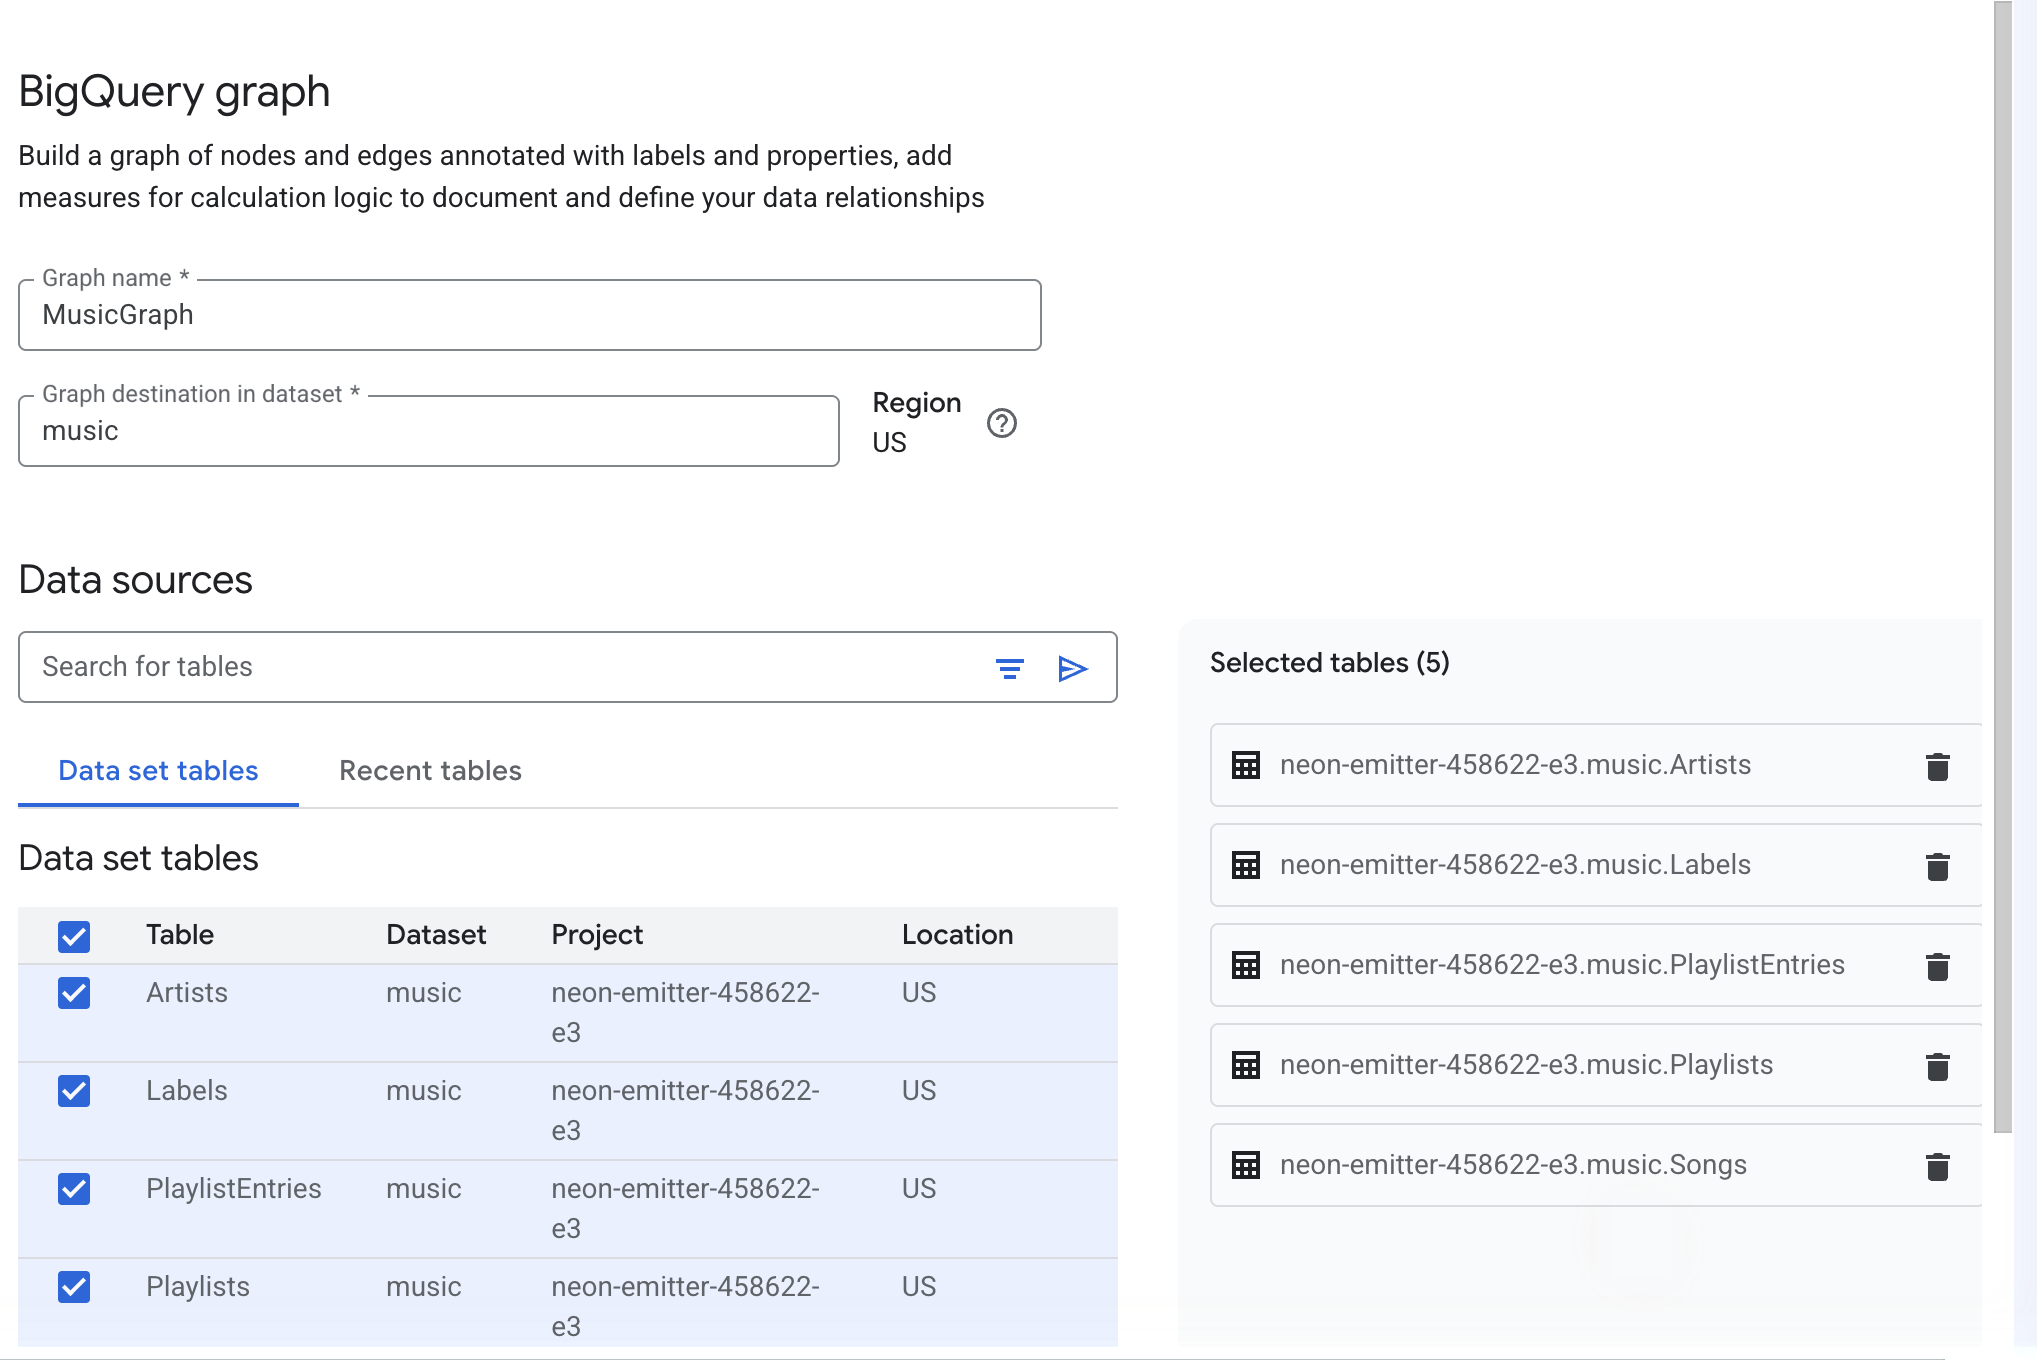
👉🌐 コンソール - BigQuery Studio の [新規作成] 行で、[AI とナレッジ] メニューを開き、[グラフ] をクリックします。
👉🌐 コンソール - [グラフ名] に MusicGraph を入力し、[データセット内のグラフの宛先] に music を入力します。リージョンはデータセット(米国)から入力されます。
👉🌐 コンソール - [データソース] で、5 つのテーブル(Artists、Labels、PlaylistEntries、Playlists、Songs)を選択し、[作成] をクリックします。
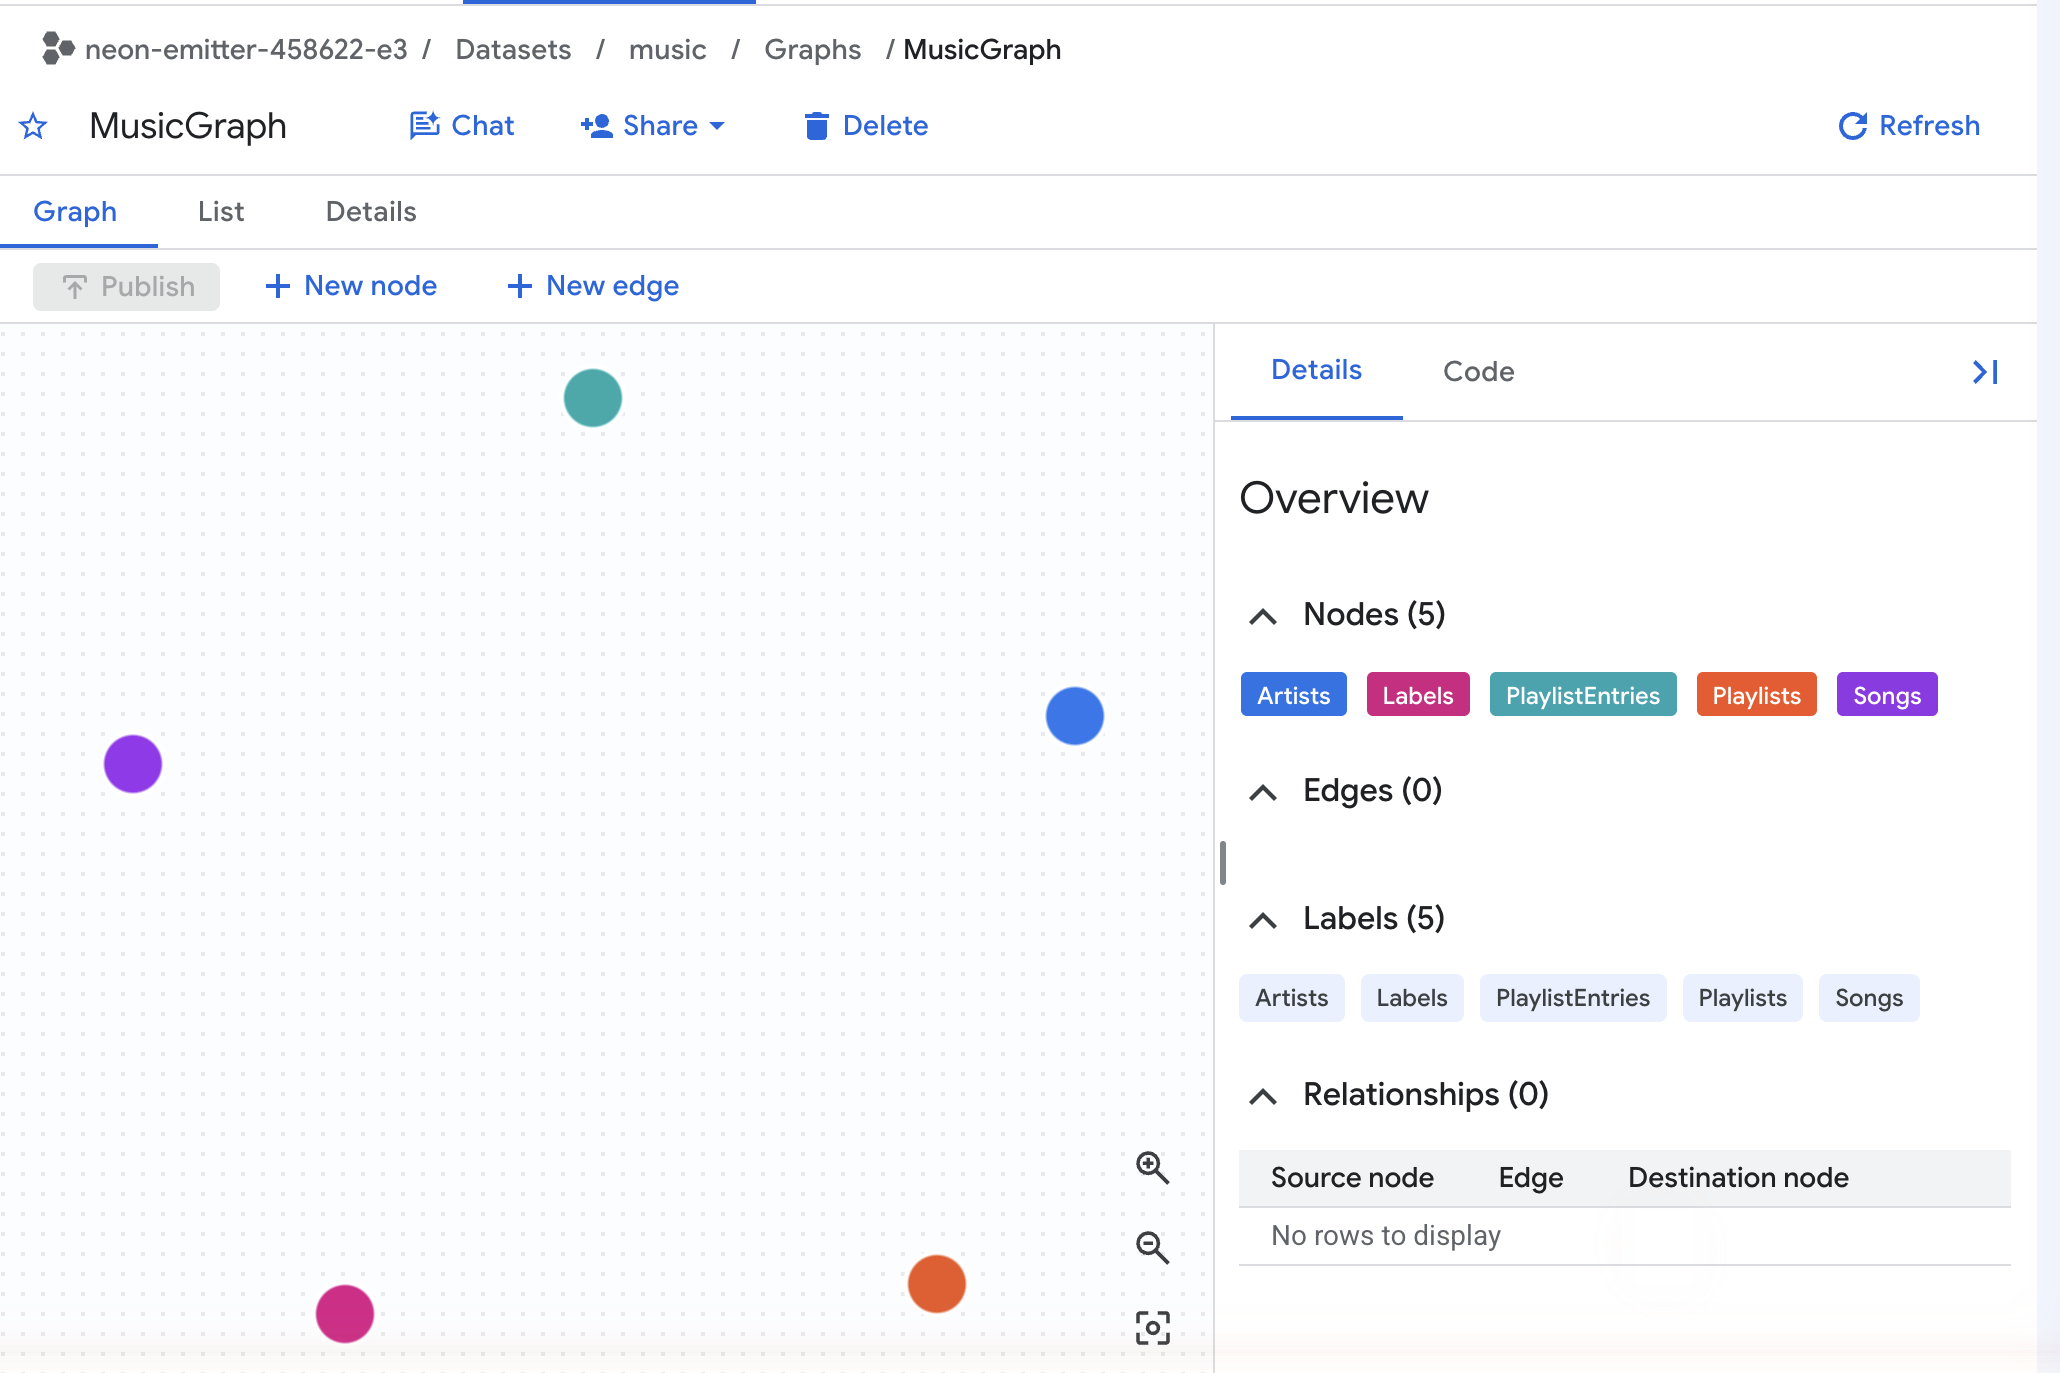
👀 キャンバスが開き、5 つの色の付いたノードが表示されます。ノード間には線がありません。右側の [詳細] パネルに、[ノード(5)] と [エッジ(0)] が表示されます。各ノードには、テーブルの主キーとすべての列がプロパティとしてすでに含まれています。ノードをクリックすると、それらを確認できます。
2. 4 つのエッジを描画する
エッジは外部キーとして描画されます。各矢印は、キーを保持するテーブルから、そのキーが指すテーブルに伸びています。
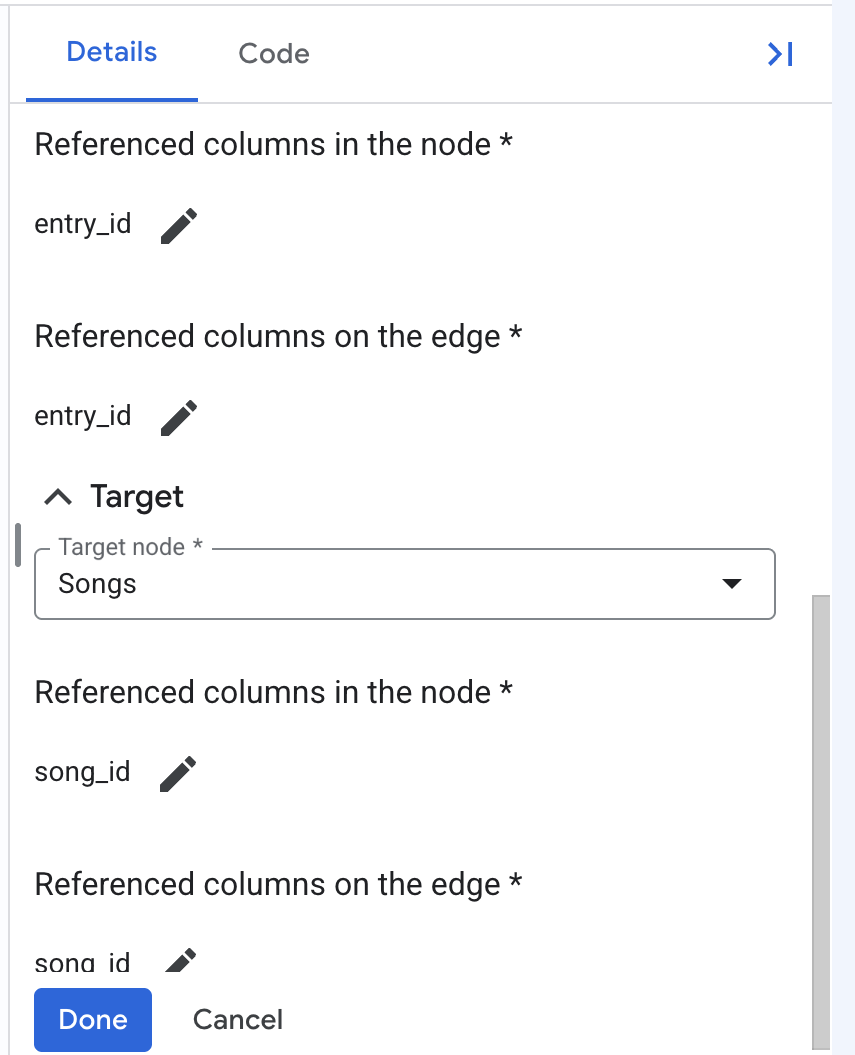
👉🌐 [Console] で [New edge] をクリックします。[テーブルを選択] ダイアログで、PlaylistEntries を選択して [追加] をクリックします。[エッジを追加] パネルで次の操作を行います。
- [名前] を
EntryToSongに設定します。 - [主キーを追加] をクリックして、
entry_idを受け入れます。 - [ソース] で、[ソースノード] を PlaylistEntries に設定し、[ノードに参照列を追加] と [エッジに参照列を追加] を使用して、両方に
entry_idを選択します。 - [ターゲット] で、[ターゲットノード] を [曲] に設定し、[ノード内の参照列] と [エッジの参照列] の両方に
song_idを選択します。 - [完了] をクリックします。
👉🌐 コンソール - あと 3 回繰り返します。
エッジ名 | テーブル | ソースノード → ターゲット ノード | 両側で選択する列 |
| PlaylistEntries | PlaylistEntries → Playlists | ソース |
| 曲 | 曲 → アーティスト | ソース |
| アーティスト | アーティスト → レーベル | ソース |
余分なプロパティのないエッジをすべて残します。
👀 [詳細] パネルに [Edges (4)] と表示され、キャンバスにチェーン(Labels ← Artists ← Songs ← PlaylistEntries → Playlists)が表示されます。
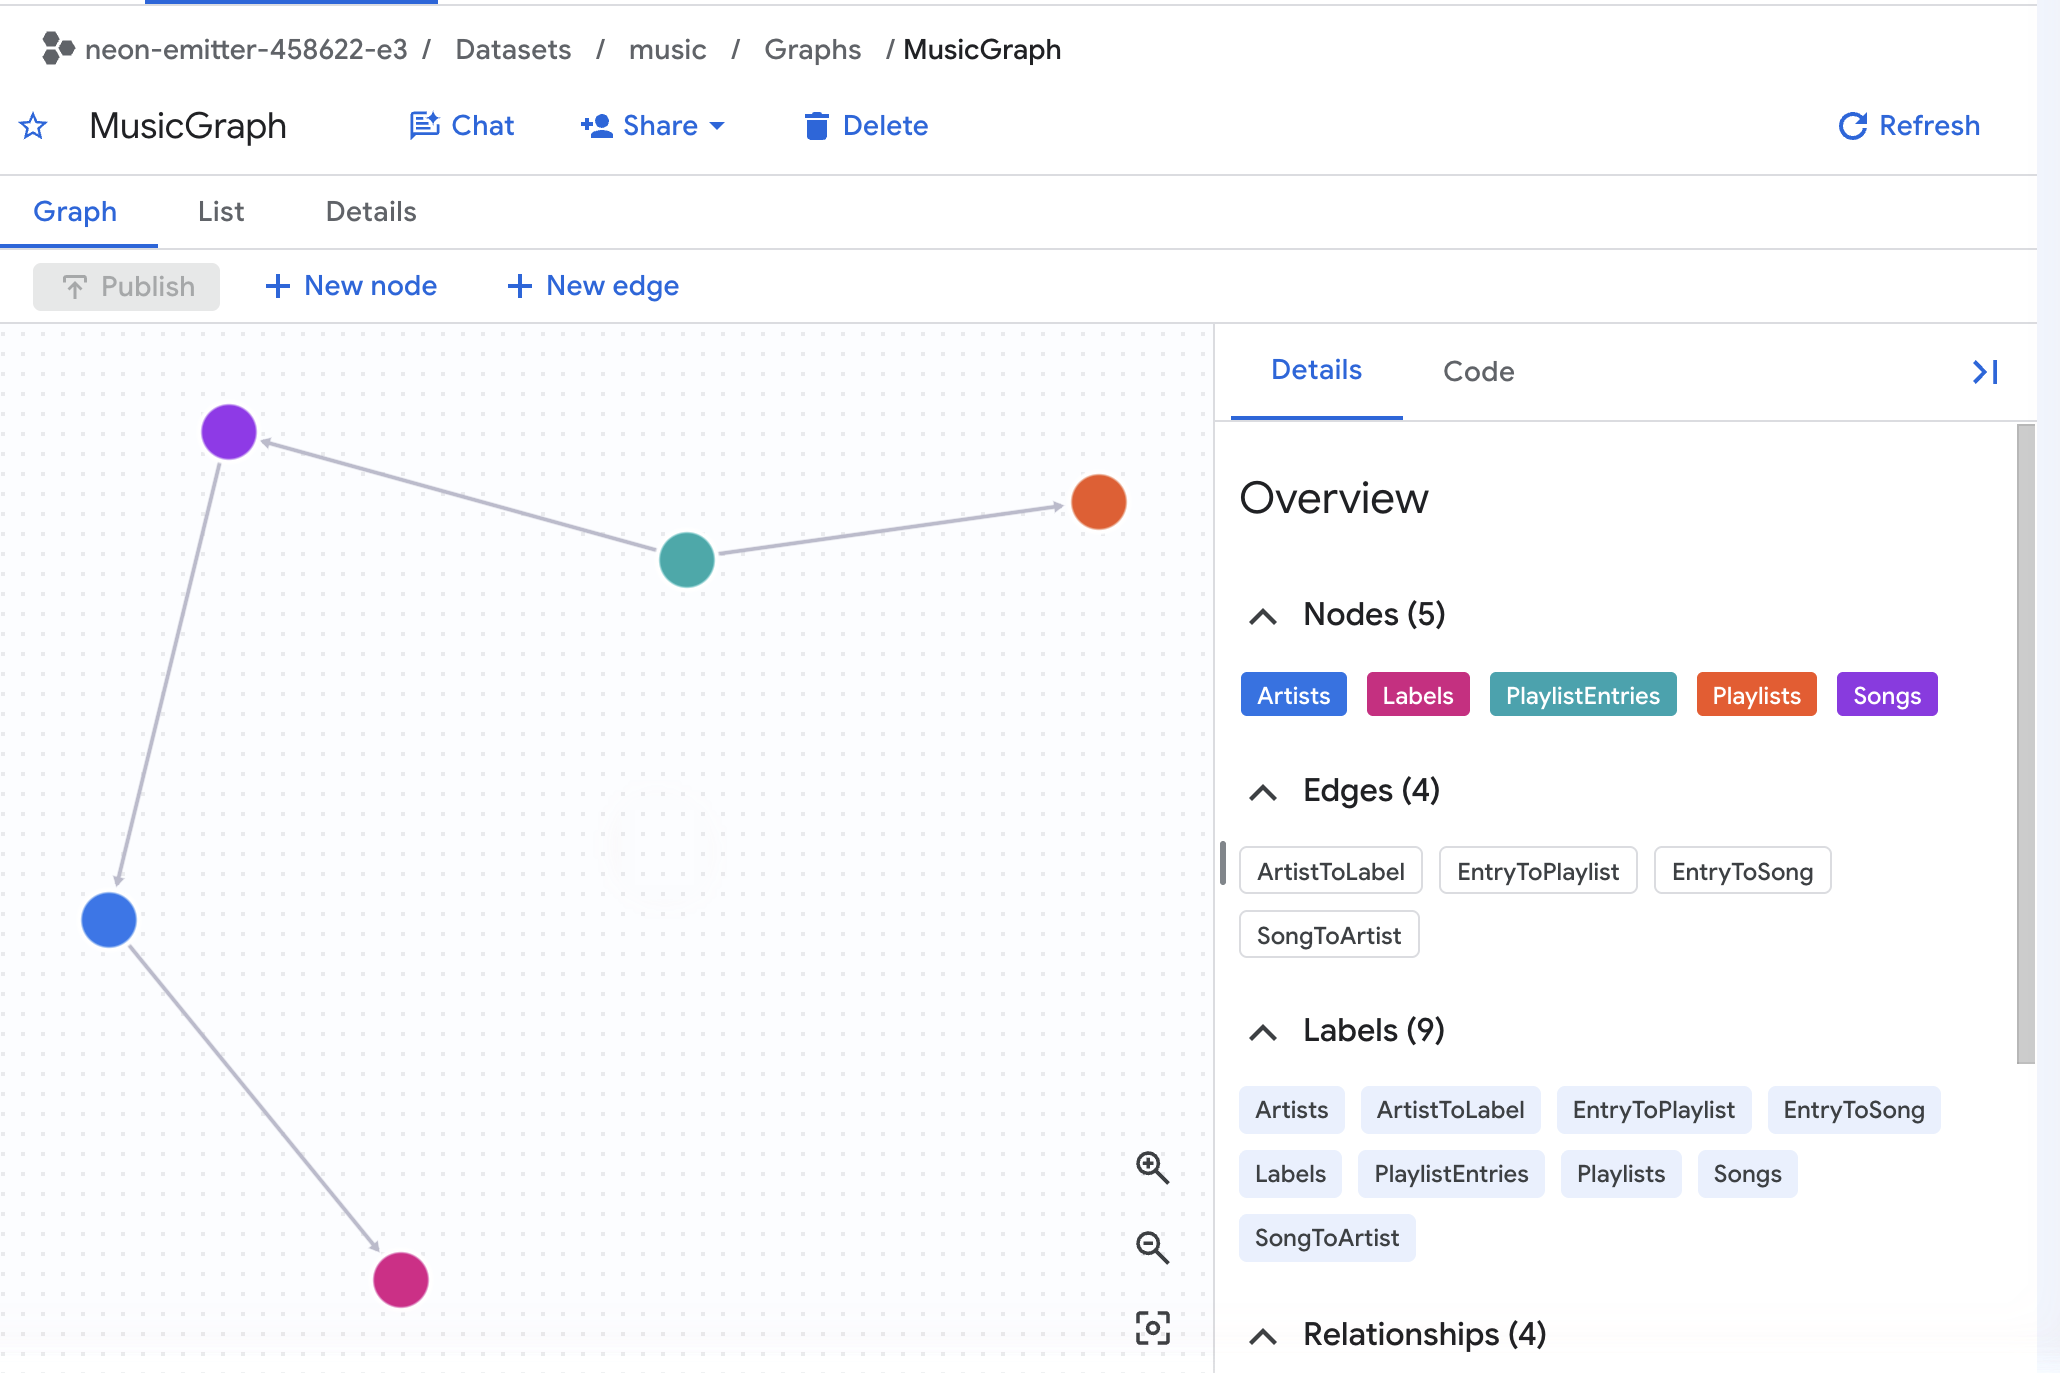
3. メジャーを追加する
👉🌐 コンソール - [Songs] ノードをクリックし、[詳細] パネルの上部にある [編集](鉛筆)アイコンをクリックします。ラベルの [プロパティ] で、[プロパティを追加]、[フィールドを追加] の順にクリックします。
👉🌐 コンソール - [フィールド名] に total_streams と入力し、[式] ボックスに次のように入力します。
MEASURE(SUM(streams))
👉🌐 [Console] - [追加]、[完了] の順にクリックします。
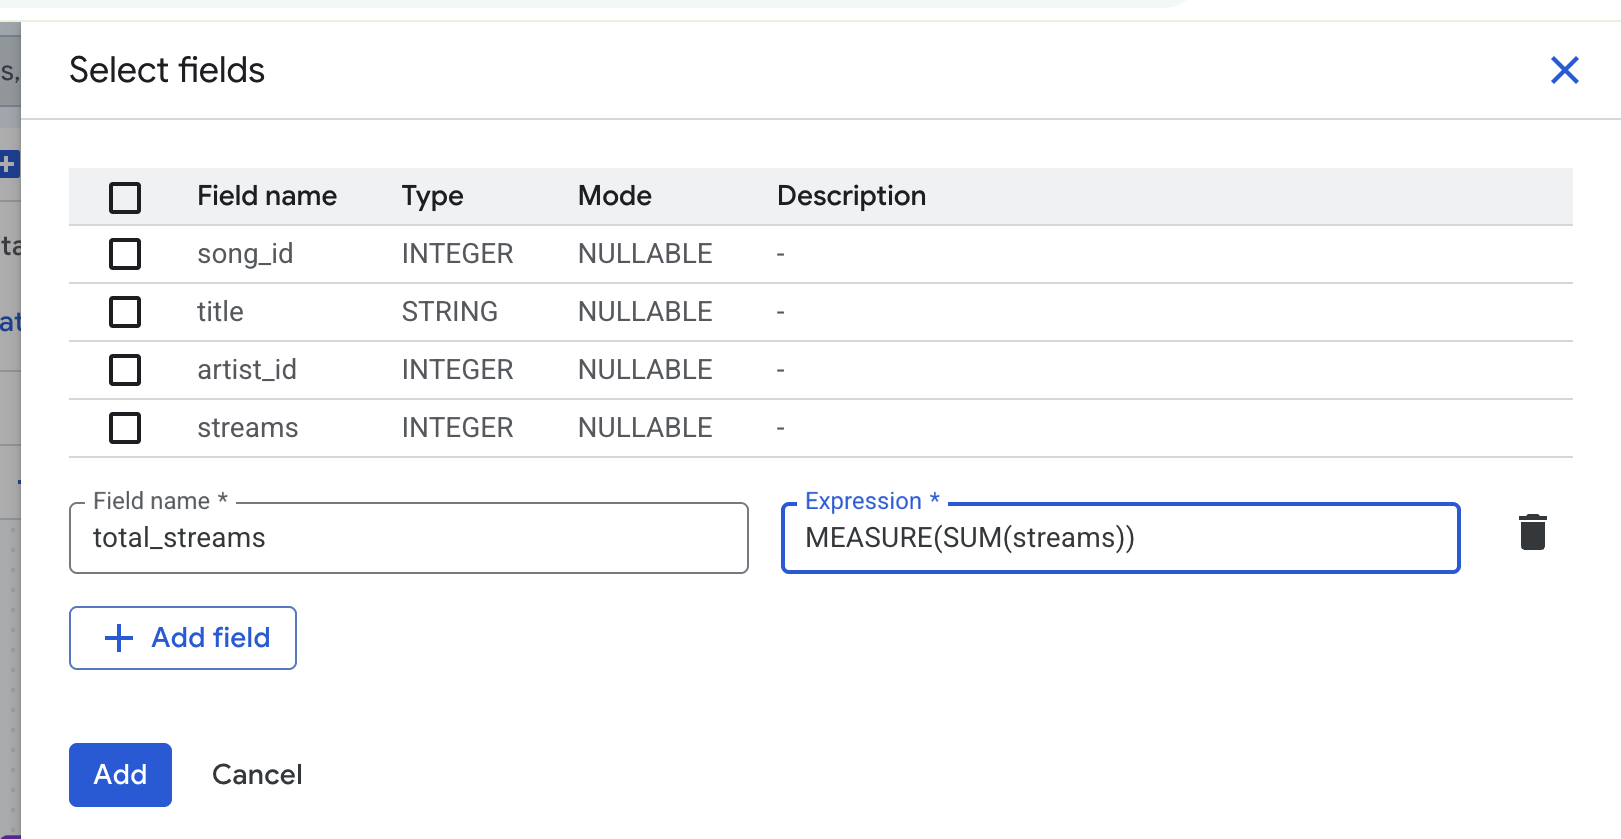
4. 記述されたコードを読み取り、公開する
👉🌐 コンソール - 右側のパネルで [コード] タブを開きます。モデラーが CREATE PROPERTY GRAPH ステートメントを記述しています。Songs ノードまでスクロールします。プロパティ リストの末尾が
MEASURE(SUM(streams)) AS `total_streams`
これが 1 行で表された機能全体です。このステップ以降は、その行の処理内容について説明します。
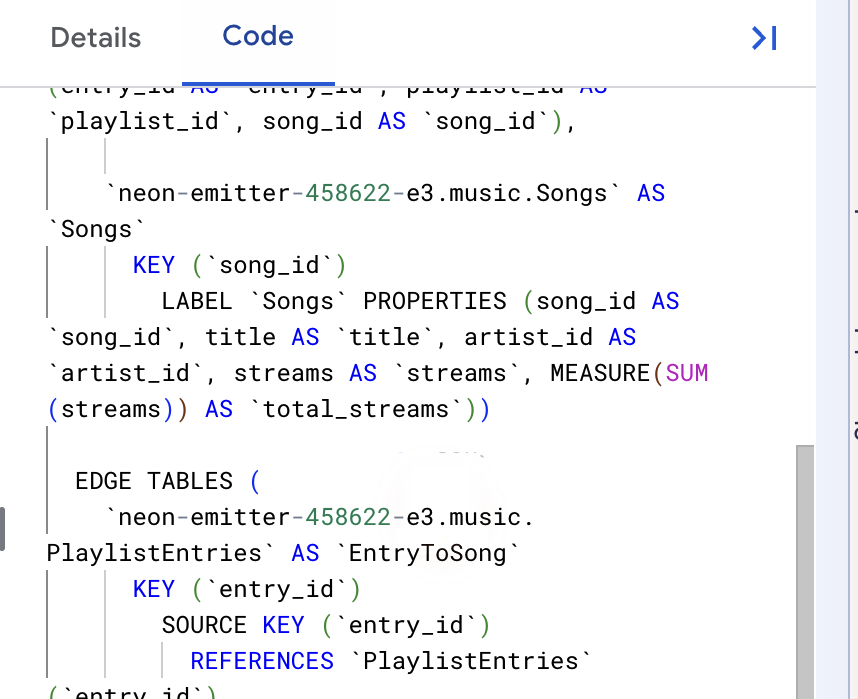
👉🌐 Console - [Publish] をクリックします。
✅ チェックポイント: エクスプローラで、music に MusicGraph を含む Graphs フォルダが追加されました。クリックすると、[コード] タブに 5 つのノード、4 つのエッジ、MEASURE(SUM(streams)) 行が表示されます。次のステップをスキップして、SUM と AGG を並べて表示するに進みます。
4. グラフを作成する - オプション B: SQL
モデラーでグラフを作成した場合は、この手順をスキップします。
👉📋 クエリエディタ - 貼り付けて [実行] をクリックします。
CREATE OR REPLACE PROPERTY GRAPH music.MusicGraph
  NODE TABLES (
    music.Labels KEY (label_id)
      PROPERTIES (label_id, label_name, marketing_budget,
        MEASURE(SUM(marketing_budget)) AS total_budget),
    music.Artists KEY (artist_id)
      PROPERTIES (artist_id, artist_name, label_id,
        MEASURE(COUNT(artist_id)) AS artist_count),
    music.Songs KEY (song_id)
      PROPERTIES (song_id, title, artist_id, streams,
        MEASURE(SUM(streams))   AS total_streams,
        MEASURE(COUNT(song_id)) AS song_count),
    music.Playlists KEY (playlist_id)
      PROPERTIES (playlist_id, playlist_name, followers,
        MEASURE(SUM(followers)) AS total_followers),
    music.PlaylistEntries KEY (entry_id)
      PROPERTIES (entry_id, playlist_id, song_id,
        MEASURE(COUNT(entry_id)) AS placement_count)
  )
  EDGE TABLES (
    music.PlaylistEntries AS EntryToSong
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (song_id) REFERENCES Songs(song_id) NO PROPERTIES,
    music.PlaylistEntries AS EntryToPlaylist
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (playlist_id) REFERENCES Playlists(playlist_id) NO PROPERTIES,
    music.Songs AS SongToArtist
      SOURCE KEY (song_id) REFERENCES Songs(song_id)
      DESTINATION KEY (artist_id) REFERENCES Artists(artist_id) NO PROPERTIES,
    music.Artists AS ArtistToLabel
      SOURCE KEY (artist_id) REFERENCES Artists(artist_id)
      DESTINATION KEY (label_id) REFERENCES Labels(label_id) NO PROPERTIES
  )
👀 結果パネルに、プロパティ グラフが作成されたと表示されます。
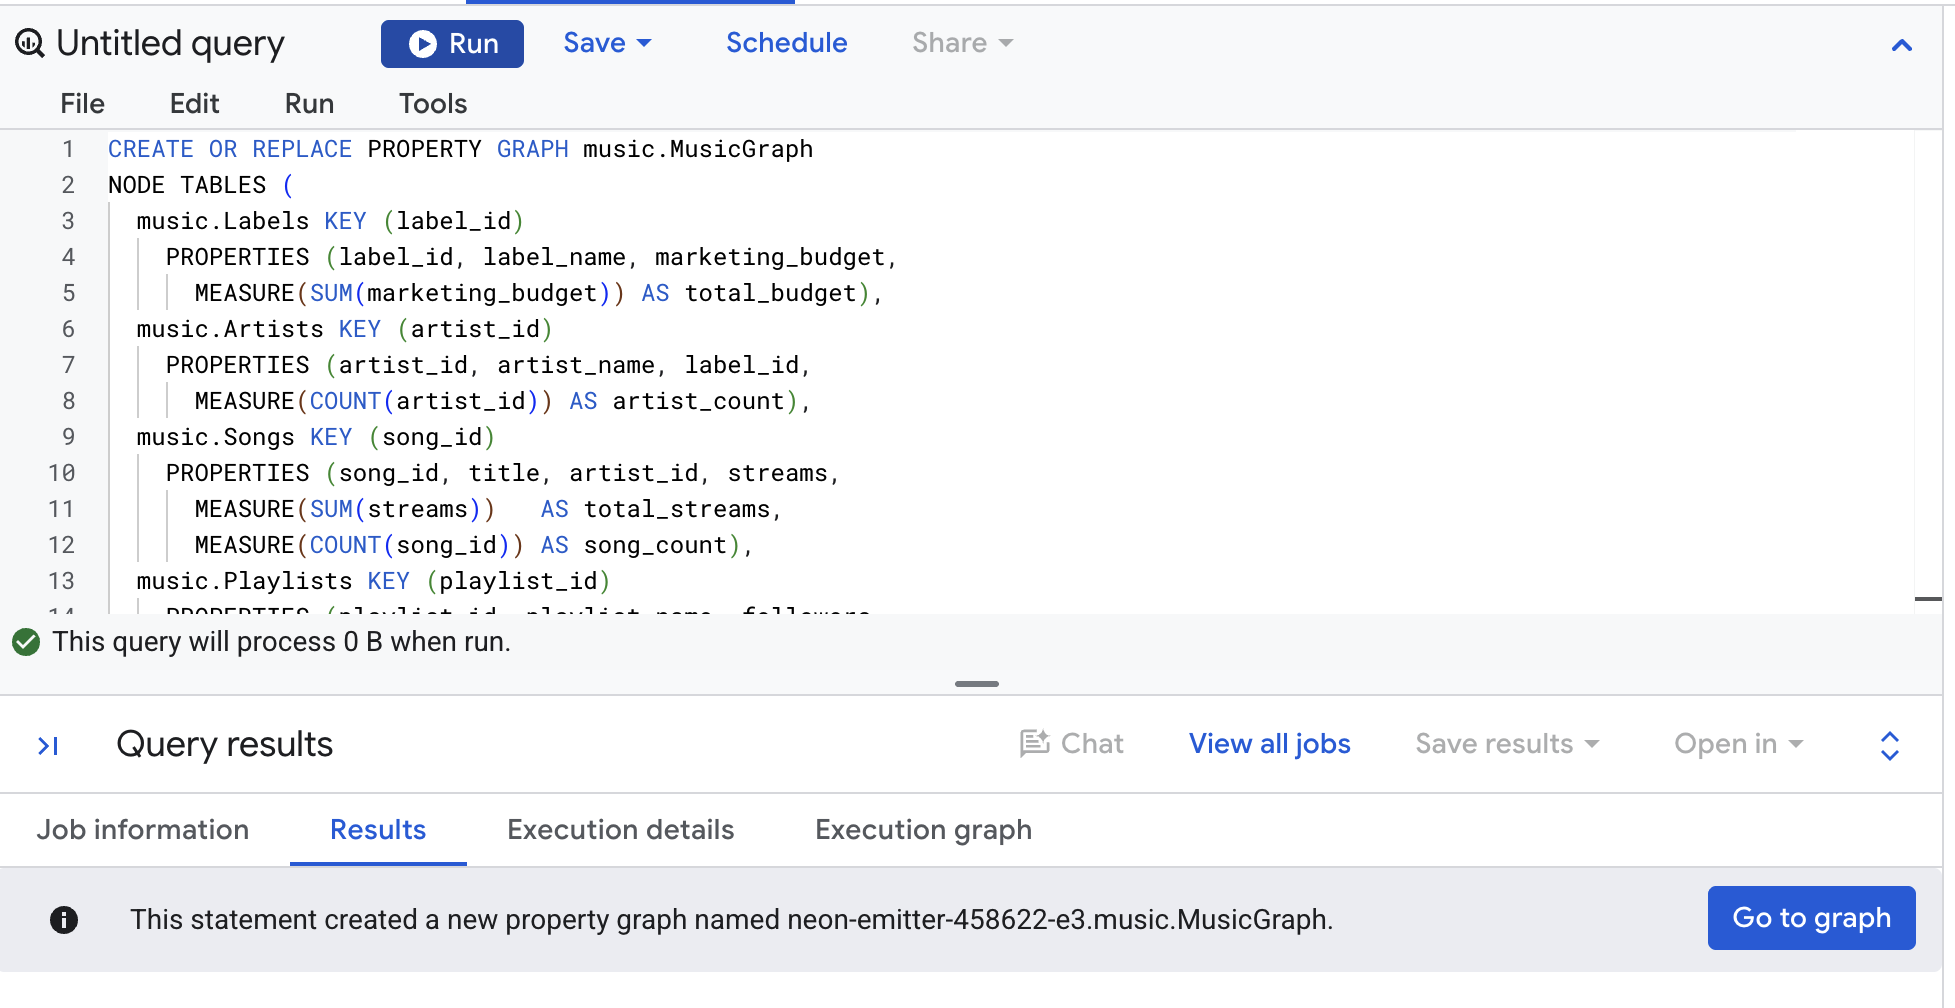
1 回読む
このグラフには、5 つのノードテーブルと 4 つのエッジテーブルがあります。各ノードテーブルは KEY に名前を付け、PROPERTIES を一覧表示します。MEASURE で始まる行が新しい部分です。各行は、サポートされている集計の 1 つをプロパティでラップし、必須のエイリアスを付与します。
各エッジテーブルは外部キーです。キーを保持するテーブルの SOURCE KEY、参照先のテーブルの DESTINATION KEY となります。NO PROPERTIES は、エッジが独自に何も持っていないことを意味します。
PlaylistEntries は 3 回出現します。1 回はノードテーブルとして、残りの 2 回は EntryToSong エッジと EntryToPlaylist エッジの背後にある物理テーブルとして出現します。これは意図的なもので、その理由については後ほど説明します。
作成したものを確認する
👉🌐 コンソール - [エクスプローラ] ペインで、music、[グラフ] の順に展開し、[MusicGraph] をクリックします。グラフページが開き、5 つのノードと 4 つのエッジを含むキャンバスが表示されます。ノードをクリックすると、そのプロパティが表示されます。指標は集計とともに表示されます。[コード] タブを開いて、画像の背後にあるステートメントを確認します。
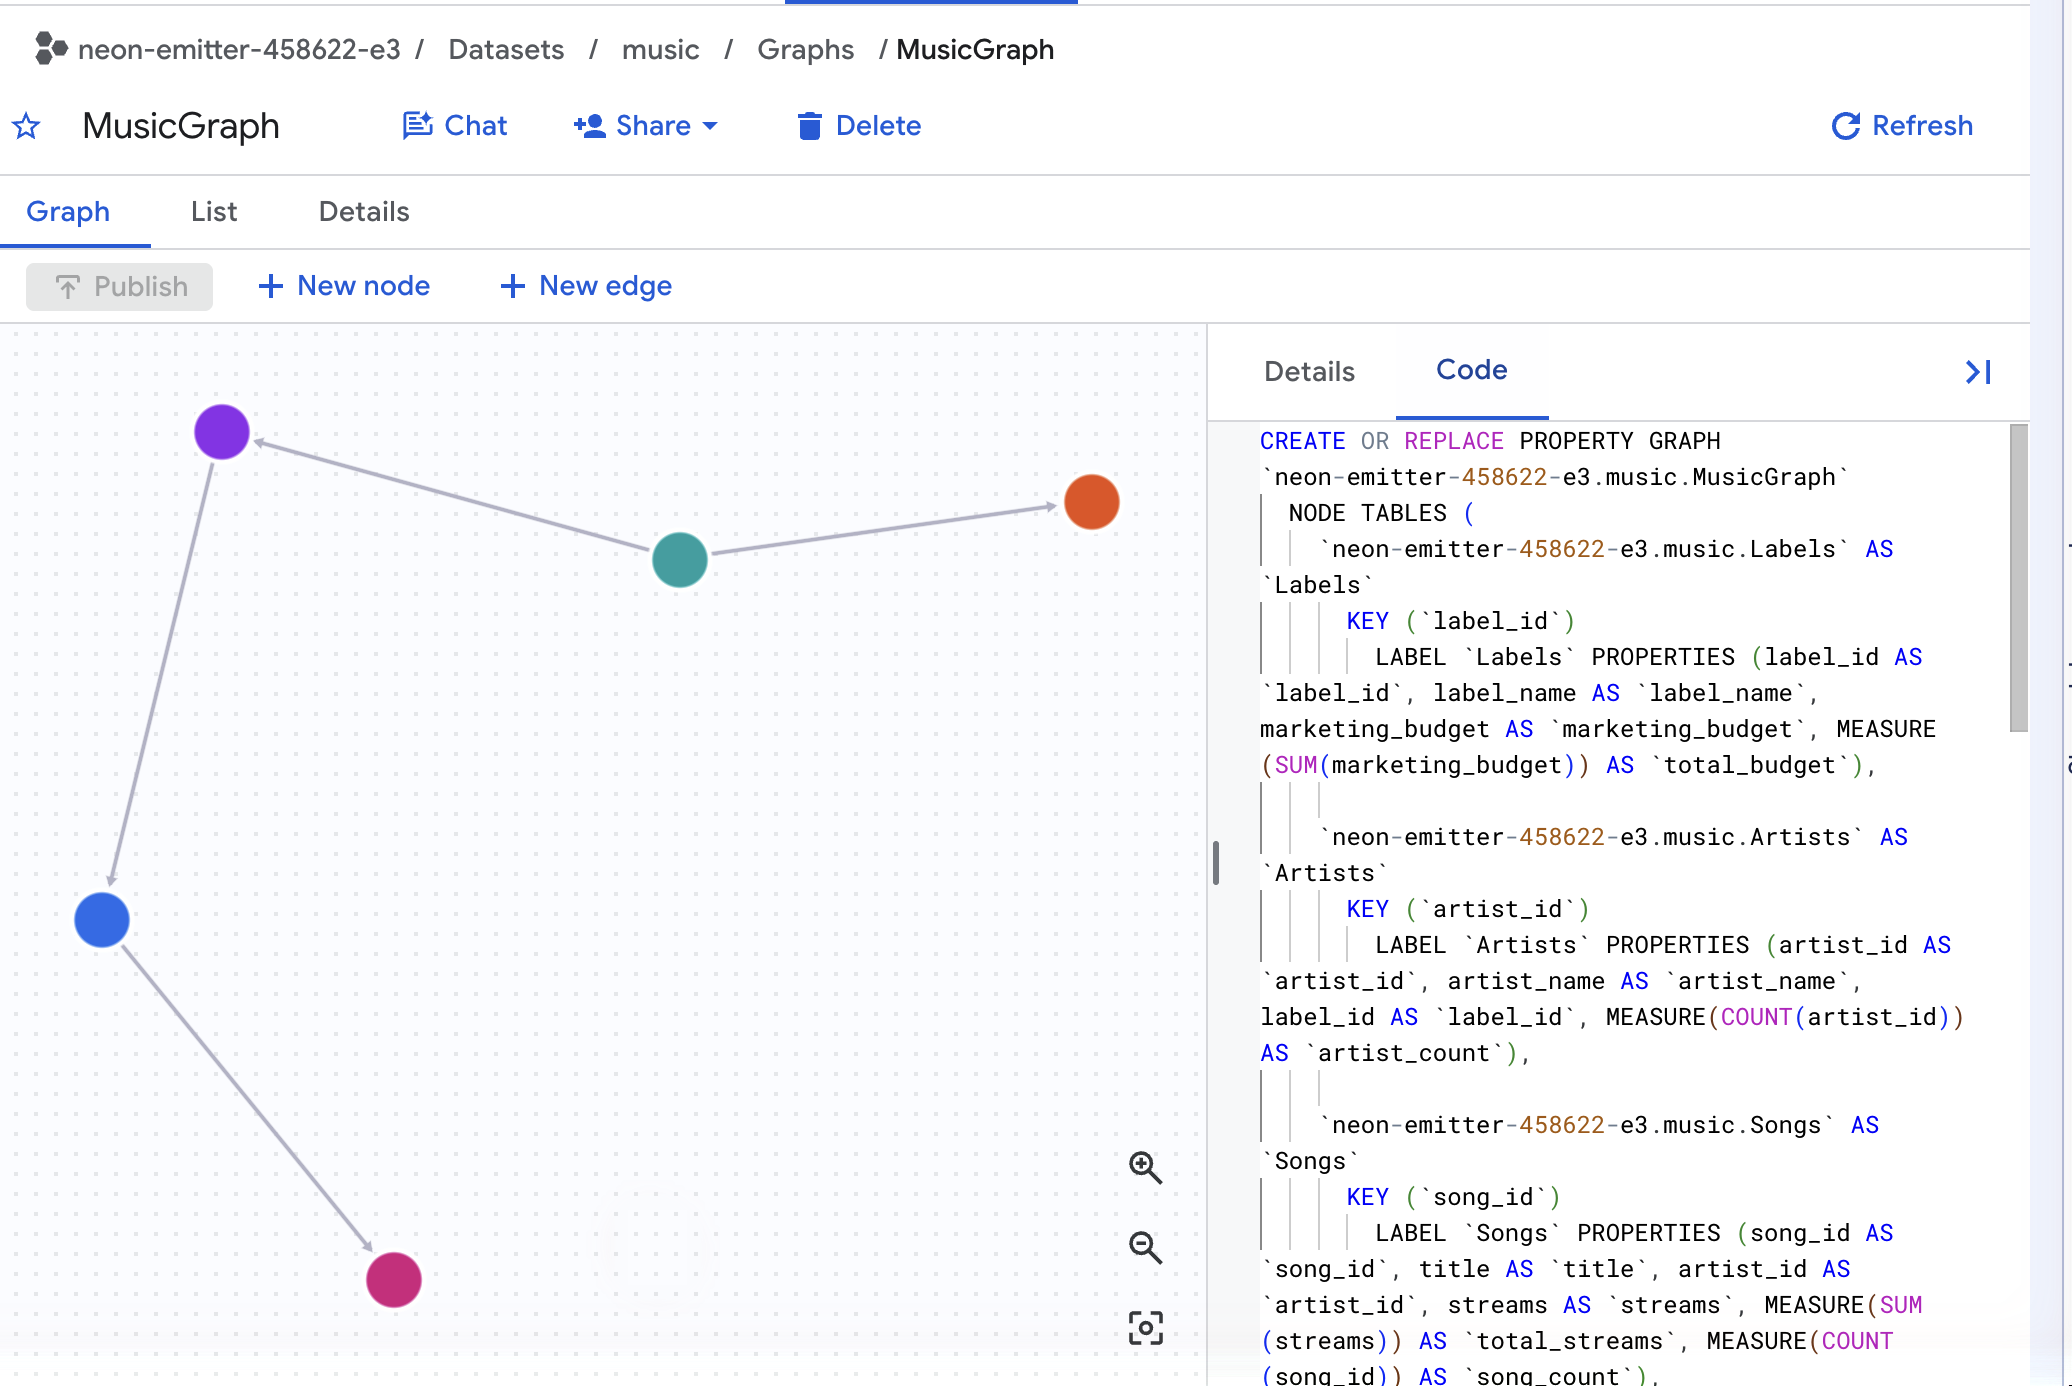
✅ チェックポイント: music に MusicGraph を含む Graphs フォルダがあり、[コード] タブに MEASURE(SUM(streams)) AS total_streams が表示されている。
5. SUM と AGG を並べて表示
これは、Codelab 全体を 1 つのクエリで実行するものです。どちらの列も、同じテーブルから同じ質問(レーベルごとの合計ストリーム数)に回答しようとしています。
このテーブルは GRAPH_EXPAND が生成するテーブルです。グラフを平坦化します。1 つのテーブルから始まり、各エッジを LEFT JOIN として外側にたどります。接続されているすべてのテーブルが 1 つの幅広の結果に並ぶまで続けます。曲ごとではなく、プレースメントごとに 1 行で、すべての列に TableLabel_property という名前が付けられています。クエリを実行する前に確認してください。
👉📋 クエリエディタ - 貼り付けて [実行] をクリックします。
SELECT Labels_label_name, Songs_title, Songs_streams, Playlists_playlist_name
FROM GRAPH_EXPAND("music.MusicGraph")
ORDER BY Songs_title, Playlists_playlist_name
👀 10 行が返されるはずです。これは、PlaylistEntries のプレースメントごとに 1 行で、セットアップで読み込まれたものとまったく同じです。Neon Summer は 4 つのプレイリストに登録されているため、4 つの Songs_streams があり、それぞれ 2,000,000,000 を読み取ります。これらの行に問題はありません。再生リストは実際に 4 つあります。しかし、曲に属する列がプレースメントに属する行全体で繰り返されるようになりました。これが、次のクエリで測定する問題全体です。
比較してみましょう。
👉📋 クエリエディタ - 貼り付けて [実行] をクリックします。
SELECT
  Labels_label_name,
  SUM(Songs_streams)       AS with_sum,
  AGG(Songs_total_streams) AS with_agg
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1 ORDER BY 1
👀 結果:
Labels_label_name | with_sum | with_agg |
Cymbal レコード | 12,600,000,000 | 5,100,000,000 |
Northwind Audio | 9,000,000,000 | 4,500,000,000 |
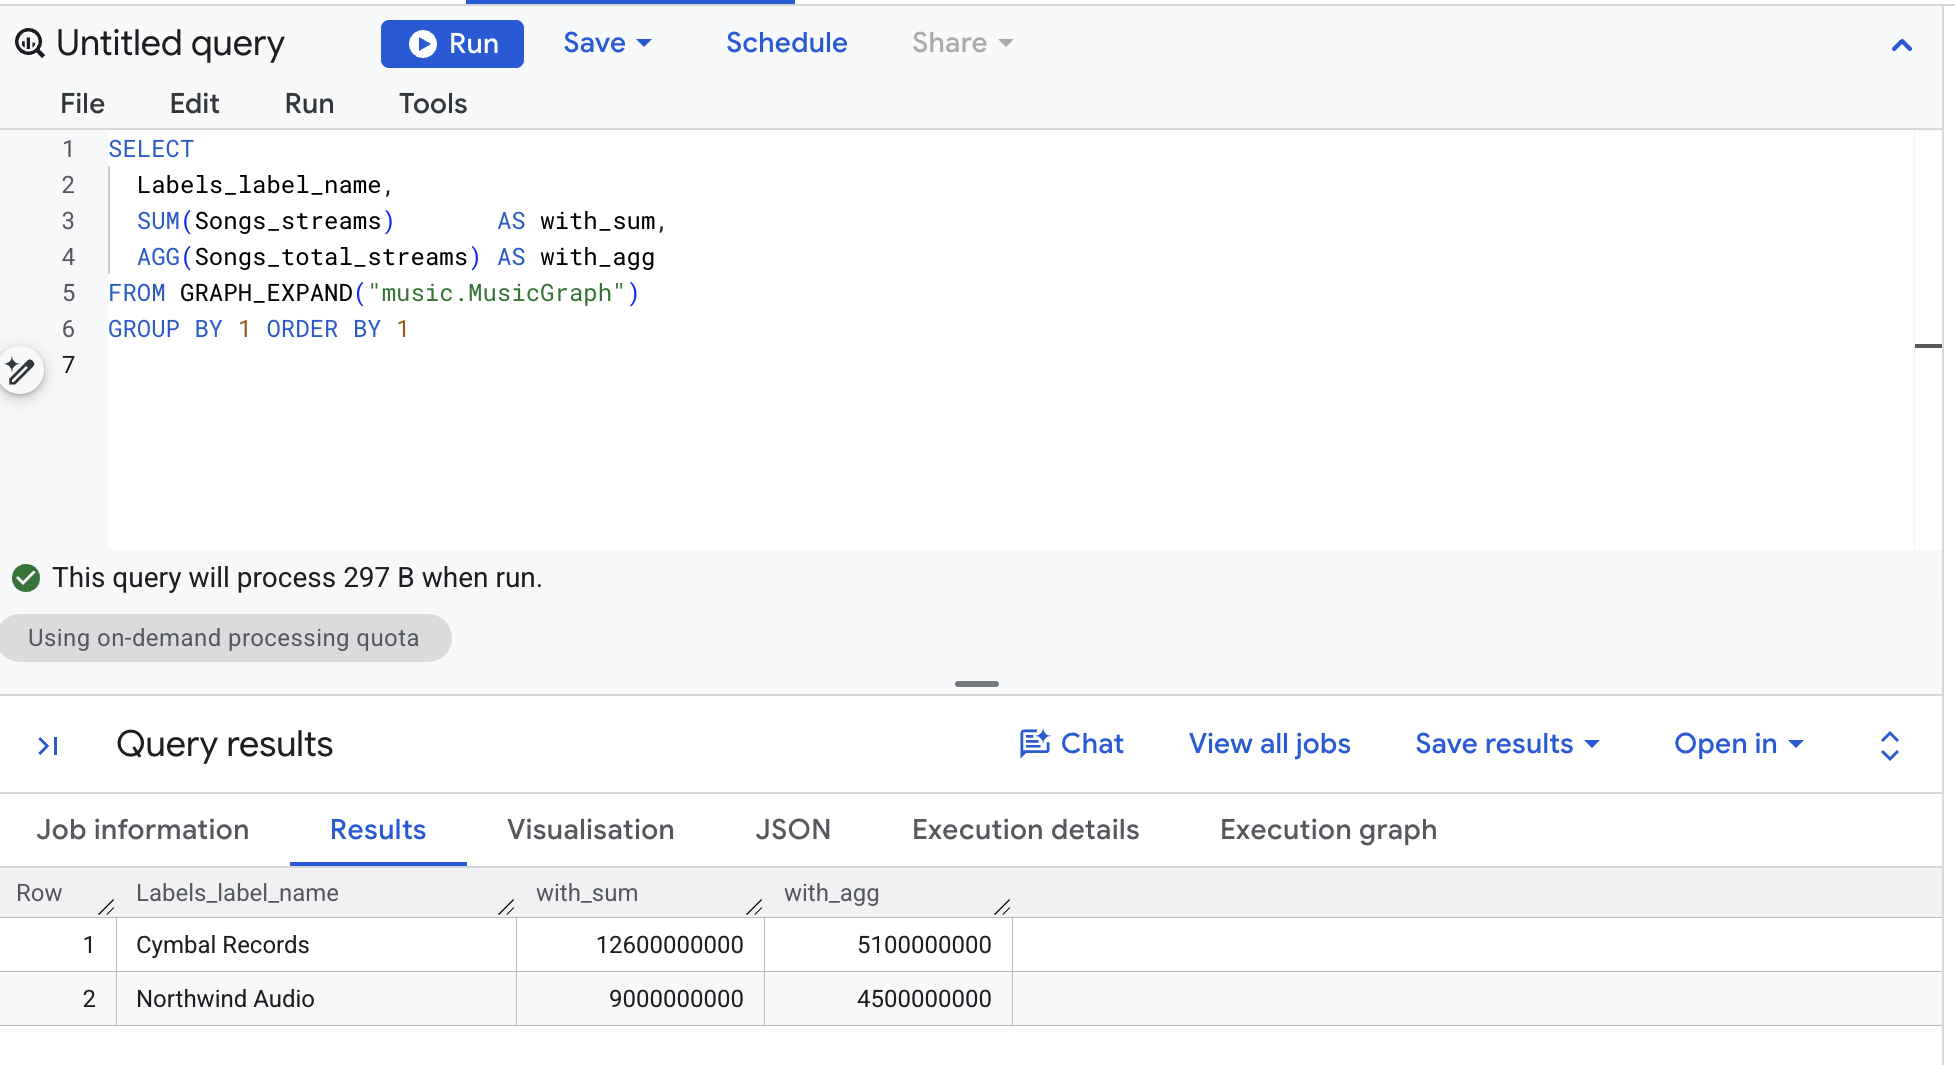
手動で確認します。Cymbal の 4 曲のストリーミング数は、20 億、15 億、12 億、4 億です。51 億です。AGG が正解です。SUM は 2.5 倍も大きくなり、Northwind の単一の曲は 2 倍になりました。
3 つの新しい構文
GRAPH_EXPAND("music.MusicGraph")は、各エッジをLEFT JOINとしてたどることで、グラフを 1 つのワイド テーブルに変換するテーブル値関数です。すべての列の名前はTableLabel_propertyです。したがって、Songs_streamsは Songs テーブルの未加工の列であり、Songs_total_streamsは宣言したメジャーです。SUM(Songs_streams)はそのワイド テーブルに対する通常の SQL であり、フラット化によって生成されたすべての重複が継承されます。AGG(Songs_total_streams)は、宣言された方法で measure を評価します。つまり、ワイドテーブルで曲が占める行数に関係なく、song_idごとに 1 回SUM(streams)を評価します。
✅ チェックポイント: 2 つのラベル、2 つの列、with_agg の数が手の数と一致している。
6. SUM が過剰にカウントされる理由
1 つの曲を取り上げて、結合によってどのように変化するかを確認します。
👉📋 クエリエディタ - 貼り付けて [実行] をクリックします。
SELECT 'BEFORE - the Songs table' AS step, title, streams, CAST(NULL AS STRING) AS playlist
FROM music.Songs WHERE title = 'Neon Summer'
UNION ALL
SELECT 'AFTER - joined to playlists', s.title, s.streams, pl.playlist_name
FROM music.Songs s
LEFT JOIN music.PlaylistEntries e ON e.song_id = s.song_id
LEFT JOIN music.Playlists pl ON pl.playlist_id = e.playlist_id
WHERE s.title = 'Neon Summer'
ORDER BY step DESC, playlist
👀 結果:
解説 | title | 受信できます | 再生リスト |
BEFORE - Songs テーブル | ネオンの夏 | 2,000,000,000 | null |
AFTER - 再生リストに結合 | ネオンの夏 | 2,000,000,000 | Gym Pump |
AFTER - 再生リストに結合 | ネオンの夏 | 2,000,000,000 | リアルタイム |
AFTER - 再生リストに結合 | ネオンの夏 | 2,000,000,000 | ライジング ポップ |
AFTER - 再生リストに結合 | ネオンの夏 | 2,000,000,000 | ロード・トリップ |
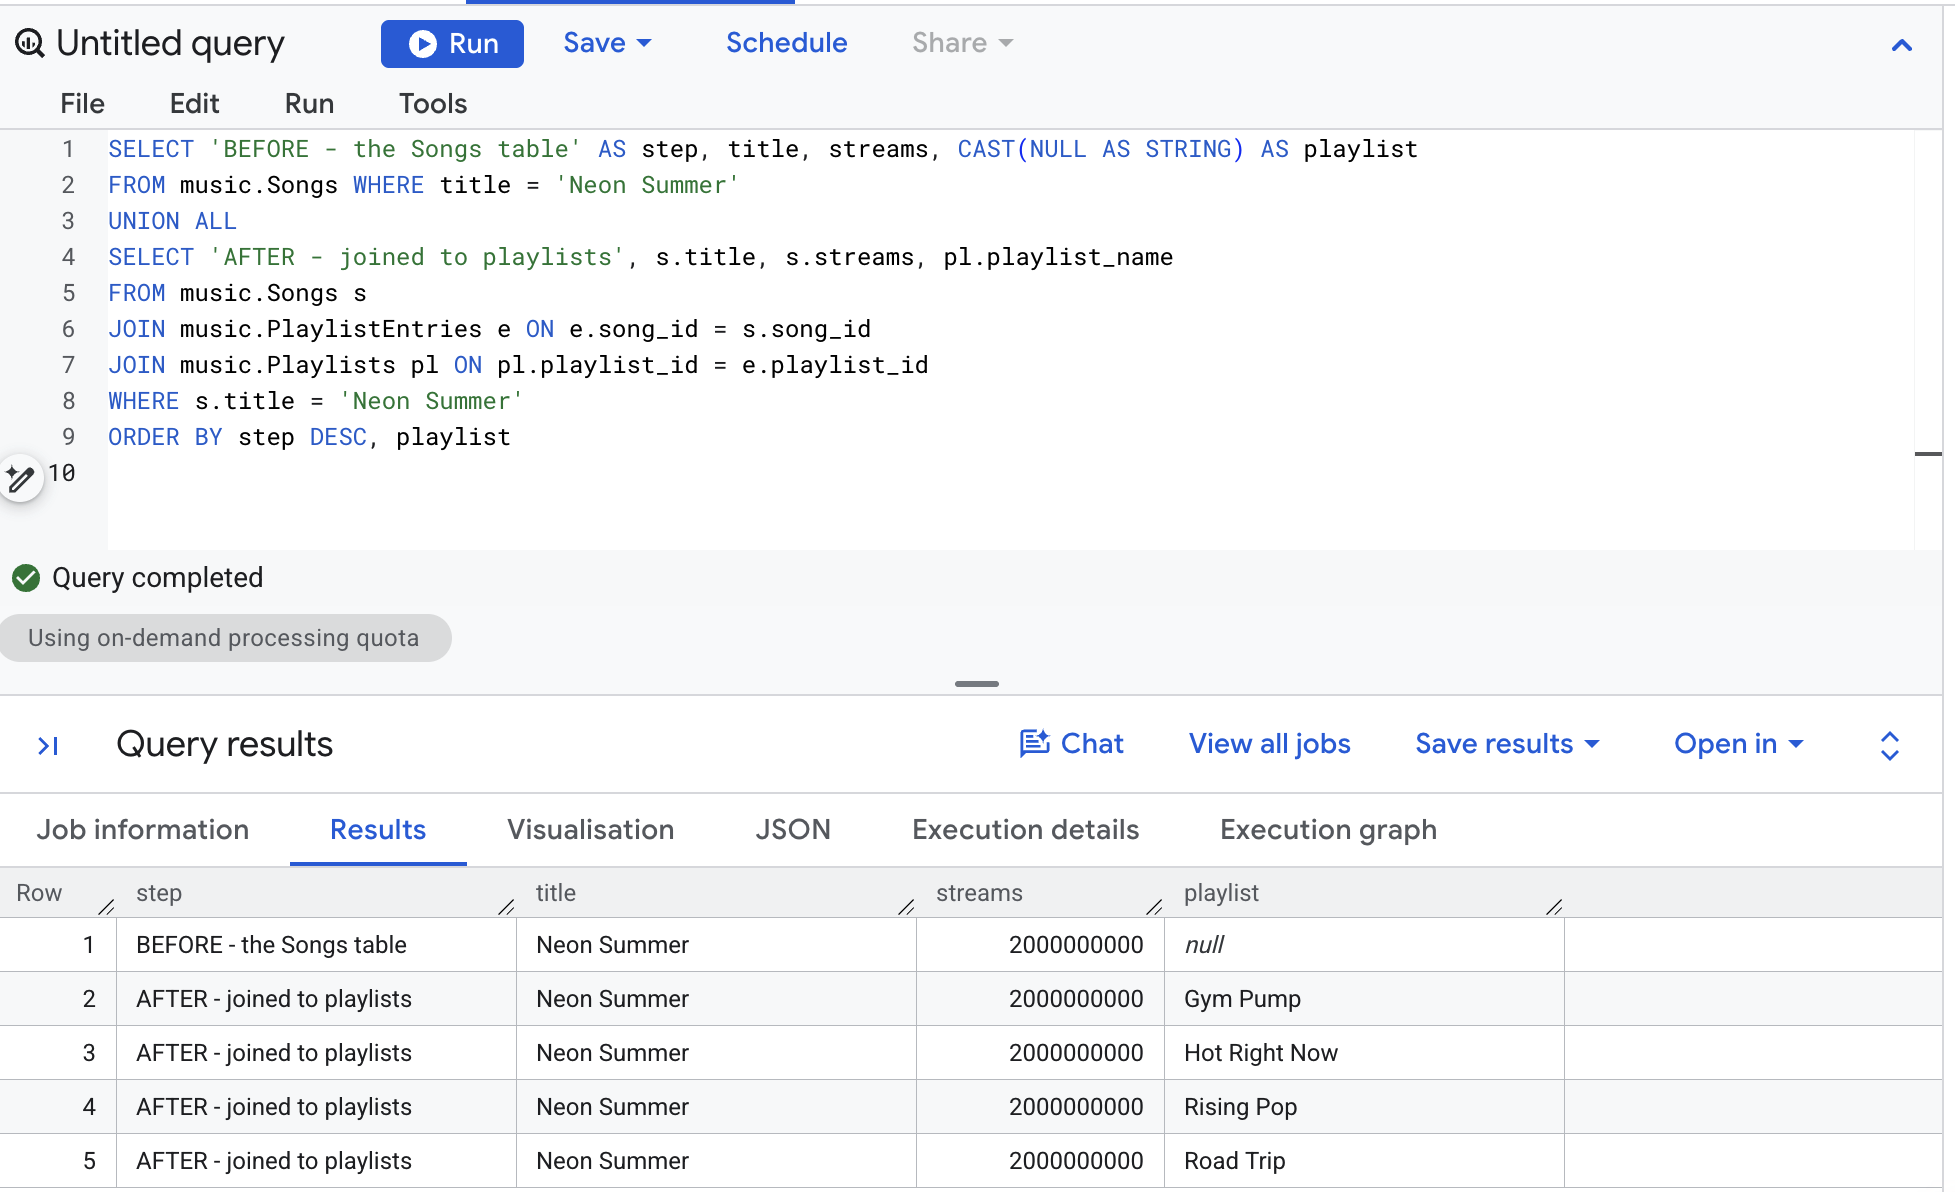
1 行が 4 行になりました。ストリーム数は変更されず、コピーされました。Cymbal Records のコピーの合計は、4 つのプレイリストで 20 億回の Neon Summer が 8.0、2 つのプレイリストで 15 億回の Paper Crown が 3.0、1 つのプレイリストで 12 億回の Double Shot、1 つのプレイリストで 4 億回の Slow Arrow です。これは 126 億で、SUM が返した数値です。Northwind の Midnight Drive は 2 つのプレイリストに登録されているため、45 億回が 90 億回になりました。
これはファンアウトであり、結合のバグではありません。プレイリストの行は実際のものです。この間違いは、プレースメントに属する行全体で、曲に属する数値を合計していることです。
この測定は、KEY (song_id) とともに Songs ノードで宣言されているため、この問題を修正します。キーは粒度です。AGG が total_streams を評価するとき、曲のキーごとに 1 回集計してから、グループ化した内容にロールアップします。
何が変更されたのですか?
以前は | メジャーあり |
必要なすべてのクエリに | グラフで 1 回 |
|
|
3 つの |
|
結合前に集計する CTE | 特にありません。 |
✅ チェックポイント: 5 行(BEFORE が 1 行、AFTER が 4 行)。これらの行から 126 億を再構築できます。
7. ルール: AGG のみがメジャーを読み取る
メジャーには独自の型 MEASURE があり、1 つの関数だけがそれを受け入れます。次の 4 つのクエリは、意図的に失敗するように作成されています。各クエリを実行して、赤いエラーを読み取ってください。これらは誰もが最初に試す 4 つの方法であり、これらの方法で解決できないことを知っておけば、後で時間を節約できます。
👉📋 クエリエディタ - プレーン列の AGG:
SELECT AGG(Songs_streams) FROM GRAPH_EXPAND("music.MusicGraph")
👀 No matching signature for aggregate function AGG ... Argument 1: expected MEASURE
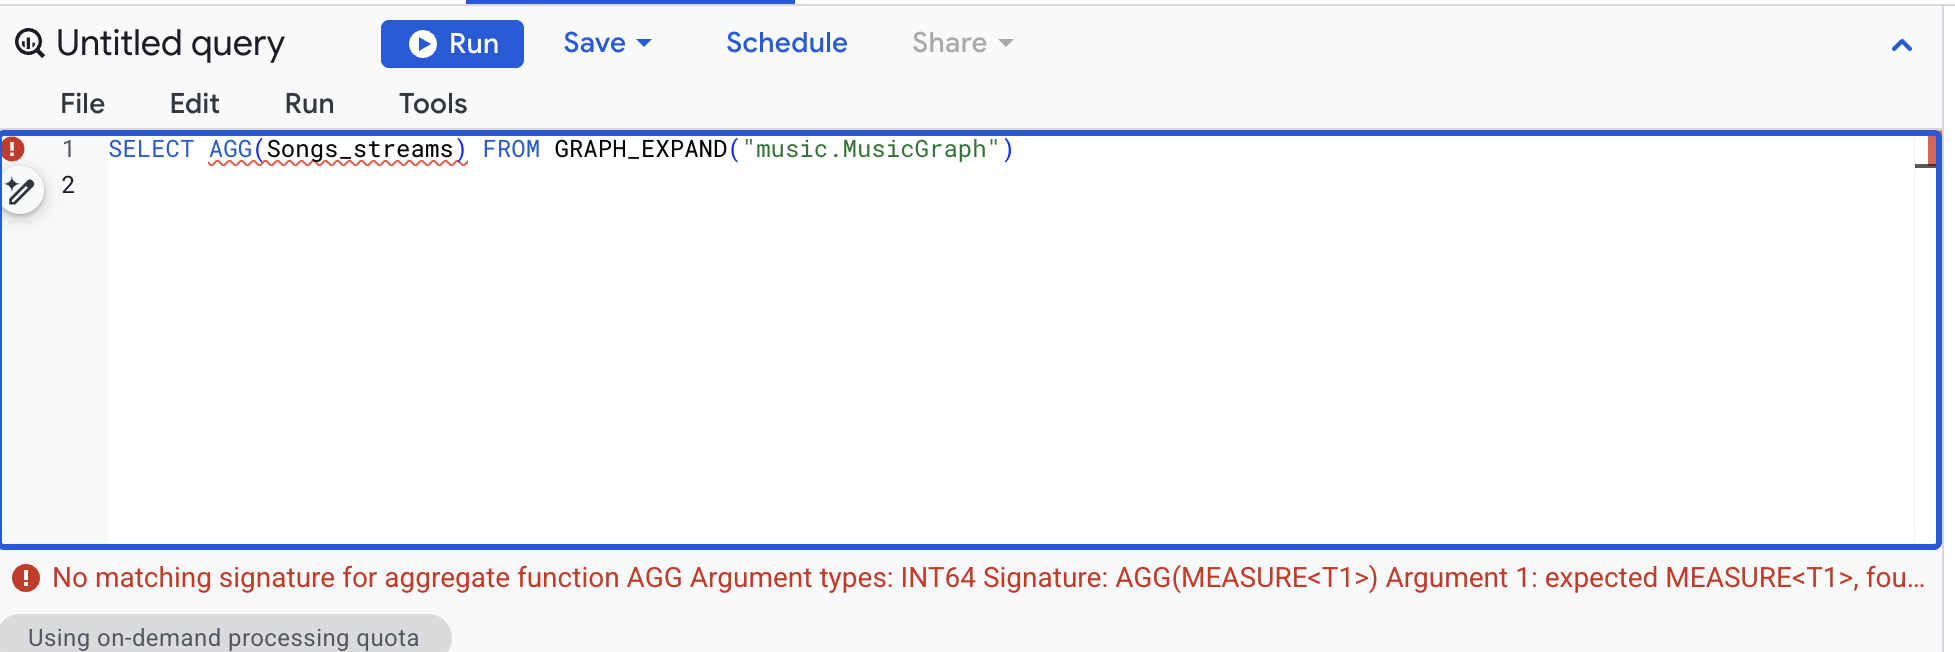
👉📋 クエリエディタ - AGG のない指標列:
SELECT Songs_total_streams FROM GRAPH_EXPAND("music.MusicGraph") LIMIT 1
👀 Returning expressions of type MEASURE is not allowed
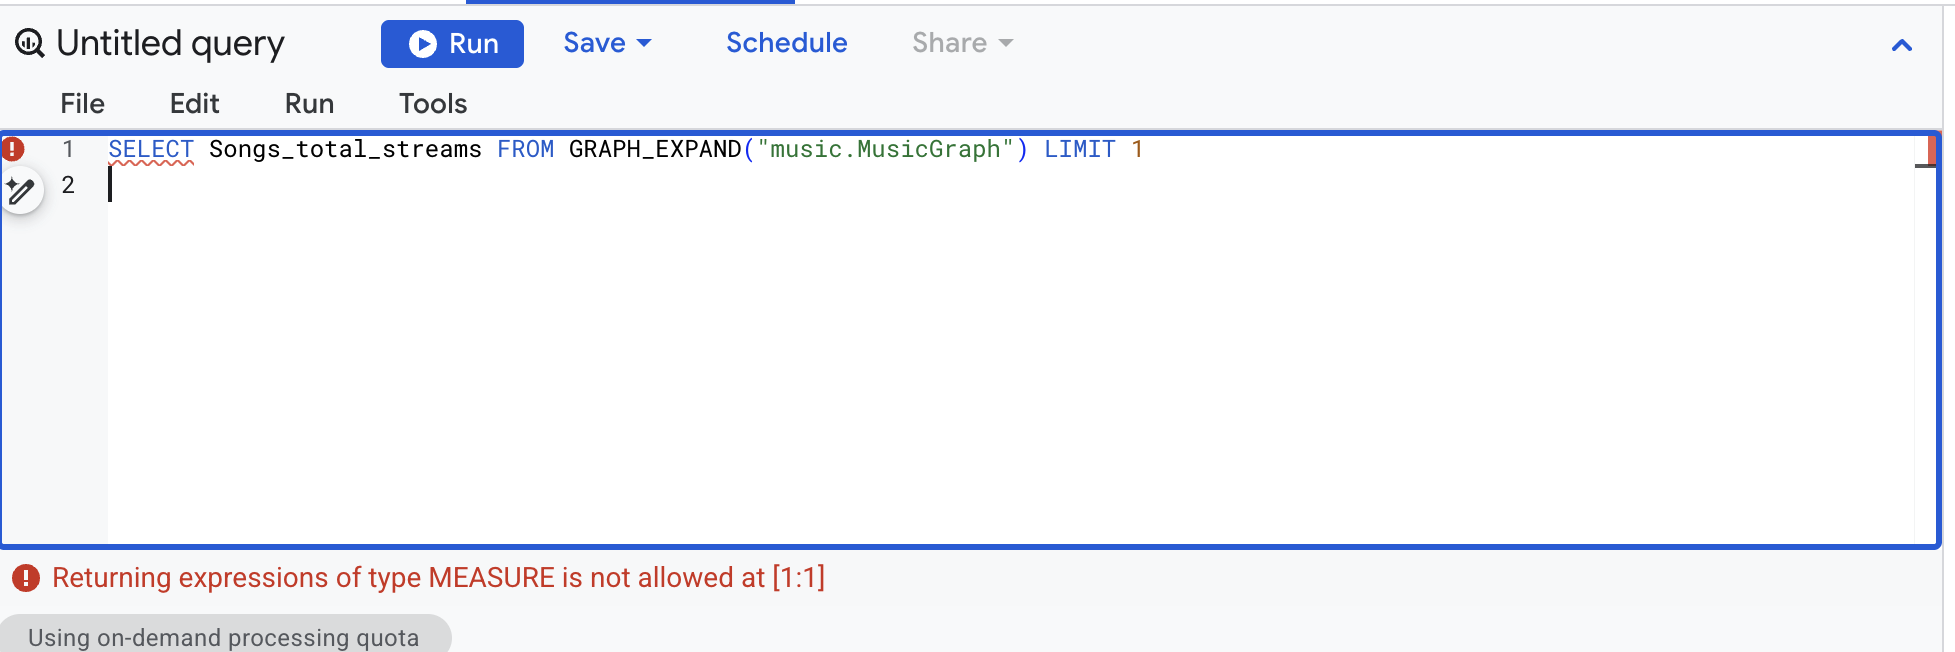
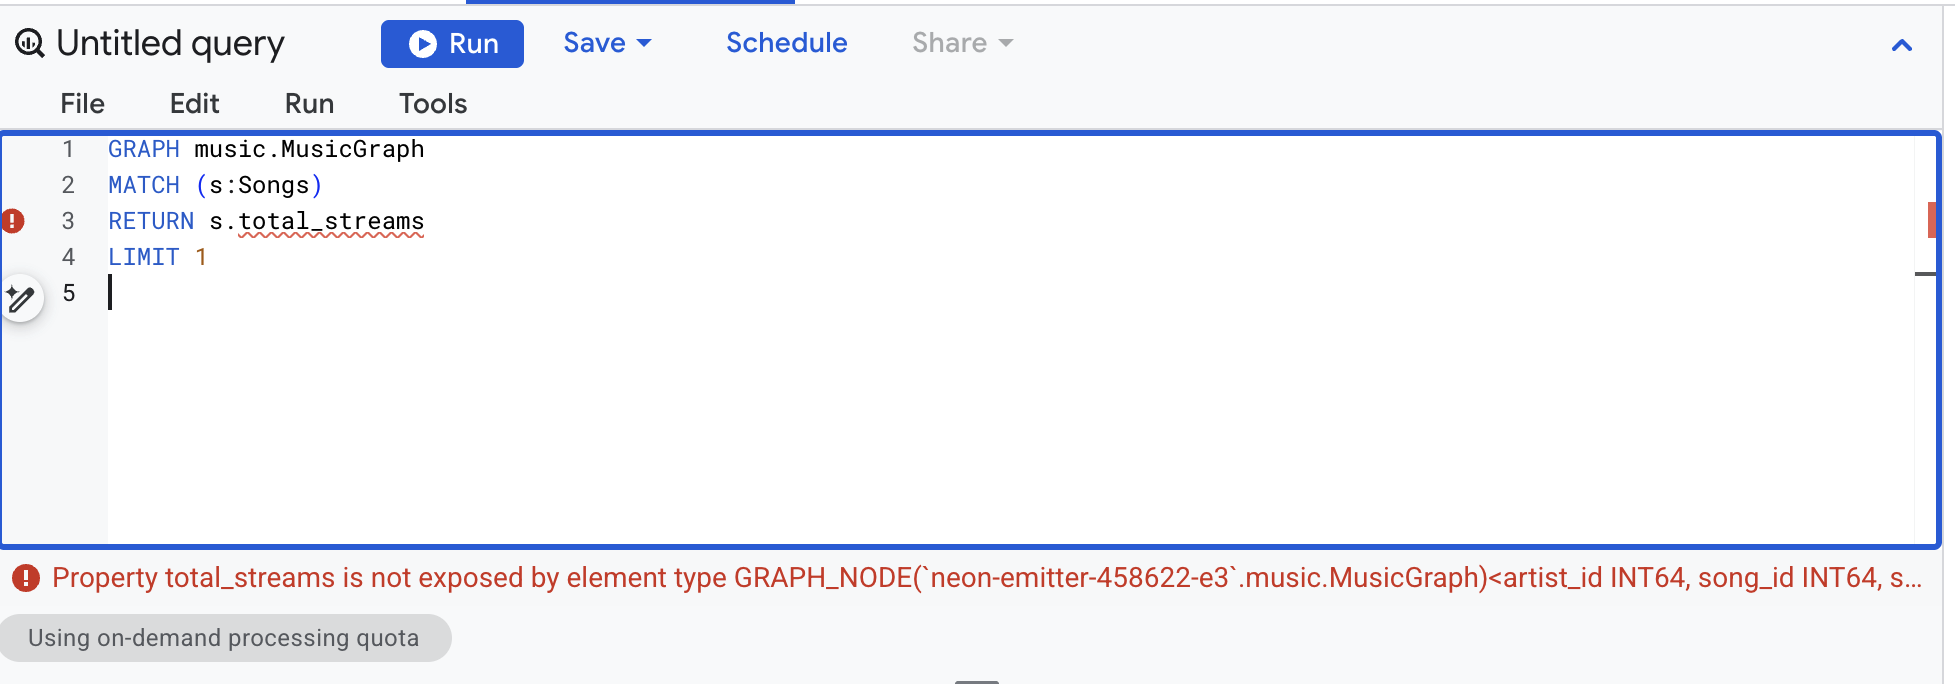
👉📋 クエリエディタ - GQL で参照されるメジャー。メジャーをまったく認識しない(これは GQL クエリです。概要の編集メモを参照してください)。
GRAPH music.MusicGraph
MATCH (s:Songs)
RETURN s.total_streams
LIMIT 1
👀 total_streams is not exposed by element type GRAPH_NODE(...)
👉📋 クエリエディタ - 測定列に対する SUM(魅力的なもの):
SELECT Labels_label_name, SUM(Songs_total_streams)
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1
👀 MEASURE-typed arguments are only permitted in the AGG function
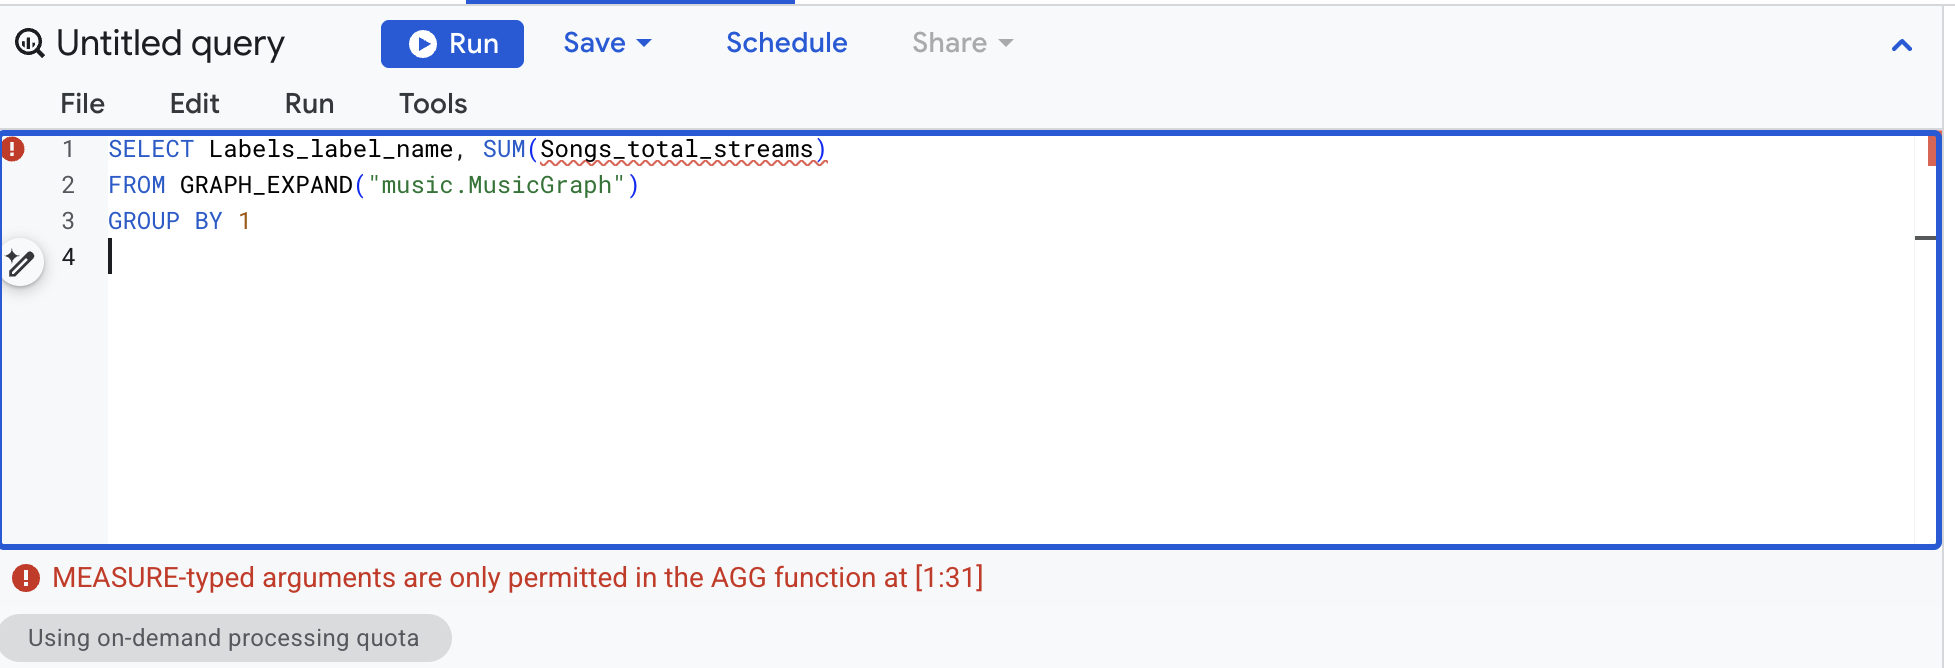
そのため、型システムがルールを適用します。メジャーは GRAPH_EXPAND を通してのみ表示され、AGG を通してのみ読み取ることができます。以前の 126 億の過剰なカウントは、未加工の列の合計からのみ発生するものであり、指標の誤った処理から発生することはありません。
✅ チェックポイント: 4 つの赤いエラーがあり、それぞれがどのルールを適用しているかを説明できます。
8. すべての集計でメジャーがサポートされる
MEASURE() は、SUM、AVG、MIN、MAX、COUNT、COUNT(DISTINCT) の 6 つの集計のいずれかをラップします。Songs ノードに 6 つすべてを含むグラフを再作成します。エッジは NO PROPERTIES のままです。これは、エッジが物理テーブルをノードと共有する場合のベスト プラクティスです。
👉📋 クエリエディタ - 貼り付けて [実行] をクリックします。
CREATE OR REPLACE PROPERTY GRAPH music.MusicGraph
  NODE TABLES (
    music.Labels KEY (label_id)
      PROPERTIES (label_id, label_name, marketing_budget,
        MEASURE(SUM(marketing_budget)) AS total_budget),
    music.Artists KEY (artist_id)
      PROPERTIES (artist_id, artist_name, label_id,
        MEASURE(COUNT(artist_id)) AS artist_count),
    music.Songs KEY (song_id)
      PROPERTIES (song_id, title, artist_id, streams,
        MEASURE(SUM(streams))              AS total_streams,
        MEASURE(AVG(streams))              AS avg_streams,
        MEASURE(MIN(streams))              AS min_streams,
        MEASURE(MAX(streams))              AS max_streams,
        MEASURE(COUNT(song_id))            AS song_count,
        MEASURE(COUNT(DISTINCT artist_id)) AS distinct_artists),
    music.Playlists KEY (playlist_id)
      PROPERTIES (playlist_id, playlist_name, followers,
        MEASURE(SUM(followers)) AS total_followers),
    music.PlaylistEntries KEY (entry_id)
      PROPERTIES (entry_id, playlist_id, song_id,
        MEASURE(COUNT(entry_id)) AS placement_count)
  )
  EDGE TABLES (
    music.PlaylistEntries AS EntryToSong
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (song_id) REFERENCES Songs(song_id) NO PROPERTIES,
    music.PlaylistEntries AS EntryToPlaylist
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (playlist_id) REFERENCES Playlists(playlist_id) NO PROPERTIES,
    music.Songs AS SongToArtist
      SOURCE KEY (song_id) REFERENCES Songs(song_id)
      DESTINATION KEY (artist_id) REFERENCES Artists(artist_id) NO PROPERTIES,
    music.Artists AS ArtistToLabel
      SOURCE KEY (artist_id) REFERENCES Artists(artist_id)
      DESTINATION KEY (label_id) REFERENCES Labels(label_id) NO PROPERTIES
  )
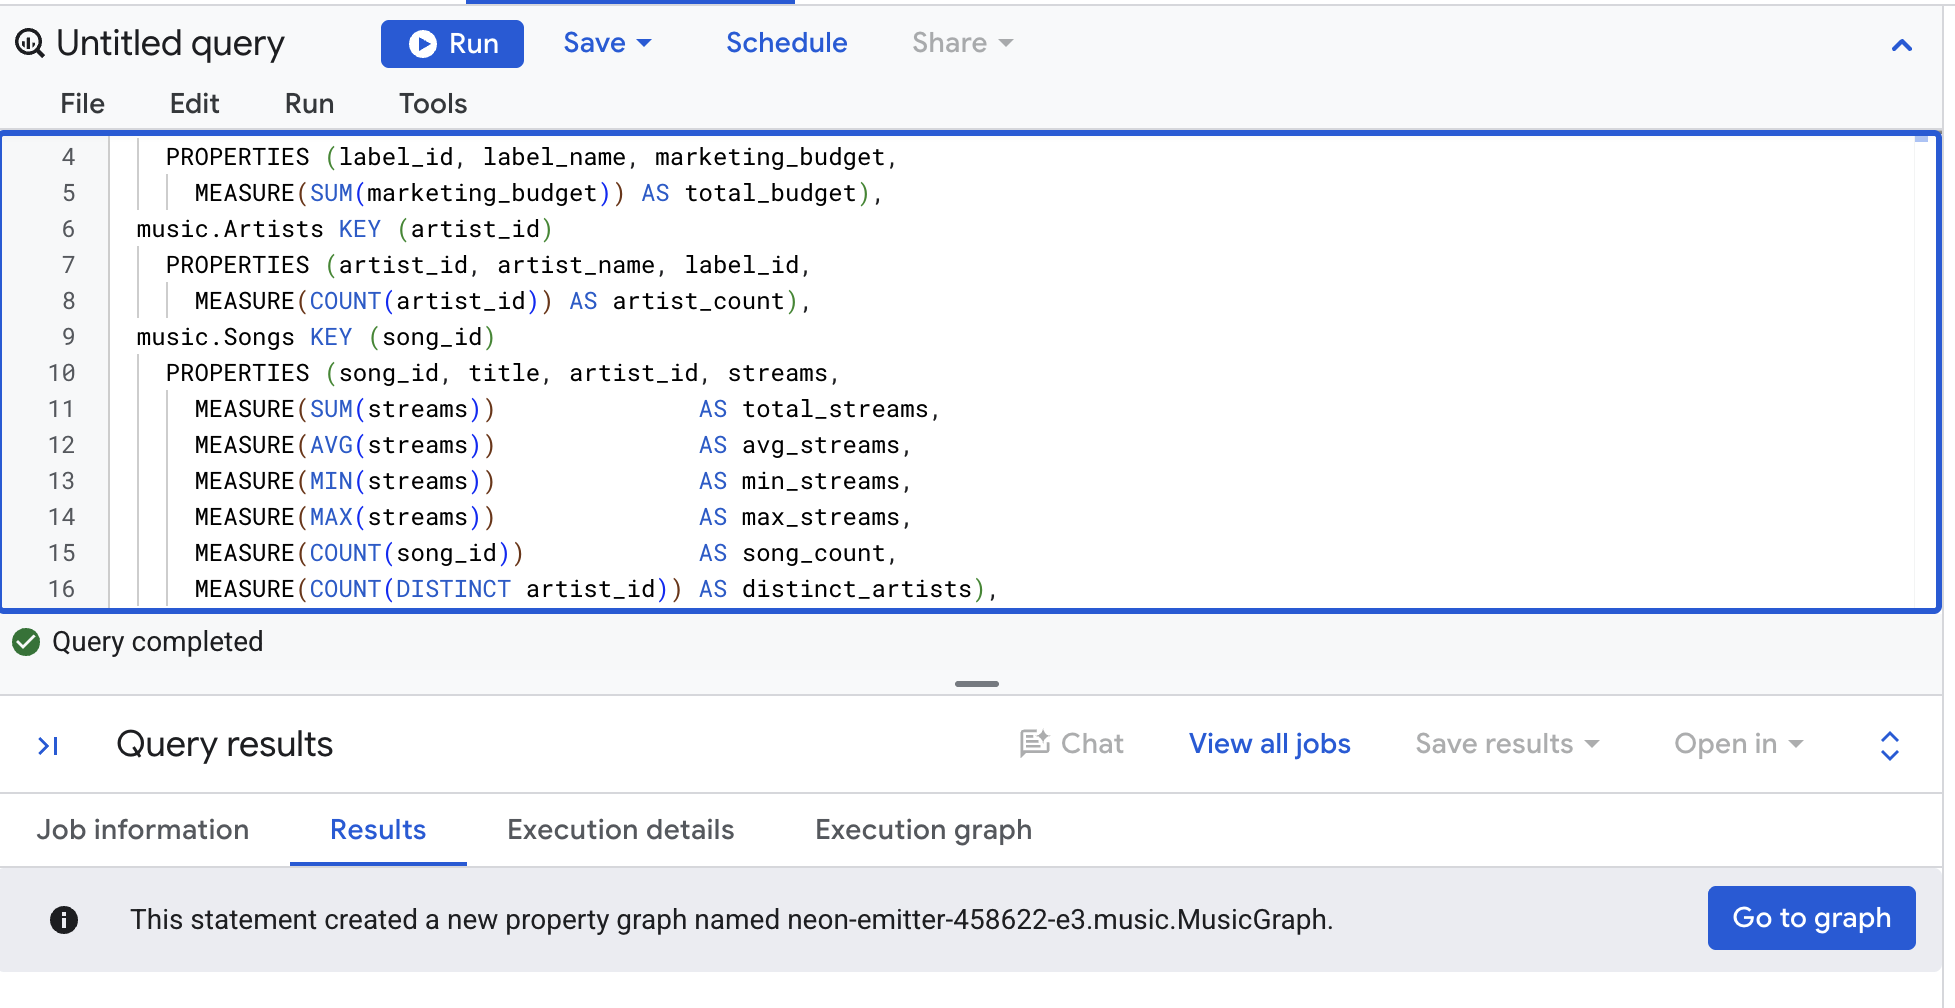
では、すべて読み返してみましょう。すべての指標が AGG を通過し、最後の列には、AGG の結果が算術演算に使用できる通常の値であることが示されています。グラフが変更されたため、まず [キャッシュされた結果を使用] をオフにします([その他] → [クエリ設定])。
👉📋 クエリエディタ - 貼り付けて [実行] をクリックします。
SELECT
  Labels_label_name,
  AGG(Songs_total_streams)    AS total_streams,
  AGG(Songs_avg_streams)      AS avg_streams,
  AGG(Songs_min_streams)      AS min_streams,
  AGG(Songs_max_streams)      AS max_streams,
  AGG(Songs_song_count)       AS songs,
  AGG(Songs_distinct_artists) AS artists,
  AGG(Songs_total_streams) / AGG(Songs_song_count) AS streams_per_song
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1
ORDER BY 1
👀 結果:
Labels_label_name | total_streams | avg_streams | min_streams | max_streams | 曲 | アーティスト | streams_per_song |
Cymbal レコード | 5,100,000,000 | 1,275,000,000 | 400,000,000 | 2,000,000,000 | 4 | 2 | 1,275,000,000 |
Northwind Audio | 4,500,000,000 | 4,500,000,000 | 4,500,000,000 | 4,500,000,000 | 1 | 1 | 4,500,000,000 |
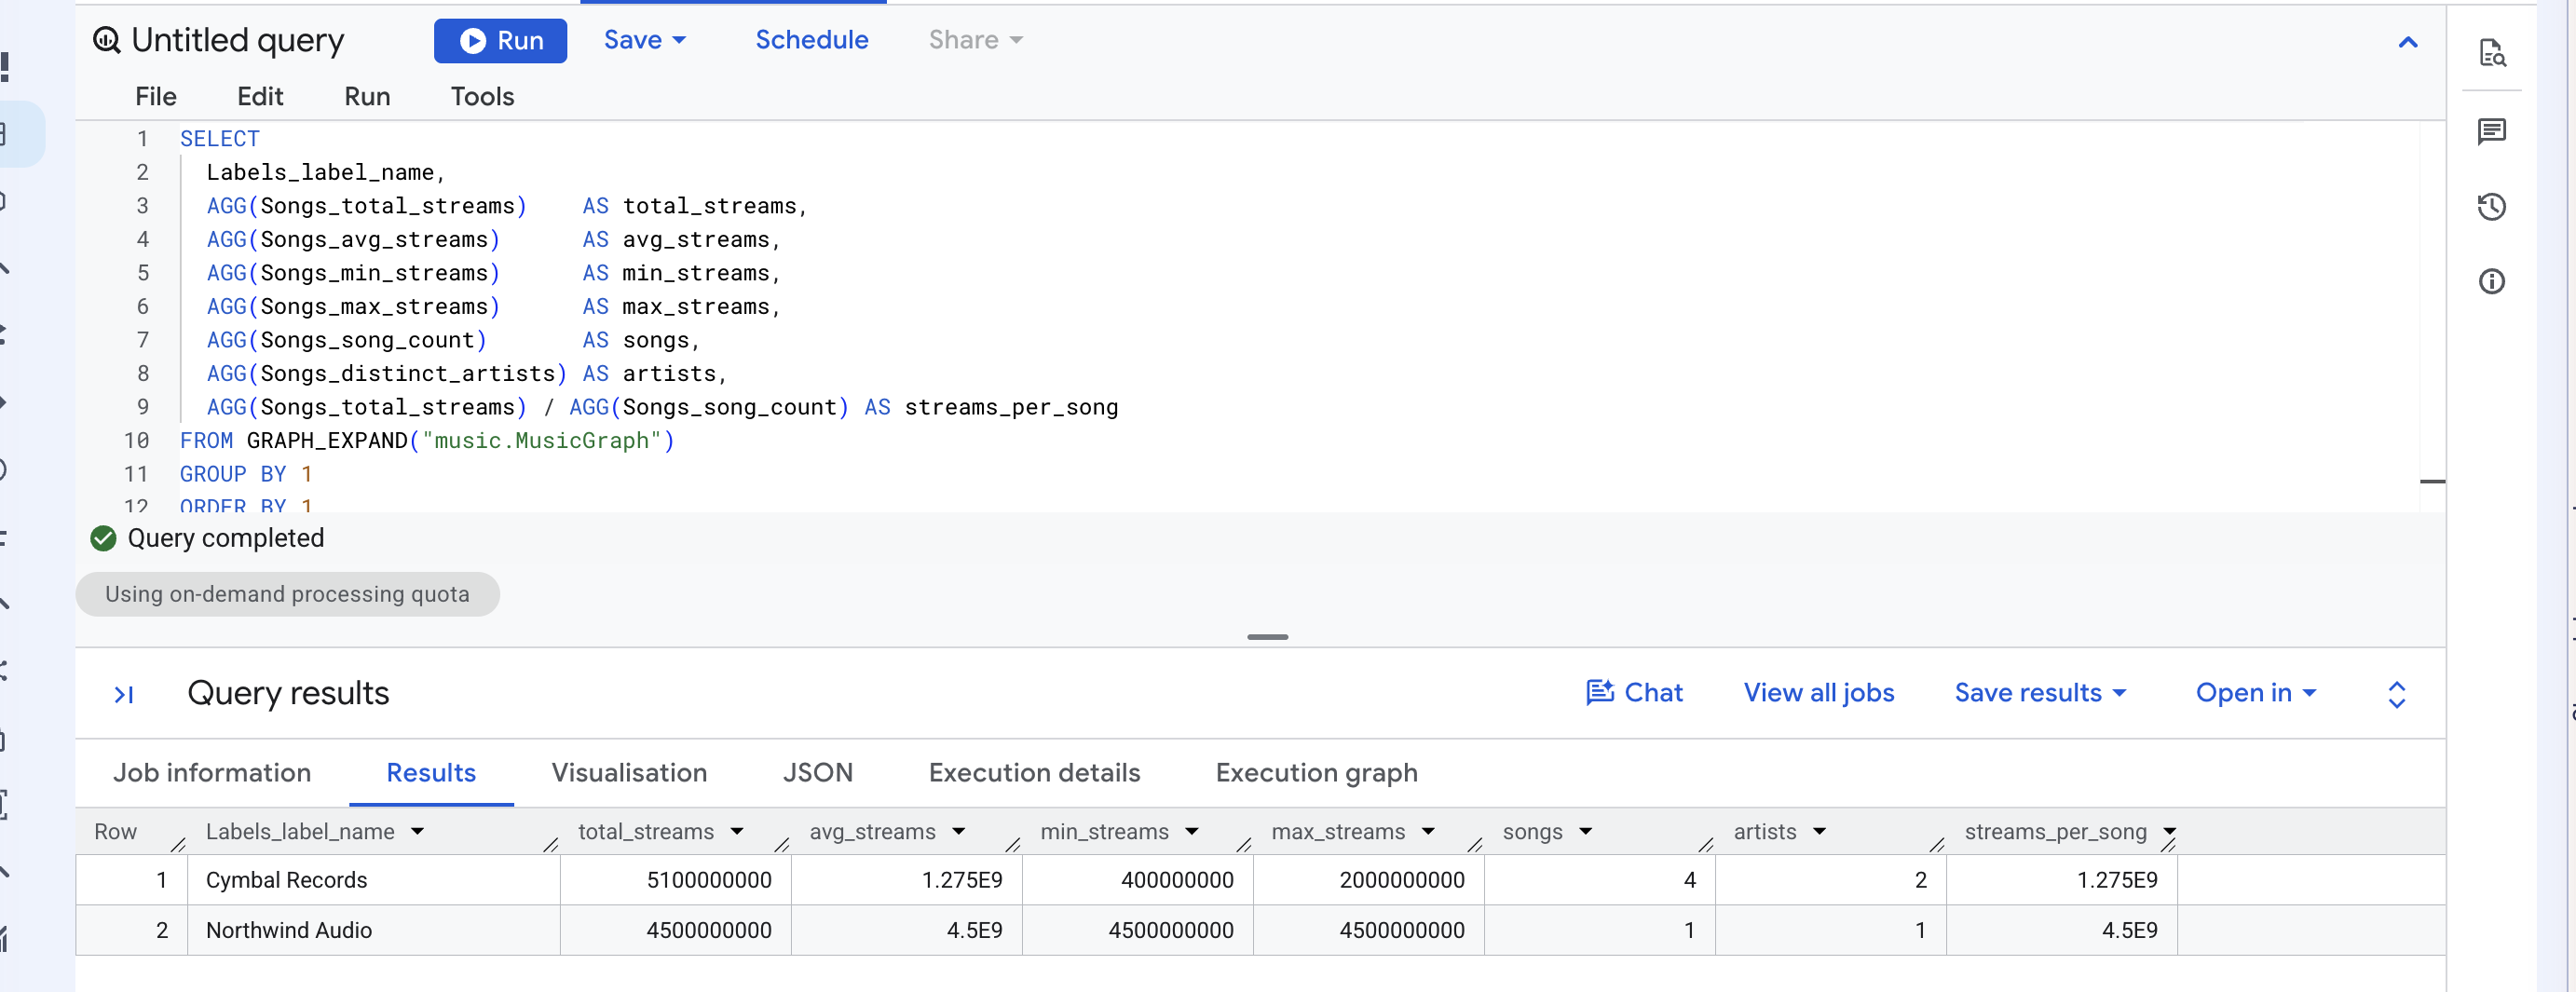
すべての数値は、10 個のプレースメント行ではなく、Cymbal の 4 曲と Northwind の 1 曲で計算されます。特に AVG は、逆の計算をすると間違った結果になります。プレースメント行で元の列の平均を計算すると、Cymbal の値は 15 億 7, 500 万になります。これは、Neon Summer の 20 億が 4 回カウントされるためです。
したがって、「SUM を AGG に置き換える」は実際には 2 つの決定です。指標を宣言するときは、6 つの集計のうちのどれであるかを選択します。指標を読み取るとき、関数は常に AGG です。
✅ チェックポイント: ラベルごとに 1 行、それぞれ 7 つの数値、streams_per_song は avg_streams と等しい。
9. メジャーではなくグループ化を変更する
同じ指標で別の質問に回答する。ラベルではなくプレイリストでグループ化します。
👉📋 クエリエディタ - 貼り付けて [実行] をクリックします。
SELECT
  Playlists_playlist_name,
  AGG(Songs_total_streams) AS streams,
  AGG(Songs_song_count)    AS songs
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1
ORDER BY 2 DESC
👀 結果:
Playlists_playlist_name | 受信できます | 曲 |
ロード・トリップ | 6,900,000,000 | 3 |
Gym Pump | 6,500,000,000 | 2 |
リアルタイム | 4,700,000,000 | 3 |
ライジング ポップ | 3,500,000,000 | 2 |
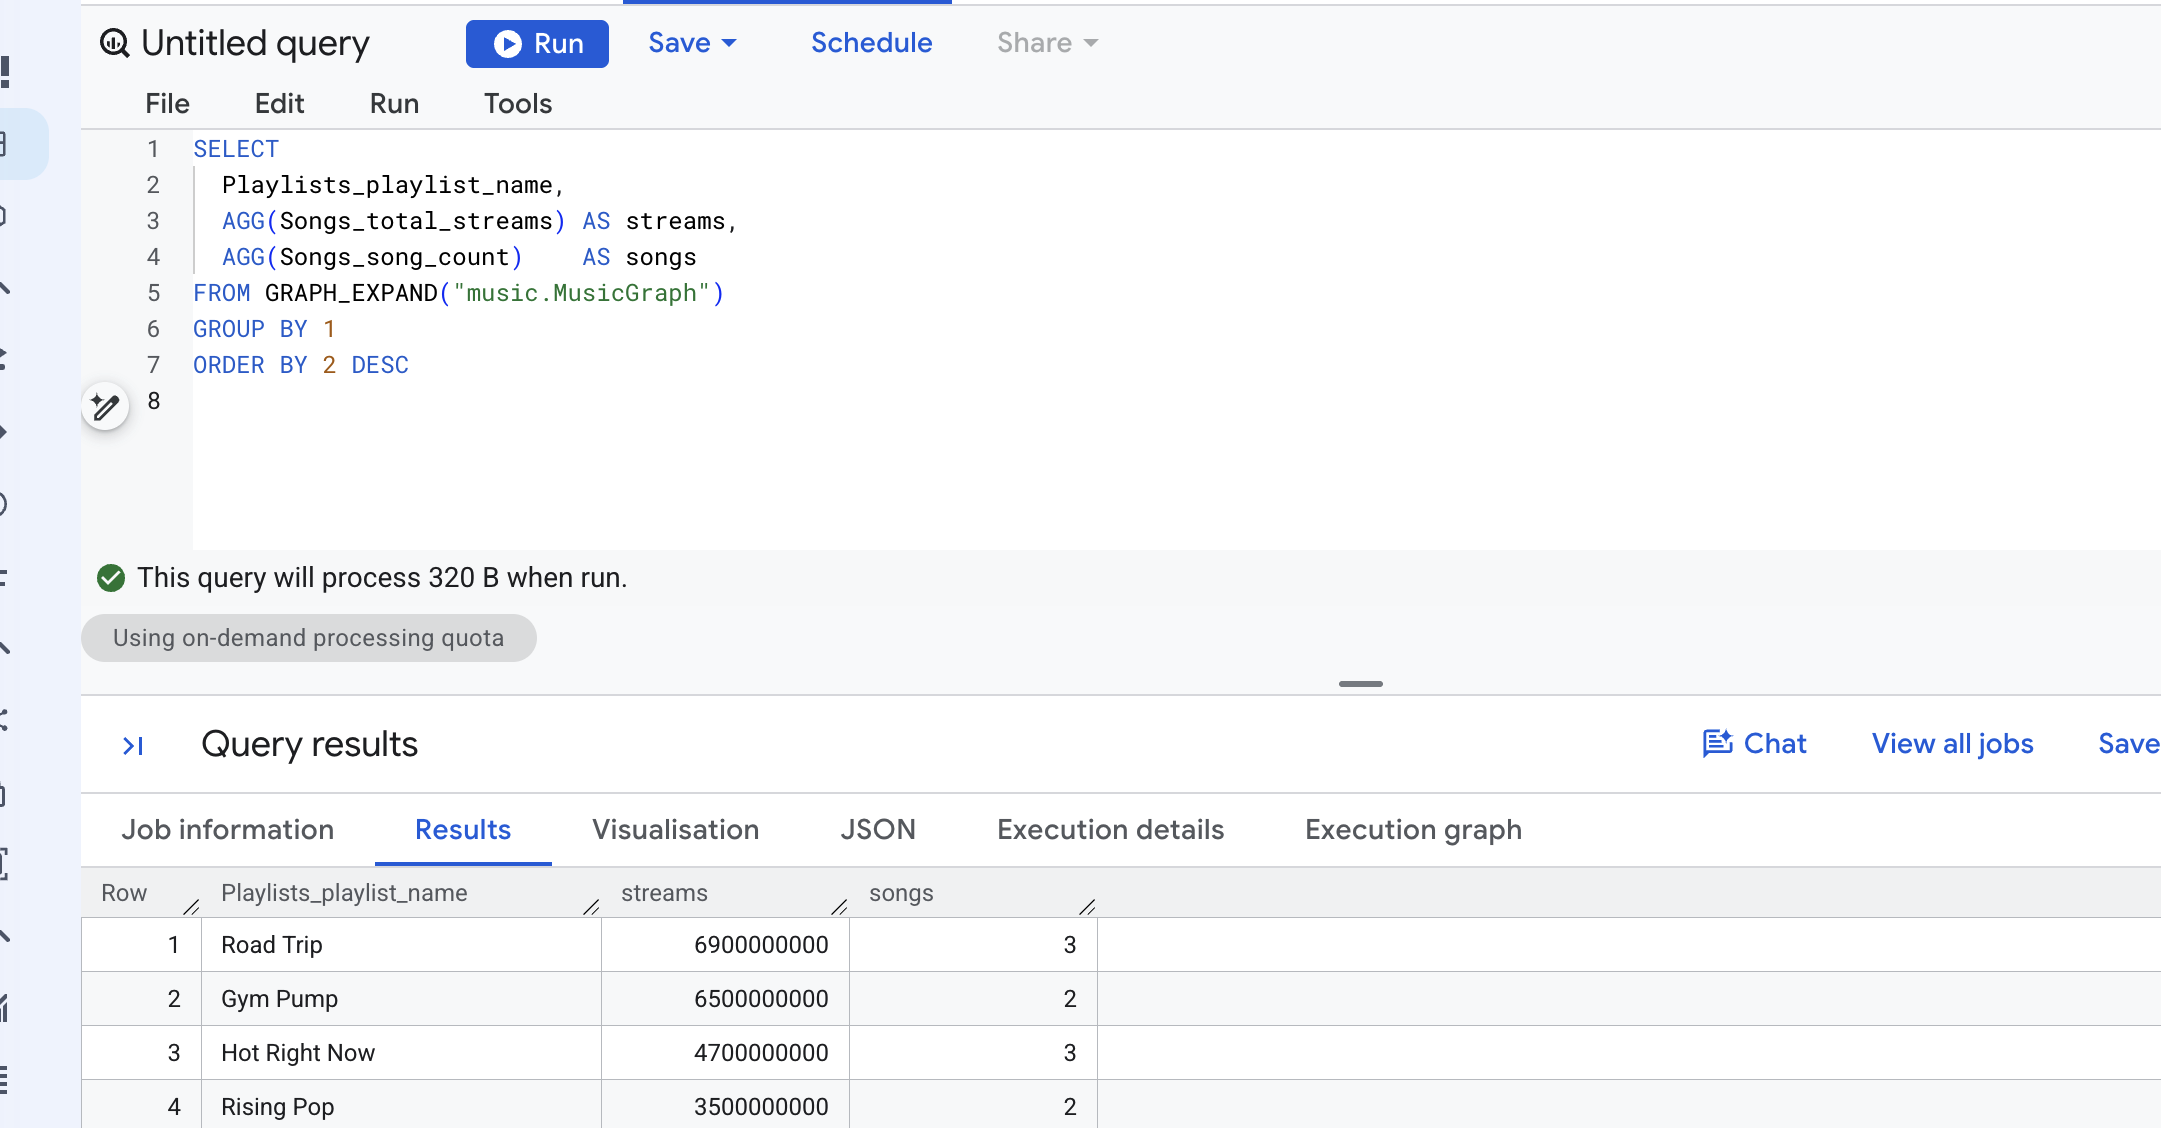
2 つの AGG 行は、SUM と AGG を並べたものとバイト単位で同じです。GROUP BY のみが移動しました。Road Trip には Neon Summer、Midnight Drive、Slow Arrow が含まれており、各曲はプレイリスト内で 1 回カウントされます。これはまさに「このプレイリストに到達したストリーム」が意味する内容です。
メジャーを作成したユーザーが粒度を 1 回決定しました。それ以降のクエリはすべて、この設定を継承します。
✅ チェックポイント: Road Trip が 69 億回でトップ。
10. GRAPH_EXPAND の結果を確認する
GRAPH_EXPAND を実行して形状を学習する必要はありません。BQ.SHOW_GRAPH_EXPAND_SCHEMA システム プロシージャは、列リストを変数に書き込みます。
👉📋 クエリエディタ - 3 行すべてを貼り付けて、[実行] をクリックします。
DECLARE schema STRING DEFAULT '';
CALL BQ.SHOW_GRAPH_EXPAND_SCHEMA('music.MusicGraph', schema);
SELECT schema;
👀 結果は 1 つの JSON 文字列です。各フィールドには名前、型、モードがあり、すべての指標列には "is_measure": true が含まれています。作成したグラフでは、次のような結果が得られます。
name | type | is_measure | |
Songs_title | STRING | ||
Songs_streams | INTEGER | ||
Songs_total_streams | INTEGER | true | |
Songs_avg_streams | FLOAT | true | |
Songs_distinct_artists | INTEGER | true | |
PlaylistEntries_placement_count | INTEGER | true | |
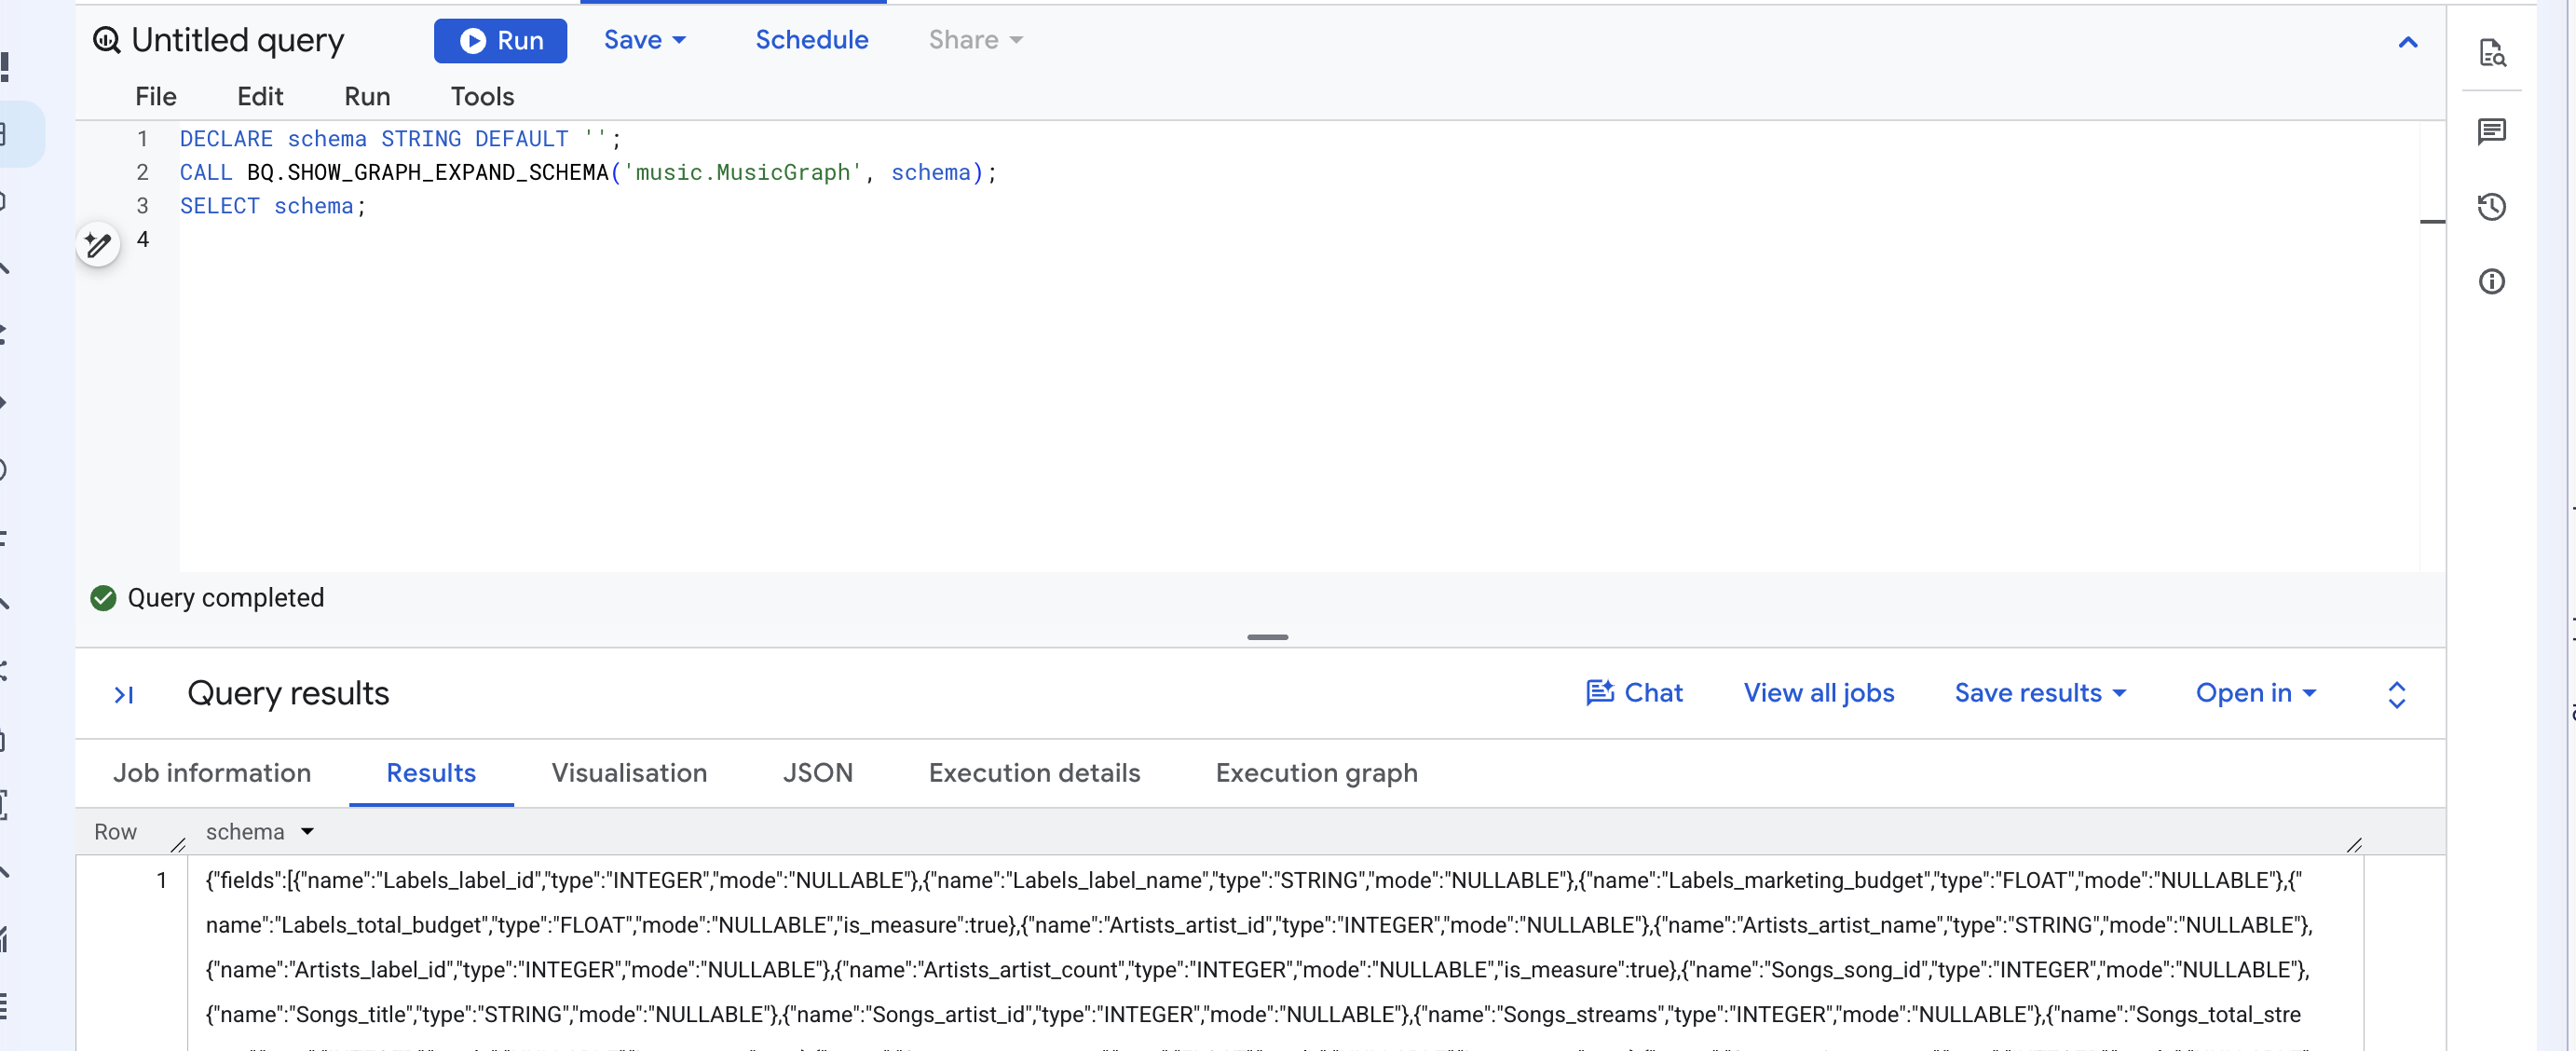
プロパティに設定した説明や同義語もここに表示されます。省略可能なチャット ステップでは、誰がメッセージを読んだかを確認できます。
✅ チェックポイント: MEASURE で宣言したすべての列に is_measure が含まれる JSON 文字列。
11. GRAPH_EXPAND がグラフの形状から必要とするもの
このステップでは実行するものはなく、読むだけです。GRAPH_EXPAND は、1 つのテーブルから始まり、外側にエッジをたどる LEFT JOIN のチェーンを使用してワイド テーブルを構築します。このことから 3 つのルールが導き出され、MusicGraph はそのすべてを満たしています。
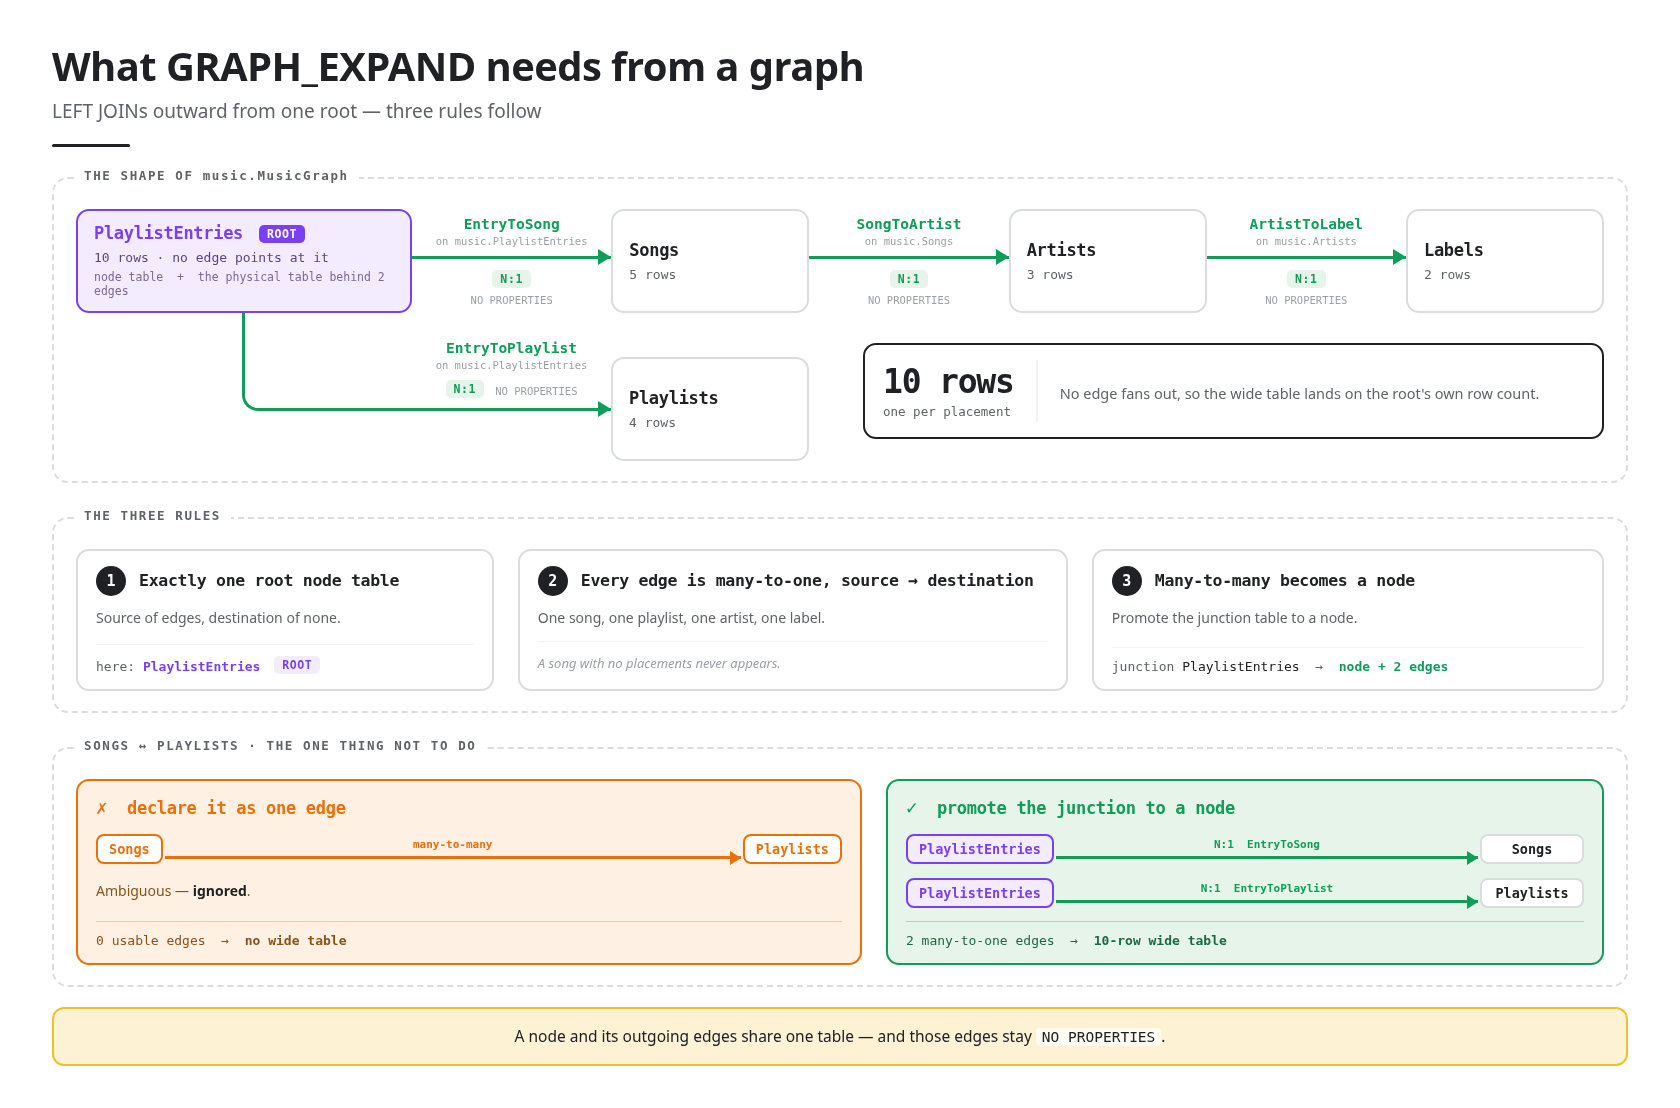
ルートノード テーブルは 1 つだけです。ルートは、キーが他のテーブルに表示されないノードテーブル(エッジが指していないテーブル)です。MusicGraph では、PlaylistEntries は 2 つのエッジのソースであり、宛先はありません。ワイド テーブルには、プレースメントごとに 1 行、合計 10 行が含まれています。
すべてのエッジは多対一(ソースから宛先)です。各エントリには 1 つの曲と 1 つのプレイリストがあり、各曲には 1 つのアーティストがあり、各アーティストには 1 つのレーベルがあります。そのため、ワイド テーブルはルート自身の行を超えて展開されることはありません。ルートがアクセスできないデータは表示されません。たとえば、プレースメントのない曲はワイドテーブルに表示されません。
多対多の関係がノードになります。曲とプレイリストは多対多の関係です。ジャンクション テーブルを Songs から Playlists への単一のエッジとして宣言した場合、GRAPH_EXPAND は曖昧なものとして無視し、使用可能なエッジが残っていないため、失敗します。PlaylistEntries を 2 つの多対 1 エッジを持つノードテーブルに昇格させることは、ドキュメントに記載されているパターンであり、グラフの構築時に実行した処理です。
12. (省略可)GQL を使用したパス
これまでの質問にはすべて、答えとして数字が返ってきています。この場合は、そうではありません。「Cymbal のストリームはリスナーにどこまで届きますか?」という質問は、グラフ内のルートに関する質問であり、合計では回答できません。合計した時点でルートは消滅しているからです。
1. ストリームの着地点を尋ねる
👉📋 クエリエディタ - 貼り付けて [実行] をクリックします。
GRAPH music.MusicGraph
MATCH (l:Labels)<-[:ArtistToLabel]-(a:Artists)<-[:SongToArtist]-(s:Songs)
      <-[:EntryToSong]-(e:PlaylistEntries)-[:EntryToPlaylist]->(pl:Playlists)
WHERE l.label_name = 'Cymbal Records'
RETURN pl.playlist_name, pl.followers,
       SUM(s.streams) AS streams_reaching_this_playlist,
       STRING_AGG(s.title, ', ') AS songs
GROUP BY pl.playlist_name, pl.followers
ORDER BY streams_reaching_this_playlist DESC
👀 4 つの再生リストが作成されます。
pl.playlist_name | pl.followers | streams_reaching_this_playlist | 曲 |
リアルタイム | 35,000,000 | 4,700,000,000 | ダブルショット、ネオン サマー、ペーパー クラウン |
ライジング ポップ | 2,000,000 | 3,500,000,000 | Neon Summer、Paper Crown |
ロード・トリップ | 5,000,000 | 2,400,000,000 | ネオンの夏、遅い矢印 |
Gym Pump | 3,000,000 | 2,000,000,000 | ネオンの夏 |
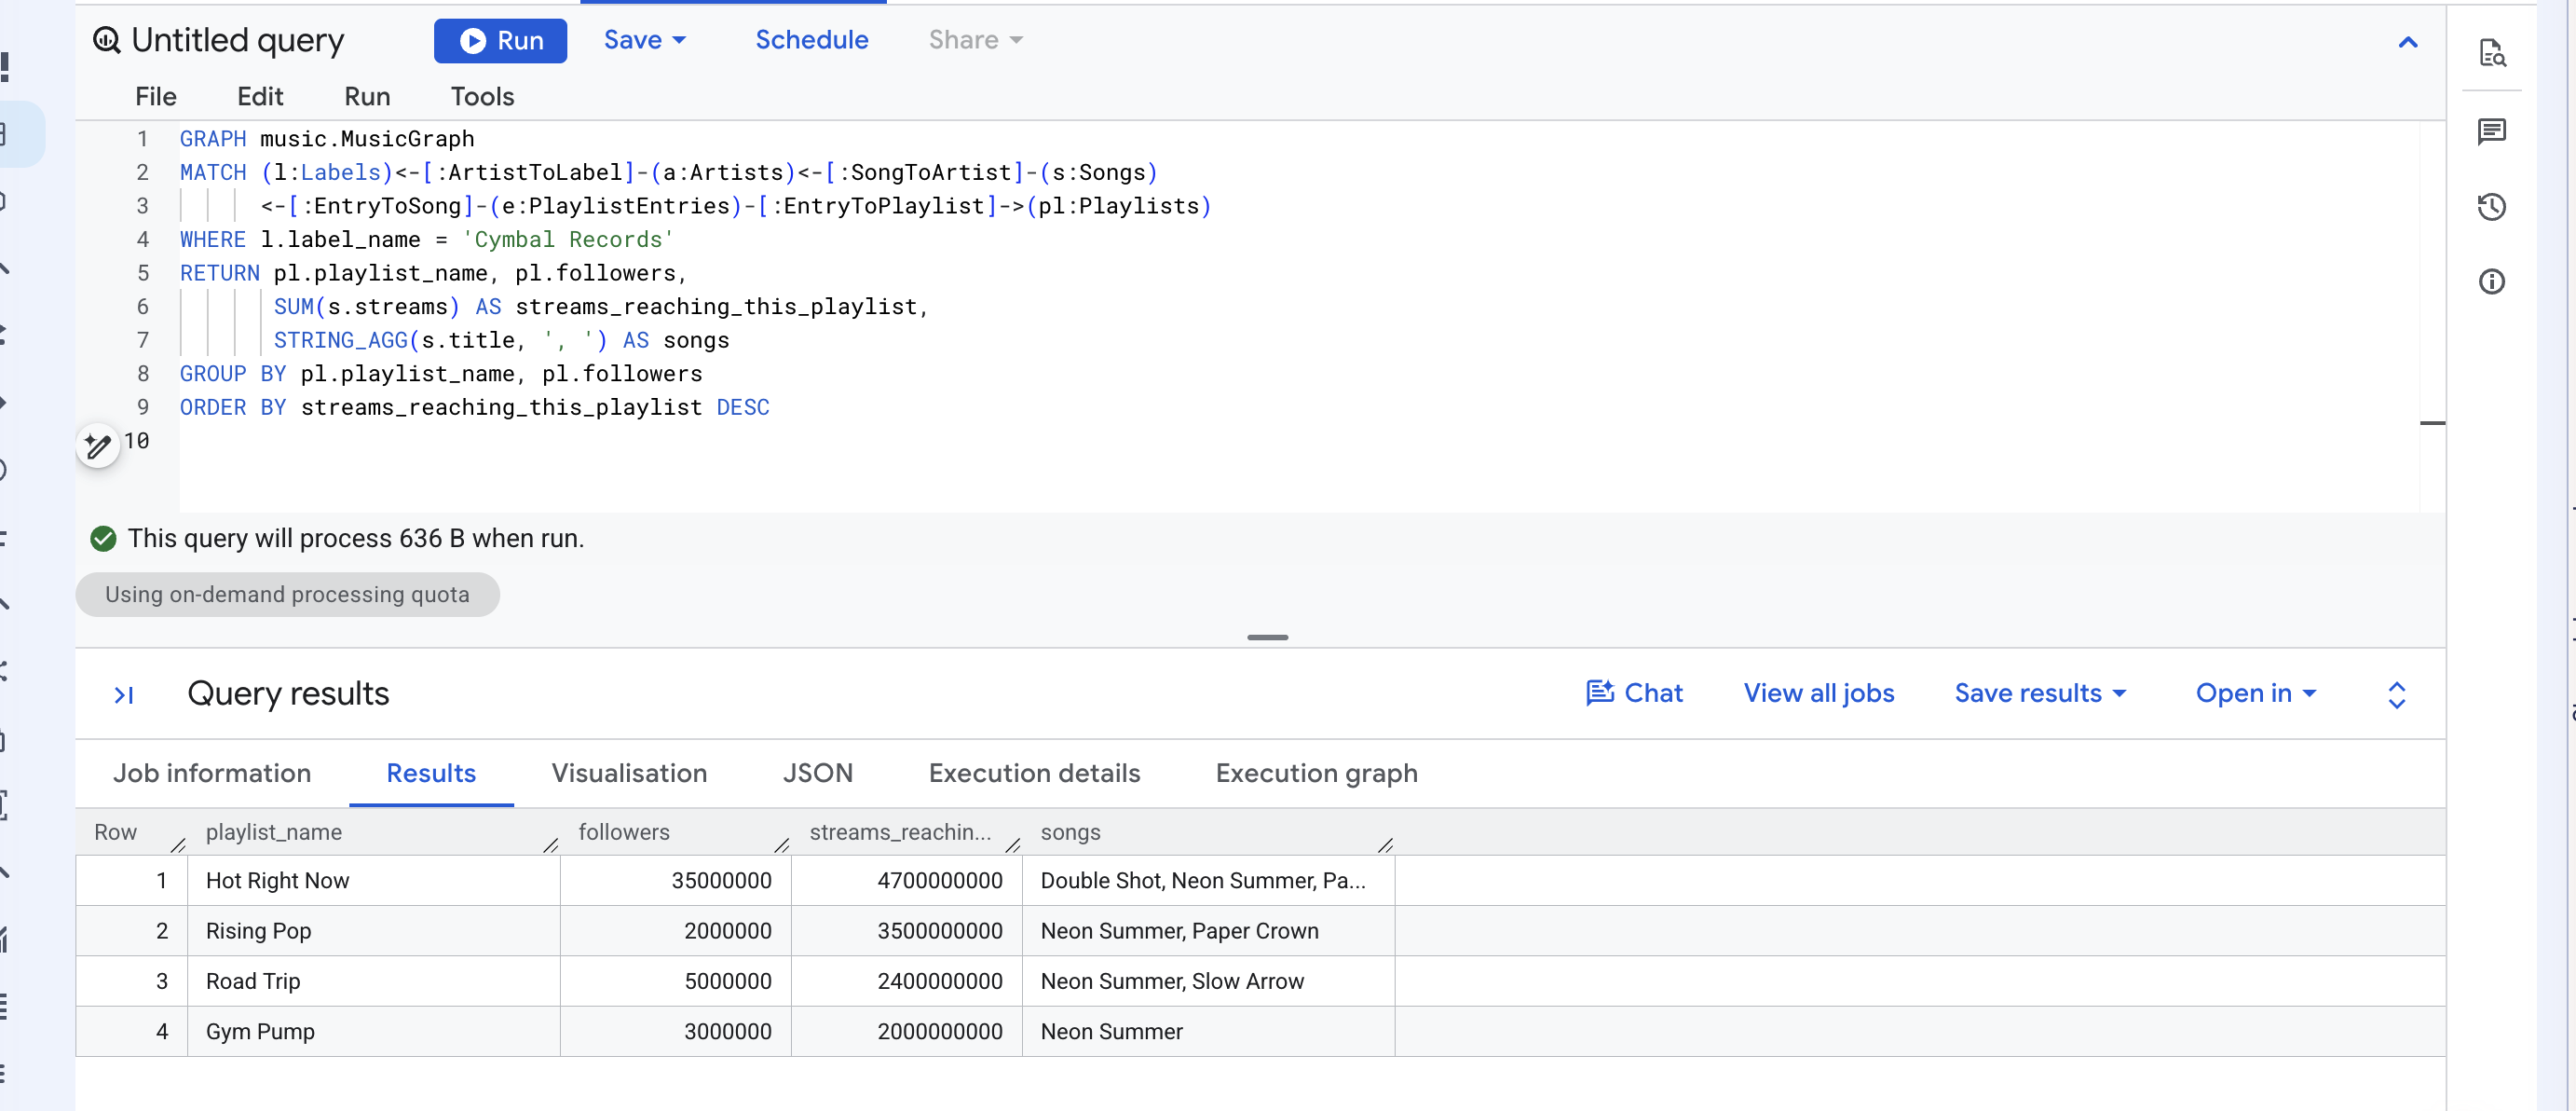
MATCH 行を文として読みます。ラベルから始まり、アーティスト、曲、曲が属するプレイリスト エントリ、プレイリストへと戻ります。矢印はエッジが宣言された方向を示します。<- は 1 つ戻ります。
3 列目の数値を合計します。126 億 - 手順 4 で SUM が提示した間違った数値。
こちらが正しいです。当時は Cymbal のストリーミング数が問題で、プレイリストに何回追加されても、曲は 1 回しかカウントされませんでした。この質問は、これらのストリームがどこに届くか、4 つのプレイリストの曲が実際に 4 つのオーディエンスに届くかというものです。GRAPH_EXPAND が生成する重複は、一方の質問に対するエラーであり、もう一方の質問に対する回答です。AGG は、重複が悪いということではなく、算術演算を質問に合わせることを目的としていました。
2. パス自体を返す
アグリゲーションを削除して、ルートをリクエストします。
👉📋 クエリエディタ - 貼り付けて [実行] をクリックします。
GRAPH music.MusicGraph
MATCH p = (l:Labels)<-[:ArtistToLabel]-(a:Artists)<-[:SongToArtist]-(s:Songs)
          <-[:EntryToSong]-(e:PlaylistEntries)-[:EntryToPlaylist]->(pl:Playlists)
WHERE l.label_name = 'Cymbal Records'
RETURN TO_JSON(p) AS path
p = は完全一致に名前を付け、TO_JSON はそれをレンダリングします。
👀 8 行、1 つの path 列が想定されます。各セルは、1 つのルートに沿ったノードとエッジの JSON 配列です。各ノードは labels と properties を保持しています。
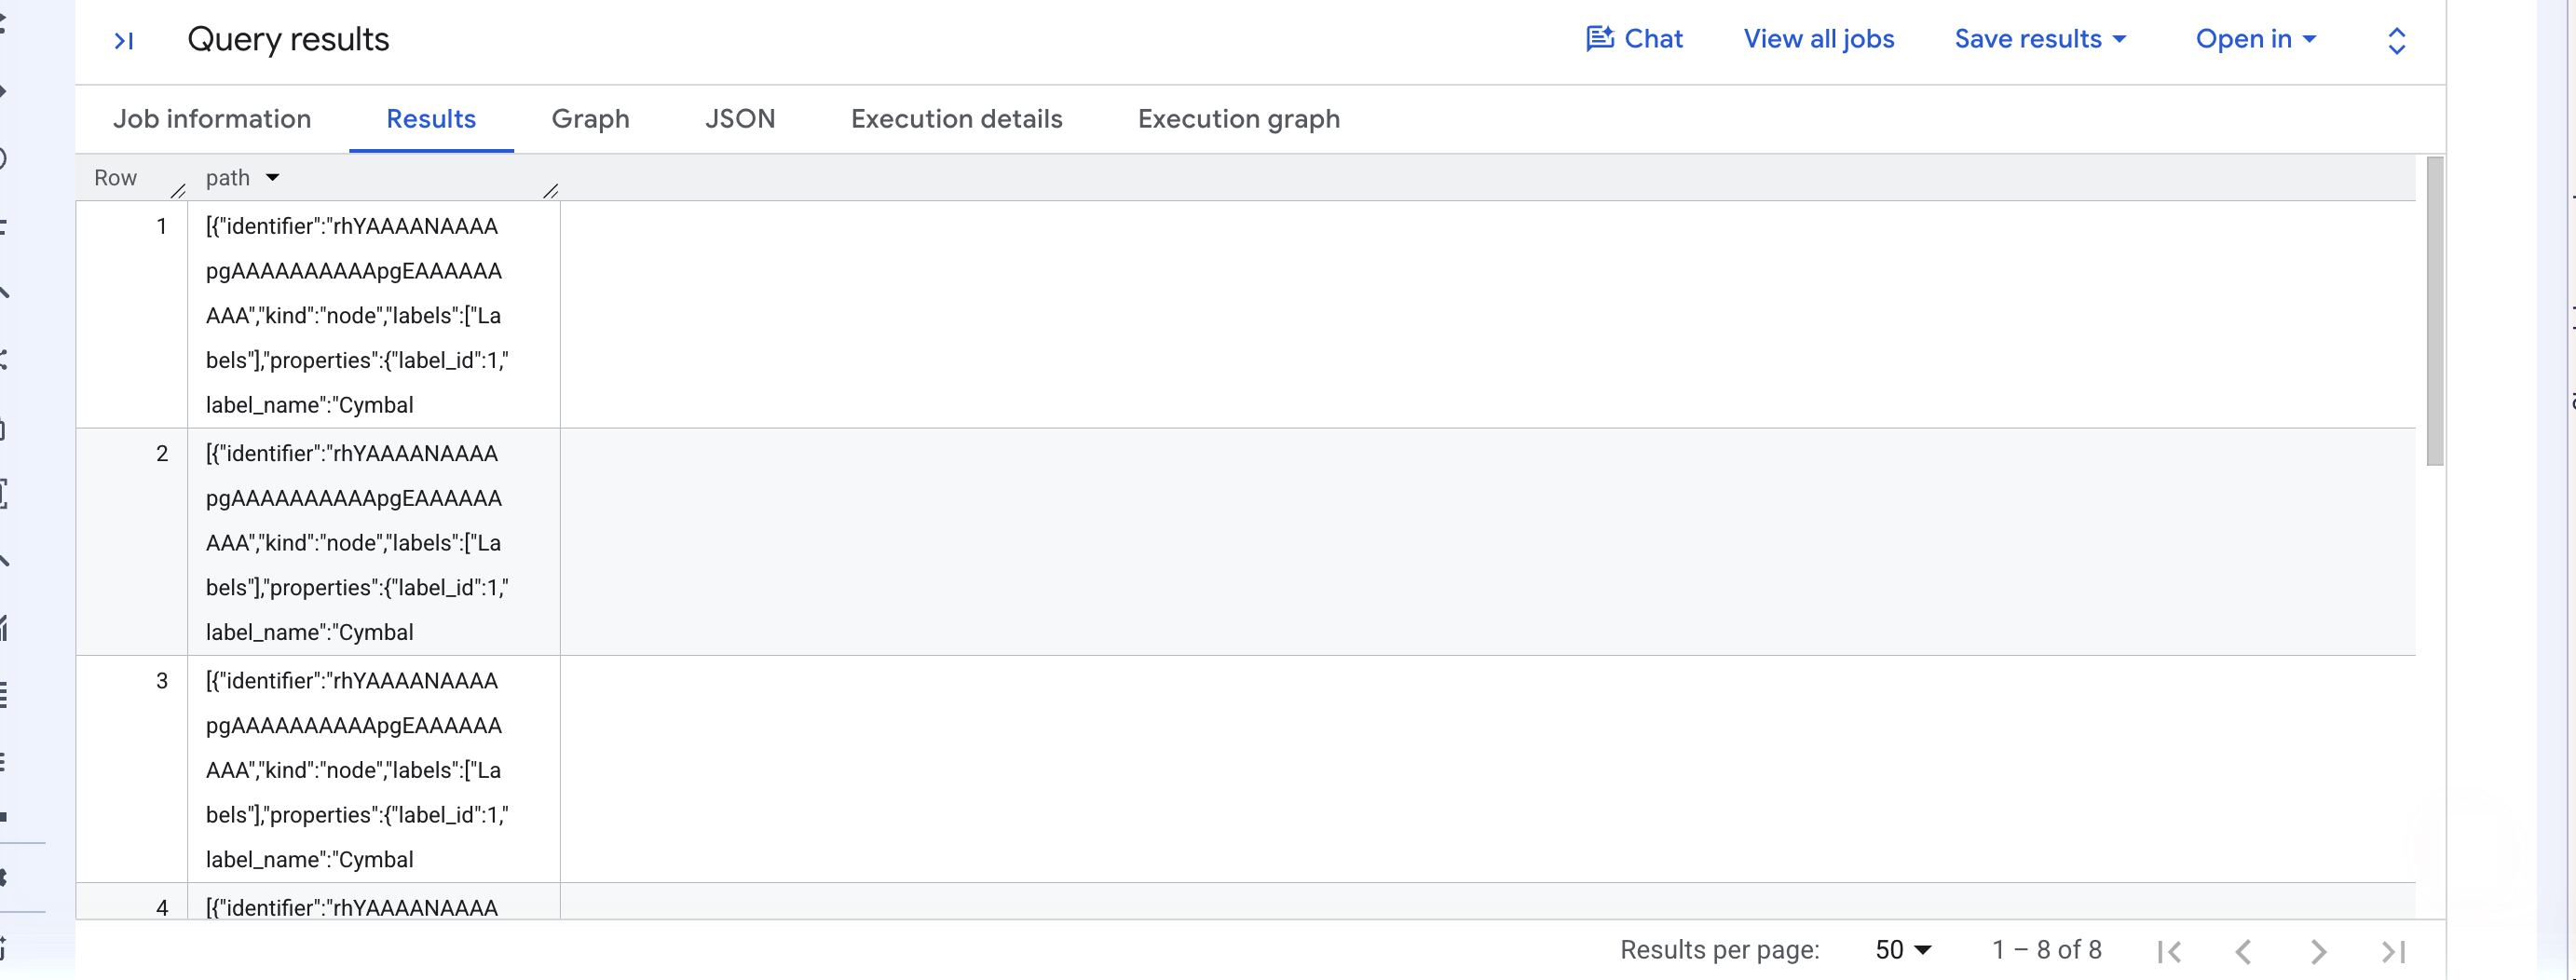
4 曲に対して 8 行。これは、曲ごとではなく、プレースメントごとにルートが存在するためです。
3. [グラフ] タブを開く
👉🌐 コンソール - 結果の上にある [グラフ] をクリックします。
このタブは、結果にグラフ要素が含まれている場合にのみ表示されます。前のクエリは数値を返したため [グラフ] タブはありませんでしたが、このクエリはパスを返すため [グラフ] タブがあります。
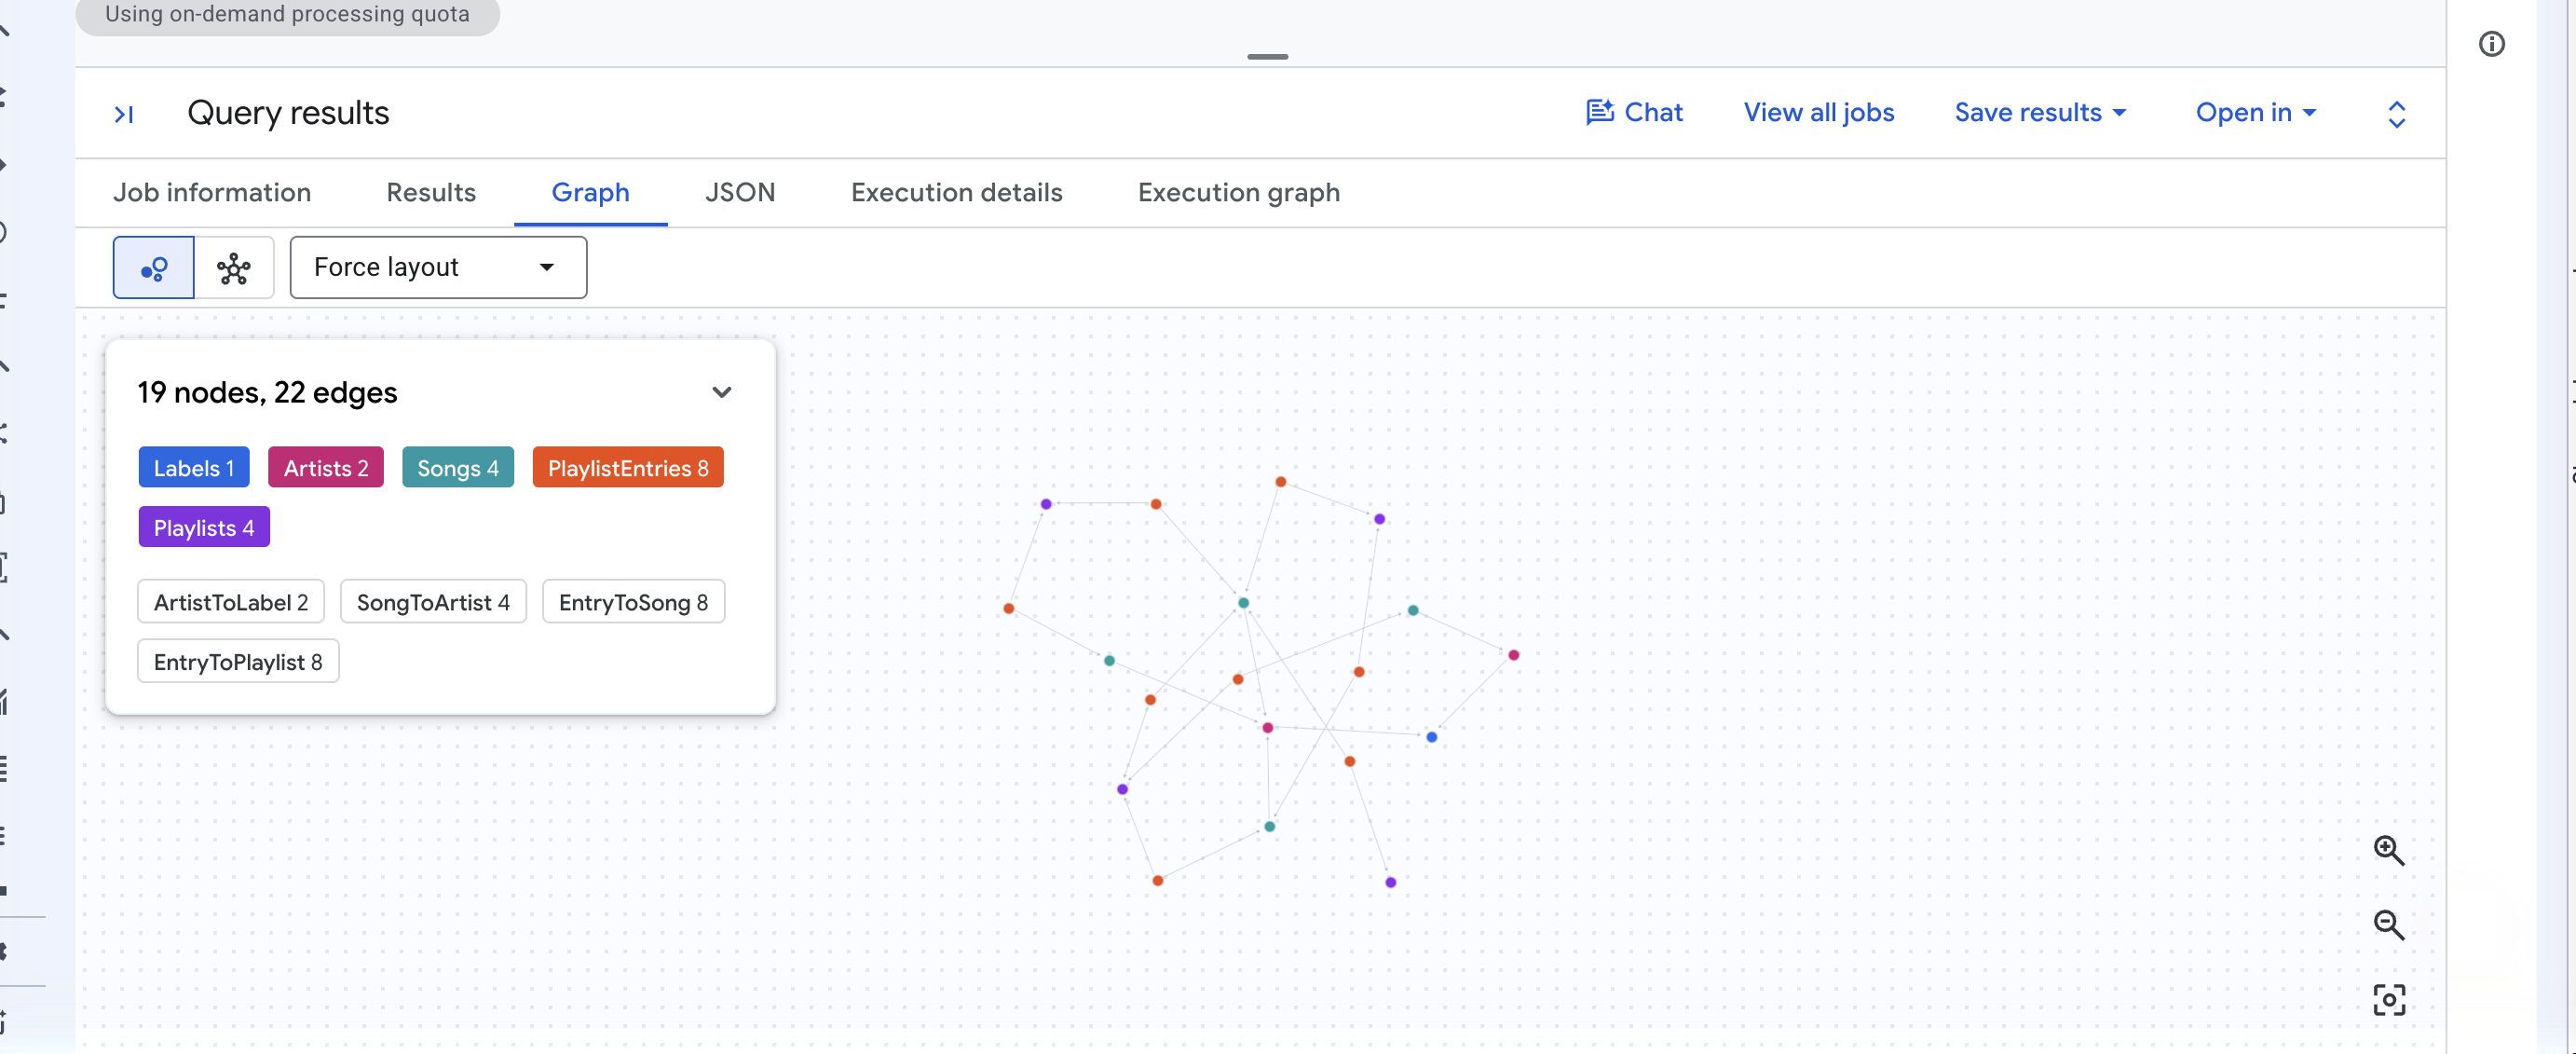
グラフの Cymbal のコーナーが、ノードとエッジの数が表示された強制レイアウトとして描画され、ラベルごとにチップが表示されます。ノードをドラッグしてレイアウトを分解します。ノードをクリックすると、そのプロパティが表示されます。
✅ チェックポイント: 最初のクエリの 3 番目の列の合計は 126 億です。2 番目のクエリは 8 つのパスを返し、[グラフ] タブにそれらが描画されます。
13. (省略可)グラフとチャットする
このステップでは SQL は使用しません。BigQuery のデータ エージェントは、グラフを知識ソースとして使用できます。ドキュメントには、マルチレベル集計に指標を使用すると記載されています。それが事実かどうかを確認してみましょう。
1. エージェントを作成する
👉🌐 コンソール - 左側の BigQuery ナビゲーション メニューで、[エージェント]、[エージェント カタログ]、[エージェントを作成] の順にクリックします。
👉🌐 Console - [Agent name] に Music graph agent と入力し、[Agent description] に次のように入力します。
Ask questions about labels, artists, songs and playlists in the music property graph.
👉🌐 コンソール - [ナレッジソース] で [ソースを追加] をクリックします。[ソースを選択] ダイアログで、プロジェクトを開き、music を開き、[グラフ] を開き、[MusicGraph] をオンにして、[確認] をクリックします。
👀 [ソースを追加] ボタンがグレー表示になります。エージェントが保持できるグラフは 1 つのみです。グラフと表を混在させることはできません。
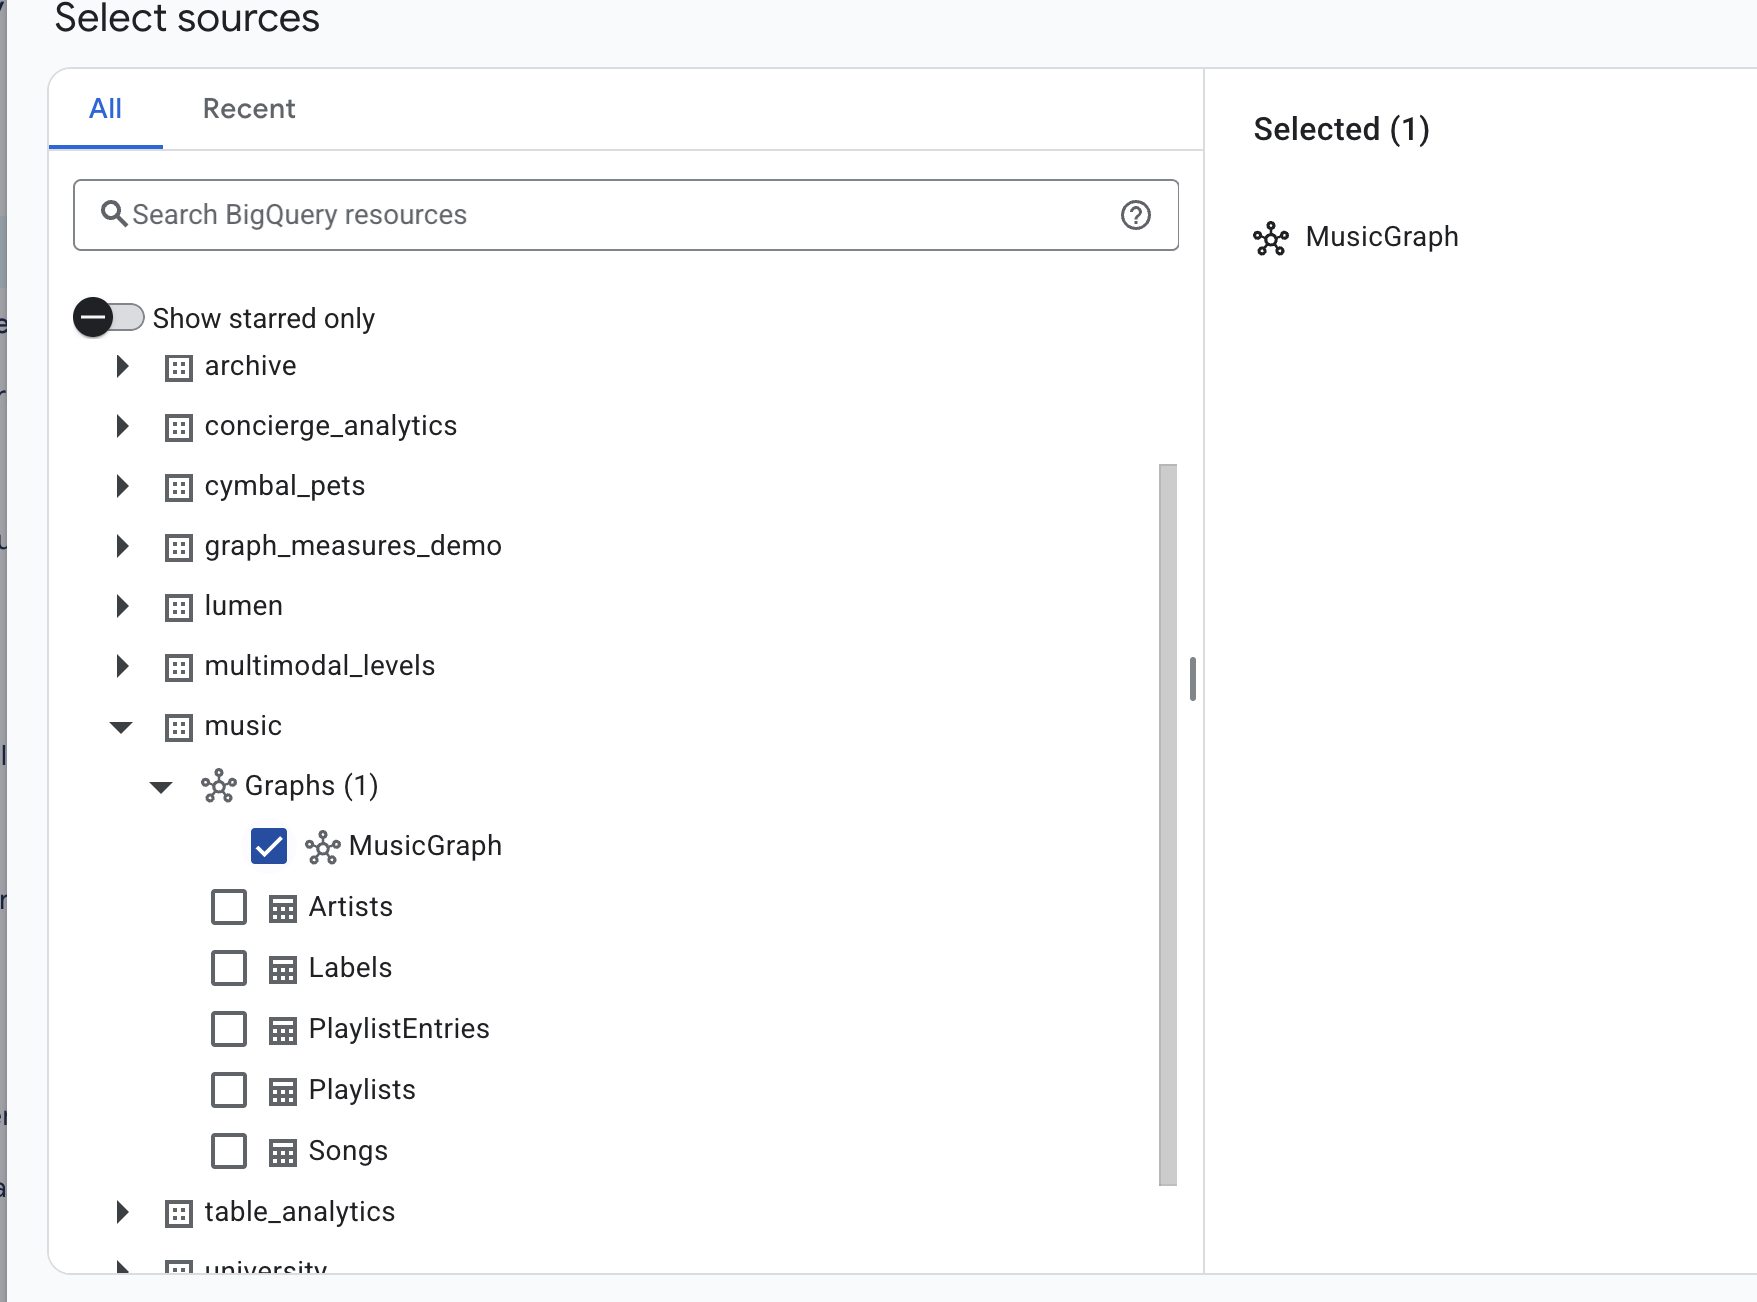
👉🌐 コンソール - グラフの場所から設定された リージョン をそのままにします。[保存]、[公開] の順にクリックします。[Publishing channels] パネルで、[Publish agent] をクリックして確認を閉じます。
2. 質問する
👉🌐 コンソール - [会話を作成] をクリックします。チャットページが開きます。下部の [質問を入力] ボックスに次のように入力して、Enter キーを押します。
For each label, show total streams and how many playlists their songs are on
👀 エージェントは表と 1 文の要約を返します。
label_name | total_streams | playlist_placements |
Cymbal の記録 | 5,100,000,000 | 8 |
Northwind Audio | 4,500,000,000 | 2 |
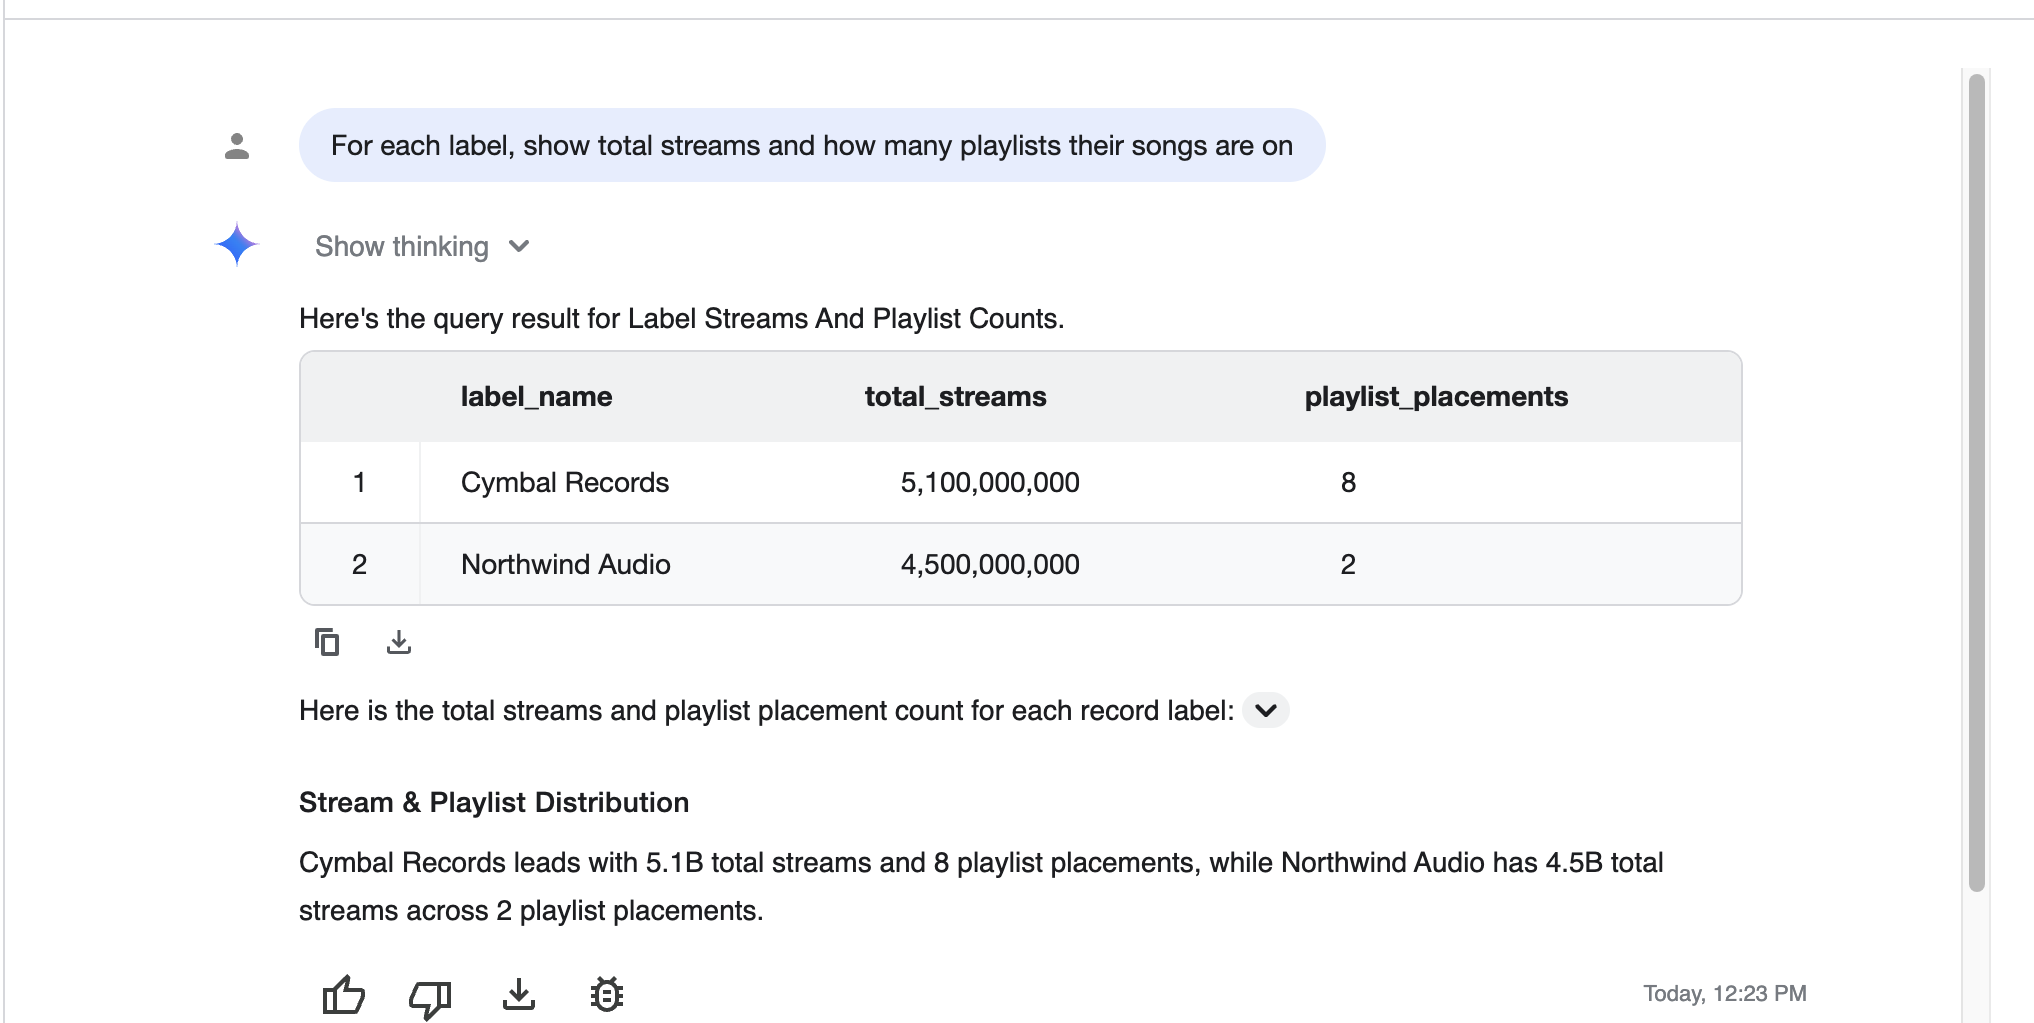
51 億件エージェントにファンアウトについて通知されなかったため、ファンアウトに該当しませんでした。
3. 作成したクエリを読み取る
👉🌐 コンソール - ナビゲーション メニューで [ジョブ エクスプローラ] をクリックし、最新のジョブをクリックします。ラベルには、エージェントの ID を含む ca-bq-job: true と data-agent-id が含まれます。クエリは次のとおりです。
SELECT
  Labels_label_name AS label_name,
  AGG(Songs_total_streams) AS total_streams,
  AGG(PlaylistEntries_placement_count) AS playlist_placements
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY label_name
ORDER BY total_streams DESC
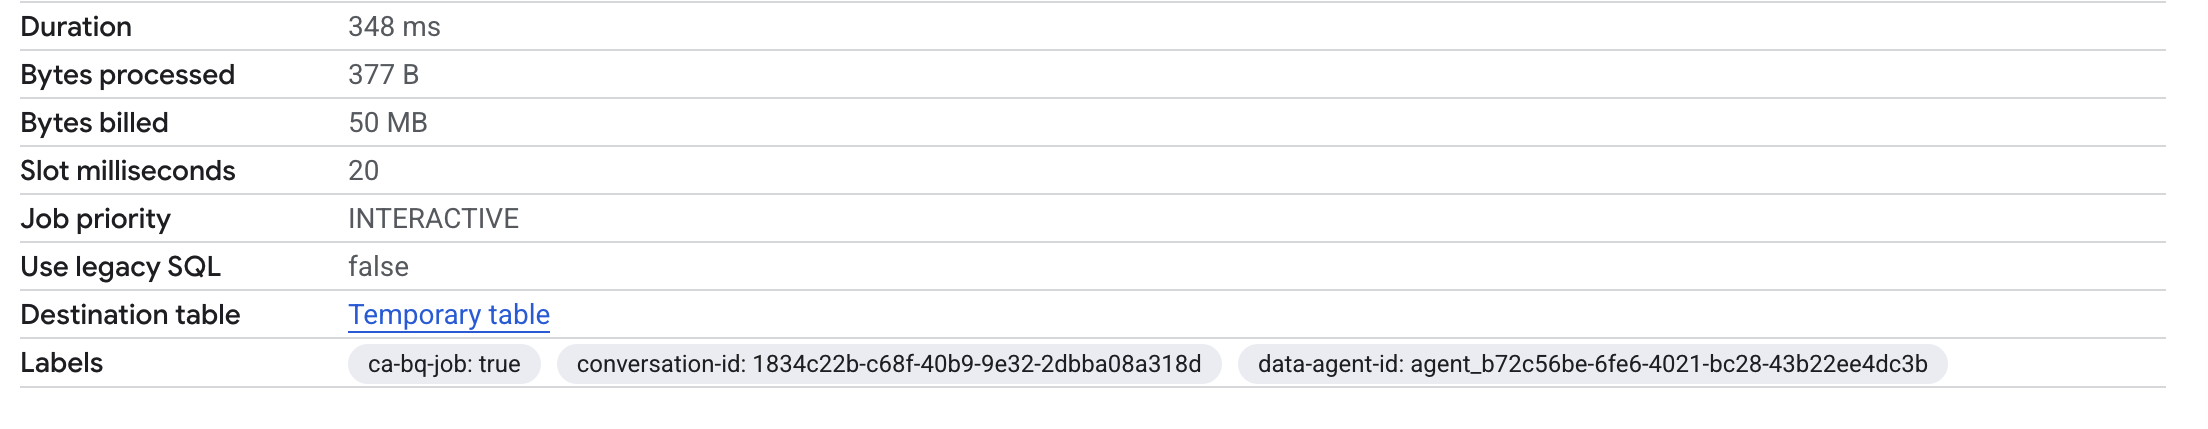
このクエリは、読み取ったスキーマに指標が含まれていたため、GRAPH_EXPAND と AGG を単独で使用しました。エージェントの説明には、それらに関する記述はありません。
✅ チェックポイント: チャットの回答に 51 億、ジョブの SQL に AGG(...) が含まれている。
14. クリーンアップ
👉💻 Cloud Shell - データセット、テーブル、プロパティ グラフを削除します。
cd ~/bq-graph-measures-lab
./cleanup.sh
👀 ✓ dropped YOUR_PROJECT_ID.music (tables and graph) を想定しています。
オプションのデータエージェントを作成した場合は、コンソールの [エージェント] → [エージェント カタログ] で削除します。./setup_project.sh がこのラボ専用のプロジェクトを作成した場合は、プロジェクト全体をシャットダウンするのが最も簡単なクリーンアップ方法です。ID は ~/project_id.txt にあります。
15. 完了
1 行の MEASURE(SUM(streams)) を宣言しただけで、126 億が 51 億に変わりました。これは、あなただけでなく、エージェントが記述するクエリを含め、そのグラフに対して後で記述されるすべてのクエリにも適用されます。
学習した内容
- メジャーは、ノードで宣言される集計です。その粒度を設定する
KEYの横にあります。 GRAPH_EXPANDは、グラフをTableLabel_property列を含む 1 つのワイド テーブルにフラット化します。AGGはメジャーを読み取る唯一の関数であり、型システムは 4 つの異なる方法でそれを強制します。- 6 つの集計が利用可能で、
AGGの結果は除算可能な通常の値です。 GROUP BYを変更すると、指標を変更せずに質問が再度行われます。GRAPH_EXPANDでは、1 つのルート、多対 1 のエッジ、ノードに昇格されたジャンクションが必要です。
意思決定表
症状 | 原因 | 修正 |
合計が大きすぎる |
| 指標を宣言し、 |
「expected MEASURE, found INT64」 | プレーン列の |
|
「MEASURE 型の式を返すことはできません」 |
| ラップします。 |
「要素タイプで公開されていません」 | GQL で参照される指標 |
|
| エッジとしてモデル化されたジャンクション | ジャンクション テーブルをノードに昇格させる |
グラフを変更した後の古い数値 | キャッシュに保存された結果 | [キャッシュに保存された結果を使用] をオフにします。 |
取り上げなかった内容(意図的)
プロパティの説明と類義語、データ エージェントの検証済みクエリと用語集、1 つの MATCH を超える GQL、複数のグラフにわたる指標。それぞれが独自のラボです。
詳細
- measure を操作する
- プロパティ グラフを作成してクエリを実行する
- 会話型分析の概要
- ラボのリポジトリ - この Codelab のすべてのクエリ(ステップごとに番号付け)