

1. 개요
코드 검토를 통과하는 대부분의 SQL 버그는 집계 버그입니다. 숫자가 포함된 표에서는 숫자가 올바르지만 조인으로 복사하면 합계가 잘못됩니다.
BigQuery Graph를 사용하면 테이블이 속성 그래프로 연결되는 방식을 한 번 설명한 다음 연결을 쿼리할 수 있습니다. 그래프 측정은 집계 자체를 설명에 추가합니다. 숫자를 소유한 노드에서 MEASURE(SUM(streams))를 선언하면 그래프를 읽는 모든 쿼리가 올바른 세부사항으로 올바른 합계를 가져옵니다. GROUP BY 트릭도 없고 누군가 기억해야 하는 CTE도 없습니다.
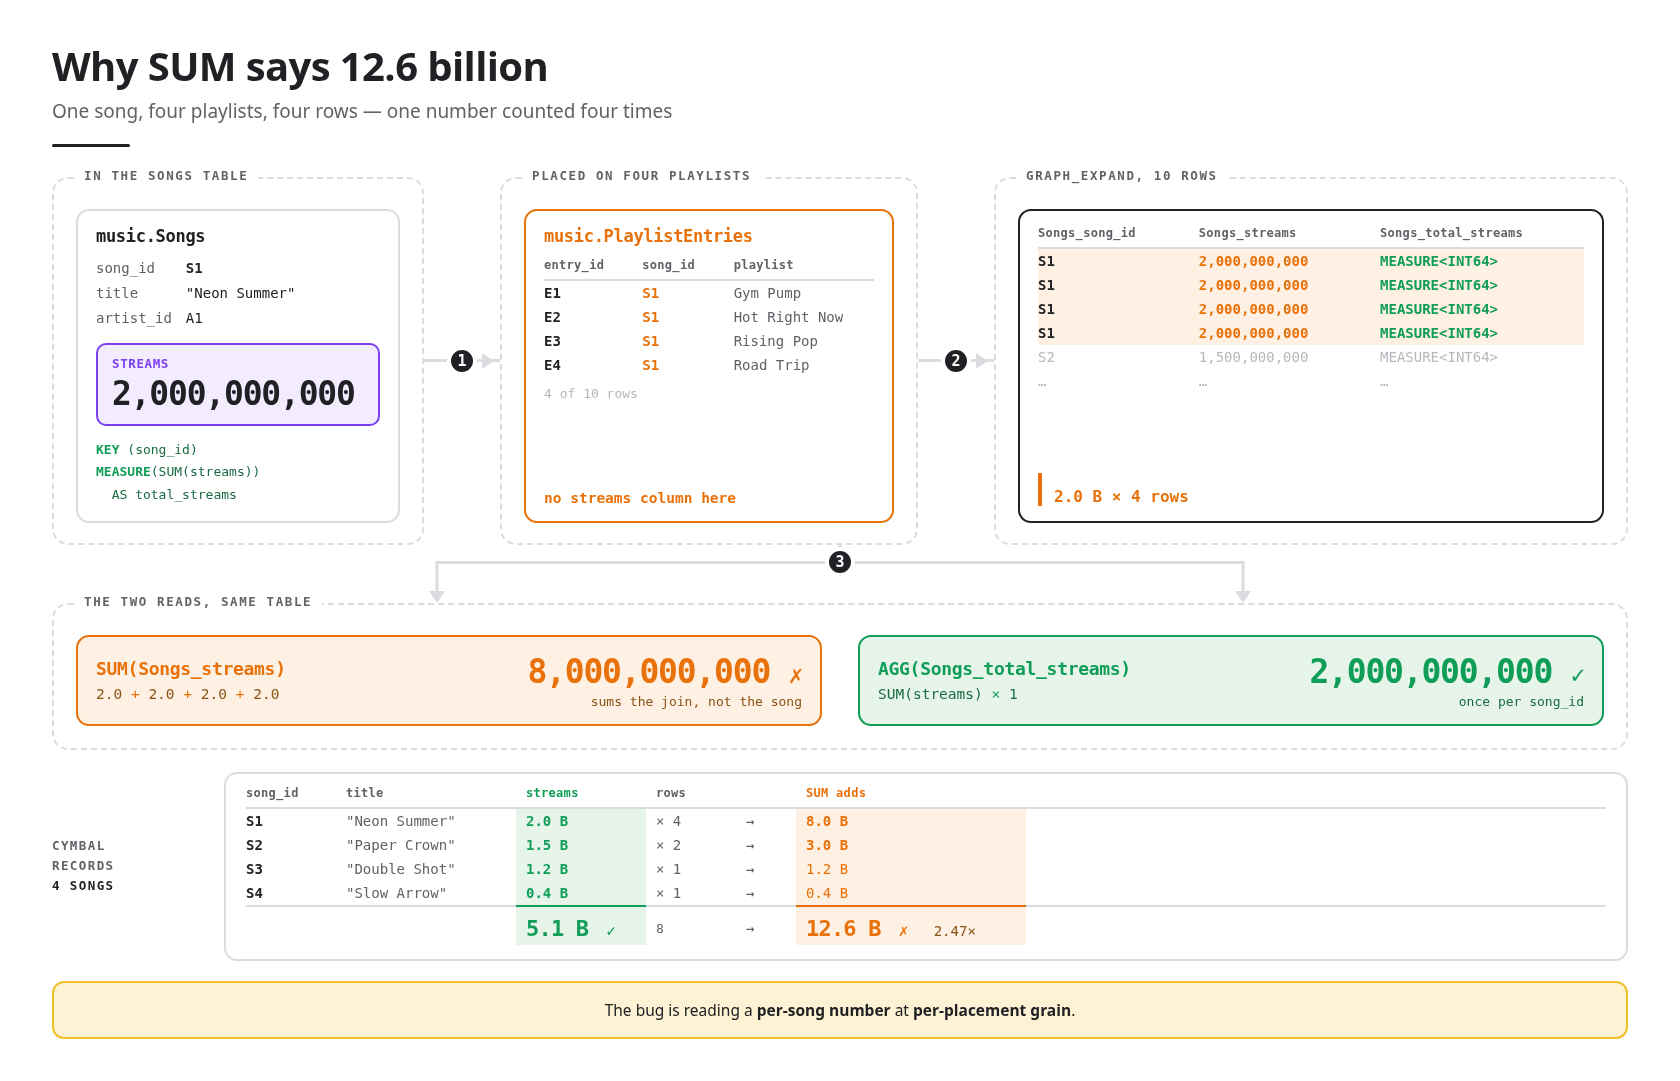
이 Codelab에서는 5개 테이블로 구성된 음악 카탈로그를 빌드하고, 여기에 한 가지 질문을 던져 SUM에서는 126억, AGG에서는 51억이라는 두 가지 다른 답변이 반환되는 것을 확인합니다. 이 갭은 카탈로그의 모양입니다. 4개의 재생목록에 있는 노래는 그래프가 평탄해지면 4개의 행이 되고 SUM는 4개 모두를 추가합니다. 그런 다음 두 번째 대답이 올바른 이유를 설명하는 규칙을 학습합니다.
입력하는 곳
이 실습에서는 다음 두 위치를 순서대로 사용합니다.
어디서 | 거기서 하는 일 | |
1 | Cloud Shell 터미널 | 설정 단계에서만 몇 가지 명령어를 사용합니다. |
2 | BigQuery 콘솔 | 기타: 쿼리 편집기에 쿼리 붙여넣기, 그래프 모델러 클릭, 에이전트와 채팅 |
모든 요청 사항에는 태그가 지정되어 있어 항상 어떤 요청 사항인지 알 수 있습니다.
- 👉💻 Cloud Shell - Cloud Shell 터미널에 입력합니다.
- 👉📋 쿼리 편집기 - BigQuery 쿼리 편집기에 붙여넣고 실행을 클릭합니다.
- 👉🌐 콘솔 - BigQuery 콘솔을 클릭합니다. 단계에서 입력하라고 하지 않는 한 아무것도 입력하지 마세요.
- 👀 - 결과를 확인합니다.
학습할 내용
- 시각적 그래프 모델러 또는 SQL에서 노드 테이블의 측정값을 선언하는 방법
GRAPH_EXPAND가 그래프를 하나의 넓은 테이블로 평탄화하는 방법AGG이 측정값을 읽을 수 있는 유일한 함수인 이유와 다른 모든 시도에서 반환되는 내용- 측정값이 지원하는 6가지 집계와 집계 간 산술 연산을 수행하는 방법
- 측정항목이 변경 없이 다르게 그룹화된 질문에 답변하는 방법
- 선택사항: GQL 및 그래프 탭에서 합계를 구할 수 없는 질문에 어떻게 답변하는지, BigQuery 데이터 에이전트가 측정항목에 대한 정보를 제공받지 않고도 측정항목을 사용하는 방법
필요한 항목
- 결제가 가능한 Google 계정 및 브라우저 Google Cloud 프로젝트는 미리 필요하지 않습니다. 설정에서 프로젝트를 만듭니다.
- 선택사항인 채팅 단계만 해당: Gemini 데이터 분석 API가 사용 설정되어 있고 Gemini 데이터 분석 데이터 에이전트 생성자 역할이 있어야 합니다.
컴퓨터에 설치할 항목이 없습니다. 모든 것은 Cloud Shell과 BigQuery 콘솔에서 실행됩니다.
제품 상태 및 비용
BigQuery 그래프가 정식 버전으로 제공됩니다. 그래프 측정, 시각적 그래프 모델러, 그래프 시각화, 그래프를 데이터 에이전트 지식 소스로 사용하는 기능은 프리뷰 상태이며 GA 이전 서비스 약관이 적용됩니다.
GRAPH_EXPAND 및 AGG은 주문형 가격으로 실행됩니다. 문서에 따르면 GQL 쿼리 (선택적 경로 단계)에는 Enterprise 또는 Enterprise Plus 버전을 사용하는 예약이 필요하므로 이 단계는 선택사항입니다.
데이터 세트가 몇 킬로바이트입니다. 주문형 가격에서는 각 쿼리에 최소 10MB가 청구되므로 전체 Codelab 비용은 1센트 미만입니다.
2. 설정
Cloud Shell을 사용하는 단계는 이것이 유일합니다. 프로젝트를 만들고, 결제를 설정하고, 원시 테이블을 빌드합니다. 그래프, 측정, 모든 쿼리는 BigQuery 콘솔에서 나중에 실행할 수 있습니다.
이 실습에서 제공할 수 없는 것이 하나 있습니다. 바로 결제가 사용 설정된 Google Cloud 프로젝트입니다. 1단계에서는 비용을 지불할 수 있는 계정을 만들고, 4단계에서는 해당 계정을 프로젝트로 전환합니다. 이 순서대로 실행하세요. 4단계 이후의 모든 단계에서는 4단계에서 만든 프로젝트를 읽습니다.
1 · 결제가 포함된 계정 만들기(~1분)
👉🌐 다른 작업보다 먼저 이 작업을 수행하세요. 결제가 사용 설정된 Google 계정으로 로그인합니다. 이러한 계정은 모두 사용할 수 있습니다. 계정이 없는 경우 무료 체험을 시작하세요. 결제 계정이 제공되므로 4단계를 완료할 수 있습니다.
2 · Cloud Shell 열기 (약 1분)
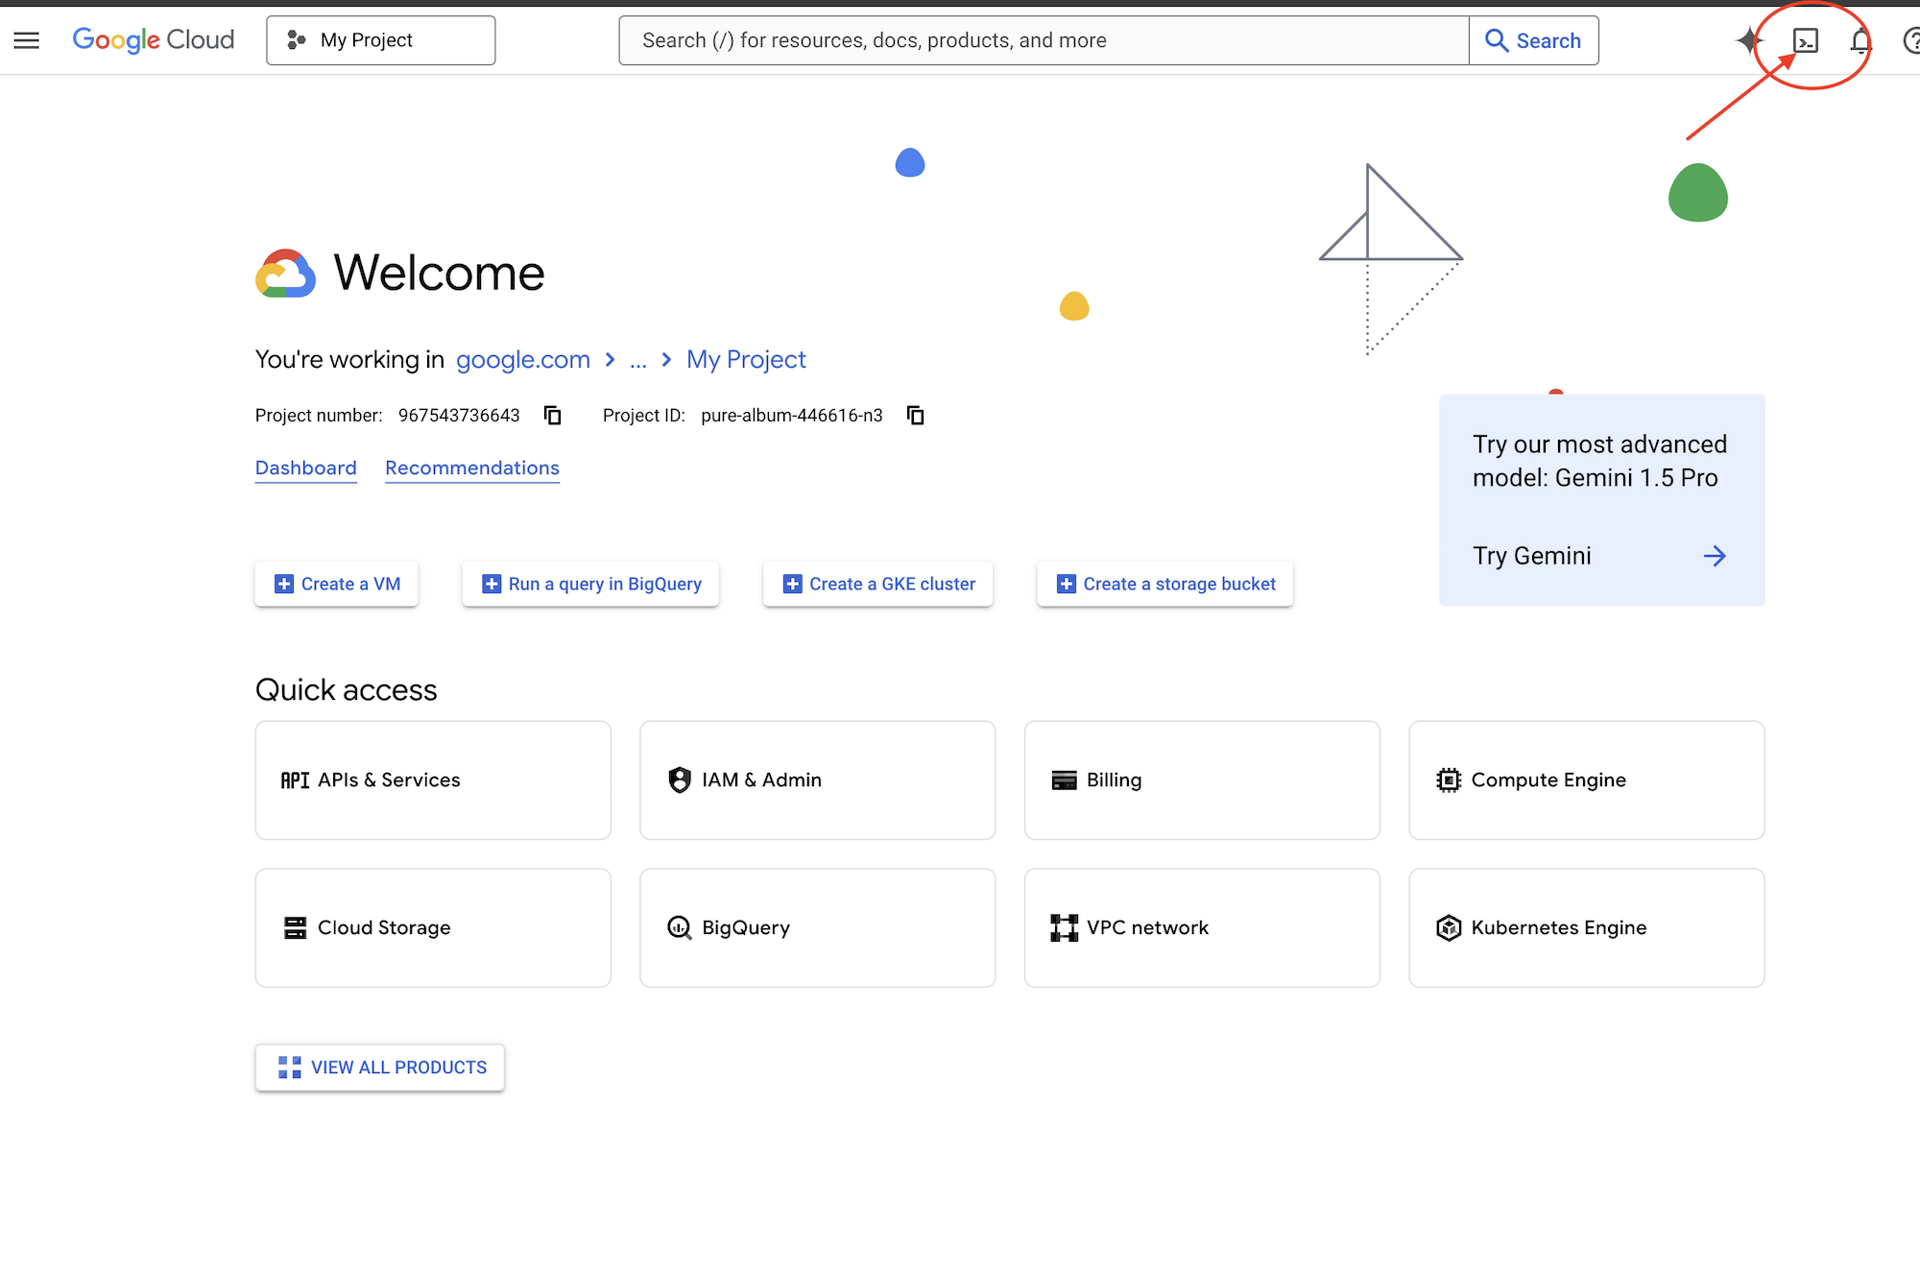
👉🌐 콘솔 — Google Cloud 콘솔 상단에서 Cloud Shell 활성화를 클릭합니다. 헤더에 있는 터미널 모양의 아이콘입니다. 페이지 하단에 터미널이 열립니다.
👉🌐 콘솔 — 오늘 언제든지 승인하라는 메시지가 표시되면 승인을 클릭하여 계속합니다.
👉💻 Cloud Shell - Cloud Shell에 로그인한 계정을 확인합니다.
gcloud auth list
👀 예상: 내 계정은 *로 표시되며 1단계에서 로그인한 계정과 동일해야 합니다. 그렇지 않은 경우 gcloud auth login를 실행하고 올바른 항목을 선택합니다.
3 · 실습 가져오기(~1분)
👉💻 Cloud Shell - 저장소 클론:
cd ~
rm -rf ~/bq-graph-measures-lab
git clone https://github.com/cuppibla/bq-graph-measures-lab.git
cd ~/bq-graph-measures-lab
4 · 프로젝트 만들기(약 2분)
👉💻 Cloud Shell - 하나의 스크립트가 결제 계정을 찾아 해당 계정에 프로젝트를 만들고 Cloud Shell이 해당 프로젝트를 가리키도록 합니다.
cd ~/bq-graph-measures-lab
./setup_project.sh
👀 선택한 결제 계정의 ✓, 생성한 프로젝트의 ✓, 다음과 같은 종료 문구를 예상합니다.
Project ready: bq-graph-4271
  Next:  ./setup.sh
bq-graph-4271는 프로젝트 ID입니다. 사용자의 프로젝트 ID는 숫자가 다릅니다. 여기서는 다음 네 가지 일이 일어납니다.
결제 | 가장 최신 | |
project |
| |
선택 | ID를 | |
대기 | 새 프로젝트가 실제로 게재되도록 허용될 때까지 최대 2분 동안 폴링합니다. | |
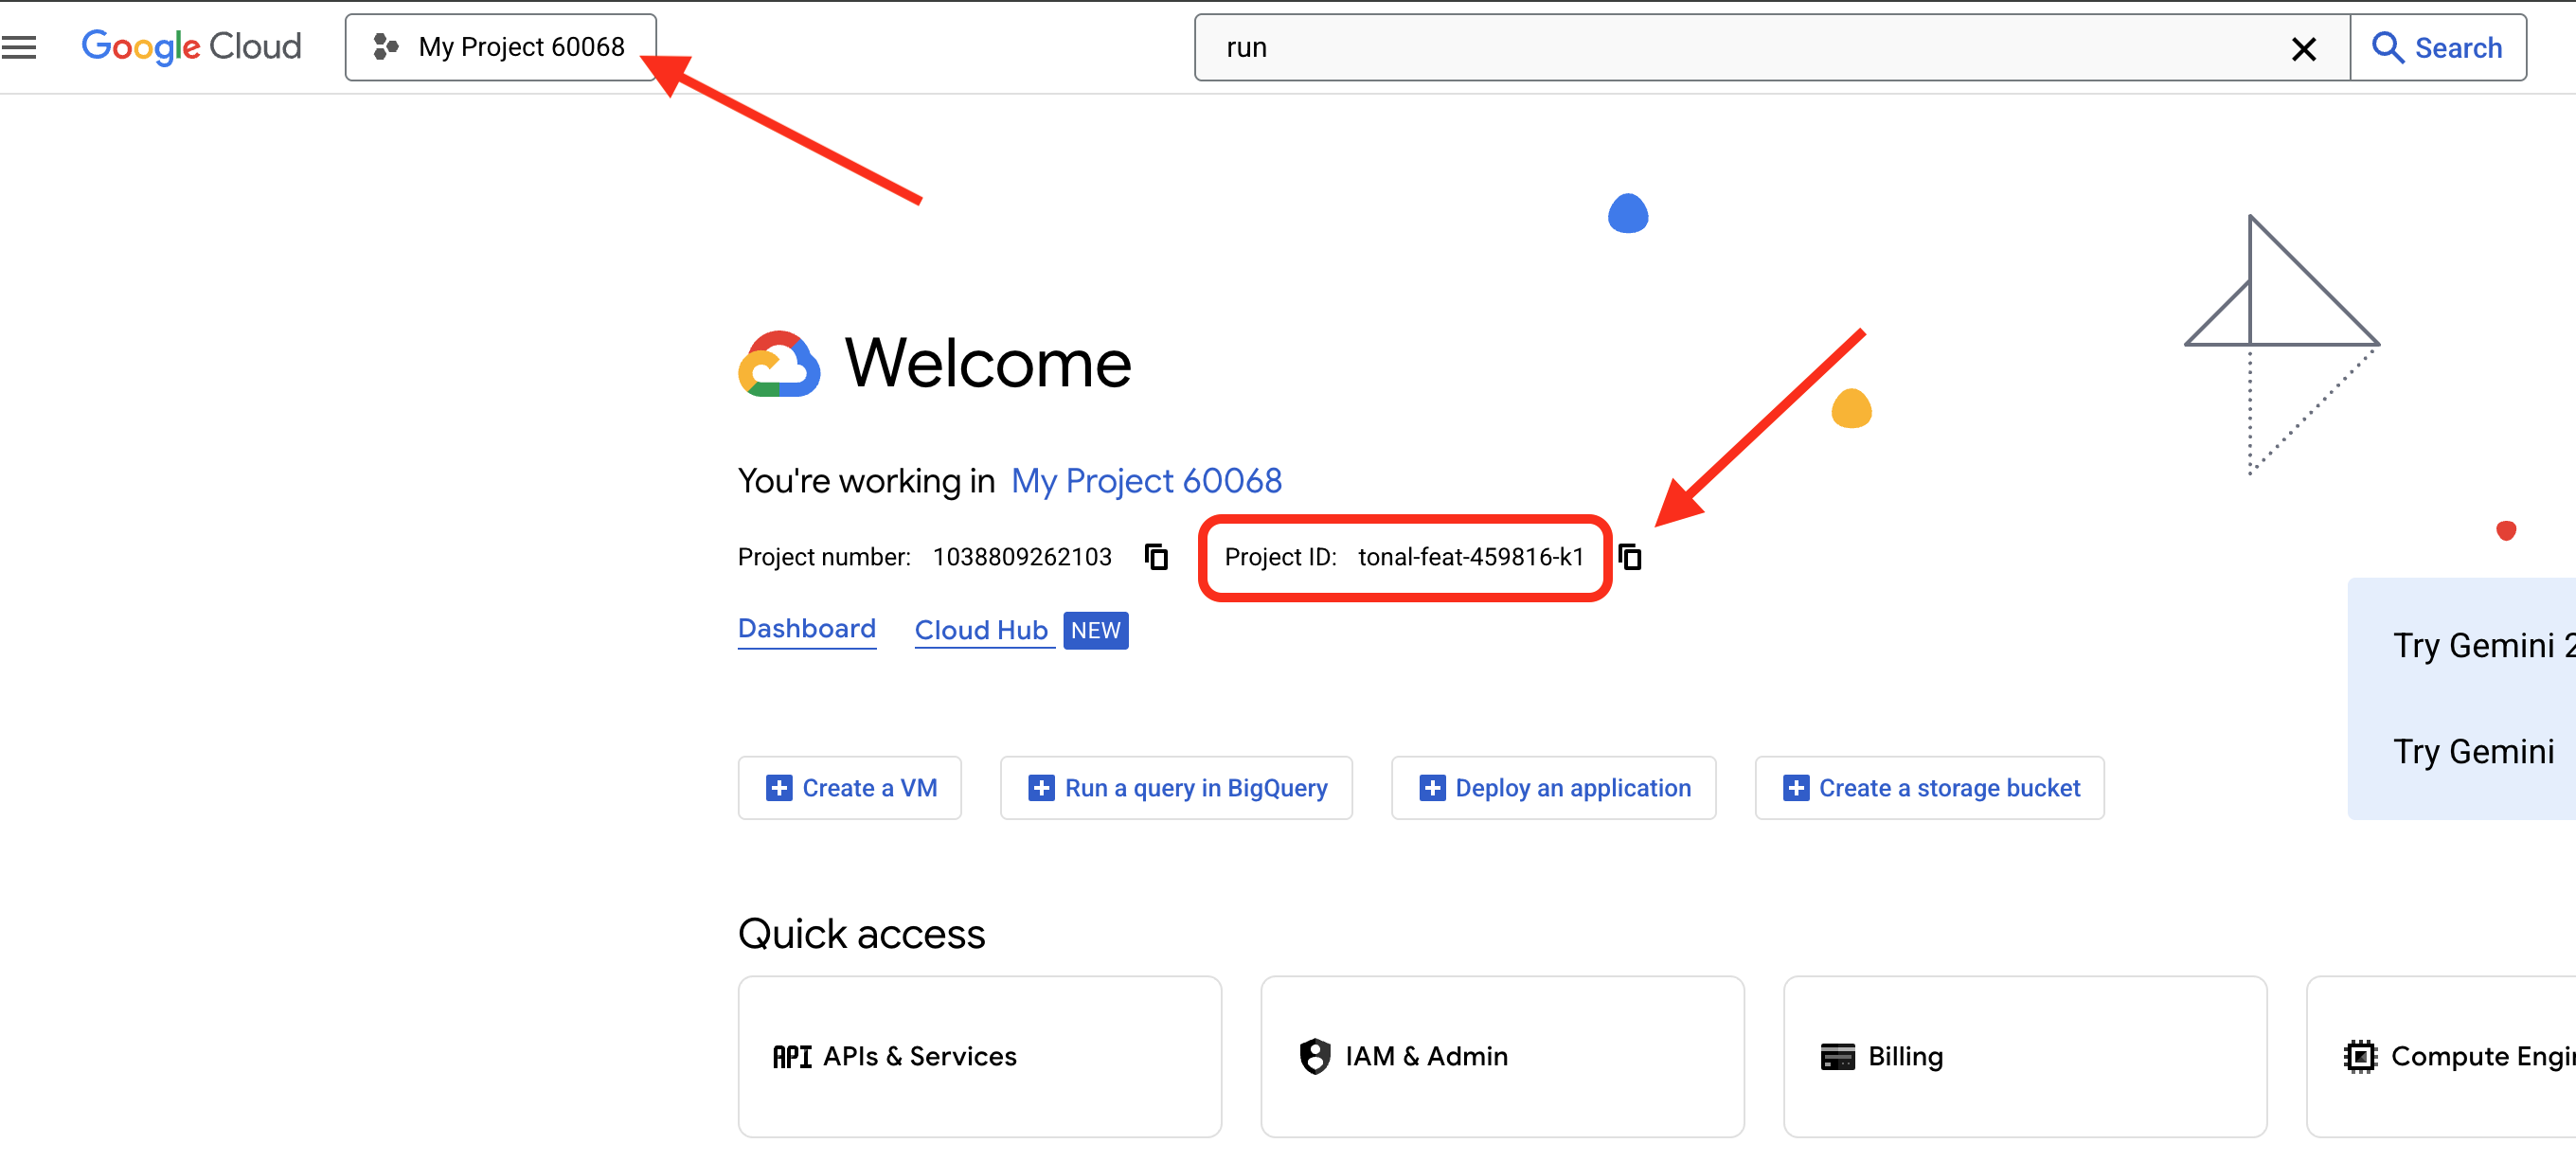
🌐 이제 콘솔에 동일한 프로젝트가 표시됩니다. ID는 대시보드의 프로젝트 정보 카드에 있습니다.
5 · 데이터 세트 만들기 (~3분)
👉💻 Cloud Shell - 테이블을 빌드하는 스크립트가 하나 더 있습니다.
cd ~/bq-graph-measures-lab
./setup.sh
스크립트는 실행될 때 각 단계를 출력합니다. 순서대로 실행되는 작업:
project |
| |
API |
| |
데이터 세트 | 미국 멀티 리전에 | |
check | 모든 테이블의 행 수를 계산하고 개수가 잘못되면 중지합니다. | |
👀 예상:
BigQuery Graph Measures · setup
  ✓ project: bq-graph-4271
  ✓ BigQuery API enabled

Creating dataset music (US) and five tables...
  ✓ music.Labels              2 rows
  ✓ music.Artists             3 rows
  ✓ music.Songs               5 rows
  ✓ music.Playlists           4 rows
  ✓ music.PlaylistEntries    10 rows

🎉 ready — open BigQuery Studio: https://console.cloud.google.com/bigquery?project=bq-graph-4271
Cloud Shell이 완료되었습니다. 닫아도 됩니다.
6 · BigQuery 및 쿼리 편집기 열기
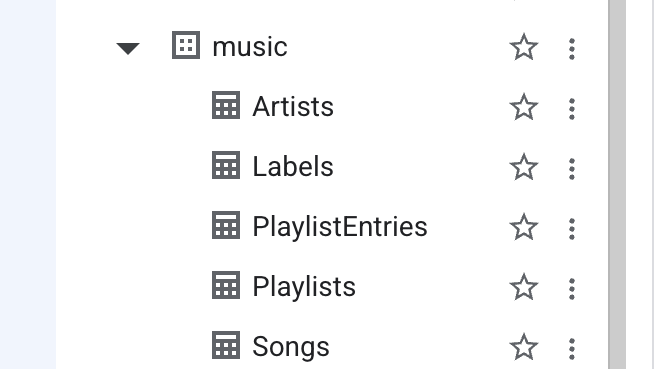
👉🌐 콘솔 - 출력 끝에 있는 링크를 클릭하거나 탐색 메뉴에서 BigQuery를 엽니다. 왼쪽의 탐색기 창에서 프로젝트를 펼칩니다. 테이블이 5개인 music 데이터 세트가 표시됩니다.
👉🌐 콘솔 - BigQuery Studio 상단의 새로 만들기 행에서 SQL 쿼리를 클릭합니다. 빈 편집기 탭이 열립니다.
이 탭을 유지합니다. 이 실습의 모든 👉📋 블록은 여기에 있습니다. 편집기의 내용을 선택하고 새 블록을 붙여넣은 후 실행을 클릭합니다. 결과는 아래 패널에 표시됩니다.
테이블 소개
이러한 테이블에 관한 두 가지 사항이 나중에 중요합니다. 모든 테이블은 기본 키를 NOT ENFORCED로 선언합니다. BigQuery에서는 이를 확인하지 않지만, 곧 빌드할 속성 그래프에서는 행을 식별하는 항목을 알기 위해 명시적 키가 필요합니다. 마지막 테이블인 PlaylistEntries는 연결 테이블입니다. 4개의 재생목록에 있는 노래는 4개의 행을 갖습니다. 이 표에서 전체 스토리가 펼쳐집니다.
표는 다음과 같이 연결됩니다. 음반사가 아티스트와 계약을 맺고, 아티스트가 노래를 발표하고, 노래가 PlaylistEntries를 통해 재생목록에 배치됩니다. Cymbal Records는 Ava Sterling과 Mina Okafor를 소유하고 있으며 이들을 통해 4곡을 소유하고 있습니다. Northwind Audio는 Kai Nakamura와 Midnight Drive라는 노래를 소유하고 있습니다.
테이블 | 행 | 키 | 보유한 항목 |
라벨 | 2 |
| 이름, 마케팅 예산 |
아티스트 | 3 |
| 이름, 라벨 |
노래 | 5 |
| 제목, 아티스트, 스트림 |
재생목록 | 4 |
| name, followers |
PlaylistEntries | 10 |
| 어떤 노래가 어떤 재생목록에 있는지 |
✅ 체크포인트: Cloud Shell에 🎉 ready, 탐색기에 music 아래에 테이블 5개, 빈 쿼리 편집기 탭이 열려 있습니다.
3. 그래프 만들기 - 옵션 A: 시각적 모델러
속성 그래프는 테이블이 연결되는 방식을 설명합니다. 시각적 그래프 모델러에서 함께 클릭하거나 (이 단계, 모든 클릭) SQL로 작성할 수 있습니다 (다음 단계, 한 번 붙여넣기). 두 방식 모두 동일한 객체를 생성하므로 둘 다가 아닌 둘 중 하나만 실행하세요.
1. 그래프 셸 만들기
👉🌐 콘솔 - BigQuery Studio의 새로 만들기 행에서 AI 및 지식 메뉴를 열고 그래프를 클릭합니다.
👉🌐 콘솔 - 그래프 이름으로 MusicGraph를, 데이터 세트의 그래프 대상으로 music를 입력합니다. 리전은 데이터 세트 (미국)에서 채워집니다.
👉🌐 콘솔 - 데이터 소스에서 아티스트, 음반사, PlaylistEntries, 재생목록, 노래의 5개 표를 선택하고 만들기를 클릭합니다.
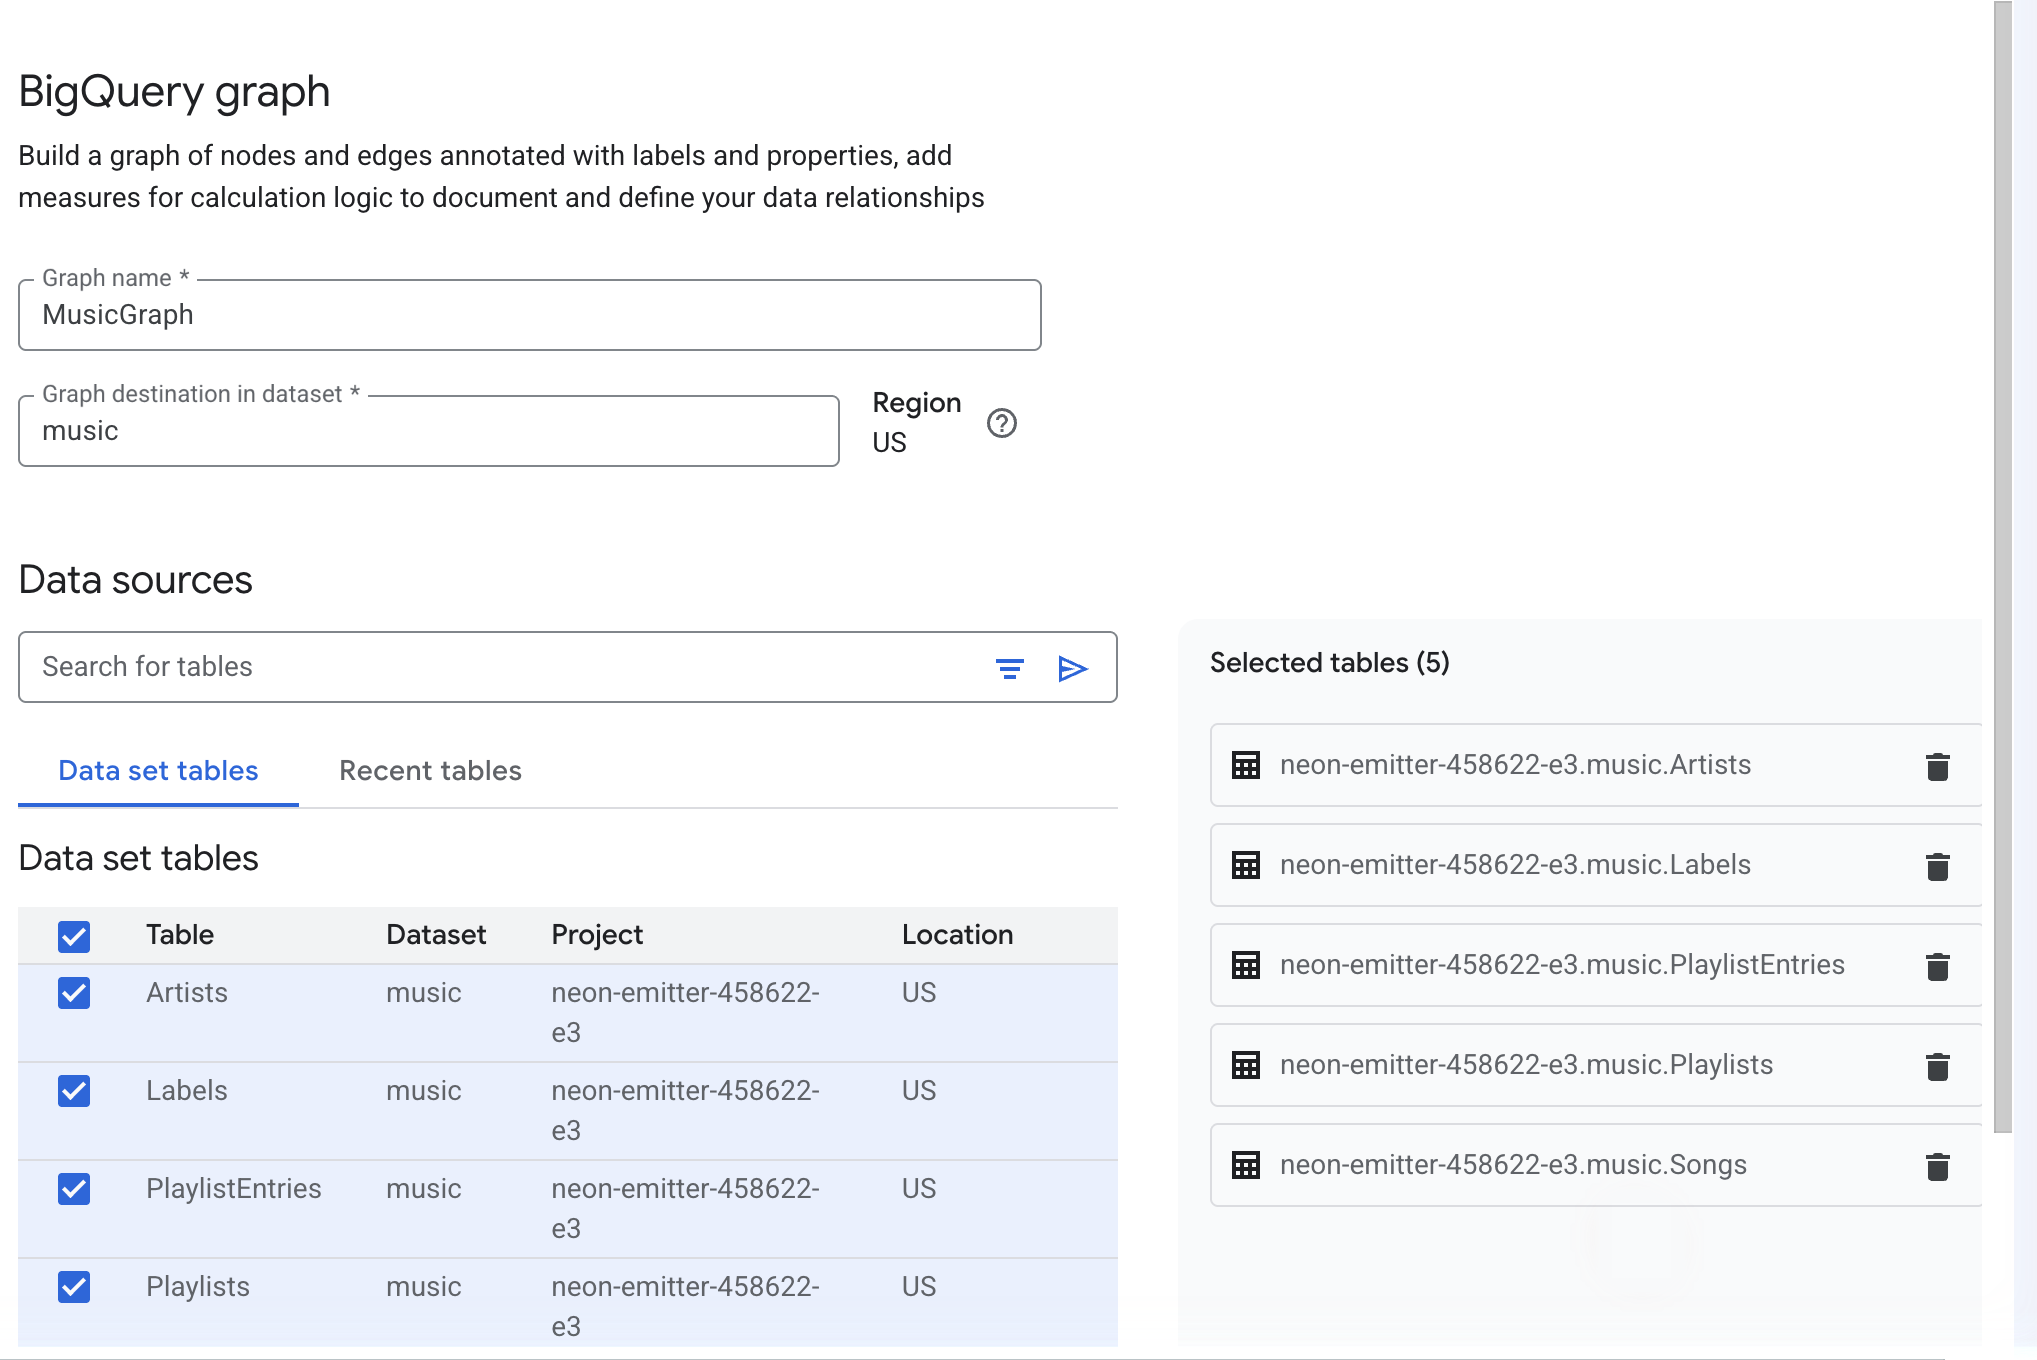
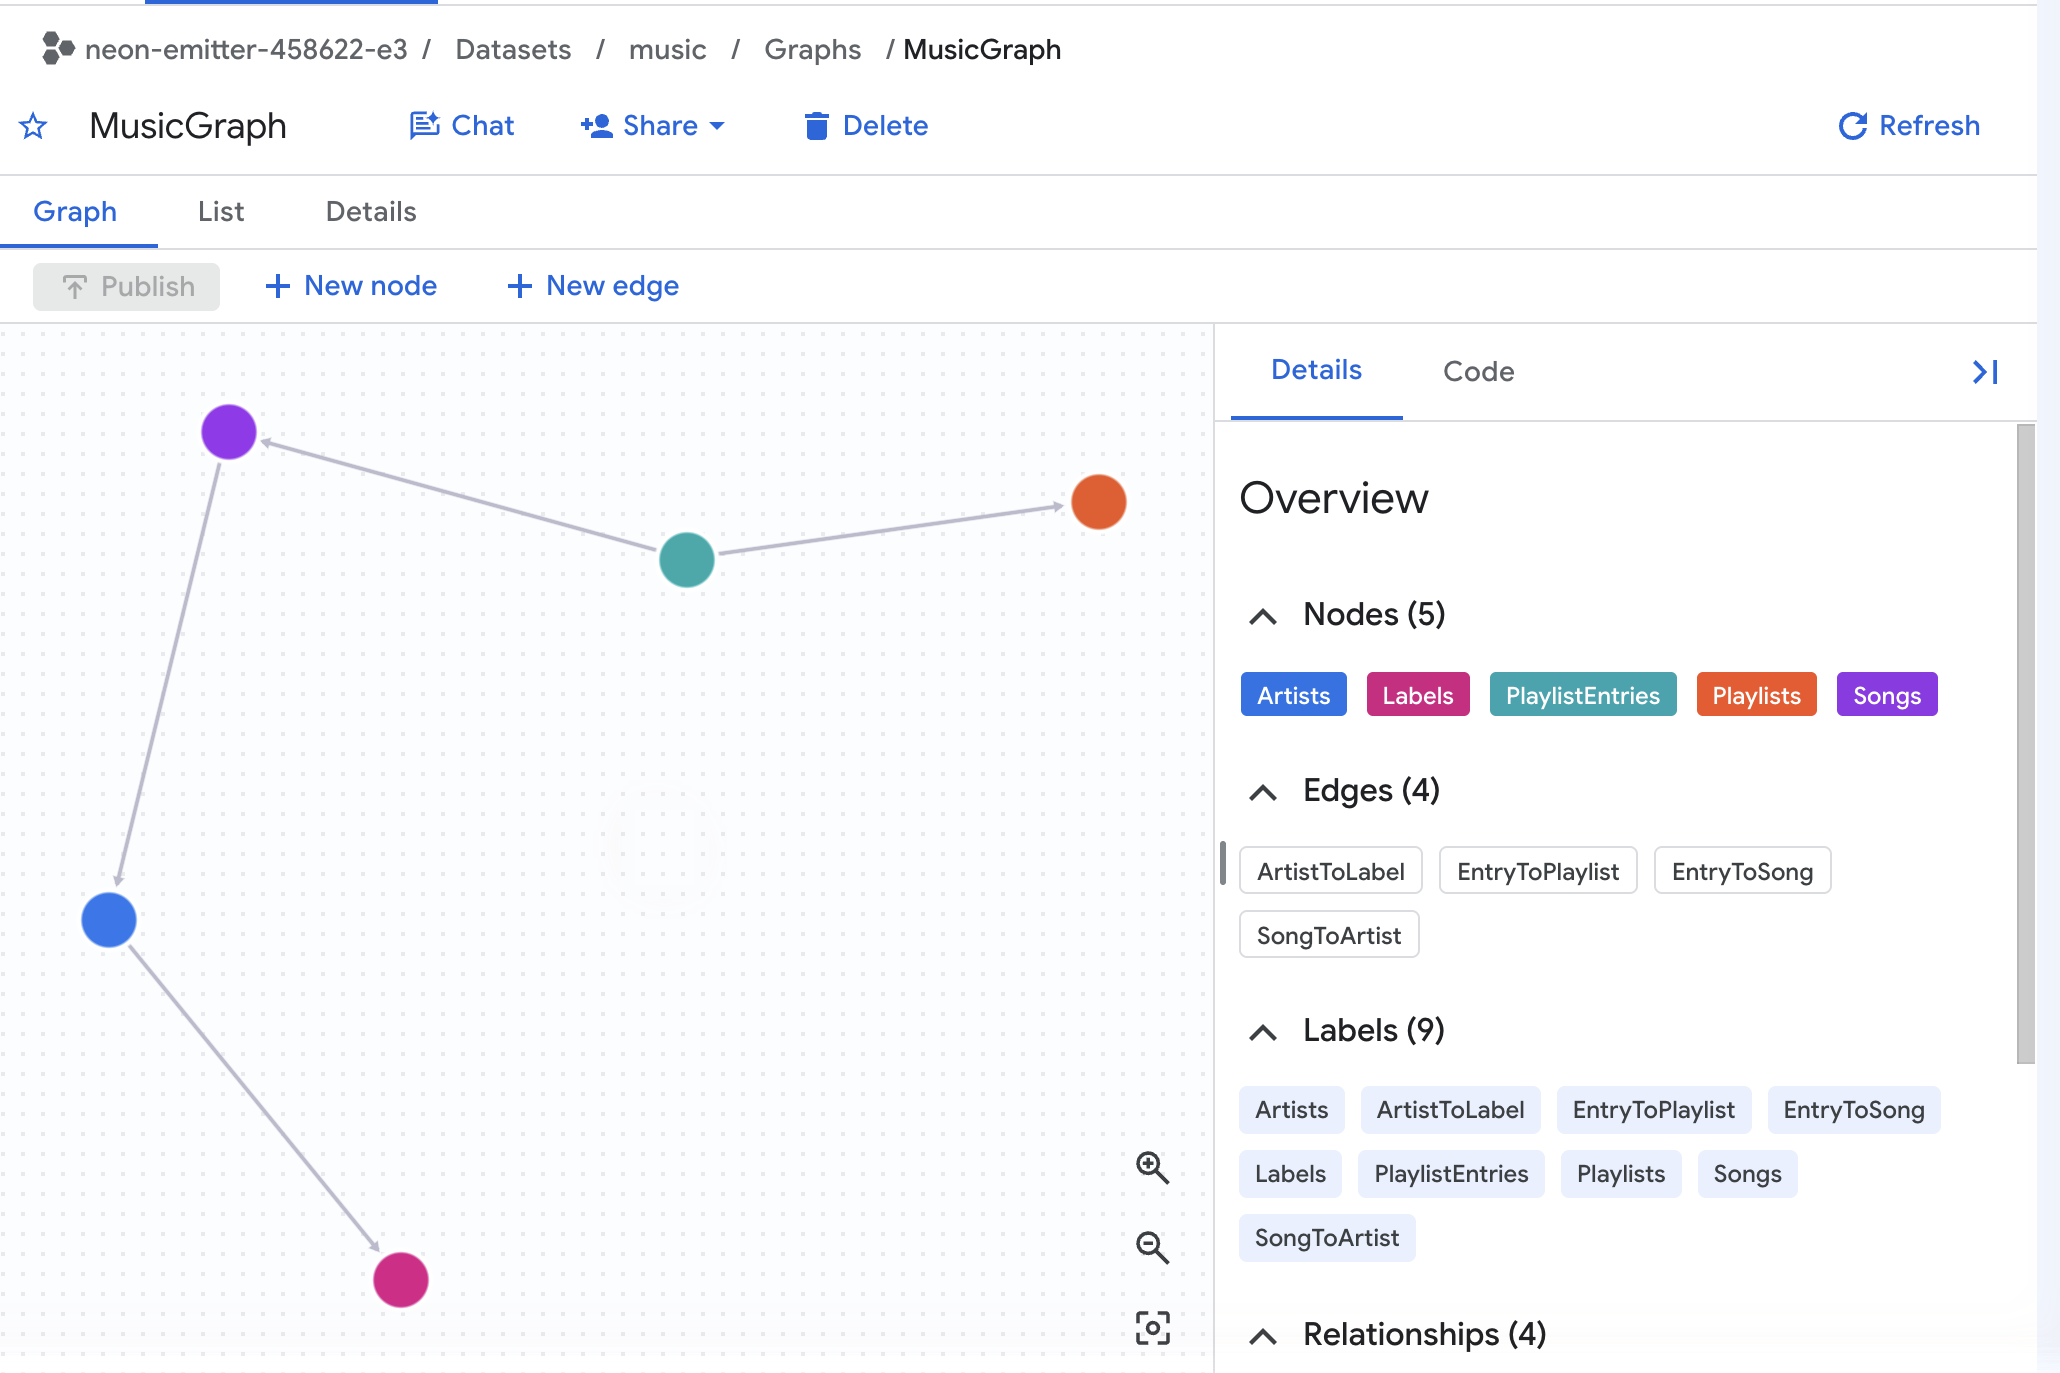
👀 캔버스가 열리고 5개의 색상 노드가 표시되지만 노드 사이에는 선이 없습니다. 오른쪽의 세부정보 패널에 노드 (5)와 엣지 (0)가 표시됩니다. 각 노드는 이미 테이블의 기본 키와 모든 열을 속성으로 보유하고 있습니다. 노드를 클릭하여 이를 확인할 수 있습니다.
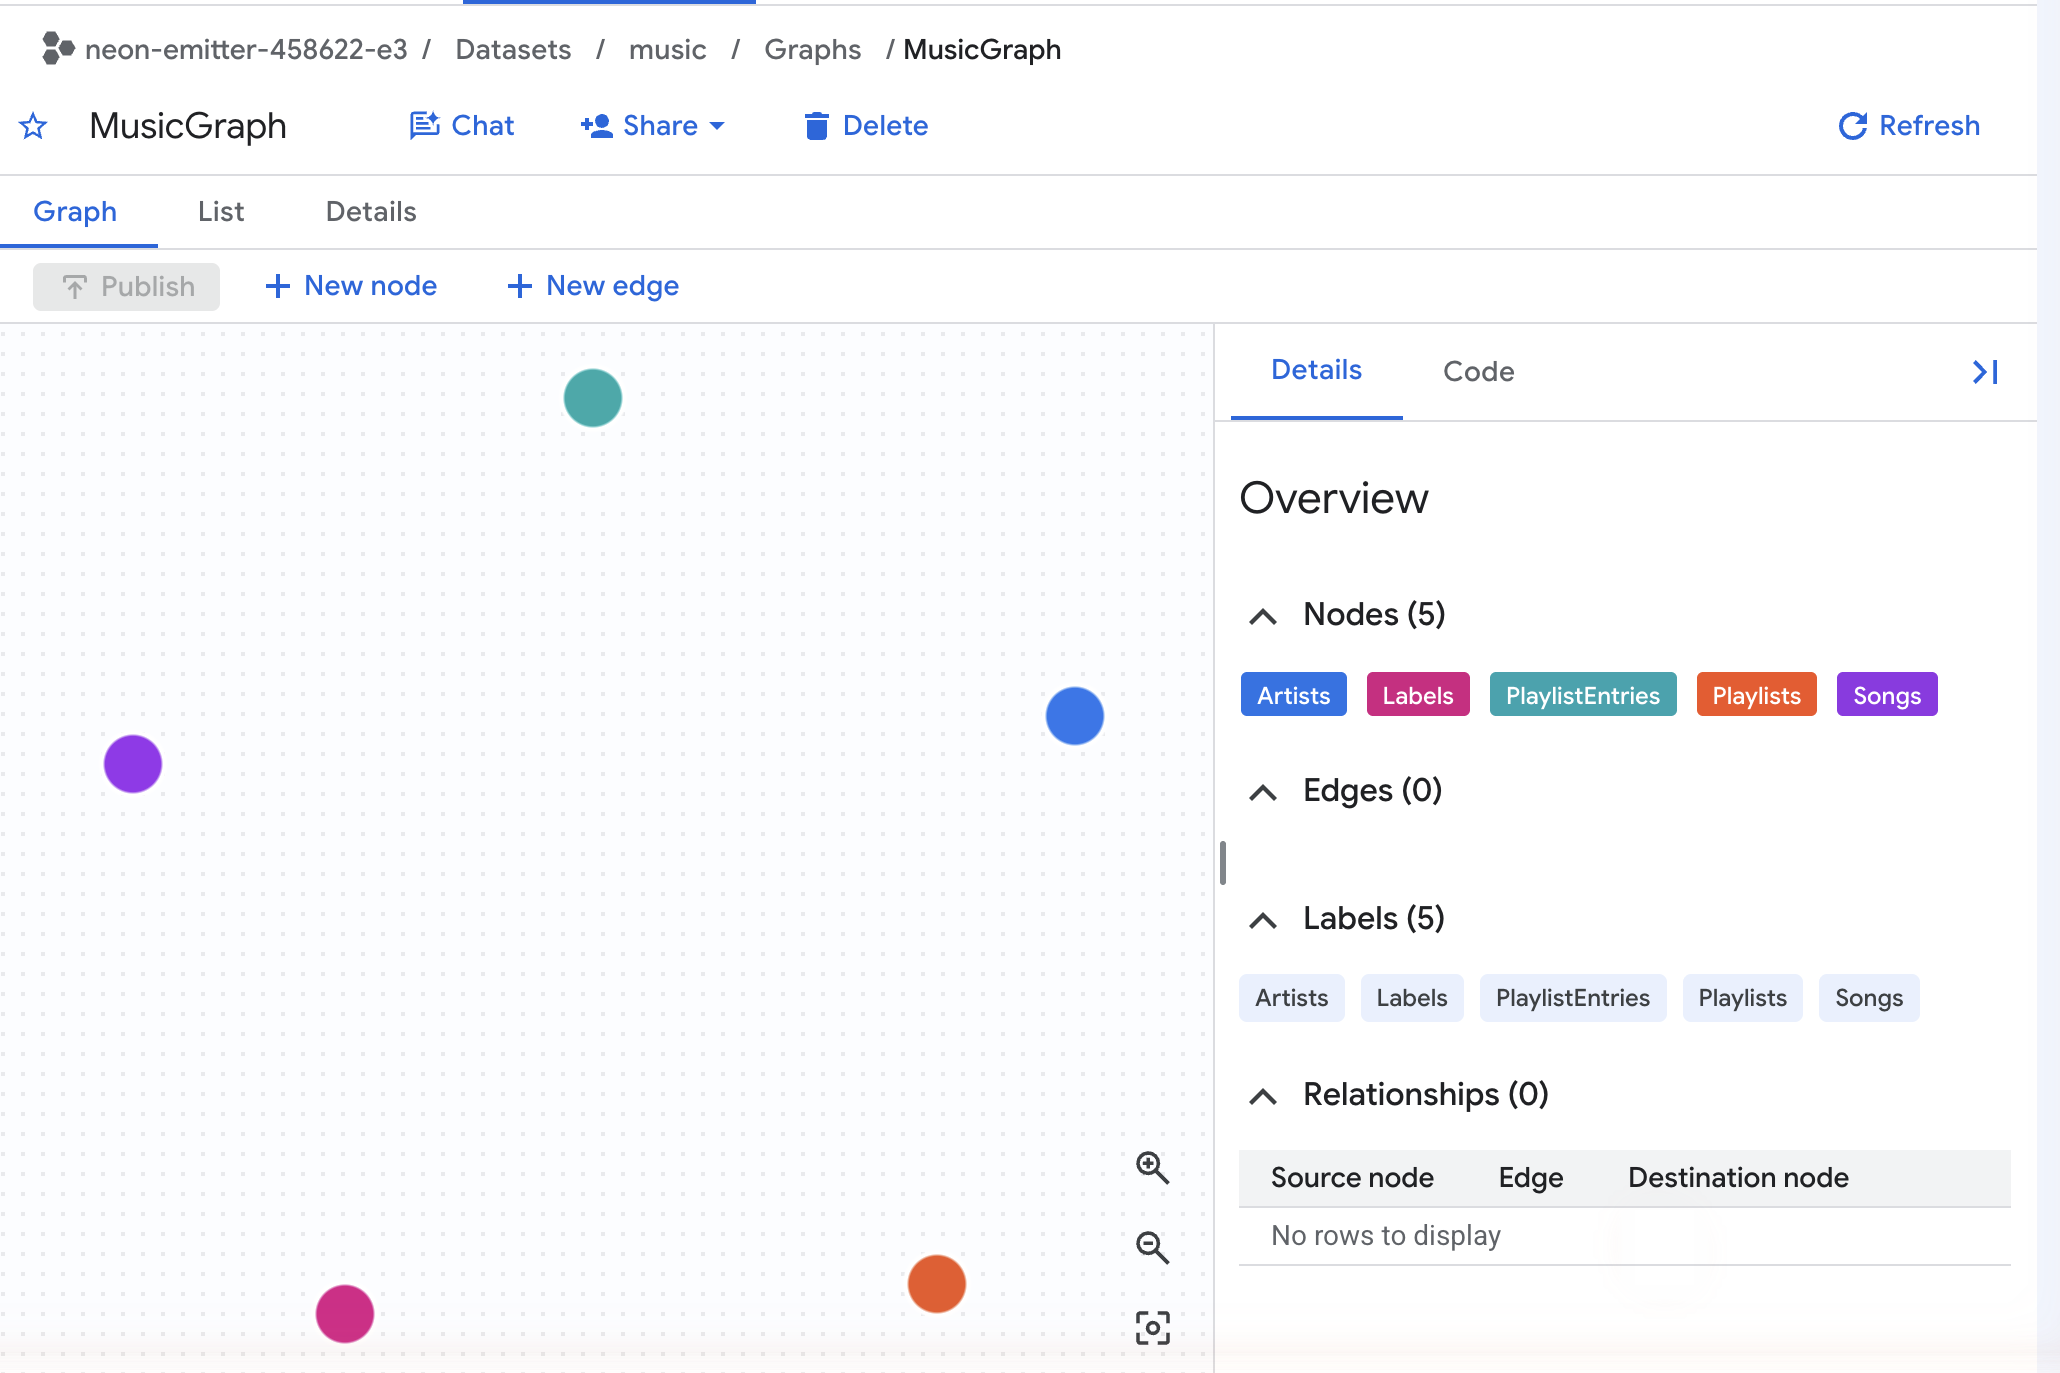
2. 네 개의 모서리를 그립니다.
테두리는 외래 키로 그려집니다. 각각 키를 보유한 테이블에서 가리키는 테이블로 이동합니다.
👉🌐 콘솔 — 새 가장자리를 클릭합니다. 표 선택 대화상자에서 PlaylistEntries를 선택하고 추가를 클릭합니다. 엣지 추가 패널에서 다음을 수행합니다.
- 이름을
EntryToSong로 설정합니다. - 기본 키 추가를 클릭하고
entry_id를 수락합니다. - 소스에서 소스 노드를 PlaylistEntries로 설정한 다음 노드에 참조된 열 추가 및 참조된 열을 가장자리에 추가를 사용하여 둘 다에 대해
entry_id를 선택합니다. - 타겟에서 타겟 노드를 노래로 설정한 다음 노드의 참조 열과 테두리의 참조 열 모두에 대해
song_id를 선택합니다. - 완료를 클릭합니다.
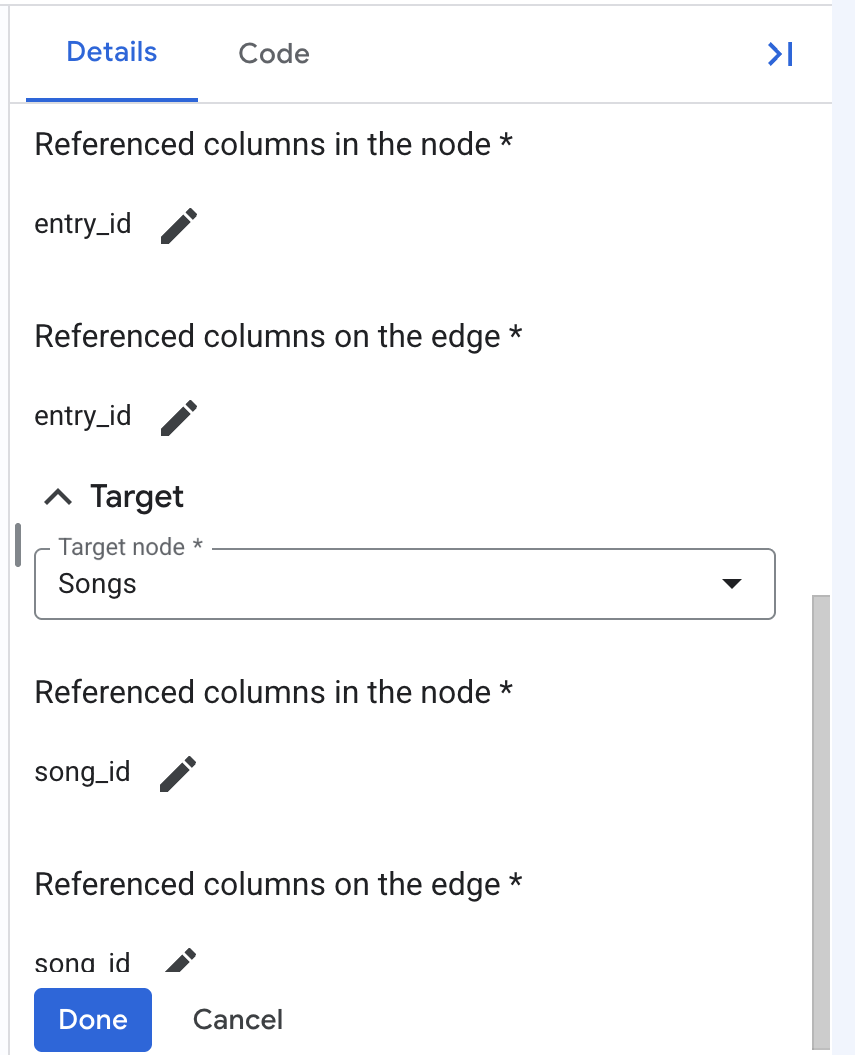
👉🌐 콘솔 - 다음을 세 번 더 반복합니다.
에지 이름 | 테이블 | 소스 노드 → 타겟 노드 | 양쪽에서 선택할 열 |
| PlaylistEntries | PlaylistEntries → Playlists | 소스 |
| 노래 | 노래 → 아티스트 | 소스 |
| 아티스트 | 아티스트 → 음반사 | 소스 |
모든 가장자리에 추가 속성이 없도록 합니다.
👀 이제 세부정보 패널에 Edges (4)가 표시되고 캔버스에 Labels ← Artists ← Songs ← PlaylistEntries → Playlists 체인이 표시됩니다.
3. 측정값 추가
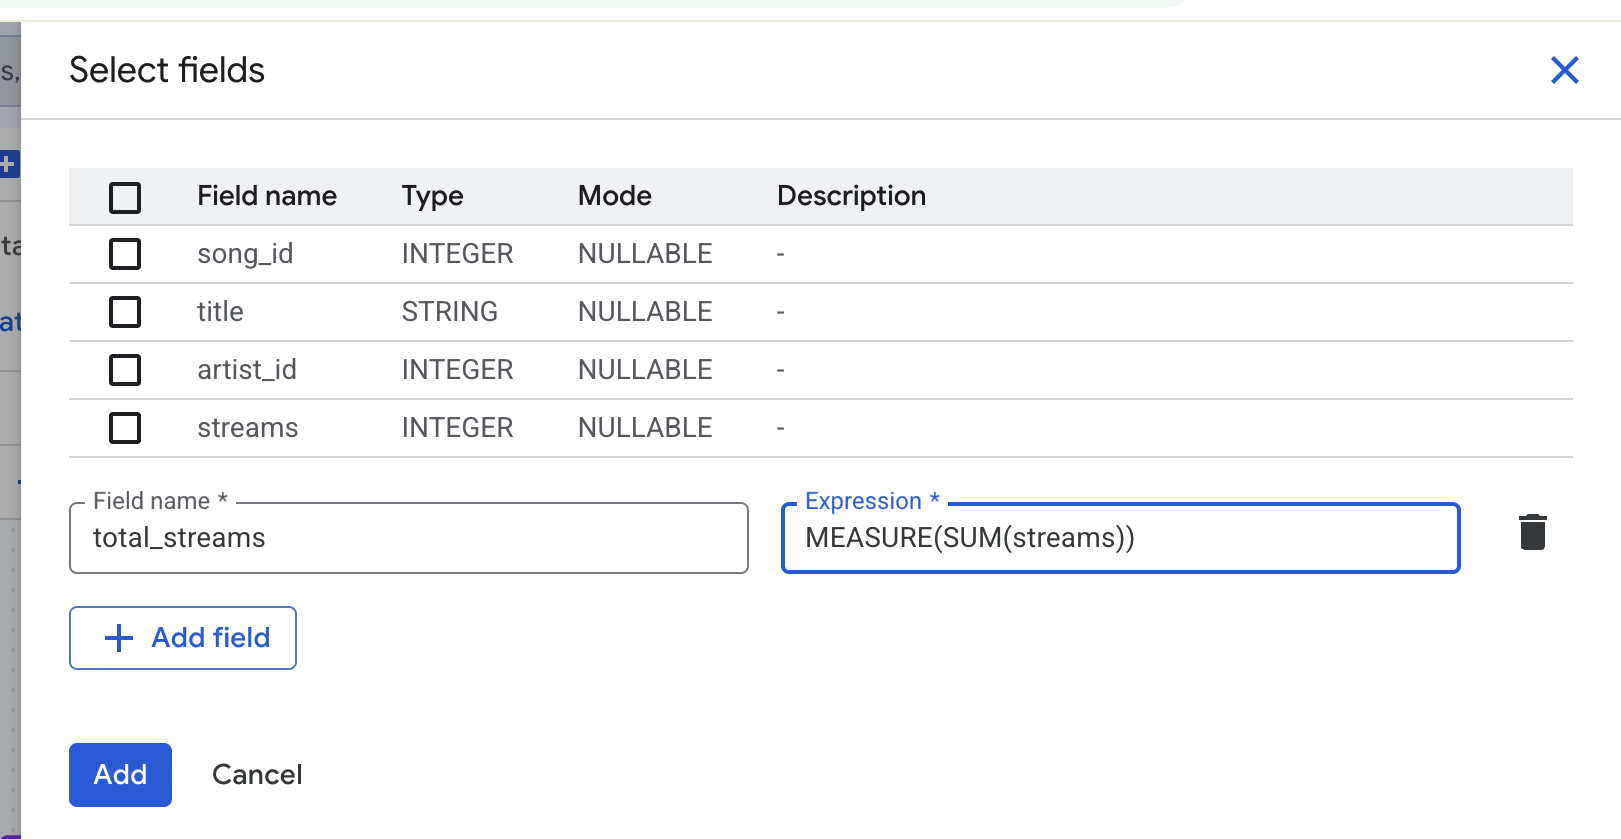
👉🌐 콘솔 - 노래 노드를 클릭한 다음 세부정보 패널 상단에 있는 수정 (연필) 아이콘을 클릭합니다. 라벨의 속성에서 속성 추가를 클릭한 다음 필드 추가를 클릭합니다.
👉🌐 콘솔 - total_streams를 필드 이름으로 입력하고 표현식 상자에 다음을 입력합니다.
MEASURE(SUM(streams))
👉🌐 콘솔 - 추가를 클릭한 다음 완료를 클릭합니다.
4. 작성된 코드를 읽은 다음 게시
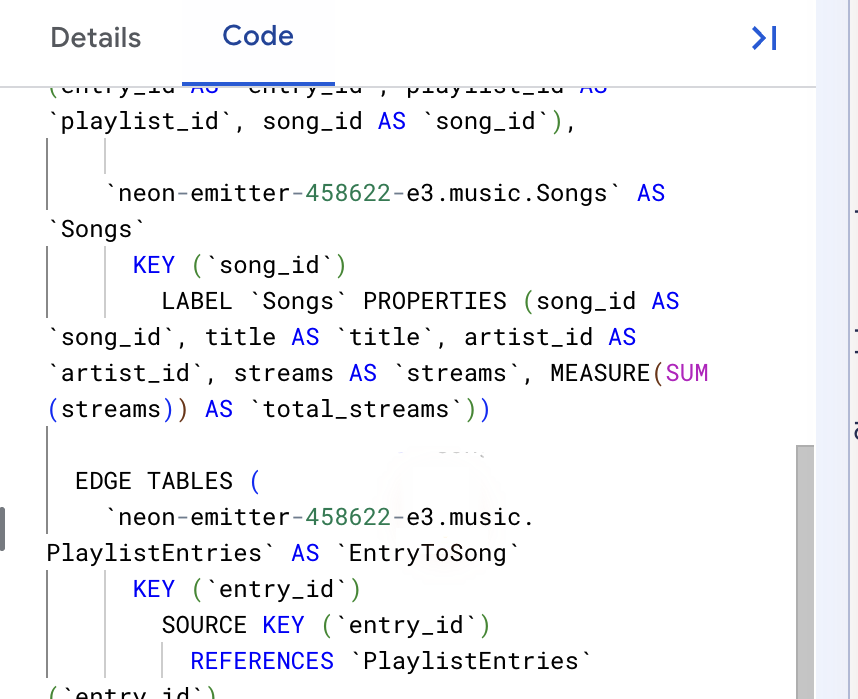
👉🌐 콘솔 - 오른쪽 패널에서 코드 탭을 엽니다. 모델러가 CREATE PROPERTY GRAPH 문을 작성했습니다. 'Songs' 노드로 스크롤합니다. 이제 속성 목록이 다음으로 끝납니다.
MEASURE(SUM(streams)) AS `total_streams`
이것이 한 줄로 된 전체 기능입니다. 이 단계 이후의 모든 내용은 해당 줄이 수행하는 작업에 관한 것입니다.
👉🌐 콘솔 — 게시를 클릭합니다.
✅ 체크포인트: 탐색기에서 music에 이제 MusicGraph가 포함된 그래프 폴더가 있습니다. 클릭하면 코드 탭에 노드 5개, 에지 4개, MEASURE(SUM(streams)) 선이 표시됩니다. 다음 단계를 건너뛰고 SUM과 AGG를 나란히 표시로 이동합니다.
4. 그래프 만들기 - 옵션 B: SQL
모델러에서 그래프를 빌드한 경우 이 단계를 건너뛰세요.
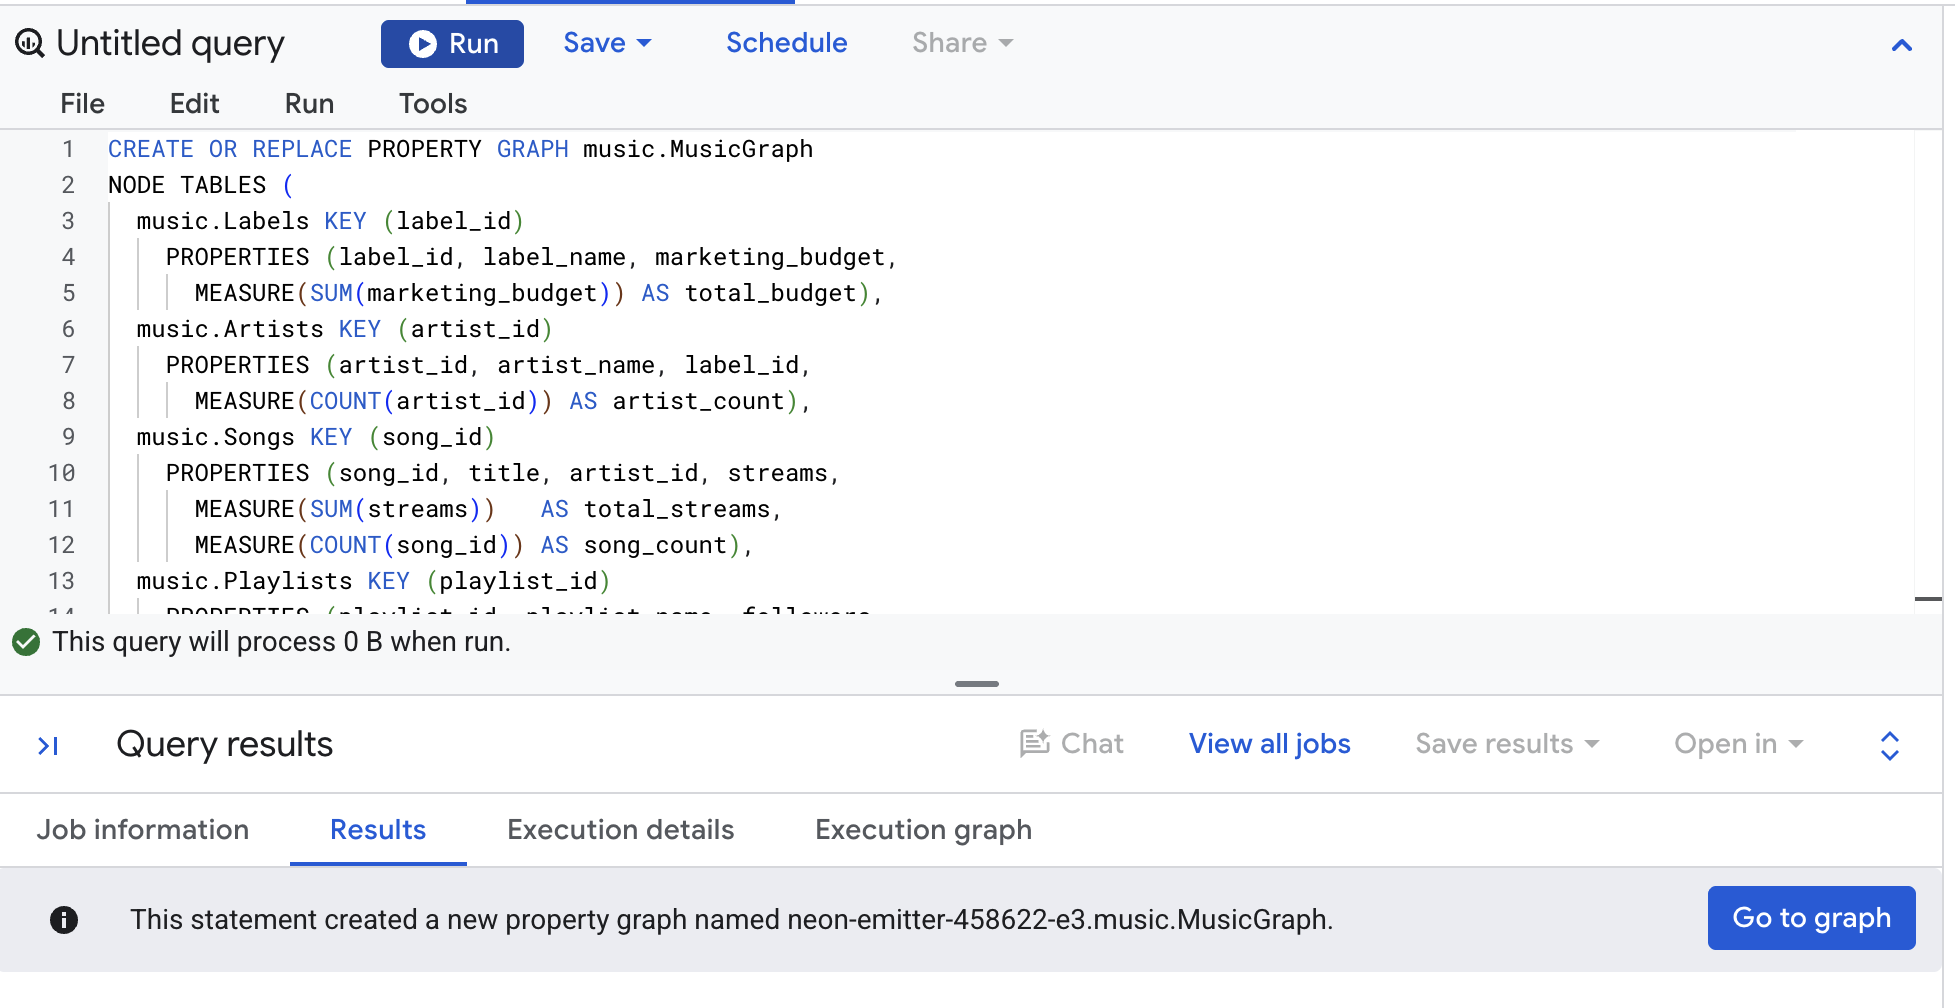
👉📋 쿼리 편집기에 붙여넣은 후 실행을 클릭합니다.
CREATE OR REPLACE PROPERTY GRAPH music.MusicGraph
  NODE TABLES (
    music.Labels KEY (label_id)
      PROPERTIES (label_id, label_name, marketing_budget,
        MEASURE(SUM(marketing_budget)) AS total_budget),
    music.Artists KEY (artist_id)
      PROPERTIES (artist_id, artist_name, label_id,
        MEASURE(COUNT(artist_id)) AS artist_count),
    music.Songs KEY (song_id)
      PROPERTIES (song_id, title, artist_id, streams,
        MEASURE(SUM(streams))   AS total_streams,
        MEASURE(COUNT(song_id)) AS song_count),
    music.Playlists KEY (playlist_id)
      PROPERTIES (playlist_id, playlist_name, followers,
        MEASURE(SUM(followers)) AS total_followers),
    music.PlaylistEntries KEY (entry_id)
      PROPERTIES (entry_id, playlist_id, song_id,
        MEASURE(COUNT(entry_id)) AS placement_count)
  )
  EDGE TABLES (
    music.PlaylistEntries AS EntryToSong
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (song_id) REFERENCES Songs(song_id) NO PROPERTIES,
    music.PlaylistEntries AS EntryToPlaylist
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (playlist_id) REFERENCES Playlists(playlist_id) NO PROPERTIES,
    music.Songs AS SongToArtist
      SOURCE KEY (song_id) REFERENCES Songs(song_id)
      DESTINATION KEY (artist_id) REFERENCES Artists(artist_id) NO PROPERTIES,
    music.Artists AS ArtistToLabel
      SOURCE KEY (artist_id) REFERENCES Artists(artist_id)
      DESTINATION KEY (label_id) REFERENCES Labels(label_id) NO PROPERTIES
  )
👀 결과 패널에 속성 그래프가 생성되었다고 표시됩니다.
한 번 읽기
그래프에는 노드 테이블 5개와 에지 테이블 4개가 있습니다. 각 노드 테이블은 KEY의 이름을 지정하고 PROPERTIES을 나열합니다. MEASURE로 시작하는 줄이 새로운 부분입니다. 각 줄은 지원되는 집계 중 하나를 속성 주위에 래핑하고 필수인 별칭을 지정합니다.
각 에지 테이블은 외래 키입니다. 키를 보유한 테이블의 SOURCE KEY, 가리키는 테이블의 DESTINATION KEY로 표기됩니다. NO PROPERTIES는 가장자리가 자체적으로 아무것도 전달하지 않음을 의미합니다.
PlaylistEntries는 노드 테이블로 한 번, EntryToSong 및 EntryToPlaylist 에지 뒤의 실제 테이블로 두 번 등 총 세 번 표시됩니다. 이는 의도적인 것이며 나중에 그 이유를 설명하겠습니다.
내가 만든 작품 확인하기
👉🌐 콘솔 - 탐색기 창에서 music, 그래프를 차례로 펼치고 MusicGraph를 클릭합니다. 그래프 페이지가 5개의 노드와 4개의 에지가 있는 캔버스에서 열립니다. 노드를 클릭하면 속성이 표시됩니다. 측정항목은 집계와 함께 나열됩니다. 코드 탭을 열어 그림 뒤에 있는 문장을 확인합니다.
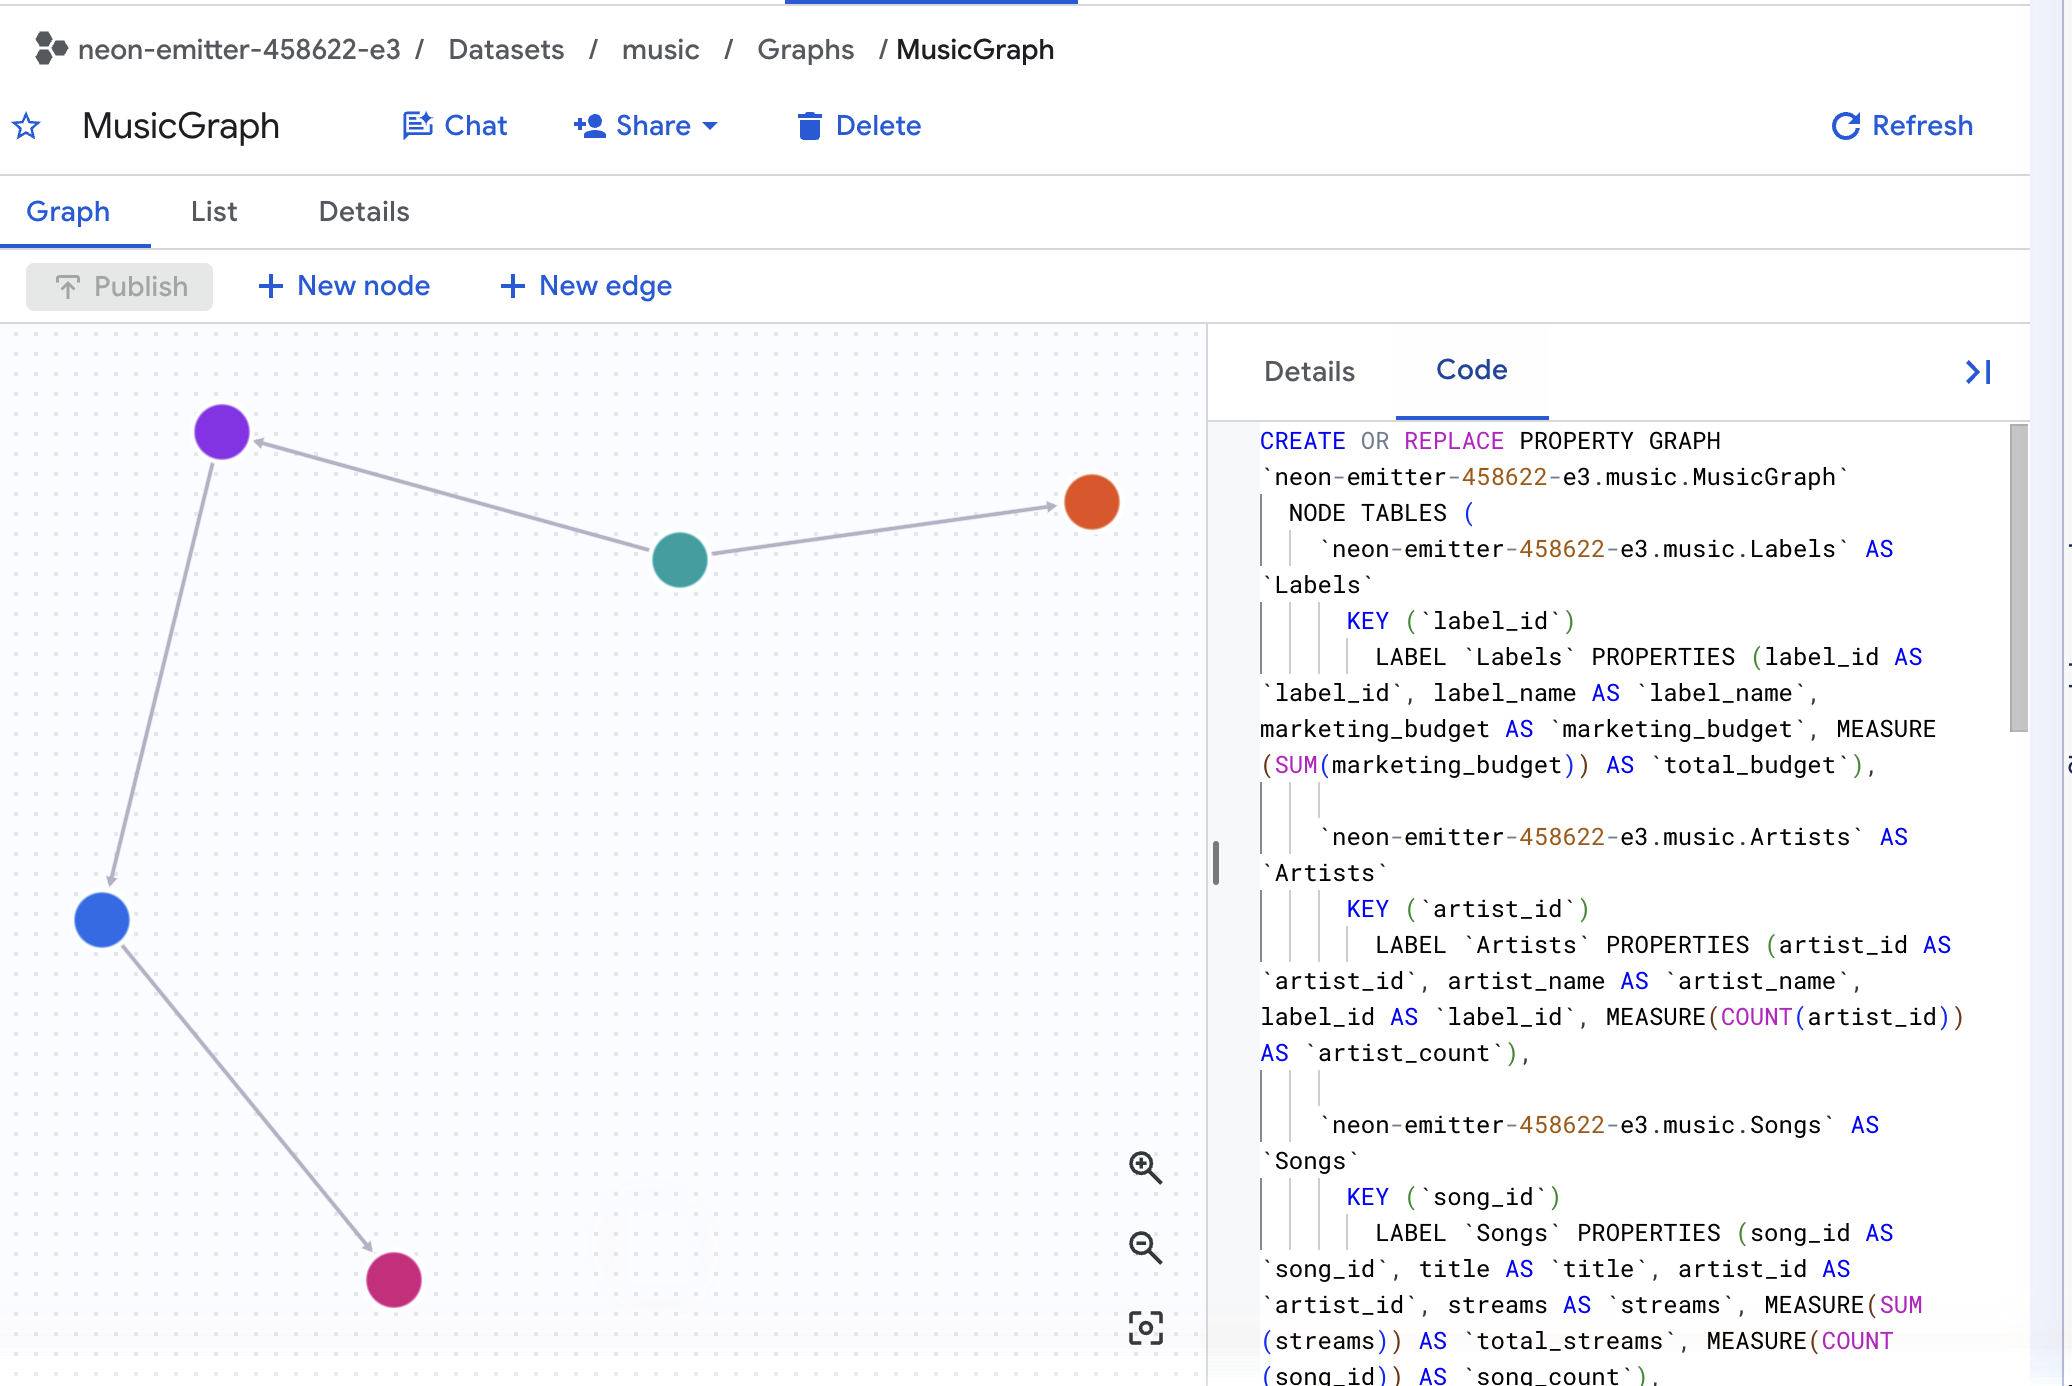
✅ 체크포인트: music에 MusicGraph가 포함된 그래프 폴더가 있고 코드 탭에 MEASURE(SUM(streams)) AS total_streams가 표시됩니다.
5. SUM과 AGG를 나란히 표시
이것이 하나의 쿼리로 된 전체 Codelab입니다. 두 열 모두 동일한 테이블에서 동일한 질문(라벨별 총 스트림)에 답하려고 합니다.
이 테이블은 GRAPH_EXPAND가 생성한 테이블입니다. 그래프를 평면화합니다. 하나의 테이블에서 시작하여 연결된 모든 테이블이 하나의 넓은 결과에 나란히 배치될 때까지 각 가장자리를 LEFT JOIN로 따라갑니다. 노래당 하나가 아닌 배치당 하나의 행이 있으며 모든 열의 이름은 TableLabel_property입니다. 쿼리하기 전에 확인하세요.
👉📋 쿼리 편집기에 붙여넣은 후 실행을 클릭합니다.
SELECT Labels_label_name, Songs_title, Songs_streams, Playlists_playlist_name
FROM GRAPH_EXPAND("music.MusicGraph")
ORDER BY Songs_title, Playlists_playlist_name
👀 예상되는 행 수는 10개입니다. PlaylistEntries의 각 배치에 하나씩 있으며 이는 설정에서 로드한 것과 정확히 일치합니다. 네온 여름은 재생목록당 하나씩 4개의 자리를 차지하며, Songs_streams는 모든 재생목록에서 2,000,000,000으로 표시됩니다. 이러한 행에는 문제가 없습니다. 재생목록이 실제로 4개입니다. 하지만 이제 노래에 속하는 열이 게재위치에 속하는 행에 반복되는데, 이것이 다음 쿼리에서 측정하는 전체 문제입니다.
이제 비교를 해 보겠습니다.
👉📋 쿼리 편집기에 붙여넣은 후 실행을 클릭합니다.
SELECT
  Labels_label_name,
  SUM(Songs_streams)       AS with_sum,
  AGG(Songs_total_streams) AS with_agg
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1 ORDER BY 1
👀 결과:
Labels_label_name | with_sum | with_agg |
Cymbal Records | 12,600,000,000 | 5,100,000,000 |
Northwind Audio | 9,000,000,000 | 4,500,000,000 |
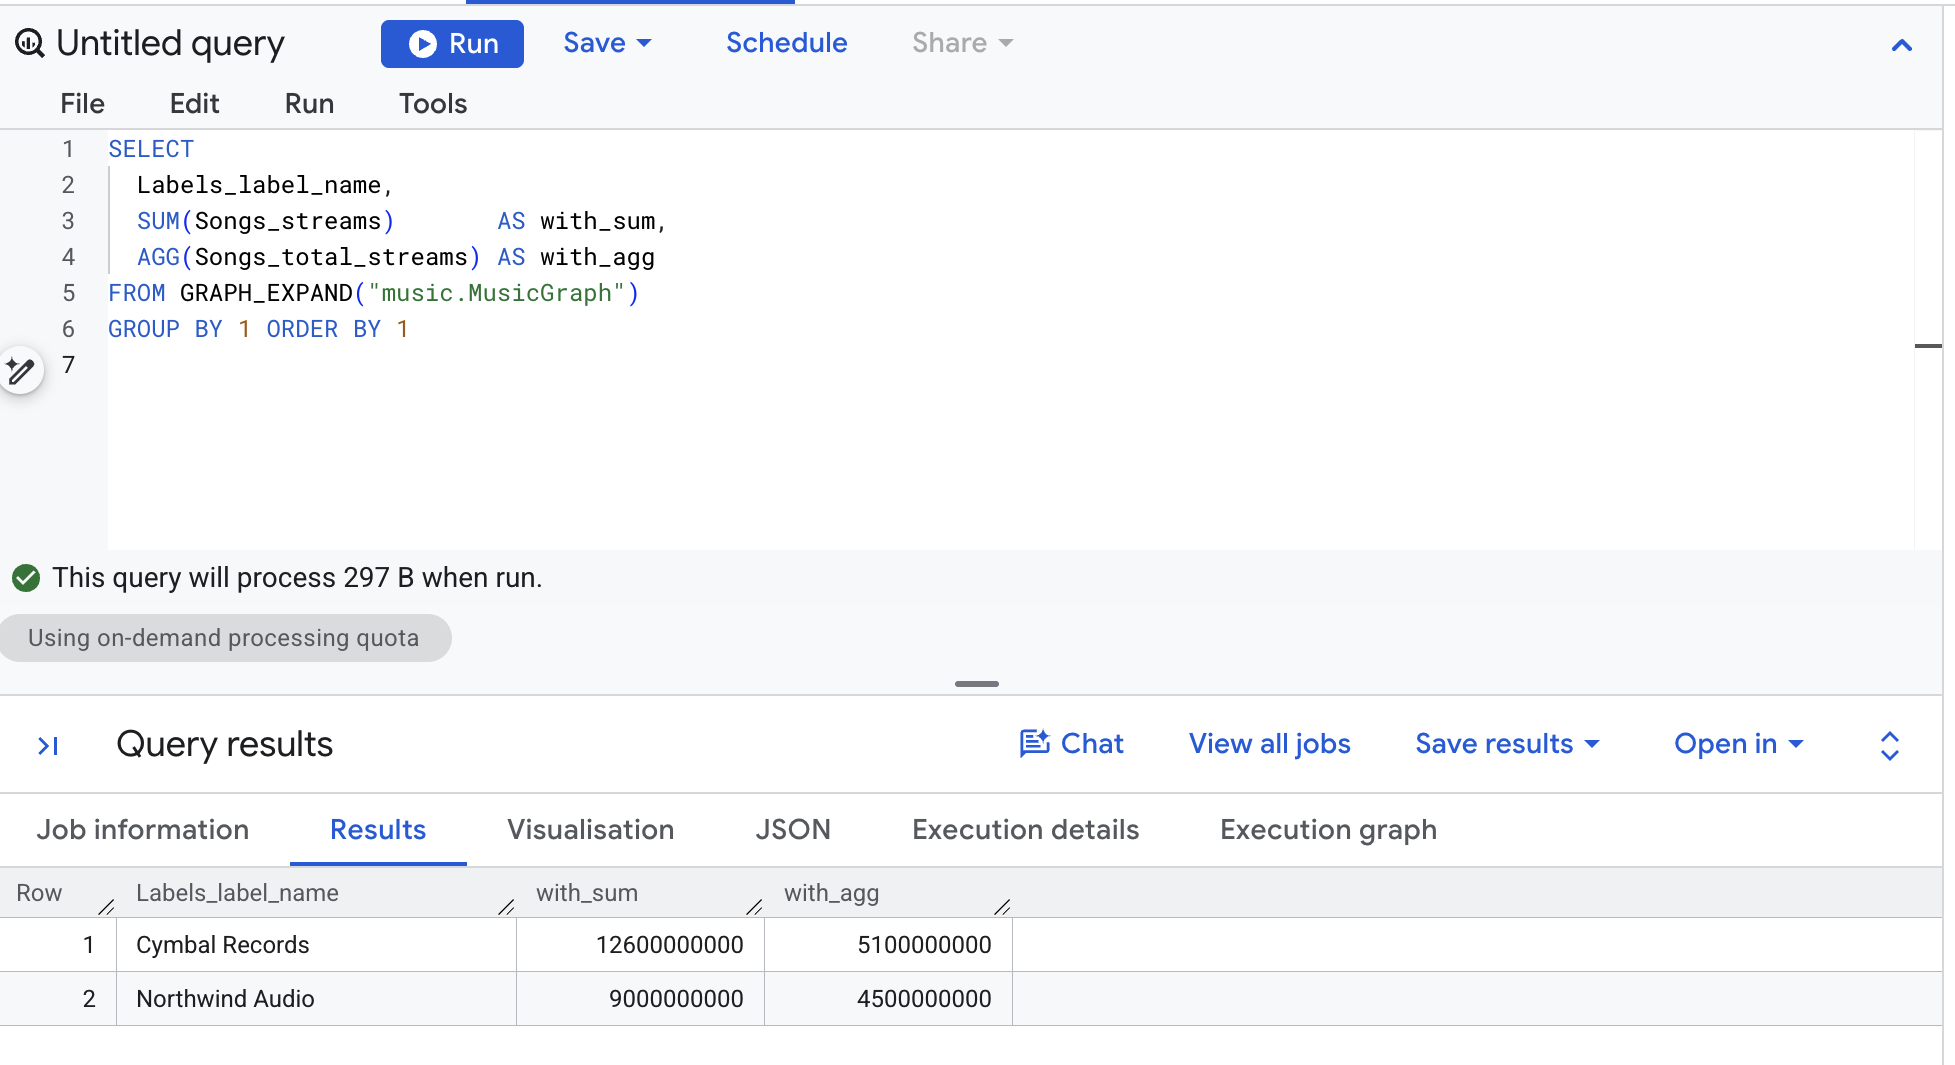
직접 확인하세요. Cymbal의 4곡은 각각 20억, 15억, 12억, 4억 스트림을 기록했습니다. 51억입니다. AGG이(가) 맞습니다. SUM는 2.5배나 커졌고 Northwind의 노래는 두 배로 늘었습니다.
세 가지 새로운 문법
GRAPH_EXPAND("music.MusicGraph")는 각 가장자리를LEFT JOIN로 따라 그래프를 하나의 넓은 테이블로 변환하는 테이블 값 함수입니다. 모든 열의 이름이TableLabel_property이므로Songs_streams은 Songs 테이블의 원시 열이고Songs_total_streams은 선언한 측정값입니다.SUM(Songs_streams)는 이 광범위한 테이블에 대한 일반 SQL이며 평탄화로 생성된 모든 중복을 상속합니다.AGG(Songs_total_streams)는 선언된 방식으로 측정값을 평가합니다. 노래가 넓은 테이블에서 차지하는 행 수와 관계없이song_id당 한 번SUM(streams)입니다.
✅ 체크포인트: 라벨 2개, 열 2개, with_agg 숫자가 손가락 수와 일치합니다.
6. SUM이 과도하게 집계하는 이유
노래 하나를 가져와서 이러한 조인이 노래에 어떤 영향을 미치는지 확인해 보세요.
👉📋 쿼리 편집기에 붙여넣은 후 실행을 클릭합니다.
SELECT 'BEFORE - the Songs table' AS step, title, streams, CAST(NULL AS STRING) AS playlist
FROM music.Songs WHERE title = 'Neon Summer'
UNION ALL
SELECT 'AFTER - joined to playlists', s.title, s.streams, pl.playlist_name
FROM music.Songs s
LEFT JOIN music.PlaylistEntries e ON e.song_id = s.song_id
LEFT JOIN music.Playlists pl ON pl.playlist_id = e.playlist_id
WHERE s.title = 'Neon Summer'
ORDER BY step DESC, playlist
👀 결과:
단계별 방법 | 제목 | 메시지를 수신할 수 있습니다 | 재생목록 |
BEFORE - Songs 테이블 | Neon Summer | 2,000,000,000 | null |
AFTER - 재생목록에 추가됨 | Neon Summer | 2,000,000,000 | Gym Pump |
AFTER - 재생목록에 추가됨 | Neon Summer | 2,000,000,000 | Hot Right Now |
AFTER - 재생목록에 추가됨 | Neon Summer | 2,000,000,000 | 라이징 팝 |
AFTER - 재생목록에 추가됨 | Neon Summer | 2,000,000,000 | 자동차 여행 |
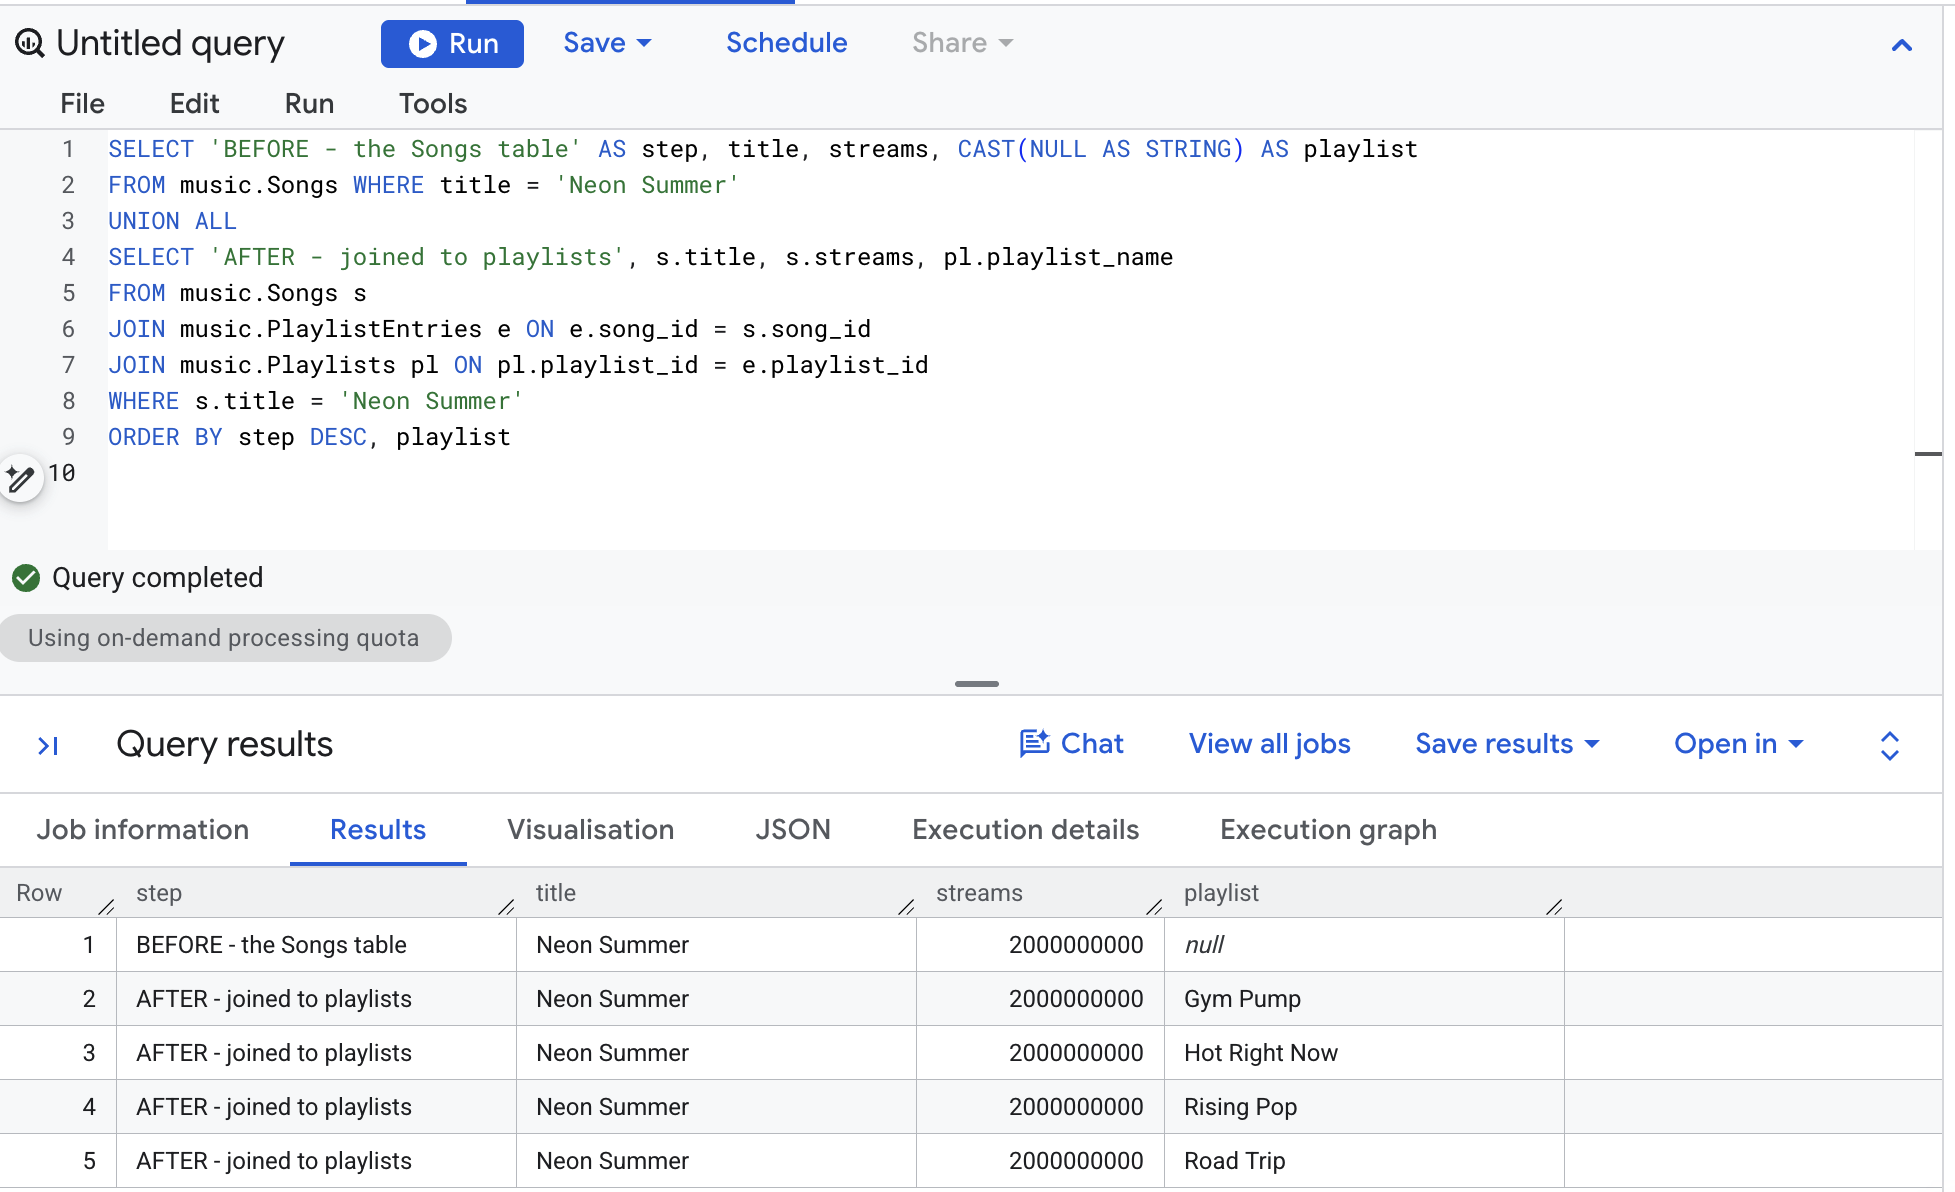
한 행이 네 행이 되었습니다. 스트림 수는 변경되지 않았으며 복사되었습니다. Cymbal Records에 대한 복사본의 효과를 합산합니다. Neon Summer 20억 회(재생목록 4개)은 8.0, Paper Crown 15억 회(재생목록 2개)은 3.0, Double Shot 12억 회(재생목록 1개), Slow Arrow 4억 회(재생목록 1개)입니다. 126억 개로, SUM이 반환된 숫자입니다. Northwind's Midnight Drive는 두 개의 재생목록에 포함되어 있으므로 45억이 90억이 되었습니다.
이는 팬아웃이며 조인의 버그가 아닙니다. 재생목록 행은 실제입니다. 이 경우 노래에 속하는 숫자를 게재위치에 속하는 행에 합산하는 것이 실수입니다.
이 측정값은 Songs 노드에서 KEY (song_id)와 함께 선언되었으므로 이 문제를 해결합니다. 키는 그레인입니다. AGG가 total_streams을 평가할 때는 노래 키별로 한 번 집계한 후 그룹화된 항목으로 롤업합니다.
변경사항
이전에는 다음과 같이 작성했습니다. | 측정치 포함 |
필요한 모든 쿼리에 |
|
|
|
3개의 |
|
조인 전에 집계하는 CTE | 없습니다. |
✅ 체크포인트: 5개 행(BEFORE 1개, AFTER 4개)에서 126억 개를 재구성할 수 있습니다.
7. 규칙: AGG만 측정값을 읽습니다.
측정값에는 자체 유형(MEASURE)이 있으며 정확히 하나의 함수가 이를 허용합니다. 아래의 네 가지 쿼리는 의도적으로 실패합니다. 각 쿼리를 실행하고 빨간색 오류를 읽어 보세요. 이러한 방법은 모든 사람이 먼저 시도하는 방법이며, 이러한 방법을 알면 나중에 시간을 절약할 수 있습니다.
👉📋 쿼리 편집기 - 일반 열에서 AGG:
SELECT AGG(Songs_streams) FROM GRAPH_EXPAND("music.MusicGraph")
👀 No matching signature for aggregate function AGG ... Argument 1: expected MEASURE
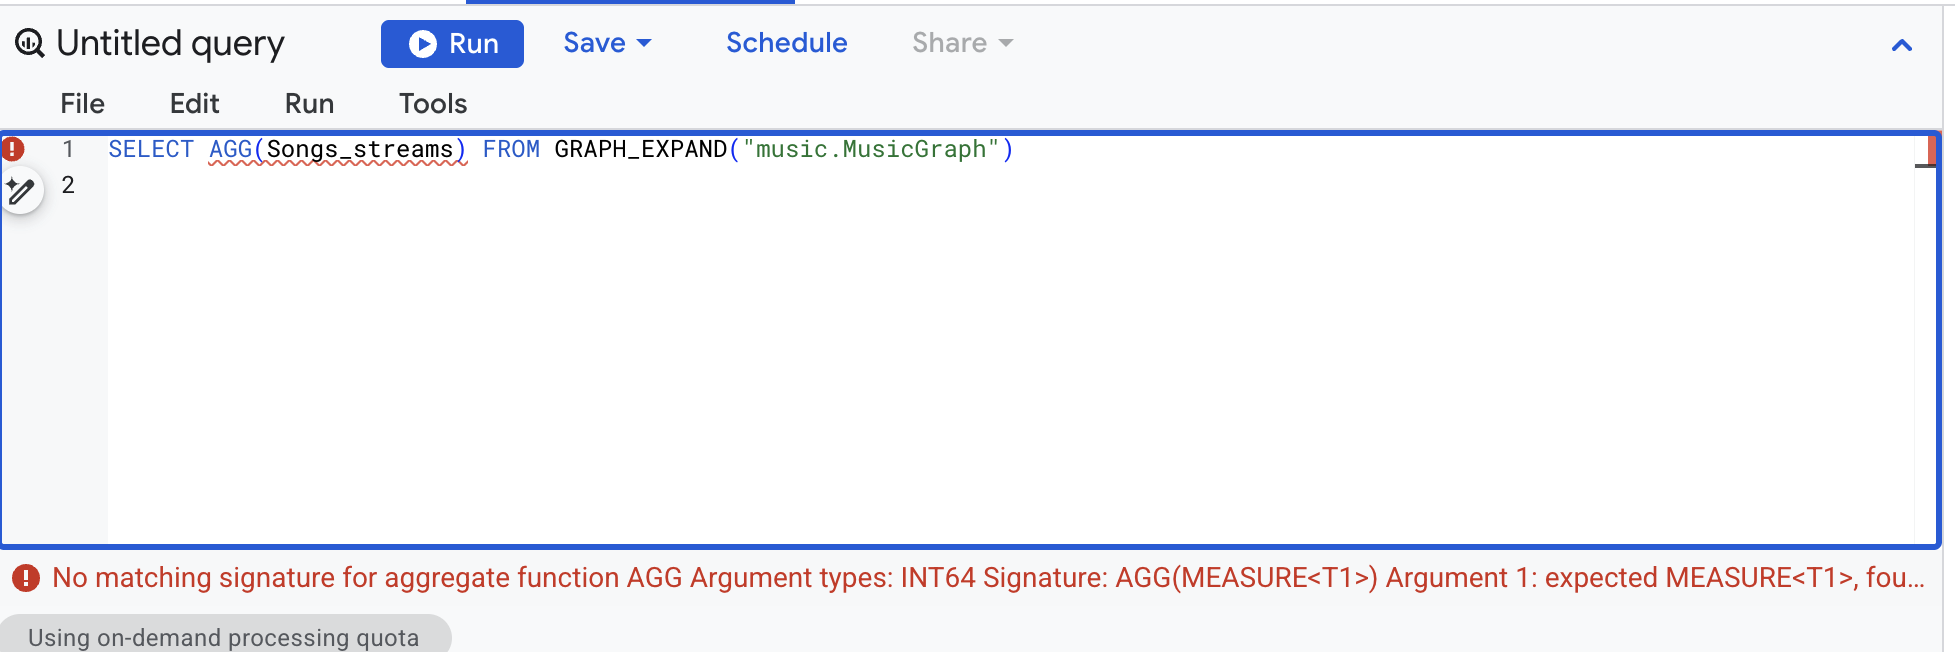
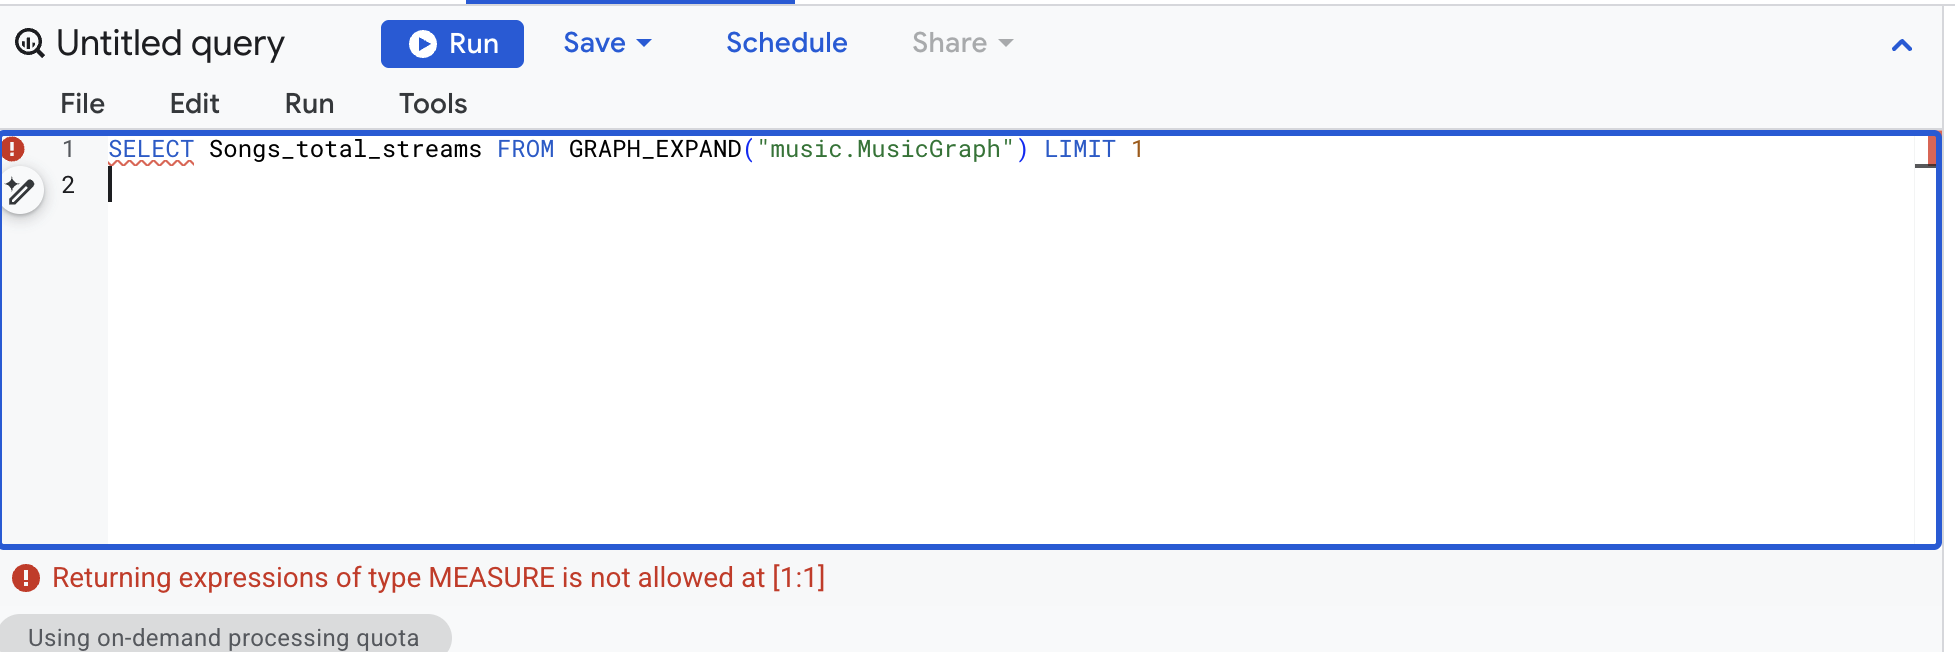
👉📋 쿼리 편집기 - AGG가 없는 측정항목 열:
SELECT Songs_total_streams FROM GRAPH_EXPAND("music.MusicGraph") LIMIT 1
👀 Returning expressions of type MEASURE is not allowed
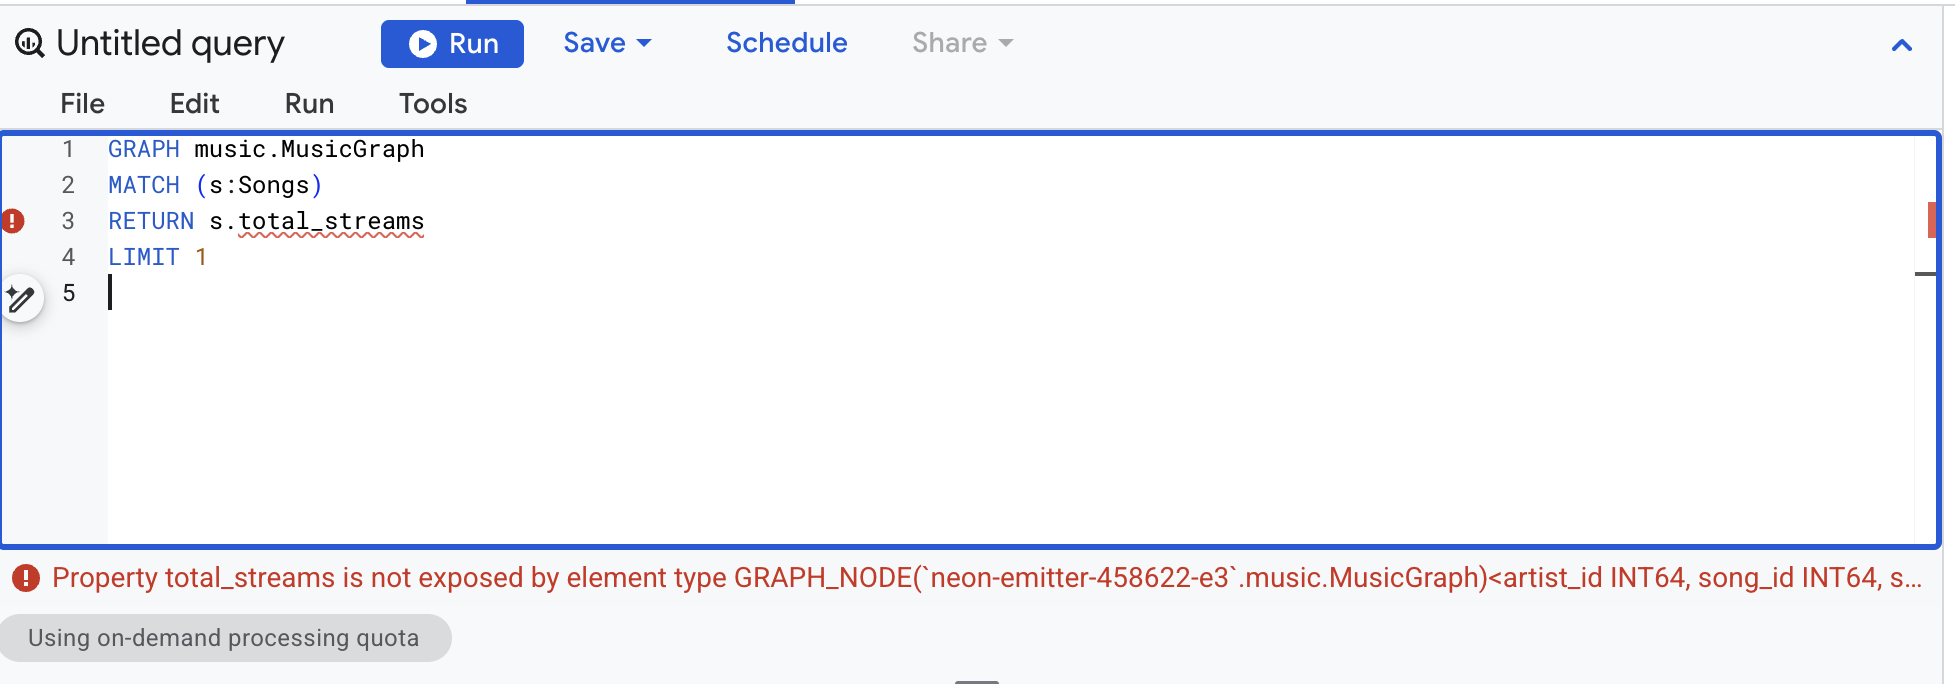
👉📋 쿼리 편집기 - GQL에서 참조되는 측정값으로, 측정값을 전혀 보지 않습니다 (이것은 GQL 쿼리임. 개요의 편집 참고사항 참고).
GRAPH music.MusicGraph
MATCH (s:Songs)
RETURN s.total_streams
LIMIT 1
👀 total_streams is not exposed by element type GRAPH_NODE(...)
👉📋 쿼리 편집기 — 측정항목 열 위로 SUM, 유혹적인 열:
SELECT Labels_label_name, SUM(Songs_total_streams)
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1
👀 MEASURE-typed arguments are only permitted in the AGG function
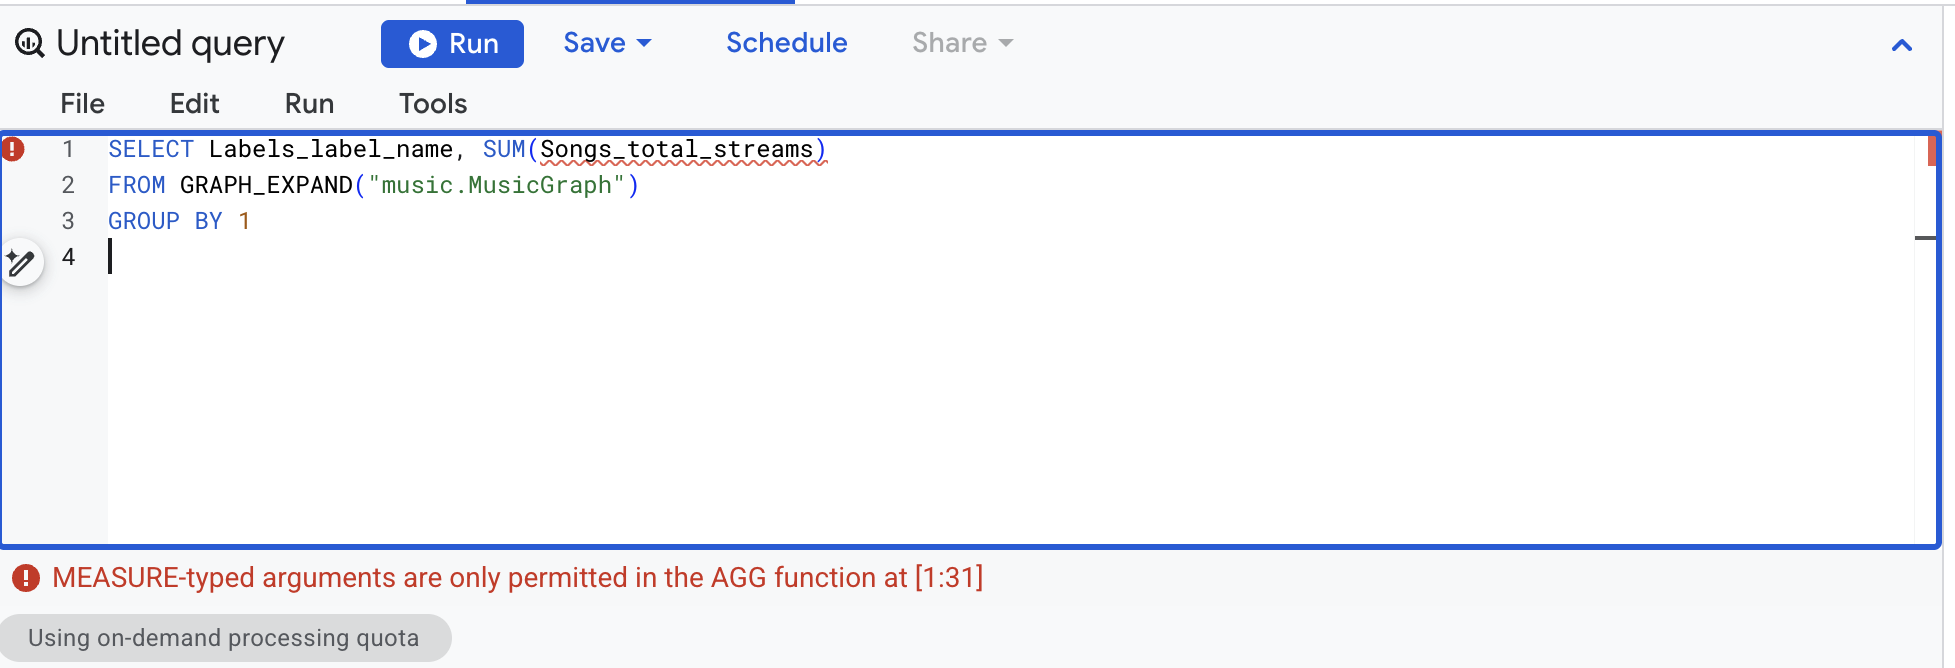
따라서 유형 시스템에서 규칙을 적용합니다. 측정항목은 GRAPH_EXPAND을 통해서만 표시되고 AGG을 통해서만 읽을 수 있습니다. 이전의 과도하게 집계된 126억은 원시 열을 합산한 결과일 뿐 측정치를 잘못 처리한 결과는 아닙니다.
✅ 체크포인트: 빨간색 오류가 4개 있으며 각 오류가 적용되는 규칙을 말할 수 있습니다.
8. 측정항목이 지원하는 모든 집계
MEASURE()는 SUM, AVG, MIN, MAX, COUNT, COUNT(DISTINCT)의 6개 집계 중 하나를 래핑합니다. Songs 노드에 6개 모두를 포함하여 그래프를 다시 만듭니다. 에지는 NO PROPERTIES로 유지됩니다. 이는 에지가 노드와 물리적 테이블을 공유할 때 문서화된 권장사항입니다.
👉📋 쿼리 편집기에 붙여넣은 후 실행을 클릭합니다.
CREATE OR REPLACE PROPERTY GRAPH music.MusicGraph
  NODE TABLES (
    music.Labels KEY (label_id)
      PROPERTIES (label_id, label_name, marketing_budget,
        MEASURE(SUM(marketing_budget)) AS total_budget),
    music.Artists KEY (artist_id)
      PROPERTIES (artist_id, artist_name, label_id,
        MEASURE(COUNT(artist_id)) AS artist_count),
    music.Songs KEY (song_id)
      PROPERTIES (song_id, title, artist_id, streams,
        MEASURE(SUM(streams))              AS total_streams,
        MEASURE(AVG(streams))              AS avg_streams,
        MEASURE(MIN(streams))              AS min_streams,
        MEASURE(MAX(streams))              AS max_streams,
        MEASURE(COUNT(song_id))            AS song_count,
        MEASURE(COUNT(DISTINCT artist_id)) AS distinct_artists),
    music.Playlists KEY (playlist_id)
      PROPERTIES (playlist_id, playlist_name, followers,
        MEASURE(SUM(followers)) AS total_followers),
    music.PlaylistEntries KEY (entry_id)
      PROPERTIES (entry_id, playlist_id, song_id,
        MEASURE(COUNT(entry_id)) AS placement_count)
  )
  EDGE TABLES (
    music.PlaylistEntries AS EntryToSong
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (song_id) REFERENCES Songs(song_id) NO PROPERTIES,
    music.PlaylistEntries AS EntryToPlaylist
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (playlist_id) REFERENCES Playlists(playlist_id) NO PROPERTIES,
    music.Songs AS SongToArtist
      SOURCE KEY (song_id) REFERENCES Songs(song_id)
      DESTINATION KEY (artist_id) REFERENCES Artists(artist_id) NO PROPERTIES,
    music.Artists AS ArtistToLabel
      SOURCE KEY (artist_id) REFERENCES Artists(artist_id)
      DESTINATION KEY (label_id) REFERENCES Labels(label_id) NO PROPERTIES
  )
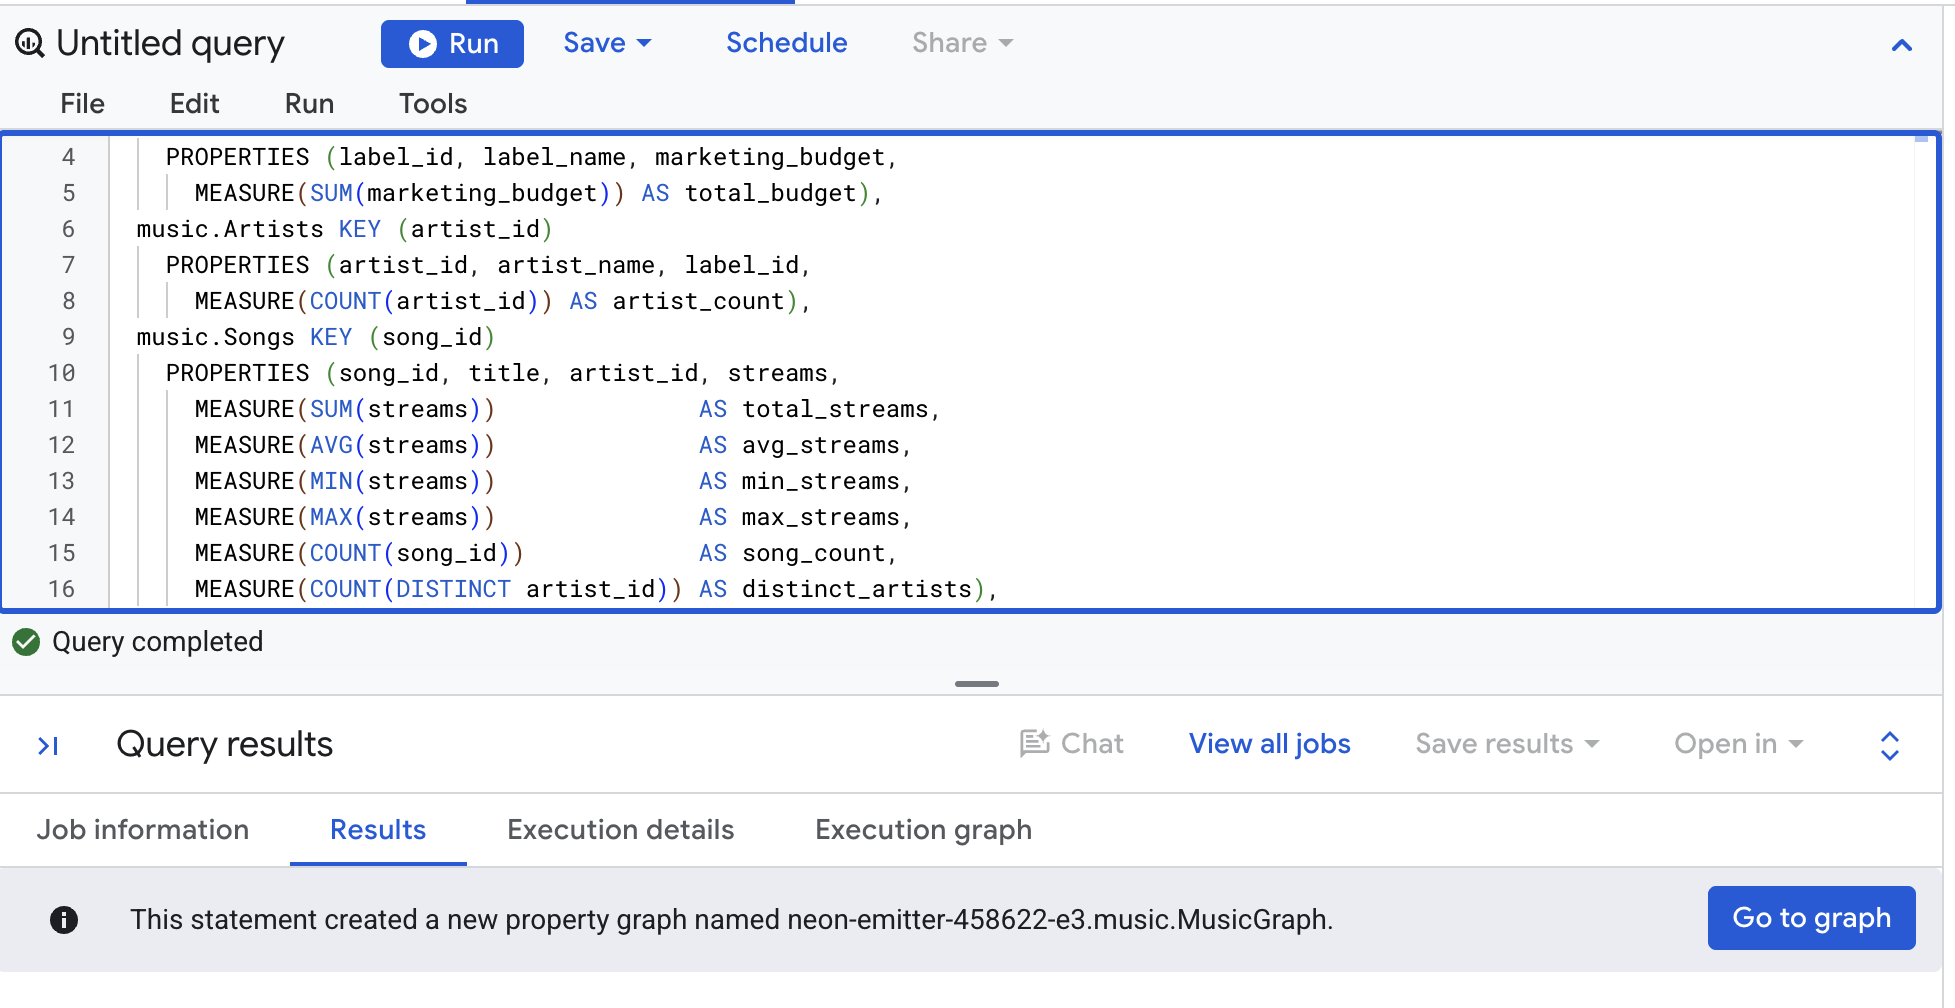
이제 모두 다시 읽어 보세요. 모든 측정값은 AGG을 거치며 마지막 열에는 AGG 결과가 산술 연산을 할 수 있는 일반 값임을 보여줍니다. 그래프가 변경되었으므로 먼저 캐시된 결과 사용 (더보기 → 쿼리 설정)을 선택 해제합니다.
👉📋 쿼리 편집기에 붙여넣은 후 실행을 클릭합니다.
SELECT
  Labels_label_name,
  AGG(Songs_total_streams)    AS total_streams,
  AGG(Songs_avg_streams)      AS avg_streams,
  AGG(Songs_min_streams)      AS min_streams,
  AGG(Songs_max_streams)      AS max_streams,
  AGG(Songs_song_count)       AS songs,
  AGG(Songs_distinct_artists) AS artists,
  AGG(Songs_total_streams) / AGG(Songs_song_count) AS streams_per_song
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1
ORDER BY 1
👀 결과:
Labels_label_name | total_streams | avg_streams | min_streams | max_streams | 노래 | 아티스트 | streams_per_song |
Cymbal Records | 5,100,000,000 | 1,275,000,000 | 400,000,000 | 2,000,000,000 | 4 | 2 | 1,275,000,000 |
Northwind Audio | 4,500,000,000 | 4,500,000,000 | 4,500,000,000 | 4,500,000,000 | 1 | 1 | 4,500,000,000 |
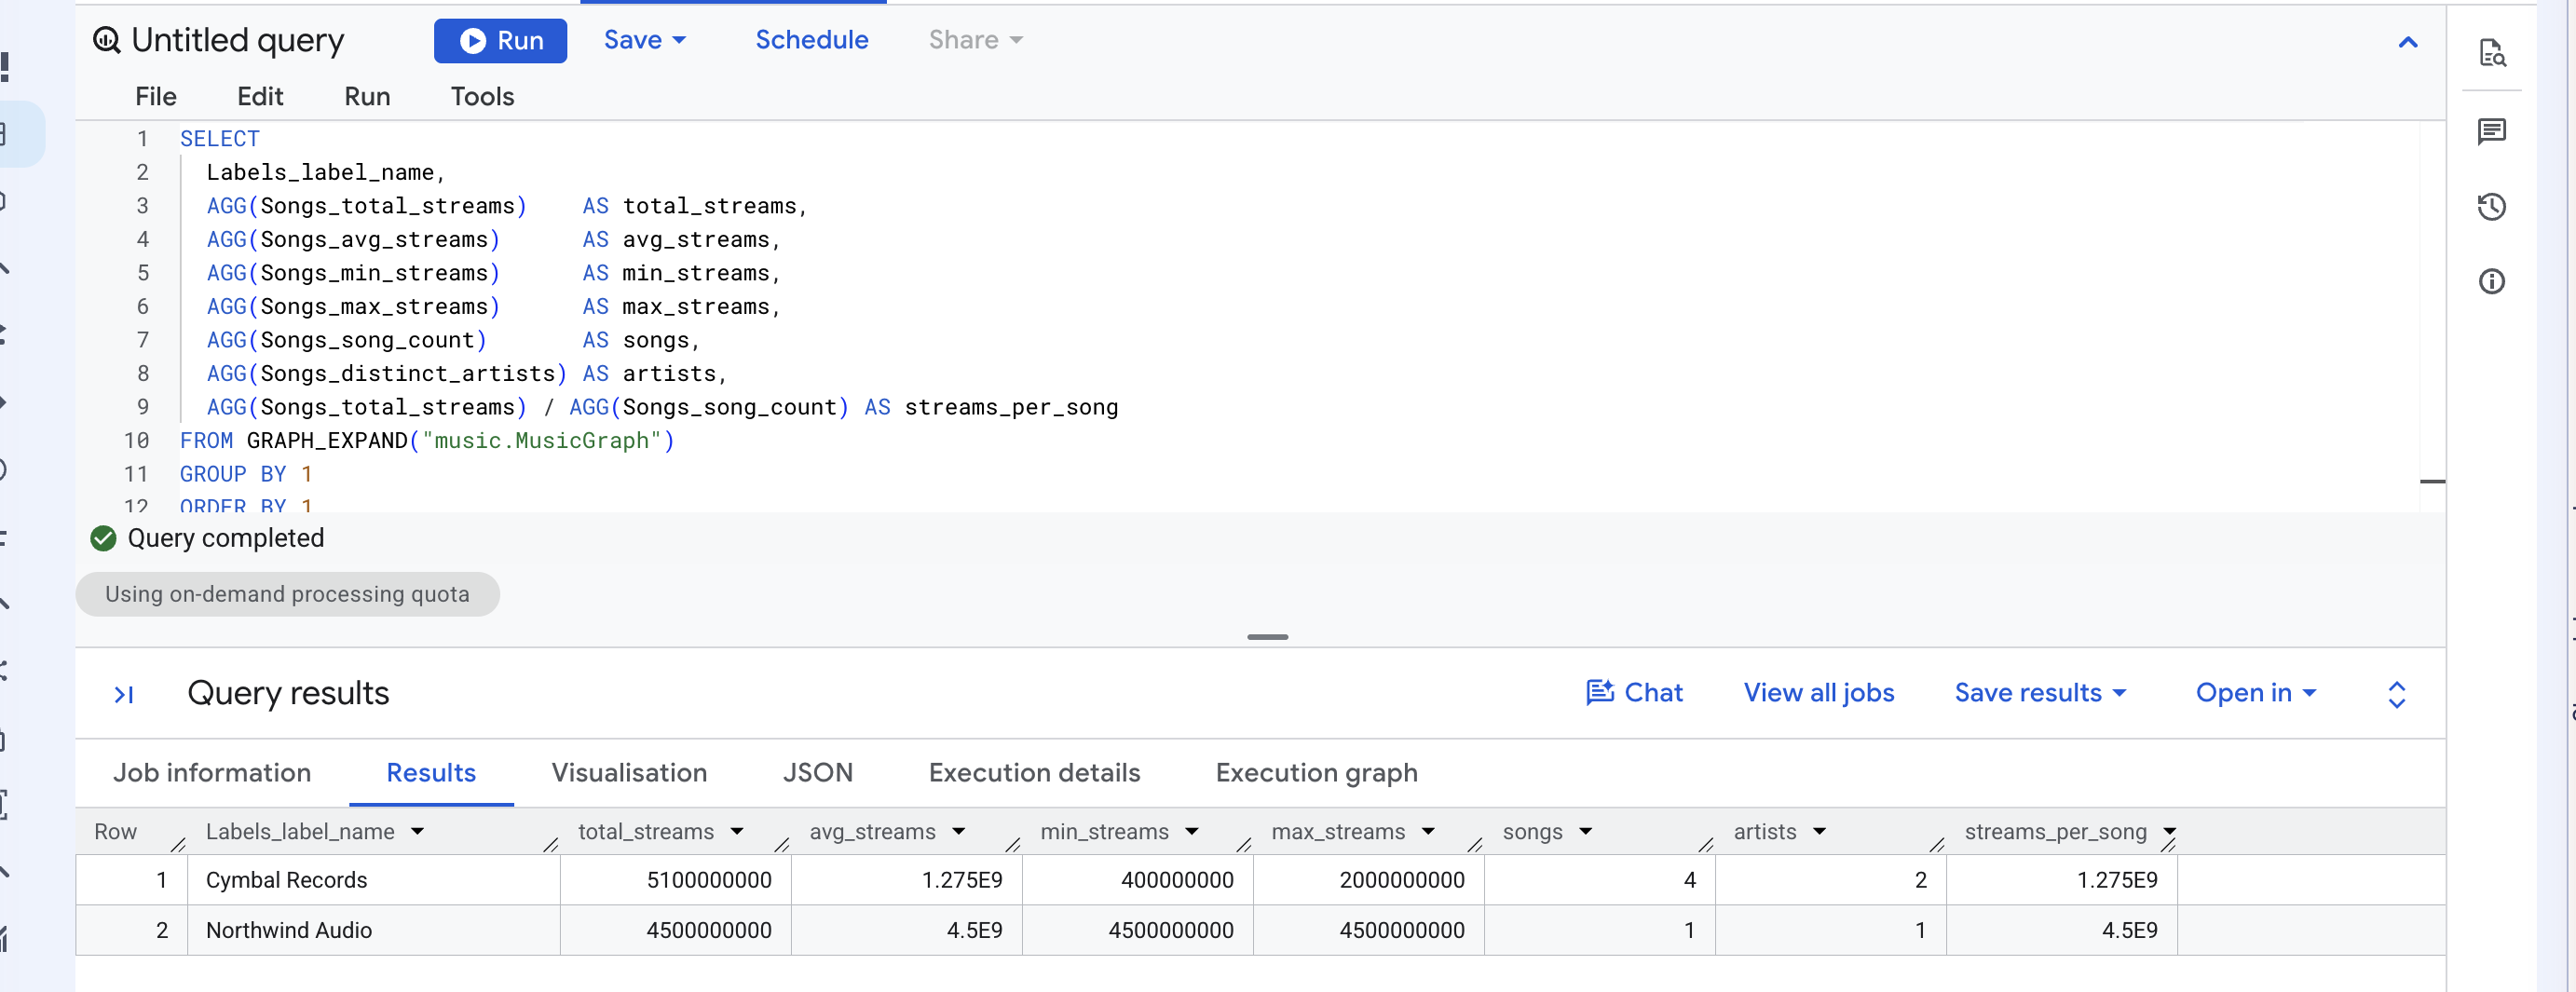
모든 숫자는 10개의 게재위치 행이 아닌 Cymbal의 4곡과 Northwind의 1곡을 기준으로 계산됩니다. 특히 AVG는 다른 방식으로 잘못되었을 것입니다.배치 행에 걸쳐 원시 열을 평균하면 Cymbal의 경우 Neon Summer의 20억이 네 번 계산되므로 15억 7, 500만입니다.
따라서 'SUM을 AGG로 바꾸기'는 실제로 두 가지 결정입니다. 측정값을 선언할 때 6개 집계 중 어떤 집계인지 선택합니다. 측정값을 읽을 때 함수는 항상 AGG입니다.
✅ 검사점: 라벨당 행 하나, 각 행에 숫자 7개, streams_per_song는 avg_streams과 같습니다.
9. 측정이 아닌 그룹화 변경
동일한 측정항목이 다른 질문에 답합니다. 라벨 대신 재생목록별로 그룹화합니다.
👉📋 쿼리 편집기에 붙여넣은 후 실행을 클릭합니다.
SELECT
  Playlists_playlist_name,
  AGG(Songs_total_streams) AS streams,
  AGG(Songs_song_count)    AS songs
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1
ORDER BY 2 DESC
👀 결과:
Playlists_playlist_name | 메시지를 수신할 수 있습니다 | 노래 |
자동차 여행 | 6,900,000,000 | 3 |
Gym Pump | 6,500,000,000 | 2 |
Hot Right Now | 4,700,000,000 | 3 |
라이징 팝 | 3,500,000,000 | 2 |
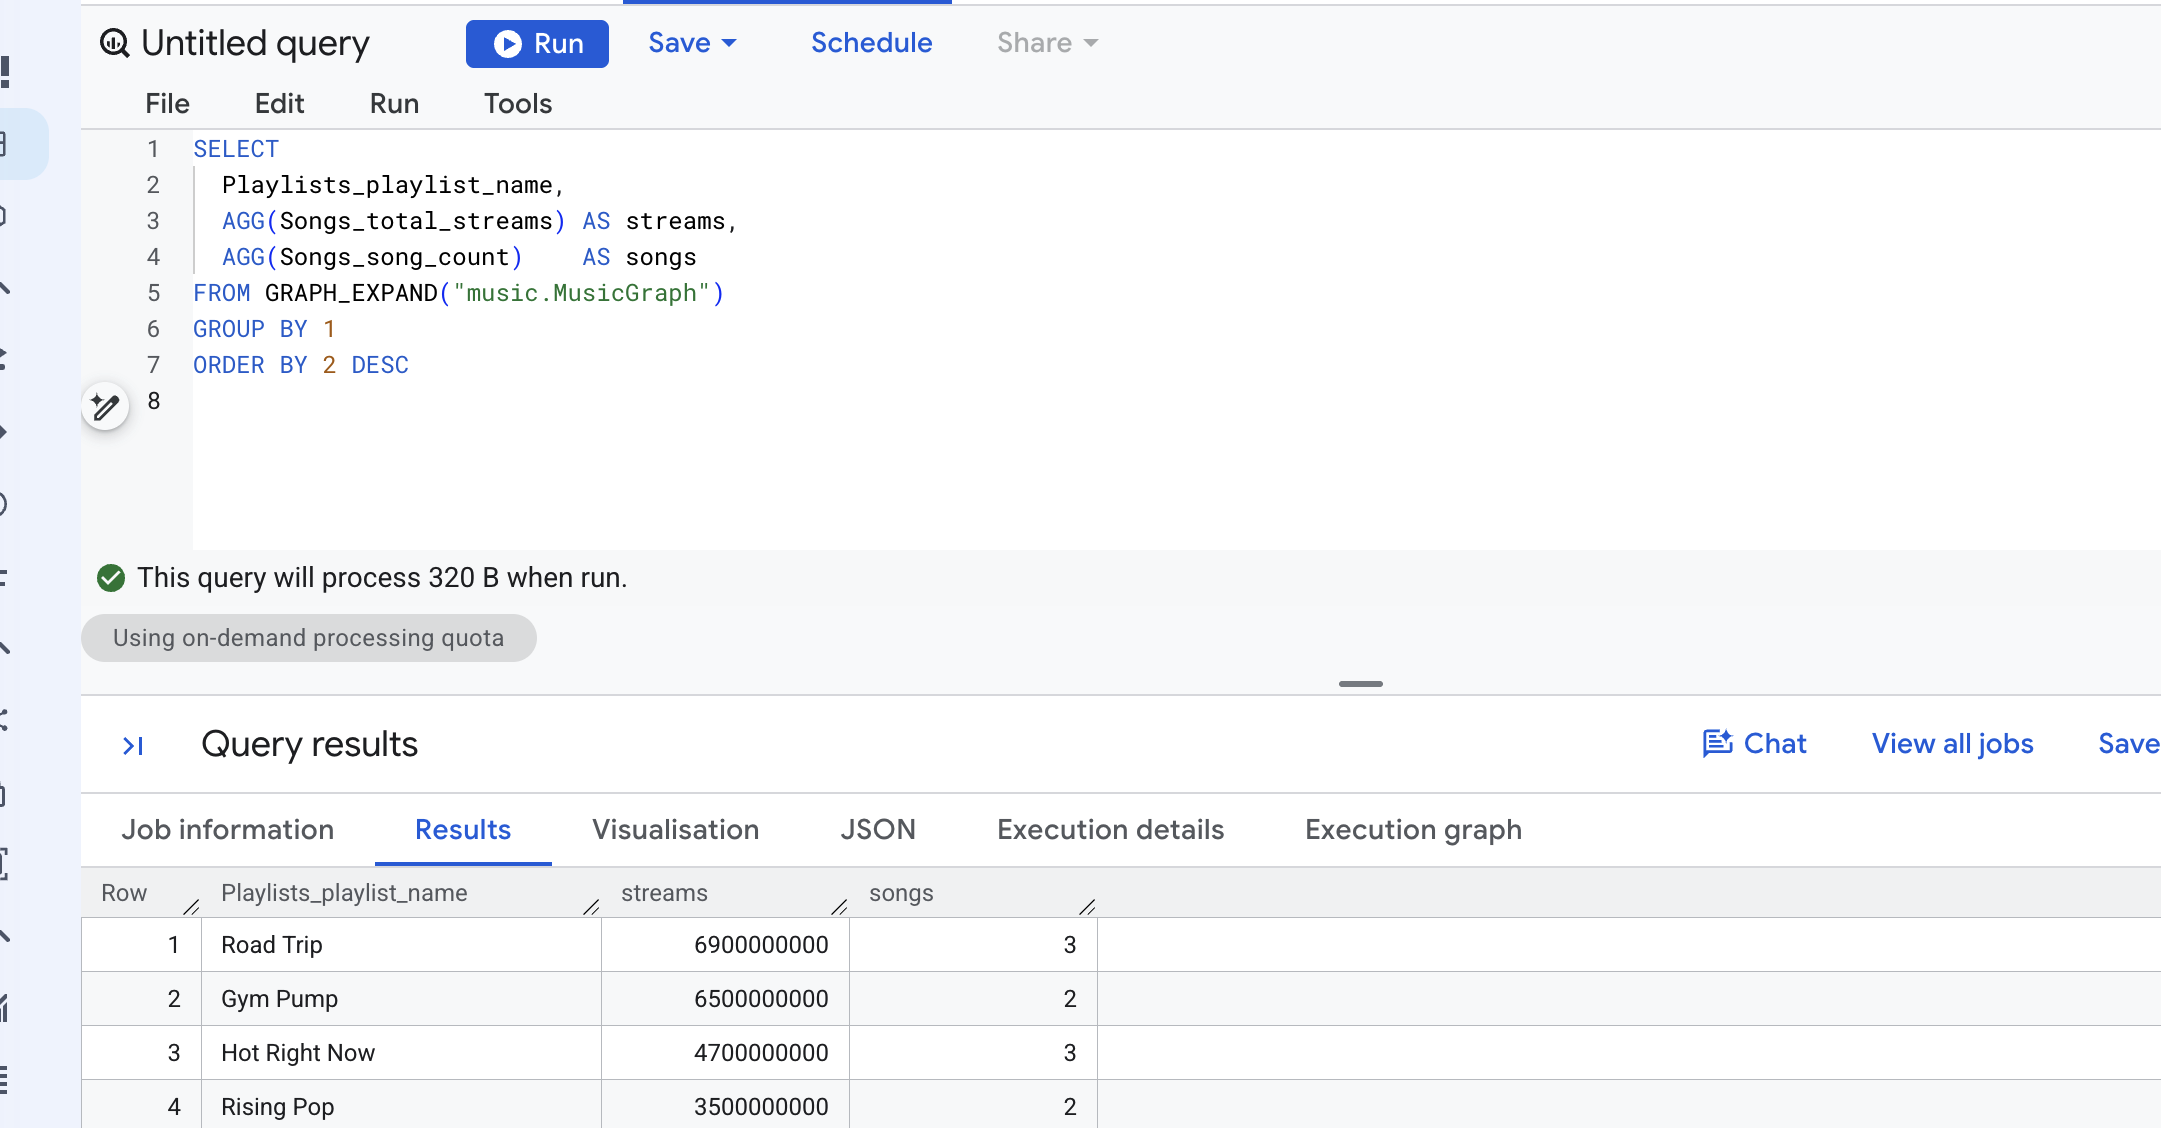
두 AGG 줄은 SUM 및 AGG, 나란히의 줄과 바이트 단위로 동일합니다. GROUP BY만 이동했습니다. Road Trip에는 Neon Summer, Midnight Drive, Slow Arrow가 포함되어 있으며 각 노래는 재생목록 내에서 한 번씩 집계됩니다. 이는 '이 재생목록에 도달한 스트림'의 의미와 정확히 일치합니다.
측정값을 작성한 사람이 한 번 결정한 것입니다. 이후에 다른 사용자가 수행하는 모든 쿼리는 이 값을 상속받습니다.
✅ 체크포인트: Road Trip이 69억으로 1위를 차지했습니다.
10. GRAPH_EXPAND가 제공하는 기능 확인
GRAPH_EXPAND를 실행하여 모양을 확인할 필요는 없습니다. BQ.SHOW_GRAPH_EXPAND_SCHEMA 시스템 프로시저는 열 목록을 변수에 씁니다.
👉📋 쿼리 편집기 — 세 줄을 모두 붙여넣은 후 실행을 클릭합니다.
DECLARE schema STRING DEFAULT '';
CALL BQ.SHOW_GRAPH_EXPAND_SCHEMA('music.MusicGraph', schema);
SELECT schema;
👀 결과는 하나의 JSON 문자열입니다. 각 필드에는 이름, 유형, 모드가 있으며 모든 측정항목 열에는 "is_measure": true가 포함됩니다. 방금 빌드한 그래프의 경우 다음을 비롯한 항목이 표시됩니다.
이름 | 유형 | is_measure | |
Songs_title | 문자열 | ||
Songs_streams | 정수 | ||
Songs_total_streams | 정수 | true | |
Songs_avg_streams | 부동 소수점 수 | true | |
Songs_distinct_artists | 정수 | true | |
PlaylistEntries_placement_count | 정수 | true | |
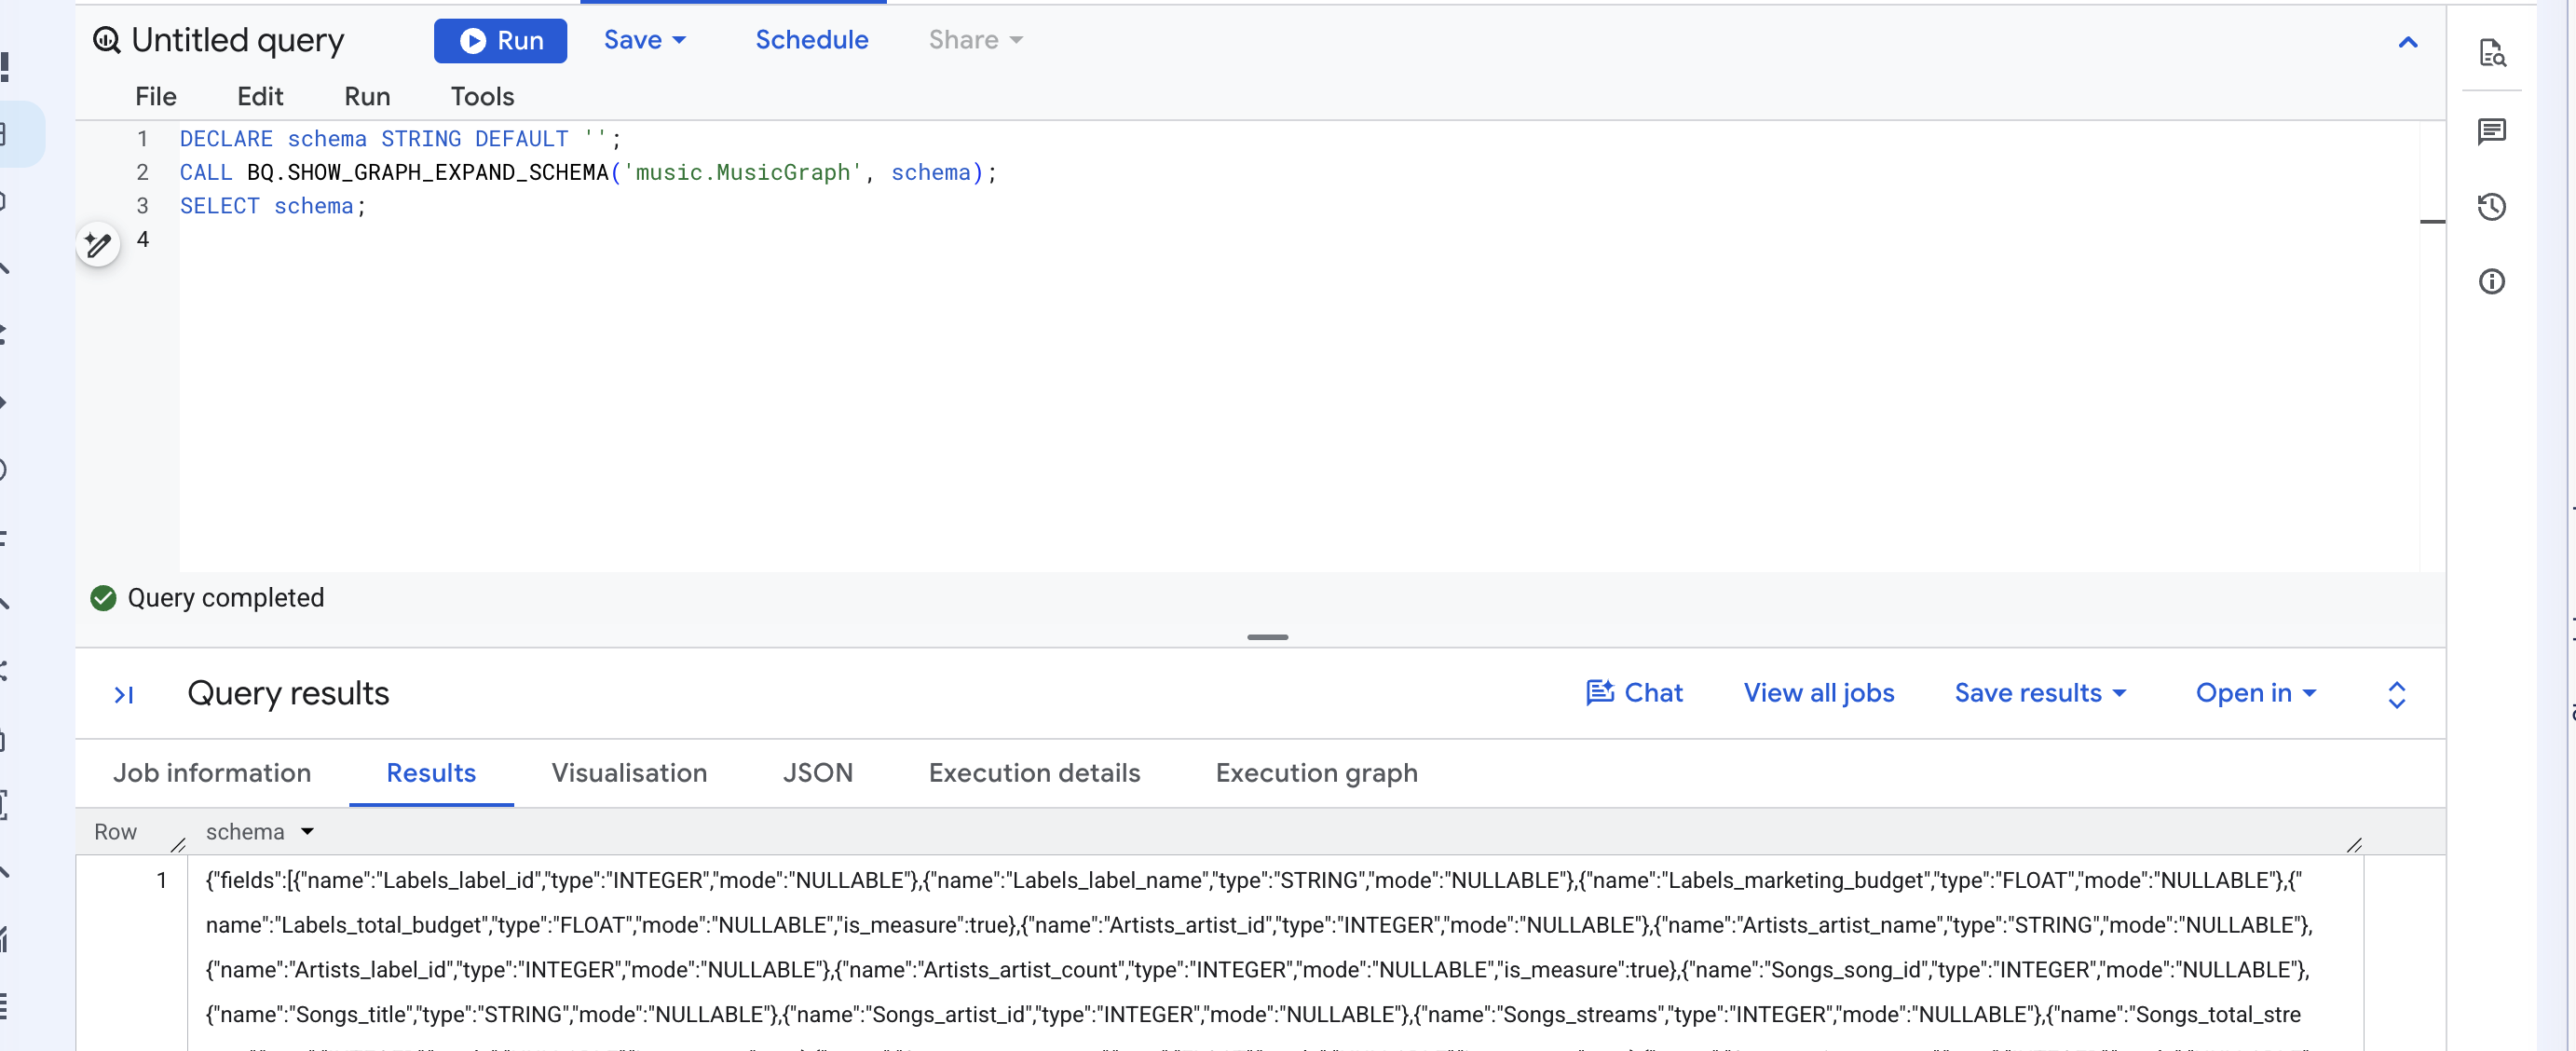
속성에 설정한 설명이나 동의어도 여기에 표시됩니다. 선택사항인 채팅 단계에서는 누가 읽었는지 표시됩니다.
✅ 체크포인트: MEASURE로 선언한 모든 열에 is_measure이 있는 JSON 문자열입니다.
11. 그래프의 모양에서 GRAPH_EXPAND에 필요한 것
이 단계에서는 실행할 것이 없고 읽기만 하면 됩니다. GRAPH_EXPAND는 하나의 테이블에서 시작하여 가장자리를 따라 바깥쪽으로 이동하는 LEFT JOIN 체인으로 와이드 테이블을 빌드합니다. 여기에서 세 가지 규칙이 파생되며 MusicGraph는 이 규칙을 모두 충족합니다.
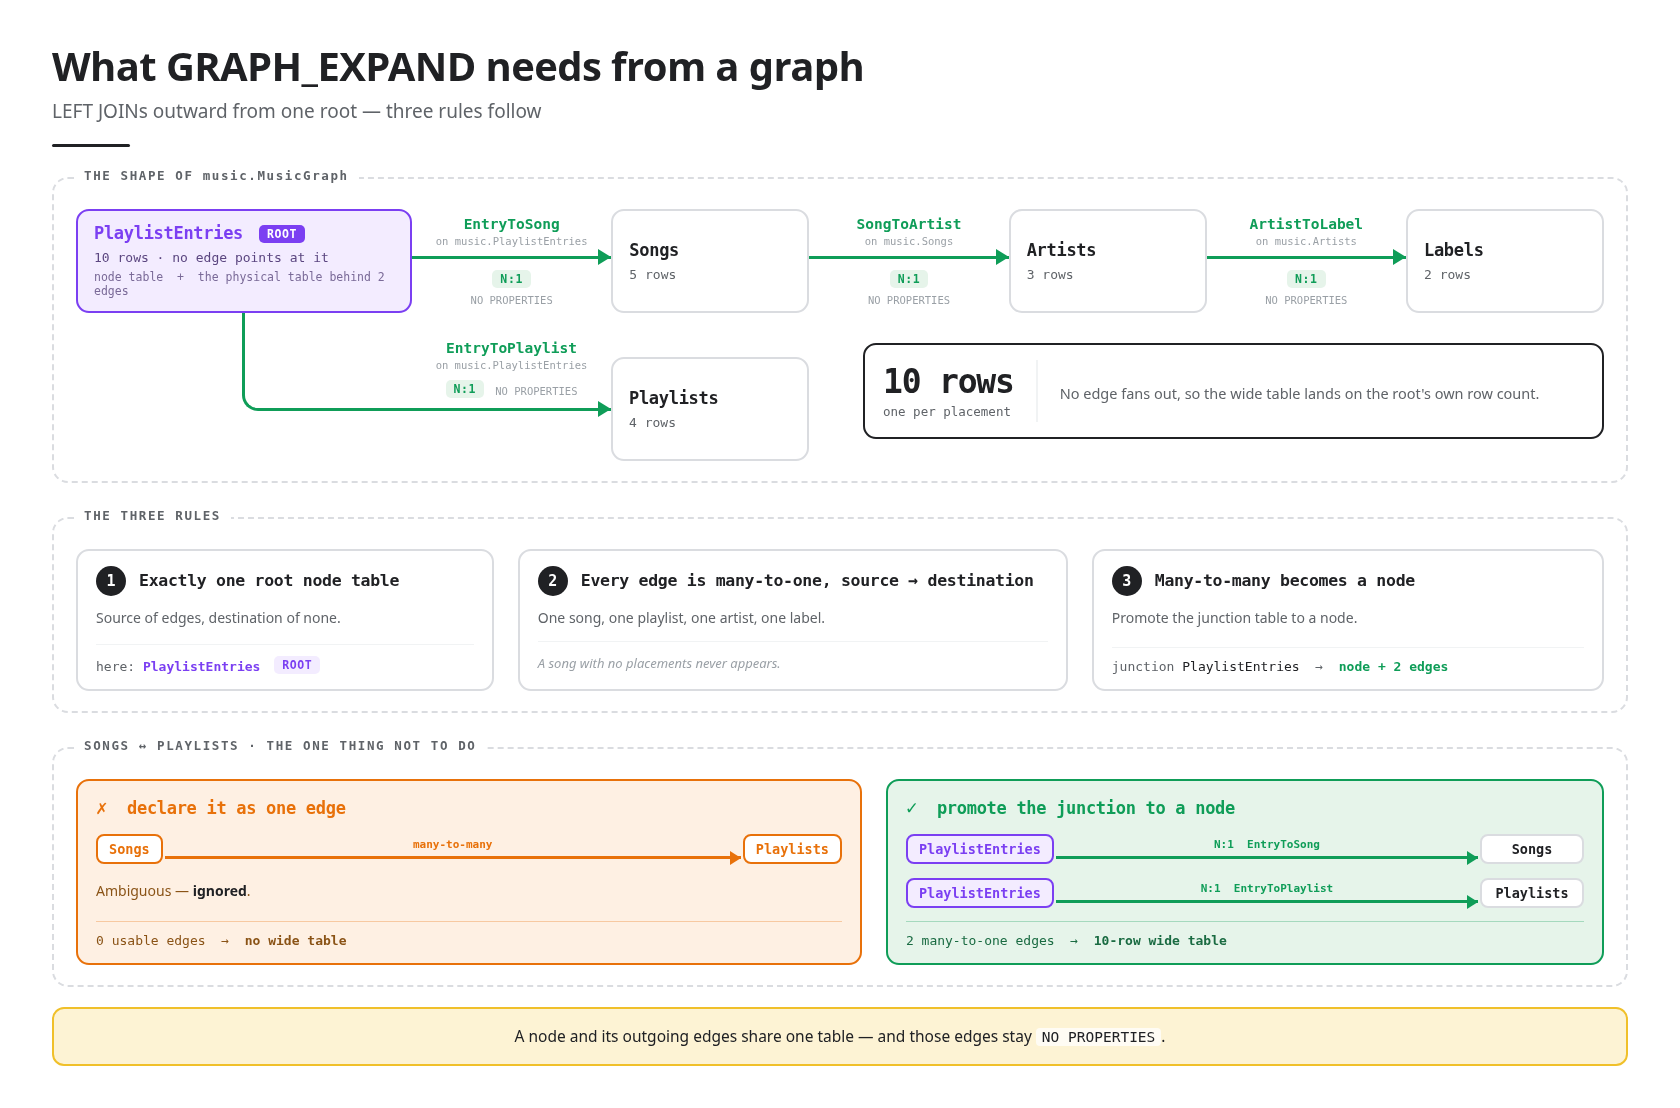
루트 노드 테이블이 정확히 하나 있어야 합니다. 루트는 키가 다른 테이블에 표시되지 않는 노드 테이블입니다. 즉, 에지가 가리키지 않는 테이블입니다. MusicGraph에서 이는 PlaylistEntries입니다. 두 개의 에지의 소스이며 대상은 없습니다. 와이드 테이블에는 게재위치당 하나씩 10개의 행이 있습니다.
모든 에지는 소스에서 대상으로의 다대일입니다. 각 항목에는 노래 하나와 재생목록 하나가 있으며, 각 노래에는 아티스트 하나가 있고, 각 아티스트에는 음반사 하나가 있습니다. 따라서 넓은 표는 루트의 자체 행을 넘어 확장되지 않습니다. 루트가 도달할 수 없는 데이터는 표시되지 않습니다. 예를 들어 배치되지 않은 노래는 와이드 테이블에서 누락됩니다.
다대다 관계가 노드가 됩니다. 노래와 재생목록은 다대다 관계입니다. 접합 테이블을 노래에서 재생목록으로의 단일 에지로 선언하면 GRAPH_EXPAND이 모호한 것으로 간주하여 무시하고, 사용할 수 있는 에지가 남지 않아 실패합니다. PlaylistEntries를 다대일 에지가 두 개인 노드 테이블로 승격하는 것이 문서화된 패턴이며 그래프를 빌드할 때 이 패턴을 사용했습니다.
12. (선택사항) GQL을 사용한 경로
지금까지 모든 질문에는 답변에 숫자가 포함되어 있습니다. 이 경우엔 그렇지 않습니다. Cymbal의 스트림이 청취자에게 도달하는 곳은 어디인가요?는 그래프를 통과하는 경로에 관한 질문이며, 합계로는 답변할 수 없습니다. 합계를 구하는 시점에는 경로가 사라지기 때문입니다.
1. 스트림이 어디에 표시되는지 묻기
👉📋 쿼리 편집기에 붙여넣은 후 실행을 클릭합니다.
GRAPH music.MusicGraph
MATCH (l:Labels)<-[:ArtistToLabel]-(a:Artists)<-[:SongToArtist]-(s:Songs)
      <-[:EntryToSong]-(e:PlaylistEntries)-[:EntryToPlaylist]->(pl:Playlists)
WHERE l.label_name = 'Cymbal Records'
RETURN pl.playlist_name, pl.followers,
       SUM(s.streams) AS streams_reaching_this_playlist,
       STRING_AGG(s.title, ', ') AS songs
GROUP BY pl.playlist_name, pl.followers
ORDER BY streams_reaching_this_playlist DESC
👀 예상되는 재생목록 4개:
pl.playlist_name | pl.followers | streams_reaching_this_playlist | 노래 |
Hot Right Now | 35,000,000 | 4,700,000,000 | 더블 샷, 네온 여름, 종이 왕관 |
라이징 팝 | 2,000,000 | 3,500,000,000 | Neon Summer, Paper Crown |
자동차 여행 | 5,000,000 | 2,400,000,000 | 네온 서머, 느린 화살표 |
Gym Pump | 3,000,000 | 2,000,000,000 | Neon Summer |
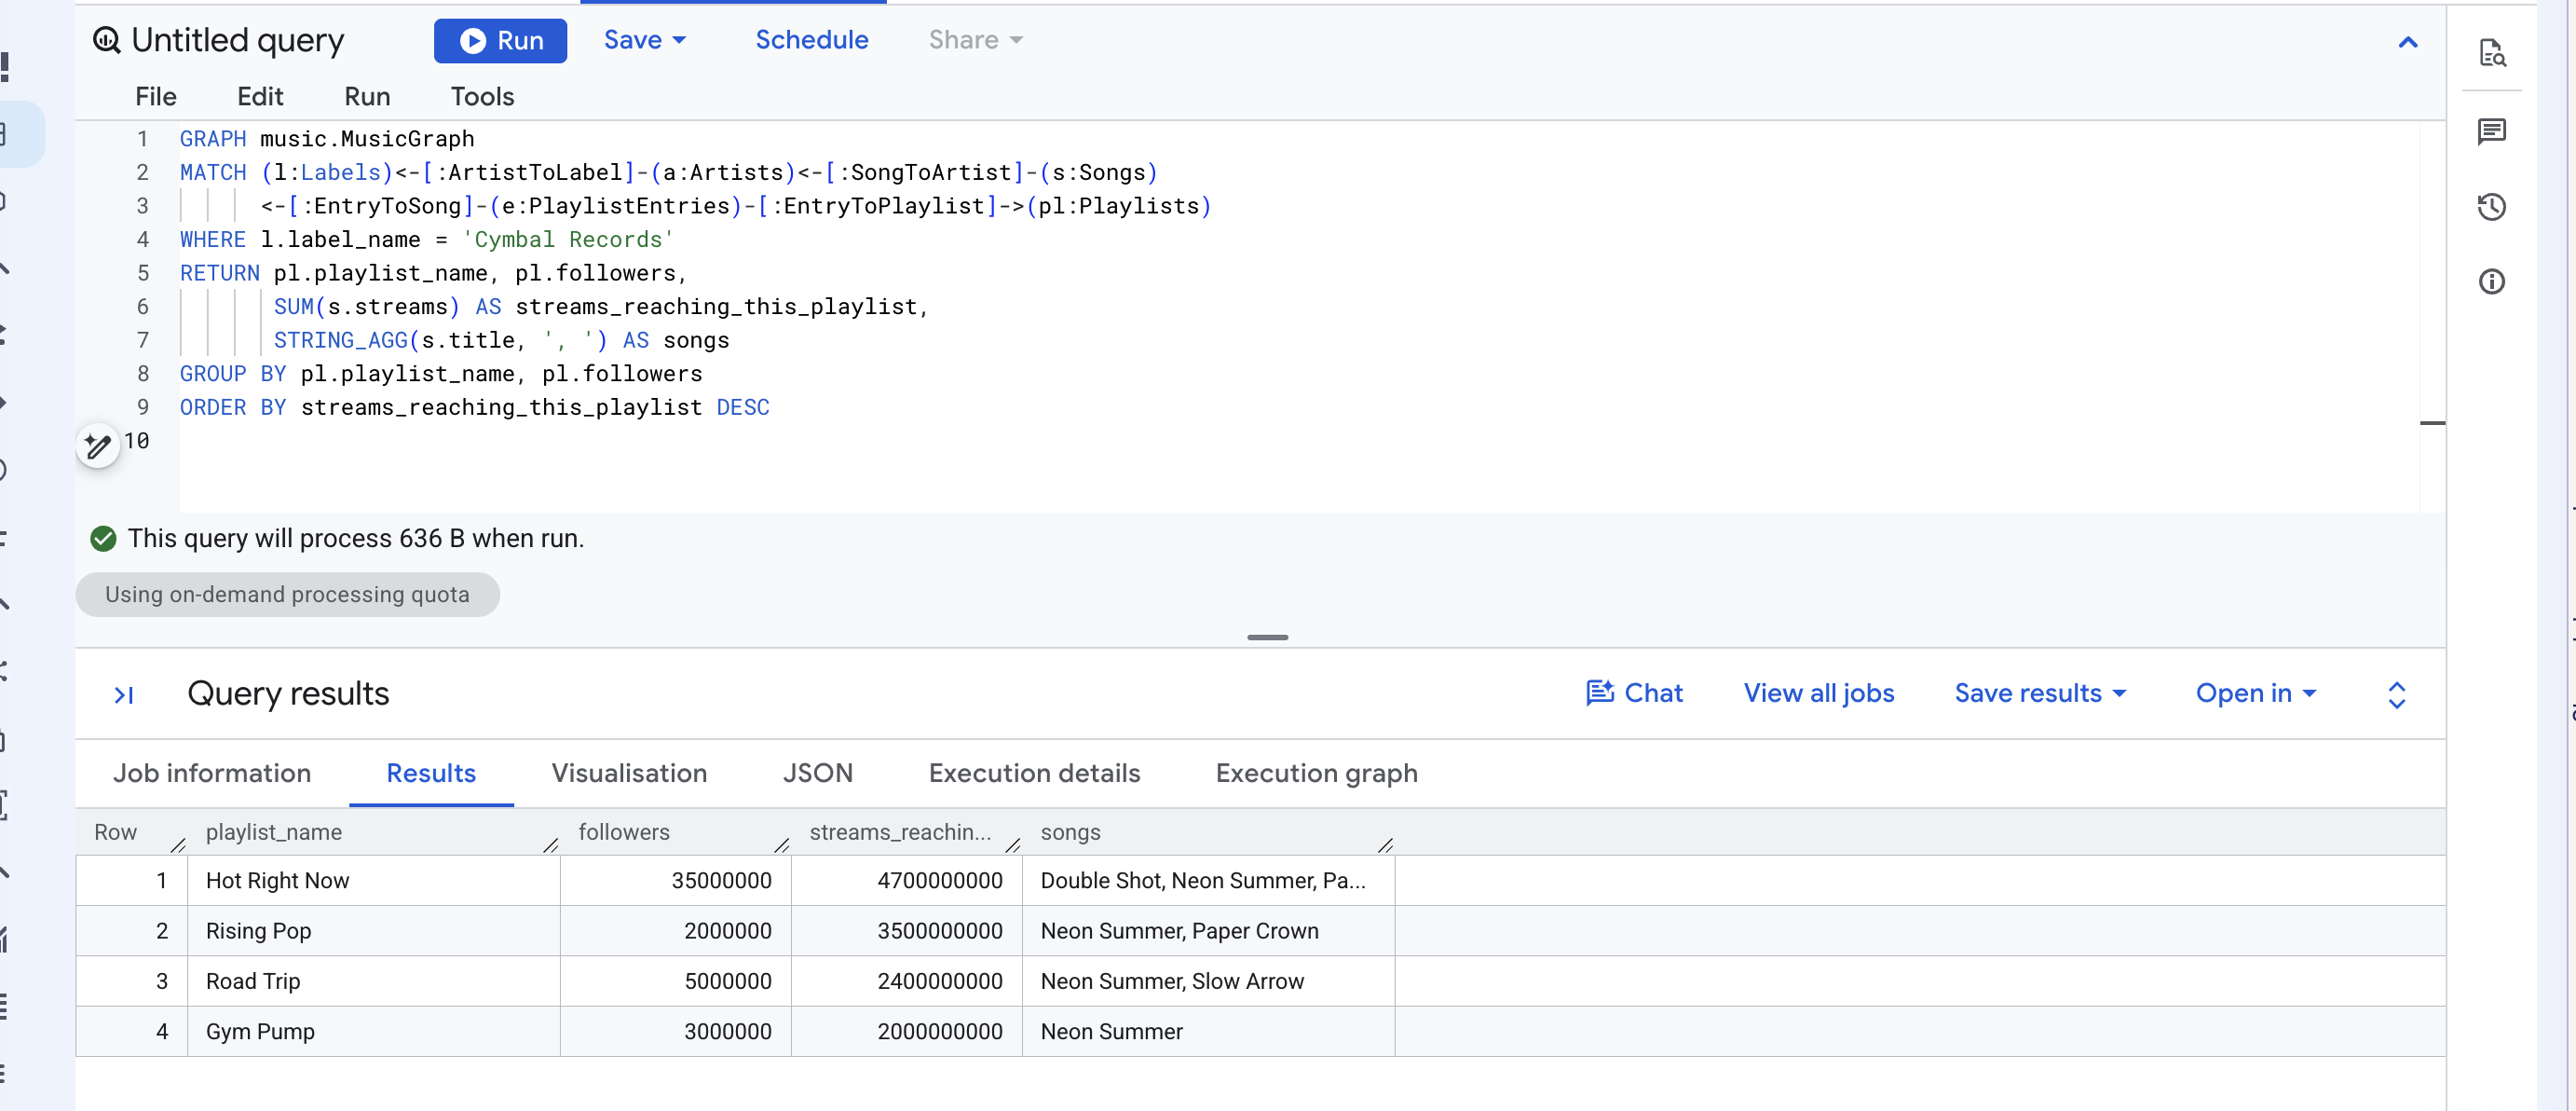
MATCH 줄을 문장으로 읽습니다. 라벨에서 시작하여 아티스트로 돌아가고, 아티스트에서 노래로 돌아가고, 노래에서 노래가 포함된 재생목록 항목으로 돌아간 다음 재생목록으로 이동합니다. 화살표는 가장자리가 선언된 방향을 가리키고 <-는 뒤로 한 번 이동합니다.
이제 세 번째 열을 더합니다. 126억 - 4단계에서 SUM가 알려준 잘못된 숫자입니다.
여기 있습니다. 당시에는 Cymbal에서 스트리밍된 횟수가 문제였으며, 노래가 포함된 재생목록의 수와 관계없이 노래는 한 번만 집계되었습니다. 이 질문은 스트림이 도달하는 위치에 관한 것이며, 4개의 재생목록에 있는 노래는 실제로 4명의 시청자에게 도달합니다. GRAPH_EXPAND에서 생성된 중복은 한 질문에 대한 오류이고 다른 질문에 대한 답변입니다. AGG는 중복이 나쁘다는 것이 아니라 질문에 맞는 산술을 수행하는 것이었습니다.
2. 경로 자체를 반환합니다.
집계를 삭제하고 경로를 요청합니다.
👉📋 쿼리 편집기에 붙여넣은 후 실행을 클릭합니다.
GRAPH music.MusicGraph
MATCH p = (l:Labels)<-[:ArtistToLabel]-(a:Artists)<-[:SongToArtist]-(s:Songs)
          <-[:EntryToSong]-(e:PlaylistEntries)-[:EntryToPlaylist]->(pl:Playlists)
WHERE l.label_name = 'Cymbal Records'
RETURN TO_JSON(p) AS path
p =는 전체 일치 항목의 이름을 지정하고 TO_JSON는 이를 렌더링합니다.
👀 행 8개, path 열 1개가 예상됩니다. 각 셀은 하나의 경로를 따라 있는 노드와 에지의 JSON 배열이며, 각 노드는 labels 및 properties를 전달합니다.
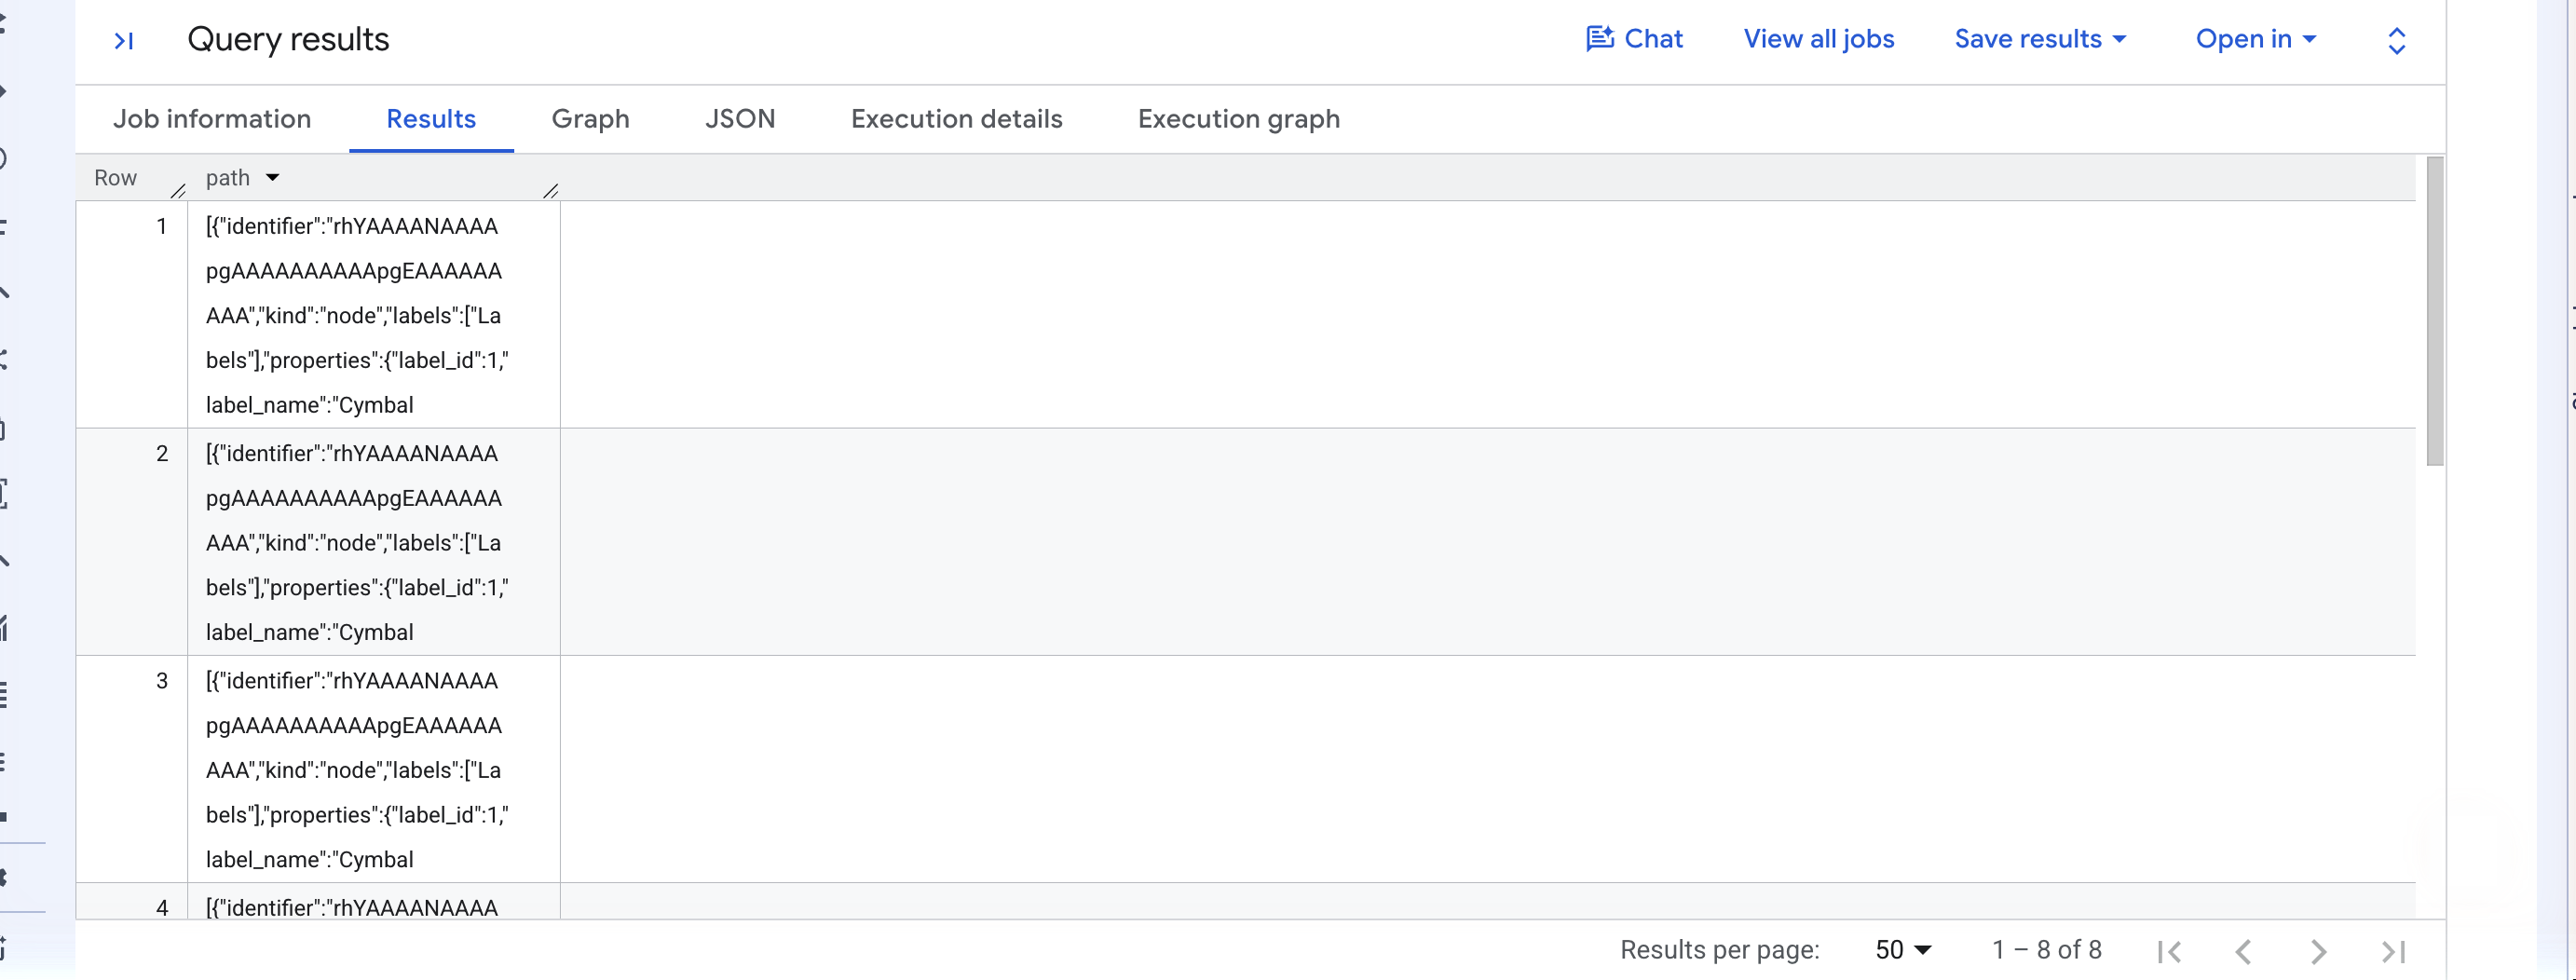
노래별이 아닌 게재위치별로 경로가 있으므로 노래 4곡에 대해 8개의 행이 있습니다.
3. 그래프 탭 열기
👉🌐 콘솔 — 결과 위에 있는 그래프를 클릭합니다.
이 탭은 결과에 그래프 요소가 포함된 경우에만 표시됩니다. 이전 쿼리는 숫자를 반환했으므로 그래프 탭이 없었지만 이 쿼리는 경로를 반환하므로 그래프 탭이 있습니다.
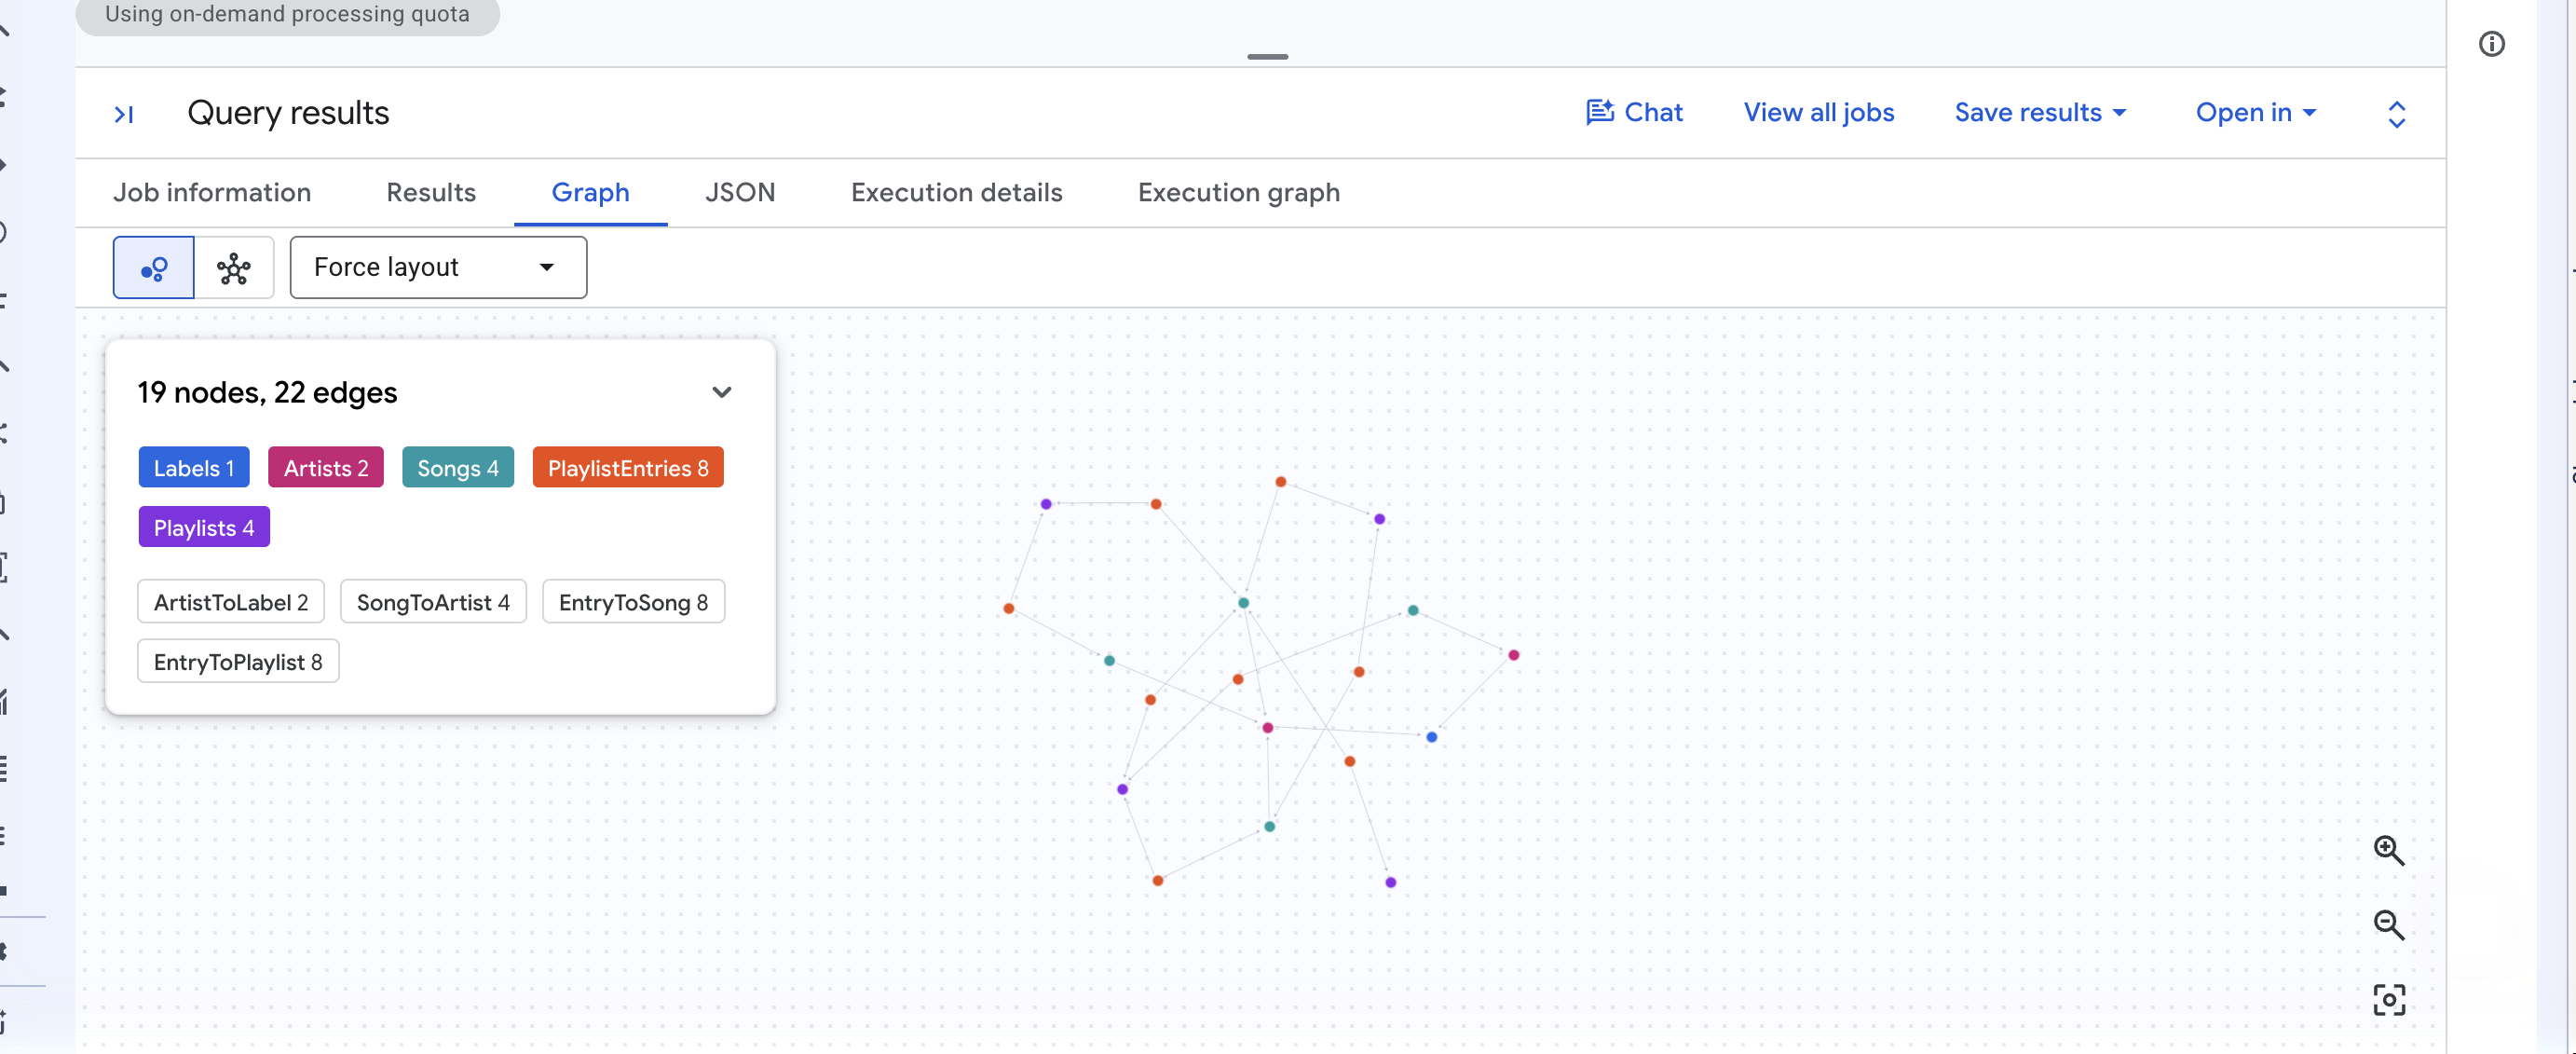
Cymbal의 그래프 모서리가 강제 레이아웃으로 그려지고, 노드와 에지의 수가 뷰에 표시되며 라벨당 칩이 표시됩니다. 노드를 드래그하여 레이아웃을 분리하고 노드를 클릭하여 속성을 읽습니다.
✅ 체크포인트: 첫 번째 쿼리의 세 번째 열의 합계는 126억이고, 두 번째 쿼리는 8개의 경로를 반환하며, 그래프 탭에 경로가 그려집니다.
13. (선택사항) 그래프와 채팅하기
이 단계에는 SQL이 없습니다. BigQuery 데이터 에이전트는 그래프를 지식 소스로 사용할 수 있으며, 문서에 따르면 다단계 집계에 측정치를 사용합니다. 사실인지 확인해 보겠습니다.
1. 에이전트 만들기
👉🌐 콘솔 — 왼쪽의 BigQuery 탐색 메뉴에서 에이전트, 에이전트 카탈로그, 에이전트 만들기를 차례로 클릭합니다.
👉🌐 콘솔 — 에이전트 이름에 Music graph agent를 입력하고 에이전트 설명에 다음을 입력합니다.
Ask questions about labels, artists, songs and playlists in the music property graph.
👉🌐 콘솔 — 지식 소스에서 소스 추가를 클릭합니다. 소스 선택 대화상자에서 프로젝트를 펼치고 music를 펼치고 그래프를 펼치고 MusicGraph를 선택하고 확인을 클릭합니다.
👀 소스 추가 버튼이 회색으로 표시됩니다. 에이전트는 그래프를 최대 1개까지 보유할 수 있으며 그래프와 표를 혼합할 수 없습니다.
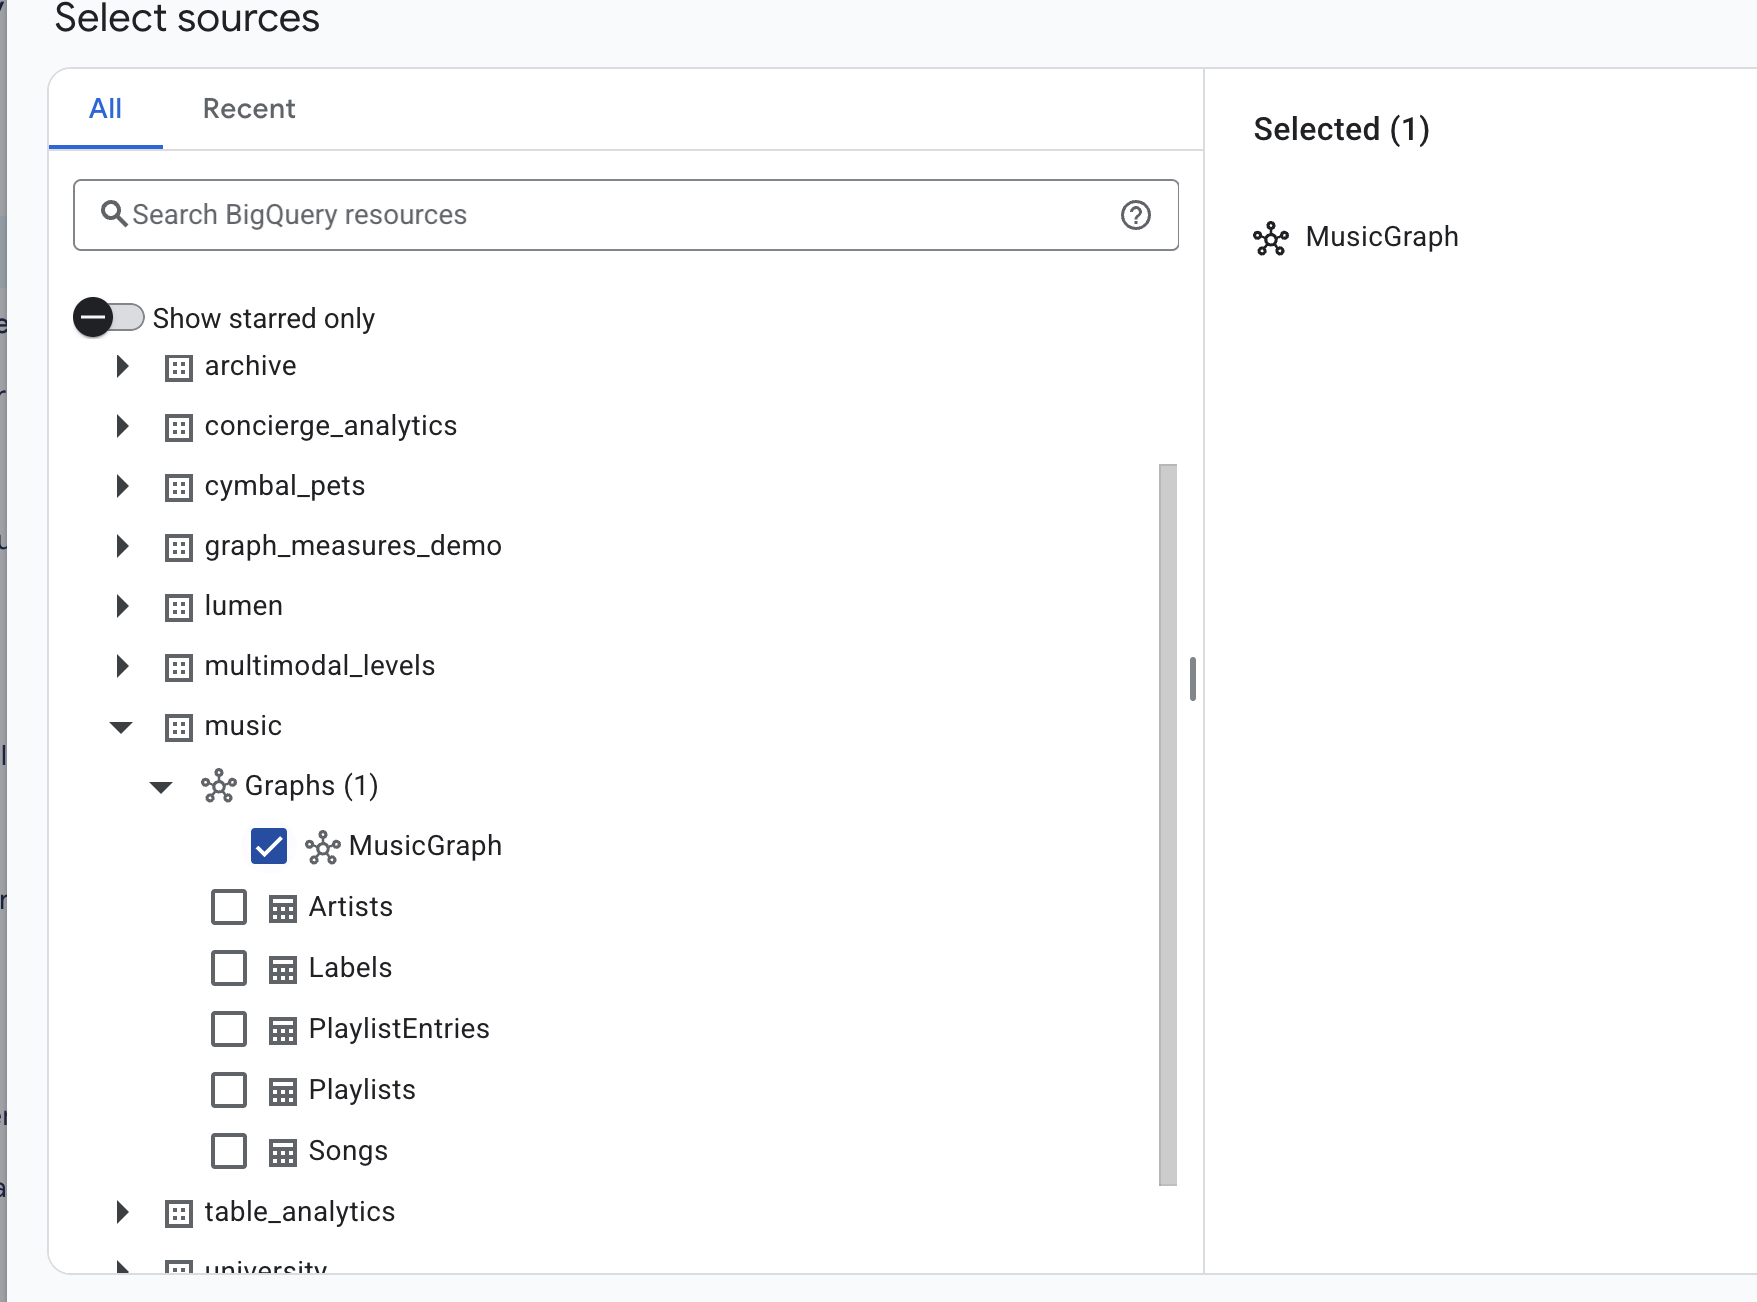
👉🌐 콘솔 - 그래프의 위치에서 설정된 대로 리전을 그대로 둡니다. 저장을 클릭한 다음 게시를 클릭합니다. 게시 채널 패널에서 에이전트 게시를 클릭하고 확인을 닫습니다.
2. 질문
👉🌐 콘솔 — 대화 만들기를 클릭합니다. 채팅 페이지가 열립니다. 하단의 질문하기 상자에 다음을 입력하고 Enter 키를 누릅니다.
For each label, show total streams and how many playlists their songs are on
👀 에이전트가 표와 한 문장 요약을 반환합니다.
label_name | total_streams | playlist_placements |
Cymbal Records | 5,100,000,000 | 8 |
Northwind Audio | 4,500,000,000 | 2 |
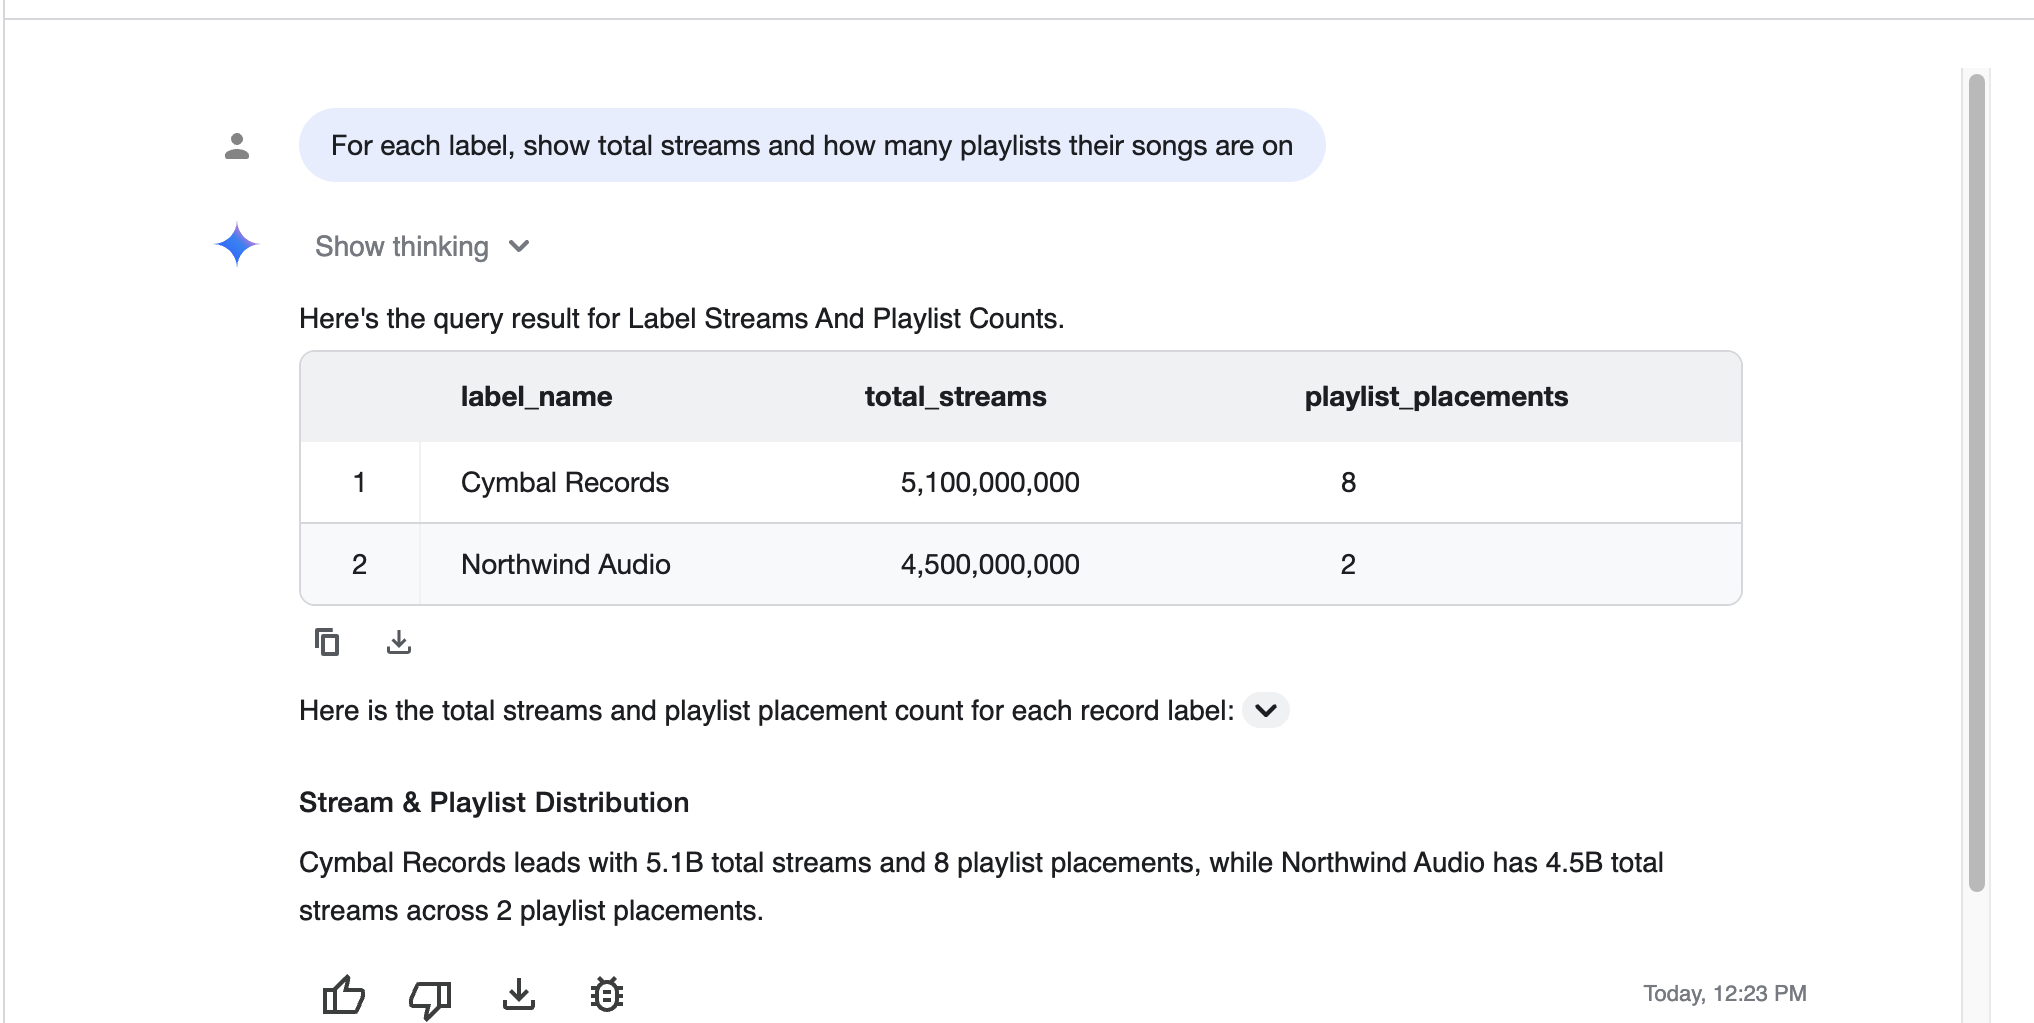
51억 아무도 에이전트에게 팬아웃에 대해 알려주지 않았고 팬아웃에 해당하지도 않았습니다.
3. 작성된 질문 읽기
👉🌐 콘솔 - 탐색 메뉴에서 작업 탐색기를 클릭하고 최신 작업을 클릭합니다. 라벨에는 에이전트 ID가 포함된 ca-bq-job: true 및 data-agent-id이 포함되며 쿼리는 다음과 같습니다.
SELECT
  Labels_label_name AS label_name,
  AGG(Songs_total_streams) AS total_streams,
  AGG(PlaylistEntries_placement_count) AS playlist_placements
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY label_name
ORDER BY total_streams DESC
측정항목이 읽은 스키마에 있었기 때문에 GRAPH_EXPAND 및 AGG를 자체적으로 사용했습니다. 에이전트 설명에 언급되지 않습니다.
✅ 체크포인트: 채팅 대답에 51억, 작업의 SQL에 AGG(...)
14. 삭제
👉💻 Cloud Shell - 데이터 세트, 테이블, 속성 그래프를 삭제합니다.
cd ~/bq-graph-measures-lab
./cleanup.sh
👀 ✓ dropped YOUR_PROJECT_ID.music (tables and graph)을 예상합니다.
선택적 데이터 에이전트를 만든 경우 콘솔의 에이전트 → 에이전트 카탈로그에서 삭제합니다. ./setup_project.sh가 이 실습만을 위한 프로젝트를 생성한 경우 모든 항목을 가장 깔끔하게 정리하려면 전체 프로젝트를 종료하면 됩니다. ID는 ~/project_id.txt에 있습니다.
15. 축하합니다
MEASURE(SUM(streams)) 한 줄을 선언하면 126억이 51억으로 변경됩니다. 이는 나뿐만 아니라 에이전트가 작성한 쿼리를 포함하여 이후에 누군가 해당 그래프에 대해 작성하는 모든 쿼리에 적용됩니다.
학습한 내용
- 측정값은 그레인을 설정하는
KEY옆에 노드에 선언된 집계입니다. GRAPH_EXPAND는 그래프를TableLabel_property열이 있는 하나의 넓은 테이블로 평면화합니다.AGG는 측정값을 읽는 유일한 함수이며, 유형 시스템은 네 가지 다른 방식으로 이를 적용합니다.- 6개의 집계를 사용할 수 있으며
AGG결과는 나눌 수 있는 일반 값입니다. GROUP BY을 변경하면 측정값을 건드리지 않고 질문이 다시 표시됩니다.GRAPH_EXPAND는 하나의 루트, 다대일 에지, 노드로 승격된 접합부를 원합니다.
결정 테이블
증상 | 원인 | 수정 |
합계가 너무 큼 |
| 측정항목을 선언하고 |
'측정값이 필요하나 INT64가 발견됨' | 일반 열의 |
|
'측정 유형의 표현식 반환은 허용되지 않습니다.' |
| 래핑: |
'요소 유형에 의해 노출되지 않음' | GQL에서 참조되는 측정항목 |
|
| 교차로가 가장자리로 모델링됨 | 접합 테이블을 노드로 승격 |
그래프를 변경한 후의 이전 번호 | 캐시된 결과 | 캐시 처리된 결과 사용을 선택 해제합니다. |
의도적으로 다루지 않은 내용
속성의 설명 및 동의어, 데이터 에이전트의 검증된 쿼리 및 용어집, MATCH 하나 이상의 GQL, 그래프가 두 개 이상인 측정값 각각은 자체 실습입니다.
자세히 알아보기
- 측정값 사용하기
- 속성 그래프 만들기 및 쿼리하기
- 대화 분석 개요
- 실습 저장소 - 이 Codelab의 모든 쿼리(단계별 번호 지정)