

1. 概览
大多数通过代码审核的 SQL bug 都是聚合 bug。某个数字在它所在的表格中是正确的,但联接会复制该数字,导致总数错误。
借助 BigQuery Graph,您可以一次性将表的连接方式描述为属性图,然后查询这些连接。图表指标会在该说明中再添加一项内容:汇总本身。您可以在拥有该数字的节点上声明 MEASURE(SUM(streams)),这样一来,读取图表的每个查询都会获得正确的总数(以正确的粒度),而无需使用 GROUP BY 技巧,也无需使用有人必须记住的 CTE。
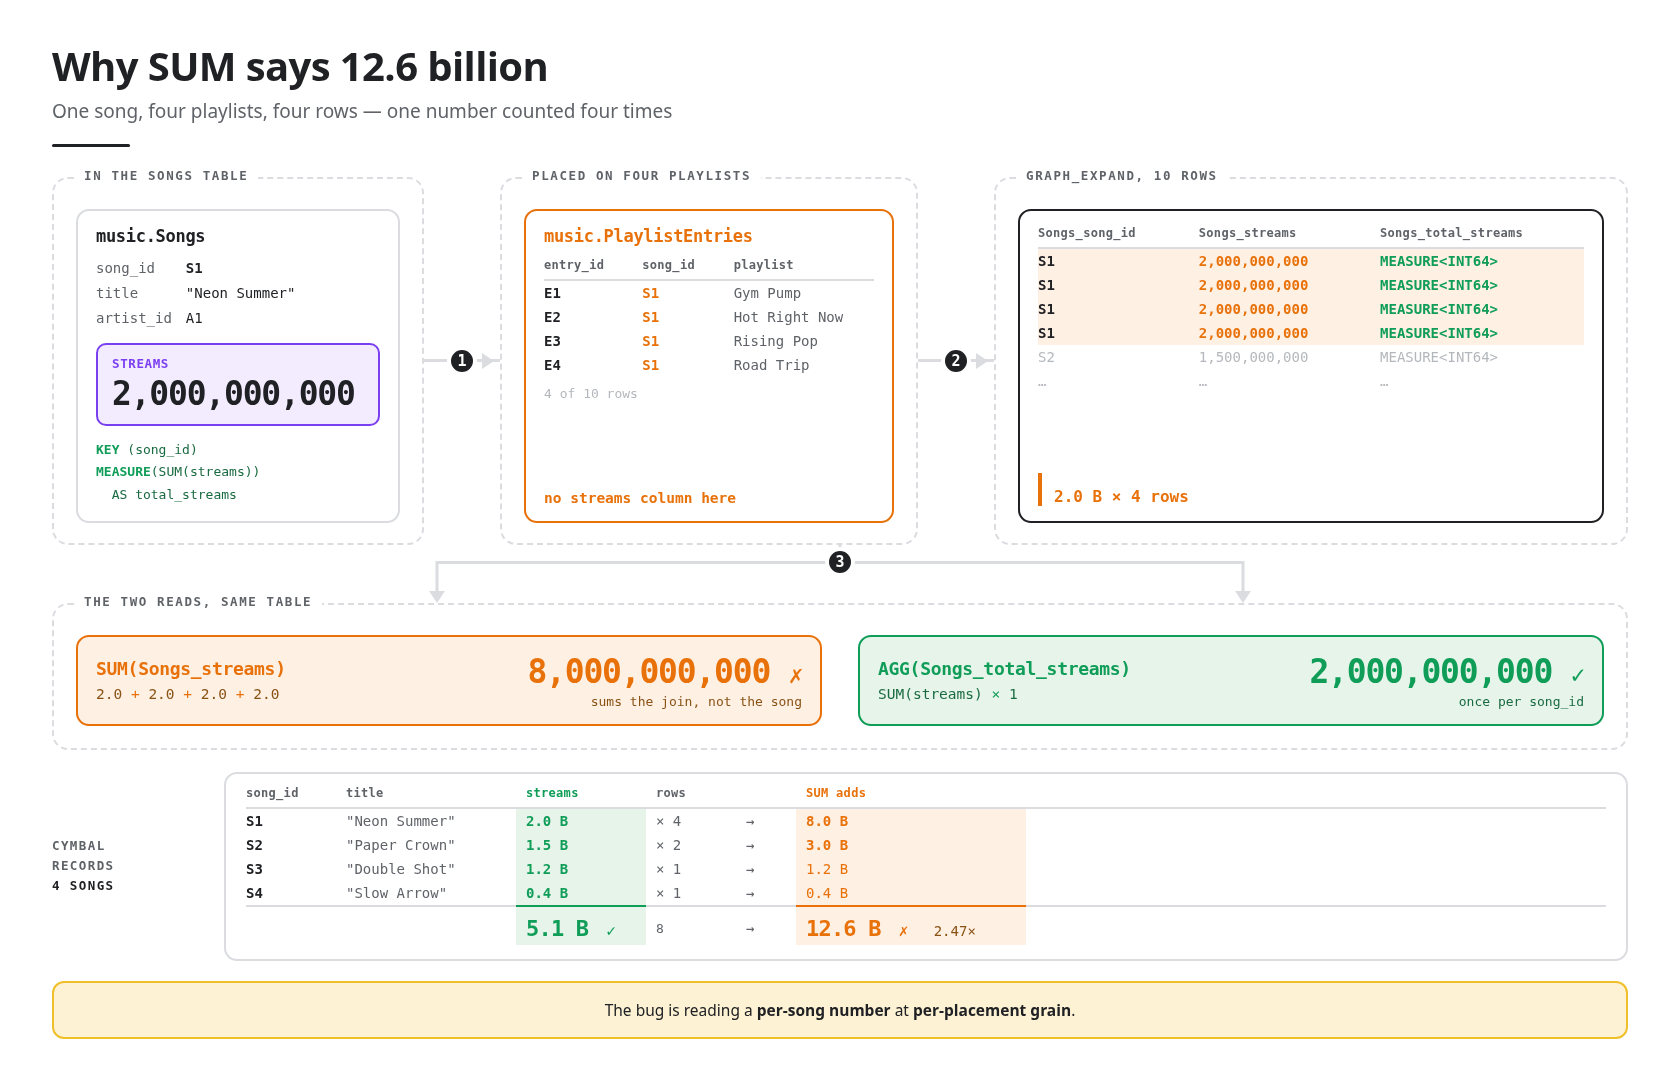
在此 Codelab 中,您将构建一个包含五张表的音乐目录,在其中放置一个衡量指标,并观察同一问题返回两个不同的答案:使用 SUM 时为 126 亿,使用 AGG 时为 51 亿。差额是目录的形状 - 一首位于四个播放列表中的歌曲在图表扁平化后会变成四行,而 SUM 会添加所有这四行。然后,您会学习使第二个句子正确的规则。
您将在此处输入内容
本实验使用以下两个位置(按此顺序):
其中 | 您在那里做什么 | |
1 | Cloud Shell 终端 | 在设置步骤中,仅使用少量命令 |
2 | BigQuery 控制台 | 其他所有操作:将查询粘贴到查询编辑器中、点击浏览图表建模器、与代理聊天 |
每条指令都带有标记,以便您随时了解其含义:
- 👉💻 Cloud Shell - 在 Cloud Shell 终端中输入此命令。
- 👉📋 查询编辑器 - 将此内容粘贴到 BigQuery 查询编辑器中,然后点击运行。
- 👉🌐 控制台 - 在 BigQuery 控制台中随意点击。除非相应步骤要求,否则无需输入任何内容。
- 👀 - 查看结果。
学习内容
- 如何在节点表上声明度量 - 在可视化图表建模工具中或在 SQL 中
GRAPH_EXPAND如何将图展平为一个宽表- 为什么
AGG是唯一可以读取指标的函数,以及其他所有尝试的返回结果 - 衡量指标支持的六种汇总方式,以及如何对这些汇总方式进行算术运算
- 一个指标如何回答分组不同的问题(无需更改)
- 可选:GQL 和“图”标签页如何回答总计无法回答的问题,以及 BigQuery 数据智能体如何在未被告知的情况下使用您的度量
所需条件
- 具有有效结算功能的 Google 账号和浏览器。您无需预先创建 Google Cloud 项目,设置过程会为您创建一个。
- 仅针对可选的聊天步骤:已启用 Gemini Data Analytics API,并且拥有 Gemini Data Analytics Data Agent Creator 角色。
无需在机器上安装任何内容。所有操作都在 Cloud Shell 和 BigQuery 控制台中运行。
商品状态和费用
BigQuery Graph 现已正式发布。图表度量、可视化图表建模工具、图表可视化和使用图表作为数据代理知识来源的功能处于预览状态,受非正式版产品使用条款约束。
GRAPH_EXPAND 和 AGG 按按需价格运行。根据文档,GQL 查询(可选路径步骤)需要使用企业版或企业 Plus 版的预留,这也是该步骤为可选的原因。
数据集的大小为几千字节。在按需价格模式下,每次查询的最低结算数据量为 10 MB,因此整个 Codelab 的费用不到一美分。
2. 设置
这是唯一一个使用 Cloud Shell 的步骤。它会创建一个项目,为其设置结算,并构建原始表。之后,您可以在 BigQuery 控制台中运行该图表、衡量指标和每个查询。
不过,本实验无法为您提供一个启用了结算功能的 Google Cloud 项目。第 1 步可让您获得一个可用于支付费用的账号;第 4 步可将该账号转换为项目。请按此顺序执行这些步骤 - 第 4 步之后的每个步骤都会读取第 4 步创建的项目。
1 · 获取具有结算功能的账号(约 1 分钟)
👉🌐 请务必先执行此操作。使用已启用结算功能的 Google 账号登录。任何此类账号均可。如果您的账号不符合要求,请开始免费试用;这样您就可以获得结算账号,而这正是第 4 步所需的。
2 · 打开 Cloud Shell (约 1 分钟)
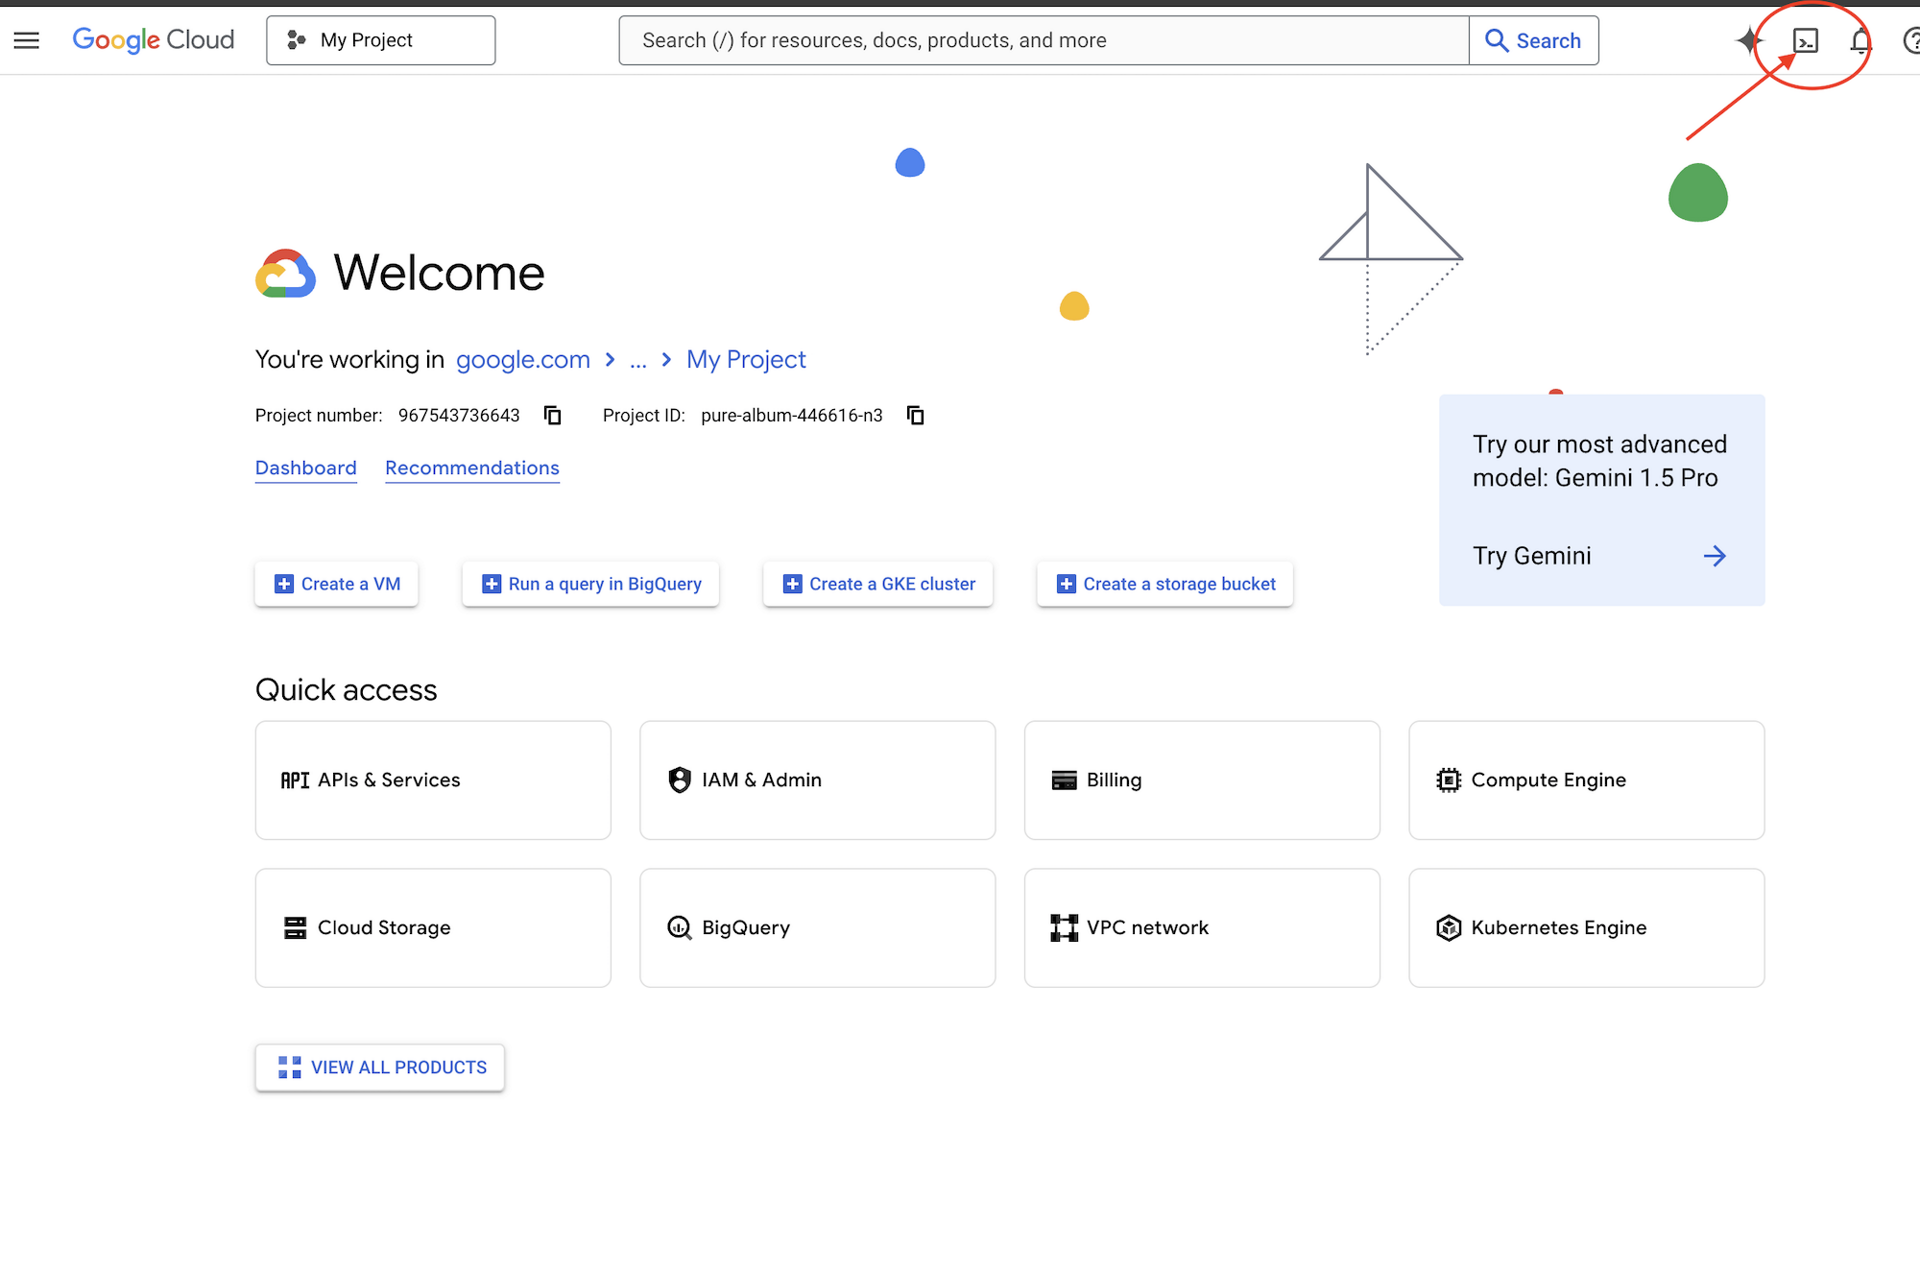
👉🌐 控制台 - 点击 Google Cloud 控制台顶部的激活 Cloud Shell - 这是标题中的终端形状图标。系统会在页面底部打开一个终端。
👉🌐 控制台 - 如果系统在任何时候提示您进行授权,请点击授权以继续操作。
👉💻 Cloud Shell - 检查 Cloud Shell 以哪个账号登录:
gcloud auth list
👀 预期:您自己的账号会带有 * 标记,并且必须是您在第 1 步中登录的同一账号。如果不是,请运行 gcloud auth login 并选择正确的账号。
3 · 完成实验 (约 1 分钟)
👉💻 Cloud Shell - 克隆代码库:
cd ~
rm -rf ~/bq-graph-measures-lab
git clone https://github.com/cuppibla/bq-graph-measures-lab.git
cd ~/bq-graph-measures-lab
4 · 创建项目 (约 2 分钟)
👉💻 Cloud Shell - 一个脚本可查找您的结算账号、在其中创建一个项目,并将 Cloud Shell 指向该项目:
cd ~/bq-graph-measures-lab
./setup_project.sh
👀 预期:系统会为所选结算账号显示一个 ✓,为所创建的项目显示一个 ✓,并显示如下结束语:
Project ready: bq-graph-4271
  Next:  ./setup.sh
bq-graph-4271 是您的项目 ID,您的项目 ID 将包含不同的数字。其中会发生以下四件事:
结算 | 如果用户有最新的 | |
项目 | 创建 | |
选择 | 将 ID 写入 | |
等待 | 轮询,直到新项目实际上可以提供服务为止,最长轮询时间为两分钟 | |
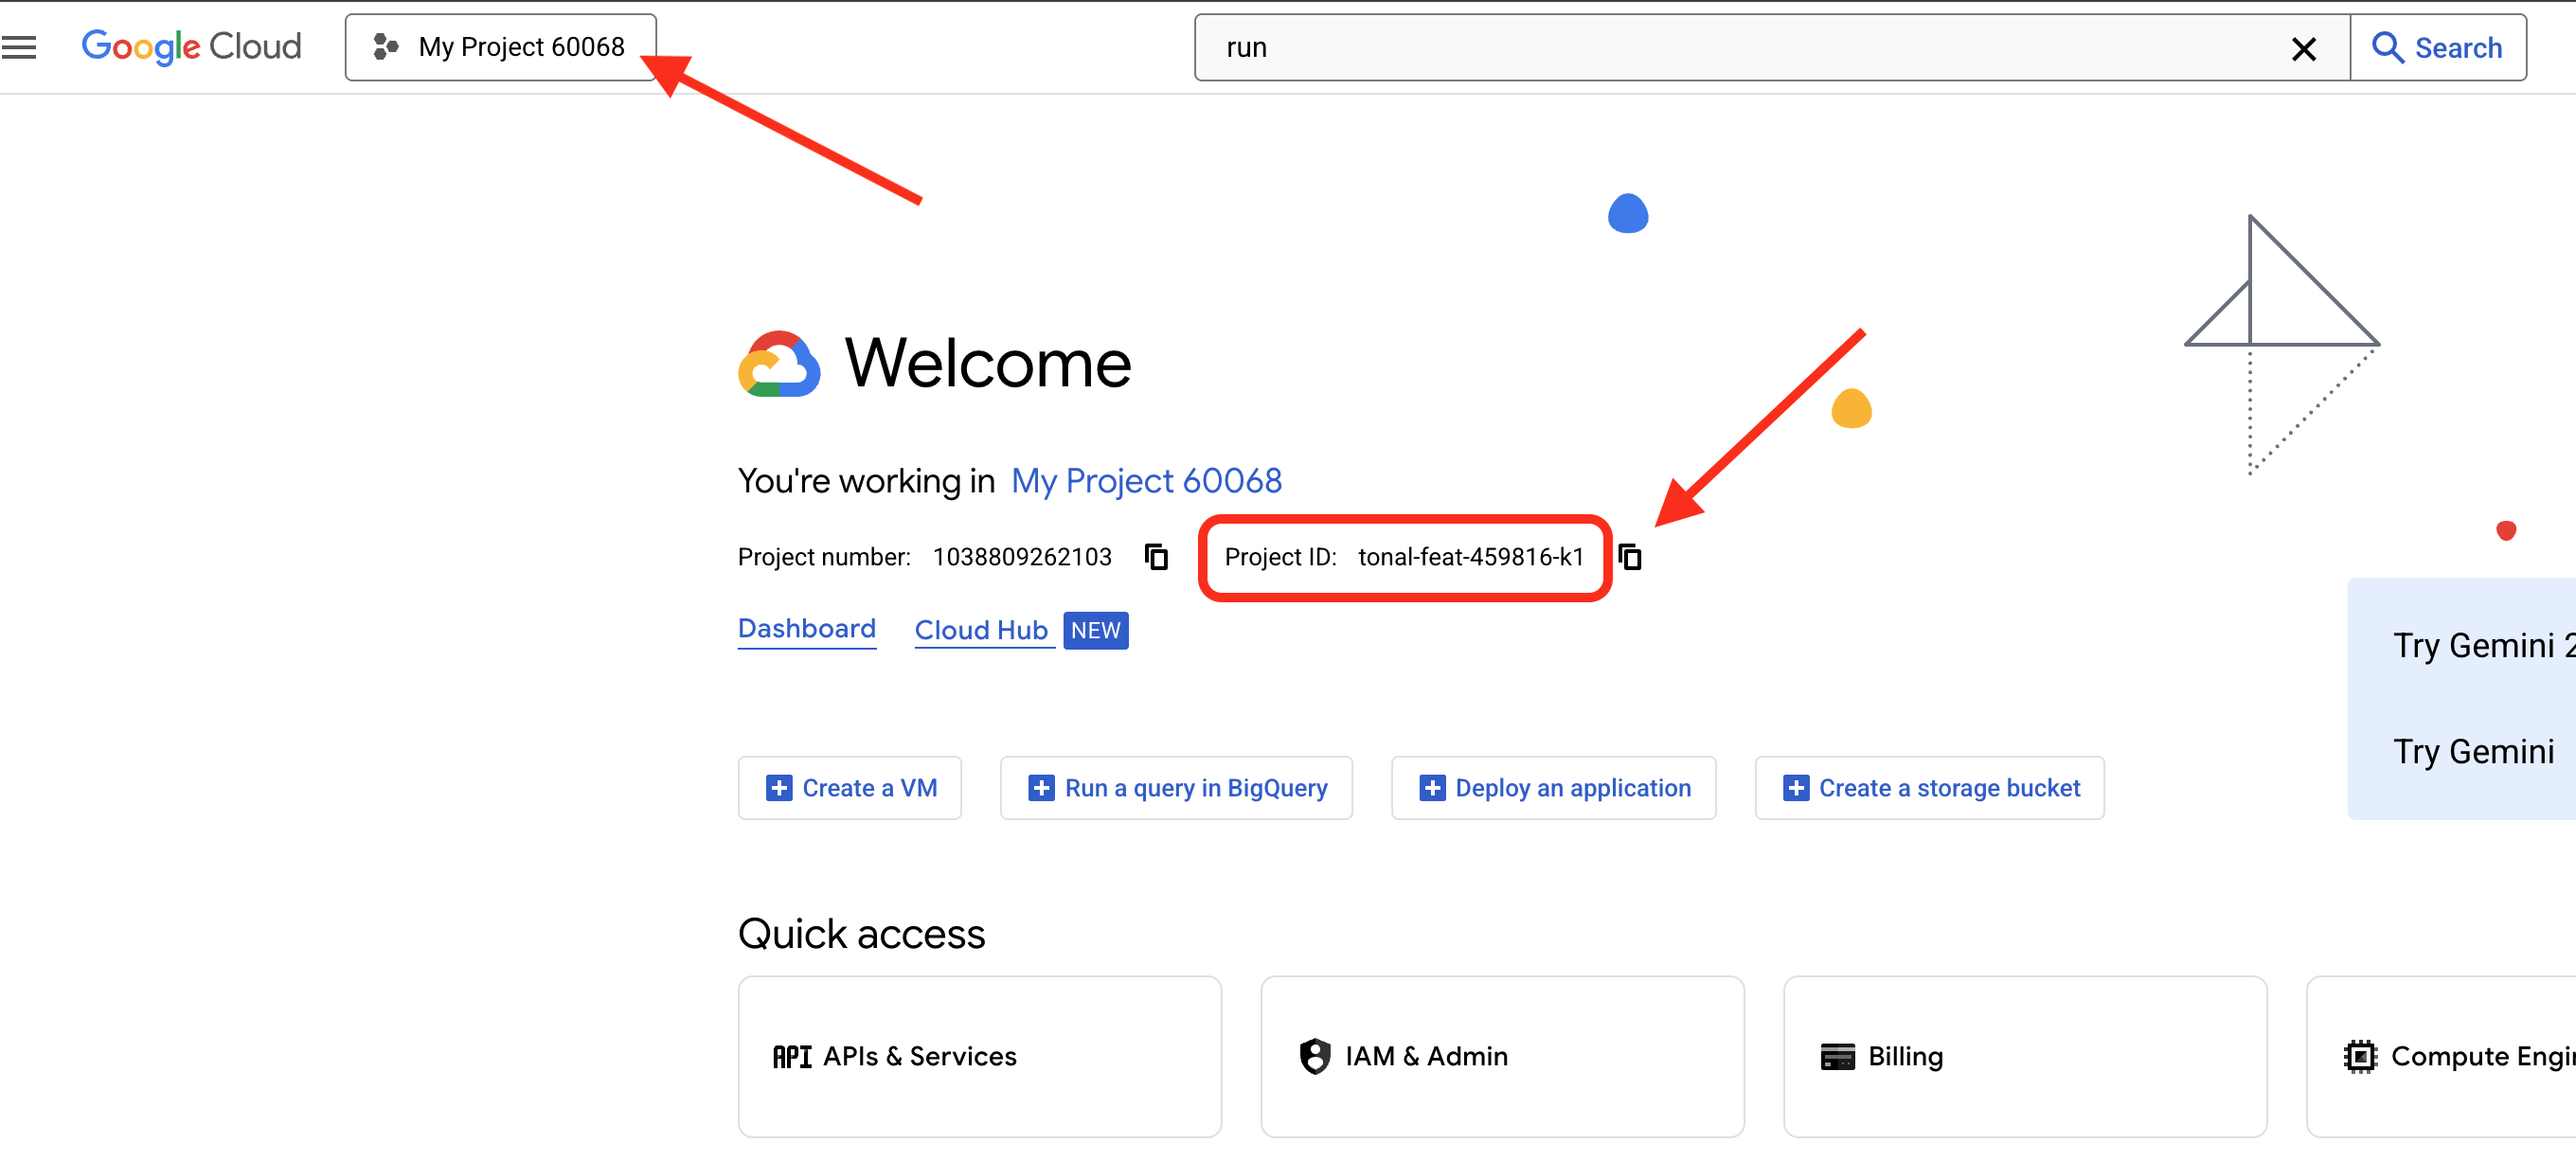
🌐 现在,控制台中显示了同一项目,其 ID 位于信息中心的项目信息卡片中:
5 · 创建数据集 (约 3 分钟)
👉💻 Cloud Shell - 另一个脚本用于构建表格:
cd ~/bq-graph-measures-lab
./setup.sh
脚本会在运行时输出每个步骤。按顺序执行的操作:
项目 | 从 | |
API | 启用 | |
数据集 | 在美国多区域位置创建 | |
检查 | 计算每个表中的行数,如果任何计数有误,则停止 | |
👀 预期:
BigQuery Graph Measures · setup
  ✓ project: bq-graph-4271
  ✓ BigQuery API enabled

Creating dataset music (US) and five tables...
  ✓ music.Labels              2 rows
  ✓ music.Artists             3 rows
  ✓ music.Songs               5 rows
  ✓ music.Playlists           4 rows
  ✓ music.PlaylistEntries    10 rows

🎉 ready — open BigQuery Studio: https://console.cloud.google.com/bigquery?project=bq-graph-4271
您已完成 Cloud Shell 操作。您可以关闭它。
6 · 打开 BigQuery 和查询编辑器
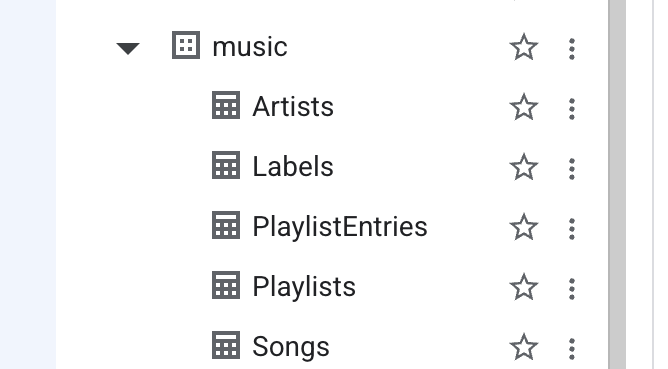
👉🌐 控制台 - 点击输出末尾的链接,或从导航菜单中打开 BigQuery。在左侧的探索器窗格中,展开您的项目:一个包含五个表的 music 数据集。
👉🌐 控制台 - 在 BigQuery Studio 顶部的新建行中,点击 SQL 查询。系统随即会打开一个空白的编辑器标签页。
保留此标签页。本实验中的每个 👉📋 代码块都应放在此处:选择编辑器中的所有内容,将新代码块粘贴到其中,然后点击运行。结果会显示在下方的面板中。
了解表格
稍后,我们将用到这些表中的两项信息。每个表都将其主键声明为 NOT ENFORCED:BigQuery 不会检查它,但您即将构建的属性图需要一个明确的键来了解标识行的内容。最后一个表 PlaylistEntries 是一个联接表:如果一首歌曲位于四个播放列表中,则该表中有四行。该表是整个故事的发生地。
这些表按如下方式链接在一起:唱片公司签约音乐人,音乐人发布歌曲,歌曲通过 PlaylistEntries 放置到播放列表中。Cymbal Records 拥有 Ava Sterling 和 Mina Okafor,以及通过她们拥有的四首歌曲。Northwind Audio 拥有 Kai Nakamura 和一首歌曲“Midnight Drive”。
桌子 | 行 | 键 | 它包含的内容 |
标签 | 2 |
| 名称、营销预算 |
音乐人 | 3 |
| 名称,哪个标签 |
歌曲 | 5 |
| 歌曲名、音乐人、播放量 |
播放列表 | 4 |
| name, followers |
PlaylistEntries | 10 |
| 哪些歌曲位于哪些播放列表中 |
✅ 检查点: 在 Cloud Shell 中,探索器中的 music 下有 5 个表,并且打开了一个空白的查询编辑器标签页。🎉 ready
3. 创建图表 - 选项 A:可视化建模工具
属性图是对表之间连接方式的描述。您可以在可视化图表建模工具中点击完成此操作(此步骤,全部点击),也可以将其写为 SQL(下一步,一次粘贴)。这两种方法会生成相同的对象,因此只需选择其中一种,而无需同时使用这两种方法。
1. 创建图表 shell
👉🌐 控制台 - 在 BigQuery Studio 中,在新建行中,打开 AI 和知识菜单,然后点击图表。
👉🌐 控制台 - 输入 MusicGraph 作为图表名称,输入 music 作为数据集中的图表目标位置。系统会根据数据集(美国)自动填充区域。
👉🌐 控制台 - 在数据源下,选择五个表格 - Artists、Labels、PlaylistEntries、Playlists、Songs - 然后点击创建。
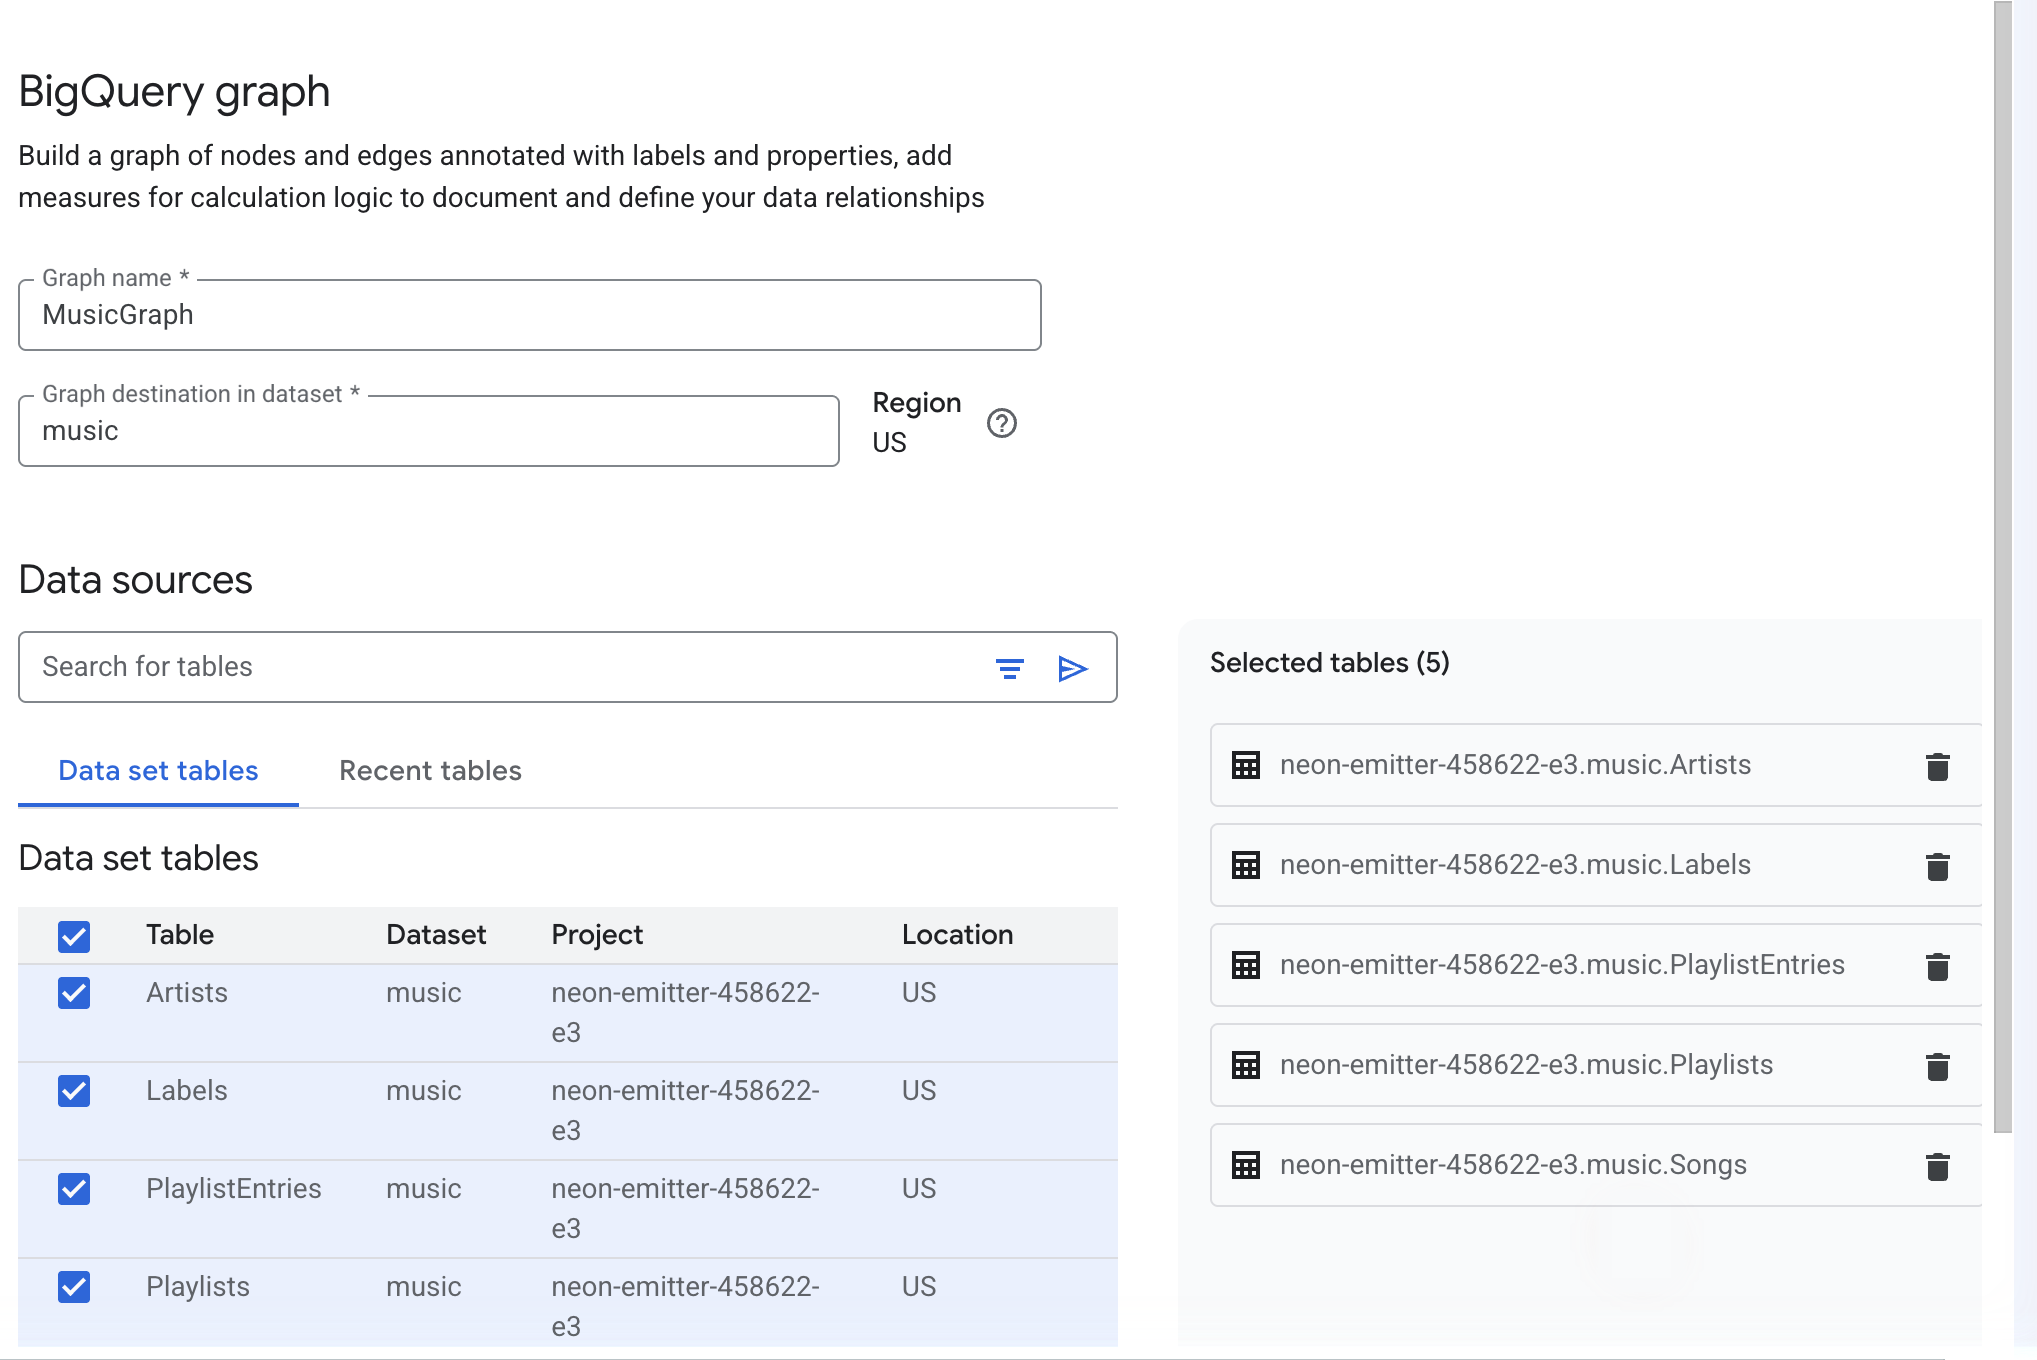
👀 画布打开,其中包含五个彩色节点,节点之间没有连线。右侧的详细信息面板列出了节点 (5) 和边 (0)。每个节点都已将其表的主键和所有列作为属性携带在其中 - 点击任意节点即可查看这些属性。
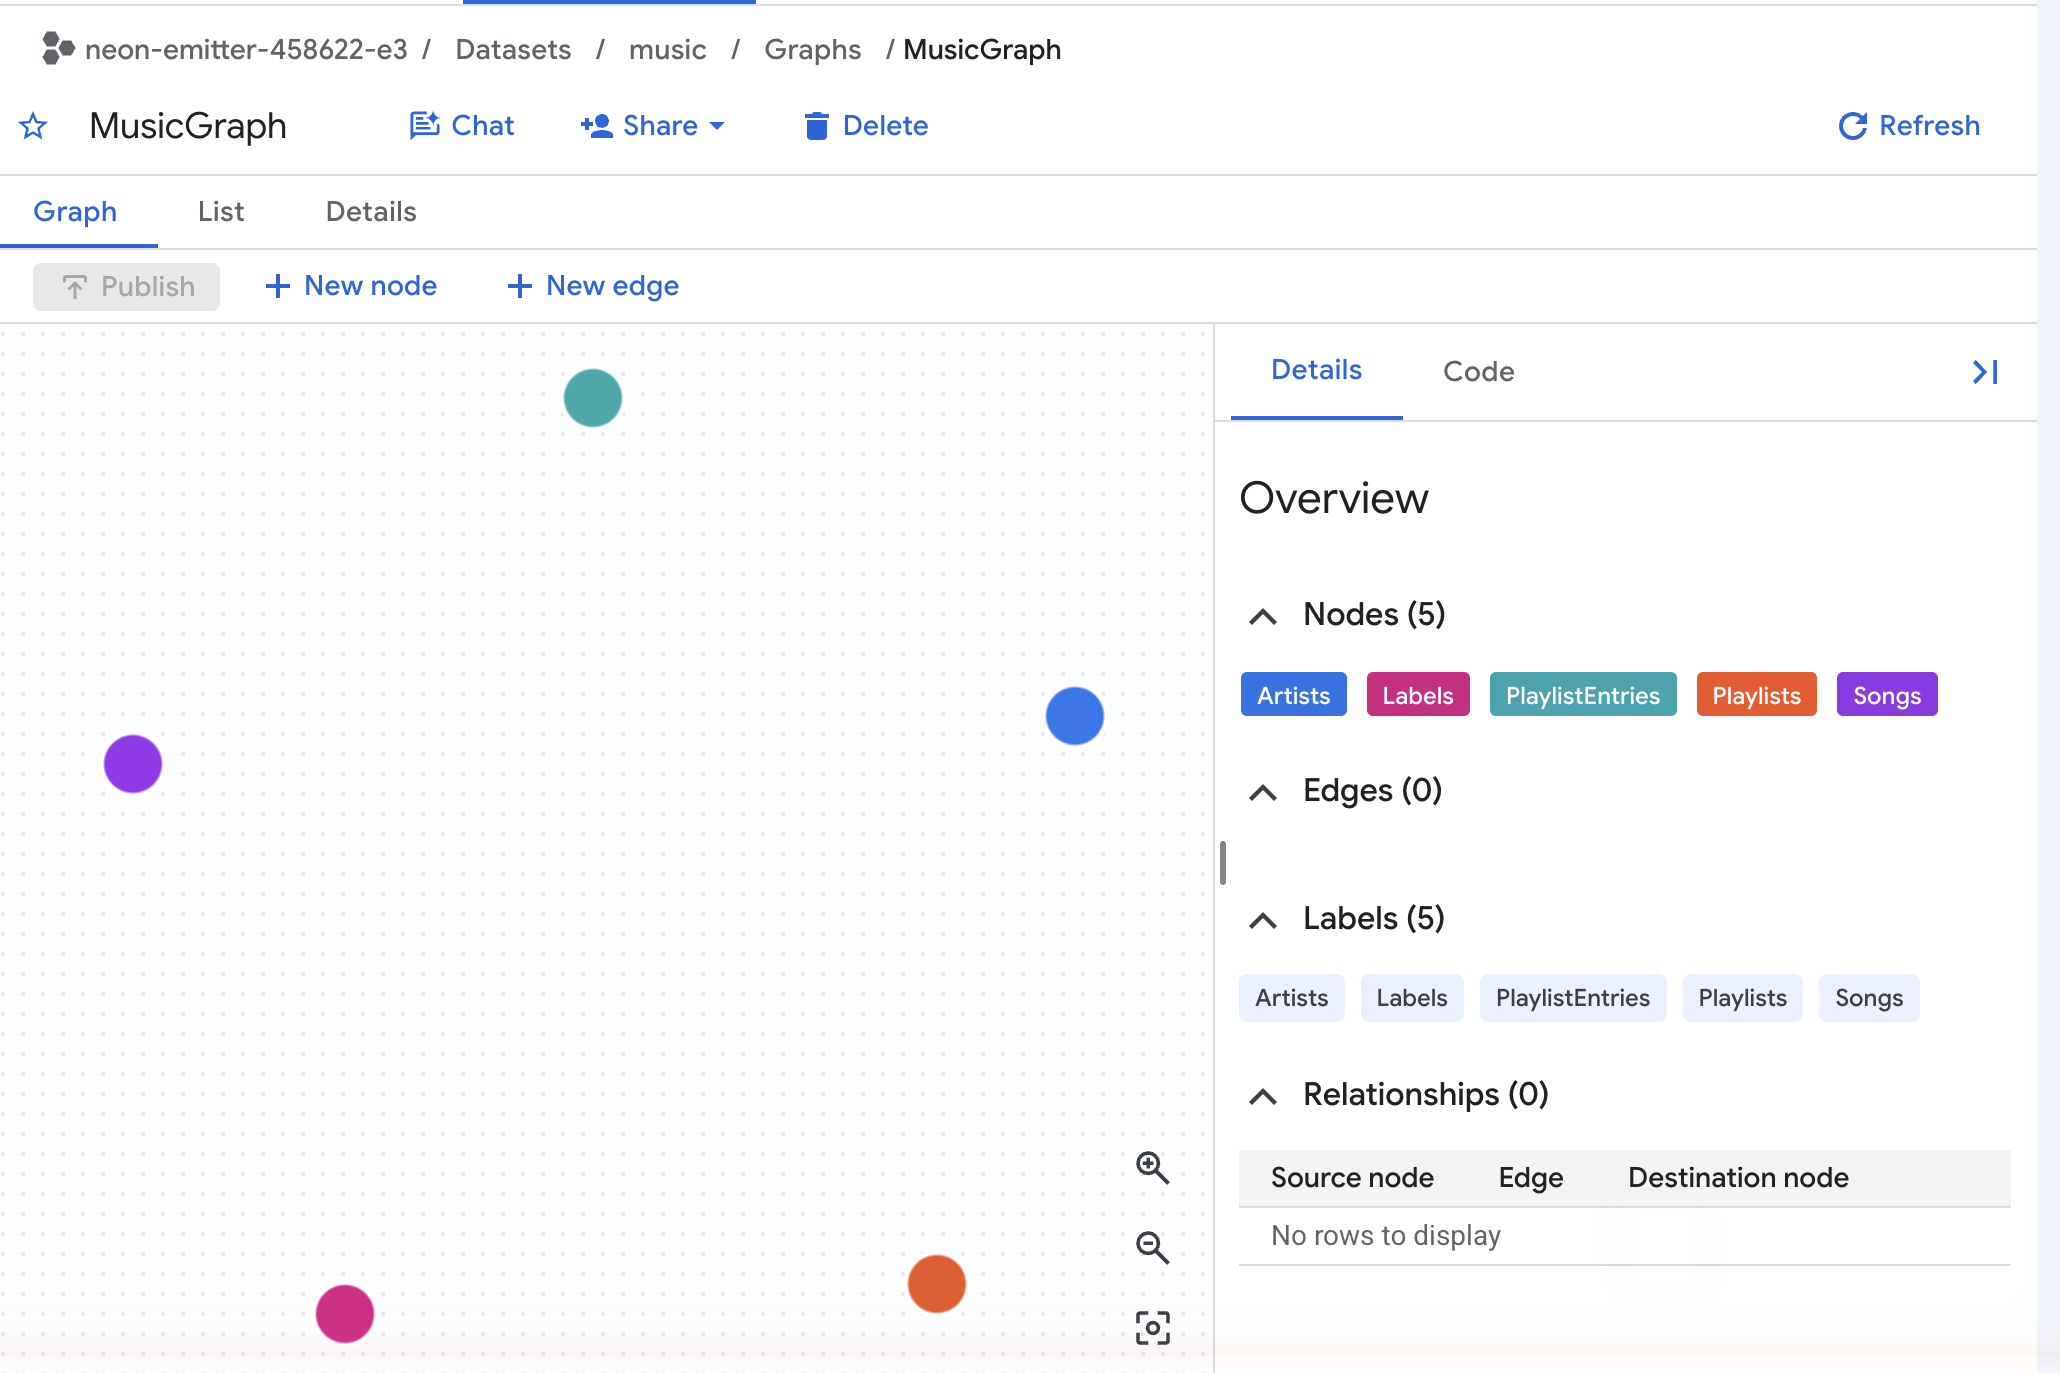
2. 绘制四个边
边是外键,已绘制。每个箭头都从包含键的表指向它所指向的表。
👉🌐 控制台 - 点击新边缘。在选择表格对话框中,选择 PlaylistEntries,然后点击添加。在添加边面板中:
- 将名称设置为
EntryToSong。 - 点击添加主键,然后接受
entry_id。 - 在来源下,将源节点设置为 PlaylistEntries,然后使用向节点添加引用列和在边上添加引用列,为两者选择
entry_id。 - 在目标下,将目标节点设置为“歌曲”,然后为节点中的引用列和边上的引用列选择
song_id。 - 点击完成。
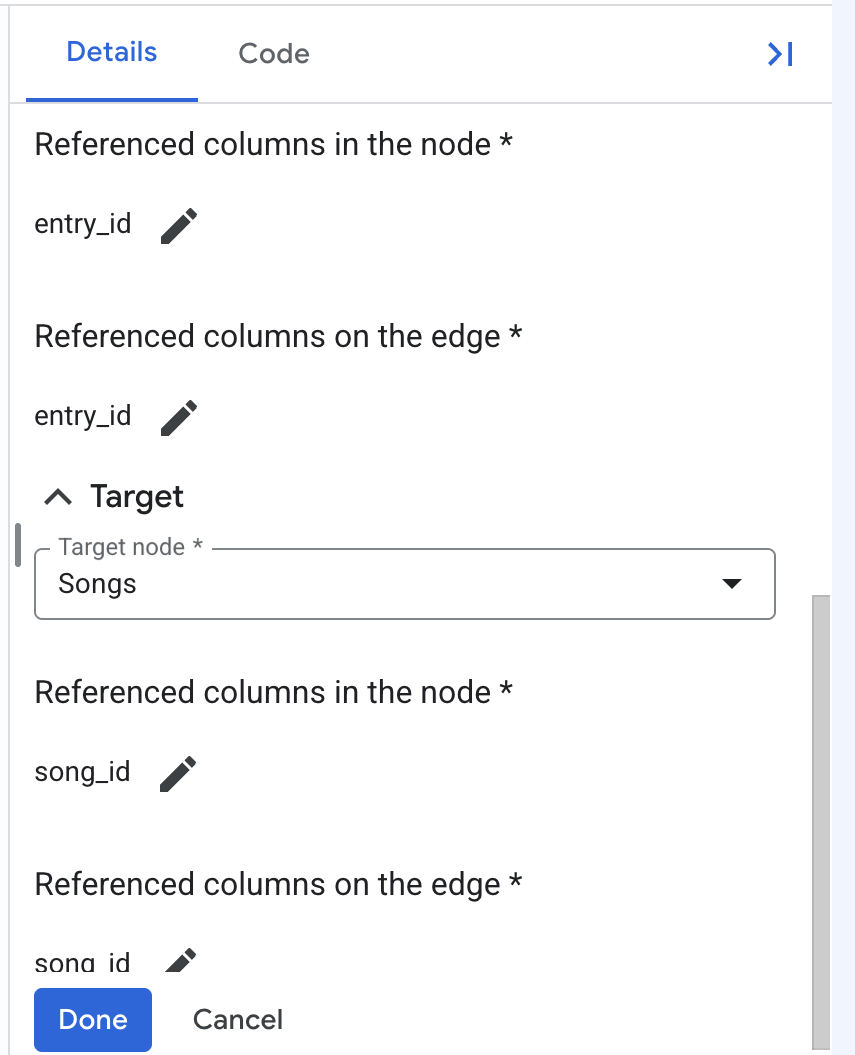
👉🌐 控制台 - 再重复三次:
边缘名称 | 桌子 | 源节点 → 目标节点 | 两侧要选择的列 |
| PlaylistEntries | PlaylistEntries → 播放列表 | 来源 |
| 歌曲 | 歌曲 → 音乐人 | 来源 |
| 音乐人 | 音乐人 → 唱片公司 | 来源 |
将每个边都保留为没有额外属性。
👀“详细信息”面板现在显示边 (4),画布上显示了链:唱片公司 ← 音乐人 ← 歌曲 ← PlaylistEntries → 播放列表。
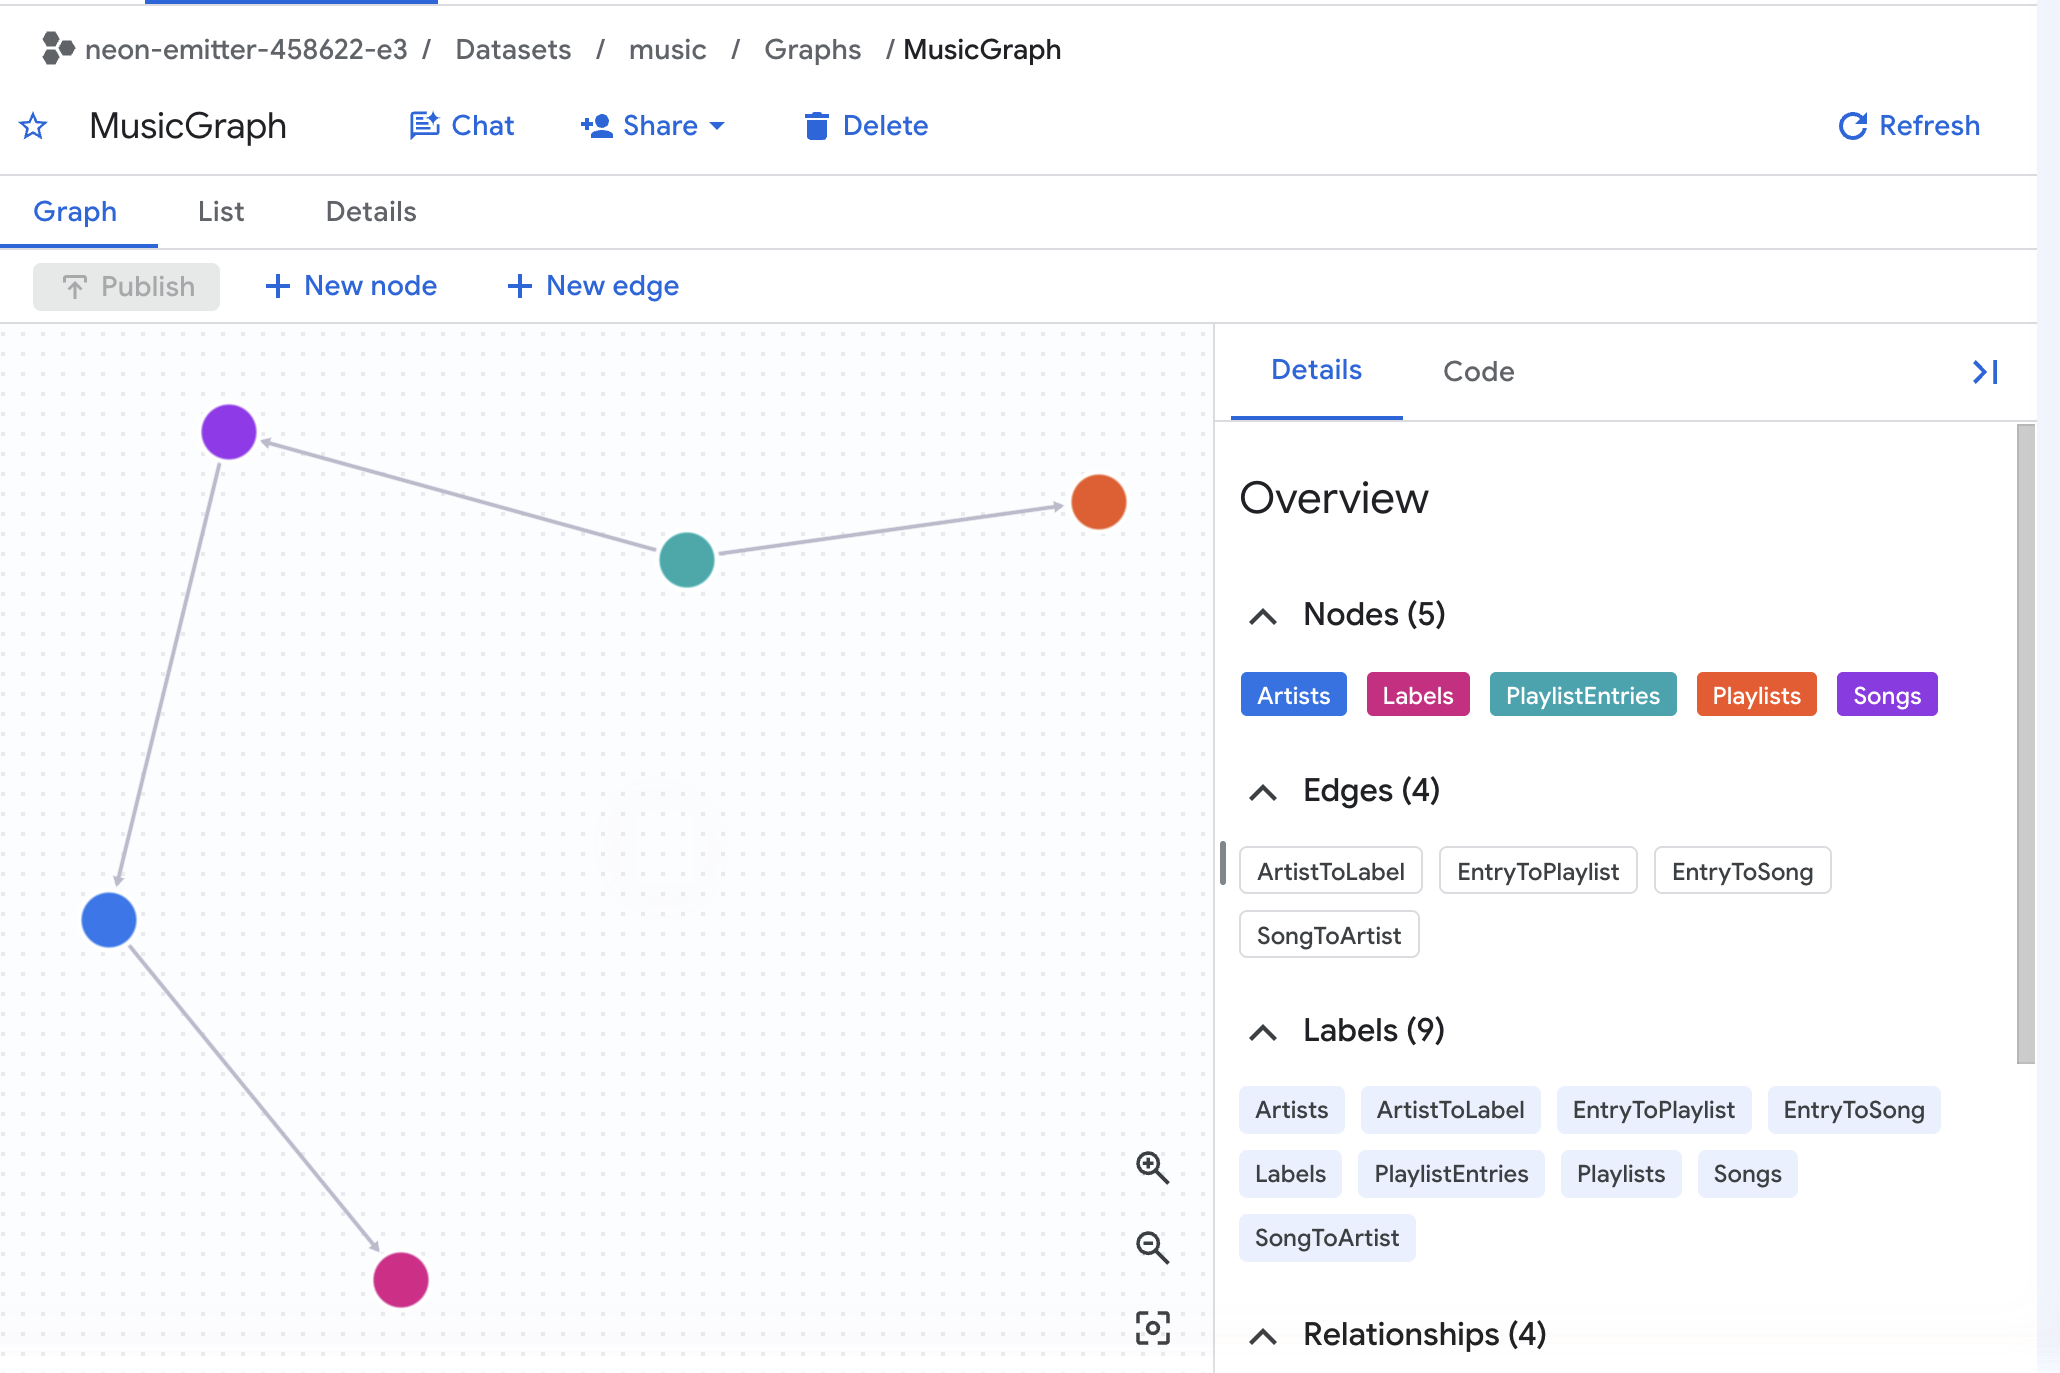
3. 添加衡量指标
👉🌐 控制台 - 点击歌曲节点,然后点击“详情”面板顶部的修改(铅笔)图标。在标签的属性下,依次点击添加属性和添加字段。
👉🌐 控制台 - 输入 total_streams 作为字段名称,然后在表达式框中输入以下内容:
MEASURE(SUM(streams))
👉🌐 控制台 - 点击添加,然后点击完成。
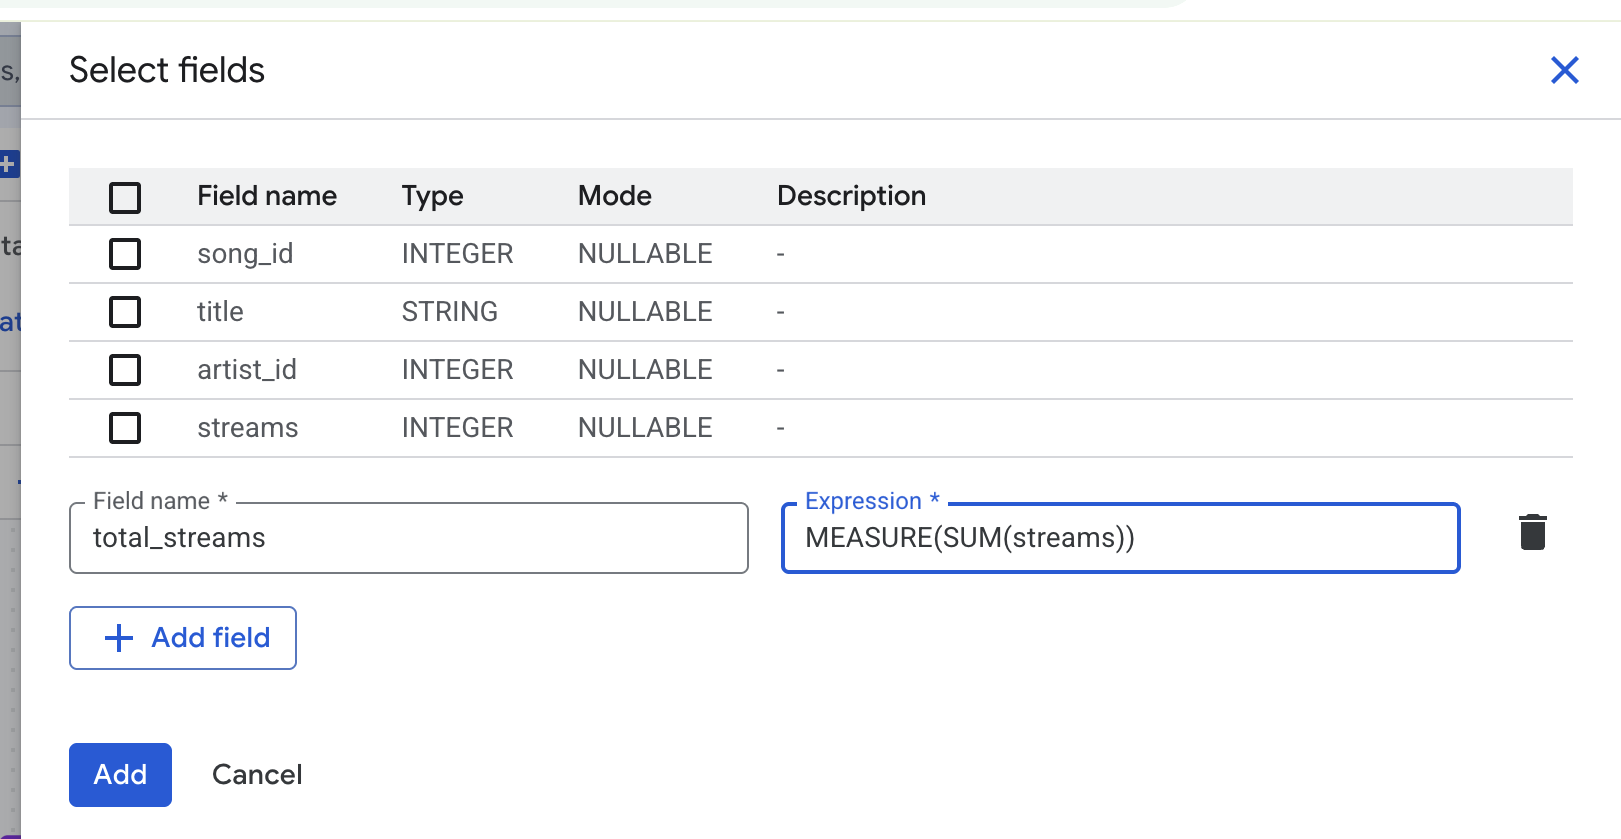
4. 阅读其编写的代码,然后发布
👉🌐 控制台 - 打开右侧面板中的代码标签页。建模者已为您撰写了 CREATE PROPERTY GRAPH 语句。滚动到“歌曲”节点:其属性列表现在以以下内容结尾
MEASURE(SUM(streams)) AS `total_streams`
这就是整个功能,只需一行代码。此步骤之后的所有内容都与该行的作用有关。
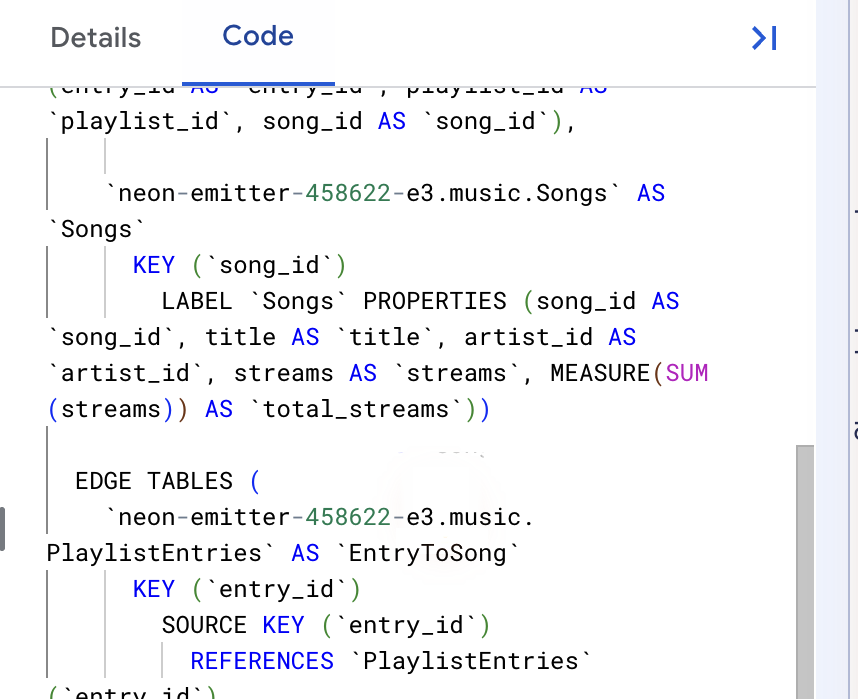
👉🌐 控制台 - 点击发布。
✅ 检查点:在探索器中,music 现在有一个包含 MusicGraph 的 Graphs 文件夹。点击它:五个节点、四条边以及“代码”标签页中的 MEASURE(SUM(streams)) 行。跳过下一步,前往并排显示 SUM 和 AGG。
4. 创建图 - 选项 B:SQL
如果您是在建模器中构建图表的,请跳过此步骤。
👉📋 查询编辑器 - 粘贴,然后点击运行:
CREATE OR REPLACE PROPERTY GRAPH music.MusicGraph
  NODE TABLES (
    music.Labels KEY (label_id)
      PROPERTIES (label_id, label_name, marketing_budget,
        MEASURE(SUM(marketing_budget)) AS total_budget),
    music.Artists KEY (artist_id)
      PROPERTIES (artist_id, artist_name, label_id,
        MEASURE(COUNT(artist_id)) AS artist_count),
    music.Songs KEY (song_id)
      PROPERTIES (song_id, title, artist_id, streams,
        MEASURE(SUM(streams))   AS total_streams,
        MEASURE(COUNT(song_id)) AS song_count),
    music.Playlists KEY (playlist_id)
      PROPERTIES (playlist_id, playlist_name, followers,
        MEASURE(SUM(followers)) AS total_followers),
    music.PlaylistEntries KEY (entry_id)
      PROPERTIES (entry_id, playlist_id, song_id,
        MEASURE(COUNT(entry_id)) AS placement_count)
  )
  EDGE TABLES (
    music.PlaylistEntries AS EntryToSong
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (song_id) REFERENCES Songs(song_id) NO PROPERTIES,
    music.PlaylistEntries AS EntryToPlaylist
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (playlist_id) REFERENCES Playlists(playlist_id) NO PROPERTIES,
    music.Songs AS SongToArtist
      SOURCE KEY (song_id) REFERENCES Songs(song_id)
      DESTINATION KEY (artist_id) REFERENCES Artists(artist_id) NO PROPERTIES,
    music.Artists AS ArtistToLabel
      SOURCE KEY (artist_id) REFERENCES Artists(artist_id)
      DESTINATION KEY (label_id) REFERENCES Labels(label_id) NO PROPERTIES
  )
👀 结果面板显示已创建属性图。
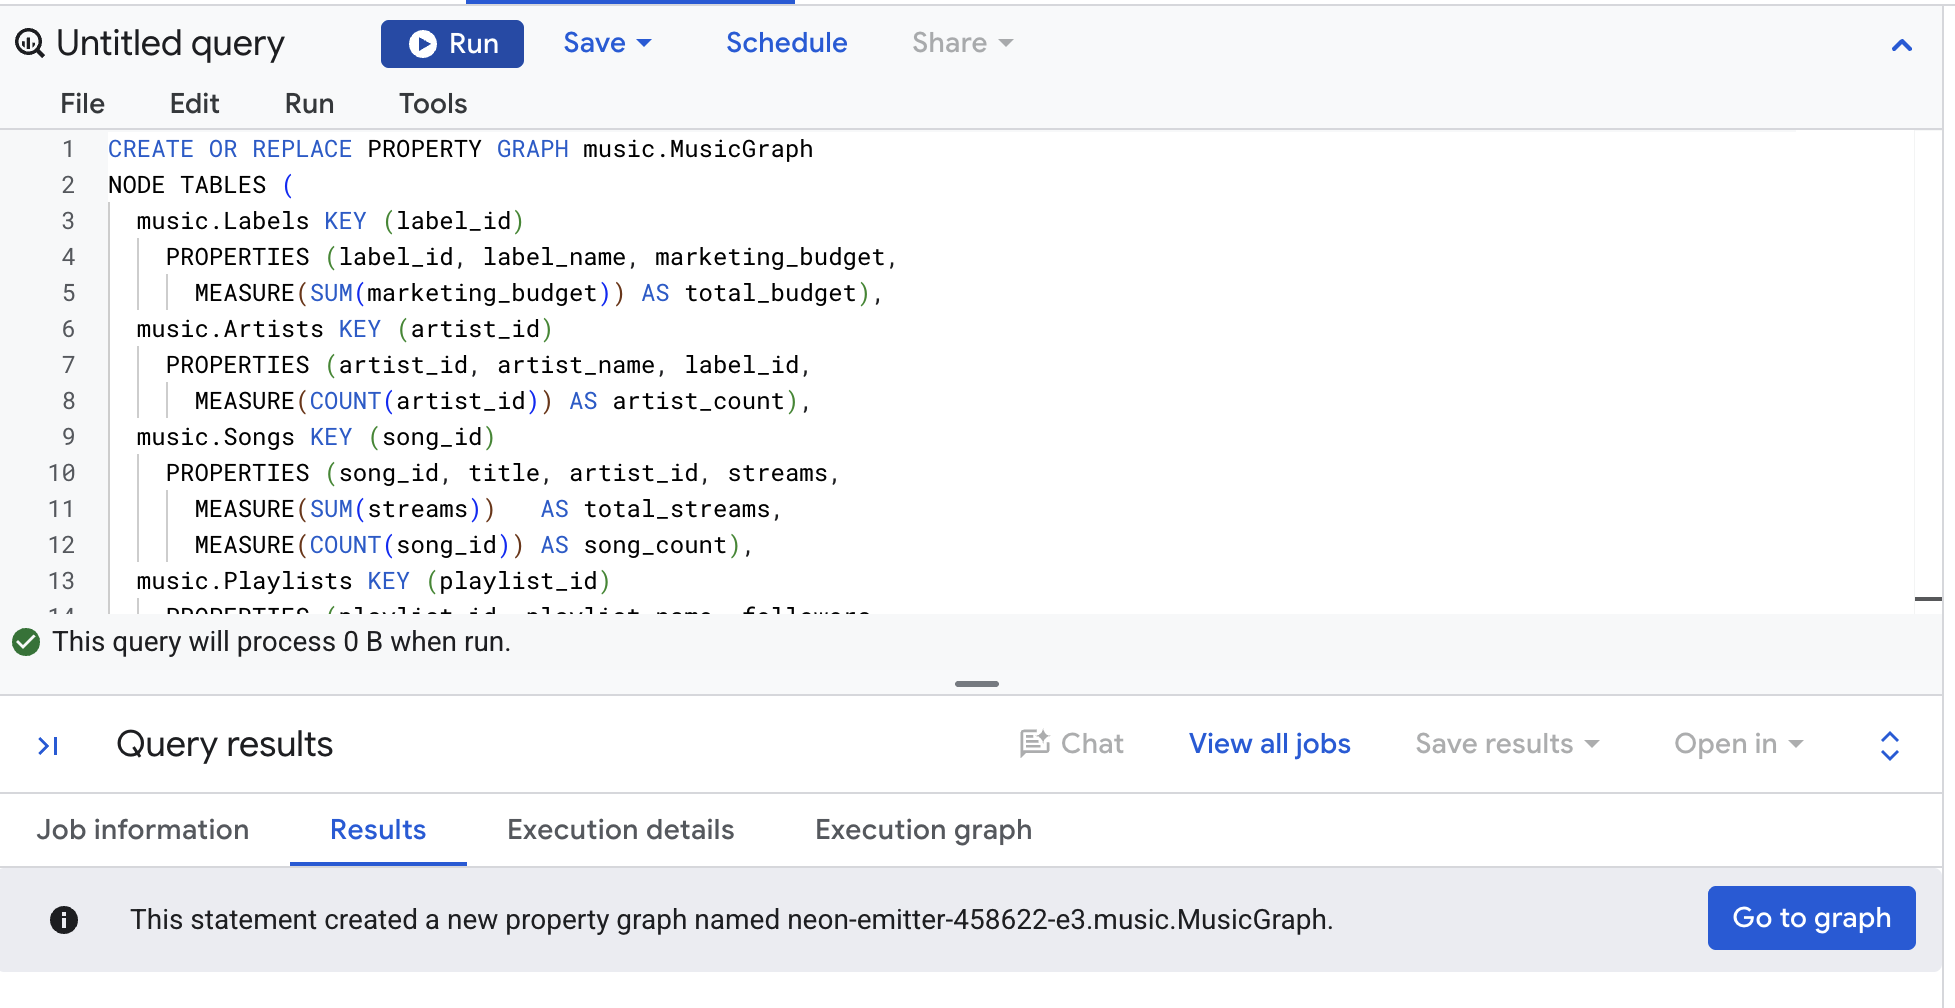
朗读一次
该图包含 5 个节点表和 4 个边表。每个节点表都会命名其 KEY 并列出其 PROPERTIES。以 MEASURE 开头的行是新增部分:每一行都将一个受支持的聚合函数封装在属性周围,并为其提供一个必需的别名。
每个边表都是一个外键,拼写如下:SOURCE KEY(在保存键的表中),DESTINATION KEY(在指向的表中)。NO PROPERTIES 表示边本身不携带任何内容。
请注意,PlaylistEntries 出现了 3 次:一次作为节点表,另外两次作为 EntryToSong 和 EntryToPlaylist 边的物理表。这是有意为之,稍后我们将解释原因。
看看你制作的内容
👉🌐 控制台 - 在“探索器”窗格中,依次展开 music 和图表,然后点击 MusicGraph。图表页面随即会在画布上打开,其中包含五个节点和四条边。点击某个节点即可查看其属性 - 系统会列出指标及其汇总值。打开代码标签页,查看图片背后的声明。
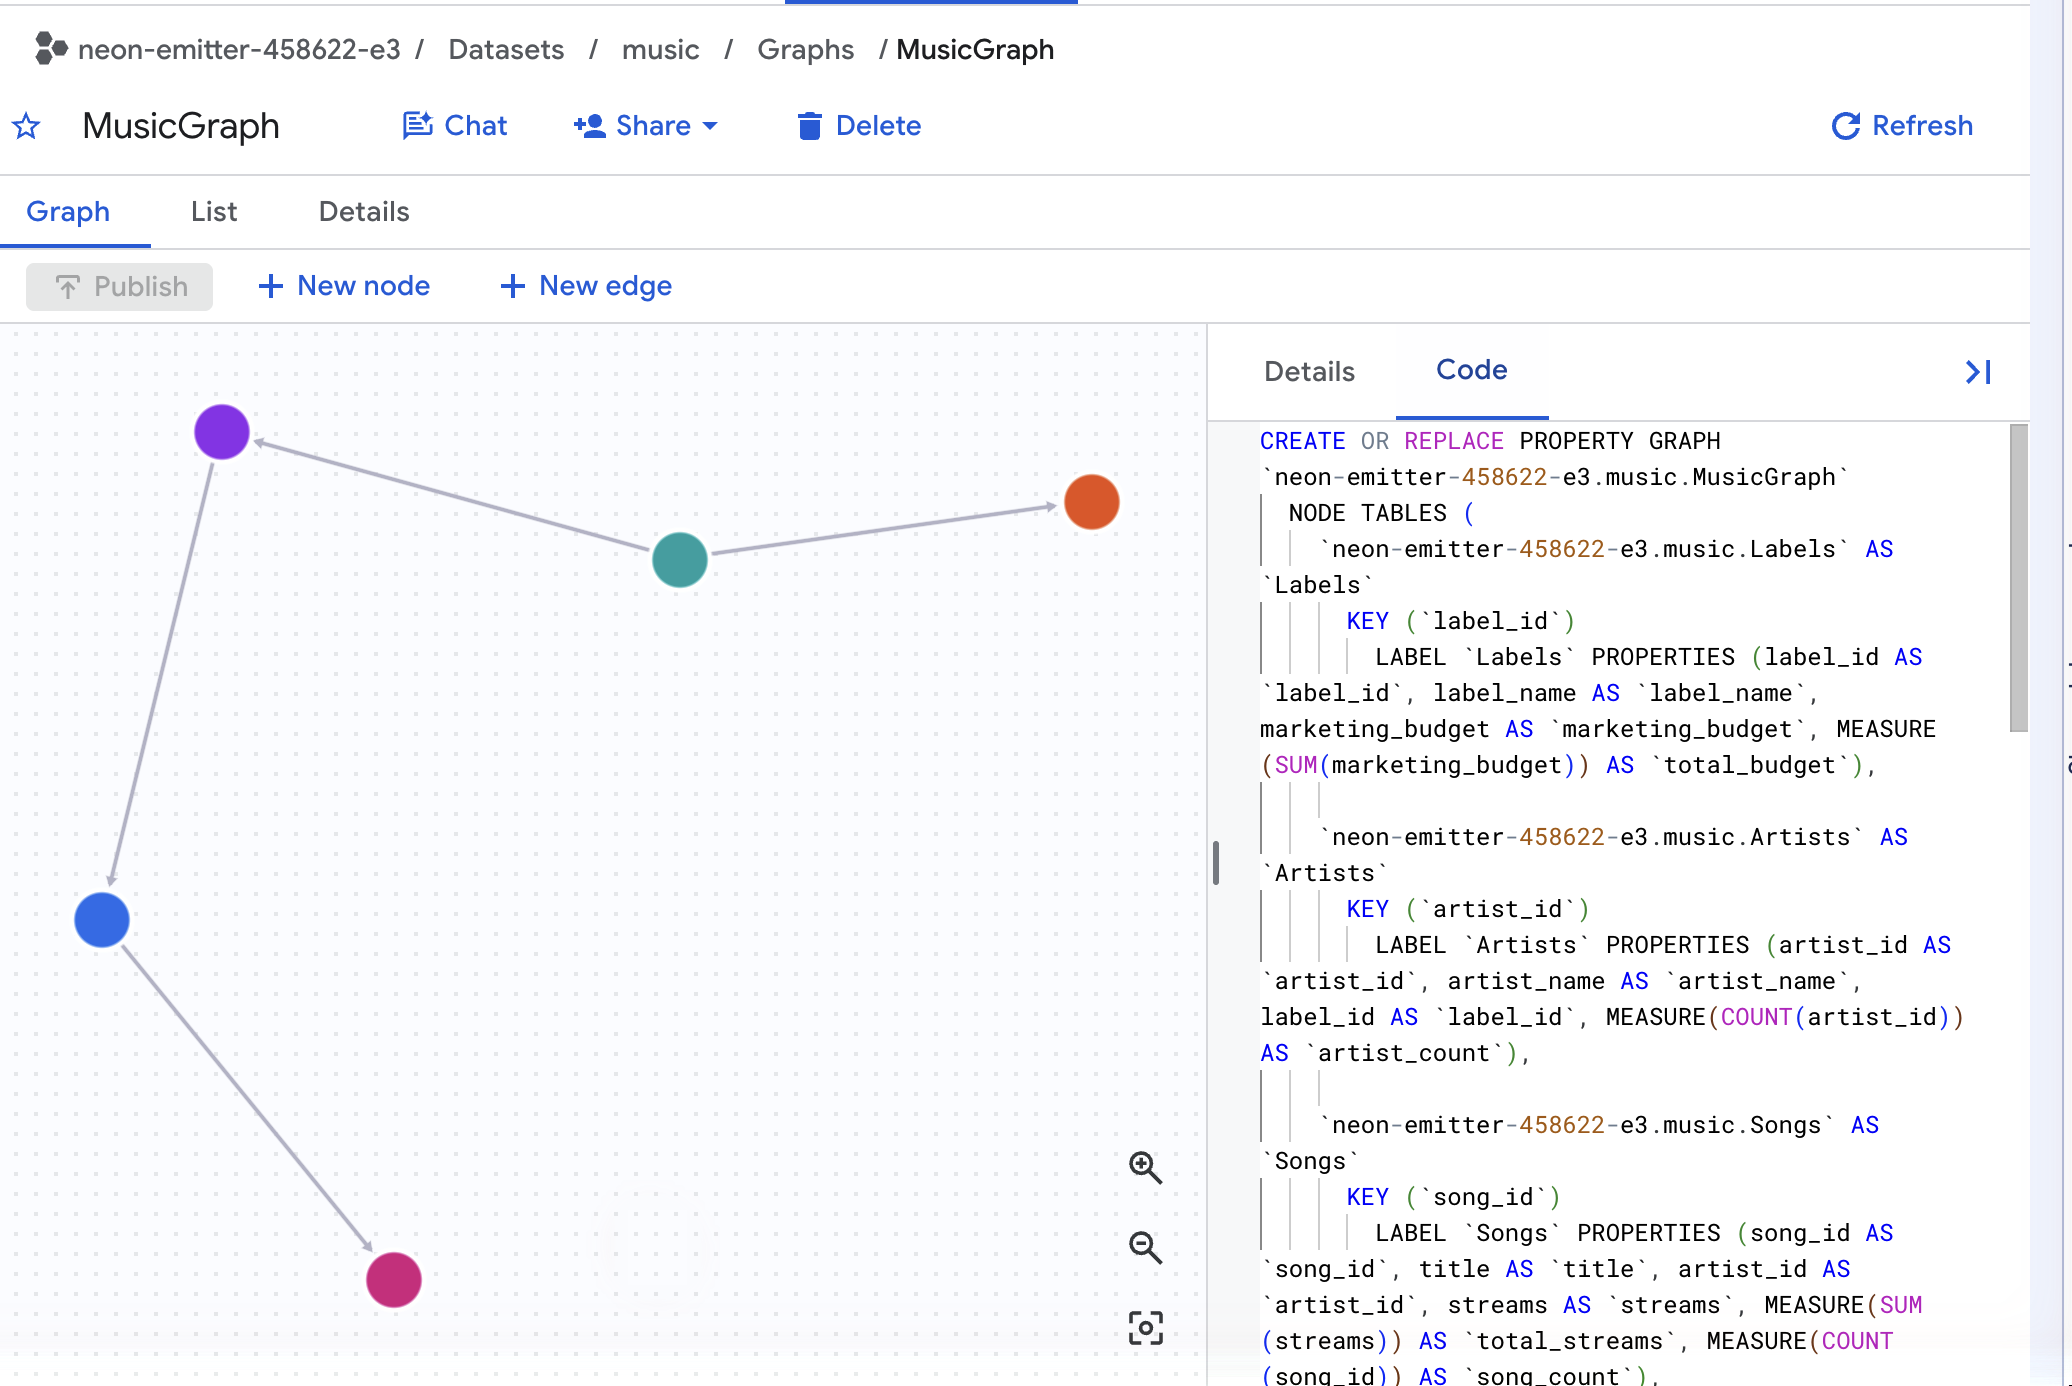
✅ 检查点:music 具有包含 MusicGraph 的 Graphs 文件夹,并且“代码”标签页显示 MEASURE(SUM(streams)) AS total_streams。
5. SUM 和 AGG,并排显示
以下是一个查询中的整个 Codelab。这两个列都试图从同一表中回答同一问题,即每个唱片的总播放量。
该表是 GRAPH_EXPAND 生成的。它会展平图表:从一个表开始,将每个边向外延伸为 LEFT JOIN,直到每个关联的表并排显示在一个宽结果中。每项放置对应一行,而不是每首歌曲对应一行,并且每个列都命名为 TableLabel_property。在查询之前查看一下。
👉📋 查询编辑器 - 粘贴,然后点击运行:
SELECT Labels_label_name, Songs_title, Songs_streams, Playlists_playlist_name
FROM GRAPH_EXPAND("music.MusicGraph")
ORDER BY Songs_title, Playlists_playlist_name
👀 预期 10 行 - PlaylistEntries 中的每个放置位置对应一行,这正是设置加载的内容。“霓虹夏日”占据了其中的 4 个位置,每个位置对应一个播放列表,并且每个位置的播放量都显示为 2,000,000,000。Songs_streams这些行没有问题;播放列表确实是 4 个。但属于歌曲的列现在会在属于展示位置的行中重复出现,而这正是下一个查询要衡量的整个问题。
现在,我们来比较一下。
👉📋 查询编辑器 - 粘贴,然后点击运行:
SELECT
  Labels_label_name,
  SUM(Songs_streams)       AS with_sum,
  AGG(Songs_total_streams) AS with_agg
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1 ORDER BY 1
👀 结果:
Labels_label_name | with_sum | with_agg |
Cymbal Records | 12,600,000,000 | 5,100,000,000 |
Northwind Audio | 9,000,000,000 | 4,500,000,000 |
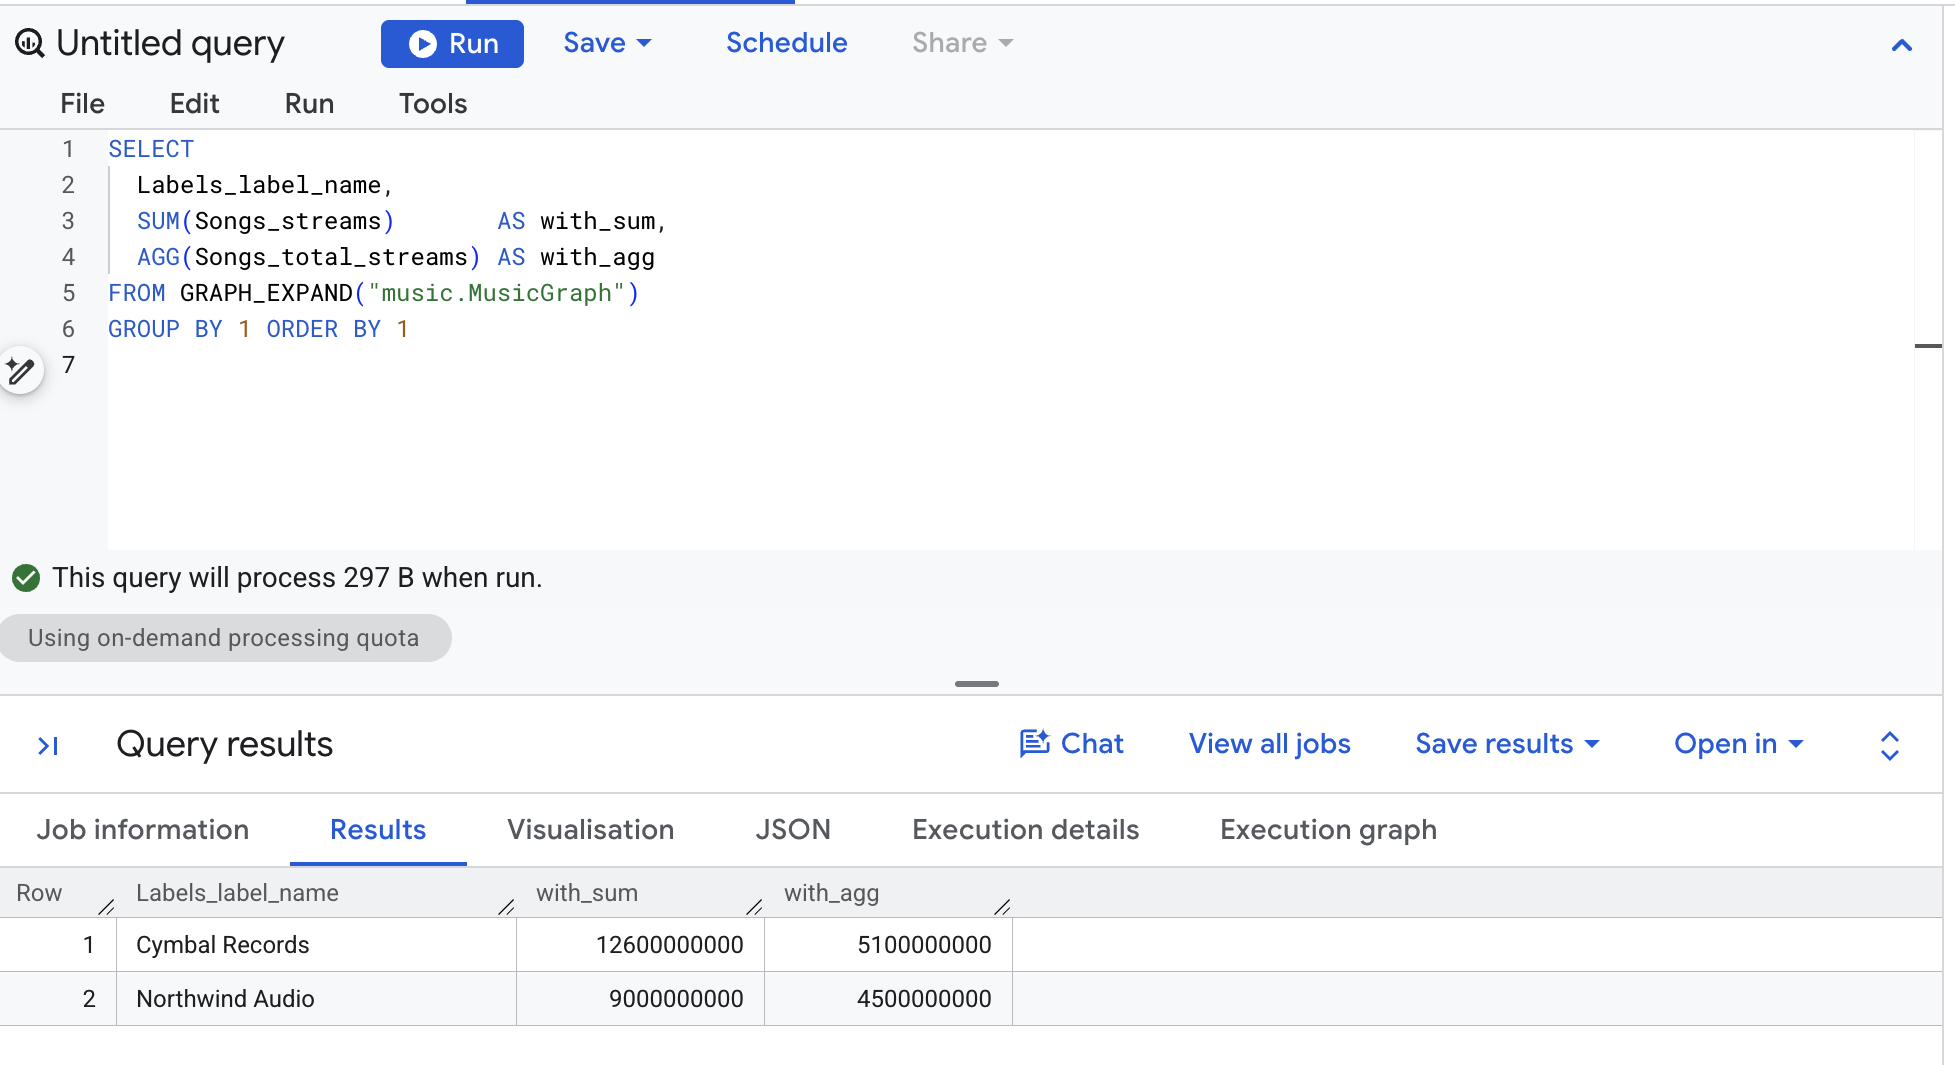
手动检查。Cymbal 的四首歌曲的播放量分别为 20 亿、15 亿、12 亿和 4 亿。也就是 51 亿。AGG 是正确的。SUM 的大小是原来的 2.5 倍,而 Northwind 的单首歌曲大小是原来的 2 倍。
三项新语法
GRAPH_EXPAND("music.MusicGraph")是一个表值函数,它通过将每条边视为LEFT JOIN,将图转换为一个宽表。每个列都命名为TableLabel_property,因此Songs_streams是 Songs 表中的原始列,而Songs_total_streams是您声明的指标。SUM(Songs_streams)是对该宽表的普通 SQL,它继承了扁平化产生的所有重复项。AGG(Songs_total_streams)会按照声明的方式评估指标:每个song_id评估一次,无论歌曲在宽表中占据多少行。SUM(streams)
✅ 检查点:两个标签、两列,且 with_agg 数字与手指数一致。
6. 为什么 SUM 会过高估计
选择一首歌曲,然后看看这些联接对歌曲有何影响。
👉📋 查询编辑器 - 粘贴,然后点击运行:
SELECT 'BEFORE - the Songs table' AS step, title, streams, CAST(NULL AS STRING) AS playlist
FROM music.Songs WHERE title = 'Neon Summer'
UNION ALL
SELECT 'AFTER - joined to playlists', s.title, s.streams, pl.playlist_name
FROM music.Songs s
LEFT JOIN music.PlaylistEntries e ON e.song_id = s.song_id
LEFT JOIN music.Playlists pl ON pl.playlist_id = e.playlist_id
WHERE s.title = 'Neon Summer'
ORDER BY step DESC, playlist
👀 结果:
步骤 | title | 溪流 | 播放列表 |
之前 - 歌曲表 | 霓虹夏日 | 2,000,000,000 | null |
之后 - 已加入播放列表 | 霓虹夏日 | 2,000,000,000 | 健身泵 |
之后 - 已加入播放列表 | 霓虹夏日 | 2,000,000,000 | 热门新作 |
之后 - 已加入播放列表 | 霓虹夏日 | 2,000,000,000 | 冉冉升起的流行音乐 |
之后 - 已加入播放列表 | 霓虹夏日 | 2,000,000,000 | 自驾行程 |
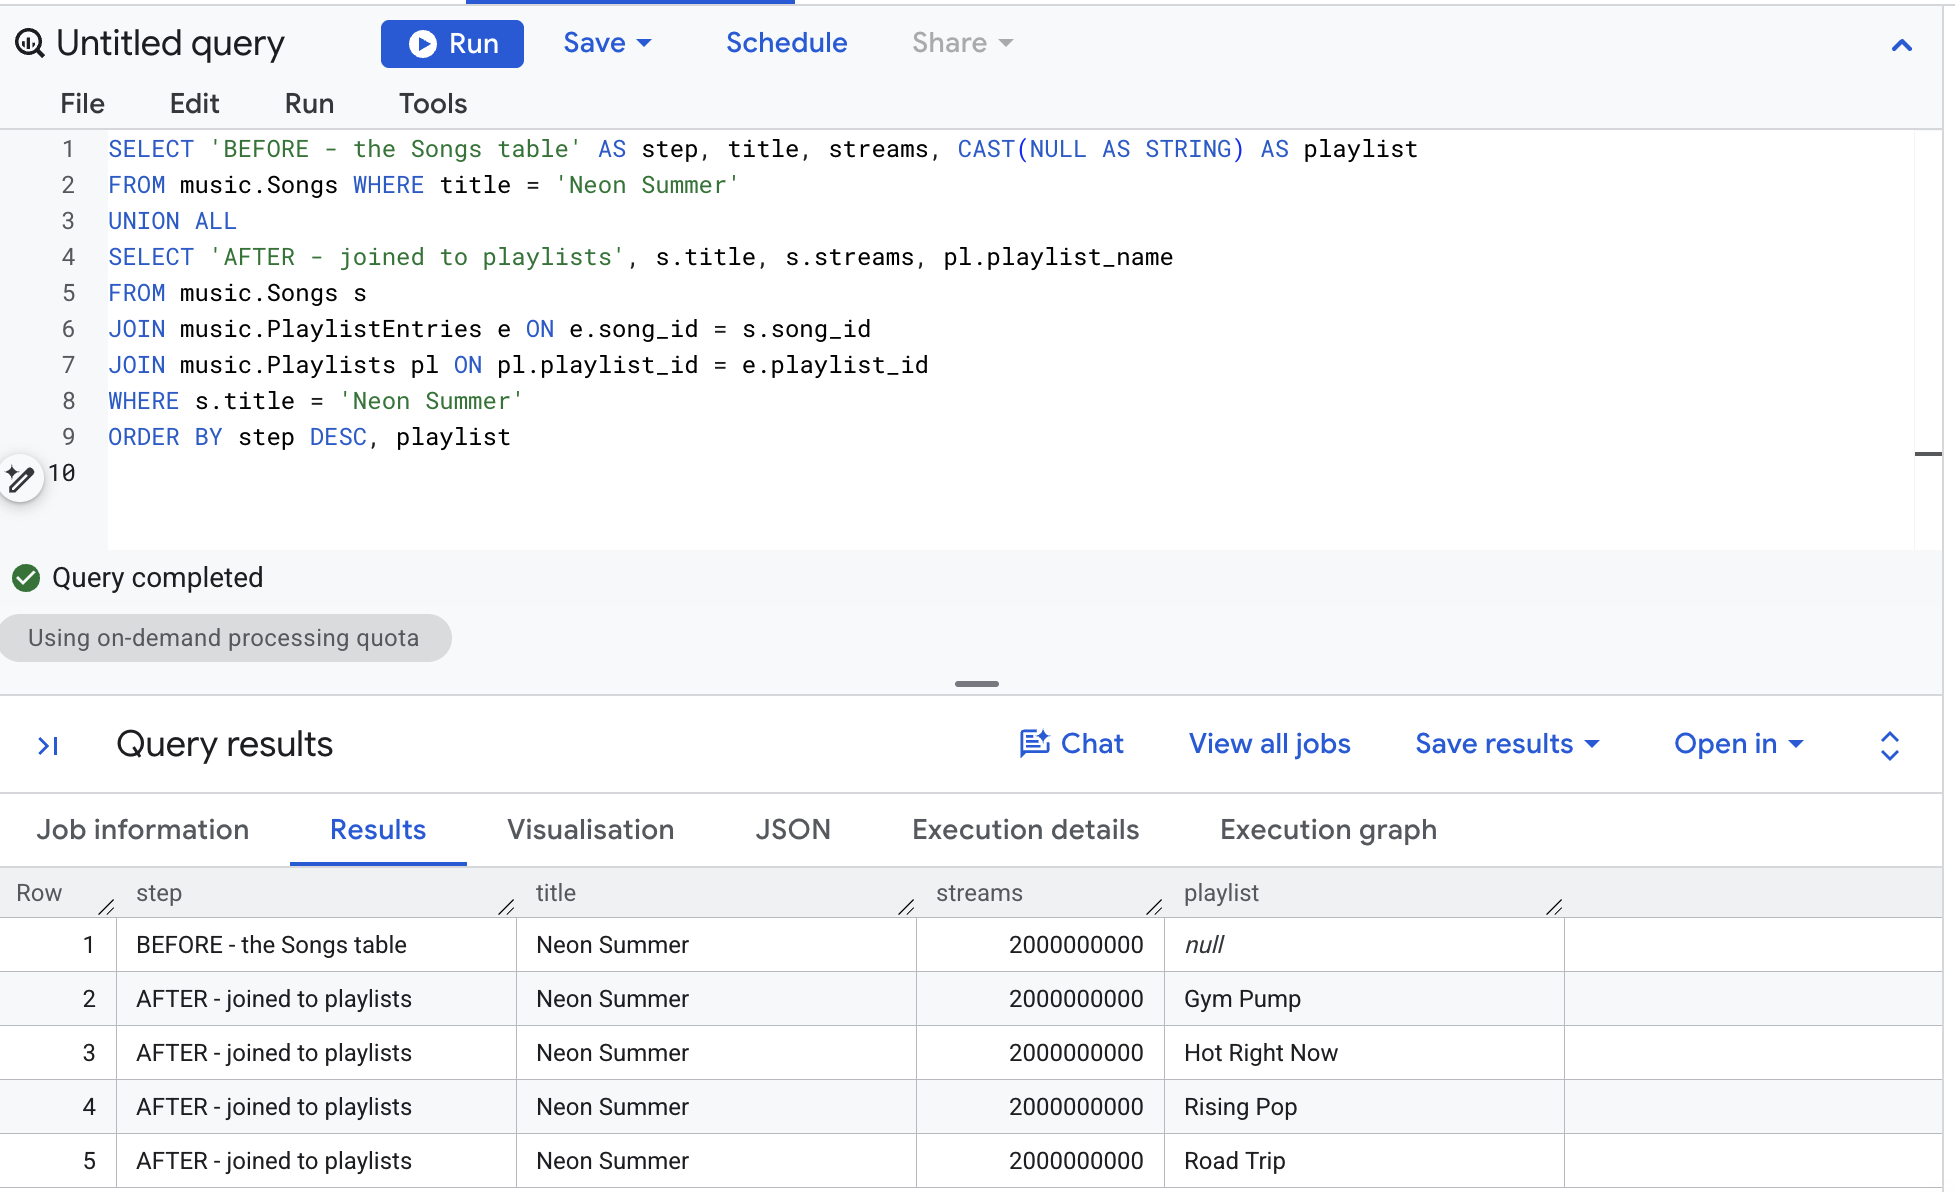
一行变成了四行。数据流数量未发生变化,只是进行了复制。将这些歌曲为 Cymbal Records 带来的收入加起来:四张播放列表中的《Neon Summer》20 亿次播放带来的收入为 80 亿,两张播放列表中的《Paper Crown》15 亿次播放带来的收入为 30 亿,一张播放列表中的《Double Shot》12 亿次播放带来的收入为 12 亿,一张播放列表中的《Slow Arrow》4 亿次播放带来的收入为 4 亿。即 126 亿,也就是返回的数字 SUM。Northwind 的《Midnight Drive》位于两个播放列表中,因此 45 亿变成了 90 亿。
这是扇出,而不是联接中的 bug。播放列表行是真实的。错误在于,将属于同一首歌曲的数字在属于不同展示位置的行中相加。
该度量修复了此问题,因为它与 KEY (song_id) 一起在 Songs 节点上声明。关键在于细分。当 AGG 评估 total_streams 时,它会按歌曲键汇总一次,然后才会汇总到您分组的任何内容。
有何变化
您之前写的内容 | 使用度量 |
|
|
|
|
3 个 |
|
在联接之前进行汇总的 CTE | 一切正常。 |
✅ 检查点:5 行 - 1 行在前面,4 行在后面 - 您可以从中重建 126 亿个。
7. 规则:只有 AGG 读取指标
度量具有自己的类型 MEASURE,并且只有一个函数接受该类型。以下四个查询会故意失败 - 请运行每个查询并阅读红色错误消息。这是每个人都会先尝试的四种方法,了解这些方法可以节省后续时间。
👉📋 查询编辑器 - 针对普通列的 AGG:
SELECT AGG(Songs_streams) FROM GRAPH_EXPAND("music.MusicGraph")
👀 No matching signature for aggregate function AGG ... Argument 1: expected MEASURE
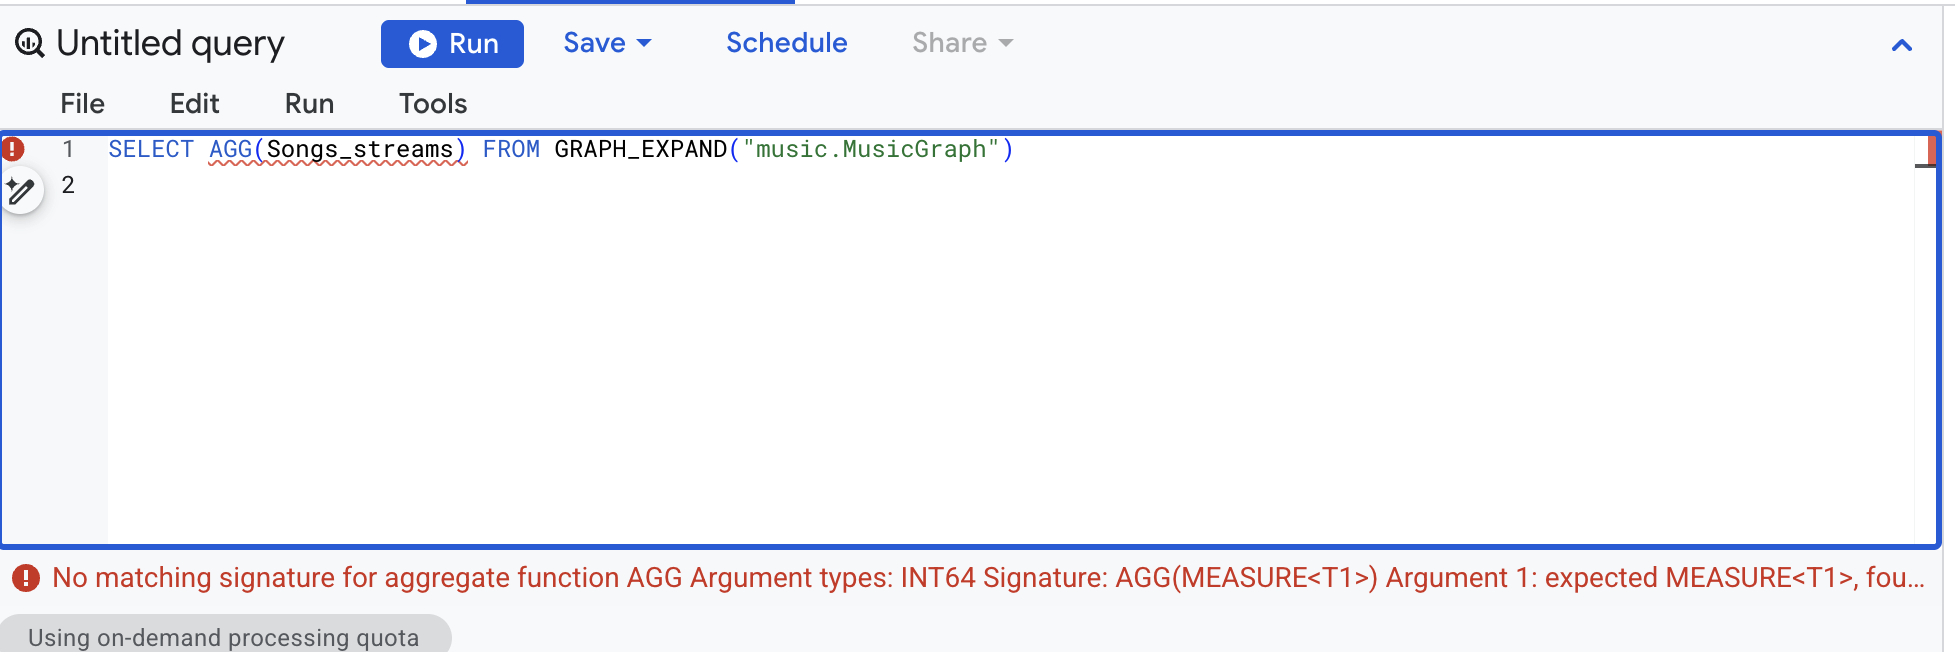
👉📋 查询编辑器 - 不含 AGG 的指标列:
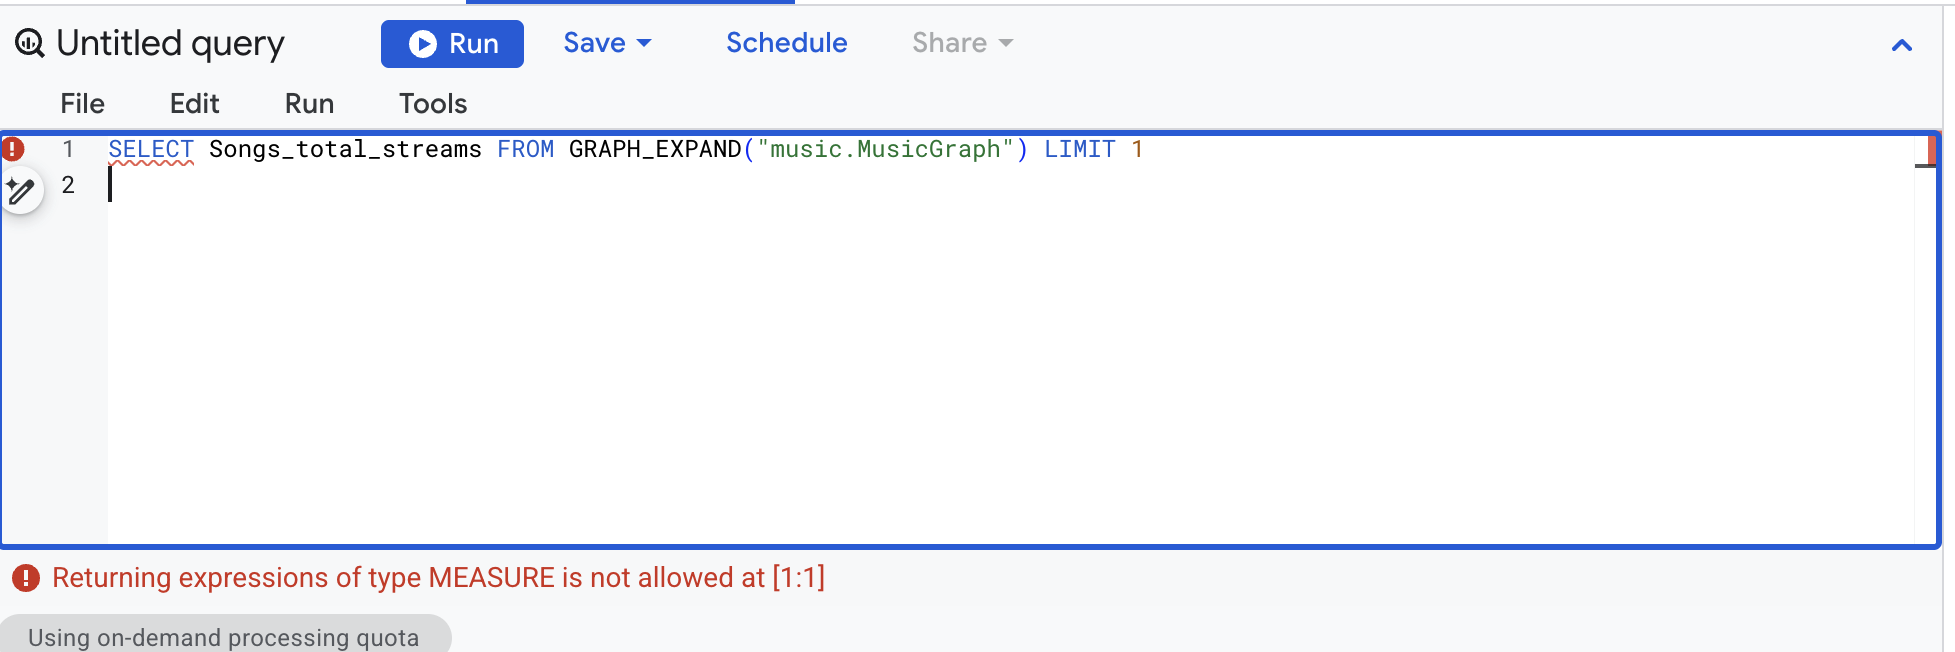
SELECT Songs_total_streams FROM GRAPH_EXPAND("music.MusicGraph") LIMIT 1
👀 Returning expressions of type MEASURE is not allowed
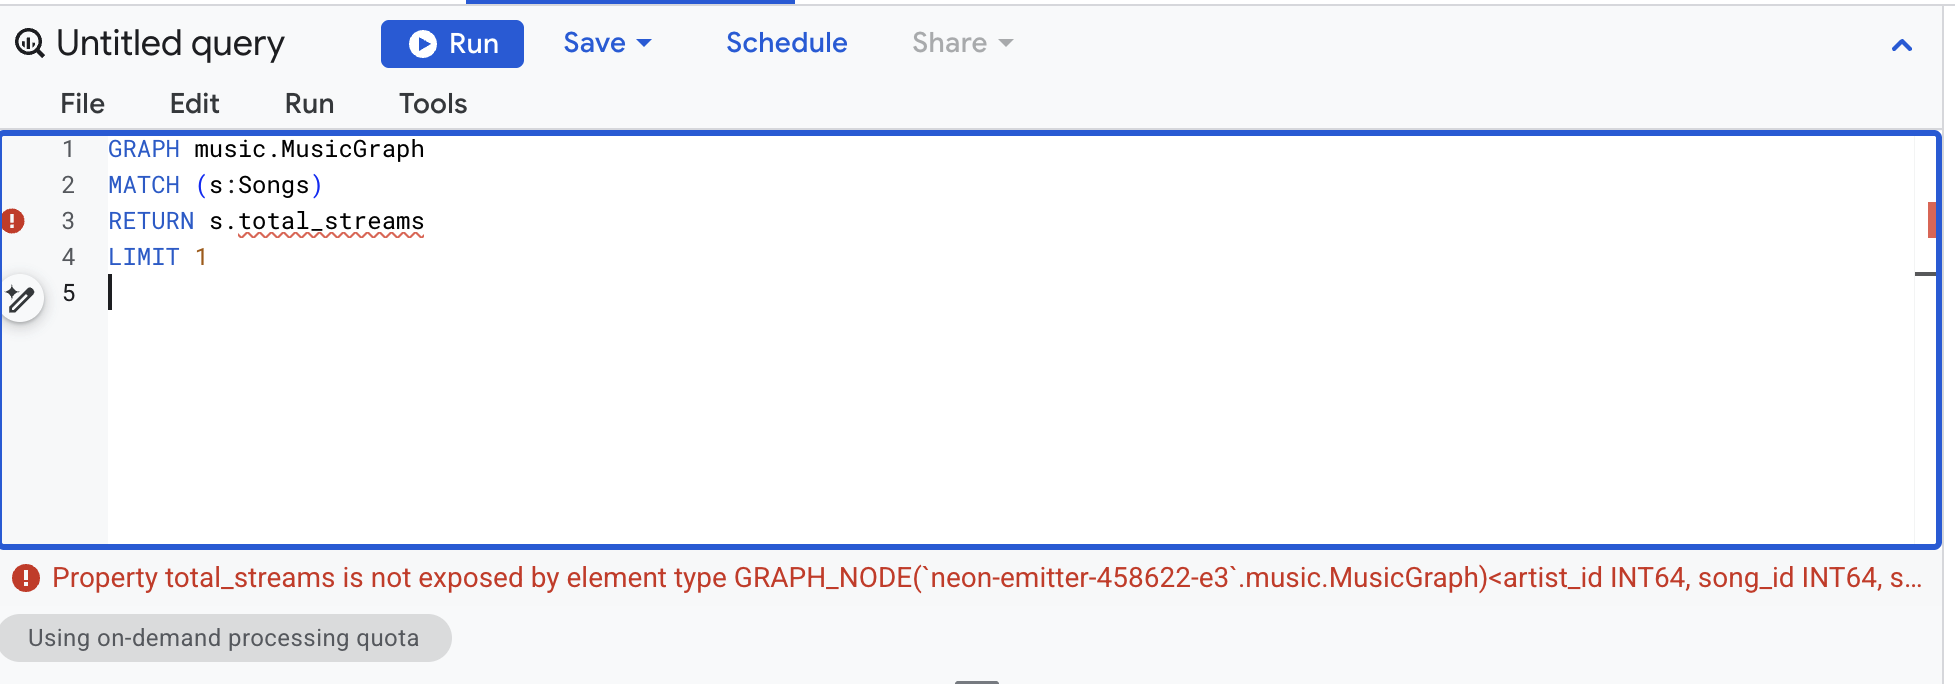
👉📋 查询编辑器 - GQL 中引用的指标,但从未看到任何指标(这是一个 GQL 查询 - 请参阅概览中的版本说明):
GRAPH music.MusicGraph
MATCH (s:Songs)
RETURN s.total_streams
LIMIT 1
👀 total_streams is not exposed by element type GRAPH_NODE(...)
👉📋 查询编辑器 - SUM 衡量指标列,即最吸引人的列:
SELECT Labels_label_name, SUM(Songs_total_streams)
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1
👀 MEASURE-typed arguments are only permitted in the AGG function
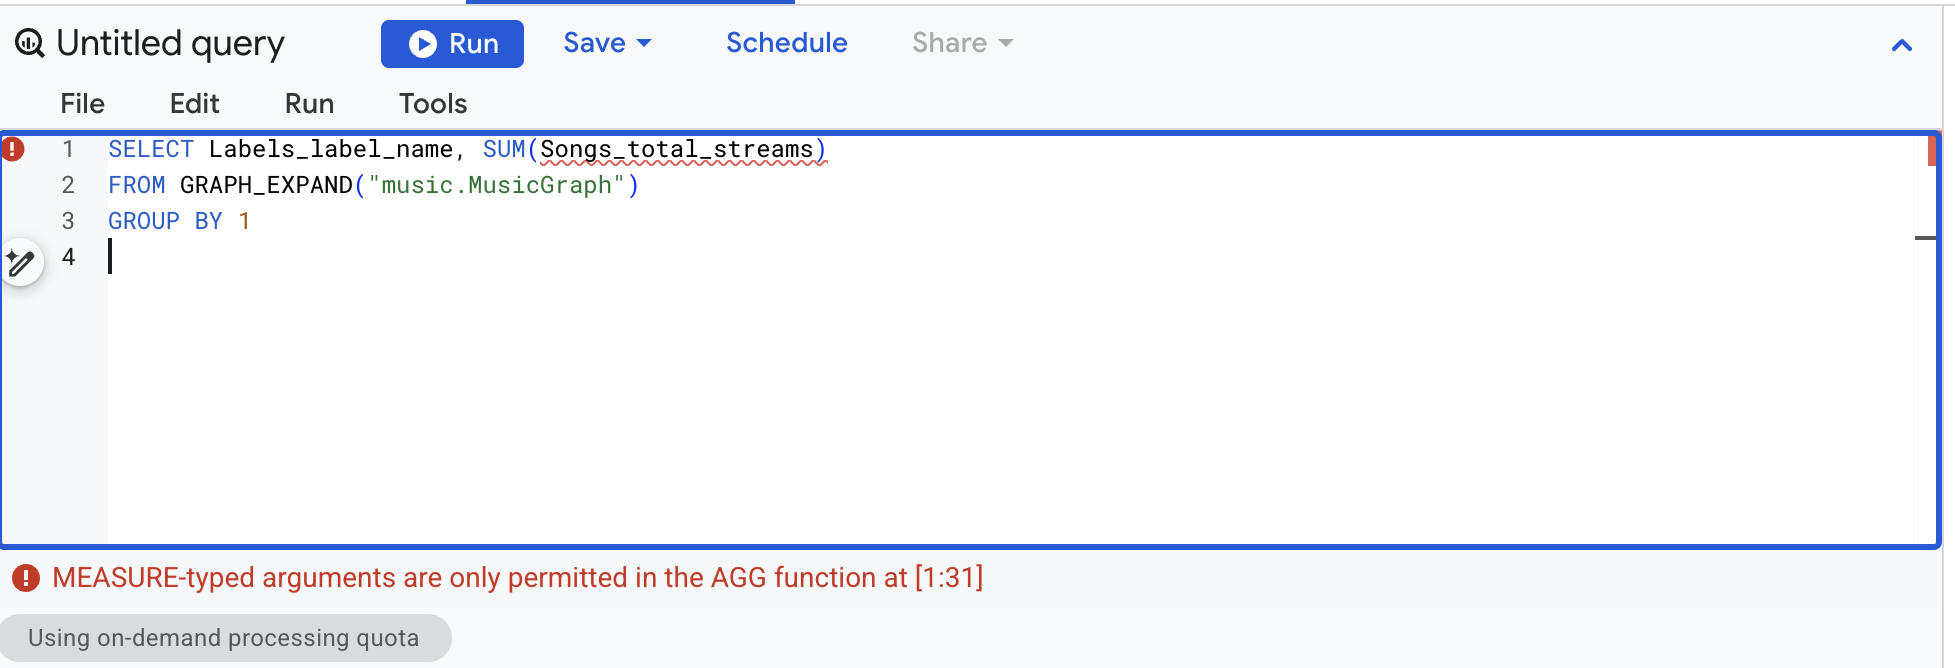
因此,类型系统会为您强制执行该规则。度量只能通过 GRAPH_EXPAND 查看,只能通过 AGG 读取。之前过高的 126 亿只能来自对原始列的求和,而绝不会来自对指标的错误处理。
✅ 检查点:四个红色错误,并且您能说出每个错误所强制执行的规则。
8. 相应指标支持的每个汇总函数
MEASURE() 封装了六个汇总之一:SUM、AVG、MIN、MAX、COUNT 和 COUNT(DISTINCT)。在“歌曲”节点上重新创建包含所有六个属性的图。边的值保持为 NO PROPERTIES,这是当边与其节点共享物理表时记录的最佳实践。
👉📋 查询编辑器 - 粘贴,然后点击运行:
CREATE OR REPLACE PROPERTY GRAPH music.MusicGraph
  NODE TABLES (
    music.Labels KEY (label_id)
      PROPERTIES (label_id, label_name, marketing_budget,
        MEASURE(SUM(marketing_budget)) AS total_budget),
    music.Artists KEY (artist_id)
      PROPERTIES (artist_id, artist_name, label_id,
        MEASURE(COUNT(artist_id)) AS artist_count),
    music.Songs KEY (song_id)
      PROPERTIES (song_id, title, artist_id, streams,
        MEASURE(SUM(streams))              AS total_streams,
        MEASURE(AVG(streams))              AS avg_streams,
        MEASURE(MIN(streams))              AS min_streams,
        MEASURE(MAX(streams))              AS max_streams,
        MEASURE(COUNT(song_id))            AS song_count,
        MEASURE(COUNT(DISTINCT artist_id)) AS distinct_artists),
    music.Playlists KEY (playlist_id)
      PROPERTIES (playlist_id, playlist_name, followers,
        MEASURE(SUM(followers)) AS total_followers),
    music.PlaylistEntries KEY (entry_id)
      PROPERTIES (entry_id, playlist_id, song_id,
        MEASURE(COUNT(entry_id)) AS placement_count)
  )
  EDGE TABLES (
    music.PlaylistEntries AS EntryToSong
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (song_id) REFERENCES Songs(song_id) NO PROPERTIES,
    music.PlaylistEntries AS EntryToPlaylist
      SOURCE KEY (entry_id) REFERENCES PlaylistEntries(entry_id)
      DESTINATION KEY (playlist_id) REFERENCES Playlists(playlist_id) NO PROPERTIES,
    music.Songs AS SongToArtist
      SOURCE KEY (song_id) REFERENCES Songs(song_id)
      DESTINATION KEY (artist_id) REFERENCES Artists(artist_id) NO PROPERTIES,
    music.Artists AS ArtistToLabel
      SOURCE KEY (artist_id) REFERENCES Artists(artist_id)
      DESTINATION KEY (label_id) REFERENCES Labels(label_id) NO PROPERTIES
  )
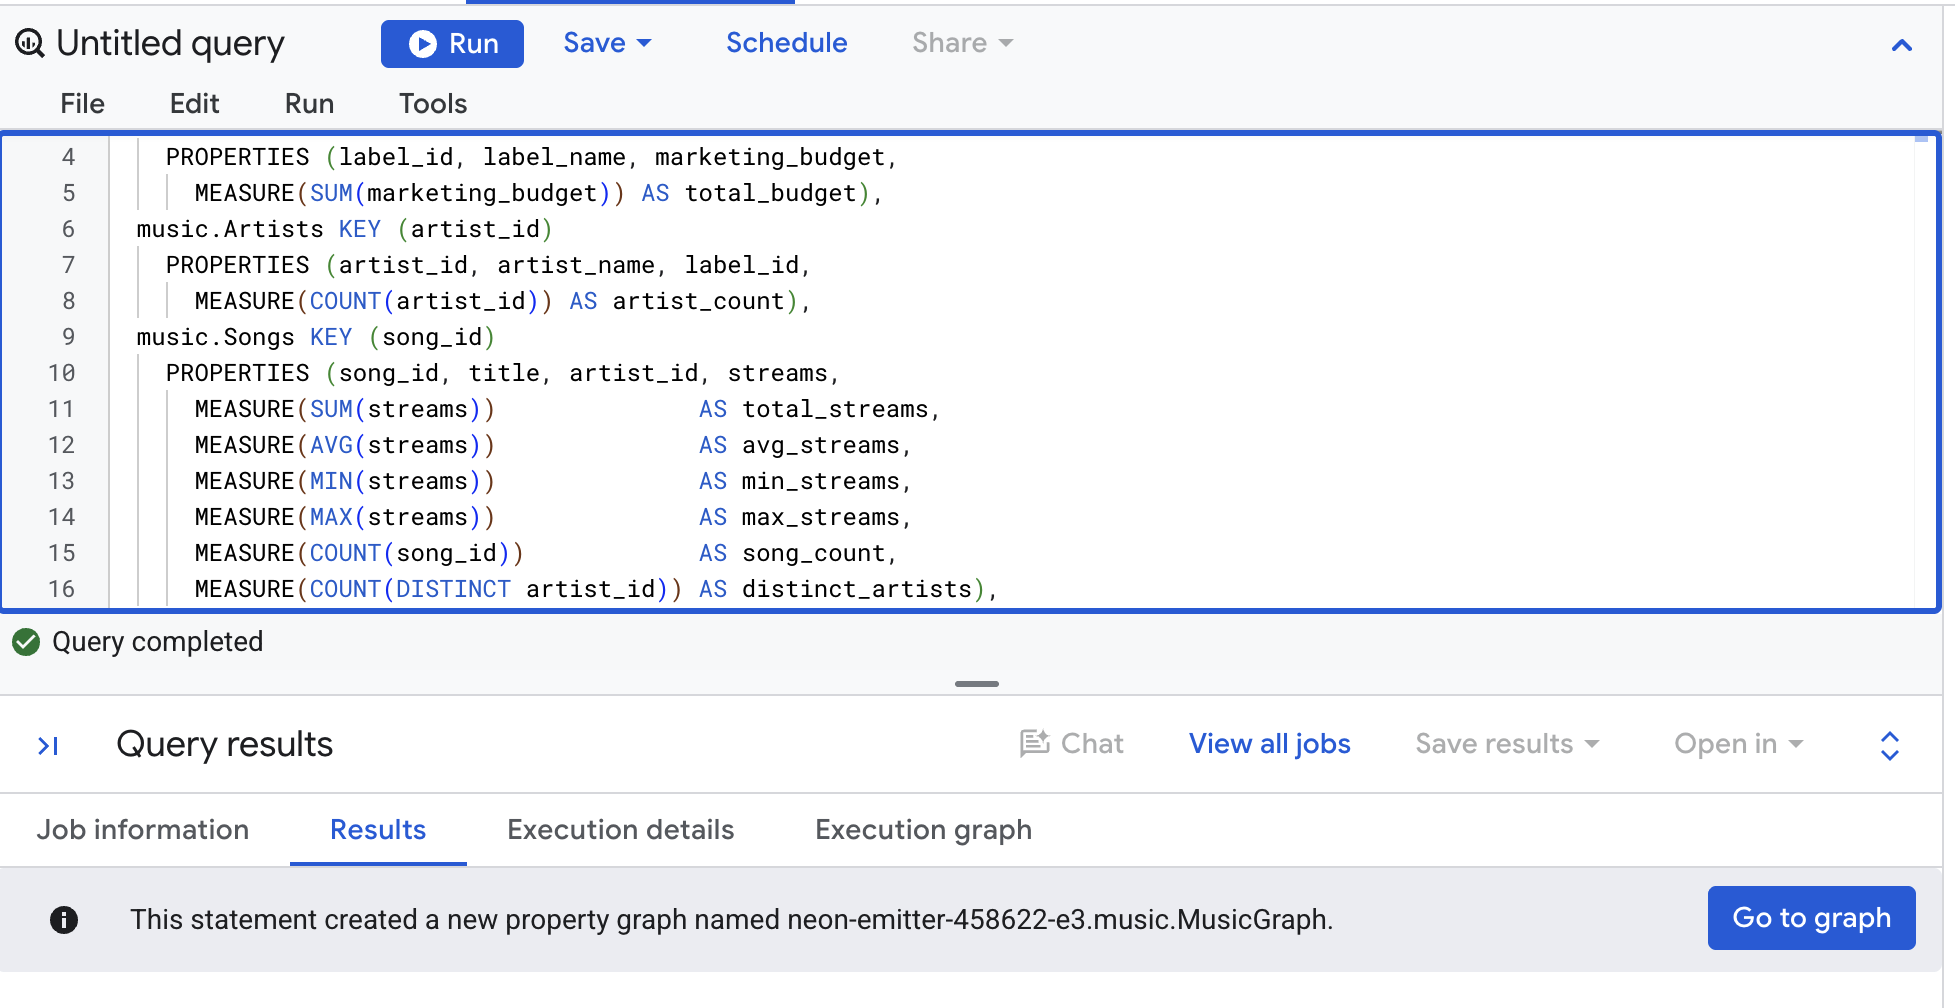
现在,请将所有这些内容读出来。每个度量都会经历 AGG,最后一列显示 AGG 结果是您可以进行算术运算的常规值。图表刚刚更改,因此请先清除使用缓存的结果(更多 → 查询设置)。
👉📋 查询编辑器 - 粘贴,然后点击运行:
SELECT
  Labels_label_name,
  AGG(Songs_total_streams)    AS total_streams,
  AGG(Songs_avg_streams)      AS avg_streams,
  AGG(Songs_min_streams)      AS min_streams,
  AGG(Songs_max_streams)      AS max_streams,
  AGG(Songs_song_count)       AS songs,
  AGG(Songs_distinct_artists) AS artists,
  AGG(Songs_total_streams) / AGG(Songs_song_count) AS streams_per_song
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1
ORDER BY 1
👀 结果:
Labels_label_name | total_streams | avg_streams | min_streams | max_streams | 歌曲 | 音乐人 | streams_per_song |
Cymbal Records | 5,100,000,000 | 1,275,000,000 | 400,000,000 | 2,000,000,000 | 4 | 2 | 1,275,000,000 |
Northwind Audio | 4,500,000,000 | 4,500,000,000 | 4,500,000,000 | 4,500,000,000 | 1 | 1 | 4,500,000,000 |
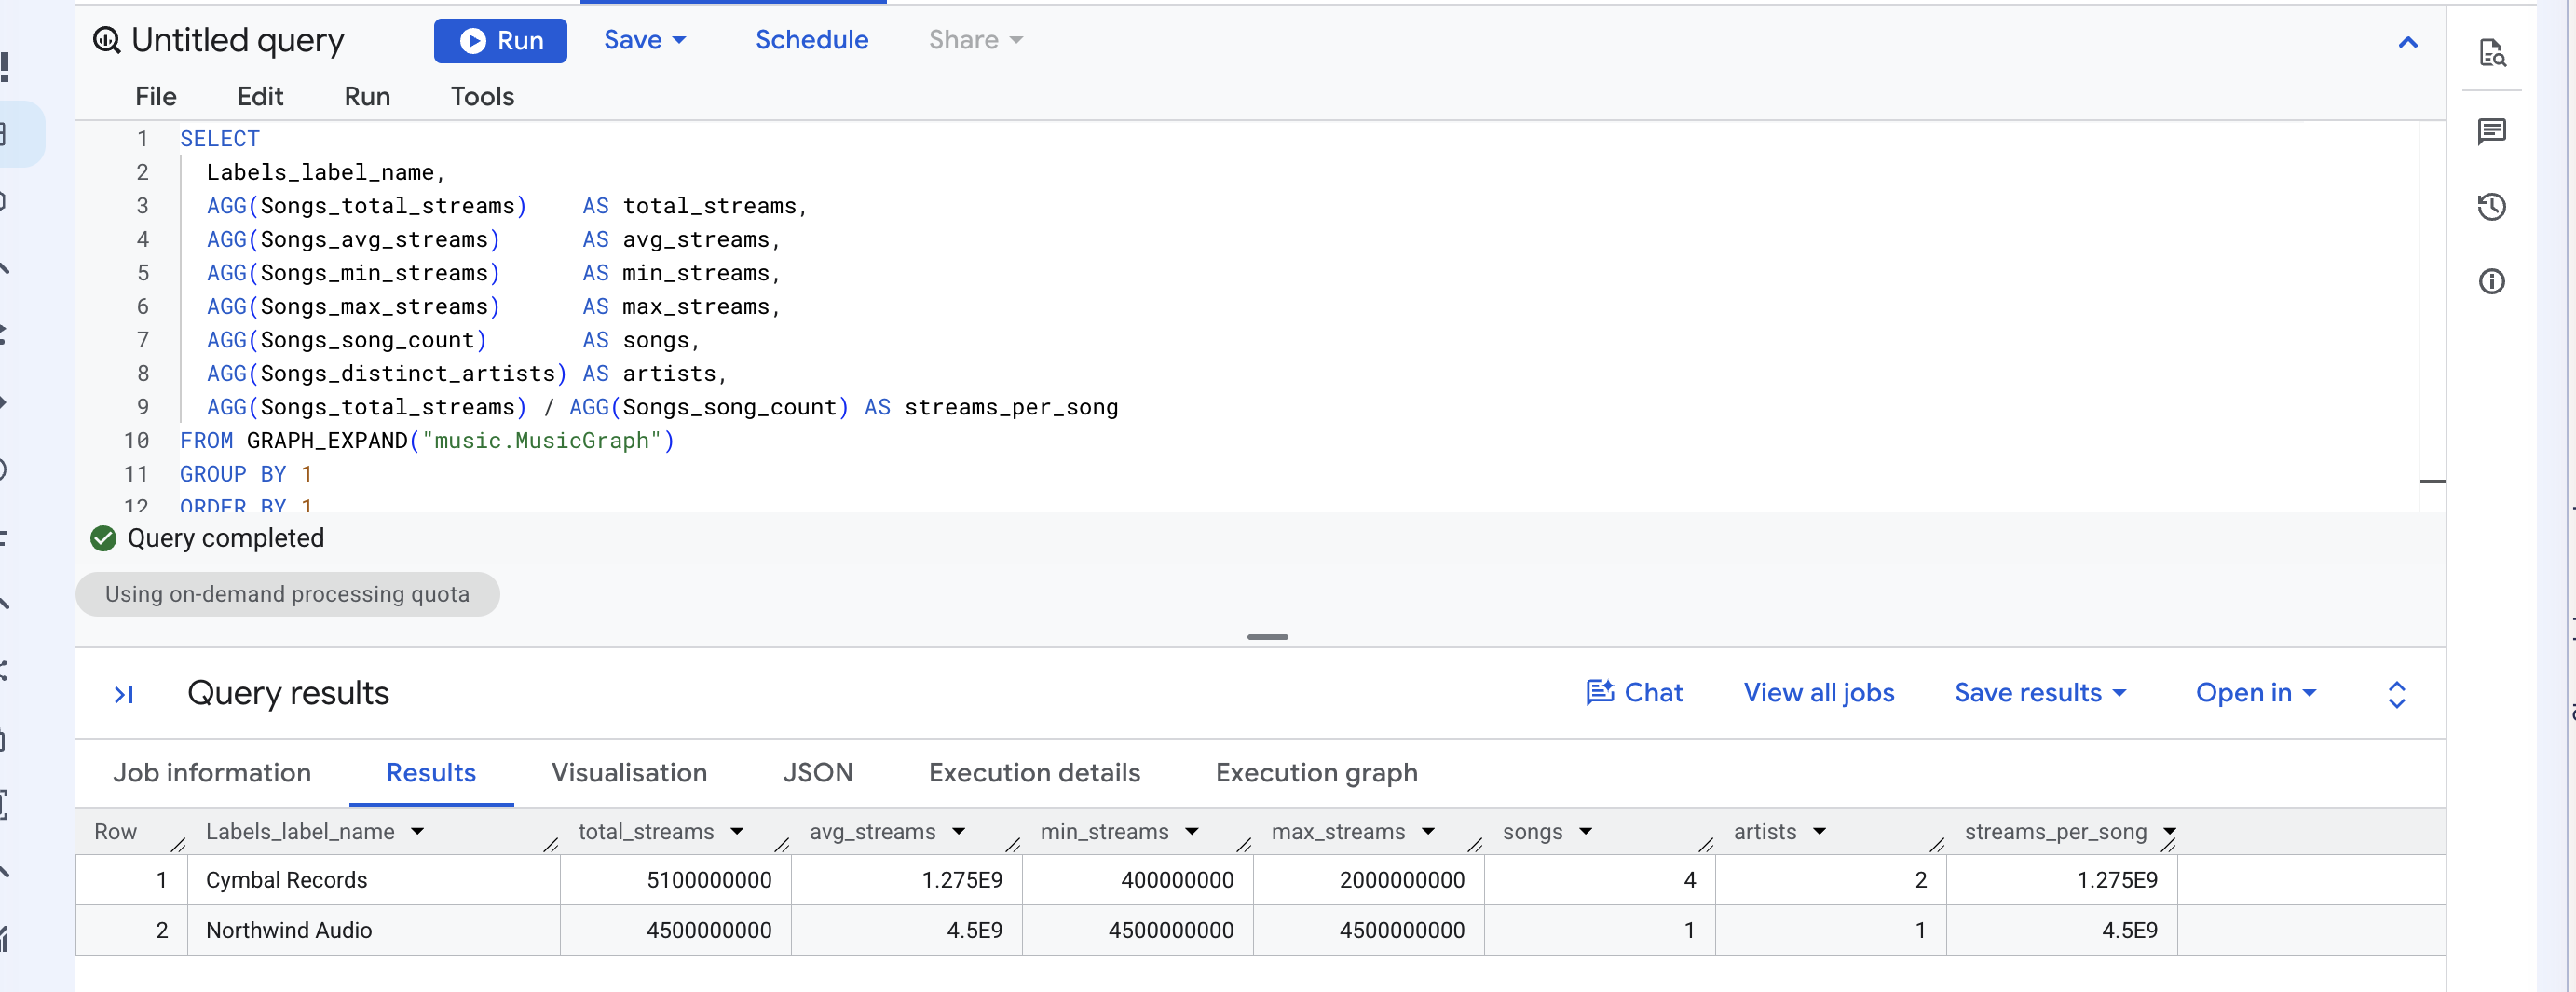
每个数字都是根据 Cymbal 的 4 首歌曲和 Northwind 的 1 首歌曲计算得出的,而不是根据 10 个展示位置行计算得出的。尤其是 AVG,如果反过来计算,结果会出错:对展示位置行的原始列求平均值,得出 Cymbal 的值为 15.75 亿,因为 Neon Summer 的 20 亿被计算了四次。
因此,“将 SUM 替换为 AGG”实际上是两项决策。在声明指标时,您仍然可以选择它是六个聚合函数中的哪一个。在读取指标时,该函数始终为 AGG。
✅ 检查点:每个标签一行,每行七个数字,且 streams_per_song 等于 avg_streams。
9. 更改分组,而非衡量指标
同一指标回答了不同的问题。按播放列表而非标签分组。
👉📋 查询编辑器 - 粘贴,然后点击运行:
SELECT
  Playlists_playlist_name,
  AGG(Songs_total_streams) AS streams,
  AGG(Songs_song_count)    AS songs
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY 1
ORDER BY 2 DESC
👀 结果:
Playlists_playlist_name | 溪流 | 歌曲 |
自驾行程 | 6,900,000,000 | 3 |
健身泵 | 6,500,000,000 | 2 |
热门新作 | 4,700,000,000 | 3 |
冉冉升起的流行音乐 | 3,500,000,000 | 2 |
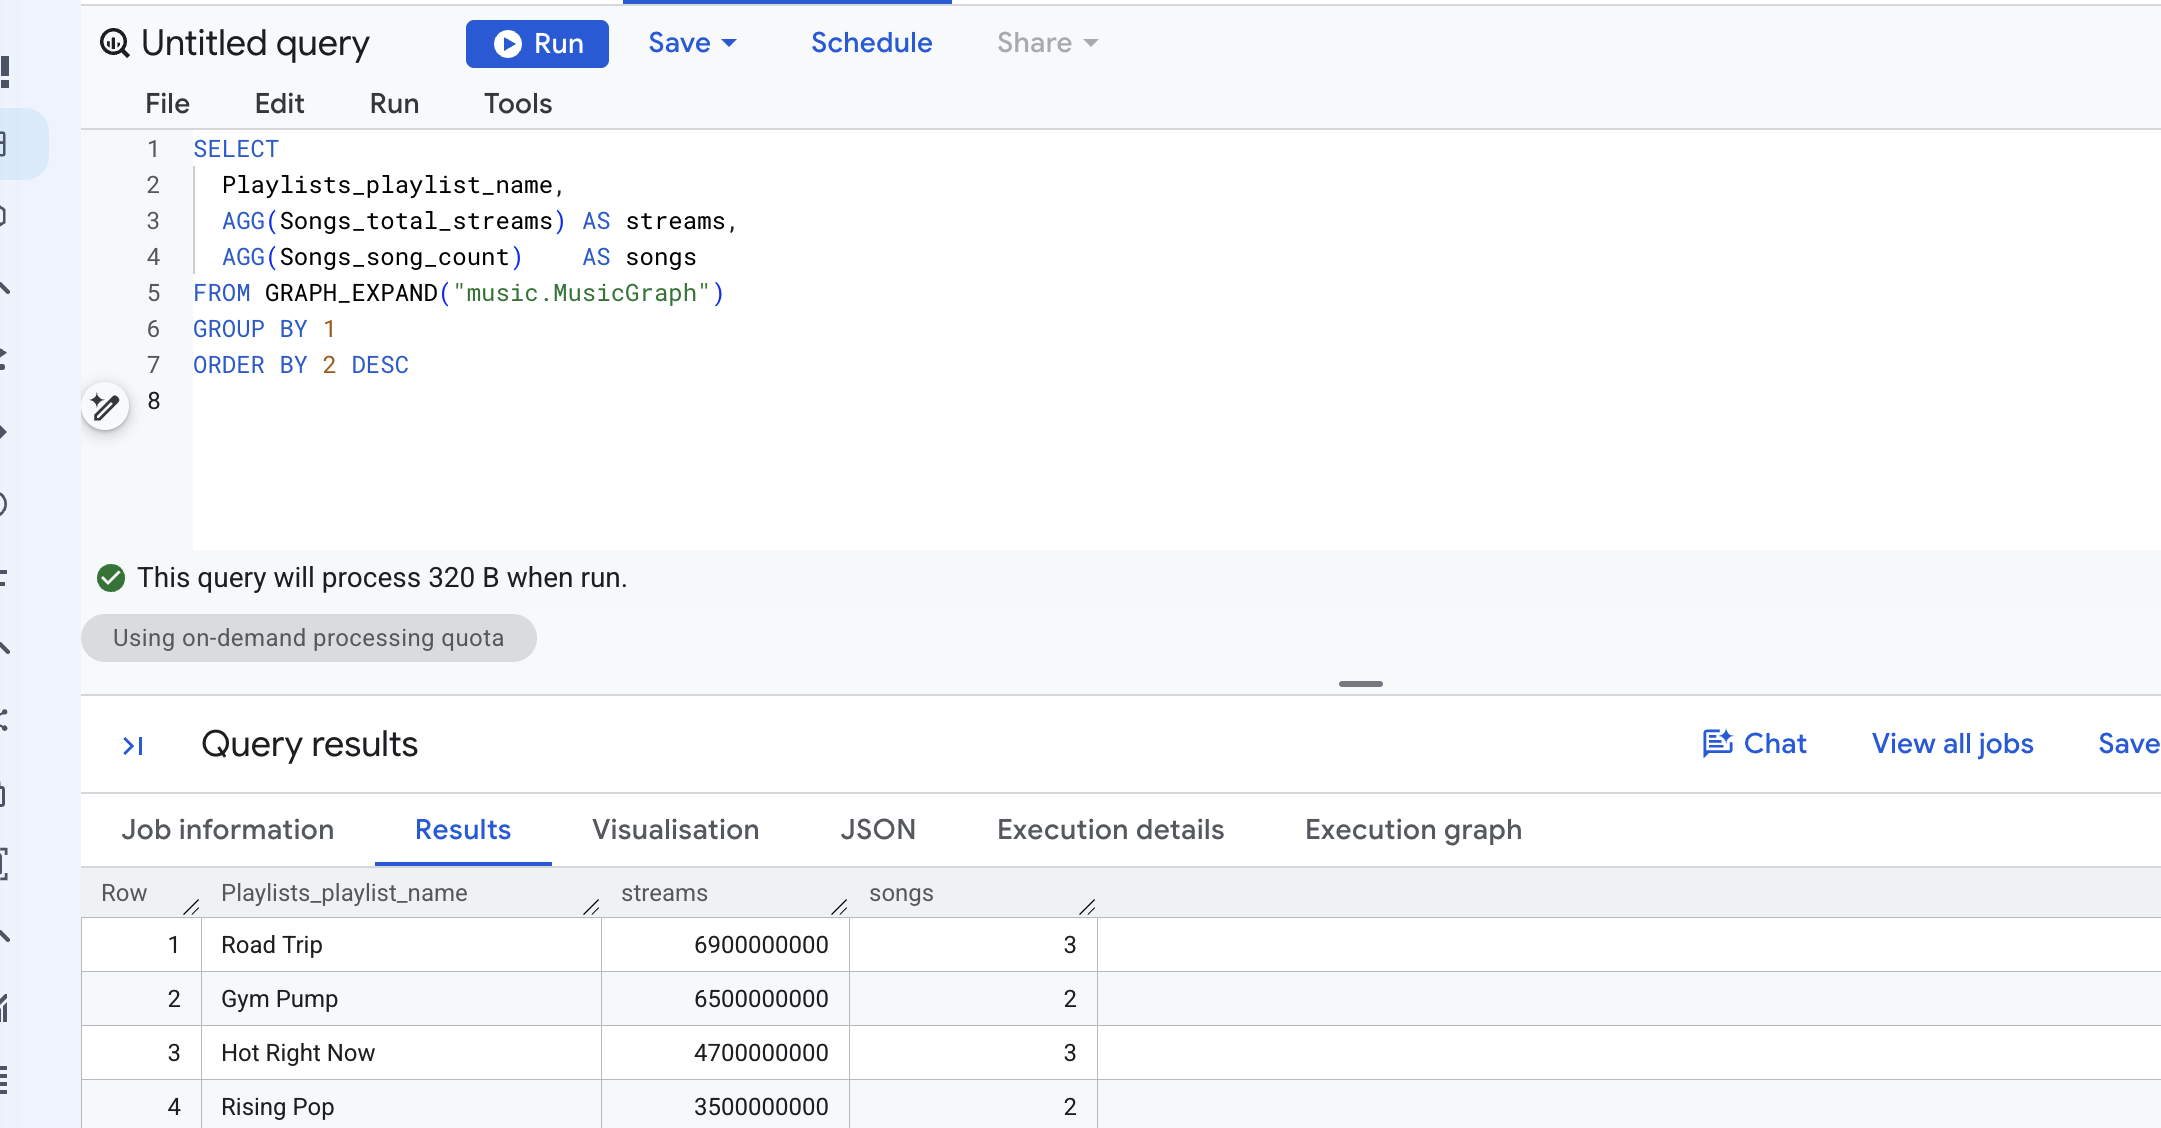
这两个 AGG 行与 SUM 和 AGG 并排显示的行完全相同。只有 GROUP BY 发生了移动。“Road Trip”播放列表包含“Neon Summer”“Midnight Drive”和“Slow Arrow”三首歌曲,每首歌曲在该播放列表中都只算一次播放,这正是“播放次数达到此播放列表”的含义。
撰写度量的人员决定了粒度。任何人在之后提出的每个查询都会继承该变量。
✅ 检查点:“公路之旅”以 69 亿次观看次数位居榜首。
10. 了解 GRAPH_EXPAND 的功能
您无需运行 GRAPH_EXPAND 即可了解其形状。BQ.SHOW_GRAPH_EXPAND_SCHEMA 系统过程将列列表写入变量。
👉📋 查询编辑器 - 粘贴所有三行,然后点击运行:
DECLARE schema STRING DEFAULT '';
CALL BQ.SHOW_GRAPH_EXPAND_SCHEMA('music.MusicGraph', schema);
SELECT schema;
👀 结果是一个 JSON 字符串。每个字段都有一个名称、一个类型和一个模式,并且每个指标列都带有 "is_measure": true。对于您刚刚构建的图表,您会获得以下信息(以及其他信息):
name | 类型 | is_measure | |
Songs_title | STRING | ||
Songs_streams | INTEGER | ||
Songs_total_streams | INTEGER | true | |
Songs_avg_streams | FLOAT | true | |
Songs_distinct_artists | INTEGER | true | |
PlaylistEntries_placement_count | INTEGER | true | |
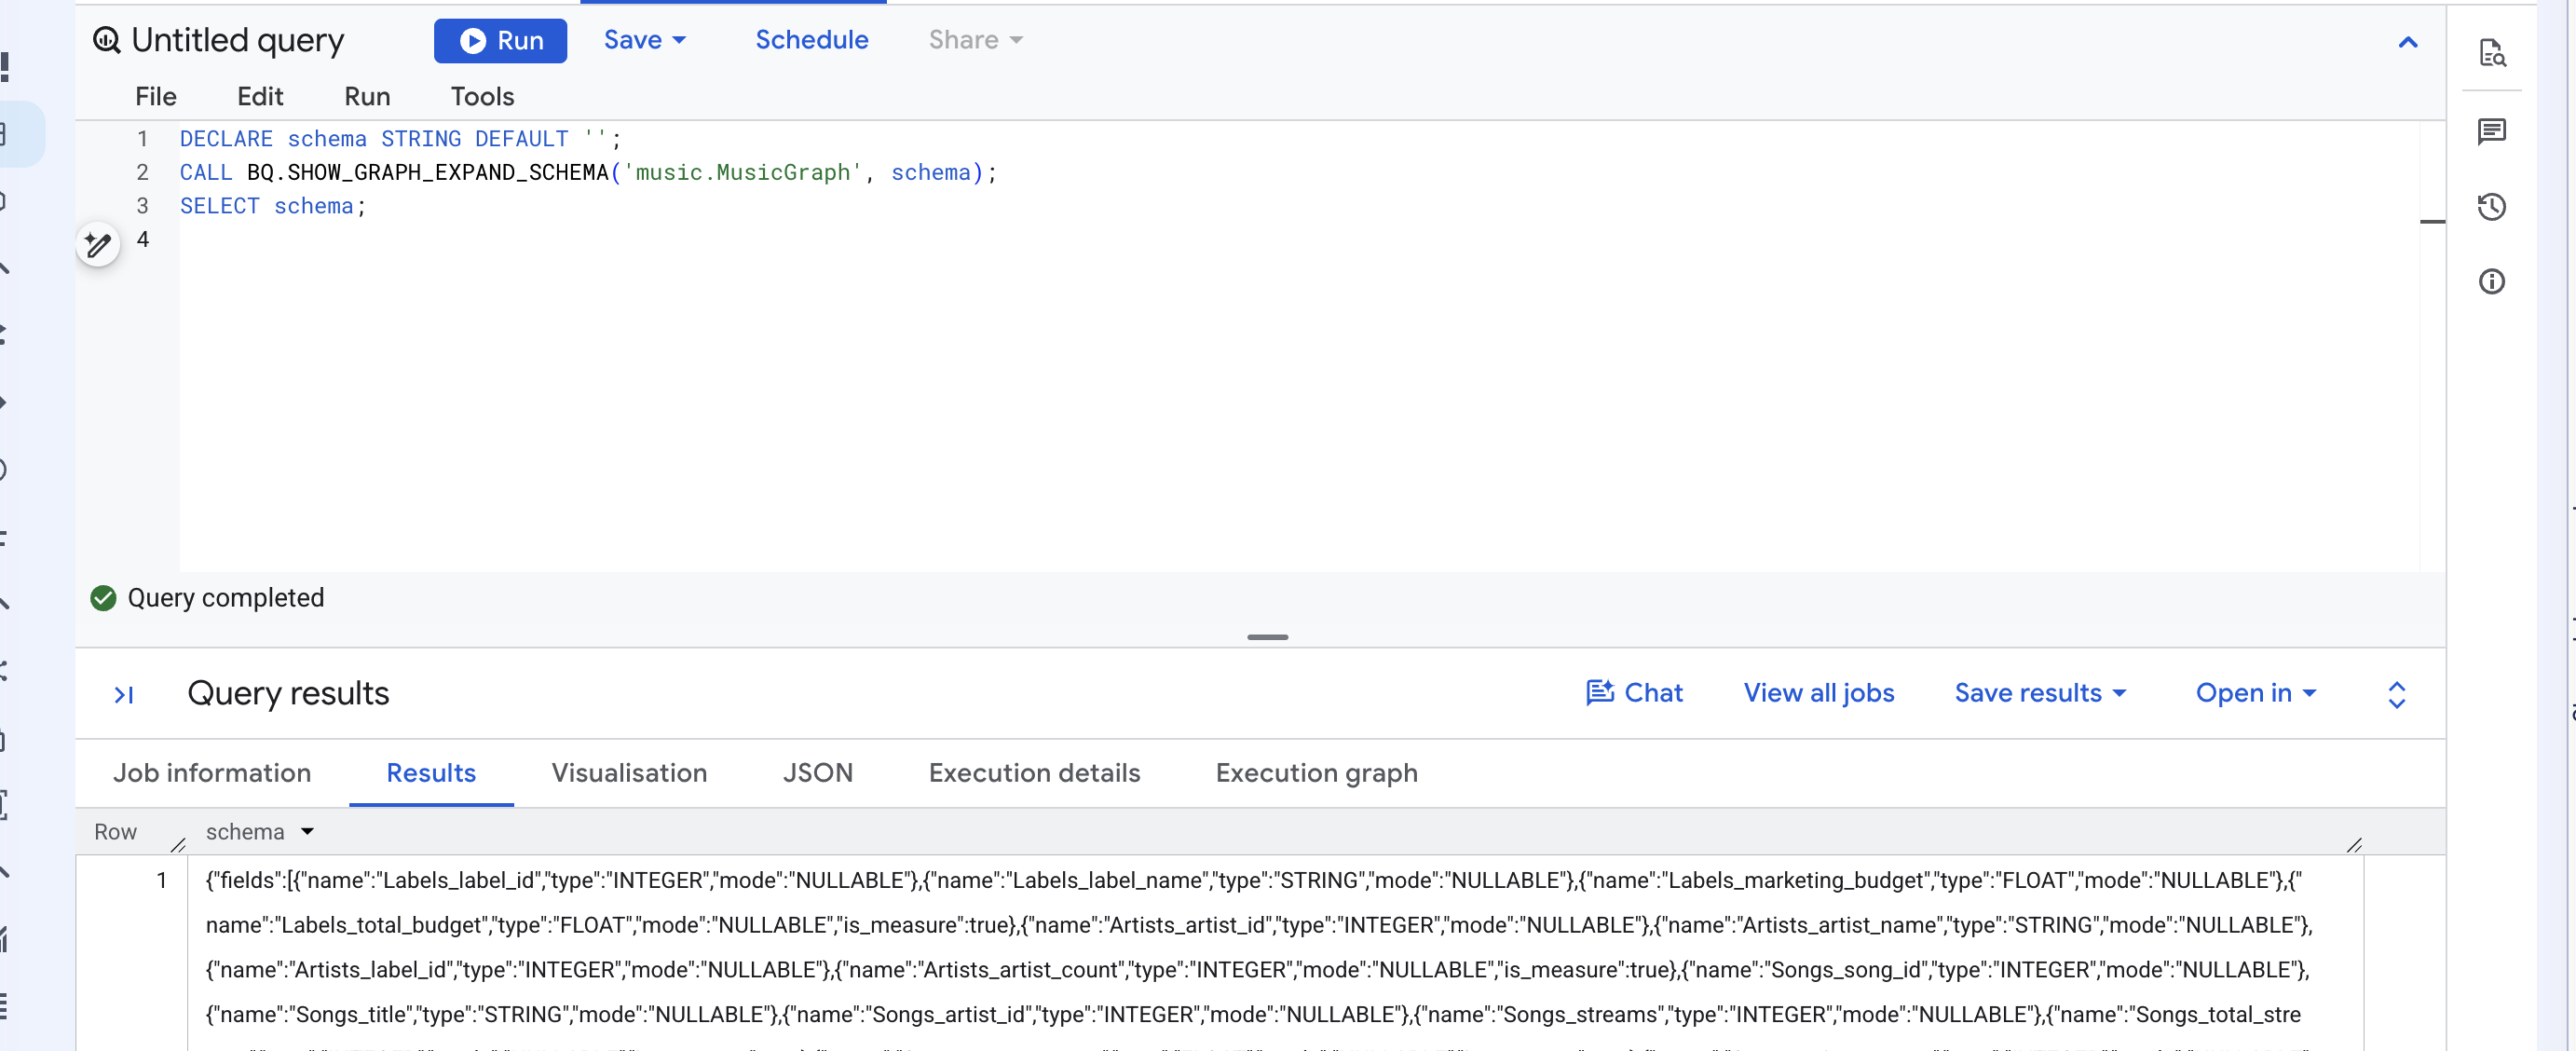
您为媒体资源设置的任何说明或同义词也会显示在此处。可选的聊天步骤会显示谁会阅读这些内容。
✅ 检查点:一个 JSON 字符串,其中包含您使用 MEASURE 声明的每个列的 is_measure。
11. GRAPH_EXPAND 对图形状的要求
此步骤无需运行任何内容,只需阅读即可。GRAPH_EXPAND 通过 LEFT JOIN 链构建其宽表,从一个表开始,然后沿着边向外扩展。由此可得出三条规则,而 MusicGraph 满足所有这些规则。
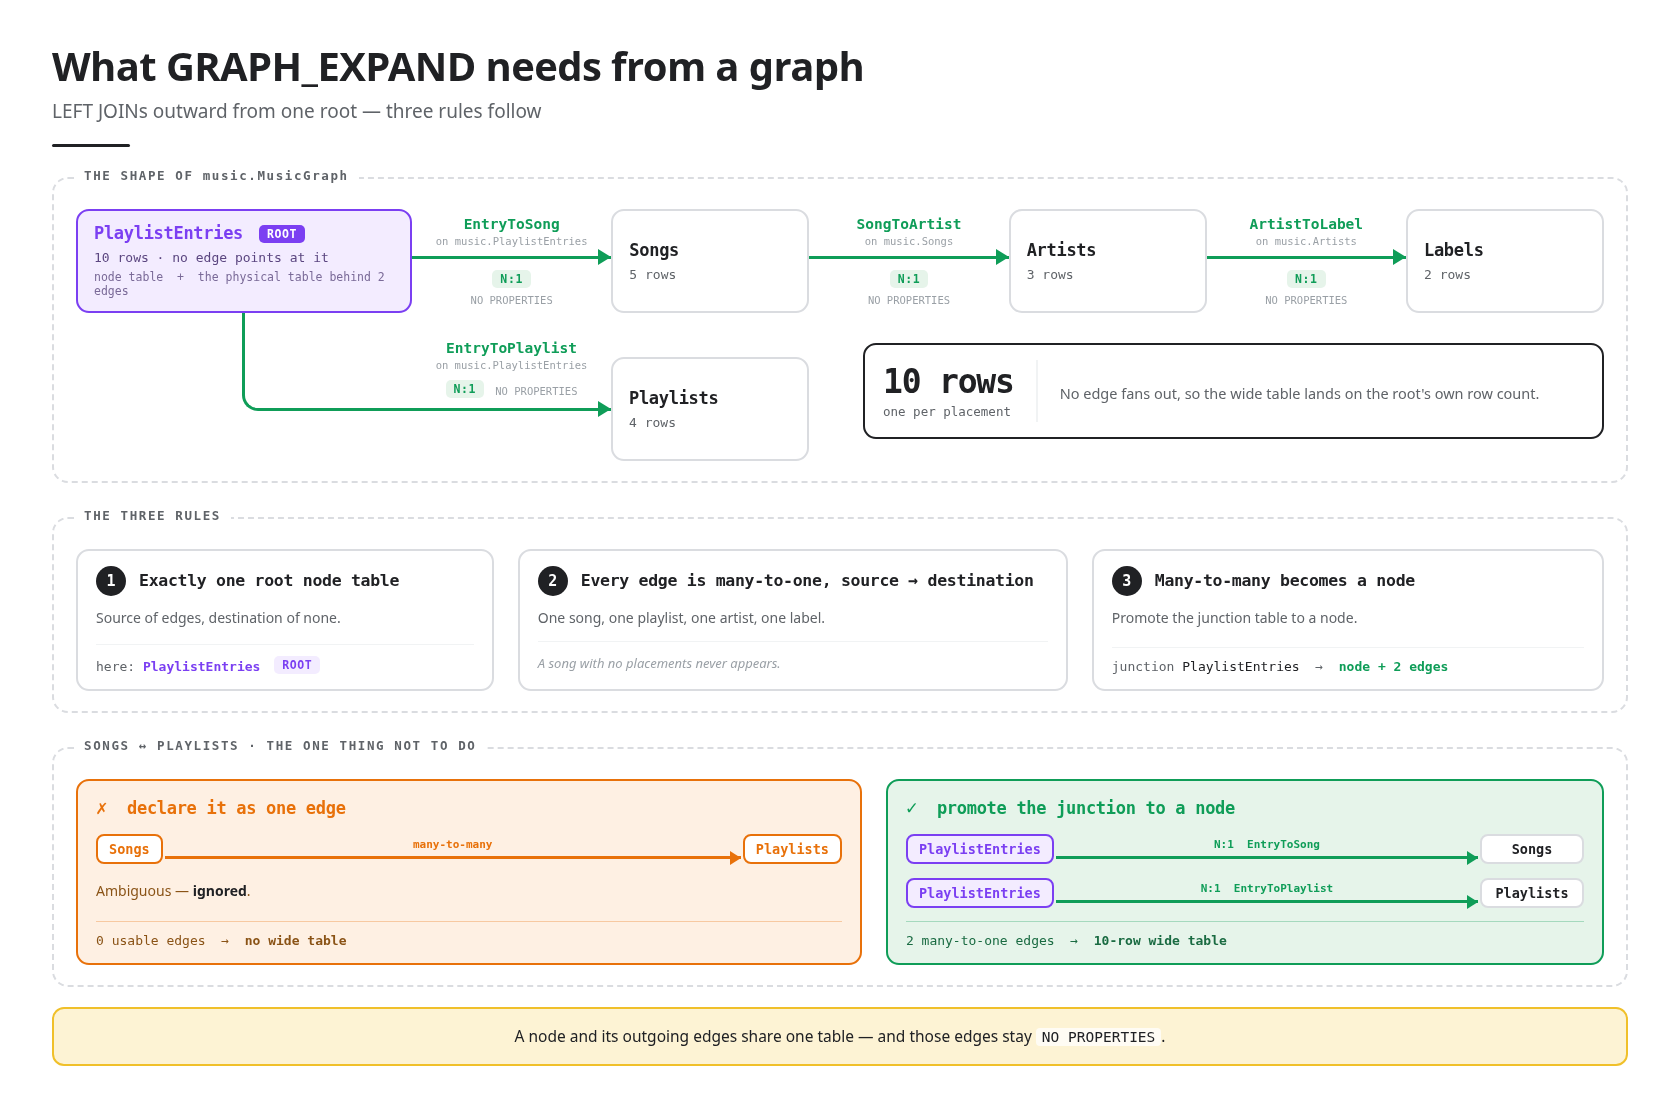
一个根节点表。根是键未出现在任何其他表中的节点表,即没有边指向的节点表。在 MusicGraph 中,PlaylistEntries 是两个边的来源,但不是任何边的目的地。宽表有 10 行,每个展示位置对应一行。
每条边的方向都是从来源到目的地,属于多对一关系。每个条目都包含一首歌曲和一个播放列表,每首歌曲都有一位音乐人,每位音乐人都有一家唱片公司。因此,宽表永远不会扩展到根的自有行之外。根无法访问的数据不会显示:没有布置的歌曲将不会显示在宽表中。
多对多关系会成为一个节点。歌曲和播放列表之间存在多对多关系。如果您将联结表声明为从歌曲到播放列表的单个边,GRAPH_EXPAND 会因其不明确而忽略它;由于没有可用的边,它会失败。将 PlaylistEntries 提升为具有两个多对一出边的节点表是已记录的模式,也是您在构建图时所做的操作。
12. (可选)使用 GQL 的路径
到目前为止,每个问题都有一个数字答案。但此功能不会。Cymbal 的流媒体如何触达听众?是一个关于图表中路径的问题,总和无法回答这个问题,因为在您求和时,路径已经消失。
1. 询问数据流的着陆位置
👉📋 查询编辑器 - 粘贴,然后点击运行:
GRAPH music.MusicGraph
MATCH (l:Labels)<-[:ArtistToLabel]-(a:Artists)<-[:SongToArtist]-(s:Songs)
      <-[:EntryToSong]-(e:PlaylistEntries)-[:EntryToPlaylist]->(pl:Playlists)
WHERE l.label_name = 'Cymbal Records'
RETURN pl.playlist_name, pl.followers,
       SUM(s.streams) AS streams_reaching_this_playlist,
       STRING_AGG(s.title, ', ') AS songs
GROUP BY pl.playlist_name, pl.followers
ORDER BY streams_reaching_this_playlist DESC
👀 预计会有 4 个播放列表:
pl.playlist_name | pl.followers | streams_reaching_this_playlist | 歌曲 |
热门新作 | 35,000,000 | 4,700,000,000 | Double Shot、Neon Summer、Paper Crown |
冉冉升起的流行音乐 | 200 万 | 3,500,000,000 | Neon Summer,Paper Crown |
自驾行程 | 5000000 | 2,400,000,000 | 霓虹夏日,慢速箭头 |
健身泵 | 3,000,000 | 2,000,000,000 | 霓虹夏日 |
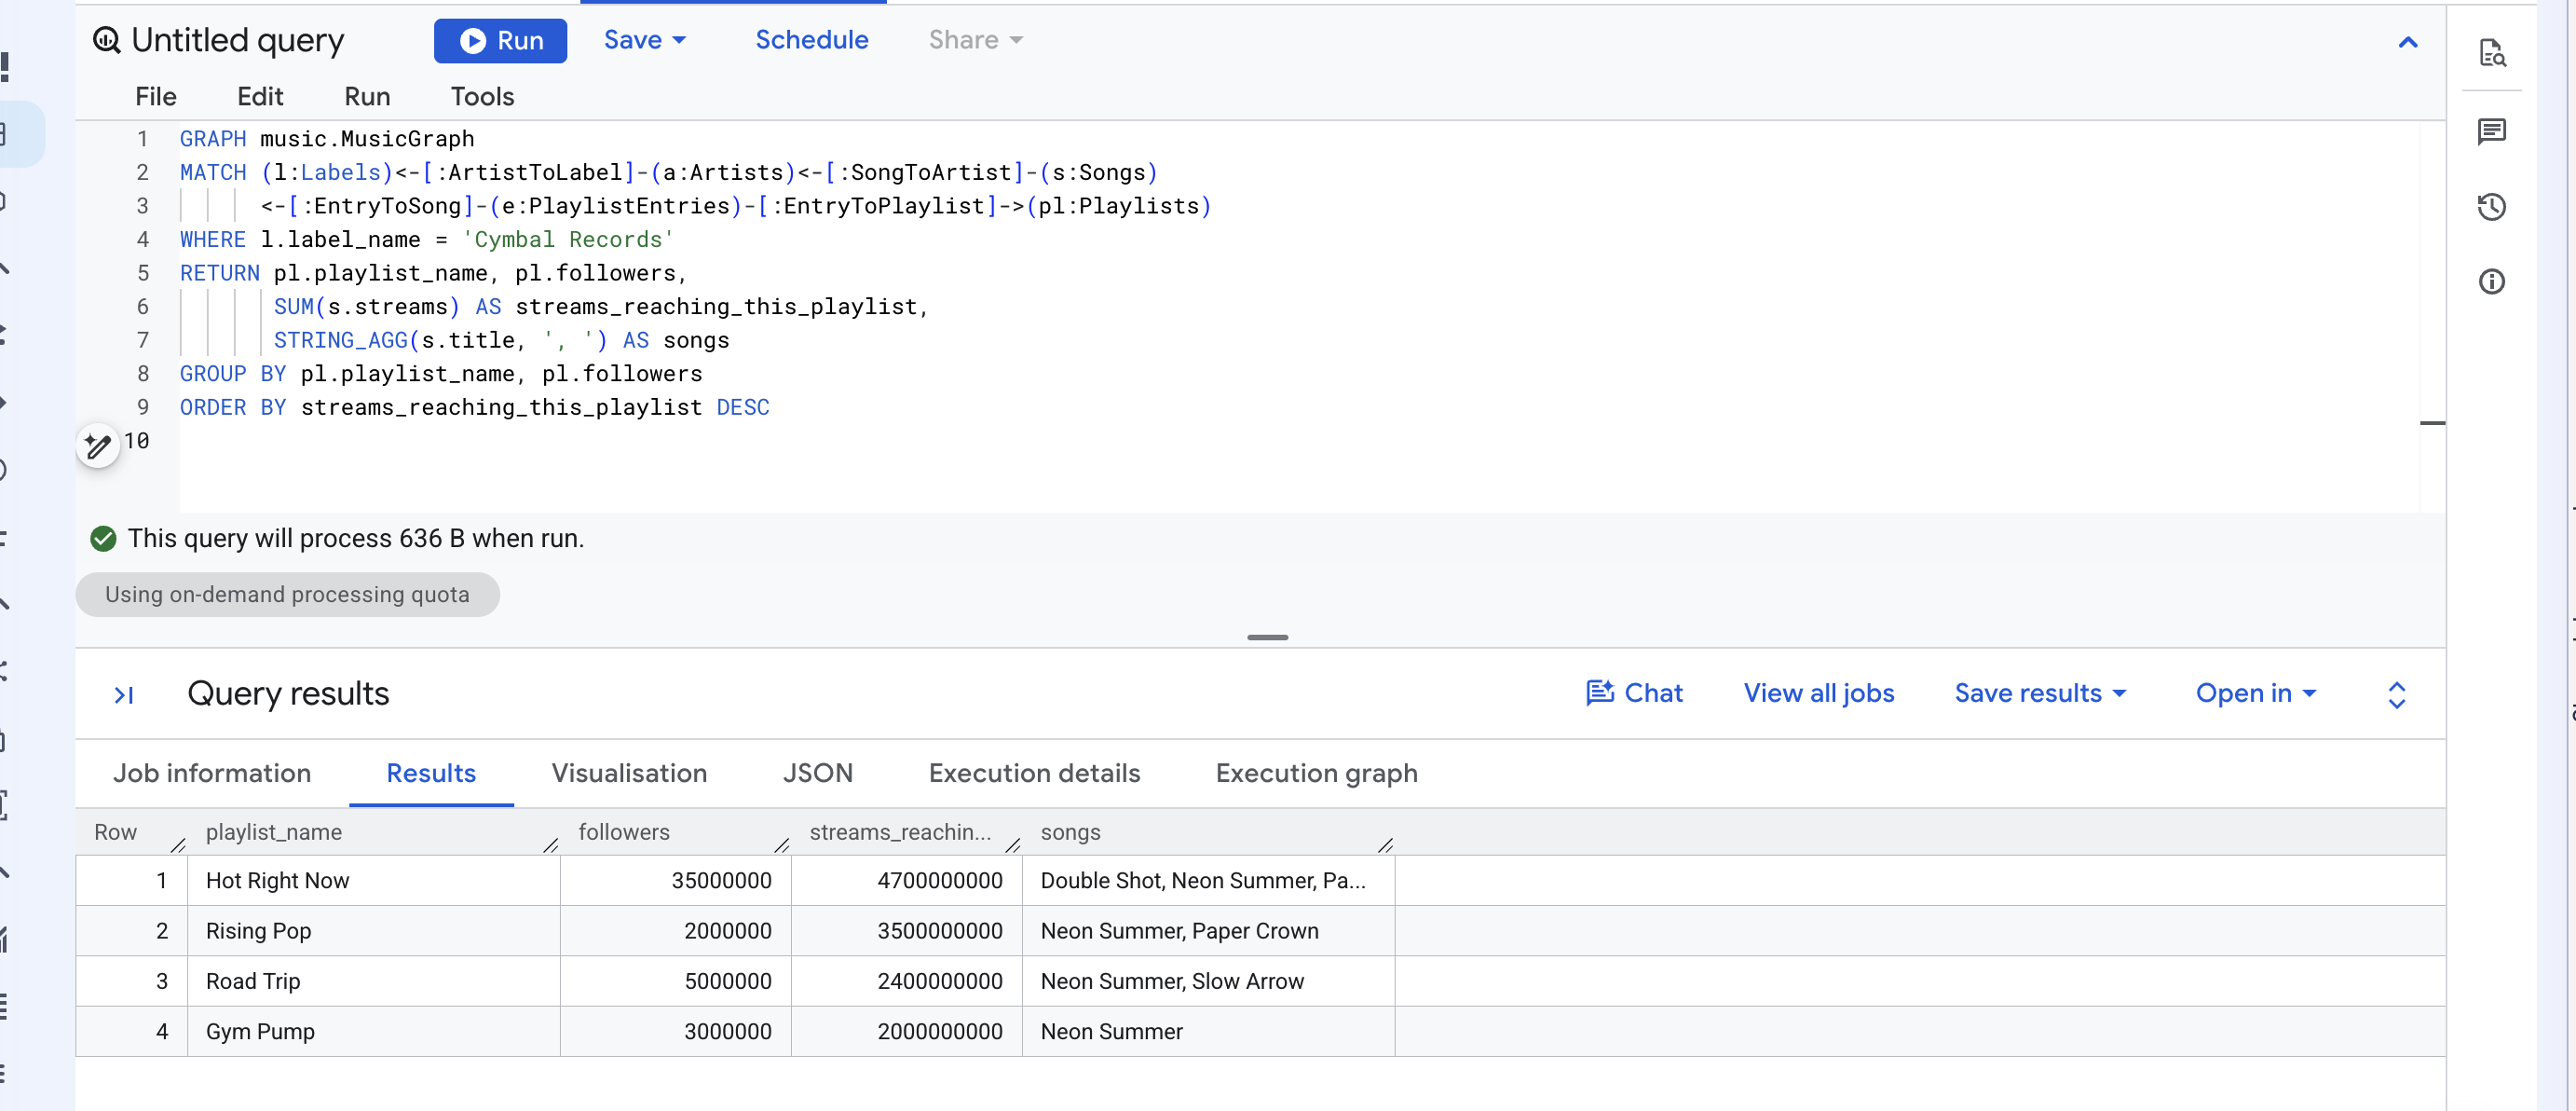
将 MATCH 行读作一个句子:从标签开始,返回到其音乐人,再返回到其歌曲,再返回到这些歌曲所在的播放列表条目,然后前进到播放列表。箭头指向边的声明方向;<- 向后走一步。
现在,将第三列中的数字相加。126 亿 - 您在第 4 步中得到的错误数字 SUM。
这里是正确的。当时的问题是 Cymbal 的播放量是多少,无论一首歌曲出现在多少个播放列表中,都只算一次。此问题是指这些播放流的覆盖范围,如果一首歌曲出现在 4 个播放列表中,则确实覆盖了 4 个受众群体。GRAPH_EXPAND 生成的重复内容对于一个问题来说是错误,但对于另一个问题来说却是答案。AGG 从来不是说重复不好,而是说算术要与问题相符。
2. 返回路径本身
舍弃聚合,并请求路线。
👉📋 查询编辑器 - 粘贴,然后点击运行:
GRAPH music.MusicGraph
MATCH p = (l:Labels)<-[:ArtistToLabel]-(a:Artists)<-[:SongToArtist]-(s:Songs)
          <-[:EntryToSong]-(e:PlaylistEntries)-[:EntryToPlaylist]->(pl:Playlists)
WHERE l.label_name = 'Cymbal Records'
RETURN TO_JSON(p) AS path
p = 命名整个匹配项,TO_JSON 呈现该匹配项。
👀 预期 8 行,1 列。path每个单元格都是一个 JSON 数组,其中包含一条路线上的节点和边,每个节点都带有其 labels 和 properties。
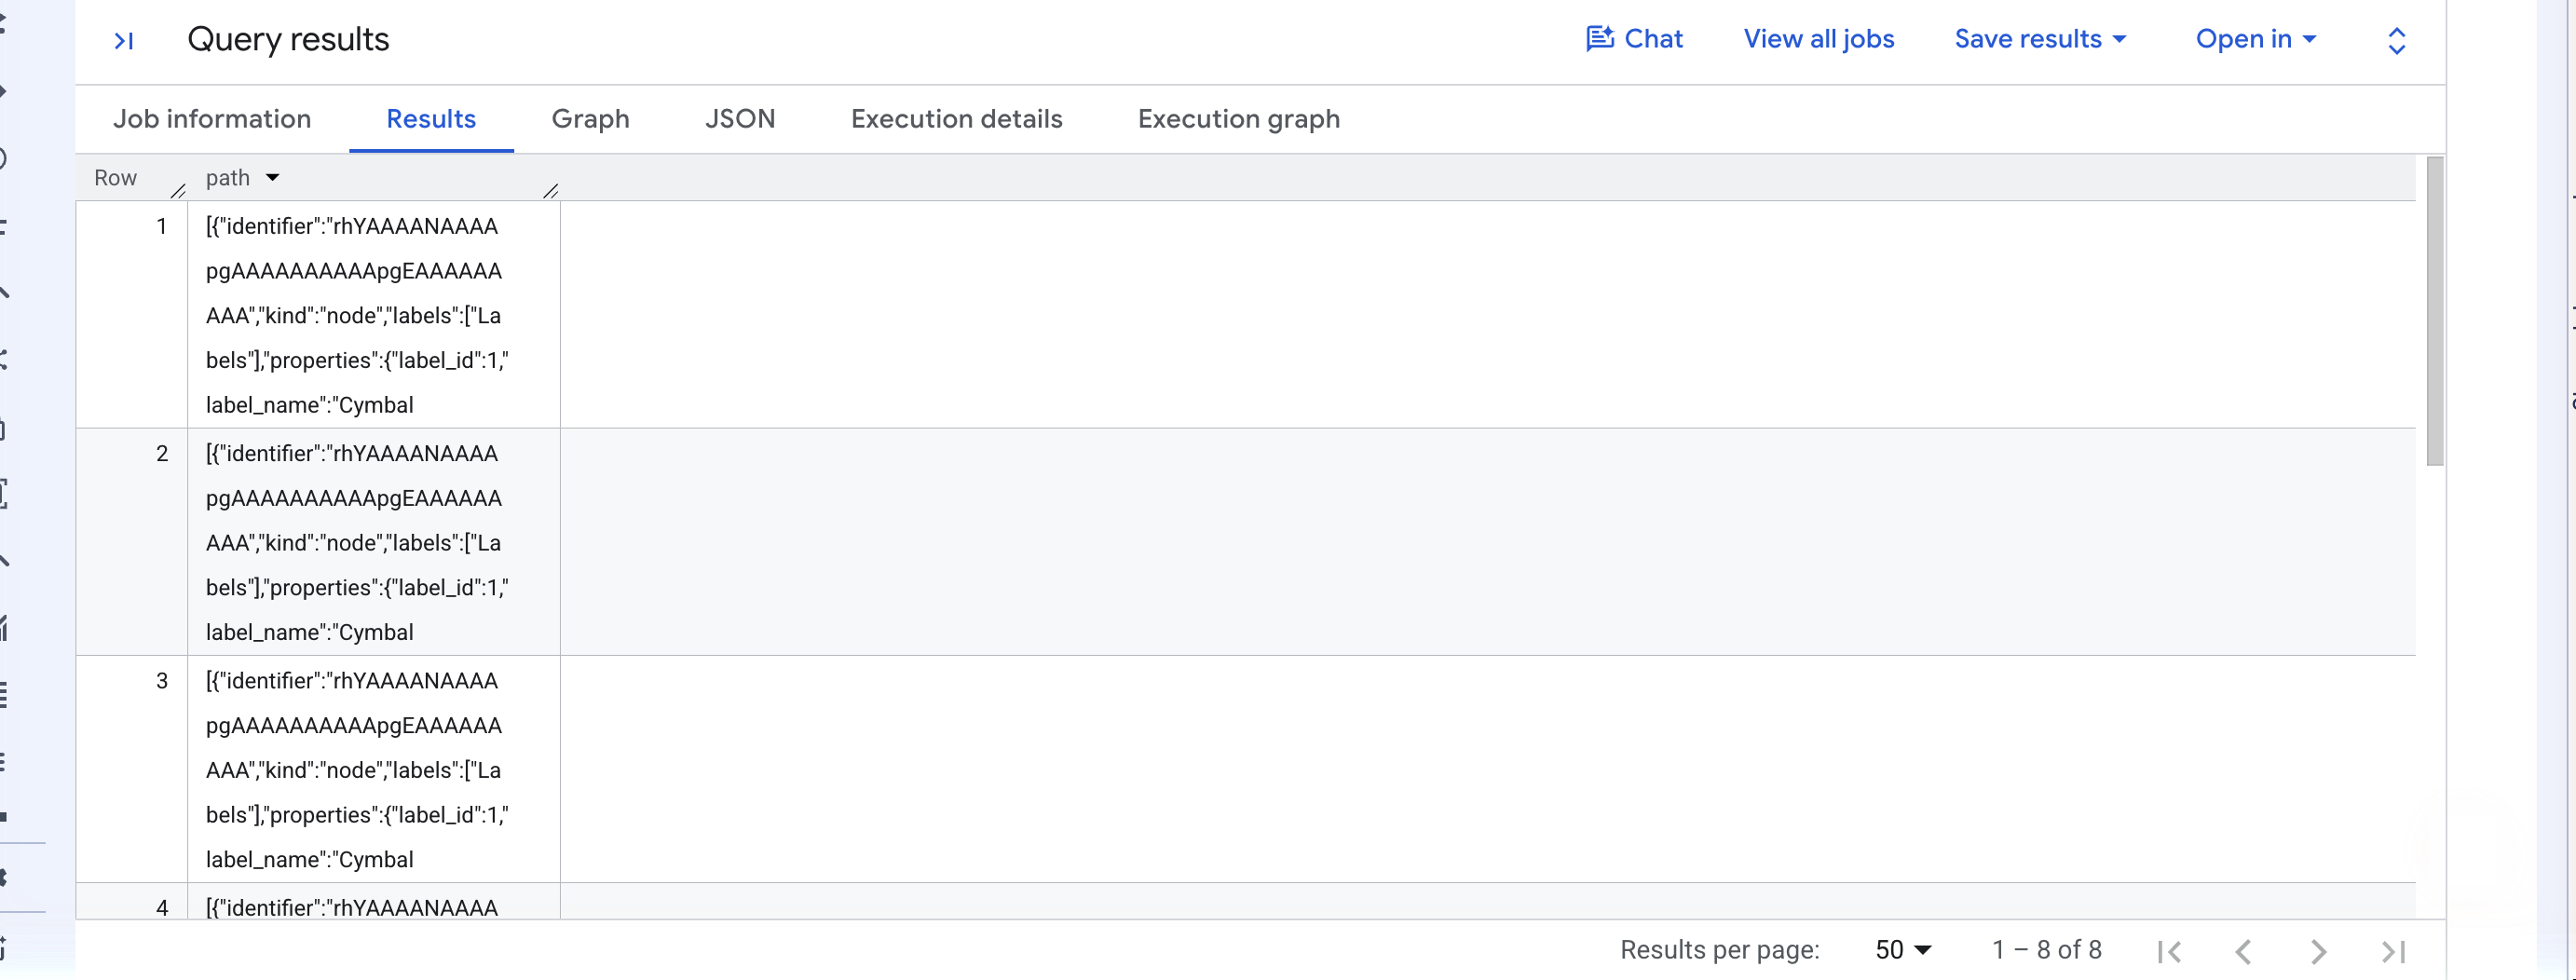
8 行,对应 4 首歌曲,因为每个展示位置都有一条路线,而不是每首歌曲都有一条路线。
3. 打开“图表”标签页
👉🌐 控制台 - 在结果上方,点击图表。
仅当结果包含图表元素时,才会显示此标签页。上一个查询返回的是数字,因此没有“图表”标签页;而此查询返回的是路径,因此有“图表”标签页。
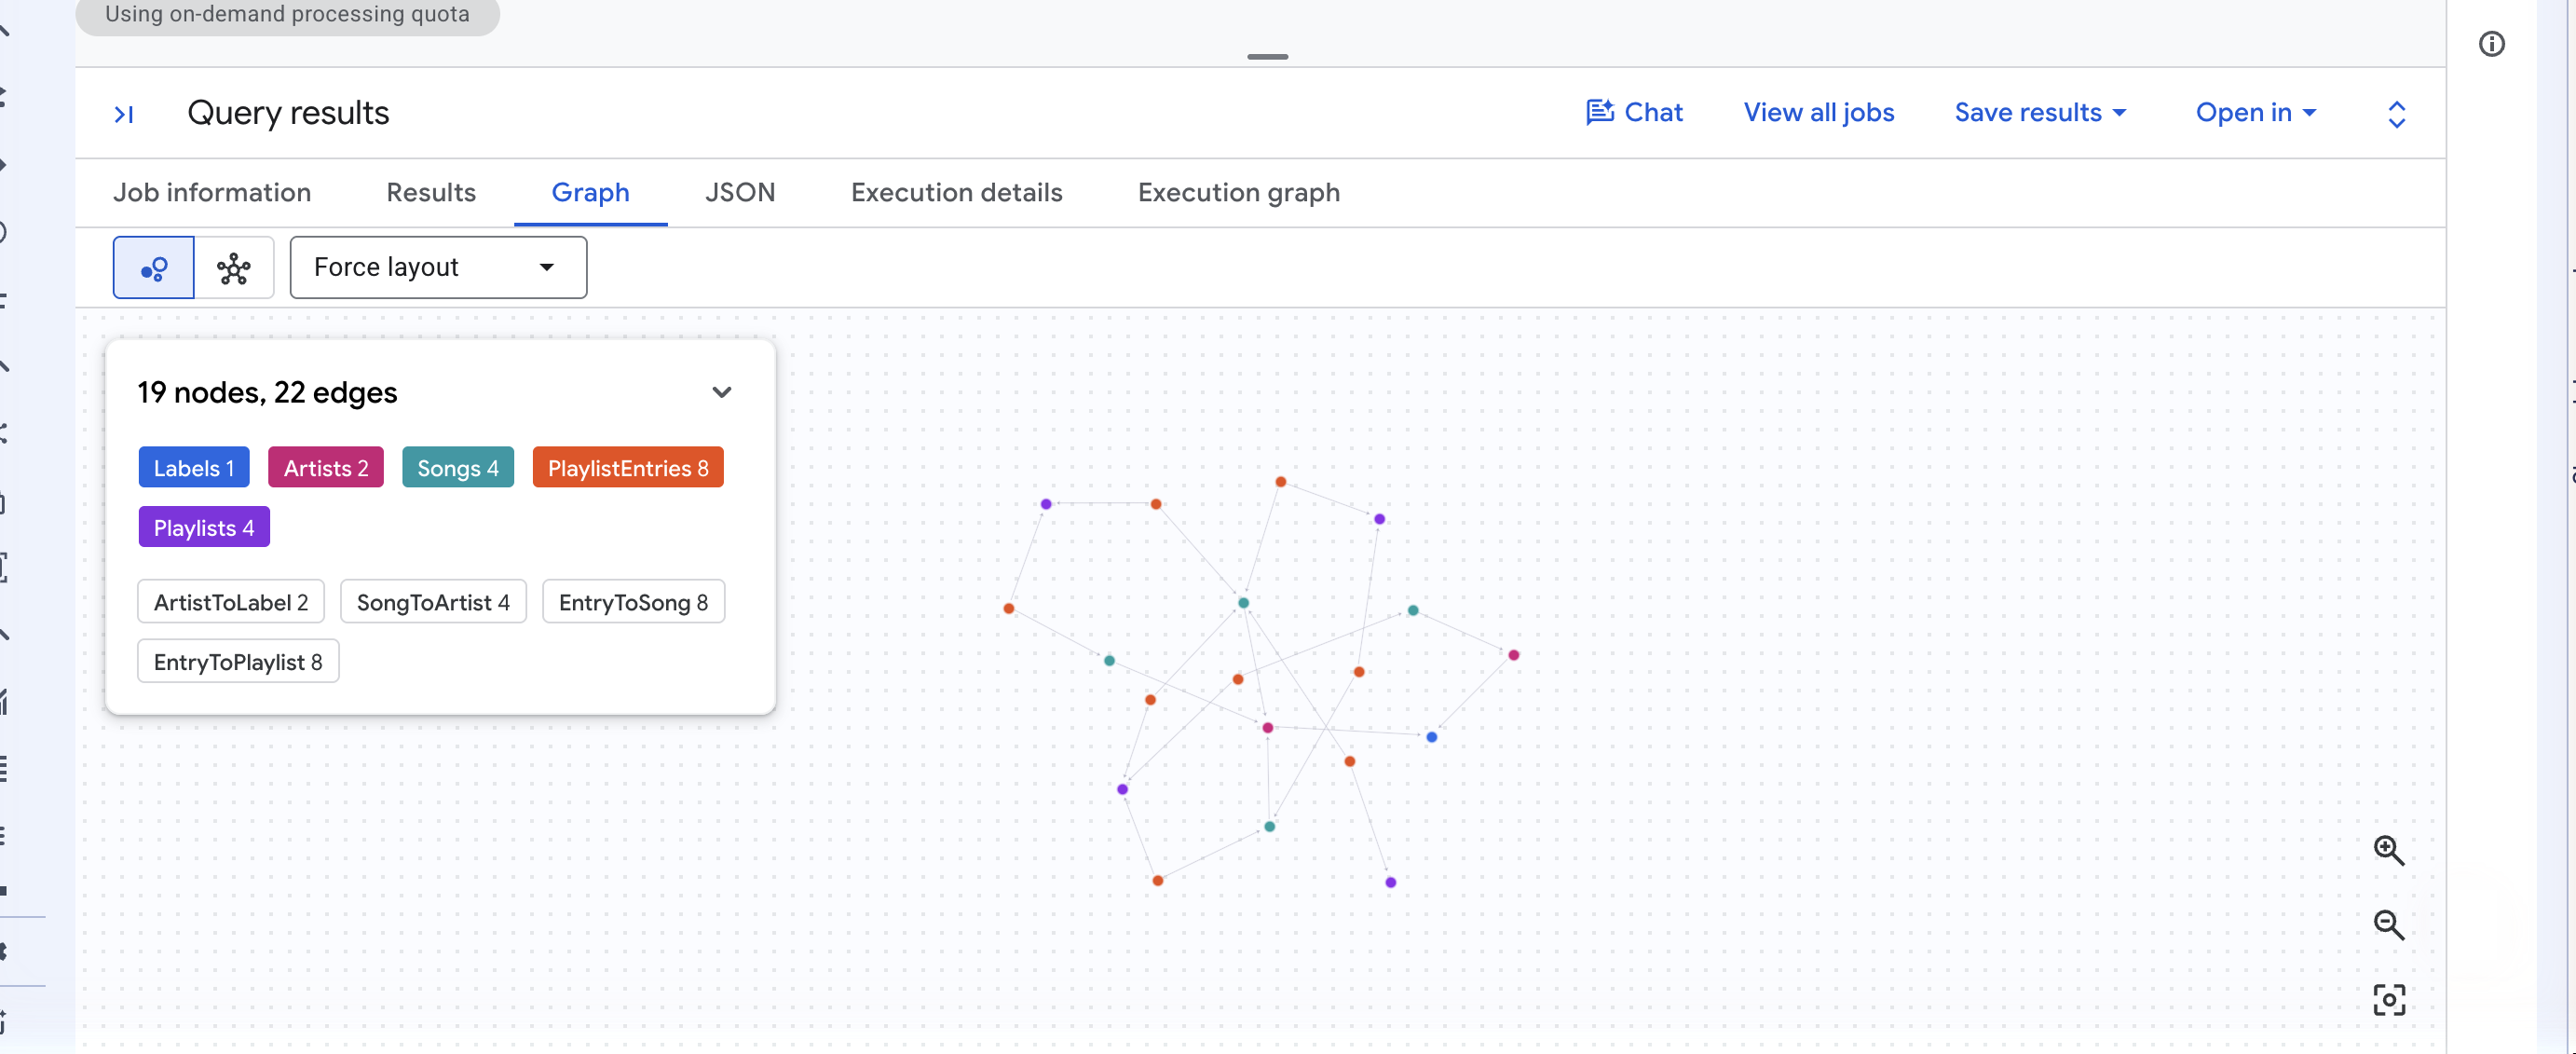
您将获得以力导向布局绘制的 Cymbal 图表一角,其中包含视图中节点和边的数量,以及每个标签对应的 chip。拖动节点可将布局拉开;点击节点可读取其属性。
✅ 检查点:第一个查询的第三列总计为 126 亿,第二个查询返回 8 条路径,并且“图表”标签页会绘制这些路径。
13. (可选)与图表对话
此步骤中没有 SQL。BigQuery 数据代理可以使用图作为知识来源,并且文档指出它们使用指标进行多级汇总。我们来看看是否属实。
1. 创建智能体
👉🌐 控制台 - 在左侧的 BigQuery 导航菜单中,依次点击代理、代理目录和创建代理。
👉🌐 控制台 - 在代理名称中输入 Music graph agent,在代理说明中输入以下内容:
Ask questions about labels, artists, songs and playlists in the music property graph.
👉🌐 控制台 - 在知识来源下,点击添加来源。在选择来源对话框中,展开您的项目,展开 music,展开图表,勾选 MusicGraph,然后点击确认。
👀“添加来源”按钮变灰。一个代理最多只能包含一个图表,并且不能将图表与表格混用。
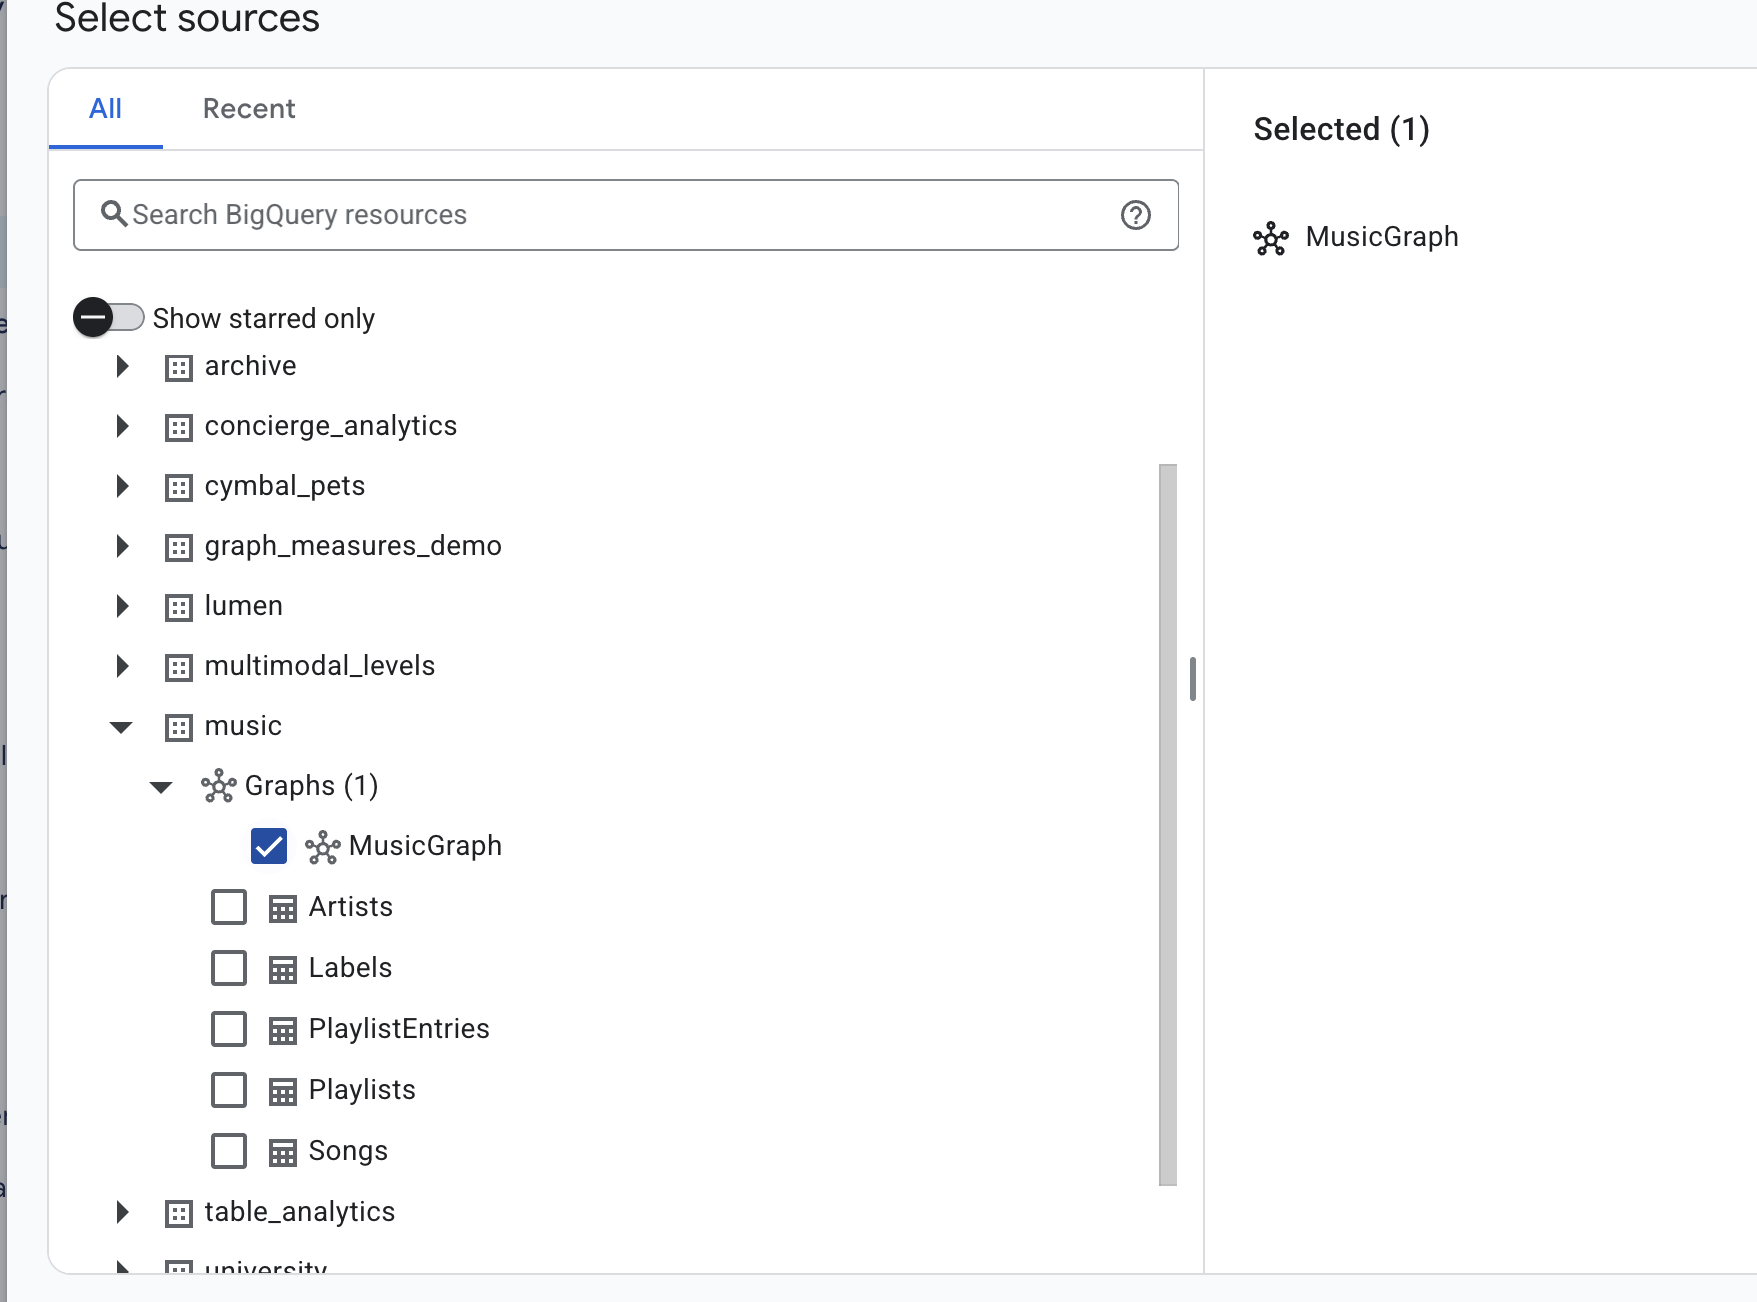
👉🌐 控制台 - 将区域保留为图表位置设置的区域。点击保存,然后点击发布。在发布渠道面板中,点击发布代理,然后关闭确认窗口。
2. 提出问题
👉🌐 控制台 - 点击创建对话。系统会打开一个聊天页面。在底部的提问框中输入以下内容,然后按 Enter 键:
For each label, show total streams and how many playlists their songs are on
👀 智能体返回一个表格和一个单句摘要:
label_name | total_streams | playlist_placements |
Cymbal Records | 5,100,000,000 | 8 |
Northwind Audio | 4,500,000,000 | 2 |
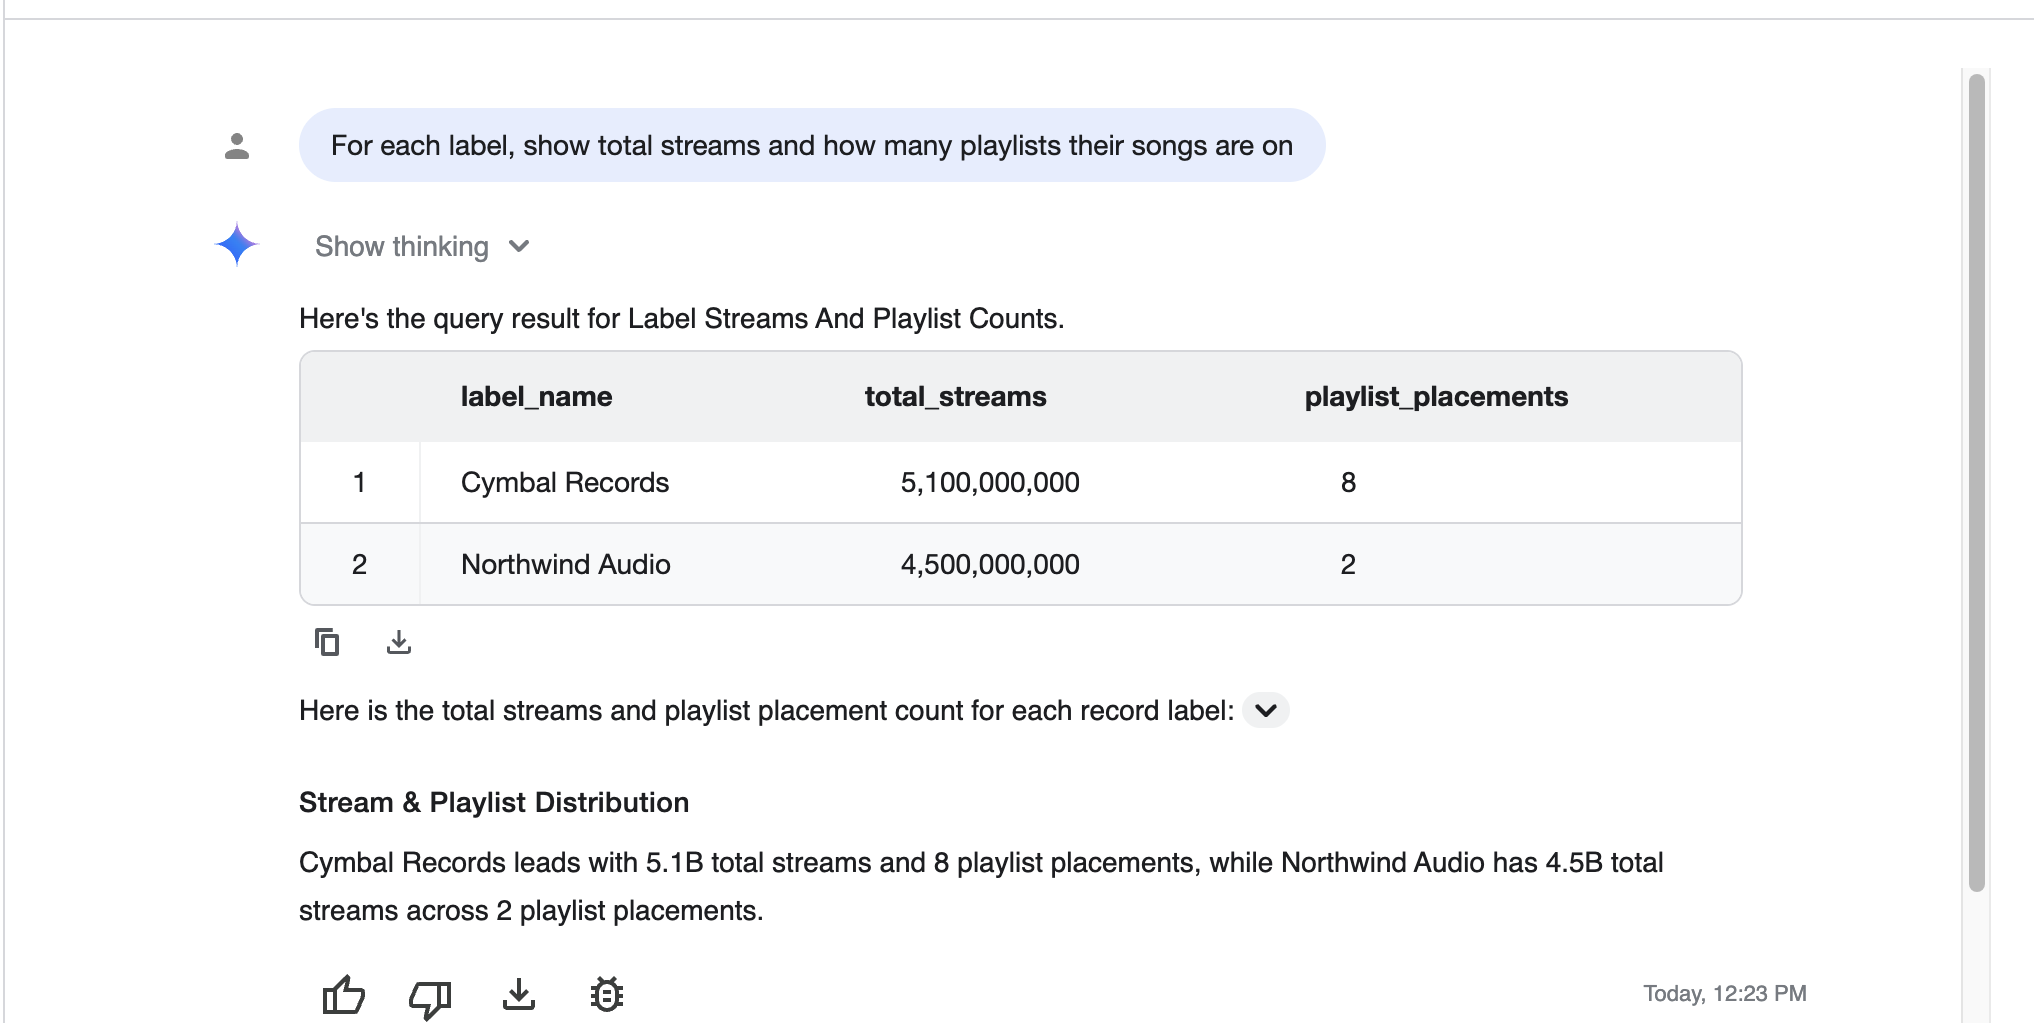
51 亿。没有人告知代理有关扇出方面的信息,因此代理没有陷入扇出。
3. 阅读其编写的查询
👉🌐 控制台 - 在导航菜单中,点击作业探索器,然后点击最新作业。其标签包括 ca-bq-job: true 和 data-agent-id(包含代理的 ID),其查询如下:
SELECT
  Labels_label_name AS label_name,
  AGG(Songs_total_streams) AS total_streams,
  AGG(PlaylistEntries_placement_count) AS playlist_placements
FROM GRAPH_EXPAND("music.MusicGraph")
GROUP BY label_name
ORDER BY total_streams DESC
它自行使用了 GRAPH_EXPAND 和 AGG,因为这些指标位于它读取的架构中。代理的说明中未提及它们。
✅ 检查点:聊天回答中为 51 亿,作业的 SQL 中为 AGG(...)。
14. 清理
👉💻 Cloud Shell - 舍弃数据集、其表和属性图:
cd ~/bq-graph-measures-lab
./cleanup.sh
👀 预计 ✓ dropped YOUR_PROJECT_ID.music (tables and graph)。
如果您创建了可选的数据代理,请在控制台中的代理 → 代理目录下将其删除。如果您只是为本实验创建了一个项目,最干净的清理方式是关停整个项目 - 项目 ID 位于 ~/project_id.txt 中。./setup_project.sh
15. 恭喜
您声明了一行代码 MEASURE(SUM(streams)),它将 126 亿更改为 51 亿,这不仅对您有效,而且对之后任何人针对该图谱编写的每个查询(包括智能体编写的查询)都有效。
要点回顾
- 度量是在节点上声明的汇总,位于设置其粒度的
KEY旁边。 GRAPH_EXPAND将图展平为一个包含TableLabel_property列的宽表。AGG是唯一一个读取度量的函数,类型系统通过四种不同的方式强制执行此操作。- 有 6 个汇总函数可用,
AGG结果是可以相除的普通值。 - 更改
GROUP BY会重新提出问题,但不会影响衡量指标。 GRAPH_EXPAND需要一个根、多对一的边,以及提升为节点的联接。
决策表
问题 | 原因 | 修复 |
总数过大 |
| 声明一个指标,并使用 |
“expected MEASURE, found INT64” |
| 使用 |
“不允许返回 MEASURE 类型的表达式” | 不含 | 封装: |
“未按元素类型公开” | GQL 中引用的度量 | 仅衡量落后于 |
| 以边的形式建模的连接 | 将联结表提升为节点 |
更改图表后的旧数字 | 缓存结果 | 清除使用缓存的结果 |
我们有意未涵盖的内容
属性的说明和同义词 · 数据代理的已验证查询和术语表 · 多个 MATCH 之外的 GQL · 多个图表中的度量。每个都是一个独立的实验。