

1. סקירה כללית

מהו Dataflow?
Dataflow הוא שירות מנוהל להרצה של מגוון רחב של דפוסי עיבוד נתונים. במסמכי התיעוד באתר הזה מוסבר איך לפרוס את צינורות עיבוד הנתונים של אצווה וסטרימינג באמצעות Dataflow, כולל הוראות לשימוש בתכונות השירות.
Apache Beam SDK הוא מודל תכנות בקוד פתוח שמאפשר לפתח צינורות להעברת נתונים באצווה וצינורות להעברת נתוני סטרימינג. אתם יוצרים את צינורות הנתונים באמצעות תוכנית Apache Beam ומריצים אותם בשירות Dataflow. בתיעוד של Apache Beam אפשר למצוא מידע תיאורטי מפורט וחומר עזר על מודל התכנות של Apache Beam, על ערכות ה-SDK ועל רכיבי Runner אחרים.
ניתוח נתונים בזמן אמת במהירות
Dataflow מאפשרת פיתוח מהיר ופשוט של צינורות נתונים בסטרימינג עם זמן אחזור נמוך יותר של נתונים.
פשטו את התפעול והניהול
הגישה של Dataflow ללא שרת מסירה את התקורה התפעולית מעומסי עבודה של הנדסת נתונים, ומאפשרת לצוותים להתמקד בתכנות במקום בניהול של אשכולות שרתים.
הפחתת עלות הבעלות הכוללת
התאמה אוטומטית של משאבים לעומס בשילוב עם יכולות עיבוד באצווה שעברו אופטימיזציה לעלויות, מאפשרת ל-Dataflow להציע קיבולת כמעט בלתי מוגבלת לניהול עומסי עבודה עונתיים ועומסי עבודה עם עליות חדות, בלי חריגה מהתקציב.
התכונות העיקריות
ניהול אוטומטי של משאבים ואיזון מחדש דינמי של עבודה
Dataflow מבצע הקצאה וניהול אוטומטיים של משאבי עיבוד כדי למזער את זמן האחזור ולמקסם את הניצול, כך שלא תצטרכו להתחיל הרצה של מופעים או לשריין אותם באופן ידני. חלוקת העבודה גם היא אוטומטית ועוברת אופטימיזציה כדי לאזן מחדש באופן דינמי עבודה שמתעכבת. אין צורך לחפש "מקשי קיצור" או לעבד מראש את נתוני הקלט.
התאמה אוטומטית אופקית לעומס
הגדלה אוטומטית אופקית של משאבי העובדים כדי להשיג תפוקה אופטימלית מובילה ליחס טוב יותר בין מחיר לביצועים באופן כללי.
תמחור של תזמון משאבים גמיש לעיבוד ברצף (batch processing)
לעיבוד עם גמישות בזמן תזמון העבודות, כמו עבודות שמתבצעות במהלך הלילה, תזמון משאבים גמיש (FlexRS) מציע מחיר נמוך יותר לעיבוד באצווה. המשימות הגמישות האלה ממוקמות בתור, עם הבטחה שהן יאוחזרו לביצוע תוך חלון של שש שעות.
המדריך הזה מבוסס על המדריך https://cloud.google.com/dataflow/docs/quickstarts/quickstart-java-maven
מה תלמדו
- איך יוצרים פרויקט Maven עם Apache Beam באמצעות Java SDK
- הפעלת צינור לדוגמה באמצעות מסוף Google Cloud Platform
- איך מוחקים את קטגוריה של Cloud Storage המשויכת ואת התוכן שלה
מה תצטרכו
איך תשתמשו במדריך הזה?
איזה דירוג מגיע לדעתך לחוויית השימוש שלך בשירותים של Google Cloud Platform?
2. הגדרה ודרישות
הגדרת סביבה בקצב אישי
- נכנסים אל Cloud Console ויוצרים פרויקט חדש או משתמשים בפרויקט קיים. (אם עדיין אין לכם חשבון Gmail או G Suite, אתם צריכים ליצור חשבון).
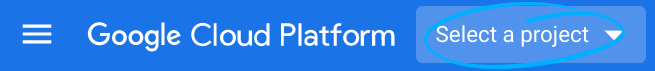
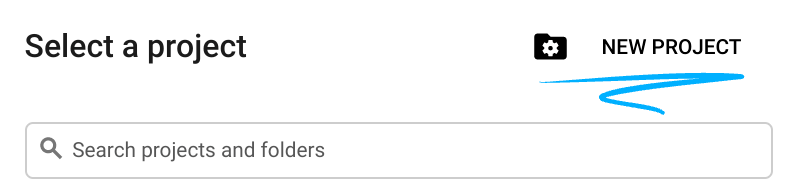
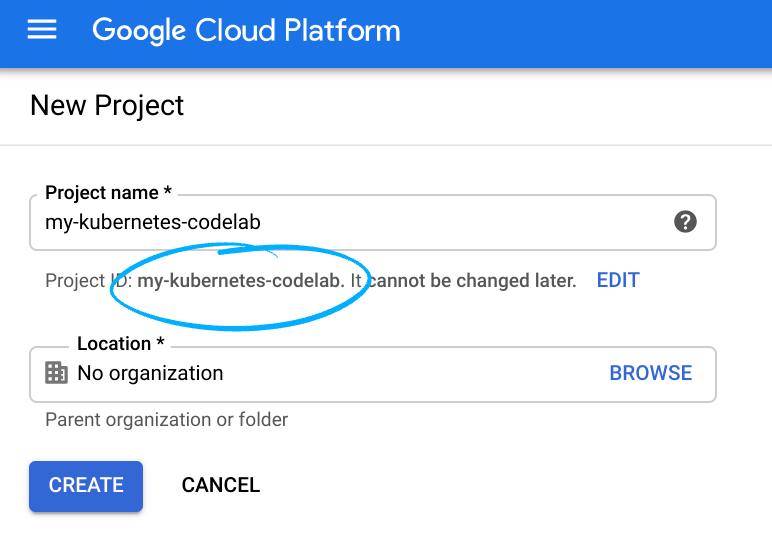
חשוב לזכור את מזהה הפרויקט, שהוא שם ייחודי בכל הפרויקטים ב-Google Cloud (השם שלמעלה כבר תפוס ולא יתאים לכם, מצטערים!). בהמשך ה-codelab הזה נתייחס אליו כאל PROJECT_ID.
- לאחר מכן, תצטרכו להפעיל את החיוב ב-Cloud Console כדי להשתמש במשאבים של Google Cloud.
העלות של התרגול הזה לא אמורה להיות גבוהה, ואולי לא תהיה עלות בכלל. חשוב לפעול לפי ההוראות בקטע 'ניקוי' שבו מוסבר איך להשבית משאבים כדי שלא תחויבו אחרי שתסיימו את המדריך הזה. משתמשים חדשים ב-Google Cloud זכאים לתוכנית תקופת ניסיון בחינם בשווי 300 USD.
הפעלת ממשקי ה-API
לוחצים על סמל התפריט בפינה השמאלית העליונה.

בתפריט הנפתח, בוחרים באפשרות APIs & Services > Dashboard (ממשקי API ושירותים > מרכז בקרה).

לוחצים על + Enable APIs and Services.

בתיבת החיפוש, מחפשים את Compute Engine. לוחצים על Compute Engine API ברשימת התוצאות שמופיעה.

בדף Google Compute Engine לוחצים על הפעלה.

אחרי ההפעלה, לוחצים על החץ כדי לחזור.
עכשיו מחפשים את ממשקי ה-API הבאים ומפעילים אותם גם כן:
- Cloud Dataflow
- Stackdriver
- Cloud Storage
- Cloud Storage JSON
- BigQuery
- Cloud Pub/Sub
- Cloud Datastore
- Cloud Resource Manager APIs
3. יצירת קטגוריה של Cloud Storage
ב-Google Cloud Platform Console, לוחצים על סמל התפריט בפינה השמאלית העליונה של המסך:
גוללים למטה ובוחרים באפשרות Cloud Storage > Browser בקטע המשנה Storage:

עכשיו אמור להופיע הדפדפן של Cloud Storage, ואם אתם משתמשים בפרויקט שאין בו כרגע קטגוריות של Cloud Storage, תופיע הזמנה ליצור קטגוריה חדשה. כדי ליצור מאגר, לוחצים על הלחצן יצירת מאגר:

מזינים שם לקטגוריה. כמו שכתוב בתיבת הדו-שיח, שמות הקטגוריות חייבים להיות ייחודיים בכל Cloud Storage. לכן, אם תבחרו שם ברור, כמו test, סביר להניח שמישהו אחר כבר יצר דלי עם השם הזה ותקבלו שגיאה.
יש גם כללים לגבי התווים שמותרים בשמות של קטגוריות. אם שם הקטגוריה מתחיל ומסתיים באות או במספר, ואם משתמשים במקפים רק באמצע, אז הכול בסדר. אם תנסו להשתמש בתווים מיוחדים, או להתחיל או לסיים את שם הקטגוריה במשהו שאינו אות או מספר, תיבת הדו-שיח תזכיר לכם את הכללים.

נותנים שם ייחודי לקטגוריה ולוחצים על Create (יצירה). אם תבחרו משהו שכבר נמצא בשימוש, תוצג הודעת השגיאה שמופיעה למעלה. אחרי שיוצרים את הקטגוריה, מועברים לקטגוריה החדשה והריקה בדפדפן:

שם הקטגוריה שיוצג לכם יהיה שונה, כי הוא חייב להיות ייחודי בכל הפרויקטים.
4. הפעלת Cloud Shell
הפעלת Cloud Shell
- ב-Cloud Console, לוחצים על Activate Cloud Shell
.
אם זו הפעם הראשונה שאתם מפעילים את Cloud Shell, יוצג לכם מסך ביניים (מתחת לקו הקיפול) עם תיאור של Cloud Shell. במקרה כזה, לוחצים על המשך (והמסך הזה לא יוצג לכם יותר). כך נראה המסך החד-פעמי:
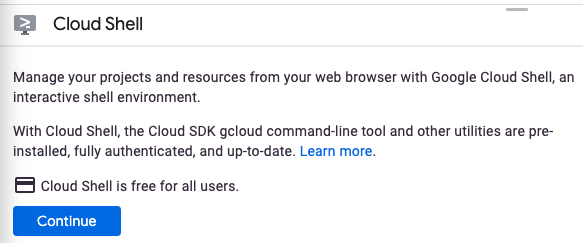
יחלפו כמה רגעים עד שההקצאה והחיבור ל-Cloud Shell יושלמו.
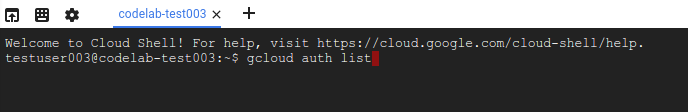
המכונה הווירטואלית הזו כוללת את כל הכלים שדרושים למפתחים. יש בה ספריית בית בנפח מתמיד של 5GB והיא פועלת ב-Google Cloud, מה שמשפר מאוד את הביצועים והאימות של הרשת. אפשר לבצע את רוב העבודה ב-codelab הזה, אם לא את כולה, באמצעות דפדפן או Chromebook.
אחרי שמתחברים ל-Cloud Shell, אפשר לראות שהאימות כבר בוצע והפרויקט כבר הוגדר לפי מזהה הפרויקט.
- מריצים את הפקודה הבאה ב-Cloud Shell כדי לוודא שאתם מאומתים:
gcloud auth list
פלט הפקודה
 Credentialed Accounts
ACTIVE  ACCOUNT
*       <my_account>@<my_domain.com>

To set the active account, run:
    $ gcloud config set account `ACCOUNT`
gcloud config list project
פלט הפקודה
[core]
project = <PROJECT_ID>
אם לא, אפשר להגדיר אותו באמצעות הפקודה הזו:
gcloud config set project <PROJECT_ID>
פלט הפקודה
Updated property [core/project].
5. יצירת פרויקט Maven
אחרי שמפעילים את Cloud Shell, מתחילים ליצור פרויקט Maven באמצעות Java SDK for Apache Beam.
Apache Beam הוא מודל תכנות בקוד פתוח לצינורות נתונים. אתם מגדירים את צינורות עיבוד הנתונים האלה באמצעות תוכנית Apache Beam, ויכולים לבחור רכיב runner, כמו Dataflow, כדי להריץ את צינור עיבוד הנתונים.
מריצים את הפקודה mvn archetype:generate במעטפת באופן הבא:
  mvn archetype:generate \
     -DarchetypeGroupId=org.apache.beam \
     -DarchetypeArtifactId=beam-sdks-java-maven-archetypes-examples \
     -DarchetypeVersion=2.46.0 \
     -DgroupId=org.example \
     -DartifactId=first-dataflow \
     -Dversion="0.1" \
     -Dpackage=org.apache.beam.examples \
     -DinteractiveMode=false
אחרי שמריצים את הפקודה, אמורה להופיע ספרייה חדשה בשם first-dataflow בספרייה הנוכחית. first-dataflow מכיל פרויקט Maven שכולל את Cloud Dataflow SDK ל-Java וצינורות לדוגמה.
6. הרצת פייפליין לעיבוד טקסט ב-Cloud Dataflow
נתחיל בשמירת מזהה הפרויקט ושמות הקטגוריות של Cloud Storage כמשתני סביבה. אפשר לעשות את זה ב-Cloud Shell. חשוב להחליף את <your_project_id> במזהה הפרויקט שלכם.
export PROJECT_ID=<your_project_id>
עכשיו נבצע את אותה הפעולה עבור קטגוריה של Cloud Storage. חשוב לזכור להחליף את <your_bucket_name> בשם הייחודי שבו השתמשתם כדי ליצור את הקטגוריה בשלב מוקדם יותר.
export BUCKET_NAME=<your_bucket_name>
עוברים לספרייה first-dataflow/.
cd first-dataflow
אנחנו נריץ צינור (pipeline) שנקרא WordCount, שקורא טקסט, מבצע טוקניזציה של שורות הטקסט למילים בודדות ומבצע ספירת תדירות של כל אחת מהמילים האלה. קודם נריץ את צינור העיבוד, ובזמן שהוא פועל נבדוק מה קורה בכל שלב.
מריצים את הפקודה mvn compile exec:java בחלון המעטפת או הטרמינל כדי להפעיל את צינור הנתונים. בארגומנטים --project, --stagingLocation, ו---output, הפקודה שלמטה מתייחסת למשתני הסביבה שהגדרתם קודם בשלב הזה.
 mvn compile exec:java \
      -Pdataflow-runner compile exec:java \
      -Dexec.mainClass=org.apache.beam.examples.WordCount \
      -Dexec.args="--project=${PROJECT_ID} \
      --stagingLocation=gs://${BUCKET_NAME}/staging/ \
      --output=gs://${BUCKET_NAME}/output \
      --runner=DataflowRunner \
      --region=us-central1 \
      --gcpTempLocation=gs://${BUCKET_NAME}/temp"
בזמן שהעבודה פועלת, נחפש את העבודה ברשימת העבודות.
פותחים את ממשק המשתמש באינטרנט של Cloud Dataflow ב-Google Cloud Platform Console. אמור להופיע לכם סטטוס של Running (פועל) למשימת ספירת המילים:

עכשיו נבחן את הפרמטרים של צינור הנתונים. מתחילים בלחיצה על שם המשרה:

כשבוחרים משימה, אפשר לראות את תרשים הביצוע. גרף ההפעלה של צינור הנתונים מייצג כל טרנספורמציה בצינור כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתיבה, כתי כדי לראות פרטים נוספים, לוחצים על החץ הקטן בפינה השמאלית העליונה של כל שלב:

עכשיו נראה איך הנתונים משתנים בכל שלב בצינור:
- קריאה: בשלב הזה, צינור העיבוד קורא ממקור קלט. במקרה הזה, זהו קובץ טקסט מ-Cloud Storage עם הטקסט המלא של המחזה המלך ליר של שייקספיר. תהליך העיבוד שלנו קורא את הקובץ שורה אחר שורה ומפיק כל שורה כ-
PCollection, כאשר כל שורה בקובץ הטקסט היא רכיב באוסף. - CountWords: לשלב
CountWordsיש שני חלקים. קודם כול, הפונקציה משתמשת בפונקציית do מקבילית (ParDo) בשםExtractWordsכדי ליצור טוקניזציה של כל שורה למילים נפרדות. הפלט של ExtractWords הוא PCollection חדש שבו כל רכיב הוא מילה. בשלב הבא,Count, נעשה שימוש בטרנספורמציה שסופקה על ידי Java SDK, שמחזירה זוגות של מפתח וערך, כאשר המפתח הוא מילה ייחודית והערך הוא מספר הפעמים שהמילה מופיעה. זו השיטה להטמעה שלCountWords. אפשר לראות את הקובץ המלא WordCount.java ב-GitHub:
 /**
   * A PTransform that converts a PCollection containing lines of text into a PCollection of
   * formatted word counts.
   *
   * <p>Concept #3: This is a custom composite transform that bundles two transforms (ParDo and
   * Count) as a reusable PTransform subclass. Using composite transforms allows for easy reuse,
   * modular testing, and an improved monitoring experience.
   */
  public static class CountWords
      extends PTransform<PCollection<String>, PCollection<KV<String, Long>>> {
    @Override
    public PCollection<KV<String, Long>> expand(PCollection<String> lines) {

      // Convert lines of text into individual words.
      PCollection<String> words = lines.apply(ParDo.of(new ExtractWordsFn()));

      // Count the number of times each word occurs.
      PCollection<KV<String, Long>> wordCounts = words.apply(Count.perElement());

      return wordCounts;
    }
  }
- MapElements: הפונקציה הזו מפעילה את הפונקציה
FormatAsTextFnשמועתקת למטה, שמגדירה את הפורמט של כל צמד מפתח-ערך למחרוזת שניתן להדפיס.
  /** A SimpleFunction that converts a Word and Count into a printable string. */
  public static class FormatAsTextFn extends SimpleFunction<KV<String, Long>, String> {
    @Override
    public String apply(KV<String, Long> input) {
      return input.getKey() + ": " + input.getValue();
    }
  }
- WriteCounts: בשלב הזה אנחנו כותבים את המחרוזות שניתנות להדפסה לכמה קובצי טקסט מחולקים.
בעוד כמה דקות נבדוק את הפלט שמתקבל מהצינור.
עכשיו אפשר לעיין בדף Job info שמשמאל לתרשים, שכולל פרמטרים של צינורות שכללנו בפקודה mvn compile exec:java.


אפשר גם לראות מונים בהתאמה אישית עבור צינור העיבוד. במקרה הזה, המונים מראים כמה שורות ריקות נתקלו עד עכשיו במהלך ההפעלה. אתם יכולים להוסיף מוני נתונים חדשים לצינור כדי לעקוב אחרי מדדים ספציפיים לאפליקציה.

כדי לראות את הודעות השגיאה הספציפיות, לוחצים על סמל היומנים בחלק התחתון של המסוף.

כברירת מחדל, בחלונית מוצגות הודעות ביומן המשימות שמדווחות על הסטטוס של המשימה כולה. אפשר להשתמש בבורר Minimum Severity (רמת חומרה מינימלית) כדי לסנן את ההתקדמות של העבודה ואת הודעות הסטטוס.

כשבוחרים שלב בצינור העיבוד בתרשים, התצוגה משתנה ליומנים שנוצרו על ידי הקוד ולקוד שנוצר שפועל בשלב בצינור העיבוד.
כדי לחזור ליומני העבודות, מבטלים את הבחירה בשלב על ידי לחיצה מחוץ לגרף או באמצעות לחצן הסגירה בחלונית הצדדית השמאלית.
אתם יכולים להשתמש בלחצן Worker Logs (יומני עובדים) בכרטיסייה Logs (יומנים) כדי לראות את יומני העובדים של מופעי Compute Engine שמריצים את צינור הנתונים. יומני Worker מורכבים משורות יומן שנוצרו על ידי הקוד שלכם ועל ידי הקוד שנוצר על ידי Dataflow שמריץ אותו.
אם אתם מנסים לנפות באגים בכשל בצינור, לרוב יהיו יומנים נוספים ביומני העובדים שיעזרו לפתור את הבעיה. חשוב לזכור שהיומנים האלה הם צבירה של כל העובדים, ואפשר לסנן ולחפש בהם.

בממשק המעקב של Dataflow מוצגות רק הודעות היומן האחרונות. כדי לראות את כל היומנים, לוחצים על הקישור Google Cloud Observability בצד שמאל של חלונית היומנים.

בטבלה הבאה מפורטים סוגי היומנים השונים שאפשר לראות בדף Monitoring→Logs:
- יומני job-message מכילים הודעות ברמת המשימה שנוצרות על ידי רכיבים שונים של Dataflow. דוגמאות: הגדרת שינוי הגודל האוטומטי, מתי העובדים מתחילים או מפסיקים לעבוד, ההתקדמות בשלב העבודה ושגיאות בעבודה. שגיאות ברמת ה-Worker שמקורן בקוד משתמש שגרם לקריסה ושמופיעות ביומני worker מועברות גם ליומני job-message.
- יומני worker נוצרים על ידי עובדי Dataflow. העובדים מבצעים את רוב העבודה בצינור (לדוגמה, החלת ה-ParDo על הנתונים). יומני Worker מכילים הודעות שנרשמו על ידי הקוד ו-Dataflow.
- יומני worker-startup קיימים ברוב משימות Dataflow ויכולים לתעד הודעות שקשורות לתהליך ההפעלה. תהליך ההפעלה כולל הורדה של קובצי JAR של משימה מ-Cloud Storage, ואז הפעלה של העובדים. אם יש בעיה בהפעלת העובדים, כדאי לבדוק את היומנים האלה.
- יומני shuffler מכילים הודעות מעובדים שמבצעים איחוד של תוצאות פעולות מקבילות בצינור.
- היומנים של docker ושל kubelet מכילים הודעות שקשורות לטכנולוגיות הציבוריות האלה, שמשמשות את העובדים של Dataflow.
בשלב הבא נבדוק שהעבודה הסתיימה בהצלחה.
7. איך בודקים שהעבודה בוצעה בהצלחה
פותחים את ממשק המשתמש באינטרנט של Cloud Dataflow ב-Google Cloud Platform Console.
בהתחלה, סטטוס העבודה של ספירת המילים יהיה Running (פועל), ואחר כך Succeeded (הושלם):

התהליך יימשך כ-3 או 4 דקות.
זוכר מתי הפעלת את צינור הנתונים וציינת דלי פלט? בואו נראה את התוצאה (כי בטח תרצו לדעת כמה פעמים כל מילה בהמלך ליר מופיעה). חוזרים לדף Cloud Storage Browser ב-Google Cloud Platform Console. בדלי, אמורים להופיע קובצי הפלט וקובצי הביניים שנוצרו על ידי העבודה:

8. כיבוי המשאבים
אפשר להשבית את המשאבים ממסוף Google Cloud Platform.
פותחים את הדף Cloud Storage browser ב-Google Cloud Platform Console.
מסמנים את התיבה ליד הקטגוריה שיצרתם ולוחצים על מחיקה כדי למחוק את הקטגוריה ואת התוכן שלה באופן סופי.


9. מעולה!
למדתם איך ליצור פרויקט Maven באמצעות Cloud Dataflow SDK, להפעיל צינור לדוגמה באמצעות Google Cloud Platform Console ולמחוק את קטגוריית Cloud Storage המשויכת ואת התוכן שלה.
מידע נוסף
- מסמכי התיעוד של Dataflow: https://cloud.google.com/dataflow/docs/
רישיון
עבודה זו מורשית תחת רישיון Creative Commons שמותנה בייחוס 3.0 כללי, ורישיון Apache 2.0.