

1. ภาพรวม

Dataflow คืออะไร
Dataflow เป็นบริการที่มีการจัดการสำหรับการดำเนินการรูปแบบการประมวลผลข้อมูลที่หลากหลาย เอกสารในเว็บไซต์นี้จะแสดงวิธีทำให้ไปป์ไลน์การประมวลผลข้อมูลแบบกลุ่มและแบบสตรีมใช้งานได้โดยใช้ Dataflow รวมถึงวิธีการใช้ฟีเจอร์ของบริการ
Apache Beam SDK เป็นโมเดลการเขียนโปรแกรมโอเพนซอร์สที่ช่วยให้คุณพัฒนาทั้งไปป์ไลน์แบบกลุ่มและแบบสตรีมได้ คุณสร้างไปป์ไลน์ด้วยโปรแกรม Apache Beam แล้วเรียกใช้ในบริการ Dataflow เอกสารประกอบของ Apache Beam มีข้อมูลเชิงแนวคิดและข้อมูลอ้างอิงเชิงลึกสำหรับโมเดลการเขียนโปรแกรม, SDK และตัวเรียกใช้อื่นๆ ของ Apache Beam
การวิเคราะห์ข้อมูลการสตรีมอย่างรวดเร็ว
Dataflow ช่วยให้พัฒนา Data Pipeline สำหรับสตรีมมิงได้อย่างรวดเร็วและง่ายขึ้น พร้อมลดเวลาในการตอบสนองของข้อมูล
ลดความซับซ้อนของการดำเนินงานและการจัดการ
ช่วยให้ทีมมุ่งเน้นที่การเขียนโปรแกรมแทนการจัดการคลัสเตอร์เซิร์ฟเวอร์ เนื่องจากแนวทางแบบ Serverless ของ Dataflow จะช่วยลดค่าใช้จ่ายในการดำเนินการจากปริมาณงานด้านวิศวกรรมข้อมูล
ลดต้นทุนรวมในการเป็นเจ้าของ
การปรับขนาดทรัพยากรโดยอัตโนมัติควบคู่กับความสามารถในการประมวลผลแบบกลุ่มที่เพิ่มประสิทธิภาพด้านต้นทุนหมายความว่า Dataflow มีความสามารถในการจัดการภาระงานตามฤดูกาลและภาระงานที่เพิ่มขึ้นอย่างรวดเร็วโดยไม่ใช้งบประมาณเกินจริง
ฟีเจอร์หลัก
การจัดการทรัพยากรแบบอัตโนมัติและการปรับสมดุลงานแบบไดนามิก
Dataflow จะจัดสรรและจัดการทรัพยากรการประมวลผลโดยอัตโนมัติเพื่อลดเวลาในการตอบสนองและเพิ่มการใช้งานสูงสุด คุณจึงไม่จำเป็นต้องเปิดใช้อินสแตนซ์หรือจองด้วยตนเอง นอกจากนี้ การแบ่งพาร์ติชันการทำงานยังเป็นแบบอัตโนมัติและเพิ่มประสิทธิภาพเพื่อจัดสมดุลการหน่วงเวลาได้แบบไดนามิก คุณไม่จำเป็นต้องค้นหา "คีย์ลัด" หรือประมวลผลข้อมูลนำเข้าล่วงหน้า
การปรับขนาดอัตโนมัติแนวนอน
การปรับขนาดทรัพยากร Worker แบบอัตโนมัติในแนวนอนเพื่อเพิ่มประสิทธิภาพอัตราการส่งข้อมูลให้สูงสุด ซึ่งจะทำให้ราคาต่อประสิทธิภาพโดยรวมดีขึ้น
ราคาการกำหนดเวลาใช้ทรัพยากรที่ยืดหยุ่นสำหรับการประมวลผลแบบกลุ่ม
สำหรับการประมวลผลที่มีความยืดหยุ่นในเวลาการกำหนดเวลางาน เช่น งานข้ามคืน การกำหนดเวลาใช้ทรัพยากรที่ยืดหยุ่น (FlexRS) จะมีราคาที่ต่ำกว่าสำหรับการประมวลผลแบบกลุ่ม ระบบจะจัดคิวงานที่ยืดหยุ่นเหล่านี้พร้อมรับประกันว่าจะดึงข้อมูลมาดำเนินการภายในกรอบเวลา 6 ชั่วโมง
บทแนะนำนี้ดัดแปลงมาจาก https://cloud.google.com/dataflow/docs/quickstarts/quickstart-java-maven
สิ่งที่คุณจะได้เรียนรู้
- วิธีสร้างโปรเจ็กต์ Maven ด้วย Apache Beam โดยใช้ Java SDK
- เรียกใช้ไปป์ไลน์ตัวอย่างโดยใช้คอนโซล Google Cloud Platform
- วิธีลบที่เก็บข้อมูล Cloud Storage ที่เชื่อมโยงและเนื้อหาของที่เก็บข้อมูล
สิ่งที่คุณต้องมี
คุณจะใช้บทแนะนำนี้อย่างไร
คุณจะให้คะแนนประสบการณ์การใช้บริการ Google Cloud Platform เท่าใด
2. การตั้งค่าและข้อกำหนด
การตั้งค่าสภาพแวดล้อมแบบเรียนรู้ด้วยตนเอง
- ลงชื่อเข้าใช้ Cloud Console แล้วสร้างโปรเจ็กต์ใหม่หรือใช้โปรเจ็กต์ที่มีอยู่ซ้ำ (หากยังไม่มีบัญชี Gmail หรือ G Suite คุณต้องสร้างบัญชี)
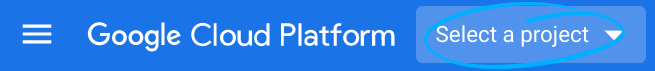
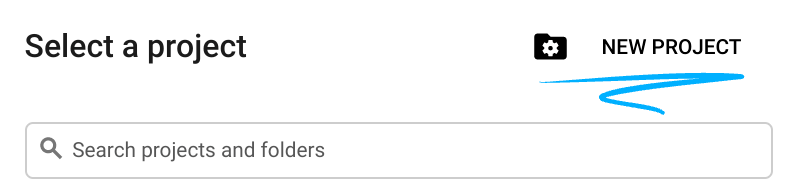
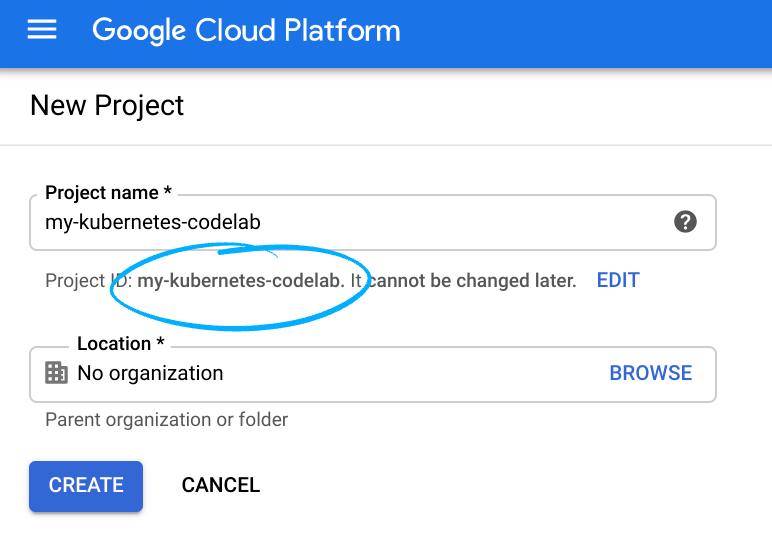
โปรดจดจำรหัสโปรเจ็กต์ ซึ่งเป็นชื่อที่ไม่ซ้ำกันในโปรเจ็กต์ Google Cloud ทั้งหมด (ชื่อด้านบนมีผู้ใช้แล้วและจะใช้ไม่ได้ ขออภัย) ซึ่งจะเรียกว่า PROJECT_ID ในภายหลังใน Codelab นี้
- จากนั้นคุณจะต้องเปิดใช้การเรียกเก็บเงินใน Cloud Console เพื่อใช้ทรัพยากร Google Cloud
การทำตาม Codelab นี้ไม่ควรมีค่าใช้จ่ายมากนัก หรืออาจไม่มีเลย โปรดทำตามวิธีการในส่วน "การล้างข้อมูล" ซึ่งจะแนะนำวิธีปิดทรัพยากรเพื่อไม่ให้มีการเรียกเก็บเงินนอกเหนือจากบทแนะนำนี้ ผู้ใช้ใหม่ของ Google Cloud มีสิทธิ์เข้าร่วมโปรแกรมช่วงทดลองใช้ฟรีมูลค่า$300USD
เปิดใช้ API
คลิกไอคอนเมนูที่ด้านซ้ายบนของหน้าจอ

เลือก API และบริการ > แดชบอร์ด จากเมนูแบบเลื่อนลง

เลือก + เปิดใช้ API และบริการ

ค้นหา "Compute Engine" ในช่องค้นหา คลิก "Compute Engine API" ในรายการผลการค้นหาที่ปรากฏขึ้น

ในหน้า Google Compute Engine ให้คลิกเปิดใช้

เมื่อเปิดใช้แล้ว ให้คลิกลูกศรเพื่อกลับไป
ตอนนี้ให้ค้นหา API ต่อไปนี้และเปิดใช้ด้วย
- Cloud Dataflow
- Stackdriver
- Cloud Storage
- JSON ของ Cloud Storage
- BigQuery
- Cloud Pub/Sub
- Cloud Datastore
- Cloud Resource Manager API
3. สร้าง Bucket ของ Cloud Storage ใหม่
ในคอนโซล Google Cloud Platform ให้คลิกไอคอนเมนูที่ด้านซ้ายบนของหน้าจอ
เลื่อนลงแล้วเลือก Cloud Storage > เบราว์เซอร์ ในส่วนย่อยพื้นที่เก็บข้อมูล

ตอนนี้คุณควรเห็นเบราว์เซอร์ Cloud Storage และหากคุณใช้โปรเจ็กต์ที่ไม่มี Bucket ของ Cloud Storage ในขณะนี้ คุณจะเห็นคำเชิญให้สร้าง Bucket ใหม่ กดปุ่มสร้าง Bucket เพื่อสร้าง

ป้อนชื่อสำหรับที่เก็บข้อมูล ดังที่กล่องโต้ตอบระบุไว้ ชื่อ Bucket ต้องไม่ซ้ำกันใน Cloud Storage ทั้งหมด ดังนั้นหากเลือกชื่อที่ชัดเจน เช่น "test" คุณอาจพบว่ามีคนสร้าง Bucket ที่มีชื่อนั้นอยู่แล้วและจะได้รับข้อผิดพลาด
นอกจากนี้ ยังมีกฎบางอย่างเกี่ยวกับอักขระที่อนุญาตให้ใช้ในชื่อที่เก็บข้อมูลด้วย หากขึ้นต้นและลงท้ายชื่อที่เก็บข้อมูลด้วยตัวอักษรหรือตัวเลข และใช้เฉพาะขีดกลางตรงกลาง คุณก็ใช้ชื่อนั้นได้ หากคุณพยายามใช้สัญลักษณ์พิเศษ หรือพยายามขึ้นต้นหรือลงท้ายชื่อ Bucket ด้วยสิ่งอื่นที่ไม่ใช่ตัวอักษรหรือตัวเลข กล่องโต้ตอบจะแจ้งเตือนกฎให้คุณทราบ

ป้อนชื่อที่ไม่ซ้ำกันสำหรับที่เก็บข้อมูล แล้วกดสร้าง หากเลือกสิ่งที่ใช้อยู่แล้ว คุณจะเห็นข้อความแสดงข้อผิดพลาดที่แสดงด้านบน เมื่อสร้าง Bucket เรียบร้อยแล้ว ระบบจะนำคุณไปยัง Bucket ใหม่ที่ว่างเปล่าในเบราว์เซอร์

แน่นอนว่าชื่อ Bucket ที่คุณเห็นจะแตกต่างกัน เนื่องจากชื่อ Bucket ต้องไม่ซ้ำกันในทุกโปรเจ็กต์
4. เริ่มต้น Cloud Shell
เปิดใช้งาน Cloud Shell
- จาก Cloud Console ให้คลิกเปิดใช้งาน Cloud Shell

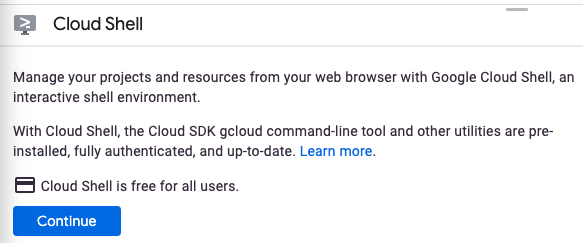
หากไม่เคยเริ่มใช้ Cloud Shell มาก่อน คุณจะเห็นหน้าจอระดับกลาง (ครึ่งหน้าล่าง) ที่อธิบายว่า Cloud Shell คืออะไร ในกรณีนี้ ให้คลิกต่อไป (และคุณจะไม่เห็นหน้าจอนี้อีก) หน้าจอแบบครั้งเดียวจะมีลักษณะดังนี้
การจัดสรรและเชื่อมต่อกับ Cloud Shell จะใช้เวลาไม่นาน
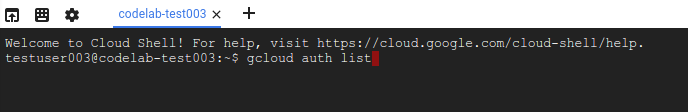
เครื่องเสมือนนี้มาพร้อมเครื่องมือพัฒนาซอฟต์แวร์ทั้งหมดที่คุณต้องการ โดยมีไดเรกทอรีหลักขนาด 5 GB ที่คงอยู่ถาวรและทำงานใน Google Cloud ซึ่งช่วยเพิ่มประสิทธิภาพเครือข่ายและการตรวจสอบสิทธิ์ได้อย่างมาก คุณสามารถทำงานในโค้ดแล็บนี้ได้โดยใช้เพียงเบราว์เซอร์หรือ Chromebook
เมื่อเชื่อมต่อกับ Cloud Shell แล้ว คุณควรจะเห็นว่าคุณได้รับการตรวจสอบสิทธิ์แล้วและโปรเจ็กต์ได้รับการตั้งค่าเป็นรหัสโปรเจ็กต์ของคุณแล้ว
- เรียกใช้คำสั่งต่อไปนี้ใน Cloud Shell เพื่อยืนยันว่าคุณได้รับการตรวจสอบสิทธิ์แล้ว
gcloud auth list
เอาต์พุตจากคำสั่ง
 Credentialed Accounts
ACTIVE  ACCOUNT
*       <my_account>@<my_domain.com>

To set the active account, run:
    $ gcloud config set account `ACCOUNT`
gcloud config list project
เอาต์พุตจากคำสั่ง
[core]
project = <PROJECT_ID>
หากไม่ได้ตั้งค่าไว้ คุณตั้งค่าได้ด้วยคำสั่งนี้
gcloud config set project <PROJECT_ID>
เอาต์พุตจากคำสั่ง
Updated property [core/project].
5. สร้างโปรเจ็กต์ Maven
หลังจากเปิด Cloud Shell แล้ว มาเริ่มกันเลยด้วยการสร้างโปรเจ็กต์ Maven โดยใช้ Java SDK สำหรับ Apache Beam
Apache Beam เป็นโมเดลการเขียนโปรแกรมโอเพนซอร์สสำหรับไปป์ไลน์ข้อมูล คุณกำหนดไปป์ไลน์เหล่านี้ด้วยโปรแกรม Apache Beam และเลือกโปรแกรมเรียกใช้ เช่น Dataflow เพื่อดำเนินการไปป์ไลน์ได้
เรียกใช้คำสั่ง mvn archetype:generate ในเชลล์ดังนี้
  mvn archetype:generate \
     -DarchetypeGroupId=org.apache.beam \
     -DarchetypeArtifactId=beam-sdks-java-maven-archetypes-examples \
     -DarchetypeVersion=2.46.0 \
     -DgroupId=org.example \
     -DartifactId=first-dataflow \
     -Dversion="0.1" \
     -Dpackage=org.apache.beam.examples \
     -DinteractiveMode=false
หลังจากเรียกใช้คำสั่งแล้ว คุณควรเห็นไดเรกทอรีใหม่ชื่อ first-dataflow ในไดเรกทอรีปัจจุบัน first-dataflow มีโปรเจ็กต์ Maven ที่มี Cloud Dataflow SDK สำหรับ Java และไปป์ไลน์ตัวอย่าง
6. เรียกใช้ไปป์ไลน์การประมวลผลข้อความใน Cloud Dataflow
มาเริ่มต้นด้วยการบันทึกรหัสโปรเจ็กต์และชื่อ Bucket ของ Cloud Storage เป็นตัวแปรสภาพแวดล้อมกัน โดยคุณจะทำขั้นตอนนี้ได้ใน Cloud Shell อย่าลืมแทนที่ <your_project_id> ด้วยรหัสโปรเจ็กต์ของคุณเอง
export PROJECT_ID=<your_project_id>
ตอนนี้เราจะทำเช่นเดียวกันกับ Bucket ของ Cloud Storage อย่าลืมแทนที่ <your_bucket_name> ด้วยชื่อที่ไม่ซ้ำกันซึ่งคุณใช้สร้าง Bucket ในขั้นตอนก่อนหน้า
export BUCKET_NAME=<your_bucket_name>
เปลี่ยนเป็นไดเรกทอรี first-dataflow/
cd first-dataflow
เราจะเรียกใช้ไปป์ไลน์ที่ชื่อ WordCount ซึ่งอ่านข้อความ เปลี่ยนแต่ละคำในบรรทัดข้อความให้เป็นโทเคน และนับจำนวนความถี่ในแต่ละคำ ก่อนอื่นเราจะเรียกใช้ไปป์ไลน์ และในขณะที่ไปป์ไลน์ทำงาน เราจะมาดูสิ่งที่เกิดขึ้นในแต่ละขั้นตอน
เริ่มไปป์ไลน์โดยเรียกใช้คำสั่ง mvn compile exec:java ในเชลล์หรือหน้าต่างเทอร์มินัล สำหรับอาร์กิวเมนต์ --project, --stagingLocation, และ --output คำสั่งด้านล่างจะอ้างอิงตัวแปรสภาพแวดล้อมที่คุณตั้งค่าไว้ก่อนหน้านี้ในขั้นตอนนี้
 mvn compile exec:java \
      -Pdataflow-runner compile exec:java \
      -Dexec.mainClass=org.apache.beam.examples.WordCount \
      -Dexec.args="--project=${PROJECT_ID} \
      --stagingLocation=gs://${BUCKET_NAME}/staging/ \
      --output=gs://${BUCKET_NAME}/output \
      --runner=DataflowRunner \
      --region=us-central1 \
      --gcpTempLocation=gs://${BUCKET_NAME}/temp"
ขณะที่งานกำลังทำงานอยู่ ให้ค้นหางานในรายการงาน
เปิดเว็บ UI ของ Cloud Dataflow ในคอนโซล Google Cloud Platform คุณควรเห็นงานนับคำที่มีสถานะเป็นกำลังทำงาน ดังนี้

ตอนนี้เรามาดูพารามิเตอร์ของไปป์ไลน์กัน เริ่มต้นโดยคลิกชื่องานของคุณ

เมื่อเลือกงาน คุณจะดูกราฟการดำเนินการได้ กราฟการดำเนินการของไปป์ไลน์จะแสดงการแปลงแต่ละรายการในไปป์ไลน์เป็นกล่องที่มีชื่อการแปลงและข้อมูลสถานะบางอย่าง คุณคลิกเครื่องหมายแครอทที่มุมขวาบนของแต่ละขั้นตอนเพื่อดูรายละเอียดเพิ่มเติมได้

มาดูกันว่าไปป์ไลน์จะเปลี่ยนรูปแบบข้อมูลในแต่ละขั้นตอนอย่างไร
- อ่าน: ในขั้นตอนนี้ ไปป์ไลน์จะอ่านจากแหล่งที่มาของอินพุต ในกรณีนี้คือไฟล์ข้อความจาก Cloud Storage ที่มีข้อความทั้งหมดของบทละคร King Lear ของเชกสเปียร์ ไปป์ไลน์ของเราจะอ่านไฟล์ทีละบรรทัดและเอาต์พุตแต่ละบรรทัดเป็น
PCollectionโดยแต่ละบรรทัดในไฟล์ข้อความจะเป็นองค์ประกอบในคอลเล็กชัน - CountWords: ขั้นตอนที่
CountWordsมี 2 ส่วน ก่อนอื่น ฟังก์ชัน do แบบขนาน (ParDo) ที่ชื่อExtractWordsจะใช้เพื่อแยกแต่ละบรรทัดเป็นคำแต่ละคำ เอาต์พุตของ ExtractWords คือ PCollection ใหม่ที่แต่ละองค์ประกอบเป็นคำ ขั้นตอนถัดไปCountใช้การเปลี่ยนรูปแบบที่ Java SDK จัดเตรียมให้ ซึ่งจะแสดงผลคู่คีย์-ค่า โดยที่คีย์คือคำที่ไม่ซ้ำกัน และค่าคือจำนวนครั้งที่คำนั้นปรากฏ ต่อไปนี้เป็นวิธีการใช้CountWordsและคุณสามารถดูไฟล์ WordCount.java แบบเต็มได้ใน GitHub
 /**
   * A PTransform that converts a PCollection containing lines of text into a PCollection of
   * formatted word counts.
   *
   * <p>Concept #3: This is a custom composite transform that bundles two transforms (ParDo and
   * Count) as a reusable PTransform subclass. Using composite transforms allows for easy reuse,
   * modular testing, and an improved monitoring experience.
   */
  public static class CountWords
      extends PTransform<PCollection<String>, PCollection<KV<String, Long>>> {
    @Override
    public PCollection<KV<String, Long>> expand(PCollection<String> lines) {

      // Convert lines of text into individual words.
      PCollection<String> words = lines.apply(ParDo.of(new ExtractWordsFn()));

      // Count the number of times each word occurs.
      PCollection<KV<String, Long>> wordCounts = words.apply(Count.perElement());

      return wordCounts;
    }
  }
- MapElements: This invokes the
FormatAsTextFn, copied below, which formats each key, value pair into a printable string.
  /** A SimpleFunction that converts a Word and Count into a printable string. */
  public static class FormatAsTextFn extends SimpleFunction<KV<String, Long>, String> {
    @Override
    public String apply(KV<String, Long> input) {
      return input.getKey() + ": " + input.getValue();
    }
  }
- WriteCounts: ในขั้นตอนนี้ เราจะเขียนสตริงที่พิมพ์ได้ลงในไฟล์ข้อความที่แยกส่วนหลายไฟล์
เราจะมาดูเอาต์พุตที่ได้จากไปป์ไลน์ในอีกไม่กี่นาที
ตอนนี้ให้ดูหน้าข้อมูลงานทางด้านขวาของกราฟ ซึ่งมีพารามิเตอร์ของไปป์ไลน์ที่เราใส่ไว้ในคำสั่ง mvn compile exec:java


นอกจากนี้ คุณยังดูตัวนับที่กำหนดเองสำหรับไปป์ไลน์ได้ด้วย ซึ่งในกรณีนี้จะแสดงจำนวนบรรทัดว่างที่พบจนถึงขณะนี้ในระหว่างการดำเนินการ คุณสามารถเพิ่มตัวนับใหม่ลงในไปป์ไลน์เพื่อติดตามเมตริกเฉพาะแอปพลิเคชันได้

คุณคลิกไอคอนบันทึกที่ด้านล่างของคอนโซลเพื่อดูข้อความแสดงข้อผิดพลาดที่เฉพาะเจาะจงได้

โดยค่าเริ่มต้น แผงจะแสดงข้อความบันทึกงานที่รายงานสถานะของงานโดยรวม คุณสามารถใช้ตัวเลือกความรุนแรงขั้นต่ำเพื่อกรองข้อความความคืบหน้าและสถานะของงาน

การเลือกขั้นตอนไปป์ไลน์ในกราฟจะเปลี่ยนมุมมองเป็นบันทึกที่โค้ดสร้างขึ้นและโค้ดที่สร้างขึ้นซึ่งทำงานในขั้นตอนไปป์ไลน์
หากต้องการกลับไปที่บันทึกของงาน ให้ยกเลิกการเลือกขั้นตอนโดยคลิกนอกกราฟหรือใช้ปุ่มปิดในแผงด้านขวา
คุณสามารถใช้ปุ่มบันทึกของ Worker ในแท็บบันทึกเพื่อดูบันทึกของ Worker สำหรับอินสแตนซ์ Compute Engine ที่เรียกใช้ไปป์ไลน์ได้ บันทึกของ Worker จะมีบรรทัดบันทึกที่สร้างขึ้นจากโค้ดและโค้ดที่สร้างโฟลว์ข้อมูลที่เรียกใช้โค้ดนั้น
หากคุณพยายามแก้ไขข้อบกพร่องในไปป์ไลน์ บ่อยครั้งที่จะมีการบันทึกเพิ่มเติมในบันทึกของ Worker ซึ่งจะช่วยแก้ปัญหาได้ โปรดทราบว่าระบบจะรวบรวมบันทึกเหล่านี้จากผู้ปฏิบัติงานทั้งหมด และสามารถกรองและค้นหาได้

อินเทอร์เฟซการตรวจสอบ Dataflow จะแสดงเฉพาะข้อความบันทึกล่าสุด คุณดูบันทึกทั้งหมดได้โดยคลิกลิงก์ Google Cloud Observability ทางด้านขวาของบานหน้าต่างบันทึก

ต่อไปนี้คือสรุปของบันทึกประเภทต่างๆ ที่ดูได้จากหน้าการตรวจสอบ→บันทึก
- บันทึก job-message มีข้อความระดับงานที่คอมโพเนนต์ต่างๆ ของ Dataflow สร้างขึ้น ตัวอย่างเช่น การกำหนดค่าการปรับขนาดอัตโนมัติ เมื่อผู้ปฏิบัติงานเริ่มหรือปิดระบบ ความคืบหน้าในขั้นตอนงาน และข้อผิดพลาดของงาน ข้อผิดพลาดระดับ Worker ที่เกิดจากการขัดข้องของโค้ดผู้ใช้และที่อยู่ในบันทึก worker จะเผยแพร่ไปยังบันทึก job-message ด้วย
- บันทึกของ Worker สร้างขึ้นโดย Dataflow Worker Worker จะทำงานในไปป์ไลน์ส่วนใหญ่ (เช่น การใช้ ParDo กับข้อมูล) บันทึกของ Worker มีข้อความที่โค้ดและ Dataflow บันทึกไว้
- บันทึก worker-startup จะอยู่ในงาน Dataflow ส่วนใหญ่และสามารถบันทึกข้อความที่เกี่ยวข้องกับกระบวนการเริ่มต้นได้ กระบวนการเริ่มต้นประกอบด้วยการดาวน์โหลดไฟล์ JAR ของงานจาก Cloud Storage แล้วจึงเริ่ม Worker หากมีปัญหาในการเริ่มต้น Worker บันทึกเหล่านี้จะเป็นที่ที่ควรดู
- บันทึกของ shuffler มีข้อความจาก Worker ที่รวมผลลัพธ์ของการดำเนินการไปป์ไลน์แบบขนาน
- บันทึกของ docker และ kubelet มีข้อความที่เกี่ยวข้องกับเทคโนโลยีสาธารณะเหล่านี้ ซึ่งใช้ในผู้ปฏิบัติงาน Dataflow
ในขั้นตอนถัดไป เราจะตรวจสอบว่างานของคุณสำเร็จหรือไม่
7. ตรวจสอบว่างานสำเร็จแล้ว
เปิดเว็บ UI ของ Cloud Dataflow ในคอนโซล Google Cloud Platform
คุณควรเห็นงานนับคำที่มีสถานะเป็นกำลังทำงานในตอนแรก จากนั้นสถานะจะเปลี่ยนเป็นสำเร็จ

งานนี้จะใช้เวลาประมาณ 3-4 นาที
คุณจำได้ไหมว่าตอนที่เรียกใช้ไปป์ไลน์และระบุที่เก็บข้อมูลเอาต์พุต มาดูผลลัพธ์กัน (เพราะคุณคงอยากรู้ว่าคำแต่ละคำในKing Lear ปรากฏกี่ครั้งใช่ไหม) กลับไปที่เบราว์เซอร์ Cloud Storage ในคอนโซล Google Cloud Platform ในที่เก็บข้อมูล คุณควรเห็นไฟล์เอาต์พุตและไฟล์ Staging ที่งานสร้างขึ้น ดังนี้

8. ปิดทรัพยากร
คุณปิดทรัพยากรได้จากคอนโซล Google Cloud Platform
เปิดเบราว์เซอร์ Cloud Storage ในคอนโซล Google Cloud Platform
เลือกช่องทําเครื่องหมายข้างที่เก็บข้อมูลที่สร้างขึ้น แล้วคลิกลบเพื่อลบที่เก็บข้อมูลและเนื้อหาอย่างถาวร


9. ยินดีด้วย
คุณได้เรียนรู้วิธีสร้างโปรเจ็กต์ Maven ด้วย Cloud Dataflow SDK, เรียกใช้ไปป์ไลน์ตัวอย่างโดยใช้คอนโซล Google Cloud Platform และลบ Bucket ของ Cloud Storage ที่เชื่อมโยงและเนื้อหาของ Bucket
ดูข้อมูลเพิ่มเติม
- เอกสารประกอบของ Dataflow: https://cloud.google.com/dataflow/docs/
ใบอนุญาต
ผลงานนี้ได้รับอนุญาตภายใต้สัญญาอนุญาตครีเอทีฟคอมมอนส์แบบระบุแหล่งที่มา 3.0 ทั่วไป และสัญญาอนุญาต Apache 2.0