

1. מבוא
| Kubeflow הוא ערכת כלים ללמידת מכונה ל-Kubernetes. הפרויקט מוקדש להפיכת פריסות של תהליכי עבודה של למידת מכונה (ML) ב-Kubernetes לפשוטות, לניידות ולהתאמה לעומס (scaling). המטרה היא לספק דרך פשוטה לפריסת מערכות קוד פתוח מהשורה הראשונה ללמידת מכונה בתשתיות מגוונות. |
| תהליך עבודה של למידת מכונה יכול לכלול שלבים רבים עם תלות הדדית, החל מהכנת נתונים וניתוח, דרך אימון והערכה, ועד לפריסה ועוד. קשה ליצור ולעקוב אחרי התהליכים האלה באופן אד-הוק – למשל, באמצעות סדרה של מחברות או סקריפטים – ודברים כמו ביקורת ושחזור הופכים לבעייתיים יותר ויותר.Kubeflow Pipelines (KFP) עוזר לפתור את הבעיות האלה על ידי מתן דרך לפרוס צינורות חזקים וניתנים לשחזור של למידת מכונה, יחד עם מעקב, ביקורת, מעקב אחר גרסאות ושחזור. בעזרת Cloud AI Pipelines קל להגדיר התקנה של KFP. |
מה תפַתחו
ב-Codelab הזה תיצרו אפליקציית אינטרנט שמסכמת בעיות ב-GitHub באמצעות Kubeflow Pipelines לאימון מודל ולהכניסו לשימוש בסביבת הייצור. היא מבוססת על דוגמה במאגר הדוגמאות של Kubeflow. בסיום התהליך, התשתית שלכם תכלול:
- אשכול Google Kubernetes Engine (GKE) עם Kubeflow Pipelines מותקן (דרך Cloud AI Pipelines).
- צינור לעיבוד נתונים שמאמן מודל Tensor2Tensor במעבדי GPU
- קונטיינר להצגת נתונים שכולל חיזויים מהמודל שאומן
- ממשק משתמש שמפרש את התחזיות כדי לספק סיכומים של בעיות ב-GitHub
- מחברת שיוצרת צינור עיבוד נתונים מאפס באמצעות Kubeflow Pipelines (KFP) SDK
מה תלמדו
צינור עיבוד הנתונים שתבנו יאמן מודל Tensor2Tensor על נתוני בעיות מ-GitHub, וילמד לחזות את כותרות הבעיות מתוך גופי הבעיות. לאחר מכן, הוא מייצא את המודל שאומן ופורס את המודל המיוצא באמצעות Tensorflow Serving. השלב האחרון בצינור מעורר אפליקציית אינטרנט, שיוצרת אינטראקציה עם מופע TF-Serving כדי לקבל תחזיות של המודל.
- איך מתקינים Kubeflow Pipelines באשכול GKE
- איך ליצור ולהפעיל תהליכי עבודה של למידת מכונה באמצעות Kubeflow Pipelines
- איך מגדירים ומריצים צינורות עיבוד נתונים מתוך AI Platform Notebook
מה תצטרכו
- הבנה בסיסית של Kubernetes תעזור, אבל היא לא הכרחית
- פרויקט פעיל ב-GCP שבו יש לכם הרשאות בעלים
- (אופציונלי) חשבון ב-GitHub
- גישה אל Google Cloud Shell, שזמין ב-Google Cloud Platform (GCP) Console
2. הגדרה
Cloud Shell
נכנסים למסוף GCP בדפדפן ומתחברים באמצעות פרטי הכניסה לפרויקט:
אם צריך, לוחצים על 'בחירת פרויקט' כדי לעבוד עם פרויקט ה-codelab.
אחר כך לוחצים על הסמל 'הפעלת Cloud Shell' בפינה הימנית העליונה של המסוף כדי להפעיל Cloud Shell.

כשמפעילים את Cloud Shell, מוצג שם הפרויקט שמוגדר לשימוש. בודקים שההגדרה הזו נכונה.
כדי למצוא את מזהה הפרויקט, עוברים לחלונית Home ב-GCP Console. אם המסך ריק, לוחצים על 'כן' בהנחיה כדי ליצור מרכז בקרה.

לאחר מכן, בטרמינל של Cloud Shell, מריצים את הפקודות הבאות אם צריך להגדיר את gcloud כך שישתמש בפרויקט הנכון:
export PROJECT_ID=<your_project_id>
gcloud config set project ${PROJECT_ID}
יצירה של קטגוריית אחסון
יוצרים קטגוריה של Cloud Storage לאחסון קבצים של צינורות. כדי להבטיח שהשם יהיה ייחודי גלובלית, כדאי להגדיר שם לקטגוריה שיכלול את מזהה הפרויקט. יוצרים את הקטגוריה באמצעות הפקודה gsutil mb (יצירת קטגוריה):
export PROJECT_ID=<your_project_id>
export BUCKET_NAME=kubeflow-${PROJECT_ID}
gsutil mb gs://${BUCKET_NAME}
אפשר גם ליצור מאגר דרך מסוף GCP.
אופציונלי**: יצירת טוקן GitHub**
ב-Codelab הזה מתבצעת קריאה ל-GitHub API כדי לאחזר נתונים שזמינים לכולם. כדי למנוע הגבלת קצב, במיוחד באירועים שבהם נשלח מספר גדול של בקשות אנונימיות לממשקי ה-API של GitHub, צריך להגדיר אסימון גישה ללא הרשאות. האימות הזה נועד רק כדי לאשר אתכם כאדם פרטי ולא כמשתמש לא רשום.
- עוברים אל https://github.com/settings/tokens ויוצרים טוקן חדש ללא היקפי הרשאה.
- שומרים אותו במקום בטוח. אם מאבדים אותו, צריך למחוק אותו וליצור חדש.
גם אם מדלגים על השלב הזה, ה-Lab עדיין יעבוד – פשוט יהיו לכם פחות אפשרויות ליצירת נתוני קלט לבדיקת המודל.
אופציונלי: הצמדת לוחות בקרה שימושיים
במסוף GCP, מצמידים את מרכזי הבקרה Kubernetes Engine ו-Storage כדי לגשת אליהם בקלות.

יצירת התקנה של AI Platform Pipelines (Hosted Kubeflow Pipelines)
כדי להגדיר מכונת GKE עם KFP מותקן, פועלים לפי ההוראות שבקטעים 'לפני שמתחילים' ו'הגדרת המכונה' כאן. חשוב לסמן את התיבה אישור גישה לממשקי Cloud API הבאים כמו שמוסבר במסמכי התיעוד. (אם לא, צינור העברת הנתונים לדוגמה לא יפעל). משאירים את מרחב השמות של ההתקנה כ-default.
תצטרכו לבחור אזור שתומך ב-Nvidia k80s. אפשר להשתמש ב-us-central1-a או ב-us-central1-c כברירות מחדל.
אחרי שההתקנה מסתיימת, כדאי לרשום את שם האשכול ואזור הזמן של GKE שמופיעים בהתקנה בלוח הבקרה של AI Pipelines, ולהגדיר משתני סביבה עם הערכים האלה.

export ZONE=<your zone>
export CLUSTER_NAME=<your cluster name>
הגדרת kubectl לשימוש בפרטי הכניסה של אשכול GKE החדש
אחרי שיוצרים את אשכול GKE, מריצים את הפקודה הבאה ב-Cloud Shell כדי להגדיר את kubectl לשימוש בפרטי הכניסה של האשכול החדש:
gcloud container clusters get-credentials ${CLUSTER_NAME} \
  --project ${PROJECT_ID} \
  --zone ${ZONE}
אפשר גם ללחוץ על שם האשכול בלוח הבקרה של AI Pipelines כדי לעבור לדף GKE שלו, ואז ללחוץ על 'התחברות' בחלק העליון של הדף. בחלונית הקופצת, מדביקים את הפקודה ב-Cloud Shell.
הפעולה הזו מגדירה את ההקשר של kubectl כדי שתוכלו ליצור אינטראקציה עם האשכול. כדי לאמת את ההגדרה, מריצים את הפקודה הבאה:
kubectl get nodes -o wide
אמורים לראות רשימה של צמתים עם הסטטוס Ready ומידע נוסף על גיל הצומת, הגרסה, כתובת ה-IP החיצונית, תמונת מערכת ההפעלה, גרסת הליבה וזמן הריצה של הקונטיינר.
הגדרת האשכול להתקנת הדרייבר של Nvidia במאגרי צמתים עם GPU
בשלב הבא, נחיל daemonset על האשכול, שיגרום להתקנת מנהל ההתקן של Nvidia בכל צמתי האשכולות שמופעל בהם GPU:
kubectl apply -f https://raw.githubusercontent.com/GoogleCloudPlatform/container-engine-accelerators/master/nvidia-driver-installer/cos/daemonset-preloaded.yaml
לאחר מכן מריצים את הפקודה הבאה, שנותנת לרכיבי KFP הרשאה ליצור משאבי Kubernetes חדשים:
kubectl create clusterrolebinding sa-admin --clusterrole=cluster-admin --serviceaccount=kubeflow:pipeline-runner
יצירת מאגר צמתים של מעבדים גרפיים
לאחר מכן, נגדיר מאגר צמתים של GPU בגודל 1:
gcloud container node-pools create gpu-pool \
    --cluster=${CLUSTER_NAME} \
    --zone ${ZONE} \
    --num-nodes=1 \
    --machine-type n1-highmem-8 \
    --scopes cloud-platform --verbosity error \
    --accelerator=type=nvidia-tesla-k80,count=1
3. הפעלת צינור עיבוד נתונים ממרכז הבקרה של צינורות עיבוד נתונים
פתיחת מרכז הבקרה של צינורות העברת הנתונים
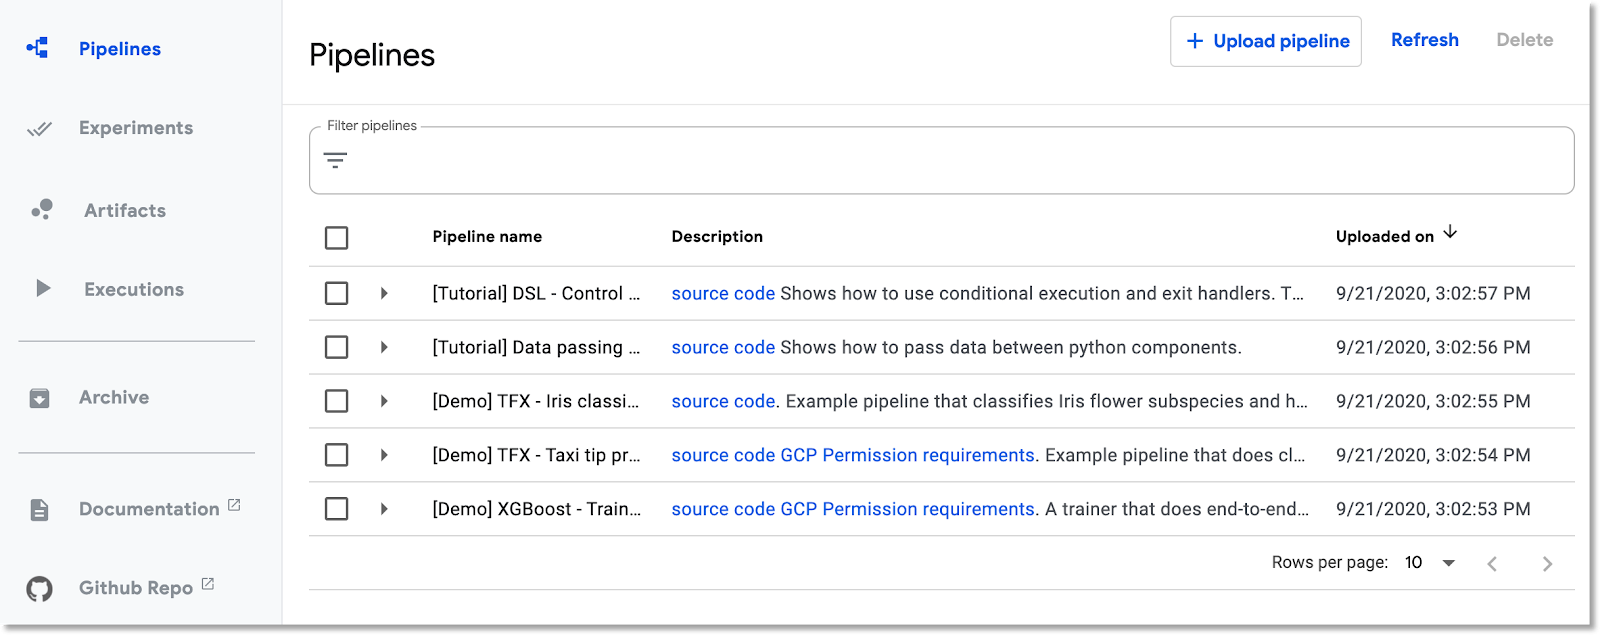
אם אתם לא נמצאים ב-Pipelines panel, נכנסים אליו ב-Cloud Console. אחר כך לוחצים על OPEN PIPELINES DASHBOARD (פתיחת לוח הבקרה של צינורות הנתונים) בהתקנה הרלוונטית, ואז על Pipelines (צינורות נתונים) בסרגל התפריטים הימני. אם מופיעה שגיאת טעינה, מרעננים את הכרטיסייה. אתם אמורים לראות דף חדש שנראה כך:
תיאור צינור עיבוד הנתונים
לצינור שתפעילו יש כמה שלבים (פרטים מופיעים בנספח של ה-codelab הזה):
- עותק של נקודת ביקורת קיימת של מודל מועתק לקטגוריה.
- מודל Tensor2Tensor עובר אימון באמצעות נתונים שעברו עיבוד מראש.
- האימון מתחיל מנקודת הבדיקה הקיימת של המודל שהועתקה בשלב הראשון, ואז מתבצע אימון של עוד כמה מאות שלבים. (ייקח יותר מדי זמן לאמן אותו באופן מלא במהלך ה-codelab).
- בסיום האימון, שלב צינור העיבוד מייצא את המודל בפורמט שמתאים להצגה על ידי TensorFlow Serving.
- מופע TensorFlow-serving נפרס באמצעות המודל הזה.
- אפליקציית אינטרנט מופעלת כדי ליצור אינטראקציה עם המודל שמוצג ולאחזר תחזיות.
הורדה והידור של הפייפליין
בקטע הזה נראה איך קומפילציה של הגדרת צינור מתבצעת. הדבר הראשון שצריך לעשות הוא להתקין את KFP SDK. מריצים את הפקודה הבאה ב-Cloud Shell:
pip3 install -U kfp
כדי להוריד את קובץ הגדרת הצינור, מריצים את הפקודה הזו מ-Cloud Shell:
curl -O https://raw.githubusercontent.com/amygdala/kubeflow-examples/ghsumm/github_issue_summarization/pipelines/example_pipelines/gh_summ_hosted_kfp.py
לאחר מכן, קומפלו את קובץ הגדרת הצינור על ידי הרצתו באופן הבא:
python3 gh_summ_hosted_kfp.py
הקובץ gh_summ_hosted_kfp.py.tar.gz יופיע כתוצאה.
העלאת צינור עיבוד הנתונים המהודר
בממשק המשתמש באינטרנט של Kubeflow Pipelines, לוחצים על Upload pipeline (העלאת צינור) ובוחרים באפשרות Import by URL (ייבוא לפי כתובת URL). מעתיקים את כתובת ה-URL הבאה ומדביקים אותה. כתובת ה-URL הזו מפנה לאותו צינור שזה עתה הידרתם. (העלאת קובץ מ-Cloud Shell דורשת כמה שלבים נוספים, אז אנחנו נשתמש בקיצור דרך).
נותנים שם לצינור (למשל, gh_summ).

הפעלת צינור עיבוד הנתונים
לוחצים על צינור העברת הנתונים שהועלה ברשימה כדי לראות את הגרף הסטטי של צינור העברת הנתונים, ואז לוחצים על יצירת ניסוי כדי ליצור ניסוי חדש באמצעות צינור העברת הנתונים. ניסוי הוא דרך לקבץ ריצות שקשורות זו לזו מבחינה סמנטית.
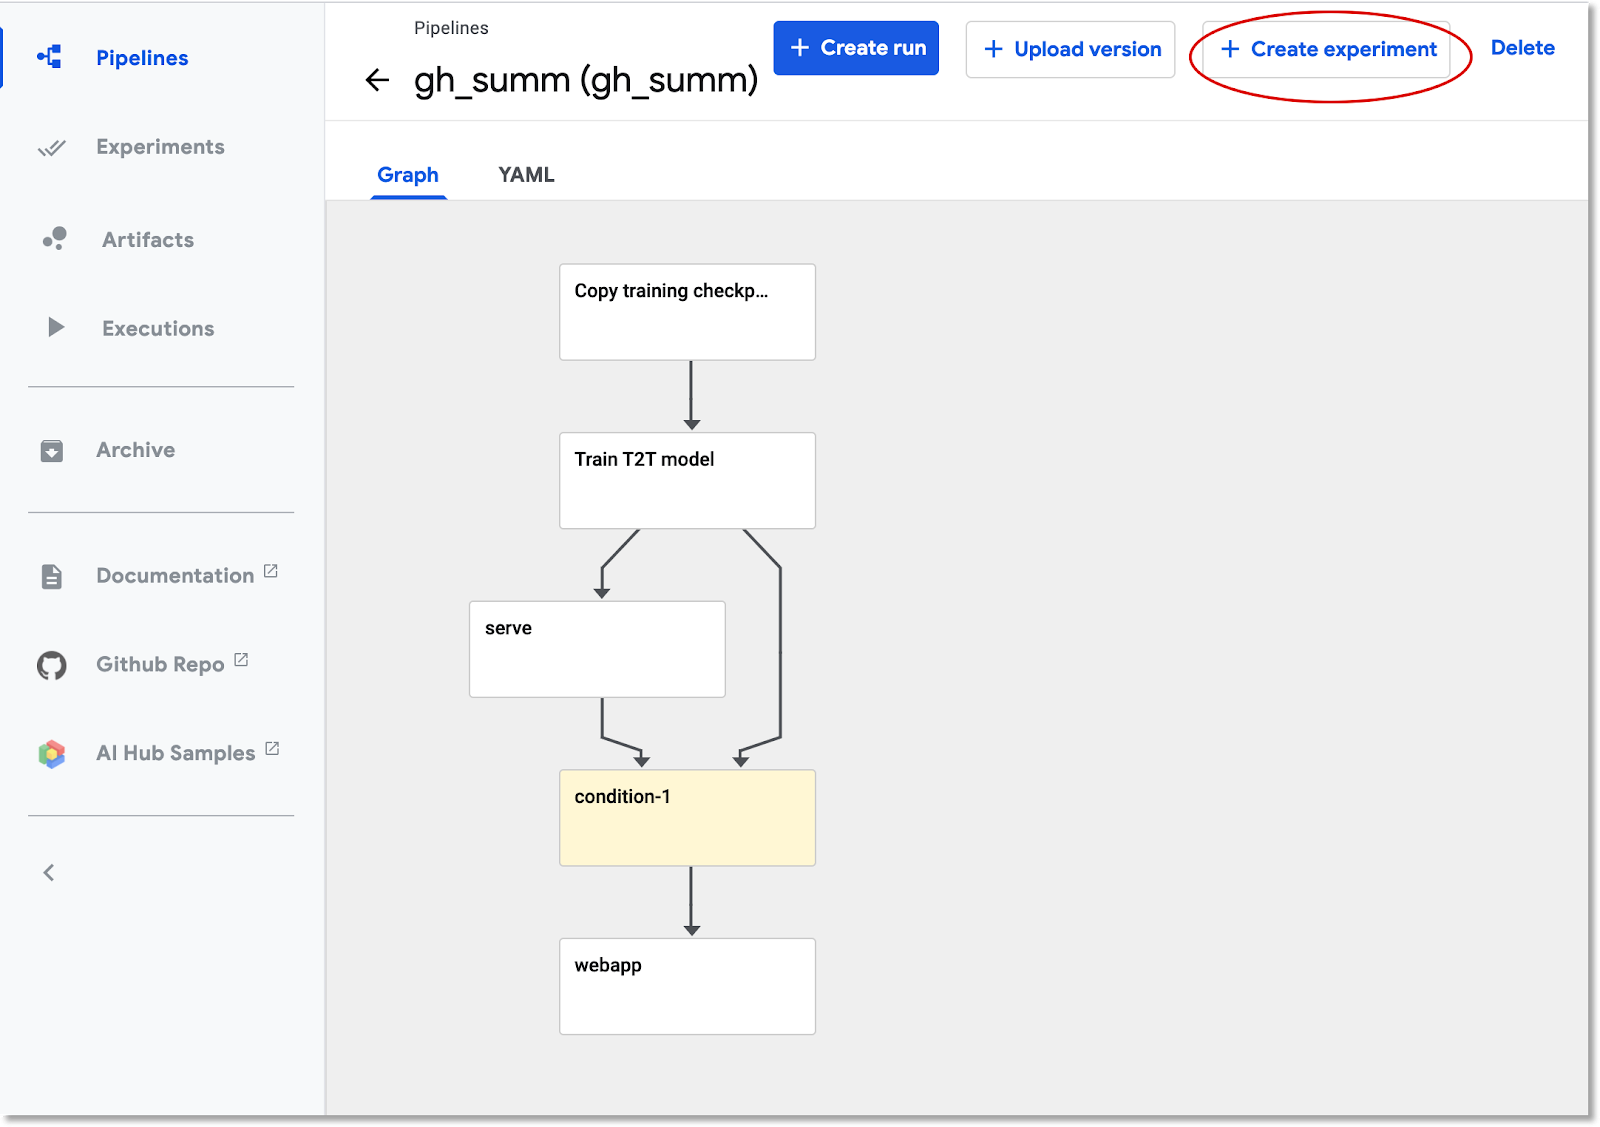
נותנים שם לניסוי (למשל, אותו שם כמו של צינור העיבוד, gh_summ) ואז לוחצים על Next (הבא) כדי ליצור אותו.

ייפתח דף שבו אפשר להזין את הפרמטרים של ההרצה ולהתחיל אותה.
כדי למלא את הפרמטרים, כדאי להריץ את הפקודות הבאות ב-Cloud Shell.
gcloud config get-value project
echo "gs://${BUCKET_NAME}/codelab"
השם של הריצה יאוכלס אוטומטית, אבל אפשר לתת לו שם אחר אם רוצים.
לאחר מכן ממלאים שלושה שדות של פרמטרים:
project- (אופציונלי)
github-token working-dir
בקטע working-dir, מזינים נתיב כלשהו בקטגוריית GCS שיצרתם. כוללים את הקידומת gs://. בשדה github-token, מזינים את האסימון שיצרתם קודם (אם יצרתם אסימון), או משאירים את מחרוזת ה-placeholder כמו שהיא (אם לא יצרתם אסימון).

אחרי שממלאים את השדות, לוחצים על התחלה ואז על ההרצה שמופיעה ברשימה כדי לראות את הפרטים שלה. בזמן ששלב מסוים בצינור העברת הנתונים פועל, אפשר ללחוץ עליו כדי לקבל מידע נוסף, כולל הצגת היומנים של ה-pod שלו. (אפשר גם לראות את היומנים של שלב בצינור דרך הקישור ליומנים שלו ב-Cloud Logging (Stackdriver), גם אם צומת האשכול פורק).

הצגת ההגדרה של צינור עיבוד הנתונים
בזמן שהצינור פועל, כדאי להתעמק בדרך שבה הוא בנוי ובמה שהוא עושה. פרטים נוספים זמינים בקטע נספח של ה-codelab.
הצגת מידע על אימון מודלים ב-TensorBoard
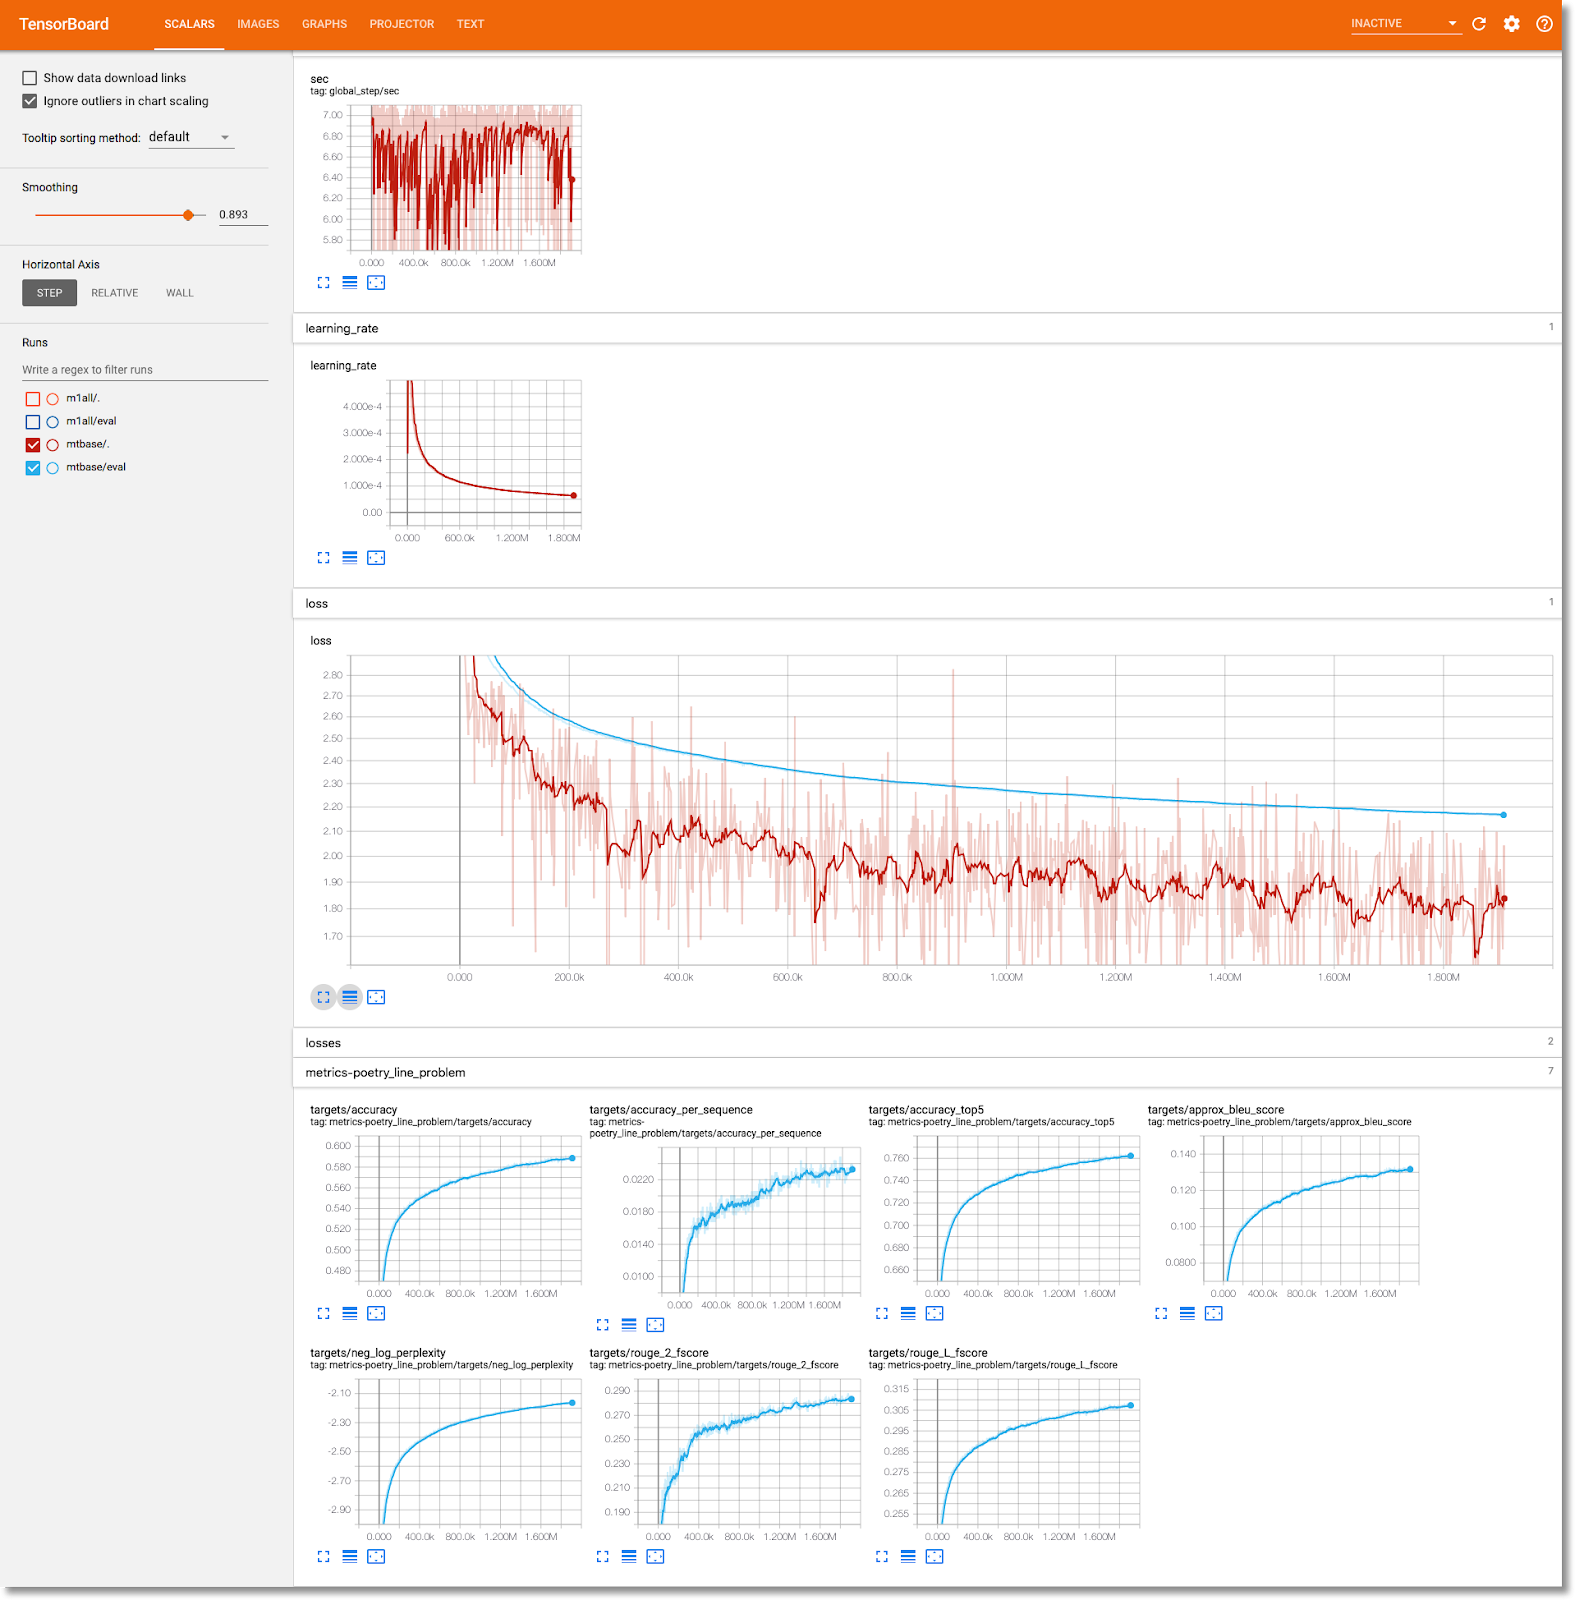
אחרי ששלב האימון מסתיים, בוחרים בכרטיסייה Visualizations (הדמיות) ולוחצים על הלחצן הכחול Start TensorBoard (הפעלת TensorBoard). כשהוא מוכן, לוחצים על Open Tensorboard (פתיחת TensorBoard).

הסבר על מרכז הבקרה של Artifacts and Executions
Kubeflow Pipelines מתעד באופן אוטומטי מטא-נתונים לגבי שלבי הצינור בזמן שהצינור פועל. המערכת מתעדת את המידע על Artifact ועל Execution. כדי לקבל מידע נוסף, לוחצים על הערכים האלה בסרגל הניווט הימני של מרכז הבקרה.
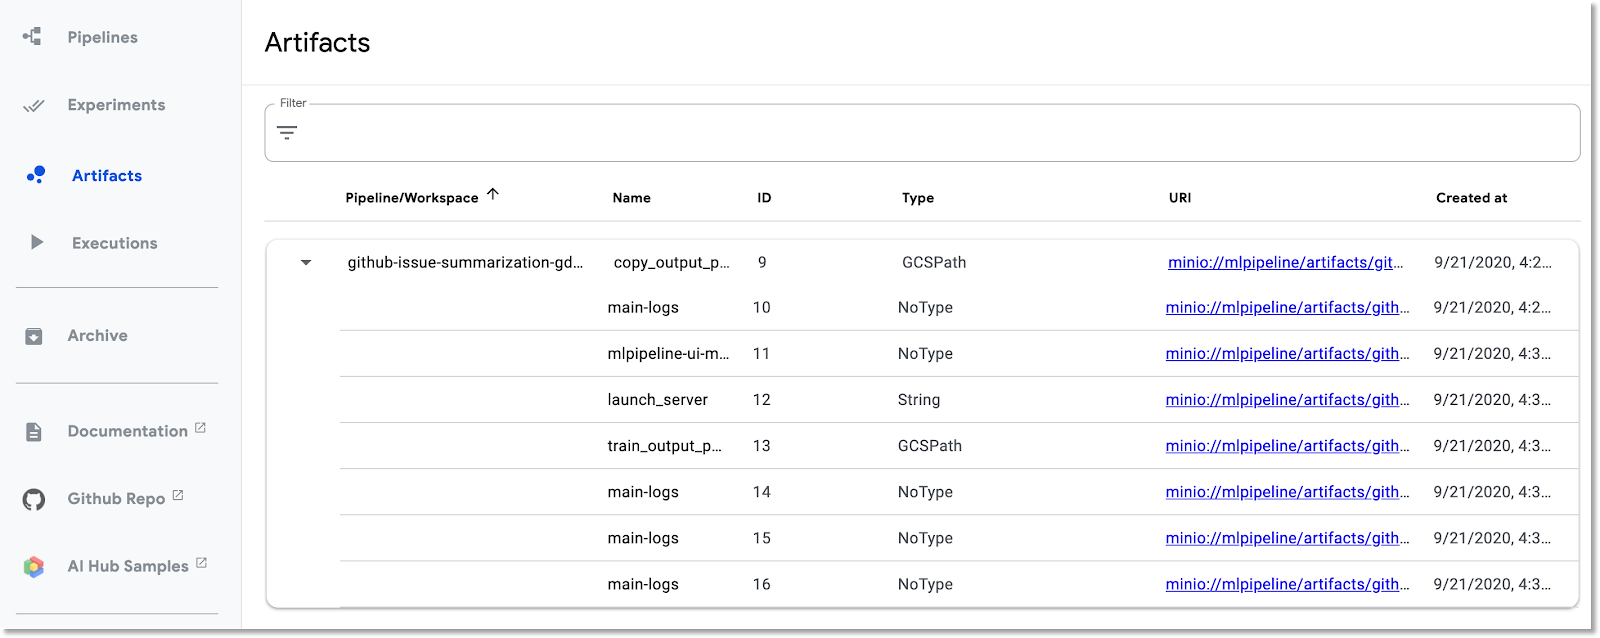
במקרה של ארטיפקטים, אפשר לראות גם חלונית סקירה כללית וגם חלונית של כלי למעקב אחר מקורות נתונים.


להציג את אפליקציית האינטרנט שנוצרה על ידי צינור עיבוד הנתונים וליצור כמה תחזיות
בשלב האחרון בצינור, נפרסת אפליקציית אינטרנט שמספקת ממשק משתמש לשליחת שאילתות למודל שאומן – המודל מוגש באמצעות TF Serving – כדי ליצור תחזיות.
אחרי שהצינור יסיים את הפעולה, מתחברים לאפליקציית האינטרנט באמצעות הפניית יציאה אל השירות שלה (אנחנו מפנים יציאה כי בשביל ה-codelab הזה, שירות אפליקציית האינטרנט לא מוגדר עם נקודת קצה חיצונית).
כדי למצוא את שם השירות, מריצים את הפקודה הבאה ב-Cloud Shell:
kubectl get services
מחפשים ברשימה שם של שירות כמו ghsumm-*-webappsvc.
אחר כך, ב-Cloud Shell, מעבירים את היציאה לשירות הזה באופן הבא, משנים את הפקודה הבאה כדי להשתמש בשם של webappsvc:
kubectl port-forward svc/ghsumm-xxxxx-webappsvc 8080:80
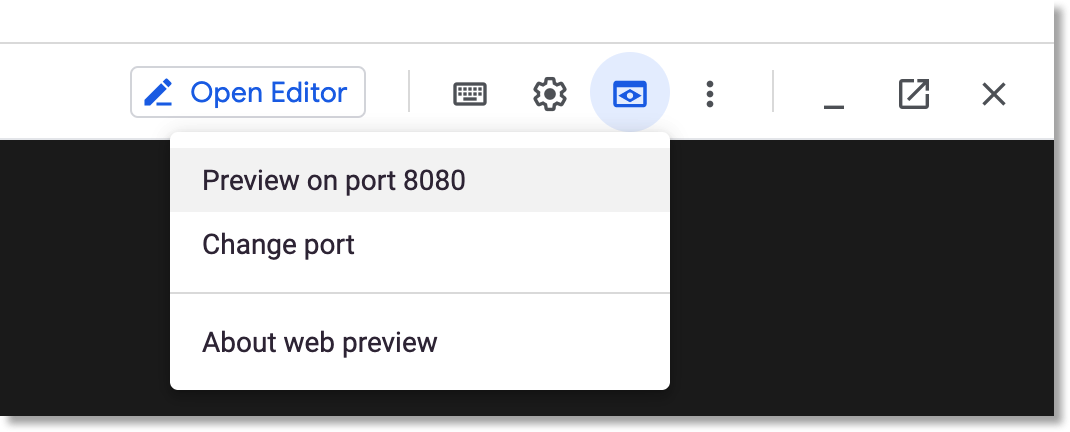
אחרי שהעברת הפורטים פועלת, לוחצים על סמל התצוגה המקדימה מעל חלונית Cloud Shell, ובתפריט הנפתח לוחצים על 'תצוגה מקדימה בפורט 8080'.
בכרטיסייה חדשה אמור להופיע דף כמו זה:

לוחצים על הכפתור Populate Random Issue (מילוי בעיה אקראית) כדי לאחזר בלוק טקסט. לוחצים על יצירת כותרת כדי להפעיל את המודל שאומן ולהציג חיזוי.
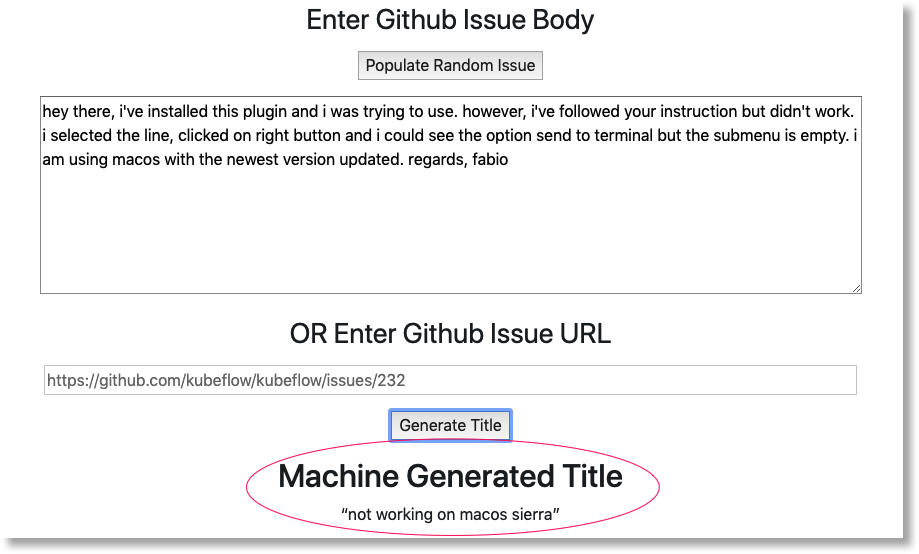
אם פרמטרי צינור העיבוד כוללים אסימון GitHub תקין, אפשר גם להזין כתובת URL של GitHub בשדה השני ואז ללחוץ על 'יצירת שם'. אם לא הגדרתם טוקן GitHub תקין, אתם יכולים להשתמש רק בשדה Populate Random Issue (מילוי בעיה אקראית).
4. הרצת צינור עיבוד נתונים מ-AI Platform Notebook
אפשר גם להגדיר ולהריץ את Kubeflow Pipelines באופן אינטראקטיבי מ-Jupyter notebook באמצעות KFP SDK. AI Platform Notebooks, שבו נשתמש ב-Codelab הזה, מאפשר לעשות את זה בקלות.
יצירת מופע של Notebook
ניצור מופע של מחברת מ-Cloud Shell באמצעות ה-API שלו. (אפשר גם ליצור מחברת דרך מסוף Cloud. מידע נוסף זמין במאמרי העזרה בנושא .
מגדירים את משתני הסביבה הבאים ב-Cloud Shell:
export INSTANCE_NAME="kfp-ghsumm"
export VM_IMAGE_PROJECT="deeplearning-platform-release"
export VM_IMAGE_FAMILY="tf2-2-3-cpu"
export MACHINE_TYPE="n1-standard-4"
export LOCATION="us-central1-c"
לאחר מכן, מריצים את הפקודה ליצירת מופע של מחברת מ-Cloud Shell:
gcloud beta notebooks instances create $INSTANCE_NAME \
  --vm-image-project=$VM_IMAGE_PROJECT \
  --vm-image-family=$VM_IMAGE_FAMILY \
  --machine-type=$MACHINE_TYPE --location=$LOCATION
כשמריצים את הפקודה הזו בפעם הראשונה, יכול להיות שתתבקשו להפעיל את notebooks API בפרויקט. אם כן, עליך להשיב 'y'.
אחרי כמה דקות, שרת המחברת יהיה פעיל. אפשר לראות את מופעי המחברת ברשימה במסוף Cloud.

העלאה של ה-Notebook של ה-Codelab
אחרי שיוצרים את מופע המחברת, לוחצים על הקישור הזה כדי להעלות את מחברת Jupyter של ה-codelab. בוחרים את מופע המחברת שרוצים להשתמש בו. ה-notebook ייפתח אוטומטית.
הפעלת ה-Notebook
פועלים לפי ההוראות במחברת כדי להשלים את שאר שיעור ה-Lab. שימו לב שבחלק 'הגדרה' של המחברת, תצטרכו למלא את הערכים שלכם לפני שתריצו את שאר המחברת.
(אם אתם משתמשים בפרויקט משלכם, אל תשכחו לחזור ולבצע את השלבים שבקטע 'ניקוי' במעבדה הזו).
5. הסרת המשאבים
אם אתם משתמשים בחשבון זמני של Codelab, אתם לא צריכים לעשות את זה, אבל אם אתם משתמשים בפרויקט משלכם, כדאי להסיר את ההתקנה של Pipelines ואת המחברת.
הסרת אשכול GKE של צינורות העברת נתונים
אפשר למחוק את אשכול הצינורות ממסוף Cloud. (יש לכם אפשרות פשוט למחוק את ההתקנה של Pipelines אם אתם רוצים לעשות שימוש חוזר באשכול GKE).
מחיקת מכונת AI Notebook
אם הפעלתם את החלק Notebook ב-codelab, תוכלו למחוק או להפסיק את מופע ה-Notebook מ-Cloud Console.
אופציונלי: הסרת הטוקן של GitHub
עוברים אל https://github.com/settings/tokens ומסירים את הטוקן שנוצר.
6. נספחים
סקירה של הקוד
הגדרת צינור עיבוד הנתונים
הצינור שבו נעשה שימוש ב-codelab הזה מוגדר כאן.
בואו נראה איך הוא מוגדר ואיך מוגדרים הרכיבים שלו (השלבים). בהמשך נציג כמה מהנקודות החשובות, אבל פרטים נוספים מופיעים במאמרי העזרה.
השלבים בצינור Kubeflow מבוססים על קונטיינרים. כשיוצרים צינור עיבוד נתונים, אפשר להשתמש ברכיבים מוכנים מראש עם קובצי אימג' של קונטיינרים שכבר נוצרו, או ליצור רכיבים משלכם. ב-Codelab הזה בנינו משלנו.
ארבעה מהשלבים בצינור מוגדרים מרכיבים לשימוש חוזר, שאפשר לגשת אליהם דרך קבצי הגדרת הרכיבים. בקטע הקוד הראשון, אנחנו ניגשים לקובצי ההגדרה של הרכיבים האלה דרך כתובת ה-URL שלהם, ומשתמשים בהגדרות האלה כדי ליצור 'פעולות' שנשתמש בהן כדי ליצור שלב בצינור.
import kfp.dsl as dsl
import kfp.gcp as gcp
import kfp.components as comp

...

copydata_op = comp.load_component_from_url(
  'https://raw.githubusercontent.com/kubeflow/examples/master/github_issue_summarization/pipelines/components/t2t/datacopy_component.yaml'
  )

train_op = comp.load_component_from_url(
  'https://raw.githubusercontent.com/kubeflow/examples/master/github_issue_summarization/pipelines/components/t2t/train_component.yaml'
  )
בהמשך מופיעה אחת מהגדרות הרכיבים, עבור פעולת ההדרכה, בפורמט yaml. אפשר לראות שהוגדרו לו קלט, פלט, קובץ אימג' של קונטיינר וארגומנטים של נקודת הכניסה של הקונטיינר.
name: Train T2T model
description: |
  A Kubeflow Pipeline component to train a Tensor2Tensor
  model
metadata:
  labels:
    add-pod-env: 'true'
inputs:
  - name: train_steps
    description: '...'
    type: Integer
    default: 2019300
  - name: data_dir
    description: '...'
    type: GCSPath
  - name: model_dir
    description: '...'
    type: GCSPath
  - name: action
    description: '...'
    type: String
  - name: deploy_webapp
    description: '...'
    type: String
outputs:
  - name: launch_server
    description: '...'
    type: String
  - name: train_output_path
    description: '...'
    type: GCSPath
  - name: MLPipeline UI metadata
    type: UI metadata
implementation:
  container:
    image: gcr.io/google-samples/ml-pipeline-t2ttrain:v3ap
    args: [
      --data-dir, {inputValue: data_dir},
      --action, {inputValue: action},
      --model-dir, {inputValue: model_dir},
      --train-steps, {inputValue: train_steps},
      --deploy-webapp, {inputValue: deploy_webapp},
      --train-output-path, {outputPath: train_output_path}
    ]
    env:
      KFP_POD_NAME: "{{pod.name}}"
    fileOutputs:
      launch_server: /tmp/output
      MLPipeline UI metadata: /mlpipeline-ui-metadata.json
אפשר גם להגדיר שלב בצינור באמצעות ה-constructor dsl.ContainerOp, כפי שמוצג בהמשך.
בהמשך מופיע רוב ההגדרה של צינור הנתונים. אנחנו מגדירים את נתוני הקלט של צינורות העיבוד (ואת ערכי ברירת המחדל שלהם). לאחר מכן מגדירים את השלבים בצינור. ברוב המקרים אנחנו משתמשים בפעולות שמוגדרות למעלה, אבל אנחנו גם מגדירים שלב של 'הכניסה לשימוש בסביבת הייצור' בתוך שורה באמצעות ContainerOp, ומציינים ישירות את קובץ אימג' של קונטיינר ואת ארגומנטי נקודת הכניסה.
אפשר לראות שבשלבים train, log_model ו-serve מתבצעת גישה לפלט משלבים קודמים כקלט. מידע נוסף על הגדרת המיקום זמין כאן.
@dsl.pipeline(
 name='Github issue summarization',
 description='Demonstrate Tensor2Tensor-based training and TF-Serving'
)
def gh_summ(  #pylint: disable=unused-argument
 train_steps: 'Integer' = 2019300,
 project: str = 'YOUR_PROJECT_HERE',
 github_token: str = 'YOUR_GITHUB_TOKEN_HERE',
 working_dir: 'GCSPath' = 'gs://YOUR_GCS_DIR_HERE',
 checkpoint_dir: 'GCSPath' = 'gs://aju-dev-demos-codelabs/kubecon/model_output_tbase.bak2019000/',
 deploy_webapp: str = 'true',
 data_dir: 'GCSPath' = 'gs://aju-dev-demos-codelabs/kubecon/t2t_data_gh_all/'
 ):


 copydata = copydata_op(
   data_dir=data_dir,
   checkpoint_dir=checkpoint_dir,
   model_dir='%s/%s/model_output' % (working_dir, dsl.RUN_ID_PLACEHOLDER),
   action=COPY_ACTION,
   )


 train = train_op(
   data_dir=data_dir,
   model_dir=copydata.outputs['copy_output_path'],
   action=TRAIN_ACTION, train_steps=train_steps,
   deploy_webapp=deploy_webapp
   )

 serve = dsl.ContainerOp(
     name='serve',
     image='gcr.io/google-samples/ml-pipeline-kubeflow-tfserve:v6',
     arguments=["--model_name", 'ghsumm-%s' % (dsl.RUN_ID_PLACEHOLDER,),
         "--model_path", train.outputs['train_output_path']
         ]
     )

 train.set_gpu_limit(1)
שימו לב: אנחנו דורשים שהשלב train יפעל בצומת באשכול שיש בו לפחות GPU אחד זמין.
train.set_gpu_limit(1)
השלב האחרון בצינור – שמוגדר גם הוא בתוך השורה – הוא שלב מותנה. היא תפעל אחרי שהשלב serve יסתיים, רק אם הפלט של שלב האימון launch_server הוא המחרוזת true. הוא מפעיל את 'אפליקציית האינטרנט לחיזוי', שבה השתמשנו כדי לבקש סיכומים של בעיות מהמודל T2T שאומן.
 with dsl.Condition(train.outputs['launch_server'] == 'true'):
   webapp = dsl.ContainerOp(
       name='webapp',
       image='gcr.io/google-samples/ml-pipeline-webapp-launcher:v1',
       arguments=["--model_name", 'ghsumm-%s' % (dsl.RUN_ID_PLACEHOLDER,),
           "--github_token", github_token]

       )
   webapp.after(serve)
הגדרות של קובצי אימג' של קונטיינרים של רכיבים
במאמרי העזרה בנושא Kubeflow Pipeline מפורטות כמה שיטות מומלצות ליצירת רכיבים משלכם. כחלק מהתהליך, תצטרכו להגדיר ולבנות קובץ אימג' של קונטיינר. כאן אפשר לראות את השלבים של צינור הנתונים של ה-codelab הזה. ההגדרות של Dockerfile נמצאות בספריות המשנה containers, לדוגמה כאן.
שימוש במכונות וירטואליות עם אפשרות קדימה (preemptible) עם יחידות GPU לאימון
מכונות וירטואליות שניתן לקטוע הן מופעים של מכונות וירטואליות של Compute Engine שנמשכים עד 24 שעות לכל היותר, ולא מספקות ערבויות זמינות. התמחור של מכונות Preemptible VM נמוך מזה של מכונות רגילות ב-Compute Engine.
עם Google Kubernetes Engine (GKE), קל להגדיר אשכול או מאגר צמתים שמשתמשים במכונות וירטואליות שניתנות להפסקת פעולה. אפשר להגדיר מאגר צמתים כזה עם מעבדי GPU שמצורפים למכונות שניתנות להפסקת פעולה. הם פועלים כמו צמתים רגילים עם GPU, אבל ה-GPU נשמר רק למשך חיי המופע.
כדי להגדיר מאגר צמתים עם אפשרות קדימה ו-GPU עבור האשכול, מריצים פקודה שדומה לפקודה הבאה, עורכים את הפקודה עם שם האשכול והאזור, ומשנים את סוג המאיץ והמספר שלו בהתאם לדרישות. אפשר גם להגדיר את מאגר הצמתים כך שיתבצע בו שינוי גודל אוטומטי על סמך עומסי העבודה הנוכחיים.
gcloud container node-pools create preemptible-gpu-pool \
    --cluster=<your-cluster-name> \
    --zone <your-cluster-zone> \
    --enable-autoscaling --max-nodes=4 --min-nodes=0 \
    --machine-type n1-highmem-8 \
    --preemptible \
    --node-taints=preemptible=true:NoSchedule \
    --scopes cloud-platform --verbosity error \
    --accelerator=type=nvidia-tesla-k80,count=4
אפשר גם להגדיר מאגר צמתים דרך Cloud Console.
הגדרת צינור עיבוד נתונים של Kubeflow שמשתמש בצמתי GKE שניתנים להפסקת פעולה
אם אתם מריצים את Kubeflow ב-GKE, עכשיו קל יותר להגדיר ולהריץ Kubeflow Pipelines שבהם שלב אחד או יותר בצינור (רכיבים) פועלים בצמתים שניתן להפסיק את הפעולה שלהם, וכך להפחית את העלות של הרצת משימה. כדי להשתמש במכונות וירטואליות שניתן להפסיק את הפעולה שלהן מראש ולקבל תוצאות נכונות, השלבים שזיהיתם כשלבים שניתן להפסיק את הפעולה שלהם מראש צריכים להיות אידמפוטנטיים (כלומר, אם מריצים שלב כמה פעמים, התוצאה תהיה זהה), או שצריך ליצור נקודת ביקורת לעבודה כדי שהשלב יוכל להמשיך מהמקום שבו הוא הופסק.
כשמגדירים Kubeflow Pipeline, אפשר לציין ששלב מסוים יפעל על צומת שניתן להפסיק את הפעולה שלו. כדי לעשות את זה, משנים את האופרטור באופן הבא:
your_pipelines_op.apply(gcp.use_preemptible_nodepool())
פרטים נוספים זמינים במסמכי התיעוד.
סביר להניח שתרצו גם לנסות שוב את השלב מספר פעמים אם הצומת נדחק. כך עושים זאת – כאן מציינים 5 ניסיונות חוזרים.
your_pipelines_op.set_gpu_limit(1).apply(gcp.use_preemptible_nodepool()).set_retry(5)
נסו לערוך את צינור עיבוד הנתונים של Kubeflow שבו השתמשנו בשיעור Codelab הזה כדי להריץ את שלב האימון במכונה וירטואלית שניתנת להפסקת פעולה.
משנים את השורה הבאה במפרט של צינור העיבוד כך שתשתמש בנוסף במאגר צמתים שניתן להפסיק (חשוב לוודא שיצרתם מאגר כזה כמו שצוין למעלה), ותנסה שוב 5 פעמים:
train.set_gpu_limit(1)
לאחר מכן, קמפלו מחדש את צינור הנתונים, העלו את הגרסה החדשה (תנו לה שם חדש) והריצו את הגרסה החדשה של צינור הנתונים.